

في مرحلة الطوابير وبث الأحداث شغلنا كل أداة وحدها بعنقود حقيقي وأوقفنا سيرفراتها أثناء العمل، فشرحنا RabbitMQ وApache Kafka وRedpanda وNATS، وبقي السؤال الذي يسأله كل فريق قبل أن يبدأ: أي واحدة أختار لمشروعي؟ والإجابة السريعة التي تسمعها عادة («Kafka للأحجام الكبيرة وRabbitMQ للمهام») صحيحة في جزء منها، لكنها لا تكفي لتقرر، لأن الفرق الحقيقي في نموذج كل أداة وما تضمنه لك عند الفشل وكم تكلفك في التشغيل، وليس في رقم السرعة الذي تراه في صفحات التسويق.
لذلك سوف نقارن الأدوات من زاوية القرار، ونشغلها كلها على جهاز واحد بنفس الحدود ونفس الاختبار، ثم نجمع كل ذلك في جدول قرار، وسوف نناقش في هذا المقال ما يلي:
- النماذج الثلاثة: الطابور Queue، والسجل Log، والموضوع Subject مع JetStream، وماذا يحدث للرسالة بعد قراءتها في كل منها.
- ضمانات التسليم Delivery Guarantees، والترتيب Ordering، وإعادة القراءة Replay.
- معنى «التأكيد» في كل أداة: هل كتبت الرسالة على القرص قبل أن يصلك التأكيد أم لا؟
- اختبار واحد مشترك على هذا الجهاز: السرعة Throughput، والتأخير Latency، والذاكرة، وإعادة القراءة.
- تكلفة التشغيل والرخص، ثم متى تختار كل أداة، مع جدول قرار في النهاية.
 دليلRabbitMQ: طوابير موثوقة لتطبيقاتك على سيرفرككيف تشغل RabbitMQ في عنقود من ثلاث عقد، وتوجه الرسائل بالموزعات، وتضمن ألا تضيع رسالة إذا سقطت عقدة.
 دليلApache Kafka: بث الأحداث بأحجام ضخمةكيف يحفظ عنقود Kafka أحداثك بنسخ على عدة سيرفرات، وماذا يحدث للمنتجين والمستهلكين عندما يسقط أحدها.
 دليلRedpanda: بديل متوافق مع Kafka وأخف تشغيلاًكيف يعمل Redpanda بواجهة Kafka نفسها دون JVM، وما الذي تسمح به رخصته، وكم يوفر من الموارد فعلاً.
 دليلNATS: رسائل سريعة وخفيفة للخدمات المصغرةكيف تربط خدماتك بالطلب والرد عبر NATS، ومتى تحتاج JetStream ليحفظ الرسائل ويتذكر أين وصل كل مستهلك.
ثلاثة نماذج مختلفة، وليست ثلاث نسخ من الشيء نفسه
شرحنا في مقال الطابور أم بث الأحداث أن السؤال الأول هو ماذا يحدث للرسالة بعد قراءتها، ولن نعيد الشرح هنا، لكن نضعه بجانب النموذج الثالث الذي يأتي به NATS حتى ترى الأدوات الثلاث في صورة واحدة. والصورة التالية تبين ذلك:
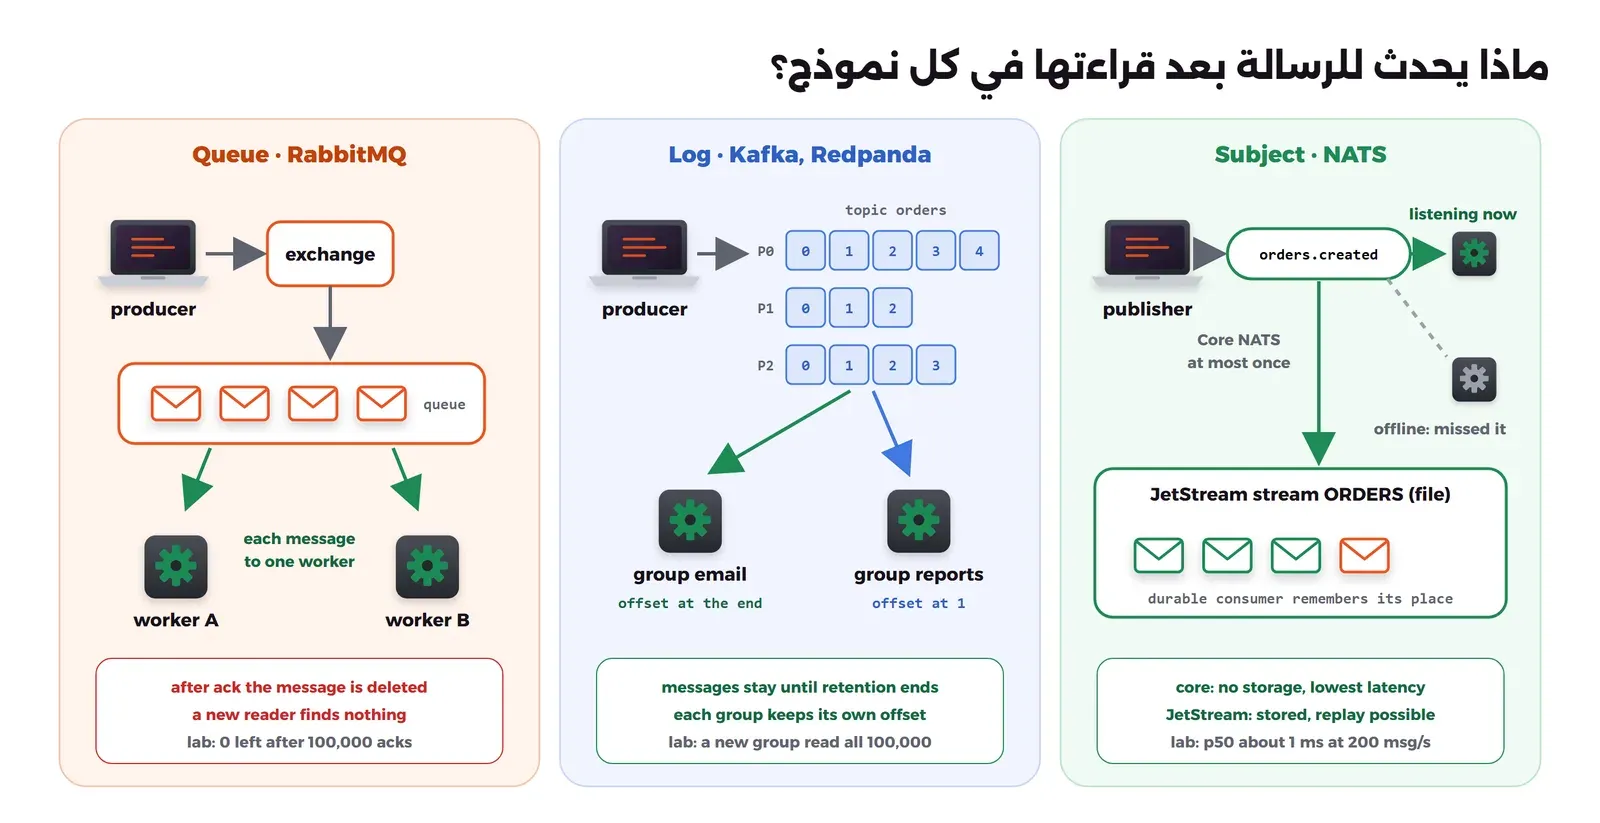
- الطابور في RabbitMQ: الوسيط Broker ذكي، يستقبل الرسالة عبر الموزع Exchange ويوجهها إلى طابور أو أكثر، ثم يسلم كل رسالة إلى Worker واحد، ويتابع التأكيد Ack لكل رسالة وحدها، ويعيد إرسال ما لم يؤكد، ويحذف ما تم تأكيده. لذلك يناسب توزيع العمل: إرسال بريد، معالجة ملف، إصدار فاتورة.
- السجل في Kafka وRedpanda: الوسيط بسيط في منطقه، يضيف الرسائل إلى آخر ملف مقسم إلى Partitions ولا يحذفها عند القراءة، والقارئ هو الذي يتذكر أين وصل عبر رقم ال Offset. لذلك يناسب الأحداث التي يقرؤها أكثر من نظام، وكل نظام بسرعته، ويعود إليها وقت الحاجة.
- الموضوع في NATS: في Core NATS لا يوجد حفظ إطلاقاً، فالرسالة تصل لمن يستمع الآن وتنتهي، وهذا يناسب الطلب والرد Request/Reply بين الخدمات والأخبار اللحظية. ومع JetStream يحفظ السيرفر الرسائل في Stream، ويصبح عندك طابور أو سجل بحسب إعداد المستهلك، أي أن NATS يغطي الشكلين معاً بحجم أصغر.
وقد يتساءل البعض: إذا كانت RabbitMQ أضافت Streams، وKafka أضافت مجموعات المشاركة Share Groups التي تعمل مثل الطابور، فهل ما زال لهذا التقسيم معنى؟ والإجابة نعم، لأن الميزة المضافة لا تغير طبيعة الأداة ولا طريقة تشغيلها ولا ما يعرفه فريقك عنها، وقد شرحنا ذلك في قسم الأداتان تقتربان من بعضهما. اختر النموذج الذي يناسب عملك أولاً، ثم انظر إلى الميزات الإضافية كبدائل احتياطية.
ماذا تضمن لك كل أداة عند الفشل؟
كل الأدوات الأربع تستطيع أن تعطيك «مرة واحدة على الأقل» At-Least-Once إذا أعددتها بشكل صحيح، أي أن الرسالة لا تضيع لكنها قد تصل مرتين، والفرق في الإعداد الذي تحتاجه وفي الإضافات فوق ذلك. والجدول التالي يجمع ما يهمك عند القرار:
| السؤال | RabbitMQ | Kafka وRedpanda | NATS |
|---|---|---|---|
| شكل التسليم الافتراضي | مرة على الأقل مع التأكيد اليدوي وتأكيد النشر | مرة على الأقل مع acks=all وحفظ ال Offset بعد المعالجة | مرة على الأكثر في Core NATS، ومرة على الأقل في JetStream |
| منع التكرار من جهة المنتج | لا يوجد داخل الوسيط، وتبنيه في المستهلك | المنتج الآمن عند التكرار Idempotent Producer والمعاملات Transactions | معرف الرسالة Nats-Msg-Id داخل نافذة زمنية |
| الترتيب | داخل الطابور الواحد، ويختل مع عدة Workers أو مع إعادة التسليم | داخل ال Partition الواحد، والمفتاح Key يحدد ال Partition | داخل ال Stream للمستهلك الواحد، ويختل مع عدة مستهلكين أو إعادة التسليم |
| إعادة القراءة | غير ممكنة في الطابور العادي، وممكنة في Streams | ممكنة دائماً ضمن مدة الحفظ | ممكنة في JetStream ضمن حدود ال Stream |
| الرسائل التي تفشل دائماً | Dead Letter Exchange جاهز، وعداد التسليم في Quorum Queues | لا يوجد DLQ في الوسيط، وتبنيه بموضوع منفصل أو في Kafka Connect | عدد محاولات أقصى للمستهلك وتنبيه Advisory عند تجاوزه |
لاحظ أن عبارة «مرة واحدة بالضبط» Exactly-Once في Kafka لها معنى محدد: القراءة من Kafka والكتابة إلى Kafka في معاملة واحدة، وقد شرحنا حدودها في قسم المنتج الآمن عند التكرار. أما عندما يرسل المستهلك بريداً أو يخصم من رصيد فالتكرار ممكن في كل الأدوات، والحل في المستهلك نفسه كما شرحنا في مقال Idempotency.
معنى «تم التأكيد» يختلف من أداة إلى أخرى
هذه النقطة تغيب عن أغلب المقارنات، وهي التي تفسر جزءاً كبيراً من أرقام السرعة التي سوف تراها في التجربة: عندما يصل للمنتج تأكيد أن الرسالة استلمت، هل كتبت على القرص فعلاً؟
- RabbitMQ مع Quorum Queues: يقول توثيق Quorum Queues إنها تحفظ كل البيانات على القرص قبل أن تفعل أي شيء، لذلك ينصح بأسرع قرص ممكن. أي أن التأكيد يأتي بعد الكتابة الفعلية Fsync على أغلبية العقد.
- Kafka: القيمة الافتراضية للإعداد
log.flush.interval.messagesفي إعدادات الوسيط هي أكبر رقم ممكن، أي أن Kafka لا تطلب من نظام التشغيل الكتابة الفورية على القرص، وتعتمد على النسخ إلى عدة سيرفرات Replication، فالتأكيد معacks=allيعني أن الرسالة في ذاكرة كل النسخ المتزامنة، وليس بالضرورة على قرصها. - NATS JetStream: بحسب جدول إعدادات السيرفر القيمة الافتراضية ل
sync_intervalدقيقتان، ويعتمد JetStream على النسخ في العنقود ليضمن بقاء البيانات بعد توقف نظام التشغيل، ويذكر الجدول نفسه أن القيمةalwaysتكتب على القرص بعد كل رسالة وتنزل بالسرعة إلى بضع مئات من الرسائل في الثانية. - Redpanda: التأكيد مع
acks=allيأتي بعد الكتابة على القرص، إلا إذا فعلت التخزين المؤقت للكتابة Write Caching، وهو بحسب توثيق إعدادات المواضيع شكل مخفف منacks=allيؤكد عندما تستلم أغلبية العقد الرسالة دون انتظار القرص.
والنتيجة العملية: على سيرفر واحد دون نسخ، فإن Kafka وNATS بإعداداتهما الافتراضية قد تفقدان آخر الرسائل إذا انقطعت الكهرباء عن السيرفر نفسه، بينما RabbitMQ مع Quorum Queues لا يفقدها لكنه يدفع ثمن ذلك في السرعة والتأخير. لذلك لا تقارن أرقام السرعة بين أداتين قبل أن تعرف هل تكتب كل منهما على القرص قبل التأكيد، وفي الإنتاج شغل الأدوات الثلاث بثلاث نسخ على الأقل، فالنسخ هو ما يحمي بياناتك في Kafka وNATS.
تجربة عملية: اختبار واحد لأربعة وسطاء
الهدف من التجربة ليس إعلان فائز، وإنما أن ترى بنفسك الفرق في الشكل: أين يكون الحد، وكم يتغير الرقم بين تشغيل وآخر، وما الذي يبقى بعد القراءة. شغلنا كل وسيط بعقدة واحدة وحدود متساوية (معالجان وذاكرة 2 جيجابايت)، وكل وسيط وحده بينما الآخرون متوقفون، على Docker Engine 29.8.0 في Docker Desktop مع WSL2 على جهاز فيه 8 معالجات و32 جيجابايت. والإصدارات: RabbitMQ 4.3.6، وApache Kafka 4.3.1 بنمط KRaft، وRedpanda 26.2.4، وNATS Server 2.15.0.
ملفات التجربة
أنشئ مجلداً فيه أربعة ملفات، أولها compose.yaml بالوسطاء الأربعة وال Container الخاص بتطبيق الاختبار:
name: lab-q2-compare

# One node of each broker with the same budget (2 CPUs, 2 GB), started one at a time for the benchmark.
x-limits: &limits
  cpus: 2
  mem_limit: 2g

services:
  rabbitmq:
    <<: *limits
    image: rabbitmq:4.3.6-management-alpine
    container_name: lab-q2-rabbitmq
    hostname: rabbitmq
    environment:
      # the server and the CLI tools share this Erlang cookie
      RABBITMQ_SERVER_ADDITIONAL_ERL_ARGS: "-setcookie lab-q2-cookie"
      RABBITMQ_CTL_ERL_ARGS: "-setcookie lab-q2-cookie"
    healthcheck:
      test: ["CMD", "rabbitmq-diagnostics", "-q", "check_running"]
      interval: 5s
      retries: 40

  kafka:
    <<: *limits
    image: apache/kafka:4.3.1
    container_name: lab-q2-kafka
    hostname: kafka
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: PLAINTEXT:PLAINTEXT,CONTROLLER:PLAINTEXT
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
    healthcheck:
      test: ["CMD-SHELL", "/opt/kafka/bin/kafka-broker-api-versions.sh --bootstrap-server localhost:9092 > /dev/null 2>&1"]
      interval: 5s
      retries: 40

  redpanda:
    <<: *limits
    image: redpandadata/redpanda:v26.2.4
    container_name: lab-q2-redpanda
    hostname: redpanda
    command:
      - redpanda
      - start
      - --smp=2
      - --memory=1536M
      - --overprovisioned                     # lab only: the cores are shared with other containers
      - --kafka-addr=internal://0.0.0.0:9092
      - --advertise-kafka-addr=internal://redpanda:9092
      - --rpc-addr=redpanda:33145
      - --advertise-rpc-addr=redpanda:33145
    healthcheck:
      test: ["CMD", "rpk", "cluster", "health", "--exit-when-healthy"]
      interval: 5s
      retries: 40

  nats:
    <<: *limits
    image: nats:2.15.0-alpine
    container_name: lab-q2-nats
    hostname: nats
    command: ["-js", "-sd", "/data", "-m", "8222"]
    healthcheck:
      test: ["CMD", "wget", "-q", "-O-", "http://localhost:8222/healthz?js-enabled-only=true"]
      interval: 5s
      retries: 40

  app:
    build: .
    image: lab-q2-bench:1
    container_name: lab-q2-app
profiles: ["tools"]وDockerfile لتطبيق الاختبار بلغة Python، مع مكتبة لكل وسيط:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir aio-pika==10.1.1 confluent-kafka==2.16.0 nats-py==2.16.0
WORKDIR /app
COPY *.py ./
ENV PYTHONUNBUFFERED=1
والملف bench.py هو الاختبار المشترك، وفيه ثلاثة أوضاع: السرعة tp بنشر 100 ألف رسالة بحجم 1 كيلوبايت ينتظر المنتج تأكيد الوسيط لكل منها مع ألف رسالة في الطريق في الوقت نفسه، ثم قراءتها كلها مع تأكيد القراءة. والتأخير lat بنشر 200 رسالة في الثانية لمدة 20 ثانية بينما المستهلك يقرأ، وحساب الوقت من لحظة الإرسال إلى لحظة الاستلام. وإعادة القراءة replay بقارئ جديد يحاول أن يبدأ من أول رسالة:
bench.py: الاختبار المشترك للوسطاء الأربعة
# One benchmark for four brokers (ArabRoot lab, illustrative numbers only).
#   docker compose run --rm app python bench.py <rabbitmq|kafka|redpanda|nats> <tp|lat|replay>
# tp:     publish N messages of SIZE bytes, each confirmed by the broker, then read them all back with acks
# lat:    publish RATE msg/s for SECS seconds while a consumer reads; end-to-end latency from a timestamp in the body
# replay: after tp, can a new reader start again from the first message?
import asyncio, os, sys, time, uuid, threading

N = int(os.getenv('N', '100000'))
SIZE = int(os.getenv('SIZE', '1024'))
RATE = int(os.getenv('RATE', '1000'))
SECS = int(os.getenv('SECS', '20'))
WINDOW = 1000                                  # messages in flight waiting for a broker confirm (sliding window)


def body(i):
    return time.time_ns().to_bytes(8, 'big') + i.to_bytes(8, 'big') + b'x' * (SIZE - 16)


def lat_ms(b):
    return (time.time_ns() - int.from_bytes(b[:8], 'big')) / 1e6


def report_tp(system, pub, con):
    mb = N * SIZE / 1e6
    print(f'{system}: produce {N} x {SIZE} B in {pub:.1f}s = {N / pub:,.0f} msg/s ({mb / pub:.1f} MB/s)')
    print(f'{system}: consume {N} in {con:.1f}s = {N / con:,.0f} msg/s')


def report_lat(system, lats, sent):
    lats.sort()
    p = lambda q: lats[min(len(lats) - 1, int(len(lats) * q))]
    print(f'{system}: {len(lats)}/{sent} received at {RATE} msg/s, latency ms '
          f'p50={p(.50):.1f} p95={p(.95):.1f} p99={p(.99):.1f} max={lats[-1]:.1f}')


async def windowed(n, publish):
    # keep WINDOW publishes in flight; a new one starts as soon as any confirm returns
    sem = asyncio.Semaphore(WINDOW)
    async def one(i):
        try: await publish(i)
        finally: sem.release()
    tasks = []
    for i in range(n):
        await sem.acquire()
        tasks.append(asyncio.ensure_future(one(i)))
    await asyncio.gather(*tasks)


async def paced(n, send):
    start = time.perf_counter()
    for i in range(n):
        delay = start + i / RATE - time.perf_counter()
        if delay > 0:
            await asyncio.sleep(delay)
        await send(i)

# ---------- RabbitMQ: quorum queue, persistent messages, publisher confirms, manual ack ----------
async def rabbit(mode):
    import aio_pika
    conn = await aio_pika.connect_robust('amqp://guest:guest@rabbitmq/')
    pch = await conn.channel(publisher_confirms=True)
    cch = await conn.channel()
    await cch.set_qos(prefetch_count=1000)
    name = 'bench-' + uuid.uuid4().hex[:6]
    args = {'x-queue-type': 'quorum'}
    await pch.declare_queue(name, durable=True, arguments=args)
    q = await cch.declare_queue(name, durable=True, arguments=args)
    pub = lambda i: pch.default_exchange.publish(aio_pika.Message(body(i), delivery_mode=aio_pika.DeliveryMode.PERSISTENT), routing_key=name)

    if mode == 'lat':
        lats, n = [], RATE * SECS
        done = asyncio.Event()
        async def on(m):
            lats.append(lat_ms(m.body)); await m.ack()
            if len(lats) == n: done.set()
        await q.consume(on)
        tasks = []
        await paced(n, lambda i: tasks.append(asyncio.ensure_future(pub(i))) or asyncio.sleep(0))
        await asyncio.gather(*tasks)
        await asyncio.wait_for(done.wait(), 30)
        report_lat('rabbitmq', lats, n)
        return await conn.close()

    t = time.perf_counter()
    await windowed(N, pub)
    tp = time.perf_counter() - t
    got, first, done = 0, [None], asyncio.Event()
    async def on(m):
        nonlocal got
        first[0] = first[0] or time.perf_counter()
        got += 1; await m.ack()
        if got == N: done.set()
    await q.consume(on)
    await done.wait()
    report_tp('rabbitmq', tp, time.perf_counter() - first[0])
    if mode == 'replay':
        left = await cch.declare_queue(name, durable=True, arguments=args, passive=True)
        print(f'rabbitmq quorum queue {name}: messages left after ack = {left.declaration_result.message_count}')
        # a stream queue keeps messages after they are read
        sname = 'bench-stream-' + uuid.uuid4().hex[:6]
        await pch.declare_queue(sname, durable=True, arguments={'x-queue-type': 'stream'})
        await asyncio.gather(*[pch.default_exchange.publish(aio_pika.Message(body(i)), routing_key=sname) for i in range(1000)])
        for reader in ('reader-1', 'reader-2'):
            ch = await conn.channel(); await ch.set_qos(prefetch_count=500)
            sq = await ch.declare_queue(sname, durable=True, arguments={'x-queue-type': 'stream'})
            seen, ev = [0], asyncio.Event()
            async def on2(m):
                seen[0] += 1; await m.ack()
                if seen[0] == 1000: ev.set()
            await sq.consume(on2, arguments={'x-stream-offset': 'first'})
            await asyncio.wait_for(ev.wait(), 20)
            print(f'rabbitmq stream queue {sname}: {reader} read {seen[0]} from offset first')
            await ch.close()
    await conn.close()

# ---------- Kafka and Redpanda: same client, acks=all, idempotent producer ----------
def kafka(system, mode):
    from confluent_kafka import Producer, Consumer
    from confluent_kafka.admin import AdminClient, NewTopic
    bs = f'{system}:9092'
    topic = 'bench-' + uuid.uuid4().hex[:6]
    admin = AdminClient({'bootstrap.servers': bs})
    admin.create_topics([NewTopic(topic, 3, 1)])[topic].result()
    p = Producer({'bootstrap.servers': bs, 'acks': 'all', 'enable.idempotence': True})
    errors = [0]
    def cb(err, msg):
        if err: errors[0] += 1
    def produce(i):
        while True:
            try:
                p.produce(topic, body(i), key=str(i % 1000), callback=cb); p.poll(0); return
            except BufferError:
                p.poll(0.05)
    def consumer(group):
        c = Consumer({'bootstrap.servers': bs, 'group.id': group, 'auto.offset.reset': 'earliest'})
        c.subscribe([topic]); return c

    if mode == 'lat':
        n, lats = RATE * SECS, []
        c = consumer('lat'); ready = threading.Event()
        def run():
            while len(lats) < n:
                m = c.poll(0.1)                    # one message at a time: no waiting to fill a batch
                if m is not None and not m.error(): lats.append(lat_ms(m.value()))
                if c.assignment(): ready.set()
        th = threading.Thread(target=run); th.start(); ready.wait(30)
        async def send(i): produce(i)
        asyncio.run(paced(n, send)); p.flush(); th.join(30); c.close()
        return report_lat(system, lats, n)

    t = time.perf_counter()
    for i in range(N): produce(i)
    p.flush(); tp = time.perf_counter() - t
    def read_all(group):
        c = consumer(group); got, first = 0, None
        while got < N:
            ms = [m for m in c.consume(1000, 1.0) if not m.error()]
            if ms and first is None: first = time.perf_counter()
            got += len(ms)
        c.close(); return time.perf_counter() - first, got
    con, _ = read_all('readers')
    report_tp(system, tp, con)
    print(f'{system}: producer errors = {errors[0]}')
    if mode == 'replay':
        _, got = read_all('replay-' + uuid.uuid4().hex[:4])
        print(f'{system}: a new consumer group read {got} messages from the beginning of {topic}')

# ---------- NATS JetStream: file storage, publish acks, durable pull consumer, explicit ack ----------
async def nats_js(mode):
    import nats
    from nats.js.api import StreamConfig, StorageType, ConsumerConfig, DeliverPolicy
    nc = await nats.connect('nats://nats:4222'); js = nc.jetstream()
    name = 'BENCH_' + uuid.uuid4().hex[:6].upper(); subj = name.lower() + '.orders'
    await js.add_stream(StreamConfig(name=name, subjects=[subj], storage=StorageType.FILE))

    if mode == 'lat':
        n, lats = RATE * SECS, []
        done = asyncio.Event()
        async def on(m):
            lats.append(lat_ms(m.data)); await m.ack()
            if len(lats) == n: done.set()
        await js.subscribe(subj, durable='lat', cb=on, manual_ack=True)
        tasks = []
        await paced(n, lambda i: tasks.append(asyncio.ensure_future(js.publish(subj, body(i)))) or asyncio.sleep(0))
        await asyncio.gather(*tasks)
        await asyncio.wait_for(done.wait(), 30)
        report_lat('nats', lats, n)
        return await nc.close()

    t = time.perf_counter()
    await windowed(N, lambda i: js.publish(subj, body(i)))
    tp = time.perf_counter() - t
    async def read_all(durable, cfg=None):
        sub = await js.pull_subscribe(subj, durable=durable, config=cfg)
        got, first = 0, None
        while got < N:
            ms = await sub.fetch(1000, timeout=5)
            first = first or time.perf_counter()
            for m in ms: await m.ack()
            got += len(ms)
        return time.perf_counter() - first, got
    con, _ = await read_all('readers')
    report_tp('nats', tp, con)
    if mode == 'replay':
        _, got = await read_all('replay', ConsumerConfig(deliver_policy=DeliverPolicy.ALL))
        print(f'nats: a new durable consumer read {got} messages from the start of stream {name}')
    await nc.close()


if __name__ == '__main__':
    system, mode = sys.argv[1], sys.argv[2]
    if system == 'rabbitmq': asyncio.run(rabbit(mode))
    elif system in ('kafka', 'redpanda'): kafka(system, mode)
    elif system == 'nats': asyncio.run(nats_js(mode))
ولأن مكتبة Python قد تكون هي الحد وليس الوسيط، نشغل أيضاً أداة القياس الرسمية لكل وسيط بنفس العدد والحجم: PerfTest لRabbitMQ، وkafka-producer-perf-test.sh مع kafka-consumer-perf-test.sh لKafka وRedpanda (فRedpanda يتكلم Kafka API)، وnats bench لNATS. والملف run.sh يشغل كل ذلك لوسيط واحد، ثلاث مرات للأداة الرسمية ومرة لاختبار Python:
#!/bin/sh
# Runs the same tests on one broker at a time (ArabRoot lab).  ./run.sh rabbitmq|kafka|redpanda|nats
set -e
s=$1; net=lab-q2-compare_default
docker compose up -d "$s" --wait
sleep 60
docker stats --no-stream --format 'idle: {{.Name}} {{.MemUsage}} {{.CPUPerc}}' "lab-q2-$s"
for run in 1 2 3; do
  echo "--- native tool, run $run"
  case $s in
    rabbitmq) docker run --rm --network $net --name lab-q2-perftest pivotalrabbitmq/perf-test:2.25.0 \
        --uri amqp://guest:guest@rabbitmq -x 1 -y 1 -s 1024 -C 100000 -D 100000 --confirm 1000 -q 1000 \
        --flag persistent --queue-args x-queue-type=quorum --auto-delete false -u native-$run 2>&1 | grep 'rate avg' ;;
    kafka|redpanda) K="docker run --rm --network $net --name lab-q2-kperf apache/kafka:4.3.1 /opt/kafka/bin"
        $K/kafka-topics.sh --bootstrap-server $s:9092 --create --topic native-$run --partitions 3 --replication-factor 1 >/dev/null
        $K/kafka-producer-perf-test.sh --topic native-$run --num-records 100000 --record-size 1024 --throughput -1 \
          --producer-props bootstrap.servers=$s:9092 acks=all 2>&1 | tail -1
        $K/kafka-consumer-perf-test.sh --bootstrap-server $s:9092 --topic native-$run --messages 100000 --group c-$run 2>&1 | tail -1 ;;
    nats) B="docker run --rm --network $net --name lab-q2-natsbench natsio/nats-box:0.20.0 nats -s nats://nats:4222 bench js"
        $B pub async native.$run --stream NATIVE$run --create --storage file --msgs 100000 --size 1024 --no-progress 2>&1 | grep 'stats:'
        $B fetch --stream NATIVE$run --msgs 100000 --no-progress 2>&1 | grep 'stats:' ;;
  esac
done
echo "--- python client (bench.py)"
docker compose run --rm -T app python bench.py "$s" replay 2>&1 | grep "^$s"
docker compose run --rm -T -e RATE=200 app python bench.py "$s" lat 2>&1 | grep "^$s"
docker stats --no-stream --format 'after: {{.Name}} {{.MemUsage}}' "lab-q2-$s"
docker compose stop "$s"
والتشغيل:
docker compose --profile tools build app
for s in rabbitmq kafka redpanda nats; do ./run.sh $s; done
السرعة بأدوات القياس الرسمية
المخرج بعد حذف أسطر Compose سوف يكون كما يلي، وهذه المرة الثانية التي شغلنا فيها الاختبار كاملاً:
idle: lab-q2-rabbitmq 91.93MiB / 2GiB
id: test-150317-650, sending rate avg: 10186 msg/s
id: test-150331-250, sending rate avg: 9880 msg/s
id: test-150344-432, sending rate avg: 6188 msg/s

idle: lab-q2-kafka 400.6MiB / 2GiB
100000 records sent, 11176.930815 records/sec (10.91 MB/sec), 1818.58 ms avg latency, 3530.00 ms max latency
100000 records sent, 14228.799089 records/sec (13.90 MB/sec), 1623.96 ms avg latency, 2174.00 ms max latency
100000 records sent, 17406.440383 records/sec (17.00 MB/sec), 1298.78 ms avg latency, 1857.00 ms max latency

idle: lab-q2-redpanda 271.4MiB / 2GiB
100000 records sent, 34423.407917 records/sec (33.62 MB/sec), 604.66 ms avg latency, 1337.00 ms max latency
100000 records sent, 32278.889606 records/sec (31.52 MB/sec), 580.22 ms avg latency, 808.00 ms max latency
100000 records sent, 42283.298097 records/sec (41.29 MB/sec), 388.39 ms avg latency, 558.00 ms max latency

idle: lab-q2-nats 5.199MiB / 2GiB
NATS JetStream asynchronous publisher stats: 43,264 msgs/sec ~ 42 MiB/sec
NATS JetStream asynchronous publisher stats: 62,922 msgs/sec ~ 61 MiB/sec
NATS JetStream asynchronous publisher stats: 42,606 msgs/sec ~ 42 MiB/sec
والجدول التالي يجمع النشر في المرتين اللتين شغلنا فيهما الاختبار كاملاً، الأولى في وقت كان الجهاز فيه أكثر انشغالاً:
| الوسيط والإعداد | المرة الأولى، رسالة في الثانية | المرة الثانية، رسالة في الثانية |
|---|---|---|
| طابور Quorum في RabbitMQ مع تأكيد النشر | 3,357 و3,465 | 10,186 و9,880 و6,188 |
موضوع Kafka بثلاثة Partitions مع acks=all | 7,627 و10,939 و23,031 | 11,177 و14,229 و17,406 |
| موضوع Redpanda بالإعداد نفسه | 11,073 و37,779 و35,499 | 34,423 و32,279 و42,283 |
| تخزين ملفات في NATS JetStream | 105,903 و99,260 و8,260 | 43,264 و62,922 و42,606 |
في المخرج أعلاه لاحظ التالي:
- الفرق بين تشغيل وآخر للأداة نفسها كبير جداً، فNATS نزل في مرة إلى 8 آلاف بعد أن كان قرابة 100 ألف، وRabbitMQ تضاعف تقريباً بين المرة الأولى والثانية. وهذا هو أهم درس في التجربة: رقم واحد من اختبار واحد لا يعني شيئاً.
- RabbitMQ كان الأبطأ في كل المرات، والسبب الرئيسي ما شرحناه في معنى التأكيد: الطابور Quorum يكتب على القرص قبل التأكيد. وقسنا زمن الكتابة الفورية Fsync على قرص Docker في هذا الجهاز ب 200 كتابة صغيرة، فكان الوسيط 3.7 ملي ثانية، لكن 5% من الكتابات أخذت أكثر من 108 ملي ثانية و1% أكثر من 349 ملي ثانية، وهذه القفزات تدفعها كل أداة تنتظر القرص.
- عند التحقق من إعداد Redpanda بعد التجربة وجدنا أن
write_caching_defaultقيمتهtrueفي هذا التشغيل، أي أن Redpanda أيضاً لم ينتظر القرص، فأرقامه هنا ليست أرقام الإنتاج بالإعداد الآمن، وقد قارنا الإعدادين في اختبار السرعة في مقال Redpanda. - Kafka وRedpanda يتكلمان البروتوكول نفسه، والأداة نفسها قاست الاثنين، وكان Redpanda أسرع في النشر في كل المرات تقريباً بهذا الإعداد، وهذا يتفق مع ما رأيناه في مقاله.
الأرقام نفسها من تطبيق Python
أداة القياس الرسمية مكتوبة لتكون سريعة، أما تطبيقك فغالباً مكتوب بلغة أخرى ومكتبة أخرى، لذلك شغلنا الاختبار المشترك bench.py بالإعداد نفسه، والمخرج في المرة الثانية سوف يكون كما يلي:
rabbitmq: produce 100000 x 1024 B in 50.5s = 1,980 msg/s (2.0 MB/s)
rabbitmq: consume 100000 in 46.6s = 2,148 msg/s
kafka: produce 100000 x 1024 B in 1.0s = 104,753 msg/s (107.3 MB/s)
kafka: producer errors = 0
redpanda: produce 100000 x 1024 B in 1.7s = 57,539 msg/s (58.9 MB/s)
redpanda: producer errors = 0
nats: produce 100000 x 1024 B in 9.8s = 10,229 msg/s (10.5 MB/s)
nats: consume 100000 in 6.1s = 16,343 msg/s
في المخرج أعلاه لاحظ التالي:
- Kafka من Python كانت أسرع من أداة Kafka الرسمية نفسها، والسبب أن مكتبة
confluent-kafkaغلاف رفيع فوق مكتبة librdkafka المكتوبة بلغة C، وهي تجمع الرسائل في دفعات Batches، بينما أداة القياس تعمل على JVM جديدة تبدأ باردة في كل مرة. وفي المرة الأولى أعطت المكتبة نفسها 13,058 رسالة فقط، فالتذبذب هنا أيضاً. - RabbitMQ وNATS من Python كانا أبطأ بكثير من أداتيهما الرسميتين، وعندما راقبنا المعالج أثناء الاختبار وجدنا تطبيق Python عند 100% من معالج واحد بينما RabbitMQ عند 92%، أي أن المكتبة
aio-pikaهي الحد وليس الوسيط. فإذا كان تطبيقك بلغة Python ويحتاج آلاف الرسائل في الثانية فاختبر المكتبة قبل الوسيط، أو شغل عدة عمليات Processes. - لم نضع أرقام قراءة Kafka وRedpanda من Python، لأن القياس يبدأ من أول رسالة تصل، والمكتبة تكون قد جلبت آلاف الرسائل إلى الذاكرة قبل ذلك، فيظهر رقم كبير جداً غير واقعي.
التأخير عند حمل خفيف
السرعة القصوى لا تهم أغلب التطبيقات، فأغلبها يرسل عشرات أو مئات الرسائل في الثانية، والذي يهمها هو كم تنتظر الرسالة حتى تصل. لذلك أرسلنا 200 رسالة في الثانية لمدة 20 ثانية، والمخرج في المرة الثانية سوف يكون كما يلي:
rabbitmq: 4000/4000 received at 200 msg/s, latency ms p50=29.4 p95=197.6 p99=412.3 max=503.0
kafka: 4000/4000 received at 200 msg/s, latency ms p50=6.6 p95=30.1 p99=63.3 max=532.7
redpanda: 4000/4000 received at 200 msg/s, latency ms p50=6.1 p95=6.8 p99=10.4 max=60.4
nats: 4000/4000 received at 200 msg/s, latency ms p50=1.0 p95=3.7 p99=14.2 max=87.0
والجدول التالي يجمع المرتين:
| الوسيط | الوسيط p50 بالملي ثانية | نسبة 99% p99 بالملي ثانية |
|---|---|---|
| طابور Quorum في RabbitMQ | 55 و65 ثم 29.4 | 413 و1515 ثم 412 |
| موضوع في Kafka | 6.4 ثم 6.6 | 42 ثم 63 |
| موضوع في Redpanda | 6.0 ثم 6.1 | 6.9 ثم 10.4 |
| تخزين ملفات في NATS JetStream | 0.8 ثم 1.0 | 1.9 ثم 14.2 |
في المخرج أعلاه لاحظ التالي:
- NATS كان الأقل تأخيراً بفرق واضح، فنصف الرسائل وصل في ملي ثانية واحدة تقريباً، وهذا من تصميمه البسيط ومن أنه لا ينتظر القرص.
- Kafka وRedpanda قرابة 6 ملي ثانية في الوسيط، وجزء من ذلك من تجميع المنتج للرسائل قبل الإرسال، وهو إعداد تستطيع أن تغيره إذا كان التأخير أهم لك من السرعة.
- RabbitMQ هو الوحيد الذي ينتظر القرص هنا، فتأخيره يتبع قفزات زمن الكتابة على القرص التي قسناها، ونسبة 99% وصلت إلى ثانية ونصف في إحدى المرات. وأداة PerfTest الرسمية أعطت النتيجة نفسها تقريباً عند 200 رسالة في الثانية، فالوسيط كان 52.7 ملي ثانية، لذلك فالحد هنا هو القرص وليس مكتبة Python. وعلى سيرفر بأقراص NVMe حقيقية سوف ترى أرقاماً أفضل بكثير، لكن الدرس يبقى: الضمان الأقوى له ثمن تراه في التأخير.
إعادة القراءة: من يحتفظ بالرسالة بعد قراءتها؟
بعد أن قرأ المستهلك الرسائل المئة ألف وأكدها، حاول قارئ جديد أن يبدأ من أول رسالة، والمخرج سوف يكون كما يلي:
rabbitmq quorum queue bench-2b36e2: messages left after ack = 0
rabbitmq stream queue bench-stream-648e8a: reader-1 read 1000 from offset first
rabbitmq stream queue bench-stream-648e8a: reader-2 read 1000 from offset first
kafka: a new consumer group read 100000 messages from the beginning of bench-ff7543
redpanda: a new consumer group read 100000 messages from the beginning of bench-32ca6e
nats: a new durable consumer read 100000 messages from the start of stream BENCH_D55AAE
وهذا ما يقوله النموذج تماماً: الطابور Quorum أصبح فارغاً بعد التأكيد، فلا يوجد شيء تعيد قراءته، بينما Stream في RabbitMQ قرأ منه قارئان الرسائل نفسها، ومجموعة مستهلكين جديدة في Kafka وRedpanda قرأت كل الرسائل، وكذلك مستهلك جديد في JetStream. فإذا كنت تحتاج أن يضاف نظام جديد بعد سنة ويقرأ الأحداث القديمة، فالطابور العادي لا يعطيك ذلك.
الذاكرة قبل الحمل وبعده
| الوسيط | في وقت الراحة | بعد الاختبارات |
|---|---|---|
| وسيط RabbitMQ | 92 ميجابايت | 219 ميجابايت |
| وسيط Kafka | 401 ميجابايت | 865 ميجابايت |
| وسيط Redpanda | 271 ميجابايت | 868 ميجابايت |
| سيرفر NATS | 5 ميجابايت | 245 ميجابايت |
لاحظ أن NATS بدأ بخمسة ميجابايت فقط، وأن Kafka تحجز ذاكرة JVM من البداية، وأن Redpanda يحجز الذاكرة التي تعطيه إياها بالخيار --memory ويستخدمها Cache، فالرقم بعد الحمل يعكس الإعداد أكثر مما يعكس الحاجة. وفي الإنتاج اترك لKafka ذاكرة إضافية خارج JVM لأنها تعتمد على Page Cache في نظام التشغيل.
حذف المختبر
docker compose --profile tools down -v
docker image rm lab-q2-bench:1 pivotalrabbitmq/perf-test:2.25.0
تكلفة التشغيل: ما الذي سوف يأخذ وقت فريقك؟
السرعة نادراً ما تكون سبب فشل المشروع، والذي يتعب الفرق فعلاً هو التشغيل اليومي: الترقيات، والمراقبة، وما يحدث عندما يتوقف سيرفر في الثالثة فجراً. والجدول التالي يلخص ما رأيناه في مقالات الأدوات:
| البند | RabbitMQ | Kafka | Redpanda | NATS |
|---|---|---|---|---|
| ما الذي تشغله | عنقود Erlang بثلاث عقد | ثلاث عقد على JVM مع KRaft | ملف تنفيذي بلغة C++ لكل عقدة | ملف تنفيذي بلغة Go لكل عقدة |
| واجهة الإدارة | واجهة Management مدمجة | لا توجد واجهة رسمية، وتحتاج أداة منفصلة | واجهة Redpanda Console | سطر الأوامر nats ونقطة مراقبة HTTP |
| أصعب ما في التشغيل | الترقية المستمرة لأن دعم المجتمع قصير، وضبط الطوابير الطويلة | ضبط ال Partitions والنسخ وإعادة التوزيع، وذاكرة JVM | متابعة الرخصة والميزات التجارية | تصميم أسماء ال Subjects والحسابات Accounts |
| النظام المحيط | مكتبات لكل لغة، وبروتوكولات AMQP وMQTT وSTOMP | الأكبر: Kafka Connect، وموصلات CDC، ومعالجة البث | متوافق مع أدوات Kafka | مكتبات رسمية كثيرة، ونظام محيط أصغر |
وقد يتساءل البعض: هل نحتاج وسيطاً منفصلاً أصلاً؟ والإجابة أن كثيراً من التطبيقات لا تحتاجه في البداية، فإذا كانت عندك PostgreSQL فطابور بالأمر FOR UPDATE SKIP LOCKED يكفي آلاف المهام في الدقيقة كما في قسم الطابور في مقال PostgreSQL لكل شيء، وإذا كان عندك Redis أو Valkey فهناك طوابير بسيطة فوقه بشروط شرحناها في مقال طوابير المهام فوق Redis وValkey. والوسيط المنفصل يستحق تكلفته عندما تحتاج ما لا تعطيه هذه الحلول: عدة أنظمة تقرأ الأحداث نفسها، أو توجيه معقد، أو أحجام كبيرة.
الرخص في أكتوبر 2026
- RabbitMQ: رخصة MPL 2.0 مفتوحة المصدر، والمشروع تحت Broadcom، ودعم المجتمع لكل سلسلة قصير، وقد شرحنا ذلك في قسم الرخصة في مقال RabbitMQ.
- Apache Kafka: رخصة Apache 2.0 تحت مؤسسة Apache، دون أي شركة تملك العلامة التجارية.
- Redpanda: الكود الأساسي برخصة BSL 1.1، وهي ليست مفتوحة المصدر، وتمنعك من تقديم Redpanda نفسه خدمة بث أو طوابير لعملائك، وبعض الميزات تحتاج رخصة تجارية، والتفاصيل في قسم الرخصة في مقال Redpanda.
- NATS: رخصة Apache 2.0، والعلامة التجارية انتقلت إلى Linux Foundation بعد خلاف 2025 بين Synadia وCNCF، والتفاصيل في قسم الرخصة في مقال NATS.
فإذا كنت شركة استضافة أو منصة يستطيع عملاؤها إنشاء مواضيعهم بأنفسهم، فاستبعد Redpanda من البداية أو تفاوض على رخصة تجارية، أما الثلاث الأخرى فتسمح بذلك.
متى تختار كل أداة؟
وسيط RabbitMQ
نقاط القوة: التوجيه بالموزعات Exchanges، والتأكيد لكل رسالة، وإعادة المحاولة وال Dead Letter Exchange الجاهزة، والأولويات، وواجهة إدارة مدمجة، وفريق يفهمه بسرعة. نقاط الضعف: لا يعيد قراءة الرسائل في الطابور العادي، والطوابير الطويلة جداً تبطئه، وضمان الكتابة على القرص يرفع التأخير على الأقراص البطيئة.
اختره عندما يكون عملك توزيع مهام على Workers: بريد، وتقارير، ومعالجة ملفات، وطلبات تمر بخطوات.
منصة Kafka
نقاط القوة: سجل دائم يقرؤه أي عدد من الأنظمة كل بسرعته، وإعادة القراءة، والترتيب لكل مفتاح، والنظام المحيط الأكبر مثل Kafka Connect ونقل التغييرات من قاعدة البيانات CDC مع Debezium. نقاط الضعف: أثقل في التشغيل والذاكرة، ولا توجد واجهة رسمية، وهي أكبر من حاجة أغلب التطبيقات الصغيرة.
اخترها عندما تكون الأحداث نفسها هي المنتج: تدفق طلبات يقرؤه المخزون والتقارير والإشعارات، أو بيانات تنقلها من قواعد بيانات إلى مخزن تحليلات.
بديل Redpanda
نقاط القوة: متوافق مع Kafka API فيعمل كودك وأدواتك دون تغيير، وأخف في الموارد، وأسرع في اختبارنا، وواجهة Console جيدة. نقاط الضعف: الرخصة BSL ليست مفتوحة المصدر، وبعض الميزات تجارية، وشركة واحدة تملك المشروع.
اختره عندما تريد نموذج Kafka بتشغيل أبسط، ورخصته تناسب استخدامك.
نظام NATS
نقاط القوة: الأخف والأقل تأخيراً في تجربتنا، والطلب والرد بين الخدمات دون Load Balancer، ويغطي البث اللحظي والطابور والسجل ومخزن المفاتيح KV في سيرفر واحد، ويعمل على الأجهزة الطرفية Edge. نقاط الضعف: لا يتكلم Kafka API، ونظامه المحيط أصغر، وبعض ما يأتي جاهزاً في RabbitMQ مثل التوجيه المعقد تبنيه بنفسك.
اختره عندما تكون الخدمات المصغرة تتكلم مع بعضها كثيراً، أو تحتاج رسائل لحظية، أو تريد أداة واحدة صغيرة لعدة أشكال من الرسائل.
جدول القرار
| حالتك | الاختيار الأنسب | والسبب |
|---|---|---|
| مهام خلفية في تطبيق واحد بحجم صغير، وعندك قاعدة بيانات | طابور في PostgreSQL أو Redis وValkey | لا يوجد نظام جديد تشغله، والمهمة تكتب في المعاملة نفسها مع البيانات |
| توزيع مهام على Workers مع إعادة محاولة وDLQ وأولويات | RabbitMQ | كل ذلك جاهز في الوسيط، والتأكيد لكل رسالة |
| أحداث يقرؤها عدة أنظمة، وتحتاج إعادة القراءة | Kafka | السجل الدائم ومجموعات المستهلكين المستقلة |
| نفس الحالة السابقة بفريق صغير وموارد أقل، والرخصة تناسبك | Redpanda | نموذج Kafka بتشغيل أبسط |
| نقل التغييرات من قاعدة البيانات إلى أنظمة أخرى | Kafka مع Debezium | الموصلات الجاهزة في Kafka Connect |
| طلب ورد بين خدمات مصغرة، ورسائل لحظية، وأجهزة طرفية | NATS | الأقل تأخيراً والأخف، وJetStream عند الحاجة للحفظ |
| منصة يستطيع عملاؤك فيها إنشاء مواضيعهم | أي واحدة من Kafka وNATS وRabbitMQ، أما Redpanda فيحتاج رخصة تجارية | رخصة BSL تمنع تقديمه خدمة بث أو طوابير |
أخطاء شائعة
- الاختيار من رقم سرعة في مقال: رأيت في تجربتنا الرقم نفسه يتغير ثلاثة أضعاف، وأرقام المقالات تأتي من أجهزة وإعدادات لا تشبه أجهزتك.
- مقارنة أداة تكتب على القرص بأداة لا تكتب: اعرف معنى التأكيد في كل أداة قبل أن تقارن السرعة أو تقرر أن إحداها «أسرع».
- Kafka لمهام خلفية صغيرة: سوف تشغل عنقوداً كاملاً وتبني إعادة المحاولة وDLQ بنفسك، بينما طابور بسيط كان يكفي.
- Core NATS لرسائل لا يجوز أن تضيع: الرسالة تصل لمن يستمع الآن فقط، فإذا كان المستهلك متوقفاً ضاعت، واستخدم JetStream لذلك.
- الاعتماد على «مرة واحدة بالضبط» دون مستهلك آمن عند التكرار: كل الأدوات قد تسلم الرسالة مرتين لنظام خارجي، فاجعل المستهلك يتحمل التكرار.
- اختبار المكتبة على أنه اختبار الوسيط: في تجربتنا كانت مكتبة Python هي الحد مع RabbitMQ وNATS، فقس الاثنين.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الأدوات تختلف في النموذج قبل السرعة: RabbitMQ طابور يوزع العمل ثم يحذفه، وKafka وRedpanda سجل يحفظ الأحداث لكل قارئ، وNATS بث لحظي يضيف الحفظ عبر JetStream.
- كل الأدوات تعطي «مرة على الأقل» بالإعداد الصحيح، والترتيب مضمون داخل طابور أو Partition أو مستهلك واحد فقط، وإعادة القراءة غير ممكنة في الطابور العادي.
- معنى التأكيد يختلف: Quorum Queues في RabbitMQ تكتب على القرص قبله، وKafka وNATS بإعداداتهما الافتراضية تعتمدان على النسخ، وهذا يفسر جزءاً كبيراً من فروق السرعة والتأخير.
- في تجربتنا على جهاز واحد مشغول كان NATS الأقل تأخيراً، وRedpanda الأسرع في النشر بين أدوات Kafka API، وRabbitMQ الأبطأ لأنه ينتظر القرص، والأرقام تذبذبت حتى ثلاثة أضعاف بين تشغيل وآخر.
- اختر بحسب شكل عملك وفريقك ورخصة الأداة، وابدأ بطابور في قاعدة بياناتك إذا كان الحجم صغيراً.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلالطابور Queue أم بث الأحداث Event Streaming؟ما يحدث للرسالة بعد قراءتها هو الفرق بين طابور مثل RabbitMQ وسجل أحداث مثل Kafka، ومنه تعرف أيهما يناسب مشروعك.
 دليلطوابير المهام فوق Redis وValkey: متى تضيع المهمة؟كيف تبني طابور مهام فوق Redis أو Valkey بالقوائم والتدفقات، وأين تضيع المهام عند توقف العامل أو امتلاء الذاكرة.
 دليلنقل تغييرات قاعدة البيانات CDC مع Debeziumكيف تنقل كل تغيير في PostgreSQL إلى Kafka مع Debezium ونمط Outbox، ولماذا قد يملأ مستهلك متوقف قرص قاعدة بياناتك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ اختبار مشترك على RabbitMQ 4.3.6 وApache Kafka 4.3.1 وRedpanda 26.2.4 وNATS Server 2.15.0 مع PerfTest 2.25.0 وnats CLI 0.5.0 وPython 3.13.16 في Docker.


