

تنشر صفحة جديدة عن منتجك، وبعد أسبوع تبحث عن عنوانها حرفياً في Google فلا تجدها، فيقول أحد الفريق: «نحتاج SEO». وهذه الكلمة تخفي سؤالاً أدق: أين توقفت الصفحة؟ هل لم يصل إليها الزاحف أصلاً، أم وصل ولم يفهم محتواها، أم فهمه وقرر أن صفحة أخرى أحق بالظهور؟ ولكل سؤال من هذه الأسئلة جواب مختلف، وأغلب أجوبة السؤالين الأولين في يد المطور لا في يد كاتب المحتوى. وتحسين الظهور في محركات البحث SEO (Search Engine Optimization) يبدأ من فهم هذه المراحل.
هذا المقال جزء من مرحلة «المحتوى وتحسين الظهور في البحث» في مسار التسويق للتقنيين، وفيها أيضاً:
 دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها بحسب ما يعرفه القارئ، وتقيس أثرها في البحث والمبيعات.
 دليلSEO التقني للمطورين: موقع عربي قبل الإصلاح وبعدهنبني موقعاً عربياً فيه عشر مشكلات تقنية شائعة، ونقيسه بأدوات مفتوحة المصدر، ثم نصلحه ونقيس الفرق بالأرقام.
 دليلأدوات SEO: الأدوات التجارية وبدائلها المجانيةما الذي تقدمه Ahrefs وSemrush وMoz فعلاً، وما الذي تغطيه مجاناً أدوات محركات البحث وأدوات مفتوحة المصدر جربناها على موقع عربي.
وفي هذا المقال سوف نتناول:
- المراحل التي تمر بها الصفحة: الاكتشاف والزحف والتصيير والفهرسة والترتيب.
- الأدوات الأربع التي يملكها المطور:
robots.txtوnoindexوالرابط القانوني Canonical والـ Sitemap، والفرق بينها. - كيف يرتب Google النتائج، وما الذي نعرفه بالمصدر الرسمي وما الذي لا نعرفه.
- كيف يتحول كود الصفحة إلى شكلها في النتائج، وما يخص المواقع العربية.
- Bing وIndexNow ونتائج الذكاء الاصطناعي، ثم من يملك ماذا في الفريق.
المراحل: من الرابط إلى نتيجة البحث
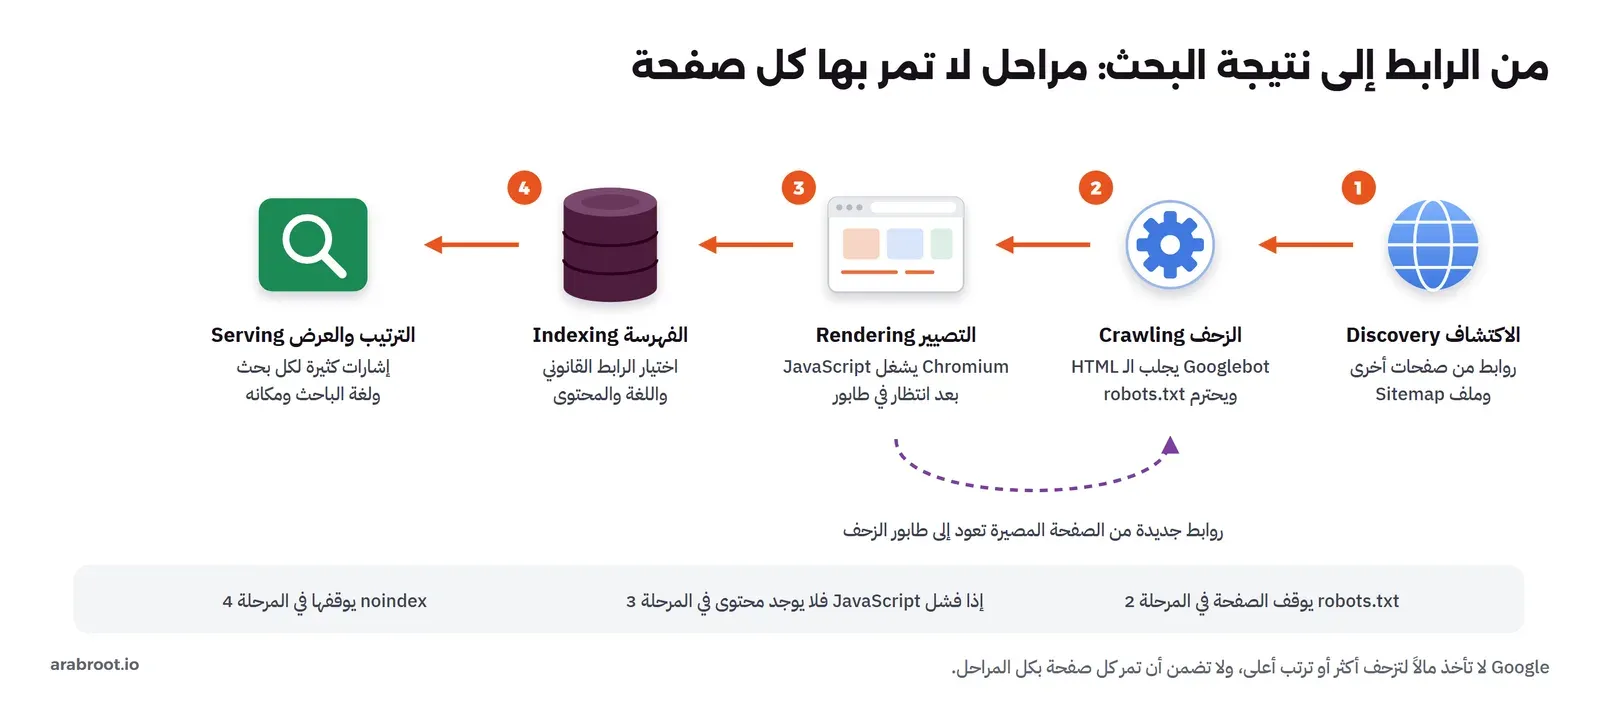
تقول Google في شرحها لطريقة عمل البحث إن البحث يعمل في ثلاث مراحل هي الزحف Crawling والفهرسة Indexing وعرض النتائج Serving، وإن الصفحات لا تمر كلها بكل المراحل، وإنها لا تأخذ مالاً لتزحف إلى موقع أكثر أو لترتبه أعلى. ونضيف إليها مرحلتين يحتاج المطور أن يراهما منفصلتين: الاكتشاف Discovery قبل الزحف، والتصيير Rendering بين الزحف والفهرسة. والصورة التالية تبين المراحل وأين تتوقف الصفحة عادة:
ولتتخيل الحجم: تقول Google في صفحة تنظيم المعلومات إن فهرسها يضم مئات المليارات من الصفحات، وبالتالي فالزاحف لا يزور كل صفحة كل يوم، ويختار ما يزوره بحسب ما يعرفه عن الموقع.
الاكتشاف Discovery
لا يوجد سجل مركزي للصفحات، فمحرك البحث يعرف بصفحتك من طريقين: رابط إليها في صفحة يعرفها، أو ملف Sitemap ترسله أنت. لذلك الصفحة التي لا يشير إليها أي رابط داخلي، ولا توجد في الـ Sitemap، تسمى صفحة يتيمة Orphan Page، وقد لا تكتشف أبداً. والرابط الذي يتبعه الزاحف هو عنصر <a> فيه href برابط حقيقي كما في إرشادات الروابط، أما زر ينقلك بـ onclick فلا يعتبر رابطاً.
الزحف Crawling
الزاحف Crawler برنامج يطلب الصفحة كما يطلبها المتصفح، واسمه عند Google هو Googlebot، وأغلب زحفه اليوم بنسخة الهاتف لأن Google تعتمد الفهرسة بنسخة الهاتف أولاً Mobile-first Indexing، وبالتالي إذا كانت نسخة الهاتف من موقعك تخفي جزءاً من المحتوى فهذا الجزء غير موجود في نظر Google.
وقبل أن يزحف يقرأ ملف robots.txt في جذر النطاق، وهو ملف قواعد بسيط موحد في RFC 9309، وتقرأ Google منه أول 500 KiB فقط. وأما ميزانية الزحف Crawl Budget، أي عدد الصفحات التي يزحف إليها Googlebot في موقعك في فترة معينة، فتقول Google في دليلها إنه موضوع للمواقع الكبيرة، أي التي فيها أكثر من مليون صفحة تتغير أسبوعياً، أو أكثر من عشرة آلاف صفحة تتغير يومياً. لذلك إذا كان موقع شركتك فيه مئتا صفحة فلا تقم بتضييع وقتك في ميزانية الزحف، والسبب أن مشكلتك في الغالب في الاكتشاف أو المحتوى.
التصيير Rendering
إذا كانت الصفحة تبني محتواها بـ JavaScript، فالـ HTML الذي جلبه الزاحف ليس الصفحة التي يراها الزائر. وتشرح Google في أساسيات JavaScript وSEO أن الصفحة تدخل طابور التصيير Render Queue، وقد تبقى فيه ثواني أو أطول، ثم يشغلها Chromium بلا واجهة، وبعدها تستخرج الروابط الجديدة وتعود إلى طابور الزحف. وهذا يعني أمرين: المحتوى الذي يأتي بـ JavaScript يتأخر، والملفات التي يحتاجها التصيير (JavaScript وCSS والـ API) يجب ألا تكون ممنوعة في robots.txt. وفي مختبر SEO التقني الذي بنيناه للموضوع رأينا مقالاً من 71 كلمة يصل إلى زاحف لا يشغل JavaScript بكلمتين فقط.
الفهرسة Indexing
بعد أن يرى المحرك محتوى الصفحة يحللها ويقرر هل تدخل الفهرس، وتحت أي رابط. وأهم ما يحدث هنا ثلاثة أمور:
- اختيار الرابط القانوني Canonicalization: نفس المحتوى قد يصل من عدة روابط، مثل
?utm_source=أو نسخة بشرطة مائلة في النهاية وأخرى دونها، فيختار Google رابطاً واحداً يمثلها. وتضع Google في صفحة دمج الروابط المكررة ترتيب الإشارات: إعادة التوجيه Redirect إشارة قوية، وrel="canonical"إشارة قوية، والوجود في الـ Sitemap إشارة ضعيفة. - معرفة اللغة: تحددها Google بخوارزمياتها من المحتوى نفسه، ولا تعتمد على
langولا hreflang لذلك كما في توثيق النسخ المحلية. - رفض الصفحة: صفحة فيها
noindex، أو صفحة خطأ ترد بالرمز 200 وتسميها Google الخطأ اللين Soft 404 في توثيق رموز HTTP، أو صفحة مكررة اختير غيرها.
أربع أدوات بيد المطور
أكثر خطأ نراه هو الخلط بين هذه الأدوات، فيستخدم المطور robots.txt ليخفي صفحة من النتائج، أو يضع noindex في صفحة ممنوعة من الزحف. والصورة التالية تفصل بينها:
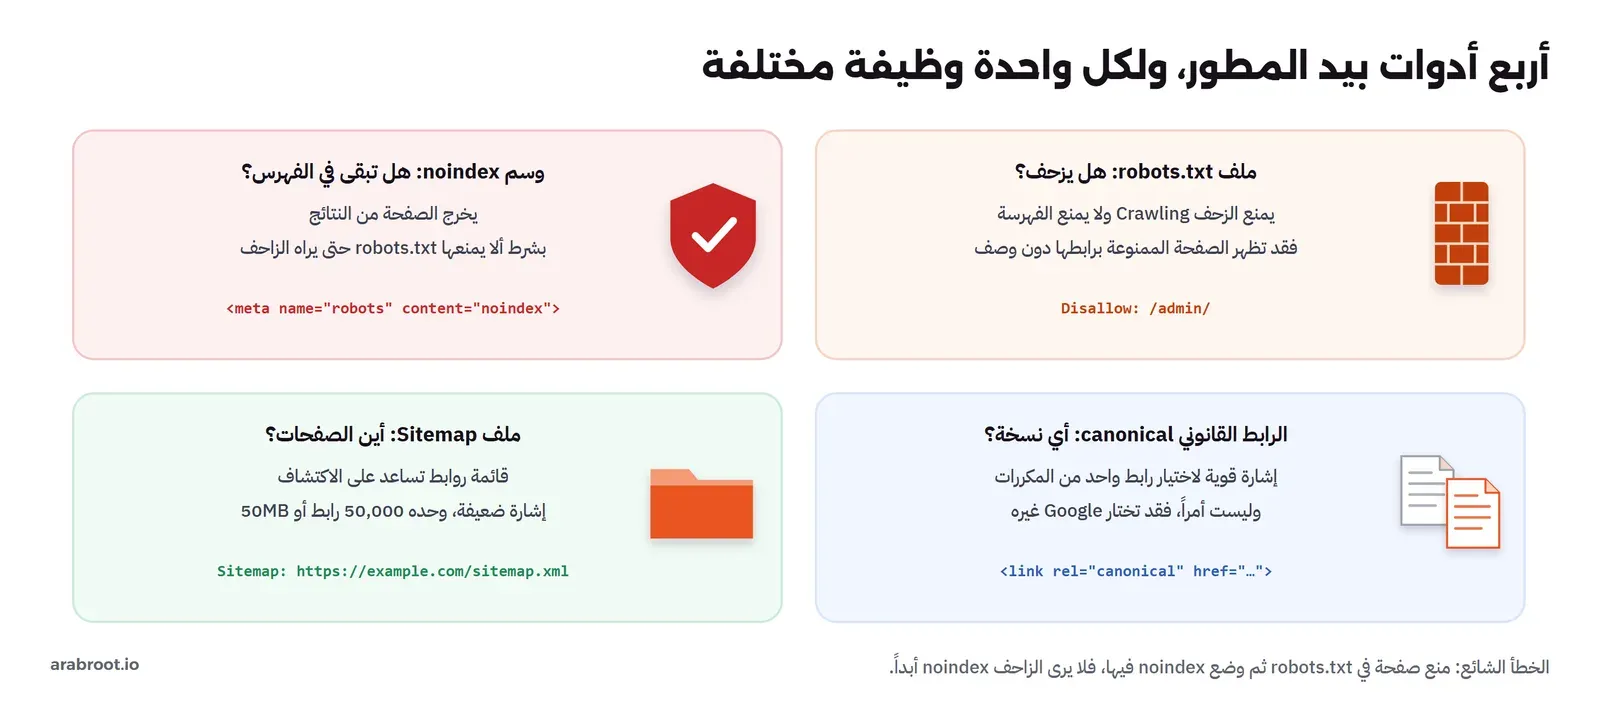
| الأداة | ماذا تفعل | ماذا لا تفعل |
|---|---|---|
robots.txt | تمنع الزحف إلى مسارات معينة، وتخفف الحمل عن السيرفر | لا تخفي الصفحة من النتائج، فقد تظهر برابطها إذا أشارت إليها مواقع أخرى |
noindex في وسم robots أو ترويسة X-Robots-Tag | تخرج الصفحة من الفهرس | لا تعمل إذا كانت الصفحة ممنوعة من الزحف، لأن الزاحف لن يقرأ الوسم |
rel="canonical" | تقترح الرابط الذي يمثل مجموعة صفحات متشابهة | ليست أمراً، فقد يختار Google رابطاً آخر إذا تعارضت الإشارات |
| Sitemap | تخبر المحرك بالروابط وتاريخ آخر تعديل lastmod | لا تضمن الفهرسة، وتتجاهل Google قيم priority وchangefreq |
robots.txt وحده، والسبب أنه لا يمنع الفهرسة ولا يمنع أحداً من فتحها. احمها بكلمة مرور أو بقائمة عناوين IP كما في كل الطرق لحماية صفحة أو أداة داخلية، وانتبه عند النشر ألا ينتقل ملف robots.txt الخاص بها إلى الإنتاج فيمنع موقعك كاملاً.الترتيب Ranking: ما الذي نعرفه بالمصدر الرسمي؟
لا يوجد ترتيب ثابت لصفحة، فلكل بحث ترتيب يتغير بحسب لغة الباحث ومكانه وجهازه. وGoogle لا تنشر وزن كل إشارة، وكل قائمة على الإنترنت تقول «200 عامل ترتيب بأوزانها» هي تخمين. وما تنشره Google رسمياً هو التالي:
- أنظمة الترتيب Ranking Systems: في دليل أنظمة الترتيب تسمي Google أنظمة بعينها، منها نظام فهم المعنى، ونظام المحتوى الأصلي، ونظام الروابط، ونظام مكافحة الإزعاج SpamBrain.
- المحتوى المفيد People-first Content: في إرشادات المحتوى المفيد أسئلة يسألها الكاتب لنفسه، مثل: هل يقدم المحتوى معلومات أو تحليلاً أصلياً؟ وهل يخرج القارئ وقد حصل على ما يكفيه؟ وهذا موضوع مقال التسويق بالمحتوى في السلسلة.
- تجربة الصفحة Page Experience: تقول Google في صفحة تجربة الصفحة إن مؤشرات أداء الويب الأساسية Core Web Vitals تستخدمها أنظمة الترتيب، والحدود الجيدة في توثيقها هي: أكبر عنصر مرئي LCP خلال 2.5 ثانية، والاستجابة للتفاعل INP أقل من 200 ملي ثانية، واهتزاز الصفحة CLS أقل من 0.1، وتقاس عند النسبة المئوية 75 من زيارات المستخدمين الحقيقيين.
- سياسات الإزعاج Spam Policies: في صفحة سياسات الإزعاج ما يخفض الموقع أو يخرجه، مثل حشو الكلمات المفتاحية Keyword Stuffing، وإنتاج المحتوى بكميات كبيرة لغرض الترتيب Scaled Content Abuse، وشراء الروابط.
وقد يتساءل البعض: هل درجة 100 في Lighthouse ترفع الترتيب؟ والإجابة لا، فـ Lighthouse قياس في المختبر Lab Data بجهاز وشبكة محاكيين، أما Google فتعتمد على قياسات زوارك الفعلية Field Data التي تجدها في تقرير Core Web Vitals في Search Console. والدرجة مفيدة لتعرف أين المشكلة، وليست هدفاً بحد ذاتها.
من كود الصفحة إلى شكلها في النتائج
بعد أن تدخل الصفحة الفهرس وتظهر في نتيجة، فإن عدة أجزاء من الـ HTML تشكل ما يراه الباحث، والصورة التالية تربط بينها:
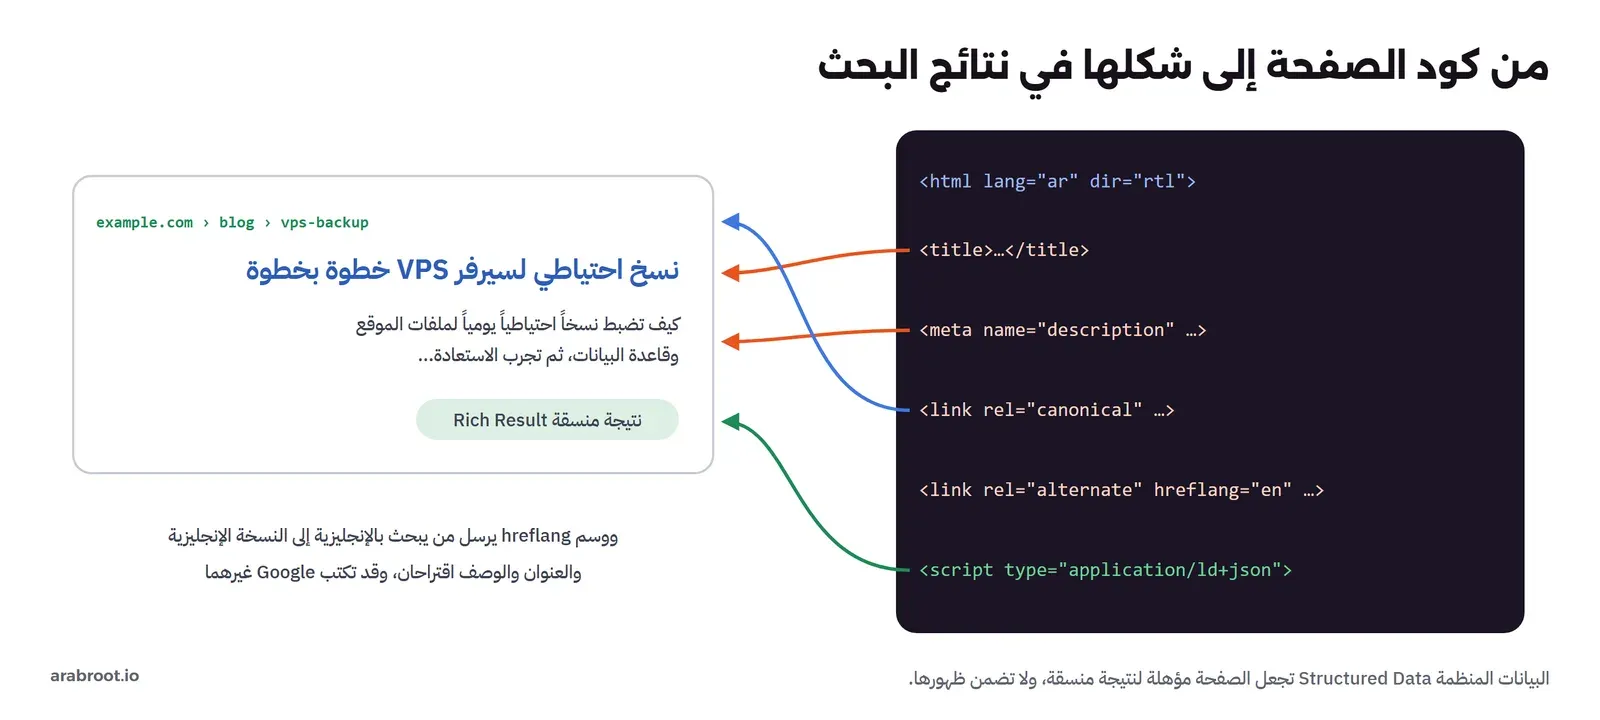
- رابط العنوان Title Link: يأتي غالباً من
<title>، ولكن Google تقول في توثيق روابط العناوين إن إنشاءه آلي بالكامل ويأخذ في الحسبان محتوى الصفحة والروابط إليها، وإنه لا يوجد حد لطول العنوان، وإنما يقطع بحسب عرض الشاشة. - المقتطف Snippet: قد يأتي من
meta descriptionإذا كان يصف الصفحة أفضل من نصها، كما في توثيق المقتطفات، والوصف ليس عامل ترتيب. - البيانات المنظمة Structured Data: كود JSON-LD بمفردات schema.org يصف الصفحة بصيغة تفهمها الآلة، فيجعلها مؤهلة لنتائج منسقة Rich Results مثل التقييمات والأسئلة الشائعة والوصفات، كما في مقدمة البيانات المنظمة.
- الصور: تحتاج نصاً بديلاً
altيصفها، واسم ملف ذا معنى، كما في إرشادات صور Google.
ما يخص المواقع العربية
- hreflang برمز اللغة: العربية
ar، وإذا كانت النسخة موجهة لبلد بعينه تضيف رمزه فتصبحar-SAأوar-EG، ولا تقم بكتابة رمز الدولة وحده مثلsa، والسبب أنه رمز لغة صحيح للسنسكريتية فلا ترفضه الأدوات. وكل نسخة تذكر نفسها والنسخ الأخرى، وتضيفx-default، كما في توثيق النسخ المحلية. - اللغة والاتجاه في الـ HTML:
<html lang="ar" dir="rtl">. لا يعتمد عليه Google لمعرفة اللغة، ولكن المتصفح وقارئ الشاشة وأدوات الترجمة وزواحف أخرى تعتمد عليه. - الروابط العربية: توصي Google في إرشادات بنية الروابط بكلمات وصفية بلغة الجمهور، وبترميز UTF-8 للحروف غير اللاتينية، وبالشرطة
-بين الكلمات. والرابط العربي يظهر مقروءاً في المتصفح، ولكنه يتحول إلى سلسلة طويلة من%D8…عند نسخه في بعض التطبيقات، فقرر مرة واحدة واثبت عليه، والسبب أن تغيير الروابط بعد النشر يحتاج إعادة توجيه لكل رابط قديم. - أطوال العناوين في الأدوات: بعض أدوات SEO تعد البايتات وليس الحروف، والحرف العربي بايتان في UTF-8، فتنبه على عنوان عربي من 50 حرفاً بأنه طويل. وقد رأينا ذلك بالكود في مختبر SEO التقني.
Bing وIndexNow ونتائج الذكاء الاصطناعي
Google ليس المحرك الوحيد، فـ Bing له أدوات مشرفي المواقع Bing Webmaster Tools، ويدعم بروتوكول IndexNow الذي يرسل فيه موقعك الروابط الجديدة أو المعدلة أو المحذوفة فور تغيرها بدل انتظار الزاحف، وهو مفيد لموقع ينشر كثيراً، ويكفي فيه ملف مفتاح وطلب HTTP واحد. وأما ملخصات الذكاء الاصطناعي في Google مثل AI Overviews وAI Mode، فتقول Google في صفحة ميزات الذكاء الاصطناعي إنه لا توجد متطلبات إضافية ولا تحسينات خاصة للظهور فيها، وإن أساسيات SEO نفسها هي المطلوبة.
من يملك ماذا في الفريق؟
| المرحلة | المسؤول غالباً | أمثلة |
|---|---|---|
| الاكتشاف والزحف | المطور | روابط <a href> حقيقية، Sitemap آلي، robots.txt صحيح، ردود HTTP صحيحة وإعادة توجيه 301 عند تغيير الروابط |
| التصيير | المطور | محتوى في الـ HTML من السيرفر SSR أو التوليد المسبق SSG، وعدم منع ملفات JavaScript وCSS |
| الفهرسة | المطور مع صاحب المحتوى | رابط قانوني صحيح، noindex لصفحات البحث الداخلي والفلاتر، hreflang، صفحة 404 حقيقية |
| الترتيب | صاحب المحتوى أولاً، والمطور في الأداء | محتوى يجيب عن سؤال الباحث، Core Web Vitals جيدة، روابط من مواقع أخرى تكسبها بالمحتوى |
| شكل النتيجة | الاثنان | عنوان ووصف لكل صفحة من نظام إدارة المحتوى CMS، بيانات منظمة في القالب |
والترتيب الذي نوصي به لموقع شركة جديدة: سجل الموقع في Search Console وBing Webmaster Tools، وأرسل الـ Sitemap، ثم افتح تقرير الصفحات Pages لترى أي الصفحات لم تفهرس ولماذا، والسبب أن هذا التقرير يجيب بالضبط عن سؤال بداية المقال: أين توقفت الصفحة؟ وكيف تفعل ذلك بأدوات مجانية ومفتوحة المصدر هو موضوع مقال أدوات SEO.
الخلاصة
- الصفحة تمر بالاكتشاف والزحف والتصيير والفهرسة ثم الترتيب، والتشخيص يبدأ بمعرفة المرحلة التي توقفت فيها.
- الاكتشاف يحتاج روابط
<a href>حقيقية وSitemap، والتصيير يحتاج محتوى في الـ HTML أو ملفات JavaScript غير ممنوعة. robots.txtيمنع الزحف، وnoindexيمنع الفهرسة، والرابط القانوني والـ Sitemap إشارتان وليسا أمرين.- Google تنشر أنظمة الترتيب وحدود Core Web Vitals وسياسات الإزعاج، ولا تنشر أوزان الإشارات، وتحديث مارس 2024 خفض المحتوى غير الأصلي في النتائج بنسبة 45% بحسب Google.
- للمواقع العربية:
hreflang="ar"وليسsa، وlang="ar" dir="rtl"، وقرار ثابت في شكل الروابط.
وفي المقالات التالية من المرحلة نجرب هذه المفاهيم على موقع عربي في Docker، ثم نقارن الأدوات التي تقيسها:
دليلSEO التقني للمطورين: موقع عربي قبل الإصلاح وبعدهنبني موقعاً عربياً فيه عشر مشكلات تقنية شائعة، ونقيسه بأدوات مفتوحة المصدر، ثم نصلحه ونقيس الفرق بالأرقام.دليلأدوات SEO: الأدوات التجارية وبدائلها المجانيةما الذي تقدمه Ahrefs وSemrush وMoz فعلاً، وما الذي تغطيه مجاناً أدوات محركات البحث وأدوات مفتوحة المصدر جربناها على موقع عربي.دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها بحسب ما يعرفه القارئ، وتقيس أثرها في البحث والمبيعات.سجل التحديثات
- أكتوبر 2026: كتابة المقال، والمصادر من توثيق Google Search Central كما ظهر في 25 أكتوبر 2026.