

أغلب مشكلات الظهور في البحث التي نراها في مواقع الشركات التقنية لا يكتبها كاتب المحتوى، وإنما تخرج من الكود: قالب يضع نفس الرابط القانوني Canonical في كل الصفحات، وواجهة React تبني المقال في المتصفح فيصل الزاحف Crawler إلى صفحة فارغة، وصورة بحجم ميغابايت يرفعها أحدهم من هاتفه، وسطر في robots.txt كتب قبل سنتين ونسيه الجميع. وفي مقال كيف تعمل محركات البحث من الداخل شرحنا المراحل التي تمر بها الصفحة من الزحف Crawling إلى الفهرسة Indexing إلى الترتيب Ranking، والآن سوف ننتقل من الشرح إلى التجربة.
 دليلكيف تعمل محركات البحث؟ SEO من الداخل للمطورينماذا يحدث لصفحتك من الزحف إلى الفهرسة إلى الترتيب، وأين تتوقف عادة، وما الذي يملكه المطور لإصلاحه.
 دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها بحسب ما يعرفه القارئ، وتقيس أثرها في البحث والمبيعات.
في هذا المقال سوف نتناول:
- بناء موقع عربي صغير في Docker فيه عشر مشكلات تقنية نجدها كثيراً في المواقع الحقيقية.
- قياسه بثلاث أدوات مفتوحة المصدر: Lighthouse لكل صفحة، والزاحف SEOnaut للموقع كاملاً، وفاحص صغير بلغة Python لما لا تفحصه الأداتان.
- إصلاح المشكلات واحدة واحدة، مع الكود قبل وبعد.
- القياس مرة ثانية بنفس الأدوات، وما الذي فاتته الأدوات نفسها، ومنها مشكلة تخص العناوين العربية.
فكرة المختبر
الموقع شركة استضافة وهمية اسمها «استضافة المثال»، فيه صفحة رئيسية ومدونة بمقالين وصفحة أسعار ونسخة إنجليزية للصفحة الرئيسية، ونفس المحتوى موجود في نسختين: site-before بالمشكلات وsite-after بعد الإصلاح، ويخدمهما Container واحد من nginx نبدل المجلد الذي يقرأ منه. والصورة التالية تبين المختبر كاملاً:
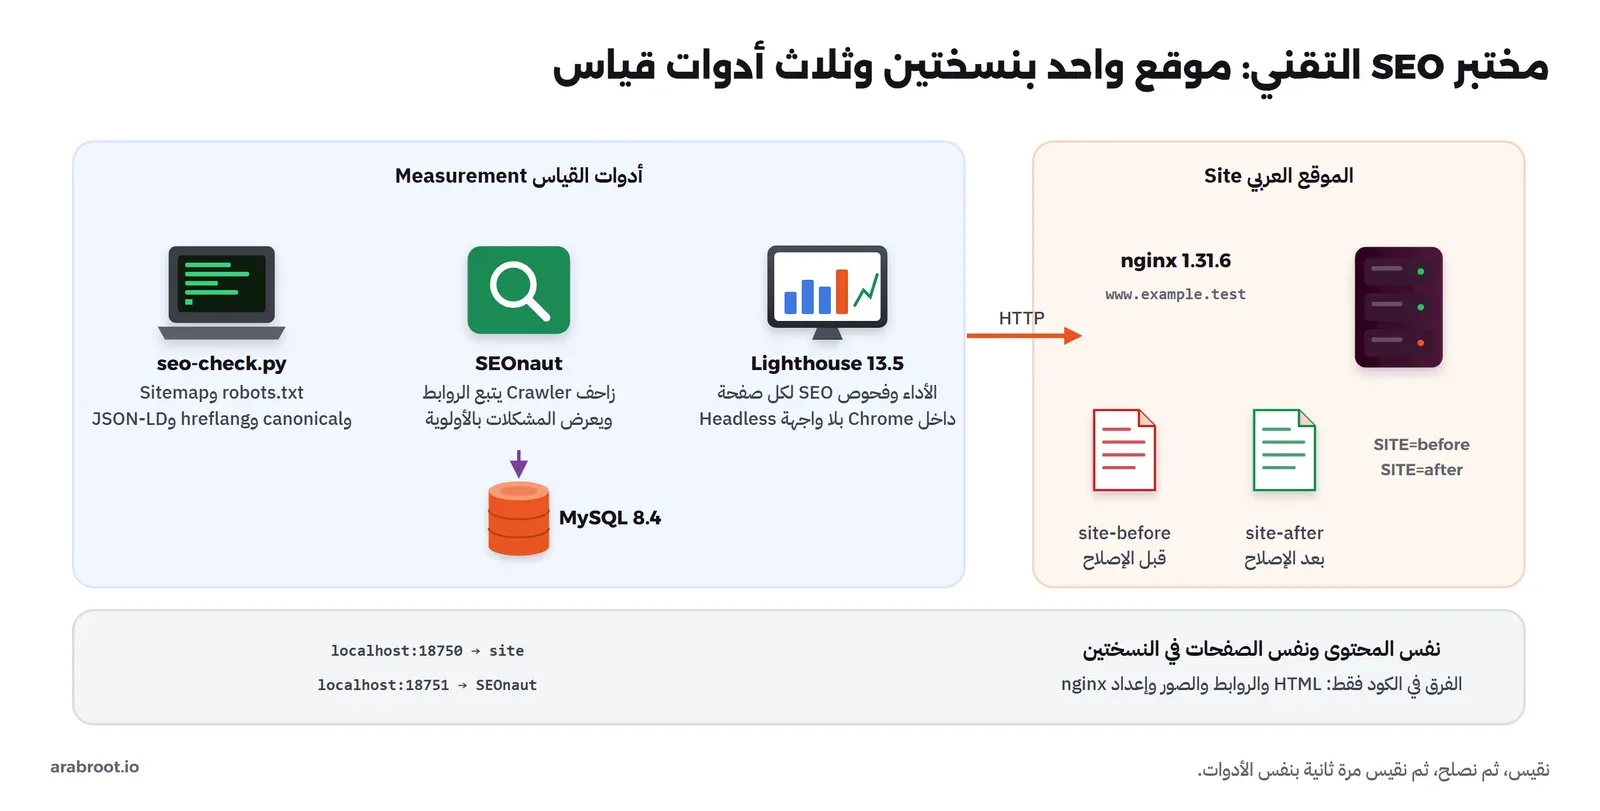
ولاحظ أننا استخدمنا النطاق www.example.test داخل شبكة Docker، والسبب أن اللاحقة .test محجوزة للاختبار فلا تتعارض مع أي نطاق حقيقي، وكل الأدوات تصل إلى الموقع بهذا الاسم كما يصل إليه Googlebot في موقعك.
المتطلبات
- Docker Engine مع Docker Compose، وذاكرة RAM بحجم 4 GB على الأقل، لأن Chrome الذي يشغله Lighthouse وMySQL الذي يحتاجه SEOnaut يأخذان أغلبها.
- اتصال بالإنترنت أول مرة لتنزيل الـ Images وحزم npm وpip.
- لا تحتاج نطاقاً ولا شهادة TLS، فكل شيء داخل شبكة Docker، وسوف نذكر لاحقاً ما يعنيه غياب HTTPS في النتائج.
الموقع قبل الإصلاح: عشر مشكلات
لم نخترع مشكلات غريبة، فكل واحدة منها تظهر في المواقع بسبب قرار برمجي عادي، والجدول التالي يجمعها مع سببها المعتاد:
| المشكلة | أين في الكود | السبب المعتاد |
|---|---|---|
| لغة الصفحة واتجاهها خاطئان | <html lang="en"> بلا dir، والاتجاه مفروض من CSS | قالب إنجليزي عرب بالـ CSS فقط |
| كل الصفحات تشير بالرابط القانوني إلى الرئيسية | <link rel="canonical" href="/"> في القالب المشترك | قيمة ثابتة في الـ Layout بدل رابط الصفحة نفسها |
| رمز لغة خاطئ في hreflang | hreflang="sa" للعربية | الخلط بين رمز الدولة SA ورمز اللغة، وsa في ISO 639-1 هي السنسكريتية |
| لا يوجد Sitemap | /sitemap.xml يرد بالصفحة الرئيسية | لم يضفه أحد |
| robots.txt يمنع ملفات التصميم والبيانات | Disallow: /assets/ وDisallow: /api/ | محاولة «إخفاء» الملفات التقنية عن محركات البحث |
| المحتوى يبنى بـ JavaScript فقط | المقال والقائمة والأسعار تأتي من /api/*.json بعد 1.2 ثانية | واجهة SPA دون توليد للصفحات في السيرفر |
| روابط لا يتبعها الزاحف | href="javascript:void(0)" وonclick | تنقل مبرمج بالـ JavaScript |
| صور ثقيلة بلا أبعاد | JPEG بعرض 2400 بكسل وحجم 1.2 MB، دون width وheight، والصورة الأولى loading="lazy" | رفع الصورة كما هي من الكاميرا |
| لا توجد بيانات منظمة Structured Data | لا يوجد JSON-LD | لا يعرف الفريق أنها موجودة |
| السيرفر: صفحة 404 ترد بـ 200، ولا ضغط Compression ولا Cache | try_files … /index.html وgzip off | إعداد SPA منسوخ لموقع عادي |
وأيضاً لا يوجد وصف Meta Description، والعنوان Title نفسه في كل الصفحات. وهذا هو قالب الصفحة في النسخة المعطوبة:
<!doctype html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>استضافة المثال</title>
<link rel="canonical" href="http://www.example.test/">
<link rel="alternate" hreflang="sa" href="http://www.example.test/">
<link rel="stylesheet" href="/assets/site.css">
<script src="/assets/app.js"></script>
</head>
<body>
<header><strong>استضافة المثال</strong>
<nav><a href="/">الرئيسية</a><a href="/blog/">المدونة</a><a href="javascript:void(0)" onclick="go('/pricing/')">الأسعار</a><a href="/en/">English</a></nav>
</header>
<main>
<div id="post">جار التحميل...</div>
<script>render('post', '/api/vps-backup.json', d => '<h1>' + d.title + '</h1>' + d.body);</script>
</main>
<footer>© 2026 استضافة المثال</footer>
</body>
</html>
وإعداد nginx للنسخة المعطوبة:
# The broken site: no compression, no cache headers, and every unknown URL answers 200 with the home page (soft 404)
server {
    listen 80;
    server_name www.example.test;
    root /usr/share/nginx/html;
    gzip off;
    location / {
        try_files $uri $uri/ /index.html;
    }
}
تشغيل المختبر
ملف Docker Compose يشغل الموقع وSEOnaut وقاعدة بياناته، والمتغير SITE يختار النسخة:
# Technical SEO lab: the same Arabic site before and after the fixes, plus the SEOnaut crawler.
#   SITE=before docker compose up -d        (then SITE=after docker compose up -d site to switch)
name: mkb-seo
services:
  site:
    image: nginx:1.31.6-alpine
    container_name: mkb-seo-site
    volumes:
      - ./site-${SITE:-before}:/usr/share/nginx/html:ro
      - ./nginx/${SITE:-before}.conf:/etc/nginx/conf.d/default.conf:ro
    ports:
      - "18750:80"
    networks:
      lab:
        aliases: [www.example.test]

  seonaut-db:
    image: mysql:8.4.11
    container_name: mkb-seo-seonaut-db
    environment:
      MYSQL_ROOT_PASSWORD: ${DB_ROOT_PASSWORD:?set in .env}
      MYSQL_DATABASE: seonaut
      MYSQL_USER: seonaut
      MYSQL_PASSWORD: ${DB_PASSWORD:?set in .env}
    volumes:
      - mkb-seo-db:/var/lib/mysql
    networks: [lab]

  seonaut:
    image: ghcr.io/stjudewashere/seonaut@${SEONAUT_DIGEST:?set in .env}
    container_name: mkb-seo-seonaut
    depends_on: [seonaut-db]
    command: sh -c "/bin/wait && /app/seonaut"
    environment:
      WAIT_HOSTS: seonaut-db:3306
      WAIT_TIMEOUT: 600
      SEONAUT_DATABASE_SERVER: seonaut-db
      SEONAUT_DATABASE_PASSWORD: ${DB_PASSWORD}
      SEONAUT_SERVER_URL: http://localhost:18751
    ports:
      - "18751:9000"
    networks: [lab]

networks:
  lab:
    name: mkb-seo-net
volumes:
  mkb-seo-db:
    name: mkb-seo-db
في الإعداد أعلاه لاحظ التالي:
- الاسم البديل Alias
www.example.testعلى شبكة المختبر هو ما يجعل كل الأدوات تصل إلى الموقع بنطاقه، فالروابط القانونية وروابط hreflang في الصفحات مطلقة Absolute وتحتاج نطاقاً ثابتاً. - SEOnaut لا ينشر إصدارات مرقمة، والـ Image المنشورة على GitHub Container Registry تحمل الوسم
latestفقط، لذلك ثبتناها بالبصمة Digest في ملف.envحتى لا تتغير النتائج بين تشغيل وآخر. - الـ Image الرسمية لـ SEOnaut تنتظر قاعدة البيانات بأداة
wait، وجعلنا مدة الانتظار 600 ثانية، والسبب أن تهيئة MySQL أول مرة على قرص بطيء قد تتجاوز الخمس دقائق الافتراضية فيتوقف SEOnaut ولا يعود.
الصور الثقيلة لا نحفظها في المستودع، وإنما يولدها سكربت make-images.py بمكتبة Pillow: صور JPEG بعرض 2400 و2000 بكسل وجودة 95 مع تشويش يشبه صور الكاميرا، فيصل حجم الواحدة إلى نحو 1 MB:
python tools/make-images.py site-before/assetshero.jpg 1273432 bytes
backup.jpg 954755 bytes
vps.jpg 966746 bytesالآن نولد كلمات المرور في ملف .env ونشغل النسخة المعطوبة:
cat > .env <<EOF
DB_ROOT_PASSWORD=$(openssl rand -hex 16)
DB_PASSWORD=$(openssl rand -hex 16)
SEONAUT_DIGEST=sha256:d18721b6c07f333694ebe241d06442827ad56e343d34103051a3e5028f1697d9
EOF
SITE=before docker compose up -d
القياس الأول
Lighthouse لكل صفحة
Lighthouse أداة Google مفتوحة المصدر بترخيص Apache-2.0، تفتح الصفحة في Chrome وتعطي درجة للأداء Performance وفئة لفحوص SEO وأخرى للممارسات الجيدة Best Practices. وقد استخدمناه في اختبار سهولة الوصول لموقع عربي لفئة سهولة الوصول، وهنا نشغله من نفس Docker Image الخاصة بـ Playwright لأنها تحتوي Chrome جاهزاً. والسكربت التالي يمر على أربع صفحات ويطبع الدرجات والفحوص التي فشلت:
#!/bin/sh
# Runs Lighthouse (mobile, default throttling) on every page and prints the scores and the failed SEO audits.
# Run inside the Playwright container on the lab network:  sh /lab/tools/lighthouse.sh before
set -e
TAG=${1:-before}
export CHROME_PATH=$(ls -d /ms-playwright/chromium-*/chrome-linux*/chrome | head -1)
mkdir -p /tmp/lh && cd /tmp/lh
[ -d node_modules/lighthouse ] || npm i --silent [email protected] >/dev/null
for P in / /blog/ /blog/vps-backup/ /pricing/; do
  OUT="/out/lh-$TAG-$(echo "$P" | tr '/' '_').json"
  npx lighthouse "http://www.example.test$P" --output=json --output-path="$OUT" --quiet \
    --only-categories=performance,seo,best-practices --chrome-flags="--headless=new --no-sandbox"
  node -e '
const r = require(process.argv[1]), a = r.audits, c = r.categories;
const s = k => Math.round(c[k].score * 100);
console.log(process.argv[2].padEnd(20), "perf", s("performance"), " seo", s("seo"), " bp", s("best-practices"),
  " LCP", a["largest-contentful-paint"].displayValue, " CLS", a["cumulative-layout-shift"].displayValue,
  " bytes", Math.round(a["total-byte-weight"].numericValue / 1024) + " KiB");
for (const id of r.categories.seo.auditRefs.map(x => x.id)) if (a[id].score === 0) console.log("    seo fail:", id, "-", a[id].title);
' "$OUT" "$P"
done
ونشغله داخل Container على شبكة المختبر:
mkdir -p out
docker run --rm --network mkb-seo-net --shm-size=1g -v "$PWD:/lab:ro" -v "$PWD/out:/out" \
  -v mkb-seo-npm:/tmp/lh mcr.microsoft.com/playwright:v1.64.0-noble sh /lab/tools/lighthouse.sh before
والمخرج سوف يكون كما يلي:
/                    perf 54  seo 85  bp 78  LCP 11.1 s  CLS 0.22  bytes 3125 KiB
    seo fail: meta-description - Document does not have a meta description
    seo fail: crawlable-anchors - Links are not crawlable
/blog/               perf 95  seo 75  bp 78  LCP 1.5 s  CLS 0.002  bytes 4 KiB
    seo fail: meta-description - Document does not have a meta description
    seo fail: crawlable-anchors - Links are not crawlable
    seo fail: canonical - Document does not have a valid `rel=canonical`
/blog/vps-backup/    perf 73  seo 77  bp 78  LCP 6.0 s  CLS 0.08  bytes 937 KiB
    seo fail: meta-description - Document does not have a meta description
    seo fail: crawlable-anchors - Links are not crawlable
    seo fail: canonical - Document does not have a valid `rel=canonical`
/pricing/            perf 100  seo 75  bp 78  LCP 1.0 s  CLS 0.007  bytes 4 KiB
    seo fail: meta-description - Document does not have a meta description
    seo fail: crawlable-anchors - Links are not crawlable
    seo fail: canonical - Document does not have a valid `rel=canonical`
في المخرج أعلاه لاحظ التالي:
- الصفحة الرئيسية ثقيلة: 3125 KiB، وأكبر عنصر مرئي LCP (Largest Contentful Paint) ظهر بعد 11.1 ثانية، والحد الذي توصي به Google هو 2.5 ثانية، واهتزاز الصفحة CLS (Cumulative Layout Shift) بلغ 0.22 والحد 0.1، والسبب الصور التي لا تحمل أبعاداً فتدفع النص للأسفل عند تحميلها.
- صفحة الأسعار أخذت 100 في الأداء، وصفحة المدونة 95، وهذا ليس لأنهما جيدتان، وإنما لأنهما شبه فارغتين عند التحميل الأول. لذلك لا تحكم على صفحة من درجة الأداء وحدها.
- فحص
canonicalفشل في كل الصفحات ما عدا الرئيسية، لأن Lighthouse يعتبر الرابط القانوني الذي يشير إلى الصفحة الرئيسية من صفحة أخرى خطأ كما في توثيق الفحص. - درجة الممارسات الجيدة 78 بسبب غياب HTTPS، وهذا متوقع في المختبر، وفي موقعك الحقيقي يجب أن يكون HTTPS مفعلاً كما في دليل Nginx Proxy Manager.
والأهم هو ما لم يقله Lighthouse: فحص hreflang نجح مع أن الرمز sa خاطئ، والسبب أنه رمز صحيح في ISO 639-1 للغة السنسكريتية، والأداة تتحقق من الصيغة وليس من المعنى. وفحص robots-txt نجح أيضاً مع أن الملف يمنع ملفات التصميم والبيانات، لأن الملف صحيح في صيغته. ولم يعترض على lang="en" في صفحة عربية.
ونتائج Lighthouse تتغير من تشغيل لآخر على نفس الجهاز، لذلك شغلنا الصفحة الرئيسية خمس مرات وأخذنا الوسيط Median كما في صفحة طريقة حساب الدرجة:
perf scores 51 55 57 64 64
median run: perf 57 seo 85 FCP 1.0 s LCP 16.8 s TBT 330 ms CLS 0.22 SI 1.4 s bytes 3125 KiB
ماذا يرى الزاحف الذي لا يشغل JavaScript؟
يعالج Googlebot الصفحات التي تعتمد على JavaScript على مرحلتين: يزحف إلى الـ HTML أولاً، ثم يضعها في طابور التصيير Render Queue حتى يشغلها Chromium لاحقاً، وبحسب توثيق Google قد تبقى الصفحة في هذا الطابور ثواني، وقد تأخذ أطول من ذلك. وأما أغلب الزواحف الأخرى، ومنها أدوات معاينة الروابط في تطبيقات المحادثة، فتقرأ الـ HTML كما هو. والسكربت التالي يعد كلمات المحتوى داخل <main> في الـ HTML الخام، ثم بعد أن يشغل Chrome السكربتات:
// What does a crawler that does not run JavaScript see? Compares the words inside <main> in the raw HTML
// (what curl, most AI crawlers and the first pass of Googlebot get) with the DOM after Chrome runs the scripts.
// node text-check.mjs http://www.example.test / /blog/ /blog/vps-backup/ /pricing/
import { execFileSync } from 'node:child_process';
const [base, ...paths] = process.argv.slice(2);
const chrome = execFileSync('sh', ['-c', 'ls -d /ms-playwright/chromium-*/chrome-linux*/chrome | head -1']).toString().trim();
const words = (html) => {
const main = (html.match(/<main[\s\S]*?<\/main>/) || [''])[0]
.replace(/<script[\s\S]*?<\/script>/g, ' ').replace(/<[^>]+>/g, ' ');
return main.split(/\s+/).filter(w => /[-ۿA-Za-z0-9]/.test(w)).length;
};
const links = (html) => [...html.matchAll(/<a [^>]*href="(\/[^"]*)"/g)].map(m => m[1]);
console.log('page'.padEnd(20), 'raw words', ' rendered words', ' raw <a href> links');
for (const p of paths) {
const raw = await (await fetch(base + p)).text();
const dom = execFileSync(chrome, ['--headless=new', '--no-sandbox', '--virtual-time-budget=10000', '--dump-dom', base + p],
{ stdio: ['ignore', 'pipe', 'ignore'] }).toString();
console.log(p.padEnd(20), String(words(raw)).padStart(9), String(words(dom)).padStart(15), ' ' + [...new Set(links(raw))].join(' '));
}docker run --rm --network mkb-seo-net --shm-size=1g -v "$PWD:/lab:ro" mcr.microsoft.com/playwright:v1.64.0-noble \
node /lab/tools/text-check.mjs http://www.example.test / /blog/ /blog/vps-backup/ /blog/choose-vps/ /pricing/والمخرج:
page                 raw words  rendered words  raw <a href> links
/                           39              39   / /blog/ /en/
/blog/                       3              13   / /blog/ /en/
/blog/vps-backup/            2              71   / /blog/ /en/
/blog/choose-vps/            2              58   / /blog/ /en/
/pricing/                    3              11   / /blog/ /en/
المقال الذي يقرؤه الزائر في 71 كلمة يصل إلى الزاحف بكلمتين هما «جار التحميل»، ولا يوجد في أي صفحة رابط حقيقي إلى المقالين أو إلى صفحة الأسعار. والصورة التالية تبين نفس الصفحة في المتصفح ودون JavaScript:
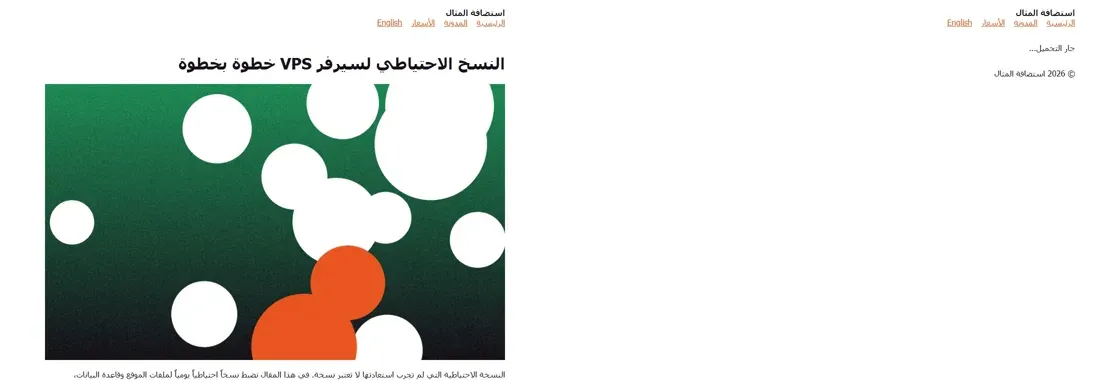
وقد يتساءل البعض: إذا كان Google يشغل JavaScript، فلماذا نهتم؟ والإجابة أن المشكلة هنا مركبة، فملف robots.txt يمنع /api/، وبالتالي حتى عندما يصير Googlebot الصفحة لن يستطيع جلب ملف JSON الذي فيه المقال، فيرى نفس الصفحة الفارغة. وهذا مثال على أن كل مشكلة وحدها قد تبدو بسيطة، واجتماعها هو الذي يخفي المحتوى.
الزاحف SEOnaut للموقع كاملاً
SEOnaut زاحف مفتوح المصدر بترخيص MIT مكتوب بلغة Go، يبدأ من الرابط الرئيسي ويتبع الروابط مثل محرك البحث، ثم يعرض المشكلات مقسمة إلى حرجة Critical وتنبيه Alert وتحذير Warning. بعد التشغيل افتح http://localhost:18751، وأنشئ حساباً، وأضف مشروعاً برابط http://www.example.test/ مع تفعيل خيار الزحف عبر الـ Sitemap، ثم اضغط Crawl Now. وجد SEOnaut ثلاث صفحات فقط من ست، هي الرئيسية والمدونة والإنجليزية، والسبب أن المقالين والأسعار لا توجد إليها روابط في الـ HTML ولا يوجد Sitemap. وهذه المشكلات التي عرضها:
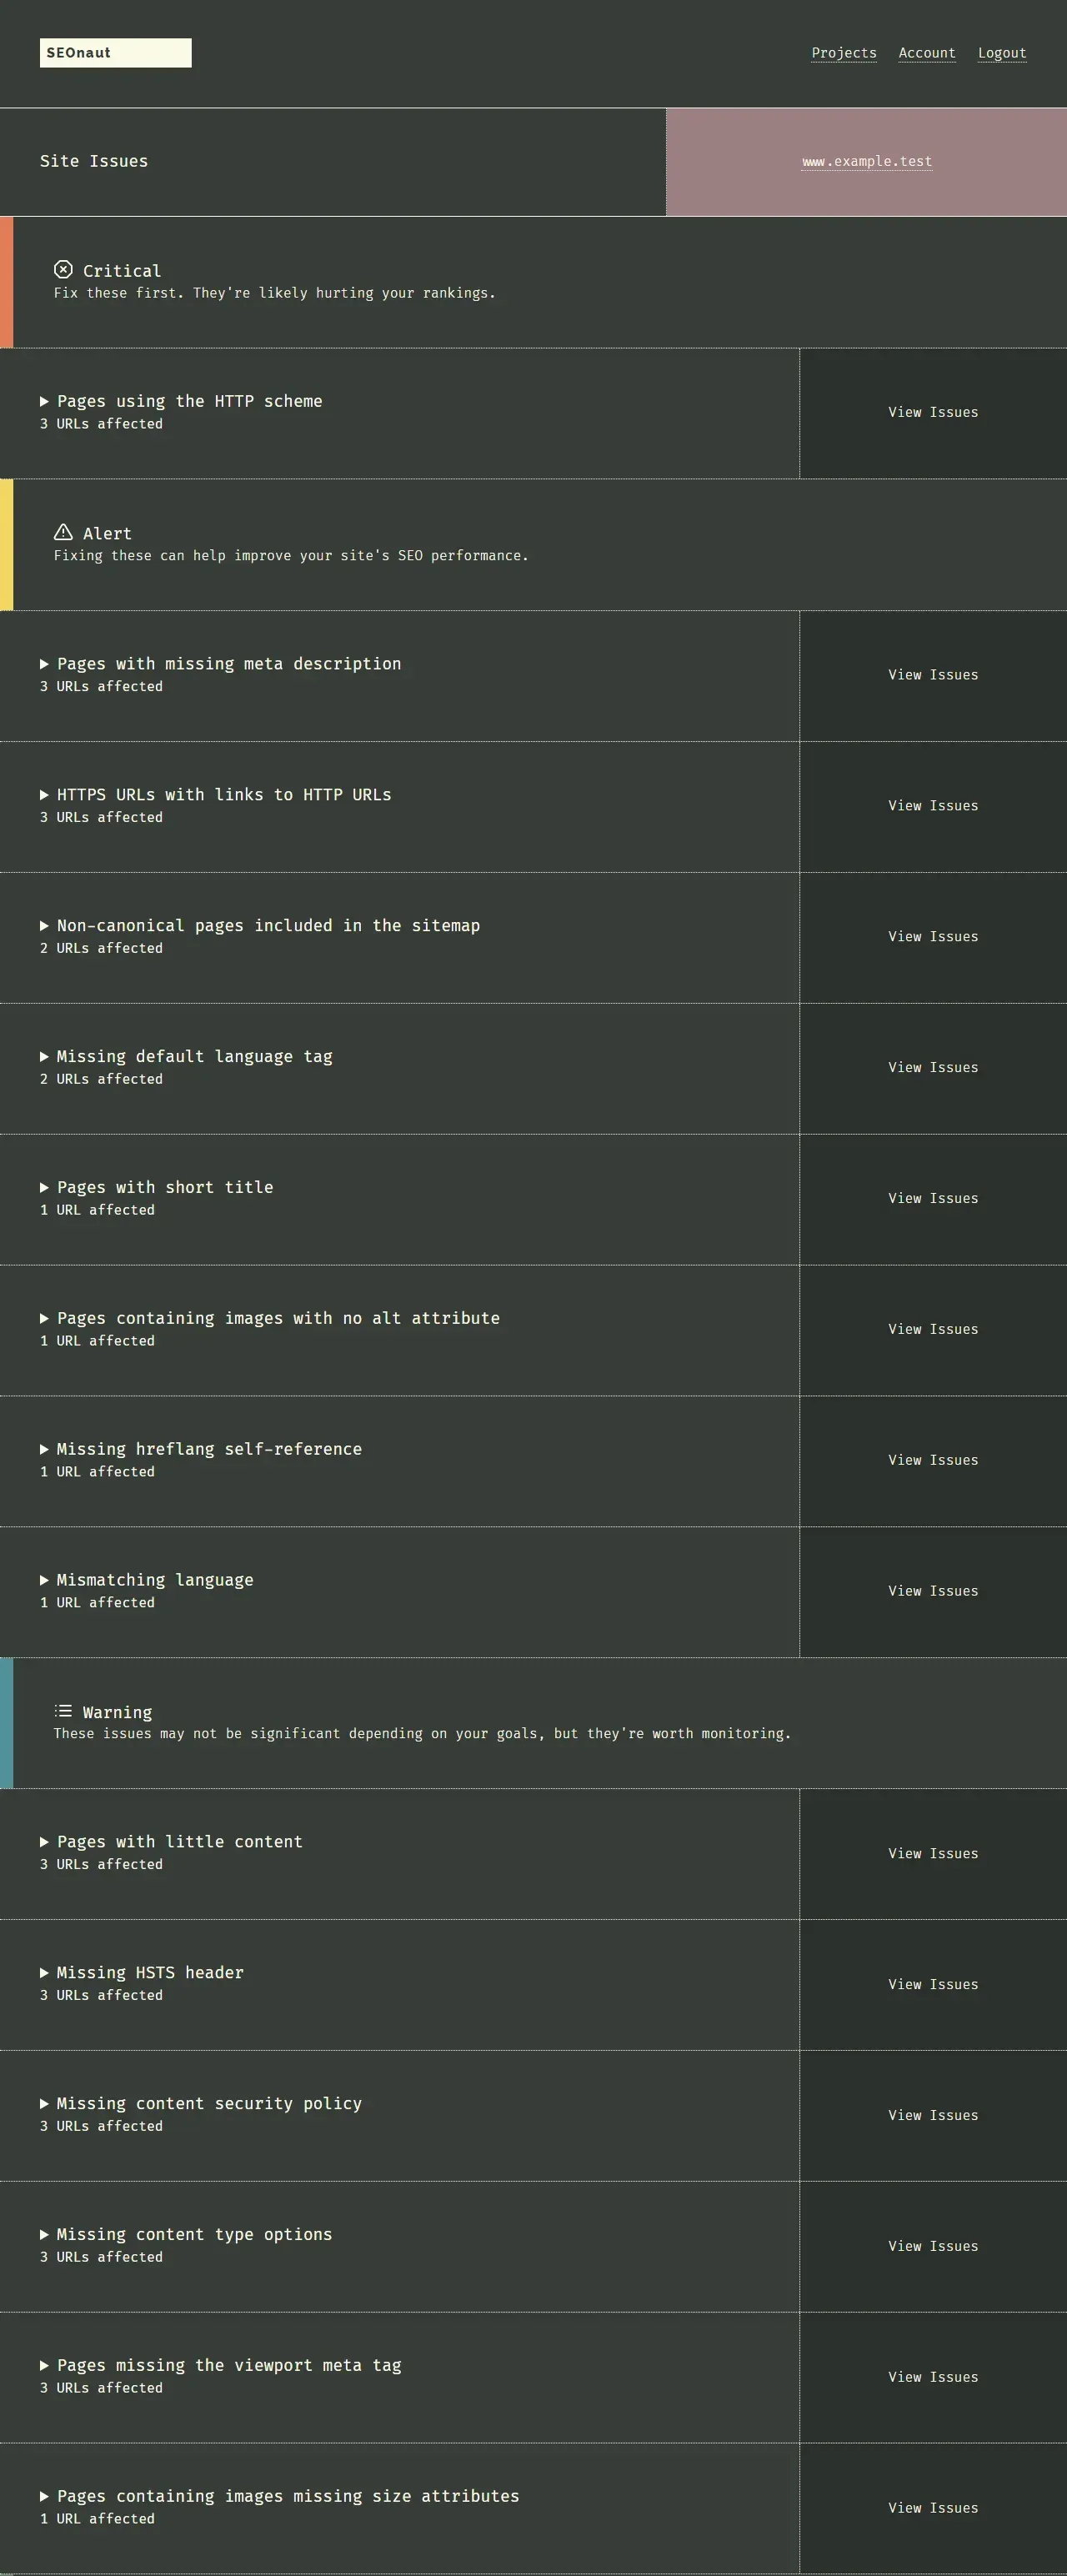
ولاحظ أن SEOnaut وجد ما فات Lighthouse: عدم تطابق اللغة Mismatching Language بين lang="en" وقيمة hreflang، وغياب الإشارة الذاتية Self-reference في hreflang، وغياب x-default، وغياب وسم viewport الذي يعني أن الصفحة غير مهيأة للهاتف. ولم يفحص Lighthouse هذه الأمور لأنه يرى صفحة واحدة، أما الزاحف فيقارن الصفحات ببعضها.
فاحص لما لا تفحصه الأداتان
بقيت أمور لا تفحصها الأداتان كما نريد: هل يستطيع Googlebot جلب ملفات CSS والبيانات بحسب robots.txt؟ وهل الـ Sitemap صحيح حسب بروتوكول Sitemaps؟ وهل كل رابط hreflang له رابط عائد Return Link؟ وهل توجد بيانات JSON-LD؟ لذلك كتبنا فاحصاً صغيراً بلغة Python يستخدم Protego، وهو المحلل الذي يستخدمه Scrapy لقراءة robots.txt بحسب RFC 9309، وextruct لاستخراج البيانات المنظمة، وlxml للتحقق من الـ Sitemap بملف sitemap.xsd الرسمي:
# Checks what Lighthouse does not: robots.txt rules (with Protego, the parser Scrapy uses), the sitemap against the
# sitemaps.org XSD, lang/dir, canonical and hreflang return links, JSON-LD (extruct), soft 404, compression and caching.
#   python seo-check.py http://www.example.test / /blog/ /blog/vps-backup/ /blog/choose-vps/ /pricing/ /en/
import sys, json, urllib.request, urllib.error
from lxml import etree, html as lhtml
from protego import Protego
import extruct

base, paths = sys.argv[1], sys.argv[2:]

def get(path, headers=None):
    req = urllib.request.Request(base + path, headers=headers or {'User-Agent': 'Mozilla/5.0 (seo-check)'})
    try:
        r = urllib.request.urlopen(req)
        return r.status, dict(r.headers), r.read()
    except urllib.error.HTTPError as e:
        return e.code, dict(e.headers), e.read()

print('== robots.txt')
st, _, body = get('/robots.txt')
rp = Protego.parse(body.decode() if st == 200 else '')
print('status', st, '| sitemaps declared:', list(rp.sitemaps) or 'none')
for p in ['/blog/vps-backup/', '/assets/site.css', '/assets/app.js', '/api/vps-backup.json']:
    print(f'  Googlebot may fetch {p:24} {rp.can_fetch(base + p, "Googlebot")}')

print('== sitemap.xml')
st, _, body = get('/sitemap.xml')
ctype = _.get('Content-Type', '')
if st != 200 or 'xml' not in ctype:
    print('status', st, ctype, '-> no sitemap')
else:
    xsd = etree.XMLSchema(etree.parse('/lab/tools/sitemap.xsd'))
    doc = etree.fromstring(body)
    ok = xsd.validate(doc)
    locs = doc.findall('.//{http://www.sitemaps.org/schemas/sitemap/0.9}loc')
    print('status', st, '| urls', len(locs), '| valid against sitemap.xsd:', ok, '' if ok else xsd.error_log.last_error)

print('== pages')
for p in paths:
    st, h, body = get(p)
    tree = lhtml.fromstring(body)
    root = tree.getroottree().getroot()
    canon = tree.xpath('//link[@rel="canonical"]/@href')
    alts = {a.get('hreflang'): a.get('href') for a in tree.xpath('//link[@rel="alternate"][@hreflang]')}
    data = extruct.extract(body.decode(), base_url=base + p, syntaxes=['json-ld'])['json-ld']
    print(f'{p:20} lang={root.get("lang")} dir={root.get("dir")} canonical={canon[0].replace(base, "") if canon else None}'
          f' hreflang={ {k: v.replace(base, "") for k, v in alts.items()} } json-ld={[d.get("@type") for d in data]}')

print('== hreflang return links')
pages = {}
for p in paths:
    _, _, body = get(p)
    tree = lhtml.fromstring(body)
    pages[p] = {a.get('hreflang'): a.get('href').replace(base, '') for a in tree.xpath('//link[@rel="alternate"][@hreflang]')}
for p, alts in pages.items():
    for code, target in alts.items():
        if target != p:
            back = target in pages and p in pages[target].values()
            print(f'  {p} -> {target} ({code}): return link {"ok" if back else "MISSING"}')

print('== server')
st, _, _ = get('/no-such-page/')
print('unknown URL status', st, '(soft 404)' if st == 200 else '')
st, h, body = get('/', {'Accept-Encoding': 'gzip, br', 'User-Agent': 'Mozilla/5.0'})
print('home Content-Encoding', h.get('Content-Encoding', 'none'))
for img in ['/assets/hero.jpg', '/assets/hero.webp']:
    st, h, body = get(img)
    if st == 200 and 'image' in h.get('Content-Type', ''):
        print(f'{img} {len(body) // 1024} KiB Cache-Control: {h.get("Cache-Control", "none")}')
نشغله في Container من Python بإصدارات محددة للحزم:
docker run --rm --network mkb-seo-net -v "$PWD:/lab:ro" -v mkb-seo-pip:/venv python:3.13.17-slim sh -c '
  [ -x /venv/bin/python ] || (python -m venv /venv && /venv/bin/pip install -q protego==0.6.0 extruct==0.18.0 lxml==6.0.2)
  /venv/bin/python /lab/tools/seo-check.py http://www.example.test / /blog/ /blog/vps-backup/ /blog/choose-vps/ /pricing/ /en/'
والمخرج سوف يكون كما يلي:
== robots.txt
status 200 | sitemaps declared: none
  Googlebot may fetch /blog/vps-backup/        True
  Googlebot may fetch /assets/site.css         False
  Googlebot may fetch /assets/app.js           False
  Googlebot may fetch /api/vps-backup.json     False
== sitemap.xml
status 200 text/html -> no sitemap
== pages
/                    lang=en dir=None canonical=/ hreflang={'sa': '/'} json-ld=[]
/blog/               lang=en dir=None canonical=/ hreflang={'sa': '/'} json-ld=[]
/blog/vps-backup/    lang=en dir=None canonical=/ hreflang={'sa': '/'} json-ld=[]
/blog/choose-vps/    lang=en dir=None canonical=/ hreflang={'sa': '/'} json-ld=[]
/pricing/            lang=en dir=None canonical=/ hreflang={'sa': '/'} json-ld=[]
/en/                 lang=en dir=None canonical=/ hreflang={} json-ld=[]
== hreflang return links
  /blog/ -> / (sa): return link MISSING
  /blog/vps-backup/ -> / (sa): return link MISSING
  /blog/choose-vps/ -> / (sa): return link MISSING
  /pricing/ -> / (sa): return link MISSING
== server
unknown URL status 200 (soft 404)
home Content-Encoding none
/assets/hero.jpg 1243 KiB Cache-Control: none
في المخرج أعلاه لاحظ التالي:
- Googlebot ممنوع من ملف التصميم
site.cssوملف السكربتapp.jsوملف المقالvps-backup.json، وبالتالي لا يستطيع أن يرى الصفحة كما يراها الزائر. وتذكر أنrobots.txtليس وسيلة لإخفاء صفحة من نتائج البحث، فهو يمنع الزحف فقط، ولإخفاء صفحة تستخدمnoindex. - الرابط
/sitemap.xmlيرد بـ 200 ولكن بنوعtext/html، فهو الصفحة الرئيسية وليس Sitemap. وهذا أثر جانبي للخطأ التالي. - أي رابط غير موجود يرد بـ 200 مع الصفحة الرئيسية، وهذا ما تسميه Google الخطأ اللين Soft 404 في توثيق رموز HTTP، فيضيع الزاحف وقته على صفحات لا وجود لها.
- لا يوجد ضغط للصفحات، والصورة الرئيسية 1243 KiB دون Cache-Control.
الإصلاحات
الآن سوف نصلح المشكلات بالترتيب الذي نوصي به في موقعك الحقيقي: أولاً ما يمنع محرك البحث من رؤية المحتوى، ثم ما يربك فهمه للصفحات، ثم السرعة، ثم الإضافات.
المحتوى في الـ HTML نفسه
الحل البسيط هو أن نرفع المنع عن /api/ في robots.txt ونترك Googlebot يصير الصفحة، وهذا يعمل مع Google في أغلب الحالات، ولكنه يترك المحتوى رهينة طابور التصيير، ولا يصل إلى الزواحف التي لا تشغل JavaScript. وأما التصيير الديناميكي Dynamic Rendering، أي أن ترسل للزواحف نسخة مصيرة وللزوار نسخة JavaScript، فتقول Google في صفحته إنه حل مؤقت ولا توصي به. والحل الأنسب هو أن يكون المحتوى في الـ HTML الذي يرسله السيرفر، إما بالتصيير في السيرفر Server-Side Rendering في إطار مثل Next.js أو Nuxt، أو بتوليد الصفحات مسبقاً Static Site Generation. وفي المختبر اخترنا التوليد المسبق، فسكربت build-after.py يقرأ نفس ملفات JSON التي كان المتصفح يجلبها ويكتب منها صفحات HTML كاملة، فلم يتغير المحتوى وإنما تغير مكان تجميعه. وأصبحت الروابط عناصر <a href> حقيقية كما في إرشادات Google للروابط:
<nav><a href="/">الرئيسية</a><a href="/blog/">المدونة</a><a href="/pricing/">الأسعار</a><a href="/en/" hreflang="en" lang="en">English</a></nav>رأس الصفحة: اللغة والعنوان والرابط القانوني
هذا رأس صفحة المقال بعد الإصلاح كما ولده السكربت:
<!doctype html>
<html lang="ar" dir="rtl">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>النسخ الاحتياطي لسيرفر VPS خطوة بخطوة | استضافة المثال</title>
<meta name="description" content="كيف تضبط نسخاً احتياطياً يومياً لملفات الموقع وقاعدة البيانات خارج السيرفر، ثم تجرب الاستعادة على سيرفر جديد.">
<link rel="canonical" href="http://www.example.test/blog/vps-backup/">
<link rel="stylesheet" href="/assets/site.css">
<script type="application/ld+json">{"@context": "https://schema.org", "@type": "Article", "headline": "النسخ الاحتياطي لسيرفر VPS خطوة بخطوة", "inLanguage": "ar", "image": ["http://www.example.test/assets/backup.webp"], "datePublished": "2026-10-01", "dateModified": "2026-10-25", "author": {"@type": "Organization", "name": "استضافة المثال", "url": "http://www.example.test/"}}</script>
</head>
في الإعداد أعلاه لاحظ التالي:
lang="ar" dir="rtl"في عنصرhtmlنفسه، وأزلنا فرض الاتجاه من CSS. وتذكر أن Google لا يعتمد علىlangولا على hreflang لمعرفة لغة الصفحة وإنما يحددها بخوارزمياته، ولكن المتصفح وقارئ الشاشة وأدوات الترجمة وزواحف أخرى تعتمد عليه، وSEOnaut نفسه قارنه بقيمة hreflang.- الرابط القانوني لكل صفحة يشير إلى نفسها، وبرابط مطلق. وتعتبر Google الرابط القانوني إشارة قوية وليس أمراً ملزماً، فإذا أشرت من كل الصفحات إلى الرئيسية فأنت تطلب منها عملياً أن تعتبر صفحاتك نسخاً مكررة من الرئيسية.
- عنوان ووصف مختلفان لكل صفحة، والوصف لا يرفع الترتيب، ولكن Google قد تستخدمه في المقتطف Snippet الذي يظهر تحت الرابط كما في توثيق المقتطفات.
- بيانات Article بصيغة JSON-LD، وهي الصيغة التي توصي بها Google في مقدمة البيانات المنظمة، والخصائص التي استخدمناها من توثيق Article. ووضعنا في الصفحة الرئيسية بيانات من نوع Organization.
hreflang بالرمز الصحيح والروابط العائدة
الصفحة الرئيسية لها نسخة إنجليزية، أما المقالات فلا، لذلك أزلنا hreflang من كل صفحة ليس لها نسخة بلغة أخرى، وأبقيناه في الصفحتين المتقابلتين فقط، وفي كل منهما نفس الأسطر الثلاثة:
<link rel="alternate" hreflang="ar" href="http://www.example.test/">
<link rel="alternate" hreflang="en" href="http://www.example.test/en/">
<link rel="alternate" hreflang="x-default" href="http://www.example.test/">
والقواعد من توثيق النسخ المحلية: كل نسخة تذكر نفسها وكل النسخ الأخرى، والرمز الأول للغة بصيغة ISO 639-1 فالعربية ar، والرمز الثاني اختياري للدولة بصيغة ISO 3166-1 فيصبح ar-SA إذا كانت الصفحة موجهة للسعودية تحديداً، وx-default للصفحة التي تعرض لمن لا تطابق لغته أي نسخة. وخطأ hreflang="sa" شائع لأن رمز الدولة SA يأتي إلى الذهن أولاً.
robots.txt وSitemap
أصبح robots.txt يسمح بكل شيء ويذكر مكان الـ Sitemap:
User-agent: *
Allow: /

Sitemap: http://www.example.test/sitemap.xml
والـ Sitemap يحتوي الصفحات الست بروابطها القانونية وتاريخ آخر تعديل:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url><loc>http://www.example.test/</loc><lastmod>2026-10-25</lastmod></url>
  <url><loc>http://www.example.test/en/</loc><lastmod>2026-10-25</lastmod></url>
  <url><loc>http://www.example.test/blog/</loc><lastmod>2026-10-25</lastmod></url>
  <url><loc>http://www.example.test/blog/vps-backup/</loc><lastmod>2026-10-25</lastmod></url>
  <url><loc>http://www.example.test/blog/choose-vps/</loc><lastmod>2026-10-25</lastmod></url>
  <url><loc>http://www.example.test/pricing/</loc><lastmod>2026-10-25</lastmod></url>
</urlset>
ولم نضع priority ولا changefreq لأن Google تتجاهلهما، وتستخدم lastmod فقط إذا كان دقيقاً بشكل يمكن التحقق منه، لذلك لا تقم بتحديث lastmod لكل الصفحات في كل عملية نشر، والسبب أن Google سوف تتعلم أن القيمة لا تعني شيئاً.
الصور: الحجم والصيغة والأبعاد
حولنا الصور إلى WebP بعرض أكبر مقاس يعرضه التصميم، والسكربت التالي يقوم بذلك بمكتبة Pillow:
# The fix for the heavy images: resize to the largest size the layout shows and save as WebP.
#   python make-webp.py site-before/assets site-after/assets
import sys
from pathlib import Path
from PIL import Image
src, dst = Path(sys.argv[1]), Path(sys.argv[2])
for name, width in [('hero', 1200), ('backup', 880), ('vps', 880)]:
    im = Image.open(src / f'{name}.jpg')
    h = round(im.height * width / im.width)
    im.resize((width, h), Image.LANCZOS).save(dst / f'{name}.webp', 'WEBP', quality=75)
    print(f'{name}.jpg {(src / f"{name}.jpg").stat().st_size // 1024} KiB -> {name}.webp {width}x{h} {(dst / f"{name}.webp").stat().st_size // 1024} KiB')
hero.jpg 1243 KiB -> hero.webp 1200x675 68 KiB
backup.jpg 932 KiB -> backup.webp 880x528 36 KiB
vps.jpg 944 KiB -> vps.webp 880x528 35 KiBثم أضفنا الأبعاد لكل صورة حتى يحجز المتصفح مكانها قبل تحميلها، وهذا ما يمنع اهتزاز الصفحة، ومعه height: auto في CSS حتى لا تتشوه الصورة على الهاتف. والصورة الأولى في الصفحة هي غالباً أكبر عنصر مرئي LCP، لذلك لا تقم بتأجيل تحميلها بـ loading="lazy"، وإنما ارفع أولويتها، وأجل الصور التي تحتها:
<img src="/assets/hero.webp" width="1200" height="675" alt="سيرفرات استضافة المثال في مركز البيانات" fetchpriority="high">
<img src="/assets/backup.webp" width="880" height="528" alt="رسم لسيرفر ونسخة احتياطية" loading="lazy">
واختيار الصيغة نفسها شرحناه في صيغ الصور وكيف تختار بينها.
السيرفر: الضغط والـ Cache وصفحة 404
# The fixed site: compression, long caching for assets, and a real 404 status for unknown URLs
server {
    listen 80;
    server_name www.example.test;
    root /usr/share/nginx/html;

    gzip on;
    gzip_types text/css application/javascript application/json application/xml image/svg+xml;
    gzip_min_length 256;

    location /assets/ {
        add_header Cache-Control "public, max-age=31536000, immutable";
    }
    location / {
        try_files $uri $uri/ =404;
    }
    error_page 404 /404.html;
}
في الإعداد أعلاه لاحظ أن immutable مع مدة سنة يناسب الملفات التي يتغير اسمها عند تغير محتواها، فإذا كنت تعدل site.css باسمه فاجعل المدة أقصر أو أضف بصمة الإصدار إلى اسم الملف. ولاحظ أيضاً أننا أضفنا favicon.ico، لأن غيابه ظهر بعد الإصلاح مباشرة: في النسخة المعطوبة كان طلبه يرد بـ 200 مع الصفحة الرئيسية بسبب الـ Soft 404، فلما أصبح الرد 404 صحيحاً ظهر الخطأ في Console المتصفح وخفض درجة الممارسات الجيدة في Lighthouse. وهذا مثال على أن الإصلاح الصحيح يكشف أخطاء كانت مختفية.
القياس الثاني
نبدل النسخة ونعيد نفس الأوامر:
mkdir -p site-after/assets
python tools/make-webp.py site-before/assets site-after/assets
python tools/build-after.py site-before site-after
SITE=after docker compose up -d siteنتيجة Lighthouse للصفحات الأربع:
/                    perf 99  seo 100  bp 78  LCP 1.6 s  CLS 0  bytes 145 KiB
/blog/               perf 100  seo 100  bp 78  LCP 0.9 s  CLS 0  bytes 2 KiB
/blog/vps-backup/    perf 100  seo 100  bp 78  LCP 1.4 s  CLS 0  bytes 39 KiB
/pricing/            perf 99  seo 100  bp 78  LCP 1.1 s  CLS 0  bytes 2 KiB
والوسيط لخمس محاولات على الصفحة الرئيسية:
perf scores 96 100 100 100 100
median run: perf 100 seo 100 FCP 1.0 s LCP 1.5 s TBT 0 ms CLS 0 SI 1.5 s bytes 145 KiB
ومقارنة النص الخام بالمصير أصبحت متطابقة، وظهرت الروابط إلى كل الصفحات في الـ HTML:
page                 raw words  rendered words  raw <a href> links
/                           39              39   / /blog/ /pricing/ /en/ /blog/vps-backup/ /blog/choose-vps/
/blog/                      13              13   / /blog/ /pricing/ /en/ /blog/vps-backup/ /blog/choose-vps/
/blog/vps-backup/           71              71   / /blog/ /pricing/ /en/
/blog/choose-vps/           58              58   / /blog/ /pricing/ /en/
/pricing/                   11              11   / /blog/ /pricing/ /en/
والفاحص:
== robots.txt
status 200 | sitemaps declared: ['http://www.example.test/sitemap.xml']
  Googlebot may fetch /blog/vps-backup/        True
  Googlebot may fetch /assets/site.css         True
  Googlebot may fetch /assets/app.js           True
  Googlebot may fetch /api/vps-backup.json     True
== sitemap.xml
status 200 | urls 6 | valid against sitemap.xsd: True
== pages
/                    lang=ar dir=rtl canonical=/ hreflang={'ar': '/', 'en': '/en/', 'x-default': '/'} json-ld=['Organization']
/blog/               lang=ar dir=rtl canonical=/blog/ hreflang={} json-ld=[]
/blog/vps-backup/    lang=ar dir=rtl canonical=/blog/vps-backup/ hreflang={} json-ld=['Article']
/blog/choose-vps/    lang=ar dir=rtl canonical=/blog/choose-vps/ hreflang={} json-ld=['Article']
/pricing/            lang=ar dir=rtl canonical=/pricing/ hreflang={} json-ld=[]
/en/                 lang=en dir=ltr canonical=/en/ hreflang={'ar': '/', 'en': '/en/', 'x-default': '/'} json-ld=[]
== hreflang return links
  / -> /en/ (en): return link ok
  /en/ -> / (ar): return link ok
  /en/ -> / (x-default): return link ok
== server
unknown URL status 404
home Content-Encoding gzip
/assets/hero.webp 68 KiB Cache-Control: public, max-age=31536000, immutable
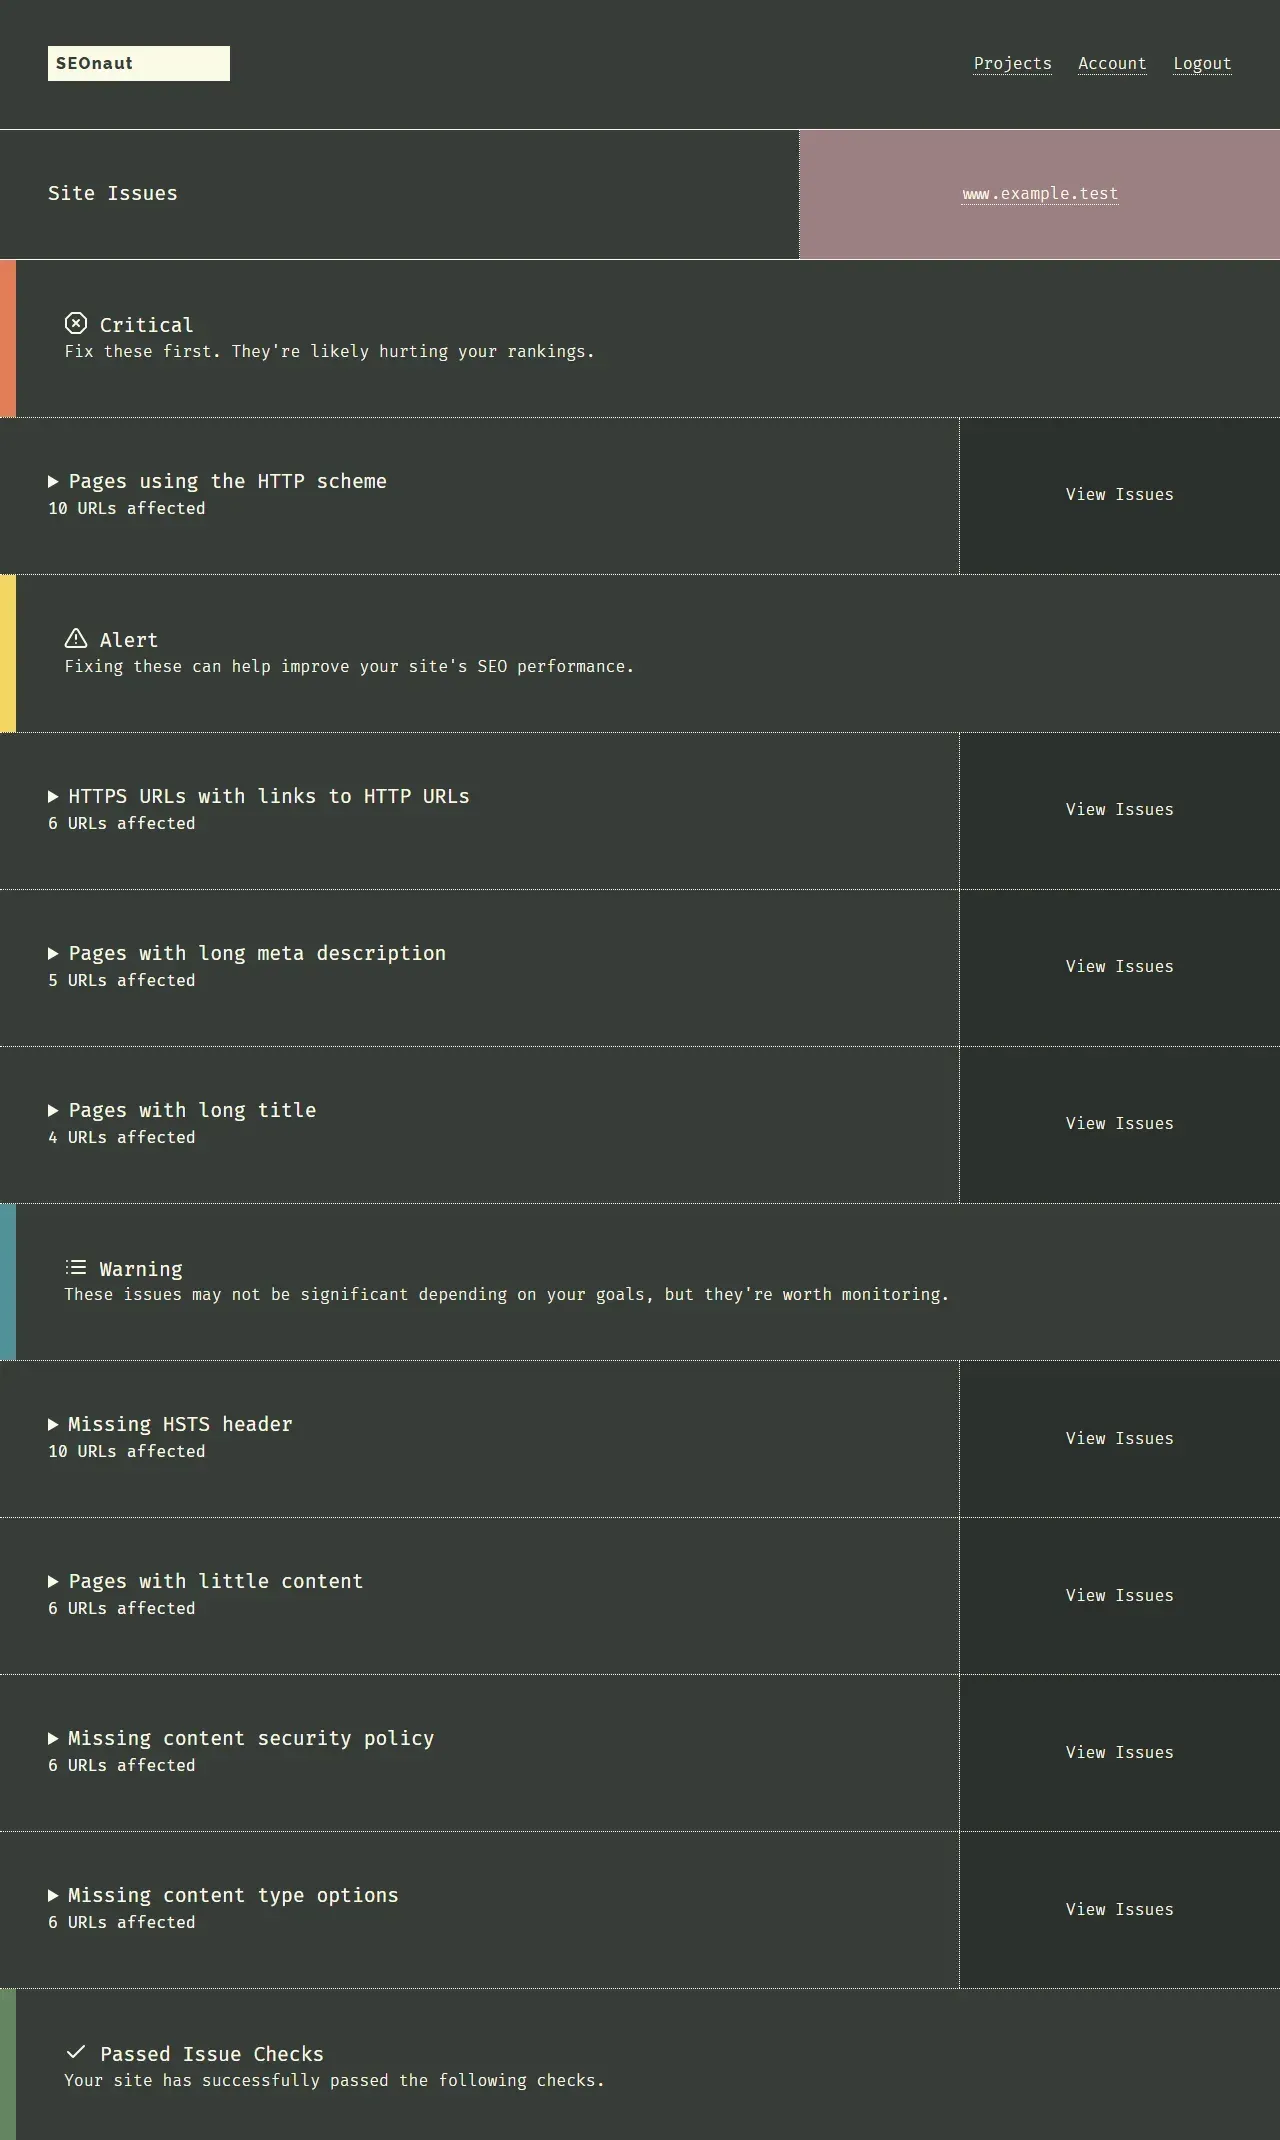
وأعدنا الزحف في SEOnaut، فوجد الصفحات الست والصور الثلاث وملف CSS، واختفت مشكلات اللغة وhreflang والوصف والصور:
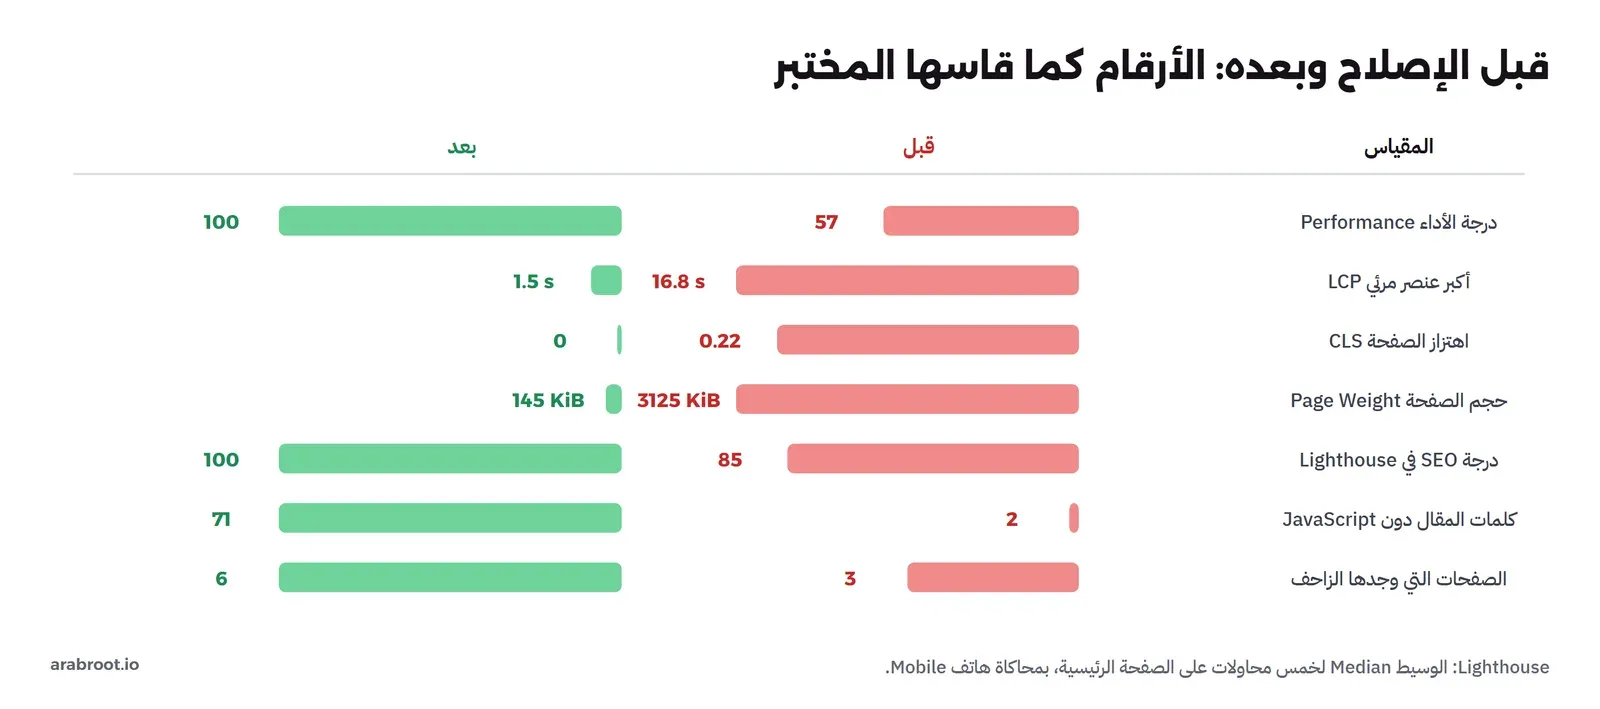
والصورة التالية تجمع الأرقام قبل وبعد:
تنبيه العنوان الطويل: الأداة تعد البايتات وليس الحروف
بعد الإصلاح ظهر تنبيهان جديدان في SEOnaut: عنوان طويل في أربع صفحات، ووصف طويل في خمس. ولكن أطول عنوان عندنا 54 حرفاً، وأطول وصف 109 حروف، وهذا ضمن الحدود التي تضعها الأداة نفسها وهي 60 للعنوان و160 للوصف. وعند قراءة كود فحص العنوان وكود فحص الوصف وجدنا أنها تستخدم دالة len() في Go، وهي تعد البايتات وليس الحروف، والحرف العربي في UTF-8 بايتان، لذلك يصبح الحد الفعلي للعنوان العربي نحو 30 حرفاً:
index.html                   title 43 chars 75 bytes | desc 109 chars 190 bytes
blog/index.html              title 51 chars 94 bytes | desc 90 chars 163 bytes
blog/vps-backup/index.html   title 54 chars 96 bytes | desc 109 chars 201 bytes
blog/choose-vps/index.html   title 52 chars 92 bytes | desc 98 chars 177 bytes
pricing/index.html           title 34 chars 59 bytes | desc 98 chars 170 bytes
en/index.html                title 50 chars 50 bytes | desc 95 chars 95 bytes
صفحة الأسعار بعنوان 34 حرفاً و59 بايتاً هي الوحيدة التي لم تنبه عليها الأداة، والصفحة الإنجليزية بنفس طول العناوين العربية تقريباً مرت دون تنبيه. لذلك عندما تستخدم أي أداة SEO على موقع عربي، فاختبر حدودها على صفحة تعرف طولها قبل أن تعدل عناوينك من أجلها. ولاحظ أيضاً أن Google لا تضع حداً بعدد الحروف للعنوان، وإنما تقطعه بحسب عرض الشاشة.
ما الذي لا يقيسه هذا المختبر؟
- بيانات المستخدمين الحقيقيين Field Data: Lighthouse يقيس في المختبر Lab Data بجهاز ومحاكاة شبكة ثابتين، أما Google فتعتمد في Core Web Vitals على قياسات زوارك الفعلية عند النسبة المئوية 75، وتجدها في تقرير Core Web Vitals في Search Console بعد أن يتراكم عدد كاف من الزيارات.
- HTTPS وترويسات الأمان: كل ما بقي في SEOnaut من الفئة الحرجة سببه HTTP في المختبر، وفي الموقع الحقيقي تفعل HTTPS وتضيف HSTS وX-Content-Type-Options وسياسة CSP على مستوى الـ Reverse Proxy.
- الفهرسة الفعلية: لا يوجد في المختبر محرك بحث، فالخطوة التالية بعد النشر أن ترسل الـ Sitemap في Search Console وتتابع تقرير الصفحات المفهرسة، وأن تفحص صفحة بأداة فحص الروابط URL Inspection لترى الـ HTML المصير كما رآه Googlebot.
- المحتوى نفسه: الإصلاحات التقنية تجعل الصفحة قابلة للزحف والفهم، ولكنها لا تجعلها تستحق الترتيب، وهذا موضوع مقال التسويق بالمحتوى.
إزالة المختبر
docker compose down -v
docker volume rm mkb-seo-npm mkb-seo-pip
docker image rm ghcr.io/stjudewashere/seonaut@sha256:d18721b6c07f333694ebe241d06442827ad56e343d34103051a3e5028f1697d9
مشكلات شائعة وحلولها
- Lighthouse يتوقف بالخطأ
NO_FCP: المتصفح لم يرسم شيئاً، وأول ما تتحقق منه أن Chrome يصل إلى الموقع بالاسم الذي تعطيه، بتشغيلchrome --headless=new --dump-domعلى نفس الرابط من نفس الـ Container. - SEOnaut يتوقف برسالة
Timeout! After 300 seconds some hosts are still not reachable: قاعدة البيانات لم تنته من التهيئة الأولى، فزدWAIT_TIMEOUTأو شغلdocker startللـ Container بعد أن تظهر رسالةready for connectionsفي سجل MySQL. - SEOnaut يجد صفحة واحدة فقط: الروابط مبنية بـ JavaScript، فهو لا يشغلها، وهذا نفس ما يحدث لأي زاحف لا يصير الصفحات، فالحل في موقعك وليس في الأداة.
- الدرجات تتغير كثيراً بين التشغيلات: الجهاز مشغول بأشياء أخرى، فخذ الوسيط لخمس محاولات أو أكثر، ولا تقارن درجة من جهاز بدرجة من جهاز آخر.
الخلاصة
- أخطر المشكلات هي التي تخفي المحتوى: محتوى يبنى بـ JavaScript فقط، وروابط ليست
<a href>، وrobots.txtيمنع ملفات التصميم والبيانات. ومجموعها جعل الزاحف يرى ثلاث صفحات من ست، ومقالاً بكلمتين. - الرابط القانوني في القالب المشترك خطأ واحد يطال كل الصفحات، فاجعله يشير إلى الصفحة نفسها.
- hreflang يحتاج رمز اللغة
arوليس رمز الدولة، وروابط عائدة بين النسخ، وx-default. - تحويل الصور إلى WebP بالمقاس الصحيح مع الأبعاد خفض الصفحة الرئيسية من 3125 KiB إلى 145 KiB، وLCP من 16.8 ثانية إلى 1.5 ثانية، وCLS من 0.22 إلى صفر.
- لا تعتمد على أداة واحدة: Lighthouse لم ير خطأ hreflang ولا منع ملفات التصميم، وSEOnaut لم ير المحتوى المخفي ورفع تنبيهات خاطئة على العناوين العربية لأنه يعد البايتات.
تدريب عملي
- شغل
text-check.mjsعلى ثلاث صفحات من موقعك، وقارن عدد الكلمات في الـ HTML الخام بعد التصيير. - أضف إلى
seo-check.pyفحصاً لطول العنوان بعدد الحروف وليس البايتات، واجعله ينبه فوق 60 حرفاً.
وأقرب المقالات إلى هذا الموضوع في السلسلة:
دليلكيف تعمل محركات البحث؟ SEO من الداخل للمطورينماذا يحدث لصفحتك من الزحف إلى الفهرسة إلى الترتيب، وأين تتوقف عادة، وما الذي يملكه المطور لإصلاحه. دليلأدوات SEO: الأدوات التجارية وبدائلها المجانيةما الذي تقدمه Ahrefs وSemrush وMoz فعلاً، وما الذي تغطيه مجاناً أدوات محركات البحث وأدوات مفتوحة المصدر جربناها على موقع عربي.دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها بحسب ما يعرفه القارئ، وتقيس أثرها في البحث والمبيعات.
سجل التحديثات
- أكتوبر 2026: كتابة المختبر وتشغيله على nginx 1.31.6 وLighthouse 13.5.0 وSEOnaut (بصمة d18721b6) وProtego 0.6.0 وextruct 0.18.0 في Docker Engine 29.8.0.


