

ملف سجلات حجمه 20 MB يصبح بعد gzip أقل من 2.4 MB، أي أصغر من ثماني مرات، بينما مجلد فيه صور JPEG بنفس الأداة لا يصغر إلا 2%، وملف مشفر قد يكبر بعد ضغطه بدل أن يصغر. وإذا كنت تدير سيرفرات فأنت تتعامل مع الضغط Compression كل يوم دون أن تفكر فيه: في تدوير السجلات Log Rotation، وفي النسخ الاحتياطية، وفي كل صفحة يرسلها ال Reverse Proxy مضغوطة إلى المتصفح، وفي صور PNG وملفات ZIP. والسؤال الذي يجيب عنه هذا المقال هو: لماذا يصغر ملف ولا يصغر آخر، وكيف تعمل الخوارزميات من الداخل، وكيف تختار الأداة والمستوى المناسبين بالأرقام وليس بالانطباع.
وهذا المقال من مرحلة أساسيات علوم الحاسب Computer Science Fundamentals، ويفترض أنك تعرف البت والبايت من مقال الأنظمة العددية للمبرمجين، وأن تعرف الفرق بين الترميز والتشفير من مقال الترميز Encoding. وسوف نناقش في هذا المقال ما يلي:
- لماذا يعمل الضغط أصلاً: التكرار Redundancy والإنتروبيا Entropy كما عرفها Shannon في 1948، مع حساب كامل باليد.
- الضغط دون فقد Lossless والضغط مع الفقد Lossy، ثم الطرق الأساسية: ترميز التكرار RLE وترميز Huffman والطرق المبنية على القاموس LZ77 وLZ78 وLZW.
- DEFLATE الذي يجمع LZ77 مع Huffman، ثم الأدوات الحديثة: Brotli وZstandard وLZMA وLZ4، والمقايضة بين السرعة والحجم.
- لماذا لا تضغط البيانات المضغوطة والمشفرة، والضغط في HTTP وهجوم BREACH باختصار.
- تجربة عملية: مقارنة ست أدوات بعدة مستويات على ثلاثة أنواع من البيانات، وبرنامج Huffman صغير بلغة Python.
لماذا يمكن ضغط البيانات أصلاً؟
الضغط Compression هو أن تكتب نفس المعلومات ببتات أقل، وهذا ممكن فقط لأن أغلب البيانات التي نتعامل معها فيها تكرار Redundancy: كلمة GET تتكرر في كل سطر من سجلات Nginx، والمفتاح "customer" يتكرر في كل سجل JSON، والحرف «ا» أكثر تكراراً في النص العربي من «ظ»، ومع ذلك نحفظ كل حرف منها بنفس عدد البايتات. ولتقريب الفكرة من الحياة، فأنت عندما تكتب لزميلك «نفس الإعداد السابق مع تغيير المنفذ إلى 8080» بدل أن تنسخ له الإعداد كاملاً، فأنت تضغط الرسالة لأنكما تشتركان في ما قبلها.
ولكن هناك حد لا يمكن تجاوزه، وقد وضعه Claude Shannon في بحثه «A Mathematical Theory of Communication» المنشور في 1948، حيث عرف الإنتروبيا Entropy، وهي متوسط كمية المعلومات في كل رمز، وتحسب بالبتات هكذا:
H = - Σ p(x) × log2 p(x)حيث p(x) هي نسبة تكرار الرمز x. والمعنى العملي أن الإنتروبيا هي أقل عدد من البتات تحتاجه لكل رمز في المتوسط إذا كنت تضغط كل رمز وحده بناء على تكراره فقط، فلا توجد أي خوارزمية من هذا النوع تستطيع أن تنزل تحتها.
لنأخذ مثالاً الكلمة ABRACADABRA، وهي 11 حرفاً: A خمس مرات، وB مرتان، وR مرتان، وC مرة، وD مرة. الآن نحسب:
- الحرف A نسبته 5/11 = 0.4545، و
log2(0.4545) = -1.1375، فمساهمته 0.4545 × 1.1375 = 0.5170 بت. - الحرفان B وR نسبة كل منهما 2/11 = 0.1818، و
log2(0.1818) = -2.4594، فمساهمة كل منهما 0.4472، ومجموعهما 0.8944 بت. - الحرفان C وD نسبة كل منهما 1/11 = 0.0909، و
log2(0.0909) = -3.4594، فمساهمة كل منهما 0.3145، ومجموعهما 0.6290 بت. - المجموع: H = 0.5170 + 0.8944 + 0.6290 = 2.040 بت لكل حرف.
أي أن هذه الكلمة تحتاج نظرياً 2.04 × 11 = 22.4 بت، أي 23 بتاً على الأقل، بينما هي مخزنة بـ ASCII أو UTF-8 في 88 بتاً، فالفرق كله تكرار يمكن حذفه. ولاحظ أن الحروف العشوائية تماماً، مثل مخرج مولد أرقام عشوائية أو بيانات مشفرة، تكون إنتروبيتها قريبة من 8 بتات لكل بايت، أي أنه لا يوجد فيها أي شيء يحذف، وهذا سوف نراه بالأرقام في التجربة.
ABRA كاملة معلومة لا يراها حساب الحروف المنفردة. ولذلك تجمع الأدوات الحديثة بين الطريقتين.الضغط دون فقد والضغط مع الفقد
الضغط دون فقد Lossless يعيد لك نفس البايتات بالضبط بعد فك الضغط، وهو الوحيد المقبول لملفات النصوص والكود والقواعد والنسخ الاحتياطية، فبايت واحد مختلف في ملف إعداد يعني ملفاً معطوباً، وكل الأدوات في هذا المقال من هذا النوع. أما الضغط مع الفقد Lossy فيحذف عن قصد تفاصيل لا يلاحظها الإنسان، وهو مقبول فقط للصور والصوت والفيديو، وقد شرحنا كيف يفعل ذلك JPEG وAVIF في مقال صيغ الصور، وكيف يفعله الفيديو في مقال مفاهيم الفيديو. ولاحظ أن أغلب صيغ الضغط مع الفقد تنتهي بمرحلة ضغط دون فقد، فـ JPEG مثلاً يحذف التفاصيل أولاً ثم يرمز ما بقي بـ Huffman الذي سوف نشرحه الآن.
ترميز التكرار المتتالي Run-Length Encoding
أبسط طريقة على الإطلاق: بدل أن تكتب AAAAAAAAAABBB تكتب 10A3B، أي الرمز وعدد مرات تكراره المتتالي. وهي ممتازة للبيانات التي فيها مساحات متصلة من نفس القيمة، مثل الصور القديمة بالأبيض والأسود أو مساحة فارغة من الأصفار، ولكنها تفشل تماماً مع النص العادي، والسبب أن الحروف في النص نادراً ما تتكرر متتالية، فكلمة ABRACADABRA تصبح 1A1B1R1A1C…، أي ضعف حجمها. ولذلك لا تستخدم RLE وحدها في الأدوات العامة، وإنما كمرحلة داخل خوارزميات أكبر، فأداة bzip2 مثلاً تبدأ بها، وهذا ما يفسر النتيجة الغريبة التي سوف تراها في التجربة عندما ضغطنا 10 MB من الأصفار.
ترميز Huffman: الرمز الأكثر تكراراً يأخذ أقصر كود
في 1952 نشر David Huffman طريقته في بحث «A Method for the Construction of Minimum-Redundancy Codes»، والفكرة تشبه شفرة Morse: الحرف الأكثر استخداماً يأخذ أقصر رمز، والنادر يأخذ رمزاً أطول، فيقل المتوسط. والجزء الذكي هو طريقة بناء الرموز بحيث لا يكون أي رمز بداية لرمز آخر، وهذا ما يسمى Prefix Code، فيستطيع القارئ أن يفك البتات المتتالية دون أي فاصل بين الحروف.
والآن نبني الشجرة باليد للكلمة نفسها ABRACADABRA:
- نعد تكرار كل حرف: A=5 وB=2 وR=2 وC=1 وD=1، ونعتبر كل حرف عقدة وحدها.
- نأخذ أقل عقدتين تكراراً، C وD، ونجمعهما تحت عقدة جديدة تكرارها 2.
- أقل عقدتين الآن B وR (لكل منهما 2)، نجمعهما تحت عقدة تكرارها 4. ولاحظ أن العقدة الجديدة من C وD تكرارها 2 أيضاً، وعند التساوي يجوز أي اختيار، والطول الكلي لن يتغير.
- نجمع العقدة 2 مع العقدة 4 تحت عقدة تكرارها 6.
- بقيت عقدتان: A=5 والعقدة 6، فنجمعهما تحت العقدة العليا وتكرارها 11، وانتهت الشجرة.
- نقرأ الرموز: كل انتقال إلى اليسار 0 وإلى اليمين 1، فيكون A=0، وC=100، وD=101، وB=110، وR=111.
الصورة التالية تبين الشجرة الناتجة:
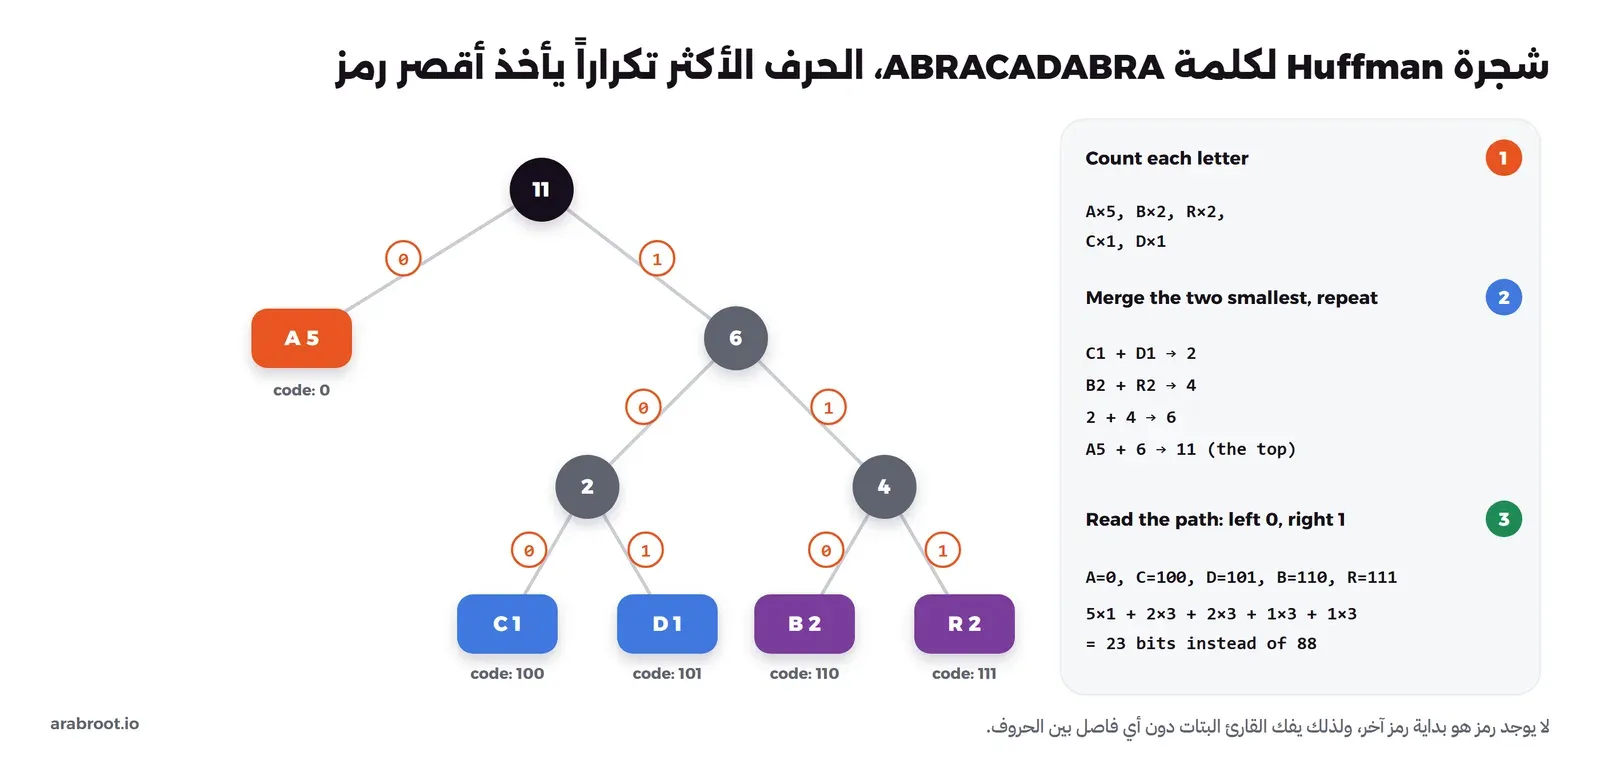
والحساب: A خمس مرات ببت واحد = 5، وB وR مرتين لكل منهما بثلاثة بتات = 12، وC وD مرة لكل منهما بثلاثة بتات = 6، فالمجموع 23 بتاً بدل 88، وهذا يساوي الحد الذي حسبناه من الإنتروبيا تقريباً، 2.09 بت لكل حرف مقابل 2.04. وقد يتساءل البعض: وكيف يعرف من يفك الضغط هذه الرموز؟ والإجابة أن جدول الرموز نفسه يجب أن يحفظ مع البيانات، ولذلك فإن Huffman لا يفيد مع النصوص القصيرة جداً، ويبدأ أثره الحقيقي عندما يكون الملف أكبر بكثير من الجدول. وفي التجربة العملية سوف نكتب برنامجاً صغيراً يبني هذه الشجرة ويطبقها على كلمة عربية أيضاً.
طرق القاموس: LZ77 وLZ78 وLZW
Huffman يرى الحروف وحدها، ولكن التكرار الحقيقي في ملفاتنا هو تكرار كلمات وأسطر كاملة. وهنا جاءت فكرة Abraham Lempel وJacob Ziv في بحثهما في 1977، والتي تسمى LZ77: يقرأ الضاغط البيانات من البداية، ويحتفظ بنافذة Window من آخر ما كتبه، وكلما وجد أن النص القادم موجود في النافذة كتب بدله إشارة قصيرة إليه: «انسخ 4 بايتات من مكان يبعد 7 بايتات للخلف»، أي الزوج (المسافة Distance، الطول Length). والصورة التالية تبين ذلك:
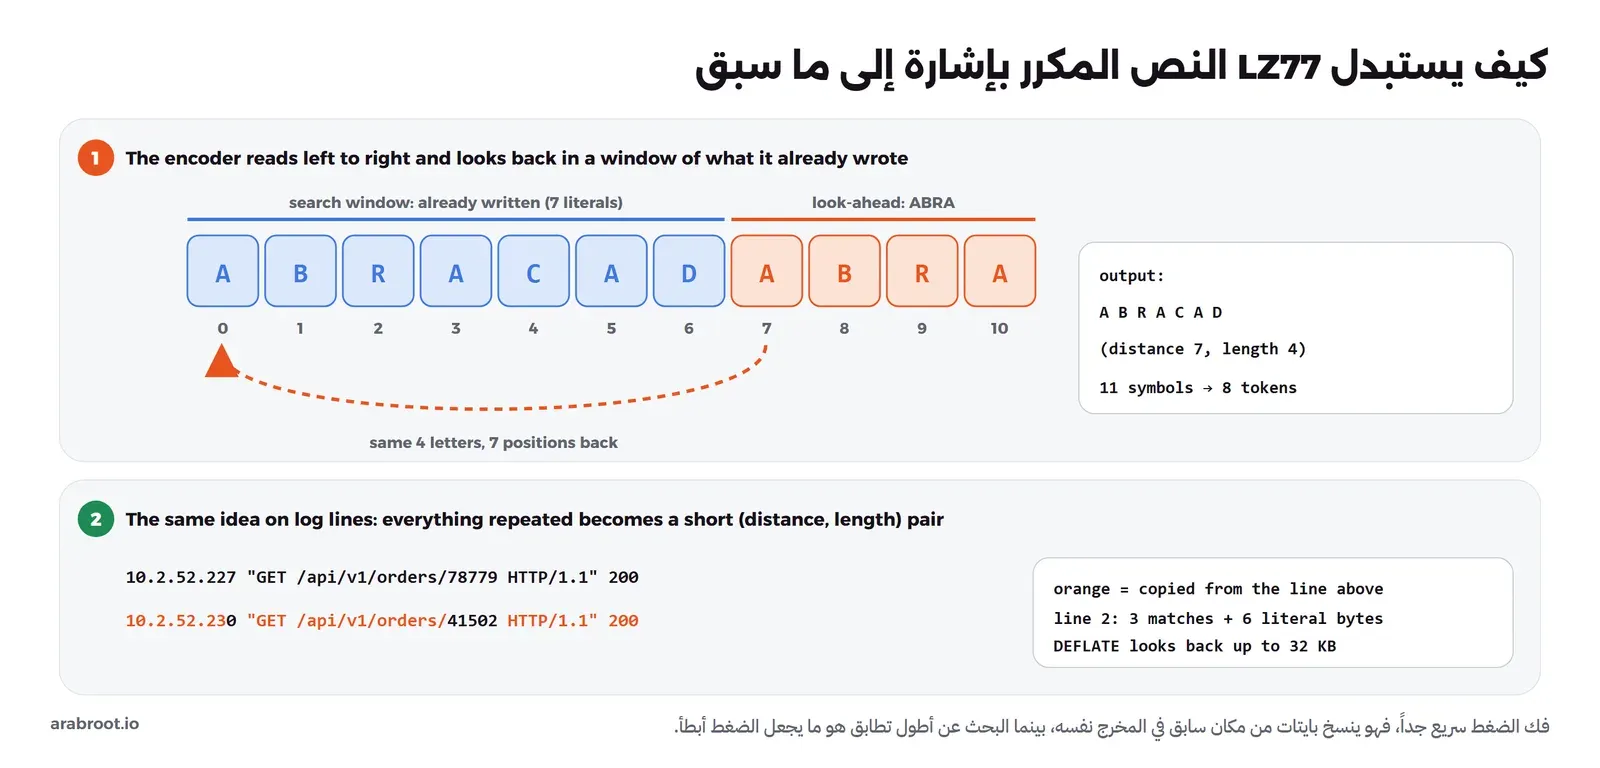
ولاحظ في السطر الثاني من السجلات أن المتغير الوحيد هو آخر رقم في عنوان IP ورقم الطلب، وكل الباقي منسوخ من السطر الذي قبله، وهذا هو السبب الحقيقي في أن ملفات السجلات تصغر أكثر من ثماني مرات. ولاحظ أيضاً أن فك الضغط سريع جداً، فهو مجرد نسخ من مكان سابق في المخرج نفسه، أما الضغط فيحتاج أن يبحث عن أطول تطابق في النافذة، وكلما بحث أكثر كان الملف أصغر والضغط أبطأ، وهذا هو معنى المستويات Levels في كل أداة.
وبعد عام نشر الباحثان نفسهما LZ78، والذي يبني قاموساً صريحاً من العبارات التي رآها ويرسل رقم العبارة في القاموس بدل المسافة، ثم طوره Terry Welch في 1984 إلى LZW، وهو الذي استخدمته صور GIF والأداة القديمة compress في Unix. أما فرع LZ77 فهو الذي تقوم عليه أغلب الأدوات التي تستخدمها اليوم: gzip وZIP وPNG وZstandard وBrotli وLZMA وLZ4.
DEFLATE: الخوارزمية التي في كل مكان
DEFLATE، الموصوفة في RFC 1951، هي بالضبط ما شرحناه في القسمين السابقين بالترتيب: LZ77 بنافذة حتى 32 KB وتطابق من 3 إلى 258 بايت، ثم Huffman على ناتجه، أي على الحروف التي لم تجد تطابقاً وعلى أرقام الأطوال والمسافات. وهذه الخوارزمية نفسها تجدها في ثلاثة أغلفة مختلفة، والصورة التالية تبين ذلك:
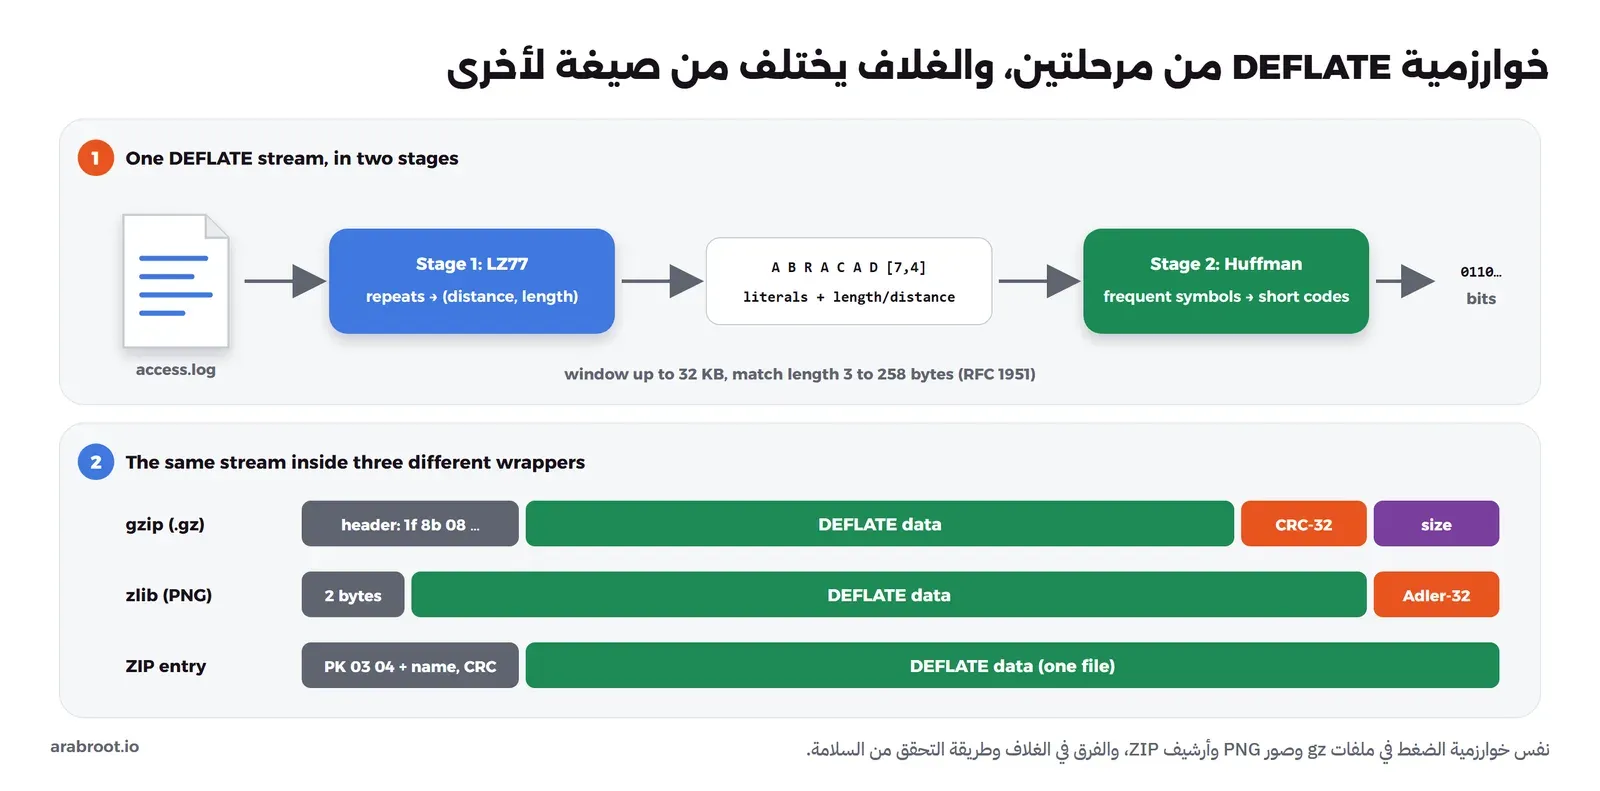
- gzip حسب RFC 1952: رأس من 10 بايتات يبدأ بـ
1f 8b، ثم البيانات، ثم قيمة التحقق CRC-32 وحجم الملف الأصلي. وقد رأينا هذه البايتات الثمانية الأخيرة وكيف يكتشفgzip -tفسادها في تجربة تحقيق Dirty Pipe. - zlib حسب RFC 1950: رأس من بايتين وقيمة تحقق Adler-32، وهو الغلاف داخل صور PNG وفي الترميز
deflateفي HTTP. - ZIP: كل ملف داخل الأرشيف مضغوط بـ DEFLATE وحده، مع رأس يحمل اسمه وقيمة CRC-32 الخاصة به، وقد شرحنا هيكل ZIP بالبايت في مقال ماذا يوجد داخل ملف ZIP.
الأدوات الحديثة: Brotli وZstandard وLZMA وLZ4
DEFLATE صمم في التسعينات بنافذة 32 KB لأن الذاكرة كانت غالية، والأدوات الحديثة تستخدم نفس الأفكار بنوافذ أكبر بكثير وترميز أذكى من Huffman، ولكل منها هدف مختلف:
- Brotli من Google، ومواصفته RFC 7932 في يوليو 2016. أهم ما يميزه قاموس ثابت مدمج في المواصفة حجمه 122,784 بايت، فيه كلمات وعبارات شائعة في صفحات الويب وHTML وJavaScript، فيستطيع أن يضغط حتى ملفاً صغيراً جيداً لأن «القاموس» موجود مسبقاً عند الطرفين. ولذلك صمم للويب: يضغط ببطء مرة واحدة، ويفك بسرعة عند كل زائر.
- Zstandard أو zstd، من Yann Collet في Facebook، ومواصفته RFC 8878 في فبراير 2021، والكود في GitHub. ميزته أنه يغطي كل المدى بأداة واحدة: المستوى 1 أسرع من gzip بكثير، والمستوى 19 يقترب من xz في الحجم، وفك الضغط سريع في كل المستويات، ولهذا أصبح الخيار المعتاد للنسخ الاحتياطية والحزم وأنظمة الملفات.
- LZMA من Igor Pavlov مؤلف 7-Zip، وتشرحه صفحة LZMA SDK، وتستخدمه صيغة 7z وأداة xz في Linux. يعطي ملفات صغيرة جداً على حساب ضغط بطيء واستهلاك ذاكرة أكبر، ولذلك تستخدمه التوزيعات لحزمها، فتضغط مرة ويفك الملايين.
- LZ4 من Yann Collet أيضاً، والكود في GitHub، وهو في الطرف الآخر: LZ77 دون أي ترميز Huffman، فالملف أكبر ولكن السرعة مئات الميغابايتات في الثانية، ولذلك تجده حيث يكون المعالج أغلى من القرص: ضغط الذاكرة وأنظمة الملفات وقواعد البيانات.
- bzip2 من Julian Seward، وموقعه الرسمي، وهو من عائلة مختلفة تماماً تعيد ترتيب البيانات بتحويل Burrows-Wheeler حتى تتجاور الحروف المتشابهة ثم تضغطها، وهو بطيء في الاتجاهين، وسوف ترى في التجربة أنه فاز في نسبة الضغط على بياناتنا المولدة.
والقاعدة العامة أن كل أداة تقدم مقايضة Trade-off بين ثلاثة أشياء: نسبة الضغط، وسرعة الضغط، وسرعة فك الضغط. ولا توجد أداة تفوز في الثلاثة، فاختر بحسب ما يتكرر أكثر: إذا كنت تضغط مرة وتفك كثيراً، مثل ملفات موقعك الثابتة أو حزم البرامج، فاختر مستوى عالياً، وإذا كنت تضغط باستمرار، مثل السجلات أو البث بين سيرفرين، فاختر مستوى سريعاً.
لماذا لا تضغط الملفات المضغوطة والمشفرة؟
الطريقة البسيطة التي يقع فيها كثيرون هي أن يضغط النسخة الاحتياطية المشفرة، أو يضغط مجلد صور JPEG وفيديوهات MP4 بأعلى مستوى وينتظر ساعة، ثم يجد أن الحجم لم يتغير. والسبب أن الملف المضغوط جيداً لم يبق فيه تكرار، فقد حذفه الضاغط الأول، والضغط لا يمكنه أن يحذف شيئاً غير موجود. أما التشفير الجيد فيجعل البيانات تبدو عشوائية تماماً، وهذا جزء من تعريف أمانه، والعشوائي إنتروبيته قريبة من 8 بتات لكل بايت، فلا يوجد فيه ما يحذف. ولذلك فالترتيب الصحيح دائماً: اضغط أولاً ثم شفر، والصورة التالية تبين النتيجة الحقيقية من التجربة:
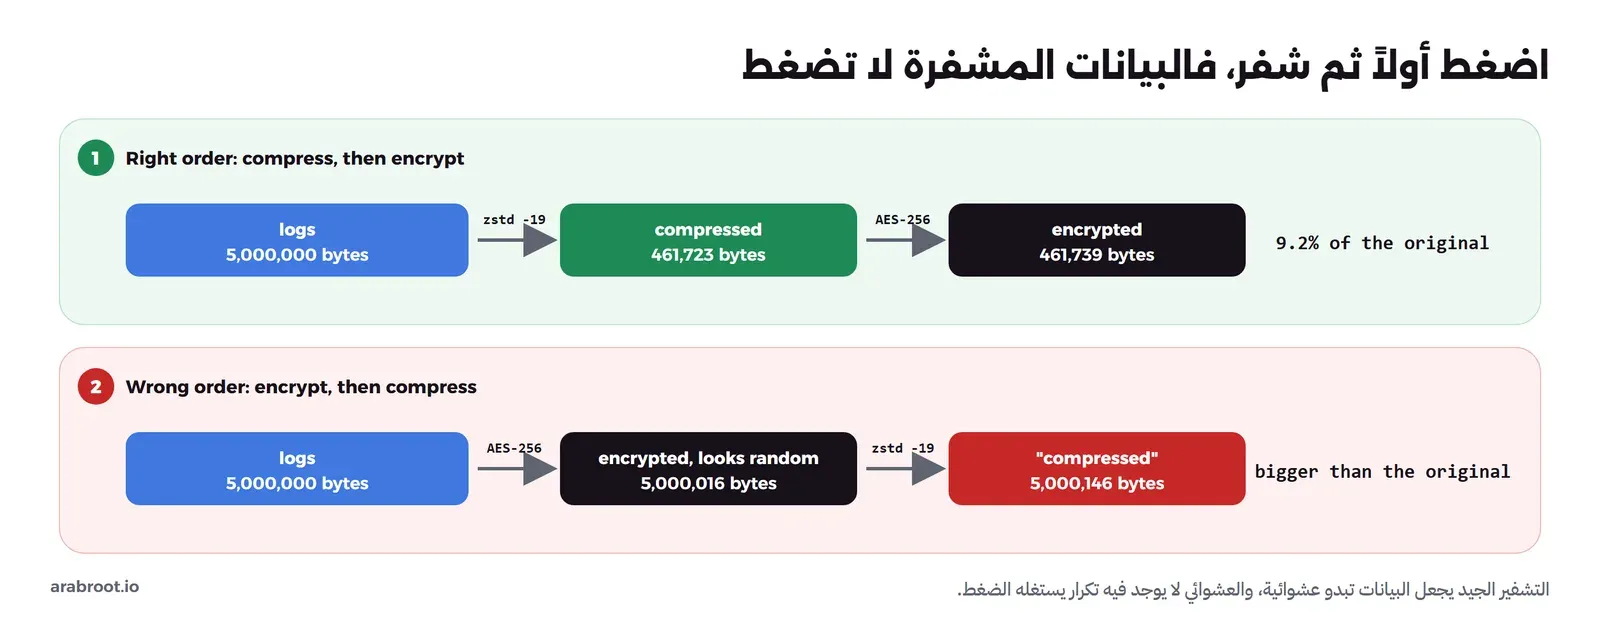
ولهذا السبب تضغط أدوات النسخ الاحتياطي الحديثة البيانات قبل تشفيرها داخلياً، وقد قارنا بعضها في مقال restic أم Borg أم Kopia، وشرحنا التشفير نفسه في مقال التشفير للمطورين.
الضغط في HTTP: gzip وBrotli وZstandard
كل صفحة HTML وملف CSS وJavaScript يرسله سيرفرك يمكن أن يضغط في الطريق، والمتصفح يعلن ما يفهمه في ترويسة Accept-Encoding، والسيرفر يختار منها ويعلن اختياره في ترويسة Content-Encoding، وهذه الآلية معرفة في RFC 9110. والقيم الشائعة اليوم gzip وbr أي Brotli، وzstd الذي سجلته RFC 8878، ثم حددت RFC 9659 في سبتمبر 2024 أن نافذته في HTTP يجب ألا تتجاوز 8 MB حتى لا تختلف المتصفحات في ما تقبله. أما دعم المتصفحات بحسب caniuse في أكتوبر 2026: zstd مدعوم في Chrome وEdge منذ الإصدار 123، وFirefox منذ 126، وSafari منذ 26.0 يفكه ولكنه لا يطلبه في كل الأنظمة، وغير مدعوم في Samsung Internet، بينما Brotli مدعوم في كل المتصفحات منذ سنوات.
ونرى ذلك على مواقع حقيقية، حيث نطلب نفس الصفحة ثلاث مرات بقيم مختلفة لـ Accept-Encoding:
for u in https://www.facebook.com/ https://www.wikipedia.org/; do
  for e in "gzip" "br, gzip" "zstd, br, gzip"; do
    printf "%-28s %-16s " "$u" "$e"
    curl -s -o /dev/null -D - -H "Accept-Encoding: $e" "$u" | grep -i "^content-encoding" | tr -d "\r"
  done
done
والمخرج سوف يكون كما يلي:
https://www.facebook.com/    gzip             content-encoding: gzip
https://www.facebook.com/    br, gzip         content-encoding: br
https://www.facebook.com/    zstd, br, gzip   content-encoding: zstd
https://www.wikipedia.org/   gzip             content-encoding: gzip
https://www.wikipedia.org/   br, gzip         content-encoding: gzip
https://www.wikipedia.org/   zstd, br, gzip   content-encoding: gzip
لاحظ أن Facebook اختار أفضل ما عرضناه في كل مرة، بينما بقي Wikipedia على gzip في الحالات الثلاث، فالقرار في النهاية للسيرفر، وgzip هو الحد الأدنى الذي يفهمه الجميع. وعلى سيرفرك تفعل هذا في ال Reverse Proxy، والقاعدة العملية: اضغط النصوص فقط، أي HTML وCSS وJavaScript وJSON وSVG، ولا تضغط الصور والفيديو والملفات المضغوطة أصلاً، والسبب ما رأيته في القسم السابق، فهي تستهلك المعالج دون أي توفير. وللملفات الثابتة التي لا تتغير، مثل حزم JavaScript بعد البناء، اضغطها مسبقاً بأعلى مستوى في Brotli أو zstd مرة واحدة واجعل السيرفر يرسل النسخة الجاهزة، بدل أن يضغطها عند كل طلب بمستوى منخفض.
وهناك تفصيل أمني يجب أن تعرفه، فقد عرض باحثون في 2013 هجوماً اسمه BREACH، مسجلاً باسم CVE-2013-3587، والفكرة أن الصفحة المضغوطة يتغير طولها بحسب التكرار فيها، فإذا كانت الصفحة تعرض في نفس الرد سراً، مثل توكن CSRF، ونصاً يتحكم فيه المهاجم، مثل كلمة بحث من الرابط، فإن المهاجم الذي يرى أطوال الردود المشفرة على الشبكة يستطيع أن يخمن السر حرفاً حرفاً: التخمين الصحيح يتكرر مع السر فيصغر الرد ببايت. والتشفير بـ TLS لا يمنع ذلك لأنه لا يخفي الطول. والحماية العملية ألا تضع الأسرار في صفحة تعكس مدخلات المستخدم، أو تغير قيمة التوكن في كل رد بقناع عشوائي Masking كما تفعل أطر العمل الحديثة، أو توقف الضغط في الردود التي تحمل أسراراً.
التجربة العملية
الآن نقيس كل ما سبق بأنفسنا. سوف نشغل Container واحداً فيه كل الأدوات، ونولد ثلاث مجموعات بيانات: سجلات وصول بصيغة Nginx، وملف JSON يشبه تصدير طلبات من قاعدة بيانات، ومجموعة صور JPEG، ثم نقيس لكل أداة نسبة الضغط وسرعة الضغط وفك الضغط، ثم نكتب برنامج Huffman صغيراً.
تجهيز ال Container والبيانات
نشغل Container من Python 3.13 بإصدار مثبت، ونعطيه مجلداً في الذاكرة /bench حتى لا تؤثر سرعة القرص على القياس، ثم نثبت الأدوات من مستودع Debian 13:
docker run -d --name lab-compress-tools --tmpfs /bench:size=2g python:3.13.16-slim sleep infinity
docker exec lab-compress-tools bash -c "apt-get update -qq && DEBIAN_FRONTEND=noninteractive apt-get install -y -qq --no-install-recommends \
  gzip bzip2 xz-utils zstd brotli lz4 zip unzip 7zip libarchive-tools xxd openssl curl"
docker exec lab-compress-tools bash -c "gzip --version|head -1; xz --version|head -1; zstd --version; brotli --version; lz4 --version"
والمخرج سوف يكون كما يلي:
gzip 1.13
xz (XZ Utils) 5.8.1
*** Zstandard CLI (64-bit) v1.5.7, by Yann Collet ***
brotli 1.1.0
*** lz4 v1.10.0 64-bit multithread, by Yann Collet ***
والبرنامج التالي يولد ملفين نصيين كل منهما 20 MB، ويبدأ المولد العشوائي بنفس الرقم في كل مرة حتى تحصل على نفس البايتات إذا أعدت التجربة:
# gen.py: generates the two text datasets of the benchmark (seeded, so every run gives the same bytes)
import random, json, datetime
random.seed(2026)
paths = ['/', '/login', '/api/v1/orders', '/api/v1/orders/{}', '/api/v1/users/{}', '/static/app.{}.js',
         '/static/style.{}.css', '/images/p/{}.webp', '/health', '/search?q={}']
agents = ['Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/141.0 Safari/537.36',
          'Mozilla/5.0 (iPhone; CPU iPhone OS 18_6 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/18.6 Mobile/15E148 Safari/604.1',
          'Mozilla/5.0 (X11; Linux x86_64; rv:143.0) Gecko/20100101 Firefox/143.0', 'curl/8.14.1', 'kube-probe/1.34']
t = datetime.datetime(2026, 10, 1, tzinfo=datetime.timezone.utc)
with open('logs.txt', 'w') as f:
    while f.tell() < 20_000_000:
        t += datetime.timedelta(milliseconds=random.randint(1, 400))
        ip = f'10.{random.randint(0,3)}.{random.randint(0,255)}.{random.randint(1,254)}'
        p = random.choice(paths).format(random.randint(1, 99999))
        st = random.choices([200, 304, 404, 500], [90, 6, 3, 1])[0]
        f.write(f'{ip} - - [{t:%d/%b/%Y:%H:%M:%S} +0000] "GET {p} HTTP/1.1" {st} {random.randint(200, 90000)} "-" "{random.choice(agents)}" rt={random.random():.3f}\n')
cities = ['Riyadh', 'Jeddah', 'Cairo', 'Amman', 'Dubai', 'Rabat', 'Doha', 'Muscat']
recs = []
size = 0
i = 0
while size < 20_000_000:
    i += 1
    r = {'id': i, 'customer': {'name': f'customer-{random.randint(1, 50000)}', 'city': random.choice(cities),
         'email': f'user{random.randint(1, 50000)}@example.com'}, 'status': random.choice(['paid', 'shipped', 'cancelled', 'refunded']),
         'total': round(random.uniform(5, 2500), 2), 'currency': 'SAR', 'created_at': f'2026-{random.randint(1,9):02d}-{random.randint(1,28):02d}T{random.randint(0,23):02d}:{random.randint(0,59):02d}:00Z',
         'items': [{'sku': f'SKU-{random.randint(1000, 9999)}', 'qty': random.randint(1, 5), 'price': round(random.uniform(1, 500), 2)} for _ in range(random.randint(1, 4))]}
    s = json.dumps(r, ensure_ascii=False)
    recs.append(s); size += len(s) + 2
with open('dump.json', 'w') as f:
    f.write('[\n' + ',\n'.join(recs) + '\n]\n')
أما مجموعة الصور فهي 24 جزءاً بمقاس 1600 × 1067 قصصناها من صورة NASA التي استخدمناها في تجربة مقال صيغ الصور، وحفظناها JPEG بالجودة 85 في ملف tar واحد، ثم نسخنا كل شيء إلى ال Container:
docker exec lab-img-tools bash -c "cd /lab && mkdir photos && for i in \$(seq 0 23); do x=\$(( (i % 4) * 900 )); y=\$(( (i / 4) * 1000 )); \
  vips crop nasa-orig.jpg photos/p\$i.jpg[Q=85,strip] \$x \$y 1600 1067; done && tar -cf photos.tar photos"
docker cp lab-img-tools:/lab/photos.tar photos.tar
docker exec lab-compress-tools mkdir -p /data
docker cp gen.py lab-compress-tools:/data/gen.py
docker cp photos.tar lab-compress-tools:/data/photos.tar
docker exec -w /bench lab-compress-tools bash -c "cp /data/* . && python3 gen.py && ls -l"
total 45040
-rw-r--r-- 1 root root 20000156 Oct 9 13:39 dump.json
-rwxr-xr-x 1 root root 2252 Oct 9 13:39 gen.py
-rw-r--r-- 1 root root 20000233 Oct 9 13:39 logs.txt
-rwxr-xr-x 1 root root 6113280 Oct 9 13:39 photos.tarولاحظ أننا نسخنا الملفات إلى /data أولاً ثم إلى /bench من داخل ال Container، والسبب أن docker cp لا يكتب داخل مجلد tmpfs، فهو يكتب في طبقة ملفات ال Container وليس في المجلد المحمل في الذاكرة.
القياس: ست أدوات على ثلاثة أنواع من البيانات
البرنامج التالي يشغل كل أداة ثلاث مرات ويأخذ أسرع مرة، للضغط ثم لفك الضغط، ويتأكد أن الملف بعد فك الضغط مطابق للأصل بايتاً ببايت:
# bench.py: ratio, compression and decompression speed for each tool on each dataset (best of 3 runs, one thread)
import subprocess, time, os, sys
TOOLS = [  # name, compress command, decompress command (stdin -> stdout)
    ('gzip -6',    ['gzip', '-6', '-c'],          ['gzip', '-d', '-c']),
    ('gzip -9',    ['gzip', '-9', '-c'],          ['gzip', '-d', '-c']),
    ('bzip2 -9',   ['bzip2', '-9', '-c'],         ['bzip2', '-d', '-c']),
    ('xz -6',      ['xz', '-6', '-T1', '-c'],     ['xz', '-d', '-T1', '-c']),
    ('zstd -1',    ['zstd', '-1', '-T1', '-q', '-c'],  ['zstd', '-d', '-q', '-c']),
    ('zstd -3',    ['zstd', '-3', '-T1', '-q', '-c'],  ['zstd', '-d', '-q', '-c']),
    ('zstd -19',   ['zstd', '-19', '-T1', '-q', '-c'], ['zstd', '-d', '-q', '-c']),
    ('brotli -11', ['brotli', '-q', '11', '-c'],  ['brotli', '-d', '-c']),
    ('lz4 -1',     ['lz4', '-1', '-q', '-c'],     ['lz4', '-d', '-q', '-c']),
]
def run(cmd, src, dst):
    best = 1e9
    for _ in range(3):
        with open(src, 'rb') as i, open(dst, 'wb') as o:
            t = time.perf_counter(); subprocess.run(cmd, stdin=i, stdout=o, check=True); best = min(best, time.perf_counter() - t)
    return best
for ds in sys.argv[1:]:
    n = os.path.getsize(ds); MB = n / 1e6
    print(f'\n{ds}: {n:,} bytes')
    print(f'{"tool":<11} {"size":>11} {"ratio":>6} {"comp MB/s":>10} {"decomp MB/s":>12}')
    for name, c, d in TOOLS:
        tc = run(c, ds, '/bench/out.z'); z = os.path.getsize('/bench/out.z')
        td = run(d, '/bench/out.z', '/bench/back')
        assert open('/bench/back', 'rb').read() == open(ds, 'rb').read()
        print(f'{name:<11} {z:>11,} {n / z:>6.2f} {MB / tc:>10.1f} {MB / td:>12.1f}')
    os.remove('/bench/out.z'); os.remove('/bench/back')
docker cp bench.py lab-compress-tools:/data/bench.py
docker exec -w /bench lab-compress-tools bash -c "cp /data/bench.py . && python3 bench.py logs.txt dump.json photos.tar"والمخرج سوف يكون كما يلي:
logs.txt: 20,000,233 bytes
tool               size  ratio  comp MB/s  decomp MB/s
gzip -6       2,319,711   8.62       31.5        159.6
gzip -9       2,191,675   9.13       15.7        129.3
bzip2 -9      1,443,200  13.86        4.0          7.2
xz -6         1,795,892  11.14        1.1         69.0
zstd -1       2,582,598   7.74      125.9        227.8
zstd -3       2,542,730   7.87       91.9        229.4
zstd -19      1,810,383  11.05        0.6        191.6
brotli -11    1,780,248  11.23        0.3        234.4
lz4 -1        4,024,072   4.97      483.9        601.1

dump.json: 20,000,156 bytes
tool               size  ratio  comp MB/s  decomp MB/s
gzip -6       2,819,390   7.09       45.1        139.9
gzip -9       2,698,387   7.41        8.8        198.4
bzip2 -9      1,680,342  11.90        3.9         13.0
xz -6         2,030,564   9.85        0.8        109.7
zstd -1       2,876,011   6.95      220.0        493.4
zstd -3       2,965,561   6.74      122.1        351.5
zstd -19      2,134,797   9.37        0.5        237.7
brotli -11    2,079,243   9.62        0.2        101.3
lz4 -1        5,008,197   3.99      409.5        385.2

photos.tar: 6,113,280 bytes
tool               size  ratio  comp MB/s  decomp MB/s
gzip -6       5,994,861   1.02       14.5         82.7
gzip -9       5,994,790   1.02       14.6         70.3
bzip2 -9      5,757,521   1.06        3.8          3.6
xz -6         5,915,220   1.03        1.2         17.8
zstd -1       6,020,316   1.02       69.5        292.0
zstd -3       6,007,324   1.02       61.6        239.3
zstd -19      5,933,685   1.03        1.6        157.8
brotli -11    5,905,833   1.04        0.2         58.5
lz4 -1        6,112,819   1.00      411.1        351.6
والصورة التالية ترسم نتائج السجلات، حيث الأعلى ملف أصغر والأيمن ضغط أسرع:
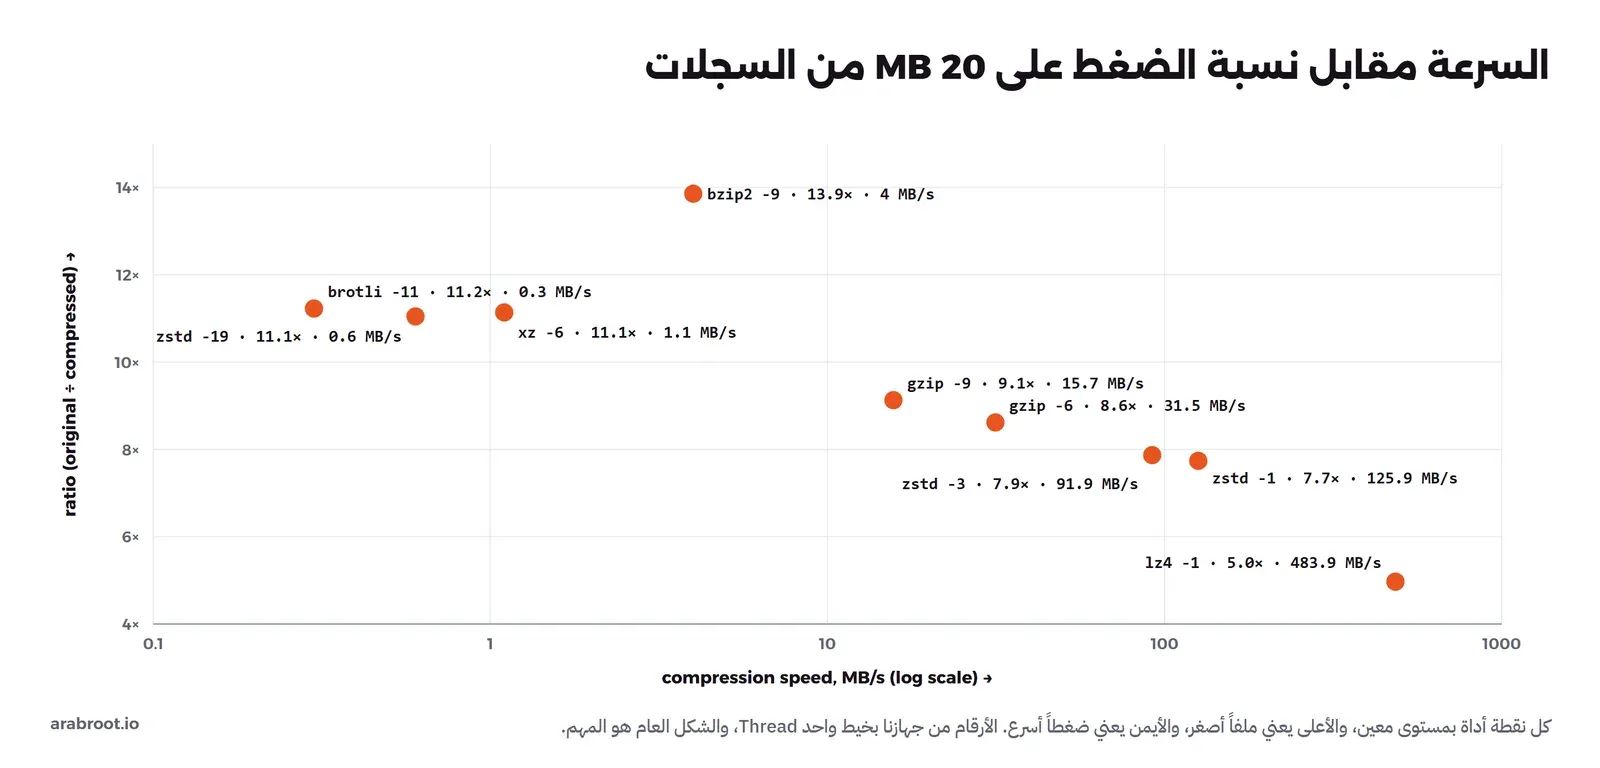
في المخرج أعلاه لاحظ التالي:
- المقايضة واضحة: LZ4 يضغط السجلات بسرعة 484 MB/s ولكن بنسبة 5 فقط، وBrotli بالمستوى 11 يصل إلى 11.2 ولكن بسرعة 0.3 MB/s، أي أبطأ بـ 1600 مرة تقريباً، فلا يصلح إلا لما يضغط مرة واحدة.
- zstd -1 أفضل من gzip -6 للعمل اليومي: نسبة أقل قليلاً، 7.7 مقابل 8.6، مقابل ضغط أسرع بأربع مرات وفك أسرع بمرة ونصف تقريباً، ولهذا السبب أصبح الخيار المعتاد لتدوير السجلات والنسخ المستمرة.
- فك الضغط سريع في كل المستويات: zstd -19 ضغط ببطء شديد ولكنه فك بسرعة 192 MB/s، قريباً من zstd -1، وهذا ما قلناه عن LZ77: البحث مكلف والنسخ رخيص. أما bzip2 فبطيء في الاتجاهين، 7.2 MB/s لفك السجلات.
- bzip2 فاز في النسبة على بياناتنا: 13.9 مقابل 11.1 لـ xz، وهذا ليس قاعدة، فبياناتنا مولدة بأرقام عشوائية كثيرة مثل عناوين IP والأحجام وأرقام الطلبات، وطريقة Burrows-Wheeler تتعامل مع هذا النوع جيداً، بينما في ملفات حقيقية فيها تكرار أطول يتقدم عادة xz وzstd -19. ولهذا السبب قس على بياناتك أنت قبل أن تقرر.
- zstd -3 كان أكبر من zstd -1 على ملف JSON، 2.97 MB مقابل 2.88 MB، أي أن المستوى الأعلى لا يضمن ملفاً أصغر في كل الحالات، وإنما في المتوسط.
- الصور لم تصغر: أفضل نتيجة 6% مع bzip2، وأغلب الأدوات بين 0% و4%، وLZ4 خرج بنفس الحجم تقريباً، فصور JPEG مضغوطة أصلاً، وضغطها مرة أخرى يستهلك الوقت دون فائدة.
البيانات المضغوطة والمشفرة والعشوائية
الآن نرى بالأرقام ما ذكرناه نظرياً: نأخذ أول 5 MB من السجلات، ونشفرها بـ AES-256، ونولد 5 MB عشوائية، ثم نجرب الضغط مرتين، والتشفير قبل الضغط وبعده:
cd /bench
head -c 5000000 logs.txt > sample.log
openssl enc -aes-256-ctr -pbkdf2 -pass pass:lab-only -in sample.log -out sample.log.enc
head -c 5000000 /dev/urandom > random.bin
gzip -9 -k -c sample.log > sample.log.gz
gzip -9 -c sample.log.gz > sample.log.gz.gz
zstd -q -19 -c sample.log.enc > sample.log.enc.zst
gzip -9 -c random.bin > random.bin.gz
gzip -9 -c sample.log.enc > sample.log.enc.gz
zstd -q -19 -c sample.log > sample.log.zst
openssl enc -aes-256-ctr -pbkdf2 -pass pass:lab-only -in sample.log.zst -out sample.log.zst.enc
ls -l sample.log sample.log.gz sample.log.gz.gz sample.log.enc sample.log.enc.gz sample.log.enc.zst random.bin random.bin.gz sample.log.zst sample.log.zst.enc | awk '{printf "%12s  %s\n", $5, $9}'
والمخرج سوف يكون كما يلي:
     5000000  random.bin
     5000794  random.bin.gz
     5000000  sample.log
     5000016  sample.log.enc
     5000814  sample.log.enc.gz
     5000146  sample.log.enc.zst
      547602  sample.log.gz
      547719  sample.log.gz.gz
      461723  sample.log.zst
      461739  sample.log.zst.enc
في المخرج أعلاه لاحظ التالي:
- البيانات العشوائية كبرت بعد gzip بـ 794 بايت، والسبب أن الضاغط لا يجد شيئاً يحذفه، فيخزنها كما هي ويضيف رؤوس الكتل والغلاف.
- السجلات المشفرة تصرفت تماماً مثل العشوائية، وكبرت مع gzip وzstd، وهذا يعني أن التشفير يعمل كما يجب، فلو صغرت لكان ذلك علامة على أن التشفير يترك أنماطاً.
- ضغط ملف gzip مرة ثانية زاده 117 بايتاً، فلا يوجد ضغط فوق الضغط.
- الترتيب الصحيح، الضغط ثم التشفير، أعطى 461,739 بايت، أي 9.2% من الأصل، والتشفير أضاف 16 بايتاً فقط، وهي الملح Salt الذي يضيفه
openssl encمع علامته.
وأخيراً حالة معاكسة تماماً، 10 MB من الأصفار، وهي أقصى تكرار ممكن:
head -c 10000000 /dev/zero > zeros.bin
for t in "gzip -9" "zstd -q -19" "xz -6 -T1" "bzip2 -9"; do printf "%-11s %s\n" "$t" $($t -c zeros.bin | wc -c); done
gzip -9 9747
zstd -q -19 330
xz -6 -T1 1584
bzip2 -9 49لاحظ أن gzip توقف عند نحو 1:1000، والسبب في مواصفة DEFLATE نفسها، فأطول تطابق في LZ77 هناك 258 بايتاً، فيحتاج 10 MB من الأصفار إلى نحو 39 ألف إشارة على الأقل. أما bzip2 فضغطها إلى 49 بايتاً فقط، لأن أول مرحلة فيه هي ترميز التكرار المتتالي RLE الذي شرحناه، وهي مصممة بالضبط لهذه الحالة. وهذه الأرقام هي أساس فكرة «القنبلة المضغوطة» Zip Bomb التي نشرحها في مقال ملفات ZIP.
برنامج Huffman صغير بلغة Python
البرنامج التالي يحسب الإنتروبيا، ويبني شجرة Huffman بنفس الخطوات التي فعلناها باليد، باستخدام طابور أولوية Priority Queue من الوحدة heapq، وقد شرحنا هذا الهيكل في مقال هياكل البيانات:
# huffman.py: entropy and a tiny Huffman encoder, to see how many bits the code saves
import heapq, math, sys
from collections import Counter

def entropy(text):
    n = len(text)
    return -sum(c / n * math.log2(c / n) for c in Counter(text).values())

def huffman(text):
    # each heap entry: (frequency, tie-breaker, {symbol: code so far})
    heap = [(f, i, {s: ''}) for i, (s, f) in enumerate(sorted(Counter(text).items(), key=lambda x: (-x[1], x[0])))]
    heapq.heapify(heap)
    tie = len(heap)
    while len(heap) > 1:
        f1, _, a = heapq.heappop(heap)          # the two least frequent groups
        f2, _, b = heapq.heappop(heap)
        merged = {s: '0' + c for s, c in a.items()} | {s: '1' + c for s, c in b.items()}
        heapq.heappush(heap, (f1 + f2, tie, merged)); tie += 1
    return heap[0][2]

for text in sys.argv[1:]:
    codes = huffman(text)
    bits = ''.join(codes[ch] for ch in text)
    utf8 = len(text.encode('utf-8')) * 8
    print(f'text: {text!r}  ({len(text)} characters, {utf8} bits in UTF-8)')
    for s, c in sorted(codes.items(), key=lambda x: (len(x[1]), x[1])):
        print(f'  {s!r:6} x{text.count(s):<3} -> {c}')
    print(f'  encoded: {bits}')
    print(f'  Huffman: {len(bits)} bits = {len(bits) / len(text):.2f} bits per character')
    print(f'  entropy: {entropy(text):.3f} bits per character, minimum {math.ceil(entropy(text) * len(text))} bits')
    print(f'  saving vs UTF-8: {100 * (1 - len(bits) / utf8):.1f}% (the code table itself is not counted)\n')
docker cp huffman.py lab-compress-tools:/data/huffman.py
docker exec -w /bench lab-compress-tools bash -c 'cp /data/huffman.py . && python3 huffman.py ABRACADABRA "سلسلة سلاسل"'والمخرج سوف يكون كما يلي:
text: 'ABRACADABRA'  (11 characters, 88 bits in UTF-8)
  'A'    x5   -> 0
  'C'    x1   -> 100
  'D'    x1   -> 101
  'B'    x2   -> 110
  'R'    x2   -> 111
  encoded: 01101110100010101101110
  Huffman: 23 bits = 2.09 bits per character
  entropy: 2.040 bits per character, minimum 23 bits
  saving vs UTF-8: 73.9% (the code table itself is not counted)

text: 'سلسلة سلاسل'  (11 characters, 168 bits in UTF-8)
  'ل'    x4   -> 0
  'س'    x4   -> 11
  'ة'    x1   -> 100
  ' '    x1   -> 1010
  'ا'    x1   -> 1011
  encoded: 11011010010101101011110
  Huffman: 23 bits = 2.09 bits per character
  entropy: 2.005 bits per character, minimum 23 bits
  saving vs UTF-8: 86.3% (the code table itself is not counted)
في المخرج أعلاه لاحظ التالي:
- الرموز التي طبعها البرنامج للكلمة الإنجليزية هي نفسها التي حسبناها باليد، والنتيجة 23 بتاً تساوي الحد الأدنى الذي تعطيه الإنتروبيا مقرباً.
- العبارة العربية فيها 11 حرفاً أيضاً، ولكنها في UTF-8 تأخذ 168 بتاً لأن كل حرف عربي بايتان، كما شرحنا في مقال الترميز، ولذلك كان التوفير أكبر، 86% مقابل 74%.
- الحرفان «ل» و«س» لهما نفس التكرار، ومع ذلك أخذ أحدهما بتاً واحداً والآخر بتين، وهذا طبيعي لأن الشجرة تبنى من أقل تكرارين في كل خطوة، والطول الكلي هو الأقل الممكن مهما اختلف توزيع الرموز.
- التوفير لا يحسب حجم جدول الرموز، وفي الملفات الحقيقية يحفظ DEFLATE الجدول بطريقة مختصرة في رأس كل كتلة، ولهذا يظهر أثر Huffman في الملفات الكبيرة وليس في كلمة واحدة.
حذف التجربة
docker rm -f lab-compress-toolsأي أداة تستخدم ومتى؟
| الحالة | الاختيار | والسبب |
|---|---|---|
| تدوير السجلات ونقل البيانات بين السيرفرات | zstd بالمستوى 1 إلى 3 | أسرع من gzip بكثير بنسبة قريبة منه |
| النسخ الاحتياطية | zstd بمستوى متوسط، أو ما تختاره أداة النسخ | ضغط سريع، وفك سريع وقت الاستعادة |
| ملف ترسله لشخص لا تعرف ما عنده | gzip أو ZIP | موجود في كل نظام دون تثبيت |
| حزمة تضغط مرة وتنزل ملايين المرات | xz أو zstd -19 | الوقت يدفع مرة، والتوفير يتكرر |
| ملفات الموقع الثابتة | Brotli بالمستوى 11 مسبقاً، وgzip كبديل | أصغر ملف للزائر، والضغط مرة عند البناء |
| صفحات تتولد عند كل طلب | Brotli أو zstd بمستوى منخفض، أو gzip | الضغط يجب ألا يؤخر الرد |
| ضغط في الذاكرة أو في قاعدة البيانات | LZ4 أو zstd -1 | المعالج أغلى من الحجم هنا |
| صور وفيديو وملفات مشفرة | لا تضغطها | لن تصغر، وقد تكبر |
أخطاء شائعة
- ضغط الملفات المشفرة: لن تصغر، فاضغط قبل التشفير دائماً.
- ضغط الصور والفيديو مرة أخرى: وقت معالج ضائع، فاستثنها من الضغط في ال Reverse Proxy ومن ضغط النسخ الاحتياطية إذا كانت أداتك تسمح.
- أعلى مستوى دائماً: zstd -19 أبطأ من zstd -1 بأكثر من 200 مرة في تجربتنا مقابل ملف أصغر بنحو 30%، وهذا يستحق لحزمة توزعها، ولا يستحق لسجلات تدورها كل ساعة.
- الاعتماد على أرقام غيرك: رأيت كيف فاز bzip2 على بياناتنا المولدة، فقس على عينة من بياناتك أنت قبل أن تقرر.
- Brotli بالمستوى 11 عند كل طلب: 0.3 MB/s في تجربتنا، فاستخدمه للملفات الجاهزة مسبقاً فقط.
- أسرار في صفحة مضغوطة تعكس مدخلات المستخدم: هذا هو شرط هجوم BREACH، فافصل الأسرار أو اجعلها تتغير في كل رد.
تدريب عملي
- شغل
bench.pyعلى نسخة من سجلات سيرفرك الحقيقية، وقارن ترتيب الأدوات بما رأيته هنا. هل بقي bzip2 الأول؟ - غير
huffman.pyحتى يحسب حجم جدول الرموز ويضيفه إلى الناتج، ثم جربه على جملة قصيرة وعلى فقرة كاملة، وابحث عن الطول الذي يبدأ عنده التوفير الحقيقي. - افحص موقعك بأمر
curlالذي في قسم HTTP، وانظر هل يرسل Brotli أو zstd، وهل يضغط الصور دون فائدة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الضغط يحذف التكرار، والإنتروبيا التي عرفها Shannon في 1948 هي الحد الأدنى لعدد البتات لكل رمز، وكلمة ABRACADABRA تحتاج 2.04 بت لكل حرف بدل 8.
- Huffman يعطي الرمز المتكرر كوداً قصيراً، وLZ77 يستبدل النص المكرر بإشارة (مسافة، طول)، وDEFLATE يجمعهما، وهو داخل gzip وzlib وPNG وZIP.
- الأدوات الحديثة مقايضة بين النسبة وسرعة الضغط وسرعة الفك: LZ4 للسرعة، وzstd لكل المدى، وxz وBrotli للحجم الأصغر عندما يضغط الملف مرة واحدة.
- البيانات المضغوطة والمشفرة والعشوائية لا تضغط، فاضغط ثم شفر، ولا تضغط الصور والفيديو.
- في HTTP يختار السيرفر من Accept-Encoding، وzstd مدعوم اليوم في Chrome وEdge وFirefox، وBrotli في كل المتصفحات، وBREACH يذكرك بأن طول الرد المضغوط يكشف معلومات.
والمقال التالي في هذه المرحلة يفتح ملفات الأرشيف نفسها: كيف يبنى ZIP بالبايت، ولماذا يختلف عنه 7z وRAR، وما الخطر في فك ملف مضغوط من مستخدم:
 دليلماذا يوجد داخل ملف ZIP، وما الذي يخفيه؟كيف يرتب ملف ZIP محتوياته من الداخل، ولماذا يستطيع ملف مضغوط صغير أن يملأ قرصك أو يكتب خارج المجلد الذي فككته فيه.
 دليلصيغ الصور: كيف تختار الصيغة المناسبة لموقعككيف تحفظ كل صيغة صور البكسلات والألوان، ولماذا يصغر الملف نفسه إلى الثلث أو أقل عندما تختار الصيغة والمقاس المناسبين.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلكيف اكتشف Max Kellermann ثغرة Dirty Pipeكيف قادت ملفات gzip تالفة مهندساً إلى ثغرة في نواة Linux تسمح بالكتابة في ملفات للقراءة فقط، وكيف تتبعها بأدواته.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على gzip 1.13 وbzip2 1.0.8 وXZ Utils 5.8.1 وzstd 1.5.7 وbrotli 1.1.0 وlz4 1.10.0 وPython 3.13.16 في Debian 13.7، على معالج Intel Core i7-7700K.


