بعد أشهر من تشغيل غرفة التبريد الأولى بالحساسات والأتمتة، أصبح لدى الشركة الصغيرة غرفتان، وحساس باب خلف بوابة، وطلب جديد من مدير العمليات لا يشبه الطلبات السابقة: «لا أريد أن أفتح صفحة كل جهاز على حدة، أريد شاشة واحدة على الحائط في المستودع فيها حرارة كل الغرف الآن، وتاريخ الأسبوع الماضي، ومتى فتح كل باب، وأريد أن أعطي العميل تقريراً عن حرارة شحنته طوال الشهرين اللذين بقيت فيهما عندنا». والطلب الأخير هو الذي يغير التصميم كله، لأن Home Assistant يحتفظ بالسجل عشرة أيام بالإعداد الافتراضي، ولأن الشاشة على الحائط يجب ألا تتوقف إذا أعاد أحدهم تشغيل سيرفر الأتمتة، ولأن «تاريخ الشهرين» يجب أن يكون كاملاً، والقراءة التي تضيع في الطريق تعني فجوة في التقرير لا يستطيع أحد أن يشرحها للعميل.
وفي هذا المقال سوف نبني لوحة المتابعة هذه بثلاث أدوات مفتوحة: Node-RED يستقبل رسائل الأجهزة من الوسيط ويتحقق منها ويحولها، وInfluxDB 3 Core يحفظها كسلاسل زمنية Time Series بوقت الجهاز، وGrafana يعرضها. والأجهزة هي نفسها التي بنيناها في أول مقال من السلسلة، فهي محاكاة بـ Python ترسل القراءات على MQTT كما يرسلها متحكم حقيقي. ثم نوقف قاعدة البيانات دقيقة كاملة ونرى كم قراءة ضاعت، ونصلح الخط مرتين. والمواضيع في السلسلة:
- إنترنت الأشياء IoT من الحساس إلى لوحة المتابعة.
- بروتوكول MQTT مع Mosquitto.
- Home Assistant مع ESPHome.
- لوحات المتابعة لإنترنت الأشياء مع Node-RED وGrafana (الموضوع الحالي).
- تحديث الأجهزة عن بعد OTA دون أن تتعطل.
- أمن إنترنت الأشياء: الأجهزة التي ينساها الجميع.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا تكفي لوحة Home Assistant، ولماذا لا نستخدم Prometheus الذي شرحناه للسيرفرات.
- الخط Pipeline من الوسيط إلى اللوحة، وما مسؤولية كل طبقة فيه.
- Node-RED: البرمجة بالتدفق Flow، وتحويل القراءة إلى صيغة Line Protocol.
- InfluxDB 3 Core: قاعدة البيانات، والتوكن Token، ومدة الاحتفاظ Retention.
- Grafana: مصدر البيانات بلغة InfluxQL، ولوحة محفوظة ككود، وثلاث مشاكل واجهتنا في الرسم.
- تجربة «ماذا يحدث إذا توقفت قاعدة البيانات؟» بثلاث نسخ من الخط، والرسالة السامة Poison Message.
- أخطاء الكتابة الحقيقية من InfluxDB وكيف تقرؤها، ثم تصميم اللوحة للمستودع، والأمان، وقائمة تحقق.
لماذا لا تكفي لوحة Home Assistant؟
في المقال السابق رأينا أن Home Assistant يحفظ كل تغيير حالة في قاعدة SQLite، وتقول صفحة المسجل إن القيمة الافتراضية للاحتفاظ عشرة أيام. ونستطيع أن نرفعها، ولكن المشكلة أكبر من الرقم: Home Assistant مصمم ليقرر الآن، ماذا أشغل وماذا أطفئ، وليس ليكون أرشيف الشركة، والسيرفر الذي يشغل الأتمتة هو أول ما يعاد تشغيله عند كل تحديث. وفوق ذلك ليست كل الأجهزة في Home Assistant أصلاً، فحساس الباب يتكلم MQTT مع البوابة، والشركة قد تضيف غداً عدادات كهرباء أو أجهزة شاحنات التبريد. ولذلك الأفضل أن يكون للقراءات طريق مستقل من الوسيط إلى قاعدة بيانات للسلاسل الزمنية، ومنها إلى اللوحة، يعمل مع Home Assistant وبدونه، وكل طرف يقرأ من الوسيط ما يحتاجه.
السحب Pull أم الدفع Push؟ ولماذا ليس Prometheus هنا
في مقال مقاييس السيرفرات مع Prometheus ولوحات Grafana شرحنا نموذج السحب: Prometheus يعرف قائمة الأهداف، ويطلب من كل هدف صفحة /metrics كل 15 ثانية، والهدف المتوقف يظهر فوراً في المقياس up. وهذا النموذج ممتاز للسيرفرات، فهي ثابتة وتعمل دائماً ويصل إليها Prometheus، ولكنه لا يناسب أجهزة غرفة التبريد لثلاثة أسباب. الأول أن الجهاز خلف راوتر وNAT في المستودع، ولا يستطيع سيرفر المراقبة أن يصل إليه ليسحب منه، وهذا بالضبط سبب وجود الوسيط. والثاني أن الجهاز قد ينام لتوفير البطارية، فلا يوجد من يجيب على السحب. والثالث، وهو الأهم، أن القراءة تحمل وقتها من الجهاز، وقد تصل متأخرة دقائق بعد انقطاع كما رأينا في المقال الأول، أما Prometheus فيضع على العينة في الحالة العادية وقت السحب، فلا مكان فيه لقراءة قيست قبل دقيقتين وتصل الآن.
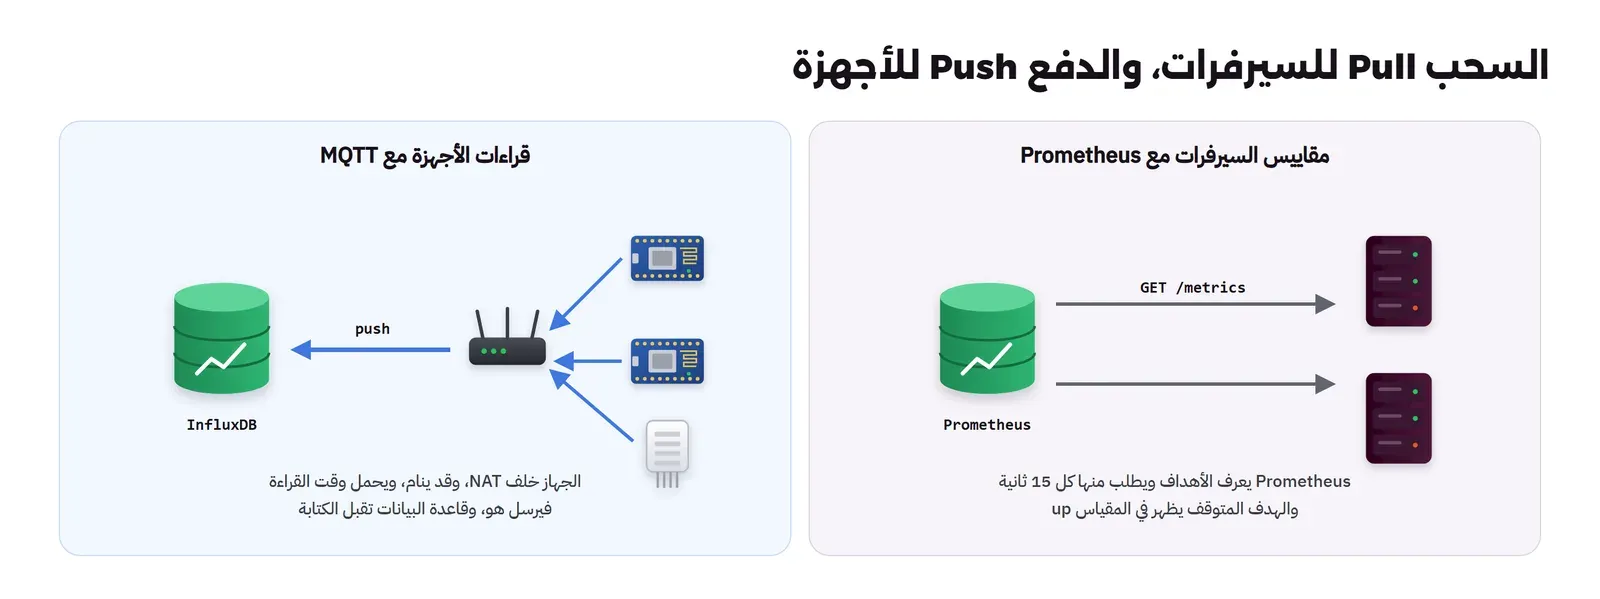
ولذلك الأنسب هنا قاعدة بيانات تقبل الكتابة Write بوقت يحدده الكاتب، وتحفظ القيم بالملي ثانية، وتحذف القديم آلياً، وتستعلم بالفترات. وقد شرحنا هذا النوع من قواعد البيانات مع TimescaleDB وInfluxDB في مقال قواعد بيانات السلاسل الزمنية، وفي هذا المقال نستخدم الجيل الثالث من InfluxDB. ولاحظ أن Prometheus يبقى مفيداً في القصة نفسها: الوسيط وNode-RED وInfluxDB نفسها سيرفرات وخدمات، ومكان مراقبة صحتها هو Prometheus، أما قراءات الحرارة فمكانها InfluxDB.
الخط Pipeline: من الوسيط إلى اللوحة
الصورة التالية تبين الخط الذي سوف نبنيه، ومسؤولية كل طبقة فيه:
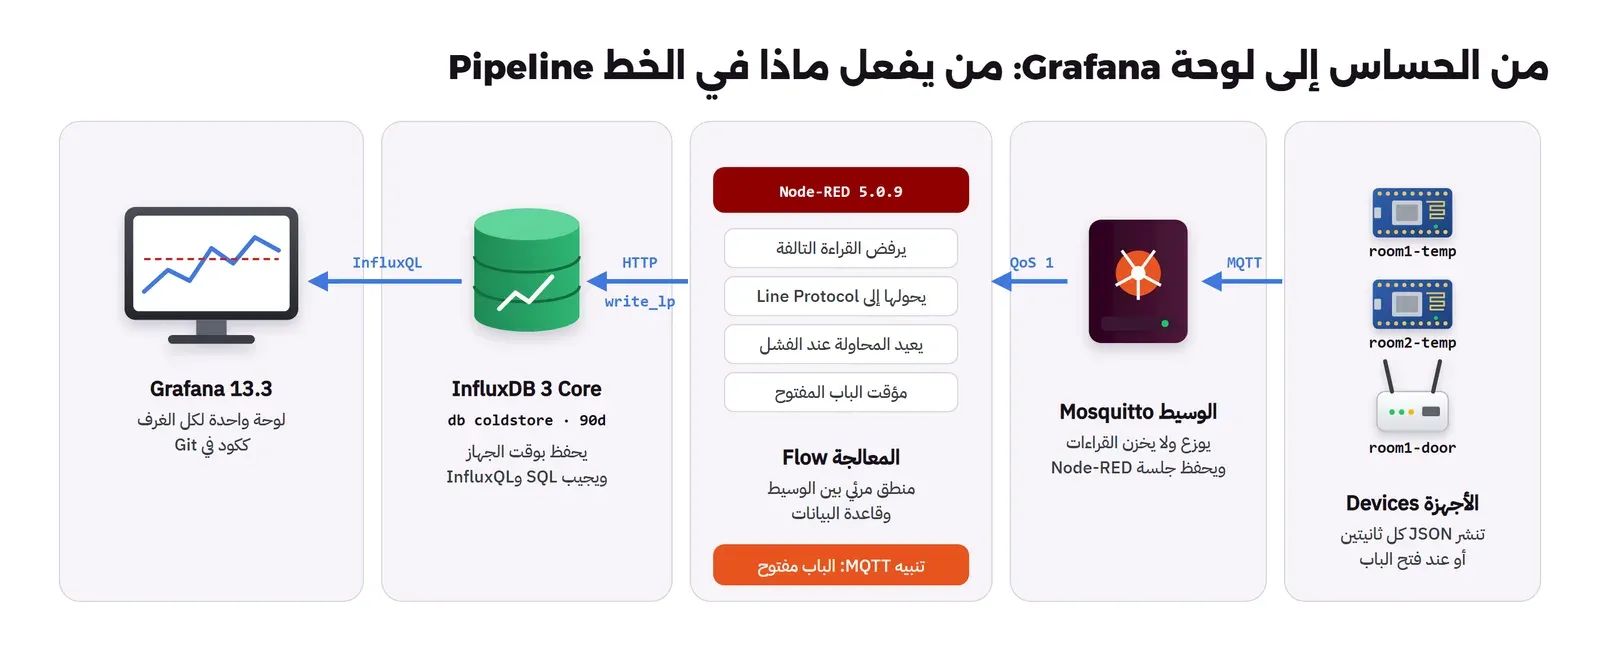
والطبقة التي تحتاج قراراً هي الوسطى، بين الوسيط وقاعدة البيانات، وفيها ثلاثة خيارات شائعة:
- خدمة تكتبها بنفسك: كما فعلنا في المقال الأول بـ Python، وهي تعطيك تحكماً كاملاً، ولكن كل تغيير يحتاج مبرمجاً ونشراً.
- وكيل جمع Agent مثل Telegraf: فيه مدخل MQTT ومخرج InfluxDB جاهزان، ويكفي ملف إعداد، وهو مناسب عندما يكون التحويل بسيطاً ومعروفاً.
- Node-RED: أداة برمجة مرئية بالتدفق، تربط فيها عقداً Nodes بخطوط، وتكتب داخل العقدة كود JavaScript عند الحاجة، وهي مناسبة عندما يكون في الطريق منطق يتغير: تحقق، وتحويل، ومؤقت للباب، وإعادة محاولة، وتنبيه. واخترناها هنا لأن فريق المستودع الصغير يستطيع أن يقرأ التدفق ويغير فيه، ولأنها تبين المنطق في صورة واحدة.
Node-RED: البرمجة بالتدفق Flow
Node-RED أداة مفتوحة المصدر برخصة Apache-2.0، مكتوبة على Node.js، وهي من مشاريع مؤسسة OpenJS. والفكرة فيها أن البرنامج تدفق Flow من عقد، كل عقدة تستقبل رسالة اسمها msg وتعدلها وترسلها إلى العقدة التالية، والرسالة كائن JavaScript فيه عادة msg.payload للمحتوى وmsg.topic للموضوع، وأي حقول أخرى تضيفها أنت. وفي المختبر استخدمنا الإصدار 5.0.9 الذي يعمل على Node.js 24، والتدفق كما ظهر في المحرر بعد التجارب:
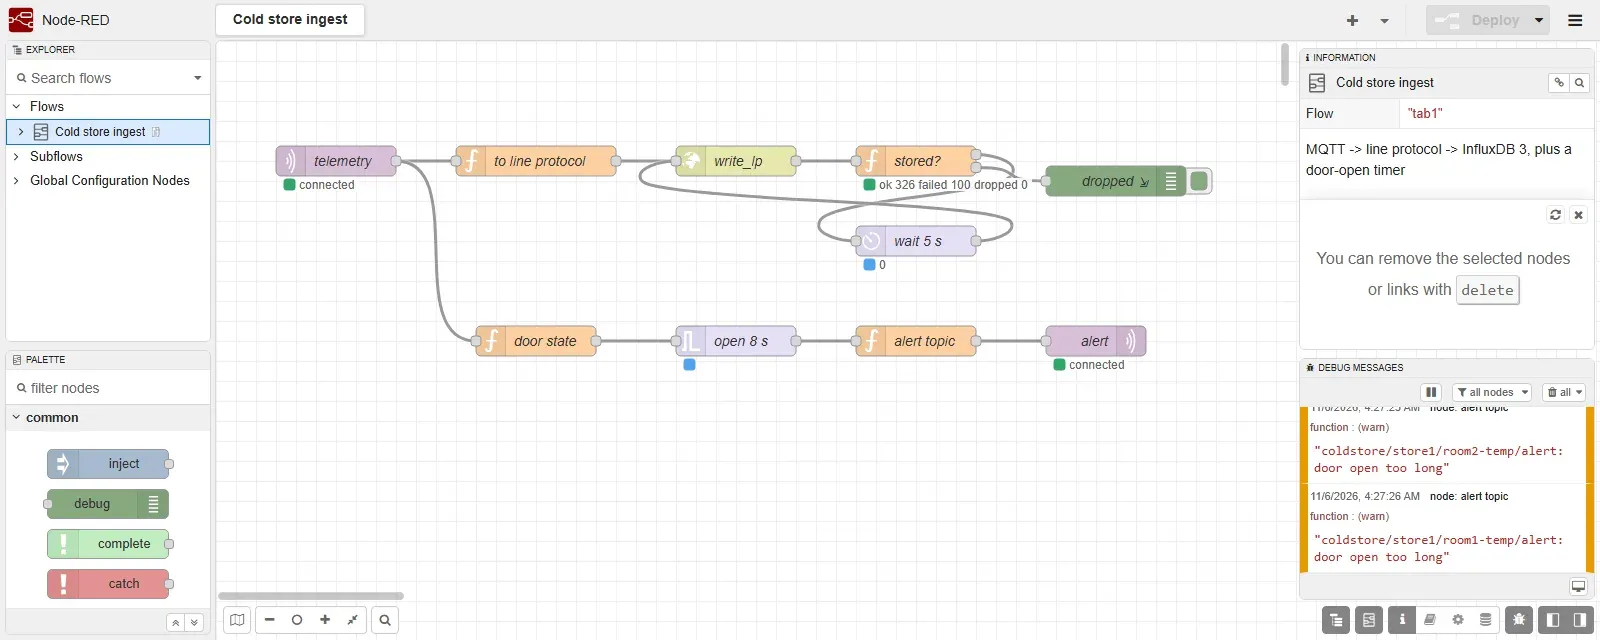
والتدفق محفوظ في ملف JSON واحد flows.json، وهذا مهم لأنك تستطيع أن تضعه في Git وتراجع تغييراته كأي كود. وفيه عقد من ثلاثة أنواع: mqtt in تشترك في coldstore/+/+/telemetry بمستوى QoS 1 وجلسة دائمة باسم ثابت nodered-ingest، كما تعلمنا في مقال MQTT، حتى يحتفظ الوسيط بالقراءات إذا أعيد تشغيل Node-RED، ثم عقد function فيها كود JavaScript، ثم http request تكتب في قاعدة البيانات. وأهم عقدة هي التي تحول القراءة:
// MQTT reading -> one line of InfluxDB line protocol, timestamp from the device (milliseconds)
const parts = msg.topic.split('/');            // coldstore/<site>/<device>/telemetry
const site = parts[1], device = parts[2];
const r = msg.payload;
if (typeof r !== 'object' || typeof r.ts !== 'number' || typeof r.seq !== 'number') {
    node.warn(`rejected reading on ${msg.topic}: ${JSON.stringify(r)}`);
    return null;
}
const f = [];
if (typeof r.temp_c === 'number') f.push(`temp_c=${r.temp_c}`);
if (typeof r.hum_pct === 'number') f.push(`hum_pct=${r.hum_pct}`);
if (r.door) f.push(`door_open=${r.door === 'open' ? 1 : 0}i`);
if (typeof r.bat_v === 'number') f.push(`bat_v=${r.bat_v}`);
f.push(`seq=${r.seq}i`, `lag_ms=${Date.now() - r.ts}i`);
msg.line = `reading,site=${site},device=${device} ${f.join(',')} ${r.ts}`;
msg.payload = msg.line;
msg.attempt = 0;
msg.headers = { 'Authorization': 'Bearer ' + env.get('INFLUX_TOKEN'), 'Content-Type': 'text/plain; charset=utf-8' };
return msg;
وفي الكود أعلاه لاحظ التالي:
- الدالة ترفض القراءة التي ليس فيها وقت أو رقم تسلسلي، و
return nullفي Node-RED يعني أن الرسالة تتوقف هنا ولا تكمل. - الموقع والجهاز يأتيان من اسم الموضوع، وليس من محتوى الرسالة، وهذا يربط بين تصميم المواضيع في المقال الأول وبين ما تحفظه قاعدة البيانات.
lag_msهو الفرق بين وقت وصول الرسالة إلى Node-RED ووقت الجهاز، وليس حتى الحفظ، وسوف نرى لماذا هذا الفرق مهم في التجربة.- التوكن يأتي من متغير البيئة
INFLUX_TOKENبالدالةenv.get، فلا يكون في ملف التدفق الذي يذهب إلى Git. - والسطر الناتج بصيغة Line Protocol، وسوف نشرحها الآن.
InfluxDB 3 Core: القاعدة، والتوكن Token، ومدة الاحتفاظ Retention
InfluxDB 3 Core هو النسخة المفتوحة من الجيل الثالث لقاعدة InfluxDB، ومستودعه فيه ملفا رخصة Apache-2.0 وMIT، والإصدار في المختبر 3.12.2. وتقول صفحة التثبيت إن النسخة التجارية Enterprise تضيف التوافرية العالية والنسخ المقروءة Read Replicas والاستعلام التاريخي، أي أن Core مصمم لسيرفر واحد، وهذا يكفي مستودعاً أو اثنين. وهو يقبل الكتابة بصيغة اسمها Line Protocol، يشرحها مرجع الصيغة، وكل سطر فيها قراءة واحدة:
reading,site=store1,device=room1-temp temp_c=3.6,hum_pct=80.8,door_open=0i,seq=18i,lag_ms=2i 1793928303876والسطر أربعة أجزاء مفصولة بمسافات وفواصل: اسم الجدول reading، ثم الوسوم Tags بعد الفاصلة، وهي هنا الموقع والجهاز، وتستخدم للتصفية والتجميع، ثم الحقول Fields وهي القيم نفسها، ثم الوقت. ولاحظ الحرف i بعد الأرقام الصحيحة، فبدونه يحفظ الرقم كعدد عشري، وهذا تفصيل صغير سوف يعطينا خطأ حقيقياً بعد قليل. والقاعدة في الاختيار بين الوسم والحقل هي نفسها في Prometheus: الوسم لشيء قيمه قليلة ومعروفة تستخدمه في التصفية، مثل اسم الجهاز، والحقل لكل قيمة تقاس.
والتشغيل في Docker بأمر serve مع تخزين على الملفات:
docker network create iot-dash-net
docker run -d --name iot-influx --network iot-dash-net -v iot-influx-data:/var/lib/influxdb3 \
  influxdb:3.12.2-core influxdb3 serve --node-id coldstore-node --object-store file --data-dir /var/lib/influxdb3/data
docker exec iot-influx influxdb3 create token --admin
وهنا واجهتنا أول مشكلة صغيرة، فقد كان رد الأمر الأخير:
Failed to create token, error: RequestSend { method: POST, url: "http://127.0.0.1:8181/api/v3/configure/token/admin", ...
ConnectError("tcp connect error", 127.0.0.1:8181, Os { code: 111, kind: ConnectionRefused, message: "Connection refused" }) }
والسبب أن السيرفر لم يكن جاهزاً بعد، فسطر السجل قال لاحقاً startup time: 7440ms address=0.0.0.0:8181، أي أن أول تشغيل استغرق أكثر من سبع ثوان، وفي التشغيلات التالية 817 ملي ثانية فقط. فإذا كتبت سكربت إعداد فانتظر هذا السطر أو انتظر نجاح طلب صحة قبل أي أمر. وبعد ثوان نجح الأمر:
New token created successfully!
Token: apiv3_XSyC9U4uco...
HTTP Requests Header: Authorization: Bearer apiv3_XSyC9U4uco...
IMPORTANT: Store this token securely, as it will not be shown again.
والتوكن يظهر مرة واحدة فقط، ولا يوجد طريقة لاسترجاعه، فاحفظه مباشرة في مدير الأسرار، وقد قصرناه هنا في النص لأنه سر. ثم أنشأنا قاعدة البيانات بمدة احتفاظ 90 يوماً، أي أطول من فترة بقاء أي شحنة في المستودع:
docker exec iot-influx influxdb3 create database coldstore --retention-period 90d --token "$INFLUX_TOKEN"
docker exec iot-influx influxdb3 show databases --token "$INFLUX_TOKEN"
Database "coldstore" created successfully
+---------------+
| iox::database |
+---------------+
| _internal |
| coldstore |
+---------------+ومدة الاحتفاظ قرار عمل وليس قراراً تقنياً: كم تحتاج أن تثبت لعميل أو لجهة رقابية حرارة البضاعة بعد أن تخرج؟ فإذا كانت الإجابة سنة فالـ 90 يوماً هنا خطأ سوف تكتشفه عندما يطلب أحد التقرير. وسجل السيرفر يقول إن مهمة الحذف تعمل كل 1800 ثانية، فلا تتوقع أن تختفي القراءات في اللحظة نفسها التي تتجاوز فيها المدة.
تشغيل الخط كاملاً في المختبر Lab
بقية الخدمات في ملف compose.yaml واحد، والأجهزة هي نفسها من المقال الأول، والتوكن في ملف .env بجانب الملف لا يرفع إلى Git:
# Dashboards lab: the cold-room devices from the first post -> Mosquitto -> Node-RED -> InfluxDB 3 Core -> Grafana.
name: iot-dash
services:
  iot-dash-mq:
    image: eclipse-mosquitto:2.1.2-alpine
    container_name: iot-dash-mq
    volumes: [ "./mosquitto.conf:/mosquitto/config/mosquitto.conf:ro", "iot-dash-mq-data:/mosquitto/data" ]
  iot-dev1:
    image: iot-py:1
    container_name: iot-dev1
    command: python -u device.py
    environment: { DEVICE: room1-temp, BROKER: iot-dash-mq }
  iot-dev2:
    image: iot-py:1
    container_name: iot-dev2
    command: python -u device.py
    environment: { DEVICE: room2-temp, BROKER: iot-dash-mq }
  iot-gw:
    image: iot-py:1
    container_name: iot-gateway
    command: python -u gateway.py
    environment: { BROKER: iot-dash-mq }
  iot-door:
    image: iot-py:1
    container_name: iot-door
    command: python -u door_sensor.py
  iot-nodered:
    image: nodered/node-red:5.0.9
    container_name: iot-nodered
    environment: { INFLUX_TOKEN: "${INFLUX_TOKEN}", RETRY: "${RETRY:-0}", TZ: Asia/Riyadh }
    volumes: [ "./nodered:/data" ]
    ports: [ "127.0.0.1:11880:1880" ]
  iot-grafana:
    image: grafana/grafana:13.3.0
    container_name: iot-grafana
    environment:
      INFLUX_TOKEN: "${INFLUX_TOKEN}"
      GF_SECURITY_ADMIN_PASSWORD: "Lab-Grafana-Pass-2026"
      GF_USERS_DEFAULT_THEME: light
    volumes: [ "./grafana/provisioning:/etc/grafana/provisioning:ro", "./grafana/dashboards:/var/lib/grafana/dashboards:ro" ]
    ports: [ "127.0.0.1:13000:3000" ]
volumes:
  iot-dash-mq-data: {}
networks:
  default: { name: iot-dash-net, external: true }
ولاحظ المتغير RETRY، فهو الذي سوف نغيره في التجربة لنقارن بين نسختين من الخط، وقيمته الافتراضية 0. وبعد التشغيل بدقيقة استعلمنا من InfluxDB بلغة SQL مباشرة:
docker exec iot-influx influxdb3 query --database coldstore --token "$INFLUX_TOKEN" \
  "SELECT device, count(*) AS n, max(seq) AS last_seq, avg(lag_ms) AS avg_lag FROM reading GROUP BY device ORDER BY device"
+------------+----+----------+--------------------+
| device | n | last_seq | avg_lag |
+------------+----+----------+--------------------+
| room1-door | 2 | 2 | 1.5 |
| room1-temp | 17 | 17 | 1187.0588235294117 |
| room2-temp | 17 | 17 | 1179.8235294117646 |
+------------+----+----------+--------------------+وفي المخرج لاحظ أن عدد القراءات يساوي آخر رقم تسلسلي لكل جهاز، أي لا يوجد فقد، وأن متوسط التأخير قرابة 1.2 ثانية، رغم أن آخر القراءات تأخيرها ملي ثانية أو اثنتان. والسبب أن أول قراءتين أو ثلاث خزنها الجهاز قبل أن يتصل بالوسيط، فوصلت متأخرة، كما رأينا في المقال الأول، وهي ترفع المتوسط، ولهذا تنظر دائماً إلى التوزيع وأكبر قيمة وليس إلى المتوسط وحده.
Grafana: مصدر البيانات Data Source، ثم لوحة ككود
InfluxDB 3 يقبل الاستعلام بلغتين: SQL، وInfluxQL وهي لغة الأجيال السابقة من InfluxDB. ويشرح دليل ربطه بـ Grafana الفرق المهم بينهما: استعلامات SQL تمر ببروتوكول Flight SQL فوق gRPC ويحتاج HTTP/2، فإذا كان بين Grafana وقاعدة البيانات Reverse Proxy لا يدعم HTTP/2 فلن تعمل، أما InfluxQL فتعمل على HTTP/1.1 العادي، وفيها يكون اسم المستخدم أي قيمة غير فارغة وكلمة المرور هي التوكن. واخترنا InfluxQL لأنها أبسط في التهيئة بالملفات Provisioning وتعمل من خلف أي Proxy، وملف مصدر البيانات:
# InfluxDB 3 Core through InfluxQL over HTTP: user can be any non-empty value, the password is the token.
apiVersion: 1
datasources:
  - name: InfluxDB coldstore
    uid: influx-coldstore
    type: influxdb
    access: proxy
    url: http://iot-influx:8181
    user: grafana
    jsonData:
      dbName: coldstore
      httpMode: POST
    secureJsonData:
      password: ${INFLUX_TOKEN}
    isDefault: true
وقبل أن نضعه في Grafana جربنا الاستعلام نفسه بـ curl، بالطريقة التي سوف يرسلها Grafana:
curl -s -u "grafana:$INFLUX_TOKEN" -X POST "http://iot-influx:8181/query" --data-urlencode "db=coldstore" \
  --data-urlencode 'q=SELECT mean("temp_c") FROM "reading" WHERE "device" =~ /temp/ AND time > now() - 2m GROUP BY time(30s), "device" fill(null)'
{"results":[{"statement_id":0,"series":[{"name":"reading","tags":{"device":"room1-temp"},"columns":["time","mean"],
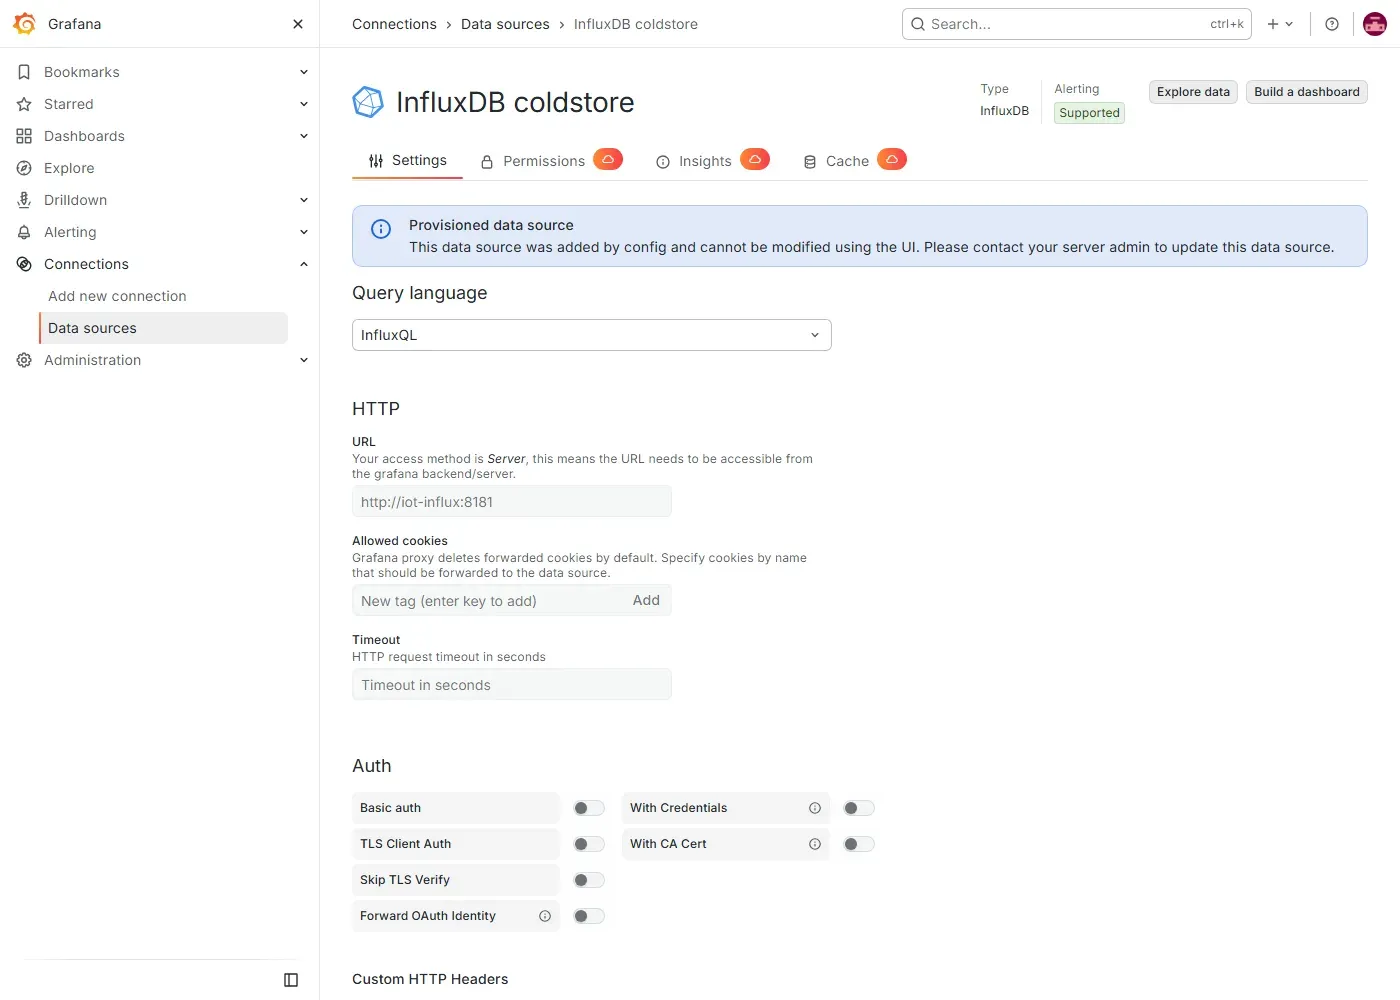
"values":[["2026-11-06T01:16:30Z",null],["2026-11-06T01:17:00Z",null],["2026-11-06T01:17:30Z",3.905],["2026-11-06T01:18:00Z",3.6719999999999997],...والقيم null في أول فترتين صحيحة، فالأجهزة لم تكن بدأت بعد، وهذه القيم الفارغة نفسها هي التي سوف تسبب لنا المشكلة الأولى في الرسم. وصفحة مصدر البيانات في Grafana تقول إنه أضيف من ملف ولا يمكن تعديله من الواجهة، وهذا ما نريده، فكل تغيير يمر بالملف وبمراجعة Git:
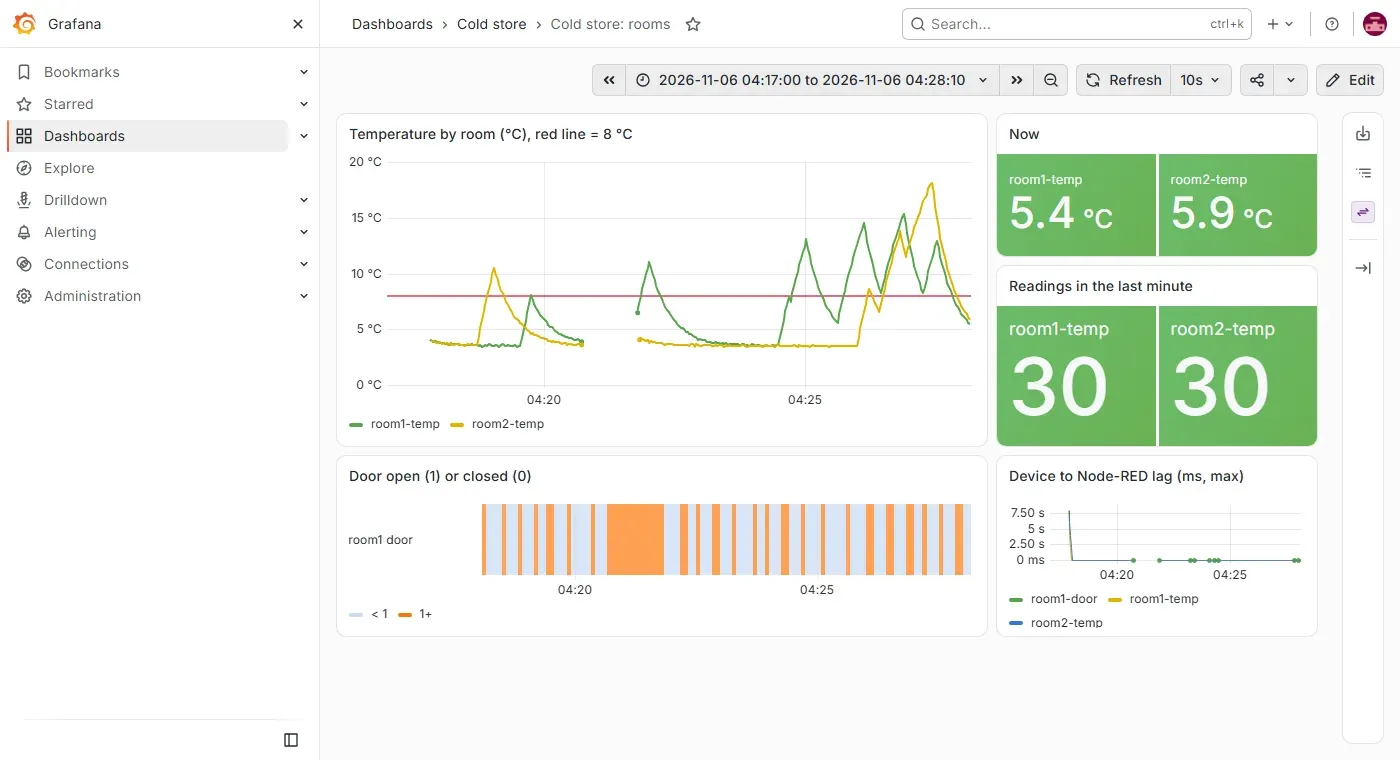
واللوحة نفسها ملف JSON في المجلد grafana/dashboards، فيه خمس لوحات فرعية Panels: الحرارة لكل غرفة مع خط أحمر عند 8 درجات، والقيمة الحالية لكل غرفة، وعدد القراءات في آخر دقيقة، وحالة الباب على خط زمني، والتأخير من الجهاز إلى Node-RED. وهذا جزء من لوحة الحرارة:
{
 "type": "timeseries",
 "title": "Temperature by room (°C), red line = 8 °C",
 "targets": [{ "rawQuery": true, "alias": "$tag_device",
   "query": "SELECT mean(\"temp_c\") FROM \"reading\" WHERE \"device\" =~ /temp/ AND $timeFilter GROUP BY time($__interval), \"device\" fill(null)" }],
 "fieldConfig": { "defaults": { "unit": "celsius", "min": 0,
   "custom": { "thresholdsStyle": { "mode": "line" }, "spanNulls": 10000, "lineWidth": 2 },
   "thresholds": { "mode": "absolute", "steps": [ { "color": "green", "value": null }, { "color": "red", "value": 8 } ] } } }
}
ولاحظ أن اللوحة ككود لها فائدة تتجاوز الترتيب: عندما يسألك أحد بعد شهر «لماذا تغير لون الغرفة الثانية في اللوحة؟» تجد الإجابة في سجل Git، من غير الحد من 8 إلى 7 ومتى ولماذا، وعندما تفتح مستودعاً جديداً تنسخ الملف وتغير اسم الموقع فقط. وبالطريقة نفسها التي شرحناها في مقال Prometheus، اجعل كل تعديل على اللوحة يمر بمراجعة كأي تعديل على الكود، لأن اللوحة التي يعتمد عليها عامل المستودع لا تقل أهمية عن البرنامج الذي يحفظ القراءات.
ثلاث مشاكل في الرسم Rendering Problems
عندما فتحنا اللوحة أول مرة ظهرت الحرارة نقاطاً متفرقة وليس خطاً. والسبب في GROUP BY time($__interval): Grafana يختار طول الفترة $__interval بحسب عرض اللوحة والمدة المعروضة، وفي آخر 15 دقيقة كانت الفترة أقصر من ثانيتين، أي أقصر من المسافة بين القراءات، فأغلب الفترات فارغة null، وGrafana لا يصل بين نقطتين بينهما قيمة فارغة. والحل الخيار spanNulls بقيمة 10000، أي صل النقاط إذا كانت المسافة بينها أقل من 10 ثوان، واترك فجوة إذا زادت. ولاحظ أننا لم نختر true الذي يصل كل شيء، لأن الفجوة الحقيقية يجب أن تظهر، فهي التي سوف تكشف التوقف في التجربة.
والمشكلة الثانية كانت في لوحة «عدد القراءات في آخر دقيقة»، فقد ظهر حساس الباب بالأحمر وعدد 6، والسبب أن الألوان مضبوطة على أن 25 قراءة في الدقيقة هي الطبيعي، وهذا صحيح لجهاز الحرارة الذي يرسل كل ثانيتين، أما الباب فيرسل عند كل فتح وإغلاق فقط. فقصرنا اللوحة على أجهزة الحرارة، والدرس أن «الطبيعي» يختلف من نوع جهاز لآخر، ولوحة واحدة بحد واحد لكل الأجهزة تعطي إنذارات كاذبة.
والمشكلة الثالثة لم نلاحظها إلا بعد التجربة: لوحة الباب تستخدم fill(previous) حتى يظهر الباب مفتوحاً طوال المدة بين رسالة الفتح ورسالة الإغلاق، وهذا صحيح عندما تصل الرسائل، ولكن أثناء توقف قاعدة البيانات لم تحفظ رسالة الإغلاق، فرسمت اللوحة الباب مفتوحاً دقيقة كاملة لم يحدث فيها ذلك. أي أن ملء الفراغ بالقيمة السابقة يخفي التوقف ويصنع حدثاً لم يقع، فإذا استخدمته فضع بجانبه لوحة تبين عدد القراءات، حتى يعرف من يقرأ أن الفترة ليس فيها بيانات أصلاً.
والصورة التالية اللوحة كاملة بعد التجارب التي سوف نشرحها الآن:
ماذا يحدث إذا توقفت قاعدة البيانات؟ تجربة What If
في المقال الأول رأينا أن غياب خدمة الاستقبال أخطر من غياب الوسيط، والآن نسأل السؤال نفسه عن قاعدة البيانات: ماذا يحدث إذا توقفت InfluxDB دقيقة لتحديث أو عطل؟ والإجابة تعتمد على شيء واحد في Node-RED: ماذا تفعل عقدة النتيجة عندما لا ينجح الحفظ. وهذه العقدة في التدفق:
// 204 = stored. Anything else: count it, and retry later if RETRY=1 (the second version of the flow)
const stats = flow.get('stats') || { ok: 0, failed: 0, retried: 0, dropped: 0 };
if (msg.statusCode === 204) { stats.ok++; flow.set('stats', stats); node.status({ fill: 'green', shape: 'dot', text: `ok ${stats.ok} failed ${stats.failed} dropped ${stats.dropped}` }); return [null, null]; }
stats.failed++;
// retry only what can succeed later: no answer (network, DNS) or a server error; a 4xx line will fail forever
const retryable = !msg.statusCode || msg.statusCode >= 500;
if (env.get('RETRY') === '1' && retryable && msg.attempt < 60) {
    stats.retried++; msg.attempt++; msg.payload = msg.line;          // the request node replaced payload with the error
    flow.set('stats', stats);
    node.status({ fill: 'yellow', shape: 'ring', text: `retrying, failed ${stats.failed}` });
    return [msg, null];
}
stats.dropped++; flow.set('stats', stats);
node.status({ fill: 'red', shape: 'ring', text: `dropped ${stats.dropped}` });
return [null, { payload: `dropped after ${msg.attempt} retries: ${msg.statusCode || msg.error} ${msg.line}` }];
وهذه هي النسخة الأخيرة بعد إصلاحين، وسطر retryable لم يكن موجوداً في النسختين الأوليين كما سيأتي. والمخرج الأول للعقدة يذهب إلى عقدة delay تنتظر 5 ثوان ثم تعيد الرسالة إلى عقدة الكتابة، والمخرج الثاني إلى سجل التصحيح Debug. وتحفظ العقدة عداداتها في سياق التدفق Flow Context، وهو ذاكرة يشترك فيها كل عقد التدفق كما يشرح دليل السياق.
النسخة الأولى: دون إعادة محاولة Retry
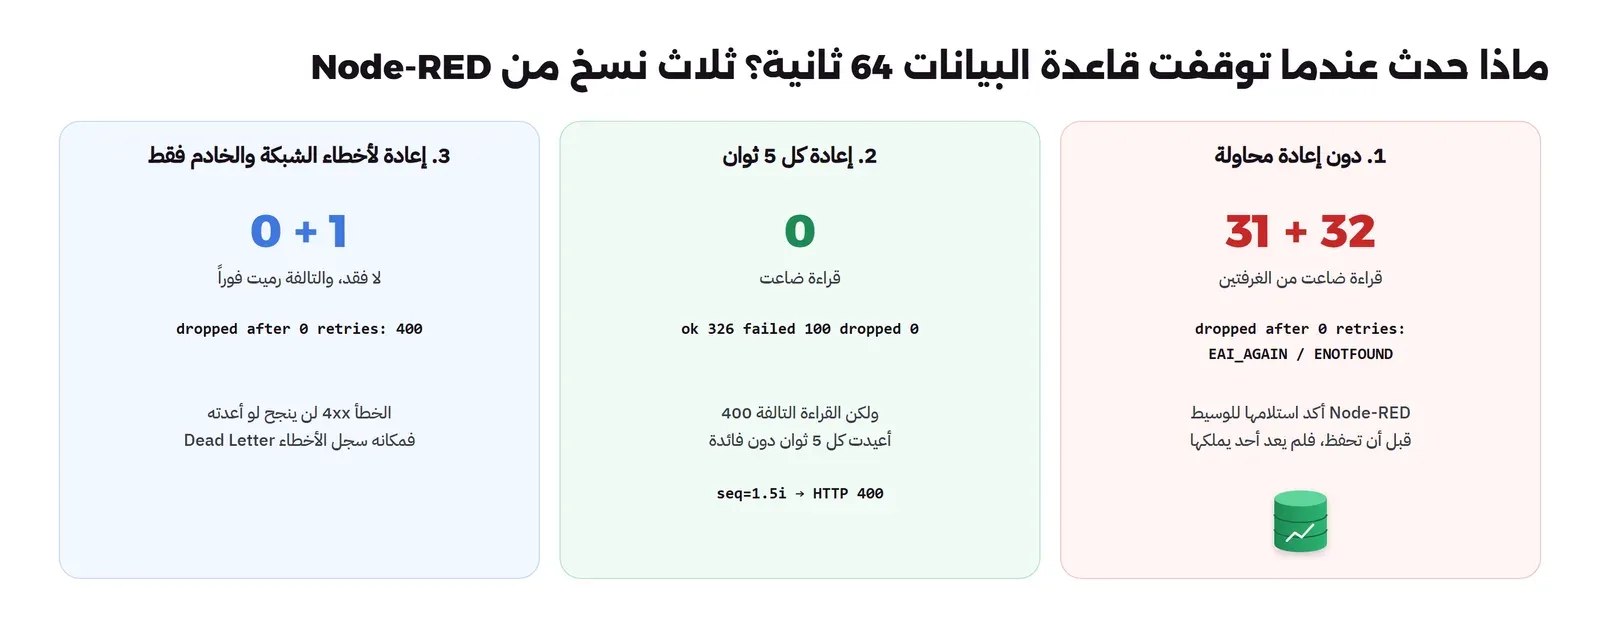
أوقفنا InfluxDB 64 ثانية والمتغير RETRY=0:
docker stop iot-influx     # 01:20:43 UTC
docker start iot-influx    # 01:21:47 UTC
وفي سجل Node-RED ظهر سطر لكل قراءة ضاعت، هذا أولها وآخرها:
6 Nov 04:20:50 - [info] [debug:dropped] dropped after 0 retries: EAI_AGAIN reading,site=store1,device=room2-temp temp_c=3.61,hum_pct=79.1,door_open=0i,seq=88i,lag_ms=4i 1793928045127
6 Nov 04:21:47 - [info] [debug:dropped] dropped after 0 retries: ENOTFOUND reading,site=store1,device=room2-temp temp_c=6.49,hum_pct=81.9,door_open=0i,seq=102i,lag_ms=1i 1793928073132
ثم بحثنا عن الفجوات في الأرقام التسلسلية بسكربت صغير يقرأ من InfluxDB:
room1-temp stored 49 from 52 to 131 missing 31 gaps [(88, 120)]
room2-temp stored 48 from 51 to 130 missing 32 gaps [(87, 120)]
وفي المخرج لاحظ التالي:
- ضاعت 31 قراءة من الغرفة الأولى و32 من الثانية، أي كل ما قاسته الأجهزة في الدقيقة، والفجوة نفسها تظهر في رسم الحرارة في اللوحة.
- الخطأ لم يكن «الاتصال مرفوض» كما قد تتوقع، وإنما
EAI_AGAINثمENOTFOUND، أي فشل في معرفة عنوان الاسمiot-influx، لأن Docker يحذف اسم الـ Container المتوقف من خدمة الأسماء في الشبكة. فإذا رأيت هذين الخطأين في نظام يعمل في Docker فأول سؤال: هل الخدمة الأخرى تعمل أصلاً؟ - والأهم أن الأجهزة والوسيط لم يفعلا أي شيء خاطئ: Node-RED استلم كل قراءة بـ QoS 1 وأكد استلامها للوسيط، فحذفها الوسيط من عنده، ثم فشل Node-RED في حفظها ورماها. أي أن التأكيد حدث قبل أن تكون القراءة في أمان، وبعد التأكيد لم يعد أحد في الخط يملك نسخة منها.
النسخة الثانية: إعادة المحاولة Retry كل 5 ثوان
أعدنا إنشاء Node-RED مع RETRY=1، وكررنا التوقف 64 ثانية:
RETRY=1 docker compose up -d iot-nodered
docker stop iot-influx     # 01:22:50 UTC
docker start iot-influx    # 01:23:54 UTC
room1-temp stored 44 from 147 to 190 missing 0 gaps []
room2-temp stored 45 from 146 to 190 missing 0 gaps []لا يوجد أي فقد، وحالة العقدة في المحرر بعد التجربة كانت ok 326 failed 100 dropped 0، أي 100 محاولة فشلت ثم نجحت إعادتها. ولاحظ أن الرسم في اللوحة لا يظهر فيه أي فجوة، لأن القراءات المتأخرة حفظت بأوقاتها الأصلية من الجهاز، ولكن أقصى lag_ms في هذه الفترة كان 108 ملي ثانية فقط، لأنه يقيس الوصول إلى Node-RED وليس الحفظ، أما القراءة الأقدم فبقيت قرابة دقيقة في حلقة الانتظار. فإذا أردت أن تعرف التأخير الحقيقي حتى الحفظ فاحسبه في عقدة النتيجة بعد 204، وهذا تحسين نتركه للتدريب.
ولكن هذه النسخة فيها مشكلة لا تظهر في التوقف. فقد أرسلنا قراءة واحدة تالفة، رقمها التسلسلي 1.5 بدل رقم صحيح، كما قد يرسلها جهاز فيه خطأ برمجي:
mosquitto_pub -h iot-dash-mq -q 1 -t coldstore/store1/test-dev/telemetry -m '{"seq":1.5,"ts":1793928778000,"temp_c":4.0}'فمرت من التحقق في دالة التحويل، لأن 1.5 رقم، وأصبحت seq=1.5i في السطر، فرفضتها InfluxDB بالرمز 400. وبعد 45 ثانية كان عداد الفشل قد ارتفع من 100 إلى 109، ثم إلى 115 بعد 20 ثانية أخرى:
{"ok":617,"failed":109,"retried":109,"dropped":0}
{"ok":650,"failed":115,"retried":115,"dropped":0}
أي أن الخط كان يعيد إرسال القراءة نفسها كل 5 ثوان، وكان سيستمر 60 مرة، خمس دقائق، دون أي فرصة للنجاح، لأن السطر نفسه خاطئ. وهذه هي الرسالة السامة Poison Message: رسالة لا يمكن معالجتها أبداً، وإعادتها تستهلك الموارد، وفي أنظمة كثيرة توقف الطابور كله خلفها.
النسخة الثالثة: إعادة لأخطاء الشبكة Network والخادم 5xx فقط
والحل السطر الذي رأيته في الكود: أعد المحاولة فقط إذا لم يصل رد أصلاً، أي خطأ شبكة أو اسم، أو إذا كان الرد 500 أو أكثر، وهو خطأ في السيرفر قد يزول، أما 400 و401 فلن ينجحا لو أعدتهما ألف مرة. وبعد التعديل أرسلنا القراءة التالفة نفسها:
6 Nov 04:32:59 - [info] [debug:dropped] dropped after 0 retries: 400 reading,site=store1,device=test-dev temp_c=4,seq=1.5i,lag_ms=1515i 1793928778000
{"ok":28,"failed":1,"retried":0,"dropped":1}
فرميت فوراً وسجلت في سجل التصحيح بسببها. وفي نظام حقيقي لا ترميها في السجل فقط، وإنما في مكان تحفظ فيه الرسائل المرفوضة، يسمى عادة طابور الرسائل الميتة Dead Letter Queue، موضوع MQTT خاص أو جدول، حتى يراجعها أحد ويصلح الجهاز. ولاحظ أن التحقق في دالة التحويل كان يجب أن يكتشفها من البداية بالشرط Number.isInteger(r.seq)، فالتحقق المبكر أرخص من أي إعادة. والصورة التالية تلخص النسخ الثلاث:
وتذكر حداً مهماً لهذا الحل: طابور إعادة المحاولة في ذاكرة Node-RED، فإذا أعيد تشغيل Node-RED نفسه أثناء توقف قاعدة البيانات ضاع ما في الحلقة، وقد حدث هذا فعلاً في المختبر عندما أعدنا إنشاء Node-RED أثناء تجربة الرسالة السامة. فإذا كانت كل قراءة مهمة فالحل الأمتن أن تكتب القراءة أولاً في تخزين دائم محلي، ملف أو قاعدة صغيرة أو طابور، ثم ترسلها منه، أو تترك الوسيط نفسه يحتفظ بالرسائل في جلسة دائمة، ولا تؤكد الاستلام إلا بعد الحفظ.
أخطاء الكتابة Write Errors: كيف تقرأ رد InfluxDB
لأن الخط كله يعتمد على رد عقدة الكتابة، جربنا الأخطاء الثلاثة الأشهر مباشرة بـ curl، والرد في كل مرة واضح:
== bad token
{"error": "the request was not authenticated"} HTTP 401
== bad line
{"error":"partial write of line protocol occurred","data":[{"error_message":"Could not parse entire line. Found trailing content: `our 179392...`","line_number":1,"original_line":"reading,site=store1,"}]} HTTP 400
== type conflict
{"error":"partial write of line protocol occurred","data":[{"error_message":"invalid column type for column 'seq', expected iox::column_type::field::integer, got iox::column_type::field::float","line_number":1,"original_line":"reading,site=store1,"}]} HTTP 400
وفي المخرج لاحظ التالي:
- التوكن الخاطئ يعطي 401، وهذا خطأ إعداد، لا ينفع معه إعادة المحاولة، ويجب أن ينبهك فوراً.
- السطر غير الصحيح، وهنا
temp_c=four، يعطي 400 مع رقم السطر وسبب الفشل، و«partial write» يعني أن الدفعة تقبل بقية الأسطر الصحيحة، لأن الخيارaccept_partialقيمته الافتراضية true بحسب صفحة الكتابة. - والخطأ الثالث هو الأخطر في إنترنت الأشياء: أول قراءة حفظت العمود
seqكعدد صحيح، فأصبح هذا نوعه إلى الأبد، وأي قراءة بعدها فيها عدد عشري ترفض. فإذا حدث جهاز ما بإصدار جديد يرسل الحرارة20بدل20.0في مكتبة تكتب الأعداد الصحيحة بحرفi، فقد يرفض كل ما يرسله. ولذلك اكتب الأنواع في مكان واحد، دالة التحويل، ولا تتركها لما يرسله كل جهاز.
التقارير Reports: كم دقيقة كانت الغرفة فوق 8 درجات؟
نعود إلى طلب المدير الذي بدأنا به: تقرير للعميل عن حرارة شحنته. واللوحة لا تجيب على هذا السؤال، لأنها ترسم، والتقرير يحتاج أرقاماً: كم دقيقة كانت الغرفة فوق الحد في كل يوم، ومتى بالضبط، وما أعلى حرارة. ولكي نجرب الاستعلامات على بيانات أطول من دقائق المختبر، كتبنا سكربت صغيراً يولد بيانات تجريبية Sample Data لأسبوع كامل من 30 أكتوبر إلى 5 نوفمبر، قراءة كل دقيقة لكل غرفة، مع فتح أبواب عشوائي في ساعات الدوام بتوقيت السعودية، وعطل في ضاغط الغرفة الثانية مدته 95 دقيقة فجر 2 نوفمبر، ثم كتبها في InfluxDB بالواجهة نفسها write_lp على دفعات من 5000 سطر. والسكربت في ملفات المختبر gen_sample_week.py، والأرقام التالية مخرجه الحقيقي، ولكنها بيانات مولدة وليست من مستودع حقيقي:
204 204 204 204 204 20160 linesأي خمس دفعات، رد السيرفر على كل منها بـ 204، ومجموعها 20160 قراءة، وهو بالضبط سبعة أيام في 1440 دقيقة في غرفتين. والسؤال الأول: كم دقيقة فوق 8 درجات في كل يوم، وما أعلى قيمة؟
SELECT device, date_bin(INTERVAL '1 day', time) AS day,
       count(*) FILTER (WHERE temp_c > 8) AS minutes_above_8, round(max(temp_c), 2) AS max_c
FROM reading GROUP BY device, day ORDER BY device, day
+------------+---------------------+-----------------+-------+
| device | day | minutes_above_8 | max_c |
+------------+---------------------+-----------------+-------+
| room1-temp | 2026-10-30T00:00:00 | 108 | 20.07 |
| room1-temp | 2026-11-02T00:00:00 | 132 | 19.17 |
| room2-temp | 2026-11-01T00:00:00 | 137 | 21.16 |
| room2-temp | 2026-11-02T00:00:00 | 225 | 19.41 |
| room2-temp | 2026-11-04T00:00:00 | 55 | 21.43 |
...والدالة date_bin تقسم الزمن إلى فترات ثابتة، هنا يوم، وهي من دوال SQL في InfluxDB 3. ولاحظ المشكلة في هذا الرقم: الغرفة الأولى فوق 8 درجات أكثر من 100 دقيقة في أغلب الأيام، والغرفة الثانية 225 دقيقة يوم العطل، فهل كل غرف المستودع خارج المواصفات طوال الوقت؟ والإجابة لا، فالعدد يجمع كل لحظة فتح فيها الباب، وكل فتحة ترفع الحرارة عند الحساس دقائق قليلة ثم تعود، أما ما يضر البضاعة فهو الارتفاع المستمر. والرقم الصحيح للتقرير هو الفترات المتصلة فوق الحد، وهذه مسألة معروفة في SQL باسم الجزر والفجوات Gaps and Islands، وحلها بدالتي ترتيب:
WITH s AS (SELECT device, time, temp_c > 8 AS hot FROM reading),
     g AS (SELECT device, time, hot,
                  row_number() OVER (PARTITION BY device ORDER BY time)
                - row_number() OVER (PARTITION BY device, hot ORDER BY time) AS grp FROM s)
SELECT device, min(time) AS started, max(time) AS ended, count(*) AS minutes
FROM g WHERE hot GROUP BY device, grp HAVING count(*) >= 15 ORDER BY device, started
+------------+---------------------+---------------------+---------+
| device | started | ended | minutes |
+------------+---------------------+---------------------+---------+
| room1-temp | 2026-11-01T09:31:00 | 2026-11-01T09:46:00 | 16 |
| room1-temp | 2026-11-01T14:47:00 | 2026-11-01T15:01:00 | 15 |
| room2-temp | 2026-10-30T08:47:00 | 2026-10-30T09:09:00 | 23 |
| room2-temp | 2026-11-01T08:19:00 | 2026-11-01T08:35:00 | 17 |
| room2-temp | 2026-11-02T01:20:00 | 2026-11-02T02:46:00 | 87 |
+------------+---------------------+---------------------+---------+والفكرة في الاستعلام أن الفرق بين ترتيب القراءة بين كل القراءات وترتيبها بين القراءات المماثلة لها، حارة أو باردة، يبقى ثابتاً طوال كل فترة متصلة، فيصبح رقماً يميز الفترة. ثم نأخذ الفترات الحارة التي طولها 15 دقيقة أو أكثر. والنتيجة تقول القصة كما هي: فترة واحدة طويلة 87 دقيقة في الغرفة الثانية من 01:20 إلى 02:46 بتوقيت UTC، أي من 04:20 إلى 05:46 فجراً بتوقيت السعودية، وهذا هو عطل الضاغط الذي وضعناه في البيانات، وأربع فترات بين 15 و23 دقيقة في ساعات الدوام، وهي في بياناتنا أبواب فتحت مدة أطول من المعتاد. ولاحظ أن العطل بدأ في البيانات 01:10، ولم تتجاوز الحرارة 8 درجات إلا في 01:20، فالتقرير يقيس أثر العطل على الغرفة وليس العطل نفسه، ولمعرفة لحظة العطل تحتاج قياساً من الضاغط نفسه. ثم ملخص الأسبوع بالاستعلام نفسه مع تجميع إضافي:
+------------+------------+-------------+---------+
| device     | excursions | longest_min | avg_min |
+------------+------------+-------------+---------+
| room1-temp | 148        | 16          | 4.7     |
| room2-temp | 166        | 87          | 5.5     |
+------------+------------+-------------+---------+
أي أن الغرفة الأولى تجاوزت 8 درجات 148 مرة في الأسبوع، متوسط كل مرة أقل من خمس دقائق وأطولها 16 دقيقة، وهذا رقم يناقش مع فريق التحميل وليس مع فني التبريد. وهذا ما نعنيه بأن التقرير يحتاج قراراً قبل الاستعلام: ما الذي يعتبر خروجاً عن المواصفات؟ تجاوز لحظي؟ أم 15 دقيقة متصلة؟ أم متوسط ساعة؟ والإجابة يجب أن تأتي من المواصفات التي اتفقت عليها الشركة مع عملائها، وليس من المبرمج. وأخيراً، الاستعلام بلغة InfluxQL أقصر للحالات البسيطة، فمتوسط كل نصف ساعة يكون:
influxdb3 query --database coldstore --language influxql \
  "SELECT mean(temp_c), max(temp_c) FROM reading WHERE device = 'room2-temp' AND time >= '2026-11-02T00:00:00Z' AND time < '2026-11-02T04:00:00Z' GROUP BY time(30m)"
| reading | 2026-11-02T01:00:00 | 6.225333333333333 | 10.21 |
| reading | 2026-11-02T01:30:00 | 12.136333333333333 | 13.15 |
| reading | 2026-11-02T02:00:00 | 13.605 | 13.86 |
| reading | 2026-11-02T02:30:00 | 9.708333333333334 | 13.99 |ولكن لاحظ كيف يخفي المتوسط القصة: فترة 01:00 متوسطها 6.2 درجة، أي داخل الحد، وأعلى قيمة فيها 10.21. فإذا أعطيت العميل متوسطات نصف ساعة فقط فقد أخفيت عنه دقائق فوق الحد، ولذلك التقرير الصادق فيه الفترات المتصلة وأعلى قيمة بجانب المتوسط.
عدة مستودعات Multi-site: الوسوم، وأين يعيش الخط
عندما يفتح المستودع الثاني تتكرر الأسئلة نفسها على مستوى أكبر. أين تعمل قاعدة البيانات؟ والخيار الأبسط سيرفر مركزي واحد، وفي كل مستودع وسيط صغير يربط بجسر Bridge بالوسيط المركزي كما ذكرنا في مقال MQTT، فإذا انقطع الإنترنت عن المستودع بقيت القراءات في طابور الجسر حتى يعود، وبقيت الأتمتة المحلية تعمل. والوسم site الذي أخذناه من اسم الموضوع هو الذي يفصل المستودعات في الاستعلامات واللوحات، فتضيف إلى Grafana متغيراً Variable للموقع، فتصبح اللوحة نفسها لكل المستودعات، ويختار المشاهد المستودع من قائمة. وهذا سبب آخر لتصميم أسماء المواضيع بعناية من اليوم الأول، فأي معلومة ليست في الموضوع أو في الرسالة لن تجدها في قاعدة البيانات.
وتذكر أن عدد السلاسل يكبر مع عدد الأجهزة وليس مع عدد القراءات، فمئة جهاز بوسمين ثابتين مئة سلسلة، وهذا رقم صغير، أما إذا وضعت في الوسوم شيئاً يتغير باستمرار، مثل رقم الشحنة أو اسم العامل الذي فتح الباب، فكل قيمة جديدة سلسلة جديدة، وهذه مشكلة كثرة القيم Cardinality التي شرحناها في مقال Prometheus. ورقم الشحنة مكانه جدول آخر يربط الشحنة بالغرفة وبفترة وجودها فيها، ثم يجمع التقرير بين الجدولين بالوقت.
تصميم اللوحة للمستودع Dashboard Design
اللوحة التي على الحائط في المستودع يقرؤها عامل يمر أمامها، وليس مهندساً جالساً أمامها، ولذلك ترتيبها يختلف عن لوحة السيرفرات. والأسئلة التي يجب أن تجيب عليها في ثانيتين بالترتيب: هل كل الغرف بخير الآن؟ ولذلك أكبر لوحة فرعية هي القيمة الحالية بلون أخضر أو برتقالي أو أحمر. ثم هل الأرقام حديثة؟ ولذلك لوحة عدد القراءات في آخر دقيقة بجانبها، فالرقم الأخضر القديم أخطر من الرقم الأحمر الحديث. ثم ماذا حدث في الساعات الماضية؟ ولذلك الرسم مع خط الحد. ثم لماذا؟ ولذلك الباب على خط زمني تحت الرسم مباشرة، حتى يرى أي أحد أن كل ارتفاع بدأ مع فتح الباب، كما في اللوحة أعلاه.
أما لوحة الفريق التقني فتضيف ما يهمه: التأخير، وعدد القراءات المرفوضة والمعادة، وحالة كل جهاز وبطاريته، وهذه مكانها لوحة ثانية وليس الشاشة نفسها. وفي الحالتين لا تجعل اللوحة هي التنبيه، فلا أحد ينظر إلى الحائط في الثالثة فجراً، وقد شرحنا كيف تبني التنبيهات وماذا يستحق أن يوقظ أحداً في مقال التنبيهات. وفي التدفق أضفنا مثالاً لتنبيه يعتمد على الأحداث وليس على القيم، وهو مؤقت الباب: عقدة trigger تبدأ العد عند فتح الباب وتلغيه عند إغلاقه، فإذا مرت المدة نشرت رسالة على موضوع .../alert، وسجل Node-RED أظهر أكثر من تنبيه «door open too long» في المختبر لأننا جعلنا المدة 8 ثوان فقط حتى نراه. وهذا النوع من المنطق، «حدث بدأ ولم ينته خلال مدة»، أسهل بكثير في Node-RED منه في استعلام على قاعدة البيانات.
حدود Node-RED Limits: متى تكتب خدمة بدلها؟
Node-RED كان مناسباً في قصتنا، ولكن من المهم أن تعرف متى يصبح العبء أكبر من الفائدة. والإشارة الأولى أن تجد نفسك تكتب أغلب المنطق داخل عقد function، فالتدفق عندها لم يعد صورة للمنطق وإنما صندوق فيه كود JavaScript بلا اختبارات، ولا يظهر الفرق بين نسختين منه إلا كنص داخل ملف JSON كبير. وقد رأيت هذا في المختبر نفسه: أهم قرار في الخط كله، أي خطأ يعاد وأي خطأ يرمى، سطر واحد داخل عقدة، ولم يكن هناك اختبار يكشف أن النسخة الثانية تعيد الخطأ 400 إلى الأبد، وإنما كشفته الرسالة السامة. فإذا أصبح المنطق بهذه الأهمية فاكتب له اختبارات، وهذا أسهل في خدمة صغيرة بلغة تعرفها منه في عقدة.
والإشارة الثانية الحجم. فالتدفق هنا يكتب كل قراءة في طلب HTTP مستقل، وهذا لا يهم مع ثلاثة أجهزة ترسل كل ثانيتين، ولكن مع مئات الأجهزة يصبح عدد الطلبات كبيراً، والحل المعتاد أن تجمع القراءات على دفعات، كل ثانية أو كل 500 قراءة، وهذا ممكن في Node-RED بعقدة تجميع، ولكن إعادة المحاولة مع الدفعات وترتيبها والتعامل مع الكتابة الجزئية «partial write» التي رأيناها تصبح منطقاً معقداً. والإشارة الثالثة أن كل ما في ذاكرة Node-RED يضيع عند إعادة تشغيله، كما رأينا في حلقة إعادة المحاولة.
وقد يتساءل البعض: إذن لماذا لا نبدأ بخدمة من اليوم الأول؟ والإجابة أن Node-RED يعطيك شيئاً لا تعطيه الخدمة بسهولة: يرى الفريق المنطق ويغيره في دقائق، ويرى الرسائل وهي تمر في سجل التصحيح، ويضيف مؤقتاً أو تنبيهاً دون نشر جديد، وهذا مهم جداً في الأشهر الأولى من مشروع ما زال يتعلم ماذا يحتاج. والطريقة العملية التي نراها أنسب: ابدأ بـ Node-RED للاستقبال والتحويل ومنطق الأحداث، واجعل الحفظ نفسه في أبسط شكل ممكن، ثم عندما يستقر الشكل ويكبر الحجم انقل الحفظ إلى خدمة أو أداة جمع تكتب على دفعات ومن تخزين دائم، واترك لـ Node-RED المنطق الذي يتغير، مثل مؤقتات الأبواب وقواعد التنبيه الخاصة بكل مستودع.
الأمان Security في هذا الخط
- محرر Node-RED مفتوح افتراضياً: من يصل إلى المنفذ 1880 يستطيع أن يغير التدفق ويكتب كود JavaScript يعمل على السيرفر، ويشرح دليل تأمين Node-RED كيف تضع له مستخدمين بالخيار
adminAuth. ولذلك نشرناه على127.0.0.1فقط في المختبر، وفي الإنتاج ضع له دخولاً وTLS ولا تفتحه للشبكة كلها. - التوكن: توكن المدير الذي أنشأناه يصلح لكل شيء، والأفضل في الإنتاج توكن خاص لـ Node-RED يكتب فقط، وآخر لـ Grafana يقرأ فقط، وكلاهما من مدير الأسرار.
- الوسيط: Node-RED هنا مشترك في كل مواضيع التطبيق، فاجعل له مستخدماً بصلاحية قراءة فقط ما عدا موضوع التنبيه، كما فعلنا في ملف الصلاحيات في مقال MQTT.
- Grafana: لا تنشر لوحة المستودع للعامة، وإذا أردت أن يراها العميل فاصنع له لوحة خاصة بشحنته، أو صدر له تقريراً، ولا تعطه دخولاً إلى كل البيانات.
أخطاء شائعة Common Mistakes
- تأكيد الاستلام قبل الحفظ: ضاعت 63 قراءة في دقيقة رغم QoS 1 والجلسة الدائمة.
- إعادة محاولة كل خطأ: الرسالة السامة أعيدت كل 5 ثوان دون فائدة.
- ترك أنواع الحقول لما يرسله الجهاز: أول قراءة تحدد نوع العمود إلى الأبد.
spanNulls: trueأوfill(previous)دون لوحة حداثة: الأولى تخفي الفجوة، والثانية تصنع حدثاً لم يقع.- حد واحد لكل أنواع الأجهزة: حساس الباب ظهر بالأحمر لأنه لا يرسل كل ثانيتين.
- الاعتماد على المتوسط: متوسط التأخير 1.2 ثانية جاء من ثلاث قراءات قديمة فقط.
- مدة احتفاظ لم يسأل عنها أحد في الإدارة: 90 يوماً قد تكون أقل مما يطلبه العميل.
- محرر Node-RED بلا دخول على الشبكة.
قائمة تحقق Checklist قبل أن تعلق الشاشة
| البند | ما يجب أن تراه |
|---|---|
| التحقق | كل قراءة بلا وقت أو تسلسل أو بنوع خاطئ ترفض في أول عقدة |
| الأنواع | نوع كل حقل يكتب في مكان واحد، والأعداد الصحيحة بحرف i |
| الحفظ | إعادة المحاولة لأخطاء الشبكة و5xx فقط، والباقي إلى طابور الرسائل الميتة |
| إعادة تشغيل الخط | تعرف ماذا يضيع إذا أعيد تشغيل Node-RED أثناء توقف القاعدة |
| الوقت | الحفظ بوقت الجهاز، والتأخير حتى الحفظ مقاس |
| مدة الاحتفاظ | بموافقة من يطلب التقارير، وليس بالقيمة التي جاءت في المثال |
| اللوحة | القيمة الآن، والحداثة، والتاريخ مع الحد، والسبب، بهذا الترتيب |
| الفجوات | تظهر في الرسم ولا تخفى بالملء |
| الأمان | دخول لمحرر Node-RED، وتوكن كتابة وتوكن قراءة منفصلان |
| الكود | flows.json واللوحة ومصدر البيانات كلها في Git |
تدريب عملي Practice
- أضف إلى عقدة النتيجة حساب التأخير حتى الحفظ
Date.now() - tsبعد الرد 204، واكتبه في جدول ثان، ثم كرر تجربة التوقف وانظر إلى أكبر قيمة. - أضف الشرط
Number.isInteger(r.seq)إلى دالة التحويل، وأرسل الرسالة السامة مرة أخرى، وتأكد أنها لا تصل إلى قاعدة البيانات أصلاً. - أعد تشغيل Node-RED أثناء توقف InfluxDB، ثم احسب الفقد من الأرقام التسلسلية، وفسر النتيجة.
حذف المختبر Cleanup
docker compose down -v
docker rm -f iot-influx
docker volume rm iot-influx-data
docker network rm iot-dash-net
docker image rm influxdb:3.12.2-core grafana/grafana:13.3.0 nodered/node-red:5.0.9
rm -f .env
وينشئ Node-RED في مجلد nodered ملفات خاصة به، منها settings.js ومجلد node_modules وملفات إعداد مخفية، فاحذفها إذا لم تكن تريدها، واحتفظ بـ flows.json وحده في Git.
الخلاصة Summary
- قراءات الأجهزة تدفع Push بوقتها، ولذلك مكانها قاعدة سلاسل زمنية تقبل الكتابة مثل InfluxDB، أما Prometheus فيبقى لمراقبة السيرفرات والخدمات نفسها.
- Node-RED في المنتصف يتحقق ويحول ويعيد المحاولة ويشغل منطق الأحداث مثل مؤقت الباب، والتدفق ملف JSON في Git.
- InfluxDB 3 Core يقبل Line Protocol ويستعلم بـ SQL وInfluxQL، وInfluxQL أبسط مع Grafana لأنها تعمل على HTTP/1.1.
- دون إعادة محاولة ضاعت 63 قراءة في دقيقة توقف، ومع إعادة المحاولة صفر، ولكن الرسالة السامة كشفت أن الإعادة يجب أن تكون لأخطاء الشبكة والخادم فقط.
- اللوحة تقول الحقيقة فقط إذا أظهرت الفجوات وحداثة الأرقام، فلا تخف الفراغ بالملء.
 دليلتحديث الأجهزة عن بعد OTA دون أن تتعطلنرسل سبعة تحديثات إلى برنامج ESP32 حقيقي في محاكي QEMU، فنرى التوقيع ورفض الرجوع إلى نسخة أقدم والرجوع التلقائي يعمل، ونرى الخطأ الذي لا ينقذك منه إلا السلك.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلTimescaleDB وInfluxDB لبيانات السلاسل الزمنية Time-Seriesكيف تحفظ قراءات الأجهزة والمقاييس سنوات دون أن يكبر القرص بلا حد، ومتى يناسبك TimescaleDB أو InfluxDB.
 دليلالتنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟نبني مع Alertmanager تنبيهات تصل فيها المشكلة الواحدة في رسالة واحدة، والعاجل فوراً والروتيني في ملخص صباحي، ونجرب كل قرار بالثواني.
وفي المقال القادم من السلسلة بإذن الله سوف نتعامل مع أصعب لحظة في حياة الجهاز: تحديث برنامجه عن بعد، ونرسل له تحديثاً فاشلاً عن قصد.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، والتجربة على Node-RED 5.0.9 (nodered/node-red:5.0.9، Node.js 24.22.2) وInfluxDB 3 Core 3.12.2 (influxdb:3.12.2-core) وGrafana 13.3.0 (grafana/grafana:13.3.0) وMosquitto 2.1.2، مع أجهزة المقال الأول بـ paho-mqtt 2.2.0، على Docker Engine 29.8.0، والمعلومات من توثيق Node-RED وInfluxData وGrafana كما قرأناها في 6 نوفمبر 2026.