

لنفرض أن فريقك أصدر ميزة استرداد التذاكر، وكل الاختبارات في خط CI خضراء، والتغطية 100%، ثم يكتشف المحاسب بعد أسبوع أن بعض العملاء استردوا المبلغ كاملاً وهم يستحقون نصفه فقط. لم يتعطل شيء، ولم يظهر خطأ في السجلات، وكل ما حدث أن أحداً لم يسأل السؤال الصحيح قبل الإصدار: ماذا يحدث قبل الحد بدقيقة؟ وهذا هو عمل ضمان الجودة Quality Assurance، واختصاراً QA، فهو لا يعني أن تكتب اختبارات أكثر، وإنما أن تعرف ماذا تختبر ولماذا، ومتى يكون الإصدار جاهزاً، ومن يقرر ذلك.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين ضمان الجودة QA وضبط الجودة QC والاختبار Testing، ولماذا يخلط الناس بينها.
- استراتيجية الاختبار Test Strategy وخطة الاختبار Test Plan، وما الذي يكتب في كل منهما.
- تصميم حالات الاختبار Test Cases بأربع طرق: الفئات المتكافئة Equivalence Partitions والقيم الحدية Boundary Values وجدول القرار Decision Table والاختبار الاستكشافي Exploratory Testing.
- تجربة عملية على ميزة استرداد حقيقية، فيها خطأ لا يكشفه إلا اختبار القيم الحدية Boundary Values، وخطأ ثان لا يكشفه إلا جدول القرار Decision Table.
- دورة حياة الخطأ Bug Lifecycle، والفرق بين الخطورة Severity والأولوية Priority.
- الاختبار حسب المخاطر Risk-based Testing، والاختبار المبكر Shift-left والاختبار بعد النشر Shift-right.
- المقاييس التي تفيد والمقاييس التي تبدو جميلة ولا تقول شيئاً.
- أدوار فريق الاختبار ومساره المهني والشهادات، وكيف يغير الذكاء الاصطناعي عمل QA.
هذا المقال هو مدخل قسم ضمان الجودة في الموقع، أما أنواع الاختبارات نفسها، من اختبار الوحدة Unit Test إلى اختبار المتصفح E2E، فقد شرحناها في مقال مستقل ولن نكررها هنا، وكذلك أتمتة الاختبارات بالذكاء الاصطناعي واختبار الأحمال وجودة الكود:
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلاختبار الأحمال والضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
 دليلما هي جودة الكود Code Quality وكيف تقيسها؟ما الذي يجعل الكود سهل التغيير، وماذا تقيس أدوات الفحص فعلاً، ولماذا يحتاج كود الوكلاء الأذكياء إلى بوابة جودة.
ما الفرق بين QA وQC والاختبار؟
كثير من الشركات تسمي كل من يختبر البرنامج «مهندس QA»، ولذلك يظن البعض أن ضمان الجودة يعني الاختبار، والحقيقة أن الكلمات الثلاث تصف ثلاثة أشياء مختلفة، وقاموس ISTQB، وهو الهيئة الدولية التي تضع أشهر شهادات الاختبار، يعرفها كما يلي:
- ضمان الجودة Quality Assurance: الأنشطة التي تهدف إلى إعطاء الثقة بأن متطلبات الجودة سوف تتحقق، أي أنه يعمل على الطريقة التي نبني بها البرنامج: تعريف «جاهز» Definition of Done، ومراجعة الكود، وقواعد خط CI، وتدريب الفريق، واستراتيجية الاختبار نفسها.
- ضبط الجودة Quality Control: الأنشطة التي تقيم جودة مكون أو نظام، أي أنه يعمل على المنتج الذي خرج من هذه الطريقة، ويسأل: هل هذه النسخة جيدة بما يكفي لننشرها؟
- الاختبار Testing: العملية التي تقيم جودة المكون أو النظام وما يتعلق به من مخرجات العمل، وهو أشهر أنشطة ضبط الجودة، وليس النشاط الوحيد، فالمراجعة والتفتيش Inspection على المتطلبات والتصميم من ضبط الجودة أيضاً.
والصورة التالية تبين العلاقة بينها:
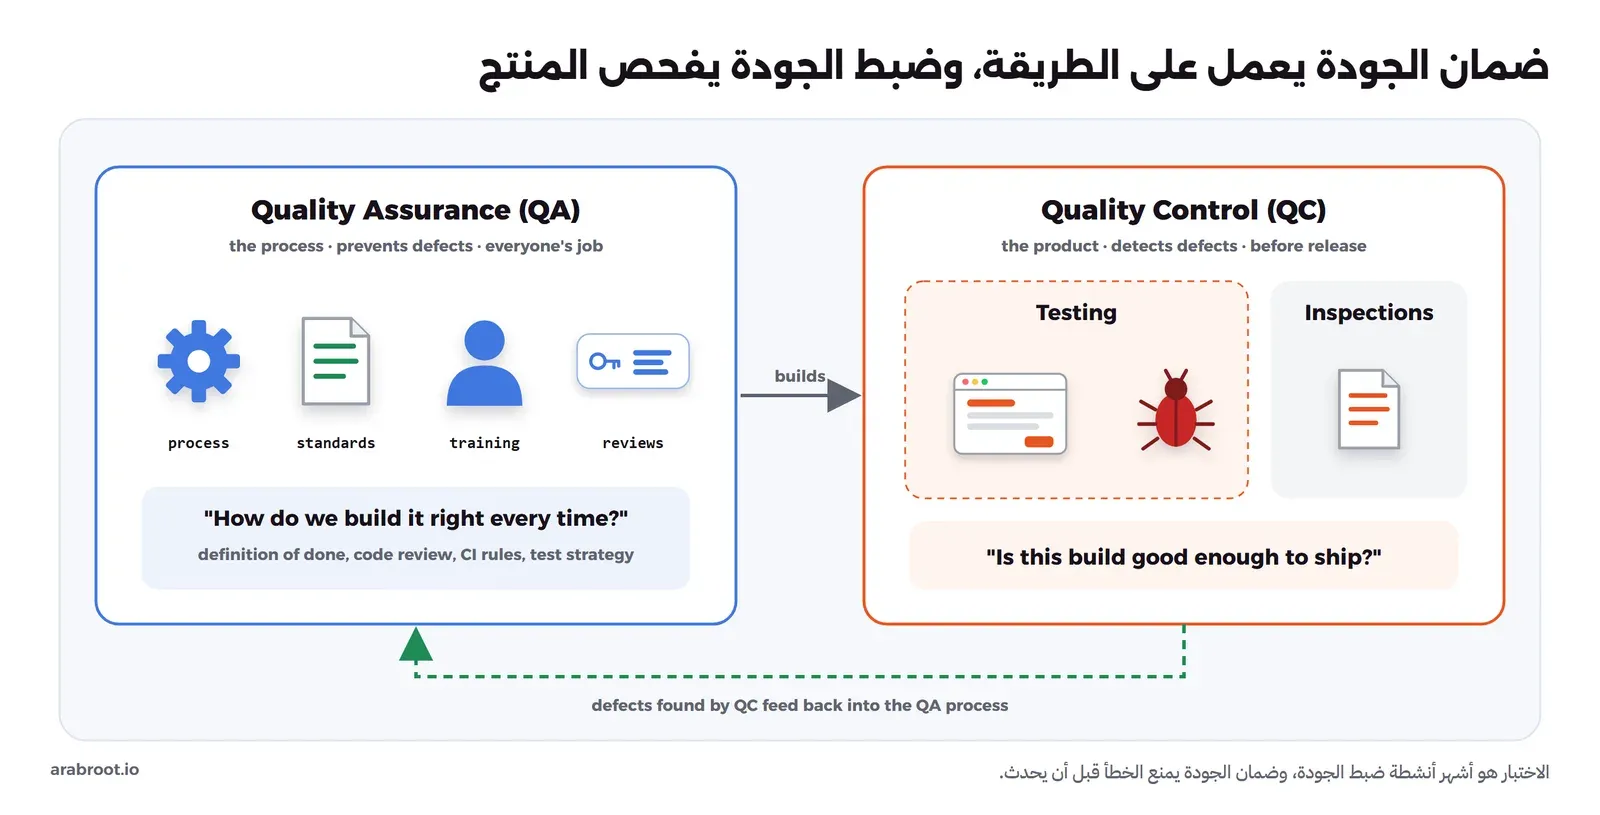
ويلخص منهج ISTQB للمستوى الأساسي الفرق في جملتين: الاختبار نشاط يركز على المنتج ويصحح الأخطاء بعد وقوعها، وضمان الجودة يركز على العملية ويمنع الأخطاء قبل وقوعها، وهو مسؤولية كل من في المشروع وليس فريق الاختبار وحده. وقد يتساءل البعض: ما الفائدة العملية من هذا التفريق؟ والإجابة أنه يغير السؤال الذي تطرحه عندما يهرب خطأ إلى الإنتاج، فبدلاً من «لماذا لم يجده المختبر؟» يصبح السؤال «أي جزء من طريقتنا سمح له أن يمر؟»، وقد يكون الجواب متطلباً غامضاً لم يراجعه أحد، وليس اختباراً ناقصاً.
وفي المنهج نفسه سبعة مبادئ للاختبار، وأهمها لما يأتي في هذا المقال ثلاثة: الاختبار يثبت وجود الأخطاء ولا يثبت غيابها، والاختبار الشامل لكل المدخلات مستحيل إلا في الحالات البسيطة جداً، والأخطاء تتجمع في عدد قليل من المكونات. والمبدأ الثاني هو سبب وجود طرق تصميم حالات الاختبار Test Cases التي سوف نشرحها بعد قليل، فما دمت لا تستطيع تجربة كل قيمة، فيجب أن تختار القيم التي يرجح أن تكشف الخطأ.
استراتيجية الاختبار Test Strategy وخطة الاختبار Test Plan
الطريقة البسيطة التي تبدأ بها أغلب الفرق الصغيرة أن يفتح أحدهم الميزة قبل النشر وينقر عليها قليلاً، وهذا يعمل حتى يكبر الفريق، ثم يبدأ كل مطور يختبر بطريقته، ولا يعرف أحد ما الذي اختبر وما الذي لم يختبر، ومتى يكون الإصدار جاهزاً. والحل هو وثيقتان بمستويين مختلفين:
- استراتيجية الاختبار Test Strategy: يعرفها قاموس ISTQB بأنها وصف لطريقة الاختبار للوصول إلى أهدافه في ظروف معينة، وهي على مستوى المنتج أو الشركة، وتتغير نادراً: ما مستويات الاختبار التي نستخدمها، وما الأدوات، ومتى يعتبر الاختبار آلياً إلزامياً، وما الذي يمنع الإصدار.
- خطة الاختبار Test Plan: وثيقة تصف أهداف الاختبار ووسائله وجدوله لمشروع أو إصدار محدد، وتبين كيف تطبق الاستراتيجية على هذه الميزة بالذات، أو لماذا تخالفها.
والصورة التالية تبين أين تقع كل وثيقة في عملية الاختبار:
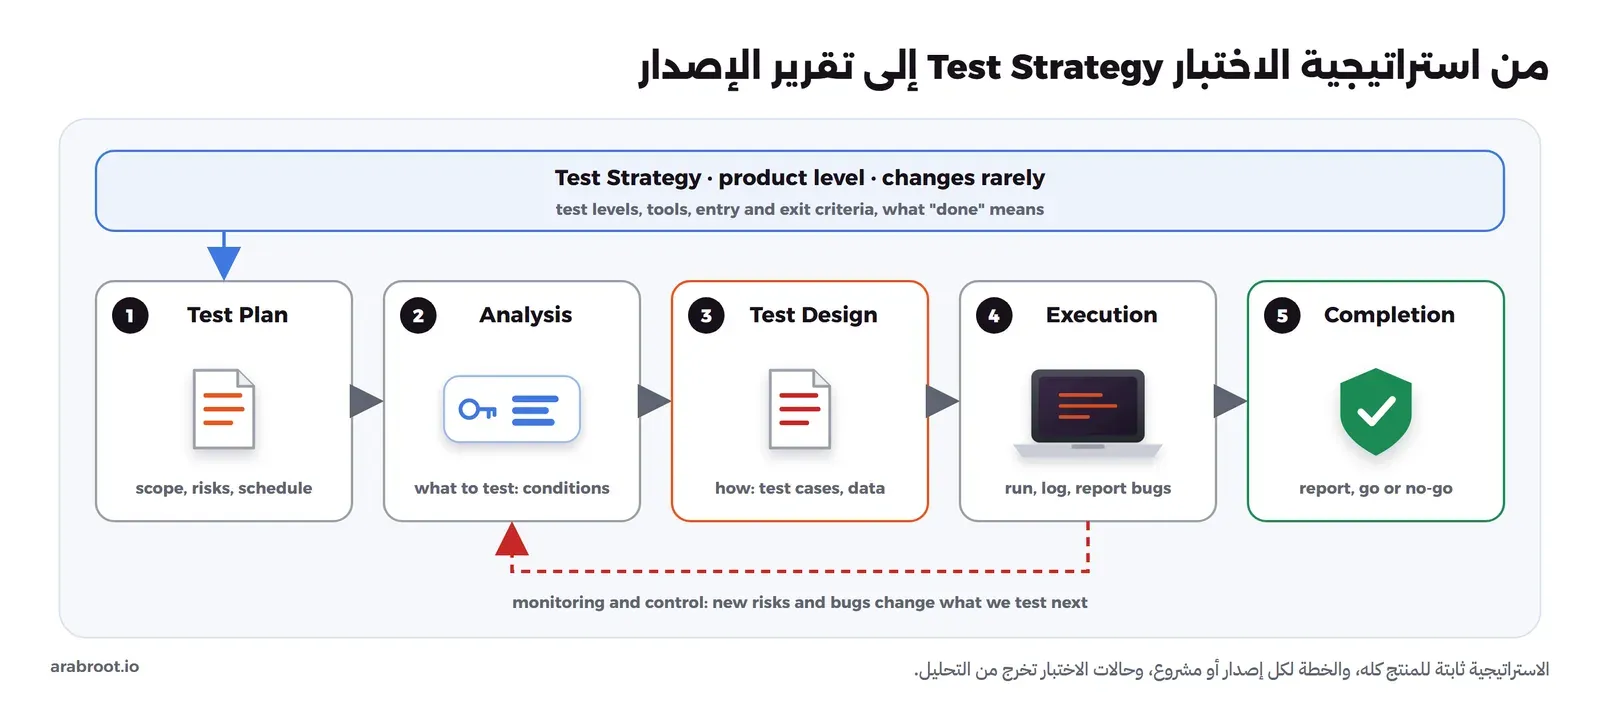
ويذكر منهج ISTQB أن المحتوى المعتاد لخطة الاختبار هو: سياق الاختبار مثل النطاق والأهداف وأساس الاختبار Test Basis، والافتراضات والقيود، وأصحاب المصلحة Stakeholders وأدوارهم، وطريقة التواصل، وسجل المخاطر Risk Register، وأسلوب الاختبار Test Approach بما فيه المستويات والأنواع والتقنيات ومعايير البدء Entry Criteria ومعايير الخروج Exit Criteria وبيانات الاختبار والبيئة، ثم الميزانية والجدول. وللتفاصيل يحيل المنهج إلى المعيار ISO/IEC/IEEE 29119-3 الخاص بوثائق الاختبار، وهو المعيار الذي حل محل IEEE 829 القديم الذي ما زالت بعض القوالب على الإنترنت تحمل اسمه.
ولا تقم بكتابة خطة من ثلاثين صفحة لميزة صغيرة، والسبب أن أحداً لن يقرأها، وإنما يكفي جدول قصير يجيب عن الأسئلة المهمة، مثل هذا الجدول لميزة الاسترداد التي سوف نختبرها في التجربة:
| البند | المحتوى |
|---|---|
| النطاق | حساب نسبة الاسترداد في الدالة refund_percent، ولا يشمل الدفع الفعلي ولا البريد |
| أساس الاختبار Test Basis | قواعد الاسترداد الخمس من مالك المنتج |
| المخاطر | خسارة مالية إذا زادت النسبة، وشكاوى وغضب إذا نقصت، فالخطر عال |
| التقنيات | الفئات المتكافئة Equivalence Partitions والقيم الحدية Boundary Values وجدول القرار Decision Table، ثم جلسة استكشافية |
| معايير البدء Entry Criteria | القواعد مكتوبة ومراجعة، والكود في طلب دمج Pull Request |
| معايير الخروج Exit Criteria | كل حالات الاختبار Test Cases ناجحة وآلية في CI، ولا يوجد خطأ مفتوح بخطورة عالية |
تصميم حالات الاختبار Test Cases
حالة الاختبار Test Case بحسب تعريف ISTQB هي مجموعة من الشروط المسبقة والمدخلات والإجراءات والنتائج المتوقعة والشروط اللاحقة، وأهم كلمة فيها «المتوقعة»، فحالة الاختبار Test Case التي لا تقول ما النتيجة الصحيحة قبل التشغيل ليست اختباراً وإنما تجربة. والسؤال الصعب ليس كيف تكتب حالة الاختبار Test Case، وإنما أي الحالات تكتب، وهنا تفيد التقنيات التالية.
ولنأخذ الميزة التي سوف نستخدمها في كل الأمثلة، وهي سياسة استرداد تذاكر فعالية، ونصها كما كتبه مالك المنتج:
- القاعدة 1: إذا ألغى المنظم الفعالية، يسترد العميل 100% مهما كان نوع التذكرة والوقت.
- القاعدة 2: التذكرة الترويجية لا تسترد ما دامت الفعالية قائمة.
- القاعدة 3: التذكرة العادية تسترد 100% إذا بقي على الفعالية 72 ساعة أو أكثر، و50% إذا بقي 24 ساعة أو أكثر وأقل من 72، ولا شيء إذا بقي أقل من 24 ساعة.
- القاعدة 4: التذكرة المميزة VIP تسترد 100% إذا بقي 24 ساعة أو أكثر، و50% إذا بقي أقل من ذلك.
- القاعدة 5: عند بداية الفعالية أو بعدها لا يوجد استرداد، إلا إذا انطبقت القاعدة 1.
الفئات المتكافئة Equivalence Partitions
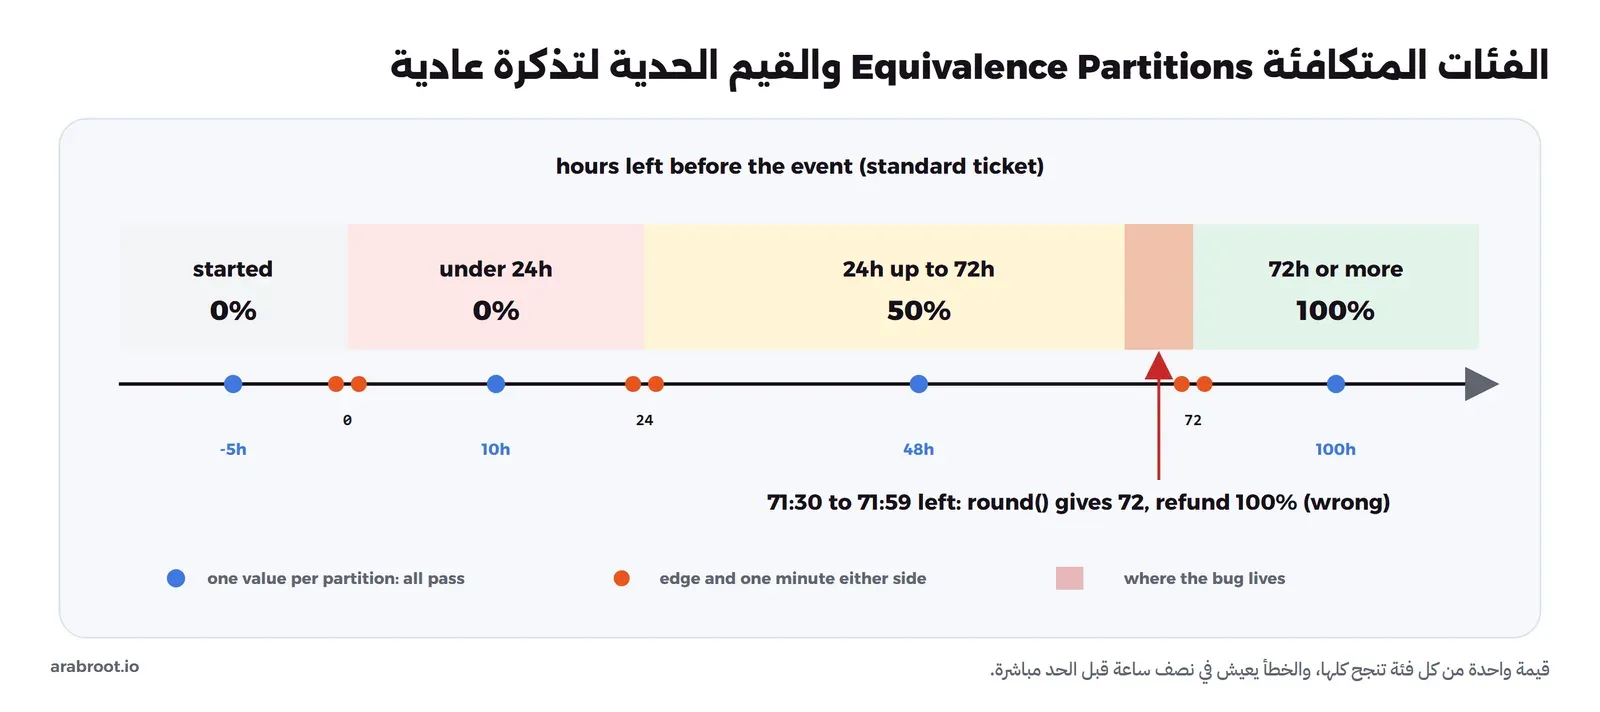
الفكرة أن تقسم المدخلات إلى فئات يتصرف البرنامج مع كل قيمها بالطريقة نفسها، ثم تختار قيمة واحدة تمثل كل فئة، والسبب أنه إذا عملت القيمة 48 ساعة بشكل صحيح فالمنطق نفسه سوف يعمل غالباً مع 50 و60 ساعة. فللتذكرة العادية أربع فئات: بعد بداية الفعالية، وأقل من 24 ساعة، ومن 24 إلى أقل من 72، و72 ساعة أو أكثر، ونختار منها مثلاً 5 ساعات بعد البداية و10 و48 و100 ساعة. ولا تنس الفئات غير الصالحة Invalid Partitions، مثل نوع تذكرة غير موجود، لأن البرنامج يجب أن يرفضه برسالة واضحة.
القيم الحدية Boundary Values
الفئات المتكافئة Equivalence Partitions تخبرك أن هناك حدوداً بين الفئات، والقيم الحدية Boundary Values تخبرك أن تختبر الحدود نفسها، والسبب كما يقول منهج ISTQB أن المطورين يخطئون عند الحدود أكثر من غيرها، فالحد قد يزاح قليلاً فوق مكانه أو تحته أو يسقط كلياً. ويشرح المنهج طريقتين: القيم الحدية Boundary Values بقيمتين، واختصاراً 2-value BVA، أي الحد وأقرب قيمة له في الفئة المجاورة، والقيم الحدية Boundary Values بثلاث قيم، واختصاراً 3-value BVA، أي الحد وجاريه من الجهتين، والثانية أدق لأنها تكشف أخطاء تفوت الأولى.
وأهم سؤال هنا: ما هي «أقرب قيمة»؟ في الأعداد الصحيحة هي واحد، أما في الوقت فهي أصغر وحدة يهتم بها العمل، وفي ميزتنا نعتبرها دقيقة واحدة، فتصبح القيم الحدية Boundary Values للتذكرة العادية: 72 ساعة و71:59 و72:01، ثم 24 ساعة و23:59، ثم لحظة البداية ودقيقة قبلها ودقيقة بعدها. والصورة التالية تبين الفئات والقيم الحدية Boundary Values على خط الوقت، والمنطقة الحمراء هي مكان الخطأ الذي سوف تجده التجربة:
جدول القرار Decision Table
عندما تعتمد النتيجة على أكثر من شرط معاً، فإن اختبار كل شرط وحده لا يكفي، لأن الخطأ قد يكون في تركيبة شرطين لم يفكر فيها أحد. واختبار جدول القرار Decision Table يكتب كل تركيبة من الشروط في عمود، والنتيجة المطلوبة تحتها، ثم تصبح كل عمود حالة اختبار Test Case. وهذا جدول ميزتنا بعد دمج الأعمدة التي لا يهم فيها شرط ما، والشرطة تعني «أي قيمة»:
| الشرط أو النتيجة | 1 | 2 | 3أ | 3ب | 3ج | 4أ | 4ب | 5 |
|---|---|---|---|---|---|---|---|---|
| هل ألغى المنظم الفعالية؟ | نعم | لا | لا | لا | لا | لا | لا | لا |
| نوع التذكرة | أي نوع | ترويجية | عادية | عادية | عادية | مميزة | مميزة | عادية أو مميزة |
| الوقت المتبقي | أي وقت | أي وقت | 72 ساعة أو أكثر | من 24 إلى أقل من 72 | أقل من 24 ساعة | 24 ساعة أو أكثر | أقل من 24 ساعة | بدأت الفعالية |
| نسبة الاسترداد | 100% | 0% | 100% | 50% | 0% | 100% | 50% | 0% |
لاحظ العمود الأول، فهو يقول إن التذكرة الترويجية تسترد كاملة إذا ألغيت الفعالية، وهذه التركيبة بالضبط هي التي ينساها من يقرأ القاعدة 2 وحدها، كما سوف ترى في التجربة. وجدول القرار Decision Table يفيد أيضاً قبل كتابة الكود، لأن كتابة الأعمدة تكشف الأسئلة التي لم يجب عنها مالك المنتج، مثل: ماذا لو ألغيت الفعالية بعد بدايتها؟
الاختبار الاستكشافي Exploratory Testing
شرحنا فكرة الاختبار الاستكشافي Exploratory Testing في مقال أنواع الاختبارات، وما نضيفه هنا هو كيف يصبح عملاً منظماً وليس نقراً عشوائياً، فمنهج ISTQB يذكر أسلوب الجلسات Session-based Testing، حيث يعمل المختبر في وقت محدد، مثل 60 دقيقة، بورقة مهمة Test Charter تحدد الهدف، مثل «استكشف الاسترداد حول منتصف الليل وتغيير المنطقة الزمنية»، ثم يكتب في نهاية الجلسة ما جربه وما وجده. وكل خطأ تجده جلسة استكشافية يتحول بعدها إلى حالة اختبار Test Case آلية، حتى لا تحتاج أن تكتشفه مرة ثانية.
تجربة عملية: خطأ لا يراه إلا اختبار الحدود
سوف نكتب دالة الاسترداد بلغة Python كما قد يكتبها مطور مستعجل، ثم نختبرها بثلاث مجموعات: الفئات المتكافئة Equivalence Partitions، ثم القيم الحدية Boundary Values، ثم جدول القرار Decision Table، ونرى ما تجده كل مجموعة. وكل شيء يعمل في Container واحد من Docker Image مبنية على python:3.13.16-slim مع pytest 9.1.1 وpytest-cov 7.1.0.
ملفات التجربة
شكل المجلد كما يلي:
lab/
├── Dockerfile
├── pytest.ini
├── refund.py
└── tests/
    ├── conftest.py
    ├── test_partitions.py
    ├── test_boundaries.py
    └── test_decision_table.py
الملف refund.py فيه الدالة كما وصلت في طلب الدمج، ولاحظ سطرين فيها، فهما سبب الخطأين اللذين سوف نجدهما:
"""Ticket refund policy (the feature under test)."""
from datetime import datetime

TYPES = {"standard", "vip", "promo"}


def refund_percent(ticket_type: str, event_start: datetime,
                   requested_at: datetime, cancelled: bool = False) -> int:
    if ticket_type not in TYPES:
        raise ValueError(f"unknown ticket type: {ticket_type}")
    if ticket_type == "promo":
        return 0
    if cancelled:
        return 100
    if requested_at >= event_start:
        return 0
    # hours left before the event starts
    hours = round((event_start - requested_at).total_seconds() / 3600)
    if ticket_type == "vip":
        return 100 if hours >= 24 else 50
    if hours >= 72:
        return 100
    if hours >= 24:
        return 50
    return 0
والملف tests/conftest.py يثبت موعد الفعالية، ويعطي الاختبارات دالة at تحسب لحظة الطلب قبل الموعد بعدد من الساعات والدقائق، وهذا يجعل كل اختبار يقرأ مثل سطر في جدول:
from datetime import datetime, timedelta

import pytest

START = datetime(2026, 11, 20, 20, 0)  # the event starts at 20:00


@pytest.fixture
def at():
    """at(hours=.., minutes=..) -> the moment that is this long before the start."""
    def _at(hours=0, minutes=0):
        return START - timedelta(hours=hours, minutes=minutes)
    return _at
وهذه الملفات الثلاثة الأخيرة، ملف Dockerfile وملف pytest.ini الذي يجعل pytest يجد refund.py وconftest.py:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir pytest==9.1.1 pytest-cov==7.1.0
WORKDIR /lab
COPY . .
CMD ["pytest", "-q"]
[pytest]
pythonpath = . tests
testpaths = testsالمجموعة الأولى: قيمة من كل فئة، والتغطية 100%
هذه هي الاختبارات التي يكتبها أغلب المطورين، قيمة واحدة من كل فئة، ومعها اختبار للنوع غير الصالح واختبار للإلغاء، في الملف tests/test_partitions.py:
# One representative value from each equivalence class (partition).
import pytest

from refund import refund_percent
from conftest import START


@pytest.mark.parametrize("ticket, hours, expected", [
    ("standard", 100, 100),   # 72h or more
    ("standard", 48, 50),     # 24h .. 72h
    ("standard", 10, 0),      # less than 24h
    ("standard", -5, 0),      # after the start
    ("vip", 48, 100),         # 24h or more
    ("vip", 10, 50),          # less than 24h
    ("vip", -5, 0),           # after the start
    ("promo", 100, 0),        # promo, event still on
])
def test_one_value_per_partition(at, ticket, hours, expected):
    assert refund_percent(ticket, START, at(hours=hours)) == expected


def test_unknown_ticket_type_is_rejected(at):
    with pytest.raises(ValueError):
        refund_percent("gold", START, at(hours=10))


def test_cancelled_event_refunds_in_full(at):
    assert refund_percent("standard", START, at(hours=10), cancelled=True) == 100
نبني ال Image ونشغل هذه المجموعة مع قياس تغطية الأسطر والفروع Branch Coverage:
docker build -t lab-qa-intro:1 .
docker run --rm --name lab-qa-intro lab-qa-intro:1 \
  pytest tests/test_partitions.py -q --cov=refund --cov-branch --cov-report=term-missing
والمخرج سوف يكون كما يلي:
..........                                                               [100%]
================================ tests coverage ================================
_______________ coverage: platform linux, python 3.13.16-final-0 _______________

Name        Stmts   Miss Branch BrPart  Cover   Missing
-------------------------------------------------------
refund.py      19      0     14      0   100%
-------------------------------------------------------
TOTAL          19      0     14      0   100%
10 passed in 0.28s
عشرة اختبارات ناجحة، وكل سطر وكل فرع في الدالة نفذ مرة على الأقل، وأي لوحة تقارير سوف تعرض هذه النتيجة باللون الأخضر، ومع ذلك فالدالة فيها خطآن كما سوف ترى، وهذا هو المعنى العملي لما شرحناه في قسم التغطية في مقال أنواع الاختبارات: التغطية تقول ما الذي نفذ، ولا تقول ما الذي تحقق منه.
المجموعة الثانية: القيم الحدية Boundary Values تجد التقريب
الآن نختبر كل حد، ودقيقة قبله ودقيقة بعده، في الملف tests/test_boundaries.py:
# Boundary values: on each edge, and one minute on each side of it.
import pytest

from refund import refund_percent
from conftest import START


@pytest.mark.parametrize("ticket, hours, minutes, expected", [
    ("standard", 72, 1, 100),   # just above 72h
    ("standard", 72, 0, 100),   # exactly 72h
    ("standard", 71, 59, 50),   # just below 72h
    ("standard", 24, 0, 50),    # exactly 24h
    ("standard", 23, 59, 0),    # just below 24h
    ("vip", 24, 0, 100),        # exactly 24h
    ("vip", 23, 59, 50),        # just below 24h
    ("vip", 0, 1, 50),          # one minute before the start
    ("vip", 0, 0, 0),           # exactly at the start
    ("vip", 0, -1, 0),          # one minute after the start
])
def test_boundaries(at, ticket, hours, minutes, expected):
    assert refund_percent(ticket, START, at(hours=hours, minutes=minutes)) == expected
docker run --rm --name lab-qa-intro lab-qa-intro:1 \
pytest tests/test_boundaries.py -v --tb=line -p no:cacheproviderوالمخرج سوف يكون كما يلي، وقد حذفنا أول خمسة أسطر من قائمة النتائج:
tests/test_boundaries.py::test_boundaries[standard-23-59-0] FAILED       [ 50%]
tests/test_boundaries.py::test_boundaries[vip-24-0-100] PASSED           [ 60%]
tests/test_boundaries.py::test_boundaries[vip-23-59-50] FAILED           [ 70%]
tests/test_boundaries.py::test_boundaries[vip-0-1-50] PASSED             [ 80%]
tests/test_boundaries.py::test_boundaries[vip-0-0-0] PASSED              [ 90%]
tests/test_boundaries.py::test_boundaries[vip-0--1-0] PASSED             [100%]

=================================== FAILURES ===================================
E   AssertionError: assert 100 == 50
     +  where 100 = refund_percent('standard', datetime.datetime(2026, 11, 20, 20, 0), datetime.datetime(2026, 11, 17, 20, 1))
     +    where datetime.datetime(2026, 11, 17, 20, 1) = <function at.<locals>._at at 0x7f87ac962700>(hours=71, minutes=59)
/lab/tests/test_boundaries.py:21: AssertionError: assert 100 == 50
E   AssertionError: assert 50 == 0
     +  where 50 = refund_percent('standard', datetime.datetime(2026, 11, 20, 20, 0), datetime.datetime(2026, 11, 19, 20, 1))
     +    where datetime.datetime(2026, 11, 19, 20, 1) = <function at.<locals>._at at 0x7f87ac962a20>(hours=23, minutes=59)
/lab/tests/test_boundaries.py:21: AssertionError: assert 50 == 0
E   AssertionError: assert 100 == 50
     +  where 100 = refund_percent('vip', datetime.datetime(2026, 11, 20, 20, 0), datetime.datetime(2026, 11, 19, 20, 1))
     +    where datetime.datetime(2026, 11, 19, 20, 1) = <function at.<locals>._at at 0x7f87ac9627a0>(hours=23, minutes=59)
/lab/tests/test_boundaries.py:21: AssertionError: assert 100 == 50
=========================== short test summary info ============================
FAILED tests/test_boundaries.py::test_boundaries[standard-71-59-50] - Asserti...
FAILED tests/test_boundaries.py::test_boundaries[standard-23-59-0] - Assertio...
FAILED tests/test_boundaries.py::test_boundaries[vip-23-59-50] - AssertionErr...
========================= 3 failed, 7 passed in 0.10s ==========================
في المخرج أعلاه لاحظ التالي:
- الاختبارات التي على الحد بالضبط نجحت كلها، أي أن المطور كتب
>=بشكل صحيح، وهذا يعني أن اختبار القيم الحدية Boundary Values بقيمتين فقط، الحد وما فوقه، كان سوف يفوت الخطأ. - الذي فشل هو الدقيقة قبل الحد في الحالات الثلاث: عميل بقي له 71 ساعة و59 دقيقة أخذ 100% بدل 50%، وعميل بقي له 23:59 أخذ 50% بدل لا شيء.
- السبب هو السطر الذي فيه
round()، فالمطور حول الوقت إلى ساعات وقربه، فأصبحت 71.98 ساعة تساوي 72، وهذا الخطأ في صالح العميل دائماً، أي أنه خسارة مالية لا يشتكي منها أحد.
المجموعة الثالثة: جدول القرار Decision Table يجد التركيبة المنسية
كل عمود من الجدول أعلاه أصبح سطراً في الملف tests/test_decision_table.py، والعمود الأخير كتبناه مرتين، مرة لكل نوع:
# One test per column of the decision table (see the article).
import pytest

from refund import refund_percent
from conftest import START

# rule, cancelled, ticket, hours before start, expected refund %
RULES = [
    ("R1-standard", True, "standard", -5, 100),
    ("R1-vip",      True, "vip",       -5, 100),
    ("R1-promo",    True, "promo",     -5, 100),
    ("R2-promo",    False, "promo",   100, 0),
    ("R3-72h-plus", False, "standard", 100, 100),
    ("R3-24-to-72h", False, "standard", 48, 50),
    ("R3-under-24h", False, "standard", 10, 0),
    ("R4-24h-plus", False, "vip",      48, 100),
    ("R4-under-24h", False, "vip",      10, 50),
    ("R5-standard", False, "standard", -5, 0),
    ("R5-vip",      False, "vip",      -5, 0),
]


@pytest.mark.parametrize("rule, cancelled, ticket, hours, expected", RULES,
                         ids=[r[0] for r in RULES])
def test_decision_table(at, rule, cancelled, ticket, hours, expected):
    assert refund_percent(ticket, START, at(hours=hours), cancelled) == expected
docker run --rm --name lab-qa-intro lab-qa-intro:1 \
pytest tests/test_decision_table.py -v --tb=line -p no:cacheproviderوالمخرج سوف يكون كما يلي:
tests/test_decision_table.py::test_decision_table[R1-standard] PASSED    [  9%]
tests/test_decision_table.py::test_decision_table[R1-vip] PASSED         [ 18%]
tests/test_decision_table.py::test_decision_table[R1-promo] FAILED       [ 27%]
tests/test_decision_table.py::test_decision_table[R2-promo] PASSED       [ 36%]
tests/test_decision_table.py::test_decision_table[R3-72h-plus] PASSED    [ 45%]
tests/test_decision_table.py::test_decision_table[R3-24-to-72h] PASSED   [ 54%]
tests/test_decision_table.py::test_decision_table[R3-under-24h] PASSED   [ 63%]
tests/test_decision_table.py::test_decision_table[R4-24h-plus] PASSED    [ 72%]
tests/test_decision_table.py::test_decision_table[R4-under-24h] PASSED   [ 81%]
tests/test_decision_table.py::test_decision_table[R5-standard] PASSED    [ 90%]
tests/test_decision_table.py::test_decision_table[R5-vip] PASSED         [100%]

=================================== FAILURES ===================================
E   AssertionError: assert 0 == 100
     +  where 0 = refund_percent('promo', datetime.datetime(2026, 11, 20, 20, 0), datetime.datetime(2026, 11, 21, 1, 0), True)
     +    where datetime.datetime(2026, 11, 21, 1, 0) = <function at.<locals>._at at 0x7f80a9c1e7a0>(hours=-5)
/lab/tests/test_decision_table.py:26: AssertionError: assert 0 == 100
=========================== short test summary info ============================
FAILED tests/test_decision_table.py::test_decision_table[R1-promo] - As...
========================= 1 failed, 10 passed in 0.11s =========================
صاحب التذكرة الترويجية لا يسترد شيئاً حتى عندما يلغي المنظم الفعالية، والسبب ترتيب الشروط في الدالة، فشرط promo جاء قبل شرط الإلغاء فأنهى الدالة قبل أن تصل إليه. ولاحظ أن مجموعة الفئات كان فيها اختبار للإلغاء واختبار للتذكرة الترويجية، ولكن كل واحد وحده، ولم تجمع أي حالة اختبار Test Case الشرطين معاً، وهذا بالضبط ما يضيفه جدول القرار Decision Table.
اكسرها لتفهمها: أين يعيش الخطأ بالضبط؟
لنقيس حجم المنطقة التي يخطئ فيها التقريب، نشغل الدالة الأصلية على عدة لحظات قبل حد 72 ساعة بملف صغير probe.py:
from datetime import timedelta
from refund import refund_percent
from tests.conftest import START

for h, m in [(71, 29), (71, 30), (71, 31), (71, 59), (72, 0)]:
    left = timedelta(hours=h, minutes=m)
    print(f"{h:02d}h{m:02d}m before -> {refund_percent('standard', START, START - left):>3}%")
docker run --rm --name lab-qa-intro -v "$PWD/probe.py:/lab/probe.py" lab-qa-intro:1 python probe.py71h29m before -> 50%
71h30m before -> 100%
71h31m before -> 100%
71h59m before -> 100%
72h00m before -> 100%الخطأ يعيش في نصف ساعة فقط، من 71:30 إلى 71:59، ومثلها قبل حد 24 ساعة، وهذا يشرح لماذا لا يجده من يختبر يدوياً بقيم مثل 48 أو 70 ساعة، ولماذا لا يجده أيضاً من يختبر الحد بالضبط، فالقيمة الوحيدة التي تجده هي جار الحد من الأسفل، أي القيم الحدية Boundary Values بثلاث قيم 3-value BVA.
الإصلاح وإعادة التشغيل
الإصلاح سطران: نقارن الوقت المتبقي كما هو دون تقريب، وننقل شرط الإلغاء قبل شرط التذكرة الترويجية:
from datetime import datetime, timedelta

TYPES = {"standard", "vip", "promo"}


def refund_percent(ticket_type: str, event_start: datetime,
                   requested_at: datetime, cancelled: bool = False) -> int:
    if ticket_type not in TYPES:
        raise ValueError(f"unknown ticket type: {ticket_type}")
    if cancelled:
        return 100
    if ticket_type == "promo":
        return 0
    if requested_at >= event_start:
        return 0
    left = event_start - requested_at  # exact time left, no rounding
    if ticket_type == "vip":
        return 100 if left >= timedelta(hours=24) else 50
    if left >= timedelta(hours=72):
        return 100
    if left >= timedelta(hours=24):
        return 50
    return 0
docker build -t lab-qa-intro:1 .
docker run --rm --name lab-qa-intro lab-qa-intro:1 pytest -q -p no:cacheprovider............................... [100%]
31 passed in 0.16sوقبل الإصلاح كانت النتيجة نفسها 4 failed, 27 passed. وعند تشغيل probe.py مرة ثانية أصبحت كل اللحظات قبل 72 ساعة تعطي 50%، واللحظة 72:00 تعطي 100%. وبعد انتهاء التجربة نحذف ال Image بالأمر docker rmi lab-qa-intro:1.
الخطأ Bug ودورة حياته
يفرق قاموس ISTQB بين ثلاث كلمات نستخدمها كأنها واحدة: الغلطة Error وهي فعل بشري مثل استخدام round()، والعيب Defect أو Bug وهو النقص في الكود الذي نتج عنها، والفشل Failure وهو الحدث الذي يراه المستخدم عندما يعمل الكود المعيب، أي استرداد 100% بدل 50%. والتفريق مفيد لأن العيب قد يبقى في الكود سنوات دون فشل، كما في قصة Exchange أعلاه، حتى يصل المدخل الذي يوقظه.
تقرير الخطأ الجيد
تقرير الخطأ Bug Report هو رسالة إلى شخص سوف يقرؤه وهو لا يعرف شيئاً عما فعلته، ويذكر منهج ISTQB أن التقرير المعتاد فيه: معرف وعنوان قصير، والتاريخ والكاتب، والنسخة والبيئة، والسياق مثل حالة الاختبار Test Case التي كانت تعمل، وخطوات إعادة الإنتاج، والنتيجة المتوقعة والفعلية، والخطورة Severity والأولوية Priority، والحالة. وهذا مثال للخطأ الذي وجدناه:
ID:        REF-142
Title:     Standard ticket refunded 100% with 71h59m left (expected 50%)
Version:   refund-service 1.4.0 (commit a1b2c3d), staging
Found by:  test_boundaries[standard-71-59-50], CI run on PR #88
Steps:     1. Event starts 2026-11-20 20:00
           2. Request refund of a standard ticket at 2026-11-17 20:01
Expected:  50%  (rule 3: 24h or more and less than 72h)
Actual:    100%
Notes:     Wrong for any request 71:30-71:59 and 23:30-23:59 before start.
           Cause: hours are rounded with round() before comparing.
Severity:  High (money lost on every affected refund)
Priority:  P1 (fix before release 1.4)
لاحظ أن التقرير يقول متى يحدث الخطأ بالضبط وليس «الاسترداد خطأ أحياناً»، وأن العنوان وحده يكفي لفهم المشكلة، وأنه يربط الخطأ بالاختبار الذي كشفه.
دورة حياة الخطأ Bug Lifecycle
كل أداة تتبع، مثل Jira أو GitHub Issues أو Kiwi TCMS، تسمي الحالات بأسماء مختلفة، ولكن الفكرة واحدة كما تبين الصورة التالية:
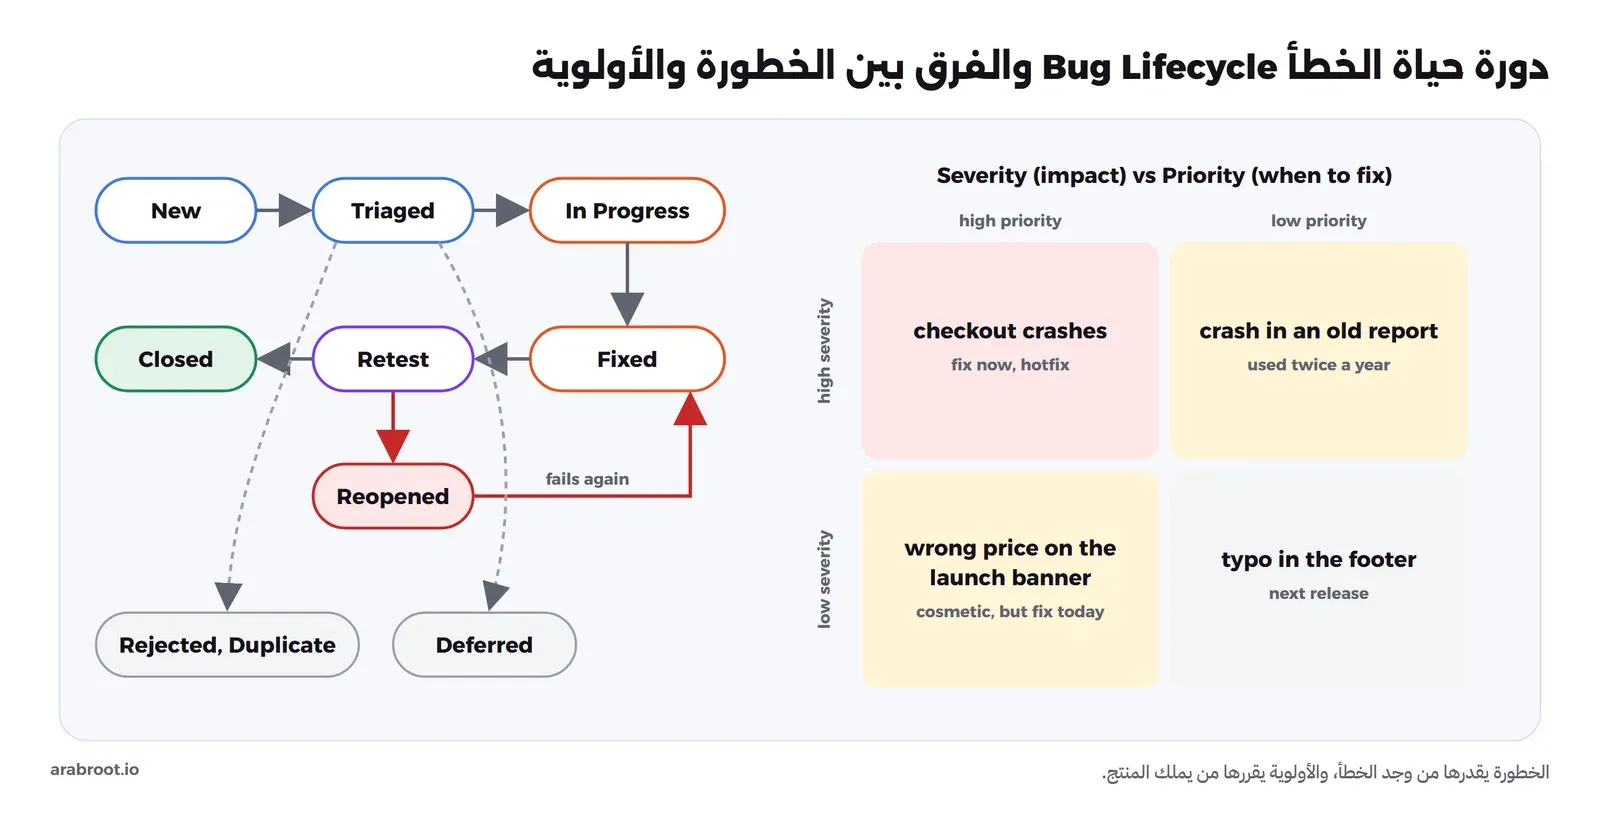
- الفرز Triage: اجتماع قصير أو مراجعة يومية يقرر فيها الفريق هل هذا خطأ حقيقي أم مكرر أم سلوك مقصود، ويحدد الأولوية Priority، وبدونه تصبح قائمة الأخطاء مقبرة لا ينظر إليها أحد.
- إعادة الاختبار Retest: يتحقق من أن الخطأ نفسه أصلح، وغالباً بالحالة نفسها التي كشفته، ثم يأتي اختبار الانحدار Regression ليتحقق من أن الإصلاح لم يكسر شيئاً آخر.
- إعادة الفتح Reopened: إذا تكررت كثيراً فهي مؤشر على مشكلة في الطريقة، مثل إصلاح دون اختبار يثبته، وهذه معلومة يأخذها ضمان الجودة QA ليحسن العملية.
الخطورة Severity والأولوية Priority
الخطورة Severity بحسب ISTQB هي درجة أثر الخطأ على النظام، والأولوية Priority هي درجة الأهمية التي تحدد متى نصلحه، والأولى تقدير فني يضعه من وجد الخطأ، والثانية قرار عمل يتخذه مالك المنتج، ولذلك لا تتطابقان دائماً كما في الصورة أعلاه: انهيار في تقرير قديم يفتحه شخصان في السنة خطورته Severity عالية وأولويته Priority منخفضة، وسعر خطأ في إعلان الإطلاق الذي سوف يراه كل الزوار اليوم خطورته Severity منخفضة لأن البرنامج يعمل، وأولويته Priority أعلى من أي شيء آخر. ولا تقم بدمج الحقلين في حقل واحد في أداة التتبع، والسبب أنك تفقد بذلك سؤال «لماذا ننتظر بخطأ خطير؟»، وهو سؤال يجب أن يجيب عنه شخص بالاسم.
الاختبار حسب المخاطر Risk-based Testing
الوقت محدود دائماً، والسؤال ليس هل تختبر كل شيء، فهذا مستحيل كما قال المبدأ الثاني، وإنما أين تضع الوقت. والاختبار حسب المخاطر Risk-based Testing يجيب بأن تختار نشاطات الاختبار وترتبها حسب مستوى الخطر، ومستوى الخطر Risk Level بحسب منهج ISTQB يتكون من عاملين: احتمال حدوث المشكلة Likelihood، وأثرها Impact إذا حدثت، وفي الأسلوب الكمي يضرب أحدهما في الآخر، وفي الأسلوب النوعي توضع في مصفوفة كما تبين الصورة التالية:
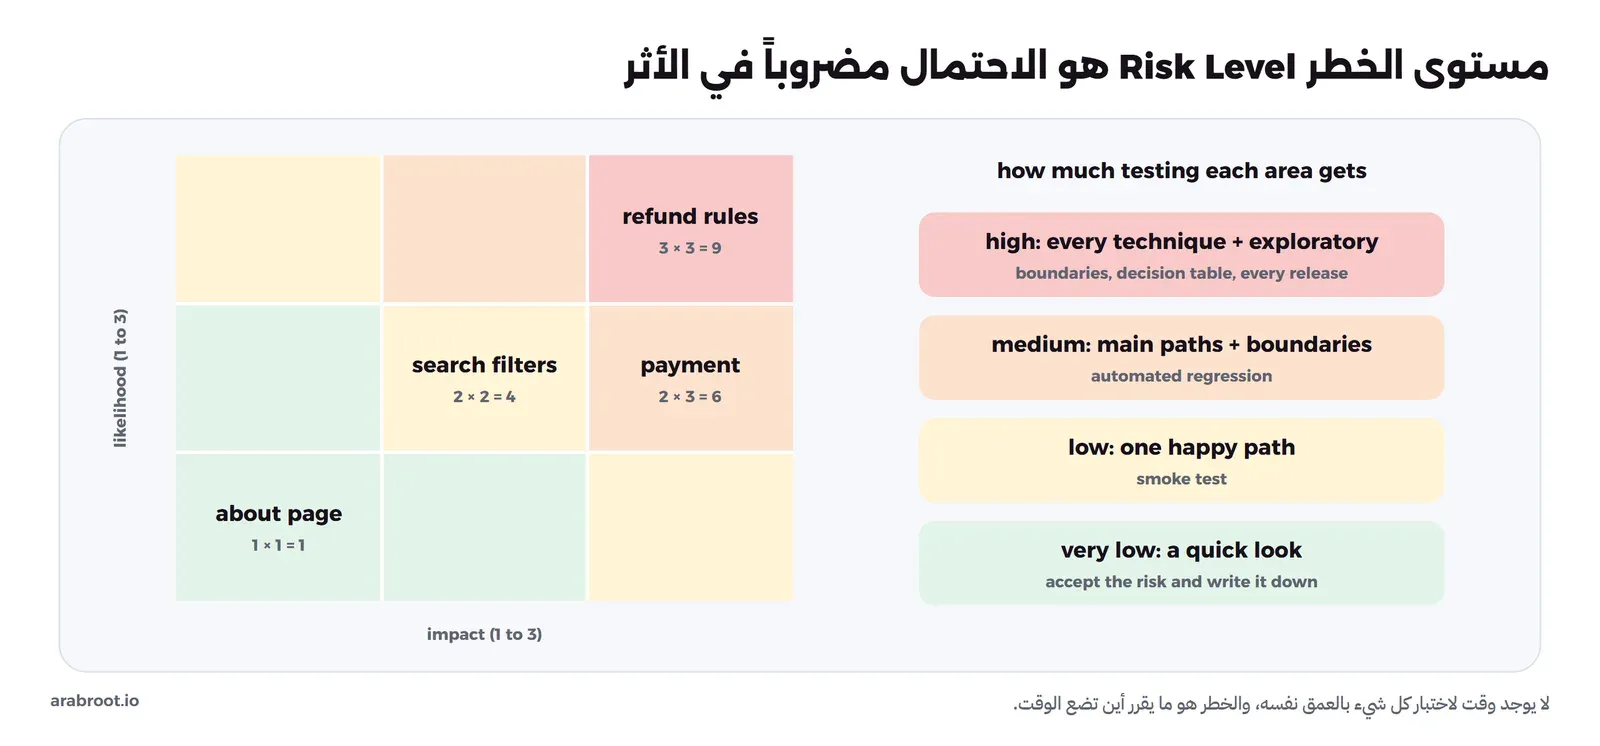
ويفرق المنهج بين مخاطر المنتج Product Risks، وهي التي تمس جودة البرنامج نفسه مثل حساب استرداد خطأ، ومخاطر المشروع Project Risks، وهي التي تمس نجاح المشروع مثل تأخر بيئة الاختبار أو مغادرة الشخص الوحيد الذي يفهم نظام الدفع. والطريقة العملية بسيطة: اجلس مع المطور ومالك المنتج نصف ساعة قبل كل إصدار، واكتبوا قائمة بالأجزاء التي تغيرت، وأعطوا كل جزء درجة من 1 إلى 3 للاحتمال والأثر، ثم ضعوا الوقت في أعلى القائمة، واكتبوا صراحة ما الذي لن تختبروه ولماذا، والسبب أن الخطر المقبول بقرار مكتوب يختلف كثيراً عن الخطر الذي نسيه الجميع.
الاختبار المبكر Shift-left والاختبار بعد النشر Shift-right
مصطلح Shift-left استخدمه Larry Smith في مقال في مجلة Dr. Dobb's سنة 2001 عن طريقة أفضل لدمج فريق ضمان الجودة مع فريق التطوير، ومعناه اليوم بحسب قاموس ISTQB أن تبدأ نشاطات الاختبار وضمان الجودة في أبكر وقت ممكن من دورة التطوير. أما Shift-right فهو الاتجاه المعاكس، أي أن تستمر في التحقق من الجودة بعد النشر على المستخدمين الحقيقيين. والصورة التالية تبين أين يقع كل منهما:
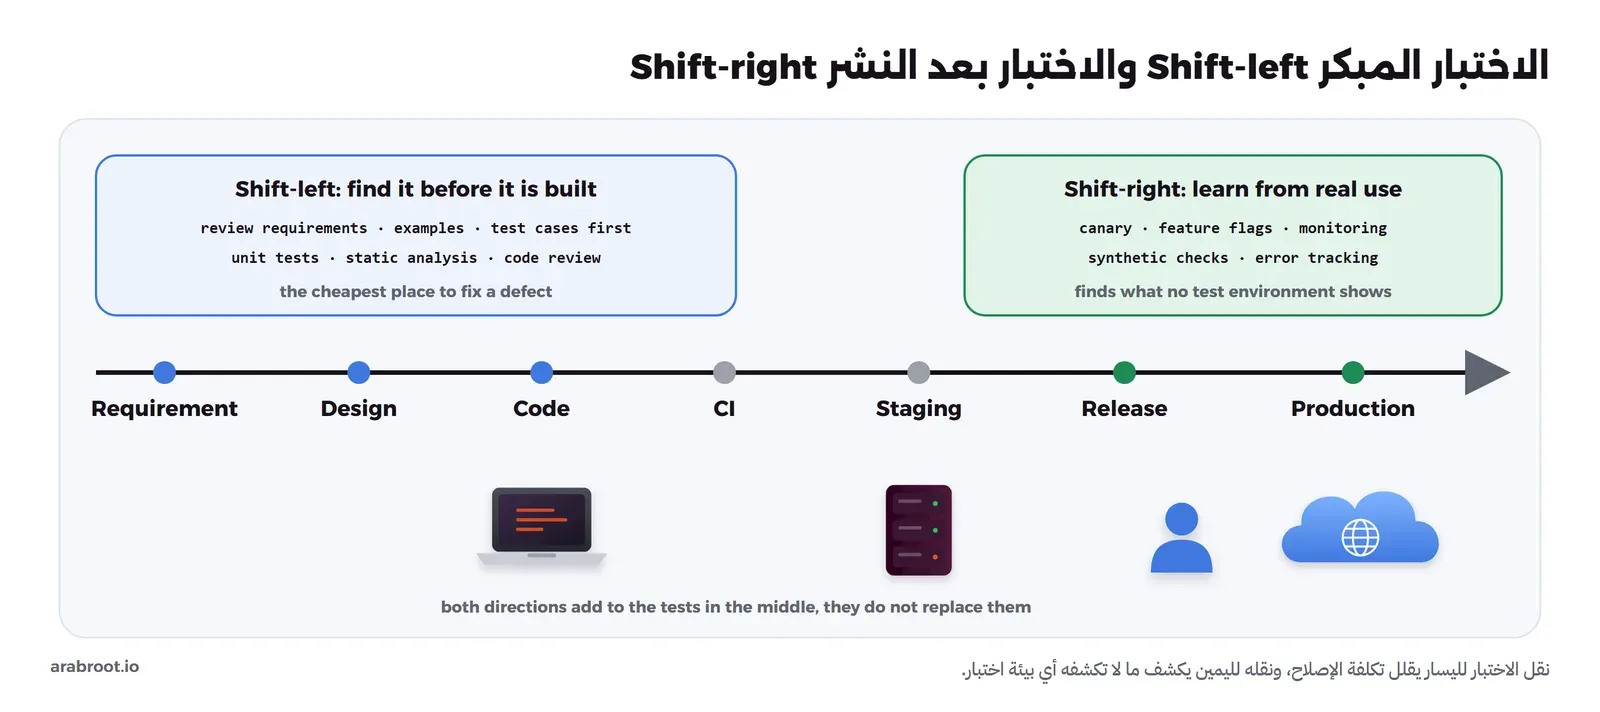
- الاختبار المبكر Shift-left عملياً: أن يقرأ المختبر قواعد الاسترداد قبل كتابة سطر كود، ويكتب جدول القرار Decision Table، فيسأل مالك المنتج عن التذكرة الترويجية عند الإلغاء قبل أن تصبح خطأ في الكود. ويحذر منهج ISTQB من فهمه بشكل خاطئ، فالاختبار المبكر لا يعني إهمال الاختبار في المراحل المتأخرة.
- الاختبار بعد النشر Shift-right عملياً: أن تطلق الميزة لنسبة صغيرة من المستخدمين عبر Feature Flags، وتراقب نسبة الاستردادات بنسبة 100% مقارنة بالأسبوع الماضي، وتضع تنبيهاً إذا ارتفعت فجأة، فهذا التنبيه كان سوف يكشف خطأ التقريب في يومين لو هرب من الاختبارات.
- وبينهما: بيئة معاينة لكل طلب دمج كما شرحنا في مقال البيئات وGitOps، يختبر عليها فريق الجودة الميزة وحدها قبل أن تختلط بغيرها، ويعمل عليها أيضاً الفحص الديناميكي DAST.
المقاييس التي تفيد والمقاييس التي تبدو جميلة
قالت عالمة الأنثروبولوجيا Marilyn Strathern في مقالها سنة 1997 عبارتها المشهورة في صياغة قانون Goodhart: عندما يصبح المقياس هدفاً يتوقف عن أن يكون مقياساً جيداً. وهذا يحدث في فرق الاختبار كل يوم، فإذا كوفئ المختبر على عدد الأخطاء التي يسجلها فسوف تصل إليك عشرة تقارير عن خطأ واحد، وإذا كان الهدف تغطية 90% فسوف تصل إليك اختبارات تنفذ الكود ولا تتحقق من شيء، كما رأيت في المجموعة الأولى من التجربة.
| المقياس | هل يفيد؟ | والسبب |
|---|---|---|
| الأخطاء التي هربت إلى الإنتاج Escaped Defects | يفيد كثيراً | يعرفه ISTQB بأنه الخطأ الذي لم يكشفه نشاط الاختبار الذي كان يفترض أن يكشفه، وكل واحد منها درس عن ثغرة في الطريقة |
| نسبة اكتشاف الأخطاء DDP | يفيد للاتجاه | عدد الأخطاء التي وجدها مستوى الاختبار مقسوماً على ما وجده هو وما وجد بعده، فإذا انخفضت فاختباراتك تفقد قدرتها |
| نسبة فشل التغيير Change Fail Rate | يفيد | من مقاييس DORA، وهي نسبة النشرات التي احتاجت تدخلاً فورياً بعد النشر، وتقيس النتيجة النهائية وليس النشاط |
| الزمن من اكتشاف الخطأ إلى إصلاحه | يفيد | يكشف هل الفرز والإصلاح يعملان أم تتراكم الأخطاء |
| نسبة الاختبارات المتقلبة Flaky Tests | يفيد | كل اختبار متقلب يعلم الفريق تجاهل اللون الأحمر، كما شرحنا في مقال أنواع الاختبارات |
| عدد حالات الاختبار Test Cases | لا يفيد وحده | ألف حالة على صفحة واحدة وصفر على الدفع رقم كبير بلا معنى |
| عدد الأخطاء لكل مختبر | يضر | يدفع إلى تقارير مكررة وتافهة، ويجعل المطور والمختبر خصمين |
| نسبة التغطية كهدف | يضر إذا كان هدفاً | تجربتنا وصلت إلى 100% والدالة فيها خطآن، واختبار الطفرات Mutation Testing في مقال الاختبارات بالذكاء الاصطناعي يقيس قوة الاختبارات بشكل أصدق |
| نجاح 100% من الاختبارات | لا يفيد وحده | قد يعني أن الاختبارات لا تختبر الأجزاء الخطرة، فاسأل دائماً: ما الذي لم نختبره؟ |
الأدوار في فريق الجودة والمسار المهني
يذكر منهج ISTQB دورين رئيسيين فقط: دور إدارة الاختبار، الذي يتحمل مسؤولية عملية الاختبار والفريق والقيادة، ويمكن أن يقوم به قائد فريق أو مدير اختبار أو مدير تطوير، ودور الاختبار الذي يتحمل الجانب الهندسي الفني. أما المسميات في إعلانات الوظائف فكثيرة وغير موحدة، وليس لها تعريف رسمي، وأشهرها كما يلي:
- محلل الاختبار Test Analyst أو المختبر اليدوي: يحلل المتطلبات ويصمم حالات الاختبار Test Cases وينفذ الاختبار الاستكشافي، وهو أقرب الأدوار إلى العمل وأصحابه.
- مهندس الجودة QA Engineer: يجمع بين التصميم والأتمتة، ويكتب اختبارات ال API والمتصفح، ويشارك في خطة الاختبار Test Plan.
- مهندس الأتمتة أو SDET: مطور تخصصه بناء أطر الاختبار وتشغيلها في CI، ويكتب الكود أكثر مما يختبر يدوياً.
- التخصصات: مختبر الأداء الذي يعمل على اختبار الأحمال، ومختبر الأمان، ومختبر سهولة الوصول Accessibility.
- قائد الجودة QA Lead ومدير الاختبار Test Manager: يكتب الاستراتيجية ويدير المخاطر والفريق، ويقدم تقرير «هل ننشر؟» للإدارة.
والمسار المعتاد يبدأ بالتصميم والاختبار اليدوي، لأنه يعلمك كيف تفكر في الحالات، ثم الأتمتة، ثم إما التخصص في مجال مثل الأداء أو الأمان، وإما الانتقال إلى القيادة. ولا تقم بالقفز إلى الأتمتة قبل أن تتعلم التصميم، والسبب أن الأتمتة تكرر بسرعة ما قررت أن تختبره، فإذا كانت الحالات ضعيفة فأنت تكرر الضعف بسرعة.
الشهادات
أشهر شهادات الاختبار في العالم من ISTQB، وهذا ما وجدناه في صفحاتها الرسمية في 12 أكتوبر 2026:
| الشهادة | الإصدار الحالي | الاختبار |
|---|---|---|
| المستوى الأساسي CTFL | الإصدار 4.0 بمنهج 4.0.1 | 40 سؤالاً، والنجاح بـ 26 درجة، في 60 دقيقة، وتزيد 25% لغير المتحدثين باللغة |
| محلل الاختبار المتقدم CTAL-TA | الإصدار 4.0 | 45 سؤالاً، والنجاح بـ 51 من 78، في 120 دقيقة |
| إدارة الاختبار المتقدمة CTAL-TM | الإصدار 3.0 | 50 سؤالاً، والنجاح بـ 58 من 88، في 120 دقيقة |
| هندسة أتمتة الاختبار CTAL-TAE | الإصدار 2.0 | 40 سؤالاً، والنجاح بـ 43 من 66، في 90 دقيقة |
| الاختبار بالذكاء الاصطناعي التوليدي CT-GenAI | منهج 1.1 | 40 سؤالاً، والنجاح بـ 30 من 46، في 60 دقيقة |
| اختبار أنظمة الذكاء الاصطناعي CT-AI | الإصدار 2.0 | 40 سؤالاً، والنجاح بـ 29 من 44، في 60 دقيقة |
وفي القائمة نفسها شهادات متخصصة أخرى، مثل اختبار تطبيقات الجوال CT-MAT واختبار الأداء CT-PT واختبار القبول CT-AcT. ولاحظ أن ISTQB لا تبيع الاختبار بنفسها، وإنما تحدد الأسعار الهيئات الوطنية الأعضاء ومزودو الاختبار، وعلى سبيل المثال تذكر الهيئة الأمريكية ASTQB أن سعر اختبار المستوى الأساسي عندها 229 دولاراً، والشهادات المتخصصة 199 دولاراً، والمتقدمة 249 دولاراً، وتذكر في صفحة أخرى أن شهادات ISTQB تحت مستوى الخبير Expert Level لا تنتهي صلاحيتها.
ومن الشهادات الأخرى شهادة مهندس جودة البرمجيات CSQE من ASQ، وهي أثقل بكثير، فتشترط ثماني سنوات خبرة يخصم منها التعليم الجامعي، ورسومها 550 دولاراً، وفيها 175 سؤالاً في أربع ساعات ونصف. وهناك أيضاً شهادتا CSTE وCSQA من QAI، ولم نتمكن من التحقق من رسومهما وشروطهما الحالية من موقع الجهة.
وهل الشهادة ضرورية؟ لا، ولكن المستوى الأساسي CTFL يعطيك لغة مشتركة مع الفريق، وهي المصطلحات التي استخدمناها في هذا المقال، وأغلب ما يسأل عنه في المقابلات. أما ما يقنع من يوظفك فعلاً فهو مستودع على GitHub فيه خطة اختبار Test Plan قصيرة وحالات اختبار Test Cases مصممة بالتقنيات أعلاه، وأتمتة تعمل في CI، وتقرير خطأ حقيقي مكتوب بشكل جيد.
كيف يغير الذكاء الاصطناعي عمل QA؟
شرحنا في مقال الاختبارات التي يكتبها الذكاء الاصطناعي ما الذي تستطيعه الأدوات اليوم، من توليد اختبارات الوحدة إلى وكلاء Playwright، وأهم ما فيه مشكلة المرجع Test Oracle، أي من يقرر ما هو الصحيح. وأثر ذلك على عمل فريق الجودة كما نراه:
- الكتابة أرخص، والتصميم أغلى: النموذج يكتب عشرين اختباراً في دقيقة، ولكن إذا أعطيته الكود المكتوب بـ
round()وطلبت منه اختبارات، فالأرجح أن يكتب اختبارات تطابق ما يفعله الكود، لا ما تقوله القاعدة 3، وتحديد القيم الحدية Boundary Values وأعمدة جدول القرار Decision Table من المتطلبات هو عمل الإنسان الذي يعرف العمل. - المراجعة أصبحت جزءاً من الوظيفة: كل اختبار يكتبه النموذج يحتاج من يسأل: ماذا يتحقق هذا فعلاً؟ واختبار الطفرات Mutation Testing أداة جيدة لهذا السؤال.
- الكود الذي يكتبه الوكلاء الأذكياء يزيد كمية التغييرات: وهذا يجعل الاختبار حسب المخاطر Risk-based Testing وبوابات الجودة في CI أهم وليس أقل، كما ناقشنا في مقال SonarQube.
- الشهادات تتبع ذلك: وجود شهادة CT-GenAI من ISTQB دليل على أن استخدام النماذج في الاختبار أصبح مهارة مطلوبة، وليس بديلاً عن المختبر.
أخطاء شائعة
- فريق الجودة آخر محطة: تسليم الميزة للمختبر في آخر يومين من ال Sprint يجعله يختبر بسرعة ما لم يشارك في تصميمه، والحل أن يقرأ المتطلبات ويكتب الحالات من أول يوم.
- قيمة واحدة لكل فئة ولا شيء عند الحد: كما رأيت في التجربة، فاختبر الحد وجاريه دائماً، وخاصة في المال والوقت.
- اختبار الشروط كل واحد وحده: عندما تجتمع ثلاثة شروط فاكتب جدول القرار Decision Table، ولو على ورقة.
- تقرير خطأ بعنوان «لا يعمل»: اكتب الخطوات والمتوقع والفعلي والنسخة، وإلا عاد إليك التقرير بسؤال «ماذا فعلت بالضبط؟».
- الخلط بين الخطورة Severity والأولوية Priority: اجعلهما حقلين منفصلين، ودع مالك المنتج يقرر الأولوية Priority بنفسه.
- مكافأة الأرقام: عدد الأخطاء أو نسبة التغطية كهدف لكل شخص يفسد المقياس والفريق معاً.
- عدم كتابة ما لن تختبره: الخطر الذي لم يكتب في الخطة لم يقبله أحد، وإنما نسيه الجميع.
الخلاصة
- ضمان الجودة QA يعمل على طريقة بناء البرنامج ويمنع الخطأ، وضبط الجودة QC يفحص المنتج ويكشفه، والاختبار هو أكبر أنشطة ضبط الجودة.
- استراتيجية الاختبار Test Strategy للمنتج كله وتتغير نادراً، وخطة الاختبار Test Plan لكل إصدار، وتكفي أحياناً في جدول من ستة أسطر فيه معايير البدء والخروج.
- حالة الاختبار Test Case بلا نتيجة متوقعة ليست اختباراً، والفئات المتكافئة Equivalence Partitions تقلل عدد الحالات، والقيم الحدية Boundary Values تجد أخطاء الحدود، وجدول القرار Decision Table يجد التركيبات المنسية.
- في التجربة نجحت عشرة اختبارات بتغطية 100% والدالة فيها خطآن، فوجدت القيم الحدية Boundary Values بثلاث قيم خطأ التقريب الذي يعيش في نصف ساعة قبل كل حد، ووجد جدول القرار Decision Table التذكرة الترويجية عند الإلغاء.
- الخطورة Severity تقدير فني والأولوية Priority قرار عمل، والخطأ يغلق عندما ينجح الاختبار الذي أعاد إنتاجه.
- الخطر، أي الاحتمال في الأثر، يقرر أين تضع الوقت، والاختبار المبكر Shift-left والاختبار بعد النشر Shift-right يضيفان إلى الاختبارات ولا يحلان محلها.
- قس ما هرب إلى الإنتاج ونسبة فشل التغيير والاختبارات المتقلبة، ولا تجعل عدد الأخطاء أو التغطية هدفاً.
- الذكاء الاصطناعي يجعل كتابة الاختبارات أرخص، ويجعل تصميمها ومراجعتها أهم.
وفي المقال التالي من القسم بإذن الله سوف نرسم خريطة أدوات ضمان الجودة، من أطر اختبار الوحدة إلى إدارة حالات الاختبار Test Management، بتراخيصها وأسعارها، ونشغل أربعاً منها على تطبيق الاسترداد نفسه. وهذه مقالات مرتبطة بالموضوع:
 دليلأدوات ضمان الجودة QA: أيها يناسب فريقك؟خريطة لأدوات الاختبار وإدارة حالاته بتراخيصها وأسعارها، مع جدول يساعدك على اختيار ما يحتاجه فريقك فعلاً.دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلأدوات جودة الكود: أيها تختار لفريقك؟مقارنة عملية بين مدققات كل لغة والأدوات الجامعة ومنصات الجودة، بتراخيصها وأسعارها ونتائجها على مستودع واحد.
 دليلDAST: فحص تطبيقك من الخارج وهو يعملكيف يفحص ZAP تطبيقك من الخارج وهو يعمل، ومتى يحق لك أن تشغله، وكيف تحول نتائجه إلى بوابة في خط CI.
 دليلمن الفرع إلى الإنتاج: البيئات وGitOps للفرقكيف يختبر فريقك كل ميزة وحدها ويعرضها على العميل دون أن تصل ميزة غير جاهزة إلى الإنتاج.
سجل التحديثات
- أكتوبر 2026: كتابة المقال اعتماداً على منهج ISTQB للمستوى الأساسي 4.0.1 وقاموس ISTQB وصفحات الشهادات الرسمية ومقاييس DORA، مع تجربة حقيقية على Python 3.13.16 وpytest 9.1.1 وpytest-cov 7.1.0.


