


عندما تجهز جهاز NAS أو سيرفراً بعدة أقراص لأول مرة، تظهر لك شاشة تسألك سؤالاً واحداً قبل أي شيء: أي مستوى RAID تريد؟ وأمامك قائمة فيها 0 و1 و5 و6 و10، وبجانب كل خيار رقم للمساحة يتغير كلما غيرت اختيارك. والأغلب يختار ما يعطي أكبر مساحة مع شيء من الحماية، أي RAID 5، ثم ينسى الأمر، ويعيش مطمئناً لأن «البيانات محفوظة على أكثر من قرص». وبعد سنتين يتعطل قرص، فتبدأ إعادة البناء وتستمر يوماً كاملاً والجهاز بطيء، أو يحذف أحد الموظفين مجلداً بالخطأ، فيكتشف الفريق أن ال RAID لم يحتفظ بأي نسخة منه.
لنفرض أنك في شركة ناشئة لديها سيرفر ملفات بأربعة أقراص بسعة 8 تيرابايت، وعليه مجلدات الفريق وأرشيف المشاريع، وتريد أن تقرر كيف ترتب هذه الأقراص. وقد لخصنا في مقال NAS وSAN حساب المساحة لكل مستوى، وناقشنا في قسم أخطاء القراءة ما تقوله أوراق المواصفات عن الخطأ أثناء إعادة البناء، أما هنا فسوف ندخل إلى داخل كل مستوى: أين تذهب الكتل، وكيف يحسب التماثل، وكم عملية تكلف الكتابة الواحدة، وماذا يحدث خطوة بخطوة عندما يتعطل قرص. وسوف نبني كل ذلك بأنفسنا بالأداة mdadm على أقراص من ملفات، ونتلف الأقراص عمداً ونعيد بناءها، ثم نحذف ملفاً ونرى أنه اختفى من القرصين معاً. وسوف نناقش في هذا المقال ما يلي:
- لماذا ظهر RAID، والأفكار الثلاث التي يقوم عليها: التوزيع Striping، والنسخ Mirroring، والتماثل Parity.
- المستويات 0 و1 و5 و6 و10: ترتيب الكتل، والمساحة، وما يتحمله كل منها، ومتى تختاره.
- عقوبة الكتابة Write Penalty، مقاسة بعدد العمليات التي تصل فعلاً إلى كل قرص.
- إعادة البناء Rebuild والوضع المتدهور Degraded، وثغرة الكتابة Write Hole في RAID 5.
- RAID العتادي وبطاقات التحكم والبطارية BBU، مقابل RAID البرمجي في Linux، ومقابل RAIDZ في ZFS.
- تجربة عملية بالأداة mdadm: RAID 1 وRAID 5 وRAID 10، تعطيل قرص وإعادة بنائه، وتعطيل قرصين، وقياس عقوبة الكتابة.
- لماذا RAID ليس نسخة احتياطية، بالتجربة وبحادثة حقيقية، ثم جدول قرار وأخطاء شائعة.
لماذا ظهر RAID؟
في 1987 نشر ثلاثة باحثين من جامعة Berkeley هم David Patterson وGarth Gibson وRandy Katz تقريراً بعنوان A Case for Redundant Arrays of Inexpensive Disks (RAID)، وفكرته أن الأقراص الكبيرة الغالية التي كانت تستخدمها الحواسيب المركزية في ذلك الوقت يمكن أن تستبدل بمجموعة من أقراص الحواسيب الشخصية الصغيرة الرخيصة، تعمل معاً كقرص واحد أسرع. والمشكلة التي واجهوها أن مجموعة من مئة قرص تتعطل أكثر بكثير من قرص واحد، فإذا تعطل قرص واحد منها ضاعت البيانات كلها، لذلك أضافوا التكرار Redundancy، أي أن تحفظ معلومات إضافية تكفي لإعادة بناء أي قرص يتعطل. ومن هذا التقرير جاءت المستويات المرقمة التي ما زلنا نستخدمها، وتغير معنى الحرف I مع الوقت من Inexpensive إلى Independent، لأن الأقراص لم تعد رخيصة بالمقارنة، ولكن الفكرة بقيت كما هي: عدة أقراص يراها نظام التشغيل قرصاً واحداً، مع تكرار يحميها من عطل قرص أو أكثر.
ولاحظ ما الذي يحميك منه RAID بالضبط، لأن كل المقال مبني عليه: عطل قرص كامل، أو قطاعات لا يستطيع القرص قراءتها. أما ما يكتبه البرنامج أو المستخدم على المصفوفة، صحيحاً كان أو خطأ، فينفذه RAID على كل الأقراص بإخلاص، وسوف نرى ذلك في التجربة.
ثلاث أفكار يقوم عليها كل مستوى
كل مستويات RAID تجمع بين ثلاث أفكار بنسب مختلفة:
- التوزيع Striping: تقسم البيانات إلى قطع بحجم ثابت يسمى Chunk، 64 كيلوبايت مثلاً، وتكتب القطعة الأولى على القرص الأول والثانية على الثاني وهكذا، والصف الواحد من القطع على كل الأقراص يسمى Stripe. والفائدة أن الملف الكبير يقرأ من كل الأقراص معاً، والطلبات الصغيرة المتفرقة تتوزع على الأقراص فيعمل كل منها على طلب مختلف.
- النسخ Mirroring: كل كتلة تكتب على قرصين أو أكثر، فإذا تعطل أحدهما بقيت النسخة الأخرى، والقراءة يمكن أن تأتي من أي منهما.
- التماثل Parity: بدلاً من نسخة كاملة، تحسب قيمة واحدة من كل الكتل في الصف بعملية XOR وتحفظها في قطعة إضافية، وهذه القيمة تكفي لإعادة حساب أي كتلة واحدة مفقودة من الصف.
والفكرة الثالثة هي التي تحتاج شرحاً، لأنها تبدو كالسحر في البداية: كيف تكفي قطعة واحدة لحماية ثلاث؟ والصورة التالية تبينها على بايت واحد من كل قرص:
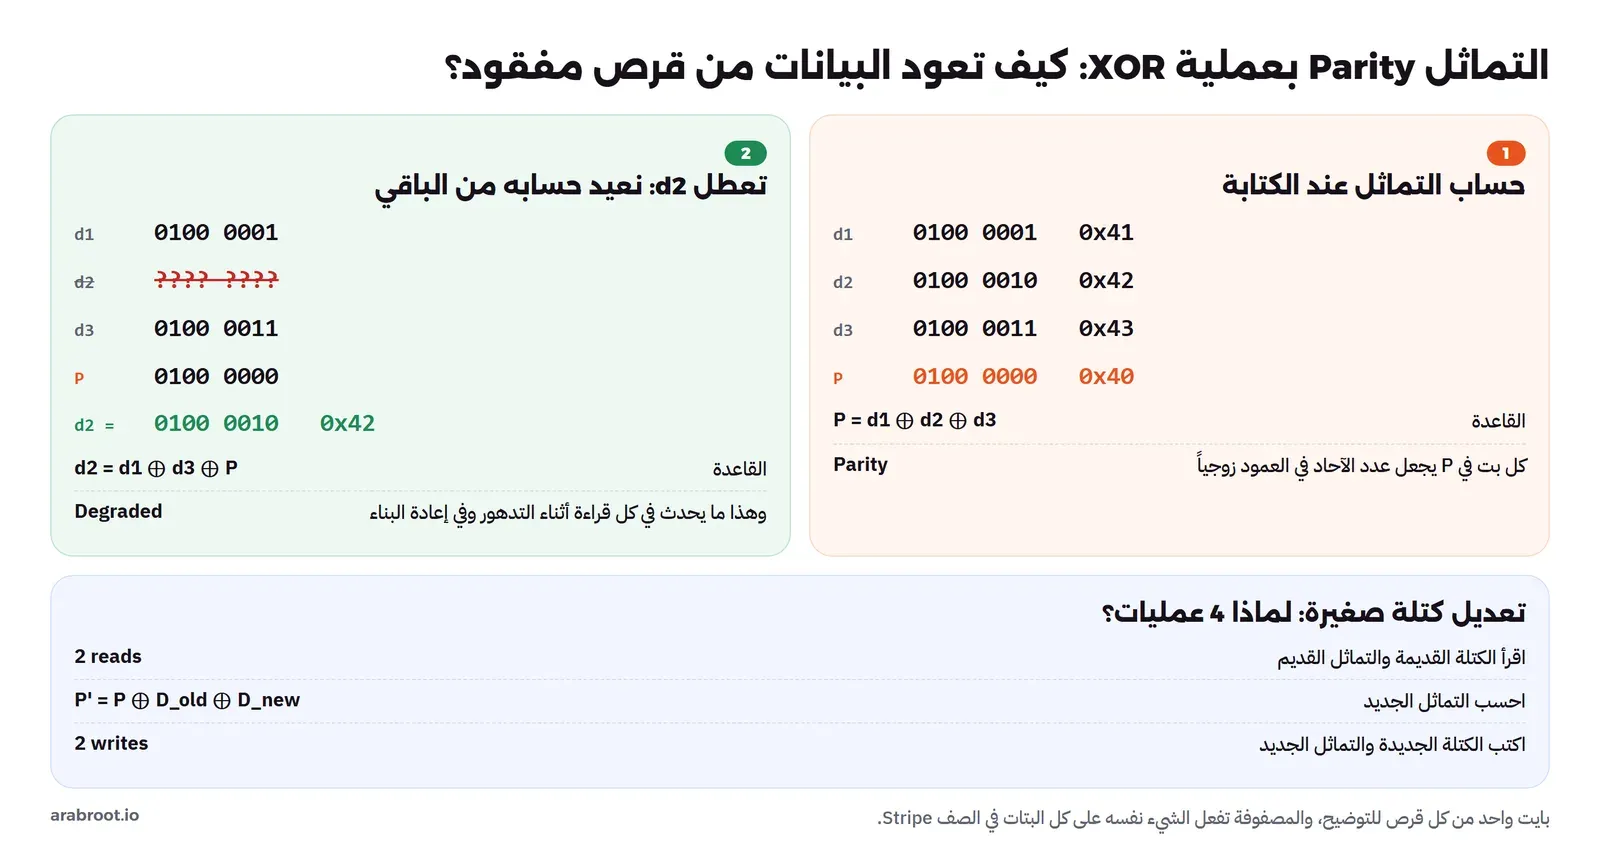
عملية XOR لها خاصية بسيطة: إذا جمعت بها عدة قيم ثم جمعت النتيجة بكل القيم إلا واحدة، حصلت على القيمة الناقصة. فالتماثل 0x40 هو 0x41 XOR 0x42 XOR 0x43، وعندما يضيع القرص الثاني نحسب 0x41 XOR 0x43 XOR 0x40 فنحصل على 0x42 بالضبط. والمصفوفة تفعل هذا على كل البتات في كل صف، وهذا ما يحدث في كل قراءة من قرص مفقود وفي إعادة البناء كلها. ولاحظ الجزء السفلي من الصورة لأنه سبب أهم عيب في مستويات التماثل: عندما تعدل كتلة واحدة صغيرة في الصف، لا تستطيع المصفوفة أن تكتبها وحدها، لأن التماثل سيصبح خاطئاً، فتقرأ الكتلة القديمة والتماثل القديم، وتحسب التماثل الجديد، ثم تكتب الاثنين، أي أربع عمليات بدل عملية واحدة، وسوف نعد هذه العمليات بأنفسنا في التجربة.
المستويات الخمسة: أين تذهب كل كتلة؟
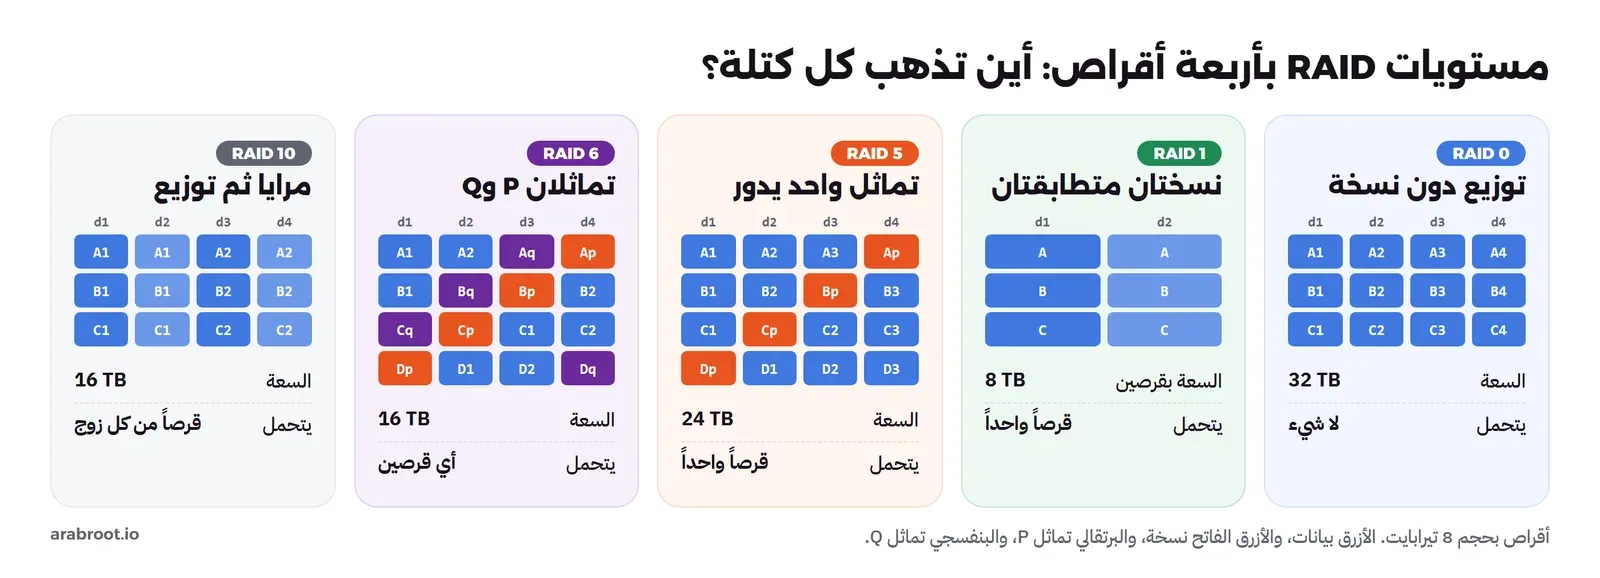
الصورة التالية تبين ترتيب الكتل في كل مستوى بأربعة أقراص بسعة 8 تيرابايت، وهي أقراص الشركة الناشئة في قصتنا، وسوف نمر على كل مستوى بعدها:
RAID 0: توزيع دون أي حماية
RAID 0 يوزع البيانات على كل الأقراص دون نسخة ولا تماثل، فتحصل على مجموع السعات، 32 تيرابايت في مثالنا، وعلى سرعة قريبة من مجموع سرعات الأقراص في القراءة والكتابة المتتابعة. ولكن الحرف R في RAID لا ينطبق عليه أصلاً، لأن كل ملف كبير موزع على كل الأقراص، فعطل أي قرص يضيع المصفوفة كلها. ومع أربعة أقراص يتضاعف احتمال الخسارة تقريباً أربع مرات مقارنة بقرص واحد. لذلك لا تضع عليه إلا بيانات تستطيع أن تعيد إنتاجها، مثل ملفات مؤقتة لمعالجة الفيديو أو ذاكرة مؤقتة Cache لخدمة تبنيها من جديد.
RAID 1: نسختان متطابقتان
RAID 1 يكتب كل كتلة على قرصين، أو أكثر إذا أردت، فتحصل على سعة قرص واحد، ويتحمل عطل أي قرص ما دام قرص واحد سليماً. والكتابة تكلف عمليتين لأن كل كتلة تكتب مرتين، ولكنهما تحدثان معاً على قرصين مختلفين، فالسرعة قريبة من قرص واحد. أما القراءة فيستطيع md في Linux أن يوزعها على القرصين بحسب صفحة md، فتتحسن عند وجود طلبات كثيرة متزامنة. وإعادة البناء فيه أبسط ما يكون: نسخ القرص السليم إلى الجديد. لذلك هو الخيار المعتاد لقرص نظام التشغيل في السيرفر، ولأي جهاز فيه قرصان فقط.
RAID 5: تماثل واحد يدور
RAID 5 يحفظ في كل صف قطعة تماثل واحدة، ويغير القرص الذي يحملها من صف إلى آخر، فلا يصبح قرص واحد هو عنق الزجاجة في كتابة التماثل، وهذا هو الفرق بينه وبين RAID 4 القديم الذي كان يضع التماثل كله على قرص واحد. والسعة كل الأقراص ناقص قرص، أي 24 تيرابايت في مثالنا، ويتحمل عطل قرص واحد فقط. والقراءة المتتابعة سريعة لأنها من كل الأقراص، والكتابة المتتابعة الكبيرة جيدة إذا كتبت صفوفاً كاملة، أما الكتابة الصغيرة العشوائية فتدفع أربع عمليات كما رأينا. ولهذا كان RAID 5 لسنوات طويلة الخيار المفضل لسيرفرات الملفات، لأنه يعطي أكبر مساحة مع حماية، ولكن مع الأقراص الكبيرة اليوم ظهرت مشكلته الحقيقية، وهي ساعات إعادة البناء الطويلة التي لا يبقى فيها أي هامش، وسوف نحسبها بعد قليل.
RAID 6: تماثلان
RAID 6 يضيف قطعة تماثل ثانية في كل صف، وتسمى P وQ، والثانية لا تحسب بعملية XOR بسيطة وإنما بحساب رياضي مختلف يسمح بإعادة بناء أي قطعتين مفقودتين من الصف معاً. والسعة كل الأقراص ناقص قرصين، 16 تيرابايت في مثالنا بأربعة أقراص، ويتحمل عطل أي قرصين. وبأربعة أقراص فقط تكون المساحة مثل RAID 10، ولكن كلما زادت الأقراص صار RAID 6 أوفر، فبثمانية أقراص يعطيك ست سعات من ثمان. وكلفته كتابة صغيرة أغلى من RAID 5 لأن تماثلين يجب أن يحدثا، وسوف نرى في التجربة أن الثمن بستة أقراص ست عمليات لكل كتابة. وهو اليوم الخيار المعتاد لمصفوفات الأقراص الدوارة الكبيرة، لأن عطل قرص يتركك بهامش قرص آخر طوال إعادة البناء.
RAID 10: مرايا موزعة
RAID 10، ويسمى أيضاً RAID 1+0، يقسم الأقراص إلى أزواج، كل زوج مرآة، ثم يوزع البيانات على الأزواج. والسعة نصف الأقراص، 16 تيرابايت في مثالنا، ويتحمل عطل قرص من كل زوج، أي أنه قد يتحمل قرصين إذا كانا في زوجين مختلفين، ولا يتحمل قرصين من الزوج نفسه. ولا يوجد فيه تماثل، فالكتابة الصغيرة تكلف عمليتين فقط، وإعادة البناء نسخ من قرص واحد، لذلك هو الخيار المعتاد لقواعد البيانات وأقراص الأجهزة الافتراضية، حيث الكتابة الصغيرة العشوائية كثيرة. وفي md يسمى هذا الترتيب near=2، وسوف نرى في التجربة كيف يعرض mdadm أي الأقراص في كل زوج.
عقوبة الكتابة Write Penalty
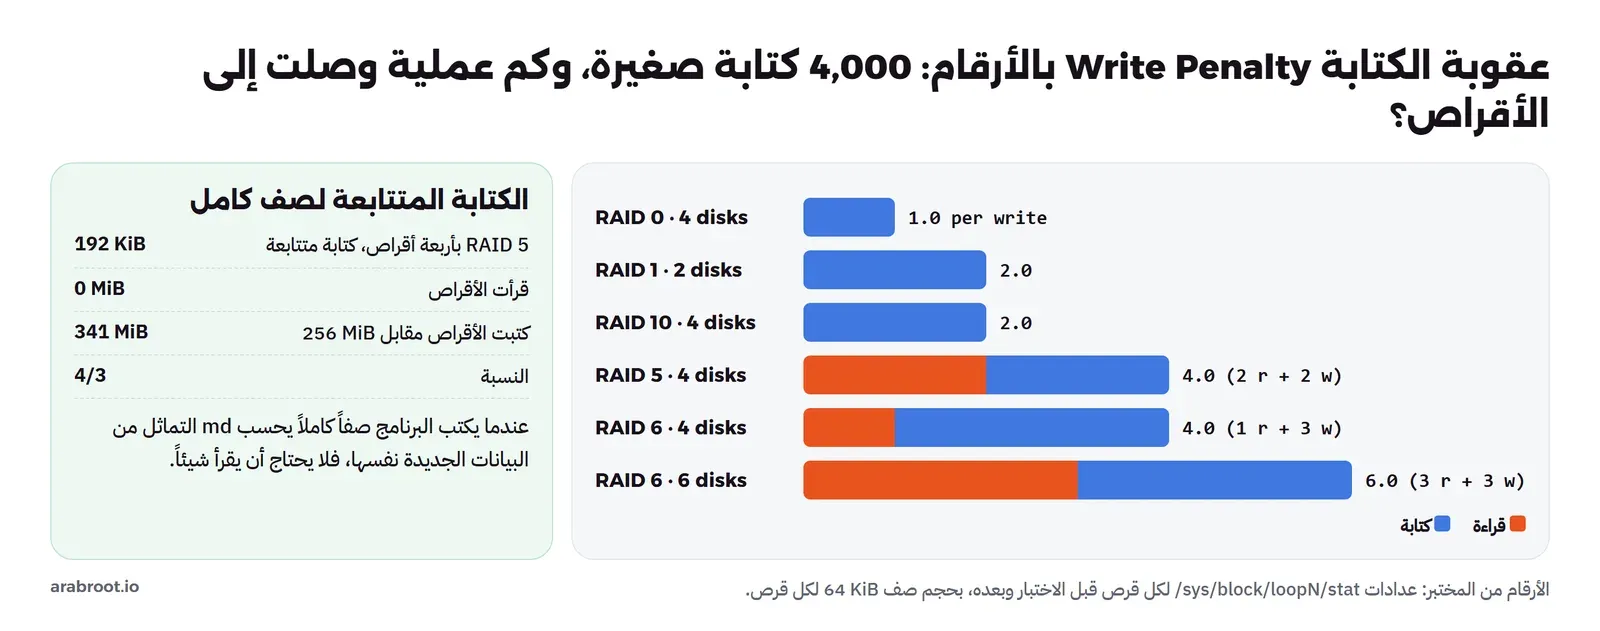
يقال عادة في الكتب إن عقوبة الكتابة في RAID 1 وRAID 10 هي 2، وفي RAID 5 هي 4، وفي RAID 6 هي 6، والمقصود عدد العمليات على الأقراص لكل كتابة صغيرة يطلبها البرنامج. وبدلاً من أن نحفظ هذه الأرقام، قسناها: أرسلنا 4,000 كتابة عشوائية بحجم 4 كيلوبايت مباشرة إلى كل مصفوفة، ثم عددنا العمليات التي وصلت إلى كل قرص من عدادات النواة نفسها، كما سوف ترى في التجربة. والنتيجة في الصورة التالية:
في الأرقام أعلاه لاحظ التالي:
- RAID 0 كتب 4,000 مرة، أي عملية لكل كتابة، وRAID 1 وRAID 10 كتبا حوالي 8,000 مرة، أي نسختين لكل كتابة، ولم يقرأ أي منها شيئاً.
- RAID 5 قرأ 7,957 مرة وكتب 8,004 مرات، أي قراءتين وكتابتين لكل كتابة، وهذه هي القراءة والكتابة للكتلة والتماثل كما في الصورة الثانية.
- RAID 6 بأربعة أقراص أعطى 4 عمليات وليس 6 كما في الكتب، والسبب أن الصف فيه قطعتا بيانات فقط، فوجد md أن الأرخص أن يقرأ القطعة الأخرى ويحسب التماثلين من جديد، أي قراءة واحدة وثلاث كتابات. أما بستة أقراص فرجع الرقم إلى 6: ثلاث قراءات وثلاث كتابات. أي أن الرقم المشهور حالة عامة، والمصفوفة تختار في كل مرة الطريقة الأرخص.
- والأهم في الجزء الأيمن: عندما كتب البرنامج صفوفاً كاملة بشكل متتابع على RAID 5، لم يقرأ md شيئاً، وكتب 341 ميجابايت مقابل 256، أي البيانات وتماثلها فقط. فعقوبة الكتابة مشكلة الكتابة الصغيرة العشوائية، وليست مشكلة نسخ ملفات الفيديو الكبيرة.
وهذا يعيدنا إلى سيرفر الشركة الناشئة: إذا كان عليه أرشيف ملفات كبيرة فلا بأس بـ RAID 5 أو RAID 6 من جهة الأداء، أما إذا وضعت عليه قاعدة بيانات أو أقراص أجهزة افتراضية فكل كتابة صغيرة تتحول إلى أربع أو ست عمليات على أقراص دوارة، كل منها يعطي حوالي مئة عملية في الثانية، وهنا يكون RAID 10 هو الحل الصحيح.
ماذا يحدث عندما يتعطل قرص؟
عندما يتعطل قرص في مصفوفة فيها تكرار، تدخل المصفوفة في الوضع المتدهور Degraded: ما زالت تعمل، وما زالت البيانات كلها متاحة، ولكن ما كان على القرص المفقود يحسب الآن عند كل قراءة. ففي RAID 1 وRAID 10 تقرأ من النسخة الأخرى ولا يتغير شيء تقريباً، أما في RAID 5 فكل قراءة لكتلة كانت على القرص المفقود تحتاج قراءة كل الأقراص الأخرى في الصف وحساب XOR، فيبطؤ السيرفر. ثم تضع قرصاً جديداً، فتبدأ إعادة البناء Rebuild، وتسمى في md أيضاً Recovery، وفيها تكتب المصفوفة القرص الجديد كله من أوله إلى آخره.
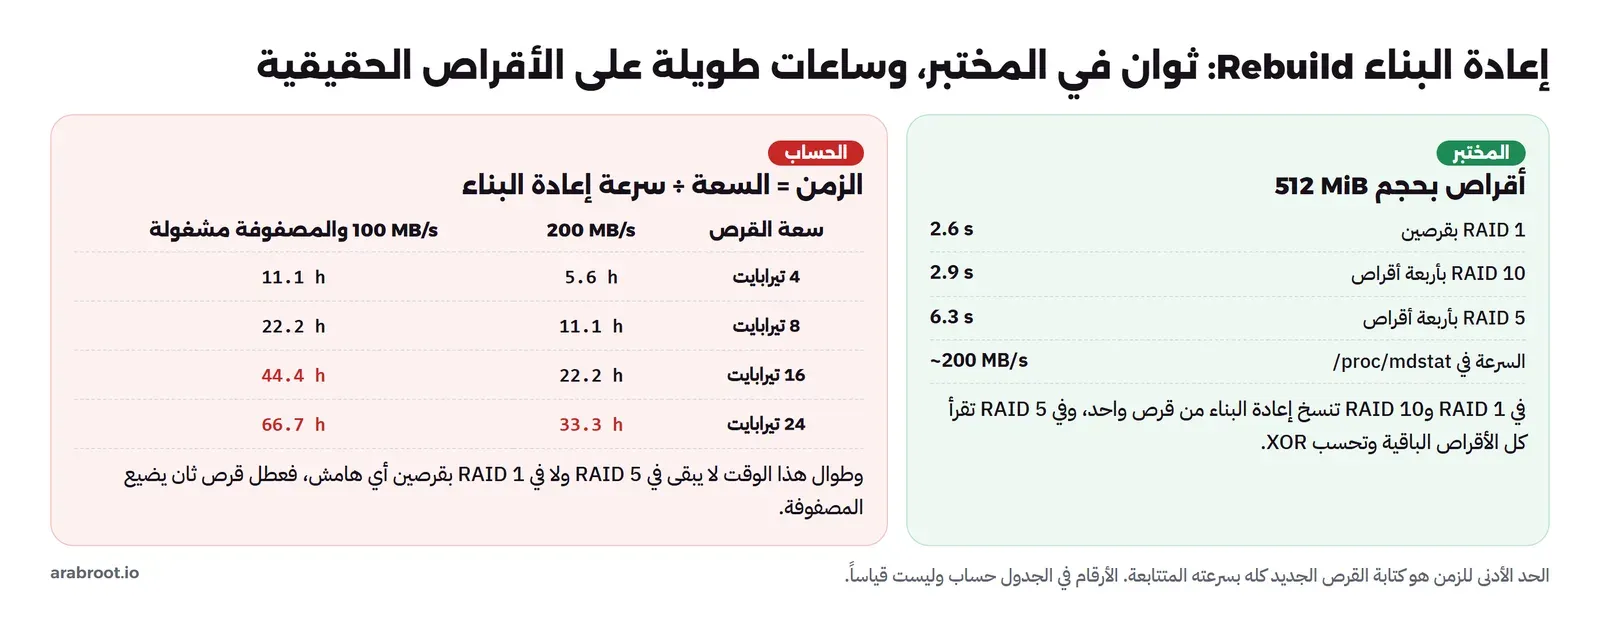
والحساب في الجدول بسيط: القرص الجديد يجب أن يكتب كله، فالزمن على الأقل سعة القرص مقسومة على سرعة كتابته المتتابعة. وقرص بسعة 16 تيرابايت بسرعة 200 ميجابايت في الثانية يحتاج 16,000,000 ÷ 200 = 80,000 ثانية، أي 22 ساعة، وهذا إذا كانت المصفوفة لا تفعل شيئاً آخر. أما في الواقع فالسيرفر يخدم المستخدمين أثناء إعادة البناء، وmd يخفض سرعة إعادة البناء تلقائياً عندما توجد طلبات أخرى بحسب الحدين speed_limit_min وspeed_limit_max في توثيق md في النواة، فيصبح الرقم يومين أو أكثر. وطوال هذا الوقت يكون RAID 5 دون أي هامش، والأقراص الباقية تعمل بأقصى طاقتها، وغالباً هي من الدفعة نفسها والعمر نفسه، فعطل قرص ثان أو خطأ قراءة في قطاع واحد في هذه الساعات يعني خسارة، وهذا ما شرحناه بالأرقام في قسم أخطاء القراءة.
ولهذا ترى التوصية الحالية في أغلب الأدلة: مع الأقراص الدوارة الكبيرة استخدم RAID 6 أو RAID 10، واترك RAID 5 للأقراص الصغيرة أو لأقراص SSD التي تعيد البناء بسرعة أكبر. وهناك أداتان تقللان هذا الخطر في md:
- القرص الاحتياطي Hot Spare: قرص إضافي في الجهاز لا يحمل بيانات، تبدأ المصفوفة إعادة البناء عليه فوراً عند أي عطل، دون أن تنتظر أن يلاحظ أحد ويشتري قرصاً ويأتي ليركبه، وهي ساعات أو أيام لا هامش فيها.
- خريطة البتات Write-intent Bitmap: سجل صغير على الأقراص يحدد المناطق التي فيها كتابة لم تكتمل، فإذا خرج قرص من المصفوفة لحظياً ثم عاد، كأن يفصل كابل أو تنقطع الكهرباء، تنسخ المصفوفة المناطق المتغيرة فقط بدل القرص كله، وتضيفها عند الإنشاء أو لاحقاً بالخيار
--bitmap=internalكما في صفحة mdadm، وثمنها قليل من الكتابة الإضافية لتحديث الخريطة.
ثغرة الكتابة Write Hole
هناك مشكلة أخرى في مستويات التماثل لا تظهر إلا مع انقطاع الكهرباء. تذكر أن تعديل كتلة يعني كتابتين: الكتلة الجديدة والتماثل الجديد، وهما على قرصين مختلفين، ولا يمكن أن تحدثا في اللحظة نفسها بالضبط. فإذا انقطعت الكهرباء بعد الأولى وقبل الثانية، بقي الصف بتماثل لا يطابق بياناته:
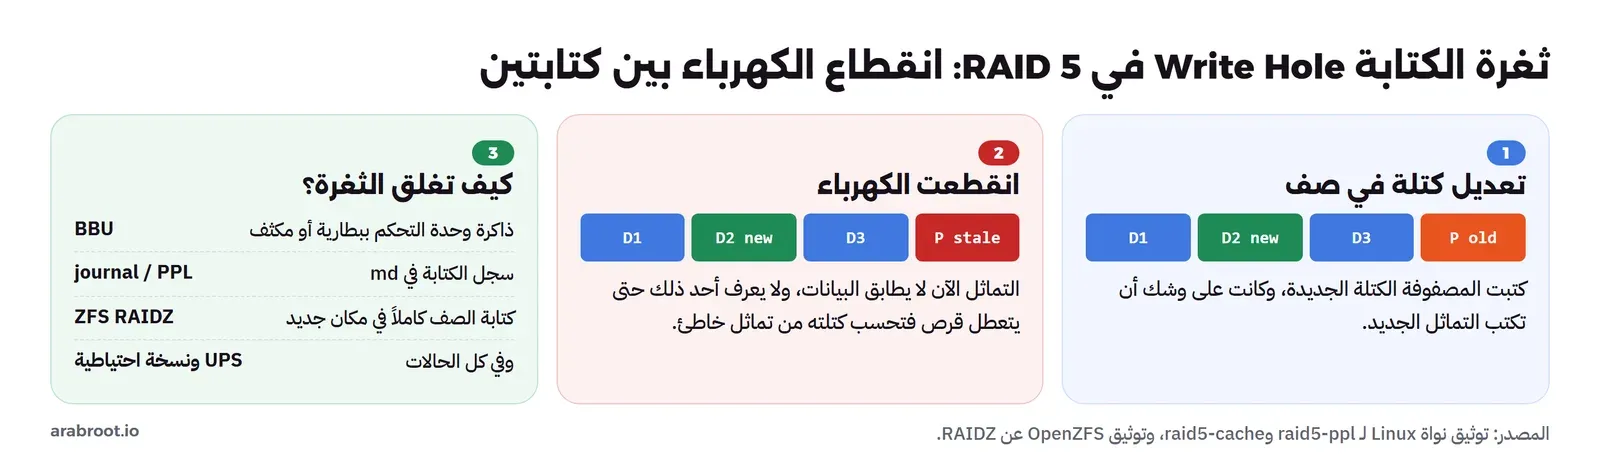
والخطير في هذه الحالة أنها صامتة، فالمصفوفة تعمل والقراءة صحيحة، لأن القراءة العادية لا تستخدم التماثل. ولكن عندما يتعطل قرص بعد أسابيع، تحسب المصفوفة كتلة هذا الصف من تماثل خاطئ، فتعطيك بيانات خاطئة دون أي رسالة خطأ. وهذا ما يسميه توثيق النواة ثغرة الكتابة RAID5 Write Hole، ويذكر في md حلين: سجل الكتابة raid5-cache الذي يكتب كل تعديل على قرص منفصل سريع قبل المصفوفة، والتماثل الجزئي PPL الذي يحفظ معلومات تكفي لإصلاح الصف بعد الانقطاع دون قرص إضافي. وبطاقات RAID العتادية تحلها بذاكرة محمية ببطارية كما سوف نرى، وZFS لا تظهر فيه أصلاً لأنه لا يعدل صفاً قائماً أبداً. وفي كل الحالات، جهاز UPS يطفئ السيرفر بشكل آمن يقلل فرصتها كثيراً.
RAID العتادي أم البرمجي؟
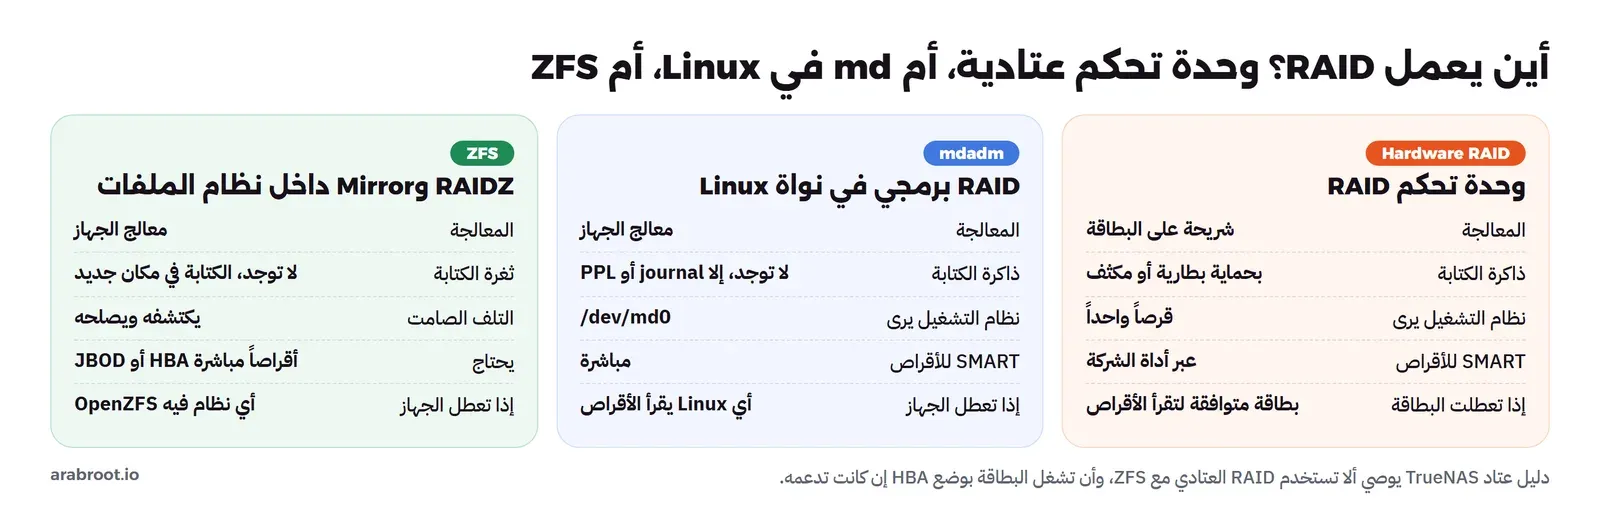
بعد أن اختار الفريق المستوى بقي سؤال: من يدير المصفوفة؟ وهناك ثلاثة أماكن يمكن أن يعمل فيها RAID، والصورة التالية تقارن بينها:
بطاقة RAID والبطارية BBU
بطاقة RAID العتادية Hardware RAID Controller بطاقة PCIe فيها معالج خاص وذاكرة، تتصل بها الأقراص مباشرة، وتقدم لنظام التشغيل قرصاً منطقياً واحداً Virtual Disk، فلا يعرف النظام شيئاً عن الأقراص خلفها. وأهم ما فيها ليس المعالج، فمعالجات السيرفرات اليوم تحسب XOR دون جهد يذكر، وإنما ذاكرة الكتابة Write Cache: البطاقة تستقبل الكتابة في ذاكرتها وتؤكدها للنظام فوراً، ثم تكتبها على الأقراص لاحقاً، وهذا ما يسمى Write-Back، فتصبح الكتابة الصغيرة سريعة جداً وتجمع البطاقة الكتابات المتجاورة في صفوف كاملة. ولكن هذه الذاكرة تضيع إذا انقطعت الكهرباء، لذلك تأتي البطاقات الجيدة بوحدة حماية: بطارية Battery Backup Unit واختصاراً BBU في الأجيال القديمة، أو مكثف كبير Supercapacitor مع ذاكرة فلاش في الأجيال الحديثة، ينقل ما في الذاكرة إلى الفلاش عند الانقطاع، كما في الصورة التالية:
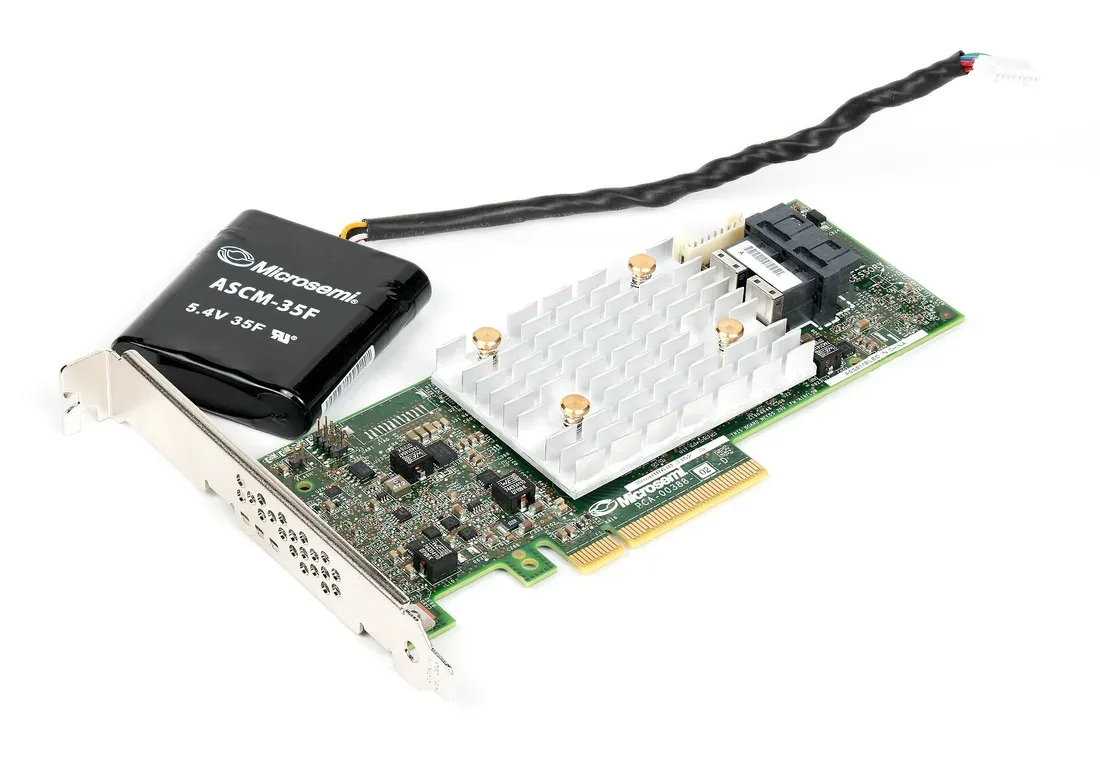
وإذا تلفت البطارية أو المكثف، فالبطاقات المحترمة تتحول تلقائياً إلى Write-Through، أي أنها لا تؤكد الكتابة حتى تصل إلى الأقراص، فيسقط الأداء فجأة، وكثير من مشكلات «السيرفر أصبح بطيئاً فجأة» سببها بطارية انتهى عمرها. أما البطاقة التي تبقي Write-Back دون حماية فهي وصفة لخسارة بيانات عند أول انقطاع. ولهذا يذكر دليل عتاد TrueNAS من مشكلات بطاقات RAID أنها قد تخفي الرقم التسلسلي للأقراص وبيانات SMART، وأنها قد تسبب خسارة بيانات إذا استخدمت ذاكرة الكتابة مع بطارية ميتة.
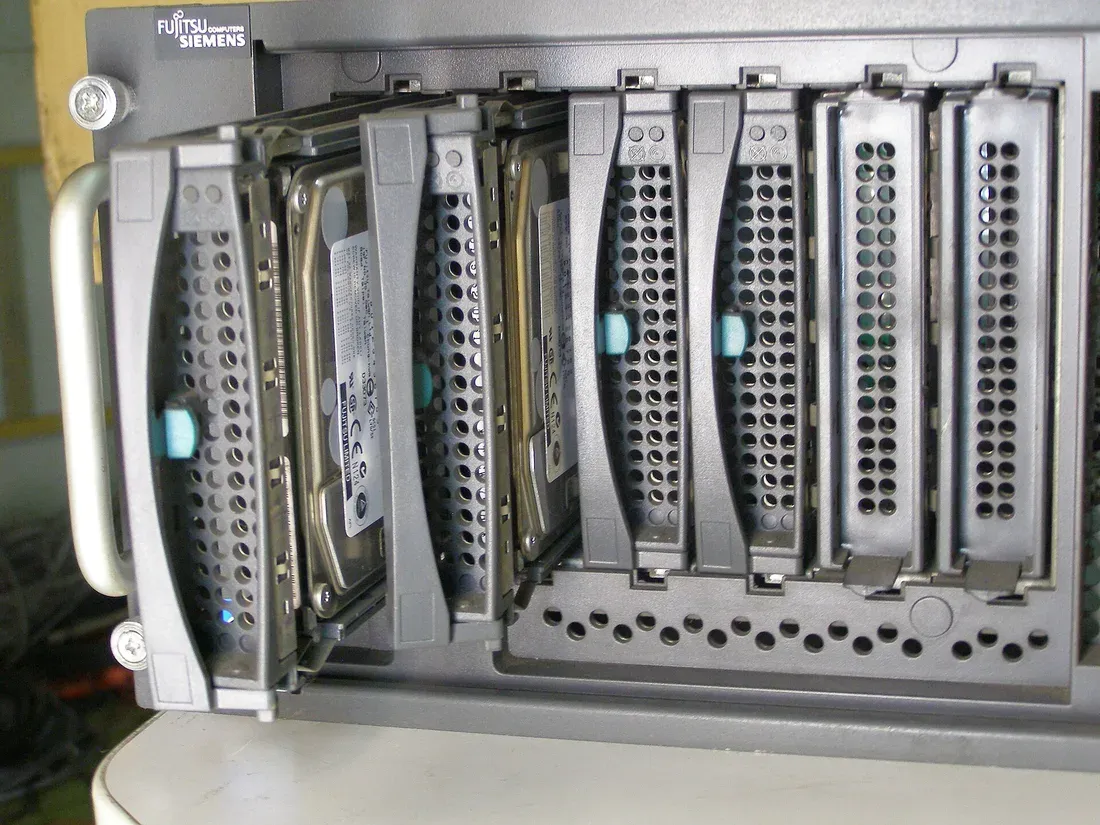
ومشكلة أخرى لا يفكر فيها أحد حتى تحدث: البطاقة تكتب على الأقراص إعداد المصفوفة بصيغة خاصة بالشركة، فإذا تعطلت البطاقة نفسها بعد خمس سنوات تحتاج بطاقة من العائلة نفسها أو متوافقة معها لتقرأ الأقراص، وليس أي جهاز. لذلك إذا كان سيرفرك يعتمد على بطاقة RAID فاعرف رقمها، وتأكد أن بديلها متاح، واحفظ إعداد المصفوفة. أما الأقراص نفسها في السيرفرات فتركب عادة في أدراج أمامية تستبدل والجهاز يعمل Hot-swap، كما في الصورة التالية لسيرفر قديم:
RAID البرمجي: md وmdadm
في Linux يوجد RAID كامل داخل النواة اسمه md، أي Multiple Devices، وتديره الأداة mdadm. وهو يعمل على أي أقراص يراها النظام، ويقدم المصفوفة كجهاز باسم مثل /dev/md0، ويكتب إعداده في بداية كل قرص أو نهايته بصيغة مفتوحة موثقة في صفحة md، فإذا تعطل السيرفر نقلت الأقراص إلى أي جهاز Linux آخر وجمعتها بأمر واحد. ونقاط ضعفه أنه لا يملك ذاكرة كتابة محمية، فالكتابة الصغيرة في RAID 5 وRAID 6 تدفع ثمنها كاملاً، وثغرة الكتابة تحتاج journal أو PPL، وأنه يستخدم معالج الجهاز، وهذا لم يعد مشكلة في الأجهزة الحديثة. أما نقاط قوته فهي أنه مجاني، وأن الأقراص تبقى ظاهرة للنظام فتقرأ SMART لكل منها مباشرة، وأنك لا تعتمد على بطاقة من شركة واحدة. لذلك تجد md تحت أغلب أجهزة NAS الجاهزة التي تعمل بـ Linux، وتحت أغلب السيرفرات الصغيرة التي لا تحتاج بطاقة.
وانتبه إلى ما يسمى Fake RAID أو RAID الخاص باللوحة الأم: كثير من اللوحات الأم فيها خيار RAID في إعدادات BIOS، وهو في الحقيقة RAID برمجي يعمل بتعريف Driver في نظام التشغيل، يجمع عيوب النوعين: صيغة خاصة بالشركة دون ذاكرة محمية. وفي Linux يستطيع md أن يقرأ بعض هذه الصيغ، ولكن الأفضل في سيرفر Linux أن تترك الأقراص عادية وتستخدم md أو ZFS مباشرة.
RAID مقابل RAIDZ في ZFS
شرحنا في مقال ZFS أن ZFS يرتب الأقراص بنفسه في Mirror أو RAIDZ1 أو RAIDZ2 أو RAIDZ3، وهي في الحماية والسعة تقابل RAID 1 وRAID 5 وRAID 6 وتماثلاً ثلاثياً. ولكن الفرق في الطريقة، فبحسب توثيق RAIDZ في OpenZFS عرض الصف في RAIDZ متغير Dynamic، فكل كتلة يكتبها ZFS هي صف كامل بعرض يناسبها، ويكتبها مع تماثلها في مكان جديد دائماً لأنه يعمل بالنسخ عند الكتابة Copy-on-Write، فلا يعدل صفاً قائماً، والصفحة نفسها تقول إن هذا يلغي ثغرة الكتابة RAID-5 Write Hole، ولا توجد قراءة للكتلة القديمة والتماثل القديم. ثم إن ZFS يحفظ مجموع تحقق لكل كتلة، فيعرف عند القراءة أي النسخ تالفة ويصلحها، وهذا ما لا يستطيعه md ولا البطاقة العتادية، كما رأينا في تجربة النسخة التالفة. وإعادة البناء في ZFS، وتسمى Resilver، تنسخ البيانات المستخدمة فقط وليس القرص كله، فمصفوفة نصفها فارغ تعيد البناء في نصف الوقت تقريباً.
وفي المقابل لـ ZFS ثمن: يحتاج ذاكرة أكثر، ولا تضع تحته بطاقة RAID عتادية، وإنما بطاقة HBA تقدم الأقراص كما هي، أو تشغل البطاقة بوضع HBA أو JBOD إذا كانت تدعمه، كما يوصي دليل TrueNAS. فإذا كان سيرفر الشركة الناشئة سيعمل بـ TrueNAS أو Proxmox فالجواب الطبيعي هو ZFS، وإذا كان سيرفر Linux عادياً بنظام ملفات ext4 أو XFS فالجواب md، وبطاقة RAID العتادية تبقى للسيرفرات التي تأتي بها ويديرها فريق يعرفها، وخصوصاً مع Windows Server أو VMware.
تجربة عملية: mdadm بأقراص من ملفات
سوف نبني المصفوفات داخل Container بصلاحيات كاملة، لأن md وأجهزة Loop جزء من النواة، والأقراص ستة ملفات بحجم 512 ميجابايت نربط كل منها بجهاز Loop. وهذا يكفي لنرى كل السلوك الذي شرحناه، أما سرعات القراءة والكتابة فلا معنى لها هنا، لأن الأقراص الستة ملفات على قرص واحد، لذلك سوف نقيس عدد العمليات وليس السرعة. ملف lab/Dockerfile:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends mdadm fio e2fsprogs util-linux procps \
 && rm -rf /var/lib/apt/lists/*
ونبنيه ونشغله، ونضع ملفات الأقراص في Volume:
docker build -t infg-raid lab/
docker run -d --name infg-raid --privileged -v infg-raid-data:/disks infg-raid sleep infinity
docker cp lab/. infg-raid:/lab
docker exec infg-raid sh -c 'mdadm --version; cat /proc/mdstat'
والمخرج سوف يكون كما يلي:
mdadm - v4.4 - 2024-11-07 - Debian 4.4-11
Personalities : [raid0] [raid1] [raid10] [raid6] [raid5] [raid4]
unused devices: <none>
السطر Personalities يعرض المستويات التي تدعمها النواة الآن، وكلها موجودة، وunused devices: <none> يعني أنه لا توجد مصفوفات بعد. ثم الملف lab/00-disks.sh ينشئ الأقراص الستة:
#!/bin/sh
# Six "disks": 512 MiB files in /disks, each attached to a free loop device.
# Loop devices belong to the shared kernel, so the names we got are saved in /disks/loops.txt for the cleanup.
set -e
for i in 1 2 3 4 5 6; do
  truncate -s 512M /disks/d$i.img
  dev=$(losetup -f --show /disks/d$i.img)
  echo "d$i $dev" >> /disks/loops.txt
done
cat /disks/loops.txt
والمخرج سوف يكون كما يلي:
d1 /dev/loop2
d2 /dev/loop3
d3 /dev/loop4
d4 /dev/loop5
d5 /dev/loop6
d6 /dev/loop7
ولاحظ أن أجهزة Loop مشتركة بين كل Containers الجهاز، لأنها من النواة نفسها، لذلك حفظنا الأسماء التي حصلنا عليها في ملف، ولن نلمس في التنظيف إلا هذه الأسماء.
بناء RAID 1
الملف lab/01-raid1.sh يبني RAID 1 من القرصين الأولين، وينشئ عليه نظام ملفات ext4، ويكتب ملفاً فيه 200 ألف سطر نحسب له Hash لنقارن به بعد كل عطل:
#!/bin/sh
# RAID 1 from d1 and d2. Metadata 1.0 keeps the md superblock at the END of each disk, so each member
# also looks like a plain ext4 disk on its own (we use that in 04-not-backup.sh).
set -e
D1=$(awk '$1=="d1"{print $2}' /disks/loops.txt); D2=$(awk '$1=="d2"{print $2}' /disks/loops.txt)
mdadm --create /dev/md101 --run --level=1 --raid-devices=2 --metadata=1.0 $D1 $D2
sleep 1; cat /proc/mdstat
mdadm --wait /dev/md101 || true
mkfs.ext4 -q -L r1data /dev/md101
mkdir -p /mnt/r1 && mount /dev/md101 /mnt/r1
# a "customers" file with 200,000 lines and its SHA-256
seq -f 'customer-%06g,active' 1 200000 > /mnt/r1/customers.csv
sync; sha256sum /mnt/r1/customers.csv
mdadm --detail /dev/md101
والمخرج سوف يكون كما يلي:
mdadm: array /dev/md101 started.
Personalities : [raid0] [raid1] [raid10] [raid6] [raid5] [raid4]
md101 : active raid1 loop3[1] loop2[0]
      524224 blocks super 1.0 [2/2] [UU]
      [=======>.............]  resync = 38.4% (201984/524224) finish=0.0min speed=201984K/sec

unused devices: <none>
4cf5b92e0675336c88598ca7b039cc69b5aa87af71341f52729104c108a659d3  /mnt/r1/customers.csv
/dev/md101:
           Version : 1.0
     Creation Time : Mon Nov 16 02:16:04 2026
        Raid Level : raid1
        Array Size : 524224 (511.94 MiB 536.81 MB)
     Used Dev Size : 524224 (511.94 MiB 536.81 MB)
      Raid Devices : 2
     Total Devices : 2
       Persistence : Superblock is persistent

       Update Time : Mon Nov 16 02:16:07 2026
             State : active
    Active Devices : 2
   Working Devices : 2
    Failed Devices : 0
     Spare Devices : 0

Consistency Policy : resync

              Name : 0b11635f0905:101  (local to host 0b11635f0905)
              UUID : 4f2c0738:2e920511:c18d0a78:a0f982bd
            Events : 18

    Number   Major   Minor   RaidDevice State
       0       7        2        0      active sync   /dev/loop2
       1       7        3        1      active sync   /dev/loop3
في المخرج أعلاه لاحظ التالي:
- سطر
/proc/mdstatهو أهم سطر في md، وتقرؤه هكذا: المصفوفةmd101تعملactiveبمستوىraid1، وفيهاloop3[1]وloop2[0]، والرقم بين القوسين موقع القرص في المصفوفة. [2/2] [UU]تعني أن المصفوفة تريد قرصين وفيها قرصان يعملان، وكل U قرص سليم Up، وعندما يتعطل قرص سوف تصبح_كما سنرى بعد قليل. وهذا السطر هو ما تراقبه أدوات المراقبة في كل سيرفر.- السطر
resync = 38.4%يعني أن md بدأ يجعل القرصين متطابقين فور الإنشاء، وكان عند 38% بسرعة حوالي 200 ميجابايت في الثانية. والمصفوفة قابلة للاستخدام أثناء ذلك، ولكن الحماية لا تكتمل حتى ينتهي. super 1.0هي صيغة إعداد md التي اخترناها بـ--metadata=1.0، وهي تضع الإعداد في نهاية كل قرص، أما الافتراضية 1.2 فتضعه قرب البداية. وسوف نستفيد من هذا الاختيار في تجربة الحذف.- في مخرج
mdadm --detailالسطرConsistency Policy : resyncيعني أنه لا توجد خريطة بتات Bitmap ولا journal ولا PPL، فبعد انقطاع الكهرباء سوف يعيد md مزامنة القرصين كاملين، وهذا ما تحسنه خريطة البتات في المصفوفات الكبيرة. - والسطر
Events : 18عداد يزيد مع كل تغيير في حالة المصفوفة، ويحفظ على كل قرص، وبه يعرف md عند الإقلاع أي قرص متأخر عن الباقين.
تعطيل قرص وإعادة البناء
الآن نفترض أن القرص الثاني تعطل، فنعلمه معطلاً بـ --fail ونخرجه، ونقرأ الملف والمصفوفة متدهورة، ثم نضع مكانه قرصاً جديداً هو d3 ونقيس زمن إعادة البناء. الملف lab/03-fail-rebuild.sh:
#!/bin/sh
# Fail one member of RAID 1, read the data while degraded, then rebuild onto a new disk (d3) and time it.
set -e
D2=$(awk '$1=="d2"{print $2}' /disks/loops.txt); D3=$(awk '$1=="d3"{print $2}' /disks/loops.txt)
mdadm /dev/md101 --fail $D2
mdadm /dev/md101 --remove $D2
cat /proc/mdstat
echo 3 > /proc/sys/vm/drop_caches
sha256sum /mnt/r1/customers.csv
mdadm --zero-superblock $D2
start=$(date +%s.%N)
mdadm /dev/md101 --add $D3
sleep 1; grep -A2 md101 /proc/mdstat
mdadm --wait /dev/md101 || true
end=$(date +%s.%N)
echo "rebuild took $(echo "$end - $start" | awk '{printf "%.1f", $1 - $3}') s"
mdadm --detail /dev/md101 | grep -E 'State :|active sync'
والمخرج سوف يكون كما يلي:
mdadm: hot removed /dev/loop3 from /dev/md101
Personalities : [raid0] [raid1] [raid10] [raid6] [raid5] [raid4]
md101 : active raid1 loop2[0]
      524224 blocks super 1.0 [2/1] [U_]

unused devices: <none>
4cf5b92e0675336c88598ca7b039cc69b5aa87af71341f52729104c108a659d3  /mnt/r1/customers.csv
mdadm: added /dev/loop4
md101 : active raid1 loop4[2] loop2[0]
      524224 blocks super 1.0 [2/1] [U_]
      [=======>.............]  recovery = 38.4% (201984/524224) finish=0.0min speed=201984K/sec
rebuild took 2.6 s
             State : active
       0       7        2        0      active sync   /dev/loop2
       2       7        4        1      active sync   /dev/loop4
في المخرج أعلاه لاحظ التالي:
- بعد إخراج القرص أصبحت الحالة
[2/1] [U_]، أي أن المصفوفة تريد قرصين وفيها واحد، والشرطة مكان القرص المفقود. وهذه هي اللحظة التي يجب أن يصلك فيها تنبيه، لأن المصفوفة الآن دون أي حماية. - ال Hash بعد تفريغ ذاكرة النظام المؤقتة هو
4cf5b92e…نفسه، فالملف قرئ من القرص الباقي وحده، والخدمة لم تتوقف. - أضفنا القرص الجديد
loop4فأخذ الرقم[2]، وبقيت الحالة[U_]مع سطرrecoveryحتى انتهت إعادة البناء. أي أن القرص الجديد لا يحسب في الحماية حتى يكتمل نسخه. - إعادة البناء أخذت 2.6 ثانية لقرص بحجم 512 ميجابايت، أي حوالي 200 ميجابايت في الثانية، ونفس الحساب لقرص 16 تيرابايت يعطي حوالي 22 ساعة كما في الجدول السابق.
- ولاحظ أننا مسحنا إعداد md من القرص القديم بـ
--zero-superblock، وهذه عادة جيدة قبل أن تعيد استخدام أي قرص خرج من مصفوفة، حتى لا يجمعه md مع مصفوفة قديمة عند الإقلاع.
RAID 5: الوضع المتدهور، ثم عطل قرصين
الملف lab/05-raid5.sh يبني RAID 5 من أربعة أقراص، ويكتب الملف نفسه، ثم يعطل قرصاً ويقرأ، ثم يعيد البناء، ثم يجرب ما يخاف منه كل مدير أنظمة: عطل قرصين:
#!/bin/sh
# RAID 5 from four disks (d2, d4, d5, d6): build it, fail one disk, read while degraded, rebuild,
# then fail two disks at once and see what the array does.
set -e
DEVS=$(awk '$1=="d2"||$1=="d4"||$1=="d5"||$1=="d6"{print $2}' /disks/loops.txt)
D5=$(awk '$1=="d5"{print $2}' /disks/loops.txt); D6=$(awk '$1=="d6"{print $2}' /disks/loops.txt)
mdadm --create /dev/md105 --run --quiet --level=5 --raid-devices=4 --chunk=64 $DEVS
mdadm --wait /dev/md105 || true
mkfs.ext4 -q -L r5data /dev/md105 && mkdir -p /mnt/r5 && mount /dev/md105 /mnt/r5
seq -f 'customer-%06g,active' 1 200000 > /mnt/r5/customers.csv && sync
grep -A2 md105 /proc/mdstat
echo "== fail one disk"
mdadm /dev/md105 --fail $D5 --remove $D5
grep -A2 md105 /proc/mdstat
echo 3 > /proc/sys/vm/drop_caches; sha256sum /mnt/r5/customers.csv
echo "== rebuild"
mdadm --zero-superblock $D5
start=$(date +%s.%N); mdadm /dev/md105 --add $D5; mdadm --wait /dev/md105 || true; end=$(date +%s.%N)
echo "rebuild took $(echo "$end $start" | awk '{printf "%.1f", $1 - $2}') s"
grep -A2 md105 /proc/mdstat
echo "== fail two disks"
mdadm /dev/md105 --fail $D5
mdadm /dev/md105 --fail $D6 || true
# mdadm refuses the second failure; a disk that dies does not ask, so mark it faulty through sysfs as the kernel would
echo faulty > /sys/block/md105/md/dev-$(basename $D6)/state 2>/dev/null || true
grep -A2 md105 /proc/mdstat
mdadm --detail /dev/md105 | grep -E 'State :|Active Devices|Failed Devices'
echo 3 > /proc/sys/vm/drop_caches
sha256sum /mnt/r5/customers.csv || true
dmesg | grep 'md/raid:md105' | tail -3
umount /mnt/r5; mdadm --stop /dev/md105
for d in $DEVS; do mdadm --zero-superblock $d; done
والمخرج سوف يكون كما يلي:
md105 : active raid5 loop7[4] loop6[2] loop5[1] loop3[0]
      1569792 blocks super 1.2 level 5, 64k chunk, algorithm 2 [4/4] [UUUU]

== fail one disk
mdadm: hot removed /dev/loop6 from /dev/md105
md105 : active raid5 loop7[4] loop5[1] loop3[0]
      1569792 blocks super 1.2 level 5, 64k chunk, algorithm 2 [4/3] [UU_U]

4cf5b92e0675336c88598ca7b039cc69b5aa87af71341f52729104c108a659d3  /mnt/r5/customers.csv
== rebuild
mdadm: added /dev/loop6
rebuild took 6.3 s
md105 : active raid5 loop6[5] loop7[4] loop5[1] loop3[0]
      1569792 blocks super 1.2 level 5, 64k chunk, algorithm 2 [4/4] [UUUU]

== fail two disks
mdadm: Cannot remove /dev/loop7 from /dev/md105, array will be failed.
md105 : active raid5 loop6[5](F) loop7[4](F) loop5[1] loop3[0]
      1569792 blocks super 1.2 level 5, 64k chunk, algorithm 2 [4/2] [UU__]

             State : clean, FAILED
    Active Devices : 2
    Failed Devices : 2
sha256sum: /mnt/r5/customers.csv: Input/output error
[103536.525876] md/raid:md105: Operation continuing on 3 devices.
[103536.632916] md/raid:md105: Disk failure on loop7, disabling device.
[103536.633464] md/raid:md105: Cannot continue operation (2/4 failed).
في المخرج أعلاه لاحظ التالي:
- السعة
1569792 blocksأي حوالي 1.5 جيجابايت من أربعة أقراص بحجم 512 ميجابايت، وهي ثلاثة أقراص، لأن قرصاً كاملاً يذهب للتماثل. والعبارةalgorithm 2هي طريقة توزيع التماثل الدوار، وهي الافتراضية في md وتسمى left-symmetric. - بعد إخراج قرص أصبحت الحالة
[4/3] [UU_U]، وقرأنا الملف كاملاً بال Hash نفسه، مع أن ربع البيانات تقريباً كان على القرص المفقود، فهذه الأجزاء حسبت من التماثل وبقية الأقراص بعملية XOR كما في الصورة الثانية. - إعادة البناء أخذت 6.3 ثانية مقابل 2.6 في RAID 1، لأن md قرأ الأقراص الثلاثة الباقية كلها وحسب كل قطعة، بدل أن ينسخ من قرص واحد.
- ثم المفاجأة الأولى: عندما طلبنا تعطيل قرص ثان رفض mdadm وقال
Cannot remove … array will be failed، وهذه حماية من الأداة نفسها حتى لا تقتل المصفوفة بأمر خاطئ. ولكن القرص الذي يتعطل في الحقيقة لا يستأذن أحداً، لذلك علمناه معطلاً من واجهة النواة فيsysfsكما تفعل النواة عند خطأ حقيقي. - وبعدها أصبحت الحالة
[4/2] [UU__]ومعهاFAILED، وقالت النواة صراحةCannot continue operation (2/4 failed)، وقراءة الملف أعطتInput/output error. أي أن المصفوفة كلها، وليس الملف فقط، أصبحت غير قابلة للقراءة.
وهذا هو السيناريو الذي يجعل الأقراص الكبيرة خطرة مع RAID 5: في المختبر كان بين إعادة البناء والعطل الثاني ثانية واحدة، وفي الواقع قد يكون بينهما ساعات إعادة البناء نفسها، والأقراص الباقية في هذه الساعات تعمل بأقصى طاقتها. ولو كانت المصفوفة RAID 6 لبقيت تعمل بقرصين معطلين.
RAID 10: من يحمي من؟
الملف lab/06-raid10.sh يبني RAID 10 بترتيب near=2 ويعرض أي قرصين يحملان النسخة نفسها، ثم يعطل قرصاً ويعيد بناءه:
#!/bin/sh
# RAID 10 (near=2) from four disks: see which disks mirror each other, fail one, rebuild and time it.
set -e
DEVS=$(awk '$1=="d2"||$1=="d4"||$1=="d5"||$1=="d6"{print $2}' /disks/loops.txt)
D4=$(awk '$1=="d4"{print $2}' /disks/loops.txt)
mdadm --create /dev/md110 --run --quiet --level=10 --layout=n2 --raid-devices=4 --chunk=64 $DEVS
mdadm --wait /dev/md110 || true
mdadm --detail /dev/md110 | grep -E 'Raid Level|Array Size|Layout|set-'
mdadm /dev/md110 --fail $D4 --remove $D4
mdadm --zero-superblock $D4
start=$(date +%s.%N); mdadm /dev/md110 --add $D4; mdadm --wait /dev/md110 || true; end=$(date +%s.%N)
echo "rebuild took $(echo "$end $start" | awk '{printf "%.1f", $1 - $2}') s"
grep -A2 md110 /proc/mdstat
mdadm --stop /dev/md110; for d in $DEVS; do mdadm --zero-superblock $d; done
والمخرج سوف يكون كما يلي:
        Raid Level : raid10
        Array Size : 1046528 (1022.00 MiB 1071.64 MB)
            Layout : near=2
       0       7        3        0      active sync set-A   /dev/loop3
       1       7        5        1      active sync set-B   /dev/loop5
       2       7        6        2      active sync set-A   /dev/loop6
       3       7        7        3      active sync set-B   /dev/loop7
mdadm: hot removed /dev/loop5 from /dev/md110
mdadm: added /dev/loop5
rebuild took 2.9 s
md110 : active raid10 loop5[4] loop7[3] loop6[2] loop3[0]
      1046528 blocks super 1.2 64K chunks 2 near-copies [4/4] [UUUU]
السعة حوالي 1 جيجابايت من أربعة أقراص، أي النصف. والعمودان set-A وset-B يبينان كيف وزع md النسخ: في ترتيب near=2 يحمل كل قرصين متجاورين في الترتيب النسختين لنفس القطع، فالقرص 0 والقرص 1 زوج، والقرص 2 والقرص 3 زوج، والأقراص في set-A وحدها تحمل نسخة كاملة من البيانات، وكذلك set-B، لذلك تتحمل المصفوفة ضياع set-A كلها أو set-B كلها، ولا تتحمل ضياع قرصين من الزوج نفسه. وإعادة البناء أخذت 2.9 ثانية، قريبة من RAID 1، لأن القرص الجديد ينسخ من شريكه فقط.
عد العمليات: كيف قسنا عقوبة الكتابة؟
الأرقام في صورة عقوبة الكتابة جاءت من الملف lab/02-penalty.sh، وفكرته أن النواة تحفظ لكل جهاز في الملف /sys/block/loopN/stat عدد عمليات القراءة والكتابة التي وصلته، فنقرأ العدادات لكل الأقراص، ونرسل 4,000 كتابة إلى المصفوفة بالأداة fio، ثم نقرأ العدادات مرة أخرى:
#!/bin/sh
# Write penalty: 4,000 writes straight to the md device (no file system, O_DIRECT), then count what the member
# disks really received from /sys/block/loopN/stat (field 1 = reads, 3 = sectors read, 5 = writes, 7 = sectors written).
# Usage: 02-penalty.sh LEVEL N [BS] [RW]   e.g. 02-penalty.sh 5 4 4k randwrite | 02-penalty.sh 5 4 192k write
# --assume-clean skips the initial sync so it does not pollute the counts (fine for counting, never for real data).
set -e
LEVEL=$1; N=$2; BS=${3:-4k}; RW=${4:-randwrite}
DEVS=$(head -n "$N" /disks/loops.txt | awk '{print $2}')
mdadm --create /dev/md100 --run --quiet --assume-clean --level="$LEVEL" --raid-devices="$N" --chunk=64 $DEVS 2>/dev/null \
  || mdadm --create /dev/md100 --run --quiet --assume-clean --level="$LEVEL" --raid-devices="$N" $DEVS
sum() { for d in $DEVS; do cat /sys/block/$(basename $d)/stat; done | awk -v f=$1 '{s+=$f} END {print s}'; }
r0=$(sum 1); w0=$(sum 5); rs0=$(sum 3); ws0=$(sum 7)
fio --name=pen --filename=/dev/md100 --rw=$RW --bs=$BS --direct=1 --ioengine=libaio --iodepth=1 \
    --number_ios=4000 --size=256m --randrepeat=1 > /dev/null
r1=$(sum 1); w1=$(sum 5); rs1=$(sum 3); ws1=$(sum 7)
echo "raid$LEVEL disks=$N $RW bs=$BS: member reads=$((r1-r0)) writes=$((w1-w0)) | read $(( (rs1-rs0)/2048 )) MiB, wrote $(( (ws1-ws0)/2048 )) MiB"
mdadm --stop /dev/md100 >/dev/null 2>&1
for d in $DEVS; do mdadm --zero-superblock $d; done
ونشغله لكل مستوى بعد أن أوقفنا المصفوفات السابقة:
docker exec infg-raid sh -c 'for l in "0 4" "1 2" "10 4" "5 4" "6 4" "6 6"; do sh /lab/02-penalty.sh $l; done
sh /lab/02-penalty.sh 5 4 192k write'
والمخرج سوف يكون كما يلي:
raid0 disks=4 randwrite bs=4k: member reads=1 writes=4000 | read 0 MiB, wrote 15 MiB
raid1 disks=2 randwrite bs=4k: member reads=1 writes=8002 | read 0 MiB, wrote 31 MiB
raid10 disks=4 randwrite bs=4k: member reads=1 writes=8004 | read 0 MiB, wrote 31 MiB
raid5 disks=4 randwrite bs=4k: member reads=7957 writes=8004 | read 31 MiB, wrote 31 MiB
raid6 disks=4 randwrite bs=4k: member reads=3983 writes=12004 | read 15 MiB, wrote 46 MiB
raid6 disks=6 randwrite bs=4k: member reads=11884 writes=12006 | read 46 MiB, wrote 46 MiB
raid5 disks=4 write bs=192k: member reads=1 writes=87428 | read 0 MiB, wrote 341 MiB
في الإعداد والمخرج أعلاه لاحظ التالي:
- الخيار
--assume-cleanيجعل md يعتبر الأقراص متطابقة دون مزامنة أولى، وهذا مناسب هنا فقط لأن المزامنة الأولى كانت ستضيف ملايين العمليات إلى العدادات، ولا تستخدمه أبداً لمصفوفة عليها بيانات حقيقية. - الكتابة مباشرة على
/dev/md100دون نظام ملفات، و--direct=1، حتى لا تضيف ext4 أو ذاكرة النظام المؤقتة عمليات من عندها. - الأرقام الزائدة الصغيرة مثل 8,002 و8,004 بدل 8,000 هي تحديثات إعداد md نفسه على الأقراص عند البداية والنهاية.
- السطر الأخير بكتابة متتابعة بحجم 192 كيلوبايت، أي ثلاث قطع من 64 كيلوبايت، وهو صف كامل في RAID 5 بأربعة أقراص، فلم يحتج md أن يقرأ شيئاً، وعدد العمليات الكبير 87,428 لأن md يقسم الصف داخلياً إلى صفحات بحجم 4 كيلوبايت، والذي يهم هنا عمود الميجابايت: 341 مقابل 256.
لماذا RAID ليس نسخة احتياطية؟
الآن نصل إلى الجملة التي في عنوان المقال. فكل ما رأيناه حتى الآن يحمي من شيء واحد: قرص يتعطل. وهذا مهم، لأنه يبقي السيرفر يعمل ويوفر عليك ساعات الاستعادة، ولكنه لا يحمي من الأشياء التي تضيع فيها البيانات في الواقع أكثر: موظف يحذف مجلداً بالخطأ، أو برنامج فدية يشفر الملفات، أو برنامج فيه خلل يكتب بيانات خاطئة، أو حريق أو سرقة تأخذ الجهاز كله. والسبب أن كل هذه عمليات كتابة صحيحة من وجهة نظر المصفوفة، فتنفذها على كل الأقراص في اللحظة نفسها، ولنر ذلك بأعيننا. الملف lab/04-not-backup.sh يعمل على RAID 1 الذي بنيناه، فينسخ ملف العملاء إلى ملف فواتير، ثم يحذف الأول ويشفر الثاني، ثم يوقف المصفوفة ويفتح كل قرص وحده:
#!/bin/sh
# RAID is not a backup: delete one file and scramble another on the RAID 1, then open each member disk on its own.
set -e
cp /mnt/r1/customers.csv /mnt/r1/invoices.csv
sha256sum /mnt/r1/*.csv
# a mistake and a "ransomware": rm, and rewriting a file in place with scrambled content (rot13 as a stand-in)
rm /mnt/r1/customers.csv
tr 'a-z' 'n-za-m' < /mnt/r1/invoices.csv > /tmp/x && cat /tmp/x > /mnt/r1/invoices.csv
sync; umount /mnt/r1
mdadm --stop /dev/md101
# metadata 1.0 puts the md superblock at the end, so each member starts with the ext4 file system itself
for d in $(awk '$1=="d1"||$1=="d3"{print $2}' /disks/loops.txt); do
  mkdir -p /mnt/check && mount -t ext4 -o ro,noload $d /mnt/check
  echo "== member $d:"; ls /mnt/check; head -2 /mnt/check/invoices.csv
  umount /mnt/check
done
والمخرج سوف يكون كما يلي:
4cf5b92e0675336c88598ca7b039cc69b5aa87af71341f52729104c108a659d3  /mnt/r1/customers.csv
4cf5b92e0675336c88598ca7b039cc69b5aa87af71341f52729104c108a659d3  /mnt/r1/invoices.csv
mdadm: stopped /dev/md101
== member /dev/loop2:
invoices.csv
lost+found
phfgbzre-000001,npgvir
phfgbzre-000002,npgvir
== member /dev/loop4:
invoices.csv
lost+found
phfgbzre-000001,npgvir
phfgbzre-000002,npgvir
القرصان، اللذان كان كل منهما يحمل نسخة كاملة من البيانات، يحملان الآن النسخة نفسها من الخطأ: ملف العملاء غير موجود على أي منهما، وملف الفواتير مشفر على الاثنين، فالسطر customer-000001,active أصبح phfgbzre-000001,npgvir. والمصفوفة لم تخطئ، فقد فعلت بالضبط ما صممت له، وهو أن تبقي القرصين متطابقين:
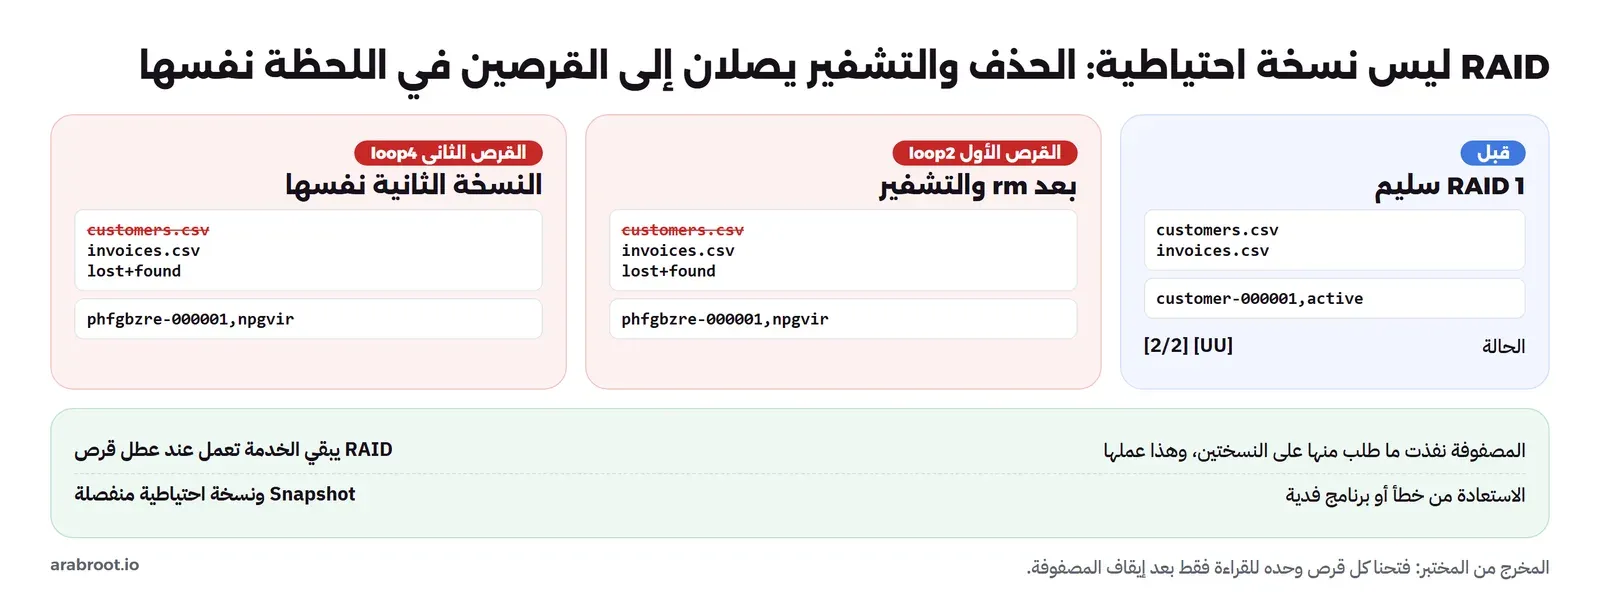
وفي التجربة واجهنا مشكلة صغيرة مفيدة: المحاولة الأولى لربط القرص وحده بالأمر mount -o ro,noload فشلت بالخطأ unknown filesystem type 'linux_raid_member'، لأن الأداة blkid وجدت إعداد md في القرص فعرفته كعضو في مصفوفة وليس كنظام ملفات، والحل أن تحدد النوع بنفسك بـ -t ext4. وهذا الخيار نفسه، أي الصيغة 1.0 والربط المباشر للقراءة فقط، هو ما قد تحتاجه يوماً لتنقذ بيانات من قرص RAID 1 منفرد في جهاز آخر، أما مع الصيغة الافتراضية 1.2 فالإعداد في البداية وتحتاج أن تجمع المصفوفة بـ mdadm.
لذلك اجعل لكل طبقة وظيفتها: RAID يبقي السيرفر يعمل عند عطل قرص، وال Snapshots في ZFS أو LVM تعيد لك ملفاً حذفته قبل ساعة، والنسخة الاحتياطية المنفصلة في مكان آخر، بقاعدة 3-2-1، تعيد لك البيانات بعد برنامج فدية أو حريق، ولا تعرف أنها تعمل حتى تجرب الاستعادة منها فعلاً.
التنظيف
الملف lab/cleanup.sh يفك الربط، ويوقف مصفوفاتنا، ويفصل أجهزة Loop التي أنشأناها فقط، لأنها من النواة المشتركة:
#!/bin/sh
# Unmount, stop our arrays, and detach only the loop devices we attached (other containers share the kernel).
umount /mnt/r1 /mnt/r5 /mnt/check 2>/dev/null
for m in /dev/md100 /dev/md101 /dev/md105 /dev/md110; do [ -e $m ] && mdadm --stop $m 2>/dev/null; done
for d in $(awk '{print $2}' /disks/loops.txt); do mdadm --zero-superblock $d 2>/dev/null; losetup -d $d; done
rm -f /disks/d*.img /disks/loops.txt
losetup -a | grep /disks/ || echo "no loop devices of ours left"
ثم احذف ال Container وال Volume وال Image:
docker exec infg-raid sh /lab/cleanup.sh
docker rm -f infg-raid
docker volume rm infg-raid-data
docker rmi infg-raid
وترتيب الأوامر في الملف مهم: في محاولتنا الأولى أوقفنا المصفوفات قبل فك الربط، فبقيت مصفوفة RAID 5 تعمل لأن نظام الملفات عليها ما زال مربوطاً، وبقيت أجهزة Loop تحتها مشغولة. لذلك فك الربط أولاً، ثم أوقف المصفوفات، ثم افصل الأقراص.
جدول القرار: أي مستوى تختار؟
| الحالة | المستوى المناسب | لماذا؟ |
|---|---|---|
| سيرفر أو جهاز فيه قرصان فقط، أو قرص نظام التشغيل | RAID 1، أو Mirror في ZFS | بسيط، وإعادة البناء نسخ من قرص واحد |
| قاعدة بيانات أو أقراص أجهزة افتراضية | RAID 10، أو عدة Mirrors في ZFS | الكتابة الصغيرة بعمليتين فقط، وإعادة بناء سريعة |
| ملفات وأرشيف على 4 إلى 12 قرصاً دواراً كبيراً | RAID 6، أو RAIDZ2 | يبقى هامش قرص طوال إعادة البناء الطويلة |
| ملفات على 3 إلى 5 أقراص SSD أو أقراص دوارة صغيرة | RAID 5 مقبول، أو RAIDZ1 | إعادة البناء قصيرة، والمساحة أكبر |
| بيانات مؤقتة يمكن إعادة إنتاجها | RAID 0 | سرعة ومساحة كاملة، ولا يهم ضياعها |
| TrueNAS أو Proxmox | ZFS مع HBA، وليس بطاقة RAID | مجموع تحقق، ولا توجد ثغرة كتابة، وSMART مباشر |
| سيرفر جاء ببطاقة RAID وفريق يعرفها | البطاقة مع BBU سليمة ومراقبة | ذاكرة كتابة محمية تسرع الكتابة الصغيرة |
أخطاء شائعة
- اعتبار RAID نسخة احتياطية: رأيت في التجربة الحذف والتشفير على القرصين معاً، فاجعل نسخة منفصلة ومجربة.
- RAID 5 على أقراص دوارة كبيرة: إعادة بناء قرص 16 تيرابايت تأخذ يوماً أو أكثر دون هامش، فاختر RAID 6 أو RAID 10.
- قاعدة بيانات على RAID 5 أو RAID 6 بأقراص دوارة: كل كتابة صغيرة تصبح أربع أو ست عمليات، كما عددناها.
- مصفوفة دون مراقبة: RAID 1 بقرص معطل منذ أشهر هو قرص واحد دون حماية، وأنت تظن أنه مصفوفة. فعل تنبيهات
mdadm --monitorأو أداة ال NAS، وراقب/proc/mdstat. - أقراص من الدفعة نفسها والعمر نفسه: تتقدم في العمر معاً، والعطل الثاني أثناء إعادة البناء أكثر احتمالاً. وزع مشترياتك على أكثر من دفعة إن استطعت، واحتفظ بقرص احتياطي.
- بطاقة RAID ببطارية ميتة: إما أداء ساقط فجأة مع Write-Through، أو خسارة بيانات مع Write-Back دون حماية. راقب حالة البطارية أو المكثف.
- بطاقة RAID تحت ZFS: تخفي الأقراص وSMART عن ZFS وتضيع فائدة مجموع التحقق، فاستخدم HBA أو وضع JBOD.
- أقراص SMR في مصفوفة: إعادة البناء كتابة مستمرة، وأقراص DM-SMR تبطئ فيها بشكل كبير.
- إعادة استخدام قرص خرج من مصفوفة دون مسح إعداده: امسحه بـ
mdadm --zero-superblockحتى لا يجمعه النظام مع مصفوفة قديمة. - دون UPS: انقطاع الكهرباء أثناء الكتابة هو ما يصنع ثغرة الكتابة ويجبر المصفوفة على مزامنة كاملة.
قائمة التحقق قبل أن تبني مصفوفة
- اخترت المستوى من نوع العمل، وليس من رقم المساحة فقط.
- حسبت زمن إعادة البناء لقرص واحد بسعة أقراصك، وعرفت كم هامشاً يبقى طواله.
- الأقراص من نوع CMR ومخصصة للعمل المستمر، ويفضل من أكثر من دفعة.
- قررت من يدير المصفوفة: md، أو ZFS مع HBA، أو بطاقة RAID ببطارية أو مكثف سليم.
- التنبيهات مفعلة لحالة المصفوفة ولـ SMART لكل قرص، وجربت أن التنبيه يصل.
- عندك قرص احتياطي في الجهاز Hot Spare أو على الرف.
- الفحص الدوري مجدول:
checkفي md أو Scrub في ZFS. - السيرفر على UPS بإطفاء آمن.
- للبيانات نسخة احتياطية منفصلة خارج المصفوفة، وجربت الاستعادة منها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- RAID يجمع عدة أقراص في قرص واحد بثلاث أفكار: التوزيع والنسخ والتماثل بعملية XOR، ويحميك من عطل قرص فقط.
- RAID 0 بلا حماية، وRAID 1 نسختان، وRAID 5 تماثل واحد يتحمل قرصاً، وRAID 6 تماثلان يتحملان أي قرصين، وRAID 10 مرايا موزعة تتحمل قرصاً من كل زوج.
- عددنا العمليات على الأقراص: كتابة صغيرة تكلف 1 في RAID 0، و2 في RAID 1 وRAID 10، و4 في RAID 5، و6 في RAID 6 بستة أقراص، أما الكتابة المتتابعة لصفوف كاملة فلا تحتاج قراءة.
- إعادة البناء تكتب القرص الجديد كله، فقرص 16 تيرابايت يحتاج يوماً تقريباً، ورأينا RAID 5 يفشل كله عند عطل قرصين.
- ثغرة الكتابة في RAID 5 تحلها ذاكرة محمية ببطارية أو journal وPPL في md أو النسخ عند الكتابة في ZFS.
- البطاقة العتادية تعطي ذاكرة كتابة محمية وتربطك بشركتها، وmd مفتوح ويقرأه أي Linux، وZFS يضيف مجموع التحقق ويحتاج أقراصاً مباشرة.
- الحذف والتشفير وصلا إلى القرصين معاً في التجربة، كما وصل خطأ GitLab إلى نسختها المتماثلة، فالنسخة الاحتياطية المنفصلة المجربة هي التي تعيد البيانات.
 دليلالفرق بين NAS وSAN، ومتى يكفيك قرص متصل مباشرةكيف تصل الأجهزة إلى الأقراص عبر الشبكة بالملفات أو بالكتل، ولماذا قد يسلمك RAID ملفاً تالفاً دون أي خطأ.
 دليلZFS للمبتدئين: كيف يحمي بياناتك من التلف الصامتكيف يكتشف ZFS التلف الصامت ويصلحه، وكيف ترتب الأقراص في Pool يتحمل العطل وتستعيد ملفاتك من Snapshots.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلTrueNAS عملياً: من التثبيت إلى أول مشاركة محميةكيف تثبت TrueNAS وتبني عليه مشاركات بصلاحيات واضحة، وتحمي ملفاتك بال Snapshots ونسخة على قرص آخر وخارج الجهاز.
 دليلأقراص التخزين: HDD وSSD وNVMe، وأي قرص لأي استخدامكيف تعمل الأقراص الدوارة وأقراص SSD من الداخل، وكيف تقرأ أرقامها بالأداة fio وSMART وتقارير الأعطال، حتى تختار القرص المناسب لقاعدة البيانات والملفات والنسخ الاحتياطية.
 دليلمشاركة التخزين عبر الشبكة: SMB وNFS وiSCSIكيف يعمل كل من SMB وNFS وiSCSI من الداخل، من التوقيع والهوية إلى أسماء IQN، مع تجربة تربط الثلاثة من كلاينت واحد وتريك ما يحدث عندما يربط سيرفران القرص نفسه.
سجل التحديثات
- 2026-11-16: كتابة المقال، مع تجربة mdadm 4.4 وfio 3.39 في Container من debian:trixie-slim على نواة Linux 5.15 (Docker Desktop WSL2) بأقراص Loop، وصور من Wikimedia Commons بتراخيص حرة.




