كل ما فعلناه في مقالات هذه المرحلة كان على سيرفر Server واحد: Docker يشغل ال Containers، وCompose يجمعها في ملف، وسياسة الإعادة Restart Policy تعيدها إذا توقفت. وهذا يكفي أغلب من يستضيف تطبيقاته بنفسه، حتى يأتي اليوم الذي يتعطل فيه السيرفر الوحيد، فيتوقف كل شيء حتى تصلحه أنت بيدك، أو يأتي اليوم الذي لا يكفي فيه سيرفر واحد لعدد الطلبات Requests. وعندها تحتاج أن تعمل عدة سيرفرات كأنها سيرفر واحد: تقول لها «أريد ست نسخ من هذه الخدمة»، فتوزعها بنفسها، وإذا مات سيرفر نقلت نسخه إلى غيره، وإذا حدثت الخدمة استبدلت النسخ واحدة واحدة دون توقف. وهذا ما يسمى تنسيق ال Containers Container Orchestration.
والاسم الذي يأتي إلى الذهن فوراً هو Kubernetes، وقد ناقشنا في مقال هل تحتاج Kubernetes فعلاً؟ ما يحله وما يكلفه، وذكرنا هناك حلولاً وسطاً أبسطها Docker Swarm. وفي هذا المقال سوف نبني عنقوداً Cluster حقيقياً من Swarm بثلاثة أجهزة افتراضية Virtual Machines، كل منها بنواته Kernel وشبكته، ونجرب عليه ما يعد به Swarm فعلاً: التوزيع، وشبكة overlay، وال Routing Mesh، والتحديث التدريجي مع تحديث فاشل يتراجع وحده، والأسرار Secrets، ثم نقتل جهازاً ونرى ما يحدث، ثم نقتل جهازاً ثانياً لنرى أين تقف حدوده.
وسوف نناقش في هذا المقال ما يلي:
- ما هو Swarm، والفرق بين Swarm المدمج في Docker وClassic Swarm القديم، ومن يطوره اليوم.
- العقد Nodes: المدير Manager والعامل Worker، وخوارزمية Raft، ولماذا ثلاثة مدراء.
- بناء العنقود بثلاثة أجهزة:
swarm initوswarm join. - الخدمات Services والنسخ Replicas، وشبكة overlay، وال Routing Mesh كما ظهرت في الطلبات.
- التحديث التدريجي Rolling Update، وتحديث فاشل يتراجع Rollback تلقائياً.
- الأسرار Secrets: أين تحفظ وكيف تصل إلى ال Container.
- موت عقدة وإعادة الجدولة Rescheduling، ثم فقدان النصاب Quorum.
- متى تختار Swarm ومتى Kubernetes، مع جدول قرار.
ما هو Docker Swarm؟
وضع Swarm Swarm Mode جزء من Docker Engine نفسه منذ الإصدار Version 1.12 في 2016، فلا تثبت أي شيء إضافي، وإنما تكتب docker swarm init على سيرفر فيصير مديراً لعنقود، ثم تضم إليه سيرفرات أخرى بأمر واحد، كما في توثيق Swarm. ويجدر التمييز هنا بين هذا الوضع وبين مشروع أقدم اسمه Docker Swarm أيضاً، ويسمى اليوم Classic Swarm، كان برنامجاً منفصلاً يجمع عدة Docker Daemons، وقد توقف تطويره منذ سنوات. فإذا وجدت دليلاً يشغل Container اسمه swarm مع خدمة اكتشاف مثل Consul فهو عن المشروع القديم، ولا ينطبق على ما في هذا المقال.
وقد يتساءل البعض: هل Swarm ما زال حياً؟ والإجابة نعم، فهو داخل Docker Engine الذي ثبتناه بالإصدار 29.10، ويعمل بنفس الأوامر، وتقدم Mirantis دعماً تجارياً Commercial Support له ضمن منتجاتها. ولكن الحقيقة أيضاً أن التطوير Development فيه بطيء، وأن منظومة Ecosystem الأدوات حوله صغيرة جداً مقارنة بـ Kubernetes، وسوف نعود إلى هذه النقطة في جدول القرار.
والفكرة الأساسية في Swarm أنك لا تشغل Containers، وإنما تعلن حالة مطلوبة Desired State: «خدمة اسمها web من هذه ال Image، ست نسخ، على هذه الشبكة، تنشر المنفذ 8080». والمدير يحفظ هذه الحالة، ثم يقارنها باستمرار بالحالة الفعلية، فإذا وجد خمس نسخ فقط أنشأ السادسة، وإذا وجد سيرفراً ميتاً نقل نسخه. وهذه هي الحلقة نفسها التي يقوم عليها Kubernetes، وقد شرحناها في مقال مصطلحات Kubernetes بالرسم، ولكن Swarm يقدمها بمفاهيم أقل بكثير: العقدة، والخدمة، والمهمة Task، والشبكة، والسر، والإعداد Config، والمجموعة Stack.
هل تحتاج عنقوداً Cluster أصلاً؟
قبل أي أمر، لنكن صريحين في السؤال الأول: العنقود لا يجعل تطبيقك أسرع، ولا يجعله أكثر أماناً، وإنما يجعله يتحمل موت سيرفر. وهذا له ثمن تدفعه كل يوم: ثلاثة سيرفرات بدلاً من واحد، وشبكة بينها يجب أن تعمل، وقاعدة بيانات لم تعد مسألة Volume بسيط، وأخطاء جديدة لم تكن موجودة، مثل نسخة تعمل على عقدة لم تسحب آخر Image، أو عقدة فقدت الاتصال بالآخرين فظنت أنها وحدها. لذلك اسأل نفسك ثلاثة أسئلة قبل أن تبدأ:
- كم دقيقة توقف تتحمل في السنة؟ إذا كان سيرفر واحد مع نسخة احتياطية مجربة يعيدك خلال ساعة، وساعة توقف في السنة مقبولة لعملائك، فالعنقود ليس أولويتك. وقد شرحنا في مقال هل تحتاج Kubernetes فعلاً؟ كيف تحسب ذلك.
- هل تطبيقك عديم الحالة Stateless؟ العنقود ينقل ال Containers بسهولة، ولا ينقل البيانات. فإذا كان كل ما عندك قاعدة بيانات واحدة كبيرة، فالتوافرية الحقيقية هي نسخ قاعدة البيانات Database Replication Replication، لا Swarm.
- هل عندك من يدير العنقود عندما يتعطل في الليل؟ كل ما رأيناه في قسم فقدان النصاب يحتاج شخصاً يفهمه تحت الضغط.
فإذا كانت الإجابات تقول إنك تحتاج عنقوداً، فـ Swarm أقصر طريق إليه لمن يعرف Docker، وهذا ما سوف نختبره الآن.
المدراء Managers والعمال Workers وخوارزمية Raft
العقدة Node هي سيرفر عليه Docker دخل العنقود، ولها دوران كما في توثيق العقد: العامل Worker يشغل المهام التي تعطى له فقط، والمدير Manager يحفظ حالة العنقود ويقرر أين تعمل كل مهمة، ويشغل مهام أيضاً إلا إذا منعته. والمدراء يحتفظون بنسخة متطابقة من حالة العنقود بخوارزمية Raft: واحد منهم قائد Leader يستقبل كل تغيير، ولا يعتبر التغيير مكتوباً حتى توافق عليه أغلبية المدراء. وهذه الأغلبية Majority تسمى النصاب Quorum، وهي سبب القاعدة التي يكتبها دليل الإدارة Management في جدول:
| عدد المدراء | الأغلبية المطلوبة | عدد المدراء الذين يمكن أن يموتوا |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
لاحظ أن مديرين أسوأ من مدير واحد: إذا مات أحدهما فقد العنقود النصاب، وصار احتمال التعطل ضعف احتماله مع مدير واحد. ولذلك يكون عدد المدراء فردياً دائماً، ثلاثة لعنقود صغير وخمسة لعنقود أكبر، والزيادة من ثلاثة إلى أربعة لا تضيف أي قدرة على التحمل. والتشبيه Analogy القريب مجلس إدارة لا يصدر قراراً إلا بأغلبية الأعضاء: إذا غاب عضو من ثلاثة فالعضوان الباقيان أغلبية، وإذا غاب اثنان فلا يصدر أي قرار، ولكن الموظفين يستمرون في عملهم بالتعليمات التي عندهم. وهذا ما سوف نراه حرفياً في المختبر.
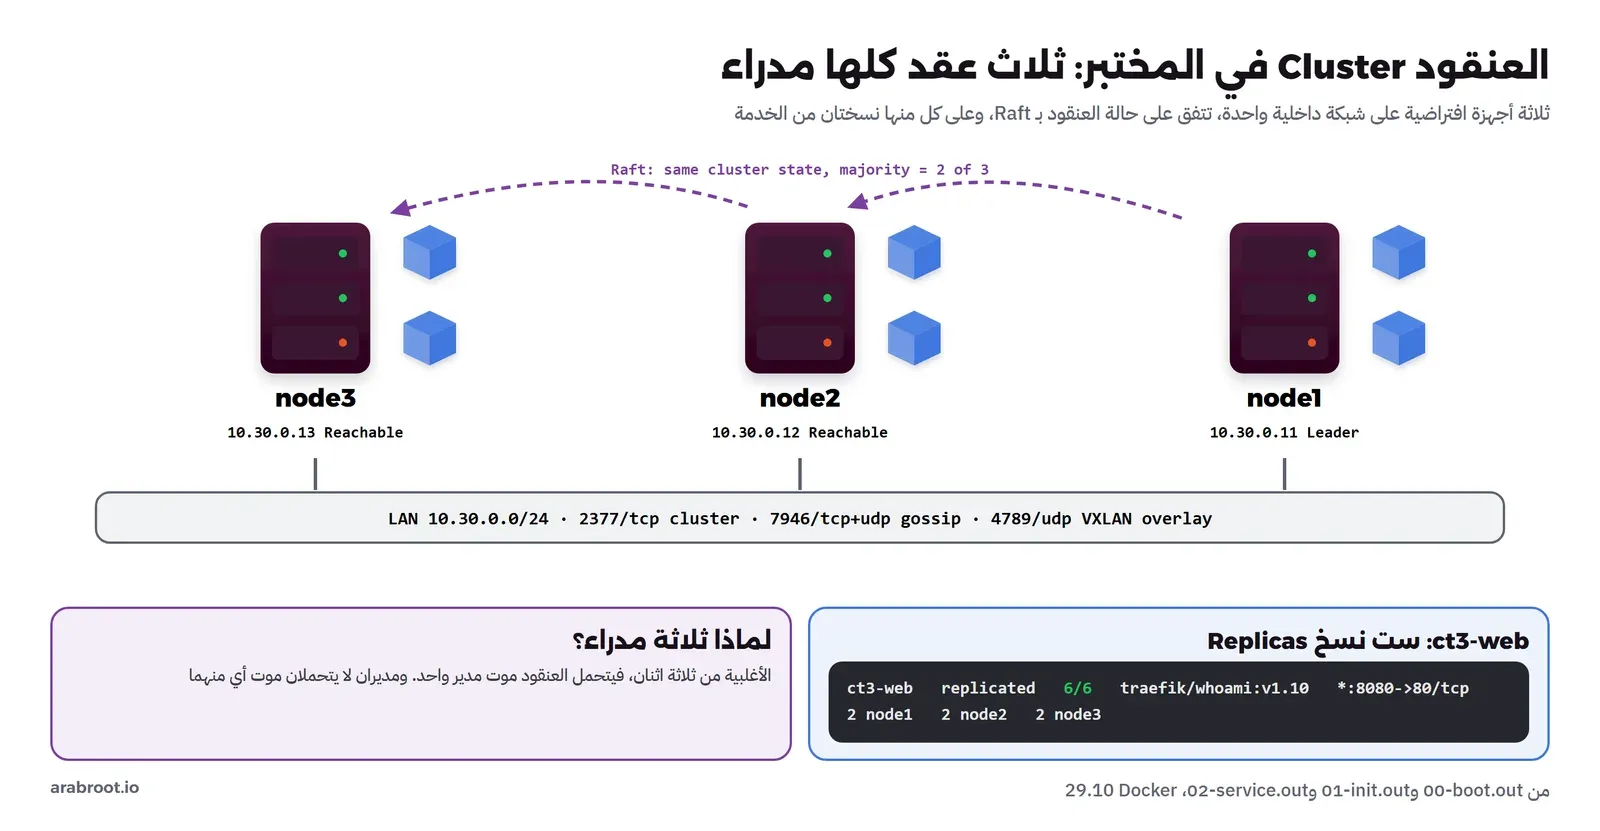
العنقود Cluster الذي سوف نبنيه
ثلاثة أجهزة افتراضية بـ QEMU مع KVM، نظام كل منها Debian 13 بنواة 6.12 وذاكرة 1.5 GB ومعالجين، وعليها Docker Engine 29.10 من المستودع الرسمي كما في دليل تثبيت Docker. والأجهزة الثلاثة على شبكة داخلية Internal Network واحدة 10.30.0.0/24 بالعناوين 10.30.0.11 و.12 و.13، ولكل منها اتصال منفصل بالإنترنت لسحب ال Images. واخترنا أجهزة افتراضية لا Containers من نوع Docker in Docker، لأن ما نريد أن نراه، شبكة overlay وموت عقدة، يحتاج نوى Kernels وواجهات شبكة حقيقية، وقتل جهاز افتراضي يشبه انقطاع الكهرباء عن سيرفر أكثر من إيقاف Container. وأول ما نتأكد منه أن الأجهزة ترى بعضها:
node1 10.30.0.11/24 docker 29.10.0
node2 10.30.0.12/24 docker 29.10.0
node3 10.30.0.13/24 docker 29.10.0
2 packets transmitted, 2 received, 0% packet loss, time 1012ms
rtt min/avg/max/mdev = 16.659/23.949/31.239/7.290 ms
وعلى سيرفرات حقيقية تحتاج أن تفتح بين العقد ثلاثة منافذ Ports في جدار الحماية Firewall: 2377/tcp لإدارة العنقود، و7946/tcp+udp لتبادل معلومات العقد، و4789/udp لحركة شبكة overlay، كما في متطلبات Swarm. ولا تقم بفتح هذه المنافذ للإنترنت أبداً، فالمنفذ 4789 تحديداً لا يحمل أي مصادقة Authentication، وقد شرحنا في دليل شبكات Docker أن Docker يكتب قواعد iptables التي قد تتجاوز ufw.
بناء العنقود Cluster: init وjoin
# on node1
docker swarm init --advertise-addr 10.30.0.11
docker swarm join-token -q manager
# on node2 and node3, with the manager token
docker swarm join --token SWMTKN-1-... 10.30.0.11:2377
# on node1
docker node ls
والمخرج سوف يكون كما يلي (أخفينا التوكن Token):
Swarm initialized: current node (oe29t6qhevlu4ou2claycjh1i) is now a manager.

To add a worker to this swarm, run the following command:

    docker swarm join --token SWMTKN-1-14j7...-9iqu... 10.30.0.11:2377

This node joined a swarm as a manager.
This node joined a swarm as a manager.
ID                            HOSTNAME   STATUS    AVAILABILITY   MANAGER STATUS   ENGINE VERSION
oe29t6qhevlu4ou2claycjh1i *   node1      Ready     Active         Leader           29.10.0
r9g1my12m84v0pi1a3m43cte5     node2      Ready     Active         Reachable        29.10.0
n3ku37242k4ks2wma9d1wb9bx     node3      Ready     Active         Reachable        29.10.0
في المخرج أعلاه لاحظ التالي:
--advertise-addrيحدد العنوان الذي Address تتكلم عليه العقد مع هذا المدير، وهو ضروري عندما يكون للسيرفر أكثر من واجهة شبكة، كما في أجهزتنا التي لها واجهة للإنترنت وواجهة للشبكة الداخلية. وإذا نسيته فقد يختار Docker الواجهة الخطأ، فتنضم العقد ثم لا ترى بعضها.- هناك توكنان: واحد للعمال يطبعه
init، وواحد للمدراء تطلبه بـjoin-token manager. والتوكن هو كل ما يحتاجه أي سيرفر ليدخل العنقود، فعامله ككلمة مرور، وإذا تسرب فغيره بـdocker swarm join-token --rotate. - ضممنا العقدتين كمديرين، فصار عندنا ثلاثة مدراء:
node1القائدLeader، والآخرانReachable. وفي عنقود أكبر يكون عندك ثلاثة مدراء وأي عدد من العمال.
وما لا يظهر في المخرج مهم أيضاً: عند init أنشأ Swarm جهة إصدار شهادات CA داخلية، وأعطى كل عقدة شهادة TLS باسمها، فكل الاتصال بين العقد على المنفذ 2377 مشفر بالتبادل Mutual TLS، والشهادات تتجدد تلقائياً، كما في توثيق PKI في Swarm. وحالة Raft نفسها مشفرة على قرص كل مدير.
الخدمات Services والنسخ Replicas وشبكة overlay
الآن ننشئ شبكة overlay، وهي الشبكة Network التي تمتد على كل العقد كما شرحنا باختصار في دليل الشبكات، ثم خدمة من ست نسخ من traefik/whoami، وهو سيرفر ويب صغير يرد باسم ال Container الذي استقبل الطلب، فنعرف أي نسخة ردت:
docker network create -d overlay --attachable ct3-net
docker service create --name ct3-web --replicas 6 --network ct3-net -p 8080:80 \
  --update-parallelism 1 --update-delay 5s --update-failure-action rollback --update-monitor 15s \
  traefik/whoami:v1.10
docker service ls
docker service ps ct3-web --format "{{.Name}} {{.Node}} {{.CurrentState}}"
ct3-net overlay swarm
ID NAME MODE REPLICAS IMAGE PORTS
hwtablqtq97k ct3-web replicated 6/6 traefik/whoami:v1.10 *:8080->80/tcp
ct3-web.1 node3 Running 34 seconds ago
ct3-web.2 node1 Running 32 seconds ago
ct3-web.3 node2 Running 32 seconds ago
ct3-web.4 node3 Running 34 seconds ago
ct3-web.5 node1 Running 32 seconds ago
ct3-web.6 node2 Running 32 seconds agoوزع المدير النسخ الست بالتساوي، نسختين على كل عقدة، و6/6 تعني أن الحالة الفعلية تساوي المطلوبة. وكل سطر هنا مهمة Task لها رقم ثابت ct3-web.1 إلى .6، وال Container الذي ينفذها قد يتغير، فإذا مات Container أنشأ Swarm آخر لنفس المهمة. وخيارات --update-* سوف نشرحها في قسم التحديث.
ال Routing Mesh: كل عقدة Node تجيب على المنفذ Port
أرسلنا اثني عشر طلباً إلى المنفذ 8080 على node1 وحده، وعددنا من رد:
for i in $(seq 1 12); do curl -s localhost:8080 | grep -m1 Hostname; done | sort | uniq -c 2 Hostname: 76e579ccd4e8
2 Hostname: c1684f721adb
2 Hostname: d2ca863e363b
2 Hostname: db4b8820fa0d
2 Hostname: df7249015136
2 Hostname: e5a61e38ef4bستة أسماء مختلفة، وكل منها رد مرتين بالضبط، مع أن الطلبات كلها ذهبت إلى node1 الذي فيه نسختان فقط. فالعقدة التي تستقبل الطلب لا تشترط أن تكون النسخة عندها، وإنما توزع الطلبات على كل النسخ في العنقود بالتناوب Round Robin، وهذا هو ال Routing Mesh الذي يشرحه توثيق ingress. ولنتأكد أكثر، قلصنا الخدمة إلى نسخة واحدة مثبتة على node1، ثم سألنا node3:
docker service update --replicas 1 --constraint-add node.hostname==node1 ct3-web
# on node3
docker ps -q --filter name=ct3-web | wc -l
curl -s 10.30.0.13:8080 | grep -E "Hostname|IP: 10"
ct3-web.1 node1
0
Hostname: 0cc775da5f47
IP: 10.0.0.12
IP: 10.0.1.12لا يوجد على node3 أي Container من الخدمة، ومع ذلك رد على الطلب، لأنه مرره عبر شبكة ingress إلى النسخة الوحيدة على node1. ولاحظ أن لل Container عنوانين: 10.0.0.12 على شبكة ingress التي ينشئها Swarm تلقائياً للمنافذ المنشورة، و10.0.1.12 على شبكتنا ct3-net. والآلية تحت ذلك أن كل عقدة تستمع على المنفذ المنشور، وتوجه الطلب بـ IPVS في النواة Kernel إلى عنوان افتراضي Virtual IP للخدمة، وهذا العنوان يوزع على النسخ:
c0e280c13047 10.30.0.11 | cdfb63ab9e3b 10.30.0.12 | eb8a31606585 10.30.0.13 |
10.0.0.5/24 10.0.1.2/24
السطر الأول قائمة العقد التي تشترك في شبكة ingress، والثاني العنوانان الافتراضيان للخدمة على الشبكتين. وال Containers الأخرى على ct3-net تصل إلى الخدمة باسمها ct3-web، فيرد DNS الداخلي بالعنوان 10.0.1.2، ويوزع هو الطلبات على النسخ. والنتيجة العملية أنك تضع أمام العنقود موزع حمل Load Balancer أو سجل Registry DNS يشير إلى كل العقد، ولا يهمك أين تعمل النسخ.
ثم أعدنا الخدمة إلى ست نسخ وأزلنا القيد، فعادت إلى نسختين على كل عقدة:
      2 node1
      2 node2
      2 node3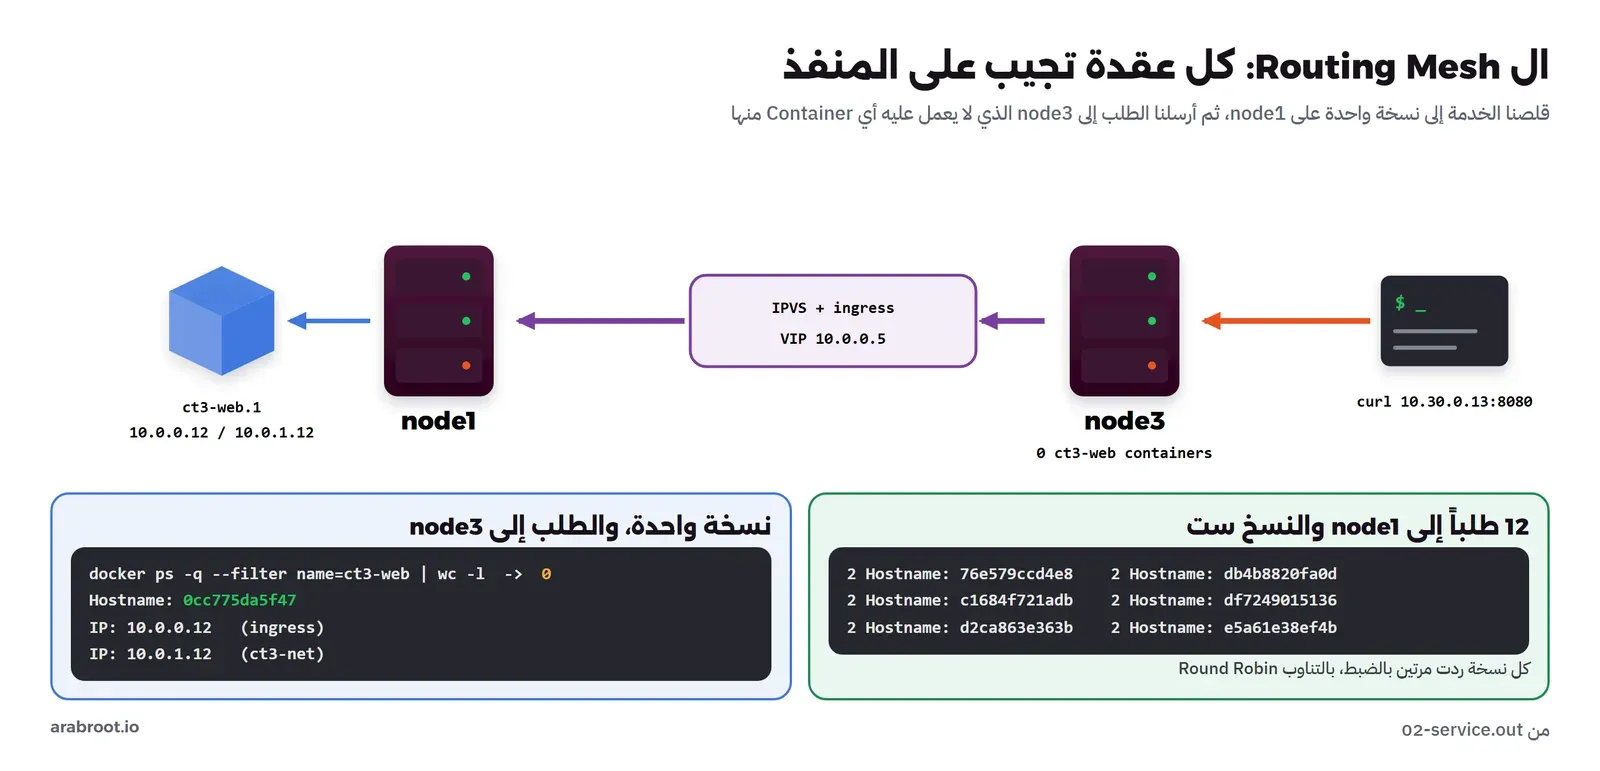
ماذا يمر على الشبكة؟ VXLAN والتشفير Encryption
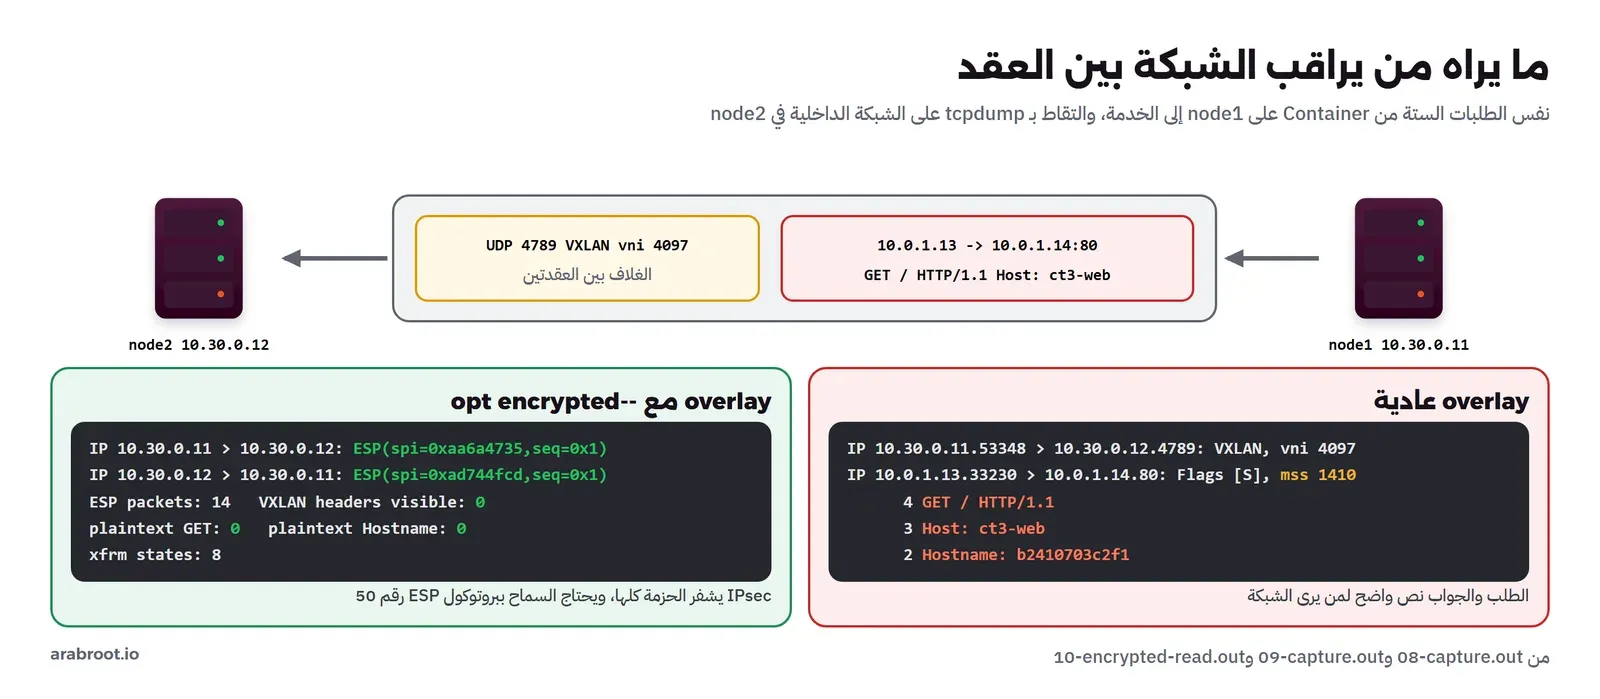
شبكة overlay تبدو لل Containers كأنها شبكة واحدة 10.0.1.0/24، مع أنها على ثلاثة سيرفرات مختلفة. والسر في تقنية VXLAN كما يشرح توثيق شبكة overlay: كل حزمة يرسلها Container إلى Container على عقدة أخرى تغلف داخل حزمة UDP عادية من عنوان العقدة إلى عنوان العقدة على المنفذ 4789، ومعها رقم الشبكة VNI. ولنر ذلك بأعيننا، شغلنا tcpdump على الشبكة الداخلية لـ node2، وأرسلنا ستة طلبات من Container على node1 إلى الخدمة باسمها:
# on node2
tcpdump -ni ens4 -c 14 -A "udp port 4789"
# on node1
docker run -d --name ct3-probe --network ct3-net alpine:3.24 sleep 600
for i in 1 2 3 4 5 6; do docker exec ct3-probe wget -q -O - http://ct3-web/ | head -1; done
21:40:19.615842 IP 10.30.0.11.53348 > 10.30.0.12.4789: VXLAN, flags [I] (0x08), vni 4097
IP 10.0.1.13.33230 > 10.0.1.14.80: Flags [S], seq 1724630610, win 64860, options [mss 1410,...], length 0
21:40:19.617330 IP 10.30.0.12.37526 > 10.30.0.11.4789: VXLAN, flags [I] (0x08), vni 4097
IP 10.0.1.14.80 > 10.0.1.13.33230: Flags [S.], seq 281595881, ack 1724630611, ...
--- counted over the 14 packets:
4 GET / HTTP/1.1
3 Host: ct3-web
2 Hostname: b2410703c2f1
14 vni 4097في المخرج أعلاه لاحظ التالي:
- كل سطر خارجي حزمة UDP بين العقدتين
10.30.0.11و10.30.0.12على المنفذ 4789، وفيهاvni 4097وهو رقم شبكةct3-net. وتحته الحزمة الداخلية بين عنواني ال Containers10.0.1.13و10.0.1.14، أي أن TCP كله يمر داخل الغلاف. - القيمة
mss 1410أقل من 1460 المعتادة، لأن غلاف VXLAN يأخذ 50 بايت من كل حزمة. وهذا سبب مشاكل غريبة في الشبكات التي فيها MTU أصغر من 1500، مثل بعض أنفاق VPN، حيث تمر الطلبات الصغيرة وتعلق الكبيرة. - والأهم: الطلب
GET / HTTP/1.1والترويسةHost: ct3-webوجواب الخدمةHostnameكلها ظاهرة نصاً واضحاً لأي شخص يرى الشبكة بين السيرفرات. فشبكة overlay العادية ليست مشفرة، والتشفير الذي رأيناه على المنفذ 2377 يحمي إدارة العنقود فقط، لا بيانات تطبيقاتك.
فإذا كانت العقد في مراكز بيانات Data Centers مختلفة، أو على شبكة لا تملكها كلها، فأنشئ الشبكة بخيار التشفير:
docker network create -d overlay --opt encrypted --attachable ct3-sec
docker network inspect ct3-sec --format '{{json .Options}}'
docker service update --network-add ct3-sec ct3-web
docker network connect ct3-sec ct3-probe
for i in 1 2 3 4 5 6; do docker exec ct3-probe wget -q -O - http://ct3-web.ct3-sec/ | head -1; done
ip xfrm state | grep -c '^src'
{"com.docker.network.driver.overlay.vxlanid_list":"4098","encrypted":""}
Hostname: 280af8fb705d
...
xfrm states: 8
--- on node2:
21:46:12.927238 IP 10.30.0.11 > 10.30.0.12: ESP(spi=0xaa6a4735,seq=0x1), length 116
21:46:12.928631 IP 10.30.0.12 > 10.30.0.11: ESP(spi=0xad744fcd,seq=0x1), length 116
ESP packets: 14 VXLAN headers visible: 0 plaintext GET: 0 plaintext Hostname: 0نفس الطلبات، ولكن الحزم صارت ESP، وهو بروتوكول IPsec الذي يشفر الحزمة كلها، فلا يظهر رقم VNI ولا أي GET ولا أي اسم. والسطر xfrm states: 8 يعني أن Docker أنشأ في النواة ثماني حالات IPsec، أي زوج مفاتيح لكل اتجاه بين العقد. والثمن معالج إضافي لكل حزمة، وأن ESP بروتوكول رقم 50 لا منفذ، فيجب أن يسمح به جدار الحماية بين العقد. ولاحظ أن تحديث الخدمة لإضافة الشبكة الجديدة أعاد توزيع النسخ 2 و2 و2، لأن إضافة شبكة تغيير في المواصفة يمر بالتحديث التدريجي.
التحديث التدريجي Rolling Update
عند إنشاء الخدمة كتبنا سياسة التحديث Update Policy، وهذا معناها كما في مرجع docker service update:
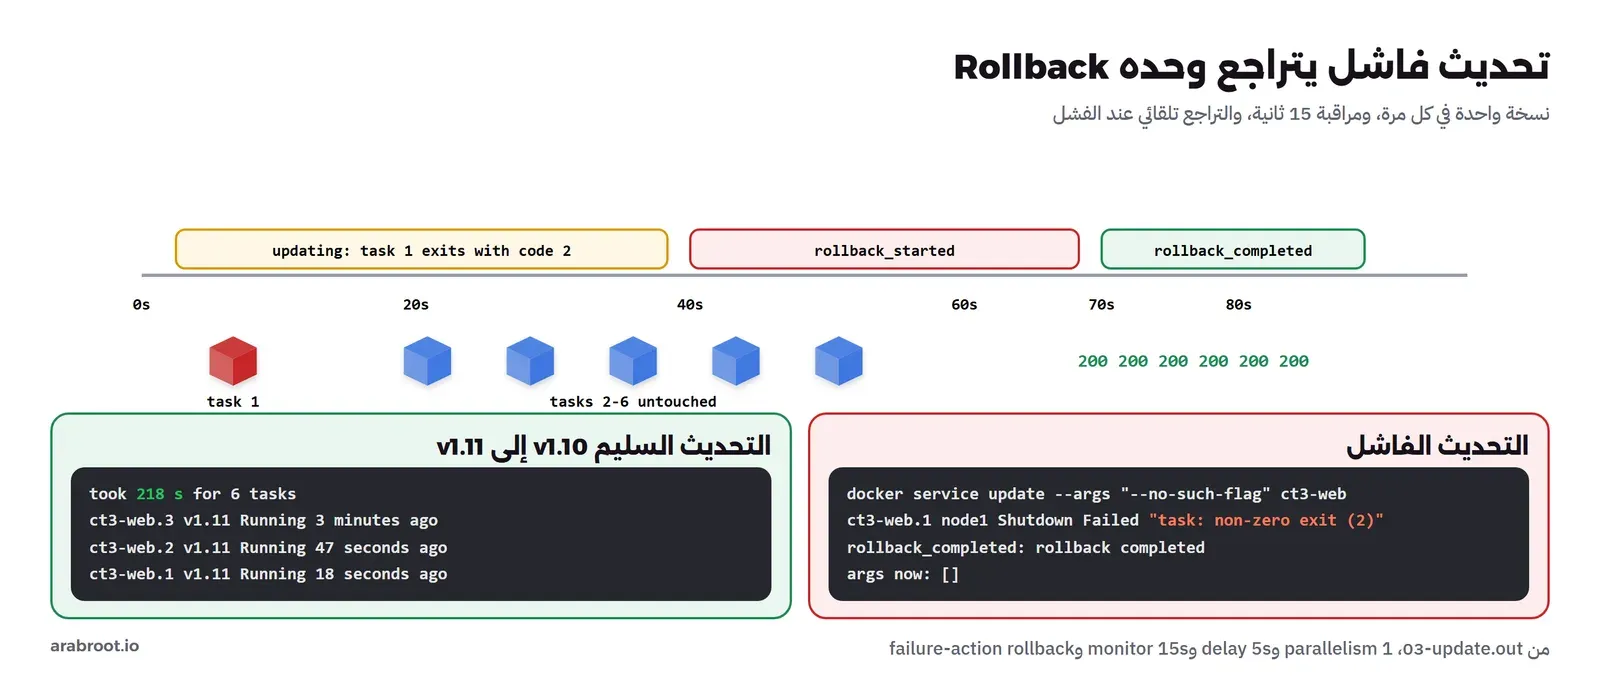
--update-parallelism 1: استبدل نسخة واحدة في كل مرة، فتبقى خمس نسخ تخدم الطلبات أثناء التحديث.--update-delay 5s: انتظر خمس ثوان بين كل نسخة والتي بعدها.--update-monitor 15s: راقب كل نسخة جديدة 15 ثانية بعد بدئها، فإذا فشلت خلالها اعتبر التحديث فاشلاً.--update-failure-action rollback: إذا فشل التحديث فارجع إلى المواصفة السابقة تلقائياً، والقيمة الافتراضيةpauseالتي توقف التحديث في منتصفه وتنتظرك.
أولاً تحديث سليم من v1.10 إلى v1.11:
docker service update --image traefik/whoami:v1.11 ct3-web
docker service ps ct3-web --format "{{.Name}} {{.Image}} {{.Node}} {{.DesiredState}} {{.CurrentState}}"
took 218 s
ct3-web.1 traefik/whoami:v1.11 node1 Running Running 18 seconds ago
ct3-web.1 traefik/whoami:v1.10 node1 Shutdown Shutdown 34 seconds ago
ct3-web.1 traefik/whoami:v1.10 node3 Shutdown Shutdown 6 minutes ago
ct3-web.2 traefik/whoami:v1.11 node3 Running Running 47 seconds ago
ct3-web.2 traefik/whoami:v1.10 node3 Shutdown Shutdown about a minute ago
ct3-web.3 traefik/whoami:v1.11 node1 Running Running 3 minutes ago
ct3-web.3 traefik/whoami:v1.10 node1 Shutdown Shutdown 3 minutes agoكل مهمة لها الآن سطر بـ v1.11 يعمل، وتحته تاريخها: ال Containers القديمة بحالة Shutdown. ولاحظ أن الأزمنة متدرجة، فالمهمة 3 تحدثت قبل ثلاث دقائق والمهمة 1 قبل 18 ثانية، أي واحدة بعد الأخرى. وأخذ التحديث كله 218 ثانية لست نسخ، وهذا قريب مما تتوقعه من السياسة: لكل نسخة 15 ثانية مراقبة و5 ثوان انتظار، أي 120 ثانية على الأقل، والباقي زمن تشغيل كل Container على أجهزتنا البطيئة. فالتحديث التدريجي آمن ولكنه بطيء عمداً، وإذا كان عندك خمسون نسخة فارفع --update-parallelism.
تحديث فاشل يتراجع وحده Automatic Rollback
والآن نخطئ عمداً: نضيف إلى أمر التشغيل خياراً لا يعرفه whoami، فيخرج كل Container جديد بخطأ فوراً. وهذا يشبه خطأ إعداد حقيقياً، مثل متغير بيئة ناقص يجعل التطبيق يخرج عند البدء:
docker service update --detach --args "--no-such-flag" ct3-web
# then every 5 s:
docker service inspect ct3-web --format "{{.UpdateStatus.State}}"
t=5s state=updating
t=10s state=updating
t=35s state=updating
t=40s state=rollback_started
t=65s state=rollback_started
t=70s state=rollback_completed
rollback_completed: rollback completeddocker service ps ct3-web --format "{{.Name}} {{.Node}} {{.DesiredState}} {{.CurrentState}} {{.Error}}"
docker service inspect ct3-web --format "args now: {{.Spec.TaskTemplate.ContainerSpec.Args}}"
for i in $(seq 1 6); do curl -s -o /dev/null -w "%{http_code} " localhost:8080; donect3-web.1 node1 Running Running 10 seconds ago
ct3-web.1 node1 Shutdown Shutdown 33 seconds ago
ct3-web.1 node1 Shutdown Failed 41 seconds ago "task: non-zero exit (2)"
ct3-web.2 node3 Running Running 2 minutes ago
ct3-web.3 node1 Running Running 4 minutes ago
ct3-web.4 node2 Running Running 2 minutes ago
args now: []
200 200 200 200 200 200في المخرج أعلاه لاحظ التالي:
- بدأ التحديث بالمهمة 1 وحدها، فخرج ال Container الجديد برمز 2 وهو رمز «خيار غير معروف» في برامج Go، وظهر الخطأ
task: non-zero exit (2)في عمودError. - بعد حوالي 40 ثانية اعتبر Swarm التحديث فاشلاً وبدأ التراجع
rollback_started، وانتهى عند 70 ثانيةrollback_completed، فعادت المهمة 1 بالمواصفة القديمة. - المهام 2 و3 و4 لم تلمس أصلاً، فتواريخها قبل دقائق، لأن التوازي واحد، فلم يصل الخطأ إلا إلى نسخة واحدة من ست.
- الأمر
args now: []يؤكد أن المواصفة نفسها رجعت دون الخيار الخاطئ، وكل الطلبات أثناء ذلك وبعده ردت بـ 200.
وهذا أهم ما يقدمه Swarm لفريق صغير: الخطأ في التحديث يكلفك نسخة واحدة لمدة دقيقة بدلاً من توقف الخدمة كلها. ولكن انتبه إلى شرط ذلك، فـ Swarm يكتشف الفشل إذا خرج ال Container أو فشل فحص الصحة Healthcheck، فإذا كان تطبيقك يبدأ ويعمل ولكنه يرد بأخطاء 500 فلن يعرف Swarm بذلك إلا إذا كتبت HEALTHCHECK يفحص ما يهمك فعلاً، وقد شرحنا كتابته في مقال أفضل الممارسات في ملفات Compose. ويمكنك أيضاً أن تتراجع يدوياً في أي وقت بالأمر docker service rollback.
الأسرار Secrets
في مقال أفضل الممارسات في ملفات Compose رأينا أن كلمات المرور في متغيرات البيئة تظهر في docker inspect وفي سجلات كثيرة. وSwarm يقدم الأسرار بشكل أصلي، كما في توثيق Secrets: تنشئ السر مرة على المدير، فيحفظ مشفراً في حالة Raft، ويرسل فقط إلى العقد التي تعمل عليها مهمة تحتاجه، ويظهر داخل ال Container كملف في الذاكرة Memory:
printf "S3cret-DB-Pass" | docker secret create ct3_db_pass -
docker secret inspect ct3_db_pass --format "{{json .Spec}}"
docker service create --name ct3-app --replicas 2 --secret ct3_db_pass alpine:3.24 sh -c "sleep 3600"
# on each node that runs a task:
docker exec $C sh -c "ls -l /run/secrets; cat /run/secrets/ct3_db_pass; grep secrets /proc/mounts"
docker inspect $C --format "env: {{.Config.Env}}"
{"Name":"ct3_db_pass","Labels":{}}
ct3-app.1 node3 Running 21 seconds ago
ct3-app.2 node2 Running 19 seconds ago
node2:
-r--r--r-- 1 root root 14 Nov 18 21:18 ct3_db_pass
S3cret-DB-Pass
tmpfs /run/secrets/ct3_db_pass tmpfs ro,relatime,inode64 0 0
env: [PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin]في المخرج أعلاه لاحظ التالي:
docker secret inspectلا يعرض القيمة أبداً، فقط الاسم والوسوم Labels، ولا يوجد أمر يقرأ السر من العنقود بعد إنشائه، فإذا أردت تغييره فأنشئ سراً جديداً باسم جديد وحدث الخدمة إليه.- داخل ال Container يظهر السر ملفاً في
/run/secrets/حجمه 14 بايت، مركباً منtmpfsللقراءة فقطro، أي في الذاكرة لا على القرص، ويختفي عندما يتوقف ال Container. - متغيرات البيئة لا تحمل أي أثر له، فـ
docker inspectلا يكشفه. والتطبيق يقرأ الملف، وكثير من ال Images الرسمية تقبل متغيراً ينتهي بـ_FILEلهذا الغرض، مثلPOSTGRES_PASSWORD_FILE=/run/secrets/db_pass. - العقدة
node1لم يظهر عندها شيء لأنه لا تعمل عليها أي مهمة منct3-app، فالسر لا يرسل إليها أصلاً.
ولاحظ حدود هذه الحماية: أي شخص يستطيع docker exec على العقدة يقرأ السر كما فعلنا، فالأسرار تحمي من التسرب في السجلات والملفات وال Images، لا من root على العقدة. ولملفات الإعداد غير السرية مثل nginx.conf يوجد مفهوم مشابه اسمه Configs.
موت عقدة Node Failure وإعادة الجدولة Rescheduling
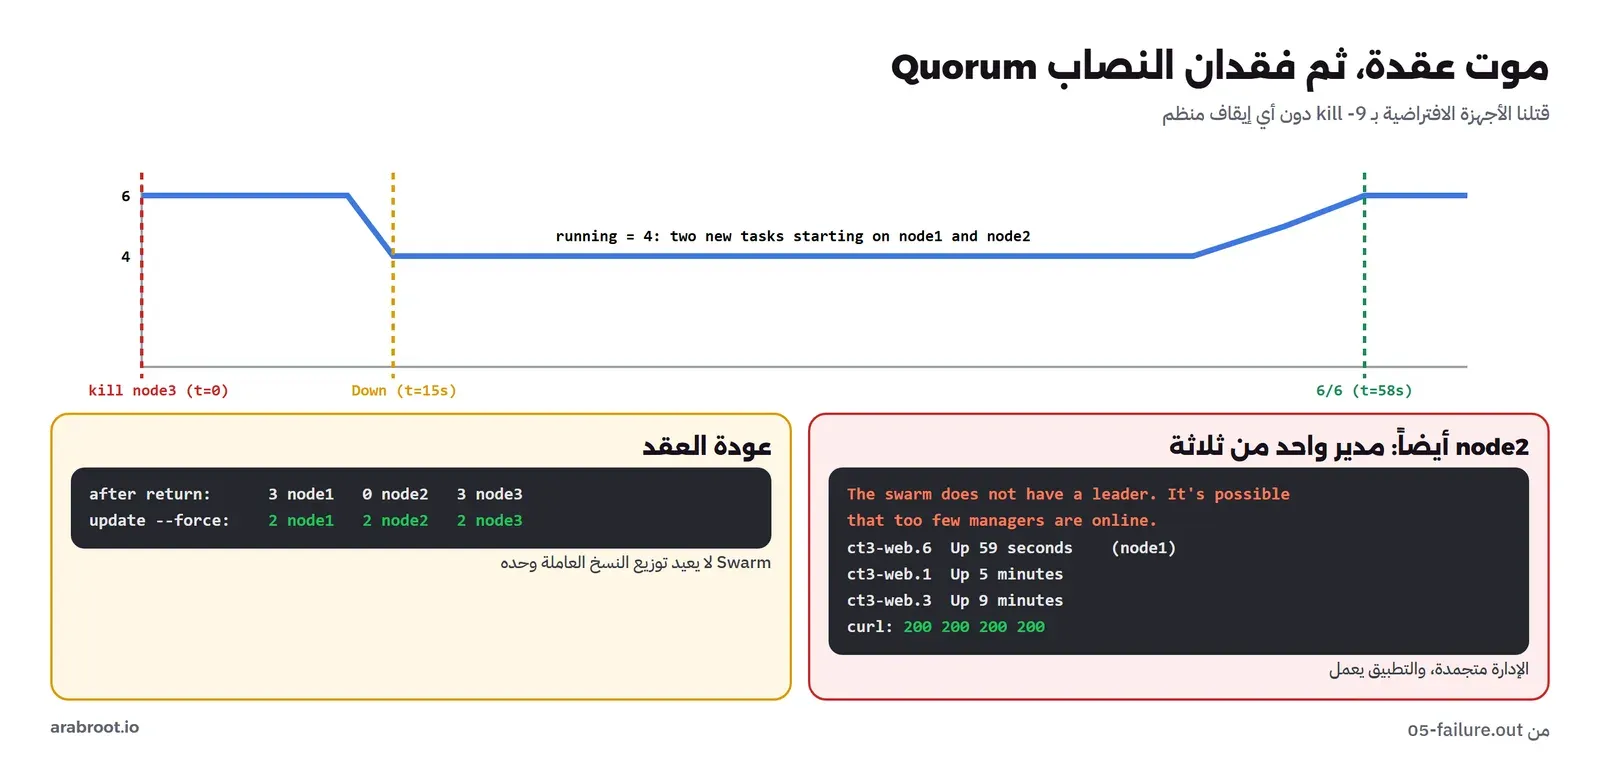
هذا هو السبب الذي تبني من أجله عنقوداً، فلنختبره بأقسى طريقة: قتلنا عملية الجهاز الافتراضي node3 من الخارج بـ kill -9، فلا يوجد إيقاف منظم ولا إشعار للعنقود، تماماً كانقطاع الكهرباء أو عطل في القرص. ثم راقبنا من node1 حالة العقدة وعدد النسخ العاملة كل بضع ثوان:
kill -9 $(cat /d/node3.pid)
# on node1, every 3 s:
docker node ls --format "{{.Hostname}} {{.Status}}" | grep node3
docker service ps ct3-web --filter desired-state=running --format "{{.Node}} {{.CurrentState}}" | grep -c Running
killed node3 at 21:20:15
t=1s node3 Ready
t=6s node3 Ready
t=11s node3 Ready
t=15s node3 Down
t=18s running=4
t=23s running=4
t=41s running=4
t=48s running=4
t=53s running=5
t=58s running=6
3 node1
3 node2
node1 Ready Leader
node2 Ready Reachable
node3 Down Unreachable
200 200 200 200 200 200في المخرج أعلاه لاحظ التالي:
- بقيت العقدة
Readyفي نظر العنقود 11 ثانية بعد موتها، ثم صارتDownعند الثانية 15. فالمدراء لا يعرفون بموت عقدة إلا عندما تتأخر نبضاتها Heartbeats عن المهلة، وهذه الثواني هي أقل زمن توقف للنسخ التي كانت عليها. - بعد اكتشاف الموت صار عدد النسخ العاملة 4 من 6، ثم بدأ المدير نسختين جديدتين على
node1وnode2، فاكتملت الست عند الثانية 58، وصار التوزيع Distribution 3 و3. وأغلب الوقت بين 18 و53 ثانية كان زمن تشغيل ال Containers الجديدة على أجهزتنا البطيئة. - العقدة
node3كانت مديراً أيضاً، فصارتUnreachable، ومع ذلك بقي العنقود يعمل لأن مديرين من ثلاثة أغلبية. - كل الطلبات أثناء ذلك ردت 200، لأن ال Routing Mesh يوجه الطلبات إلى النسخ الحية فقط.
وماذا لو مات مدير ثان؟ فقدان النصاب Quorum
والآن نذهب أبعد مما يتحمله العنقود: قتلنا node2 أيضاً، فبقي node1 وحده، أي مدير واحد من ثلاثة، وهذا أقل من الأغلبية:
kill -9 $(cat /d/node2.pid)
# on node1
docker node ls
docker service ls
docker ps --filter name=ct3-web --format "{{.Names}} {{.Status}}"
for i in $(seq 1 4); do curl -s -o /dev/null -w "%{http_code} " --max-time 3 localhost:8080; done
Error response from daemon: rpc error: code = DeadlineExceeded desc = stream terminated by RST_STREAM with error code: CANCEL
Error response from daemon: rpc error: code = Unknown desc = The swarm does not have a leader. It's possible that too few managers are online. Make sure more than half of the managers are online.
ct3-web.6.w7a5gql6ezc5b9h9ajxoet83l Up 59 seconds
ct3-web.1.p2bcb81m1b7fmc0s9s7cmokfv Up 5 minutes
ct3-web.3.5qnfuubx6g9oixzt8j68hr9wn Up 9 minutes
200 200 200 200وهذا بالضبط ما يصفه دليل الإدارة. فكل أمر إداري فشل: node ls بانتهاء المهلة، وservice ls برسالة واضحة «The swarm does not have a leader»، ولن تستطيع أن تنشر أو تحدث أو تنقل أي شيء. ولكن طبقة البيانات Data Plane لم تتوقف: النسخ الثلاث على node1 ما زالت تعمل، والطلبات ترد 200. أي أن فقدان النصاب لا يوقف تطبيقك، وإنما يجمد العنقود على حاله، فلا يعيد أي نسخة تموت بعد ذلك. وإذا لم تستطع إعادة المدراء الموتى أبداً، فالحل أن تنشئ عنقوداً جديداً من المدير الباقي بالأمر docker swarm init --force-new-cluster، فيحتفظ بالخدمات والعمال، ثم ترقي عقداً أخرى إلى مدراء.
عودة العقد Nodes: التوازن Rebalancing لا يرجع وحده
أعدنا تشغيل الجهازين، فرجعا إلى العنقود وعاد النصاب، ثم نظرنا إلى توزيع النسخ:
node1 Ready Leader
node2 Ready Reachable
node3 Ready Reachable
      3 node1
      3 node3
والمفاجأة هنا أن node2 لا يعمل عليه أي نسخة، والسبب أن المهام الثلاث التي كانت عليه لم يكن ممكناً نقلها وقت فقدان النصاب، فلما عاد النصاب كانت node3 قد رجعت قبله، فوضعها المدير عليها. وSwarm لا يعيد توزيع النسخ العاملة من تلقاء نفسه عندما تعود عقدة، لأن نقل نسخة تعمل جيداً يعني إيقافها، وهو لا يوقف ما يعمل دون سبب. فإذا أردت التوازن فاطلبه صراحة:
docker service update --force ct3-web 2 node1
2 node2
2 node3والخيار --force يعيد إنشاء كل المهام بنفس المواصفة، وبنفس سياسة التحديث التدريجي، فيوزعها المدير من جديد على كل العقد. وهذا ما يجب أن تتذكره بعد أي صيانة لعقدة: بعد docker node update --availability drain ثم active لن تعود المهام وحدها.
عمليات يومية Operations: الصيانة والخدمات العامة وحجز الموارد
صيانة Maintenance عقدة: drain
موت العقدة الذي رأيناه حالة طارئة، أما في الأيام العادية فأنت تريد أن تحدث نظام عقدة أو تعيد تشغيلها دون أن تفقد أي طلب. والطريقة أن تفرغها Drain أولاً، فينقل المدير مهامها إلى العقد الأخرى بنفس سياسة التحديث التدريجي، ثم تعمل على العقدة وهي فارغة، ثم تعيدها:
docker node update --availability drain node3
docker service ps ct3-web --filter desired-state=running --format "{{.Node}}" | sort | uniq -c
docker node ls --format "{{.Hostname}} {{.Availability}}"
docker node update --availability active node3
docker service ps ct3-web --filter desired-state=running --format "{{.Node}}" | sort | uniq -c
3 node1
3 node2
node1 Active
node2 Active
node3 Drain
3 node1
3 node2بعد التفريغ انتقلت نسختا node3 إلى العقدتين الأخريين، ولكن لاحظ السطرين الأخيرين: بعد أن أعدنا العقدة active بقي التوزيع 3 و3، ولم تعد أي نسخة إلى node3. وهذا نفس سلوك عودة العقدة الميتة الذي رأيناه، فالعقدة المتاحة تستقبل المهام الجديدة فقط. لذلك اجعل الأمر docker service update --force جزءاً من خطوات الصيانة Maintenance بعد آخر عقدة، أو اتركه حتى أول نشر قادم. ولاحظ أيضاً أن التفريغ لا يلمس ال Containers التي شغلتها بـ docker run العادي على العقدة، فهو يعرف المهام التي يديرها Swarm وحدها.
خدمة عامة Global Service: نسخة على كل عقدة
بعض البرامج يجب أن تعمل على كل سيرفر في العنقود بالضبط مرة واحدة: وكيل جمع السجلات Logs، ووكيل المراقبة Monitoring Agent الذي يقرأ استهلاك السيرفر، وأداة النسخ الاحتياطي. ولهذا يوجد الوضع global بدلاً من عدد النسخ:
docker service create --name ct3-agent --mode global alpine:3.24 sleep 3600
docker service ls --filter name=ct3-agent --format "{{.Name}} {{.Mode}} {{.Replicas}}"
docker service ps ct3-agent --format "{{.Node}} {{.CurrentState}}"
ct3-agent global 3/3
node3 Running 42 seconds ago
node1 Running 26 seconds ago
node2 Running 42 seconds agoثلاث نسخ لثلاث عقد دون أن نكتب الرقم، وإذا أضفت عقدة رابعة غداً فسوف تبدأ عليها نسخة تلقائياً. وهذا ما يسمى DaemonSet في Kubernetes.
حجز الموارد Reservations: المهمة التي لا تجد عقدة
عندما تكتب لخدمة --reserve-memory فأنت تقول للمدير: لا تضع هذه المهمة إلا على عقدة فيها هذا القدر من الذاكرة غير محجوز لغيرها. وهذا يمنع أن يضع المدير عشر قواعد بيانات على عقدة واحدة. ولنر ماذا يحدث إذا طلبت أكثر مما عند أي عقدة، وذاكرة كل عقدة عندنا 1.5 GB:
docker service create -d --name ct3-big --reserve-memory 2g alpine:3.24 sleep 3600
docker service ps ct3-big --format "{{.CurrentState}} | {{.Error}}" --no-trunc
Pending 9 seconds ago | "no suitable node (insufficient resources on 3 nodes)"
Mem: 1470 393 869 0 342 1077المهمة في حالة Pending، والرسالة تقول السبب صراحة، ولن يحدث أي خطأ آخر: الأمر service create نجح، والخدمة موجودة في service ls بـ 0/1، وتنتظر حتى تظهر عقدة مناسبة. وهذه حالة شائعة بعد موت عقدة في عنقود ممتلئ، فالمهام التي كانت عليها لا تجد مكاناً على العقد الباقية، وتبقى Pending دون أن ينبهك أحد. لذلك راقب عدد النسخ في docker service ls لا حالة العقد فقط، واترك في العنقود سعة فارغة تكفي لعقدة كاملة.
قفل المدراء Autolock والنسخ الاحتياطي Backup
ذكرنا أن حالة Raft مشفرة على قرص كل مدير، ومعها الأسرار، ولكن مفتاح فك هذا التشفير محفوظ افتراضياً على نفس القرص، فمن يسرق قرص مدير أو نسخة احتياطية منه يستطيع أن يقرأ كل الأسرار. والخيار Autolock يحل ذلك، كما في توثيق القفل: يأخذ Docker المفتاح من القرص ويعطيه لك، فلا يبدأ أي مدير بعد إعادة تشغيله حتى تعطيه المفتاح بيدك. فعلناه على node1 ثم أعدنا تشغيل Docker على node3:
# on node1
docker swarm update --autolock=true
# on node3
systemctl restart docker
docker node ls
docker info --format '{{.Swarm.LocalNodeState}}'
docker ps --filter name=ct3-web --format '{{.Names}}' | wc -l
Swarm updated.
To unlock a swarm manager after it restarts, run the `docker swarm unlock`
command and provide the following key:
SWMKEY-1-...
Remember to store this key in a password manager, since without it you
will not be able to restart the manager.
Error response from daemon: Swarm is encrypted and needs to be unlocked before it can be used. Please use "docker swarm unlock" to unlock it.
locked
0بعد إعادة التشغيل صارت العقدة locked، ورفضت كل أوامر العنقود، والأهم السطر الأخير: لا تعمل عليها أي نسخة من ct3-web. فإعادة تشغيل Docker أوقفت ال Containers، والعقدة المقفلة لا تستطيع أن تستلم مهامها حتى تفتح. وبعد docker swarm unlock بالمفتاح صارت active ورجعت إلى العنقود. وهذا يعني أن Autolock يحول كل إعادة تشغيل غير متوقعة لمدير، مثل تحديث تلقائي للنواة في الليل، إلى عقدة متوقفة حتى يتدخل إنسان. لذلك فعله إذا كانت الأسرار حساسة فعلاً، واحفظ المفتاح في مدير كلمات مرور Password Manager يصل إليه كل من يناوب، وإلا فاتركه مغلقاً واحم الأقراص والنسخ الاحتياطية بتشفير القرص.
أما النسخ الاحتياطي فحالة العنقود كلها، الخدمات والشبكات والأسرار والعقد، في المجلد /var/lib/docker/swarm على أي مدير، وكان حجمه عندنا 123M بعد ساعة من التجارب، أغلبه سجلات Raft. ويوصي دليل الإدارة بأن توقف Docker على مدير ليس القائد، وتنسخ المجلد كله، ثم تعيد تشغيله، وأن تحفظ مفتاح Autolock معه إذا كان مفعلاً. والاستعادة على سيرفر جديد تكون بنسخ المجلد ثم docker swarm init --force-new-cluster. وتذكر أن هذه النسخة لا تحتوي بيانات تطبيقاتك في ال Volumes، فتلك تنسخها كما في أي سيرفر.
ملف Compose على العنقود: docker stack deploy
كتبنا كل شيء في هذا المقال بأوامر docker service حتى نرى كل خيار، ولكنك في العمل اليومي تكتب ملف Compose وتنشره على العنقود كله بأمر واحد، كما في مرجع docker stack deploy. وجربنا ذلك بملف فيه خدمتنا وخدمة ثانية تبنى من Dockerfile كما تفعل عادة على سيرفر واحد:
services:
  web:
    image: traefik/whoami:v1.11
    ports: ["8081:80"]
    networks: [ct3-net]
    secrets: [ct3_db_pass]
    deploy:
      replicas: 3
      update_config: { parallelism: 1, delay: 5s, monitor: 15s, failure_action: rollback }
      restart_policy: { condition: on-failure }
      resources:
        limits: { memory: 64M, cpus: "0.25" }
  build-me:
    build: .
networks:
  ct3-net: { external: true }
secrets:
  ct3_db_pass: { external: true }
docker stack deploy -c stack.yaml ct3Ignoring unsupported options: build
invalid image reference for service build-me: no image specifiedرفض Swarm الملف كله بسبب الخدمة الثانية: stack deploy لا يبني Images، فتجاهل build، ثم وجد خدمة دون Image. والسبب منطقي: Image تبنيها على العقدة التي كتبت عليها الأمر لن توجد على العقدتين الأخريين، فكل Image في Swarm يجب أن تكون في سجل تسحب منه كل العقد، وهذا موضوع مقال سجل Docker Images الخاص. وبعد حذف الخدمة الثانية:
Creating service ct3_web
ct3_web 3/3 traefik/whoami:v1.11 *:8081->80/tcp
ct3_web.1 node3 Running 8 seconds ago
ct3_web.2 node2 Running 9 seconds ago
ct3_web.3 node1 Running 9 seconds ago
limits: 67108864 250000000
Hostname: 5c7c9c3b1171
اسم الخدمة صار ct3_web، أي اسم المجموعة Stack ثم اسم الخدمة، ونسخة على كل عقدة، والحدود من القسم deploy ظهرت كما كتبناها: 64 MiB بالبايت، وربع معالج بوحدة النانو. وحذف المجموعة كلها أمر واحد docker stack rm ct3. وهناك فروق أخرى يجب أن تعرفها: لا يدعم depends_on للترتيب، فكل خدمة يجب أن تتحمل غياب الأخرى عند البدء وتعيد المحاولة. والبيانات: Volume محلي على عقدة لا ينتقل معها إذا انتقلت المهمة إلى عقدة أخرى، فقاعدة البيانات في Swarm إما مثبتة على عقدة واحدة بقيد node.hostname، أو على تخزين شبكي Network Storage مثل NFS، أو خارج العنقود أصلاً، وهذا هو أصعب جزء في أي منسق، وفي Kubernetes أيضاً.
متى Swarm ومتى Kubernetes؟
بعد هذه التجارب نستطيع أن نجيب بدقة أكبر مما في الإعلانات. Swarm فعل في هذا المقال كل ما يعد به: التوزيع، وإعادة الجدولة بعد موت عقدة، والتحديث التدريجي مع التراجع، والأسرار، وشبكة على عدة سيرفرات، وكل ذلك بأوامر Docker التي تعرفها ودون أي برنامج إضافي، وفي ساعة واحدة من الإعداد. وفيما يلي نقاط القوة ونقاط الضعف لكل منهما:
| Docker Swarm | Kubernetes | |
|---|---|---|
| نقاط القوة | مدمج في Docker، ملف Compose نفسه تقريباً، مفاهيم قليلة، TLS بين العقد وأسرار مشفرة افتراضياً، عنقود في دقائق | معيار الصناعة، منظومة ضخمة من الأدوات (Helm وIngress Controllers وOperators وأدوات المراقبة)، تخزين وشبكات بمواصفات قابلة للتبديل، مزودون سحابيون يديرونه لك |
| نقاط الضعف | تطوير بطيء ومنظومة صغيرة، لا يوجد توسع تلقائي Autoscaling، لا يوجد ما يعادل Operators لقواعد البيانات، تخزين متعدد العقد ضعيف، قلة من يعرفه في سوق العمل Job Market | مفاهيم كثيرة، Control Plane يحتاج رعاية وتحديثاً كل سنة على الأقل، كلفة تعلم وتشغيل حقيقية لفريق صغير |
والقاعدة التي نخرج بها: إذا كان سيرفر واحد مع Compose يكفيك، فلا تنتقل إلى أي منسق. وإذا احتجت سيرفرين أو ثلاثة للتوافرية High Availability، وفريقك صغير، وتطبيقاتك عديمة الحالة Stateless في الغالب، فـ Swarm يعطيك 80% مما تحتاجه بـ 10% من التعقيد. وإذا كان المستقبل عشرات الخدمات وعدة فرق، أو تحتاج التوسع التلقائي وقواعد بيانات تديرها Operators، أو ستعمل على منصة سحابية مدارة، فابدأ بـ Kubernetes مباشرة، لأن الانتقال من Swarm إليه لاحقاً يعني إعادة كتابة النشر كله، كما يشرح مقال الانتقال من Compose إلى Kubernetes.
وإذا بدأت بـ Swarm ثم كبرت، فالانتقال ممكن ولكنه ليس آلياً. فالأداة Kompose تحول ملف Compose إلى ملفات Kubernetes من نوع Deployment وService، وهي نقطة بداية جيدة، ولكن ما لا تنقله هو ما يعطي Swarm قيمته: سياسة التحديث تتحول إلى strategy بخيارات مختلفة، والأسرار تصبح Secrets بصيغة أخرى، وال Routing Mesh يحل محله Service مع Ingress أو Gateway، والقيود على العقد تصبح Node Affinity. والأهم أن الفريق نفسه يحتاج أن يتعلم طريقة تفكير جديدة. لذلك نصيحتنا العملية: إذا كنت تعرف من اليوم أن المنصة سوف تكبر إلى عشرات الخدمات خلال سنة، فلا تبن على Swarm مرحلة مؤقتة، أما إذا كان عنقود من ثلاثة سيرفرات هو أقصى ما تتوقعه، فـ Swarm قد يبقى معك سنوات دون أن تحتاج غيره.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلKubernetes من الداخل: Control Plane وetcd والعقد Nodesعنقود حقيقي من ثلاث عقد نفتحه من الداخل، فنقرأ etcd ونشاهد حلقة التحكم والمجدول، ثم نوقف عقدة ونقيس كم احتاج العنقود ليلاحظ وماذا تعطل في الطريق.
 دليلنقل تطبيق Docker Compose إلى Kubernetes خطوة بخطوةننقل تطبيقاً من أربع خدمات من Docker Compose إلى Kubernetes، ونرى ما أخطأ فيه kompose وما تعلمناه من كل عطل حتى عمل التطبيق.
أخطاء شائعة Common Mistakes
- عنقود بمديرين، أو بعدد زوجي من المدراء، والظن أنه أكثر توافرية من مدير واحد.
- جعل كل العقد عمالاً ما عدا مديراً واحداً، فإذا مات هذا المدير لا يستطيع أحد تعديل أي شيء.
- نسيان
--advertise-addrعلى سيرفر بعدة واجهات، أو عدم فتح المنافذ 2377 و7946 و4789 بين العقد، فتنضم العقد ولا تعمل شبكة overlay. - فتح هذه المنافذ للإنترنت، أو تسريب توكن الانضمام دون تدويره.
- تحديث دون
--update-failure-action rollbackودونHEALTHCHECK، فيتوقف التحديث في منتصفه أو يكمل ببناء معطوب. - تشغيل قاعدة بيانات بـ Volume محلي دون قيد على عقدة، فتنتقل المهمة إلى عقدة أخرى بقاعدة فارغة.
- استخدام
latestفي الخدمات، فتسحب كل عقدة إصداراً مختلفاً حسب وقت السحب. - الظن أن الخدمة متوازنة بعد عودة عقدة ميتة، والمهام لا تعود إليها إلا مع
--forceأو تحديث جديد. - الخلط بين Swarm المدمج وClassic Swarm القديم في الأدلة.
قائمة تحقق Checklist لعنقود Swarm في الإنتاج Production
- ثلاثة مدراء أو خمسة، على سيرفرات في أماكن مختلفة إن أمكن، وأي عدد من العمال.
- المنافذ 2377 و7946 و4789 مفتوحة بين العقد فقط، و
--advertise-addrعلى الشبكة الداخلية. - سجل Images خاص تسحب منه كل العقد، والخدمات بإصدار ثابت أو بالبصمة Digest.
- لكل خدمة
HEALTHCHECKوسياسة تحديث بالتراجع وحدود ذاكرة ومعالج. - الأسرار في
docker secretلا في متغيرات البيئة. - خطة واضحة للبيانات: قيد على عقدة، أو تخزين شبكي، أو قاعدة بيانات خارج العنقود.
- نسخة احتياطية Backup من مجلد
/var/lib/docker/swarmعلى مدير، مع تجربة استعادة بـ--force-new-cluster. - موزع حمل أو DNS أمام كل العقد، ومراقبة لحالة
docker node ls.
جدول القرار Decision Table: Compose أم Swarm أم Kubernetes؟
| الحالة | الأنسب | والسبب |
|---|---|---|
| تطبيقات على سيرفر واحد، والتوقف دقائق عند العطل مقبول | Docker Compose | أبسط حل، والنسخ الاحتياطي يكفي للاستعادة |
| تحتاج أن تبقى الخدمة تعمل إذا مات سيرفر، وفريقك صغير | Swarm بثلاثة مدراء | إعادة جدولة وتحديث تدريجي بملف Compose نفسه تقريباً |
| تطبيقات Stateless كثيرة وقاعدة بيانات واحدة | Swarm مع قاعدة البيانات خارج العنقود أو مثبتة على عقدة | يتجنب أصعب جزء في Swarm وهو التخزين |
| عشرات الخدمات وعدة فرق، أو توسع تلقائي | Kubernetes | المنظومة والأدوات والصلاحيات لكل فريق |
| منصة سحابية تقدم Kubernetes مداراً | Kubernetes المدار | المزود Provider يدير Control Plane عنك |
| تريد أن تتعلم Kubernetes للعمل | Kubernetes ولو على سيرفر واحد مع K3s | Swarm لن يعلمك ما يطلبه سوق العمل |
حذف المختبر Cleanup
# on node1
docker service rm ct3-web ct3-app
docker secret rm ct3_db_pass
docker network rm ct3-net
# on every node
docker swarm leave --force
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Swarm جزء من Docker Engine منذ 2016، تبدؤه بـ
swarm initوتضم العقد بتوكن، ويشفر الاتصال بين العقد بـ TLS افتراضياً. - المدراء يتفقون بـ Raft، والعنقود يحتاج أغلبيتهم، فثلاثة مدراء يتحملون موت واحد فقط، والعدد الزوجي لا يضيف شيئاً.
- ست نسخ توزعت نسختين على كل عقدة، واثنا عشر طلباً إلى عقدة واحدة توزعت على النسخ الست، وعقدة بلا نسخ ردت عبر ال Routing Mesh.
- التحديث السليم استبدل النسخ واحدة واحدة في 218 ثانية، والتحديث الفاشل وصل إلى نسخة واحدة ثم تراجع وحده في 70 ثانية، وكل الطلبات ردت 200.
- السر لا يقرأ من العنقود، ويظهر في ال Container ملفاً في tmpfs للقراءة فقط، ولا يرسل إلا للعقد التي تحتاجه.
- عقدة قتلناها صارت Down بعد 15 ثانية، واكتملت النسخ الست على العقدتين الباقيتين بعد 58 ثانية. وبموت مدير ثان فقد العنقود النصاب فتجمدت الإدارة، وبقي التطبيق يرد 200، وبعد عودة العقد احتجنا
update --forceلإعادة التوازن. - شبكة overlay العادية نقلت الطلبات بين السيرفرات نصاً واضحاً داخل VXLAN، والخيار
--opt encryptedحولها إلى حزم ESP لا يظهر منها أي نص. - تفريغ عقدة للصيانة بـ
drainنقل نسخها دون توقف، ولكنها لم تعد إليها بعد إرجاعها، وخيار Autolock جعل المدير الذي أعيد تشغيله مقفلاً بلا أي نسخة حتى أعطيناه المفتاح.
وبهذا المقال نكون قد أكملنا مرحلة Docker وال Containers، والمرحلة التالية في هذا المسار بإذن الله هي Kubernetes. وهذه مقالات مرتبطة:
 دليلشبكات Docker وأفضل الممارسات مع Docker Composeلماذا يبقى المنفذ الذي تنشره في Compose مفتوحاً للإنترنت رغم ufw، وكيف تصل التطبيقات إلى بعضها عبر شبكات Docker دون نشر منافذ.
 دليلأفضل الممارسات Best Practices في ملفات Docker Composeكيف تكتب ملف Compose يبدأ خدماته بالترتيب الصحيح ويحمي كلمات المرور ويضبط الذاكرة ويفصل التطوير عن الإنتاج، مع تجربة أظهرت أين يخدعك كل إعداد افتراضي.
 دليلسجل Docker Images خاص: Registry وHarborنبني سجل Images خاصاً على سيرفرك بـ distribution مع TLS وكلمة مرور ثم بـ Harbor، ونرى ال Digest وجمع المهملات وفحص الثغرات ومنع تغيير ال Tags وذاكرة السحب أمام Docker Hub.
 دليلأمان ال Containers وقت التشغيل: Rootless وCapabilitiesنختبر على سيرفر Debian كل طبقة تحمي السيرفر من ال Container، من Capabilities وseccomp وAppArmor إلى Rootless وحدود العمليات، ونرى ماذا يحدث عندما نزيلها.
 دليلPodman: بديل Docker دون Daemon ودون rootنشغل Podman بمستخدم عادي بجانب Docker على نفس السيرفر، من ال Pods وQuadlet مع systemd إلى أداة docker وCompose عبر مقبسه، ونقيس الفرق في السرعة والذاكرة.دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
سجل التحديثات Changelog
- 19 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على عنقود من ثلاثة أجهزة افتراضية Debian 13.7 بنواة 6.12.117 مع Docker Engine 29.10.0 في وضع Swarm، وtraefik/whoami v1.10 وv1.11.