في مقال ما هي ال Containers؟ رأينا أن ال Container عملية عادية على نواة المضيف Host Kernel، وأن المستخدم root داخله هو root المضيف نفسه من وجهة نظر النواة، ثم توقفنا عند سؤال مهم: إذا كان الأمر كذلك، فما الذي يمنع تطبيقاً مخترقاً Compromised Application داخل Container من الوصول إلى السيرفر Server كله؟ والإجابة أن Docker لا يعتمد على جدار واحد، وإنما يضع حول كل عملية عدة طبقات صغيرة Layers، كل واحدة منها تمنع نوعاً معيناً من الأفعال، وأغلب هذه الطبقات تعمل افتراضياً دون أن تطلبها، ولذلك لا يعرف كثير من الناس أنها موجودة إلا عندما يعطلونها بخيار واحد مثل --privileged ويظنون أنه خيار عادي لحل مشكلة صلاحيات.
وفي هذا المقال سوف نفتح هذه الطبقات واحدة واحدة على سيرفر حقيقي، ونرى كل طبقة وهي ترفض أمراً بعينه، ثم نرى ماذا يحدث عندما نزيلها. والسيرفر هنا جهاز افتراضي Debian 13 بنواة 6.12 فيه Docker Engine 29.10 مع cgroup v2 وAppArmor، أي البيئة نفسها التي سوف تجدها على أي VPS حديث، لأن Docker Desktop على Windows لا يحمل AppArmor ويعمل بنواة WSL2 على cgroup v1، فلا يصلح لرؤية كل شيء. وسوف تكون كل المخرجات في هذا المقال حقيقية من هذا الجهاز.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يحتاج ال Container إلى طبقات أمان فوق مساحات الأسماء Namespaces، وما هي هذه الطبقات.
- صلاحيات النواة Capabilities: ما يعطيه Docker افتراضياً، وإسقاطها كلها ثم إعادة واحدة، ومشكلة nginx عندما أسقطناها.
- فلتر استدعاءات النظام seccomp: ماذا يمنع الملف الافتراضي، وكيف تكتب ملفاً خاصاً.
- AppArmor وSELinux: الطبقة التي ترفض حتى عندما تملك الصلاحية.
- الخيار
no-new-privilegesوبرامج setuid. - الخيار
--privileged: تجربة نركب فيها قرص المضيف من داخل Container ونقرأ ملف كلمات المرور. - مساحة المستخدمين userns-remap ووضع Rootless، والمشاكل التي ظهرت معنا في كل منهما.
- حدود الموارد: قنبلة Fork Bomb محصورة، والذاكرة Memory، والمعالج CPU، والحد الذي يضعه systemd دون أن تعرف.
- ثغرات runc الحقيقية من 2019 إلى 2025، ومعيار CIS Docker Benchmark، وقائمة تحقق.
لماذا لا تكفي مساحات الأسماء Namespaces وحدها؟
مساحات الأسماء تحدد ما تراه العملية، فهي لا ترى عمليات المضيف ولا ملفاته ولا شبكته، ولكنها لا تحدد ما تستطيع العملية أن تطلبه من النواة. والعملية داخل ال Container تكلم النواة نفسها التي يكلمها كل شيء على السيرفر، عبر استدعاءات النظام System Calls التي شرحناها في مقال فضاء النواة وفضاء المستخدم واستدعاءات النظام، وفي Linux أكثر من 450 استدعاء، بعضها يركب أنظمة ملفات File Systems، وبعضها يحمل وحدات في النواة Kernel Modules، وبعضها يغير ساعة الجهاز System Clock أو يعيد تشغيله. فإذا كانت العملية تعمل كـ root ولم يمنعها شيء آخر، فهي تستطيع أن تطلب أي واحد منها، ومساحة الأسماء لن تقف في الطريق لأنها لم تصمم لذلك.
لذلك يضع Docker حول كل Container خمس طبقات أخرى، كما يشرح توثيق أمان Docker، وفيما يلي ترتيبها من الأسئلة التي تجيب عنها:
- من أنت؟ المستخدم داخل ال Container، ومساحة المستخدمين User Namespace التي تجعل root في الداخل مستخدماً عادياً في الخارج. وهذه الطبقة الوحيدة التي لا يفعلها Docker افتراضياً.
- ماذا يسمح لك كـ root؟ صلاحيات النواة Capabilities، وهي تقسيم صلاحيات root إلى قطع صغيرة، يعطي Docker منها 14 فقط من 41.
- أي استدعاءات تستطيع أن تطلبها أصلاً؟ فلتر seccomp، الذي يرفض الاستدعاء قبل أن تنظر النواة فيه.
- أي ملفات وعمليات تستطيع أن تلمسها حتى لو كانت الصلاحية معك؟ نظام الحماية الإلزامي Mandatory Access Control، وهو AppArmor على Debian وUbuntu، وSELinux على Fedora وRHEL.
- كم تأخذ؟ مجموعات التحكم cgroups للذاكرة والمعالج وعدد العمليات، وقد شرحنا الذاكرة والمعالج بالتفصيل في مقال ال Containers، وهنا نكمل بعدد العمليات.
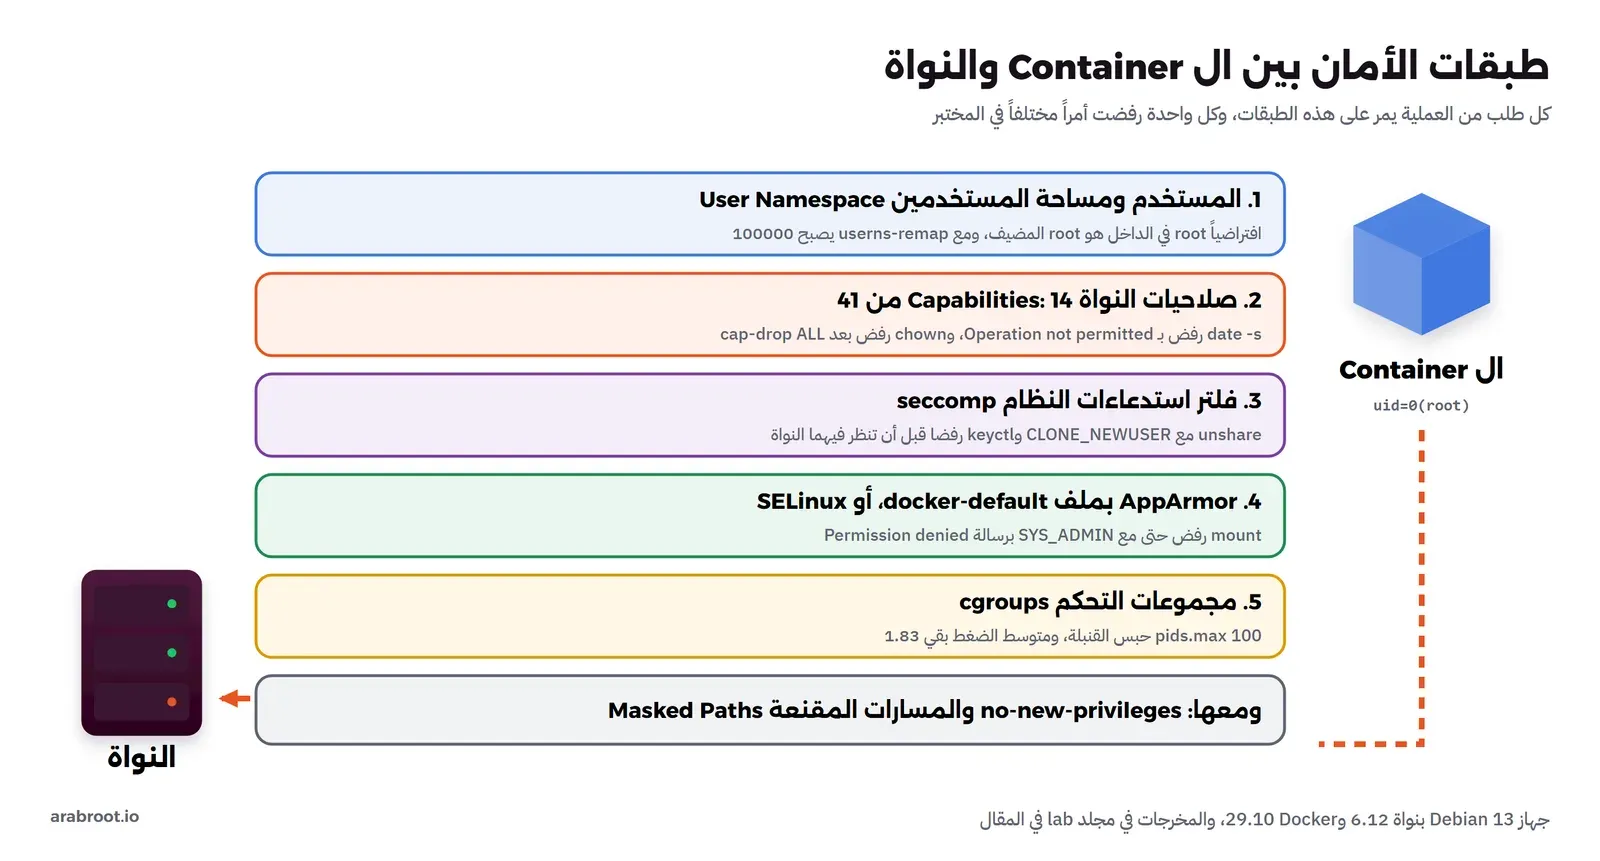
والفكرة المهمة في الرسم أن الطبقات مستقلة، فإذا سمحت إحداها بشيء وجدته الأخرى أمامه، وسوف نرى ذلك عملياً عندما نعطي ال Container صلاحية CAP_SYS_ADMIN ثم يرفض AppArmor أمر mount مع أن الصلاحية معه. وهذا ما يسمى الدفاع بالعمق Defense in Depth: لا يوجد جدار واحد مثالي، فالأفضل أن يحتاج المهاجم Attacker إلى تجاوز عدة جدران مختلفة في وقت واحد.
السيرفر Server الذي سوف نعمل عليه
جهزنا جهازاً افتراضياً بـ QEMU مع KVM، نظامه Debian 13.7 ونواته 6.12.117+deb13-cloud-amd64، فيه Docker Engine من المستودع Repository الرسمي كما في دليل تثبيت Docker، وذاكرته 3 GB ومعالجان. وأول ما نفعله أن نسأل Docker عن طبقات الأمان المفعلة عنده:
docker info --format 'cg={{.CgroupVersion}} drv={{.CgroupDriver}} sec={{.SecurityOptions}}'
runc --version | head -1
cat /sys/kernel/security/lsm
والمخرج سوف يكون كما يلي:
cg=2 drv=systemd sec=[name=apparmor,profile=default name=seccomp,profile=builtin name=cgroupns]
runc version 1.5.3
lockdown,capability,landlock,yama,apparmor,tomoyo,bpf,ipe,ima,evm
في المخرج أعلاه لاحظ التالي:
name=apparmor,profile=default: كل Container يبدأ داخل ملف AppArmor Profile اسمهdocker-default، وهذا لا يظهر على Docker Desktop عندنا، فهناك تجد seccomp وحده.name=seccomp,profile=builtin: الملف الافتراضي لـ seccomp المبني داخل Docker نفسه.cgroupns: كل Container له مساحة cgroup خاصة، وهذا يحدث مع cgroup v2.- السطر الأخير قائمة وحدات الأمان Security Modules LSM التي حملتها النواة، وفيها
apparmor. وإذا لم تجده في سيرفرك فلن يحميك ملف AppArmor مهما كتبته.
والآن نشغل Container عادياً تماماً، بلا أي خيار، ونسأله عن نفسه:
docker run --rm alpine:3.24 sh -c 'id; grep -E "^(CapEff|CapBnd|NoNewPrivs|Seccomp):" /proc/self/status; cat /proc/self/attr/current'
capsh --decode=00000000a80425fb
والمخرج سوف يكون كما يلي:
uid=0(root) gid=0(root) groups=0(root),0(root),1(bin),2(daemon),3(sys),4(adm),6(disk),10(wheel),11(floppy),20(dialout),26(tape),27(video)
CapEff:	00000000a80425fb
CapBnd:	00000000a80425fb
NoNewPrivs:	0
Seccomp:	2
docker-default (enforce)
0x00000000a80425fb=cap_chown,cap_dac_override,cap_fowner,cap_fsetid,cap_kill,cap_setgid,cap_setuid,cap_setpcap,cap_net_bind_service,cap_net_raw,cap_sys_chroot,cap_mknod,cap_audit_write,cap_setfcap
هذه المخرجات القصيرة فيها كل الطبقات. فالعملية root بالرقم 0، ولكن صلاحياتها الفعلية CapEff رقم ست عشري Hexadecimal يمثل 14 صلاحية فقط فكها الأمر capsh، والقيمة Seccomp: 2 تعني أن فلتراً من النوع Filter مطبق عليها، والسطر الأخير يقول إنها داخل ملف AppArmor في وضع الإلزام Enforce Mode Enforce. أما NoNewPrivs: 0 فتقول إن خيار منع رفع الصلاحيات غير مفعل، وسوف نفعله لاحقاً.
root داخل ال Container هو root على السيرفر
قبل أن ندخل في الطبقات، لنتأكد من نقطة البداية التي ذكرناها، وهي أن root في الداخل هو root في الخارج ما دمنا لم نستخدم مساحة المستخدمين. نركب مجلداً من المضيف ونكتب فيه ملفاً، ثم ننظر إلى صاحبه وإلى صاحب العملية من الخارج:
mkdir -p /srv/ct3-demo
docker run --rm -v /srv/ct3-demo:/data alpine:3.24 sh -c 'echo hi > /data/from-container.txt'
ls -ln /srv/ct3-demo
docker run -d --name ct3-sleep alpine:3.24 sleep 300
ps -o user,pid,cmd -p $(docker inspect -f '{{.State.Pid}}' ct3-sleep)
والمخرج سوف يكون كما يلي:
-rw-r--r-- 1 0 0 3 Nov 18 17:48 from-container.txt
USER         PID CMD
root        1223 sleep 300
الملف ملك المستخدم رقم 0 على المضيف، والعملية تظهر في قائمة عمليات السيرفر باسم root. وهذا يعني أن كل ما يمنع هذه العملية من إيذاء السيرفر هو الطبقات التالية، فإذا أزلتها كلها فأنت تشغل برنامجاً كـ root على السيرفر مع اختلاف بسيط في ما يراه.
صلاحيات النواة Capabilities: root مقسم إلى قطع
في الأنظمة القديمة كان المستخدم إما root يستطيع كل شيء، أو مستخدماً عادياً تمر كل طلباته على فحص الصلاحيات. ومنذ النواة 2.2 قسم Linux صلاحيات root إلى وحدات صغيرة اسمها Capabilities، تصفها صفحة capabilities(7): CAP_CHOWN لتغيير مالك ملف، وCAP_NET_BIND_SERVICE للاستماع على منفذ أقل من 1024، وCAP_SYS_TIME لتغيير ساعة الجهاز، وCAP_SYS_ADMIN التي تجمع عدداً كبيراً من الأفعال الإدارية حتى صارت تسمى «root الجديد». والتشبيه القريب حلقة مفاتيح موظف الأمن في مبنى: بدلاً من أن تعطي العامل المفتاح الرئيسي الذي يفتح كل الأبواب، تعطيه مفتاح المخزن وحده.
وعلى المضيف نفسه، عملية root عادية تحمل كل المفاتيح:
CapEff:	000001ffffffffff
41
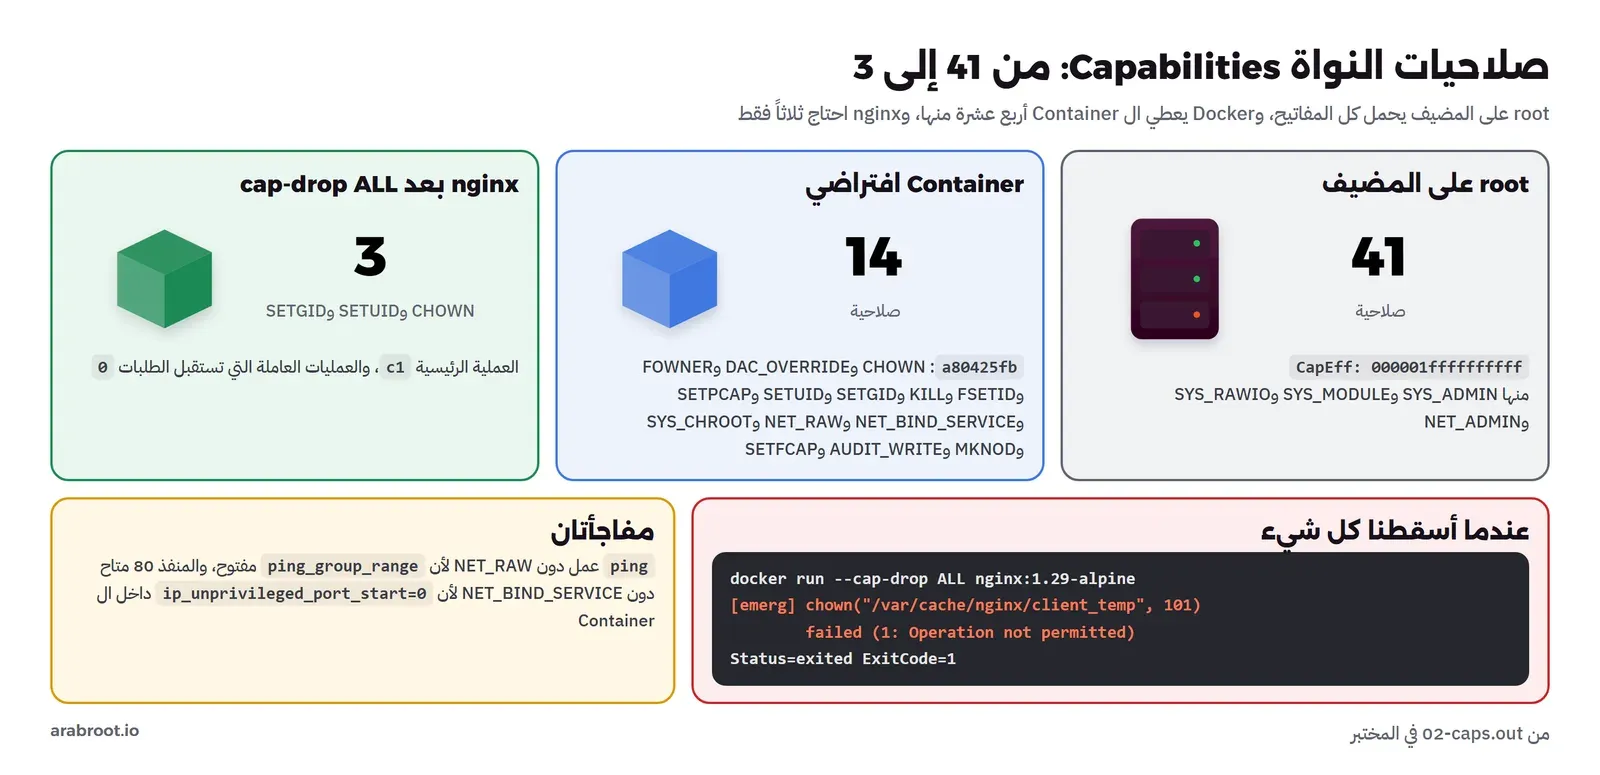
أي 41 صلاحية في النواة 6.12، بينما رأينا أن ال Container يأخذ 14 منها فقط. والسبع والعشرون التي أسقطها Docker تشمل كل ما هو خطر على السيرفر: تحميل وحدات النواة CAP_SYS_MODULE، والوصول إلى الأجهزة الخام CAP_SYS_RAWIO، وتتبع العمليات CAP_SYS_PTRACE، وإدارة الشبكة Network CAP_NET_ADMIN، وCAP_SYS_ADMIN. ولنر أثر ذلك بمثالين، تغيير مالك ملف وهو مسموح افتراضياً، وتغيير الساعة وهو غير مسموح:
docker run --rm alpine:3.24 sh -c 'touch /tmp/f && chown 1000:1000 /tmp/f && ls -n /tmp/f; date -s "2030-01-01 00:00"; echo "date exit=$?"'والمخرج سوف يكون كما يلي:
-rw-r--r--    1 1000     1000             0 Nov 18 17:48 /tmp/f
Tue Jan  1 00:00:00 UTC 2030
date exit=0
date: can't set date: Operation not permitted
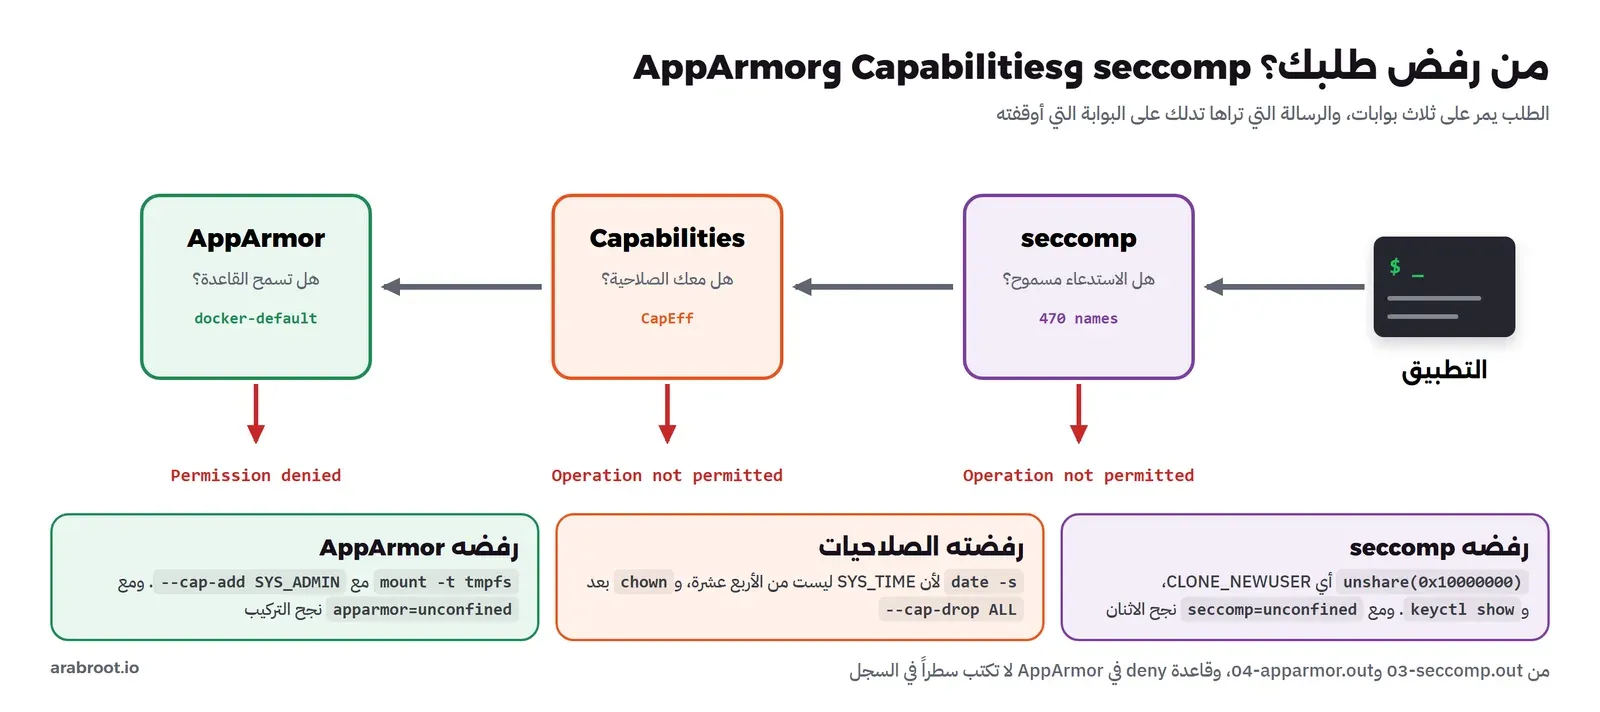
نجح chown لأن CAP_CHOWN من الأربع عشرة. أما date فطبع التاريخ الذي طلبناه ثم رفضت النواة تغيير الساعة برسالة Operation not permitted، وهذه الرسالة نفسها هي ما سوف تراه في كل مرة ترفض فيها صلاحية. ولاحظ أن رمز الخروج Exit Code كان 0 مع أن الأمر فشل، فنسخة date في BusyBox تطبع الخطأ ولا تغير رمز الخروج، ولذلك لا تعتمد على رمز الخروج وحده عندما تختبر صلاحية، واقرأ الرسالة أيضاً.
إسقاط الصلاحيات كلها Drop ALL ثم إعادة واحدة
القاعدة التي يوصي بها التوثيق ومعيار CIS أن تبدأ من الصفر ثم تضيف ما يحتاجه التطبيق فقط، لأن قائمة Docker الافتراضية مصممة لتعمل مع أكبر عدد من ال Images، لا لتطبيقك أنت. والخيار --cap-drop ALL يسقط الأربع عشرة كلها:
docker run --rm --cap-drop ALL alpine:3.24 sh -c 'grep CapEff /proc/self/status; touch /tmp/f && chown 1000:1000 /tmp/f; echo "chown exit=$?"; ping -c1 -W1 127.0.0.1 >/dev/null; echo "ping exit=$?"'
docker run --rm --cap-drop ALL --cap-add CHOWN alpine:3.24 sh -c 'grep CapEff /proc/self/status; touch /tmp/f && chown 1000:1000 /tmp/f && ls -n /tmp/f'
والمخرج سوف يكون كما يلي:
CapEff:	0000000000000000
chown exit=1
ping exit=0
chown: /tmp/f: Operation not permitted
CapEff:	0000000000000001
-rw-r--r--    1 1000     1000             0 Nov 18 17:48 /tmp/f
في المخرج أعلاه لاحظ التالي:
- بعد الإسقاط صار
CapEffصفراً، فرفضت النواةchownمع أن المستخدم ما زال root بالرقم 0. وهذا هو المعنى العملي لتقسيم root: الرقم 0 وحده لم يعد يكفي. - الأمر
pingنجح دونCAP_NET_RAW، وهذه نقطة تفاجئ كثيرين. والسبب أن Docker يضبط داخل كل Container القيمةnet.ipv4.ping_group_rangeعلى0 2147483647، فيستخدمpingمقبس ICMP Socket عادياً لا يحتاج صلاحية، ولذلك فإسقاطNET_RAWلن يكسر ping عندك، ولكنه يمنع إرسال حزم مصنوعة يدوياً، وهي ما يحتاجه المهاجم لانتحال عناوين على شبكة ال Containers. - مع
--cap-add CHOWNصارCapEffيساوي 1، وهو رقم البت الأول، أيCAP_CHOWNوحدها، فنجح الأمر.
وبنفس الطريقة وجدنا أن Docker يضبط net.ipv4.ip_unprivileged_port_start على 0 داخل ال Container، فيستطيع تطبيقك أن يستمع على المنفذ Port 80 حتى دون CAP_NET_BIND_SERVICE:
0
0	2147483647
وهذا يعني أن أغلب تطبيقات الويب التي تعمل بمستخدم عادي لا تحتاج أي صلاحية على الإطلاق.
المشكلة Problem: nginx يتوقف بعد إسقاط الصلاحيات Capabilities
الأمثلة السابقة سهلة، فلنجرب تطبيقاً حقيقياً. شغلنا ال Image الرسمية لـ nginx مع --cap-drop ALL ونحن نتوقع أن يعمل لأنه خادم ويب بسيط:
docker run -d --name ct3-nginx --cap-drop ALL nginx:1.29-alpine
docker inspect ct3-nginx --format 'Status={{.State.Status}} ExitCode={{.State.ExitCode}}'
docker logs ct3-nginx 2>&1 | grep emerg
والمخرج سوف يكون كما يلي:
Status=exited ExitCode=1
2026/11/18 17:51:53 [emerg] 1#1: chown("/var/cache/nginx/client_temp", 101) failed (1: Operation not permitted)
nginx: [emerg] chown("/var/cache/nginx/client_temp", 101) failed (1: Operation not permitted)
توقف nginx فوراً برمز 1. والسبب في السطر نفسه: العملية الرئيسية لـ nginx تبدأ كـ root، ثم تغير مالك مجلدات التخزين المؤقت Cache إلى المستخدم nginx برقمه 101، ثم تشغل العمليات العاملة Workers بهذا المستخدم. وهذا يعني أنها تحتاج ثلاث صلاحيات: CHOWN لتغيير المالك، وSETUID وSETGID لتتحول إلى المستخدم 101. فأعدنا هذه الثلاث فقط:
docker run -d --name ct3-nginx --cap-drop ALL --cap-add CHOWN --cap-add SETUID --cap-add SETGID -p 8080:80 nginx:1.29-alpine
curl -s -o /dev/null -w 'http %{http_code}\n' localhost:8080
docker exec ct3-nginx sh -c 'for p in $(pgrep nginx); do echo "pid $p user $(stat -c %U /proc/$p) $(grep CapEff /proc/$p/status)"; done'
والمخرج سوف يكون كما يلي:
http 200
pid 1 user root CapEff:	00000000000000c1
pid 29 user nginx CapEff:	0000000000000000
pid 30 user nginx CapEff:	0000000000000000
عمل nginx وأعطى 200. والرقم c1 هو مجموع البتات 0 و6 و7، أي CHOWN وSETGID وSETUID بالضبط، وهي عند العملية الرئيسية وحدها. أما العمليات العاملة التي تستقبل الطلبات من الإنترنت فصلاحياتها صفر، لأن النواة تسقط الصلاحيات عندما تتحول العملية من root إلى مستخدم عادي. وهذا هو الوضع الذي تريده: لو وجد مهاجم ثغرة Vulnerability في nginx فهو داخل عملية لا تملك أي صلاحية.
والطريقة العامة لتعرف ما يحتاجه تطبيقك هي ما فعلناه هنا: ابدأ بـ --cap-drop ALL، واقرأ السجل Log عند الفشل، وابحث عن الاستدعاء الذي رفض (chown وsetuid وbind)، ثم أضف الصلاحية المقابلة له وحدها. ولا تقم بإضافة SYS_ADMIN لأن الخطأ غامض، فهي تفتح أكثر بكثير مما تحتاجه، وسوف نرى بعد قليل أنها تكفي لتركيب أنظمة ملفات. وإذا كانت ال Image مبنية لتعمل بمستخدم عادي من البداية، كما شرحنا في مقال تقليل حجم ال Images وتأمينها، فغالباً لن تحتاج أي صلاحية.
فلتر استدعاءات النظام seccomp
الصلاحيات تقول ماذا يسمح لـ root أن يفعل، أما seccomp فيقول أي استدعاءات النظام تستطيع العملية أن تطلبها من الأساس. وهو برنامج صغير بلغة BPF تربطه النواة بالعملية، فيفحص رقم كل استدعاء ومعاملاته Arguments قبل أن ينفذ، ويقرر: اسمح، أو ارجع بخطأ، أو اقتل العملية، كما تصف صفحة seccomp(2). وما يجعل seccomp مهماً أن كثيراً من ثغرات النواة تكون في استدعاءات نادرة لا يحتاجها تطبيق ويب عادي، فإذا منعتها فأنت تغلق باب الثغرة قبل أن تكتشف.
والملف الذي يطبقه Docker افتراضياً منشور في مستودع moby/profiles، وهو قائمة سماح Allowlist: الإجراء الافتراضي فيه هو الرفض، ثم قائمة بالاستدعاءات المسموحة. ويشرح توثيق seccomp في Docker أنه يمنع حوالي 44 استدعاء من أكثر من 300، منها unshare وmount وkeyctl وadd_key وkexec_load وreboot. ولنجرب اثنين منها.
إنشاء مساحة مستخدمين User Namespace من داخل ال Container
الأمر unshare --user ينشئ مساحة مستخدمين جديدة، وهذا يبدو بريئاً، ولكن مساحة المستخدمين تعطي من ينشئها كل الصلاحيات داخلها، وقد استغلت ثغرات عديدة في النواة هذه الطريقة لتصل إلى أجزاء من الكود لا يصل إليها مستخدم عادي. ولذلك يمنعها الملف الافتراضي إلا إذا كانت CAP_SYS_ADMIN مع العملية:
docker run --rm alpine:3.24 unshare --user --map-root-user id; echo "exit=$?"
docker run --rm --security-opt seccomp=unconfined alpine:3.24 unshare --user --map-root-user id; echo "exit=$?"
والمخرج سوف يكون كما يلي:
unshare: unshare(0x10000000): Operation not permitted
exit=1
uid=0(root) gid=0(root) groups=0(root),0(root),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody),65534(nobody)
exit=0
الرقم 0x10000000 في الرسالة هو العلم CLONE_NEWUSER، فالفلتر لم يمنع الاستدعاء unshare كله، وإنما نظر في معامله ورفض هذا العلم بالذات، وهذه قدرة seccomp على فحص المعاملات لا الأسماء فقط. ومع seccomp=unconfined نجح الأمر وظهرت المجموعات كلها nobody، لأن المساحة الجديدة لا تعرف إلا الرقم الذي ربطناه.
مفاتيح النواة Kernel Keyring والأمر keyctl
النواة تحفظ مفاتيح التشفير وكلمات المرور المؤقتة لبعض الأنظمة في مخزن اسمه Keyring، وهو ليس معزولاً بمساحات الأسماء، فلو سمح لـ Container أن يقرأه لربما رأى مفاتيح غيره. ولذلك يمنع الملف الافتراضي keyctl وadd_key وrequest_key:
docker run --rm debian:trixie-slim sh -c 'apt-get -qq update; apt-get -qq install -y keyutils; keyctl show @s; echo "exit=$?"'
docker run --rm --security-opt seccomp=unconfined debian:trixie-slim sh -c 'apt-get -qq update; apt-get -qq install -y keyutils; keyctl show @s'
والمخرج سوف يكون كما يلي (حذفنا سطور التثبيت):
Keyring
Unable to dump key: Operation not permitted
exit=1
Keyring
 821048228 --alswrv      0     0  keyring: _ses.29aee7f72c898f0612452700e58ab56ebd79d6a341c833d51b41a1e9d34b0cb6
مع الفلتر رفض الطلب، ودونه ظهر مخزن الجلسة Session Keyring. ولاحظ اسمه _ses.29aee...: هذا مخزن جديد ينشئه runc لكل Container حتى لا يشترك ال Container في مخزن جلسة المضيف، أي أن هناك طبقة إضافية صغيرة حتى عندما تزيل الفلتر، ولكنها لا تغني عنه.
ملف seccomp خاص Custom Profile بتطبيقك
تستطيع أن تكتب ملفك الخاص، والطريقة الأسهل أن تبدأ من الملف الافتراضي وتعدله بدلاً من الكتابة من الصفر. وللتجربة سوف نحذف منه الاستدعاءين mkdir وmkdirat ونرى أثر ذلك:
curl -fsSL https://raw.githubusercontent.com/moby/profiles/main/seccomp/default.json -o /root/default.json
jq '.syscalls |= map(.names -= ["mkdir","mkdirat"])' /root/default.json > /root/no-mkdir.json
jq '[.syscalls[].names[]] | length' /root/default.json /root/no-mkdir.json
jq -r '.defaultAction, .defaultErrnoRet' /root/default.json
docker run --rm --security-opt seccomp=/root/no-mkdir.json alpine:3.24 sh -c 'touch /tmp/a && echo "touch ok"; mkdir /tmp/d; echo "mkdir exit=$?"'
والمخرج سوف يكون كما يلي:
470
468
SCMP_ACT_ERRNO
1
touch ok
mkdir exit=1
mkdir: can't create directory '/tmp/d': Operation not permitted
في المخرج أعلاه لاحظ التالي:
- الملف الافتراضي فيه 470 اسماً في قوائم السماح، وبعد الحذف صار 468. والأسماء أكثر من عدد الاستدعاءات في معمارية Architecture واحدة لأن الملف يغطي عدة معماريات وبعض الاستدعاءات مكررة بشروط مختلفة.
defaultActionهوSCMP_ACT_ERRNOمعdefaultErrnoRetبالقيمة 1، أي أن أي استدعاء غير موجود في القائمة يرجع بالخطأ رقم 1 وهوEPERM، ولذلك ترى دائماً «Operation not permitted» ولا تقتل العملية.- نجح
touchوفشلmkdir، فالفلتر يعمل على مستوى الاستدعاء الواحد بدقة.
وماذا لو كان الملف معطوباً؟ كتبنا ملفاً ينقصه إغلاق القوس:
docker: compacting json for seccomp profile (/root/broken.json) failed: unexpected end of JSON input
exit=125
رفض Docker تشغيل ال Container برمز 125، وهو رمز أخطاء Docker نفسه قبل أن يبدأ ال Container كما شرحنا في مقال أوامر Docker الأساسية. وهذا سلوك آمن، فلن يشغل Docker ال Container بلا فلتر لأن ملفك فيه خطأ. وفي الواقع قل من يحتاج ملفاً خاصاً، والأهم ألا تستخدم seccomp=unconfined لحل مشكلة، فإذا احتاج تطبيق استدعاء ممنوعاً فأضفه وحده إلى نسخة من الملف الافتراضي.
AppArmor وSELinux: الرفض Deny حتى مع الصلاحية Capability
الطبقة الرابعة لا تنظر إلى من أنت ولا إلى الاستدعاء، وإنما إلى الشيء الذي تريد أن تلمسه: هذا الملف، هذا المسار، هذه العملية، هذا النوع من التركيب. ويسمى هذا النوع التحكم الإلزامي بالوصول Mandatory Access Control، ومعنى «إلزامي» أن القاعدة يضعها مدير النظام System Administrator ولا يستطيع صاحب الملف ولا root تجاوزها. وعلى Debian وUbuntu تجد AppArmor الذي يكتب قواعده بالمسارات، وعلى Fedora وRHEL وRocky تجد SELinux الذي يضع وسماً Label على كل ملف وعملية، ويعطي كل Container وسماً مختلفاً حتى لا يقرأ ملفات غيره. وكلاهما يعمل داخل النواة كوحدة أمان LSM.
ويطبق Docker على كل Container ملف AppArmor اسمه docker-default كما في توثيق AppArmor في Docker، ومن أهم ما فيه منع التركيب mount، ومنع الكتابة في أجزاء حساسة من /proc و/sys. ولنر الفرق بين الطبقات عملياً: سوف نعطي ال Container الصلاحية CAP_SYS_ADMIN، وهي الصلاحية التي يحتاجها التركيب، ونرى من يرفض:
docker run --rm --cap-add SYS_ADMIN alpine:3.24 sh -c 'cat /proc/self/attr/current; mount -t tmpfs none /mnt; echo "mount exit=$?"'
journalctl -k --since "-1min" | grep -o 'apparmor="DENIED" operation="mount".*' | tail -1
docker run --rm --cap-add SYS_ADMIN --security-opt apparmor=unconfined alpine:3.24 sh -c 'cat /proc/self/attr/current; mount -t tmpfs none /mnt && echo mounted && grep " /mnt " /proc/mounts'
والمخرج سوف يكون كما يلي:
docker-default (enforce)
mount exit=255
mount: mounting none on /mnt failed: Permission denied
unconfined
mounted
none /mnt tmpfs rw,relatime,inode64 0 0
مع أن الصلاحية معه، رفض التركيب برسالة مختلفة هذه المرة: Permission denied لا Operation not permitted. وهذا الفرق مفيد في التشخيص Troubleshooting، فالأولى غالباً من AppArmor أو SELinux، والثانية غالباً من صلاحية ناقصة أو فلتر seccomp. وعندما أزلنا AppArmor بـ apparmor=unconfined ومع بقاء SYS_ADMIN نجح التركيب. ويجدر الإشارة هنا إلى أن الأمر journalctl لم يطبع أي سطر رفض في تجربتنا، لأن ملف docker-default يمنع التركيب بقاعدة deny صريحة، وهذا النوع من القواعد لا يسجل افتراضياً في AppArmor، فلا تعتمد على وجود سطر في السجل لتعرف أن AppArmor هو من رفض، وجرب الأمر نفسه مع apparmor=unconfined على Container تجربة كما فعلنا.
وجربنا أيضاً الكتابة في ملفين حساسين بصلاحيات ال Container الافتراضية:
sh: can't create /proc/sysrq-trigger: Read-only file system
cat: can't open '/sys/firmware/acpi/tables/DSDT': No such file or directory
الملف /proc/sysrq-trigger يسمح بإعادة تشغيل الجهاز فوراً بكتابة حرف واحد، وDocker يركبه للقراءة فقط، والمجلد Directory /sys/firmware مخفي تماماً. وهذه طبقة سادسة صغيرة اسمها المسارات المقنعة Masked Paths والمسارات للقراءة فقط Read-only Paths، يضعها runc نفسه قبل أن يبدأ التطبيق، وهي التي استهدفتها ثغرات runc في 2025 كما سوف يأتي.
منع رفع الصلاحيات no-new-privileges
لنفرض أنك اتبعت النصيحة الشائعة، وشغلت تطبيقك بمستخدم عادي رقمه 1000. هل هذا يكفي؟ ليس دائماً، فإذا كان في ال Image برنامج بعلامة setuid، أي برنامج يعمل بصلاحيات مالكه لا بصلاحيات من شغله، ومالكه root، فإن أي عملية تستطيع تشغيله تصبح root مؤقتاً. وبرامج مثل su وpasswd وmount تأتي هكذا في كثير من ال Images. ولنصنع مثالاً واضحاً: نسخة من الأمر id بعلامة setuid، داخل Image تعمل بالمستخدم 1000:
FROM debian:trixie-slim
RUN cp /usr/bin/id /usr/local/bin/rootid && chmod 4755 /usr/local/bin/rootid && useradd -u 1000 app
USER 1000
docker run --rm ct3-suid:1 sh -c 'ls -l /usr/local/bin/rootid; id; rootid'
docker run --rm --security-opt no-new-privileges ct3-suid:1 sh -c 'grep NoNewPrivs /proc/self/status; rootid'والمخرج سوف يكون كما يلي:
-rwsr-xr-x 1 root root 51656 Nov 18 18:00 /usr/local/bin/rootid
uid=1000(app) gid=1000(app) groups=1000(app)
uid=1000(app) gid=1000(app) euid=0(root) groups=1000(app)
NoNewPrivs:	1
uid=1000(app) gid=1000(app) groups=1000(app)
الحرف s في -rwsr-xr-x هو علامة setuid. وفي التشغيل الأول بدأ المستخدم 1000، ثم شغل البرنامج فظهر euid=0(root)، أي أن العملية صار لها رقم فعلي Effective UID يساوي root. وفي التشغيل الثاني مع no-new-privileges صار NoNewPrivs: 1، وتجاهلت النواة علامة setuid تماماً، فبقي المستخدم 1000. وهذا العلم كما يشرح توثيق النواة لا يمكن إلغاؤه بعد وضعه، ويرثه كل أبناء العملية، ولذلك فهو من أرخص الخيارات وأكثرها فائدة، ويمكنك أن تجعله افتراضياً لكل Containers السيرفر بالسطر "no-new-privileges": true في daemon.json.
الخيار Option --privileged: كل الأبواب مفتوحة
يظهر الخيار --privileged في كثير من الأدلة على الإنترنت كحل سريع: «إذا ظهر Permission denied أضف --privileged». ولنر ماذا يفعل هذا الخيار فعلاً. وتنبيه مهم قبل التجربة: هذه التجربة تركب قرص السيرفر نفسه وتكتب عليه، ولذلك أجريناها في الجهاز الافتراضي Virtual Machine المخصص للمختبر، ولا تقم بتجربتها على سيرفر فيه بيانات حقيقية. أولاً Container عادي:
docker run --rm alpine:3.24 sh -c 'ls /dev; mount /dev/vda /mnt; echo "mount exit=$?"'والمخرج سوف يكون كما يلي:
core
fd
full
mqueue
null
ptmx
pts
random
shm
stderr
stdin
stdout
tty
urandom
zero
mount: permission denied (are you root?)
mount exit=1
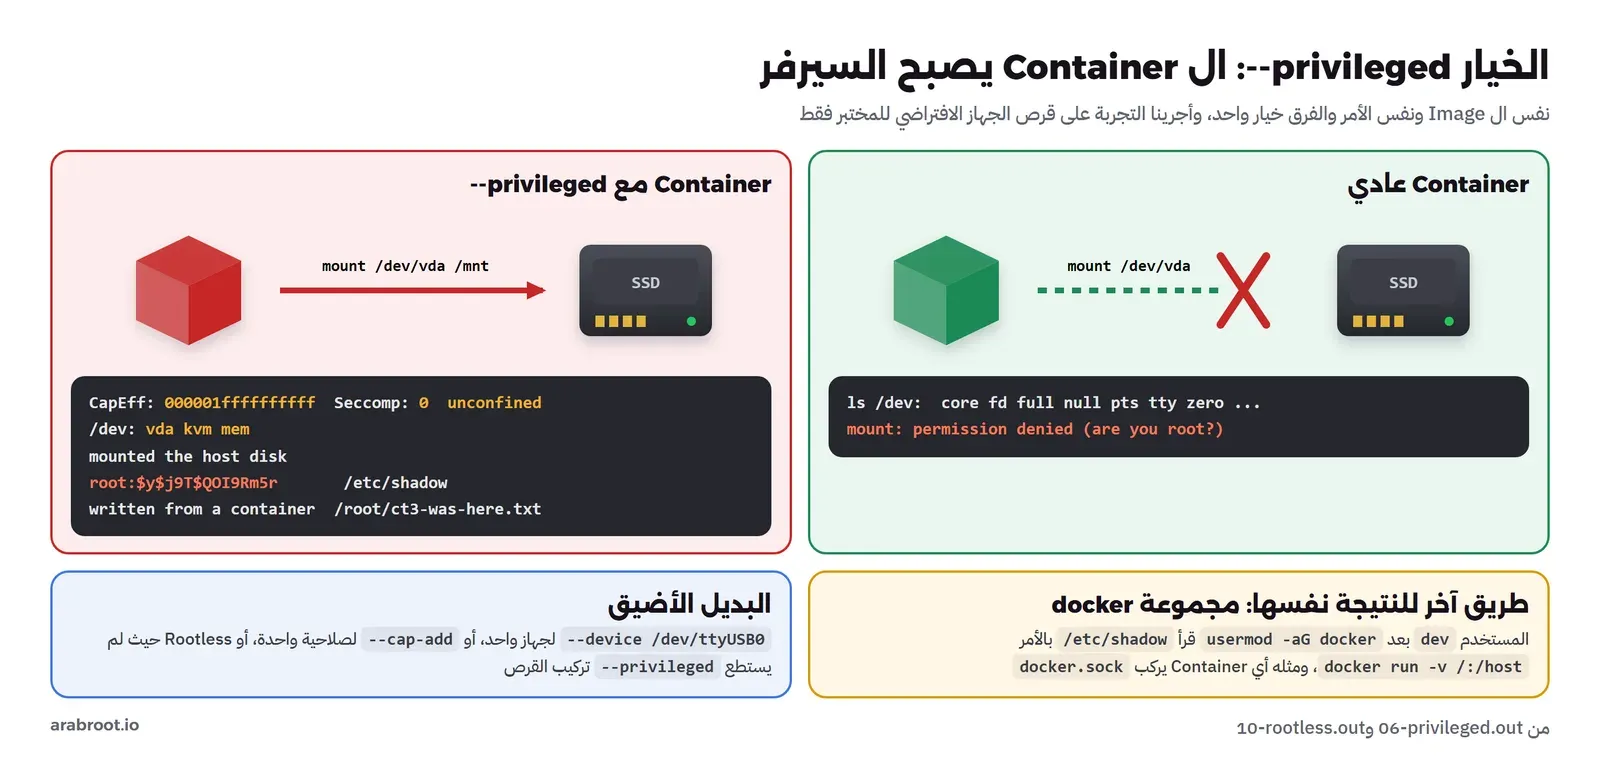
المجلد /dev فيه الأجهزة الأساسية فقط، ولا يوجد أي قرص، والتركيب مرفوض. والآن نفس الشيء مع --privileged:
docker run --rm --privileged alpine:3.24 sh -c '
  grep -E "^(CapEff|Seccomp):" /proc/self/status; cat /proc/self/attr/current
  ls /dev | grep -E "^vd|^kvm|^mem$"
  mount /dev/vda /mnt && echo "mounted the host disk" && grep "^root:" /mnt/etc/shadow | cut -c1-20
  echo "written from a container at $(date +%T)" > /mnt/root/ct3-was-here.txt'
cat /root/ct3-was-here.txt
والمخرج سوف يكون كما يلي:
CapEff:	000001ffffffffff
Seccomp:	0
unconfined
kvm mem vda
mounted the host disk
root:$y$j9T$QOI9Rm5r
written from a container at 18:01:59
في المخرج أعلاه لاحظ التالي:
- الصلاحيات 41 كاملة، وseccomp صفر أي لا يوجد فلتر، وAppArmor
unconfined. أي أن الخيار أزال ثلاث طبقات في وقت واحد. - ظهرت كل أجهزة المضيف في
/dev: القرصvda، وkvm، وmemالتي تمثل ذاكرة الجهاز. - ركبنا قرص السيرفر، وقرأنا بداية هاش كلمة مرور Password Hash root من
/etc/shadow، ثم كتبنا ملفاً في مجلد root على المضيف وقرأناه من المضيف. ولو كان هذا مهاجماً لكتب مفتاح SSH في/root/.ssh/authorized_keysأو مهمة مجدولة Cron Job، وانتهى الأمر.
وبالتالي فإن --privileged ليس خياراً للصلاحيات، وإنما هو إعلان بأن هذا ال Container هو السيرفر نفسه. وله استخدامات حقيقية محدودة، مثل تشغيل Docker داخل Docker أو أدوات تدير أجهزة المضيف، وفي هذه الحالات عامله كأنه برنامج root على السيرفر، وابحث أولاً عن البديل الأضيق: --device /dev/ttyUSB0 لجهاز واحد، أو --cap-add لصلاحية واحدة.
وهناك طريق آخر للنتيجة نفسها دون --privileged، وهو مجموعة docker. فأي مستخدم في هذه المجموعة يستطيع أن يطلب من Docker أي Container يريده، ومنها Container يركب جذر المضيف:
usermod -aG docker dev
su - dev -c 'docker run --rm -v /:/host alpine:3.24 sh -c "head -c 20 /host/etc/shadow; echo; id"'
root:$y$j9T$QOI9Rm5r
uid=0(root) gid=0(root) groups=0(root),...المستخدم dev عادي تماماً، ومع ذلك قرأ ملف كلمات المرور خلال ثانية. وهذا ما يقصده توثيق Docker عندما يقول إن من يتحكم في ال Daemon يتحكم في السيرفر، ولذلك فإضافة مستخدم إلى مجموعة docker كما في دليل التثبيت تساوي إعطاءه sudo دون كلمة مرور، وقد شرحنا ما يعنيه ذلك في مقال المستخدمون والمجموعات وsudo. ونفس الكلام عن تركيب /var/run/docker.sock داخل Container، وهو ما تفعله أدوات مثل Portainer وTraefik، فهذا ال Container يملك السيرفر إذا اخترق.
مساحة المستخدمين User Namespace: root في الداخل، مستخدم عادي في الخارج
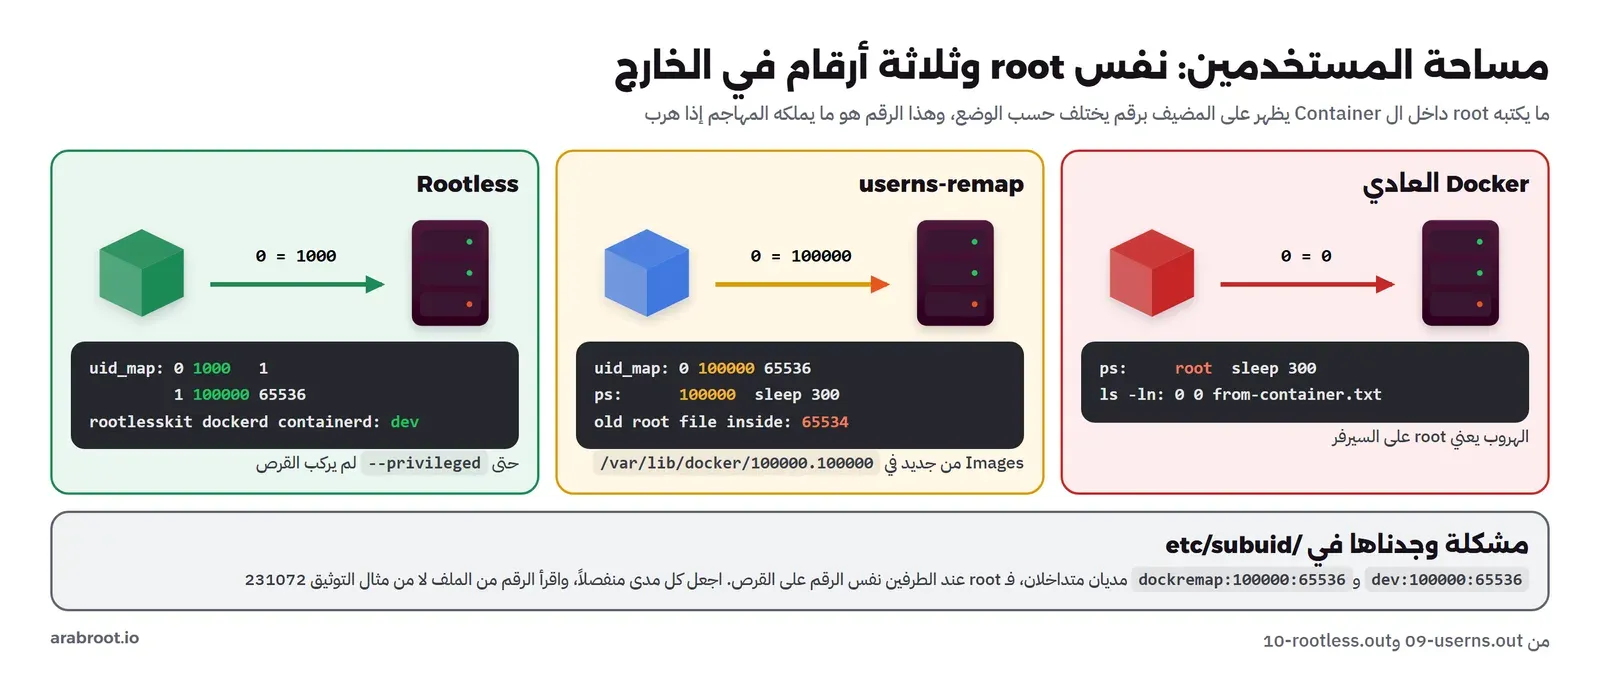
كل الطبقات السابقة تقلل ما يستطيعه root داخل ال Container، ولكنه ما زال root، فإذا وجد ثغرة تخرجه من ال Container، مثل ثغرات runc التي سوف نذكرها، فهو root على السيرفر. ومساحة المستخدمين User Namespace تحل هذه المشكلة من أصلها: تربط النواة الرقم 0 في الداخل برقم عادي كبير في الخارج مثل 100000، فيبقى root في الداخل يملك كل شيء داخل مساحته، ولكنه خارجها مستخدم غريب لا يملك أي ملف. وتصف صفحة user_namespaces(7) هذا الربط، وفي Docker طريقتان لاستخدامه: userns-remap الذي يبقي ال Daemon كـ root ويربط ال Containers وحدها، ووضع Rootless الذي يشغل ال Daemon نفسه بمستخدم عادي.
userns-remap: سطر واحد في daemon.json
كما في توثيق userns-remap، نكتب السطر ونعيد تشغيل Docker:
echo '{ "userns-remap": "default" }' > /etc/docker/daemon.json
systemctl restart docker
grep dockremap /etc/passwd /etc/subuid /etc/subgid
docker info --format 'sec={{.SecurityOptions}} root={{.DockerRootDir}}'
docker images -q | wc -l
والمخرج سوف يكون كما يلي:
/etc/passwd:dockremap:x:100:102::/nonexistent:/bin/false
/etc/subuid:dockremap:100000:65536
/etc/subgid:dockremap:100000:65536
sec=[name=apparmor,profile=default name=seccomp,profile=builtin name=userns name=cgroupns] root=/var/lib/docker/100000.100000
0
أنشأ Docker المستخدم dockremap وحجز له 65536 رقماً تبدأ من 100000 في الملفين /etc/subuid و/etc/subgid. وهنا أول مفاجأة: عدد ال Images صار صفراً. والسبب في السطر الثاني، فمجلد بيانات Docker Data Root صار /var/lib/docker/100000.100000، أي أن Docker يحتفظ بنسخة منفصلة من كل شيء لكل ربط، لأن ملفات ال Images القديمة ملك root الحقيقي ولا يستطيع root المربوط قراءتها بشكل صحيح. فكل ال Images يجب أن تسحب مرة أخرى، وكل ال Containers وال Volumes القديمة لا تظهر حتى تلغي الإعداد. ولاحظنا أيضاً أن docker inspect صار يذكر محرك التخزين Storage Driver overlay2 بدلاً من overlayfs الخاص بـ containerd، فهذا الوضع يعمل بمحرك التخزين القديم. لذلك فعل userns-remap على سيرفر جديد قبل أن تبدأ، لا على سيرفر يعمل.
والآن نشغل Container يركب المجلد نفسه الذي كتبنا فيه بداية المقال:
docker run -d --name ct3-remap -v /srv/ct3-demo:/data alpine:3.24 sh -c 'id; cat /proc/self/uid_map; sleep 300'
docker logs ct3-remap
ps -o user,pid,cmd -p $(docker inspect -f '{{.State.Pid}}' ct3-remap)
docker exec ct3-remap sh -c 'echo x > /data/remap.txt; echo "write exit=$?"'
والمخرج سوف يكون كما يلي:
uid=0(root) gid=0(root) groups=0(root),...
         0     100000      65536
USER         PID CMD
100000      9054 sleep 300
sh: can't create /data/remap.txt: Permission denied
write exit=1
من الداخل ما زال root بالرقم 0، والملف uid_map يقول القاعدة صراحة: الرقم 0 في الداخل يقابله 100000 في الخارج، والمدى Range 65536 رقماً. ومن الخارج تظهر العملية بالمستخدم 100000 لا root. ولذلك رفضت الكتابة في المجلد، لأنه ملك root الحقيقي، وroot المربوط غريب عنه.
وهنا ارتكبنا خطأ يستحق الذكر: غيرنا مالك المجلد إلى 231072، وهو الرقم الذي يظهر في مثال التوثيق، فاستمر الرفض. والسبب أن الرقم الصحيح هو الذي في /etc/subuid على سيرفرك، وكان عندنا 100000، فلا تنسخ الرقم من أي مقال، واقرأه من الملف. وبعد تصحيح المالك:
chown 100000:100000 /srv/ct3-demo
docker exec ct3-remap sh -c 'echo x > /data/remap.txt && echo "write ok after chown"; ls -ln /data'
ls -ln /srv/ct3-demo
write ok after chown
-rw-r--r-- 1 65534 65534 3 Nov 18 17:48 from-container.txt
-rw-r--r-- 1 0 0 2 Nov 18 18:10 remap.txt
-rw-r--r-- 1 0 0 3 Nov 18 17:48 from-container.txt
-rw-r--r-- 1 100000 100000 2 Nov 18 18:10 remap.txtنفس الملفين برؤيتين. فالملف الجديد ملك 0 من الداخل و100000 من الخارج، والملف القديم الذي كتبه root الحقيقي يظهر في الداخل بالرقم 65534 أي nobody، لأن رقمه خارج المدى المربوط فلا تعرف المساحة كيف تعرضه. وهذا ما سوف تراه مع كل Volume قديم بعد تفعيل الربط، وهو امتداد لمشكلة الأرقام التي شرحناها في مقال بيانات ال Containers.
وماذا عن --privileged في هذا الوضع؟
docker: Error response from daemon: privileged mode is incompatible with user namespaces. You must run the container in the host namespace when running privileged modeيرفضه Docker، وإذا أردته فعليك أن تخرج ذلك ال Container من الربط بالخيار --userns=host، فيعود root الحقيقي بربط 0 0 4294967295. وهذا جيد لأنه يجعل الاستثناء مكتوباً وظاهراً في الأمر.
/etc/subuid في آخر التجربة وجدنا سطرين بنفس المدى: dev:100000:65536 وdockremap:100000:65536. فالمستخدم dev أخذ هذا المدى عند إنشائه، ثم أضاف Docker المستخدم dockremap بنفس البداية. والمديان المتداخلان يعنيان أن root في Containers ال Daemon وroot في Containers المستخدم dev هما نفس الرقم على القرص، فيقرأ أحدهما ملفات الآخر. راجع الملف بعد كل تغيير، واجعل كل مدى منفصلاً عن غيره.وضع Rootless: ال Daemon نفسه بلا root
userns-remap يحمي من ال Container، ولكن ال Daemon ما زال root، فإذا وجد ثغرة في dockerd نفسه أو وصل مهاجم إلى المقبس فهو root. ووضع Rootless يشغل dockerd وcontainerd وكل شيء بمستخدم عادي داخل مساحة مستخدمين خاصة به. وتثبيته من الحزمة docker-ce-rootless-extras بأمر واحد يشغله المستخدم نفسه، بعد أن نسمح لخدماته بالبقاء بعد خروجه بالأمر loginctl enable-linger:
loginctl enable-linger dev
su - dev -c 'dockerd-rootless-setuptool.sh install'
su - dev -c 'export DOCKER_HOST=unix:///run/user/1000/docker.sock
  docker info --format "sec={{.SecurityOptions}} root={{.DockerRootDir}}"
  docker run -d --name ct3-rl alpine:3.24 sh -c "id; cat /proc/self/uid_map; sleep 300"; docker logs ct3-rl'
ps -o user,pid,cmd -u dev
والمخرج سوف يكون كما يلي (اختصرنا السطور الطويلة):
sec=[name=seccomp,profile=builtin name=rootless name=cgroupns] root=/home/dev/.local/share/docker
uid=0(root) gid=0(root) groups=0(root),...
         0       1000          1
         1     100000      65536
USER         PID CMD
dev        10417 rootlesskit --state-dir=/run/user/1000/dockerd-rootless --net=slirp4netns --mtu=65520 --slirp
dev        10458 slirp4netns --mtu 65520 -r 3 --disable-host-loopback --enable-seccomp --userns-path=/proc/104
dev        10466 dockerd
dev        10490 /usr/bin/containerd --config /run/user/1000/docker/containerd/containerd.toml
dev        10782 /usr/bin/containerd-shim-runc-v2 -namespace moby -id 72658a7354f41151aad990ff983fac2befdfc4e8
dev        10810 sleep 300
في المخرج أعلاه لاحظ التالي:
- كل السلسلة ملك المستخدم
dev: منrootlesskitالذي ينشئ مساحة المستخدمين، إلىdockerdوcontainerd، إلى ال Shim، إلىsleepنفسه. فلا توجد أي عملية root في القصة. - الربط هنا من سطرين: root في الداخل يقابله
devنفسه برقم 1000، وبقية الأرقام من 1 فصاعداً تقابل مدىdevفي/etc/subuid. وهذا يعني أن الملفات التي يكتبها root في ال Container تظهر على المضيف ملكdev، وهو أمر مريح عند استخدام Bind Mounts في مجلد المستخدم. - اختفى AppArmor من قائمة الأمان، فـ Rootless لا يطبق ملف
docker-default، وبقي seccomp. والحماية الأساسية هنا أن الهروب من ال Container لا يعطي إلا صلاحياتdev. - الشبكة تمر عبر
slirp4netns، وهو برنامج في فضاء المستخدم يترجم الحزم، لأن المستخدم العادي لا يستطيع إنشاء واجهات شبكة حقيقية على المضيف. وهذا أبطأ من شبكة Docker العادية، وتستطيع استبداله بـ pasta من الحزمةpasst.
وحدود الموارد تعمل في هذا الوضع لأن systemd يفوض متحكمات cgroup v2 لخدمة المستخدم، فوجدنا في cgroup.controllers الخاص بالمستخدم cpu memory pids، وطبق Docker الأرقام 67108864 و50000 100000 و50 لحدود -m 64m --cpus 0.5 --pids-limit 50. أما على نظام بـ cgroup v1 مثل Docker Desktop عندنا فلا تعمل هذه الحدود في Rootless إطلاقاً.
والمشكلة التي واجهتنا كانت مع المنفذ 80:
docker: Error response from daemon: failed to set up container networking: driver failed programming external connectivity on endpoint ct3-rl-web (8eca81ef...): error while calling RootlessKit PortManager.AddPort(): cannot expose privileged port 80, you can add 'net.ipv4.ip_unprivileged_port_start=80' to /etc/sysctl.conf (currently 1024), or set CAP_NET_BIND_SERVICE on rootlesskit binary, or choose a larger port number (>= 1024): listen tcp4 0.0.0.0:80: bind: permission deniedوالرسالة نفسها تشرح السبب والحلول الثلاثة، وهو أن المستخدم العادي لا يستطيع الاستماع على منفذ أقل من 1024 على المضيف. والمنفذ 8081 عمل مباشرة وأعطى 200. والحل الأنسب على سيرفر ويب أن يستمع ال Reverse Proxy على 80 و443 والتطبيقات خلفه على منافذ عالية، أو أن تخفض ip_unprivileged_port_start إلى 80 إذا كان السيرفر لك وحدك.
وأخيراً جربنا --privileged نفسه داخل Rootless:
CapEff:	000001ffffffffff
         0       1000          1
         1     100000      65536
mount: permission denied (are you root?)
mount exit=1
الصلاحيات 41 كاملة في الظاهر، ولكنها صلاحيات داخل مساحة المستخدم dev فقط، فلم يستطع ال Container تركيب قرص المضيف. وهذه هي قيمة Rootless بالأرقام: نفس الخيار الذي أعطانا ملف كلمات المرور قبل قليل لم يعط شيئاً هنا.
حدود الموارد Resource Limits: الأمان الذي ينساه الجميع
الأمان لا يعني السرية فقط، وإنما التوافر Availability أيضاً، وContainer واحد بلا حدود يستطيع أن يوقف السيرفر كله دون أن يخرج من عزلته. وقد رأينا في مقال ال Containers قتل OOM عند تجاوز الذاكرة وتقييد المعالج، فلن نكرر ذلك هنا، وسوف نركز على عدد العمليات لأنه الأخطر والأقل معرفة، ثم نرى ما يضعه Docker وsystemd عندما لا تكتب شيئاً.
قنبلة Fork Bomb داخل --pids-limit
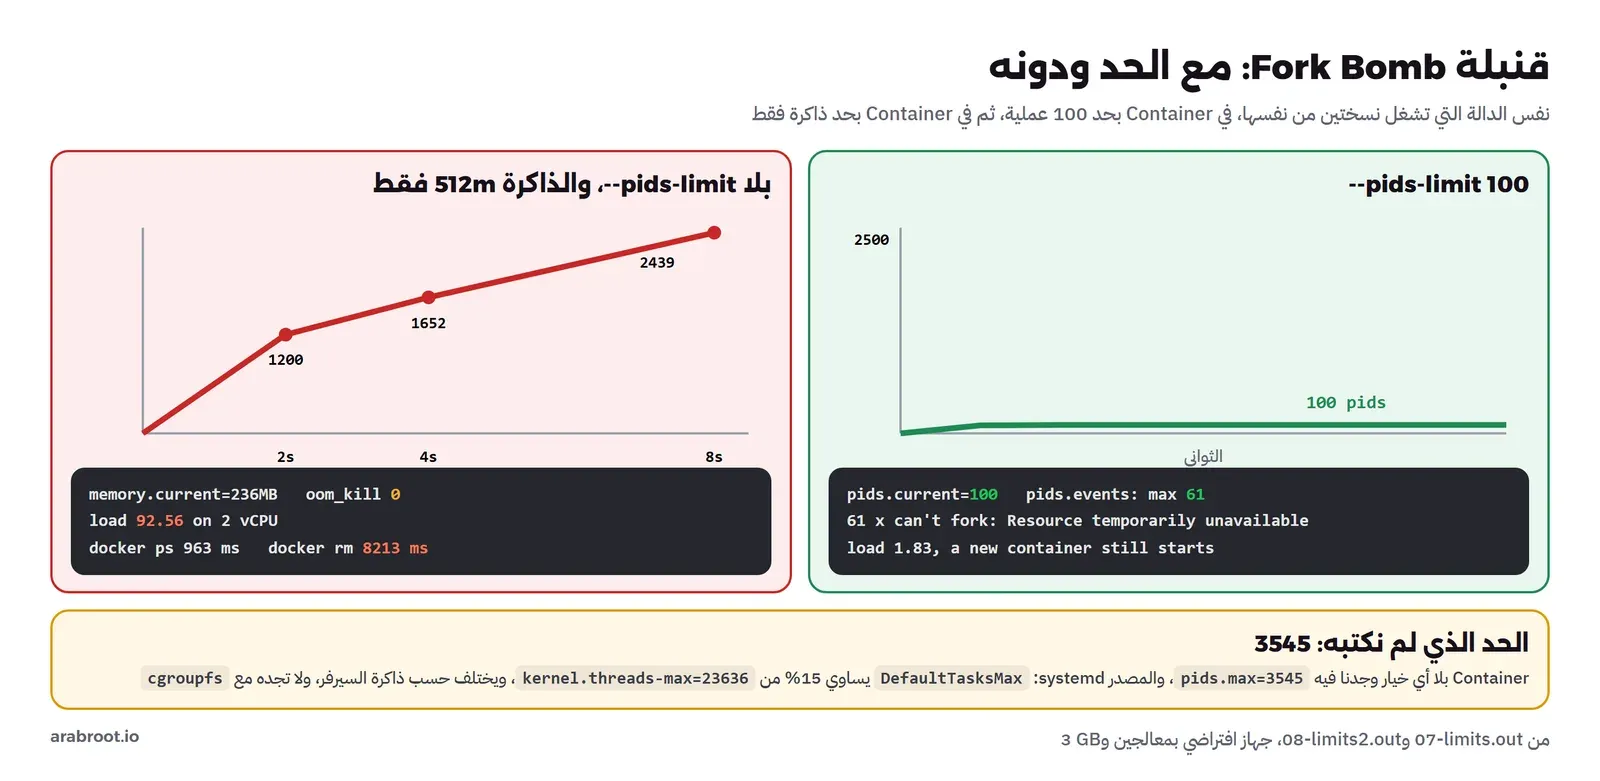
القنبلة دالة تشغل نسختين من نفسها، وكل نسخة تشغل نسختين، فيتضاعف العدد كل جزء من الثانية حتى ينفد جدول العمليات في النواة، وعندها لا يستطيع أي برنامج على السيرفر أن يبدأ، ولا حتى ssh لتدخل وتصلح. وهذه ليست مجرد نكتة قديمة، فأي تطبيق فيه خطأ في حلقة تشغل عمليات أبناء يصنع نفس الأثر. شغلناها داخل حد 100 عملية:
docker run -d --name ct3-bomb --pids-limit 100 -m 256m alpine:3.24 sh -c 'bomb() { bomb | bomb & }; bomb; sleep 3600'
sleep 8
CG=/sys/fs/cgroup/system.slice/docker-$(docker inspect -f '{{.Id}}' ct3-bomb).scope
echo "pids.max=$(cat $CG/pids.max) pids.current=$(cat $CG/pids.current) $(cat $CG/pids.events)"
docker logs ct3-bomb 2>&1 | sort | uniq -c
cat /proc/loadavg
docker run --rm alpine:3.24 echo "a new container still starts"
والمخرج سوف يكون كما يلي:
pids.max=100 pids.current=100 max 61
      7 can't fork: Resource temporarily unavailable
     47 sh: can't fork: Resource temporarily unavailable
      7 sh: sh: can't fork: Resource temporarily unavailable
1.83 1.45 1.21 1/229 4253
a new container still starts
في المخرج أعلاه لاحظ التالي:
- العدد وصل إلى 100 بالضبط وتوقف، والملف
pids.eventsيقولmax 61، أي أن النواة رفضت 61 محاولة لإنشاء عملية جديدة. - كل رفض ظهر في السجل كرسالة
can't fork: Resource temporarily unavailable، وهي الخطأEAGAIN، و61 رسالة تساوي عدد الأحداث بالضبط. - متوسط الضغط Load Average على السيرفر 1.83 على معالجين، والسيرفر يعمل بشكل طبيعي، وبدأ Container جديد دون مشكلة. فالقنبلة محبوسة في مجموعتها.
ماذا لو لم تضع الحد Limit؟ systemd يضع حداً بدلاً منك
قبل أن نجرب القنبلة بلا حد، أردنا أن نعرف ما يضعه Docker عندما لا نكتب شيئاً، فشغلنا Container عادياً وقرأنا ملفاته في cgroup v2:
pids.max=3545
memory.max=max
memory.swap.max=max
cpu.max=max 100000
cpu.weight=100
الذاكرة والمعالج بلا حد كما توقعنا، ولكن pids.max يساوي 3545، مع أننا لم نطلب أي حد. ومن أين جاء هذا الرقم؟ بحثنا فوجدناه عند systemd لا عند Docker:
kernel.threads-max = 23636
kernel.pid_max = 4194304
DefaultTasksMax=3545
TasksMax=infinity
Docker على هذا السيرفر يستخدم systemd لإدارة مجموعات التحكم drv=systemd، فكل Container يصبح وحدة Scope عند systemd، وsystemd يعطي كل وحدة افتراضياً حداً يساوي 15% من kernel.threads-max، و15% من 23636 هي 3545. والرقم threads-max نفسه تحسبه النواة من حجم الذاكرة، فعلى سيرفر بذاكرة 32 GB سوف تجد الحد الافتراضي أكبر بعشر مرات تقريباً. وهذه الحماية الخفية جيدة، ولكنها لا تعتمد عليها، فهي تختلف من نظام لآخر، وعلى سيرفر يستخدم cgroupfs بدلاً من systemd لن تجدها. ثم شغلنا القنبلة بحد ذاكرة 512 MB فقط ودون --pids-limit:
t~2s pids.current=1200 memory.current=101MB load=1.38
t~4s pids.current=1652 memory.current=163MB load=1.38
t~8s pids.current=2439 memory.current=236MB load=92.56
docker ps took 963 ms
rm took 8213 ms
خلال ثماني ثوان وصل العدد إلى 2439 عملية، وقفز متوسط الضغط من 1.38 إلى 92.56 على سيرفر فيه معالجان، أي أن هناك 92 عملية تنتظر المعالج في كل لحظة. ولم تقتل النواة أي عملية بسبب الذاكرة لأن 236 MB أقل من الحد، فحد الذاكرة وحده لم يحم شيئاً. والأمر docker ps أخذ ثانية كاملة، وحذف ال Container أخذ أكثر من ثماني ثوان، لأن Docker يجب أن يقتل آلاف العمليات. ولو كان الحد الذي يضعه systemd غير موجود لاستمرت حتى تملأ الذاكرة. لذلك ضع --pids-limit لكل Container، ورقم مثل 100 أو 200 يكفي أغلب تطبيقات الويب، أما قواعد البيانات التي تشغل عملية لكل اتصال مثل PostgreSQL فتحتاج أكثر.
الذاكرة Memory والمعالج CPU باختصار
ولتكتمل الصورة، هذه الملفات التي كتبها Docker عندما طلبنا -m 64m ثم --cpus 0.5 مع حلقة مشغولة مدة عشر ثوان:
memory.max=67108864 memory.swap.max=67108864
cpu.max=50000 100000
usage_usec 5578771
nr_periods 115
nr_throttled 104
throttled_usec 5990157
لاحظ أن -m 64m وحده جعل حد ال Swap يساوي 64 MB أيضاً، أي أن ال Container يستطيع استخدام 64 MB من الذاكرة و64 MB أخرى من ال Swap إذا كان على السيرفر Swap، وهذا سلوك Docker الافتراضي الذي يشرحه توثيق حدود الموارد. فإذا أردت حداً حقيقياً واحداً فاكتب --memory-swap بنفس القيمة. أما المعالج فأخذت الحلقة 5.58 ثانية من المعالج خلال عشر ثوان، أي النصف تقريباً، وأوقفتها النواة في 104 فترة من 115. وقد شرحنا في مقال ال Containers لماذا لا يقتل حد المعالج العملية وإنما يؤخرها.
ثغرات Vulnerabilities حقيقية في runc: لماذا تحتاج كل هذه الطبقات؟
قد يتساءل البعض: إذا كانت الطبقات الافتراضية بهذه الجودة، فلماذا نتعب أنفسنا بـ Rootless وإسقاط الصلاحيات؟ والإجابة في تاريخ runc نفسه، البرنامج الذي ينشئ كل Container في Docker وcontainerd وKubernetes:
- في فبراير 2019 نشرت الثغرة CVE-2019-5736: عملية root داخل Container خبيث تستطيع أن تكتب فوق ملف runc نفسه على المضيف عبر
/proc/self/exe، فتنفذ ما تريد كـ root على السيرفر في المرة التالية التي يشغل فيها أحدdocker exec. والشرط المهم فيها أن العملية root في الداخل، فكانت ال Containers التي تعمل بمستخدم عادي أو بمساحة مستخدمين في أمان منها، كما يشرح إعلان Kubernetes عنها. - في يناير 2024 نشرت CVE-2024-21626 بدرجة 8.6 من 10: كان runc يترك وصف ملف مفتوحاً على
/sys/fs/cgroupالمضيف داخل العملية الجديدة، فإذا كانت ال Image تضع مجلد العملWORKDIRعلى/proc/self/fd/7بدأ ال Container ومجلده الحالي داخل نظام ملفات المضيف. والإصدارات Versions المصابة من 1.0.0-rc93 إلى 1.1.11، والإصلاح Fix في 1.1.12. أي أن مجرد تشغيل Image خبيثة يكفي، وهذا سبب إضافي لأن تعرف مصدر كل Image تشغلها، كما في مقال أمن سلسلة التوريد البرمجية. - في نوفمبر 2025 نشرت ثلاث ثغرات معاً: CVE-2025-31133 وCVE-2025-52565 وCVE-2025-52881، وكلها تستغل سباقاً Race Condition أثناء تجهيز المسارات المقنعة مثل
/dev/nullو/dev/consoleو/proc، وهي نفس الطبقة الصغيرة التي رأيناها تحمي/proc/sysrq-trigger، فيستطيع المهاجم أن يجعل runc يكتب في ملف من ملفات المضيف. والإصلاح في 1.2.8 و1.3.3 و1.4.0-rc.3.
والدرس المشترك من الحوادث الثلاث أن الهروب ممكن مهما كانت الطبقات جيدة، ولذلك فالسؤال الصحيح ليس «هل يستطيع المهاجم الهروب؟» وإنما «إذا هرب، ماذا يملك؟». ومع Container يعمل كـ root بلا ربط فهو يملك السيرفر، ومع مستخدم عادي أو userns-remap أو Rootless فهو يملك رقماً لا قيمة له. والدرس الثاني أن تحديث runc وcontainerd والنواة جزء من الأمان، فإصدار runc في مختبرنا 1.5.3 وهو بعد كل هذه الإصلاحات، وتستطيع أن تعرف إصدارك بالأمر runc --version أو من docker info.
معيار CIS Docker Benchmark: ماذا تفحص Audit؟
معيار CIS Docker Benchmark قائمة توصيات من مركز أمن الإنترنت CIS، يستخدمها المدققون Auditors والفرق الأمنية، وفيها أقسام لإعدادات السيرفر وال Daemon وملفاته وال Images، وقسم كامل لوقت التشغيل Container Runtime هو موضوع هذا المقال. وقد شرحنا طريقة التعامل مع معايير CIS عموماً في مقال تقوية السيرفر وقياسها مع Lynis وCIS. وتوجد أداة رسمية من Docker تفحص هذه التوصيات هي docker-bench-security، ولكنك تستطيع أن تفحص أهم بنود قسم التشغيل بنفسك بأمر docker inspect واحد. شغلنا nginx مرتين، مرة بالأمر المعتاد، ومرة بكل ما تعلمناه في هذا المقال:
docker run -d --name ct3-loose -p 8082:80 nginx:1.29-alpine
docker run -d --name ct3-tight --read-only --tmpfs /var/cache/nginx --tmpfs /run \
  --cap-drop ALL --cap-add CHOWN --cap-add SETUID --cap-add SETGID \
  --security-opt no-new-privileges --pids-limit 100 -m 128m --cpus 0.5 \
  --restart on-failure:5 -p 127.0.0.1:8083:80 nginx:1.29-alpine
curl -s -o /dev/null -w 'tight http %{http_code}\n' 127.0.0.1:8083
for c in ct3-loose ct3-tight; do docker inspect $c --format "$c Privileged={{.HostConfig.Privileged}} ReadonlyRootfs={{.HostConfig.ReadonlyRootfs}} CapAdd={{.HostConfig.CapAdd}} CapDrop={{.HostConfig.CapDrop}} SecurityOpt={{.HostConfig.SecurityOpt}} Memory={{.HostConfig.Memory}} NanoCpus={{.HostConfig.NanoCpus}} PidsLimit={{.HostConfig.PidsLimit}} Restart={{.HostConfig.RestartPolicy.Name}}:{{.HostConfig.RestartPolicy.MaximumRetryCount}} Ports={{json .HostConfig.PortBindings}}"; done
والمخرج سوف يكون كما يلي:
tight http 200
ct3-loose Privileged=false ReadonlyRootfs=false CapAdd=<no value> CapDrop=<no value> SecurityOpt=<no value> Memory=0 NanoCpus=0 PidsLimit=<no value> Restart=no:0 Ports={"80/tcp":[{"HostIp":"","HostPort":"8082"}]}
ct3-tight Privileged=false ReadonlyRootfs=true CapAdd=[CAP_CHOWN CAP_SETGID CAP_SETUID] CapDrop=[ALL] SecurityOpt=[no-new-privileges] Memory=134217728 NanoCpus=500000000 PidsLimit=100 Restart=on-failure:5 Ports={"80/tcp":[{"HostIp":"127.0.0.1","HostPort":"8083"}]}
وكلاهما يعمل ويعطي نفس الصفحة، ولكن الأول يخالف معظم بنود القسم الخامس، والثاني يطابقها. والجدول التالي يربط كل حقل في المخرج بالبند الذي يفحصه:
| الحقل في docker inspect | ما يفحصه المعيار | ct3-loose | ct3-tight |
|---|---|---|---|
Privileged | لا Containers بصلاحيات كاملة | false | false |
ReadonlyRootfs | نظام ملفات ال Container للقراءة فقط | false | true |
CapDrop وCapAdd | تقييد صلاحيات النواة | الأربع عشرة الافتراضية | ثلاث فقط |
SecurityOpt | منع رفع الصلاحيات، وعدم تعطيل AppArmor وseccomp | لا شيء | no-new-privileges |
Memory وNanoCpus | حدود الذاكرة والمعالج | 0 أي بلا حد | 128 MB ونصف معالج |
PidsLimit | حد عدد العمليات | بلا قيمة | 100 |
RestartPolicy | عدد محدود لمحاولات الإعادة | no | on-failure:5 |
PortBindings | ربط المنفذ بعنوان محدد لا بكل الواجهات | كل الواجهات | 127.0.0.1 |
ولاحظ أن خيار --read-only احتاج مجلدين في الذاكرة لـ nginx: /var/cache/nginx للتخزين المؤقت و/run لملف رقم العملية، وقد شرح مقال تقليل حجم ال Images وتأمينها هذا الخيار مع tmpfs بالتفصيل. وفي ملف Compose تكتب الخيارات نفسها بالأسماء cap_drop وcap_add وsecurity_opt وpids_limit وread_only، وتجد طريقة ترتيبها في مقال أفضل الممارسات في ملفات Compose.
أخطاء شائعة Common Mistakes
- إضافة
--privilegedلحل أي رسالة Permission denied. رأينا أنه يزيل ثلاث طبقات ويعطي أقراص السيرفر، والبديل غالباً صلاحية واحدة أو جهاز واحد بـ--device. - إضافة
CAP_SYS_ADMINلأن الخطأ غامض. هذه الصلاحية تفتح التركيب وعشرات الأفعال الإدارية، وكانت شرطاً في كثير من طرق الهروب المنشورة. - استخدام
seccomp=unconfinedأوapparmor=unconfinedبشكل دائم بدلاً من تعديل الملف للاستدعاء أو المسار المطلوب وحده. - إضافة مستخدمين إلى مجموعة
dockerدون أن تعرف أنها تساوي root، أو تركيبdocker.sockفي Container يستقبل طلبات من الإنترنت. - تفعيل userns-remap على سيرفر يعمل، ثم اكتشاف أن كل ال Images وال Containers وال Volumes اختفت من القائمة.
- نسخ أرقام
subuidمن مقال بدلاً من قراءتها من/etc/subuid، أو ترك مديين متداخلين لمستخدمين مختلفين. - الاكتفاء بحد الذاكرة وترك عدد العمليات بلا حد، مع أن القنبلة في تجربتنا لم تتجاوز 236 MB ورفعت الضغط إلى 92.
- تشغيل التطبيق كـ root داخل ال Container لأن «ال Container معزول». كل ثغرات runc الكبرى كانت أخطر بكثير على ال Containers التي تعمل كـ root.
- تأجيل تحديث runc وcontainerd لأن «Docker يعمل». الثغرات الثلاث في نوفمبر 2025 أغلقت في إصدارات تصحيحية عادية.
قائمة تحقق Checklist لكل Container في الإنتاج Production
- التطبيق يعمل بمستخدم عادي برقمه، لا root.
--cap-drop ALLثم--cap-addلما يحتاجه فقط، مع سبب مكتوب لكل صلاحية.--security-opt no-new-privileges، أو جعله افتراضياً فيdaemon.json.- ملف seccomp الافتراضي وملف AppArmor أو SELinux مفعلان، ولا يوجد
unconfinedإلا لسبب مكتوب. - لا يوجد
--privileged، ولاdocker.sockداخل Containers تواجه الإنترنت. --pids-limitو-mمع--memory-swapو--cpusلكل Container.--read-onlyمعtmpfsللمجلدات التي يكتب فيها التطبيق فعلاً.- المنافذ مربوطة بعنوان محدد خلف Reverse Proxy، كما في دليل شبكات Docker وأفضل الممارسات.
- على سيرفر يشترك فيه أشخاص أو عملاء لا تثق بهم كلياً: userns-remap أو Rootless، أو جهاز افتراضي لكل طرف.
- runc وcontainerd وDocker والنواة محدثة، وتعرف إصداراتها.
جدول القرار Decision Table: أي مستوى عزل Isolation تحتاج؟
| الحالة | الأنسب | والسبب |
|---|---|---|
| تطبيقاتك أنت على سيرفرك، وأنت وحدك تدير Docker | Docker العادي مع قائمة التحقق أعلاه | الطبقات الافتراضية مع إسقاط الصلاحيات ومستخدم عادي تكفي، والإعداد بسيط |
| سيرفر يشغل Images من مصادر خارجية كثيرة | userns-remap على سيرفر جديد | إذا هرب ال Container فهو مستخدم 100000 لا root، وال Daemon يبقى كما هو |
| مطورون يحتاجون Docker على سيرفر مشترك | Rootless لكل مطور | لا أحد يحتاج مجموعة docker، وكل مطور يملك Daemon بصلاحياته هو فقط |
| Runner لـ CI يبني Images من كود لم تراجعه | Rootless أو جهاز افتراضي مؤقت لكل مهمة | الكود الغريب يجب ألا يصل إلى root بأي طريق |
| عملاء مختلفون لا يثق بعضهم ببعض | جهاز افتراضي لكل عميل | النواة المشتركة نفسها هدف، وثغرة واحدة فيها تصل إلى الجميع |
| أداة تحتاج أجهزة المضيف أو تدير Docker | أضيق خيار ممكن: --device أو صلاحية واحدة | عامل كل استثناء كأنه برنامج root على السيرفر |
حذف المختبر Cleanup
كل ما أنشأناه يحمل البادئة ct3-، والتجارب كلها في الجهاز الافتراضي، ولكن إذا جربتها على سيرفر فهذه أوامر الإزالة وإرجاع الإعدادات Settings:
docker rm -f ct3-sleep ct3-nginx ct3-bomb ct3-bomb2 ct3-remap ct3-loose ct3-tight 2>/dev/null
docker rmi ct3-suid:1
echo '{}' > /etc/docker/daemon.json && systemctl restart docker
su - dev -c 'dockerd-rootless-setuptool.sh uninstall'
rm -rf /srv/ct3-demodockerd-rootless-setuptool.sh uninstall يوقف خدمة المستخدم ولكنه لا يحذف بياناته في ~/.local/share/docker، وهذا مقصود حتى لا تضيع ال Volumes، فاحذفها بنفسك إذا لم تعد تحتاجها. ولا تقم بحذف مجلد /var/lib/docker/100000.100000 وأنت تظن أنه مخلفات، فهو كل بيانات userns-remap.الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- مساحات الأسماء تحدد ما يراه ال Container، وخمس طبقات أخرى تحدد ما يستطيع فعله: المستخدم ومساحة المستخدمين، وCapabilities، وseccomp، وAppArmor أو SELinux، وcgroups.
- Docker يعطي 14 صلاحية من 41. وnginx بعد
--cap-drop ALLاحتاج ثلاثاً فقط، وعملياته العاملة بصلاحيات صفر. - seccomp رفض
unshareبعلمCLONE_NEWUSERوkeyctl، وAppArmor رفضmountحتى معSYS_ADMIN. و«Operation not permitted» غالباً صلاحية أو seccomp، و«Permission denied» غالباً AppArmor أو SELinux. no-new-privilegesأبطل برنامج setuid كان يحول المستخدم 1000 إلى root.--privilegedأعطى 41 صلاحية وأزال seccomp وAppArmor، فركبنا قرص السيرفر وقرأنا/etc/shadow. ومجموعةdockerتعطي النتيجة نفسها.- userns-remap جعل root في الداخل 100000 في الخارج، مع ثمن: Images جديدة ومجلد بيانات منفصل. وRootless جعل السلسلة كلها ملك مستخدم عادي، و
--privilegedفيه لم يستطع تركيب القرص. --pids-limit 100حبس القنبلة عند 100 عملية، ودونها وصلت إلى 2439 في ثماني ثوان، وsystemd يضع حداً خفياً 15% منthreads-max.- ثغرات runc في 2019 و2024 و2025 تقول إن الهروب ممكن، فاجعل ما يملكه الهارب أقل ما يمكن، وحدث runc.
وفي المقالات التالية من هذه المرحلة بإذن الله سوف نتحدث عن السجل الخاص لل Images، وعن Podman الذي يعمل دون Daemon وبلا root افتراضياً، ثم عن Docker Swarm. وهذه مقالات مرتبطة:
 دليلما هي ال Containers؟ الفرق بينها وبين الأجهزة الافتراضيةنفتح Container حقيقياً من الخارج ثم نبني واحداً بأيدينا بـ unshare وchroot وcgroup v2، لنفهم ما الذي يعزله فعلاً وأين تقف حدوده أمام الجهاز الافتراضي.
 دليلتقليل حجم ال Docker Images وتأمينها Hardeningكيف تبني Image فيها ما يحتاجه تطبيقك فقط، وتقيس الفرق بين slim وalpine وdistroless وscratch بالحجم والثغرات، ثم تشغلها بمستخدم عادي وتوقعها قبل النشر.
 دليلكتابة Dockerfile صحيح: Multi-stage وLayer Cachingخمس نسخ من Dockerfile للتطبيق نفسه نزلت بال Image من 641 ميجابايت إلى 66 وبالبناء بعد تعديل سطر من خمس دقائق إلى أقل من أربع ثوان، مع شرح كل سطر والأرقام المقاسة.
 دليلأفضل الممارسات Best Practices في ملفات Docker Composeكيف تكتب ملف Compose يبدأ خدماته بالترتيب الصحيح ويحمي كلمات المرور ويضبط الذاكرة ويفصل التطوير عن الإنتاج، مع تجربة أظهرت أين يخدعك كل إعداد افتراضي.
 دليلPodman: بديل Docker دون Daemon ودون rootنشغل Podman بمستخدم عادي بجانب Docker على نفس السيرفر، من ال Pods وQuadlet مع systemd إلى أداة docker وCompose عبر مقبسه، ونقيس الفرق في السرعة والذاكرة.
 دليلسجل Docker Images خاص: Registry وHarborنبني سجل Images خاصاً على سيرفرك بـ distribution مع TLS وكلمة مرور ثم بـ Harbor، ونرى ال Digest وجمع المهملات وفحص الثغرات ومنع تغيير ال Tags وذاكرة السحب أمام Docker Hub.
 دليلتقوية السيرفر Hardening وقياسها مع Lynis ومعايير CISيواجه مسؤول نظم طلب المستشفى بدليل تقوية، فيقيس خادمه بـ Lynis وCIS ويقويه ويعيد القياس، ويكشف مفاجأة تخفض الدرجة.
 دليلأمن سلسلة التوريد البرمجية Software Supply Chain للمبتدئينكل ما بين كود غيرك وسيرفرك قد يحمل كود المهاجم، وهنا تعرف التهديدات الحقيقية بحوادث موثقة والدفاع المناسب لكل حلقة.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب في جهاز افتراضي Debian 13.7 بنواة 6.12.117 وcgroup v2 وAppArmor 4.1، مع Docker Engine 29.10.0 وcontainerd 2.4.2 وrunc 1.5.3 وRootlessKit 3.3.0.