

لنفرض أن مديرك طلب منك «مساعداً ذكياً للموظفين»، يجيب عن أسئلتهم في سياسات الشركة، ويكتب بأسلوب الشركة وشكلها المعتاد، ويخبر الموظف بحالة تذكرته في نظام التذاكر Ticketing System، ويفتح تذكرة جديدة ويبلغ الفريق المختص ثم يلخص ما فعله. ثم دخلت أول اجتماع عن المشروع فسمعت أربعة اقتراحات في عشر دقائق: أحدهم يقول «سوف ندرب النموذج على مستنداتنا»، والثاني يقول «نحتاج RAG»، والثالث يقول «الحل هو MCP»، والرابع يقول «لنبن Agent يفعل كل شيء». والمشكلة أن كل واحد منهم يتكلم عن أداة صحيحة ولكن لحاجة مختلفة، فالتدريب Fine-tuning يغير أسلوب النموذج ولا يضيف إليه معلومات يمكن الاعتماد عليها، وRAG يعطيه المعرفة ولا يستطيع أن يقرأ حالة تذكرة تغيرت قبل دقيقة، وMCP بروتوكول لربط الأدوات وليس قدرة جديدة في النموذج، والوكيل Agent قد يكون أغلى وأخطر حل ممكن لمهمة خطواتها معروفة مسبقاً.
الفرق باختصار قبل التفاصيل: RAG يعطي النموذج معلومات من مستنداتك وقت السؤال، وMCP طريقة موحدة لربط النموذج بأدواتك وأنظمتك، وAgent نموذج يقرر خطواته بنفسه ويستدعي الأدوات حتى ينهي المهمة، وFine-tuning يغير أسلوب النموذج وسلوكه وليس معلوماته.
| المصطلح | ماذا يفعل | متى تستخدمه | متى لا تستخدمه |
|---|---|---|---|
| RAG | يبحث في مستنداتك ويضع الأجزاء المناسبة مع السؤال | أسئلة عن سياسات ومستندات تتغير، وتحتاج ذكر المصدر | بيانات حية تتغير كل دقيقة مثل حالة تذكرة |
| MCP | بروتوكول يعرض أدواتك وبياناتك للنموذج بشكل موحد | عندما يحتاج النموذج قراءة نظام أو تنفيذ عملية فيه | عندما تكفيك إجابة من النص وحده |
| Agent | يخطط ويقرر الخطوة التالية ويستدعي الأدوات بنفسه | مهام خطواتها غير معروفة مسبقاً | مهام خطواتها ثابتة، فسير العمل Workflow أرخص وأأمن |
| Fine-tuning | يدرب النموذج على أمثلة فيتغير أسلوبه | أسلوب أو شكل إجابة ثابت لا تكفيه التعليمات | إضافة معلومات يجب أن تكون صحيحة ومحدثة |
وقد جمعنا تعريف كل مصطلح من هذه المصطلحات باختصار في مقال مصطلحات الذكاء الاصطناعي ونماذج اللغة، وشرحنا ما يحدث داخل النموذج نفسه في مقال كيف تعمل نماذج اللغة الكبيرة LLM، لذلك لن نعيد التعريفات هنا، وإنما نجيب عن السؤال الذي يأتي بعدها: أي طريقة تحل أي مشكلة، وما ثمنها، ومتى تكون اختياراً خاطئاً؟ وسوف نستخدم مثال المساعد نفسه من أول المقال إلى آخره، ونشغل أجزاءه على نموذج صغير حتى ترى بعينك ما تحله كل طريقة وما لا تحله.
وسوف نناقش في هذا المقال ما يلي:
- المثال الذي نستخدمه: مساعد واحد بأربع حاجات مختلفة، ولماذا تفشل الحلول البسيطة.
- سلم الطرق من الأرخص إلى الأغلى: التعليمات Prompt، والمخرج المنظم Structured Output واستدعاء الأدوات Tool Calling، وRAG، والأدوات مع MCP، وسير العمل Workflow، والوكيل Agent، والضبط الدقيق Fine-tuning مع LoRA، والتدريب المسبق Pre-training، مع نقاط القوة ونقاط الضعف والكلفة والمخاطر لكل منها.
- تجربة حقيقية على نموذج صغير في Ollama تغطي الحاجات الأربع.
- الفروق التي يخلط بينها الناس: المعرفة Knowledge مقابل السلوك Behaviour، والبروتوكول Protocol مقابل القدرة Capability، وسير العمل مقابل الوكيل.
- كيف تجتمع الطرق في نظام واحد، ومخاطر كل طريقة، وجدول مقارنة وخريطة قرار.
- أخطاء شائعة، وقائمة تحقق، ثم الخلاصة.
والمقالات التالية تشرح كل جزء بالتفصيل، فارجع إليها كلما احتجت أن تتعمق في طريقة واحدة:
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلمصطلحات الذكاء الاصطناعي ونماذج اللغة للمبتدئينشرح قصير مع مثال لكل مصطلح ستسمعه في نقاشات الذكاء الاصطناعي ونماذج اللغة، حتى تفهم ما يعرضه عليك أي فريق أو مزود.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليلبروتوكول MCP للمبتدئين: كيف تربط النماذج بأدواتك بأمانكيف يربط بروتوكول MCP نماذج اللغة بأنظمتك وبياناتك، ولماذا الأمان أهم ما فيه، مع سيرفر MCP صغير تبنيه بنفسك.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
المثال الذي سوف نستخدمه: مساعد واحد وأربع حاجات Requirements
قبل أن نختار أي أداة لنقسم طلب المدير إلى حاجات منفصلة، لأن كل حاجة منها مشكلة من نوع مختلف، والصورة التالية تبين هذا التقسيم والطريقة التي تناسب كل حاجة، وهي الخريطة التي سوف نرجع إليها في كل قسم:
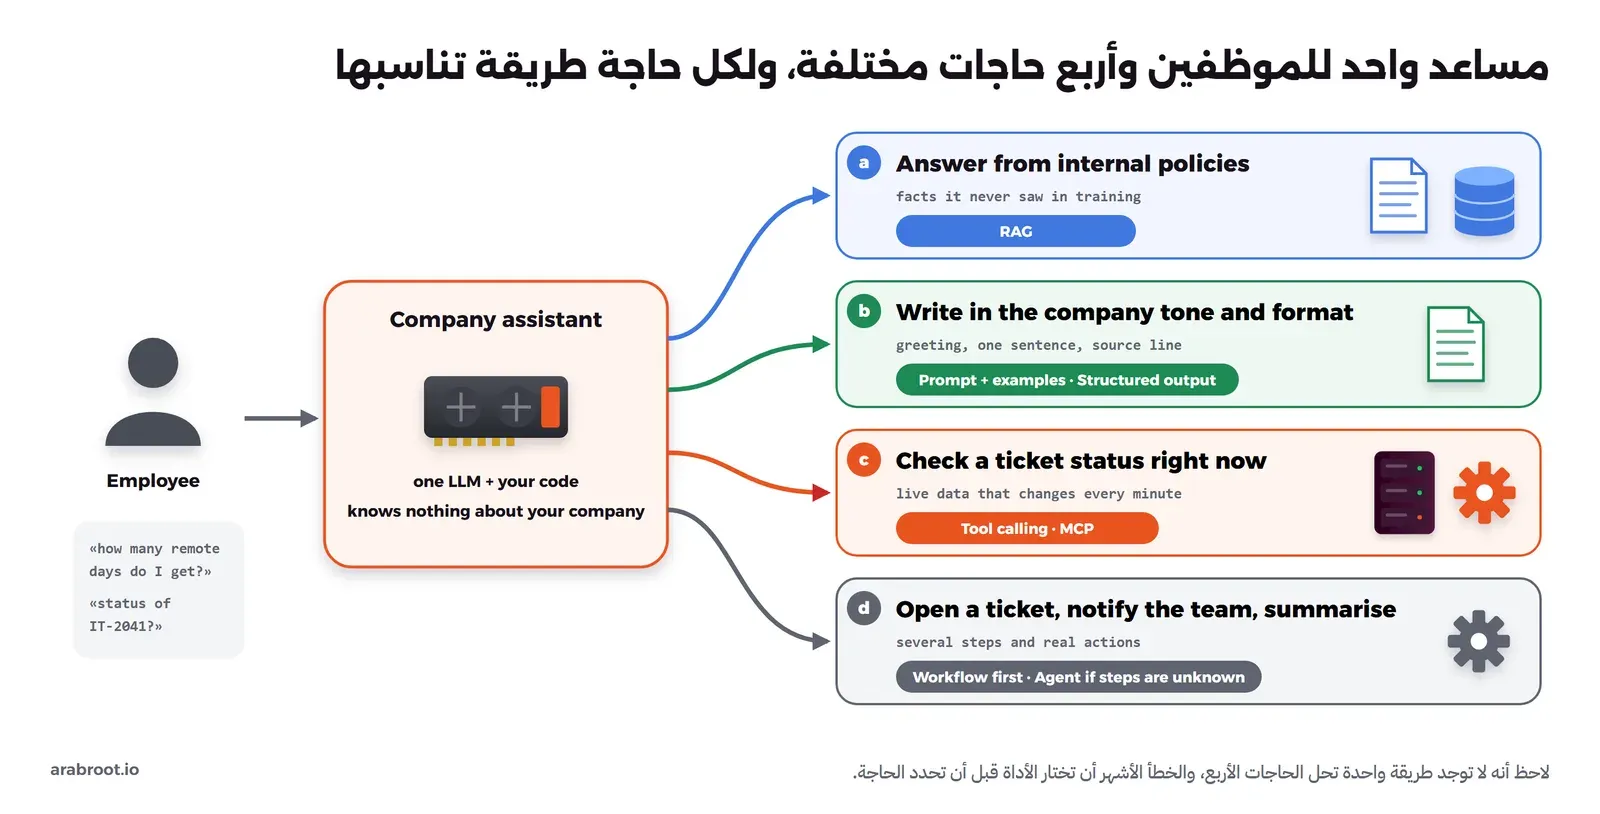
- الحاجة (أ) الإجابة من السياسات الداخلية: «كم يوماً يحق لي العمل عن بعد؟»، وهذه مشكلة معرفة Knowledge، فالنموذج لم ير سياسات شركتك في تدريبه أبداً، والسياسة تتغير كل فترة.
- الحاجة (ب) الكتابة بأسلوب الشركة وشكلها: تبدأ الإجابة بعبارة ترحيب ثابتة، وتكون في جملة واحدة، وتنتهي بسطر المصدر، وهذه مشكلة سلوك Behaviour وشكل Format، وليست مشكلة معلومات.
- الحاجة (ج) معرفة حالة التذكرة IT-2041 الآن: وهذه بيانات حية Live Data تتغير كل دقيقة، فلا يصلح لها أي مستند ولا أي تدريب، وإنما تحتاج قراءة من نظام التذاكر لحظة السؤال.
- الحاجة (د) «افتح تذكرة، وأبلغ الفريق، ثم لخص لي»: وهذه مهمة متعددة الخطوات Multi-step فيها أفعال حقيقية Actions تكتب في أنظمة الشركة، والسؤال هنا من يقرر ترتيب الخطوات، كودك أم النموذج.
الحلول البسيطة Naive Solutions ولماذا تفشل
الحل البسيط الأول أن تختار نموذجاً أكبر وتكتب له تعليمات أطول، على أمل أن «يعرف» الإجابة، والمشكلة أن حجم النموذج لا يغير حقيقة أنه لم ير سياسات شركتك ولا نظام تذاكرك، فالنموذج الأكبر يكتب لغة أفضل ويخطئ في الأسئلة الأصعب بثقة أكبر كما شرحنا في لماذا يخطئ النموذج، وسوف ترى في التجربة أن نموذجاً صغيراً اخترع رقماً لمادة في سياسة لا يعرفها ونسبه إليها بثقة كاملة.
والحل البسيط الثاني أن تقول «سوف ندرب النموذج على مستنداتنا»، وهو أكثر ما نسمعه في الاجتماعات، والمشكلة أن الضبط الدقيق Fine-tuning يعلم النموذج أسلوباً وشكلاً أكثر مما يحفظ حقائق، وكل تعديل في سياسة يعني تدريباً جديداً، والنموذج المدرب لا يستطيع أن يذكر من أي مستند جاءت المعلومة، ولا يستطيع أن يمنع موظفاً من معلومة حفظها من مستند سري، وسوف نعرض الأدلة على ذلك في قسم المعرفة أم السلوك.
والحل البسيط الثالث أن تبني وكيلاً Agent وتعطيه كل الأدوات وكل الصلاحيات ثم تقول له «ساعد الموظف»، والمشكلة أن هذا يعطي القرار في كل خطوة لنموذج قد يخطئ، فيفتح تذكرة مكررة، أو يرسل رسالة قبل أن يعرف رقم التذكرة، أو يدخل في حلقة تستهلك الميزانية، وسوف ترى في التجربة أن الوكيل أرسل رسالة الإبلاغ قبل أن يعرف رقم التذكرة فعلاً.
والطريقة الصحيحة أن تحل كل حاجة بأرخص طريقة تكفيها، ثم تصعد درجة فقط إذا قست أن الدرجة الحالية لا تكفي، وهذا ما يسمى سلم الطرق، وهو موضوع القسم التالي.
سلم الطرق من الأرخص إلى الأغلى The Ladder
الصورة التالية ترتب ثماني طرق لتغيير ما يفعله تطبيق الذكاء الاصطناعي، من الأرخص في الكلفة والوقت والمخاطر إلى الأغلى، وتقسمها إلى ثلاث مجموعات: طرق تغير ما يراه النموذج في السياق Context، وطرق تغير من يقرر الخطوات Control، وطرق تغير أوزان النموذج نفسها Weights:
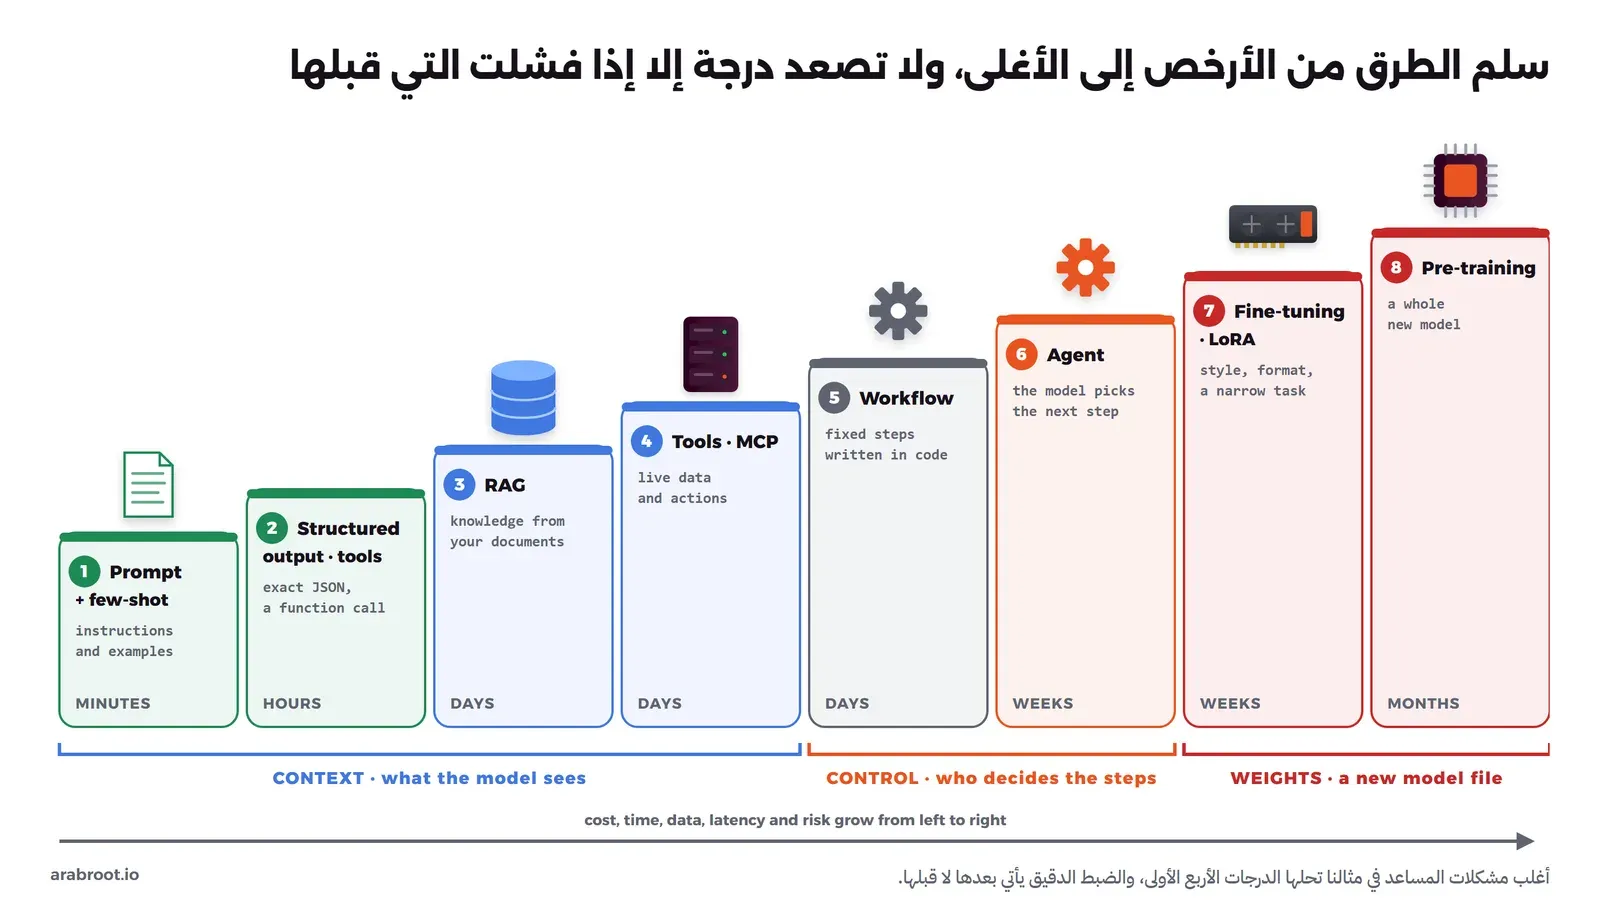
والأزمنة في الصورة تقديرية لفريق صغير، والهدف منها أن ترى الفرق في الحجم بين الدرجات وليس أن تخطط بها. وفيما يلي كل درجة باختصار، ما الذي تحله، وما الذي لا تحله، وكم تكلف، وما الذي تحتاجه، وما مخاطرها:
الدرجة 1: التعليمات Prompt والأمثلة القليلة Few-shot
أن تكتب للنموذج تعليمات واضحة بالدور والمهمة وشكل الإجابة، وتضع معها مثالاً أو أمثلة قليلة محلولة يقلدها، دون أي تدريب، وفي مثالنا هي أول ما نجربه للحاجة (ب): «ابدأ بعبارة أهلاً بك، وأجب في جملة واحدة، واذكر المصدر». وتوثيق هندسة التعليمات Prompt Engineering من Anthropic ودليل تحسين النماذج Model Optimization من OpenAI كلاهما يضع هذه الخطوة مع التقييم Evals قبل أي ضبط دقيق.
- نقاط القوة: تأخذ دقائق، ولا تحتاج بيانات ولا عتاداً، وتغييرها فوري، وتعمل مع أي نموذج.
- نقاط الضعف: لا تعطي النموذج معلومة لا يعرفها، والنموذج الصغير قد يتبع جزءاً من الشكل ويترك جزءاً كما سوف ترى في التجربة، وكل مثال تضيفه يكلف توكنز Tokens في كل طلب.
- الكلفة وزمن الاستجابة Latency: الأقل، وتزيد قليلاً مع طول التعليمات والأمثلة.
- البيانات المطلوبة: بضعة أمثلة جيدة تكتبها بيدك.
- الصيانة Maintenance: ملف نصي تراجعه كلما تغير النموذج، مع مجموعة أسئلة تقييم ثابتة.
- المخاطر Risks: تعليمات النظام System Prompt ليست سراً ولا حماية، فلا تضع فيها باسورد ولا قاعدة صلاحيات.
الدرجة 2: المخرج المنظم Structured Output واستدعاء الأدوات Tool Calling
أن تجبر النموذج على مخرج JSON بمخطط Schema تحدده، أو تعطيه وصف دوال يطلب تنفيذها بدلاً من أن يكتب نصاً، وقد شرحنا الاثنين بتجربة في قسم التجربة في مقال المصطلحات. وفي مثالنا يحل المخرج المنظم الحاجة (ب) بطريقة أثبت من التعليمات وحدها، لأن الكود هو الذي يكتب عبارة الترحيب وسطر المصدر، والنموذج يملأ الحقول فقط.
- نقاط القوة: الشكل مضمون من سيرفر التشغيل نفسه، والكود يقرأ المخرج دون تنظيف، وهي الأساس الذي تقوم عليه الأدوات والوكلاء.
- نقاط الضعف: تضمن الشكل وليس صحة القيم، واستدعاء الأدوات في النماذج الصغيرة غير ثابت، وقد رأينا في التجربة أن النموذج لم يطلب الأداة عندما كان السؤال بالعربية.
- الكلفة: قريبة من الدرجة الأولى، مع وقت تكتب فيه المخطط ووصف الأدوات.
- البيانات المطلوبة: المخطط ووصف كل أداة، والوصف نفسه جزء من التعليمات.
- المخاطر: أي أداة تعطيها للنموذج ينفذها برنامجك بصلاحياته، وهذا موضوع مخاطر الأدوات.
الدرجة 3: التوليد المعزز بالاسترجاع RAG للمعرفة Knowledge
قبل أن يصل السؤال إلى النموذج يبحث التطبيق في مستنداتك ويضع المقاطع المناسبة في السياق مع طلب «أجب من هذه المصادر فقط»، والفكرة من ورقة Lewis وزملائه 2020، وقد بنينا نظاماً كاملاً منها في مقال البحث في مستنداتك مع RAG. وفي مثالنا هي طريقة الحاجة (أ).
- نقاط القوة: تعديل المستند يظهر في الإجابة التالية مباشرة، وكل إجابة تذكر مصدرها، والصلاحيات تطبق في البحث، والنموذج نفسه لا يتغير.
- نقاط الضعف: لا تغير أسلوب النموذج، ولا تقرأ البيانات الحية، وإذا أخطأ البحث في اختيار المقطع أخطأت الإجابة أو قالت «لا أعرف».
- الكلفة وزمن الاستجابة: كل مقطع يضاف إلى التعليمات توكنز تدفع ثمنها في كل سؤال، ورأيت في تجربة مقال RAG أن التعليمات كبرت عشر مرات بسبب أربعة مقاطع.
- البيانات المطلوبة: مستنداتك نفسها، مع استخراج النص والتقطيع Chunking ونموذج تضمين Embedding Model وفهرس بحث.
- الصيانة: إعادة الفهرسة كلما تغير مستند، وأسئلة تقييم تقيس جودة البحث.
- المخاطر: صلاحيات المستندات، والبيانات القديمة، وحقن التعليمات داخل المستندات، وتفصيلها في مخاطر RAG.
الدرجة 4: الأدوات Tools وبروتوكول MCP للبيانات الحية والأفعال
عندما تحتاج الإجابة إلى بيانات تتغير كل دقيقة أو إلى فعل في نظام، تعطي النموذج أداة مثل get_ticket_status، فيطلبها وينفذها برنامجك ويعيد النتيجة إليه. وبروتوكول سياق النموذج Model Context Protocol واختصاراً MCP طريقة موحدة لتقديم هذه الأدوات من سيرفر منفصل يستخدمه أي تطبيق يدعم البروتوكول، وتفصيله في مقال بروتوكول MCP للمبتدئين. وفي مثالنا هي طريقة الحاجة (ج).
- نقاط القوة: البيانات من مصدرها لحظة السؤال، والأداة نفسها تعمل مع أكثر من تطبيق عندما تقدم عبر MCP.
- نقاط الضعف: النموذج قد لا يطلب الأداة أو يطلبها بمعاملات خاطئة، وكل استدعاء أداة يضيف طلباً آخر إلى النموذج ووقتاً.
- الكلفة: أيام لكتابة الأدوات وصلاحياتها واختبارها، أكثر من كتابة الوصف نفسه.
- البيانات المطلوبة: API للنظام وحساب خدمة Service Account بأقل الصلاحيات.
- المخاطر: الصلاحيات الزائدة Excessive Agency، وهي من أخطر ما في القائمة كلها، وتفصيلها في مخاطر الأدوات.
الدرجة 5: سير العمل Workflow بخطوات يحددها الكود
نظام تمر فيه استدعاءات النموذج والأدوات بمسار مكتوب مسبقاً في الكود، فالكود يقرر الخطوة التالية، والنموذج يقوم بالجزء اللغوي فقط داخل كل خطوة. وفي مثالنا هي الطريقة الأولى للحاجة (د): الكود يفتح التذكرة، ثم يبلغ الفريق برقمها، ثم يكتب الملخص.
- نقاط القوة: نفس الخطوات في كل مرة، فيسهل اختبارها وشرحها ومراقبتها، والكلفة معروفة مسبقاً.
- نقاط الضعف: لا تتكيف مع حالة لم تكتب لها مساراً، وكل حالة جديدة تحتاج كوداً جديداً.
- الكلفة: أيام من البرمجة العادية، واستدعاءات قليلة للنموذج.
- البيانات المطلوبة: أن تعرف الخطوات مسبقاً، وهذا هو الشرط الحقيقي.
- المخاطر: أقل من الوكيل، لأن الأفعال التي تكتب في الأنظمة تمر من كودك بترتيب تعرفه.
الدرجة 6: الوكيل Agent الذي يختار خطوته التالية
نظام يعطى هدفاً وأدوات، ويكرر حلقة: يطلب أداة، ويقرأ نتيجتها، ثم يقرر هل انتهى أم يكمل، والقرار في كل خطوة بيد النموذج. وفي مثالنا يصلح للحاجة (د) فقط إذا كانت خطوات المهمة غير معروفة مسبقاً، كأن يطلب الموظف «اعرف لماذا لا يعمل VPN عندي وافعل ما يلزم».
- نقاط القوة: يتعامل مع مهام مفتوحة لا تستطيع أن تكتب خطواتها مسبقاً.
- نقاط الضعف: أصعب في التوقع والاختبار، والخطأ في خطوة يتراكم في الخطوات التالية، وكل خطوة استدعاء جديد للنموذج.
- الكلفة وزمن الاستجابة: الأعلى بين طرق السياق، وتختلف من طلب لآخر بحسب عدد الخطوات.
- البيانات المطلوبة: أدوات موصوفة بعناية، ومهام اختبار بنتائج معروفة.
- المخاطر: الحلقات Loops، والكلفة المفتوحة، والأفعال التي لا يمكن التراجع عنها، وتفصيلها في مخاطر الوكلاء.
الدرجة 7: الضبط الدقيق Fine-tuning وLoRA للسلوك Behaviour
أن تكمل تدريب نموذج جاهز على مئات أو آلاف الأمثلة من عملك، فتتغير أوزانه أو تضاف إليه طبقة صغيرة اسمها Adapter. وفي مثالنا لا نحتاجه إلا إذا فشلت الدرجتان الأولى والثانية في تثبيت أسلوب الشركة وشكلها، ولدينا مئات الإجابات الجيدة المكتوبة بهذا الشكل.
- نقاط القوة: يثبت الأسلوب والشكل والمهمة الضيقة، ويختصر التعليمات، ويجعل نموذجاً صغيراً جيداً في عمل واحد.
- نقاط الضعف: لا يصلح لإضافة معلومات تتغير، ولا يذكر مصدراً، وكل تغيير في البيانات أو في النموذج الأساسي يعني تدريباً جديداً.
- الكلفة: أسابيع بين تجهيز البيانات والتدريب والتقييم، مع عتاد للتدريب وكلفة استضافة النموذج المعدل.
- البيانات المطلوبة: بحسب توثيق Microsoft مجموعة صغيرة عالية الجودة من مئات إلى بضعة آلاف من أزواج السؤال والإجابة.
- المخاطر: تسرب بيانات التدريب، ونسيان قدرات سابقة، وتسميم البيانات، وتفصيلها في مخاطر الضبط الدقيق.
الدرجة 8: التدريب المسبق Pre-training
بناء نموذج جديد من البداية على ترليونات التوكنز، وقد شرحنا هذه المرحلة في التدريب المسبق Pretraining، وهي تحتاج آلاف البطاقات الرسومية وأشهراً من العمل، لذلك فهي ليست خياراً لمساعد موظفين ولا لأغلب المؤسسات، وقد وضعناها في السلم حتى تعرف أين تقع عندما يقترحها أحد في اجتماع.
تجربة حقيقية: الحاجات الأربع على نموذج صغير
الآن سوف نشغل الحاجات الأربع على نموذج صغير هو qwen2.5:1.5b في Ollama، وهو نموذج حجمه قرابة 1 GB يعمل على المعالج دون بطاقة رسومية. والهدف ليس أن نقيس جودة النموذج، وإنما أن نرى ما تحله كل طريقة وما لا تحله، لذلك فكل المخرجات التالية سلوك نموذج صغير واحد في يوم واحد، والنموذج الأكبر سوف يخطئ أقل ولكن في نفس الأماكن. والأزمنة توضيحية فقط، لأن الجهاز مشترك مع تجارب أخرى، وقد شرحنا ما تتوقعه من جهازك في تشغيل نماذج اللغة على جهازك.
تجهيز بيئة التجربة
docker volume create lab-cmp-ollama
docker run -d --name lab-cmp-ollama -p 127.0.0.1:20580:11434 \n  -v lab-cmp-ollama:/root/.ollama ollama/ollama:0.35.1
docker exec lab-cmp-ollama ollama pull qwen2.5:1.5b
لاحظ أن المنفذ منشور على 127.0.0.1 فقط، والسبب أن واجهة Ollama لا تطلب أي مصادقة. والبرامج تحتاج Python 3 على جهازك دون أي مكتبة إضافية، وكلها تستخدم الملف common.py التالي لإرسال المحادثة إلى Ollama بدرجة حرارة Temperature صفر وبذرة Seed ثابتة حتى يتكرر المخرج:
import json, time, urllib.request
URL = "http://127.0.0.1:20580/api/chat"
MODEL = "qwen2.5:1.5b"
def chat(messages, tools=None):
    body = {"model": MODEL, "stream": False, "messages": messages, "options": {"temperature": 0, "seed": 1}}
    if tools: body["tools"] = tools
    req = urllib.request.Request(URL, json.dumps(body).encode(), {"Content-Type": "application/json"})
    t = time.time()
    r = json.load(urllib.request.urlopen(req))
    r["_secs"] = time.time() - t
    return r
وإذا كنت على Windows فقد تظهر لك رسالة UnicodeEncodeError عند طباعة النص العربي، والسبب أن الطرفية Terminal تستخدم ترميزاً Encoding قديماً، والحل أن تشغل البرامج بعد الأمر set PYTHONIOENCODING=utf-8 في cmd، أو $env:PYTHONIOENCODING="utf-8" في PowerShell، وهذا ما حدث معنا بالضبط في أول تشغيل.
الحاجة (أ): النموذج وحده Bare Model ثم RAG مصغر
البرنامج policy.py يسأل النموذج عن مادة في سياسة العمل عن بعد، مرة وحده، ومرة مع مقطعين من دليل السياسات كما يرجعهما البحث في نظام RAG، ولم نبن هنا نظام بحث كاملاً لأن ذلك موضوع مقال RAG، وإنما لصقنا المقطعين مباشرة حتى نرى أثر وجود المعلومة في السياق:
import sys
from common import chat
Q = "بحسب المادة 3 من سياسة العمل عن بعد HR-07، كم يوماً في الأسبوع يحق لي العمل عن بعد؟ أجب في جملة واحدة."
# مقطعان من دليل السياسات الداخلي، كما يرجعهما البحث في نظام RAG
CHUNKS = """[1] سياسة العمل عن بعد HR-07، المادة 3: يحق للموظف العمل عن بعد يومين في الأسبوع بحد أقصى، بعد إكمال ستة أشهر في الشركة، وبموافقة المدير المباشر عبر نظام الطلبات.
[2] سياسة الأجهزة IT-02، المادة 5: لا يسمح بالاتصال بأنظمة الشركة من خارج المكتب إلا عبر VPN الشركة ومن جهاز الشركة."""
mode = sys.argv[1]
if mode == "bare":
    msgs = [{"role": "user", "content": Q}]
else:
    msgs = [{"role": "system", "content": "أجب من المصادر التالية فقط، واذكر رقم المصدر بين قوسين، وإذا لم تجد الإجابة فقل: لا أعرف.\n" + CHUNKS},
            {"role": "user", "content": Q}]
r = chat(msgs)
print(r["message"]["content"])
print(f"--- prompt {r['prompt_eval_count']} tokens | answer {r['eval_count']} tokens | {r['_secs']:.1f} s")
python3 policy.py bare
python3 policy.py ragوالمخرج سوف يكون كما يلي:
كما ورد في المادة 3 من سياسة العمل عن بعد HR-07، يحق لك العمل عن بعد لمدة لا تقل عن 8 ساعات في الأسبوع.
--- prompt 68 tokens | answer 38 tokens | 1.9 s
يمكنني العمل عن بعد يومين في الأسبوع بحد أقصى.
--- prompt 185 tokens | answer 17 tokens | 1.0 s
في المخرج أعلاه لاحظ التالي:
- النموذج وحده لم يقل «لا أعرف»، وإنما ذكر اسم السياسة ورقم المادة كما جاءا في السؤال، ثم اخترع لها حكماً لا وجود له «لا تقل عن 8 ساعات في الأسبوع»، وهذا أخطر من الاعتذار، لأن الموظف يرى رقم المادة فيصدق الإجابة.
- ولاحظ أننا عندما سألناه بصيغة «بحسب سياسة شركتنا» دون رقم المادة اعتذر بأنه لا يملك معلومات عن شركتنا، أي أن نفس النموذج يعتذر مرة ويخترع مرة بحسب صياغة السؤال، وهذا بالضبط ما يجعل الاعتماد على ذاكرته غير ممكن.
- مع المقطعين جاء الرقم الصحيح «يومين في الأسبوع بحد أقصى»، لأن عمل النموذج أصبح قراءة نص أمامه بدلاً من التذكر، ولكنه لم يذكر رقم المصدر رغم أننا طلبنا ذلك، وكتب «يمكنني» بدلاً من «يمكنك»، وهذه مشكلة شكل وأسلوب، أي الحاجة (ب)، وRAG لا يحلها.
- التعليمات كبرت من 68 توكناً إلى 185 بسبب مقطعين فقط، وهذا ثمن RAG في كل سؤال.
الحاجة (ب): أسلوب الشركة بالتعليمات Prompt ثم بالمخرج المنظم Structured Output
قبل أن يفكر أحد في الضبط الدقيق لنجرب الدرجة الأولى، فالبرنامج tone.py يضيف تعليمات بالشكل المطلوب ومثالاً واحداً محلولاً Few-shot يبين الشكل:
from common import chat
Q = "بحسب المادة 3 من سياسة العمل عن بعد HR-07، كم يوماً في الأسبوع يحق لي العمل عن بعد؟ أجب في جملة واحدة."
# مقطعان من دليل السياسات الداخلي، كما يرجعهما البحث في نظام RAG
CHUNKS = """[1] سياسة العمل عن بعد HR-07، المادة 3: يحق للموظف العمل عن بعد يومين في الأسبوع بحد أقصى، بعد إكمال ستة أشهر في الشركة، وبموافقة المدير المباشر عبر نظام الطلبات.
[2] سياسة الأجهزة IT-02، المادة 5: لا يسمح بالاتصال بأنظمة الشركة من خارج المكتب إلا عبر VPN الشركة ومن جهاز الشركة."""
RULES = ("أنت مساعد الموظفين في شركتنا. أجب من المصادر التالية فقط.\n"
         "شكل الإجابة إلزامي: ابدأ بعبارة «أهلاً بك،» ثم الإجابة في جملة واحدة موجهة للموظف بصيغة «يحق لك»، "
         "ثم سطر جديد فيه «المصدر:» ورمز السياسة ورقم المادة. وإذا لم تجد الإجابة فقل: لا أعرف.\n" + CHUNKS)
# مثال واحد محلول Few-shot يبين الشكل المطلوب
EXAMPLE_Q = "هل أستطيع الدخول إلى أنظمة الشركة من جهازي الشخصي في البيت؟"
EXAMPLE_A = "أهلاً بك، لا يحق لك ذلك، فالاتصال من خارج المكتب يكون عبر VPN الشركة ومن جهاز الشركة فقط.\nالمصدر: IT-02، المادة 5"
r = chat([{"role": "system", "content": RULES},
          {"role": "user", "content": EXAMPLE_Q}, {"role": "assistant", "content": EXAMPLE_A},
          {"role": "user", "content": Q}])
print(r["message"]["content"])
print(f"--- prompt {r['prompt_eval_count']} tokens | answer {r['eval_count']} tokens | {r['_secs']:.1f} s")
والمخرج سوف يكون كما يلي:
أهلاً بك، يحق لك العمل عن بعد يومين في الأسبوع بحد أقصى.
--- prompt 326 tokens | answer 23 tokens | 1.4 s
التعليمات والمثال نجحا في جزء من الشكل، فبدأت الإجابة بعبارة «أهلاً بك» وتوجهت للموظف بصيغة «يحق لك»، ولكن سطر المصدر لم يظهر رغم أنه في التعليمات وفي المثال. وهنا يقترح البعض الضبط الدقيق مباشرة، والدرجة الثانية أرخص بكثير، فالبرنامج format.py يطلب من النموذج ثلاثة حقول فقط بمخطط JSON Schema، ويكتب الكود شكل الشركة الثابت حولها:
import json, urllib.request
from common import URL, MODEL
Q = "بحسب المادة 3 من سياسة العمل عن بعد HR-07، كم يوماً في الأسبوع يحق لي العمل عن بعد؟"
CHUNKS = """[1] سياسة العمل عن بعد HR-07، المادة 3: يحق للموظف العمل عن بعد يومين في الأسبوع بحد أقصى، بعد إكمال ستة أشهر في الشركة، وبموافقة المدير المباشر عبر نظام الطلبات.
[2] سياسة الأجهزة IT-02، المادة 5: لا يسمح بالاتصال بأنظمة الشركة من خارج المكتب إلا عبر VPN الشركة ومن جهاز الشركة."""
schema = {"type": "object", "required": ["answer", "policy", "article"],
          "properties": {"answer": {"type": "string"}, "policy": {"type": "string"}, "article": {"type": "integer"}}}
body = {"model": MODEL, "stream": False, "format": schema, "options": {"temperature": 0, "seed": 1},
        "messages": [{"role": "system", "content": "أجب من المصادر التالية فقط، واذكر رمز السياسة ورقم المادة.\n" + CHUNKS},
                     {"role": "user", "content": Q}]}
r = json.load(urllib.request.urlopen(urllib.request.Request(URL, json.dumps(body).encode(), {"Content-Type": "application/json"})))
data = json.loads(r["message"]["content"])
# الكود هو الذي يكتب شكل الشركة الثابت، والنموذج يملأ الحقول فقط
print(f"أهلاً بك، {data['answer']}\nالمصدر: {data['policy']}، المادة {data['article']}")
والمخرج سوف يكون كما يلي:
أهلاً بك، يمكن للموظف العمل عن بعد يومين في الأسبوع بحد أقصى
المصدر: HR-07، المادة 3
في المخرج أعلاه لاحظ التالي:
- عبارة الترحيب وسطر المصدر ظهرا في كل مرة، لأن الكود هو الذي يكتبهما، والنموذج أعطى رمز السياسة HR-07 ورقم المادة 3 في حقلين منفصلين.
- الحقل answer جاء بصيغة «يمكن للموظف» وليس «يحق لك»، أي أن أسلوب الجملة نفسها ما زال من النموذج، فإذا كان هذا الفرق مهماً لشركتك، وجربت نموذجاً أكبر ولم يكف، وعندك مئات الإجابات المكتوبة بالأسلوب الصحيح، فهنا فقط يبدأ الحديث عن الضبط الدقيق.
الحاجة (ج): حالة التذكرة باستدعاء الأدوات Tool Calling
حالة التذكرة لا توجد في أي مستند، لذلك لا يفيد فيها RAG ولا الضبط الدقيق، وإنما تحتاج أداة تقرأ من نظام التذاكر لحظة السؤال. والبرنامج ticket.py يعرف أداة واحدة للقراءة فقط، ترجع هنا بيانات تجريبية ثابتة، ويسأل النموذج بها:
import json, sys
from common import chat
# نظام التذاكر: دالة عادية في برنامجنا ترجع بيانات تجريبية ثابتة، وفي الواقع تستدعي API النظام بصلاحية قراءة فقط
def get_ticket_status(ticket_id):
    tickets = {"IT-2041": {"status": "in_progress", "assignee": "network-team", "updated": "2026-10-05 14:10"}}
    return json.dumps(tickets.get(ticket_id, {"error": "ticket not found"}))
tools = [{"type": "function", "function": {
    "name": "get_ticket_status",
    "description": "Read the current status of one IT ticket from the ticketing system (read only)",
    "parameters": {"type": "object", "required": ["ticket_id"],
                   "properties": {"ticket_id": {"type": "string", "description": "ticket id, e.g. IT-2041"}}}}}]
question, mode = sys.argv[1], (sys.argv[2:] or ["tools"])[0]
messages = [{"role": "user", "content": question}]
if mode == "notools":
    print(chat(messages)["message"]["content"]); raise SystemExit
r = chat(messages, tools)
msg = r["message"]
print("1) model asked for:", json.dumps(msg.get("tool_calls"), ensure_ascii=False), "| text:", msg["content"])
if not msg.get("tool_calls"): raise SystemExit   # النموذج لم يطلب الأداة، فلا يوجد ما ننفذه
messages.append(msg)
for call in msg.get("tool_calls", []):
    result = get_ticket_status(**call["function"]["arguments"])   # برنامجنا هو الذي ينفذ
    print("2) our code returned:", result)
    messages.append({"role": "tool", "tool_name": call["function"]["name"], "content": result})
print("3) final answer:", chat(messages, tools)["message"]["content"])
python3 ticket.py "ما حالة التذكرة IT-2041؟" notools
python3 ticket.py "ما حالة التذكرة IT-2041؟"
python3 ticket.py "What is the status of ticket IT-2041?"والمخرج سوف يكون كما يلي:
عذراً، أنا لا أستطيع مساعدتك في هذا.
1) model asked for: null | text: سيتم الطلب من تطبيق التذكرة IT-2041.
1) model asked for: [{"id": "call_4p3acm2a", "function": {"index": 0, "name": "get_ticket_status", "arguments": {"ticket_id": "IT-2041"}}}] | text:
2) our code returned: {"status": "in_progress", "assignee": "network-team", "updated": "2026-10-05 14:10"}
3) final answer: The ticket IT-2041 is currently in progress and has been assigned to the network team. The last update was on October 5, 2026, at 14:10.
في المخرج أعلاه لاحظ التالي:
- دون أدوات اعتذر النموذج، وهذا أفضل من أن يخترع حالة، ولكنه لا يفيد الموظف بشيء.
- مع الأداة والسؤال بالعربية لم يطلب النموذج الأداة أصلاً، وإنما كتب جملة عامة، ومع نفس السؤال بالإنجليزية طلبها بالمعامل الصحيح IT-2041، ونفذها برنامجنا، فكتب النموذج الإجابة من نتيجتها. وقد جربنا إضافة تعليمات نظام تقول له «استدع الأداة لأي سؤال عن تذكرة» فبقي يعتذر بالعربية، لذلك فهذا قيد في هذا النموذج الصغير مع العربية، والنموذج الأكبر يتعامل معها أفضل غالباً، ولكن لا تفترض ذلك دون أن تقيسه على أسئلة موظفيك.
- الخطوة الثانية نفذها برنامجنا وليس النموذج، وهذا ما شرحناه في مقال المصطلحات، فالصلاحية التي تعطيها للأداة هي صلاحية برنامجك.
وقد يتساءل البعض: إذا كان النموذج لا يطلب الأداة بثبات، فهل نحتاج نموذجاً أكبر؟ والإجابة أن هذا السؤال بالذات لا يحتاج أن يقرر النموذج شيئاً، فرقم التذكرة له شكل ثابت يكفي لكشفه تعبير منتظم Regular Expression، والبرنامج workflow.py يجعل الكود يقرر ويستدعي النظام، ويترك للنموذج كتابة الجملة فقط:
import re, json
from common import chat
def get_ticket_status(ticket_id):          # نفس الأداة، بصلاحية قراءة فقط
    tickets = {"IT-2041": {"status": "in_progress", "assignee": "network-team", "updated": "2026-10-05 14:10"}}
    return json.dumps(tickets.get(ticket_id, {"error": "ticket not found"}))
question = "ما حالة التذكرة IT-2041؟"
# الخطوة 1: الكود وليس النموذج يقرر أن السؤال عن تذكرة، بتعبير منتظم بسيط
m = re.search(r"\b[A-Z]{2,5}-\d+\b", question)
if not m:
    raise SystemExit("not a ticket question: send it to the policy assistant (RAG)")
# الخطوة 2: الكود يستدعي النظام مباشرة
data = get_ticket_status(m.group())
print("1) code called get_ticket_status:", m.group(), "->", data)
# الخطوة 3: النموذج يكتب الإجابة فقط من البيانات التي أعطيناه إياها
r = chat([{"role": "system", "content": "اكتب للموظف حالة تذكرته بالعربية في جملة واحدة، من البيانات التالية فقط:\n" + data},
          {"role": "user", "content": question}])
print("2) answer:", r["message"]["content"])
والمخرج سوف يكون كما يلي:
1) code called get_ticket_status: IT-2041 -> {"status": "in_progress", "assignee": "network-team", "updated": "2026-10-05 14:10"}
2) answer: الحالة التذكرة IT-2041 هي في حالة تقدم.
الآن وصلت البيانات الصحيحة في كل مرة لأن الكود هو الذي استدعى النظام، أما الجملة العربية «في حالة تقدم» فترجمة ضعيفة للقيمة in_progress، والحل الأنسب أن تترجم الحالات الثابتة في الكود بجدول صغير، وألا تترك للنموذج إلا ما يحتاج لغة فعلاً. وهذه أول إشارة إلى الفكرة التي سوف نعود إليها: كل قرار تستطيع أن تكتبه في الكود فلا تتركه للنموذج.
الحاجة (د): نفس المهمة بالوكيل Agent ثم بسير العمل Workflow
البرنامج agent.py يعطي النموذج هدف الموظف وأداتين تجريبيتين لا تكتبان في أي نظام: create_ticket وnotify_team، ثم يكرر حلقة الوكيل بحد أقصى خمس خطوات نضعه نحن:
import json, sys
from common import chat
# أدوات تجريبية: تطبع ما كانت ستفعله فقط، ولا تكتب في أي نظام
def create_ticket(title, team):
    return json.dumps({"ticket_id": "IT-2042", "title": title, "team": team})
def notify_team(team, message):
    return json.dumps({"sent_to": team, "ok": True})
FUNCS = {"create_ticket": create_ticket, "notify_team": notify_team}
def tool(name, desc, props):
    return {"type": "function", "function": {"name": name, "description": desc,
            "parameters": {"type": "object", "required": list(props), "properties": {k: {"type": "string", "description": v} for k, v in props.items()}}}}
tools = [tool("create_ticket", "Open a new IT ticket", {"title": "short title", "team": "team that should handle it"}),
         tool("notify_team", "Send a chat message to a team", {"team": "team name", "message": "message text"})]
messages = [{"role": "user", "content": sys.argv[1]}]
MAX_STEPS = 5                                    # حد نضعه نحن، لا نتركه للنموذج
for step in range(1, MAX_STEPS + 1):
    msg = chat(messages, tools)["message"]
    messages.append(msg)
    calls = msg.get("tool_calls") or []
    if not calls:                                # النموذج قرر أنه انتهى
        print(f"step {step}: done ->", msg["content"]); break
    for c in calls:
        name, args = c["function"]["name"], c["function"]["arguments"]
        result = FUNCS[name](**args) if name in FUNCS else json.dumps({"error": "unknown tool"})
        print(f"step {step}: {name}({json.dumps(args, ensure_ascii=False)}) -> {result}")
        messages.append({"role": "tool", "tool_name": name, "content": result})
else:
    print("stopped: MAX_STEPS reached")
python3 agent.py "شبكة VPN متوقفة في مكتب جدة. افتح تذكرة لفريق الشبكات، وأبلغهم، ثم لخص لي ما فعلته في جملة واحدة."والمخرج سوف يكون كما يلي:
step 1: create_ticket({"title": "VPN Network is Down in Jeddah Office", "team": "Network Team"}) -> {"ticket_id": "IT-2042", "title": "VPN Network is Down in Jeddah Office", "team": "Network Team"}
step 1: notify_team({"message": "VPN network is down in Jeddah office. Please check and resolve the issue.", "team": "Network Team"}) -> {"sent_to": "Network Team", "ok": true}
step 2: done -> تم فتح تذكرة IT رقم IT-2042 حول توقف الشبكة VPN في مكتب جدة. تم إبلاغ الفريق الشبكات بخصوص هذا الموضوع.
ثم البرنامج flow.py الذي ينفذ نفس المهمة كسير عمل، فالكود يحدد الخطوات وترتيبها، والنموذج يكتب عنوان التذكرة فقط في حقل JSON واحد:
import json, urllib.request
from common import URL, MODEL
def create_ticket(title, team):                    # نفس الأداتين التجريبيتين في agent.py
    return json.dumps({"ticket_id": "IT-2042", "title": title, "team": team}, ensure_ascii=False)
def notify_team(team, message):
    return json.dumps({"sent_to": team, "message": message, "ok": True}, ensure_ascii=False)
request = "شبكة VPN متوقفة في مكتب جدة."
TEAM = "network-team"                              # قيمة ثابتة من قائمة الفرق، وليست نصاً حراً
# الخطوة 1: النموذج يكتب العنوان فقط، في حقل JSON واحد
body = {"model": MODEL, "stream": False, "options": {"temperature": 0, "seed": 1},
        "format": {"type": "object", "required": ["title"], "properties": {"title": {"type": "string"}}},
        "messages": [{"role": "user", "content": "اكتب عنوان تذكرة دعم فني قصيراً بالعربية لهذا البلاغ:\n" + request}]}
r = json.load(urllib.request.urlopen(urllib.request.Request(URL, json.dumps(body).encode(), {"Content-Type": "application/json"})))
title = json.loads(r["message"]["content"])["title"]
# الخطوة 2: الكود يفتح التذكرة
ticket = json.loads(create_ticket(title, TEAM))
print("1) create_ticket ->", json.dumps(ticket, ensure_ascii=False))
# الخطوة 3: الكود يبلغ الفريق بعد أن أصبح رقم التذكرة معروفاً
print("2) notify_team   ->", notify_team(TEAM, f"{ticket['ticket_id']}: {title}"))
# الخطوة 4: الملخص قالب في الكود، فلا يحتاج نموذجاً ولا يعد بشيء لم يحدث
print(f"3) summary: تم فتح التذكرة {ticket['ticket_id']} لفريق الشبكات بعنوان «{title}»، وتم إبلاغ الفريق.")
والمخرج سوف يكون كما يلي:
1) create_ticket -> {"ticket_id": "IT-2042", "title": "عنوان تذكرة دعم فني: شبكة VPN في مكتب جدة متوقفة", "team": "network-team"}
2) notify_team   -> {"sent_to": "network-team", "message": "IT-2042: عنوان تذكرة دعم فني: شبكة VPN في مكتب جدة متوقفة", "ok": true}
3) summary: تم فتح التذكرة IT-2042 لفريق الشبكات بعنوان «عنوان تذكرة دعم فني: شبكة VPN في مكتب جدة متوقفة»، وتم إبلاغ الفريق.
والصورة التالية تضع التشغيلين جنباً إلى جنب:
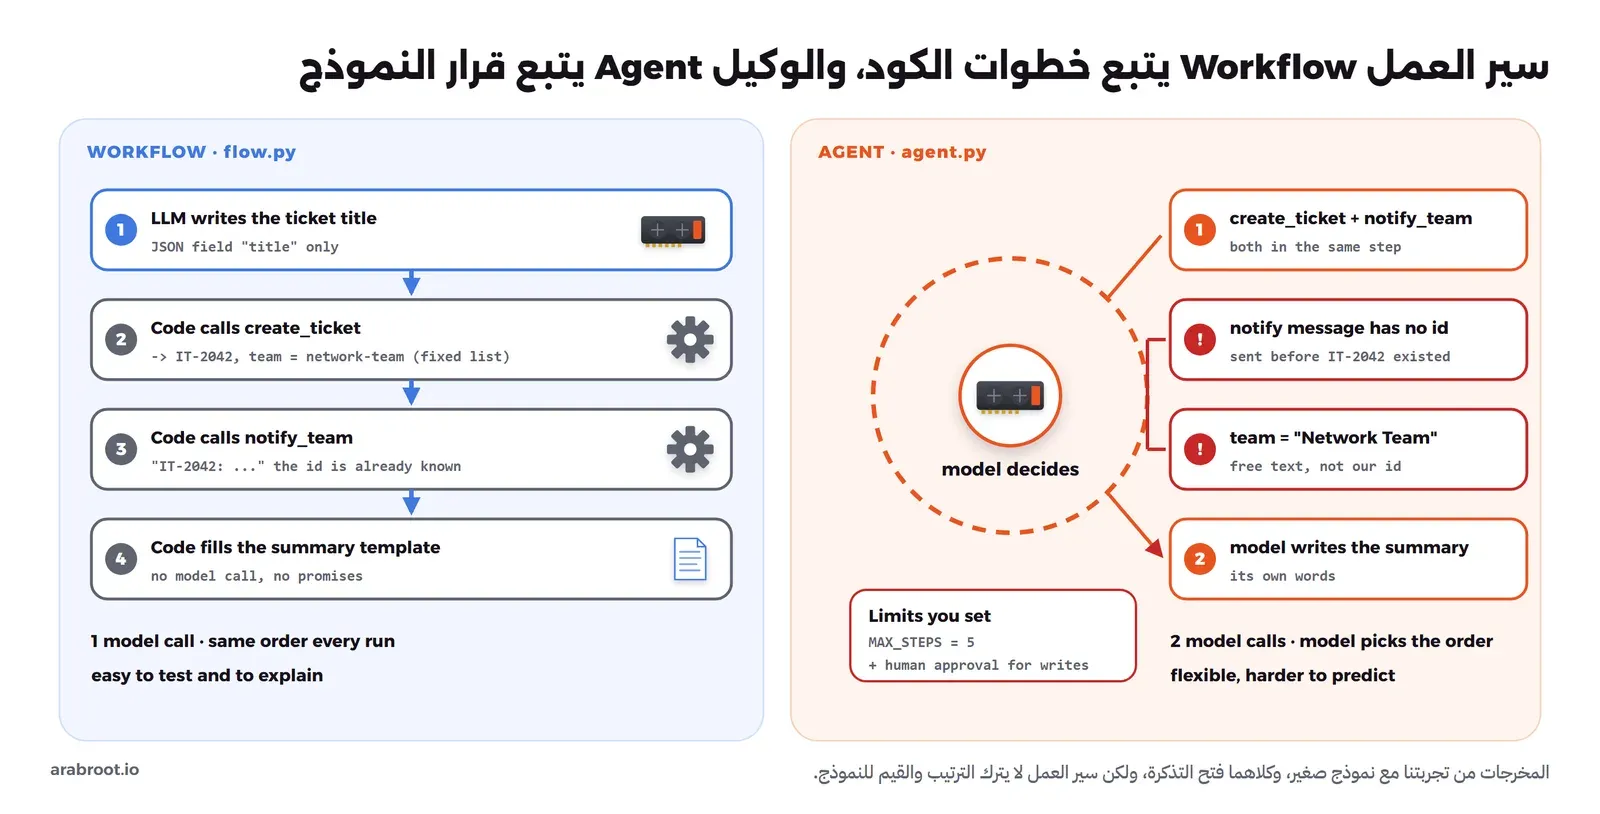
في المخرجين أعلاه لاحظ التالي:
- الوكيل أنجز المهمة في خطوتين، ولكنه طلب فتح التذكرة وإبلاغ الفريق في نفس الخطوة، فخرجت رسالة الإبلاغ دون رقم التذكرة IT-2042 لأنه لم يكن معروفاً بعد، وهذا خطأ في الترتيب لا يظهر في الملخص الذي كتبه.
- الوكيل كتب اسم الفريق «Network Team» نصاً حراً، ولو كانت الأداة حقيقية لكان عليك أن تتأكد أن هذا الاسم يطابق فريقاً موجوداً، أما سير العمل فاستخدم المعرف الثابت network-team من قائمة الفرق.
- سير العمل استدعى النموذج مرة واحدة فقط، وأرسل الإبلاغ بعد أن عرف الرقم، وكتب الملخص من قالب Template في الكود فلا يعد الموظف بشيء لم يحدث. ولاحظ أن النموذج أضاف إلى العنوان عبارة «عنوان تذكرة دعم فني:» التي لا نريدها، وهذا يبين أن مخرج النموذج يحتاج تحققاً Validation حتى داخل سير العمل، ولكن الخطأ هنا محصور في حقل واحد تعرف مكانه.
- المهمة (د) خطواتها معروفة مسبقاً، لذلك فسير العمل هو الحل الأنسب لها، والوكيل لا يستحق كلفته وصعوبة اختباره إلا عندما لا تستطيع أن تكتب الخطوات مسبقاً.
لماذا لم نجرب الضبط الدقيق Fine-tuning في هذه التجربة؟
الضبط الدقيق بطريقة LoRA ممكن تقنياً على المعالج لنموذج صغير، ولكن تجربة أمينة تحتاج مئات الأمثلة الجيدة بأسلوب الشركة، ووقت تدريب طويل على المعالج، ثم تقييماً على أسئلة لم يرها النموذج، ثم تحويل النتيجة إلى صيغة يشغلها Ollama، وتجربة بعشرة أمثلة لا تثبت شيئاً إلا أننا قمنا بها. والأهم أن التجربة أعلاه بينت أن مثالنا لا يحتاجه أصلاً، فالمخرج المنظم ثبت الشكل، وRAG أعطى المعلومة، والكود قام بالباقي.
إزالة التجربة
docker rm -f lab-cmp-ollama
docker volume rm lab-cmp-ollama
المعرفة أم السلوك: RAG مقابل الضبط الدقيق Fine-tuning
هذا أكثر خلط نسمعه، والصورة التالية تبين الفرق في جملة: RAG يغير ما يقرؤه النموذج عند كل سؤال، والضبط الدقيق يغير طريقة كتابته:
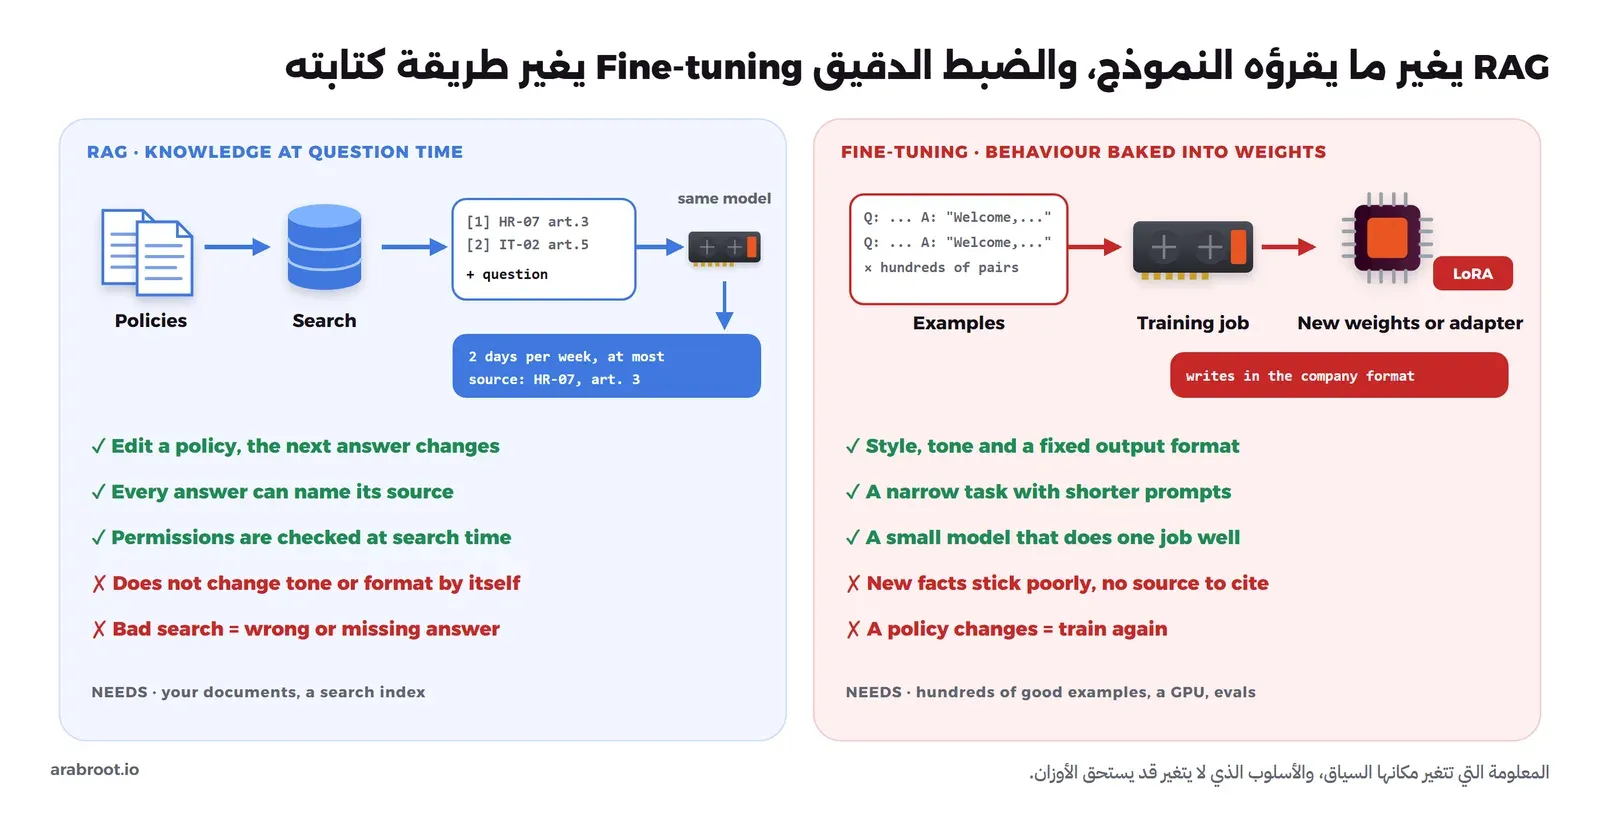
والأدلة على هذا التقسيم من مصادر مختلفة تقول نفس الشيء:
- قارنت ورقة Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs التي نشرها Oded Ovadia وزملاؤه في ديسمبر 2023 بين الضبط الدقيق غير الموجه Unsupervised Fine-tuning وبين RAG في أسئلة تحتاج معرفة، فوجدت أن RAG تفوق عليه باستمرار، سواءً في المعرفة التي رآها النموذج في تدريبه أو في المعرفة الجديدة تماماً، وأن النماذج تجد صعوبة في تعلم حقائق جديدة بالضبط الدقيق، وأن عرض الحقيقة الواحدة بصيغ كثيرة أثناء التدريب يخفف هذه المشكلة.
- يضع توثيق Microsoft لاعتبارات الضبط الدقيق حالات الاستخدام المناسبة له: تقليل عبء التعليمات الطويلة، وتعديل الأسلوب والنبرة Style and Tone، والمخرج بشكل أو مخطط محدد، وتحسين استخدام الأدوات، ونقل قدرة نموذج كبير إلى نموذج صغير، ويذكر من قيوده أنه قد يحتاج إعادة كلما تحدثت البيانات أو صدر نموذج أساسي جديد.
- يصف دليل OpenAI لتحسين النماذج الضبط الدقيق بأنه يجعل النموذج يكتب بشكل ثابت أو يتعامل مع مدخلات جديدة، ويضعه بعد التقييم Evals والتعليمات في دورة واحدة. ولاحظ أن نفس الصفحة تقول اليوم إن OpenAI توقف منصة الضبط الدقيق تدريجياً، فلم تعد متاحة للمستخدمين الجدد، وهذا تذكير بأن أي نموذج مضبوط عند مزود خارجي مربوط بقراره، أما النموذج المفتوح الذي تضبطه على سيرفرك فيبقى عندك.
أما LoRA فهي الطريقة التي جعلت الضبط الدقيق ممكناً لمن لا يملك مركز بيانات، فبحسب ورقة LoRA عام 2021 تجمد الأوزان الأصلية وتضيف إلى كل طبقة مصفوفات صغيرة تتدرب وحدها، فقلت المعاملات المدربة عشرة آلاف مرة وذاكرة البطاقة ثلاث مرات مقارنة بضبط GPT-3 كاملاً، دون زمن إضافي عند التشغيل. ثم جاءت QLoRA عام 2023 فحفظت النموذج الأصلي مكمماً بأربع بتات أثناء التدريب، حتى أمكن ضبط نموذج من 65 مليار معامل على بطاقة واحدة بذاكرة 48 GB، وتجد الطريقتين في مكتبة PEFT من Hugging Face.
ومتى يستحق ضبط نموذج صغير محلي؟ عندما تجتمع ثلاثة أشياء: مهمة ضيقة تتكرر كثيراً مثل تصنيف الرسائل أو استخراج حقول ثابتة أو كتابة ملخص بقالب واحد، ومئات الأمثلة الجيدة لهذه المهمة بالذات، وسبب يمنعك من الخدمة السحابية أو يجعلها مكلفة مع الحجم، كما شرحنا في هل تحتاج تشغيله على جهازك أصلاً. ففي هذه الحالة قد يقوم نموذج صغير مضبوط بالعمل بكلفة تشغيل أقل من نموذج كبير، ويبقى RAG معه لكل ما هو معلومات، وتذكر أن النموذج المضبوط يحتاج ذاكرة على قدر النموذج الأساسي كما في القاعدة الوحيدة للذاكرة.
MCP بروتوكول Protocol وليس قدرة جديدة Capability
لاحظ أن التجربة كلها لم تستخدم MCP، ومع ذلك طلب النموذج الأداة ونفذها برنامجنا، والسبب أن قدرة النموذج على طلب أداة هي استدعاء الأدوات Tool Calling، وهي موجودة في واجهة النموذج نفسه كما في توثيق Tool Calling في Ollama. فما الذي يضيفه MCP إذن؟ والإجابة أنه يوحد طريقة تقديم الأدوات، فقد أعلنته Anthropic في نوفمبر 2024 لحل مشكلة أن كل مصدر بيانات جديد يحتاج ربطاً خاصاً به في كل تطبيق، فبدلاً من أن تكتب أداة التذاكر مرة لمساعد الموظفين ومرة لمحرر الكود ومرة لواجهة المحادثة، تكتبها مرة واحدة في سيرفر MCP، ويستخدمها كل تطبيق يدعم البروتوكول.
وبحسب المواصفة الرسمية يقدم السيرفر ثلاثة أنواع من الإمكانيات، والفرق بينها هو من يتحكم فيها:
- الأدوات Tools: يتحكم فيها النموذج Model-controlled، فيكتشفها ويطلبها بحسب السؤال، مثل get_ticket_status وcreate_ticket في مثالنا.
- الموارد Resources: يتحكم فيها التطبيق Application-driven، وهي بيانات للقراءة لكل منها عنوان URI، مثل نص سياسة HR-07 بعنوان policy://HR-07، والتطبيق هو الذي يقرر متى يضعها في السياق.
- القوالب Prompts: رسائل جاهزة يختارها المستخدم.
وبالتالي فالسؤال «هل نحتاج MCP؟» سؤال عن عدد التطبيقات والأدوات وليس عن ذكاء النموذج: إذا كان لديك تطبيق واحد بأداتين فاستدعاء الأدوات مباشرة من كودك كما في التجربة يكفي، وإذا كانت لديك أدوات كثيرة يستخدمها أكثر من تطبيق، أو تريد أن تستخدم سيرفرات جاهزة لأنظمة مثل Git وقواعد البيانات، فهنا يوفر عليك MCP كتابة الربط مرة بعد مرة. ولاحظ أن MCP لا يجعل الأدوات آمنة، فالمواصفة نفسها تقول إن الأدوات تنفيذ لكود عشوائي Arbitrary Code Execution يجب التعامل معه بحذر، وإن على المضيف Host أخذ موافقة صريحة من المستخدم قبل استدعاء أي أداة، وإن المواصفة لا تستطيع أن تفرض ذلك بنفسها، فالتطبيق هو الذي يطبقه، وقد بنينا سيرفراً كاملاً بهذا الأسلوب في مقال بروتوكول MCP للمبتدئين.
سير العمل Workflow أم الوكيل Agent؟
فرقت Anthropic بينهما في مقال Building effective agents المنشور في 19 ديسمبر 2024، فسير العمل نظام تمر فيه النماذج والأدوات بمسارات محددة مسبقاً في الكود، أما الوكيل فنظام يوجه فيه النموذج خطواته واستخدامه للأدوات بنفسه، وتسمي الاثنين معاً الأنظمة الوكيلة Agentic Systems. والنصائح في المقال نفسه هي ما رأيته في التجربة:
- ابحث عن أبسط حل ممكن، ولا تزد التعقيد إلا عند الحاجة، وقد يعني ذلك ألا تبني نظاماً وكيلاً أصلاً، فكثير من التطبيقات يكفيها استدعاء واحد للنموذج مع الاسترجاع والأمثلة في السياق.
- سير العمل يعطيك قابلية التوقع والثبات في المهام المحددة جيداً، والوكيل أنسب عندما تحتاج المرونة وقرارات النموذج، أي في المشكلات المفتوحة التي يصعب أو يستحيل فيها أن تعرف عدد الخطوات مسبقاً.
- استقلالية الوكيل تعني كلفة أعلى واحتمال أن تتراكم الأخطاء Compounding Errors، لذلك ينصح المقال باختبار واسع في بيئة معزولة Sandbox مع حواجز Guardrails مناسبة، وبشروط توقف مثل أقصى عدد من الخطوات.
ويصف المقال أنماطاً جاهزة لسير العمل قبل الوصول إلى الوكيل، منها تسلسل الاستدعاءات Prompt Chaining حيث يعالج كل استدعاء مخرج الذي قبله، والتوجيه Routing حيث يصنف المدخل ثم يرسل إلى مسار مخصص له. ومساعدنا في الحقيقة توجيه بسيط: سؤال فيه رقم تذكرة يذهب إلى أداة التذاكر، وسؤال عن سياسة يذهب إلى RAG، وطلب فتح تذكرة يذهب إلى سير العمل الثابت، ولا يحتاج وكيلاً إلا إذا أضفنا لاحقاً مهاماً مفتوحة مثل «اعرف سبب المشكلة وأصلحها». لذلك ابدأ بسير العمل دائماً، والسبب أنك تستطيع أن تختبره كما تختبر أي كود، فإذا وجدت حالات حقيقية لا يغطيها، فهنا تنقل تلك الحالات فقط إلى وكيل محدود.
كيف تجتمع الطرق في نظام واحد Combinations
الطرق ليست بدائل يختار منها واحداً، وإنما طبقات تجتمع في نفس النظام، والصورة التالية تبين مساعدنا كاملاً كما يمكن أن يبنى في مؤسسة:
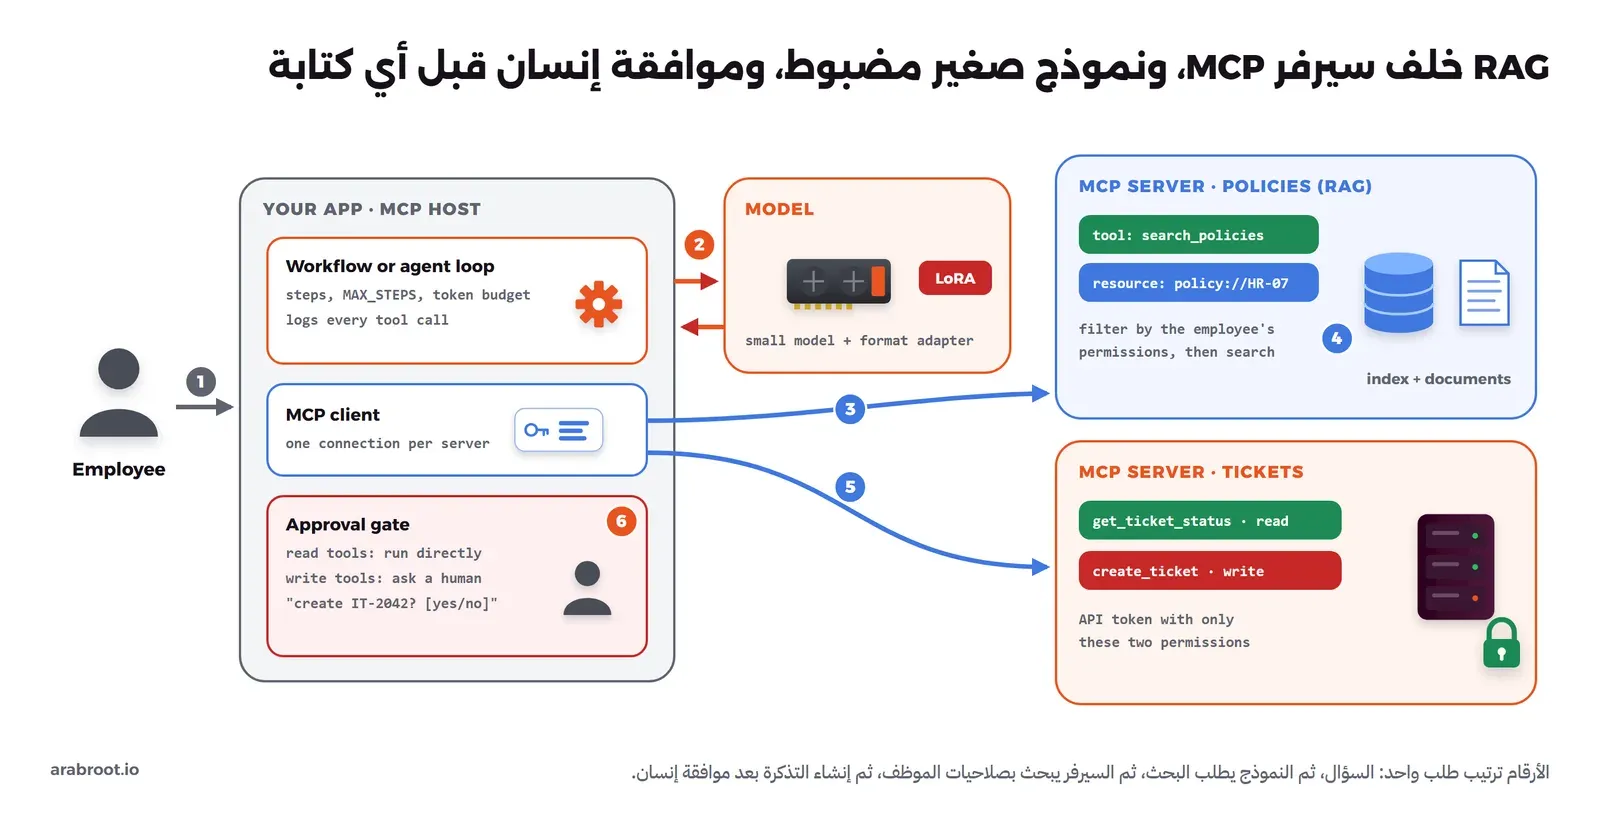
وفي الصورة أعلاه ثلاثة أنماط شائعة للجمع:
- RAG كأداة أو مورد في MCP: سيرفر السياسات يقدم البحث كأداة search_policies يطلبها النموذج عند الحاجة، ويقدم نص السياسة الكاملة كمورد يضعه التطبيق في السياق، والمهم أن السيرفر يطبق صلاحيات الموظف قبل البحث، كما شرحنا في الصلاحيات تطبق في البحث وليس في التعليمات.
- وكيل أو سير عمل يستخدم RAG وأدوات MCP معاً: مثل طلب «هل يحق لي العمل عن بعد غداً؟ وإذا كان يحق لي فافتح الطلب»، فهو يقرأ السياسة بالبحث ثم يكتب في نظام الطلبات بأداة، وهنا تمر أداة الكتابة على بوابة الموافقة.
- نموذج صغير مضبوط مع RAG: الضبط الدقيق يثبت الشكل والأسلوب، وRAG يعطي المعلومة الحالية، ويذكر توثيق Microsoft نفسه أن الجمع بين الضبط الدقيق والاسترجاع قد يحسن قدرة النموذج على استخدام المقاطع المسترجعة وتجاهل غير المفيد منها.
المخاطر لكل طريقة Risks
جمعت OWASP أغلب مخاطر تطبيقات نماذج اللغة في OWASP Top 10 for LLM Applications 2025، والمهم هنا أن كل طريقة في السلم تفتح باباً مختلفاً، لذلك فالحماية تختلف بحسب الطريقة التي اخترتها، وإذا كنت تبني النظام من البداية فابدأ بقائمة التهديدات كما في نمذجة التهديدات Threat Modeling.
مخاطر RAG: الصلاحيات Permissions والبيانات القديمة وحقن التعليمات
- الصلاحيات: تضع OWASP في LLM08:2025 Vector and Embedding Weaknesses خطر أن يسترجع النظام مقاطع من مستندات لا يحق للسائل قراءتها، وتنصح بقاعدة متجهات تراعي الصلاحيات وبفصل بيانات كل مجموعة من المستخدمين، لذلك طبق الصلاحية في استعلام البحث نفسه وليس في جملة داخل التعليمات.
- البيانات القديمة Stale Data: إذا تغيرت السياسة ولم تعد فهرستها فسوف يجيب المساعد من النسخة القديمة بنفس الثقة ومع ذكر المصدر، وهذا أسوأ من عدم الإجابة، لذلك اربط الفهرسة بنظام إدارة المستندات، واحفظ تاريخ كل مقطع وأظهره في المصدر.
- حقن التعليمات غير المباشر Indirect Prompt Injection: أي مستند يكتب فيه الموظفون قد يحمل تعليمات للنموذج، وتقول OWASP في LLM01:2025 Prompt Injection إن RAG والضبط الدقيق لا يمنعان هذه الثغرة بشكل كامل، وقد رأيت مثالاً حياً في قسم حقن التعليمات في مقال RAG.
مخاطر الأدوات وMCP: الصلاحيات الزائدة Excessive Agency
تعرف OWASP في LLM06:2025 Excessive Agency هذا الخطر بأنه الثغرة التي تسمح بأفعال ضارة استجابة لمخرج غير متوقع أو غامض أو متلاعب به من النموذج، أياً كان سبب خطئه، هلوسة Hallucination أو حقن تعليمات Prompt Injection، وتقول إن جذره واحد أو أكثر من ثلاثة: وظائف زائدة Excessive Functionality، وصلاحيات زائدة Excessive Permissions، واستقلالية زائدة Excessive Autonomy. وتطبيقها على مساعدنا كما يلي:
- أقل عدد من الأدوات: المساعد يحتاج قراءة حالة التذكرة وفتح تذكرة، فلا تعطه إضافة لنظام التذاكر فيها حذف وإغلاق وتعديل لمجرد أنها جاهزة.
- تجنب الأدوات المفتوحة Open-ended Extensions: أداة «نفذ أمر Shell» أو «اطلب أي URL» تحول أي خطأ إلى أي فعل، والبديل أداة محددة تفعل شيئاً واحداً.
- أقل الصلاحيات وفي سياق المستخدم: مفتاح API بصلاحيتي القراءة والإنشاء فقط، والأفضل أن ينفذ الطلب بهوية الموظف نفسه وليس بحساب خدمة يرى كل التذاكر.
- موافقة إنسان Human-in-the-loop للأفعال المؤثرة، والتحقق من الصلاحية في النظام نفسه وليس بسؤال النموذج «هل هذا مسموح؟»، وهو ما تسميه OWASP الوساطة الكاملة Complete Mediation.
- سجل لكل استدعاء أداة وحد لعدد الأفعال في الدقيقة، وهذان لا يمنعان الخطأ ولكنهما يحدان من ضرره ويكشفانه، وقد شرحنا ما يسجل في سجل التدقيق Audit Trail.
مخاطر الوكلاء: الحلقات Loops والكلفة والأفعال التي لا يمكن التراجع عنها
- الحلقات: الوكيل قد يطلب نفس الأداة مرة بعد مرة لأنه لا يفهم نتيجتها، لذلك ضع أقصى عدد للخطوات كما فعلنا بالمتغير MAX_STEPS، وأوقف الحلقة إذا تكرر نفس الاستدعاء بنفس المعاملات.
- الكلفة المفتوحة: كل خطوة استدعاء جديد يرسل المحادثة كلها مع نتائج الأدوات، وتصنف OWASP في LLM10:2025 Unbounded Consumption خطر استنزاف الميزانية Denial of Wallet في الخدمات التي تحاسب بالاستخدام، لذلك ضع ميزانية توكنز لكل طلب ولكل مستخدم، وقد ذكرنا أرقام Anthropic عن استهلاك الوكلاء في قسم الربط والتنفيذ في مقال المصطلحات.
- الأفعال التي لا يمكن التراجع عنها Irreversible Actions: إرسال بريد، وحذف سجل، وتحويل مبلغ، وكلها تحتاج موافقة إنسان قبل التنفيذ وليس بعده، وتنصح مواصفة MCP بأن يكون هناك دائماً إنسان يستطيع رفض استدعاء الأداة.
- الأخطاء المتراكمة: رأيت في التجربة رسالة إبلاغ خرجت دون رقم التذكرة، ولو كانت الخطوة التالية تعتمد على تلك الرسالة لانتقل الخطأ إليها، لذلك اختبر الوكيل على مهام بنتائج معروفة كما تختبر أي كود، كما في أتمتة الاختبارات بالذكاء الاصطناعي.
مخاطر الضبط الدقيق: تسرب بيانات التدريب والنسيان Catastrophic Forgetting
- تسرب بيانات التدريب Training Data Leakage: بينت ورقة Extracting Training Data from Large Language Models عام 2020 أن المهاجم يستطيع استخراج نصوص حرفية من بيانات تدريب GPT-2 بسؤال النموذج فقط، منها أسماء وأرقام هواتف وعناوين بريد، حتى لو ظهر النص في مستند واحد فقط، وأن النماذج الأكبر أكثر عرضة لذلك. لذلك لا تضع في بيانات الضبط الدقيق ما لا تريد أن يقرأه كل من يستخدم النموذج، والسبب أن النموذج المضبوط لا يعرف الصلاحيات.
- النسيان الكارثي Catastrophic Forgetting: وجدت ورقة Luo وزملائه عام 2023 أن النماذج من 1 إلى 7 مليارات معامل تنسى جزءاً من معرفتها وقدرتها على الاستدلال والفهم أثناء الضبط المتتابع على تعليمات جديدة، لذلك قس النموذج بعد الضبط على أسئلة عامة وليس على مهمتك فقط.
- تسميم البيانات Data Poisoning: تضع OWASP في LLM04:2025 Data and Model Poisoning خطر التلاعب ببيانات التدريب أو الضبط الدقيق لزرع ثغرة أو انحياز، لذلك اعرف مصدر كل مثال في بيانات التدريب وراجعها قبل التدريب.
جدول المقارنة Comparison Table
والجدول التالي يجمع ما سبق، والأزمنة فيه تقديرية لفريق صغير يبني أول نسخة:
| الطريقة | تحل | لا تحل | الكلفة | البيانات المطلوبة | زمن البناء | أهم المخاطر |
|---|---|---|---|---|---|---|
| التعليمات Prompt وFew-shot | الدور والشكل البسيط والمهمة الواضحة | المعلومات الجديدة والبيانات الحية | الأقل | أمثلة قليلة | دقائق إلى ساعات | كشف تعليمات النظام |
| المخرج المنظم Structured Output | شكل ثابت يقرؤه الكود | صحة القيم | منخفضة | مخطط JSON Schema | ساعات | قيمة صحيحة الشكل خاطئة المعنى |
| RAG | المعرفة من مستنداتك مع المصدر | الأسلوب والبيانات الحية والأفعال | متوسطة، وتوكنز أكثر لكل سؤال | المستندات وفهرس بحث | أيام إلى أسابيع | الصلاحيات والبيانات القديمة والحقن |
| الأدوات Tools وMCP | البيانات الحية والأفعال | المعرفة في المستندات | متوسطة | API وحساب بأقل الصلاحيات | أيام | الصلاحيات الزائدة LLM06 |
| سير العمل Workflow | مهام متعددة الخطوات معروفة مسبقاً | الحالات التي لم يكتب لها مسار | منخفضة إلى متوسطة | الخطوات نفسها | أيام | أقلها بين طرق التحكم |
| الوكيل Agent | مهام مفتوحة خطواتها غير معروفة | القابلية للتوقع والاختبار السهل | عالية ومتغيرة | أدوات جيدة ومهام اختبار | أسابيع | الحلقات والكلفة والأفعال النهائية |
| الضبط الدقيق Fine-tuning وLoRA | الأسلوب والشكل والمهمة الضيقة | الحقائق المتغيرة والمصادر والصلاحيات | عالية مع التدريب والاستضافة | مئات إلى آلاف الأمثلة | أسابيع | تسرب بيانات التدريب والنسيان |
| التدريب المسبق Pre-training | نموذج جديد كلياً | أي حاجة في مثالنا | هائلة | ترليونات التوكنز | أشهر | لا ينطبق على أغلب المؤسسات |
كيف تختار؟ خريطة القرار Decision Chart
الصورة التالية تحول الجدول إلى أربعة أسئلة تسألها بالترتيب، وكل سؤال تجيب عنه بنعم يضيف طريقة إلى نظامك، ولا يلغي التي قبلها:
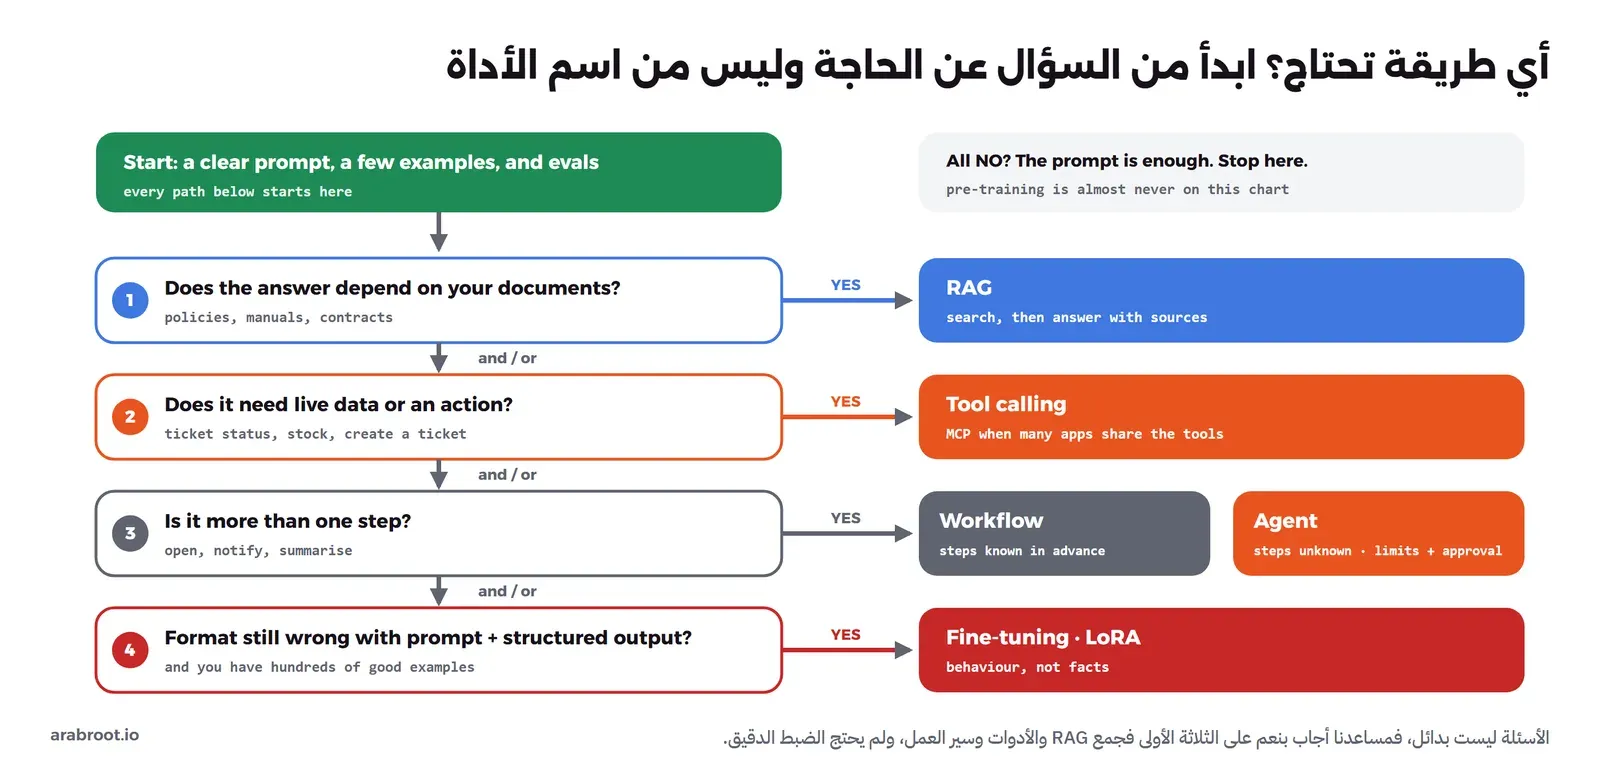
ولنطبقها على مساعدنا: الإجابة عن السياسات تعتمد على المستندات فأخذنا RAG، وحالة التذكرة بيانات حية وفتحها فعل فأخذنا الأدوات، ومهمة «افتح وأبلغ ولخص» خطواتها معروفة فأخذنا سير العمل، وأسلوب الشركة ثبته المخرج المنظم مع قالب في الكود فلم نصل إلى الضبط الدقيق، وأما MCP فنضيفه عندما تريد تطبيقات أخرى في الشركة استخدام نفس أدوات التذاكر والسياسات.
أخطاء شائعة Common Mistakes
- الضبط الدقيق لإضافة معلومات: «سوف ندرب النموذج على السياسات» يعطيك نموذجاً يكتب بأسلوب السياسات ويخلط أحكامها، ولا يذكر مصدره، ويحتاج تدريباً جديداً مع كل تعديل، والطريقة الصحيحة للمعلومات هي RAG، ولا تقم بالضبط الدقيق إلا للأسلوب والشكل والمهمة الضيقة.
- وكيل لمهمة خطواتها معروفة: إذا استطعت أن تكتب الخطوات في قائمة على ورقة فاكتبها في الكود كسير عمل، والسبب أن الوكيل يضيف كلفة وأخطاء متراكمة دون فائدة، كما رأيت في رسالة الإبلاغ التي خرجت دون رقم التذكرة.
- أدوات بصلاحية الكتابة افتراضياً: لا تعط المساعد أي أداة كتابة أو حذف إلا إذا احتاجها فعلاً، وكل أداة كتابة تمر على موافقة إنسان، والسبب أن أي حقن تعليمات أو هلوسة يصبح فعلاً حقيقياً بصلاحيات برنامجك.
- اعتبار MCP طبقة حماية أو قدرة جديدة: MCP يوحد الربط فقط، والصلاحيات والموافقات تبقى مسؤولية التطبيق والسيرفر.
- ترك قرارات يستطيع الكود أن يتخذها للنموذج: كشف رقم التذكرة، واختيار الفريق من قائمة، وترجمة الحالات الثابتة، كلها قرارات يتخذها الكود بدقة كاملة ودون كلفة.
- الحكم من ثلاث تجارب: رأيت أن نفس النموذج يعتذر مرة ويخترع مرة بحسب صياغة السؤال، لذلك قس كل تغيير على مجموعة أسئلة ثابتة من عملك قبل أن تقرر.
- القفز إلى درجة أعلى قبل قياس الدرجة الحالية: كل درجة في السلم أغلى من التي قبلها، فإذا لم تقس أن التعليمات والمخرج المنظم لا يكفيان فأنت لا تعرف أنك تحتاج الضبط الدقيق.
قائمة التحقق Checklist
- قسمت المشروع إلى حاجات منفصلة: معرفة، وأسلوب وشكل، وبيانات حية، وأفعال متعددة الخطوات.
- لديك مجموعة أسئلة تقييم Evals من عملك الحقيقي بإجابات معروفة، وتشغلها بعد كل تغيير.
- جربت التعليمات والأمثلة والمخرج المنظم قبل أي ضبط دقيق، وقست النتيجة.
- كل معلومة تتغير تأتي من RAG مع مصدرها وتاريخها، والصلاحيات مطبقة في البحث.
- البيانات الحية تأتي من أدوات قراءة بأقل الصلاحيات، وكل أداة كتابة تمر على موافقة إنسان.
- كل قرار يستطيع الكود أن يتخذه مكتوب في الكود، والنموذج يقوم بالجزء اللغوي فقط.
- المهام متعددة الخطوات سير عمل، والوكيل محصور في المهام المفتوحة مع حد للخطوات وميزانية توكنز.
- كل استدعاء أداة مسجل مع المستخدم والمعاملات والنتيجة.
- إذا قررت الضبط الدقيق فلديك مئات الأمثلة المراجعة، وليس فيها بيانات سرية، وتقيس النموذج بعده على أسئلة عامة أيضاً.
- MCP تضيفه عندما تتشارك أكثر من تطبيق نفس الأدوات، وليس لأنه اسم شائع.
تدريب عملي
- أضف إلى policy.py سؤالاً لا توجد إجابته في المقطعين، مثل عدد أيام الإجازة المرضية، وتأكد أن النموذج يقول «لا أعرف»، فإذا لم يقلها فعدل التعليمات حتى يقولها في كل مرة.
- عدل agent.py حتى يرفض تنفيذ notify_team إذا لم تحتو الرسالة على رقم تذكرة بالصيغة IT-رقم، ثم شغله مرة أخرى ولاحظ ماذا يفعل النموذج عندما ترجع له الأداة خطأ.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ابدأ من الحاجة وليس من اسم الأداة: المعرفة مكانها RAG، والأسلوب والشكل مكانهما التعليمات والمخرج المنظم ثم الضبط الدقيق إذا لم يكفيا، والبيانات الحية والأفعال مكانها الأدوات، والمهام متعددة الخطوات مكانها سير العمل.
- اصعد سلم الطرق درجة درجة، ولا تنتقل إلى درجة أغلى إلا إذا قست أن الحالية لا تكفي، والتدريب المسبق ليس خياراً لأغلب المؤسسات.
- RAG يغير ما يقرؤه النموذج، والضبط الدقيق يغير طريقة كتابته، والأدلة من ورقة Ovadia وتوثيق Microsoft وOpenAI تقول إن الحقائق المتغيرة لا تثبت جيداً في الأوزان.
- MCP بروتوكول يوحد تقديم الأدوات والموارد بين التطبيقات، وليس قدرة جديدة في النموذج ولا طبقة حماية.
- سير العمل يقرر فيه الكود، والوكيل يقرر فيه النموذج، فابدأ بسير العمل، ولا تنقل إلى الوكيل إلا المهام المفتوحة مع حدود وموافقة إنسان.
- لكل طريقة مخاطرها: الصلاحيات والبيانات القديمة والحقن في RAG، والصلاحيات الزائدة في الأدوات، والحلقات والكلفة والأفعال النهائية في الوكلاء، وتسرب بيانات التدريب والنسيان في الضبط الدقيق.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي على سيرفرك بإذن الله سوف نكمل بناء هذه الطبقات عملياً، وإذا لم تقرأ بعد مقال لماذا تفوقت نماذج اللغة على التعلم الآلي التقليدي فهو يكمل هذا المقال من جهة أخرى، فليس كل مشكلة تحتاج نموذج لغة أصلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجربة على Docker Engine 29.8.0 (معالج فقط) مع Ollama 0.35.1 والنموذج qwen2.5:1.5b، وPython 3.13 دون مكتبات إضافية.


