

في دليل Meilisearch بنينا مربع بحث فورياً على سيرفر واحد، ورأينا أن النسخ بين عدة سيرفرات في نسخته المجانية غير موجود، فإذا سقط السيرفر توقف البحث. أما Typesense فهو من نفس العائلة، محرك بحث للتطبيقات يتحمل الأخطاء الإملائية ويرجع النتائج أثناء الكتابة، لكن العنقود Cluster فيه جزء من النسخة المفتوحة: ثلاثة سيرفرات تتفق فيما بينها بخوارزمية Raft، ويسقط أحدها فيكمل الآخران. وسوف نشغل ذلك فعلاً ونوقف السيرفرات واحداً بعد الآخر.
وسوف نناقش في هذا المقال ما يلي:
- متى يناسبك Typesense، ورخصته GPL-3.0 وما تعنيه لك.
- عنقود من ثلاث عقد Nodes في Docker Compose.
- المخطط Schema وأنواع الحقول، والاستيراد Import وأخطاؤه.
- تحمل الأخطاء الإملائية Typo Tolerance، والفلاتر والأوجه Facets والترتيب.
- العربية: الإعداد
localeوالجذعstem، وقياسهما على خمسين سؤالاً. - المفاتيح المحدودة Scoped API Keys لكل مستخدم.
- التوفر العالي مع Raft: نوقف عقدة ثم عقدتين، ونرى ما يحدث.
ما هو Typesense ومتى يناسبك؟
Typesense محرك بحث مكتوب بلغة C++، يحفظ الفهرس كله في الذاكرة RAM ويكتب نسخته على القرص، ويستقبل المستندات بصيغة JSON عبر HTTP. ويختلف عن Meilisearch في أنه يطلب منك مخططاً Schema للحقول وأنواعها من البداية، أو يستنتجه إذا طلبت ذلك، ويختلف عن OpenSearch في أن إعداداته الافتراضية مصممة لمربع بحث يكتب فيه إنسان وليس لتحليل السجلات.
يناسبك عندما تريد بحثاً فورياً في تطبيق أو متجر، والبيانات تتسع في ذاكرة سيرفر واحد (كل عقدة تحمل نسخة كاملة)، وتحتاج أن يستمر البحث إذا سقط سيرفر، دون رخصة تجارية.
لا يناسبك عندما تكون البيانات أكبر من ذاكرة السيرفر، فالعنقود ينسخ البيانات كاملة إلى كل عقدة ولا يقسمها، ولا للسجلات والتجميعات الكبيرة، ولا عندما تريد محللاً عربياً تتحكم في كل مرحلة منه كما في OpenSearch.
الرخصة: GPL-3.0
بحسب ملف الرخصة عند الإصدار 30.2 فإن Typesense تحت رخصة GPL-3.0، وكل الميزات في الكود المفتوح نفسه، ومنها العنقود والمفاتيح المحدودة والبحث الدلالي، ولا توجد نسخة Enterprise مغلقة، والشركة تبيع الاستضافة Typesense Cloud. والرخصة GPL تلزمك بنشر الكود إذا وزعت Typesense نفسه معدلاً، أما تشغيله سيرفراً يتصل به تطبيقك عبر HTTP فلا يلزمك بشيء في كود تطبيقك، وقد شرحنا الفرق بين الرخص في مقال البرمجيات مفتوحة المصدر وتراخيصها.
والإصدار المستقر عند كتابة المقال (أكتوبر 2026) هو 30.2 الصادر في أبريل 2026، والإصدار 31.0 ما زال في مرحلة الإصدارات التجريبية Release Candidates، لذلك استخدمنا 30.2، ولا تستخدم وسم latest أو إصداراً تجريبياً في الإنتاج.
التجربة: عنقود من ثلاث عقد
نستخدم نفس بيانات تجربة Meilisearch: 366 مقالاً من الموقع بعناوينها ومقتطفاتها ومساراتها وتواريخها، وخمسين سؤالاً حددنا إجاباتها بأنفسنا. وكل عقدة في Typesense تحتاج أن تعرف عناوين العقد الأخرى، وهذه تكتب في ملف واحد بصيغة peering_address:peering_port:api_port كما يشرح دليل التوفر العالي، لذلك أعطينا كل عقدة عنواناً ثابتاً. احفظ الملف التالي باسم nodes:
10.213.89.11:8107:8108,10.213.89.12:8107:8108,10.213.89.13:8107:8108والملف compose.yaml:
# Typesense lab: a three-node Raft cluster on a private network with fixed addresses, and a Python client.
# Each node answers the API on 8108 and talks to the others on 8107 (Raft, unencrypted: keep it private).
name: lab-srch2-ts

x-node: &node
  image: typesense/typesense:30.2
  environment:
    TYPESENSE_API_KEY: ${TYPESENSE_API_KEY}
    TYPESENSE_DATA_DIR: /data
    TYPESENSE_NODES: /etc/typesense/nodes
    TYPESENSE_PEERING_PORT: "8107"
    TYPESENSE_API_PORT: "8108"
  volumes:
    - ./nodes:/etc/typesense/nodes:ro
  mem_limit: 1g

services:
  ts1:
    <<: *node
    container_name: lab-srch2-ts1
    command: ["--peering-address", "10.213.89.11"]
    volumes: [./nodes:/etc/typesense/nodes:ro, ts1:/data]
    networks: { default: { ipv4_address: 10.213.89.11 } }
    ports: ["127.0.0.1:18108:8108"]
  ts2:
    <<: *node
    container_name: lab-srch2-ts2
    command: ["--peering-address", "10.213.89.12"]
    volumes: [./nodes:/etc/typesense/nodes:ro, ts2:/data]
    networks: { default: { ipv4_address: 10.213.89.12 } }
  ts3:
    <<: *node
    container_name: lab-srch2-ts3
    command: ["--peering-address", "10.213.89.13"]
    volumes: [./nodes:/etc/typesense/nodes:ro, ts3:/data]
    networks: { default: { ipv4_address: 10.213.89.13 } }

  py:
    image: python:3.13.16-slim
    container_name: lab-srch2-tspy
    working_dir: /lab
    environment:
      TYPESENSE_API_KEY: ${TYPESENSE_API_KEY}
    volumes: ["./:/lab"]
    command: ["sleep", "infinity"]

networks:
  default:
    ipam:
      config:
        - subnet: 10.213.89.0/24

volumes:
  ts1: { name: lab-srch2-ts1-data }
  ts2: { name: lab-srch2-ts2-data }
  ts3: { name: lab-srch2-ts3-data }
في الإعداد أعلاه لاحظ التالي:
- كل العقد لها نفس مفتاح البدء
TYPESENSE_API_KEY، وهذا شرط في التوثيق. - المنفذ 8107 لاتصال العقد ببعضها بخوارزمية Raft، وهو غير مشفر، لذلك يبقى على شبكة خاصة ولا يخرج للإنترنت، والمنفذ 8108 للتطبيقات.
- عقدة واحدة فقط منشورة على
127.0.0.1للتجربة من الجهاز، والكلاينت داخل الشبكة يصل إلى الثلاث.
printf 'TYPESENSE_API_KEY=%s\n' "$(openssl rand -base64 32 | tr -d '/+=')" > .env
docker compose up -d
والملف lab.py فيه الدوال المشتركة، ومنها دالة توحيد للنص العربي سوف نستخدمها لاحقاً:
# Small helpers for the Typesense lab, standard library only.
import json, os, urllib.error, urllib.parse, urllib.request

KEY = os.environ["TYPESENSE_API_KEY"]
NODES = ["http://lab-srch2-ts1:8108", "http://lab-srch2-ts2:8108", "http://lab-srch2-ts3:8108"]


def call(method, path, body=None, key=KEY, node=0, params=None, raw=None, timeout=30):
    url = NODES[node] + path + ("?" + urllib.parse.urlencode(params) if params else "")
    data = raw.encode() if raw is not None else (json.dumps(body, ensure_ascii=False).encode() if body is not None else None)
    req = urllib.request.Request(url, data=data, method=method,
                                 headers={"Content-Type": "application/json", "X-TYPESENSE-API-KEY": key})
    try:
        with urllib.request.urlopen(req, timeout=timeout) as r:
            text = r.read().decode()
            return r.status, (json.loads(text) if raw is None or path.endswith("/search") else text)
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")
    except (urllib.error.URLError, TimeoutError) as e:
        return 0, {"message": str(getattr(e, "reason", e))}


def search(coll, q, key=KEY, node=0, **params):
    return call("GET", f"/collections/{coll}/documents/search", key=key, node=node,
                params={"q": q, "query_by": "title,excerpt", **params})


def load_docs():
    return [json.loads(l) for l in open("data/articles.jsonl", encoding="utf-8") if l.strip()]


def load_queries():
    return json.load(open("data/queries.json", encoding="utf-8"))


HARAKAT = {chr(c) for c in range(0x064B, 0x0653)} | {"ٰ", "ـ"}   # diacritics, dagger alef, tatweel
FOLD = str.maketrans("أإآٱىة", "اااايه")


def normalize(text):
    """The same folding on documents and queries: no diacritics, one alef, ya for alef maqsura, ha for ta marbuta."""
    return "".join(ch for ch in text if ch not in HARAKAT).translate(FOLD)
ونتأكد أن العنقود تكون، فالطريق /debug يعطي حالة كل عقدة، والقيمة 1 تعني القائد Leader و4 تعني تابعاً Follower:
docker exec -w /lab lab-srch2-tspy python -c "
from lab import call
for n in range(3): print(n, call('GET','/debug',node=n), call('GET','/health',node=n))"
0 (200, {'state': 1, 'version': '30.2'}) (200, {'ok': True})
1 (200, {'state': 4, 'version': '30.2'}) (200, {'ok': True})
2 (200, {'state': 4, 'version': '30.2'}) (200, {'ok': True})المخطط Schema والاستيراد
سوف ننشئ أربع مجموعات Collections من نفس المستندات، والفرق بينها فقط في طريقة تحليل حقلي العنوان والمقتطف، حتى نقيس أثر كل إعداد على العربية: plain بالإعداد الافتراضي، وar مع "locale": "ar"، وar_stem مع اللغة والجذع "stem": true، وnorm مثل السابقة لكننا نوحد النص في الكود قبل إرساله. احفظ الملف التالي باسم setup.py:
# Four collections from the same 366 articles, different only in how the text fields are analysed:
#   plain    : default tokenizer
#   ar       : "locale": "ar"
#   ar_stem  : "locale": "ar" and "stem": true (Snowball Arabic stemmer)
#   norm     : like ar_stem, but title and excerpt are normalized by our code before import (lab.normalize)
import json, time
from lab import call, load_docs, normalize

docs = load_docs()
plain_jsonl = "\n".join(json.dumps(d, ensure_ascii=False) for d in docs)
norm_jsonl = "\n".join(json.dumps({**d, "title": normalize(d["title"]), "excerpt": normalize(d["excerpt"])},
                                  ensure_ascii=False) for d in docs)

def text(name, extra):
    return {"name": name, "type": "string", **extra}

STEM = {"locale": "ar", "stem": True}
for coll, extra in [("plain", {}), ("ar", {"locale": "ar"}), ("ar_stem", STEM), ("norm", STEM)]:
    call("DELETE", f"/collections/{coll}")
    status, r = call("POST", "/collections", {
        "name": coll,
        "fields": [
            text("title", extra), text("excerpt", extra),
            {"name": "track", "type": "string", "facet": True},
            {"name": "stage", "type": "string", "facet": True},
            {"name": "published", "type": "int64", "sort": True},
        ],
        "default_sorting_field": "published",
    })
    assert status == 201, r
    t0 = time.time()
    jsonl = norm_jsonl if coll == "norm" else plain_jsonl
    status, out = call("POST", f"/collections/{coll}/documents/import", params={"action": "upsert"}, raw=jsonl, timeout=300)
    ok = sum(1 for l in out.splitlines() if json.loads(l).get("success"))
    print(f"{coll:<8} HTTP {status}  imported {ok}/{len(docs)} in {time.time() - t0:.2f}s")
plain HTTP 200 imported 366/366 in 0.06s
ar HTTP 200 imported 366/366 in 0.05s
ar_stem HTTP 200 imported 366/366 in 0.12s
norm HTTP 200 imported 366/366 in 0.12sفي الإعداد أعلاه لاحظ التالي:
"facet": trueشرط للأوجه وللفلترة السريعة على الحقل، و"sort": trueشرط للترتيب بالحقل.default_sorting_fieldيرتب النتائج المتساوية في الصلة، واخترنا تاريخ النشر حتى يأتي الأحدث أولاً.- الاستيراد
/documents/importيستقبل سطراً لكل مستند JSONL، وينفذupsertفيضيف الجديد ويستبدل الموجود بنفس المعرفid.
ولنكسر الاستيراد: ماذا يحدث إذا أرسلنا مستندات لا توافق المخطط؟ احفظ الملف التالي باسم bad_import.py:
# Typesense checks every document against the schema and reports per line; the import call itself returns 200.
import json
from lab import call
rows = [
    {"id": "ok-1", "title": "صف سليم", "excerpt": "نص", "track": "lab", "stage": "lab", "published": 1},
    {"id": "bad-1", "title": "دون تاريخ", "excerpt": "نص", "track": "lab", "stage": "lab"},
    {"id": "bad-2", "title": "تاريخ نصي", "excerpt": "نص", "track": "lab", "stage": "lab", "published": "أمس"},
]
status, out = call("POST", "/collections/ar_stem/documents/import", params={"action": "upsert"},
                   raw="\n".join(json.dumps(r, ensure_ascii=False) for r in rows))
print("HTTP", status)
for line in out.splitlines():
    print(line)
HTTP 200
{"success":true}
{"code":400,"error":"Field `published` has been declared as a default sorting field, but is not found in the document.","success":false}
{"code":400,"error":"Field `published` must be an int64.","success":false}الطلب كله رجع برمز 200، والخطأ في سطر كل مستند، وهذا معناه أن كوداً يفحص رمز HTTP فقط سوف يعتبر أن كل شيء نجح، بينما ضاع مستندان. لذلك اقرأ نتيجة كل سطر بعد كل استيراد كما يفعل setup.py عندما يعد success.
تحمل الأخطاء والفلاتر والأوجه
بحسب توثيق البحث فإن القيم الافتراضية تسمح بخطأين في الكلمة num_typos: 2، بشرط أن يكون طولها 4 أحرف على الأقل لخطأ واحد min_len_1typo و7 أحرف لخطأين min_len_2typo. احفظ الملف التالي باسم search_demo.py:
# Typo tolerance, filters, facets and sorting on the ar_stem collection.
import json
from lab import search

for q, extra in [("Kubernets", {}), ("Wiregaurd", {}), ("Redsi", {}),
                 ("Redsi", {"num_typos": 0})]:
    _, r = search("ar_stem", q, per_page=3, include_fields="id", **extra)
    print(f"{q:<10}{json.dumps(extra):<18}found {r['found']:>2}  {[h['document']['id'] for h in r['hits']]}")

_, r = search("ar_stem", "PostgreSQL", per_page=4, include_fields="id,track", facet_by="track",
              filter_by="track:[software,apps]", sort_by="published:desc")
print("\nPostgreSQL, track in [software, apps], newest first:", r["found"],
      [h["document"]["id"] for h in r["hits"]])
print("facets:", {c["value"]: c["count"] for c in r["facet_counts"][0]["counts"]})
s, r = search("ar_stem", "PostgreSQL", sort_by="title:asc")
print("sort by a field without sort:", s, r.get("message"))
والمخرج سوف يكون كما يلي:
Kubernets {}                found  4  ['cloudnativepg', 'k8s-terms', 'k8s-need']
Wiregaurd {}                found  2  ['wireguard', 'mikrotik-scenarios']
Redsi     {}                found  3  ['redis-valkey', 'build-recommender', 'postgres-for-everything']
Redsi     {"num_typos": 0}  found  0  []

PostgreSQL, track in [software, apps], newest first: 15 ['postgres-mysql-mongodb', 'clickhouse', 'event-sourcing-cqrs', 'cloudnativepg']
facets: {'software': 13, 'apps': 2}
sort by a field without sort: 404 Could not find a field named `title` in the schema for sorting.
صيغة الفلتر في Typesense مختلفة عن Meilisearch: track:=security للتطابق التام، وtrack:[software,apps] لأي قيمة من القائمة، وpublished:>1759276800 للأرقام، وتجمع الشروط بـ &&. ولاحظ أن الترتيب بحقل لم نعلن له sort رجع خطأ 404 وليس 400، فاكتب معالجة الأخطاء في كودك على أساس الرسالة وليس الرمز وحده.
العربية: locale وstem
شرحنا في مقال البحث في النصوص العربية لماذا يحتاج النص العربي توحيد الحروف والجذع الخفيف، والسؤال هنا: ماذا يفعل Typesense من ذلك؟ يقول توثيق المجموعات إن locale يضيف تخصيصات للتقطيع في لغات محددة مثل اليابانية والصينية والتايلندية، وإن stem يستخدم جذع Snowball للغة التي يحددها locale. احفظ الملف التالي باسم arabic.py:
# The same word written in different ways: how many articles each collection finds, and the first three in norm.
from lab import search, normalize

QUERIES = [
    "التشفير", "التَّشْفِير",              # diacritics
    "الاحتياطية", "الاحتياطيه",            # ta marbuta / ha
    "الأحمال", "الاحمال",                  # hamza on alef
    "الخرائط", "خرائط",                    # with and without «ال»
    "طابور", "طوابير",                     # singular / broken plural
    "شهادة", "الشهادات",                   # singular / sound plural
    "شركة ناشئة", "كاميرا مراقبة",
]
print(f"{'query':<14}{'plain':>6}{'ar':>5}{'ar_stem':>9}{'norm':>6}   top 3 (norm)")
for q in QUERIES:
    found = {}
    for coll in ("plain", "ar", "ar_stem", "norm"):
        _, r = search(coll, normalize(q) if coll == "norm" else q, per_page=3, include_fields="id")
        found[coll] = r["found"]
        top = ", ".join(h["document"]["id"] for h in r["hits"])
    print(f"{q:<14}{found['plain']:>6}{found['ar']:>5}{found['ar_stem']:>9}{found['norm']:>6}   {top}")
والمخرج سوف يكون كما يلي:
query          plain   ar  ar_stem  norm   top 3 (norm)
التشفير            3    3        3     3   crypto-for-devs, gpg-basics, device-management
التَّشْفِير        0    0        3     3   crypto-for-devs, gpg-basics, device-management
الاحتياطية         4    4       17     4   s3-object-lock, ovh-fire, ntfy
الاحتياطيه         9    9        0     4   s3-object-lock, ovh-fire, ntfy
الأحمال            1    1        1     1   load-testing
الاحمال            1    1        1     1   load-testing
الخرائط            4    4        5     5   mapping-vehicles, build-map-app, maps-basics
خرائط              2    2        5     5   mapping-vehicles, build-map-app, maps-basics
طابور              2    2        2     2   queue-vs-streaming, queue-concepts
طوابير             1    1        1     1   rabbitmq
شهادة              2    2        7     7   certificates, dokploy, caddy
الشهادات           1    1        7     7   certificates, dokploy, caddy
شركة ناشئة         3    3        6     3   medical-ai-startup, acqui-hiring, saas-cto-blueprint
كاميرا مراقبة      1    1        2     2   frigate, camera-types
في المخرج أعلاه لاحظ التالي:
"locale": "ar"وحده لم يغير شيئاً: العمودان plain وar متطابقان في كل الأسئلة، فلا تتوقع منه توحيداً أو جذعاً.- دون الجذع لا يحذف التشكيل:
التَّشْفِيررجعت صفراً في plain وar، أما معstemفوجدت المقالات الثلاثة، لأن جذع Snowball العربي يحذف التشكيل ويفصل «ال». - الجذع يجمع المفرد والجمع السالم: «شهادة» و«الشهادات» وجدتا سبعة مقالات بدل اثنين وواحد، و«خرائط» وجدت كل مقالات الخرائط. أما جمع التكسير «طوابير» فلا يجمعه أي جذع خفيف.
- الهاء مكان التاء المربوطة كسرت الجذع: «الاحتياطيه» رجعت صفراً في ar_stem، بينما وجدت plain تسعة مقالات عبر تحمل الأخطاء، لأن الجذع حول الكلمتين إلى شكلين مختلفين.
- التوحيد في الكود أصلح الهاء وأفسد غيرها: في المجموعة norm حولنا كل تاء مربوطة إلى هاء قبل الجذع، فتطابقت «الاحتياطية» و«الاحتياطيه»، لكن «الاحتياطية» نزلت من 17 إلى 4، و«شركة ناشئة» من 6 إلى 3، لأن الجذع العربي يعرف التاء المربوطة ويحذفها، أما الهاء فلا يحذفها.
وقد يتساءل البعض: أي الطريقتين أفضل إذن؟ والإجابة لا نعرفها من جدول كلمات، وإنما من القياس على الأسئلة كلها.
القياس: خمسون سؤالاً على ست طرق
الملف metrics.py هو نفسه في تجربة Meilisearch، ويحسب recall@5 وMRR@10 وnDCG@10 وعدد الأسئلة التي لا ترجع شيئاً. واحفظ الملف التالي باسم evaluate.py، وفيه الإعداد drop_tokens_threshold، فبحسب توثيق البحث إذا لم يجد Typesense هذا العدد من النتائج بكل كلمات السؤال يبدأ بحذف الكلمات، والقيمة الافتراضية 1، أي أنه لا يحذف أي كلمة ما دامت هناك نتيجة واحدة فيها كل الكلمات:
# The 50 labelled questions (30 from the semantic search article + 20 Arabic spelling variants) on the four collections.
from lab import search, load_queries, normalize
from metrics import table

def ids(coll, q, **p):
    status, r = search(coll, q, per_page=10, include_fields="id", **p)
    assert status == 200, r
    return [h["document"]["id"] for h in r["hits"]]

CONFIGS = {
    "A plain":                  lambda q: ids("plain", q),
    "B locale ar":              lambda q: ids("ar", q),
    "C ar + stem":              lambda q: ids("ar_stem", q),
    "D C + our normalize":      lambda q: ids("norm", normalize(q)),
    "E D + drop_tokens 10":     lambda q: ids("norm", normalize(q), drop_tokens_threshold=10),
    "F C + drop_tokens 10":     lambda q: ids("ar_stem", q, drop_tokens_threshold=10),
}
queries = load_queries()
table({c: {q["q"]: f(q["q"]) for q in queries} for c, f in CONFIGS.items()}, queries)
والمخرج سوف يكون كما يلي:
config                      set        recall@5  MRR@10  nDCG@10  zero
A plain                     semantic      0.386   0.457    0.390     2
A plain                     arabic        0.600   0.825    0.648     2
B locale ar                 semantic      0.386   0.457    0.390     2
B locale ar                 arabic        0.600   0.825    0.648     2
C ar + stem                 semantic      0.364   0.433    0.375     1
C ar + stem                 arabic        0.840   1.000    0.888     0
D C + our normalize         semantic      0.381   0.461    0.393     1
D C + our normalize         arabic        0.808   0.950    0.834     0
E D + drop_tokens 10        semantic      0.494   0.611    0.505     1
E D + drop_tokens 10        arabic        0.828   0.975    0.853     0
F C + drop_tokens 10        semantic      0.500   0.577    0.499     1
F C + drop_tokens 10        arabic        0.865   1.000    0.900     0
في المخرج أعلاه لاحظ التالي:
- الجذع هو أكبر قفزة: الأسئلة العربية من 0.648 إلى 0.888 بإضافة
"stem": trueفقط. - لا توحد التاء المربوطة قبل جذع Snowball: الإعداد D أقل من C، ووجدنا في سؤال «النسخه الاحتياطيه» أن C أخذ 0.97 وD أخذ صفراً، والسبب ما رأيناه في الجدول السابق.
drop_tokens_threshold: 10رفع أسئلة المستخدمين: من 0.375 إلى 0.499، لأن الأسئلة الطويلة نادراً ما تجد عشرة مستندات فيها كل الكلمات، فيحذف Typesense الكلمات الأقل فائدة ويكمل.- الأفضل هنا F: لغة عربية وجذع وحد أعلى لحذف الكلمات، دون توحيد في الكود. ولو احتجت الهاء مكان التاء المربوطة فأضفها مرادفاً Synonym أو اجعل الكود يرسل السؤال بالشكلين، ولا تغير النص المخزن.
المفاتيح المحدودة Scoped API Keys
الفكرة هي نفسها التي رأيناها في رموز المستأجرين في دليل Meilisearch: المتصفح يبحث مباشرة، والسيرفر الخلفي يعطيه مفتاحاً فيه فلتر لا يستطيع تعديله. والفرق في الصيغة، فالمفتاح المحدود في Typesense ليس JWT، وإنما بحسب توثيق المفاتيح نص Base64 فيه توقيع HMAC-SHA256 للمعاملات بمفتاح البحث الأب، ثم أول أربعة أحرف من المفتاح الأب، ثم المعاملات نفسها. احفظ الملف التالي باسم keys.py:
# A search-only key for one collection, then a scoped key made from it without calling the server:
# base64( HMAC-SHA256(parent key, params) + first 4 characters of the parent key + params ).
import base64, hashlib, hmac, json, time
from lab import call, search

def scoped(parent, params):
    p = json.dumps(params, separators=(",", ":"))
    digest = base64.b64encode(hmac.new(parent.encode(), p.encode(), hashlib.sha256).digest()).decode()
    return base64.b64encode((digest + parent[:4] + p).encode()).decode()

def facets(key, **p):
    status, r = search("ar_stem", "*", key=key, per_page=0, facet_by="track", **p)
    if status != 200:
        return status, r.get("message")
    return status, {c["value"]: c["count"] for c in r["facet_counts"][0]["counts"]}

status, k = call("POST", "/keys", {"description": "site search, ar_stem only",
                                  "actions": ["documents:search"], "collections": ["ar_stem"]})
print("new key:", status, k["id"], k["actions"], k["collections"])
print("search with it      :", facets(k["value"])[0])
print("import a document   :", call("POST", "/collections/ar_stem/documents", {"id": "x"}, key=k["value"])[0])
print("search collection ar:", search("ar", "x", key=k["value"])[0])

tok = scoped(k["value"], {"filter_by": "track:=security", "expires_at": int(time.time()) + 1200})
print("\nscoped, no filter            :", facets(tok))
print("scoped, asks for software    :", facets(tok, filter_by="track:=software"))

old = scoped(k["value"], {"filter_by": "track:=security", "expires_at": int(time.time()) - 60})
edited = base64.b64encode(base64.b64decode(tok).replace(b"security", b"software")).decode()
print("\nexpired scoped key           :", facets(old))
print("filter edited by the client  :", facets(edited))
call("DELETE", f"/keys/{k['id']}")
print("parent key deleted           :", facets(tok))
والمخرج سوف يكون كما يلي:
new key: 201 1 ['documents:search'] ['ar_stem']
search with it      : 200
import a document   : 401
search collection ar: 401

scoped, no filter            : (200, {'security': 39})
scoped, asks for software    : (200, {})

expired scoped key           : (401, 'Forbidden - a valid `x-typesense-api-key` header must be sent.')
filter edited by the client  : (401, 'Forbidden - a valid `x-typesense-api-key` header must be sent.')
parent key deleted           : (401, 'Forbidden - a valid `x-typesense-api-key` header must be sent.')
في المخرج أعلاه لاحظ التالي:
- المفتاح المحدود أنشأناه في Python دون أي طلب إلى السيرفر، فالسيرفر الخلفي يستطيع إصدار مفتاح لكل مستخدم مع كل جلسة دون أن يضيف حملاً على Typesense.
- المستخدم الذي فك ترميز Base64 وغير
securityإلىsoftwareأفسد التوقيع فرفض طلبه، وعندما أرسل فلتره الخاص دمج مع فلتر المفتاح فرجعت النتيجة فارغة. - المعاملات المضمنة تبقى مقروءة لكل من يملك المفتاح، فلا تضع فيها سراً، وإنما فلتراً ومدة صلاحية
expires_at. - حذف المفتاح الأب أبطل كل المفاتيح المشتقة منه، وهذا طريقك عند التسرب.
التوفر العالي مع Raft: نوقف العقد واحدة بعد الأخرى
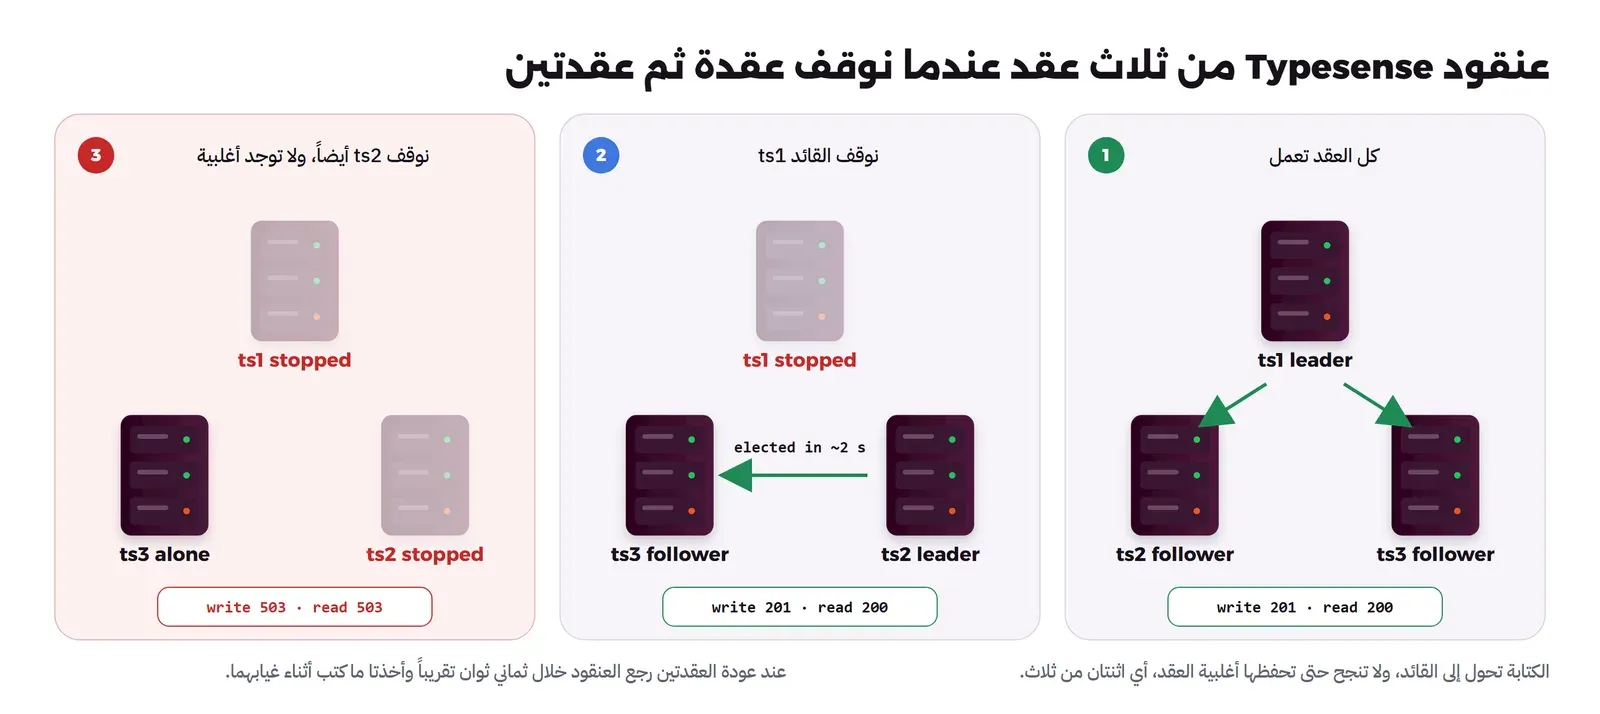
شرحنا خوارزمية Raft والأغلبية Quorum في قسم الإجماع في مقال الأنظمة الموزعة، والخلاصة أن عقدة واحدة هي القائد Leader تستقبل كل كتابة وتنسخها إلى التابعين، ولا تعتبر الكتابة ناجحة حتى تحفظها أغلبية العقد، فعنقود من ثلاث يتحمل سقوط واحدة فقط. وبحسب دليل التوفر العالي فإن القراءة تخدمها العقدة التي استقبلت الطلب، والكتابة تحول داخلياً إلى القائد. والصورة التالية تبين ما سوف نفعله:
احفظ الملف التالي باسم ha.py، وهو يطبع حالة كل عقدة، ثم يكتب مستنداً عبر كل عقدة حية، ثم يعد المستندات منها:
# Cluster check used between the docker stop/start steps:
#   python ha.py <doc-id>   shows each node's Raft state, writes one document through every live node, and counts
import sys, time
from lab import call, search

doc_id = sys.argv[1]
STATE = {1: "leader", 4: "follower"}
for n in range(3):
    s, d = call("GET", "/debug", node=n, timeout=5)
    if s != 200:
        print(f"ts{n + 1}: down ({d.get('message')})"); continue
    t0 = time.time()
    ws, w = call("POST", "/collections/ar_stem/documents", node=n, timeout=15, params={"action": "upsert"},
                 body={"id": f"{doc_id}-via-ts{n + 1}", "title": "تجربة", "excerpt": "تجربة", "track": "lab",
                       "stage": "lab", "published": 0})
    took = time.time() - t0
    rs, r = search("ar_stem", "*", node=n, per_page=0)
    total = r.get("found") if rs == 200 else r.get("message")
    print(f"ts{n + 1}: {STATE.get(d['state'], d['state'])}, write HTTP {ws} in {took:.2f}s"
          f"{'' if ws in (200, 201) else ' ' + str(w.get('message'))[:60]}, read HTTP {rs}, documents {total}")
نبدأ والعقد الثلاث تعمل:
docker exec -w /lab lab-srch2-tspy python ha.py beforets1: leader, write HTTP 201 in 0.01s, read HTTP 200, documents 367
ts2: follower, write HTTP 201 in 0.01s, read HTTP 200, documents 367
ts3: follower, write HTTP 201 in 0.01s, read HTTP 200, documents 368لاحظ أن ts2 كتبت مستنداً ثانياً ثم قرأت 367 وليس 368، والسبب أن الكتابة ذهبت إلى القائد ونجحت، لكن نسختها لم تصل إلى ts2 نفسها قبل القراءة التي جاءت بعدها بأجزاء من الثانية. فالقراءة من تابع قد تتأخر قليلاً عن آخر كتابة، وإذا كان تطبيقك يكتب ثم يعرض النتيجة مباشرة للمستخدم نفسه فلا تفترض أنها ظهرت.
الآن نوقف القائد ts1، وننتظر حتى تصبح عقدة أخرى قائداً بالسكربت wait.sh، وهو يسأل /debug كل ثانية:
#!/bin/sh
# sh wait.sh leader   waits until ts2 or ts3 reports state 1 (leader) after ts1 is stopped
# sh wait.sh healthy  waits until all three nodes answer /health with 200
START=$(date +%s)
if [ "$1" = leader ]; then
  CHECK='import sys; from lab import call; sys.exit(0 if any(call("GET", "/debug", node=n, timeout=3)[1].get("state") == 1 for n in (1, 2)) else 1)'
  WHAT="new leader"
else
  CHECK='import sys; from lab import call; sys.exit(0 if all(call("GET", "/health", node=n, timeout=3)[0] == 200 for n in range(3)) else 1)'
  WHAT="all healthy"
fi
until docker exec -w /lab lab-srch2-tspy python -c "$CHECK" 2>/dev/null; do sleep 1; done
echo "$WHAT after ~$(( $(date +%s) - START ))s"
docker stop lab-srch2-ts1
sh wait.sh leader
docker exec -w /lab lab-srch2-tspy python ha.py one-downnew leader after ~2s
ts1: down ([Errno -5] No address associated with hostname)
ts2: leader, write HTTP 201 in 0.02s, read HTTP 200, documents 370
ts3: follower, write HTTP 201 in 0.01s, read HTTP 200, documents 370انتخبت ts2 قائداً خلال ثانيتين تقريباً، وبقيت الكتابة والقراءة تعملان من العقدتين. الآن نوقف ts2 أيضاً:
docker stop lab-srch2-ts2
docker exec -w /lab lab-srch2-tspy python ha.py two-down
docker exec -w /lab lab-srch2-tspy python -c "from lab import call; print(call('GET','/health',node=2,timeout=5))"
ts1: down ([Errno -5] No address associated with hostname)
ts2: down ([Errno -5] No address associated with hostname)
ts3: follower, write HTTP 503 in 0.00s Not Ready or Lagging, read HTTP 503, documents Not Ready or Lagging
(503, {'ok': False})وهذا ما يفاجئ كثيرين: العقدة ts3 تعمل وفيها كل البيانات، ومع ذلك رفضت القراءة أيضاً وليس الكتابة فقط، والسبب أنها لا تعرف إن كانت بياناتها هي الأحدث بعد أن فقدت الأغلبية، فتفضل أن ترفض على أن ترجع نتائج قديمة. لذلك عنقود من ثلاث عقد لا يعني أن البحث يعمل ما دامت عقدة واحدة حية. والآن نعيد تشغيل العقدتين:
docker start lab-srch2-ts1 lab-srch2-ts2
sh wait.sh healthy
docker exec -w /lab lab-srch2-tspy python ha.py after
all healthy after ~8s
ts1: follower, write HTTP 201 in 0.03s, read HTTP 200, documents 371
ts2: follower, write HTTP 201 in 0.03s, read HTTP 200, documents 372
ts3: leader, write HTTP 201 in 0.03s, read HTTP 200, documents 374رجع العنقود خلال ثماني ثوان تقريباً دون أي تدخل، والعقدتان العائدتان أخذتا المستندات التي كتبت أثناء غيابهما. وفي الإنتاج ضع العقد الثلاث على سيرفرات مختلفة، ويفضل في أماكن مختلفة، واجعل الكلاينت يعرف العقد الثلاث، فمكتبات Typesense الرسمية تجرب العقدة التالية إذا لم ترد الأولى كما يشرح دليل التوفر العالي، أو ضع أمامها موزع حمل Load Balancer يفحص /health.
اللقطة Snapshot والنسخ الاحتياطي
العنقود يحميك من سقوط سيرفر، ولا يحميك من حذف مجموعة بالخطأ، فالحذف ينسخ إلى كل العقد في ثوان. لذلك تحتاج نسخاً احتياطياً منفصلاً، والطريق /operations/snapshot ينشئ لقطة من بيانات العقدة في المجلد الذي تحدده. احفظ الملف التالي باسم backup.py:
# Snapshot of one node's data directory (run it on each node you want to keep, or on one follower).
from lab import call
print(call("POST", "/operations/snapshot", node=1, params={"snapshot_path": "/data/snapshots/2026-10-12"}))
docker exec -w /lab lab-srch2-tspy python backup.py
docker exec lab-srch2-ts2 sh -c 'ls -la /data/snapshots/2026-10-12; du -sh /data/snapshots/2026-10-12 /data/db'(201, {'success': True})
total 12
drwxr-xr-x 3 root root 4096 Oct 12 20:20 .
drwxr-xr-x 3 root root 4096 Oct 12 20:20 ..
drwxr-xr-x 4 root root 4096 Oct 12 20:20 state
664K /data/snapshots/2026-10-12
4.7M /data/dbاللقطة على قرص العقدة نفسها، فانسخها إلى مكان آخر مباشرة كما تقول قاعدة 3-2-1. ولم نجرب الاسترجاع من اللقطة في هذه التجربة، وخطواته في توثيق عمليات العنقود، فجربها على عقدة منفصلة قبل أن تعتمد عليها، أو احتفظ أيضاً بمصدر البيانات الأصلي (قاعدة بيانات تطبيقك) وسكربت يعيد الاستيراد كاملاً، فالاستيراد في تجربتنا أخذ أقل من ثانية لكل 366 مستنداً.
التشغيل اليومي
- الذاكرة: كل عقدة استخدمت قرابة 210 إلى 220 ميجابايت مع أربع مجموعات صغيرة، وTypesense يحفظ الفهرس في الذاكرة، فخطط لذاكرة كل عقدة على أساس حجم البيانات كاملة وليس ثلثها.
- الترقية: قم بترقية عقدة واحدة كل مرة، وانتظر حتى تعود
/healthإلىokقبل التالية، حتى تبقى الأغلبية دائماً. - التشفير: المنفذ 8108 يدعم TLS بالخيارين
--ssl-certificateو--ssl-certificate-keyكما يذكر دليل التوفر العالي، أو ضع أمامه Reverse Proxy، أما 8107 فيبقى على الشبكة الخاصة.
أخطاء شائعة
- عقدتان بدل ثلاث: عنقود من عقدتين لا يتحمل سقوط أي عقدة، لأن الواحدة الباقية ليست أغلبية.
- فحص رمز HTTP للاستيراد فقط: الطلب يرجع 200 حتى لو فشلت كل المستندات.
- توحيد التاء المربوطة قبل الجذع: في تجربتنا أفسد نتائج أكثر مما أصلح.
- الاعتماد على
locale: arوحده: لم يغير أي نتيجة دونstem. - وضع مفتاح البدء في الواجهة: هو مفتاح Admin كامل، فأنشئ مفتاح بحث ثم مفاتيح محدودة منه.
- اعتبار العنقود نسخة احتياطية: الحذف بالخطأ يصل إلى كل العقد.
تدريب عملي
- أضف مرادفاً يجمع «طابور» و«طوابير»، وقس الأسئلة العربية مرة أخرى بالإعداد F.
- أوقف عقدة تابعة، ثم احذف مجموعة من القائد، ثم أعد العقدة، وتأكد أن الحذف وصل إليها.
حذف المختبر
docker compose down -v
rm -f .env
docker image rm typesense/typesense:30.2
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Typesense محرك بحث للتطبيقات تحت GPL-3.0، والعنقود والمفاتيح المحدودة جزء من الكود المفتوح دون نسخة تجارية.
- عنقود من ثلاث عقد انتخب قائداً جديداً خلال ثانيتين عند سقوط القائد، وعند سقوط اثنتين رفضت العقدة الباقية القراءة والكتابة معاً.
- للعربية استخدم
"stem": trueمع"locale": "ar"، فالجذع رفع جودة الترتيب في أسئلتنا العربية من 0.65 إلى 0.89، ولا توحد التاء المربوطة إلى هاء قبله. - ارفع
drop_tokens_thresholdإذا كان المستخدمون يكتبون أسئلة طويلة. - أعط المتصفح مفتاحاً محدوداً بفلتر ومدة، واقرأ نتيجة كل سطر في الاستيراد، وخذ لقطات منفصلة عن العنقود.
 دليلMeilisearch: مربع بحث فوري داخل تطبيقككيف تشغل Meilisearch على سيرفرك بمفاتيح محدودة لكل مستخدم ونسخ احتياطي تسترجعه، وتضبطه حتى يفهم النص العربي.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلأي محرك بحث يناسب تطبيقك ونصوصك العربية؟قارنا أربعة محركات بحث على الأسئلة العربية نفسها في جودة النتائج والذاكرة والسرعة والرخصة، لتعرف أيها يناسب حالتك.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على عنقود Typesense 30.2 من ثلاث عقد وPython 3.13.16 في Docker.


