

عندما تحتاج بحثاً داخل تطبيقك تجد أمامك أسماء كثيرة: Meilisearch وTypesense اللذين يعدانك بنتائج أثناء الكتابة، وOpenSearch الذي تشغله الشركات الكبيرة، وPostgreSQL الذي عندك أصلاً ويقول البعض إنه يكفي. وكل مقارنة تقرؤها تعتمد على بيانات إنجليزية، والسؤال الذي يهمنا مختلف: أي محرك يفهم ما يكتبه المستخدم العربي، بالهمزة ودونها، وبالتاء المربوطة أو الهاء، وبكلماته هو وليس بكلمات العنوان، وكم يكلفك في الذاكرة والتشغيل؟
لذلك شغلنا المحركات الأربعة على جهاز واحد بنفس الحدود، وأعطيناها نفس المستندات ونفس الأسئلة، وقسنا كل محرك مرتين: بإعداداته الافتراضية، وبعد الضبط الذي شرحناه في دليله. وقد شرحنا كل محرك وحده في الأدلة التالية:
 دليلMeilisearch: مربع بحث فوري داخل تطبيقككيف تشغل Meilisearch على سيرفرك بمفاتيح محدودة لكل مستخدم ونسخ احتياطي تسترجعه، وتضبطه حتى يفهم النص العربي.
 دليلTypesense: بحث سريع يتحمل الأخطاء الإملائيةكيف تبني على Typesense بحثاً يتحمل الأخطاء ويفهم العربية، وتشغله في عنقود من ثلاث عقد يستمر إذا سقطت إحداها.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
وسوف نناقش في هذا المقال ما يلي:
- التجربة المشتركة: البيانات والأسئلة والإعدادات لكل محرك.
- جودة النتائج على أسئلة المستخدمين وعلى الكتابة العربية، قبل الضبط وبعده.
- الموارد على مئة ألف مستند: وقت الفهرسة، والحجم، والذاكرة، وزمن البحث.
- الرخص والتوفر العالي، ونقاط القوة والضعف لكل محرك.
- جدول قرار في النهاية.
التجربة المشتركة
البيانات هي عناوين 366 مقالاً من الموقع ومقتطفاتها، وهي نفسها في مقال البحث الدلالي، والأسئلة خمسون في مجموعتين:
- أسئلة المستخدمين semantic: الأسئلة الثلاثون من مقال البحث الدلالي كما هي، مثل «كيف أمنع موظفاً غادر الشركة من الدخول إلى الأنظمة»، وأغلبها بكلمات لا توجد في العنوان، وبعضها بالعامية أو بالإنجليزية.
- الكتابة العربية arabic: عشرون سؤالاً قصيراً يختبر كل منها مشكلة واحدة: «خرائط» دون «ال»، و«النسخه الاحتياطيه» بالهاء، و«اختبار الاحمال» دون همزة، و
التَّشْفِيربالتشكيل، و«Wiregaurd» بخطأ إملائي، و«طوابير» جمعاً لكلمة «طابور»، وغيرها.
ولكل سؤال قائمة المقالات الصحيحة التي حددناها بأنفسنا، فالأرقام توضيحية على مجموعة صغيرة كتبناها نحن، والفرق بين 0.86 و0.89 هنا سؤال أو سؤالان، وإنما خذ منها الطريقة والاتجاه. والإعدادات التي قسناها:
| المحرك | الافتراضي default | بعد الضبط tuned |
|---|---|---|
| Meilisearch 1.55.0 | فهرس دون إعدادات | الحقول القابلة للبحث، واللغة ara في localizedAttributes |
| Typesense 30.2 | حقول string دون لغة | "locale": "ar" و"stem": true، وdrop_tokens_threshold: 10 |
| OpenSearch 3.9.0 | المحلل standard | المحلل arabic، والبحث بتحمل الأخطاء fuzziness فقط عندما لا توجد نتائج |
| PostgreSQL 18.6 | websearch_to_tsquery('simple')، أي كل الكلمات مطلوبة | الإعداد arabic مع دالة توحيد، وأي كلمة تكفي مع ترتيب ts_rank_cd، وتشابه pg_trgm عندما لا توجد نتائج |
وكل محرك محدود بمعالجين و2 جيجابايت ذاكرة في ملف compose.yaml التالي:
# Search comparison lab: the same articles and questions in four engines, each limited to 2 CPUs and 2 GB.
# Security is off in OpenSearch and the keys are fixed lab values: this network never leaves 127.0.0.1.
name: lab-srch2-cmp

x-limits: &limits
  cpus: 2
  mem_limit: 2g

services:
  meili:
    <<: *limits
    image: getmeili/meilisearch:v1.55.0
    container_name: lab-srch2-cmp-meili
    environment:
      MEILI_ENV: development
      MEILI_MASTER_KEY: lab-only-master-key-0123456789
      MEILI_NO_ANALYTICS: "true"

  typesense:
    <<: *limits
    image: typesense/typesense:30.2
    container_name: lab-srch2-cmp-typesense
    command: ["--data-dir", "/data", "--api-key", "lab-only-typesense-key"]
    volumes: ["ts-data:/data"]

  opensearch:
    <<: *limits
    image: opensearchproject/opensearch:3.9.0
    container_name: lab-srch2-cmp-opensearch
    environment:
      discovery.type: single-node
      OPENSEARCH_JAVA_OPTS: -Xms512m -Xmx512m
      DISABLE_SECURITY_PLUGIN: "true"
      DISABLE_INSTALL_DEMO_CONFIG: "true"

  postgres:
    <<: *limits
    image: postgres:18.6
    container_name: lab-srch2-cmp-postgres
    environment:
      POSTGRES_PASSWORD: lab-only-password

  py:
    image: python:3.13.16-slim
    container_name: lab-srch2-cmp-py
    working_dir: /lab
    volumes: ["./:/lab"]
    command: ["sh", "-c", "pip install -q 'psycopg[binary]==3.3.6' && sleep infinity"]

volumes:
  ts-data: { name: lab-srch2-cmp-ts-data }
والملف engines.py فيه محول صغير لكل محرك، يبني الفهرسين ويرجع أول عشر نتائج لكل سؤال:
# One small adapter per engine: index(docs) builds the "default" and the "tuned" index, search(cfg, q) returns ids.
# Standard library + psycopg only.
import json, time, urllib.error, urllib.parse, urllib.request
import psycopg


def http(method, url, body=None, headers=None, raw=None, timeout=600):
    data = raw.encode() if raw is not None else (json.dumps(body, ensure_ascii=False).encode() if body is not None else None)
    req = urllib.request.Request(url, data=data, method=method,
                                 headers={"Content-Type": "application/json", **(headers or {})})
    try:
        with urllib.request.urlopen(req, timeout=timeout) as r:
            t = r.read().decode()
            try:
                return r.status, json.loads(t)
            except json.JSONDecodeError:
                return r.status, t
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")


def jsonl(docs):
    return "\n".join(json.dumps(d, ensure_ascii=False) for d in docs)


# ---------------------------------------------------------------- Meilisearch
class Meili:
    URL, H = "http://lab-srch2-cmp-meili:7700", {"Authorization": "Bearer lab-only-master-key-0123456789"}

    def wait(self, t):
        while True:
            _, s = http("GET", f"{self.URL}/tasks/{t['taskUid']}", headers=self.H)
            if s["status"] in ("succeeded", "failed"):
                return s
            time.sleep(0.1)

    def index(self, docs, suffix=""):
        for name in ("default" + suffix, "tuned" + suffix):
            http("DELETE", f"{self.URL}/indexes/{name}", headers=self.H)
            self.wait(http("POST", f"{self.URL}/indexes", {"uid": name, "primaryKey": "id"}, self.H)[1])
            if name.startswith("tuned"):
                self.wait(http("PATCH", f"{self.URL}/indexes/{name}/settings", {
                    "searchableAttributes": ["title", "excerpt"], "filterableAttributes": ["track"],
                    "localizedAttributes": [{"attributePatterns": ["*"], "locales": ["ara"]}]}, self.H)[1])
            for i in range(0, len(docs), 20000):
                self.wait(http("POST", f"{self.URL}/indexes/{name}/documents",
                               headers={**self.H, "Content-Type": "application/x-ndjson"}, raw=jsonl(docs[i:i + 20000]))[1])

    def search(self, cfg, q, suffix=""):
        _, r = http("POST", f"{self.URL}/indexes/{cfg}{suffix}/search",
                    {"q": q, "limit": 10, "attributesToRetrieve": ["id"]}, self.H)
        return [h["id"] for h in r["hits"]]

    def size(self, suffix=""):
        return http("GET", f"{self.URL}/indexes/tuned{suffix}/stats", headers=self.H)[1]["indexSize"]


# ---------------------------------------------------------------- Typesense
class Typesense:
    URL, H = "http://lab-srch2-cmp-typesense:8108", {"X-TYPESENSE-API-KEY": "lab-only-typesense-key"}

    def index(self, docs, suffix=""):
        for name, extra in (("default" + suffix, {}), ("tuned" + suffix, {"locale": "ar", "stem": True})):
            http("DELETE", f"{self.URL}/collections/{name}", headers=self.H)
            http("POST", f"{self.URL}/collections", {"name": name, "fields": [
                {"name": "title", "type": "string", **extra}, {"name": "excerpt", "type": "string", **extra},
                {"name": "track", "type": "string", "facet": True}, {"name": "published", "type": "int64"}]}, self.H)
            for i in range(0, len(docs), 10000):
                http("POST", f"{self.URL}/collections/{name}/documents/import?action=upsert",
                     headers=self.H, raw=jsonl(docs[i:i + 10000]))

    def search(self, cfg, q, suffix=""):
        p = {"q": q, "query_by": "title,excerpt", "per_page": 10, "include_fields": "id"}
        if cfg == "tuned":
            p["drop_tokens_threshold"] = 10
        _, r = http("GET", f"{self.URL}/collections/{cfg}{suffix}/documents/search?" + urllib.parse.urlencode(p),
                    headers=self.H)
        return [h["document"]["id"] for h in r["hits"]]


# ---------------------------------------------------------------- OpenSearch
class OpenSearch:
    URL = "http://lab-srch2-cmp-opensearch:9200"

    def index(self, docs, suffix=""):
        for name, analyzer in (("default" + suffix, "standard"), ("tuned" + suffix, "arabic")):
            http("DELETE", f"{self.URL}/{name}")
            http("PUT", f"{self.URL}/{name}", {"settings": {"number_of_shards": 1, "number_of_replicas": 0},
                 "mappings": {"properties": {"title": {"type": "text", "analyzer": analyzer},
                                             "excerpt": {"type": "text", "analyzer": analyzer},
                                             "track": {"type": "keyword"}, "published": {"type": "long"}}}})
            for i in range(0, len(docs), 10000):
                bulk = "".join(json.dumps({"index": {"_index": name, "_id": d["id"]}}) + "\n"
                               + json.dumps(d, ensure_ascii=False) + "\n" for d in docs[i:i + 10000])
                http("POST", f"{self.URL}/_bulk", headers={"Content-Type": "application/x-ndjson"}, raw=bulk)
            http("POST", f"{self.URL}/{name}/_refresh")

    def query(self, name, q, fuzzy=False):
        m = {"query": q, "fields": ["title^2", "excerpt"]}
        if fuzzy:
            m["fuzziness"] = "AUTO"
        _, r = http("POST", f"{self.URL}/{name}/_search", {"size": 10, "_source": False, "query": {"multi_match": m}})
        return [h["_id"] for h in r["hits"]["hits"]]

    def search(self, cfg, q, suffix=""):
        ids = self.query(cfg + suffix, q)
        if cfg == "tuned" and not ids:            # typo tolerance only when nothing matched
            ids = self.query(cfg + suffix, q, fuzzy=True)
        return ids

    def size(self, suffix=""):
        return http("GET", f"{self.URL}/tuned{suffix}/_stats/store")[1]["_all"]["primaries"]["store"]["size_in_bytes"]


# ---------------------------------------------------------------- PostgreSQL
class Postgres:
    DSN = "host=lab-srch2-cmp-postgres user=postgres password=lab-only-password"
    # the same folding as in the "PostgreSQL for everything" article: no diacritics or tatweel, one alef, ya, ha
    SETUP = r"""
    CREATE EXTENSION IF NOT EXISTS pg_trgm;
    CREATE OR REPLACE FUNCTION ar_normalize(t text) RETURNS text LANGUAGE sql IMMUTABLE PARALLEL SAFE AS $$
      SELECT translate(regexp_replace(t, '[ً-ْـ]', '', 'g'), 'أإآٱىة', 'اااايه') $$;
    """

    def __init__(self):
        self.db = psycopg.connect(self.DSN, autocommit=True)

    def index(self, docs, suffix=""):
        t = "articles" + suffix
        self.db.execute(self.SETUP)
        self.db.execute(f"DROP TABLE IF EXISTS {t}")
        self.db.execute(f"""CREATE TABLE {t} (id text PRIMARY KEY, title text, excerpt text, track text, published bigint,
            fts_simple tsvector GENERATED ALWAYS AS (
                setweight(to_tsvector('simple', title), 'A') || setweight(to_tsvector('simple', excerpt), 'B')) STORED,
            fts_ar tsvector GENERATED ALWAYS AS (
                setweight(to_tsvector('arabic', ar_normalize(title)), 'A') ||
                setweight(to_tsvector('arabic', ar_normalize(excerpt)), 'B')) STORED)""")
        with self.db.cursor() as c:
            with c.copy(f"COPY {t} (id, title, excerpt, track, published) FROM STDIN") as cp:
                for d in docs:
                    cp.write_row((d["id"], d["title"], d["excerpt"], d["track"], d["published"]))
        self.db.execute(f"CREATE INDEX ON {t} USING gin (fts_simple)")
        self.db.execute(f"CREATE INDEX ON {t} USING gin (fts_ar)")
        self.db.execute(f"CREATE INDEX ON {t} USING gin (ar_normalize(title || ' ' || excerpt) gin_trgm_ops)")
        self.db.execute(f"ANALYZE {t}")

    def search(self, cfg, q, suffix=""):
        t = "articles" + suffix
        if cfg == "default":   # what most tutorials show: websearch syntax, every word must match
            sql = (f"SELECT id FROM {t}, websearch_to_tsquery('simple', %(q)s) q "
                   f"WHERE fts_simple @@ q ORDER BY ts_rank(fts_simple, q) DESC LIMIT 10")
            return [r[0] for r in self.db.execute(sql, {"q": q})]
        # tuned: normalized Arabic, any word may match (OR), ranked; trigram similarity when nothing matched
        # the words are stemmed once by to_tsvector('arabic'), then joined with | as they are ('simple')
        sql = f"""SELECT id FROM {t}, to_tsquery('simple', coalesce(nullif(array_to_string(array(
                    SELECT quote_literal(w) FROM unnest(tsvector_to_array(to_tsvector('arabic', ar_normalize(%(q)s)))) w),
                    ' | '), ''), '''''')) q
                  WHERE fts_ar @@ q ORDER BY ts_rank_cd(fts_ar, q) DESC LIMIT 10"""
        ids = [r[0] for r in self.db.execute(sql, {"q": q})]
        if not ids:
            sql = f"""SELECT id FROM {t} WHERE ar_normalize(%(q)s) <%% ar_normalize(title || ' ' || excerpt)
                      ORDER BY word_similarity(ar_normalize(%(q)s), ar_normalize(title || ' ' || excerpt)) DESC LIMIT 10"""
            ids = [r[0] for r in self.db.execute(sql, {"q": q})]
        return ids

    def size(self, suffix=""):
        return self.db.execute(f"SELECT pg_total_relation_size('articles{suffix}')").fetchone()[0]


ENGINES = {"Meilisearch": Meili, "Typesense": Typesense, "OpenSearch": OpenSearch, "PostgreSQL": Postgres}
في الإعداد أعلاه لاحظ التالي:
- في PostgreSQL نقطع السؤال بالإعداد
arabicمرة واحدة، ثم نجمع الكلمات بالعلامة|عبرto_tsquery('simple'). وكان في أول نسخة من الملفto_tsquery('arabic')هنا، فكان يجذع الكلمة التي جذعناها، فتحولت «ذاكره» إلى شكل آخر لا يطابق الفهرس، ورجعت أسئلة مثلالذَّاكِرَةصفراً، وبعد الإصلاح ارتفع مقياس الأسئلة العربية من 0.607 إلى 0.727. - دالة
ar_normalizeهي نفسها في قسم البحث النصي في مقال PostgreSQL لكل شيء. - الأمن معطل في OpenSearch والمفاتيح ثابتة لأن الشبكة لا تخرج من الجهاز، وقد شرحنا الإعداد الآمن في دليل كل محرك.
والملف metrics.py هو نفسه في دليل Meilisearch، والملف evaluate.py يشغل كل شيء:
# Relevance: the 50 labelled questions on the default and the tuned setup of each engine.
import json
from engines import ENGINES
from metrics import table

docs = [json.loads(l) for l in open("data/articles.jsonl", encoding="utf-8") if l.strip()]
queries = json.load(open("data/queries.json", encoding="utf-8"))
results = {}
for name, cls in ENGINES.items():
    e = cls()
    e.index(docs)
    for cfg in ("default", "tuned"):
        results[f"{name} {cfg}"] = {q["q"]: e.search(cfg, q["q"]) for q in queries}
table(results, queries)
json.dump(results, open("results.json", "w", encoding="utf-8"), ensure_ascii=False, indent=1)
docker compose up -d
docker exec -w /lab lab-srch2-cmp-py python evaluate.pyجودة النتائج
والمخرج سوف يكون كما يلي:
config                      set        recall@5  MRR@10  nDCG@10  zero
Meilisearch default         semantic      0.353   0.432    0.383     5
Meilisearch default         arabic        0.738   0.856    0.765     2
Meilisearch tuned           semantic      0.353   0.426    0.376     6
Meilisearch tuned           arabic        0.838   0.956    0.860     0
Typesense default           semantic      0.369   0.456    0.390     2
Typesense default           arabic        0.600   0.800    0.635     2
Typesense tuned             semantic      0.475   0.574    0.498     1
Typesense tuned             arabic        0.865   0.975    0.886     0
OpenSearch default          semantic      0.511   0.546    0.499     3
OpenSearch default          arabic        0.368   0.454    0.356     8
OpenSearch tuned            semantic      0.531   0.587    0.533     1
OpenSearch tuned            arabic        0.884   1.000    0.934     0
PostgreSQL default          semantic      0.183   0.200    0.187    24
PostgreSQL default          arabic        0.127   0.300    0.166    14
PostgreSQL tuned            semantic      0.536   0.581    0.518     1
PostgreSQL tuned            arabic        0.695   0.838    0.727     1
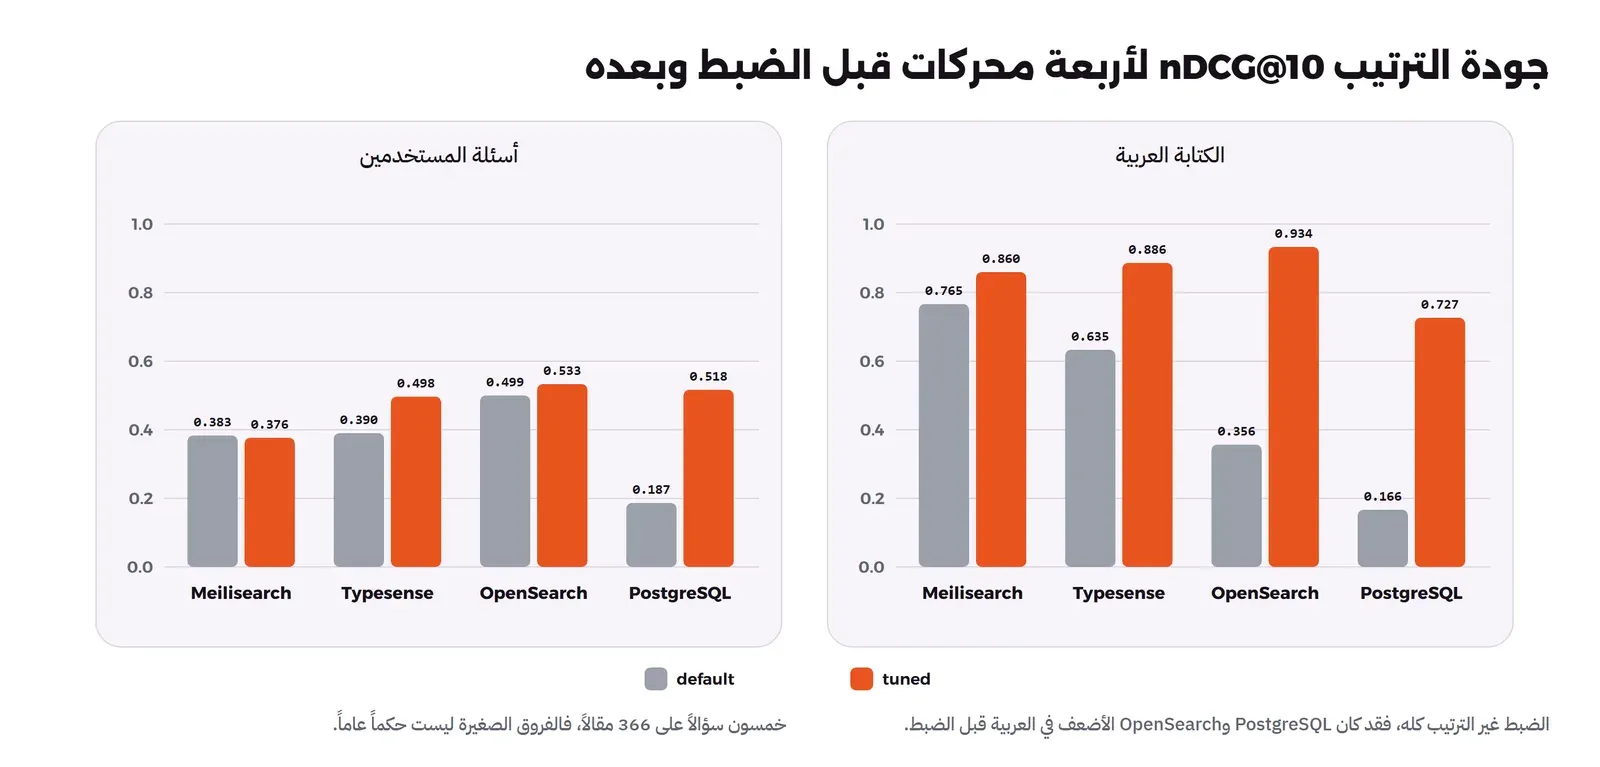
والصورة التالية تبين عمود nDCG@10 من الجدول:
في المخرج أعلاه لاحظ التالي:
- الإعداد الافتراضي ليس مقارنة عادلة: PostgreSQL الافتراضي أعطى 0.17 لأن كل كلمات السؤال مطلوبة، فرجع 24 سؤالاً من ثلاثين صفحة فارغة، وOpenSearch بالمحلل standard أسوأ من Meilisearch في العربية لأنه لا يوحد شيئاً، وبعد الضبط تغير الترتيب كله. فإذا قرأت مقارنة لم تضبط المحركات فهي تقارن من كتب الإعدادات الافتراضية وليس المحركات.
- الكتابة العربية: OpenSearch بالمحلل arabic هو الأفضل (0.934)، لأن فيه توحيداً وجذعاً خفيفاً معاً، ثم Typesense مع الجذع (0.886)، ثم Meilisearch (0.860) الذي يوحد ولا يجذع، ثم PostgreSQL (0.727) الذي يجذع لكن جذعه يعطي أحياناً شكلين للكلمة نفسها، كما رأينا في «مراقبة» التي أصبحت
مراقبفي السؤال ومراقبهفي «المراقبة». - أسئلة المستخدمين: كل المحركات بين 0.38 و0.53، وهذا سقف البحث بالكلمات على أسئلة لا تشبه العناوين. وMeilisearch هنا الأضعف لأنه يفضل المستندات التي فيها كل كلمات السؤال ثم يحذف من آخره، أما المحركات التي ترتب بأي كلمة مع وزن للكلمات النادرة فكانت أفضل.
- البحث الهجين يغير الصورة: في دليل Meilisearch أضفنا التضمين bge-m3 فارتفعت أسئلة المستخدمين إلى 0.814 والكتابة العربية إلى 0.951، وهو أعلى من أي رقم في هذا الجدول. والمحركات الأربعة كلها تدعم المتجهات: Meilisearch بمضمن داخلي، وOpenSearch كما في مقال البحث الدلالي، وPostgreSQL مع pgvector كما في مقال RAG، وTypesense بحسب توثيق البحث بالمتجهات. فإذا كانت أسئلة مستخدميك طويلة وبكلماتهم، فالقرار الأهم هو إضافة المتجهات وليس اختيار المحرك.
الموارد على مئة ألف مستند
366 مستنداً لا تكفي لقياس الموارد، لذلك كررنا المقالات 275 مرة مع خلط كلمات المقتطف في كل نسخة، فأصبحت 100,650 مستنداً، وفهرسناها في المحرك بالإعدادين، ثم شغلنا الأسئلة الخمسين خمس مرات على الإعداد tuned، طلباً بعد طلب. احفظ الملف التالي باسم bench.py:
# Resource use: about 100,000 documents (the 366 articles x 275, words of each excerpt shuffled) in the tuned
# setup of one engine, then the 50 questions five times each, one request at a time.
#   python bench.py <Meilisearch|Typesense|OpenSearch|PostgreSQL>
import json, random, statistics, sys, time
from engines import ENGINES

name = sys.argv[1]
base = [json.loads(l) for l in open("data/articles.jsonl", encoding="utf-8") if l.strip()]
rnd = random.Random(42)
docs = []
for k in range(275):
    for d in base:
        words = d["excerpt"].split()
        rnd.shuffle(words)
        docs.append({**d, "id": f"{d['id']}-{k}", "excerpt": " ".join(words)})
queries = [q["q"] for q in json.load(open("data/queries.json", encoding="utf-8"))]

e = ENGINES[name]()
t0 = time.time()
e.index(docs, suffix="_big")           # builds default_big and tuned_big
took = time.time() - t0
size = e.size("_big") if hasattr(e, "size") else None

lat = []
for _ in range(5):
    for q in queries:
        t = time.perf_counter()
        e.search("tuned", q, suffix="_big")
        lat.append((time.perf_counter() - t) * 1000)
lat.sort()
print(f"{name}: {len(docs)} docs x 2 indexes in {took:.1f}s, tuned index size "
      f"{size / 2**20:.1f} MiB" if size else f"{name}: {len(docs)} docs x 2 indexes in {took:.1f}s", end="")
print(f", search p50 {statistics.median(lat):.1f} ms, p95 {lat[int(len(lat) * 0.95)]:.1f} ms, max {lat[-1]:.1f} ms")
for e in PostgreSQL Meilisearch Typesense OpenSearch; do docker exec -w /lab lab-srch2-cmp-py python bench.py $e; done
docker stats --no-stream --format '{{.Name}} {{.MemUsage}}' lab-srch2-cmp-meili lab-srch2-cmp-typesense lab-srch2-cmp-opensearch lab-srch2-cmp-postgres
docker exec lab-srch2-cmp-typesense du -sh /data/db
docker exec lab-srch2-cmp-meili du -sh /meili_data/data.msوالمخرج سوف يكون كما يلي:
PostgreSQL: 100650 docs x 2 indexes in 58.0s, tuned index size 180.7 MiB, search p50 18.2 ms, p95 1879.3 ms, max 5538.4 ms
Meilisearch: 100650 docs x 2 indexes in 107.9s, tuned index size 248.9 MiB, search p50 4.2 ms, p95 9.1 ms, max 17.6 ms
Typesense: 100650 docs x 2 indexes in 107.2s, search p50 5.6 ms, p95 923.4 ms, max 2763.0 ms
OpenSearch: 100650 docs x 2 indexes in 41.6s, tuned index size 26.9 MiB, search p50 10.7 ms, p95 40.3 ms, max 200.1 ms
lab-srch2-cmp-meili 318MiB / 2GiB
lab-srch2-cmp-typesense 421.8MiB / 2GiB
lab-srch2-cmp-opensearch 1.04GiB / 2GiB
lab-srch2-cmp-postgres 304.9MiB / 2GiB
92M	/data/db
528.9M /meili_data/data.msفي المخرج أعلاه لاحظ التالي:
- زمن البحث: Meilisearch الأثبت، فأبطأ طلب أخذ 17.6 مللي ثانية. أما PostgreSQL وTypesense فالوسيط سريع لكن الطلبات البطيئة طويلة جداً، وسوف نرى في الملف التالي أنها الأسئلة الطويلة. ففي PostgreSQL أي كلمة شائعة في السؤال تجعل آلاف الصفوف تطابق، ثم ترتبها كلها
ts_rank_cdقبلLIMIT، لذلك إذا كان مستخدموك يكتبون جملاً طويلة فاحذف الكلمات الشائعة Stop Words قبل البحث أو اجعل البحث يطلب أغلب الكلمات. - الذاكرة: OpenSearch يحجز ذاكرة ال Heap التي حددناها (512 ميجابايت) من البداية، فكان عند 1 جيجابايت قبل الفهرسة الكبيرة وبعدها. وTypesense يحفظ الفهرس في الذاكرة فارتفع من 221 إلى 422 ميجابايت مع فهرسين. وPostgreSQL وMeilisearch يعتمدان على ذاكرة نظام الملفات Page Cache، فالرقم يتغير بحسب ما قرئ مؤخراً.
- الحجم على القرص: Meilisearch الأكبر بفارق واضح (249 ميجابايت للفهرس tuned، و529 للفهرسين)، وOpenSearch الأصغر بعد ضغط Lucene، وTypesense قرابة 92 ميجابايت للمجموعتين. ورقم PostgreSQL للجدول كله مع عمودي tsvector وفهرسي GIN وفهرس trigram.
- الفهرسة: OpenSearch وPostgreSQL الأسرع هنا، وMeilisearch وTypesense قرابة 108 ثوان للفهرسين، وكل الأرقام تشمل الإعدادين معاً.
ولنعرف أي الأسئلة هي البطيئة، احفظ الملف التالي باسم slowest.py:
# Which questions are slow on the 100,000 documents? (run after bench.py for the same engine)
#   python slowest.py <engine>
import json, sys, time
from engines import ENGINES

e = ENGINES[sys.argv[1]]()
rows = []
for q in json.load(open("data/queries.json", encoding="utf-8")):
    t = time.perf_counter()
    e.search("tuned", q["q"], suffix="_big")
    rows.append(((time.perf_counter() - t) * 1000, q["q"]))
for ms, q in sorted(rows, reverse=True)[:4]:
    print(f"{ms:8.1f} ms  {q}")
for e in PostgreSQL Typesense; do echo "== $e"; docker exec -w /lab lab-srch2-cmp-py python slowest.py $e; done== PostgreSQL
1957.3 ms كيف أرجع قاعدة البيانات لما كانت عليه قبل ساعة من حذف خاطئ
1284.7 ms كيف أمنع موظفاً غادر الشركة من الدخول إلى الأنظمة
1223.3 ms الرسائل التي أرسلها من سيرفري تذهب إلى البريد المزعج
1151.2 ms الصوت في المكالمة يصل من طرف واحد فقط
== Typesense
1256.0 ms كيف أرجع قاعدة البيانات لما كانت عليه قبل ساعة من حذف خاطئ
569.6 ms كيف أمنع موظفاً غادر الشركة من الدخول إلى الأنظمة
469.0 ms الرسائل التي أرسلها من سيرفري تذهب إلى البريد المزعج
329.9 ms مكان واحد يدخل منه الموظفون إلى كل الأنظمة بحساب واحدكلها جمل طويلة فيها كلمات شائعة. وفي Typesense قسنا السؤال الأول بالقيمة الافتراضية drop_tokens_threshold: 1 فأخذ 1250 مللي ثانية، فالبطء ليس من الإعداد الذي أضفناه، ولم نفحص سببه داخل المحرك، فإذا كان مستخدموك يكتبون جملاً طويلة فقس هذا قبل أن تختاره.
الرخص والتوفر العالي
| المحرك | الرخصة (أكتوبر 2026) | أكثر من سيرفر |
|---|---|---|
| Meilisearch | MIT لنسخة المجتمع، وBUSL 1.1 لملفات Enterprise | التقسيم والنسخ في نسخة Enterprise فقط، والمجانية سيرفر واحد |
| Typesense | GPL-3.0 | عنقود Raft مجاني، وكل عقدة تحمل البيانات كاملة |
| OpenSearch | Apache-2.0 تحت مؤسسة Linux Foundation | عنقود مجاني بتقسيم Shards ونسخ Replicas |
| PostgreSQL | PostgreSQL License | النسخ المتماثل Replication مع أداة تبديل كما في عناقيد قواعد البيانات |
وقصة رخصة Elasticsearch وسبب ولادة OpenSearch شرحناها في مقال مجموعة ELK، ولذلك لم نضع Elasticsearch في هذه المقارنة، فهو في السؤال نفسه مع OpenSearch.
متى تختار كل محرك؟
محرك Meilisearch
نقاط القوة: أسهل بداية، وزمن بحث ثابت حتى في الطلبات الطويلة، وتحمل أخطاء وتوحيد للعربية دون إعداد كبير، ورموز مستأجرين JWT، وبحث هجين يستدعي النموذج بنفسه. نقاط الضعف: لا يجذع الكلمات العربية، والأسئلة الطويلة بكلمات المستخدم أضعف من غيره، والفهرس على القرص الأكبر، والتوفر العالي يحتاج رخصة تجارية.
محرك Typesense
نقاط القوة: عنقود Raft مجاني يتحمل سقوط عقدة، ومفاتيح محدودة تصدرها دون طلب إلى السيرفر، وجذع Snowball عربي بإعداد واحد. نقاط الضعف: كل عقدة تحمل البيانات كاملة في الذاكرة، والأسئلة الطويلة كانت بطيئة في تجربتنا، وlocale وحده لا يوحد شيئاً في العربية.
محرك OpenSearch
نقاط القوة: أفضل نتائج عربية في تجربتنا بالمحلل arabic، وتحكم كامل في كل مرحلة من التحليل، وعنقود يقسم البيانات على سيرفرات كثيرة، والسجلات والتجميعات والبحث الدلالي في أداة واحدة، ورخصة Apache. نقاط الضعف: أثقل في الذاكرة من البداية، وتشغيل العنقود وتحديثه وتأمينه عمل مستمر، وتحمل الأخطاء ونتائج أثناء الكتابة تبنيها أنت بالاستعلامات.
قاعدة PostgreSQL
نقاط القوة: لا توجد خدمة جديدة ولا مزامنة بين قاعدة البيانات والفهرس، فالنتيجة تظهر مع المعاملة Transaction نفسها، والفلاتر والصلاحيات هي SQL الذي تعرفه، وأسئلة المستخدمين قريبة من OpenSearch بعد الضبط. نقاط الضعف: الإعداد الافتراضي الذي في أغلب الأمثلة سيئ جداً للعربية، والترتيب ليس BM25، والأسئلة الطويلة على جداول كبيرة بطيئة، وتحمل الأخطاء والتوحيد تكتبهما بنفسك.
جدول القرار
| حالتك | الاختيار | السبب |
|---|---|---|
| بياناتك في PostgreSQL وحجمها متوسط، والبحث ميزة ثانوية | PostgreSQL | لا خدمة جديدة ولا مزامنة، بشرط أن تضبط العربية ولا تترك websearch_to_tsquery الافتراضي |
| مربع بحث فوري في تطبيق أو متجر، وفريق صغير، والتوقف دقائق مقبول | Meilisearch | أسهل تشغيل وأثبت زمن بحث، مع لقطات للاسترجاع السريع |
| نفس الحالة، والبحث يجب ألا يتوقف إذا سقط سيرفر | Typesense | عنقود Raft مجاني، والبيانات تتسع في ذاكرة كل عقدة |
| نصوص عربية طويلة وتحتاج أفضل مطابقة للكلمات وتحكماً في التحليل | OpenSearch | المحلل العربي بالتوحيد والجذع، وكان الأفضل في تجربتنا |
| بيانات أكبر من ذاكرة سيرفر واحد، أو سجلات وتحليلات مع البحث | OpenSearch، أو Manticore أو Solr | تقسيم البيانات على عدة سيرفرات |
| تطبيق SaaS يبحث فيه كل عميل في بياناته من المتصفح | Meilisearch أو Typesense | رموز المستأجرين أو المفاتيح المحدودة بفلتر لا يعدله المستخدم |
| المستخدمون يكتبون أسئلة طويلة بكلماتهم | أي محرك مع المتجهات | البحث الهجين رفع جودة الترتيب في تجربتنا من 0.38 إلى 0.81 |
أخطاء شائعة
- المقارنة بالإعدادات الافتراضية: رأينا PostgreSQL ينتقل من 0.17 إلى 0.73 في الأسئلة العربية، وOpenSearch من 0.36 إلى 0.93، بالإعداد وحده.
- اختيار المحرك من سرعة الوسيط: الوسيط في PostgreSQL وTypesense جيد، لكن الطلبات الطويلة أخذت ثانيتين، فانظر إلى p95 وأبطأ طلب.
- القياس بأسئلة من العناوين: المستخدمون لا يكتبون العنوان، فأضف أسئلتهم الحقيقية من سجلات البحث إلى مجموعة القياس.
- نسيان الرخصة عند التوسع: عنقود Meilisearch يحتاج نسخة Enterprise، فاعرف ذلك قبل أن تبني عليه.
حذف المختبر
docker compose down -v
docker image rm getmeili/meilisearch:v1.55.0 typesense/typesense:30.2
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- بعد الضبط، OpenSearch كان الأفضل في الكتابة العربية (0.934) ثم Typesense (0.886) ثم Meilisearch (0.860) ثم PostgreSQL (0.727)، وقبل الضبط كان الترتيب مختلفاً تماماً.
- في أسئلة المستخدمين بكلماتهم لم يتجاوز أي محرك 0.54 بالكلمات وحدها، والبحث الهجين هو الذي يغير النتيجة.
- Meilisearch الأثبت في زمن البحث والأكبر على القرص، وTypesense يحفظ كل شيء في الذاكرة ويعطيك عنقوداً مجانياً، وOpenSearch الأثقل في الذاكرة والأقوى في التحليل والتوسع، وPostgreSQL يكفي إذا ضبطته وكانت الأسئلة قصيرة.
- اختر بحسب حالتك من جدول القرار، ثم قس على بياناتك وأسئلة مستخدميك قبل أن تلتزم.
 دليلكيف يعمل البحث؟ الفهرس المعكوس Inverted Index وترتيب النتائجلماذا لا يكفي LIKE للبحث في تطبيقك، وكيف يجد محرك البحث الكلمات في جزء من الثانية ويرتب أهم النتائج في الأعلى.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلالبحث الدلالي Semantic Search بالـ Embeddingsمتى يتفوق البحث بالمعنى على البحث بالكلمات في النص العربي، وكيف تقيس ذلك على أسئلتك قبل أن تختار.
 دليلManticore Search وApache Solr للأحمال الكبيرةمتى تحتاج Manticore Search أو Apache Solr بدل المحركات الأخف، وكيف تضبط كلاً منهما للعربية وتختبره على مليون مستند.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة مشتركة على Meilisearch 1.55.0 وTypesense 30.2 وOpenSearch 3.9.0 وPostgreSQL 18.6 مع Python 3.13.16 وpsycopg 3.3.6 في Docker.


