

في مقارنة محركات البحث وضعنا Meilisearch وTypesense وOpenSearch وPostgreSQL على نفس الأسئلة، وكان أحد أسطر جدول القرار: إذا كانت بياناتك أكبر من ذاكرة سيرفر واحد فتحتاج محركاً يقسمها على عدة سيرفرات. وOpenSearch ليس الخيار الوحيد هنا، فهناك محركان آخران لهذا العمل: Apache Solr المبني على مكتبة Lucene نفسها، وManticore Search الذي ورث محرك Sphinx ويتكلم SQL. وسوف نشغلهما معاً على نفس البيانات العربية، ثم نكبر البيانات إلى مليون مستند.
وسوف نناقش في هذا المقال ما يلي:
- ما هو كل محرك، ورخصته، ومتى تختاره بدل OpenSearch أو المحركات الأخف.
- تشغيلهما في Docker Compose، ومفاجآت Solr 10 في الإعداد.
- العربية: الجذع الخفيف والأصل الاشتقاقي Root، وتوحيد الحروف في كل محرك، والقياس على خمسين سؤالاً.
- تحمل الأخطاء الإملائية في كل منهما.
- مئة ألف ثم مليون مستند: وقت الفهرسة والحجم والذاكرة وزمن البحث.
- كيف يتوسع كل منهما على عدة سيرفرات.
محركان للأحمال الكبيرة
Apache Solr سيرفر بحث مبني على مكتبة Apache Lucene، وهي نفس المكتبة التي يقوم عليها OpenSearch وElasticsearch كما يذكر تعريف Solr في توثيقه، لذلك المحلل العربي وترتيب BM25 فيه هما نفسهما تقريباً. وفي الإصدار 10.0.0 (مارس 2026) الذي استخدمناه كانت مكتبة Lucene بالإصدار 10.3.2، ويعمل في وضع SolrCloud: عدة سيرفرات تتفق عن طريق Apache ZooKeeper، وكل مجموعة Collection تقسم إلى Shards ولكل منها نسخ Replicas. والرخصة Apache-2.0 تحت مؤسسة Apache، ولم تتغير رخصته كما تغيرت رخصة Elasticsearch.
Manticore Search مكتوب بلغة C++، وبحسب مستودعه تفرع عن Sphinx 2.3.2 سنة 2017، ورخصته GPLv3 أو أحدث، مع مكتبات مساعدة مثل المكتبة العمودية Columnar تحت Apache-2.0. وتتكلم معه بلغة SQL عبر بروتوكول MySQL على المنفذ 9306، أو عبر HTTP بصيغة JSON أو SQL على المنفذ 9308، والنسخ بين السيرفرات فيه مبني على مكتبة Galera بحسب توثيق النسخ، والتقسيم يتم بجداول موزعة Distributed Tables تجمع جداول على سيرفرات مختلفة كما في توثيق الجداول الموزعة.
وقد يتساءل البعض: لماذا لا أستخدم OpenSearch وكفى؟ والإجابة أن OpenSearch خيار جيد لأغلب الحالات كما رأينا في دليله، لكن لكل من هذين المحركين حالة يتفوق فيها:
- Solr عندما يكون فريقك أو نظامك مبنياً عليه أصلاً، أو عندما تريد Lucene برخصة Apache وتحت مؤسسة Apache تحديداً.
- Manticore عندما يكون فريقك يعرف SQL وMySQL أكثر من DSL البحث، وتريد محركاً خفيفاً في الذاكرة على بيانات كبيرة، كما سوف نرى في القياس.
التجربة
البيانات هي نفسها في المقارنة: 366 مقالاً بعناوينها ومقتطفاتها، وخمسون سؤالاً حددنا إجاباتها بأنفسنا، ثلاثون بكلمات المستخدمين وعشرون تختبر الكتابة العربية. والملف compose.yaml:
# Manticore Search and Apache Solr side by side, each limited to 2 CPUs and 2 GB, plus a Python client.
# Solr 10 starts in SolrCloud mode with an embedded ZooKeeper by default (fine for a lab, not for production).
name: lab-srch2-ms

services:
  manticore:
    image: manticoresearch/manticore:29.9.0
    container_name: lab-srch2-manticore
    cpus: 2
    mem_limit: 2g
    volumes: ["manticore-data:/var/lib/manticore"]
    ports: ["127.0.0.1:19306:9306", "127.0.0.1:19308:9308"]

  solr:
    image: solr:10.0.0
    container_name: lab-srch2-solr
    environment:
      SOLR_HEAP: 1g
    cpus: 2
    mem_limit: 2g
    volumes: ["solr-data:/var/solr"]
    ports: ["127.0.0.1:18983:8983"]

  py:
    image: python:3.13.16-slim
    container_name: lab-srch2-ms-py
    working_dir: /lab
    volumes: ["./:/lab"]
    command: ["sleep", "infinity"]

volumes:
  manticore-data: { name: lab-srch2-manticore-data }
  solr-data: { name: lab-srch2-solr-data }
وفي أول تشغيل كتبنا لSolr الأمر ["solr-foreground", "-c"] كما تجده في أمثلة كثيرة لتشغيل SolrCloud، فلم يعمل Solr وطبع شرح الخيارات، والسبب أن Solr 10 غير أداة سطر الأوامر، فبحسب صفحة التغييرات الكبيرة في Solr 10 أصبح -c اختصاراً لاسم المجموعة --name، وأصبح bin/solr start يبدأ في وضع SolrCloud افتراضياً، والوضع المستقل يحتاج --user-managed. لذلك حذفنا السطر كله:
docker compose up -d
curl -s "http://127.0.0.1:18983/solr/admin/info/system?wt=json" | python3 -c "import json,sys; d=json.load(sys.stdin); print(d['lucene']['solr-spec-version'], d['lucene']['lucene-spec-version'], d['mode'], d.get('zkHost'))"
curl -s -X POST "http://127.0.0.1:19308/sql?mode=raw" -d "query=SHOW STATUS LIKE 'version'"
والمخرج سوف يكون كما يلي:
10.0.0 10.3.2 solrcloud 192.168.80.4:9983
[{
"columns":[{"Counter":{"type":"string"}},{"Value":{"type":"string"}}],
"data":[
{"Counter":"version","Value":"29.9.0 58e88d5ab@26091108 (columnar 14.2.1 cb282a2@26090615) (secondary 14.2.1 cb282a2@26090615) (knn 14.2.1 cb282a2@26090615) (embeddings 1.1.1 cb282a2@26090615) (buddy v4.4.3+26083121-976df147)"}
],
"total":1,
"error":"",
"warning":""
}]
لاحظ أن Solr يعمل مع ZooKeeper مضمن على المنفذ 9983، وهذا مناسب للتجربة فقط، فبحسب توثيق ZooKeeper إذا توقف السيرفر الذي يحمل ZooKeeper المضمن توقف معه العنقود، وفي الإنتاج تحتاج ZooKeeper منفصلاً من ثلاث عقد.
والملف engines.py فيه كل ما يخص المحركين: الجداول في Manticore بلغة SQL، والمجموعات في Solr عبر Collections API وSchema API، والبحث في كل منهما:
# Manticore Search and Apache Solr adapters for the lab, standard library only.
#   Manticore: SQL over HTTP (/sql?mode=raw) and JSON bulk inserts (/bulk)
#   Solr: Collections API, Schema API, JSON update and /select with edismax
import json, time, urllib.error, urllib.parse, urllib.request

MANTICORE = "http://lab-srch2-manticore:9308"
SOLR = "http://lab-srch2-solr:8983/solr"


def http(method, url, body=None, raw=None, ctype="application/json", timeout=600):
    data = raw.encode() if raw is not None else (json.dumps(body, ensure_ascii=False).encode() if body is not None else None)
    req = urllib.request.Request(url, data=data, method=method, headers={"Content-Type": ctype})
    try:
        with urllib.request.urlopen(req, timeout=timeout) as r:
            return r.status, json.loads(r.read() or b"{}")
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")


# ---------------------------------------------------------------- Manticore
# alef with hamza or madda -> alef, alef maqsura -> ya, ta marbuta -> ha (applied while tokenizing)
FOLD = "U+0623->U+0627, U+0625->U+0627, U+0622->U+0627, U+0671->U+0627, U+0649->U+064A, U+0629->U+0647"

MANTICORE_TABLES = {
    # name: extra table options
    "m_plain":   "",
    "m_stem":    "morphology='stem_ar'",
    "m_snow":    "morphology='libstemmer_ar'",
    "m_tuned":   f"morphology='libstemmer_ar' charset_table='non_cont, {FOLD}' min_infix_len='3'",
}


def sql(query):
    status, r = http("POST", f"{MANTICORE}/sql?mode=raw", raw="query=" + urllib.parse.quote(query),
                     ctype="application/x-www-form-urlencoded")
    r = r[0] if isinstance(r, list) else r
    if r.get("error"):
        raise RuntimeError(f"{query[:80]} -> {r['error']}")
    return r.get("data", [])


def manticore_index(docs, tables=MANTICORE_TABLES, suffix=""):
    for name, opts in tables.items():
        t = name + suffix
        sql(f"DROP TABLE IF EXISTS {t}")
        sql(f"CREATE TABLE {t} (slug string, title text, excerpt text, track string, published bigint) {opts}")
        for i in range(0, len(docs), 5000):
            bulk = "".join(json.dumps({"insert": {"table": t, "id": n + 1, "doc": {
                "slug": d["id"], "title": d["title"], "excerpt": d["excerpt"], "track": d["track"],
                "published": d["published"]}}}, ensure_ascii=False) + "\n" for n, d in enumerate(docs[i:i + 5000], start=i))
            status, r = http("POST", f"{MANTICORE}/bulk", raw=bulk, ctype="application/x-ndjson")
            assert status == 200 and not r.get("errors"), str(r)[:300]


def manticore_search(table, q, any_word=True, fuzzy=False):
    """any_word: the quorum operator "w1 w2 w3"/1 (at least one word), instead of the default: every word."""
    words = q.replace('"', " ").replace("'", " ").split()
    if fuzzy:   # fuzzy search (Manticore Buddy) accepts plain words only, without operators
        rows = sql(f"SELECT slug FROM {table} WHERE MATCH('{' '.join(words)}') LIMIT 10 OPTION fuzzy=1")
        return [r["slug"] for r in rows]
    expr = ('"' + " ".join(words) + '"/1') if any_word else " ".join(words)
    rows = sql(f"SELECT slug FROM {table} WHERE MATCH('@(title,excerpt) {expr}') ORDER BY weight() DESC LIMIT 10")
    return [r["slug"] for r in rows]


# ---------------------------------------------------------------- Solr
SOLR_COLLECTIONS = {"s_general": "text_general", "s_ar": "text_ar"}


def solr_index(docs, collections=SOLR_COLLECTIONS, suffix="", shards=1):
    for name, ftype in collections.items():
        c = name + suffix
        http("GET", f"{SOLR}/admin/collections?action=DELETE&name={c}")
        # every collection gets its own copy of the _default configset: the Schema API edits the configset,
        # so two collections on the same configset would share (and fight over) their fields
        http("GET", f"{SOLR}/admin/configs?action=DELETE&name={c}_cfg")
        http("GET", f"{SOLR}/admin/configs?action=CREATE&name={c}_cfg&baseConfigSet=_default")
        status, r = http("GET", f"{SOLR}/admin/collections?action=CREATE&name={c}&numShards={shards}"
                                f"&replicationFactor=1&collection.configName={c}_cfg")
        assert status == 200, r
        fields = [{"name": "title", "type": ftype, "stored": True}, {"name": "excerpt", "type": ftype, "stored": True},
                  {"name": "track", "type": "string", "stored": True}, {"name": "published", "type": "plong"}]
        status, r = http("POST", f"{SOLR}/{c}/schema", {"add-field": fields})
        assert status == 200, r
        for i in range(0, len(docs), 10000):
            status, r = http("POST", f"{SOLR}/{c}/update?commit=false", docs[i:i + 10000])
            assert status == 200, r
        http("GET", f"{SOLR}/{c}/update?commit=true")


def solr_search(coll, q, fuzzy=False):
    terms = [w for w in q.replace(":", " ").split() if w]
    if fuzzy:
        terms = [w + "~" for w in terms]                 # edit distance up to 2 for every word
    p = {"q": " ".join(terms), "defType": "edismax", "qf": "title^2 excerpt", "q.op": "OR",
         "fl": "id", "rows": 10}
    status, r = http("GET", f"{SOLR}/{coll}/select?" + urllib.parse.urlencode(p))
    assert status == 200, r
    return [d["id"] for d in r["response"]["docs"]]


def load_docs():
    return [json.loads(l) for l in open("data/articles.jsonl", encoding="utf-8") if l.strip()]


def load_queries():
    return json.load(open("data/queries.json", encoding="utf-8"))
في الإعداد أعلاه لاحظ التالي:
- في Manticore أربعة جداول تختلف في الإعداد
morphology: دون معالجة، وstem_arوهو يرجع الكلمة إلى أصلها الاشتقاقي Root، وlibstemmer_arوهو جذع Snowball الخفيف، والجدولm_tunedيضيف إلى الأخير توحيد الحروف داخلcharset_table، كما يشرح توثيق المعالجة اللغوية. - البحث في Manticore بالصيغة
"w1 w2 w3"/1، وهي مشغل النصاب Quorum Operator، أي أن كلمة واحدة على الأقل تكفي، والسبب أنMATCHدون مشغل يطلب كل الكلمات، كما سوف نرى في القياس. - في Solr مجموعتان:
text_generalوtext_ar، وكلاهما نوع حقل جاهز في مجموعة الإعدادات_default، والبحث بالمحلل edismax على العنوان بوزن 2 والمقتطف. - كل مجموعة في Solr تأخذ نسخة خاصة من الإعدادات Configset، والقصة في القسم التالي.
نكسر Solr: مجموعتان على نفس الإعدادات
في أول نسخة من engines.py أنشأنا المجموعتين على الإعدادات _default نفسها، ثم أضفنا الحقول بالطلب add-field، فنجحت المجموعة الأولى وفشلت الثانية (اختصرنا الرسالة):
AssertionError: {'responseHeader': {'status': 400, 'QTime': 126}, 'error': {..., 'msg': 'error processing commands', 'details': [{'errorMessages': ["Field 'title' already exists.\n"], 'add-field': {'name': 'title', 'type': 'text_ar', 'stored': True}}, ...], 'code': 400}}والسبب أن Schema API في SolrCloud لا يعدل المجموعة وحدها، وإنما يعدل الإعدادات المحفوظة في ZooKeeper التي تشترك فيها كل المجموعات على نفس ال Configset، فالحقل title الذي أضفناه للمجموعة الأولى بالنوع text_general أصبح موجوداً في الثانية، ولو لم يكن الخطأ لأصبحت المجموعة العربية تحلل العنوان بالمحلل العام دون أن تعرف. والأسوأ أن الإعدادات _default نفسها تغيرت، فلما أصلحنا الكود لينسخ إعدادات خاصة لكل مجموعة من _default بقي الخطأ نفسه، لأن النسخة جاءت بالحقول التي أضفناها، فحذفنا Solr وبياناته وبدأنا من جديد. لذلك:
- أنشئ Configset خاصاً لكل مجموعة بالأمر
action=CREATE&baseConfigSet=_defaultفي Configsets API قبل أن تعدل ال Schema. - لا تعدل
_defaultأبداً، فهو القالب الذي تنسخ منه كل المجموعات الجديدة. - وتذكر أن Solr 10 لا يحذف ال Configset عند حذف المجموعة، بحسب صفحة التغييرات نفسها، فاحذفه بنفسك.
العربية في المحركين
شرحنا في مقال البحث في النصوص العربية لماذا نفضل الجذع الخفيف على الأصل الاشتقاقي Root، والآن نرى ماذا يحفظ كل إعداد من نفس الجملة. احفظ الملف التالي باسم tokens.py، وهو يبني الجداول والمجموعات ثم يسأل Manticore بالأمر CALL KEYWORDS وSolr بالطريق /analysis/field:
# What does each Manticore table and each Solr field type keep from the same Arabic text?
import urllib.parse
from engines import sql, http, SOLR, manticore_index, solr_index, load_docs, MANTICORE_TABLES

TEXT = "الذَّاكِرَة المستشفيات مستشفى أجهزة الشبكة والكاميرات"

manticore_index(load_docs())
for t in MANTICORE_TABLES:
    toks = sql(f"CALL KEYWORDS('{TEXT}', '{t}')")
    print(f"{t:<10}", " ".join(r["normalized"] for r in toks))

solr_index(load_docs())
for c, ftype in (("s_general", "text_general"), ("s_ar", "text_ar")):
    _, r = http("GET", f"{SOLR}/{c}/analysis/field?" + urllib.parse.urlencode(
        {"analysis.fieldtype": ftype, "analysis.fieldvalue": TEXT, "wt": "json"}))
    stages = r["analysis"]["field_types"][ftype]["index"]
    print(f"{ftype:<12}", " ".join(t["text"] for t in stages[-1]))
    if ftype == "text_ar":
        print("  chain:", " -> ".join(stages[i].split(".")[-1] for i in range(0, len(stages), 2)))
docker exec -w /lab -e PYTHONIOENCODING=utf-8 lab-srch2-ms-py python tokens.pyوالمخرج سوف يكون كما يلي:
m_plain    الذَّاكِرَة المستشفيات مستشفى اجهزة الشبكة والكاميرات
m_stem     ذكر المستشفيات مستشفى جهز لشب كمر
m_snow     ذاكر مستشف مستشفي اجهز شبك والكاميرا
m_tuned    ذاكره مستشف مستشف اجهز شبكه والكاميرا
text_general الذَّاكِرَة المستشفيات مستشفى أجهزة الشبكة والكاميرات
text_ar      ذاكر مستشف مستشف اجهز شبك كامير
  chain: StandardTokenizer -> LowerCaseFilter -> StopFilter -> ArabicNormalizationFilter -> ArabicStemFilter
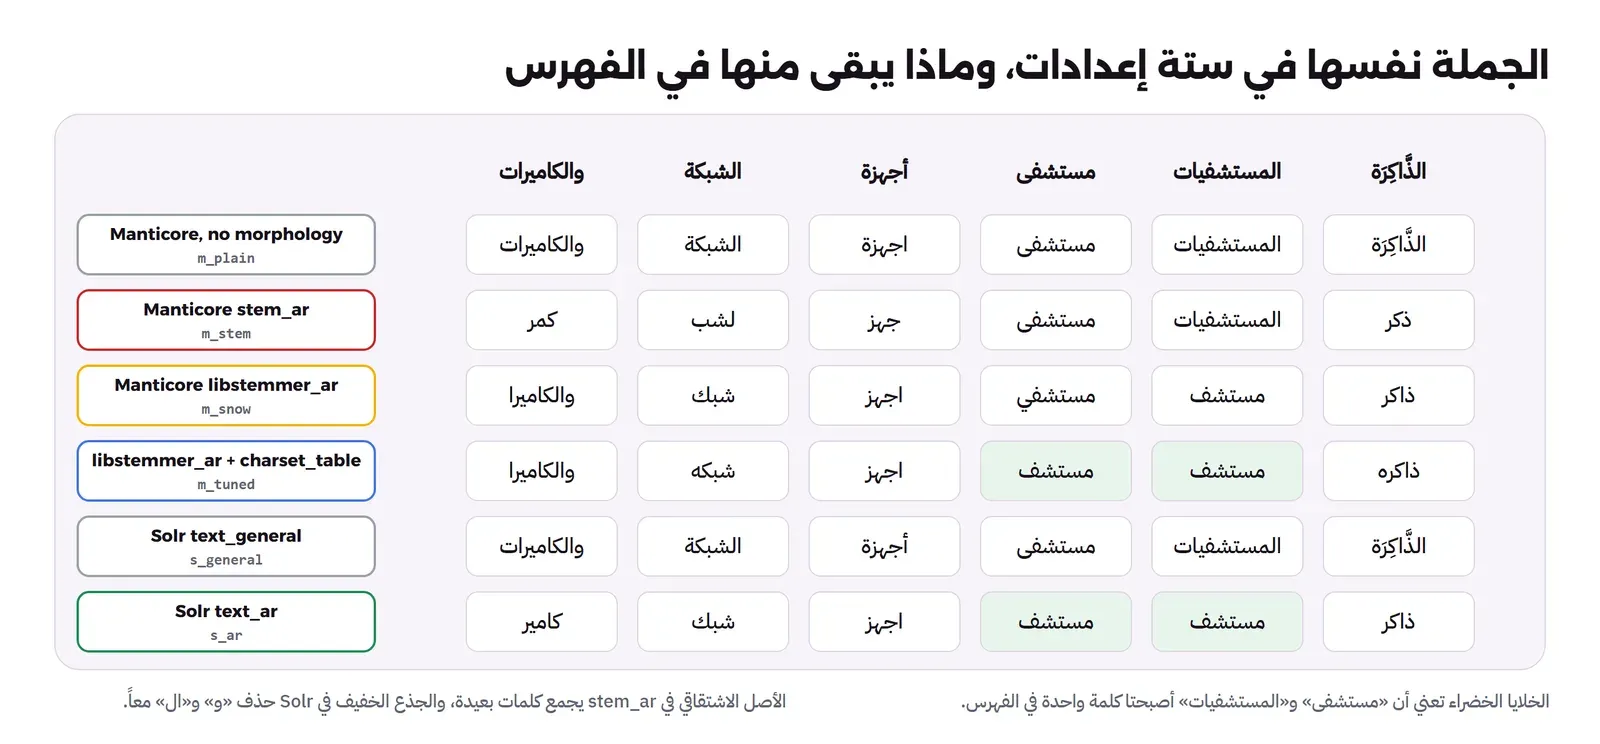
والصورة التالية تبين المخرج نفسه كلمة بكلمة:
في المخرج أعلاه لاحظ التالي:
- دون معالجة: Manticore أبقى التشكيل كما هو، فالبحث عن «الذاكرة» دون تشكيل لن يجد مستنداً مشكولاً، لكنه وحد الألف بالهمزة «أجهزة» إلى «اجهزة» من نفسه. أما
text_generalفي Solr فأبقى كل شيء كما هو. - الأصل الاشتقاقي
stem_ar: «الذاكرة» أصبحت «ذكر»، وهي نفس أصل «تذكرة» و«مذكرات»، و«الشبكة» أصبحت «لشب» وهي ليست أصلاً صحيحاً، و«المستشفيات» بقيت دون تغيير. فهو يجمع كلمات كثيرة لا علاقة بينها، ويترك كلمات أخرى. - Snowball
libstemmer_ar: حذف التشكيل و«ال» وأرجع الكلمات إلى جذع خفيف، لكن «مستشفى» أصبحت «مستشفي» و«المستشفيات» أصبحت «مستشف» فلا يتطابقان، و«والكاميرات» بقيت بالواو في أولها. - التوحيد في
charset_table: بتحويل الألف المقصورة إلى ياء أصبحت الكلمتان «مستشف»، وبتحويل التاء المربوطة إلى هاء أصبحت «الذاكرة» «ذاكره»، أي أن الجذع لم يعد يحذف آخرها، وهي نفس الملاحظة التي رأيناها في دليل Typesense، لكنها هنا لا تضر لأن التحويل يحدث في الكتابة وفي السؤال معاً قبل الجذع. - Solr
text_ar: أفضل نتيجة: التوحيد ثم الجذع الخفيف من Lucene، فحذف «و» و«ال» من «والكاميرات» وأصبحت «كامير»، وتطابقت «مستشفى» و«المستشفيات».
ولنكسر Manticore قبل القياس: أول ما استخدمناه لحذف التشكيل كان الإعداد ignore_chars بحروف التشكيل، فرفض Manticore إنشاء الجدول:
RuntimeError: CREATE TABLE m_tuned (slug string, title text, excerpt text, track string, publi -> error adding table 'm_tuned': 'ignore_chars': ignored characters must not be referenced anywhere else (code=U+64b)والسبب أن حروف التشكيل موجودة أصلاً في مجموعة الحروف non_cont التي تحددها charset_table، وManticore لا يقبل الحرف في المكانين، كما يشرح توثيق التقطيع. والحل الذي اخترناه أن نترك حذف التشكيل للجذع libstemmer_ar كما رأينا في المخرج.
القياس: خمسون سؤالاً على ثمانية إعدادات
الملف metrics.py هو نفسه في دليل Meilisearch، والملف evaluate.py يقيس كل الإعدادات، وفي الإعدادين الأخيرين لكل محرك نبحث بتحمل الأخطاء فقط عندما لا توجد نتائج: في Manticore بالخيار OPTION fuzzy=1 الذي يشرحه توثيق تصحيح الأخطاء، وفي Solr بإضافة ~ بعد كل كلمة:
# The 50 labelled questions on the Manticore tables and the Solr collections (indexes built by tokens.py).
from engines import manticore_search as ms, solr_search as ss, load_queries
from metrics import table


def fallback(first, second):
    return lambda q: first(q) or second(q)       # typo tolerance only when nothing matched


CONFIGS = {
    "M1 plain, every word":       lambda q: ms("m_plain", q, any_word=False),
    "M2 plain, any word /1":      lambda q: ms("m_plain", q),
    "M3 stem_ar (roots)":         lambda q: ms("m_stem", q),
    "M4 libstemmer_ar":           lambda q: ms("m_snow", q),
    "M5 M4 + char map + fuzzy":   fallback(lambda q: ms("m_tuned", q), lambda q: ms("m_tuned", q, fuzzy=True)),
    "S1 text_general":            lambda q: ss("s_general", q),
    "S2 text_ar":                 lambda q: ss("s_ar", q),
    "S3 text_ar + fuzzy":         fallback(lambda q: ss("s_ar", q), lambda q: ss("s_ar", q, fuzzy=True)),
}
queries = load_queries()
table({c: {q["q"]: f(q["q"]) for q in queries} for c, f in CONFIGS.items()}, queries)
والمخرج سوف يكون كما يلي:
config                      set        recall@5  MRR@10  nDCG@10  zero
M1 plain, every word        semantic      0.183   0.200    0.187    24
M1 plain, every word        arabic        0.227   0.400    0.266    12
M2 plain, any word /1       semantic      0.469   0.551    0.483     2
M2 plain, any word /1       arabic        0.360   0.533    0.409     7
M3 stem_ar (roots)          semantic      0.514   0.647    0.550     1
M3 stem_ar (roots)          arabic        0.773   0.875    0.793     2
M4 libstemmer_ar            semantic      0.575   0.632    0.557     1
M4 libstemmer_ar            arabic        0.650   0.698    0.646     4
M5 M4 + char map + fuzzy    semantic      0.575   0.653    0.567     1
M5 M4 + char map + fuzzy    arabic        0.778   0.867    0.778     0
S1 text_general             semantic      0.528   0.575    0.514     3
S1 text_general             arabic        0.368   0.454    0.356     8
S2 text_ar                  semantic      0.564   0.621    0.558     1
S2 text_ar                  arabic        0.826   0.900    0.838     2
S3 text_ar + fuzzy          semantic      0.564   0.621    0.558     0
S3 text_ar + fuzzy          arabic        0.926   1.000    0.938     0
في المخرج أعلاه لاحظ التالي:
MATCHيطلب كل الكلمات: الإعداد M1 رجع 24 سؤالاً من ثلاثين صفحة فارغة، وهو نفس رقم PostgreSQL الافتراضي في المقارنة، ومشغل النصاب/1وحده رفع أسئلة المستخدمين من 0.19 إلى 0.48.- الأصل الاشتقاقي أفضل من المتوقع في الأسئلة العربية: M3 أعطى 0.793 مقابل 0.646 للجذع الخفيف M4، لأنه جمع «الاحتياطيه» و«الاحتياطية» و«شهادة» و«الشهادات»، لكن على بيانات أكبر سوف يجمع كلمات لا علاقة بينها كما رأينا في «ذكر»، وهذا لا يظهر في 366 مقالاً.
- التوحيد وتحمل الأخطاء أصلحا الجذع الخفيف: M5 وصل إلى 0.778 دون أي سؤال فارغ.
- Solr مع text_ar هو الأفضل: 0.938 في الأسئلة العربية مع تحمل الأخطاء، وهو قريب جداً من OpenSearch بالمحلل arabic في المقارنة (0.934)، وهذا متوقع لأن المحللين من مكتبة Lucene نفسها.
وفي M5 أخطأنا أول مرة فوضعنا OPTION fuzzy=1 على نفس الاستعلام بمشغل النصاب وتحديد الحقول، فلم يرجع شيئاً، وبقيت «Kubernets» و«Wiregaurd» دون نتائج، بينما رجعت النتائج الصحيحة عندما أرسلنا الكلمات وحدها:
print(sql("SELECT slug FROM m_tuned WHERE MATCH('Wiregaurd') OPTION fuzzy=1"))[{'slug': 'wireguard'}, {'slug': 'mikrotik-scenarios'}]لذلك أصبحت الدالة manticore_search ترسل الكلمات دون مشغلات عند تحمل الأخطاء، وأضفنا في الخطوة نفسها تحويل التاء المربوطة إلى هاء في charset_table، فارتفع M5 في الأسئلة العربية من 0.641 إلى 0.778.
مئة ألف ثم مليون مستند
الآن الجزء الذي من أجله تختار هذين المحركين. احفظ الملف التالي باسم bench.py، وهو يكرر المقالات مع خلط كلمات المقتطف، ويفهرسها في الجدول m_tuned والمجموعة text_ar، ثم يشغل الأسئلة الخمسين خمس مرات طلباً بعد طلب:
# Larger loads: the 366 articles copied N times (words of each excerpt shuffled), indexed in the tuned Manticore
# table and the text_ar Solr collection, then the 50 questions five times each, one request at a time.
#   python bench.py <copies>        275 copies = 100,650 documents, 2750 copies = 1,006,500 documents
import json, random, statistics, sys, time
from engines import (MANTICORE_TABLES, SOLR_COLLECTIONS, manticore_index, manticore_search, solr_index,
                     solr_search, sql, http, SOLR, load_docs, load_queries)

copies = int(sys.argv[1])
rnd = random.Random(42)
base = load_docs()


def docs():
    out = []
    for k in range(copies):
        for d in base:
            words = d["excerpt"].split()
            rnd.shuffle(words)
            out.append({**d, "id": f"{d['id']}-{k}", "excerpt": " ".join(words)})
    return out


def timed(search):
    lat = []
    for _ in range(5):
        for q in load_queries():
            t = time.perf_counter()
            search(q["q"])
            lat.append((time.perf_counter() - t) * 1000)
    lat.sort()
    return f"p50 {statistics.median(lat):.1f} ms, p95 {lat[int(len(lat) * 0.95)]:.1f} ms, max {lat[-1]:.1f} ms"


data = docs()
suffix = f"_x{copies}"

t0 = time.time()
manticore_index(data, {"m_tuned": MANTICORE_TABLES["m_tuned"]}, suffix)
took = time.time() - t0
st = {r["Variable_name"]: r["Value"] for r in sql(f"SHOW TABLE m_tuned{suffix} STATUS")}
size = int(st["disk_bytes"]) + int(st["ram_bytes"])
print(f"Manticore {len(data)} docs: indexed in {took:.1f}s, disk+ram {size / 2**20:.0f} MiB, "
      + timed(lambda q: manticore_search(f"m_tuned{suffix}", q)))

t0 = time.time()
solr_index(data, {"s_ar": "text_ar"}, suffix)
took = time.time() - t0
_, m = http("GET", f"{SOLR}/admin/cores?action=STATUS&wt=json")
size = sum(c["index"]["sizeInBytes"] for name, c in m["status"].items() if name.startswith(f"s_ar{suffix}_"))
print(f"Solr      {len(data)} docs: indexed in {took:.1f}s, index {size / 2**20:.0f} MiB, "
      + timed(lambda q: solr_search(f"s_ar{suffix}", q)))
docker exec -w /lab -e PYTHONIOENCODING=utf-8 lab-srch2-ms-py python bench.py 275
docker exec -w /lab -e PYTHONIOENCODING=utf-8 lab-srch2-ms-py python bench.py 2750
docker stats --no-stream --format '{{.Name}} {{.MemUsage}}' lab-srch2-manticore lab-srch2-solrوالمخرج سوف يكون كما يلي، ونتيجة docker stats بعد كل تشغيل:
Manticore 100650 docs: indexed in 36.7s, disk+ram 61 MiB, p50 11.1 ms, p95 41.7 ms, max 93.2 ms
Solr      100650 docs: indexed in 75.3s, index 28 MiB, p50 10.3 ms, p95 42.6 ms, max 234.4 ms
lab-srch2-manticore 199.4MiB / 2GiB
lab-srch2-solr 1.292GiB / 2GiB

Manticore 1006500 docs: indexed in 345.0s, disk+ram 564 MiB, p50 9.3 ms, p95 299.7 ms, max 562.4 ms
Solr      1006500 docs: indexed in 108.4s, index 291 MiB, p50 5.4 ms, p95 22.5 ms, max 115.7 ms
lab-srch2-manticore 387.5MiB / 2GiB
lab-srch2-solr 1.323GiB / 2GiBفي المخرج أعلاه لاحظ التالي:
- الذاكرة: Manticore استخدم 388 ميجابايت مع مليون مستند ومئة ألف في جدولين، وSolr بقي قرابة 1.3 جيجابايت لأن JVM يحجز ال Heap الذي حددناه (1 جيجابايت) من البداية، وهذا هو الفرق الذي يجعل Manticore مناسباً لسيرفر صغير.
- الفهرسة: Solr فهرس المليون في 108 ثوان، وManticore في 345 ثانية، ولاحظ أن طريقة الإرسال مختلفة، فقد أرسلنا المستندات إلى Manticore عبر
/bulkبخمسة آلاف مستند في كل طلب، وإلى Solr بعشرة آلاف دونcommitحتى النهاية، ولا نعرف من تجربتنا إن كان الفرق من المحرك أم من طريقة الإرسال، فجرب حجم الدفعة على بياناتك. - زمن البحث مع المليون: الوسيط في المحركين أقل من 10 مللي ثانية، لكن p95 في Manticore ارتفع إلى 300 مللي ثانية. ولم نفحص هنا أي الأسئلة هي البطيئة، لكن الصيغة
/1تجعل أي كلمة شائعة تطابق عدداً كبيراً من المستندات، وهذا ما رأيناه مع الأسئلة الطويلة في PostgreSQL في المقارنة، فقس أسئلتك الطويلة قبل أن تقرر. - الحجم: فهرس Solr أصغر (291 ميجابايت للمليون) بضغط Lucene، ورقم Manticore يجمع القرص والذاكرة من
SHOW TABLE STATUS، لذلك لا تقارن الرقمين مباشرة.
التوسع على عدة سيرفرات
لم نبن عنقوداً من عدة سيرفرات في هذه التجربة، وإنما سيرفراً واحداً لكل محرك، فالفقرات التالية من التوثيق وليست من قياسنا:
- Solr: المجموعة تقسم إلى Shards بالخيار
numShardsالذي رأيته فيengines.py، ولكل Shard نسخ بالخيارreplicationFactor، وZooKeeper يحفظ حالة العنقود والإعدادات، وتشرح صفحة أنواع العناقيد الفرق بين SolrCloud والوضع المستقل. وفي الإنتاج ثلاث عقد ZooKeeper على الأقل منفصلة عن Solr. - Manticore: النسخ بين السيرفرات بمكتبة Galera، وكل عقدة تقبل القراءة والكتابة، والتقسيم بجدول موزع يرسل السؤال إلى الجداول على السيرفرات الأخرى ويجمع النتائج. أي أن النسخ والتقسيم أمران منفصلان تبنيهما بنفسك، بينما يجمعهما Solr في مفهوم المجموعة.
وفي الحالتين ارجع إلى مفاهيم التوفر العالي والأغلبية Quorum، فهي نفسها في كل عنقود.
متى تختار كلاً منهما؟
محرك Apache Solr
نقاط القوة: أفضل نتائج عربية في تجربتنا مع النوع الجاهز text_ar، وفهرسة المليون كانت الأسرع، وزمن بحث ثابت، ورخصة Apache تحت مؤسسة Apache، وتقسيم ونسخ في مفهوم واحد. نقاط الضعف: ذاكرة JVM من البداية، وZooKeeper خدمة إضافية تديرها، وتغييرات Solr 10 في سطر الأوامر تكسر الأمثلة القديمة، وال Configset المشترك فخ يقع فيه كثيرون.
محرك Manticore Search
نقاط القوة: أخف في الذاكرة بفارق كبير، وSQL عبر بروتوكول MySQL فيتصل به أي برنامج يعرف MySQL، وخيارات متعددة للعربية بين الأصل الاشتقاقي والجذع الخفيف. نقاط الضعف: الإعداد الافتراضي يطلب كل الكلمات ولا يحذف التشكيل، وتحمل الأخطاء لا يعمل مع المشغلات في تجربتنا، والطلبات الطويلة كانت أبطأ مع المليون، والرخصة GPLv3.
| حالتك | الاختيار |
|---|---|
| نص عربي كثير وتريد أفضل مطابقة دون بناء محلل بنفسك | Solr مع text_ar |
| سيرفر صغير الذاكرة وملايين المستندات وفريق يعرف SQL | Manticore مع libstemmer_ar وتوحيد الحروف |
| نظام قائم على Solr منذ سنوات | ابق على Solr وخطط للترقية إلى 10 بعد قراءة صفحة التغييرات |
| سجلات وتحليلات مع البحث، أو فريق يعرف Elasticsearch | OpenSearch |
| بيانات تتسع في ذاكرة سيرفر واحد ومربع بحث فوري | Meilisearch أو Typesense |
أخطاء شائعة
- نسخ أوامر Solr 9 إلى Solr 10: الخيار
-cأصبح اسم المجموعة وليس وضع العنقود. - تعديل ال Schema لمجموعة على Configset مشترك: التعديل يصل إلى كل المجموعات، وإلى
_defaultإذا كان هو المستخدم. - ZooKeeper المضمن في الإنتاج: لا يوجد تبديل عند سقوط السيرفر الذي يحمله.
- MATCH بكل الكلمات في Manticore لأسئلة المستخدمين: ثلثا الأسئلة رجعت صفحة فارغة.
- اختيار الأصل الاشتقاقي لأنه أعطى رقماً أعلى على بيانات صغيرة: اختبره على بياناتك الكبيرة، فهو يجمع كلمات لا علاقة بينها.
حذف المختبر
docker compose down -v
docker image rm manticoresearch/manticore:29.9.0 solr:10.0.0
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Solr وManticore محركان للبيانات الكبيرة، Solr على مكتبة Lucene برخصة Apache، وManticore من إرث Sphinx برخصة GPLv3 ولغة SQL.
- في الأسئلة العربية كان Solr مع
text_arوتحمل الأخطاء الأفضل (0.938)، وManticore وصل إلى 0.778 بالجذع الخفيف وتوحيد الحروف وتحمل الأخطاء. - مع مليون مستند كان Manticore أخف في الذاكرة بفارق كبير، وSolr أسرع في الفهرسة وأثبت في زمن البحث للأسئلة الطويلة.
- في Solr 10 انتبه لتغيير سطر الأوامر ولل Configset المشترك، وفي Manticore استخدم مشغل النصاب وأرسل الكلمات دون مشغلات عند تحمل الأخطاء.
 دليلأي محرك بحث يناسب تطبيقك ونصوصك العربية؟قارنا أربعة محركات بحث على الأسئلة العربية نفسها في جودة النتائج والذاكرة والسرعة والرخصة، لتعرف أيها يناسب حالتك.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على Manticore Search 29.9.0 وApache Solr 10.0.0 (Lucene 10.3.2) مع Python 3.13.16 في Docker.


