إذا كان فريقك يختلف على عنوان صفحة، أو نص زر، أو طريقة عرض الأسعار، وتريد أن تحسم الخلاف بالأرقام لا بالرأي، فهذا المقال لك. ستعرف فيه ما هو اختبار A/B، وكيف تخطط له، وكم زائراً يحتاج، وكيف تقرأ نتيجته دون أن تخدعك الأرقام، وكم تكلف أداة مثل GrowthBook في السنة.
المقال لأصحاب المنتجات ومسؤولي التسويق والمؤسسين، ولا يحتاج خبرة في الإحصاء أو البرمجة. جربنا GrowthBook بأنفسنا، وسنشرح ما رأيناه بلغة بسيطة.
وقد شرحنا في دليل Feature Flags أن التجربة نوع من الأعلام Experiment Flags، وفي مقال قياس التسويق كيف تحدد التحويل Conversion الذي تقيسه:
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
 دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تحدده أنت، ونموذج إسناد تفهم ما يحسبه.
باختصار In Short
قبل البدء: اكتب فرضية واحدة، ومقياساً واحداً تقرر به، واحسب عدد الزوار الذي تحتاجه، واكتب قرارك لكل نتيجة.
عند القراءة: لا تصدق الرقم الأوسط وحده. انظر إلى الهامش، أي المدى الذي يقع فيه الفرق الحقيقي.
أكبر خطأ: أن تفتح النتائج كل يوم وتوقف التجربة عند أول نتيجة جيدة. هذا يكثر «الفائزين» الوهميين.
التكلفة في السنة: GrowthBook مجاني على سيرفرك، أو مجاني في السحابة حتى 3 مستخدمين، ثم 480 دولاراً لكل مستخدم في خطة Pro.
ما هو اختبار A/B؟ A/B Testing
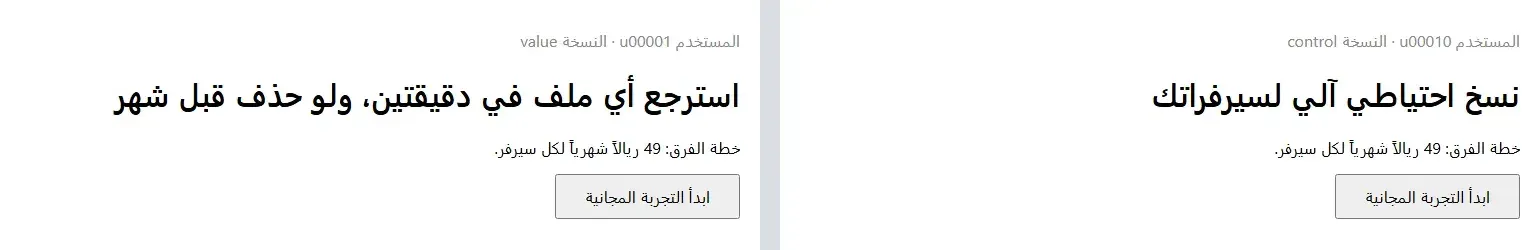
لنفرض أن فريقك مختلف على عنوان صفحة الأسعار:
- النسخة A: عنوان عام، مثل «نسخ احتياطي آلي لسيرفراتك».
- النسخة B: عنوان يذكر فائدة محددة، مثل «استرجع أي ملف في دقيقتين، ولو حذف قبل شهر».
الطريقة الخاطئة: أن تغير العنوان هذا الأسبوع، وتقارن التسجيلات بالأسبوع الماضي. المشكلة أن الأسبوعين مختلفان في كل شيء آخر: حملة إعلانية، أو موسم، أو عطلة، أو مقال انتشر لكم. فلا تعرف هل العنوان صنع الفرق أم شيء آخر.
الطريقة الصحيحة: اختبار A/B. تعرض النسختين في نفس الأسبوع، كل نسخة على نصف الزوار يختارون عشوائياً. فكل ما يحدث في الأسبوع يؤثر على النسختين بالتساوي، ويبقى الفرق الوحيد بينهما هو العنوان.
مكونات التجربة Experiment Design
قبل أن تفتح أي أداة، اكتب في نصف صفحة هذه المكونات الخمسة:
| المكون | ما هو | مثال |
|---|---|---|
| الفرضية Hypothesis | جملة واحدة: ماذا تغير، ولماذا تتوقع أثراً | «العنوان الذي يذكر الاسترجاع في دقيقتين يزيد التسجيل، لأن الاسترجاع هو ما يقلق العميل» |
| المقياس الرئيسي Goal Metric | مقياس واحد تقرر به | نسبة من سجل في التجربة المجانية |
| مقياس الحماية Guardrail Metric | مقياس يتأكد أنك لم تفسد شيئاً آخر | نسبة من يلغي في أول يوم |
| العدد الكافي Sample Size | كم زائراً تحتاج حتى تثق بالنتيجة | تحسبه قبل البدء، كما في قسم لاحق |
| القرار المسبق | ماذا ستفعل في كل نتيجة، قبل أن تراها | إذا فاز الجديد نعتمده، وإذا خسر أو لم تحسم التجربة نبقي القديم |
لماذا كل هذا؟
- الفرضية Hypothesis تمنعك من البحث بعد التجربة عن أي رقم تحسن، ثم ادعاء النجاح.
- مقياس الحماية مهم لأن عنواناً يعد بأكثر مما يقدمه المنتج قد يرفع التسجيل، ويرفع الإلغاء معه.
- القرار المسبق يمنع الفريق من تفسير النتيجة بما يريده.
كيف تقسم الأداة الزوار؟ Randomization
الأداة تضع كل زائر في إحدى النسختين عشوائياً، ويبقى فيها في كل زياراته. فلو رأى العنوان الأول اليوم والثاني غداً، لاختلطت التجربتان في رأسه.
والأداة تفعل ذلك بحساب رقم ثابت من معرف الزائر واسم التجربة. فنفس الزائر يحصل دائماً على نفس الرقم، فيرى نفس النسخة، دون أن تخزن الأداة شيئاً. ودخول اسم التجربة في الحساب يمنع أن يقع نفس الزوار في «مجموعة التغيير» في كل التجارب.
وتسجل الصفحة لحظة رأى الزائر النسخة فعلاً، وتسمى العرض Exposure. فمن لم ير الصفحة لا يدخل في الحساب.
الأدوات: GrowthBook والخدمات التجارية Tools
كانت Google Optimize الأداة المجانية التي يبدأ بها أغلب الناس، وقد أوقفتها Google في 30 سبتمبر 2023. فانقسم السوق بين:
- خدمات تجارية للتجارب، مثل Optimizely وVWO.
- أدوات منتجات تضم التجارب مع التحليلات، مثل PostHog.
- أدوات مفتوحة المصدر Open Source مخصصة للتجارب، أشهرها GrowthBook.
GrowthBook: منصة للتجارب ولأعلام الميزات Feature Flags. آخر إصدار جربناه 5.1.0 في 22 سبتمبر 2026. ترخيصه MIT لأغلب الكود، مع ترخيص منفصل لميزات الخطط المدفوعة.
ما يميزه: لا يجمع البيانات بنفسه، وإنما يقرأ من قاعدة البيانات Database التي تملكها شركتك أصلاً. فرقم التجربة ورقم تقريرك الشهري يأتيان من نفس المصدر، ولا يتجادل أحد لاحقاً لماذا تقول أداة التجارب شيئاً والتقرير شيئاً آخر.
نقاط القوة: يقرأ من بياناتك، ويحسب النتائج بطريقتين إحصائيتين، وفيه حاسبة لعدد الزوار، وتجارب غير محدودة في النسخة المجانية.
نقاط الضعف: يحتاج شخصاً تقنياً يربطه بقاعدة البيانات ويعرف المقاييس. والواجهة بالإنجليزية فقط. وبعض الميزات المتقدمة في الخطط المدفوعة. وإذا استضفته بنفسك يحتاج سيرفراً بذاكرة جيدة.
المصدر: صفحة إيقاف Google Optimize، وموقع GrowthBook، وصفحة الإصدار 5.1.0، والترخيص، ودليل الاستضافة الذاتية.
التكلفة في السنة Yearly Costs
| الخيار | السنة الأولى | كل سنة بعدها | ملاحظة |
|---|---|---|---|
| GrowthBook على سيرفرك | الأداة مجاناً | الأداة مجاناً | سعر السيرفر، ووقت من يديره |
| GrowthBook Cloud Starter | مجاناً | مجاناً | حتى 3 مستخدمين ومشروع واحد |
| GrowthBook Cloud Pro | 480 دولاراً لكل مستخدم | 480 دولاراً لكل مستخدم | 40 دولاراً لكل مستخدم في الشهر، حتى 30 مستخدماً |
| GrowthBook Enterprise | بعرض سعر | بعرض سعر | للشركات الكبيرة |
حسبنا السعر السنوي بضرب السعر الشهري في 12. والمستخدم هنا عضو الفريق الذي يدخل الأداة، لا زائر موقعك.
مثال: فريق من ثلاثة أشخاص يكفيه Starter مجاناً. وفريق من خمسة يحتاج Pro: 5 × 480 = 2,400 دولار في السنة. أو يستضيف الأداة بنفسه إذا كان عنده شخص تقني.
المصدر: أسعار GrowthBook كما قرأناها في 25 أكتوبر 2026.
قراءة النتيجة Reading Results
هنا تحدث أغلب الأخطاء. فأداة مثل GrowthBook تعطيك ثلاثة أرقام لكل نسخة:
| الرقم | ماذا يعني | كيف تقرؤه |
|---|---|---|
| التغير Change | أفضل تقدير للفرق بين النسختين | الرقم الذي يكتبه الجميع في الرسائل، وكثيراً ما يكون أكبر من الحقيقة |
| الهامش Interval | المدى الذي يقع فيه الفرق الحقيقي غالباً | هذا هو النتيجة الحقيقية. شريط عريض يعني أنك لا تعرف حجم الفرق بدقة |
| فرصة الفوز Chance to Win | احتمال أن النسخة الجديدة أفضل | يجيب عن «هل هي أفضل؟» لا عن «بكم؟». وتوثيق GrowthBook ينصح بانتظار 95% |
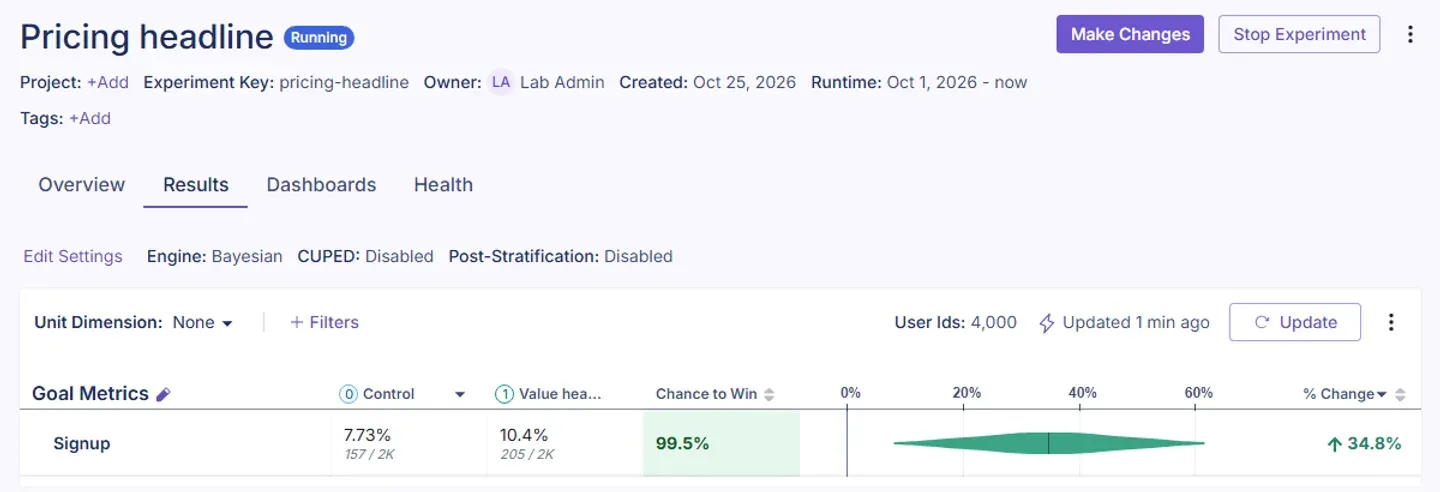
ما تعلمناه من تجربتنا: شغلنا GrowthBook بزوار مصطنعين، وحددنا نحن الفرق الحقيقي بين النسختين مسبقاً، حتى نعرف الإجابة الصحيحة. فكانت النتيجة:
- فرصة الفوز عالية جداً، أي أن العنوان الجديد أفضل غالباً. وهذا صحيح.
- التغير المعروض أكبر بكثير من الفرق الحقيقي الذي حددناه.
- الفرق الحقيقي كان داخل الشريط، لكن الشريط كان عريضاً جداً.
- عندما زدنا عدد الزوار إلى ثلاثة أضعاف، ضاق الشريط، واقترب التغير المعروض من الحقيقة.
القراءة الأمينة: «العنوان الجديد أفضل على الأرجح، والزيادة في مكان ما داخل الشريط». ولا تبن خطة الإيرادات Revenue على الرقم الأوسط. ابن عليها الحد الأدنى من الشريط، لأنه ما تستطيع أن تدافع عنه بعد ثلاثة أشهر.
مثال محسوب باليد
صفحة نسبة التسجيل فيها 8%، والعنوان الجديد يرفعها فعلاً إلى 9.6%، أي زيادة 20%. عرضت كل نسخة على 2,000 زائر:
- النسخة القديمة: 8% من 2,000 = 160 تسجيلاً في المتوسط.
- النسخة الجديدة: 9.6% من 2,000 = 192 تسجيلاً في المتوسط.
لكن الصدفة تحرك هذه الأرقام في كل تجربة. فقد ترى في تجربتك تسجيلات أقل من المتوسط في القديمة وأكثر منه في الجديدة، فتبدو الزيادة أكبر بكثير من 20%. أو يحدث العكس، فتبدو صغيرة. ولهذا تعطيك الأداة شريطاً لا رقماً واحداً: لأن تجربة واحدة بعدد صغير لا تعرف الحجم الحقيقي بدقة.
طريقتا الحساب: Bayesian وFrequentist
في GrowthBook طريقتان إحصائيتان لحساب النتيجة:
- Bayesian، وهي الافتراضية: تعطيك «فرصة الفوز». جملة يفهمها أي مدير دون شرح.
- Frequentist: تعطيك «قيمة p» P-value. وهي تقول: ما احتمال أن ترى فرقاً بهذا الحجم لو لم يكن هناك فرق أصلاً؟ وأشهر خطأ أن تقرأها «احتمال أنك مخطئ»، وهي ليست كذلك.
وفي تجربتنا أعطت الطريقتان نفس التغير ونفس الشريط تقريباً. فالخلاف بينهما يهم الإحصائيين أكثر مما يهم قرار عنوان. اختر واحدة، واعرض الشريط دائماً بجانبها.
المصدر: توثيق الإحصاء في GrowthBook.
تجربة دون أي فرق A/A Test
هل يمكن أن يظهر فرق حيث لا يوجد فرق؟ نعم. جربنا ذلك: نسختان متطابقتان تماماً. فأظهرت الأداة أن إحداهما «متفوقة» بفرصة فوز تبدو جيدة. لو كان هذا عنواناً جديداً لطلب أحدهم اعتماده. لكن الشريط كان يشمل الصفر بوضوح، أي أن النتيجة لا تقول شيئاً.
لماذا تجري تجربة A/A؟ قبل أول تجربة حقيقية، شغل تجربة بنسختين متطابقتين أسبوعاً كاملاً. فإذا ظهر فيها «فائز» قوي ثابت، فالمشكلة في الإعداد لا في المنتج. ومن أشهر هذه المشكلات:
- الصفحة تسجل أن الزائر رأى النسخة قبل أن تظهر له فعلاً.
- إضافات حجب الإعلانات تحجب التسجيل في نسخة دون الأخرى.
- الصفحة محفوظة في ذاكرة مؤقتة Cache، فيرى الزائر نسخة غير التي سجلت له.
وتحقق من نسبة التقسيم: إذا كان عدد الزوار بين النسختين بعيداً عن النصف بفرق كبير، فهناك خلل يسمى عدم تطابق النسب Sample Ratio Mismatch. وGrowthBook ينبهك إليه.
المصدر: صفحة حل مشكلات التجارب في GrowthBook.
كم زائراً تحتاج؟ Sample Size
هذه أهم خطوة يتجاهلها الجميع. فالعدد تحسبه قبل أن تبدأ، لا بعد أن ترى النتيجة. ويعتمد على ثلاثة أشياء:
- نسبتك الحالية: مثلاً 8% من الزوار يسجلون.
- أصغر فرق يهمك: مثلاً زيادة 20%.
- درجة الثقة: المعتاد أن تقبل خطأ 5%، وأن تكتشف الفرق إذا وجد في 80% من الحالات.
ولا تحتاج أن تحسبه بنفسك. في GrowthBook حاسبة اسمها Power Calculator تعطيك العدد.
وحتى تعرف حجم الأرقام، حسبنا العدد بالمعادلة المعروفة لمقارنة نسبتين، بخطأ مقبول 5% وقوة اكتشاف Power تساوي 80%:
| نسبتك الحالية | الزيادة التي تريد اكتشافها | الزوار المطلوبون (للنسختين معاً) | المدة مع 2,000 زائر في الأسبوع |
|---|---|---|---|
| 8% | 20% (من 8% إلى 9.6%) | قرابة 9,800 | قرابة 5 أسابيع |
| 8% | 10% (من 8% إلى 8.8%) | قرابة أربعة أضعاف العدد السابق | قرابة 19 أسبوعاً، أي أكثر من أربعة أشهر |
| 2% | 20% (من 2% إلى 2.4%) | أكثر من 42,000 | أكثر من 20 أسبوعاً |
ومعنى الجدول: صفحة بألفي زائر في الأسبوع تستطيع أن تحسم تغييراً كبيراً في شهر ونصف تقريباً، لكن تغييراً صغيراً يأخذ فصلاً كاملاً. وتجربة بأربعة آلاف زائر فقط، أي أقل من نصف العدد المطلوب في السطر الأول، صغيرة على هذه الزيادة.
ثلاث قواعد تعرفها دون حساب:
- الفرق الصغير يحتاج عدداً أكبر بكثير: إذا أردت أن تكتشف نصف الفرق، تحتاج قرابة أربعة أضعاف الزوار، لأن العدد يتناسب مع مربع الفرق.
- النسبة الصغيرة تحتاج عدداً أكبر: صفحة نسبة التسجيل فيها 2% تحتاج زواراً أكثر بكثير من صفحة نسبتها 8%، لنفس الزيادة.
- حول العدد إلى أسابيع: اقسم العدد المطلوب على زوار الصفحة في الأسبوع. فإذا خرج الرقم أشهراً، فالتجربة ستطول حتى يتغير كل شيء حولها.
ماذا يعني هذا لشركة ناشئة بزوار قليلين؟ لا تختبر تغييرات صغيرة مثل لون زر أو ترتيب الخطط، فأثرها صغير وتجربتها ستأخذ فصلاً كاملاً. اختبر تغييرات كبيرة تغير ما يقرؤه الزائر فعلاً، مثل العنوان والجملة تحت السعر. أو اختبر في مكان أعلى في القمع فيه زوار أكثر.
المصدر: توثيق حاسبة القوة في GrowthBook.
لا توقف التجربة مبكراً Peeking
أشهر خطأ: أن تفتح النتائج كل صباح، وتوقف التجربة عند أول يوم تصير فيه النتيجة خضراء. يبدو هذا أسرع، لكنه يخدعك.
لماذا؟ النتيجة تتأرجح في الأيام الأولى صعوداً وهبوطاً بسبب الصدفة. ومن ينظر كل يوم سيرى اللون الأخضر في يوم ما، حتى لو كانت النسختان متطابقتين.
وجربنا ذلك بمحاكاة آلاف التجارب بنسختين متطابقتين:
- من انتظر حتى النهاية وقرر مرة واحدة، رأى «فائزاً» في نحو 5% منها، وهذا هو الخطأ المقبول.
- من نظر كل يوم وتوقف عند أول نتيجة جيدة، رأى «فائزاً» في عدة أضعاف هذه النسبة، مع أن النسختين متطابقتان تماماً.
الحل: حدد العدد مسبقاً ولا تقرر قبله. وإذا كان فريقك يريد أن ينظر يومياً، فعل في GrowthBook الاختبار المتتابع Sequential Testing، فهو يصحح الحساب لمن ينظر باستمرار، مقابل شريط أعرض.
لماذا يبدو الفائز أكبر من حقيقته؟ Winner's Curse
وفي نفس المحاكاة جربنا تجارب فيها فرق حقيقي، لكن بعدد زوار صغير:
- أكثر من نصف التجارب انتهت «دون حسم»، مع أن الفرق موجود.
- والتجارب التي «نجحت» أظهرت فرقاً أكبر بكثير من الحقيقي.
والسبب بسيط: مع عدد صغير، لا تنجح التجربة إلا إذا ساعدتها الصدفة. فالتجارب الناجحة هي بالضبط التي بالغت فيها الصدفة. ومع زيادة الزوار، اكتشفت أغلب التجارب الفرق، واقترب الرقم المعروض من الحقيقة.
القاعدة: الرقم الذي يدخل خطة الإيرادات هو الحد الأدنى من الشريط، أو نتيجة تجربة بالعدد الكافي. لا الرقم الأوسط من تجربة صغيرة.
المصدر: توثيق الاختبار المتتابع في GrowthBook.
متى لا تجري اختبار A/B؟ When Not to Test
- حين لا يكفي عدد الزوار: إذا كانت التجربة تحتاج أشهراً، فالبديل اختبار تغيير أكبر، أو مكان فيه زوار أكثر، أو مقابلات مع المستخدمين.
- حين يكون التغيير إصلاحاً واضحاً: زر لا يعمل على الجوال، أو خطأ إملائي، أو صفحة بطيئة. هذه تصلحها ولا تختبرها.
- حين يكون القرار مكلفاً أو يضر الثقة: سعران مختلفان لعملاء يعرف بعضهم بعضاً قد يضر الثقة أكثر مما تفيد المعلومة.
- حين لا تعرف ماذا تختبر: جلسة مع خمسة عملاء تعطيك أفكاراً تستحق الاختبار أسرع من عشر تجارب عشوائية.
فاختبار A/B أداة لحسم خلاف بين خيارين معقولين، في مكان فيه زوار كافون، وبقرار تستطيع أن تتراجع عنه.
خطوات إجراء تجربة Step by Step
الخطوة 1: اكتب الفرضية
جملة واحدة: ماذا تغير، ولماذا تتوقع أثراً.
الخطوة 2: اختر المقياس الرئيسي ومقياس الحماية
مقياس واحد تقرر به، ومقياس يتأكد أنك لم تفسد شيئاً آخر.
الخطوة 3: احسب العدد والمدة
استخدم حاسبة GrowthBook، ثم اقسم العدد على زوار الصفحة في الأسبوع. فإذا كانت المدة طويلة جداً، اختر تغييراً أكبر أو صفحة أخرى.
الخطوة 4: اكتب القرار لكل نتيجة
إذا فاز الجديد، وإذا خسر، وإذا لم تحسم التجربة. واكتبه قبل أن ترى أي رقم.
الخطوة 5: جرب A/A مرة واحدة
قبل أول تجربة حقيقية في أداة جديدة، لتتأكد أن الإعداد سليم.
الخطوة 6: شغل التجربة أسابيع كاملة
لا تقرر قبل العدد المحسوب. وشغلها أسبوعاً كاملاً على الأقل، أو أسبوعين، حتى لو وصلت إلى العدد قبلها، لأن سلوك الزوار يختلف بين أيام الأسبوع.
الخطوة 7: اقرأ الشريط لا الرقم
نفذ القرار المكتوب. وفي الخطة اكتب الحد الأدنى من الشريط. وتأكد أن مقياس الحماية لم يتراجع.
الخطوة 8: سجل التجربة
في سجل تجارب الفريق: الفرضية، والعدد المحسوب، والنتيجة بشريطها، والقرار، وما تعلمتموه. فأغلب ما تتعلمه الفرق يضيع حين يغادر من أجرى التجربة، ثم يقترح أحدهم بعد سنة نفس الفكرة لأنها «لم تجرب».
أخطاء القراءة الشائعة Common Mistakes
- التوقف المبكر: فتح النتائج كل يوم والتوقف عند أول لون أخضر يكثر الفائزين الوهميين.
- تصديق الرقم الأوسط: الشريط هو النتيجة، لا الرقم الأوسط.
- مقاييس كثيرة دون فرضية: إذا قست عشرين مقياساً، فسيتحسن واحد منها غالباً بالصدفة.
- تجاهل مقياس الحماية: قد تعتمد تغييراً يرفع التسجيل ويخسر على المدى البعيد.
- اعتبار «لا نتيجة» فشلاً: التجربة التي لم تحسم بعدد كاف تقول لك إن الفرق، إن وجد، أصغر مما يهمك. وهذه معلومة مفيدة.
- أسبوع واحد فقط: سلوك الزوار يختلف بين أيام الأسبوع.
- تقسيم معطوب: عدد الزوار بين النسختين بعيد عن النصف بفرق كبير يعني خللاً في الإعداد.
قائمة قبل أن تبدأ أي تجربة Checklist
| السؤال | لماذا |
|---|---|
| هل الفرضية مكتوبة في جملة واحدة مع سببها؟ | تمنع البحث بعد التجربة عن أي مقياس تحسن |
| هل المقياس الرئيسي واحد، ومعه مقياس حماية؟ | مقاييس كثيرة تعطي فائزاً بالصدفة |
| هل حسبنا العدد الكافي، وكم أسبوعاً يحتاج؟ | العدد الصغير يفوت الفرق الحقيقي ويضخم الفائز |
| هل كتبنا القرار لكل نتيجة قبل أن نراها؟ | يمنع تفسير النتيجة بما يريده الفريق |
| هل جربنا A/A أو تحققنا من نسبة التقسيم؟ | خلل الإعداد يظهر كأنه فرق في المنتج |
| هل اتفقنا ألا نقرر قبل العدد، أو فعلنا الاختبار المتتابع؟ | النظر اليومي يكثر الإنذار الكاذب |
| هل سنكتب في الخطة الحد الأدنى من الشريط؟ | الفائز في العينة الصغيرة يبالغ في حجمه |
| هل سنسجل التجربة ونتيجتها في سجل الفريق؟ | حتى لا تعاد التجربة نفسها بعد سنة |
الخلاصة
- اختبار A/B يعرض النسختين في نفس الوقت على زوار مقسمين عشوائياً، فيبقى الفرق الوحيد هو ما غيرته.
- قبل البدء: فرضية، ومقياس رئيسي، ومقياس حماية، وعدد محسوب، وقرار مكتوب.
- اقرأ الشريط لا الرقم الأوسط، وابن خطتك على حده الأدنى.
- تجربة بنسختين متطابقتين قد تظهر «فائزاً»، فجرب A/A قبل أول تجربة حقيقية.
- لا توقف التجربة عند أول نتيجة جيدة، أو فعل الاختبار المتتابع.
- مع عدد صغير، يبدو الفائز أكبر من حقيقته، وكثير من الفروق الحقيقية لا تكتشف.
- GrowthBook مجاني على سيرفرك أو لثلاثة مستخدمين في السحابة، ثم 480 دولاراً لكل مستخدم في السنة.
وأقرب المقالات إلى هذا الموضوع:
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تحدده أنت، ونموذج إسناد تفهم ما يحسبه.
 دليلتحليلات المنتج Product Analytics مع PostHog على سيرفركنشغل PostHog على سيرفرنا ونتتبع المستخدم من أول زيارة إلى أول فاتورة، ونقيس ما يحتاجه من ذاكرة ووقت إقلاع.
 دليلمقاييس المنتج Product Metrics وكيف تعرف أن الميزة نجحتكيف تختار رقماً رئيسياً North Star لمنتجك، وتقرأ قمع التحويل Funnel وجدول العودة Retention دون أن تخدعك لوحة الأرقام.
سجل التحديثات
- 2026-11-13: إعادة كتابة المقال بلغة أوضح وخطوات وجداول، دون كود.
- 2026-11-14: مراجعة المقال وإعادة المعلومات المفيدة ونتائج البيانات الحقيقية التي حذفت في إعادة الكتابة.
- أكتوبر 2026: كتابة الدليل واختباره على GrowthBook 5.1.0 بحركة زوار مصطنعة بفرق حقيقي معروف.
- أكتوبر 2026: إضافة محاكاة آلاف التجارب للتوقف المبكر وحجم الفائز في العينة الصغيرة، وأقسام متى لا تختبر وقائمة قبل البدء.