في مقال التفعيل والاحتفاظ وجدنا في البيانات أن من يربط قناة التنبيه في أسبوعه الأول يعود أكثر بسبع مرات، ورأينا أن المجموعات التي ظهرت لها قائمة خطوات البداية Onboarding Checklist عادت أكثر من التي قبلها. ولكن الجدول لا يثبت السبب، فقد يكون الموسم أو مصدر الزوار هو الذي تغير، والطريقة الوحيدة لكي تعرف أن القائمة نفسها هي التي رفعت التفعيل أن تعرضها على نصف المستخدمين الجدد في نفس الفترة وتقارن بالنصف الآخر، أي تجربة A/B. وهذا ما وصلت إليه الشركة الناشئة في قصة المقالين السابقين: مؤسس أداة مراقبة الخوادم يريد أن يعرف هل القائمة نفسها هي ما رفع التفعيل، قبل أن يبني عليها التهيئة كلها، وقبل أن يزيد ميزانية الإعلانات التي تجلب مستخدمين يمرون بها.
وفي هذا المقال سوف نمر بالتجربة كاملة كما يمر بها فريق نمو صغير، من كتابة الفرضية إلى القرار، على مختبر يعمل في Docker. أما شرح GrowthBook بالتفصيل والإحصاء خلف اختبارات A/B فلهما مقال مستقل في مرحلة التحليلات، وسوف نناقش في هذا المقال ما يلي:
- وثيقة التجربة: الفرضية، ومقياس الهدف، ومقياس الحماية Guardrail، وحجم العينة، وقاعدة القرار قبل البدء.
- بناء المختبر: تطبيق تجريبي، وGrowthBook للتقسيم والتحليل، وPostgreSQL كمستودع للأحداث.
- حساب حجم العينة Sample Size بالأرقام.
- تشغيل التجربة بزيارات محاكاة Simulated Traffic، وقراءة النتيجة المبكرة ثم النهائية.
- نجرب العطل: تحويلات تضيع لأن التطبيق سجل الحدث قبل التعرض Exposure.
- القرار عندما لا تكون النتيجة حاسمة، وهو ما حدث فعلاً في هذه التجربة.
- تجربة ثانية بلا خوادم: نحاكي ألفي تجربة لنرى بالأرقام ماذا يفعل النظر المبكر، وكم مرة تكتشف التجربة أثراً حقيقياً.
- تصميم التجربة التالية، وماذا يحدث عندما يتغير شيء، وقائمة تحقق قبل أي تجربة.
قبل أي كود: وثيقة التجربة
أغلب التجارب الفاشلة تفشل قبل أن تبدأ، لأن الفريق لم يحدد ماذا يقيس ومتى يتوقف وماذا سيفعل بالنتيجة، فيبقى ينظر إلى اللوحة كل يوم حتى يرى رقماً يعجبه. لذلك اكتب الوثيقة التالية قبل أن تكتب أي سطر، وهذه وثيقة تجربتنا:
| البند | في تجربتنا | لماذا |
|---|---|---|
| الفرضية Hypothesis | إذا عرضنا على المستخدم الجديد قائمة من ثلاث خطوات تبدأ بربط قناة التنبيه، فإن نسبة من يربط قناة تنبيه خلال 72 ساعة سترتفع من 30% إلى 34.5% على الأقل | الفرضية تذكر التغيير، والمقياس، والرقم المتوقع، والسبب |
| مقياس الهدف Goal Metric | نسبة من سجل حدث alert_connected خلال 72 ساعة من أول تعرض | مقياس واحد يحسم القرار، وهو لحظة التفعيل التي وجدناها في المقال السابق |
| مقياس الحماية Guardrail Metric | نسبة من ألغى التجربة المجانية trial_cancelled | للتأكد أن القائمة لا تزعج المستخدمين فتدفعهم للمغادرة |
| أصغر فرق يهمنا Minimum Detectable Effect | 15% نسبياً، أي من 30% إلى 34.5% | الفرق الأصغر من ذلك لا يستحق أن نبني عليه، ويحتاج عينة أكبر بكثير |
| حجم العينة | 1647 مستخدماً في كل نسخة، أي 3294 على الأقل | نحسبه بعد قليل، ولا نقرر قبل الوصول إليه |
| قاعدة القرار | نعمم القائمة إذا كانت p-value أقل من 0.05 والفرق موجب، ولم يرتفع الإلغاء | تكتب قبل البدء، لكي لا تتغير بعد رؤية النتيجة |
المتطلبات
- Docker مع Docker Compose، وحوالي 4.7 GB لـ Docker Images، منها 2.67 GB لـ GrowthBook وحده و1.28 GB لـ MongoDB.
- المنافذ 18840 لواجهة GrowthBook، و18841 لواجهة البرمجة API، و18842 للتطبيق التجريبي، وكلها على
127.0.0.1فقط. - متصفح لواجهة GrowthBook، وNode.js إذا أردت أن تشغل حاسبة حجم العينة خارج الـ Container.
بناء المختبر
المختبر فيه أربع خدمات، والصورة التالية تبين دور كل منها وكيف تتحرك البيانات بينها:
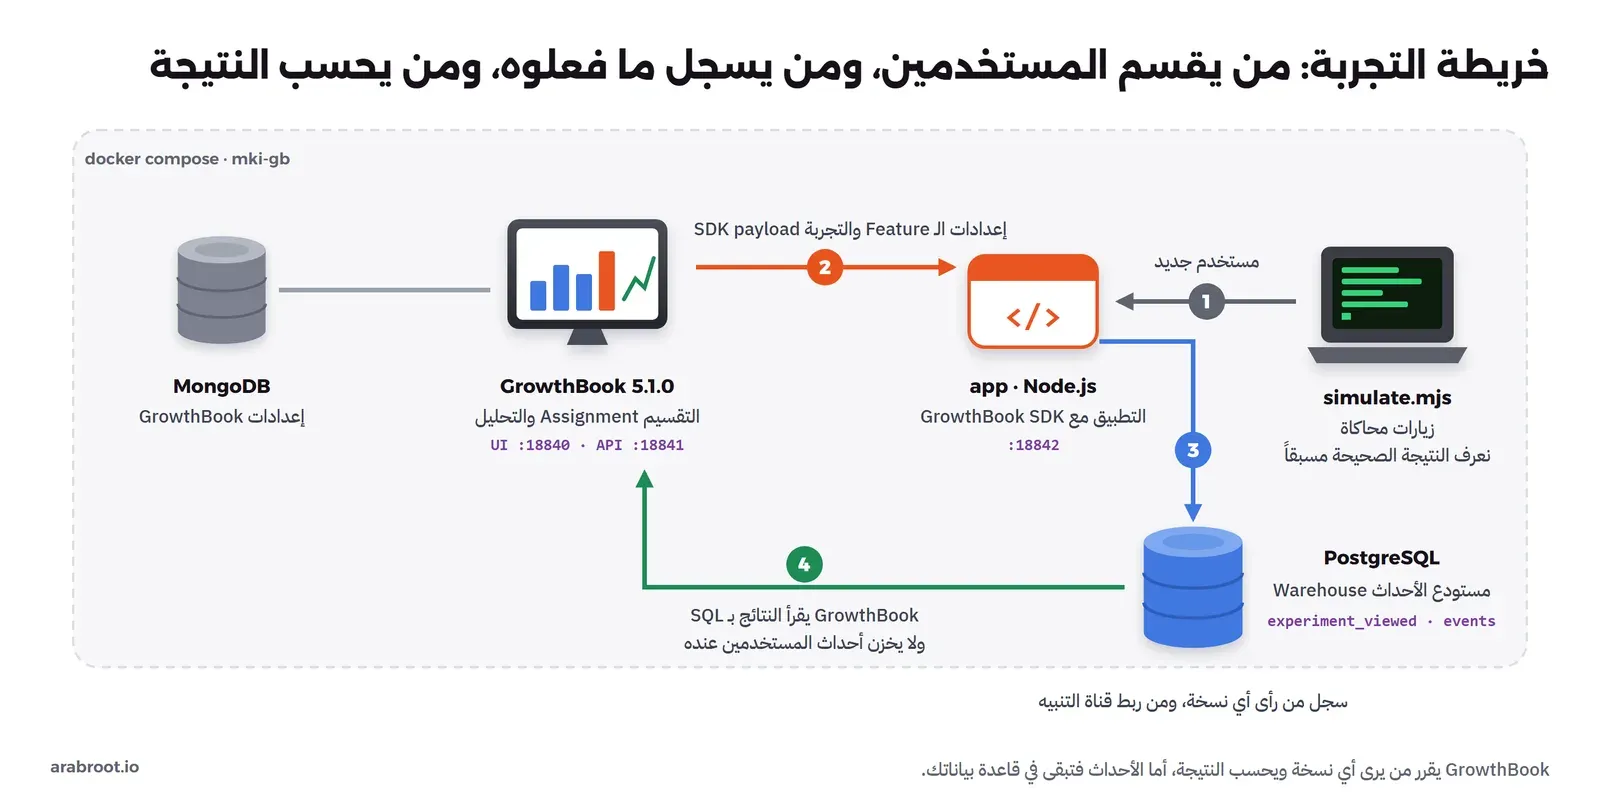
ولاحظ أن GrowthBook لا يستقبل أحداث المستخدمين ولا يخزنها، وإنما يقرأها من قاعدة بياناتك بـ SQL عند كل تحليل، وهذا هو الفرق الأساسي بينه وبين أدوات مثل PostHog التي تجمع الأحداث عندها. وهذا يناسب الشركة التي عندها جدول أحداث أصلاً، ويعني أن بيانات المستخدمين لا تخرج من قاعدة بياناتك.
وشكل المجلد كما يلي:
growth-lab/
  compose.yaml
  warehouse.sql
  .env
  app/
    Dockerfile
    package.json
    server.mjs
    simulate.mjs
    size.mjs
نبدأ بملف .env وفيه كلمات المرور والمفاتيح، ونولدها عشوائياً بدل أن نكتبها بأيدينا:
{ echo "MONGO_PASSWORD=$(openssl rand -hex 16)"; echo "PG_PASSWORD=$(openssl rand -hex 16)"; \
  echo "JWT_SECRET=$(openssl rand -hex 32)"; echo "ENCRYPTION_KEY=$(openssl rand -hex 32)"; } > .env
ثم ملف compose.yaml:
# Growth experiment lab: GrowthBook (assignment + analysis), PostgreSQL as the events warehouse, a demo app.
name: mki-gb
services:
  mongo:                       # GrowthBook's own settings (features, experiments, users)
    image: mongo:8.0.32
    environment:
      MONGO_INITDB_ROOT_USERNAME: root
      MONGO_INITDB_ROOT_PASSWORD: ${MONGO_PASSWORD}
    volumes: [mongodata:/data/db]
  warehouse:                   # the app writes exposures and events here, GrowthBook reads them with SQL
    image: postgres:16.15-alpine
    environment:
      POSTGRES_DB: product
      POSTGRES_USER: product
      POSTGRES_PASSWORD: ${PG_PASSWORD}
    volumes:
      - pgdata:/var/lib/postgresql/data
      - ./warehouse.sql:/docker-entrypoint-initdb.d/warehouse.sql:ro
    healthcheck:
      test: ["CMD", "pg_isready", "-U", "product"]
      interval: 5s
  growthbook:
    image: growthbook/growthbook:5.1.0
    ports:
      - "127.0.0.1:18840:3000"   # web UI
      - "127.0.0.1:18841:3100"   # API and SDK endpoint
    depends_on: [mongo, warehouse]
    environment:
      MONGODB_URI: mongodb://root:${MONGO_PASSWORD}@mongo:27017/growthbook?authSource=admin
      APP_ORIGIN: http://localhost:18840
      API_HOST: http://localhost:18841
      JWT_SECRET: ${JWT_SECRET}
      ENCRYPTION_KEY: ${ENCRYPTION_KEY}
      NODE_ENV: production
    volumes: [uploads:/usr/local/src/app/packages/back-end/uploads]
  app:                         # the demo product: signup page with or without the onboarding checklist
    build: ./app
    ports: ["127.0.0.1:18842:3000"]
    depends_on:
      warehouse: { condition: service_healthy }
    environment:
      DATABASE_URL: postgres://product:${PG_PASSWORD}@warehouse:5432/product
      GB_API_HOST: http://growthbook:3100
      GB_CLIENT_KEY: ${GB_CLIENT_KEY:-}
volumes:
  mongodata:
  pgdata:
  uploads:
في الإعداد أعلاه لاحظ التالي:
- ثبتنا الإصدارات كلها، ومنها
growthbook/growthbook:5.1.0، والسبب أن الوسمlatestفي GrowthBook يتبع الفرع الرئيسي كما يذكر دليل الاستضافة الذاتية. ENCRYPTION_KEYيشفر بيانات الاتصال بقاعدة البيانات التي يحفظها GrowthBook في MongoDB، فإذا ضاع هذا المفتاح فلن يستطيع GrowthBook أن يفتح اتصالاته المحفوظة، لذلك احفظه مع النسخة الاحتياطية.- الـ MongoDB هنا مناسبة للتجربة فقط، ويذكر نفس الدليل أن الإنتاج يحتاج MongoDB مدارة أو قاعدة متوافقة معها.
- كل المنافذ مربوطة على
127.0.0.1، وإذا أردت أن تفتح الواجهة لفريقك فضعها خلف Reverse Proxy مع TLS.
وملف warehouse.sql ينشئ الجدولين عند أول تشغيل لـ PostgreSQL:
-- Two tables are enough for an experiment: who saw which variation, and what users did.
CREATE TABLE experiment_viewed (
  user_id       TEXT NOT NULL,
  experiment_id TEXT NOT NULL,
  variation_id  TEXT NOT NULL,
  timestamp     TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE TABLE events (
  user_id   TEXT NOT NULL,
  event     TEXT NOT NULL,          -- signup, alert_connected, trial_cancelled
  timestamp TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE INDEX ON experiment_viewed (experiment_id, user_id);
CREATE INDEX ON events (event, user_id);
التطبيق التجريبي
التطبيق يمثل الشاشة الأولى بعد التسجيل في أداة مراقبة خوادم، فإذا كانت ميزة onboarding-checklist مفعلة للمستخدم رأى القائمة، وإلا رأى لوحة فارغة. والملف app/package.json يثبت نسخ المكتبتين:
{
  "name": "mki-growth-app",
  "private": true,
  "type": "module",
  "dependencies": {
    "@growthbook/growthbook": "1.8.0",
    "pg": "8.23.1"
  }
}
والملف app/Dockerfile:
FROM node:24.22.1-bookworm-slim
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY *.mjs ./
USER node
CMD ["node", "server.mjs"]
والتطبيق نفسه app/server.mjs:
// Demo product: the first screen after signup, with or without the onboarding checklist.
// GrowthBook decides the variation (feature "onboarding-checklist"); the app records exposures and events in PostgreSQL.
import http from 'node:http';
import pg from 'pg';
import { GrowthBook } from '@growthbook/growthbook';

const db = new pg.Pool({ connectionString: process.env.DATABASE_URL });
const { GB_API_HOST, GB_CLIENT_KEY } = process.env;

// The SDK payload (features and experiment rules) is fetched from GrowthBook and refreshed every 10 seconds
let payload = { features: {} };
async function refresh() {
    if (!GB_CLIENT_KEY) return;
    try { payload = await (await fetch(`${GB_API_HOST}/api/features/${GB_CLIENT_KEY}`)).json(); }
    catch (e) { console.error('cannot load features:', e.message); }   // keep the last payload; defaults apply if none
}
await refresh();
setInterval(refresh, 10_000);

function gbFor(userId) {
    const gb = new GrowthBook({
        attributes: { id: userId },
        // called when the user is put into a variation of a running experiment
        trackingCallback: (experiment, result) =>
            db.query('INSERT INTO experiment_viewed (user_id, experiment_id, variation_id) VALUES ($1, $2, $3)',
                [userId, experiment.key, String(result.key)]).catch(e => console.error(e.message)),
    });
    gb.initSync({ payload });
    return gb;
}

const page = (uid, checklist) => `<!doctype html><html lang="ar" dir="rtl"><meta charset="utf-8"><title>مرحباً</title>
<body style="font-family:system-ui;max-width:640px;margin:40px auto;line-height:1.8">
<h1>أهلاً بك في مراقب الخوادم</h1><p>المستخدم: <code>${uid}</code></p>
${checklist ? `<h2>ابدأ في ثلاث خطوات</h2><ol>
<li>أضف أول خادم تريد مراقبته</li><li><b>اربط قناة التنبيه Alert Channel</b>: Slack أو البريد أو SMS</li><li>جرب تنبيهاً تجريبياً</li></ol>`
        : `<p>لوحة التحكم فارغة، أضف خادماً من القائمة.</p>`}
<button>اربط قناة التنبيه</button></body></html>`;

http.createServer(async (req, res) => {
    const url = new URL(req.url, 'http://app');
    const uid = url.searchParams.get('uid');
    try {
        if (url.pathname === '/start' && uid) {                  // first screen after signup
            await db.query('INSERT INTO events (user_id, event) VALUES ($1, $2)', [uid, 'signup']);
            const checklist = gbFor(uid).isOn('onboarding-checklist');
            if (url.searchParams.get('format') === 'json') {
                res.writeHead(200, { 'content-type': 'application/json' }).end(JSON.stringify({ uid, checklist }));
            } else res.writeHead(200, { 'content-type': 'text/html; charset=utf-8' }).end(page(uid, checklist));
        } else if (url.pathname === '/event' && uid && req.method === 'POST') {
            await db.query('INSERT INTO events (user_id, event) VALUES ($1, $2)', [uid, url.searchParams.get('name')]);
            res.writeHead(204).end();
        } else res.writeHead(404).end();
    } catch (e) { res.writeHead(500).end(e.message); }
}).listen(3000, () => console.log('app on :3000, client key', GB_CLIENT_KEY ? 'set' : 'missing (everyone sees the default)'));
في الكود أعلاه لاحظ التالي:
- التطبيق يجلب إعدادات الـ Features من GrowthBook كل 10 ثوان ويحفظها في الذاكرة، ثم يقرر النسخة لكل مستخدم محلياً دون أي طلب شبكة، وإذا توقف GrowthBook يبقى التطبيق يعمل بآخر إعدادات وصلته، وهذا ما شرحناه في مقال Feature Flags.
- التقسيم يعتمد على هاش Hash لمعرف المستخدم
id، فنفس المستخدم يرى نفس النسخة في كل زيارة دون أن نحفظ شيئاً. - الدالة
trackingCallbackهي أهم سطر في التجربة، لأنها تسجل أن هذا المستخدم دخل التجربة ورأى النسخة كذا، وبدونها لا يعرف GrowthBook من رأى ماذا، وسوف نرى بعد قليل خطأ فيها يضيع بعض التحويلات.
بعد ذلك نشغل الخدمات:
docker compose up -d --buildوننتظر حتى يجيب GrowthBook على فحص الصحة:
curl -s http://127.0.0.1:18841/healthcheck{"status":200,"healthy":true}إعداد GrowthBook
افتح http://localhost:18840 وأنشئ الحساب الأول، وهو يصبح مدير الجهة تلقائياً، ثم نحتاج أربعة أشياء في الواجهة. والإعداد الأول هو مصدر البيانات Data Source من Metrics and Data ← Data Sources، نختار PostgreSQL ونكتب اسم الخدمة warehouse كعنوان لأن GrowthBook يتصل بها من داخل شبكة Docker، ثم نضيف استعلام التعرض Experiment Assignment Query الذي يقول لـ GrowthBook من رأى أي نسخة:
SELECT user_id, timestamp, experiment_id, variation_id FROM experiment_viewed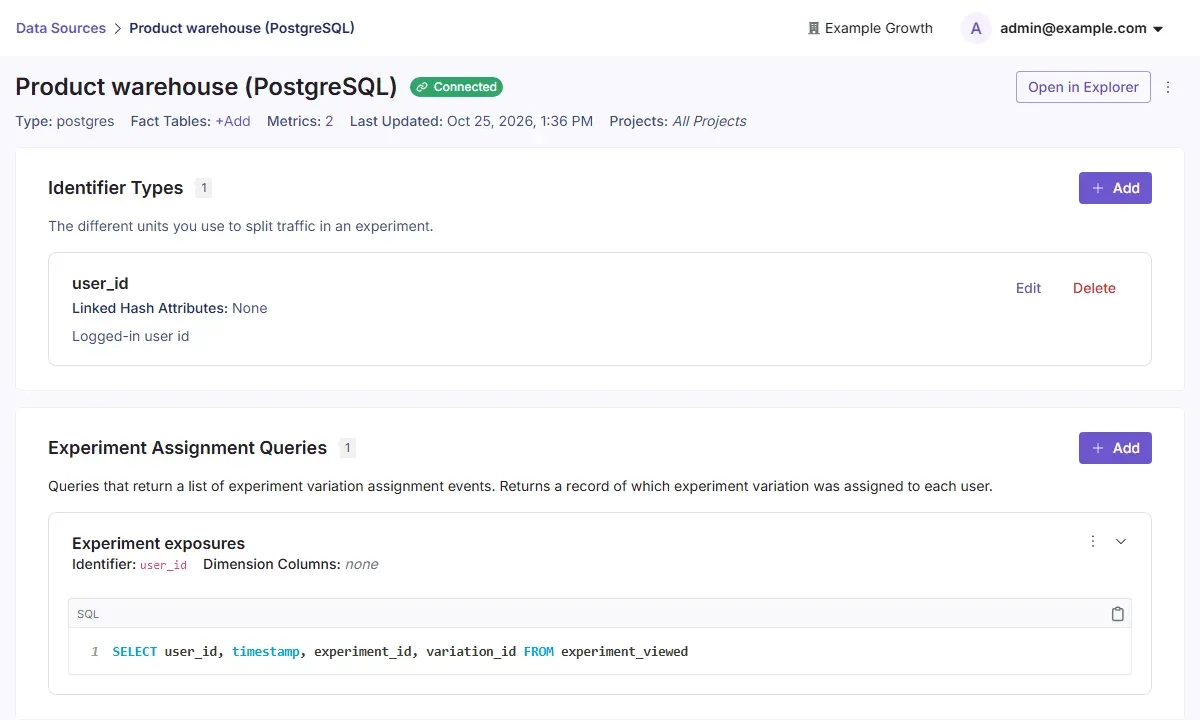
والإعداد الثاني هو المقياسان من Metrics، كلاهما من نوع Binomial، أي نسبة من قام بالحدث، وكل منهما باستعلام بسيط ونافذة تحويل Conversion Window مدتها 72 ساعة من أول تعرض:
-- مقياس الهدف: ربط قناة التنبيه Alert connected
SELECT user_id, timestamp FROM events WHERE event = 'alert_connected'
-- مقياس الحماية: إلغاء التجربة Trial cancelled (Inverse: الأقل أفضل)
SELECT user_id, timestamp FROM events WHERE event = 'trial_cancelled'
والإعداد الثالث هو اتصال الـ SDK من SDK Configuration ← SDK Connections، نختار Node.js وبيئة production، فيعطينا مفتاح عميل يبدأ بـ sdk-. وهذا المفتاح ليس سراً، فهو يقرأ إعدادات الـ Features فقط، ولذلك نضعه في .env ونعيد تشغيل التطبيق:
echo "GB_CLIENT_KEY=sdk-xxxxxxxxxxxxxxxx" >> .env
docker compose up -d app
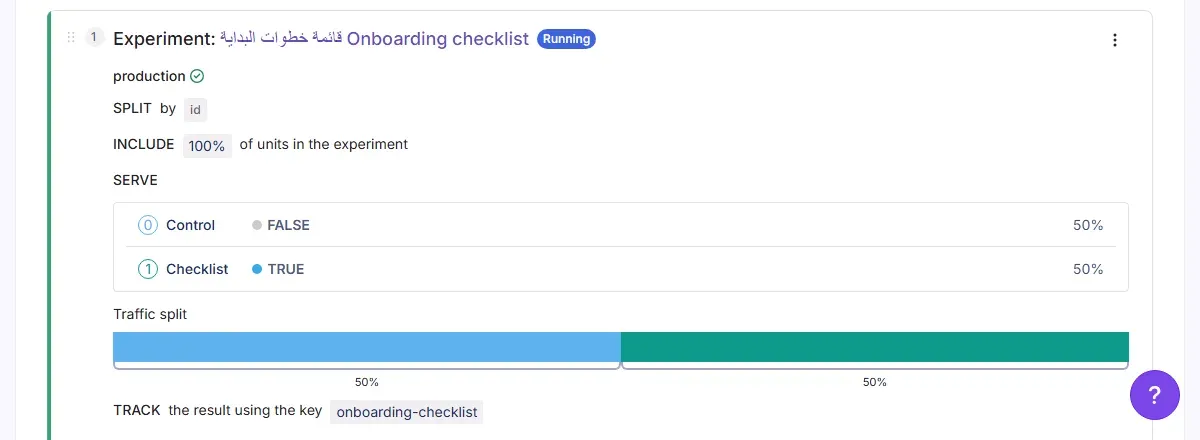
والإعداد الرابع هو التجربة نفسها: ننشئ ميزة Feature من نوع Boolean باسم onboarding-checklist وقيمتها الافتراضية false، ونضيف لها قاعدة تجربة Experiment Rule تقسم المستخدمين 50% و50% حسب id، ونكتب في التجربة الفرضية ومقياس الهدف ومقياس الحماية ونختار المحرك الإحصائي Frequentist لكي يتطابق مع طريقة حساب حجم العينة. ثم ننشر التعديل ونبدأ التجربة، وهذا ما فعلناه بواجهة البرمجة REST API لأنها تسمح بأتمتة نفس الخطوات في CI:
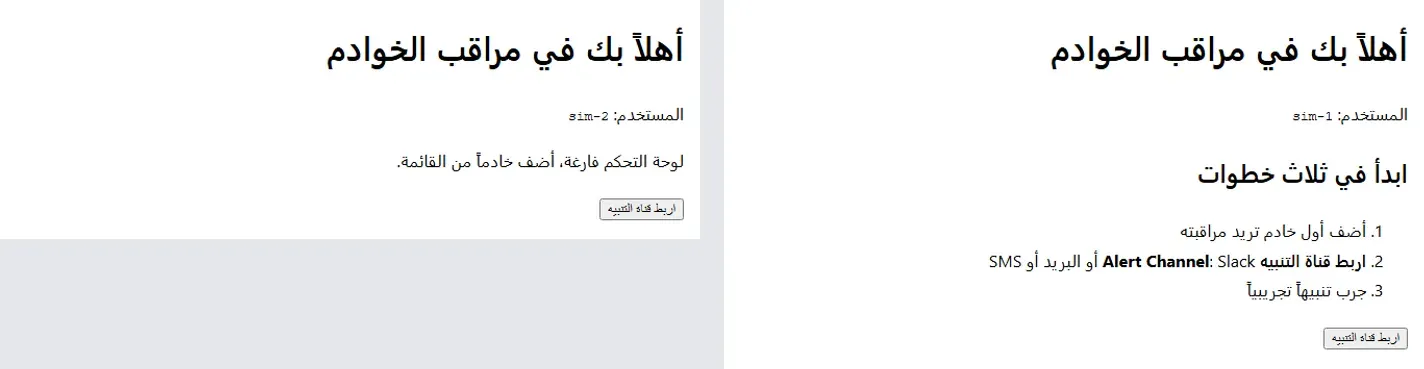
والآن نتأكد أن التطبيق يقسم المستخدمين فعلاً، فنفتح الصفحة لمستخدمين مختلفين، والصورة التالية تبين النسختين:
كم مستخدماً نحتاج؟
حجم العينة يعتمد على أربعة أرقام: النسبة الحالية 30%، وأصغر فرق يهمنا 15% نسبياً، ومستوى الدلالة 5%، وقوة الاختبار Statistical Power وهي 80%، أي احتمال أن نكتشف الفرق إذا كان موجوداً فعلاً. والملف app/size.mjs يحسبه بنفس معادلة حاسبة Evan Miller:
// Sample size per variation for a conversion metric (two-sided test, normal approximation),
// the same formula as Evan Miller's calculator.
//   node size.mjs <baseline> <relative-lift> [alpha] [power]
const [p1, lift, alpha = 0.05, power = 0.8] = process.argv.slice(2).map(Number);

// standard normal quantile (Acklam's rational approximation, error below 1.2e-9)
function quantile(p) {
    const a = [-39.69683028665376, 220.9460984245205, -275.9285104469687, 138.357751867269, -30.66479806614716, 2.506628277459239];
    const b = [-54.47609879822406, 161.5858368580409, -155.6989798598866, 66.80131188771972, -13.28068155288572];
    const c = [-0.007784894002430293, -0.3223964580411365, -2.400758277161838, -2.549732539343734, 4.374664141464968, 2.938163982698783];
    const d = [0.007784695709041462, 0.3224671290700398, 2.445134137142996, 3.754408661907416];
    if (p > 0.5) return -quantile(1 - p);
    if (p < 0.02425) {
        const r = Math.sqrt(-2 * Math.log(p));
        return (((((c[0] * r + c[1]) * r + c[2]) * r + c[3]) * r + c[4]) * r + c[5]) / ((((d[0] * r + d[1]) * r + d[2]) * r + d[3]) * r + 1);
    }
    const r = p - 0.5, s = r * r;
    return (((((a[0] * s + a[1]) * s + a[2]) * s + a[3]) * s + a[4]) * s + a[5]) * r / (((((b[0] * s + b[1]) * s + b[2]) * s + b[3]) * s + b[4]) * s + 1);
}

const zA = quantile(1 - alpha / 2), zB = quantile(power);
const p2 = p1 * (1 + lift), delta = p2 - p1;
const n = Math.ceil(((zA * Math.sqrt(2 * p1 * (1 - p1)) + zB * Math.sqrt(p1 * (1 - p1) + p2 * (1 - p2))) / delta) ** 2);
console.log(`baseline ${(100 * p1).toFixed(1)}% -> ${(100 * p2).toFixed(1)}% (relative lift ${(100 * lift).toFixed(0)}%), alpha ${alpha}, power ${power}`);
console.log(`z(1-alpha/2) = ${zA.toFixed(4)}, z(power) = ${zB.toFixed(4)}`);
console.log(`users per variation: ${n}, both variations: ${2 * n}`);
ونشغله داخل Container التطبيق لثلاثة أحجام للفرق:
docker compose exec -T app node --version
docker compose exec -T app node size.mjs 0.30 0.15
docker compose exec -T app node size.mjs 0.30 0.10
docker compose exec -T app node size.mjs 0.30 0.063
والمخرج سوف يكون كما يلي:
v24.22.1
baseline 30.0% -> 34.5% (relative lift 15%), alpha 0.05, power 0.8
z(1-alpha/2) = 1.9600, z(power) = 0.8416
users per variation: 1647, both variations: 3294
baseline 30.0% -> 33.0% (relative lift 10%), alpha 0.05, power 0.8
z(1-alpha/2) = 1.9600, z(power) = 0.8416
users per variation: 3692, both variations: 7384
baseline 30.0% -> 31.9% (relative lift 6%), alpha 0.05, power 0.8
z(1-alpha/2) = 1.9600, z(power) = 0.8416
users per variation: 9276, both variations: 18552
وفي المخرج أعلاه لاحظ أن الفرق النسبي 15% يحتاج 1647 مستخدماً في كل نسخة، وإذا أردنا أن نكتشف فرقاً أصغر بالثلث، أي 10%، احتجنا 3692، وفرق 6% يحتاج أكثر من 9 آلاف في كل نسخة. والسطر الأخير سوف نحتاجه عند القرار، لأن 6.3% هو الفرق الذي ظهر في النتيجة النهائية. ولو كانت شركتك تستقبل 330 تسجيلاً في الأسبوع، كما في مقال التفعيل والاحتفاظ، فإن تجربة الـ 15% تحتاج عشرة أسابيع، وتجربة الـ 10% تحتاج أكثر من 22 أسبوعاً، وهذا هو السبب في أن الشركات الصغيرة يجب أن تختبر التغييرات الكبيرة لا التفاصيل الصغيرة.
تشغيل التجربة بزيارات محاكاة
الملف app/simulate.mjs يمثل المستخدمين الجدد، ويعطي كل مستخدم رقماً عشوائياً ثابتاً مشتقاً من معرفه، لكي يعطي نفس النتيجة في كل تشغيل:
// Simulated traffic: N new users open the first screen, then "decide" whether to connect an alert channel.
// The behaviour is ours, not real people's: the true rates below are assumptions, so we know the right answer
// in advance and can check whether the experiment finds it.
//   node simulate.mjs <users> <first-user-number>
const APP = process.env.APP_URL || 'http://app:3000';
const TRUE_RATE = { control: 0.30, checklist: 0.345 };   // alert_connected: +15% relative, the effect we hope to detect
const CANCEL_RATE = 0.06;                                // trial_cancelled: same in both, the guardrail should stay flat

// deterministic random number per user and purpose (a string hash fed to mulberry32), so runs are repeatable
function rand(seedText) {
    let h = 1779033703;
    for (const c of seedText) { h = Math.imul(h ^ c.charCodeAt(0), 3432918353); h = (h << 13) | (h >>> 19); }
    let t = (h += 0x6D2B79F5);
    t = Math.imul(t ^ (t >>> 15), t | 1); t ^= t + Math.imul(t ^ (t >>> 7), t | 61);
    return ((t ^ (t >>> 14)) >>> 0) / 4294967296;
}

const [n, from] = process.argv.slice(2).map(Number);
const seen = { control: 0, checklist: 0 }, conv = { control: 0, checklist: 0 };
for (let i = from; i < from + n; i++) {
    const uid = `sim-${i}`;
    const { checklist } = await (await fetch(`${APP}/start?uid=${uid}&format=json`)).json();
    const arm = checklist ? 'checklist' : 'control';
    seen[arm]++;
    if (rand(uid + ':alert') < TRUE_RATE[arm]) {
        conv[arm]++;
        await fetch(`${APP}/event?uid=${uid}&name=alert_connected`, { method: 'POST' });
    }
    if (rand(uid + ':cancel') < CANCEL_RATE) await fetch(`${APP}/event?uid=${uid}&name=trial_cancelled`, { method: 'POST' });
}
for (const arm of ['control', 'checklist'])
    console.log(`${arm.padEnd(10)} users ${String(seen[arm]).padStart(5)}  alert_connected ${String(conv[arm]).padStart(5)}  ${(100 * conv[arm] / seen[arm]).toFixed(1)}%`);
النظرة المبكرة: 600 مستخدم
نبدأ بـ 600 مستخدم فقط، كما يحدث في الأيام الأولى لأي تجربة:
docker compose exec -T app node simulate.mjs 600 1control users 295 alert_connected 75 25.4%
checklist users 305 alert_connected 96 31.5%ثم نحدث النتائج في GrowthBook من زر Update في تبويب Results، فتظهر الصورة التالية:
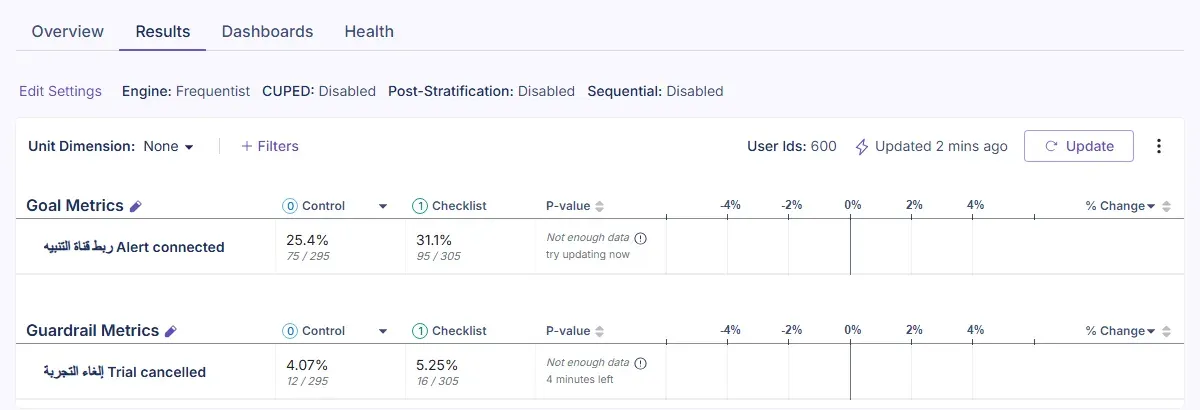
الفرق يبدو كبيراً: 25.4% مقابل 31.1%، وقد يتحمس أحد في الفريق ويقول «القائمة رفعت التفعيل 22%، لنعممها اليوم». ولكن GrowthBook يكتب Not enough data بدل p-value، والسبب أنه يخفي النتيجة حتى يصل عدد التحويلات في النسخة الأساسية إلى حد أدنى، والقيمة الافتراضية لهذا الحد 150 كما في الكود المصدري للإصدار 5.1.0، ويذكر توثيق التجارب أن الهدف منه منع النظر المبكر Peeking. وقرأنا القيم من واجهة البرمجة لكي نرى ما تخفيه الواجهة:
users 600  SRM p-value 0.6831
## ربط قناة التنبيه Alert connected
  Control    users   295  conversions   75  rate 25.42%
  Checklist  users   305  conversions   95  rate 31.15%  change +22.5%  CI [-9.0%, +54.1%]  p-value 0.162
## إلغاء التجربة Trial cancelled
  Control    users   295  conversions   12  rate  4.07%
  Checklist  users   305  conversions   16  rate  5.25%  change +29.0%  CI [-65.5%, +123.4%]  p-value 0.547
فترة الثقة Confidence Interval للفرق تمتد من 9% سالب إلى 54% موجب، أي أن البيانات حتى الآن تقبل أن تكون القائمة ضارة أو مفيدة جداً، والـ p-value هي 0.162، فلا يوجد ما نقرره. وهذا ما يشرحه Evan Miller في مقال How Not To Run an A/B Test: من ينظر إلى النتيجة كل يوم ويتوقف عند أول دلالة إحصائية يرفع نسبة النتائج الكاذبة كثيراً، والحل أن تحدد حجم العينة قبل البدء وتلتزم به.
النتيجة النهائية: 3400 مستخدم
نكمل حتى 3400 مستخدم، أي أكثر من 3294 التي حسبناها:
docker compose exec -T app node simulate.mjs 2800 601control users 1426 alert_connected 442 31.0%
checklist users 1374 alert_connected 442 32.2%ونحدث النتائج مرة أخرى:
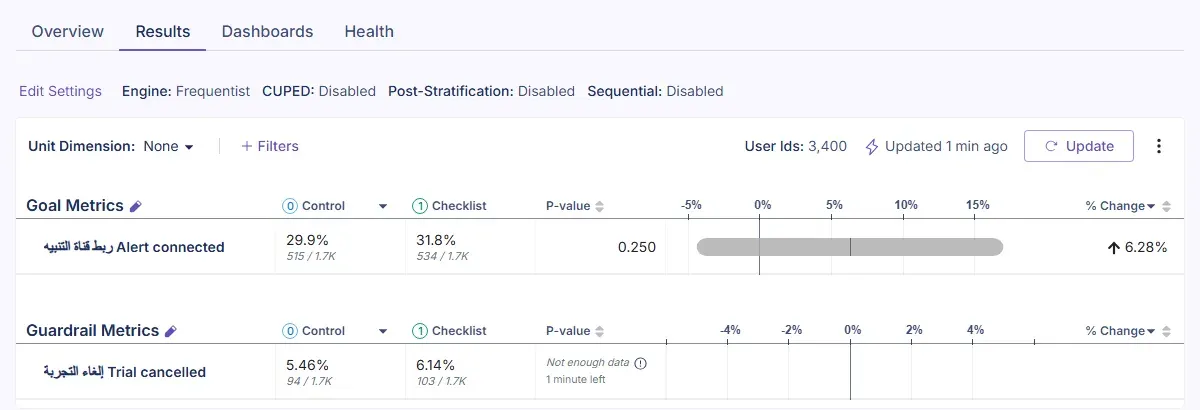
ونفس الأرقام من واجهة البرمجة، عبر سكربت صغير results.py يطبع الحقول المهمة من رد /api/v1/experiments/<id>/results:
curl -s -H "Authorization: Bearer $GB_SECRET" http://localhost:18841/api/v1/experiments/<id>/results \
  | docker run --rm -i -v "$(pwd)":/lab -w /lab python:3.13.17-slim python3 results.py
users 3400 SRM p-value 0.4713
## ربط قناة التنبيه Alert connected
Control users 1721 conversions 515 rate 29.92%
Checklist users 1679 conversions 534 rate 31.80% change +6.3% CI [-4.4%, +17.0%] p-value 0.250
## إلغاء التجربة Trial cancelled
Control users 1721 conversions 94 rate 5.46%
Checklist users 1679 conversions 103 rate 6.13% change +12.3% CI [-18.2%, +42.8%] p-value 0.428وقبل أن نقرأ الفرق نتأكد أن التقسيم نفسه سليم، ففي تبويب Health يفحص GrowthBook عدم تطابق نسبة العينة Sample Ratio Mismatch، أي هل وصل إلى كل نسخة عدد قريب من المتوقع:
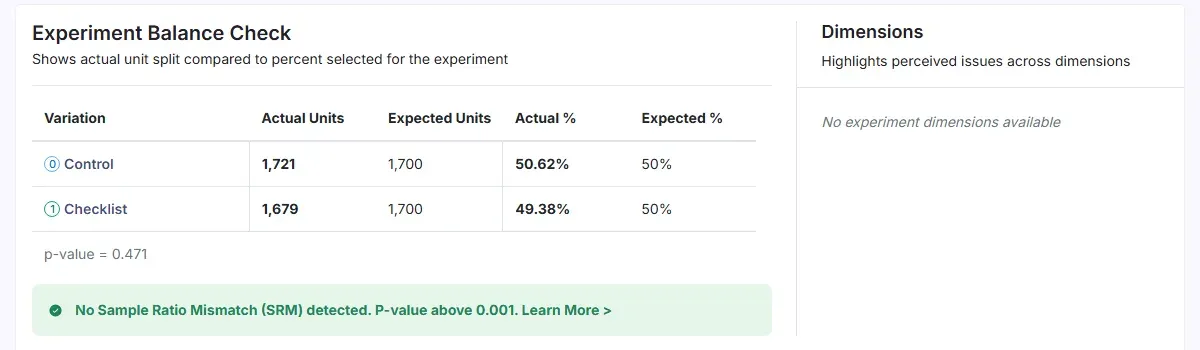
ولو كان الفرق بين النسختين كبيراً، مثل 2000 مقابل 1400 في تقسيم 50% و50%، لكان هذا دليلاً على خطأ في التطبيق، مثل أن نسخة تتعطل قبل أن تسجل التعرض، وعندها لا قيمة لأي نتيجة حتى تصلح الخطأ.
نجرب العطل: تحويلات ضاعت قبل أن يسجل التعرض
إذا قارنت أرقام GrowthBook بأرقام السكربت وجدت فرقاً صغيراً، فسألنا قاعدة البيانات مباشرة عن عدد من ربط قناة التنبيه في كل نسخة:
docker exec mki-gb-warehouse-1 psql -U product -c "SELECT v.variation_id, COUNT(DISTINCT v.user_id) AS users, COUNT(DISTINCT e.user_id) FILTER (WHERE e.event='alert_connected') AS alert_connected FROM experiment_viewed v LEFT JOIN events e ON e.user_id = v.user_id GROUP BY 1 ORDER BY 1" variation_id | users | alert_connected
--------------+-------+-----------------
0 | 1721 | 517
1 | 1679 | 538
(2 rows)قاعدة البيانات فيها 517 و538، وGrowthBook حسب 515 و534، أي أن 6 تحويلات لم تحسب. والسبب أن GrowthBook يعد الحدث فقط إذا وقع بعد أول تعرض للمستخدم، وهذا صحيح منطقياً، فنبحث عن الأحداث التي سبقت التعرض:
docker exec mki-gb-warehouse-1 psql -U product -c "SELECT v.variation_id, COUNT(*) AS alert_before_exposure, ROUND(AVG(EXTRACT(EPOCH FROM v.timestamp - e.timestamp)*1000)) AS avg_ms_late FROM experiment_viewed v JOIN events e ON e.user_id = v.user_id AND e.event = 'alert_connected' WHERE e.timestamp < v.timestamp GROUP BY 1 ORDER BY 1" variation_id | alert_before_exposure | avg_ms_late
--------------+-----------------------+-------------
0 | 2 | 1
1 | 4 | 0
(2 rows)وجدنا 2 و4 مستخدمين، وهو نفس الفرق تماماً، وسجل التعرض عندهم متأخراً بأقل من ملي ثانية. والسبب في الكود: الدالة trackingCallback تكتب التعرض في قاعدة البيانات دون await، فيرد التطبيق على المستخدم ويرسل المستخدم طلب الحدث التالي قبل أن تنتهي كتابة التعرض. وفي تجربتنا ضاع 6 من 1055 تحويلاً، ولكن في تطبيق حقيقي يرسل التعرض إلى خدمة تحليلات عبر الشبكة قد يتأخر التعرض ثوان، وقد يضيع كلياً إذا أغلق المستخدم الصفحة، وعندها تتحيز النتيجة دون أن تنتبه.
والحل أن تسجل التعرض قبل أن تعرض النسخة للمستخدم، أو أن تضيف هامشاً زمنياً في استعلام المقياس، والأول أفضل لأنه يصلح السبب لا النتيجة.
القرار: ماذا نفعل بنتيجة غير حاسمة؟
لنقرأ النتيجة النهائية بهدوء:
- النسخة Checklist أعلى بـ 6.3% نسبياً، ولكن فترة الثقة من 4.4% سالب إلى 17% موجب، وp-value تساوي 0.250، أي أن قاعدة القرار التي كتبناها قبل البدء لم تتحقق.
- نحن نعرف أن الأثر الحقيقي 15% لأننا كتبناه في السكربت، والتجربة لم تكتشفه. وهذا ليس خطأ في GrowthBook، وإنما معنى قوة 80%: من كل خمس تجارب لها أثر حقيقي بهذا الحجم، تفوت واحدة تقريباً بسبب العشوائية وحدها، ونتيجتنا كانت من هذه الحالات.
- مقياس الحماية لم يصل إلى الحد الأدنى من البيانات، فلا نستطيع أن نقول إن القائمة لا ترفع الإلغاء.
وقد يتساءل البعض: إذا كان الفرق موجباً فلماذا لا نعمم القائمة؟ والإجابة أن هذا ممكن كقرار منتج، فالقائمة رخيصة ولا يوجد دليل على ضرر، ولكن يجب أن يكتب على أنه قرار منتج لا نتيجة تجربة، لأن البيانات لا تفرق بين أثر 0% وأثر 15%. وأما الخيار الذي يغري الفرق كثيراً، وهو أن نكمل نفس التجربة أسبوعاً آخر حتى تصبح دالة، فهو نفس مشكلة النظر المبكر، لأنك غيرت حجم العينة بعد أن رأيت النتيجة. والجدول التالي يجمع الخيارات:
| الخيار | متى يناسب | المشكلة |
|---|---|---|
| إبقاء النسخة الحالية Control | التغيير مكلف في الصيانة، أو له مخاطر | قد تخسر أثراً حقيقياً لم تكتشفه التجربة |
| التعميم كقرار منتج | التغيير رخيص، والنقطة الوسطى موجبة، ولا دليل على ضرر | لا تستطيع أن تنسب أي تحسن لاحق إلى القائمة |
| إطالة نفس التجربة | لا يناسب | نظر مبكر بشكل آخر، يرفع النتائج الكاذبة |
| تجربة جديدة بعينة جديدة | الفرق مهم ويستحق الانتظار | فرق 10% يحتاج 3692 في كل نسخة، أي أكثر من خمسة أشهر بمعدل 330 تسجيلاً في الأسبوع |
وقرارنا في هذه التجربة: النتيجة غير حاسمة، فنبقي النسخة الحالية، ونعيد تصميم القائمة لكي يكون أثرها أكبر، مثل أن تربط قناة التنبيه في نفس الشاشة بدل أن تشرح الخطوة، ثم نختبرها في تجربة جديدة. ونسجل القرار وسببه في GrowthBook نفسه عند إيقاف التجربة، لكي يجده من يأتي بعدنا:
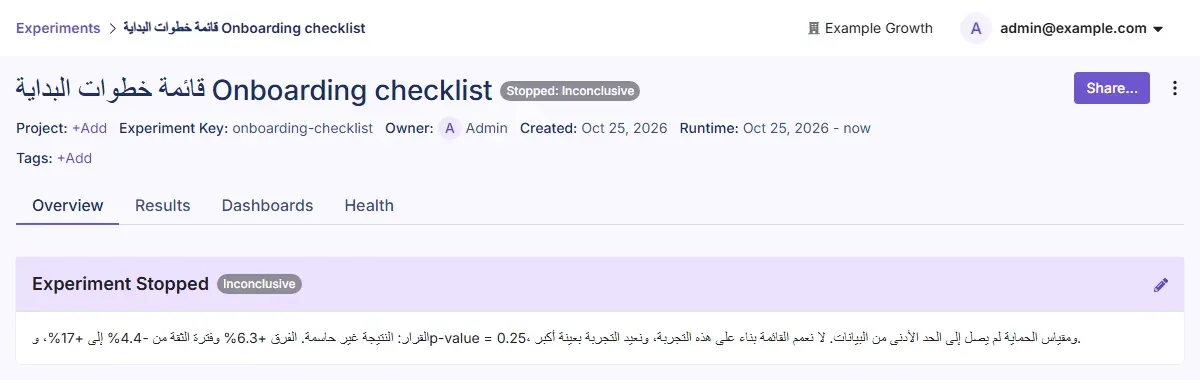
ولاحظ في الصورة أعلاه أن GrowthBook يحفظ النص العربي ويعرضه، ولكنه يعرضه من اليسار إلى اليمين، فتنتقل علامة % والنقطة إلى أماكن خاطئة، ونفس الشيء يحدث في حقل الفرضية. وهذا لا يغير أي حساب، ولكن إذا كان فريقك يكتب بالعربية فاكتب النتائج في الوثيقة الأصلية للتجربة وضع رابطها في GrowthBook، أو اكتب في GrowthBook بالإنجليزية.
كيف يقال «غير حاسمة» للإدارة؟
أصعب جزء في هذه التجربة لم يكن الإحصاء، وإنما الاجتماع الذي عرضت فيه النتيجة. فالإدارة كانت تنتظر «نعم» أو «لا»، والنتيجة «لا نعرف بعد». فكتب الفريق الملخص بثلاث جمل لا تحتاج إحصاء: جربنا القائمة على 3400 مستخدم جديد، وكانت النسخة الجديدة أعلى بـ 6.3% لكن هذا الفرق قد يكون صدفة، وحجم التجربة لا يكفي ليفرق بين أثر صغير وعدم وجود أثر. ثم جملة رابعة بالقرار: نبقي النسخة الحالية، ونختبر نسخة أقوى في عشرة أسابيع. ولم يعرض الفريق رقم 22.5% الذي ظهر بعد 600 مستخدم، لأن الرقم المبكر يبقى في الذاكرة أكثر من النهائي، ويعود في كل نقاش لاحق كأنه نتيجة.
والطريقة نفسها تصلح لكل نتيجة: ما جربنا، وماذا رأينا، وكم نثق فيه، وماذا قررنا. ومن يكتبها بهذا الترتيب لا يحتاج أن يشرح فترة الثقة لأحد، لكنه يحتاج أن يعرفها هو.
تجربة ثانية بلا خوادم: لماذا ننتظر الحجم المخطط؟
في القصة اعترض أحد أعضاء الفريق على القرار: «كانت النتيجة بعد 600 مستخدم 22.5%، فلماذا لا نتوقف عند أول نتيجة دالة بدل أن ننتظر 3400؟». والإجابة في المقال كانت مبدأ، والمبدأ يقنع أقل من الرقم. فكتبنا محاكاة صغيرة بمكتبة Python القياسية وحدها، لا تحتاج GrowthBook ولا قاعدة بيانات، تجري آلاف التجارب الوهمية وتعد كم منها يعطي نتيجة «دالة» في كل حالة، ونحفظها باسم lab/peeking.py:
# Why the article waited for the planned sample: simulated A/A tests with daily peeking, and the power of the real 30% -> 34.5% test
import math, random

def p_value(c1, n1, c2, n2):
    p = (c1 + c2) / (n1 + n2)
    se = math.sqrt(p * (1 - p) * (1 / n1 + 1 / n2))
    if se == 0:
        return 1.0
    z = abs(c1 / n1 - c2 / n2) / se
    return math.erfc(z / math.sqrt(2))          # two-sided

def run(rate_a, rate_b, users=3400, look_every=200, rnd=random.Random(1)):
    ca = cb = na = nb = 0
    peeked = False
    for i in range(1, users + 1):
        if rnd.random() < 0.5:
            na += 1; ca += rnd.random() < rate_a
        else:
            nb += 1; cb += rnd.random() < rate_b
        if i % look_every == 0 and i < users and p_value(ca, na, cb, nb) < 0.05:
            peeked = True                        # a team that peeks would have stopped here
    return peeked or p_value(ca, na, cb, nb) < 0.05, p_value(ca, na, cb, nb) < 0.05

SIMS = 2000
rnd = random.Random(2026)
aa = [run(0.30, 0.30, rnd=rnd) for _ in range(SIMS)]
print(f"A/A tests (no real difference), {SIMS} runs of 3400 users:")
print(f"  'significant' at the planned end only:       {sum(f for _, f in aa) / SIMS:.1%}")
print(f"  'significant' at any of 16 peeks or the end: {sum(p for p, _ in aa) / SIMS:.1%}")
ab = [run(0.30, 0.345, rnd=rnd) for _ in range(SIMS)]
print(f"A/B tests with the real +15% lift: detected at the planned end in {sum(f for _, f in ab) / SIMS:.1%} of runs")
في الكود أعلاه لاحظ التالي:
- الدالة
p_valueاختبار الفرق بين نسبتين Two-proportion z-test، وهو الاختبار نفسه الذي يقابل حساب حجم العينة في المقال. - كل تجربة 3400 مستخدم يقسمون عشوائياً بين نسختين، ويحسب السكربت الدلالة كل 200 مستخدم، أي 16 مرة قبل النهاية، كما يفعل من يفتح لوحة النتائج كل يوم.
- تجارب A/A نسختاها متطابقتان، أي 30% و30%، فكل نتيجة «دالة» فيها كاذبة بالتعريف. وتجارب A/B فيها الأثر الحقيقي نفسه الذي كتبناه في محاكاة الزيارات، من 30% إلى 34.5%.
- المولد العشوائي ببذرة ثابتة، فمن يعيد التشغيل يحصل على الأرقام نفسها.
ونشغله:
docker run --rm -v "$(pwd)/lab:/w" -w /w python:3.13.17-slim python peeking.pyوالمخرج بعد نحو 26 ثانية سوف يكون كما يلي:
A/A tests (no real difference), 2000 runs of 3400 users:
  'significant' at the planned end only:       6.2%
  'significant' at any of 16 peeks or the end: 23.8%
A/B tests with the real +15% lift: detected at the planned end in 80.8% of runs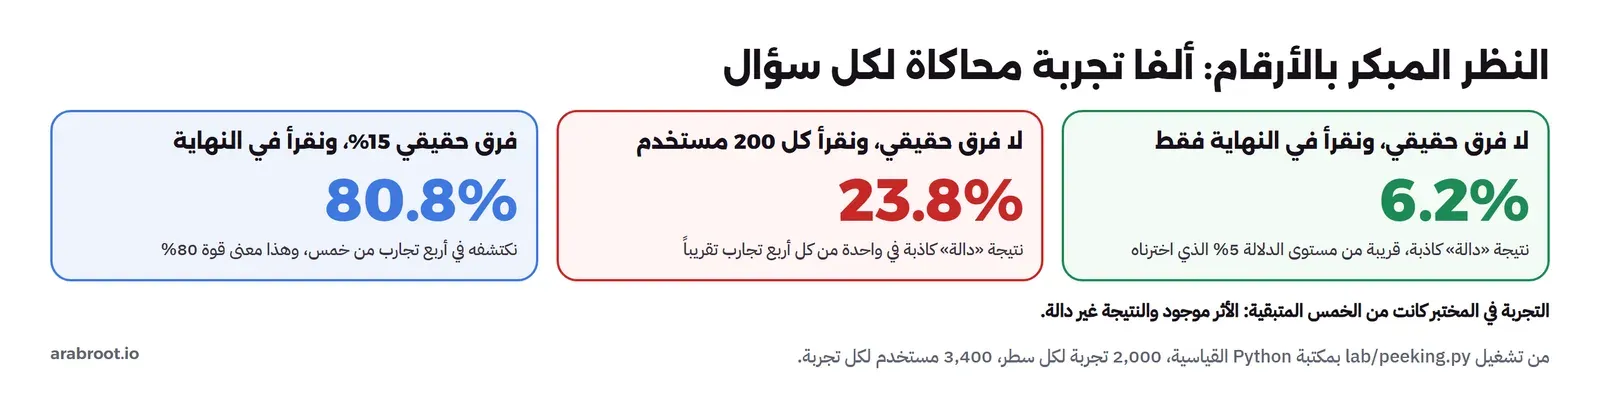
في المخرج أعلاه لاحظ التالي، سطراً سطراً:
- 6.2% في النهاية فقط: حين لا يوجد فرق حقيقي، وننتظر الحجم المخطط ثم نقرأ مرة واحدة، تعطي 6.2% من التجارب نتيجة دالة كاذبة. وهذا قريب من مستوى الدلالة 5% الذي اخترناه في وثيقة التجربة، والفرق الصغير من العشوائية في ألفي تجربة فقط.
- 23.8% مع النظر المبكر: التجارب نفسها، لكن من يتوقف عند أول قراءة دالة في أي من القراءات الست عشرة يعلن «فائزاً» كاذباً في نحو ربع التجارب. أي أن الفريق الذي يفتح اللوحة كل يوم ويتوقف عند أول نتيجة تعجبه يخطئ أربع مرات أكثر مما يظن، دون أن يغير شيئاً في الإحصاء نفسه.
- 80.8% للأثر الحقيقي: حين يوجد الأثر الذي وضعناه، وتنتظر التجربة حجمها، تكتشفه في 80.8% من المرات، وهذا هو معنى قوة 80% في حساب حجم العينة. والتجربة الحقيقية في المختبر كانت من الـ 19.2% الباقية، أي أن ما حدث فيها ليس خطأ، وإنما الاحتمال الذي قبلناه حين كتبنا الوثيقة.
وهذه الأسطر الثلاثة هي ما عرضه المؤسس على الفريق بدل أي شرح: الانتظار ليس تشدداً، وإنما الطريقة الوحيدة التي يبقى فيها رقم 5% في الوثيقة صحيحاً. وإذا احتاج الفريق أن ينظر مبكراً لسبب حقيقي، مثل أن نسخة تضر المستخدمين، فهذا ما يخدمه مقياس الحماية، أو طرق إحصائية مصممة للمراقبة المستمرة يشرحها مقال اختبارات A/B، وليس النظر إلى الدلالة نفسها كل يوم.
التجربة التالية: كيف صمم الفريق النسخة الثانية؟
القرار كان أن تعاد القائمة بتصميم أثره أكبر، والسؤال: كيف يصمم الفريق تغييراً أثره أكبر؟ والإجابة جاءت من مقال التفعيل: الفعل الذي يصنع الفرق هو ربط قناة التنبيه، والقائمة الأولى كانت تشرح هذه الخطوة ولا تقوم بها. فالنسخة الثانية تضع زر الربط نفسه في الشاشة الأولى بعد التسجيل، مع تنبيه تجريبي يصل فور الربط، أي أنها تختصر الطريق إلى القيمة بدل أن تصفه.
وكتب الفريق وثيقة التجربة الثانية بالطريقة نفسها، مع ثلاثة تغييرات تعلمها من الأولى. الأول أن التعرض يسجل قبل عرض النسخة، كما ظهر في قسم العطل، حتى لا تضيع تحويلات. والثاني أن مقياس الحماية، أي الإلغاء، يحتاج عينة أكبر بكثير من مقياس الهدف لأنه نادر، فقرر الفريق أن يتابعه في تقرير منفصل بعد التجربة، وألا ينتظر أن يصل إلى الحد الأدنى من البيانات داخلها. والثالث أن مدة التجربة حسبت من حجم العينة قبل البدء: 1647 مستخدماً في كل نسخة لأثر 15%، أي نحو عشرة أسابيع بـ 330 تسجيلاً في الأسبوع، وهذه المدة كتبت في الوثيقة حتى لا يغريه أحد بالتوقف عند الأسبوع الثالث.
ولاحظ أن الشركة الصغيرة لا تستطيع أن تجري أكثر من تجربة أو اثنتين على التسجيلات الجديدة في الوقت نفسه، لأن كل تجربة تأخذ نصف المستخدمين أو أكثر. فاختيار ما يختبر أولاً قرار مهم بقدر التجربة نفسها، والتغييرات الصغيرة، مثل لون زر أو صياغة جملة، لا تستحق عشرة أسابيع من التسجيلات.
وبقي سؤال حسمه الفريق قبل أن يكتب الحجم: هل يبقى أصغر أثر يهمه 15%؟ فالمحاكاة قالت إن التجربة بهذا الحجم تكتشف أثراً بحجم 15% في أربع مرات من خمس، وإن الأثر الأصغر يحتاج أضعاف المستخدمين. والنسخة الثانية تقوم بالخطوة بدل أن تشرحها، فتوقع الفريق أن يكون أثرها أكبر من الأولى، لكنه لم يكتب هذا التوقع في الحساب، لأن كتابة أثر أكبر مما يتوقعه بثقة تقصر التجربة على الورق وتجعلها تفوت الأثر الحقيقي في الواقع. فبقي الرقم 15%، وبقيت المدة عشرة أسابيع، واتفق الفريق على أن يقبل نتيجة غير حاسمة مرة أخرى إن جاءت، لأن البديل، أي تجربة أقصر بأثر متخيل، أسوأ من الانتظار. وكتب في الوثيقة أيضاً ما سيفعله إن جاءت النتيجة دالة لصالح النسخة الجديدة، وما سيفعله إن جاءت ضدها، حتى يكون القرار مكتوباً قبل أن تظهر أي أرقام.
سجل التجارب: ذاكرة الفريق
بعد التجربة الأولى بدأ الفريق سجلاً بسيطاً للتجارب، صفاً لكل تجربة فيه الفرضية والمقياس والحجم المخطط والحجم الفعلي والنتيجة وفترة الثقة والقرار ورابط الوثيقة. والسبب أن الشركة الصغيرة تنسى بسرعة: بعد سنة يقترح أحدهم قائمة خطوات البداية من جديد، ولا يعرف أنها جربت ولم تحسم. والسجل يقول له ما جرب، وبأي حجم، وما الذي لم يعرف بعد. وفي GrowthBook نفسه مكان لهذا الملخص عند إيقاف كل تجربة، كما فعلنا في القرار، لكن الفريق احتفظ بنسخة في وثائقه أيضاً بسبب اتجاه النص العربي الذي رأيناه في الواجهة، ولأن السجل يجب أن يقرأه من لا يدخل الأداة.
ماذا يحدث عندما يتغير شيء؟
- بدأت حملة إعلانية أثناء التجربة: التقسيم العشوائي يحمي المقارنة لأن الجمهور الجديد يذهب إلى النسختين بالتساوي، لكن الأثر قد يختلف لجمهور مختلف، فاكتب في وثيقة التجربة متى بدأت الحملة، واقرأ النتيجة لكل مصدر إن كان العدد يكفي.
- ظهر خطأ في إحدى النسختين: افحص SRM أولاً، فإن ظهر تحذير فلا تقرأ النتيجة، وأصلح الخطأ وأعد التجربة من البداية.
- انخفض عدد التسجيلات: تطول التجربة لأن حجم العينة ثابت، ولا تختصرها، وإنما أعد حساب الموعد أو اختبر تغييراً أثره أكبر.
- تغير تعريف التفعيل: مثل أن تصبح لحظة التفعيل حدثاً آخر بعد ميزة جديدة، فالتجارب السابقة قيست على تعريف قديم، ولا تقارن أرقامها بالتجارب الجديدة.
ولاحظ أن كل حالة في القائمة تعود إلى قاعدة واحدة: لا تغير شروط التجربة بعد أن ترى نتيجتها. فإذا تغير شيء في العالم أثناء التجربة، فاكتبه في الوثيقة واقرأ النتيجة في ضوئه، أو أوقف التجربة وأعدها، لكن لا تغير الحجم ولا المقياس ولا قاعدة القرار لأن الأرقام جاءت على غير ما تحب. وهذه القاعدة هي ما يجعل نتيجة التجربة دليلاً يمكن أن يبنى عليه، وليس رأياً بأرقام. والشركة الصغيرة التي تلتزم بها تتعلم أبطأ مما تريد، لكنها لا تتعلم أشياء خاطئة، وهذا ما يجعل كل تجربة بعدها أسهل في القراءة وأسرع في القرار. ولهذا وضع الفريق القاعدة في أول سطر من وثيقة كل تجربة، قبل الفرضية نفسها، حتى يقرأها كل من يفتح الوثيقة ليقترح «أسبوعاً آخر فقط».
قائمة تحقق قبل أي تجربة
| السؤال | كيف تتحقق |
|---|---|
| هل الفرضية والمقياس ومقياس الحماية وقاعدة القرار مكتوبة؟ | وثيقة التجربة قبل أي كود |
| هل حسب حجم العينة والمدة من عدد التسجيلات الفعلي؟ | size.mjs وعدد التسجيلات الأسبوعي |
| هل التغيير كبير بما يكفي لأن يكتشف في هذه المدة؟ | أصغر أثر يهمك في الحساب |
| هل يسجل التعرض قبل عرض النسخة؟ | مقارنة أحداث قاعدة البيانات بأرقام الأداة |
| هل يفحص SRM قبل قراءة أي نتيجة؟ | تبويب Health في GrowthBook |
| هل اتفق الفريق على ألا يتوقف قبل الحجم المخطط؟ | الحجم والموعد مكتوبان في الوثيقة |
| هل القرار وسببه مسجلان عند إيقاف التجربة؟ | ملخص التجربة في الأداة ورابط الوثيقة |
حذف المختبر
docker compose down -v
docker rmi growthbook/growthbook:5.1.0 mki-gb-app
والخيار -v يحذف الـ Volumes، أي إعدادات GrowthBook والأحداث، فلا تستخدمه على مختبر تريد أن تعود إليه.
مشكلات شائعة وحلولها
- كل المستخدمين يرون النسخة الافتراضية: التطبيق لم يجد مفتاح الـ SDK، أو التجربة ما زالت مسودة Draft، فتأكد من
GB_CLIENT_KEYفي سجل التطبيق، ومن أن حالة التجربة Running وأن التعديل على الميزة منشور Published. - GrowthBook لا يتصل بقاعدة البيانات: اكتب اسم الخدمة
warehouseلاlocalhost، لأنlocalhostداخل Container GrowthBook هو الـ Container نفسه. - Not enough data لفترة طويلة: الحد الأدنى للتحويلات يحسب في النسخة الأساسية، فالمقياس النادر مثل الإلغاء يحتاج عينة أكبر بكثير من مقياس الهدف، وخطط لذلك في حجم العينة.
- تحذير SRM: لا تقرأ النتيجة، وابحث عن نسخة تتعطل أو لا تسجل التعرض، وراجع دليل حل مشكلات التجارب.
- Multiple Exposures: المعرف الذي يقسم به الـ SDK يختلف عن المعرف المسجل في جدول التعرض، فاستخدم نفس المعرف في المكانين.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- اكتب الفرضية والمقياس ومقياس الحماية وحجم العينة وقاعدة القرار قبل أي كود، فهي التي تحميك من قراءة النتيجة على هواك.
- فرق 15% على نسبة 30% يحتاج 1647 مستخدماً في كل نسخة، والفرق الأصغر يحتاج أضعاف ذلك، لذلك تختبر الشركة الصغيرة التغييرات الكبيرة.
- بعد 600 مستخدم بدا الفرق 22.5%، وبعد 3400 أصبح 6.3% وغير دال، وهذا هو سبب منع النظر المبكر.
- التجربة فاتها أثر حقيقي نعرفه، وهذا متوقع مرة من كل خمس مرات بقوة 80%، فالنتيجة غير الدالة لا تعني أن التغيير بلا أثر.
- سجل التعرض قبل أن يرى المستخدم النسخة، وافحص SRM قبل أن تقرأ أي فرق.
- في محاكاة ألفي تجربة بلا فرق حقيقي، رفع النظر كل 200 مستخدم النتائج الكاذبة من 6.2% إلى 23.8%، والأثر الحقيقي اكتشف في 80.8% من التجارب، كما تقول قوة 80%.
ولمزيد من التفصيل في GrowthBook والإحصاء خلفه، وفي جمع الأحداث مع PostHog:
 دليلاختبارات A/B بدقة مع GrowthBook على سيرفركنشغل GrowthBook مع PostgreSQL ونجري تجربة نعرف فرقها الحقيقي مسبقاً، لنتعلم قراءة فرصة الفوز والهامش وقيمة p دون أن نخدع أنفسنا.
 دليلتحليلات المنتج Product Analytics مع PostHog على سيرفركنشغل PostHog على سيرفرنا ونتتبع المستخدم من أول زيارة إلى أول فاتورة، ونقيس ما يحتاجه من ذاكرة ووقت إقلاع.
 دليلالتفعيل Activation والاحتفاظ Retention: لماذا يغادر المستخدمون؟كيف تجد اللحظة التي يرى فيها المستخدم قيمة منتجك، وتقرأ منحنى الاحتفاظ والتسرب، مع تجربة تحسبها بـ Python وSQL.
 دليلأدوات النمو: Amplitude وMixpanel وبدائلها مفتوحة المصدرمقارنة أدوات تحليلات المنتج والتجارب والإحالة بالترخيص وآخر إصدار والسعر، مع اختبار فعلي للعربية في GrowthBook وUnleash.
 دليلتسويق النمو Growth Marketing: مقاييس AARRR وحلقات النموكيف يعمل فريق النمو على كل مرحلة من مسار المستخدم، ولماذا تنمو الشركات بالحلقات لا بالقمع، وكم تجربة تحتاج.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
سجل التحديثات
- أكتوبر 2026: إضافة قصة الشركة الناشئة، ومحاكاة النظر المبكر وقوة الاختبار بسكربت
lab/peeking.pyعلى Python 3.13.17، وتصميم التجربة التالية، وماذا يحدث عندما يتغير شيء، وقائمة تحقق، وشكل جديد. - أكتوبر 2026: كتابة الدليل واختباره على GrowthBook 5.1.0 مع MongoDB 8.0.32 وPostgreSQL 16.15 وتطبيق Node.js 24.22.1 بالمكتبة @growthbook/growthbook 1.8.0، بزيارات محاكاة لـ 3400 مستخدم.