


تفتح طلب الدمج Pull Request بعد يوم عمل، والاختبارات تنجح على جهازك كلها، ثم يظهر الخط أحمر في Gitea بسبب اختبار لم تلمسه أصلاً، فتضغط إعادة التشغيل Re-run وتنتظر دقيقة، فيظهر أخضر، فتدمج وتنسى. وبعد شهر يكون كل من في الفريق قد تعلم أن الأحمر في خط CI لا يعني شيئاً بالضرورة، وأن الحل الأسرع هو إعادة التشغيل، حتى يأتي يوم يكون فيه الفشل حقيقياً فيضغط أحدهم الزر نفسه ويدمج. ومع الاختبارات المتقلبة يأتي البطء، فالخط الذي كان يأخذ دقيقة أصبح يأخذ خمساً، ثم عشراً، فيجمع المطورون تغييرات أكثر في كل دفع لكي ينتظروا مرات أقل، فتكبر طلبات الدمج ويصعب مراجعتها.
وقد شرحنا في مفهوم CI/CD للمبتدئين ما هو خط CI وكيف يعمل ال Runner، وشرحنا تثبيت Gitea Actions على سيرفرك في دليل Gitea Actions، وفي أنواع الاختبارات رأينا أين يعمل كل نوع من الاختبارات في الخط. وهذا المقال يأخذ خطوة إلى الأمام: الخط يعمل والاختبارات موجودة، فكيف تجعله سريعاً، وكيف تستخدم التوازي Parallelism دون أن تفسد الاختبارات، وماذا تفعل بالاختبار المتقلب Flaky Test عندما يظهر. وسوف نتبع فيه فريقاً صغيراً يبني واجهة برمجية API لحجز مواعيد العيادات، فيها حساب المواعيد المتاحة، وتسجيل الدخول بكلمات مرور مخزنة بالهاش، وحجوزات في PostgreSQL، ونبني لها خطاً حقيقياً في Gitea Actions ونعدله تسع مرات، وكل رقم في المقال جاء من تشغيل فعلي لهذا الخط.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تعمل الاختبارات في خط CI، وأين يذهب وقت المهمة Job بالضبط، ولماذا تقيس قبل أن تسرع.
- تثبيت الاعتماديات Dependencies: ال Cache مقابل Job Image جاهزة، وما يكلفه كل منهما.
- التوازي داخل المهمة مع pytest-xdist وبين المهام، والحالة المشتركة التي تظهر عندما تعمل الاختبارات معاً، ومتى لا يفيد التوازي أصلاً.
- الاختبارات المتقلبة Flaky Tests: أسبابها في خط CI بالذات، وكيف تكشفها، والعزل Quarantine، وسياسة إعادة المحاولة Retry.
- تقارير الاختبارات Test Reports والملفات المرفقة Artifacts.
- تجربة كاملة على Gitea 28.3.0 مع Runner 5.3.0: من خط أحمر في 43 ثانية إلى مهمتين خضراوين في 21 ثانية، وثلاث مشكلات حقيقية ظهرت في الطريق.
لماذا تعمل الاختبارات في خط CI أصلاً؟ The Merge Gate
قد يتساءل البعض: إذا كان كل مطور يشغل الاختبارات على جهازه، فلماذا نشغلها مرة أخرى في الخط؟ والإجابة أن الخط يجيب عن سؤالين لا يجيب عنهما جهاز المطور. السؤال الأول: هل تعمل الاختبارات على الكود بعد دمجه مع آخر نسخة من الفرع الرئيسي، وليس على فرع المطور كما هو على جهازه؟ والسؤال الثاني: هل تعمل في بيئة نظيفة لا تعتمد على شيء ثبته المطور يدوياً قبل سنة ونسيه؟ فكل مهمة في Gitea Actions تبدأ في Container جديد كما شرحنا في ماذا يحدث داخل ال Runner، فإذا نجحت هناك فهي تنجح لأن الكود صحيح وليس لأن الجهاز محظوظ.
ولكي يكون الخط بوابة فعلية للدمج Merge Gate وليس مجرد إشعار، فإن Gitea يسمح لك في حماية الفروع Protected Branches أن تشترط نجاح فحوص حالة Status Checks محددة قبل الدمج، مثل ci / unit وci / integration. وهنا يظهر سبب أهمية السرعة والثبات: البوابة البطيئة تجعل الناس ينتظرون، والبوابة التي تغلق دون سبب تجعل الناس يبحثون عن طريق حولها، ومدير المستودع الذي يدمج «هذه المرة فقط» دون انتظار الخط هو بداية النهاية للبوابة كلها. وتذكر أن صفحة التكامل المستمر في DORA تنص على أن الاختبارات في الخط يجب أن تعمل في دقائق قليلة أو أقل، وأن الهدف أن يعرف المطور نتيجة تغييره وهو ما زال يفكر فيه.
أين يذهب وقت الخط؟ Pipeline Time Breakdown
عندما يقول الفريق «الخط بطيء» فإنه غالباً يقصد الرقم الذي يظهر بجانب التشغيل، مثل 39 ثانية أو ثماني دقائق، ولكن هذا الرقم مجموع مراحل مختلفة لكل منها سبب وعلاج مختلف. وفي أول خط بنيناه في التجربة، أي مهمة واحدة فيها PostgreSQL كخدمة Service وكل الاختبارات، كان توزيع 39 ثانية في أحد التشغيلات كما يلي:
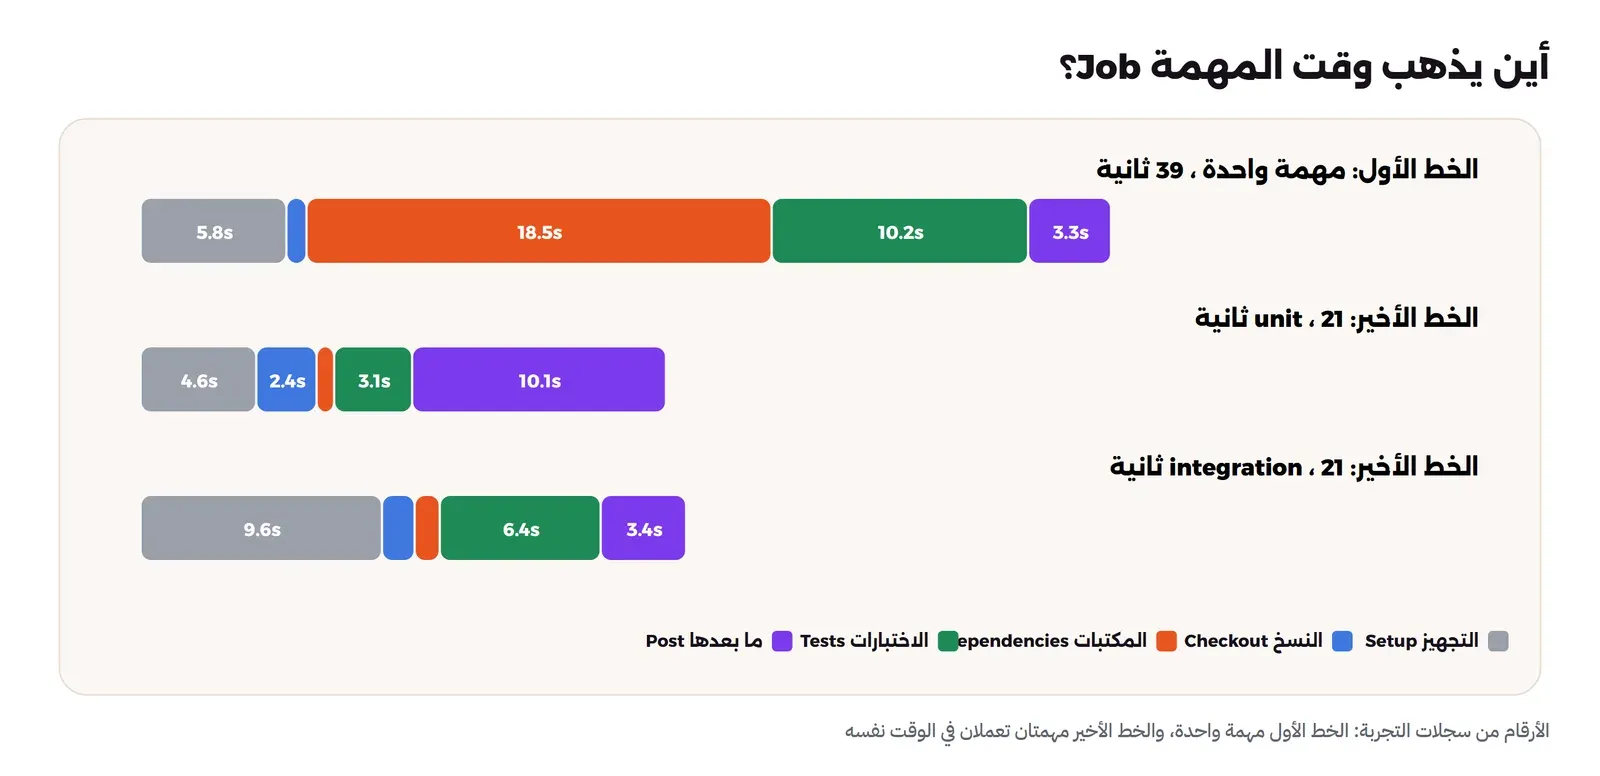
- الانتظار في الطابور Queue: الوقت بين الدفع وبداية المهمة، ويطول عندما تكون كل أماكن ال Runner مشغولة، ويتحكم فيه الإعداد
capacityفي ال Runner وعدد ال Runners. - التجهيز Setup: سحب Job Image إذا لم تكن موجودة، وإنشاء Container المهمة، وتشغيل الخدمات مثل PostgreSQL وانتظار جاهزيتها، وتنزيل ال Actions الخارجية مثل
actions/cacheمن مستودعها. وكان بين 4 و20 ثانية في تشغيلاتنا. - نسخ المستودع Checkout: ثانية إلى ثلاث ثوان لمستودع صغير، وتطول مع المستودعات الكبيرة وتاريخها الطويل.
- تثبيت الاعتماديات Dependencies:
pip installأوnpm ciأو تنزيل مكتبات Maven، وكان 18.5 ثانية من أصل 39 في التشغيل أعلاه، أي أكبر مرحلة. - الاختبارات Tests: 10.15 ثانية فقط، ونصفها تقريباً لاختبارات كلمات المرور Passwords كما سنرى.
- الخطوات اللاحقة والتنظيف Post and Cleanup: حفظ ال Cache، ورفع التقارير، وطباعة سجل الخدمات، وإيقاف ال Containers وحذفها، وكان التنظيف وحده بين ثانية ونصف و17 ثانية في تشغيلاتنا.
ومن هذا التوزيع تفهم لماذا لا يفيد تسريع الاختبارات وحدها في البداية، فلو جعلت الاختبارات أسرع مرتين لوفرت خمس ثوان من 39، أما تثبيت المكتبات فيوفر أكثر من ذلك دون أن تلمس اختباراً واحداً. والطريقة العملية لترى هذا التوزيع في Gitea أن تفتح صفحة المهمة، فكل خطوة Step يظهر بجانبها زمنها، أو أن تقرأ السجل عبر ال API كما فعلنا في التجربة بسكربت صغير يحسب الفرق بين أوقات بداية الخطوات.
قس قبل أن تسرع Measure First
القاعدة الأولى في تسريع الخط أن تقيس قبل أن تغير، وأن تقيس أكثر من مرة. ففي التجربة شغلنا الإعداد نفسه على ال Commit نفسه ثلاث مرات فأخذت المهمة 83 ثم 40 ثم 77 ثانية، والسبب أن ال Runner يعمل على جهاز يتشاركه مع أعمال أخرى، فإذا كان الجهاز مشغولاً في تلك الدقيقة طالت كل مرحلة، من تثبيت المكتبات إلى الاختبارات. وهذا ما يحدث تماماً على Runner مشترك في شركة أو على سيرفر صغير عليه خدمات أخرى، لذلك لا تحكم على تحسين من تشغيل واحد، وإنما قارن الوسيط Median لعدة تشغيلات، أو قس المرحلة نفسها على جهاز هادئ كما فعلنا عندما قسنا التوازي.
وداخل مرحلة الاختبارات استخدم الخيار --durations=5 في pytest، أو ما يقابله في أداة اختبارك، ليعرض أبطأ الاختبارات، وفي أول تشغيل كان المخرج كما يلي:
============================= slowest 5 durations ==============================
0.59s call     tests/unit/test_slots.py::test_slot_search_is_fast
0.56s call     tests/unit/test_auth.py::test_wrong_password_is_rejected[xxxxxxxxxxxx…]
0.52s call     tests/unit/test_auth.py::test_wrong_password_is_rejected[كل…]
0.44s call     tests/unit/test_auth.py::test_wrong_password_is_rejected[with space]
0.41s call     tests/unit/test_auth.py::test_wrong_password_is_rejected[\xf1and\xfa]
197 passed in 10.15s
أربعة من الخمسة اختبارات كلمات مرور، وكل منها يأخذ قرابة نصف ثانية، والسبب ليس في الاختبار وإنما في دالة الهاش scrypt التي تستخدم في الاختبار التكلفة نفسها التي تستخدمها في الإنتاج، وهذه التكلفة مقصودة لكي يكون تخمين كلمات المرور مكلفاً على المخترق، ولكنها تكلفة لا معنى لها في 24 اختباراً يتحقق كل منها من المنطق وليس من قوة الهاش. والخامس اختبار يقيس الزمن بالساعة، وسوف يكون بطل قسم الاختبارات المتقلبة.
تثبيت الاعتماديات Dependencies: Cache أم Job Image جاهزة؟
أكبر مرحلة في المهمة الأولى كانت تثبيت المكتبات، وهي مرحلة تتكرر في كل تشغيل بالنتيجة نفسها ما دام ملف المتطلبات Requirements لم يتغير. وهناك طريقتان معروفتان لتجنب تكرارها، ولكل منهما ثمن.
ال Cache بين التشغيلات Dependency Cache
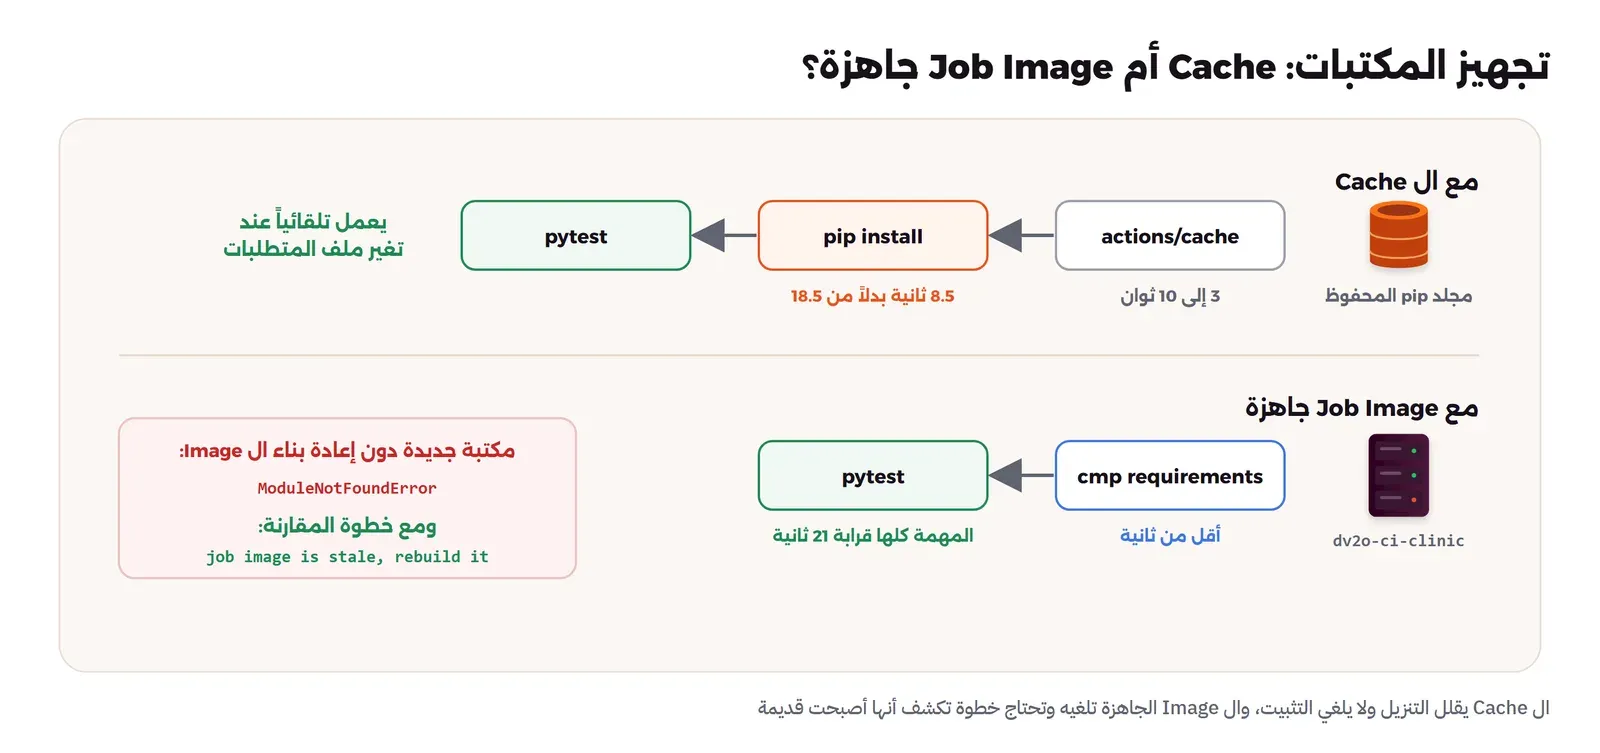
الفكرة أن تحفظ مجلد التنزيلات بعد التثبيت، مثل ~/.cache/pip أو ~/.npm، وتسترجعه في التشغيل التالي، فيثبت pip من الملفات المحفوظة بدلاً من الإنترنت. ويتم ذلك بال Action المعروفة actions/cache، وال Runner في Gitea فيه خادم Cache مدمج يفعل بالإعداد cache.enabled، فلا تحتاج خدمة خارجية. والمهم في ال Cache هو المفتاح Key، وفي التجربة جعلناه هاش ملف المتطلبات pip-${{ hashFiles('requirements-test.txt') }}، فإذا تغير الملف تغير المفتاح فبدأ Cache جديد، وإذا لم يتغير استرجعنا المحفوظ. وفي التشغيل الأول لم يجد ال Action شيئاً فسجل Cache not found وحفظ ال Cache في نهاية المهمة، وفي التشغيل الثاني سجل Cache hit فنزل زمن التثبيت من 18.5 إلى 8.5 ثانية.
ولاحظ أن ال Cache لم يلغ التثبيت، فما زال pip يفك الحزم ويثبتها في كل تشغيل، وما زال ال Action نفسه يأخذ بين 3 و10 ثوان لينزل ال Action من مستودعها ويفك الملف المضغوط. ولاحظ أيضاً أن ال Action تحتاج Node.js داخل Job Image، لأن أغلب ال Actions المشهورة مكتوبة بلغة JavaScript، لذلك أضفنا nodejs إلى Image الخط من البداية.
Job Image فيها المكتبات Baked Image
الطريقة الثانية أن تبني Image للخط فيها المكتبات مثبتة مسبقاً، فلا يبقى في المهمة تثبيت ولا Cache، وتبدأ الاختبارات بعد نسخ المستودع مباشرة. وفي التجربة نزل زمن المهمة بعدها إلى قرابة 21 ثانية، وهذا أكبر تحسين في الخط كله. ولكن هذه الطريقة لها ثمن واضح: ال Image أصبحت نسخة ثانية من ملف المتطلبات، فإذا أضاف مطور مكتبة في طلب دمج دون أن يعيد بناء ال Image فسوف تفشل الاختبارات بخطأ ModuleNotFoundError، وهذا ما حدث في التجربة فعلاً. والحل أن تضع في Image نسخة من ملف المتطلبات الذي بنيت منه، وأن تبدأ المهمة بخطوة تقارنه بالملف في المستودع، فإذا اختلفا تفشل المهمة برسالة واضحة: «ال Image قديمة، أعد بناءها»، بدلاً من خطأ استيراد يحير من يقرؤه. والفرق بين الطريقتين يلخصه الجدول التالي:
| المعيار | ال Cache | Job Image جاهزة |
|---|---|---|
| زمن التثبيت في التجربة | 8.5 ثانية عند الإصابة، و18.5 عند عدم الإصابة | صفر |
| عند إضافة مكتبة | يعمل تلقائياً، والمفتاح يتغير | يجب إعادة بناء ال Image وتحديث ال Runner |
| يحتاج | Node.js في ال Image وخادم Cache | Registry أو بناء على جهاز ال Runner، وخطوة مقارنة |
| الأنسب | مستودعات كثيرة تتغير مكتباتها كثيراً | مستودع رئيسي واحد مكتباته ثابتة نسبياً |
والصورة التالية تبين المسارين:
التوازي Parallelism: داخل المهمة وبين المهام
بعد الاعتماديات يفكر الجميع في التوازي: إذا كان عندنا أربع أنوية فلماذا لا نشغل الاختبارات على أربعة أجزاء؟ وهناك مستويان للتوازي، والفرق بينهما مهم.
داخل المهمة: Workers مع pytest-xdist
الإضافة pytest-xdist تشغل عدة عمليات Workers وتوزع الاختبارات عليها بالخيار -n 4، وفي JavaScript يفعل Vitest وJest ذلك تلقائياً، وفي Playwright هناك Workers داخل الجهاز وتقسيم Sharding بين الأجهزة كما ذكرنا في دليل Playwright. ويبدو التوازي تحسيناً مجانياً، ولكن قياسه على جهاز هادئ أعطانا هذه الأرقام لاختبارات الوحدة Unit Tests وحدها، أي 178 اختباراً:
-n 0: 178 passed, 1 deselected in 6.15s
-n 2: 178 passed in 7.64s
-n 4: 178 passed in 5.08s
-n 8: 178 passed in 6.10s
SCRYPT_N=1024 -n 0: 178 passed, 1 deselected in 0.83s
SCRYPT_N=1024 -n 4: 178 passed in 2.22s
في المخرج أعلاه لاحظ التالي:
- أربعة Workers وفرت ثانية واحدة فقط من ست ثوان، وعاملان كانا أبطأ من التشغيل العادي، وثمانية لم تفد شيئاً.
- السبب الأول أن كل Worker عملية Python جديدة تحتاج أن تبدأ وتجمع الاختبارات Collection وتتواصل مع العملية الرئيسية، وهذه تكلفة ثابتة قرابة ثانية ونصف لا تستحق إلا إذا كانت المجموعة طويلة.
- والسبب الثاني أن اختبارات scrypt تستهلك الذاكرة بكثافة، 32 ميجابايت لكل هاش بالتكلفة الحالية، فإذا عملت أربعة منها معاً تزاحمت على الذاكرة نفسها.
- وعندما خفضنا تكلفة الهاش في الاختبارات أصبحت المجموعة كلها 0.83 ثانية دون توازي، و2.22 ثانية مع التوازي، أي أن التوازي أصبح يضر.
والدرس أن التوازي يضرب الوقت في عامل، ولكنه يضيف تكلفة ثابتة، فإذا كانت مجموعتك دقيقة أو أقل فالأولى أن تبحث عن الاختبار البطيء نفسه، وإذا كانت عشر دقائق من اختبارات كثيرة متوسطة السرعة فالتوازي هو الحل الصحيح.
عندما تتشارك ال Workers قاعدة البيانات Shared State
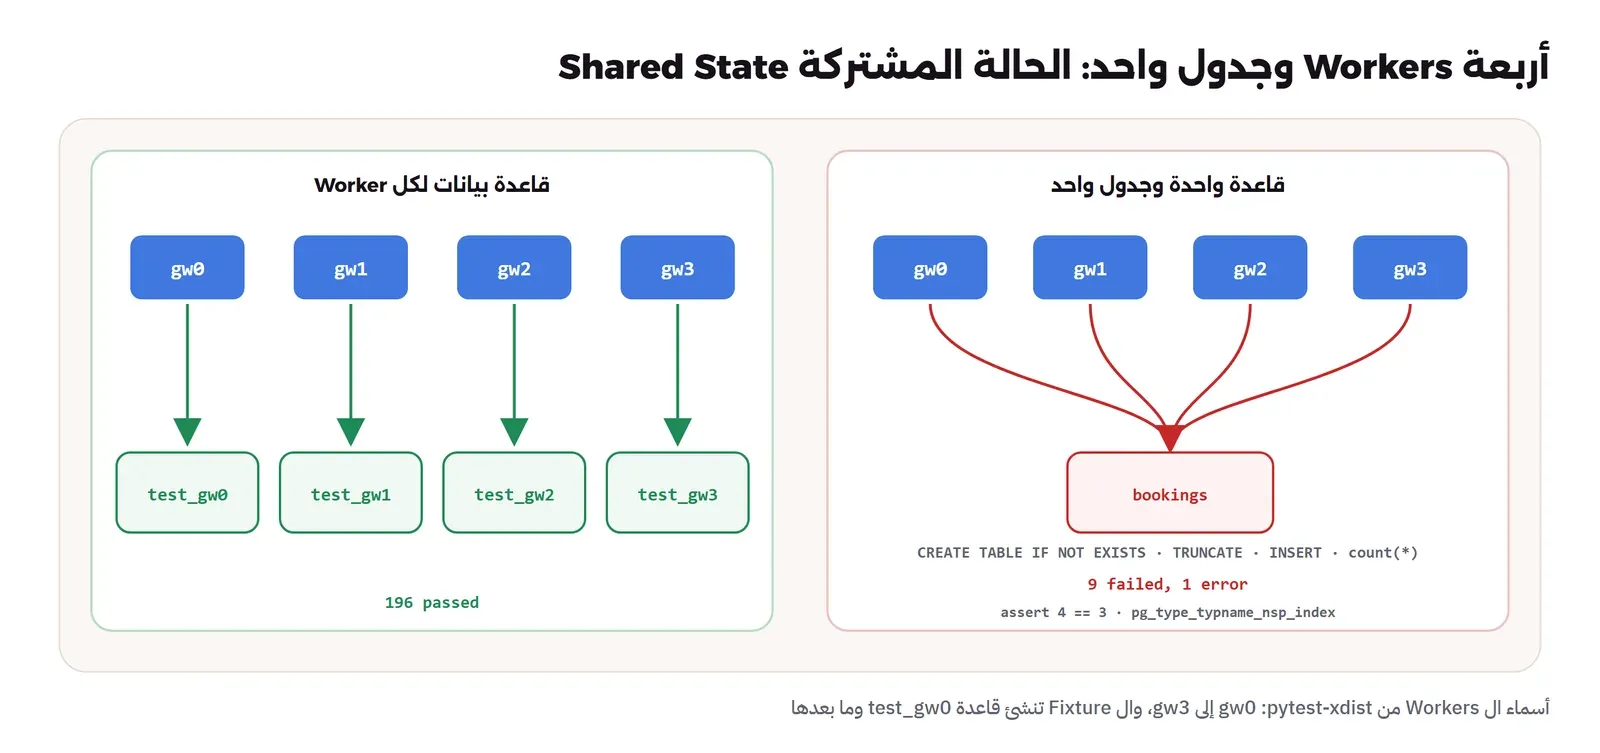
المشكلة الثانية في التوازي أنه يكشف كل حالة مشتركة بين الاختبارات كانت مختبئة لأن الاختبارات تعمل واحداً بعد الآخر. ففي التجربة كانت اختبارات التكامل تنشئ الجدول bookings إذا لم يكن موجوداً، ثم تفرغه بالأمر TRUNCATE قبل كل اختبار، وهذا يعمل تماماً عندما يعمل اختبار واحد في كل لحظة. وعندما أضفنا -n 4 فشلت تسعة اختبارات وظهر خطأ في التجهيز:
FAILED tests/integration/test_bookings.py::test_a_slot_can_be_booked_once[d-noura] - AssertionError: assert not True
FAILED tests/integration/test_bookings.py::test_count_after_three_bookings[d-amal] - assert 4 == 3
FAILED tests/integration/test_bookings.py::test_count_after_three_bookings[d-faisal] - assert 5 == 3
E           psycopg.errors.UniqueViolation: duplicate key value violates unique constraint "pg_type_typname_nsp_index"
9 failed, 187 passed, 1 error in 6.54s
وكل سطر هنا يحكي قصة. فالعدد 4 أو 5 بدلاً من 3 يعني أن Worker آخر أضاف حجوزاته إلى الجدول نفسه بين التفريغ والعد، وassert not True يعني أن الحجز الثاني نجح لأن Worker آخر فرغ الجدول بين الحجزين. أما الخطأ على pg_type_typname_nsp_index فهو أطرف، فقد حاول Workerان إنشاء الجدول نفسه في اللحظة نفسها بالأمر CREATE TABLE IF NOT EXISTS، وهذا الأمر لا يحمي من التسابق Race Condition، لأن كلاً منهما تحقق أن الجدول غير موجود ثم حاول إنشاءه، ففشل الثاني على الفهرس Index الداخلي الذي يحفظ أسماء الأنواع في PostgreSQL.
والحل أن يكون لكل Worker عالمه الخاص، وهنا أعطينا كل Worker قاعدة بيانات باسمه، فالإضافة تعطي الاختبارات Fixture اسمه worker_id قيمته gw0 وgw1 وهكذا، أو master إذا لم يكن هناك توازي، كما في صفحة How-to في وثائق pytest-xdist:
import os

import psycopg
import pytest

from clinic.repo import Bookings


@pytest.fixture(scope="session")
def database_url(worker_id):
    """One database per xdist worker (gw0, gw1, ...), so workers never share tables."""
    base = os.environ["DATABASE_URL"]
    name = f"test_{worker_id}"
    with psycopg.connect(base, autocommit=True) as admin:
        admin.execute(f'DROP DATABASE IF EXISTS "{name}"')
        admin.execute(f'CREATE DATABASE "{name}"')
    yield base.rsplit("/", 1)[0] + "/" + name


@pytest.fixture
def bookings(database_url):
    with psycopg.connect(database_url, autocommit=True) as conn:
        repo = Bookings(conn)
        repo.create_schema()
        conn.execute("TRUNCATE bookings")
        yield repo
وهناك طرق أخرى بحسب ما تملك: Schema لكل Worker في قاعدة واحدة، أو معاملة Transaction تبدأ قبل كل اختبار وتلغى بعده Rollback، أو بيانات بمعرفات فريدة لكل اختبار. والمبدأ واحد في كل الطرق: لا يعتمد اختبار على أن غيره لا يعمل في الوقت نفسه.
بين المهام: تقسيم Jobs إلى Shards
المستوى الثاني أن تقسم الاختبارات على مهام Jobs تعمل في الوقت نفسه على Runners مختلفة أو على أماكن مختلفة في ال Runner نفسه، وفي ال Runner الذي استخدمناه يحدد الإعداد capacity: 3 أن ثلاث مهام تعمل معاً. والتقسيم الطبيعي الأول هو حسب نوع الاختبار، فاختبارات الوحدة لا تحتاج قاعدة بيانات، فلماذا تنتظر تشغيل PostgreSQL وإيقافه؟ لذلك فصلنا في التجربة مهمة unit بلا خدمات عن مهمة integration مع PostgreSQL، فأصبحت كل منهما قصيرة ومستقلة، وأصبح اسم المهمة الفاشلة وحده يخبرك أين تبحث.
والتقسيم الثاني هو تقسيم المجموعة نفسها إلى أجزاء Shards متساوية على عدة مهام، عبر مصفوفة strategy.matrix وخيار في أداة الاختبار مثل --shard=1/4 في Playwright. وهذا مفيد عندما تكون المجموعة طويلة فعلاً، ولكن تذكر أن كل مهمة تدفع تكلفة التجهيز كاملة، وكانت في تجربتنا بين 4 و20 ثانية للتجهيز وحده، فإذا كانت المجموعة كلها عشر ثوان فإن تقسيمها على أربع مهام يجعل الخط أبطأ ويستهلك أماكن ال Runner التي يحتاجها طلب دمج آخر.
الاختبار البطيء نفسه Slow Tests
أكبر تسريع لمرحلة الاختبارات في التجربة لم يأت من التوازي، وإنما من سطر واحد في الخط: SCRYPT_N: "1024". فالكود يقرأ تكلفة الهاش من متغير بيئة، وقيمتها الافتراضية 2 أس 15 أي 32768 كما يناسب الإنتاج، وفي الاختبارات نعطيها 1024، فنزلت اختبارات الوحدة من 6.15 إلى 0.83 ثانية على الجهاز نفسه. والسؤال الطبيعي هنا: ألا نخسر شيئاً عندما نختبر بتكلفة غير تكلفة الإنتاج؟ والإجابة أن الاختبارات الأربعة والعشرين تتحقق من المنطق: كلمة المرور الصحيحة تقبل، والخاطئة ترفض، والهاشان لكلمة واحدة يختلفان، وهذا المنطق لا يتغير بالتكلفة. أما التكلفة نفسها فلها اختبار واحد يتحقق أن القيمة الافتراضية في الكود لم تنخفض، وهذا اختبار لا يحتاج أن يحسب هاشاً أصلاً.
وهذا النمط يتكرر في أغلب المشاريع: اختبار ينتظر sleep حقيقياً بدلاً من ساعة مزيفة، واختبار ينشئ قاعدة بيانات كاملة بدلاً من تفريغ جدول، واختبار يرسم ملف PDF كاملاً ليتحقق من اسم العميل فيه، واختبار E2E يكرر ما يغطيه اختبار API. فقبل أن تشتري أنوية أكثر للخط، افتح قائمة أبطأ عشرة اختبارات واسأل عن كل منها: ما الذي يأخذ الوقت؟ وهل هذا الوقت جزء مما نختبره فعلاً؟
الترتيب والمهلة: Fail Fast مع Timeout
الخط الجيد يخبرك بالفشل في أسرع وقت ممكن، لذلك ضع المراحل السريعة أولاً: الفحص Lint، ثم اختبارات الوحدة، ثم التكامل، ثم E2E. وفي Gitea Actions تستطيع أن تجعل مهمة تنتظر نجاح أخرى بالخيار needs، وهذا يوفر موارد ال Runner عندما يفشل شيء مبكراً، ولكنه يطيل الخط عندما ينجح كل شيء لأن المهام تعمل واحدة بعد الأخرى. وفي التجربة اخترنا أن تعمل مهمتا الوحدة والتكامل معاً لأن كلتيهما قصيرة، فإذا كانت عندك مهمة E2E طويلة فاجعلها تنتظر نجاح المهمتين، لأنه لا معنى لتشغيل متصفح عشر دقائق واختبار وحدة فشل في الثانية الأولى.
وأضف لكل مهمة مهلة timeout-minutes مناسبة، فالاختبار الذي يعلق في انتظار اتصال لا يأتي يحجز مكاناً في ال Runner حتى المهلة العامة، وكانت 30 دقيقة في إعداد ال Runner، وخلال هذه المدة تنتظر طلبات الدمج الأخرى في الطابور. والمهلة القصيرة لا تجعل الخط أسرع، ولكنها تحول التعليق الصامت إلى فشل واضح له وقت محدد.
الاختبارات المتقلبة Flaky Tests
الاختبار المتقلب كما عرفه John Micco من Google ونقلته مدونة GitHub الهندسية هو اختبار يعطي نجاحاً وفشلاً على الكود نفسه. وقد شرحنا أشهر أسبابه في مقال أنواع الاختبارات، وهنا نركز على ما يحدث في خط CI بالذات، لأن الخط بيئة مختلفة عن جهاز المطور: الجهاز مشترك، والخدمات تبدأ من الصفر في كل مهمة، والاختبارات قد تعمل بالتوازي، والوقت بتوقيت UTC.
أسباب التقلب في خط CI Flakiness Sources
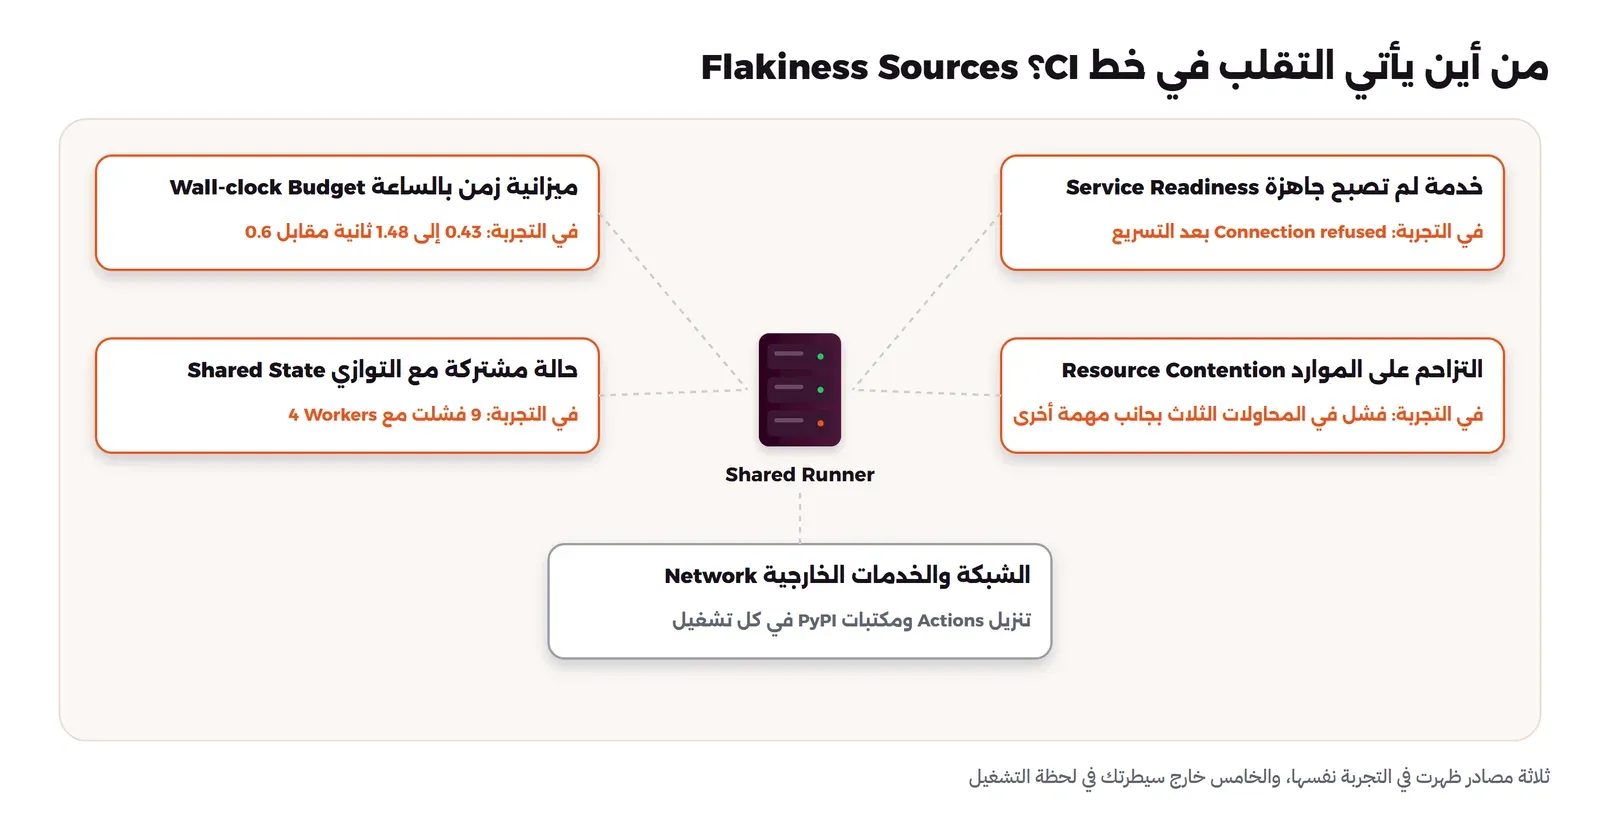
- ميزانية زمن بالساعة Wall-clock Budget: اختبار يتحقق أن عملية تمت في أقل من كذا ملي ثانية، فينجح على جهاز سريع هادئ ويفشل على Runner مشترك. وفي التجربة قاس الاختبار نفسه بين 0.43 و1.48 ثانية في الخط على الكود نفسه، وبين 0.50 و0.84 ثانية على الجهاز نفسه دون أي ضغط آخر.
- خدمة لم تصبح جاهزة Service Readiness: الخدمة بدأت ولكنها لا تقبل الاتصالات بعد، وهذا ما ظهر في التجربة بعد أن سرعنا الخط، وسوف نشرحه بعد قليل لأنه الأخطر.
- الحالة المشتركة مع التوازي: كما رأيت في قسم التوازي، ويظهر عادة يوم تضيف
-nأو تقسم المجموعة. - التزاحم على الموارد Resource Contention: مهمة أخرى على ال Runner نفسه تستهلك المعالج أو القرص، ففي التشغيل الذي عملت فيه مهمة العزل بجانب مهمة الاختبارات الرئيسية فشل اختبار الزمن في المحاولات الثلاث كلها.
- الشبكة والخدمات الخارجية: تنزيل Action من GitHub أو مكتبة من PyPI، أو API لطرف آخر يحد معدل الطلبات، وكل هذه تقع خارج سيطرتك في لحظة التشغيل.
السرعة تكشف التسابق Race Condition: الخدمة التي لم تجهز
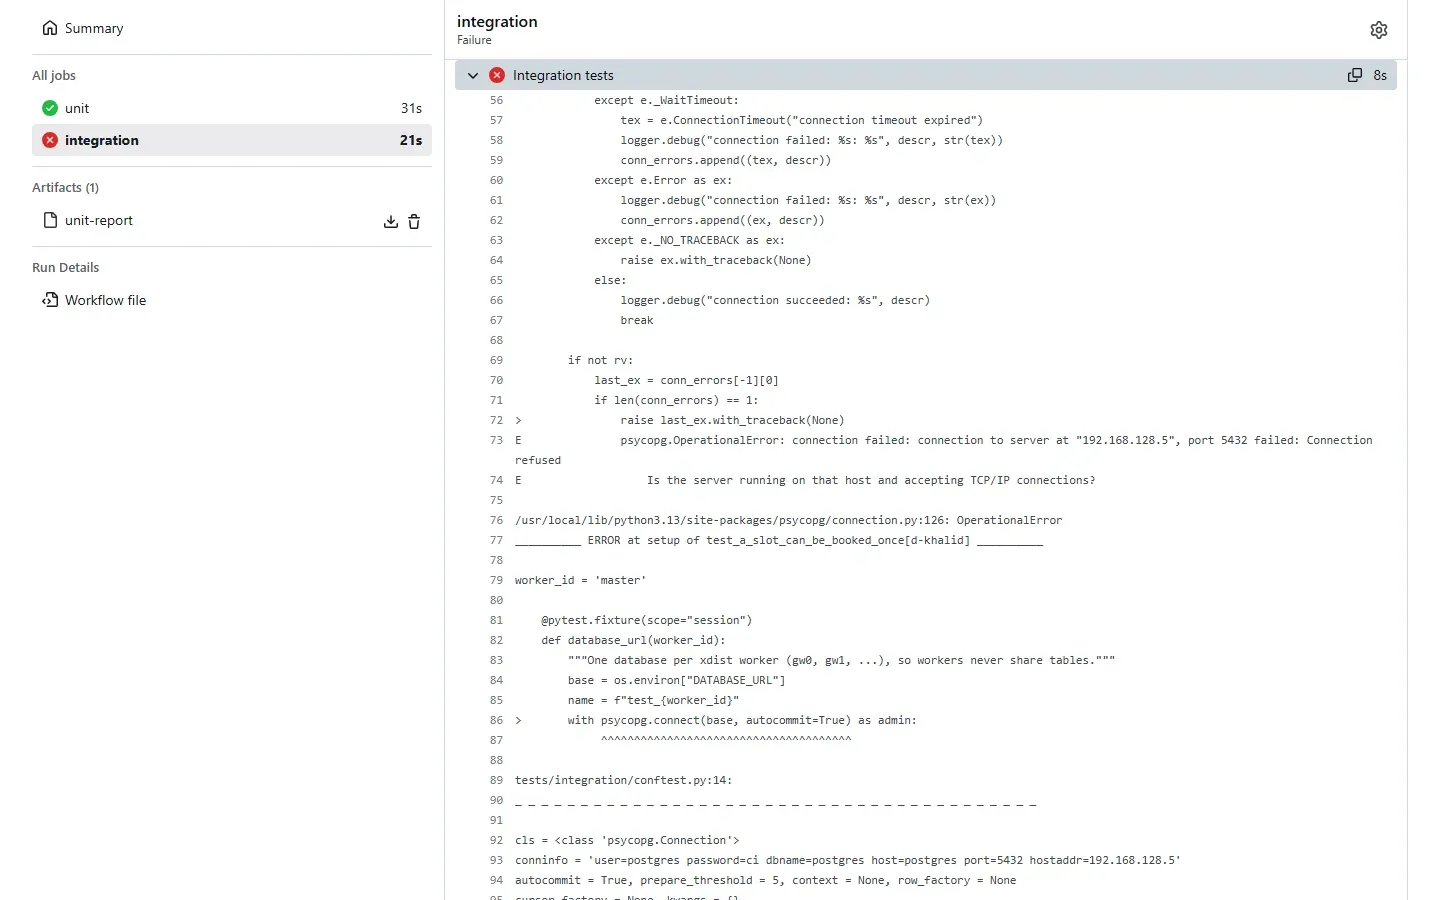
هذه أطرف قصة في التجربة. فبعد أن انتقلنا إلى Job Image فيها المكتبات، فشلت مهمة التكامل في التشغيل الثاني بهذا الخطأ:
E               psycopg.OperationalError: connection failed: connection to server at "192.168.128.5", port 5432 failed: Connection refused
18 errors in 1.78s
والسجل نفسه يقول إن الخدمة جاهزة، فقد ظهر فيه السطر postgres service is healthy. في الساعة 18:39:43، وبدأت الاختبارات في 18:39:47، بينما سجل PostgreSQL نفسه يقول إنه أصبح يقبل الاتصالات في 18:39:52. والسبب أن Image الرسمية لـ PostgreSQL ليس فيها فحص صحة Health Check، فيعتبر ال Runner الخدمة جاهزة بمجرد أن يبدأ ال Container، بينما PostgreSQL في أول تشغيل ينشئ قاعدة البيانات initdb بخادم مؤقت لا يستمع على الشبكة، ثم يوقفه ويبدأ الخادم الحقيقي، كما يشرح توثيق ال Image في قسم التهيئة. وقبل ذلك كانت خطوة pip install تأخذ عشر ثوان أو أكثر، فكانت تعطي PostgreSQL الوقت الكافي بالصدفة، فلما ألغيناها لتسريع الخط ظهر التسابق الذي كان موجوداً من البداية.
والحل أن تعطي الخدمة فحص صحة حقيقياً يتصل عبر الشبكة كما يتصل التطبيق، وهذا ما تبينه وثائق GitHub Actions لخدمة PostgreSQL بالخيار --health-cmd pg_isready، ولكننا أضفنا -h 127.0.0.1 لكي يتصل الفحص عبر TCP، لأن الخادم المؤقت أثناء التهيئة يقبل الاتصال عبر Unix Socket فقط، فقد يجيب الفحص بأنه جاهز وهو لم يجهز بعد:
    services:
      postgres:
        image: postgres:18.6
        env:
          POSTGRES_PASSWORD: ci
        # the image has no health check: without one the job starts while initdb is still running
        options: >-
          --health-cmd "pg_isready -h 127.0.0.1 -U postgres"
          --health-interval 2s --health-timeout 5s --health-retries 20
وبعد هذا التعديل شغلنا الخط ثلاث مرات ونجحت المهمتان في كل مرة. والدرس العام أن كل تسريع للخط قد يكشف تسابقاً كان الوقت الضائع يخفيه، لذلك بعد أي تحسين كبير في السرعة شغل الخط عدة مرات قبل أن تعتبره مستقراً.
كيف تكشف الاختبار المتقلب؟ Detection
الطريقة الأبسط هي التي استخدمها نظام GitHub: إذا فشل اختبار فأعد تشغيله على ال Commit نفسه، فإذا نجح فهو متقلب، وإذا فشل مرة أخرى فالفشل غالباً حقيقي. وفي pytest تفعل الإضافة pytest-rerunfailures ذلك بالخيار --reruns 2، وتطبع مع الخيار -rR قسماً خاصاً بالاختبارات التي أعيدت، وفي Playwright هناك الخيار retries الذي يصنف الاختبار في التقرير بأنه flaky. والمهم هنا أن تكون إعادة المحاولة أداة قياس تسجل في التقرير، وليست وسيلة لإخفاء الفشل في صمت، والفرق بينهما أن يعرف الفريق كم اختباراً احتاج إعادة، وأيها، وكم مرة في الأسبوع. وأبسط مصدر لهذه البيانات هو ملف JUnit XML من كل تشغيل، فإذا جمعته من التشغيلات الأخيرة تستطيع أن ترى الاختبار الذي يتكرر فشله ثم نجاحه.
العزل Quarantine: أين تضع الاختبار المتقلب؟
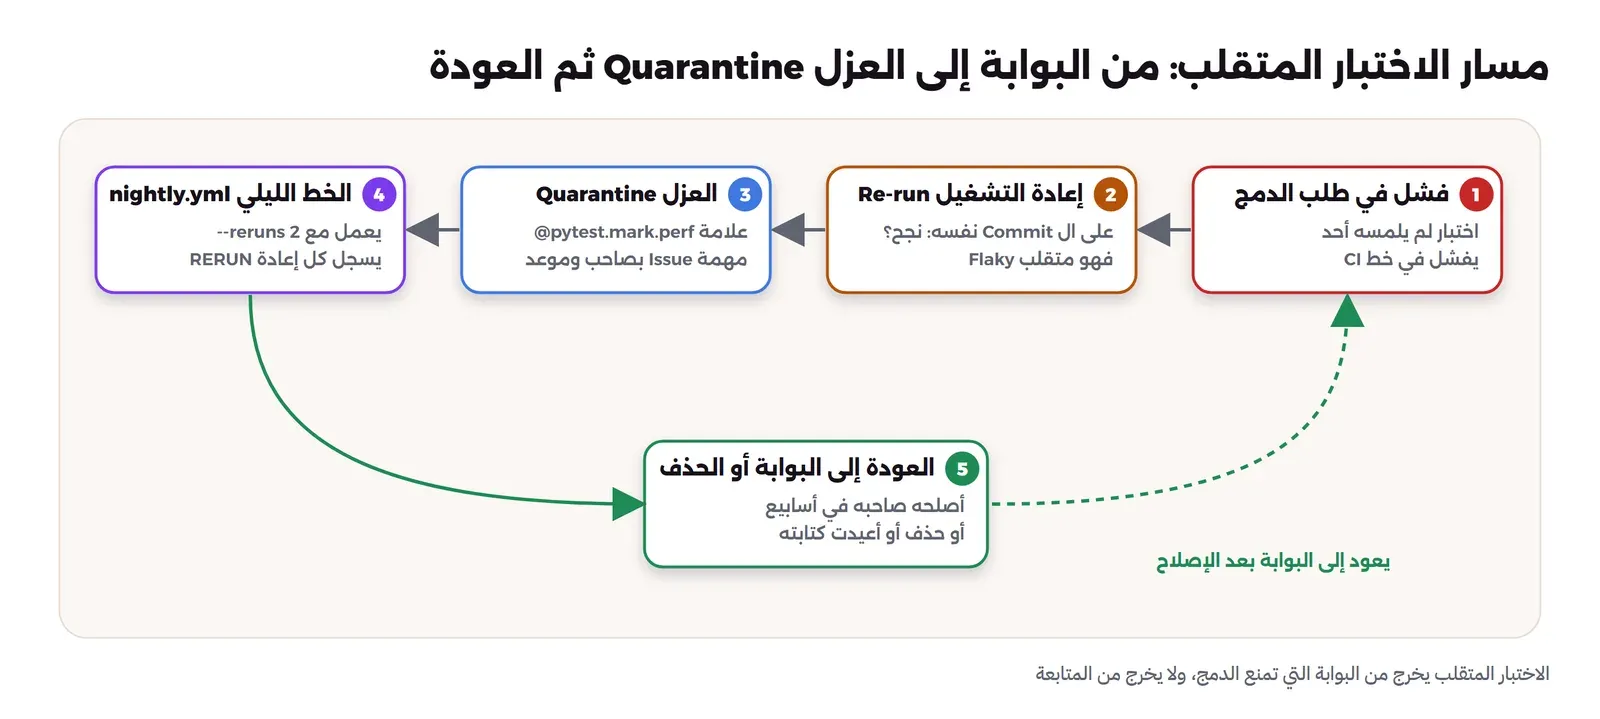
عندما تعرف أن اختباراً متقلب ولا تستطيع إصلاحه اليوم، فهناك ثلاثة خيارات سيئة: أن تتركه يفشل الخط عشوائياً، أو أن تحذفه، أو أن تضيف له إعادة محاولة صامتة. والخيار الرابع هو العزل، أي أن تخرجه من البوابة التي تمنع الدمج إلى مكان يعمل فيه ويسجل نتيجته دون أن يمنع أحداً، كما يقترح Martin Fowler في Eradicating Non-Determinism in Tests. وفي التجربة وضعنا على اختبار الزمن علامة @pytest.mark.perf، واستبعدناه من الخط الرئيسي بالخيار -m "not perf"، ووضعناه في مهمة خاصة.
وفي المحاولة الأولى جعلنا مهمة العزل جزءاً من الخط نفسه مع continue-on-error: true، فظهرت مشكلة لم نتوقعها: التشغيل كله اعتبر ناجحاً، ولكن Gitea سجل لكل مهمة فحص حالة مستقلاً على ال Commit، فأصبحت الحالة المجمعة للـ Commit حمراء:
run 5: completed success
commit status: failure
ci / tests (push) success
ci / quarantine (push) failure
أي أن العلامة الحمراء عادت على ال Commit وفي قائمة طلبات الدمج، وهي بالضبط ما أردنا التخلص منه. لذلك نقلنا مهمة العزل إلى ملف مستقل nightly.yml يعمل كل ليلة وعند الطلب، فتظهر نتيجته في صفحة Actions ولا تظهر على طلبات الدمج:
name: nightly
on:
  schedule:
    - cron: "30 0 * * *"          # 00:30 UTC
  workflow_dispatch:

jobs:
  quarantine:
    runs-on: python
    steps:
      - uses: builtin:checkout
      - name: Install test dependencies
        run: pip install -r requirements-test.txt
      - name: Quarantined tests, retried to measure flakiness
        run: pytest -q -m perf --reruns 2 -rR
وشغلناه ثلاث مرات عند الطلب، فنجح الاختبار من المحاولة الأولى مرة، وفشل في المحاولات الثلاث مرة، ونجح بعد إعادة واحدة مرة، وهذه البيانات هي ما تحتاجه لتقرر: الاختبار يقيس شيئاً لا يمكن قياسه بثبات على هذا ال Runner، فالأنسب أن يتحول إلى اختبار أداء Benchmark يقارن بالأرقام السابقة على جهاز مخصص، أو أن يقيس عدد العمليات بدلاً من الزمن.
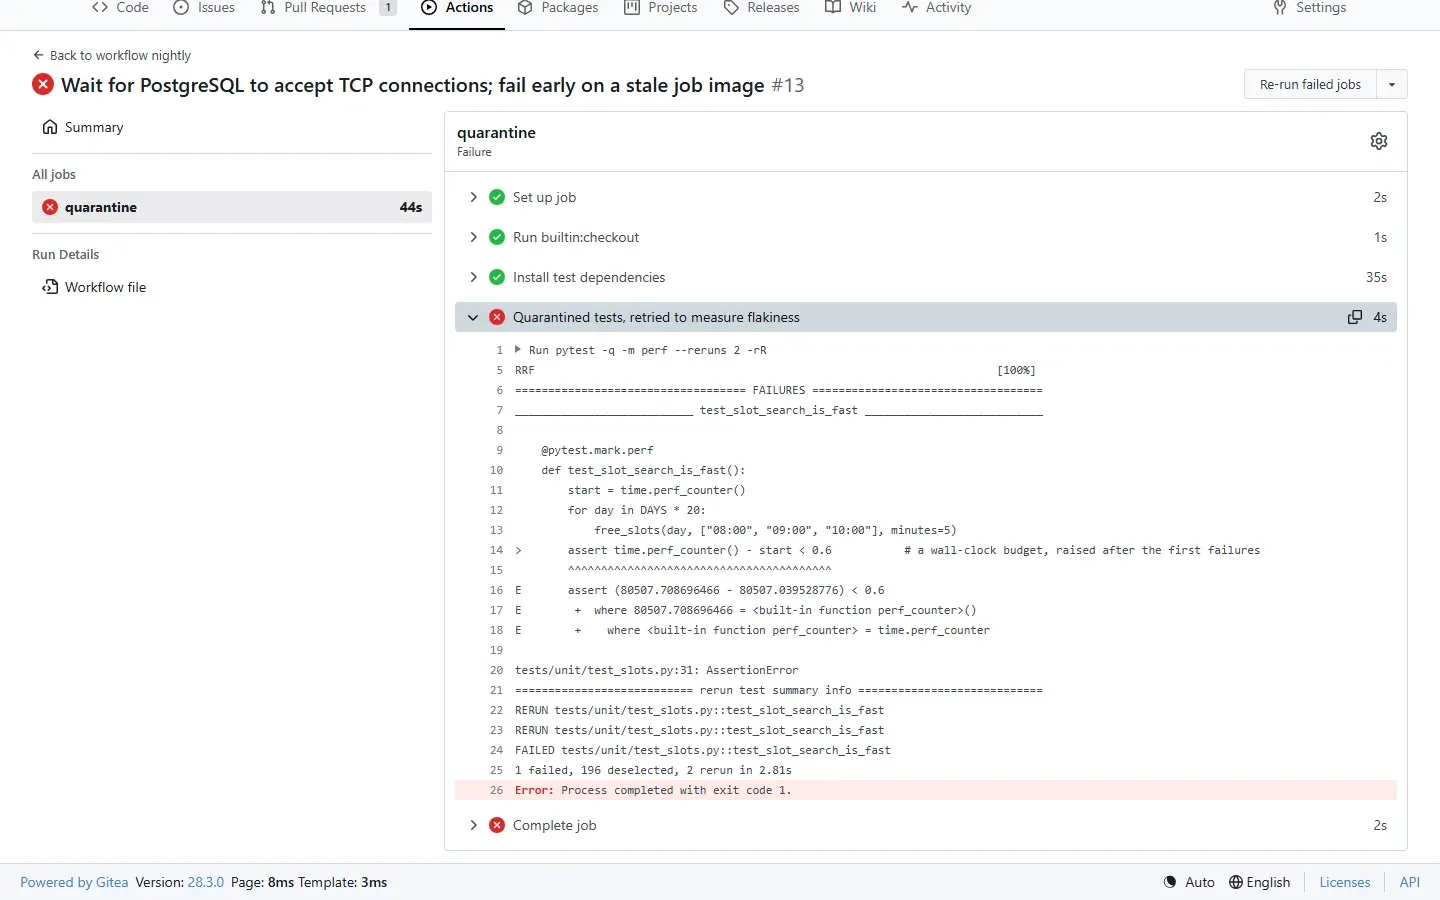
والعزل له قواعد حتى لا يتحول إلى مقبرة: لكل اختبار معزول مهمة Issue باسم صاحبها وموعد، والعزل لا يتجاوز أسابيع، فإن لم يصلح فاحذفه أو أعد كتابته، لأن الاختبار المعزول إلى الأبد لا يحمي شيئاً. وراجع قائمة المعزولين في اجتماع الفريق الأسبوعي كما تراجع الأخطاء المفتوحة.
سياسة إعادة المحاولة Retry Policy
هل نمنع إعادة المحاولة إذن؟ لا، ولكن نحدد أين تكون. فإعادة المحاولة مناسبة للعمليات التي تفشل لأسباب في البنية خارج الكود، مثل تنزيل مكتبة أو سحب Image أو الاتصال بال Registry، فهذه تعيدها في الخطوة نفسها بعدد محدود. أما إعادة الاختبار نفسه تلقائياً في البوابة الرئيسية فتخفي حالات التسابق Race Conditions الحقيقية في الكود، وهي من أصعب الأخطاء التي تصل إلى الإنتاج، لأن الخطأ الذي يظهر مرة من عشر في الخط يظهر مرة من عشر عند العملاء أيضاً. لذلك إذا استخدمت إعادة الاختبار في البوابة فاجعلها تسجل الاختبار متقلباً وتفتح له مهمة كما فعل نظام GitHub، ولا تجعلها تحول الأحمر إلى أخضر دون أثر.
تقارير الاختبارات Test Reports مع الملفات المرفقة Artifacts
سجل المهمة يكفي لقراءة فشل واحد، ولكنه لا يكفي لمعرفة الاتجاه: هل أصبحت الاختبارات أبطأ هذا الشهر؟ ما الاختبار الذي يتكرر فشله؟ لذلك اطلب من أداة الاختبار تقريراً بصيغة JUnit XML، وهي صيغة تفهمها أغلب أدوات CI، وفي pytest يتم ذلك بالخيار --junitxml=unit.xml، ثم ارفعه كملف مرفق Artifact بال Action actions/upload-artifact مع الشرط if: always()، لكي يرفع التقرير حتى عندما تفشل الاختبارات، فهذا بالضبط الوقت الذي تحتاجه فيه. وفي التجربة عمل الإصدار v4 من ال Action مع Gitea 28.3.0 دون تعديل، وظهر التقرير في صفحة التشغيل تحت Artifacts. والتقرير مفيد أيضاً لاختبارات المتصفح بشكل خاص، فملف التتبع Trace في Playwright يغني المطور عن إعادة التشغيل ليرى ما حدث.
تجربة عملية Lab: من 43 ثانية حمراء إلى 21 ثانية خضراء
في هذه التجربة نبني المشروع والخط خطوة خطوة على Gitea 28.3.0 مع Gitea Runner 5.3.0، وكل تعديل Commit مستقل، وملفات المشروع وال Images والسكربتات كاملة في مجلد lab مع المقال. وقائمة التعديلات بالترتيب هي:
92b46b6 Clinic API with tests and a first pipeline
d5448da Raise the slot search budget to 0.6 s
727a6db Cache pip downloads between runs
bd81806 Run tests on 4 workers with pytest-xdist
be75dbb One database per xdist worker; quarantine the wall-clock test; keep the JUnit report
40a7ac7 Quarantine runs nightly, not on every push; cheap scrypt cost in tests
0e6ebf2 Split unit and integration jobs; drop xdist after measuring
63d6cc3 Use a job image with the test dependencies installed
93e0dd3 Wait for PostgreSQL to accept TCP connections; fail early on a stale job image
التجهيز Setup
نبدأ بـ Gitea وال Runner كما في تجربة مفهوم CI/CD، مع فرقين: سعة ال Runner ثلاث مهام، والوسم python يشير إلى Image فيها Python وgit وNode.js، لأن builtin:checkout يحتاج git، وال Actions مثل actions/cache تحتاج Node.js:
# Job image for the "python" runner label: Python, git (builtin:checkout) and Node.js (JavaScript actions such as actions/cache)
FROM python:3.13.18-slim
RUN apt-get update \
 && apt-get install -y --no-install-recommends git ca-certificates nodejs \
 && rm -rf /var/lib/apt/lists/*
docker network create dv2o-net
docker run -d --name dv2o-gitea --network dv2o-net -p 3481:3000 \
-e GITEA__security__INSTALL_LOCK=true \
-e GITEA__server__ROOT_URL=http://localhost:3481/ \
-e GITEA__database__DB_TYPE=sqlite3 \
-v dv2o-gitea-data:/data gitea/gitea:28.3.0
docker exec -u git dv2o-gitea gitea admin user create --admin \
--username dev1 --password 'Lab-Pass-2026!' --email [email protected] --must-change-password=false
TOKEN=$(docker exec -u git dv2o-gitea gitea actions generate-runner-token)
docker build -t dv2o-ci-python:3.13 ci-image/وعند أول تشغيل لهذا الأمر فشل إنشاء المستخدم برسالة SQL logic error: no such table: user، والسبب أن Gitea لم يكمل إنشاء جداوله بعد، فالأمر docker run -d يرجع فوراً بينما Gitea يحتاج ثوان ليجهز، والحل أن تنتظر حتى يجيب /api/healthz قبل أي أمر إداري. وإعداد ال Runner في صورته النهائية كما يلي:
log:
  level: info
runner:
  capacity: 3
  timeout: 30m
  labels:
    - "python:docker://dv2o-ci-python:3.13"
    - "clinic:docker://dv2o-ci-clinic:2026-11-03.2"
cache:
  enabled: true
container:
  network: dv2o-net
  force_pull: false
docker run -d --name dv2o-runner --network dv2o-net \
-e GITEA_INSTANCE_URL=http://dv2o-gitea:3000 \
-e GITEA_RUNNER_REGISTRATION_TOKEN="$TOKEN" \
-e GITEA_RUNNER_NAME=runner-01 \
-e CONFIG_FILE=/config/config.yaml \
-v "$PWD/runner-config.yaml:/config/config.yaml:ro" \
-v /var/run/docker.sock:/var/run/docker.sock \
-v dv2o-runner-data:/data gitea/runner:5.3.0وإذا كنت تشغل الأوامر من Git Bash على Windows فانتبه لمشكلة ظهرت لنا هنا: Git Bash يحول المسارات التي تبدأ بـ / إلى مسارات Windows، فوصل إلى ال Runner مسار مثل Files/Git/config/config.yaml وتوقف برسالة unknown command، والحل أن تشغل الأمر مع المتغير MSYS_NO_PATHCONV=1 وأن تعطي مسار الملف على الجهاز بصيغة Windows.
المشروع والاختبارات Project
المشروع ثلاثة ملفات: slots.py لحساب المواعيد المتاحة، وauth.py لهاش كلمات المرور، وrepo.py للحجوزات في PostgreSQL مع قيد فريد يمنع حجز الموعد نفسه مرتين. وأهم ما فيها ملف الهاش، لأنه يقرأ التكلفة من البيئة:
"""Password hashing with scrypt. The cost comes from the environment so tests can lower it."""
import hashlib
import hmac
import os

N = int(os.environ.get("SCRYPT_N", 2 ** 15))     # production cost


def hash_password(password: str, salt: bytes | None = None) -> str:
    salt = salt or os.urandom(16)
    digest = hashlib.scrypt(password.encode(), salt=salt, n=N, r=8, p=1, maxmem=128 * 1024 * 1024)
    return f"{N}${salt.hex()}${digest.hex()}"


def verify_password(password: str, stored: str) -> bool:
    n, salt, digest = stored.split("$")
    check = hashlib.scrypt(password.encode(), salt=bytes.fromhex(salt), n=int(n), r=8, p=1, maxmem=128 * 1024 * 1024)
    return hmac.compare_digest(check.hex(), digest)
واختبارات الوحدة 179 اختباراً، أغلبها جدول حالات للمواعيد، و24 اختباراً لكلمات المرور، واختبار واحد بميزانية زمن:
import time

import pytest

from clinic.slots import day_slots, first_free, free_slots

DAYS = [f"2026-11-{d:02d}" for d in range(1, 31)]


@pytest.mark.parametrize("day", DAYS)
@pytest.mark.parametrize("minutes, count", [(20, 24), (30, 16), (15, 32), (60, 8)])
def test_day_has_expected_number_of_slots(day, minutes, count):
    assert len(day_slots(day, minutes=minutes)) == count


@pytest.mark.parametrize("day", DAYS)
def test_booked_slots_are_not_free(day):
    assert "08:20" not in free_slots(day, ["08:00", "08:20"])


@pytest.mark.parametrize("after, expected", [("00:00", "08:40"), ("09:00", "09:00"), ("15:40", "15:40"), ("15:41", None)])
def test_first_free_after(after, expected):
    assert first_free("2026-11-03", ["08:00", "08:20"], after=after) == expected


@pytest.mark.perf
def test_slot_search_is_fast():
    start = time.perf_counter()
    for day in DAYS * 20:
        free_slots(day, ["08:00", "09:00", "10:00"], minutes=5)
    assert time.perf_counter() - start < 0.6           # a wall-clock budget, raised after the first failures
واختبارات التكامل 18 اختباراً على PostgreSQL، وكانت ال Fixture في نسختها الأولى كما يلي، وهي النسخة التي سوف تفشل مع التوازي:
@pytest.fixture
def bookings():
    with psycopg.connect(os.environ["DATABASE_URL"], autocommit=True) as conn:
        repo = Bookings(conn)
        repo.create_schema()
        conn.execute("TRUNCATE bookings")
        yield repo
أول تشغيل: ميزانية زمن خاطئة Wall-clock Budget
الخط الأول مهمة واحدة: خدمة PostgreSQL، ثم تثبيت المكتبات، ثم كل الاختبارات:
name: ci
on:
  push:
    branches: [main]
  pull_request:

jobs:
  tests:
    runs-on: python
    services:
      postgres:
        image: postgres:18.6
        env:
          POSTGRES_PASSWORD: ci
    env:
      DATABASE_URL: postgresql://postgres:ci@postgres:5432/postgres
    steps:
      - uses: builtin:checkout
      - name: Install test dependencies
        run: pip install -r requirements-test.txt
      - name: All tests
        run: pytest -q --durations=5
وكانت النتيجة فشلاً في 43 ثانية:
>       assert time.perf_counter() - start < 0.25          # a wall-clock budget
E       assert (78510.876193123 - 78510.333986866) < 0.25
tests/unit/test_slots.py:30: AssertionError
1 failed, 196 passed in 10.07s
البحث في المواعيد أخذ 0.54 ثانية والميزانية 0.25، وأعدنا تشغيل ال Commit نفسه ثلاث مرات بزر Re-run، ففشل في الثلاث بأزمنة 0.43 و0.92 و1.48 ثانية. ولكي نعرف هل المشكلة في الخط أم في الرقم، قسنا الحلقة نفسها عشر مرات داخل Job Image نفسها على الجهاز دون أي ضغط آخر:
[0.656, 0.602, 0.66, 0.839, 0.542, 0.596, 0.501, 0.543, 0.537, 0.587]أي أن الرقم 0.25 لم يكن ممكناً أصلاً على هذا الجهاز، وأن الزمن نفسه يتغير بين 0.50 و0.84 ثانية دون أي سبب في الكود.
نفس ال Commit: أحمر ثم أخضر ثم أحمر
هنا فعلنا ما يفعله أغلب الفرق، فرفعنا الميزانية إلى 0.6 ثانية، وهو رقم قريب من الوسط، ثم شغلنا ال Commit الجديد ثلاث مرات:
5	tests	failure	42s
6	tests	success	39s
7	tests	failure	41s
وهذا هو الاختبار المتقلب بشكله الكامل: الكود نفسه، والخط نفسه، ونتيجتان مختلفتان. ولو كان هذا خط فريقك لتعلم الجميع في أسبوع أن يضغطوا Re-run عند أي أحمر.
ال Cache للاعتماديات Dependency Cache
قبل أن نعالج التقلب نعالج البطء، فأضفنا خطوة ال Cache قبل التثبيت:
      - name: Cache pip downloads
        uses: actions/cache@v4
        with:
          path: /root/.cache/pip
          key: pip-${{ hashFiles('requirements-test.txt') }}
Cache not found for input keys: pip-7ddd589192d39372dd03f950fac52c17a5eba544a27aca3d46e3bfb8698db4ee
...
Cache saved with key: pip-7ddd589192d39372dd03f950fac52c17a5eba544a27aca3d46e3bfb8698db4eeوفي التشغيل التالي:
Cache hit for: pip-7ddd589192d39372dd03f950fac52c17a5eba544a27aca3d46e3bfb8698db4ee
Cache Size: ~8 MB (7908342 B)
Cache restored successfully
نزل زمن pip install من 18.5 إلى 8.5 ثانية، ولكن المهمة كلها بقيت بين 55 و58 ثانية، لأن خطوة ال Cache نفسها أخذت قرابة أربع ثوان، ولأن إيقاف خدمة PostgreSQL وحذفها في نهاية المهمة أخذ بين 14 و17 ثانية في هذين التشغيلين، وهي مرحلة لا يراها أحد حتى يقرأ أوقات السجل.
أربعة Workers: تسعة فشلت وخطأ واحد
غيرنا أمر الاختبار إلى pytest -q -n 4 --durations=5، فظهرت الأخطاء التي شرحناها في قسم الحالة المشتركة: 9 failed, 187 passed, 1 error in 6.54s، مع فشل اختبار الزمن أيضاً لأن أربعة Workers كانت تحسب الهاش بجانبه، فأخذ 0.98 ثانية. ثم أضفنا Fixture قاعدة بيانات لكل Worker، ووضعنا علامة perf على اختبار الزمن، ورفعنا تقرير JUnit:
name: ci
on:
  push:
    branches: [main]
  pull_request:

jobs:
  tests:
    runs-on: python
    services:
      postgres:
        image: postgres:18.6
        env:
          POSTGRES_PASSWORD: ci
    env:
      DATABASE_URL: postgresql://postgres:ci@postgres:5432/postgres
      PIP_CACHE_DIR: /root/.cache/pip
    steps:
      - uses: builtin:checkout
      - name: Cache pip downloads
        uses: actions/cache@v4
        with:
          path: /root/.cache/pip
          key: pip-${{ hashFiles('requirements-test.txt') }}
      - name: Install test dependencies
        run: pip install -r requirements-test.txt
      - name: All tests except quarantined
        run: pytest -q -n 4 -m "not perf" --durations=5 --junitxml=report.xml
      - name: Keep the test report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: junit-report
          path: report.xml

  quarantine:
    runs-on: python
    continue-on-error: true
    steps:
      - uses: builtin:checkout
      - name: Install test dependencies
        run: pip install -r requirements-test.txt
      - name: Quarantined tests, retried to measure flakiness
        run: pytest -q -m perf --reruns 2 -rR
فنجحت المهمة الرئيسية 196 passed in 8.46s، وفشلت مهمة العزل بعد محاولتين إضافيتين، وظهرت مشكلة الحالة الحمراء على ال Commit التي شرحناها في قسم العزل، فنقلنا العزل إلى الخط الليلي، وخفضنا تكلفة الهاش في الاختبارات.
القياس على جهاز هادئ Local Measurement
عند هذه النقطة كانت أرقام الخط متقلبة جداً، فالتشغيل بعد تخفيض تكلفة الهاش أخذ 95 ثانية، منها 20.8 لخطوة ال Cache و23.9 لرفع التقرير، والاختبارات نفسها 5.54 ثانية، والسبب أن الجهاز كان مشغولاً بأعمال أخرى في تلك الدقائق. لذلك قسنا التوازي في Container واحد خارج الخط، وهي الأرقام التي عرضناها في قسم التوازي، والقرار الذي خرجنا به أن نلغي -n 4، لأن المجموعة بعد تخفيض الهاش أقل من ثانية، والتوازي يضيف أكثر مما يوفر.
مهمتان بدلاً من مهمة Job Split
قسمنا الخط إلى مهمة unit دون خدمات، ومهمة integration مع PostgreSQL، وكل منهما يثبت المكتبات مع ال Cache. وشغلنا ال Commit ثلاث مرات فأخذت المهمتان 83 و75 ثانية، ثم 40 و41، ثم 77 و81، وفي كل مرة كان pip install بين 11 و35 ثانية بحسب ضغط الجهاز، والاختبارات نفسها 178 passed, 1 deselected in 1.21s و18 passed in 1.40s. أي أن الاختبارات لم تعد المشكلة، والذي بقي هو التثبيت والتجهيز.
Job Image جاهزة، ثم Connection refused
بنينا Image فوق Image الخط فيها المكتبات، وأضفنا وسماً جديداً clinic إلى ال Runner:
# Job image with the test dependencies already installed: rebuilt when requirements-test.txt changes
FROM dv2o-ci-python:3.13
COPY requirements-test.txt /tmp/
RUN pip install --no-cache-dir -r /tmp/requirements-test.txt
وحذفنا من الخط خطوتي ال Cache والتثبيت، فأخذت المهمتان 36 و26 ثانية في التشغيل الأول، ثم فشلت مهمة التكامل في التشغيل الثاني بخطأ Connection refused الذي شرحناه في قسم الخدمة التي لم تجهز. فأضفنا فحص الصحة، وخطوة تقارن ملف المتطلبات بالنسخة داخل ال Image، وهذا هو الخط النهائي:
name: ci
on:
  push:
    branches: [main]
  pull_request:

jobs:
  unit:
    runs-on: clinic                  # job image with the test dependencies baked in
    timeout-minutes: 10
    env:
      SCRYPT_N: "1024"
    steps:
      - uses: builtin:checkout
      - name: Job image matches requirements-test.txt
        run: cmp requirements-test.txt /tmp/requirements-test.txt || { echo "::error::job image is stale, rebuild it"; exit 1; }
      - name: Unit tests
        run: pytest -q tests/unit -m "not perf" --durations=3 --junitxml=unit.xml
      - name: Keep the test report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: unit-report
          path: unit.xml

  integration:
    runs-on: clinic
    timeout-minutes: 10
    services:
      postgres:
        image: postgres:18.6
        env:
          POSTGRES_PASSWORD: ci
        # the image has no health check: without one the job starts while initdb is still running
        options: >-
          --health-cmd "pg_isready -h 127.0.0.1 -U postgres"
          --health-interval 2s --health-timeout 5s --health-retries 20
    env:
      DATABASE_URL: postgresql://postgres:ci@postgres:5432/postgres
    steps:
      - uses: builtin:checkout
      - name: Job image matches requirements-test.txt
        run: cmp requirements-test.txt /tmp/requirements-test.txt || { echo "::error::job image is stale, rebuild it"; exit 1; }
      - name: Integration tests
        run: pytest -q tests/integration --durations=3
وشغلناه ثلاث مرات فأخذت المهمتان 21 و21 ثانية، ثم 24 و23، ثم 21 و20، وكلها خضراء. والصورة التالية من صفحة Actions في Gitea بعد كل التعديلات:
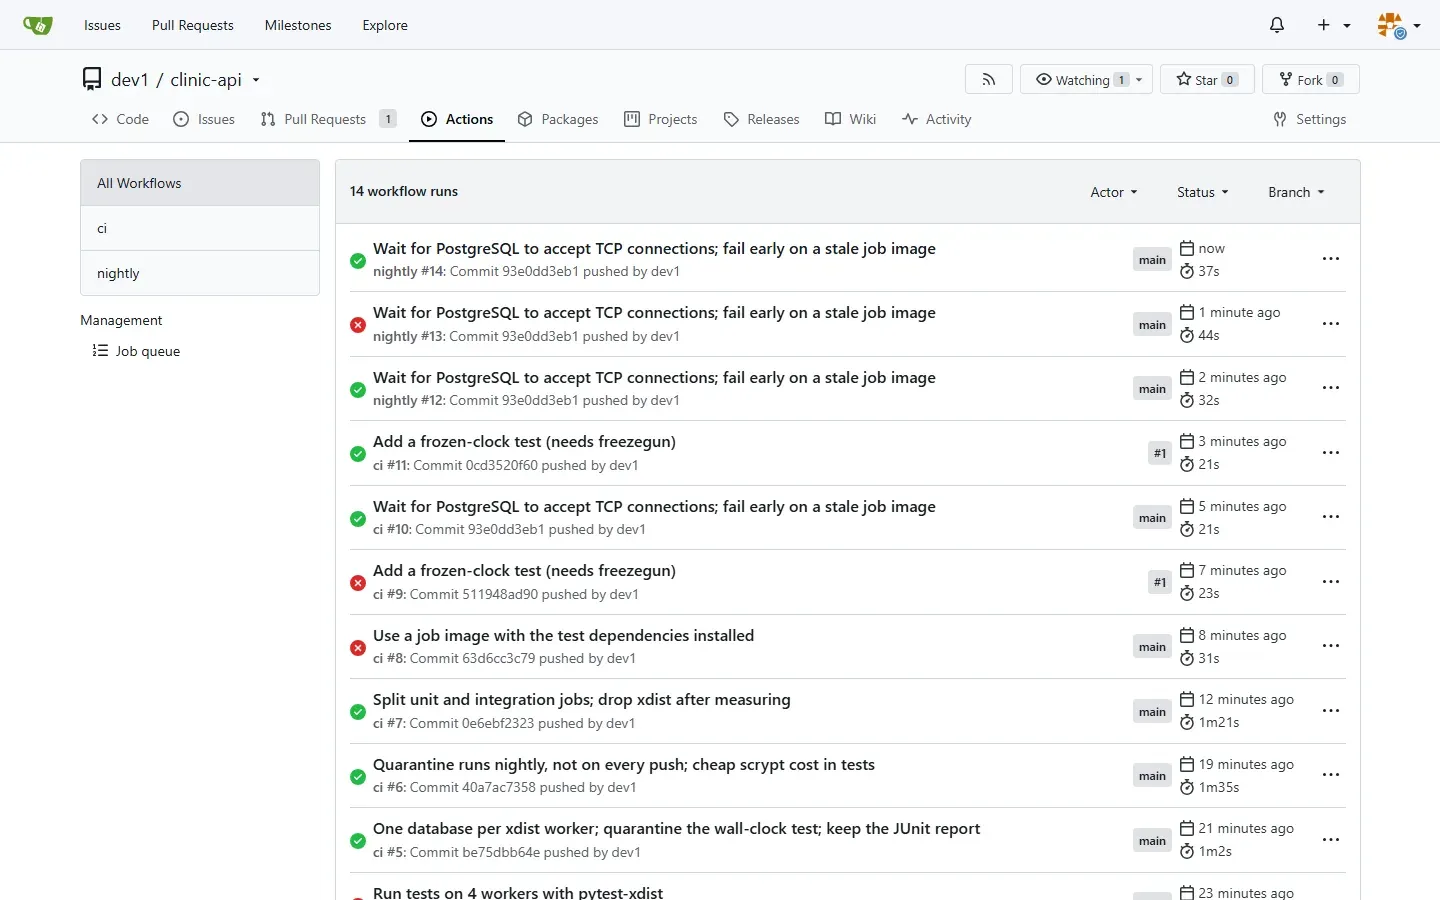
ماذا لو أضاف أحد مكتبة جديدة؟ What If
هذه هي نقطة الضعف المعروفة في ال Image الجاهزة، فاختبرناها: فتحنا فرعاً يضيف freezegun إلى ملف المتطلبات واختباراً يستخدمها، وفتحنا طلب دمج. وقبل أن نضيف خطوة المقارنة كانت النتيجة في طلب دمج سابق بالمحتوى نفسه:
E   ModuleNotFoundError: No module named 'freezegun'
!!!!!!!!!!!!!!!!!!!! Interrupted: 1 error during collection !!!!!!!!!!!!!!!!!!!!
ومع خطوة المقارنة فشلت المهمتان في الخطوة الأولى بعد نسخ المستودع، برسالة تقول ما يجب فعله:
cmp: EOF on /tmp/requirements-test.txt after byte 84, line 4
::error::job image is stale, rebuild it
فأعدنا بناء ال Image بوسم جديد dv2o-ci-clinic:2026-11-03.2، وغيرنا الوسم في إعداد ال Runner وأعدنا تشغيله، ثم أعدنا تشغيل طلب الدمج فنجح 179 passed, 1 deselected in 1.99s و18 passed in 1.22s. ولاحظ أننا أعطينا ال Image وسماً جديداً بدلاً من الكتابة فوق الوسم القديم، لكي يبقى الفرع الرئيسي يعمل بال Image القديمة حتى يدمج الطلب، وهذا يعني في فريق حقيقي أن بناء Image الخط يجب أن يكون هو نفسه خطاً يعمل عند تغير ملف المتطلبات، وليس أمراً يتذكره أحد.
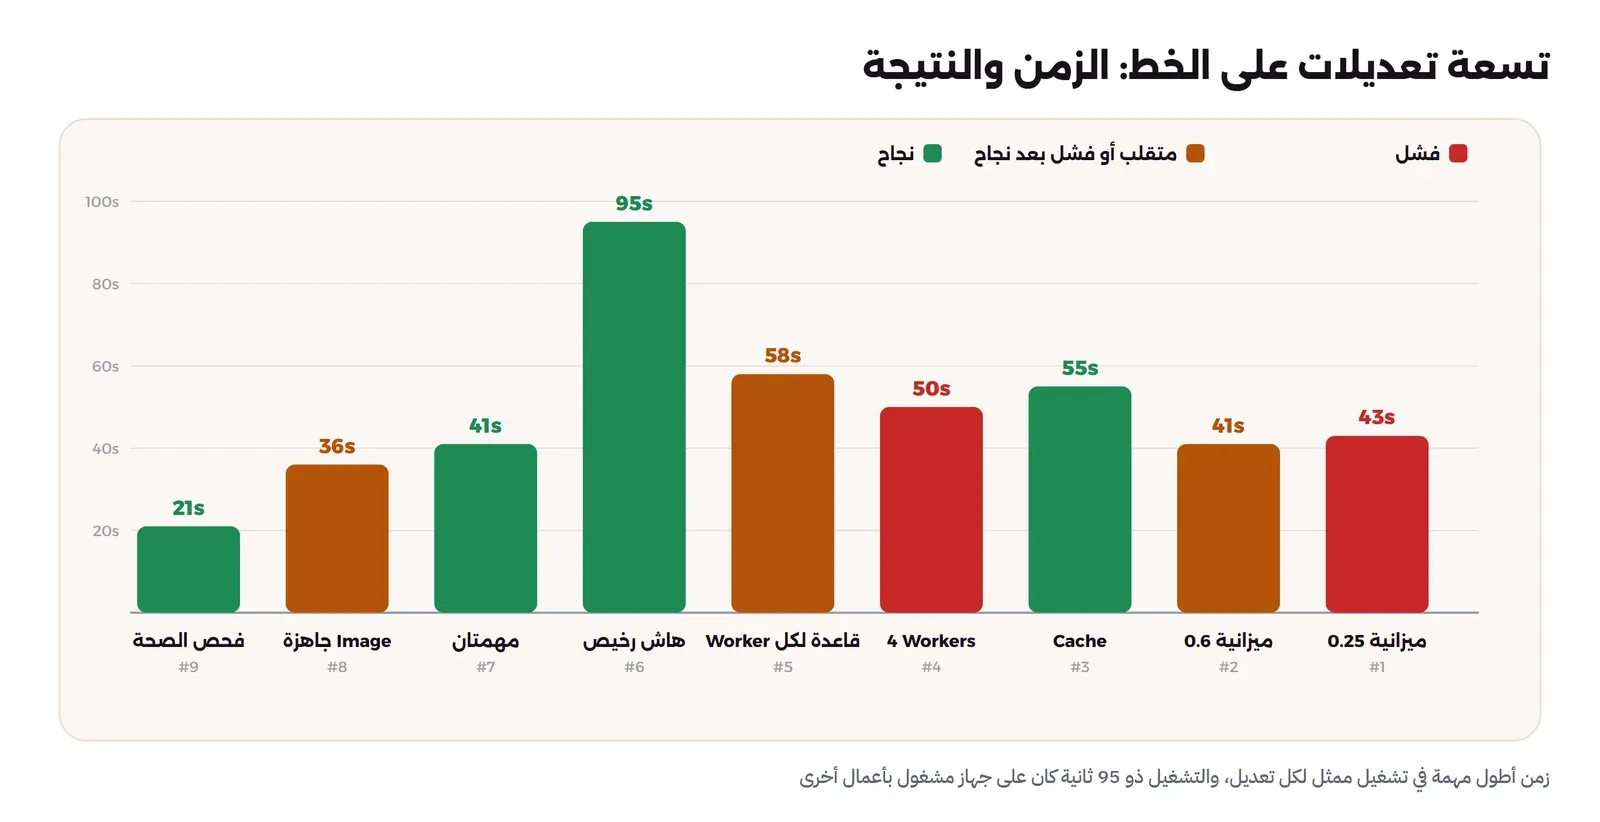
النتائج في جدول Results
| التعديل | زمن المهمة أو المهمتين | الاختبارات | النتيجة |
|---|---|---|---|
| مهمة واحدة، ميزانية 0.25 ثانية | 32 إلى 44 ثانية في 4 تشغيلات | 7.23 إلى 16.07 ثانية | فشل في الأربعة |
| ميزانية 0.6 ثانية | 39 إلى 42 ثانية | 10.15 إلى 11.16 ثانية | فشل ثم نجاح ثم فشل |
| Cache للمكتبات | 58 ثم 55 ثانية | 8.28 و8.72 ثانية | نجاح، والتثبيت من 18.5 إلى 8.5 ثانية |
| أربعة Workers | 50 ثانية | 6.54 ثانية | 9 فشلت وخطأ واحد |
| قاعدة لكل Worker مع العزل في الخط | 58 ثانية | 8.46 ثانية | نجاح، والـ Commit أحمر |
| العزل ليلاً وهاش رخيص | 95 ثانية على جهاز مشغول | 5.54 ثانية | نجاح |
| مهمتان دون توازي | 40 إلى 83 ثانية | 1.21 و1.40 ثانية | نجاح |
| Job Image جاهزة | 26 إلى 36 ثانية | 1.9 و2.35 ثانية | نجاح، ثم Connection refused |
| فحص الصحة وخطوة المقارنة | 20 إلى 24 ثانية | 1.34 و1.97 ثانية | نجاح في 3 تشغيلات |
التنظيف Cleanup
docker rm -f dv2o-runner dv2o-gitea
docker volume rm dv2o-gitea-data dv2o-runner-data
docker network rm dv2o-net
docker rmi dv2o-ci-clinic:2026-11-03 dv2o-ci-clinic:2026-11-03.2 dv2o-ci-python:3.13 gitea/runner:5.3.0
أخطاء شائعة Common Mistakes
- البدء بالتوازي: التوازي يضيف تكلفة ثابتة ويكشف كل حالة مشتركة، وفي التجربة كان أبطأ من التشغيل العادي بعد أن أصلحنا الاختبار البطيء.
- الحكم من تشغيل واحد: المهمة نفسها أخذت 40 و83 ثانية على ال Commit نفسه، فقارن عدة تشغيلات.
- تكلفة الإنتاج في الاختبارات: هاش كلمات المرور وانتظار
sleepوملفات كبيرة، كلها قيم إعداد يجب أن تتغير في بيئة الاختبار. - ميزانية زمن بالساعة في البوابة: هذه اختبارات أداء، ومكانها جهاز مخصص يقارن بالتاريخ، وليس Runner مشتركاً.
- خدمة دون فحص صحة: «Container بدأ» لا تعني «الخدمة تقبل الاتصال»، والوقت الضائع في الخط قد يخفي هذا التسابق حتى تسرعه.
- إعادة محاولة صامتة: تحول الأحمر إلى أخضر دون أثر، وتخفي حالات التسابق الحقيقية، فسجل كل إعادة.
- العزل داخل الخط نفسه: مع
continue-on-errorبقيت حالة ال Commit حمراء في Gitea، فضع العزل في خط مستقل. - عزل دون صاحب: الاختبار المعزول بلا مهمة ولا موعد يبقى معزولاً إلى الأبد.
- Job Image دون حارس: مكتبة جديدة تظهر كخطأ استيراد غامض، فقارن ملف المتطلبات في أول خطوة.
- رفع التقرير عند النجاح فقط: دون
if: always()لا يرفع التقرير في الحالة الوحيدة التي تحتاجه فيها.
قائمة تحقق Checklist
- البوابة تشترط فحوص حالة محددة في حماية الفرع، وأسماء المهام توضح نوع الاختبار.
- تعرف توزيع زمن المهمة على مراحلها، من عدة تشغيلات وليس من تشغيل واحد.
- تثبيت المكتبات إما مع Cache مفتاحه هاش ملف المتطلبات، وإما في Job Image بوسم مثبت وخطوة مقارنة.
- أبطأ عشرة اختبارات معروفة ومراجعة، وقيم الإنتاج المكلفة مستبدلة في بيئة الاختبار.
- التوازي مقاس قبل اعتماده، ولكل Worker بياناته الخاصة.
- كل خدمة في الخط لها فحص صحة حقيقي عبر الشبكة.
- لكل مهمة
timeout-minutesقريبة من زمنها الطبيعي. - الاختبارات المتقلبة تعزل في خط مستقل، ولكل منها صاحب وموعد، وتراجع أسبوعياً.
- إعادة المحاولة للبنية فقط، وأي إعادة لاختبار تسجل في التقرير.
- تقرير JUnit يرفع في كل تشغيل مع
if: always().
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- زمن الخط مجموع مراحل، وفي تجربتنا كان تثبيت المكتبات نصف المهمة والاختبارات ربعها، فابدأ بأكبر مرحلة بعد أن تقيسها.
- ال Cache خفض التثبيت من 18.5 إلى 8.5 ثانية، وال Image الجاهزة ألغته، ولكنها تحتاج خطوة تكشف أنها أصبحت قديمة.
- التوازي ليس مجانياً: وفر ثانية من ست ثوان، وأصبح يضر بعد إصلاح الاختبار البطيء، وكشف حالة مشتركة أفشلت تسعة اختبارات.
- أكبر تسريع للاختبارات جاء من تخفيض تكلفة الهاش في بيئة الاختبار: من 6.15 إلى 0.83 ثانية.
- التقلب في الخط له أسباب لا تظهر على جهازك: ميزانيات الزمن، والخدمات غير الجاهزة، والتزاحم، والتوازي، وتسريع الخط قد يكشف تسابقاً كان مخفياً.
- اعزل الاختبار المتقلب في خط مستقل مع صاحب وموعد، واستخدم إعادة المحاولة لقياس التقلب وليس لإخفائه.
وإذا أردت أن تعرف هل الاختبارات التي تعمل في خطك تكشف الأخطاء فعلاً، فاقرأ اختبار الطفرات في خط CI، وإذا أردت أن تضيف للخط الفحوص الأمنية فقد شرحناها في خط CI/CD آمن من البداية للنهاية.
 دليلمفهوم CI/CD للمبتدئين: من كل Push إلى سيرفر يعملما الذي يعنيه التكامل المستمر والتسليم المستمر فعلاً، وكيف تبني خطاً صغيراً يختبر كل Push وينشر إلى staging ويتحقق منه، مع الأخطاء الحقيقية التي يكشفها وتلك التي لا يكشفها.
 دليلGitea Actions: تشغيل CI/CD وبناء Docker Images على سيرفركاجعل سيرفرك يختبر الكود ويبني Docker Images تلقائياً مع كل push، دون أن يخرج كودك أو أسرارك إلى خدمة CI خارجية.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلاختبارات E2E مع Playwright: من أول اختبار إلى CIكيف تكتب اختبارات متصفح ثابتة لموقع عربي مع Playwright، وتشخص الاختبار المتقلب، وتقسمها على أكثر من جهاز في خط CI.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع Gitea 28.3.0 (gitea/gitea:28.3.0) وGitea Runner 5.3.0 (gitea/runner:5.3.0) وPostgreSQL 18.6 (postgres:18.6) وPython 3.13.18 (python:3.13.18-slim) مع git 2.47.3 وNode.js 20.19.2، وpytest 9.2.0 وpytest-xdist 3.8.0 وpytest-rerunfailures 16.7 وpsycopg 3.3.7 وfreezegun 1.5.5، وactions/cache@v4 وactions/upload-artifact@v4.


