


لنفرض أن متجر القهوة والتمور أضاف صفحة «تتبع طلبك»، يرى فيها العميل حالة الطلب وهي تتغير: استلمنا الطلب، ثم قيد التجهيز، ثم مع المندوب، ثم تم التوصيل. والنسخة الأولى كانت بسيطة: الصفحة تسأل السيرفر كل ثلاث ثوان «هل تغيرت الحالة؟». ثم جاء موسم رمضان، وصار في الموقع آلاف العملاء يفتحون الصفحة في نفس الوقت، فارتفع عدد الطلبات على السيرفر عشرات المرات، وأغلبها يرجع بنفس الجواب: لا جديد. فقرر الفريق الانتقال إلى WebSocket، وعمل كل شيء على جهاز المطور، ثم نشروه خلف Nginx في الإنتاج، فلم تصل أي حالة، وظهر في Console المتصفح سطر واحد: WebSocket connection failed. وبعد أن أصلحوا ذلك، بدأت تصلهم شكاوى من عملاء تركوا الصفحة مفتوحة فتوقفت عن التحديث بعد دقيقة دون أي رسالة.
وهذه القصة تتكرر في كل فريق يبني إشعارات أو محادثة أو تتبعاً لحظياً، والسبب أن HTTP صمم في الأساس لطلب ورد: المتصفح يسأل والسيرفر يجيب، ولا يستطيع السيرفر أن يبدأ الحديث. ولذلك ظهرت عدة طرق للالتفاف على هذا القيد، ولكل طريقة ثمن في التأخير وعدد الطلبات والبايتات، وفي طريقة تعاملها مع الـ Reverse Proxy وانقطاع الشبكة. وهذا المقال من مرحلة هندسة الواجهات وتطبيقات الويب Frontend، وقد شرحنا في مقال HTTP كيف يعمل الطلب والرد وإعادة استخدام الاتصال، وهنا نبني فوق ذلك ونقيس الطرق الأربع في Chrome، مباشرة إلى Node.js ثم خلف Nginx.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي HTTP العادي، والطرق الأربع: الاستطلاع Polling، والاستطلاع الطويل Long Polling، والأحداث من السيرفر Server-Sent Events، وWebSocket.
- كيف تعمل كل طريقة من الداخل: صيغة الرسائل، وإعادة الاتصال، والمصافحة Handshake، والنبضات Heartbeats.
- التجربة العملية: سيرفر Node.js يرسل حالة الطلب كل ثانيتين، وصفحة في Chrome تقيس التأخير وعدد الطلبات والبايتات بكل طريقة.
- ما يفعله Nginx بالاتصال المفتوح: WebSocket الذي يفشل، والأحداث التي لا تصل مع الضغط، والاتصال الذي يغلق بعد مهلة الصمت.
- التوسع إلى آلاف الاتصالات، وإعادة الاتصال واستكمال ما فات، والأمان، والأخطاء الشائعة، وكيف تختار.
لماذا لا يكفي HTTP العادي؟
في HTTP كل شيء يبدأ من المتصفح: يرسل طلباً، والسيرفر يرد، وينتهي الحوار. وحتى مع الاتصال الدائم Keep-Alive الذي يبقى مفتوحاً بين الطلبات، فإن السيرفر لا يرسل على هذا الاتصال شيئاً لم يطلبه المتصفح. وهذا التصميم مناسب جداً للصفحات والملفات، فهو بسيط، ويمكن تخزينه مؤقتاً Cache، ويمر عبر أي Proxy. ولكنه لا يناسب حدثاً يقع في السيرفر في لحظة لا يعرفها المتصفح، مثل تغير حالة الطلب أو وصول رسالة جديدة في محادثة.
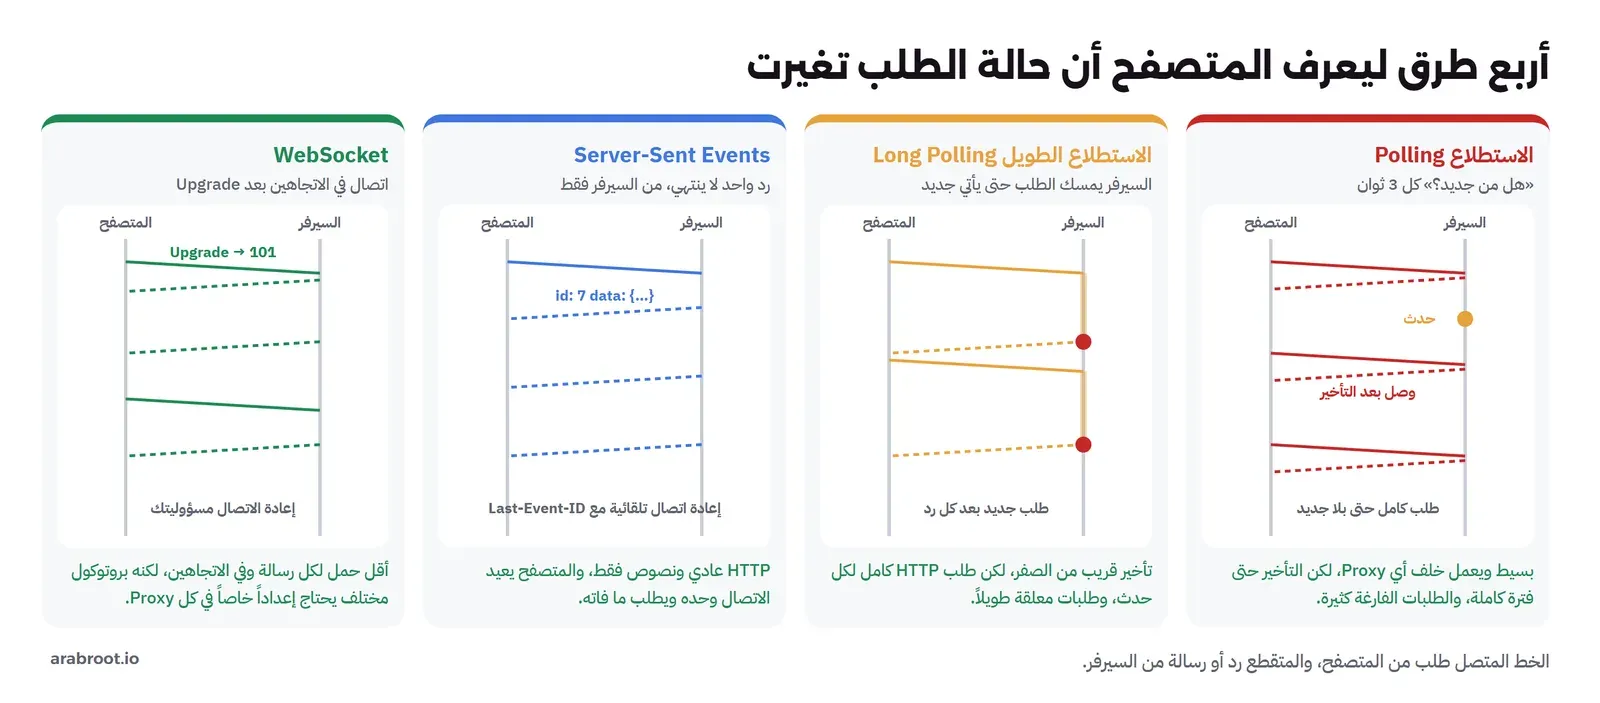
والطرق الأربع التي سوف نقارنها هي إجابات مختلفة لنفس السؤال: كيف يعرف المتصفح أن شيئاً حدث في السيرفر؟ الطريقتان الأوليان تبقيان داخل نموذج الطلب والرد وتلتفان عليه، والثالثة تستخدم HTTP عادياً ولكن برد لا ينتهي، والرابعة تخرج من HTTP إلى بروتوكول آخر بعد أول طلب. والصورة التالية تبين شكل الحوار في كل طريقة:
الاستطلاع Polling: «هل من جديد؟»
الاستطلاع Polling هو أبسط حل، وهو ما بدأ به المتجر في القصة: كل عدد ثابت من الثواني ترسل الصفحة طلباً عادياً يسأل عن الجديد، والسيرفر يرد فوراً بما عنده، حتى لو كان الرد فارغاً. وميزته أنه لا يحتاج أي شيء خاص: نفس الـ API، ونفس Nginx، ونفس الـ Load Balancer، ويمكن تخزين الرد مؤقتاً، ولا توجد اتصالات مفتوحة تقلق بشأنها.
ولكن له ثمنان واضحان. الأول التأخير، فالحدث الذي يقع بعد الطلب مباشرة ينتظر حتى الطلب التالي، أي أن التأخير يتراوح بين الصفر وفترة كاملة، ومتوسطه نصف الفترة. والثاني الطلبات الفارغة، فكل طلب يحمل ترويسات HTTP كاملة في الاتجاهين، ومع آلاف المستخدمين يصبح أغلب ما يعالجه السيرفر أسئلة جوابها «لا جديد». وإذا قصرت الفترة لتقلل التأخير زادت الطلبات، وإذا أطلتها زاد التأخير، ولا يوجد حل وسط يربح الاثنين.
ويمكن تخفيف ثمن الاستطلاع قليلاً بالطلبات الشرطية Conditional Requests، فيرسل السيرفر مع كل رد معرفاً للنسخة في الترويسة ETag، ويرسله المتصفح في الطلب التالي في If-None-Match، فإذا لم يتغير شيء يرد السيرفر بـ 304 Not Modified بدون جسم. وهذا يوفر جسم الرد، ولكنه لا يوفر الطلب نفسه ولا ترويساته، ولا يقلل التأخير، ولذلك فهو تحسين للاستطلاع وليس بديلاً عنه. والقاعدة العملية أن الاستطلاع مناسب عندما تكون الأحداث نادرة، والتأخير المقبول بالثواني أو الدقائق، وعدد المستخدمين معقولاً، مثل لوحة إدارة يفتحها عشرة موظفين وتتحدث كل دقيقة.
الاستطلاع الطويل Long Polling: السيرفر يمسك الطلب
في الاستطلاع الطويل يرسل المتصفح نفس الطلب، ولكن السيرفر لا يرد فوراً إذا لم يكن عنده جديد، وإنما يمسك الطلب مفتوحاً حتى يقع حدث، فيرد به، أو حتى تنتهي مهلة محددة، فيرد برد فارغ. وبمجرد أن يصل الرد يرسل المتصفح طلباً جديداً. وبهذا يصل الحدث بعد وقوعه مباشرة تقريباً، وتختفي أغلب الطلبات الفارغة، وكل هذا باستخدام HTTP عادي يفهمه أي Proxy. وهذه هي الطريقة التي استخدمتها تطبيقات المحادثة على الويب قبل WebSocket، ويصفها المعيار RFC 6202 مع مشكلاتها المعروفة.
ومن أهم هذه المشكلات أن كل حدث ما زال يكلف طلب HTTP كاملاً بترويساته، وأن السيرفر يحتاج أن يمسك طلباً مفتوحاً لكل مستخدم، وأن الأحداث التي تقع بين الرد والطلب التالي يجب أن يحفظها السيرفر حتى يسأل عنها المتصفح، وإلا ضاعت. لذلك يرسل المتصفح في كل طلب آخر حدث وصله، كما سوف ترى في التجربة بالمعامل since. والمشكلة الأخيرة أن المهلة يجب أن تكون أقصر من مهلة كل Proxy في الطريق، وإلا أغلق الـ Proxy الطلب قبل السيرفر.
الأحداث من السيرفر Server-Sent Events
الأحداث من السيرفر Server-Sent Events، واختصاراً SSE، جزء من معيار HTML، وفكرتها بسيطة: المتصفح يرسل طلباً عادياً، والسيرفر يرد بالنوع text/event-stream، ثم لا ينهي الرد أبداً، وإنما يكتب فيه حدثاً بعد حدث. وكل حدث سطور نصية بسيطة تنتهي بسطر فارغ، والمثال التالي بنفس شكل ما يرسله سيرفر التجربة، والحدث فيه من رد حقيقي للسيرفر:
retry: 1000

id: 3
data: {"seq":3,"t":1793389361251,"status":"مع المندوب"}

: ping
والسطر retry يقول للمتصفح كم ينتظر بالملي ثانية قبل أن يعيد الاتصال إذا انقطع، والسطر id رقم الحدث، والسطر data محتواه، والسطر الذي يبدأ بنقطتين تعليق يتجاهله المتصفح، وسوف نستخدمه كنبضة. وفي المتصفح تكفي EventSource لاستقبال الأحداث، والأجمل فيها أنها تعيد الاتصال وحدها عند الانقطاع، وترسل في الطلب الجديد الترويسة Last-Event-ID بآخر رقم وصلها، فيستطيع السيرفر أن يرسل ما فاتها. أي أن إعادة الاتصال واستكمال الأحداث يأتيان مجاناً.
وحدود SSE ثلاثة. الأولى أنها في اتجاه واحد فقط، من السيرفر إلى المتصفح، وما يرسله المتصفح يذهب بطلبات HTTP عادية. والثانية أنها نصية، فالبيانات الثنائية تحتاج ترميزاً. والثالثة، وهي الأهم، حد الاتصالات في HTTP/1.1، فبحسب دليل MDN يسمح المتصفح بستة اتصالات فقط لكل نطاق، فإذا فتح المستخدم الموقع في سبعة تبويبات بقي السابع ينتظر. ومع HTTP/2 تختفي هذه المشكلة تقريباً، لأن كل الطلبات تمر على اتصال واحد مع حد يتفق عليه الطرفان يكون عادة 100 طلب متزامن، ولذلك فإن SSE خلف HTTPS مع HTTP/2 خيار ممتاز. وهذه الطريقة هي نفسها التي تستخدمها أغلب واجهات نماذج اللغة لإرسال الرد كلمة بكلمة.
WebSocket: اتصال في الاتجاهين
WebSocket بروتوكول مستقل معرف في RFC 6455، يبدأ بطلب HTTP عادي فيه الترويستان Upgrade: websocket وConnection: Upgrade، فإذا وافق السيرفر يرد بالرمز 101 Switching Protocols، ومن هذه اللحظة لا يبقى على الاتصال أي HTTP، وإنما إطارات Frames صغيرة يرسلها الطرفان في أي وقت. وكل إطار يحمل ترويسة من بضعة بايتات فقط، والإطارات من المتصفح إلى السيرفر مقنعة Masked بمفتاح عشوائي حتى لا تخدع الـ Proxies القديمة التي تظن أنها HTTP. ويوجد في البروتوكول نفسه إطارا التحكم Ping وPong لفحص أن الطرف الآخر ما زال موجوداً.
وهذا يجعل WebSocket الأنسب عندما تكون الرسائل كثيرة وفي الاتجاهين، مثل المحادثة والمحررات المشتركة والألعاب. ولكن لاحظ ما لا يعطيك: لا توجد إعادة اتصال تلقائية في واجهة WebSocket في المتصفح، ولا يوجد رقم حدث ولا استكمال لما فات، ولا يوجد Cache، وكل Proxy في الطريق يجب أن يعرف كيف يمرر الترقية ويبقي الاتصال مفتوحاً. أي أن كل ما جاء مجاناً في SSE عليك أن تكتبه بنفسك هنا. وفي Node.js تستخدم أغلب المشاريع المكتبة ws في السيرفر، وهي التي استخدمناها في التجربة.
التجربة العملية Lab: حالة الطلب كل ثانيتين
الآن نقيس. السيرفر server.mjs ينتج حدثاً كل ثانيتين فيه رقم متسلسل ووقت إنشائه وحالة الطلب، ويقدمه بالطرق الأربع على أربعة مسارات. والصفحة client.html تستقبل الأحداث بالطريقة المحددة في الرابط، وتحسب لكل حدث التأخير بين إنشائه في السيرفر ووصوله إلى الصفحة، وهذا ممكن بدقة لأن السيرفر والمتصفح على نفس الجهاز بنفس الساعة. ويقود السكربت measure.mjs Chrome 156 بدون واجهة عبر المساعد scripts/lab/browser.mjs، ويقرأ من السيرفر نفسه عدد الطلبات واتصالات TCP الجديدة والبايتات في الاتجاهين.
السيرفر والصفحة و Nginx: الإعداد Setup
جوهر السيرفر هو الدالة التي تنشر كل حدث إلى المنتظرين بالطرق الثلاث التي تبقي شيئاً مفتوحاً:
function publish() {
  if (Date.now() < pausedUntil) return;
  const ev = { seq: ++seq, t: Date.now(), status: STATUSES[seq % STATUSES.length] };
  history.push(ev); if (history.length > 100) history.shift();
  for (const res of waiting) { waiting.delete(res); clearTimeout(res.timer); json(res, { events: [ev] }); }
  for (const res of sseClients) res.write(`id: ${ev.seq}\ndata: ${JSON.stringify(ev)}\n\n`);
  for (const ws of wsClients) ws.send(JSON.stringify(ev));
}
setInterval(publish, EVENT_MS);
ومسار SSE يرد بالنوع text/event-stream، ويرسل retry، ويستكمل ما فات إذا وصلته Last-Event-ID:
    case "/sse": {                        // Server-Sent Events: one response that never ends
      count("sse");
      res.writeHead(200, { "content-type": "text/event-stream", "cache-control": "no-store", connection: "keep-alive",
        ...(url.searchParams.has("nobuffer") ? { "x-accel-buffering": "no" } : {}) });
      res.write("retry: 1000\n\n");
      const last = Number(req.headers["last-event-id"] ?? 0);
      if (last) for (const e of history.filter((e) => e.seq > last)) res.write(`id: ${e.seq}\ndata: ${JSON.stringify(e)}\n\n`);
      sseClients.add(res);
      req.on("close", () => sseClients.delete(res));
      return;
    }
وفي الصفحة، الاستطلاع الطويل حلقة تطلب من جديد بمجرد وصول الرد، وWebSocket لا يعيد الاتصال إلا إذا طلبنا ذلك بالمعامل reconnect=1، لأن هذا هو السلوك الافتراضي في المتصفح:
async function long() {                               // long polling: ask again as soon as an answer arrives
  for (;;) {
    try {
      lab.requests++;
      const r = await fetch(`/long?since=${last}`);
      if (!r.ok) { note(`long HTTP ${r.status}`); await sleep(1000); continue; }
      for (const e of (await r.json()).events) receive(e);
    } catch (e) { note(`long error ${e.message}`); await sleep(1000); }
  }
}
function ws() {                                       // no reconnect unless the page writes one
  const url = `${location.protocol === "https:" ? "wss" : "ws"}://${location.host}/ws`;
  const s = new WebSocket(url);
  s.onopen = () => note("ws open");
  s.onerror = () => note("ws error");
  s.onclose = (e) => { note(`ws close code ${e.code}`); if (q.get("reconnect") === "1") setTimeout(ws, 1000); };
  s.onmessage = (m) => receive(JSON.parse(m.data));
}
أما Nginx فيعمل في Container باسم sfr-rt-nginx من الصورة الرسمية nginx:1.31.6-alpine، وفي ملف إعداده ثلاثة سيرفرات: الأول على المنفذ 19398 بالإعداد الذي ينسخه أغلب الناس أول مرة، أي proxy_pass فقط، والثاني على 19397 مثله مع ضغط gzip للنوع text/event-stream، والثالث على 19399 بالإعداد المصحح. وفي الثلاثة جعلنا proxy_read_timeout عشر ثوان بدلاً من القيمة الافتراضية 60 ثانية، حتى تظهر مشكلة الصمت في التجربة بسرعة. والإعداد المصحح كما يلي:
server {
    listen 81;
    location / {
        proxy_pass http://host.docker.internal:19395;
        proxy_http_version 1.1;
        proxy_read_timeout 10s;
    }
    location /sse {
        proxy_pass http://host.docker.internal:19395;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_buffering off;
        proxy_read_timeout 10s;
    }
    location /ws {
        proxy_pass http://host.docker.internal:19395;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_read_timeout 10s;
    }
}
والتشغيل كما يلي:
npm install ws@8
node server.mjs
docker run -d --name sfr-rt-nginx -p 127.0.0.1:19397:82 -p 127.0.0.1:19398:80 -p 127.0.0.1:19399:81 -v "$PWD/nginx/default.conf:/etc/nginx/conf.d/default.conf:ro" --add-host host.docker.internal:host-gateway nginx:1.31.6-alpine
node traffic.mjs
node measure.mjs
docker rm -f sfr-rt-nginx
الخطوة الأولى: مباشرة إلى Node.js
كل طريقة تعمل 30 ثانية، أي قرابة 15 حدثاً، والمخرج سوف يكون كما يلي:
== A) direct to Node.js, 30 s each
mode=poll              events 13, delay median 1665 ms, p95 2678 ms, max 2678 ms, missed 0 | server: requests {"poll":10}, new TCP 4, bytes out 6739, in 7646, out/event 518
mode=long              events 15, delay median 1 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"long":16}, new TCP 2, bytes out 7779, in 10370, out/event 519
mode=sse               events 15, delay median 1 ms, p95 1 ms, max 1 ms, missed 0 | server: requests {"sse":1}, new TCP 2, bytes out 4904, in 1481, out/event 327
   log: 3 ms sse open
mode=ws                events 15, delay median 1 ms, p95 1 ms, max 1 ms, missed 0 | server: requests {"ws-upgrade":1}, new TCP 3, bytes out 4549, in 1385, out/event 303
   log: 12 ms ws open
وفي المخرج أعلاه لاحظ التالي:
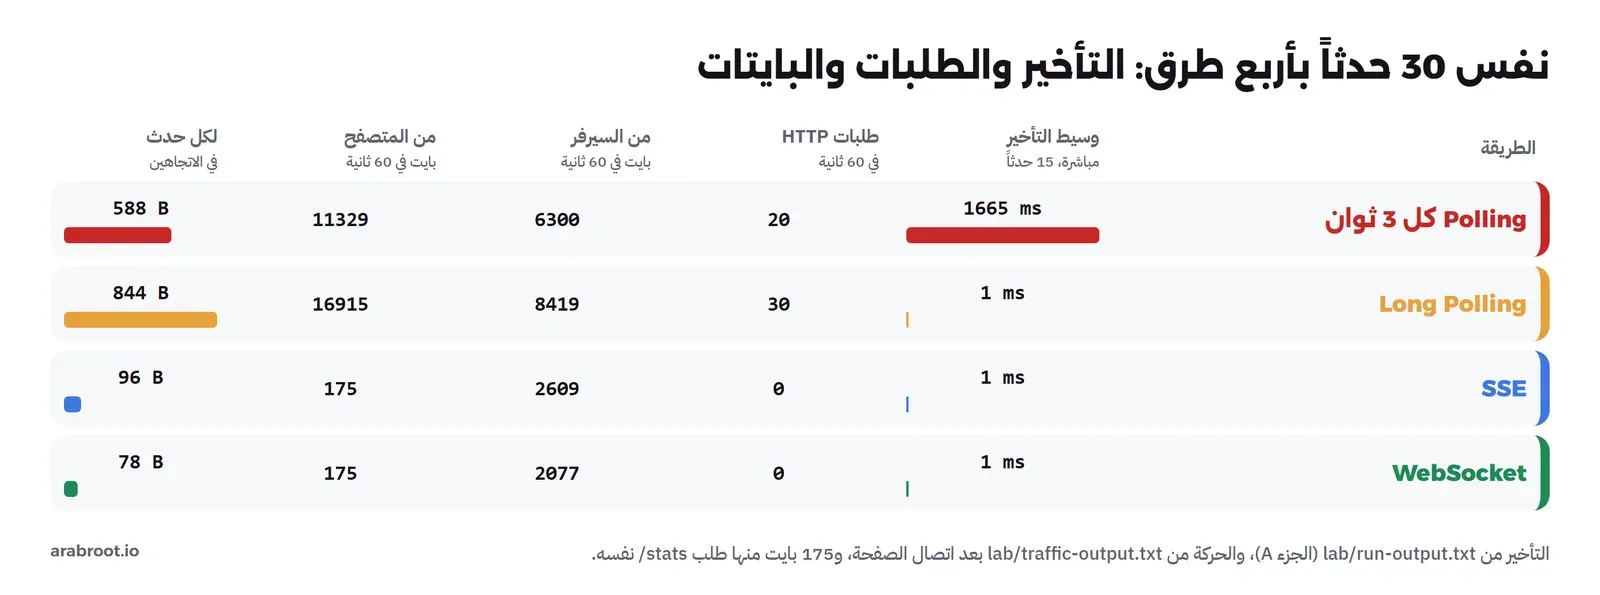
- الاستطلاع كل ثلاث ثوان أعطى وسيط تأخير 1665 ms، وأسوأ حدث انتظر 2678 ms، وهذا ما توقعناه: نصف الفترة في المتوسط، وفترة كاملة تقريباً في الأسوأ. ولاحظ أنه استقبل 13 حدثاً فقط من 15، لأن آخر حدثين وقعا بعد آخر طلب في الثلاثين ثانية.
- الطرق الثلاث الأخرى أوصلت كل حدث في 1 إلى 2 ms، أي أن الفرق بينها في التأخير غير موجود عملياً على نفس الجهاز، والفرق الحقيقي في عدد الطلبات وفي السلوك خلف الـ Proxy.
- الاستطلاع الطويل احتاج 16 طلباً لخمسة عشر حدثاً، أي طلباً لكل حدث تقريباً، أما SSE وWebSocket فطلب واحد في الثلاثين ثانية.
- أرقام البايتات هنا تشمل تحميل الصفحة نفسها، ولذلك قسنا الحركة في الخطوة التالية بعد أن تتصل الصفحة.
والعمود missed يساوي صفراً في كل السطور، أي أن السكربت لم يجد فجوة في الأرقام المتسلسلة، فلم يضع أي حدث في أي طريقة. وهذا متوقع على اتصال مستقر، والفجوات تظهر عادة عند الانقطاع وإعادة الاتصال، وهو ما سوف نختبره في قسم الصمت. أما الفرق بين الوسيط والشريحة 95% فصغير جداً في الطرق الثلاث، أي أن كل الأحداث وصلت تقريباً في نفس الزمن، بينما في الاستطلاع يتوزع التأخير بين الصفر وفترة كاملة بحسب لحظة وقوع الحدث.
الخطوة الثانية: الطلبات والبايتات Traffic
السكربت traffic.mjs يفتح الصفحة بكل طريقة، وينتظر حتى تتصل، ثم يصفر عدادات السيرفر، ويعد كل شيء لمدة 60 ثانية، أي 30 حدثاً:
mode   events  requests  newTCP  bytes server->browser  browser->server  per event (both ways)
poll       30        20       2                   6300            11329                   588
long       30        30       1                   8419            16915                   844
sse        29         0       1                   2609              175                    96
ws         29         0       1                   2077              175                    78
اتصال TCP واحد و175 بايت في كل سطر هي طلب السكربت نفسه إلى /stats، فالمتصفح في SSE وWebSocket لم يرسل أي بايت ولم يفتح أي اتصال خلال الدقيقة، وإنما استقبل فقط. أما الاستطلاع فأرسل 20 طلباً حملت من المتصفح 11,329 بايت، وبعد طرح طلب /stats يبقى قرابة 558 بايت لكل طلب، وأغلبها ترويسات يرسلها Chrome مع كل طلب: نوع المتصفح واللغات والأنواع المقبولة وغيرها، والاستطلاع الطويل أرسل 30 طلباً حملت 16,915 بايت. وبالنتيجة كلف الحدث الواحد 588 بايت بالاستطلاع، و844 بالاستطلاع الطويل، و96 بـ SSE، و78 بـ WebSocket. ولاحظ أن الاستطلاع الطويل أغلى من الاستطلاع العادي في البايتات هنا، لأن الأحداث متقاربة، فكل حدث صار طلباً كاملاً، أما الاستطلاع العادي فجمع أحياناً حدثين في رد واحد.
وقد تبدو 500 بايت رقماً صغيراً، ولكن اضربه في عدد المستخدمين، فعشرة آلاف عميل يفتحون صفحة التتبع بالاستطلاع كل ثلاث ثوان يعني قرابة 3,300 طلب في الثانية على السيرفر، كل منها يمر بالـ Reverse Proxy والتطبيق وربما قاعدة البيانات، حتى لو لم يتغير شيء. ونفس العملاء بـ SSE يعني عشرة آلاف اتصال مفتوح، لا يمر عليها شيء إلا عند وقوع حدث.
الخطوة الثالثة: خلف Nginx بالإعداد الأول Reverse Proxy
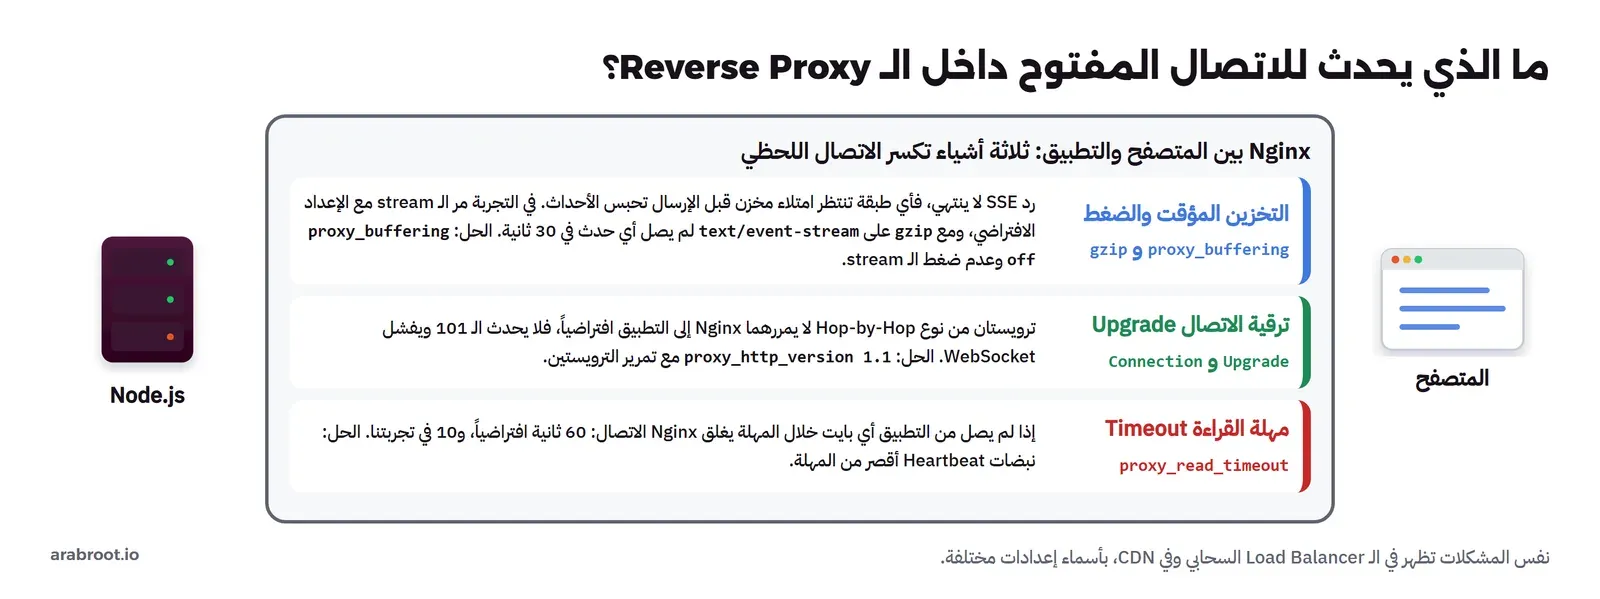
الآن نضع Nginx بين المتصفح والسيرفر، بالإعداد الذي فيه proxy_pass فقط، ثم بنفس الإعداد مع الضغط:
== B) behind Nginx with the default-style config (port 19398), 30 s each
mode=poll              events 14, delay median 1739 ms, p95 2759 ms, max 2759 ms, missed 0 | server: requests {"poll":10}, new TCP 15, bytes out 6800, in 7477, out/event 486
mode=long              events 15, delay median 3 ms, p95 8 ms, max 8 ms, missed 0 | server: requests {"long":16}, new TCP 19, bytes out 7779, in 10136, out/event 519
mode=sse               events 15, delay median 2 ms, p95 3 ms, max 3 ms, missed 0 | server: requests {"sse":1}, new TCP 3, bytes out 4904, in 1455, out/event 327
   log: 19 ms sse open
mode=ws                events  0, delay median - ms, p95 - ms, max - ms, missed 0 | server: requests {}, new TCP 3, bytes out 3609, in 1342
   log: 19 ms ws error | 19 ms ws close code 1006

== B2) port 19398 plus gzip on the event stream (port 19397), 30 s
mode=sse               events  0, delay median - ms, p95 - ms, max - ms, missed 0 | server: requests {"sse":1}, new TCP 4, bytes out 5047, in 2071
وفي المخرج أعلاه لاحظ التالي:
- WebSocket فشل فوراً: خطأ ثم إغلاق بالرمز
1006بعد 19 ms، ولم يصل السيرفر أي طلب ترقية، فعدادws-upgradeغير موجود. والسبب كما يشرح توثيق Nginx أن الترويستينUpgradeوConnectionمن نوع Hop-by-Hop، أي أنهما تخصان الاتصال بين طرفين متجاورين فقط، فلا يمررهما Nginx إلى التطبيق إلا إذا طلبت ذلك صراحة. والرمز 1006 بحسب MDN يعني إغلاقاً غير طبيعي بدون إطار إغلاق، وهو نفس الرمز الذي سوف تراه عندما ينقطع الاتصال لأي سبب في الشبكة، ولذلك فهو لا يقول لك السبب. وهذا بالضبط ما حدث للمتجر في القصة. - SSE مرت بالإعداد الأول بتأخير 2 ms، أي أن التخزين المؤقت الافتراضي في Nginx لم يحبس الأحداث في هذه التجربة، ولكن لا تعتمد على ذلك، فالسلوك يتغير مع أي طبقة إضافية كما في السطر التالي.
- ولكن مع
gzipعلىtext/event-streamلم يصل أي حدث في 30 ثانية، ولم يسجل حتى حدث الفتح، مع أن السيرفر كتب الأحداث. فالضغط يجمع البيانات في كتل قبل أن يرسلها، والأحداث الصغيرة لا تملأ كتلة أبداً. وهذا خطر حقيقي لأن إعدادات الضغط توضع عادة فيhttpلكل الموقع، فيضيف أحدهمtext/event-streamإلى قائمة الأنواع لأنه «نص»، فتتوقف كل الأحداث. - عدد اتصالات TCP إلى التطبيق صار 15 لعشرة طلبات استطلاع و19 لستة عشر طلباً طويلاً، بعد أن كان 4 و2 مباشرة، لأن Nginx يفتح اتصالاً جديداً إلى التطبيق لكل طلب ما لم تضبط له مجمع اتصالات بالتوجيه
keepaliveفيupstream، كما شرحنا في قسم الاتصال بين Nginx وتطبيقك في مقال HTTP. ومع الاستطلاع وآلاف المستخدمين يعني هذا آلاف الاتصالات الجديدة في الثانية بين Nginx والتطبيق.
الخطوة الرابعة: الإعداد المصحح Fixed Config
== C) behind the fixed Nginx config (port 19399), 30 s each
mode=long              events 15, delay median 3 ms, p95 5 ms, max 5 ms, missed 0 | server: requests {"long":16}, new TCP 20, bytes out 9176, in 10753, out/event 612
mode=sse               events 15, delay median 2 ms, p95 9 ms, max 9 ms, missed 0 | server: requests {"sse":1}, new TCP 3, bytes out 6158, in 1455, out/event 411
   log: 7 ms sse open
mode=ws                events 15, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"ws-upgrade":1}, new TCP 3, bytes out 4549, in 1383, out/event 303
   log: 19 ms ws open
مع تمرير Upgrade وConnection وصل الـ 101 وعمل WebSocket، واستقبل 15 حدثاً بتأخير 2 ms. وSSE مع proxy_buffering off عملت كما كانت، والإعداد هنا يحميك من أي تخزين مؤقت قد يضاف لاحقاً، ويمكن أيضاً أن يقرر التطبيق نفسه بإرسال الترويسة X-Accel-Buffering: no كما يشرح توثيق proxy_buffering، وهذا ما يفعله المعامل nobuffer في السيرفر. ولاحظ أن الاستطلاع الطويل ما زال يفتح اتصالاً لكل طلب، لأن الإعداد المصحح لم يضف keepalive، فهو يصلح الاتصال اللحظي ولا يصلح كل شيء.
مشكلة واجهناها في أول تشغيل Lab
في أول تشغيل كاملاً ظهرت للاستطلاع أرقام غريبة جداً: 30 حدثاً في 30 ثانية مع أن السيرفر ينتج 15 فقط، ووسيط تأخير 3892 ms وأسوأ حدث 32528 ms، وخلف Nginx وصل الاستطلاع إلى 90 حدثاً بتأخير يتجاوز دقيقتين. والسبب أن الصفحة كانت تبدأ أول طلب بـ since=0، فيرد السيرفر بكل الأحداث المحفوظة في history منذ بدأ، وكان السيرفر يعمل منذ دقائق، فوصلت عشرات الأحداث القديمة وحسبت كأنها تأخرت. والإصلاح كان مساراً جديداً /now يرجع رقم آخر حدث، تبدأ منه الصفحة. والمخرج الكامل لذلك التشغيل موجود في run-output-first.txt مع المقال.
وهذه المشكلة ليست مشكلة تجربة فقط، فكل نظام لحظي يحتاج أن يقرر: عندما يتصل عميل جديد، من أين يبدأ؟ من الآن، أم من آخر حدث رآه، أم من حالة كاملة يرسلها السيرفر أولاً ثم الأحداث بعدها؟ والإجابة الشائعة لصفحة التتبع أن ترسل الحالة الحالية كاملة عند الاتصال، ثم التغييرات فقط، لأن العميل الجديد لا يهمه تاريخ الطلب، وإنما أين هو الآن.
ماذا يحدث إذا صمت الاتصال؟ مهلة الصمت Idle Timeout
هذه هي الشكوى الثانية في القصة: صفحة مفتوحة تتوقف عن التحديث. في التجربة يوقف السكربت الأحداث 16 ثانية بعد خمس ثوان من فتح الصفحة، ومهلة Nginx عشر ثوان، أي أن الاتصال يبقى صامتاً أطول من المهلة. ثم نعيد نفس التجربة والسيرفر يرسل نبضة كل خمس ثوان: تعليقاً : ping في SSE، وإطار Ping في WebSocket:
== D) what if the stream goes quiet for 16 s? (proxy_read_timeout is 10 s), no heartbeat
mode=sse               events 10, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"sse":2}, new TCP 5, bytes out 4924, in 2255, out/event 492
   log: 7 ms sse open | 14177 ms sse error, readyState 0 | 15189 ms sse open
mode=ws                events  3, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"ws-upgrade":1}, new TCP 4, bytes out 4047, in 1572, out/event 1349
   log: 20 ms ws open | 14906 ms ws close code 1006
mode=ws&reconnect=1    events  9, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"ws-upgrade":2}, new TCP 5, bytes out 4562, in 2104, out/event 507
   log: 19 ms ws open | 13682 ms ws close code 1006 | 14697 ms ws open

== E) the same quiet period with a heartbeat every 5 s (SSE comment, WebSocket ping)
mode=sse               events 10, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"sse":1}, new TCP 4, bytes out 4849, in 1644, out/event 485
   log: 7 ms sse open
mode=ws                events  9, delay median 2 ms, p95 2 ms, max 2 ms, missed 0 | server: requests {"ws-upgrade":1}, new TCP 5, bytes out 4449, in 1614, out/event 494
   log: 16 ms ws open
وفي المخرج أعلاه لاحظ التالي:
- SSE انقطعت عند 14,177 ms، أي بعد قرابة عشر ثوان من آخر حدث، وهي مهلة Nginx، ثم عادت وحدها بعد ثانية بالضبط عند 15,189 ms، وهي قيمة
retry: 1000التي أرسلها السيرفر، واستقبلت الصفحة كل الأحداث بعد الصمت دون أن نكتب سطراً لإعادة الاتصال. وعداد السيرفر يبين طلبين لـ/sse. - WebSocket بدون كود إعادة اتصال انقطع عند 14,906 ms بالرمز 1006 ولم يعد، واستقبل 3 أحداث فقط قبل الصمت، ثم لم يستقبل شيئاً حتى نهاية التجربة، والصفحة تعرض آخر حالة وكأن شيئاً لم يحدث. وهذا هو العميل الذي ترك صفحة التتبع مفتوحة.
- WebSocket مع إعادة الاتصال عاد بعد ثانية، لأننا كتبنا ذلك في
onclose، واستقبل 9 أحداث. - مع النبضات لم ينقطع أي اتصال: طلب واحد لـ SSE وترقية واحدة لـ WebSocket، لأن Nginx يرى بايتات تمر كل خمس ثوان فلا تنتهي المهلة. وهذا ما يوصي به توثيق Nginx نفسه لـ WebSocket: إما أن تزيد
proxy_read_timeout، أو أن يرسل التطبيق إطارات Ping دورية.
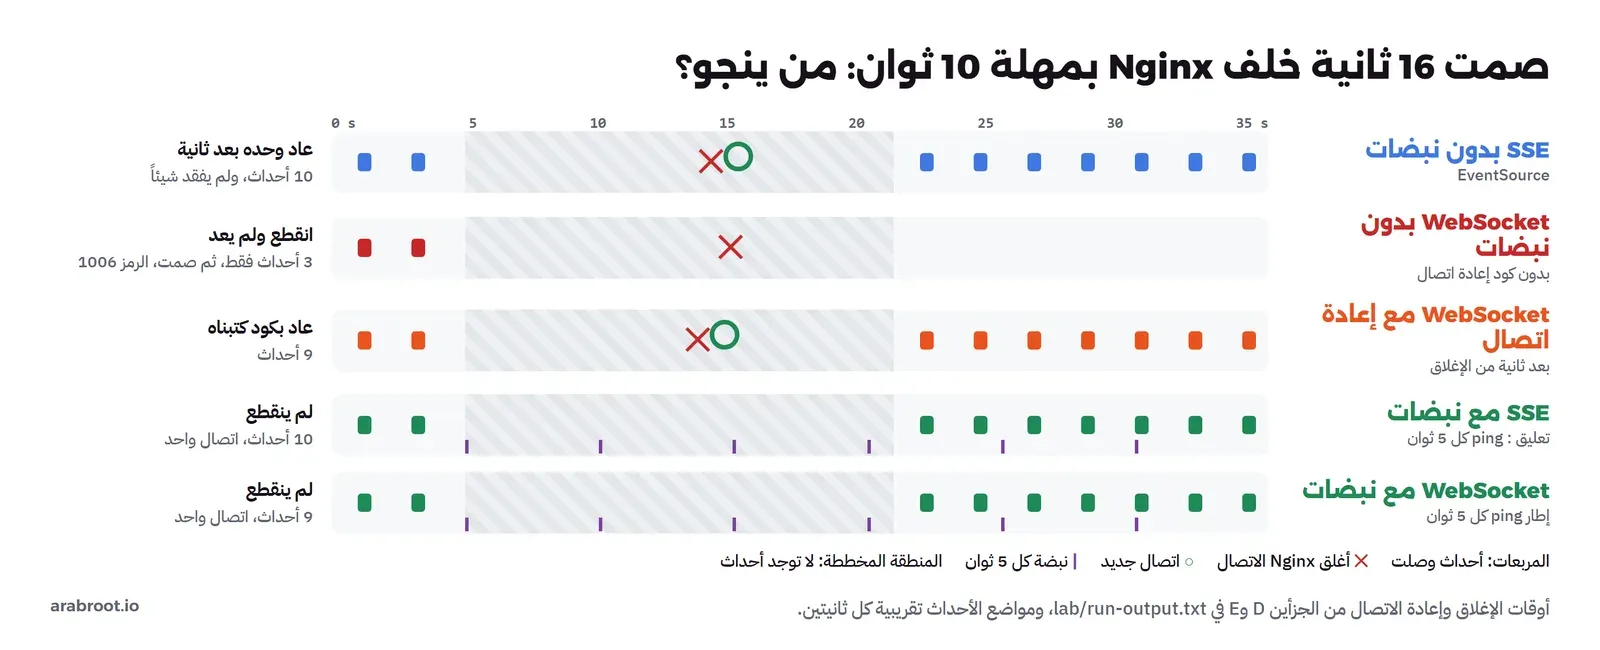
وتذكر أن Nginx ليس الوحيد في الطريق، فالـ Load Balancer في السحابة، وشبكة CDN، وجدار الحماية في شبكة الشركة التي يعمل منها المستخدم، وشبكة الجوال نفسها، كلها قد تغلق الاتصال الصامت بعد مدة لا تعرفها. لذلك اجعل النبضة أقصر من أقصر مهلة تتوقعها، وقيمة بين 15 و30 ثانية شائعة، واكتب إعادة الاتصال دائماً، لأن النبضة تقلل الانقطاع ولا تمنعه.
كيف يبقى الاتصال المفتوح Open Connection حياً داخل السيرفر؟
قد يتساءل البعض: كيف يستطيع سيرفر واحد أن يمسك آلاف الطلبات المفتوحة في SSE والاستطلاع الطويل، والطلب العادي ينتهي في ملي ثوان؟ والإجابة في طريقة عمل Node.js، فالطلب المفتوح ليس خيطاً Thread ينتظر، وإنما كائن في الذاكرة يمثل الرد، ومقبس Socket مسجل عند نظام التشغيل. فعندما يكتب السيرفر res.write بدون res.end يرسل Node.js الجزء الأول من الرد بترميز الأجزاء Chunked Transfer Encoding في HTTP/1.1، ويبقى المقبس مفتوحاً، ولا يعمل أي كود لهذا العميل حتى يأتي الحدث التالي. ولذلك فإن تكلفة الاتصال الصامت هي ذاكرته فقط، وقد شرحنا في مقال حلقة الأحداث لماذا لا يحجز الانتظار الخيط الرئيسي.
أما في WebSocket فالأمر أبعد قليلاً، فبعد الرد 101 يسلم Node.js المقبس الخام إلى المكتبة ws، وهي التي تقرأ الإطارات وتكتبها، ولا يبقى لخادم HTTP أي علاقة بالاتصال. ولهذا كان مسار /ws في التجربة يعالج في الحدث upgrade وليس في معالج الطلبات العادي. وفي الحالتين، الشيء الذي يجب أن تراقبه هو ما يحدث عند كل حدث: إذا كان عندك عشرة آلاف اتصال، فإن نشر حدث واحد يعني عشرة آلاف عملية كتابة في نفس الدورة من حلقة الأحداث، وإذا كان كل حدث يحتاج استعلاماً أو تحويلاً ثقيلاً لكل عميل على حدة، فهنا يظهر البطء. لذلك جهز الحدث مرة واحدة ثم أرسل نفس النص إلى الجميع، كما تفعل الدالة publish في التجربة التي تحول الحدث إلى JSON مرة لكل طريقة وليس لكل عميل.
التوسع Scaling: آلاف الاتصالات المفتوحة
عندما يصبح عندك آلاف المستخدمين بـ SSE أو WebSocket، فأنت تتعامل مع آلاف الاتصالات المفتوحة في نفس الوقت، وهذا يختلف عن آلاف الطلبات القصيرة. فكل اتصال يحجز في السيرفر ذاكرة صغيرة وواصف ملف File Descriptor، وفي Linux حد افتراضي لعدد الملفات المفتوحة لكل عملية يجب أن ترفعه، وفي Nginx حد لعدد الاتصالات لكل Worker، وكل اتصال عبر Nginx يحسب مرتين: مرة من المتصفح ومرة إلى التطبيق. والخبر الجيد أن Node.js مناسب لهذا النوع من العمل، لأن الاتصال الصامت لا يكلف شيئاً على حلقة الأحداث، كما شرحنا في مقال حلقة الأحداث، والتكلفة الحقيقية تأتي عند إرسال حدث إلى آلاف الاتصالات دفعة واحدة.
والمشكلة الأكبر تظهر عندما يكون عندك أكثر من نسخة من التطبيق خلف الـ Load Balancer، فالعميل متصل بالنسخة الأولى، والحدث وقع في النسخة الثانية التي استقبلت تحديث المندوب. والحل المعروف أن تنشر الأحداث عبر وسيط مشترك، مثل خاصية النشر والاشتراك Pub/Sub في Redis التي شرحناها في مقال Redis وValkey، فكل نسخة تشترك في القناة وترسل الحدث إلى العملاء المتصلين بها. وانتبه إلى أن نشر نسخة جديدة من التطبيق يغلق كل الاتصالات المفتوحة عليها دفعة واحدة، فيعيد آلاف العملاء الاتصال في نفس الثانية، وهذا ما يسمى قطيع الرعد Thundering Herd، والحل أن تضيف تأخيراً عشوائياً Jitter إلى إعادة الاتصال في العميل.
وقد يتساءل البعض: هل أحتاج الجلسات اللاصقة Sticky Sessions في الـ Load Balancer؟ والإجابة أن الاتصال الواحد في SSE أو WebSocket يبقى على نفس النسخة طوال عمره، لأنه اتصال TCP واحد، فلا يحتاج التصاقاً. والمشكلة تظهر فقط في الاستطلاع الطويل عندما تحفظ كل نسخة أحداثها في ذاكرتها، فيذهب الطلب التالي إلى نسخة أخرى لا تعرف ما فات العميل. والحل هنا أيضاً هو الوسيط المشترك، أو أن تحفظ الأحداث الأخيرة في Redis بدلاً من ذاكرة كل نسخة، فلا يهم أي نسخة استقبلت الطلب.
إعادة الاتصال Reconnect واستكمال ما فات
رأيت في التجربة أن الانقطاع سيحدث، والسؤال هو ماذا يحدث بعده. في SSE يتكفل المتصفح بإعادة الاتصال، ويرسل Last-Event-ID، وعلى السيرفر أن يحفظ آخر الأحداث لفترة كافية ليرسل ما فات، كما يفعل السيرفر في التجربة بآخر مئة حدث. وفي WebSocket عليك أن تكتب كل هذا: انتظار يزيد مع كل محاولة فاشلة Exponential Backoff حتى لا تضرب السيرفر وهو متعطل، وتأخير عشوائي حتى لا يعود الجميع في نفس اللحظة، ورسالة أولى بعد الاتصال يرسل فيها العميل آخر رقم وصله. وأياً كانت الطريقة، يجب أن يتعامل العميل مع الأحداث المكررة، لأن الحدث قد يصل قبل الانقطاع ثم يرسل مرة أخرى بعده، ولذلك تتجاهل الصفحة في التجربة أي رقم رأته من قبل. والأبسط في كثير من التطبيقات أن تطلب الصفحة الحالة الكاملة بطلب HTTP عادي بعد كل إعادة اتصال، ثم تكمل بالأحداث، بدلاً من الاعتماد على استكمال دقيق.
الأمان Security: من يتصل بقناتك؟
الاتصال اللحظي يحتاج نفس المصادقة والصلاحيات التي يحتاجها أي API، وبعض التفاصيل خاصة به. فطلب WebSocket الأول يحمل ملفات تعريف الارتباط مثل أي طلب، ولكن سياسة CORS التي شرحناها في مقال CORS لا تحمي WebSocket، فالمتصفح يسمح لأي موقع أن يفتح WebSocket إلى سيرفرك، ويرسل معه كوكيز المستخدم. لذلك يجب أن يتحقق السيرفر من الترويسة Origin في طلب الترقية ويرفض المصادر التي لا يعرفها، وإلا استطاع موقع خبيث أن يقرأ رسائل المستخدم، وهذا ما يسمى اختطاف WebSocket عبر المواقع Cross-Site WebSocket Hijacking. ولا تضع التوكن في رابط الاتصال إذا استطعت تجنب ذلك، لأن الروابط تظهر في سجلات الـ Proxy، واستخدم wss:// دائماً في الإنتاج، فهو WebSocket فوق TLS، وبدونه تمر الرسائل كنص مقروء. وتذكر أيضاً أن تتحقق في كل رسالة من أن المستخدم يملك الصلاحية عليها، فصفحة تتبع طلب يجب ألا تستقبل أحداث طلبات عملاء آخرين لأن أحدهم غير رقم الطلب في الرسالة.
المراقبة Monitoring: كيف تعرف أن الاتصالات بخير؟
المشكلة في الاتصال اللحظي أن فشله صامت، فالصفحة التي انقطع عنها WebSocket في التجربة لم تظهر أي خطأ، وبقيت تعرض آخر حالة. لذلك لا يكفي أن تراقب أخطاء السيرفر، وإنما تحتاج مقاييس خاصة بهذه الاتصالات. وأهمها أربعة: عدد الاتصالات المفتوحة الآن في كل نسخة من التطبيق، وعدد مرات إعادة الاتصال في الدقيقة، فإذا ارتفع فجأة فهناك Proxy يغلق الاتصالات أو نسخة تعيد التشغيل، وتوزيع رموز الإغلاق في WebSocket، فكثرة 1006 تعني انقطاعاً في الشبكة أو مهلة في الطريق، وزمن التوصيل، أي الفرق بين وقت إنشاء الحدث في السيرفر ووقت وصوله إلى المتصفح.
والمقياس الأخير هو نفسه ما قسناه في التجربة، فكل حدث يحمل وقت إنشائه t، والصفحة تحسب الفرق عند الوصول. وفي الإنتاج لا تكون ساعة المتصفح مضبوطة مع ساعة السيرفر، لذلك يرسل العميل الفرق مع ما يعرفه عن انحراف ساعته، أو يقاس الزمن في نقطة أقرب داخل البنية، مثل وقت خروج الحدث من التطبيق ووقت كتابته في المقبس. وأياً كانت الطريقة، فإن رسماً بيانياً واحداً لزمن التوصيل يكشف لك مشكلة مثل ضغط gzip على الـ stream في دقائق، بدلاً من أن تكتشفها من شكوى عميل بعد أسبوع.
ماذا عن HTTP/2 و WebTransport؟
الطرق الأربع في هذا المقال هي ما تستخدمه أغلب التطبيقات اليوم، ولكن يوجد تطوران يستحقان المعرفة. الأول HTTP/2، الذي يحمل كل الطلبات على اتصال واحد، فيحل مشكلة الاتصالات الست في SSE، ويجعل الاستطلاع أرخص قليلاً لأن الترويسات المتكررة تضغط، ولذلك فإن SSE فوق HTTP/2 تغطي اليوم أغلب حالات «من السيرفر إلى المتصفح» دون أي بروتوكول إضافي. والثاني WebTransport، وهو واجهة حديثة فوق HTTP/3 وQUIC، تعطيك عدة تدفقات مستقلة ورسائل لا تحتاج وصولاً مضموناً، وهي مفيدة للألعاب وبث الوسائط حيث تفضل أن تفقد رسالة قديمة على أن تنتظرها. ولكن دعمها في المتصفحات والسيرفرات والـ Proxies ما زال أقل بكثير من WebSocket، لذلك فهي ليست الاختيار الأول لصفحة تتبع طلب أو إشعارات.
كيف تبني صفحة التتبع Order Tracking في المتجر؟
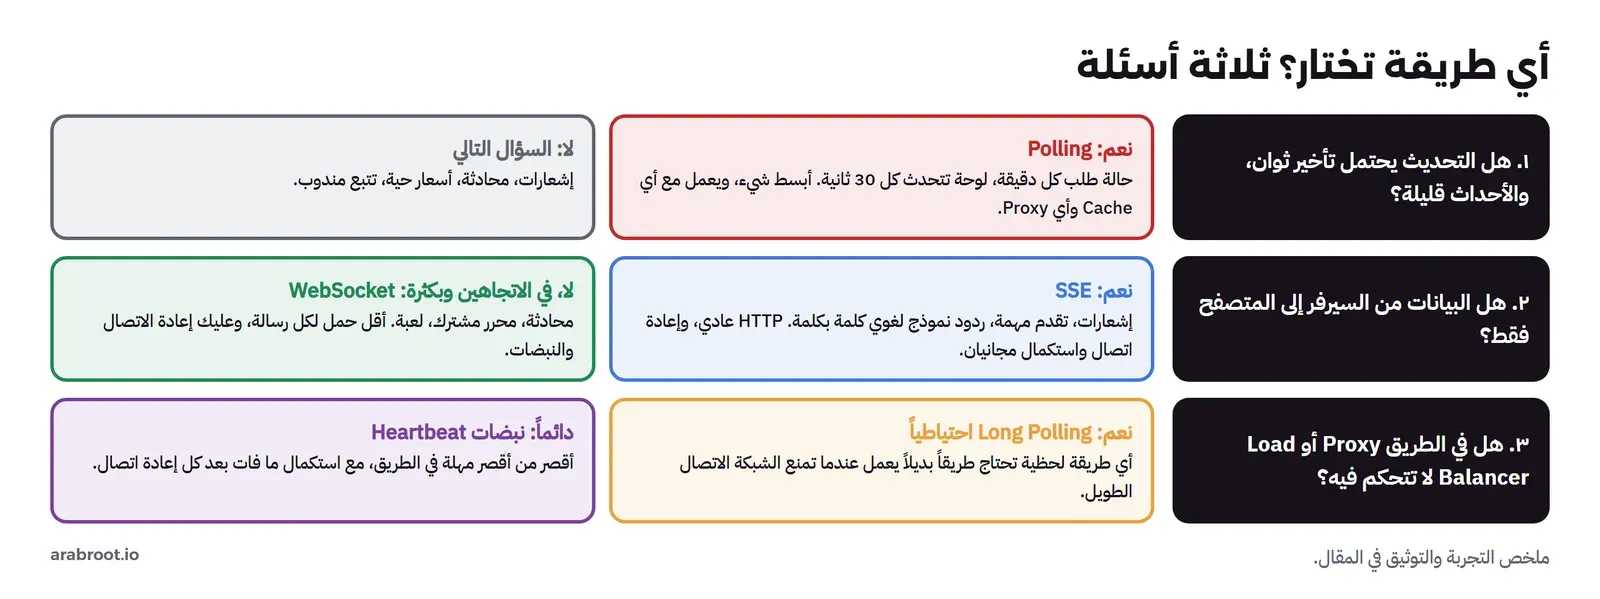
بالعودة إلى قصة المتجر، فالبيانات في صفحة التتبع تذهب في اتجاه واحد، من السيرفر إلى العميل، والأحداث قليلة: خمس حالات أو ست لكل طلب على مدى ساعات. لذلك فإن الاختيار الأنسب هنا هو SSE، لا WebSocket، والتصميم الكامل كما يلي. عند فتح الصفحة تطلب الحالة الحالية بطلب HTTP عادي، فتعرضها فوراً حتى لو تأخر الاتصال اللحظي أو فشل. ثم تفتح EventSource على مسار خاص بهذا الطلب، والسيرفر يتحقق من أن المستخدم يملك الطلب قبل أن يبدأ الإرسال. والسيرفر يرسل نبضة كل 20 ثانية، وكل حدث برقم متسلسل، ويحفظ آخر الأحداث لكل طلب حتى يستكمل بعد الانقطاع. وفي Nginx مسار SSE بدون تخزين مؤقت وبدون ضغط، ومع مهلة أطول من النبضة بهامش واضح. وبين نسخ التطبيق تمر الأحداث عبر Redis، لأن تحديث المندوب قد يصل إلى نسخة غير التي يتصل بها العميل.
وماذا لو فشل SSE تماماً عند عميل معين، مثلاً خلف Proxy في شبكة شركة يحبس الردود الطويلة؟ هنا يأتي دور الطريقة البسيطة كاحتياط، فإذا لم يصل أي حدث ولا نبضة خلال دقيقة، تتحول الصفحة إلى الاستطلاع كل 30 ثانية. فالعميل في أسوأ الأحوال يرى التحديث متأخراً نصف دقيقة، بدلاً من ألا يراه أبداً. وبهذا الشكل تكون الصفحة سريعة عند أغلب العملاء، وصحيحة عند الجميع، وهذا هو الهدف الحقيقي من أي ميزة لحظية.
أخطاء شائعة Common Mistakes
- نشر WebSocket خلف Proxy دون تمرير الترقية. النتيجة في التجربة: إغلاق فوري بالرمز 1006. مرر
UpgradeوConnection، وجرب خلف نفس الـ Proxy الذي في الإنتاج. - ضغط
text/event-stream. لم يصل أي حدث في 30 ثانية. أخرج هذا النوع من قائمةgzip_types، وأوقف التخزين المؤقت لمسار SSE. - عدم كتابة إعادة الاتصال في WebSocket. الصفحة تبقى على آخر حالة بلا أي رسالة. أعد الاتصال مع انتظار متزايد وتأخير عشوائي، واعرض للمستخدم حالة الاتصال.
- اتصال بلا نبضات. كل Proxy يغلق الصامت بعد مهلته. أرسل نبضة أقصر من أقصر مهلة.
- الاعتماد على وصول كل حدث مرة واحدة. الأحداث تتكرر وتضيع حول الانقطاع. استخدم أرقاماً متسلسلة، وتجاهل المكرر، واستكمل ما فات أو اطلب الحالة الكاملة.
- اختيار WebSocket لكل شيء. إذا كانت البيانات من السيرفر فقط فـ SSE أبسط، وتعطيك إعادة الاتصال والاستكمال مجاناً، وتعمل مع أدوات HTTP العادية.
- استطلاع بفترة قصيرة لآلاف المستخدمين. كل مستخدم يرسل قرابة 558 بايت مع كل طلب، أغلبها ترويسات، والطلبات الفارغة تأكل السيرفر.
- عدم التحقق من
Originفي WebSocket. CORS لا تحميك هنا، والتحقق مسؤولية السيرفر.
جدول قرار Decision Table وقائمة تحقق Checklist
| الطريقة | التأخير في التجربة | لكل حدث | الاتجاه | إعادة الاتصال | خلف Proxy | تناسب |
|---|---|---|---|---|---|---|
| Polling | 1665 ms مع فترة 3 ثوان | 588 بايت | من المتصفح يسأل | لا تحتاجها | يعمل دائماً | تحديثات قليلة تحتمل التأخير |
| Long Polling | 1 ms | 844 بايت | من السيرفر عبر طلبات | طلب جديد بعد كل رد | يعمل، والمهلة أقصر من مهلة الـ Proxy | بديل احتياطي عندما يمنع الطريق الاتصال الطويل |
| SSE | 1 ms | 96 بايت | من السيرفر فقط | تلقائية مع Last-Event-ID | يحتاج إيقاف التخزين المؤقت والضغط ونبضات | الإشعارات والتتبع وبث النتائج |
| WebSocket | 1 ms | 78 بايت | في الاتجاهين | تكتبها بنفسك | يحتاج تمرير الترقية ونبضات | المحادثة والتعاون والألعاب |
وقبل أن تطلق ميزة لحظية راجع النقاط التالية:
- هل جربت الاتصال خلف نفس سلسلة الـ Proxies التي في الإنتاج، وليس على جهازك فقط؟
- هل يرسل السيرفر نبضة أقصر من أقصر مهلة في الطريق؟
- هل يعيد العميل الاتصال بانتظار متزايد وتأخير عشوائي، ويعرض حالة الاتصال للمستخدم؟
- هل يستكمل العميل ما فاته بعد الانقطاع، ويتجاهل الأحداث المكررة؟
- هل تصل الأحداث إلى كل نسخ التطبيق عبر وسيط مشترك عندما يكون عندك أكثر من نسخة؟
- هل يتحقق السيرفر من
Originومن صلاحية المستخدم على كل قناة؟ - هل رفعت حد الملفات المفتوحة في السيرفر وعدد الاتصالات في Nginx؟
تدريب عملي Practice
- أضف
upstreamمعkeepalive 16إلى إعداد Nginx المصحح، وشغلmeasure.mjs، وقارن عدد اتصالات TCP في الاستطلاع الطويل. - غير مهلة الاستطلاع الطويل في السيرفر من 25 ثانية إلى 30، وأوقف الأحداث دقيقة، وراقب ما يحدث خلف Nginx بمهلة 10 ثوان.
- اكتب في
client.htmlإعادة اتصال لـ WebSocket بانتظار يتضاعف من ثانية إلى 30 ثانية مع تأخير عشوائي، ثم أوقف السيرفر دقيقة وأعد تشغيله، وعد محاولات الاتصال. - افتح صفحة SSE في سبعة تبويبات على
http://، ولاحظ ماذا يحدث للتبويب السابع، ثم فكر كيف يحل HTTP/2 ذلك.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- HTTP طلب ورد، والطرق الأربع تلتف على ذلك: الاستطلاع يسأل كل فترة، والاستطلاع الطويل يمسك الطلب، وSSE رد لا ينتهي، وWebSocket بروتوكول آخر بعد الترقية.
- الاستطلاع كل ثلاث ثوان أعطى وسيط تأخير 1665 ms، والطرق الثلاث الأخرى 1 إلى 2 ms، والحدث كلف 588 و844 و96 و78 بايت بالترتيب.
- خلف Nginx بإعداد
proxy_passوحده فشل WebSocket بالرمز 1006، ومع ضغطtext/event-streamلم يصل أي حدث، والإصلاح تمرير الترقية وإيقاف التخزين المؤقت والضغط للـ stream. - الصمت أطول من مهلة الـ Proxy أغلق الاتصالات: SSE عادت وحدها بعد ثانية، وWebSocket بقي مغلقاً حتى كتبنا إعادة الاتصال، والنبضة كل خمس ثوان منعت الانقطاع.
- التوسع يحتاج وسيطاً مشتركاً للأحداث بين نسخ التطبيق، وإعادة اتصال بتأخير عشوائي، والتحقق من
Originوالصلاحيات.
وفي مرحلة هندسة الواجهات وتطبيقات الويب تجد المقالات التي تكمل هذا المقال:
 دليلHTTP وHTTPS ببساطة: ماذا يحدث بين الرابط والصفحةماذا يحدث بين كتابة الرابط وظهور الصفحة، وكيف تقرأ الطلب والرد ورموز مثل 502 و504، ولماذا يكلف الاتصال الجديد أكثر.
 دليلCORS: لماذا يرفض المتصفح طلبك، وكيف تسمح به بأمانلماذا يمنع المتصفح صفحتك من قراءة رد ال API، وكيف تفتح CORS هذا الباب لمصادر محددة دون أن تفتحه لكل موقع.
 دليلحلقة الأحداث Event Loop: لماذا تتأخر النقرة في صفحتك؟كيف ترتب JavaScript المهام والوعود والرسم على خيط واحد، ولماذا تنتظر النقرة خلف مهمة طويلة، وكيف تقسم العمل لتبقى الصفحة سريعة.
 دليلالتخزين في المتصفح وتطبيقات PWA: الحدود والعمل دون إنترنتقسنا في Chrome حدود الكوكيز وlocalStorage وIndexedDB وCache API حتى رفض المتصفح، ثم شغلنا تطبيقاً والسيرفر متوقف ونشرنا إصداراً جديداً لنرى متى يصل.
 دليلCSR و SSR و SSG: أين ترسم صفحة الويب ومتى؟قسنا نفس صفحة المتجر مرسومة في المتصفح وفي السيرفر ومولدة مسبقاً على شبكة بطيئة في Chrome، لترى متى يظهر المحتوى ومتى تعمل الأزرار وماذا يرى محرك البحث.
 دليلRedis وبديله المفتوح Valkey: التخزين المؤقت والجلساتكيف تستخدم Redis للجلسات والعدادات دون أن تمتلئ الذاكرة، وماذا تعني رخصته الجديدة، ومتى يكفيك Valkey بدلاً منه.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة بـ Node.js v22.14.0 والمكتبة ws 8.22.0، وNginx من الصورة nginx:1.31.6-alpine في Docker، والقياس في Chrome 156.0.8078.49 بدون واجهة.


