في المقال السابق من هذه المرحلة كتبنا لمسجل الحرارة في الشركة الناشئة أول برنامج يعمل على الشريحة مباشرة: حلقة واحدة تقلب الضوء وتطبع على المنفذ التسلسلي، وكود بداية وملف ربط كتبناهما بأيدينا. ثم كبر الجهاز كما تكبر كل الأجهزة، فصار فيه حساس حرارة يجب أن يقرأ في موعد ثابت، وذاكرة فلاش يكتب فيها السجل وقد تأخذ الكتابة الواحدة عشرات الملي ثواني، واتصال Bluetooth يفرغ منه السائق السجل عند الوصول ويجب أن يرد على كل رسالة خلال وقت قصير وإلا قطع الهاتف الاتصال. وأول ما فعله الفريق أنه أضاف هذه الأعمال إلى نفس الحلقة واحداً بعد الآخر، فعملت في الاختبار، ثم بدأت التقارير تصل: الاتصال ينقطع أحياناً أثناء التفريغ، وقراءات الحرارة ليست كل دقيقة بالضبط وإنما تتأخر ثانية أو ثانيتين بين حين وآخر. والسبب ليس خطأ في سطر معين، وإنما في الطريقة نفسها، فالحلقة الواحدة لا تعرف أن الرد على الهاتف أهم من الكتابة في الفلاش.
وهنا يأتي نظام التشغيل الفوري Real-Time Operating System، واختصاراً RTOS، وهو نظام تشغيل صغير جداً يعمل داخل المتحكم نفسه، ويسمح لك أن تكتب كل عمل كمهمة Task مستقلة لها أولوية، ثم يقرر هو في كل لحظة أي مهمة تعمل. وفي هذا المقال سوف نشرح كيف يعمل من الداخل، ثم نشغل أشهر نظامين مفتوحي المصدر، FreeRTOS وZephyr، على معالج Cortex-M في المحاكي QEMU، ونعيد بأيدينا مشكلة حقيقية أوقفت مركبة فضائية على المريخ عام 1997، ونقيسها بالملي ثانية، ثم نصلحها بتغيير سطر واحد.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا تكفي الحلقة الواحدة Super Loop، وما معنى «فوري» Real-Time بالضبط.
- المهام Tasks وحالاتها، والمجدول Scheduler والأولويات Priorities، وكيف يتم تبديل المهام Context Switch على Cortex-M.
- الطوابير Queues والإشارات Semaphores والأقفال Mutexes، ومتى تستخدم كلاً منها.
- انعكاس الأولوية Priority Inversion وقصة Mars Pathfinder، ووراثة الأولوية Priority Inheritance التي تحلها.
- المختبر: ثلاث مهام على FreeRTOS في QEMU مع قفل بدون وراثة ثم مع وراثة، وطابور يمتلئ، ثم نفس التجربة على Zephyr.
- الاختيار بين FreeRTOS وZephyr، والأخطاء الشائعة، وقائمة تحقق.
لماذا لا تكفي الحلقة الواحدة Super Loop؟
أغلب البرامج المدمجة تبدأ بالشكل الذي كتبناه في المقال السابق: حلقة لا نهائية تنفذ الأعمال بالترتيب، وتسمى الحلقة الكبرى Super Loop. وهذا الشكل جيد جداً عندما يكون العمل قليلاً، لأنك تعرف بالضبط ما الذي يحدث في كل لحظة، ولا توجد مفاجآت. ولكن لنأخذ مسجل الحرارة بعد أن كبر، فالحلقة صارت تقرأ الحساس في 1 ms، وتكتب في الفلاش في زمن قد يصل إلى 40 ms عندما تحتاج الذاكرة مسح قطاع Sector قبل الكتابة، وتسأل وحدة Bluetooth هل وصلت رسالة، والرسالة تحتاج رداً خلال 5 ms. فإذا وصلت الرسالة في بداية كتابة طويلة فلن يراها أحد قبل 40 ms، أي أن زمن الرد على أي حدث في الحلقة هو مجموع أزمان كل الأعمال الأخرى في أسوأ حالاتها، وكل عمل جديد يضيفه أحد في الفريق يزيد هذا الزمن للجميع.
والحل البسيط الأول هو المقاطعات Interrupts، فوحدة Bluetooth تولد مقاطعة عند وصول رسالة، ودالة المقاطعة تقطع الحلقة في أي مكان وترد فوراً. وهذا يعمل للأعمال القصيرة جداً، ولكن دالة المقاطعة يجب أن تكون قصيرة، لأنها أثناء عملها تؤخر كل المقاطعات الأقل منها، ولا يمكنها أن تنتظر شيئاً. فالرد على الهاتف قد يحتاج قراءة من الفلاش أو حساب تشفير، وهذا لا يصلح داخل مقاطعة. فيأتي الحل الثاني: المقاطعة ترفع علماً Flag فقط، والحلقة تفحص الأعلام وتنفذ العمل، وهذا يعيدنا إلى نفس المشكلة، لأن الحلقة لن تفحص العلم حتى تنتهي الكتابة الطويلة. ثم يأتي الحل الثالث، وهو أن تقسم الكتابة الطويلة إلى أجزاء صغيرة يدوياً وتحفظ حالتها بين دورة وأخرى، أي أن تكتب آلة حالات State Machine لكل عمل، وهذا ممكن، ولكنه يجعل الكود صعب القراءة، وكل عمل جديد يحتاج تقسيماً جديداً، والخطأ في حفظ الحالة من أصعب الأخطاء في التتبع.
والنظام الفوري يفعل هذا التقسيم بالنيابة عنك، فكل عمل يكتب كمهمة بحلقتها الخاصة وكأنها وحدها في الجهاز، وعندما تصبح مهمة أهم جاهزة للعمل يوقف النظام المهمة الحالية في منتصف أي سطر، ويحفظ كل حالتها، ويشغل الأهم، ثم يعيد الأولى من حيث توقفت. فتكتب مهمة الكتابة في الفلاش كأنها حلقة بسيطة تأخذ 40 ms، ومهمة الراديو تقطعها كلما وصلت رسالة، بدون أن تقسم أي شيء بيدك.
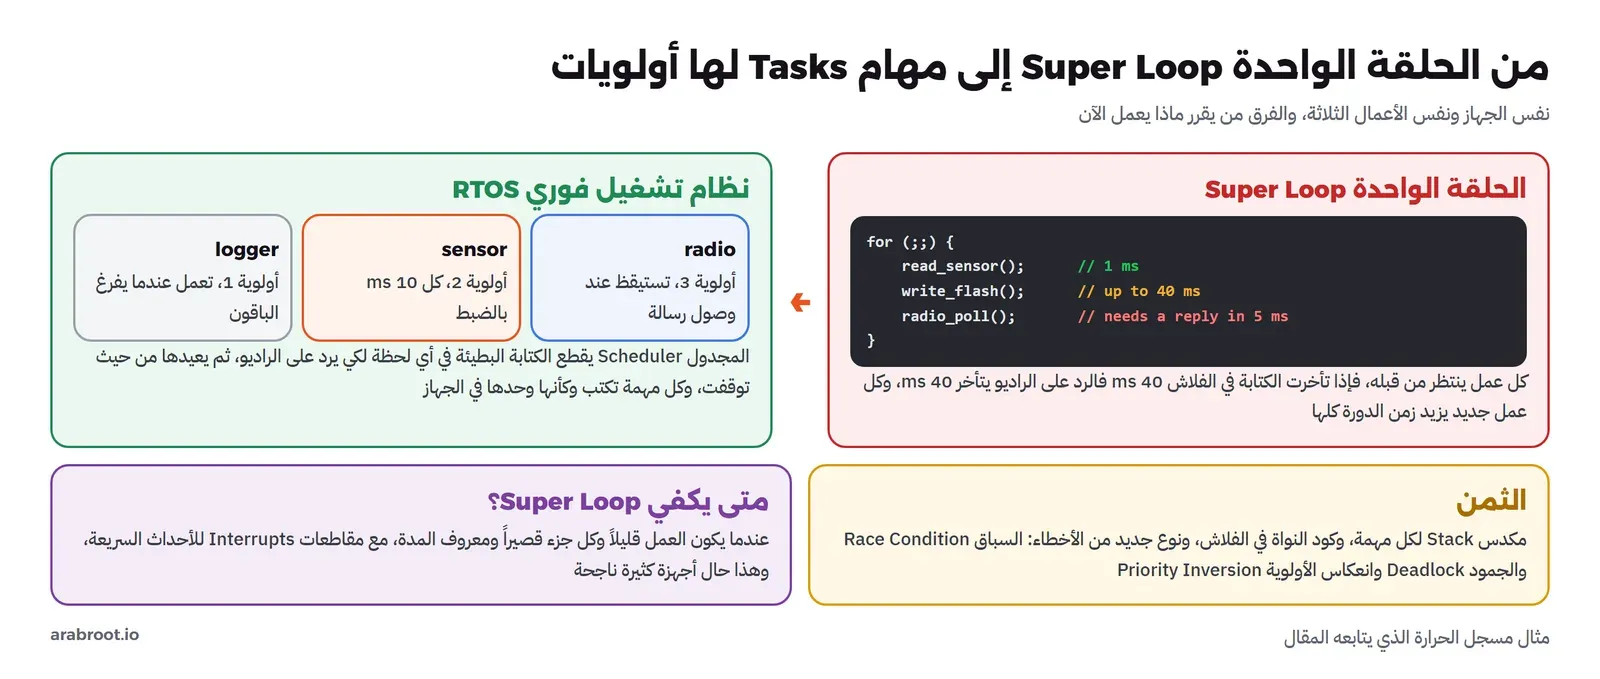
ولكن لا تفهم من هذا أن كل جهاز يحتاج نظاماً فورياً، فالنظام له ثمن: كل مهمة تحتاج مكدساً Stack خاصاً بها في الذاكرة، والنواة نفسها تأخذ بضعة كيلوبايتات من الفلاش، وأهم من ذلك أنك تدخل نوعاً جديداً من الأخطاء لم يكن موجوداً في الحلقة الواحدة: السباق على البيانات المشتركة Race Condition، والجمود Deadlock، وانعكاس الأولوية الذي هو موضوع المختبر. وكثير من الأجهزة الناجحة تعمل بحلقة واحدة مع مقاطعات طوال عمرها، والقاعدة العملية أن تنتقل إلى نظام فوري عندما يصبح في الجهاز أكثر من عمل له موعد، وأعمال طويلة لا تريد تقسيمها يدوياً، أو عندما تحتاج مكتبات جاهزة مثل الشبكة أو Bluetooth لأنها في الغالب مكتوبة لتعمل فوق نظام فوري.
ما معنى «فوري» Real-Time؟
أكثر خطأ شائع في فهم الأنظمة الفورية أن «فوري» تعني «سريع»، والحقيقة أنها تعني «في الموعد»، أي أن صحة النتيجة تعتمد على زمن وصولها وليس على قيمتها فقط. فحساب صحيح لزاوية فرامل السيارة يصل بعد فوات الأوان هو حساب خاطئ. ولذلك فالسؤال الذي يجيب عليه النظام الفوري ليس «كم متوسط زمن الرد؟» كما في خدمات الويب، وإنما «ما أسوأ زمن رد ممكن؟» أي زمن الرد في أسوأ الحالات Worst Case Response Time، ويريد أن يكون هذا الرقم محدوداً ومعروفاً مسبقاً، وهذا ما يسمى الحتمية Determinism.
ويقسم المهندسون المواعيد إلى نوعين: موعد صارم Hard Deadline يعتبر تجاوزه فشلاً للنظام كله، مثل التحكم في محرك أو في وسادة هوائية، وموعد مرن Soft Deadline يقلل تجاوزه الجودة ولا يسبب كارثة، مثل تأخر إطار في تشغيل فيديو. وفي مسجل الحرارة الرد على الهاتف خلال 5 ms موعد صارم بمعنى عملي، لأن تجاوزه يقطع الاتصال ويضيع على السائق وقتاً، وقراءة الحساس كل دقيقة لها موعد مرن، فتأخرها 20 ms لا يغير شيئاً في السجل. ولاحظ أن نظام Linux العادي ليس فورياً بهذا المعنى، فقد يتأخر برنامجك عشرات الملي ثواني لأن النواة تكتب على القرص أو تنقل صفحات ذاكرة، وقد شرحنا جدولة المعالج فيه في مقال العمليات وجدولة المعالج في Linux، وهو يهدف إلى العدل بين البرامج والإنتاجية الكلية، أما النظام الفوري فيهدف إلى أن تعمل المهمة الأهم دائماً، حتى لو كان ذلك ظلماً للباقي.
المهام Tasks: كل عمل وكأنه وحده في الجهاز
المهمة Task في نظام فوري تشبه الخيط Thread في البرامج العادية، وقد شرحنا الخيوط في مقال الخيوط Threads والأقفال: دالة C عادية فيها غالباً حلقة لا تنتهي، ولها مكدس خاص بها، وكل المهام تتشارك نفس الذاكرة ونفس المتغيرات العامة، فلا توجد حماية بينها كما بين العمليات Processes في Linux. وتسمي Zephyr المهمة خيطاً Thread، والفكرة واحدة. والنواة تحفظ لكل مهمة بنية صغيرة تسمى كتلة التحكم بالمهمة Task Control Block، واختصاراً TCB، فيها أولويتها وحالتها ومؤشر مكدسها، وعندما توقف النواة المهمة تحفظ كل مسجلات المعالج في مكدسها، فتصبح المهمة كأنها مجمدة في لحظة معينة، وعندما تعيدها تسترجع المسجلات فتكمل وكأن شيئاً لم يحدث.
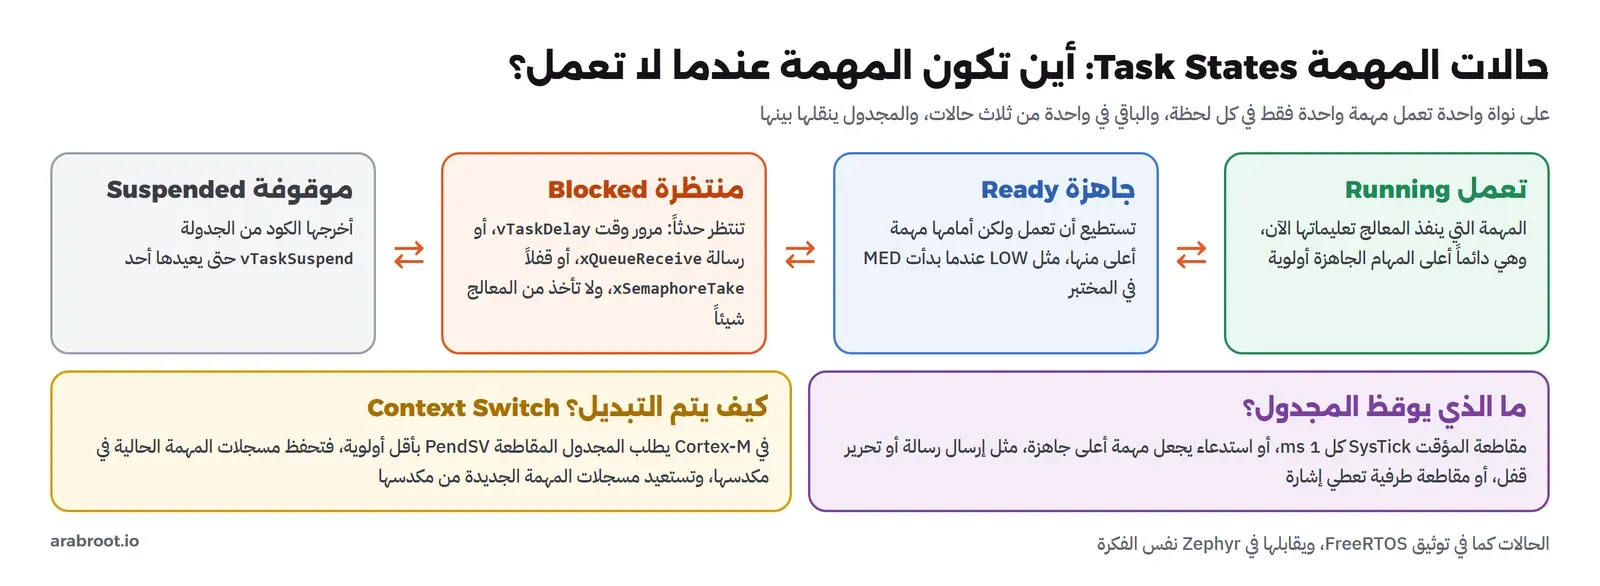
والمهمة في أي لحظة في واحدة من أربع حالات كما يصفها FreeRTOS: تعمل Running، وجاهزة Ready تنتظر دورها لأن أمامها مهمة أعلى، ومنتظرة Blocked تنتظر حدثاً مثل مرور وقت أو وصول رسالة أو تحرير قفل، وموقوفة Suspended أخرجها الكود من الجدولة. والحالة المهمة هنا هي الانتظار Blocked، فالمهمة المنتظرة لا تأخذ من المعالج أي شيء، وهذا هو الفرق الكبير عن الحلقة التي كتبناها في المقال السابق، حيث كانت دالة التأخير تدور في حلقة فارغة وتحرق وقت المعالج. فعندما تكتب vTaskDelay(10) فأنت تقول للنواة: لا تعطني المعالج قبل 10 ticks، فتعطيه لغيري، وإذا لم يكن أحد جاهزاً تشغل النواة مهمة الخمول Idle Task، التي يمكن أن تضع المعالج في وضع السكون لتوفير الطاقة، وهذا موضوع مقال قادم في هذه المرحلة بإذن الله.
وقد يتساءل البعض: كم حجم مكدس كل مهمة؟ والإجابة أنك أنت من يحدده عند إنشائها، وهذا من أصعب القرارات في المشروع، لأن المكدس الصغير يمتلئ فيكتب فوق ذاكرة مهمة أخرى أو فوق المتغيرات بدون أي رسالة، والمكدس الكبير يضيع ذاكرة قليلة أصلاً، فعشر مهام بمكدس 2 KB لكل واحدة تعني 20 KB من ذاكرة قد يكون حجمها كله 32 KB. ولذلك تعطيك الأنظمة الفورية أدوات لقياس الاستخدام الفعلي، مثل الدالة uxTaskGetStackHighWaterMark في FreeRTOS التي تعطيك أقل مساحة حرة وصل إليها مكدس المهمة منذ بدايتها، وفحص امتلاء المكدس الذي فعلناه في المختبر بالإعداد configCHECK_FOR_STACK_OVERFLOW 2، حيث تملأ النواة المكدس بقيمة معروفة وتفحص آخر جزء منه عند كل تبديل.
المجدول Scheduler مع الأولويات Priorities: من يعمل الآن؟
المجدول في أغلب الأنظمة الفورية الصغيرة يتبع قاعدة واحدة بسيطة: المهمة الجاهزة ذات الأولوية الأعلى هي التي تعمل، دائماً وفوراً. وهذا ما يسمى الجدولة الاستباقية بالأولوية الثابتة Fixed Priority Preemptive Scheduling، وكلمة استباقية Preemptive تعني أن النواة لا تنتظر المهمة الحالية لكي تتنازل، وإنما تقطعها في اللحظة التي تصبح فيها مهمة أعلى جاهزة. وعندما تتساوى أولوية مهمتين جاهزتين تتقاسمان المعالج بالتناوب كل tick، وهذا تقسيم الوقت Time Slicing، وهو مفعل في إعدادنا بالخيار configUSE_TIME_SLICING 1. ولاحظ أن الأولوية في FreeRTOS رقم أكبر يعني أهم، وفي Zephyr العكس تماماً، فالرقم الأصغر أهم، وهذا يسبب أخطاء حقيقية عندما ينقل فريق كوده من نظام إلى آخر.
والنواة تحتاج أن تستيقظ لكي تتخذ قراراتها، وهذا يحدث في حالتين. الأولى مقاطعة المؤقت، وهي في Cortex-M غالباً المؤقت SysTick الذي رأيناه في المقال السابق، وتسمى النبضة Tick، وفي إعدادنا كل 1 ms بالخيار configTICK_RATE_HZ 1000، وفي كل نبضة تزيد النواة عداد الوقت، وتنقل كل مهمة انتهى انتظارها إلى الجاهزة، وإذا صارت إحداها أعلى من الحالية تطلب تبديلاً. والثانية استدعاء من الكود يجعل مهمة أعلى جاهزة، مثل إرسال رسالة إلى طابور تنتظره مهمة أعلى، أو تحرير قفل، فيحدث التبديل في نفس اللحظة ولا ينتظر النبضة التالية.
والتبديل نفسه Context Switch على معالجات Cortex-M له تصميم جميل يستحق أن تعرفه، لأنك ستراه في جدول المقاطعات. فالنواة لا تبدل المهام داخل مقاطعة SysTick مباشرة، وإنما تطلب مقاطعة خاصة اسمها PendSV وتعطيها أقل أولوية في النظام، فتنتظر PendSV حتى تنتهي كل المقاطعات الأخرى، ثم تعمل فتحفظ المسجلات R4 إلى R11 في مكدس المهمة الحالية، ويكون المعالج قد حفظ الباقي تلقائياً عند دخول المقاطعة، ثم تأخذ مؤشر مكدس المهمة الجديدة وتسترجع منه مسجلاتها، وعند الخروج من المقاطعة يكمل المعالج المهمة الجديدة. ولهذا السبب وضعنا في جدول المقاطعات في المختبر ثلاث دوال من FreeRTOS في الخانات 11 و14 و15: vPortSVCHandler لبدء أول مهمة، وxPortPendSVHandler للتبديل، وxPortSysTickHandler للنبضة.
وكيف تختار الأولويات؟ هذا سؤال له نظرية كاملة في علم الأنظمة الفورية، والقاعدة الأشهر منها اسمها الأولوية بحسب المعدل Rate Monotonic: المهمة التي تتكرر أكثر تأخذ أولوية أعلى، فمهمة كل 5 ms أعلى من مهمة كل 10 ms، وهذه قاعدة جيدة للبداية. ولكن في الواقع العملي يضيف المهندسون سؤالاً ثانياً: ما المهمة التي يكون تأخرها أخطر؟ ففي مسجل الحرارة جعلنا الراديو أعلى من الحساس رغم أن الحساس يتكرر أكثر، لأن تأخر الراديو يقطع الاتصال، وتأخر قراءة واحدة لا يغير شيئاً. وأسوأ ما يمكن أن تفعله أن تعطي كل المهام نفس الأولوية لأنك لا تريد أن تقرر، فتعود عملياً إلى حلقة واحدة يتناوب فيها الجميع.
الطوابير Queues: كيف تتكلم المهام مع بعضها؟
المهام تتشارك الذاكرة، فأسهل طريقة لتمرير قراءة الحرارة من مهمة الحساس إلى مهمة السجل أن تضعها في متغير عام، وهذه هي الطريقة البسيطة التي يبدأ بها الجميع، وهي خاطئة لسببين. الأول أن مهمة السجل لا تعرف متى وصلت قراءة جديدة، فتضطر أن تفحص المتغير باستمرار، وهذا يحرق المعالج. والثاني أن مهمة الحساس قد تكتب قراءة جديدة بينما مهمة السجل في منتصف قراءة القديمة، فتأخذ نصف القيمة من هذه ونصفها من تلك، وهذا هو السباق Race Condition. والحل الذي تعطيك إياه كل الأنظمة الفورية هو الطابور Queue، وهو قائمة بطول ثابت تحدده عند إنشائها، ترسل إليه مهمة بالدالة xQueueSend وتستقبل منه أخرى بالدالة xQueueReceive.
والطابور يحل المشكلتين معاً، فالمهمة التي تستقبل من طابور فارغ تنتقل إلى حالة الانتظار ولا تأخذ من المعالج شيئاً، وتوقظها النواة في نفس اللحظة التي يصل فيها عنصر، والنواة تنسخ العنصر كاملاً إلى داخل الطابور عند الإرسال، ثم تنسخه إلى متغير المستقبل عند الاستقبال، فلا يوجد متغير مشترك يتسابق عليه أحد. ونقطة النسخ هذه مهمة، فالطابور في FreeRTOS يحفظ القيمة وليس المؤشر، وهذا آمن ولكنه مكلف للعناصر الكبيرة، ولذلك عندما تمرر مخازن Buffers كبيرة ترسل مؤشراً إليها في الطابور، وعندها تصبح أنت مسؤولاً عن ألا يكتب أحد في المخزن بعد إرساله. وفي Zephyr يسمى نفس الشيء طابور الرسائل Message Queue بالدالة k_msgq_put، وتجد وصفه في توثيق Zephyr.
والسؤال الذي يجب أن تجيب عليه عند كل طابور: ماذا يحدث عندما يمتلئ؟ فالدالة xQueueSend تأخذ معاملاً ثالثاً هو مدة الانتظار، وإذا كان صفراً تعود فوراً بفشل عندما يكون الطابور ممتلئاً، وإذا كان أكبر تنتظر المهمة المرسلة حتى يفرغ مكان. وفي مسجل الحرارة لا نريد أن تنتظر مهمة الحساس أبداً، لأن انتظارها يؤخر القراءة التالية، فنرسل بمدة صفر ونعد القراءات الضائعة، وهذا ما سنقيسه في المختبر. وهذا قرار تصميم وليس تفصيلاً: هل الأفضل أن تضيع قراءة، أم أن تتأخر كل القراءات؟ والإجابة تختلف من جهاز لآخر، ولكن يجب أن تكون مكتوبة في الكود وليست نتيجة صدفة.
الإشارات Semaphores أم الأقفال Mutexes: ما الفرق؟
بعض البيانات لا يمكن تمريرها في طابور لأنها مورد مشترك يستخدمه أكثر من طرف، مثل ذاكرة الفلاش نفسها أو مخزن السجل في الذاكرة أو ناقل SPI الذي تتصل به عدة قطع، وهنا تحتاج قفلاً يضمن أن مهمة واحدة فقط تستخدم المورد في كل لحظة، أي الاستبعاد المتبادل Mutual Exclusion، وقد شرحنا الفكرة في سياق قواعد البيانات في مقال الأقفال Locks والجمود Deadlock وفي سياق الخيوط في مقال التزامن في C. وفي الأنظمة الفورية أداتان تبدوان متشابهتين جداً:
- الإشارة الثنائية Binary Semaphore: عداد قيمته صفر أو واحد، تأخذه مهمة فيصبح صفراً، وتعطيه أي مهمة أو أي مقاطعة فيصبح واحداً. وهي مصممة أصلاً للإشارة بين طرفين، مثل مقاطعة تعطي الإشارة عندما يصل بايت، ومهمة تنتظرها لكي تقرأه، ولذلك لا يوجد لها «مالك».
- القفل Mutex: يشبه الإشارة الثنائية، ولكن له مالك، وهو المهمة التي أخذته، ولا يحرره إلا هي، ولا يستخدم من داخل مقاطعة. ولأن النواة تعرف المالك، يمكنها أن تفعل شيئاً لا تستطيعه مع الإشارة: أن ترفع أولوية المالك مؤقتاً إذا انتظرته مهمة أعلى منه، وهذه هي وراثة الأولوية التي تحل مشكلة المختبر.
وكثير من المبرمجين يستخدمون الإشارة الثنائية كقفل لأنها تعمل في الاختبار، ولأن الكود يبدو أبسط، ثم يكتشفون الفرق في الإنتاج، وهذه بالضبط القصة التالية. ولاحظ تفصيلاً صغيراً في FreeRTOS: الإشارة الثنائية التي تنشئها الدالة xSemaphoreCreateBinary تبدأ فارغة، أي أن أول من يحاول أخذها ينتظر، ولذلك أعطيناها مرة بعد إنشائها في المختبر، أما القفل من xSemaphoreCreateMutex فيبدأ متاحاً. وهذا يذكر صراحة في توثيق الأقفال في FreeRTOS، وكثير من المبتدئين يقضون ساعة يبحثون لماذا لا تبدأ مهمتهم.
انعكاس الأولوية Priority Inversion: عندما تنتظر المهمة الأهم الأقل أهمية
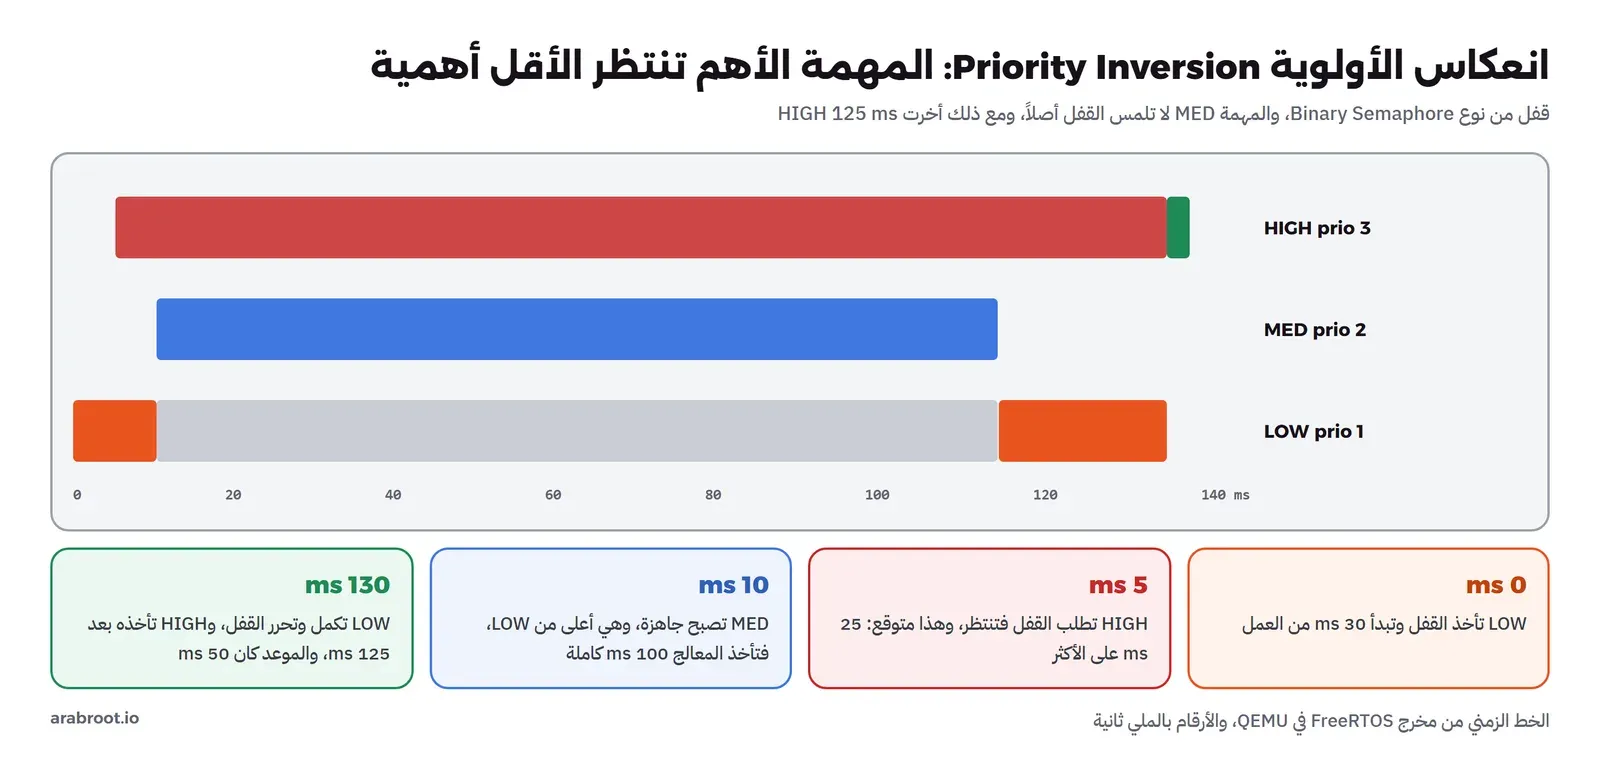
لنفرض أن في مسجل الحرارة ثلاث مهام: مهمة منخفضة LOW تكتب السجل في الفلاش وتحتاج قفل مخزن السجل، ومهمة عالية HIGH ترد على الهاتف وتحتاج نفس القفل لكي تقرأ السجل وترسله، ومهمة متوسطة MED تضغط البيانات أو تحسب الإحصائيات ولا تحتاج القفل أبداً. والسيناريو يبدأ بشكل طبيعي: LOW تأخذ القفل وتبدأ الكتابة، ثم تصل رسالة من الهاتف فتعمل HIGH وتطلب القفل فتنتظر، وهذا متوقع ومقبول، لأن LOW ستنتهي خلال وقت قصير وتحرر القفل. ولكن قبل أن تنتهي LOW تصبح MED جاهزة، وأولويتها أعلى من LOW، فيقطع المجدول LOW ويشغل MED، وهو يفعل ما صمم له بالضبط. والآن HIGH تنتظر LOW، وLOW تنتظر MED، أي أن المهمة الأهم في الجهاز تنتظر المهمة المتوسطة التي لا علاقة لها بالقفل أصلاً، ومدة الانتظار لم تعد محدودة بعمل LOW القصير، وإنما بكل ما تريد MED أن تعمله، وكل مهمة متوسطة أخرى في النظام. وهذا هو انعكاس الأولوية Priority Inversion، وأسوأ ما فيه أنه لا يظهر في أغلب الاختبارات، لأنه يحتاج أن تحدث ثلاثة أشياء بترتيب معين في نافذة وقت قصيرة.
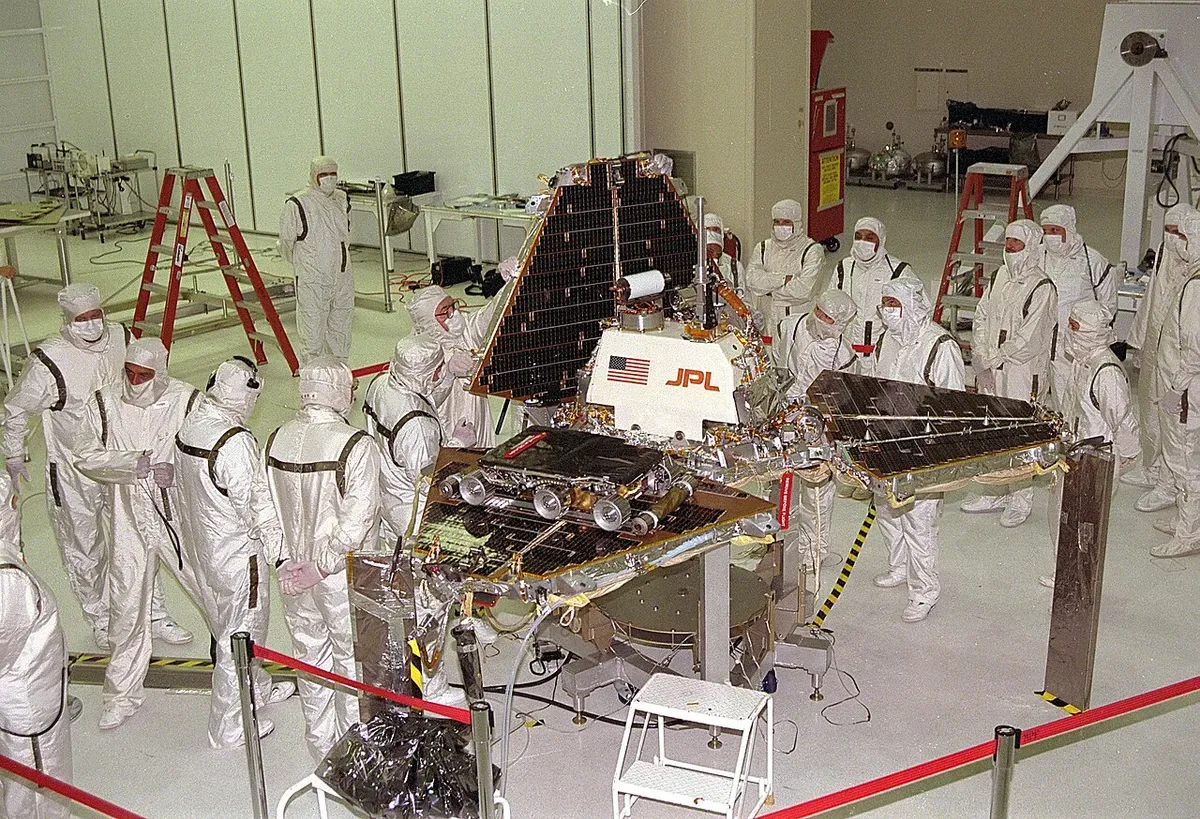
والدرس من هذه القصة أكبر من الخيار نفسه، فالقفل كان من نوع Mutex، والنظام يدعم الوراثة، ولكن الخيار لم يكن مفعلاً في ذلك القفل بالذات، لأنه داخل مكتبة النظام وليس في كود الفريق، ويذكر Reeves أن هذا الإعداد لم يكن موثقاً. ولاحظ أيضاً ما الذي أنقذ المهمة: أداة التسجيل والتتبع Trace التي تركها الفريق في البرنامج، والتي سمحت لهم أن يروا ترتيب الأحداث بالضبط، والنسخة الأرضية التي أعادوا عليها المشكلة.
والحلول المعروفة لانعكاس الأولوية ثلاثة، ولكل منها ثمن:
- وراثة الأولوية Priority Inheritance: عندما تنتظر مهمة عالية قفلاً تملكه مهمة منخفضة، ترفع النواة أولوية المالك مؤقتاً إلى أولوية المنتظر حتى يحرر القفل، فلا تستطيع المهام المتوسطة أن تقطعه. وهذا ما تفعله الأقفال في FreeRTOS وZephyr افتراضياً، وهو الحل الأكثر استخداماً لأنه لا يحتاج منك أي تخطيط.
- سقف الأولوية Priority Ceiling: تعطي كل قفل أولوية تساوي أعلى مهمة قد تستخدمه، وأي مهمة تأخذه ترتفع فوراً إلى هذه الأولوية، حتى لو لم ينتظرها أحد. وهو يمنع الانعكاس والجمود معاً في أنظمة معينة، ولكنه يحتاج أن تعرف مسبقاً من يستخدم كل قفل.
- تجنب القفل نفسه: أن تجعل مهمة واحدة فقط تملك المورد، والباقون يرسلون إليها طلباتهم في طابور، فلا يوجد قفل ولا انعكاس، وهذا كثيراً ما يكون التصميم الأبسط والأوضح.
المختبر Lab: انعكاس الأولوية على FreeRTOS في QEMU
الآن نعيد السيناريو بالضبط ونقيسه. واخترنا للتجربة المحاكي QEMU بالبورد mps2-an385، وهي لوحة تطوير حقيقية من Arm بمعالج Cortex-M3، يحاكيها QEMU بالكامل كما في توثيقه، وعليها يختبر فريق FreeRTOS نفسه عدداً من أمثلته. ونستخدم نفس Docker Image من المقال السابق، فيها QEMU 10.0 والمترجم arm-none-eabi-gcc، ونضيف إليها نواة FreeRTOS بإصدار V11.3.3 الصادر في 30 أكتوبر 2026، ونحفظها في Docker Volume لكي لا تنزل في كل مرة:
docker volume create fw-src
docker run --rm -v fw-src:/src fw-toolchain:1 \
  git clone --depth 1 --branch V11.3.3 https://github.com/FreeRTOS/FreeRTOS-Kernel.git /src/freertos
والنواة كلها بضعة ملفات C، نحتاج منها خمسة فقط: tasks.c للمهام والمجدول، وqueue.c للطوابير والأقفال، وlist.c للقوائم التي تستخدمها النواة داخلياً، وport.c الخاص بمعالج Cortex-M3 ومترجم GCC وفيه دوال التبديل، وheap_4.c الذي يحجز ذاكرة المهام من مصفوفة ثابتة. وكل إعدادات النواة في ملف واحد تكتبه أنت اسمه FreeRTOSConfig.h:
/* FreeRTOS settings for the Arm MPS2 AN385 board (Cortex-M3 at 25 MHz) in QEMU */
#ifndef FREERTOS_CONFIG_H
#define FREERTOS_CONFIG_H

#define configCPU_CLOCK_HZ                      25000000UL
#define configTICK_RATE_HZ                      1000          /* one tick = 1 ms */
#define configUSE_PREEMPTION                    1             /* a higher-priority ready task runs at once */
#define configUSE_TIME_SLICING                  1             /* equal priorities share the CPU tick by tick */
#define configMAX_PRIORITIES                    5
#define configMINIMAL_STACK_SIZE                256           /* in words, not bytes */
#define configTOTAL_HEAP_SIZE                   (32 * 1024)
#define configTICK_TYPE_WIDTH_IN_BITS           TICK_TYPE_WIDTH_32_BITS
#define configUSE_MUTEXES                       1
#define configUSE_IDLE_HOOK                     0
#define configUSE_TICK_HOOK                     0
#define configCHECK_FOR_STACK_OVERFLOW          2
#define configSUPPORT_DYNAMIC_ALLOCATION        1
#define configSUPPORT_STATIC_ALLOCATION         0
#define configUSE_TIMERS                        0

/* Cortex-M interrupt priorities: the AN385 NVIC implements 3 priority bits */
#define configPRIO_BITS                         3
#define configKERNEL_INTERRUPT_PRIORITY         (7 << (8 - configPRIO_BITS))
#define configMAX_SYSCALL_INTERRUPT_PRIORITY    (2 << (8 - configPRIO_BITS))

#define INCLUDE_vTaskDelay                      1
#define INCLUDE_vTaskDelete                     1
#define INCLUDE_uxTaskPriorityGet               1
#define INCLUDE_xTaskDelayUntil                 1

void fail(const char *why);
#define configASSERT(x) do { if (!(x)) fail("configASSERT " __FILE__); } while (0)
#endif
في الإعداد أعلاه لاحظ التالي:
configTICK_RATE_HZ 1000يجعل النبضة كل 1 ms، فكل الأرقام في المخرج بالملي ثانية، وفي الأجهزة الحقيقية يختار كثيرون 100 أو 1000 بحسب دقة التوقيت المطلوبة، والنبضة الأسرع تعني دقة أعلى واستيقاظاً أكثر للمعالج.configMINIMAL_STACK_SIZE 256بالكلمات وليس بالبايت، أي 1 KB لكل مهمة، وهذا خطأ شائع عند من يقرأ الرقم لأول مرة.configTOTAL_HEAP_SIZEهو حجم المصفوفة التي تحجز منها النواة المهام والطوابير، وهي 32 KB تظهر كاملة في القسم.bss.- أولويات المقاطعات بثلاثة بتات لأن معالج هذه اللوحة ينفذ ثلاثة بتات فقط، وكل مقاطعة تستدعي دوال النواة يجب أن تكون أقل أولوية من
configMAX_SYSCALL_INTERRUPT_PRIORITY، وإلا فقد تقطع النواة في منتصف تعديل قوائمها. configASSERTمعرف لكي يطبع ويوقف المحاكي، وفي FreeRTOS مئات الفحوص الداخلية التي لا تعمل إلا إذا عرفته، فعرفه دائماً أثناء التطوير.
والبرنامج نفسه ثلاث مهام وقفل واحد، ونوع القفل يتغير بخيار عند الترجمة LOCK_IS_MUTEX، ومدة عمل المهمة المتوسطة بالخيار MED_WORK:
// Priority inversion on FreeRTOS: three tasks share one lock.
//   LOCK_IS_MUTEX=0 : binary semaphore (no priority inheritance)
//   LOCK_IS_MUTEX=1 : mutex (priority inheritance)
//   MED_WORK        : CPU ticks the medium task burns (default 100)
#include <stdint.h>
#include "FreeRTOS.h"
#include "task.h"
#include "semphr.h"

#ifndef LOCK_IS_MUTEX
#define LOCK_IS_MUTEX 0
#endif
#ifndef MED_WORK
#define MED_WORK 100
#endif

#define UART0_DATA  (*(volatile uint32_t *)0x40004000u)   // CMSDK APB UART0
#define UART0_STATE (*(volatile uint32_t *)0x40004004u)   // bit 0: TX buffer full
#define UART0_CTRL  (*(volatile uint32_t *)0x40004008u)   // bit 0: TX enable
#define UART0_BAUD  (*(volatile uint32_t *)0x40004010u)

static void putc_(char c) { while (UART0_STATE & 1u) { } UART0_DATA = (uint32_t)c; }
static void puts_(const char *s) { while (*s) putc_(*s++); }
static void putu(uint32_t v, int width) {
    char b[11]; int i = 10; b[i] = 0;
    do { b[--i] = (char)('0' + v % 10); v /= 10; } while (v);
    for (int pad = width - (10 - i); pad > 0; pad--) putc_(' ');
    puts_(&b[i]);
}
static void log_event(const char *who, const char *what) {
    taskENTER_CRITICAL();                       // one line at a time, no task switch mid-line
    putc_('['); putu(xTaskGetTickCount(), 4); puts_(" ms] ");
    puts_(who); puts_(" prio="); putu(uxTaskPriorityGet(NULL), 1); puts_("  "); puts_(what); puts_("\n");
    taskEXIT_CRITICAL();
}
static void semihost_exit(void) {               // ask QEMU to stop (semihosting SYS_EXIT)
    register uint32_t r0 __asm__("r0") = 0x18, r1 __asm__("r1") = 0x20026;
    __asm__ volatile ("bkpt 0xAB" : : "r"(r0), "r"(r1));
}
void fail(const char *why) { taskDISABLE_INTERRUPTS(); puts_("FAIL: "); puts_(why); puts_("\n"); semihost_exit(); for (;;) { } }
void vApplicationStackOverflowHook(TaskHandle_t t, char *name) { (void)t; fail(name); }

// Burn n ticks of *this task's* CPU time: count tick changes only while we are running.
static void burn(uint32_t n) {
    TickType_t last = xTaskGetTickCount();
    while (n) { TickType_t now = xTaskGetTickCount(); if (now != last) { last = now; n--; } }
}

static SemaphoreHandle_t lock;
static TickType_t high_asked, high_got;

static void low_task(void *p) {
    (void)p;
    xSemaphoreTake(lock, portMAX_DELAY);
    log_event("LOW ", "took the lock, writing the log buffer (30 ticks of work)");
    burn(30);
    log_event("LOW ", "releasing the lock");
    xSemaphoreGive(lock);
    log_event("LOW ", "done");
    vTaskDelete(NULL);
}
static void high_task(void *p) {
    (void)p;
    vTaskDelay(pdMS_TO_TICKS(5));
    high_asked = xTaskGetTickCount();
    log_event("HIGH", "needs the lock (deadline: 50 ms)");
    xSemaphoreTake(lock, portMAX_DELAY);
    high_got = xTaskGetTickCount();
    log_event("HIGH", "got the lock");
    xSemaphoreGive(lock);
    vTaskDelay(pdMS_TO_TICKS(MED_WORK + 60));    // let the others finish, then report
    puts_(LOCK_IS_MUTEX ? "RESULT lock=mutex" : "RESULT lock=binary-semaphore");
    puts_(" med_work="); putu(MED_WORK, 1);
    puts_(" high_waited="); putu(high_got - high_asked, 1); puts_(" ms");
    puts_((high_got - high_asked) > 50 ? "  DEADLINE MISSED\n" : "  deadline met\n");
    semihost_exit();
}
static void med_task(void *p) {
    (void)p;
    vTaskDelay(pdMS_TO_TICKS(10));
    log_event("MED ", "starts CPU work, never touches the lock");
    burn(MED_WORK);
    log_event("MED ", "done");
    vTaskDelete(NULL);
}

int main(void) {
    UART0_BAUD = 16; UART0_CTRL = 1;
    puts_("FreeRTOS " tskKERNEL_VERSION_NUMBER " on MPS2-AN385, tick 1 ms\n");
    lock = LOCK_IS_MUTEX ? xSemaphoreCreateMutex() : xSemaphoreCreateBinary();
    if (!LOCK_IS_MUTEX) xSemaphoreGive(lock);    // a binary semaphore starts empty
    xTaskCreate(low_task,  "low",  configMINIMAL_STACK_SIZE, NULL, 1, NULL);
    xTaskCreate(med_task,  "med",  configMINIMAL_STACK_SIZE, NULL, 2, NULL);
    xTaskCreate(high_task, "high", configMINIMAL_STACK_SIZE, NULL, 3, NULL);
    vTaskStartScheduler();                       // never returns while the scheduler runs
    fail("scheduler returned");
}
في الكود أعلاه لاحظ التالي:
- الأولويات 1 و2 و3 لـ LOW وMED وHIGH، والمهمتان HIGH وMED تبدآن بانتظار 5 و10 ms، لكي تأخذ LOW القفل أولاً ويحدث السيناريو بالترتيب الذي وصفناه.
- الدالة
burnتمثل عملاً حقيقياً على المعالج، وهي لا تعد الوقت المنقضي وإنما النبضات التي رأتها وهي تعمل، فإذا قطعتها مهمة أخرى لا يحسب ذلك الوقت من عملها، وهذا مهم لأن LOW يجب أن تحتاج 30 ms من عمل المعالج مهما تأخرت. - الطباعة داخل
taskENTER_CRITICALلكي لا يتداخل سطران، وهي تعطل المقاطعات أثناء الطباعة، وهذا مقبول في تجربة، أما في جهاز حقيقي فالطباعة البطيئة داخل قسم حرج تؤخر كل شيء، والحل مهمة طباعة واحدة تأخذ الأسطر من طابور. - الموعد الصارم لـ HIGH 50 ms، وفي النهاية تطبع النتيجة وتطلب من QEMU أن يتوقف عبر استدعاء Semihosting، وهو طريقة يطلب بها البرنامج من المحاكي أو المصحح خدمة مثل الخروج أو الطباعة.
وكود البداية مثل المقال السابق، والفرق الوحيد أن ثلاث خانات في جدول المقاطعات صارت لدوال FreeRTOS:
// Startup for MPS2 AN385 (Cortex-M3): vector table, .data/.bss setup, FreeRTOS exception handlers.
#include <stdint.h>
extern uint32_t _sidata, _sdata, _edata, _sbss, _ebss, _estack;
int main(void);
void vPortSVCHandler(void);
void xPortPendSVHandler(void);
void xPortSysTickHandler(void);

void Reset_Handler(void) {
    uint32_t *s = &_sidata, *d = &_sdata;
    while (d < &_edata) *d++ = *s++;
    for (d = &_sbss; d < &_ebss; ) *d++ = 0;
    main();
    for (;;) { }
}
void Default_Handler(void) { for (;;) { } }
void HardFault_Handler(void) __attribute__((weak, alias("Default_Handler")));

// Slots 11, 14 and 15 belong to the FreeRTOS port: SVC starts the first task, PendSV switches tasks, SysTick is the tick.
__attribute__((section(".isr_vector"), used))
const void *const vector_table[16] = {
    &_estack, Reset_Handler, Default_Handler, HardFault_Handler,
    Default_Handler, Default_Handler, Default_Handler, 0, 0, 0, 0,
    vPortSVCHandler, Default_Handler, 0, xPortPendSVHandler, xPortSysTickHandler,
};
والتشغيل بالأمر التالي، وكل التجارب في الملف lab/run-freertos.sh:
qemu-system-arm -M mps2-an385 -cpu cortex-m3 -display none -monitor none -serial stdio \
  -semihosting-config enable=on,target=native -icount shift=5,align=off -kernel /tmp/sem.elf
والخيار المهم هنا -icount shift=5، فبدونه يربط QEMU الوقت الافتراضي بساعة جهازك، فتختلف النتائج قليلاً في كل تشغيل بحسب ما يفعله جهازك في تلك اللحظة، ومعه يحسب الوقت من عدد التعليمات المنفذة، كل تعليمة 2 أس 5 أي 32 نانو ثانية، فتصبح النتائج متطابقة في كل تشغيل، وهذا ما تحتاجه عندما تقيس توقيتاً أو تكتب اختباراً يعتمد عليه.
التشغيل الأول: قفل من نوع Binary Semaphore
والمخرج سوف يكون كما يلي:
   text	   data	    bss	    dec	    hex	filename
   7304	      4	  33056	  40364	   9dac	/tmp/sem.elf
FreeRTOS V11.3.3 on MPS2-AN385, tick 1 ms
[   0 ms] LOW  prio=1  took the lock, writing the log buffer (30 ticks of work)
[   5 ms] HIGH prio=3  needs the lock (deadline: 50 ms)
[  10 ms] MED  prio=2  starts CPU work, never touches the lock
[ 110 ms] MED  prio=2  done
[ 130 ms] LOW  prio=1  releasing the lock
[ 130 ms] HIGH prio=3  got the lock
[ 130 ms] LOW  prio=1  done
RESULT lock=binary-semaphore med_work=100 high_waited=125 ms  DEADLINE MISSED
ولنقرأ السطور واحداً واحداً:
- مخرج
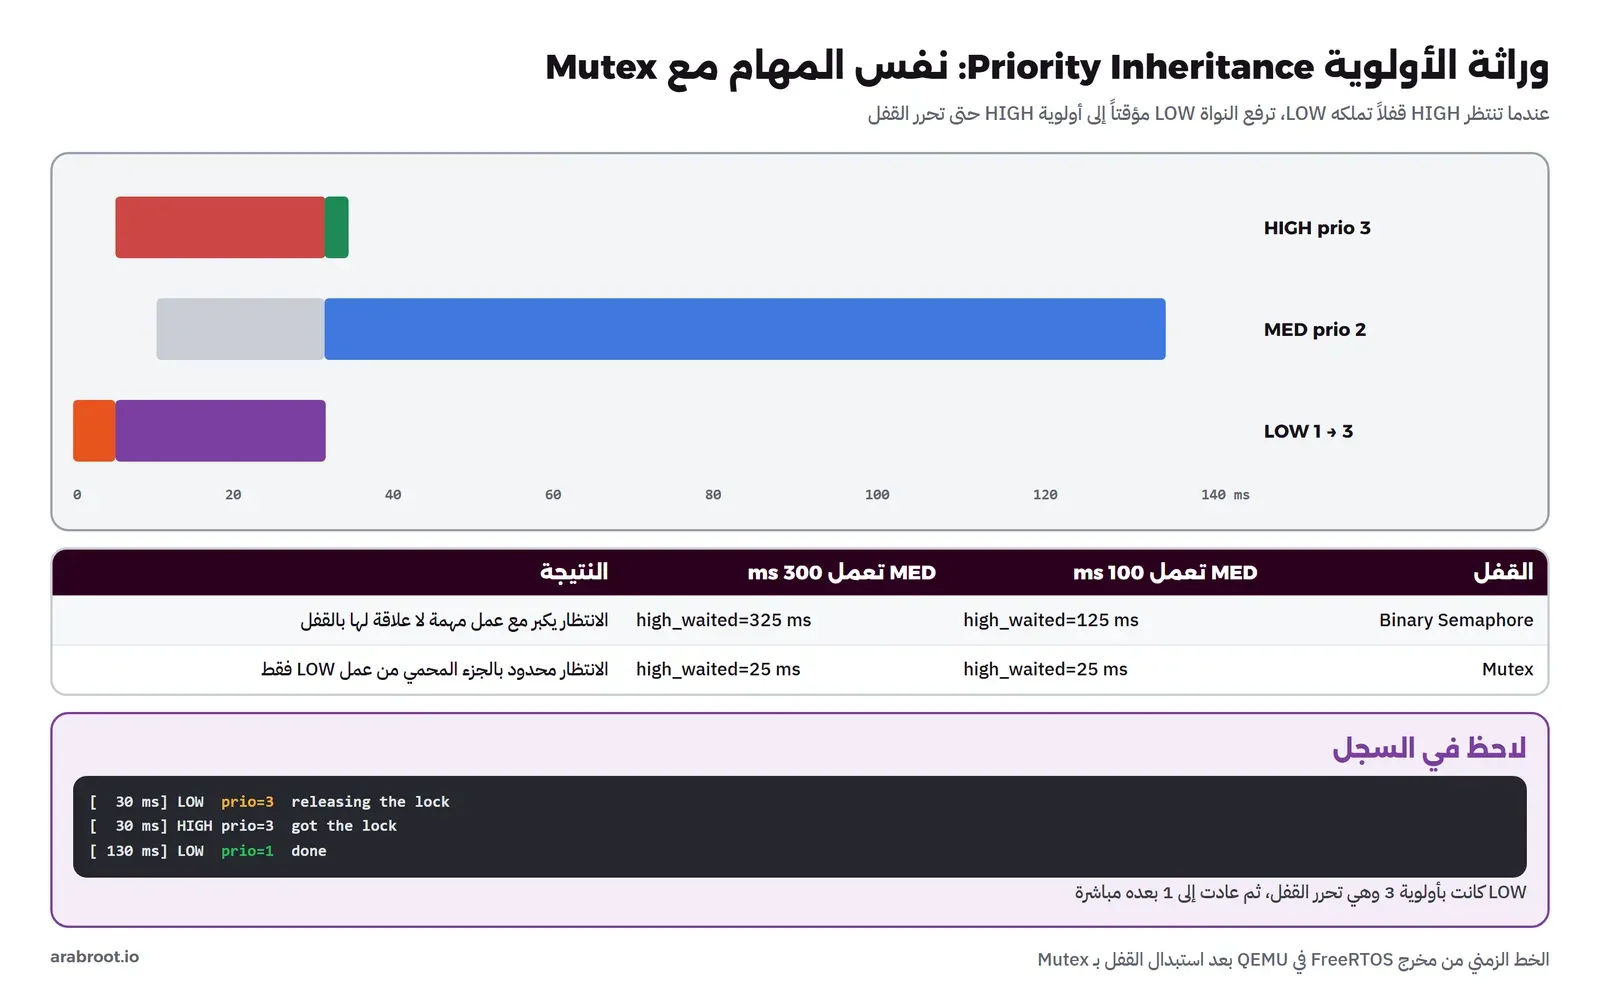
sizeيقول إن البرنامج كله مع النواة 7304 بايت من الفلاش، وهذا حجم صغير جداً لنظام فيه مهام وأقفال وطوابير، وbss33056 بايت أغلبها مصفوفة الذاكرة 32 KB. [0 ms] LOW prio=1 took the lock: المجدول بدأ بـ HIGH لأنها الأعلى، فانتظرت 5 ms، ثم MED فانتظرت 10 ms، فبقيت LOW وحدها جاهزة، فأخذت القفل.[5 ms] HIGH prio=3 needs the lock: استيقظت HIGH وقطعت LOW فوراً، وطلبت القفل فانتقلت إلى الانتظار، فعادت LOW تعمل. وحتى هذه اللحظة كل شيء صحيح: HIGH يجب أن تنتظر 25 ms على الأكثر، أي ما بقي من عمل LOW.[10 ms] MED prio=2 starts CPU work: استيقظت MED، وأولويتها 2 أعلى من LOW، فقطعتها. وهنا بدأ الانعكاس.[110 ms] MED done: عملت MED 100 ms كاملة، وLOW جاهزة ولكنها لا تعمل، وHIGH تنتظر LOW.[130 ms] LOW releasingثمHIGH got the lockفي نفس الملي ثانية: أكملت LOW ما بقي من عملها، أي 20 ms، وحررت القفل، فقطعتها HIGH فوراً، ولذلك ظهر سطرLOW doneبعد سطر HIGH رغم أنه يأتي بعده مباشرة في كود LOW.- والنتيجة:
high_waited=125 msوالموعد 50 ms، أي أن المهمة الأهم في الجهاز تأخرت مرتين ونصف موعدها بسبب مهمة لا تلمس القفل.
ماذا يحدث إذا عملت المهمة المتوسطة 300 ms؟
والسؤال المهم الآن: هل هذا التأخر محدود؟ أي هل يمكن أن نقول إن HIGH تنتظر 125 ms في أسوأ الحالات ونصمم على ذلك؟ لنجرب أن نجعل MED تعمل 300 ms بدل 100، بدون أي تغيير آخر:
FreeRTOS V11.3.3 on MPS2-AN385, tick 1 ms
[   0 ms] LOW  prio=1  took the lock, writing the log buffer (30 ticks of work)
[   5 ms] HIGH prio=3  needs the lock (deadline: 50 ms)
[  10 ms] MED  prio=2  starts CPU work, never touches the lock
[ 310 ms] MED  prio=2  done
[ 330 ms] LOW  prio=1  releasing the lock
[ 330 ms] HIGH prio=3  got the lock
[ 330 ms] LOW  prio=1  done
RESULT lock=binary-semaphore med_work=300 high_waited=325 ms  DEADLINE MISSED
والانتظار صار 325 ms، أي أنه زاد بالضبط بمقدار ما زاد عمل MED. وهذا هو المعنى الحقيقي لكلمة «غير محدود» Unbounded في وصف انعكاس الأولوية: زمن انتظار المهمة العالية لم يعد يعتمد على المهمة التي تملك القفل، وإنما على كل مهمة أخرى في النظام أولويتها بين الاثنتين، وأي مهندس في الفريق يضيف مهمة متوسطة جديدة لشيء لا علاقة له بالقفل يمكن أن يجعل الجهاز يفوت موعده، بدون أن يلمس سطراً واحداً من كود HIGH أو LOW. ولذلك لا يمكنك أن تحسب زمن الرد في أسوأ الحالات لنظام فيه هذا النوع من الأقفال، وهذا يلغي الفكرة الأساسية من النظام الفوري.
الإصلاح: Mutex مع وراثة الأولوية Priority Inheritance
والإصلاح سطر واحد: xSemaphoreCreateMutex() بدل xSemaphoreCreateBinary()، وفي برنامجنا الخيار -DLOCK_IS_MUTEX=1:
   text	   data	    bss	    dec	    hex	filename
   7316	      4	  33056	  40376	   9db8	/tmp/mtx.elf
FreeRTOS V11.3.3 on MPS2-AN385, tick 1 ms
[   0 ms] LOW  prio=1  took the lock, writing the log buffer (30 ticks of work)
[   5 ms] HIGH prio=3  needs the lock (deadline: 50 ms)
[  30 ms] LOW  prio=3  releasing the lock
[  30 ms] HIGH prio=3  got the lock
[  30 ms] MED  prio=2  starts CPU work, never touches the lock
[ 130 ms] MED  prio=2  done
[ 130 ms] LOW  prio=1  done
RESULT lock=mutex med_work=100 high_waited=25 ms  deadline met
وهنا ترى الوراثة تعمل في السجل نفسه:
- حتى 5 ms نفس القصة: LOW أخذت القفل، وHIGH طلبته وانتظرت.
- لا يوجد سطر لـ MED عند 10 ms، والسبب أن النواة عندما انتظرت HIGH القفل عند 5 ms رفعت أولوية مالكه LOW إلى 3، فلما استيقظت MED بأولوية 2 وجدت أمامها مهمة أعلى، فبقيت جاهزة ولم تعمل.
[30 ms] LOW prio=3 releasing the lock: لاحظprio=3، فـ LOW تعمل الآن بأولوية HIGH، وأكملت عملها 30 ms بدون انقطاع.- وعند تحرير القفل أعادت النواة LOW إلى أولويتها الأصلية 1، فأخذت HIGH القفل في نفس اللحظة، ثم بدأت MED عملها عند 30 ms وأكملته عند 130، وفي النهاية
LOW prio=1 done. - والنتيجة
high_waited=25 ms، أي بالضبط ما بقي من عمل LOW في القسم المحمي بالقفل، والموعد تحقق.
ثم نفس التجربة مع MED تعمل 300 ms:
FreeRTOS V11.3.3 on MPS2-AN385, tick 1 ms
[   0 ms] LOW  prio=1  took the lock, writing the log buffer (30 ticks of work)
[   5 ms] HIGH prio=3  needs the lock (deadline: 50 ms)
[  30 ms] LOW  prio=3  releasing the lock
[  30 ms] HIGH prio=3  got the lock
[  30 ms] MED  prio=2  starts CPU work, never touches the lock
[ 330 ms] MED  prio=2  done
[ 330 ms] LOW  prio=1  done
RESULT lock=mutex med_work=300 high_waited=25 ms  deadline met
والانتظار بقي 25 ms، فعمل MED لم يعد يؤثر على HIGH إطلاقاً، وأصبح زمن الانتظار محدوداً بطول القسم المحمي بالقفل في كود LOW، وهذا رقم يمكنك أن تقيسه وتصمم عليه. ولاحظ أن MED لم تخسر شيئاً في الحقيقة، فقد أنهت عملها عند 130 ms في الحالتين تقريباً، والفرق فقط في الترتيب، وأن مخرج size زاد 12 بايت فقط، وهو كود الوراثة في النواة.
وقد يتساءل البعض: إذا كانت الوراثة تحل المشكلة بهذه السهولة، فلماذا لا تكون في كل الإشارات؟ والإجابة أن الوراثة تحتاج مالكاً، والإشارة لا مالك لها بطبيعتها، فقد تعطيها مقاطعة أو مهمة أخرى غير التي أخذتها، فالنواة لا تعرف من ترفع أولويته. ولذلك القاعدة الصحيحة: استخدم Mutex لكل حماية لمورد مشترك، واترك الإشارات للإشارة بين طرفين، مثل مقاطعة تخبر مهمة أن البيانات وصلت. ولاحظ أن الوراثة لا تحل كل شيء، فإذا كان القسم المحمي نفسه طويلاً فسوف تنتظر HIGH طوله كاملاً، ولذلك أبق الأقسام المحمية أقصر ما يمكن، ولا تقم بأي عمل بطيء مثل الكتابة في الفلاش أو الطباعة وأنت تمسك قفلاً تحتاجه مهمة عالية.
الطابور Queue في المختبر: ماذا يحدث عندما يبطؤ المستهلك؟
والتجربة الثانية على الطوابير، فمهمة الحساس بأولوية 3 تنتج قراءة كل 10 ms بالضبط بالدالة vTaskDelayUntil، التي تحسب الموعد التالي من الموعد السابق وليس من لحظة الاستيقاظ فلا يتراكم التأخير، وترسل القراءة إلى طابور بطول 8 بدون انتظار، ومهمة السجل بأولوية 1 تأخذ القراءة وتكتبها، والكتابة تمثلها vTaskDelay بمدة LOGGER_MS:
typedef struct { uint32_t seq; int16_t temp_c10; TickType_t at; } reading_t;   // 4.5 C is stored as 45
static QueueHandle_t q;
static uint32_t sent, dropped, written, max_depth;

static void sensor_task(void *p) {
    (void)p;
    TickType_t next = xTaskGetTickCount();
    for (uint32_t seq = 1; seq <= 50; seq++) {
        vTaskDelayUntil(&next, pdMS_TO_TICKS(10));                 // exact 10 ms period, no drift
        reading_t r = { seq, (int16_t)(40 + (int16_t)(seq % 7)), xTaskGetTickCount() };
        if (xQueueSend(q, &r, 0) == pdPASS) sent++; else dropped++; // never block the sensor
        UBaseType_t depth = uxQueueMessagesWaiting(q);
        if (depth > max_depth) max_depth = depth;
    }
    vTaskDelay(pdMS_TO_TICKS(LOGGER_MS * QLEN + 50));
    puts_("RESULT logger_ms="); putu(LOGGER_MS); puts_(" qlen="); putu(QLEN);
    puts_(" sent="); putu(sent); puts_(" dropped="); putu(dropped);
    puts_(" written="); putu(written); puts_(" max_depth="); putu(max_depth); puts_("\n");
    semihost_exit();
}
static void logger_task(void *p) {
    (void)p;
    reading_t r;
    for (;;) {
        xQueueReceive(q, &r, portMAX_DELAY);                        // sleeps until a reading arrives
        vTaskDelay(pdMS_TO_TICKS(LOGGER_MS));                       // stands for a slow flash write
        written++;
        if (r.seq % 10 == 0) { puts_("["); putu(xTaskGetTickCount()); puts_(" ms] wrote #"); putu(r.seq);
            puts_(" temp="); putu((uint32_t)r.temp_c10 / 10); puts_("."); putu((uint32_t)r.temp_c10 % 10);
            puts_(" age="); putu(xTaskGetTickCount() - r.at); puts_(" ms\n"); }
    }
}
ومع كتابة تأخذ 4 ms لكل قراءة:
[104 ms] wrote #10 temp=4.3 age=4 ms
[204 ms] wrote #20 temp=4.6 age=4 ms
[304 ms] wrote #30 temp=4.2 age=4 ms
[404 ms] wrote #40 temp=4.5 age=4 ms
[504 ms] wrote #50 temp=4.1 age=4 ms
RESULT logger_ms=4 qlen=8 sent=50 dropped=0 written=50 max_depth=1
والطابور لم يتجاوز عنصراً واحداً max_depth=1، لأن السجل ينتهي من كل قراءة قبل أن تصل التالية بـ 6 ms، وعمر القراءة عند كتابتها age=4 ms، أي مدة الكتابة نفسها. والآن ماذا يحدث إذا صارت الكتابة في الفلاش 15 ms، وهذا ليس افتراضاً بعيداً، فذاكرة الفلاش تبطؤ عندما تحتاج مسح قطاع قبل الكتابة؟
[160 ms] wrote #10 temp=4.3 age=60 ms
[310 ms] wrote #20 temp=4.6 age=110 ms
[430 ms] wrote #30 temp=4.2 age=130 ms
[625 ms] wrote #50 temp=4.1 age=125 ms
RESULT logger_ms=15 qlen=8 sent=41 dropped=9 written=41 max_depth=8
وهنا تغير كل شيء:
max_depth=8: الطابور امتلأ، لأن السجل يأخذ قراءة كل 15 ms والحساس ينتج قراءة كل 10 ms، أي أن الطابور يزيد عنصراً كل 30 ms تقريباً حتى يمتلئ.dropped=9: تسع قراءات من 50 ضاعت، لأن الحساس أرسل بمدة انتظار صفر فرجعت الدالة بفشل، وهذا ما اخترناه عمداً، ولاحظ أن القراءة رقم 40 لا تظهر في السجل لأنها من الضائعة.age=125 ms: القراءة التي تكتب الآن عمرها 125 ms، لأنها انتظرت خلف سبع قراءات في الطابور، فالطابور الممتلئ لا يضيع البيانات فقط، وإنما يؤخر كل ما يصل.
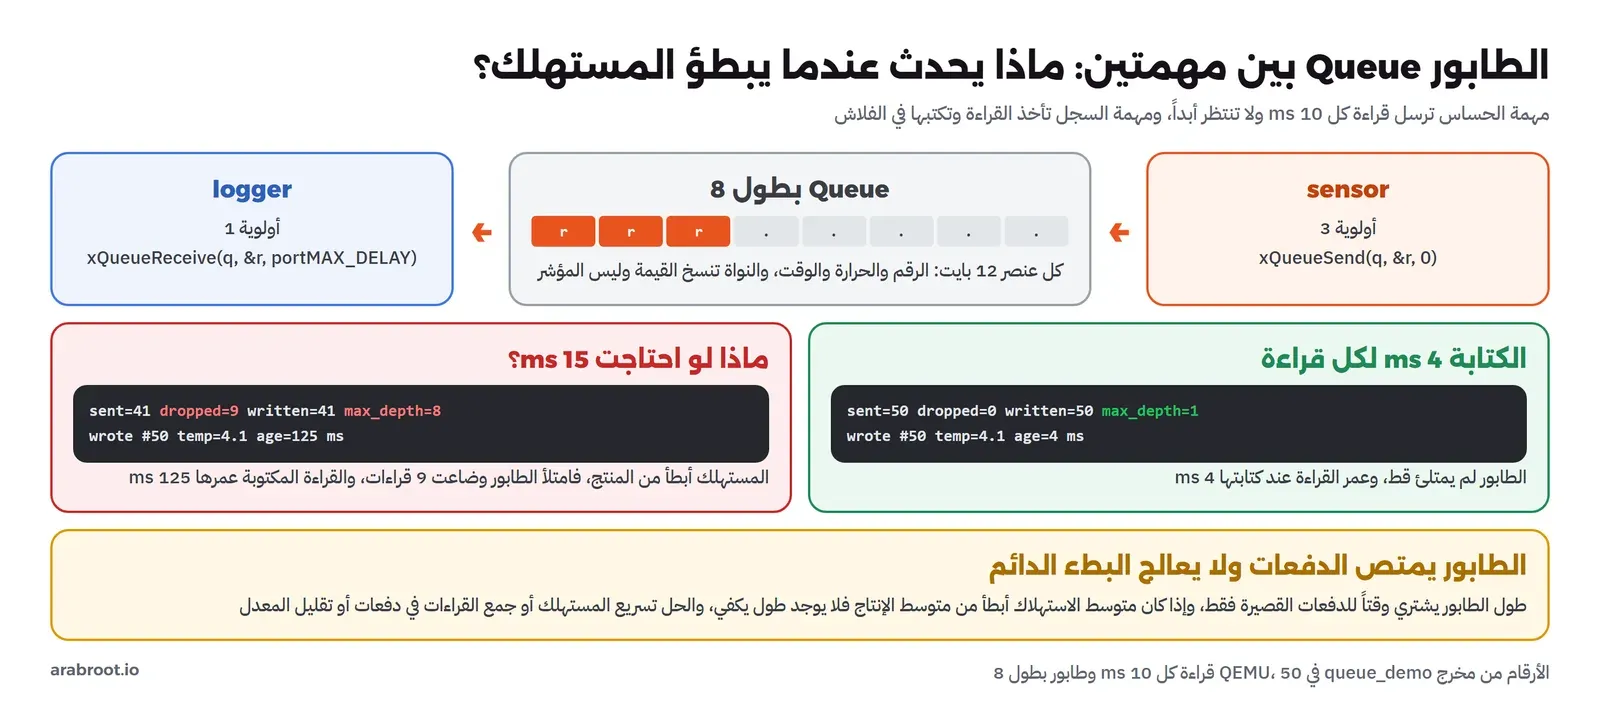
والدرس أن الطابور يمتص الدفعات القصيرة Bursts، أي أن يأتي عدد من القراءات معاً ثم يهدأ الوضع، ولكنه لا يحل مشكلة مستهلك أبطأ من المنتج في المتوسط، فهنا لا يوجد طول يكفي، وأي طابور أطول يؤخر الضياع فقط ويزيد عمر البيانات. والحل يكون في المستهلك: أن يجمع عدة قراءات ويكتبها في كتابة واحدة، لأن كلفة الكتابة في الفلاش أغلبها ثابتة للكتابة الواحدة، أو أن يقلل الحساس معدله، أو أن يحسب متوسطاً ويرسل قيمة واحدة كل عدة قراءات. وهذا نفس المنطق الذي تراه في أنظمة الرسائل في السيرفرات مثل Kafka، والفرق أن ذاكرة مسجل الحرارة تكفي ثمانية عناصر وليس ملايين.
كم تكلف النواة Kernel من الفلاش والذاكرة؟
وآخر ما نقرؤه من FreeRTOS أكبر الرموز في البرنامج مرتبة بالحجم:
00000c04 000000c4 T xTaskRemoveFromEventList
00000658 000000e0 T vTaskDelete
000017f0 000000e8 T vPortFree
00001978 000000ec T memcpy
00001580 000000fc T xPortStartScheduler
00001100 00000124 T xQueueGenericSend
00001248 00000134 T xQueueSemaphoreTake
00000994 00000158 T xTaskResumeAll
0000167c 00000174 T pvPortMalloc
0000080c 00000188 T xTaskIncrementTick
00000488 000001d0 T xTaskCreate
20000124 00008000 b ucHeap
وأكبر شيء على الإطلاق ucHeap بحجم 0x8000 أي 32 KB، وهي المصفوفة التي تحجز منها النواة المهام والطوابير، وحرف b الصغير يعني أنها في .bss وخاصة بالملف. وأكبر دوال النواة xTaskCreate بحجم 464 بايت وxTaskIncrementTick التي تعمل في كل نبضة بحجم 392 بايت، والتبديل نفسه في xPortPendSVHandler أصغر من أن يظهر في القائمة لأنه بضع تعليمات بلغة التجميع. وهذا هو ما يجعل FreeRTOS مناسبة لشرائح صغيرة جداً، فالنواة كلها بضعة كيلوبايتات، والذاكرة التي تحتاجها تحددها أنت في FreeRTOSConfig.h.
نفس التجربة على Zephyr
النظام الثاني Zephyr مشروع مفتوح المصدر تحت مؤسسة Linux Foundation، وفكرته مختلفة عن FreeRTOS، فهو ليس نواة تضيفها إلى مشروعك، وإنما نظام كامل: نواة ومشغلات Drivers لمئات الشرائح، ووصف للعتاد بشجرة الأجهزة Devicetree كما في Linux، وطبقة شبكة وBluetooth وتحديث عن بعد، ونظام بناء يعتمد على CMake وأداة اسمها west تدير المستودعات. والمحاكي هنا QEMU بالبورد qemu_cortex_m3، وهي محاكاة للوحة Stellaris من Texas Instruments بمعالج Cortex-M3، ويدعمها Zephyr رسمياً كما في صفحة البورد.
والطريقة الرسمية لتجهيز Zephyr تنزل كل المستودعات التي يعتمد عليها، وهي عشرات المستودعات لكل الشركات المصنعة، وأغلبها لا نحتاجه. لذلك نزلنا الإصدار v4.5.0 الصادر في 28 أكتوبر 2026، ثم طلبنا من west ثلاثة مستودعات فقط يحتاجها معالج Cortex-M3: cmsis وcmsis_6 ومكتبة C الصغيرة picolibc، واستخدمنا مترجم GCC الموجود في الـ Image بدل حزمة أدوات Zephyr SDK، بالمتغير ZEPHYR_TOOLCHAIN_VARIANT=gnuarmemb كما في توثيق Zephyr:
git clone --depth 1 --branch v4.5.0 https://github.com/zephyrproject-rtos/zephyr.git /src/zp/zephyr
cd /src/zp && west init -l zephyr
west update --narrow --fetch-opt=--depth=1 cmsis cmsis_6 picolibc
export ZEPHYR_TOOLCHAIN_VARIANT=gnuarmemb GNUARMEMB_TOOLCHAIN_PATH=/usr
west build -p always -b qemu_cortex_m3 -d /tmp/hello zephyr/samples/hello_world
وبهذا نزل Zephyr نفسه 706 MB والمستودعات الثلاثة 73 MB، بدل عدة جيجابايت للتنزيل الكامل. ونبدأ بمثالين يأتيان مع Zephyr:
Memory region         Used Size  Region Size  %age Used
           FLASH:       10668 B       256 KB      4.07%
             RAM:        4176 B        64 KB      6.37%
        IDT_LIST:           0 B        32 KB      0.00%
Generating files from /tmp/hello/zephyr/zephyr.elf for board: qemu_cortex_m3/ti_lm3s6965
*** Booting Zephyr OS build v4.5.0 ***
Hello World! qemu_cortex_m3/ti_lm3s6965Memory region         Used Size  Region Size  %age Used
           FLASH:       12092 B       256 KB      4.61%
             RAM:        6672 B        64 KB     10.18%
        IDT_LIST:           0 B        32 KB      0.00%
*** Booting Zephyr OS build v4.5.0 ***
thread_a: Hello World from cpu 0 on qemu_cortex_m3!
thread_b: Hello World from cpu 0 on qemu_cortex_m3!
thread_a: Hello World from cpu 0 on qemu_cortex_m3!
thread_b: Hello World from cpu 0 on qemu_cortex_m3!
thread_a: Hello World from cpu 0 on qemu_cortex_m3!
thread_b: Hello World from cpu 0 on qemu_cortex_m3!
thread_a: Hello World from cpu 0 on qemu_cortex_m3!
ولاحظ أن Zephyr يطبع بعد البناء جدولاً بالذاكرة المستخدمة، وهو نفس ما يعطيك size، فالمثال hello_world يأخذ 10668 بايت من الفلاش و4176 من الذاكرة، والمثال synchronization فيه خيطان يتبادلان إشارتين فيطبعان بالتناوب، وهذا أصغر مثال على الإشارة بين مهمتين.
ثم كتبنا نفس تجربة الانعكاس بواجهة Zephyr، بالإشارة k_sem مرة وبالقفل k_mutex مرة، ولاحظ أن الأولويات معكوسة هنا، فـ HIGH رقمها 5 وLOW رقمها 7:
/* Priority inversion on Zephyr: the same three tasks as the FreeRTOS demo.
 *   CONFIG_APP_USE_MUTEX=n : k_sem (no priority inheritance)
 *   CONFIG_APP_USE_MUTEX=y : k_mutex (priority inheritance)
 * In Zephyr a SMALLER number is a HIGHER priority: high=5, med=6, low=7.
 */
#include <zephyr/kernel.h>
#include <zephyr/sys/printk.h>
#include <zephyr/version.h>

#define MED_WORK 100

#ifdef CONFIG_APP_USE_MUTEX
K_MUTEX_DEFINE(lock);
#define LOCK()   k_mutex_lock(&lock, K_FOREVER)
#define UNLOCK() k_mutex_unlock(&lock)
#define KIND     "k_mutex"
#else
K_SEM_DEFINE(lock, 1, 1);
#define LOCK()   k_sem_take(&lock, K_FOREVER)
#define UNLOCK() k_sem_give(&lock)
#define KIND     "k_sem"
#endif

static uint32_t t0, high_asked, high_got;
static void log_event(const char *who, const char *what)
{
	printk("[%4u ms] %s prio=%d  %s\n", k_uptime_get_32() - t0, who,
	       k_thread_priority_get(k_current_get()), what);
}

/* Burn n ms of this thread's CPU time: count uptime changes only while running. */
static void burn(uint32_t n)
{
	uint32_t last = k_uptime_get_32();
	while (n) {
		uint32_t now = k_uptime_get_32();
		if (now != last) { last = now; n--; }
	}
}

static void low_fn(void *a, void *b, void *c)
{
	LOCK();
	log_event("LOW ", "took the lock (30 ms of work)");
	burn(30);
	log_event("LOW ", "releasing the lock");
	UNLOCK();
}

static void high_fn(void *a, void *b, void *c)
{
	k_msleep(5);
	high_asked = k_uptime_get_32();
	log_event("HIGH", "needs the lock (deadline: 50 ms)");
	LOCK();
	high_got = k_uptime_get_32();
	log_event("HIGH", "got the lock");
	UNLOCK();
	k_msleep(MED_WORK + 60);
	printk("RESULT lock=%s high_waited=%u ms %s\n", KIND, high_got - high_asked,
	       (high_got - high_asked) > 50 ? "DEADLINE MISSED" : "deadline met");
}

static void med_fn(void *a, void *b, void *c)
{
	k_msleep(10);
	log_event("MED ", "starts CPU work, never touches the lock");
	burn(MED_WORK);
	log_event("MED ", "done");
}

K_THREAD_STACK_DEFINE(low_stack, 1024);
K_THREAD_STACK_DEFINE(med_stack, 1024);
K_THREAD_STACK_DEFINE(high_stack, 1024);
static struct k_thread low_t, med_t, high_t;

int main(void)
{
	printk("Zephyr %s on %s, lock=%s\n", KERNEL_VERSION_STRING, CONFIG_BOARD, KIND);
	t0 = k_uptime_get_32();
	k_thread_create(&low_t, low_stack, K_THREAD_STACK_SIZEOF(low_stack), low_fn, NULL, NULL, NULL, 7, 0, K_NO_WAIT);
	k_thread_create(&med_t, med_stack, K_THREAD_STACK_SIZEOF(med_stack), med_fn, NULL, NULL, NULL, 6, 0, K_NO_WAIT);
	k_thread_create(&high_t, high_stack, K_THREAD_STACK_SIZEOF(high_stack), high_fn, NULL, NULL, NULL, 5, 0, K_NO_WAIT);
	return 0;
}
مشكلة حقيقية في البناء: KERNEL_VERSION_STRING
وأول بناء لهذا البرنامج فشل بهذا الخطأ:
FAILED: CMakeFiles/app.dir/src/main.c.obj
/work/zephyr-inversion/src/main.c:78:46: error: 'KERNEL_VERSION_STRING' undeclared (first use in this function)
والسبب أننا افترضنا أن zephyr/kernel.h يأتي بكل شيء، كما يفعل FreeRTOS.h الذي جاء بالثابت tskKERNEL_VERSION_NUMBER، ولكن Zephyr يفصل الثوابت التي يولدها نظام البناء في ملفات خاصة، وثابت الإصدار في zephyr/version.h الذي يولده CMake من الملف VERSION. والحل سطر #include <zephyr/version.h>، وتجده في البرنامج أعلاه. والدرس العام أن Zephyr يولد جزءاً كبيراً من ترويساته أثناء البناء من Kconfig وشجرة الأجهزة، فإذا لم تجد ثابتاً تعرف أنه موجود فابحث عنه في مجلد البناء build/zephyr/include/generated قبل أن تبحث في الكود المصدري.
النتيجة على Zephyr
والمخرج مع الإشارة k_sem:
Memory region         Used Size  Region Size  %age Used
           FLASH:         12 KB       256 KB      4.69%
             RAM:        7656 B        64 KB     11.68%
        IDT_LIST:           0 B        32 KB      0.00%
*** Booting Zephyr OS build v4.5.0 ***
Zephyr 4.5.0 on qemu_cortex_m3, lock=k_sem
[   0 ms] LOW  prio=7  took the lock (30 ms of work)
[   6 ms] HIGH prio=5  needs the lock (deadline: 50 ms)
[  11 ms] MED  prio=6  starts CPU work, never touches the lock
[ 111 ms] MED  prio=6  done
[ 129 ms] LOW  prio=7  releasing the lock
[ 129 ms] HIGH prio=5  got the lock
RESULT lock=k_sem high_waited=123 ms DEADLINE MISSED
ومع القفل k_mutex:
Memory region         Used Size  Region Size  %age Used
           FLASH:       13052 B       256 KB      4.98%
             RAM:        7664 B        64 KB     11.69%
        IDT_LIST:           0 B        32 KB      0.00%
*** Booting Zephyr OS build v4.5.0 ***
Zephyr 4.5.0 on qemu_cortex_m3, lock=k_mutex
[   0 ms] LOW  prio=7  took the lock (30 ms of work)
[   6 ms] HIGH prio=5  needs the lock (deadline: 50 ms)
[  30 ms] LOW  prio=5  releasing the lock
[  30 ms] HIGH prio=5  got the lock
[  30 ms] MED  prio=6  starts CPU work, never touches the lock
[ 130 ms] MED  prio=6  done
RESULT lock=k_mutex high_waited=24 ms deadline met
وهي نفس القصة بنفس الأرقام تقريباً: 123 ms مع الإشارة و24 ms مع القفل، وفي سطر LOW prio=5 releasing the lock ترى الوراثة، فـ LOW رقمها الأصلي 7 وارتفعت إلى 5 أي أولوية HIGH. والفرق الصغير في التوقيت له سبب يستحق أن تعرفه: HIGH طلبت القفل عند 6 ms وليس 5، وMED بدأت عند 11 وليس 10، والسبب أن k_msleep(5) في Zephyr تعد بانتظار 5 ms على الأقل، فإذا جاء الطلب في منتصف نبضة فإن النواة تكمل تلك النبضة ثم تعد خمساً بعدها، وهذا مذكور في توثيق الخيوط. وFreeRTOS تعد النبضات بطريقة مختلفة قليلاً، وكلا السلوكين صحيح، ولكن إذا نقلت كوداً بين النظامين يحسب توقيتات دقيقة فلا تفترض أن نفس الرقم يعطي نفس الانتظار. وفي آخر المخرج إعدادات النواة التي يقوم عليها السلوك، ومنها CONFIG_PRIORITY_CEILING=-128، وهو حد تفرضه Zephyr على الأولوية التي يمكن أن ترتفع إليها مهمة بالوراثة، وقيمته الافتراضية لا تقيد شيئاً في مثالنا.
FreeRTOS أم Zephyr؟ كيف تختار؟
بعد أن رأيت الاثنين يعملان على نفس المعالج ويحلان نفس المشكلة بنفس الطريقة، الاختيار بينهما ليس في النواة غالباً، وإنما في كل ما حولها:
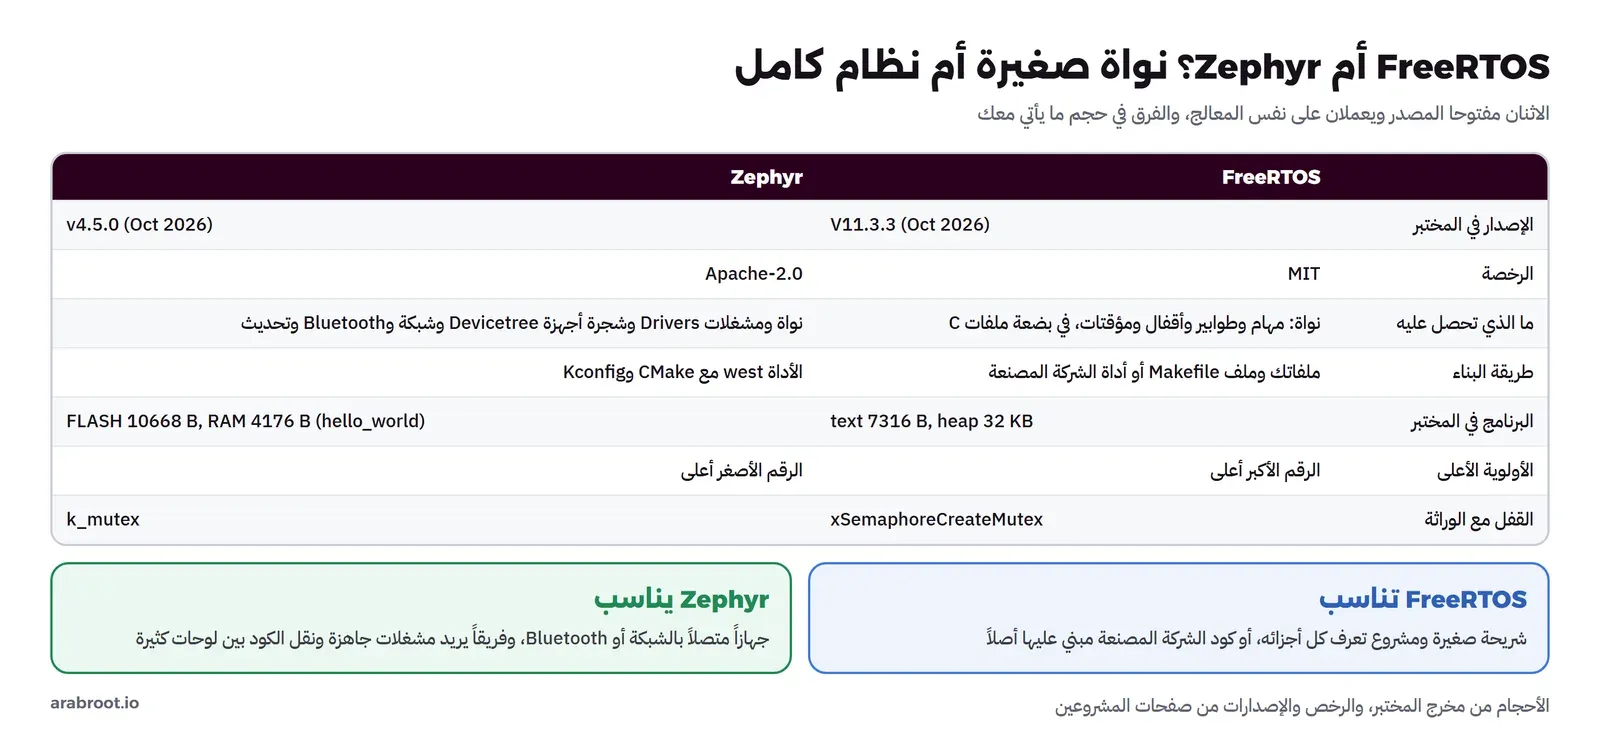
- FreeRTOS نواة صغيرة برخصة MIT، تديرها Amazon منذ 2017، وتأتي مع أدوات أغلب الشركات المصنعة للشرائح، فمولد الكود من ST مثلاً يضيفها لك بضغطة. ونقاط القوة: الحجم الصغير، والبساطة، وأنك تعرف كل ملف في مشروعك. ونقاط الضعف: أن المشغلات والشبكة والتحديث مسؤوليتك أو مسؤولية مكتبات الشركة المصنعة، وكل شركة بطريقتها.
- Zephyr نظام كامل برخصة Apache-2.0، تشارك فيه شركات كثيرة من صناع الشرائح. ونقاط القوة: مشغلات موحدة لمئات الشرائح، وطبقة شبكة وBluetooth جاهزة، وأن نفس الكود يعمل على لوحات من شركات مختلفة بتغيير اسم البورد. ونقاط الضعف: منحنى تعلم أطول، فعليك أن تفهم west وKconfig وشجرة الأجهزة، وحجم أكبر قليلاً، ونظام بناء يولد الكثير خلف ظهرك كما رأيت في مشكلة
KERNEL_VERSION_STRING.
والقاعدة العملية: إذا كان جهازك شريحة صغيرة بعمل محدد ولا يحتاج شبكة، أو كان كود الشركة المصنعة الذي ستعتمد عليه مبنياً على FreeRTOS، فابدأ بها. وإذا كان جهازك متصلاً بالشبكة أو Bluetooth، أو تتوقع أن تغير الشريحة أكثر من مرة في عمر المنتج، أو تريد طبقة تحديث وأمان جاهزة، فـ Zephyr تستحق وقت التعلم. وفي مسجل الحرارة الذي فيه Bluetooth وتحديث عن بعد، كان الفريق سيميل إلى Zephyr، ولكن هذا قرار يتخذ مع معرفة الشريحة وكودها المتوفر.
كيف تعمل الفرق الحقيقية مع RTOS؟
- جدول المهام مكتوب: لكل مهمة اسمها وأولويتها ودورتها وموعدها وحجم مكدسها والأقفال التي تستخدمها، في ملف واحد يراجع مع كل تغيير، لأن مهمة جديدة بأولوية خاطئة قد تغير توقيت كل المهام الأخرى.
- دوال المقاطعة قصيرة: تقرأ البيانات وتعطي إشارة أو ترسل إلى طابور بدوال
FromISRمثلxQueueSendFromISR، والعمل الحقيقي في مهمة، ولا تستدعى أي دالة قد تنتظر من داخل مقاطعة. - قياس المكدس:
uxTaskGetStackHighWaterMarkفي نسخة الاختبار، وفحص الامتلاء مفعل دائماً أثناء التطوير، وهامش واضح لكل مهمة. - أدوات التتبع Tracing: كما أنقذت أداة التسجيل فريق Pathfinder، تستخدم الفرق أدوات تسجل كل تبديل وكل أخذ وتحرير لقفل مع الوقت، وتعرضها كخط زمني مثل الذي رسمناه، وFreeRTOS فيها ماكرو للتتبع في كل حدث داخل النواة لهذا الغرض، وZephyr فيه نظام تتبع مدمج.
- Mutex لكل مورد مشترك، وإشارة فقط للإشارة بين طرفين، وأقسام محمية قصيرة، وترتيب ثابت لأخذ الأقفال إذا احتاجت مهمة أكثر من قفل، لكي لا يحدث جمود.
- اختبارات توقيت في المحاكي: نفس ما فعلناه بـ
-icount، اختبار في CI يشغل السيناريو ويفشل إذا تجاوز انتظار المهمة العالية حداً معيناً، فيكتشف الفريق الانعكاس قبل أن يكتشفه العميل.
أخطاء شائعة Common Mistakes
- استخدام Binary Semaphore لحماية مورد مشترك، فيحدث انعكاس الأولوية بلا حدود كما رأينا: 125 ms ثم 325 ms.
- عمل بطيء داخل قسم محمي بقفل، مثل الكتابة في الفلاش أو الطباعة، فيطول انتظار كل من يحتاج القفل حتى مع الوراثة.
- إعطاء كل المهام نفس الأولوية لتجنب القرار، أو نسيان أن الرقم الأكبر أعلى في FreeRTOS والأصغر أعلى في Zephyr.
- حلقة انتظار فارغة داخل مهمة بدل
vTaskDelayأو الانتظار على طابور، فتأخذ المعالج من كل المهام الأقل منها إلى الأبد. - استدعاء دالة قد تنتظر من داخل مقاطعة، أو استخدام الدوال العادية بدل نسخ
FromISR. - مقاطعة تستدعي النواة بأولوية أعلى من
configMAX_SYSCALL_INTERRUPT_PRIORITY، فتقطع النواة في منتصف تعديل قوائمها، وتظهر أعطال عشوائية بعد ساعات. - مكدس صغير لمهمة تستدعي
printfأو تحجز مصفوفة كبيرة محلية، وفحص الامتلاء غير مفعل. - الظن أن الطابور الأطول يحل مستهلكاً بطيئاً، وهو يؤخر الضياع فقط ويزيد عمر البيانات كما رأينا من 4 إلى 125 ms.
- نسيان أن
xSemaphoreCreateBinaryتبدأ فارغة، فتنتظر المهمة الأولى للأبد. vTaskDelayفي مهمة دورية بدلvTaskDelayUntil، فيتراكم زمن العمل على الدورة ويتأخر كل موعد عن الذي قبله.
قائمة تحقق Checklist قبل اعتماد نظام فوري
- هل يحتاج الجهاز نظاماً فورياً فعلاً؟ أكثر من عمل له موعد، أو أعمال طويلة، أو مكتبات تحتاجه.
- جدول مكتوب للمهام: الأولوية والدورة والموعد والمكدس والأقفال لكل مهمة.
- الأولويات مبنية على الدورة وخطورة التأخر، والمقاطعات التي تستدعي النواة في المدى المسموح.
- Mutex لكل مورد مشترك، وأقسام محمية قصيرة، وترتيب ثابت للأقفال المتعددة.
- لكل طابور قرار مكتوب عند الامتلاء: انتظار أم ضياع، وعداد للضائع يظهر في السجلات.
configASSERTوفحص امتلاء المكدس مفعلان في التطوير، وقياسHighWaterMarkلكل مهمة.- اختبار توقيت في المحاكي بوقت حتمي مثل
-icount، يفشل عند تجاوز المواعيد. - أداة تتبع جاهزة في البرنامج قبل أن تحتاجها، لا بعد أن يقع العطل.
تدريب عملي Practice
- غير أولوية MED في برنامج FreeRTOS إلى 3 أي مساوية لـ HIGH، مع الإشارة الثنائية، وتوقع النتيجة قبل التشغيل، ثم فسر ما تراه مع تقسيم الوقت.
- عدل
queue_demo.cبحيث يجمع السجل أربع قراءات ويكتبها في كتابة واحدة مدتها 15 ms، وقسdroppedوage. - أضف إلى برنامج Zephyr مهمة رابعة بأولوية 6 تعمل 100 ms أخرى، وقس انتظار HIGH مع
k_semومعk_mutex. - استبدل القفل بمهمة واحدة تملك المخزن وتستقبل الطلبات من طابور، وتأكد أن HIGH لم تعد تنتظر أي قفل.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الحلقة الواحدة تجعل زمن الرد على أي حدث مجموع كل الأعمال الأخرى، والنظام الفوري يقسم العمل إلى مهام ويشغل الأعلى أولوية دائماً وفوراً.
- «فوري» تعني في الموعد وبزمن رد محدود في أسوأ الحالات، وليس سريعاً في المتوسط.
- لكل مهمة مكدسها وحالتها، والمنتظرة لا تأخذ شيئاً من المعالج، والتبديل على Cortex-M يتم في المقاطعة PendSV بأقل أولوية.
- الطابور يمرر البيانات بالنسخ ويوقظ المستقبل، ويمتص الدفعات، ولكن مستهلكاً أبطأ من المنتج ضيع 9 قراءات من 50 ورفع عمر البيانات إلى 125 ms.
- مع Binary Semaphore انتظرت المهمة العالية 125 ms ثم 325 ms بحسب عمل مهمة لا تلمس القفل، ومع Mutex ووراثة الأولوية انتظرت 25 ms في الحالتين، وعلى Zephyr 123 ثم 24 ms.
- Mars Pathfinder أعادت تشغيل نفسها على المريخ عام 1997 لنفس السبب، وأصلحها الفريق بتفعيل الوراثة في قفل واحد، بعد أن أعادوا المشكلة بأداة تتبع.
- FreeRTOS نواة صغيرة تضيفها لمشروعك، وZephyr نظام كامل بمشغلات وشبكة، والنواتان تحلان نفس المشكلات بنفس الأفكار.
وفي المقال القادم من مرحلة البرمجيات المدمجة Firmware بإذن الله سوف نكتب نفس البرنامج الأول بلغة Rust، ونرى أي الأخطاء التي رأيناها في C يمسكها المترجم قبل التشغيل. وإلى ذلك الحين، هذه مقالات تكمل ما بنينا عليه:
 دليلRust للأنظمة المدمجة: no_std مع HAL ثم RTICنكتب برنامج C الأول بلغة Rust بثلاث طبقات على نفس لوحة STM32 في Renode، ونقارن الحجم بايتاً ببايت، ونرى خمسة أخطاء من C يوقفها المترجم قبل أن تصل إلى الشريحة.
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلالتزامن في C: الخيوط pthreads والأقفال Locksنقيس بلغة C مئة طلب شبكة وألفي ختم SHA-256 بالتسلسل وبالخيوط وبحلقة أحداث وOpenMP، ثم نصنع سباق بيانات وجموداً حقيقيين ونكشفهما بـ ThreadSanitizer ونصلحهما.
 دليلالعمليات Processes وجدولة المعالج CPU Scheduling في Linuxنرى من داخل النواة كيف يختار المجدول من يعمل الآن، ولماذا يبطئ سكربت ليلي واجهتك البرمجية، وكيف يعيدها سطر واحد إلى سرعتها.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
 دليلTherac-25: حين أصبح خطأ برمجي خطراً على المرضىكيف تسبب سباق بين مهمتين وعداد من بايت واحد في جرعات إشعاع زائدة، وماذا تتعلم منها عن الأنظمة الحرجة وكودك اليومي.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل كل التجارب داخل Container من Docker Image fw-toolchain:1 المبنية على Debian 13، مع FreeRTOS-Kernel V11.3.3 على QEMU 10.0.13 بالبورد mps2-an385، وZephyr v4.5.0 بالبورد qemu_cortex_m3 مع arm-none-eabi-gcc 14.2.rel1، على Docker Engine 29.8.0.