


في الشركة الناشئة التي تبيع القهوة والتمور، ومكتبتنا الصغيرة بلغة C التي بنيناها في مقالات لغة C السابقة، جاء طلبان في نفس الأسبوع. الأول من فريق الشحن: كل ليلة يجب أن تسأل خدمة شركة الشحن عن حالة مئة شحنة، وكل سؤال يأخذ حوالي 50 ملي ثانية حتى يرجع الجواب، والبرنامج الحالي يسأل واحداً بعد الآخر. والثاني من فريق الحسابات: كل فاتورة تختم بسلسلة هاش لكي يكشف أي تعديل لاحق عليها، وتقرير نهاية الشهر يحسب ألفي ختم، كل ختم ألفا دورة من SHA-256، والتقرير يأخذ ثواني طويلة على سيرفر فيه ثماني أنوية لا يعمل منها إلا واحدة. والحل في الحالتين واحد في أي لغة: أن تعمل أشياء كثيرة في نفس الوقت. ولكن «في نفس الوقت» في C تعني أن تنشئ الخيوط Threads بنفسك، وأن تحمي كل متغير مشترك بنفسك، وأن تعرف أن اللغة لن تخبرك إذا نسيت.
وقد شرحنا الأفكار العامة للتزامن والخيوط والأقفال في مقالي المعالج والخيوط والتزامن والخيوط والأقفال وasync للمبرمجين، وفي هذا المقال نراها بلغة C نفسها: نفس المهمتين اللتين نقيسهما في كل لغات هذه السلسلة، مهمة تنتظر الشبكة ومهمة تستهلك المعالج، بالتسلسل ثم بالتزامن، مع الأرقام من تشغيل حقيقي، ثم سباق بيانات Data Race حقيقي وجمود Deadlock حقيقي، وكيف تكشفهما الأدوات وكيف تصلحهما.
وسوف نناقش في هذا المقال ما يلي:
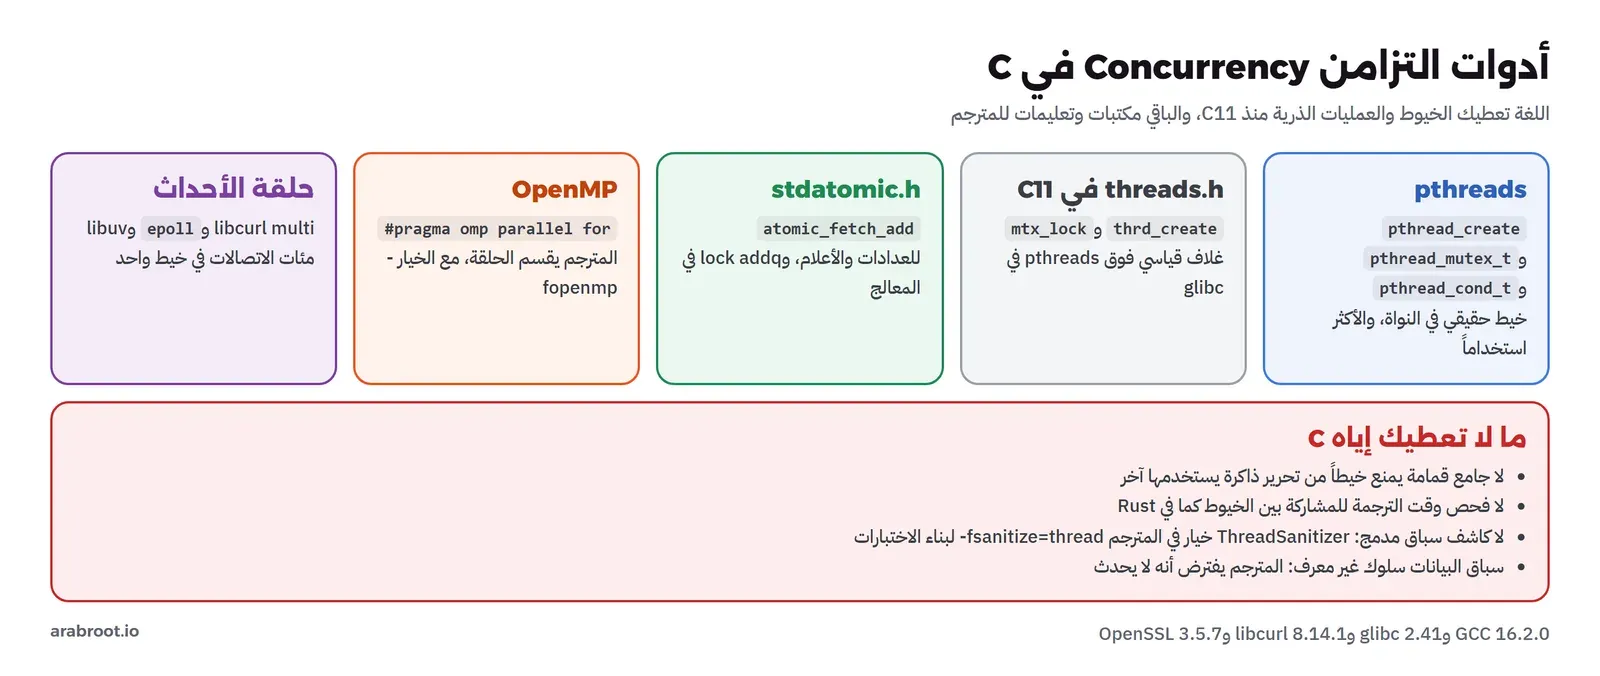
- نموذج التزامن في C: خيوط النظام عبر pthreads، والخيوط في C11، والعمليات الذرية Atomics، وOpenMP، وحلقة الأحداث Event Loop عبر المكتبات.
- المهمة المرتبطة بالشبكة I/O-bound: مئة طلب HTTP إلى نقطة نهاية بطيئة، بالتسلسل وبخيط لكل طلب وبمجمع خيوط Thread Pool وبحلقة أحداث في خيط واحد.
- المهمة المرتبطة بالمعالج CPU-bound: SHA-256 لألفي نص في ألفي دورة، بخيط واحد وبعدة خيوط وبـ OpenMP، ثم داخل Container محدود بمعالجين.
- سباق البيانات Data Race: عداد مبيعات خسر ربع العمليات، وما يراه ThreadSanitizer، والإصلاح بالقفل Mutex وبالعملية الذرية وثمن كل منهما.
- الجمود Deadlock: نقل رصيد بين فرعين توقف إلى الأبد، وكيف كشفه ThreadSanitizer، والإصلاح بترتيب الأقفال.
نموذج التزامن Concurrency Model في C: ماذا تعطيك اللغة؟
اللغة نفسها لم تعرف شيئاً عن الخيوط حتى معيار C11 عام 2011، وقبل ذلك كان كل شيء في مكتبات النظام. ولذلك ستجد في كود C الحقيقي خمس أدوات، ولكل منها مكانها:
- خيوط POSIX واختصاراً pthreads: الواجهة القياسية على Linux وmacOS وكل أنظمة Unix، وفيها
pthread_createلإنشاء خيط، وpthread_joinلانتظاره، وpthread_mutex_tللأقفال، وpthread_cond_tللانتظار على شرط. وهي الأكثر استخداماً بفارق كبير، وصفحة pthreads(7) هي نقطة البداية. وكل خيط هنا خيط حقيقي في النواة، تجدوله النواة على الأنوية كما تجدول العمليات. - الخيوط في C11 من
threads.h:thrd_createوmtx_lockوغيرها، وهي نسخة قياسية مبسطة من نفس الفكرة. وعلى Linux هي غلاف رفيع فوق pthreads في glibc، وتستخدم في الكود الذي يريد أن يبنى على Windows أيضاً، ولكن أغلب المكتبات ما زالت تستخدم pthreads مباشرة. - العمليات الذرية Atomics من
stdatomic.hفي C11: متغيرات تضمن اللغة أن الزيادة عليها أو المقارنة والتبديل عملية واحدة لا يقطعها خيط آخر، وسوف نقيس ثمنها مقابل القفل. - OpenMP: ليس مكتبة بالمعنى المعتاد، وإنما تعليمات للمترجم بالسطر
#pragma ompفوق الحلقة، فيقسم المترجم الحلقة على خيوط بنفسه. وهو منتشر جداً في الحساب العلمي، والمواصفات على موقع OpenMP. - حلقة الأحداث Event Loop: خيط واحد يراقب مئات الاتصالات بطلبات النظام
epollعلى Linux، ويعمل على الاتصال الجاهز فقط. واللغة لا تعطيك هذا، وإنما تعطيك إياه مكتبات مثل libcurl في وضع multi، أو libuv التي تقوم عليها Node.js، وهي نفس الفكرة التي شرحناها في مقال حلقة الأحداث Event Loop في JavaScript.
والشيء الذي لا تعطيك إياه C، بخلاف Go وJava وRust، أي حماية: لا يوجد جامع قمامة يمنع خيطاً من تحرير ذاكرة يستخدمها خيط آخر، ولا مترجم يرفض متغيراً مشتركاً بلا قفل كما تفعل Rust، ولا كاشف سباق مدمج يعمل بخيار واحد كما في Go. وكل ما سنراه من حماية في هذا المقال يأتي من أدوات خارج اللغة.
ما هو الخيط في Linux من الداخل؟ Threads and the Kernel
قبل القياس يفيدك أن تعرف ما الذي يحدث عندما تستدعي pthread_create. ففي Linux لا يوجد فرق كبير بين العملية والخيط داخل النواة، فكلاهما «مهمة» Task تجدولها النواة بنفس الطريقة، والفرق في ما تتشاركه. والطلب الذي ينشئ الاثنين هو clone، وعندما تستدعيه مكتبة الخيوط في glibc، واسمها NPTL كما في صفحة nptl(7)، تطلب أن تتشارك المهمة الجديدة مع الأولى الذاكرة كلها والملفات المفتوحة ومعالجات الإشارات، ولا يختلف بينهما إلا ال Stack والسجلات. ولهذا فالخيط في C خيط حقيقي بنفس ثقل أي مهمة في النواة، وليس خيطاً خفيفاً تديره بيئة تشغيل مثل Goroutines في Go أو الخيوط الافتراضية في Java، التي تشغل آلاف المهام على عدد قليل من خيوط النظام. فإذا أنشأت عشرة آلاف خيط في C، فالنواة تجدول عشرة آلاف مهمة، ولكل منها Stack محجوز في الذاكرة الافتراضية.
وقد رأينا هذا فعلاً عندما شغلنا مقياس القفل تحت الأداة strace لنعد طلبات النظام، فظهر سطران عن إنشاء الخيوط الثمانية: clone3 مرة واحدة بخطأ، ثم clone ثماني مرات بنجاح. والسبب أن glibc الحديثة تجرب الطلب الأحدث clone3 أولاً، وإعدادات الأمان الافتراضية في Docker لم تكن تسمح به في هذا الإعداد فرجعت بخطأ، فرجعت glibc إلى الطلب القديم clone دون أن يلاحظ البرنامج شيئاً. وهذه تفصيلة تريك أن بين كودك والنواة طبقة مكتبة C تتعامل مع اختلافات البيئة نيابة عنك.
تجهيز المختبر Lab: نقطة نهاية بطيئة وصورة GCC
كل التجارب تعمل في صورة المختبر slr-c-dev:1 التي بنيناها في المقال الأول على GCC 16.2، ومعها libcurl لطلبات HTTP، وOpenSSL لحساب SHA-256، وlibmicrohttpd لكتابة نقطة النهاية البطيئة نفسها. ونقطة النهاية برنامج C صغير يرد بالنص ok بعد 50 ملي ثانية، بخيط لكل اتصال لكي لا يكون هو عنق الزجاجة في القياس:
static enum MHD_Result handle(void *cls, struct MHD_Connection *c, const char *url, const char *method,
                              const char *version, const char *data, size_t *size, void **state) {
    if (*state == NULL) { *state = (void *)1; return MHD_YES; }   // first call: headers only
    usleep(50 * 1000);
    static const char body[] = "ok\n";
    struct MHD_Response *r = MHD_create_response_from_buffer_static(sizeof body - 1, body);
    enum MHD_Result ret = MHD_queue_response(c, MHD_HTTP_OK, r);
    MHD_destroy_response(r);
    return ret;
}
docker network create slr-c-net
docker run -d --name slr-c-slow --network slr-c-net -v "$PWD":/lab slr-c-dev:1 \
sh -c 'gcc -O2 /lab/slow.c -o /tmp/slow -lmicrohttpd && exec /tmp/slow 8080'
docker run --rm --network slr-c-net -v "$PWD":/lab slr-c-dev:1 sh /lab/run.shوالسطر الأول من المخرج هو nproc، أي عدد الأنوية التي يراها البرنامج، ثم زمن طلب واحد بالأداة curl:
8
one call: 0.067663 s
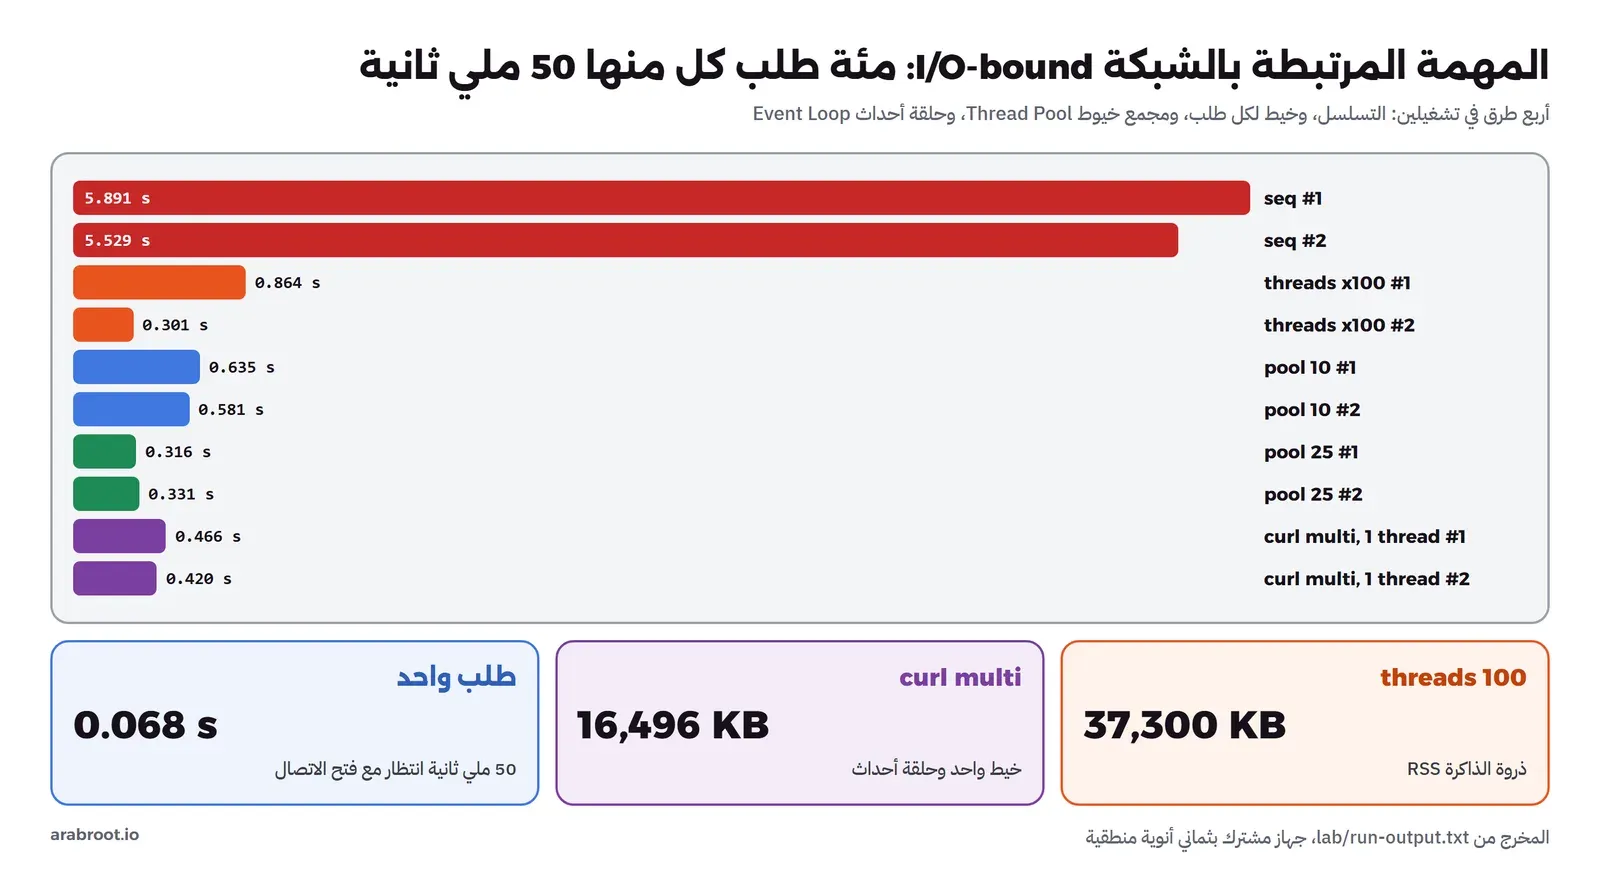
الطلب الواحد أخذ 68 ملي ثانية مع فتح الاتصال، أي 50 ملي ثانية من الانتظار المقصود و18 لفتح اتصال TCP جديد والإرسال والاستقبال عبر شبكة Docker. ويجدر الإشارة هنا إلى مشكلة يقع فيها من يكتب نقطة نهاية بطيئة بنفسه: إذا كان السيرفر يرسل الترويسات في كتابة والجسم في كتابة ثانية على اتصال مفتوح Keep-Alive، فقد تجتمع خوارزمية Nagle في TCP مع التأخير في تأكيد الاستلام Delayed ACK فيضيفان حوالي 40 ملي ثانية لكل طلب، فيصبح الطلب 90 ملي ثانية بدلاً من 50. ولكي نتأكد أن نقطة النهاية لا تعاني من ذلك نظرنا إلى زمن مئة طلب متتالية على نفس الاتصال في القسم التالي، فكان بين 5.5 و5.9 ثانية، أي 55 إلى 59 ملي ثانية للطلب، وهذا قريب من المتوقع.
المهمة المرتبطة بالشبكة I/O-bound: مئة طلب HTTP
البرنامج lab/io.c يرسل مئة طلب إلى نقطة النهاية بأربع طرق، كل طريقة دالة، ويطبع عدد الطلبات الناجحة والزمن. الطريقة الأولى بالتسلسل، بمقبض curl واحد يعيد استخدام نفس الاتصال:
static int run_seq(void) {
    CURL *h = curl_easy_init();          // one handle, reused: keeps the connection open
    int ok = 0;
    for (int i = 0; i < CALLS; i++) ok += call_once(h);
    curl_easy_cleanup(h);
    return ok;
}
والثانية خيط لكل طلب، مئة خيط تبدأ معاً، وكل خيط بمقبض خاص به، لأن توثيق libcurl عن الأمان مع الخيوط يقول إن المقبض الواحد لا يستخدم في خيطين في نفس الوقت، وإن curl_global_init تستدعى مرة واحدة قبل إنشاء أي خيط:
static void *one_call(void *arg) {
    CURL *h = curl_easy_init();          // a curl handle must not be shared between threads
    *(int *)arg = call_once(h);
    curl_easy_cleanup(h);
    return NULL;
}

static int run_threads(void) {
    pthread_t t[CALLS];
    int res[CALLS] = {0}, ok = 0;
    for (int i = 0; i < CALLS; i++) pthread_create(&t[i], NULL, one_call, &res[i]);
    for (int i = 0; i < CALLS; i++) { pthread_join(t[i], NULL); ok += res[i]; }
    return ok;
}
لاحظ كيف يرجع الخيط نتيجته: كل خيط يأخذ مؤشراً إلى خانته الخاصة في المصفوفة res، فلا يكتب خيطان في نفس المكان، ولا نحتاج قفلاً. وهذا أبسط أنواع التزامن الآمن في C: لا تشارك شيئاً. والطريقة الثالثة مجمع خيوط Thread Pool، أي عدد ثابت من الخيوط يأخذ كل منها الطلب التالي من عداد مشترك، وهنا يجب القفل لأن العداد مشترك:
static void *worker(void *arg) {
    CURL *h = curl_easy_init();
    for (;;) {
        pthread_mutex_lock(&mu);
        int i = next_call++;
        pthread_mutex_unlock(&mu);
        if (i >= CALLS) break;
        int r = call_once(h);
        pthread_mutex_lock(&mu);
        pool_ok += r;
        pthread_mutex_unlock(&mu);
    }
    curl_easy_cleanup(h);
    return NULL;
}
والرابعة لا تنشئ أي خيط: مئة مقبض في مقبض multi واحد، ودالة curl_multi_poll تنتظر حتى يصبح أي اتصال جاهزاً، ثم curl_multi_perform تتقدم في كل الاتصالات الجاهزة، وكل هذا في خيط واحد. وهذه حلقة الأحداث التي تعمل بها Node.js وnginx، تأتيك هنا من libcurl. وشغلنا الطرق الأربع مرتين، ومجمع الخيوط بعشرة خيوط وبخمسة وعشرين:
seq      : 100/100 ok in 5.891 s
threads  : 100/100 ok in 0.864 s
pool     10: 100/100 ok in 0.635 s
pool     25: 100/100 ok in 0.316 s
multi    : 100/100 ok in 0.466 s
seq      : 100/100 ok in 5.529 s
threads  : 100/100 ok in 0.301 s
pool     10: 100/100 ok in 0.581 s
pool     25: 100/100 ok in 0.331 s
multi    : 100/100 ok in 0.420 s
threads: peak RSS 37300 KB
multi:   peak RSS 16496 KB
ولنقرأ الأرقام:
- التسلسل 5.5 إلى 5.9 ثانية، وهذا هو الحساب المتوقع: مئة طلب في 55 ملي ثانية تقريباً. والبرنامج قضى أغلب هذا الوقت نائماً ينتظر الشبكة، والمعالج لا يعمل تقريباً.
- مجمع العشرة 0.58 إلى 0.64 ثانية، والحساب يقول عشر جولات في 50 ملي ثانية، أي نصف ثانية، والباقي فتح الاتصالات. ومجمع الخمسة والعشرين 0.32 إلى 0.33، أي أربع جولات مع نفس الفرق. فالمجمع يعطيك زمناً تتوقعه من حجمه، وهذه أهم مزاياه.
- خيط لكل طلب أعطى 0.86 ثانية مرة و0.30 مرة، وهو أكبر فرق بين تشغيلين في الجدول. والسبب أن مئة خيط تبدأ في نفس اللحظة، ومئة اتصال جديد يفتح في نفس اللحظة، والسيرفر ينشئ مئة خيط ليرد، فكل شيء يتزاحم على جهاز مشترك تعمل عليه برامج أخرى، والنتيجة تتأثر بما يحدث على الجهاز في تلك اللحظة.
- حلقة الأحداث 0.42 إلى 0.47 ثانية بخيط واحد، ونصف ذاكرة الخيوط: 16 MB مقابل 37 MB. وهي لم تصل إلى 50 ملي ثانية النظرية، لأن الطلبات المئة تحتاج مئة اتصال جديد، ومئة عملية بحث عن اسم السيرفر
slr-c-slowفي DNS الخاص بشبكة Docker، وكلها تمر على نفس الخيط.
والدرس العملي أن الخيوط في C ليست رخيصة ولا غالية، فالخيط في Linux يحجز افتراضياً مساحة Stack افتراضية بحجم حد ال Stack، أي 8 MB، كما في صفحة pthread_create(3)، ولكن الذاكرة الحقيقية لا تؤخذ إلا للصفحات التي يلمسها الخيط، ولذلك رأينا 37 MB لمئة خيط لا 800 MB. ولكن مع آلاف الاتصالات يصبح الخيط لكل اتصال ثقيلاً، وهنا تأتي حلقة الأحداث، وهذا بالضبط سبب تصميم nginx على حلقة أحداث وليس خيطاً لكل اتصال. أما لعشرات المهام فمجمع خيوط بحجم معروف هو الحل الأبسط والأكثر قابلية للتوقع.
انتظار العمل بدون استهلاك المعالج: متغير الشرط Condition Variable
مجمع الخيوط الذي قسناه بسيط لأن المهام كلها معروفة من البداية، فكل خيط يأخذ رقماً من العداد وينتهي عندما تنتهي الأرقام. أما في خدمة حقيقية فالمهام تصل في أي وقت، والخيوط يجب أن تنتظر حتى تصل مهمة. والحل البسيط حلقة تفحص الطابور كل لحظة، وهي تحرق المعالج بلا فائدة. والحل الصحيح متغير الشرط pthread_cond_t، كما في صفحة pthread_cond_wait: الخيط يأخذ قفل الطابور، وإذا كان فارغاً يستدعي pthread_cond_wait التي تترك القفل وتنيم الخيط في خطوة واحدة، ومن يضيف مهمة يستدعي pthread_cond_signal فتوقظ خيطاً واحداً يعود ومعه القفل. والتفصيلة التي يخطئ فيها الجميع أن الانتظار يكون داخل حلقة while وليس if، أي أن الخيط بعد أن يستيقظ يفحص الطابور من جديد، لأن المعيار يسمح بالاستيقاظ دون إشارة Spurious Wakeup، ولأن خيطاً آخر قد يكون أخذ المهمة قبله. وهذا هو التمرين الأول في آخر المقال، وهو نفس ما تفعله مكتبة libmicrohttpd داخلياً في مجمع خيوطها الذي سنستخدمه في الخدمة.
المهمة المرتبطة بالمعالج CPU-bound: ألفا ختم SHA-256
المهمة الثانية مختلفة تماماً: لا انتظار، وكل الوقت حساب. والبرنامج lab/cpu.c يحسب لكل نص من ألفي نص هاش SHA-256، ثم هاش الناتج، وهكذا ألفي دورة، أي أربعة ملايين حساب، ويقسم النصوص على عدد من الخيوط بالتساوي، كل خيط يأخذ نطاقاً متصلاً ويكتب في خاناته من مصفوفة النتائج فقط:
static void hash_one(int i) {
    char s[32];
    int n = snprintf(s, sizeof s, "order-%d", i);
    unsigned char h[SHA256_DIGEST_LENGTH];
    SHA256((const unsigned char *)s, (size_t)n, h);
    for (int r = 1; r < ROUNDS; r++) SHA256(h, sizeof h, h);
    memcpy(out[i], h, sizeof h);
}

    if (!strcmp(mode, "threads")) {
        pthread_t t[64];
        Range r[64];
        for (int k = 0; k < n; k++) {               // split the strings into n equal ranges
            r[k].from = STRINGS * k / n;
            r[k].to = STRINGS * (k + 1) / n;
            pthread_create(&t[k], NULL, work, &r[k]);
        }
        for (int k = 0; k < n; k++) pthread_join(t[k], NULL);
    } else if (!strcmp(mode, "omp")) {
#pragma omp parallel for schedule(static)
        for (int i = 0; i < STRINGS; i++) hash_one(i);
    }
ولاحظ نسخة OpenMP: سطر واحد فوق الحلقة العادية، وبنيناها بالخيار -fopenmp. وبدون هذا الخيار يتجاهل GCC السطر ويحذرك، وهذا ما ظهر فعلاً في بناء النسخة العادية من نفس الملف: warning: ignoring '#pragma omp parallel' [-Wunknown-pragmas]. ثم إن دالة SHA256 من OpenSSL آمنة للاستدعاء من عدة خيوط لأن كل استدعاء يعمل على بياناته فقط، كما في توثيق OpenSSL عن الخيوط. وشغلنا كل وضع مرتين:
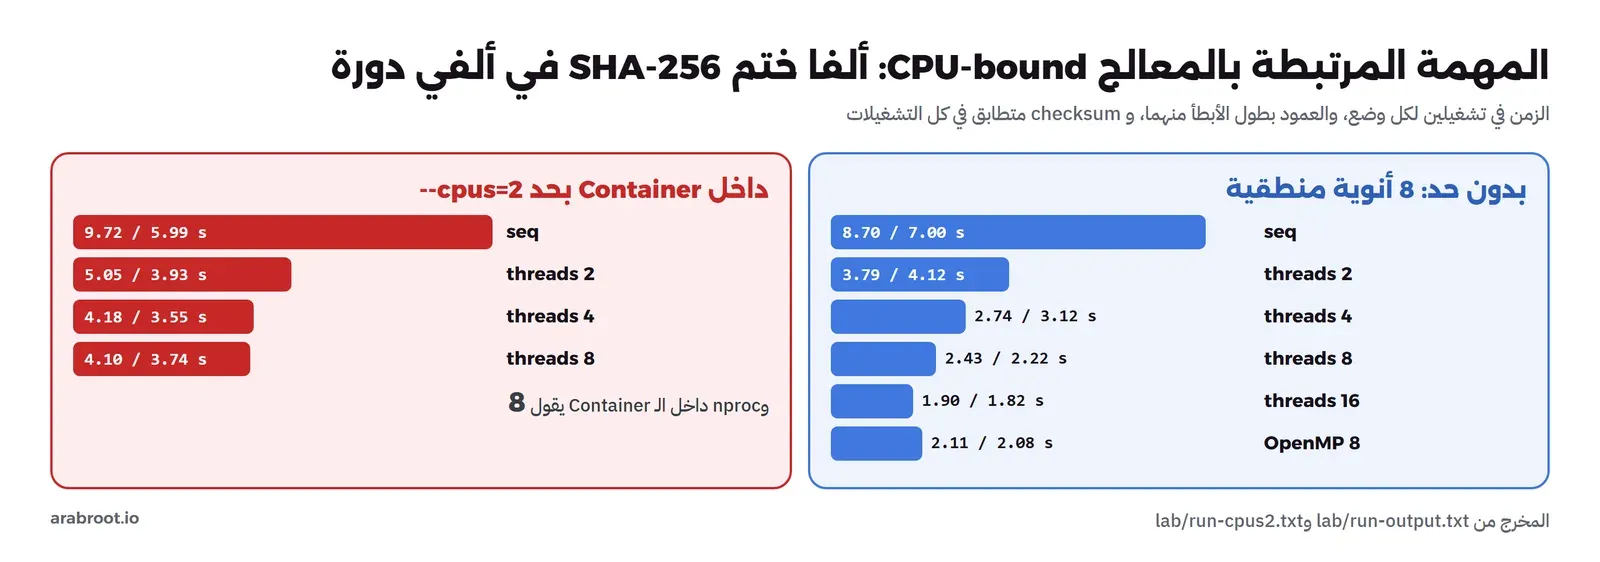
seq      1: 8.695 s, checksum 119355024
threads  2: 3.788 s, checksum 119355024
threads  4: 2.738 s, checksum 119355024
threads  8: 2.431 s, checksum 119355024
threads 16: 1.897 s, checksum 119355024
omp      8: 2.108 s, checksum 119355024
seq      1: 7.002 s, checksum 119355024
threads  2: 4.125 s, checksum 119355024
threads  4: 3.115 s, checksum 119355024
threads  8: 2.218 s, checksum 119355024
threads 16: 1.821 s, checksum 119355024
omp      8: 2.076 s, checksum 119355024
في المخرج أعلاه لاحظ التالي:
- الرقم
checksumمتطابق في كل التشغيلات، أي أن تقسيم العمل على الخيوط لم يغير النتيجة، وهذا أول ما تتحقق منه. - بالتسلسل 7 إلى 8.7 ثانية، وبخيطين حوالي 4 ثوان، أي ضعف السرعة تقريباً كما نتوقع. ثم يقل المكسب: أربعة خيوط حوالي 3 ثوان، وثمانية حوالي 2.3، أي ثلاثة إلى أربعة أضعاف التسلسل على جهاز فيه ثماني أنوية منطقية.
- والسبب الأول أن الأنوية المنطقية الثماني ليست ثماني أنوية حقيقية، فالمعالجات الحديثة تشغل خيطين على كل نواة حقيقية Hyper-Threading، ويتشاركان نفس وحدات الحساب، فالمكسب من الخيط الثاني على نفس النواة أقل بكثير من نواة جديدة. والسبب الثاني أن الجهاز مشترك، وكانت تعمل عليه تجارب أخرى في نفس الوقت، فلم تكن الأنوية الثماني لنا وحدنا.
- والنتيجة الغريبة أن ستة عشر خيطاً كانت أسرع من ثمانية في التشغيلين، على ثماني أنوية فقط. وهذا لا يعني أن الخيوط الزائدة تسرع الحساب، وإنما أن النواة توزع وقت المعالج على الخيوط القابلة للتشغيل، وعندما يتنافس برنامجنا مع برامج أخرى على الجهاز فإن عدداً أكبر من الخيوط يأخذ حصة أكبر من المعالج. وعلى جهاز هادئ لن ترى هذا المكسب، فلا تبن قراراً على هذا الرقم.
- OpenMP بثمانية خيوط حوالي 2.1 ثانية، أي مثل الخيوط اليدوية، بسطر واحد بدلاً من عشرين.
ماذا يحدث إذا حددت الـ Container بمعالجين؟ nproc لا يرى الحد
السيرفرات الحقيقية تعمل في Containers بحدود، والخدمة في مقال الخدمة من هذه المرحلة سوف نقيسها بحد معالجين. فشغلنا نفس البرنامج بالخيار --cpus=2:
8
seq      1: 9.725 s, checksum 119355024
threads  2: 5.050 s, checksum 119355024
threads  4: 4.178 s, checksum 119355024
threads  8: 4.098 s, checksum 119355024
seq      1: 5.986 s, checksum 119355024
threads  2: 3.927 s, checksum 119355024
threads  4: 3.549 s, checksum 119355024
threads  8: 3.742 s, checksum 119355024
والسطر الأول هو المفاجأة المهمة: nproc ما زال يقول 8 داخل Container محدود بمعالجين. والسبب أن --cpus لا يخفي أي نواة، وإنما يعطي البرنامج حصة من وقت المعالج في كل فترة، بآلية في جدولة النواة اسمها CFS Bandwidth Control الموثقة في توثيق نواة Linux، أي ما يعادل نواتين من الوقت موزعة على أي من الأنوية الثماني. فالبرنامج الذي يقرأ عدد الأنوية بالدالة sysconf(_SC_NPROCESSORS_ONLN) أو بالأمر nproc لكي يقرر عدد الخيوط سوف ينشئ ثمانية خيوط لحصة نواتين. والأرقام تبين ما يحدث بعد ذلك: من خيطين إلى أربعة إلى ثمانية لم يتحسن الزمن تقريباً، وفي التشغيل الثاني صارت الثمانية أبطأ قليلاً من الأربعة، لأن الخيوط الزائدة تتنافس على نفس الحصة. والحل أن تجعل عدد الخيوط إعداداً تقرؤه الخدمة من متغير بيئة، كما سنفعل بالمتغير THREADS في خدمة الطلبات، وأن تضبطه على حد الـ Container وليس على عدد الأنوية الذي يراه البرنامج.
سباق البيانات Data Race: عداد خسر ربع المبيعات
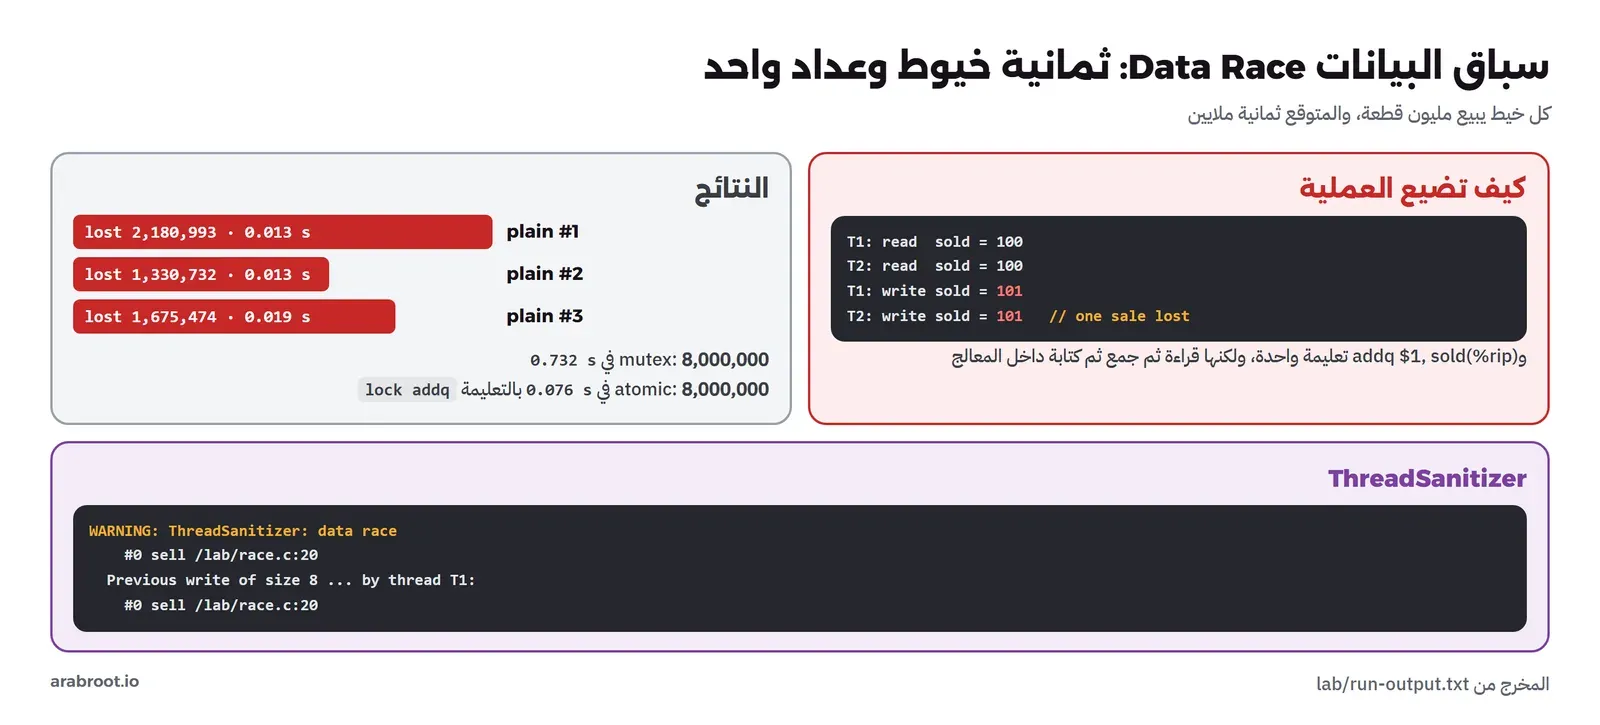
الآن الخطأ الذي يجعل التزامن في C صعباً. نقطة البيع تعد القطع المبيعة في عداد عام، وثمانية خيوط تبيع كل منها مليون قطعة. والبرنامج lab/race.c يزيد العداد بثلاث طرق: بلا حماية، وبقفل، وبعملية ذرية:
static long sold;                       // shared, unprotected
static atomic_long sold_atomic;
static pthread_mutex_t mu = PTHREAD_MUTEX_INITIALIZER;

static void *sell(void *arg) {
    for (int i = 0; i < PER_THREAD; i++) {
        if (mode[0] == 'p') {
            sold++;                     // load, add, store: three steps another thread can interleave
        } else if (mode[0] == 'm') {
            pthread_mutex_lock(&mu);
            sold++;
            pthread_mutex_unlock(&mu);
        } else {
            atomic_fetch_add_explicit(&sold_atomic, 1, memory_order_relaxed);
        }
    }
    return NULL;
}
plain sold 5819007 of 8000000 (lost 2180993) in 0.013 s
plain sold 6669268 of 8000000 (lost 1330732) in 0.013 s
plain sold 6324526 of 8000000 (lost 1675474) in 0.019 s
mutex sold 8000000 of 8000000 (lost 0) in 0.732 s
atomic sold 8000000 of 8000000 (lost 0) in 0.076 sفي ثلاثة تشغيلات بلا حماية ضاع بين 1.3 و2.2 مليون عملية بيع من ثمانية ملايين، والرقم مختلف في كل مرة، ولم يظهر أي خطأ. والسبب أن sold++ تبدو عملية واحدة، ولكنها ثلاث خطوات: اقرأ القيمة من الذاكرة، أضف واحداً، اكتبها. فإذا قرأ خيطان القيمة 100 في نفس الوقت، كتب كل منهما 101، وضاعت عملية. ولكي نرى ما فعله المترجم فعلاً نظرنا إلى لغة التجميع للبناء المحسن:
	lock addq	$1, sold_atomic(%rip)
--
	addq	$1, sold(%rip)
	subl	$1, %ebx
	jne	.L5
نسخة العداد العادي صارت تعليمة واحدة addq $1, sold(%rip)، ومع ذلك ضاعت العمليات. وهذا يكسر افتراضاً شائعاً بأن «التعليمة الواحدة آمنة»: فالمعالج ينفذ هذه التعليمة داخلياً قراءة ثم جمعاً ثم كتابة، ونواة أخرى تستطيع أن تقرأ نفس الخانة بين القراءة والكتابة. أما النسخة الذرية فنفس التعليمة مع البادئة lock، التي تجعل النواة تحجز خط الذاكرة طوال العملية فلا يلمسه أحد. والأدهى من ذلك أن سباق البيانات في C سلوك غير معرف، كما شرحنا في مقال الأنواع والذاكرة، فالمترجم يحق له أن يفترض أن لا خيط آخر يكتب في sold، فيحتفظ بها في سجل طوال الحلقة ويكتبها مرة واحدة في النهاية، وعندها تضيع ملايين العمليات لا آلافاً.
كيف تكشف السباق؟ ThreadSanitizer
السباق لا يظهر في الاختبار عادة، لأنه يحتاج توقيتاً معيناً، وفي برنامج حقيقي قد يضيع بيع واحد من مليون فلا يلاحظه أحد حتى الجرد. والأداة التي تكشفه هي ThreadSanitizer، وهي خيار في المترجم -fsanitize=thread يسجل كل قراءة وكتابة وكل قفل، ويبحث عن وصولين لنفس الذاكرة من خيطين دون ترتيب بينهما، كما في توثيق ThreadSanitizer:
WARNING: ThreadSanitizer: data race (pid=1228)
    #0 sell /lab/race.c:20 (race-tsan+0x401244)
  Previous write of size 8 at 0x0000004040a0 by thread T1:
    #0 sell /lab/race.c:20 (race-tsan+0x401259)
    #0 pthread_create <null> (libtsan.so.2+0x58c86)
SUMMARY: ThreadSanitizer: data race /lab/race.c:20 in sell
والتقرير يقول: كتابة بحجم 8 بايت في السطر 20 من خيط، وكتابة سابقة في نفس العنوان ونفس السطر من الخيط T1، ولا قفل بينهما، ثم يذكر أين أنشئ كل خيط. والسطر 20 هو sold++ بالضبط. والأداة تجد السباق حتى لو لم تضع أي عملية في هذا التشغيل بالذات، لأنها لا تبحث عن نتيجة خاطئة، وإنما عن غياب الترتيب. وثمنها أنها تبطئ البرنامج وتضاعف ذاكرته عدة مرات، ولا تعمل مع AddressSanitizer في نفس البناء، فتبني لها نسخة اختبار خاصة.
القفل Mutex أم العملية الذرية Atomic؟ ثمن كل منهما
الإصلاحان أعطيا ثمانية ملايين بالضبط، ولكن بثمن مختلف جداً: القفل 0.732 ثانية، والعملية الذرية 0.076 ثانية، والنسخة الخاطئة 0.013 ثانية. فالقفل هنا أبطأ من الخطأ ستين مرة تقريباً، والسبب أن كل زيادة تحتاج أن تأخذ القفل وتتركه، وثمانية خيوط تتصارع عليه ملايين المرات، فيقضي أغلبها الوقت في الانتظار، ومع التنافس تنام الخيوط وتوقظها النواة. والعملية الذرية أرخص بعشر مرات لأنها تعليمة واحدة، ولكنها ليست مجانية، فهي أبطأ من الخطأ ست مرات لأن خط الذاكرة الذي فيه العداد يتنقل بين الأنوية في كل عملية.
فمتى تختار كل واحد؟ العملية الذرية لمتغير واحد وعملية بسيطة: عداد، علامة توقف، رقم تسلسلي. والقفل لكل ما هو أكثر من ذلك: تعديل متغيرين معاً، مثل الرصيد والسجل، أو بنية بيانات مثل قائمة أو جدول هاش. وكثيرون يحاولون بناء بنى معقدة بالعمليات الذرية وحدها لتجنب ثمن القفل، وهذا مجال صعب جداً تقع فيه أخطاء لا يكشفها حتى ThreadSanitizer أحياناً. والحل الأفضل من الاثنين في هذا المثال بالذات هو ألا تشارك: كل خيط يعد في متغير محلي، ثم يجمع المجموع مرة واحدة في النهاية، كما فعلنا مع خانات res في مهمة الشبكة.
لماذا كان القفل بطيئاً؟ داخل القفل futex
القفل في glibc ليس طلباً إلى النواة في كل مرة، ولو كان كذلك لكان أبطأ بكثير. فهو مبني على آلية اسمها futex، كما في صفحة futex(7): القفل عدد صحيح في ذاكرة البرنامج، وأخذه عندما يكون حراً عملية ذرية واحدة في فضاء المستخدم دون أي طلب نظام. ولا تتدخل النواة إلا عندما يكون القفل مأخوذاً، فيطلب الخيط من النواة أن تنيمه حتى يتحرر، ويطلب من يفك القفل أن توقظ من ينتظره. ولكي نرى هذا بالأرقام شغلنا نسخة القفل ونسخة العملية الذرية تحت strace -f -c، الذي يعد طلبات النظام لكل الخيوط، وهنا يحتاج الـ Container الخيار --cap-add SYS_PTRACE:
--- mutex
mutex  sold 8000000 of 8000000 (lost 0) in 0.986 s
 99.92    2.678050         646      4142      1502 futex
  0.08    0.002064         258         8           clone
  0.00    0.000034          34         1         1 clone3
--- atomic
atomic sold 8000000 of 8000000 (lost 0) in 0.130 s
100.00    0.110922       55461         2           futex
  0.00    0.000000           0         8           clone
ثمانية ملايين عملية أخذ وترك للقفل، ولكن 4142 طلب futex فقط، أي أن أكثر من 99.9% من العمليات تمت في فضاء المستخدم دون أن تعرف النواة بها. ولكن هذه الطلبات القليلة هي التي أخذت الوقت: 2.68 ثانية من وقت الخيوط مجتمعة في النوم والإيقاظ، وطلب واحد من كل ثلاثة رجع بخطأ، وهو في الغالب الحالة التي تحرر فيها القفل قبل أن تنيم النواة الخيط فيرجع ليحاول من جديد. أما نسخة العملية الذرية فطلبا futex فقط، وهما من pthread_join في النهاية. ولاحظ أن الزمنين هنا 0.99 و0.13 ثانية، أعلى من التشغيل بدون strace، لأن الأداة نفسها تبطئ البرنامج. فالخلاصة أن القفل رخيص عندما لا يتنافس عليه أحد، وغال عندما تتصارع عليه الخيوط، ولذلك فالسؤال المهم في تصميم كود الخيوط ليس «هل أستخدم قفلاً؟» وإنما «كم خيطاً سيطلب هذا القفل في نفس اللحظة؟».
نموذج الذاكرة Memory Model: ماذا تعني memory_order_relaxed؟
في نسخة العملية الذرية كتبنا memory_order_relaxed، وهذا يستحق شرحاً لأنه أصعب جزء في C11. فالمعالج والمترجم كلاهما يعيدان ترتيب العمليات على الذاكرة لكي يكون البرنامج أسرع، طالما أن الخيط الواحد لا يلاحظ الفرق. ولكن خيطاً آخر قد يلاحظ: إذا كتب خيط البيانات ثم رفع علامة «جاهز»، فقد يرى خيط آخر العلامة مرفوعة قبل أن يرى البيانات. والترتيب Memory Order الذي تمرره للعملية الذرية يقول للمترجم ما الذي يجب أن يبقى مرتباً حولها. والخيار relaxed يقول: أريد فقط أن تكون هذه العملية نفسها ذرية، ولا يهمني ترتيب أي شيء آخر حولها، وهذا يكفي لعداد لا يقرؤه أحد إلا بعد pthread_join. أما العلامة التي تحرس بيانات فتحتاج أن يكتبها الأول بـ memory_order_release ويقرأها الثاني بـ memory_order_acquire، فيضمن ذلك أن كل ما كتبه الأول قبل العلامة يراه الثاني بعدها. وإذا لم تكتب أي ترتيب، فالافتراضي هو الأقوى memory_order_seq_cst، وهو الأبطأ قليلاً والأسهل فهماً، والنصيحة لمن يبدأ أن يستخدمه ولا ينزل إلى الأضعف إلا بقياس وسبب.
ومن هنا أيضاً أشهر خطأ في كود C القديم: الكلمة volatile. فكثيرون يظنون أنها تجعل المتغير آمناً بين الخيوط، وهي لا تفعل ذلك، وإنما تمنع المترجم من حذف القراءة والكتابة أو جمعها، وقد صممت للسجلات المرتبطة بأجهزة، ولا تجعل x++ ذرية ولا تضمن أي ترتيب بين الأنوية. وقد جربنا ذلك فعلاً، فغيرنا العداد في race.c إلى static volatile long sold; وشغلنا النسخة بلا حماية ثلاث مرات:
plain  sold 5083519 of 8000000 (lost 2916481) in 0.015 s
plain  sold 3468021 of 8000000 (lost 4531979) in 0.008 s
plain  sold 5717236 of 8000000 (lost 2282764) in 0.011 s
ضاع بين 2.3 و4.5 مليون عملية. ونظرنا إلى لغة التجميع فوجدنا نفس التعليمة addq $1, sold(%rip) بلا البادئة lock، أي أن volatile لم تغير شيئاً في الكود الناتج هنا، والفرق في عدد العمليات الضائعة بين هذه التشغيلات والتشغيلات السابقة هو تذبذب التوقيت على جهاز مشترك فقط. فالمشكلة في تداخل القراءة والكتابة بين الأنوية، وvolatile لا تقترب منها.
الجمود Deadlock: نقل رصيد بين فرعين توقف إلى الأبد
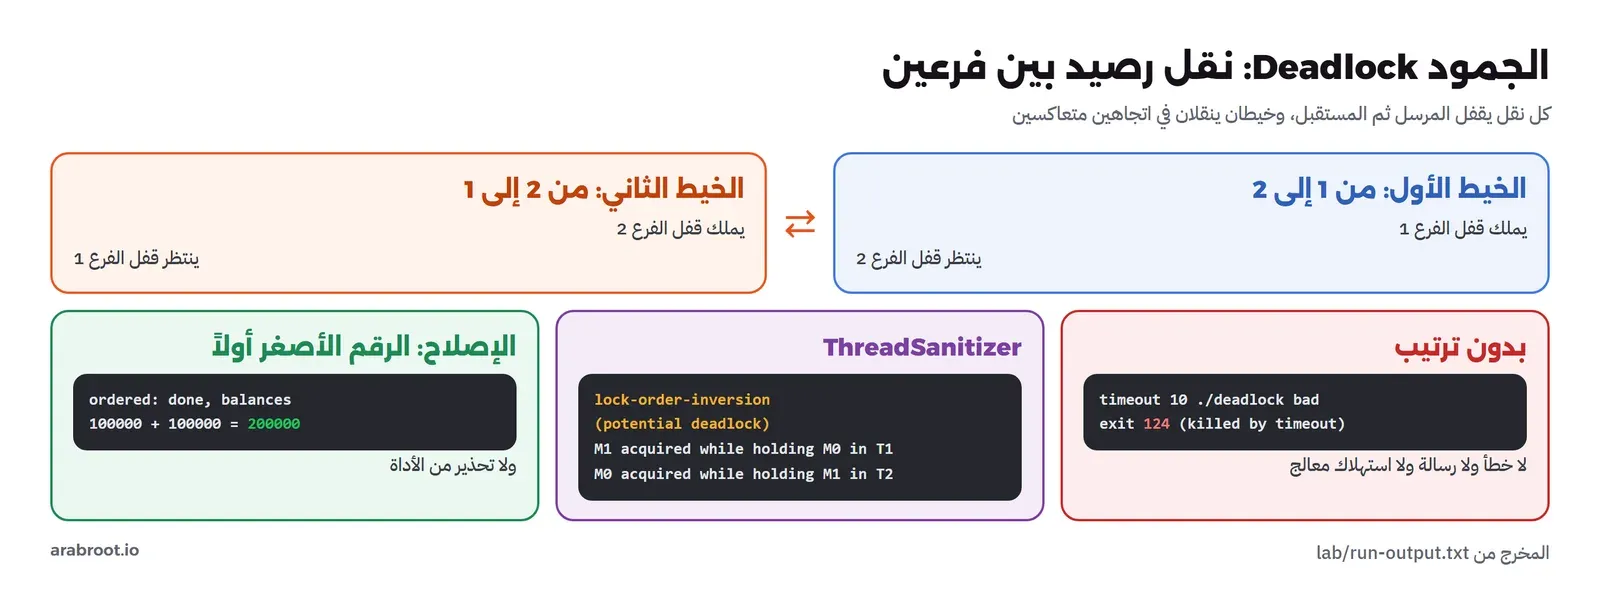
المتجر له فرعان، ولكل فرع رصيد وقفل، ونقل مبلغ من فرع إلى آخر يقفل الفرعين لكي لا يرى أحد حالة نصف منقولة. والبرنامج lab/deadlock.c يشغل خيطين، الأول ينقل من الفرع 1 إلى الفرع 2 عشرة آلاف مرة، والثاني ينقل في الاتجاه المعاكس، وكل نقل يقفل «المرسل» أولاً ثم «المستقبل»:
static void transfer(Account *from, Account *to, long amount) {
    Account *first = from, *second = to;
    if (ordered && to->id < from->id) { first = to; second = from; }   // always lock the lower id first
    pthread_mutex_lock(&first->mu);
    usleep(10);                          // widen the window so the problem shows quickly
    pthread_mutex_lock(&second->mu);
    from->balance -= amount;
    to->balance += amount;
    pthread_mutex_unlock(&second->mu);
    pthread_mutex_unlock(&first->mu);
}
exit 124 (124 = killed by timeout)
ordered: done, balances 100000 + 100000 = 200000النسخة الأولى لم تنته، فأوقفها الأمر timeout بعد عشر ثوان برمز 124. والذي حدث أن الخيط الأول أخذ قفل الفرع 1 وانتظر قفل الفرع 2، وفي نفس اللحظة أخذ الخيط الثاني قفل الفرع 2 وانتظر قفل الفرع 1، فكل خيط ينتظر قفلاً يملكه الآخر، ولن يتركه أحد. ولا يوجد أي خطأ ولا أي رسالة ولا استهلاك للمعالج، فالبرنامج نائم إلى الأبد، وهذا ما يجعل الجمود في الإنتاج يبدو كأن الخدمة «علقت». والسطر usleep(10) وضعناه لكي يظهر الجمود بسرعة في التجربة، ولكنه لا يصنعه، فبدونه يحدث نفس الشيء بعد عدد أكبر من المحاولات، وغالباً تحت الضغط في الإنتاج.
والإصلاح هو القاعدة الكلاسيكية: رتب الأقفال. فإذا كان كل خيط يأخذ قفل الفرع ذي الرقم الأصغر أولاً، مهما كان اتجاه النقل، فلا يمكن أن ينتظر خيطان بعضهما في دائرة. والنسخة ordered أنهت العشرين ألف نقل، والمجموع 200000 كما بدأ، فلم يضع ولم يتكرر أي مبلغ. وهذه نفس القاعدة التي تستخدمها قواعد البيانات، وقد شرحناها في مقال الأقفال والجمود في قواعد البيانات، وسوف نطبقها في مقال الخدمة، حيث نقفل صفوف المنتجات في الطلب بترتيب رقم المنتج.
هل تكشف الأدوات الجمود قبل أن يحدث؟ Lock Order Inversion
الجمود مثل السباق، قد لا يحدث في الاختبار. ولكن ThreadSanitizer تراقب ترتيب أخذ الأقفال أيضاً، فإذا رأت خيطاً يأخذ القفل B وهو يملك A، ثم خيطاً يأخذ A وهو يملك B، حذرت حتى لو لم يحدث الجمود فعلاً في هذا التشغيل:
WARNING: ThreadSanitizer: lock-order-inversion (potential deadlock) (pid=1266)
  Mutex M1 acquired here while holding mutex M0 in thread T1:
    #0 pthread_mutex_lock <null> (libtsan.so.2+0x58271)
  Mutex M0 acquired here while holding mutex M1 in thread T2:
    #0 pthread_mutex_lock <null> (libtsan.so.2+0x58271)
والكلمة المهمة potential، أي محتمل: الأداة لا تحتاج أن يعلق البرنامج، يكفي أن ترى الترتيبين المتعاكسين مرة واحدة في أي وقت من التشغيل. ومع النسخة المرتبة ordered لم يظهر أي تحذير. ولهذا يستحق بناء اختبارات بـ ThreadSanitizer مكاناً في خط الاختبارات الآلية لأي كود C فيه خيوط، فهي تحول خطأين يظهران مرة في الشهر في الإنتاج إلى تقرير في كل تشغيل للاختبارات.
كيف تفعلها مشاريع C الكبيرة؟ عمليات Processes أم خيوط Threads
قد يبدو بعد كل هذا أن الخيوط هي الطريقة الوحيدة للتزامن في C، ولكن أشهر مشروعين بلغة C في عالم السيرفرات اختارا شيئاً آخر. فـ PostgreSQL ينشئ عملية Process كاملة لكل اتصال، كما في فصل البنية في توثيقه، لا خيطاً. والسبب أن العمليات لا تتشارك الذاكرة إلا ما تشاركه عمداً عبر الذاكرة المشتركة Shared Memory، فخطأ ذاكرة في اتصال واحد لا يفسد ذاكرة اتصال آخر، والسباق على متغير عام غير ممكن أصلاً لأن كل عملية لها نسختها. والثمن أن العملية أثقل من الخيط، ولهذا يحتاج PostgreSQL أدوات مثل PgBouncer أمامه عندما تكثر الاتصالات. أما nginx فيجمع الطريقتين بطريقة أخرى، كما في دليل المطورين: عملية رئيسية Master تقرأ الإعداد، وعدد قليل من عمليات العمل Workers، غالباً واحدة لكل نواة، وكل عملية عمل تخدم آلاف الاتصالات بحلقة أحداث في خيط واحد، مع مجمع خيوط اختياري للعمليات التي تحجب، مثل قراءة ملف من قرص بطيء.
والدرس من هذين المشروعين أن السؤال في C ليس «كيف أستخدم الخيوط؟» وإنما «ما أقل قدر من المشاركة يكفيني؟». فكلما قلت الذاكرة المشتركة قل ما يمكن أن يفسده خطأ، وقلت الأقفال التي يجب أن ترتبها، وقلت المواضع التي يجب أن يراقبها ThreadSanitizer. وفي الخدمة التي سنبنيها في المقال التالي سوف نتبع نفس الفكرة: خيوط libmicrohttpd لا تتشارك شيئاً تقريباً، وكل خيط له اتصاله بقاعدة البيانات، والتنسيق الوحيد بين الطلبات المتزامنة على نفس المنتج يحدث داخل PostgreSQL بأقفال الصفوف، لا في ذاكرة البرنامج.
ويبقى تحذيران لمن يخلط العمليات بالخيوط في نفس البرنامج. الأول أن استدعاء fork في برنامج فيه خيوط ينسخ الخيط الذي استدعاه فقط، فإذا كان خيط آخر يمسك قفلاً في تلك اللحظة، بقي القفل مأخوذاً إلى الأبد في العملية الجديدة، ولذلك لا يسمح بعد fork في برنامج متعدد الخيوط إلا بالدوال الآمنة حتى تستدعي exec، كما تشرح صفحة pthread_atfork. والثاني أن الإشارة Signal مثل SIGTERM تصل إلى أي خيط لم يحجبها، فالبرنامج الذي يتوقع أن يستقبلها الخيط الرئيسي قد يفاجأ، والأسلوب المعتاد أن تحجبها في كل الخيوط إلا خيطاً واحداً مخصصاً لها، أو أن يكتفي معالج الإشارة برفع علامة يقرؤها الخيط الرئيسي، وهو ما سنفعله في الخدمة.
كيف تختار؟ جدول قرار Decision Table
| المهمة | الأداة في C | من المختبر |
|---|---|---|
| عشرات الطلبات إلى خدمة بطيئة | مجمع خيوط بحجم ثابت | 25 خيطاً: 0.32 ثانية بدلاً من 5.5، وزمن يمكن توقعه |
| مئات أو آلاف الاتصالات | حلقة أحداث: libcurl multi أو epoll أو libuv | خيط واحد، 0.42 ثانية، ونصف ذاكرة الخيوط |
| حلقة حساب كبيرة مستقلة العناصر | OpenMP أو خيوط بنطاقات | 8 خيوط: 2.1 إلى 2.4 ثانية بدلاً من 7 إلى 8.7 |
| عداد أو علامة مشتركة | عملية ذرية من stdatomic.h | 0.076 ثانية مقابل 0.732 للقفل |
| تعديل عدة متغيرات معاً | قفل pthread_mutex_t بترتيب ثابت | الترتيب أنهى الجمود، والمجموع بقي 200000 |
| خدمة في Container محدود | عدد خيوط من الإعداد لا من nproc | nproc قال 8 مع --cpus=2 |
أخطاء شائعة Common Mistakes
- الظن أن
x++آمنة لأنها تعليمة واحدة: ضاع حتى 2.2 مليون من 8 ملايين. - مشاركة مقبض curl أو اتصال قاعدة بيانات بين خيطين، والمكتبات تقول صراحة إن المقبض لخيط واحد في كل لحظة.
- نسيان
curl_global_initقبل الخيوط، أو استدعاؤها من داخل كل خيط. - بناء OpenMP بدون
-fopenmp: يتجاهل المترجم السطر ويعمل البرنامج بخيط واحد مع تحذير فقط. - تحديد عدد الخيوط من
nprocداخل Container: ثمانية خيوط لحصة نواتين لم تسرع شيئاً. - الحكم على مكسب الخيوط من تشغيل واحد على جهاز مشترك: نفس الوضع أعطى 0.30 و0.86 ثانية.
- أخذ قفلين بترتيب يعتمد على اتجاه العملية، كما في «المرسل ثم المستقبل».
- استخدام قفل لعداد واحد في حلقة ساخنة، بينما العملية الذرية أو العد المحلي أرخص بكثير.
- الظن أن
volatileتجعل المتغير آمناً بين الخيوط، وهي لا تجعل الزيادة ذرية ولا تضمن ترتيباً. - انتظار متغير الشرط داخل
ifبدلاً منwhile. - تشغيل الاختبارات بدون ThreadSanitizer، فلا يظهر السباق ولا ترتيب الأقفال المعكوس إلا في الإنتاج.
- مصفوفة محلية كبيرة داخل دالة الخيط، مع أن Stack الخيط له حد خاص يمكن تغييره بـ pthread_attr_setstacksize.
قائمة تحقق Checklist لكود C بالخيوط
- لكل متغير مشترك جواب مكتوب: لا يشارك، أو ذري، أو يحميه القفل الفلاني.
- كل الأقفال لها ترتيب موثق، ولا تستدعى دالة خارجية وأنت تمسك قفلاً إن أمكن.
- المكتبات الخارجية: تحقق من توثيقها عن الخيوط، ومقبض أو اتصال لكل خيط.
- عدد الخيوط إعداد يقرأ من متغير بيئة، ومضبوط على حد الـ Container.
- بناء اختبارات بـ
-fsanitize=threadفي خط الاختبارات الآلية، منفصل عن بناء ASan. - قبل أي خيط جديد اسأل: هل تكفي عملية منفصلة أو حلقة أحداث أو عدم المشاركة؟ وأقل ذاكرة مشتركة تعني أقل أقفال وأقل أخطاء.
- لا
forkفي برنامج متعدد الخيوط إلا متبوعاً بـexec، والإشارات لها خيط واحد أو معالج يرفع علامة فقط. - القياس يتكرر مرتين على الأقل، والنتيجة يتحقق منها بمجموع أو هاش قبل مقارنة الزمن.
تدريب عملي Practice
- غير مجمع الخيوط في
io.cلكي يستخدم متغير شرطpthread_cond_tوطابور مهام بدلاً من العداد، وأرسل إليه المهام من الخيط الرئيسي. - أضف إلى
race.cوضعاً رابعاً يعد فيه كل خيط في متغير محلي ويضيفه في النهاية، وقارن زمنه بالعملية الذرية. - شغل
cpu.cبالخيار--cpuset-cpus=0,1بدلاً من--cpus=2، ولاحظ ماذا يقولnprocهذه المرة ولماذا.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التزامن في C خيوط نظام عبر pthreads، ومعها
threads.hوعمليات ذرية من C11، وOpenMP للحلقات، وحلقات الأحداث عبر المكتبات، وكل الحماية من أدوات خارج اللغة. - مئة طلب كل منها 50 ملي ثانية: 5.5 ثانية بالتسلسل، و0.32 بمجمع من 25 خيطاً، و0.42 بحلقة أحداث في خيط واحد بنصف الذاكرة، وخيط لكل طلب تذبذب بين 0.30 و0.86.
- ألفا ختم SHA-256 في ألفي دورة: 7 إلى 8.7 ثانية بخيط، وحوالي 2.3 بثمانية خيوط، وOpenMP بنفس السرعة بسطر واحد.
- الخيط في Linux مهمة حقيقية في النواة تنشأ بالطلب
clone، وليس خيطاً خفيفاً كما في Go، ولهذا اختار PostgreSQL عملية لكل اتصال واختار nginx عمليات قليلة مع حلقة أحداث، وكلاهما يقلل الذاكرة المشتركة إلى أدنى حد. - بحد
--cpus=2بقيnprocيقول 8، والخيوط فوق اثنين لم تسرع شيئاً، فعدد الخيوط إعداد لا يقرأ من النظام. - العداد بلا حماية خسر حتى 2.2 مليون عملية مع أنه تعليمة واحدة، والإصلاح بالقفل كلف 0.73 ثانية وبالعملية الذرية 0.076، وThreadSanitizer أشار إلى السطر.
- القفل مبني على futex: ثمانية ملايين عملية قفل احتاجت 4142 طلب نظام فقط، وهي التي أخذت الوقت لأنها حالات التنافس.
- النقل بين فرعين بترتيب «المرسل ثم المستقبل» توقف إلى الأبد، وترتيب الأقفال بالرقم أنهاه، وThreadSanitizer حذر من الترتيب المعكوس قبل أن يعلق شيء.
وفي المقال التالي من مرحلة لغة C للمطورين نجمع كل ما سبق في خدمة طلبات حقيقية، فيها مجمع خيوط واتصال قاعدة بيانات لكل خيط وأقفال صفوف مرتبة:
 دليلالمؤشرات Pointers والذاكرة والأخطاء في لغة Cنقرأ ملف طلبات نقطة البيع بلغة C ونقف عند كل ما تسمح به اللغة دون أن تخبرك: تحويلات الأنواع، والحشو، وتجاوز المخزن، ومن يحرر الذاكرة، وكيف تصل الأخطاء بقيمة الرجوع وerrno.
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب داخل Containers مبنية على gcc:16.2.0-trixie مع GCC 16.2.0 وlibcurl وOpenSSL 3 وlibmicrohttpd من Debian 13، على Docker Engine 29.8.0 بمعالج فيه 8 أنوية منطقية على جهاز مشترك.


