لاحظ ما يحدث للنقطة الزرقاء في تطبيق الخرائط عندما تدخل مجمعاً تجارياً كبيراً: تبقى عند المدخل، أو تقفز بين جهتي المبنى، أو تتسع الدائرة حولها حتى تغطي نصف المجمع، ثم تعود دقيقة فجأة عندما تقترب من الواجهة الزجاجية. والسبب أن الهاتف في الخارج يعرف موقعه من الأقمار الصناعية، وفي الداخل لا تصله إشارتها كما يجب، فيبحث عن مصادر أخرى: شبكات Wi-Fi حوله، ومنارات Bluetooth، وحساسات الحركة فيه. وإذا كنت تبني تطبيقاً لمنشأة، مستشفى أو جامعة أو مستودع، وبنيت لها الخريطة الداخلية كما شرحنا في المقال السابق من هذه المرحلة عن الطوابق وIMDF، فالسؤال التالي الذي سوف تسمعه: هل نستطيع أن نعرض للزائر أين هو الآن؟ وبأي دقة؟ وبأي تكلفة؟
والإجابة الصادقة أن الدقة تعتمد على التقنية والمبنى والهاتف، وأن الأرقام في الإعلانات غالباً لأفضل حالة. لذلك سوف نجيب في هذا المقال بأرقام نحسبها بأنفسنا: من بيانات Wi-Fi حقيقية جمعت في ثلاثة مبان جامعية بأكثر من عشرين هاتفاً، ومن محاكاة بنموذج انتشار منشور من الاتحاد الدولي للاتصالات. وسوف نناقش في هذا المقال ما يلي:
- لماذا يضيع GNSS داخل المباني، وما الذي يبقى للهاتف ليحدد موقعه.
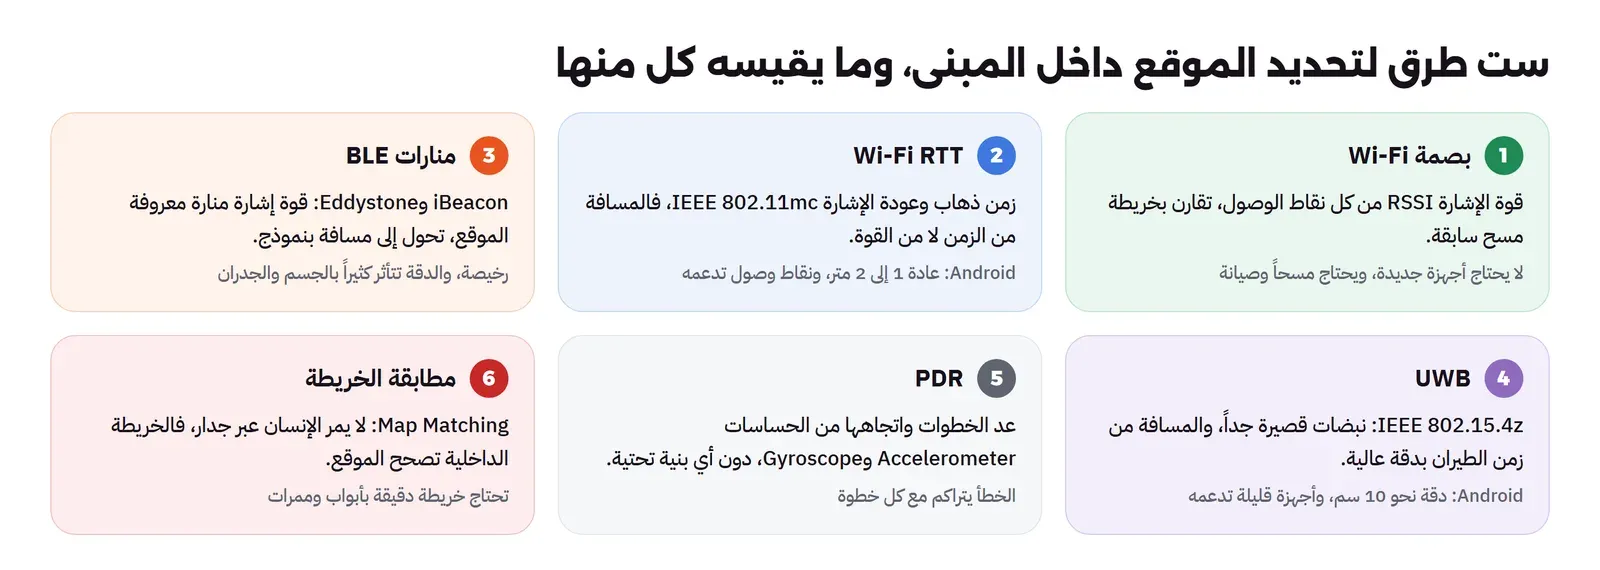
- ست طرق: بصمة Wi-Fi، وقياس زمن الذهاب والعودة Wi-Fi RTT، ومنارات BLE، وUWB، وعد الخطوات PDR، ومطابقة الخريطة، وما تقيسه كل منها.
- مختبر على بيانات UJIIndoorLoc الحقيقية: بصمة Wi-Fi بخوارزمية kNN، ودقة الطابق والمبنى، والخطأ بالمتر لكل طابق ولكل هاتف.
- محاكاة بنموذج ITU-R P.1238: لماذا تحويل قوة الإشارة إلى مسافة يخطئ بهذا القدر، وماذا يعطي التثليث بكل تقنية.
- التثليث Trilateration على قراءات RSSI الحقيقية، ولماذا كان أسوأ من البصمة.
- الخصوصية: ما الذي تقوله Android وApple عن الموقع وعناوين MAC، وما الذي يجب أن تفكر فيه قبل أن تتبع أي شخص داخل مبنى.
لماذا يضيع GPS داخل المبنى؟
شرحنا في مقال تحديد الموقع بالأقمار الصناعية من هذا المسار كيف يحسب الهاتف موقعه من أزمنة وصول إشارات GNSS، والشرط الأساسي هناك أن تصل الإشارة في خط مستقيم من القمر إلى الهاتف، لأن المسافة محسوبة من الزمن بسرعة الضوء. والصورة التالية تبين ما يحدث داخل المبنى:
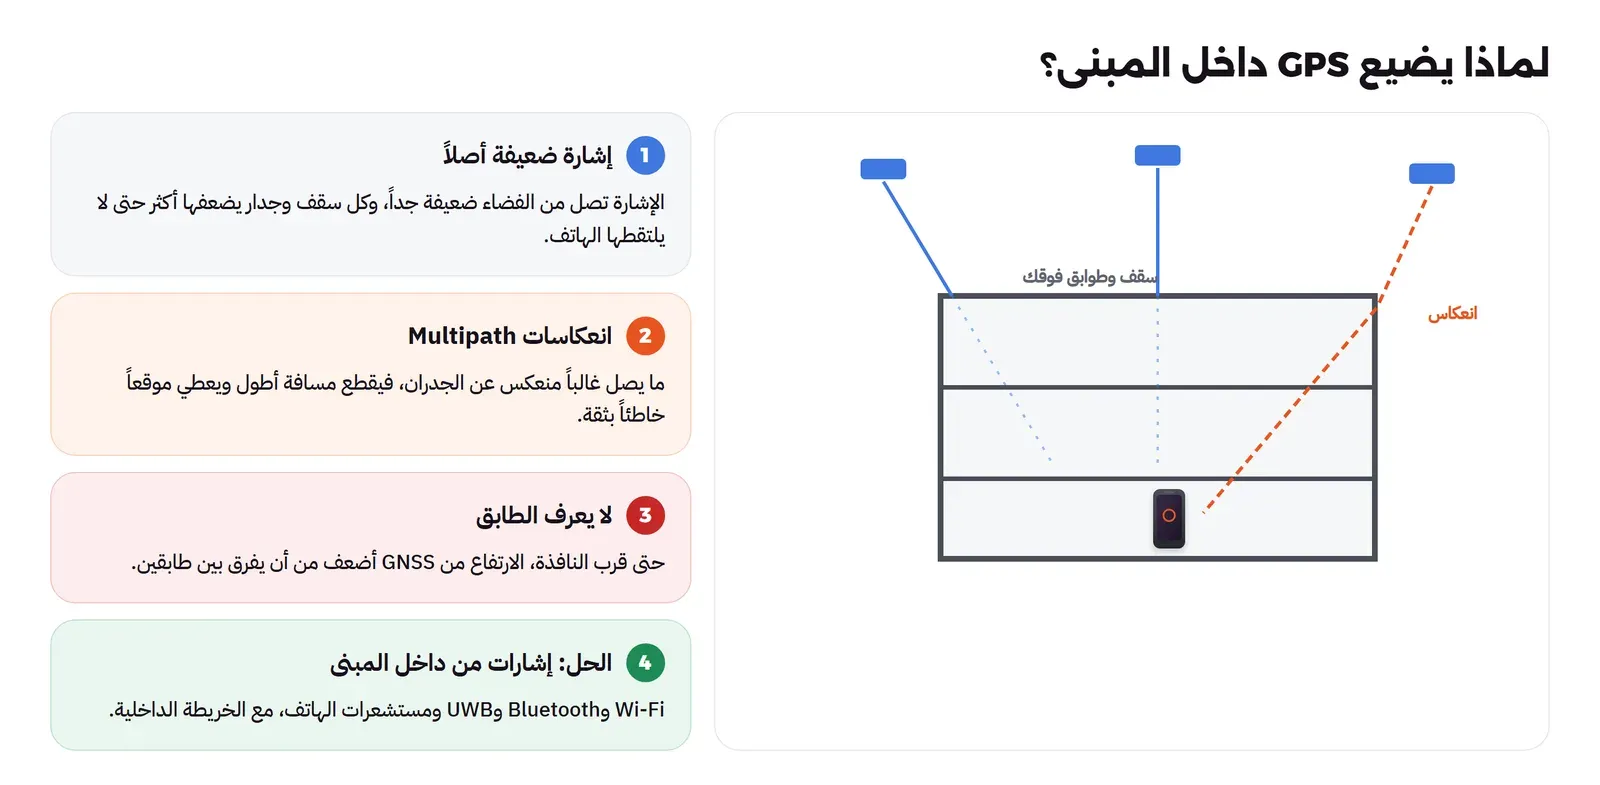
- الإشارة ضعيفة من الأصل: تصل من مدار بعيد بقدرة قريبة من مستوى الضوضاء، وكل سقف خرساني وطابق فوقك يضعفها أكثر، فلا يلتقط الهاتف عدداً كافياً من الأقمار.
- الانعكاسات Multipath: ما يصل إلى الهاتف قرب النوافذ غالباً إشارة منعكسة عن جدار، قطعت مسافة أطول من الخط المستقيم، فيحسب الهاتف موقعاً خاطئاً بعشرات الأمتار، والمشكلة أنه لا يعرف أنه خاطئ.
- الطابق: الارتفاع من GNSS أقل دقة من الموقع الأفقي، فلا يكفي للتفريق بين طابقين المسافة بينهما أربعة أمتار، حتى لو كانت الإشارة جيدة.
لذلك فإن كل تقنيات الموقع الداخلي تعتمد على إشارات مصدرها داخل المبنى، مواقعها معروفة أو يمكن تعلمها، مع الحساسات في الهاتف نفسه. وقبل أن ندخل في التفاصيل، الصورة التالية تلخص الطرق الست:
بصمة Wi-Fi Fingerprinting
لنبدأ بالطريقة الأكثر انتشاراً، لأنها لا تحتاج أجهزة جديدة: أي مبنى حديث فيه عشرات نقاط الوصول Access Points، وكل هاتف يستطيع أن يمسح الشبكات حوله ويقرأ قوة إشارة كل نقطة بوحدة dBm، وهي قيمة سالبة، كلما اقتربت من الصفر كانت الإشارة أقوى. والفكرة أن قائمة القوى هذه في نقطة معينة من المبنى تشبه البصمة: في الممر الشرقي من الطابق الثاني تسمع النقاط 7 و12 و40 بقوة -55 و-68 و-80، وفي الممر الغربي تسمع نقاطاً أخرى بقوى أخرى.
والطريقة البسيطة أن تحول قوة الإشارة إلى مسافة، ثم تحسب الموقع من المسافات إلى ثلاث نقاط وصول معروفة المكان، وهذا ما سوف نجربه لاحقاً ونرى لماذا لا يعمل جيداً. أما البصمة فلا تحتاج أي نموذج للإشارة، ولا تحتاج أن تعرف أين نقاط الوصول أصلاً، وإنما تعمل على مرحلتين:
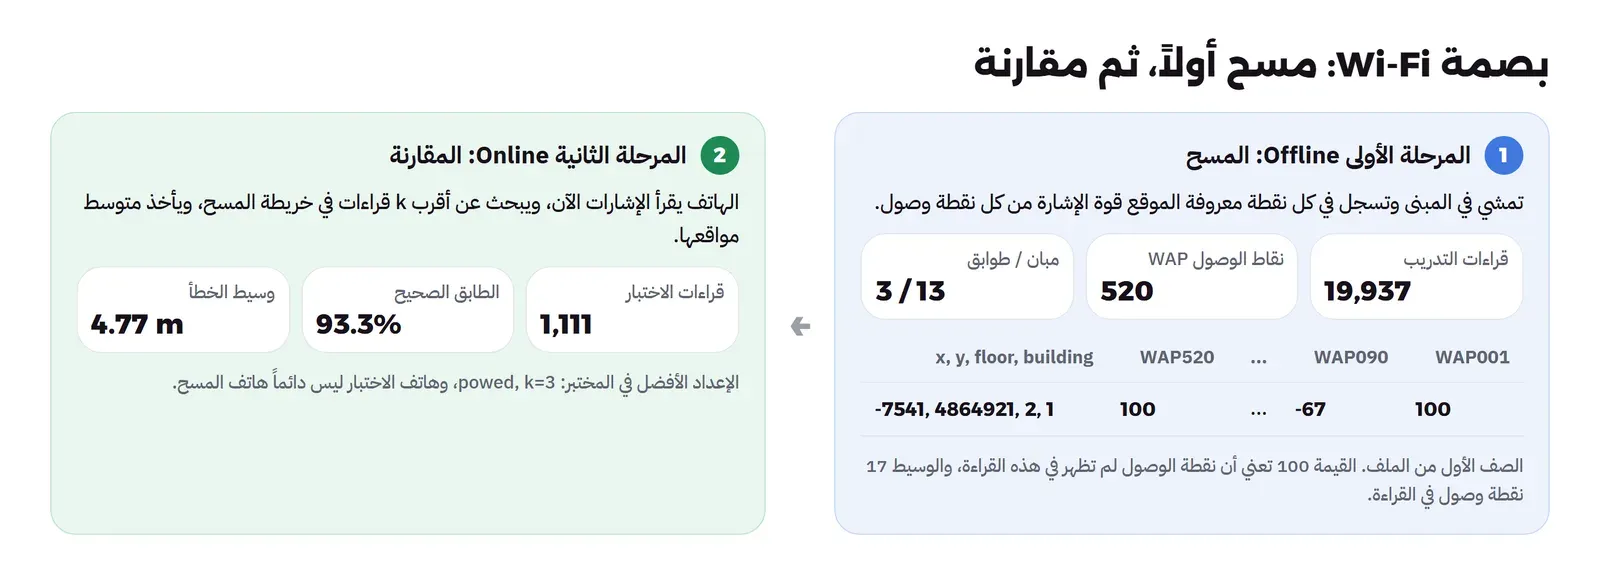
- المسح Offline: يمشي شخص في المبنى بهاتف، ويسجل في نقاط كثيرة معروفة الموقع قراءة كاملة: قوة كل نقطة وصول، والموقع، والطابق. والنتيجة خريطة راديو Radio Map.
- التحديد Online: هاتف الزائر يقرأ الإشارات، ويبحث في خريطة الراديو عن أقرب القراءات إليها، أي الجيران الأقرب K-Nearest Neighbours واختصاراً kNN، ويأخذ متوسط مواقعها. وقد شرحنا kNN كخوارزمية في مقال التعلم الآلي للمبتدئين، وهنا «القرب» هو التشابه بين قائمتي القوى، لا المسافة على الخريطة.
ونقطة القوة أن البصمة تتعلم كل ما في المبنى من جدران وانعكاسات دون أن تفهمه، فإذا كانت إشارة نقطة ما تضعف خلف عمود، فهذا مسجل في البصمة نفسها. ونقطة الضعف أن المسح مكلف ويتقادم: كل نقطة وصول تستبدل أو تنقل، وكل تغيير في الأثاث، يغير البصمات، وهاتف الزائر قد يقرأ الإشارة نفسها بقيمة مختلفة عن هاتف المسح. وهذا ما سوف نقيسه الآن على بيانات حقيقية.
المختبر: بيانات UJIIndoorLoc
مجموعة UJIIndoorLoc منشورة في مستودع UCI للتعلم الآلي منذ 2014 برخصة CC BY 4.0، وهي قراءات Wi-Fi جمعت في ثلاثة مبان جامعية بطوابق تصل إلى خمسة، بخمسة وعشرين جهاز Android وأكثر من عشرين مستخدماً، ومعها لكل قراءة الموقع بالمتر والطابق والمبنى. وتأتي في ملفين: ملف تدريب للمسح، وملف تحقق جمع في وقت لاحق، وهذا مهم، لأن الاختبار على قراءات من وقت آخر أقرب إلى الواقع من تقسيم عشوائي لملف واحد. والرخصة تسمح بالاستخدام والنشر مع ذكر المصدر، وصفحة المجموعة تطلب الاستشهاد بعمل Joaquín Torres-Sospedra وزملائه الذين جمعوها، ولذلك تجد الرابط إلى معرف DOI الخاص بها في هذا المقال. ولاحظ أن هذه البيانات من عام 2013 تقريباً، بهواتف تلك الفترة ونقاط وصولها، فالأرقام المطلقة قد تختلف اليوم، أما الدروس، مثل أثر التمثيل والطابق والهاتف، فلا تتغير.
نستخدم Container من python:3.13-slim مع المكتبات العلمية، وهو الملف lab/Dockerfile:
FROM python:3.13-slim
RUN pip install --no-cache-dir numpy pandas scipy scikit-learn matplotlib
WORKDIR /data
mkdir -p ip-lab && cd ip-lab # the lab/ files of this article, and an Arabic font in fonts/
docker build -t lab-ip .
docker volume create lab-ip-data
curl -fsSLo uji.zip https://archive.ics.uci.edu/static/public/310/ujiindoorloc.zip
sha256sum uji.zip
alias ip='docker run --rm -v lab-ip-data:/data -v "$PWD:/lab:ro" -v "$PWD/fonts:/fonts:ro" -w /data lab-ip'
ip python -c "import zipfile; zipfile.ZipFile('/lab/uji.zip').extractall('/data')"
ip python -c "import sklearn, numpy, pandas, scipy, matplotlib, sys; print(sys.version.split()[0], sklearn.__version__, numpy.__version__, pandas.__version__, scipy.__version__, matplotlib.__version__)"الملف المضغوط حجمه 1.46 ميغابايت، وبصمة SHA-256 التي حصلنا عليها 893512b82dfd7a7c345d84195b1c8019fbca0fa0d7820ce491ce5aa45ec3782f، والسطر الأخير يطبع 3.13.18 1.9.1 2.5.5 3.1.1 1.18.1 3.11.2، أي scikit-learn 1.9.1 وnumpy 2.5.5 وpandas 3.1.1. ثم نلقي النظرة الأولى، وهو الملف lab/01_explore.py:
# A first look at UJIIndoorLoc: 520 Wi-Fi access points, 3 buildings, up to 5 floors.
import numpy as np
import pandas as pd

tr = pd.read_csv("/data/UJIndoorLoc/trainingData.csv")
va = pd.read_csv("/data/UJIndoorLoc/validationData.csv")
waps = [c for c in tr.columns if c.startswith("WAP")]
print("training", tr.shape, "| validation", va.shape, "| WAP columns", len(waps))
print(tr[["LONGITUDE", "LATITUDE", "FLOOR", "BUILDINGID", "USERID", "PHONEID"]].describe().loc[["min", "max"]].to_string())

rssi = tr[waps].to_numpy()
seen = rssi != 100                                   # 100 means "not detected" in this dataset
print("value range when seen:", rssi[seen].min(), "to", rssi[seen].max(), "dBm")
per_scan = seen.sum(axis=1)
print(f"APs per scan: median {np.median(per_scan):.0f}, min {per_scan.min()}, max {per_scan.max()}, "
      f"scans with zero APs {int((per_scan == 0).sum())}")
print("APs never seen in training:", int((~seen.any(axis=0)).sum()))
print("samples per building/floor (training):")
print(tr.pivot_table(index="BUILDINGID", columns="FLOOR", values="WAP001", aggfunc="size", fill_value=0).to_string())
print("validation users/phones:", va["USERID"].unique().tolist(), "/", va["PHONEID"].nunique(), "phones")
hist = np.histogram(rssi[seen], bins=[-105, -90, -80, -70, -60, -50, -40, 0])
for lo, hi, n in zip(hist[1][:-1], hist[1][1:], hist[0]):
    print(f"  {lo:5.0f} .. {hi:4.0f} dBm  {n:7d}  {100 * n / seen.sum():5.1f}%")
ip python /lab/01_explore.pytraining (19937, 529) | validation (1111, 529) | WAP columns 520
LONGITUDE LATITUDE FLOOR BUILDINGID USERID PHONEID
min -7691.33840 4.864746e+06 0.0 0.0 1.0 1.0
max -7300.81899 4.865017e+06 4.0 2.0 18.0 24.0
value range when seen: -104 to 0 dBm
APs per scan: median 17, min 0, max 51, scans with zero APs 76
APs never seen in training: 55
samples per building/floor (training):
FLOOR 0 1 2 3 4
BUILDINGID
0 1059 1356 1443 1391 0
1 1368 1484 1396 948 0
2 1942 2162 1577 2709 1102
validation users/phones: [0] / 11 phones
-105 .. -90 dBm 49541 13.8%
-90 .. -80 dBm 141735 39.5%
-80 .. -70 dBm 85352 23.8%
-70 .. -60 dBm 47121 13.1%
-60 .. -50 dBm 22590 6.3%
-50 .. -40 dBm 9864 2.7%
-40 .. 0 dBm 2560 0.7%في المخرج أعلاه لاحظ التالي:
- 19,937 قراءة تدريب و1,111 قراءة تحقق، وفي كل منها 520 عموداً لنقاط الوصول، ثم الموقع والطابق والمبنى والمستخدم والهاتف.
- الإحداثيات بالمتر في نظام مسقط، لذلك فإن الخطأ بالمتر هو مجرد فرق الأرقام، دون تحويل كما رأينا في مقالات نظام الإحداثيات.
- القيمة 100 تعني أن نقطة الوصول لم تظهر في القراءة، والقيم الحقيقية من -104 إلى 0. والوسيط 17 نقطة وصول في القراءة من 520، أي أن 97% من كل صف «لم تظهر»، وهذا يحدد كيف يجب أن نمثل البيانات، كما سوف نرى.
- 76 قراءة تدريب بلا أي نقطة وصول، و55 نقطة وصول لم تظهر في التدريب أبداً، فهذه أعمدة لا فائدة منها، وقراءات لا يمكن أن تحدد موقعاً.
- المبنى 2 فيه خمسة طوابق والمبنيان الآخران أربعة، فالتصنيف يجب أن يعرف أن الطابق 4 موجود في مبنى واحد فقط.
- قراءات التحقق كلها من مستخدم واحد بأحد عشر هاتفاً، وهذا سوف يظهر في النتائج.
- أكثر من نصف القراءات بين -90 و-70 dBm، أي إشارات ضعيفة، والقوية فوق -50 أقل من 4%.
kNN على البصمات: ما الذي يغير الدقة؟
الملف التالي يدرب ثلاثة نماذج kNN: واحد يصنف المبنى، وواحد يصنف الطابق، وواحد يقدر الموقع، ويجرب أربع طرق لتمثيل قوة الإشارة وأربع قيم لـ k، ثم يطبع أفضل إعداد لكل مبنى وطابق. وهو الملف lab/02_knn.py:
# Wi-Fi fingerprinting with kNN on UJIIndoorLoc: train on trainingData, test on validationData.
import time
import numpy as np
import pandas as pd
from sklearn.neighbors import KNeighborsClassifier, KNeighborsRegressor

tr = pd.read_csv("/data/UJIndoorLoc/trainingData.csv")
va = pd.read_csv("/data/UJIndoorLoc/validationData.csv")
waps = [c for c in tr.columns if c.startswith("WAP")]

def features(df, mode):
    x = df[waps].to_numpy(dtype=float, copy=True)   # pandas 3 returns a read-only view otherwise
    if mode == "raw":                    # 100 (not seen) stays 100: stronger than any real signal
        return x
    x[x == 100] = -105                   # not seen = weaker than the weakest reading
    if mode == "dbm":
        return x
    pos = (x + 105) / 105                # 0 = not seen, 1 = 0 dBm
    return pos ** np.e if mode == "powed" else pos

def evaluate(mode, k, weights="distance", metric="euclidean"):
    xt, xv = features(tr, mode), features(va, mode)
    t = time.perf_counter()
    b = KNeighborsClassifier(k, weights=weights, metric=metric).fit(xt, tr["BUILDINGID"]).predict(xv)
    f = KNeighborsClassifier(k, weights=weights, metric=metric).fit(xt, tr["BUILDINGID"] * 10 + tr["FLOOR"]).predict(xv) % 10
    xy = KNeighborsRegressor(k, weights=weights, metric=metric).fit(xt, tr[["LONGITUDE", "LATITUDE"]]).predict(xv)
    ms = (time.perf_counter() - t) * 1000 / len(va)
    err = np.hypot(*(xy - va[["LONGITUDE", "LATITUDE"]].to_numpy()).T)
    return b, f, err, ms

print(f"{'features':8} {'k':>2} {'building':>9} {'floor':>7} {'mean m':>7} {'median':>7} {'p75':>6} {'p90':>6} {'ms/scan':>8}")
for mode in ["raw", "dbm", "positive", "powed"]:
    for k in [1, 3, 5, 9]:
        b, f, err, ms = evaluate(mode, k)
        print(f"{mode:8} {k:2} {100 * (b == va['BUILDINGID']).mean():8.1f}% {100 * (f == va['FLOOR']).mean():6.1f}% "
              f"{err.mean():7.2f} {np.median(err):7.2f} {np.percentile(err, 75):6.2f} {np.percentile(err, 90):6.2f} {ms:8.2f}")

b, f, err, _ = evaluate("powed", 3)
va = va[["BUILDINGID", "FLOOR", "PHONEID"]].assign(err=err, floor_ok=(f == va["FLOOR"]), bld_ok=(b == va["BUILDINGID"]))
print("\nbest setting (powed, k=3), per building and floor:")
table = va.groupby(["BUILDINGID", "FLOOR"]).agg(scans=("err", "size"), floor_hit=("floor_ok", "mean"),
                                                 median_m=("err", "median"), p90_m=("err", lambda e: np.percentile(e, 90)))
table["floor_hit"] = (100 * table["floor_hit"]).round(1)
print(table.round(2).to_string())
wrong = va[~va["floor_ok"]]
print(f"\nwrong floor: {len(wrong)} scans; their median horizontal error {wrong['err'].median():.2f} m "
      f"vs {va[va['floor_ok']]['err'].median():.2f} m when the floor is right")
va[["BUILDINGID", "FLOOR", "PHONEID", "err", "floor_ok"]].to_csv("/data/knn_errors.csv", index=False)
وفي أول تشغيل أعطى الإعداد الأول أرقامه بأربع قيم لـ k، ثم توقف بهذا الخطأ:
features  k  building   floor  mean m  median    p75    p90  ms/scan
raw       1     98.8%   75.3%   15.85    9.17  17.48  29.88    21.40
raw       3     99.5%   74.2%   13.78    9.36  16.49  25.80     9.96
raw       5     99.2%   74.0%   14.05    8.96  16.17  26.43     4.59
raw       9     99.1%   74.1%   14.19    8.97  16.37  27.29     3.47
Traceback (most recent call last):
  File "/lab/02_knn.py", line 34, in <module>
    b, f, err, ms = evaluate(mode, k)
                    ~~~~~~~~^^^^^^^^^
  File "/lab/02_knn.py", line 22, in evaluate
    xt, xv = features(tr, mode), features(va, mode)
             ~~~~~~~~^^^^^^^^^^
  File "/lab/02_knn.py", line 15, in features
    x[x == 100] = -105                   # not seen = weaker than the weakest reading
    ~^^^^^^^^^^
ValueError: assignment destination is read-only
والسبب أن pandas 3 فعلت نظام النسخ عند الكتابة Copy-on-Write للجميع، فأصبحت to_numpy() تعيد في حالات كثيرة مصفوفة للقراءة فقط تشير إلى بيانات الجدول نفسها، حتى لا يغير تعديل المصفوفة الجدول دون أن تقصد. والإعداد الأول raw لم يكتب في المصفوفة فمر، والثاني حاول أن يكتب فيها فتوقف. والحل copy=True الذي تراه في الكود، وهذا تغيير ستراه في كثير من الكود القديم الذي يكتب في ناتج to_numpy() مباشرة. وبعد الإصلاح:
ip python /lab/02_knn.pyfeatures k building floor mean m median p75 p90 ms/scan
raw 1 98.8% 75.3% 15.85 9.17 17.48 29.88 4.37
raw 3 99.5% 74.2% 13.78 9.36 16.49 25.80 4.03
raw 5 99.2% 74.0% 14.05 8.96 16.17 26.43 3.29
raw 9 99.1% 74.1% 14.19 8.97 16.37 27.29 3.28
dbm 1 99.5% 89.7% 9.85 6.00 11.87 20.81 3.93
dbm 3 99.5% 89.7% 8.91 5.49 10.71 19.12 4.17
dbm 5 99.7% 90.1% 8.85 5.35 10.31 19.24 2.59
dbm 9 99.7% 89.8% 9.06 5.61 10.27 18.29 4.01
positive 1 99.5% 89.6% 9.85 6.00 11.87 20.81 2.66
positive 3 99.5% 89.7% 8.92 5.49 10.77 19.12 3.89
positive 5 99.7% 90.1% 8.85 5.35 10.33 19.24 3.17
positive 9 99.7% 89.8% 9.06 5.61 10.27 18.29 4.33
powed 1 99.6% 92.9% 9.09 5.31 10.87 21.02 3.23
powed 3 99.5% 93.3% 8.15 4.77 9.86 18.20 2.11
powed 5 99.7% 93.5% 8.16 4.84 9.89 18.09 1.63
powed 9 99.7% 93.4% 8.34 5.01 9.61 17.34 1.58
best setting (powed, k=3), per building and floor:
scans floor_hit median_m p90_m
BUILDINGID FLOOR
0 0 78 97.4 4.29 15.30
1 208 98.1 2.80 11.45
2 165 94.5 4.08 13.46
3 85 97.6 3.69 14.03
1 0 30 63.3 9.80 22.76
1 143 79.7 6.09 18.56
2 87 94.3 7.21 31.50
3 47 95.7 5.20 21.48
2 0 24 91.7 8.17 28.87
1 111 97.3 5.83 13.62
2 54 96.3 7.92 27.79
3 40 100.0 4.37 12.31
4 39 92.3 8.99 26.78
wrong floor: 74 scans; their median horizontal error 13.53 m vs 4.45 m when the floor is rightفي المخرج أعلاه لاحظ التالي:
- تمثيل «لم تظهر» أهم من أي شيء آخر: بالقيمة الخام 100 كانت دقة الطابق 74% فقط ووسيط الخطأ 9 أمتار، لأن 100 أكبر من أقوى إشارة حقيقية، فالنموذج يرى نقطة الوصول الغائبة كأنها أقوى ما في القراءة. وعندما جعلنا الغائبة -105، أي أضعف من أضعف قراءة، قفزت دقة الطابق إلى 90% ونزل الخطأ إلى 5.5 متر، دون أي تغيير في الخوارزمية.
- التمثيل
powed: نحول القوة إلى قيمة بين 0 و1 ثم نرفعها لقوة e، فتكبر الفروق بين الإشارات القوية وتصغر بين الضعيفة، لأن الإشارة القوية أدل على القرب من نقطة الوصول. وهذا أعطى أفضل النتائج: الطابق الصحيح 93.3% مع k=3، ووسيط الخطأ 4.77 متر. - المبنى سهل: 99.5% وما فوق في كل الإعدادات تقريباً، لأن المباني الثلاثة تسمع نقاط وصول مختلفة.
- k: الفرق بين 3 و5 و9 صغير، وk=1 أسوأ قليلاً لأن قراءة واحدة شاذة تحدد النتيجة.
- المتوسط والوسيط: المتوسط 8.15 متر والوسيط 4.77، والنسبة 90 هي 18.2 متر، أي أن الخطأ ليس متماثلاً: أغلب القراءات قريبة، وقليل منها بعيد جداً، وهذا ما يجعل النقطة الزرقاء تقفز فجأة.
- الطابق الخاطئ: 74 قراءة صنفت في طابق خاطئ، ووسيط خطئها الأفقي 13.5 متر، مقابل 4.45 متر عندما يكون الطابق صحيحاً، لأن الجيران الذين اختارهم النموذج في طابق آخر، ومواقعهم في ذلك الطابق.
- الزمن: قرابة مللي ثانية إلى 4 مللي ثانية للقراءة على سيرفر، وهذا يكفي لتحديث الموقع عدة مرات في الثانية.
وفي الكود قرار آخر لم نشرحه بعد، وهو الخيار weights="distance"، أي أن الجار الأقرب في البصمة يحصل على وزن أكبر في متوسط المواقع، بدل أن يتساوى الجيران الثلاثة. وهذا منطقي هنا، لأن القراءة الأقرب بصمة غالباً هي الأقرب مكاناً، ولكن له جانب سيئ: إذا كان أقرب جار في طابق آخر، فوزنه الكبير يسحب الموقع إليه. ولاحظ أيضاً أننا نصنف الطابق مع المبنى في رقم واحد، المبنى ضرب عشرة زائد الطابق، حتى لا يخلط النموذج الطابق 2 في المبنى 0 مع الطابق 2 في المبنى 2، فالرقم نفسه لا يعني المكان نفسه. وفي نظام حقيقي يكون الترتيب بالعكس عادة: حدد المبنى أولاً، وهو سهل كما رأينا، ثم الطابق بنموذج خاص بذلك المبنى، ثم الموقع بنموذج خاص بذلك الطابق، فيصبح كل نموذج أصغر وأدق، وهذا ما تجده في التدريب العملي في آخر المقال.
لماذا يختلف الطابق عن الطابق؟
الجدول في آخر المخرج يبين أن الدقة ليست رقماً واحداً للمبنى. ففي المبنى 0 كانت دقة الطابق بين 94% و98% ووسيط الخطأ بين 2.8 و4.3 متر، أما الطابق 0 في المبنى 1 فدقة طابقه 63% فقط، ووسيط خطئه 9.8 متر. وهذا ما تجده في أي مبنى حقيقي: الطابق الأرضي قد يكون فيه بهو مفتوح على الطابق الذي فوقه، فيسمع الهاتف نقاط الوصول نفسها في الطابقين، والطوابق ذات الممرات المغلقة تعطي بصمات أوضح. لذلك لا تعلن دقة واحدة لنظامك، وإنما قسها لكل طابق، وابدأ التحسين من أسوأها، لأن الزائر لا يهتم بالمتوسط وإنما بالمكان الذي يقف فيه.
والهاتف نفسه؟
ثم رسمنا توزيع الخطأ، وحسبنا الوسيط لكل هاتف في قراءات التحقق، وهو الملف lab/05_plot.py الذي يستخدم أيضاً نتائج التثليث من القسم التالي:
# Error curves of the three methods on the same 1,111 validation scans, and kNN error per phone.
import matplotlib
import numpy as np
import pandas as pd
from matplotlib import font_manager
matplotlib.use("Agg")
import matplotlib.pyplot as plt

font_manager.fontManager.addfont("/fonts/IBMPlexSansArabic-Regular.ttf")
plt.rcParams["font.family"] = "IBM Plex Sans Arabic"
knn = pd.read_csv("/data/knn_errors.csv")
tri = pd.read_csv("/data/tri_errors.csv")

fig, ax = plt.subplots(figsize=(10, 5.6), dpi=150)
for label, e, color in [("بصمة Wi-Fi مع kNN", knn["err"], "#1F8A55"),
                        ("المركز الموزون Weighted Centroid", tri["weighted centroid"], "#3F78E0"),
                        ("التثليث Trilateration من RSSI", tri["trilateration"], "#C62828")]:
    x = np.sort(e.to_numpy())
    ax.plot(x, np.arange(1, len(x) + 1) / len(x) * 100, color=color, lw=2.4, label=f"{label}: الوسيط {np.median(x):.1f} م")
ax.set_xlim(0, 40); ax.set_ylim(0, 100)
ax.set_xlabel("خطأ الموقع الأفقي بالمتر"); ax.set_ylabel("نسبة القراءات %")
ax.grid(alpha=.3); ax.legend(loc="lower right")
ax.set_title("خطأ الموقع في 1,111 قراءة اختبار من بيانات UJIIndoorLoc")
fig.savefig("/data/error-cdf.png", bbox_inches="tight")

per_phone = knn.groupby("PHONEID")["err"].agg(["size", "median"]).sort_values("median")
print(per_phone.round(2).to_string())
size median
PHONEID
13 369 3.56
0 120 4.04
9 77 4.11
4 69 4.83
12 70 5.04
15 36 5.72
21 60 6.71
20 213 6.72
2 52 6.82
14 28 8.41
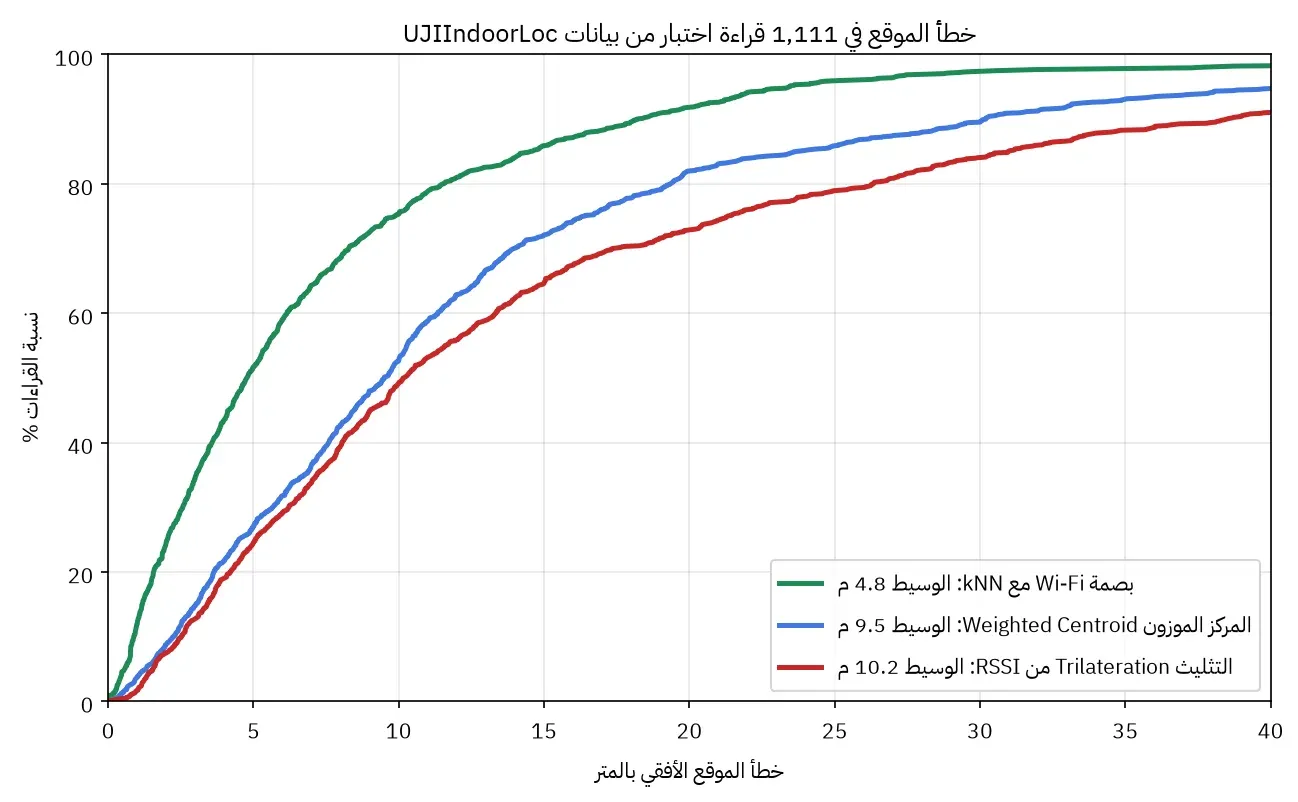
5 17 14.45وسيط الخطأ من 3.56 متر في أفضل هاتف إلى 8.41 في هاتف آخر بقراءات كافية، و14.45 في هاتف له 17 قراءة فقط فلا نبني عليه كثيراً. والسبب أن كل هاتف يقيس القوة بهوائي ودائرة مختلفة، فقد يقرأ هاتفان في المكان نفسه إشارة النقطة نفسها بفرق عدة dBm، والبصمة المسجلة بهاتف المسح تقارن بقراءة هاتف آخر. وهذه مشكلة معروفة باسم اختلاف الأجهزة Device Heterogeneity، وحلولها تبدأ من التمثيل نفسه: مقارنة ترتيب النقاط بدل قيمها، أو معايرة كل طراز بقراءات قليلة. والصورة التالية من الملف نفسه تقارن البصمة بطريقتين أخريين على القراءات نفسها:
كيف تجمع البصمات في مبناك؟
بيانات UJIIndoorLoc جاهزة، أما في مبناك فالمسح هو أغلب العمل، وأغلب أسباب فشل الأنظمة. وفيما يلي ما تعلمناه من قراءة البيانات نفسها، وما يجب أن تخطط له قبل أن تبدأ:
- كثافة النقاط: البصمة لا تعرف إلا الأماكن التي مسحتها، فالموقع المقدر دائماً متوسط لمواقع مسجلة. فإذا كانت نقاط المسح كل عشرة أمتار، فلا تتوقع دقة أفضل من بضعة أمتار مهما حسنت الخوارزمية، وفي الممرات الطويلة يكفي خط واحد، أما القاعات الكبيرة فتحتاج شبكة نقاط.
- الاتجاه والجسم: جسم من يحمل الهاتف يحجب جزءاً من الإشارات، فقراءة الشخص نفسه في المكان نفسه تختلف بحسب الاتجاه الذي يواجهه. لذلك سجل في كل نقطة أكثر من قراءة وبأكثر من اتجاه، كما فعل جامعو UJIIndoorLoc بتسجيل عدة قراءات في كل موقع.
- أكثر من هاتف: رأينا أن الوسيط تضاعف بين هاتف وآخر، فاجمع المسح بطرازين أو ثلاثة على الأقل من الهواتف التي يحملها زوارك فعلاً.
- حدود المسح في Android: أربعة طلبات مسح كل دقيقتين لتطبيق في المقدمة تجعل المسح بطيئاً، والتوثيق نفسه يذكر خياراً للمطورين يوقف هذا الحد للاختبار المحلي، فاستخدمه في هاتف المسح فقط.
- التاريخ: احفظ تاريخ كل قراءة وطراز الهاتف وقائمة نقاط الوصول التي ظهرت، فعندما تتغير الشبكة تعرف أي جزء من الخريطة يحتاج مسحاً جديداً بدل إعادة المبنى كله.
من قوة الإشارة إلى المسافة
الطريقة التي تبدو أبسط من البصمة أن تعرف مواقع نقاط الوصول أو المنارات، وتحول قوة كل إشارة إلى مسافة، ثم تحسب الموقع الذي يحقق هذه المسافات، وهذا هو التثليث Trilateration. والتحويل يحتاج نموذجاً لضعف الإشارة مع المسافة Path Loss، وأشهره النموذج اللوغاريتمي Log-distance: الفقد يزيد بمقدار ثابت كلما تضاعفت المسافة عشر مرات. وأكثر مرجع موثوق لقيم هذا النموذج داخل المباني توصية الاتحاد الدولي للاتصالات ITU-R P.1238، وإصدارها الأخير P.1238-13 صدر في سبتمبر 2025. وفي جدولها الثاني نموذج عام للمكاتب بالصيغة:
L(d, f) = 10 * a * log10(d) + b + 10 * g * log10(f_GHz) + X,   X ~ N(0, sigma)

office, LoS  : a = 1.47, b = 34.17, g = 2.08, sigma = 3.68 dB
office, NLoS : a = 2.39, b = 30.13, g = 2.40, sigma = 5.01 dB
والحد الأخير X هو التظليل Shadowing، أي أن الفقد عند المسافة نفسها ليس ثابتاً، وإنما يتغير بتوزيع طبيعي بانحراف معياري خمسة ديسيبل تقريباً في حالة عدم وجود خط رؤية NLoS، لأن الجسم والأثاث والأبواب والناس تقف في الطريق بشكل مختلف كل مرة. وفي الجدول الخامس فقد إضافي 14 dB عند 2.4 GHz للإشارة التي تعبر أرضية طابق واحد في مبنى مكاتب. والملف التالي يحاكي ما يعنيه ذلك لمنارة BLE، وهو الملف lab/03_pathloss_sim.py:
# Simulation with the site-general indoor model of ITU-R P.1238-13 (Table 2, office) at 2.4 GHz.
#   L(d) = 10*a*log10(d) + b + 10*g*log10(f_GHz) + X,   X ~ N(0, sigma)
import numpy as np
from scipy.optimize import least_squares

rng = np.random.default_rng(2026)
F = 2.4
MODEL = {"office LoS": (1.47, 34.17, 2.08, 3.68), "office NLoS": (2.39, 30.13, 2.40, 5.01)}
FLOOR_LOSS_DB = 14            # Table 5, office, 2.4 GHz, one floor
PTX = 0                       # dBm transmitted (EIRP) by the beacon, an assumption for the example

def loss(d, a, b, g):
    return 10 * a * np.log10(d) + b + 10 * g * np.log10(F)

def distance_from_rssi(rssi, a, b, g):
    return 10 ** ((PTX - rssi - b - 10 * g * np.log10(F)) / (10 * a))

print("1) one beacon, distance read from RSSI (10,000 draws each)")
print(f"{'model':12} {'true m':>6} {'median rssi':>11} {'median est':>10} {'p10 est':>8} {'p90 est':>8}")
for name, (a, b, g, s) in MODEL.items():
    for d in (2, 5, 10, 20):
        rssi = PTX - loss(d, a, b, g) - rng.normal(0, s, 10_000)
        est = distance_from_rssi(rssi, a, b, g)
        print(f"{name:12} {d:6} {np.median(rssi):11.1f} {np.median(est):10.1f} {np.percentile(est, 10):8.1f} {np.percentile(est, 90):8.1f}")
a, b, g, s = MODEL["office NLoS"]
print(f"   one standard deviation ({s} dB) multiplies or divides the distance by {10 ** (s / (10 * a)):.2f}")
print(f"   a beacon one floor away ({FLOOR_LOSS_DB} dB more loss) looks {10 ** (FLOOR_LOSS_DB / (10 * a)):.2f}x farther")

print("\n2) position in a 30 x 20 m hall with 4 anchors in the corners and 2 in the middle of the long walls")
anchors = np.array([[0, 0], [30, 0], [30, 20], [0, 20], [15, 0], [15, 20]], float)

def solve(ranges):
    x0 = anchors.mean(axis=0)
    return least_squares(lambda p: np.hypot(*(anchors - p).T) - ranges, x0).x

def run(label, ranges_fn, n=3000):
    pts = rng.uniform([1, 1], [29, 19], (n, 2))
    err = np.array([np.hypot(*(solve(ranges_fn(p)) - p)) for p in pts])
    print(f"   {label:46} median {np.median(err):5.2f} m   p90 {np.percentile(err, 90):5.2f} m")

def ble(p, samples=1):
    d = np.hypot(*(anchors - p).T)
    rssi = PTX - loss(d, a, b, g) - rng.normal(0, s, (samples, len(d))).mean(axis=0)
    return distance_from_rssi(rssi, a, b, g)

run("BLE RSSI, NLoS model, one reading", ble)
run("BLE RSSI, mean of 10 independent readings", lambda p: ble(p, 10))
run("Wi-Fi RTT, range error 1 m (sd)", lambda p: np.hypot(*(anchors - p).T) + rng.normal(0, 1.0, 6))
run("UWB, range error 0.10 m (sd)", lambda p: np.hypot(*(anchors - p).T) + rng.normal(0, 0.10, 6))
ip python /lab/03_pathloss_sim.py1) one beacon, distance read from RSSI (10,000 draws each)
model true m median rssi median est p10 est p90 est
office LoS 2 -46.6 2.0 0.9 4.2
office LoS 5 -52.3 5.0 2.4 10.5
office LoS 10 -56.7 9.9 4.8 20.9
office LoS 20 -61.2 20.0 9.6 41.8
office NLoS 2 -46.4 2.0 1.1 3.7
office NLoS 5 -56.0 5.0 2.7 9.3
office NLoS 10 -63.2 10.1 5.4 18.6
office NLoS 20 -70.4 20.0 10.7 37.6
one standard deviation (5.01 dB) multiplies or divides the distance by 1.62
a beacon one floor away (14 dB more loss) looks 3.85x farther
2) position in a 30 x 20 m hall with 4 anchors in the corners and 2 in the middle of the long walls
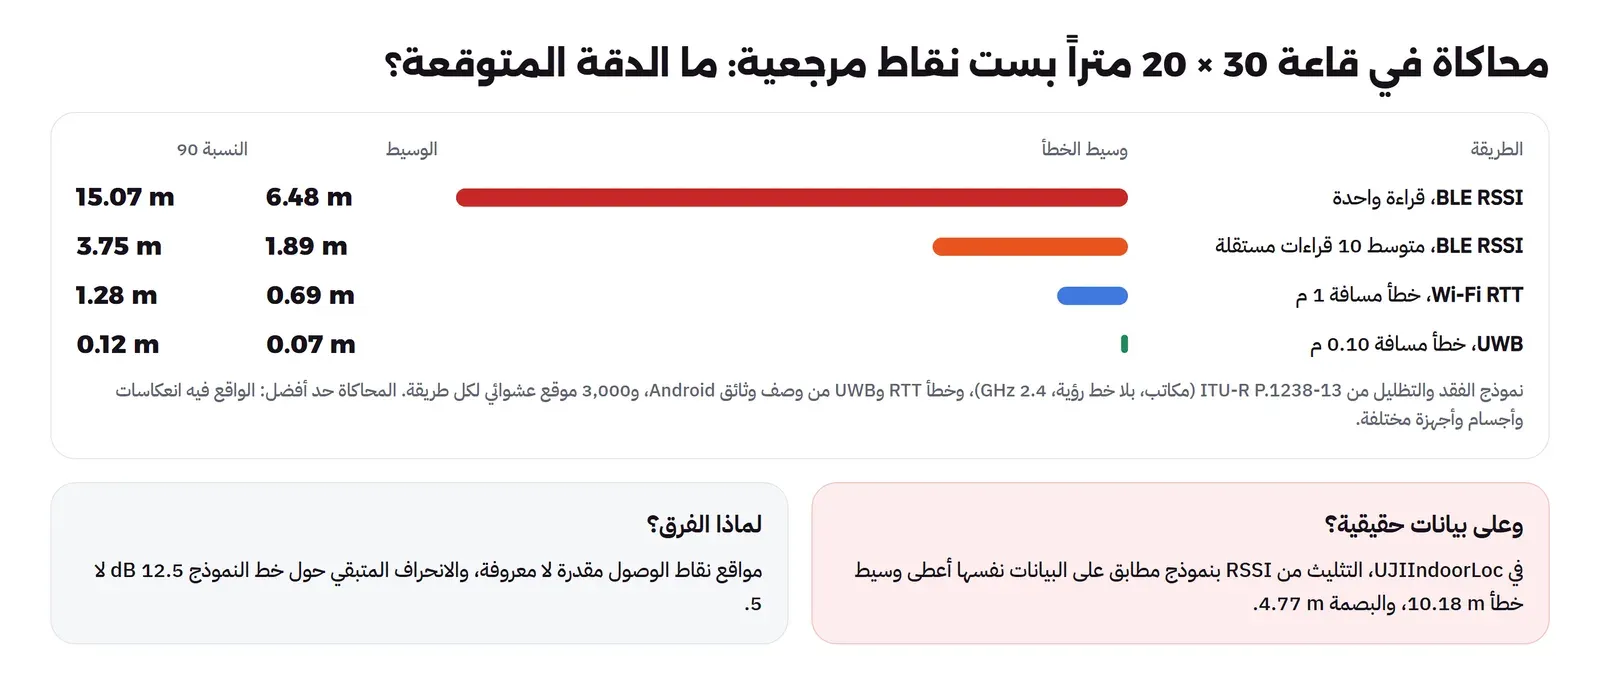
BLE RSSI, NLoS model, one reading median 6.48 m p90 15.07 m
BLE RSSI, mean of 10 independent readings median 1.89 m p90 3.75 m
Wi-Fi RTT, range error 1 m (sd) median 0.69 m p90 1.28 m
UWB, range error 0.10 m (sd) median 0.07 m p90 0.12 m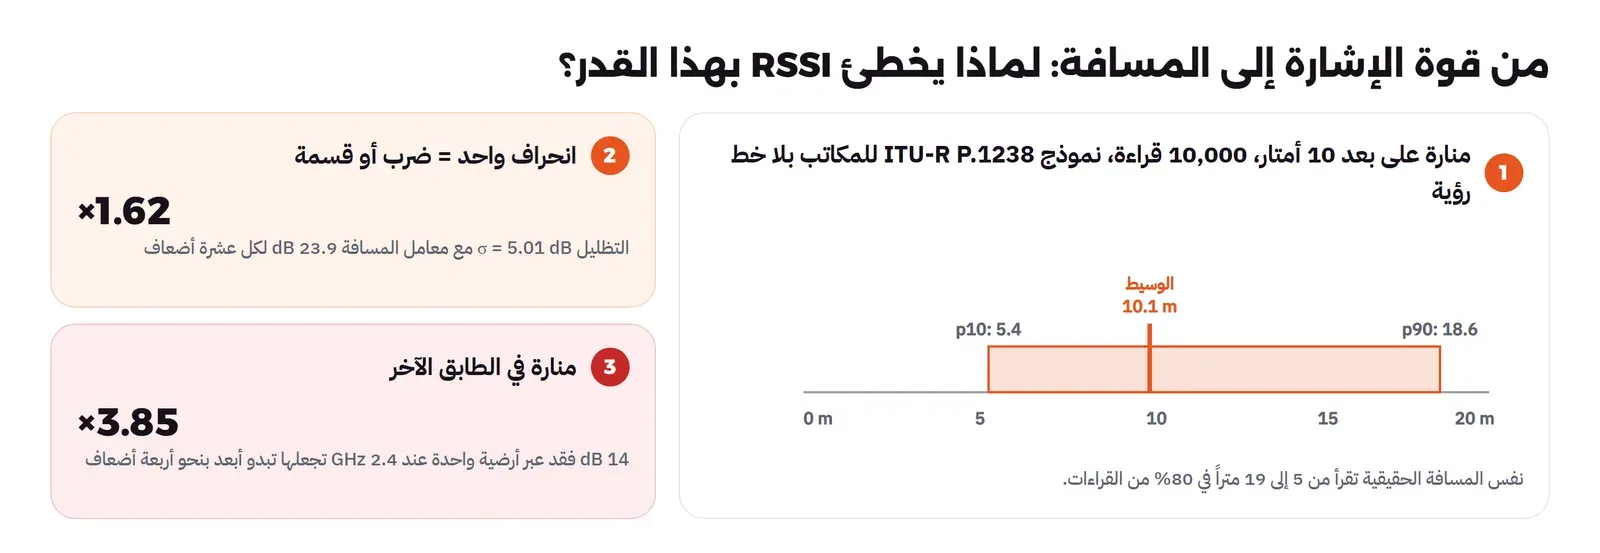
في المخرج أعلاه لاحظ التالي:
- الوسيط صحيح دائماً، 10.1 متر لمنارة على 10 أمتار، لأن النموذج نفسه هو الذي يحول، ولكن 80% من القراءات تقع بين 5.4 و18.6 متر، أي أن قراءة واحدة لا تعرف هل المنارة على خمسة أمتار أم عشرين.
- انحراف معياري واحد في الإشارة يضرب المسافة أو يقسمها على 1.62، وهذه طبيعة اللوغاريتم: الخطأ بالديسيبل ثابت، فيصبح الخطأ بالمتر نسبة من المسافة، ويكبر مع البعد.
- المفاجأة أن خط الرؤية LoS أعطى انتشاراً أوسع رغم أن تظليله أقل، 3.68 مقابل 5.01، والسبب أن معامل المسافة فيه أصغر، 14.7 ديسيبل لكل عشرة أضعاف مقابل 23.9، فالإشارة تتغير ببطء مع المسافة، وكل ديسيبل خطأ يعني أمتاراً أكثر.
- المنارة في الطابق الآخر تبدو أبعد 3.85 مرة، أي أن منارة على بعد خمسة أمتار فوقك قد تقرأ كمنارة على بعد 19 متراً في طابقك، فإذا لم تعرف الطابق أولاً فالتثليث يخلط المنارات.
BLE وWi-Fi RTT وUWB: ماذا يقيس كل منها؟
منارات BLE: iBeacon وEddystone
المنارة Beacon جهاز صغير ببطارية يبث كل جزء من الثانية رسالة Bluetooth Low Energy فيها معرف، والهاتف يقرأ المعرف وقوة الإشارة. وهناك صيغتان مشهورتان للرسالة: iBeacon من Apple، ومعرفها ثلاثة أجزاء: UUID للمنشأة ثم Major وMinor للمنطقة والمنارة، وتقرؤه تطبيقات iOS عبر Core Location، وEddystone المفتوحة من Google برخصة Apache 2.0، وفيها أنواع رسائل منها معرف ثابت، ورابط URL، وبيانات قياس TLM مثل حرارة المنارة وبطاريتها، ونوع EID بمعرف يتغير ويشفر حتى لا يقرأه إلا المصرح له. وكلتا الصيغتين تحمل قيمة القوة المقاسة على بعد متر، وهي التي يحولها التطبيق إلى مسافة بالنموذج الذي حاكيناه، ولهذا السبب فإن واجهات Apple نفسها تعرض المسافة كدرجات قرب Proximity، قريب جداً وقريب وبعيد، لا كرقم بالمتر.
ونقطة القوة في المنارات أنها رخيصة وتعمل مع كل هاتف تقريباً، وأنك تضعها حيث تحتاج الدقة: عند المداخل والمصاعد وأمام الأقسام. ونقطة الضعف ما رأيناه في المحاكاة: من قراءة واحدة كان وسيط الخطأ 6.5 متر في قاعة 30 في 20 متراً، ومع متوسط عشر قراءات مستقلة نزل إلى 1.9 متر. ولاحظ كلمة مستقلة، فالقراءات العشر في الواقع ليست مستقلة: إذا كان جسمك بين الهاتف والمنارة فسيبقى بينهما في القراءات العشر، والمتوسط لا يصلح خطأ ثابتاً. لذلك فإن 1.9 متر حد أفضل لا وعد.
Wi-Fi RTT: الزمن بدل القوة
المعيار IEEE 802.11mc أضاف إلى Wi-Fi بروتوكولاً اسمه Fine Timing Measurement، يقيس فيه الهاتف زمن ذهاب الرسالة إلى نقطة الوصول وعودتها Round Trip Time، ومن الزمن والسرعة يحسب المسافة، مثل ما يفعله GNSS، فلا يتأثر بقوة الإشارة. وتوثيق Android يقول إن قياس المسافة إلى ثلاث نقاط وصول أو أكثر يعطي موقعاً دقته عادة بين متر ومترين، وإن الميزة متاحة منذ Android 9، وإن Android 15 أضاف دعم IEEE 802.11az. وعلى Android 10 وما بعده يمكن أن ترسل نقطة الوصول موقعها نفسه أثناء القياس، فلا تحتاج قاعدة بيانات لمواقع النقاط. والواجهة في الكود هي WifiRttManager، وتحتاج صلاحية الموقع الدقيق ACCESS_FINE_LOCATION، أو NEARBY_WIFI_DEVICES بحسب نوع الطلب وإصدار النظام.
والشرط الذي يغفل عنه الناس: نقاط الوصول نفسها يجب أن تدعم 802.11mc كمستجيب Responder، والهاتف يجب أن يدعمه، فإذا كانت شبكة المبنى قديمة فلا فائدة من الميزة. وفي المحاكاة بخطأ مسافة قدره متر واحد، كان وسيط الخطأ 0.69 متر والنسبة 90 هي 1.28 متر، وهذا قريب مما يقوله التوثيق، مع أن المحاكاة لا تحتوي على انعكاسات تطيل الزمن في الواقع.
ولماذا يحتاج قياس الزمن إلى بروتوكول خاص؟ لأن الضوء يقطع 30 سنتيمتراً في النانوثانية الواحدة، فخطأ عشر نانوثوان في التوقيت يعني ثلاثة أمتار. وفي Fine Timing Measurement يسجل الطرفان أربعة أوقات: إرسال نقطة الوصول للرسالة، ووصولها إلى الهاتف، وإرسال الهاتف للتأكيد، ووصوله إلى نقطة الوصول، فيطرح زمن انتظار الهاتف بين الوصول والرد من الزمن الكلي، ولا يبقى إلا زمن الطيران في الاتجاهين، ثم يقسم على اثنين. وبهذه الطريقة لا تحتاج ساعتا الطرفين أن تكونا متزامنتين، لأن كل طرف يطرح أوقاته هو. والمشكلة الباقية الانعكاسات: إذا كان الخط المستقيم محجوباً ووصل أول ما وصل من انعكاس، فالزمن أطول والمسافة أكبر، ولذلك فإن عرض النطاق أهم من القوة هنا، لأن النطاق الأعرض يفصل بين الإشارة المباشرة والمنعكسة بدقة أكبر، وهذا بالضبط ما تستغله UWB بنطاقها الواسع جداً.
UWB: سنتيمترات
الحزمة فائقة العرض Ultra-Wideband ترسل نبضات قصيرة جداً على نطاق واسع من الترددات، فيمكن قياس زمن وصولها بدقة عالية، والمعيار الذي تقوم عليه أجهزة اليوم هو IEEE 802.15.4z الذي أضاف حماية لتوقيت النبضات حتى لا يزوره أحد. وتوثيق Android يصف UWB بأنها تقنية للقياس الدقيق بدقة 10 سنتيمترات، ويشترط Android 12 أو ما بعده، وعلى iPhone الواجهة Nearby Interaction. وأشهر استخدام لها البحث الدقيق عن AirTag، والصفحة الرسمية لـ AirTag تقول إن البحث الدقيق Precision Finding يحتاج iPhone يدعم UWB، وإن مواد الجدران والأجسام بين الهاتف وAirTag قد تؤثر في الأداء.
وفي المحاكاة بخطأ 10 سنتيمترات كان وسيط الخطأ 7 سنتيمترات. والثمن أن UWB تحتاج مراسي Anchors خاصة بها في السقف، وكل مرساة تحتاج كهرباء ومزامنة، وأن الهواتف التي تدعمها أقل من التي تدعم Wi-Fi وBluetooth، لذلك تجدها في المستودعات والمصانع لتتبع الأصول والمعدات بدقة، أكثر مما تجدها لزوار المجمعات. والصورة التالية تجمع نتائج المحاكاة:
التثليث على قراءات حقيقية
المحاكاة تفترض أننا نعرف مواقع النقاط بالضبط، وأن النموذج صحيح. فماذا يحدث على قراءات حقيقية؟ بيانات UJIIndoorLoc لا تحتوي على مواقع نقاط الوصول، وهذا هو الحال في أغلب المباني التي لم يركب شبكتها فريقك، لذلك نقدرها من بيانات التدريب: موقع كل نقطة هو المركز الموزون لأقوى عشر قراءات لها، ثم نطابق خطاً واحداً للنموذج اللوغاريتمي على كل القراءات، ثم نحدد موقع كل قراءة تحقق بطريقتين: المركز الموزون Weighted Centroid لأقوى نقاطها، والتثليث بالمربعات الصغرى Least Squares. وهو الملف lab/04_trilateration.py:
# Trilateration on the real RSSI of UJIIndoorLoc. The dataset has no AP positions, so we estimate them
# from the training scans, fit one path-loss line, then locate the validation scans.
import numpy as np
import pandas as pd
from scipy.optimize import least_squares

tr = pd.read_csv("/data/UJIndoorLoc/trainingData.csv")
va = pd.read_csv("/data/UJIndoorLoc/validationData.csv")
waps = [c for c in tr.columns if c.startswith("WAP")]
R = tr[waps].to_numpy(dtype=float, copy=True)
XY = tr[["LONGITUDE", "LATITUDE"]].to_numpy()
FL = (tr["BUILDINGID"] * 10 + tr["FLOOR"]).to_numpy()

# 1) AP position = weighted centre of the 10 strongest readings, on the floor where it is strongest
ap = {}
for j, w in enumerate(waps):
    seen = np.where(R[:, j] != 100)[0]
    if len(seen) < 10:
        continue
    top = seen[np.argsort(R[seen, j])[-10:]]
    weight = 10 ** (R[top, j] / 10)                       # dBm to mW
    floor = pd.Series(FL[top]).mode()[0]
    ap[j] = (np.average(XY[top], axis=0, weights=weight), floor, R[top, j].max())
print(f"APs with a position estimate: {len(ap)} of {len(waps)}")

# 2) one log-distance line for all APs: RSSI = A - 10 n log10(d), same floor only, d >= 1 m
rows = []
for j, (pos, floor, _) in ap.items():
    seen = np.where((R[:, j] != 100) & (FL == floor))[0]
    d = np.hypot(*(XY[seen] - pos).T)
    keep = d >= 1
    rows.append(np.c_[np.log10(d[keep]), R[seen[keep], j]])
fit = np.vstack(rows)
slope, A = np.polyfit(fit[:, 0], fit[:, 1], 1)
n = -slope / 10
resid = fit[:, 1] - (A + slope * fit[:, 0])
print(f"fitted on {len(fit):,} readings: A = {A:.1f} dBm at 1 m, n = {n:.2f}, residual sd = {resid.std():.1f} dB")

def rssi_to_d(r):
    return 10 ** ((A - r) / (10 * n))

# 3) locate each validation scan from its strongest APs that have a position
Rv = va[waps].to_numpy(dtype=float, copy=True)
truth = va[["LONGITUDE", "LATITUDE"]].to_numpy()
res = {"weighted centroid": [], "trilateration": []}
used = []
for i in range(len(va)):
    cand = [j for j in np.argsort(Rv[i])[::-1] if Rv[i, j] != 100 and j in ap][:6]
    if len(cand) < 3:
        continue
    pos = np.array([ap[j][0] for j in cand])
    w = 10 ** (Rv[i, cand] / 10)
    c = np.average(pos, axis=0, weights=w)
    d = rssi_to_d(Rv[i, cand])
    t = least_squares(lambda p: (np.hypot(*(pos - p).T) - d) / d, c).x   # relative error: near APs count more
    res["weighted centroid"].append(np.hypot(*(c - truth[i])))
    res["trilateration"].append(np.hypot(*(t - truth[i])))
    used.append(i)
print(f"validation scans with 3+ located APs: {len(used)} of {len(va)}")
for name, e in res.items():
    e = np.array(e)
    print(f"  {name:18} median {np.median(e):6.2f} m   p75 {np.percentile(e, 75):6.2f} m   p90 {np.percentile(e, 90):6.2f} m")
d_est = rssi_to_d(np.array([-50, -60, -70, -80, -90]))
print("distance read from RSSI with the fitted line:", {r: round(float(x), 1) for r, x in zip([-50, -60, -70, -80, -90], d_est)})
pd.DataFrame({"scan": used, **res}).to_csv("/data/tri_errors.csv", index=False)
ip python /lab/04_trilateration.pyAPs with a position estimate: 392 of 520
fitted on 130,424 readings: A = -48.2 dBm at 1 m, n = 1.81, residual sd = 12.5 dB
validation scans with 3+ located APs: 1109 of 1111
weighted centroid median 9.50 m p75 16.42 m p90 30.19 m
trilateration median 10.18 m p75 21.33 m p90 38.49 m
distance read from RSSI with the fitted line: {-50: 1.3, -60: 4.5, -70: 16.0, -80: 57.2, -90: 204.5}في المخرج أعلاه لاحظ التالي:
- قدرنا مواقع 392 نقطة وصول من 520، والباقي ظهر في أقل من عشر قراءات.
- الخط المطابق على 130 ألف قراءة: القوة على بعد متر -48.2 dBm، ومعامل المسافة n=1.81، أي أقل من معامل ITU للمكاتب بلا خط رؤية 2.39، وجزء من السبب أن مواقع النقاط المقدرة منحازة نحو الأماكن التي مشى فيها المساح، فتبدو النقاط أقرب من حقيقتها.
- الأهم الانحراف المتبقي حول الخط: 12.5 ديسيبل، أي أكثر من ضعفي التظليل في نموذج ITU، لأن هذه قراءات بهواتف مختلفة، في طوابق مختلفة، بمواقع نقاط تقديرية. وبهذا الانحراف يصبح تحويل القوة إلى مسافة شبه عشوائي: -80 dBm تعني 57 متراً، و-90 تعني 204 أمتار، أي أبعد من المبنى.
- النتيجة: التثليث وسيط خطئه 10.18 متر، والمركز الموزون البسيط 9.50 متر، أي أن الحساب الأعقد كان أسوأ، لأنه يثق في مسافات لا تستحق الثقة، بينما المركز الموزون يقول فقط «أنت قرب النقاط الأقوى». والبصمة على البيانات نفسها 4.77 متر، أي نصف الخطأ.
والدرس العملي: إذا كانت أداتك قوة الإشارة، فالبصمة أو المركز الموزون أفضل من التثليث، والتثليث يستحق فقط عندما تقيس الزمن، أي RTT أو UWB، حيث تكون المسافة نفسها موثوقة.
عد الخطوات PDR ومطابقة الخريطة
الطرق السابقة تعطي موقعاً مطلقاً كل ثانية أو بضع ثوان، وكل قراءة مستقلة عن التي قبلها، لذلك تقفز النقطة. أما عد الخطوات Pedestrian Dead Reckoning واختصاراً PDR فيعمل بالعكس: يستخدم حساسات الهاتف، مقياس التسارع Accelerometer لكشف الخطوة، والجيروسكوب Gyroscope والبوصلة لاتجاهها، ويضيف كل خطوة إلى الموقع السابق. وتوثيق حساسات الحركة في Android يصف حساسات جاهزة مثل كاشف الخطوة Step Detector وعداد الخطوات Step Counter. ونقطة القوة أنه سلس ولا يحتاج أي بنية في المبنى، ونقطة الضعف أن الخطأ يتراكم: خطأ صغير في طول الخطوة أو الاتجاه يكبر مع كل خطوة، فبعد دقيقة من المشي قد تكون في الممر الخطأ.
وهنا تأتي الخريطة الداخلية التي بنيناها في المقال السابق، فهي ليست للعرض فقط، وإنما قيد على الموقع: الإنسان لا يمر عبر الجدار، ولا ينتقل إلى طابق آخر إلا عند درج أو مصعد. وهذا ما يسمى مطابقة الخريطة Map Matching، وأشهر طريقة له المرشح الجسيمي Particle Filter: آلاف الاحتمالات للموقع، تتحرك كلها مع كل خطوة، ويحذف منها ما عبر جداراً، ويقوى ما يوافق قراءة Wi-Fi. والصورة التالية تبين كيف تجتمع المصادر في تطبيق حقيقي:
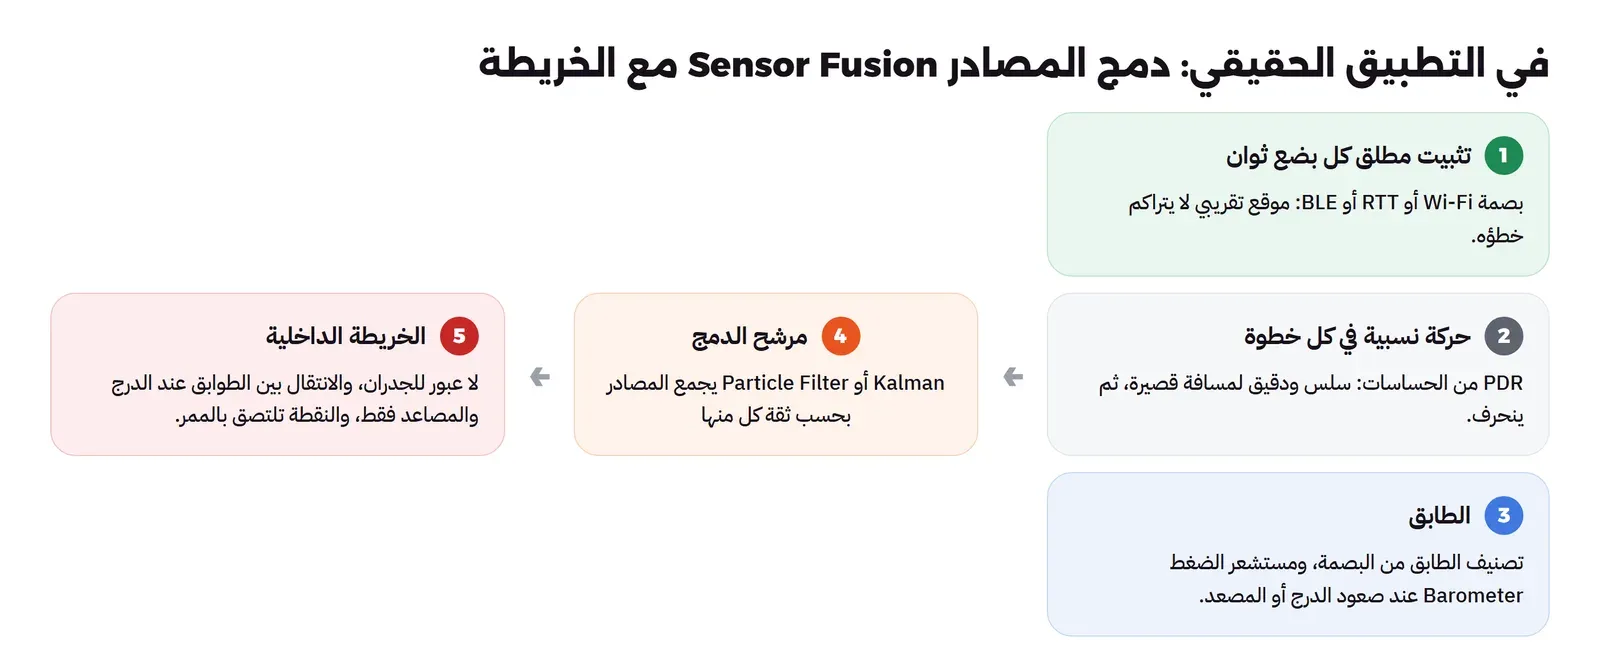
ولاحظ في الصورة مستشعر الضغط Barometer: الضغط الجوي ينخفض قليلاً مع الارتفاع، فعندما يصعد الزائر درجاً يرى الهاتف تغيراً واضحاً في الضغط خلال ثوان، وهذا أدل على تغيير الطابق من البصمة وحدها، التي رأينا أنها أخطأت الطابق في 74 قراءة من 1,111. والضغط وحده لا يعرف رقم الطابق، لأنه يتغير مع الطقس، ولكنه يعرف متى تغير الطابق وفي أي اتجاه، والبصمة تعرف أي طابق، فيكمل كل منهما الآخر.
هل تبني النظام بنفسك أم تستخدم ما في نظام التشغيل؟
قبل أن تكتب سطراً، اسأل: هل يكفيني ما يعطيه الهاتف جاهزاً؟ فخدمات الموقع في Android وiOS تدمج بنفسها GNSS وWi-Fi والحساسات، وتعطي التطبيق موقعاً مع نصف قطر للدقة، وفي كثير من المباني الكبيرة يكون هذا الموقع جيداً بما يكفي لعرض الطابق التقريبي والجهة. وApple تذكر في صفحة برنامج الخرائط الداخلية أن المنشأة التي تسجل خريطتها بصيغة IMDF وتجري مسحاً للإشارات بتطبيق Indoor Survey تحصل على تحديد موقع داخلي يعتمد على شبكة Wi-Fi الموجودة دون أجهزة إضافية، وتصل إليه التطبيقات عبر Core Location وMapKit، أي أن Apple هي التي تبني البصمة وتحسب الموقع، وأنت تعرضه.
ومتى تبني نظامك؟ في ثلاث حالات: عندما تحتاج الموقع على كل الهواتف بالطريقة نفسها، لا على منصة واحدة، وعندما تريد أن تبقى البيانات وخريطة الراديو عندك لأسباب السيادة على البيانات، وعندما تحتاج دقة لا يعطيها النظام، مثل تتبع معدات بـ UWB في مستودع. وفي غير ذلك، ابدأ بما في النظام، وقس دقته في مبناك بالطريقة نفسها التي قسنا بها في المختبر: قراءات في مواقع معروفة، والوسيط والنسبة 90 لكل طابق، ثم قرر إن كان الفرق يستحق مشروع مسح كامل.
الخصوصية: من يعرف أين أنت؟
الموقع داخل المبنى أكثر حساسية من الموقع خارجه، لأنه يقول أي عيادة دخلت، وكم دقيقة وقفت أمام أي محل، وأين مكتب كل موظف. لذلك فإن الأنظمة وأنظمة التشغيل نفسها تضع قيوداً، وعليك أن تعرفها قبل التصميم:
- الصلاحيات: في Android يحتاج مسح Wi-Fi لتحديد الموقع صلاحية الموقع الدقيق، والتوثيق يذكر أنها صلاحية خطرة Dangerous تطلب من المستخدم وقت التشغيل، وأن الموقع في الخلفية يحتاج صلاحية إضافية. وبحسب توثيق المسح فإن التطبيق في المقدمة يستطيع أن يطلب المسح أربع مرات كل دقيقتين منذ Android 9، والتطبيقات في الخلفية مجتمعة مرة كل 30 دقيقة، وهذا وحده يجعل تتبع شخص في الخلفية بالبصمة غير عملي على Android.
- عناوين MAC العشوائية: الأنظمة الحديثة لا ترسل عنوان MAC الحقيقي لكل شبكة، فـ Android يولد عنواناً عشوائياً لكل شبكة منذ Android 10، وأجهزة Apple تستخدم عنواناً مختلفاً لكل شبكة وقد تغيره دورياً. ولهذا السبب فإن أنظمة التتبع التي تعتمد على التقاط عناوين الهواتف من نقاط الوصول في المجمعات لم تعد تعرف الزائر نفسه بين زيارة وأخرى، وهذا مقصود.
- الاتجاه مهم: في البصمة والمنارات والـ RTT من جهة الهاتف، الهاتف هو الذي يقيس ويحسب، والمنشأة لا تعرف موقعه إلا إذا أرسله التطبيق. أما الأنظمة التي تقيس من جهة البنية، مثل نقاط الوصول التي تراقب الأجهزة أو مراسي UWB التي تتبع بطاقات، فالمنشأة تعرف الموقع مباشرة، وهنا يجب أن يكون الهدف والموافقة واضحين.
- النظام المحلي: الموقع المرتبط بشخص بيانات شخصية، وفي المملكة يحكمها نظام حماية البيانات الشخصية، وقد شرحنا ما يعنيه للخدمات المستضافة في مقال PDPL: هدف محدد، وموافقة، وأقل قدر من البيانات، ومدة حفظ معلنة.
والقاعدة التي نتبعها: احسب الموقع على الهاتف، ولا ترسله إلى السيرفر إلا لغرض يطلبه المستخدم، مثل مشاركة موقعه مع موظف الاستقبال، ولا تحفظ مسار الحركة إلا مجمعاً وبلا معرف للشخص إذا كان الهدف إحصاء ازدحام الممرات. وإذا كان النظام لتتبع الموظفين أو المعدات، كما في مقال تتبع المندوبين في الخارج، فالشفافية مع الموظفين جزء من التصميم لا ملحق.
جدول الدقة والتكلفة
| التقنية | ما يقيسه | الدقة: المصدر | ما تحتاجه في المبنى | نقاط الضعف |
|---|---|---|---|---|
| بصمة Wi-Fi مع kNN | قوة الإشارة RSSI | وسيط 4.77 م وطابق صحيح 93.3%: مختبرنا على UJIIndoorLoc | شبكة Wi-Fi موجودة ومسح للمبنى | المسح يتقادم، واختلاف الهواتف، ومحدودية المسح في Android |
| تثليث RSSI | قوة الإشارة كمسافة | وسيط 10.18 م: مختبرنا، و6.48 م في المحاكاة | مواقع النقاط ونموذج للإشارة | انحراف 12.5 dB حول النموذج في البيانات الحقيقية |
| منارات BLE | قوة الإشارة | وسيط 1.89 إلى 6.48 م في المحاكاة بحسب عدد القراءات | منارات ببطاريات، وصيانتها | الجسم والجدران، والبطاريات |
| Wi-Fi RTT | زمن الذهاب والعودة | عادة 1 إلى 2 م: توثيق Android، و0.69 م في المحاكاة | نقاط وصول تدعم 802.11mc | دعم الأجهزة والشبكة، والانعكاسات |
| UWB | زمن الطيران | نحو 10 سم: توثيق Android، و0.07 م في المحاكاة | مراسي UWB بكهرباء ومزامنة | التكلفة، وهواتف قليلة تدعمها |
| PDR | الخطوات والاتجاه | جيد لمسافة قصيرة ثم ينحرف | لا شيء | تراكم الخطأ، ويحتاج تثبيتاً مطلقاً |
من أين تبدأ؟
- تطبيق زوار لمنشأة فيها شبكة Wi-Fi حديثة: ابدأ بالبصمة مع PDR والخريطة، وقس الدقة لكل طابق، وإذا كانت المنشأة تريد Apple Maps فبرنامج Apple الذي ذكرناه في المقال السابق يقوم على مسح Wi-Fi أيضاً.
- شبكة جديدة ستركب: اشترط في المواصفات دعم 802.11mc في نقاط الوصول، فهو يعطيك قياس مسافة حقيقياً بلا أجهزة إضافية للهواتف التي تدعمه.
- نقاط محددة تحتاج دقة، مثل المداخل والمصاعد: منارات BLE في هذه النقاط فقط كتثبيت، لا في كل المبنى.
- تتبع معدات أو أصول بدقة سنتيمترات: UWB ببطاقات على المعدات ومراس في السقف، مع سياسة واضحة لمن يرى البيانات.
- لا ميزانية ولا بنية: PDR مع الخريطة الداخلية ونقطة بداية يختارها المستخدم بمسح رمز QR عند المدخل، وهذا أفضل من لا شيء بكثير.
أخطاء شائعة وحلولها
- تمثيل «لم تظهر» بقيمة كبيرة: القيمة 100 أنزلت دقة الطابق من 93% إلى 74%، فاجعل الغائبة أضعف من أضعف قراءة.
- دقة واحدة للمبنى: قس لكل طابق، ففي المختبر كان أسوأ طابق 63% وأفضله 100%.
- الاختبار بهاتف المسح نفسه: اختبر بهواتف مختلفة، فالوسيط تراوح من 3.56 إلى 8.41 متر بين الهواتف.
- التثليث من RSSI: كان أسوأ من المركز الموزون البسيط، فلا تستخدمه إلا مع قياس زمن.
- تجاهل الطابق: منارة في الطابق الآخر تبدو أبعد أربع مرات تقريباً، فحدد الطابق أولاً ثم الموقع.
- متوسط القراءات كحل لكل شيء: يصلح الضوضاء العشوائية فقط، لا الجسم الثابت بين الهاتف والمنارة.
ValueError: assignment destination is read-onlyفي pandas 3: استخدمto_numpy(copy=True)قبل أن تكتب في المصفوفة.- إرسال الموقع إلى السيرفر بلا داع: احسبه على الهاتف، وأرسله فقط عندما يطلب المستخدم.
قائمة تحقق قبل أن تعد بدقة
- هل قست الدقة على قراءات جمعت في وقت غير وقت المسح، وبهواتف غير هاتف المسح؟
- هل تعرف الدقة لكل طابق، ونسبة الطابق الصحيح؟
- هل تعلن الوسيط والنسبة 90، لا المتوسط وحده؟
- هل خطة تحديث المسح مكتوبة، ومن يبلغك عند تغيير نقاط الوصول؟
- هل تدعم نقاط الوصول 802.11mc إذا كنت ستعتمد على RTT؟
- هل الخريطة الداخلية دقيقة بأبوابها ودرجها، لأن مطابقة الخريطة تعتمد عليها؟
- هل الصلاحيات المطلوبة مشروحة للمستخدم، وأين يحسب الموقع، ومن يراه، وكم يحفظ؟
تنظيف المختبر
docker volume rm lab-ip-data
docker image rm lab-ip
تدريب عملي
- غير
02_knn.pyبحيث يصنف المبنى أولاً، ثم يدرب نموذج الطابق والموقع على بيانات ذلك المبنى فقط، وقارن دقة الطابق في المبنى 1 بما رأيناه. - في
03_pathloss_sim.pyأضف منارة في الطابق الذي فوق القاعة بفقد 14 dB، وانظر كيف يتغير خطأ BLE إذا لم يعرف الحل أنها في طابق آخر.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- داخل المبنى تضعف إشارة GNSS وتنعكس ولا تعرف الطابق، فيعتمد الموقع على Wi-Fi وBluetooth وUWB وحساسات الهاتف مع الخريطة الداخلية.
- بصمة Wi-Fi مع kNN على بيانات UJIIndoorLoc الحقيقية أعطت الطابق الصحيح في 93.3% من القراءات ووسيط خطأ 4.77 متر، وتمثيل «لم تظهر» وحده رفع دقة الطابق من 74% إلى 90%.
- الدقة تختلف بين الطوابق، من 63% إلى 100% للطابق الصحيح، وبين الهواتف، من 3.56 إلى 8.41 متر وسيطاً.
- تحويل قوة الإشارة إلى مسافة يخطئ بطبيعته: بنموذج ITU-R P.1238 تقرأ منارة على 10 أمتار من 5 إلى 19 متراً، وعلى البيانات الحقيقية كان الانحراف 12.5 dB والتثليث أسوأ من المركز الموزون.
- قياس الزمن هو الذي يعطي مسافة موثوقة: Wi-Fi RTT بدقة متر إلى مترين بحسب Android، وUWB بنحو 10 سنتيمترات، والثمن دعم الشبكة والأجهزة.
- الحل الحقيقي دمج: تثبيت مطلق من الإشارات، وحركة من PDR، وطابق من الضغط، وخريطة تمنع عبور الجدران.
- الموقع داخل المبنى بيانات شخصية: احسبه على الهاتف، واطلب الموافقة، واحفظ أقل ما يمكن.
 دليلالخرائط الداخلية Indoor Maps: الطوابق وIMDF وOSMكيف تصف المبنى من الداخل بطوابقه وغرفه وأبوابه بثلاثة نماذج مفتوحة، مع مختبر يحول مبنى جامعياً حقيقياً من OpenStreetMap إلى خريطة بطوابق وأرشيف IMDF يمر من قواعد التحقق.
 دليلتتبع مواقع المندوبين لحظياً: من الهاتف إلى الخريطةكيف تستقبل مواقع آلاف المندوبين كل بضع ثوان، وتحفظ آخر موقع لكل منهم، وتوصله إلى العميل الذي ينتظر طلبه.
 دليلكيف تبني تطبيق خرائط وملاحة مثل هدهد وGoogle Maps؟ما الذي يقف خلف كل ميزة في تطبيقات الخرائط، وكيف تبني نسخة أولى منها بأدوات مفتوحة المصدر وبيانات مرخصة بشكل صحيح.
 دليلكيف تعمل شبكة Wi-Fi؟ النطاقات والقنوات والتشفيرشرح مبسط لما يحدث داخل شبكة Wi-Fi من نقطة الوصول والنطاقات والقنوات إلى أجيال Wi-Fi والتشفير، لتفهم لوحة الراوتر وتحل مشكلات التغطية والبطء من أسبابها.
 دليلنقاط الوصول Access Points في المكتب: Mesh وWi-Fi 7كيف تختار نقاط الوصول لمكتبك وتحسب عددها ومواقعها، وتوزع القنوات وتضبط التجوال والإدارة حتى لا تنقطع المكالمات بين الغرف.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلحماية البيانات الشخصية PDPL للخدمات التي تستضيفهاما يعنيه نظام حماية البيانات الشخصية لمن يشغل خدمة على سيرفراته، من العقد مع العميل والإشعار بالتسرب إلى النسخ والسجلات والنقل للخارج.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على بيانات UJIIndoorLoc من مستودع UCI (CC BY 4.0) مع Python 3.13.18 وscikit-learn 1.9.1 وnumpy 2.5.5 وpandas 3.1.1 وscipy 1.18.1 وmatplotlib 3.11.2 على Debian 13، والمحاكاة بمعاملات ITU-R P.1238-13 (09/2025).