

النقطة التي تتحرك على خريطة تطبيق التوصيل وأنت تنتظر طلبك تبدو أبسط ميزة في التطبيق، ولكن خلفها هاتف مندوب يرسل موقعه كل بضع ثوان، ومعه آلاف الهواتف الأخرى في المدينة نفسها، وسيرفرات يجب أن تستقبل هذه النقاط كلها، وتحفظ آخر موقع لكل مندوب، وتعطيه لمحرك التوزيع عندما يبحث عن أقرب مندوب، وتوصله إليك أنت وحدك لأنك صاحب الطلب. وفي مقال محرك التوزيع افترضنا أن مواقع المندوبين موجودة وجاهزة للبحث، وفي هذا المقال سوف نبني هذا الجزء، وسوف نناقش ما يلي:
- حساب معدل الكتابة: كم رسالة في الثانية، وكم بايت في اليوم، وما الذي تخسره عندما تقلل التحديثات.
- المعمارية الكاملة: المكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو والأعطال.
- قيود البطارية والشبكة على الهاتف، وما يقوله توثيق Android عنها.
- طرق نقل الموقع: السؤال المتكرر Polling، والاتصال المفتوح WebSocket، والوسيط MQTT.
- أين تحفظ آخر موقع: Redis GEO أم PostGIS أم جدول سلاسل زمنية Time Series، ولماذا تحتاج غالباً أكثر من واحد.
- توصيل الموقع لكل من يتابع الطلب Fan-out، وتوزيع النقاط على عدة Workers.
- الخصوصية ومدة الاحتفاظ بحسب نظام حماية البيانات الشخصية.
- تجربة عملية فيها آلاف المندوبين عبر Mosquitto إلى Redis، مع أرقام مقاسة على جهاز واحد.
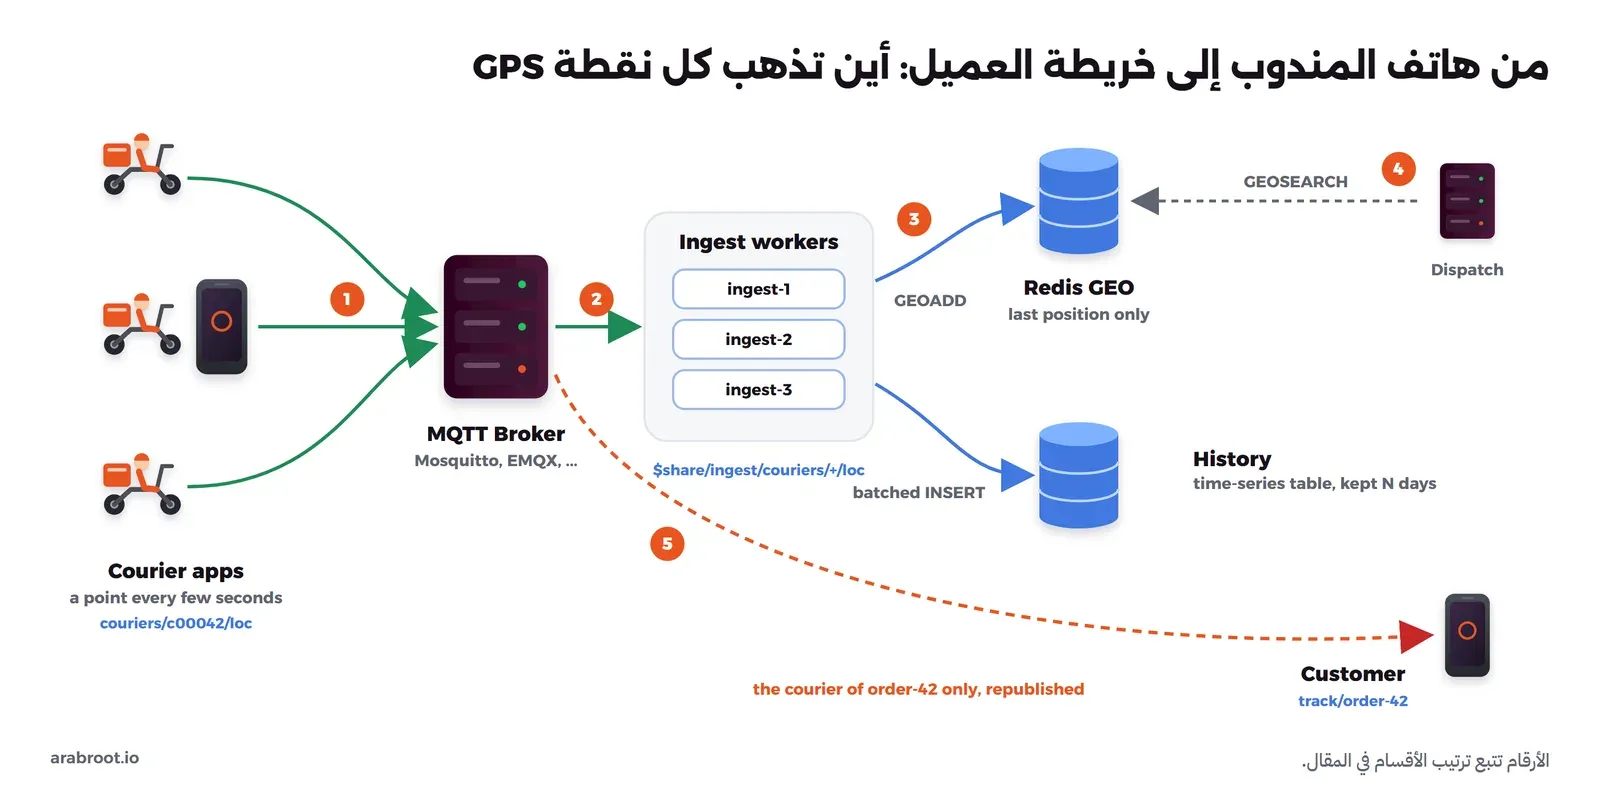
والصورة التالية تبين أين تذهب كل نقطة GPS، والأرقام فيها تتبع ترتيب الأقسام:
كل كم ثانية؟ حساب معدل الكتابة
أول سؤال في هذا النظام ليس أي أداة تستخدم، وإنما كم مرة يرسل المندوب موقعه، لأن كل الأرقام الأخرى تأتي من هذا الرقم. لنفرض أن لديك عشرة آلاف مندوب متصلين في وقت الذروة، وأن المندوب يتحرك بسرعة 30 كم في الساعة، أي قرابة 8.3 متر في الثانية. فإذا أرسل موقعه كل ثانية فإن النظام يستقبل 10,000 رسالة في الثانية، وإذا أرسله كل 4 ثوان صارت 2,500، وكل 10 ثوان صارت 1,000. وفي المقابل فإن الموقع الذي تراه على الخريطة متأخر عن الحقيقة بمقدار السرعة مضروبة في الفترة: 8 أمتار عند ثانية واحدة، و33 متراً عند 4 ثوان، و83 متراً عند 10 ثوان.
وأما الحجم فقد قسناه في المختبر: الرسالة التي يرسلها المحاكي بصيغة JSON حجمها 85 بايت، واسم الموضوع couriers/c00042/loc حجمه 19 بايت، وتضيف رسالة PUBLISH في MQTT 5 بايتين للرأس الثابت Fixed Header، وبايتين لطول اسم الموضوع، وبايتاً لطول الخصائص Properties، فيصبح المجموع 109 بايت لكل نقطة قبل رؤوس TCP وIP وTLS. والصورة التالية تجمع الحساب لخمس فترات:
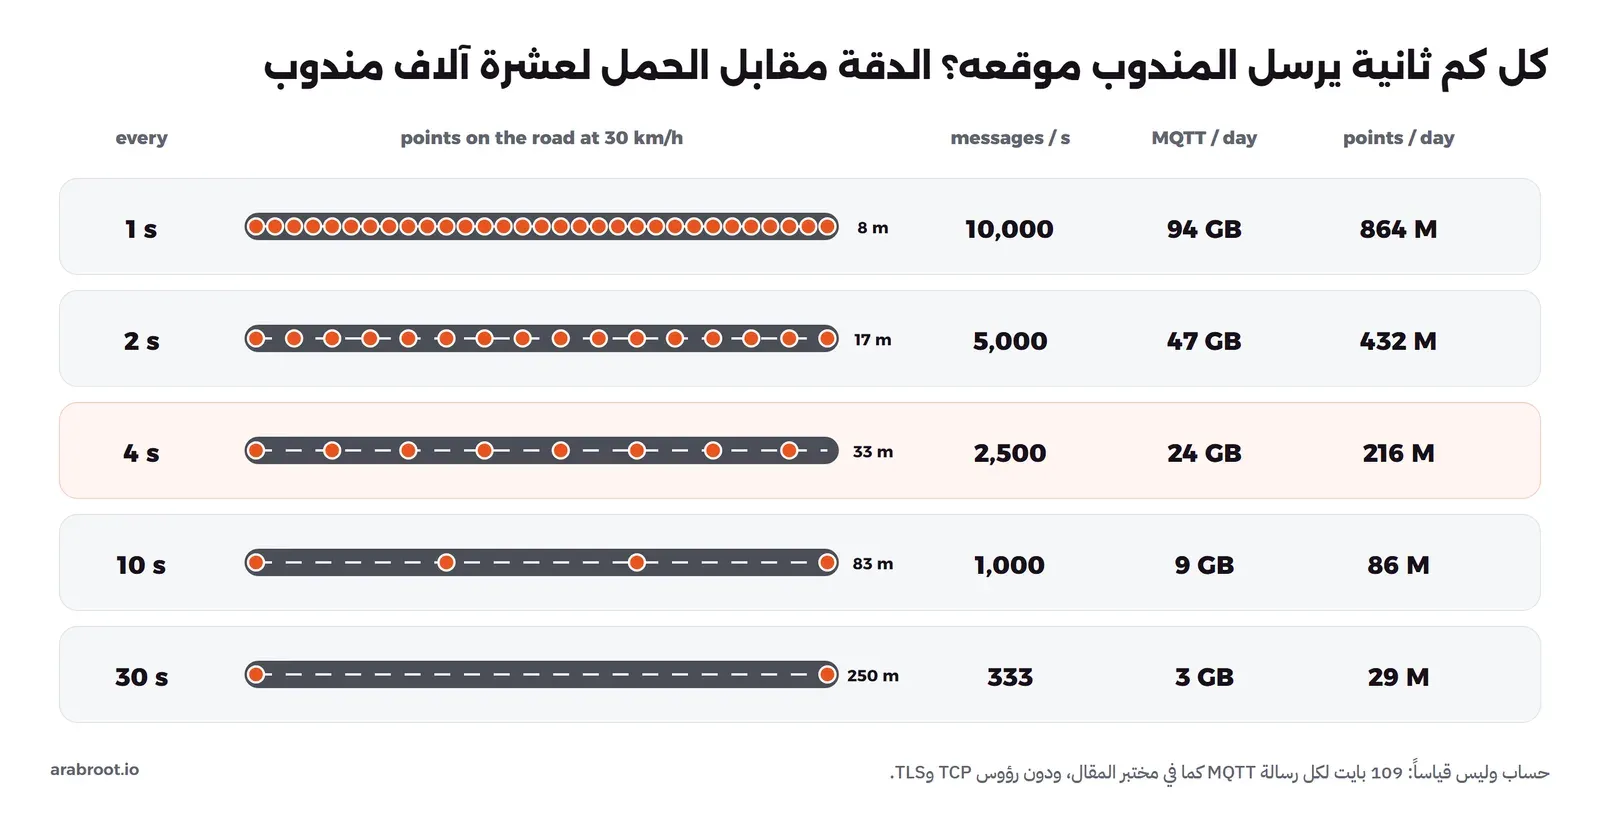
وقد يتساءل البعض: لماذا لا نرسل كل ثانية ونرتاح؟ والإجابة في العمود الأخير، فكل نقطة تكتب في التاريخ تصبح سطراً في قاعدة البيانات، و864 مليون سطر في اليوم مشكلة تخزين وفهرسة وحذف، وليست مشكلة شبكة فقط. لذلك فالطريقة الصحيحة ليست رقماً ثابتاً، وإنما فترة تتغير بحسب حالة المندوب:
- خارج الدوام Offline: لا يرسل شيئاً، ولا يجوز أن يرسل، كما سوف نرى في قسم الخصوصية.
- متاح ينتظر طلباً Available: يكفي كل 15 إلى 30 ثانية، فمحرك التوزيع يحتاج المنطقة التي فيها المندوب، وليس مكانه بالمتر.
- في الطريق إلى المطعم أو العميل: كل 3 إلى 5 ثوان، لأن العميل يراقب، ولأن زمن الوصول المتوقع يحسب من هذه النقاط.
- بحسب المسافة وليس الوقت: المندوب الواقف عند المطعم لا يحتاج أن يرسل النقطة نفسها كل 4 ثوان، فأرسل عندما يتحرك أكثر من مسافة معينة، أو عندما يتغير اتجاهه، مع نبضة كل فترة طويلة تثبت أن التطبيق ما زال يعمل.
المعمارية الكاملة: كيف تتصل الأجزاء ببعضها؟
الصورة في بداية المقال تبين أين تذهب النقطة الواحدة، وقبل أن ندخل في البطارية والبروتوكولات والتخزين سوف نرى النظام كله بمكوناته الحقيقية، ومن يكتب ومن يقرأ، وأي جزء يتحمل الحمل الذي حسبناه للتو. والصورة التالية تبين ذلك في طبقات من اليسار إلى اليمين: التطبيقات، ثم الحافة Edge، ثم الخدمات، ثم البيانات، ثم الخدمات التي تقرأ المواقع، ثم المزود الخارجي:
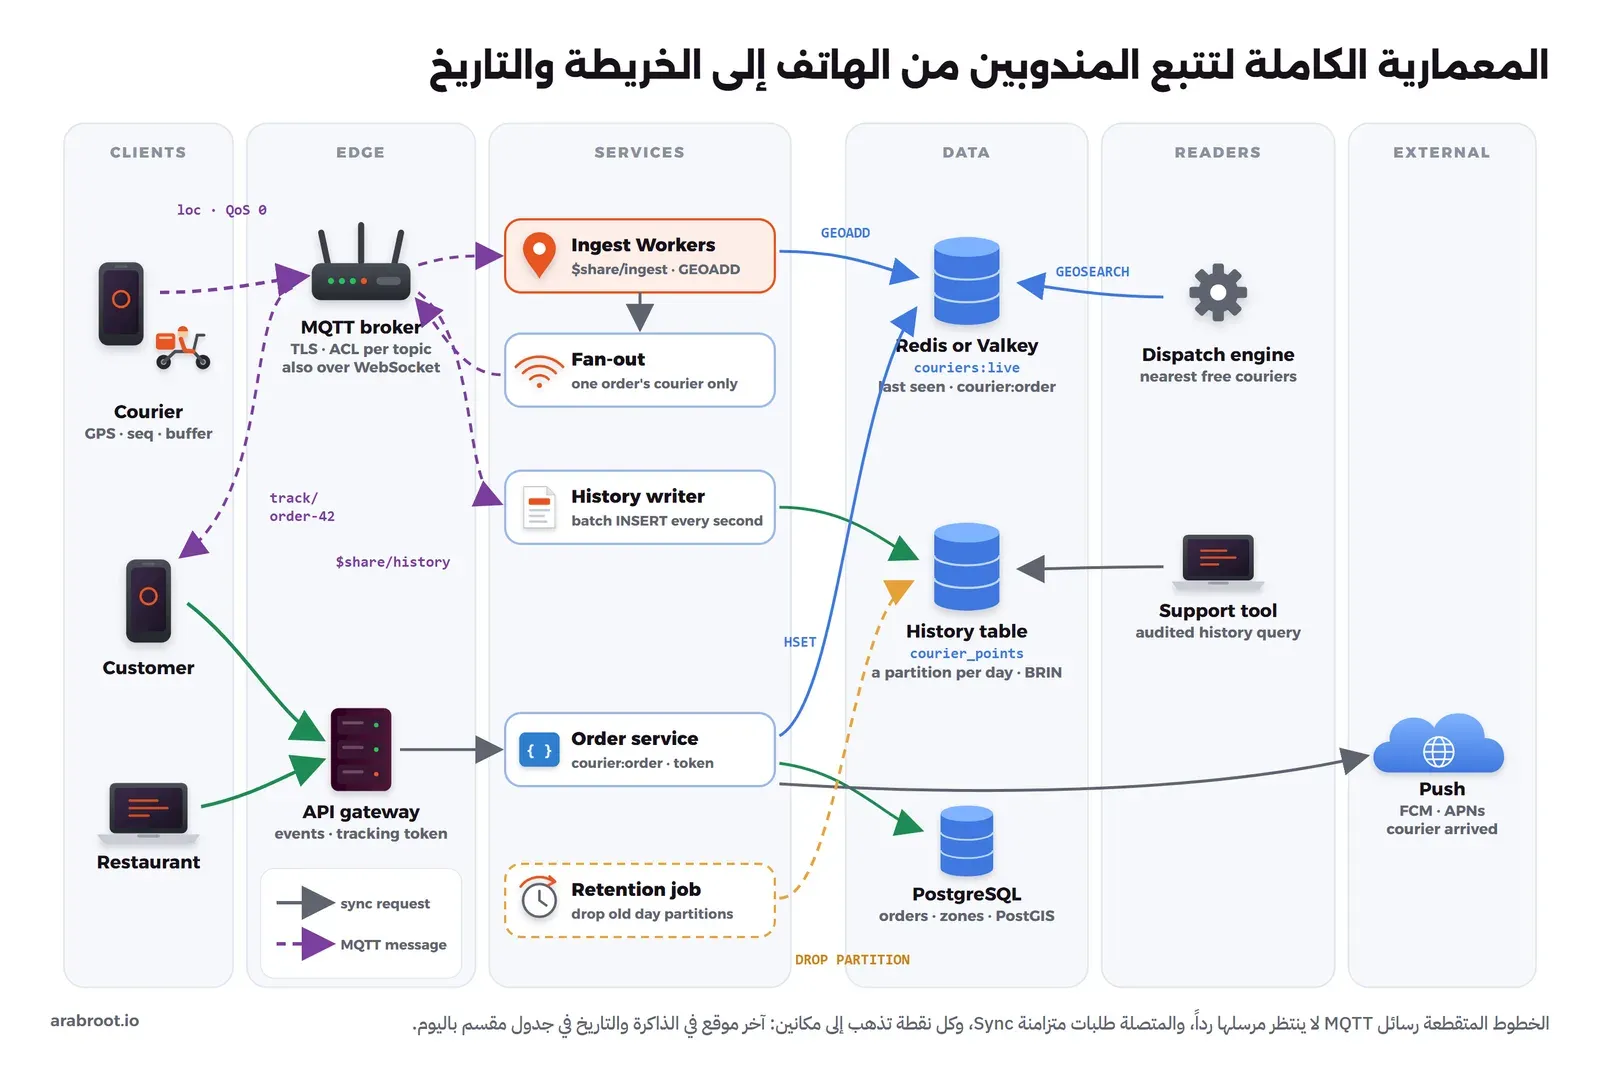
في الصورة أعلاه لاحظ التالي:
- الوسيط هو الباب الوحيد للنقاط، وهو يوزعها على مجموعتين مستقلتين بالاشتراك المشترك: Workers آخر موقع، وWorkers التاريخ، فإذا تأخر التاريخ لم يتأخر آخر موقع الذي يحتاجه محرك التوزيع الآن.
- تطبيق العميل لا يسأل أي قاعدة بيانات، وإنما يأخذ توكناً قصير العمر من خدمة الطلبات، ثم يشترك به في موضوع طلبه فقط عبر MQTT فوق WebSocket.
- الأحداث المهمة مثل «تم التسليم» لا تمر بالوسيط بمستوى QoS 0، وإنما بطلب HTTP عادي إلى بوابة ال API مع مفتاح منع التكرار، كما ذكرنا في قسم البروتوكولات.
المكونات ومسؤولية كل منها
| المكون | مسؤوليته | أداة مفتوحة المصدر مقترحة | لماذا هي |
|---|---|---|---|
| وسيط MQTT | استقبال النقاط من الهواتف، والصلاحيات لكل موضوع، والاشتراك المشترك، وإيصال موضوع الطلب للعميل عبر WebSocket | Mosquitto (رخصة EPL-2.0 أو EDL-1.0) | هو الوسيط الذي قسناه في التجربة العملية، ويدعم MQTT 5 والاستماع فوق WebSocket. وإذا احتجت عنقوداً من الوسطاء Cluster فراجع الرخصة قبل الاختيار، فـ EMQX مثلاً صار برخصة BSL 1.1 من الإصدار 5.9.0، وهي ليست رخصة مفتوحة المصدر |
| بوابة ال API | الأحداث المهمة من تطبيق المندوب، وتوكن التتبع لتطبيق العميل | NGINX (رخصة BSD-2-Clause) أو HAProxy (رخصة GPLv2) | طلبات قليلة نسبياً، وتحتاج TLS وحد معدل الطلبات فقط |
| Workers آخر موقع | قراءة النقاط، ورفض النقطة الأقدم بحسب رقم التسلسل، والكتابة بدفعات Pipeline، ونشر موقع مندوب الطلب على موضوع الطلب | كودك، مثل ingest.py في التجربة | كل نسخة تأخذ جزءاً من الرسائل بالاشتراك المشترك، فتضيف نسخاً عندما يزيد الحمل |
| آخر موقع | سؤال «من القريب الآن؟» لمحرك التوزيع، ووقت آخر ظهور | Redis 8 كما في التجربة (رخصة AGPLv3 أو RSALv2 أو SSPLv1 بحسب اختيارك)، أو Valkey (رخصة BSD-3-Clause) | أوامر GEO نفسها في الاثنين، والكتابة في الذاكرة أسرع بكثير من حاجتنا كما رأيت في قياس redis-benchmark |
| Workers التاريخ | تجميع النقاط وكتابتها كل ثانية بأمر واحد | كودك، باشتراك مشترك ثان | بطء قاعدة البيانات لا يؤخر آخر موقع، لأن المجموعتين منفصلتان |
| جدول التاريخ | كل النقاط لمدة الاحتفاظ، للنزاعات والمستحقات وتحليل الطرق | PostgreSQL مع pg_partman (رخصة PostgreSQL License) لإنشاء أقسام الأيام وحذفها | إضافة فقط، وفهرس BRIN صغير على الوقت، وحذف يوم كامل بأمر واحد، وشرحنا ذلك في مقال الجداول الضخمة |
| الطلبات والمناطق | من يحمل أي طلب، ومناطق التوصيل | PostgreSQL مع PostGIS (رخصة GPLv2 أو أحدث) | بيانات قليلة التغير تحتاج معاملات وربطاً بين الجداول |
| مهمة الاحتفاظ | حذف أقسام الأيام بعد مدة السياسة، وتجميع الأرقام دون معرفات | pg_partman مع cron | الحذف يحدث وحده بحسب السياسة المكتوبة، ولا يعتمد على تذكر أحد |
| الإشعارات الفورية | «المندوب وصل» عندما يكون تطبيق العميل مغلقاً | مزود خارجي: FCM لأجهزة Android وAPNs لأجهزة Apple | لا يوجد اتصال مفتوح مع تطبيق مغلق، وشرحنا ذلك في مقال الإشعارات الفورية |
نموذج البيانات
المفاتيح والمواضيع هي نفسها التي تستخدمها ملفات التجربة العملية في آخر المقال، ونضيف إليها جدول التاريخ الذي لم نبنه في التجربة:
| الاسم | النوع | ما فيه |
|---|---|---|
couriers/{id}/loc | موضوع MQTT | نقطة المندوب: {"id","lat","lon","ts","seq"} بمستوى QoS 0 |
track/{order} | موضوع MQTT | موقع مندوب الطلب فقط، ويشترك فيه العميل والمطعم بتوكن |
couriers:live | GEO في Redis | آخر موقع لكل مندوب، يكتب بالأمر GEOADD ويبحث فيه محرك التوزيع |
couriers:seen | Sorted Set في Redis | وقت آخر نقطة لكل مندوب، لحذف من سكت |
courier:order | Hash في Redis | الطلب الذي يحمله المندوب، ليعرف ال Worker أين ينشر موقعه |
-- History: append only, one partition per day, dropped when the retention period ends
CREATE TABLE courier_points (
    courier_id  text             NOT NULL,       -- c00042, the same id as in the MQTT topic
    seq         bigint           NOT NULL,       -- from the phone, grows with every point
    phone_ts    timestamptz      NOT NULL,       -- "ts" in the payload: the phone's clock
    received_at timestamptz      NOT NULL DEFAULT now(),   -- the server's clock
    order_id    text,                            -- set while the courier carries an order
    lat         double precision NOT NULL,
    lon         double precision NOT NULL
) PARTITION BY RANGE (received_at);

CREATE INDEX ON courier_points USING brin (received_at);
CREATE INDEX ON courier_points (courier_id, received_at);   -- "where was c00042 at 13:05?"

-- pg_partman can create these ahead of time and drop the old ones
CREATE TABLE courier_points_2026_10_10 PARTITION OF courier_points
    FOR VALUES FROM ('2026-10-10') TO ('2026-10-11');
الواجهات الرئيسية
| الطلب | المسار أو الموضوع | ما يفعله | ملاحظات |
|---|---|---|---|
| MQTT CONNECT | هوية المندوب | بداية الاتصال، مع رسالة Last Will على couriers/{id}/status | TLS، ولكل مندوب هوية خاصة، والنبضة Keep Alive تكشف الانقطاع |
| MQTT PUBLISH | couriers/{id}/loc | نقطة الموقع | QoS 0، والصلاحية على موضوعه فقط |
| MQTT SUBSCRIBE | $share/ingest/couriers/+/loc | Workers آخر موقع، وكل رسالة لواحد منهم | ومثلها $share/history/... لمجموعة التاريخ |
| POST | /orders/{id}/tracking-token | توكن قصير العمر يسمح بالاشتراك في موضوع هذا الطلب فقط | لصاحب الطلب ومطعمه، وينتهي مع التسليم |
| MQTT SUBSCRIBE | track/{order} فوق WebSocket | العميل يستقبل موقع المندوب | بالتوكن السابق، ولا يقبل الوسيط track/# |
| POST | /orders/{id}/events | الاستلام والتسليم من تطبيق المندوب | Idempotency-Key، ولا يضيع لأنه ليس QoS 0 |
| GET | /couriers/{id}/trail?from=&to= | مسار المندوب في فترة محددة لموظف الدعم | صلاحية محددة، وسبب مكتوب، وسطر في سجل التدقيق |
تقدير السعة بالأرقام
نكمل من أرقام القسم السابق، ونطبق فيها الفترة المتغيرة بحسب حالة المندوب بدل الفترة الثابتة، مع افتراضات نكتبها صراحة:
- من القسم السابق: عشرة آلاف مندوب في الذروة، وكل نقطة 109 بايت كما قسناها في التجربة.
- افتراض: في الذروة 60% من المندوبين في الطريق ويرسلون كل 4 ثوان، و40% متاحون ويرسلون كل 20 ثانية.
- افتراض: كل مندوب في الطريق يتابعه شخصان، العميل والمطعم، ومتوسط اليوم كله نصف الذروة.
- افتراض: سطر التاريخ مع فهارسه قرابة 120 بايت، ومدة الاحتفاظ 30 يوماً كما في مثال سياسة الاحتفاظ.
- من مقال محرك التوزيع: خمسون طلباً في الثانية في الذروة، وافتراض بحثين في Redis لكل طلب عند توسيع نصف القطر.
| الكمية | الحساب | النتيجة |
|---|---|---|
| رسائل المندوبين في الطريق | 6,000 ÷ 4 | 1,500 رسالة في الثانية |
| رسائل المندوبين المتاحين | 4,000 ÷ 20 | 200 رسالة في الثانية |
| المجموع الداخل | 1,500 + 200 | 1,700 رسالة في الثانية، بدل 2,500 بفترة ثابتة كل 4 ثوان |
| الشبكة الداخلة | 1,700 × 109 بايت | قرابة 185 كيلوبايت في الثانية، أي 1.5 ميغابت قبل رؤوس TCP وTLS |
| الرسائل الخارجة للمتابعين | 1,500 × 2 | 3,000 رسالة في الثانية |
| الاتصالات المفتوحة في الوسيط | 10,000 مندوب + 6,000 عميل + 6,000 مطعم في أسوأ الحالات | قرابة 22,000 اتصال |
| Workers آخر موقع | 1,700 رسالة، وWorker واحد من Python كتب 2,000 في الثانية في تجربتنا، وبدأ الوسيط يسقط الرسائل عند 4,000 | اثنان على الأقل، وأربعة لتبقى مساحة للذروة |
| ذاكرة آخر موقع | 954,928 بايت ÷ 11,787 مندوباً في التجربة × 10,000 | قرابة 0.8 ميغابايت، ومثلها تقريباً لوقت آخر ظهور |
| البحث من محرك التوزيع | 50 × 2 | 100 بحث في الثانية، والتجربة نفذت أكثر من 2,600 في الثانية من كلاينت واحد |
| نقاط التاريخ في اليوم | 850 × 86,400 | قرابة 73 مليون نقطة |
| تخزين التاريخ | 73,440,000 × 120 بايت | قرابة 8.8 غيغابايت في اليوم، و264 غيغابايت لثلاثين يوماً |
والخلاصة أن آخر موقع صغير جداً، أقل من ميغابايتين لكل مندوبي مدينة كبيرة، وأن الحد الأول الذي ستصل إليه هو ال Workers ومعهم الوسيط، كما رأيت في التجربة، ثم التاريخ الذي يكبر كل يوم ويحتاج سياسة حذف من اليوم الأول. وتذكر أن أرقام ال Workers والبحث في الجدول قياس محلي على جهاز واحد، فهي تعطيك ترتيب الحجم فقط، وأعد القياس على سيرفراتك.
مراحل النمو: ماذا تبني اليوم، وماذا تؤجل؟
| الجزء | البداية MVP: سيرفر أو اثنان | النمو: آلاف المندوبين المتصلين | الحجم الكبير: عشرات الآلاف في عدة مدن |
|---|---|---|---|
| النقل | طلب HTTP لكل نقطة إلى التطبيق نفسه | Mosquitto واحد بتشفير وصلاحيات، والعميل عبر WebSocket | وسيط أو أكثر لكل منطقة، أو عنقود وسطاء بعد مراجعة رخصته |
| آخر موقع | عمود في جدول المندوبين في PostgreSQL مع PostGIS | Redis أو Valkey GEO مع نسخة متماثلة | مفتاح GEO لكل مدينة، وربما نسخة Redis لكل مجموعة مدن |
| ال Workers | داخل التطبيق | من اثنين إلى أربعة باشتراك مشترك، ومراقبة عداد الرسائل المسقطة | Kafka بمفتاح المندوب، فتذهب نقاط المندوب الواحد إلى Worker واحد بالترتيب |
| التاريخ | جدول واحد مع حذف يومي بأمر DELETE | جدول مقسم باليوم مع pg_partman وفهرس BRIN | قاعدة منفصلة للتاريخ، وأرقام مجمعة دون معرفات للتحليل الطويل |
| العميل | Polling كل بضع ثوان | اشتراك في موضوع الطلب بتوكن | بوابة WebSocket منفصلة إذا كثرت الاتصالات على الوسيط |
والذي لا تبنيه في اليوم الأول: لا تضع Kafka ولا عنقود وسطاء ولا قاعدة سلاسل زمنية متخصصة قبل أن يقول لك القياس إن Mosquitto واحداً مع Workers متعددة وجدولاً مقسماً لا تكفي، والسبب أن ما قسناه في التجربة على جهاز واحد يتجاوز ما تحتاجه أغلب المدن. أما ما يجب أن يكون موجوداً من البداية فهو رقم التسلسل في كل نقطة، والصلاحية على المواضيع، وتوقف التتبع خارج الدوام، ومدة الاحتفاظ المكتوبة.
ماذا لو تعطل جزء منها؟
| ماذا لو تعطل | الأثر | كيف تخفف الأثر |
|---|---|---|
| وسيط MQTT | لا تصل نقاط جديدة، والخريطة تتجمد، والتوزيع يعمل بمواقع قديمة | التطبيق يحفظ النقاط برقم التسلسل ويعيد الاتصال بانتظار يتزايد Backoff، ومحرك التوزيع يتجاهل من تجاوز وقت آخر ظهور، ووسيط ثان جاهز |
| Workers آخر موقع أبطأ من الحمل | الوسيط يسقط الرسائل دون أي خطأ ظاهر، كما رأيت في التجربة | أكثر من Worker بالاشتراك المشترك من البداية، وتنبيه على عداد الرسائل المسقطة في الموضوع $SYS |
| Redis أو Valkey | محرك التوزيع لا يجد مرشحين | نسخة متماثلة، والفهرس يعاد بناؤه وحده من النقاط القادمة خلال فترة إرسال واحدة، فلا تحتاج حفظه على القرص |
| جدول التاريخ | تتأخر كتابة التاريخ | مجموعة التاريخ منفصلة، فآخر موقع لا يتأثر، وال Workers تجمع في الذاكرة إلى حد معين ثم تسقط الأقدم وتسجل ذلك |
| طريق العميل عبر WebSocket | النقطة على خريطة العميل لا تتحرك | التطبيق يرجع إلى Polling كل عشر ثوان حتى يعود الاتصال |
| GPS في الهاتف | نقاط في 0,0 أو في موقع افتراضي واحد | رفض النقاط التي لا معنى لها عند الاستقبال، وإلا انهار البحث كما في قسم نكسر الإعداد |
البطارية والشبكة على الهاتف
المندوب يعمل ثماني ساعات أو أكثر، وإذا استنزف تطبيقك بطارية هاتفه قبل نهاية الدوام فهو لن يعمل معك غداً، لذلك فقيود الهاتف جزء من التصميم وليست تفصيلاً يتركه المهندس لفريق التطبيق. وفي توثيق Android عن الموقع والبطارية ثلاثة أشياء تتحكم في الاستهلاك:
- الدقة Accuracy: الأولوية العالية PRIORITY_HIGH_ACCURACY تستخدم GPS وWi-Fi والأبراج والحساسات، ويصفها التوثيق بأنها قد تستنزف البطارية بشكل كبير، ويوصي بها للتطبيقات التي تعمل في الواجهة وتحتاج الموقع لحظياً، وهذه حالة المندوب أثناء التوصيل فعلاً.
- التكرار Frequency: يوصي التوثيق بأكبر فترة ممكنة في setIntervalMillis، ويقصر الفترات القصيرة من بضع ثوان على الاستخدام في الواجهة.
- التأخير Latency: الإعداد setMaxUpdateDelayMillis يسمح للنظام بتجميع عدة نقاط وتسليمها دفعة واحدة، وهذا يوفر البطارية مقابل وصول النقاط متأخرة، وهو مناسب للمندوب المتاح وليس للمندوب الذي يراقبه العميل.
ويضيف Android قيداً أهم من كل ما سبق، فمنذ Android 8.0 لا يحسب النظام الموقع للتطبيق الذي يعمل في الخلفية إلا بضع مرات في الساعة، كما يذكر توثيق حدود الموقع في الخلفية، والطريقة المعتمدة للاستمرار هي خدمة في الواجهة Foreground Service تظهر للمستخدم كإشعار دائم، ويذكر التوثيق نفسه أن هذه الخدمة لا تصل إلى الموقع في Android 11 وما بعده إلا إذا منح المستخدم صلاحية الموقع في الخلفية. وهذا يعني أن تطبيق المندوب يجب أن يطلب الصلاحيات بوضوح، وأن يظهر للمندوب أنه يتتبع موقعه الآن، وأن يتوقف عندما ينتهي الدوام.
وأما الشبكة فهي أسوأ من البطارية، فالمندوب يدخل مواقف تحت الأرض ومصاعد وطرقاً ضعيفة التغطية، لذلك يجب أن يحفظ التطبيق النقاط في ذاكرته عندما ينقطع الاتصال، ثم يرسلها دفعة واحدة عند عودته، ولكل نقطة وقتها الأصلي من الهاتف ورقم تسلسل Sequence يزيد مع كل نقطة. والسبب أن النقاط القديمة سوف تصل بعد النقاط الجديدة أحياناً، والسيرفر يجب أن يكتبها في التاريخ دون أن يجعلها «آخر موقع»، وهذا ما يفعله ال Worker في المختبر بالمقارنة على رقم التسلسل. وتذكر أن ساعة الهاتف قد تكون خاطئة، فاحفظ وقت الهاتف ووقت وصول النقطة إلى السيرفر معاً، كما شرحنا في مقال التاريخ والوقت.
كيف تصل النقطة إلى السيرفر؟ Polling وWebSocket وMQTT
الطريقة البسيطة أن يرسل تطبيق المندوب طلب HTTP عادياً بكل نقطة، وأن يسأل تطبيق العميل السيرفر كل بضع ثوان عن موقع المندوب، وهذا يسمى السؤال المتكرر Polling. وهو يعمل في البداية، ولكن كل طلب يحمل رؤوس HTTP كاملة، وأغلب أسئلة العميل جوابها «لا جديد»، والنقطة الجديدة تنتظر حتى السؤال التالي. والصورة التالية تبين الفرق بين الطرق الثلاث:
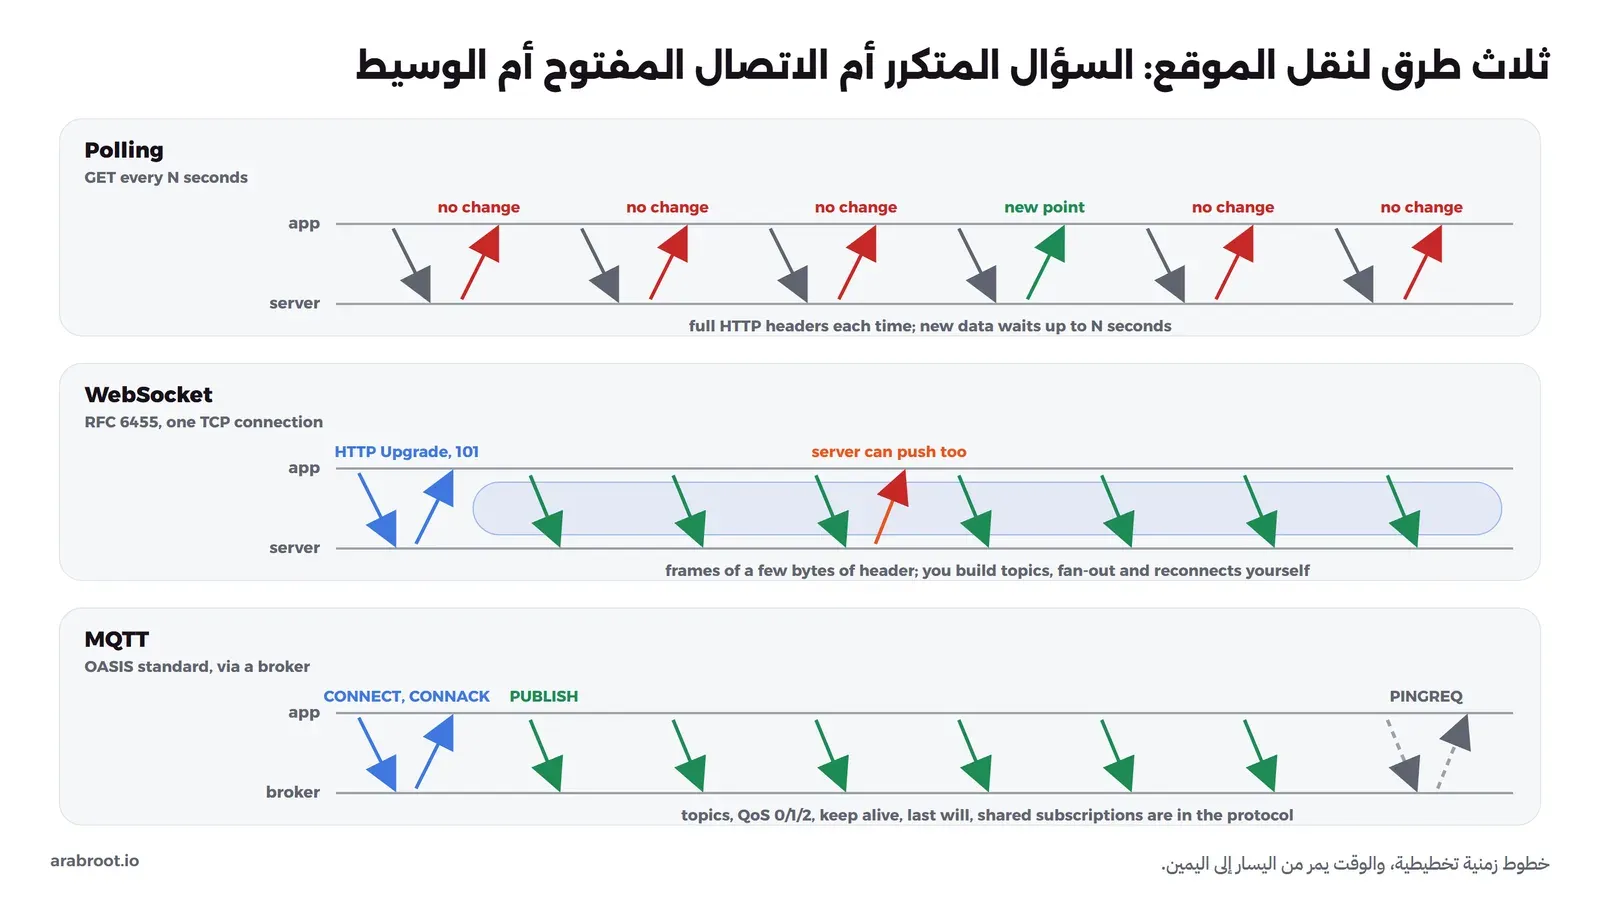
- WebSocket: بروتوكول من RFC 6455 في ديسمبر 2011، يبدأ بطلب HTTP يطلب الترقية Upgrade، ثم يبقى الاتصال مفتوحاً في الاتجاهين، ورأس كل إطار Frame من بايتين في أقصر حالاته، ويضاف إليه مفتاح الإخفاء Masking Key من أربعة بايتات في الإطارات القادمة من الكلاينت. وهو مدعوم في كل المتصفحات، ولكنه ينقل بايتات فقط، أما المواضيع ومن يستلم ماذا وإعادة الاتصال فعليك أن تبنيها بنفسك.
- MQTT: بروتوكول رسائل خفيف من OASIS، وآخر إصداراته MQTT 5.0 المعتمد في مارس 2019، صمم أصلاً للأجهزة ضعيفة الاتصال، وفيه الوسيط Broker والمواضيع Topics ومستويات ضمان التسليم QoS 0 و1 و2، ورسالة الوصية الأخيرة Last Will التي ينشرها الوسيط إذا انقطع الجهاز فجأة، والنبضة Keep Alive، حيث يقطع الوسيط اتصال الكلاينت إذا لم يستلم منه شيئاً خلال مرة ونصف من فترة النبضة بحسب المعيار، وهذا يعطيك طريقة جاهزة لتعرف أن المندوب انقطع. ويعمل MQTT فوق TCP مباشرة أو فوق WebSocket، فيستطيع المتصفح استخدامه أيضاً.
ولاحظ أن نقطة الموقع رسالة يجوز أن تضيع، لأن النقطة التالية تأتي بعد ثوان وتغني عنها، لذلك فالمستوى المناسب لها هو QoS 0 الذي لا يحتاج تأكيداً، أما حدث مثل «تم التسليم» فلا يجوز أن يضيع، فيرسل بطلب HTTP عادي مع مفتاح منع التكرار، أو برسالة QoS 1 مع معالج لا يتأثر بالتكرار. وأما الخلاصة العملية فهي كما يلي:
| الطريقة | نقاط القوة | نقاط الضعف | متى تستخدمها |
|---|---|---|---|
| Polling | أبسط شيء، يعمل خلف أي Proxy | رؤوس متكررة، وتأخير يساوي الفترة، وطلبات بلا فائدة | نسخة أولى، أو لوحات تتحدث كل دقيقة |
| WebSocket | اتصال واحد في الاتجاهين، ومدعوم في المتصفحات | المواضيع والتوزيع وإعادة الاتصال عليك | تطبيق العميل وواجهات الويب، إذا كان عندك بوابة WebSocket |
| MQTT | مواضيع وQoS ووصية أخيرة واشتراك مشترك في المعيار | وسيط إضافي تشغله وتراقبه | تطبيق المندوب وكل جهاز يرسل باستمرار |
وعندما يكون تطبيق العميل مغلقاً فلا يوجد اتصال مفتوح أصلاً، وهنا يأتي دور الإشعارات الفورية Push Notifications لأحداث مثل «المندوب وصل»، وقد شرحناها في مقال الإشعارات الفورية.
أين تحفظ آخر موقع؟ Redis GEO وPostGIS والسلاسل الزمنية
الخطأ الأشهر هنا أن تستخدم مكاناً واحداً لسؤالين مختلفين تماماً: «من هو القريب الآن؟» وهو سؤال عن آخر موقع لكل مندوب، و«أين كان المندوب 42 الساعة الواحدة وخمس دقائق؟» وهو سؤال عن التاريخ. والصورة التالية تبين الخيارات الثلاثة:
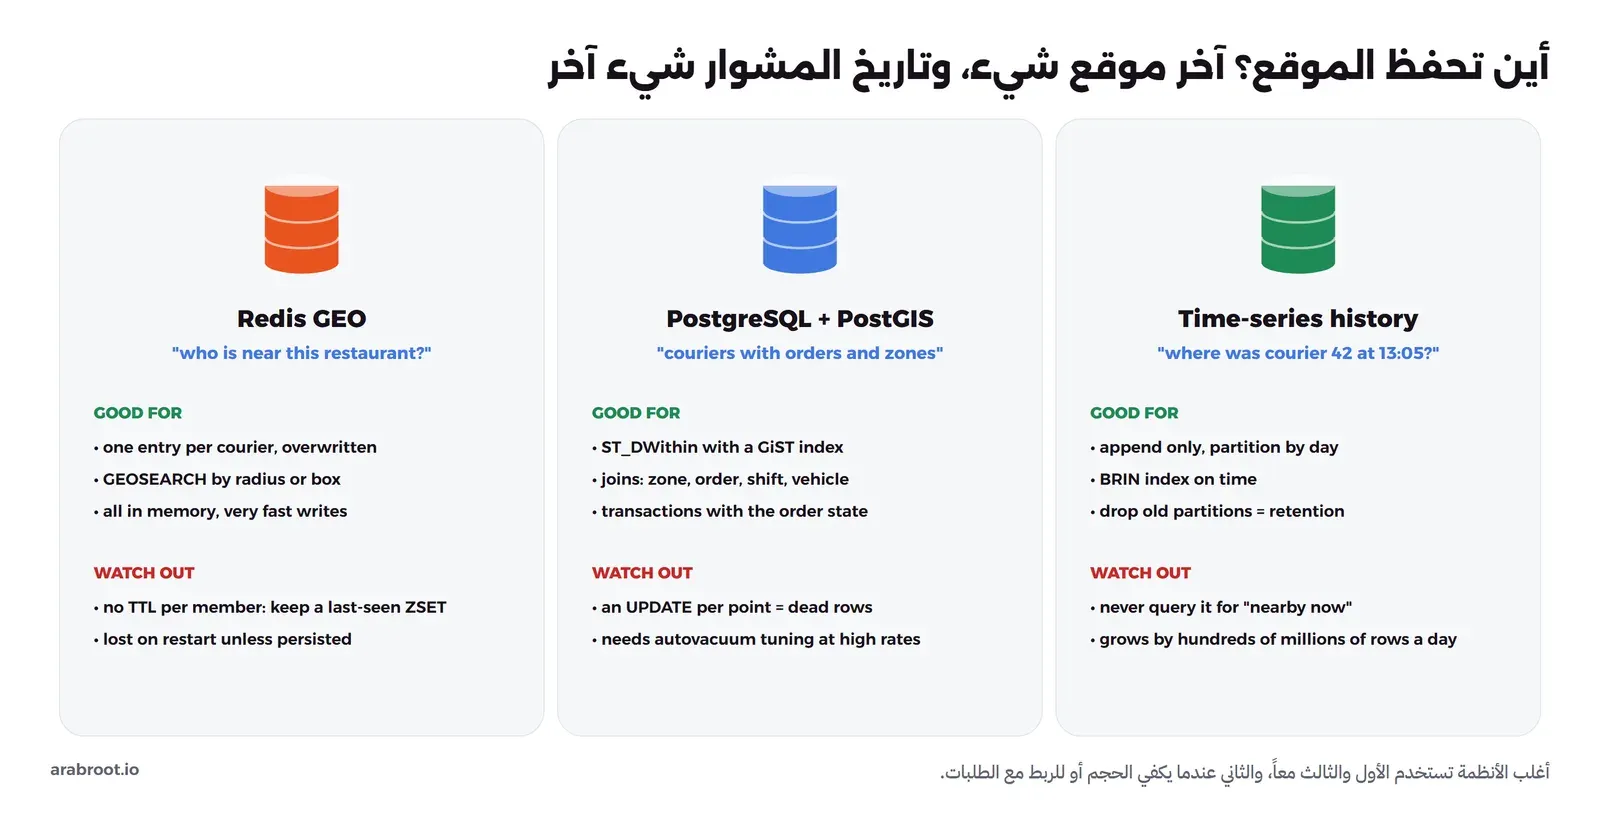
- Redis GEO: يخزن المواقع في مجموعة مرتبة Sorted Set، ودرجة كل عضو رقم GeoHash من 52 بت، ويبحث بالأمر GEOSEARCH بنصف قطر أو مستطيل، ويذكر توثيق GEOADD أن الحساب يفترض الأرض كرة بمعادلة Haversine فيصل الخطأ في أسوأ الحالات إلى 0.5%، وهذا مقبول تماماً لاختيار مندوب. ولاحظ أنه لا يوجد أمر لحذف عضو جغرافي غير ZREM، ولا توجد مدة صلاحية TTL لكل عضو، لذلك نحفظ وقت آخر ظهور في مجموعة مرتبة ثانية، ونحذف من سكت أكثر من مدة معينة، كما سوف نفعل في المختبر.
- PostgreSQL مع PostGIS: مناسب عندما تريد أن تربط الموقع بالطلبات والمناطق والورديات في استعلام واحد، أو داخل المعاملة نفسها التي تغير حالة الطلب، وقد شرحناه في مقال PostgreSQL لكل شيء. ولكن تحديث سطر المندوب مع كل نقطة يعني آلاف عمليات UPDATE في الثانية، وكل UPDATE في PostgreSQL يترك نسخة ميتة من السطر يجب أن ينظفها autovacuum، فيصلح هذا الخيار للأعداد المتوسطة، أو لنسخة من آخر موقع تتحدث كل بضع ثوان من Redis.
- جدول السلاسل الزمنية للتاريخ: إضافة فقط Append-only، مقسم باليوم Partitioning، مع فهرس BRIN على الوقت، ويحذف القسم كله عندما تنتهي مدة الاحتفاظ بدل حذف ملايين الأسطر واحداً واحداً، وقد شرحنا هذا في قسم السلاسل الزمنية وفي مقال الجداول الضخمة. ولا تكتب في هذا الجدول نقطة نقطة، وإنما بدفعات كل ثانية أو أكثر، وهذا هو الجدول courier_points ومجموعة Workers التاريخ في المعمارية الكاملة أعلاه.
توصيل الموقع لمن يتابع Fan-out
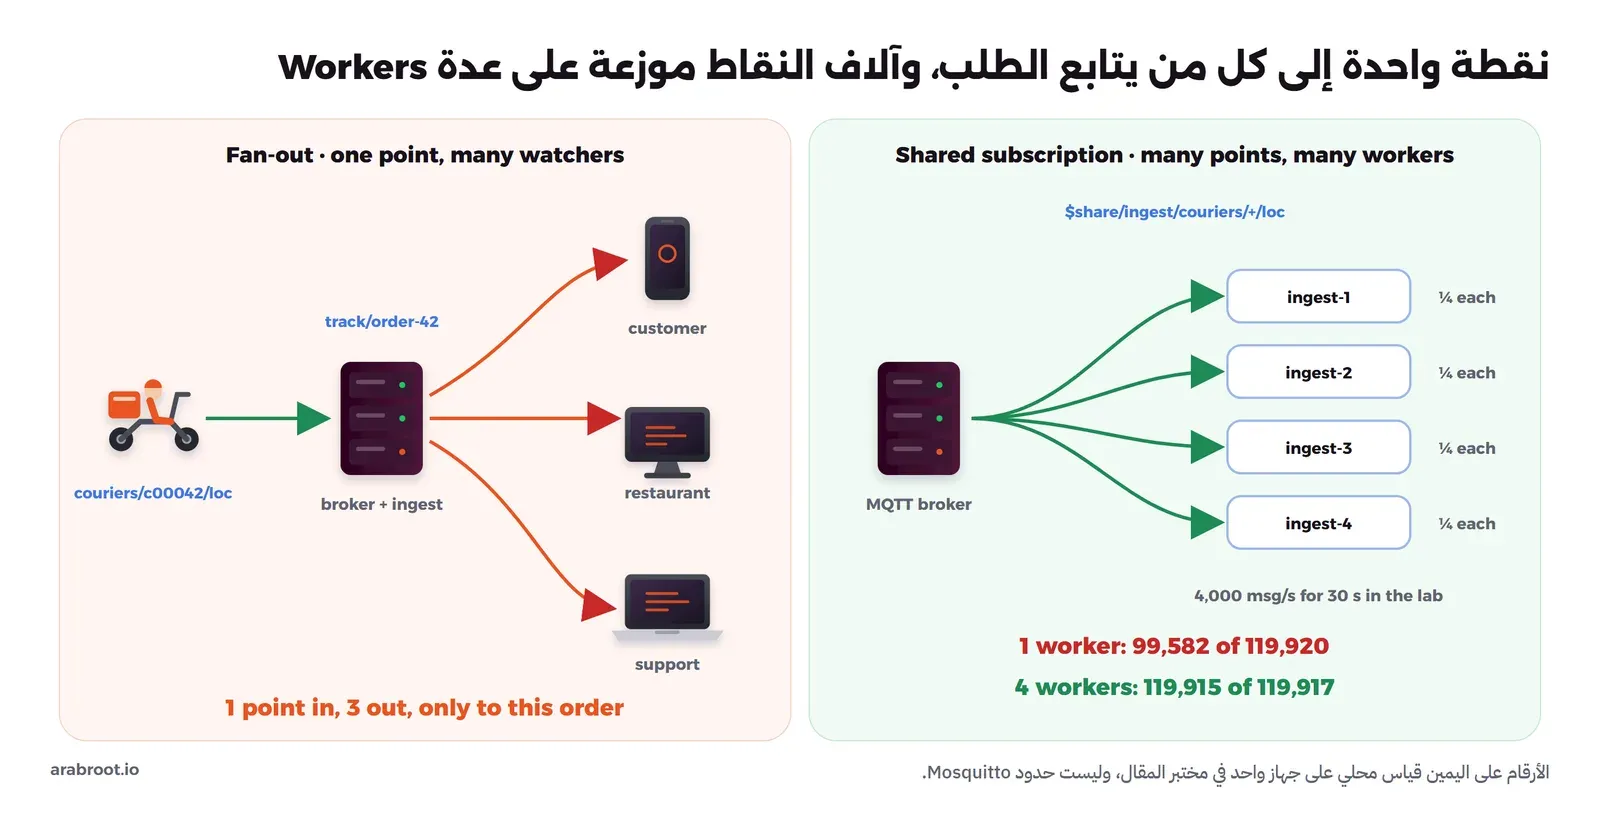
النقطة التي تصل من المندوب لها جمهوران: محرك التوزيع الذي يقرأ آخر موقع من Redis عندما يحتاجه، والأشخاص الذين يتابعون طلباً محدداً ويريدون أن تصلهم كل نقطة بنفسها، وهم العميل والمطعم وموظف الدعم إذا فتح الطلب. والطريقة البسيطة أن يسأل كل منهم قاعدة البيانات كل ثانية، وهذا يعيدنا إلى مشكلة Polling مضروبة في عدد المتابعين. والطريقة الأفضل أن يكون لكل طلب موضوع خاص به مثل track/order-42، وأن ينشر ال Worker عليه موقع مندوب هذا الطلب فقط، فيوصله الوسيط إلى كل من اشترك فيه، وهذا هو التوزيع إلى عدة مستلمين Fan-out، كما في الجهة اليسرى من الصورة التالية:
وفي هذا التصميم ثلاث قواعد لا تتنازل عنها:
- الصلاحية على الموضوع: العميل يستطيع الاشتراك في موضوع طلبه فقط، وطوال مدة الطلب فقط، وهذا يكتب في قائمة صلاحيات الوسيط ACL أو في البوابة التي يمر بها WebSocket، والسبب أن من يستطيع الاشتراك في track/# يرى كل المندوبين في المدينة، ولهذا يأخذ العميل في المعمارية أعلاه توكناً قصير العمر لموضوع طلبه فقط.
- لا يحتاج العميل كل نقطة: يكفيه تحديث كل ثانيتين أو ثلاث، والتطبيق يحرك النقطة على الخريطة بين التحديثين بشكل ناعم، فلا ترسل له أكثر مما تحتاجه الشاشة.
- الاتجاه المعاكس أيضاً يحتاج توزيعاً: Worker واحد لا يستقبل كل نقاط المدينة إلى الأبد، والحل في MQTT 5 هو الاشتراك المشترك Shared Subscription بالصيغة $share/ingest/couriers/+/loc، حيث يرسل الوسيط كل رسالة إلى واحد فقط من المشتركين في المجموعة بحسب المعيار، وهذا ما تبينه الجهة اليمنى من الصورة بأرقام المختبر.
ولاحظ أن الاشتراك المشترك يوزع الرسائل دون اعتبار للمندوب، فقد تصل نقطتان متتاليتان لنفس المندوب إلى Workerين مختلفين، فإذا كتب الثاني قبل الأول ظهر الموقع القديم على أنه الأحدث. ومقارنة رقم التسلسل في ذاكرة كل Worker كما في المختبر لا تكفي هنا، والحل أن تجعل المقارنة داخل Redis نفسه بسكربت Lua يكتب فقط إذا كان التسلسل أكبر، أو أن تستخدم أداة توزع بحسب مفتاح مثل Kafka، فتذهب كل نقاط المندوب الواحد إلى Worker واحد بالترتيب، وقد شرحنا الفرق بين الطابور وبث الأحداث في مقال الطابور أم بث الأحداث.
الخصوصية ومدة الاحتفاظ
موقع المندوب كل ثلاث ثوان طوال دوامه يكشف أين يسكن وأين يصلي وأين يأكل، وموقع العميل يكشف بيته، وقد شرحنا في مقال الزحام لماذا تكون نقاط GPS بيانات شخصية حتى بعد حذف الاسم، وكيف تجمع وتخفي الهوية بحد أدنى للعدد. وفي المملكة يحكم هذا نظام حماية البيانات الشخصية الصادر بالمرسوم الملكي م/19 بتاريخ 1443/2/9هـ وتعديلاته، وفيه مادتان تمسان هذا التصميم مباشرة:
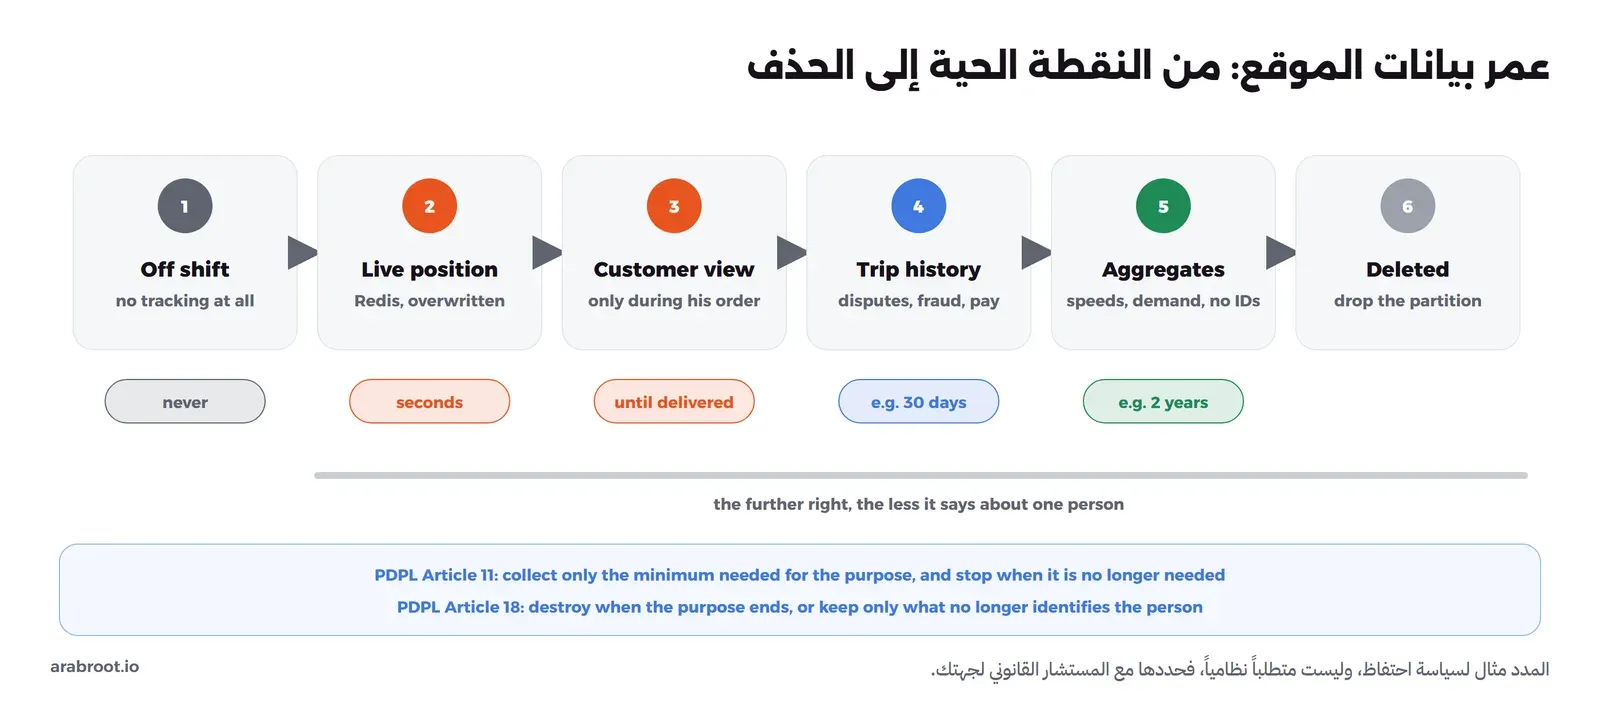
- المادة الحادية عشرة: يجب أن يكون محتوى البيانات ملائماً ومقصوراً على الحد الأدنى اللازم لتحقيق الغرض من جمعها، وإذا اتضح أنها لم تعد ضرورية فعلى جهة التحكم أن تتوقف عن جمعها وأن تتلف ما جمعته دون تأخير. وتطبيق هذا في الكود واضح: لا تتبع خارج الدوام، ولا تجمع كل ثانية إذا كان الغرض يكفيه أقل.
- المادة الثامنة عشرة: على جهة التحكم إتلاف البيانات بعد انتهاء الغرض من جمعها دون تأخير، ويجوز الاحتفاظ بها بعد ذلك إذا أزيل كل ما يؤدي إلى معرفة صاحبها وفق ضوابط اللوائح، ويجب الاحتفاظ بها إذا وجد مسوغ نظامي لمدة محددة أو قضية منظورة.
والمادة الثانية عشرة تطلب سياسة خصوصية متاحة لصاحب البيانات عند الجمع تحدد الغرض والمحتوى وطريقة الحفظ والإتلاف، أي أن مدد الاحتفاظ يجب أن تكون مكتوبة قبل أن تكون كوداً. والصورة التالية تبين سياسة احتفاظ مقترحة، والمدد فيها مثال فقط:
ولا تنس أن موظفيك أيضاً يستطيعون رؤية المواقع، لذلك اجعل الوصول إلى تاريخ المشاوير بصلاحية محددة وسبب مكتوب، وسجل من فتح ماذا في سجل تدقيق كما شرحنا في مقال سجل التدقيق، ولا تكتب الإحداثيات في سجلات التطبيق العادية كما ذكرنا في مقال السجلات.
التجربة العملية: آلاف المندوبين عبر MQTT إلى Redis GEO
في هذه التجربة سوف نشغل وسيط Mosquitto وقاعدة Redis وContainer من Python، ثم نحاكي آلاف المندوبين يرسلون مواقعهم داخل مستطيل الرياض، ونقيس كم رسالة يستطيع Worker واحد أن يستقبل ويكتب، ومتى يبدأ الوسيط بإسقاط الرسائل، وماذا يحدث عندما نوزعها على أربعة Workers. وكل الأرقام في هذا القسم قياس محلي على جهاز واحد عليه Docker Engine 29.8.0 بثماني وحدات معالجة، والمحاكي والوسيط وال Workers وRedis كلها على الجهاز نفسه وتتقاسم المعالج، لذلك فهي تقارن بين الإعدادات ولا تصف حدود أي أداة.
ملفات التجربة
ملف Compose بثلاث خدمات، والمنافذ مربوطة على 127.0.0.1 فقط:
name: lab-case-live
services:
  mqtt:
    image: eclipse-mosquitto:2.1.2-alpine
    container_name: lab-case-live-mqtt
    volumes:
      - ./mosquitto.conf:/mosquitto/config/mosquitto.conf:ro
    ports:
      - "127.0.0.1:18830:1883"
  redis:
    image: redis:8.8.3-alpine
    container_name: lab-case-live-redis
    command: ["redis-server", "--save", "", "--appendonly", "no"]
    ports:
      - "127.0.0.1:16390:6379"
  app:
    image: python:3.13.16-slim
    container_name: lab-case-live-app
    working_dir: /lab
    volumes:
      - ./:/lab
    command: ["sh", "-c", "pip install -q --root-user-action=ignore -r requirements.txt && sleep infinity"]
وإعداد Mosquitto للمختبر فقط، فلا تستخدم الاتصال دون مستخدم في أي مكان آخر:
# Lab only: anonymous access on a private Docker network. In production use TLS and per-device credentials.
listener 1883
allow_anonymous true
persistence false
log_dest stdout
log_type error
log_type warning
والمكتبات بإصدارات مثبتة:
paho-mqtt==2.1.0
redis==8.1.0
الملف simulate.py هو المندوبون، كل مندوب يتحرك عشوائياً بسرعة قرابة 30 كم في الساعة وينشر نقطته على الموضوع الخاص به بمستوى QoS 0:
#!/usr/bin/env python3
"""Simulated couriers: each one moves inside a Riyadh rectangle and publishes its position over MQTT.

  python simulate.py --couriers 2000 --interval 4 --seconds 30
Topic: couriers/<id>/loc   payload: {"id","lat","lon","ts","seq"}   QoS 0 (a lost point is replaced by the next one).
The couriers are split over a few MQTT connections to keep the lab light; on real phones each courier has its own.
"""
import argparse
import json
import math
import random
import threading
import time

import paho.mqtt.client as mqtt

LAT, LON = (24.60, 24.85), (46.55, 46.85)


def courier_loop(ids, args, stats, lock):
    cli = mqtt.Client(mqtt.CallbackAPIVersion.VERSION2, client_id=f"sim-{ids[0]}")
    cli.connect(args.host, 1883, keepalive=30)
    cli.loop_start()
    rnd = random.Random(ids[0])
    state = {i: [rnd.uniform(*LAT), rnd.uniform(*LON), rnd.uniform(0, 2 * math.pi), 0] for i in ids}
    # spread the first message of each courier over one interval, as real phones do not start together
    nxt = {i: time.time() + rnd.uniform(0, args.interval) for i in ids}
    end = time.time() + args.seconds
    sent = 0
    while time.time() < end:
        now = time.time()
        for i in ids:
            if nxt[i] > now:
                continue
            s = state[i]
            step_km = 30 / 3600 * args.interval                # about 30 km/h
            s[2] += rnd.gauss(0, 0.4)
            s[0] = min(max(s[0] + step_km / 111 * math.sin(s[2]), LAT[0]), LAT[1])
            s[1] = min(max(s[1] + step_km / 101 * math.cos(s[2]), LON[0]), LON[1])
            s[3] += 1
            cli.publish(f"couriers/{i}/loc",
                        json.dumps({"id": i, "lat": round(s[0], 6), "lon": round(s[1], 6),
                                    "ts": round(now, 3), "seq": s[3]}), qos=0)
            sent += 1
            nxt[i] += args.interval
        time.sleep(0.005)
    cli.loop_stop()
    cli.disconnect()
    with lock:
        stats["sent"] += sent


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--host", default="lab-case-live-mqtt")
    ap.add_argument("--couriers", type=int, default=1000)
    ap.add_argument("--interval", type=float, default=4.0, help="seconds between two points of one courier")
    ap.add_argument("--seconds", type=float, default=30)
    ap.add_argument("--connections", type=int, default=8)
    args = ap.parse_args()
    ids = [f"c{n:05d}" for n in range(args.couriers)]
    groups = [ids[k::args.connections] for k in range(args.connections)]
    stats, lock = {"sent": 0}, threading.Lock()
    t0 = time.time()
    threads = [threading.Thread(target=courier_loop, args=(g, args, stats, lock)) for g in groups if g]
    for t in threads:
        t.start()
    for t in threads:
        t.join()
    took = time.time() - t0
    print(f"sim: {args.couriers} couriers every {args.interval}s -> expected {args.couriers / args.interval:.0f} msg/s; "
          f"sent {stats['sent']} in {took:.1f}s = {stats['sent'] / took:.0f} msg/s")


if __name__ == "__main__":
    main()
والملف ingest.py هو ال Worker الذي يستقبل النقاط ويكتبها في Redis، ويعيد نشر نقطة مندوب الطلب على موضوع الطلب:
#!/usr/bin/env python3
"""Ingest: MQTT -> Redis GEO, plus fan-out of a courier's position to the customer who is watching his order.

  python ingest.py --mode pipeline --seconds 40
For each point:  GEOADD couriers:live lon lat id   and   ZADD couriers:seen ts id
If the courier carries an order (HGET courier:order id), the point is republished to track/<order>.
--mode single sends each command on its own round trip; --mode pipeline sends them in batches.
"""
import argparse
import json
import queue
import threading
import time

import paho.mqtt.client as mqtt
import redis

ap = argparse.ArgumentParser()
ap.add_argument("--mqtt", default="lab-case-live-mqtt")
ap.add_argument("--redis", default="lab-case-live-redis")
ap.add_argument("--mode", choices=["single", "pipeline"], default="pipeline")
ap.add_argument("--seconds", type=float, default=40)
ap.add_argument("--batch", type=int, default=500)
ap.add_argument("--share", action="store_true", help="join the shared subscription $share/ingest/... (MQTT 5)")
ap.add_argument("--name", default="ingest-1")
args = ap.parse_args()

r = redis.Redis(host=args.redis, port=6379)
inbox = queue.Queue()
stats = {"in": 0, "written": 0, "stale": 0, "fanout": 0, "flushes": 0}


def on_message(cli, userdata, msg):
    inbox.put(msg.payload)


cli = mqtt.Client(mqtt.CallbackAPIVersion.VERSION2, client_id=args.name, protocol=mqtt.MQTTv5)
cli.on_message = on_message
cli.connect(args.mqtt, 1883, keepalive=30)
cli.subscribe(("$share/ingest/" if args.share else "") + "couriers/+/loc", qos=0)
cli.loop_start()

last_seq = {}            # drop points that arrive after a newer point of the same courier
orders = {}              # courier -> order he is delivering (refreshed every second)


def flush(points):
    fresh = []
    for p in points:
        if p["seq"] <= last_seq.get(p["id"], 0):
            stats["stale"] += 1
            continue
        last_seq[p["id"]] = p["seq"]
        fresh.append(p)
    if args.mode == "single":
        for p in fresh:
            r.geoadd("couriers:live", (p["lon"], p["lat"], p["id"]))
            r.zadd("couriers:seen", {p["id"]: p["ts"]})
    else:
        pipe = r.pipeline(transaction=False)
        for p in fresh:
            pipe.geoadd("couriers:live", (p["lon"], p["lat"], p["id"]))
            pipe.zadd("couriers:seen", {p["id"]: p["ts"]})
        pipe.execute()
    for p in fresh:
        o = orders.get(p["id"])
        if o:
            cli.publish(f"track/{o}", json.dumps({"lat": p["lat"], "lon": p["lon"], "ts": p["ts"]}), qos=0)
            stats["fanout"] += 1
    stats["written"] += len(fresh)
    stats["flushes"] += 1


t0 = time.time()
tick, per_sec = t0, []
prev_written = 0
while time.time() - t0 < args.seconds:
    batch = []
    try:
        batch.append(json.loads(inbox.get(timeout=0.1)))
        while len(batch) < (1 if args.mode == "single" else args.batch):
            batch.append(json.loads(inbox.get_nowait()))
    except queue.Empty:
        pass
    stats["in"] += len(batch)
    if batch:
        flush(batch)
    if time.time() - tick >= 1:
        tick = time.time()
        orders = {k.decode(): v.decode() for k, v in r.hgetall("courier:order").items()}
        per_sec.append(stats["written"] - prev_written)
        prev_written = stats["written"]

busy = [x for x in per_sec if x > 0]
print(f"{args.name} ({args.mode}): received {stats['in']}, written {stats['written']}, dropped out-of-order {stats['stale']}, "
      f"fan-out {stats['fanout']}, round trips {stats['flushes'] if args.mode == 'pipeline' else stats['written'] * 2}")
if busy:
    print(f"{args.name} ({args.mode}): written per second  min {min(busy)}  median {sorted(busy)[len(busy) // 2]}  max {max(busy)}")
print(f"{args.name} ({args.mode}): backlog left in the inbox {inbox.qsize()}")
في الكود أعلاه لاحظ التالي:
- الدالة on_message تضع الرسالة في طابور داخل البرنامج فقط، والكتابة في Redis تتم في الحلقة الرئيسية، حتى لا تتأخر قراءة الشبكة بسبب الكتابة.
- كل نقطة تكتب في مكانين: couriers:live بالأمر GEOADD للبحث، وcouriers:seen بالأمر ZADD ودرجتها وقت النقطة، لنعرف من سكت.
- الخيار --mode single يرسل كل أمر في ذهاب وعودة مستقل على الشبكة Round Trip، والخيار pipeline يجمع ما وصل في دفعة واحدة، وقد شرحنا فكرة ال Pipeline والاتصال بـ Redis في مقال تجميع الاتصالات.
- الخيار --share يجعل ال Worker ينضم إلى الاشتراك المشترك، فيقسم الوسيط الرسائل بين كل من فيه.
والملف watch.py هو العميل الذي يتابع طلبه:
#!/usr/bin/env python3
"""The customer's side: subscribe to one order and print where its courier is."""
import json
import sys
import time

import paho.mqtt.client as mqtt

order = sys.argv[1] if len(sys.argv) > 1 else "order-42"
seconds = float(sys.argv[2]) if len(sys.argv) > 2 else 15
got = []


def on_message(cli, userdata, msg):
    p = json.loads(msg.payload)
    got.append(p)
    print(f"{msg.topic}  ({p['lat']:.5f}, {p['lon']:.5f})  delay {1000 * (time.time() - p['ts']):.0f} ms", flush=True)


cli = mqtt.Client(mqtt.CallbackAPIVersion.VERSION2, client_id=f"watch-{order}")
cli.on_message = on_message
cli.connect("lab-case-live-mqtt", 1883, keepalive=30)
cli.subscribe(f"track/{order}", qos=0)
cli.loop_start()
time.sleep(seconds)
cli.loop_stop()
print(f"{len(got)} updates in {seconds:.0f}s")
والملف query.py يسأل الأسئلة التي يسألها محرك التوزيع: من هم الخمسة الأقرب إلى المطعم، وكم يستغرق البحث، ومن سكت أكثر من 15 ثانية:
#!/usr/bin/env python3
"""Questions the dispatch engine asks: who is near this restaurant, and who stopped sending?"""
import time

import redis

r = redis.Redis(host="lab-case-live-redis", port=6379, decode_responses=True)
restaurant = (46.6744, 24.7114)          # lon, lat (Kingdom Centre); GEO commands take longitude first

print("members in couriers:live:", r.zcard("couriers:live"))
near = r.geosearch("couriers:live", longitude=restaurant[0], latitude=restaurant[1],
                   radius=2, unit="km", sort="ASC", count=5, withdist=True, withcoord=True)
print("5 nearest within 2 km:")
for name, dist, (lon, lat) in near:
    age = time.time() - r.zscore("couriers:seen", name)
    print(f"  {name}  {dist:.3f} km  ({lat:.5f}, {lon:.5f})  last seen {age:.1f}s ago")

n = 2000
t0 = time.perf_counter()
for _ in range(n):
    r.geosearch("couriers:live", longitude=restaurant[0], latitude=restaurant[1],
                radius=2, unit="km", sort="ASC", count=10)
took = time.perf_counter() - t0
print(f"{n} GEOSEARCH (2 km, COUNT 10) one after another: {took * 1000 / n:.3f} ms each, {n / took:.0f} per second")

cut = time.time() - 15
stale = r.zrangebyscore("couriers:seen", "-inf", cut)
print(f"couriers silent for more than 15 s: {len(stale)}")
if stale:
    pipe = r.pipeline()
    pipe.zrem("couriers:live", *stale)
    pipe.zrem("couriers:seen", *stale)
    print("removed from the live index:", pipe.execute())
print("members in couriers:live now:", r.zcard("couriers:live"))
print("memory used by couriers:live:", r.memory_usage("couriers:live"), "bytes")
وأخيراً الملف step.sh الذي يشغل قياساً واحداً: ينظف Redis، ويشغل ال Workers، ثم المحاكي لمدة 30 ثانية، ثم يطبع النتائج وعدد الرسائل التي أسقطها الوسيط من عداده الداخلي على الموضوع $SYS:
#!/bin/sh
# One measurement: <workers> ingest processes, <couriers> sending every <interval> seconds for 30 s.
#   sh step.sh 1 2000 4            one worker, 500 msg/s, pipelined writes
#   sh step.sh 1 4000 4 single     one worker, 1000 msg/s, one Redis round trip per command
#   TRACK=1 sh step.sh 1 2000 4    also: courier c00042 carries order-42 and a customer watches it
W=$1; N=$2; I=$3; M=${4:-pipeline}
dropped() { docker exec lab-case-live-mqtt sh -c 'mosquitto_sub -h localhost -t "\$SYS/broker/publish/messages/dropped" -C 1 -W 3'; }
d0=$(dropped)
docker exec lab-case-live-redis redis-cli FLUSHALL > /dev/null
[ -n "$TRACK" ] && docker exec lab-case-live-redis redis-cli HSET courier:order c00042 order-42 > /dev/null
SHARE=""; [ "$W" -gt 1 ] && SHARE="--share"
for k in $(seq 1 $W); do
  docker exec lab-case-live-app python ingest.py --mode $M --seconds 42 $SHARE --name ingest-$k > out-ingest-$k.txt 2>&1 &
done
[ -n "$TRACK" ] && docker exec lab-case-live-app python watch.py order-42 12 > out-watch.txt 2>&1 &
sleep 3
docker exec lab-case-live-app python simulate.py --couriers $N --interval $I --seconds 30 --connections 16
wait
cat $(ls out-ingest-*.txt | head -n $W)
[ -n "$TRACK" ] && cat out-watch.txt
echo "broker dropped during this step: $(( $(dropped) - d0 ))"
rm -f out-ingest-*.txt out-watch.txt
التشغيل
docker compose up -d
docker compose ps --format '{{.Name}}  {{.Image}}  {{.Status}}  {{.Ports}}'
والمخرج سوف يكون كما يلي:
lab-case-live-app  python:3.13.16-slim  Up 46 minutes
lab-case-live-mqtt  eclipse-mosquitto:2.1.2-alpine  Up 46 minutes  127.0.0.1:18830->1883/tcp
lab-case-live-redis  redis:8.8.3-alpine  Up 46 minutes  127.0.0.1:16390->6379/tcp
ألفا مندوب كل 4 ثوان، وعميل يتابع طلبه
نبدأ بألفي مندوب كل 4 ثوان، أي 500 رسالة في الثانية، والمندوب c00042 يحمل الطلب order-42، والعميل يتابعه:
TRACK=1 sh step.sh 1 2000 4والمخرج سوف يكون كما يلي:
sim: 2000 couriers every 4.0s -> expected 500 msg/s; sent 15003 in 31.0s = 483 msg/s
ingest-1 (pipeline): received 15003, written 15003, dropped out-of-order 0, fan-out 8, round trips 9971
ingest-1 (pipeline): written per second  min 15  median 502  max 531
ingest-1 (pipeline): backlog left in the inbox 0
track/order-42  (24.69338, 46.60370)  delay 2 ms
track/order-42  (24.69366, 46.60359)  delay 2 ms
track/order-42  (24.69388, 46.60337)  delay 2 ms
3 updates in 12s
broker dropped during this step: 0
في المخرج أعلاه لاحظ التالي:
- المحاكي أرسل 483 رسالة في الثانية بدل 500 المتوقعة، لأن المندوبين يبدؤون في أوقات موزعة على أول 4 ثوان، وال Worker كتب كل ما استلمه.
- ال Worker أعاد نشر 8 نقاط على موضوع الطلب، أي نقطة كل 4 ثوان لمدة 30 ثانية، ولم يرسل للعميل أي نقطة لمندوب آخر.
- التأخير من لحظة إنشاء النقطة إلى وصولها للعميل 2 ميلي ثانية على جهاز واحد، وفي الواقع تضاف إليه شبكة الهاتفين.
ألف رسالة في الثانية: أمر بأمر أم دفعة واحدة
sh step.sh 1 4000 4 single
sh step.sh 1 4000 4
$ sh step.sh 1 4000 4 single
sim: 4000 couriers every 4.0s -> expected 1000 msg/s; sent 30031 in 31.0s = 968 msg/s
ingest-1 (single): received 30031, written 30031, dropped out-of-order 0, fan-out 0, round trips 60062
ingest-1 (single): written per second min 14 median 1006 max 1150
ingest-1 (single): backlog left in the inbox 0
broker dropped during this step: 0
$ sh step.sh 1 4000 4
sim: 4000 couriers every 4.0s -> expected 1000 msg/s; sent 30031 in 31.0s = 968 msg/s
ingest-1 (pipeline): received 30031, written 30031, dropped out-of-order 0, fan-out 0, round trips 25883
ingest-1 (pipeline): written per second min 14 median 1002 max 1043
ingest-1 (pipeline): backlog left in the inbox 0
broker dropped during this step: 0كلا الوضعين كتب 30,031 نقطة، ولكن الوضع single احتاج 60,062 Round Trip إلى Redis، أي اثنين لكل نقطة، والوضع pipeline احتاج 25,883 فقط، لأن ما يصل في اللحظة نفسها يرسل في دفعة واحدة. ولاحظ أن الفرق يكبر مع الضغط، ففي القياس التالي عند 2,000 رسالة في الثانية كان عدد ال Round Trips 43,587 لأكثر من 60 ألف نقطة.
أين يتوقف Worker واحد؟
sh step.sh 1 8000 4
sh step.sh 1 16000 4
sh step.sh 4 16000 4
$ sh step.sh 1 8000 4
sim: 8000 couriers every 4.0s -> expected 2000 msg/s; sent 60030 in 31.1s = 1933 msg/s
ingest-1 (pipeline): received 60030, written 60030, dropped out-of-order 0, fan-out 0, round trips 43587
ingest-1 (pipeline): written per second min 9 median 2023 max 2134
ingest-1 (pipeline): backlog left in the inbox 0
broker dropped during this step: 0
$ sh step.sh 1 16000 4
sim: 16000 couriers every 4.0s -> expected 4000 msg/s; sent 119920 in 31.1s = 3857 msg/s
ingest-1 (pipeline): received 99582, written 99582, dropped out-of-order 0, fan-out 0, round trips 51701
ingest-1 (pipeline): written per second min 1035 median 3027 max 3989
ingest-1 (pipeline): backlog left in the inbox 0
broker dropped during this step: 20337
$ sh step.sh 4 16000 4
sim: 16000 couriers every 4.0s -> expected 4000 msg/s; sent 119917 in 31.1s = 3858 msg/s
ingest-1 (pipeline): received 29979, written 29979, dropped out-of-order 0, fan-out 0, round trips 22053
ingest-1 (pipeline): written per second min 217 median 994 max 1036
ingest-1 (pipeline): backlog left in the inbox 0
ingest-2 (pipeline): received 29979, written 29979, dropped out-of-order 0, fan-out 0, round trips 21750
ingest-2 (pipeline): written per second min 181 median 994 max 1036
ingest-2 (pipeline): backlog left in the inbox 0
ingest-3 (pipeline): received 29978, written 29978, dropped out-of-order 0, fan-out 0, round trips 21784
ingest-3 (pipeline): written per second min 54 median 1000 max 1031
ingest-3 (pipeline): backlog left in the inbox 0
ingest-4 (pipeline): received 29979, written 29979, dropped out-of-order 0, fan-out 0, round trips 21859
ingest-4 (pipeline): written per second min 71 median 1000 max 1032
ingest-4 (pipeline): backlog left in the inbox 0
broker dropped during this step: 0وهنا أهم نتيجة في التجربة: عند 2,000 رسالة في الثانية استلم ال Worker الواحد كل شيء، وعند 4,000 استلم 99,582 من 119,920 رسالة، وأسقط الوسيط 20,337 رسالة لأن ال Worker لم يسحبها بالسرعة الكافية، ولا يوجد أي خطأ ظاهر في سجلات ال Worker نفسه. ثم عندما وزعنا الحمل نفسه على أربعة Workers بالاشتراك المشترك استلم كل منهم قرابة الربع، ولم يسقط الوسيط شيئاً. ولاحظ أن Redis لم يكن هو الحد، فكل Worker في الحالة الأخيرة كتب ألف نقطة في الثانية فقط، والحد كان معالج Python الواحد الذي يقرأ الشبكة ويفك JSON، وهذا ما سوف نتأكد منه بعد قليل. والدرس العملي: راقب عداد الرسائل المسقطة في الوسيط، فهو المكان الوحيد الذي يظهر فيه هذا النوع من الفقد.
البحث عن الأقرب، وتنظيف من سكت
docker exec lab-case-live-app python query.pymembers in couriers:live: 16000
5 nearest within 2 km:
c05338 0.062 km (24.71181, 46.67482) last seen 14.7s ago
c09112 0.085 km (24.71136, 46.67356) last seen 13.5s ago
c06744 0.136 km (24.71122, 46.67573) last seen 11.5s ago
c07993 0.263 km (24.71185, 46.67695) last seen 13.8s ago
c04301 0.288 km (24.70958, 46.67237) last seen 11.6s ago
2000 GEOSEARCH (2 km, COUNT 10) one after another: 0.374 ms each, 2672 per second
couriers silent for more than 15 s: 4213
removed from the live index: [4213, 4213]
members in couriers:live now: 11787
memory used by couriers:live: 954928 bytesفي المخرج أعلاه لاحظ التالي:
- البحث عن الأقرب ضمن 2 كم حول برج المملكة بين 16,000 مندوب أخذ 0.374 ميلي ثانية للطلب الواحد من Python، وأغلب هذا الوقت ذهاب الطلب وعودته على الشبكة وليس البحث.
- شغلنا الاستعلام بعد توقف المحاكي ببضع ثوان، فكل المندوبين يكبر عمر آخر نقطة لهم، و4,213 منهم تجاوزوا 15 ثانية فحذفوا من الفهرس الحي، وفي النظام الحقيقي يشغل هذا التنظيف كل بضع ثوان، أو يستخدم محرك التوزيع الوقت مباشرة ليتجاهل من سكت.
- الفهرس الحي لـ 11,787 مندوباً يأخذ قرابة 955 كيلوبايت فقط، أي أن آخر موقع لكل مندوبي مدينة كبيرة يتسع في ذاكرة أي سيرفر.
هل Redis هو الحد؟
نستخدم أداة redis-benchmark من داخل Container ال Redis نفسه، بخمسين اتصالاً، مرة بأمر واحد في كل Round Trip، ومرة بخمسين أمراً في كل Round Trip بال Pipeline:
docker exec lab-case-live-redis redis-benchmark -q -n 200000 -c 50 -r 20000 -P 1 GEOADD bench:live 46.6744 24.7114 c__rand_int__
docker exec lab-case-live-redis redis-benchmark -q -n 1000000 -c 50 -r 20000 -P 50 GEOADD bench:live 46.6744 24.7114 c__rand_int__
docker exec lab-case-live-redis redis-benchmark -q -n 200000 -c 50 GEOSEARCH couriers:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10
$ redis-benchmark -q -n 200000 -c 50 -r 20000 -P 1 GEOADD bench:live 46.6744 24.7114 c__rand_int__
GEOADD bench:live 46.6744 24.7114 c__rand_int__: 65231.57 requests per second, p50=0.423 msec
$ redis-benchmark -q -n 1000000 -c 50 -r 20000 -P 50 GEOADD bench:live 46.6744 24.7114 c__rand_int__
GEOADD bench:live 46.6744 24.7114 c__rand_int__: 477554.91 requests per second, p50=4.567 msec
$ redis-benchmark -q -n 200000 -c 50 GEOSEARCH couriers:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10
GEOSEARCH couriers:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10: 11468.55 requests per second, p50=3.751 msec
20000أكثر من 65 ألف GEOADD في الثانية بأمر في كل Round Trip، وأكثر من 477 ألفاً مع ال Pipeline، وأكثر من 11 ألف بحث في الثانية بخمسين كلاينت، على الجهاز نفسه. أي أن Redis يستطيع أن يستقبل أضعاف ما استطاع ال Worker أن يرسله في القياس السابق، والحد الحقيقي كان في ال Worker، وهو الجزء الذي يجب أن تخطط لتوزيعه على عدة نسخ من البداية.
نكسر الإعداد: كل المندوبين في نقطة واحدة
لاحظ أن أمر الكتابة في القياس السابق وضع 20,000 مندوب في النقطة نفسها، وهذا يشبه مدينة ترسل فيها كل التطبيقات موقعاً افتراضياً واحداً عندما لا يعمل GPS، أو حدثاً كبيراً يتجمع فيه آلاف المندوبين في ساحة واحدة. فماذا يحدث للبحث؟
docker exec lab-case-live-redis redis-cli ZCARD bench:live
docker exec lab-case-live-redis redis-benchmark -q -n 2000 -c 50 GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10
docker exec lab-case-live-redis redis-benchmark -q -n 200000 -c 50 GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km COUNT 10 ANY
$ redis-cli ZCARD bench:live
20000
$ redis-benchmark -q -n 2000 -c 50 GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10
GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km ASC COUNT 10: 259.27 requests per second, p50=184.191 msec
$ redis-benchmark -q -n 200000 -c 50 GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km COUNT 10 ANY
GEOSEARCH bench:live FROMLONLAT 46.6744 24.7114 BYRADIUS 2 km COUNT 10 ANY: 25361.40 requests per second, p50=0.951 msecنزل البحث من أكثر من 11 ألفاً في الثانية إلى 259 فقط، وصار نصف الطلبات يأخذ 184 ميلي ثانية أو أكثر، مع أننا طلبنا عشرة نتائج فقط. والسبب مكتوب في توثيق GEOSEARCH: بدون الخيار ANY يعمل Redis بجهد يتناسب مع كل العناصر داخل المنطقة ثم يرتبها، فإذا كان في الدائرة عشرون ألف عنصر فهو يرتب عشرين ألفاً ليعطيك عشرة. ومع ANY رجع إلى أكثر من 25 ألف بحث في الثانية، لأنه يتوقف عند أول عشرة يجدها، ولكنها لم تعد الأقرب بالضرورة. والدرس: لا تقبل النقطة التي لا معنى لها مثل 0,0 أو الموقع الافتراضي، واجعل نصف قطر البحث صغيراً ثم وسعه عند الحاجة كما فعلنا بالحلقات في مقال التوزيع، واستخدم ANY عندما يكفيك «أي عشرة قريبين».
حذف المختبر
هذا المختبر لا ينشئ Volumes، فيكفي حذف المشروع بالاسم، وهو يحذف ال Containers الثلاثة والشبكة التي أنشأها Compose:
docker compose -p lab-case-live downمن المختبر إلى الإنتاج
- التشفير والهوية: MQTT فوق TLS، ولكل مندوب هوية خاصة به، وقائمة صلاحيات تمنعه من النشر إلا على موضوعه، فلا ينشر مندوب موقعاً باسم غيره.
- الوصية الأخيرة: اجعل تطبيق المندوب يسجل رسالة Last Will على موضوع حالته، فيعرف النظام خلال مرة ونصف من فترة النبضة أن المندوب انقطع، بدل أن ينتظر نهاية مهلة آخر ظهور.
- Workers متعددة من البداية: بالاشتراك المشترك أو بالتقسيم بحسب المدينة، مع مراقبة عداد الرسائل المسقطة في الوسيط وطول الطابور داخل كل Worker.
- Redis له نسخة احتياطية: آخر موقع يمكن أن يعاد بناؤه خلال ثوان من النقاط القادمة، لذلك لا تحتاج حفظاً دائماً له، ولكنك تحتاج نسخة متماثلة Replica حتى لا يتوقف التوزيع إذا توقف Redis، كما شرحنا في مقال التوفر العالي.
- التاريخ بدفعات: اكتب نقاط التاريخ في قاعدة البيانات كل ثانية أو أكثر بأمر واحد، واحذف الأقسام القديمة بحسب سياسة الاحتفاظ.
أخطاء شائعة
- فترة إرسال ثابتة قصيرة لكل الحالات: تستنزف البطارية والتخزين دون فائدة للمندوب المتاح أو الواقف.
- آخر موقع والتاريخ في جدول واحد: يجعل السؤالين بطيئين معاً.
- اعتبار آخر نقطة وصلت هي الأحدث: النقاط المؤجلة بسبب انقطاع الشبكة تصل متأخرة، فقارن بالتسلسل أو بالوقت.
- موضوع واحد لكل المواقع يشترك فيه العميل: يكشف كل المندوبين لكل من يعرف اسم الموضوع.
- Worker واحد دون مراقبة الوسيط: الفقد يحدث بصمت عند الوسيط كما رأينا في المختبر.
- تتبع خارج الدوام أو الاحتفاظ بلا مدة: مخالف لمبدأ الحد الأدنى في نظام حماية البيانات الشخصية، وخطر عند أي تسرب.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- فترة الإرسال تحدد كل شيء: عشرة آلاف مندوب كل 4 ثوان تعني 2,500 رسالة في الثانية و216 مليون نقطة في اليوم، فاجعلها تتغير بحسب حالة المندوب.
- على الهاتف: دقة عالية فقط أثناء التوصيل، وخدمة في الواجهة يراها المندوب، وحفظ النقاط عند انقطاع الشبكة مع رقم تسلسل.
- MQTT مناسب لتطبيق المندوب لأن المواضيع والنبضة والوصية الأخيرة والاشتراك المشترك في المعيار، وWebSocket مناسب لتطبيق العميل والويب.
- آخر موقع في Redis GEO أو PostGIS، والتاريخ في جدول إضافة فقط مقسم باليوم، ولكل منهما سؤال مختلف.
- في المختبر المحلي توقف Worker واحد من Python قرب 3,000 رسالة في الثانية وأسقط الوسيط الباقي بصمت، بينما استقبل Redis على الجهاز نفسه أكثر من 65 ألف كتابة في الثانية، وأربعة Workers باشتراك مشترك استقبلت كل شيء.
- الموقع بيانات شخصية: لا تتبع خارج الدوام، ولا تعرض لأحد غير صاحب الطلب، واكتب مدد الاحتفاظ قبل أن تكتب الكود.
 دليلكيف يختار تطبيق التوصيل المندوب؟ محرك التوزيع Dispatchكيف تختار تطبيقات التوصيل المندوب لكل طلب، ولماذا يكون التوزيع على دفعات أفضل من إعطاء كل طلب أقرب مندوب.
 دليلالمحفظة الرقمية من الداخل: دفتر القيد المزدوج Ledgerكيف تبني محفظة رقمية لا يضيع فيها ريال ولا يخصم مرتين، بالقيد المزدوج والمعاملات والمطابقة مع مزود الدفع.
 دليلكيف تعرف الخرائط الزحام وسرعة الطريق؟كيف تتحول نقاط GPS من الهواتف إلى سرعة لكل شارع وزمن وصول أدق، وما الذي يحمي خصوصية أصحابها.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلكيف تعمل الإشعارات الفورية Push Notifications؟كيف يصل الإشعار إلى تطبيق مغلق عبر خدمات Apple وGoogle، وما الذي تراه هذه الخدمات من بيانات مستخدميك.
 دليلالطابور Queue أم بث الأحداث Event Streaming؟ما يحدث للرسالة بعد قراءتها هو الفرق بين طابور مثل RabbitMQ وسجل أحداث مثل Kafka، ومنه تعرف أيهما يناسب مشروعك.
سجل التحديثات
- أكتوبر 2026: إضافة قسم المعمارية الكاملة: المخطط والمكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو.
- أكتوبر 2026: كتابة المقال، والتحقق من توثيق Android وRedis ومعيار MQTT 5.0 وRFC 6455 ونص نظام حماية البيانات الشخصية، وتشغيل المختبر على Mosquitto 2.1.2 وRedis 8.8.3 وPython 3.13.16 مع paho-mqtt 2.1.0 وredis-py 8.1.0.


