

عندما تضغط «اطلب» في تطبيق توصيل مثل جاهز أو Keeta، فإن الطلب يصل إلى المطعم خلال ثوان، ولكن السؤال الأصعب في النظام كله يأتي بعد ذلك: من هو المندوب الذي سوف يأخذ هذا الطلب؟ وقد يبدو الجواب بديهياً، أقرب مندوب متاح، ولكن عندما يكون في المدينة آلاف المندوبين وآلاف الطلبات في الدقيقة نفسها فإن «الأقرب» يصبح سؤالاً مكلفاً في الحساب، ويصبح أيضاً جواباً خاطئاً في أحيان كثيرة. والجزء الذي يجيب عن هذا السؤال يسمى محرك التوزيع Dispatch Engine، وهو موضوع هذا المقال، وهو أول مقالات مرحلة دراسات الحالة التي نطبق فيها ما شرحناه في مدخل تصميم الأنظمة على أنظمة تستخدمها كل يوم.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي تنشره Uber وجاهز وKeeta فعلاً عن أنظمتها، وما الذي لا تنشره.
- مسار الطلب داخل محرك التوزيع من لحظة الدفع إلى قبول المندوب.
- المعمارية الكاملة حول المحرك: المكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو والأعطال.
- الفهرسة الجغرافية Geo-Indexing بخلايا GeoHash وH3 وS2، ولماذا لا نحسب المسافة لكل المندوبين.
- زمن الوصول ETA من محرك المسارات بدل الخط المستقيم.
- ثلاث طرق للمطابقة Matching: الأقرب أولاً، والتوزيع على دفعات Batched Matching، والخوارزمية الهنغارية Hungarian Algorithm بمثال نحسبه باليد.
- حالات الطلب والمندوب State Machine، ومنع الإسناد المكرر، ومفتاح منع التكرار Idempotency Key.
- التسعير الديناميكي Dynamic Pricing باختصار.
- محاكاة بلغة Python على إحداثيات الرياض تقارن الطريقتين بمخرجات حقيقية.
ماذا تنشر الشركات عن أنظمتها؟
قبل أن نصمم أي شيء يجب أن نفصل بين ما نعرفه من مصادر رسمية وما نستنتجه من الهندسة العامة، والسبب أن هذا النوع من الأنظمة سر تجاري، فلا تنشر أغلب الشركات تفاصيله. وأوضح ما هو منشور يأتي من Uber، فصفحتها الرسمية كيف نطابق الركاب مع السائقين تقول إنها كانت في البداية تسند طلب الركوب لأقرب سائق متاح بمجرد الطلب، ثم وجدت أن الأقرب ليس دائماً الأسرع بسبب الزحام والجسور والأنهار، وأن هذه الطريقة أعطت بعض الركاب انتظاراً طويلاً تراكم على مستوى المدينة، فانتقلت إلى المطابقة على دفعات Batched Matching: تنتظر ثواني قليلة بعد الطلب حتى تتجمع دفعة من الركاب والسائقين القريبين، ثم توزعهم بهدف تقليل متوسط الانتظار للجميع وليس للزوج الأقرب فقط، وتذكر الصفحة أن ذلك يوفر عشر سنوات من وقت الناس كل يوم بحسب تقديرها. وفي مقال H3 على مدونة Uber في يونيو 2018 تذكر الشركة أنها تستخدم الخلايا السداسية لتحليل السوق وتحسينه في كل مدنها، وأنها تحسب التسعير المرتفع Surge Pricing بقياس العرض والطلب في هذه الخلايا.
أما جاهز فتذكر صفحة علاماتها التجارية أن التطبيق تأسس سنة 2016، وأنه يتيح للعميل تتبع التوصيل لحظياً، وأن المجموعة أطلقت في 2021 شركة Logi للخدمات اللوجستية المملوكة لها بالكامل، والتي تشغل أسطولاً من المندوبين السعوديين المستقلين ومندوبين دائمين، وتقدم تتبع التوصيل والاستلام المتعدد Multiple Pickups. وأما Keeta فهي علامة التوصيل الدولية لشركة Meituan الصينية، ويذكر التقرير السنوي لشركة Meituan عن 2025 أن الطلبات على Keeta في السعودية نمت بسرعة طوال العام، وأن الشركة توسعت في النصف الثاني من 2025 إلى قطر والكويت والإمارات والبرازيل، وهي الدول التي يعرضها موقع Keeta الرسمي مع السعودية وهونغ كونغ والبحرين. ولا تنشر جاهز ولا Keeta في مصادرهما الرسمية كيف يعمل التوزيع داخلياً، لذلك فكل ما يأتي بعد هذا القسم هو تصميم عام مبني على مصادر مفتوحة، وليس وصفاً لنظام أي منهما.
مسار الطلب داخل محرك التوزيع
الصورة التالية تبين أين يقع محرك التوزيع بين تطبيق العميل وتطبيق المندوب، والخطوات الست التي يمر بها كل طلب:
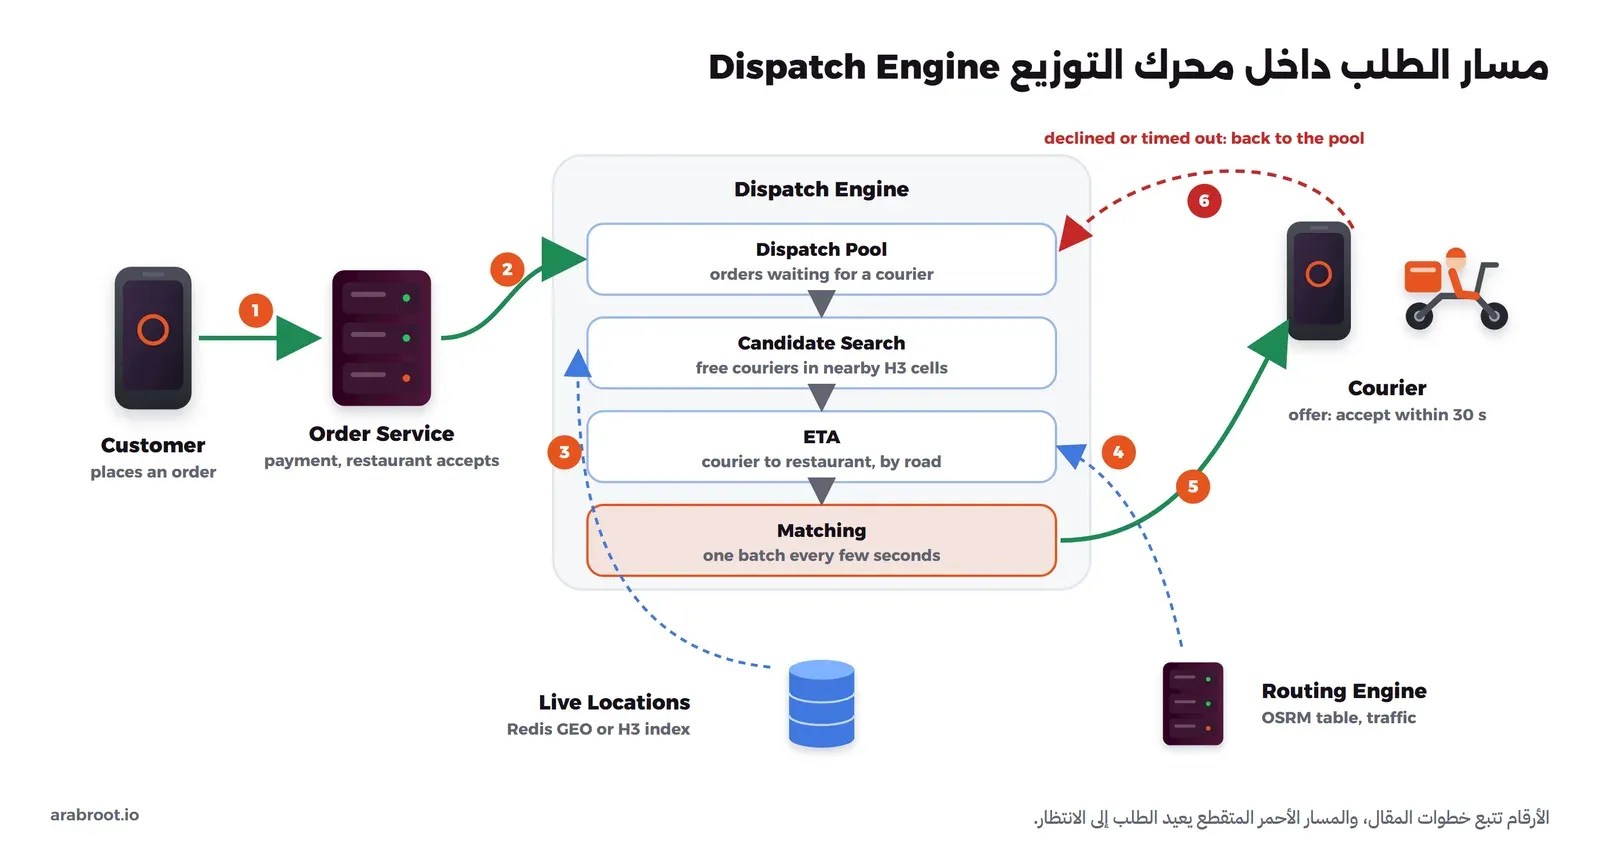
- الطلب: العميل يدفع، والمطعم يقبل الطلب ويقدر وقت التحضير.
- قائمة الانتظار Dispatch Pool: يدخل الطلب إلى قائمة الطلبات التي تحتاج مندوباً، ولا يدخلها بالضرورة فور الدفع، والسبب أن المندوب الذي يصل قبل جاهزية الطعام بعشرين دقيقة يضيع وقته وهو واقف عند المطعم، لذلك فالأنظمة الجيدة تحسب متى يجب أن يتحرك المندوب ليصل مع جاهزية الطعام تقريباً.
- البحث عن المرشحين Candidate Search: من بين آلاف المندوبين، من هم المتاحون القريبون من المطعم؟ وهذا سؤال جغرافي يجيب عنه فهرس المواقع، وسوف نفصله في القسم التالي، والمواقع نفسها تصل من هواتف المندوبين كما نشرح في مقال تتبع المواقع لحظياً.
- زمن الوصول ETA: لكل مرشح، كم دقيقة يحتاج حتى يصل إلى المطعم بالطريق الفعلي وليس بالخط المستقيم.
- المطابقة Matching: قرار من يأخذ ماذا، ثم إرسال عرض Offer إلى المندوب.
- القبول أو الرفض: المندوب يقبل خلال مهلة محددة، وإذا رفض أو انتهت المهلة يعود الطلب إلى القائمة ويستبعد هذا المندوب منه.
ولاحظ أن الخطوات من 3 إلى 5 تتكرر كل بضع ثوان على كل الطلبات المنتظرة، وأن كل خطوة منها لها طريقة بسيطة وطريقة صحيحة، وهذا ما سوف نمر عليه واحدة بعد الأخرى.
المعمارية الكاملة: أين يقع محرك التوزيع بين بقية الأجزاء؟
الصورة السابقة تبين ما يحدث داخل محرك التوزيع، ولكن المحرك لا يعمل وحده، فهو يأخذ الطلبات من خدمة الطلبات، والمواقع من خدمة تستقبل نقاط المندوبين، والأزمنة من محرك المسارات، ثم يسلم قراره لخدمة ترسل العرض وتنتظر الرد. والصورة التالية تبين النظام كله في طبقات من اليسار إلى اليمين: التطبيقات الثلاثة، ثم الحافة Edge، ثم الخدمات، ثم البيانات ومحرك المسارات، ثم بث الأحداث، ثم المزودون الخارجيون، وهي معمارية مقترحة مبنية على ما شرحناه في هذا المقال، وليست وصفاً لنظام شركة بعينها:
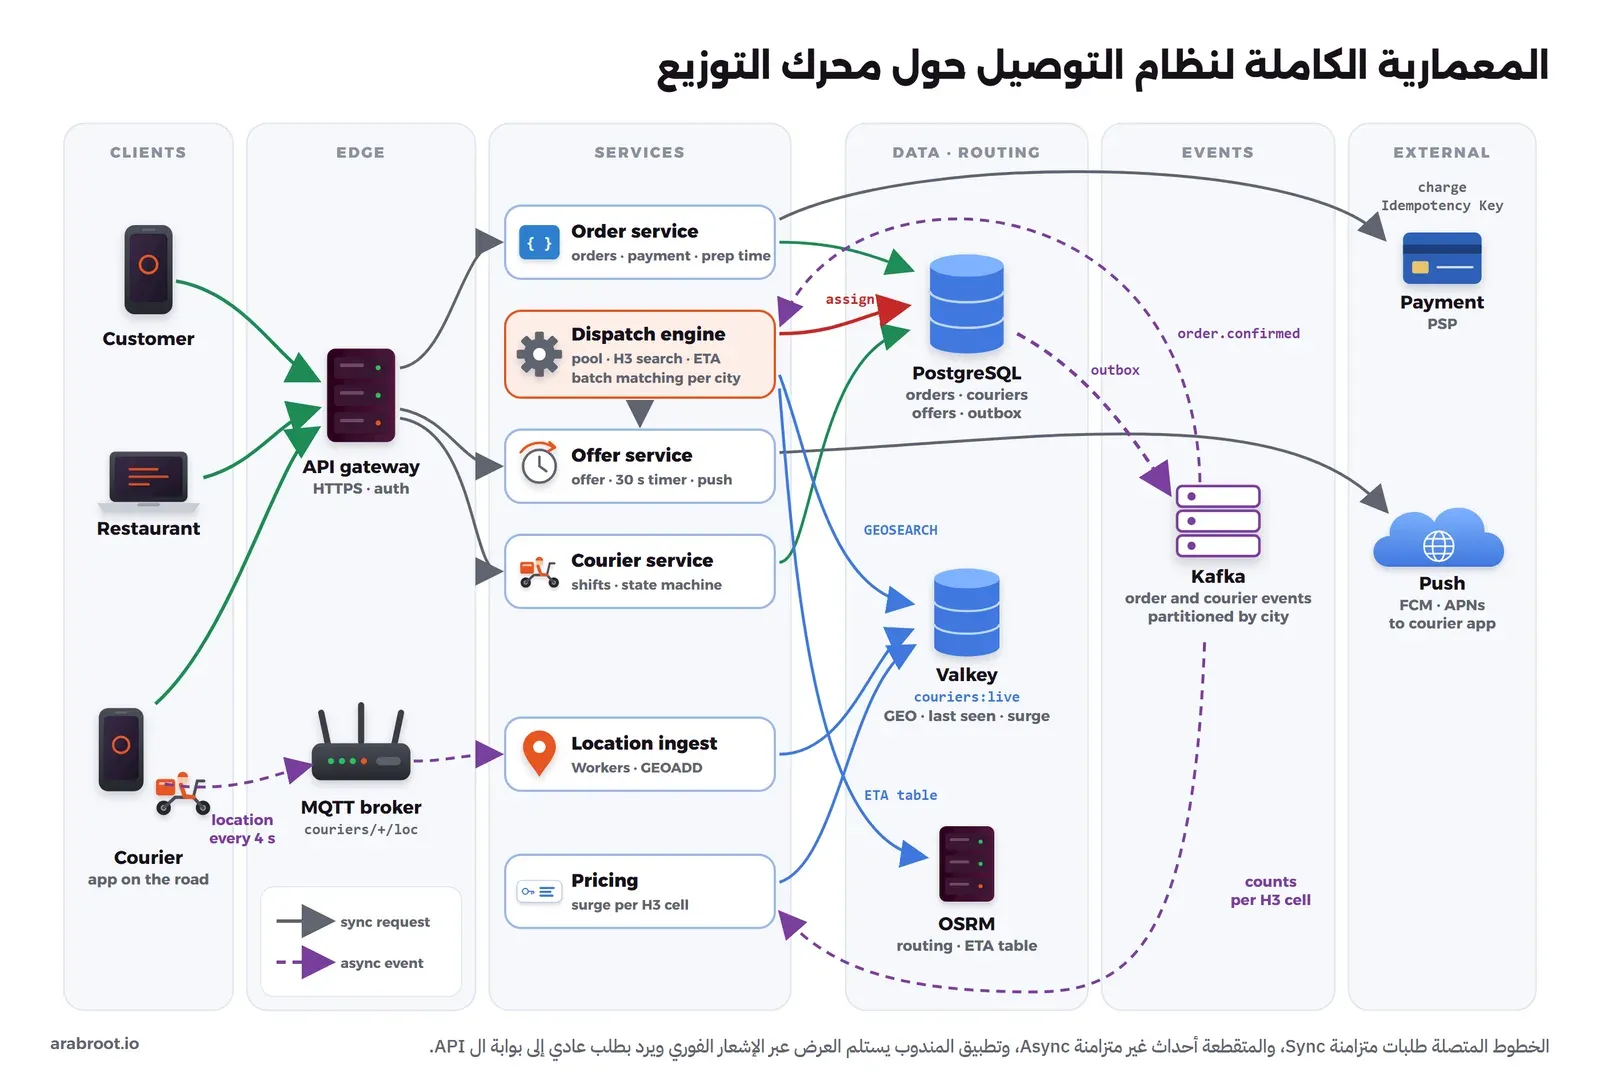
في الصورة أعلاه لاحظ التالي:
- موقع المندوب لا يمر ببوابة ال API ولا يكتب في PostgreSQL، وإنما يصل عبر MQTT إلى Workers تكتبه في Valkey، والسبب أنه آلاف الرسائل في الثانية التي يجوز أن تضيع واحدة منها، وتفاصيل هذا الطريق في مقال تتبع المواقع لحظياً.
- محرك التوزيع يقرأ من مكانين بسرعة، المواقع من Valkey والأزمنة من OSRM، ويكتب في مكان واحد فقط هو PostgreSQL بجملة مشروطة بالحالة، فإذا عملت نسختان منه بالخطأ على المدينة نفسها لم يسند المندوب مرتين.
- المندوب يستلم العرض بإشعار فوري، ويرد بطلب HTTP عادي يحمل مفتاح منع التكرار، أما المؤقت الذي ينهي العرض بعد ثلاثين ثانية فهو في السيرفر داخل Offer service وليس في الهاتف.
المكونات ومسؤولية كل منها
| المكون | مسؤوليته | أداة مفتوحة المصدر مقترحة | لماذا هي |
|---|---|---|---|
| بوابة ال API | TLS والتحقق من الهوية وحد معدل الطلبات لتطبيقات العميل والمطعم والمندوب | NGINX (رخصة BSD-2-Clause) أو HAProxy (رخصة GPLv2) | مجربان تحت الحمل، ويكفيان للطلبات العادية التي لا تتجاوز مئات في الثانية |
| وسيط MQTT | استقبال مواقع المندوبين وتوزيعها على ال Workers | Mosquitto (رخصة EPL-2.0 أو EDL-1.0) | خفيف، والنبضة والوصية الأخيرة والاشتراك المشترك في المعيار نفسه، وقسنا حدوده في مقال تتبع المواقع |
| خدمة الطلبات Order service | إنشاء الطلب والدفع ووقت التحضير، وحفظ السعر النهائي مع الطلب | كودك فوق PostgreSQL (رخصة PostgreSQL License) مع PostGIS (رخصة GPLv2 أو أحدث) | الطلب مال وحالة، فيحتاج معاملات وقيوداً، وPostGIS لمناطق التوصيل حول المطعم |
| محرك التوزيع Dispatch engine | قائمة الطلبات المنتظرة، والبحث عن المرشحين، والمطابقة على دفعات لكل مدينة | كودك مع مكتبة h3 (رخصة Apache-2.0) وSciPy (رخصة BSD-3-Clause) | نفس المكتبتين في المختبر، والدالة linear_sum_assignment تحل مسألة الإسناد دون أن تكتب الخوارزمية بنفسك |
| خدمة العروض Offer service | إرسال العرض، والمؤقت في السيرفر، وإعادة الطلب إلى القائمة عند الرفض أو انتهاء المهلة | كودك، وجدول العروض في PostgreSQL | المؤقت عمود expires_at يفحصه المحرك في كل دورة، فلا يضيع إذا أعيد تشغيل الخدمة |
| خدمة المندوبين Courier service | الورديات وحالات المندوب، والأحداث من تطبيقه مثل الاستلام والتسليم | كودك فوق PostgreSQL | كل انتقال جملة UPDATE مشروطة بالحالة السابقة كما في قسم الحالات |
| المواقع الحية | آخر موقع لكل مندوب، والبحث عن الأقرب | Valkey (رخصة BSD-3-Clause)، أو Redis 8 الذي استخدمناه في مختبر تتبع المواقع (رخصة AGPLv3 أو RSALv2 أو SSPLv1 بحسب اختيارك) | أوامر GEOADD وGEOSEARCH في الذاكرة، وأوامر GEO نفسها موجودة في الاثنين |
| محرك المسارات | مصفوفة أزمنة الوصول بالطريق الفعلي | OSRM (رخصة BSD-2-Clause) أو Valhalla (رخصة MIT) | طلب جدول Table واحد لكل دفعة، وشرحناهما في مقال المسارات |
| بث الأحداث Event Streaming | نقل أحداث الطلبات والمندوبين بين الخدمات، وإلى التسعير والتحليل | Apache Kafka (رخصة Apache-2.0) | المفتاح هو رقم الطلب، فتصل أحداث الطلب الواحد بالترتيب، والتقسيم Partitions حسب المدينة يطابق تقسيم محرك التوزيع، والفرق بينه وبين الطابور في مقال الطابور أم بث الأحداث |
| التسعير Pricing | عدد الطلبات والمندوبين المتاحين في كل خلية H3 على نافذة دقائق، ثم المضاعف | كودك يقرأ من Kafka ويكتب في Valkey | القيمة تحسب على نافذة زمنية وليس على كل طلب، كما في قسم التسعير |
| الإشعارات الفورية | إيصال العرض إلى تطبيق المندوب | مزود خارجي: FCM لأجهزة Android وAPNs لأجهزة Apple | لا يوجد طريق آخر لإيقاظ تطبيق في الخلفية، وشرحناه في مقال الإشعارات الفورية |
نموذج البيانات
الحالات في الجداول التالية هي نفس حالات الطلب والمندوب في صورة آلة الحالات في قسم الحالات أدناه، والجدول couriers هو نفسه الذي نستخدمه هناك في جملة الإسناد المشروطة:
CREATE EXTENSION IF NOT EXISTS postgis;

CREATE TABLE couriers (
    id         bigint      PRIMARY KEY,
    city       text        NOT NULL,                 -- the dispatch partition
    state      text        NOT NULL DEFAULT 'offline'
               CHECK (state IN ('offline', 'available', 'offered', 'to_restaurant', 'at_restaurant', 'delivering')),
    order_id   bigint,                               -- the order he is offered or delivering
    updated_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id               bigint      GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    city             text        NOT NULL,
    restaurant_id    bigint      NOT NULL,
    pickup           geography(Point, 4326) NOT NULL,
    dropoff          geography(Point, 4326) NOT NULL,
    state            text        NOT NULL DEFAULT 'created'
                     CHECK (state IN ('created', 'confirmed', 'dispatching', 'offered', 'assigned',
                                      'picked_up', 'delivered', 'cancelled')),
    food_ready_at    timestamptz,                    -- from the restaurant: when dispatching should start
    courier_id       bigint      REFERENCES couriers,
    price_multiplier numeric(3,2) NOT NULL DEFAULT 1.00,  -- shown before ordering, never changes after payment
    idempotency_key  text        NOT NULL UNIQUE,
    created_at       timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE offers (
    id         bigint      GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id   bigint      NOT NULL REFERENCES orders,
    courier_id bigint      NOT NULL REFERENCES couriers,
    eta_min    numeric(5,1) NOT NULL,                 -- from the OSRM table of this batch
    expires_at timestamptz NOT NULL,                  -- the server-side 30 s timer
    result     text        CHECK (result IN ('accepted', 'declined', 'expired')),
    UNIQUE (order_id, courier_id)                     -- a courier who declined is not asked again
);

CREATE TABLE order_events (                           -- every transition; also the outbox for Kafka
    id              bigint      GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id        bigint      NOT NULL REFERENCES orders,
    from_state      text,
    to_state        text        NOT NULL,
    idempotency_key text        UNIQUE,               -- the courier's "picked up" sent twice is one event
    created_at      timestamptz NOT NULL DEFAULT now(),
    published_at    timestamptz                       -- NULL until the relay sends it to Kafka
);
وأما في Valkey فنستخدم نفس المفاتيح التي بنيناها في مختبر تتبع المواقع، ونضيف مفتاحاً للتسعير:
| المفتاح | النوع | ما فيه |
|---|---|---|
couriers:live | GEO (Sorted Set) | آخر موقع لكل مندوب، ويبحث فيه المحرك بالأمر GEOSEARCH |
couriers:seen | Sorted Set | وقت آخر نقطة لكل مندوب، لتجاهل من سكت |
courier:order | Hash | الطلب الذي يحمله كل مندوب، لتوصيل موقعه لصاحب الطلب |
surge:{h3_cell} | String مع EXPIRE | المضاعف الحالي للخلية، وينتهي وحده إذا توقف التسعير عن تحديثه فيعود السعر إلى 1.0 |
الواجهات الرئيسية
| الطلب | المسار أو الموضوع | ما يفعله | ملاحظات |
|---|---|---|---|
| POST | /orders | العميل ينشئ الطلب ويدفع، بالسعر الذي رآه | Idempotency-Key، والمضاعف يحفظ مع الطلب |
| POST | /restaurant/orders/{id}/accept | المطعم يقبل ويقدر وقت التحضير، فيعرف المحرك متى يبدأ التوزيع | شرط الحالة created، وتوكن المطعم |
| POST | /couriers/me/shift | بداية الوردية أو نهايتها، أي available أو offline | التتبع يتوقف مع نهاية الوردية |
| MQTT | couriers/{id}/loc | موقع المندوب كل بضع ثوان | QoS 0، وصلاحية النشر على موضوعه فقط |
| Push | offer | عرض فيه الطلب وزمن الوصول ومدة 30 ثانية | المؤقت في السيرفر وليس في الإشعار |
| POST | /offers/{id}/accept | قبول العرض، فيصبح الطلب assigned | Idempotency-Key، ويرد 409 إذا انتهت المهلة أو سبقه تغيير آخر |
| POST | /offers/{id}/decline | رفض العرض، فيعود الطلب إلى القائمة دون هذا المندوب | Idempotency-Key |
| POST | /orders/{id}/events | picked_up ثم delivered من تطبيق المندوب | Idempotency-Key، والانتقال مشروط بالحالة السابقة |
| حدث | order.confirmed وبقية order.* | من order_events إلى Kafka، فيدخل الطلب قائمة المحرك ويحسب التسعير | المفتاح رقم الطلب، وقد يصل الحدث مرتين |
تقدير السعة بالأرقام
نبدأ من الأرقام التي افترضناها في قسم الفهرسة الجغرافية التالي، ونضيف إليها افتراضات نكتبها صراحة لأنها هي التي تتغير من مدينة إلى أخرى:
- من المقال: عشرة آلاف مندوب متصلين وقت الذروة، وخمسون طلباً في الثانية في الذروة.
- افتراض: الذروة ثلاثة أضعاف المتوسط، والتطبيق يعمل 14 ساعة في اليوم.
- افتراض: نافذة الدفعة 10 ثوان، والمدينة مقسمة إلى 20 منطقة توزيع، وفي كل منطقة قرابة 100 مندوب مرشح للدفعة.
- افتراض: كل طلب يكتب عشر مرات في قاعدة البيانات بين الحالات والعروض وحالات المندوب، و30% من الطلبات تحتاج عرضاً ثانياً، وكل طلب مع عروضه وتاريخ حالاته يأخذ قرابة 2 كيلوبايت.
- افتراض: المندوب يرسل موقعه كل 4 ثوان كما في مقال تتبع المواقع.
| الكمية | الحساب | النتيجة |
|---|---|---|
| متوسط الطلبات | 50 ÷ 3 | قرابة 16.7 طلب في الثانية |
| الطلبات في اليوم | 16.7 × 3,600 × 14 | قرابة 840,000 طلب |
| حسابات الزمن دون فهرسة | 50 × 10,000 | 500,000 في الثانية، وهو الرقم الذي جعلنا نستخدم الخلايا |
| طلبات الدفعة الواحدة | 50 × 10 ثوان ÷ 20 منطقة | 25 طلباً في كل منطقة |
| خانات جدول OSRM | 25 مطعماً × 100 مندوب × 20 منطقة ÷ 10 ثوان | 5,000 خانة في الثانية |
| حجم مسألة الإسناد | مصفوفة 25 × 100، والزمن يكبر مع مكعب الحجم في أسوأ تقدير، أي 100 × 100 × 100 | مليون عملية لكل دفعة في أسوأ تقدير، وهذا صغير جداً على أي سيرفر |
| الكتابة في PostgreSQL | 50 × 10 | 500 كتابة في الثانية في الذروة |
| الإشعارات للمندوبين | 50 × 1.3 | 65 عرضاً في الثانية |
| رسائل المواقع | 10,000 ÷ 4 | 2,500 رسالة في الثانية، إلى Valkey وليس إلى PostgreSQL |
| تخزين الطلبات | 840,000 × 2 كيلوبايت | قرابة 1.7 غيغابايت في اليوم، و610 غيغابايت في السنة |
والخلاصة أن محرك التوزيع نفسه ليس ثقيلاً في الحساب بعد أن اختصرت الخلايا المرشحين، فخمسمئة كتابة في الثانية تتحملها قاعدة PostgreSQL واحدة جيدة، والأثقل في النظام هو رسائل المواقع التي تزيد خمس مرات على كتابات الطلبات، وتاريخ هذه المواقع الذي حسبناه في مقال تتبع المواقع بأكثر من 200 مليون نقطة في اليوم، ولذلك فصلناه في طريق خاص به. وتذكر أن هذه أرقام من افتراضات، فقسها على بياناتك بعد الإطلاق قبل أن تبني عليها أي قرار.
مراحل النمو: ماذا تبني اليوم، وماذا تؤجل؟
| الجزء | البداية MVP: سيرفر أو اثنان | النمو: آلاف المندوبين المتصلين | الحجم الكبير: ملايين الطلبات في اليوم |
|---|---|---|---|
| المواقع | جدول آخر موقع في PostgreSQL مع PostGIS والدالة ST_DWithin، والتطبيق يرسل بطلب HTTP | MQTT وValkey GEO وWorkers متعددة | Workers لكل مدينة، وتاريخ المواقع في جداول مقسمة باليوم |
| المطابقة | الأقرب أولاً Greedy بزمن الوصول | دفعات بنافذة تتغير حسب الضغط في كل مدينة | نسخة لكل منطقة، مع احتمال القبول وجمع طلبين في مشوار واحد |
| زمن الوصول | OSRM واحد لمدينتك، أو المسافة المستقيمة مع معامل طرق مؤقتاً | OSRM بطلب Table لكل دفعة | محرك مسارات يعرف الزحام كما في مقال الزحام، موزع على عدة سيرفرات |
| الأحداث | جدول order_events ومهمة تقرؤه كل ثانية | Kafka أو RabbitMQ | Kafka مقسم حسب المدينة، وتحليل لحظي للتسعير |
| قاعدة البيانات | PostgreSQL واحدة مع نسخ احتياطي | نسخة متماثلة وتحويل تلقائي بأداة مثل Patroni (رخصة MIT) | قاعدة لكل مجموعة مدن، لأن الطلب لا يعبر المدينة |
والذي لا تبنيه في اليوم الأول: لا تبدأ بالتوزيع على دفعات، فقد رأيت في المختبر أنه لا يفيد شيئاً وقت الهدوء، ولا تبن التسعير الديناميكي ولا Kafka ولا نموذج احتمال القبول قبل أن يكون لديك ضغط حقيقي وبيانات تقيس بها. أما ما يجب أن يكون موجوداً من البداية فهو آلة الحالات بشروطها، ومفتاح منع التكرار، والمؤقت في السيرفر، لأن الأخطاء فيها تظهر مع أول مئة مندوب.
ماذا لو تعطل جزء منها؟
| ماذا لو تعطل | الأثر | كيف تخفف الأثر |
|---|---|---|
| محرك المسارات OSRM | لا توجد أزمنة وصول دقيقة للمطابقة | تقدير احتياطي بالمسافة المستقيمة مضروبة في معامل الطرق كما في قسم Haversine، مع تنبيه للفريق |
| Valkey | لا يجد المحرك مرشحين | نسخة متماثلة، والفهرس الحي يعاد بناؤه خلال ثوان من النقاط القادمة لأن كل مندوب يرسل كل بضع ثوان |
| نسخة محرك التوزيع لمدينة | الطلبات تبقى في حالة dispatching دون إسناد | كل مدينة لها قفل بمهلة Lease تأخذه نسخة أخرى عند انتهائه، والإسناد المشروط بالحالة يمنع الإسناد المكرر إذا عادت النسخة الأولى فجأة |
| الإشعار أو هاتف المندوب | لا يصل العرض أو لا يأتي الرد | المؤقت في السيرفر ينهي العرض بعد ثلاثين ثانية ويعيد الطلب إلى القائمة |
| PostgreSQL الرئيسية | لا طلبات جديدة ولا انتقالات حالة | تحويل تلقائي إلى النسخة المتماثلة، وتطبيق المندوب يعيد الأحداث بنفس مفتاح منع التكرار بعد العودة |
| Kafka | تتأخر الأحداث، ويتجمد التسعير | الأحداث محفوظة في order_events ولا تضيع، ومفتاح التسعير ينتهي فيعود المضاعف إلى 1.0 بدل أن يبقى مرتفعاً |
أين المندوبون؟ الفهرسة الجغرافية Geo-Indexing
الطريقة البسيطة للبحث عن المرشحين أن تحسب المسافة من المطعم إلى كل مندوب متاح ثم ترتبها، وهذه الطريقة تعمل جيداً مع مئة مندوب، ولكن لنفرض أن لديك عشرة آلاف مندوب متصلين في المدينة وخمسين طلباً في الثانية وقت الذروة، فهذا يعني نصف مليون حساب مسافة في الثانية، ومعظمها لمندوبين في الطرف الآخر من المدينة لا يمكن أن يأخذوا الطلب أصلاً. والحل أن تقسم الأرض إلى خلايا لكل منها رقم، فيحفظ كل مندوب في خلية، وعندما يأتي طلب تنظر في خلية المطعم والخلايا المحيطة بها فقط. وقد شرحنا فكرة الخلايا وGeoHash في مقال أساسيات الخرائط، وهنا سوف نركز على استخدامها في التوزيع، وفيما يلي الأنظمة الثلاثة الأشهر:
- GeoHash: يحول النقطة إلى نص قصير، والنقاط المتقاربة تشترك عادة في بدايته، فيصبح البحث عن القريب بحثاً عن بادئة نص في فهرس عادي، وهو ما تستخدمه قاعدة Redis داخلياً في أوامر GEO كما يذكر توثيق GEOADD، فهي تخزن كل نقطة كرقم من 52 بت تتداخل فيه بتات خط العرض وخط الطول.
- H3: نظام مفتوح المصدر من Uber يقسم الأرض إلى خلايا سداسية Hexagons في 16 مستوى، وكل مستوى أدق مساحة خليته سبع مساحة المستوى الذي قبله، وفي كل مستوى 12 خلية خماسية فقط كما يبين جدول المستويات في توثيق H3. وفي المستوى 8 الذي نستخدمه في المختبر يبلغ متوسط ضلع الخلية 0.53 كم ومساحتها 0.74 كم مربع.
- S2: مكتبة من Google تسقط الأرض على أوجه مكعب ستة، ثم تقسم كل وجه إلى أربعة مربعات بشكل متكرر، في 31 مستوى من 0 إلى 30، ولكل خلية رقم من 64 بت يتبع منحنى Hilbert، والخلية في المستوى الأخير عرضها قرابة سنتيمتر واحد كما يذكر توثيق S2.
وقد يتساءل البعض: لماذا اختارت Uber السداسي ولم تكتف بالمربع؟ والإجابة في مقال H3 نفسه: للسداسي مسافة واحدة بين مركزه ومراكز جيرانه الستة، أما المربع فله مسافتان، جار بالضلع وجار بالزاوية، والمثلث له ثلاث، وهذا يجعل «الحلقة الأولى حول المطعم» دائرة تقريبية متساوية من كل الجهات. والصورة التالية تبين البحث بالحلقات في H3، ومشكلة الحافة في GeoHash:
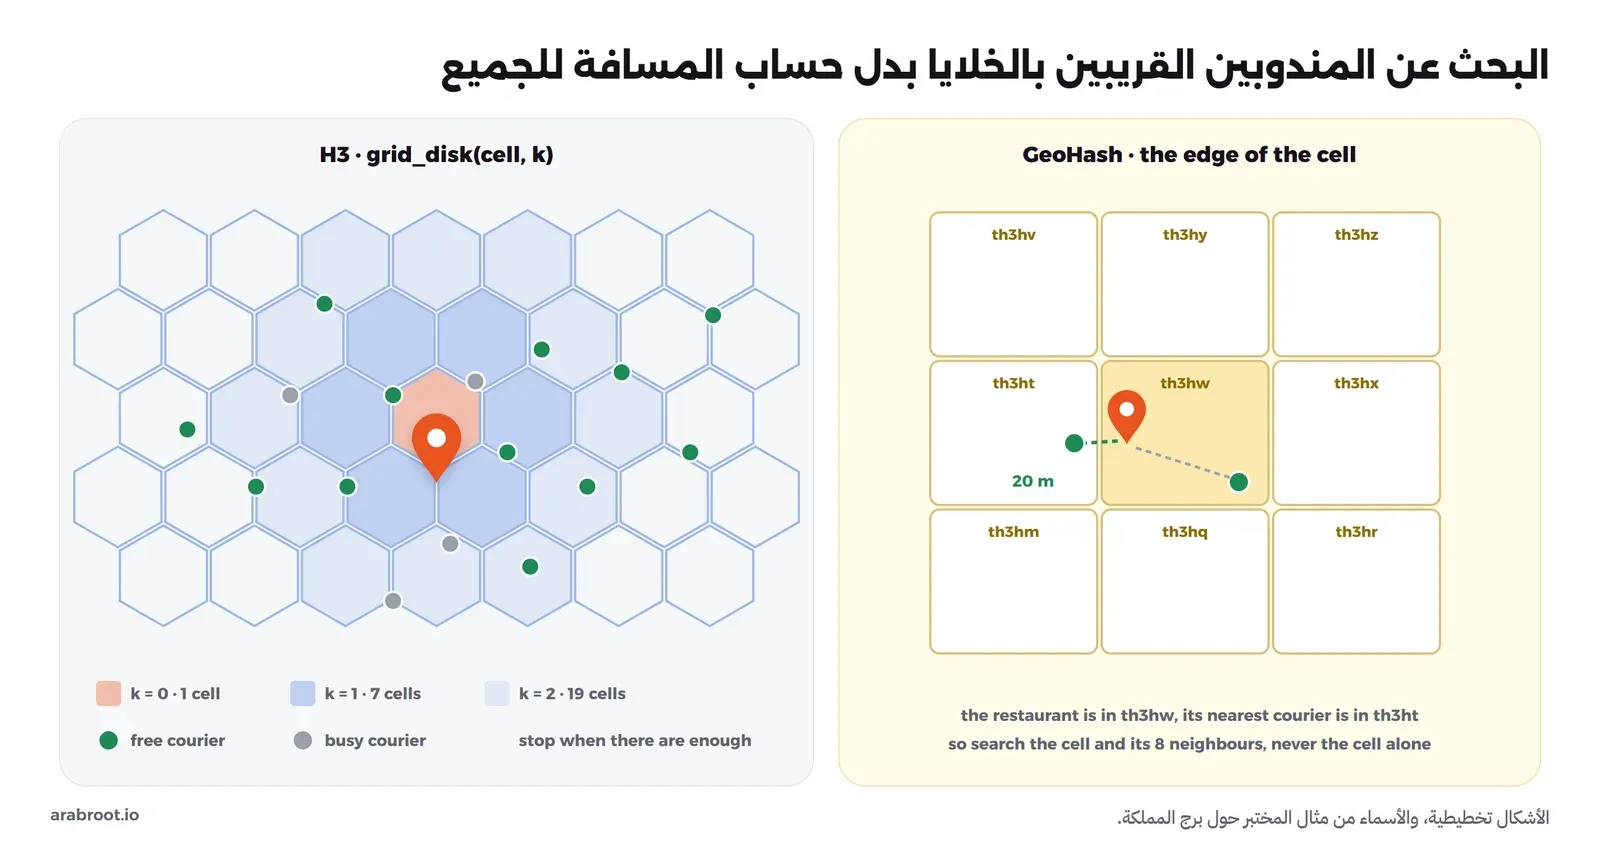
والدالة grid_disk في H3 تعطيك خلية المطعم مع كل الخلايا حتى المسافة k، وعددها 1 ثم 7 ثم 19 ثم 37 لأن الحلقة رقم k فيها 6k خلية، والطريقة المعتادة أن تبدأ بالحلقة صفر وتوسع حتى تجد عدداً كافياً من المندوبين المتاحين أو تصل إلى حد أقصى للمسافة. ولاحظ أن مشكلة الحافة موجودة في H3 أيضاً، فالمندوب الذي يبعد عشرين متراً قد يكون في الخلية المجاورة كما سوف نرى في المختبر، ولكن البحث بالحلقات يغطيها تلقائياً، أما في GeoHash فعليك أن تضيف الجيران الثمانية بنفسك، وهذا ما يفعله Redis في الأمر GEOSEARCH عندما يفحص تسع مناطق تغطي الدائرة.
| النظام | شكل الخلية | المستويات | الجيران | أين تجده |
|---|---|---|---|---|
| GeoHash | مستطيل يختلف بحسب خط العرض | بطول النص | 8 جيران بمسافتين مختلفتين | Redis GEO وPostGIS والفهارس النصية |
| H3 | سداسي، و12 خماسياً في كل مستوى | 16 (0 إلى 15) | 6 جيران بمسافة واحدة تقريباً | التحليل والتسعير والتوزيع، ومكتبات بلغات كثيرة |
| S2 | رباعي على سطح الكرة | 31 (0 إلى 30) | 4 جيران بالضلع | تغطية الأشكال بالخلايا، وفهارس قواعد بيانات جغرافية |
وفي التطبيق العملي لا تحتاج أن تخزن الخلايا بنفسك في البداية، فإذا كانت مواقع المندوبين في Redis فالأمر GEOSEARCH يعطيك الأقرب داخل نصف قطر، وإذا كانت في PostgreSQL فالإضافة PostGIS مع الدالة ST_DWithin تفعل الشيء نفسه بفهرس مكاني، وقد شرحنا الثانية في مقال PostgreSQL لكل شيء. أما H3 فتظهر قيمته عندما تريد أن تجمع أرقاماً لكل منطقة، مثل عدد الطلبات والمندوبين في كل خلية للتسعير أو لتوجيه المندوبين إلى المناطق المزدحمة.
المسافة ليست الوقت: زمن الوصول ETA
المندوب الذي يبعد كيلومتراً واحداً بخط مستقيم قد يحتاج عشر دقائق إذا كان على الجهة الأخرى من طريق سريع ولا يوجد جسر قريب، والمندوب الذي يبعد ثلاثة كيلومترات على الطريق نفسه قد يصل في خمس دقائق، وهذا بالضبط ما قصدته Uber بأن الأقرب ليس دائماً الأسرع. لذلك فالمعيار الصحيح في المطابقة هو زمن الوصول ETA بالطريق الفعلي، ويأتي من محرك مسارات مثل OSRM أو Valhalla، وقد شرحنا في مقال المسارات كيف تطلب مصفوفة المسافات Distance Matrix بطلب واحد من عدة نقاط إلى عدة نقاط، وفي مقال الزحام كيف تجعل هذه الأزمنة تعرف الزحام.
وقد يتساءل البعض: إذا كان محرك المسارات أدق، فلماذا نحتاج الخلايا أصلاً؟ والإجابة أن طلب المصفوفة أغلى بكثير من حساب المسافة، لذلك يعمل النظام على مرحلتين: الخلايا تختصر آلاف المندوبين إلى عشرة أو عشرين مرشحاً، ثم يطلب النظام مصفوفة واحدة لكل الطلبات والمرشحين في الدفعة. ويتكون زمن الطلب كله من ثلاثة أجزاء يجب أن تفصل بينها في الكود والقياس: زمن المندوب إلى المطعم، ووقت الانتظار حتى يجهز الطعام، وزمن الطريق من المطعم إلى العميل، والمطابقة تتحكم في الجزء الأول فقط، ولكن العميل يرى المجموع.
وأين Haversine؟ متى تكفي المسافة المستقيمة
صيغة Haversine تحسب المسافة بين نقطتين من خط العرض وخط الطول على سطح كرة، وهي مستخدمة في محاكاة هذا المقال نفسها، وتستخدمها أيضاً أوامر Redis الجغرافية، إذ تذكر صفحة GEODIST أنها تفترض أن الأرض كرة تامة، فقد يصل الخطأ إلى 0.5% في بعض الحالات، ومثلها في PostGIS الدالة ST_DistanceSphere، أما ST_Distance على نوع geography فتحسب على الشكل البيضاوي Spheroid افتراضياً وهي أدق وأبطأ قليلاً. ولكي نعرف هل هذا الخطأ مهم في مدينة مثل الرياض، قارنا Haversine بالحساب الدقيق على نموذج WGS84 لثلاث مسافات تقريبية من برج المملكة:
| من برج المملكة إلى | Haversine | WGS84 الدقيق | الفرق |
|---|---|---|---|
| برج الفيصلية | 2.572 كم | 2.564 كم | 0.30% |
| مطار الملك خالد | 27.487 كم | 27.383 كم | 0.38% |
| الدمام | 391.668 كم | 391.848 كم | 0.05% |
والفرق كما ترى أقل من نصف بالمئة، بينما الفرق بين الخط المستقيم والطريق الفعلي في المدينة قد يصل إلى عشرات بالمئة، ولذلك فخطأ Haversine نفسه لا يهم في التوزيع، والمشكلة الحقيقية أنه لا يعرف الطرق ولا الجسور ولا الاتجاه الواحد ولا الزحام. وعليه فاستخدامه مناسب في هذه المواضع:
- ترتيب المرشحين ترتيباً أولياً بعد تصفية الخلايا، قبل أن تطلب مصفوفة زمن الوصول من محرك المسارات لأفضل عشرة أو عشرين منهم فقط.
- كشف قفزات GPS غير المنطقية، مثل مندوب انتقل خمسة كيلومترات في ثانيتين.
- تقدير احتياطي Fallback عندما يتعطل محرك المسارات، مضروباً في معامل طرق تقيسه من بياناتك أنت لا من رقم ثابت، كما فعلنا في المحاكاة بالمعامل 1.35 وهو افتراض لا قياس، وهذا أول سطر في جدول الأعطال في المعمارية الكاملة أعلاه.
- الحسابات التي لا تحتاج دقة الطريق، مثل نطاق التوصيل التقريبي حول المطعم.
أما زمن الوصول الذي تقرر به من يأخذ الطلب، أو الذي تعرضه للعميل، فلا تعتمد فيه على Haversine وحده، وخذه من محرك المسارات مع بيانات الزحام كما شرحنا في بداية هذا القسم.
من يأخذ الطلب؟ طرق المطابقة Matching
الطريقة البسيطة: أقرب مندوب متاح Greedy
الطريقة البسيطة أن تعالج الطلبات بترتيب وصولها، فكل طلب يأخذ المندوب المتاح صاحب أقل زمن وصول، ويسمى هذا الأسلوب الجشع Greedy لأنه يأخذ أفضل خيار في اللحظة دون أن ينظر إلى أثره على الطلب التالي. ومزاياه واضحة، فهو سريع وسهل الفهم، ويسند الطلب فوراً دون انتظار، ولكن مشكلته أن الطلب الأول قد يأخذ المندوب الوحيد القريب من الطلب الثاني، بينما كان عند الطلب الأول بديل قريب أيضاً.
مثال صغير نحسبه باليد
لنفرض أن لدينا ثلاثة مندوبين A وB وC وثلاثة طلبات وصلت بالترتيب 1 ثم 2 ثم 3، والجدول التالي يبين زمن وصول كل مندوب إلى كل مطعم بالدقائق، وهذه هي مصفوفة التكلفة Cost Matrix:
| المندوب | الطلب 1 | الطلب 2 | الطلب 3 |
|---|---|---|---|
| A | 2 | 3 | 7 |
| B | 4 | 12 | 6 |
| C | 8 | 11 | 5 |
بالطريقة الجشعة يأخذ الطلب 1 المندوب A لأن زمنه دقيقتان فقط، ثم يبقى للطلب 2 المندوبان B وC بزمن 12 و11، فيأخذ C، ثم يأخذ الطلب 3 المندوب B بست دقائق، والمجموع 2 + 11 + 6 = 19 دقيقة. ولكن لو أعطينا الطلب 2 للمندوب A بثلاث دقائق، والطلب 1 للمندوب B بأربع، والطلب 3 للمندوب C بخمس، لكان المجموع 12 دقيقة فقط، أي أقل بسبع دقائق، مع أن الطلب 1 أخذ مندوباً أبعد بدقيقتين. والصورة التالية تبين الحالتين:
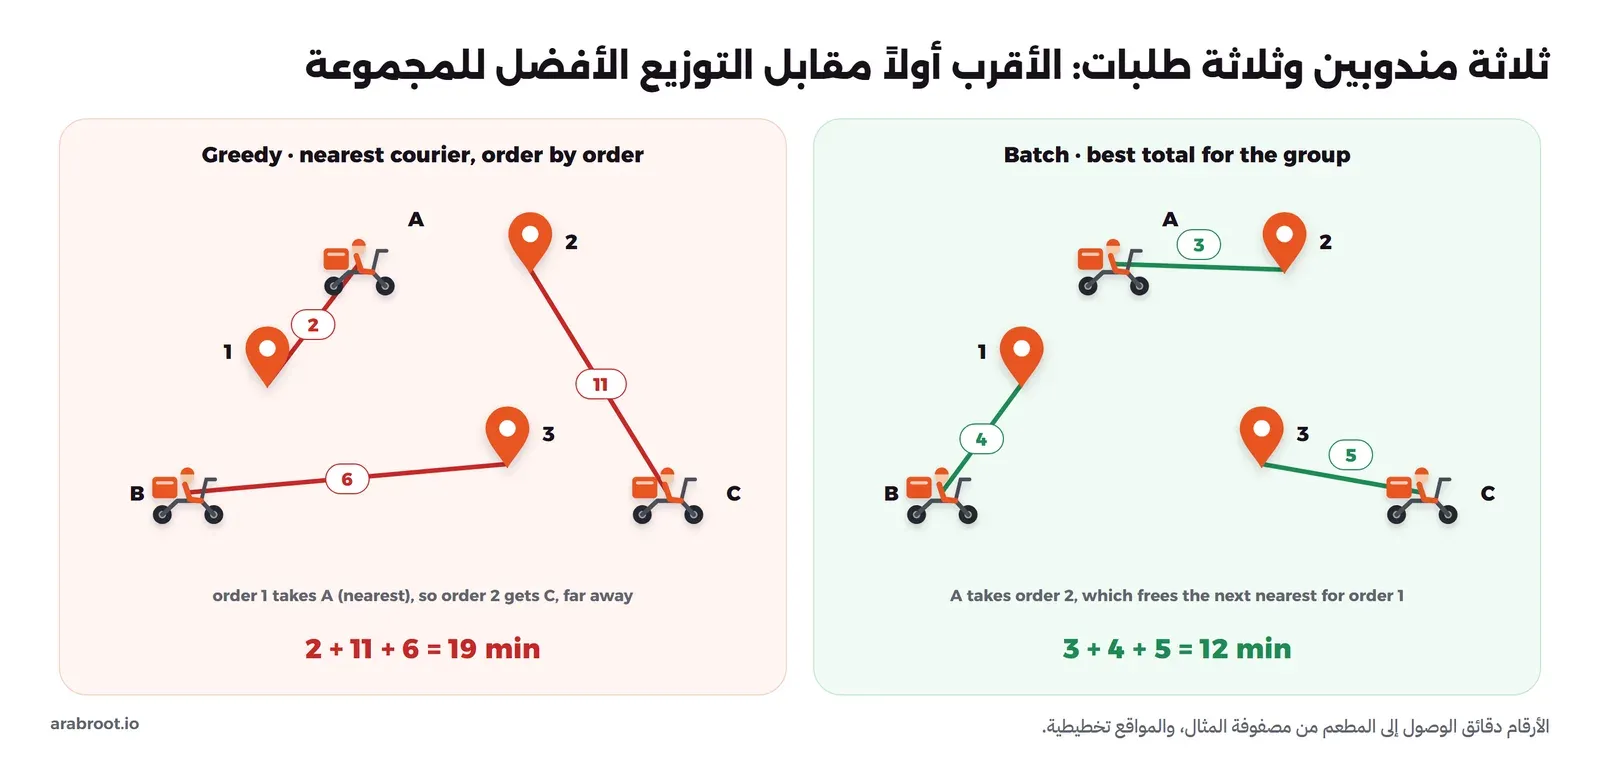
ومع ثلاثة مندوبين وثلاثة طلبات يمكنك أن تجرب كل الاحتمالات، وهي 3! أي ستة احتمالات كما سوف نرى في المختبر، ولكن مع عشرين طلباً وعشرين مندوباً يصبح عدد الاحتمالات 20! وهو رقم من 19 خانة، لذلك نحتاج خوارزمية تجد الأفضل دون أن تجرب الكل.
الخوارزمية الهنغارية Hungarian Algorithm خطوة بخطوة
مشكلة إسناد n عامل إلى n مهمة بأقل مجموع تكلفة اسمها مسألة الإسناد Assignment Problem، وأشهر حل لها الخوارزمية الهنغارية التي نشرها Harold Kuhn سنة 1955، والصيغ المحسنة منها يكبر زمن تنفيذها مع مكعب عدد العناصر O(n³). والفكرة الأساسية فيها أنك إذا طرحت الرقم نفسه من كل خانات صف أو عمود فإن الإسناد الأفضل لا يتغير، لأن كل إسناد كامل يأخذ خانة واحدة من كل صف ومن كل عمود، فيقل مجموع كل الاحتمالات بالمقدار نفسه. وهذا ما نفعله بالمصفوفة أعلاه:
- طرح أصغر رقم في كل صف: أصغر رقم في صف A هو 2 فيصبح الصف 0، 1، 5، وفي صف B هو 4 فيصبح 0، 8، 2، وفي صف C هو 5 فيصبح 3، 6، 0.
- طرح أصغر رقم في كل عمود: العمود الأول فيه صفر والثالث فيه صفر، أما الثاني فأصغر رقم فيه 1، فنطرحه منه، فتصبح أرقام المندوب A هي 0 و0 و5، وأرقام B هي 0 و7 و2، وأرقام C هي 3 و5 و0.
- البحث عن أصفار مستقلة: نحتاج ثلاثة أصفار لا يجمع أي اثنين منها صف واحد أو عمود واحد. الصف B ليس فيه صفر إلا في العمود 1، فيأخذ B الطلب 1، والصف C ليس فيه صفر إلا في العمود 3، فيأخذ C الطلب 3، ويبقى للمندوب A الطلب 2 وفيه صفر أيضاً.
- النتيجة: A للطلب 2، وB للطلب 1، وC للطلب 3، والتكلفة من المصفوفة الأصلية 3 + 4 + 5 = 12 دقيقة.
وفي هذا المثال وجدنا الأصفار الثلاثة بعد خطوتين، أما إذا لم تكف الأصفار فإن الخوارزمية تغطي الأصفار بأقل عدد من الخطوط، ثم تطرح أصغر رقم غير مغطى وتضيفه عند تقاطع الخطوط، وتكرر حتى يصبح عدد الخطوط مساوياً لعدد الصفوف. ولن تكتب هذا بنفسك في الغالب، فالدالة linear_sum_assignment في مكتبة SciPy تحل المسألة نفسها، ويذكر توثيقها أنها تستخدم صيغة معدلة من خوارزمية Jonker-Volgenant بحسب ورقة Crouse سنة 2016، وهي خوارزمية مختلفة في الطريق ولكنها تصل إلى الإسناد الأفضل نفسه، وتقبل مصفوفة غير مربعة، أي عدداً من الطلبات لا يساوي عدد المندوبين.
التوزيع على دفعات Batched Matching
الخوارزمية الهنغارية تحتاج مجموعة من الطلبات لتوزعها معاً، ولكن الطلبات لا تصل معاً، وإنما واحداً بعد الآخر، لذلك تأتي فكرة الدفعات التي تصفها Uber: يجمع النظام الطلبات والمندوبين المتاحين في نافذة زمنية قصيرة، ثم يحل مسألة الإسناد للنافذة كلها مرة واحدة. وفي هذا مقايضة واضحة يجب أن تقيسها: كل ثانية تنتظرها النافذة تضاف إلى انتظار العميل، ولكنها تعطي المطابقة خيارات أكثر. وكما سوف ترى في المختبر فإن الدفعات لا تكاد تفيد وقت الهدوء، لأن عند كل طلب مندوبين كثيرين متاحين، وتفيد كثيراً وقت الذروة عندما يقل المندوبون المتاحون ويصبح كل قرار مؤثراً على غيره.
ولا تقتصر تكلفة الخانة في المصفوفة على زمن الوصول في الأنظمة الحقيقية، فمن الممكن أن تضيف إليها عقوبة للمندوب الذي سيصل قبل جاهزية الطعام بكثير، أو أفضلية للمندوب الذي انتظر طويلاً دون طلب ليكون التوزيع عادلاً بين المندوبين، أو تكلفة كبيرة جداً لزوج لا يجوز، مثل مندوب رفض هذا الطلب قبل قليل، وهذا ما فعلناه في المختبر بالقيمة BIG للمندوبين خارج حلقات البحث. ويجدر التفريق هنا بين معنيين لكلمة Batching: الأول هو ما نشرحه هنا، أي توزيع مجموعة طلبات على مجموعة مندوبين في نافذة واحدة، والثاني هو إعطاء مندوب واحد طلبين من المطعم نفسه أو من مطعمين متقاربين في مشوار واحد، ويسمى أحياناً Stacking، وهو أصعب لأن المسألة لم تعد إسناداً واحداً لواحد.
حالات الطلب والمندوب State Machine
المطابقة تنتج قراراً، ولكن القرار يجب أن ينفذ على هواتف ومطاعم وشبكات لا يمكن الاعتماد عليها، لذلك فالطلب والمندوب كل منهما آلة حالات State Machine، أي مجموعة حالات محددة لا ينتقل بينها إلا بحدث معروف. والصورة التالية تبين الحالتين:
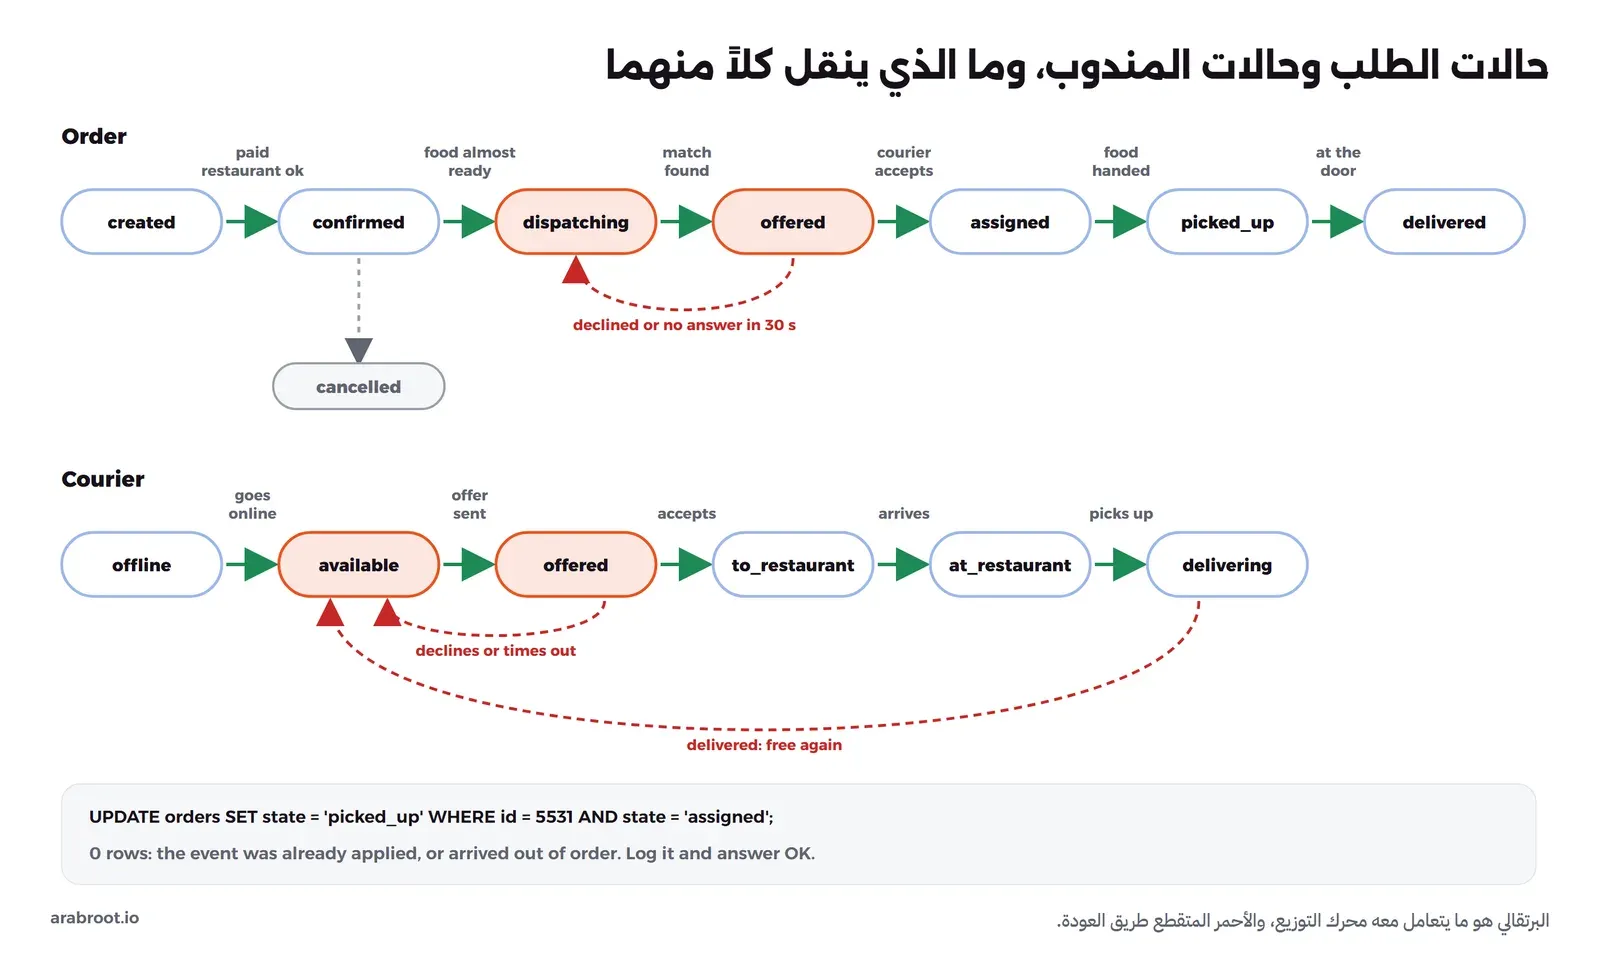
وفي هذا التصميم ثلاث نقاط يقع فيها أغلب الأخطاء:
- المندوب الذي يسند مرتين: إذا عملت نسختان من محرك التوزيع على المدينة نفسها، أو تداخلت دفعتان، فقد يعرض المندوب نفسه على طلبين في اللحظة نفسها. والحل أن يكون العرض تغييراً مشروطاً للحالة:
UPDATE couriers SET state = 'offered', order_id = 5531 WHERE id = 42 AND state = 'available'، فإذا أعاد صفراً من الصفوف فقد سبقك غيرك إلى هذا المندوب، فتعيد الطلب إلى الدفعة التالية. وهذا هو نفس مبدأ مقارنة القيمة ثم تغييرها Compare-and-Set الذي شرحناه في مقال الأنظمة الموزعة. - الضغطة المكررة: المندوب يضغط «قبول» والشبكة ضعيفة، فلا يصل الرد، فيعيد التطبيق الطلب تلقائياً، والحل أن يرسل التطبيق مفتاح منع التكرار Idempotency Key مع كل طلب يغير شيئاً، فيعرف السيرفر أنه نفس الطلب ويعيد النتيجة نفسها، وقد شرحنا هذا بالتفصيل في مقال تصميم ال API وفي مقال الأنظمة الموزعة، وسوف نبنيه في قاعدة بيانات حقيقية في مقال المحفظة الرقمية.
- الأحداث التي تصل مرتين أو بترتيب مختلف: حدث «استلم الطعام» يمر عادة عبر طابور Queue، والطابور يضمن أن الرسالة تصل مرة واحدة على الأقل، وليس مرة واحدة بالضبط، كما شرحنا في مقال الطوابير. لذلك يكون كل معالج حدث مشروطاً بالحالة السابقة كما في الصورة، فإذا وصل الحدث مرة ثانية لم يتغير شيء، وإذا وصل «تم التسليم» قبل «تم الاستلام» بسبب تأخر الشبكة فالنظام يسجله ويقرر بحسب قواعد واضحة، ولا يترك الطلب في حالة لا يعرفها أحد.
والمهلة Timeout جزء من الحالة وليست تفصيلاً، فالعرض الذي لا يرد عليه المندوب خلال ثلاثين ثانية مثلاً يجب أن ينتهي بمؤقت في السيرفر، وهو العمود expires_at في جدول offers في نموذج البيانات أعلاه، وليس بانتظار هاتف قد يكون فقد الاتصال، وإلا بقي الطلب في حالة offered إلى الأبد والعميل ينتظر.
التسعير الديناميكي Dynamic Pricing باختصار
عندما يزيد الطلب على عدد المندوبين في منطقة ما فإن المطابقة وحدها لا تحل المشكلة، فلا يوجد مندوب تسنده أصلاً، وهنا تستخدم بعض الشركات السعر لتوازن العرض والطلب. وتشرح Uber في صفحة التسعير المرتفع للسائقين أن الأسعار ترتفع عندما يزيد عدد الطلبات على السيارات المتاحة، مثل وقت المطر أو الذروة أو الفعاليات، وأن السائق يرى ذلك على شكل مضاعف للسعر أو مبلغ إضافي أو سعر مسبق يشمل الزيادة بحسب المدينة، وأن التسعير يتغير لحظياً ويختلف من حي إلى آخر في المدينة نفسها، وأن نسبة رسوم الخدمة التي تأخذها Uber لا تتغير وقت ارتفاع السعر. ومن مقال H3 نعرف أن قياس العرض والطلب يتم لكل خلية سداسية، والصورة التالية توضح الفكرة بأرقام توضيحية:
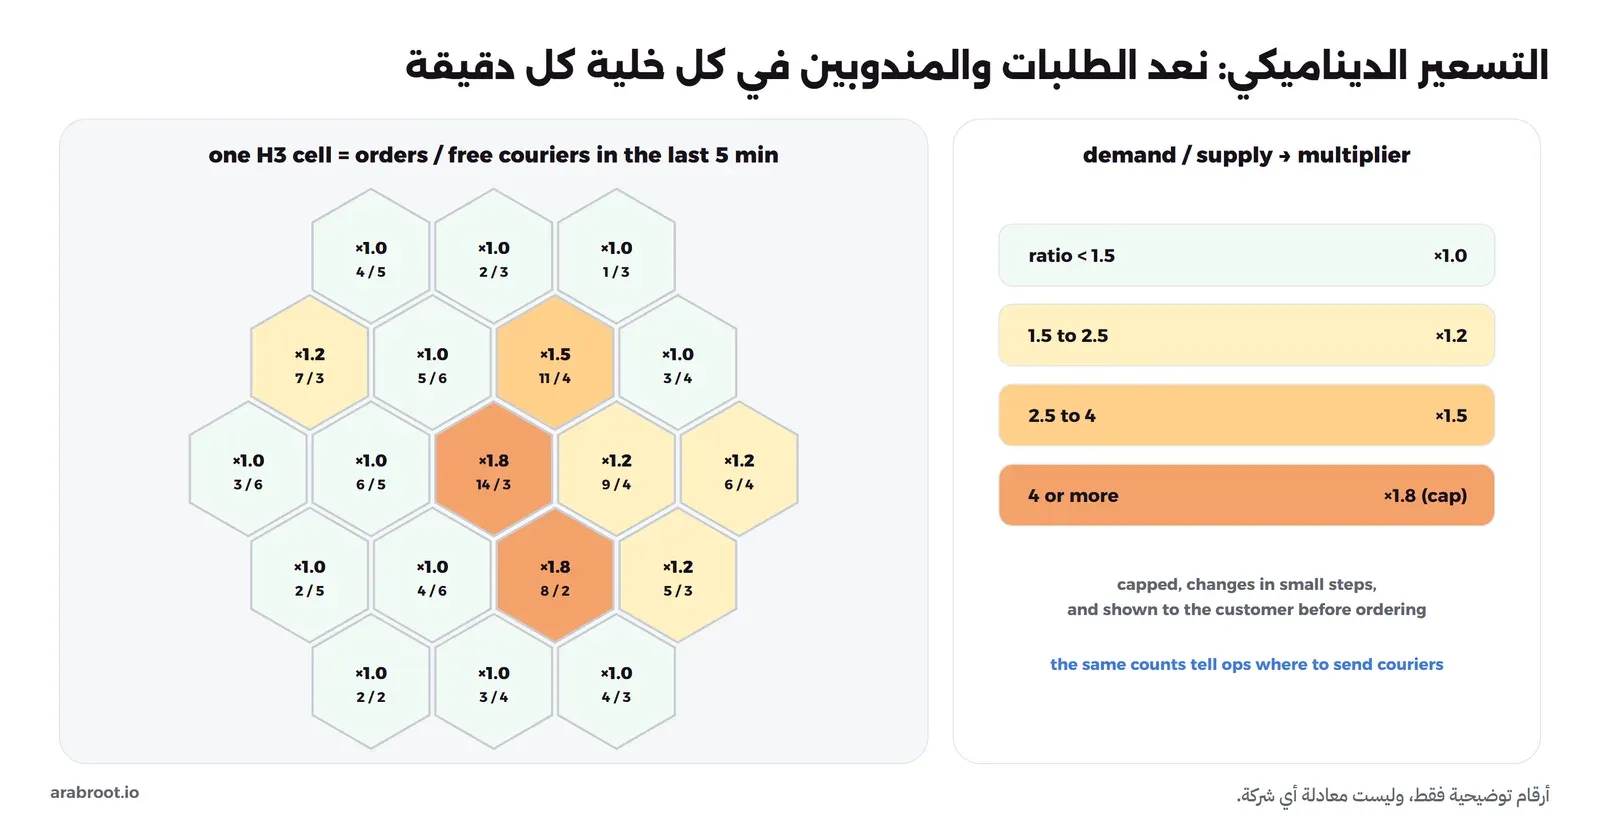
وإذا قررت أن تبني شيئاً من هذا فهناك قواعد هندسية لا علاقة لها بشركة معينة: احسب النسبة على نافذة زمنية من بضع دقائق وليس على اللحظة، وإلا قفز السعر وهبط مع كل طلب، وغير المضاعف بخطوات صغيرة مع حد أعلى، واعرض السعر النهائي للعميل قبل أن يطلب واحفظه مع الطلب، فلا يتغير بعد الدفع. ولاحظ أن الأرقام نفسها التي تحسب بها السعر تفيد فريق التشغيل أيضاً، فهي تبين أين يجب أن يتجه المندوبون المتاحون قبل أن ترتفع الأسعار.
التجربة العملية: محاكاة توزيع الطلبات في الرياض
في هذه التجربة سوف نكتب محاكاة لمندوبين وطلبات على إحداثيات حقيقية داخل مستطيل يغطي معظم الرياض، ونقارن الطريقة الجشعة بالتوزيع على دفعات بدالة SciPy، ونقيس كم وفرت خلايا H3 من الحسابات. وتذكر أن هذه محاكاة وليست نظاماً حقيقياً، فزمن الوصول فيها تقدير بسيط من المسافة المستقيمة مضروبة في معامل الطرق 1.35 بسرعة 25 كم في الساعة، أما في الإنتاج فيأتي من مصفوفة OSRM كما ذكرنا، والأرقام تقارن الطريقتين على البيانات نفسها ولا تصف أداء أي شركة.
تجهيز البيئة
نحتاج مجلداً فيه أربعة ملفات: ملف المكتبات، وثلاثة ملفات Python نعرضها في الأقسام التالية. وهذا ملف المكتبات بإصدارات مثبتة:
h3==4.5.0
numpy==2.5.3
scipy==1.18.1
ثم نشغل Container من Python ونثبت فيه المكتبات، وكل الأوامر التالية تعمل من داخل المجلد نفسه:
docker run -d --name lab-case-dispatch -v "$PWD:/lab" -w /lab python:3.13.16-slim sleep infinity
docker exec lab-case-dispatch pip install -q --root-user-action=ignore -r requirements.txt
docker exec lab-case-dispatch pip list | grep -i -E '^(h3|numpy|scipy) '
والمخرج سوف يكون كما يلي:
h3      4.5.0
numpy   2.5.3
scipy   1.18.1
خلايا H3 حول برج المملكة
الملف cells.py يحسب خلية برج المملكة في ثلاثة مستويات، وعدد الخلايا في الحلقات، والمسافة من مركز الخلية إلى مراكز جيرانها، ثم يكتب GeoHash لنقطتين بينهما عشرون متراً على جانبي حد خلية:
#!/usr/bin/env python3
"""H3 cells around a Riyadh point, and the GeoHash edge problem."""
import math
import h3

BASE32 = "0123456789bcdefghjkmnpqrstuvwxyz"


def geohash(lat, lon, length=6):
    """Plain GeoHash encoder: interleave longitude and latitude bits, 5 bits per character."""
    lat_r, lon_r, bits, out, even = [-90.0, 90.0], [-180.0, 180.0], [], [], True
    while len(out) < length:
        r, v = (lon_r, lon) if even else (lat_r, lat)
        mid = (r[0] + r[1]) / 2
        if v >= mid:
            bits.append(1)
            r[0] = mid
        else:
            bits.append(0)
            r[1] = mid
        even = not even
        if len(bits) == 5:
            out.append(BASE32[int("".join(map(str, bits)), 2)])
            bits = []
    return "".join(out)


def km(a, b):
    lat1, lon1, lat2, lon2 = map(math.radians, (*a, *b))
    h = math.sin((lat2 - lat1) / 2) ** 2 + math.cos(lat1) * math.cos(lat2) * math.sin((lon2 - lon1) / 2) ** 2
    return 2 * 6371.0088 * math.asin(math.sqrt(h))


p = (24.7114, 46.6744)        # Kingdom Centre, Riyadh
print("h3", h3.__version__)
for res in (7, 8, 9):
    c = h3.latlng_to_cell(*p, res)
    print(f"res {res}: cell {c}  avg edge {h3.average_hexagon_edge_length(res, 'km'):.3f} km"
          f"  avg area {h3.average_hexagon_area(res, 'km^2'):.3f} km2")
c8 = h3.latlng_to_cell(*p, 8)
for k in (1, 2, 3):
    print(f"grid_disk(k={k}) -> {len(h3.grid_disk(c8, k))} cells")
print("parent at res 7:", h3.cell_to_parent(c8, 7))
nbrs = sorted(h3.grid_ring(c8, 1))
centre = h3.cell_to_latlng(c8)
print("distance from centre to the 6 neighbours (km):",
      " ".join(f"{km(centre, h3.cell_to_latlng(n)):.3f}" for n in nbrs))

print("\nGeoHash of the same point:", geohash(*p, 6))
# two points 20 m apart, on both sides of a GeoHash cell boundary (longitude 46.669921875)
a, b = (24.7114, 46.66983), (24.7114, 46.67003)
print(f"a {a} -> {geohash(*a, 6)}   b {b} -> {geohash(*b, 6)}   distance {km(a, b) * 1000:.0f} m")
print(f"H3 res 8: a -> {h3.latlng_to_cell(*a, 8)}  b -> {h3.latlng_to_cell(*b, 8)}"
      f"  grid_distance = {h3.grid_distance(h3.latlng_to_cell(*a, 8), h3.latlng_to_cell(*b, 8))}")
docker exec lab-case-dispatch python cells.pyوالمخرج سوف يكون كما يلي:
h3 4.5.0
res 7: cell 87537369affffff  avg edge 1.406 km  avg area 5.161 km2
res 8: cell 88537369abfffff  avg edge 0.531 km  avg area 0.737 km2
res 9: cell 89537369aafffff  avg edge 0.201 km  avg area 0.105 km2
grid_disk(k=1) -> 7 cells
grid_disk(k=2) -> 19 cells
grid_disk(k=3) -> 37 cells
parent at res 7: 87537369affffff
distance from centre to the 6 neighbours (km): 0.941 0.909 0.909 0.941 0.885 0.884

GeoHash of the same point: th3hw4
a (24.7114, 46.66983) -> th3htf   b (24.7114, 46.67003) -> th3hw4   distance 20 m
H3 res 8: a -> 88537369a1fffff  b -> 88537369abfffff  grid_distance = 1
في المخرج أعلاه لاحظ التالي:
- متوسط الضلع والمساحة في المستويات 7 و8 و9 يطابق جدول توثيق H3، وكل مستوى مساحته سبع ما قبله تقريباً.
- عدد الخلايا في grid_disk هو 7 ثم 19 ثم 37، وهو ما نعتمد عليه عند توسيع البحث.
- المسافات إلى الجيران الستة بين 0.884 و0.941 كم، أي متقاربة جداً وليست متساوية تماماً، لأن الأرض ليست مسطحة والخلايا تتشوه قليلاً.
- النقطتان a وb بينهما عشرون متراً فقط، ومع ذلك فهما في خليتين مختلفتين في GeoHash بطول 5 أحرف (th3ht وth3hw) وفي H3 أيضاً، والمسافة بين خليتيهما في H3 هي 1، أي أن الحلقة الأولى تكفي لتجد المندوب، بينما يحتاج البحث بالبادئة في GeoHash إلى إضافة الجيران بنفسك.
المثال الصغير: ثلاثة مندوبين وثلاثة طلبات
الملف small.py يحسب المثال الذي حللناه باليد، بالطريقة الجشعة ثم بكل الاحتمالات ثم بالدالة linear_sum_assignment:
#!/usr/bin/env python3
"""The 3x3 example from the article: greedy vs optimal assignment."""
from itertools import permutations
import numpy as np
from scipy.optimize import linear_sum_assignment

couriers = ["A", "B", "C"]
orders = ["1", "2", "3"]
# minutes from each courier to each restaurant (rows: couriers, columns: orders)
eta = np.array([
    [2, 3, 7],
    [4, 12, 6],
    [8, 11, 5],
])

# Greedy: orders arrive 1, 2, 3 and each takes the nearest free courier
free = set(range(3))
total = 0
for j in range(3):
    i = min(free, key=lambda r: eta[r, j])
    free.remove(i)
    total += eta[i, j]
    print(f"greedy   order {orders[j]} -> courier {couriers[i]} ({eta[i, j]} min)")
print(f"greedy   total = {total} min\n")

# Every possible assignment (3! = 6), to check by hand
for p in permutations(range(3)):
    cost = sum(eta[i, p[i]] for i in range(3))
    pairs = " ".join(f"{couriers[i]}{orders[p[i]]}" for i in range(3))
    print(f"option   {pairs}  = {cost}")

rows, cols = linear_sum_assignment(eta)
print()
for i, j in zip(rows, cols):
    print(f"optimal  order {orders[j]} -> courier {couriers[i]} ({eta[i, j]} min)")
print(f"optimal  total = {eta[rows, cols].sum()} min")
docker exec lab-case-dispatch python small.pyوالمخرج سوف يكون كما يلي:
greedy   order 1 -> courier A (2 min)
greedy   order 2 -> courier C (11 min)
greedy   order 3 -> courier B (6 min)
greedy   total = 19 min

option   A1 B2 C3  = 19
option   A1 B3 C2  = 19
option   A2 B1 C3  = 12
option   A2 B3 C1  = 17
option   A3 B1 C2  = 22
option   A3 B2 C1  = 27

optimal  order 2 -> courier A (3 min)
optimal  order 1 -> courier B (4 min)
optimal  order 3 -> courier C (5 min)
optimal  total = 12 min
ولاحظ أن احتمالين من الستة يعطيان 19 دقيقة مثل الطريقة الجشعة، وأن الاحتمال الوحيد بزمن 12 هو نفسه الذي وصلنا إليه باليد في قسم الخوارزمية الهنغارية.
المحاكاة: ساعة من الطلبات في الرياض
الملف sim.py ينشئ 120 مندوباً في أماكن عشوائية، و25 منطقة مطاعم، وطلبات تصل عشوائياً بمعدل ثابت في الدقيقة بتوزيع Poisson، ولكل طلب مكان توصيل يبعد من 1 إلى 6 كم عن المطعم. والساعة تتقدم خمس ثوان في كل خطوة، والمندوب الذي يأخذ طلباً يبقى مشغولاً حتى يصل إلى المطعم ثم إلى العميل، ثم يعود متاحاً في مكان التسليم. والمندوبون المتاحون محفوظون في خلايا H3 بالمستوى 8، وكل طلب يبحث في الحلقات حول مطعمه حتى يجد ثمانية مرشحين على الأقل:
#!/usr/bin/env python3
"""Dispatch simulation in Riyadh: greedy vs batched matching (linear_sum_assignment).

Couriers and orders are random points inside a Riyadh rectangle. Free couriers are indexed in H3 cells,
and each order only looks at couriers in the rings around its restaurant's cell (candidate search).
ETA is a simple model: straight-line distance x road factor / city speed. In production you would ask
a routing engine (an OSRM table call) for these numbers instead.
"""
import argparse
import math
import random
import statistics

import h3
import numpy as np
from scipy.optimize import linear_sum_assignment

LAT = (24.60, 24.85)          # south .. north
LON = (46.55, 46.85)          # west .. east
ROAD_FACTOR = 1.35            # road distance / straight-line distance (assumption)
SPEED_KMH = 25.0              # average city speed (assumption)
HANDOVER_MIN = 3.0            # minutes at the restaurant and at the door, together
RES = 8                       # H3 resolution: average edge about 0.53 km
MIN_CANDIDATES = 8            # stop widening the search when we have this many couriers
MAX_K = 8                     # never look further than 8 rings
TICK_MIN = 5 / 60             # the simulation clock moves 5 seconds at a time
BIG = 1e6


def haversine_km(a, b):
    lat1, lon1, lat2, lon2 = map(math.radians, (a[0], a[1], b[0], b[1]))
    h = math.sin((lat2 - lat1) / 2) ** 2 + math.cos(lat1) * math.cos(lat2) * math.sin((lon2 - lon1) / 2) ** 2
    return 2 * 6371.0088 * math.asin(math.sqrt(h))


def eta_min(a, b):
    return haversine_km(a, b) * ROAD_FACTOR / SPEED_KMH * 60


def clip(p):
    return (min(max(p[0], LAT[0]), LAT[1]), min(max(p[1], LON[0]), LON[1]))


def make_scenario(seed, couriers, rate, minutes):
    rnd = random.Random(seed)
    rand_point = lambda: (rnd.uniform(*LAT), rnd.uniform(*LON))
    hubs = [rand_point() for _ in range(25)]                 # restaurant areas
    start = [rand_point() for _ in range(couriers)]
    orders, t = [], 0.0
    while True:
        t += rnd.expovariate(rate)                           # Poisson arrivals
        if t > minutes:
            break
        hub = rnd.choice(hubs)
        pickup = clip((hub[0] + rnd.gauss(0, 0.01), hub[1] + rnd.gauss(0, 0.01)))
        d_km, ang = rnd.uniform(1, 6), rnd.uniform(0, 2 * math.pi)
        drop = clip((pickup[0] + d_km / 111 * math.sin(ang),
                     pickup[1] + d_km / (111 * math.cos(math.radians(pickup[0]))) * math.cos(ang)))
        orders.append({"id": len(orders), "created": t, "pickup": pickup, "drop": drop})
    return start, orders


class FreeIndex:
    """Free couriers by H3 cell."""

    def __init__(self):
        self.cells = {}

    def add(self, cid, pos):
        self.cells.setdefault(h3.latlng_to_cell(pos[0], pos[1], RES), set()).add(cid)

    def remove(self, cid, pos):
        self.cells[h3.latlng_to_cell(pos[0], pos[1], RES)].discard(cid)

    def candidates(self, pos):
        origin = h3.latlng_to_cell(pos[0], pos[1], RES)
        found = []
        for k in range(MAX_K + 1):
            for cell in h3.grid_ring(origin, k):
                found.extend(self.cells.get(cell, ()))
            if len(found) >= MIN_CANDIDATES:
                break
        return found


def run(strategy, start, orders, batch_sec, horizon):
    checked = brute = 0                                      # ETAs computed vs ETAs without H3
    pos = list(start)
    busy_until = [0.0] * len(start)
    free = set(range(len(start)))
    index = FreeIndex()
    for cid in free:
        index.add(cid, pos[cid])
    pending, nxt, t = [], 0, 0.0
    last_batch = -1

    def assign(cid, o, eta):
        o["courier"], o["assigned"], o["pickup_eta"] = cid, t, eta
        free.discard(cid)
        index.remove(cid, pos[cid])
        trip = eta + HANDOVER_MIN + eta_min(o["pickup"], o["drop"])
        busy_until[cid] = t + trip
        pos[cid] = o["drop"]                                 # where the courier will be when free again

    while t <= horizon:
        for cid in range(len(start)):                        # couriers who finished a delivery
            if cid not in free and busy_until[cid] <= t:
                free.add(cid)
                index.add(cid, pos[cid])
        while nxt < len(orders) and orders[nxt]["created"] <= t:
            pending.append(orders[nxt])
            nxt += 1
        if strategy == "greedy":
            still = []
            for o in pending:                                # first come, first served
                if not free:
                    still.append(o)
                    continue
                cands = index.candidates(o["pickup"])
                if not cands:
                    still.append(o)
                    continue
                checked += len(cands)
                brute += len(free)
                best = min(cands, key=lambda c: eta_min(pos[c], o["pickup"]))
                assign(best, o, eta_min(pos[best], o["pickup"]))
            pending = still
        else:
            slot = int(t * 60 // batch_sec)
            if slot != last_batch and pending and free:
                last_batch = slot
                cand = {o["id"]: index.candidates(o["pickup"]) for o in pending}
                riders = sorted({c for cs in cand.values() for c in cs})
                if riders:
                    col = {c: i for i, c in enumerate(riders)}
                    cost = np.full((len(pending), len(riders)), BIG)
                    for r, o in enumerate(pending):
                        checked += len(cand[o["id"]])
                        brute += len(free)
                        for c in cand[o["id"]]:
                            cost[r, col[c]] = eta_min(pos[c], o["pickup"])
                    rows, cols = linear_sum_assignment(cost)
                    done = set()
                    for r, c in zip(rows, cols):
                        if cost[r, c] < BIG:
                            assign(riders[c], pending[r], cost[r, c])
                            done.add(r)
                    pending = [o for r, o in enumerate(pending) if r not in done]
        if nxt == len(orders) and not pending and t > orders[-1]["created"]:
            break
        t += TICK_MIN

    got = [o for o in orders if "assigned" in o]
    to_pickup = [o["assigned"] + o["pickup_eta"] - o["created"] for o in got]
    result = {
        "orders": len(orders),
        "assigned": len(got),
        "mean_pickup_eta": statistics.mean(o["pickup_eta"] for o in got),
        "sum_pickup_eta": sum(o["pickup_eta"] for o in got),
        "mean_wait_assign": statistics.mean(o["assigned"] - o["created"] for o in got),
        "mean_to_pickup": statistics.mean(to_pickup),
        "p90_to_pickup": statistics.quantiles(to_pickup, n=10)[-1],
        "checked": checked,
        "brute": brute,
    }
    for o in orders:                                         # clean for the next strategy
        for k in ("courier", "assigned", "pickup_eta"):
            o.pop(k, None)
    return result


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--couriers", type=int, default=120)
    ap.add_argument("--rate", type=float, default=4.0, help="orders per minute")
    ap.add_argument("--minutes", type=float, default=60)
    ap.add_argument("--batch", type=int, nargs="+", default=[30], help="batch windows in seconds")
    ap.add_argument("--seed", type=int, default=7)
    a = ap.parse_args()
    start, orders = make_scenario(a.seed, a.couriers, a.rate, a.minutes)
    print(f"Riyadh box {LAT} x {LON}, H3 res {RES}, {a.couriers} couriers, "
          f"{len(orders)} orders in {a.minutes:.0f} min ({a.rate}/min), seed {a.seed}")
    print("minutes; wait = order created -> courier assigned; to pickup = order created -> courier at restaurant")
    print(f"{'strategy':<12}{'avg ETA':>9}{'sum ETA':>9}{'wait':>7}{'to pickup':>11}{'p90':>7}{'ETAs (H3)':>11}{'ETAs (all)':>12}")
    runs = [("greedy", "greedy", 0)] + [(f"batch {b}s", "batch", b) for b in a.batch]
    for name, strat, b in runs:
        r = run(strat, start, orders, b, a.minutes + 180)
        assert r["assigned"] == r["orders"]
        print(f"{name:<12}{r['mean_pickup_eta']:>9.2f}{r['sum_pickup_eta']:>9.0f}"
              f"{r['mean_wait_assign']:>7.2f}{r['mean_to_pickup']:>11.2f}{r['p90_to_pickup']:>7.2f}"
              f"{r['checked']:>11}{r['brute']:>12}")


if __name__ == "__main__":
    main()
في الكود أعلاه لاحظ التالي:
- الكلاس FreeIndex هو فهرس المواقع، يحفظ المندوبين المتاحين فقط، ويخرج المندوب منه لحظة الإسناد ويعود إليه عندما ينتهي من التوصيل.
- الطريقة الجشعة تعالج الطلبات المنتظرة في كل خطوة بترتيب وصولها، والتوزيع على دفعات يجمعها ويحل مسألة الإسناد مرة كل batch_sec ثانية.
- المصفوفة في الدفعة فيها صف لكل طلب منتظر وعمود لكل مرشح ظهر لأي طلب، والزوج الذي ليس في حلقات البحث يأخذ القيمة BIG، والإسناد الذي يقع عليها يرفض ويبقى الطلب للدفعة التالية.
- العمود ETAs (H3) يعد حسابات الزمن التي تمت فعلاً على المرشحين، والعمود ETAs (all) يعد ما كان سيحدث لو حسبنا الزمن لكل المندوبين المتاحين، وفي الدفعات يتكرر الطلب المنتظر في أكثر من دفعة فيكبر هذا الرقم.
الآن سوف نشغل المحاكاة بثلاثة مستويات من الضغط: طلبان في الدقيقة، ثم أربعة، ثم خمسة، ونقارن الطريقة الجشعة بثلاث نوافذ للدفعات:
for r in 2 4 5; do docker exec lab-case-dispatch python sim.py --rate $r --batch 10 30 60; echo; doneوالمخرج سوف يكون كما يلي:
Riyadh box (24.6, 24.85) x (46.55, 46.85), H3 res 8, 120 couriers, 137 orders in 60 min (2.0/min), seed 7
minutes; wait = order created -> courier assigned; to pickup = order created -> courier at restaurant
strategy      avg ETA  sum ETA   wait  to pickup    p90  ETAs (H3)  ETAs (all)
greedy           8.18     1121   0.08       8.26  16.28       1052       11131
batch 10s        8.18     1121   0.09       8.27  16.28       1053       11579
batch 30s        8.09     1108   0.21       8.29  16.26       1071       11468
batch 60s        7.97     1092   0.41       8.39  15.73       1070       11391

Riyadh box (24.6, 24.85) x (46.55, 46.85), H3 res 8, 120 couriers, 265 orders in 60 min (4.0/min), seed 7
minutes; wait = order created -> courier assigned; to pickup = order created -> courier at restaurant
strategy      avg ETA  sum ETA   wait  to pickup    p90  ETAs (H3)  ETAs (all)
greedy          11.04     2926   1.57      12.61  22.38       1119       11923
batch 10s       10.10     2678   1.26      11.36  20.65       1295       36671
batch 30s       10.12     2683   1.27      11.39  20.26       1300       25998
batch 60s       10.37     2748   1.65      12.02  21.59       1330       20733

Riyadh box (24.6, 24.85) x (46.55, 46.85), H3 res 8, 120 couriers, 323 orders in 60 min (5.0/min), seed 7
minutes; wait = order created -> courier assigned; to pickup = order created -> courier at restaurant
strategy      avg ETA  sum ETA   wait  to pickup    p90  ETAs (H3)  ETAs (all)
greedy          12.07     3899   6.15      18.22  31.32       1102       11654
batch 10s        8.96     2893   4.57      13.53  23.89       2204       96973
batch 30s        9.13     2948   4.33      13.45  23.85       2175       52389
batch 60s        9.22     2979   4.75      13.97  24.45       2265       37455
ولأن نتيجة تشغيل واحد قد تكون صدفة، نعيد التشغيل بضغط أربعة طلبات في الدقيقة على ثلاث بذور عشوائية أخرى Seeds، أي ثلاث مدن مختلفة في أماكن المطاعم والمندوبين:
for s in 1 2 3; do docker exec lab-case-dispatch python sim.py --rate 4 --batch 30 --seed $s | tail -n 2; donegreedy 10.63 2753 0.63 11.26 20.04 1262 11438
batch 30s 10.26 2659 0.79 11.05 20.64 1357 18248
greedy 12.55 3388 4.17 16.72 30.10 913 12285
batch 30s 10.16 2744 4.38 14.55 25.49 1658 70391
greedy 9.58 1993 0.29 9.87 20.02 1257 12765
batch 30s 9.26 1926 0.49 9.75 19.34 1314 17193ماذا تقول الأرقام؟
- وقت الهدوء (طلبان في الدقيقة): الطريقتان متساويتان تقريباً، فمتوسط الزمن إلى المطعم 8.26 دقيقة بالطريقة الجشعة و8.29 بدفعات كل 30 ثانية، والسبب أن عند كل طلب مندوبين متاحين كثيرين فلا يأخذ طلب مندوب طلب آخر.
- الضغط المتوسط (أربعة طلبات): دفعات كل 30 ثانية خفضت متوسط زمن المندوب إلى المطعم من 11.04 إلى 10.12 دقيقة، والزمن من الطلب إلى وصول المندوب من 12.61 إلى 11.39، أي قرابة 10%.
- الذروة (خمسة طلبات): الفرق كبير، فالزمن إلى المطعم نزل من 12.07 إلى 9.13 دقيقة، والزمن الكلي من 18.22 إلى 13.45، والنسبة المئوية 90 P90 من 31.32 إلى 23.85 دقيقة. ولاحظ أن الانتظار قبل الإسناد قل أيضاً مع أن الدفعات تنتظر عمداً، والسبب أن المندوبين يقطعون مسافات أقل فيعودون متاحين أسرع.
- البذور الأخرى: الفائدة بين 1% و13% بحسب المدينة العشوائية، وأكبر فائدة كانت في البذرة 2 حيث كان الضغط أعلى، وهذا يؤكد أن قيمة الدفعات تأتي من الضغط وليس من الخوارزمية وحدها.
- خلايا H3: في وقت الهدوء حسبت الطريقة الجشعة 1,052 زمن وصول بدل 11,131، أي أقل بعشر مرات، ومع آلاف المندوبين في مدينة حقيقية يصبح الفرق أكبر بكثير.
نكسر الإعداد: دفعة كل دقيقة وقت الهدوء
قد يبدو من النتائج أن النافذة الأطول أفضل دائماً، فلنعد إلى الجدول الأول: بدفعة كل 60 ثانية وقت الهدوء ارتفع الانتظار قبل الإسناد من 0.08 إلى 0.41 دقيقة، وارتفع الزمن الكلي إلى المطعم من 8.26 إلى 8.39، أي أن العميل انتظر نصف دقيقة إضافية دون أي فائدة لأن المطابقة لم تجد ما تحسنه. وفي الضغط المتوسط كانت نافذة 60 ثانية أسوأ من 10 و30 ثانية. لذلك لا تثبت طول النافذة، وإنما اجعله يتغير بحسب عدد الطلبات المنتظرة والمندوبين المتاحين في كل منطقة، فتكون قصيرة أو صفراً وقت الهدوء، وأطول قليلاً وقت الذروة.
حذف المختبر
احذف ال Container بالاسم الذي أنشأناه، ثم احذف المجلد إذا لم تعد تحتاجه:
docker rm -f lab-case-dispatchمن المحاكاة إلى الإنتاج
المحاكاة أعلاه تشرح الفكرة، ولكن النظام الحقيقي يحتاج أشياء لم نضعها فيها عمداً لنبقي الكود قصيراً، وأهمها:
- وقت تحضير الطعام: التكلفة الحقيقية ليست زمن وصول المندوب، وإنما الفرق بين وقت وصوله ووقت جاهزية الطعام، والمندوب الذي يصل مبكراً جداً يهدر وقتاً كان يمكن أن يوصل فيه طلباً آخر.
- احتمال القبول: المندوب قد يرفض، لذلك تحسب بعض الأنظمة احتمال القبول من تاريخ المندوب، وتعرض الطلب على من يرجح أن يقبله.
- التقسيم بحسب المدينة Partitioning: مندوب في جدة لا يأخذ طلباً في الرياض، لذلك يعمل محرك التوزيع لكل مدينة أو منطقة كوحدة مستقلة، وهذا يجعل التوسع أفقياً سهلاً، فكل نسخة مسؤولة عن مناطق محددة، وهذا سبب تقسيم Kafka حسب المدينة في المعمارية الكاملة أعلاه، كما شرحنا في قسم التقسيم في مقال الأنظمة الموزعة.
- ميزانية الزمن: الدفعة يجب أن تنتهي قبل الدفعة التالية، فإذا كانت النافذة 10 ثوان وكان حل المصفوفة مع طلبات مصفوفة المسافات يأخذ 12 ثانية فقد انهار النظام، لذلك قس زمن كل دفعة وحجمها.
- ماذا تراقب: زمن الإسناد من الطلب إلى قبول المندوب، ونسبة القبول، والفرق بين زمن الوصول المتوقع والفعلي، وعدد الطلبات المنتظرة في كل منطقة، وهذه أرقام يفهمها فريق العمليات قبل المهندسين.
أخطاء شائعة
- المسافة المستقيمة بدل زمن الطريق: تعطي مندوباً قريباً على الخريطة بعيداً بالطريق، فاستخدمها للتصفية الأولى فقط.
- البحث في خلية المطعم وحدها: أقرب مندوب قد يكون خلف حد الخلية بأمتار، فابحث دائماً في الجيران أو بالحلقات.
- إسناد بلا شرط على الحالة: يجعل المندوب نفسه يستلم طلبين، فاجعل كل تغيير للحالة مشروطاً بالحالة السابقة.
- عرض بلا مهلة في السيرفر: يترك الطلب معلقاً إذا فقد هاتف المندوب الاتصال.
- نافذة دفعات ثابتة: تضيف انتظاراً بلا فائدة وقت الهدوء، كما رأينا في المختبر.
- نسخ أرقام شركة أخرى: لا تبن قراراتك على أرقام سمعتها عن شركة، وإنما على محاكاة ببياناتك وقياس بعد الإطلاق.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- محرك التوزيع يكرر أربع خطوات: قائمة الطلبات المنتظرة، ثم البحث عن المرشحين، ثم زمن الوصول، ثم المطابقة، والعرض الذي يرفض يعيد الطلب إلى القائمة.
- الخلايا مثل H3 وGeoHash وS2 تختصر البحث من كل المندوبين إلى من حول المطعم، وفي المختبر خفضت حسابات الزمن عشر مرات.
- زمن الوصول يأتي من محرك المسارات بالطريق الفعلي، والمسافة المستقيمة تصلح للتصفية فقط.
- الطريقة الجشعة جيدة وقت الهدوء، والتوزيع على دفعات بالخوارزمية الهنغارية أو Jonker-Volgenant يفيد وقت الذروة، وفي المحاكاة خفض الزمن إلى المطعم قرابة 25% في أعلى ضغط.
- الطلب والمندوب آلتا حالات، وكل انتقال مشروط بالحالة السابقة، وكل طلب يغير شيئاً يحمل مفتاح منع التكرار.
- Uber تنشر أنها تطابق على دفعات وتحسب التسعير بخلايا H3، أما جاهز وKeeta فلا تنشران تفاصيل التوزيع، فلا تبن تصميمك على تخمين ما يفعلانه.
 دليلتتبع مواقع المندوبين لحظياً: من الهاتف إلى الخريطةكيف تستقبل مواقع آلاف المندوبين كل بضع ثوان، وتحفظ آخر موقع لكل منهم، وتوصله إلى العميل الذي ينتظر طلبه.
 دليلالمحفظة الرقمية من الداخل: دفتر القيد المزدوج Ledgerكيف تبني محفظة رقمية لا يضيع فيها ريال ولا يخصم مرتين، بالقيد المزدوج والمعاملات والمطابقة مع مزود الدفع.
 دليلحساب أقصر طريق وزمن الوصول مع OSRM وValhallaكيف يحسب محرك المسارات أقصر طريق وزمن الوصول على شوارع مدينتك، وكيف تشغله على سيرفرك وتقيس سرعته بنفسك.
 دليلكيف تعرف الخرائط الزحام وسرعة الطريق؟كيف تتحول نقاط GPS من الهواتف إلى سرعة لكل شارع وزمن وصول أدق، وما الذي يحمي خصوصية أصحابها.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
سجل التحديثات
- أكتوبر 2026: إضافة قسم المعمارية الكاملة: المخطط والمكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو.
- أكتوبر 2026: إضافة فقرة Haversine ومتى تكفي المسافة المستقيمة، مع مقارنة بالحساب الدقيق على WGS84.
- أكتوبر 2026: كتابة المقال، والتحقق من صفحات Uber الرسمية عن المطابقة والتسعير ومقال H3، وصفحات مجموعة جاهز، والتقرير السنوي لشركة Meituan عن 2025، وتشغيل المحاكاة على Python 3.13.16 مع h3 4.5.0 وNumPy 2.5.3 وSciPy 1.18.1.


