


أضاف فريق المتجر سيرفراً ثالثاً للتطبيق قبل موسم التخفيضات، ووضع أمام السيرفرات الثلاثة HAProxy بالإعداد الذي يظهر في كل دليل: balance roundrobin. ولوحة الإحصاءات تقول إن كل سيرفر يأخذ الثلث بالضبط، والمعالج في كل سيرفر لا يتجاوز النصف، ومع ذلك يشتكي العملاء في المساء من صفحات تتأخر ثانية أو أكثر، ثم تعود طبيعية في الطلب التالي. والسيرفر الثالث في الحقيقة جهاز أقدم من الآخرين، والفريق يعرف ذلك، ولكنه افترض أن الموزع «سوف يتصرف». والسؤال الذي يطرحه هذا الموقف أعمق من إعداد واحد: كيف يقرر موزع الطلبات أين يذهب كل طلب؟ وهل التوزيع بالتساوي هو التوزيع الصحيح أصلاً؟ ومتى يجب أن يذهب الطلب إلى السيرفر نفسه كل مرة؟
في مقال هل تحتاج High Availability فعلاً؟ حسبنا أن أرخص طبقة تبدأ بها التوفر العالي هي سيرفرات التطبيق التي لا تحتفظ بحالة خلف موزع طلبات، وشرحنا في دليل HAProxy تثبيته وإعداده وفحوص الصحة وشهادات TLS، فلن نعيد شيئاً من ذلك هنا. وإنما نركز على القرار الذي يتخذه الموزع آلاف المرات في الثانية: خوارزمية التوزيع Load Balancing Algorithm. وسوف نقيس كل خوارزمية في مختبر حقيقي بثلاثة سيرفرات خلف HAProxy 3.4.6، مرة والسيرفرات متساوية، ومرة وأحدها أبطأ، ومرة وأحدها معطل بطريقة خبيثة، ونرى بالأرقام ما يشعر به المستخدم في كل حالة.
وسوف نناقش في هذا المقال ما يلي:
- ماذا يقرر موزع الطلبات Load Balancer بالضبط، ولماذا يختلف التوزيع لكل اتصال عن التوزيع لكل طلب.
- الخوارزميات الثابتة والديناميكية: التناوب Round Robin والأوزان، وأقل اتصالات Least Connections، واختيار الأفضل من اثنين Power of Two Choices، والهاش Hashing بنوعيه.
- مختبر حقيقي يقيس زمن الاستجابة الذي يشعر به المستخدم لكل خوارزمية، مع مشكلة حقيقية جعلت طلباً من 20 ملي ثانية يستغرق 75.
- ما يحدث عندما يكون أحد السيرفرات أبطأ، وكيف يحل طابور HAProxy المشكلة دون تغيير الخوارزمية.
- كم مفتاحاً ينتقل عند إزالة سيرفر أو إضافته في الهاش العادي والهاش المتسق Consistent Hashing.
- السيرفر الذي يفشل بسرعة فيسحب الطلبات إليه Sinkholing، والجلسات اللاصقة Sticky Sessions، والمقابل في Nginx، وجدول قرار.
ماذا يقرر موزع الطلبات Load Balancer بالضبط؟
موزع الطلبات هو البرنامج الذي يقف بين المستخدمين ومجموعة من السيرفرات التي تقدم الخدمة نفسها، ويسمى هذا المجموع في HAProxy الخلفية Backend وفي Nginx المجموعة Upstream، فيستقبل كل طلب ويختار سيرفراً من المجموعة ويمرر إليه الطلب. وقد شرحنا في مقارنة Reverse Proxy مع Load Balancer مع API Gateway الفرق بين الطبقة الرابعة L4 التي ترى الاتصالات فقط، والطبقة السابعة L7 التي ترى طلبات HTTP، وهذا الفرق يحدد شيئاً مهماً هنا: متى يتخذ الموزع قراره. فموزع الطبقة الرابعة يختار السيرفر مرة واحدة عند فتح الاتصال، وكل ما يمر في هذا الاتصال بعد ذلك يذهب إلى السيرفر نفسه، أما موزع الطبقة السابعة فيستطيع أن يختار سيرفراً لكل طلب داخل الاتصال الواحد. والفرق كبير عندما يفتح المتصفح أو التطبيق اتصالاً واحداً ويرسل فيه مئات الطلبات، فالتوزيع لكل اتصال قد يجعل سيرفراً يحمل مستخدماً نشيطاً جداً وآخر يحمل مستخدمين نائمين.
والموزع يحتاج ثلاثة أشياء حتى يقوم بعمله، وكل واحد منها يجيب عن سؤال مختلف:
- من المتاح؟ قائمة السيرفرات وحالة كل واحد منها، وهذا عمل فحوص الصحة Health Checks التي شرحناها في دليل HAProxy، فالسيرفر الذي فشل في الفحص يخرج من القائمة.
- من الأنسب الآن؟ وهذا عمل الخوارزمية، وهي موضوع هذا المقال: هل يكفي أن نأخذ التالي في الدور، أم ننظر إلى عدد الطلبات المفتوحة عند كل سيرفر، أم نحسب من الطلب نفسه سيرفراً ثابتاً؟
- ماذا نفعل إذا كان الجميع مشغولاً؟ وهذا عمل الطابور Queue والحدود Limits، وهو الجزء الذي ينساه كثيرون، وسوف ترى في المختبر أنه قد يكون أهم من الخوارزمية نفسها.
وقد يتساءل البعض: لماذا لا نترك التوزيع لـ DNS، فنضع ثلاثة عناوين للنطاق نفسه ويختار المتصفح واحداً منها؟ والإجابة أن DNS لا يعرف شيئاً عن حالة السيرفرات، فإذا توقف أحدها بقي عنوانه في الإجابة حتى تنتهي مدة الصلاحية TTL وبعدها أحياناً، ولا يعرف أي السيرفرات مشغول الآن، والمتصفحات لا تتفق على طريقة الاختيار بين العناوين. لذلك يبقى DNS مفيداً لتوزيع المستخدمين بين المواقع أو المناطق، أما التوزيع بين السيرفرات داخل الموقع فيحتاج موزعاً يرى كل طلب.
خوارزميات ثابتة Static أم ديناميكية Dynamic؟
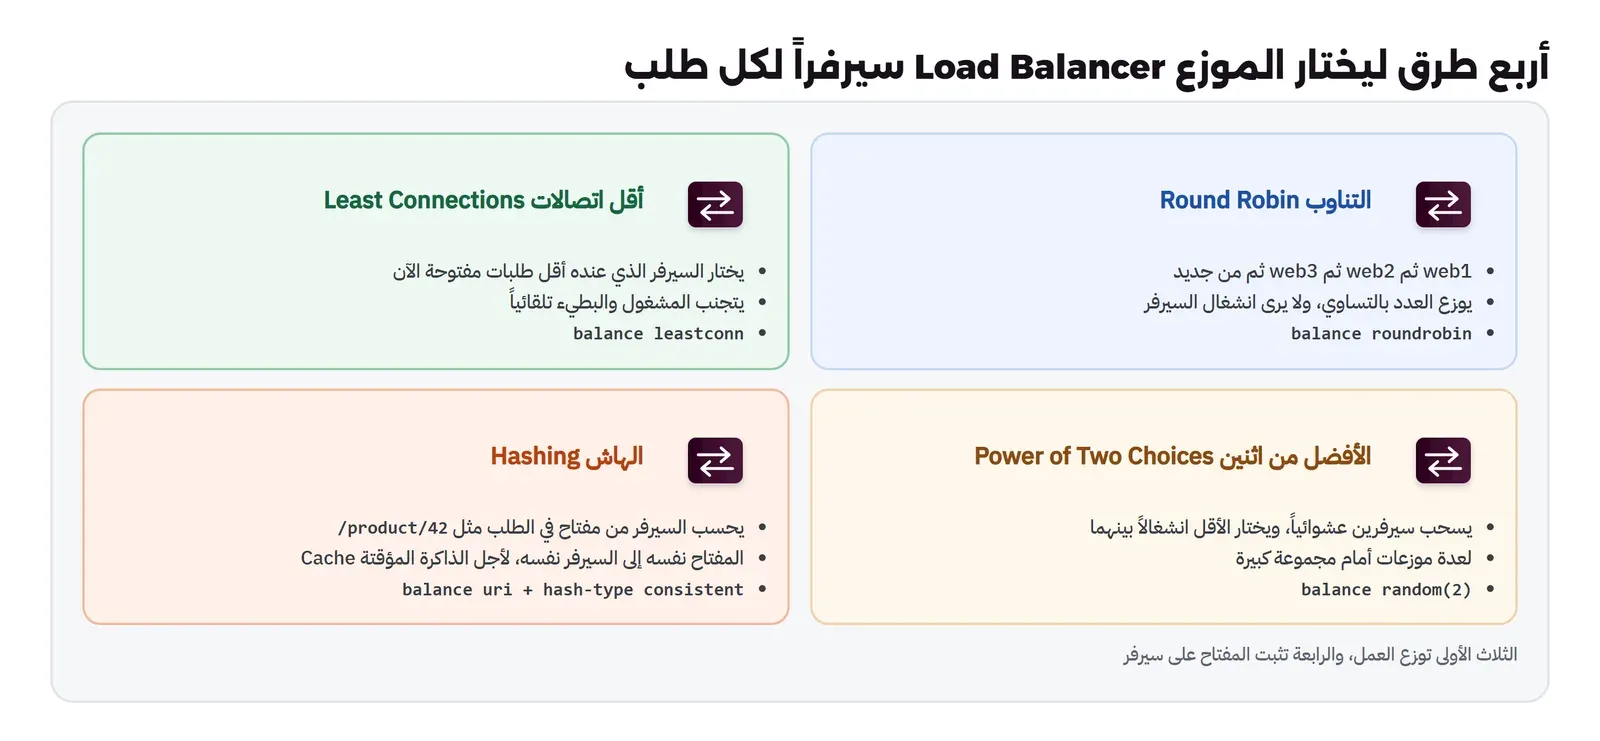
الخوارزميات كلها تنقسم إلى نوعين، والفرق بينهما هو السؤال: هل ينظر الموزع إلى حالة السيرفرات في لحظة القرار؟ فالخوارزمية الثابتة تقرر من معلومات لا تتغير مع الضغط Load، مثل ترتيب السيرفرات أو أوزانها أو هاش الطلب، والخوارزمية الديناميكية تقرر من حالة متغيرة، مثل عدد الاتصالات المفتوحة الآن عند كل سيرفر. والصورة التالية تبين الخوارزميات الأربع التي سوف نقيسها:
التناوب Round Robin مع الأوزان Weights
التناوب هو أبسط خوارزمية: الطلب الأول إلى السيرفر الأول، والثاني إلى الثاني، والثالث إلى الثالث، ثم نعود إلى الأول. ومع الأوزان Weights يأخذ السيرفر الذي وزنه 2 ضعف ما يأخذه السيرفر الذي وزنه 1، وهذا ما تفعله balance roundrobin في HAProxy، والسلوك الافتراضي في Nginx دون أي خيار. ويقول توثيق HAProxy إنها أنعم الخوارزميات وأعدلها عندما يكون زمن المعالجة عند السيرفرات موزعاً بالتساوي، وهذا الشرط هو المهم، والسبب أن التناوب يوزع عدد الطلبات بالتساوي وليس العمل. فإذا كان طلب من كل عشرة طلبات تقريراً يأخذ 400 ملي ثانية، والبقية صفحات تأخذ 20، فالتناوب لا يعرف ذلك، وقد يرسل تقريرين متتاليين إلى السيرفر نفسه، فينتظر خلفهما كل طلب خفيف يأتي بعدهما إلى هذا السيرفر، بينما السيرفران الآخران فارغان. والفرق بين roundrobin وstatic-rr في HAProxy أن الأولى تقبل تغيير الأوزان أثناء العمل، وهو ما يحتاجه البدء التدريجي Slow Start لسيرفر عاد للتو، والثانية لا تقبله ولكنها لا حد لعدد سيرفراتها.
أقل اتصالات Least Connections
هنا ينظر الموزع إلى عدد الطلبات أو الاتصالات المفتوحة الآن عند كل سيرفر، ويختار الأقل، وإذا تساوى أكثر من سيرفر استخدم التناوب بينها. والفكرة أن السيرفر المشغول بطلب ثقيل سوف يبقى عنده اتصال مفتوح مدة أطول، فيتجنبه الموزع تلقائياً، والسيرفر الأبطأ سوف يتراكم عنده عدد أكبر، فيأخذ أقل. والطريف أن توثيق HAProxy نفسه يقول إن leastconn مناسبة للجلسات الطويلة مثل LDAP وSQL، وليست مناسبة جداً للبروتوكولات ذات الجلسات القصيرة مثل HTTP. والسبب أن الطلبات إذا كانت قصيرة جداً فالعدد عند كل سيرفر صفر أو واحد في أغلب الوقت، فتتحول الخوارزمية إلى تناوب مع حسابات إضافية، ولكن عندما يكون في الطلبات خليط من الخفيف والثقيل، أو يكون الضغط Load قريباً من سعة السيرفرات، يصبح العدد معلومة مفيدة، وهذا بالضبط ما سوف يظهره المختبر.
اختيار الأفضل من اثنين Power of Two Choices
عندما يكون عندك عشرات الموزعات أمام مئات السيرفرات، فكل موزع يرى فقط الطلبات التي مرت به، ولا يعرف الحالة الحقيقية لكل سيرفر، وقد يقرر عشرة موزعات في اللحظة نفسها أن السيرفر نفسه هو الأقل انشغالاً، فيرسل إليه كل واحد منها طلباً، ويتحول الأقل انشغالاً إلى الأكثر انشغالاً. والحل الذي أثبته Michael Mitzenmacher في رسالته عن قوة الاختيارين بسيط ومدهش: اختر سيرفرين عشوائياً، ثم أرسل الطلب إلى الأقل انشغالاً بينهما. فالاختيار العشوائي وحده يترك بعض السيرفرات مزدحمة بالصدفة، أما المقارنة بين اثنين فقط فتقلل هذا الازدحام بشكل كبير جداً، دون أن يحتاج الموزع إلى معرفة حالة كل السيرفرات. وفي HAProxy هي balance random(2)، والرقم هو عدد السحبات، ويذكر التوثيق أنها مفيدة مع المجموعات الكبيرة أو عندما تضاف السيرفرات وتزال كثيراً، وفي Nginx هي random two least_conn.
الهاش Hashing: نفس المفتاح إلى نفس السيرفر
الخوارزميات السابقة كلها تحاول أن توزع العمل، أما الهاش فيحاول شيئاً آخر: أن يذهب الطلب نفسه إلى السيرفر نفسه كل مرة. ويحسب الموزع هاش من جزء في الطلب، مثل المسار /product/42 أو عنوان العميل أو ترويسة أو معامل في الرابط، ثم يحول الهاش إلى رقم سيرفر. والسبب الذي يجعلك تريد ذلك هو الذاكرة المؤقتة Cache: إذا كان كل سيرفر يحتفظ في ذاكرته بالمنتجات التي خدمها، فإرسال طلبات المنتج 42 إلى السيرفر نفسه يعني أن ذاكرته تحتوي عليه دائماً، بينما التوزيع العشوائي يجعل كل سيرفر يحمل نسخة من كل شيء ويخطئ في الذاكرة ثلاث مرات أكثر. ولكن الهاش له نوعان، والفرق بينهما يظهر في يوم واحد فقط، هو اليوم الذي يتغير فيه عدد السيرفرات:
- الهاش العادي Map-based: يقسم الهاش على عدد السيرفرات ويأخذ الباقي، وهذا يعطي توزيعاً ناعماً جداً، ولكن عندما يتغير العدد يتغير الباقي لأغلب المفاتيح، ويقول التوثيق إن أغلب الارتباطات تتغير عندما يتوقف سيرفر أو يعود أو يضاف.
- الهاش المتسق Consistent Hashing: يضع السيرفرات على دائرة بنقاط كثيرة لكل سيرفر، ويضع كل مفتاح على الدائرة نفسها، ثم يذهب المفتاح إلى أقرب سيرفر بعده. فإذا خرج سيرفر انتقلت مفاتيحه فقط إلى جيرانه، وإذا دخل سيرفر أخذ جزءاً صغيراً فقط من مفاتيح جيرانه. والفكرة نشرها David Karger وزملاؤه في 1997 لتوزيع الذاكرة المؤقتة على الويب، وهي اليوم في Nginx باسم
hash $key consistentمع طريقة ketama، وفي HAProxy باسمhash-type consistent.
وقد شرحنا الدائرة نفسها بالتفصيل في مقال الأنظمة الموزعة، والجديد هنا أننا سوف نقيس كم مفتاحاً ينتقل فعلاً في HAProxy عند إزالة سيرفر وإضافة آخر، وسوف ترى أيضاً ثمن الهاش المتسق الذي يذكره التوثيق صراحة: التوزيع لا يكون ناعماً أبداً.
وهناك خوارزميات أخرى في HAProxy تستحق أن تعرفها: source وهي هاش لعنوان العميل، وfirst التي تملأ السيرفر الأول حتى حده ثم تنتقل إلى الثاني، وهي مفيدة عندما تريد أن تطفئ السيرفرات الزائدة في الليل، وhdr وurl_param للهاش على ترويسة أو معامل. وفي الأنظمة الكبيرة جداً توجد خوارزميات تعتمد على معلومات يرسلها السيرفر نفسه عن حالته، مثل الوزن الذي يتغير بحسب استهلاك المعالج، ويصف فصل توزيع الطلبات داخل مركز البيانات في كتاب Google SRE كيف انتقلت Google من التناوب إلى أقل الطلبات ثم إلى التناوب الموزون Weighted Round Robin المبني على هذه المعلومات، ولماذا.
المختبر Lab: ثلاثة سيرفرات وخمس خوارزميات
الآن نبني مختبراً صغيراً يشبه ما حدث في المتجر: ثلاثة سيرفرات تطبيق متطابقة في الكود، كل واحد منها عنده أربعة عمال Workers فقط، أي أنه يخدم أربعة طلبات في الوقت نفسه، وأي طلب خامس ينتظر عاملاً يتحرر، وهذا ما يحدث في أغلب سيرفرات التطبيقات التي تعمل بعدد ثابت من العمليات أو الخيوط. وأمامها HAProxy 3.4.6 يستمع على منفذ مختلف لكل خوارزمية، حتى نقارن الخوارزميات على السيرفرات نفسها في اللحظة نفسها تقريباً. ومولد طلبات بعشرة عملاء، كل واحد منهم بالاتصال نفسه Keep-Alive كما يفعل المتصفح، و90% من طلباتهم خفيفة تحتاج 20 ملي ثانية من العمل، و10% تقارير ثقيلة تحتاج 400 ملي ثانية.
ملفات المختبر Lab Files
سيرفر التطبيق يحجز عاملاً من أربعة، وينام المدة المطلوبة مضروبة في معامل البطء SLOWDOWN، ثم يرد باسمه وكم انتظر حتى وجد عاملاً، وفيه وضع ثالث FAIL=1 يرد فيه بالرمز 500 فوراً دون أي عمل، وسوف نحتاجه في آخر تجربة. احفظه باسم backend.py:
# One backend server: GET /work?ms=N holds one of WORKERS slots for N * SLOWDOWN ms, then answers
# with its name, so the client can see who served it, how long it waited for a free slot, and how busy it was.
import os, threading, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
from urllib.parse import urlparse, parse_qs
NAME, WORKERS, SLOWDOWN = os.environ["NAME"], int(os.environ.get("WORKERS", "4")), float(os.environ.get("SLOWDOWN", "1"))
FAIL = os.environ.get("FAIL") == "1"            # a broken server that answers 500 at once, without doing the work
slots, lock, busy = threading.Semaphore(WORKERS), threading.Lock(), [0]

class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    disable_nagle_algorithm = True               # headers and body go out as two writes; without this, delayed ACK adds ~40 ms
    def log_message(self, *a): pass
    def do_GET(self):
        u = urlparse(self.path)
        ms = float(parse_qs(u.query).get("ms", ["0"])[0])
        if FAIL:
            body = f"{NAME} waited=0 busy=0 error\n".encode()
            self.send_response(500); self.send_header("Content-Length", str(len(body))); self.end_headers(); self.wfile.write(body); return
        t0 = time.time()
        with slots:                                  # wait for a free worker, like a real app server
            waited = (time.time() - t0) * 1000
            with lock: busy[0] += 1; now = busy[0]
            time.sleep(ms * SLOWDOWN / 1000)
            with lock: busy[0] -= 1
        body = f"{NAME} waited={waited:.0f} busy={now}\n".encode()
        self.send_response(200); self.send_header("Content-Length", str(len(body))); self.end_headers(); self.wfile.write(body)

ThreadingHTTPServer(("0.0.0.0", 8080), H).serve_forever()
ومولد الطلبات يشغل عدداً من العملاء لمدة محددة، ويطبع عدد الطلبات في الثانية، ومئينات زمن الاستجابة Percentiles لكل الطلبات وللخفيفة وحدها، وحصة كل سيرفر ومتوسط انتظار العامل عنده وعدد أخطائه. ولاحظ أننا نطبع مئينات الطلبات الخفيفة وحدها، والسبب أن المئين 99 لكل الطلبات سوف يكون دائماً قريباً من 400 ملي ثانية بسبب التقارير نفسها، وهذا لا يخبرنا شيئاً عن الخوارزمية، أما الطلب الخفيف الذي يأخذ 300 ملي ثانية فهو مستخدم انتظر خلف تقرير لا علاقة له به. احفظه باسم load.py:
# Load generator: CLIENTS threads, each with its own keep-alive connection, for SECONDS.
# 90% of requests are light (20 ms of work), 10% heavy (400 ms), the mix of a real API with a few slow reports.
# Prints per-server counts and the latency percentiles the users felt.
import http.client, os, random, statistics, sys, threading, time, collections
HOST, PORT = os.environ.get("LB", "wr-ha-lb"), int(sys.argv[1])
CLIENTS, SECONDS = int(os.environ.get("CLIENTS", "16")), float(os.environ.get("SECONDS", "30"))
random.seed(42)
lat, light, per, errs, waits, lock = [], [], collections.Counter(), collections.Counter(), collections.defaultdict(list), threading.Lock()

def worker(seed):
    rnd, end = random.Random(seed), time.time() + SECONDS
    c = http.client.HTTPConnection(HOST, PORT, timeout=10)
    while time.time() < end:
        ms = 400 if rnd.random() < 0.10 else 20
        t0 = time.time()
        try:
            c.request("GET", f"/work?ms={ms}"); r = c.getresponse(); body = r.read().decode()
        except Exception:
            c.close(); c = http.client.HTTPConnection(HOST, PORT, timeout=10); continue
        dt = (time.time() - t0) * 1000
        name, waited = body.split()[0], float(body.split()[1].split("=")[1])
        with lock:
            lat.append(dt); per[name] += 1; waits[name].append(waited)
            if r.status >= 500: errs[name] += 1
            if ms == 20: light.append(dt)

ts = [threading.Thread(target=worker, args=(i,)) for i in range(CLIENTS)]
[t.start() for t in ts]; [t.join() for t in ts]
lat.sort(); light.sort(); q = lambda p, a=lat: a[int(p * len(a)) - 1]
print(f"port {PORT}: {len(lat)} requests, {len(lat) / SECONDS:.0f} req/s  p50 {q(.5):.0f} ms  p95 {q(.95):.0f} ms  p99 {q(.99):.0f} ms  max {lat[-1]:.0f} ms")
print(f"  light requests (20 ms of work): p50 {q(.5, light):.0f} ms  p95 {q(.95, light):.0f} ms  p99 {q(.99, light):.0f} ms")
for n in sorted(per):
    print(f"  {n}: {per[n]:5} requests ({per[n] / len(lat) * 100:4.1f}%)  avg wait for a worker {statistics.mean(waits[n]):6.1f} ms" + (f"  errors {errs[n]}" if errs[n] else ""))
وملف HAProxy يعرف منفذاً لكل خوارزمية، وكل منفذ أمام السيرفرات الثلاثة نفسها، ومعها سيرفر رابع web4 معطل في البداية بالكلمة disabled سوف نضيفه في تجربة الهاش، ومنفذ للواجهة البرمجية Runtime API حتى نخرج السيرفرات وندخلها أثناء العمل دون إعادة تحميل الإعداد، كما في دليل الإدارة. احفظه باسم haproxy.cfg:
global
    stats socket [email protected]:9999 level admin    # runtime API, lab network only

defaults
    mode http
    timeout connect 2s
    timeout client 30s
    timeout server 30s
    default-server check inter 2s

# one frontend port per algorithm, same three servers behind each
frontend rr
    bind :8001
    default_backend be_rr
frontend lc
    bind :8002
    default_backend be_lc
frontend p2c
    bind :8003
    default_backend be_p2c
frontend hmap
    bind :8004
    default_backend be_hmap
frontend hcons
    bind :8005
    default_backend be_hcons

backend be_rr
    balance roundrobin
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080

backend be_lc
    balance leastconn
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080

backend be_p2c
    balance random(2)
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080

backend be_hmap
    balance uri path-only
    hash-type map-based
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080
    server web4 wr-ha-web4:8080 disabled

backend be_hcons
    balance uri path-only
    hash-type consistent
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080
    server web4 wr-ha-web4:8080 disabled
في الإعداد أعلاه لاحظ التالي:
stats socket [email protected]:9999 level adminيفتح الواجهة البرمجية على شبكة المختبر بصلاحية كاملة، ولا تقم بذلك أبداً على عنوان يصل إليه غيرك، والسبب أن من يصل إليها يستطيع أن يخرج كل السيرفرات من الخدمة بأمر واحد، والأنسب في الإنتاج ملف Socket محلي.default-server check inter 2sيجعل كل سيرفر يفحص كل ثانيتين، وهو هنا فحص TCP فقط، أي أن الموزع يتأكد أن المنفذ مفتوح ولا شيء غير ذلك، وسوف نرى ثمن ذلك في التجربة الأخيرة.balance uri path-onlyيحسب الهاش من المسار فقط دون اسم النطاق، فيكون/product/42هو المفتاح، ويتجاهل ما بعد علامة الاستفهام إلا إذا أضفتwhole.
الآن نشغل السيرفرات الأربعة والموزع وحاوية للعميل على شبكة واحدة:
export MSYS_NO_PATHCONV=1
docker network create wr-ha-net
for i in 1 2 3 4; do
  docker run -d --name wr-ha-web$i --network wr-ha-net -e NAME=web$i -v "$(pwd -W):/lab:ro" \
    python:3.13-slim python -u /lab/backend.py
done
docker run -d --name wr-ha-lb --network wr-ha-net \
  -v "$(pwd -W)/haproxy.cfg:/usr/local/etc/haproxy/haproxy.cfg:ro" haproxy:3.4.6
docker run -d --name wr-ha-client --network wr-ha-net -v "$(pwd -W):/lab" -w /lab python:3.13-slim sleep infinity
for p in 8001 8002 8003; do docker exec -e CLIENTS=10 -e SECONDS=30 wr-ha-client python load.py $p; done
مشكلة واجهتنا: طلب من 20 ملي ثانية يستغرق 75 Delayed ACK
عندما شغلنا التجربة أول مرة كان في النتائج شيء غير منطقي: الوسيط p50 لكل الخوارزميات حوالي 69 ملي ثانية، مع أن 90% من الطلبات تحتاج 20 ملي ثانية فقط من العمل، والسيرفرات لم تكن مزدحمة. فقسنا طلباً واحداً متكرراً مباشرة إلى السيرفر ثم عبر الموزع، بالسكربت التالي من داخل حاوية العميل:
import http.client, time
for host, port in (("wr-ha-web1", 8080), ("wr-ha-lb", 8001)):
    c, ts = http.client.HTTPConnection(host, port), []
    for i in range(30):
        t = time.time(); c.request("GET", "/work?ms=20"); c.getresponse().read(); ts.append((time.time() - t) * 1000)
    ts.sort(); print(host, port, "median %.1f ms" % ts[15])
والمخرج سوف يكون كما يلي، قبل أن نضيف السطر disable_nagle_algorithm = True إلى السيرفر:
wr-ha-web1 8080 median 75.3 ms
wr-ha-lb 8001 median 22.1 ms
أي أن الطلب المباشر إلى السيرفر أبطأ من الطلب الذي يمر بالموزع بثلاثة أضعاف، وهذا عكس المتوقع تماماً. والسبب تفاعل معروف بين خوارزميتين في TCP: خوارزمية Nagle الموصوفة في RFC 896، التي تمنع إرسال قطعة صغيرة جديدة حتى يصل تأكيد ACK للقطعة السابقة، والتأكيد المؤجل Delayed ACK الموصوف في RFC 1122، الذي يجعل الطرف الآخر ينتظر قليلاً قبل أن يرسل التأكيد، على أمل أن يرسله مع بيانات. وسيرفر Python الافتراضي يكتب الترويسات في عملية كتابة، ثم الجسم في عملية ثانية، فيخرج الجزء الأول، وينتظر الجزء الثاني تأكيده، والعميل يؤجل التأكيد حوالي 40 ملي ثانية على Linux، فيضيع هذا الوقت في كل طلب. ولم تظهر المشكلة في الطلب الواحد عبر HAProxy، ولكنها ظهرت في اختبار الضغط عبره، وهذا ما يجعلها خطيرة: تظهر في مسار وتختفي في آخر، فتضيع وقتك في البحث عنها في الخوارزمية أو في الموزع.
والحل أن يرسل السيرفر بالخيار TCP_NODELAY، وفي سيرفر Python يكفي السطر disable_nagle_algorithm = True في الكلاس، وبعده أصبح الوسيط 21.3 ملي ثانية مباشرة و21.6 عبر الموزع. ولاحظ أن هذه المشكلة لا تخص Python، فأي سيرفر يكتب الرد على أكثر من دفعة صغيرة دون TCP_NODELAY قد يقع فيها، ولذلك إذا رأيت زمن استجابة يقترب من 40 ملي ثانية أو مضاعفاتها بشكل ثابت دون سبب، فابدأ بالبحث هنا قبل أي شيء آخر. وكل الأرقام التالية في المقال بعد هذا الإصلاح.
ثلاثة سيرفرات متساوية Equal Servers
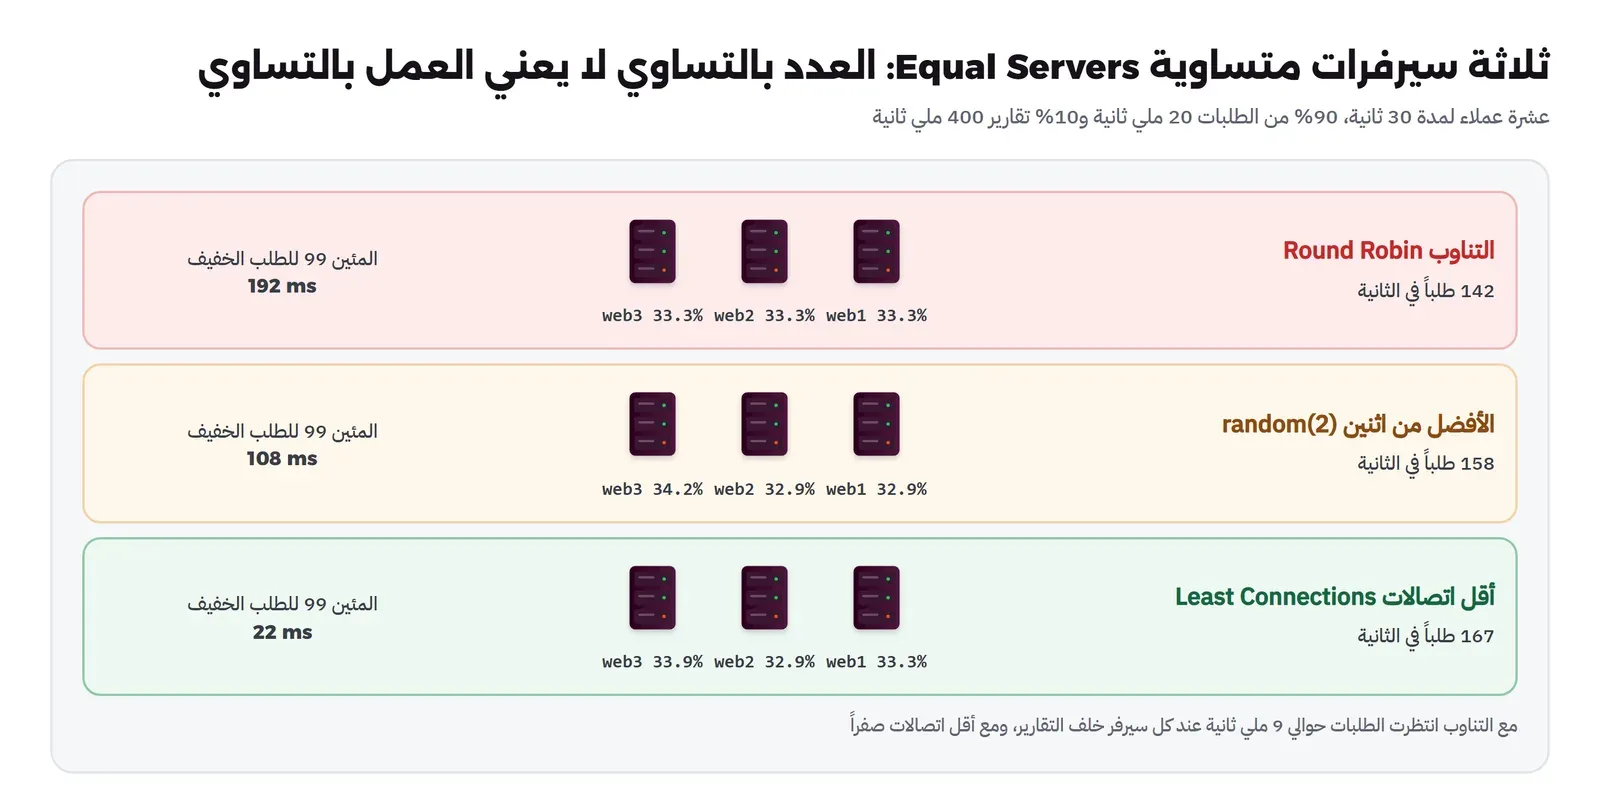
أول تجربة والسيرفرات الثلاثة متساوية، عشرة عملاء لمدة 30 ثانية على كل خوارزمية، والمخرج سوف يكون كما يلي:
port 8001: 4273 requests, 142 req/s  p50 21 ms  p95 401 ms  p99 421 ms  max 627 ms
  light requests (20 ms of work): p50 21 ms  p95 80 ms  p99 192 ms
  web1:  1424 requests (33.3%)  avg wait for a worker    8.6 ms
  web2:  1424 requests (33.3%)  avg wait for a worker    9.1 ms
  web3:  1425 requests (33.3%)  avg wait for a worker    9.1 ms
port 8002: 5020 requests, 167 req/s  p50 21 ms  p95 401 ms  p99 401 ms  max 405 ms
  light requests (20 ms of work): p50 21 ms  p95 22 ms  p99 22 ms
  web1:  1670 requests (33.3%)  avg wait for a worker    0.0 ms
  web2:  1650 requests (32.9%)  avg wait for a worker    0.0 ms
  web3:  1700 requests (33.9%)  avg wait for a worker    0.0 ms
port 8003: 4754 requests, 158 req/s  p50 21 ms  p95 401 ms  p99 405 ms  max 677 ms
  light requests (20 ms of work): p50 21 ms  p95 39 ms  p99 108 ms
  web1:  1565 requests (32.9%)  avg wait for a worker    4.5 ms
  web2:  1565 requests (32.9%)  avg wait for a worker    1.0 ms
  web3:  1624 requests (34.2%)  avg wait for a worker    3.6 ms
وهذا المخرج يحمل الدرس الأول في المقال، فلنقرأه بعناية:
- التناوب، المنفذ 8001: التوزيع مثالي بالعدد، 1424 و1424 و1425، وهذا ما رآه الفريق في لوحة الإحصاءات. ولكن الطلب الخفيف في المئين 99 أخذ 192 ملي ثانية بدلاً من 21، والسبب في العمود الأخير: كل سيرفر انتظرت عنده الطلبات حوالي 9 ملي ثانية في المتوسط حتى تجد عاملاً، أي أن طلبات كثيرة وصلت إلى سيرفر عماله الأربعة مشغولون بتقارير، بينما كان عند سيرفر آخر عامل فارغ.
- أقل اتصالات، المنفذ 8002: الانتظار صفر عند السيرفرات الثلاثة، والطلب الخفيف في المئين 99 أخذ 22 ملي ثانية، أي أن أحداً لم ينتظر خلف تقرير. وارتفع عدد الطلبات في الثانية من 142 إلى 167، والسبب أن العملاء العشرة يرسلون الطلب التالي بعد أن يصلهم الرد، فكلما قل الانتظار زادت الطلبات التي ينجزونها في المدة نفسها.
- الأفضل من اثنين، المنفذ 8003: في المنتصف بين الاثنين، فالمئين 99 للطلب الخفيف 108 ملي ثانية، لأن الموزع يقارن بين سيرفرين فقط من ثلاثة، فأحياناً يكون السيرفر الثالث غير المختار هو الفارغ. وهذه الخوارزمية لا تظهر قوتها مع ثلاثة سيرفرات وموزع واحد يرى كل شيء، وإنما مع عشرات السيرفرات وعدة موزعات لا يرى أي منها الصورة كاملة.
والصورة التالية تجمع النتائج:
سيرفر أبطأ من الآخرين Heterogeneous Servers
الآن نعيد ما حدث في المتجر فعلاً: السيرفر الثالث أقدم، فكل عمل عنده يأخذ مرتين ونصفاً من الوقت، أي أن الطلب الخفيف عنده 50 ملي ثانية والتقرير ثانية كاملة. نعيد تشغيله بمعامل البطء:
docker rm -f wr-ha-web3
docker run -d --name wr-ha-web3 --network wr-ha-net -e NAME=web3 -e SLOWDOWN=2.5 -v "$(pwd -W):/lab:ro" \
  python:3.13-slim python -u /lab/backend.py
for p in 8001 8002 8003; do docker exec -e CLIENTS=10 -e SECONDS=30 wr-ha-client python load.py $p; done
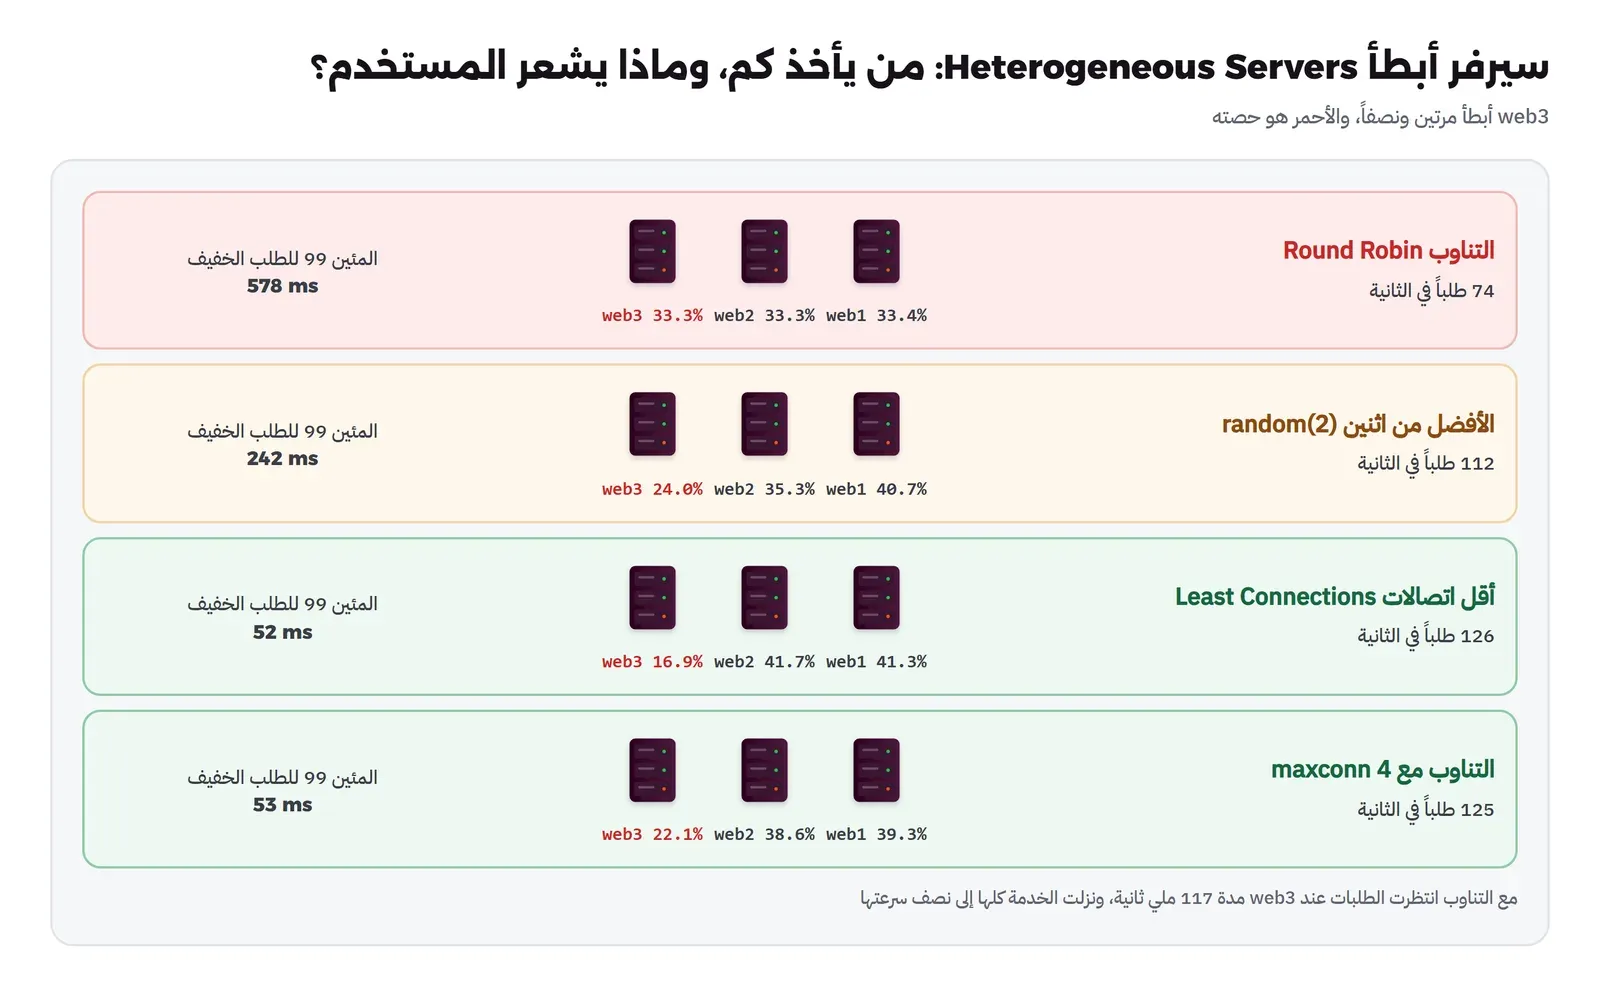
والمخرج سوف يكون كما يلي:
port 8001: 2224 requests, 74 req/s  p50 21 ms  p95 522 ms  p99 1121 ms  max 1809 ms
  light requests (20 ms of work): p50 21 ms  p95 242 ms  p99 578 ms
  web1:   742 requests (33.4%)  avg wait for a worker    0.2 ms
  web2:   741 requests (33.3%)  avg wait for a worker    0.8 ms
  web3:   741 requests (33.3%)  avg wait for a worker  117.1 ms
port 8002: 3790 requests, 126 req/s  p50 21 ms  p95 401 ms  p99 1001 ms  max 1010 ms
  light requests (20 ms of work): p50 21 ms  p95 51 ms  p99 52 ms
  web1:  1567 requests (41.3%)  avg wait for a worker    0.0 ms
  web2:  1582 requests (41.7%)  avg wait for a worker    0.0 ms
  web3:   641 requests (16.9%)  avg wait for a worker    0.0 ms
port 8003: 3355 requests, 112 req/s  p50 21 ms  p95 401 ms  p99 1002 ms  max 1436 ms
  light requests (20 ms of work): p50 21 ms  p95 85 ms  p99 242 ms
  web1:  1367 requests (40.7%)  avg wait for a worker    0.8 ms
  web2:  1184 requests (35.3%)  avg wait for a worker    1.1 ms
  web3:   804 requests (24.0%)  avg wait for a worker   27.6 ms
في المخرج أعلاه لاحظ التالي:
- مع التناوب ما زال كل سيرفر يأخذ الثلث بالضبط، ولكن الطلبات عند السيرفر البطيء تنتظر 117 ملي ثانية في المتوسط حتى تجد عاملاً، والطلب الخفيف في المئين 99 أصبح 578 ملي ثانية، والأسوأ أن عدد الطلبات في الثانية نزل من 142 إلى 74، أي النصف تقريباً. والسبب أن العملاء الذين وقعوا على السيرفر البطيء ينتظرون، والتناوب يستمر في إرسال ثلث الطلبات إليه مهما طال طابوره، فأصبح أبطأ سيرفر هو الذي يحدد سرعة الخدمة كلها. وهذا بالضبط ما اشتكى منه عملاء المتجر: صفحات تتأخر ثانية ثم تعود طبيعية في الطلب التالي، لأن الطلب التالي ذهب إلى سيرفر آخر.
- مع أقل اتصالات أخذ السيرفر البطيء 16.9% فقط، وأخذ كل من السيرفرين السريعين حوالي 41%، دون أن نخبر الموزع بأي شيء عن سرعة السيرفرات. والسبب أن الطلبات عند السيرفر البطيء تبقى مفتوحة أطول، فيرى الموزع عنده عدداً أكبر ويتجنبه. والطلب الخفيف في المئين 99 أصبح 52 ملي ثانية، وهو تقريباً زمن الطلب الخفيف على السيرفر البطيء نفسه دون أي انتظار.
- الأفضل من اثنين أعطى السيرفر البطيء 24%، وبقي عنده انتظار 27.6 ملي ثانية، فهو أفضل كثيراً من التناوب وأقل من أقل اتصالات، للسبب نفسه في التجربة السابقة.
وقد يتساءل البعض: لماذا لا نحل المشكلة بالأوزان، فنعطي السيرفر البطيء وزناً أقل؟ والإجابة أن هذا يعمل إذا عرفت النسبة بالضبط، وإذا بقيت ثابتة، والواقع أن السرعة تتغير مع نوع الطلبات ومع ما يعمل على السيرفر في الخلفية، فالوزن الذي يصلح في الصباح قد لا يصلح في المساء. والأوزان مفيدة للفرق الكبير المعروف، مثل سيرفر فيه ضعف عدد المعالجات، أما الفرق الذي لا تعرفه مسبقاً فتتعامل معه الخوارزمية الديناميكية أو الطابور، كما في التجربة التالية.
ماذا لو جعلنا الطابور في HAProxy؟ maxconn What If
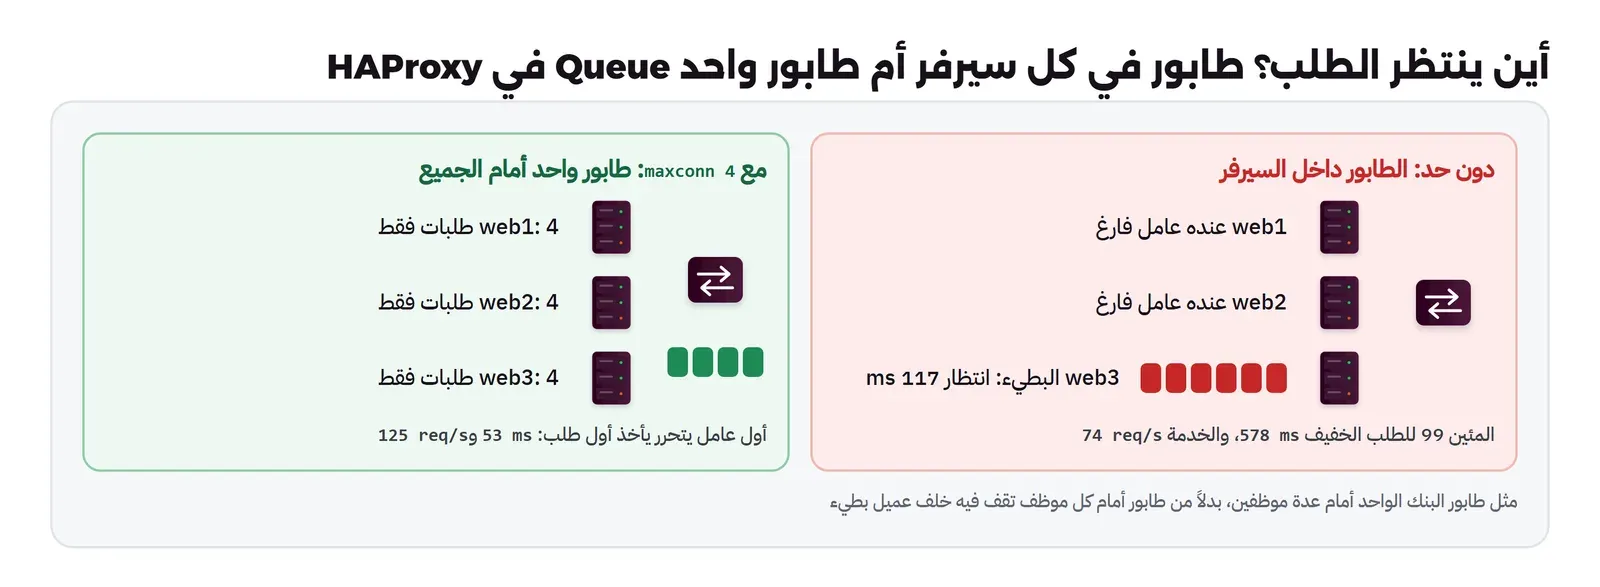
في تجربة التناوب كانت الطلبات تنتظر في طابور داخل السيرفر البطيء، بينما عند السيرفرين الآخرين عمال فارغون، والموزع لا يعرف ذلك. فماذا لو منعنا الموزع من إرسال أكثر من أربعة طلبات في الوقت نفسه إلى كل سيرفر، وهو عدد العمال عنده، وجعلنا الطلب الخامس ينتظر في HAProxy نفسه؟ في هذه الحالة يكون الطابور واحداً أمام كل السيرفرات، ويأخذ أول عامل يتحرر في أي سيرفر أول طلب في الطابور، وهذا هو نموذج طابور البنك الواحد أمام عدة موظفين، بدلاً من طابور أمام كل موظف تقف فيه خلف عميل بطيء بينما الموظف الآخر فارغ. نضيف إلى الإعداد خلفية جديدة على المنفذ 8006 بالتناوب نفسه مع الخيار maxconn 4 لكل سيرفر:
# what if: round robin again, but each server takes at most 4 requests (its worker count)
# and the rest wait in HAProxy's queue for the first free slot
frontend rrq
    bind :8006
    default_backend be_rrq
backend be_rrq
    balance roundrobin
    timeout queue 10s
    server web1 wr-ha-web1:8080 maxconn 4
    server web2 wr-ha-web2:8080 maxconn 4
    server web3 wr-ha-web3:8080 maxconn 4
ثم نعيد تشغيل الموزع ونقيس والسيرفر الثالث ما زال بطيئاً:
docker restart wr-ha-lb
docker exec -e CLIENTS=10 -e SECONDS=30 wr-ha-client python load.py 8006
والمخرج سوف يكون كما يلي:
port 8006: 3757 requests, 125 req/s  p50 21 ms  p95 401 ms  p99 1001 ms  max 1002 ms
  light requests (20 ms of work): p50 21 ms  p95 51 ms  p99 53 ms
  web1:  1475 requests (39.3%)  avg wait for a worker    0.0 ms
  web2:  1452 requests (38.6%)  avg wait for a worker    0.0 ms
  web3:   830 requests (22.1%)  avg wait for a worker    0.0 ms
والنتيجة أن التناوب نفسه، دون تغيير الخوارزمية، أصبح بنفس جودة أقل اتصالات تقريباً: 125 طلباً في الثانية بدلاً من 74، والطلب الخفيف في المئين 99 أصبح 53 ملي ثانية بدلاً من 578، والانتظار عند السيرفرات صفر لأن الانتظار انتقل إلى HAProxy. والسبب أن الحد يجعل التناوب يتخطى السيرفر الممتلئ، فيذهب الطلب إلى السيرفر التالي الذي عنده مكان، وإذا امتلأ الجميع انتظر الطلب في طابور الخلفية. وهذا درس أهم من الخوارزمية نفسها: إذا كان سيرفر التطبيق يعمل بعدد ثابت من العمال، فاجعل maxconn لكل سيرفر في الموزع مساوياً لهذا العدد أو قريباً منه، وضع timeout queue معقولاً حتى لا ينتظر الطلب إلى الأبد إذا امتلأ كل شيء، وراقب طول الطابور في صفحة الإحصاءات، فهو أوضح إشارة إلى أن السعة لم تعد تكفي.
الهاش عند إزالة سيرفر وإضافته Rehashing
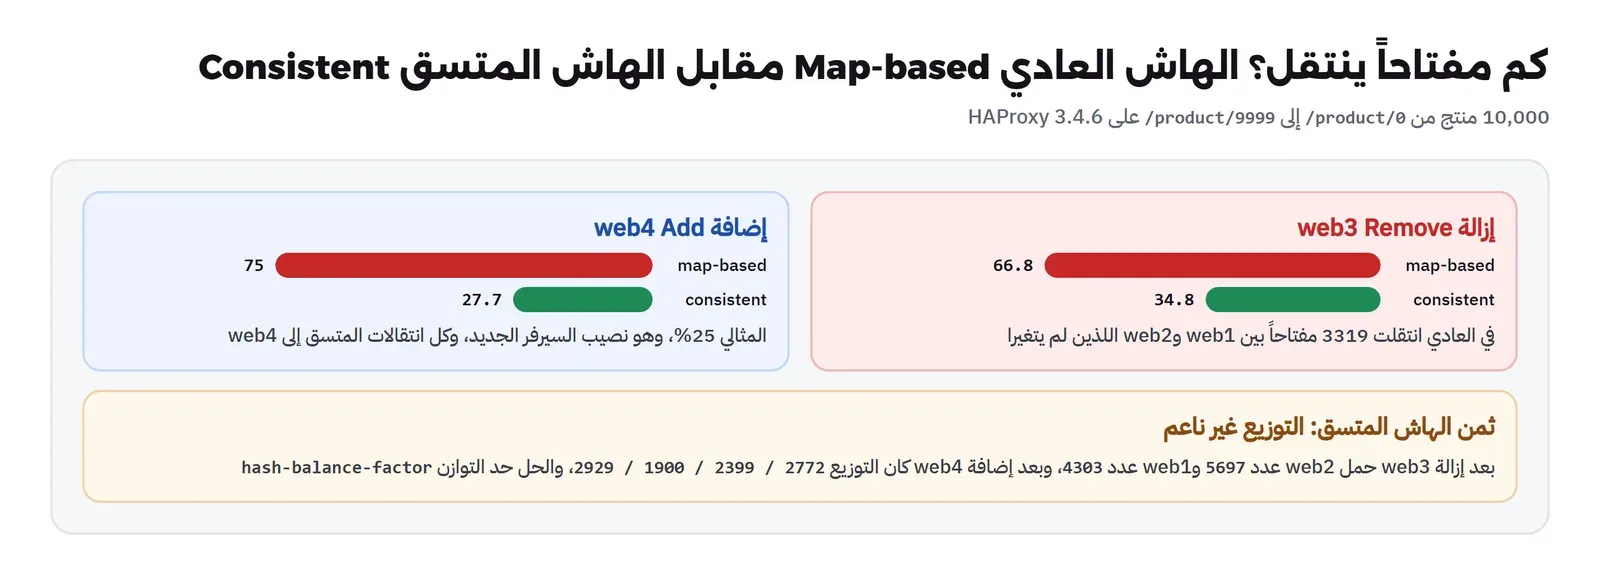
الآن نقيس الهاش. نرسل 10,000 طلب لعشرة آلاف منتج مختلف، من /product/0 إلى /product/9999، ونسجل أي سيرفر خدم كل منتج، ثم نخرج سيرفراً من الخدمة ونعيد القياس، ثم نعيده ونضيف سيرفراً رابعاً ونعيد القياس، ونحسب في كل مرة كم منتجاً انتقل إلى سيرفر آخر. وكل منتج ينتقل يعني ذاكرة مؤقتة فارغة لهذا المنتج في السيرفر الجديد، أي طلباً يذهب إلى قاعدة البيانات بدلاً من الذاكرة. احفظ السكربت التالي باسم keys.py:
# Hashing test: which server gets each of 10,000 cache keys, before and after a change in the pool.
#   python keys.py <port> <out.json>         record key -> server
#   python keys.py compare a.json b.json      how many keys moved, and where
import collections, http.client, json, os, sys
if sys.argv[1] == "compare":
    a, b = json.load(open(sys.argv[2])), json.load(open(sys.argv[3]))
    moved = [k for k in a if a[k] != b[k]]
    print(f"{len(moved)} of {len(a)} keys moved ({len(moved) / len(a) * 100:.1f}%)")
    print("  before:", dict(sorted(collections.Counter(a.values()).items())))
    print("  after: ", dict(sorted(collections.Counter(b.values()).items())))
    print("  moves: ", dict(collections.Counter(f"{a[k]}->{b[k]}" for k in moved).most_common(6)))
    sys.exit()
c, out = http.client.HTTPConnection(os.environ.get("LB", "wr-ha-lb"), int(sys.argv[1]), timeout=5), {}
for i in range(10_000):
    c.request("GET", f"/product/{i}?ms=0"); out[str(i)] = c.getresponse().read().decode().split()[0]
json.dump(out, open(sys.argv[2], "w"))
print(dict(sorted(collections.Counter(out.values()).items())))
وسكربت صغير يرسل أمراً واحداً إلى الواجهة البرمجية، واحفظه باسم api.py:
# Send one command to the HAProxy runtime API (stats socket on port 9999) and print the answer.
import socket, sys
s = socket.create_connection(("wr-ha-lb", 9999)); s.sendall((" ".join(sys.argv[1:]) + "\n").encode())
print(s.makefile().read().strip())
ثم نشغل التجربة على الخلفيتين، الهاش العادي على المنفذ 8004 والمتسق على 8005:
mkdir -p out; C="docker exec wr-ha-client"
for b in hmap:8004 hcons:8005; do n=${b%:*}; p=${b#*:}; echo "== $n"
  $C python keys.py $p out/$n-3.json
  $C python api.py set server be_$n/web3 state maint
  $C python keys.py $p out/$n-2.json; $C python keys.py compare out/$n-3.json out/$n-2.json
  $C python api.py set server be_$n/web3 state ready; $C python api.py set server be_$n/web4 state ready; sleep 3
  $C python keys.py $p out/$n-4.json; $C python keys.py compare out/$n-3.json out/$n-4.json
done
والمخرج سوف يكون كما يلي، بعد حذف الأسطر الفارغة التي يرد بها الأمر set server:
== hmap
{'web1': 3301, 'web2': 3340, 'web3': 3359}
{'web1': 5000, 'web2': 5000}
6678 of 10000 keys moved (66.8%)
  before: {'web1': 3301, 'web2': 3340, 'web3': 3359}
  after:  {'web1': 5000, 'web2': 5000}
  moves:  {'web3->web2': 1681, 'web3->web1': 1678, 'web2->web1': 1670, 'web1->web2': 1649}
{'web1': 2497, 'web2': 2499, 'web3': 2503, 'web4': 2501}
7500 of 10000 keys moved (75.0%)
  before: {'web1': 3301, 'web2': 3340, 'web3': 3359}
  after:  {'web1': 2497, 'web2': 2499, 'web3': 2503, 'web4': 2501}
  moves:  {'web3->web4': 841, 'web3->web2': 840, 'web3->web1': 838, 'web2->web3': 836, 'web2->web4': 835, 'web2->web1': 834}
== hcons
{'web1': 3507, 'web2': 3009, 'web3': 3484}
{'web1': 4303, 'web2': 5697}
3484 of 10000 keys moved (34.8%)
  before: {'web1': 3507, 'web2': 3009, 'web3': 3484}
  after:  {'web1': 4303, 'web2': 5697}
  moves:  {'web3->web2': 2688, 'web3->web1': 796}
{'web1': 2929, 'web2': 1900, 'web3': 2399, 'web4': 2772}
2772 of 10000 keys moved (27.7%)
  before: {'web1': 3507, 'web2': 3009, 'web3': 3484}
  after:  {'web1': 2929, 'web2': 1900, 'web3': 2399, 'web4': 2772}
  moves:  {'web2->web4': 1109, 'web3->web4': 1085, 'web1->web4': 578}
وهذا المخرج يبين الفرق بين النوعين أوضح من أي شرح:
- الهاش العادي عند إزالة سيرفر: انتقل 66.8% من المنتجات، أي ثلثا الذاكرة المؤقتة أصبحت فارغة في لحظة. والأغرب في سطر
movesأن 1670 منتجاً انتقلت من web2 إلى web1، و1649 من web1 إلى web2، مع أن السيرفرين لم يتغيرا، والسبب أن الباقي من القسمة على 2 يختلف عن الباقي من القسمة على 3 لأغلب المفاتيح. والتوزيع بعد الإزالة ناعم جداً، 5000 و5000 بالضبط. - الهاش العادي عند إضافة سيرفر: انتقل 75% من المنتجات، وهذا يعني أن إضافة سيرفر لتخفيف الضغط في الذروة تفرغ ثلاثة أرباع الذاكرة المؤقتة، فيذهب الضغط كله إلى قاعدة البيانات في أسوأ وقت.
- الهاش المتسق عند إزالة سيرفر: انتقلت 3484 منتجاً فقط، وهي بالضبط عدد المنتجات التي كانت عند web3، أي أن أحداً غيرها لم يتحرك، وسطر
movesلا يحتوي إلا على انتقالات من web3. ولكن لاحظ الثمن: ذهب 2688 منها إلى web2 و796 فقط إلى web1، فأصبح web2 يحمل 5697 مقابل 4303، أي أن السيرفر الذي يجاور web3 على الدائرة ورث أغلب مفاتيحه. - الهاش المتسق عند إضافة سيرفر: انتقل 27.7%، والمثالي 25% وهو نصيب السيرفر الجديد، وكل الانتقالات إلى web4 فقط. ولكن التوزيع بعد الإضافة 2929 و1900 و2399 و2772، أي أن أكبر سيرفر يحمل أكثر من أصغرهم بحوالي 54%.
وهذا بالضبط ما يحذر منه التوثيق: الهاش المتسق لا يكون توزيعه ناعماً أبداً، وقد تحتاج إلى تعديل الأوزان أو أرقام تعريف السيرفرات حتى يتحسن، وأيضاً يجب أن تكون أرقام تعريف السيرفرات متطابقة في كل الموزعات إذا كان لديك أكثر من موزع، وإلا اختلف التوزيع بينها. وفي HAProxy الخيار hash-balance-factor الذي يمنع أي سيرفر من أن يتجاوز نسبة معينة فوق المتوسط في عدد الاتصالات، فإذا تجاوزها انتقل الطلب إلى السيرفر التالي على الدائرة، وهو تطبيق لفكرة الهاش المتسق ذي الحمولة المحدودة. والقاعدة العملية أن تستخدم الهاش المتسق دائماً إذا كان سبب الهاش هو الذاكرة المؤقتة، وتقبل التوزيع غير الناعم، وتضع له حداً.
ماذا لو كان السيرفر يفشل بسرعة؟ Sinkholing What If
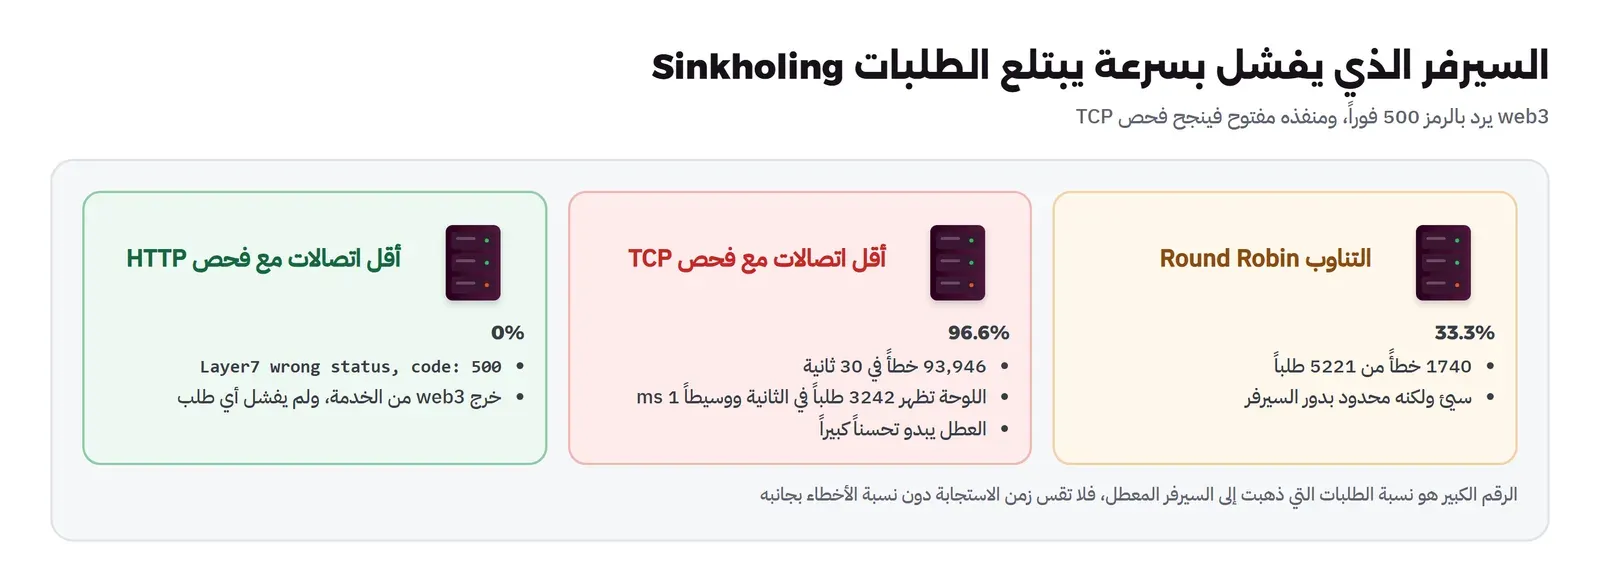
بعد كل هذه النتائج قد يبدو أن أقل اتصالات هي الخوارزمية المثالية دائماً، وهنا تأتي التجربة التي تبين خطرها. فقد كتب فريق Google في فصل توزيع الطلبات داخل مركز البيانات أنهم تعلموا «بالطريقة الصعبة» أن السيرفر المعطل جداً قد يرد بأخطاء على كل الطلبات، وأن رد الخطأ أسرع بكثير من معالجة الطلب، فتظن الخوارزمية أن هذا السيرفر هو الأقل انشغالاً، وترسل إليه طلبات أكثر وأكثر، ويسمون ذلك أن السيرفر أصبح يبتلع الحركة Sinkholing. ولنجرب ذلك: نجعل web3 يرد بالرمز 500 فوراً على كل طلب، وهذا ما يحدث مثلاً عندما يفقد التطبيق اتصاله بقاعدة البيانات أو يمتلئ قرصه، بينما يبقى منفذه مفتوحاً فينجح فحص TCP. ونضيف خلفية ثالثة على المنفذ 8007 بأقل اتصالات مع فحص HTTP حقيقي:
# the fix for a server that fails fast: an HTTP health check that expects 200, not only an open port
frontend lcchk
    bind :8007
    default_backend be_lcchk
backend be_lcchk
    balance leastconn
    option httpchk GET /work?ms=0
    http-check expect status 200
    server web1 wr-ha-web1:8080
    server web2 wr-ha-web2:8080
    server web3 wr-ha-web3:8080
ثم نشغل web3 بالوضع المعطل ونقيس التناوب وأقل اتصالات دون فحص HTTP ومعه:
docker rm -f wr-ha-web3
docker run -d --name wr-ha-web3 --network wr-ha-net -e NAME=web3 -e FAIL=1 -v "$(pwd -W):/lab:ro" \
  python:3.13-slim python -u /lab/backend.py
docker restart wr-ha-lb; sleep 8; docker logs wr-ha-lb 2>&1 | grep lcchk
for p in 8001 8002 8007; do docker exec -e CLIENTS=10 -e SECONDS=30 wr-ha-client python load.py $p; done
والمخرج سوف يكون كما يلي، وقد كتبنا السيرفرين web1 وweb2 بوضعهما العادي:
[WARNING]  (8) : Server be_lcchk/web3 is DOWN, reason: Layer7 wrong status, code: 500, info: "Internal Server Error", check duration: 1ms. 2 active and 0 backup servers left. 0 sessions active, 0 requeued, 0 remaining in queue.
port 8001: 5221 requests, 174 req/s  p50 21 ms  p95 401 ms  p99 451 ms  max 707 ms
  light requests (20 ms of work): p50 21 ms  p95 101 ms  p99 258 ms
  web1:  1741 requests (33.3%)  avg wait for a worker   26.1 ms
  web2:  1740 requests (33.3%)  avg wait for a worker   26.1 ms
  web3:  1740 requests (33.3%)  avg wait for a worker    0.0 ms  errors 1740
port 8002: 97246 requests, 3242 req/s  p50 1 ms  p95 3 ms  p99 22 ms  max 415 ms
  light requests (20 ms of work): p50 1 ms  p95 3 ms  p99 22 ms
  web1:  1559 requests ( 1.6%)  avg wait for a worker    0.0 ms
  web2:  1741 requests ( 1.8%)  avg wait for a worker    0.0 ms
  web3: 93946 requests (96.6%)  avg wait for a worker    0.0 ms  errors 93946
port 8007: 3931 requests, 131 req/s  p50 35 ms  p95 415 ms  p99 421 ms  max 700 ms
  light requests (20 ms of work): p50 34 ms  p95 41 ms  p99 137 ms
  web1:  2046 requests (52.0%)  avg wait for a worker   14.0 ms
  web2:  1885 requests (48.0%)  avg wait for a worker   15.2 ms
وهذا أخطر مخرج في المختبر كله:
- التناوب: ثلث الطلبات فشلت، 1740 من 5221، وهذا سيئ ولكنه محدود، لأن التناوب لا يعطي السيرفر المعطل أكثر من دوره.
- أقل اتصالات دون فحص HTTP: ذهب 96.6% من الطلبات إلى السيرفر المعطل، 93,946 خطأً في 30 ثانية، لأن كل طلب عنده ينتهي في أقل من ملي ثانية، فالعدد عنده صفر دائماً، فهو الأقل دائماً. والأخطر من النسبة شكل الأرقام: الطلبات في الثانية ارتفعت إلى 3242، والوسيط p50 أصبح 1 ملي ثانية، أي أن لوحة مراقبة تعرض زمن الاستجابة والإنتاجية Throughput فقط سوف تظهر أن الخدمة في أفضل حالاتها، بينما هي معطلة لكل العملاء تقريباً. لذلك لا تقس زمن الاستجابة أبداً دون نسبة الأخطاء بجانبه، كما شرحنا في مقال الإشارات الذهبية.
- أقل اتصالات مع فحص HTTP: السطر الأول من المخرج يبين أن HAProxy أخرج web3 من الخدمة لأنه رد بالرمز 500 على الفحص، فلم يصله أي طلب، وتوزعت الطلبات على السيرفرين السليمين، ولم يفشل أي طلب. والثمن أن السيرفرين وحدهما أبطأ قليلاً، فالوسيط 34 ملي ثانية، وهذا ثمن السعة المفقودة، وليس ثمن الخوارزمية.
والدرس أن الخوارزمية الديناميكية تحتاج فحص صحة يعرف معنى «سليم» فعلاً، أي مسار يتحقق من أن التطبيق يستطيع أن يخدم، وليس منفذاً مفتوحاً فقط. ومع ذلك فالفحص كل ثانيتين يترك ثوان يبتلع فيها السيرفر الطلبات قبل أن يخرج، لذلك يضيف HAProxy خيارات تراقب الردود الحقيقية نفسها، مثل observe layer7 مع error-limit وon-error، فيخرج السيرفر بعد عدد من الأخطاء المتتالية في الطلبات الحقيقية دون أن ينتظر الفحص التالي.
حذف المختبر Cleanup
docker rm -f wr-ha-web1 wr-ha-web2 wr-ha-web3 wr-ha-web4 wr-ha-lb wr-ha-client
docker network rm wr-ha-net
docker rmi haproxy:3.4.6
السيرفر العائد والسيرفر الخارج: Slow Start مع Draining
الخوارزمية تقرر في الأيام العادية، ولكن أصعب لحظتين على أي موزع هما لحظة دخول سيرفر إلى المجموعة ولحظة خروجه منها، وكلتاهما تحدث كل يوم تقريباً مع كل نشر لإصدار جديد. فعندما يعود سيرفر بعد إعادة تشغيل، فذاكرته المؤقتة فارغة، واتصالاته بقاعدة البيانات لم تفتح بعد، وبعض اللغات مثل Java تحتاج دقائق حتى تصبح سريعة، ومع ذلك تراه خوارزمية أقل اتصالات السيرفر الأقل انشغالاً على الإطلاق، لأن عدد اتصالاته صفر، فترسل إليه دفعة كبيرة من الطلبات في الثانية الأولى، فيبطئ أو يتوقف من جديد، ويخرجه فحص الصحة، ثم يعود، ويتكرر ذلك. والحل في HAProxy الخيار slowstart في سطر السيرفر، مثل slowstart 30s، فيبدأ وزن السيرفر العائد صغيراً ويرتفع تدريجياً خلال المدة، ويذكر التوثيق أن هذا يعمل مع الخوارزميات الديناميكية التي تقبل تغيير الوزن أثناء العمل، أي التناوب وأقل اتصالات والهاش المتسق، وأن الحد maxconn يرتفع تدريجياً أيضاً. ولاحظ شرطين في التوثيق: البدء التدريجي لا يعمل عند تشغيل HAProxy نفسه، وإنما فقط لسيرفر رآه معطلاً ثم عاد، والوزن يتغير مع كل فحص صحة، لذلك يجب أن تكون مدة الفحص inter أصغر بكثير من مدة slowstart حتى يرتفع الوزن على خطوات كثيرة.
واللحظة الثانية هي خروج السيرفر للصيانة أو للنشر، فإذا أوقفته مباشرة انقطعت الطلبات التي يعالجها الآن، ورأى أصحابها خطأً لا ذنب لهم فيه. والطريقة الصحيحة أن تجعله في حالة التصريف Drain أولاً، بالأمر set server be_app/web1 state drain عبر الواجهة البرمجية، فلا يأخذ أي طلب جديد، ويكمل الطلبات المفتوحة، ثم تراقب عدد اتصالاته في صفحة الإحصاءات حتى يصل إلى صفر، وبعدها توقفه. وهذا ما يسميه فصل Google SRE حالة البطة العرجاء Lame Duck، حيث يخبر السيرفر نفسه عملاءه أنه سوف يخرج قبل أن يخرج فعلاً. والخطوتان معاً، التصريف قبل الخروج والبدء التدريجي بعد العودة، هما ما يجعل النشر على سيرفر بعد سيرفر لا يراه المستخدم أبداً، وهما أهم من الخوارزمية في اليوم الذي تنشر فيه.
الجلسات اللاصقة Sticky Sessions: متى تحتاجها؟
الهاش يرسل المفتاح نفسه إلى السيرفر نفسه، والجلسات اللاصقة Sticky Sessions ترسل المستخدم نفسه إلى السيرفر نفسه، والسبب المعتاد أن التطبيق يحفظ جلسة المستخدم في ذاكرة السيرفر، فإذا ذهب الطلب التالي إلى سيرفر آخر لم يجد الجلسة وطلب من المستخدم أن يدخل من جديد. وفي HAProxy أنظف طريقة لذلك أن يضيف الموزع ملف تعريف ارتباط Cookie باسم السيرفر بالخيار cookie SERVERID insert indirect nocache مع cookie web1 في سطر كل سيرفر، فيعرف الموزع من الطلب التالي أين يرسله، بدلاً من هاش عنوان العميل الذي يتغير مع الشبكات الخلوية ويجمع مستخدمين كثيرين خلف عنوان واحد في الشركات.
ولكن الجلسات اللاصقة تعيد المشاكل التي أراد الموزع أن يحلها. فإذا توقف السيرفر فقد كل مستخدميه جلساتهم في اللحظة نفسها، وإذا أضفت سيرفراً جديداً فلن يأخذ إلا المستخدمين الجدد، فيبقى السيرفر القديم مزدحماً ساعات، وإذا التصق بسيرفر مستخدم نشيط جداً فلن تستطيع الخوارزمية أن تنقله. لذلك الحل الأنسب أن تجعل التطبيق لا يحتفظ بحالة Stateless، وتنقل الجلسات إلى مخزن مشترك مثل Redis أو Valkey كما شرحنا في دليل Redis وValkey، فيصبح أي سيرفر قادراً على خدمة أي طلب، وتعود لك حرية اختيار الخوارزمية. واستخدم الجلسات اللاصقة فقط للتطبيقات التي لا تستطيع تغييرها، أو للاتصالات الطويلة مثل WebSocket التي لا معنى لنقلها أصلاً.
نفس الخوارزميات في Nginx
إذا كان موزعك Nginx وليس HAProxy، فالخوارزميات نفسها موجودة بأسماء أخرى في وحدة upstream، والجدول التالي يبين المقابل:
| الخوارزمية | HAProxy | Nginx | ملاحظة |
|---|---|---|---|
| التناوب مع الأوزان | balance roundrobin | الافتراضي، مع weight= | ينظر إلى العدد وليس إلى العمل |
| أقل اتصالات | balance leastconn | least_conn | يحتاج فحص صحة حقيقياً |
| الأفضل من اثنين | balance random(2) | random two least_conn | للمجموعات الكبيرة وعدة موزعات |
| هاش عادي | hash-type map-based | hash $request_uri | يحرك أغلب المفاتيح عند أي تغيير |
| هاش متسق | hash-type consistent | hash $request_uri consistent | طريقة ketama، والتوزيع غير ناعم |
| هاش عنوان العميل | balance source | ip_hash | يتغير مع شبكة الجوال |
| حد لكل سيرفر | maxconn مع طابور | max_conns | الطابور queue في نسخة Nginx التجارية فقط |
ولاحظ السطر الأخير، فهو الفرق العملي الأكبر بين الاثنين في موضوع هذا المقال: HAProxy يحتفظ بالطلب في طابور الخلفية إذا امتلأت كل السيرفرات حتى تنتهي مهلة الطابور، أما Nginx المفتوح فالخيار queue في وحدة upstream موجود في النسخة التجارية فقط بحسب التوثيق، فإذا وصلت كل السيرفرات إلى max_conns رد Nginx بخطأ. لذلك إذا كانت تجربة الطابور الواحد مهمة لك، فهي سبب وجيه لاختيار HAProxy في هذه الطبقة.
أي خوارزمية تختار؟ Decision Table
بعد كل هذه الأرقام، هذا هو القرار مختصراً بحسب حالتك:
| حالتك | الخيار | والسبب |
|---|---|---|
| سيرفرات متساوية وطلبات متشابهة وقصيرة | التناوب | أبسط شيء يعمل، والعدد يساوي العمل تقريباً |
| طلبات مختلفة الطول، أو سيرفرات مختلفة السرعة | أقل اتصالات مع فحص HTTP | يتجنب المشغول دون أن تخبره بشيء |
| سيرفر التطبيق بعدد ثابت من العمال | أي خوارزمية مع maxconn وطابور | طابور واحد أمام الجميع، وأوضح إشارة لنقص السعة |
| عشرات السيرفرات أو عدة موزعات | الأفضل من اثنين | لا يتجمع الكل على السيرفر نفسه في اللحظة نفسها |
| ذاكرة مؤقتة في كل سيرفر | هاش متسق مع حد للتوازن | يحرك مفاتيح السيرفر المتغير وحده |
| اتصالات طويلة مثل WebSocket وقواعد البيانات | أقل اتصالات | العدد هنا يساوي الضغط فعلاً |
| تطبيق يحفظ الجلسة في الذاكرة ولا يمكن تغييره | جلسات لاصقة بملف تعريف ارتباط | حل مؤقت حتى تنقل الجلسات إلى مخزن مشترك |
أخطاء شائعة Common Mistakes
- الحكم على التوزيع من عدد الطلبات: فتظن أن التناوب ممتاز لأن كل سيرفر يأخذ الثلث، والصحيح أن تنظر إلى زمن الانتظار عند كل سيرفر وإلى المئين 99 للطلبات الخفيفة.
- فحص TCP فقط مع خوارزمية ديناميكية: فيبتلع السيرفر المعطل أغلب الحركة، والصحيح فحص HTTP يتحقق من قدرة التطبيق على الخدمة، مع مراقبة الأخطاء الحقيقية.
- لوحة تعرض زمن الاستجابة دون الأخطاء: فيبدو العطل تحسناً كبيراً، فالخطأ السريع يخفض الوسيط ويرفع الإنتاجية.
- لا يوجد حد لكل سيرفر: فتتكون الطوابير داخل السيرفرات بدلاً من الموزع، ويحدد أبطأ سيرفر سرعة الخدمة.
- الهاش العادي للذاكرة المؤقتة: فتفرغ ثلاثة أرباع الذاكرة عند إضافة سيرفر في الذروة.
- الهاش المتسق دون حد: فيرث سيرفر واحد أغلب مفاتيح جاره المتوقف ويزدحم وحده.
- الجلسات اللاصقة كحل دائم: فتفقد مرونة الخوارزمية وتفقد الجلسات عند توقف السيرفر.
- زمن استجابة ثابت قريب من 40 ملي ثانية: غالباً تفاعل Nagle مع التأكيد المؤجل، وليس مشكلة في الخوارزمية.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| الخوارزمية مناسبة لنوع الطلبات | أطوال الطلبات وتنوعها معروفة من السجلات |
| فحص الصحة يفحص التطبيق | option httpchk مع مسار يتحقق من الاعتمادات، وexpect status 200 |
| حد لكل سيرفر | maxconn قريب من عدد العمال، وtimeout queue مكتوب |
| الطابور مراقب | طول الطابور في صفحة الإحصاءات مع تنبيه عند ارتفاعه |
| الأخطاء بجانب زمن الاستجابة | اللوحة تعرض نسبة الأخطاء لكل سيرفر |
| الهاش متسق إذا كان للذاكرة المؤقتة | hash-type consistent مع hash-balance-factor |
| أرقام تعريف السيرفرات متطابقة في كل الموزعات | الهاش المتسق يعطي النتيجة نفسها من كل موزع |
| الجلسات في مخزن مشترك | إيقاف أي سيرفر لا يخرج أي مستخدم |
| السيرفر العائد يبدأ تدريجياً | slowstart في سطر السيرفر حتى لا يغمره الضغط فور عودته |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الخوارزمية الثابتة تقرر من الترتيب أو الهاش، والديناميكية من حالة السيرفرات الآن، والطابور والحدود قد تكون أهم من الخوارزمية نفسها.
- على ثلاثة سيرفرات متساوية وزع التناوب الثلث بالضبط، ومع ذلك كان المئين 99 للطلب الخفيف 192 ملي ثانية، ومع أقل اتصالات 22.
- عندما كان سيرفر أبطأ مرتين ونصفاً نزلت الخدمة مع التناوب إلى 74 طلباً في الثانية، ومع أقل اتصالات أخذ البطيء 16.9% فقط وبقيت الخدمة 126 طلباً.
- التناوب نفسه مع
maxconn 4لكل سيرفر وطابور في HAProxy أعطى 125 طلباً في الثانية و53 ملي ثانية، أي مثل أقل اتصالات. - الهاش العادي حرك 66.8% من المفاتيح عند إزالة سيرفر و75% عند إضافة سيرفر، والمتسق حرك 34.8% و27.7% فقط، ولكن توزيعه غير ناعم.
- السيرفر الذي يرد بالخطأ فوراً أخذ 96.6% من الطلبات مع أقل اتصالات وفحص TCP، وفحص HTTP أخرجه فلم يفشل أي طلب.
- طلب من 20 ملي ثانية استغرق 75 بسبب تفاعل Nagle مع التأكيد المؤجل، والحل
TCP_NODELAYفي السيرفر.
وفي المقال القادم من مرحلة التوفر العالي بإذن الله ننتقل من الطبقة التي لا تحتفظ بحالة إلى الطبقة الأصعب: قاعدة بيانات PostgreSQL بثلاث نسخ وانتقال تلقائي مع Patroni، ونقتل السيرفر الرئيسي ونقيس ما يحدث.
 دليلHAProxy: توزيع الطلبات Load Balancing أمام خدماتكعندما يعمل تطبيقك على أكثر من سيرفر، يوزع HAProxy الطلبات بينها ويستبعد المعطل منها تلقائياً مع شهادات HTTPS.
 دليلعنوان IP عائم بين سيرفرين مع Keepalived وVRRPكيف ينقل Keepalived عنواناً واحداً بين سيرفرين تلقائياً عندما يتوقف أحدهما، مع تجربة حقيقية تقيس زمن الانتقال بالثواني.
 دليلReverse Proxy أم Load Balancer أم API Gateway؟بماذا تقرر كل طبقة أمام تطبيقك، ومتى تضيف موزع الطلبات أو بوابة ال API، مع تجربة تقيس ما تضيفه كل طبقة.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلRedis وبديله المفتوح Valkey: التخزين المؤقت والجلساتكيف تستخدم Redis للجلسات والعدادات دون أن تمتلئ الذاكرة، وماذا تعني رخصته الجديدة، ومتى يكفيك Valkey بدلاً منه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال وتنفيذ المختبر على HAProxy 3.4.6 وPython 3.13.18 على Docker Engine 29.8.0.


