


توقف المتجر ليلة الجمعة ثلاث ساعات، والسبب أن قرص السيرفر الوحيد امتلأ بالسجلات فتوقفت قاعدة البيانات، ولم يلاحظ أحد ذلك حتى كتب أحد العملاء في حساب المتجر على وسائل التواصل أن صفحة الدفع لا تعمل. وفي صباح السبت جمع المدير الفريق وقال الجملة المتوقعة: «لا نريد أن يتكرر هذا، أريد توفراً عالياً مثل الشركات الكبيرة»، وبعد يومين وصل إلى بريدك عرض سعر من مزود استضافة لعنقود من خمسة سيرفرات مع موزع طلبات وقاعدة بيانات بثلاث نسخ، ومعه سطر صغير في آخر الصفحة عن رسوم الدعم الشهرية. والسؤال الذي يجب أن تجيب عنه قبل أن توقع ليس «هل التوفر العالي جيد؟»، فهو جيد بالطبع، وإنما: كم كلفتنا هذه الساعات الثلاث فعلاً، وكم مرة سوف تتكرر، وكم سوف يكلفنا منعها، وهل كان العنقود سيمنعها أصلاً؟
وهذا المقال يجيب عن هذا السؤال بالأرقام. فقد شرحنا في مفاهيم التوفر العالي High Availability التكرار والانتقال وحساب التوفر في السلسلة والتوازي، وختمنا ذلك المقال بأن السؤال الصحيح هو «كم يكلفنا التوقف، وكم يكلفنا منعه؟»، وشرحنا في ماذا تعني 99.9%؟ جدول الدقائق المسموح بها لكل نسبة، فلن نعيد هذا ولا ذاك. وإنما سوف نتابع متجراً إلكترونياً صغيراً يبيع العطور بحوالي ستين ألف ريال في اليوم، ونقيس في مختبر حقيقي كم يستغرق التعافي على سيرفر واحد في ثلاثة أنواع من الأعطال، ثم نحول هذه الدقائق إلى ريالات، ونقارن ثلاثة تصاميم: السيرفر كما هو اليوم، والسيرفر نفسه مصنوعاً بشكل جيد، والتوفر العالي الكامل.
وسوف نناقش في هذا المقال ما يلي:
- مما تتكون تكلفة ساعة التوقف، ولماذا لا تساوي كل ساعة الساعة الأخرى.
- كيف تقدر عدد الأعطال في السنة لكل نوع، وكيف تقسم زمن الاستعادة MTTR إلى أجزاء تستطيع أن تقيسها.
- ماذا يكلف التوفر العالي فعلاً، وما الأعطال التي لا يحميك منها مهما كان عدد السيرفرات، مع حادثة GitHub في 2018.
- مختبر حقيقي على Docker: تعطل التطبيق، وتوقف PostgreSQL المفاجئ، وفقدان السيرفر والاستعادة من النسخة الليلية، مع مشكلة حقيقية في أرقام الطلبات ظهرت بعد الاستعادة.
- نموذج تكلفة بسكربت Python يحول الدقائق المقاسة إلى ريالات، ويحسب متى يدفع التوفر العالي ثمنه، ويبين كيف تبدو السنة السيئة وليس المتوسطة فقط.
- الطريق الأوسط الذي يكفي أغلب الفرق، ومتى يستحق التوفر العالي تكلفته، وكيف تعرض القرار على الإدارة.
لماذا يبدأ القرار من تكلفة التوقف Downtime Cost؟
قد يبدو السؤال غريباً، فمن لا يريد خدمة لا تتوقف؟ ولكن التوفر العالي ليس ميزة تضيفها مرة وتنساها، وإنما تصميم يضاعف عدد السيرفرات ويضاعف ما يجب أن يفهمه الفريق ويحدثه ويختبره ويراقبه، وكل جزء جديد في هذا التصميم يمكن أن يتعطل هو أيضاً. لذلك فالقرار في حقيقته موازنة بين رقمين: الخسارة المتوقعة من التوقف في السنة دون التصميم الجديد، والتكلفة السنوية للتصميم الجديد مضافاً إليها الخسارة التي سوف تبقى معه، لأن التوفر العالي لا يجعل التوقف صفراً. فإذا كان الرقم الأول أكبر فالتصميم يستحق، وإذا كان أصغر فأنت تدفع لتشعر بالأمان وليس لتكون أكثر أماناً.
والصورة التالية تبين طرفي هذه الموازنة:
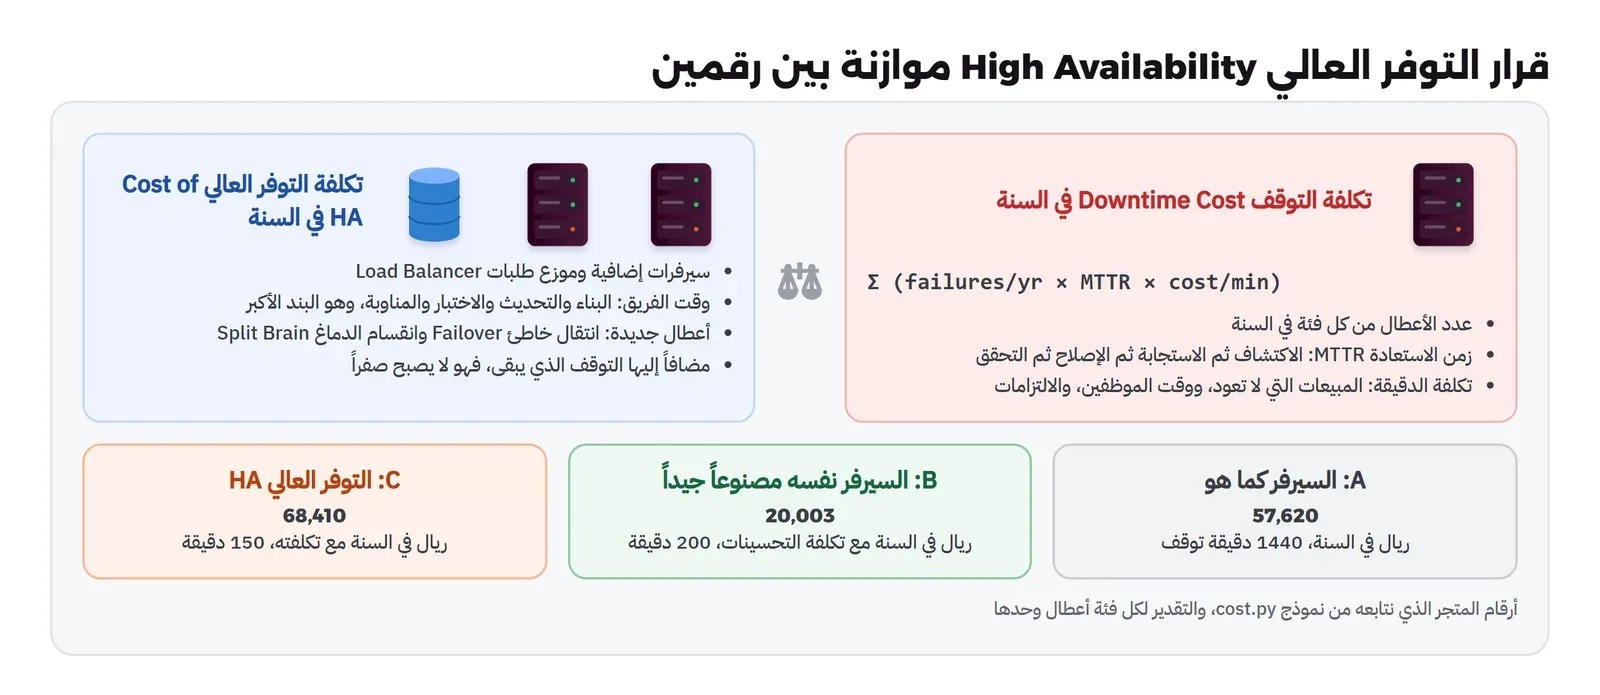
ولاحظ أن الكفة اليسرى فيها شيء ينساه أغلب الناس، وهو الأعطال التي يضيفها التوفر العالي نفسه، مثل انتقال يحدث في غير وقته، أو انقسام الدماغ Split Brain، أو نسخة احتياطية في العنقود توقفت عن التزامن منذ أسابيع دون أن يلاحظ أحد. وقد يتساءل البعض: هل هذا واقعي أم مجرد احتمال نظري؟ والإجابة أن كثيراً من أطول الحوادث الموثقة في الشركات الكبيرة بدأت من آلية الانتقال التلقائي نفسها، كما سوف ترى في حادثة GitHub بعد قليل.
والسبب الثاني لأن تبدأ بالتكلفة أن الرقم يغير طريقة الحوار مع الإدارة. فعبارة «نريد توفراً عالياً» لا يمكن الاعتراض عليها ولا يمكن تنفيذها، أما عبارة «التوقف يكلفنا حوالي ثمانية آلاف ريال في السنة إذا أحسنا تشغيل السيرفر الحالي، والعنقود يكلف اثنين وستين ألفاً ويوفر منها ألفين» فهي قرار يستطيع المدير أن يوقع عليه أو يرفضه وهو يعرف ماذا يفعل. وهذا بالضبط ما يقترحه فصل قبول المخاطرة في كتاب Google SRE، حيث يقارن الفريق تكلفة رفع التوفر من رقم إلى رقم أعلى بالإيراد الذي يحميه هذا الفرق، ويقرر على هذا الأساس.
مما تتكون تكلفة ساعة التوقف Cost of Downtime؟
أسهل خطأ هنا أن تقسم إيراد السنة على عدد ساعاتها وتقول إن هذه تكلفة الساعة، والسبب أن هذا الرقم أكبر من الحقيقة في جهة وأصغر منها في جهة أخرى. فهو أكبر لأن جزءاً من العملاء يعودون بعد أن تعمل الخدمة ويكملون الشراء، وأصغر لأنه لا يحسب الموظفين الذين يتوقف عملهم ولا الغرامات ولا العميل الذي لا يعود أبداً. لذلك قسم التكلفة إلى أجزائها، واكتب لكل جزء من أين أخذت رقمه:
- المبيعات التي لا تعود Lost Revenue: ليست كل مبيعات الساعة، وإنما الجزء الذي يضيع فعلاً، فالعميل الذي يريد عطراً معيناً قد يعود بعد ساعة، والعميل الذي يشتري هدية لحفلة الليلة سوف يشتريها من متجر آخر. وأفضل مصدر لهذا الرقم سجلاتك أنت: قارن مبيعات اليوم الذي حدث فيه التوقف بمبيعات الأيام المشابهة، وانظر هل ارتفعت المبيعات بعد عودة الخدمة. وفي المتجر الذي نتابعه افترضنا أن 60% من مبيعات ساعة التوقف لا تعود، وهو رقم يجب أن تستبدله برقمك.
- وقت الموظفين Staff Cost: فريق خدمة العملاء الذي يرد على الشكاوى، والمستودع الذي ينتظر الطلبات، والمهندسون الذين يتركون عملهم ليصلحوا العطل، ثم يعملون يوماً كاملاً بعد ذلك على تصحيح الطلبات المعلقة. وفي المثال جعلنا هذا الجزء 900 ريال في الساعة.
- الالتزامات التعاقدية SLA Penalties: إذا كنت تبيع خدمة لشركات وبينك وبينهم اتفاقية مستوى خدمة، فالتوقف قد يعني تعويضاً أو خصماً، وقد شرحنا في مقال أهداف الخدمة كيف تكتب هذه الاتفاقيات وكيف يكون التعويض في الغالب جزءاً من الفاتورة فقط. والمتجر في قصتنا يبيع للأفراد، فلا توجد اتفاقية، ولكن فريقاً يبيع لشركات يجب أن يضع هذا الجزء أولاً.
- البيانات التي تضيع Data Loss: وهي تكلفة مختلفة عن الوقت، فإذا خسرت طلبات نصف ساعة قبل العطل لأن آخر نسخة احتياطية كانت قبلها، فأنت أمام عملاء دفعوا ولم يصل طلبهم، وهذا رقم يحدده RPO الذي شرحناه في دليل النسخ الاحتياطي 3-2-1، وسوف ترى في المختبر أن هذه الخسارة لها شكل لا يتوقعه أحد.
- الثقة والسمعة Reputation: وهي أصعب جزء في التقدير، ولا تحاول أن تضع لها رقماً دقيقاً، ولكن لا تتجاهلها أيضاً، والطريقة العملية أن تحسب الأجزاء الأخرى ثم تسأل الإدارة: هل هذا الرقم يبدو صحيحاً لكم؟ فإذا قال المدير إن ساعة في موسم التخفيضات تؤذي المتجر أكثر من ذلك بكثير، فقد عرفت أن الرقم يجب أن يرتفع في هذا الموسم.
وقد شرحنا في دليل استمرارية الأعمال BCP كيف تقدر أثر التوقف لكل عملية في الشركة وترتبها في طبقات، وهذا المقال يأخذ عملية واحدة هي المتجر، ويذهب بها إلى مستوى أدق: كم ريالاً في كل ساعة من اليوم، وكم دقيقة في كل نوع من الأعطال.
الساعة ليست كأي ساعة: توزيع المبيعات Hourly Profile
المتجر لا يبيع بالتساوي على مدار اليوم، فالمبيعات في الثالثة فجراً قليلة جداً، وفي التاسعة مساءً تصل إلى ذروتها، وفي الأسبوع الذي فيه تخفيضات قد يبيع اليوم الواحد أضعاف اليوم العادي. وهذا يعني أن العطل نفسه بالمدة نفسها قد يكلف أربعة أضعاف إذا جاء في الذروة، لذلك قسمنا مبيعات اليوم على ساعاته بنسب تشبه متجراً يبيع للأفراد، والصورة التالية تبين تكلفة ساعة التوقف بحسب الساعة التي تبدأ فيها، كما حسبها السكربت الذي سوف تراه في المختبر:
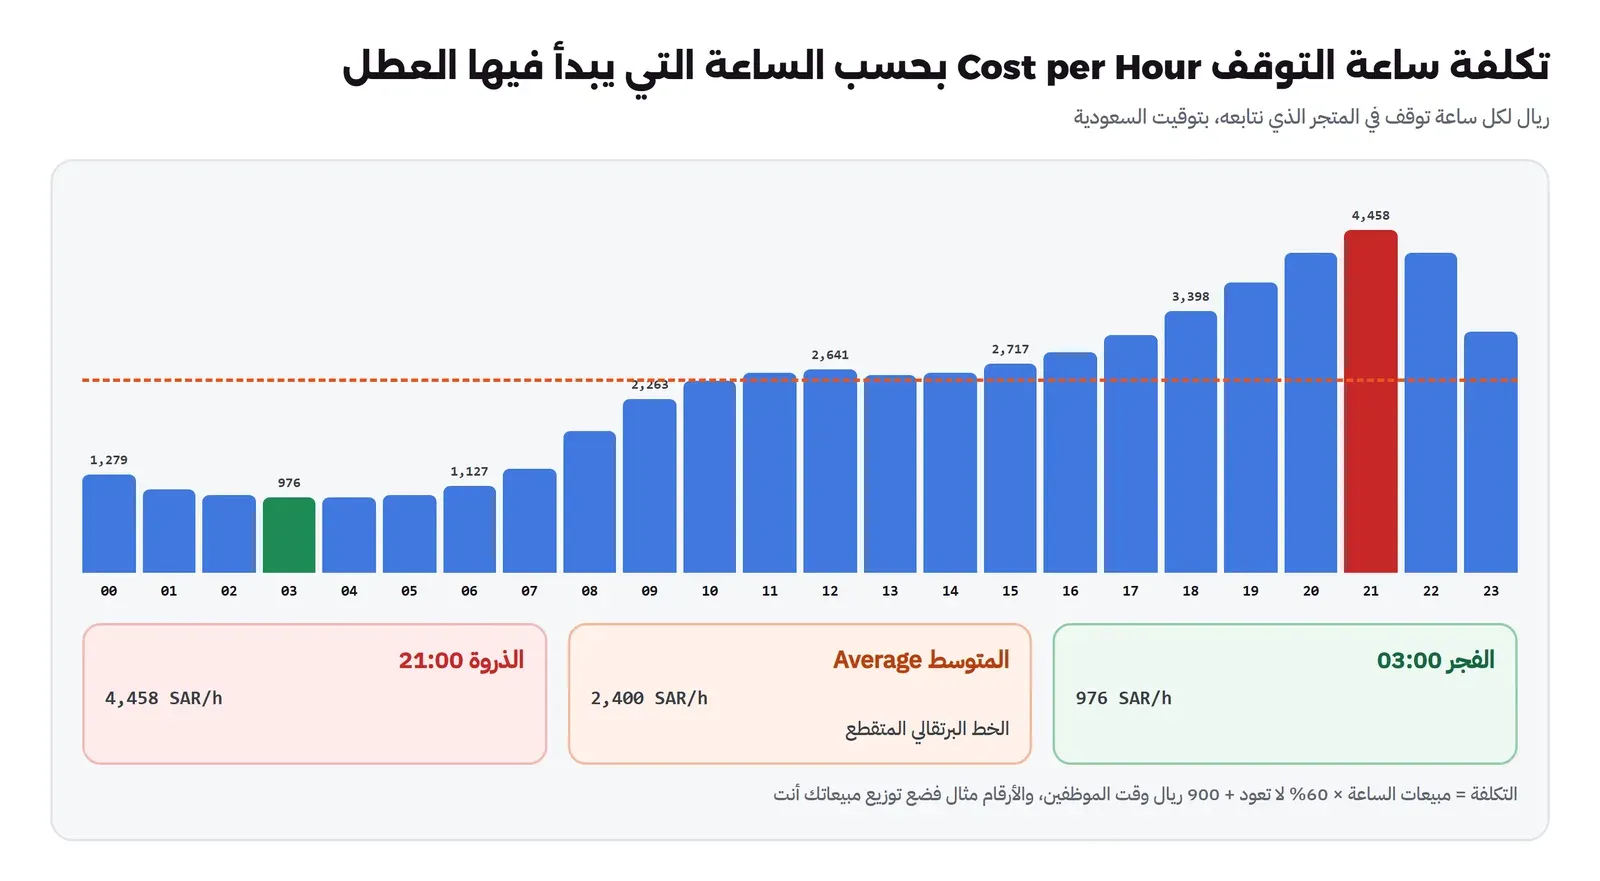
وفي الصورة أعلاه لاحظ أن متوسط الساعة 2,400 ريال، ولكن الساعة الأسوأ 4,458 ريالاً، والأفضل 976 ريالاً فقط، وهذا الفرق له نتيجتان عمليتان. الأولى أن الصيانة المخطط لها مكانها الطبيعي في الفجر، وأن سيرفراً واحداً تستطيع أن تعيد تشغيله في الثالثة فجراً كل شهر قد لا يحتاج توفراً عالياً من أجل الصيانة. والثانية أن الأعطال لا تختار الفجر، بل الواقع أن كثيراً منها يأتي في الذروة، لأن الضغط Load الأعلى هو ما يملأ القرص ويستهلك الاتصالات ويظهر الأخطاء، لذلك عندما تحسب الأسوأ احسبه في ساعة الذروة وليس في المتوسط.
كم مرة يتوقف سيرفر واحد؟ Failure Classes
بعد أن عرفت تكلفة الساعة تحتاج الطرف الآخر من الضرب: كم ساعة توقف في السنة؟ والخطأ الشائع أن تضع رقماً واحداً لكل الأعطال، مثل «السيرفر يتوقف مرتين في السنة»، والسبب أن الأعطال أنواع، ولكل نوع تكرار مختلف وزمن استعادة مختلف، والأهم أن التوفر العالي يحمي من بعضها ولا يحمي من غيرها أبداً. لذلك قسم الأعطال إلى فئات، واكتب لكل فئة كم مرة تتوقع حدوثها في السنة، وكم دقيقة تستغرق الاستعادة منها. وهذه هي الفئات التي استخدمناها للمتجر:
- تعطل عملية التطبيق App Crash: خطأ في الكود، أو امتلاء الذاكرة فيقتل النظام العملية Out of Memory. وهذه الأكثر تكراراً، ويكفي غالباً أن تعود العملية للعمل تلقائياً.
- توقف قاعدة البيانات المفاجئ Database Crash: العملية تتوقف دون إغلاق سليم، فتحتاج عند التشغيل أن تعيد تطبيق السجل WAL حتى تصل إلى حالة متسقة.
- الصيانة المخطط لها Planned Maintenance: تحديثات نظام التشغيل وإعادة التشغيل وترقية قاعدة البيانات، وهي توقف تختار أنت وقته، ولكنه توقف.
- النشر الخاطئ أو الإعداد الخاطئ Bad Deploy: إصدار فيه خطأ، أو تغيير في ملف إعداد، أو شهادة TLS انتهت صلاحيتها. وهذه الفئة مهمة جداً لأنها تصيب كل النسخ معاً.
- فقدان السيرفر أو القرص Server Loss: عطل في العتاد، أو قرص تالف، أو جهاز افتراضي حذفه المزود بالخطأ، وهنا لا ينفع إعادة التشغيل، وإنما تحتاج سيرفراً جديداً واستعادة البيانات.
- توقف المزود أو الموقع Provider Outage: مركز البيانات كله أو شبكته، وهنا لا يحميك سيرفر ثان في المركز نفسه.
ومن أين تأتي الأرقام؟ أفضل مصدر هو سجل الحوادث عندك، فإذا كنت تكتب مراجعة لكل حادثة كما شرحنا في دليل إدارة الحوادث، فسوف تجد بعد سنة أن عندك عدد الأعطال من كل نوع ومدة كل واحد منها. وإذا لم يكن عندك سجل، فابدأ بأرقام تقديرية واكتب أنها تقديرية، ثم صححها مع الوقت. وللعتاد مصادر منشورة، فمثلاً تنشر Backblaze كل ربع سنة نسبة التعطل السنوية AFR لأقراصها بحسب الطراز والعمر، ولكن تذكر أن القرص جزء واحد من السيرفر، وأن أغلب حالات «فقدان السيرفر» في الاستضافة الافتراضية تأتي من أسباب أخرى لا تنشر لها إحصائيات، مثل حذف خاطئ أو عطل في مضيف المزود.
زمن الاستعادة MTTR من أربعة أجزاء
زمن الاستعادة MTTR (Mean Time To Recovery) هو متوسط الزمن من بداية العطل حتى عودة الخدمة، والمشكلة أن أغلب الفرق تحسب منه الجزء التقني فقط، أي كم دقيقة يستغرق الأمر الذي يصلح المشكلة، وتنسى الأجزاء التي حوله. والصورة التالية تبين الأجزاء الأربعة لعطل واحد هو فقدان سيرفر قاعدة البيانات، في تصميمين مختلفين:
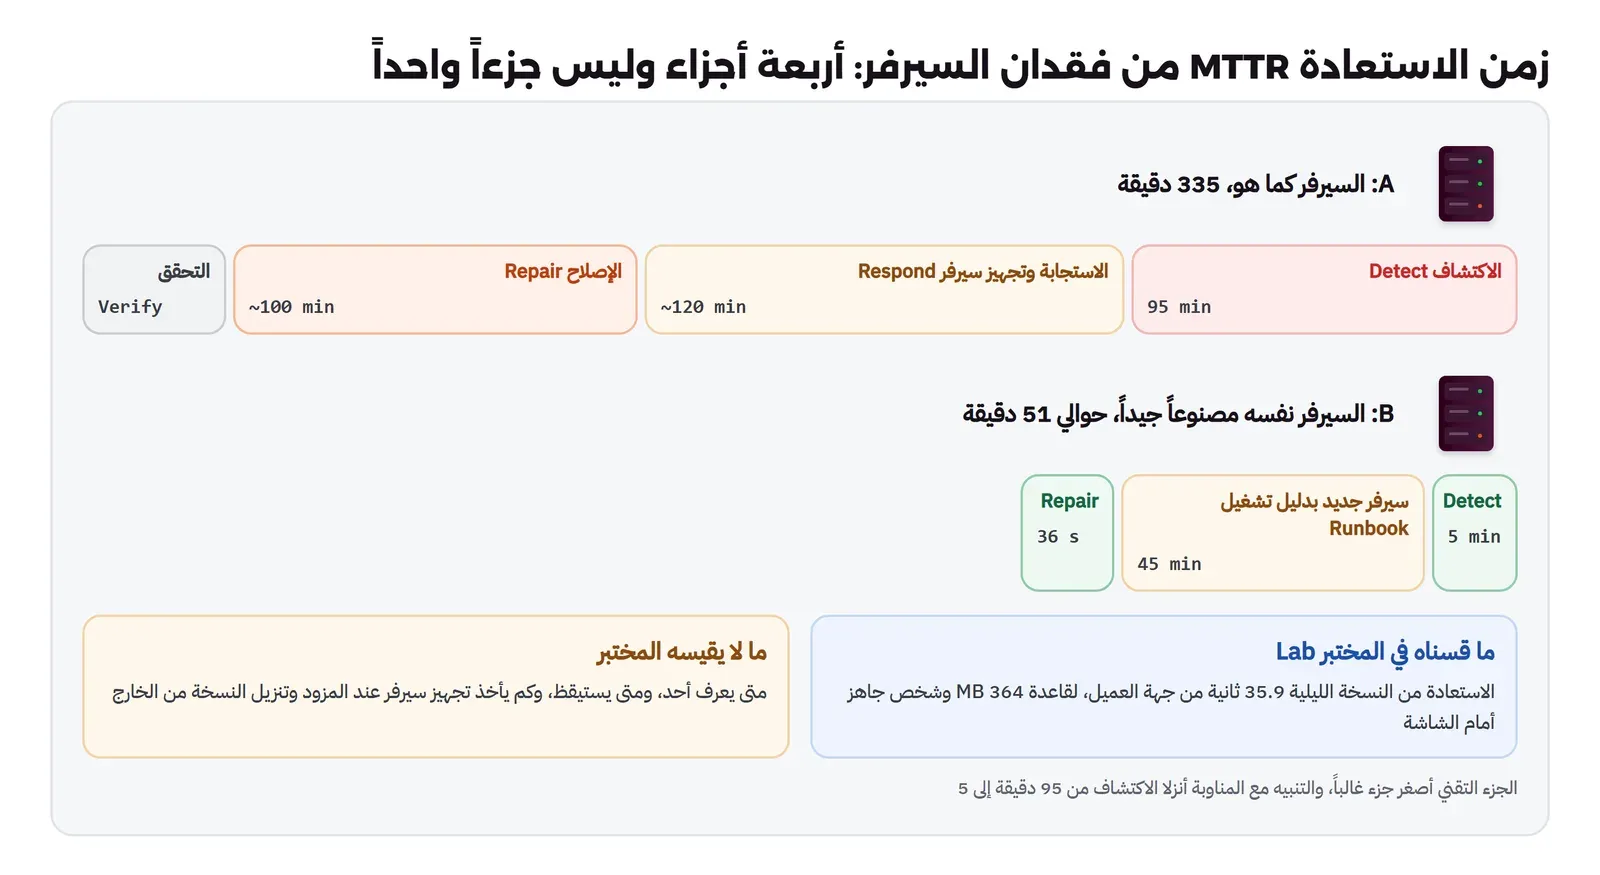
- الاكتشاف Detect: من بداية العطل حتى يعرف شخص يستطيع أن يتصرف. وفي قصتنا كان هذا الجزء ساعتين ونصفاً تقريباً، لأن المتجر لا يملك فحصاً خارجياً ولا تنبيهاً يوقظ أحداً، وقد شرحنا في فحص التوفر Uptime Checks والتنبيهات Alerting كيف يصبح هذا الجزء دقائق.
- الاستجابة Respond: من التنبيه حتى يبدأ العمل الفعلي: أن يستيقظ المناوب ويفتح جهازه ويفهم ما يحدث ويقرر ماذا يفعل.
- الإصلاح Repair: الأمر الذي يعيد الخدمة، مثل إعادة التشغيل أو الاستعادة من النسخة، وهو الجزء الوحيد الذي يقيسه المهندسون عادة.
- التحقق Verify: أن تتأكد أن الخدمة تعمل فعلاً للمستخدمين، وأن البيانات صحيحة، وأن ما فقد أثناء العطل معروف.
والدرس من هذا التقسيم أن أكبر تحسين في التوفر قد لا يأتي من سيرفر إضافي، وإنما من تقصير الاكتشاف والاستجابة، وهذا ما رأيته في مقال المفاهيم حين خفض تقليل زمن الإصلاح من ساعتين إلى ربع ساعة التوقف السنوي من 729 دقيقة إلى 91 دون أي عتاد جديد. ولذلك سوف نقيس في المختبر الجزء التقني فقط، لأنه الجزء الذي يمكن قياسه على جهازك، ونضيف إليه في النموذج دقائق الاكتشاف والاستجابة كأرقام تكتبها أنت من واقع فريقك.
ماذا يكلف التوفر العالي فعلاً؟ Cost of HA
عرض السعر الذي وصل إلى بريدك فيه سطر للسيرفرات، وهذا السطر هو أصغر جزء من التكلفة الحقيقية، والسبب أن التوفر العالي يكلف في أربعة أماكن:
- العتاد والسيرفرات Infrastructure: سيرفر ثان للتطبيق، وموزع طلبات وربما اثنان مع عنوان عائم، وثلاث نسخ لقاعدة البيانات بدلاً من واحدة، لأن الانتقال التلقائي الآمن يحتاج نصاباً Quorum من ثلاثة أصوات كما شرحنا في مقال المفاهيم. وفي المثال افترضنا أربعة سيرفرات إضافية بثلاثمئة ريال لكل واحد في الشهر.
- وقت الفريق Engineering Time: بناء العنقود أول مرة، ثم تحديث كل جزء فيه، ومراقبة التزامن بين النسخ، واختبار الانتقال كل فترة، والتدريب عليه، ومعرفة ماذا تفعل عندما يتصرف بطريقة غير متوقعة. وهذا هو البند الأكبر عادة، وفي المثال افترضنا يومي عمل في الشهر من مهندس، أي 24 يوماً في السنة.
- التعقيد Complexity: كل تغيير بسيط على سيرفر واحد يصبح على العنقود تغييراً له ترتيب: أي نسخة أولاً، وماذا يحدث للنسخ الأخرى أثناء ذلك، وهل يحدث انتقال في منتصفه. وهذا يبطئ الفريق في كل شيء، وليس في التوفر فقط.
- الأعطال الجديدة New Failure Modes: الانتقال الذي يحدث بسبب بطء مؤقت في الشبكة، والسيرفر القديم الذي يعود ويظن أنه ما زال الرئيسي، والنسخة التي تأخرت عن الرئيسي فأصبحت هي الرئيسي وفقدت آخر الطلبات. وفي النموذج سوف نضع لهذه الفئة رقماً، ثم نرى كيف تتغير النتيجة عندما يتغير.
ما لا يحميك منه التوفر العالي HA
قبل أن تحسب ما يوفره التصميم الجديد، ارجع إلى فئات الأعطال وضع بجانب كل فئة سؤالاً واحداً: هل نسخة ثانية تعمل في الوقت نفسه سوف تمنع هذا العطل؟ وسوف تجد أن الإجابة «لا» في فئات مهمة:
- النشر الخاطئ: الإصدار الذي فيه خطأ ينشر على السيرفرين معاً، والإعداد الخاطئ ينسخ إلى كل النسخ، والشهادة تنتهي على الجميع في اليوم نفسه. والذي يحميك هنا هو النشر التدريجي والتراجع السريع كما في دليل الإطلاق التدريجي، وليس عدد السيرفرات.
- حذف البيانات أو تلفها: أمر
DELETEدون شرط ينتقل إلى كل النسخ خلال جزء من الثانية، وكذلك برنامج الفدية الذي يشفر البيانات، والذي يحميك هنا هو النسخ الاحتياطي والاستعادة إلى لحظة معينة. - توقف المزود أو الموقع: ثلاث نسخ في مركز بيانات واحد تتوقف معاً إذا توقف المركز، والذي يحميك هنا موقع ثان، وهو قرار أكبر بكثير من التوفر العالي داخل الموقع.
- الأشخاص: إذا كان شخص واحد يعرف كيف يعمل العنقود، فالعنقود يزيد نقطة الفشل الواحدة بدلاً من أن يزيلها.
وهذا هو سبب أن الحساب يجب أن يكون لكل فئة وحدها، فلو جمعت كل دقائق التوقف في رقم واحد ثم افترضت أن التوفر العالي يزيلها كلها، لكانت النتيجة أن العنقود يستحق دائماً، وهذا غير صحيح كما سوف يظهر في النموذج.
المختبر Lab: كم يستغرق التعافي على سيرفر واحد؟
الآن نقيس الجزء التقني من الاستعادة في ثلاثة أعطال على سيرفر واحد: تعطل عملية التطبيق، وتوقف PostgreSQL المفاجئ أثناء الكتابة، وفقدان السيرفر بالكامل مع الاستعادة من النسخة الليلية. والمختبر يتكون من ثلاث Containers على شبكة Docker واحدة: قاعدة بيانات PostgreSQL 18.6 فيها خمسة ملايين طلب، وتطبيق صغير يقبل الطلبات، وعميل يرسل طلب شراء كل 100 ملي ثانية ويسجل كل محاولة، حتى نعرف بالضبط متى توقفت الخدمة ومتى عادت، وأي الطلبات أكدها المتجر للعميل.
ملفات المختبر Lab Files
التطبيق يفتح اتصالاً جديداً بقاعدة البيانات لكل طلب، وهذا ليس ما تفعله في الإنتاج، ولكنه يجعل التطبيق يعود للعمل وحده بعد أن تعود قاعدة البيانات، دون أن نحتاج إلى إصلاح مجمع اتصالات Connection Pool معطل، فيكون ما نقيسه هو زمن قاعدة البيانات وليس زمن المجمع. والتطبيق لا يرد بالرمز 201 إلا بعد أن يتم COMMIT، أي أن كل طلب أكده للعميل يجب أن يكون محفوظاً. احفظ الملف التالي باسم app.py:
# Store API stand-in: POST /order inserts one order and answers 201 only after COMMIT.
# One short connection per request, so the app survives a database restart without a pool to repair.
import json, os, psycopg
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
DSN = os.environ.get("DSN", "postgresql://postgres:lab-only-pass@wr-ha-db/shop")

class H(BaseHTTPRequestHandler):
    def log_message(self, *a): pass
    def reply(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code); self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data))); self.end_headers(); self.wfile.write(data)
    def do_POST(self):
        try:
            with psycopg.connect(DSN, connect_timeout=2, autocommit=True) as c:
                oid = c.execute("insert into orders(amount) values (%s) returning id", (150,)).fetchone()[0]
            self.reply(201, {"id": oid})
        except Exception as e:
            self.reply(503, {"error": type(e).__name__})
    def do_GET(self):
        self.reply(200, {"ok": True})

ThreadingHTTPServer(("0.0.0.0", 8000), H).serve_forever()
والعميل يرسل طلب شراء كل 100 ملي ثانية بمهلة 3 ثوان، ويحفظ كل محاولة مع وقتها ونتيجتها ورقم الطلب الذي أكده المتجر، ثم يطبع نوافذ التوقف، أي الفترات التي فشلت فيها المحاولات متتالية. احفظه باسم client.py:
# Customer stand-in: one order every 100 ms. Logs every attempt, then prints the outage windows
# (consecutive failures) and the ids the store confirmed, so we can check what survived.
import json, os, socket, sys, time, urllib.request, urllib.error
BASE, SECONDS, OUT = os.environ.get("BASE", "http://wr-ha-app:8000"), float(os.environ.get("SECONDS", "60")), sys.argv[1]
end, log = time.time() + SECONDS, []
while time.time() < end:
    t0, status, oid = time.time(), 0, None
    try:
        req = urllib.request.Request(BASE + "/order", method="POST")
        with urllib.request.urlopen(req, timeout=3) as r: status, oid = r.status, json.load(r)["id"]
    except urllib.error.HTTPError as e: status = e.code
    except (urllib.error.URLError, socket.timeout, ConnectionError, TimeoutError): status = 0
    log.append((t0, status, oid))
    time.sleep(max(0, 0.1 - (time.time() - t0)))
json.dump(log, open(OUT, "w"))
ok = [x for x in log if x[1] == 201]
print(f"attempts {len(log)}  confirmed {len(ok)}  failed {len(log) - len(ok)}")
win, start = [], None
for t, s, _ in log:
    if s != 201 and start is None: start = t
    if s == 201 and start is not None: win.append((start, t)); start = None
if start is not None: win.append((start, log[-1][0]))
for a, b in win:
    print(f"outage {time.strftime('%H:%M:%S', time.gmtime(a))} -> {time.strftime('%H:%M:%S', time.gmtime(b))} UTC  {b - a:6.1f} s")
print("last confirmed id", ok[-1][2] if ok else None)
ثم ملف Dockerfile يجمع الاثنين في Image واحدة، وملف الجدول schema.sql:
FROM python:3.13-slim
RUN pip install --no-cache-dir "psycopg[binary]==3.3.7"
COPY app.py client.py /lab/
CMD ["python", "-u", "/lab/app.py"]
create table orders (id bigserial primary key, amount int not null, created_at timestamptz not null default now());الآن نبني ال Image ونشغل قاعدة البيانات والتطبيق، وكلاهما بسياسة إعادة التشغيل unless-stopped، وهي السياسة التي تجعل Docker يعيد تشغيل ال Container إذا توقفت عمليته، كما في توثيق سياسات إعادة التشغيل. وفي Git Bash على Windows نضع MSYS_NO_PATHCONV=1 حتى لا يحول المسارات داخل الأوامر:
export MSYS_NO_PATHCONV=1
docker build -q -t wr-ha-app:1 .
docker network create wr-ha-net
docker run -d --name wr-ha-db --network wr-ha-net --restart unless-stopped \
  -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop \
  -v wr-ha-pgdata:/var/lib/postgresql postgres:18.6
docker run -d --name wr-ha-app --network wr-ha-net --restart unless-stopped wr-ha-app:1
docker exec -i wr-ha-db psql -U postgres -d shop < schema.sql
docker exec wr-ha-db psql -U postgres -d shop -c "insert into orders(amount, created_at)
  select (random()*900+50)::int, now() - (g || ' seconds')::interval from generate_series(1,5000000) g" \
  -c "select pg_size_pretty(pg_database_size('shop')), count(*) from orders"
والمخرج سوف يكون كما يلي:
INSERT 0 5000000
 pg_size_pretty |  count
----------------+---------
 364 MB         | 5000000
(1 row)
أي أن قاعدة البيانات فيها خمسة ملايين طلب بحجم 364 MB، وهي أصغر بكثير من قاعدة متجر حقيقي بعد سنوات، ولكنها تكفي لنرى كل جزء من الاستعادة يحدث بوضوح، ثم نتكلم عن أثر الحجم في النموذج.
تعطل التطبيق App Crash مع سياسة إعادة التشغيل Restart Policy
أول تجربة تبدو بسيطة: نشغل العميل 40 ثانية، وبعد 10 ثوان نوقف التطبيق فجأة كما لو أنه تعطل، ثم ننتظر أن يعيده Docker. والطريقة التي تخطر على البال أولاً هي الأمر docker kill:
docker run -d --name wr-ha-client --network wr-ha-net -e SECONDS=40 -v "$(pwd -W)/out:/out" \
  wr-ha-app:1 python -u /lab/client.py /out/a-app-kill.json
sleep 10; docker kill wr-ha-app
sleep 3; docker ps -a --filter name=wr-ha-app --format '{{.Names}} {{.Status}}'
sleep 30; docker logs wr-ha-client
docker inspect -f '{{.RestartCount}} {{.State.Status}}' wr-ha-app
والمخرج سوف يكون كما يلي:
wr-ha-app Exited (137) 3 seconds ago
attempts 112  confirmed 102  failed 10
outage 23:48:03 -> 23:48:29 UTC    26.4 s
last confirmed id 5000102
0 exited
وهذه أول مشكلة واجهتنا في المختبر: التطبيق لم يعد أبداً، فعدد مرات إعادة التشغيل 0، والحالة exited، والتوقف استمر حتى نهاية التجربة. والسبب أن Docker يعتبر docker kill إيقافاً يدوياً، والتوثيق يقول إن سياسة إعادة التشغيل لا تعمل على Container أوقفته أنت، حتى لا يعيد تشغيل شيء أوقفته عمداً. ولاحظ أيضاً أن العميل لم يحاول إلا 112 مرة في 40 ثانية بدلاً من حوالي 400، والسبب أن اسم wr-ha-app لم يعد موجوداً في DNS الداخلي لشبكة Docker بعد توقف ال Container، فكل محاولة كانت تنتظر حتى يفشل البحث عن الاسم. والدرس هنا أكبر من المختبر: إذا كان اختبار التعطل عندك هو docker kill أو docker stop، فأنت لا تختبر ما يحدث عند تعطل حقيقي، وقد تظن أن سياسة إعادة التشغيل لا تعمل أو تظن العكس.
والتعطل الحقيقي هو أن تموت العملية من تلقاء نفسها، كما يفعل النظام عندما يقتل عملية استهلكت الذاكرة. ولكي نحاكي ذلك نرسل الإشارة SIGKILL إلى عملية التطبيق من خارج ال Container، أي من مساحة العمليات الخاصة بالمضيف، عبر Container مؤقتة بالخيار --pid=host:
docker start wr-ha-app
docker run -d --name wr-ha-client --network wr-ha-net -e SECONDS=40 -v "$(pwd -W)/out:/out" \
  wr-ha-app:1 python -u /lab/client.py /out/a-app-crash.json
sleep 10; P=$(docker inspect -f '{{.State.Pid}}' wr-ha-app)
docker run --rm --pid=host --privileged alpine:3.24 kill -9 $P
sleep 32; docker logs wr-ha-client
docker inspect -f 'restarts={{.RestartCount}} {{.State.Status}}' wr-ha-app
والمخرج سوف يكون كما يلي:
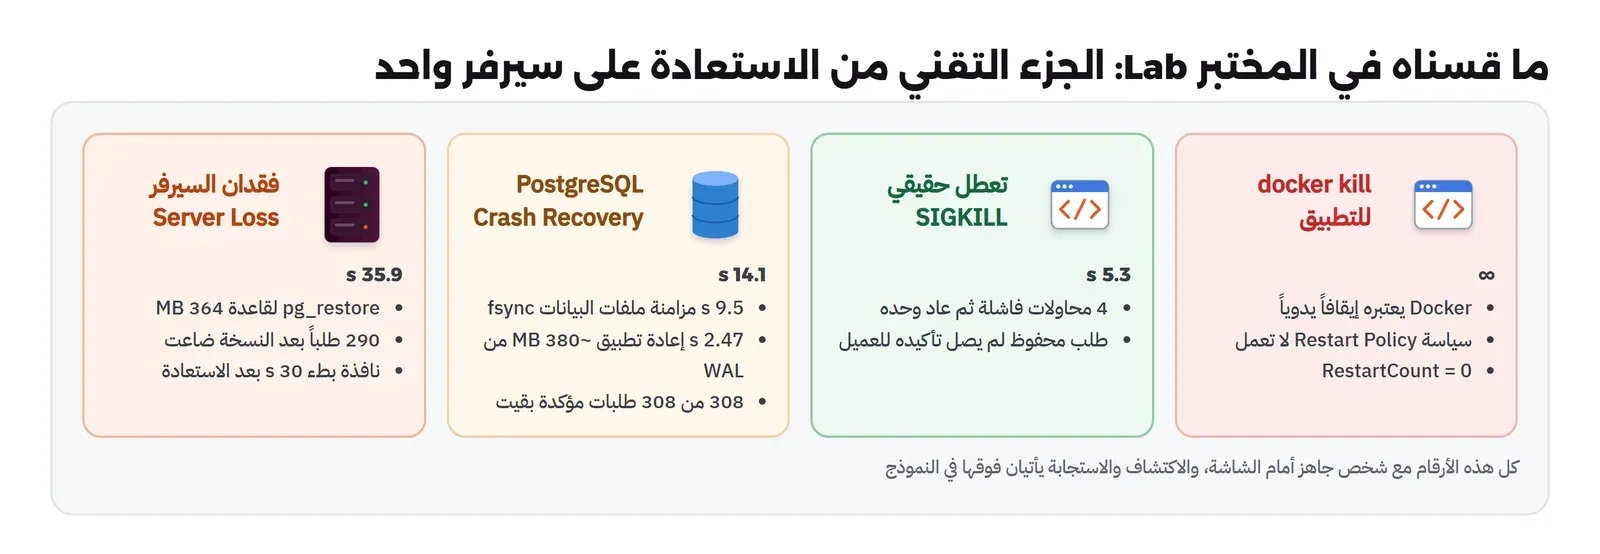
attempts 347  confirmed 343  failed 4
outage 23:51:04 -> 23:51:10 UTC     5.3 s
last confirmed id 5000447
restarts=1 running
في المخرج أعلاه لاحظ التالي:
- التوقف 5.3 ثانية فقط، وفشلت فيه 4 محاولات، ثم عاد التطبيق وحده، وعدد مرات إعادة التشغيل أصبح 1. أي أن أكثر الأعطال تكراراً في السنة يكلف ثوان إذا كانت سياسة إعادة التشغيل مضبوطة، ويكلف ساعات إذا لم تكن، لأن أحداً يجب أن يلاحظ ويشغل التطبيق بيده.
- عندما قارنا بعد ذلك أرقام الطلبات التي أكدها المتجر للعميل بالجدول، وجدنا طلبين محفوظين في قاعدة البيانات لم يصل تأكيدهما للعميل أبداً، رقم 5000103 في التجربة الأولى ورقم 5000225 في الثانية. والسبب أن العملية ماتت بعد
COMMITوقبل أن ترسل الرد، فالعميل يظن أن الطلب فشل، والمتجر سجله. وهذا يحدث في كل نظام، ولذلك يحتاج طلب الدفع إلى مفتاح منع التكرار Idempotency Key، حتى لا يدفع العميل مرتين عندما يعيد المحاولة.
توقف PostgreSQL المفاجئ Crash Recovery
التجربة الثانية أصعب: نقتل عملية PostgreSQL الرئيسية بالإشارة SIGKILL أثناء الكتابة، فلا يتم أي إغلاق سليم، ثم يعيد Docker تشغيلها، فتبدأ استعادة ما بعد التعطل Crash Recovery، أي إعادة تطبيق سجل الكتابة WAL من آخر نقطة تفتيش Checkpoint حتى آخر سجل مكتوب، كما في شرح WAL في التوثيق:
docker run -d --name wr-ha-client --network wr-ha-net -e SECONDS=45 -v "$(pwd -W)/out:/out" \
  wr-ha-app:1 python -u /lab/client.py /out/b-db-crash.json
sleep 10; P=$(docker inspect -f '{{.State.Pid}}' wr-ha-db)
docker run --rm --pid=host --privileged alpine:3.24 sh -c "date -u +%T; kill -9 $P"
sleep 36; docker logs wr-ha-client
docker logs wr-ha-db 2>&1 | grep -vE 'starting up|not yet accepting|Consistent recovery'
والمخرج سوف يكون كما يلي، وقد حذفنا من سجل PostgreSQL مئات الأسطر المتكررة التي ترفض فيها القاعدة الاتصالات أثناء الاستعادة:
23:54:00
attempts 439  confirmed 308  failed 131
outage 23:54:00 -> 23:54:14 UTC    14.1 s
last confirmed id 5000784
23:54:02.053 UTC [32] LOG:  database system was interrupted; last known up at 2026-11-04 23:49:25 UTC
23:54:11.621 UTC [32] LOG:  database system was not properly shut down; automatic recovery in progress
23:54:11.627 UTC [32] LOG:  redo starts at 0/22302968
23:54:14.099 UTC [32] LOG:  redo done at 0/39E53D38 system usage: CPU: user: 1.84 s, system: 0.62 s, elapsed: 2.47 s
23:54:14.107 UTC [30] LOG:  checkpoint starting: end-of-recovery immediate wait
23:54:14.516 UTC [30] LOG:  checkpoint complete: wrote 16372 buffers (99.9%) ... distance=388420 kB
23:54:14.526 UTC [1] LOG:  database system is ready to accept connections
وهذا المخرج يستحق أن نقرأه سطراً سطراً، لأن فيه كل ما يحدث داخل قاعدة البيانات عندما تتعطل:
database system was interrupted; last known up at 23:49:25: القاعدة تعرف أنها لم تغلق بشكل سليم، وآخر نقطة تفتيش ناجحة كانت قبل خمس دقائق تقريباً، وكل ما كتب بعدها موجود في ال WAL فقط.- تسع ثوان ونصف بين السطر الأول والثاني: من 23:54:02 إلى 23:54:11 لا يظهر شيء، وهذا الوقت تقضيه القاعدة في مزامنة كل ملفات مجلد البيانات مع القرص قبل أن تبدأ الاستعادة، لأن الإعداد
recovery_init_sync_methodقيمته الافتراضيةfsync، والتوثيق في صفحة معالجة الأخطاء يشرح أنها تفتح كل ملف وتزامنه، ويذكر بديلاً على Linux هوsyncfs. وهذا الجزء يكبر مع عدد الملفات، فقاعدة فيها آلاف الجداول والفهارس تقضي فيه وقتاً أطول. redo startsثمredo done ... elapsed: 2.47 s: إعادة تطبيق السجل نفسها أخذت ثانيتين ونصفاً، وdistance=388420 kBفي سطر نقطة التفتيش تقول إن السجل كان حوالي 380 MB، وأغلبه من إدخال الخمسة ملايين طلب قبل التجربة. وهذا الرقم يكبر مع كمية الكتابة منذ آخر نقطة تفتيش، ولذلك يحدد الإعدادانcheckpoint_timeoutوmax_wal_sizeأقصى زمن لهذا الجزء.checkpoint starting: end-of-recovery: بعد الاستعادة تكتب القاعدة نقطة تفتيش فوراً حتى لا تحتاج إلى إعادة الشيء نفسه إذا تعطلت مرة أخرى، ثم تقبل الاتصالات.- التوقف من جهة العميل 14.1 ثانية فشلت فيها 131 محاولة كلها بالرمز 503، أي أن التطبيق كان يعمل ويرد، ولكن قاعدة البيانات كانت ترفض الاتصال.
وبقي السؤال الأهم: هل ضاع أي طلب أكده المتجر؟ قارنا أرقام الطلبات المؤكدة في سجل العميل بالجدول، فوجدنا كل الطلبات المؤكدة في هذه التجربة، وعددها 308، موجودة في قاعدة البيانات، والسبب أن PostgreSQL لا يرد على COMMIT إلا بعد أن يكتب السجل على القرص، فالتعطل المفاجئ للعملية لا يضيع شيئاً أكدته القاعدة. وهذا يعني أن التعطل المفاجئ لقاعدة البيانات على سيرفر سليم يكلف ثوان، وأن التوفر العالي لن يوفر فيه الكثير، لأن الانتقال إلى نسخة أخرى نفسه يأخذ ثوان أيضاً.
فقدان السيرفر Server Loss ثم الاستعادة من النسخة الليلية
التجربة الثالثة هي العطل الذي يخافه الجميع: السيرفر ذهب، ومعه القرص. نأخذ أولاً النسخة الليلية بالأداة pg_dump بالصيغة المخصصة كما شرحنا في دليل نسخ قواعد البيانات بشكل متسق، ونحفظها في Volume منفصل يمثل التخزين الخارجي:
docker volume create wr-ha-backup
time docker run --rm --network wr-ha-net -e PGPASSWORD=lab-only-pass -v wr-ha-backup:/backup \
  postgres:18.6 pg_dump -h wr-ha-db -U postgres -Fc -f /backup/shop.dump shop
واستغرقت النسخة 7.5 ثانية، وحجم الملف 37,172,340 بايت، أي حوالي 35 MiB، لأن الصيغة المخصصة مضغوطة والجدول فيه أرقام متكررة كثيراً. ثم نكتب سكربت الاستعادة كما سوف ينفذه المناوب، مع وقت كل خطوة، واحفظه باسم restore.sh:
#!/bin/sh
# Rebuild the database on a new "server" from the last nightly dump, timing each step (UTC).
set -e
export MSYS_NO_PATHCONV=1
t() { date -u +%T; }
echo "$(t) start: new database container"
docker run -d --name wr-ha-db --network wr-ha-net --restart unless-stopped \
  -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop -v wr-ha-pgdata:/var/lib/postgresql postgres:18.6 >/dev/null
until docker exec wr-ha-db pg_isready -U postgres -q 2>/dev/null && docker exec wr-ha-db psql -U postgres -tAc 'select 1' >/dev/null 2>&1; do sleep 0.5; done
sleep 2; until docker exec wr-ha-db pg_isready -U postgres -q 2>/dev/null; do sleep 0.5; done
echo "$(t) empty database ready, pg_restore starts"
docker run --rm --network wr-ha-net -e PGPASSWORD=lab-only-pass -v wr-ha-backup:/backup postgres:18.6 \
  pg_restore -h wr-ha-db -U postgres -d shop --no-owner -j 2 /backup/shop.dump
echo "$(t) restore done"
docker exec wr-ha-db psql -U postgres -d shop -tAc "select count(*), max(id) from orders"
ثم نأخذ نسخة جديدة، ونترك العميل يشتري 30 ثانية بعدها، ثم نحذف ال Container وال Volume معاً كأن السيرفر ذهب، ونشغل السكربت فوراً:
docker run --rm --network wr-ha-net -e PGPASSWORD=lab-only-pass -v wr-ha-backup:/backup \
  postgres:18.6 pg_dump -h wr-ha-db -U postgres -Fc -f /backup/shop.dump shop
docker run -d --name wr-ha-client --network wr-ha-net -e SECONDS=170 -v "$(pwd -W)/out:/out" \
  wr-ha-app:1 python -u /lab/client.py /out/c-server-lost.json
sleep 30; echo "$(date -u +%T) server lost"
docker rm -f wr-ha-db; docker volume rm wr-ha-pgdata
sh restore.sh
والمخرج سوف يكون كما يلي، ومعه سجل العميل بعد انتهاء التجربة:
00:14:34 nightly dump done, max id 5000784
00:15:06 server lost
00:15:08 start: new database container
00:15:37 empty database ready, pg_restore starts
00:15:56 restore done
5000796|5000825

attempts 1037  confirmed 739  failed 298
outage 00:15:06 -> 00:15:48 UTC    41.7 s
outage 00:15:49 -> 00:15:52 UTC     3.0 s
outage 00:16:39 -> 00:17:24 UTC    45.1 s
في المخرج أعلاه لاحظ التالي:
- تجهيز قاعدة بيانات فارغة على Volume جديد أخذ 29 ثانية، وهو وقت
initdbمع إعادة التشغيل التي يفعلها ال Image بعد التهيئة الأولى، ثم أخذت الاستعادة نفسها 19 ثانية. أي أن السيرفر الذي فقدناه عاد في أقل من دقيقة، ولكن تذكر أن هذا الرقم لا يحتوي على الاكتشاف ولا على تجهيز سيرفر جديد عند المزود ولا على تنزيل النسخة من التخزين الخارجي، وهي التي تأخذ الدقائق الحقيقية. - السطر
5000796|5000825غريب: النسخة كان فيها 5,000,755 طلباً وآخر رقم فيها 5000784، والآن الجدول فيه 41 طلباً أكثر. والسبب أن التطبيق كان يعمل طوال الاستعادة، فبدأ يكتب في الجدول بمجرد أن أنشأهpg_restore، وأول طلب جديد كتب في الساعة 00:15:39، أي قبل أن تنتهي الاستعادة بـ 17 ثانية. - هناك نافذة توقف ثالثة بعد الاستعادة بحوالي 43 ثانية مدتها 45 ثانية، وسوف نعود إليها في القسم التالي.
مشكلة واجهتنا: أرقام طلبات تتكرر بعد الاستعادة Reused IDs
عندما قارنا سجل العميل بالجدول بعد الاستعادة ظهرت المشكلة الحقيقية في هذه التجربة. فالمتجر أكد للعملاء 296 طلباً بين النسخة الليلية ولحظة فقدان السيرفر، وهذه الطلبات ضاعت كلها، وهذا متوقع، فهو بالضبط RPO النسخة: كل ما كتب بعدها يضيع. ولكن غير المتوقع أن أرقام هذه الطلبات نفسها أعطيت لطلبات جديدة بعد الاستعادة:
confirmed between dump and loss 296  lost from db 296  ids reused 296
5000785 confirmed 00:14:36 now row from 00:15:45
5000786 confirmed 00:14:36 now row from 00:15:39
5000787 confirmed 00:14:36 now row from 00:15:48
والسبب أن النسخة تحفظ قيمة العداد Sequence كما كانت لحظة النسخ، أي 5000784، فعندما استعدناها بدأ العداد من بعدها، وأعطى الرقم 5000785 لطلب جديد في الساعة 00:15:45، مع أن الرقم نفسه أكده المتجر لعميل آخر في الساعة 00:14:36. والصورة التالية تبين ما حدث:
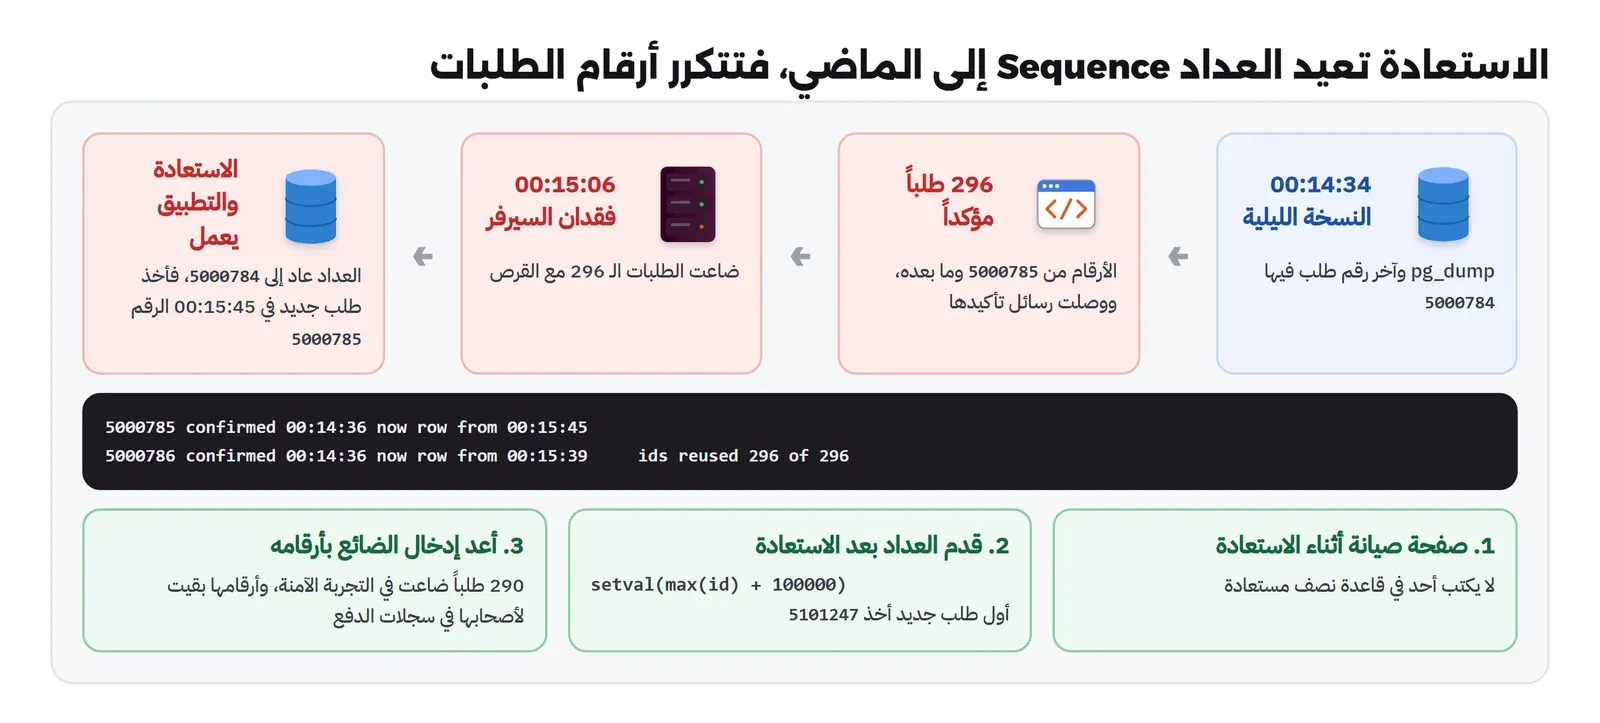
وقد يتساءل البعض: وما المشكلة إذا كانت الطلبات الأصلية قد ضاعت أصلاً؟ والإجابة أنها لم تضع من العالم، وإنما من قاعدة البيانات فقط. فالعميل عنده رسالة تأكيد بالرقم 5000785، وبوابة الدفع عندها عملية مرتبطة بالرقم نفسه، وشركة الشحن ربما استلمت الرقم أيضاً، فعندما يتصل العميل ليسأل عن طلبه، سوف يجد فريق خدمة العملاء طلباً آخر لعميل آخر بالرقم نفسه، وقد يرسل له تفاصيله. أي أن الاستعادة لم تضيع البيانات فقط، وإنما خلطتها، وفصل الطلبات المختلطة بعد ذلك أصعب بكثير من إعادة إدخال الطلبات الضائعة.
والمشكلة الثانية في هذه التجربة أن التطبيق كتب في قاعدة البيانات أثناء الاستعادة، أي أن عملاء اشتروا من متجر بياناته نصف موجودة، وكان يمكن أن يرى العميل قائمة طلبات ناقصة أو رصيداً خاطئاً. لذلك يجب أن يكون التطبيق مغلقاً، أو في وضع صفحة الصيانة، حتى تنتهي الاستعادة وتتحقق منها.
الاستعادة الآمنة Safe Restore، ثم ما بعدها
الآن نكرر التجربة بالطريقة الصحيحة: نوقف التطبيق قبل أن نبدأ، وبعد الاستعادة نقدم العداد بمسافة كبيرة باستخدام الدالة setval الموصوفة في توثيق دوال العدادات، حتى لا يأخذ أي طلب جديد رقماً ربما أعطي لعميل قبل العطل، ثم نشغل التطبيق. احفظ السكربت التالي باسم restore-safe.sh:
#!/bin/sh
# Same rebuild, done the safe way: the store stays closed until the restore is complete,
# and the order sequence jumps ahead so no lost order number is ever given to a new customer.
set -e
export MSYS_NO_PATHCONV=1
t() { date -u +%T; }
echo "$(t) stop the app (maintenance page in real life)"
docker stop wr-ha-app >/dev/null
echo "$(t) start: new database container"
docker run -d --name wr-ha-db --network wr-ha-net --restart unless-stopped \
  -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop -v wr-ha-pgdata:/var/lib/postgresql postgres:18.6 >/dev/null
sleep 3; until docker exec wr-ha-db psql -U postgres -tAc 'select 1' >/dev/null 2>&1 && [ "$(docker logs wr-ha-db 2>&1 | grep -c 'ready to accept')" -ge 2 ]; do sleep 0.5; done
echo "$(t) empty database ready, pg_restore starts"
docker run --rm --network wr-ha-net -e PGPASSWORD=lab-only-pass -v wr-ha-backup:/backup postgres:18.6 \
  pg_restore -h wr-ha-db -U postgres -d shop --no-owner -j 2 /backup/shop.dump
echo "$(t) restore done, sequence before: $(docker exec wr-ha-db psql -U postgres -d shop -tAc "select last_value from orders_id_seq")"
docker exec wr-ha-db psql -U postgres -d shop -tAc "select setval('orders_id_seq', (select max(id) from orders) + 100000)"
docker start wr-ha-app >/dev/null
echo "$(t) app started"
ولاحظ شرط الانتظار في السكربت، فهو ينتظر أن يظهر السطر ready to accept مرتين في سجل القاعدة، والسبب أن ال Image الرسمية تشغل القاعدة مرة أولى مؤقتة لتنفذ التهيئة ثم توقفها وتشغلها التشغيل الحقيقي، فإذا بدأت الاستعادة في المرة الأولى توقفت في منتصفها. ونشغل التجربة كما قبلها، والمخرج سوف يكون كما يلي:
00:33:10 nightly dump done, max id 5001246
00:33:42 server lost
00:33:44 stop the app (maintenance page in real life)
00:33:52 start: new database container
00:34:04 empty database ready, pg_restore starts
00:34:17 restore done, sequence before: 5001246
5101246
00:34:18 app started

attempts 795  confirmed 767  failed 28
outage 00:33:43 -> 00:34:19 UTC    35.9 s
outage 00:35:10 -> 00:35:40 UTC    30.1 s
في المخرج أعلاه لاحظ التالي:
- إيقاف التطبيق أخذ 8 ثوان، والسبب أن عملية Python في التطبيق لا تتعامل مع الإشارة
SIGTERMلأنها العملية رقم 1 في ال Container، فينتظر Docker المهلة ثم يرسلSIGKILL. وهذه ثوان صغيرة في المختبر، ولكنها في الإنتاج تعني أن التطبيق لا يغلق اتصالاته بشكل سليم، فعالج الإشارة في تطبيقك أو استخدم الخيار--init. - التوقف من جهة العميل 35.9 ثانية، وفشلت فيه 28 محاولة فقط بدلاً من مئات، لأن التطبيق كان متوقفاً فكانت كل محاولة تنتظر حتى تفشل. وفي الإنتاج سوف يرى العميل هنا صفحة صيانة بدلاً من خطأ.
- العداد كان 5001246 كما في النسخة، وقدمناه إلى 5101246، فأخذ أول طلب بعد الاستعادة الرقم 5101247، أي أن الطلبات الـ 290 التي ضاعت هذه المرة، من 5001247 إلى 5001536، بقيت أرقامها لأصحابها، ويستطيع الفريق أن يبحث عنها في سجلات بوابة الدفع ويعيد إدخالها بأرقامها نفسها.
بقيت نافذة التوقف الثانية، وقد ظهرت في التجربتين: بعد انتهاء الاستعادة بحوالي 45 إلى 55 ثانية تأتي نافذة مدتها 30 إلى 45 ثانية، لا ترفض فيها قاعدة البيانات الاتصال، وإنما تتجاوز الطلبات مهلة الثواني الثلاث. وفي التجربة الثانية فشلت 11 محاولة من 25 في هذه النافذة، وكلها بلا رد. وعندما فحصنا جدول pg_stat_user_tables وجدنا أن autovacuum انتهى من المرور على جدول الطلبات المستعاد في 00:34:57 ثم حدث الإحصاءات في 00:34:58، أي قبل النافذة مباشرة، ثم شغلنا العميل بعد ذلك 90 ثانية دون أي تغيير فنجحت المحاولات كلها، 886 من 886. والتفسير الأقرب أن القاعدة المستعادة تمر في دقائقها الأولى بعمل ثقيل على القرص: autovacuum يمر على كل الجدول ويكتب صفحاته، والذاكرة المؤقتة Cache فارغة، وكل هذا يتنافس على القرص مع كتابة الطلبات. والدرس العملي أن ساعة التوقف لا تنتهي عند السطر restore done، فالخدمة تبقى أبطأ أو متقطعة دقائق بعده، لذلك أضف في دليل الاستعادة خطوة VACUUM ANALYZE قبل أن تفتح المتجر، وراقب زمن الاستجابة بعد الفتح قبل أن تعلن انتهاء الحادثة.
والصورة التالية تجمع ما قسناه في المختبر لكل عطل:
من الدقائق إلى الريالات: نموذج التكلفة Cost Model
الآن نضع الأرقام المقاسة في نموذج واحد مع دقائق البشر التي لا يقيسها المختبر. والنموذج يقارن ثلاثة تصاميم للمتجر نفسه:
- التصميم A، السيرفر كما هو: لا توجد سياسة إعادة تشغيل، ولا تنبيه يوقظ أحداً، فالاكتشاف في المتوسط 95 دقيقة، وهو تقريباً ما حدث ليلة الجمعة.
- التصميم B، السيرفر نفسه مصنوعاً جيداً: سياسة إعادة تشغيل، وفحص خارجي مع تنبيه ومناوبة فيصبح الاكتشاف 5 دقائق، ودليل استعادة مكتوب ومجرب فيصبح فقدان السيرفر 45 دقيقة لتجهيز سيرفر جديد مع 36 ثانية للاستعادة كما قسناها. وتكلفته 12 ألف ريال في السنة للمراقبة ومكافأة المناوبة وتمرين الاستعادة كل ثلاثة أشهر.
- التصميم C، التوفر العالي: سيرفران للتطبيق خلف موزع طلبات، وقاعدة بيانات بانتقال تلقائي، مع كل ما في التصميم B، وتكلفته 12 ألفاً مضافاً إليها أربعة سيرفرات بثلاثمئة ريال شهرياً و24 يوم عمل في السنة بألف وخمسمئة ريال لليوم.
احفظ السكربت التالي باسم cost.py، وكل رقم فيه مثال للمتجر الذي نتابعه، والمطلوب أن تستبدله بأرقامك قبل أن تأخذ النتيجة إلى أي اجتماع:
# cost.py: expected yearly cost of downtime for three designs of the same store.
# Every number below is an EXAMPLE input: replace it with your own sales, your own failure history
# and your own quotes. The measured lab times (restart 5.3 s, crash recovery 14.1 s, restore 36 s)
# appear where they belong, next to the human minutes that the lab cannot measure.
import math, random, sys

DAY_SALES = 60_000                       # SAR per day, average day
LOST_SHARE = 0.6                         # share of sales in an outage that never come back
STAFF_HOUR = 900                         # SAR per hour: support and staff who wait or apologise
# share of the day's sales in each hour (UTC+3), evening peak; sums to 1
HOURS = [1, .5, .3, .2, .2, .3, .6, 1.2, 2.5, 3.6, 4.2, 4.5, 4.6, 4.4, 4.5, 4.8, 5.2, 5.8, 6.6, 7.6, 8.6, 9.4, 8.6, 5.9]
HOURS = [h / sum(HOURS) for h in HOURS]

def hour_cost(h):                       # SAR lost per hour of outage that starts at hour h
    return DAY_SALES * HOURS[h] * LOST_SHARE + STAFF_HOUR

AVG_HOUR = sum(hour_cost(h) for h in range(24)) / 24

# failure classes: (name, per year, minutes to recover for each design)
# design A = one server as it is today: no restart policy, nobody paged at night
# design B = the same one server, done well: restart policy, alert + on-call, a tested restore runbook
# design C = HA: two app servers behind a load balancer, PostgreSQL with automatic failover
DETECT_A, DETECT_B = 95, 5               # minutes until someone knows (A: next morning or a customer call)
CLASSES = [
    ("app process crash",          6.0, {"A": DETECT_A + 2,  "B": 5.3 / 60,          "C": 0.1}),
    ("database process crash",     1.0, {"A": DETECT_A + 2,  "B": 14.1 / 60,         "C": 0.5}),
    ("planned maintenance",       12.0, {"A": 10,           "B": 5,                 "C": 0.2}),
    ("bad deploy or config",       4.0, {"A": DETECT_A + 10, "B": DETECT_B + 10,      "C": DETECT_B + 10}),
    ("server or disk lost",        0.5, {"A": DETECT_A + 240, "B": DETECT_B + 45 + 36 / 60, "C": 0.5}),
    ("provider or site outage",    0.3, {"A": 180,           "B": 180,               "C": 180}),
    ("HA itself misbehaves",       0.5, {"A": 0,             "B": 0,                 "C": DETECT_B + 60}),
]
DESIGN_COST = {"A": 0, "B": 12_000, "C": 12_000 + 4 * 300 * 12 + 24 * 1_500}   # SAR per year on top of today

def expected(design):
    minutes = sum(f * m[design] for _, f, m in CLASSES)
    return minutes, minutes / 60 * AVG_HOUR

print(f"average outage hour costs {AVG_HOUR:,.0f} SAR; the worst hour (21:00) {hour_cost(21):,.0f}, the best (03:00) {hour_cost(3):,.0f}\n")
print(f"{'design':38} {'down min/yr':>11} {'downtime SAR':>13} {'design SAR':>11} {'total SAR':>10}")
for d, name in (("A", "A one server, as it is"), ("B", "B one server, done well"), ("C", "C high availability")):
    mins, cost = expected(d)
    print(f"{name:38} {mins:11.0f} {cost:13,.0f} {DESIGN_COST[d]:11,} {cost + DESIGN_COST[d]:10,.0f}")

print("\nwhere design B's minutes come from:")
for n, f, m in CLASSES:
    if f * m["B"]: print(f"  {n:28} {f:4} x {m['B']:7.2f} min = {f * m['B']:6.1f} min/yr")

# break-even: daily sales at which C costs the same as B, for HA that misbehaves more or less often
print("\nHA misbehaves  C saves over B   C pays for itself above")
for rate in (0.5, 0.2, 0.05):
    CLASSES[-1] = (CLASSES[-1][0], rate, CLASSES[-1][2])
    mb, _ = expected("B"); mc, _ = expected("C")
    saved_hours = (mb - mc) / 60
    if saved_hours <= 0:
        print(f"  {rate:4}/yr      {mb - mc:6.0f} min/yr   never: C is down longer than B"); continue
    # one saved hour is worth sales * LOST_SHARE / 24 + STAFF_HOUR, so solve for the daily sales
    breakeven = ((DESIGN_COST["C"] - DESIGN_COST["B"]) / saved_hours - STAFF_HOUR) * 24 / LOST_SHARE
    print(f"  {rate:4}/yr      {mb - mc:6.0f} min/yr   {breakeven:12,.0f} SAR of sales per day")
CLASSES[-1] = (CLASSES[-1][0], 0.5, CLASSES[-1][2])

# Monte Carlo: failures arrive at random (Poisson) and at random hours, so one year can be much worse than the average
random.seed(int(sys.argv[1]) if len(sys.argv) > 1 else 7)
def one_year(design, peak=1.0):
    total = 0.0
    for _, f, m in CLASSES:
        n, p, limit = 0, 1.0, math.exp(-f)                                 # Poisson count (Knuth)
        while True:
            p *= random.random()
            if p < limit: break
            n += 1
        for _ in range(n):
            h = random.randrange(24)
            total += m[design] / 60 * (DAY_SALES * peak * HOURS[h] * LOST_SHARE + STAFF_HOUR)
    return total
for d in ("A", "B", "C"):
    ys = sorted(one_year(d) for _ in range(20_000))
    q = lambda p: ys[int(p * len(ys)) - 1]
    print(f"design {d}: median {q(.5):9,.0f}  p90 {q(.9):9,.0f}  p99 {q(.99):9,.0f}  worst {ys[-1]:9,.0f} SAR/yr")
# what if the server is lost on the sale week, when a day sells four times as much?
print("\nserver lost at 21:00 on a sale day (x4 sales):")
for d in ("B", "C"):
    m = dict((n, mm) for n, _, mm in CLASSES)["server or disk lost"][d]
    print(f"  design {d}: {m:6.1f} min -> {m / 60 * (DAY_SALES * 4 * HOURS[21] * LOST_SHARE + STAFF_HOUR):9,.0f} SAR")
ثم شغله بالأمر:
docker run --rm -v "$(pwd -W):/w" -w /w python:3.13-slim python cost.pyوالمخرج سوف يكون كما يلي:
average outage hour costs 2,400 SAR; the worst hour (21:00) 4,458, the best (03:00) 976

design                                 down min/yr  downtime SAR  design SAR  total SAR
A one server, as it is                        1440        57,620           0     57,620
B one server, done well                        200         8,003      12,000     20,003
C high availability                            150         6,010      62,400     68,410

where design B's minutes come from:
  app process crash             6.0 x    0.09 min =    0.5 min/yr
  database process crash        1.0 x    0.23 min =    0.2 min/yr
  planned maintenance          12.0 x    5.00 min =   60.0 min/yr
  bad deploy or config          4.0 x   15.00 min =   60.0 min/yr
  server or disk lost           0.5 x   50.60 min =   25.3 min/yr
  provider or site outage       0.3 x  180.00 min =   54.0 min/yr

HA misbehaves  C saves over B   C pays for itself above
   0.5/yr          50 min/yr      2,392,184 SAR of sales per day
   0.2/yr          69 min/yr      1,709,077 SAR of sales per day
  0.05/yr          79 min/yr      1,493,880 SAR of sales per day
design A: median    55,826  p90    81,895  p99   108,255  worst   157,506 SAR/yr
design B: median     6,497  p90    15,082  p99    24,227  worst    41,437 SAR/yr
design C: median     4,387  p90    13,168  p99    22,689  worst    38,232 SAR/yr

server lost at 21:00 on a sale day (x4 sales):
  design B:   50.6 min ->    12,763 SAR
  design C:    0.5 min ->       126 SAR
وهذا أهم مخرج في المقال، فلنقرأه جزءاً جزءاً:
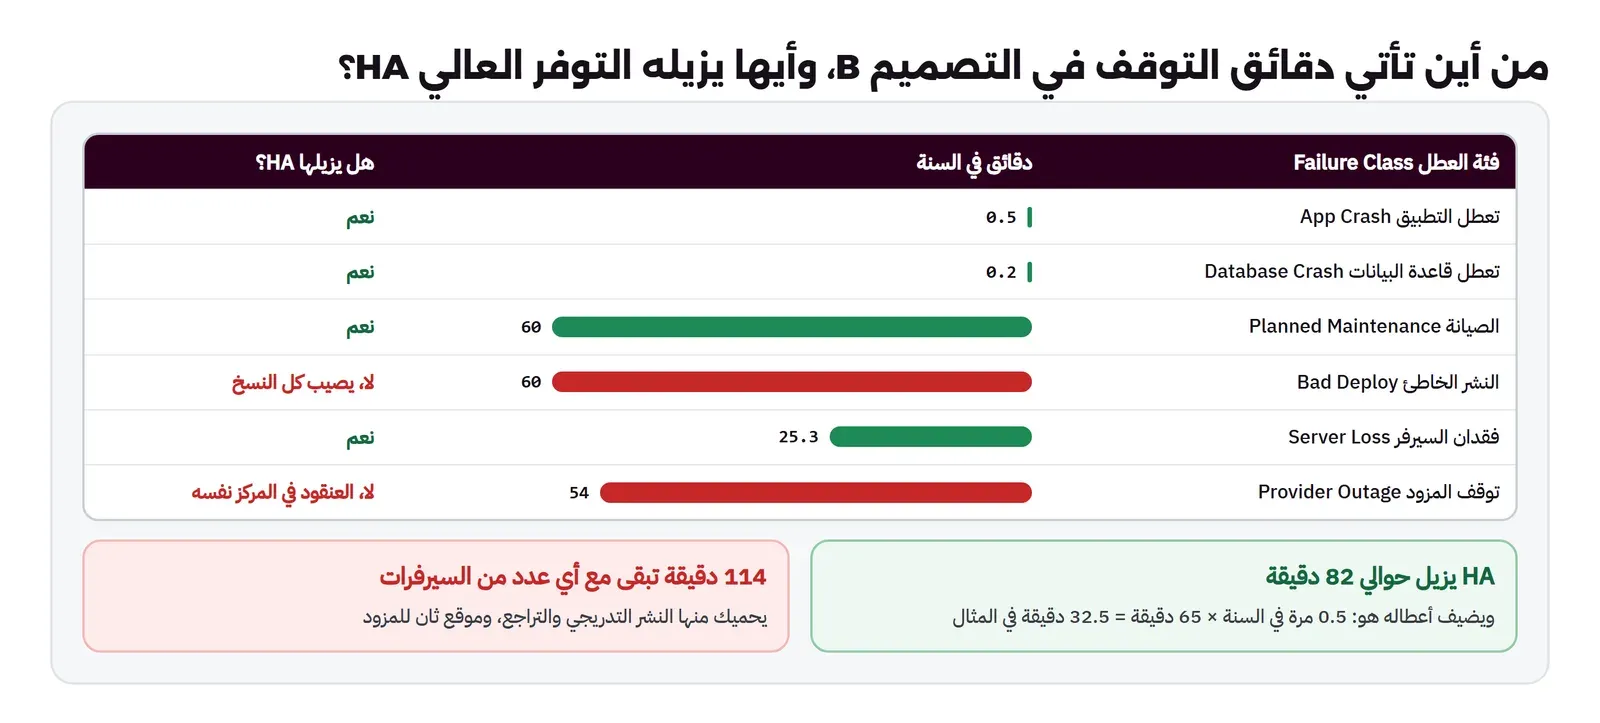
- الجدول الأول: السيرفر كما هو يتوقف حوالي 1440 دقيقة في السنة، أي 24 ساعة، ويكلف 57,620 ريالاً. والسيرفر نفسه مصنوعاً جيداً ينزل إلى 200 دقيقة و8,003 ريالات، ومع تكلفة التحسينات يصبح المجموع 20,003 ريالات، أي أن التصميم B يوفر حوالي 37 ألف ريال في السنة دون أي سيرفر جديد. أما التوفر العالي فينزل التوقف من 200 إلى 150 دقيقة فقط، ويرفع المجموع إلى 68,410 ريالات، أي أنه أغلى من السيرفر كما هو.
- من أين تأتي دقائق التصميم B: أغلب الدقائق المتبقية من ثلاث فئات: الصيانة 60 دقيقة، والنشر الخاطئ 60 دقيقة، وتوقف المزود 54 دقيقة. والتوفر العالي يزيل الأولى فقط، أما النشر الخاطئ فيصيب السيرفرين معاً، وتوقف المزود يصيب العنقود كله في المركز نفسه. وفقدان السيرفر، وهو العطل الذي جاء عرض السعر من أجله، 25 دقيقة في السنة فقط، لأنه يحدث مرة كل سنتين في المتوسط.
- جدول نقطة التعادل Break-even: يحسب حجم المبيعات اليومية الذي يجعل التصميم C يساوي التصميم B في التكلفة، لثلاث قيم لعدد مرات تصرف التوفر العالي بشكل خاطئ في السنة. وحتى مع عنقود لا يخطئ إلا مرة كل عشرين سنة، يحتاج المتجر أن يبيع حوالي 1.5 مليون ريال في اليوم حتى يستحق العنقود تكلفته بهذه الأرقام، أي 25 ضعف مبيعاته الحالية. ولاحظ كيف يتغير الرقم مع جودة العنقود: كلما كان اختبار الانتقال أفضل، قلت الأعطال التي يضيفها، ونزلت نقطة التعادل.
- المحاكاة Monte Carlo: المتوسط يخفي أن الأعطال تأتي عشوائياً، فبعض السنوات أسوأ بكثير، والمحاكاة ترمي الأعطال على 20 ألف سنة عشوائية وفي ساعات عشوائية من اليوم. والسنة السيئة جداً، أي المئين 99 Percentile، تكلف في التصميم B حوالي 24,227 ريالاً، وأسوأ سنة من العشرين ألفاً 41,437 ريالاً، وهي ما زالت أقل من تكلفة العنقود السنوية. أي أن الفرق لم يأت من حظ في المتوسط.
والصورة التالية تبين دقائق التصميم B فئة فئة، وأيها يزيله التوفر العالي وأيها يبقى مهما كان عدد السيرفرات:
ماذا لو جاء العطل في ليلة التخفيضات؟ What If
آخر جزء في المخرج هو التجربة التي سوف يسألك عنها المدير: ماذا لو فقدنا السيرفر في التاسعة مساءً في أسبوع التخفيضات، واليوم يبيع أربعة أضعاف اليوم العادي؟ والنموذج يقول إن هذا العطل وحده يكلف في التصميم B حوالي 12,763 ريالاً، وفي التصميم C حوالي 126 ريالاً. والفرق هنا كبير وحقيقي، وهو السبب الذي يجعل بعض الشركات تختار التوفر العالي رغم أن المتوسط لا يبرره: ليس لأن الساعة العادية مكلفة، وإنما لأن ساعة واحدة في يوم واحد قد تكون مؤلمة جداً. ولكن لاحظ أن هذا العطل نفسه في أسوأ يوم ما زال يكلف أقل من ربع تكلفة العنقود السنوية، فإذا كان القلق من موسم واحد، فهناك حلول أرخص للموسم نفسه، مثل سيرفر احتياطي دافئ Warm Standby تشغله قبل الموسم بأسبوع، أو تجميد النشر في أسبوع التخفيضات، وهو ما يزيل جزءاً كبيراً من فئة النشر الخاطئ.
وجرب بنفسك تغيير ثلاثة أرقام في السكربت لترى كيف يتحرك القرار: اجعل DAY_SALES مليوني ريال، فيصبح التوفر العالي مبرراً في كل الحالات تقريباً. واجعل DETECT_B ثلاثين دقيقة بدلاً من خمس، أي مناوبة لا ترد بسرعة، فترى أن الفرق بين B وC يكبر، لأن التوفر العالي لا ينتظر شخصاً حتى يستيقظ. واجعل فقدان السيرفر في التصميم B ست ساعات بدلاً من 50 دقيقة، كما يحدث عندما تكون القاعدة 2 TB والنسخة في تخزين خارجي بطيء، فترى أن حجم البيانات وحده قد يغير القرار، ولذلك قس زمن الاستعادة على بياناتك أنت بحجمها الحقيقي، كما شرحنا في دليل النسخة خارج السيرفر.
حذف المختبر Cleanup
docker rm -f wr-ha-app wr-ha-db wr-ha-client
docker volume rm wr-ha-pgdata wr-ha-backup
docker network rm wr-ha-net
docker rmi wr-ha-app:1
الطريق الأوسط: سيرفر واحد مصنوع جيداً Single Server Done Well
النتيجة التي خرج بها النموذج تتكرر في أغلب الفرق الصغيرة والمتوسطة: أكبر تحسن في التوفر لا تأتي من السيرفر الثاني، وإنما من تشغيل السيرفر الأول بشكل صحيح. وهذه هي الخطوات التي نقلت المتجر من التصميم A إلى التصميم B، مرتبة بحسب ما توفره من الدقائق:
- الاكتشاف خلال دقائق: فحص خارجي من مكان آخر غير السيرفر، وتنبيه يصل إلى الهاتف، ومناوبة مكتوبة يعرف فيها كل شخص متى يكون دوره. وهذه الخطوة وحدها نقلت الاكتشاف من 95 دقيقة إلى 5، وهي أرخص خطوة في القائمة.
- سياسة إعادة التشغيل لكل خدمة:
restart: unless-stoppedفي Docker Compose، أوRestart=on-failureفي systemd، واختبرها بتعطل حقيقي كما فعلنا، وليس بالأمرdocker kill. - مراقبة الأسباب الشائعة قبل أن تصبح أعطالاً: امتلاء القرص، وانتهاء الشهادات، وامتلاء الذاكرة، وهي التي أوقفت المتجر ليلة الجمعة، وقد شرحنا ماذا تراقب في دليل المراقبة.
- دليل استعادة مكتوب ومجرب: الخطوات التي نفذناها في
restore-safe.sh، مكتوبة في دليل تشغيل Runbook، ومجربة كل ثلاثة أشهر على سيرفر جديد، مع قياس الوقت في كل مرة. والتجربة هي ما كشف لنا مشكلة الأرقام المتكررة، ولو لم نجربها لظهرت في يوم العطل الحقيقي. - نسخ احتياطي بـ RPO يناسب الطلبات: النسخة الليلية في المختبر أضاعت 30 ثانية من الطلبات لأننا فقدنا السيرفر بعدها مباشرة، ولكن في الواقع قد تفقده قبل النسخة التالية بساعة، فتضيع طلبات 23 ساعة. والاستعادة إلى أي لحظة كما في دليل pgBackRest تنزل هذا إلى دقائق دون أي عنقود.
- نشر يمكن التراجع عنه بسرعة: فئة النشر الخاطئ 60 دقيقة في السنة، والتراجع بأمر واحد مع نشر تدريجي ينزلها أكثر من أي سيرفر إضافي.
- صيانة في الفجر بإشعار مسبق: خمس دقائق في الثالثة فجراً تكلف حوالي 81 ريالاً بأرقام المتجر، فلا تحتاج عنقوداً لتتجنبها.
وكل هذه الخطوات يحتاجها التوفر العالي أيضاً، فالعنقود الذي لا يراقبه أحد ولا يوجد له دليل تشغيل أسوأ من السيرفر الواحد، لذلك فالتصميم B ليس بديلاً عن التوفر العالي، وإنما الخطوة الأولى في الطريق إليه، والتي يجب أن تكملها قبل أي خطوة أخرى.
متى يستحق التوفر العالي تكلفته؟ When HA Pays
بعد كل هذا قد يبدو أن المقال ضد التوفر العالي، والحقيقة أن النموذج نفسه يبين متى يستحق، فالقرار يتغير عندما يتغير أحد الأرقام التالية:
- تكلفة الساعة كبيرة: عندما تقترب المبيعات أو الالتزامات من نقطة التعادل التي حسبها النموذج، أو عندما يكون التوقف نفسه غير مقبول، مثل نظام دفع تعتمد عليه متاجر أخرى، أو نظام في مستشفى.
- اتفاقية بعقوبات: عندما تعد عميلاً من الشركات بنسبة لا يستطيع سيرفر واحد تحقيقها، فإذا كانت الصيانة وحدها 60 دقيقة في السنة، فهذا وحده أكثر من نصف ما تسمح به 99.99%.
- لا توجد نافذة صيانة: خدمة يستخدمها الناس في كل ساعات اليوم وفي كل المناطق الزمنية، فلا يوجد فجر رخيص تعيد فيه التشغيل.
- الاستعادة طويلة بسبب الحجم: عندما تصبح استعادة السيرفر ساعات بسبب حجم البيانات، فيصبح فقدان السيرفر، وهو نادر، مكلفاً جداً عندما يحدث.
- الخطر في يوم واحد وليس في المتوسط: كما رأيت في تجربة ليلة التخفيضات، فإذا كانت ساعة واحدة في الموسم قد تضر الشركة أكثر بكثير مما يقوله المتوسط، فهذا قرار عمل مشروع، بشرط أن يتخذ وهو يعرف رقمه.
وإذا قررت أن تبني، فلا تبن كل شيء مرة واحدة، وإنما ابدأ بأضعف طبقة في حساب السلسلة كما شرحنا في مقال المفاهيم: سيرفرات التطبيق التي لا تحتفظ بحالة خلف HAProxy هي الأسهل والأرخص، ثم الموزع نفسه مع عنوان IP عائم مع Keepalived، ثم قاعدة البيانات، وهي الأصعب والأخطر، وقد شرحنا أشكالها وما يحدث فيها عند الانتقال في دليل عناقيد قواعد البيانات. وبين كل خطوة والتي بعدها أعد تشغيل النموذج بأرقامك الجديدة، لأن كل طبقة تضيفها تغير الدقائق المتبقية، وقد تجد أنك وصلت إلى ما تحتاجه قبل أن تصل إلى قاعدة البيانات.
كيف تعرض القرار على الإدارة؟ Decision Memo
المدير الذي طلب التوفر العالي لا يريد أن يقرأ سكربت Python، وإنما يريد أن يعرف ماذا سوف يحصل عليه مقابل ماله، لذلك اكتب القرار في صفحة واحدة فيها خمسة أجزاء:
- ما حدث: توقف ليلة الجمعة ثلاث ساعات، منها ساعتان ونصف قبل أن يعرف أحد، وتكلفته التقديرية بأرقام الساعة التي حسبتها.
- تكلفة التوقف المتوقعة في السنة لكل تصميم: الجدول الأول من مخرج النموذج، بالدقائق والريالات، مع جملة واحدة عن مصدر كل رقم، وأي الأرقام تقديرية.
- ما لا يحميه أي تصميم: النشر الخاطئ وتوقف المزود وحذف البيانات، وما الذي يحمي منها فعلاً.
- التوصية: التصميم B الآن بتكلفته وجدوله الزمني، ومراجعة القرار عندما تصل المبيعات إلى رقم معين أو عندما يطلب عميل اتفاقية بعقوبات.
- الخطر المقبول: فقدان السيرفر في ليلة التخفيضات يكلف حوالي 13 ألف ريال، وهذا ما تقبله الشركة بهذا القرار، مكتوباً وموقعاً.
والجزء الأخير هو أهم جزء، والسبب أن القرار بعدم بناء التوفر العالي ليس إهمالاً إذا كان مكتوباً بأرقامه وموقعاً من صاحب القرار، فإذا جاء العطل الكبير يوماً ما، فالجميع يعرف أنه خطر قبلته الشركة وهي تعرف حجمه، وليس مفاجأة لم يحسبها أحد.
أخطاء شائعة Common Mistakes
- تكلفة الساعة من قسمة الإيراد السنوي: فتبالغ في الساعة العادية وتقلل من ساعة الذروة، والصحيح توزيع المبيعات على الساعات، مع نسبة ما لا يعود.
- رقم واحد لكل الأعطال: فيبدو أن التوفر العالي يزيل كل التوقف، والصحيح أن تحسب كل فئة وحدها وتسأل هل تحميك منها نسخة ثانية.
- قياس الجزء التقني فقط: فتظن أن الاستعادة دقيقة واحدة، بينما الاكتشاف والاستجابة ساعات، والمختبر نفسه أعاد السيرفر في 36 ثانية لأن الشخص كان جاهزاً أمام الشاشة.
- اختبار التعطل بالأمر
docker kill: فلا تعمل سياسة إعادة التشغيل، وتظن أنها معطلة، أو تختبر شيئاً آخر غير التعطل الحقيقي. - الاستعادة والتطبيق يعمل: فيكتب العملاء في قاعدة نصف مستعادة، والصحيح صفحة صيانة حتى تنتهي الاستعادة وتتحقق منها.
- نسيان العداد بعد الاستعادة: فتتكرر أرقام الطلبات الضائعة مع طلبات جديدة، والصحيح أن تقدم العداد بمسافة كبيرة قبل أن تفتح المتجر.
- إهمال الأعطال التي يضيفها التوفر العالي: فتقارن عنقوداً مثالياً بسيرفر حقيقي، والصحيح أن تضع لها رقماً، وأن تعرف أن هذا الرقم ينزل فقط مع اختبار الانتقال المستمر.
- شراء العنقود قبل التصميم B: فيصبح لديك خمسة سيرفرات لا يراقبها أحد بدلاً من سيرفر واحد لا يراقبه أحد.
قائمة القرار Decision Checklist
| السؤال | كيف تجيب عنه |
|---|---|
| كم تكلف ساعة التوقف في المتوسط وفي الذروة؟ | المبيعات بحسب الساعة، مع نسبة ما لا يعود، ووقت الموظفين والالتزامات |
| ما فئات الأعطال وكم مرة تحدث كل فئة؟ | سجل الحوادث، وإذا لم يوجد فأرقام تقديرية مكتوبة على أنها تقديرية |
| كم دقيقة الاكتشاف والاستجابة؟ | من آخر حوادث حقيقية، وليس من الإعداد المكتوب |
| كم دقيقة الاستعادة التقنية؟ | تمرين استعادة حقيقي على بياناتك بحجمها الحقيقي |
| ما الذي لا يحميك منه التوفر العالي؟ | النشر الخاطئ وتوقف المزود وحذف البيانات، وما الذي يحميك منها |
| كم يكلف التصميم الجديد في السنة؟ | السيرفرات مع وقت الفريق في البناء والتحديث والاختبار والمناوبة |
| كم مرة سوف يخطئ التصميم الجديد؟ | رقم صريح، ينزل فقط مع اختبار الانتقال المستمر |
| هل أكملت التصميم B؟ | تنبيه ومناوبة وإعادة تشغيل ودليل استعادة مجرب ونسخ بـ RPO مناسب |
| ما الخطر الذي تقبله الشركة؟ | أسوأ عطل في أسوأ ساعة بالريال، مكتوب وموقع من صاحب القرار |
| متى تراجع القرار؟ | رقم مبيعات معين، أو عميل يطلب اتفاقية بعقوبات، أو استعادة أصبحت ساعات |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- قرار التوفر العالي موازنة بين خسارة التوقف المتوقعة في السنة، وتكلفة التصميم الجديد مع التوقف الذي يبقى معه والأعطال التي يضيفها هو نفسه.
- ساعة التوقف في المتجر الذي تابعناه تكلف بين 976 ريالاً في الفجر و4,458 في الذروة، والمتوسط 2,400، فاحسب الأسوأ في الذروة.
- في المختبر عاد التطبيق بعد تعطل حقيقي في 5.3 ثانية، وعادت PostgreSQL بعد قتلها في 14.1 ثانية دون أن يضيع أي طلب مؤكد، وعاد السيرفر المفقود من النسخة في 35.9 ثانية، و
docker killلا يعيده Docker أبداً. - الاستعادة والتطبيق يعمل أعطت 296 رقم طلب لعملاء جدد بعد أن أكدتها لعملاء آخرين، والحل صفحة صيانة ثم تقديم العداد قبل الفتح.
- تشغيل السيرفر الواحد بشكل جيد نزل التوقف من 1440 دقيقة إلى 200 ووفر 37 ألف ريال، والتوفر العالي نزله إلى 150 فقط بتكلفة 50 ألفاً إضافية، لأن النشر الخاطئ وتوقف المزود يصيبان العنقود أيضاً.
- التوفر العالي يستحق عندما تكبر تكلفة الساعة أو توجد اتفاقية بعقوبات أو لا توجد نافذة صيانة أو تصبح الاستعادة ساعات، وابدأ بأضعف طبقة، واكتب الخطر الذي تقبله.
وفي المقالات القادمة من مرحلة التوفر العالي بإذن الله نبدأ البناء لمن قرر أنه يحتاجه: مفاهيم توزيع الطلبات Load Balancing وخوارزمياته مقاسة في مختبر، ثم الانتقال التلقائي لقاعدة PostgreSQL مع Patroni.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلماذا تعني 99.9%؟ أهداف الخدمة SLO للمبتدئيننقيس خدمة حقيقية من أربعة أماكن فنحصل على أربعة أرقام، ونحول الهدف إلى دقائق مسموحة وميزانية أخطاء وسياسة تحكم قرارات الفريق.
 دليلعنوان IP عائم بين سيرفرين مع Keepalived وVRRPكيف ينقل Keepalived عنواناً واحداً بين سيرفرين تلقائياً عندما يتوقف أحدهما، مع تجربة حقيقية تقيس زمن الانتقال بالثواني.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلاستمرارية الأعمال BCP والتعافي من الكوارث DRP: الخطة والاختبارحولنا جرد عمليات شركة إلى طبقات تعاف بسكربت صغير، فكشف خدمة ظنها الفريق ثانوية وهي حرجة، وشرحنا MTD وRTO وRPO والموقع البديل.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال وتنفيذ المختبر على PostgreSQL 18.6 وPython 3.13.18 مع psycopg 3.3.7 على Docker Engine 29.8.0.


