


لنفرض أن لديك شركة ناشئة تدير برنامج نقاط ولاء لعدة متاجر، وكل عملية شراء تنقل نقاطاً بين محافظ العملاء في قاعدة PostgreSQL، وبجانبها متجر إلكتروني على MySQL، والاثنان في Containers على سيرفر واحد. والنسخ الاحتياطي الذي أعده أول مطور في الفريق سطر واحد في Cron: يضغط مجلدات ال Volumes كلها بالأمر tar كل ليلة ويرسلها إلى مكان آخر. وقد جربه مرة واحدة: فك الأرشيف على جهازه، وشغل ال Containers، فعملت القاعدتان، فاعتبر الموضوع منتهياً. والسؤال الذي لم يسأله أحد: هل الملفات التي نسخها تمثل لحظة واحدة من حياة القاعدة؟ أم أن كل ملف نسخ في لحظة مختلفة بينما القاعدة تكتب؟ وهل نجاح التشغيل مرة يعني أنه سوف ينجح في الليلة التي تحتاجه فيها؟
وقد شرحنا في النسخ الاحتياطي بقاعدة 3-2-1 كم نسخة تحتفظ بها وأين، ومعنى RPO وRTO، وشرحنا في PostgreSQL للفرق سكربتاً ليلياً بالأداة pg_dump، وفي الاستعادة إلى أي لحظة مع pgBackRest النسخ الفيزيائي المستمر. وهذا المقال يجيب عن السؤال الذي يقع تحت كل ذلك: ما الذي يجعل نسخة قاعدة البيانات متسقة Consistent، أي أنها تمثل حالة كانت القاعدة عليها فعلاً، ولماذا تنجح بعض الطرق في الاختبار ثم تخذلك، وكيف تثبت أن النسخة تستعاد قبل أن تحتاجها. وكل رقم في المقال جاء من تجربة على PostgreSQL 18.6 وMySQL 8.4.11 والقاعدتان تكتبان أثناء النسخ.
وسوف نناقش في هذا المقال ما يلي:
- معنى النسخة المتسقة، والفرق بين الاتساق على مستوى المعاملات Transaction Consistent والاتساق كأن السيرفر انطفأ Crash Consistent والنسخة غير المتسقة.
- النسخ المنطقي Logical مقابل الفيزيائي Physical، ومتى تختار كلاً منهما.
- PostgreSQL: كيف يأخذ pg_dump لحظة واحدة، والصيغ، والأدوار التي لا يحفظها، ورموز الخروج في pg_restore.
- MySQL: الفرق بين
--single-transactionوقفل الجداول وتركه، وأدوات النسخ الفيزيائي. - نسخ مجلد البيانات وال Volume وهو يعمل، واللقطة الذرية Atomic Snapshot، و
docker pause. - النسخة الفيزيائية الصحيحة مع pg_basebackup والتحقق منها بالأداة pg_verifybackup.
- اختبار الاستعادة Restore Test: ما الذي يتحقق منه، مع حادثة GitLab في 2017، ثم SQLite وRedis باختصار.
- تجربة كاملة: نسخ أثناء الكتابة بست طرق، ونسخة MySQL بدأت بنجاح ثم توقفت عند أول استعلام، وسكربت اختبار استعادة كشف ملفاً مقطوعاً لم يكشفه الفحص المعتاد.
ما معنى نسخة متسقة؟ Consistent Backup
قاعدة البيانات ليست مجموعة ملفات مستقلة، وإنما ملفات بينها علاقات: صفحات الجداول، وصفحات الفهارس، وسجل الكتابة المسبقة WAL في PostgreSQL أو سجل Redo في InnoDB، وملف التحكم الذي يقول أين وصلت القاعدة. وفي برنامج النقاط كل عملية نقل تعدل محفظتين وتضيف سطراً في جدول السجل، داخل معاملة Transaction واحدة. لذلك نستطيع أن نكتب قاعدة يجب أن تصح دائماً، وهي ما يسمى الثابت Invariant: مجموع النقاط في كل المحافظ ثابت، ورصيد كل محفظة يساوي رصيدها الأول مع ما وصلها وناقص ما خرج منها في جدول السجل. وهذا الثابت هو ما سوف نستخدمه في التجربة لنحكم على كل نسخة.
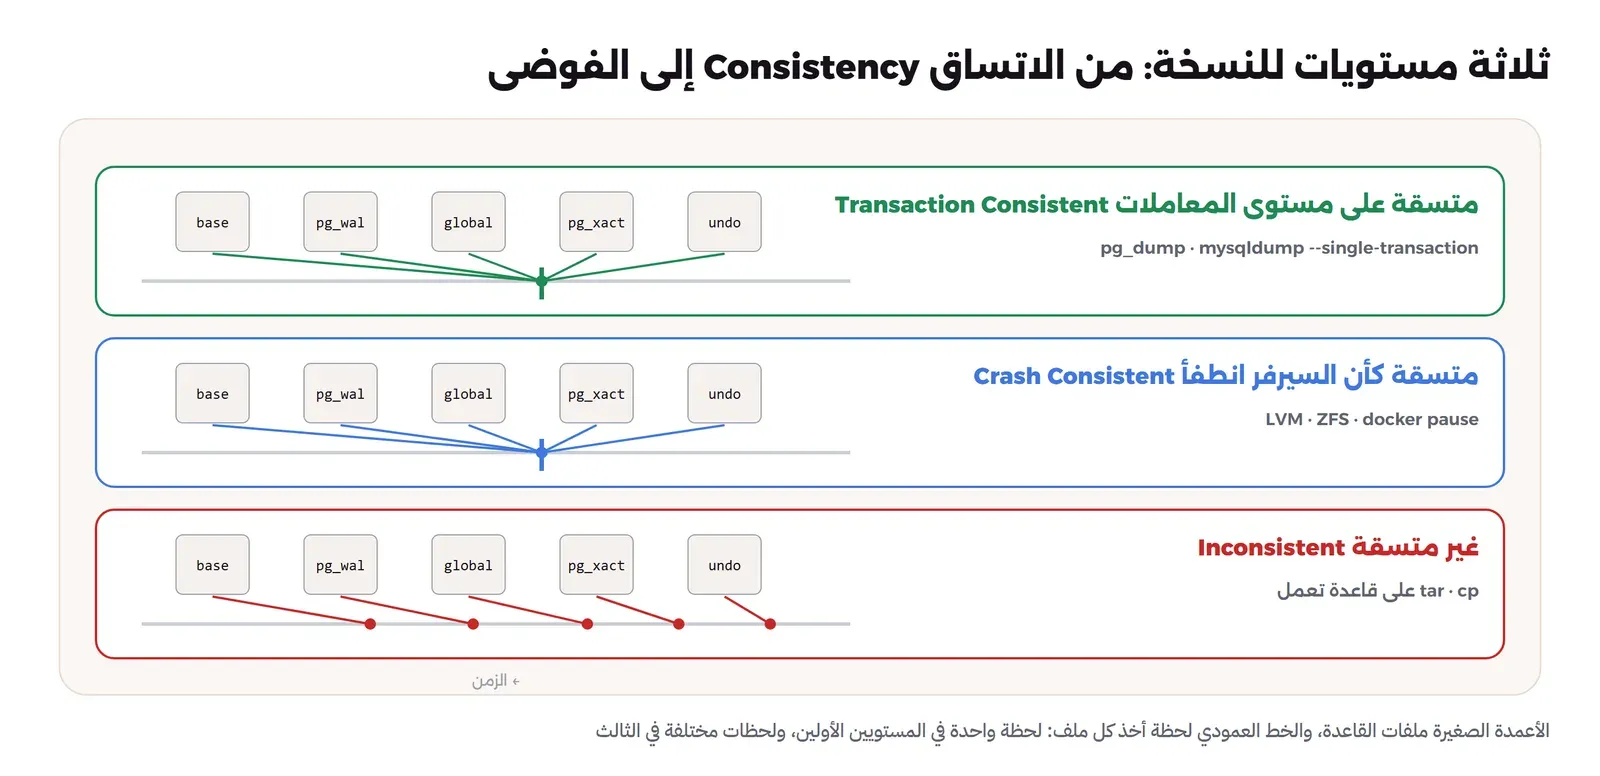
ومن هنا تخرج ثلاثة مستويات للنسخة:
- متسقة على مستوى المعاملات Transaction Consistent: تمثل حالة القاعدة بعد آخر معاملة اكتملت قبل لحظة معينة، وكل معاملة إما موجودة كاملة أو غير موجودة. وهذا ما يعطيه pg_dump وmysqldump مع الخيار المناسب.
- متسقة كأن السيرفر انطفأ Crash Consistent: صورة الملفات في لحظة واحدة بالضبط، كما لو انقطعت الكهرباء عن السيرفر، فعند تشغيلها تقرأ القاعدة سجلها وتكمل أو تلغي ما كان في منتصف الطريق، تماماً كما تفعل بعد انقطاع حقيقي. وهذا ما تعطيه اللقطة الذرية للقرص Atomic Snapshot.
- غير متسقة Inconsistent: كل ملف نسخ في لحظة مختلفة، فقد يكون ملف جدول من الدقيقة الأولى وسجل WAL من الدقيقة الثالثة، وهذه حالة لم تكن القاعدة عليها أبداً، ولا يوجد سجل يستطيع إصلاحها. وهذا ما يعطيه
tarأوcpعلى مجلد بيانات قاعدة تعمل.
وأقرب تشبيه لذلك صورة البانوراما في جوالك، فأنت تحرك الجوال ببطء من اليسار إلى اليمين والكاميرا تلتقط شريحة بعد شريحة، فإذا تحرك شخص في الغرفة أثناء ذلك ظهر في الصورة مرتين، أو ظهر بنصف جسم، مع أن كل شريحة وحدها صورة صحيحة تماماً. والنسخ بالأمر tar لقاعدة تعمل هو هذه البانوراما بالضبط: كل ملف صحيح في لحظته، والصورة كاملة لم تحدث أبداً. أما النسخة المتسقة فهي الصورة العادية التي تلتقط الغرفة كلها في لحظة واحدة، سواءً أخذتها القاعدة نفسها من داخلها كما يفعل pg_dump، أو أخذها نظام الملفات من الخارج كما تفعل اللقطة الذرية.
والخطير في النسخة غير المتسقة أنها لا تفشل دائماً، فإذا كانت الكتابة قليلة أثناء النسخ فقد تبدو سليمة، وقد تبدأ القاعدة منها وتعمل، وهذا ما رأيناه في التجربة ثلاث مرات قبل أن نرى المرة الرابعة. والنسخة التي تنجح أحياناً أسوأ من النسخة التي تفشل دائماً، لأن الثانية تكتشفها في أول اختبار.
النسخ المنطقي Logical مقابل الفيزيائي Physical
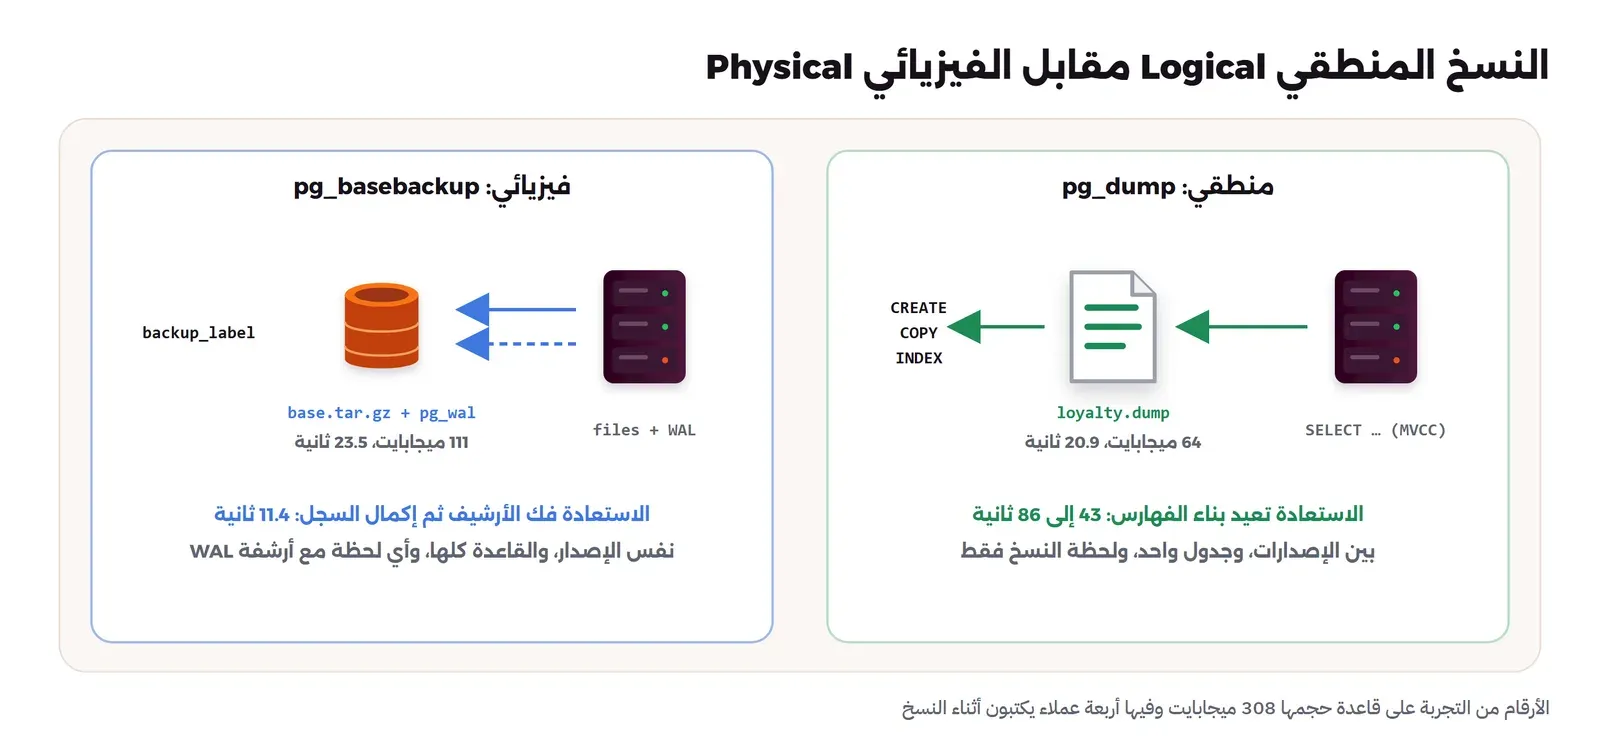
النسخ المنطقي يقرأ البيانات عبر القاعدة نفسها ويكتبها كأوامر أو صيغة خاصة: CREATE TABLE ثم البيانات ثم الفهارس، وأدواته pg_dump وmysqldump. أما النسخ الفيزيائي فينسخ ملفات القاعدة كما هي على القرص، مع السجل الذي يجعلها متسقة، وأدواته pg_basebackup وpgBackRest في PostgreSQL، وPercona XtraBackup وMySQL Enterprise Backup وإضافة Clone في MySQL. والجدول التالي يلخص الفرق كما ظهر في التجربة على قاعدة حجمها 308 ميجابايت:
| المعيار | منطقي: pg_dump | فيزيائي: pg_basebackup |
|---|---|---|
| حجم النسخة في التجربة | 64 ميجابايت، صيغة custom مضغوطة | 111 ميجابايت مضغوطة |
| زمن النسخ أثناء الكتابة | 20.9 ثانية | 23.5 ثانية |
| زمن الاستعادة | بين 43 و86 ثانية، لأنه يعيد بناء الفهارس | 11.4 ثانية لفك الأرشيف، وثوان للتشغيل |
| بين إصدارات مختلفة | نعم، وهو طريقة الترقية المعتادة | لا، نفس الإصدار الرئيسي فقط |
| استعادة جدول واحد | نعم | لا، القاعدة كلها |
| الاستعادة إلى لحظة معينة | لا، لحظة النسخ فقط | نعم مع أرشفة WAL المستمرة |
| يكشف التلف المنطقي | يقرأ كل صف، فيفشل إذا وجد صفحة تالفة | ينسخ الصفحة التالفة كما هي |
والقاعدة العملية أن تبدأ بالمنطقي لأي قاعدة صغيرة أو متوسطة، لأنه بسيط ومرن ويعمل بين الإصدارات، ثم تضيف الفيزيائي عندما تكبر القاعدة حتى تصبح الاستعادة المنطقية أطول من ال RTO الذي تقبله، أو عندما تحتاج أن تستعيد إلى ما قبل خطأ في منتصف اليوم. وكثير من الفرق تحتفظ بالنوعين: فيزيائي مستمر للكوارث، ومنطقي يومي للاستعادة الجزئية والترقيات.
PostgreSQL مع pg_dump: لحظة واحدة دون إيقاف
كيف يأخذ pg_dump لحظة واحدة؟ Snapshot
قد يتساءل البعض: إذا كان pg_dump يقرأ الجداول واحداً بعد الآخر خلال عشرين ثانية، والقاعدة تكتب طوال هذا الوقت، فكيف يكون الملف متسقاً؟ والإجابة في التحكم بالتزامن متعدد النسخ MVCC، فالأداة تفتح معاملة واحدة بمستوى عزل REPEATABLE READ أو أعلى، وتقرأ كل الجداول داخلها، فترى كل الجداول كما كانت عند بداية المعاملة، ولا ترى أي تعديل حدث بعدها، كما تذكر وثائق pg_dump أن النسخة متسقة حتى لو كانت القاعدة تستخدم في الوقت نفسه، وأن الأداة لا تمنع المستخدمين الآخرين من القراءة أو الكتابة. وفي التجربة شغلنا pg_dump بينما أربعة عملاء يرسلون قرابة 580 عملية نقل في الثانية، وكان الثابت سليماً في النسخة المستعادة.
ولكن لهذه اللحظة ثمن يجب أن تعرفه. فالأداة تأخذ قفلاً خفيفاً ACCESS SHARE على كل جدول، وهذا القفل لا يمنع القراءة ولا الكتابة، ولكنه يجعل أي تعديل في بنية الجدول مثل ALTER TABLE ينتظر حتى ينتهي النسخ، فإذا كان عندك ترحيل Migration يعمل ليلاً في وقت النسخ فسوف يتأخر، والأسوأ أن الاستعلامات التي تأتي بعد الترحيل تنتظر خلفه. والثمن الثاني أن المعاملة الطويلة تمنع تنظيف الصفوف القديمة VACUUM طوال مدتها، فنسخة تأخذ ساعتين على قاعدة كثيرة الكتابة تترك خلفها انتفاخاً Bloat يحتاج تنظيفاً. لذلك اختر وقت النسخ بعيداً عن الترحيلات، وراقب مدته مع نمو القاعدة.
الصيغ Formats مع التوازي Parallelism
لأداة pg_dump أربع صيغ، والاختيار بينها يحدد ما تستطيع فعله عند الاستعادة:
- plain: ملف SQL نصي تقرؤه بعينك وتشغله بالأداة psql، وهو مناسب لقاعدة صغيرة جداً أو لنقل بين أنظمة، ولكنه لا يسمح باستعادة جزئية ولا متوازية.
- custom: ملف واحد مضغوط تقرؤه الأداة pg_restore، ويسمح باستعادة جدول واحد وباستعادة متوازية بالخيار
--jobs، وهو الاختيار الافتراضي المعقول، واستخدمناه في التجربة. - directory: مجلد فيه ملف لكل جدول، وهو الصيغة الوحيدة التي تسمح بالنسخ المتوازي نفسه بالخيار
--jobs، فإذا كانت القاعدة كبيرة وزمن النسخ هو المشكلة فهذه صيغتك. - tar: مثل directory في أرشيف واحد، دون ضغط ودون توازي، ونادراً ما تحتاجها.
ما لا يحفظه pg_dump: الأدوار Roles
pg_dump ينسخ قاعدة واحدة، والأدوار Roles وكلمات مرورها ليست جزءاً من أي قاعدة، وإنما من ال Cluster كله، لذلك يحتاج كل نسخ إلى ملف ثان من الأمر pg_dumpall --globals-only كما في وثائق pg_dumpall. وفي التجربة عرفنا ماذا يحدث إذا نسيته: الاستعادة أدخلت كل البيانات وكان الثابت سليماً، ولكن الجداول أصبحت ملكاً للمستخدم postgres، والتطبيق لا يستطيع الدخول أصلاً لأن دوره غير موجود، ورمز الخروج كان 1. ولاحظ أن ملف الأدوار فيه هاش كلمات المرور، فإذا احتفظت به كما هو فعامله معاملة الأسرار Secrets في التشفير والصلاحيات، أو استخدم الخيار --no-role-passwords كما فعلنا في مقال PostgreSQL للفرق وأعد ضبط كلمات المرور من مخزن الأسرار عند الاستعادة.
رموز الخروج في pg_restore Exit Codes
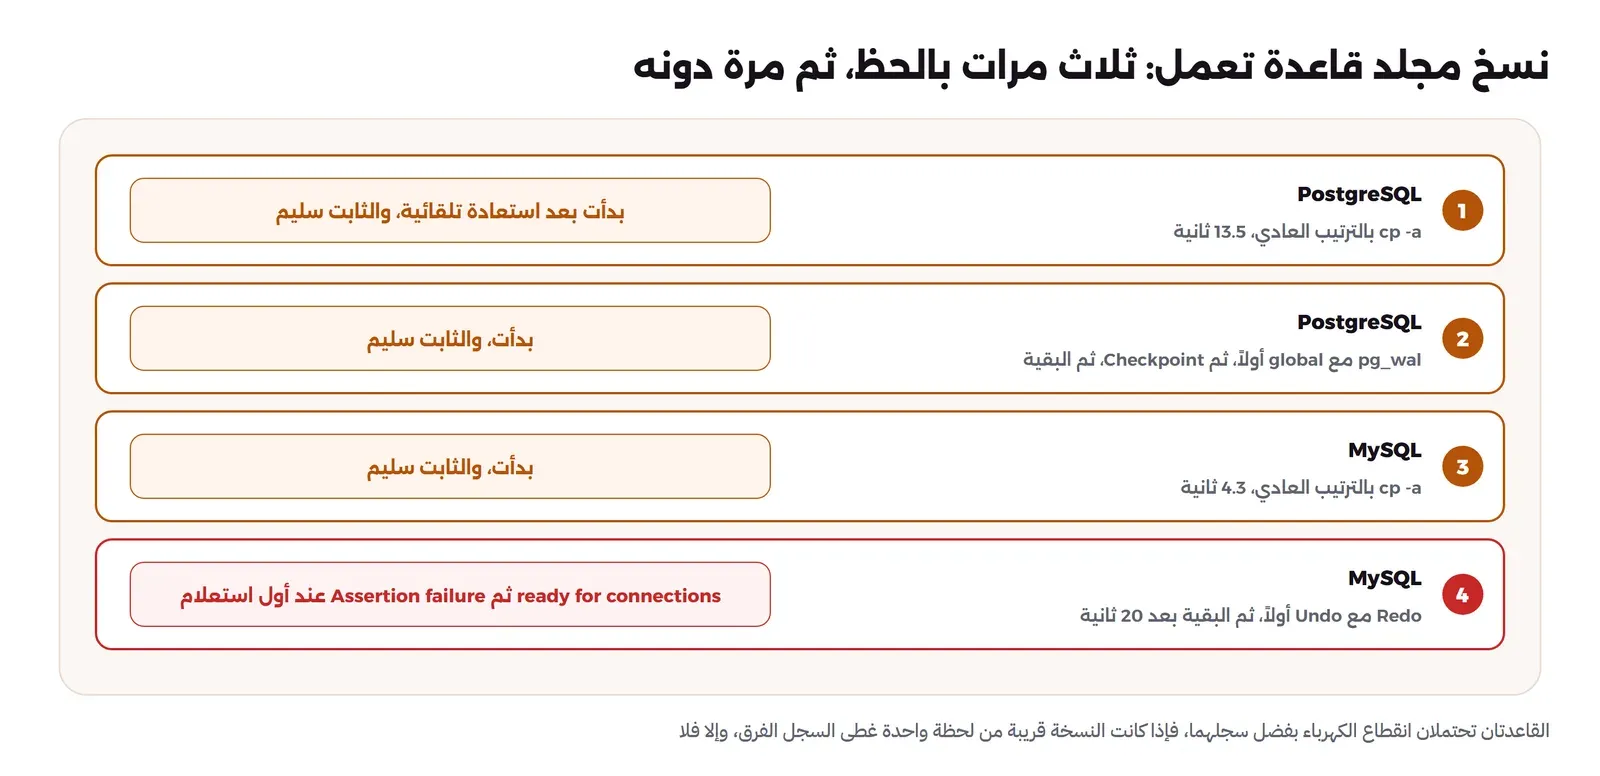
الأداة pg_restore تكمل الاستعادة عند الأخطاء افتراضياً، ثم تخرج بالرمز 1 وتطبع عدد الأخطاء التي تجاهلتها. وهذا مفيد عندما تستعيد يدوياً وتقرأ كل سطر، وخطير في سكربت لا يقرأ أحد مخرجاته، فالسكربت الذي لا يفحص رمز الخروج سوف يعتبر استعادة ناقصة استعادة ناجحة. لذلك استخدم في سكربتات الاستعادة الخيار --exit-on-error لكي تتوقف عند أول خطأ، وافحص رمز الخروج دائماً، وتذكر أن pg_restore --list يقرأ فهرس الملف فقط، وقد رأينا في التجربة ملفاً مقطوعاً عند 30 ميجابايت من 64 قرأته --list بنجاح ورمز خروج صفر، ثم فشلت استعادته.
MySQL مع mysqldump: ثلاثة خيارات وثلاث نتائج
mysqldump أقدم وأبسط من pg_dump، وطريقة حصوله على الاتساق تعتمد كلياً على الخيارات التي تعطيها، وهنا يخطئ كثيرون. والصورة التالية تبين ما يحدث في الحالات الثلاث:
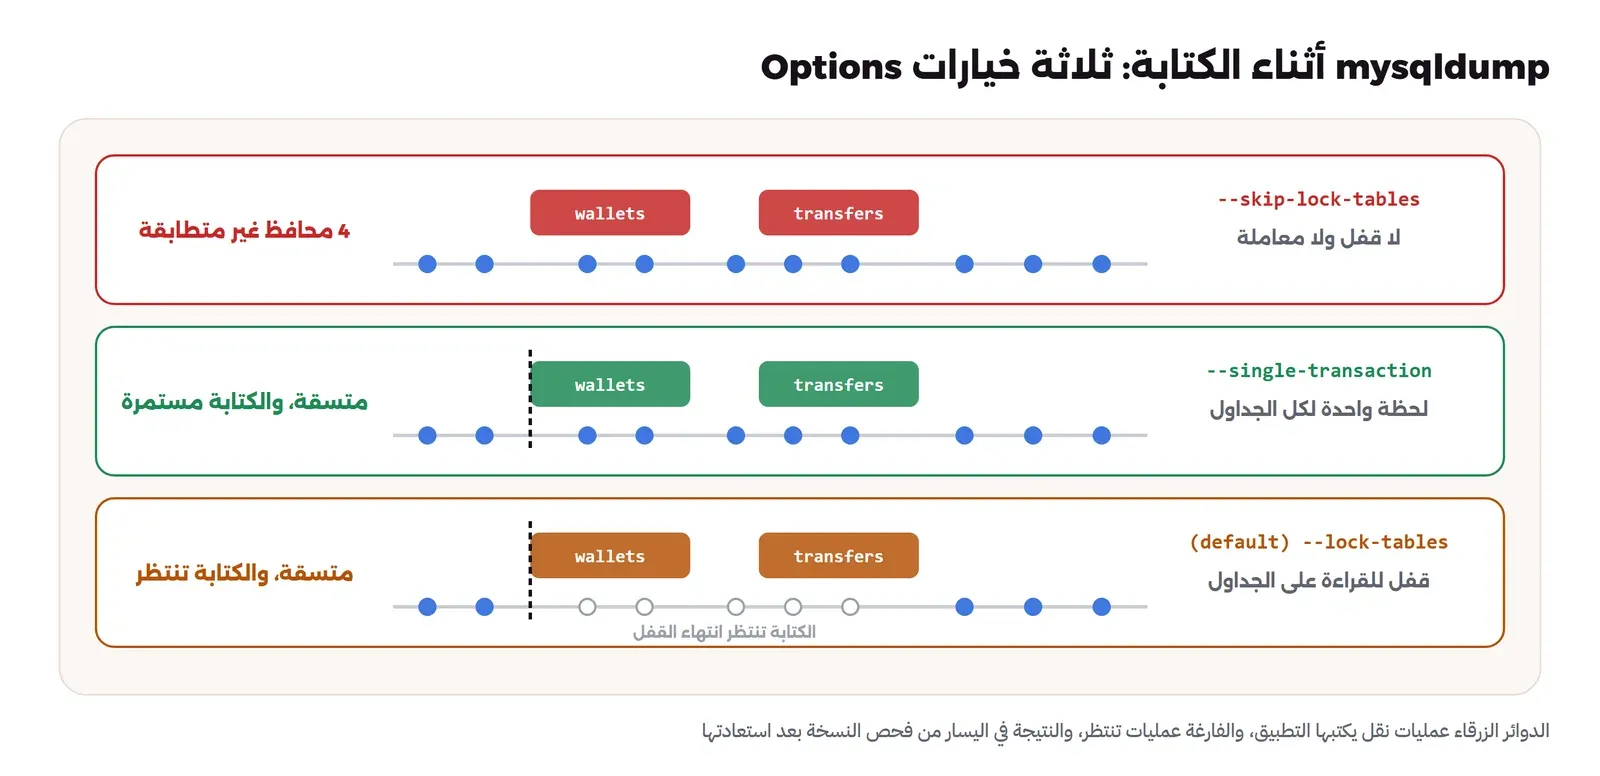
- الخيار الافتراضي: يفعل mysqldump مجموعة الخيارات
--optومنها--lock-tables، أي أنه يقفل جداول القاعدة للقراءة قبل النسخ، فتكون النسخة متسقة لأن أحداً لا يكتب، ولكن كل كتابة في التطبيق تنتظر حتى ينتهي النسخ. وفي قاعدة التجربة الصغيرة أخذ ذلك نصف ثانية، وفي قاعدة بعشرات الجيجابايت يعني دقائق من التوقف كل ليلة. --single-transaction: يبدأ معاملة بمستوى REPEATABLE READ ويقرأ كل الجداول منها، مثل pg_dump تماماً، فتكون النسخة متسقة دون قفل، ولكن هذا يصح لجداول InnoDB فقط، كما تنبه وثائق mysqldump، لأن MyISAM لا يدعم المعاملات. ويجب ألا يعمل أثناءه أي أمر يغير البنية مثلALTER TABLEأوTRUNCATEعلى الجداول المنسوخة.--skip-lock-tablesوحده: لا قفل ولا معاملة، فيقرأ كل جدول في لحظته. وهذا ما يحدث عندما يضيف أحدهم هذا الخيار لأن «النسخ يوقف المتجر» دون أن يضيف--single-transaction، وفي التجربة أعطى نسخة فيها 4 محافظ لا تطابق سجلها، مع أن مجموع النقاط كان صحيحاً، لأن كل جدول وحده متسق، والعلاقة بين الجدولين هي التي اختلت.
ولاحظ أن الفحص البسيط «مجموع النقاط ثابت» لم يكشف المشكلة، والذي كشفها هو مقارنة جدولين ببعضهما، وهذا درس مهم لاختبار الاستعادة: اختر فحوصاً تربط الجداول ببعضها، وليس فحوصاً لكل جدول وحده.
النسخ الفيزيائي في MySQL Physical Backup
للقواعد الكبيرة تحتاج MySQL أيضاً نسخاً فيزيائياً، والخيارات المعروفة كما تذكرها صفحة طرق النسخ في وثائق MySQL: MySQL Enterprise Backup وهي تجارية، وPercona XtraBackup مفتوحة المصدر وتعمل مع InnoDB دون إيقاف، وإضافة Clone المدمجة التي تنسخ القاعدة كاملة إلى مجلد أو إلى سيرفر آخر. وإذا كنت تستخدم MariaDB فأداتها mariadb-backup، ولا تخلط بين أدوات الاثنين، فقد شرحنا في MySQL أم MariaDB أن ملفات البيانات لم تعد متوافقة بينهما. والفكرة في كل هذه الأدوات واحدة: تنسخ ملفات InnoDB وهي تتغير، وتنسخ معها سجل Redo من بداية النسخ إلى نهايته، ثم تطبق السجل في خطوة تحضير Prepare، فتخرج نسخة متسقة.
نسخ مجلد البيانات Data Directory أثناء عمل القاعدة
نعود إلى سطر Cron الذي بدأنا به. فنسخ مجلد البيانات أو ال Volume بالأمر tar أو cp أو حتى rsync والقاعدة تعمل يعطي نسخة غير متسقة، وتقول وثائق PostgreSQL عن النسخ على مستوى الملفات بوضوح إن السيرفر يجب أن يوقف لكي تكون النسخة صالحة، وإن منع الاتصالات وحده لا يكفي، لأن tar لا يأخذ لقطة ذرية للملفات، ولأن السيرفر يحتفظ ببيانات في ذاكرته لم يكتبها بعد.
لماذا تعمل النسخة الحية أحياناً؟ Live Copy
في التجربة نسخنا مجلد PostgreSQL مرتين أثناء الكتابة، مرة بالترتيب العادي ومرة بترتيب معكوس مع نقطة تفتيش Checkpoint في منتصف النسخ، ونسخنا مجلد MySQL مرة بالترتيب العادي، والثلاث بدأت وكان الثابت فيها سليماً. والسبب أن PostgreSQL وInnoDB صمما ليتحملا انقطاع الكهرباء، فعند التشغيل يقرآن السجل من آخر نقطة تفتيش ويعيدان تطبيقه، فإذا كانت الملفات قريبة من حالة متسقة لأن الكتابة قليلة والنسخ سريع، فإن السجل يغطي الفرق. ولكن هذا حظ وليس ضماناً، فلا شيء يضمن أن صفحة في ملف الجدول لم تنسخ في منتصف كتابتها، أو أن ملف السجل نسخ قبل تغيير موجود في ملف بيانات نسخ بعده. وفي المحاولة الرابعة، على MySQL بترتيب نسخ مختلف، ظهر ما يحدث عندما ينفد الحظ: بدأ السيرفر وكتب ready for connections، ثم توقف عند أول استعلام برسالة تقول إن رقم معاملة في أحد الجداول أحدث من أكبر رقم يعرفه النظام، ثم Assertion failure وإيقاف السيرفر. أي أن اختبار «هل تبدأ القاعدة؟» كان سيقول إن النسخة سليمة.
اللقطة الذرية Atomic Snapshot مع docker pause
هل يعني هذا أن نسخ الملفات ممنوع دائماً؟ لا، فإذا أخذت الملفات كلها في لحظة واحدة بالضبط فأنت تملك نسخة متسقة كأن السيرفر انطفأ، وتستطيع القاعدة أن تبدأ منها كما تبدأ بعد انقطاع الكهرباء، وتقول وثائق PostgreSQL نفسها إن اللقطة المجمدة Frozen Snapshot للقرص طريقة مقبولة إذا كان نظام الملفات يدعمها. وهذا ما تعطيه لقطات LVM وZFS وBtrfs، ولقطات أقراص مزودي السحابة، بشرط أن تكون كل ملفات القاعدة على قرص واحد، أو أن تؤخذ لقطات كل الأقراص في اللحظة نفسها، فإذا كان سجل WAL على قرص والبيانات على قرص آخر ولقطتاهما في لحظتين مختلفتين عدت إلى النسخة غير المتسقة.
وفي Docker تستطيع أن تحصل على الأثر نفسه بالأمر docker pause، الذي يجمد كل عمليات ال Container، فلا يكتب شيئاً حتى تفك التجميد، فتنسخ ال Volume وهو ثابت. وفي التجربة بدأت النسخة كما تبدأ بعد انقطاع: database system was not properly shut down; automatic recovery in progress، ثم أكملت السجل في أقل من ثانية، وكان الثابت سليماً. ولكن النسخ نفسه أخذ 106 ثوان، والقاعدة مجمدة طوال هذا الوقت، أي أن التطبيق توقف دقيقتين تقريباً، وهذا الفرق بين لقطة نظام الملفات التي تأخذ جزءاً من الثانية مهما كان الحجم، ونسخ الملفات أثناء التجميد الذي يطول مع الحجم. لذلك فإن docker pause مع النسخ مناسب لقاعدة صغيرة تقبل توقفاً قصيراً، وغير مناسب إطلاقاً لقاعدة كبيرة.
وتذكر أن اللقطة على القرص نفسه ليست نسخة احتياطية بعد، فإذا تلف القرص أو حذف أحدهم ال Volume ذهبت اللقطة معه، وإنما هي نقطة متسقة تنسخ منها إلى مكان آخر كما في قاعدة 3-2-1.
النسخة الفيزيائية الصحيحة: pg_basebackup
إذا أردت نسخة فيزيائية لقاعدة PostgreSQL تعمل دون أن توقفها أو تجمدها، فالأداة الرسمية هي pg_basebackup. وهي تتصل بالقاعدة كما يتصل سيرفر نسخ متماثل Replica، وتطلب نقطة تفتيش، ثم تنسخ الملفات وهي تتغير، وتسحب معها سجل WAL من بداية النسخ إلى نهايته بالخيار --wal-method=stream، وتكتب ملف backup_label الذي يخبر القاعدة عند التشغيل من أين تبدأ قراءة السجل. والنتيجة نسخة غير متسقة في ملفاتها، ولكنها تحمل معها كل ما تحتاجه لتصبح متسقة، وهذا ما ظهر في سجل التشغيل: starting backup recovery ثم consistent recovery state reached.
وتكتب الأداة أيضاً ملف بيان Manifest فيه قائمة الملفات وحجم كل منها وبصمته Checksum، وتستطيع الأداة pg_verifybackup أن تتحقق من النسخة مقابل البيان دون أن تشغلها. وفي التجربة أتلفنا 14 بايت في وسط أرشيف النسخة، فأخرجت الأداة checksum mismatch for file "base/16385/16425"، بينما النسخة السليمة أعطت backup successfully verified. وإذا أردت أن تستعيد إلى أي لحظة، وليس فقط إلى لحظة النسخ، فأنت تحتاج أرشفة WAL المستمرة، وهي موضوع مقال pgBackRest.
اختبار الاستعادة Restore Test: ماذا تتحقق منه؟
كل ما سبق يصنع ملفاً، ولا شيء منه يثبت أن الملف يستعاد. والفرق بين الفريق الذي يملك نسخاً احتياطية والفريق الذي يظن أنه يملكها هو اختبار استعادة يعمل تلقائياً ويصرخ عندما يفشل.
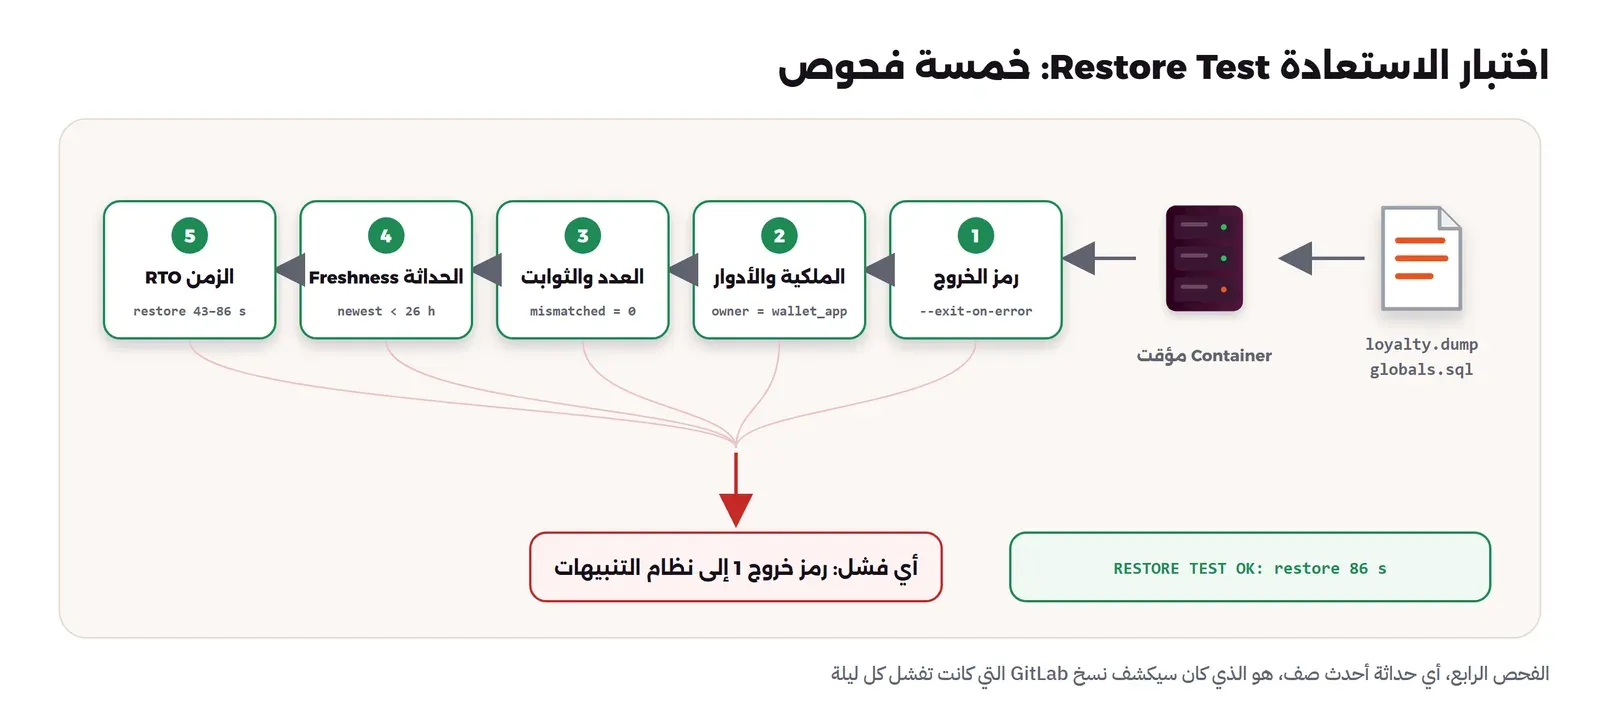
ومن هذه الحادثة ومن التجربة تخرج قائمة ما يجب أن يتحقق منه اختبار الاستعادة:
- الاستعادة نفسها نجحت: رمز خروج صفر مع
--exit-on-error، وليس «الملف موجود» ولا «الفهرس مقروء». - الأدوار والملكية: الجداول ملك دور التطبيق، والتطبيق يستطيع الدخول.
- العدد والثوابت: عدد الصفوف في الجداول المهمة، وثوابت تربط الجداول ببعضها، مثل رصيد المحفظة مقابل سجلها، أو مجموع بنود الفاتورة مقابل إجماليها.
- الحداثة Freshness: أحدث صف في النسخة عمره أقل من 26 ساعة، وهذا الفحص هو الذي كان سيكشف نسخ GitLab التي لم تعمل، فالنسخة القديمة تستعاد بنجاح تام وتكون قديمة.
- الزمن: كم أخذت الاستعادة، وهذا رقمك الحقيقي لل RTO، وفي التجربة تراوح بين 43 و86 ثانية لقاعدة 308 ميجابايت على الجهاز نفسه بحسب ضغطه.
- التنبيه: الفشل يصل إلى نظام التنبيهات الذي يراه الفريق، وليس إلى بريد قد يرفض، كما شرحنا في التنبيهات Alerting.
وشغل الاختبار على سيرفر غير سيرفر الإنتاج إن استطعت، لكي لا تضغط عليه، ولكي يثبت أيضاً أن النسخة تستعاد بعيداً عن السيرفر الأصلي، واكتب خطوات الاستعادة اليدوية الكاملة في دليل تشغيل Runbook، لأن السكربت يتحقق من النسخة، ولكن الإنسان هو الذي سيستعيد في الليلة الصعبة.
قواعد أخرى على سيرفرك: SQLite مع Redis
ليست كل البيانات على سيرفرك في PostgreSQL أو MySQL، فكثير من التطبيقات التي تستضيفها بنفسك تحفظ بياناتها في SQLite، مثل مدير كلمات المرور أو أداة المراقبة الصغيرة، وكثير من الأنظمة تضع Redis بجانب القاعدة الرئيسية. والسؤال نفسه ينطبق عليها: هل الملف الذي تنسخه يمثل لحظة واحدة؟
في SQLite القاعدة ملف واحد، وقد يكون معه ملف سجل -wal إذا كان التطبيق يستخدم وضع WAL، فإذا نسخت الملف الرئيسي وحده والتطبيق يكتب فقد تنسخ صفحات من لحظتين مختلفتين، أو تنسخ الملف دون التغييرات التي ما زالت في ملف السجل. والطريقة الصحيحة أن تطلب النسخة من SQLite نفسها، إما بواجهة Online Backup API التي يستخدمها الأمر .backup في أداة sqlite3، وإما بالأمر VACUUM INTO 'backup.db' الذي تشرحه وثائق VACUUM ويكتب نسخة متسقة ومضغوطة في ملف جديد داخل معاملة قراءة واحدة. وإذا لم يكن في Image التطبيق أداة sqlite3 فأوقف التطبيق لثوان وانسخ الملفين معاً، فالتوقف القصير المخطط أفضل من نسخة لا تعرف هل هي سليمة.
أما Redis فحالته معاكسة، فملف اللقطة RDB الذي يكتبه آمن للنسخ والسيرفر يعمل، والسبب كما تذكر وثائق الاستمرارية في Redis أن الملف لا يتغير بعد إنشائه، وأن Redis يكتبه باسم مؤقت ثم يعيد تسميته باسمه النهائي في عملية ذرية عند اكتماله، فأنت تنسخ دائماً لقطة كاملة. والسؤال الأهم في Redis ليس كيف تنسخه، وإنما هل يجب أن تنسخه أصلاً، فإذا كان Cache يعاد بناؤه من القاعدة فلا معنى لنسخه، وإذا كانت فيه بيانات لا توجد في مكان آخر، مثل طوابير المهام أو الجلسات التي لا تريد أن يفقدها المستخدمون، فعامله كقاعدة بيانات واختبر استعادته مثلها.
الجدولة والاحتفاظ Scheduling
النسخ ليس مجانياً على السيرفر، ففي التجربة كان pg_dump يقرأ القاعدة كلها خلال عشرين ثانية، وهذا ضغط على القرص والمعالج يشعر به التطبيق في قاعدة كبيرة. لذلك اختر وقتاً هادئاً، وابتعد عن وقت الترحيلات والمهام الليلية الثقيلة، وإذا كانت عندك نسخة متماثلة Replica فخذ النسخ المنطقي منها بدلاً من القاعدة الرئيسية. ولكن انتبه لمشكلة معروفة هنا، فالنسخة المتماثلة في PostgreSQL تطبق تغييرات الرئيسية باستمرار، فإذا كان pg_dump يقرأ صفوفاً تريد الرئيسية تنظيفها، فإن النسخة المتماثلة إما أن تؤخر تطبيق التغييرات حتى ينتهي النسخ، وإما أن تلغي استعلام النسخ برسالة canceling statement due to conflict with recovery، والذي يحدد ذلك الإعدادان max_standby_streaming_delay وhot_standby_feedback كما تشرح وثائق Hot Standby. لذلك إذا نقلت النسخ إلى نسخة متماثلة فراقب أول أسبوع: هل اكتملت كل النسخ؟ وكم تأخرت النسخة المتماثلة عن الرئيسية أثناءها؟ أما كم نسخة تحتفظ بها، وكم منها خارج السيرفر، فقد شرحنا سياسة الاحتفاظ Retention في مقال قاعدة 3-2-1، وأدوات نقل الملفات إلى مكان آخر في مقارنة أدوات النسخ الاحتياطي. والمهم هنا أن ملف التفريغ يمر عبر هذه الأدوات كأي ملف آخر، وأن ال Volume الذي فيه بيانات القاعدة الحية لا يمر عبرها أبداً.
تجربة عملية Lab: ست طرق للنسخ أثناء الكتابة
في هذه التجربة نبني برنامج النقاط على PostgreSQL 18.6 وعلى MySQL 8.4.11، ونشغل عليهما كتابة مستمرة، ثم ننسخ بكل طريقة ونستعيد ونفحص الثابت. وملفات التجربة كاملة في مجلد lab مع المقال.
البيانات والثابت Invariant
القاعدة فيها 200 ألف محفظة بألف نقطة لكل منها، وجدول سجل للتحويلات. ثم أضفنا ثلاثة ملايين تحويل وأعدنا حساب الأرصدة منها، فأصبح حجم القاعدة 308 ميجابايت:
-- Loyalty points: every transfer moves points between two wallets and is logged.
-- Invariant checked after every restore: points = 1000 + received - sent, for every wallet.
CREATE ROLE wallet_app LOGIN PASSWORD 'app-pass';
CREATE DATABASE loyalty OWNER wallet_app;
\c loyalty
SET ROLE wallet_app;
CREATE TABLE wallets (id int PRIMARY KEY, owner text NOT NULL, points bigint NOT NULL);
CREATE TABLE transfers (id bigserial PRIMARY KEY, from_id int NOT NULL, to_id int NOT NULL, amount int NOT NULL, at timestamptz NOT NULL DEFAULT now());
INSERT INTO wallets SELECT g, 'customer-' || g, 1000 FROM generate_series(1, 200000) g;
CREATE INDEX transfers_from ON transfers(from_id);
CREATE INDEX transfers_to ON transfers(to_id);
والكتابة أثناء النسخ تقوم بها الأداة pgbench التي تأتي مع PostgreSQL، بسكربت يمثل عملية نقل واحدة داخل معاملة:
\set a random(1, 200000)
\set b random(1, 200000)
\set n random(1, 50)
BEGIN;
UPDATE wallets SET points = points - :n WHERE id = :a;
UPDATE wallets SET points = points + :n WHERE id = :b;
INSERT INTO transfers (from_id, to_id, amount) VALUES (:a, :b, :n);
COMMIT;
وهذا هو الفحص الذي نشغله على كل نسخة مستعادة:
-- 1) total points never changes; 2) every wallet matches its transfer log
SELECT (SELECT count(*) FROM wallets) AS wallets,
       (SELECT count(*) FROM transfers) AS transfers,
       (SELECT sum(points) FROM wallets) AS total_points,
       (SELECT count(*) FROM wallets w
         LEFT JOIN (SELECT to_id id, sum(amount) s FROM transfers GROUP BY to_id) i USING (id)
         LEFT JOIN (SELECT from_id id, sum(amount) s FROM transfers GROUP BY from_id) o USING (id)
         WHERE w.points <> 1000 + coalesce(i.s, 0) - coalesce(o.s, 0)) AS mismatched_wallets;
docker network create dv2o-db
docker run -d --name dv2o-pg --network dv2o-db -e POSTGRES_PASSWORD=lab-pass \
-v dv2o-pg-data:/var/lib/postgresql -v "$PWD:/lab:ro" postgres:18.6
docker exec dv2o-pg psql -U postgres -q -f /lab/schema-pg.sql
docker exec dv2o-pg pgbench -U wallet_app -h 127.0.0.1 -n -f /lab/transfer.pgbench -c 4 -T 20 loyaltynumber of transactions actually processed: 11622
number of failed transactions: 0 (0.000%)
latency average = 6.881 ms
tps = 581.319710 (without initial connection time)أربعة عملاء نفذوا قرابة 580 عملية نقل في الثانية، وهذا هو الضغط الذي يعمل أثناء كل نسخ في التجربة. وفي أول محاولة لإضافة الملايين الثلاثة كتبنا الإدراج وإعادة الحساب والأمر VACUUM في خيار -c واحد، فعملت الأوامر دقيقتين ونصف ثم ألغيت كلها بالخطأ VACUUM cannot run inside a transaction block، لأن psql ينفذ الأوامر المتعددة في -c واحد كمعاملة واحدة، والحل أن تعطي كل أمر خياره -c الخاص.
نسخ مجلد PostgreSQL أثناء الكتابة Live Copy
شغلنا pgbench دقيقتين، ونسخنا ال Volume بالأمر cp من Container آخر يربطه للقراءة فقط، ثم شغلنا PostgreSQL على النسخة:
docker exec -d dv2o-pg pgbench -U wallet_app -h 127.0.0.1 -n -f /lab/transfer.pgbench -c 4 -T 120 loyalty
docker run --rm -v dv2o-pg-data:/src:ro -v dv2o-copy-live:/dst alpine:3.24 sh -c 'cp -a /src/. /dst/ && du -sh /dst'
docker run -d --name dv2o-pg-live --network dv2o-db -v dv2o-copy-live:/var/lib/postgresql postgres:18.6
LOG: database system was interrupted; last known up at 2026-11-03 19:21:28 UTC
LOG: database system was not properly shut down; automatic recovery in progress
LOG: redo starts at 0/B05BA410
LOG: invalid record length at 0/B2C64508: expected at least 24, got 0
LOG: redo done at 0/B2C644E0 system usage: CPU: user: 0.13 s, system: 0.09 s, elapsed: 0.23 s
LOG: database system is ready to accept connections wallets | transfers | total_points | mismatched_wallets
---------+-----------+--------------+--------------------
200000 | 3013828 | 200000000 | 0في المخرج أعلاه لاحظ التالي:
- القاعدة عرفت أنها لم تغلق بشكل صحيح، فبدأت الاستعادة التلقائية وأعادت تطبيق السجل من آخر نقطة تفتيش.
- السطر
invalid record lengthليس خطأ، وإنما الطريقة التي تعرف بها القاعدة أنها وصلت إلى نهاية السجل المكتوب. - الثابت سليم، والنسخة تبدو ممتازة، وهذا بالضبط ما يجعل هذه الطريقة خادعة.
ثم كررنا التجربة بترتيب نسخ مختلف: سجل WAL وملفات global أولاً، ثم انتظار ثماني ثوان، ونقطة تفتيش أثناءها، ثم بقية الملفات، وكانت النتيجة أيضاً قاعدة تبدأ وثابتاً سليماً. أي أن PostgreSQL تحمل المحاولتين بفضل سجله وقلة الوقت بين أول ملف وآخر ملف.
نسخ مجلد MySQL: يبدأ ثم يتوقف
على MySQL أنشأنا الجداول نفسها وإجراءً مخزناً churn ينفذ عمليات النقل في حلقة، فكانت الكتابة أبطأ بكثير، قرابة 35 عملية في الثانية، لأن كل Commit ينتظر الكتابة إلى القرص في Volume على Docker Desktop. والنسخة الحية الأولى بالترتيب العادي بدأت وكان الثابت سليماً، فاخترنا ترتيباً آخر يشبه ما تفعله أداة نسخ تعمل على عدة ملفات بالتوازي: سجل Redo وملفات النظام أولاً، ثم بعد 20 ثانية بقية الملفات:
docker run --rm -v dv2o-my-data:/src:ro -v dv2o-mycopy-order:/dst alpine:3.24 sh -c \
  'cd /src; cp -a "#innodb_redo" ibdata1 undo_001 undo_002 /dst/; sleep 20;
   for f in $(ls -A); do [ -e "/dst/$f" ] || cp -a "$f" /dst/; done'
بدأ السيرفر وكتب في سجله ready for connections، وعند أول استعلام فحص:
[Warning] [MY-013021] [InnoDB] A transaction id in a record of table `mysql`.`innodb_table_stats` is newer than the system-wide maximum.
[ERROR] [MY-013183] [InnoDB] Assertion failure: trx0rec.ic:93:next_undo_offset > undo_offset thread 140340946363968
InnoDB: We intentionally generate a memory trap.
InnoDB: If you get repeated assertion failures or crashes, even
InnoDB: immediately after the mysqld startup, there may be
InnoDB: corruption in the InnoDB tablespace.
mysqld got signal 6 ;
والرسالة الأولى تشرح ما حدث: ملفات الجداول نسخت بعد سجل التراجع Undo بعشرين ثانية، ففيها معاملات أحدث من كل ما يعرفه سجل النظام، أي حالة لم تكن القاعدة عليها أبداً. وال Container توقف، والعميل رأى Lost connection to MySQL server during query. وتخيل أن اختبار الاستعادة عندك يتوقف عند «هل بدأ السيرفر؟».
docker pause: نسخة متسقة مع توقف 106 ثوان
time (docker pause dv2o-pg && docker run --rm -v dv2o-pg-data:/src:ro -v dv2o-copy-paused:/dst alpine:3.24 cp -a /src/. /dst/; docker unpause dv2o-pg)real 1m46.625sLOG: database system was not properly shut down; automatic recovery in progress
LOG: redo starts at 0/B4F55268
LOG: redo done at 0/B8E9C120 system usage: CPU: user: 0.32 s, system: 0.52 s, elapsed: 0.84 s
LOG: database system is ready to accept connections
wallets | transfers | total_points | mismatched_wallets
---------+-----------+--------------+--------------------
200000 | 3044613 | 200000000 | 0النسخة متسقة كأن السيرفر انطفأ في لحظة التجميد، وأكملت القاعدة سجلها في 0.84 ثانية. ولكن عمليات pgbench الأربع كانت متوقفة 106 ثوان لأن القاعدة مجمدة، وهذا هو ثمن هذه الطريقة: النسخة تأخذ وقت نسخ 1.3 جيجابايت من الملفات، والقاعدة متوقفة طوال هذا الوقت.
pg_dump أثناء الكتابة
docker exec dv2o-pg sh -c 'mkdir -p /backup && pg_dump -U postgres --format=custom --file=/backup/loyalty.dump loyalty && pg_dumpall -U postgres --globals-only > /backup/globals.sql && ls -l /backup'-rw-r--r-- 1 root root 944 Nov 3 19:28 globals.sql
-rw-r--r-- 1 root root 63774669 Nov 3 19:28 loyalty.dump
real 0m20.883sعشرون ثانية والكتابة مستمرة دون أي توقف، وملف بحجم 64 ميجابايت لقاعدة حجمها 308، لأن الصيغة custom مضغوطة ولأن الفهارس لا تنسخ كبيانات وإنما كأوامر إنشاء.
ماذا لو نسيت ملف الأدوار؟ What If
استعدنا الملف في PostgreSQL جديد دون ملف الأدوار:
docker exec dv2o-pg-restore psql -U postgres -qc "CREATE DATABASE loyalty"
docker exec dv2o-pg-restore pg_restore -U postgres -d loyalty --jobs=4 /backup/loyalty.dump
pg_restore: error: could not execute query: ERROR: role "wallet_app" does not exist
Command was: ALTER TABLE public.transfers OWNER TO wallet_app;
pg_restore: error: could not execute query: ERROR: role "wallet_app" does not exist
Command was: ALTER SEQUENCE public.transfers_id_seq OWNER TO wallet_app;
real 0m39.478s
wallets | transfers | total_points | mismatched_wallets
---------+-----------+--------------+--------------------
200000 | 3044614 | 200000000 | 0البيانات كلها موجودة والثابت سليم، ورمز الخروج كان 1، ومحاولة الدخول بدور التطبيق أعطت FATAL: role "wallet_app" does not exist. أي أن سكربتاً يفحص الثابت فقط ويتجاهل رمز الخروج سوف يقول إن الاستعادة نجحت، والتطبيق لا يعمل. ومع ملف الأدوار أولاً ثم CREATE DATABASE loyalty OWNER wallet_app ثم الاستعادة مع --exit-on-error كان رمز الخروج صفراً، وأصبح مالك الجدولين wallet_app، وأخذت العملية 42.8 ثانية. ولاحظ عند تشغيل ملف الأدوار أنه أعطى ERROR: role "postgres" already exists، وهذا متوقع ولا يضر لأن الدور موجود في كل تثبيت جديد. ولاحظ أيضاً في بداية الملف سطراً جديداً \restrict يضيفه pg_dumpall في الإصدارات الحديثة لحماية psql من أوامر خطرة داخل ملف معدل، فلا تحذفه.
pg_basebackup مع pg_verifybackup
docker exec dv2o-pg pg_basebackup -U postgres -D /backup/base --format=tar --gzip --wal-method=stream --checkpoint=fast --progress342687/342687 kB (100%), 1/1 tablespace
-rw------- 1 root root 173595 Nov 3 19:28 backup_manifest
-rw------- 1 root root 110853314 Nov 3 19:28 base.tar.gz
-rw------- 1 root root 17111 Nov 3 19:28 pg_wal.tar.gz
real 0m23.520sفككنا الأرشيفين في Volume جديد في 11.4 ثانية، ثم شغلنا القاعدة:
LOG:  starting backup recovery with redo LSN 0/BA000028, checkpoint LSN 0/BA000080, on timeline ID 1
LOG:  redo starts at 0/BA000028
LOG:  completed backup recovery with redo LSN 0/BA000028 and end LSN 0/BA000158
LOG:  consistent recovery state reached at 0/BA000158
LOG:  database system is ready to accept connections
ولاحظ الفرق عن النسخة الحية: هنا القاعدة تعرف من ملف backup_label أنها تستعيد نسخة، وتعرف بالضبط النقطة التي تصبح عندها متسقة، وتكتب ذلك صراحة. ثم تحققنا من النسخة دون تشغيلها، ويحتاج الخيار --no-parse-wal مع صيغة tar، لأن الأداة لا تقرأ سجل WAL من داخل الأرشيف، وهذا ما أخبرتنا به في المحاولة الأولى:
pg_verifybackup: error: pg_waldump cannot read tar files
pg_verifybackup: hint: You must use -n/--no-parse-wal when verifying a tar-format backup.
وعلى النسخة السليمة، ثم بعد أن كتبنا 14 بايت في وسط base.tar.gz:
pg_verifybackup --no-parse-wal /backup/basebackup successfully verifiedpg_verifybackup: error: checksum mismatch for file "base/16385/16425" in archive "base.tar.gz"
pg_verifybackup: error: input file does not appear to be a valid tar archivemysqldump بثلاثة خيارات
شغلنا الإجراء churn في الخلفية، ثم شغلنا هذا السكربت داخل Container MySQL، وهو ينسخ القاعدة بالخيارات الثلاثة ويستعيد كل نسخة في قاعدة مستقلة ويفحصها:
#!/bin/sh
# Three ways to dump the same live database, each restored into its own schema and checked.
P="-uroot -plab-pass"
for mode in skip-lock-tables single-transaction default; do
  case $mode in
    skip-lock-tables)   OPTS="--skip-lock-tables" ;;
    single-transaction) OPTS="--single-transaction" ;;
    default)            OPTS="" ;;
  esac
  before=$(mysql $P -N store -e "SELECT COUNT(*) FROM transfers" 2>/dev/null)
  start=$(date +%s.%N)
  mysqldump $P $OPTS --routines store > /tmp/store-$mode.sql 2>/dev/null
  end=$(date +%s.%N)
  after=$(mysql $P -N store -e "SELECT COUNT(*) FROM transfers" 2>/dev/null)
  db="r_$(echo $mode | tr - _)"
  mysql $P -e "DROP DATABASE IF EXISTS $db; CREATE DATABASE $db" 2>/dev/null
  mysql $P $db < /tmp/store-$mode.sql 2>/dev/null
  echo "== $mode: $(awk "BEGIN{printf \"%.2f\", $end-$start}") s, transfers written during the dump: $((after-before)), file $(wc -c < /tmp/store-$mode.sql) bytes"
  mysql $P -t $db < /lab/check-my.sql 2>/dev/null
done
== skip-lock-tables: 2.15 s, transfers written during the dump: 10, file 7072759 bytes
| wallets | transfers | total_points | mismatched_wallets |
| 200000 | 20123 | 200000000 | 4 |
== single-transaction: 0.32 s, transfers written during the dump: 41, file 7086535 bytes
| wallets | transfers | total_points | mismatched_wallets |
| 200000 | 20429 | 200000000 | 0 |
== default: 0.47 s, transfers written during the dump: 6, file 7109441 bytes
| wallets | transfers | total_points | mismatched_wallets |
| 200000 | 20939 | 200000000 | 0 |في المخرج أعلاه لاحظ التالي:
- مع
--skip-lock-tablesوحده خرجت نسخة فيها 4 محافظ لا تطابق سجلها، لأن جدول المحافظ نسخ قبل جدول التحويلات، وبينهما تمت تحويلات وصلت إلى السجل ولم تصل إلى المحافظ في النسخة. - مجموع النقاط صحيح في الثلاث، لأن كل جدول نسخ في لحظة واحدة، والذي اختل هو العلاقة بين الجدولين.
--single-transactionمتسق والكتابة استمرت أثناءه، والخيار الافتراضي متسق لأنه قفل الجداول، فكتب التطبيق أثناءه أقل.- الأرقام في عمود «كتبت أثناء النسخ» تقريبية لأنها تشمل وقت أوامر العد نفسها، والقاعدة صغيرة، فلا تبن عليها مقارنة سرعة، وإنما على الاتساق في العمود الأخير.
سكربت اختبار الاستعادة Restore Test Script
هذا السكربت يجمع كل ما سبق: يشغل PostgreSQL مؤقتاً، ويستعيد آخر نسخة، ويفحص رمز الخروج والعدد والثابت والحداثة والملكية، ويطبع الزمن، ويخرج بالرمز 1 عند أي فشل لكي يلتقطه نظام التنبيهات:
#!/bin/sh
# Restore test: restores a pg_dump into a throwaway PostgreSQL, checks it, prints how long it took.
# usage: restore-test.sh <backup dir with globals.sql and loyalty.dump>   (exit 1 on any failure)
set -eu
DIR=$1; NAME=dv2o-restore-test; IMAGE=postgres:18.6
fail() { echo "RESTORE TEST FAILED: $*"; docker rm -f $NAME >/dev/null 2>&1; exit 1; }
start=$(date +%s)
docker run -d --name $NAME -e POSTGRES_PASSWORD=throwaway -v "$DIR:/backup:ro" $IMAGE >/dev/null
until docker exec $NAME pg_isready -h 127.0.0.1 -q; do sleep 1; done
docker exec $NAME psql -U postgres -q -f /backup/globals.sql >/dev/null 2>&1 || true   # "role postgres already exists" is expected
docker exec $NAME psql -U postgres -qc "CREATE DATABASE loyalty OWNER wallet_app" || fail "wallet_app role missing from globals.sql"
docker exec $NAME pg_restore -U postgres -d loyalty --jobs=4 --exit-on-error /backup/loyalty.dump || fail "pg_restore exited with $?"
restored=$(date +%s)
q() { docker exec $NAME psql -U postgres -d loyalty -Atc "$1"; }
[ "$(q 'SELECT count(*) FROM wallets')" = 200000 ] || fail "wallets count"
[ "$(q 'SELECT sum(points) FROM wallets')" = 200000000 ] || fail "total points changed"
mismatched=$(docker exec -i $NAME psql -U postgres -d loyalty -At < "$(dirname "$0")/check.sql" | cut -d'|' -f4)
[ "$mismatched" = 0 ] || fail "$mismatched wallets do not match their transfers"
age=$(q "SELECT extract(epoch FROM now() - max(at))::int FROM transfers")
[ "$age" -lt 93600 ] || fail "newest transfer is ${age}s old: the dump is stale"
[ "$(q "SELECT tableowner FROM pg_tables WHERE tablename = 'wallets'")" = wallet_app ] || fail "wrong owner"
end=$(date +%s)
echo "RESTORE TEST OK: restore $((restored - start)) s, checks $((end - restored)) s, newest transfer ${age} s old"
docker rm -f $NAME >/dev/null
وفي أول تشغيل فشل السكربت على نسخة سليمة:
RESTORE TEST FAILED: wallets do not match their transfersولاحظ المسافتين بعد النقطتين: عدد المحافظ غير المتطابقة كان نصاً فارغاً، والسبب أن نسخته الأولى أرسلت ملف الفحص إلى docker exec عبر الإدخال القياسي دون الخيار -i، فلم يصل إلى psql شيء، فرجع نصاً فارغاً. والجيد هنا أن الشرط كان يقارن بالصفر صراحة، فالفارغ لا يساوي صفراً ففشل الاختبار، ولو كتبنا الشرط بصيغة «إذا كان هناك رقم أكبر من صفر» لنجح الاختبار دون أن يفحص شيئاً. فاكتب فحوص النسخ بحيث يكون النجاح هو الحالة التي يجب إثباتها. وبعد إضافة -i:
RESTORE TEST OK: restore 86 s, checks 9 s, newest transfer 1838 s old

real	1m37.589s
ثم أعطيناه نسخة مقطوعة عند 30 ميجابايت من 64، كما يحدث عندما يمتلئ القرص أثناء النسخ أو ينقطع النقل. فالفحص المعتاد بالأمر pg_restore --list قرأ الفهرس ورجع بالرمز صفر، لأن فهرس الملف في بدايته:
3297; 1259 16409 INDEX public transfers_from wallet_app
3300; 1259 16410 INDEX public transfers_to wallet_app
list exit: 0
أما سكربت الاستعادة فكشفها:
pg_restore: error: could not find block ID 3448 in archive -- possibly corrupt archive
pg_restore: error: a worker process died unexpectedly
RESTORE TEST FAILED: pg_restore exited with 1
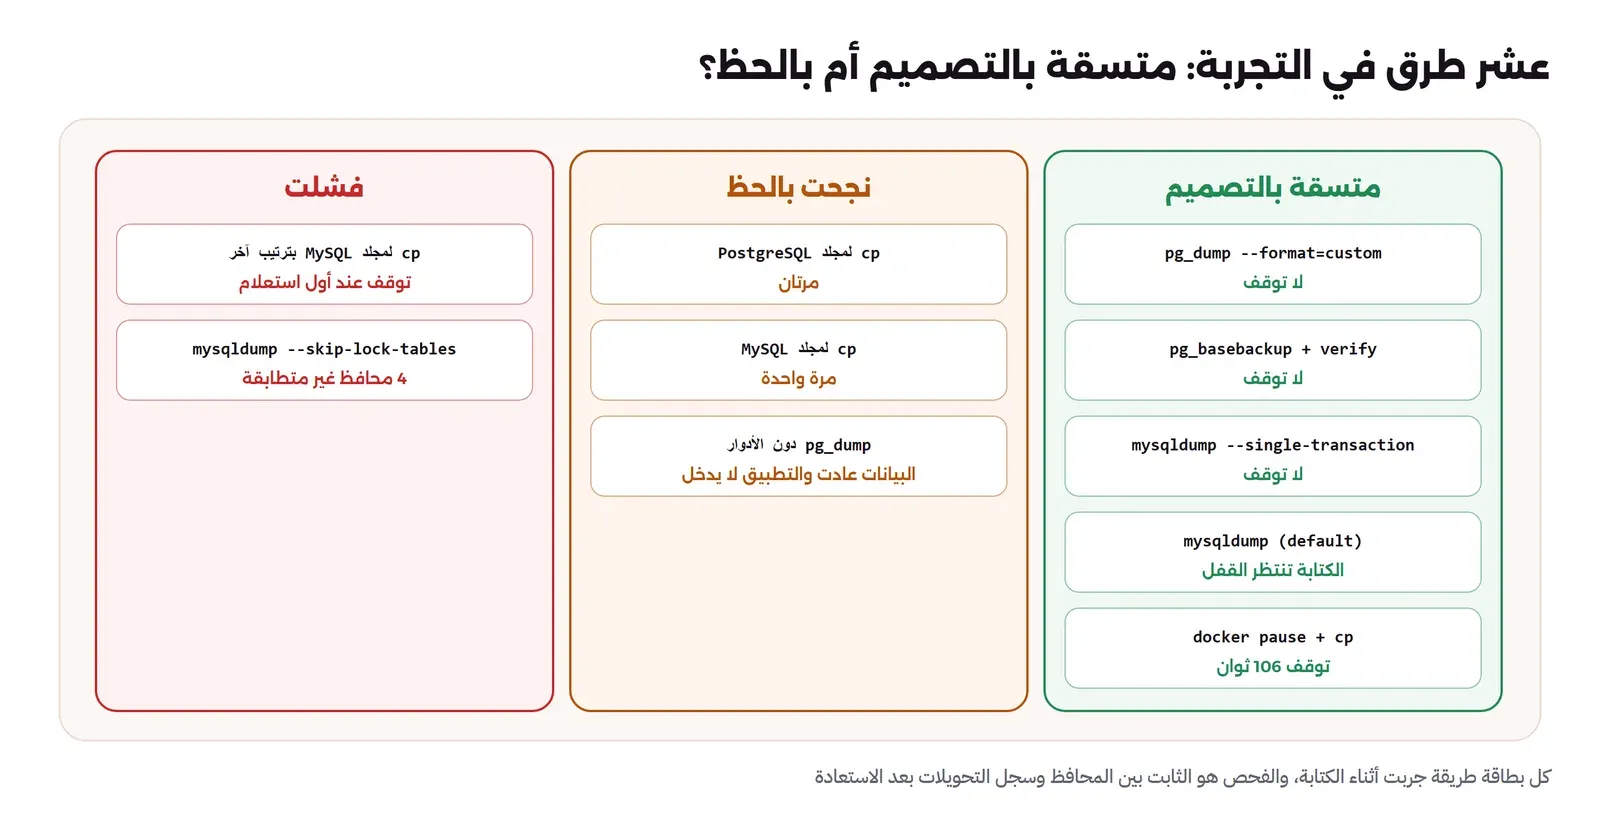
النتائج في جدول Results
| الطريقة | التوقف أثناء النسخ | بدأت القاعدة؟ | الثابت |
|---|---|---|---|
cp لمجلد PostgreSQL أثناء الكتابة، مرتان | لا يوجد | نعم | سليم في المرتين، بالحظ |
cp لمجلد MySQL بالترتيب العادي | لا يوجد | نعم | سليم، بالحظ |
cp لمجلد MySQL بترتيب مختلف | لا يوجد | نعم، ثم توقفت عند أول استعلام | لم يمكن فحصه |
docker pause ثم cp | 106 ثوان | نعم بعد استعادة تلقائية | سليم |
| pg_dump بصيغة custom | لا يوجد | نعم، 43 إلى 86 ثانية | سليم |
| pg_dump دون ملف الأدوار | لا يوجد | نعم، ورمز الخروج 1 | سليم، والتطبيق لا يدخل |
| pg_basebackup | لا يوجد | نعم، 11.4 ثانية للفك | سليم |
mysqldump مع --skip-lock-tables | لا يوجد | نعم | 4 محافظ غير متطابقة |
mysqldump مع --single-transaction | لا يوجد | نعم | سليم |
| mysqldump بالخيار الافتراضي | الكتابة تنتظر القفل | نعم | سليم |
التنظيف Cleanup
docker rm -f dv2o-pg dv2o-pg-live dv2o-pg-base dv2o-pg-restore dv2o-my dv2o-my-live
docker volume rm dv2o-pg-data dv2o-my-data dv2o-copy-live dv2o-copy-base dv2o-mycopy-live
docker network rm dv2o-db
docker rmi mysql:8.4.11
أخطاء شائعة Common Mistakes
- نسخ ال Volume والقاعدة تعمل: ينجح مرات كثيرة ثم يعطيك قاعدة تبدأ وتتوقف عند أول استعلام، فاستخدم أداة القاعدة أو لقطة ذرية.
- لقطات غير متزامنة: البيانات على قرص وسجل WAL على قرص آخر، ولقطتاهما في لحظتين مختلفتين.
- اعتبار
docker pauseحلاً لقاعدة كبيرة: القاعدة متوقفة طوال مدة النسخ، وكانت 106 ثوان لـ 1.3 جيجابايت. - pg_dump دون ملف الأدوار: البيانات تعود والتطبيق لا يدخل.
- تجاهل رمز الخروج في pg_restore: الاستعادة الناقصة تبدو ناجحة، فاستخدم
--exit-on-error. --skip-lock-tablesدون--single-transaction: لا قفل ولا اتساق، وفي التجربة 4 محافظ غير متطابقة.--single-transactionمع جداول MyISAM: لا يحميها، فحولها إلى InnoDB أو استخدم القفل.- اعتبار
pg_restore --listدليلاً: قرأ ملفاً مقطوعاً بنجاح. - اختبار استعادة يتوقف عند «بدأت القاعدة»: نسخة MySQL في التجربة بدأت ثم توقفت.
- إخطارات فشل النسخ بالبريد وحده: كما في GitLab، فاجعلها تذهب إلى نظام التنبيهات.
- إصدار أداة النسخ أقدم من القاعدة: pg_dump يجب أن يكون بإصدار القاعدة أو أحدث، وأسهل طريقة أن تشغله من داخل Container القاعدة نفسها.
قائمة تحقق Checklist
- النسخ بأداة القاعدة: pg_dump أو pg_basebackup، وmysqldump مع
--single-transactionأو أداة فيزيائية، ولا نسخ لمجلد بيانات يعمل. - ملف الأدوار مع كل نسخة PostgreSQL، ويحفظ كأي سر إذا كان فيه هاش كلمات المرور.
- كل جداول MySQL بمحرك InnoDB، أو خطة واضحة لغيرها.
- النسخ الفيزيائية مع بيان Manifest، والتحقق منها بالأداة pg_verifybackup.
- اختبار استعادة تلقائي يفحص رمز الخروج والملكية والعدد وثوابت بين الجداول والحداثة، ويخرج بغير الصفر عند الفشل.
- زمن الاستعادة مقاس ومسجل، ويقارن بال RTO.
- الفشل يصل إلى نظام التنبيهات، وهناك تنبيه أيضاً عند غياب نسخة جديدة.
- خطوات الاستعادة اليدوية مكتوبة في دليل تشغيل ومجربة.
- النسخ تنتقل إلى خارج السيرفر حسب قاعدة 3-2-1.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- النسخة المتسقة تمثل حالة كانت القاعدة عليها فعلاً، إما بعد معاملات كاملة كما في pg_dump، وإما كأن السيرفر انطفأ كما في اللقطة الذرية.
- نسخ مجلد البيانات وهو يعمل نجح ثلاث مرات في التجربة ثم أعطى قاعدة MySQL تبدأ وتتوقف عند أول استعلام، والنسخة التي تنجح أحياناً لا تصلح نسخة احتياطية.
- pg_dump يأخذ لحظة واحدة دون إيقاف بفضل MVCC، ولكنه لا يحفظ الأدوار، وpg_restore يكمل عند الأخطاء ما لم تطلب غير ذلك.
- mysqldump متسق مع
--single-transactionلجداول InnoDB، أو مع القفل الافتراضي الذي يوقف الكتابة، وغير متسق دونهما. - pg_basebackup يعطي نسخة فيزيائية تعرف القاعدة كيف تجعلها متسقة، وpg_verifybackup يكشف تلفها دون تشغيلها.
- اختبار الاستعادة يفحص الحداثة والثوابت بين الجداول والملكية ورمز الخروج، ويصرخ في نظام التنبيهات، فنسخ GitLab كانت تفشل كل ليلة دون أن يعلم أحد.
وبعد أن تملك نسخة متسقة ومختبرة، فالخطوة التالية أن تخرجها من السيرفر، وقد شرحنا الأدوات في مقارنة restic وBorg وKopia، والحماية من الحذف في النسخ إلى S3 مع Object Lock.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلأي أداة نسخ احتياطي Backup تناسب سيرفرك؟مقارنة عملية لأشهر أدوات النسخ الاحتياطي مفتوحة المصدر على البيانات نفسها في الوقت والحجم والذاكرة، لتعرف أيها يناسب سيرفرك.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
 دليلدليل التشغيل Runbook: وثق الإجراء قبل أن تحتاجهنكتب دليل تشغيل لقاعدة بيانات امتلأ قرصها، ثم ننفذه بالثواني في يوم تجربة، فنكتشف فيه خطأين لم يظهرا إلا عند التنفيذ.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع PostgreSQL 18.6 (postgres:18.6) وpg_dump وpg_basebackup وpg_verifybackup من الإصدار نفسه وpgbench، وMySQL 8.4.11 (mysql:8.4.11) مع mysqldump من الإصدار نفسه، وalpine:3.24 لنسخ ال Volumes.


