بعد أسابيع من استعمال وكيل البرمجة Coding Agent يصل أغلب المطورين إلى واحد من رأيين: إما أن الوكيل يوفر عليهم نصف اليوم، وإما أنه يضيع نصف اليوم في إصلاح ما يكتبه. والغريب أن الاثنين يستعملون في الغالب الأداة نفسها والنموذج نفسه، والفرق بينهما في عادات صغيرة لا يذكرها أحد في صفحة الأداة: كيف يكتب الطلب، وكم يعطي الوكيل في المرة الواحدة، وأي المهام يعطيها له وأيها يكتبها بنفسه، وماذا يفعل عندما يرجع الوكيل بنتيجة.
وهذا المقال عن هذه العادات، من التوثيق الرسمي للأدوات ومن تجارب حقيقية شغلناها على مستودع صغير بنموذج محلي، فالنموذج الصغير يظهر الأخطاء بوضوح أكبر من النموذج الكبير، لأنه لا يغطي على الطلب السيئ بذكائه. وما يحدث معه بشكل واضح يحدث مع النماذج الكبيرة أيضاً، ولكن بشكل أخفى وفي مهام أكبر.
في هذا المقال سوف نتناول:
- ما الذي يعرفه الوكيل وما الذي لا يعرفه، ولماذا تبدأ كل العادات من هنا.
- كيف تكتب الطلب: الملف والسلوك المطلوب ومتى ننتهي.
- حجم المهمة: لماذا ثلاث مهام في طلب واحد أسوأ من ثلاثة طلبات.
- ماذا تعطي للوكيل وماذا تبقي لنفسك.
- عادات المراجعة: ماذا تقرأ قبل أن تقبل.
- مختبر حقيقي: الهدف نفسه بأربع صيغ للطلب، واختبارات قبول مخفية تحكم.
- متى توقف الوكيل وتبدأ من جديد، والأخطاء التي تتكرر.
وهذا المقال هو المدخل لمرحلة سير العمل اليومي مع الوكيل، وكل عادة فيه لها مقال يتعمق فيها: التخطيط قبل التنفيذ، والاختبار أولاً، وGit مع الوكلاء، والمراجعة:
 دليلخطط ثم نفذ ثم تحقق: حلقة العمل مع وكيل البرمجةخطة قصيرة يراجعها إنسان، ثم خطوة واحدة في كل طلب، ثم دليل من أمر يرجع بنجاح أو فشل، مع مختبر يجرب الميزة نفسها بست طرق ويحكم عليها باختبارات لم يرها الوكيل.
 دليلالتطوير بالاختبار أولاً TDD مع وكلاء البرمجةاكتب الاختبارات التي تقول ما هو الصحيح، واقفلها، ثم دع الوكيل يصل إلى الأخضر، مع مختبر يقارن الكود أولاً بالاختبار أولاً ويحكم عليهما باختبارات قبول لم يرها الوكيل.
 دليلGit مع وكلاء البرمجة: فروع وWorktrees ورجوع آمنفرع وWorktree لكل مهمة، وcommit صغير برسالة تقول من كتبه، وفحص لا يتجاوزه الوكيل، وطريق معروف للرجوع، مع مختبر حقيقي فيه خطاف لم يعمل وcommit أوقف المشروع وجده git bisect.
 دليلمراجعة كود الذكاء الاصطناعي دون أن تصبح شكليةكيف تراجع طلبات الدمج التي يكتبها الذكاء الاصطناعي بحسب خطرها، وتترك للبوابات الآلية ما تستطيع قياسه.
 دليلهندسة السياق Context Engineering: ما يراه الوكيل وما لا يراهما الذي يرسله الوكيل فعلاً مع طلبك، ولماذا يخطئ النموذج عندما يكون أمامه ملف لا يحتاجه أو سجل طويل أو جلسة قصت من أولها، مع تجارب على نموذج محلي تغير السياق وحده.
ما الذي يعرفه الوكيل وما الذي لا يعرفه؟
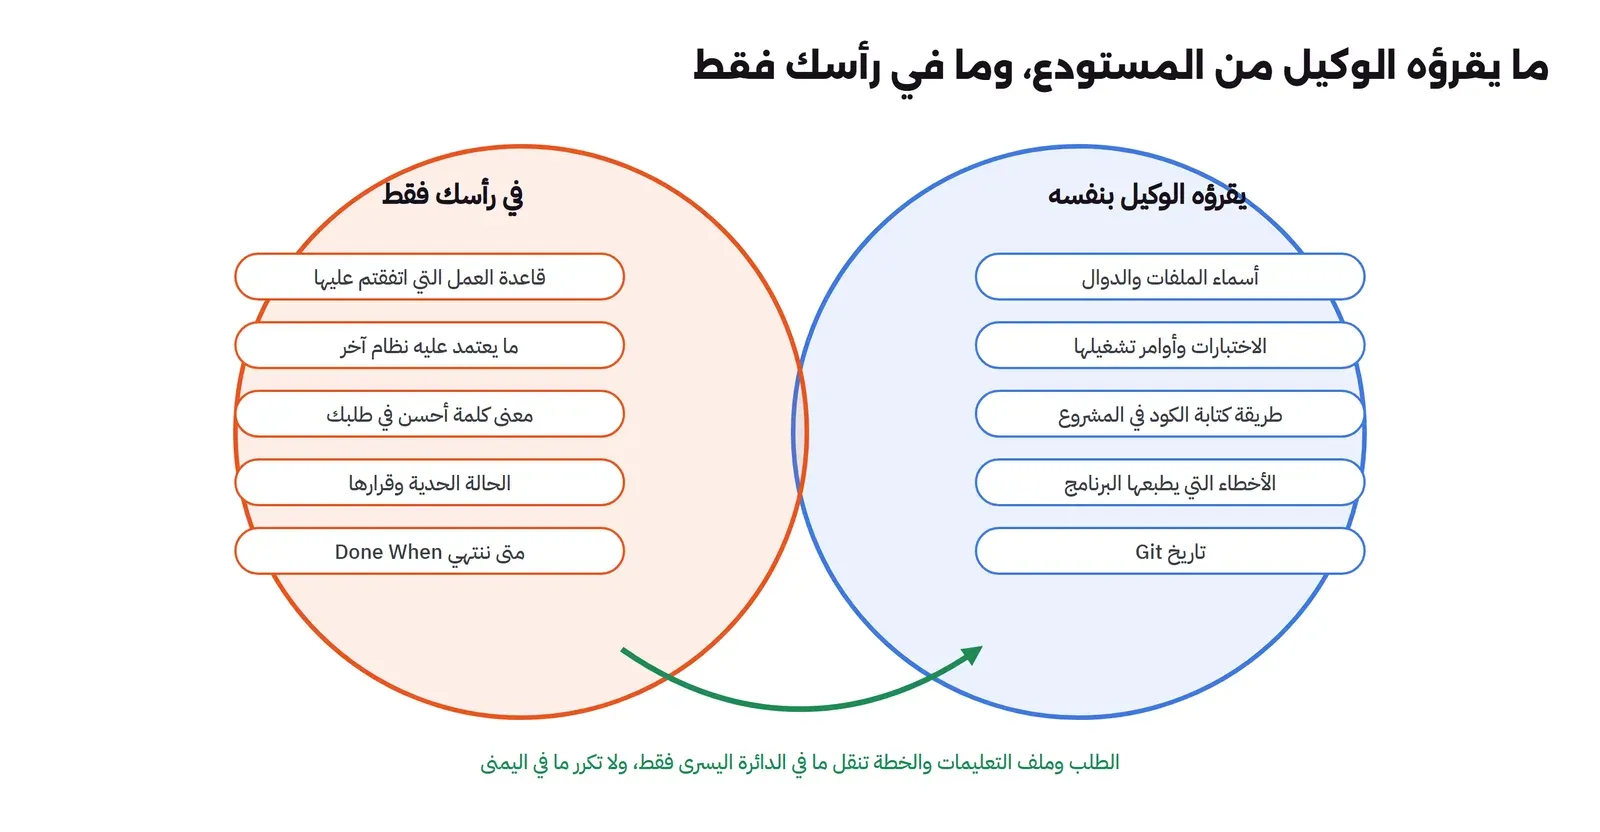
الوكيل يعرف ما في الكود، أو على الأقل ما يقرؤه منه، فهو يرى أسماء الملفات والدوال، ويقرأ الاختبارات، ويفهم طريقة كتابة الكود في المشروع. وما لا يعرفه هو كل ما في رأسك وليس في المستودع: لماذا كتبت الدالة بهذه الطريقة، وما القاعدة التي اتفق عليها الفريق في اجتماع الأمس، وما الذي يعتمد عليه نظام آخر لا يراه الوكيل، وما الذي تقصده بكلمة «أحسن» في طلبك. ويقول توثيق أفضل الممارسات في Claude Code إن أغلب الجلسات التي لا تسير كما تتوقع يكون سببها واحداً من اثنين: إما أن الوكيل بنى شيئاً مختلفاً عما في رأسك لأنه ينقصه ما لا يستطيع أن يقرأه من المستودع، وإما أنه قال إنه انتهى ولم ينته لأنه لا يملك طريقة يفحص بها عمله.
وكل العادات في هذا المقال هي طرق لسد هاتين الفجوتين: أن تعطي الوكيل ما لا يستطيع أن يراه، وأن تعطيه طريقة يعرف بها هل انتهى. وما عدا ذلك فالوكيل في الغالب يحسنه أفضل منك، فلا تقم بشرح هيكل المشروع له في كل طلب، والسبب أنه يقرؤه بنفسه أسرع منك، وكل سطر زائد في الطلب يأخذ مكاناً في السياق Context الذي شرحناه في مقال هندسة السياق.
كيف تكتب الطلب؟ الملف والسلوك ومتى ننتهي
الطلب الجيد لوكيل البرمجة فيه ثلاثة أشياء، وكل واحد منها يسد فجوة مختلفة:
- أين: الملف أو الدالة بالاسم إذا كنت تعرفه. فإذا لم تعرفه فاطلب من الوكيل أن يبحث ويخبرك قبل أن يعدل، ولا تتركه يختار ويعدل في الخطوة نفسها.
- ماذا بالضبط: السلوك المطلوب بلغة يمكن اختبارها، مع الحالات التي فيها قرار، مثل ماذا يحدث مع القيمة الفارغة وبأي صيغة يكون المخرج.
- متى ننتهي Done When: الأمر الذي يجب أن ينجح، مثل
python -m unittest، وما الذي يجب ألا يتغير.
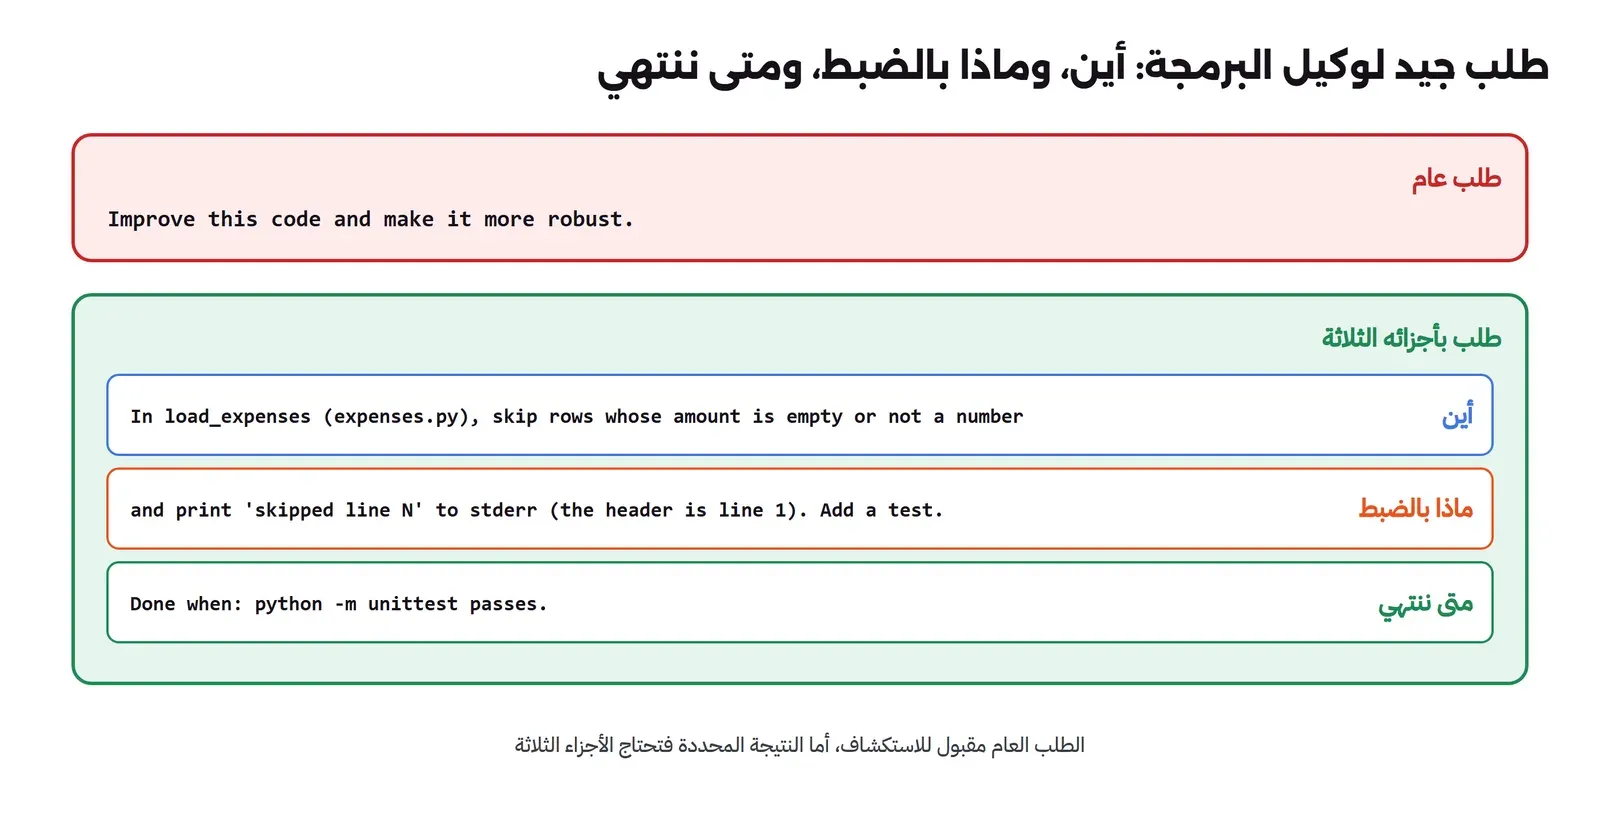
والتوثيق نفسه يضع أمثلة واضحة لهذا الفرق، فبدل «أصلح خطأ تسجيل الدخول» يقترح طلباً يذكر العرض الذي يراه المستخدمون، والمجلد الذي يجب أن ينظر فيه الوكيل، وأن يكتب اختباراً يفشل ويعيد الخطأ ثم يصلحه. ويذكر أيضاً أن الطلب العام مثل «ماذا تحسن في هذا الملف؟» مقبول تماماً عندما تستكشف ولا تصلح شيئاً محدداً، والثمن أنك سوف تصحح أكثر. وهذه نقطة مهمة: الطلب العام ليس خطأ في ذاته، وإنما الخطأ أن تعطيه وتتوقع نتيجة محددة، أو أن تقبل ما يرجع به دون أن تقرأه.
وقد يتساءل البعض: هل أكتب الطلب بالعربية أم بالإنجليزية؟ والإجابة أن النماذج الكبيرة تفهم الاثنين، ولكن أسماء الدوال والملفات والأخطاء بالإنجليزية في الكود، فاكتبها كما هي داخل الطلب حتى لو كان باقي الطلب بالعربية، لأن الوكيل يبحث عنها في الكود حرفاً بحرف. ومع النماذج الصغيرة المحلية يكون الطلب بالإنجليزية أكثر ثباتاً في الغالب، لأن أغلب بيانات تدريبها في البرمجة بالإنجليزية، وهذا ما فعلناه في المختبر.
حجم المهمة: طلب واحد لتغيير واحد
عندما يكون عندك ثلاثة أشياء صغيرة تريدها في المشروع فإن الإغراء أن تكتبها في طلب واحد مرتب بأرقام، فالوكيل سريع وسوف ينتهي منها كلها في دقيقة. والمشكلة أن الطلب الواحد يعني رداً واحداً وفرقاً واحداً وcommit واحداً، فإذا أخطأ الوكيل في الثالثة فإنك تراجع الثلاث معاً، وترجع عن الثلاث معاً، ويحمل السياق في المحاولة التالية كل ما كتبه في المحاولة الأولى. ومع النماذج الصغيرة يزيد على ذلك أن الرد الطويل يصل إلى حد طول الرد قبل أن ينتهي، فينقطع في منتصف ملف.
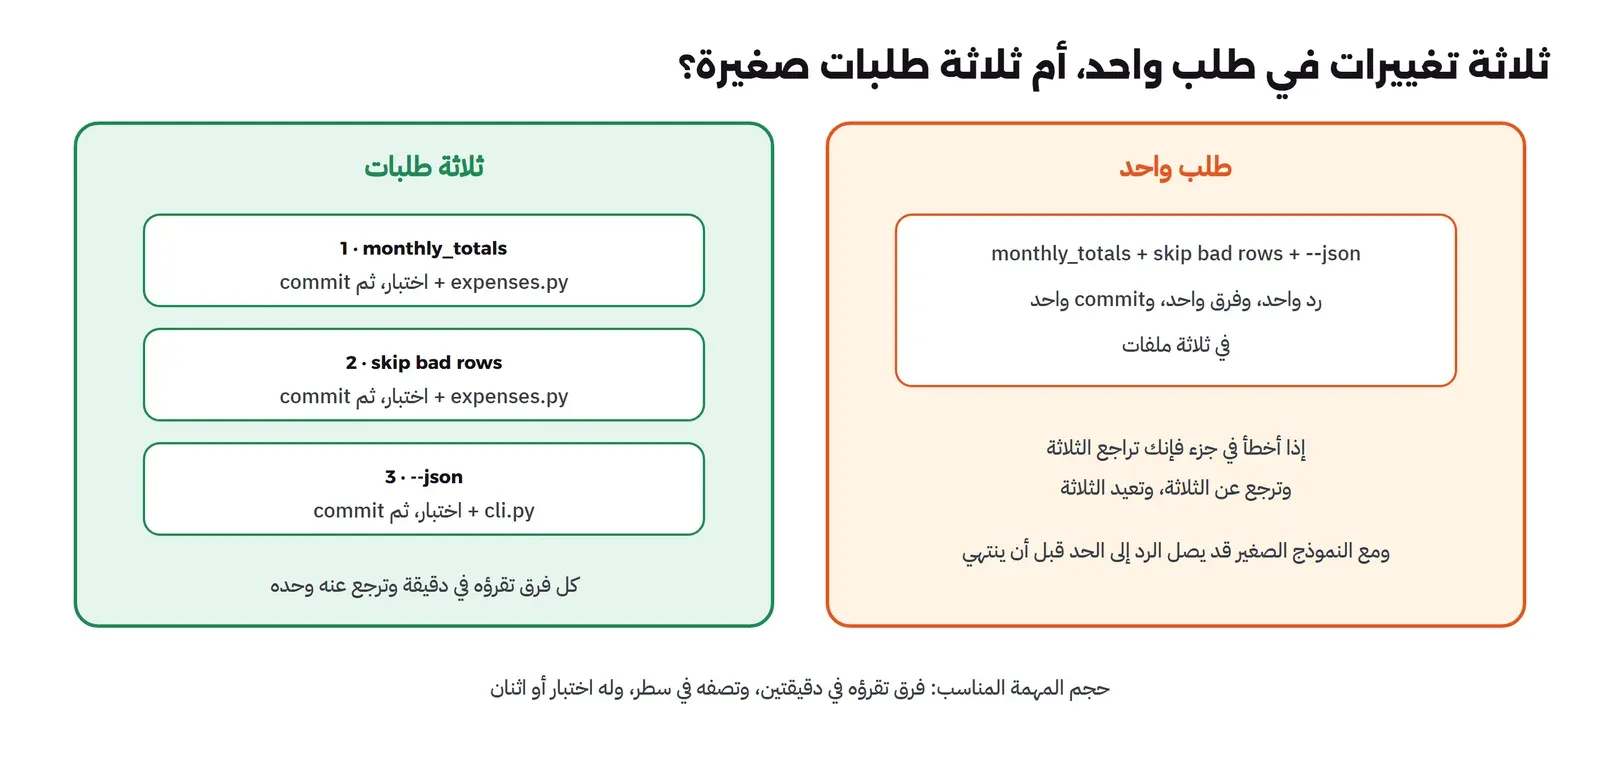
والقاعدة العملية أن حجم المهمة المناسب هو ما تستطيع أن تراجع فرقه في دقيقة أو دقيقتين، وأن تصفه في سطر واحد في رسالة commit، وأن تكتب له اختباراً واحداً أو اثنين يقولان هل نجح. فإذا كانت المهمة أكبر من ذلك فقسمها قبل أن تعطيها، أو اطلب من الوكيل أن يقسمها في خطة تراجعها أنت، كما نشرح في مقال خطط ثم نفذ ثم تحقق من هذه المرحلة. وفي المختبر قارنا الأمرين بالأرقام.
وقد يتساءل البعض: النماذج الكبيرة اليوم تكتب ميزة كاملة في عدة ملفات دون أخطاء ظاهرة، فلماذا أقسم ثلاثة تغييرات صغيرة؟ والإجابة أن التقسيم ليس للنموذج فقط وإنما لك أنت: الفرق الذي يجمع ثلاثة تغييرات تراجعه مرة واحدة وبتركيز أقل، والخطأ الذي فيه يختبئ بين سطور صحيحة، والرجوع عنه يأخذ معه ما كان صحيحاً. والنموذج الكبير يرفع حجم المهمة التي يستطيع أن ينجح فيها، ولكنه لا يغير حجم الفرق الذي تستطيع أنت أن تراجعه بجدية. ولذلك فإن المقياس هو قدرتك على المراجعة، لا قدرة النموذج على الكتابة. وشرحنا في مقال الفايب كودنج ما يحدث عندما تقبل فروقاً كبيرة دون أن تقرأها، بحوادث موثقة.
ماذا تعطي للوكيل وماذا تبقي لنفسك؟
ليس كل عمل يستحق أن تعطيه للوكيل، وليس كل عمل يجب أن تكتبه بنفسك، والذي يحدد ذلك سؤالان: هل تستطيع أن تفحص النتيجة بسرعة، وكم يكلف الخطأ إذا مر دون أن تلاحظه. والجدول التالي يجمع الحالات المعتادة:
| نوع العمل | أعطه للوكيل؟ | لماذا |
|---|---|---|
| تغيير آلي في ملفات كثيرة: إعادة تسمية، أو تحديث استدعاء مكتبة، أو إضافة نوع Type Hints | نعم، مع الاختبارات | عمل ممل يخطئ فيه الإنسان أيضاً، ونتيجته تفحص بالاختبارات والبناء |
| إصلاح خطأ يعيده اختبار يفشل | نعم | عنده فحص واضح ينجح أو يفشل، فيستطيع أن يكرر حتى ينجح |
| كتابة اختبارات لسلوك موجود | نعم، وتراجع ما يختبره | سريع فيها، ولكنه قد يختبر ما يفعله الكود لا ما يجب أن يفعله، كما في مقال اختبارات الذكاء الاصطناعي |
| استكشاف كود لا تعرفه وشرحه | نعم، دون تعديل | يقرأ أسرع منك، والخطأ في الشرح لا يدخل الكود |
| قرار تصميم Design Decision أو تغيير في واجهة يعتمد عليها غيرك | لا، اكتب القرار بنفسك ثم أعط التنفيذ | القرار معرفة في رأسك وليست في الكود، والخطأ فيه مكلف |
| كود الأمان والمال والصلاحيات | بحذر شديد ومراجعة سطراً سطراً | الخطأ الصغير فيه مكلف، والاختبار لا يكشف كل شيء |
| شيء تريد أن تتعلمه | اكتبه أنت أولاً | إذا كتبه الوكيل فأنت لم تتعلمه، وشرحنا ذلك في مقال تمارين Kata |
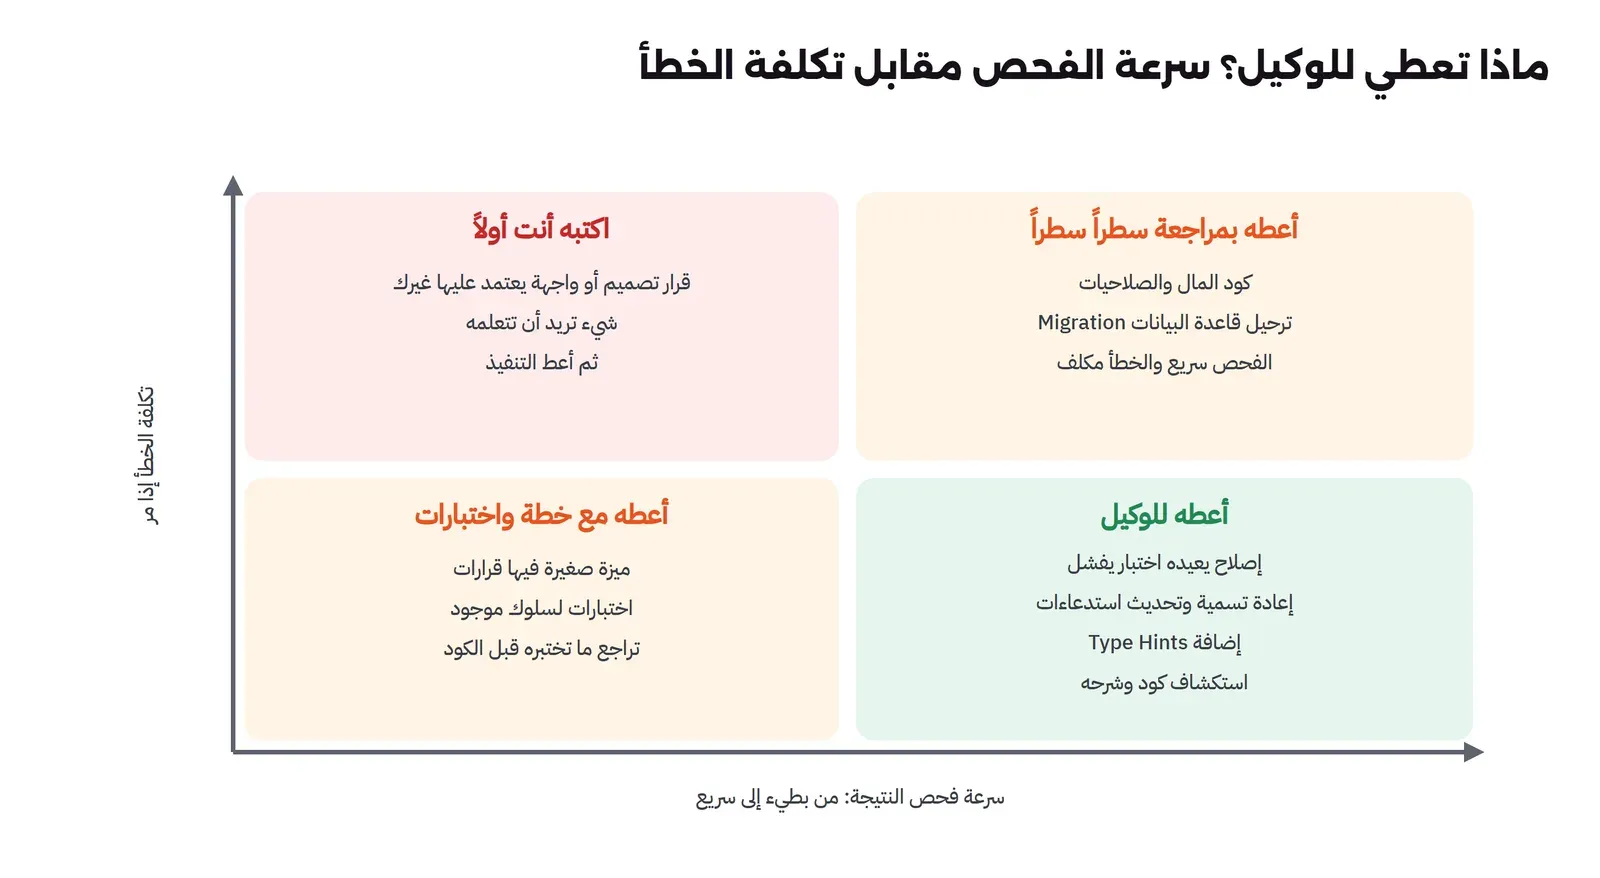
ولاحظ أن الجدول لا يقول إن الوكيل لا يستطيع أن يكتب كود الأمان أو التصميم، فهو يستطيع، ولكنه يقول إن قيمة ما يوفره من وقت هناك أقل من تكلفة مراجعة ما يكتبه بالدقة المطلوبة. ولذلك فإن السؤال الصحيح ليس «هل يستطيع الوكيل؟» وإنما «هل أستطيع أن أعرف بسرعة أنه أصاب؟».
عادات المراجعة: ماذا تقرأ قبل أن تقبل؟
المراجعة مع الوكيل تختلف عن مراجعة كود زميل، لأن الوكيل يكتب رسالة واثقة في كل مرة، سواء نجح أم فشل، ولأنه قد يغير أشياء لم تطلبها. وهذه العادات الأربع تأخذ دقيقتين وتوفر عليك ساعة:
- اقرأ قائمة الملفات قبل الكود: الأمر
git diff --statيريك أي الملفات تغيرت وكم سطراً، فإذا رأيت ملفاً لا علاقة له بالمهمة، أو ملفاً جديداً لم تطلبه، فهذه أول ملاحظة. - شغل الفحص بنفسك: لا تقبل «كل الاختبارات نجحت» من الوكيل، وشغلها أنت أو اطلب المخرج الكامل للأمر.
- اقرأ الاختبارات التي أضافها قبل الكود: إذا كان الاختبار يختبر شيئاً تافهاً أو يختبر عكس ما تريد، فنجاحه لا يعني شيئاً.
- ابحث عما لم يتغير: القاعدة التي ذكرتها في الطلب، هل تجد لها كوداً واختباراً في الفرق؟
وشرحنا المراجعة بالتفصيل، مع قائمة خاصة بأخطاء كود الذكاء الاصطناعي وبوابات آلية قبل الدمج، في مقال مراجعة كود الذكاء الاصطناعي، وشرحنا كيف تبقي فرق الوكيل صغيراً ومنفصلاً في Git في مقال Git مع الوكلاء.
أي الملفات تعطيه؟ السياق جزء من الطلب
الطلب ليس النص الذي تكتبه فقط، وإنما كل ما يدخل السياق معه: الملفات التي يقرؤها الوكيل، وملف التعليمات، ومخرجات الأوامر. وفي الوكلاء الذين يبحثون بأنفسهم، مثل Claude Code وCodex، يقرر الوكيل أي الملفات يفتح، أما في Aider فأنت من يضيف الملفات إلى المحادثة غالباً. وفي الحالتين فإن القاعدة واحدة: الملف الذي يجب أن يتغير يكون في السياق، والملف الذي يوضح السلوك المطلوب، مثل الاختبارات أو كود يستدعي الدالة، يكون للقراءة فقط، وكل ملف آخر يأخذ مكاناً ويشتت النموذج دون فائدة.
وقد يبدو هذا تفصيلاً صغيراً، ولكنه غير النتيجة في مختبر مقال خطط ثم نفذ ثم تحقق تغييراً كاملاً: الطلب نفسه، بالنموذج نفسه، كتب الكود في ملف جديد باسم خاطئ عندما كان في السياق ملف الكود وحده، وكتبه في الملف الصحيح عندما أضيف معه ملف الاختبارات وأمر تشغيلها، والاختبارات تستورد من الملف الصحيح فرأى النموذج اسمه. أي أن ملفاً واحداً في السياق كان أنفع من سطر شرح في الطلب.
ما يتكرر في كل طلب مكانه ملف التعليمات
إذا وجدت نفسك تكتب الشيء نفسه في كل طلب، مثل «شغل الاختبارات بالأمر كذا» أو «لا تضف مكتبات جديدة» أو «اكتب رسائل commit بصيغة كذا»، فهذا مكانه ملف تعليمات المشروع، أي AGENTS.md أو CLAUDE.md، الذي يقرؤه الوكيل في بداية كل جلسة. وشرحنا ماذا تكتب فيه وماذا لا تكتب، وما يحدث عندما ينتفخ، في مقال ملف تعليمات المشروع. والتوثيق الذي ذكرناه يقول إن أنفع سطر في هذا الملف هو الأمر الذي يفحص به الوكيل عمله، وإن وصف هيكل المشروع لم يعد ضرورياً لأن الوكيل يقرؤه بنفسه، فاكتب فيه فقط ما لا يوجد في المستودع.
والفرق بين الطلب وملف التعليمات أن الطلب للمهمة الحالية، والملف لكل المهام. فالقرار الخاص بميزة واحدة يكتب في الطلب أو في الخطة، أما قاعدة الفريق التي تنطبق على كل شيء فتكتب مرة واحدة في الملف، وتراجعها مع الكود في طلبات الدمج كأي ملف آخر.
جلسة لكل مهمة
العادة الأخيرة قبل المختبر أن تبدأ كل مهمة في جلسة جديدة، والسبب أن المحادثة كلها جزء من السياق: إذا أنهيت مهمة عن الدفع ثم بدأت في المحادثة نفسها مهمة عن التقارير، فإن النموذج يقرأ كل ما دار في مهمة الدفع وهو يعمل على التقارير، وقد يطبق عليها قراراً لا يخصها. والأدوات تعطيك طرقاً لذلك، مثل /clear في Claude Code و/clear أو /reset في Aider، والتوثيق الذي ذكرناه يقول إن /clear بين المهام ما زال يستحق، لأن السياق المركز يعطيك إجابات أفضل ويكلف أقل. وإذا احتجت شيئاً من المهمة السابقة فانقله بنفسك في سطر واحد، بدل أن تحمل المحادثة كلها.
الصلاحيات عادة يومية، لا إعداد مرة واحدة
كل أداة تسألك في أول يوم: هل توافق على كل أمر، أم تسمح للوكيل أن يعمل وحده؟ وأغلب المطورين يختارون مرة واحدة ثم ينسون، والأفضل أن يكون الاختيار بحسب المهمة. فالمهمة التي يقرأ فيها الوكيل الكود ويشرحه لا تحتاج أي صلاحية كتابة، والمهمة التي يعدل فيها ملفين ويشغل الاختبارات تحتاج الكتابة في مجلد المشروع وتشغيل أمر واحد، أما المهمة التي يثبت فيها حزمة أو يتصل بخدمة خارجية فتحتاج أن تراها قبل أن تحدث. وشرحنا الصلاحيات والصندوق المعزول Sandbox من الداخل في مقال بيئة تشغيل الوكيل، وما يمكن أن يتسرب من جهازك في مقال الأسرار والصندوق المعزول.
والقاعدة العملية: ابدأ كل مهمة جديدة بأقل صلاحية تكفيها، وارفعها عندما تحتاج، ولا تقم بتفعيل الموافقة التلقائية على كل الأوامر في مشروع فيه ملفات أسرار مثل .env، والسبب أن الوكيل الذي يعمل بصلاحيات حسابك يرى ما يراه حسابك، وأي تعليمات مخفية في ملف يقرؤه قد تجعله ينفذ ما لم تطلبه، كما شرحنا في مقال حقن التعليمات Prompt Injection. والموافقة على كل أمر ليست بطئاً، فهي الدقيقة الأولى التي ينصح التوثيق بمراقبتها، وفيها ترى إلى أين يتجه الوكيل قبل أن يبتعد.
مهمة واحدة من البداية إلى النهاية
لنجمع العادات السابقة في مهمة حقيقية بخطواتها، مثل تذكرة تطلب أن يرفض نموذج التسجيل البريد المكرر. الترتيب الذي نقترحه كما يلي، وكل خطوة فيه لها سبب رأيناه أعلاه أو في المختبر:
- فرع جديد للمهمة: قبل أن تكتب أي طلب، حتى يكون كل ما يفعله الوكيل في مكان تستطيع أن تحذفه كله.
- سؤال قبل التعديل: «أين يتحقق الكود من البريد عند التسجيل؟ لا تعدل شيئاً»، فيقرأ الوكيل ويرجع بالملف والدالة، وتعرف هل فهم المهمة.
- القرارات: تكتب ما لا يعرفه، مثل هل المقارنة حساسة لحالة الأحرف، وما رسالة الخطأ، وهل تحتاج قيداً في قاعدة البيانات أيضاً.
- طلب لكل تغيير: الأول للتحقق في الكود مع اختبار، والثاني للقيد في قاعدة البيانات مع اختبار، وكل طلب يذكر الملف والقرار وأمر الاختبار.
- مراجعة بعد كل طلب: قائمة الملفات، ثم الاختبار بنفسك، ثم قراءة الاختبار الجديد، ثم الكود.
- طلب الدمج: تصف فيه القرارات وما كتبه الوكيل وما اختبرته أنت، كما في مقال سياسة الفريق.
وقد تبدو هذه الخطوات كثيرة لتذكرة صغيرة، ولكن أغلبها دقيقة أو أقل، والبديل الذي يبدو أسرع، أي طلب واحد بالتذكرة كما هي، هو بالضبط الصيغة التي أعطت أسوأ النتائج في المختبر التالي.
هل هذه العادات تجعلك أسرع؟ قس بنفسك
في مقال الإنتاجية الحقيقية Productivity رأينا أن الشعور بالسرعة مع الوكيل لا يطابق القياس دائماً، وأن المطورين الخبراء في تجربة METR كانوا أبطأ وهم يظنون أنهم أسرع. ولذلك لا تقم بالحكم على عاداتك من الشعور، والسبب أن الوقت الذي يوفره الوكيل في الكتابة يظهر فوراً، أما الوقت الذي تضيعه في مراجعة فرق كبير أو إصلاح خطأ دخل دون أن تلاحظه فيظهر بعد أيام. والقياس البسيط الذي تستطيع أن تبدأ به: لكل مهمة تعطيها للوكيل اكتب كم طلباً احتجت، وكم مرة رجعت عن تعديل، وهل وجد المراجع أو خط CI خطأً بعد أن قلت إنها انتهت. وبعد أسبوعين سوف ترى أي العادات تقلل هذه الأرقام عندك فعلاً.
النموذج المناسب للمهمة
العادة الأخيرة أن تختار النموذج بحسب المهمة، لا أن تستعمل الأكبر في كل شيء ولا الأرخص في كل شيء. فالمهمة الآلية مثل إعادة التسمية أو كتابة الاختبارات لسلوك واضح يكفيها نموذج أصغر وأرخص، أما إصلاح خطأ في كود لم تكتبه، أو تغيير يجب أن يجد فيه الوكيل كل من يستعمل شكلاً قديماً من البيانات، فيستحق النموذج الأقوى أو مستوى تفكير أعلى، كما يقول توثيق أفضل الممارسات في Claude Code. والنموذج الذي شغلناه في المختبر صغير جداً عن قصد، ليظهر الأخطاء بوضوح، وشرحنا ما تتوقعه من النماذج المحلية في مقال النماذج المحلية، وتكلفة النماذج الكبيرة في مقال تكلفة وكلاء البرمجة.
المختبر: الهدف نفسه بأربع صيغ للطلب
لنرى أثر هذه العادات بالأرقام، أعطينا الوكيل الهدف نفسه بأربع طرق، وحكمنا على النتيجة باختبارات قبول مخفية لم يرها الوكيل. والإعداد كما يلي:
- الوكيل: Aider 0.86.2 في Container، وشرحنا طريقة عمله في مقال الوكلاء مفتوحة المصدر.
- النموذج:
qwen2.5-coder:3bعلى Ollama 0.40.13، على معالج Intel Core i7-7700K دون بطاقة رسومية، بنافذة سياق 8192 توكن وحد لطول الرد 1200 توكن في ملف إعدادات Aider، لأن النموذج الصغير دون هذا الحد قد يكتب رداً لا ينتهي. - الحرارة Temperature: Aider يرسل الطلب بحرارة صفر لهذا النموذج، فالنتيجة تقريباً ثابتة إذا أعدت التشغيل بالطلب نفسه، وما يتغير بين التشغيلات هو صيغة الطلب والملفات التي نعطيها فقط.
- المستودع: متتبع مصروفات صغير فيه ملف
expenses.pyيقرأ ملف CSV ويجمع المصروفات حسب الفئة، وملفcli.pyيطبع المجاميع، واختباران.
والهدف ثلاثة تغييرات صغيرة يحتاجها المستخدم:
- دالة
monthly_totalsترجع مجموع كل شهر. - أن تتجاوز
load_expensesالسطر الذي فيه مبلغ فارغ أو غير رقمي بدل أن تتوقف، وتطبعskipped line Nعلى مخرج الأخطاء stderr. - خيار
--jsonفيcli.pyيطبع المجاميع بصيغة JSON، مع بقاء المخرج العادي كما هو.
واختبارات القبول المخفية سبعة: اثنان لكل تغيير، وواحد يتأكد أن load_expenses ما زالت ترجع الصفوف السليمة كما كانت. والصيغ الأربع للطلب كانت كما يلي:
| الصيغة | الطلب | الملفات في المحادثة | يشغل الاختبارات؟ |
|---|---|---|---|
| U1: عام | Improve this code and make it more robust. | expenses.py وcli.py | لا |
| U2: الثلاثة في طلب واحد | التغييرات الثلاثة مرقمة في رسالة واحدة | الملفات الثلاثة | لا |
| U2T: الثلاثة في طلب واحد مع فحص | الرسالة نفسها | الملفات الثلاثة | نعم، --test-cmd و--auto-test |
| U3: ثلاثة طلبات صغيرة | طلب لكل تغيير، مع «أضف اختباراً» و«ننتهي عندما ينجح python -m unittest» | الملفات التي يحتاجها كل تغيير فقط | نعم |
والطلب في الصيغة الثانية كان كما يلي، وهو مكتوب بعناية وفيه كل التفاصيل التي تحتاجها اختبارات القبول، أي أن الفرق بينه وبين الصيغة الرابعة ليس في المعلومة وإنما في الحجم وفي وجود الفحص:
Please make three changes. 1) Add monthly_totals(rows) to expenses.py that returns the total per month
as a dict like {'2026-11': 20.75}, using the first 7 characters of the date. 2) In load_expenses, skip
rows whose amount is empty or not a number instead of crashing, and print 'skipped line N' to stderr,
where N is the line number in the file (the header is line 1). 3) Add a --json flag to cli.py:
python cli.py --json file.csv prints the totals per category as a JSON object instead of the text lines.
U1: الطلب العام
بدأنا بأكثر طلب نسمعه من المطورين في أسبوعهم الأول، مع الملفين في المحادثة:
Added cli.py to the chat.
Added expenses.py to the chat.
Sure, I'll help improve the code. Please provide the files you'd like me to
review and suggest changes for.
Tokens: 1.1k sent, 25 received.
== elapsed 30 s
== git log
393ad3d initial: expense tracker
...
FAILED (errors=5)
والمخرج أعلاه يقول الكثير في سطرين: الملفان في المحادثة فعلاً، كما يقول Aider في أول سطرين، والنموذج طلب أن نعطيه الملفات. أي أن الطلب العام لم يعطه شيئاً يبدأ منه، فرد بجملة عامة مثله، في 25 توكناً. ولم يتغير أي ملف، ونجح من اختبارات القبول اثنان فقط، وهما اللذان يفحصان أن السلوك القديم لم يتغير. ومع نموذج أكبر لن يكون الرد بهذا الشكل غالباً، وإنما سوف يقرر هو ما معنى «أكثر متانة» ويغير ما يراه، وهذا أسوأ من الرفض، لأنك سوف تراجع تغييرات لم تطلبها لتعرف هل تريدها.
U2: الثلاثة في طلب واحد
في الصيغة الثانية أعطيناه الطلب المكتوب بعناية الذي عرضناه أعلاه، والملفات الثلاثة، دون أمر للاختبار. فرجع برد واحد طبقه Aider على الملفات الثلاثة وعمل له commit، ثم أمسك فاحص الكود في Aider خطأً واضحاً فأصلحه الوكيل في commit ثان:
Tokens: 1.4k sent, 930 received.
Applied edit to expenses.py
Applied edit to test_expenses.py
Applied edit to cli.py
Commit b07556d feat: add monthly_totals(rows) to expenses.py, skip rows with empty or non-numeric amounts, and add --json flag to cli.py
expenses.py:15:56: F821 undefined name 'sys'
...
Tokens: 3.1k sent, 324 received.
Applied edit to expenses.py
Commit 8420c83 fix: add import statement for sys
== elapsed 482 s
والحكم كان كما يلي:
== diff stat since initial
 cli.py           | 26 ++++++++++++++++++++++----
 expenses.py      | 22 ++++++++++++++++++++--
 test_expenses.py | 10 ++++++----
 3 files changed, 48 insertions(+), 10 deletions(-)
== repo tests
OK
== hidden acceptance
test_a1_monthly_totals ... ok
test_a2_monthly_totals_empty ... ok
test_b1_bad_rows_are_skipped ... ERROR
test_b2_skipped_lines_reported_on_stderr ... ERROR
test_c1_json_flag ... ok
test_c2_plain_output_unchanged ... FAIL
test_d1_old_load_still_works ... ok
FAILED (failures=1, errors=2)
أربعة من سبعة، واختبارات المستودع كلها ناجحة، ورسالة commit تقول إن الثلاثة نفذت. ولكن عندما قرأنا الفرق وجدنا ثلاث مشاكل لا تظهر في الرسالة:
def main(argv):
    if len(argv) != 2:
        print("Usage: python cli.py expenses.csv", file=sys.stderr)
        return 1

    path = argv[1]
    ...
    else:
        for category, total in sorted(total_by_category(rows).items()):
            print(f"{category}: {total:.2f}")
        print(f"Monthly totals:")
        for month, total in sorted(monthly_totals(rows).items()):
print(f"{month}: {total:.2f}")- غير الوكيل طريقة استدعاء
main: كانت تأخذ المسار فيargv[0]، وأصبحت تشترط عنصرين وتأخذ المسار منargv[1]، فالاستدعاء القديمmain(["file.csv"])يطبع رسالة الاستعمال ويخرج. أي أنه غير واجهة لم يطلب أحد أن تتغير، وهذا ما كشفه الاختبارc2. - أضاف إلى المخرج العادي قسماً اسمه
Monthly totalsلم يطلبه أحد، لأنه رأى الدالة الجديدة فقرر أن يعرضها، وهذا مثال صغير على ما سماه Kent Beck الوظائف التي لم تطلبها حتى لو كانت خطوة منطقية. - لكي يطبع رقم السطر استعمل
f.tell()، وهي لا تعطي رقم السطر أصلاً، بل لا تعمل أثناء قراءة الملف سطراً سطراً، ولذلك توقفت الدالة عند أول سطر خاطئ بدل أن تتجاوزه، وهذا ما كشفه الاختبارانb1وb2.
ولاحظ أن أياً من هذه المشاكل لم يظهر في اختبارات المستودع، لأن الوكيل أضاف اختباراً لـ monthly_totals فقط، أي للجزء الذي نجح فيه. والفرق كله 48 سطراً في ثلاثة ملفات، ومراجعته تأخذ وقتاً أطول من مراجعة ثلاثة فروق صغيرة، لأنك تقرأ الثلاثة معاً وتحاول أن تفصل بينها في رأسك.
U2T: الثلاثة في طلب واحد مع الاختبارات
في الصيغة الثالثة أعدنا الطلب نفسه، وأضفنا أمر الاختبار حتى يتحقق الوكيل بنفسه. والنتيجة كانت أسوأ قليلاً:
Tokens: 1.4k sent, 904 received.
Applied edit to test_expenses.py
Applied edit to cli.py
Applied edit to expenses.py
Commit 7eb83f1 feat: add monthly_totals(rows) to expenses.py, skip rows with ...
...
Commit 21c8807 fix: add import statement for sys
Ran 3 tests in 0.001s
OK
== elapsed 418 s
...
test_c1_json_flag ... ERROR
test_c2_plain_output_unchanged ... usage: python -m unittest [-h] [--json] file
...
FAILED (errors=4)
في المخرج أعلاه لاحظ التالي:
- شغل Aider الاختبارات بعد التعديل فنجحت الثلاثة، فاعتبر المهمة منتهية. أي أن خطوة التحقق عملت، ولكنها فحصت اختباراً واحداً جديداً لـ
monthly_totalsواختبارين قديمين، ولم يكتب الوكيل اختباراً للجزأين الآخرين رغم أنهما في الطلب نفسه. - هذه المرة استعمل
argparseوحللargv[1:]، فأسقط أول عنصر في القائمة، وهو المسار نفسه في الاستدعاء القديم، فطبع رسالة الاستعمال داخل الاختبار. - والخيار
--jsonيطبع القاموس Dictionary بالدالةprintلا بصيغة JSON، أي بعلامات تنصيص مفردة لا يقرؤها أي برنامج يتوقع JSON.
والنتيجة 3 من 7. والدرس هنا أن الفحص في طلب كبير لا ينقذه، لأن الوكيل يكتب الاختبارات للجزء الذي فكر فيه، والأجزاء الأخرى تمر دون فحص.
U3: ثلاثة طلبات صغيرة، لكل منها ملفاته واختباره
في الصيغة الرابعة قسمنا الهدف إلى ثلاثة طلبات، كل طلب بتغيير واحد، ومعه الملفات التي يحتاجها فقط، وجملة «أضف اختباراً» وجملة «ننتهي عندما ينجح python -m unittest»، ومع أمر الاختبار:
Added expenses.py to the chat.
Added test_expenses.py to the chat.
Tokens: 1.2k sent, 618 received.
Commit 3b6e771 feat: add monthly_totals(rows) to expenses.py and test it
Ran 3 tests in 0.001s
OK
== elapsed 175 s

Tokens: 1.4k sent, 801 received.
Commit 63f6c99 fix: handle empty and non-numeric amounts in load_expenses, print skipped lines to stderr
Ran 5 tests in 0.007s
FAILED (errors=2)
...
Only 3 reflections allowed, stopping.
== elapsed 672 s

Added cli.py to the chat.
Added test_expenses.py to the chat.
Tokens: 1.4k sent, 152 received.
Commit d36ee6d feat(cli.py): add --json flag to main()
== elapsed 258 s
والحكم النهائي كان 5 من 7:
test_a1_monthly_totals ... ok
test_a2_monthly_totals_empty ... ok
test_b1_bad_rows_are_skipped ... ERROR
test_b2_skipped_lines_reported_on_stderr ... ERROR
test_c1_json_flag ... ok
test_c2_plain_output_unchanged ... ok
test_d1_old_load_still_works ... ok
FAILED (errors=2)
في المخرج أعلاه لاحظ التالي:
- الطلب الأول نجح في 175 ثانية بـ commit واحد واختبار، والطلب الثالث نجح بـ 152 توكناً فقط، وهذا هو الكود الذي كتبه، وهو أصغر وأصح من الصيغتين السابقتين لأنه لا يغير طريقة الاستدعاء ولا يضيف شيئاً لم يطلب:
def main(argv):
    if '--json' in argv:
        json_output = True
        argv.remove('--json')
    else:
        json_output = False

    rows = load_expenses(argv[0])
    totals = total_by_category(rows)

    if json_output:
        print(json.dumps(totals, indent=4))
    else:
        for category, total in sorted(totals.items()):
            print(f"{category}: {total:.2f}")

return 0- الطلب الثاني فشل بالخطأ نفسه الذي رأيناه في الصيغتين السابقتين، أي
f.tell()، ولكن الفرق المهم أن الوكيل كتب هذه المرة اختبارين لهذا الجزء، فظهر الفشل باسمه في اختبارات المستودع نفسها:
ERROR: test_load_empty_amount (test_expenses.ExpensesTest.test_load_empty_amount)
ValueError: could not convert string to float: ''
OSError: telling position disabled by next() call- النموذج لم يستطع أن يصلح هذا الخطأ في ثلاث محاولات، وكل محاولة رجعت بالرد نفسه، 250 توكناً. ولكنك تعرف الآن بالضبط أي طلب فشل، وفي أي سطر، وبأي خطأ، وعندك commit سليم قبله ترجع إليه. والإصلاح الذي يحتاجه سطر واحد تعرفه أنت: أن يعد السطور بـ
enumerate(..., start=2)بدلf.tell()، فتكتبه بنفسك أو تعطيه للوكيل في طلب جديد يذكره بالاسم.
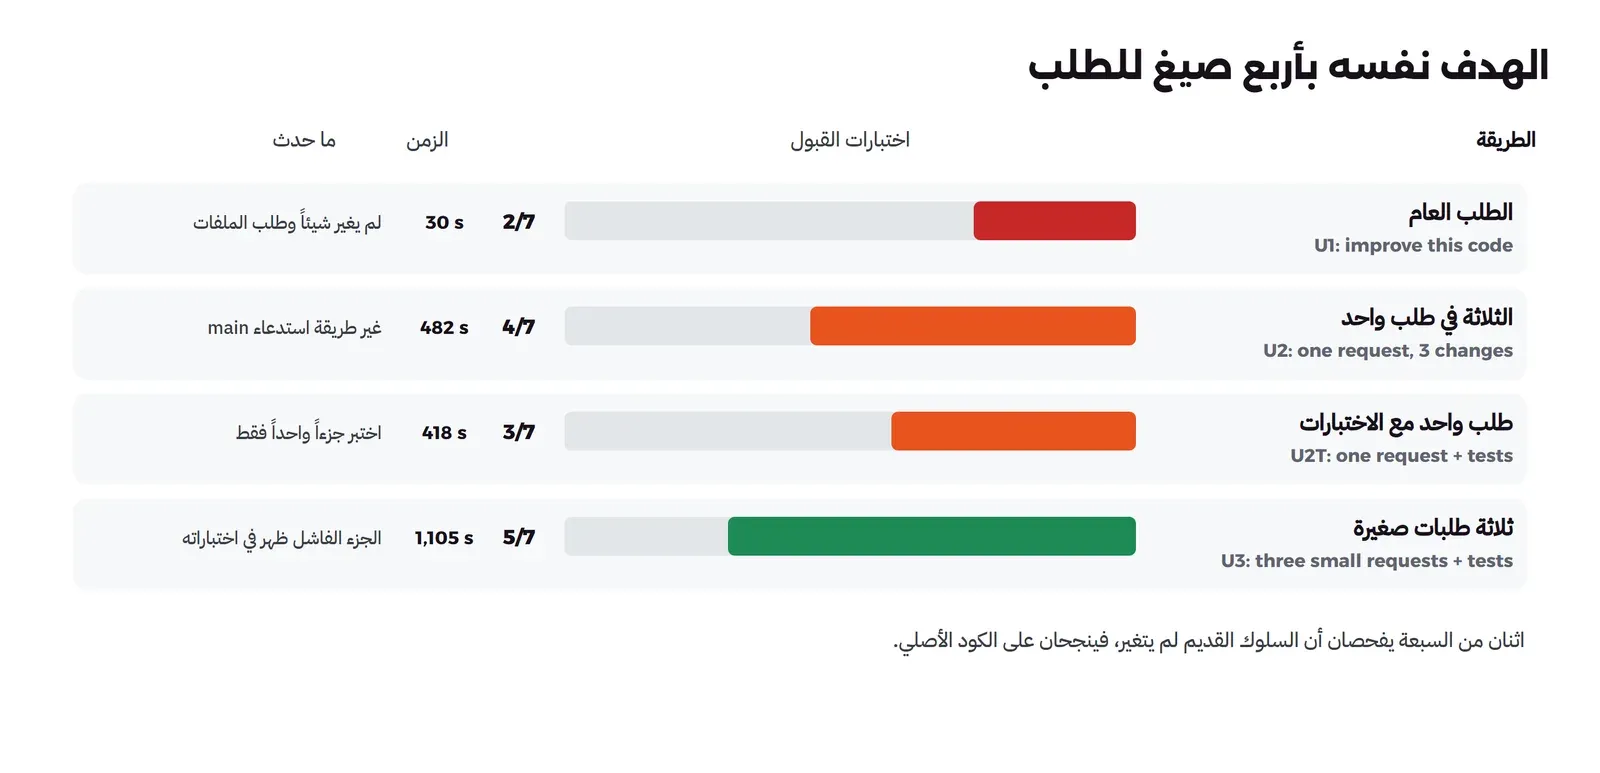
ولو كان هذا عملاً حقيقياً وليس تجربة، فهذا ما كنا سوف نفعله بعد كل صيغة: في U1 نكتب طلباً محدداً بدل الطلب العام، فالرد نفسه طلب منا ذلك. وفي U2 وU2T نرجع عن الـ commit كله، لأن فيه تغييراً لواجهة main لا نريده مختلطاً بتغييرين صحيحين، ثم نعيد المهمة مقسمة. أما في U3 فنحتفظ بالـ commit الأول والثالث كما هما، ونرجع عن الثاني وحده بـ git revert، ونعطي الوكيل طلباً جديداً يذكر سبب الفشل بالاسم، أو نكتب السطر بأنفسنا. أي أن الطلبات الصغيرة لم تعطنا نتيجة كاملة، ولكنها أعطتنا نتيجة نستطيع أن نبني عليها دون أن نبدأ من الصفر، وهذا هو الفرق الذي يظهر في يومك أكثر مما يظهر في الرقم.
ماذا يعلمنا المختبر؟
- الطلب العام لا يعطي الوكيل شيئاً يبدأ منه: النموذج الصغير رد بطلب عام مثله، والكبير سوف يقرر بنفسه، وفي الحالتين لا تقترب من هدفك.
- المعلومة نفسها في طلب واحد أسوأ منها في ثلاثة: الطلبان U2 وU3 فيهما التفاصيل نفسها حرفياً تقريباً، والطلب الكبير غير واجهة
mainوأضاف مخرجاً لم يطلب، والطلبات الصغيرة لم تفعل ذلك. - الوكيل يختبر ما فكر فيه: في الطلب الكبير كتب اختباراً لجزء واحد من ثلاثة، وفي الطلبات الصغيرة كتب اختباراً لكل جزء لأن كل طلب يقول «أضف اختباراً» لتغيير واحد.
- الفشل المرئي أنفع من النجاح الكاذب: U2T انتهى باختبارات خضراء ونتيجة 3 من 7، وU3 انتهى باختبارين أحمرين يشيران إلى السطر الخاطئ بالضبط ونتيجة 5 من 7.
- الطلبات الصغيرة ليست أسرع دائماً: U3 أخذ 1,105 ثوان مقابل 482 لـ U2، لأن الطلب الفاشل أعاد المحاولة ثلاث مرات. والوقت الذي يهمك ليس وقت الوكيل، وإنما وقتك أنت في المراجعة والإصلاح بعده.
عادات قديمة تستطيع أن تتركها
بعض النصائح التي انتشرت في 2023 و2024 كانت حلولاً لضعف النماذج في ذلك الوقت، ولم تعد ضرورية مع النماذج الحالية. وفي توثيق أفضل الممارسات في Claude Code جدول صريح بعنوان ما تستطيع أن تتوقف عن فعله، وأهم ما فيه:
- الكتابة بالأحرف الكبيرة وكلمة IMPORTANT: النماذج الحالية تتبع السطر المكتوب بوضوح، والتأكيد الزائد يجعلها تطبق القاعدة أكثر من اللازم. وإذا كانت القاعدة لا تحتمل الاستثناء فمكانها خطاف Hook أو قاعدة منع Deny Rule، لا كلمة بخط عريض.
- عبارات مثل «فكر بعمق» و«كن دقيقاً»: التوثيق يقول إنها نص عادي يدفع النموذج قليلاً داخل مستوى التفكير المضبوط، وإن الأداة التي تتحكم في عمق التفكير هي إعداد الجهد Effort، لا كلمات الطلب.
- «استمر حتى تنتهي ولا تتكاسل»: النماذج الحالية تكمل المهمة المتفق عليها غالباً، وهذه العبارات تسبب عملاً زائداً أكثر مما تصلح توقفاً. أما أن تعطيه فحصاً يجب أن ينجح فهذا ما زال مفيداً.
- شرح هيكل المشروع في ملف التعليمات: الوكيل يقرأ المستودع بنفسه، فاكتب فقط ما لا يوجد فيه.
ولاحظ أن هذا الجدول خاص بنماذج Claude الحالية كما يقول التوثيق، والنماذج الصغيرة المحلية مثل التي في المختبر ما زالت أضعف من ذلك بكثير، فقد تحتاج معها تحديداً أكثر، وهذا ما رأيناه في المختبر. والقاعدة المشتركة بين الاثنين: الطلب الذي ينقل معلومة لا يعرفها الوكيل يبقى مفيداً، والطلب الذي يحاول أن يدفع النموذج بالكلمات يفقد قيمته مع كل نموذج جديد.
اقرأ ما يفعله الوكيل، لا ما يقوله
كل وكيل ينهي عمله بخلاصة: رسالة commit، أو فقرة تقول ما الذي غيره، أو سطر يقول إن الاختبارات نجحت. وهذه الخلاصة مفيدة لتعرف ماذا حاول، ولكنها ليست الحكم. ففي المختبر قالت رسالة الـ commit في الصيغة الثانية إن الوكيل أضاف الدالة وتجاوز الصفوف الخاطئة وأضاف الخيار، والفرق نفسه كان فيه تغيير لواجهة main لم تذكره الرسالة بكلمة، وكان تجاوز الصفوف لا يعمل أصلاً. وفي مقال الخطة رأينا رسالة تقول إن الوكيل أضاف الكلاس فقط، والفرق فيه الخطوتان معاً بشرط خاطئ.
ولذلك فإن العادة التي تحميك هي أن تقرأ ثلاثة أشياء يكتبها البرنامج لا النموذج: قائمة الملفات التي تغيرت من Git، ونتيجة الاختبار التي يطبعها مشغل الاختبارات، وعدد الاختبارات التي شغلت. وإذا كانت الأداة تعطيك سجلاً بالأوامر التي نفذها الوكيل، كما يطبع Aider سطر Applied edit لكل ملف وسطر Commit لكل commit، فاقرأه أيضاً، ولكن تذكر أن سطر Applied edit يعني أن الأداة طبقت ما أرسله النموذج، لا أن شيئاً تغير فعلاً، والحكم على التغيير هو git diff.
لا تلصق كل شيء
عندما يفشل شيء فالإغراء أن تلصق في الطلب السجل كاملاً، أو مخرج الاختبارات كله، أو ملفاً من ألف سطر. والمشكلة أن هذا كله يدخل السياق ويبقى فيه في كل دورة، فيدفع المعلومة المهمة إلى الهامش، ويكلفك وقتاً على النماذج المحلية ومالاً على النماذج المستضافة. والأفضل أن تلصق الجزء الذي فيه الخطأ مع سطور قليلة قبله، أو أن تعطي الوكيل الأمر الذي يعيد الخطأ فيشغله هو ويقرأ ما يحتاجه، وشرحنا بالتجربة ماذا يحدث لمخرج الأدوات الطويل في السياق في مقال هندسة السياق.
متى توقف الوكيل وتبدأ من جديد؟
أصعب عادة على المطور الجديد مع الوكيل هي أن يتوقف، فعندما يخطئ الوكيل فإن الطبيعي أن تصحح له في المحادثة نفسها، فيعدل، فيخطئ في شيء آخر، فتصحح مرة ثانية. والمشكلة أن كل تصحيح يبقى في السياق، أي أن النموذج في المحاولة الثالثة يقرأ محاولتين فاشلتين وتصحيحين، ويبني عليهما. ولذلك ينصح توثيق أفضل الممارسات في Claude Code بقاعدة واضحة: راقب الدقيقة الأولى وأوقف الوكيل لحظة يبتعد، وإذا صححت الشيء نفسه مرتين وما زال خطأً فابدأ جلسة جديدة بطلب أفضل يحمل ما تعلمته، بدل أن تكتب التصحيح الثالث.
وعلامات أن الوقت حان لتبدأ من جديد:
- الوكيل يكرر الخطأ نفسه بعد أن صححته، أو يرجع إلى حل رفضته قبل قليل.
- الرد يطول ويدخل في أشياء لم تطلبها، مثل ملفات توثيق أو إعدادات أو اختبارات مكررة بأسماء متشابهة.
- الوكيل يغير الاختبار أو يعطله ليجعله ينجح.
- لم تعد تعرف ما الذي تغير منذ آخر نقطة كان فيها الكود يعمل.
وفي كل هذه الحالات فإن Git هو ما يجعل البداية الجديدة رخيصة: إذا كان الوكيل يعمل على فرع منفصل، وكل خطوة في commit، فإنك ترجع إلى آخر نقطة جيدة بأمر واحد، وتبدأ جلسة جديدة بطلب فيه ما تعلمته من المحاولة الفاشلة، مثل اسم الملف الصحيح، أو القاعدة التي نسيها. وشرحنا هذه الأوامر مع الوكيل في مقال Git مع الوكلاء.
أخطاء شائعة Common Mistakes
- أن تطلب «حسن الكود» وتقبل النتيجة: الطلب العام مقبول للاستكشاف، ولكن نتيجته يجب أن تقرأها كاقتراح، لا أن تدمجها كما هي. ففي المختبر لم يفعل الطلب العام شيئاً أصلاً، ومع نموذج أكبر قد يغير أشياء كثيرة لم تطلبها، وفي الحالتين لا يقربك من هدف محدد.
- أن تجمع مهام كثيرة في طلب واحد: فرق واحد كبير تراجعه مرة واحدة وترجع عنه مرة واحدة، وكل خطأ في جزء منه يكلفك المهمة كلها.
- أن تشرح للوكيل ما يستطيع أن يقرأه: هيكل المشروع وأسماء المجلدات يقرؤها بنفسه، واكتب بدلاً منها ما لا يراه: القاعدة، والقرار، ومتى ننتهي.
- أن تثق برسالة الـ commit أو بخلاصة الوكيل: الرسالة تصف ما أراد الوكيل أن يفعله، والحكم هو الفرق والاختبار.
- أن تترك الوكيل دون فحص يشغله: بدون أمر اختبار أو فحص يتوقف الوكيل عندما يبدو العمل منتهياً، وتصبح أنت مجموعة الاختبارات.
- أن تعطيه ما تريد أن تتعلمه: المهارة التي لا تستعملها تضعف، والوكيل لا يعلمك إذا كتب هو كل شيء.
- أن تصحح للمرة الثالثة في المحادثة نفسها: ابدأ جلسة جديدة بطلب أفضل.
قائمة تحقق Checklist قبل أن ترسل الطلب
- هل ذكرت الملف أو الدالة بالاسم، أو طلبت من الوكيل أن يبحث ويخبرك قبل أن يعدل؟
- هل كتبت السلوك المطلوب بأمثلة أو قواعد يمكن اختبارها، مع الحالات الحدية؟
- هل كتبت متى ننتهي: الأمر الذي يجب أن ينجح، وما الذي يجب ألا يتغير؟
- هل المهمة صغيرة بما يكفي لتراجع فرقها في دقيقتين؟ وإذا لم تكن فهل قسمتها؟
- هل أعطيت الوكيل الملفات التي يحتاجها فقط، وجعلت ما لا يجب أن يعدله للقراءة فقط؟
- هل هو على فرع منفصل؟
- بعد أن ينتهي: هل قرأت قائمة الملفات، وشغلت الفحص بنفسك، وقرأت الاختبارات التي أضافها؟
تدريب عملي
- شغل المختبر من مجلد
labبنموذج أكبر تتسع له ذاكرتك، وقارن الصيغ الأربع، ولاحظ هل يغير الطلب الكبير واجهةmainمرة أخرى. - أصلح الطلب الثاني في U3 بطلب جديد يذكر السبب بالاسم: لا تستعمل
f.tell()وعد السطور بـenumerate، ثم شغل اختبارات القبول. - خذ آخر ثلاثة طلبات أعطيتها لوكيلك في العمل، واكتب لكل واحد منها: أين، وماذا بالضبط، ومتى ننتهي. كم طلباً كان فيه الثلاثة؟
- اكتب في ملف التعليمات في مشروعك أمر الاختبار وقاعدة واحدة تكررها في كل طلب، واحذفها من طلباتك.
الخلاصة
- الوكيل يقرأ ما في المستودع، وينقصه ما في رأسك: القاعدة، والقرار، ومعنى «أحسن»، ومتى ننتهي. الطلب الجيد ينقل هذا فقط.
- اكتب في الطلب ثلاثة أشياء: أين، وماذا بالضبط بأمثلة يمكن اختبارها، ومتى ننتهي بأمر يرجع بنجاح أو فشل.
- طلب واحد لتغيير واحد: في المختبر غير الطلب الكبير واجهة لم يطلب أحد تغييرها، واختبر جزءاً واحداً من ثلاثة.
- أعط الوكيل ما تستطيع أن تفحصه بسرعة، واكتب بنفسك القرارات وما تريد أن تتعلمه، وراجع كود المال والصلاحيات سطراً سطراً.
- راجع بالترتيب: قائمة الملفات، ثم الفحص بنفسك، ثم الاختبارات التي أضافها، ثم الكود.
- اقرأ ما يكتبه البرنامج لا ما يكتبه النموذج: قائمة الملفات من Git، ونتيجة الاختبار، وعدد الاختبارات التي شغلت، فرسالة الـ commit وخلاصة الوكيل تصفان ما حاول، لا ما فعل.
- ابدأ كل مهمة بأقل صلاحية تكفيها، ولا تفعل الموافقة التلقائية على كل الأوامر في مشروع فيه أسرار.
- بعد تصحيحين فاشلين ارجع إلى آخر commit سليم وابدأ جلسة جديدة بطلب أفضل.
وكل عادة في هذا المقال لها مقال يتعمق فيها في هذه المرحلة من المسار بإذن الله، من الخطة قبل التنفيذ إلى الاختبار أولاً إلى Git:
دليلخطط ثم نفذ ثم تحقق: حلقة العمل مع وكيل البرمجةخطة قصيرة يراجعها إنسان، ثم خطوة واحدة في كل طلب، ثم دليل من أمر يرجع بنجاح أو فشل، مع مختبر يجرب الميزة نفسها بست طرق ويحكم عليها باختبارات لم يرها الوكيل.دليلالتطوير بالاختبار أولاً TDD مع وكلاء البرمجةاكتب الاختبارات التي تقول ما هو الصحيح، واقفلها، ثم دع الوكيل يصل إلى الأخضر، مع مختبر يقارن الكود أولاً بالاختبار أولاً ويحكم عليهما باختبارات قبول لم يرها الوكيل.دليلGit مع وكلاء البرمجة: فروع وWorktrees ورجوع آمنفرع وWorktree لكل مهمة، وcommit صغير برسالة تقول من كتبه، وفحص لا يتجاوزه الوكيل، وطريق معروف للرجوع، مع مختبر حقيقي فيه خطاف لم يعمل وcommit أوقف المشروع وجده git bisect. دليلملف تعليمات المشروع AGENTS.md وCLAUDE.md: ماذا تكتب فيهأين تضع ملف تعليمات الوكيل، وكيف تجمعه Codex وClaude Code وCopilot من المجلدات، ومتى يقطع دون أن يعرف النموذج، وماذا يتغير فعلاً عندما تكتبه.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وتشغيل المختبر بأربع صيغ للطلب بـ Aider 0.86.2 مع Ollama 0.40.13 ونموذج Qwen2.5-Coder 3B على معالج دون بطاقة رسومية، ومراجعة توثيق أفضل الممارسات في Claude Code.