تصلك رسالة قصيرة: «الموقع أعطى أخطاء قبل ساعة لعدة دقائق، وهل هناك من يحاول الدخول إلى السيرفر؟». ولا توجد لوحة مراقبة ولا نظام سجلات مركزي، فقط سيرفر Linux عليه nginx وSSH، وفي المجلد /var/log ملفات نصية فيها كل ما حدث سطراً سطراً. والسؤال الآن ليس أين المعلومة، فهي موجودة، وإنما كيف تستخرج من مئات أو ملايين السطور جواباً واحداً واضحاً: كم خطأ، ومتى بدأ، ومن أي عنوان، وعلى أي مسار. وهذا بالضبط ما صنعت له أدوات النصوص في Linux: grep وawk وsed وsort وuniq وأخواتها، وكل واحدة منها تفعل شيئاً صغيراً، والقوة كلها في ربطها بالأنابيب Pipes.
وفي هذا الدليل لن نعمل على أمثلة مصطنعة من ثلاثة سطور، وإنما شغلنا سيرفراً حقيقياً فيه nginx وOpenSSH، وأرسلنا إليه حركة حقيقية من ستة أجهزة لعدة دقائق: زوار عاديون، وأداة فحص تبحث عن ملفات حساسة، ومحاولات تخمين لكلمة مرور SSH، ومسؤول يدخل مرتين، وواجهة برمجية تتوقف قرابة دقيقة. ثم أجبنا على أسئلة المسؤول عن السيرفر من السجلات وحدها، وكل مخرج تراه هنا خرج من تلك السجلات. وإذا لم تكن تعرف بعد التوجيه Redirection والأنبوب | فقد شرحناهما في مقال سطر الأوامر في Linux للمبتدئين، وإذا كانت التعبيرات النمطية جديدة عليك فارجع إلى مقال التعبيرات النمطية Regex للمبتدئين، لأننا سوف نستخدمها هنا دون شرح مكوناتها.
وسوف نناقش في هذا المقال ما يلي:
- فكرة الأنبوب Pipeline: لماذا نربط أدوات صغيرة بدلاً من برنامج واحد كبير.
- المختبر: سيرفر nginx وSSH وستة أجهزة تولد سجلات حقيقية.
- القراءة السريعة مع
wcوheadوtail، والبحث معgrepوفخ اسم العملية الذي تغير في OpenSSH. - العد والترتيب مع
cutوsortوuniq: أكثر العناوين طلباً. awk: الحقول والشروط والمصفوفات، والسطر الذي أفسد عدنا لرموز الحالة، والأخطاء 5xx في كل دقيقة.sedوtr: الاستبدال والنطاقات وتعديل ملفات الإعداد، ولماذا لا تستخدمsed -iعلى سجل مفتوح.xargs: من قائمة إلى أوامر، والأسماء التي فيها مسافات.- المتابعة الحية مع
tail -fومشكلة التخزين المؤقت Buffering. - سجل SSH: محاولات الدخول الفاشلة لكل عنوان ولكل مستخدم، والدخول الناجح.
- متى تتوقف عن هذه الأدوات وتنتقل إلى نظام سجلات، والأخطاء الشائعة، وجدول الأسئلة والأوامر.
فكرة الأنبوب Pipeline: أدوات صغيرة تتصل ببعضها
كل أداة من أدوات النصوص تقرأ سطوراً من مدخلها القياسي stdin، وتفعل بها شيئاً واحداً، وتكتب سطوراً إلى مخرجها القياسي stdout. والأنبوب | يصل مخرج الأداة الأولى بمدخل الثانية، فتمر البيانات بينها دون ملفات وسيطة، وتعمل كلها في نفس الوقت. وهذه هي فلسفة Unix التي كتبها Doug McIlroy منذ السبعينيات: اكتب برامج تفعل شيئاً واحداً وتفعله جيداً، واجعلها تعمل معاً، واجعل النص هو الواجهة بينها. والفائدة العملية أنك لا تحتاج برنامجاً لكل سؤال، وإنما تركب الجواب من قطع تعرفها، وتبنيه خطوة خطوة وأنت ترى النتيجة بعد كل قطعة:
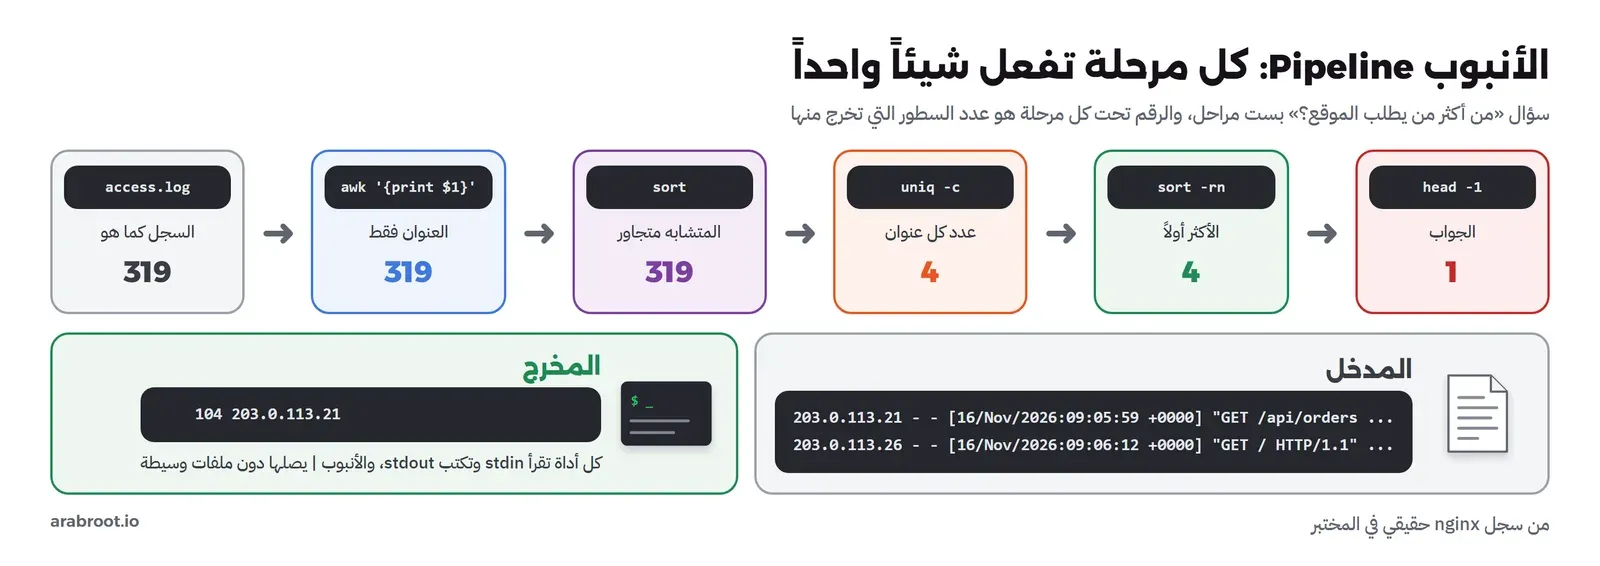
وقبل أن نبدأ تذكر قاعدة واحدة: ابن الأنبوب من اليسار إلى اليمين، وشغله بعد كل إضافة. فإذا أضفت خمس مراحل دفعة واحدة وجاء الجواب خاطئاً فلن تعرف أي مرحلة أخطأت، أما إذا رأيت المخرج بعد كل مرحلة فسوف ترى الخطأ في لحظة دخوله، كما سيحدث معنا مع رموز الحالة.
تجهيز المختبر Lab: سيرفر وسجلات حقيقية
السيرفر Container من Debian 13 فيه nginx وOpenSSH وrsyslog الذي يكتب سجل الدخول /var/log/auth.log، وخلف nginx واجهة برمجية صغيرة بلغة Python على المنفذ 9000 فيها مساران: /orders يرد فوراً، و/report يتأخر ثانيتين ونصف. وأضفنا إلى صيغة سجل nginx المعتادة combined حقلاً أخيراً هو مدة الطلب بالثواني $request_time، لأنه أول ما تحتاجه عندما يقال لك «الموقع بطيء». وهذا ملف الموقع:
# combined log format plus the request time in seconds as the last field
log_format timed '$remote_addr - $remote_user [$time_local] "$request" '
                 '$status $body_bytes_sent "$http_referer" "$http_user_agent" $request_time';
server {
    listen 80 default_server;
    access_log /var/log/nginx/access.log timed;
    root /var/www/html;
    location / { try_files $uri $uri/ =404; }
    location /api/ { proxy_pass http://127.0.0.1:9000/; proxy_read_timeout 5s; }
}
ووضعنا السيرفر وستة أجهزة على شبكة Docker واحدة بعناوين من النطاق 203.0.113.0/24، وهو نطاق مخصص للتوثيق، حتى تبدو السجلات كسجلات سيرفر حقيقي على الإنترنت:
docker network create --subnet 203.0.113.0/24 lnxb-net
docker run -d --name lnxb-logsrv --hostname web01 --network lnxb-net --ip 203.0.113.10 lnxb-logsrv:1
for i in 21 22 23 24 25 26; do
  docker run -d --name lnxb-c$i --network lnxb-net --ip 203.0.113.$i lnxb-client:1 sleep infinity
done
ثم شغلنا سكربت الحركة traffic.sh الموجود مع ملفات المقال، وهو يوزع الأدوار كالتالي على مدى ست دقائق تقريباً:
- العناوين
.21و.22و.26: زوار عاديون يطلبون الصفحات وملفات CSS وJS والواجهة البرمجية، وأحياناً التقرير البطيء. - العنوان
.23: أداة فحص تطلب مسارات مثل/.envو/wp-login.php، ثم ترسل بداية اتصال TLS إلى منفذ HTTP العادي، كما تفعل أدوات الفحص الحقيقية. - العنوان
.24: يخمن كلمات مرور SSH لمستخدمين مثل root وadmin وubuntu. - العنوان
.25: المسؤول الحقيقي، يخطئ في كلمة المرور مرة ثم يدخل، ويدخل مرة ثانية بعد دقائق. - وفي الدقيقة الثالثة نوقف الواجهة البرمجية قرابة 70 ثانية ثم نعيدها.
والنسخة التي حللناها من السجلين موجودة أيضاً مع ملفات المقال في lab/access.log وlab/auth.log، ومعها السكربت analysis.sh الذي فيه كل أمر في هذا المقال، فتستطيع أن تعيد كل شيء على جهازك دون Docker. والأدوات التي استخدمناها هي ما يأتي مع Debian 13: GNU grep 3.11 وGNU sed 4.9 وcoreutils 9.7 وmawk 1.3.4، وهو تطبيق awk الافتراضي في Debian وUbuntu.
النظرة الأولى: wc وhead وtail
أول سؤال مع أي ملف سجل: كم حجمه، وما شكل سطوره؟ لأن الجواب يحدد الأدوات المناسبة، فملف من 300 سطر تقرؤه بعينك، وملف من عشرة ملايين سطر تحتاج معه أن تفكر في كل مرحلة:
wc -l access.log auth.log
head -n 2 access.log
319 access.log
186 auth.log
505 total
203.0.113.21 - - [16/Nov/2026:09:05:59 +0000] "GET /api/orders HTTP/1.1" 200 22 "-" "curl/8.23.0" 0.005
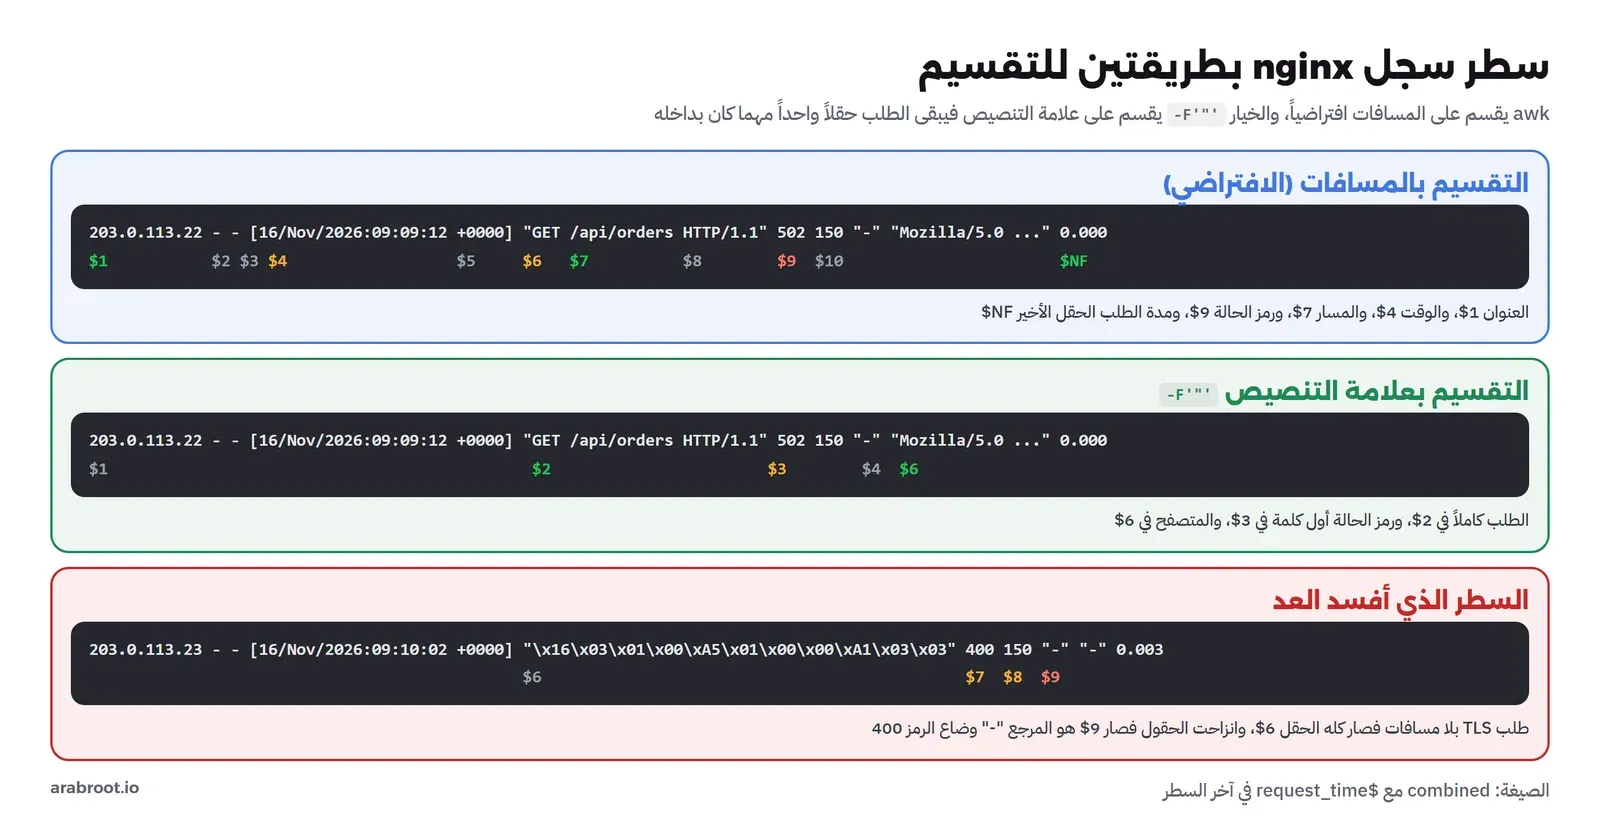
203.0.113.26 - - [16/Nov/2026:09:06:12 +0000] "GET / HTTP/1.1" 200 15 "-" "Mozilla/5.0 (X11; Linux x86_64) Firefox/140.0" 0.000والأمر wc -l يعد السطور، والأمر head -n 2 يعرض أول سطرين، وtail -n 20 يعرض آخر عشرين، وهي عادة الأحدث في السجل. وعلى السيرفر الحقيقي تجد بجانب الملف نسخاً قديمة باسم access.log.1 وaccess.log.2.gz صنعها logrotate، والملفات المضغوطة تقرؤها بالأوامر zcat وzgrep دون فكها على القرص. والصورة التالية تشرح السطر الذي سوف نعمل عليه طوال المقال، لأن كل أمر بعد ذلك يعتمد على معرفة مكان كل معلومة فيه:
البحث مع grep
الأداة grep تطبع السطور التي تطابق نمطاً، وهي أكثر ما ستكتبه في حياتك على السيرفر. والخيارات التي تحتاجها كل يوم قليلة، وكلها موثقة في صفحة grep(1):
| الخيار | ماذا يفعل | مثال |
|---|---|---|
-c | يطبع عدد السطور المطابقة بدلاً منها | grep -c " 502 " access.log |
-v | يعكس البحث: السطور التي لا تطابق | grep -v " 200 " access.log |
-i | يتجاهل حالة الحروف | grep -i "error" app.log |
-E | تعبيرات نمطية موسعة: | و+ و() دون شرطة مائلة | grep -E "Accepted|Failed" auth.log |
-o | يطبع الجزء المطابق فقط، لا السطر كله | grep -oE "Invalid user [^ ]+" auth.log |
-w | يطابق كلمة كاملة فقط | grep -w "root" auth.log |
-n | يضيف رقم السطر | grep -n "x16" access.log |
-r | يبحث في مجلد كامل | grep -r "listen" /etc/nginx/ |
-A و-B | يعرض سطوراً بعد المطابقة وقبلها | grep -B2 -A5 "Traceback" app.log |
ولاحظ في المثال الأول أننا كتبنا المسافات حول 502، والسبب أن الرقم 502 قد يظهر في حجم الرد أو في المسار أو في الوقت، فالنمط 502 وحده سوف يعد سطوراً لا علاقة لها بالأخطاء. وهذه أول قاعدة في البحث في السجلات: اجعل النمط محدداً بما حوله بقدر ما تستطيع، أو انتقل إلى awk الذي يقارن حقلاً بعينه.
مشكلة واجهتنا: grep لم يجد شيئاً، والسجل مليء بالمحاولات
في أغلب الشروحات القديمة ستجد للبحث عن محاولات الدخول الفاشلة نمطاً مثل sshd\[.*Failed password، أي سطور العملية sshd برقمها بين قوسين. وعندما جربناه على سجلنا:
grep -c 'sshd\[.*Failed password' auth.log; echo "exit=$?"0
exit=1صفر، والسجل فيه 37 محاولة فاشلة. والسبب يظهر عندما تقرأ السطور نفسها:
2026-11-16T09:05:56.701347+00:00 web01 sshd[11]: Server listening on 0.0.0.0 port 22.
2026-11-16T09:06:46.754564+00:00 web01 sshd-session[36]: Failed password for deploy from 203.0.113.25 port 53770 ssh2
2026-11-16T09:06:49.981988+00:00 web01 sshd-session[40]: Accepted password for deploy from 203.0.113.25 port 53772 ssh2
2026-11-16T09:07:02.063316+00:00 web01 sshd-session[57]: Invalid user admin from 203.0.113.24 port 46252
2026-11-16T09:07:03.415790+00:00 web01 sshd-session[57]: Failed password for invalid user admin from 203.0.113.24 port 46252 ssh2
منذ OpenSSH 9.8 صارت جلسات الدخول تعمل في برنامج منفصل اسمه sshd-session، كما في ملاحظات إصدار OpenSSH 9.8، فبقي sshd يكتب سطر الاستماع فقط، وكل سطور الدخول صارت باسم sshd-session. وأي سكربت مراقبة أو قاعدة في fail2ban كتبت بالنمط القديم سوف تعطي صفراً بصمت بعد ترقية النظام، ولن يخبرك أحد. ولاحظ أيضاً رمز الخروج 1، فالأداة grep تخرج بالرمز 0 إذا وجدت، و1 إذا لم تجد، و2 إذا حدث خطأ مثل ملف غير موجود، وهذا مفيد في السكربتات، ولكنه فخ مع set -e كما سنرى في مقال سكربتات Bash. والدرس أن تبحث بالرسالة نفسها Failed password، وأن تتأكد من كل نمط بالعين على سطر حقيقي قبل أن تثق بالعدد.
العد والترتيب: cut وsort وuniq
السؤال الأول للمسؤول: من أكثر من يطلب الموقع؟ والجواب هو الأنبوب الأشهر في إدارة السيرفرات:
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -5 104 203.0.113.21
96 203.0.113.26
88 203.0.113.22
31 203.0.113.23اقرأه مرحلة مرحلة: awk '{print $1}' يطبع الحقل الأول من كل سطر وهو العنوان، ثم sort يرتب العناوين فتتجاور المتشابهة، ثم uniq -c يجمع كل مجموعة متجاورة في سطر واحد مع عددها، ثم sort -rn يرتب بالعدد رقمياً من الأكبر، ثم head -5 يأخذ الخمسة الأولى. وظهرت أربعة عناوين فقط لأن .24 لم يطلب الموقع أبداً وإنما حاول SSH، و.25 كذلك. ويمكنك أن تأخذ الحقل الأول بالأداة cut بدلاً من awk:
cut -d' ' -f1 access.log | sort | uniq -c | sort -rn | head -3 104 203.0.113.21
96 203.0.113.26
88 203.0.113.22والفرق بينهما أن cut يقسم على حرف واحد بالضبط، فإذا كان بين الحقلين مسافتان اعتبر بينهما حقلاً فارغاً، بينما awk يعتبر أي عدد من المسافات فاصلاً واحداً. فاستخدم cut عندما يكون الفاصل ثابتاً، مثل النقطتين في /etc/passwd أو الفاصلة في ملف CSV بسيط، واستخدم awk في السجلات.
فخان في sort وuniq
الفخ الأول أن sort وحده يرتب كنص، حرفاً حرفاً، وليس كأرقام:
printf '9\n100\n25\n' | sort
printf '9\n100\n25\n' | sort -n
100
25
9
9
25
100كنص، يأتي 100 قبل 25 لأن الحرف 1 قبل 2، ولذلك تكتب دائماً sort -n عندما ترتب أرقاماً، وsort -rn للأكبر أولاً، وsort -h لأحجام مثل 4K و31M التي يطبعها du -h. والفخ الثاني أن uniq يجمع السطور المتشابهة المتجاورة فقط، فإذا نسيت sort قبله:
awk '{print $1}' access.log | uniq -c | head -4
awk '{print $1}' access.log | uniq -c | wc -l
1 203.0.113.21
1 203.0.113.26
1 203.0.113.21
1 203.0.113.22
304304 مجموعة بدلاً من 4، لأن الطلبات من العناوين المختلفة متداخلة في السجل. وهذا السلوك ليس خطأ في uniq، وإنما تصميمه، وهو الذي سوف نستفيد منه بعد قليل عندما نعد الأخطاء في كل دقيقة، فالسجل مرتب بالوقت أصلاً ولا نحتاج sort.
awk: لغة صغيرة للأعمدة
الأداة awk ليست أمراً وإنما لغة برمجة صغيرة، صممها Aho وWeinberger وKernighan في Bell Labs عام 1977، والفكرة فيها بسيطة: لكل سطر في المدخل، قسمه إلى حقول، ثم نفذ القواعد التي تكتبها، وكل قاعدة شرط وعمل بالشكل شرط { عمل }. والحقول اسمها $1 و$2 وهكذا، والسطر كله $0، وعدد الحقول NF فيكون الحقل الأخير $NF، ورقم السطر NR. والمرجع هو مواصفة awk في POSIX، ولاحظ أن Debian وUbuntu يأتيان بالتطبيق mawk، وهو سريع ويلتزم بالمواصفة، ولكن بعض إضافات gawk غير موجودة فيه.
والسؤال الثاني للمسؤول: كم طلباً نجح وكم فشل؟ رمز الحالة في الحقل التاسع، فكتبنا:
awk '{print $9}' access.log | sort | uniq -c | sort -rn 281 200
30 404
7 502
1 "-"مشكلة واجهتنا: سطر واحد أفسد رموز الحالة
السطر الأخير "-" ليس رمز حالة، فمن أين جاء؟ عندما لا تفهم سطراً في النتيجة فاطلب السطور التي أنتجته، وهنا نطلب كل سطر حقله التاسع ليس رقماً:
awk '$9 !~ /^[0-9]+$/' access.log203.0.113.23 - - [16/Nov/2026:09:10:02 +0000] "\x16\x03\x01\x00\xA5\x01\x00\x00\xA1\x03\x03" 400 150 "-" "-" 0.003هذا هو اتصال TLS الذي أرسلته أداة الفحص إلى منفذ HTTP العادي. وnginx لم يفهمه فرد بالرمز 400، وكتب البايتات كما وصلت مكان الطلب. والطلب العادي "GET / HTTP/1.1" فيه ثلاث كلمات تأخذ الحقول 6 و7 و8، أما هذا الطلب فكلمة واحدة بلا مسافات، فانزاحت كل الحقول بعده بمقدار حقلين، وصار الحقل التاسع هو "-" الخاص بالمرجع Referer، وضاع الرمز 400 من العد. ولو كان في السجل مليون سطر لما انتبهت إلى سطر واحد غريب، ولكن الذي يرسل هذا السطر في الواقع هو بالضبط من تبحث عنه. وهذا ما يحدث مع أي حقل يكتبه العميل كما يشاء: الطلب، والمتصفح User-Agent، والمرجع.
والحل أن نقسم السطر على علامة التنصيص بدلاً من المسافة، بالخيار -F'"'، فيصبح الطلب كاملاً هو الحقل 2 مهما كان بداخله، والجزء بعده 400 150 هو الحقل 3، ثم نقسم الحقل 3 بالدالة split لنأخذ أول كلمة فيه:
awk -F'"' '{ split($3, s, " "); print s[1] }' access.log | sort | uniq -c | sort -rn 281 200
30 404
7 502
1 400والآن صار العد صحيحاً: 281 نجاحاً، و30 طلباً لمسار غير موجود، و7 أخطاء 502، وطلب واحد مرفوض. والصيغة التي تعتمد على علامة التنصيص أقوى لأن nginx يهرب Escape أي علامة تنصيص يرسلها العميل داخل الطلب، فتبقى علامات الفصل في مكانها مهما كتب العميل.
الأخطاء 5xx في كل دقيقة
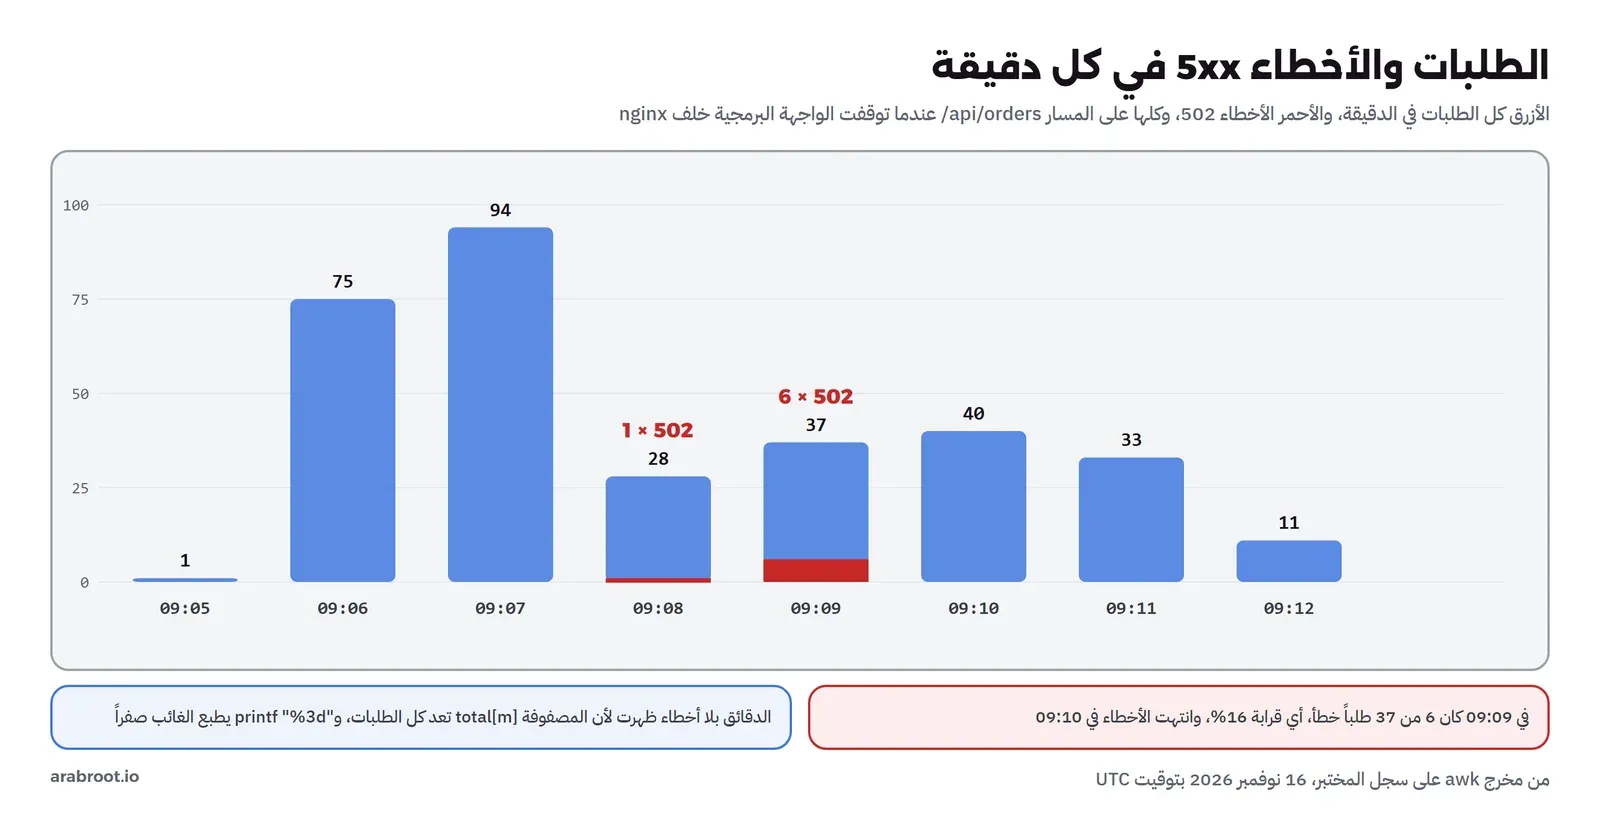
السؤال الثالث والأهم: متى بدأت الأخطاء ومتى انتهت؟ الوقت في الحقل 1 بعد القوس [، والدقيقة هي أول 17 حرفاً بعده، مثل 16/Nov/2026:09:09. فنطبع الدقيقة لكل سطر رمزه يبدأ بالرقم 5، ثم نعدها بالأداة uniq -c دون sort، لأن السجل مرتب بالوقت:
awk -F'"' '{ split($3, s, " "); if (s[1] ~ /^5/) print substr($1, index($1, "[") + 1, 17) }' access.log | uniq -c 1 16/Nov/2026:09:08
6 16/Nov/2026:09:09الأخطاء بدأت في الدقيقة 09:08 واستمرت في 09:09، وهذا يطابق ما فعلناه بالواجهة البرمجية. ولكن هذا المخرج يخفي شيئاً: الدقائق التي ليس فيها أخطاء لا تظهر أصلاً، ولا تعرف نسبة الأخطاء إلى الطلبات. والحل أن نجمع الرقمين معاً في مصفوفة Array لكل دقيقة، ونطبعها في النهاية في القسم END الذي يعمل بعد آخر سطر:
awk -F'"' '{
    split($3, s, " ")
    m = substr($1, index($1, "[") + 13, 5)
    total[m]++
    if (s[1] ~ /^5/) err[m]++
} END { for (m in total) printf "%s %4d %3d\n", m, total[m], err[m] }' access.log | sort
09:05 1 0
09:06 75 0
09:07 94 0
09:08 28 1
09:09 37 6
09:10 40 0
09:11 33 0
09:12 11 0في الكود أعلاه لاحظ التالي:
- المصفوفات في awk ترابطية Associative، أي أن مفتاحها نص مثل
"09:08"، ولا تحتاج تعريفاً، فالتعبيرtotal[m]++ينشئ العنصر بالقيمة صفر ثم يزيده. - العنصر
err[m]لدقيقة بلا أخطاء غير موجود، ولكنprintf "%3d"يطبعه صفراً، وهذا ما جعل الجدول كاملاً. - الحلقة
for (m in total)لا تضمن أي ترتيب، ولذلك أضفناsortفي النهاية. - والجواب الآن أوضح: في 09:09 كان 6 من 37 طلباً خطأ، أي قرابة 16%، والأخطاء انتهت في 09:10.
ثم سألنا عن المسار، لأن «الموقع أعطى أخطاء» قد تعني صفحة واحدة:
awk -F'"' '{ split($3, s, " "); if (s[1] ~ /^5/) { split($2, r, " "); print s[1], r[2] } }' access.log | sort | uniq -c 7 502 /api/ordersكل الأخطاء على /api/orders وبالرمز 502، وهو رمز Bad Gateway الذي يكتبه nginx عندما لا يستطيع الوصول إلى ما خلفه، أي أن nginx نفسه كان يعمل والمشكلة في الواجهة البرمجية. وبهذه الأسطر الثلاثة صار عندك جواب كامل للرسالة: الأخطاء على مسار الواجهة البرمجية فقط، بين 09:08 و09:09، والسبب أن الخدمة خلف nginx لم تكن ترد، والخطوة التالية هي سجل تلك الخدمة. وقد شرحنا كيف تقرأ سجل خدمة في systemd في مقال الخدمات والسجلات مع systemd، وكيف تتتبع العطل من طرف المستخدم إلى القرص في مقال استكشاف أعطال السيرفر.
الطلبات البطيئة ومتوسط المدة
الحقل الأخير $NF هو مدة الطلب، وهو مكان آمن لأنه آخر السطر مهما انزاح ما قبله. والشرط في awk يمكن أن يكون مقارنة رقمية مباشرة:
awk '$NF > 1 {print $NF, $7}' access.log | sort -rn | head -42.502 /api/report
2.502 /api/report
2.502 /api/report
2.501 /api/reportكل الطلبات التي أخذت أكثر من ثانية هي التقرير، وكلها قرابة ثانيتين ونصف، وهي المدة التي وضعناها في الكود. وفي سيرفر حقيقي سوف تجد التوزيع أوسع، وعندها يفيدك أن تحسب المتوسط لكل مسار بنفس فكرة المصفوفات: { n[$7]++; t[$7] += $NF } END { for (p in n) print p, n[p], t[p]/n[p] }، ولكن تذكر أن المتوسط يخفي الطلبات البطيئة النادرة، وأن ما يشعر به المستخدم هو النسب العليا مثل p95 وp99.
من يبحث عن ملفات حساسة؟
الطلبات 404 كثيراً ما تكشف أدوات الفحص، فسألنا عن أكثر المسارات المفقودة طلباً، ثم عن العنوان والمتصفح الذي طلبها:
awk -F'"' '{ split($3, s, " "); if (s[1] == 404) { split($2, r, " "); print r[2] } }' access.log | sort | uniq -c | sort -rn | head -5
awk -F'"' '{ split($3, s, " "); if (s[1] == 404) { split($1, ip, " "); print ip[1], $6 } }' access.log | sort | uniq -c
3 /wp-login.php
3 /wp-admin/
3 /server-status
3 /phpmyadmin/
3 /config.php
30 203.0.113.23 zgrab/0.xكل الطلبات الثلاثين المفقودة جاءت من عنوان واحد بمتصفح واحد، ولا يوجد طلب 404 واحد من الزوار العاديين، وهذا يعني أن موقعك لا يحتوي روابط معطلة الآن، وأن هذا العنوان أداة فحص آلية. ولاحظ المسارات: /.env و/.git/config و/.aws/credentials ملفات يتركها المطورون بالخطأ في مجلد الموقع وفيها كلمات مرور ومفاتيح، فإذا رأيت أحدها برمز 200 بدلاً من 404 فعندك حادثة أمنية لا مشكلة أداء.
sed: التعديل على الطريق
الأداة sed محرر نصوص يعمل على التدفق Stream Editor، أي أنه يقرأ السطور ويطبق عليها أوامر ويطبعها، والأمر الذي ستستخدمه في أغلب الأحيان هو الاستبدال s/النمط/البديل/، والتفاصيل في صفحة sed(1). ومن أشهر استخداماته مع السجلات أن تخفي جزءاً من البيانات قبل أن ترسل السجل لشخص آخر، مثل آخر رقم من كل عنوان IP:
head -n 2 access.log | sed -E 's/^([0-9]+\.[0-9]+\.[0-9]+)\.[0-9]+/\1.0/'203.0.113.0 - - [16/Nov/2026:09:05:59 +0000] "GET /api/orders HTTP/1.1" 200 22 "-" "curl/8.23.0" 0.005
203.0.113.0 - - [16/Nov/2026:09:06:12 +0000] "GET / HTTP/1.1" 200 15 "-" "Mozilla/5.0 (X11; Linux x86_64) Firefox/140.0" 0.000والخيار -E يفعل التعبيرات الموسعة، والأقواس تلتقط مجموعة Group نعيدها في البديل بالرمز \1، والرمز ^ يربط النمط ببداية السطر حتى لا يمس أرقاماً تشبه العناوين في مكان آخر من السطر. ونفس الفكرة تستخرج اسم المستخدم من سطور SSH، سواء كان مستخدماً موجوداً أو غير موجود:
grep 'Failed password' auth.log | sed -E 's/.*Failed password for (invalid user )?([^ ]+) from.*/\2/' | sort | uniq -c | sort -rn 7 deploy
6 ubuntu
6 test
6 root
6 oracle
6 adminوهنا المجموعة الأولى (invalid user )? اختيارية، فتطابق السطرين Failed password for root وFailed password for invalid user admin بنفس النمط، والمجموعة الثانية هي الاسم.
مشكلة واجهتنا: نطاق sed الذي لم يبدأ
يستطيع sed أن يطبع نطاقاً من السطور بين نمطين بالشكل sed -n '/بداية/,/نهاية/p'، وهذا مفيد جداً لاستخراج نافذة زمنية من السجل. فطلبنا السطور بين 09:09:00 و09:09:30:
sed -n '/T09:09:00/,/T09:09:30/p' auth.log | wc -l
sed -n '/T09:09:/,/T09:10:/p' auth.log | grep -c 'Failed password'
0
6الأمر الأول أعطى صفراً، والسبب أن النطاق يبدأ فقط عندما يجد سطراً يطابق النمط الأول، ولا يوجد في السجل سطر كتب في الثانية 09:09:00 بالضبط، فلم يبدأ النطاق أبداً. والأمر الثاني يبدأ من أول سطر في الدقيقة 09:09 أياً كانت ثانيته، وينتهي عند أول سطر في 09:10، فأعطى 6 محاولات فاشلة، وهو نفس العدد الذي سوف نراه في عد الدقائق. والقاعدة أن تجعل نمط البداية أوسع من اللحظة، أو أن تستخدم awk مع مقارنة نصية مثل $1 >= "2026-11-16T09:09" && $1 < "2026-11-16T09:10"، وهي تعمل لأن صيغة الوقت ISO 8601 في هذا السجل ترتب كنص بنفس ترتيبها الزمني.
تعديل ملف إعداد مع sed -i، ولماذا لا تفعله بسجل مفتوح
الخيار -i يجعل sed يعدل الملف نفسه بدلاً من الطباعة، وهو مفيد في السكربتات لتغيير إعداد واحد. وأضف دائماً لاحقة للنسخة الاحتياطية مثل -i.bak، ثم راجع الفرق بالأمر diff:
sed -i.bak -E 's/^#?PasswordAuthentication .*/PasswordAuthentication no/' /tmp/sshd_config
diff /tmp/sshd_config.bak /tmp/sshd_config
57c57
< #PasswordAuthentication yes
---
> PasswordAuthentication noوالنمط ^#? يطابق السطر سواء كان معلقاً أو لا، فلا يبقى في الملف سطران متعارضان. ولكن لاحظ أن ملف sshd_config في Debian وUbuntu يقرأ أيضاً الملفات في /etc/ssh/sshd_config.d/، وقد يكون فيها إعداد يغلب تعديلك، ولذلك تتأكد بعد أي تعديل بالأمر sshd -T | grep -i passwordauthentication الذي يطبع الإعداد الفعلي.
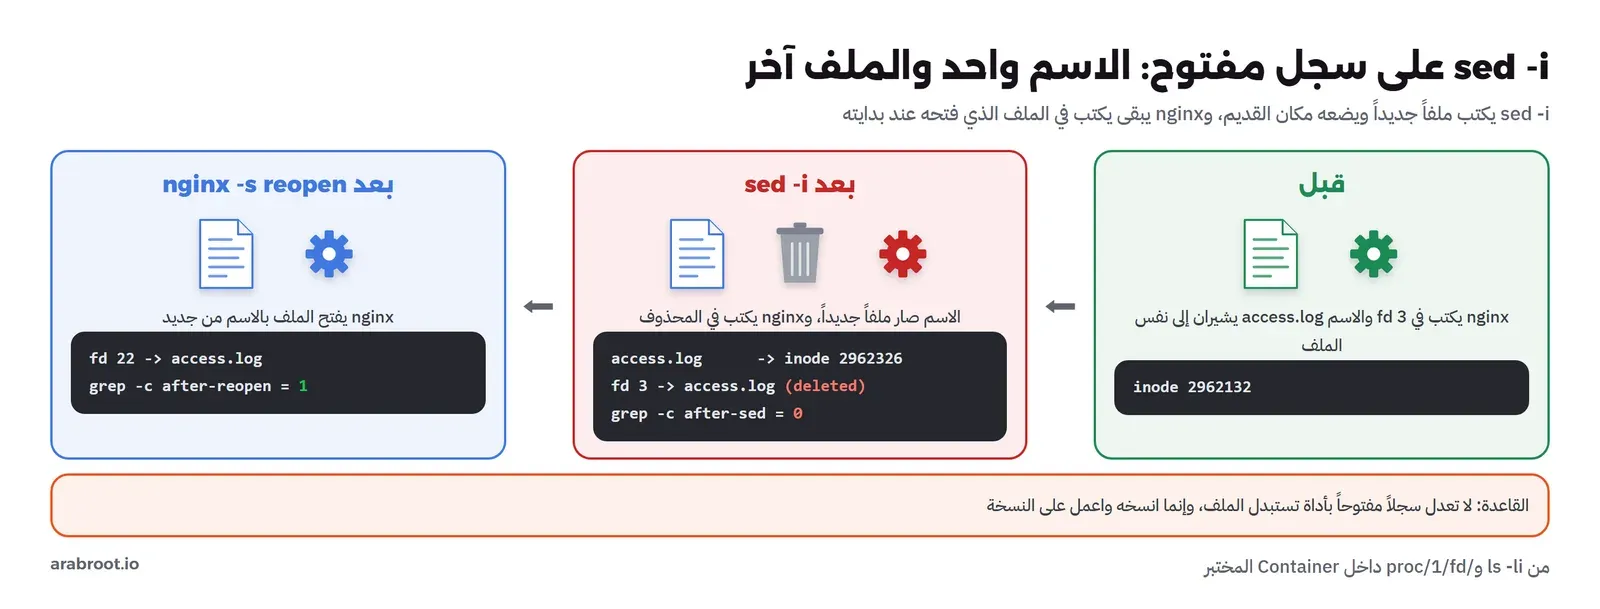
والآن المشكلة الحقيقية التي وقعنا فيها أثناء كتابة هذا المقال: أضفنا إلى السجل سطوراً للتجربة ثم حذفناها بالأمر sed -i '/missing/d' access.log، وبعدها لم يعد أي طلب جديد يظهر في السجل. والسبب أن sed -i لا يعدل الملف في مكانه كما يوحي اسمه، وإنما يكتب ملفاً جديداً ثم يستبدل به القديم، فيتغير رقم الملف Inode، بينما nginx يكتب في الملف الذي فتحه عند بدايته:
2962132 -rw-r----- 1 www-data adm 42816 Nov 16 09:23 /var/log/nginx/access.log
l-wx------ 1 root root 64 Nov 16 09:24 3 -> /var/log/nginx/access.log
2962326 -rw-r----- 1 www-data adm 42816 Nov 16 09:24 /var/log/nginx/access.log
l-wx------ 1 root root 64 Nov 16 09:24 3 -> /var/log/nginx/access.log (deleted)
0
l-wx------ 1 root root 64 Nov 16 09:24 22 -> /var/log/nginx/access.log
1
في المخرج أعلاه لاحظ التالي:
- السطر الأول رقم الملف قبل التعديل 2962132، والسطر الثالث بعده 2962326، أي أنه ملف آخر بنفس الاسم.
- السطر الثاني والرابع من
/proc/1/fd، وهي الملفات التي يفتحها nginx، وبعد التعديل صار ملف السجل الذي يكتب فيه(deleted). - ثم أرسلنا طلباً إلى
/after-sedوبحثنا عنه في السجل فوجدنا0، فالطلب كتب في ملف محذوف لا تراه، وسوف يضيع عند إعادة تشغيل nginx. - والحل كان
nginx -s reopenالذي يجعله يفتح الملف بالاسم من جديد، وبعده ظهر الطلب/after-reopenفي السجل.
والقاعدة: لا تعدل سجلاً مفتوحاً بأداة تستبدل الملف، لا sed -i ولا محرر نصوص، وإنما انسخه واعمل على النسخة. وهذه نفس فكرة القرص الممتلئ الذي لا يفرغ بعد حذف السجل، لأن البرنامج ما زال يكتب في الملف المحذوف، وقد رأيناها في مقال استكشاف الأعطال.
tr: تحويل الحروف
الأداة tr أبسط من sed: تحول حرفاً إلى حرف، أو تحذف حروفاً، أو تضغط التكرار. وأكثر ما تحتاجه منها ثلاث حالات: ضغط المسافات المتكررة إلى واحدة بالخيار -s قبل cut، وتحويل فاصل إلى سطر جديد، وتحويل الأسطر إلى سطر واحد:
echo "Failed  password   for root" | tr -s " "
echo "GET,POST,PUT" | tr "," "\n"
grep -oE 'Invalid user [^ ]+' auth.log | cut -d' ' -f3 | sort -u | tr '\n' ' '
Failed password for root
GET
POST
PUT
admin oracle test ubuntuوالسطر الأخير يجيب عن سؤال مفيد: ما أسماء المستخدمين غير الموجودة التي جربها المهاجم؟ فإذا وجدت فيها اسماً حقيقياً من شركتك فهناك من يعرف عنكم أكثر من قوائم الأسماء العامة.
سجل الدخول SSH: من يحاول، ومن دخل؟
ننتقل الآن إلى الشق الثاني من الرسالة. وفي سطور Failed password العنوان دائماً في الحقل الرابع من آخر السطر، سواء كان المستخدم موجوداً أو لا، لأن عدد الكلمات قبل العنوان يتغير ولكن ما بعده ثابت port 46252 ssh2. ولذلك نعد من النهاية بالتعبير $(NF-3):
grep 'Failed password' auth.log | awk '{print $(NF-3)}' | sort | uniq -c | sort -rn
grep 'Failed password' auth.log | cut -c12-16 | uniq -c
36 203.0.113.24
1 203.0.113.25
2 09:06
8 09:07
3 09:08
6 09:09
6 09:10
5 09:11
7 09:1236 محاولة من عنوان واحد على مدى سبع دقائق، بمعدل محاولة كل عشر ثوان تقريباً، وهذا نمط التخمين البطيء الذي يحاول ألا يلفت النظر. ومحاولة واحدة من .25، وهو المسؤول الذي أخطأ مرة. والأمر الثاني استخدم cut -c لأخذ الحروف من 12 إلى 16 من كل سطر، وهي الساعة والدقيقة في الوقت بصيغة ISO، وهذا أسرع من awk عندما يكون موقع المعلومة في السطر ثابتاً بالحرف. ثم السؤال الأهم: هل نجح أحد؟
grep 'Accepted' auth.log | awk '{print substr($1, 1, 19), $(NF-5), $(NF-3), $(NF-7)}'2026-11-16T09:06:49 deploy 203.0.113.25 password
2026-11-16T09:11:14 deploy 203.0.113.25 passwordدخولان ناجحان فقط، كلاهما للمستخدم deploy من عنوان المسؤول وبكلمة مرور، ولم ينجح العنوان .24 في أي محاولة. ولاحظ الكلمة الأخيرة password، فهي طريقة الدخول، والطريقة المفضلة في سيرفر على الإنترنت هي publickey، وإذا رأيت password في سيرفر عام فهذه توصية بتعطيلها كما شرحنا في دليل تأمين خادم VPS من أول دخول. والصورة التالية تجمع الجواب:
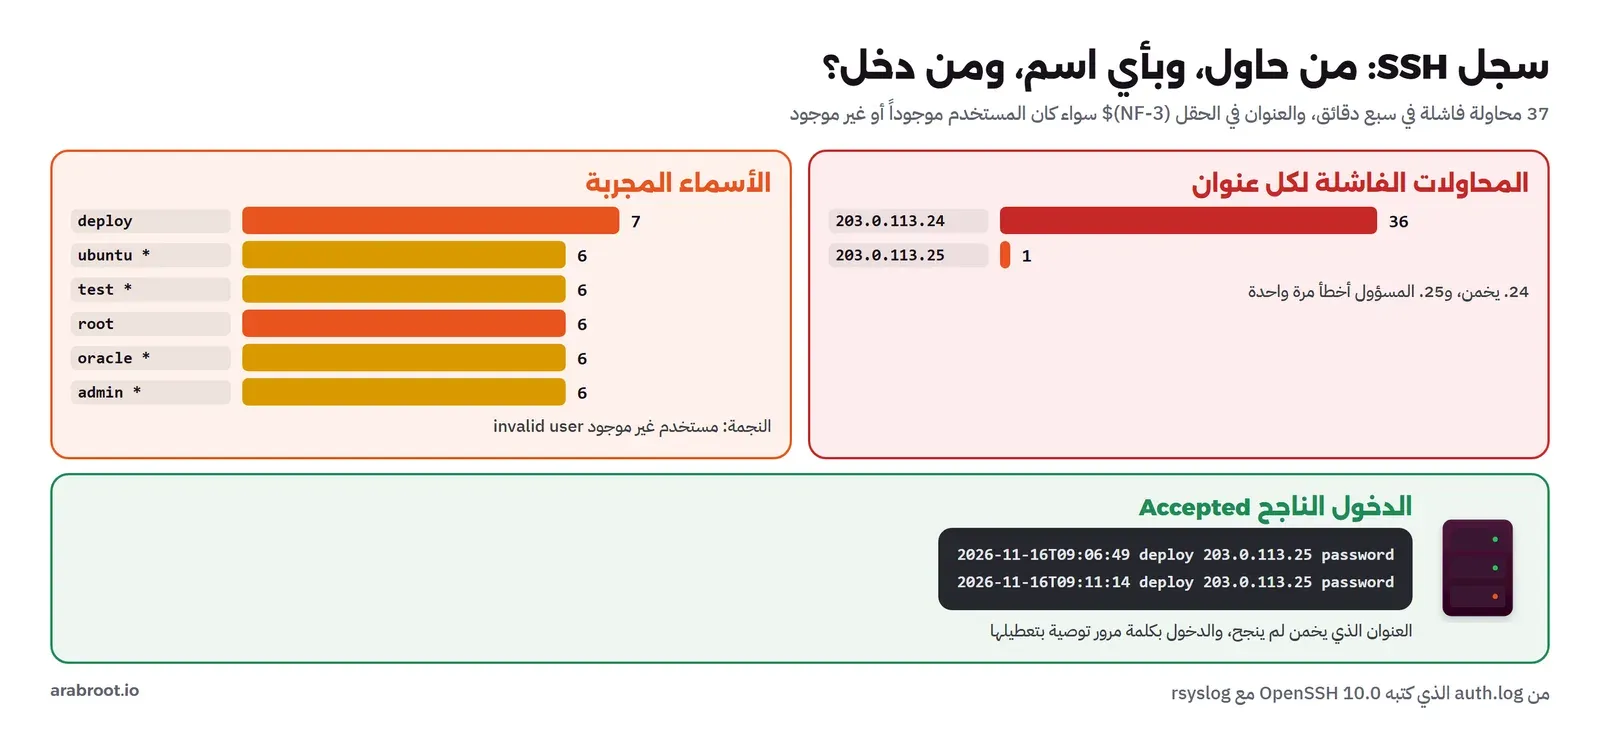
ولاحظ في عد المستخدمين أن deploy جرب 7 مرات، منها 6 من المهاجم، أي أن المهاجم جرب اسماً موجوداً فعلاً على السيرفر، وهذه السطور لا تحمل عبارة invalid user. وهذا يكفي لتعرف أن تعطيل الدخول بكلمة المرور ليس رفاهية، وأن أداة مثل fail2ban التي تقرأ نفس هذه السطور وتحظر العنوان بعد عدد من المحاولات تستحق التشغيل.
xargs: من قائمة إلى أوامر
كل الأدوات السابقة تقرأ نصاً من مدخلها، ولكن بعض الأوامر لا تقرأ المدخل وإنما تأخذ الوسائط Arguments في سطر الأمر، مثل rm وgzip وnft. والأداة xargs تقرأ القائمة من المدخل وتحولها إلى وسائط لأمر آخر، كما في صفحة xargs(1). ولنفرض أنك تريد قائمة أوامر تحظر كل عنوان له 10 محاولات فاشلة أو أكثر، تقرؤها قبل أن تنفذها:
grep 'Failed password' auth.log | awk '{print $(NF-3)}' | sort | uniq -c \
  | awk '$1 >= 10 {print $2}' \
  | xargs -r -I{} echo nft add element inet filter blocklist '{ {} }'
nft add element inet filter blocklist { 203.0.113.24 }والخيار -I{} يضع كل سطر مكان الرمز {} وينفذ الأمر مرة لكل سطر، والأمر هنا echo فقط، فهو يطبع ما سوف ينفذ ولا ينفذه، وهذه عادة جيدة مع أي أنبوب ينتهي بأمر يغير شيئاً. والخيار -r مهم أكثر مما يبدو، فبدونه ينفذ xargs الأمر مرة واحدة حتى لو كانت القائمة فارغة، وجربنا ذلك بعنوان غير موجود في السجل:
would block:سطر بلا عنوان، ومع أمر مثل rm فإن تنفيذه بلا وسائط قد يعني شيئاً لا تريده. والفخ الثاني مع xargs هو المسافة في أسماء الملفات، فهو يقسم المدخل على المسافات افتراضياً. صنعنا ملفين قديمين للسجل أحدهما في اسمه مسافة، ثم ضغطناهما:
find /srv/old-logs -name "*.log" | xargs gzip -v
find /srv/old-logs -name "*.log" -print0 | xargs -0 -r gzip -v
/srv/old-logs/access-2026-11-15.log: 95.3% -- replaced with /srv/old-logs/access-2026-11-15.log.gz
gzip: /srv/old-logs/access: No such file or directory
gzip: 2026-11-14.log: No such file or directory
/srv/old-logs/access 2026-11-14.log: 95.3% -- replaced with /srv/old-logs/access 2026-11-14.log.gzفي المرة الأولى قسم xargs الاسم access 2026-11-14.log إلى اسمين غير موجودين، وفي الثانية جعل find -print0 الفاصل بين الأسماء هو البايت الصفري الذي لا يمكن أن يظهر في اسم ملف، وقرأه xargs -0 بنفس الطريقة فنجح. واجعل -print0 مع -0 عادة كلما مررت أسماء ملفات، حتى لو كنت تظن أن أسماءك نظيفة، فالملف الذي فيه مسافة يأتي دائماً في اليوم الذي لا تتوقعه. ولاحظ أن find نفسه يستطيع التنفيذ بالخيار -exec gzip {} + دون xargs، وهو آمن مع المسافات أيضاً.
المتابعة الحية: tail -f ومشكلة التخزين المؤقت Buffering
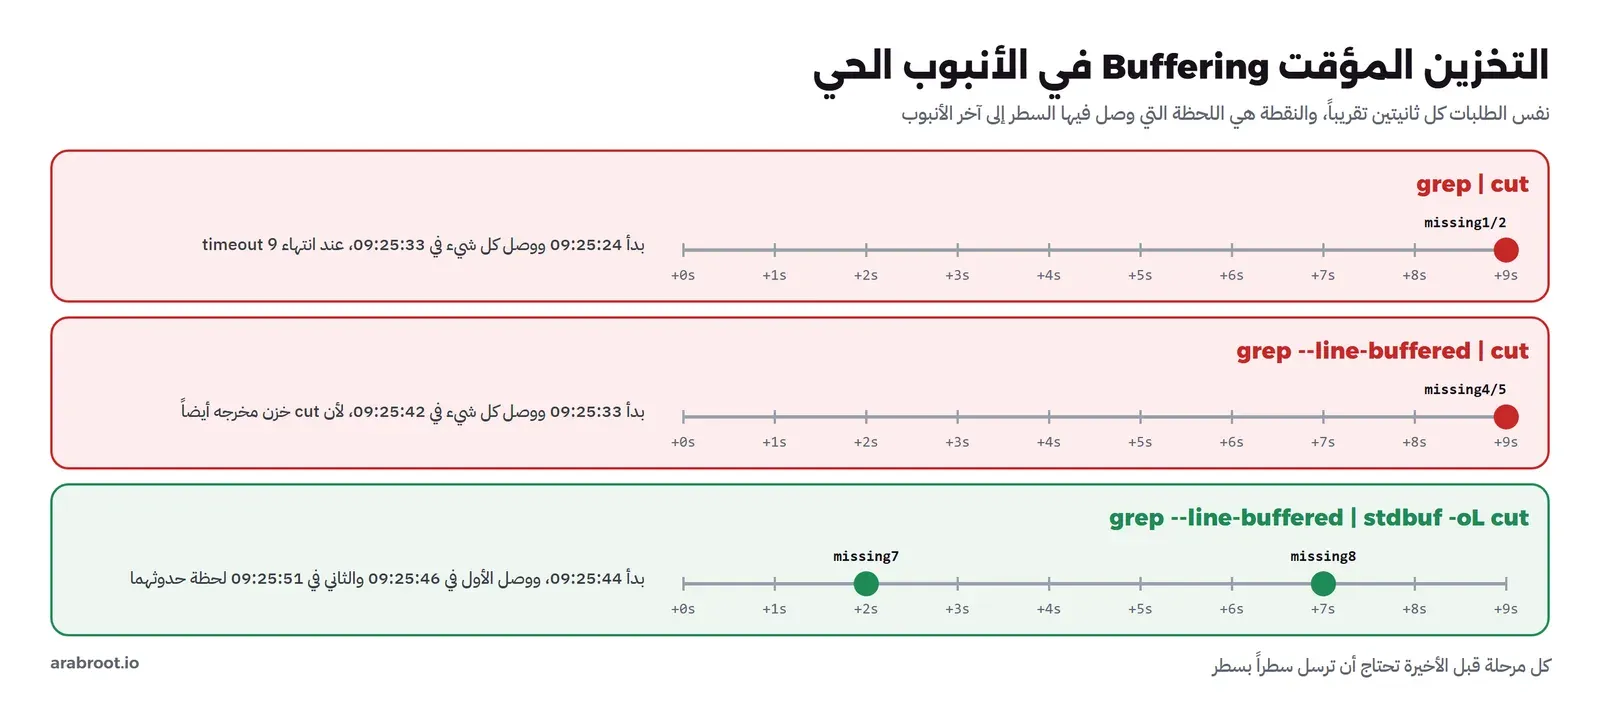
كل ما سبق على ملف ثابت، ولكن أثناء الحادثة تريد أن ترى الأخطاء لحظة حدوثها. والأمر tail -f يبقى يقرأ الملف ويطبع كل سطر جديد، فتضع بعده الفلتر الذي تريده. ولتجربة ذلك شغلنا الأنبوب تسع ثوان، وفي نفس الوقت أرسلنا من جهاز آخر طلباً لمسار غير موجود كل ثانيتين تقريباً، وأضفنا في النهاية دالة صغيرة stamp تطبع وقت وصول كل سطر إليها:
stamp() { while read -r l; do echo "$(date +%T) got: $l"; done; }
timeout 9 tail -n0 -f access.log | grep " 404 " | cut -d" " -f7 | stamp
timeout 9 tail -n0 -f access.log | grep --line-buffered " 404 " | cut -d" " -f7 | stamp
timeout 9 tail -n0 -f access.log | grep --line-buffered " 404 " | stdbuf -oL cut -d" " -f7 | stamp
والمخرج للمحاولات الثلاث بالترتيب، وأول سطر في كل واحدة وقت بدايتها:
start 09:25:24
09:25:33 got: /missing1
09:25:33 got: /missing2
start 09:25:33
09:25:42 got: /missing4
09:25:42 got: /missing5start 09:25:44
09:25:46 got: /missing7
09:25:51 got: /missing8في المحاولة الأولى لم يصل أي سطر حتى انتهت الثواني التسع، ثم وصلت كلها في 09:25:33 دفعة واحدة. والسبب أن grep عندما يكتب إلى أنبوب وليس إلى طرفية يجمع مخرجه في ذاكرة مؤقتة Buffer حجمها عدة كيلوبايتات، ولا يرسلها حتى تمتلئ أو حتى ينتهي، وهذه نفس مشكلة Python التي رأيناها مع systemd. وفي المحاولة الثانية أضفنا --line-buffered إلى grep ومع ذلك وصلت السطور في النهاية أيضاً، لأن cut بعده يفعل نفس الشيء. وفي الثالثة جعلنا cut يرسل كل سطر فوراً بالأداة stdbuf -oL، فوصل السطر الأول بعد ثانيتين من البداية والثاني بعد خمس ثوان من الأول بحسب وقت إرسال الطلب. والقاعدة: في الأنبوب الحي، كل مرحلة قبل الأخيرة تحتاج أن ترسل سطراً بسطر، والمرحلة الأخيرة التي تكتب إلى الطرفية لا تحتاج ذلك. وبعض الأدوات لها خيار خاص لذلك، مثل grep --line-buffered وsed -u، وفي mawk الخيار -W interactive، والباقي يعمل معه stdbuf -oL.
ماذا يحدث مع ملف كبير؟ قياس السرعة Performance
سجلنا 319 سطراً فقط، وكل أمر فيه ينتهي قبل أن ترفع إصبعك عن المفتاح، ولكن سجل سيرفر مشغول قد يصل إلى ملايين السطور في اليوم. ولكي نرى الفرق كررنا نفس السجل 3200 مرة في ملف واحد، فصار 1,020,800 سطراً بحجم 131M، ثم قسنا ثلاث طرق للسؤال الأول «من أكثر من يطلب الموقع؟» بالأمر time، ثلاث مرات لكل طريقة:
for i in $(seq 3200); do cat access.log; done > big.log
# sort-utf8 and sort-C: the usual pipeline under two locales
LC_ALL=C.UTF-8 awk '{print $1}' big.log | LC_ALL=C.UTF-8 sort | uniq -c | sort -rn | head -3 > /tmp/o
LC_ALL=C awk '{print $1}' big.log | LC_ALL=C sort | uniq -c | sort -rn | head -3 > /tmp/o
# awk-array: one pass, one counter per address
awk '{n[$1]++} END {for (i in n) print n[i], i}' big.log | sort -rn | head -3 > /tmp/o
# grep-i-utf8 and grep-i-C
LC_ALL=C.UTF-8 grep -ci "firefox" big.log > /tmp/o
LC_ALL=C grep -ci "firefox" big.log > /tmp/o
run 1 | sort-utf8 real 3.04 | sort-C real 2.08 | awk-array real 0.87 | grep-i-utf8 real 0.19 | grep-i-C real 0.16
run 2 | sort-utf8 real 1.68 | sort-C real 1.84 | awk-array real 1.19 | grep-i-utf8 real 0.31 | grep-i-C real 0.29
run 3 | sort-utf8 real 2.25 | sort-C real 1.29 | awk-array real 0.81 | grep-i-utf8 real 0.20 | grep-i-C real 0.18في المخرج أعلاه لاحظ التالي:
- الأنبوب المعتاد مع
sortأخذ بين 1.3 و3 ثوان، لأنsortيرتب مليون سطر كاملة قبل أن يعدuniqأي شيء، وعندما لا تكفي الذاكرة يكتب ملفات مؤقتة على القرص. - مصفوفة awk أخذت أقل من ثانية ونصف في كل مرة، لأنها تمر على الملف مرة واحدة وتحفظ في الذاكرة عداداً لكل عنوان فقط، أي أربعة عناصر هنا، ثم يرتب
sortأربعة أسطر بدلاً من مليون. ونقطة ضعفها أن عدد المفاتيح المختلفة هو حجم الذاكرة، فإذا جمعت ملايين المسارات المختلفة فقد تستهلك الذاكرة كلها، بينماsortيتعامل مع ذلك بالقرص. grepمر على الملف كله في أقل من ثلث ثانية، ولذلك ابدأ دائماً بفلترة السطور بالأداةgrepقبل أي معالجة أثقل، فكل سطر تحذفه مبكراً لا تدفع ثمنه في المراحل التالية.- الفرق بين اللغة
LC_ALL=CوC.UTF-8لم يكن ثابتاً في قياسنا، فمرة أسرع ومرة أبطأ، ولذلك لا تعتمد على هذه النصيحة المنتشرة دون أن تقيسها على بياناتك.
وواجهتنا مشكلة صغيرة في القياس نفسه: في أول محاولة وجهنا مخرج grep إلى /dev/null فكانت المدة صفراً، والسبب أن GNU grep يلاحظ أن مخرجه يذهب إلى /dev/null فيتوقف عند أول مطابقة لأن أحداً لن يقرأ النتيجة، فوجهنا المخرج إلى ملف مؤقت لنحصل على أرقام حقيقية. وهذا مثال جيد على قاعدة عامة في القياس: تأكد أن الأداة تفعل العمل الذي تظن أنك تقيسه.
متى تتوقف عن هذه الأدوات؟
أدوات النصوص سريعة جداً وموجودة على كل سيرفر، ولكن لها حدود واضحة، وأن تعرف هذه الحدود جزء من استخدامها:
- عندما تكون السجلات على أكثر من سيرفر: لن تستطيع أن تجمع الدقائق من عشرة سيرفرات بأنبوب واحد، وهنا تحتاج نظاماً مركزياً مثل Grafana Loki أو مجموعة ELK.
- عندما يكون السجل بصيغة JSON: لا تقسم JSON بالمسافات ولا بالتعبيرات النمطية، فاستخدم
jq، أوjournalctl -o jsonمع سجلات systemd. - عندما تحتاج جواباً عبر أيام وأسابيع: فهنا تحتاج قاعدة بيانات للسجلات وفهارس، لا قراءة ملفات مضغوطة كل مرة.
- وعندما يتكرر نفس الأنبوب كل يوم: فاكتبه في سكربت فيه شرح لكل مرحلة، أو حوله إلى تنبيه في نظام المراقبة.
وأفضل من كل ذلك أن تكتب سجلات تطبيقك بطريقة تجعل الجواب سهلاً من البداية، بحقول ثابتة ومعرف لكل طلب، وقد شرحنا ذلك في مقال سجلات تساعدك فعلاً.
أخطاء شائعة
- الثقة بالعدد دون النظر إلى السطور: نمط
sshd\[أعطى صفراً، والحقل التاسع أعطى"-"، وكلاهما كان سيمر لو لم ننظر. - تقسيم سجل nginx على المسافات مع حقول يكتبها العميل: استخدم
-F'"'، أو الحقل الأخير$NFللحقول الرقمية في آخر السطر. uniq -cدونsortقبله، إلا إذا كانت المدخلات مرتبة أصلاً كالوقت.sortدون-nلأرقام، أو دون-hلأحجام مثل31M.- نمط بحث قصير مثل
502يطابق أرقاماً في الحجم أو المسار. - نطاق
sedيبدأ بلحظة دقيقة قد لا تكون في السجل. sed -iعلى سجل مفتوح: البرنامج يبقى يكتب في الملف المحذوف.xargsدون-rودون-0مع أسماء الملفات.- أنبوب حي دون
--line-bufferedأوstdbuf -oLفي كل مرحلة قبل الأخيرة. - تشغيل أنبوب ينتهي بأمر يغير شيئاً دون أن تجربه أولاً مع
echo.
جدول الأسئلة والأوامر Cheat Sheet
| السؤال | الأمر |
|---|---|
| أكثر العناوين طلباً | awk '{print $1}' access.log | sort | uniq -c | sort -rn | head |
| عدد كل رمز حالة | awk -F'"' '{split($3,s," "); print s[1]}' access.log | sort | uniq -c |
| الأخطاء 5xx في كل دقيقة | awk -F'"' '{split($3,s," "); if (s[1] ~ /^5/) print substr($1, index($1,"[")+1, 17)}' access.log | uniq -c |
| المسارات التي فشلت | awk -F'"' '{split($3,s," "); if (s[1] ~ /^5/) {split($2,r," "); print r[2]}}' access.log | sort | uniq -c |
| الطلبات الأبطأ من ثانية | awk '$NF > 1 {print $NF, $7}' access.log | sort -rn | head |
| محاولات SSH الفاشلة لكل عنوان | grep 'Failed password' auth.log | awk '{print $(NF-3)}' | sort | uniq -c | sort -rn |
| الدخول الناجح | grep 'Accepted' auth.log |
| نافذة زمنية من السجل | sed -n '/T09:09:/,/T09:10:/p' auth.log |
| متابعة حية للأخطاء | tail -f access.log | grep --line-buffered ' 50[0-9] ' |
| سجلات قديمة مضغوطة | zgrep 'Failed password' /var/log/auth.log.2.gz |
تدريب عملي
- من ملف
lab/access.logاطبع لكل عنوان IP عدد طلباته وعدد أخطائه 4xx و5xx في سطر واحد، باستخدام مصفوفات awk. - اكتب أنبوباً يطبع العناوين التي فشلت في SSH ثم نجحت لاحقاً من نفس العنوان، فهذه أخطر حالة في سجل الدخول. وستجد تمارين أخرى بمستويات مختلفة مع حلولها في تمارين Kata في Linux.
حذف المختبر Cleanup
docker rm -f lnxb-logsrv lnxb-c21 lnxb-c22 lnxb-c23 lnxb-c24 lnxb-c25 lnxb-c26
docker network rm lnxb-net
docker rmi lnxb-logsrv:1 lnxb-client:1
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كل أداة تفعل شيئاً واحداً، والجواب يبنى في أنبوب مرحلة مرحلة مع النظر إلى المخرج بعد كل مرحلة.
- من 319 سطراً عرفنا أن الأخطاء 7 طلبات 502 على
/api/ordersفقط بين 09:08 و09:09، أي أن الخدمة خلف nginx توقفت وليس nginx. - سطر TLS واحد بلا مسافات أزاح الحقول وأخفى الرمز 400، والتقسيم بعلامة التنصيص
-F'"'أصلح العد. - منذ OpenSSH 9.8 صارت سطور الدخول باسم
sshd-session، والنمط القديمsshd\[أعطى صفراً بصمت. - 36 محاولة تخمين من عنوان واحد لم تنجح، ودخولان ناجحان من عنوان المسؤول بكلمة مرور.
sed -iاستبدل ملف السجل فبقي nginx يكتب في ملف محذوف حتىnginx -s reopen.- في الأنبوب الحي كل مرحلة تخزن مخرجها، فتحتاج
--line-bufferedأوstdbuf -oLلكل مرحلة قبل الأخيرة.
وفي المقال التالي بإذن الله سوف نجمع هذه الأوامر في سكربتات Bash حقيقية فيها معالجة الأخطاء والقفل والسجلات وتعمل من Cron وsystemd. وهذه مقالات مرتبطة:
 دليلسطر الأوامر في Linux للمبتدئين: أول ما تحتاجه على السيرفركيف تتنقل بين الملفات على السيرفر، وتربط الأوامر ببعضها، وتتحكم في العمليات Processes دون أن تحذف شيئاً بالخطأ.
 دليلالتعبيرات النمطية Regex للمبتدئين، مع النص العربيكيف تقرأ وتكتب تعبيراً نمطياً جزءاً بجزء، ولماذا يختلف سلوكه مع النص العربي بين اللغات، وكيف يوقف نمط واحد سيرفرك.
 دليلإدارة الخدمات Services والسجلات Logs مع systemdننقل واجهة برمجية من nohup إلى خدمة systemd تعود وحدها بعد التوقف والإقلاع، ونقرأ سجلاتها مع journalctl، ونرى ثلاث مشاكل حقيقية واجهتنا في الطريق.
 دليلسكربتات Bash Scripts لأتمتة المهام اليوميةنكتب ونشغل ثلاثة سكربتات Bash حقيقية للنسخ الاحتياطي وتنبيه امتلاء القرص وتقرير المستخدمين، ونرى الأخطاء التي اكتشفتها ShellCheck والتي لم يكشفها إلا التشغيل من Cron وsystemd.
 دليلاستكشاف أعطال السيرفر Troubleshooting: خمس حوادث حقيقيةنعطل خدمة على سيرفر Linux خمس مرات بأسباب تحدث كل يوم، ونتبع في كل مرة نفس الأسئلة الستة حتى نصل إلى السبب برقمه، ونرى أين تسكت الأدوات أو تخدعك.
 دليلتمارين Kata في Linux بثلاثة مستويات مع الحلولتمارين في سطر أوامر Linux تحلها بيدك دون ذكاء اصطناعي، من قراءة الصلاحيات إلى القرص الذي يمتلئ بسبب ملف محذوف.
 دليلسجلات تساعدك فعلاً: من «حدث خطأ» إلى سبب المشكلةكيف تكتب سجلات تجيب عن أسئلة الحادثة، بتحقيق في عطل حقيقي بسجلات سيئة ثم بحدث واسع Wide Event لكل طلب، مع قياس الفرق.
سجل التحديثات
- 16 نوفمبر 2026: كتابة الدليل، وتنفيذ التجارب على سجلات حقيقية من nginx 1.26 وOpenSSH 10.0 مع rsyslog في Container من Debian 13 (trixie)، بأدوات GNU grep 3.11 وGNU sed 4.9 وcoreutils 9.7 وmawk 1.3.4، على Docker Engine 29.8.0.