اخترت نموذجاً مفتوحاً Open Model، وقرأت رخصته License، وعرفت كم ذاكرة يحتاج، ثم بحثت عن طريقة تشغيله فوجدت ثلاثة أسماء تتكرر في كل نقاش: Ollama وllama.cpp وvLLM. وكل اسم له مدافعون: هذا يقول إن Ollama أمر واحد ويعمل، وذاك يقول إن llama.cpp هو المحرك Engine الحقيقي وكل ما سواه غلاف، وثالث يقول إن vLLM هو ما تستخدمه الشركات في الإنتاج Production. والحقيقة أن الثلاثة لا تتنافس على نفس المكان، فكل أداة صممت لجمهور وعتاد مختلف، والسؤال الصحيح ليس «أيها الأفضل» وإنما «من سيستخدم النموذج، وكم شخصاً في نفس اللحظة، وعلى أي عتاد».
وقد شرحنا في تشغيل نماذج اللغة على جهازك العتاد والذاكرة Memory، وعرضنا هذه الأدوات Tools في جدول قصير مع رخصها، أما هنا فنشغل الثلاثة على نفس النموذج ونفس الجهاز، ونرسل إليها نفس الطلب من نفس الكود Code، ثم نضغط عليها بطلبات متزامنة Concurrent Requests ونقيس ما يحدث.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي تفعله كل أداة، ولمن صممت، وما الفرق بينها في الصيغة والذاكرة وجدولة الطلبات Request Scheduling.
- تشغيل نفس النموذج Qwen2.5-1.5B-Instruct على الأدوات الثلاث في Docker، وإرسال نفس الطلب إليها بصيغة OpenAI.
- قياس زمن أول توكن والإنتاجية Throughput مع طلب واحد وأربعة وثمانية طلبات متزامنة، وما تعنيه الأرقام.
- مشكلات حقيقية: طلب أطول من الخانة، وملف أوزان ناقص، وvLLM الذي يأخذ نصف ساعة في التجهيز على المعالج CPU.
- المصادقة Authentication في كل أداة، ونقاط القوة ونقاط الضعف، وجدول للاختيار.
والصورة التالية تبين الأدوات الثلاث في سطر واحد لكل منها:
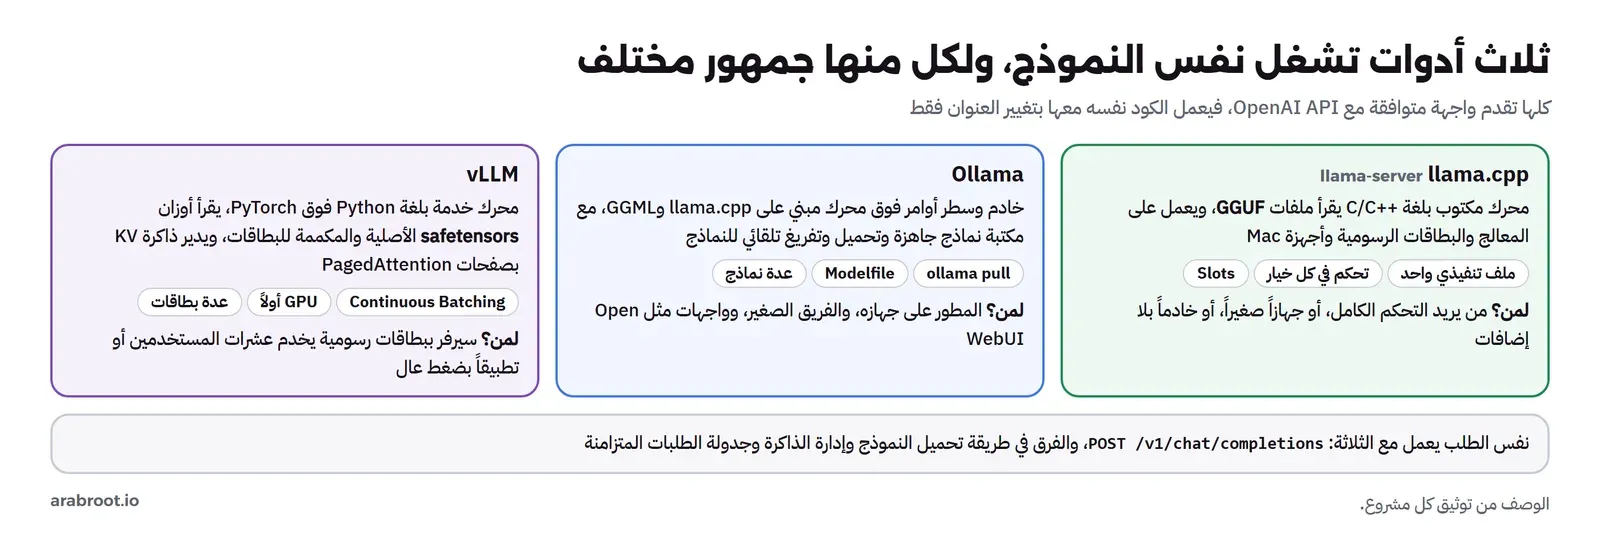
ثلاث أدوات، ولكل منها جمهور
قبل التجربة لنعرف ما تفعله كل أداة بالضبط، لأن الفرق بينها ليس في جودة الإجابة، فالنموذج واحد والحساب Compute واحد في جوهره، وإنما في ثلاثة أشياء: صيغة الملف File Format الذي تقرؤه، وطريقة إدارة الذاكرة، وطريقة جدولة الطلبات التي تصل في نفس اللحظة. والصورة التالية تلخص الثلاثة:
llama.cpp: المحرك
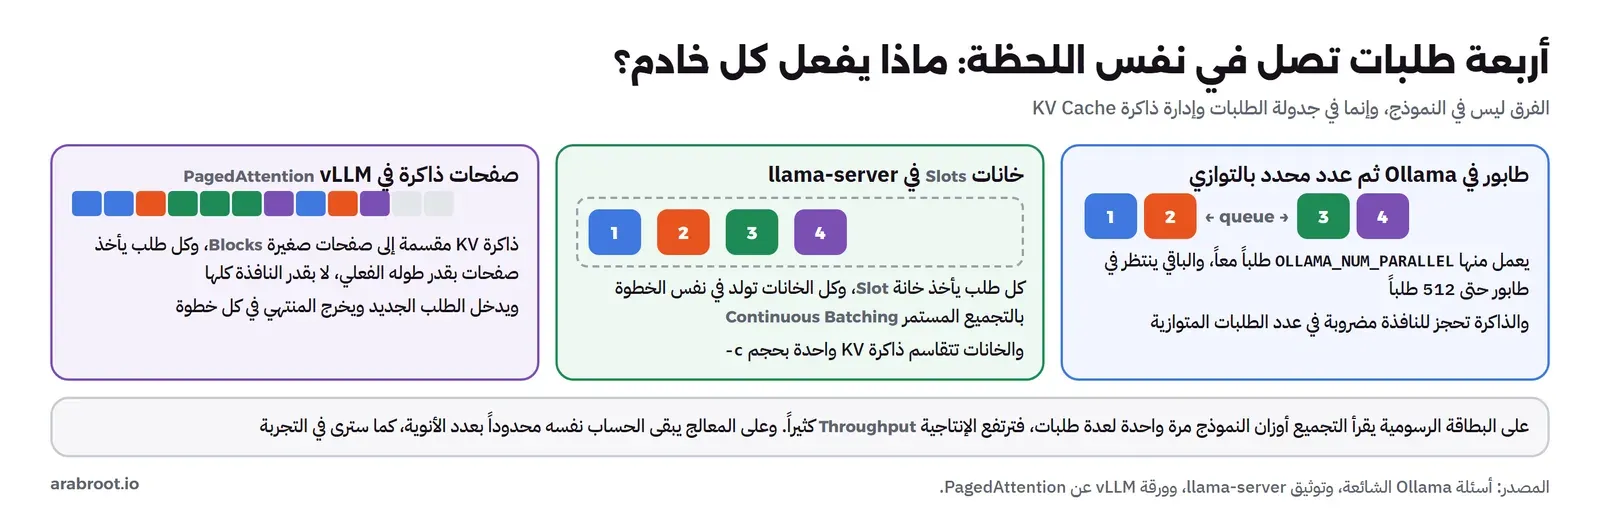
llama.cpp مشروع مكتوب بلغتي C وC++ برخصة MIT، بدأ لتشغيل نماذج Llama على أجهزة Mac، ثم أصبح المحرك الذي تقوم عليه أغلب أدوات التشغيل المحلي، ومعه مكتبة GGML التي تحسب العمليات على المعالج والبطاقات. ويقرأ ملفات GGUF فقط، ويأتي بعدة أدوات: llama-cli للمحادثة من الطرفية، وllama-bench للقياس، وllama-quantize للتكميم، وllama-server الذي يهمنا هنا، وهو خادم HTTP بواجهة متوافقة مع OpenAI. والخادم يقسم ذاكرة السياق إلى خانات Slots، كل خانة تخدم طلباً، ويجمع الخانات العاملة في خطوة حساب واحدة بالتجميع المستمر Continuous Batching المفعل افتراضياً.
Ollama: الخادم الجاهز
Ollama برخصة MIT أيضاً، ومكتوب بلغة Go فوق مكتبة GGML نفسها، ويضيف ما يحتاجه من لا يريد أن يتعامل مع الملفات والخيارات: مكتبة نماذج Model Library تحملها بالأمر ollama pull، وتحميل النموذج عند أول طلب وتفريغه بعد خمس دقائق دون استخدام بحسب أسئلته الشائعة، وتشغيل أكثر من نموذج في نفس الخادم، وملف Modelfile تبني به نسختك من نموذج بتعليمات نظام System Prompt وإعدادات ثابتة. ويستقبل الطلبات المتزامنة بعدد محدد بالمتغير OLLAMA_NUM_PARALLEL، وما زاد ينتظر في طابور Queue حتى 512 طلباً.
vLLM: خادم الإنتاج للبطاقات الرسومية
vLLM برخصة Apache-2.0، مكتوب بلغة Python فوق PyTorch، وبدأ في جامعة Berkeley بفكرة واحدة نشرت في ورقة عام 2023: أن تدار ذاكرة KV Cache مثل الذاكرة الافتراضية في نظام التشغيل، بصفحات صغيرة Blocks تعطى لكل طلب بقدر طوله الفعلي، بدلاً من حجز النافذة كاملة لكل طلب، وسموها PagedAttention. وقالت الورقة إن هذا رفع الإنتاجية Throughput بين ضعفين وأربعة أضعاف مقارنة بأنظمة ذلك الوقت. ويقرأ الأوزان الأصلية من Hugging Face بصيغة safetensors، والصيغ المكممة للبطاقات مثل AWQ وGPTQ وFP8، ويوزع النموذج الكبير على عدة بطاقات. وتوثيقه يذكر دعم بطاقات NVIDIA وAMD والمعالجات x86 وARM وPowerPC، ولكن صفحة المعالج نفسها تقول إن تعليمات AVX-512 «مستحسنة»، وإن AVX2 تعطي «ميزات محدودة»، والأنواع المدعومة على المعالج FP32 وFP16 وBF16، أي أن المعالج عند vLLM طريق للتجربة والتطوير، أما مكانه الطبيعي فالبطاقات الرسومية GPUs.
والفرق الأهم بينها يظهر عندما يصل أكثر من طلب في نفس اللحظة، والصورة التالية تبين ما يفعله كل خادم بأربعة طلبات:
تجهيز التجربة: نفس النموذج في ثلاث صيغ
اخترنا النموذج Qwen2.5-1.5B-Instruct برخصة Apache-2.0، وهو نفس النموذج الذي كممناه في مقال النماذج المفتوحة، وحجمه يسمح بتشغيل الأدوات الثلاث على معالج فقط. والمشكلة الأولى أن الأدوات لا تقرأ نفس الملف: Ollama وllama.cpp يقرآن GGUF، فأعطيناهما نفس الملف بالضبط qwen2.5-1.5b-instruct-q4_k_m.gguf، أما vLLM فيقرأ الأوزان الأصلية BF16 بصيغة safetensors من المستودع الأصلي. لذلك لاحظ من الآن أن المقارنة مع vLLM ليست بنفس الأرقام في الذاكرة: نسخة GGUF تأخذ 1.04 GiB، والنسخة الأصلية 2.88 GiB.
وكل الأوامر التالية على جهاز بمعالج Intel Core i7-7700K بأربع أنوية دون بطاقة رسومية، في Docker Desktop مع WSL2، وهو جهاز تعمل عليه أعمال أخرى في نفس الوقت، لذلك خذ من الأرقام العلاقات بين الأدوات والإعدادات Configuration، ولا تقارن بها جهازك رقماً برقم.
تشغيل llama-server
بنينا llama.cpp الإصدار 1.0.0 من الكود المصدري على debian:trixie-slim كما في مقال النماذج المفتوحة، ثم نشغل الخادم على ملف GGUF بأربع خانات Slots ونافذة 8192 توكناً:
docker run -d --name ad2-llama -p 127.0.0.1:9563:8080 -v ad2-models:/models ad2-llamacpp:1.0.0 \
  llama-server -m /models/qwen2.5-1.5b-instruct-q4_k_m.gguf --alias qwen2.5-1.5b \
  --host 0.0.0.0 --port 8080 -t 4 -c 8192 -np 4
تشغيل Ollama على نفس الملف
Ollama لا يحتاج أن تحمل النموذج من مكتبته، فتستطيع أن تبني نموذجاً من ملف GGUF موجود عندك بملف Modelfile من سطر واحد، وهذا ما يضمن أن الأداتين تعملان على نفس الأوزان بالضبط. ويقول توثيق الاستيراد إن Ollama لا يكمم ملفات GGUF أثناء الاستيراد، أي أن الملف يدخل كما هو:
printf 'FROM /models/qwen2.5-1.5b-instruct-q4_k_m.gguf\n' > Modelfile
docker run -d --name ad2-ollama -p 127.0.0.1:9562:11434 -v ad2-ollama:/root/.ollama \
  -v ad2-models:/models:ro -v "$PWD:/lab:ro" ollama/ollama:0.40.13
docker exec ad2-ollama ollama create qwen2.5-1.5b -f /lab/Modelfile
docker exec ad2-ollama ollama show qwen2.5-1.5b
والمخرج سوف يكون كما يلي:
parsing GGUF
using existing layer sha256:b66e0350b994a95e26e9c41f05410c39f1ec84838b96144f494f87a5aaee8bf5
writing manifest
success
  Model
    architecture        qwen2
    parameters          1.8B
    context length      8192
    embedding length    1536
    quantization        Q4_K_M
    template source     gguf_chat_template

  Capabilities
    tools
    completion
في المخرج أعلاه لاحظ التالي:
- Ollama نسخ الملف إلى مخزنه كطبقة Layer لها بصمة sha256، فإذا بنيت منه نموذجاً آخر بتعليمات مختلفة استخدم نفس الطبقة دون نسخة ثانية.
- السطر
template source gguf_chat_templateيعني أن Ollama قرأ قالب المحادثة من ملف GGUF نفسه، فلم نحتج أن نكتب TEMPLATE في Modelfile، وطول السياق 8192 جاء من الملف أيضاً. - لم نحدد
OLLAMA_NUM_PARALLEL، وسجل بدء التشغيل يكتب قيمتهOLLAMA_NUM_PARALLEL:1وOLLAMA_MAX_QUEUE:512، وسوف نرى أثر ذلك في القياس Benchmark.
وبعد أول طلب، يبين الأمر ollama ps المحرك الذي يعمل تحته:
NAME                   ID              SIZE      PROCESSOR    CONTEXT    RUNNER      UNTIL
qwen2.5-1.5b:latest    9b08a2b6b68b    1.3 GB    100% CPU     4096       llamacpp    4 minutes from now
وعمود RUNNER يكتب llamacpp، أي أن Ollama شغل هذا النموذج بمحرك llama.cpp، فالمقارنة بين الاثنين على المعالج هي في الحقيقة مقارنة بين طريقتين لإدارة نفس المحرك. ونرسل نفس req.json إلى المنفذ 9562 فيأتي نفس الجواب حرفياً «المنفذ الافتراضي لبروتوكول HTTPS هو 443.» بنفس العدد 50 و20 من التوكنز، ولكن دون الحقل timings، وبدلاً منه "system_fingerprint": "fp_ollama".
ومن سجل التشغيل Startup Log هذه الأسطر:
W srv  server_setup: security: no API key is set and CORS allows all origins (see https://github.com/ggml-org/llama.cpp/pull/25655)
I srv    load_model: initializing, n_slots = 4, n_ctx_slot = 2048, kv_unified = 'false'
I srv  server_on_li: listening on http://0.0.0.0:8080
في المخرج أعلاه لاحظ التالي:
- طلبنا نافذة 8192 وأربع خانات، فقسمها الخادم بالتساوي: 2048 توكناً لكل خانة
n_ctx_slot = 2048، أي أن أطول محادثة يقبلها الخادم الآن 2048 توكناً وليس 8192، وسوف نرى بعد قليل ماذا يحدث إذا تجاوزناها. - السطر الأول تحذير أمني Security Warning نعود إليه في قسم المصادقة.
والآن نرسل أول طلب بصيغة OpenAI. والملف req.json سوف نستخدمه مع الأدوات الثلاث كما هو، ولا يتغير فيه إلا العنوان URL:
{"model": "qwen2.5-1.5b", "messages": [{"role": "user", "content": "ما المنفذ الافتراضي لبروتوكول HTTPS؟ أجب في جملة."}], "temperature": 0, "max_tokens": 40}curl -s 127.0.0.1:9563/v1/chat/completions -H 'Content-Type: application/json' -d @req.jsonوالمخرج سوف يكون كما يلي، بعد تنسيقه وحذف بعض الحقول:
{
    "choices": [
        {
            "finish_reason": "stop",
            "index": 0,
            "message": {
                "role": "assistant",
                "content": "المنفذ الافتراضي لبروتوكول HTTPS هو 443."
            }
        }
    ],
    "model": "qwen2.5-1.5b",
    "system_fingerprint": "b1-b1b770d",
    "object": "chat.completion",
    "usage": {
        "completion_tokens": 20,
        "prompt_tokens": 50,
        "total_tokens": 70,
        "prompt_tokens_details": {
            "cached_tokens": 0
        }
    },
    "timings": {
        "prompt_n": 50,
        "prompt_ms": 2286.655,
        "prompt_per_second": 21.866000774056428,
        "predicted_n": 20,
        "predicted_ms": 4288.942,
        "predicted_per_second": 4.429996954959988
    }
}
في المخرج أعلاه لاحظ أن الشكل هو نفس شكل رد OpenAI: choices ثم message ثم usage، فأي مكتبة كتبت لـ OpenAI تفهمه، وأن llama.cpp يضيف من عنده الحقل timings بسرعة القراءة والتوليد لهذا الطلب، وهو مفيد جداً للقياس. ولاحظ أيضاً أن سؤالاً من ثماني كلمات أصبح 50 توكناً، لأن قالب المحادثة يضيف تعليمات نظام افتراضية من ملف GGUF نفسه.
تشغيل vLLM على المعالج
لـ vLLM Image رسمية للمعالج اسمها vllm/vllm-openai-cpu بحسب صفحة التثبيت على المعالج، وحجمها 1.8 GB مضغوطة و7.69 GB بعد التحميل، وهي تقرأ مجلد النموذج الأصلي من Hugging Face. وأول تشغيل لنا كان دون الخيار --enforce-eager، ففشل بسبب تحميل ناقص لملف الأوزان، وهذا خطأ يستحق أن تعرفه:
safetensors._safetensors_rust.SafetensorError: Error while deserializing header: incomplete metadata, file not fully coveredوالسبب أن ملف model.safetensors عندنا كان 1,810,246,042 بايت بدل 3,087,467,144، لأن التحميل انقطع دون أن يظهر خطأ. وصيغة safetensors تبدأ بترويسة Header تصف كل مصفوفة ومكانها في الملف، فإذا كان الملف أقصر مما تصفه الترويسة رفضه vLLM من أول سطر. والحل أن تقارن البصمة SHA-256 بالقيمة التي يعرضها Hugging Face في الترويسة X-Linked-ETag قبل أي تشغيل:
curl -sSL -C - -o model.safetensors https://huggingface.co/Qwen/Qwen2.5-1.5B-Instruct/resolve/main/model.safetensors
sha256sum model.safetensors
curl -sI https://huggingface.co/Qwen/Qwen2.5-1.5B-Instruct/resolve/main/model.safetensors | grep -i x-linked-etag
dd924a11b4c220f385b51ffa522daea7c9f3d850e31b162bb5661df483c6d3ee model.safetensors
X-Linked-ETag: "dd924a11b4c220f385b51ffa522daea7c9f3d850e31b162bb5661df483c6d3ee"وفي التشغيل الثاني حمل vLLM النموذج، ثم بدأ تجهيز الحساب مسبقاً بأداة torch.compile، وهذه الخطوة على هذا المعالج وهو يشغل أعمالاً أخرى أخذت 31 دقيقة كما في سجله:
(Worker pid=96) INFO 11-18 18:43:37 [monitor.py:91] [backbone] Initial profiling/warmup run took 1870.02 sثم بقي بعدها أكثر من عشرين دقيقة دون أن يقبل أي طلب، فأوقفناه. والطريقة التي نجحت أن نوقف التجهيز المسبق Precompilation كله بالخيارين --enforce-eager و-O0، وأن نصغر الحدود على قدر تجربتنا:
docker run -d --name ad2-vllm -p 127.0.0.1:9564:8000 -v ad2-hf:/hf --shm-size 4g vllm/vllm-openai-cpu:v0.34.0-x86_64 \
  /hf/Qwen2.5-1.5B-Instruct --served-model-name qwen2.5-1.5b --dtype bfloat16 \
  --max-model-len 4096 --max-num-seqs 8 --kv-cache-memory-bytes 2G --enforce-eager -O0
فأصبح جاهزاً خلال دقيقتين تقريباً، ومن سجله هذه الأسطر:
WARNING [vllm.py:1709] Enforce eager set, disabling torch.compile, CUDAGraphs, and JIT kernel warmup.
INFO [default_loader.py:543] Loading weights took 19.55 seconds
WARNING [utils.py:838] Failed to create oneDNN linear, fallback to torch linear. Exception: could not create a primitive descriptor for the matmul primitive.
INFO [model_runner.py:441] Model loading took 2.89 GiB memory and 23.949905 seconds
INFO [cpu_worker.py:255] Explicitly set (2.0/31.29) GiB for KV cache on node 0.
INFO [kv_cache_utils.py:1168] CPU KV cache size: 74,880 tokens, Maximum concurrency for 4,096 tokens per request: 18.28x
INFO:     Application startup complete.
في المخرج أعلاه لاحظ التالي:
- النموذج بدقة BF16 أخذ 2.89 GiB، أي قرابة ثلاثة أضعاف نسخة Q4_K_M في الأداتين الأخريين.
- سطر oneDNN هو ما تقصده صفحة التثبيت بعبارة «ميزات محدودة» مع AVX2: مكتبة Intel للحساب السريع لم تجد على هذا المعالج تعليمات تحتاجها لضرب المصفوفات بهذه الدقة، فرجع vLLM إلى الطريقة العامة في PyTorch، وهي أبطأ.
- ذاكرة KV التي حددناها بـ 2 GB تتسع لـ 74,880 توكناً، فيقول vLLM إنه يستطيع خدمة 18 طلباً معاً بطول 4096 لكل منها، وهذه فكرة الصفحات: يحسب السعة Capacity بالتوكنز وليس بعدد الخانات.
وأرسلنا نفس req.json إلى المنفذ 9564 فجاء نفس الجواب «المنفذ الافتراضي لبروتوكول HTTPS هو 443.» بنفس عدد التوكنز 50 و20، وفي الرد حقول إضافية خاصة بـ vLLM مثل prompt_logprobs وkv_transfer_params، وكلها null هنا.
ماذا يحدث عندما يسأل عدة مستخدمين معاً؟
طلب واحد لا يقول لك شيئاً عن سيرفر يخدم فريقاً، لذلك كتبنا برنامجاً صغيراً bench.py بمكتبات Python الأساسية، يرسل نفس السؤال من عدة خيوط في نفس اللحظة بطريقة البث Streaming، ويقيس لكل طلب زمن أول توكن Time to First Token واختصاراً TTFT، وسرعته، ثم الإنتاجية الكلية Throughput أي مجموع التوكنز التي ولدها الخادم لكل الطلبات مقسوماً على الزمن كله:
# Sends N identical chat requests at the same moment to an OpenAI-compatible server and measures
# time to first token (TTFT), per-request speed and total throughput. Python standard library only.
#   python3 bench.py http://127.0.0.1:PORT/v1 MODEL 1 2 4 8
import json, sys, time, threading, urllib.request, statistics

BASE, MODEL, LEVELS = sys.argv[1], sys.argv[2], [int(x) for x in sys.argv[3:]]
PROMPT = "اشرح في فقرة واحدة لماذا نحتاج نسخة احتياطية خارج السيرفر."
MAX_TOKENS = 128

def one(results, i):
    body = {"model": MODEL, "messages": [{"role": "user", "content": PROMPT}], "max_tokens": MAX_TOKENS,
            "temperature": 0, "stream": True, "stream_options": {"include_usage": True}}
    req = urllib.request.Request(BASE + "/chat/completions", json.dumps(body).encode(),
                                 {"Content-Type": "application/json"})
    t0 = time.perf_counter(); first = None; chunks = 0; usage = None
    with urllib.request.urlopen(req, timeout=1800) as r:
        for raw in r:
            line = raw.decode().strip()
            if not line.startswith("data:") or line == "data: [DONE]":
                continue
            d = json.loads(line[5:])
            if d.get("usage"):
                usage = d["usage"]
            for c in d.get("choices", []):
                if c.get("delta", {}).get("content"):
                    chunks += 1
                    if first is None:
                        first = time.perf_counter()
    t1 = time.perf_counter()
    toks = usage["completion_tokens"] if usage else chunks
    results[i] = (first - t0, toks, toks / (t1 - first) if t1 > first else 0, t1 - t0)

print(f"{'parallel':>8} {'TTFT avg s':>11} {'TTFT max s':>11} {'tok/s each':>11} {'total tok/s':>12} {'wall s':>7}")
for n in LEVELS:
    res = [None] * n
    th = [threading.Thread(target=one, args=(res, i)) for i in range(n)]
    t0 = time.perf_counter()
    for t in th: t.start()
    for t in th: t.join()
    wall = time.perf_counter() - t0
    ttft = [r[0] for r in res]; total = sum(r[1] for r in res)
    print(f"{n:>8} {statistics.mean(ttft):>11.2f} {max(ttft):>11.2f} {statistics.mean(r[2] for r in res):>11.1f} {total / wall:>12.1f} {wall:>7.1f}")
وقد يتساءل البعض: لماذا نرسل طلبات متزامنة إلى خادم على معالج بأربع أنوية، وهل يفيد ذلك أصلاً؟ والإجابة أن هذا بالضبط ما نريد أن نعرفه، لأن الفريق Team لا يرسل طلباته بالترتيب، ولأن كل طلب ينتظر في التوليد قراءة الأوزان من الذاكرة، فإذا جمع الخادم عدة طلبات في خطوة واحدة قرأ الأوزان مرة واحدة لها كلها.
شغلنا البرنامج على كل إعداد بثلاثة مستويات: طلب واحد، ثم أربعة طلبات معاً، ثم ثمانية. والجهاز مشترك تعمل عليه أعمال أخرى، لذلك أعدنا القياسات التالية متتالية في فترة هادئة، وهي نتيجة تشغيل واحد لكل إعداد:
python3 bench.py http://127.0.0.1:9562/v1 qwen2.5-1.5b 1 4 8   # Ollama
python3 bench.py http://127.0.0.1:9563/v1 qwen2.5-1.5b 1 4 8   # llama-server
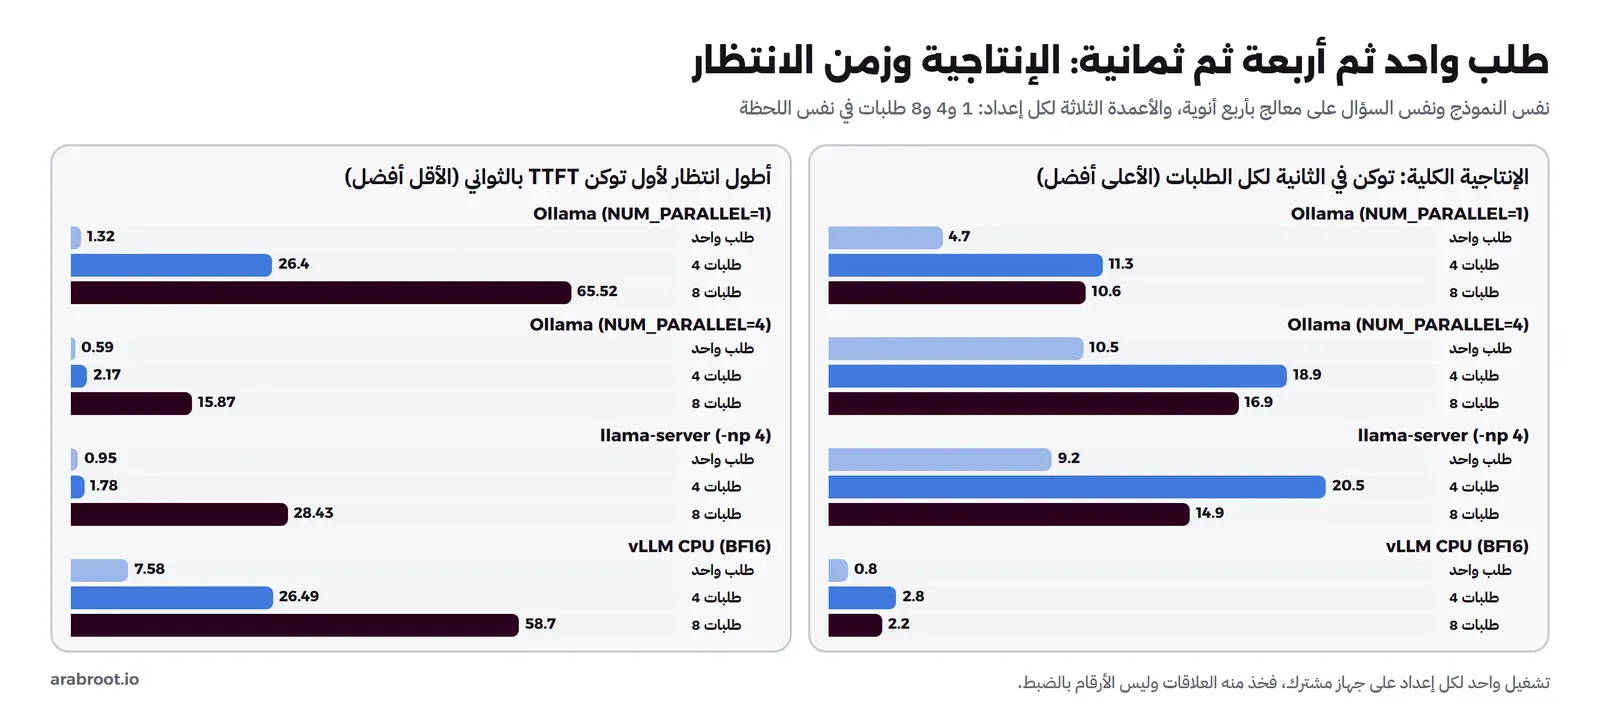
Ollama بالإعداد الافتراضي OLLAMA_NUM_PARALLEL=1، كما يظهر في سجل بدء التشغيل:
parallel  TTFT avg s  TTFT max s  tok/s each  total tok/s  wall s
       1        1.32        1.32         5.0          4.7    21.6
       4       14.31       26.40        11.8         11.3    35.8
       8       32.04       65.52        10.8         10.6    76.0
Ollama بعد OLLAMA_NUM_PARALLEL=4:
parallel  TTFT avg s  TTFT max s  tok/s each  total tok/s  wall s
       1        0.59        0.59        11.2         10.5    10.6
       4        2.17        2.17         5.8         18.9    16.4
       8        6.25       15.87         5.4         16.9    41.8
llama-server بأربع خانات -np 4:
parallel  TTFT avg s  TTFT max s  tok/s each  total tok/s  wall s
       1        0.95        0.95        10.3          9.2     9.0
       4        1.78        1.78         6.0         20.5    19.9
       8       12.08       28.43         4.1         14.9    52.8
في المخرج أعلاه لاحظ التالي:
- مع طلب واحد الثلاثة متقاربة، قرابة 10 توكنز في الثانية، وهذا متوقع لأن Ollama يشغل نفس المحرك، فعمود RUNNER في
ollama psكتبllamacpp. والرقم 4.7 في الصف الأول من Ollama الافتراضي سببه أن ذلك الطلب كان أول طلب بعد التحميل وجاء في لحظة ضغط على الجهاز، وهذا ما نقصده بأن القياس الواحد على جهاز مشترك لا يكفي. - بالإعداد الافتراضي يعالج Ollama طلباً واحداً في كل مرة، فعندما وصلت أربعة طلبات معاً انتظر الرابع 26.4 ثانية قبل أول توكن، ومع ثمانية طلبات انتظر الأخير 65.5 ثانية، أي أن المستخدم يرى شاشة فارغة أكثر من دقيقة رغم أن كل طلب نفسه يولد بسرعة 11 توكناً في الثانية.
- عندما سمحنا بأربعة طلبات متوازية، في Ollama أو llama-server، ارتفعت الإنتاجية الكلية من قرابة 10 إلى قرابة 19 و20 توكناً في الثانية، ونزل زمن أول توكن مع أربعة طلبات إلى ثانيتين، والسبب التجميع: أربع طلبات تقرأ الأوزان مرة واحدة. والثمن أن كل مستخدم يرى سرعة أقل، 6 توكنز في الثانية بدل 10.
- مع ثمانية طلبات وأربع خانات فقط ينتظر نصفها، فيرتفع أعلى زمن انتظار إلى 16 و28 ثانية، ولا ترتفع الإنتاجية، بل نزلت قليلاً، لأن المعالج بأربع أنوية وصل إلى حده في الحساب. وعلى البطاقة الرسومية تستمر الإنتاجية في الارتفاع مع التجميع حتى عشرات الطلبات، وهذا ما بنيت له vLLM.
- الذاكرة هي الثمن الثاني: حجم النموذج في
ollama psكان 1.3 GB مع طلب واحد و1.7 GB مع أربعة، لأن كل طلب متواز يحجز نافذة 4096 خاصة به.
والصورة التالية تجمع الإنتاجية الكلية وزمن انتظار أول توكن للإعدادات الأربعة:
لماذا أعدنا القياس؟
القياس الأول لـ Ollama بالإعداد الافتراضي كان في فترة يعمل فيها الجهاز بأعمال أخرى ثقيلة، وهذا ما خرج:
parallel  TTFT avg s  TTFT max s  tok/s each  total tok/s  wall s
       1        3.99        3.99         1.6          1.5    73.7
       2       34.85       68.56         1.6          1.6   127.6
       4       64.16      128.41         2.5          2.4   165.2
       8      108.38      177.29         5.1          3.8   210.0
أي 1.5 توكن في الثانية بدل قرابة 10، ولو اعتمدنا هذا الرقم لقلنا إن Ollama أبطأ من llama-server بست مرات، وهذا خطأ، فالمحرك واحد. والدرس أن القياس على جهاز مشترك، أو سيرفر سحابي بمعالج مشترك Shared vCPU، يحتاج أن تكرره، وأن تقيس الأدوات المتنافسة متتالية في نفس الفترة، وأن تنظر إلى الأرقام التي تتكرر وليس إلى أفضلها ولا أسوئها.
vLLM تحت نفس الضغط
python3 bench.py http://127.0.0.1:9564/v1 qwen2.5-1.5b 1 4 8 # vLLMparallel TTFT avg s TTFT max s tok/s each total tok/s wall s
1 7.58 7.58 0.8 0.8 155.1
4 22.33 26.49 0.8 2.8 173.5
8 51.89 58.70 0.3 2.2 450.9في المخرج أعلاه لاحظ التالي:
- طلب واحد ولد 0.8 توكن في الثانية، أي أبطأ من llama.cpp على نفس الجهاز بأكثر من عشر مرات، والأسباب ثلاثة رأيتها في السجل: أوزان BF16 أكبر بثلاث مرات من Q4_K_M، والرجوع من oneDNN إلى الحساب العام لأن المعالج دون AVX-512، وإيقاف التجهيز المسبق الذي جعلنا نتجنب الدقائق الطويلة عند البدء. وهذا لا يقول شيئاً عن vLLM على البطاقة الرسومية، وإنما يؤكد ما تقوله صفحته عن المعالج.
- ولكن انظر إلى السطر الثاني: أربعة طلبات أخذت 173.5 ثانية، وطلب واحد أخذ 155.1، أي أن vLLM خدم أربعة مستخدمين في وقت مستخدم واحد تقريباً، وارتفعت الإنتاجية من 0.8 إلى 2.8، أي 3.5 أضعاف. وهذا بالضبط ما صمم له: التجميع المستمر يجمع الطلبات في نفس الخطوة.
- مع ثمانية طلبات نزلت الإنتاجية إلى 2.2، لأننا حددنا
--max-num-seqs 8على معالج لا يحتمل هذا الحجم من الحساب بدقة BF16، فالتجميع يفيد حتى يصل الحساب نفسه إلى حده.
والخلاصة من هذا القسم أن vLLM يعمل على المعالج، وأنه مفيد لتجربة الإعداد والواجهة API وكتابة الكود قبل أن تنقله إلى سيرفر ببطاقة، ولكنه ليس الأداة التي تخدم بها فريقاً على معالج، وسوف نشغله على بطاقة رسومية لفريق كامل في مقال خدمة النماذج لفريق كامل مع vLLM.
لماذا يرفع التجميع Batching الإنتاجية؟ نظرة من الداخل
لكي تفهم الأرقام في التجربة، تذكر ما شرحناه في قسم السرعة: توليد كل توكن يحتاج أن يقرأ المعالج أوزان النموذج كلها من الذاكرة، فنموذج 1 GB يقرأ قرابة 1 GB لكل توكن. والحل البسيط لخدمة عدة مستخدمين أن تعالج طلباتهم واحداً بعد الآخر، وهذا ما يفعله Ollama بإعداده الافتراضي، والمشكلة أن كل مستخدم ينتظر انتهاء كل من قبله، فيصبح زمن الانتظار مجموع زمن الطلبات السابقة، وهذا ما رأيته في الدقيقة التي انتظرها الطلب الثامن.
والحل الثاني أن تجمع الطلبات في دفعة ثابتة Static Batching: تنتظر حتى تصل أربعة طلبات، ثم تولد لها معاً، فتقرأ الأوزان مرة واحدة لكل خطوة وتستخدمها لأربعة توكنز بدل توكن واحد. والمشكلة أن الطلبات لا تنتهي معاً، فالطلب الذي يحتاج عشرين توكناً ينتظر الطلب الذي يحتاج خمسمئة حتى تنتهي الدفعة، والطلب الجديد ينتظر حتى تفرغ الدفعة كلها.
والطريقة التي تستخدمها llama-server وvLLM اليوم هي التجميع المستمر Continuous Batching: في كل خطوة توليد يخرج الطلب الذي انتهى ويدخل مكانه طلب جديد من الطابور Queue، فلا ينتظر أحد نهاية الدفعة. وتبقى مشكلة أخيرة هي الذاكرة، لأن كل طلب يحتاج ذاكرة KV Cache على قدر طوله، والأنظمة القديمة كانت تحجز لكل طلب مساحة النافذة القصوى مقدماً، فتضيع أغلب الذاكرة على طلبات قصيرة. وهذا ما حلته فكرة PagedAttention في ورقة vLLM: ذاكرة KV تقسم إلى صفحات صغيرة ثابتة الحجم، ويأخذ كل طلب صفحات بقدر ما كتب فعلاً، كما يأخذ البرنامج صفحات الذاكرة من نظام التشغيل، وقد رأيت في سجل vLLM أنه حسب سعته بالتوكنز: 74,880 توكناً في 2 GB، أي 18 طلباً بطول 4096 معاً.
وقد يتساءل البعض: إذا كان التجميع بهذه الفائدة، فلماذا لم ترتفع الإنتاجية في تجربتنا إلا إلى الضعف تقريباً؟ والإجابة أن التجميع يوفر قراءة الأوزان، ولكنه لا يوفر الحساب نفسه، فأربعة توكنز تحتاج أربعة أضعاف عمليات الضرب. وعلى البطاقة الرسومية الحساب رخيص جداً مقارنة بقراءة الذاكرة، فيستمر التحسن حتى عشرات الطلبات، أما المعالج بأربع أنوية فيصل إلى حد الحساب بسرعة، وهذا ما رأيته عندما نزلت الإنتاجية مع ثمانية طلبات.
ملاحظة صغيرة: ذاكرة البادئة Prefix Cache
في القياس الأول لـ llama-server كان متوسط زمن أول توكن مع طلبين 0.47 ثانية، أي أقل من طلب واحد 1.40، رغم أن الخادم يخدم ضعف العمل. والسبب أن الطلبات كلها لها نفس النص، فالخادم يحفظ ذاكرة KV للنص الذي قرأه، وإذا جاء طلب يبدأ بنفس التوكنز استخدمها دون أن يقرأها من جديد، وهذا ما يظهر في الحقل cache_n وفي cached_tokens داخل usage. وفي الواقع تستفيد من هذا كثيراً، لأن تعليمات النظام System Prompt الطويلة نفسها في كل طلب، ولكن انتبه عندما تقيس: إذا أرسلت نفس السؤال مرتين فالمرة الثانية أسرع لأسباب لا علاقة لها بالأداة.
كم ذاكرة أخذت كل أداة؟
| الإعداد | الذاكرة | من أين الرقم |
|---|---|---|
llama-server، Q4_K_M، أربع خانات، -c 8192 | 935 MiB | docker stats بعد القياس |
| Ollama، Q4_K_M، طلب واحد، نافذة 4096 | 1.3 GB | ollama ps |
Ollama، Q4_K_M، OLLAMA_NUM_PARALLEL=4 | 1.7 GB | ollama ps |
vLLM، BF16، --kv-cache-memory-bytes 2G | 2.89 GiB للنموذج و2 GiB لذاكرة KV | سجل vLLM |
ولاحظ أن vLLM يحجز ذاكرة KV التي تعطيها له كلها من البداية، ثم يوزعها صفحات على الطلبات، فعلى البطاقة الرسومية يأخذ افتراضياً نسبة كبيرة من VRAM، وهذا مقصود، فلا تشغل بجانبه شيئاً آخر على نفس البطاقة دون أن تحدد هذه النسبة.
نفتعل الخطأ: طلب أطول من الخانة
قسم llama-server النافذة 8192 على أربع خانات، فلنرسل إليه مستنداً أطول من 2048 توكناً، وهو أول ثلث مقالة «حاسوب» من ويكيبيديا العربية، قرابة 1383 كلمة، مع طلب تلخيصه في ثلاث جمل:
curl -s 127.0.0.1:9563/v1/chat/completions -H 'Content-Type: application/json' --data-binary @long.json{"error":{"code":400,"message":"request (3921 tokens) exceeds the available context size (2048 tokens), try increasing it","type":"exceed_context_size_error","n_prompt_tokens":3921,"n_ctx":2048}}والصورة التالية تبين ما حدث:
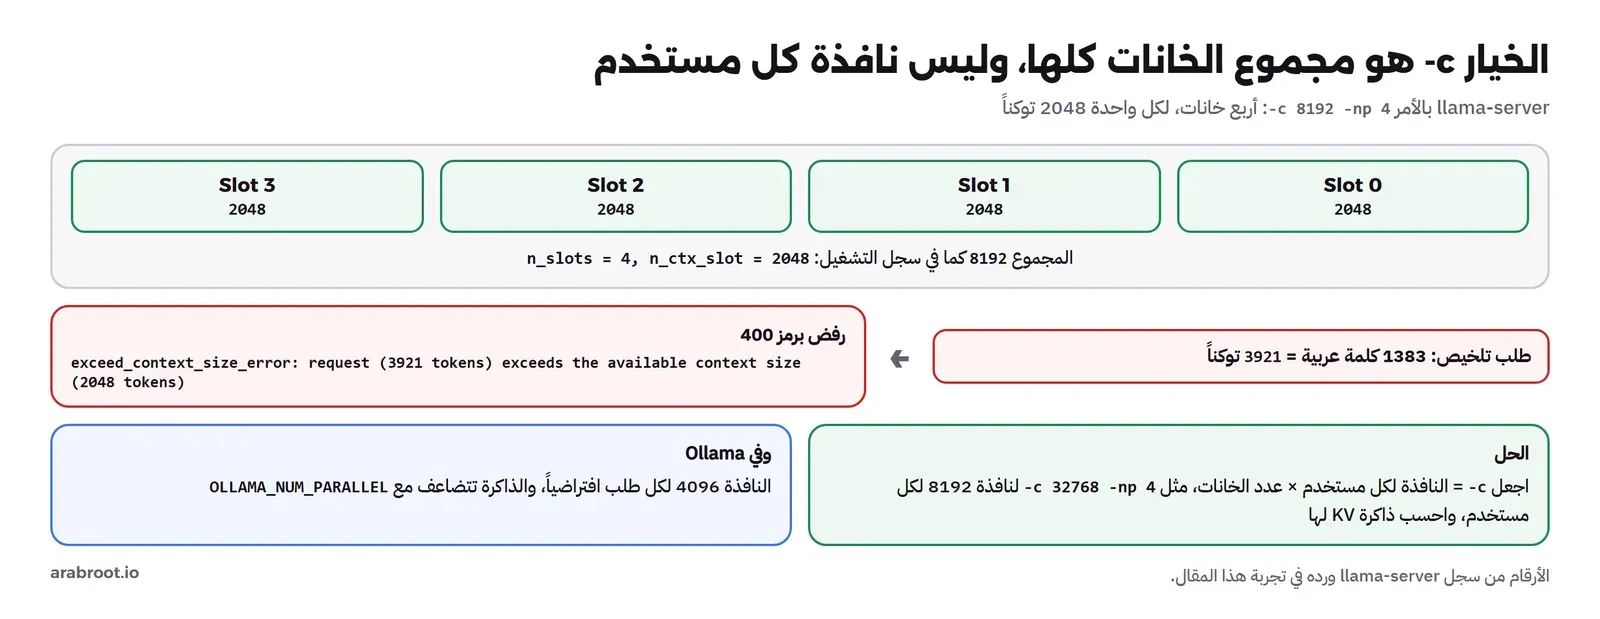
في المخرج أعلاه لاحظ التالي:
- الخادم رفض الطلب برمز 400 ونوع خطأ واضح
exceed_context_size_error، ولم يقطع النص بصمت، وهذا جيد، لأن القطع الصامت يعطيك ملخصاً لنصف المستند وأنت لا تعلم. - 1383 كلمة عربية أصبحت 3921 توكناً، أي قرابة 2.8 توكن لكل كلمة، وهذا ما شرحناه عن تكلفة العربية في مقال معالجة العربية.
- الحد هنا 2048 وليس 8192 الذي طلبناه، لأن الخيار
-cهو مجموع الخانات كلها. فإذا أردت أن يقبل كل مستخدم 8192 توكناً مع أربعة مستخدمين معاً، فاجعل-c 32768 -np 4، واحسب ذاكرة KV لهذه النافذة كما في قسم كلفة السياق.
وفي Ollama يحدث شيء مشابه بطريقة مختلفة: النافذة الافتراضية 4096 توكناً لكل طلب كما رأيت في عمود CONTEXT في ollama ps، وتتضاعف الذاكرة مع OLLAMA_NUM_PARALLEL بحسب أسئلته الشائعة.
من يستطيع أن يسأل خادمك؟ المصادقة Authentication في الأدوات الثلاث
أول سطر تحذير كتبه llama-server في سجله عند التشغيل لم يكن عن الذاكرة ولا عن النموذج، وإنما عن الأمان:
W srv server_setup: security: no API key is set and CORS allows all origins (see https://github.com/ggml-org/llama.cpp/pull/25655)ومعنى السطر أن الخادم يقبل أي طلب دون مفتاح، وأن أي صفحة ويب يفتحها مستخدم على نفس الشبكة Network تستطيع أن ترسل إليه طلبات من المتصفح، لأن سياسة CORS تسمح لكل المصادر Origins. والأدوات الثلاث تختلف هنا:
| الأداة | المصادقة في الأداة نفسها | ماذا تفعل |
|---|---|---|
| Ollama | لا يوجد، ويقول توثيق OpenAI compatibility إن مفتاح API مطلوب في المكتبة ولكن Ollama يتجاهله | اجعله على 127.0.0.1 أو شبكة Docker داخلية، وضع أمامه Reverse Proxy بمصادقة أو واجهة مثل Open WebUI |
| llama-server | الخيار --api-key، ويقبل عدة مفاتيح مفصولة بفواصل | فعله دائماً، وانشر المنفذ على 127.0.0.1 إذا كان العميل على نفس الجهاز |
| vLLM | الخيار --api-key، ولكن توثيقه يحذر من أنه يحمي المسارات Paths التي تبدأ بـ /v1 و/v2 و/inference و/cohere فقط، ويبقى /invocations مفتوحاً وهو يقدم نفس قدرات /v1 | لا تعتمد على المفتاح وحده، وضع vLLM خلف Reverse Proxy يسمح بالمسارات التي تحتاجها فقط، مع TLS |
ولنتأكد من llama-server، أعدنا تشغيله بالخيار --api-key lab-secret-key، ثم أرسلنا نفس الطلب دون مفتاح، ثم طلبنا قائمة النماذج بالمفتاح:
curl -s -w '\nHTTP %{http_code}\n' 127.0.0.1:9563/v1/chat/completions -H 'Content-Type: application/json' -d @req.json
curl -s -w '\nHTTP %{http_code}\n' 127.0.0.1:9563/v1/models -H 'Authorization: Bearer lab-secret-key'
{"error":{"message":"Invalid API Key","type":"authentication_error","code":401}}
HTTP 401
{"models":[{"name":"qwen2.5-1.5b","model":"qwen2.5-1.5b","modified_at":"","size":"","digest":"","type":"model", ...واختفى تحذير الأمان من أول سطر في السجل، لأن الخادم لم يعد مفتوحاً للجميع. ولاحظ أن مفتاح API وحده لا يشفر الطلب، فالمفتاح نفسه يمر نصاً واضحاً إذا لم يكن أمام الخادم TLS، وقد شرحنا وضع أي خدمة خلف Reverse Proxy بشهادة في تطبيقك خلف Reverse Proxy.
صيغة الملف تحدد الأداة قبل أن تختارها
من أكثر ما يفاجئ من ينتقل بين الأدوات أن الملف الذي حملته لأداة لا يصلح للأخرى، والجدول التالي يجمع ما رأيته في التجربة وما تذكره صفحات التوثيق:
| الأداة | الصيغة الأساسية | التكميم Quantization المعتاد | حجم Qwen2.5-1.5B في تجربتنا |
|---|---|---|---|
| llama.cpp | GGUF، ملف واحد | Q8_0 وQ5_K_M وQ4_K_M وغيرها | 1.04 GiB بتكميم Q4_K_M |
| Ollama | GGUF داخل مكتبته، أو ملفك أنت عبر Modelfile | Q4_K_M افتراضياً في المكتبة | 1.1 GB في ollama list |
| vLLM | safetensors من Hugging Face، مجلد كامل | FP8 وAWQ وGPTQ وINT8 للبطاقات، وBF16 على المعالج، وGGUF تجريبي | 2.89 GiB بدقة BF16 |
وعن GGUF في vLLM تحديداً، فصفحته تقول إن الدعم «تجريبي جداً وغير محسن حالياً»، وتنصح باستخدام المقطع Tokenizer من النموذج الأصلي بدل المقطع الموجود في ملف GGUF، لذلك إذا كنت تخطط للانتقال من Ollama إلى vLLM مع نمو الفريق، فاحتفظ برابط المستودع الأصلي للنموذج، لأنك سوف تحمل منه نسخة أخرى بصيغة أخرى.
ما الذي تحتاجه في الإنتاج غير السرعة؟
الأرقام أعلاه تحسم السؤال على جهاز بالمعالج، ولكن الخادم الذي يعمل كل يوم يحتاج أشياء أخرى، وهذه مقارنتها في الأدوات الثلاث:
- إدارة النماذج: Ollama وحده يحمل النماذج ويفرغها ويشغل أكثر من نموذج في نفس الخادم، أما llama-server وvLLM فخادم واحد لنموذج واحد في الاستخدام العادي، فإذا احتجت نموذجين شغلت خادمين، أو وضعت أمامهما بوابة توزع الطلبات.
- المراقبة Monitoring: llama-server يقدم نقطة
/metricsبصيغة Prometheus بالخيار--metrics، ونقطة/healthالتي ترجع 503 أثناء التحميل و200 عندما يكون جاهزاً، وvLLM يقدم/metricsو/healthأيضاً بحسب صفحة الخدمة، أما Ollama فتراقبه من سجله ومن الأمرollama ps. - زمن البدء: llama-server جهز خلال ثوان، وOllama يحمل النموذج عند أول طلب ثم يبقيه خمس دقائق افتراضياً، أما vLLM فاحتاج دقيقتين دون التجهيز المسبق، و31 دقيقة معه على هذا الجهاز، فخطط لذلك عند إعادة التشغيل والتحديث.
- حجم الـ Image: صنعنا llama.cpp في Image حجمها 175 MB، وImage الخاصة بـ Ollama 8.47 GB لأنها تحمل مكتبات البطاقات الرسومية معها، وImage الخاصة بـ vLLM للمعالج 7.69 GB.
- الكود الذي يستدعي الخادم: لم نغير في
bench.pyولا فيreq.jsonشيئاً بين الأدوات الثلاث غير العنوان، وهذه أهم نتيجة عملية في هذا المقال، فاكتب كودك لواجهة OpenAI المتوافقة، وسوف نشرح ذلك بالتفصيل في مقال استدعاء نموذج اللغة من الكود.
نقاط القوة ونقاط الضعف
Ollama
نقاط القوة:
- أسرع طريق من الصفر إلى نموذج يعمل: أمر لتحميل النموذج وأمر لتشغيله، ومكتبة نماذج بأسماء ثابتة وقوالب محادثة مضبوطة.
- يدير الذاكرة عنك: يحمل النموذج عند أول طلب ويفرغه بعد مدة الخمول، ويشغل عدة نماذج على نفس الخادم.
- أكثر الواجهات والأدوات تدعمه مباشرة، مثل Open WebUI وn8n ومكتبات البرمجة.
نقاط الضعف:
- لا يوجد أي مصادقة في واجهته، فكل من يصل إلى المنفذ يتحكم في الخادم كله، بما في ذلك تحميل النماذج وحذفها.
- الطلبات المتزامنة محدودة بـ
OLLAMA_NUM_PARALLEL، وكل زيادة فيه تحجز ذاكرة سياق كاملة إضافية. - بعض الخيارات المتقدمة في llama.cpp لا تظهر فيه، أو تظهر بأسماء مختلفة.
llama.cpp
نقاط القوة:
- ملف تنفيذي واحد بلا خدمات إضافية، يعمل على أضعف الأجهزة وأقواها.
- كل خيار في يدك: عدد الخانات، وطول السياق، والخيوط Threads، ونوع ذاكرة KV، ومفتاح API، ونقطة
/metricsلـ Prometheus. - أدوات القياس والتكميم من نفس المشروع، فتقيس على جهازك قبل أن تقرر.
نقاط الضعف:
- نموذج واحد لكل خادم في الوضع العادي، وتحميل الملفات وتحديثها مسؤوليتك.
- الإعداد الافتراضي يسمح لأي موقع بالاتصال به من المتصفح CORS ولا يطلب مفتاحاً، كما يحذرك هو نفسه في أول سطر من سجله.
- تقسيم السياق على الخانات يحتاج فهماً، وإلا رفض طلبات طويلة كما رأيت في التجربة.
vLLM
نقاط القوة:
- صمم لخدمة مستخدمين كثيرين على البطاقات الرسومية، بإدارة ذاكرة KV بالصفحات والتجميع المستمر وتخزين البادئات المشتركة Prefix Caching.
- يقرأ الأوزان الأصلية من Hugging Face مباشرة، ويوزع النموذج على عدة بطاقات.
- يحمي واجهته بمفتاح API بخيار واحد، ويقدم مقاييس جاهزة للمراقبة.
نقاط الضعف:
- ثقيل: Image بحجم عدة جيجابايتات، وبدء تشغيل يأخذ دقائق لأنه يجهز الحساب Compilation مسبقاً.
- على المعالج دون AVX-512 يعمل بميزات محدودة كما يقول توثيقه، وهذا ما رأيته في التجربة.
- لا يقرأ GGUF في الاستخدام العادي، فالنموذج الذي جهزته لـ Ollama لا ينتقل إليه كما هو.
وماذا عن العتاد الآخر؟
جربنا على المعالج فقط، ولكن اختيارك قد يتغير بحسب العتاد الذي تملكه، وهذا ما تذكره صفحات التوثيق باختصار، وقد شرحنا العتاد نفسه في قسم الأجهزة:
- أجهزة Mac بمعالجات Apple Silicon: llama.cpp يعتبرها من أهم منصاته ويستخدم Metal، وOllama يعمل عليها بنفس المحرك، فالاثنان الخيار الطبيعي هنا، أما vLLM فيذكر Apple Silicon ضمن الإضافات Plugins خارج النسخة الأساسية.
- بطاقات NVIDIA: الثلاثة تعمل، والفرق يظهر مع عدد المستخدمين، فلشخص واحد يكفيك Ollama، ولعشرات المستخدمين على نفس البطاقة يعطيك vLLM إنتاجية أعلى بالتجميع والصفحات.
- بطاقات AMD: llama.cpp وOllama يدعمانها عبر ROCm وVulkan بقائمة بطاقات محددة، وvLLM يذكر AMD GPUs في دعمه الأساسي.
- عدة بطاقات في سيرفر واحد أو عدة سيرفرات: vLLM مصمم لهذا بتوزيع النموذج Tensor Parallelism وغيره، أما llama.cpp وOllama فيوزعان الطبقات على البطاقات في نفس الجهاز.
خطة الانتقال مع نمو الفريق
الأدوات الثلاث ليست اختياراً واحداً لمرة واحدة، وإنما مراحل يمر بها أغلب الفرق، ولأن الواجهة واحدة فالانتقال بينها أسهل مما يبدو إذا خططت له من البداية:
- المرحلة الأولى، التجربة: Ollama على جهاز مطور أو سيرفر صغير، ونموذج من مكتبته، وكود يستدعي
/v1/chat/completions. والهدف هنا أن تعرف هل يكفي نموذج صغير لمهمتك، كما في الاختبار العربي في مقال النماذج المفتوحة. - المرحلة الثانية، فريق صغير: نفس Ollama على سيرفر داخلي، مع
OLLAMA_NUM_PARALLELعلى قدر المستخدمين المتزامنين، وواجهة بحسابات وصلاحيات أمامه، ولا ينشر منفذه أبداً. - المرحلة الثالثة، خدمة ثابتة لتطبيق: إذا كان لديك نموذج واحد يستدعيه تطبيق بضغط معروف، فـ llama-server يعطيك ملفاً تنفيذياً واحداً بإعدادات ثابتة ومراقبة Prometheus ومفتاح API، دون مكتبة نماذج لا تحتاجها.
- المرحلة الرابعة، بطاقة رسومية ومستخدمون كثيرون: هنا تنتقل إلى vLLM، وتحمل النسخة الأصلية من النموذج أو نسخة مكممة للبطاقات مثل AWQ أو FP8 من نفس المستودع، وتقيس من جديد، لأن الأرقام على البطاقة تختلف تماماً عما رأيته هنا.
وفي كل مرحلة اجعل عنوان الخادم واسم النموذج في إعدادات تطبيقك وليس في الكود، فالانتقال من مرحلة إلى أخرى يصبح تغيير سطرين، كما فعلنا في bench.py عندما غيرنا المنفذ من 9562 إلى 9563 إلى 9564 دون أي تعديل آخر.
أي أداة تختار؟
بعد التجربة نرجع إلى السؤال الذي بدأنا به: من سيستخدم النموذج، وكم شخصاً في نفس اللحظة، وعلى أي عتاد؟ والصورة التالية تضع الإجابة في ثلاثة أسئلة بالترتيب:
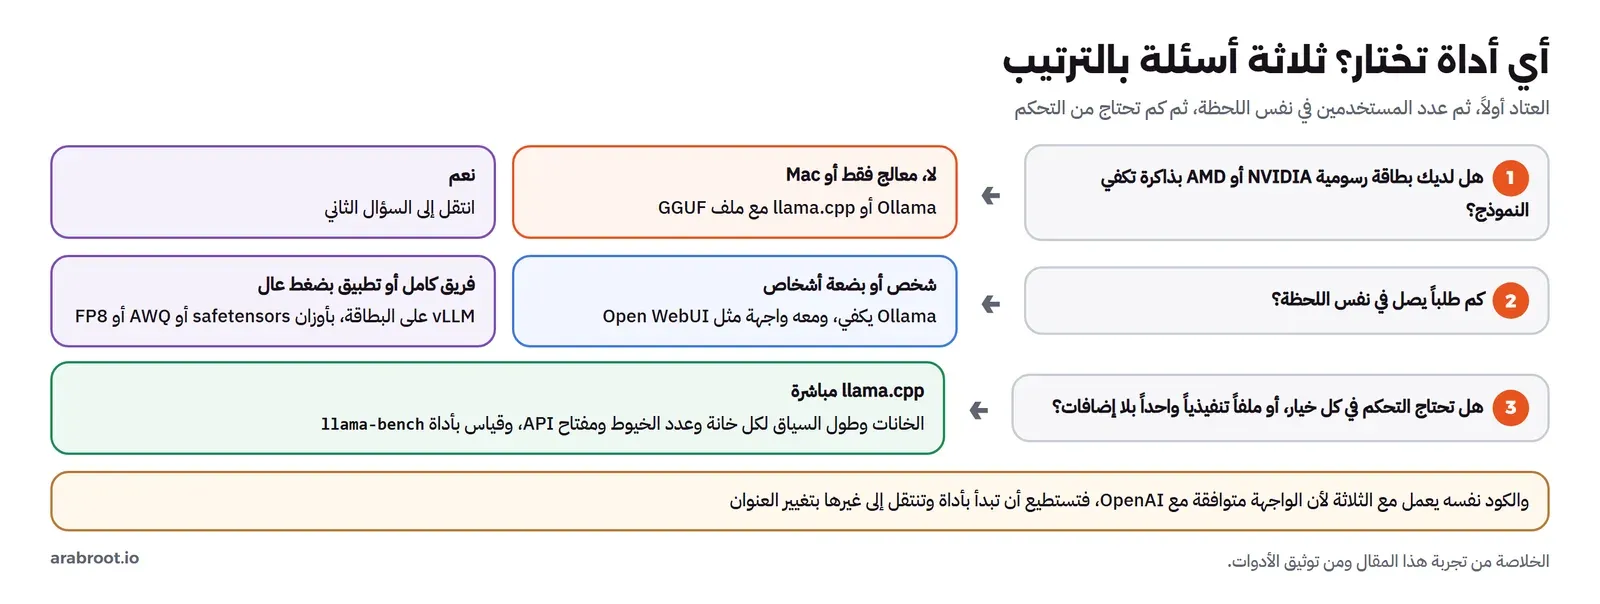
وقبل أن تختار، اسأل سؤالاً أخيراً: هل تحتاج خادماً أصلاً؟ فإذا كانت بياناتك لا تمنعك من خدمة سحابية، وكان استخدامك قليلاً أو متقطعاً، فالدفع لكل توكن قد يكون أرخص وأسهل من تشغيل أي من الثلاثة وصيانته، وقد ناقشنا هذا القرار وتكلفته في الذكاء الاصطناعي في العمل وتكلفة الذكاء الاصطناعي بالتوكنات. أما إذا قررت التشغيل الداخلي، فالجدول التالي نقطة البداية:
| حالتك | الأداة | والسبب من التجربة |
|---|---|---|
| مطور يجرب على جهازه، أو فريق من بضعة أشخاص على معالج | Ollama، مع رفع OLLAMA_NUM_PARALLEL إلى 2 أو 4 | نفس سرعة llama.cpp، وإدارة النماذج جاهزة، والإعداد الافتراضي يخدم طلباً واحداً فقط فارفعه |
| خادم صغير لنموذج واحد بإعداد ثابت، أو جهاز ضعيف | llama-server | Image من 175 MB، وخانات وسياق ومفتاح API في يدك، ونقطة /metrics |
| واجهة محادثة لفريق | Ollama خلف Open WebUI | الحسابات والصلاحيات في الواجهة، وOllama لا يراه أحد |
| سيرفر ببطاقة رسومية وعشرات المستخدمين أو تطبيق | vLLM | رأيت أن أربعة طلبات أخذت وقت طلب واحد حتى على المعالج، وعلى البطاقة يتسع هذا لعشرات الطلبات |
| معالج فقط وتريد vLLM لأن الإنتاج سيكون عليه | vLLM للتجربة فقط، بالخيارين --enforce-eager -O0 | يعمل، ولكنه أبطأ بعشر مرات من llama.cpp على معالج دون AVX-512 |
أخطاء شائعة
- ترك Ollama على
OLLAMA_NUM_PARALLEL=1ثم الشكوى من بطئه مع عدة مستخدمين، والمشكلة في الطابور وليس في السرعة. - رفع عدد الخانات في llama-server دون رفع
-c، فتقصر النافذة لكل مستخدم ويرفض الطلبات الطويلة. - مقارنة الأدوات بأوزان مختلفة، Q4_K_M في أداة وBF16 في أخرى، ثم نسبة الفرق إلى الأداة.
- قياس مرة واحدة على جهاز مشترك واعتماد الرقم.
- نشر منفذ Ollama للإنترنت، أو تشغيل llama-server دون
--api-key، أو الاعتماد على مفتاح vLLM وحده. - تحميل ملف كبير دون مقارنة بصمته، ثم البحث ساعات عن سبب خطأ «incomplete metadata».
- تشغيل vLLM على المعالج بالإعداد الافتراضي ثم انتظار التجهيز المسبق دقائق طويلة عند كل إعادة تشغيل.
قائمة التحقق
- هل حددت العتاد أولاً: معالج أم Mac أم بطاقة رسومية، وكم ذاكرة؟
- هل تعرف أقصى عدد من الطلبات المتزامنة، وضبطت
OLLAMA_NUM_PARALLELأو-npأو--max-num-seqsعليه؟ - هل حسبت النافذة لكل طلب:
-cمقسوماً على الخانات في llama-server، و4096 افتراضياً في Ollama؟ - هل قست TTFT والإنتاجية بطلبات متزامنة على جهازك، وكررت القياس؟
- هل الخادم خلف مصادقة وTLS، ولا ينشر إلا على الشبكة التي تحتاجها؟
- هل يكتب كودك لواجهة OpenAI المتوافقة، حتى تنقله بين الأدوات بتغيير العنوان؟
تدريب عملي
- شغل
bench.pyعلى Ollama عندك بالإعداد الافتراضي ثم بـOLLAMA_NUM_PARALLEL=4، وقارن عمود TTFT max مع أربعة طلبات. - شغل llama-server بالخيارين
-c 8192 -np 4ثم-c 32768 -np 4، وأرسل مستنداً طويلاً في كل مرة، وراقب الذاكرة بالأمرdocker stats.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الأدوات الثلاث تتكلم نفس الواجهة المتوافقة مع OpenAI، فلم نغير في الكود شيئاً غير العنوان، والفرق بينها في الصيغة وإدارة الذاكرة وجدولة الطلبات.
- على المعالج أعطت Ollama وllama-server نفس السرعة تقريباً لطلب واحد، قرابة 10 توكنز في الثانية، لأن Ollama يشغل محرك llama.cpp نفسه.
- Ollama الافتراضي يخدم طلباً واحداً في كل مرة، فانتظر ثامن الطلبات أكثر من دقيقة، وبأربعة طلبات متوازية ارتفعت الإنتاجية إلى قرابة الضعف ونزل الانتظار إلى ثانيتين، والثمن ذاكرة سياق لكل طلب.
- في llama-server الخيار
-cهو مجموع الخانات، فأربع خانات من 8192 تعني 2048 لكل مستخدم، والطلب الأطول يرفض برسالة واضحة. - vLLM يعمل على المعالج، ولكنه على معالج دون AVX-512 أبطأ بعشر مرات، ويحتاج
--enforce-eager -O0حتى لا ينتظر التجهيز المسبق طويلاً، وقيمته الحقيقية في التجميع على البطاقة الرسومية، وقد رأيت أثره حتى هنا: أربعة طلبات في وقت طلب واحد. - لا يوجد مصادقة في Ollama، وفعل
--api-keyفي llama-server، ولا تعتمد على مفتاح vLLM وحده.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي على سيرفرك بإذن الله سوف نضع Open WebUI أمام Ollama لفريق كامل، ثم نشغل vLLM على بطاقة رسومية، ثم نكتب الكود الذي يستدعي أي خادم منها.
 دليلOllama وOpen WebUI: مساعد ذكي داخل شبكتكنبني مساعداً لفريقك من Ollama وOpen WebUI بحسابات ومجموعات وصلاحيات على النماذج، ويجيب بالعربية من مستنداتك، مع ثلاث مشكلات حقيقية واجهتنا وحلها.
 دليلاستدعاء نموذج اللغة من الكود عبر API متوافقة مع OpenAIكيف تستدعي نموذجاً على سيرفرك من الكود بنفس واجهة OpenAI، وتتعامل مع البث والمخرج المنظم والأدوات والأخطاء وتحسب تكلفة كل طلب.
 دليلالنماذج المفتوحة Open Weights: الرخص والأحجام والعربيةما الذي تحمله عندما تحمل نموذجاً مفتوحاً، وماذا تسمح لك رخص Qwen وLlama وMistral وDeepSeek وGemma، وكم تخسر بالتكميم في العربية بقياس حقيقي.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
 دليلمصطلحات الذكاء الاصطناعي ونماذج اللغة للمبتدئينشرح قصير مع مثال لكل مصطلح ستسمعه في نقاشات الذكاء الاصطناعي ونماذج اللغة، حتى تفهم ما يعرضه عليك أي فريق أو مزود.
 دليلكيف يرى تطبيقك عنوان الزائر الحقيقي خلف ال Reverse Proxyإذا كان تطبيقك يرى عنوان ال Proxy بدلاً من الزائر أو يولد روابط http، فهذا هو السبب والإعداد الصحيح لإطار عملك.
سجل التحديثات
- 19 نوفمبر 2026: كتابة المقال واختباره على Ollama 0.40.13 وllama.cpp 1.0.0 وvLLM 0.34.0 للمعالج، بالنموذج Qwen2.5-1.5B-Instruct (Q4_K_M في GGUF وBF16 في vLLM)، على معالج Intel Core i7-7700K دون بطاقة رسومية مع Docker Desktop وWSL2.