


لنفرض أنك مطور في شركة ناشئة تبيع منتجات عبر متجر إلكتروني، وفريقكم قسم النظام إلى ثلاثة أجزاء: خدمة الدفع checkout كتبها فريق الواجهة بلغة Node.js، وخدمة الأسعار pricing كتبها فريق البيانات بلغة Python، وعامل الخلفية email-worker الذي يرسل إيميل التأكيد بعد كل طلب، ويأخذ مهامه من طابور Queue في Redis. وفي صباح أحد الأيام كتب عميل للدعم: «دفعت أمس الساعة التاسعة ولم يصلني إيميل التأكيد». وفي الفريق تتبع موزع يعمل منذ شهر، ولكن عندما فتحتم ال Trace وجدتم شيئاً غريباً: خدمة الأسعار تظهر فيه، وخدمة الدفع تظهر باسم غريب، والإيميل غير موجود أصلاً، لأن العامل يبدأ كل مرة Trace جديداً لا يعرف أحد إلى أي طلب ينتمي.
وقد شرحنا في التتبع الموزع Distributed Tracing مع OpenTelemetry المفاهيم الأساسية: ال Trace وال Span، وترويسة traceparent، والعينة في البداية والنهاية، وشغلنا ثلاث خدمات Python بالقياس التلقائي دون تعديل الكود. وهذا المقال يكمل من هناك للمطور الذي سوف يكتب كود التتبع بنفسه، فلن نعيد شرح تلك المفاهيم، وإنما ندخل إلى ال SDK نفسه بلغتين مختلفتين، ونقل السياق عبر طابور حيث لا توجد ترويسات HTTP، وال Collector بمعالجات تحمي البيانات الشخصية، ثم نقيس ماذا يضيع إذا توقف ال Collector، وكم يكلف التتبع من زمن الطلب.
وسوف نناقش في هذا المقال ما يلي:
- ماذا يحدث لل Span من لحظة إنشائه في كودك حتى يخرج من التطبيق: ال API وال SDK والعينة والمعالج والمصدر والمورد Resource.
- القياس التلقائي واليدوي في Node.js وPython معاً، ومتى تحتاج كل واحد منهما.
- مختبر حقيقي بخدمتين بلغتين وطابور Redis وCollector وJaeger، ومشكلتان واجهتانا في التشغيل.
- نقل السياق عبر الطابور بيديك، وما يحدث إذا نسيته، ومتى تستخدم الروابط Links بدل علاقة الأب بالابن.
- الاتفاقيات الدلالية Semantic Conventions: لماذا ظهر الطلب نفسه بأسماء خصائص مختلفة في اللغتين، وكيف توحدها.
- معالجات ال Collector: حماية الذاكرة، وحذف البيانات الشخصية قبل أن تخرج.
- ماذا يحدث إذا توقف ال Collector، وكم يكلف التتبع من زمن الطلب، بأرقام قسناها.
ماذا يحدث لل Span داخل ال SDK؟ الطريق من الكود إلى المصدر Exporter
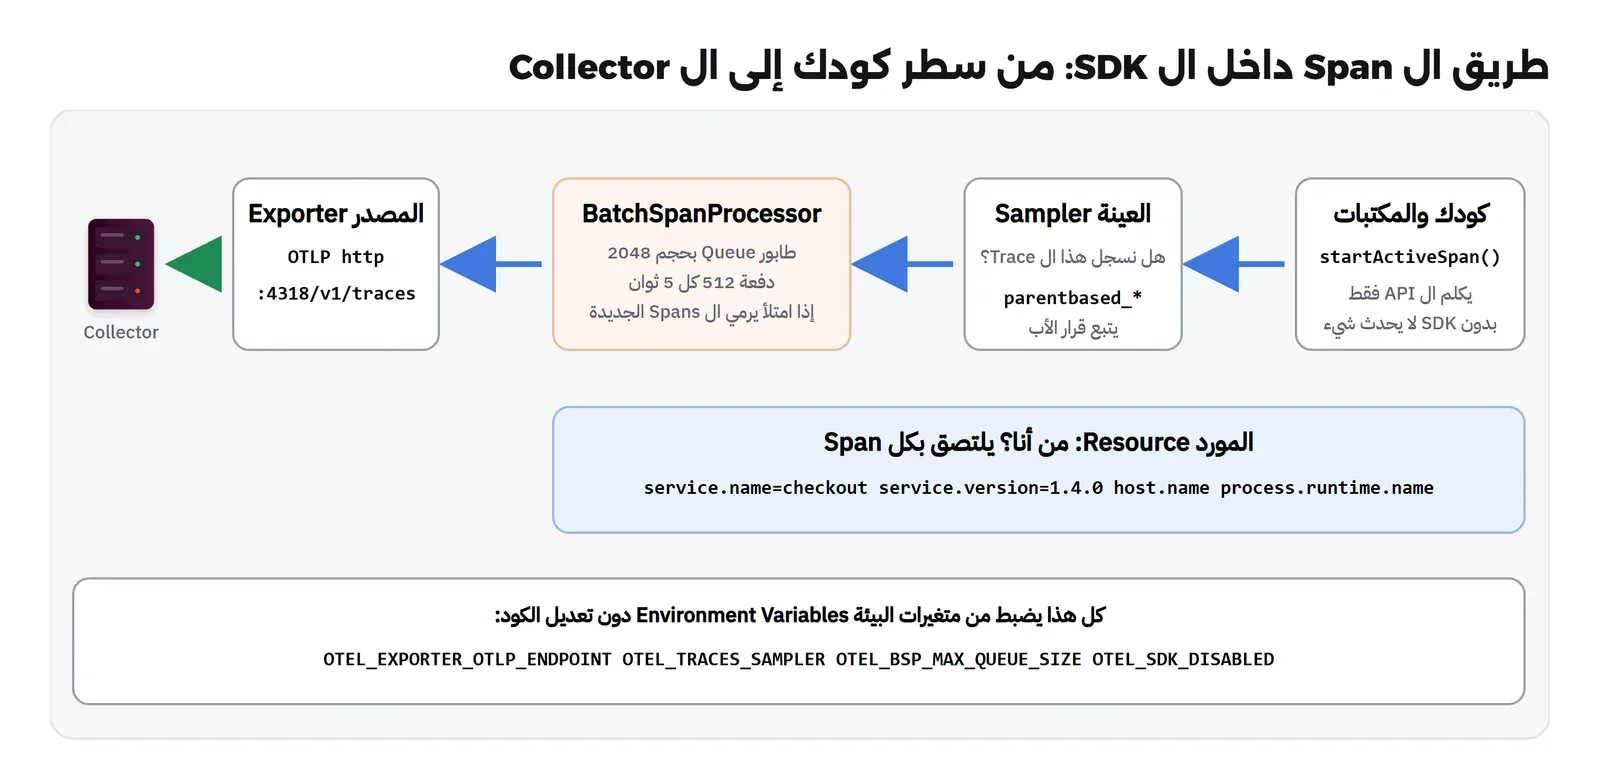
عندما تكتب في كودك tracer.startActiveSpan('validate-cart', …) فأنت تكلم ال API فقط، وهو كما ذكرنا في المقال السابق واجهة خفيفة لا تفعل شيئاً وحدها، والسبب أن المكتبات مثل عميل HTTP أو عميل قاعدة البيانات تعتمد على ال API لتضيف Spans، ولا يريد كاتب المكتبة أن يفرض عليك SDK أو إعداداً. فإذا لم يسجل التطبيق SDK في بدايته أصبحت كل هذه الاستدعاءات بلا أثر وبتكلفة قريبة من الصفر. أما عندما يوجد SDK فإن ال Span يمر بالمراحل التي تبينها الصورة التالية، وكلها موصوفة في مواصفة ال SDK:
وفيما يلي كل مرحلة وما يهمك منها كمطور:
- المورد Resource: مجموعة خصائص تصف من أنتج ال Span، أهمها
service.nameالذي تظهر به الخدمة في كل أداة، وservice.versionالذي يسمح لك بأن تقارن سلوك الإصدار الجديد بالقديم. ويضيف ال SDK بعض الخصائص تلقائياً عن الجهاز والعملية، كما يشرح توثيق الموارد، وسوف ترى في المختبر أن Node أضاف حتى سطر الأمر الذي شغل العملية. - العينة Sampler: تقرر في أول Span هل يسجل هذا ال Trace أم لا، والافتراضي
parentbased_always_on، أي سجل كل شيء واتبع قرار الخدمة التي قبلك. والقرار مكتوب في آخر حقل من ترويسة traceparent كما شرحنا في المقال السابق. - المعالج Span Processor: المعالج البسيط Simple يرسل كل Span عند انتهائه فوراً، وهو مناسب للتجارب فقط لأنه ينتظر الشبكة في كل مرة. أما المعالج بالدفعات Batch فيضع ال Span في طابور في الذاكرة ويرسل كل فترة، وقيمه الافتراضية في متغيرات بيئة ال SDK: طابور بحجم 2048، ودفعة حتى 512، كل 5000 ملي ثانية. والنقطة التي ينساها أغلب المطورين: إذا امتلأ الطابور رمى ال SDK ال Spans الجديدة ولم ينتظر، لأن تطبيقك أهم من تتبعه، وسوف نرى هذا بالأرقام.
- المصدر Exporter: يحول الدفعة إلى بروتوكول OTLP ويرسلها، ونستخدم في المختبر OTLP عبر HTTP على المنفذ 4318، ويقرأ العنوان من
OTEL_EXPORTER_OTLP_ENDPOINTويضيف إليه/v1/traces.
وقد يتساءل البعض: لماذا أكتب إعداد ال SDK في الكود إذا كان القياس التلقائي يفعل ذلك من سطر الأمر؟ والإجابة أن الطريقتين صحيحتان، ولكن عندما تكتبه في الكود تعرف بالضبط ماذا يعمل في تطبيقك، وتختار المكتبات التي تقاس، وتضيف Spans يدوية في المكان الصحيح، وهذا ما يحتاجه المطور الذي سوف يصلح المشكلة عندما يختفي جزء من ال Trace.
القياس التلقائي Auto مع القياس اليدوي Manual: من يقيس ماذا؟
القياس التلقائي في OpenTelemetry يعني مكتبات قياس Instrumentation Libraries تلف مكتبة معروفة، مثل وحدة http في Node أو Flask في Python، فتنشئ Span لكل طلب يدخل أو يخرج، وتقرأ ترويسة traceparent من الطلب الداخل، وتضيفها إلى الطلب الخارج. وهذا هو الجزء الذي لا يجب أن تكتبه بنفسك أبداً، لأنه مكرر في كل تطبيق، والخطأ فيه يقطع ال Trace. ولكن المكتبة لا تعرف شيئاً عن منطقك، فلا تعرف أن «التحقق من السلة» خطوة مستقلة، ولا أن الرسالة التي وضعتها في Redis ستعالج في عملية أخرى. ولذلك يشرح توثيق القياس أن الطريقتين تكملان بعضهما، والقاعدة العملية:
- تلقائي: حدود الخدمة، أي HTTP الداخل والخارج، وقواعد البيانات، وعملاء الطوابير المعروفة إذا كانت لها مكتبة قياس.
- يدوي: الخطوات المهمة في منطقك التي تريد أن تعرف وقتها، والخصائص التي تبحث بها لاحقاً مثل رقم الطلب، وتسجيل الاستثناء وحالة الخطأ في المكان الذي يعرف السبب، ونقل السياق في أي قناة لا تعرفها المكتبات.
ولاحظ أن مستوى نضج القياس يختلف من لغة إلى أخرى ومن مكتبة إلى أخرى، فبعض مكتبات القياس ما زالت تجريبية بأرقام إصدار تنتهي بـ b مثل مكتبة Flask التي نستخدمها، وبعضها مستقر، وهذا يؤثر على أسماء الخصائص كما سوف ترى، فراجع حالة كل مكتبة قبل أن تبني عليها لوحات أو تنبيهات في الإنتاج.
وسوف ترى في المختبر الحالتين في كل خدمة: Spans تلقائية من مكتبة HTTP في Node ومن Flask في Python، وSpans يدوية حول التحقق من السلة وحساب الخصم والنشر في الطابور ومعالجته.
المختبر Lab: خدمتان بلغتين مع طابور Redis
سوف نبني المتجر الذي في القصة بخمس Containers في Docker Compose، وكل ال Containers أسماؤها تبدأ بـ dv2m-، والصورة التالية تبينها:
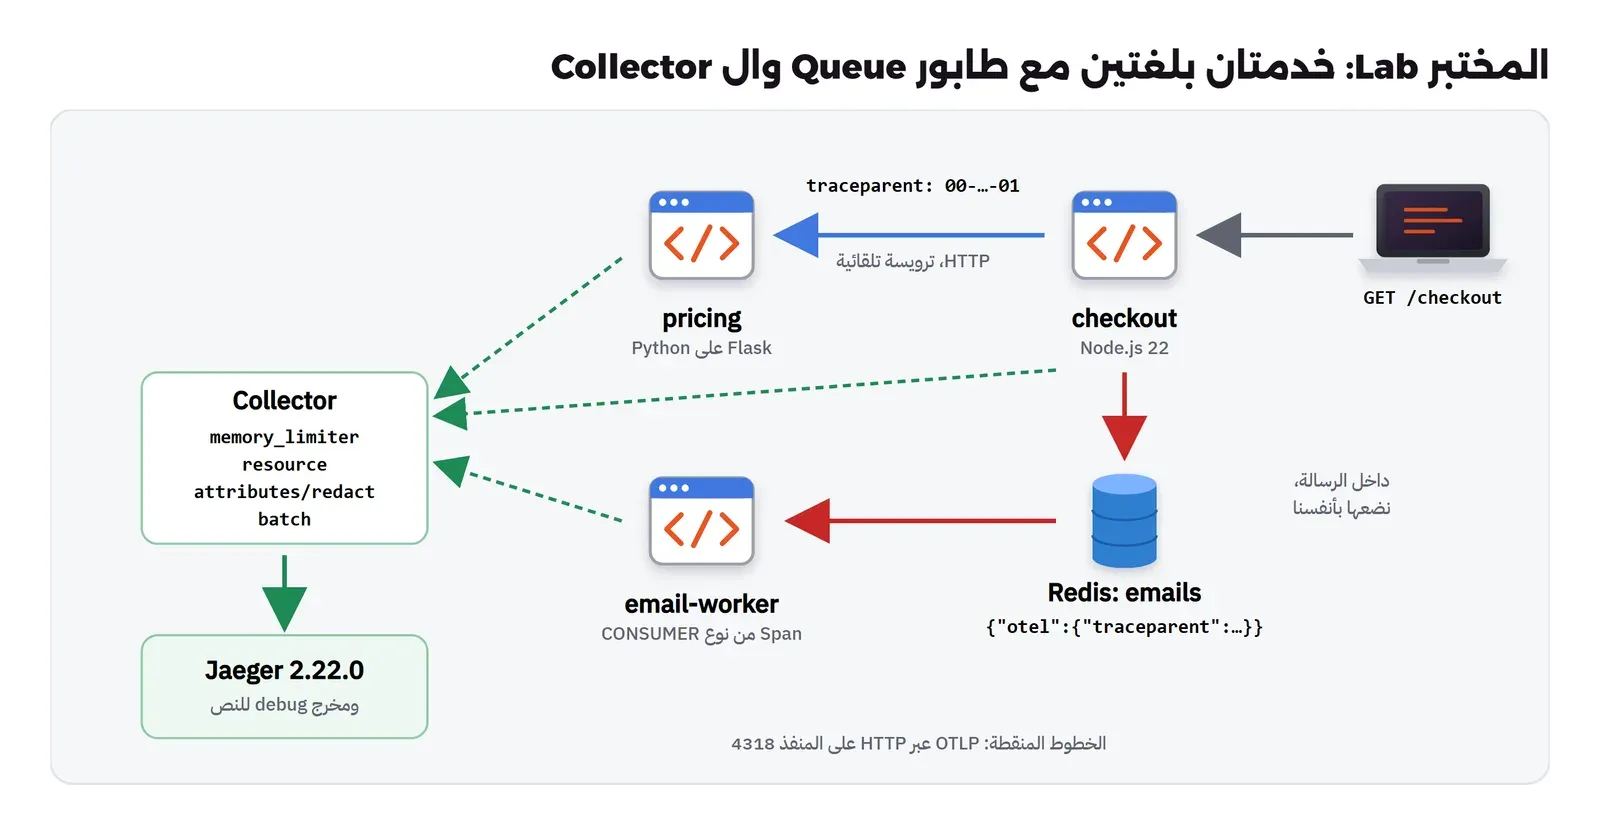
والإصدارات المثبتة هي: Node.js 22.23.4 مع حزم OpenTelemetry JS بالإصدار 0.300.0 والسلسلة 3.0 من ال SDK التي صدرت في أكتوبر 2026 كما في صفحة إصدارات المشروع، وPython 3.13.17 مع opentelemetry-sdk 1.45.2 ومكتبة Flask للقياس 0.66b2، وOpenTelemetry Collector Contrib 0.164.0، وJaeger 2.22.0، وRedis 8.10.3.
خدمة checkout بلغة Node.js: ال SDK قبل التطبيق
في Node يجب أن يعمل ال SDK قبل أن يحمل التطبيق أي مكتبة، لأن مكتبة القياس تلف وحدة http عند تحميلها، فإذا حملها التطبيق قبلها لم يلفها شيء. لذلك نضع الإعداد في ملف مستقل ونحمله بالعلم --require، كما يشرح دليل البداية لNode.js:
// OpenTelemetry SDK for the checkout service, loaded before the app: node --require ./tracing.cjs server.cjs
// The SDK reads OTEL_EXPORTER_OTLP_ENDPOINT, OTEL_TRACES_SAMPLER(_ARG) and OTEL_BSP_* from the environment.
const { NodeSDK } = require('@opentelemetry/sdk-node');
const { OTLPTraceExporter } = require('@opentelemetry/exporter-trace-otlp-http');
const { HttpInstrumentation } = require('@opentelemetry/instrumentation-http');
const { resourceFromAttributes } = require('@opentelemetry/resources');

if (process.env.OTEL_SDK_DISABLED === 'true') return;   // the "no tracing" run of the overhead test
const sdk = new NodeSDK({
  resource: resourceFromAttributes({
    'service.name': 'checkout',
    'service.version': '1.4.0',
  }),
  traceExporter: new OTLPTraceExporter(),            // http/protobuf to $OTEL_EXPORTER_OTLP_ENDPOINT/v1/traces
  instrumentations: [new HttpInstrumentation()],      // server and client spans for node:http, plus traceparent on outgoing calls
});
sdk.start();
process.on('SIGTERM', () => sdk.shutdown().finally(() => process.exit(0)));   // flush the last batch before exit
في الإعداد أعلاه لاحظ التالي:
- اخترنا مكتبة قياس واحدة هي HTTP بدل حزمة القياس التلقائي الكاملة التي تحمل عشرات المكتبات، والسبب أن كل مكتبة قياس تلف شيئاً في تطبيقك وتكلف وقت بدء وذاكرة، فحمل ما تستخدمه فقط.
- عندما تعطي
traceExporterلل NodeSDK يضعه خلف معالج الدفعات تلقائياً، فلا تحتاج أن تكتب المعالج بنفسك. - السطر الأخير مهم أكثر مما يبدو: عند إيقاف ال Container يرسل Docker الإشارة SIGTERM، فإذا لم تستدع
shutdown()ضاعت الدفعة الأخيرة في الطابور، أي آخر خمس ثوان قبل كل نشر جديد، وهي غالباً الثواني التي تريدها عندما يفشل النشر.
وقد يتساءل البعض: لماذا ملفات .cjs وليس وحدات ES الحديثة؟ والإجابة أن مكتبات القياس في Node تعمل بأن تعترض تحميل الوحدة http وتلفها، وهذا الاعتراض مباشر في نظام CommonJS، أما مع وحدات ES فيحتاج خطافاً Hook يسجل قبل التحميل بالعلم --import، وما زالت بعض المكتبات تتصرف بشكل مختلف فيه. فإذا كان مشروعك ES Modules فاتبع قسم ESM في دليل JavaScript بدقة، وتأكد بعد التشغيل أن Span السيرفر يظهر فعلاً لأول طلب، فإذا لم يظهر فالقياس لم يلف شيئاً، والسبب في الغالب ترتيب التحميل وليس الإعداد.
ثم الخدمة نفسها، وفيها Span يدوي حول التحقق من السلة، واستدعاء خدمة الأسعار، ونشر مهمة الإيميل في Redis مع نقل السياق بأيدينا:
// checkout: validates the cart, asks pricing for the total, then queues a confirmation email in Redis.
// QUEUE_PROPAGATION=off sends the job without trace context (the broken version).
const http = require('node:http');
const { trace, context, propagation, SpanKind, SpanStatusCode } = require('@opentelemetry/api');
const { createClient } = require('redis');

const tracer = trace.getTracer('checkout', '1.4.0');
const redis = createClient({ url: process.env.REDIS_URL });
redis.connect();

function getJSON(url) {                                   // node:http, so the http instrumentation adds the client span
  return new Promise((resolve, reject) => {
    http.get(url, (res) => { let b = ''; res.on('data', (c) => (b += c)); res.on('end', () => resolve({ status: res.statusCode, body: JSON.parse(b) })); })
      .on('error', reject);
  });
}

async function checkout(user, amount) {
  // a manual span around our own logic: libraries do not know this step exists
  await tracer.startActiveSpan('validate-cart', async (span) => {
    span.setAttribute('app.cart.items', 3);
    span.setAttribute('user.email', `${user}@example.com`);   // personal data on purpose: the collector must remove it
    await new Promise((r) => setTimeout(r, 5));
    span.end();
  });
  const price = await getJSON(`${process.env.PRICING_URL}/price?amount=${amount}`);
  if (price.status !== 200) throw new Error(`pricing returned ${price.status}: ${price.body.error}`);

  // PRODUCER span: the job leaves this process, so we carry the context inside the message ourselves
  await tracer.startActiveSpan('emails publish', { kind: SpanKind.PRODUCER, attributes: {
      'messaging.system': 'redis', 'messaging.destination.name': 'emails', 'messaging.operation.type': 'send' } }, async (span) => {
    const job = { order: `o-${Date.now()}`, user, total: price.body.total, otel: {} };
    if (process.env.QUEUE_PROPAGATION !== 'off') propagation.inject(context.active(), job.otel);   // adds traceparent
    await redis.rPush('emails', JSON.stringify(job));
    span.end();
  });
  return price.body;
}
في الكود أعلاه لاحظ التالي:
startActiveSpanيجعل ال Span الجديد هو الحالي داخل الدالة، فأي Span ينشأ داخلها يصبح ابناً له تلقائياً، وفي Node ينتقل هذا السياق عبرawaitبآلية AsyncLocalStorage دون أن تمرره.- أسماء الخصائص
messaging.*ليست اختراعنا، وإنما من الاتفاقيات الدلالية للرسائل، والسبب أن الأدوات تفهمها وتعرض ال Span بطريقة خاصة، كما سوف ترى في Jaeger. - وضعنا البريد في خاصية عمداً، لأن هذا ما يفعله المطورون كثيراً عندما يريدون البحث بالعميل، وسوف نحذفه في ال Collector قبل أن يصل إلى أي تخزين.
- لا يوجد Span لعملية Redis نفسها لأننا لم نحمل مكتبة قياس Redis، فال Span الوحيد هو PRODUCER الذي كتبناه، وهذا كاف لأن ما يهمنا هو الربط مع العامل.
أما بقية الملف فهو سيرفر HTTP صغير يستدعي checkout() ويسجل الاستثناء وحالة الخطأ على Span السيرفر إذا فشلت خدمة الأسعار، وهو موجود كاملاً في مجلد المختبر.
خدمة pricing مع العامل بلغة Python: الإعداد في الكود
في Python كتبنا الإعداد في ملف واحد تستخدمه الخدمة والعامل معاً، بدل الأمر opentelemetry-instrument الذي استخدمناه في المقال السابق، وهي الطريقة التي يشرحها دليل القياس في Python:
# SDK setup in code (no opentelemetry-instrument wrapper): resource, sampler from the environment, batch processor, OTLP exporter.
import os
from opentelemetry import trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

def setup(service_name: str, version: str) -> trace.Tracer:
    resource = Resource.create({"service.name": service_name, "service.version": version})
    provider = TracerProvider(resource=resource)                 # sampler: OTEL_TRACES_SAMPLER, default parentbased_always_on
    provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))   # queue 2048, batch 512, every 5 s (OTEL_BSP_*)
    trace.set_tracer_provider(provider)
    return trace.get_tracer(service_name, version)
ثم خدمة الأسعار، وفيها قياس Flask التلقائي، وSpanان يدويان، وتسجيل استثناء وحالة خطأ عندما يكون المبلغ غير صالح:
# pricing: Flask service called by checkout over HTTP. Flask spans come from FlaskInstrumentor, the rest are manual.
import time
from flask import Flask, jsonify, request
from opentelemetry.instrumentation.flask import FlaskInstrumentor
from opentelemetry.trace import Status, StatusCode
from otel_setup import setup

tracer = setup("pricing", "2.0.3")
app = Flask(__name__)
FlaskInstrumentor().instrument_app(app)                     # reads traceparent from the request and makes the SERVER span

@app.get("/price")
def price():
    amount = float(request.args["amount"])
    with tracer.start_as_current_span("load-price-rules") as span:
        time.sleep(0.02)                                      # pretend: rules from a cache
        span.set_attribute("app.rules.count", 14)
    with tracer.start_as_current_span("compute-discount") as span:
        if amount <= 0:
            err = ValueError(f"invalid amount {amount}")
            span.record_exception(err)
            span.set_status(Status(StatusCode.ERROR, str(err)))
            return jsonify({"error": str(err)}), 400
        discount = 0.1 if amount >= 500 else 0.0
        span.set_attribute("app.discount", discount)
    return jsonify({"amount": amount, "total": round(amount * (1 - discount), 2)})
ثم العامل، وهو أهم ملف في المقال، لأنه يأخذ السياق من الرسالة نفسها:
# worker: takes jobs from the Redis list "emails". The trace context travels inside the job (job["otel"]),
# so the CONSUMER span continues the checkout trace. Without it, every job starts a new trace.
import json, os, time
import redis
from opentelemetry import propagate, trace
from opentelemetry.trace import SpanKind
from otel_setup import setup

tracer = setup("email-worker", "0.9.1")
r = redis.Redis.from_url(os.environ["REDIS_URL"])
print("worker waiting for jobs", flush=True)
while True:
    item = r.blpop(["emails"], timeout=2)                 # shorter than redis-py 8's default 5 s socket timeout
    if item is None:
        continue
    job = json.loads(item[1])
    ctx = propagate.extract(job.get("otel", {}))           # empty carrier -> empty context -> a new trace
    with tracer.start_as_current_span("emails process", context=ctx, kind=SpanKind.CONSUMER, attributes={
            "messaging.system": "redis", "messaging.destination.name": "emails", "messaging.operation.type": "process",
            "app.order.id": job["order"]}):
        with tracer.start_as_current_span("render-template"):
            time.sleep(0.01)
        with tracer.start_as_current_span("smtp-send"):
            time.sleep(0.04)
في العامل أعلاه لاحظ التالي:
propagate.extractيقرأ traceparent من القاموسjob["otel"]بالطريقة نفسها التي يقرأها بها Flask من ترويسات HTTP، فالناقل Carrier قد يكون ترويسات أو قاموساً أو خصائص رسالة في Kafka، والمهم أن يكتب المرسل ويقرأ المستقبل بالمفتاح نفسه.- تمرير
context=ctxهو ما يجعل Span المعالجة ابناً لSpan النشر، وإذا كان القاموس فارغاً أصبح ال Span جذراً لTrace جديد، وهذا ما سوف نفتعله بعد قليل. - السطر الذي فيه
timeout=2لم يكن موجوداً في النسخة الأولى، والقسم التالي يشرح السبب.
مشكلتان واجهتانا في التشغيل Startup
شغلنا كل شيء بالأمر docker compose -p dv2m-otel up -d --build، وكان أول ما رأيناه أن خدمة checkout والعامل توقفا خلال ثوان:
  syscall: 'getaddrinfo',
  hostname: 'dv2m-redis'
}
Node.js v22.23.4
redis.exceptions.ConnectionError: Error -5 connecting to dv2m-redis:6379. No address associated with hostname.
والسبب أن Compose شغل ال Containers كلها معاً، فحاولت الخدمتان الاتصال بRedis قبل أن يسجل اسمه في شبكة Docker، وخدمة Node توقفت كلها لأن خطأ الاتصال في عميل Redis لم يجد من يعالجه. والحل الذي يكفي للمختبر هو depends_on لكل خدمة على ما تحتاجه، أما في الإنتاج فالحل الصحيح أن يعيد التطبيق المحاولة عند فشل الاتصال، لأن Redis قد يعيد التشغيل في أي وقت، وليس فقط عند البداية.
والمشكلة الثانية أغرب: بعد أن عمل كل شيء وعالج العامل أول مهمة، توقف بعد دقائق بهذا الخطأ رغم أن الطابور كان فارغاً:
TimeoutError: timed out
During handling of the above exception, another exception occurred:
redis.exceptions.TimeoutError: Timeout reading from socket
والأمر BLPOP دون مهلة ينتظر إلى الأبد حتى تصل رسالة، وهذا هو المطلوب في العامل، ولكن عندما طبعنا إعدادات الاتصال في الإصدار المثبت من مكتبة redis-py وجدنا:
8.1.0
{'host': 'x', 'port': 6379, ..., 'orig_socket_timeout': 5, 'orig_socket_connect_timeout': 5}
أي أن الإصدار 8 من المكتبة يضع مهلة قراءة افتراضية بخمس ثوان، فإذا انتظر BLPOP أكثر من خمس ثوان قطعت المكتبة الاتصال ورمت استثناء. والحل أن تعطي BLPOP مهلة أقصر من مهلة القراءة وتدور في حلقة، كما في النسخة أعلاه. وهذه المشكلة ليست في OpenTelemetry، ولكنها تذكير بأن ترقية مكتبة رئيسية قد تغير قيمة افتراضية تعتمد عليها، فاقرأ ملاحظات الإصدار قبل أن تثبت رقماً جديداً.
أول Trace عبر لغتين
بعد الإصلاح أرسلنا عشرة طلبات، ثم سألنا Jaeger عن ال Traces بسكربت صغير يستخدم واجهته البرمجية الثالثة API v3:
for i in $(seq 1 10); do curl -s -o /dev/null "http://127.0.0.1:13000/checkout?user=u$i&amount=$((i*90))"; done
python traces.py checkout 10 30
bd1132b643b99ef9adae40a6c01cb65c 10 spans ['checkout', 'email-worker', 'pricing'] root= checkout: GET
3d3e3637ce095a5092f13cc3e99c3f6a 10 spans ['checkout', 'email-worker', 'pricing'] root= checkout: GET
...
2cae382f9efffe5dfebafe99caea1955 6 spans ['checkout', 'pricing'] root= checkout: GETكل Trace فيه عشرة Spans من ثلاث خدمات بلغتين، وال Trace الأخير فيه ستة فقط لأنه الطلب الذي أرسلناه بمبلغ سالب، ففشلت خدمة الأسعار ولم تنشر خدمة الدفع أي مهمة. والصورة التالية تبين أحد هذه ال Traces في Jaeger:
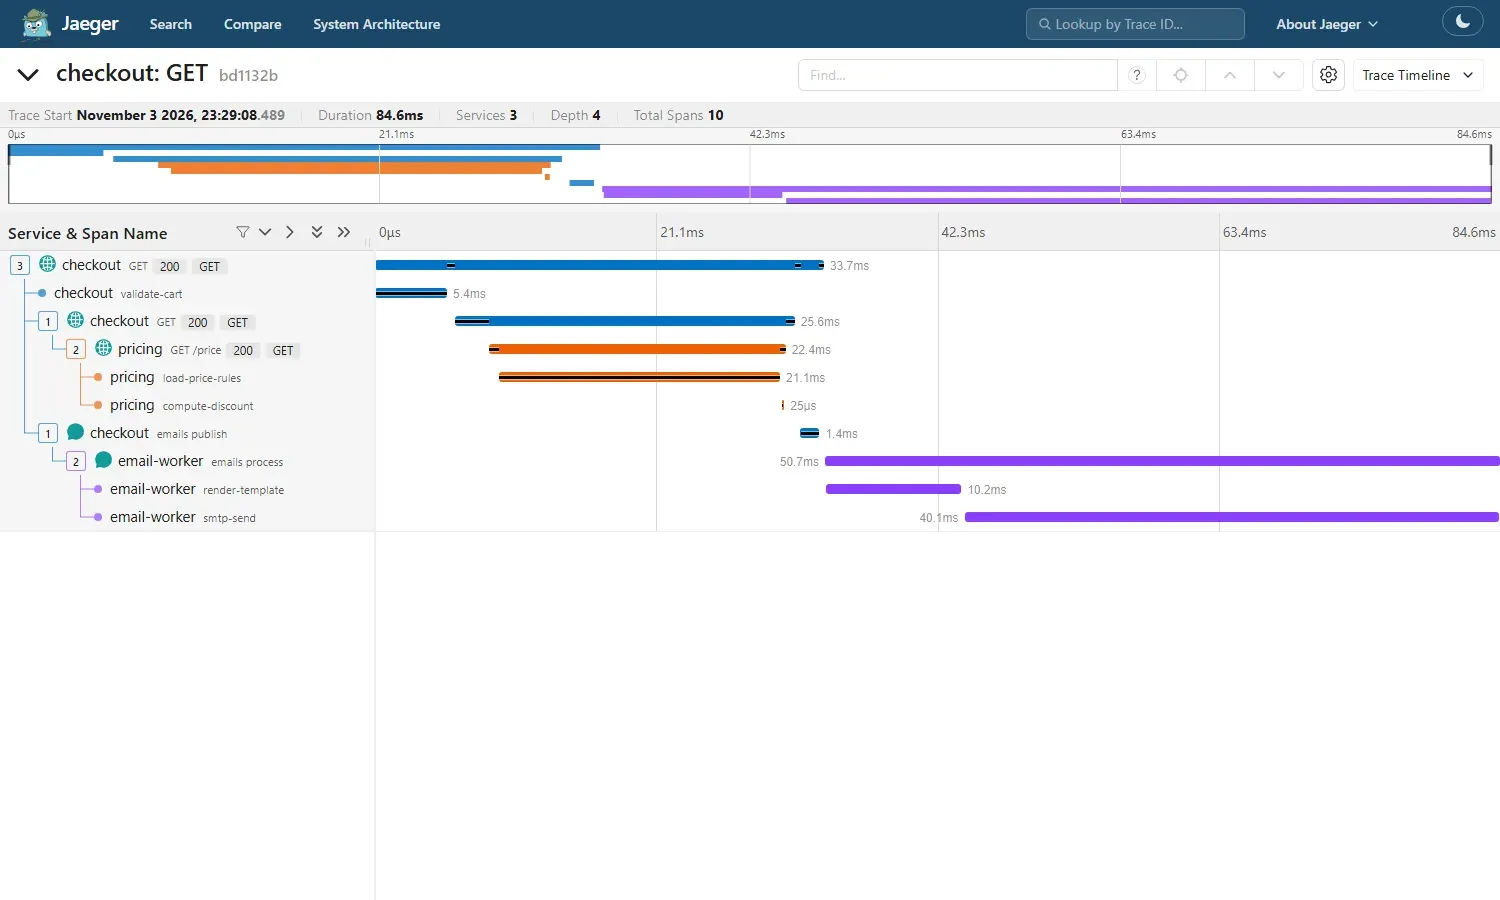
في الصورة أعلاه لاحظ التالي:
- ال Trace مدته 84.6 ملي ثانية، بينما طلب المستخدم نفسه 33.7 ملي ثانية فقط، والفرق هو العامل الذي بدأ بعد أن انتهى الطلب. فلا تحسب زمن الاستجابة من مدة ال Trace في الأنظمة التي فيها عمل في الخلفية، وإنما من مدة Span الجذر.
- Jaeger يعرض Spans الرسائل بأيقونة مختلفة لأنها من نوع PRODUCER وCONSUMER وفيها خصائص
messaging.*. - اسم Span السيرفر في Node هو
GETفقط، أما في Flask فهوGET /price، والسبب أن Flask يعرف قالب المسار Route، أما وحدةhttpالخام في Node فلا تعرفه، ولا تضع المسار الكامل في الاسم لأن ذلك ينتج اسماً مختلفاً لكل رقم طلب. فإذا استخدمت إطاراً مثل Express فحمل مكتبة قياسه، وإذا لم تستخدمه فغير الاسم بنفسك بالدالةupdateNameعلى Span السيرفر.
الخطأ عبر لغتين: الحالة Status مع الاستثناء Exception
أرسلنا طلباً بمبلغ سالب حتى نرى كيف يظهر الخطأ نفسه في الخدمتين، وقرأنا ال Spans من مخرج debug، فكانت هذه هي ال Spans المهمة مختصرة:
service.name: pricing
    Name           : compute-discount
    Status code    : Error
    Status message : invalid amount -5.0
Events:
SpanEvent #0
     -> Name: exception
          -> exception.type: Str(ValueError)
          -> exception.message: Str(invalid amount -5.0)
    Name           : GET /price
    Kind           : Server
    Status code    : Unset
     -> http.status_code: Int(400)
service.name: checkout
    Name           : GET
    Kind           : Client
    Status code    : Error
    Name           : GET
    Kind           : Server
    Status code    : Error
     -> http.response.status_code: Int(502)
     -> error.type: Str(502)
     -> Name: exception
          -> exception.type: Str(Error)
          -> exception.message: Str(pricing returned 400: invalid amount -5.0)
في المخرج أعلاه لاحظ التالي:
- الخطأ الحقيقي في Span
compute-discount، لأن الكود هناك هو الذي يعرف السبب، فسجل الاستثناء كحدث Event باسمexceptionفيه النوع والرسالة ومكدس الاستدعاءات، وعين الحالة Error. وهذا هو المكان الذي يجب أن يبدأ منه من يقرأ ال Trace. - Span السيرفر في Flask حالته Unset رغم الرمز 400، وهذا مقصود في الاتفاقيات كما شرحنا في المقال السابق: السيرفر رفض طلباً غير صالح وقام بعمله بشكل صحيح.
- Span العميل في Node حالته Error لأن طلبه لم ينجح، وSpan السيرفر في Node حالته Error مع الرمز 502 والخاصية
error.type، والاستثناء الذي سجله كودنا يحمل رسالة خدمة الأسعار كاملة.
والدرس العملي: سجل الاستثناء في Span الذي يعرف السبب، وليس في كل طبقة يمر بها الخطأ، وإلا رأيت الخطأ نفسه أربع مرات في ال Trace بأربع رسائل مختلفة. أما الطبقات الأعلى فيكفيها أن تعين الحالة Error، والأداة سوف تلون المسار كله من الخطأ حتى الجذر.
نقل السياق Context Propagation عبر الطابور بيديك
في HTTP تقرأ مكتبة القياس الترويسة وتكتبها نيابة عنك، أما الطابور فهو قناة لا تعرفها المكتبات في الغالب، أو تعرفها مكتبة لا تستخدمها، ولذلك يجب أن تحمل السياق بنفسك داخل الرسالة. وهذا بالضبط سبب شكوى العميل في القصة: العامل كان يعمل، والإيميل فشل، ولكن لا يوجد ما يربط فشله بالطلب. وحتى نرى ذلك أعدنا تشغيل خدمة checkout دون نقل السياق:
QUEUE_PROPAGATION=off docker compose -p dv2m-otel up -d checkout
for i in 1 2 3; do curl -s -o /dev/null "http://127.0.0.1:13000/checkout?user=x$i&amount=120"; done
python traces.py checkout 1 10; python traces.py email-worker 1 10
9afb401b4158152e1a477983b309e7d0 7 spans ['checkout', 'pricing'] root= checkout: GET
edc32826fea866705eb9509b6a728394 7 spans ['checkout', 'pricing'] root= checkout: GET
40cb46c101d9d70eceeaf31f5b80a529 7 spans ['checkout', 'pricing'] root= checkout: GET
---
a5c9604d8980992bf148fa97c8fd076d 3 spans ['email-worker'] root= email-worker: emails process
982b25f77cd0e5cef07d6df90411aff3 3 spans ['email-worker'] root= email-worker: emails process
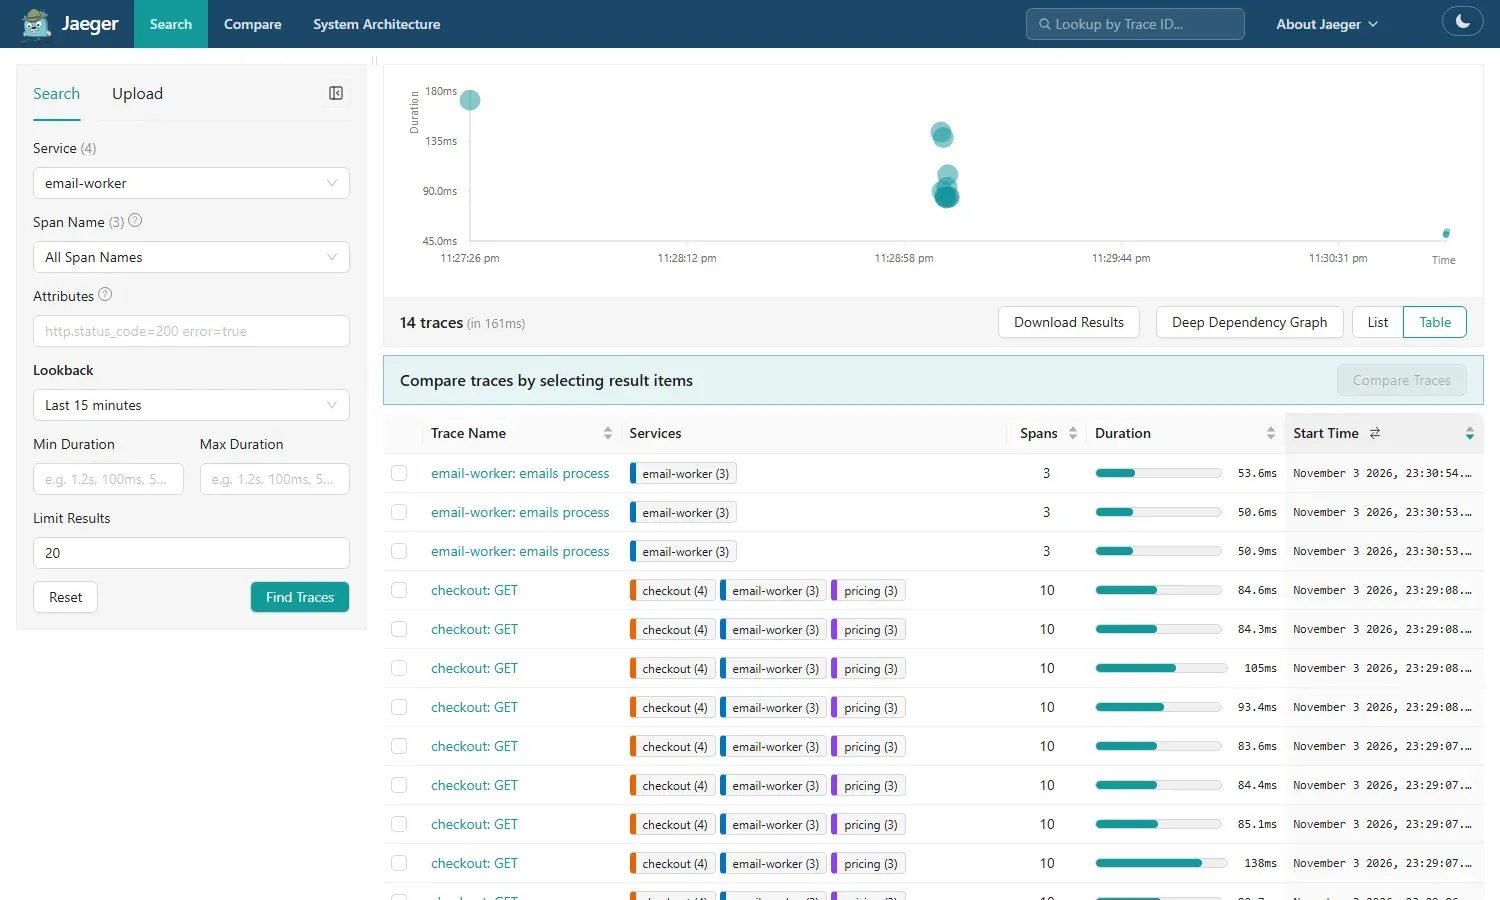
02728982151eef446d6c4fa6e11e03f7 3 spans ['email-worker'] root= email-worker: emails processالطلب نفسه أصبح ستة Traces بدل ثلاثة: ثلاثة لخدمتي الدفع والأسعار بسبعة Spans، وثلاثة للعامل وحده بجذر جديد لكل مهمة. وفي صفحة البحث في Jaeger تراها جنباً إلى جنب مع ال Traces الكاملة السابقة:
ثم أعدنا النقل، والتقطنا الرسالة نفسها في Redis بالأمر redis-cli MONITOR أثناء طلب واحد:
"RPUSH" "emails" "{\"order\":\"o-1793738506226\",\"user\":\"u42\",\"total\":630,\"otel\":{\"traceparent\":\"00-2457bbb9747c396e9d00fb9a2438cb9a-0ea6beb481390e97-01\"}}"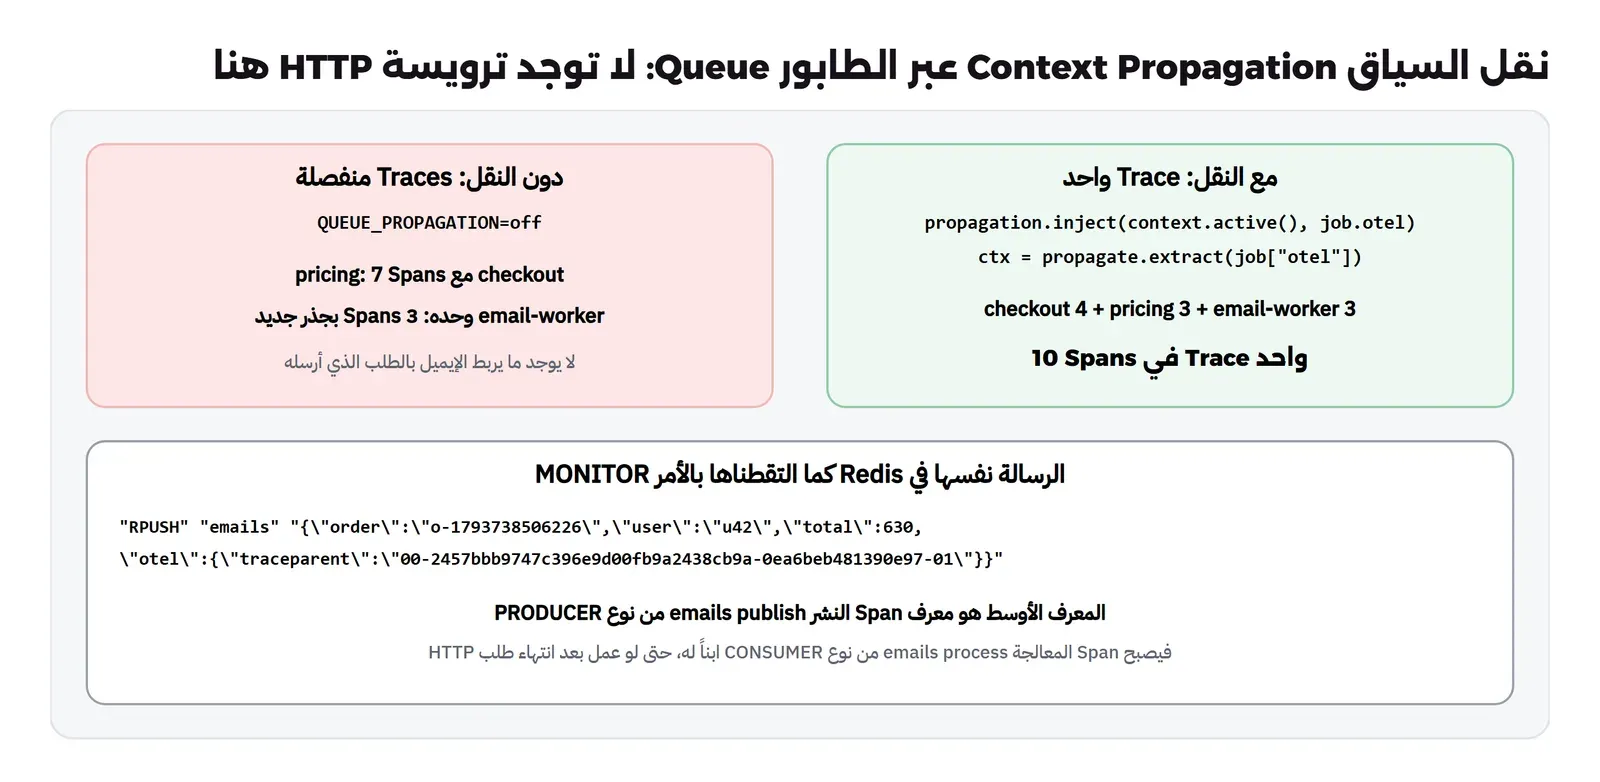
والمعرف الأوسط في القيمة 0ea6beb481390e97 هو معرف Span النشر، لأن inject كتب السياق النشط لحظة النشر، فيصبح Span المعالجة ابناً له. وهذا يعمل جيداً عندما يعالج العامل رسالة واحدة في كل مرة، ولكن ماذا لو أخذ العامل مئة رسالة دفعة واحدة من Kafka؟ لا يمكن أن يكون لل Span الواحد مئة أب، ولذلك تنص الاتفاقيات الدلالية للرسائل على أن Span المعالجة يربط بسياق كل رسالة برابط Link، وتسمح بعلاقة الأب بالابن فقط في حالة الرسالة الواحدة. والرابط في ال API هو قائمة links تمررها عند إنشاء ال Span، وفيها سياق كل رسالة، وJaeger يعرضها كمراجع تنقلك إلى ال Traces الأخرى.
الاتفاقيات الدلالية Semantic Conventions: الطلب نفسه بأسماء مختلفة
عندما قرأنا مخرج ال Collector بالتفصيل وجدنا أن Span العميل في Node وSpan السيرفر في Python لطلب HTTP واحد يصفانه بأسماء خصائص مختلفة. فهذا من Node:
Name           : GET
Kind           : Client
     -> http.request.method: Str(GET)
     -> server.address: Str(dv2m-pricing)
     -> server.port: Int(5000)
     -> url.full: Str(http://dv2m-pricing:5000/price?amount=700)
     -> http.response.status_code: Int(200)
     -> network.protocol.version: Str(1.1)
وهذا من Flask للطلب نفسه:
Name           : GET /price
Kind           : Server
     -> http.method: Str(GET)
     -> http.host: Str(dv2m-pricing:5000)
     -> http.target: Str(/price?amount=700)
     -> http.flavor: Str(1.1)
     -> http.route: Str(/price)
     -> http.status_code: Int(200)
والسبب أن الاتفاقيات الدلالية لHTTP غيرت أسماء الخصائص عندما أصبحت مستقرة Stable، ومكتبة Node بالإصدار 0.300.0 تكتب الأسماء الجديدة، أما مكتبة Flask بالإصدار 0.66b2 فما زالت تكتب القديمة افتراضياً، وتنتقل إلى الجديدة فقط إذا طلبت ذلك بالمتغير OTEL_SEMCONV_STABILITY_OPT_IN كما يشرح دليل الانتقال. والمشكلة العملية أن لوحة أو تنبيهاً يبحث عن http.status_code=500 لن يرى أخطاء Node، ولوحة تبحث بالاسم الجديد لن ترى Python. فأعدنا تشغيل خدمة الأسعار بالقيمة http:
PRICING_SEMCONV=http docker compose -p dv2m-otel up -d pricingName : GET /price
-> http.request.method: Str(GET)
-> url.scheme: Str(http)
-> server.address: Str(dv2m-pricing:5000)
-> server.port: Int(5000)
-> url.path: Str(/price)
-> url.query: Str(amount=300)
-> client.address: Str(192.168.112.4)
-> http.route: Str(/price)
-> http.response.status_code: Int(200)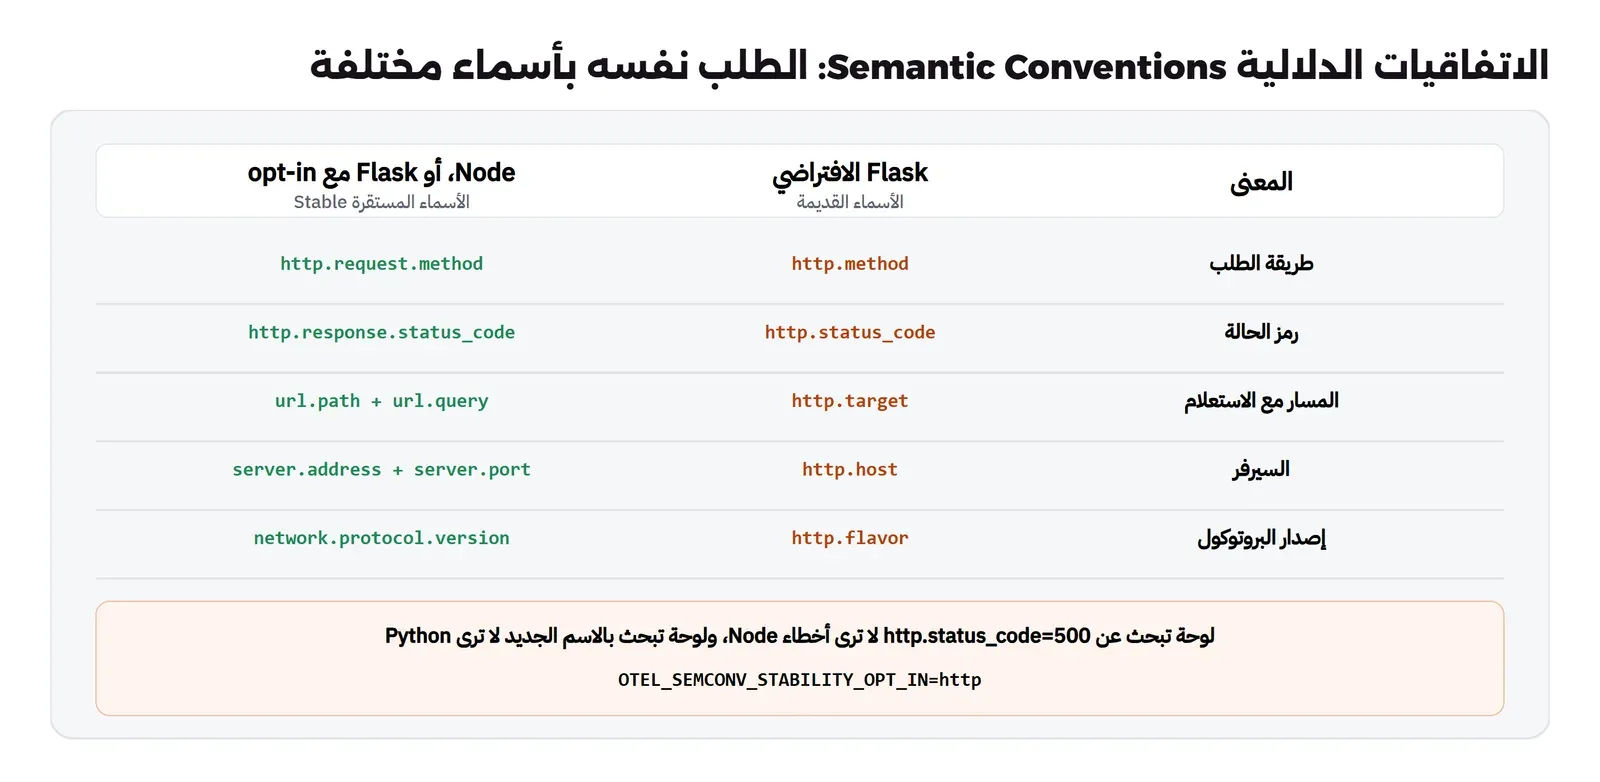
ولاحظ شيئين في المخرج الجديد: الأول أن url.query يحمل نص الاستعلام كاملاً، فإذا كانت تطبيقاتك تضع توكن أو بريداً في رابط الطلب فسوف يصل إلى التتبع، وهذا سبب إضافي لمعالج الحذف في ال Collector. والثاني أن هناك قيمة ثالثة http/dup تكتب الاسمين معاً، وهي مفيدة في فترة الانتقال عندما تكون لوحاتك القديمة ما زالت تستخدم الأسماء القديمة، ثم تحذفها بعد أن تعدل اللوحات.
ماذا تضع في الخصائص Attributes؟ الحدود Limits مع الأسماء
بعد أن توحد الأسماء القياسية يأتي سؤال الخصائص التي تكتبها أنت، وهنا ثلاث قواعد تعلمناها من هذا المختبر ومن مواصفة ال SDK:
- اسم ال Span قليل القيم، والتفاصيل في الخصائص: اسم مثل
GET /orders/{id}أوemails processيتكرر في كل الطلبات، فتستطيع الأداة أن تجمع حوله وتحسب متوسطه، أما اسم مثلGET /orders/8812فيصنع اسماً جديداً لكل طلب، فتمتلئ قائمة العمليات في Jaeger بآلاف الأسماء ولا تستطيع أن تقارن شيئاً. لذلك ضع رقم الطلب في خاصية مثلapp.order.idكما فعلنا في العامل. - بادئة لخصائصك: استخدم بادئة مثل
app.لكل ما تخترعه، حتى لا يتعارض مع اسم قياسي يظهر في إصدار قادم من الاتفاقيات، وحتى يعرف من يقرأ ال Span أن الخاصية من كودكم وليست من مكتبة. - الحدود: ال SDK يضع حداً افتراضياً لعدد الخصائص في كل Span وعدد الأحداث والروابط، وقيمها في متغيرات البيئة مثل
OTEL_SPAN_ATTRIBUTE_COUNT_LIMITوOTEL_SPAN_EVENT_COUNT_LIMIT، وما يتجاوز الحد يرمى ويظهر في العداداتDroppedAttributesCountوDroppedEventsCountالتي رأيتها في مخرج debug بقيمة صفر. فإذا وجدت قيمة غير صفرية هناك فهناك كود يضع في ال Span أكثر مما يجب، غالباً حلقة تضيف حدثاً لكل عنصر في قائمة.
وقد يتساءل البعض: لماذا لا أضع جسم الطلب كاملاً في خاصية، فأرى كل شيء عند الخطأ؟ والإجابة أن ال Span ليس سجلاً، فكل خاصية تنتقل عبر الشبكة وتخزن مع كل Trace، وجسم الطلب قد يكون كيلوبايتات ويحمل بيانات شخصية وبطاقات، والمكان الصحيح للتفاصيل الكبيرة هو السجل المرتبط بال Trace عبر trace_id، كما شرحنا في سجلات تساعدك فعلاً.
الإعداد بمتغيرات البيئة Environment Variables بدل الكود
لاحظ أننا لم نكتب في الكود عنوان ال Collector ولا نوع العينة ولا حجم الطابور، وإنما وضعناها كلها في ملف Compose، والسبب أن هذه القيم تختلف بين بيئة التطوير والإنتاج، ولا يجب أن تعيد بناء ال Image لتغييرها. والمتغيرات نفسها تعمل في كل اللغات لأنها جزء من المواصفة، وهذه أهمها:
| المتغير | ماذا يضبط | القيمة في المختبر |
|---|---|---|
OTEL_EXPORTER_OTLP_ENDPOINT | عنوان ال Collector، ويضاف إليه /v1/traces | http://dv2m-collector:4318 |
OTEL_TRACES_SAMPLER وOTEL_TRACES_SAMPLER_ARG | نوع العينة ونسبتها | parentbased_always_on ثم parentbased_traceidratio بنسبة 0.1 |
OTEL_BSP_MAX_QUEUE_SIZE | حجم طابور المعالج في الذاكرة | الافتراضي 2048 |
OTEL_SDK_DISABLED | إيقاف ال SDK كله دون حذف الكود | true في تجربة التكلفة |
OTEL_SEMCONV_STABILITY_OPT_IN | أسماء الخصائص المستقرة في مكتبات Python | http |
ولاحظ أن OTEL_SDK_DISABLED احترمته مكتبة Python بنفسها، أما في Node فقرأناه في ملف الإعداد بأيدينا قبل تشغيل NodeSDK، فلا تفترض أن كل متغير مدعوم في كل لغة بالطريقة نفسها، وجربه قبل أن تعتمد عليه.
اختبار نقل السياق Testing قبل أن يصل إلى الإنتاج
رأينا أن سطراً واحداً هو inject يفرق بين Trace كامل وTraces مقطوعة، وهذا السطر هو أول ما يحذفه زميل يعيد كتابة كود النشر بعد ستة أشهر دون أن يعرف لماذا هو موجود، ولن يلاحظ أحد حتى يكتب عميل آخر للدعم. والحل أن تكتب اختباراً يفشل إذا انقطع السياق، وهذا ممكن دون Collector ودون Jaeger، لأن ال SDK في Python فيه مصدر يحفظ ال Spans في الذاكرة InMemorySpanExporter، تستخدمه مع المعالج البسيط حتى يصل كل Span لحظة انتهائه:
# A unit test that fails if someone removes context propagation from the queue: no collector, spans kept in memory.
# run: python -m unittest test_propagation -v
import json, unittest
from opentelemetry import propagate, trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import SimpleSpanProcessor
from opentelemetry.sdk.trace.export.in_memory_span_exporter import InMemorySpanExporter
from opentelemetry.trace import SpanKind

exporter = InMemorySpanExporter()
provider = TracerProvider()
provider.add_span_processor(SimpleSpanProcessor(exporter))   # simple processor: spans are exported the moment they end
tracer = provider.get_tracer("test")

def publish(job: dict) -> str:                                   # what checkout does, in Python for the test
    with tracer.start_as_current_span("emails publish", kind=SpanKind.PRODUCER):
        job["otel"] = {}
        propagate.inject(job["otel"])
        return json.dumps(job)

def process(raw: str) -> None:                                   # what the worker does
    job = json.loads(raw)
    with tracer.start_as_current_span("emails process", context=propagate.extract(job.get("otel", {})), kind=SpanKind.CONSUMER):
        pass

class PropagationTest(unittest.TestCase):
    def setUp(self):
        exporter.clear()

    def test_worker_continues_the_trace(self):
        process(publish({"order": "o-1"}))
        producer, consumer = exporter.get_finished_spans()
        self.assertEqual(consumer.context.trace_id, producer.context.trace_id)
        self.assertEqual(consumer.parent.span_id, producer.context.span_id)

    def test_message_without_context_starts_a_new_trace(self):
        process(json.dumps({"order": "o-2"}))                    # the QUEUE_PROPAGATION=off case
        (consumer,) = exporter.get_finished_spans()
        self.assertIsNone(consumer.parent)

if __name__ == "__main__":
    unittest.main()
وشغلناه داخل Image خدمة الأسعار نفسها لأن فيها ال SDK:
test_message_without_context_starts_a_new_trace ... ok
test_worker_continues_the_trace ... ok
----------------------------------------------------------------------
Ran 2 tests in 0.001s
OK
ثم حذفنا سطر inject من نسخة مؤقتة من الاختبار لنرى ماذا سوف يرى الزميل في مسار CI:
FAIL: test_worker_continues_the_trace (test_propagation.PropagationTest.test_worker_continues_the_trace)
    self.assertEqual(consumer.context.trace_id, producer.context.trace_id)
AssertionError: 239915991227063920083390513165337541763 != 316625166632281690392895148446671108232
FAILED (failures=1)
معرفا ال Trace مختلفان، أي أن العامل بدأ Trace جديداً، والاختبار يقول ذلك في ثانية بدل أن يكتشفه العميل. ولاحظ أن الاختبار يحتفظ بمعالج بسيط Simple لأنه يريد ال Spans فوراً، وهذا هو الاستخدام الصحيح الوحيد للمعالج البسيط تقريباً. وفي Node توجد الفكرة نفسها بمصدر في الذاكرة في حزمة ال SDK، فاكتب الاختبار في اللغة التي فيها كود النشر، لأن النشر هو الطرف الذي ينسى.
ال Collector بمعالجات Processors تحمي الذاكرة والبيانات
شرحنا في المقال السابق لماذا يوجد Collector في المنتصف، وفي هذا المختبر أضفنا إليه ثلاثة معالجات قبل معالج الدفعات، والترتيب في القائمة مهم لأن البيانات تمر بها بالترتيب، كما يشرح توثيق إعداد ال Collector:
# OpenTelemetry Collector between the services and Jaeger: protect memory, add/remove attributes, batch, export.
receivers:
  otlp:
    protocols:
      http:
        endpoint: 0.0.0.0:4318
processors:
  memory_limiter:                      # first in the pipeline: refuses data before the collector runs out of memory
    check_interval: 1s
    limit_mib: 200
    spike_limit_mib: 50
  resource:
    attributes:
      - key: deployment.environment.name
        value: lab
        action: upsert
  attributes/redact:                   # personal data never leaves the collector
    actions:
      - key: user.email
        action: delete
  batch: {}
exporters:
  debug:
    verbosity: detailed
  otlp_grpc/jaeger:
    endpoint: dv2m-jaeger:4317
    tls:
      insecure: true
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, resource, attributes/redact, batch]
      exporters: [otlp_grpc/jaeger, debug]
في الإعداد أعلاه لاحظ التالي:
- memory_limiter أولاً: بحسب توثيق المعالج يفحص الذاكرة كل فترة، فإذا تجاوزت الحد الناعم بدأ يرفض البيانات الجديدة حتى تنخفض، والرفض يرجع إلى المرسل خطأ يعيد عليه المحاولة. ومكانه أول القائمة حتى يرفض قبل أن يصرف أي معالج آخر ذاكرة على البيانات، والبديل أن يقتل نظام التشغيل ال Collector كله بسبب نفاد الذاكرة OOM فتضيع البيانات التي في ذاكرته.
- resource: يضيف
deployment.environment.nameإلى كل البيانات في مكان واحد، بدل أن تعدل كل خدمة. - attributes/redact: يحذف
user.emailمن كل Span. ويستطيع معالج الخصائص أيضاً أن يحول القيمة إلى هاش بالفعلhashإذا أردت أن تبحث بالعميل دون أن تحفظ بريده، أو أن يحذف بتعبير نمطي على أسماء المفاتيح. - debug: يطبع كل Span في سجل ال Collector، وهو ما استخدمناه في القسم السابق لنقرأ الخصائص كما هي، وفي الإنتاج اجعله
basicأو احذفه لأنه يكتب كثيراً.
وحتى نتأكد أن الحذف يعمل قرأنا Span validate-cart من مخرج debug، وهو ال Span الذي أضاف إليه الكود البريد:
Span #0
    Trace ID       : abe4346a3779a6070fc75126c6789ffd
    Parent ID      : 01bd41409f0f44db
    ID             : 46cdcd1edab552b4
    Name           : validate-cart
    Kind           : Internal
Attributes:
     -> app.cart.items: Int(3)
الخاصية app.cart.items وصلت، أما user.email فلم تصل إلى المخرج ولا إلى Jaeger، مع أن الكود كتبها. وهذا هو المكان الصحيح للحماية: لا تعتمد على أن كل مطور في كل فريق سوف يتذكر ألا يضع بيانات شخصية في التتبع، وإنما ضع قاعدة واحدة في ال Collector تحمي الجميع، وراجعها كل ما ظهرت خاصية جديدة. وإذا كانت عندكم متطلبات لحماية البيانات الشخصية فالتتبع مكان تتسرب منه هذه البيانات دون أن يلاحظ أحد، لأنه لا يظهر في قاعدة البيانات ولا في الواجهة.
ماذا يحدث إذا توقف ال Collector؟
ال Collector برنامج مثل أي برنامج، يحدث ويعيد التشغيل ويتوقف. والسؤال الذي يجب أن تعرف إجابته قبل الإنتاج: ماذا يحدث لتطبيقك ولل Spans أثناء توقفه؟ فأوقفنا ال Collector وأرسلنا ألف طلب، ثم أعدنا تشغيله بعد 51 ثانية:
date -u +%T; docker stop dv2m-collector; node load.mjs 1000 4; date -u +%T
# ...
docker start dv2m-collector
20:33:02
requests=1000 parallel=4 errors=0 seconds=14.4 p50=53.8 p95=92.7 p99=121.2
20:33:17التطبيق لم يتأثر: ألف طلب دون خطأ واحد، والسبب أن المصدر يعمل في الخلفية، والمعالج لا ينتظره. أما سجل خدمة الأسعار فكان فيه:
Transient error HTTPConnectionPool(host='dv2m-collector', port=4318): Max retries exceeded with url: /v1/traces
  (Caused by NameResolutionError(...)) encountered while exporting spans batch, retrying in 0.83s.
Failed to export spans batch due to timeout, max retries or shutdown.
Queue full, dropping Span.
ثم عددنا ال Spans التي وصلت إلى Jaeger من تلك الفترة بسكربت count.py:
checkout: traces with a checkout span = 0; spans by service in those traces = {}
pricing: traces with a pricing span = 171; spans by service in those traces = {'pricing': 512, 'email-worker': 513}
email-worker: traces with a email-worker span = 408; spans by service in those traces = {'email-worker': 1223, 'pricing': 512}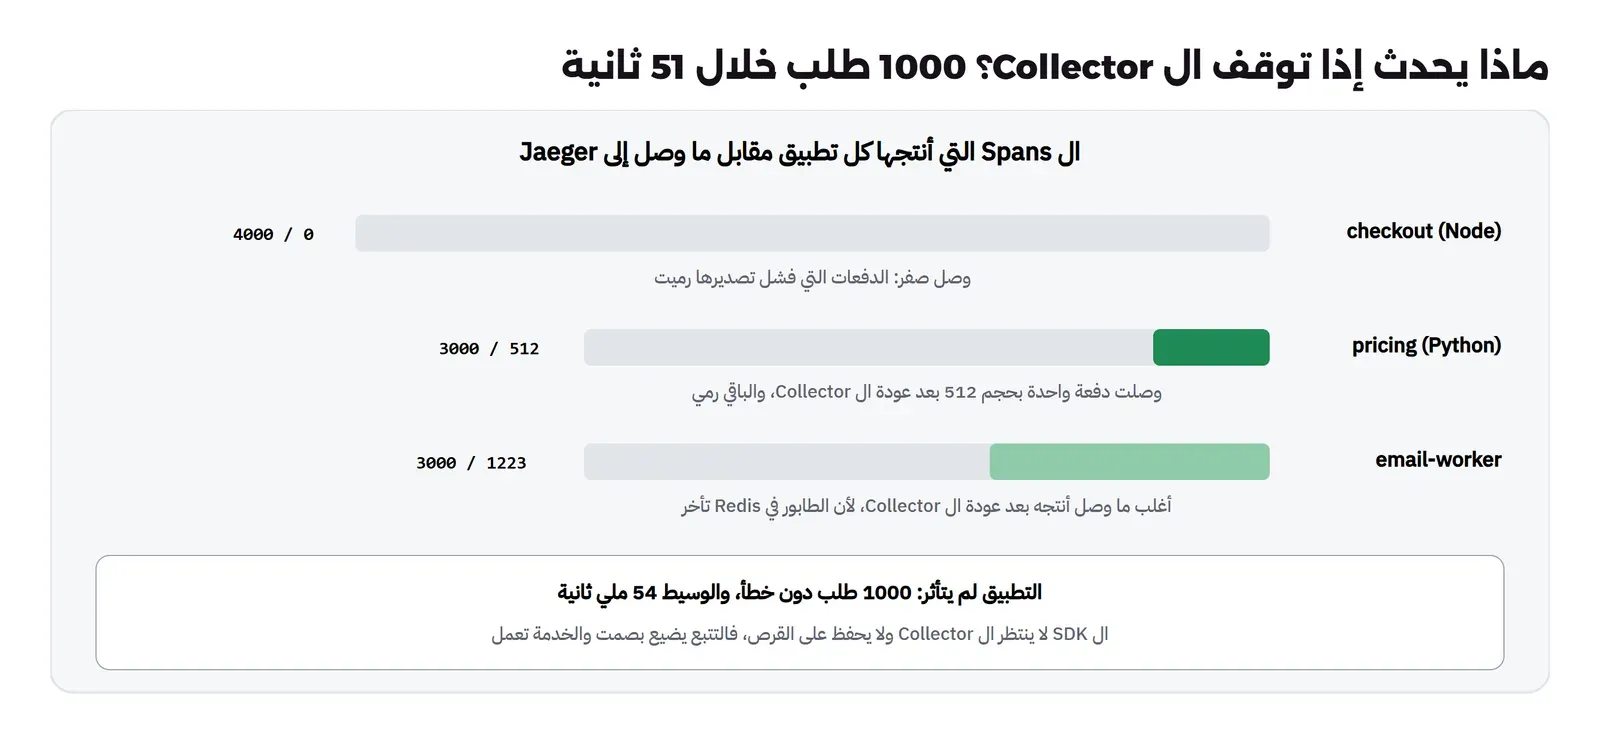
في النتائج أعلاه لاحظ التالي:
- Node أضاع كل شيء: أربعة آلاف Span من خدمة الدفع لم يصل منها شيء، لأن المصدر جرب كل دفعة عدة مرات ثم رماها، وال Collector كان ما زال متوقفاً.
- Python أنقذ دفعة واحدة: وصلت 512 Span بالضبط، وهي آخر دفعة كانت ما زالت تعاد عندما عاد ال Collector، أما الباقي فرمي إما عند فشل التصدير أو لأن الطابور امتلأ بحجمه 2048، كما تقول رسالة
Queue full. - العامل يبدو أفضل حالاً، ولكن لسبب آخر: المهام تراكمت في Redis، والعامل يعالج مهمة كل 50 ملي ثانية تقريباً، فأغلب ال Spans التي وصلت منه أنتجها بعد أن عاد ال Collector.
- لا يوجد أي خطأ ظاهر في Node: سجل خدمة Node كان فارغاً، لأن ال SDK في JavaScript لا يطبع أخطاءه إلا إذا فعلت مسجل التشخيص
diag، فلا تفترض أن التتبع يعمل لأن السجل نظيف.
وقد يخطر لك أن تكبر الطابور حتى يتحمل توقفاً أطول، بالمتغير OTEL_BSP_MAX_QUEUE_SIZE. وهذا يساعد في التوقف القصير جداً، ولكن احسبه قبل أن تفعله: خدمة الدفع في مختبرنا أنتجت أربعة آلاف Span في 14 ثانية، أي قرابة 280 Span في الثانية، فطابور بحجم 2048 يكفي سبع ثوان فقط، وطابور يكفي دقيقة كاملة يحتاج قرابة 17 ألف Span في ذاكرة كل نسخة من الخدمة، وكلها تضيع على أي حال إذا أعيد تشغيل الخدمة. فالطابور في التطبيق لامتصاص الارتفاع المفاجئ Spike في عدد الطلبات، وليس لتعويض Collector متوقف، ومكان التحمل الحقيقي هو ال Collector القريب من التطبيق.
والقاعدة من ذلك: ال SDK يحفظ ثوان قليلة في الذاكرة فقط، ولا يحفظ على القرص، وهذا قرار مقصود حتى لا يتأثر تطبيقك. لذلك يجب أن يكون ال Collector الذي يستقبل من التطبيق قريباً منه ومتاحاً دائماً، والنمط الذي يوصي به توثيق النشر هو Collector بدور الوكيل Agent على كل سيرفر أو بجانب كل خدمة، يستقبل بسرعة ويحفظ في طابور خاص به، ثم يرسل إلى Collector مركزي أو إلى أداة التخزين. وإذا أردت أن تنجو من توقف أطول فال Collector نفسه يستطيع أن يحفظ طابور الإرسال على القرص بإضافة تخزين، بدل الذاكرة. وأضف تنبيهاً على توقف ال Collector مثل أي خدمة، كما شرحنا في فحص التوفر.
كم يكلف التتبع Tracing Overhead من زمن الطلب؟
أول سؤال يسأله أي فريق قبل أن يفعل التتبع في الإنتاج: كم سوف يبطئ الطلبات؟ فشغلنا ألفي طلب، أربعة بالتوازي، ثلاث مرات في كل حالة من ثلاث: ال SDK متوقف بالمتغير OTEL_SDK_DISABLED=true، ثم ال SDK مع تسجيل كل الطلبات، ثم ال SDK مع عينة 10% بالمتغير OTEL_TRACES_SAMPLER=parentbased_traceidratio. والوقت من جهة الكلاينت بسكربت Node صغير:
off run1 requests=2000 parallel=4 errors=0 seconds=22.5 p50=40.8 p95=68.8 p99=90.3
off run2 requests=2000 parallel=4 errors=0 seconds=15.9 p50=31.2 p95=34.6 p99=38.9
off run3 requests=2000 parallel=4 errors=0 seconds=15.9 p50=31.2 p95=35.0 p99=40.0
on-all run1 requests=2000 parallel=4 errors=0 seconds=19.9 p50=36.8 p95=56.3 p99=82.6
on-all run2 requests=2000 parallel=4 errors=0 seconds=20.0 p50=36.0 p95=61.0 p99=95.7
on-all run3 requests=2000 parallel=4 errors=0 seconds=19.6 p50=35.5 p95=61.2 p99=89.6
on-10pct run1 requests=2000 parallel=4 errors=0 seconds=21.7 p50=38.6 p95=70.3 p99=97.8
on-10pct run2 requests=2000 parallel=4 errors=0 seconds=19.0 p50=35.4 p95=53.3 p99=74.6
on-10pct run3 requests=2000 parallel=4 errors=0 seconds=19.9 p50=35.4 p95=61.9 p99=96.2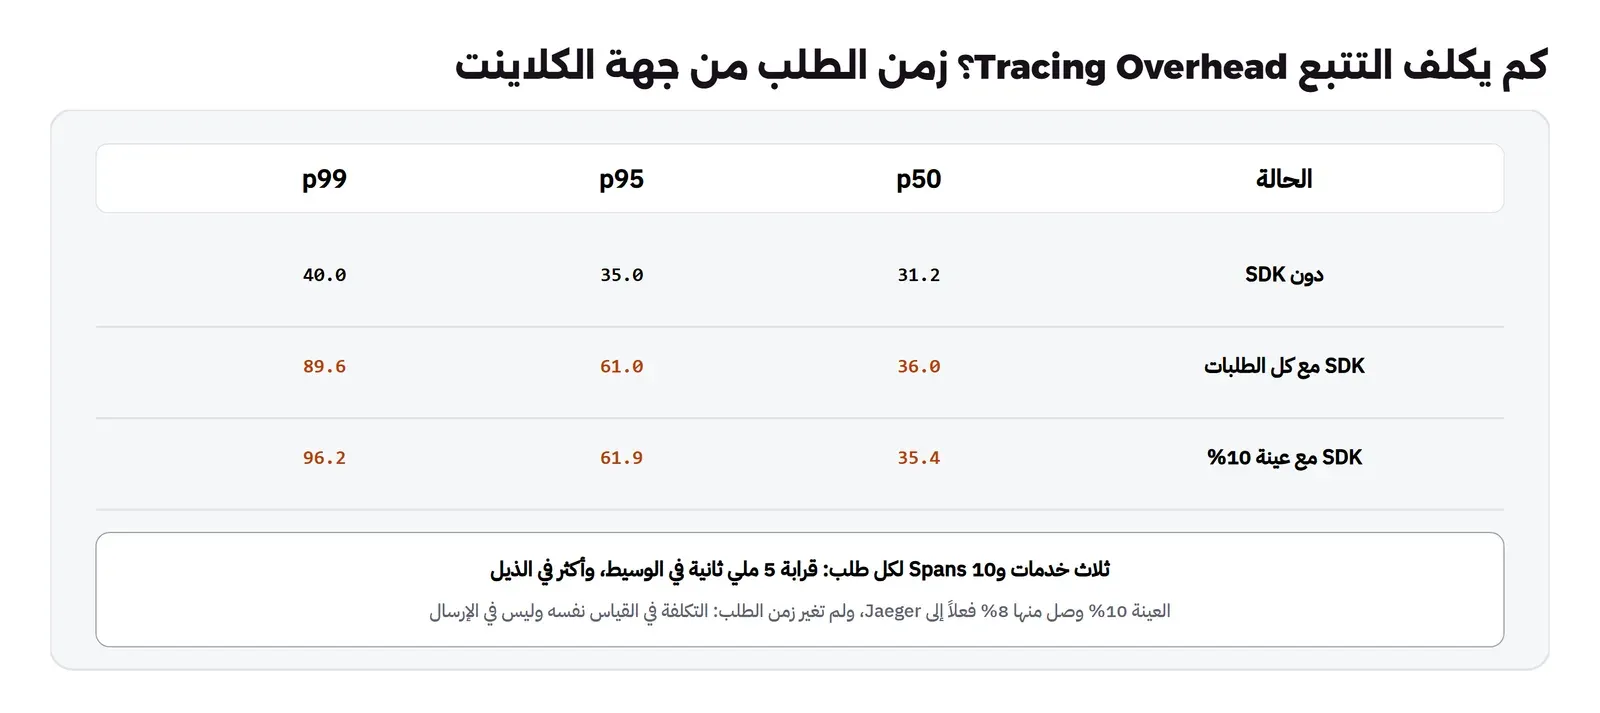
في النتائج أعلاه لاحظ التالي:
- المرة الأولى دون SDK أبطأ من الباقي: لأن الخدمات كانت قد أعيد تشغيلها قبلها بثوان، رغم أننا أرسلنا مئتي طلب للتسخين، لذلك قارنا بالمرتين الثانية والثالثة.
- الوسيط زاد قرابة 5 ملي ثانية: من 31.2 إلى 36 تقريباً لطلب يمر بثلاث خدمات وينتج عشرة Spans، أي نصف ملي ثانية تقريباً لكل Span، وهذا مقبول لأغلب التطبيقات.
- الذيل زاد أكثر: p95 من 35 إلى 61 ملي ثانية، والتفسير الأرجح أن الإرسال بالدفعات يعمل في العملية نفسها كل خمس ثوان، وفي Node على حلقة الأحداث Event Loop نفسها، وفي Python مع قفل GIL، فالطلبات التي تصادف لحظة تحويل دفعة من 512 Span إلى OTLP تنتظر قليلاً. فإذا كان ذيل زمن الاستجابة مهماً عندك فقس على خدمتك قبل وبعد.
- العينة 10% لم تخفف شيئاً: وصل إلى Jaeger قرابة 8% من الطلبات، أي أن العينة عملت، ولكن الزمن لم يتغير، والسبب أن مكتبات القياس ما زالت تعمل في كل طلب: تقرأ الترويسة وتنشئ Span غير مسجل وتنقل السياق، والذي وفرته العينة هو الشبكة والتخزين في Jaeger وليس زمن الطلب. فالعينة أداة لتكلفة التخزين، وليست أداة للأداء.
وهناك نقطة ثانية في تجربة العينة تستحق الانتباه: عددنا ال Traces التي وصلت أثناء تشغيل العينة 10% فكانت 453، وكلها فيها الخدمات الثلاث، ولا يوجد Trace واحد فيه خدمة الدفع وحدها أو العامل وحده، وفي تشغيل تسجيل كل الطلبات قبلها 6342 Trace كلها كاملة أيضاً. والسبب أن القرار اتخذ مرة واحدة في خدمة Node، ثم انتقل في علم sampled داخل traceparent إلى Python عبر HTTP، وإلى العامل داخل الرسالة، والعينة parentbased_* في Python احترمته. وهذا ما يجعل العينة في البداية عملية عبر اللغات: كل لغة تكتب ال SDK بطريقتها، ولكن القرار ينتقل بالمعيار نفسه. ولو استخدمت في إحدى الخدمات عينة لا تتبع الأب، مثل traceidratio وحدها، لوصلتك Traces ناقصة لا تعرف لماذا ينقصها جزء.
أخطاء شائعة Common Mistakes
- تحميل ال SDK بعد التطبيق في Node: لا تقاس وحدة
httpولا تظهر أي Spans تلقائية، فاستخدم--requireأو--import. - نسيان
shutdown()عند الإيقاف: تضيع آخر دفعة في كل نشر جديد. - الطابور دون نقل السياق: كل مهمة في الخلفية Trace جديد لا يربطه شيء بالطلب، كما رأينا.
- جعل Span المعالجة ابناً لكل رسائل الدفعة: لا يوجد إلا أب واحد، فاستخدم الروابط Links عند معالجة دفعة.
- بيانات شخصية في الخصائص أو في الرابط: البريد والتوكن في
url.query، فاحذفها أو حولها إلى هاش في ال Collector. - لوحات على أسماء خصائص قديمة وجديدة معاً: وحدها بالمتغير
OTEL_SEMCONV_STABILITY_OPT_IN. - Collector واحد بعيد بلا تنبيه: توقفه دقيقة أضاع أغلب ال Traces بصمت.
- الاعتماد على العينة لتسريع الطلبات: وفرت التخزين ولم تغير زمن الطلب في مختبرنا.
- حساب زمن الاستجابة من مدة ال Trace: العامل في الخلفية جعل ال Trace أطول بمرتين ونصف من الطلب نفسه.
قائمة تحقق Checklist قبل الإنتاج
| البند | كيف تتحقق منه |
|---|---|
كل خدمة لها service.name وservice.version | قائمة الخدمات في Jaeger، ورقم الإصدار في خصائص المورد |
| ال SDK يحمل قبل التطبيق ويغلق عند الإيقاف | Span سيرفر يظهر لأول طلب، وآخر طلب قبل إيقاف ال Container يصل |
| كل قناة غير HTTP تنقل السياق | Trace واحد من الطلب حتى آخر عامل، لكل طابور ومهمة مجدولة |
| أسماء الخصائص موحدة | مخرج debug يبين الأسماء نفسها من كل لغة |
| لا بيانات شخصية تصل إلى التخزين | بحث في Jaeger عن بريد أو رقم هوية يرجع صفراً |
| memory_limiter أول معالج | ترتيب processors في ال Pipeline |
| Collector قريب ومراقب | Collector على كل سيرفر، وتنبيه عند توقفه، وتجربة إيقاف |
| التكلفة مقاسة | p50 وp95 قبل التتبع وبعده على خدمتك نفسها |
تدريب عملي Practice
- غير العامل ليأخذ عشر مهام دفعة واحدة، وأنشئ Span معالجة واحداً فيه رابط Link لكل مهمة، ثم افتحه في Jaeger وانتقل من الروابط إلى Traces الطلبات.
- غير معالج الحذف في ال Collector من
deleteإلىhash، وابحث في Jaeger بالهاش عن كل Traces عميل واحد دون أن يظهر بريده.
حذف المختبر Cleanup
docker compose -p dv2m-otel down --rmi local
docker rmi otel/opentelemetry-collector-contrib:0.164.0 redis:8.10.3-alpine
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كودك يكلم ال API فقط، وال SDK هو الذي يقرر ويجمع ويرسل: المورد يقول من أنت، والعينة تقرر، ومعالج الدفعات يحفظ 2048 Span في الذاكرة ويرمي ما بعدها، والمصدر يرسل OTLP.
- القياس التلقائي لحدود الخدمة، واليدوي لمنطقك وللقنوات التي لا تعرفها المكتبات، وأهمها الطوابير.
- في الطابور تنقل السياق بيديك بـ
injectوextract، ودونه أصبح كل إيميل Trace منفصلاً، وعند معالجة دفعة استخدم الروابط Links. - Node وPython كتبا الطلب نفسه بأسماء خصائص مختلفة حتى فعلنا
OTEL_SEMCONV_STABILITY_OPT_IN=http، وحذف ال Collector البريد قبل أن يخرج. - توقف ال Collector 51 ثانية أضاع كل Spans خدمة Node وأغلب Spans خدمة Python دون أي خطأ في التطبيق، والتتبع أضاف قرابة 5 ملي ثانية للوسيط، ولم تخففها العينة.
وفي المقال القادم بإذن الله نأخذ هذه ال Traces إلى Jaeger نفسه بعمق: التخزين الدائم والاحتفاظ، والعينة من ال Jaeger، ولوحة أداء الخدمات.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلتتبع الأخطاء Error Tracking للمطورين مع GlitchTipماذا يضيف تتبع الأخطاء فوق السجلات، وكيف تشغل GlitchTip بديلاً خفيفاً لـ Sentry يستقبل أخطاء تطبيقك بالـ SDK نفسه.
 دليلسجلات تساعدك فعلاً: من «حدث خطأ» إلى سبب المشكلةكيف تكتب سجلات تجيب عن أسئلة الحادثة، بتحقيق في عطل حقيقي بسجلات سيئة ثم بحدث واسع Wide Event لكل طلب، مع قياس الفرق.
 دليلSigNoz: بديل Datadog مفتوح المصدر Open Source على سيرفرككيف تشغل SigNoz وترسل إليه التتبع والسجلات والمقاييس عبر OpenTelemetry، وما الذي يقدمه فعلاً مقابل Datadog وبكم من الذاكرة.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات OpenTelemetry JS SDK 0.300.0 على Node.js 22.23.4، وOpenTelemetry Python SDK 1.45.2 مع Flask 3.1.3، وOpenTelemetry Collector Contrib 0.164.0، وJaeger 2.22.0، وRedis 8.10.3.


