


في المقال السابق «Python للمطورين» بنينا الوحدة shop التي تحسب أسعار الطلبات في متجر صغير يبيع القهوة والتمور، ومرت الاختبارات الثلاثة بنجاح، ثم انتقل الكود إلى بيئة التجربة فظهرت مشكلتان في نفس الأسبوع. الأولى أن عملية الاستيراد الليلية التي تقرأ ملف أسعار المورد وفيه مليون سطر صارت تختفي في منتصف الليل، فالـ Container يعيد التشغيل كل مرة دون أي Traceback في السجل، ولا يوجد إلا رقم واحد في حالة الـ Container هو 137. والثانية أن عميلاً كتب الكمية بالحروف «ثلاثة» في نموذج الطلب، فرجعت له صفحة خطأ 500 بدل رسالة واضحة، وفي السجل خطأ ValueError لا يقول للفريق أي طلب وأي سطر. وكلا المشكلتين لا علاقة لهما بالتركيب الذي تعلمته في اليوم الأول، وإنما بثلاثة أسئلة لا بد أن يجيب عليها كل من يأتي إلى Python من لغة أخرى: ما هو المتغير فعلاً وما نوعه؟ ومن يحجز الذاكرة ومن يحررها؟ وكيف تعبر اللغة عن الخطأ؟
وهذا المقال الثاني في مرحلة لغة Python للمطورين، وقد شرحنا المفاهيم العامة لكل اللغات في مقالات أنظمة الأنواع وإدارة الذاكرة والتعامل مع الأخطاء، أما هنا فنأخذ Python 3.15.2 بالتحديد، ونقيس كل شيء داخل Container محدود بمعالجين و512 ميجابايت من الذاكرة. وسوف نناقش في هذا المقال ما يلي:
- الأسماء والكائنات Names and Objects: الهوية والمساواة، والأنواع التي تتغير والتي لا تتغير، والنسخ السطحي والعميق، والنوع الجديد
frozendict. - نظام الأنواع Type System: ديناميكي وقوي، وتلميحات الأنواع Type Hints التي لا يفحصها CPython، وما يكشفه mypy منها.
- من يدير الذاكرة في CPython: عداد المراجع Reference Counting وجامع الدورات Cycle Collector، مع قياس حقيقي.
- الأعداد والمال: لماذا لا تصلح
roundلتقريب الضريبة، ومتى تستعملDecimalأو الهللة. - كم تأخذ مليون قيمة من الذاكرة، ومتى تفيد
__slots__وarray، وهل ترجع الذاكرة إلى النظام بعد الحذف. - ماذا يحدث إذا توقف جامع الدورات داخل Container محدود الذاكرة، ولماذا لا ترى أي رسالة خطأ.
- الاستثناءات Exceptions: التشغيل الفاشل وقراءته، والسلسلة
raise from، ومجموعات الأخطاء ExceptionGroup، وثمنtry.
كل شيء كائن Object: ما هو المتغير في Python؟
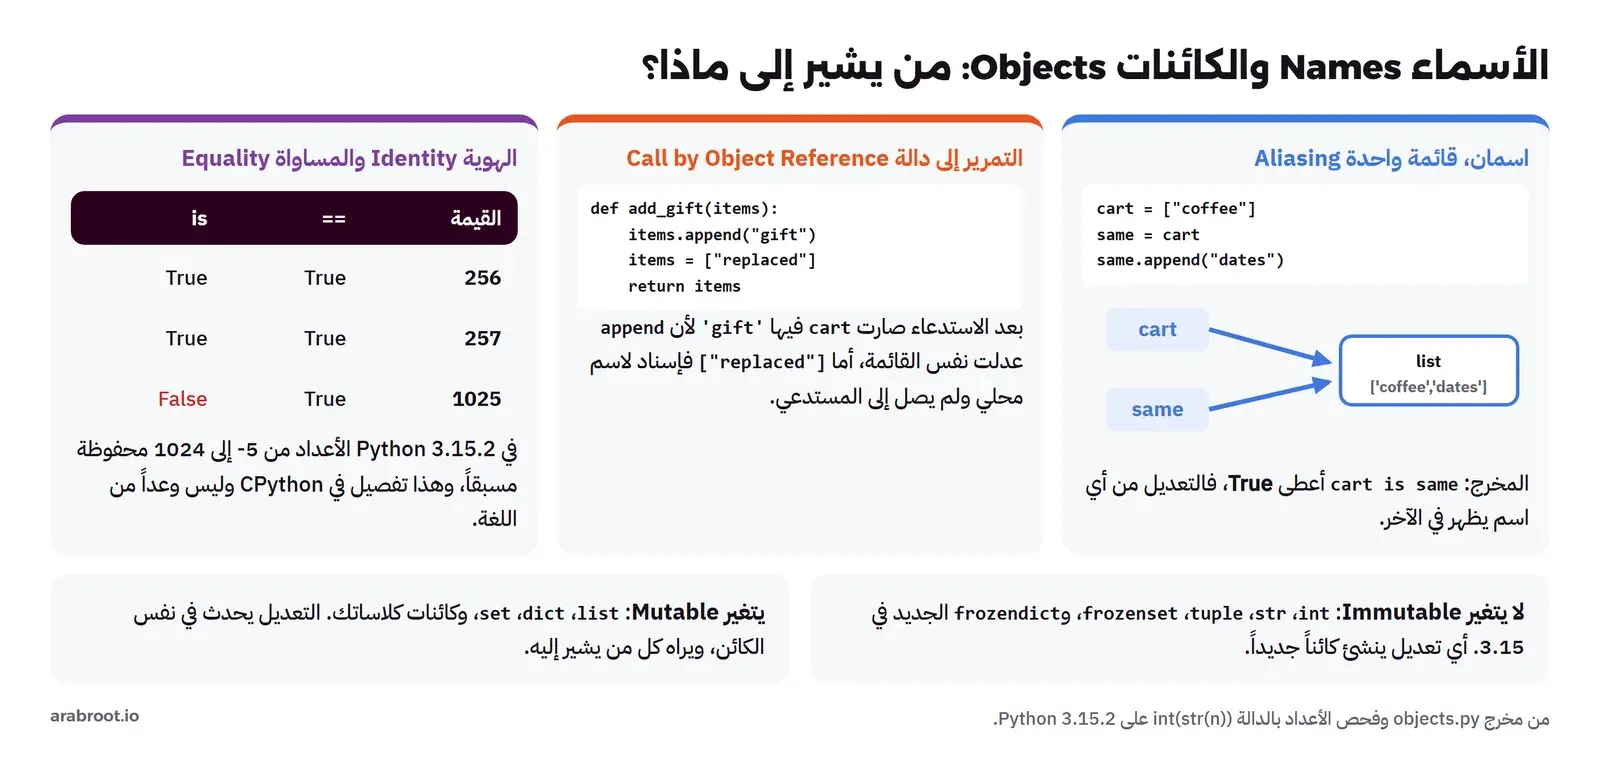
في Java وC# عندما تكتب int x = 5 فأنت تحجز مكاناً بحجم معين في الذاكرة اسمه x وتضع فيه القيمة 5، أما في Python فالسطر x = 5 يعمل بطريقة أخرى تماماً: يوجد في الذاكرة كائن Object من نوع int قيمته 5، والسطر يربط الاسم x بهذا الكائن، فالاسم مثل بطاقة معلقة على الكائن وليس صندوقاً يحتويه. وكل شيء في Python كائن بهذا المعنى: الأعداد والنصوص والدوال والكلاسات والوحدات نفسها، ولكل كائن ثلاث صفات كما يذكر نموذج البيانات في مرجع اللغة: هوية Identity لا تتغير طوال عمره وتعطيها الدالة id()، ونوع Type يحدد ما يمكن فعله به، وقيمة Value. وهذا الفهم يفسر أغلب المفاجآت التي يقع فيها القادمون من لغات أخرى، والشكل التالي يلخص ما سوف نراه في المختبر:
والملف objects.py في المختبر يمر على هذه النقاط، وجزؤه الأول كما يلي:
import copy

print("== identity vs equality")
a = 256; b = int("256")
c = 257; d = int("257")
print("256:", a == b, a is b, "| 257:", c == d, c is d)
x = None
print("None is a single object:", x is None, id(None) == id(x))

print("== aliasing: two names, one list")
cart = ["coffee"]
same = cart
same.append("dates")
print(cart, same, cart is same)

print("== function arguments are passed as object references")
def add_gift(items):
    items.append("gift")
    items = ["replaced"]          # rebinding the local name does not touch the caller
    return items
r = add_gift(cart)
print(cart, r)

print("== shallow vs deep copy")
order = {"id": 1, "lines": [{"sku": "c1", "qty": 2}]}
shallow = copy.copy(order)
deep = copy.deepcopy(order)
order["lines"][0]["qty"] = 99
print("shallow sees", shallow["lines"][0]["qty"], "| deep sees", deep["lines"][0]["qty"])
شغلناه داخل الـ Container بالأمر python objects.py، والمخرج من هذا الجزء كما يلي:
== identity vs equality
256: True True | 257: True True
None is a single object: True True
== aliasing: two names, one list
['coffee', 'dates'] ['coffee', 'dates'] True
== function arguments are passed as object references
['coffee', 'dates', 'gift'] ['replaced']
== shallow vs deep copy
shallow sees 99 | deep sees 2
الهوية Identity والمساواة Equality: متى تستعمل is؟
العامل == يسأل: هل القيمتان متساويتان؟ ويستدعي لذلك الدالة __eq__ في الكلاس، أما is فيسأل: هل هذان الاسمان يشيران إلى نفس الكائن؟ ويقارن الهوية فقط. وفي السطر الأول من المخرج أعطت 256 is int("256") القيمة True، وهذا متوقع لمن قرأ عن Python من قبل، فالمفسر يحفظ الأعداد الصغيرة مسبقاً ويعيد نفس الكائن كل مرة لكي لا ينشئ ملايين الكائنات للعدد 1 أو 0. ولكن المفاجأة أن 257 أعطى True أيضاً، وأغلب الشروحات في الإنترنت تقول إن الحد هو 256. فقمنا بفحص سريع يبحث عن أول عدد لا يعود فيه نفس الكائن:
n = next(i for i in range(0, 100000) if int(str(i)) is not int(str(i)))
m = next(i for i in range(0, -100000, -1) if int(str(i)) is not int(str(i)))
والنتيجة على Python 3.15.2 كانت كما يلي:
first non-cached: 1025
first non-cached negative: -6
أي أن الأعداد المحفوظة في هذا الإصدار من -5 إلى 1024، وهذا رقم تغير عما كتبته الشروحات القديمة، والدرس الحقيقي ليس الرقم نفسه، وإنما أن هذا تفصيل داخلي في CPython وليس وعداً من اللغة، فقد يتغير في أي إصدار، ولذلك لا تقارن الأعداد أو النصوص بـ is أبداً، فالكود الذي يعمل عندك لأن القيمة صغيرة سوف يفشل في الإنتاج عندما تكبر القيمة. والاستعمال الصحيح الوحيد لـ is هو مع الكائنات التي يوجد منها نسخة واحدة في البرنامج كله، وأشهرها None وTrue وFalse، كما رأينا في السطر الثاني من المخرج، ولذلك نكتب if x is None وليس if x == None، وقد رأينا في المقال السابق أن ruff يعترض على الشكل الثاني.
الأسماء المتعددة Aliasing والتمرير إلى الدوال
في القسم الثاني من المخرج عدلنا القائمة عبر الاسم same فظهر التعديل في cart، والسبب أن السطر same = cart لا ينسخ القائمة وإنما يعلق اسماً ثانياً على نفس الكائن، وcart is same أعطت True. وهذا يشبه ما يحدث مع الكائنات في Java وJavaScript، ولكن الفرق أن Python لا يوجد فيها أنواع أولية Primitives تنسخ بالقيمة، فكل شيء يعامل بنفس الطريقة.
والقسم الثالث يبين كيف تمرر المعاملات إلى الدوال، وهي نقطة يختلف فيها الناس كثيراً: هل Python تمرر بالقيمة By Value أم بالمرجع By Reference؟ والإجابة أنها لا هذه ولا تلك، وإنما تمرر مرجعاً إلى الكائن Call by Object Reference: الدالة add_gift استلمت اسماً محلياً items يشير إلى نفس قائمة المستدعي، فعندما استدعت items.append("gift") عدلت القائمة نفسها وظهر التعديل في cart، أما السطر items = ["replaced"] فهو إسناد Rebinding يعلق الاسم المحلي على كائن جديد، ولا يغير شيئاً عند المستدعي، ولذلك بقيت cart كما هي ورجعت ["replaced"] فقط كقيمة إرجاع. والقاعدة العملية: إذا كانت دالتك تعدل مجموعة وصلتها كمعامل فاكتب ذلك في اسمها أو في توثيقها، أو الأفضل أن تنشئ نسخة جديدة وترجعها، لأن التعديل الخفي على معاملات الدالة من أصعب الأخطاء تتبعاً.
النسخ السطحي Shallow Copy والنسخ العميق Deep Copy
والقسم الرابع يبين خطأ نراه كثيراً في الكود الذي يعالج الطلبات: نسخنا الطلب بـ copy.copy لنعدل النسخة بأمان، ثم غيرنا الكمية في الطلب الأصلي إلى 99، فظهرت 99 في النسخة السطحية أيضاً. والسبب أن النسخ السطحي ينشئ قاموساً جديداً، ولكن قيمه هي نفس الكائنات القديمة، فالقائمة lines وما بداخلها مشتركة بين الأصل والنسخة، أما copy.deepcopy فينسخ كل مستوى إلى أعمق نقطة، ولذلك بقيت الكمية فيه 2. والنسخ العميق أبطأ وأكبر في الذاكرة، فلا تستعمله في كل مكان، وإنما عندما تحتاج فعلاً أن تعدل بنية متداخلة دون أن تؤثر على الأصل، كما في حفظ نسخة من الطلب قبل تطبيق الخصومات عليه.
ما يتغير Mutable وما لا يتغير Immutable، والنوع frozendict
الجزء الثاني من objects.py يبين الأنواع التي لا تتغير:
s = "قهوة"; before = id(s)
s += " عربية"
print("str id changed:", before != id(s))
t = (1, [2, 3])
t[1].append(4)
print("tuple holding a list still changed:", t)
try:
    t[0] = 9
except TypeError as e:
    print("TypeError:", e)
try:
    print(hash(t))
except TypeError as e:
    print("TypeError:", e)

prices = frozendict(coffee=4500, dates=990)
print(prices, hash(prices) == hash(frozendict(dates=990, coffee=4500)))
try:
    prices["coffee"] = 1
except TypeError as e:
    print("TypeError:", e)
cache = {prices: "price list v1"}
print(cache[frozendict(coffee=4500, dates=990)])
والمخرج سوف يكون كما يلي:
str id changed: True
tuple holding a list still changed: (1, [2, 3, 4])
TypeError: 'tuple' object does not support item assignment
TypeError: unhashable type: 'list'
frozendict({'coffee': 4500, 'dates': 990}) True
TypeError: 'frozendict' object does not support item assignment
price list v1
في المخرج أعلاه لاحظ التالي:
- النص لا يتغير، فالعملية
s += " عربية"أنشأت نصاً جديداً وعلقت عليه الاسم، وتغيرت الهوية. ولهذا السبب بالذات يكون دمج النصوص بـ+=داخل حلقة طويلة بطيئاً، لأن كل دورة تنشئ نصاً جديداً، والطريقة الصحيحة أن تجمع الأجزاء في قائمة ثم تستدعي"".join(parts)مرة واحدة. - الـ tuple لا يتغير، ولكن هذا يعني أن مراجعه لا تتغير، وليس أن ما تشير إليه لا يتغير، ولذلك استطعنا أن نضيف عنصراً إلى القائمة التي داخله، بينما رفض
t[0] = 9. - ولأن داخله قائمة، رفض
hash(t)بالخطأunhashable type: 'list'، فالكائن يصلح مفتاحاً في قاموس أو عنصراً في مجموعة فقط إذا كان كل ما فيه لا يتغير، والسبب أن القاموس يحسب مكان المفتاح من الهاش Hash، فإذا تغير المفتاح بعد إدخاله ضاع مكانه. - النوع
frozendictجديد في Python 3.15 بحسب PEP 814، وهو قاموس لا يتغير، ولاحظ أن هاشه لا يعتمد على ترتيب الإدخال، فالقاموسان بترتيبين مختلفين أعطيا نفس الهاش، ولذلك استعملناه مفتاحاً فيcache. وكان المطورون قبله يستعملونtypes.MappingProxyTypeأو tuple من الأزواج، وكلاهما غير مريح، أما الآن فقائمة الأسعار الثابتة أو الإعدادات التي تقرأ مرة واحدة مكانها الطبيعيfrozendict.
نظام الأنواع Type System: ديناميكي وقوي، والتلميحات للأدوات
رأينا في المقال السابق أن Python ديناميكية الأنواع Dynamically Typed، أي أن النوع يتحدد وقت التشغيل مع الكائن، وقوية الأنواع Strongly Typed، أي أنها لا تحول نوعاً إلى آخر في العمليات من تلقاء نفسها. وتضيف Python فوق ذلك فكرة اسمها Duck Typing: لا يهم ما هو نوع الكائن، وإنما يهم هل يملك الدوال التي تحتاجها، فالدالة التي تمر على شيء بـ for تقبل القائمة والملف والمولد وأي كلاس عرف الدالة __iter__، دون أن تحتاج واجهة Interface مشتركة كما في Java.
ومنذ Python 3.5 أضاف PEP 484 تلميحات الأنواع Type Hints، وهي طريقة لكتابة الأنواع في الكود مثل def find(products: list[Product], pid: int) -> Product | None، ولكن النقطة التي يجب أن تفهمها من البداية أن CPython لا يفحص هذه التلميحات عند التشغيل إطلاقاً، فهي تحفظ كمعلومات في الدالة وتقرؤها الأدوات والمحررات، أما المفسر فيتجاهلها. وهذا ما يبينه الملف hints.py:
from dataclasses import dataclass
from typing import Protocol


@dataclass
class Product:
    id: int
    name_ar: str
    price_halalas: int


def find(products: list[Product], pid: int) -> Product | None:
    for p in products:
        if p.id == pid:
            return p
    return None


def line_total(p: Product, qty: int) -> int:
    return p.price_halalas * qty


class HasPrice(Protocol):
    price_halalas: int


def cheapest(items: list[HasPrice]) -> int:
    return min(i.price_halalas for i in items)


catalog = [Product(1, "قهوة", 4500), Product(2, "تمر", 990)]
print(line_total(catalog[1], "3"))                 # runs: 990 * "3" repeats the string
p = find(catalog, 7)
print(line_total(p, 2))                            # p may be None
print(cheapest(catalog))
شغلناه بالأمر python hints.py، والمخرج كما يلي بعد اختصار السطر الأول:
333333333333333333333333333333333333333333333333333333…3
Traceback (most recent call last):
  File "/tmp/w/hints.py", line 35, in <module>
    print(line_total(p, 2))                            # p may be None
          ~~~~~~~~~~^^^^^^
  File "/tmp/w/hints.py", line 21, in line_total
    return p.price_halalas * qty
           ^^^^^^^^^^^^^^^
AttributeError: 'NoneType' object has no attribute 'price_halalas'
exit code: 1
السطر الأول هو الأخطر في المخرج كله: الدالة line_total قالت إن qty عدد صحيح، ومررنا لها النص "3"، فلم يعترض أحد، وضربت Python العدد 990 في النص، والضرب بين عدد ونص في Python معناه التكرار، فطبع البرنامج النص «3» مكرراً 990 مرة. وهذا هو بالضبط خطأ parse_qty من المقال السابق لو وصل إلى الإنتاج: لا يوجد استثناء ولا رسالة، وإنما قيمة خاطئة تمر إلى الفاتورة. والسطر الثاني أوقف البرنامج لأن find لم تجد المنتج 7 فرجعت None، ولاحظ أن Python وضعت العلامات ~~~^^^ تحت الجزء الذي فشل بالضبط في السطر، وهذا يوفر عليك وقتاً كبيراً عندما يكون في السطر أكثر من استدعاء.
الآن نشغل mypy على نفس الملف:
pip install --root-user-action=ignore -q mypy==2.4.1
mypy hints.py
والمخرج سوف يكون كما يلي:
hints.py:33: error: Argument 2 to "line_total" has incompatible type "str"; expected "int"  [arg-type]
hints.py:35: error: Argument 1 to "line_total" has incompatible type "Product | None"; expected "Product"  [arg-type]
hints.py:36: error: Argument 1 to "cheapest" has incompatible type "list[Product]"; expected "list[HasPrice]"  [arg-type]
hints.py:36: note: "list" is invariant -- see https://mypy.readthedocs.io/en/stable/common_issues.html#variance
hints.py:36: note: Consider using "Sequence" instead, which is covariant
Found 3 errors in 1 file (checked 1 source file)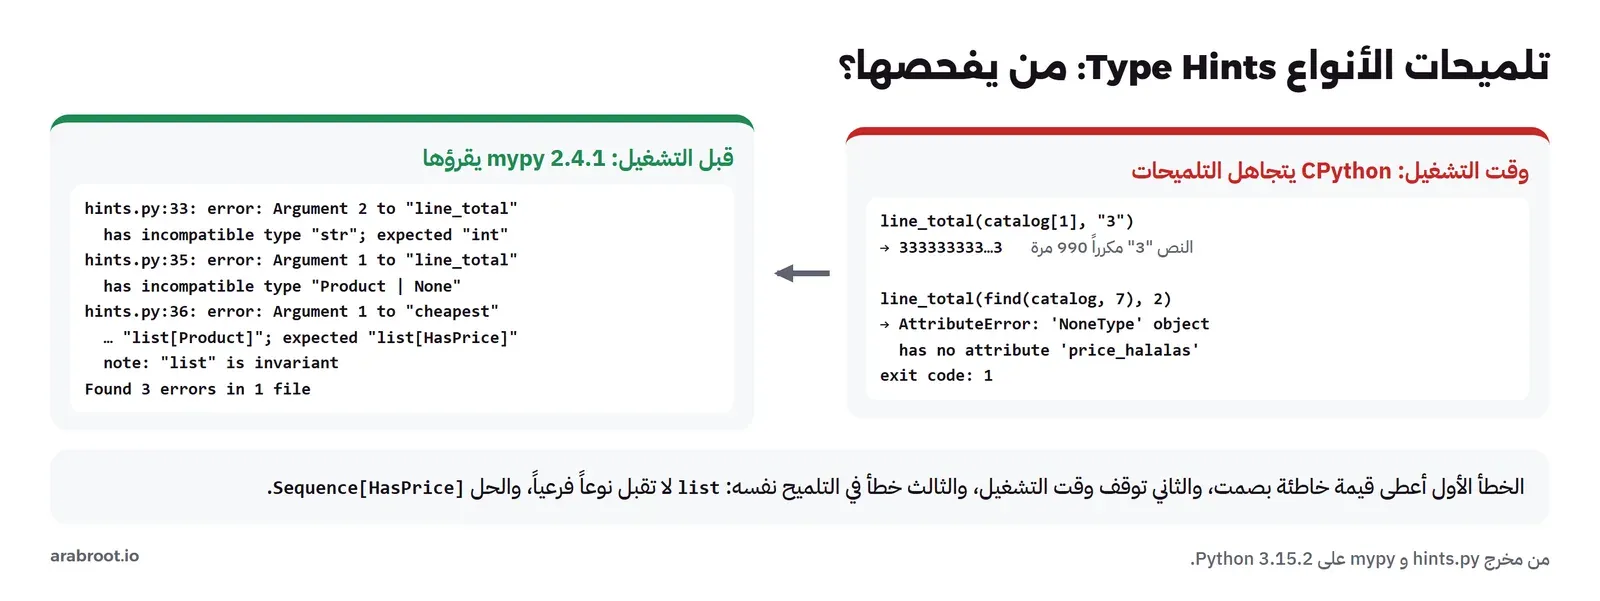
في المخرج أعلاه لاحظ التالي:
- الخطأ الأول هو الذي مر بصمت وقت التشغيل، وmypy رآه في السطر 33 قبل أن يعمل الكود، وهذا أهم سبب لتشغيل mypy في CI.
- الخطأ الثاني يقول إن
findقد ترجعNone، وأنت مررت الناتج إلى دالة لا تقبلNone، والإصلاح أن تتحقق قبل الاستدعاءif p is None: ...، وبعد هذا الشرط يفهم mypy أنpصارProduct، وهذا ما يسمى التضييق Narrowing. - الخطأ الثالث خطأ في التلميح نفسه وليس في الكود:
Productيطابق البروتوكولHasPriceلأن فيه الحقلprice_halalas، وهذه هي الأنواع البنيوية Structural Typing التي عرفها PEP 544، أي أن Duck Typing صار له شكل يفحصه mypy. ولكنlist[Product]لا تقبل كـlist[HasPrice]، لأن القائمة تتغير، ولو قبلها mypy لاستطاعت الدالة أن تضيف إليها كائناً آخر فيهprice_halalasوليسProduct. والحل كما يقترح mypy نفسه أن تكتبSequence[HasPrice]، لأنSequenceللقراءة فقط. - الخيار
--strictأعطى نفس الأخطاء الثلاثة في هذا الملف، لأنه مكتوب بتلميحات كاملة أصلاً، أما في مشروع حقيقي فهو يضيف فحوصاً مثل منع الدوال بدون تلميحات، ولذلك ابدأ به في المشاريع الجديدة.
وقد يتساءل البعض: إذا كانت التلميحات لا تفحص وقت التشغيل، فكيف أحمي الخدمة من بيانات خاطئة تأتي من الخارج؟ والإجابة أن ما يأتي من JSON أو نموذج أو ملف يحتاج تحققاً وقت التشغيل Runtime Validation، إما بكود تكتبه بنفسك مثل parse_qty الذي سوف نراه في قسم الاستثناءات، أو بمكتبة تقرأ التلميحات وتتحقق بها عند الحدود، وهذا ما يفعله FastAPI مع Pydantic في مقال الخدمة الحقيقية من هذه المرحلة. وهي نفس الفكرة التي رأيناها مع TypeScript: الأنواع تحمي ما بداخل البرنامج، والتحقق يحمي حدوده. ومرجع كل ما يخص التلميحات هو توثيق الوحدة typing.
الأعداد Numeric Types والمال: round أم Decimal أم الهللة؟
وفي نظام الأنواع نقطة تمس متجرنا مباشرة، وهي الأنواع الرقمية: int بحجم غير محدود، وfloat عدد عشري بمعيار IEEE 754 بدقة مزدوجة كما في Java وJavaScript، وdecimal.Decimal عدد عشري بالنظام العشري الذي نكتب به الأسعار. وقد يظن المطور القادم من لغة أخرى أن الدالة المدمجة round تكفي لتقريب الضريبة، والملف rss_numbers.py في المختبر يبين لماذا لا تكفي:
print("round(0.5), round(1.5), round(2.5):", round(0.5), round(1.5), round(2.5))
print("round(4.455, 2):", round(4.455, 2), "| exact value:", Decimal(4.455))
print("0.1 + 0.2 == 0.3:", 0.1 + 0.2 == 0.3, "|", 0.1 + 0.2)
vat = Decimal("29.70") * Decimal("0.15")
print("Decimal VAT:", vat, "->", vat.quantize(Decimal("0.01"), rounding=ROUND_HALF_UP))
print("integer halalas:", (2970 * 15 + 50) // 100)
والمخرج سوف يكون كما يلي:
round(0.5), round(1.5), round(2.5): 0 2 2
round(4.455, 2): 4.46 | exact value: 4.4550000000000000710542735760100185871124267578125
0.1 + 0.2 == 0.3: False | 0.30000000000000004
Decimal VAT: 4.4550 -> 4.46
integer halalas: 446
في المخرج أعلاه لاحظ التالي:
- الدالة
roundفي Python 3 لا تقرب النصف لأعلى كما تعلمنا في المدرسة، وإنما إلى أقرب عدد زوجي، وهذا ما يسمى تقريب المصرفيين Banker's Rounding، ولذلك أعطتround(0.5)صفراً وround(2.5)اثنين، وهذا موثق في توثيق الدالة round. والسبب أن هذا التقريب لا يميل لأعلى في المتوسط عند جمع ملايين القيم، ولكنه ليس ما تطلبه منك قاعدة الفاتورة. - السطر الثاني أعطى 4.46 بالصدفة، فالعدد 4.455 لا يمثل في
floatبدقة، وقيمته الحقيقية المخزنة أكبر بقليل كما طبعهاDecimal(4.455)، فلو كانت أصغر بقليل لأعطى 4.45. أي أن النتيجة الصحيحة جاءت من خطأ التمثيل وليس من قاعدة التقريب، وهذا أسوأ من الخطأ الواضح، لأنه يمر في الاختبار ثم يفشل مع رقم آخر. Decimalالمبني من نص يحسب بالضبط 4.4550، ومعROUND_HALF_UPيعطي 4.46 لأن القاعدة نفسها صحيحة، وهو خيار جيد إذا احتجت كسوراً عشرية في الحساب.- والطريقة التي نعتمدها في كل خدمات هذا المسار هي الأعداد الصحيحة بالهللة، فالسطر الأخير أعطى 446 هللة بعملية صحيحة واحدة، ولا يوجد فيه أي تمثيل عشري يمكن أن يخطئ، وهو نفس الحساب في كل اللغات التي نقارن بينها.
من يدير الذاكرة Memory Management في CPython؟
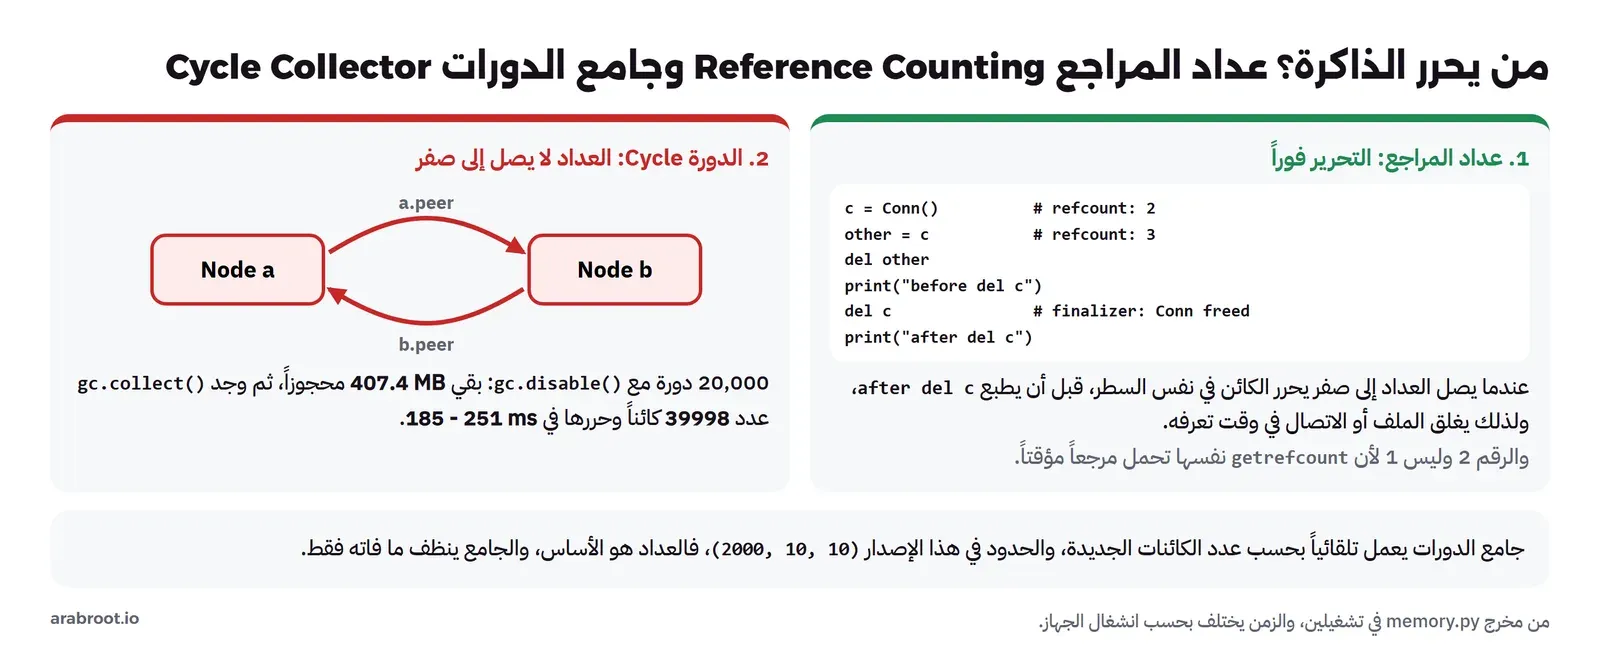
في C تحجز الذاكرة بـ malloc وتحررها بـ free بنفسك، وفي Java وC# يوجد جامع قمامة Garbage Collector يمر على الذاكرة من وقت لآخر ويحرر ما لم يعد مستعملاً، وفي Rust يحدد المترجم وقت التحرير من قواعد الملكية Ownership، وقد قارنا بين هذه الطرق في مقال إدارة الذاكرة. أما CPython فيستعمل طريقتين معاً: الأساس هو عداد المراجع Reference Counting، أي أن كل كائن يحمل عداداً بعدد الأسماء والمراجع التي تشير إليه، فكلما علقت عليه اسماً أو وضعته في قائمة زاد العداد، وكلما زال مرجع نقص، وعندما يصل العداد إلى صفر يحرر الكائن في نفس اللحظة. وفوقه جامع الدورات Cycle Collector الذي يبحث فقط عن الكائنات التي يشير بعضها إلى بعض في دائرة، لأن هذه لا يصل عدادها إلى صفر أبداً حتى لو لم يعد أحد يستعملها. والشكل التالي يبين الطريقتين بأرقام المختبر:
عداد المراجع Reference Counting في المختبر
الجزء التالي من memory.py يتابع عداد كائن واحد، ويسجل دالة تطبع رسالة عند تحريره بالوحدة weakref:
class Conn:
    pass
c = Conn()
weakref.finalize(c, print, "   finalizer: Conn freed")
print("refcount:", sys.getrefcount(c))
other = c
print("refcount after second name:", sys.getrefcount(c))
del other
print("before del c")
del c
print("after del c")
والمخرج سوف يكون كما يلي:
refcount: 2
refcount after second name: 3
before del c
   finalizer: Conn freed
after del c
أعطى العداد 2 وليس 1 لأن الدالة getrefcount نفسها تحمل مرجعاً مؤقتاً للكائن أثناء الاستدعاء، ثم صار 3 مع الاسم الثاني. والنقطة المهمة هي ترتيب الأسطر الثلاثة الأخيرة: رسالة التحرير ظهرت بين before del c وafter del c، أي أن الكائن حرر في نفس السطر الذي حذف فيه آخر مرجع، ولم ينتظر أي جامع. وهذا يعطي CPython سلوكاً يمكن توقعه، فالملف الذي ينتهي آخر مرجع له يغلق فوراً، ولكن لا تقم بالاعتماد على ذلك لإغلاق الموارد، والسبب أن هذا تفصيل في CPython وحده، وأن مرجعاً منسياً في قائمة أو في Traceback محفوظ يبقي الكائن حياً، ولذلك نستعمل with للملفات والاتصالات كما رأينا في المقال السابق.
الدورات Cycles وجامعها
والجزء الذي يليه ينشئ 20,000 زوج من الكائنات، كل كائن يشير إلى صاحبه، ومع كل كائن عشرة آلاف بايت من البيانات، بعد أن أوقفنا الجامع بـ gc.disable():
class Node:
    def __init__(self):
        self.peer = None
        self.payload = bytearray(10_000)
gc.disable()
gc.collect()
tracemalloc.start()
for _ in range(20_000):
    a, b = Node(), Node()
    a.peer, b.peer = b, a            # a cycle: refcounts never reach zero
cur, _ = tracemalloc.get_traced_memory()
print(f"after 20,000 cycles, gc disabled: {cur / 1e6:6.1f} MB still held")
t = time.perf_counter()
found = gc.collect()
cur2, _ = tracemalloc.get_traced_memory()
print(f"gc.collect() found {found} objects in {(time.perf_counter() - t) * 1000:.0f} ms, now {cur2 / 1e6:.1f} MB")
tracemalloc.stop()
gc.enable()
print("gc thresholds:", gc.get_threshold())
والمخرج من تشغيلين منفصلين كما يلي:
after 20,000 cycles, gc disabled:  407.4 MB still held
gc.collect() found 39998 objects in 251 ms, now 0.0 MB
gc thresholds: (2000, 10, 10)
peak RSS of this process: 466 MB

after 20,000 cycles, gc disabled:  407.4 MB still held
gc.collect() found 39998 objects in 185 ms, now 0.0 MB
gc thresholds: (2000, 10, 10)
peak RSS of this process: 468 MB
في المخرج أعلاه لاحظ التالي:
- في كل دورة من الحلقة يعلق الاسمان
aوbعلى زوج جديد، فلم يعد أحد يستعمل الزوج القديم، ولكن كل كائن فيه ما زال يشير إلى صاحبه، فعداده لا يصل إلى صفر، وبقي 407.4 ميجابايت محجوزاً لبيانات لا يستطيع أحد الوصول إليها. - الأمر
gc.collect()وجد 39998 كائناً، أي كل الأزواج تقريباً عدا الزوج الأخير الذي ما زال الاسمان يشيران إليه، وحررها كلها في 185 إلى 251 ميلي ثانية، والفرق بين الرقمين هو انشغال الجهاز وقت التشغيل. - الحدود
(2000, 10, 10)تعني أن الجامع يعمل تلقائياً بعد زيادة عدد الكائنات المتتبعة بمقدار معين، وتفاصيل هذه الحدود وطريقة عمل الأجيال Generations في توثيق الوحدة gc، والقاعدة العملية أن تتركها على قيمها الافتراضية حتى يقول لك قياس حقيقي غير ذلك. - أعلى استهلاك للعملية وصل 466 و468 ميجابايت، وهذا قريب جداً من حد الـ Container البالغ 512 ميجابايت، ومن هنا جاءت التجربة التالية.
ومن الأسباب الحقيقية التي تجعل فريقاً يوقف الجامع أو يغير حدوده أن الجامع عندما يمر على الكائنات يكتب في رؤوسها، وهذا يفسد مشاركة الذاكرة بين العمليات التي تنشأ بـ fork()، كما في سيرفرات الويب التي تحمل التطبيق مرة ثم تنشئ عدة Workers منه. ولذلك أضافت Python 3.7 الدالة gc.freeze() التي تنقل كل الكائنات الموجودة إلى جيل دائم لا يمر عليه الجامع، ويشرح توثيقها الترتيب الذي ينصح به: إيقاف الجامع مبكراً في العملية الأم، ثم gc.freeze() قبل fork() مباشرة، ثم تفعيل الجامع في العمليات الأبناء.
كم تأخذ مليون قيمة من الذاكرة Memory Footprint؟
نعود إلى عملية الاستيراد الليلية التي تقرأ مليون سطر من ملف المورد، فالسؤال الأول عند أي مشكلة ذاكرة هو: كم يأخذ كل سطر؟ وفي Python الإجابة مفاجئة للقادمين من C أو Go، لأن كل قيمة كائن كامل له رأس Header فيه نوعه وعداد مراجعه. والجزء الأول من memory.py يطبع حجم كائنات مفردة بالدالة sys.getsizeof:
                                  0  28
                                  1  28
                         1073741824  32
    1267650600228229401496703205376  40
                                1.5  24
                                 ''  41
                                'a'  42
                                'ب'  60
                                 []  56
                                 {}  64
                                 ()  48
العدد 0 يأخذ 28 بايت بينما يأخذ في C أربعة أو ثمانية، والعدد الكبير يكبر كلما احتاج خانات أكثر، والنص الفارغ 41 بايت، ولاحظ أن نصاً فيه حرف عربي واحد أخذ 60 بايت بينما الحرف اللاتيني 42، والسبب أن CPython يختار حجم الحرف الداخلي بحسب أكبر حرف في النص: بايت واحد إذا كانت كل الحروف من Latin-1، وبايتان إذا كان فيه حرف مثل العربية، وأربعة إذا كان فيه رمز تعبيري Emoji، ومع كل حجم رأس مختلف، ولذلك النصوص العربية تأخذ تقريباً ضعف المساحة.
بعد ذلك نبني مليون عنصر بست طرق مختلفة، ونقيس ما بقي محجوزاً بعد البناء بالوحدة tracemalloc، ونقيس زمن البناء في مرة ثانية بعد إيقاف tracemalloc لأنها تبطئ كل عملية حجز:
class Plain:
    def __init__(self, pid, price):
        self.pid = pid; self.price = price

class Slotted:
    __slots__ = ("pid", "price")
    def __init__(self, pid, price):
        self.pid = pid; self.price = price

@dataclass(slots=True)
class DSlots:
    pid: int
    price: int

measure("list of int (range)", lambda: list(range(N)))
measure("array('q') of int", lambda: array.array("q", range(N)))
measure("list of tuple (pid, price)", lambda: [(i, i * 10) for i in range(N)])
measure("list of Plain objects", lambda: [Plain(i, i * 10) for i in range(N)])
measure("list of __slots__ objects", lambda: [Slotted(i, i * 10) for i in range(N)])
measure("list of dataclass(slots=True)", lambda: [DSlots(i, i * 10) for i in range(N)])
والمخرج سوف يكون كما يلي:
== 1,000,000 items: memory held (tracemalloc) and build time
list of int (range)                       40.0 MB      367 ms
array('q') of int                          8.2 MB      398 ms
list of tuple (pid, price)               136.4 MB      708 ms
list of Plain objects                    160.4 MB     2199 ms
list of __slots__ objects                120.4 MB     3242 ms
list of dataclass(slots=True)            120.4 MB     2772 ms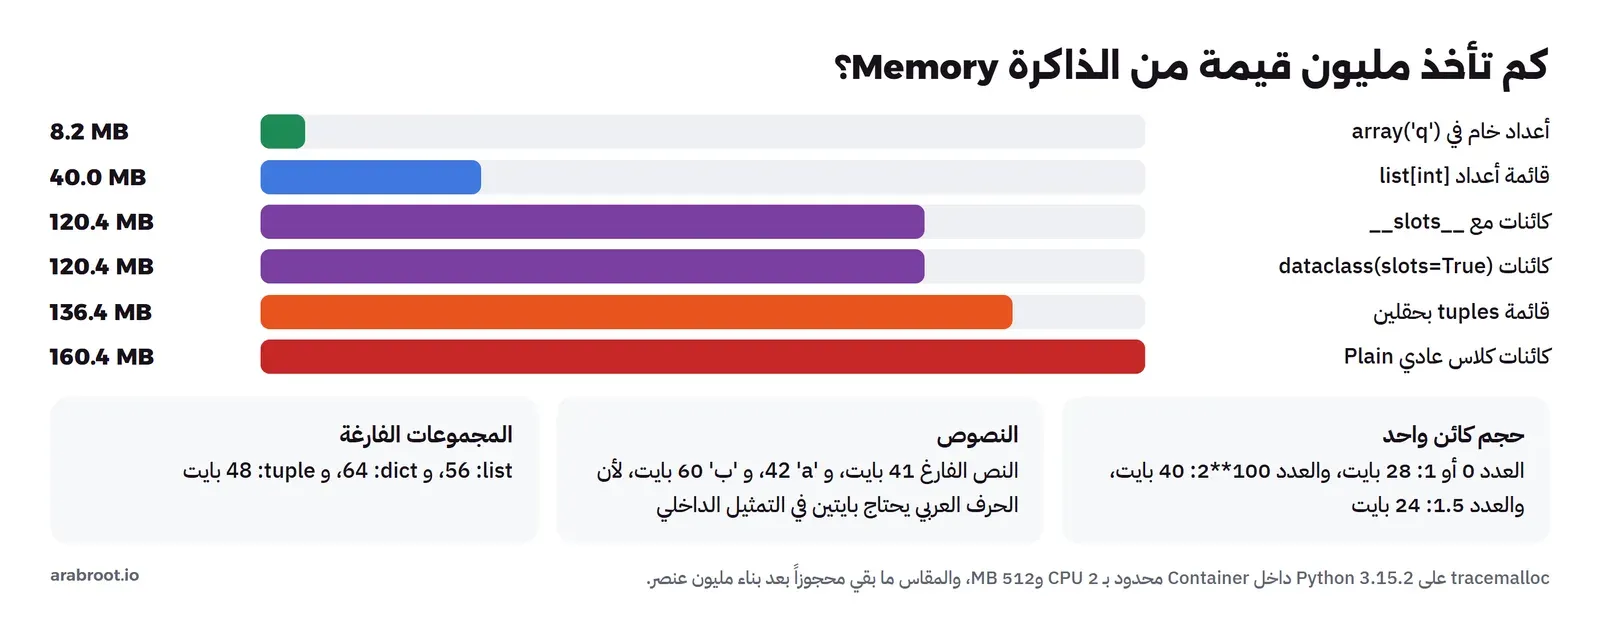
في المخرج أعلاه لاحظ التالي:
- قائمة مليون عدد أخذت 40 ميجابايت، أي حوالي 40 بايت لكل عدد: ثمانية للمرجع في القائمة، و28 للكائن نفسه، والباقي مساحة احتياطية تحجزها القائمة لتكبر. أما
array('q')فتحفظ الأعداد كقيم خام بثمانية بايتات كما في C، فأخذت 8.2 ميجابايت فقط، أي خمس المساحة، وهذا هو نفس السبب الذي يجعل مكتبات مثل NumPy أسرع وأصغر بكثير مع الأرقام. - الكائن من كلاس عادي أخذ حوالي 160 بايت للسطر، ومع
__slots__نزل إلى 120، أي توفير الربع، والسبب أن الكلاس العادي يحجز مكاناً لقاموس الخصائص__dict__الذي يسمح لك أن تضيف أي خاصية في أي وقت، أما__slots__فيحدد الخصائص مسبقاً ويحجز لها أماكن ثابتة، ويمنع إضافة غيرها، والتفاصيل في مرجع اللغة. - الـ
dataclass(slots=True)أعطت نفس حجم__slots__المكتوب يدوياً، فهي أسهل طريقة للحصول على التوفير مع كود أقصر، ولذلك نستعملها لكائنات البيانات الكثيرة مثل أسطر الطلبات. - أزمنة البناء في العمود الأخير تختلف من تشغيل لآخر لأن الجهاز كان مشغولاً بأعمال أخرى، فالتشغيل الأول أعطى أرقاماً أعلى بكثير لنفس الحالات، ولذلك لا تبن قراراً على الزمن هنا، أما أرقام الذاكرة فكانت متطابقة بالخانة في التشغيلين.
والقرار العملي لعملية الاستيراد: إذا كنت تمر على السطور واحداً بعد الآخر فلا تحملها كلها في قائمة أصلاً، واستعمل مولداً Generator يقرأ سطراً ويعالجه ويتركه، فالذاكرة تبقى ثابتة مهما كبر الملف. وإذا احتجت أن تحتفظ بها كلها في الذاكرة فاستعمل dataclass(slots=True) بدل القواميس أو الكلاسات العادية، وإذا كانت أرقاماً فقط فاستعمل array أو مكتبة بيانات عمودية.
هل ترجع الذاكرة إلى النظام؟ المخصص pymalloc والـ Arenas
بعد أن تحرر Python كائناً، هل يعود حجمه إلى نظام التشغيل؟ هذا سؤال يهمك عندما تراقب ذاكرة الخدمة في لوحة المراقبة وترى أنها لا تنزل بعد انتهاء عملية الاستيراد. والإجابة تحتاج أن تعرف أن CPython لا يطلب الذاكرة من النظام لكل كائن صغير، وإنما يستعمل مخصصاً خاصاً اسمه pymalloc للكائنات التي حجمها 512 بايت أو أقل، وهذا المخصص يحجز من النظام قطعاً كبيرة اسمها Arenas حجم كل واحدة 1 ميجابايت على أنظمة 64 بت كما في توثيق إدارة الذاكرة، ثم يقسمها إلى صفحات وكتل صغيرة يوزعها على الكائنات. والـ Arena لا تعود إلى النظام إلا إذا صارت فارغة بالكامل، فإذا بقي فيها كائن واحد حي بقيت كلها محجوزة. قسنا ذلك بقراءة VmRSS من الملف /proc/self/status، أي الذاكرة الفعلية التي تحجزها العملية من النظام، والمخرج من rss_numbers.py كما يلي:
start                         RSS   13.4 MB
after 1,000,000 objects       RSS  173.8 MB
after del + gc.collect()      RSS   15.5 MB
built again                   RSS  173.7 MB
after 150 x 1 MB bytearrays   RSS  159.4 MB
after del of the bytearrays   RSS   29.9 MB
عندما حذفنا مليون كائن بالكامل نزلت الذاكرة من 173.8 إلى 15.5 ميجابايت، أي أن CPython أرجع الـ Arenas الفارغة إلى النظام، وهذا عكس ما يقوله كثير من الناس من أن Python لا ترجع الذاكرة أبداً. والكائنات الكبيرة مثل bytearray بحجم ميجابايت لا تمر على pymalloc أصلاً، وإنما تحجز مباشرة من مخصص النظام، ولذلك رجعت هي أيضاً عند حذفها. ولكن الحالة التي تراها في الإنتاج غالباً مختلفة، والملف rss_frag.py يبينها: نبني نفس المليون كائن، ثم نحتفظ بكائن واحد من كل مئة ونحذف الباقي:
rows = [Plain(i, i * 10) for i in range(1_000_000)]
keep = rows[::100]
del rows
gc.collect()
start RSS 9.7 MB
after 1,000,000 objects RSS 170.7 MB
kept 10,000 (1 in 100) RSS 163.1 MB
after del of the kept ones RSS 11.7 MBبقي في الذاكرة عشرة آلاف كائن فقط، أي 1% من البيانات، ولكن الذاكرة الفعلية بقيت 163.1 ميجابايت، لأن الكائنات الباقية موزعة على كل الـ Arenas تقريباً، فلا توجد Arena فارغة يمكن إرجاعها، وهذا ما يسمى التجزئة Fragmentation. وعندما حذفنا الكائنات الباقية نزلت الذاكرة مباشرة إلى 11.7 ميجابايت. والدرس لعملية الاستيراد: لا تحتفظ بجزء صغير من نتائج عملية كبيرة داخل نفس العملية، كقاموس يحفظ آخر سعر لكل منتج مع كل سطر تقرؤه، بل انسخ ما تحتاجه في بنية جديدة أو اكتبه في قاعدة البيانات، أو شغل الأعمال الكبيرة في عملية منفصلة تنتهي عند انتهاء العمل فتعود كل ذاكرتها إلى النظام.
ماذا لو What If: توقف جامع الدورات في Container محدود الذاكرة؟
الآن نصل إلى المشكلة الأولى في القصة: عملية تختفي دون أي رسالة ورقم 137 في حالة الـ Container. ولكي نرى ما حدث بالضبط كتبنا الملف cycles_oom.py، وهو نفس حلقة الدورات ولكن بمئة ألف زوج، مع خيار لتشغيل الجامع أو إيقافه، وشغلناه في Container بحد 256 ميجابايت دون أي ذاكرة Swap:
import gc, sys
if "gc-on" not in sys.argv:
    gc.disable()
class Node:
    def __init__(self):
        self.peer = None
        self.payload = bytearray(10_000)
for i in range(1, 100_001):
    a, b = Node(), Node()
    a.peer, b.peer = b, a
    if i % 2_000 == 0:
        print(f"{i:>6} cycles, about {i * 2 * 10_000 / 1e6:.0f} MB of payload", flush=True)
print("finished, peak RSS", __import__("resource").getrusage(__import__("resource").RUSAGE_SELF).ru_maxrss // 1024, "MB")
docker run --name slp-py-oom --cpus 2 --memory 256m --memory-swap 256m \
-v "$PWD:/lab" python:3.15.2-slim-trixie python /lab/cycles_oom.py
echo "docker run exit code: $?"
docker inspect slp-py-oom --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}'والمخرج مع الجامع متوقفاً كما يلي:
  2000 cycles, about 40 MB of payload
  4000 cycles, about 80 MB of payload
  6000 cycles, about 120 MB of payload
  8000 cycles, about 160 MB of payload
 10000 cycles, about 200 MB of payload
 12000 cycles, about 240 MB of payload
docker run exit code: 137
OOMKilled=true ExitCode=137
ثم شغلنا نفس الملف مع الوسيط gc-on، فوصل إلى نهايته:
 98000 cycles, about 1960 MB of payload
100000 cycles, about 2000 MB of payload
finished, peak RSS 29 MB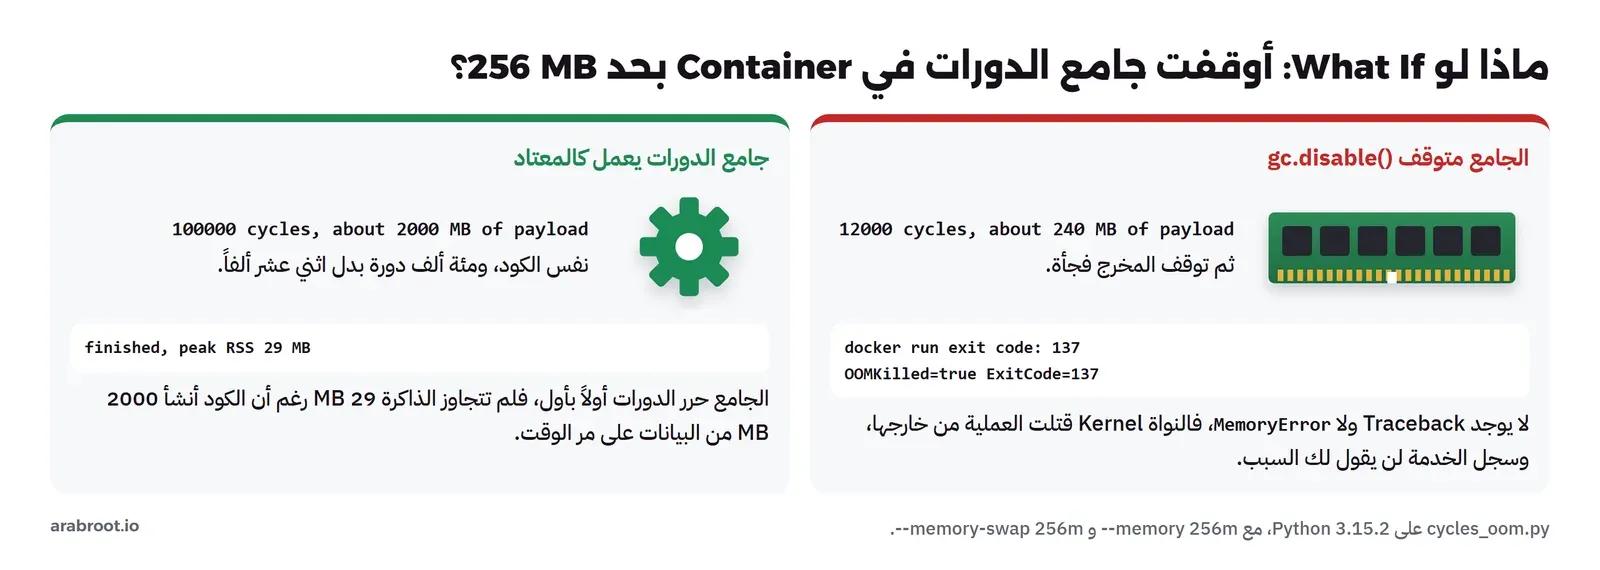
في المخرج أعلاه لاحظ التالي:
- آخر سطر طبعه البرنامج كان عند 240 ميجابايت تقريباً، ثم توقف بدون أي Traceback، وبدون
MemoryErrorالذي قد تتوقعه، والسبب أن Python لم تفشل في حجز الذاكرة، وإنما تجاوز الـ Container حده فقتلت نواة Linux العملية من الخارج بالإشارةSIGKILL، وهذه الإشارة لا يمكن التقاطها، فلا يجد البرنامج فرصة ليكتب شيئاً. - الرقم 137 هو 128 + 9، أي أن العملية انتهت بالإشارة رقم 9 وهي
SIGKILL، وOOMKilled=trueفي حالة الـ Container تؤكد أن السبب حد الذاكرة، والتفاصيل في توثيق Docker لحدود الموارد. ولذلك عندما ترى 137 في Kubernetes أو Docker فأول ما تفحصه هو الذاكرة وليس الكود. - مع الجامع يعمل أنشأ الكود 2000 ميجابايت من البيانات على مر الوقت، ولكن الذروة لم تتجاوز 29 ميجابايت، لأن الجامع كان يعمل كلما زاد عدد الكائنات الجديدة فوق الحد ويحرر الدورات القديمة.
وفي القصة الحقيقية لم يكن أحد قد أوقف الجامع بنفسه، ولكن النتيجة من نفس النوع: العملية تجمع كائنات لا تتحرر، إما لأنها في دورات مع مكتبة أوقفت الجامع لتسريع التحميل، أو لأنها محفوظة في قاموس عام يستعمل كذاكرة مؤقتة Cache بدون حد. والطريقة التي تكشف بها ذلك هي نفسها في المختبر: tracemalloc يقول لك كم حجزت ومن أين، وgc.collect() يرجع عدد الكائنات التي وجدها في دورات، فإذا كان الرقم كبيراً في كل مرة فعندك دورات تنشأ باستمرار.
الأخطاء Exceptions: الطريقة التي تعبر بها Python عن الفشل
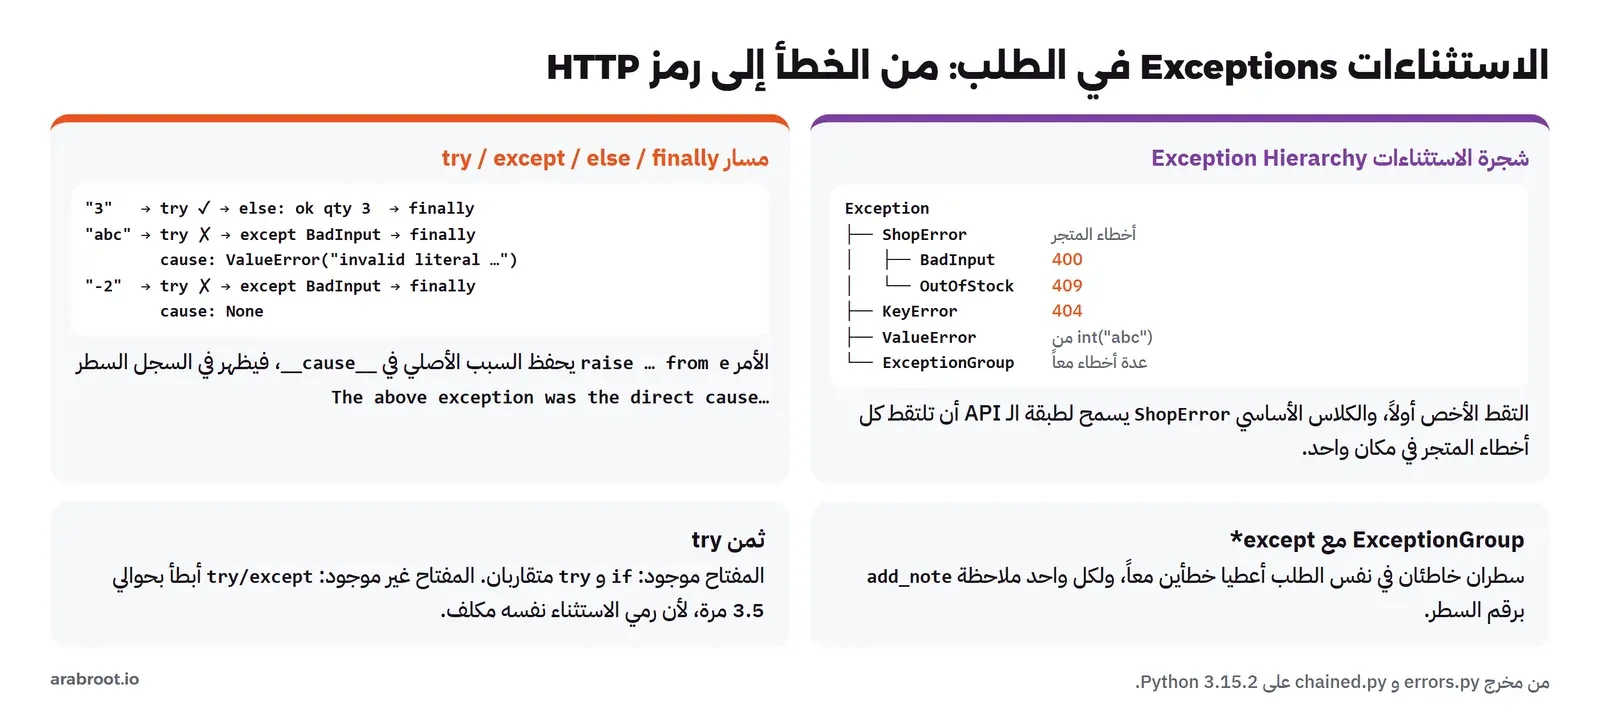
اللغات تختلف في طريقة التعبير عن الخطأ كما شرحنا في مقال التعامل مع الأخطاء: Go ترجع الخطأ كقيمة ثانية، وRust ترجع نوع Result، أما Python فتعتمد على الاستثناءات Exceptions بالكامل، والدوال المدمجة نفسها ترمي استثناء عند الفشل بدل أن ترجع قيمة خاصة، فالدالة int("abc") ترمي ValueError، والوصول إلى مفتاح غير موجود في قاموس يرمي KeyError. ولهذا السبب يشيع في Python أسلوب يسمى EAFP، أي «أسهل أن تطلب السماح من أن تستأذن» كما في مسرد المصطلحات الرسمي: جرب العملية والتقط الاستثناء، بدل أن تفحص كل الشروط قبلها LBYL. والشكل التالي يبين كيف نربط ذلك بخدمة الطلبات:
استثناءات خاصة بالمتجر Custom Exceptions
الملف errors.py يعرف كلاساً أساسياً لأخطاء المتجر، ومنه نوعان، ثم دالتين تستعملانهما:
class ShopError(Exception):
    """Base class for errors the API turns into HTTP responses."""

class OutOfStock(ShopError):
    def __init__(self, product_id: int, wanted: int, left: int):
        super().__init__(f"product {product_id}: wanted {wanted}, only {left} left")
        self.product_id, self.wanted, self.left = product_id, wanted, left

class BadInput(ShopError):
    pass


def parse_qty(text: str) -> int:
    try:
        qty = int(text)
    except ValueError as e:
        raise BadInput(f"qty must be a whole number, got {text!r}") from e
    if qty <= 0:
        raise BadInput(f"qty must be positive, got {qty}")
    return qty


def reserve(stock: dict[int, int], pid: int, qty: int) -> None:
    left = stock[pid]                      # KeyError if the product does not exist
    if qty > left:
        raise OutOfStock(pid, qty, left)
    stock[pid] = left - qty


stock = {1: 10, 2: 0}
for raw in ["3", "abc", "-2"]:
    try:
        q = parse_qty(raw)
    except BadInput as e:
        print("400:", e, "| cause:", repr(e.__cause__))
    else:
        print("ok qty", q)
    finally:
        print("   (finally runs every time)")

for pid, qty in [(1, 4), (2, 1), (9, 1)]:
    try:
        reserve(stock, pid, qty)
        print("reserved", pid, qty, "->", stock)
    except OutOfStock as e:
        print("409:", e, "| fields:", e.product_id, e.wanted, e.left)
    except KeyError as e:
        print("404: no product", e)
والمخرج سوف يكون كما يلي:
ok qty 3
   (finally runs every time)
400: qty must be a whole number, got 'abc' | cause: ValueError("invalid literal for int() with base 10: 'abc'")
   (finally runs every time)
400: qty must be positive, got -2 | cause: None
   (finally runs every time)
reserved 1 4 -> {1: 6, 2: 0}
409: product 2: wanted 1, only 0 left | fields: 2 1 0
404: no product 9
في الكود والمخرج أعلاه لاحظ التالي:
- الكتلة
elseبعدtryلا تعمل إلا إذا لم يحدث استثناء، وهي المكان الصحيح للكود الذي يعتمد على نجاح المحاولة، والسبب أنك إذا وضعته داخلtryفسوف تلتقط بالخطأ استثناءات من كود لم تقصد حمايته. أماfinallyفتعمل في كل الحالات كما ظهر بعد كل قيمة، ومكانها تحرير الموارد. - السطر
raise BadInput(...) from eيرمي خطأ المتجر ويحفظ الخطأ الأصلي في الخاصية__cause__، ولذلك ظهرValueErrorكسبب في الحالة"abc"، بينما كان السببNoneفي الحالة"-2"لأنها رميت مباشرة دون خطأ سابق. - الاستثناء
OutOfStockيحمل حقولاً منظمةproduct_idوwantedوleftوليس نصاً فقط، فطبقة الـ API تستطيع أن تبني منها رداً JSON واضحاً للعميل دون أن تحلل نص الرسالة. - الكلاس الأساسي
ShopErrorيسمح للخدمة أن تلتقط كل أخطاء المتجر المتوقعة في مكان واحد وتحولها إلى رمز HTTP مناسب، أي 400 للمدخلات الخاطئة و409 لنقص المخزون، وأي استثناء آخر غير متوقع يذهب إلى 500 مع السجل الكامل، وهذا هو التصميم الذي سوف نبني عليه خدمة الطلبات. - التقطنا
KeyErrorلنرجع 404، وهذا مقبول في مثال صغير، أما في الخدمة فالأفضل أن تحولreserveهذا الخطأ إلى استثناء خاص مثلNotFound، والسبب أنKeyErrorقد يأتي من أي سطر فيه قاموس، فتعطي 404 لخطأ برمجي حقيقي في مكان آخر.
قراءة الـ Traceback لخطأ غير ملتقط
الآن نعود إلى المشكلة الثانية في القصة: العميل الذي كتب «ثلاثة». الملف chained.py يستدعي parse_qty("ثلاثة") دون أن يلتقط شيئاً، وهو ما يحدث عندما ينسى أحدهم معالجة الخطأ في طبقة الـ API:
Traceback (most recent call last):
  File "/tmp/w/errors_lib.py", line 19, in parse_qty
    qty = int(text)
ValueError: invalid literal for int() with base 10: 'ثلاثة'

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "/tmp/w/chained.py", line 4, in <module>
    parse_qty("ثلاثة")
    ~~~~~~~~~^^^^^^^^^
  File "/tmp/w/errors_lib.py", line 21, in parse_qty
    raise BadInput(f"qty must be a whole number, got {text!r}") from e
errors_lib.BadInput: qty must be a whole number, got 'ثلاثة'
exit code: 1
والـ Traceback في Python يقرأ من الأسفل إلى الأعلى، وهذا عكس ما تعوده بعض مطوري Java: السطر الأخير هو الخطأ النهائي ونوعه errors_lib.BadInput مع الرسالة، وفوقه سلسلة الاستدعاءات من الأقدم في الأعلى إلى الأحدث في الأسفل. وبسبب from e ظهر Traceback ثان في الأعلى للخطأ الأصلي ValueError، يفصل بينهما السطر The above exception was the direct cause of the following exception، فترى في السجل القصة كاملة: ماذا كتب العميل، وأين فشل التحويل، وأي خطأ رماه الكود بسببه. وانتهت العملية برمز الخروج 1، وهو ما ترجعه Python لأي استثناء لم يلتقط. وقد شرحنا طريقة قراءة الـ Stack Trace بالتفصيل في مقال قراءة ال Stack Trace.
مجموعات الأخطاء ExceptionGroup والملاحظات add_note
عندما يرسل العميل طلباً فيه عشرة أسطر، وثلاثة منها خاطئة، فالأفضل أن تخبره بالأخطاء الثلاثة معاً بدل أن يصلحها واحداً بعد الآخر في ثلاث محاولات. ولهذا أضافت Python 3.11 الكلاس ExceptionGroup والصيغة except* بحسب PEP 654، وأضافت الدالة add_note بحسب PEP 678 لكي تضيف سياقاً إلى استثناء موجود دون أن تغير نوعه:
def validate(lines):
    errors = []
    for i, (pid, raw) in enumerate(lines):
        try:
            parse_qty(raw)
        except BadInput as e:
            e.add_note(f"line {i}, product {pid}")
            errors.append(e)
    if errors:
        raise ExceptionGroup("order has bad lines", errors)

try:
    validate([(1, "2"), (2, "x"), (3, "0")])
except* BadInput as eg:
    for e in eg.exceptions:
        print("  -", e, e.__notes__)
والمخرج سوف يكون كما يلي:
  - qty must be a whole number, got 'x' ['line 1, product 2']
  - qty must be positive, got 0 ['line 2, product 3']
جمعت الدالة الخطأين في مجموعة واحدة، والتقطت except* BadInput كل استثناءات هذا النوع من المجموعة، ولكل واحد ملاحظته برقم السطر والمنتج. وهذه الصيغة هي نفسها التي تستعملها asyncio.TaskGroup عندما تفشل عدة مهام متزامنة معاً، وسوف نراها في مقال التزامن.
كم يكلف try؟ LBYL مقابل EAFP
وقد يتساءل البعض: إذا كانت Python تشجع على try، أليس الاستثناء مكلفاً؟ قسنا ذلك على قاموس فيه مفتاح واحد، بطريقتين: فحص المفتاح قبل الوصول إليه، أو الوصول إليه والتقاط KeyError، مرة مع مفتاح موجود ومرة مع مفتاح غير موجود:
d = {'coffee': 4500}
def lbyl(k):
    return d[k] if k in d else 0
def eafp(k):
    try:
        return d[k]
    except KeyError:
        return 0
والنتيجة، أقل زمن من سبع محاولات في كل واحدة مليون استدعاء:
key 'coffee' if-check    399.2 ns
key 'coffee' try/except  388.9 ns
key 'tea'    if-check    341.2 ns
key 'tea'    try/except 1190.6 ns
عندما يكون المفتاح موجوداً كانت الطريقتان متقاربتين، فدخول try نفسه شبه مجاني في الإصدارات الحديثة، أما عندما يكون المفتاح غير موجود فكانت try/except أبطأ بحوالي 3.5 مرة، لأن إنشاء كائن الاستثناء ورميه والبحث عن معالج له عمل حقيقي. والأرقام المطلقة هنا عالية لأن الجهاز كان مشغولاً وقت القياس، فانظر إلى النسبة وليس إلى النانوثانية. والقاعدة: استعمل try عندما يكون الفشل نادراً، كتحويل كمية كتبها العميل، واستعمل الفحص أو dict.get(k, 0) عندما يكون الفشل جزءاً عادياً من العمل، كالبحث عن منتج قد لا يكون موجوداً في نصف الحالات.
أخطاء شائعة Common Mistakes
- مقارنة الأعداد أو النصوص بـ
is: تعمل مع القيم الصغيرة لأن CPython يحفظها مسبقاً، ثم تفشل عندما تكبر القيمة، والحد نفسه تغير بين الإصدارات. - تعديل قائمة أو قاموس وصل كمعامل إلى دالة دون أن يعرف المستدعي، ثم البحث طويلاً عن سبب تغير البيانات.
- استعمال
copy.copyلبنية متداخلة ثم تعديل مستوى داخلي فيها. - الاعتقاد أن تلميحات الأنواع تحمي الكود وقت التشغيل، فلا يشغل أحد mypy ولا يتحقق من المدخلات.
- تحميل ملف كبير كله في قائمة من القواميس، بدل المرور عليه بمولد أو حفظه في
dataclass(slots=True). - التقاط
except Exceptionأوexcept:بدون نوع، فيختفي الخطأ الحقيقي، والأسوأ أنexcept:وحدها تلتقط حتىKeyboardInterruptوSystemExit. - رمي استثناء جديد داخل
exceptبدونfrom e، فتضيع معلومة السبب أو تظهر برسالة أقل وضوحاً. - تقريب المبالغ بالدالة
round، فهي تقرب النصف إلى العدد الزوجي، وتعمل علىfloatالذي لا يمثل أغلب الأسعار بدقة. - الاحتفاظ بجزء صغير من نتائج عملية كبيرة في نفس العملية، فتبقى الذاكرة محجوزة كلها بسبب التجزئة حتى لو كان الباقي 1% فقط.
- تفسير رقم الخروج 137 كخطأ في الكود والبحث عن Traceback غير موجود، بدل فحص حد الذاكرة.
جدول القرار Decision Table: أي بنية تحفظ بها بياناتك؟
| الحالة | البنية المناسبة | السبب من المختبر |
|---|---|---|
| ملايين الأرقام من نفس النوع | array أو مكتبة عمودية | 8.2 MB مقابل 40 MB لقائمة الأعداد |
| ملايين السجلات بحقول ثابتة | dataclass(slots=True) | 120.4 MB مقابل 160.4 MB للكلاس العادي |
| سجل تحتاج أن تضيف له حقولاً وقت التشغيل | كلاس عادي أو dict | المرونة لها ثمن في الذاكرة |
| إعدادات أو قائمة أسعار لا تتغير وتصلح مفتاحاً | frozendict | جديد في 3.15، وله هاش لا يعتمد على الترتيب |
| ملف كبير تمر عليه مرة واحدة | مولد Generator | الذاكرة ثابتة مهما كبر الملف |
| خطأ متوقع من المستخدم | استثناء خاص يرث من ShopError | يحمل حقولاً ويتحول إلى 400 أو 409 |
| عدة أخطاء في نفس الطلب | ExceptionGroup مع add_note | العميل يرى كل الأسطر الخاطئة مرة واحدة |
تدريب عملي
- غير التلميح في
cheapestإلىSequence[HasPrice]منcollections.abc، وأضف شرطif p is Noneقبل السطر 35، ثم شغل mypy حتى لا يبقى أي خطأ. - عدل الدالة
measureلتقيس قائمة من مليون قاموس{"pid": i, "price": i * 10}، وقارن الرقم بالكائنات العادية و__slots__. - شغل
cycles_oom.pyبحد 512 ميجابايت بدل 256، وتوقع قبل التشغيل عند أي سطر سوف يتوقف. - أضف إلى
reserveاستثناءNotFoundيرث منShopError، واجعل الكود الذي يستدعيها يلتقطShopErrorفقط ويحول كل نوع إلى رمز HTTP من قاموس واحد.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المتغير في Python اسم يشير إلى كائن، والنوع للكائن، والتمرير إلى الدوال يمرر المرجع، فالتعديل داخل الدالة يظهر عند المستدعي والإسناد لا يظهر.
isللهوية و==للقيمة، والأعداد المحفوظة مسبقاً في 3.15.2 من -5 إلى 1024 وليس 256 كما تقول الشروحات القديمة، وهذا سبب إضافي لعدم استعمالisإلا معNone.- تلميحات الأنواع لا تفحص وقت التشغيل، والنص
"3"مر إلى دالة تنتظر عدداً فأعطى النص مكرراً 990 مرة، بينما وجد mypy الأخطاء الثلاثة قبل التشغيل. - CPython يحرر الذاكرة بعداد المراجع فوراً، وجامع الدورات ينظف الدوائر، وبدونه بقي 407 ميجابايت محجوزاً حتى حررها في أقل من ربع ثانية.
- مليون سجل أخذت 160 ميجابايت ككائنات عادية و120 مع
slots=True، ومليون عدد أخذ 40 ميجابايت في قائمة و8.2 فيarray. - CPython يرجع الذاكرة إلى النظام عندما تفرغ الـ Arena بالكامل، فنزلت من 173.8 إلى 15.5 ميجابايت بعد الحذف، ولكن كائناً واحداً من كل مئة أبقى 163 ميجابايت محجوزة.
- عندما يتجاوز الـ Container حد الذاكرة تقتل النواة العملية برمز 137 دون أي رسالة من Python، فابحث عن السبب في الذاكرة وليس في الكود.
- الاستثناءات الخاصة مع
raise fromوExceptionGroupتجعل الخطأ واضحاً في السجل وفي الرد على العميل، وtryرخيص عندما ينجح ومكلف عندما يفشل.
وفي المقال التالي من مرحلة لغة Python للمطورين سوف ننتقل إلى التزامن وقفل GIL، ونقيس نفس المهمة بالخيوط وasyncio والعمليات والبناء الخالي من القفل:
 دليلPython للمطورين: التركيب Syntax والأدوات في يوم واحددليل لمن يبرمج بلغة أخرى ويريد أن يبدأ بـ Python 3.15 من أول يوم: التثبيت، وما يختلف في التركيب، والأدوات uv وruff وmypy وpytest على مشروع حقيقي بمخرجه الفعلي.
 دليلإدارة الذاكرة: يدوياً أم Garbage Collector أم Ownership؟نقيس بأيدينا في C وGo وPython وRust من يحرر الذاكرة ومتى، وكم يكلف ذلك من الذاكرة والوقت، وما الأخطاء التي تبقى ممكنة في كل طريقة.
 دليلكيف تتعامل لغات البرمجة مع الأخطاء؟لماذا ترمي Java وPython الاستثناءات بينما ترجع Go وRust الخطأ كقيمة، وكيف تمنع الخطأ من أن يختفي بصمت في كودك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على Python 3.15.2 في الـ Image الرسمية python:3.15.2-slim-trixie داخل Container محدود بـ 2 CPU و512 MB، وتجربة حد الذاكرة بـ 256 MB، مع mypy 2.4.1.


