إذا كنت تجمع بيانات لبحثك، أو تكتب مقترحاً لممول يطلب «خطة لإدارة البيانات»، أو تعمل في عمادة بحث علمي أو مكتبة وتريد أن تبني خدمة لبيانات البحث في جامعتك، فهذا المقال لك.
ستعرف فيه كيف تحفظ بيانات بحثك وتصفها وتشاركها حتى لا تضيع، وماذا تعني مبادئ FAIR، وماذا يطلب الممولون الكبار في خطة إدارة البيانات، وكيف تشارك بيانات عن أشخاص دون أن تكشف هويتهم. وفي آخره قالب لخطة إدارة البيانات تعدله لمشروعك.
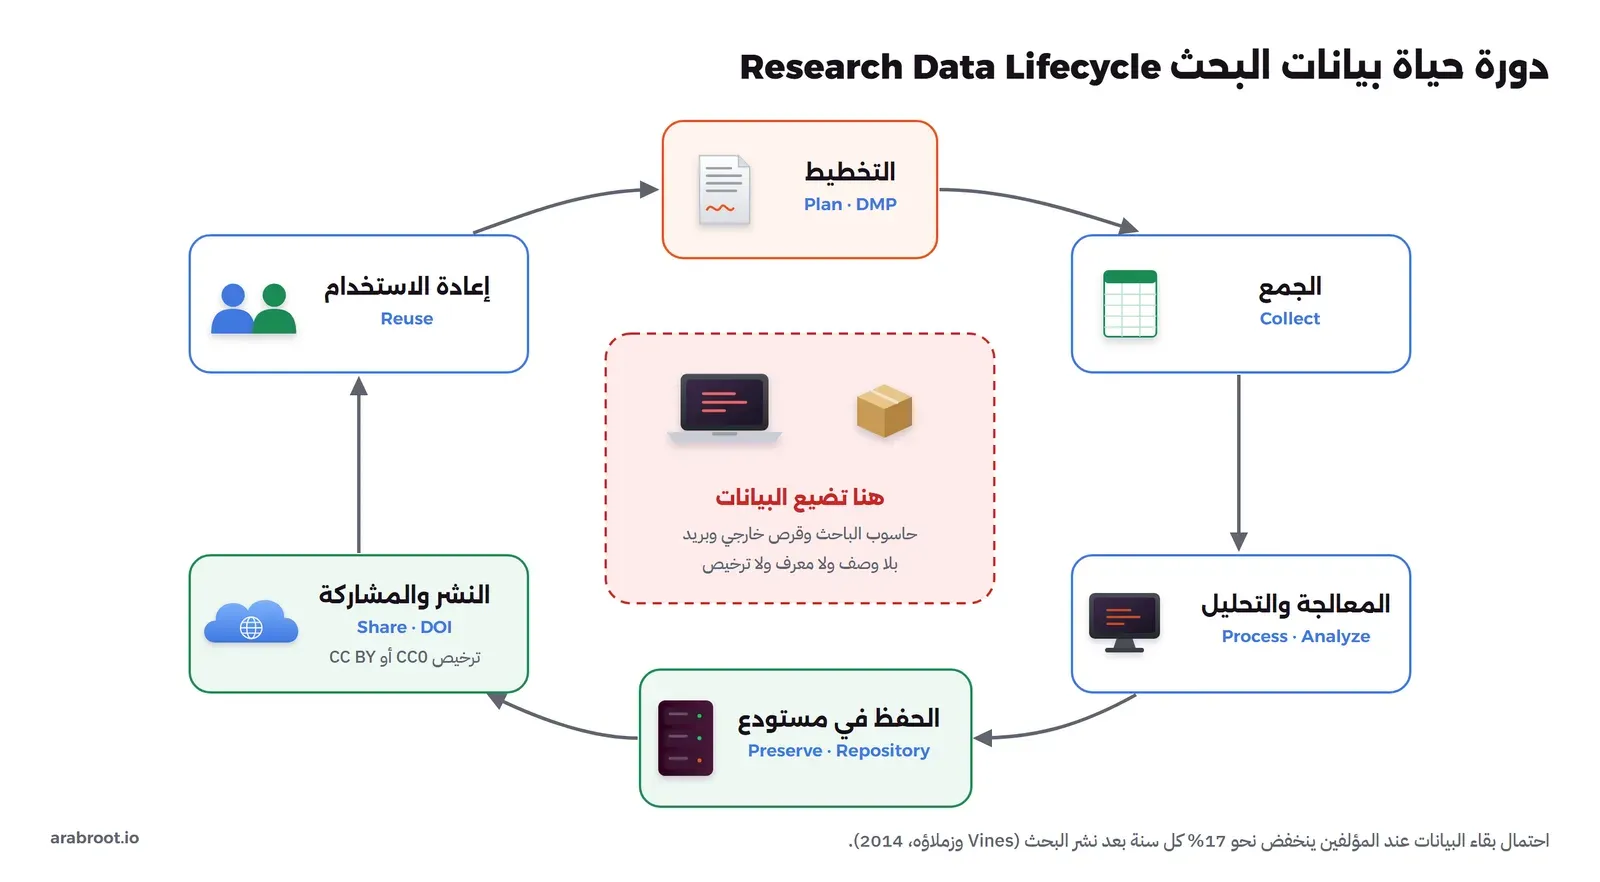
ولماذا يهم هذا؟ في 2014 نشر فريق من جامعة British Columbia دراسة طلب فيها بيانات 516 بحثاً منشوراً في علم البيئة، أعمارها بين سنتين و22 سنة. والنتيجة أن احتمال بقاء البيانات موجودة ينخفض بنحو 17% مع كل سنة تمر على نشر البحث. واحتمال الوصول إلى بريد يعمل لأحد المؤلفين ينخفض 7% في السنة.
أي أن البيانات كانت على حاسوب الباحث أو قرص خارجي أو في بريده، ثم تعطل الحاسوب أو انتقل الباحث، فضاعت. ولم يعد أحد قادراً على التحقق من البحث أو البناء عليه.
المصدر: ملخص الدراسة في Current Biology.
باختصار Quick Summary
مبادئ FAIR: معرف دائم، ووصف كاف، وصيغ مفتوحة، وترخيص واضح. ولا تعني أن تنشر كل شيء للجميع.
خطة إدارة البيانات DMP: وثيقة قصيرة تكتبها قبل جمع البيانات، ويطلبها NIH وNSF وHorizon Europe.
الترخيص: CC0 للوصف دائماً، وCC0 أو CC BY للبيانات المفتوحة.
البيانات عن أشخاص: حذف الاسم لا يكفي. والبيانات المرمزة ما زالت بيانات شخصية بحسب نظام حماية البيانات الشخصية.
ما هي إدارة بيانات البحث Research Data Management؟
هي كل ما تفعله بالبيانات، من لحظة التخطيط لجمعها إلى أن يعيد شخص آخر استخدامها بعد سنوات. وتشمل:
- كيف تسمي الملفات، وأين تحفظها، ومن يصل إليها.
- كيف تصفها حتى يفهمها غيرك.
- أين تودعها في النهاية، وبأي ترخيص.
والصورة التالية تبين دورة حياة البيانات Research Data Lifecycle، والمكان الذي تضيع فيه عادة:
وهذه ثلاث طرق لحفظ البيانات، من الأضعف إلى الأفضل:
| الطريقة | ما يحميه | أين تفشل |
|---|---|---|
| على حاسوب الباحث، مع نسخة على قرص خارجي ونسخة في البريد | تعمل ما دام الباحث نفسه يعمل على المشروع | تفشل عندما يسأل محكم أو باحث آخر عن البيانات بعد خمس سنوات |
| مجلد مشترك على خادم الجامعة أو خدمة سحابية | يحمي من تعطل الحاسوب | ملف مثل «final_v3_corrected.xlsx» بلا وصف لا يفهمه غير صاحبه، وليس له رابط ثابت يستشهد به، ولا يعرف من يجده هل يحق له استخدامه |
| خطة مكتوبة من البداية، ووصف كاف، ومستودع بيانات Data Repository، وترخيص واضح | البيانات تبقى، ويفهمها غيرك، ولها معرف دائم Persistent Identifier يستشهد به | هذا ما تطلبه الجهات الممولة اليوم |
مبادئ FAIR: ماذا تعني لملفاتك؟
في مارس 2016 نشرت مجلة Scientific Data مقالاً لمجموعة من الباحثين والناشرين والممولين، على رأسهم Mark Wilkinson، بعنوان «The FAIR Guiding Principles». وهو أول نشر رسمي لمبادئ FAIR، بعد ورشة عقدت في Leiden في 2014.
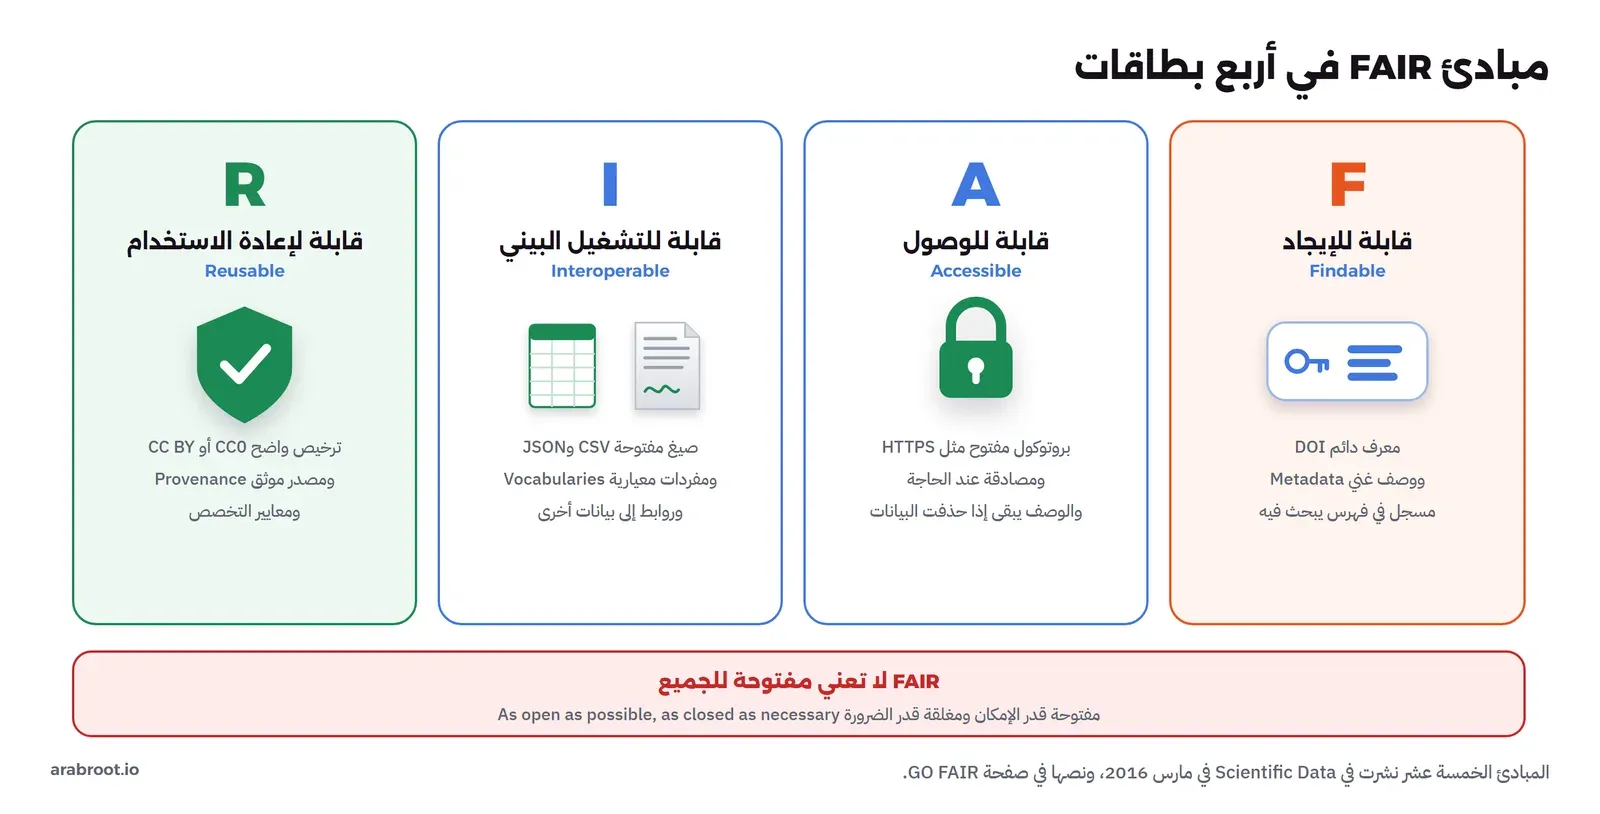
والحروف الأربعة اختصار لأربع صفات للبيانات:
- F: قابلة للإيجاد Findable. يستطيع غيرك أن يجدها.
- A: قابلة للوصول Accessible. يعرف كيف يصل إليها.
- I: قابلة للتشغيل البيني Interoperable. تعمل مع أدوات وبيانات أخرى دون تحويل معقد.
- R: قابلة لإعادة الاستخدام Reusable. يفهمها، ويعرف هل يحق له استخدامها.
وما يميز FAIR أنها تخاطب الآلة قبل الإنسان. أي أن يستطيع برنامج لم ير بياناتك من قبل أن يجدها، ويعرف نوعها وترخيصها، ويقرر هل تفيده. والسبب أن حجم البيانات اليوم أكبر من أن يبحث فيه الإنسان بنفسه.
والجدول التالي يضع المبادئ الخمسة عشر كما في صفحة مبادرة GO FAIR، ومعها ما تعنيه في عملك اليومي:
| المبدأ | النص المختصر | ما يعنيه لك |
|---|---|---|
| F1 | معرف فريد ودائم Persistent Identifier للبيانات ووصفها | معرف DOI من المستودع، بدلاً من رابط مجلد في Google Drive يتغير أو يحذف. |
| F2 | وصف غني Rich Metadata | عنوان وملخص وكلمات مفتاحية وطريقة الجمع، وليس اسم الملف فقط. |
| F3 | الوصف يذكر معرف البيانات صراحة | المستودع يفعل هذا تلقائياً. |
| F4 | الوصف مسجل في مكان يبحث فيه | مستودع تفهرسه DataCite ومحركات البحث، لا ملف على حاسوبك. |
| A1 | الوصول بالمعرف عبر طريقة اتصال معيارية | رابط DOI يفتح صفحة البيانات في المتصفح. |
| A1.1 | طريقة الاتصال مفتوحة ومجانية | لا تحتاج برنامجاً تجارياً لتصل إلى الصفحة. |
| A1.2 | تسمح بالتحقق من الهوية والصلاحيات عند الحاجة | البيانات الحساسة يمكن أن تكون مقيدة بطلب وصول، وتبقى FAIR. |
| A2 | الوصف يبقى متاحاً حتى لو لم تعد البيانات متاحة | إذا حذفت البيانات لسبب نظامي، تبقى صفحة الوصف تقول ماذا كان هنا ولماذا حذف. |
| I1 | لغة مشتركة لوصف البيانات | صيغ مفتوحة مثل CSV، ووصف بمعيار مثل DataCite أو Dublin Core. |
| I2 | مفردات معيارية Vocabularies | أسماء الدول برموز ISO، والتخصصات من قائمة معروفة، والوحدات من نظام SI. |
| I3 | إشارات واضحة إلى بيانات أخرى | اربط البيانات بالبحث المنشور، وبالبيانات التي بنيت عليها، بمعرفاتها. |
| R1 | وصف دقيق بعناصر كثيرة | ملف README، وقاموس متغيرات Codebook يشرح كل عمود ووحدته. |
| R1.1 | ترخيص استخدام واضح | CC0 أو CC BY مكتوب في صفحة البيانات. |
| R1.2 | مصدر موثق Provenance | من جمع البيانات، ومتى، وكيف، وما المعالجة التي مرت بها. |
| R1.3 | معايير مجتمع التخصص | إذا كان لتخصصك معيار وصف أو مستودع متخصص، فاستخدمه. |
هل FAIR تعني أن أنشر كل بياناتي للجميع؟ لا. المبدأ A1.2 نفسه يسمح بالتحقق من الهوية والصلاحيات. والدليل الرسمي لاتفاقية منح الاتحاد الأوروبي يلخص ذلك في عبارة مشهورة: «مفتوحة قدر الإمكان، ومغلقة قدر الضرورة» As open as possible, as closed as necessary.
فبيانات المرضى مثلاً لا تنشر للجميع. لكن وصفها يمكن أن ينشر، ومعه طريقة طلب الوصول. وبهذا تكون قابلة للإيجاد، ولها معرف وترخيص، وإن كانت مقيدة.
المصدر: مقال FAIR في Scientific Data، وصفحة مبادرة GO FAIR.
خطة إدارة البيانات Data Management Plan
ما هي: وثيقة قصيرة تكتبها قبل أن تجمع البيانات. تجيب فيها عن أسئلة محددة:
- ما البيانات التي ستنتجها، وبأي صيغة؟
- كيف تحفظها وتحميها أثناء المشروع؟
- أين تودعها في النهاية، ومتى، وبأي ترخيص؟
- من المسؤول؟
لماذا يطلبها الممولون مع المقترح: لأن تكاليف الحفظ والمستودع، والوقت اللازم لتنظيف البيانات ووصفها، يجب أن تدخل الميزانية من البداية. وإلا تحولت المشاركة إلى عمل إضافي لا يجد الباحث وقتاً له في آخر المشروع.
وقد شرحنا أقسام المقترح وكيف يقيمه الممول في مقال كيف تكتب مقترح البحث Research Proposal الذي يقنع الممول. وهنا نركز على قسم البيانات.
ماذا يطلب الممولون؟
الجدول التالي يجمع ما يطلبه ثلاثة من أكبر ممولي البحث في العالم، كما في صفحاتهم الرسمية حتى أكتوبر 2026:
| الممول | متى تقدم الخطة | الطول والشكل | متى تشارك البيانات |
|---|---|---|---|
| المعاهد الوطنية للصحة الأمريكية NIH | مع طلب المنحة، منذ سريان سياسة DMS في 25 يناير 2023 | صفحتان أو أقل، بستة عناصر محددة | في أقرب وقت، وبحد أقصى عند نشر البحث المرتبط أو نهاية فترة المنحة، أيهما أسبق |
| مؤسسة العلوم الوطنية الأمريكية NSF | مع كل مقترح. والمقترح الذي لا يحتويها يعاد دون تحكيم | منذ 27 أبريل 2026 تكتب في أداة على Research.gov، بدلاً من وثيقة الصفحتين، بحسب الإشعار NSF 26-202 | خلال وقت معقول، وبتكلفة لا تزيد عن التكلفة الإضافية، كما في سياسة NSF لمشاركة البيانات |
| برنامج Horizon Europe | تسليم إلزامي Deliverable خلال 6 أشهر من توقيع المنحة غالباً، ثم تحديث في منتصف المشروع وفي نهايته | قالب الاتحاد الأوروبي موصى به وغير إلزامي | الإيداع في مستودع موثوق في أقرب وقت، وبحد أقصى نهاية المشروع، بترخيص CC BY أو CC0 للبيانات المفتوحة |
العناصر الستة في NIH: تصلح لأي ممول تقريباً، لذلك نذكرها هنا:
- نوع البيانات Data Type: ما البيانات التي ستنتجها؟ ماذا ستشارك منها، وماذا لن تشارك ولماذا؟ وما الوصف الذي يرافقها؟
- الأدوات والبرامج Related Tools and Software: هل يحتاج من يعيد استخدام البيانات برنامجاً خاصاً؟ وهل هو مجاني مفتوح أم تجاري؟
- المعايير Standards: صيغ الملفات، وقواميس البيانات، والمعرفات. وإذا لم يكن لتخصصك معيار متفق عليه، فاكتب ذلك صراحة.
- الحفظ والوصول والجدول الزمني Preservation, Access, and Timelines: اسم المستودع، ومتى تتاح البيانات، وإلى متى تبقى.
- قيود الوصول وإعادة الاستخدام Access, Distribution, or Reuse Considerations: القيود التي تفرضها موافقة المشاركين أو الأنظمة أو الاتفاقيات، وكيف تحمي خصوصيتهم.
- الإشراف Oversight: من يتابع تنفيذ الخطة، وكل كم مرة.
تفاصيل من الاتحاد الأوروبي تستحق أن تعرفها، حتى لو لم يكن ممولك أوروبياً:
- الوصف Metadata يجب أن يكون مفتوحاً بترخيص CC0، حتى لو كانت البيانات مقيدة.
- الوصف يذكر الممول، ورقم المنحة، والترخيص، ومعرفات البيانات والمؤلفين.
- الإيداع لا يعني بالضرورة أن البيانات مفتوحة، وإنما أن وصفها قابل للإيجاد.
- الممارسة الموصى بها أن تبقى البيانات متاحة خمس سنوات على الأقل، ويفضل عشر سنوات أو أكثر.
المصدر: عناصر خطة NIH، والدليل المشروح لاتفاقية منح الاتحاد الأوروبي Annotated Grant Agreement.
الوصف Metadata: ماذا تكتب مع بياناتك؟
الوصف هو «بيانات عن البيانات». وهو مستويان:
| المستوى | من يقرؤه | ماذا يشمل |
|---|---|---|
| وصف المجموعة كلها Dataset | محركات البحث والمستودعات | المعيار الأشهر هو مخطط DataCite. وعناصره الإلزامية في الإصدار 4.7 ستة فقط: المعرف Identifier، والمؤلف Creator، والعنوان Title، والناشر Publisher، وسنة النشر PublicationYear، ونوع المورد ResourceType. والمستودع يملؤها معك عندما يسجل DOI. |
| وصف كل ملف وكل متغير | الباحث الذي يريد أن يعيد التحليل | ملف README، وقاموس المتغيرات Codebook. وهذا المستوى يهمله أغلب الباحثين، وهو الذي يجعل البيانات قابلة لإعادة الاستخدام فعلاً. |
وقد شرحنا كيف يعمل DOI ومن يسجله في مقال معرف ORCID وDOI.
ماذا تكتب في ملف README:
- عنوان المشروع، والمؤلفون بمعرفات ORCID.
- كيف جمعت البيانات، ومتى، وأين.
- قائمة الملفات، وما في كل ملف.
- المعالجة التي مرت بها البيانات.
- الترخيص، وكيف يستشهد بها.
ماذا تكتب في قاموس المتغيرات Codebook: لكل عمود اسمه، ومعناه، ونوعه، ووحدته، والقيم المسموحة، وماذا تعني الخانة الفارغة. فالرقم 99 في عمود العمر قد يكون عمراً، وقد يكون رمزاً لـ «لم يجب».
إذا كانت بياناتك عربية:
- احفظ الملفات بصيغة CSV بترميز UTF-8، ولا تعتمد على ملفات Excel وحدها. CSV تفتحها كل الأدوات، بينما الصيغ المغلقة تحتاج برنامجاً بعينه.
- اكتب العنوان والملخص بالعربية والإنجليزية إذا سمح المستودع. فمن يبحث عن بياناتك قد يبحث بأي اللغتين.
- اكتب أسماء المؤلفين كما في ORCID. فالاسم العربي يكتب بالإنجليزية بأكثر من طريقة، والمعرف هو الذي يجمعها.
المصدر: مخطط DataCite Metadata Schema، والعناصر الإلزامية في الإصدار 4.7.
الترخيص License: CC0 أم CC BY؟
البيانات بلا ترخيص لا يعرف من يجدها هل يحق له استخدامها، فيتجنبها الباحث الحريص. لذلك جعلت FAIR الترخيص مبدأً مستقلاً. وهذان الخياران الأكثر استخداماً للبيانات:
| الترخيص | ماذا يعني | متى تختاره |
|---|---|---|
| CC0 1.0 | تتنازل عن حقوقك قدر ما يسمح القانون، فيستخدم أي أحد البيانات دون شرط | للوصف Metadata دائماً، وللبيانات التي تريد أن تستخدمها المستودعات والأدوات الآلية دون تعقيد |
| CC BY 4.0 | يستخدم أي أحد البيانات بشرط أن ينسبها إليك | عندما تريد أن يكون ذكرك شرطاً قانونياً، لا عرفاً علمياً فقط |
لماذا لا أمنع الاستخدام التجاري NonCommercial لأحمي بياناتي؟ لأن هذا القيد يمنع إعادة الاستخدام في حالات كثيرة لم تقصدها. مثل باحث في شركة ناشئة، أو مستودع تجاري يجمع البيانات للفهرسة. لذلك تطلب اتفاقية Horizon Europe ترخيص CC BY أو CC0 أو ما يعادلهما للبيانات المفتوحة. والاستشهاد بك يبقى عرفاً ملزماً في المجتمع البحثي، حتى مع CC0.
تنبيه: الترخيص يمنح حقوقاً تملكها أنت. فإذا أخذت البيانات من جهة أخرى بشروطها، فشروطها هي التي تحكم. ولا تضع عليها ترخيصاً من عندك.
البيانات الشخصية والحساسة Sensitive Data ونظام PDPL
إذا كانت بياناتك عن أشخاص، كاستبانة أو مقابلات أو سجلات طبية، فأنت تحتاج قبل كل شيء موافقة لجنة أخلاقيات البحث. وقد شرحنا ذلك، ومتى يجوز استخدام البيانات دون موافقة أصحابها بحسب المادة 27 من النظام، في مقال أخلاقيات البحث على البشر.
وهنا نركز على سؤال واحد: كيف تحفظ هذه البيانات وتشاركها دون أن تكشف أصحابها؟
ماذا يقول نظام حماية البيانات الشخصية PDPL ولائحته؟
| المصطلح | ماذا يقول النظام أو اللائحة |
|---|---|
| البيانات الحساسة Sensitive Data | البيانات المتعلقة بالأصل العرقي أو الإثني، أو المعتقد الديني أو الفكري أو السياسي، والبيانات الأمنية والجنائية، وبيانات السمات الحيوية التي تحدد الهوية، والبيانات الوراثية والصحية، والبيانات التي تدل على أن الفرد مجهول الأبوين أو أحدهما. وكثير من بيانات البحث الطبي والاجتماعي يقع في هذه القائمة. |
| البحث العلمي دون موافقة صاحب البيانات (المادة 30 من اللائحة) | تحدد الغرض في سجل أنشطة المعالجة، وتجمع الحد الأدنى اللازم فقط، وتستخدم الترميز Pseudonymisation ما دام لا يعطل الغرض. |
| إخفاء الهوية Anonymization (المادة 9 من اللائحة) | أن تصبح إعادة التعرف على الشخص مستحيلة، مع تقييم الأثر ومراجعة فعالية الطرق المستخدمة. والبيانات بعد إخفاء الهوية لا تعد بيانات شخصية. |
| الترميز Pseudonymisation (دليل سدايا، أغسطس 2024) | استبدال ما يعرف الشخص برمز. لكن البيانات المرمزة تبقى بيانات شخصية، لأنه يمكن ربطها بأصحابها بمعلومات إضافية. وهذه المعلومات يجب أن تحفظ منفصلة. |
ويذكر دليل سدايا من طرق تقليل الكشف:
- التعميم Generalization: مثل فئات العمر بدلاً من العمر الدقيق.
- التجميع Aggregation: مثل سنة الميلاد بدلاً من تاريخها الكامل.
- التشفير Encryption.
- الإخفاء الجزئي Masking.
والفرق بين الترميز وإخفاء الهوية ليس فرقاً لغوياً. هو الذي يحدد هل تستطيع أن تودع البيانات في مستودع مفتوح أم لا.
المصدر: نظام حماية البيانات الشخصية بعد تعديله بالمرسوم م/148، واللائحة التنفيذية، ودليل سدايا لإتلاف البيانات الشخصية وإخفاء هويتها وترميزها.
لماذا لا يكفي حذف الاسم؟
الطريقة البسيطة أن تحذف عمود الاسم ورقم الهوية، وتنشر الباقي. والمشكلة أن الأعمدة الباقية مجتمعة قد تدل على الشخص. وتسمى «أشباه المعرفات» Quasi-Identifiers.
وفي 2000 نشرت Latanya Sweeney من جامعة Carnegie Mellon دراسة مشهورة. وجدت فيها، من بيانات تعداد 1990 الأمريكي، أن 87% من سكان الولايات المتحدة، أي 216 مليوناً من 248 مليوناً، يمكن تمييزهم بثلاثة حقول فقط: الرمز البريدي من خمسة أرقام، والجنس، وتاريخ الميلاد.
فالاستبانة التي فيها العمر الدقيق والجنس والمدينة والتخصص قد تكشف المشارك لزميله في القسم، دون اسم.
المصدر: دراسة Simple Demographics Often Identify People Uniquely.
كيف تقيس الخطر؟ فكرة k-anonymity
اجمع المشاركين في مجموعات بحسب أشباه المعرفات، مثل العمر والجنس والمدينة. ثم انظر إلى أصغر مجموعة:
- إذا كانت أصغر مجموعة فيها شخص واحد، فهذا الشخص مكشوف لمن يعرف صفاته.
- إذا كانت كل مجموعة فيها خمسة أشخاص على الأقل، فالقيمة k تساوي 5. أي أن كل مشارك يختفي بين أربعة آخرين على الأقل.
مثال بسيط: استبانة في قسم جامعي، وفيها العمر الدقيق والجنس والمدينة. في القسم امرأة واحدة عمرها 46 سنة من مدينة معينة. كل من يعرفها يستطيع أن يجد إجاباتها، حتى دون اسم. هذه مجموعة من شخص واحد، أي k تساوي 1.
ماذا تفعل؟ لديك طريقتان، ولكل منهما ثمن:
| الطريقة | ماذا تفعل | الثمن |
|---|---|---|
| التعميم Generalization | تحول العمر الدقيق إلى فئات، مثل 40 إلى 49. فتكبر المجموعات | تفقد دقة العمر |
| حذف متغير | تحذف المدينة من ملف المشاركة. فتكبر المجموعات أكثر | تفقد متغير المدينة في الملف المشترك |
وهذا هو التوازن الدائم بين الخصوصية وفائدة البيانات. فإذا كانت المدينة مهمة لسؤالك البحثي، فالحل أن تبقي البيانات مقيدة الوصول، بدلاً من حذفها.
ولا يوجد رقم k واحد يناسب كل البيانات. لجنة الأخلاقيات أو مسؤول حماية البيانات في جهتك هو من يحدد المقبول، بحسب حساسية البيانات.
خطوات إعداد ملف المشاركة
والصورة التالية تبين المسار من الملف الخام إلى ملف المشاركة:
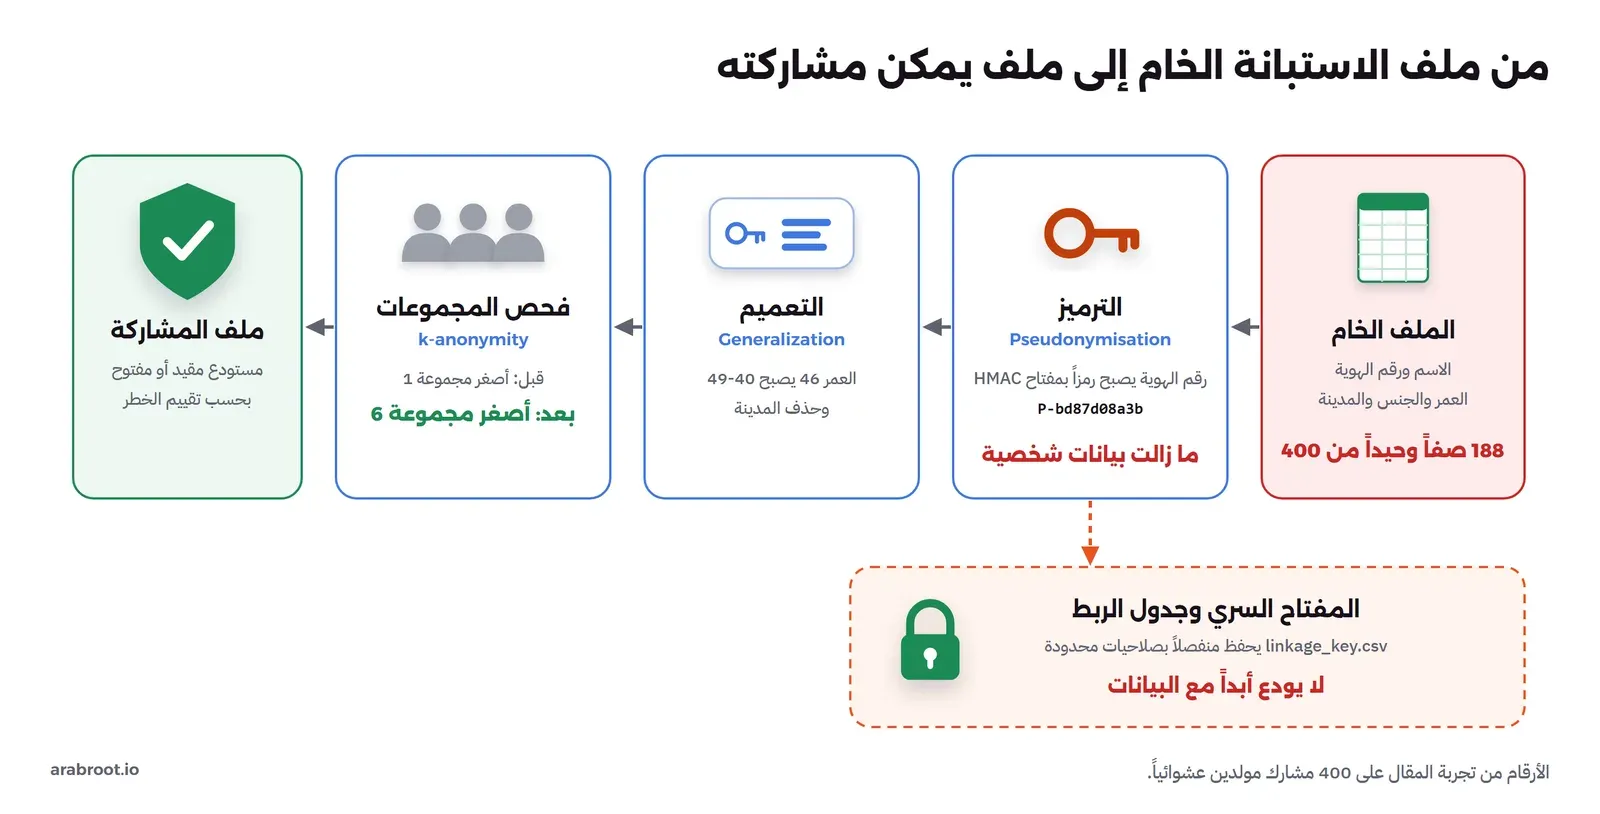
- الترميز: استبدل الاسم ورقم الهوية برمز مشارك، مثل P-0001. واحفظ «جدول الربط» الذي يربط كل رمز بصاحبه في ملف منفصل.
- احفظ جدول الربط بعيداً: في مكان منفصل بصلاحيات محدودة. ولا تودعه أبداً مع البيانات. فجدول الربط هو ما يجعل البيانات «مرمزة» وليست «مجهولة الهوية».
- التعميم: حول العمر إلى فئات، واحذف أو اجمع ما يكشف الشخص، مثل المدينة.
- قس k: تأكد أن كل مجموعة فيها العدد الذي تطلبه لجنة الأخلاقيات أو مسؤول حماية البيانات.
- راجع ما لا يقاس بسهولة: النصوص المفتوحة في الاستبانة، والتسجيلات الصوتية، وتواريخ الأحداث النادرة. كلها قد تكشف الشخص.
- أتلف جدول الربط عندما تنتهي حاجتك إليه. هذا ما يقترب بالبيانات من إخفاء الهوية.
وهذا الفحص لا يغني عن تقييم خطر إعادة التعرف الذي تطلبه المادة 9 من اللائحة. لكنه يعطيك نقطة بداية واضحة، بدلاً من الانطباع.
قالب خطة إدارة البيانات DMP
هذا القالب يجمع العناصر الستة في NIH، مع أسئلة قالب Horizon Europe، ومتطلبات النظام السعودي للبيانات الشخصية. وهو مكتوب ليكون في حدود صفحتين. فإذا كان لممولك نموذج، فالتزم بنموذجه، واستخدم هذا القالب لتتأكد أنك لم تنس شيئاً.
في رأس الخطة: عنوان المشروع، واسم الباحث الرئيسي ومعرف ORCID، ورقم الإصدار، والتاريخ.
| القسم | ماذا تكتب فيه |
|---|---|
| 1. البيانات Data Type | ما البيانات التي ستنتجها (استبانة، مقابلات صوتية، قياسات، صور)؟ صيغتها وحجمها المتوقع (مثلاً CSV بترميز UTF-8). البيانات المأخوذة من مصادر أخرى وشروطها. ما الذي ستشاركه، وما الذي لن تشاركه ولماذا (نظامي، تعاقدي، أخلاقي)؟ |
| 2. الأدوات Tools | البرامج اللازمة لقراءة البيانات: مجانية مفتوحة أم تجارية؟ وأين تحفظ ملفات التحليل، مع نسخة مؤرشفة بمعرف DOI. |
| 3. المعايير والوصف Standards and Metadata | معيار الوصف (DataCite أو معيار تخصصك). ملف README وقاموس متغيرات لكل ملف. طريقة تسمية الملفات (مثلاً المشروع ثم الأداة ثم التاريخ ثم رقم النسخة). العنوان والملخص بالعربية والإنجليزية. |
| 4. الحفظ أثناء المشروع Storage and Security | أين تحفظ البيانات (خادم الجامعة أو تخزين مؤسسي، لا الحاسوب الشخصي وحده). النسخ الاحتياطي Backup (مثلاً يومي، نسختان في مكانين). من يصل إلى البيانات الخام. الترميز، ومكان حفظ جدول الربط منفصلاً. |
| 5. الإيداع والوصول والجدول الزمني | اسم المستودع ولماذا اخترته. معرف DOI لكل مجموعة بيانات. موعد الإتاحة (عند نشر البحث أو نهاية المشروع، أيهما أسبق). مدة الحفظ (10 سنوات على الأقل مثلاً). الترخيص: البيانات CC BY 4.0 أو CC0، والوصف CC0. |
| 6. الأخلاقيات والأنظمة Ethics and Legal | رقم موافقة لجنة أخلاقيات البحث وتاريخها. نص موافقة المشاركين يذكر المشاركة وإعادة الاستخدام. هل فيها بيانات حساسة بحسب النظام، وما هي؟ طريقة إخفاء الهوية قبل الإيداع، ونتيجة تقييم الخطر (قيمة k). والبيانات التي لا يمكن إخفاء هويتها: وصول مقيد بطلب، ومن يوافق عليه. |
| 7. المسؤوليات والتكلفة Oversight and Costs | المسؤول عن تنفيذ الخطة ومراجعتها، وكل كم مرة (مثلاً كل 6 أشهر). تكلفة إعداد البيانات ووصفها ورسوم المستودع، وأنها في الميزانية. |
قائمة تحقق Checklist
- كتبت خطة إدارة البيانات قبل جمع البيانات، وفيها التكلفة.
- بياناتي على خادم مؤسسي مع نسخة احتياطية، لا على حاسوبي وحده.
- لكل ملف README وقاموس متغيرات. وجربت أن يشرح زميل لا يعرف المشروع ثلاثة أعمدة من الوصف وحده.
- الملفات بصيغة مفتوحة مثل CSV بترميز UTF-8.
- اخترت مستودعاً يعطي DOI، وترخيصاً واضحاً.
- إذا كانت البيانات عن أشخاص: رمزتها، وحفظت جدول الربط منفصلاً، وقست k، وراجعت النصوص المفتوحة.
أخطاء شائعة
- كتابة الخطة للممول ثم نسيانها: الخطة وثيقة حية، وNIH وHorizon Europe يطلبان تحديثها. وستوفر عليك أسابيع في آخر المشروع إذا التزمت بالتسمية والوصف من البداية.
- الوعد بمشاركة كل شيء: لا تكتب «ستتاح كل البيانات للجميع» إذا كانت عن أشخاص. فموافقة المشاركين قد لا تسمح بذلك، وما تعد به في الخطة يحاسبك عليه الممول.
- رابط Google Drive بدلاً من مستودع: الرابط يتعطل عندما يتغير حسابك أو تتوقف الخدمة، ولا يعطي DOI ولا وصفاً يفهرس.
- إيداع جدول الربط مع البيانات: أسوأ الأخطاء، لأنه يعيد الهوية لكل المشاركين بخطوة واحدة.
- صيغ مغلقة بلا بديل: ملف SPSS أو Excel وحده قد لا يفتح بعد عشر سنوات، فأودع معه نسخة CSV.
- الاكتفاء بحذف الاسم: أشباه المعرفات مجتمعة قد تكشف الشخص.
الخلاصة
- البيانات التي تبقى عند الباحث وحده تضيع مع الوقت. واحتمال وجودها ينخفض نحو 17% كل سنة، بحسب دراسة 2014.
- مبادئ FAIR تعني معرفاً دائماً ووصفاً غنياً وصيغاً مفتوحة وترخيصاً واضحاً. ولا تعني أن تكون البيانات مفتوحة للجميع.
- NIH وNSF وHorizon Europe يطلبون خطة لإدارة البيانات مع المقترح أو في الأشهر الأولى. والعناصر الستة في NIH تصلح لأي ممول.
- CC0 للوصف دائماً، وCC0 أو CC BY للبيانات المفتوحة. وتجنب القيود التي تمنع إعادة الاستخدام.
- البيانات المرمزة ما زالت بيانات شخصية بحسب لائحة نظام حماية البيانات الشخصية. وقس خطر إعادة التعرف قبل أن تشارك أي ملف.
وفي المقالين التاليين من هذه المرحلة بإذن الله نختار المستودع الذي نودع فيه البيانات، ثم نرى كيف يعيد غيرك تحليلك ويحصل على الأرقام نفسها:
 دليلمستودع البيانات Data Repository: Dataverse أم Zenodo؟الفرق بين مستودعات بيانات البحث وبوابات البيانات المفتوحة، مع تجربة كاملة لإيداع بيانات بوصف عربي ونشرها بمعرف DOI في Dataverse.
 دليلالبحث القابل لإعادة الإنتاج Reproducibility مع Dockerكيف تحزم تحليلك بحيث يعيد أي أحد تشغيله فيحصل على أرقامك نفسها، مع تجربة حقيقية لأسباب اختلاف النتائج بين التشغيلات والأجهزة.
سجل التحديثات
- 2026-11-13: إعادة كتابة المقال بلغة أوضح وخطوات وجداول، دون كود.
- أكتوبر 2026: كتابة المقال، ومراجعة متطلبات NIH وNSF وHorizon Europe ولائحة نظام حماية البيانات الشخصية من صفحاتها الرسمية.