إذا كان لشركتك أو مشروعك موقع، ونشرت فيه صفحة جديدة ثم بحثت عنها في Google فلم تجدها، فهذا المقال لك. ستفهم فيه ماذا يحدث لصفحتك من لحظة نشرها حتى تظهر في نتائج البحث، وأين تتوقف الصفحات عادة، وما الذي تطلبه من فريقك ليصلحه.
والمقال لصاحب الموقع ومسؤول التسويق ومدير المنتج. لا تحتاج أن تكون مبرمجاً لتفهمه. لكنك ستعرف الأسئلة الصحيحة التي تسألها للمطور.
وتحسين الظهور في محركات البحث اسمه SEO، اختصار Search Engine Optimization. وكلمة «نحتاج SEO» تخفي سؤالاً أدق: أين توقفت الصفحة؟ هل لم يصل إليها محرك البحث أصلاً؟ أم وصل ولم يفهمها؟ أم فهمها وقرر أن صفحة أخرى أحق بالظهور؟ ولكل سؤال جواب مختلف.
هذا المقال جزء من مرحلة «المحتوى وتحسين الظهور في البحث» في مسار التسويق للتقنيين، وفيها أيضاً:
 دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها في خطوات واضحة، وتقيس أثرها في البحث والمبيعات.
 دليلSEO التقني للمطورين: موقع عربي قبل الإصلاح وبعدهنبني موقعاً عربياً فيه عشر مشكلات تقنية شائعة، ونقيسه بأدوات مفتوحة المصدر، ثم نصلحه ونقيس الفرق بالأرقام.
 دليلأدوات SEO Tools: التجارية وبدائلها المجانيةما الذي تعطيك إياه Ahrefs وSemrush وMoz فعلاً وكم تكلف في السنة، وما الذي تحصل عليه مجاناً من محركات البحث وأدوات مفتوحة المصدر.
باختصار In Short
أغلب المشاكل تقنية: المرحلتان الأولى والثانية في يد المطور، وليس في يد كاتب المحتوى.
أربع أدوات أساسية: ملف robots.txt، ووسم noindex، والرابط القانوني Canonical، وخريطة الموقع Sitemap. ولكل منها عمل مختلف.
الترتيب: Google لا تنشر أوزان العوامل. ما تنشره: محتوى مفيد، وصفحة سريعة، وعدم التلاعب.
أول خطوة لك: سجل موقعك في Google Search Console، وافتح تقرير الصفحات Pages، لترى أي الصفحات لم تظهر ولماذا.
المراحل الخمس: من النشر إلى نتيجة البحث Stages
تقول Google في شرحها لطريقة عمل البحث إن البحث يعمل في ثلاث مراحل: الزحف Crawling، والفهرسة Indexing، وعرض النتائج Serving. وإن الصفحات لا تمر كلها بكل المراحل. وإنها لا تأخذ مالاً لتزور موقعاً أكثر أو ترتبه أعلى.
ونضيف مرحلتين يفيدك أن تراهما منفصلتين، فتصبح خمساً:
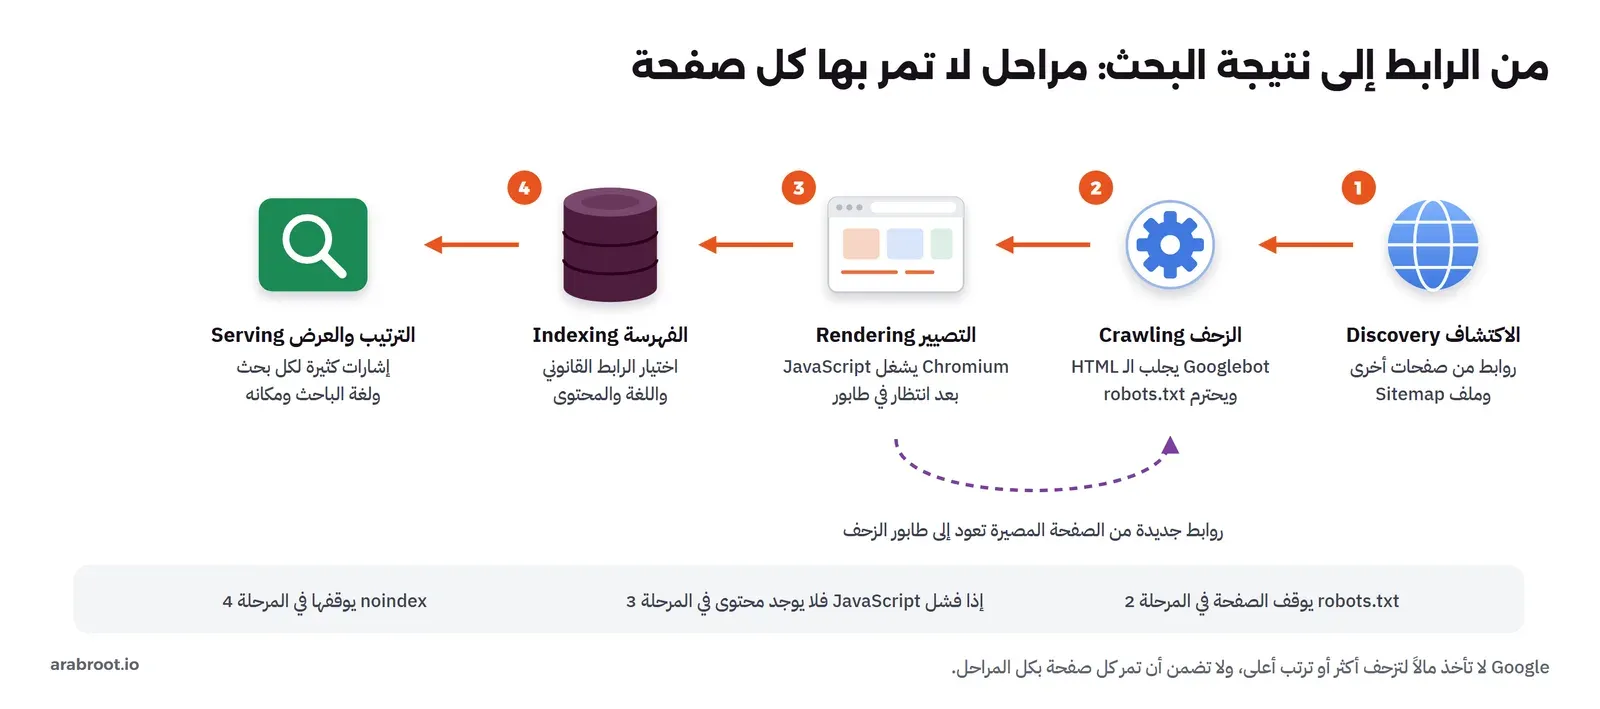
| المرحلة | ماذا يحدث فيها | أين تتوقف الصفحة عادة |
|---|---|---|
| 1. الاكتشاف Discovery | محرك البحث يعرف أن صفحتك موجودة | لا يوجد رابط إليها، وليست في خريطة الموقع |
| 2. الزحف Crawling | برنامج محرك البحث يفتح الصفحة ويقرؤها | ملف robots.txt يمنعه، أو السيرفر لا يرد |
| 3. التصيير Rendering | محرك البحث يشغل الصفحة كما يشغلها المتصفح، ليرى محتواها كاملاً | المحتوى يظهر متأخراً أو لا يظهر |
| 4. الفهرسة Indexing | محرك البحث يقرر هل يحفظ الصفحة في فهرسه، وتحت أي رابط | الصفحة فيها noindex، أو مكررة، أو صفحة خطأ |
| 5. الترتيب Ranking | محرك البحث يقرر مكان الصفحة لكل عبارة بحث | صفحة أخرى أنفع للباحث |
ولتتخيل الحجم: تقول Google في صفحة تنظيم المعلومات إن فهرسها يضم مئات المليارات من الصفحات. لذلك لا يزور محرك البحث كل صفحة كل يوم، ويختار ما يزوره بحسب ما يعرفه عن الموقع.
المرحلة 1: الاكتشاف Discovery
لا يوجد سجل مركزي للصفحات. فمحرك البحث يعرف صفحتك من طريقين فقط:
- رابط إليها في صفحة يعرفها.
- خريطة الموقع Sitemap، وهي ملف فيه قائمة بروابط موقعك ترسله أنت إلى محرك البحث.
والصفحة التي لا يصل إليها أي رابط، وليست في خريطة الموقع، تسمى «الصفحة اليتيمة» Orphan Page. وقد لا يجدها محرك البحث أبداً.
مثال شائع: فريق التصميم يضع زر «الأسعار» بشكل جميل، لكنه مبرمج كزر وليس كرابط عادي. والزر لا يعتبر رابطاً عند Google. فإذا لم تكن صفحة الأسعار في خريطة الموقع أيضاً، فلن يجدها محرك البحث. والحل أن يكون الزر رابطاً عادياً بنفس الشكل.
المصدر: إرشادات Google عن الروابط.
المرحلة 2: الزحف Crawling
الزاحف Crawler برنامج يفتح الصفحات كما يفتحها المتصفح. واسمه عند Google هو Googlebot.
نسخة الهاتف أولاً: Google تقرأ أغلب المواقع اليوم بنسخة الهاتف، وتسمي هذا الفهرسة بنسخة الهاتف أولاً Mobile-first Indexing. فإذا كانت نسخة الهاتف من موقعك تخفي جزءاً من المحتوى، فهذا الجزء غير موجود في نظر Google.
ملف robots.txt: قبل أن يزحف، يقرأ الزاحف ملفاً صغيراً اسمه robots.txt في موقعك. فيه قواعد بسيطة: أي الأقسام يسمح له بزيارتها، وأيها لا. وتقرأ Google منه أول 500 KiB فقط.
ميزانية الزحف Crawl Budget: هي عدد الصفحات التي يزورها Googlebot في موقعك خلال فترة. وتقول Google في دليلها إنها تهم المواقع الكبيرة فقط: أكثر من مليون صفحة تتغير كل أسبوع، أو أكثر من عشرة آلاف صفحة تتغير كل يوم. فإذا كان موقعك فيه مئتا صفحة، فلا تشغل نفسك بها. مشكلتك غالباً في الاكتشاف أو المحتوى.
كيف يقرأ الزاحف ملف robots.txt؟
اقترح Martijn Koster هذا الملف في 1994، وبقي قرابة ثلاثين سنة اتفاقاً غير مكتوب. ثم صدر معيار RFC 9309 في سبتمبر 2022 وحدد قواعده. وأهم ما يعنيك منها ثلاث قواعد:
| ماذا يرد موقعك عندما يطلب الزاحف الملف | ماذا يفهم الزاحف |
|---|---|
| الملف موجود ويفتح بشكل طبيعي | يطبق القواعد التي فيه. وإذا تعارضت قاعدتان، تطبق الأكثر تحديداً |
| الملف غير موجود (خطأ 404) | لا قيود، كل شيء مسموح |
| السيرفر يرد بخطأ، مثل 503 أثناء الصيانة | يفترض أن كل الموقع ممنوع، ولا يزور أي صفحة ما دام الخطأ مستمراً |
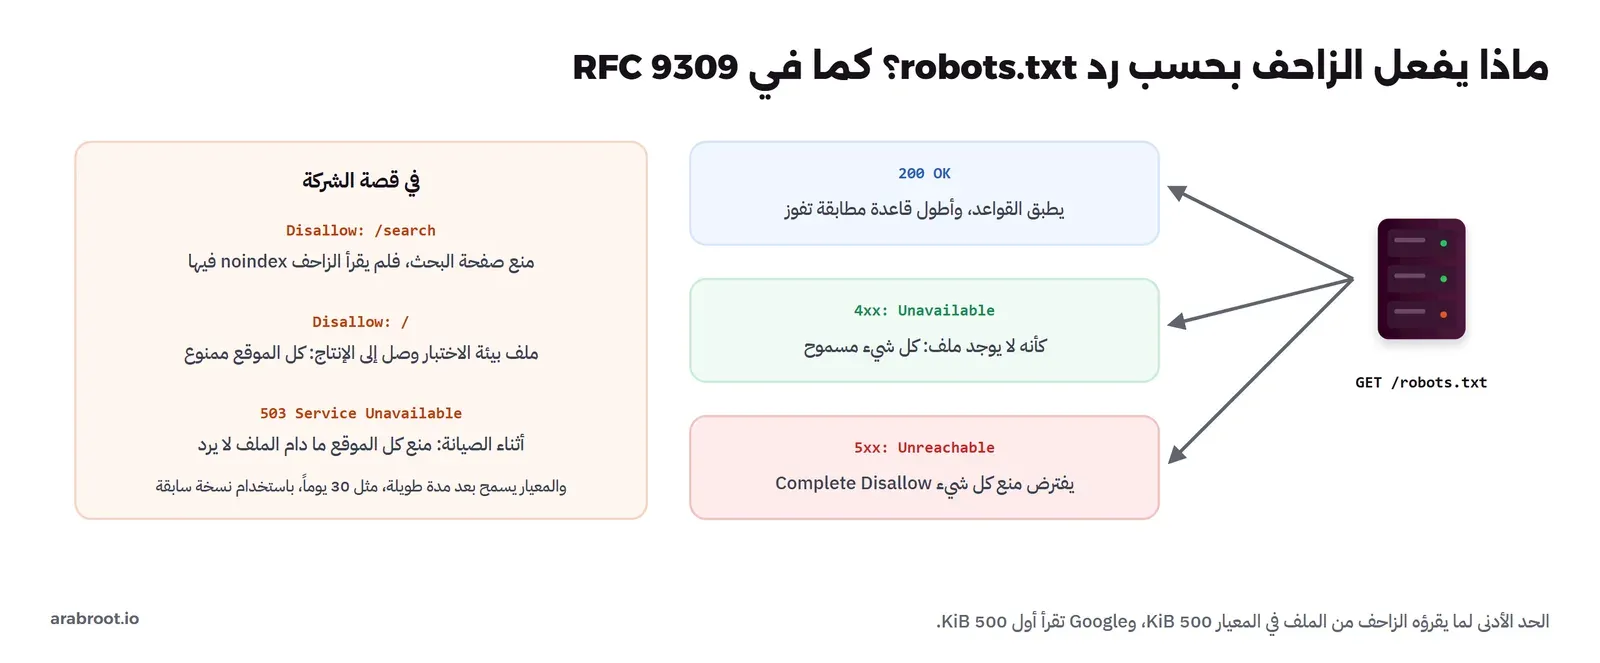
خطآن شائعان يمنعان الموقع كله:
- صفحة الصيانة: يضع الفريق صفحة «الموقع تحت الصيانة» أمام الموقع كله، فترد بخطأ 503 على كل طلب، ومنها ملف robots.txt. فيتوقف الزاحف عن زيارة الموقع كله ما دامت الصيانة. والحل: اطلب من الفريق أن يستثني هذا الملف من صفحة الصيانة.
- ملف بيئة الاختبار: بيئة الاختبار Staging نسخة من الموقع يجرب فيها الفريق قبل النشر. وملف robots.txt فيها يمنع كل شيء. فإذا انتقل هذا الملف مع النشر إلى الموقع الحقيقي، يمنع محرك البحث من موقعك كاملاً. والحل: فحص آلي بعد كل نشر يتأكد أن الملف لا يمنع الموقع كله.
المرحلة 3: التصيير Rendering
بعض المواقع تبني محتوى الصفحة داخل المتصفح بعد أن تفتح، بلغة JavaScript. فما يقرؤه الزاحف أولاً يكون قالباً شبه فارغ، والمحتوى يظهر لاحقاً.
وتشرح Google في أساسيات JavaScript وSEO أن هذه الصفحات تدخل طابور انتظار Render Queue، ثم يشغلها Google ليرى محتواها. وهذا يعني أمرين:
- المحتوى الذي يبنى في المتصفح يتأخر في الوصول إلى Google.
- محركات بحث وأدوات أخرى لا تشغل JavaScript أصلاً، فلا ترى هذا المحتوى أبداً.
مثال: صفحة المدونة الرئيسية تجلب قائمة المقالات بعد أن تفتح. فكل مقال جديد ينتظر دوره في الطابور حتى يكتشف. والحل الذي يقترحه المطور عادة: أن تبنى صفحات المدونة كاملة عند النشر، ويسمى هذا التوليد المسبق Static Site Generation. فالمحتوى لا يتغير بين زائر وآخر، فلا داعي لبنائه في متصفح كل زائر.
المرحلة 4: الفهرسة Indexing
بعد أن يرى محرك البحث محتوى الصفحة، يقرر هل يحفظها في فهرسه، وتحت أي رابط. وأهم ما يحدث هنا ثلاثة أمور:
- اختيار رابط واحد للمحتوى المكرر: نفس الصفحة قد تصل من عدة روابط، مثل رابط فيه وسوم حملة تسويقية UTM ورابط دونها. فيختار Google رابطاً واحداً يمثلها، ويسمى «الرابط القانوني» Canonical. وفي صفحة دمج الروابط المكررة ترتب Google الإشارات: التحويل Redirect من الرابط القديم إلى الجديد إشارة قوية، ووسم الرابط القانوني إشارة قوية، والوجود في خريطة الموقع إشارة ضعيفة.
- معرفة اللغة: تعرفها Google من نص الصفحة نفسه، كما في توثيق النسخ المحلية.
- رفض الصفحة: إذا كان فيها وسم noindex، أو كانت مكررة واختير غيرها، أو كانت صفحة خطأ تقول «غير موجود» لكن السيرفر يرد عليها كأنها صفحة سليمة. وهذه الأخيرة تسميها Google «الخطأ اللين» Soft 404 في توثيق رموز HTTP. والحل أن يرد السيرفر برمز «غير موجود» الحقيقي 404 أو 410.
أربع أدوات بيد فريقك Controls
أكثر خطأ شائع هو الخلط بين هذه الأدوات. مثلاً: يستخدم الفريق robots.txt ليخفي صفحة من النتائج، وهذا لا يخفيها. والصورة والجدول التاليان يفصلان بينها:
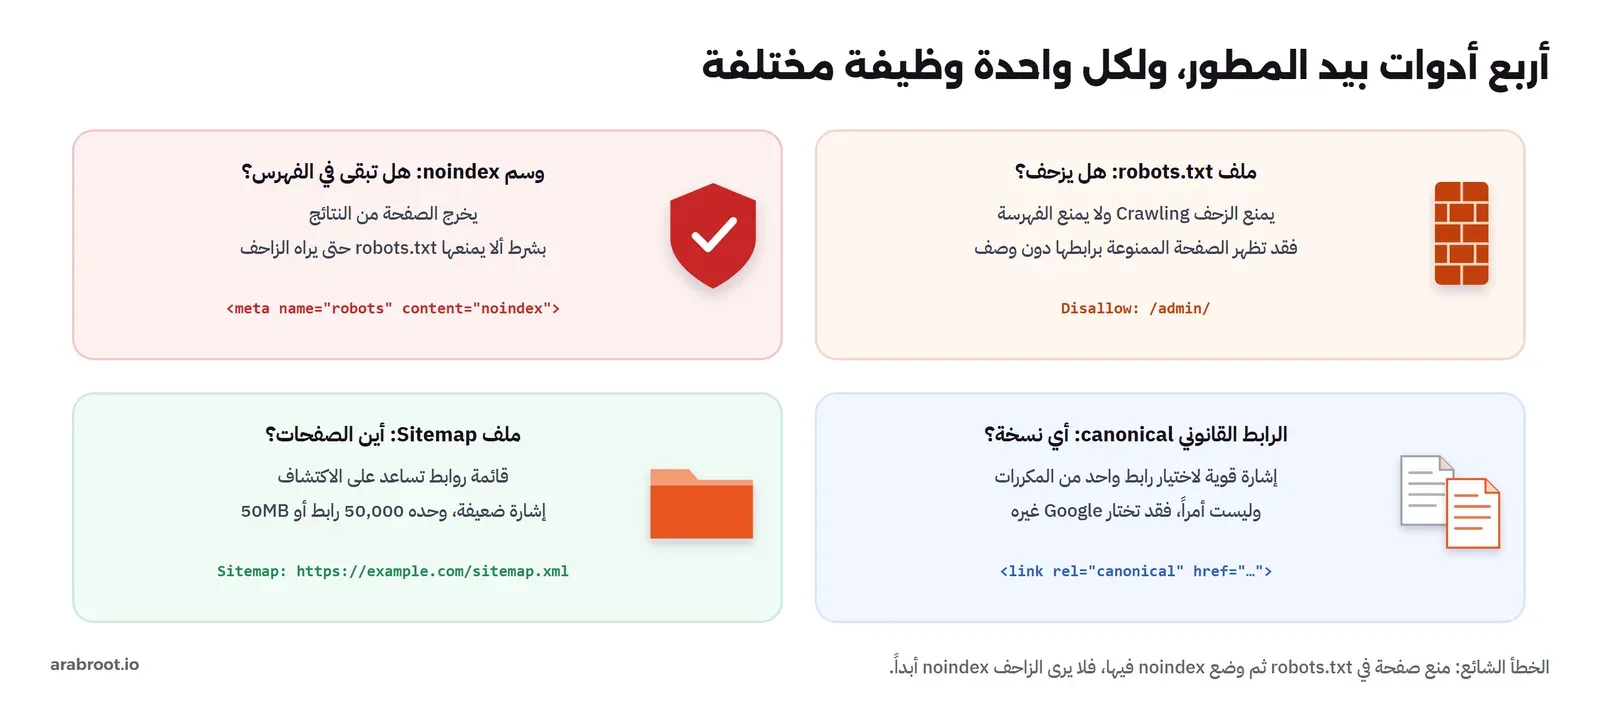
| الأداة | ما هي | ماذا تفعل | ماذا لا تفعل |
|---|---|---|---|
| robots.txt | ملف قواعد للزاحف | تمنع الزاحف من زيارة أقسام معينة، وتخفف الضغط Load عن السيرفر | لا تخفي الصفحة من النتائج، فقد تظهر برابطها إذا أشارت إليها مواقع أخرى |
| noindex | وسم داخل الصفحة، يسمى وسم robots | يخرج الصفحة من نتائج البحث | لا يعمل إذا كانت الصفحة ممنوعة في robots.txt، لأن الزاحف لن يقرأه |
| الرابط القانوني Canonical | وسم يقترح الرابط الرئيسي للصفحة | يقترح رابطاً واحداً لصفحات متشابهة | ليس أمراً، فقد يختار Google رابطاً آخر |
| خريطة الموقع Sitemap | قائمة بروابط موقعك وتاريخ آخر تعديل لكل منها | تساعد محرك البحث على الاكتشاف | لا تضمن الفهرسة، وتتجاهل Google حقلي الأولوية ومعدل التغيير فيها |
القاعدة التي تفاجئ أغلب الناس: لكي تخرج صفحة من النتائج، يجب أن تسمح للزاحف بقراءتها، ثم تضع فيها noindex. فإذا منعتها في robots.txt، لن يقرأ الزاحف وسم noindex أبداً، وقد يبقى رابطها في النتائج.
الترتيب Ranking: ما الذي نعرفه من Google؟
لا يوجد ترتيب ثابت لصفحة. لكل بحث ترتيب يتغير بحسب لغة الباحث ومكانه وجهازه. وGoogle لا تنشر وزن كل عامل. فكل قائمة تقول «200 عامل ترتيب بأوزانها» هي تخمين.
وهذا ما تنشره Google رسمياً:
| ما تنشره Google | معناه ببساطة | المصدر |
|---|---|---|
| أنظمة الترتيب Ranking Systems | أنظمة لها أسماء، منها نظام فهم المعنى، ونظام المحتوى الأصلي، ونظام الروابط، ونظام مكافحة الإزعاج SpamBrain | دليل أنظمة الترتيب |
| المحتوى المفيد People-first Content | أسئلة يسألها الكاتب لنفسه: هل في المحتوى معلومات أصلية؟ هل يخرج القارئ وقد حصل على ما يكفيه؟ | إرشادات المحتوى المفيد |
| تجربة الصفحة Page Experience | سرعة الصفحة وثباتها تستخدمها أنظمة الترتيب | صفحة تجربة الصفحة |
| سياسات الإزعاج Spam Policies | ما يخفض الموقع أو يخرجه: حشو الكلمات المفتاحية، وإنتاج صفحات كثيرة لغرض الترتيب، وشراء الروابط | صفحة سياسات الإزعاج |
مؤشرات أداء الويب الأساسية Core Web Vitals
هي ثلاثة أرقام تقيس تجربة الزائر. والحدود الجيدة في توثيق Google:
| المؤشر | ماذا يقيس | الحد الجيد |
|---|---|---|
| LCP | متى يظهر أكبر عنصر في الصفحة | خلال 2.5 ثانية |
| INP | سرعة استجابة الصفحة عندما تضغط شيئاً | أقل من 200 ملي ثانية |
| CLS | اهتزاز الصفحة وتحرك العناصر أثناء التحميل | أقل من 0.1 |
وتقاس عند النسبة المئوية 75 من زيارات المستخدمين الحقيقيين. أي أن 75% من زوارك على الأقل يجب أن يحصلوا على الحد الجيد.
هل درجة 100 في Lighthouse ترفع الترتيب؟ لا. Lighthouse أداة تقيس الصفحة في جهاز وشبكة تجريبيين. أما Google فتعتمد على قياسات زوارك الحقيقيين، وتجدها في تقرير Core Web Vitals في Search Console. فالدرجة مفيدة لتعرف أين المشكلة، وليست هدفاً بذاتها.
صفحات كثيرة من قالب واحد Scaled Content
في مارس 2024 أعلنت Google تحديثاً للترتيب وسياسات جديدة للإزعاج. ومنها «إساءة استخدام المحتوى بالجملة» Scaled Content Abuse، أي إنتاج صفحات كثيرة بأي وسيلة، بشرية أو آلية، لغرض الترتيب وليس لخدمة القارئ.
وقالت في إعلانها إنها توقعت أن ينخفض المحتوى الضعيف وغير الأصلي في النتائج بنسبة 40%. ثم كتبت في 26 أبريل 2024، بعد اكتمال التحديث، أن الانخفاض وصل إلى 45%.
مثال على فكرة تسمعها كثيراً: صفحة لكل مدينة ولكل قطاع، مثل «نظام حضور وانصراف في الرياض» و«نظام حضور وانصراف للمستشفيات في الدمام»، كلها من قالب واحد يتغير فيه الاسم فقط. الفكرة سهلة التنفيذ، لكنها بالضبط ما تستهدفه السياسة. والبديل الأفضل: صفحة لكل قطاع لك فيه عملاء حقيقيون، فيها ما يختلف فعلاً لذلك القطاع، مع مثال من عميل وافق على ذكره.
كيف تظهر صفحتك في النتائج Search Result
عندما تظهر صفحتك في البحث، تتكون النتيجة من أجزاء يكتبها فريقك في الصفحة:
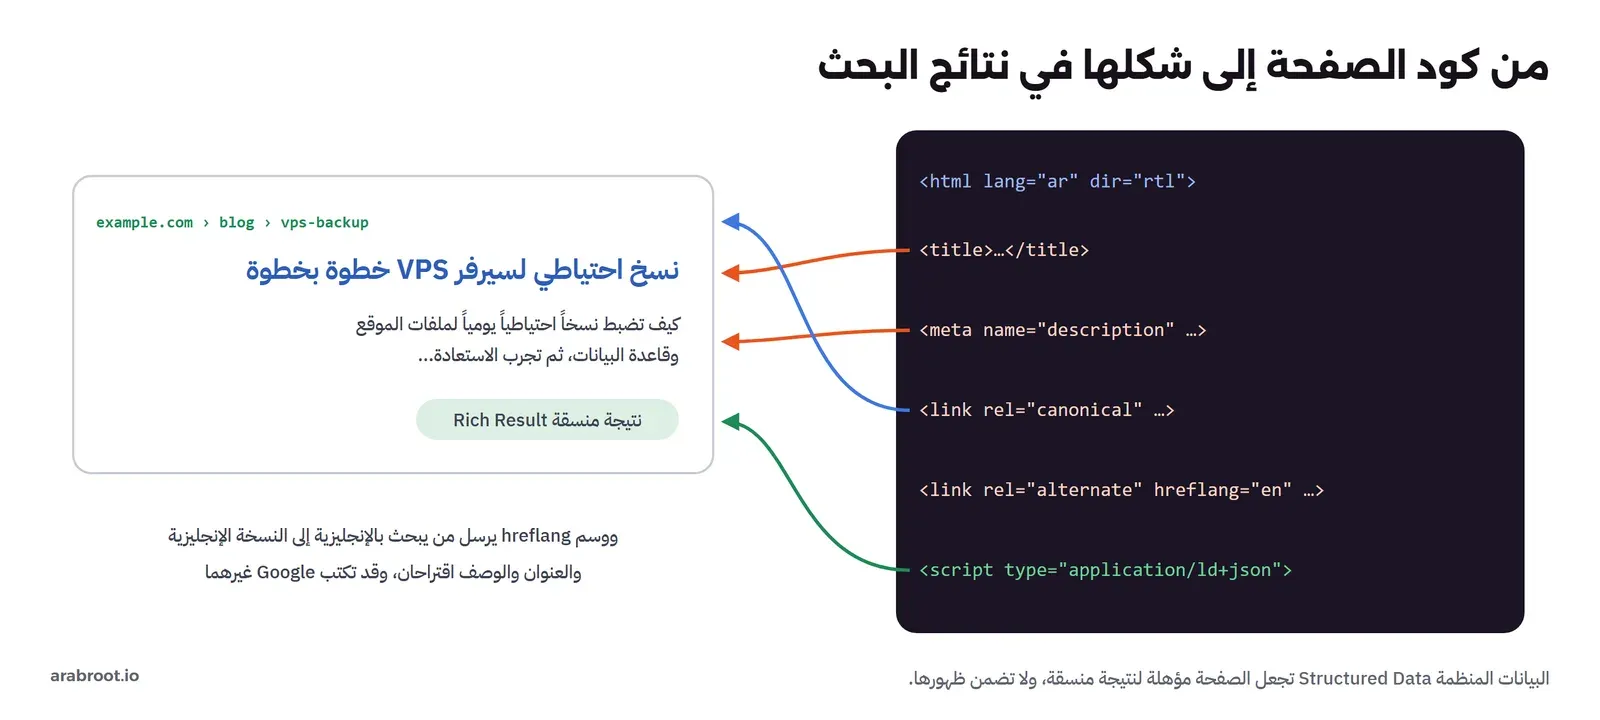
| الجزء | من أين يأتي | ما يجب أن تعرفه |
|---|---|---|
| العنوان Title Link | غالباً من عنوان الصفحة الذي يكتبه فريقك | Google تنشئه آلياً وقد تغيره، ولا يوجد حد لطوله، وإنما يقطع بحسب عرض الشاشة. المصدر: توثيق روابط العناوين |
| الوصف Snippet | من وصف الصفحة Meta Description إذا كان يصفها أفضل من نصها | الوصف ليس عامل ترتيب، لكنه يشجع على النقر. المصدر: توثيق المقتطفات |
| النتائج المنسقة Rich Results | من البيانات المنظمة Structured Data بمفردات schema.org | تجعل الصفحة مؤهلة لعرض التقييمات والأسئلة الشائعة والوصفات، ولا تضمنه. المصدر: مقدمة البيانات المنظمة |
| الصور | من نص بديل يصف الصورة، واسم ملف له معنى | المصدر: إرشادات صور Google |
ما يخص المواقع العربية Arabic Sites
- رمز اللغة hreflang: إذا كان موقعك بأكثر من لغة، يكتب الفريق رمز كل نسخة. والعربية رمزها ar، وللسعودية ar-SA، ولمصر ar-EG. ولا تكتب رمز الدولة وحده مثل sa، لأنه رمز صحيح لكن للغة السنسكريتية، فلا ترفضه الأدوات وتقع في الخطأ. المصدر: توثيق النسخ المحلية.
- اللغة والاتجاه في الصفحة: اطلب أن تحمل كل صفحة إعداد اللغة العربية والاتجاه من اليمين. Google لا تعتمد عليه لمعرفة اللغة، لكن المتصفح وقارئ الشاشة وأدوات الترجمة تعتمد عليه.
- أطوال العناوين في الأدوات: بعض أدوات SEO تعد البايتات وليس الحروف. والحرف العربي بايتان في ترميز UTF-8، فتنبهك الأداة أن عنواناً عربياً من 50 حرفاً «طويل»، وهو ليس كذلك.
روابط عربية أم إنجليزية؟ URL Slugs
توصي Google في إرشادات بنية الروابط بكلمات وصفية بلغة جمهورك، وبالشرطة بين الكلمات.
والرابط العربي يظهر مقروءاً في المتصفح ونتائج البحث. لكن عندما تنسخه في بعض التطبيقات يتحول إلى رموز طويلة. والسبب أن الحرف العربي بايتان، وكل بايت يكتب بثلاثة رموز مثل %D8. أي أن الحرف العربي الواحد يصبح 6 رموز عند النسخ. فكلمة عربية من خمسة حروف تصبح 30 رمزاً.
وكم يطول الرابط العربي فعلاً؟ قسنا في أكتوبر 2026 كل الروابط في جدول نشر موقع عرب رووت، وهو يستخدم روابط عربية، وعددها 698 رابطاً:
| القياس (الوسيط Median) | الطول |
|---|---|
| الحروف كما تراها في المتصفح | 40 حرفاً |
| البايتات بترميز UTF-8 | 65 بايتاً |
| الطول حين ينسخ الرابط مرمزاً | 163 رمزاً، أي أربعة أضعاف ما يراه القارئ تقريباً |
ووجدنا أن 180 رابطاً من 698 تتجاوز 200 رمز بعد الترميز، وأطولها 301. وهذا ما يجعل الرابط العربي يبدو طويلاً جداً في رسالة بريد أو تقرير.
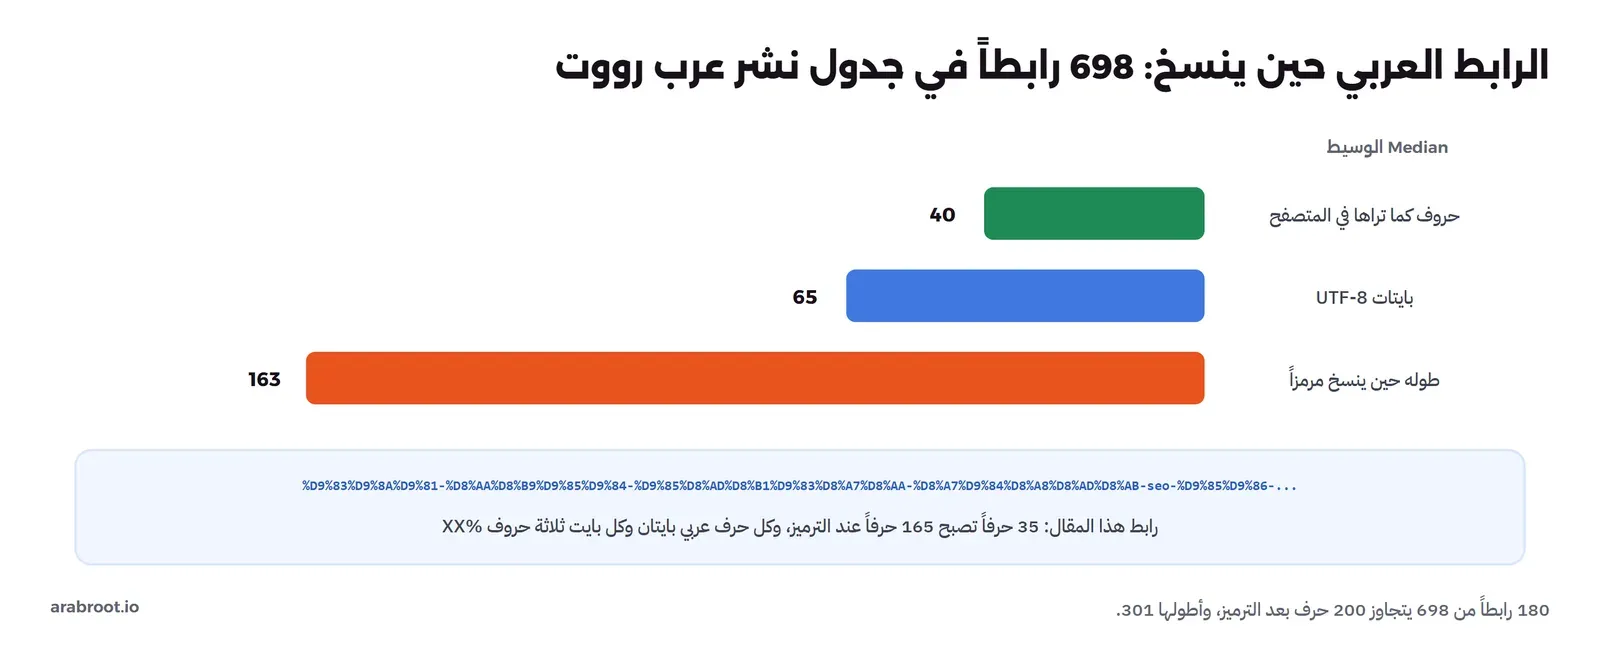
فالرابط العربي مقروء حيث يفك الترميز، أي في المتصفح ونتائج البحث، وطويل في كل مكان آخر.
القرار العملي:
- روابط عربية للمقالات، لأنها تقرأ في نتائج البحث وتخبر القارئ بالموضوع قبل أن يضغط.
- روابط إنجليزية قصيرة للصفحات التي تطبع أو تكتب يدوياً، مثل صفحة الأسعار.
- رابط مختصر للحملات، كما شرحنا في مقال الروابط المختصرة.
- والأهم أن يبقى القرار ثابتاً. فتغيير الروابط بعد النشر يحتاج تحويلاً من كل رابط قديم إلى الجديد.
Bing وIndexNow ونتائج الذكاء الاصطناعي
- Bing: له أداة مثل Search Console اسمها Bing Webmaster Tools.
- IndexNow: طريقة يخبر بها موقعك محركات البحث المشاركة، مثل Bing، بكل صفحة جديدة أو معدلة أو محذوفة فور تغيرها، بدل انتظار الزاحف. وهي مفيدة لموقع ينشر كثيراً. لكن Google لا تذكرها ضمن طرقها، فخريطة الموقع تبقى الطريق الموثق إليها. المصدر: توثيق IndexNow.
- ملخصات الذكاء الاصطناعي: مثل AI Overviews وAI Mode في Google. وتقول Google في صفحة ميزات الذكاء الاصطناعي إنه لا توجد متطلبات إضافية للظهور فيها، وإن أساسيات SEO نفسها هي المطلوبة.
ماذا تفعل لموقعك: ست خطوات Steps
الخطوة 1: سجل موقعك في Search Console وBing
ما هي: أداتان من Google وBing تخبرانك كيف يرى محرك البحث موقعك.
لماذا تهم: بدونها لا تعرف أي صفحاتك ظهرت وأيها لم تظهر.
المصدر: Search Console، وBing Webmaster Tools.
الخطوة 2: أرسل خريطة الموقع Sitemap
ماذا تطلب من المطور: خريطة موقع تتولد آلياً من نظام إدارة المحتوى، فيها كل الصفحات وتاريخ آخر تعديل حقيقي لكل منها. ثم أرسلها في الأداتين.
لماذا تهم: تحل مشكلة الاكتشاف للصفحات التي لا يصل إليها رابط. لكنها لا تغني عن الروابط الداخلية.
الخطوة 3: افتح تقرير الصفحات Pages
ما هو: تقرير في Search Console يعرض الصفحات التي لم تدخل الفهرس، وسبب كل منها.
لماذا يهم: يجيب عن سؤال بداية المقال: أين توقفت الصفحة؟ وابحث فيه خاصة عن: «ممنوعة بملف robots.txt»، و«مكررة»، و«خطأ لين Soft 404».
الوقت: ربع ساعة كل أسبوع.
الخطوة 4: افحص أهم صفحاتك URL Inspection
ما هي: أداة في Search Console تكتب فيها رابط صفحة، فتعرض كيف رآها Googlebot آخر مرة، وهل هي مفهرسة، وأي رابط اختاره Google رابطاً قانونياً. وتسمح لك بطلب الفهرسة.
انتبه: طلب الفهرسة لا يضمنها ولا يرفع الترتيب. هو يضع الصفحة في طابور الانتظار فقط.
الخطوة 5: افحص robots.txt بعد كل إطلاق أو صيانة
لماذا تهم: كما رأينا، ملف بيئة الاختبار أو صفحة الصيانة قد يمنعان الموقع كله دون أن ينتبه أحد.
ماذا تطلب من المطور: فحص آلي بعد كل نشر يتأكد أن الملف يفتح بشكل طبيعي ولا يمنع الموقع كله، وأن صفحة الصيانة تستثنيه.
الخطوة 6: قس كل أسبوع، ولا تنتظر
متى تظهر النتيجة؟ Google لا تعطي مدة. فالأفضل أن تقيس: تقرير الصفحات كل أسبوع، وعدد الصفحات المفهرسة، والعبارات التي بدأت تظهر فيها صفحاتك في تقرير الأداء.
وأدوات القياس المجانية ومفتوحة المصدر هي موضوع مقال أدوات SEO في هذه المرحلة.
من يملك ماذا في الفريق؟
| المرحلة | المسؤول غالباً | ماذا يفعل |
|---|---|---|
| الاكتشاف والزحف | المطور | روابط عادية لكل صفحة مهمة، وخريطة موقع آلية، وملف robots.txt صحيح، وتحويل من كل رابط قديم تغير |
| التصيير | المطور | محتوى الصفحة جاهز من السيرفر، وليس مبنياً في المتصفح فقط |
| الفهرسة | المطور مع صاحب المحتوى | رابط قانوني صحيح، وnoindex لصفحات البحث الداخلي والفلاتر، وصفحة «غير موجود» حقيقية |
| الترتيب | صاحب المحتوى أولاً، والمطور في السرعة | محتوى يجيب عن سؤال الباحث، وصفحة سريعة، وروابط من مواقع أخرى تكسبها بالمحتوى |
| شكل النتيجة | الاثنان | عنوان ووصف لكل صفحة من نظام إدارة المحتوى، وبيانات منظمة في القالب |
ورتب الإصلاح بحسب المرحلة: الزحف أولاً، ثم الاكتشاف، ثم الفهرسة، ثم شكل النتيجة. فإصلاح الترتيب لا يفيد صفحة لم تفهرس، وإصلاح الفهرسة لا يفيد صفحة لم تكتشف.
وإذا أردت أن ترى هذه المفاهيم مطبقة على موقع حقيقي، فقد شرحناها لفريقك التقني في مختبر SEO التقني.
أخطاء شائعة Common Mistakes
| الخطأ | لماذا يحدث | كيف تلاحظه في Search Console |
|---|---|---|
| ملف robots.txt من بيئة الاختبار في الموقع الحقيقي | ملف واحد لكل البيئات | صفحات كثيرة «ممنوعة بملف robots.txt» فجأة |
| منع صفحة في robots.txt ووضع noindex فيها | الظن أن المنع أقوى | روابط تظهر في النتائج دون وصف |
| أزرار بدل روابط | تصميم الواجهة لا يستخدم الروابط العادية | صفحة موجودة في خريطة الموقع فقط |
| صفحة «غير موجود» ترد كأنها سليمة | الموقع يعرض الرسالة دون رمز الخطأ | Soft 404 في تقرير الصفحات |
| تغيير الروابط دون تحويل | إعادة تصميم الموقع | زيادة أخطاء 404، واختفاء صفحات كانت تظهر |
| روابط حملات UTM دون رابط قانوني | روابط الحملات داخل الموقع نفسه | «مكررة» في تقرير الصفحات |
قائمة تحقق قبل إطلاق موقع أو إعادة تصميمه Checklist
- ملف robots.txt في الموقع الحقيقي يفتح بشكل طبيعي، ولا يمنع الموقع كله، حتى أثناء الصيانة.
- كل صفحة مهمة يصل إليها رابط عادي من صفحة أخرى، وليس زراً فقط.
- خريطة الموقع آلية ومرسلة إلى Google وBing دون أخطاء.
- الصفحات التي تريد إخفاءها فيها noindex، وغير ممنوعة في robots.txt.
- الصفحة غير الموجودة ترد بخطأ 404 حقيقي.
- كل قالب فيه رابط قانوني، وروابط الحملات تشير إلى الرابط النظيف.
- كل رابط قديم تغير يحول إلى الجديد.
- كل صفحة تحمل إعداد اللغة العربية والاتجاه، ورمز hreflang صحيح.
- قرار ثابت في شكل الروابط: عربية أم إنجليزية.
الخلاصة
- الصفحة تمر بالاكتشاف والزحف والتصيير والفهرسة ثم الترتيب. والتشخيص يبدأ بمعرفة المرحلة التي توقفت فيها.
- الاكتشاف يحتاج روابط عادية وخريطة موقع. والتصيير يحتاج محتوى جاهزاً في الصفحة.
- robots.txt يمنع الزيارة، وnoindex يمنع الظهور، والرابط القانوني وخريطة الموقع إشارتان وليسا أمرين.
- إذا رد ملف robots.txt بخطأ مثل 503، يتوقف الزاحف عن موقعك كله.
- لكي تخرج صفحة من النتائج، اسمح للزاحف بقراءتها، ثم ضع فيها noindex.
- Google تنشر أنظمة الترتيب وحدود Core Web Vitals وسياسات الإزعاج، ولا تنشر الأوزان. وتحديث مارس 2024 خفض المحتوى غير الأصلي في النتائج بنسبة 45% بحسب Google.
- للمواقع العربية: رمز اللغة ar وليس sa، وقرار ثابت في شكل الروابط.
وفي المقالات التالية من المرحلة نطبق هذه المفاهيم على موقع عربي، ثم نقارن الأدوات التي تقيسها:
دليلSEO التقني للمطورين: موقع عربي قبل الإصلاح وبعدهنبني موقعاً عربياً فيه عشر مشكلات تقنية شائعة، ونقيسه بأدوات مفتوحة المصدر، ثم نصلحه ونقيس الفرق بالأرقام.دليلأدوات SEO Tools: التجارية وبدائلها المجانيةما الذي تعطيك إياه Ahrefs وSemrush وMoz فعلاً وكم تكلف في السنة، وما الذي تحصل عليه مجاناً من محركات البحث وأدوات مفتوحة المصدر.دليلالتسويق بالمحتوى Content Marketing: ماذا تكتب ولمن؟كيف تختار موضوعات تجيب عن أسئلة عملائك قبل أن يعرفوك، وترتبها في خطوات واضحة، وتقيس أثرها في البحث والمبيعات.سجل التحديثات
- 2026-11-13: إعادة كتابة المقال بلغة أوضح وخطوات وجداول، دون كود.
- 2026-11-14: مراجعة المقال وإعادة المعلومات المفيدة ونتائج البيانات الحقيقية التي حذفت في إعادة الكتابة.
- أكتوبر 2026: كتابة المقال، والمصادر من توثيق Google Search Central كما ظهر في 25 أكتوبر 2026.
- أكتوبر 2026: توسيع المقال بقسم قراءة robots.txt بحسب RFC 9309، وأخطاء شائعة، وقائمة تحقق.