

في الجزء الثاني بنينا أول نموذج لغة يتوقع الحرف التالي من شعر المتنبي، ووصلت شبكة MLP التي تنظر إلى آخر ثمانية حروف إلى خطأ 2.2123 على نص لم تره، وكتبت كلمات عربية وأبياتاً لها شطران، ولكنها لم تستطع أن تربط الشطر الثاني بالأول، لأنها لا ترى إلا ثمانية حروف، ولأن تكبير النافذة في نفس التصميم يعني أوزاناً منفصلة لكل موضع. وهذه بالضبط المشكلة التي حلتها ورقة Attention Is All You Need سنة 2017 بفكرة الانتباه Attention ومعمارية المحول Transformer، وهي الفكرة التي تقوم عليها كل نماذج GPT حتى اليوم.
وقد شرحنا الفكرة نفسها بالصور في فهم السياق: الانتباه Attention وكتلة Transformer، لذلك لن نعيد الشرح العام هنا، وإنما سوف نكتب كل قطعة بلغة C# فوق محرك الجزء الأول، ونربطها معاً في نموذج GPT صغير، وندربه على المعالج، ونثبت بالتحقق من التدرج أن النموذج كاملاً صحيح، ونرى كيف يتغير الشعر الذي يكتبه أثناء التدريب.
المواضيع في السلسلة:
- محرك التعلم والتفاضل التلقائي Autograd: المشتقة والتدرج وقاعدة السلسلة Chain Rule، والكلاس Tensor، والتحقق من التدرج Gradient Check، والمحسن AdamW.
- أول نموذج لغة يتوقع الحرف التالي: مقسم على مستوى الحرف Character Tokenizer للنص العربي، ثم نموذج Bigram بالعد، ثم نفس النموذج كشبكة مدربة، ثم شبكة MLP تنظر إلى آخر ثمانية حروف، والتدريب على شعر المتنبي.
- ابن نموذج لغة بلغة C# من الصفر (3): GPT صغير بالانتباه Attention والمحول Transformer (الموضوع الحالي).
- تحميل أوزان GPT-2 الحقيقية وتشغيلها: قراءة ملف safetensors، ومقسم BPE الخاص ب GPT-2، والتوليد مع ذاكرة KV Cache، ومقارنة المخرج رقماً برقم مع Hugging Face.
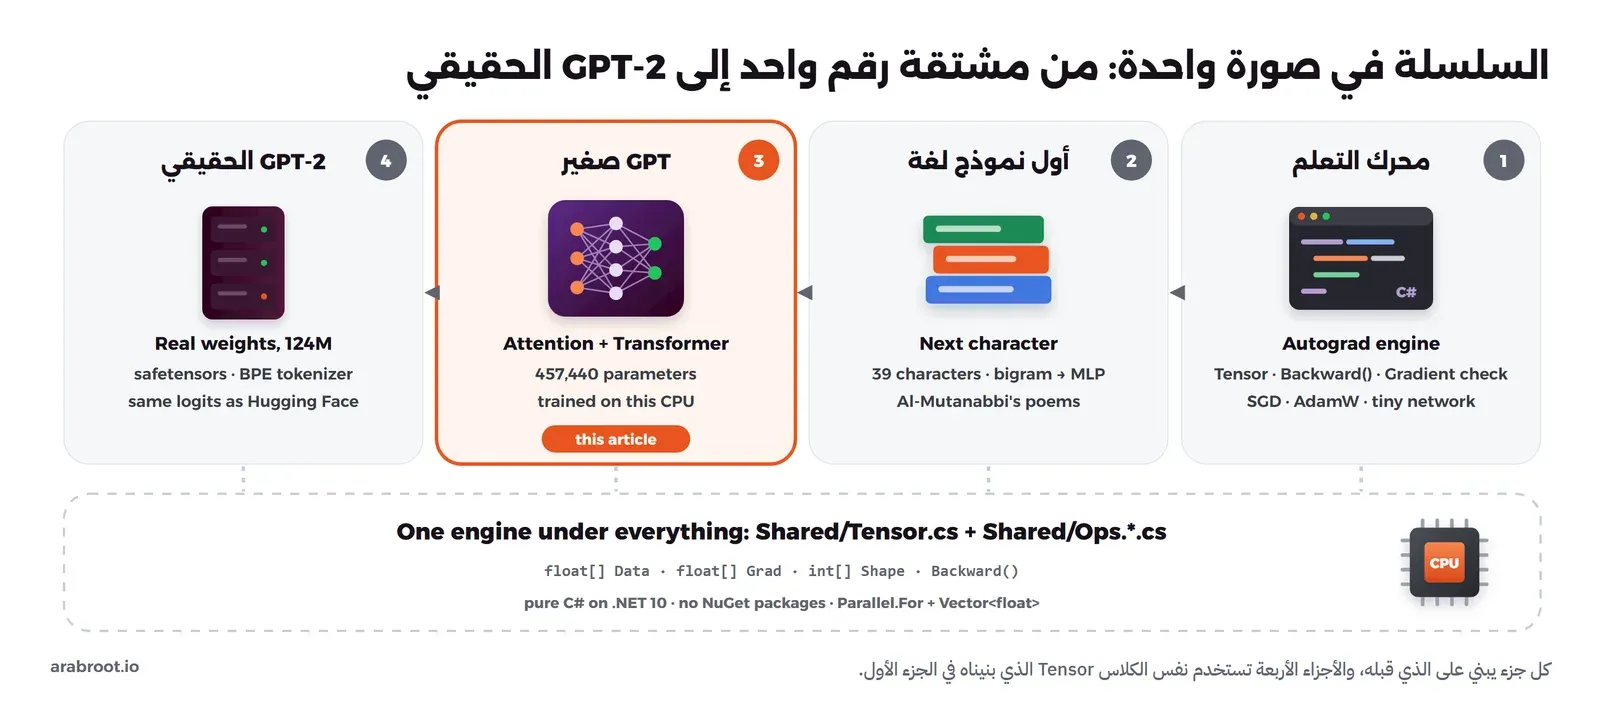
الصورة التالية تبين السلسلة كاملة، والجزء الحالي هو البطاقة الثالثة من اليمين:
وسوف نناقش في هذا المقال ما يلي:
- تضمين التوكن Token Embedding وتضمين الموضع Position Embedding، ولماذا نحتاج الاثنين.
- الانتباه الذاتي Self-Attention برأس واحد: السؤال Query والمفتاح Key والقيمة Value، ثم القناع السببي Causal Mask.
- الانتباه متعدد الرؤوس Multi-Head Attention، والوصلات المتبقية Residual Connections، وتطبيع الطبقة LayerNorm، وطبقة MLP.
- كتلة Transformer كاملة، ثم نموذج GPT صغير فيه 457,440 معاملاً.
- التدريب على المعالج 2500 خطوة، ومنحنى الخطأ Loss Curve، والشعر الذي يكتبه النموذج عند الخطوات 0 و250 و1000 و2500.
- التحقق من التدرج Gradient Check للنموذج كاملاً، وفكرة ذاكرة KV Cache التي نستخدمها في الجزء الرابع.
- لماذا ما زال النموذج ضعيفاً، وما الذي ينقصه.
تشغيل هذا الجزء
الكود في المجلد Part3_TinyGpt/ من نفس المشروع، وهو يستخدم البيانات التي نزلناها في الجزء الثاني، فإذا لم تقم بتنزيلها بعد فابدأ بالأمر download data. وفي هذا الجزء ثلاثة أوامر: التدريب ثم حفظ النموذج، والتحقق من التدرج للنموذج كاملاً، والتوليد من النموذج المحفوظ:
cd content/labs/llm-csharp
dotnet run -c Release -- part3 train        # 2500 خطوة ثم حفظ models/tiny-gpt.bin
dotnet run -c Release -- part3 check        # التحقق من تدرج GPT صغير جداً كاملاً
dotnet run -c Release -- part3 sample 0.8   # توليد نص من النموذج المحفوظ
وكل المخرجات في هذا المقال هي مخرج هذه الأوامر كما ظهر عندنا، وهي محفوظة في الملفات outputs/part3-train.txt وoutputs/part3-loss.csv وoutputs/part3-check.txt وoutputs/part3-sample.txt. والتدريب أخذ عندنا 18 دقيقة على المعالج، ولكن خذ هذا الرقم للتوضيح فقط، لأن الجهاز كان يشغل أعمالاً أخرى في نفس الوقت. وعند بداية التدريب يطبع البرنامج إعدادات النموذج كما يلي:
config: GptConfig { VocabSize = 39, BlockSize = 64, Layers = 4, Heads = 4, Embd = 96 }
parameters: 457,440, batch 32 x 64 = 2048 tokens per step, 2500 steps
CPU: 8 logical processors, Vector<float>.Count = 8
لاحظ أن النموذج ينظر إلى 64 حرفاً (BlockSize) بدلاً من ثمانية، وأن فيه أربع طبقات Layers وأربعة رؤوس Heads وكل حرف يمثله متجه من 96 رقماً (Embd)، وأن كل خطوة تدريب ترى 32 مقطعاً طول كل منها 64 حرفاً، أي 2048 حرفاً، وأن Vector<float>.Count = 8 يعني أن المعالج يضرب ثمانية أرقام في تعليمة واحدة كما شرحنا في الجزء الأول.
تضمين التوكن والموضع Token and Position Embeddings
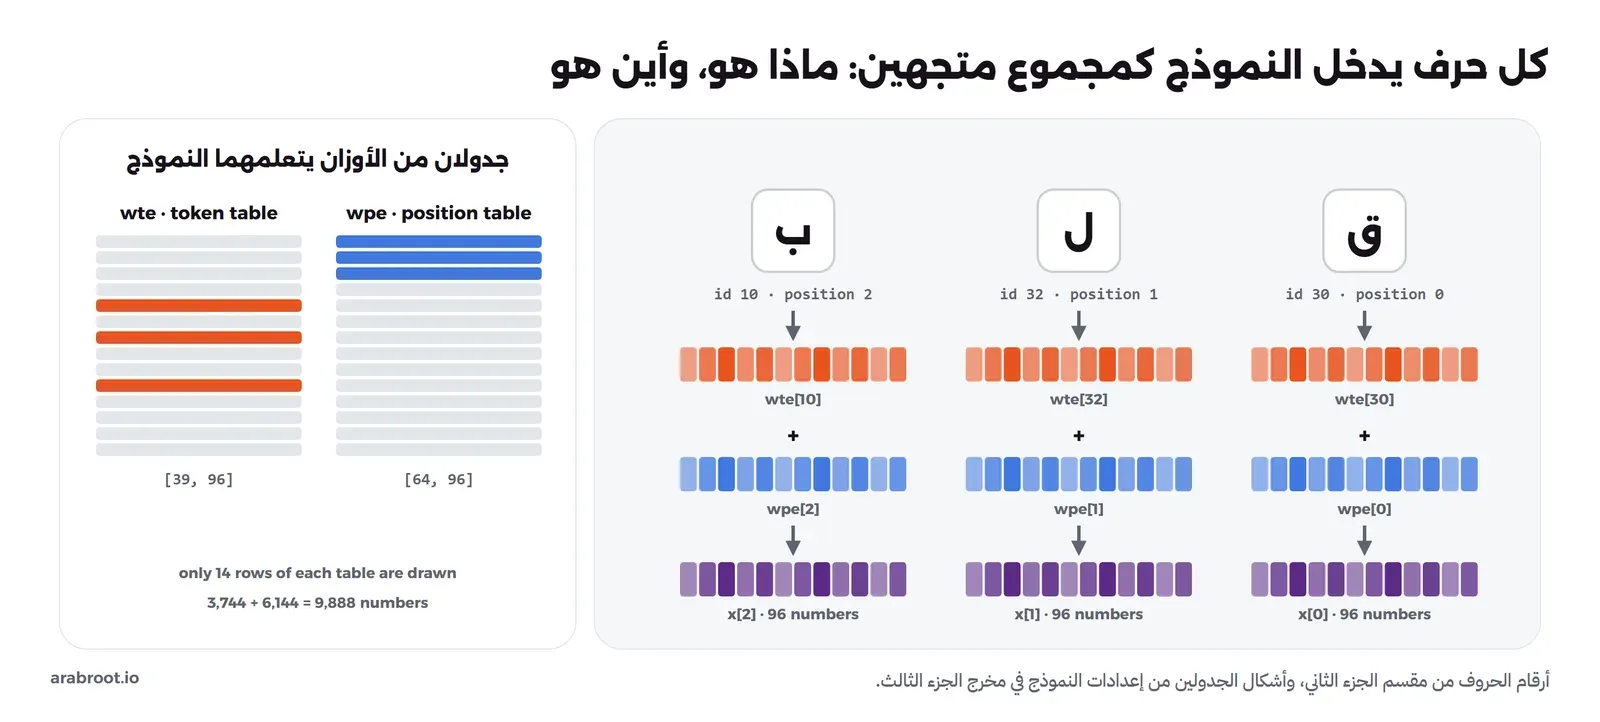
في الجزء الثاني كان لكل موضع في النافذة أوزانه الخاصة، فالنموذج يعرف موضع الحرف من مكانه في المتجه الطويل. أما في Transformer فكل المواضع تمر على نفس الأوزان، وهذا هو سر قدرته على التعامل مع نافذة طويلة، ولكنه يطرح مشكلة: إذا كانت كل المواضع تعامل بنفس الطريقة، فكيف يعرف النموذج أن «ق» جاءت قبل «ل» وليس بعدها؟ والحل في GPT بسيط: جدولان من الأوزان، الأول wte فيه متجه لكل حرف (ماذا هو الحرف)، والثاني wpe فيه متجه لكل موضع من 0 إلى 63 (أين هو الحرف)، ونجمع المتجهين. والكود التالي من الملف Part3_TinyGpt/Gpt.cs:
// ids: [B*T] token ids -> logits [B, T, V]
public Tensor Forward(int[] ids, int batch, int t)
{
    if (t > Config.BlockSize) throw new ArgumentException($"sequence {t} longer than block size {Config.BlockSize}");
    var tok = Ops.Embedding(wte, ids, batch, t);                          // [B, T, C] what each token is
    var pos = Ops.Embedding(wpe, Enumerable.Range(0, t).ToArray(), t);    // [T, C] where it is
    var x = Ops.Add(tok, pos);                                           // positions repeat for every sample
    foreach (var block in blocks) x = block.Forward(x);
    x = lnF.Forward(x);
    return Ops.MatMulT(x, wte);   // weight tying: the same table turns vectors back into token scores
}
الصورة التالية تبين ذلك على أول ثلاثة حروف من كلمة «قلب»:
في الكود أعلاه لاحظ التالي:
- العملية
Ops.Embeddingهي نفسها التي استخدمناها في الجزء الثاني، والجمعOps.Addيكرر متجهات المواضع لكل مقطع في الدفعة Batch تلقائياً (وهذا ما يسمى Broadcast في الجزء الأول). - السطر الأخير يستخدم نفس الجدول
wteمرة ثانية ليحول المتجه النهائي إلى درجة لكل حرف، بضرب المتجه فيwteمقلوباً (MatMulT)، وهذا يسمى ربط الأوزان Weight Tying، والفكرة أن الحرف الذي يشبه متجهه المتجه النهائي يأخذ درجة عالية، وهو نفس ما يفعله GPT-2، ويوفر جدولاً كاملاً من الأوزان. - جدول المواضع فيه 64 صفاً فقط، لذلك لا يستطيع النموذج أن يرى أكثر من 64 حرفاً، والدالة ترفض أي مقطع أطول بخطأ واضح بدلاً من أن تقرأ ذاكرة خارج الجدول.
الانتباه الذاتي Self-Attention: بحث مرجح بالسؤال Query والمفتاح Key والقيمة Value
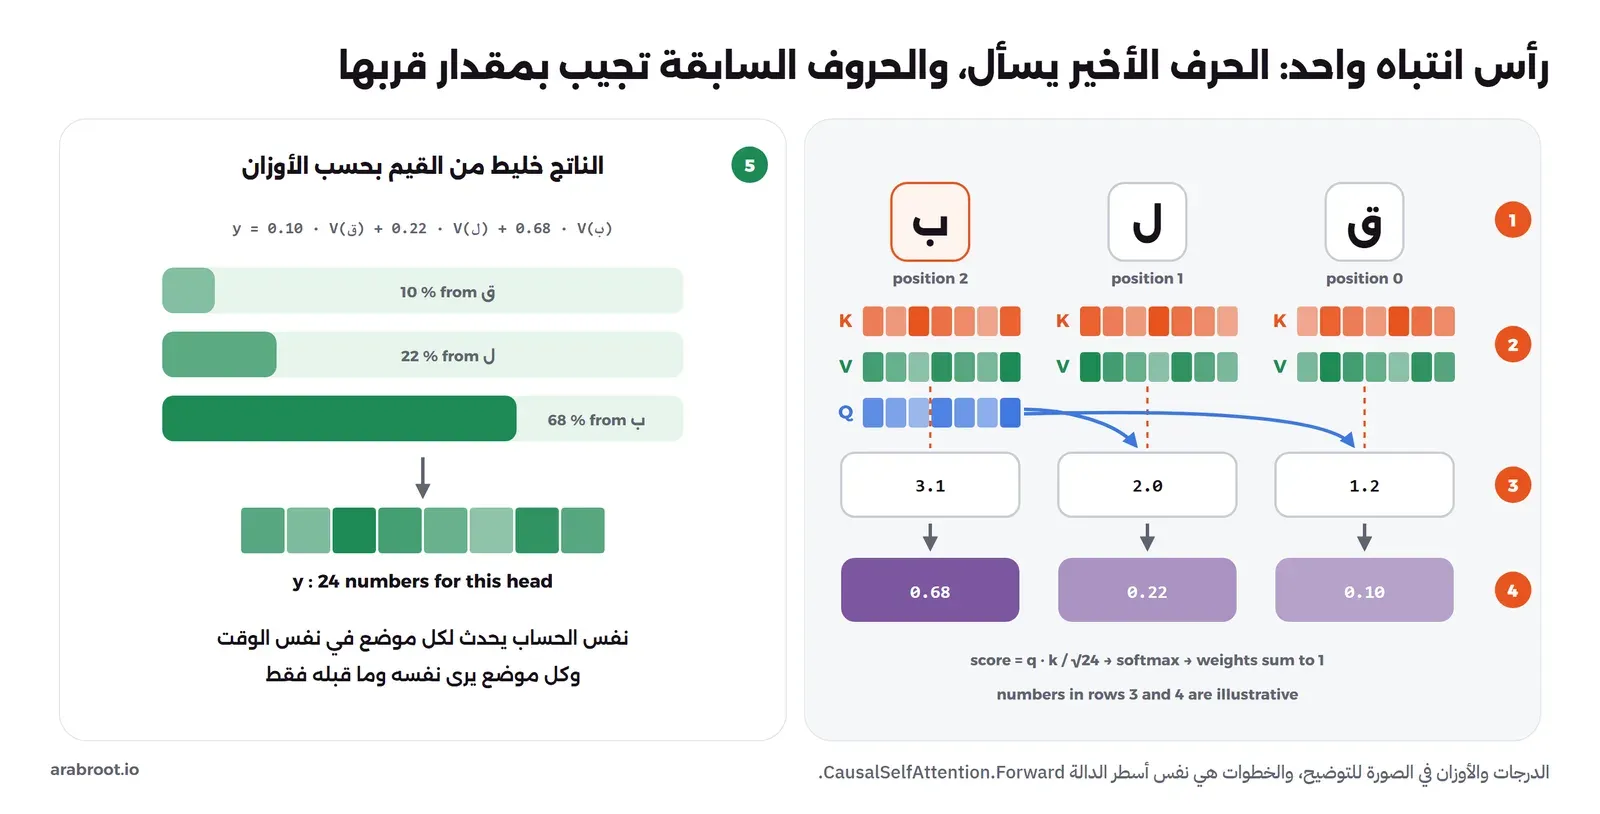
الآن كل حرف متجه من 96 رقماً، ولكن كل متجه لا يعرف شيئاً عن الحروف التي قبله، والانتباه Attention هو الطريقة التي يجمع بها كل موضع معلومات من المواضع السابقة. والفكرة تشبه البحث في قاموس C# من نوع Dictionary، ولكن بشكل تقريبي: كل موضع يصنع من متجهه ثلاثة متجهات بثلاث طبقات خطية، الأول السؤال Query («ما الذي أبحث عنه؟»)، والثاني المفتاح Key («ما الذي أحمله؟»)، والثالث القيمة Value («ما الذي أعطيه إذا اخترتني؟»). ثم يقارن سؤال كل موضع بمفاتيح كل المواضع بالضرب النقطي Dot Product، فالمفتاح الذي يشبه السؤال يعطي رقماً كبيراً، ثم نحول الأرقام إلى أوزان مجموعها 1 بالدالة Softmax، ونجمع القيم مضروبة في هذه الأوزان. فبدلاً من أن نأخذ قيمة واحدة كما يفعل القاموس، نأخذ خليطاً من كل القيم بحسب قربها من السؤال.
الصورة التالية تبين هذه الخطوات لموضع واحد، وهو الحرف الأخير في «قلب»:
والكود التالي من الملف Part3_TinyGpt/Attention.cs:
namespace LlmCs.Part3;

// Multi-head causal self-attention: every position asks a question (query), every position offers
// a label (key) and a content (value). The scores q.k decide how much of each value to take,
// and the mask makes sure a position only reads positions before it.
public sealed class CausalSelfAttention : Module
{
    readonly int heads;
    readonly Linear cAttn, cProj;   // cAttn makes q, k and v in one MatMul: [C] -> [3C]

    public CausalSelfAttention(Random rng, GptConfig cfg, string name)
    {
        heads = cfg.Heads;
        cAttn = new Linear(rng, cfg.Embd, 3 * cfg.Embd, name + ".c_attn");
        cProj = new Linear(rng, cfg.Embd, cfg.Embd, name + ".c_proj", 0.02f / MathF.Sqrt(2 * cfg.Layers));
        Add(cAttn);
        Add(cProj);
    }

    // x: [B, T, C] -> [B, T, C]
    public Tensor Forward(Tensor x)
    {
        int c = x.Cols, headSize = c / heads;
        var qkv = cAttn.Forward(x);                                   // [B, T, 3C]
        var q = Ops.SplitHeads(Ops.Narrow(qkv, 0, c), heads);         // [B, H, T, hs]
        var k = Ops.SplitHeads(Ops.Narrow(qkv, c, c), heads);
        var v = Ops.SplitHeads(Ops.Narrow(qkv, 2 * c, c), heads);
        var scores = Ops.Scale(Ops.BatchMatMulT(q, k), 1f / MathF.Sqrt(headSize));   // [B, H, T, T]
        var weights = Ops.CausalSoftmax(scores);                     // each row sums to 1, future = 0
        var y = Ops.BatchMatMul(weights, v);                          // [B, H, T, hs]
        return cProj.Forward(Ops.MergeHeads(y));                      // [B, T, C]
    }
في الكود أعلاه لاحظ التالي:
- الطبقة
cAttnتصنع السؤال والمفتاح والقيمة معاً بضرب مصفوفات واحد من 96 إلى 288 رقماً، ثم نقطعها إلى ثلاثة أجزاء بالعمليةNarrow، وهذا أسرع من ثلاث طبقات منفصلة، وهو نفس الترتيب الذي يحفظ به GPT-2 أوزانه، وسوف نحتاج ذلك في الجزء الرابع. - العملية
BatchMatMulTتضرب كل سؤال في كل مفتاح دفعة واحدة، فيخرج لكل رأس مصفوفة[T, T]فيها درجة لكل زوج من المواضع. - نقسم الدرجات على الجذر التربيعي لطول المتجه (
headSize = 24)، والسبب أن الضرب النقطي لمتجهات طويلة يعطي أرقاماً كبيرة، والدالة Softmax على أرقام كبيرة تعطي 1 لموضع واحد وصفراً لكل الباقي، فيصبح تدرجها قريباً من الصفر ويتوقف التعلم. - بعد جمع القيم نمررها في طبقة خطية أخيرة
cProjتعيدها إلى 96 رقماً.
القناع السببي Causal Mask: النموذج لا يرى المستقبل
في التدريب نعطي النموذج مقطعاً من 64 حرفاً، ونطلب منه أن يتوقع الحرف التالي في كل موضع من المواضع ال 64 في نفس الوقت، وهذا يجعل التدريب أسرع بكثير. ولكن هناك مشكلة رئيسية: إذا كان الموضع الخامس يستطيع أن ينتبه إلى الموضع السادس، فهو يرى الإجابة، ويتعلم أن ينسخها بدلاً من أن يتوقعها، ثم يفشل تماماً عند التوليد لأن الحرف السادس لم يكتب بعد. والحل هو القناع السببي Causal Mask: الموضع i ينتبه إلى المواضع من 0 إلى i فقط، أي أن نصف المصفوفة الأعلى يأخذ احتمالاً صفراً. والصورة التالية تبين القناع لمقطع من خمسة حروف:
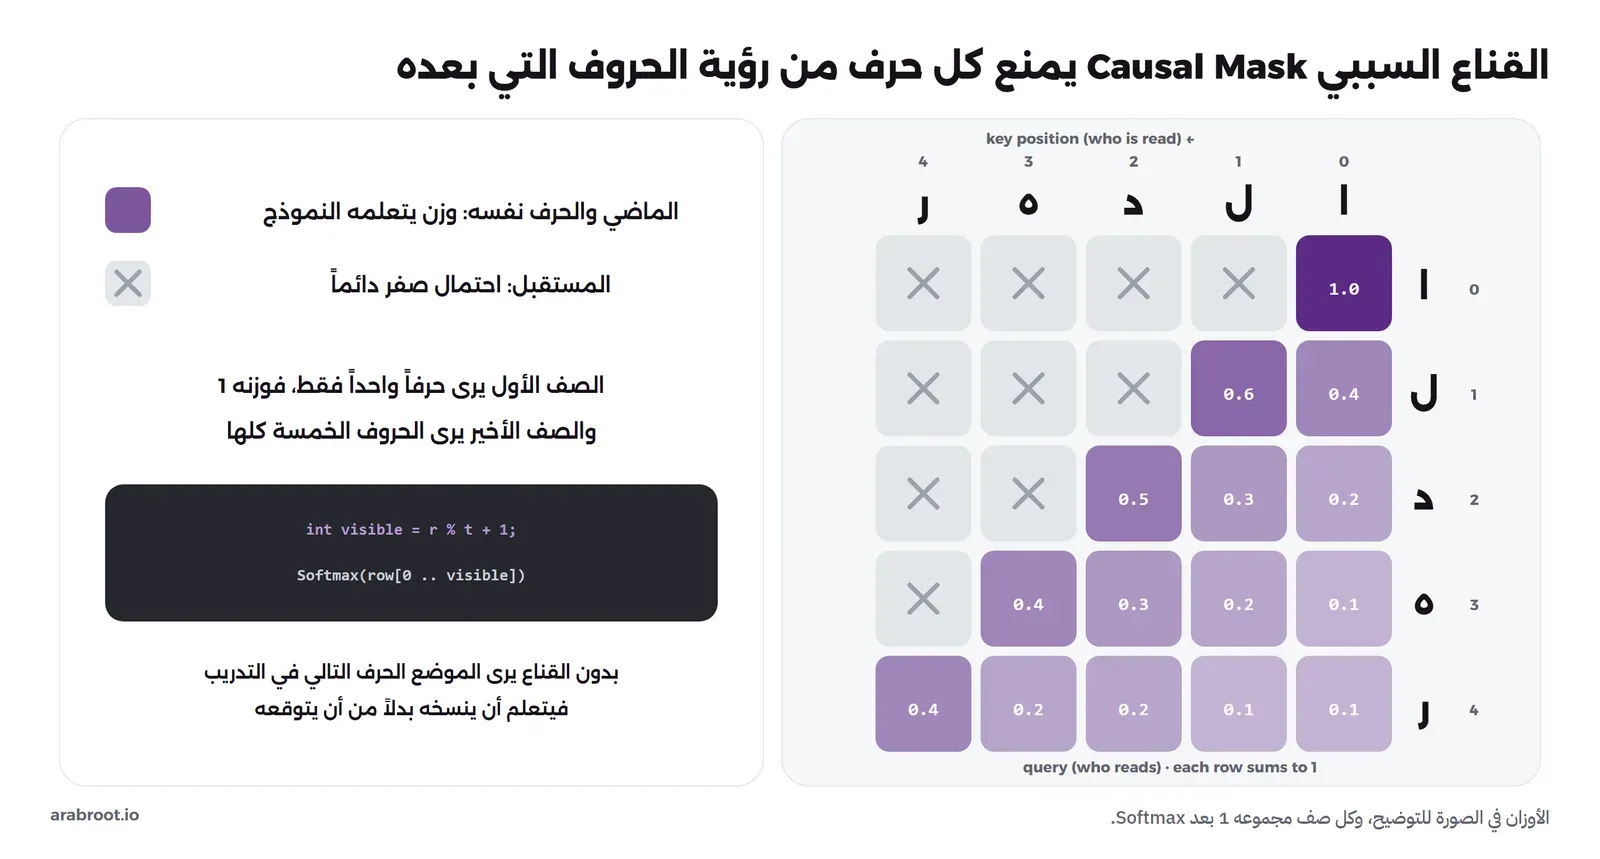
وأغلب المكتبات تطبق القناع بأن تضع سالب مالانهاية في الخانات المستقبلية قبل Softmax، أما نحن فكتبنا عملية واحدة CausalSoftmax تحسب Softmax على الجزء المسموح من كل صف فقط، من الملف Shared/Ops.Attention.cs:
// Softmax over the last dimension of [...,T,T] where position i may only look at positions 0..i:
// the future gets probability 0, so the model cannot cheat by reading the next token.
public static Tensor CausalSoftmax(Tensor x)
{
    int t = x.Cols, rows = x.Rows;
    if (x.Shape[^2] != t) throw new ArgumentException($"causal softmax needs [...,T,T], got {x}");
    var y = new float[x.Size];
    Kernels.ParallelFor(rows, t * 3, (s, e) =>
    {
        for (int r = s; r < e; r++)
        {
            int visible = r % t + 1;   // row i of each matrix sees i+1 positions
            Softmax(x.Data.AsSpan(r * t, visible), y.AsSpan(r * t, visible));
        }
    });
لاحظ السطر int visible = r % t + 1، فالصف رقم i في كل مصفوفة يرى i + 1 موضعاً، والخانات بعدها تبقى صفراً كما أنشأناها، فلا نحتاج سالب مالانهاية ولا نحسب Exp لخانات سوف ترمى. وهذه العملية مرت بالتحقق من التدرج في الجزء الأول مع بقية عمليات الانتباه.
الانتباه متعدد الرؤوس Multi-Head Attention
الرأس الواحد يحسب خليطاً واحداً من المواضع السابقة، ولكن الحرف الواحد قد يحتاج أكثر من نوع من المعلومات في نفس الوقت: الحرف الذي قبله مباشرة لإكمال الكلمة، والعلامة * ليعرف هل هو في الشطر الأول أم الثاني، وآخر حرف في البيت السابق ليلتزم بالقافية. لذلك نقسم المتجه ذا ال 96 رقماً إلى أربعة رؤوس Heads، كل رأس يأخذ 24 رقماً ويحسب انتباهه بسؤاله ومفتاحه وقيمته الخاصة، ثم نضع النتائج الأربع جنباً إلى جنب ونمررها في cProj. والصورة التالية تبين الفكرة:
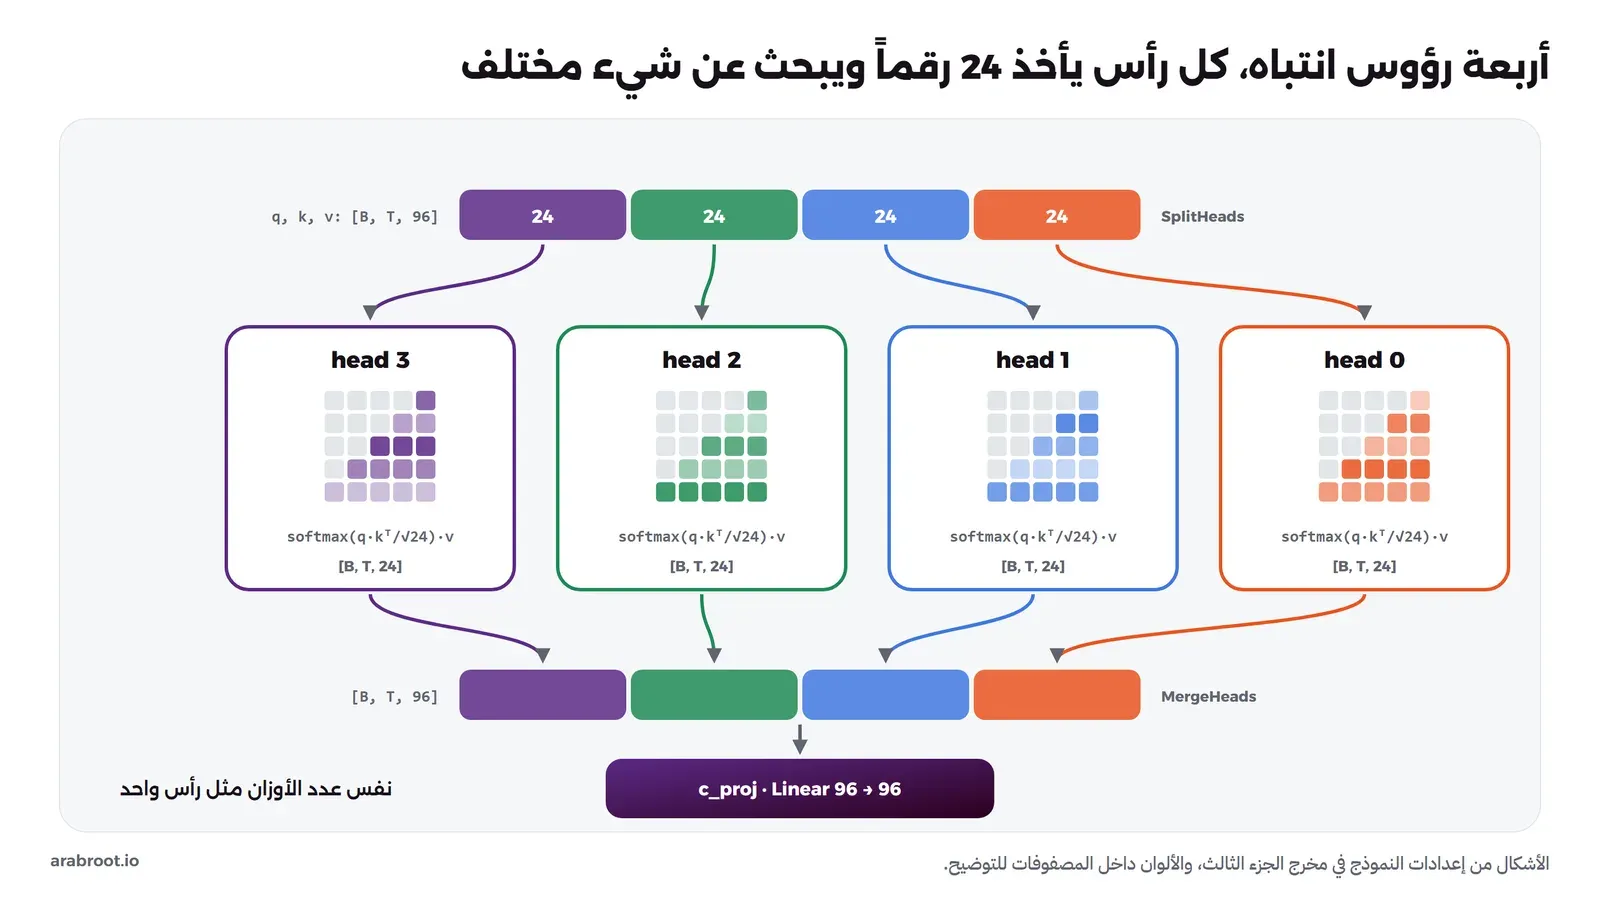
لاحظ أن الرؤوس الأربعة لا تضيف أي أوزان مقارنة برأس واحد بحجم 96، فالطبقة cAttn هي نفسها، والفرق فقط في طريقة تقسيم الأرقام. والتقسيم نفسه هو العملية SplitHeads التي تعيد ترتيب ال Tensor من [B, T, 96] إلى [B, 4, T, 24]، فيصبح لكل رأس مصفوفته المستقلة، ثم تعيدها MergeHeads كما كانت، وكلتاهما في الملف Shared/Ops.Attention.cs.
الوصلات المتبقية Residual Connections وتطبيع الطبقة LayerNorm
إذا وضعنا طبقات الانتباه فوق بعضها مباشرة فسوف يصعب تدريبها، والسبب أن التدرج يجب أن يمر عائداً على كل الطبقات، وفي كل طبقة يضرب في مشتقات قد تكون صغيرة، فيصل إلى الطبقات الأولى ضعيفاً جداً. والحل الذي نشره He وزملاؤه في ورقة ResNet هو الوصلة المتبقية Residual Connection: بدلاً من x = layer(x) نكتب x = x + layer(x)، فالطبقة تتعلم فقط «تصحيحاً» تضيفه إلى x، والتدرج يجد طريقاً مباشراً عبر الجمع، لأن مشتقة الجمع 1 كما رأينا في الجزء الأول. ولاحظ أن x هنا يستخدم مرتين، في الطبقة وفي الجمع، وهذا بالضبط المكان الذي ذكرنا في الجزء الأول أن الخطأ = بدلاً من += سوف يظهر فيه.
والقطعة الثانية هي تطبيع الطبقة Layer Normalization: قبل كل طبقة نطرح من متجه كل موضع متوسطه ونقسمه على انحرافه المعياري، فتصبح أرقامه حول الصفر بنفس المقياس دائماً، ثم نضربه في أوزان gamma ونضيف beta حتى يستطيع النموذج أن يعيد المقياس الذي يناسبه. والكود التالي من الملف Part3_TinyGpt/Layers.cs فيه الطبقة الخطية وطبقة التطبيع:
// y = x @ W + b. W is stored [in, out], the same layout as GPT-2's Conv1D,
// so its weights load without a transpose (PyTorch's nn.Linear stores [out, in]).
public sealed class Linear : Module
{
    public readonly Tensor W, B;

    public Linear(Random rng, int inFeatures, int outFeatures, string name, float std = 0.02f)
    {
        W = Param(name + ".weight", Tensor.Randn(rng, std, inFeatures, outFeatures));
        B = Param(name + ".bias", Tensor.Zeros(outFeatures));
    }

    public Tensor Forward(Tensor x) => Ops.Add(Ops.MatMul(x, W), B);
}

public sealed class LayerNorm : Module
{
    readonly Tensor gamma, beta;

    public LayerNorm(int dim, string name)
    {
        gamma = Param(name + ".weight", Tensor.Fill(1f, dim));
        beta = Param(name + ".bias", Tensor.Zeros(dim));
    }

    public Tensor Forward(Tensor x) => Ops.LayerNorm(x, gamma, beta);
}
لاحظ التعليق على الكلاس Linear: نحفظ الأوزان بالشكل [in, out]، وهو نفس الشكل الذي يحفظ به GPT-2 أوزانه، بينما الطبقة nn.Linear في PyTorch تحفظها بالشكل [out, in]، وهذا القرار الصغير سوف يجعل تحميل أوزان GPT-2 في الجزء الرابع نسخاً مباشراً دون أي قلب للمصفوفات.
كتلة Transformer كاملة
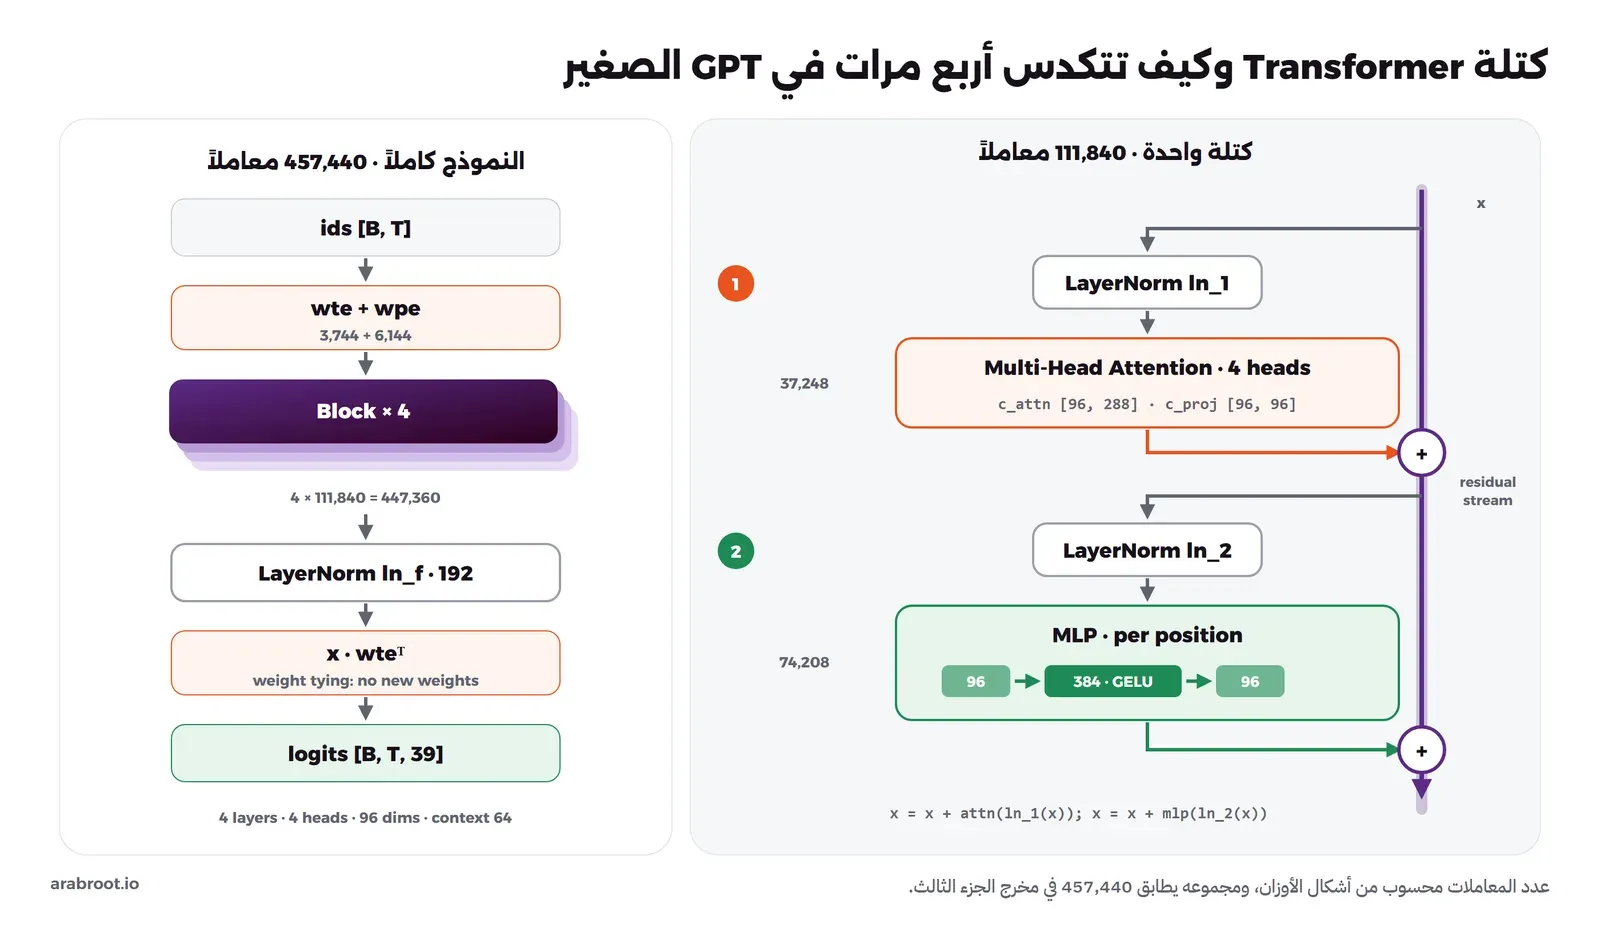
الآن عندنا كل القطع، وكتلة Transformer بترتيب GPT-2 هي: تطبيع ثم انتباه ثم جمع مع الأصل، ثم تطبيع ثم MLP ثم جمع مع الأصل. وال MLP هنا طبقتان: الأولى توسع المتجه من 96 إلى 384 رقماً (أربعة أضعاف)، ثم الدالة GELU، ثم الثانية تعيده إلى 96. والانتباه هو المكان الذي تتبادل فيه المواضع المعلومات، أما ال MLP فيعمل على كل موضع وحده ويعالج ما جمعه. والكود التالي من الملف Part3_TinyGpt/Gpt.cs:
// MLP of the block: widen to 4C, GELU, back to C
public sealed class Mlp : Module
{
    readonly Linear cFc, cProj;

    public Mlp(Random rng, GptConfig cfg, string name)
    {
        cFc = new Linear(rng, cfg.Embd, 4 * cfg.Embd, name + ".c_fc");
        cProj = new Linear(rng, 4 * cfg.Embd, cfg.Embd, name + ".c_proj", 0.02f / MathF.Sqrt(2 * cfg.Layers));
        Add(cFc);
        Add(cProj);
    }

    public Tensor Forward(Tensor x) => cProj.Forward(Ops.Gelu(cFc.Forward(x)));
}

// One Transformer block (GPT-2 order): normalize, attend, add back; normalize, MLP, add back.
// "Add back" is the residual connection: the block only learns a correction to x.
public sealed class Block : Module
{
    readonly LayerNorm ln1, ln2;
    readonly CausalSelfAttention attn;
    readonly Mlp mlp;

    public Block(Random rng, GptConfig cfg, string name)
    {
        ln1 = new LayerNorm(cfg.Embd, name + ".ln_1");
        attn = new CausalSelfAttention(rng, cfg, name + ".attn");
        ln2 = new LayerNorm(cfg.Embd, name + ".ln_2");
        mlp = new Mlp(rng, cfg, name + ".mlp");
        Add(ln1); Add(attn); Add(ln2); Add(mlp);
    }

    public Tensor Forward(Tensor x)
    {
        x = Ops.Add(x, attn.Forward(ln1.Forward(x)));
        return Ops.Add(x, mlp.Forward(ln2.Forward(x)));
    }
والصورة التالية تبين الكتلة كاملة والنموذج الذي يتكون من أربع كتل منها، مع عدد المعاملات في كل جزء:
والكلاس Gpt يربط كل ذلك، من نفس الملف:
public sealed class Gpt : Module
{
    public readonly GptConfig Config;
    readonly Tensor wte, wpe;   // token table [V, C] and position table [BlockSize, C]
    readonly Block[] blocks;
    readonly LayerNorm lnF;

    public Gpt(GptConfig cfg, int seed = 1337)
    {
        Config = cfg;
        var rng = new Random(seed);
        wte = Param("wte.weight", Tensor.Randn(rng, 0.02f, cfg.VocabSize, cfg.Embd));
        wpe = Param("wpe.weight", Tensor.Randn(rng, 0.01f, cfg.BlockSize, cfg.Embd));
        blocks = new Block[cfg.Layers];
        for (int i = 0; i < cfg.Layers; i++) Add(blocks[i] = new Block(rng, cfg, $"h.{i}"));
        lnF = new LayerNorm(cfg.Embd, "ln_f");
        Add(lnF);
    }

    public int ParameterCount => Parameters.Sum(p => p.Size);
والجدول التالي يبين أين تذهب المعاملات ال 457,440 (والأرقام محسوبة من أشكال الأوزان أعلاه):
| الجزء | الشكل | عدد المعاملات |
|---|---|---|
جدول الحروف wte | [39, 96] | 3,744 |
جدول المواضع wpe | [64, 96] | 6,144 |
الانتباه في كتلة واحدة (c_attn وc_proj) | [96, 288] و[96, 96] مع ال Bias | 37,248 |
ال MLP في كتلة واحدة (c_fc وc_proj) | [96, 384] و[384, 96] مع ال Bias | 74,208 |
| طبقتا LayerNorm في كتلة واحدة | [96] × 4 | 384 |
| أربع كتل | 4 × 111,840 | 447,360 |
LayerNorm الأخيرة ln_f | [96] × 2 | 192 |
| المجموع | 457,440 |
لاحظ أن 98% من المعاملات في الكتل، وأن ال MLP فيه ضعف ما في الانتباه، وهذه النسبة نفسها تقريباً في GPT-2 والنماذج الأكبر منه، أما جدولا التضمين فصغيران هنا لأن المفردات 39 حرفاً فقط، وفي GPT-2 سوف نرى أن جدول التوكنز وحده فيه قرابة 39 مليون رقم.
التدريب Training: 2500 خطوة على المعالج CPU
حلقة التدريب هي نفس الحلقة ذات الخطوات الأربع، مع ثلاث إضافات يستخدمها كل من يدرب GPT، وتجدها مثلاً في مشروع nanoGPT التعليمي. والكود التالي من الملف Part3_TinyGpt/Part3.cs:
static void Train(int steps)
{
    string text = PoemText.Load();
    var tok = new CharTokenizer(text);
    int[] data = tok.Encode(text);
    int split = (int)(data.Length * 0.9);
    int[] train = data[..split], val = data[split..];

    var cfg = new GptConfig(VocabSize: tok.VocabSize, BlockSize: 64, Layers: 4, Heads: 4, Embd: 96);
    const int batch = 32;
    var model = new Gpt(cfg);
    Console.WriteLine($"config: {cfg}");
    Console.WriteLine($"parameters: {model.ParameterCount:N0}, batch {batch} x {cfg.BlockSize} = {batch * cfg.BlockSize} tokens per step, {steps} steps");
    Console.WriteLine($"CPU: {Environment.ProcessorCount} logical processors, Vector<float>.Count = {System.Numerics.Vector<float>.Count}");

    var opt = new AdamW(model.Parameters, lr: 1e-3f, weightDecay: 0.1f, beta2: 0.99f);
    var rng = new Random(1);
    var csv = new StringBuilder("step,train_loss,val_loss,seconds\n");
    int[] sampleAt = [0, 250, 1000, steps];
    int evalEvery = 250;
    double trainSum = 0;
    var sw = Stopwatch.StartNew();
    for (int step = 0; step <= steps; step++)
    {
        if (sampleAt.Contains(step)) PrintSample(model, tok, step);

        opt.LearningRate = LearningRate(step, steps, 1e-3f, 1e-4f, warmup: 100);
        var (x, y) = GetBatch(train, batch, cfg.BlockSize, rng);
        var logits = model.Forward(x, batch, cfg.BlockSize);
        var loss = Ops.SoftmaxCrossEntropy(logits, y);
        opt.ZeroGrad();
        loss.Backward();
        opt.ClipGradNorm(1f);
        opt.Step();
        trainSum += loss.Item;

        if (step % evalEvery == 0)
        {
            float trainLoss = step == 0 ? loss.Item : (float)(trainSum / evalEvery);
            float valLoss = Evaluate(model, val, batch, cfg.BlockSize);
            Console.WriteLine($"step {step,5}  train {trainLoss:F4}  val {valLoss:F4}  lr {opt.LearningRate:E1}  {sw.Elapsed.TotalSeconds,7:F1}s");
            csv.Append(CultureInfo.InvariantCulture, $"{step},{trainLoss:F4},{valLoss:F4},{sw.Elapsed.TotalSeconds:F1}\n");
            trainSum = 0;
        }
    }
    Console.WriteLine($"training time: {sw.Elapsed.TotalMinutes:F1} minutes ({sw.Elapsed.TotalMilliseconds / steps:F0} ms per step)");
    Checkpoint.Save(ModelPath, model, tok.Decode(Enumerable.Range(0, tok.VocabSize)));
    Directory.CreateDirectory("outputs");
    File.WriteAllText("outputs/part3-loss.csv", csv.ToString());
    Console.WriteLine($"saved {ModelPath} and outputs/part3-loss.csv");
}

// Warm up linearly, then follow a cosine curve from maxLr down to minLr
static float LearningRate(int step, int steps, float maxLr, float minLr, int warmup)
{
    if (step < warmup) return maxLr * (step + 1) / warmup;
    double progress = (double)(step - warmup) / Math.Max(1, steps - warmup);
    return minLr + (maxLr - minLr) * 0.5f * (1 + (float)Math.Cos(Math.PI * progress));
}

// B random windows of T tokens; the target of every position is the token after it
static (int[] x, int[] y) GetBatch(int[] data, int batch, int t, Random rng)
{
    var x = new int[batch * t];
    var y = new int[batch * t];
    for (int b = 0; b < batch; b++)
    {
        int start = rng.Next(data.Length - t - 1);
        Array.Copy(data, start, x, b * t, t);
        Array.Copy(data, start + 1, y, b * t, t);
    }
    return (x, y);
}
في الكود أعلاه لاحظ التالي:
- الدالة
GetBatchتأخذ 32 مقطعاً عشوائياً من 64 حرفاً، والإجابة الصحيحة لكل موضع هي الحرف الذي بعده، أي نفس المقطع مزاحاً حرفاً واحداً، فكل مقطع يعطي 64 مثالاً للتدريب في تشغيل واحد بفضل القناع السببي. - معدل التعلم Learning Rate يبدأ صغيراً ويرتفع خطياً في أول 100 خطوة، وهذا يسمى الإحماء Warmup، والسبب أن الأوزان في البداية عشوائية والتدرجات كبيرة وغير مستقرة، ثم ينخفض على شكل منحنى جيب التمام Cosine حتى 0.0001 في النهاية.
- السطر
opt.ClipGradNorm(1f)يقص التدرج Gradient Clipping: إذا كان طول متجه التدرجات كله أكبر من 1 نصغره إلى 1، والسبب أن دفعة غريبة واحدة قد تعطي تدرجاً كبيراً جداً يرمي الأوزان بعيداً ويضيع ما تعلمه النموذج. - نقيس خطأ التحقق كل 250 خطوة على نفس 16 دفعة دائماً (البذرة 123)، حتى تكون الأرقام قابلة للمقارنة، ونحفظها في الملف
part3-loss.csv. - 2500 خطوة في 2048 حرفاً تعني أن النموذج رأى قرابة 5.1 مليون حرف، أي أنه مر على نص التدريب (252,987 حرفاً) قرابة 20 مرة.
والمخرج (أسطر الخطأ فقط، والنصوص في قسم لاحق) سوف يكون كما يلي:
step     0  train 3.7258  val 3.7189  lr 1.0E-005      4.7s
step   250  train 2.7229  val 2.4754  lr 9.9E-004    106.8s
step   500  train 2.3941  val 2.3444  lr 9.4E-004    213.5s
step   750  train 2.2822  val 2.2588  lr 8.5E-004    319.2s
step  1000  train 2.2131  val 2.2023  lr 7.2E-004    430.3s
step  1250  train 2.1537  val 2.1669  lr 5.8E-004    540.7s
step  1500  train 2.1115  val 2.1226  lr 4.3E-004    651.1s
step  1750  train 2.0715  val 2.1002  lr 3.0E-004    756.0s
step  2000  train 2.0397  val 2.0783  lr 1.9E-004    865.2s
step  2250  train 2.0168  val 2.0653  lr 1.2E-004    971.0s
step  2500  train 2.0023  val 2.0577  lr 1.0E-004   1078.1s
training time: 18.0 minutes (431 ms per step)
saved models/tiny-gpt.bin and outputs/part3-loss.csv
في المخرج أعلاه لاحظ التالي:
- الخطأ في الخطوة 0 هو 3.7189، أي أعلى قليلاً من خط الأساس 3.6636، لأن الأوزان العشوائية لا تعطي احتمالات متساوية تماماً.
- بعد 1000 خطوة وصل خطأ التحقق إلى 2.2023، أي نفس ما وصلت إليه شبكة MLP في الجزء الثاني بعد 6000 خطوة، ثم استمر في الانخفاض حتى 2.0577.
- خطأ التدريب 2.0023 وخطأ التحقق 2.0577 متقاربان، فالنموذج لم يبدأ بالحفظ الأعمى بعد، أي أن المشكلة الآن ليست في الحفظ وإنما في حجم النموذج والبيانات، كما سنرى في آخر المقال.
- كل خطوة أخذت قرابة 431 ميلي ثانية للحساب للأمام والرجوع والتحديث على 2048 حرفاً، والرقم للتوضيح فقط.
ويجدر الإشارة هنا إلى أن خطأ الجزء الثاني قيس على كل نص التحقق حرفاً حرفاً، أما هنا فقيس على 16 دفعة عشوائية من نص التحقق، والمواضع الأولى في كل مقطع ترى سياقاً قصيراً، لذلك فالمقارنة بين الرقمين تقريبية وليست دقيقة، ولكن الفرق بين 2.2123 و2.0577 أكبر من أن يكون سببه طريقة القياس وحدها.
منحنى الخطأ Loss Curve
الصورة التالية ترسم الأرقام الحقيقية من الملف part3-loss.csv، ومعها خطأ نموذج Bigram وشبكة MLP من الجزء الثاني للمقارنة:
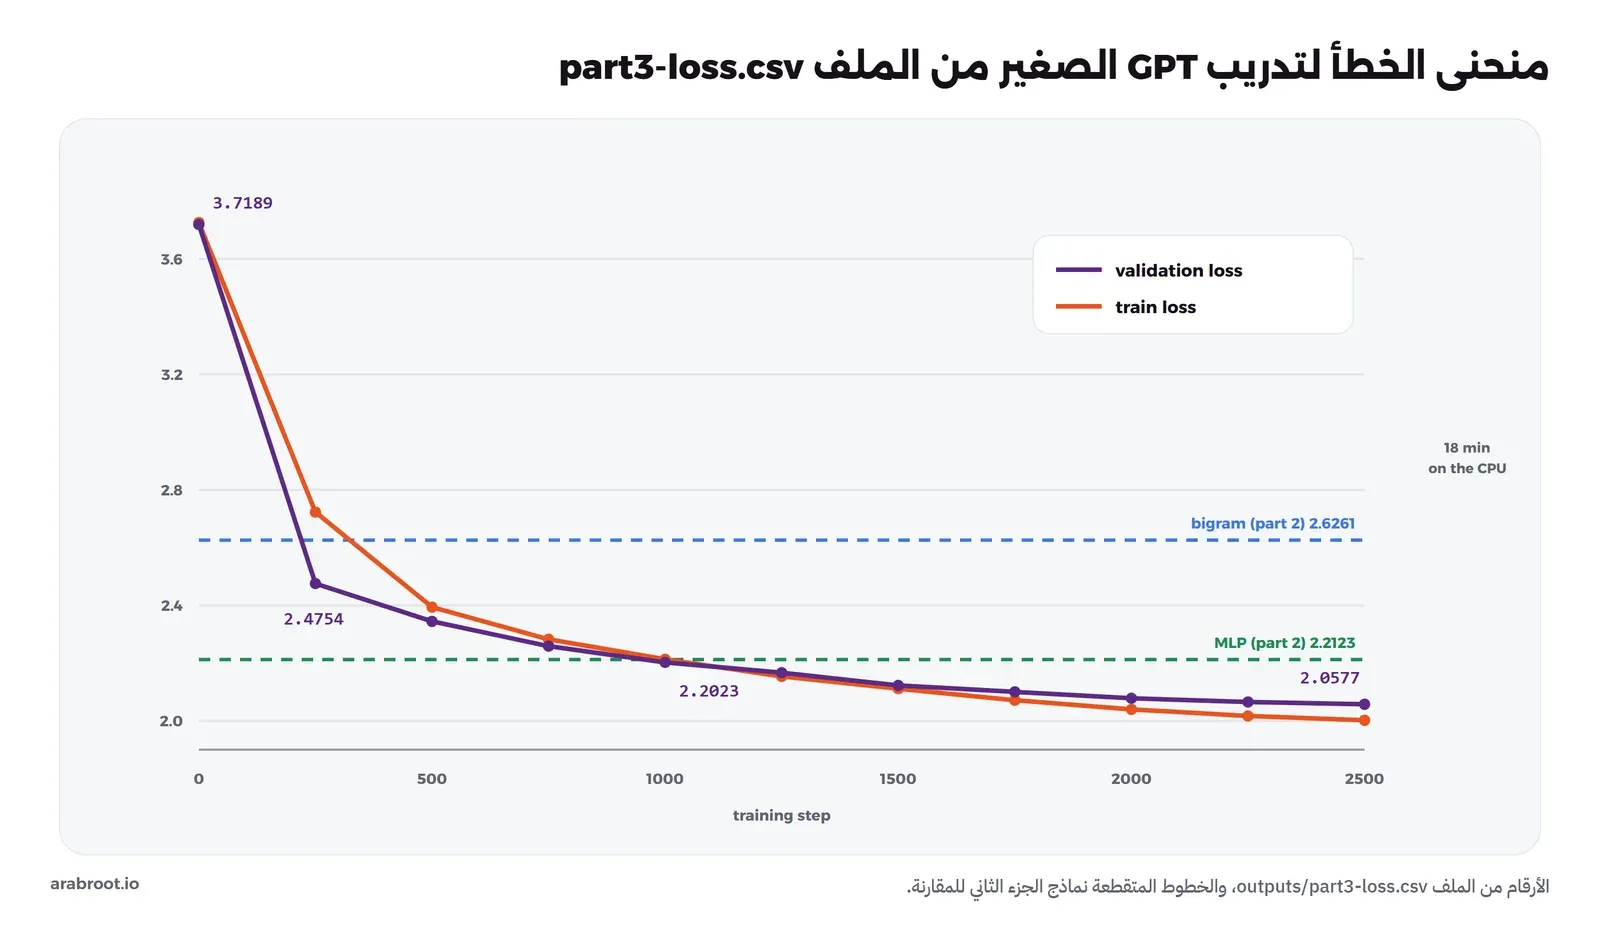
لاحظ شكل المنحنى، فهو نفس الشكل الذي تراه في تدريب أي نموذج لغة مهما كان حجمه: في البداية يتعلم النموذج الأشياء السهلة بسرعة (الحروف الشائعة والمسافات وشكل الكلمة)، فينخفض الخطأ من 3.72 إلى 2.48 في 250 خطوة، ثم يصبح كل تحسن إضافي أصعب وأبطأ، لأنه يحتاج قواعد أعمق مثل الكلمات الكاملة وتركيب الجملة.
كيف تغير الشعر أثناء التدريب؟
البرنامج يولد 240 حرفاً بدرجة حرارة 0.8 عند الخطوات 0 و250 و1000 و2500، وبنفس البذرة العشوائية في كل مرة، فالفرق بين النصوص سببه الأوزان فقط. والدالة التي تولد النص من الملف Part3_TinyGpt/Gpt.cs:
// Autoregressive generation: run the model, sample one token from the last position, append, repeat.
public List<int> Generate(List<int> prompt, int maxNewTokens, float temperature, int topK, Random rng)
{
    bool old = Tensor.NoGrad;
    Tensor.NoGrad = true;   // no graph needed: faster and less memory
    var ids = new List<int>(prompt);
    var probs = new float[Config.VocabSize];
    for (int i = 0; i < maxNewTokens; i++)
    {
        var window = ids.Skip(Math.Max(0, ids.Count - Config.BlockSize)).ToArray();   // the last BlockSize tokens
        var logits = Forward(window, 1, window.Length);
        var last = logits.Data.AsSpan((window.Length - 1) * Config.VocabSize, Config.VocabSize);
        ids.Add(SampleNext(last, probs, temperature, topK, rng));
    }
    Tensor.NoGrad = old;
    return ids;
}
والنص عند الخطوة 0، أي بأوزان عشوائية لم تتعلم شيئاً، سوف يكون كما يلي:
--- sample at step 0 (temperature 0.8)
ضأأرأئغزؤغئئدثثار قضخأآعكش ظؤهفشإ*بسك
ركقخأ  فعآئفتضأ*صز حعظا
ةب*ع*خ
فذزز
ك


ص نوزحص تأحقسدتنصع
مىتظؤآخثفؤأإسسيكغغتريظ
ةه
ؤئ ؤسذءيأآةةظك

كنبههةذطضؤبإ ؤويلأمإاززطآصخنذجىذسونآآ
آوقدشخآهىوإةذضونقةةدقبمعإئئلظءثقملووزمىأساصزضءفجزطإرقصئو* أبؤاب
---
حروف عشوائية تماماً، وأسطر فارغة، والعلامة * في أي مكان، وهذا ما تتوقعه من نموذج كل احتمالاته متقاربة. وبعد 250 خطوة:
--- sample at step 250 (temperature 0.8)
ه ألا لفتت الدض حاللد أنما فرى الأسمن
لمن ا أنفت لخل * قارك ا زرال فأن في ن * لأوه تقاد تنتربه مالي
وا حرما القيرد الير الأرب الطاي * حمن أنوانج فيد الأريوف
وا فيراربه العظى ال الملما نين * ليله تفي وقبا وقالهحبهد ووالب جم
والمادك الأب الد
---
ظهرت «ال» التعريف والمسافات بين الكلمات، وظهرت العلامة * في وسط السطر، وكلمات قليلة صحيحة («ألا» و«لمن» و«أنما»). وبعد 1000 خطوة:
--- sample at step 1000 (temperature 0.8)
نا ذا فما الشرب فإنفا * وقال ولا أرضى
لو ثر أنا الخف أن أصعر * ظال تأنت جام

أم ينبت أصارص برى كأني عبادة * جفريك لغطير الأرب
تعزاي الدهل أهو ولا عفاد * ويم وبدارم صرى
في عين ابديد على وما رسيعا * وتنف المعاس وليل وهاد
وكل مرضع سور وادت الخ
---
أصبح شكل البيت واضحاً: شطران بينهما * في كل سطر تقريباً، وكلمات صحيحة كثيرة («ولا أرضى» و«كأني» و«الدهر» بخطأ صغير «الدهل»). وبعد 2500 خطوة:
--- sample at step 2500 (temperature 0.8)
وأحسب قصحت الخطار والبحر * وأوفت أعطي في الأثلاء
وبلا غيث عن أسد كأن لم يؤم * وأنه ذكر المفت والأهوام
أكذب العرين من يعاره * أرعم يا بعضض إلي نقصر حاسب
رويق محبتة الذي حياة كأن * وسل النوار من غمر مدها المقالد
وهي من رأيت الذي الملاه * فإن
---
كل سطر بيت بشطرين، وأغلب الكلمات عربية صحيحة («والبحر» و«غيث» و«أسد» و«كأن لم» و«حاسب» و«من رأيت»)، وفيها مفردات من عالم المتنبي (الأسد والغيث والبحر والحاسد)، ولكن الأبيات ما زالت بلا معنى متصل ولا وزن ولا قافية واحدة. وبعد التدريب يمكنك أن تولد نصاً أطول من النموذج المحفوظ بالأمر part3 sample 0.8، والمخرج سوف يكون كما يلي:
في إذا منازه الروح * وإن أي خلم الأجمالا
وإذا كفت القوم لا تقاف * وتأنف لي أعبى الجسمان
والقطر مقيود صر حعامه * فاحتما بمن لكف خلفه
أفاقوا ومن أوقد الأتى لها * كار لي يوسال من الملكاك الأسلم
ألا بني وخف أصدر بجر نلاك * وما اتزار أي الذي بكل تنجف
أم أرض ذا الأود سرا ماءها * وكان يذكر من التي حسامه
ترحب الطير في الغادث من * أصبحت في الجسان في القتلم
وليس من الخيل العاشقن طربا * فإؤاد ولا مشر إلى الن
(400 characters in 3.1s, temperature 0.8)
لاحظ أن ثمانية أسطر كلها بنفس الشكل، وأن النموذج حافظ على الشطرين في كل سطر، وهذا شيء لم تستطعه شبكة الجزء الثاني بثبات. ولاحظ أيضاً السطر الأخير: 400 حرف في 3.1 ثانية، وسوف نعود إلى هذا الرقم بعد قليل.
التحقق من التدرج Gradient Check ل GPT كاملاً
في الجزء الأول تحققنا من تدرج كل عملية على حدة، ولكن هذا لا يثبت أن النموذج كاملاً صحيح، فقد نربط العمليات بطريقة خاطئة، أو ننسى تسجيل وزن في قائمة المعاملات فلا يتدرب أبداً، أو نستخدم Tensor مرتين في مكان لم ننتبه له. لذلك نطبق نفس الاختبار على GPT صغير جداً بكل طبقاته: مفردات من 7 رموز، ومقطع من 5 مواضع، وكتلتان، ورأسان، ومتجهات من 8 أرقام، ونحرك كل معامل فيه للأمام وللخلف. والكود التالي من الملف Part3_TinyGpt/Part3.cs:
// Gradient check of the whole GPT (every parameter of a very small one) against numeric derivatives
static void CheckWholeModel()
{
    var cfg = new GptConfig(VocabSize: 7, BlockSize: 5, Layers: 2, Heads: 2, Embd: 8);
    var model = new Gpt(cfg, seed: 3);
    var rng = new Random(5);
    foreach (var p in model.Parameters)   // larger random weights than at training start, so every path matters
        for (int i = 0; i < p.Size; i++) p.Data[i] += 0.3f * Rng.Normal(rng);
    int[] x = Enumerable.Range(0, 10).Select(_ => rng.Next(7)).ToArray();
    int[] y = Enumerable.Range(0, 10).Select(_ => rng.Next(7)).ToArray();
    var (abs, rel) = Part1.GradCheck.Run(() => Ops.SoftmaxCrossEntropy(model.Forward(x, 2, 5), y), model.Parameters.ToArray());
    Console.WriteLine($"whole GPT ({model.ParameterCount} parameters, {model.Parameters.Count} tensors): max abs diff = {abs:E2}   max rel diff = {rel:E2}   {(rel < 1e-3 ? "OK" : "FAIL")}");
}
والمخرج سوف يكون كما يلي:
whole GPT (1856 parameters, 28 tensors): max abs diff = 6.93E-005 max rel diff = 1.67E-004 OKلاحظ أن الاختبار شمل 1,856 معاملاً في 28 Tensor، أي كل وزن في النموذج من جدول التضمين إلى آخر LayerNorm، وأن الخطأ النسبي 1.67E-004، أي أقل من الحد 1e-3 بست مرات تقريباً. وهو أكبر من خطأ العمليات المنفردة في الجزء الأول (رتبة 1e-5)، وهذا متوقع، لأن أخطاء التقريب في float تتراكم عبر عشرات العمليات المتتالية، أما الخطأ الحقيقي في الكود فيعطي رتبة 0.1 كما رأينا. ولاحظ السطر الذي يضيف أرقاماً عشوائية إلى الأوزان قبل الاختبار، والسبب أن الأوزان الأولى صغيرة جداً (0.02)، فبعض المسارات في النموذج يكون أثرها على الخطأ قريباً من الصفر، وخطأ في قاعدة رجوعها قد لا يظهر.
فكرة ذاكرة KV Cache
عد إلى الدالة Generate أعلاه، فهي في كل حرف جديد تشغل النموذج على النافذة كاملة، أي حتى 64 موضعاً، ثم تأخذ درجات الموضع الأخير فقط وترمي الباقي. وهذا هدر كبير، لأن المفاتيح Keys والقيم Values للمواضع السابقة لا تتغير أبداً عندما نضيف حرفاً جديداً، فالقناع السببي يضمن أن الموضع 10 لا يرى ما بعده، لذلك فحسابه اليوم هو نفس حسابه أمس. والحل هو ذاكرة KV Cache: نحفظ مفتاح وقيمة كل موضع في كل طبقة عند حسابه أول مرة، وعند كل حرف جديد نحسب سؤاله ومفتاحه وقيمته هو فقط، ونقارن سؤاله بكل المفاتيح المحفوظة، وقد شرحنا أثرها على الذاكرة في نافذة السياق وذاكرة KV Cache.
ونموذجنا الصغير يولد 400 حرف في 3.1 ثانية دون هذه الذاكرة، وهذا مقبول لأنه صغير، ولكن في GPT-2 الذي فيه 124 مليون معامل يصبح الفرق كبيراً جداً، لذلك كتبنا الدوال Step وGenerateCached والكلاس KvCache في نفس ملفات هذا الجزء، وسوف نشرحها ونقيس أثرها في الجزء الرابع على GPT-2 الحقيقي.
لماذا ما زال النموذج ضعيفاً؟
النموذج تعلم شكل البيت والكلمة، ولكنه لم يتعلم المعنى ولا الوزن ولا القافية، وقد يتساءل البعض: إذا كانت المعمارية هي نفسها معمارية GPT، فما الذي ينقصه؟ والإجابة ثلاثة أشياء:
- البيانات: النموذج تعلم من 253 ألف حرف، أي 448,391 بايتاً بترميز UTF-8، بينما تدرب GPT-2 على 40 GB من النصوص بحسب ورقته، أي أكثر بعشرات آلاف المرات، والنموذج لا يستطيع أن يتعلم المعنى من نص صغير مهما كانت معماريته.
- الحجم: 457,440 معاملاً مقابل 124 مليوناً في أصغر نسخة من GPT-2، أي أقل بقرابة 270 مرة، والنموذج الصغير لا يملك أرقاماً كافية ليحفظ مفردات اللغة وقواعدها معاً.
- التقسيم على مستوى الحرف: النموذج يحتاج أن يكتب الكلمة حرفاً حرفاً، فالبيت الواحد في بياناتنا 50 حرفاً في المتوسط، والنافذة 64 حرفاً بالكاد ترى البيت السابق، أما المقسم BPE الذي سوف نراه في الجزء الرابع فيضع الكلمة الشائعة في توكن واحد، فيرى النموذج سياقاً أطول بنفس العدد من المواضع.
وقد شرحنا لماذا كان الحجم والبيانات هما الفرق الأهم بين نماذج اللغة والخوارزميات التي سبقتها في الحجم Scale. والخبر الجيد أن الكود الذي كتبناه لا يعرف شيئاً عن هذه الأرقام، فإذا غيرنا GptConfig إلى 12 طبقة و12 رأساً و768 رقماً لكل متجه و1024 موضعاً، وحملنا الأوزان التي دربتها OpenAI، فنحن نشغل GPT-2، وهذا موضوع الجزء القادم.
أخطاء شائعة Common Mistakes
- نسيان القناع السببي: خطأ التدريب ينخفض بشكل مدهش لأن النموذج ينسخ الحرف التالي من الموضع الذي بعده، ثم يكتب نصاً بلا معنى عند التوليد، وإذا رأيت خطأ تدريب قريباً من الصفر في نموذج لغة صغير فابدأ بالبحث هنا.
- نسيان القسمة على جذر طول الرأس: الدرجات تصبح كبيرة، وSoftmax تختار موضعاً واحداً فقط، والتدريب يبطئ أو يتوقف.
- نسيان تضمين الموضع: بدونه لا يعرف النموذج ترتيب الحروف، فكلمة «قلب» و«بلق» عنده نفس المجموعة من المتجهات.
- معدل تعلم كبير دون إحماء ودون قص للتدرج: قد يقفز الخطأ فجأة إلى رقم كبير أو إلى
NaNفي أول الخطوات، ولا يعود. - قلب أبعاد الأوزان: إذا حفظت
Wبالشكل[out, in]ثم ضربت بالترتيب الآخر فقد يعمل الكود إذا كانت المصفوفة مربعة، ويعطي أرقاماً خاطئة دون أي خطأ برمجي، والتحقق من التدرج لا يكتشف ذلك لأن التدرج صحيح لنموذج خاطئ، ولكن مقارنة المخرج مع مرجع خارجي تكتشفه، كما سنفعل في الجزء الرابع.
تدريب عملي
- غير عدد الرؤوس في
Trainمن 4 إلى 1 مع بقاءEmbd = 96، ودرب النموذج، وقارن خطأ التحقق النهائي، ولاحظ أن عدد المعاملات لم يتغير. - احذف السطر
var pos = ...واجعلx = tokفقط، ثم شغلpart3 checkللتأكد أن التدرج ما زال صحيحاً، ثم درب النموذج وقارن النصوص. - غير
LayerNormفيBlock.Forwardلتأتي بعد الجمع بدلاً من قبل الطبقة (ترتيب ورقة Transformer الأصلية)، وقارن منحنى الخطأ. - درب النموذج 5000 خطوة بالأمر
part3 train 5000، وراقب الفرق بين خطأ التدريب وخطأ التحقق، هل بدأ النموذج بالحفظ الأعمى؟
الخلاصة
- كل موضع في Transformer يمر على نفس الأوزان، ويعرف ترتيبه من تضمين الموضع الذي يضاف إلى تضمين الحرف.
- الانتباه بحث مرجح: كل موضع يصنع سؤالاً، ويقارنه بمفاتيح المواضع السابقة، ويأخذ خليطاً من قيمها، والقناع السببي يمنعه من رؤية المستقبل، والرؤوس المتعددة تبحث عن أشياء مختلفة بنفس عدد الأوزان.
- الوصلات المتبقية وLayerNorm هي التي تجعل تكديس الكتل ممكناً، والكتلة هي انتباه ثم MLP، كل منهما يضيف تصحيحاً إلى المسار.
- نموذجنا فيه 457,440 معاملاً، وتدرب 2500 خطوة على المعالج، وانخفض خطأ التحقق من 3.7189 إلى 2.0577، أي أقل من شبكة MLP في الجزء الثاني (2.2123).
- التحقق من التدرج للنموذج كاملاً (1,856 معاملاً) أعطى خطأ نسبياً
1.67E-004، فكل الطبقات مربوطة بشكل صحيح. - النموذج يكتب أبياتاً بشطرين وكلمات صحيحة ولكن بلا معنى، والذي ينقصه هو البيانات والحجم، وليس المعمارية.
وفي الجزء القادم بإذن الله سوف نحمل أوزان GPT-2 الحقيقية التي دربتها OpenAI في نفس الكلاس Gpt الذي كتبناه هنا، ونكتب مقسم BPE، ونستخدم ذاكرة KV Cache، ونقارن المخرج رقماً برقم مع مكتبة Hugging Face.
 دليلابن نموذج لغة بلغة C# من الصفر (1): محرك التعلم Autogradنبني بلغة C# ودون أي مكتبة المحرك الذي تتعلم به كل الشبكات العصبية، ونتأكد بالأرقام أن كل عملية فيه صحيحة.
 دليلابن نموذج لغة بلغة C# من الصفر (2): توقع الحرف التالينستخدم محرك الجزء الأول لنبني نموذج لغة يتعلم من شعر المتنبي كيف يتوقع الحرف التالي ويكتب أبياتاً جديدة.
 دليلابن نموذج لغة بلغة C# من الصفر (4): تشغيل أوزان GPT-2نحمل أوزان GPT-2 الحقيقية في النموذج الذي كتبناه بلغة C#، ونثبت أن نتائجه تطابق Hugging Face رقماً برقم.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتدريب GPT الصغير على .NET 10 (SDK 10.0.400) دون أي حزمة NuGet على قصائد المتنبي التي نزلناها من ويكي مصدر بتاريخ 6 أكتوبر 2026.