

في الجزء الثالث بنينا بلغة C# نموذج GPT صغيراً فيه 457,440 معاملاً، ودربناه على شعر المتنبي، فتعلم شكل البيت والكلمة ولكنه لم يتعلم المعنى، وقلنا إن الذي ينقصه هو البيانات والحجم وليس المعمارية. وفي هذا الجزء الأخير سوف نثبت ذلك بطريقة مباشرة: نأخذ نفس الكلاس Gpt الذي كتبناه، ونعطيه أحجام GPT-2، ثم نحمل فيه الأوزان الحقيقية التي دربتها OpenAI على 40 GB من النصوص، ونشغله دون أي سطر من PyTorch، ثم نثبت أن مخرجه يطابق مخرج مكتبة Hugging Face رقماً برقم.
وهذا الجزء هو الامتحان الحقيقي لكل ما كتبناه في السلسلة، لأن التحقق من التدرج يثبت أن كل عملية متسقة مع نفسها، ولكنه لا يثبت أنها نفس العمليات التي استخدمتها OpenAI، فإذا كان في الكود ترتيب خاطئ لأبعاد مصفوفة أو نسخة مختلفة من الدالة GELU أو قيمة مختلفة ل Epsilon في LayerNorm، فسوف تعمل الأوزان وتعطي نصاً، ولكنه نص خاطئ. أما مقارنة 251,285 رقماً مع مرجع خارجي فلا تترك مكاناً لهذا النوع من الأخطاء.
المواضيع في السلسلة:
- محرك التعلم والتفاضل التلقائي Autograd: المشتقة والتدرج وقاعدة السلسلة Chain Rule، والكلاس Tensor، والتحقق من التدرج Gradient Check، والمحسن AdamW.
- أول نموذج لغة يتوقع الحرف التالي: مقسم على مستوى الحرف Character Tokenizer للنص العربي، ثم نموذج Bigram بالعد، ثم نفس النموذج كشبكة مدربة، ثم شبكة MLP تنظر إلى آخر ثمانية حروف، والتدريب على شعر المتنبي.
- GPT صغير بالانتباه Attention والمحول Transformer: تضمين التوكن والموضع، والانتباه متعدد الرؤوس Multi-Head Attention، وكتلة Transformer، ونموذج فيه قرابة نصف مليون معامل يتدرب على المعالج في دقائق.
- ابن نموذج لغة بلغة C# من الصفر (4): تحميل أوزان GPT-2 الحقيقية وتشغيلها (الموضوع الحالي).
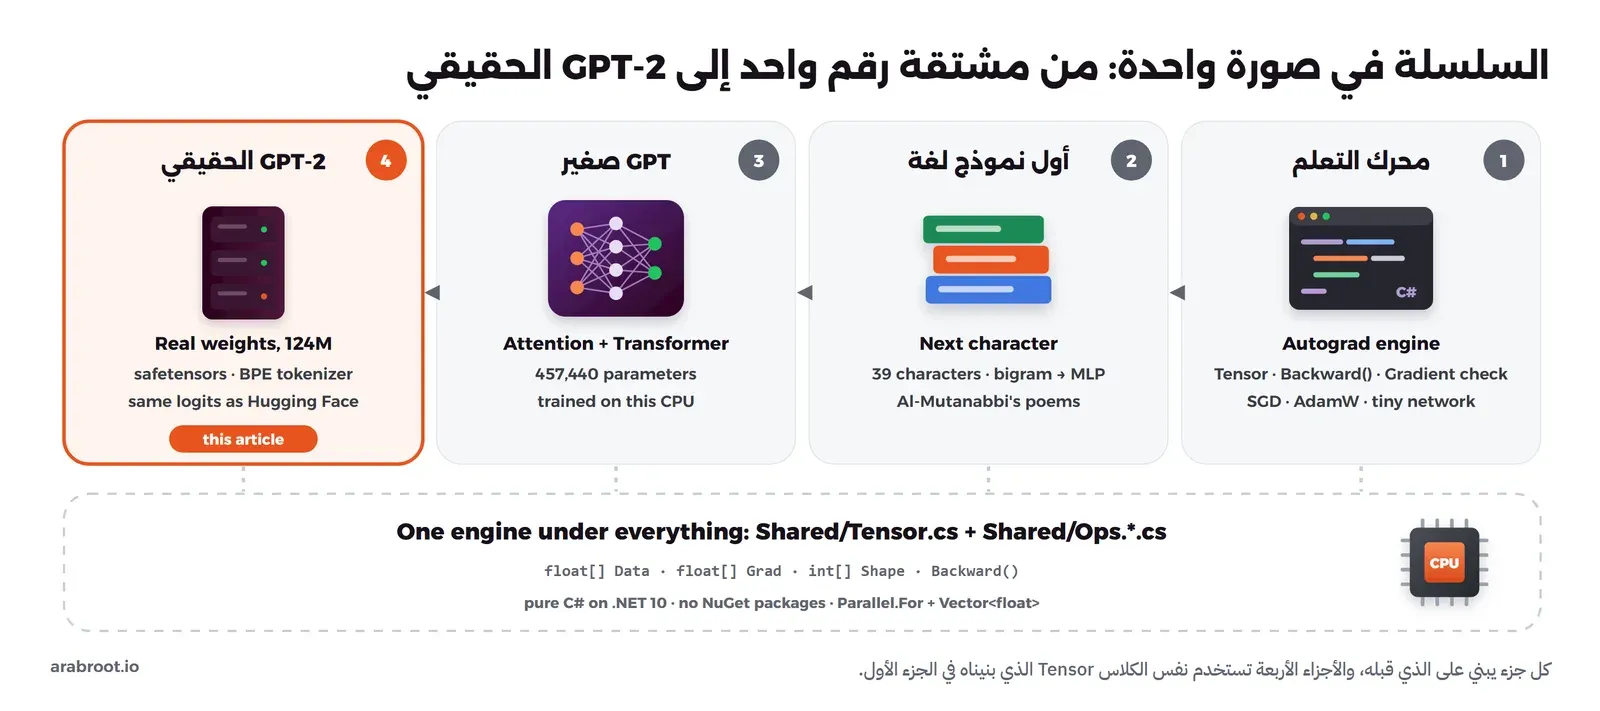
الصورة التالية تبين السلسلة كاملة، والجزء الحالي هو البطاقة الأخيرة:
وسوف نناقش في هذا المقال ما يلي:
- تنزيل GPT-2 ورخصته، وصيغة الملف safetensors وكيف نقرؤها بلغة C# في بضعة أسطر.
- تحميل 148 مصفوفة في كلاساتنا بالاسم، ولماذا لا نحتاج قلب أي مصفوفة، وما هي المصفوفات ال 12 التي لا نستخدمها.
- المقسم BPE على مستوى البايت Byte-level BPE الخاص ب GPT-2، مكتوباً من الصفر، ومطابقته مع Hugging Face في ستة نصوص منها العربي والرموز التعبيرية Emoji.
- أول توقع من GPT-2، ثم إثبات الصحة: 251,285 درجة Logit تختلف عن Hugging Face بأقل من
3.4E-004. - التوليد مع ذاكرة KV Cache، وأثرها على السرعة، ودرجة الحرارة Temperature واختيار أفضل K توكن Top-k.
- لماذا GPT-2 ضعيف في العربية، وما الذي يفصل هذا النموذج عن نماذج اليوم، وإلى أين تذهب بعد هذه السلسلة.
تنزيل GPT-2 وتشغيل هذا الجزء
الأوزان التي نستخدمها هي أصغر نسخة من GPT-2، المنشورة في صفحة openai-community/gpt2 على Hugging Face برخصة MIT، وهي نفس رخصة مستودع OpenAI الأصلي المعدلة Modified MIT License، فيمكنك استخدامها وتوزيعها بحرية بشرط الإبقاء على نص الرخصة. ونحتاج من الصفحة أربعة ملفات فقط: إعدادات النموذج config.json، والأوزان model.safetensors، وملفا المقسم vocab.json وmerges.txt، والأمر download gpt2 ينزلها كما يلي، من الملف Shared/Download.cs:
// GPT-2 124M from https://huggingface.co/openai-community/gpt2 (MIT licence)
static async Task Gpt2()
{
    string dir = Part4.Part4.Dir;
    Directory.CreateDirectory(dir);
    foreach (var file in new[] { "config.json", "vocab.json", "merges.txt", "model.safetensors" })
    {
        string path = Path.Combine(dir, file);
        if (File.Exists(path)) { Console.WriteLine($"{path} exists"); continue; }
        string url = $"https://huggingface.co/openai-community/gpt2/resolve/main/{file}";
        Console.WriteLine($"GET {url}");
        using var resp = await Http.GetAsync(url, HttpCompletionOption.ResponseHeadersRead);
        resp.EnsureSuccessStatusCode();
        await using (var fs = File.Create(path + ".part"))
            await resp.Content.CopyToAsync(fs);
        File.Move(path + ".part", path);
        Console.WriteLine($"  -> {path} ({new FileInfo(path).Length:N0} bytes)");
    }
}
لاحظ أن الملف ينزل أولاً باسم مؤقت ينتهي ب .part، ثم ينقل إلى اسمه النهائي بعد اكتمال التنزيل، والسبب أن ملف الأوزان حجمه 548 MB، فإذا انقطع الاتصال في المنتصف لا يبقى ملف ناقص باسم صحيح يظنه البرنامج كاملاً في المرة القادمة. ولتشغيل هذا الجزء نفذ الأوامر التالية:
cd content/labs/llm-csharp
dotnet run -c Release -- download gpt2      # أربعة ملفات (548 MB) إلى models/gpt2/
dotnet run -c Release -- part4              # تحميل الأوزان والمقسم والتوقع والتوليد
dotnet run -c Release -- part4 compare      # المقارنة مع Hugging Face (بعد تشغيل المرجع)
وإذا أردت حفظ الأوزان في قرص آخر فضع مسار المجلد في متغير البيئة GPT2_DIR. وكل المخرجات في هذا المقال من الملفين outputs/part4.txt وoutputs/part4-compare.txt كما ظهرت عندنا، والأزمنة والسرعات فيها للتوضيح فقط، لأنها قيست على نفس الجهاز المشغول الذي ذكرناه في الأجزاء السابقة (Intel Core i7-7700K بأربع أنوية وثمانية خيوط).
صيغة الملف safetensors
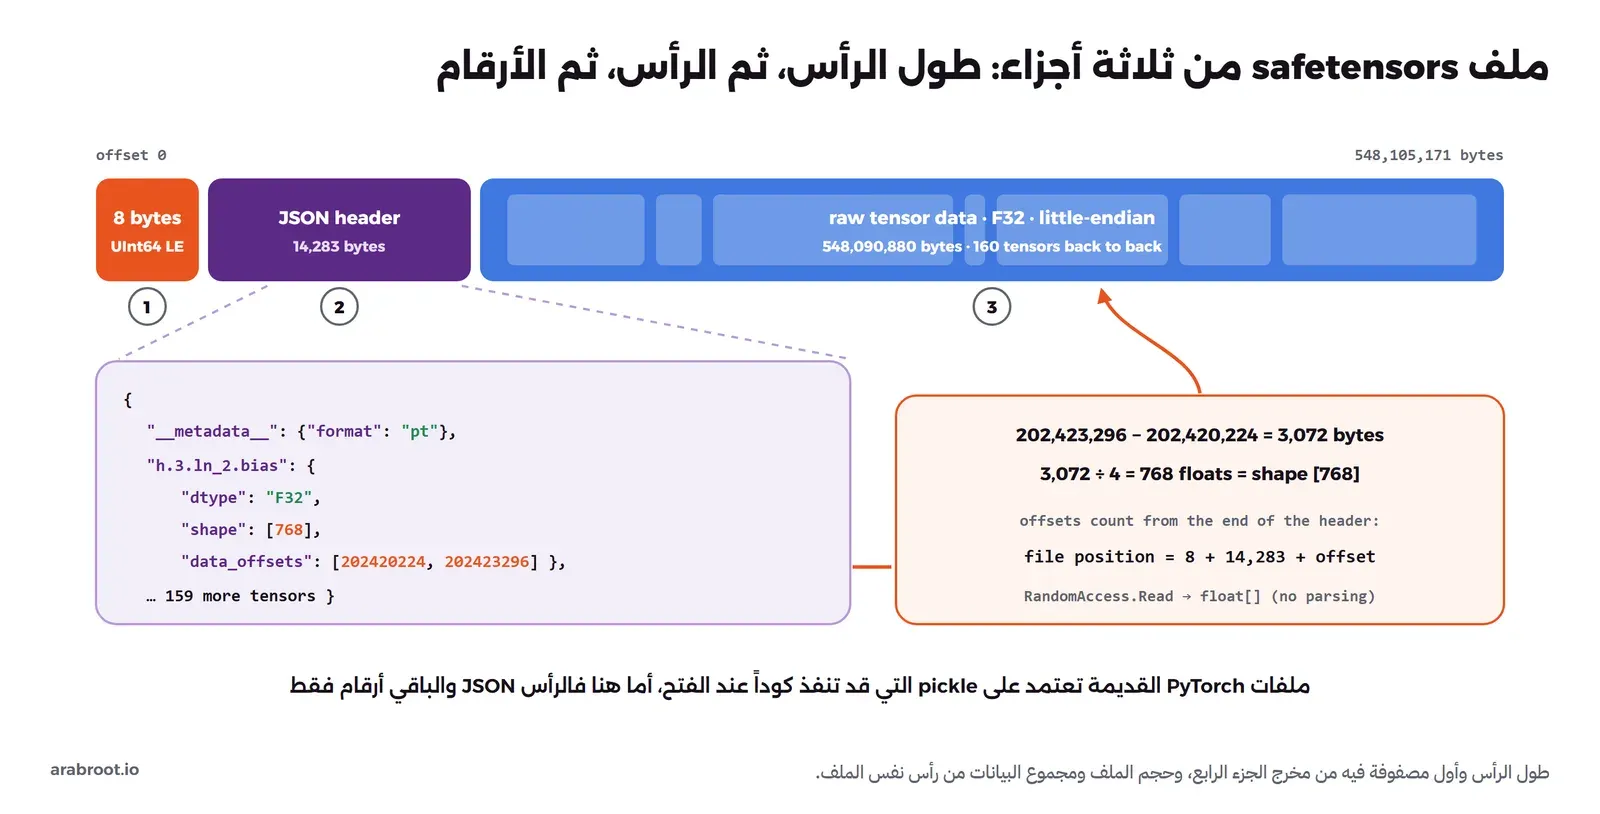
قد يتساءل البعض: لماذا لا نقرأ ملف الأوزان الذي يحفظه PyTorch مباشرة؟ والإجابة أن الصيغة القديمة لملفات PyTorch تعتمد على pickle الخاصة بلغة Python، وهي صيغة تستطيع أن تنفذ كوداً عند فتح الملف، فتحميل ملف أوزان من مصدر غير موثوق قد يشغل على جهازك برنامجاً لم تطلبه، كما يشرح مستودع safetensors، كما أن قراءتها من C# تحتاج تنفيذ جزء من Python. لذلك أنشأت Hugging Face صيغة safetensors، وهي بسيطة جداً لدرجة أن وصفها كله ثلاثة أسطر:
- أول 8 بايتات: رقم N من نوع
UInt64بترتيب Little-endian، وهو طول الرأس Header. - الN بايت التالية: نص JSON فيه لكل مصفوفة اسمها ونوع أرقامها
dtypeوشكلهاshapeوموقع بايتاتهاdata_offsets. - بقية الملف: أرقام المصفوفات خاماً Raw Bytes، متتالية دون أي فواصل.
والصورة التالية تبين ملف GPT-2 بهذا الشكل:
والقارئ الذي كتبناه من الملف Part4_Gpt2/SafeTensors.cs:
// The safetensors format (Hugging Face):
//   8 bytes   little-endian unsigned length N of the header
//   N bytes   JSON: { "name": { "dtype": "F32", "shape": [..], "data_offsets": [begin, end] }, ... }
//   the rest  raw tensor bytes; offsets are relative to the end of the header
public sealed class SafeTensors
{
    public sealed record Entry(string DType, int[] Shape, long Begin, long End);

    readonly string path;
    readonly long dataStart;
    public readonly Dictionary<string, Entry> Tensors = [];

    public SafeTensors(string path)
    {
        this.path = path;
        using var fs = File.OpenRead(path);
        Span<byte> lenBytes = stackalloc byte[8];
        fs.ReadExactly(lenBytes);
        long headerLen = (long)BitConverter.ToUInt64(lenBytes);   // x86/x64/ARM64 are little-endian, like the file
        var header = new byte[headerLen];
        fs.ReadExactly(header);
        dataStart = 8 + headerLen;

        using var json = JsonDocument.Parse(header);
        foreach (var prop in json.RootElement.EnumerateObject())
        {
            if (prop.Name == "__metadata__") continue;
            var e = prop.Value;
            var offsets = e.GetProperty("data_offsets");
            Tensors[prop.Name] = new Entry(
                e.GetProperty("dtype").GetString()!,
                e.GetProperty("shape").EnumerateArray().Select(x => x.GetInt32()).ToArray(),
                offsets[0].GetInt64(), offsets[1].GetInt64());
        }
    }

    // Read one F32 tensor straight into a float[] (the bytes are copied as they are: no parsing)
    public float[] ReadFloats(string name)
    {
        var e = Tensors[name];
        if (e.DType != "F32") throw new NotSupportedException($"{name}: dtype {e.DType}, only F32 is handled here");
        var data = new float[(e.End - e.Begin) / 4];
        using var handle = File.OpenHandle(path);
        var bytes = MemoryMarshal.AsBytes(data.AsSpan());
        long offset = dataStart + e.Begin;
        while (bytes.Length > 0)
        {
            int n = RandomAccess.Read(handle, bytes, offset);
            if (n == 0) throw new EndOfStreamException(name);
            bytes = bytes[n..];
            offset += n;
        }
        return data;
    }
في الكود أعلاه لاحظ التالي:
- القراءة كلها من مكتبة .NET الأساسية:
BitConverterلطول الرأس، وSystem.Text.Jsonللرأس، وRandomAccess.Readلقراءة البايتات من موقع محدد في الملف دون أن نمر على ما قبله. - السطر
MemoryMarshal.AsBytes(data.AsSpan())يعرض مصفوفةfloat[]كمصفوفة بايتات دون نسخ، فنقرأ بايتات الملف مباشرة في ذاكرة الأرقام، وهذا يعمل لأن الملف بترتيب Little-endian مثل المعالجات التي يعمل عليها .NET اليوم (x86 وx64 وARM64)، ولأنfloatفي C# هو نفسF32في الملف (IEEE 754 بأربع بايتات). - نتحقق من النوع، فإذا كان الملف بأرقام
F16أوBF16نرفضه بخطأ واضح بدلاً من أن نقرأ أرقاماً لا معنى لها، وملف GPT-2 هذا كلهF32.
والمخرج عند التحميل سوف يكون كما يلي:
header length = 14,283 bytes, first bytes of the JSON: {"__metadata__":{"format":"pt"},"h.3.ln_2.bias":{"dtype":"F32","shape":[768],"data_offsets":[202420224,202423296]},"h.10
160 tensors in the file, 148 parameters in our model (124,439,808 numbers)
  wte.weight                   F32 [50257, 768]
  wpe.weight                   F32 [1024, 768]
  h.0.ln_1.weight              F32 [768]
  h.0.attn.c_attn.weight       F32 [768, 2304]
  h.0.attn.c_proj.weight       F32 [768, 768]
  h.0.mlp.c_fc.weight          F32 [768, 3072]
  h.0.mlp.c_proj.weight        F32 [3072, 768]
  ln_f.weight                  F32 [768]
not used: 12 tensors (h.7.attn.bias, h.2.attn.bias, h.4.attn.bias...)
loaded in 4.1s
في المخرج أعلاه لاحظ التالي:
- الرأس طوله 14,283 بايتاً فقط، أي أن الجزء الذي نحتاج أن نفهمه من ملف حجمه 548 MB هو 14 KB من JSON، والباقي أرقام.
- المصفوفات في الرأس ليست بالترتيب (أول اسم ظهر
h.3.ln_2.bias)، وهذا لا يهم، لأننا نصل إلى كل مصفوفة باسمها وموقعها. - جدول التوكنز
wte.weightشكله[50257, 768]، أي 50,257 توكناً لكل منها متجه من 768 رقماً، وهو وحده 38,597,376 رقماً، أي قرابة ثلث النموذج. - الأوزان
c_attnشكلها[768, 2304]، أي أن السؤال والمفتاح والقيمة في مصفوفة واحدة بالضبط كما كتبناها في الجزء الثالث (2304 = 3 × 768)، وال MLP يوسع من 768 إلى 3072، أي أربعة أضعاف كما في نموذجنا الصغير. - التحميل كله أخذ 4.1 ثانية، وأغلبه قراءة نصف جيجابايت من القرص.
تحميل الأوزان Weights في كلاساتنا
الآن نأتي إلى الفكرة التي جهزنا لها منذ الجزء الثالث: لن نكتب نموذجاً جديداً ل GPT-2، وإنما ننشئ نفس الكلاس Gpt بأحجام GPT-2 من الملف config.json (12 طبقة و12 رأساً و768 رقماً لكل متجه و1024 موضعاً و50,257 توكناً)، ثم نمر على كل معامل فيه ونبحث عن مصفوفة بنفس الاسم في الملف وننسخ أرقامها. والسبب أن هذا ممكن هو أننا سمينا كل وزن في الجزء الثالث بنفس الاسم الذي تستخدمه نسخة Hugging Face (h.0.attn.c_attn.weight مثلاً). والكود التالي من الملف Part4_Gpt2/Part4.cs:
// Build our own GPT class with GPT-2 124M's sizes and copy every weight in by name
public static Gpt Load(bool verbose)
{
    string file = Path.Combine(Dir, "model.safetensors");
    if (!File.Exists(file)) throw new FileNotFoundException($"{file} not found: run `dotnet run -c Release -- download gpt2` first");
    using var cfgJson = JsonDocument.Parse(File.ReadAllText(Path.Combine(Dir, "config.json")));
    int Get(string k) => cfgJson.RootElement.GetProperty(k).GetInt32();
    var cfg = new GptConfig(Get("vocab_size"), Get("n_positions"), Get("n_layer"), Get("n_head"), Get("n_embd"));

    var st = new SafeTensors(file);
    var model = new Gpt(cfg);
    if (verbose)
    {
        Console.WriteLine(SafeTensors.HeaderPreview(file, 120));
        Console.WriteLine($"{st.Tensors.Count} tensors in the file, {model.Parameters.Count} parameters in our model ({model.ParameterCount:N0} numbers)");
        foreach (var name in new[] { "wte.weight", "wpe.weight", "h.0.ln_1.weight", "h.0.attn.c_attn.weight", "h.0.attn.c_proj.weight", "h.0.mlp.c_fc.weight", "h.0.mlp.c_proj.weight", "ln_f.weight" })
            if (st.Tensors.ContainsKey(name)) Console.WriteLine("  " + st.Describe(name));
    }
    var used = new HashSet<string>();
    foreach (var p in model.Parameters)
    {
        string name = st.Tensors.ContainsKey(p.Name) ? p.Name : "transformer." + p.Name;
        var e = st.Tensors[name];
        // Conv1D stores [in, out] like our Linear, so shapes must match exactly: no transpose needed
        if (!e.Shape.SequenceEqual(p.Shape))
            throw new InvalidDataException($"{name}: file [{string.Join(",", e.Shape)}] vs model [{string.Join(",", p.Shape)}]");
        st.ReadFloats(name).CopyTo(p.Data, 0);
        used.Add(name);
    }
    if (verbose)
    {
        var unused = st.Tensors.Keys.Where(k => !used.Contains(k)).ToList();
        Console.WriteLine($"not used: {unused.Count} tensors ({string.Join(", ", unused.Take(3))}...)");
    }
    return model;
}
والصورة التالية تبين الطريق من الملف إلى كلاساتنا:
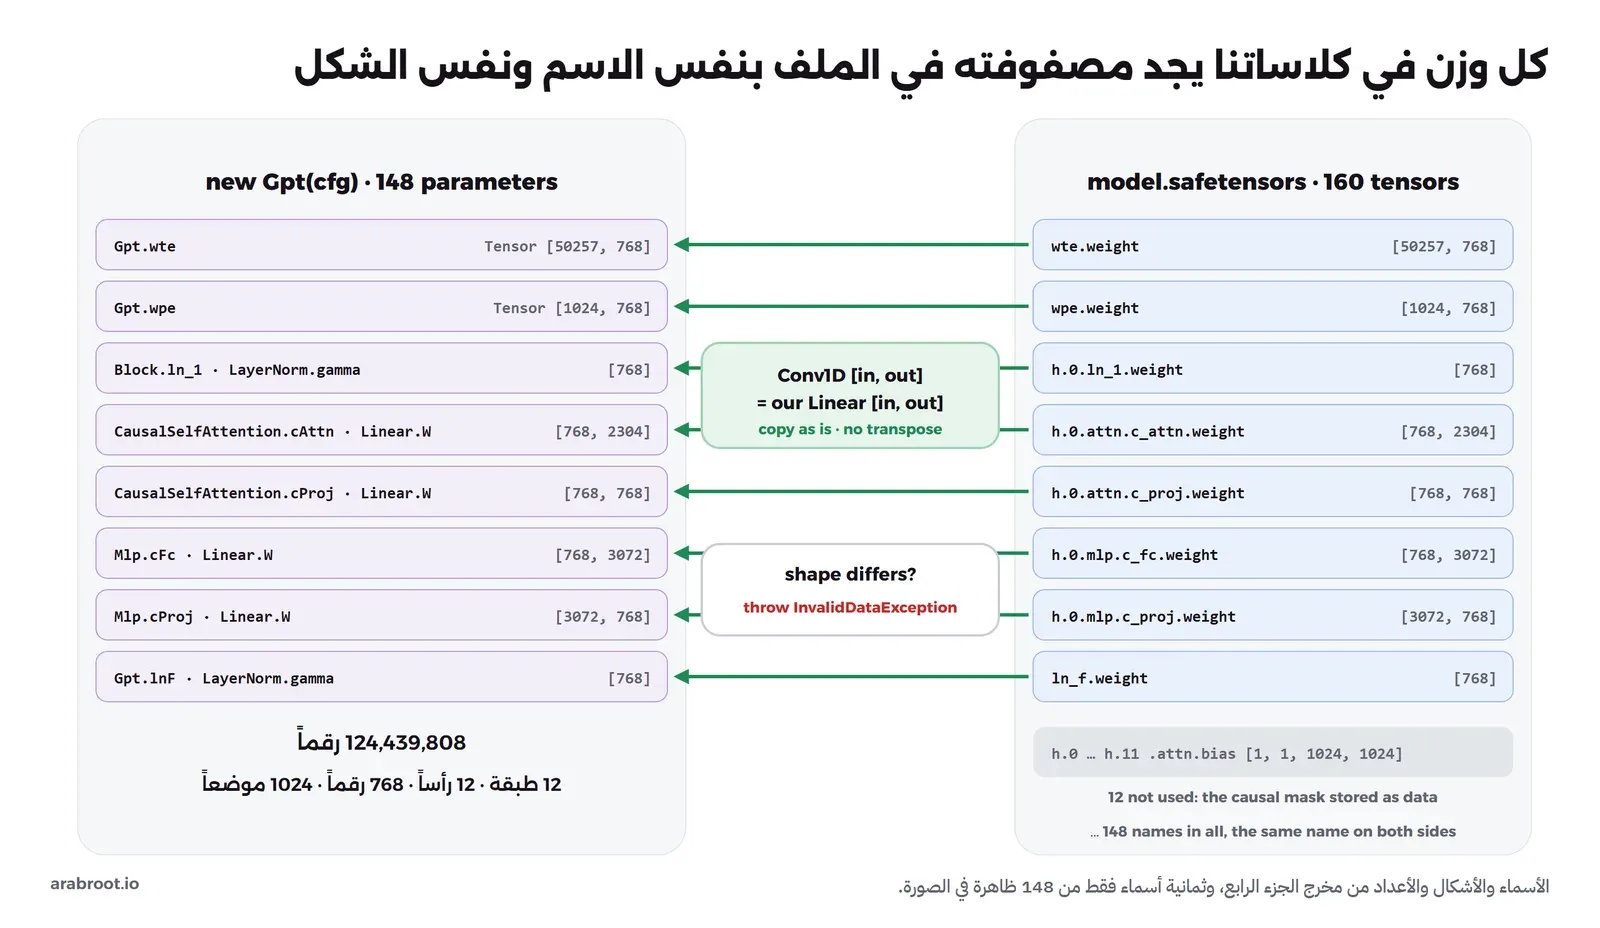
في الكود والصورة أعلاه لاحظ التالي:
- إذا اختلف شكل أي مصفوفة في الملف عن شكل الوزن في نموذجنا نرمي خطأ فوراً، فلا يمكن أن يحمل النموذج أوزاناً في المكان الخطأ بصمت.
- الأوزان في GPT-2 محفوظة بطبقة اسمها Conv1D، وتوثيقها في مكتبة transformers يقول إنها تعمل مثل الطبقة الخطية ولكن أوزانها مقلوبة، أي
[in, out]بدلاً من[out, in]فيnn.Linear. ولأن الكلاسLinearعندنا يحفظ الأوزان بالشكل[in, out]من البداية، كما ذكرنا في الجزء الثالث، فالنسخ مباشر دون أي قلب للمصفوفات. - بعض الملفات تحفظ الأسماء مع البادئة
transformer.، لذلك نبحث بالاسمين، والملف الذي نزلناه يستخدم الأسماء دون البادئة. - لا يوجد في الملف وزن للطبقة الأخيرة التي تحول المتجه إلى درجات، لأن GPT-2 يستخدم ربط الأوزان Weight Tying، أي نفس الجدول
wte، وهو نفس ما فعلناه في الجزء الثالث بالعمليةMatMulT. - نموذجنا فيه 148 مصفوفة بمجموع 124,439,808 رقماً، وهو العدد الذي يذكر عادة باسم «GPT-2 124M»، أما ورقة GPT-2 الأصلية فذكرت أصغر نموذج باسم 117M.
المصفوفات Tensors ال 12 التي لا نستخدمها
الملف فيه 160 مصفوفة ونموذجنا يحتاج 148، والفرق هو 12 مصفوفة اسمها h.N.attn.bias، واحدة لكل طبقة. والاسم مضلل، فهي ليست Bias يتعلمه النموذج، وإنما القناع السببي Causal Mask نفسه محفوظاً كمصفوفة من الأصفار والآحاد، فإذا قرأت رأس الملف ستجد أن شكل كل واحدة منها [1, 1, 1024, 1024]، أي 4 MB لكل طبقة، و48 MB للطبقات كلها من حجم الملف بدون أي معلومة جديدة. ونحن لا نحتاجها، لأن العملية CausalSoftmax التي كتبناها في الجزء الثالث تطبق القناع بالحساب (visible = r % t + 1) دون أن تحفظه في الذاكرة.
مقسم GPT-2: ترميز أزواج البايتات BPE على مستوى البايت
في الجزء الثاني كان المقسم 39 حرفاً، أما GPT-2 فيستخدم 50,257 توكناً، وكلها مبنية بطريقة ترميز أزواج البايتات Byte-Pair Encoding، واختصاراً BPE، التي شرحنا فكرتها في ما هو التوكن Token. والملفان اللذان نزلناهما هما كل ما نحتاجه: vocab.json فيه كل توكن ورقمه، وmerges.txt فيه قائمة الدمج مرتبة، أي «إذا رأيت هذين الرمزين متجاورين فادمجهما»، والدمج الذي يأتي أولاً في القائمة له الأولوية. وقد كتبنا المقسم من وصفه في ورقة GPT-2 ومن شكل الملفين، والكود التالي من الملف Part4_Gpt2/Gpt2Tokenizer.cs:
// GPT-2's byte-level BPE tokenizer (vocab.json + merges.txt), written from the description in the GPT-2 paper
// and the format of the files:
//  1) split the text into pieces with a regex (words with their leading space, numbers, punctuation, spaces)
//  2) turn each piece into UTF-8 bytes, and every byte into one printable character (so no byte is lost)
//  3) merge neighbouring symbols again and again, always the pair that comes first in merges.txt
//  4) look up every final symbol in vocab.json
public sealed partial class Gpt2Tokenizer
{
    readonly Dictionary<string, int> encoder;
    readonly string[] decoder;
    readonly Dictionary<(string, string), int> mergeRank = [];
    readonly char[] byteToChar = new char[256];
    readonly Dictionary<char, byte> charToByte = [];
    readonly Dictionary<string, int[]> cache = [];

    [GeneratedRegex(@"'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+")]
    private static partial Regex PreTokenize();

    public Gpt2Tokenizer(string dir)
    {
        encoder = JsonSerializer.Deserialize<Dictionary<string, int>>(File.ReadAllText(Path.Combine(dir, "vocab.json")))!;
        decoder = new string[encoder.Count];
        foreach (var (token, id) in encoder) decoder[id] = token;

        var lines = File.ReadAllLines(Path.Combine(dir, "merges.txt"));
        int rank = 0;
        foreach (var line in lines.Skip(1))   // first line is "#version: 0.2"
        {
            var parts = line.Split(' ');
            if (parts.Length == 2) mergeRank[(parts[0], parts[1])] = rank++;
        }

        // Printable bytes map to themselves; the other 68 bytes (control chars, space...) map to 256, 257, ...
        int extra = 0;
        for (int b = 0; b < 256; b++)
        {
            bool printable = (b >= '!' && b <= '~') || (b >= 0xA1 && b <= 0xAC) || (b >= 0xAE && b <= 0xFF);
            byteToChar[b] = printable ? (char)b : (char)(256 + extra++);
            charToByte[byteToChar[b]] = (byte)b;
        }
    }
في الكود أعلاه لاحظ التالي:
- الخطوة الأولى تقطع النص بتعبير منتظم Regular Expression إلى كلمات مع المسافة التي قبلها، وأرقام، وعلامات ترقيم، ومسافات، وهو نفس التعبير الموجود في ملف encoder.py في مستودع OpenAI، ومحرك التعبيرات المنتظمة في .NET يدعم
\p{L}(أي حرف من أي لغة) و\p{N}(أي رقم)، فلا نحتاج أي مكتبة. والسبب في هذه الخطوة أن الدمج لا يعبر حدود القطع، فلا يندمج آخر الكلمة مع علامة الترقيم بعدها، كما تشرح الورقة، فلا نحصل على توكن مختلف ل «dog» و«dog.» و«dog!». - الخطوة الثانية تحول كل قطعة إلى بايتات UTF-8، وهذا ما يجعل المقسم يقبل أي نص في العالم، فأي حرف في Unicode هو بضعة بايتات، والبايتات 256 فقط، وكلها موجودة في المفردات.
- كل بايت يتحول إلى حرف يمكن طباعته، فالبايتات التي يمكن طباعتها تبقى كما هي، والباقي (مثل المسافة
0x20) يأخذ حرفاً من 256 وما بعده، ولهذا تظهر المسافة فيvocab.jsonبالشكلĠ(أيU+0120)، والسبب كما يذكر التعليق في نفس الملف encoder.py أن كود BPE لا يتعامل جيداً مع المسافات وحروف التحكم، ولاحظ أيضاً أن ملف الدمج نفسه يفصل بين الزوجين بمسافة.
أما الدمج نفسه فهو الدالة Bpe من نفس الملف:
public List<int> Encode(string text)
{
    var ids = new List<int>();
    foreach (Match m in PreTokenize().Matches(text))
    {
        if (!cache.TryGetValue(m.Value, out var pieceIds))
        {
            string mapped = new(Encoding.UTF8.GetBytes(m.Value).Select(b => byteToChar[b]).ToArray());
            cache[m.Value] = pieceIds = Bpe(mapped).Select(s => encoder[s]).ToArray();
        }
        ids.AddRange(pieceIds);
    }
    return ids;
}

// Start from single characters and keep merging the best-ranked neighbouring pair
List<string> Bpe(string piece)
{
    var symbols = piece.Select(c => c.ToString()).ToList();
    while (symbols.Count > 1)
    {
        int best = -1, bestRank = int.MaxValue;
        for (int i = 0; i + 1 < symbols.Count; i++)
            if (mergeRank.TryGetValue((symbols[i], symbols[i + 1]), out int r) && r < bestRank) { bestRank = r; best = i; }
        if (best < 0) break;   // no known pair left
        var pair = (symbols[best], symbols[best + 1]);
        var merged = new List<string>(symbols.Count);
        for (int i = 0; i < symbols.Count; i++)   // merge every occurrence of this pair
        {
            if (i + 1 < symbols.Count && (symbols[i], symbols[i + 1]) == pair) { merged.Add(symbols[i] + symbols[i + 1]); i++; }
            else merged.Add(symbols[i]);
        }
        symbols = merged;
    }
    return symbols;
}

public string Decode(IEnumerable<int> ids)
{
    var bytes = ids.SelectMany(id => decoder[id]).Select(c => charToByte[c]).ToArray();
    return Encoding.UTF8.GetString(bytes);   // a cut in the middle of a character shows as U+FFFD
}
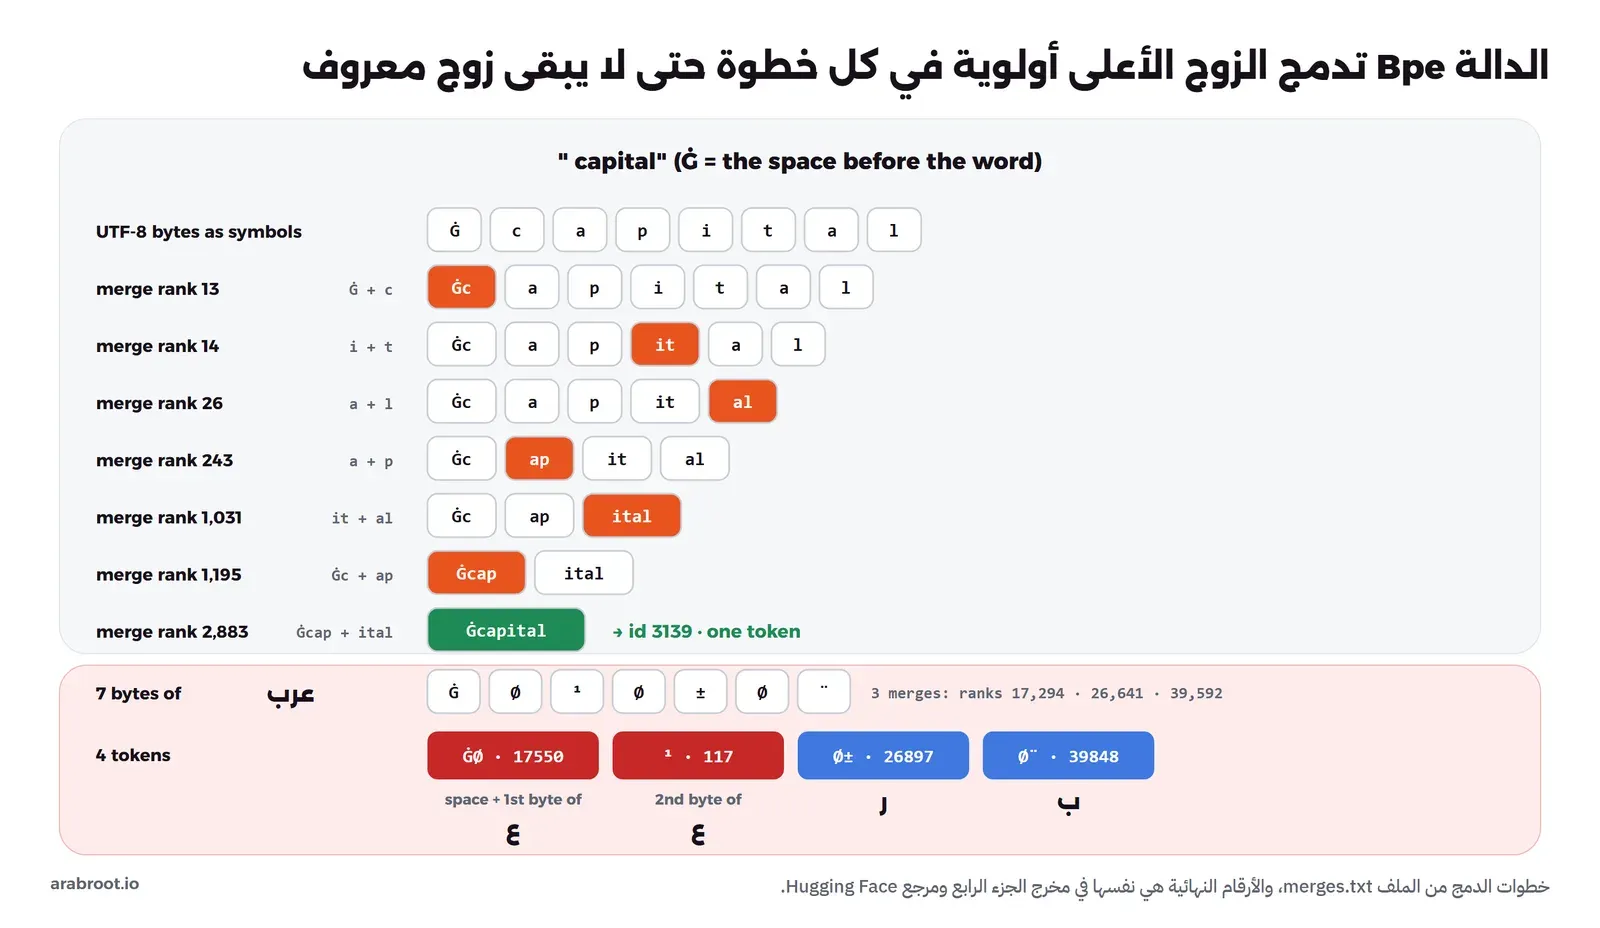
والصورة التالية تبين ما تفعله الدالة Bpe بكلمة « capital» مع المسافة التي قبلها، ثم بكلمة « عرب»، وكل خطوة فيها هي الزوج الذي له أعلى أولوية في merges.txt:
والمخرج عند تقسيم الجملة الإنجليزية وجملة عربية سوف يكون كما يلي:
== Tokenizer
"The capital of France is" (24 chars) -> 5 tokens: [464, 3139, 286, 4881, 318]
"مرحبا بكم في عرب رووت" (21 chars) -> 23 tokens: [25405, 26897, 148, 255, 39848, 12919, 17550, 101, 149, 225, 25405, 18923, 223, 22654, 17550, 117, 26897, 39848, 17550, 109, 30335, 30335, 41486]
لاحظ أن 24 حرفاً إنجليزياً أصبحت 5 توكنز، أما 21 حرفاً عربياً فأصبحت 23 توكناً، أي أكثر من توكن لكل حرف، وسوف نعود إلى هذه النقطة بعد قليل لأنها تفسر أغلب ضعف GPT-2 في العربية.
أول توقع Prediction من GPT-2
الآن نعطي النموذج الجملة «The capital of France is» ونطلب منه درجة كل توكن من ال 50,257 أن يكون التالي، ثم نحولها إلى احتمالات ونطبع أفضل خمسة. والكود التالي من الملف Part4_Gpt2/Part4.cs:
Console.WriteLine($"== Next token after \"{prompt}\"");
var promptIds = tok.Encode(prompt);
Tensor.NoGrad = true;
var logits = model.Forward(promptIds.ToArray(), 1, promptIds.Count);
var last = logits.Data.AsSpan((promptIds.Count - 1) * model.Config.VocabSize, model.Config.VocabSize);
var probs = new float[last.Length];
Ops.Softmax(last, probs);
foreach (int id in TopK(last, 5))
    Console.WriteLine($"{id,6}  {Show(tok.Decode([id])),-12} logit {last[id],8:F3}   p = {probs[id]:P1}");
Console.WriteLine();
والمخرج سوف يكون كما يلي:
== Next token after "The capital of France is"
   262  " the"       logit -100.250   p = 8.5 %
   783  " now"       logit -100.818   p = 4.8 %
   257  " a"         logit -100.855   p = 4.6 %
  4881  " France"    logit -101.210   p = 3.2 %
  6342  " Paris"     logit -101.214   p = 3.2 %
في المخرج أعلاه لاحظ التالي:
- الدرجات Logits كلها حول −100، وهذا طبيعي في GPT-2 ولا يعني شيئاً بنفسه، لأن الدالة Softmax لا تهتم إلا بالفرق بين الدرجات، فالفرق 0.568 بين « the» و« now» هو الذي جعل الأول 8.5% والثاني 4.8%.
- « Paris» في المرتبة الخامسة باحتمال 3.2% فقط، وأول اختيار هو « the»، وهذا ليس خطأ في الكود، وإنما هو سلوك النموذج الأساسي Base Model: فهو لم يتعلم أن يجيب على الأسئلة، وإنما أن يكمل النص كما يكمله الإنترنت، وجملة «The capital of France is the city of…» إكمال طبيعي جداً، وقد شرحنا الفرق بين النموذج الأساسي والنموذج الذي يجيب في ضبط التعليمات وضبط التفضيلات.
- الأرقام وحدها لا تثبت أن الكود صحيح، فنموذج فيه خطأ صغير قد يعطي أيضاً « the» و« Paris» في الأعلى، والإثبات في القسم التالي.
هل الأرقام صحيحة؟ المقارنة مع Hugging Face
المرجع الذي نقارن به هو مكتبة transformers من Hugging Face، وهي التنفيذ الأكثر استخداماً ل GPT-2، تشغل نفس الملفات على PyTorch، ثم تحفظ الدرجات Logits كأرقام خام في ملف، وأرقام التوكنز لستة نصوص في ملف JSON. والسكربت التالي من الملف reference/hf_reference.py:
# Reference run with Hugging Face transformers (PyTorch, CPU) on the same files (MODEL_DIR, default /model).
# Writes hf_reference.json (token ids, top-5) and hf_logits.f32 (raw little-endian float32 logits [T, vocab]).
import json
import os
import torch
from transformers import GPT2LMHeadModel, GPT2TokenizerFast

PROMPT = "The capital of France is"
TESTS = [
    PROMPT,
    "Hello world! It's 2026, and we're testing GPT-2's tokenizer.",
    "   leading spaces, tabs\tand\nnew lines   ",
    "numbers 3.14159 and 1,000,000",
    "مرحبا بكم في عرب رووت",
    "C# is fun 🎉🎉",
]

MODEL = os.environ.get("MODEL_DIR", "/model")   # the folder with config.json, model.safetensors, vocab.json, merges.txt
tok = GPT2TokenizerFast.from_pretrained(MODEL)
model = GPT2LMHeadModel.from_pretrained(MODEL, dtype=torch.float32).eval()

ids = tok(PROMPT, return_tensors="pt").input_ids
with torch.no_grad():
    logits = model(ids).logits[0]          # [T, vocab]
logits.numpy().astype("<f4").tofile(os.path.join(MODEL, "hf_logits.f32"))

top = torch.topk(logits[-1], 5)
ref = {
    "prompt": PROMPT,
    "input_ids": ids[0].tolist(),
    "top5": [{"id": int(i), "token": tok.decode([int(i)]), "logit": float(v)} for v, i in zip(top.values, top.indices)],
    "tokenizer_tests": [{"text": t, "ids": tok(t).input_ids} for t in TESTS],
    "versions": {"torch": torch.__version__, "transformers": __import__("transformers").__version__},
}
json.dump(ref, open(os.path.join(MODEL, "hf_reference.json"), "w", encoding="utf-8"), ensure_ascii=False, indent=1)
print(json.dumps({k: ref[k] for k in ("prompt", "input_ids", "top5", "versions")}, ensure_ascii=False, indent=1))
وقد كتبنا السكربت ليعمل داخل Container مؤقت (الأمر موجود في الملف README.md للمشروع)، ولكن Docker كان متوقفاً على جهاز الاختبار وقت التشغيل، لذلك شغلناه في بيئة Python افتراضية venv على نفس الجهاز، وبإصدارات torch 2.14.1+cpu وtransformers 5.18.0 كما سجلها السكربت في الملف outputs/part4-hf-reference.json، والطريقتان تشغلان نفس الكود على نفس الملفات. ثم يقوم الأمر part4 compare بالمقارنة، من الملف Part4_Gpt2/Part4.cs:
// Compare our logits with the ones Hugging Face transformers produced (reference/hf_reference.py)
static void Compare()
{
    using var meta = JsonDocument.Parse(File.ReadAllText(Path.Combine(Dir, "hf_reference.json")));
    var root = meta.RootElement;
    var tok = new Gpt2Tokenizer(Dir);

    Console.WriteLine("== Tokenizer: ours vs Hugging Face");
    int same = 0, total = 0;
    foreach (var t in root.GetProperty("tokenizer_tests").EnumerateArray())
    {
        string text = t.GetProperty("text").GetString()!;
        var expected = t.GetProperty("ids").EnumerateArray().Select(x => x.GetInt32()).ToList();
        var ours = tok.Encode(text);
        bool ok = expected.SequenceEqual(ours);
        total++; if (ok) same++;
        Console.WriteLine($"{(ok ? "same" : "DIFFERENT"),-9} {ours.Count,3} tokens  {Show(text)}");
    }
    Console.WriteLine($"{same}/{total} texts tokenized identically");
    Console.WriteLine();

    string prompt = root.GetProperty("prompt").GetString()!;
    var ids = tok.Encode(prompt);
    var hfIds = root.GetProperty("input_ids").EnumerateArray().Select(x => x.GetInt32()).ToList();
    Console.WriteLine($"== Logits for \"{prompt}\" ({ids.Count} tokens, same ids as HF: {ids.SequenceEqual(hfIds)})");
    var model = Load(verbose: false);
    Tensor.NoGrad = true;
    var sw = Stopwatch.StartNew();
    var logits = model.Forward(ids.ToArray(), 1, ids.Count);
    Console.WriteLine($"forward pass: {sw.Elapsed.TotalMilliseconds:F0} ms");

    var hfBytes = File.ReadAllBytes(Path.Combine(Dir, "hf_logits.f32"));
    var hf = MemoryMarshal.Cast<byte, float>(hfBytes).ToArray();
    if (hf.Length != logits.Size) throw new InvalidDataException($"HF has {hf.Length} logits, we have {logits.Size}");
    float maxDiff = 0, maxAbs = 0;
    for (int i = 0; i < hf.Length; i++)
    {
        maxDiff = MathF.Max(maxDiff, MathF.Abs(hf[i] - logits.Data[i]));
        maxAbs = MathF.Max(maxAbs, MathF.Abs(hf[i]));
    }
    Console.WriteLine($"{hf.Length:N0} logits compared ({ids.Count} positions x {model.Config.VocabSize}), largest |logit| = {maxAbs:F2}");
    Console.WriteLine($"max abs difference vs Hugging Face = {maxDiff:E2}");

    int v = model.Config.VocabSize, lastRow = (ids.Count - 1) * v;
    var oursTop = TopK(logits.Data.AsSpan(lastRow, v), 5);
    var hfTop = TopK(hf.AsSpan(lastRow, v), 5);
    Console.WriteLine("top-5 next tokens   ours                    Hugging Face");
    for (int i = 0; i < 5; i++)
        Console.WriteLine($"  {i + 1}               {oursTop[i],6} {Show(tok.Decode([oursTop[i]])),-14}  {hfTop[i],6} {Show(tok.Decode([hfTop[i]]))}  logit {logits.Data[lastRow + oursTop[i]]:F4} / {hf[lastRow + hfTop[i]]:F4}");
    Console.WriteLine($"same top-5: {oursTop.SequenceEqual(hfTop)}");
}
والمخرج سوف يكون كما يلي:
== Tokenizer: ours vs Hugging Face
same        5 tokens  "The capital of France is"
same       20 tokens  "Hello world! It's 2026, and we're testing GPT-2's tokenizer."
same       14 tokens  "   leading spaces, tabs	and\nnew lines   "
same       12 tokens  "numbers 3.14159 and 1,000,000"
same       23 tokens  "مرحبا بكم في عرب رووت"
same       10 tokens  "C# is fun 🎉🎉"
6/6 texts tokenized identically
== Logits for "The capital of France is" (5 tokens, same ids as HF: True)
forward pass: 303 ms
251,285 logits compared (5 positions x 50257), largest |logit| = 129.87
max abs difference vs Hugging Face = 3.36E-004
top-5 next tokens   ours                    Hugging Face
  1                  262 " the"             262 " the"  logit -100.2498 / -100.2498
  2                  783 " now"             783 " now"  logit -100.8175 / -100.8175
  3                  257 " a"               257 " a"  logit -100.8555 / -100.8555
  4                 4881 " France"         4881 " France"  logit -101.2102 / -101.2102
  5                 6342 " Paris"          6342 " Paris"  logit -101.2142 / -101.2143
same top-5: True
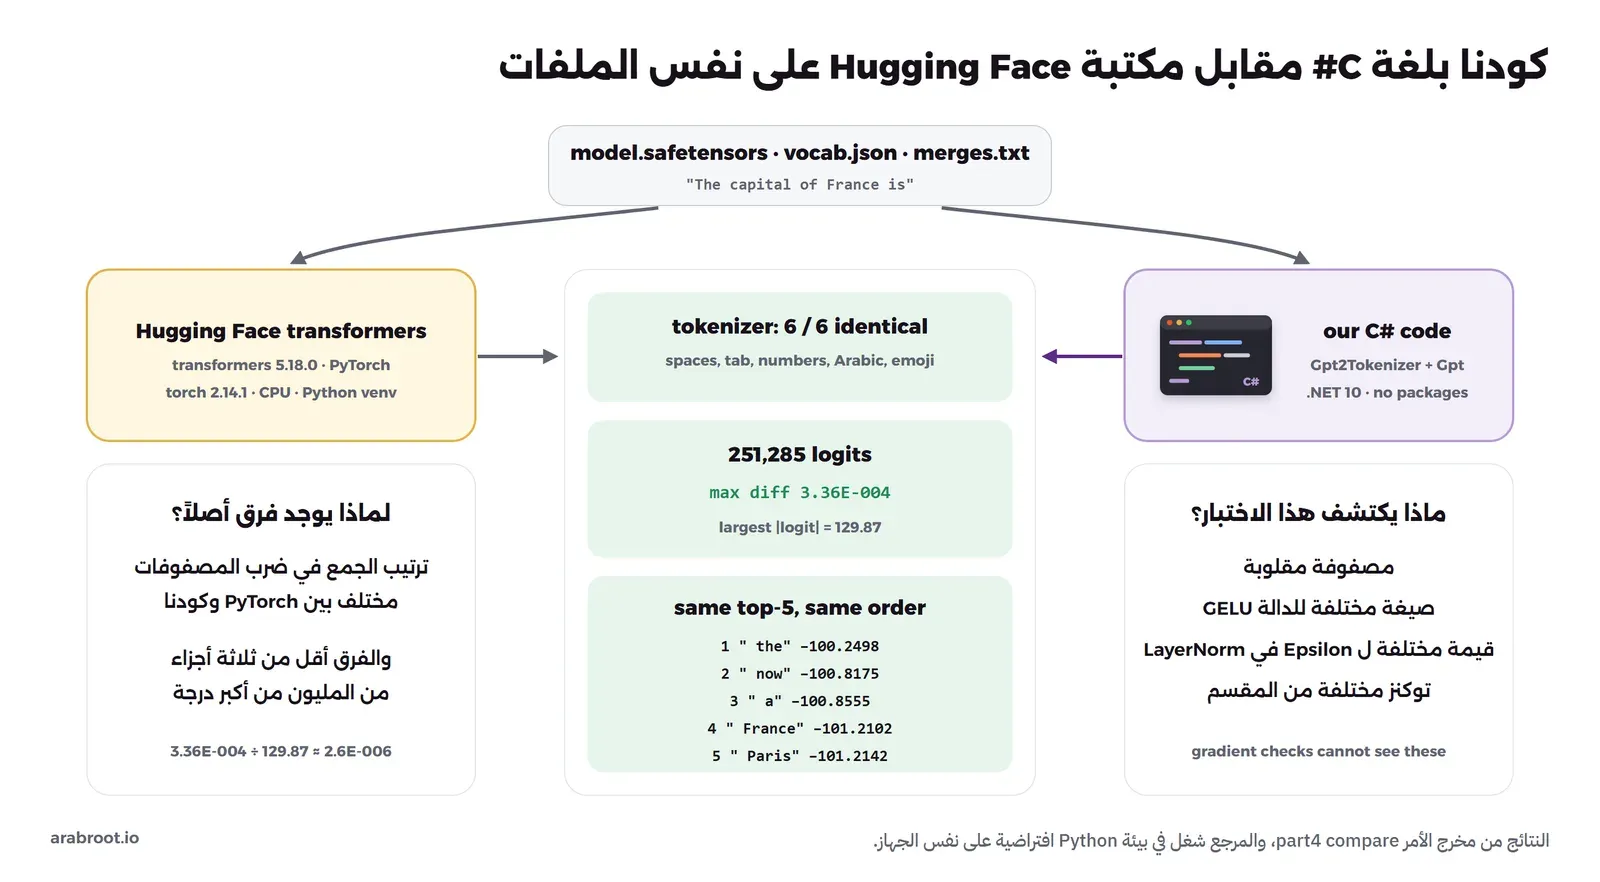
الصورة التالية تلخص المقارنة:
في المخرج والصورة أعلاه لاحظ التالي:
- المقسم أعطى نفس التوكنز بالضبط في النصوص الستة، ومنها نص بمسافات في أوله وآخره وTab وسطر جديد، ونص بأرقام عشرية وفواصل، والنص العربي (23 توكناً)، ورموز تعبيرية Emoji كل واحد منها أربعة بايتات (10 توكنز).
- قارننا كل الدرجات للمواضع الخمسة، أي
5 × 50,257 = 251,285رقماً، وأكبر فرق بينها3.36E-004، بينما أكبر درجة بالقيمة المطلقة 129.87، أي أن الفرق أقل من ثلاثة أجزاء من المليون من أكبر درجة، وهو في حدود دقةfloatبعد 12 طبقة من العمليات المتراكمة. - أفضل خمسة توكنز متطابقة بنفس الترتيب، والدرجات متطابقة في المنازل العشرية الأربع المطبوعة، ما عدا « Paris» بفرق في المنزلة الرابعة (−101.2142 مقابل −101.2143).
- والفرق الصغير طبيعي، لأن ترتيب الجمع في ضرب المصفوفات مختلف بين كودنا وPyTorch، والجمع في
floatيعطي نتائج مختلفة قليلاً بحسب الترتيب، كما رأينا في قسم السرعة في الجزء الأول. أما الخطأ الحقيقي (مثل GELU بالصيغة الدقيقة بدلاً من صيغةtanhالتي يستخدمها GPT-2، أو مصفوفة مقلوبة) فيعطي فرقاً واضحاً أكبر من ذلك بكثير، ويغير غالباً ترتيب أفضل خمسة توكنز.
وبهذا الشكل نكون قد أثبتنا أن محرك الجزء الأول ونموذج الجزء الثالث، دون أي تعديل، يشغلان GPT-2 الحقيقي بنفس نتيجة المكتبة التي يستخدمها الجميع.
التوليد مع ذاكرة KV Cache
في الجزء الثالث شرحنا الفكرة: الدالة Generate تشغل النموذج على النص كاملاً لكل توكن جديد، وتحسب درجات ال 50,257 توكناً لكل المواضع، ثم تأخذ الموضع الأخير فقط، بينما مفاتيح وقيم المواضع السابقة لا تتغير أبداً. والحل أن نحفظها في ذاكرة KV Cache لكل طبقة، ونعالج التوكن الجديد وحده. والكود التالي من الملف Part3_TinyGpt/Attention.cs:
    // Inference with a KV cache: process ONE new token, keep its key and value, and attend over all the keys
    // and values kept so far. Same weights and same math as Forward, without recomputing the old positions.
    public Tensor Step(Tensor x, KvCache cache)   // x: [1, C]
    {
        int c = x.Cols, headSize = c / heads;
        var qkv = cAttn.Forward(x).Data;            // [3C]
        cache.Append(qkv.AsSpan(c, c), qkv.AsSpan(2 * c, c));
        int t = cache.Length;
        var y = new float[c];
        var scores = new float[t];
        float scale = 1f / MathF.Sqrt(headSize);
        for (int h = 0; h < heads; h++)
        {
            var q = qkv.AsSpan(h * headSize, headSize);
            for (int j = 0; j < t; j++) scores[j] = Kernels.Dot(q, cache.Key(j).Slice(h * headSize, headSize)) * scale;
            Ops.Softmax(scores, scores);   // no mask needed: the cache only holds the past
            var yh = y.AsSpan(h * headSize, headSize);
            for (int j = 0; j < t; j++) Kernels.Axpy(scores[j], cache.Value(j).Slice(h * headSize, headSize), yh);
        }
        return cProj.Forward(new Tensor([1, c], y));
    }
}

// Keys and values of every position seen so far, for one layer
public sealed class KvCache(int dim)
{
    readonly List<float[]> keys = [], values = [];
    public int Length => keys.Count;
    public void Append(ReadOnlySpan<float> k, ReadOnlySpan<float> v) { keys.Add(k.ToArray()); values.Add(v.ToArray()); }
    public ReadOnlySpan<float> Key(int j) => keys[j].AsSpan(0, dim);
    public ReadOnlySpan<float> Value(int j) => values[j].AsSpan(0, dim);
}
وفي الملف Part3_TinyGpt/Gpt.cs تمرر الدالة Step التوكن الجديد على كل الطبقات، كل طبقة بذاكرتها، والدالة GenerateCached تمرر النص الأول توكناً توكناً ثم تولد:
// One new token at position `pos` with a KV cache per layer -> logits [1, V] (inference only)
public Tensor Step(int token, int pos, KvCache[] caches)
{
    var x = Ops.Add(Ops.Embedding(wte, [token], 1), Ops.Embedding(wpe, [pos], 1));   // [1, C]
    for (int i = 0; i < blocks.Length; i++) x = blocks[i].Step(x, caches[i]);
    return Ops.MatMulT(lnF.Forward(x), wte);
}

public KvCache[] NewCache() => blocks.Select(_ => new KvCache(Config.Embd)).ToArray();

// Generation with the KV cache: feed the prompt token by token, then sample and feed each new token.
// Each step costs one position instead of the whole sequence. Stops at BlockSize tokens.
public List<int> GenerateCached(List<int> prompt, int maxNewTokens, float temperature, int topK, Random rng)
{
    bool old = Tensor.NoGrad;
    Tensor.NoGrad = true;
    var ids = new List<int>(prompt);
    var caches = NewCache();
    var probs = new float[Config.VocabSize];
    Tensor logits = null!;
    for (int pos = 0; pos < prompt.Count; pos++) logits = Step(prompt[pos], pos, caches);
    for (int i = 0; i < maxNewTokens && ids.Count < Config.BlockSize; i++)
    {
        int next = SampleNext(logits.Data, probs, temperature, topK, rng);
        ids.Add(next);
        logits = Step(next, ids.Count - 1, caches);
    }
    Tensor.NoGrad = old;
    return ids;
}
في الكود أعلاه لاحظ التالي:
- الدالة
Stepلا تحتاج القناع السببي، لأن الذاكرة لا تحتوي إلا على الماضي، فكل ما فيها مسموح أن يراه التوكن الجديد. - هذه الدالة تعمل بأرقام
Spanوحلقات مباشرة ولا تبني رسماً بيانياً للتدرج، لأنها للتوليد فقط، وهي نفس الحساب الرياضي لدالةForward، لذلك يجب أن تعطي نفس الدرجات، ونحن نتحقق من ذلك في المخرج. - الذاكرة تكبر مع كل توكن، ففي كل طبقة نحفظ 768 رقماً للمفتاح و768 للقيمة، وهذا هو السبب الذي يجعل نافذة السياق الطويلة تكلف ذاكرة كما شرحنا في نافذة السياق تكلف ذاكرة.
والكود الذي يتحقق من الذاكرة ثم يولد بالطريقتين من الملف Part4_Gpt2/Part4.cs:
// The cached path must give the same logits as the full forward pass
var caches = model.NewCache();
Tensor stepLogits = null!;
for (int pos = 0; pos < promptIds.Count; pos++) stepLogits = model.Step(promptIds[pos], pos, caches);
float cacheDiff = 0;
for (int i = 0; i < last.Length; i++) cacheDiff = MathF.Max(cacheDiff, MathF.Abs(stepLogits.Data[i] - last[i]));
Console.WriteLine($"KV cache path vs full forward: max abs difference = {cacheDiff:E2}");
Console.WriteLine();

foreach (bool cached in new[] { false, true })
{
    Console.WriteLine($"== Generation (temperature 0.8, top-k 40, 40 new tokens, {(cached ? "with" : "without")} KV cache)");
    sw.Restart();
    var outIds = cached
        ? model.GenerateCached(promptIds, 40, temperature: 0.8f, topK: 40, new Random(42))
        : model.Generate(promptIds, 40, temperature: 0.8f, topK: 40, new Random(42));
    double secs = sw.Elapsed.TotalSeconds;
    Console.WriteLine(tok.Decode(outIds));
    Console.WriteLine($"{40 / secs:F2} tokens/second ({secs:F1}s, {Environment.ProcessorCount} logical CPUs)");
    Console.WriteLine();
}
والمخرج سوف يكون كما يلي:
KV cache path vs full forward: max abs difference = 5.34E-005

== Generation (temperature 0.8, top-k 40, 40 new tokens, without KV cache)
The capital of France is now a big city, and so it is important to have a place for the city, because it is a very important city in the history of France. In the 19th century that is no longer
3.18 tokens/second (12.6s, 8 logical CPUs)

== Generation (temperature 0.8, top-k 40, 40 new tokens, with KV cache)
The capital of France is now a big city, and so it is important to have a place for the city, because it is a very important city in the history of France. In the 19th century that is no longer
23.59 tokens/second (1.7s, 8 logical CPUs)
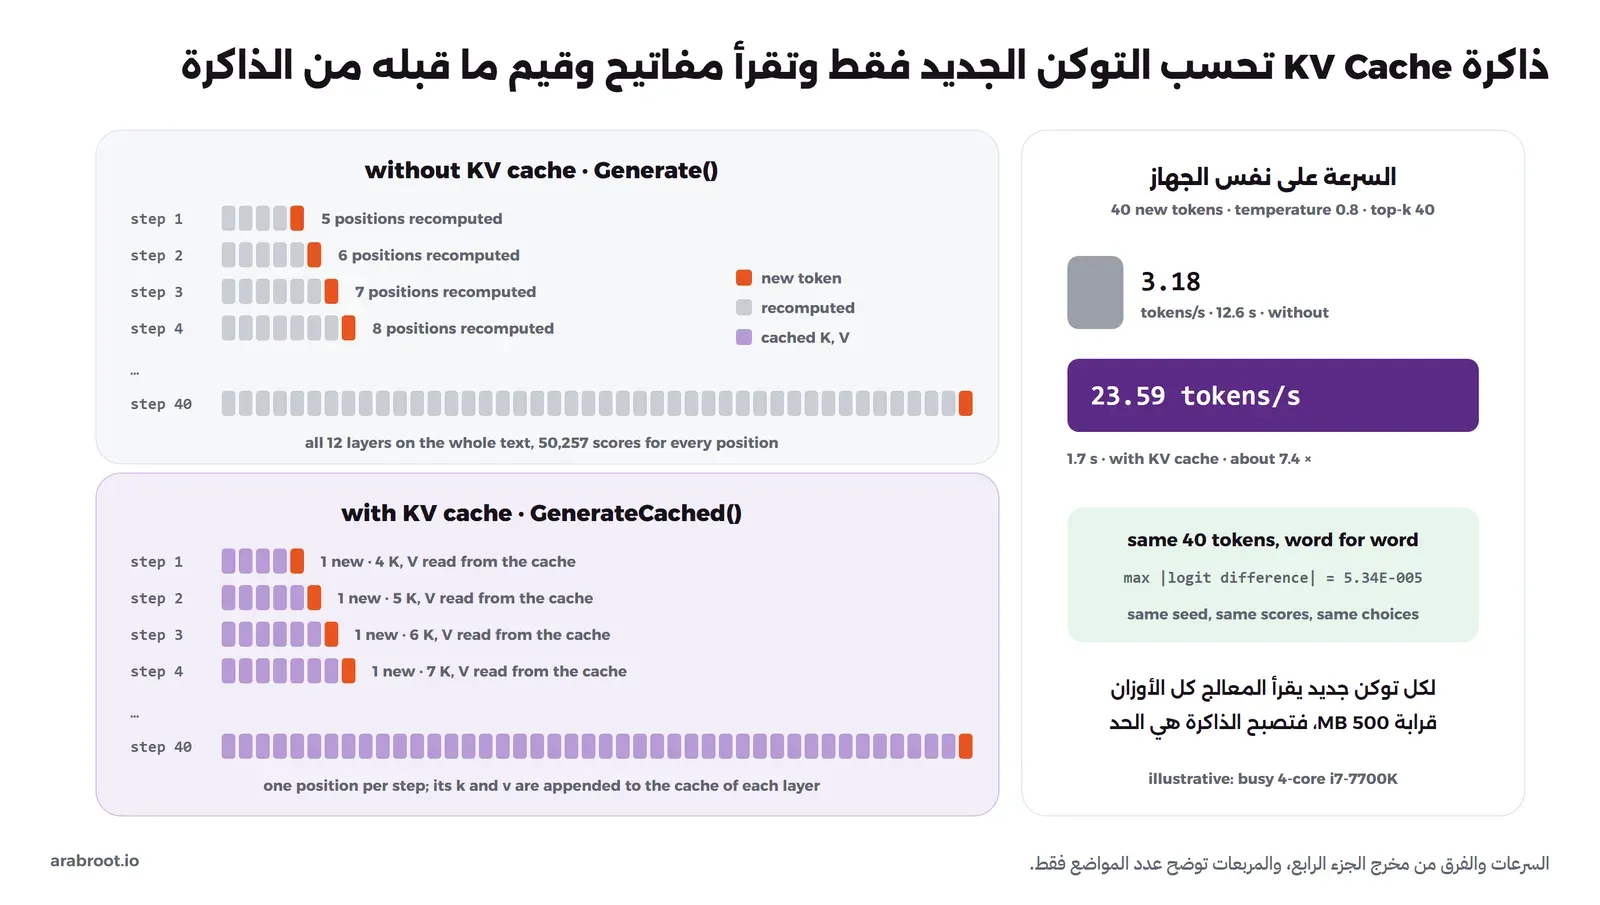
والصورة التالية تبين الفرق بين الطريقتين:
في المخرج والصورة أعلاه لاحظ التالي:
- الفرق بين درجات المسار مع الذاكرة والمسار الكامل
5.34E-005، أي أنهما نفس الحساب، والفرق سببه ترتيب الجمع فقط. - النص المولد هو نفسه بالحرف في الحالتين، لأن الدرجات نفسها والبذرة العشوائية نفسها، فاختيار كل توكن كان نفسه.
- السرعة ارتفعت من 3.18 إلى 23.59 توكن في الثانية، أي قرابة 7.4 أضعاف، والأرقام للتوضيح فقط لأن الجهاز كان مشغولاً. والسبب أن المسار دون ذاكرة يعالج في الخطوة الأخيرة 44 موضعاً ويحسب لكل منها درجات 50,257 توكناً، بينما المسار مع الذاكرة يعالج موضعاً واحداً.
- لماذا لم يكن الفرق أكبر؟ لأن التوكن الواحد يحتاج أن يمر على كل الأوزان، أي 124 مليون رقم بأربع بايتات (قرابة 500 MB) تقرأ من الذاكرة لكل توكن، فتصبح سرعة الذاكرة هي الحد وليس الحساب، كما شرحنا في لماذا تحدد الذاكرة سرعة التوليد، وهذا نفسه السبب الذي يجعل النماذج المكممة Quantized أسرع.
درجة الحرارة Temperature واختيار أفضل K توكن Top-k
في الجزء الثاني رأينا أثر درجة الحرارة على 39 حرفاً، أما مع 50,257 توكناً فهناك مشكلة إضافية: آلاف التوكنز احتمال كل منها صغير جداً، ولكن مجموعها كبير، فإذا اخترنا عشوائياً من كل التوكنز فسوف يظهر بين حين وآخر توكن لا علاقة له بالنص. والحل البسيط هو Top-k: نبقي أفضل K توكن فقط (40 في مثالنا) ونجعل احتمال الباقي صفراً، ثم نختار عشوائياً منها بدرجة الحرارة. والكود التالي من الملف Part3_TinyGpt/Gpt.cs:
// temperature < 1 sharpens the distribution, > 1 flattens it; topK > 0 keeps only the K best tokens
public static int SampleNext(ReadOnlySpan<float> logits, float[] probs, float temperature, int topK, Random rng)
{
    Span<float> l = logits.ToArray();
    if (topK > 0 && topK < l.Length)
    {
        float kth = l.ToArray().OrderDescending().ElementAt(topK - 1);
        for (int j = 0; j < l.Length; j++) if (l[j] < kth) l[j] = float.NegativeInfinity;
    }
    Ops.Softmax(l, probs, temperature);
    return Rng.Sample(rng, probs);
}
لاحظ أننا نضع سالب مالانهاية في درجات التوكنز التي خارج أفضل K، فتعطي الدالة Exp صفراً لها، وقد شرحنا البديل الأشهر Top-p في درجة الحرارة Temperature وTop-p. والنص الذي ولده GPT-2 بهذه الإعدادات («The capital of France is now a big city, and so it is important to have a place for the city…») إنجليزي سليم ومتصل المعنى، وهو ما عجز عنه نموذجنا الصغير في الجزء الثالث، مع أن الكود الذي ولده هو نفس الكود حرفياً، والفرق كله في الأوزان.
لماذا GPT-2 ضعيف في العربية؟
لنعط النموذج جملة عربية قصيرة بالأمر dotnet run -c Release -- part4 "مرحبا بكم"، وهذا تشغيل إضافي قمنا به أثناء كتابة المقال وليس ضمن ملفات المجلد outputs، والمخرج (دون أسطر التحميل والتوليد الأول) كان كما يلي:
"مرحبا بكم" (9 chars) -> 11 tokens: [25405, 26897, 148, 255, 39848, 12919, 17550, 101, 149, 225, 25405]

== Next token after "مرحبا بكم"
 26897  "ر"          logit  -72.545   p = 19.2 %
 12919  "ا"          logit  -72.571   p = 18.8 %
 23338  "ن"          logit  -73.205   p = 10.0 %
 41486  "ت"          logit  -73.758   p = 5.7 %
 38843  "د"          logit  -73.894   p = 5.0 %

KV cache path vs full forward: max abs difference = 3.05E-005

== Generation (temperature 0.8, top-k 40, 40 new tokens, with KV cache)
مرحبا بكمرض بكمرض بكمرض بكمرض بكمرض بكم
25.93 tokens/second (1.5s, 8 logical CPUs)
لاحظ أن أفضل خمسة توقعات كلها حروف مفردة وليست كلمات، وأن النموذج كتب «بكمرض» ثم كرر نفس المقطع خمس مرات، بينما كتب في الإنجليزية جملاً متصلة بنفس الكود ونفس الإعدادات. والسبب سببان مرتبطان. الأول هو بيانات التدريب: ورقة GPT-2 تقول صراحة إن OpenAI حذفت الصفحات غير الإنجليزية من بيانات WebText عمداً كخطوة تنظيف، فما رآه النموذج من العربية قليل جداً. والثاني نتيجة للأول: المقسم BPE تعلم قائمة الدمج من نفس البيانات، فلم يتعلم دمجاً للحروف العربية إلا قليلاً، لذلك رأينا في صورة المقسم أعلاه أن كلمة « عرب» أصبحت أربعة توكنز، وأن حرف العين نفسه انقسم بايتاه (0xD8 0xB9) على توكنين مختلفين، فالتوكن 117 وحده ليس حرفاً أصلاً، وإذا حاولت أن تعرضه وحده فسوف تظهر علامة الحرف غير الصالح U+FFFD كما يذكر التعليق في الدالة Decode.
وهذا يعني أن الجملة العربية تأخذ توكنز أكثر بكثير من نفس المعنى بالإنجليزية (23 مقابل 5 في مثالنا)، فتمتلئ نافذة السياق أسرع، ويحتاج النموذج أن يتعلم تجميع البايتات إلى حروف ثم الحروف إلى كلمات، وكل ذلك من بيانات قليلة. وقد قسنا هذا الفرق في مقسمات النماذج الحديثة في ما هو التوكن Token، والنماذج الحديثة متعددة اللغات تحل المشكلة بمفردات أكبر تشمل العربية، وببيانات تدريب فيها عربية كثيرة.
ما الذي يفصل هذا النموذج عن نماذج اليوم؟
الكود الذي يشغل GPT-2 هنا هو في جوهره نفس الكود الذي يشغل النماذج الحديثة، فهي أيضاً تضمين ثم كتل انتباه وMLP ثم Softmax، مع تحسينات في التفاصيل (طرق أخرى لتمثيل الموضع، ودوال تفعيل أخرى، وانتباه يشارك المفاتيح بين الرؤوس ليوفر ذاكرة KV Cache). أما الفرق الكبير فهو في أربعة أشياء خارج الكود:
- الحجم Scale: GPT-2 الذي شغلناه فيه 124 مليون معامل، والنماذج المفتوحة الشائعة اليوم من مليارات إلى مئات المليارات، وقد شرحنا أثر الحجم في الحجم Scale.
- البيانات: GPT-2 تدرب على 40 GB من النصوص الإنجليزية، والنماذج الحديثة على آلاف المرات أكثر بلغات كثيرة وكود، كما شرحنا في التدريب المسبق Pretraining.
- ضبط التعليمات Instruction Tuning: النموذج الأساسي يكمل النص، ولكي يجيب على سؤال يدرب بعد ذلك على أمثلة من أسئلة وإجابات، وهذا ما ينقص GPT-2 حتى يجيب «Paris» بدلاً من «the».
- ضبط التفضيلات RLHF: التعلم المعزز من ملاحظات البشر Reinforcement Learning from Human Feedback، أو بدائله مثل DPO، يجعل النموذج يفضل الإجابة المفيدة والآمنة، وقد شرحنا المرحلتين في ضبط التعليمات وضبط التفضيلات.
إلى أين بعد هذه السلسلة؟
الآن تعرف ما الذي يحدث داخل النموذج في كل سطر، من المشتقة إلى توليد النص، وهذه المعرفة تفيدك في ثلاثة اتجاهات عملية:
- تشغيل النماذج على جهازك: الأدوات الحقيقية مثل llama.cpp وOllama تفعل ما فعلناه هنا، ولكن بأرقام مكممة Quantization (4 أو 8 بت بدلاً من 32) وبكود مكتوب لكل معالج وبطاقة رسومية، وتجد كيف تختار الجهاز والتكميم في اختيار التكميم في الواقع.
- الضبط الدقيق Fine-tuning: حلقة التدريب التي كتبناها في الجزء الثالث تعمل على أوزان GPT-2 المحملة كما هي، فتستطيع أن تكمل تدريبها على نصوصك، وهذا هو الضبط الدقيق، ولكن قبل أن تختاره اقرأ متى تحتاجه فعلاً ومتى يكفي RAG أو MCP في RAG أم Fine-tuning أم MCP أم Agents.
- بناء تطبيقات على النماذج: تجد المصطلحات التي سوف تقابلها (السياق والأدوات والوكلاء) في مصطلحات الذكاء الاصطناعي ونماذج اللغة.
أخطاء شائعة Common Mistakes
- قلب المصفوفات عند التحميل: من ينقل أوزان GPT-2 إلى
nn.Linearيحتاج أن يقلبها لأنها محفوظة بطبقة Conv1D، ومن يقلبها مرتين أو ينسى قلبها يحصل على نموذج يعمل ويكتب كلاماً بلا معنى، أو يحصل على خطأ شكل إذا لم تكن المصفوفة مربعة. - استخدام GELU بالصيغة الدقيقة: GPT-2 يستخدم صيغة
tanhالتقريبية (gelu_newفيconfig.json)، والصيغة الأخرى تعطي أرقاماً قريبة جداً، فلا يظهر الخطأ في النص، ولكنه يظهر في المقارنة مع المرجع. - تقسيم النص بالمسافات: المسافة في GPT-2 جزء من الكلمة التي بعدها (« capital» وليس «capital»)، فإذا قسمت النص بالمسافات ثم أعطيت كل كلمة للمقسم فسوف تحصل على توكنز مختلفة تماماً عن التي تدرب عليها النموذج.
- عرض التوكن العربي وحده: توكن واحد قد يكون نصف حرف، فإذا حولت كل توكن إلى نص وحده أثناء البث Streaming ظهرت علامات
U+FFFD، والحل أن تجمع البايتات حتى يكتمل الحرف قبل عرضه. - الحكم على صحة النموذج من النص المولد: نموذج فيه خطأ صغير يكتب نصاً مقبولاً أحياناً، والطريقة الوحيدة للتأكد هي مقارنة الدرجات مع مرجع موثوق كما فعلنا.
- تحميل ملف أوزان pickle من مصدر غير موثوق: قد ينفذ كوداً على جهازك، فاستخدم safetensors كلما كان متاحاً.
تدريب عملي
- غير الدالة
GeluفيShared/Ops.Nn.csإلى الصيغة الدقيقة0.5 * x * (1 + erf(x / √2))، وشغلpart4 compare، ولاحظ كم يكبر أكبر فرق مع Hugging Face، وهل تغير ترتيب أفضل خمسة توكنز. - جرب الأمر
part4 "C# is a programming language that"ثم جملة عربية، وقارن عدد التوكنز وجودة النص المولد. - غير
topKمن 40 إلى 0 (أي دون حد) وإلى 1 (أي اختيار الأفضل دائماً)، ولاحظ أثر كل منهما على النص. - اكتب دالة تقرأ رأس ملف safetensors وتطبع مجموع أحجام المصفوفات، وتأكد أن المجموع مع 8 بايتات وطول الرأس يساوي حجم الملف بالضبط.
الخلاصة
- ملف safetensors هو 8 بايتات لطول الرأس، ثم رأس JSON فيه اسم وشكل وموقع كل مصفوفة، ثم الأرقام خاماً، وقراءته بلغة C# تحتاج بضعة أسطر من مكتبة .NET الأساسية فقط.
- نفس الكلاس
Gptمن الجزء الثالث، بأحجام GPT-2، حمل 148 مصفوفة (124,439,808 رقماً) بالاسم دون أي قلب، لأنLinearيحفظ الأوزان بشكل Conv1D نفسه، والمصفوفات ال 12 الباقية قناع سببي محفوظ لا نحتاجه. - المقسم BPE على مستوى البايت أعطى نفس توكنز Hugging Face في ستة نصوص من ستة، منها العربي والرموز التعبيرية.
- 251,285 درجة تختلف عن Hugging Face بأقل من
3.4E-004، وأفضل خمسة توكنز متطابقة، فالمحرك والنموذج صحيحان. - ذاكرة KV Cache أعطت نفس النص بالحرف وبسرعة 23.59 توكن في الثانية بدلاً من 3.18 على نفس الجهاز.
- GPT-2 ضعيف في العربية لأن بياناته إنجليزية، فمقسمه يقطع الحرف العربي إلى بايتات، والذي يفصله عن نماذج اليوم هو الحجم والبيانات وضبط التعليمات والتفضيلات، وليس الكود.
وبهذا الشكل نكون قد وصلنا لنهاية السلسلة: بدأنا بمشتقة الدالة x * x في الجزء الأول، وانتهينا بتشغيل GPT-2 الحقيقي بلغة C# ومطابقته مع المكتبة التي يستخدمها الجميع، ونتمنى أن يكون كل سطر في هذا الطريق قد أصبح واضحاً، وأن تعود إلى أي مكتبة بعد ذلك وأنت تعرف ما الذي تفعله في الخلفية.
 دليلابن نموذج لغة بلغة C# من الصفر (1): محرك التعلم Autogradنبني بلغة C# ودون أي مكتبة المحرك الذي تتعلم به كل الشبكات العصبية، ونتأكد بالأرقام أن كل عملية فيه صحيحة.
 دليلابن نموذج لغة بلغة C# من الصفر (2): توقع الحرف التالينستخدم محرك الجزء الأول لنبني نموذج لغة يتعلم من شعر المتنبي كيف يتوقع الحرف التالي ويكتب أبياتاً جديدة.
 دليلابن نموذج لغة بلغة C# من الصفر (3): GPT صغير بالانتباه Attentionنضيف الانتباه Attention وكتلة Transformer إلى نموذجنا بلغة C# فيصبح GPT صغيراً، ونرى كيف يتغير الشعر الذي يكتبه أثناء التدريب.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
 دليلمن RAG إلى Agents: أي طريقة يحتاجها مساعد شركتك؟ما الذي تحله كل طريقة لبناء مساعد ذكي للموظفين وما الذي لا تحله، ولماذا تبدأ بالأرخص ولا تنتقل إلى الأغلى إلا عند الحاجة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل GPT-2 124M على .NET 10 (SDK 10.0.400) دون أي حزمة NuGet، ومقارنته مع transformers 5.18.0 وtorch 2.14.1 (CPU) في بيئة Python افتراضية على نفس الجهاز.