

في الجزء الأول بنينا بلغة C# محرك التعلم كاملاً: الكلاس Tensor والانتشار العكسي Backpropagation والتحقق من التدرج Gradient Check والمحسن AdamW، ورأينا شبكة صغيرة تتعلم هل النقطة داخل دائرة أم خارجها. ولكن النقاط والدوائر ليست لغة، والسؤال الآن: كيف نستخدم نفس المحرك لنبني برنامجاً يكتب نصاً عربياً؟ والإجابة أن نموذج اللغة Language Model في أبسط صوره هو برنامج يجيب على سؤال واحد فقط، وهو «ما الحرف أو التوكن التالي؟»، كما شرحنا في الفكرة كلها في جملة واحدة، فإذا أجاب عليه جيداً ثم كررنا السؤال مرة بعد مرة خرج لنا نص كامل.
وفي هذا الجزء سوف نبني أول نموذج لغة حقيقي، ونبدأ بأبسط حل ممكن ثم نكسره ونحسنه خطوة بخطوة، ونقيس كل خطوة برقم واحد، وسوف ندرب كل شيء على قصائد أبي الطيب المتنبي، لأن الشعر العربي له شكل واضح جداً (شطران بينهما فاصل، ووزن وقافية)، فنستطيع أن نرى بأعيننا ماذا تعلم النموذج وماذا لم يتعلم.
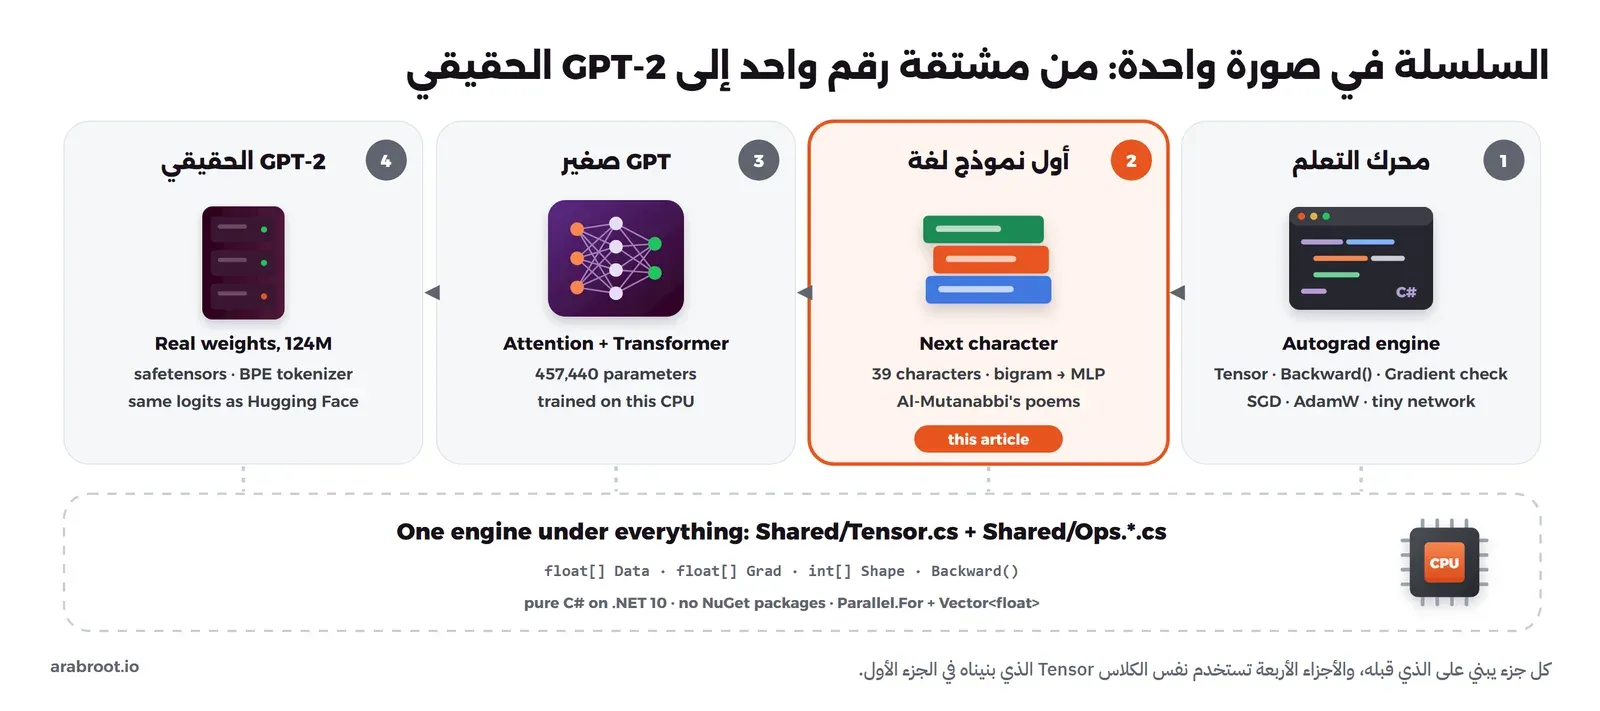
المواضيع في السلسلة:
- محرك التعلم والتفاضل التلقائي Autograd: المشتقة والتدرج وقاعدة السلسلة Chain Rule، والكلاس Tensor، والتحقق من التدرج Gradient Check، والمحسن AdamW.
- ابن نموذج لغة بلغة C# من الصفر (2): أول نموذج لغة يتوقع الحرف التالي (الموضوع الحالي).
- GPT صغير بالانتباه Attention والمحول Transformer: تضمين التوكن والموضع، والانتباه متعدد الرؤوس Multi-Head Attention، وكتلة Transformer، ونموذج فيه قرابة نصف مليون معامل يتدرب على المعالج في دقائق.
- تحميل أوزان GPT-2 الحقيقية وتشغيلها: قراءة ملف safetensors، ومقسم BPE الخاص ب GPT-2، والتوليد مع ذاكرة KV Cache، ومقارنة المخرج رقماً برقم مع Hugging Face.
الصورة التالية تبين السلسلة كاملة، والجزء الحالي هو البطاقة الثانية من اليمين:
وسوف نناقش في هذا المقال ما يلي:
- تجهيز بيانات التدريب من ويكي مصدر Wikisource، ولماذا لا نضع الملف في المستودع.
- لماذا نحذف التشكيل Diacritics، وكيف تحفظ C# الحرف العربي في الذاكرة.
- المقسم على مستوى الحرف Character Tokenizer، وتقسيم البيانات إلى تدريب وتحقق Train and Validation.
- خط الأساس Baseline لنموذج لا يعرف شيئاً، ثم نموذج Bigram بالعد فقط، ثم نفس النموذج كشبكة تتعلم بالتدرج.
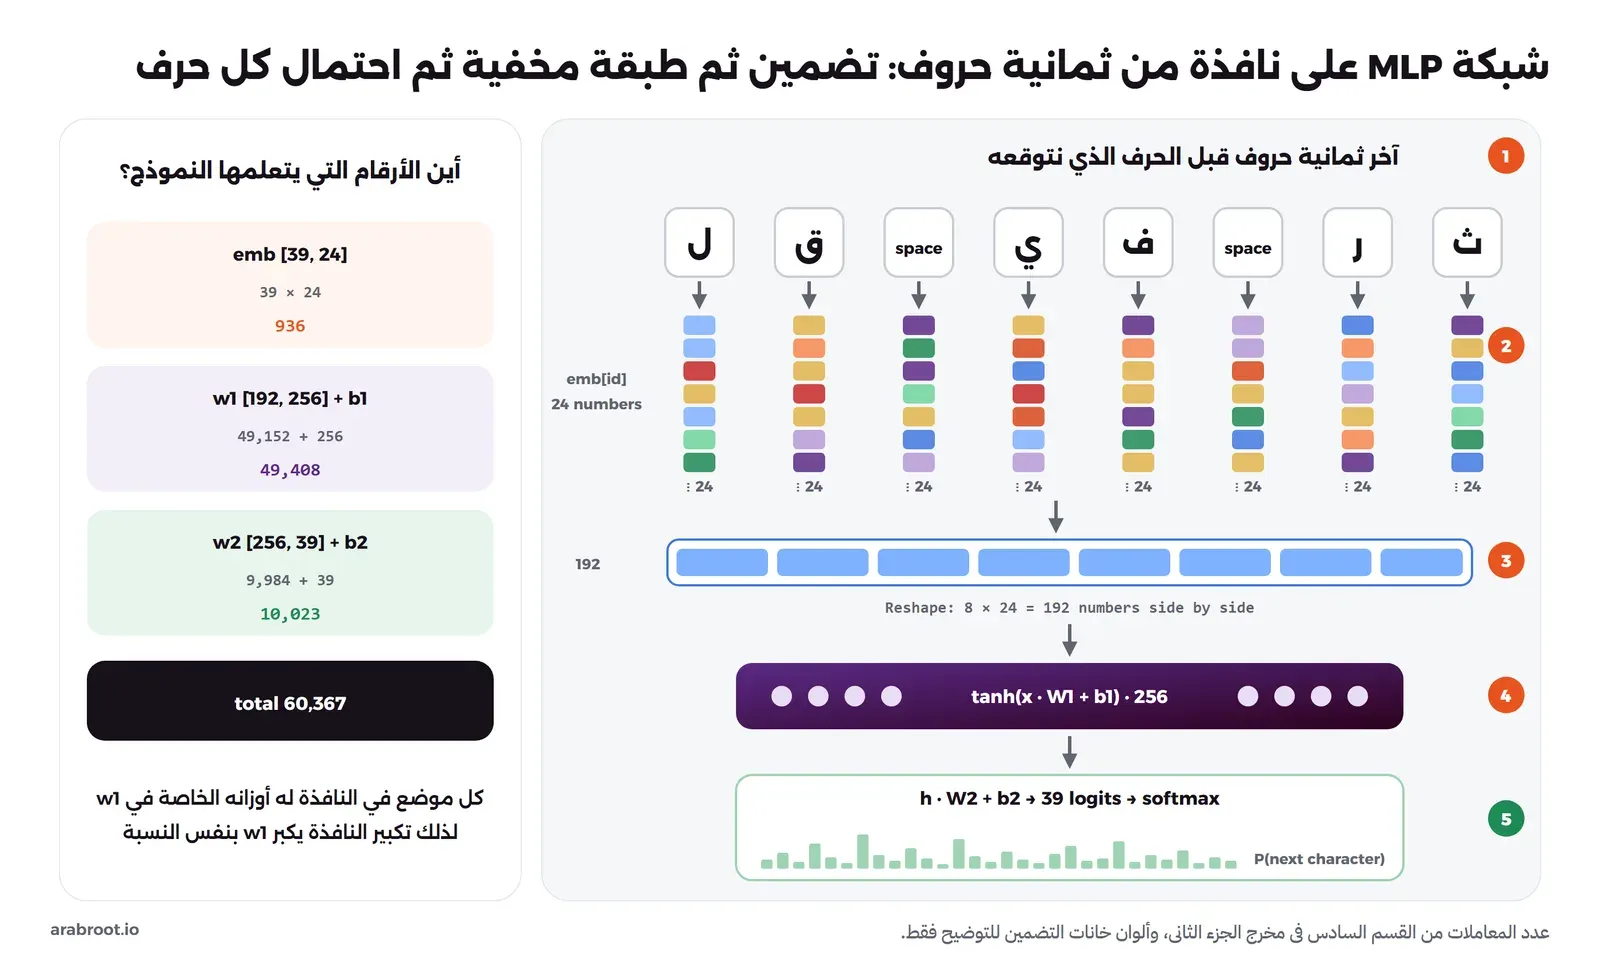
- تضمين الحروف Embedding ونافذة السياق Context Window، وشبكة MLP تنظر إلى آخر ثمانية حروف.
- مقارنة الخطأ Loss بين النماذج الأربعة، والتوليد Generation بدرجات حرارة Temperature مختلفة.
- ماذا تعلم النموذج من الشعر وماذا لم يتعلم، ولماذا نحتاج الانتباه Attention في الجزء القادم.
تشغيل هذا الجزء
الكود في نفس المشروع الذي جهزناه في الجزء الأول، في المجلد Part2_CharModel/، ولا يضيف أي حزمة NuGet. ولكن هذا الجزء يحتاج بيانات، لذلك نقوم أولاً بتنزيل الشعر ثم نشغل الجزء الثاني كما يلي:
cd content/labs/llm-csharp
dotnet run -c Release -- download data
dotnet run -c Release -- part2
وكل المخرجات في هذا المقال هي مخرج الأمر الثاني كما ظهر عندنا، وهي محفوظة كاملة في الملف outputs/part2.txt، أما الأزمنة فهي للتوضيح فقط، لأنها قيست على نفس الجهاز الذي ذكرناه في الجزء الأول (Intel Core i7-7700K بأربع أنوية) وكان يشغل أعمالاً أخرى في نفس الوقت.
بيانات التدريب Training Data: شعر المتنبي من ويكي مصدر Wikisource
أي نموذج لغة يتعلم من النص الذي نعطيه له فقط، لذلك فاختيار البيانات هو أول قرار. واخترنا قصائد أبي الطيب المتنبي لثلاثة أسباب: الأول أن الشاعر توفي سنة 965م، فالقصائد نفسها في الملك العام Public Domain، والثاني أن حجمها مناسب لجهاز عادي، فهي بضع مئات من آلاف الحروف تتدرب عليها الشبكة في دقائق، والثالث أن الشعر له شكل ثابت يسهل أن نحكم عليه بالعين: كل سطر بيت، وكل بيت شطران.
والقصائد منشورة في صفحة المتنبي في ويكي مصدر، وقد يتساءل البعض: إذا كان الشعر في الملك العام فلماذا لا نضع الملف في المستودع مباشرة؟ والإجابة أن نصوص الصفحات في ويكي مصدر (أي طريقة كتابتها وتشكيلها وتصحيحها) منشورة بترخيص CC BY-SA 4.0، وهذا الترخيص يشترط نسبة العمل لمصدره ونشر أي نسخة معدلة بنفس الترخيص، لذلك لا نضع الملف في المستودع، وإنما يقوم الأمر download data بتنزيله على جهازك من واجهة برمجة ويكي مصدر API، ويكتب رابط كل صفحة استخدمها في الملف data/SOURCES.txt، فيبقى المصدر معروفاً لكل سطر. والكود التالي من الملف Shared/Download.cs:
// Poems of Al-Mutanabbi (died 965 CE, public domain) from Arabic Wikisource.
// The list comes from the author page; each poem page keeps its verses in a {{أبيات|...}} template.
const string Api = "https://ar.wikisource.org/w/api.php";
const string AuthorPage = "مؤلف:المتنبي";

static async Task Poems()
{
    Directory.CreateDirectory("data");
    string author = (await FetchPages([AuthorPage])).Values.Single();
    var titles = LinkRegex().Matches(author).Select(m => m.Groups[1].Value.Trim()).Distinct().ToList();
    Console.WriteLine($"{titles.Count} poem titles on {AuthorPage}");

    var text = new StringBuilder();
    var sources = new StringBuilder($"Source: Arabic Wikisource, retrieved {DateTime.UtcNow:yyyy-MM-dd}\n");
    int poems = 0, verses = 0;
    for (int i = 0; i < titles.Count; i += 50)   // the API returns up to 50 pages per request
    {
        var pages = await FetchPages(titles.Skip(i).Take(50).ToList());
        foreach (var title in titles.Skip(i).Take(50))
        {
            if (!pages.TryGetValue(title, out string? wikitext)) continue;
            var lines = ExtractVerses(wikitext);
            if (lines.Count == 0) continue;
            foreach (var line in lines) text.Append(line).Append('\n');
            text.Append('\n');   // an empty line between poems
            poems++; verses += lines.Count;
            sources.Append("https://ar.wikisource.org/wiki/").Append(Uri.EscapeDataString(title.Replace(' ', '_'))).Append('\n');
        }
        await Task.Delay(1000);   // be gentle with the servers
    }
    await File.WriteAllTextAsync("data/mutanabbi.txt", text.ToString());
    await File.WriteAllTextAsync("data/SOURCES.txt", sources.ToString());
    Console.WriteLine($"{poems} poems, {verses} verses, {text.Length:N0} characters -> data/mutanabbi.txt");
}

// Each verse is "first half\\second half" inside {{أبيات| ... }}: we keep one verse per line, halves split by " * "
static List<string> ExtractVerses(string wikitext)
{
    var result = new List<string>();
    foreach (Match m in VersesRegex().Matches(wikitext))
        foreach (var raw in m.Groups[1].Value.Split('\n'))
        {
            var halves = raw.Split("\\\\").Select(h => Regex.Replace(h, @"\s+", " ").Trim()).Where(h => h.Length > 0).ToArray();
            if (halves.Length == 2) result.Add($"{halves[0]} * {halves[1]}");
        }
    return result;
}
في الكود أعلاه لاحظ التالي:
- نقرأ أولاً صفحة المؤلف ونستخرج منها عناوين القصائد، ثم نطلب الصفحات خمسين صفحة في كل طلب، وهو الحد الذي تسمح به واجهة MediaWiki لطلب واحد، وننتظر ثانية بين الطلبات حتى لا نضغط على السيرفرات.
- كل قصيدة في ويكي مصدر مكتوبة داخل قالب
{{أبيات|...}}، والشطران مفصولان بعلامة\\، فنحول كل بيت إلى سطر واحد والشطرين بينهما*، ونترك سطراً فارغاً بين القصائد. - الملف
data/SOURCES.txtفيه تاريخ التنزيل ورابط كل قصيدة، وعندنا كان فيه 288 رابطاً، أي 288 قصيدة فيها 5,474 بيتاً. - المجلد
data/موجود في الملف.gitignore، فلا يمكن أن يرفع إلى المستودع بالخطأ.
حذف التشكيل Diacritics: لماذا نحذفه؟
النص الذي ننزله من ويكي مصدر مشكول بالكامل، والتشكيل مهم جداً لقراءة الشعر ووزنه، ولكنه يصعب المهمة على نموذج صغير لثلاثة أسباب. الأول أن كل علامة تشكيل في الذاكرة حرف مستقل، فالكلمة المشكولة تصبح ضعف طولها تقريباً، والنموذج الذي ينظر إلى آخر ثمانية حروف سوف يرى نصف المسافة فقط. والثاني أن النموذج يجب أن يتعلم رموزاً أكثر، وكل رمز يحتاج أمثلة كافية حتى يتعلم متى يأتي. والثالث أن التشكيل في الصفحات غير موحد، فبعض القصائد مشكولة كاملة وبعضها جزئياً. لذلك نحذف التشكيل والتطويل Tatweel ونحتفظ بالحروف العربية والمسافة وسطر جديد والعلامة * فقط، والكود التالي من الملف Part2_CharModel/PoemText.cs:
// Keep the 36 Arabic letters (U+0621..U+064A), space, newline and '*'. Diacritics (tashkeel) and the
// tatweel are removed: fewer symbols to learn, shorter sequences, and the poem stays readable.
public static string Clean(string raw)
{
    var sb = new StringBuilder(raw.Length);
    foreach (char ch in raw.Replace('ک', 'ك'))   // a Persian kaf that slipped into a few pages
    {
        if (ch >= 'ء' && ch <= 'ي' && ch != 'ـ') sb.Append(ch);
        else if (ch == ' ' || ch == '\n' || ch == '*') sb.Append(ch);
    }
    // removing marks can leave double spaces
    return System.Text.RegularExpressions.Regex.Replace(sb.ToString(), " {2,}", " ");
}
لاحظ أن الشرط ch >= 'ء' && ch <= 'ي' يأخذ الحروف من U+0621 إلى U+064A في جدول Unicode للحروف العربية، وعلامات التشكيل تأتي بعدها مباشرة من U+064B، فتسقط تلقائياً، أما التطويل U+0640 فيقع داخل المجال لذلك استثنيناه بالاسم. والسطر الأول يستبدل الكاف الفارسية ک بالكاف العربية، لأنها ظهرت في بعض الصفحات، ولو بقيت لأصبحت حرفاً مستقلاً يتعلمه النموذج من أمثلة قليلة جداً. والمخرج سوف يكون كما يلي:
== 1) Text: 399,219 chars as downloaded, 281,097 after removing diacritics
آخر ما الملك معزى به * هذا الذي أثر في قلبه
لا جزعا بل أنفا شابه * أن يقدر الدهر على غصبه
لو درت الدنيا بما عنده * لاستحيت الأيام من عتبه
لاحظ أن حذف التشكيل وحده أنقص النص من 399,219 حرفاً إلى 281,097، أي قرابة 30%، وأن الأبيات ما زالت مقروءة تماماً لأي قارئ عربي.
كيف تحفظ C# الحرف العربي؟
قبل أن نحول النص إلى أرقام يجب أن نعرف ما هو «الحرف» عند C#، فالنوع char في .NET هو وحدة واحدة من ترميز UTF-16 (أي 16 بت)، وكل الحروف العربية تقع في المجال U+0600 إلى U+06FF، فكل حرف عربي هو char واحد بالضبط، وقد شرحنا الفرق بين الحرف ورقمه وترميزه بالبايتات في قسم مجموعات الحروف والترميز. والكود التالي من الملف Part2_CharModel/Part2.cs يطبع الكلمة نفسها قبل التشكيل وبعده:
// How C# stores Arabic text: one char (UTF-16 code unit) per letter, and diacritics are separate chars
static void ShowChars()
{
    Console.WriteLine("== 2) Characters, UTF-16 and UTF-8");
    foreach (string w in new[] { "قلب", "قَلْبُ" })
    {
        var units = string.Join(" ", w.Select(c => $"U+{(int)c:X4}"));
        Console.WriteLine($"\"{w}\": Length = {w.Length} chars ({units}), UTF-8 = {Encoding.UTF8.GetByteCount(w)} bytes");
    }
    Console.WriteLine();
}
والمخرج سوف يكون كما يلي:
== 2) Characters, UTF-16 and UTF-8
"قلب": Length = 3 chars (U+0642 U+0644 U+0628), UTF-8 = 6 bytes
"قَلْبُ": Length = 6 chars (U+0642 U+064E U+0644 U+0652 U+0628 U+064F), UTF-8 = 12 bytes
لاحظ أن الكلمة المشكولة طولها ستة char وليس ثلاثة، فكل فتحة وسكون وضمة رمز مستقل، وأن الحرف العربي يأخذ بايتين في UTF-8 وليس بايتاً واحداً كالحرف الإنجليزي، وهذه النقطة سوف تهمنا جداً في الجزء الرابع عندما نرى كيف يقطع GPT-2 النص العربي إلى بايتات.
المقسم على مستوى الحرف Character Tokenizer
النموذج يتعامل مع أرقام فقط، فنحتاج برنامجاً يحول النص إلى أرقام ويعيدها، وهذا هو ال Tokenizer. وقد شرحنا في ما هو التوكن Token أن النماذج الكبيرة تقطع النص إلى قطع متوسطة الطول، أما نحن فسوف نبدأ بأبسط تقسيم ممكن: كل حرف توكن، والمفردات Vocabulary هي قائمة الحروف المختلفة في النص مرتبة، ورقم الحرف هو موقعه في القائمة. والكود التالي من الملف Part2_CharModel/CharTokenizer.cs:
// The simplest tokenizer: every distinct character in the text is one token.
// A C# char is one UTF-16 code unit, and every Arabic letter (U+0600..U+06FF) fits in exactly one.
public sealed class CharTokenizer
{
    readonly char[] chars;                       // id -> char
    readonly Dictionary<char, int> ids = [];     // char -> id

    public CharTokenizer(string text)
    {
        chars = text.Distinct().Order().ToArray();
        for (int i = 0; i < chars.Length; i++) ids[chars[i]] = i;
    }

    public int VocabSize => chars.Length;
    public char this[int id] => chars[id];

    public int[] Encode(string s) => s.Select(c => ids[c]).ToArray();
    public string Decode(IEnumerable<int> tokens) => new(tokens.Select(t => chars[t]).ToArray());
}
والمخرج سوف يكون كما يلي:
== 3) Vocabulary: 39 characters
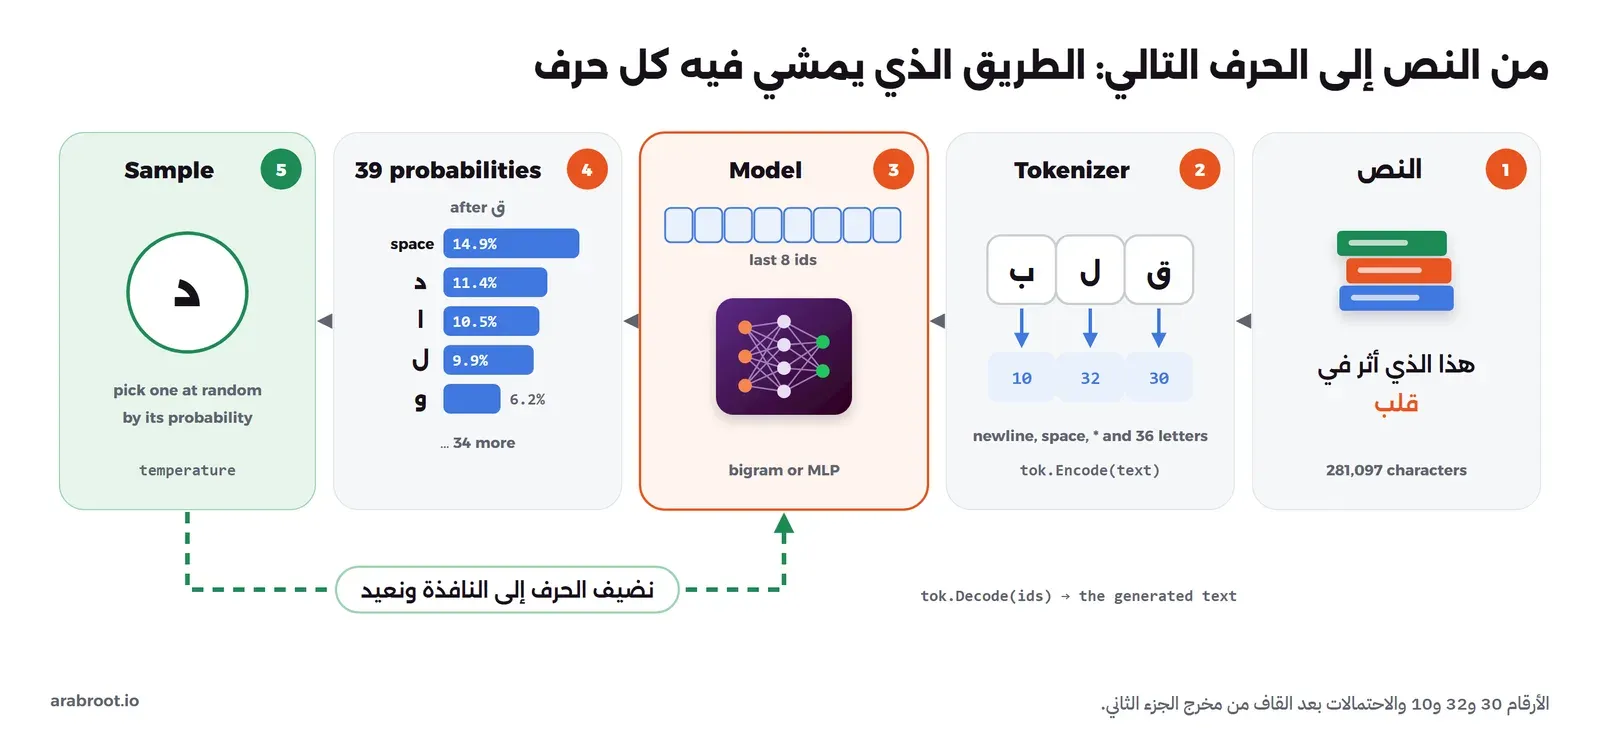
0:\n 1:␣ 2:* 3:ء 4:آ 5:أ 6:ؤ 7:إ 8:ئ 9:ا 10:ب 11:ة 12:ت 13:ث 14:ج 15:ح 16:خ 17:د 18:ذ 19:ر 20:ز 21:س 22:ش 23:ص 24:ض 25:ط 26:ظ 27:ع 28:غ 29:ف 30:ق 31:ك 32:ل 33:م 34:ن 35:ه 36:و 37:ى 38:ي
Encode("قلب") = [30, 32, 10]   Decode back = قلب
لاحظ أن المفردات كلها 39 رمزاً: سطر جديد (رقم 0) والمسافة (رقم 1، وطبعناها ␣ حتى تظهر) والعلامة * ثم 36 حرفاً عربياً، فالهمزة على الألف والياء والواو والألف المقصورة والتاء المربوطة كلها حروف مستقلة. وكلمة «قلب» أصبحت ثلاثة أرقام [30, 32, 10]، والدالة Decode تعيدها كما كانت. والصورة التالية تبين الطريق الذي سوف يمشي فيه كل حرف في هذا المقال:
بيانات التدريب Train وبيانات التحقق Validation
إذا قسنا جودة النموذج على نفس النص الذي تدرب عليه فقد يخدعنا، لأن النموذج يستطيع أن يحفظ النص بدلاً من أن يتعلم قواعده، وهذا ما يسمى الحفظ الأعمى Overfitting وشرحناه في مقال التعلم الآلي. لذلك نقسم النص إلى جزأين: أول 90% يتعلم منه النموذج، وآخر 10% لا يراه النموذج أثناء التدريب أبداً، ونقيس عليه فقط. والكود التالي من الملف Part2_CharModel/Part2.cs:
int[] data = tok.Encode(text);
int split = (int)(data.Length * 0.9);   // first 90% to learn from, last 10% only to measure
int[] train = data[..split], val = data[split..];
int newline = tok.Encode("\n")[0];
Console.WriteLine($"train: {train.Length:N0} tokens, validation: {val.Length:N0} tokens");
Console.WriteLine($"a model that knows nothing (uniform): loss = ln({tok.VocabSize}) = {MathF.Log(tok.VocabSize):F4}");
والمخرج سوف يكون كما يلي:
train: 252,987 tokens, validation: 28,110 tokens
a model that knows nothing (uniform): loss = ln(39) = 3.6636
لاحظ أننا قسمنا النص بالترتيب ولم نخلطه عشوائياً، والسبب أن الأبيات المتتالية في القصيدة الواحدة متشابهة جداً في القافية والكلمات، فإذا خلطنا الحروف عشوائياً فسوف يرى النموذج في التدريب بيتاً ثم نختبره على البيت الذي بعده، فيبدو أفضل مما هو عليه، أما التقسيم بالترتيب فيجعل آخر القصائد كلها خارج التدريب.
خط الأساس Baseline: نموذج لا يعرف شيئاً
قبل أن نبني أي نموذج نحتاج رقماً نقارن به، وأبسط نموذج ممكن هو الذي يعطي كل حرف من الحروف ال 39 نفس الاحتمال، أي 1 من 39. والخطأ Loss الذي نستخدمه في هذه السلسلة هو سالب لوغاريتم الاحتمال الذي أعطاه النموذج للحرف الصحيح، ويسمى Cross Entropy كما شرحنا في الجزء الأول، فإذا أعطى النموذج الحرف الصحيح احتمال 1 فالخطأ صفر، وكلما نقص الاحتمال زاد الخطأ. والنموذج الذي لا يعرف شيئاً خطؤه -ln(1/39) = ln(39) = 3.6636 على أي نص، وهذا هو الرقم الذي ظهر في المخرج أعلاه، وأي نموذج نبنيه يجب أن يكون خطؤه أقل منه، وإلا فهو لم يتعلم شيئاً.
ويجدر الإشارة هنا إلى طريقة مفيدة لقراءة هذا الرقم، فإذا رفعت العدد e إلى قوة الخطأ حصلت على ما يسمى الحيرة Perplexity، وهي تقول «النموذج محتار كأنه يختار بالتساوي بين كم حرف؟»، فالنموذج الذي لا يعرف شيئاً حيرته e^3.6636 = 39، أي محتار بين كل الحروف، وسوف نرى كيف ينخفض هذا الرقم مع كل نموذج.
أبسط نموذج لغة Language Model هو Bigram بالعد
الآن أول نموذج حقيقي، ولا يوجد فيه أي تدريب بالتدرج، وإنما عد فقط: نمشي على نص التدريب، ولكل حرف نعد كم مرة جاء بعده كل حرف آخر، فيصبح لدينا جدول حجمه 39 في 39، ثم نقسم كل صف على مجموعه فيصبح احتمالات. وهذا يسمى نموذج Bigram، لأنه ينظر إلى زوج من الحروف فقط: الحرف الحالي والحرف التالي. والكود التالي من الملف Part2_CharModel/BigramCounts.cs:
// A language model without any training: count how often character b follows character a,
// and turn every row of counts into probabilities.
public sealed class BigramCounts
{
    readonly int v;
    readonly float[] probs;   // [v, v]: probs[a*v + b] = P(next = b | current = a)

    public BigramCounts(int[] train, int vocabSize, float smoothing = 1f)
    {
        v = vocabSize;
        var counts = new float[v * v];
        Array.Fill(counts, smoothing);   // +1 for every pair, so a pair never seen is not impossible
        for (int i = 0; i + 1 < train.Length; i++) counts[train[i] * v + train[i + 1]]++;
        probs = new float[v * v];
        for (int a = 0; a < v; a++)
        {
            float rowSum = 0;
            for (int b = 0; b < v; b++) rowSum += counts[a * v + b];
            for (int b = 0; b < v; b++) probs[a * v + b] = counts[a * v + b] / rowSum;
        }
    }

    public float P(int a, int b) => probs[a * v + b];

    // Average negative log-likelihood: how surprised the model is by the real next character
    public float Loss(int[] data)
    {
        double nll = 0;
        for (int i = 0; i + 1 < data.Length; i++) nll -= Math.Log(P(data[i], data[i + 1]));
        return (float)(nll / (data.Length - 1));
    }
في الكود أعلاه لاحظ التالي:
- نبدأ كل خانة في الجدول بالرقم 1 وليس 0، وهذا يسمى التنعيم Smoothing، والسبب أن الزوج الذي لم يظهر في التدريب قد يظهر في نص التحقق، فإذا كان احتماله صفراً فإن
-ln(0)مالانهاية، وخطأ واحد بهذا الشكل يجعل متوسط الخطأ كله مالانهاية. - الدالة
Lossتحسب نفس المقياس الذي حسبناه لخط الأساس، أي متوسط سالب اللوغاريتم لاحتمال الحرف الصحيح، فالأرقام قابلة للمقارنة مباشرة. - الدالة
Sampleتكتب نصاً: تبدأ من حرف، وتختار الحرف التالي عشوائياً بحسب احتمالات صفه في الجدول، ثم تكرر.
والمخرج سوف يكون كما يلي:
== 4) Bigram by counting
after 'ق' the most likely next characters: ␣ 14.9 %  د 11.4 %  ا 10.5 %  ل 9.9 %  و 6.2 %
loss: train 2.6229  validation 2.6261
sample:
غيش بل ومنانأجوجه ه
وض دا
ى
فيكأجا * ألى فإذعيفله المهالم قبم
فإذالا
وعلني * أه ات اشى الابكبأذي يود جس عل مناتصة * م فالقلمة إلمامب جتهم لى ما ولت إن * منالنالحر ذقى هواشقتكالالهالى ن ن اكلأبغافركودي
الصورة التالية تبين جزءاً من هذا الجدول لعشرة حروف، كل صف هو الحرف الحالي وكل عمود هو الحرف التالي، وكلما كان اللون أغمق كان الاحتمال أكبر:
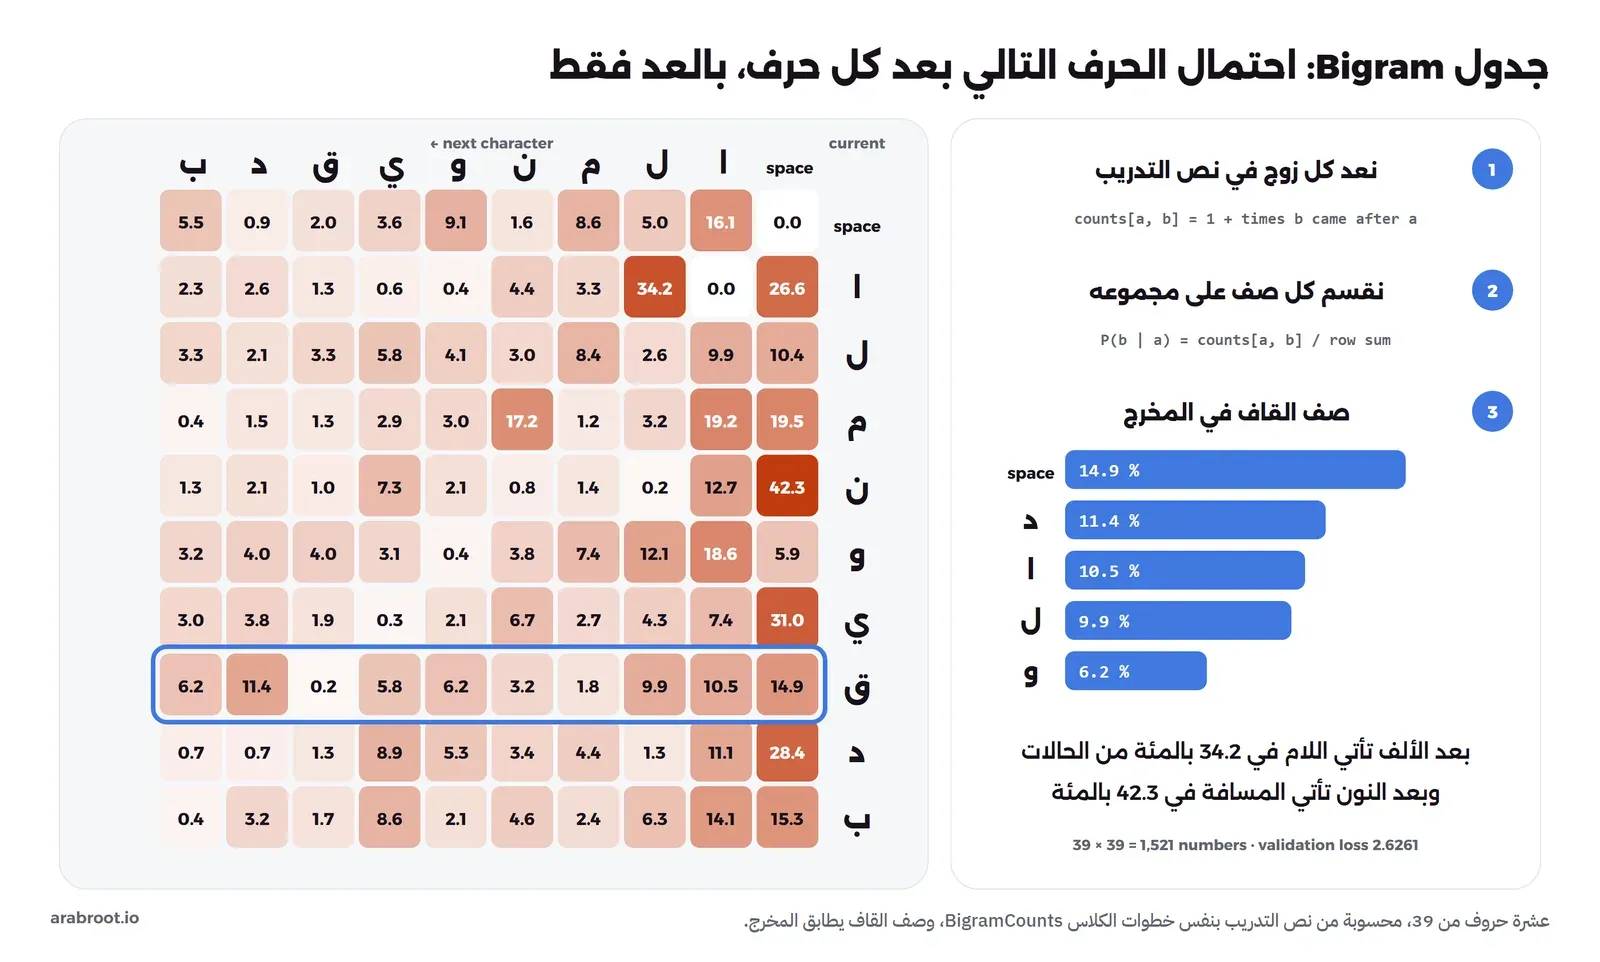
في المخرج والصورة أعلاه لاحظ التالي:
- الجدول تعلم أشياء حقيقية عن العربية، فبعد الألف تأتي اللام في 34.2% من الحالات بسبب «ال» التعريف، وبعد النون تأتي المسافة في 42.3% من الحالات، لأن النون تأتي كثيراً في آخر الكلمة.
- الخطأ على بيانات التحقق 2.6261، أي أقل بكثير من 3.6636، والحيرة
e^2.6261قرابة 13.8، أي أن النموذج أصبح محتاراً بين 14 حرفاً تقريباً بدلاً من 39. - خطأ التدريب 2.6229 وخطأ التحقق 2.6261 متقاربان جداً، فالنموذج لا يحفظ شيئاً، لأنه أصغر من أن يحفظ، فهو 1,521 رقماً فقط.
- النص الذي كتبه ليس عربياً، ولكن فيه شيء من العربية: «بل» و«عل» و«ما» و«إن» والعلامة
*في وسط السطر أحياناً، والسبب أن النموذج لا يرى إلا الحرف الأخير، فهو لا يعرف أنه في وسط كلمة أو أنه كتب الشطر الأول للتو.
نفس النموذج كشبكة عصبية Neural Network تتعلم بالتدرج Gradient
قد يتساءل البعض: إذا كان العد يعطي نموذجاً بهذه السهولة، فلماذا نحتاج التدريب بالتدرج أصلاً؟ والإجابة أن العد يعمل فقط عندما يكون الجدول صغيراً، فإذا أردنا أن ننظر إلى آخر ثمانية حروف بدلاً من حرف واحد فسوف يصبح الجدول 39^8 صفاً، أي أكثر من خمسة آلاف مليار صف، ولن تظهر أغلب هذه التركيبات في النص ولو مرة واحدة. لذلك نحتاج طريقة تتعلم القواعد وتعممها، وليس جدولاً يحفظ كل تركيبة، وهذه هي الشبكة. ولكن قبل أن نبني شبكة أكبر سوف نتأكد أن الطريقة تعمل على نفس المسألة التي نعرف حلها: نجعل الجدول 39 في 39 أوزاناً Weights تبدأ من الصفر، ونعتبر صف الحرف الحالي هو درجات Logits الحروف التالية، ثم ندرب الجدول بالتدرج والمحسن AdamW كما في الجزء الأول. والكود التالي من الملف Part2_CharModel/Part2.cs:
// The same bigram, learned: a [V,V] table of logits trained by gradient descent
static void BigramNetwork(CharTokenizer tok, int[] train, int[] val, BigramCounts counts)
{
    Console.WriteLine("== 5) The same bigram as a network trained with gradients");
    int v = tok.VocabSize;
    var rng = new Random(8);
    var w = Tensor.Zeros(v, v);   // row a = scores for every next character after a
    var opt = new AdamW([w], lr: 0.1f, weightDecay: 0);
    Tensor Loss(int[] data, int[] positions)
    {
        var x = positions.Select(p => data[p]).ToArray();
        var y = positions.Select(p => data[p + 1]).ToArray();
        return Ops.SoftmaxCrossEntropy(Ops.Embedding(w, x, x.Length), y);
    }
    for (int step = 0; step <= 1000; step++)
    {
        var batch = Enumerable.Range(0, 4096).Select(_ => rng.Next(train.Length - 1)).ToArray();
        var loss = Loss(train, batch);
        opt.ZeroGrad();
        loss.Backward();
        opt.Step();
        if (step % 250 == 0) Console.WriteLine($"step {step,4}  loss {loss.Item:F4}");
    }
    Tensor.NoGrad = true;
    float valLoss = Loss(val, Enumerable.Range(0, val.Length - 1).ToArray()).Item;
    Tensor.NoGrad = false;
    Console.WriteLine($"validation loss {valLoss:F4} (counting gave {counts.Loss(val):F4})");
    Console.WriteLine();
}
لاحظ أن «اختيار صف الحرف الحالي» هو نفسه العملية Ops.Embedding التي كتبناها في الجزء الأول، فهي تأخذ رقم الحرف وتعيد صفه من الجدول، وفي كل خطوة نأخذ 4096 موضعاً عشوائياً من نص التدريب. والمخرج سوف يكون كما يلي:
== 5) The same bigram as a network trained with gradients
step    0  loss 3.6636
step  250  loss 2.6078
step  500  loss 2.6419
step  750  loss 2.6238
step 1000  loss 2.6169
validation loss 2.6322 (counting gave 2.6261)
في المخرج أعلاه لاحظ التالي:
- الخطوة 0 خطؤها 3.6636 بالضبط، لأن الأوزان كلها صفر، والدالة Softmax تحول الدرجات المتساوية إلى احتمالات متساوية، فهي نفس نموذج خط الأساس.
- بعد 250 خطوة فقط أصبح الخطأ قريباً من نموذج العد، ثم صار يتذبذب قليلاً لأن كل خطوة ترى عينة عشوائية مختلفة من النص.
- خطأ التحقق النهائي 2.6322، والعد أعطى 2.6261، أي أن الشبكة وصلت إلى نفس الحل تقريباً. وهذا منطقي، لأن العد هو أفضل حل ممكن لنموذج Bigram (فهو الاحتمال الذي يجعل نص التدريب أكثر احتمالاً)، والشبكة تقترب منه بخطوات صغيرة، والفرق الصغير بينهما سببه أن العد يستخدم التنعيم وأن الشبكة لم تكمل الوصول.
وبهذا الشكل نكون قد أثبتنا أن التدريب بالتدرج يصل إلى نفس النتيجة الصحيحة، والميزة الآن أن الشبكة يمكن أن تكبر، وهذا موضوع القسم التالي. وهذا الطريق من Bigram بالعد إلى Bigram كشبكة ثم MLP هو نفس الطريق الذي يمشي فيه مشروع makemore التعليمي على أسماء الأشخاص بلغة Python، أما نحن فنمشي فيه بلغة C# وعلى الشعر العربي.
تضمين الحروف Embedding ونافذة السياق Context Window
النموذج الأفضل يجب أن ينظر إلى أكثر من حرف واحد، فالحرف بعد «ال» يختلف عن الحرف بعد «ل» وحدها، والحرف بعد «قلب» يختلف عن الحرف بعد «ب». والفكرة التي تحل هذه المشكلة نشرها Bengio وزملاؤه في ورقة سنة 2003، وهي ثلاث خطوات:
- نافذة السياق Context Window: النموذج ينظر إلى آخر عدد ثابت من الحروف، واخترنا ثمانية، وهذا يعني أنه يرى كلمة أو كلمتين.
- التضمين Embedding: كل حرف يتحول إلى متجه Vector من 24 رقماً بدلاً من رقم واحد، وهذه الأرقام أوزان يتعلمها النموذج، فالحروف التي تتصرف بنفس الطريقة (مثل الحروف التي تأتي في آخر الكلمة) سوف تتعلم متجهات متقاربة، وقد شرحنا فكرة التضمين بالتفصيل في التضمين Embedding.
- الطبقة المخفية Hidden Layer: نضع المتجهات الثمانية جنباً إلى جنب في متجه واحد من 192 رقماً، ونمررها في طبقة خطية Linear Layer فيها 256 خلية مع الدالة Tanh، ثم طبقة أخيرة تخرج 39 درجة Logit، واحدة لكل حرف ممكن.
الصورة التالية تبين هذه الخطوات على نافذة حقيقية من النص:
والكود التالي من الملف Part2_CharModel/MlpModel.cs:
// Bengio et al. (2003): look up a vector for each of the last `context` characters, put them side by side,
// pass them through one hidden layer with tanh, and score every possible next character.
public sealed class MlpModel
{
    public readonly int Context;
    readonly Tensor emb, w1, b1, w2, b2;
    public readonly Tensor[] Parameters;

    public MlpModel(Random rng, int vocab, int context, int embDim, int hidden)
    {
        Context = context;
        emb = Tensor.Randn(rng, 1f, vocab, embDim);
        w1 = Tensor.Randn(rng, 1f / MathF.Sqrt(context * embDim), context * embDim, hidden);   // keeps tanh out of its flat ends at the start
        b1 = Tensor.Zeros(hidden);
        w2 = Tensor.Randn(rng, 0.01f, hidden, vocab);   // small: the first guesses are close to uniform
        b2 = Tensor.Zeros(vocab);
        Parameters = [emb, w1, b1, w2, b2];
    }

    public int ParameterCount => Parameters.Sum(p => p.Size);

    // windows: [batch * context] ids -> logits [batch, vocab]
    public Tensor Forward(int[] windows)
    {
        int batch = windows.Length / Context;
        var e = Ops.Embedding(emb, windows, batch, Context);         // [B, ctx, D]
        var x = Ops.Reshape(e, batch, Context * emb.Cols);            // [B, ctx*D] the vectors side by side
        var h = Ops.Tanh(Ops.Add(Ops.MatMul(x, w1), b1));             // [B, hidden]
        return Ops.Add(Ops.MatMul(h, w2), b2);                        // [B, vocab]
    }
}
في الكود أعلاه لاحظ التالي:
- كل الأرقام التي يتعلمها النموذج في خمسة Tensors فقط: جدول التضمين
embبحجم 39 في 24، ثمw1وb1للطبقة المخفية، ثمw2وb2للطبقة الأخيرة، ومجموعها936 + 49,152 + 256 + 9,984 + 39 = 60,367رقماً. - الدالة
Forwardلا تحتوي على أي كود رجوع Backward، لأن كل عملية فيها (EmbeddingوReshapeوMatMulوAddوTanh) تسجل نفسها في الرسم البياني كما رأينا في الجزء الأول، وكلها مرت بالتحقق من التدرج هناك. - الأوزان الأولى ل
w1مقسومة على الجذر التربيعي لعدد المدخلات، والسبب أننا نجمع 192 رقماً في كل خلية، فإذا كانت الأوزان كبيرة يصبح المجموع كبيراً، والدالة Tanh تصبح مسطحة عند الأرقام الكبيرة (قيمتها 1 أو −1 تقريباً)، فيصبح تدرجها قريباً من الصفر ولا تتعلم. - الأوزان الأولى ل
w2صغيرة جداً (0.01)، فتكون الدرجات الأولى كلها قريبة من الصفر والاحتمالات قريبة من التساوي، أي أن النموذج يبدأ من خط الأساس 3.66 وليس من خطأ أكبر منه.
تدريب Training الشبكة على آخر ثمانية حروف
حلقة التدريب هي نفس الحلقة ذات الخطوات الأربع التي بنيناها في الجزء الأول، والفرق الوحيد هو تجهيز البيانات: في كل خطوة نختار 128 موضعاً عشوائياً من نص التدريب، ولكل موضع نأخذ الحروف الثمانية التي قبله كمدخل، والحرف نفسه كإجابة صحيحة. والكود التالي من الملف Part2_CharModel/Part2.cs:
static void Mlp(CharTokenizer tok, int[] train, int[] val, int newline)
{
    const int context = 8, steps = 6000, batch = 128;
    Console.WriteLine($"== 6) MLP over the last {context} characters (Bengio et al. 2003)");
    var rng = new Random(9);
    var model = new MlpModel(rng, tok.VocabSize, context, embDim: 24, hidden: 256);
    Console.WriteLine($"parameters: {model.ParameterCount:N0}");
    var opt = new AdamW(model.Parameters, lr: 3e-3f, weightDecay: 0.01f);
    var sw = Stopwatch.StartNew();
    for (int step = 0; step <= steps; step++)
    {
        var targets = new int[batch];
        var windows = new int[batch * context];
        for (int b = 0; b < batch; b++)
            targets[b] = Window(train, rng.Next(train.Length), context, newline, windows.AsSpan(b * context, context));
        if (step == steps * 3 / 4) opt.LearningRate = 3e-4f;   // smaller steps at the end
        var loss = Ops.SoftmaxCrossEntropy(model.Forward(windows), targets);
        opt.ZeroGrad();
        loss.Backward();
        opt.Step();
        if (step % 1000 == 0)
            Console.WriteLine($"step {step,5}  train loss (this batch) {loss.Item:F4}  validation loss {Evaluate(model, val, newline):F4}  {sw.Elapsed.TotalSeconds,5:F1}s");
    }
    foreach (float temp in new[] { 0.5f, 0.8f, 1.0f, 1.5f })
    {
        Console.WriteLine($"-- sample, temperature {temp}");
        Console.WriteLine(Generate(model, tok, new Random(10), newline, 250, temp).Trim());
    }
    Console.WriteLine();
}

// Fill `window` with the `context` characters before position `pos` (newlines before the start of the text)
// and return the character at `pos`, the one to predict.
static int Window(int[] data, int pos, int context, int pad, Span<int> window)
{
    for (int i = 0; i < context; i++)
    {
        int p = pos - context + i;
        window[i] = p >= 0 ? data[p] : pad;
    }
    return data[pos];
}
في الكود أعلاه لاحظ التالي:
- الدالة
Windowتملأ النافذة بالحروف الثمانية قبل الموضع، فإذا كنا في أول النص ولا توجد حروف قبله نضع سطراً جديداً، وهذا منطقي لأن النص كله يبدأ بعد سطر جديد. - بعد 75% من الخطوات نخفض معدل التعلم Learning Rate عشر مرات، والسبب أن الخطوات الكبيرة مفيدة في البداية لنقترب بسرعة، ولكنها تجعل الخطأ يتذبذب حول الحل في النهاية، والخطوات الصغيرة تستقر فيه.
- كل 1000 خطوة نقيس الخطأ على بيانات التحقق كاملة (28,110 حرفاً) وليس على عينة، حتى يكون الرقم ثابتاً وقابلاً للمقارنة.
والمخرج سوف يكون كما يلي:
== 6) MLP over the last 8 characters (Bengio et al. 2003)
parameters: 60,367
step     0  train loss (this batch) 3.6734  validation loss 3.6047    0.3s
step  1000  train loss (this batch) 2.2241  validation loss 2.4056    6.1s
step  2000  train loss (this batch) 2.0801  validation loss 2.3399   11.6s
step  3000  train loss (this batch) 2.0672  validation loss 2.3161   17.2s
step  4000  train loss (this batch) 1.9059  validation loss 2.3053   22.6s
step  5000  train loss (this batch) 2.2219  validation loss 2.2294   27.8s
step  6000  train loss (this batch) 2.0511  validation loss 2.2123   32.9s
في المخرج أعلاه لاحظ التالي:
- عدد المعاملات 60,367، أي قرابة أربعين ضعف نموذج Bigram، والتدريب كله أخذ 33 ثانية تقريباً على المعالج.
- العمود الأول هو خطأ الدفعة Batch الحالية فقط (128 مثالاً)، لذلك يقفز صعوداً وهبوطاً، فالدفعة في الخطوة 5000 كانت أصعب من الدفعة في الخطوة 4000، أما العمود الثاني فهو خطأ التحقق، وهو الرقم الذي نعتمد عليه.
- خطأ التحقق ينخفض من 3.6047 إلى 2.2123، وهذا أقل بوضوح من نموذج Bigram (2.6261)، والحيرة
e^2.2123قرابة 9.1، أي أن النموذج أصبح محتاراً بين تسعة حروف تقريباً. - لاحظ الانخفاض الواضح بين الخطوة 4000 و5000 (من 2.3053 إلى 2.2294)، وهذا بعد تخفيض معدل التعلم عند الخطوة 4500 مباشرة.
مقارنة الخطأ Loss بين النماذج الأربعة
الآن عندنا أربعة نماذج، وكلها قيست بنفس المقياس على نفس بيانات التحقق التي لم يرها أي منها في التدريب، والصورة التالية تضعها جنباً إلى جنب:
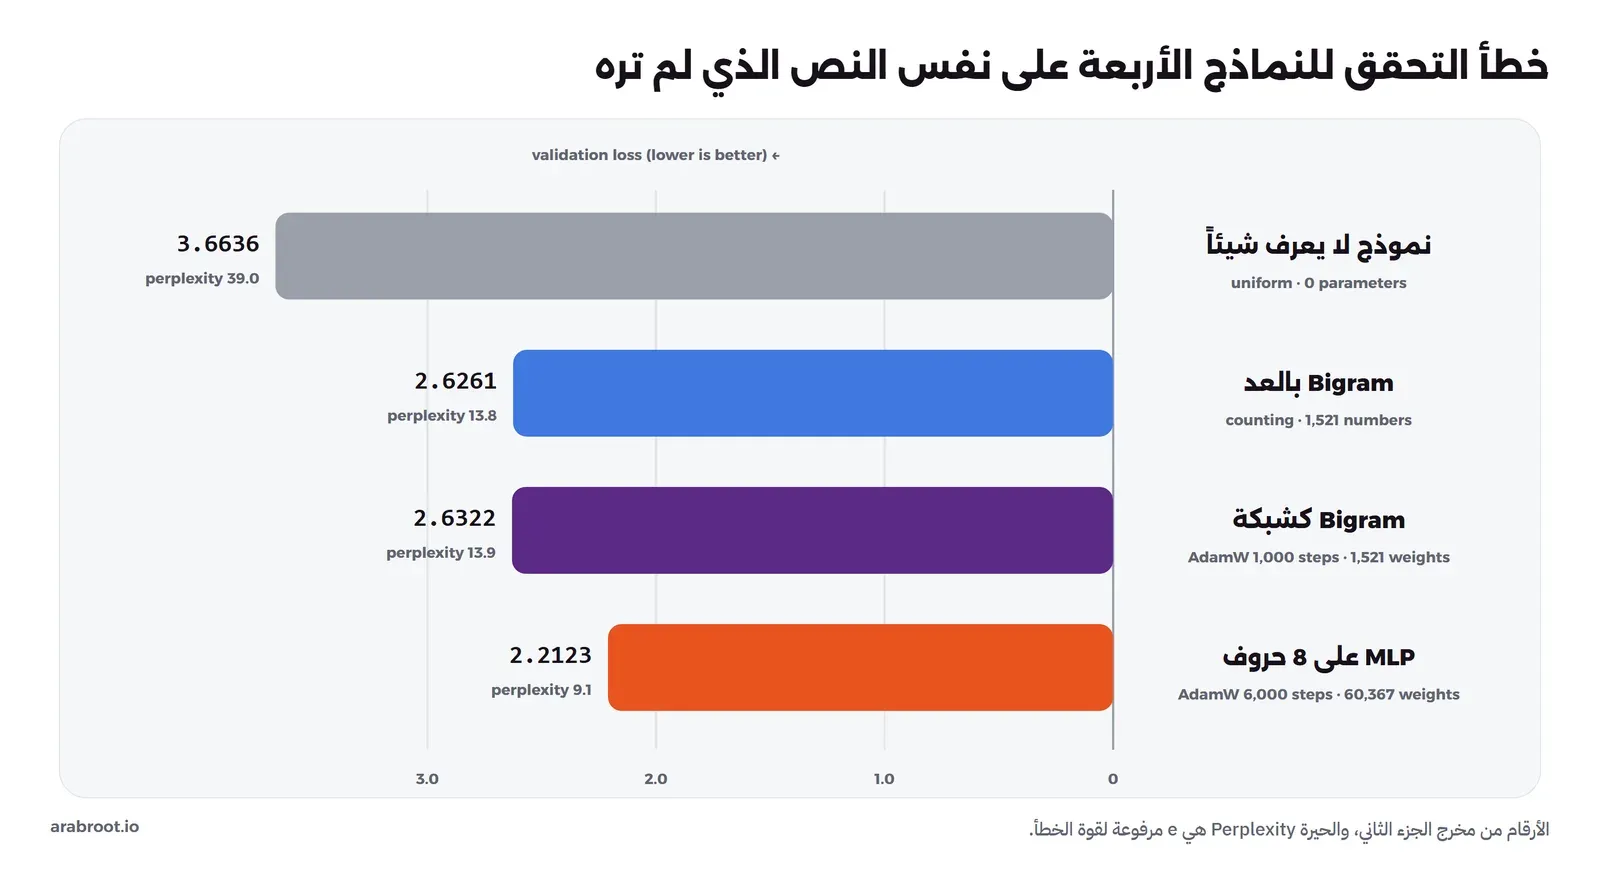
وأهم ملاحظة في الصورة أن القفزة الكبيرة الأولى جاءت من النظر إلى الحرف السابق، ثم جاءت القفزة الثانية من النظر إلى ثمانية حروف، أما تحويل نفس الجدول إلى شبكة فلم يحسن شيئاً، وهذا متوقع لأنه نفس النموذج. أي أن ما يحسن نموذج اللغة هو السياق الذي يراه وقدرته على تعميم ما تعلمه، وليس طريقة التدريب وحدها.
التوليد Generation ودرجة الحرارة Temperature
النموذج يخرج احتمالاً لكل حرف، ولكي يكتب نصاً يجب أن نختار حرفاً واحداً، ثم نضيفه إلى النافذة ونحذف أقدم حرف منها، ثم نسأل النموذج مرة أخرى، وهذه هي حلقة التوليد التي شرحناها في حلقة التوليد ومتى تتوقف. والكود التالي من الملف Part2_CharModel/Part2.cs:
// Generation: predict, sample one character, append it, slide the window, repeat
static string Generate(MlpModel model, CharTokenizer tok, Random rng, int start, int length, float temperature)
{
    Tensor.NoGrad = true;
    var window = Enumerable.Repeat(start, model.Context).ToList();
    var outIds = new List<int>();
    var probs = new float[tok.VocabSize];
    for (int i = 0; i < length; i++)
    {
        var logits = model.Forward(window.ToArray());
        Ops.Softmax(logits.Data, probs, temperature);
        int next = Rng.Sample(rng, probs);
        outIds.Add(next);
        window.RemoveAt(0);
        window.Add(next);
    }
    Tensor.NoGrad = false;
    return tok.Decode(outIds);
}
لاحظ أننا لا نختار الحرف الأكثر احتمالاً دائماً، وإنما نختار عشوائياً بحسب الاحتمالات، والسبب أن الاختيار الأكثر احتمالاً دائماً يجعل النموذج يكرر نفس العبارة إلى ما لا نهاية. والمعامل temperature يمرر إلى الدالة Softmax التي كتبناها في الجزء الأول، وهي تقسم كل درجة Logit على درجة الحرارة قبل Exp، فإذا كانت أقل من 1 تكبر الفروق بين الدرجات، فيأخذ الحرف الأفضل نصيباً أكبر، وإذا كانت أكبر من 1 تصغر الفروق، فتقترب الاحتمالات من التساوي، وقد شرحنا الفكرة في درجة الحرارة Temperature. والصورة التالية تبين أثرها على صف القاف من جدول Bigram:
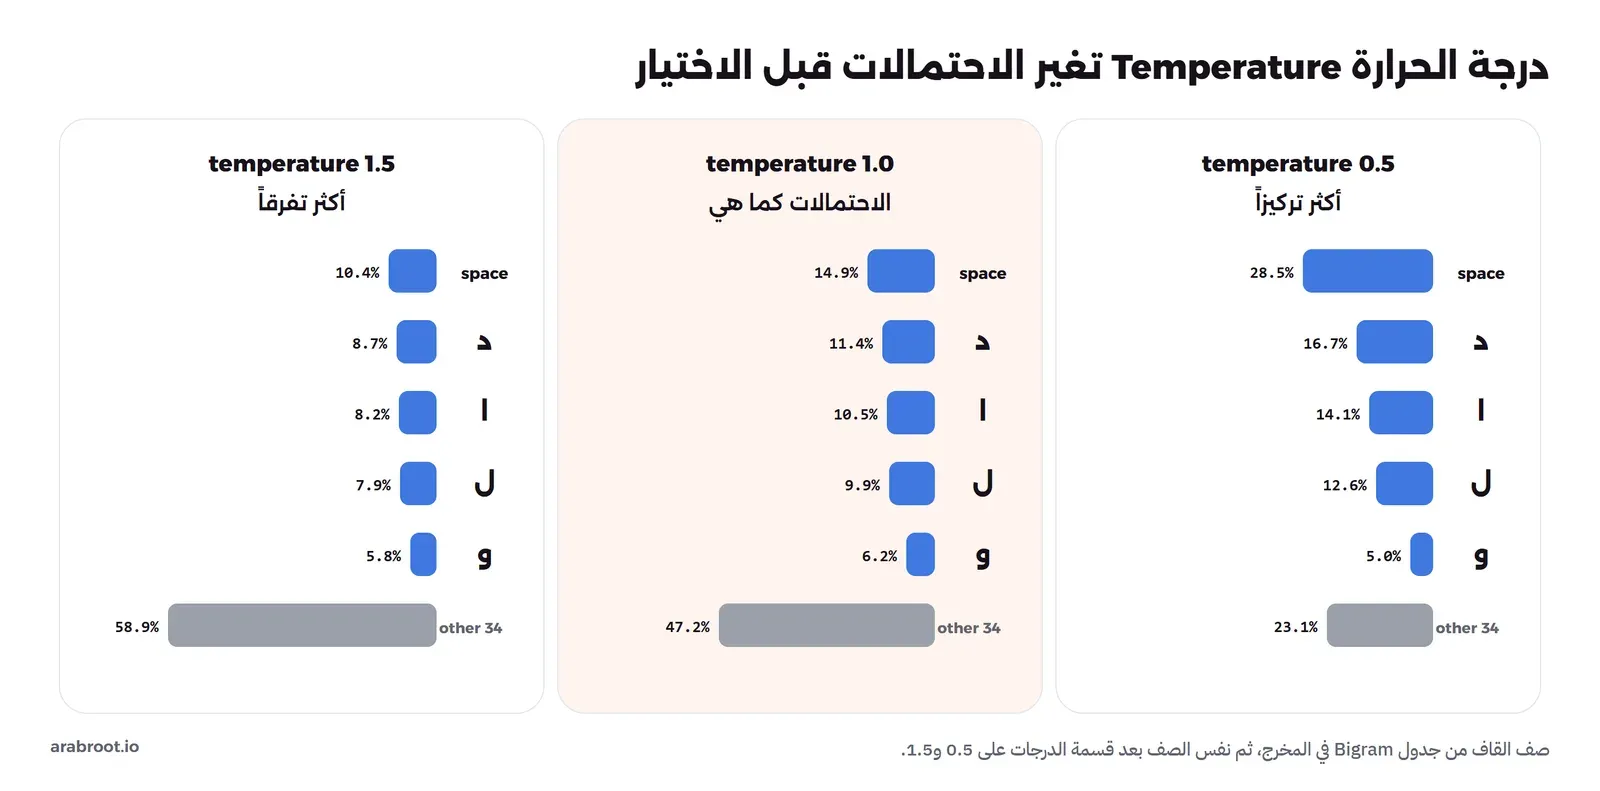
وعند التشغيل نولد 250 حرفاً بأربع درجات حرارة، والمخرج سوف يكون كما يلي:
-- sample, temperature 0.5
قلس سقلت يسجمان * يدار الناس الأسادي * وأنت بها * وتنت رأيا الحجارة والناس من الحمام مغيبه
فإن جرت تعطانه * وكان وحد الفراش
ولكن شجال أن تحمل الدلاق * وأن قبل الأرض من به * ومن كل ما خلت المطر في الروا في الكرام بل القنا الذي أنت الذي أن تقصي * يضى ا
-- sample, temperature 0.8
ملك على العدت والأوادي أموت الماء الذي لا يدت قد رعتاتها
إذا عاب سوبه وما * فرب الكرب الأطب المفام في أصرب حاسبها الكرار الأفودا
أشفيقا وحبه على الجهاني والح الأست اللجدا
فتلومها * لا ترسب والمشوج المطامن
مقل حمر العتكم * وقد عليه منها خداك وأبسير عل
-- sample, temperature 1
وكمع ترقحها بني أديائها في مدان البحاج لدعي ألنز بك مرام
إبين البلي عنيك جأها احتى مكفة * تاجدين مرفك أطفن العحللو من شست إذا قنب الهمام حتى فرد الجه ويجوت بألن الحدى * و دحكما كم مساكا
ناسوالغول
فإذا أنو في أشغع اجفانا * وعد غون السين لا يسوا
جير حج
-- sample, temperature 1.5
وكمك ترصتها دميت الجتجفعان هذام
خخت تحاق شوج غنظ عماما
لإذ كمت أتفية لين خأنر احتيقنا * أعبآ بها قثلت أسفم ععس منى من سرح إبنها رتخليلا مضبها الدرابة ويخود ابنع
تبجتخه حم
ثدظننه لحلب
صرت أضيرهم مزر الشاكى
ملك دكر جؤل لهن
مغظت عنها مصيلة * وعن أزيد جح
في المخرج أعلاه لاحظ التالي:
- بدرجة 0.5 ظهرت كلمات عربية صحيحة كثيرة («الناس» و«الأرض» و«الكرام» و«القنا» و«ولكن» و«وأنت بها»)، والعلامة
*في وسط السطر تقريباً، فالنموذج تعلم أن البيت شطران، ولكن الجمل لا معنى لها. - بدرجة 0.8 وبدرجة 1 ما زالت أغلب الكلمات تشبه العربية، وتظهر كلمات لا توجد في اللغة («العتكم» و«مرفك»)، لأن النموذج يأخذ أحياناً حرفاً احتماله متوسط.
- بدرجة 1.5 أصبح النص حروفاً متتالية لا تشبه العربية في أغلبها («خخت» و«ععس»)، لأن الحروف النادرة أخذت احتمالاً قريباً من الحروف الشائعة.
- لا يوجد رقم «صحيح» لدرجة الحرارة، فالمساعدات التي تكتب كوداً تستخدم عادة درجة منخفضة، والكتابة الإبداعية درجة أعلى، وفي هذه السلسلة سوف نستخدم 0.8 في الغالب.
ماذا تعلم النموذج وماذا لم يتعلم؟
من الأرقام والنصوص أعلاه نستطيع أن نقول بدقة ماذا تعلمت شبكة فيها 60 ألف رقم من 253 ألف حرف من الشعر:
- تعلم شكل الكلمة العربية: «ال» في أول الكلمة، والحروف التي تأتي في آخرها، وأن الكلمة لا تكون طويلة جداً، وكلمات شائعة كثيرة في شعر المتنبي.
- تعلم شكل البيت: سطر فيه علامة
*واحدة تقريباً في وسطه، وليس في أوله أو آخره. - لم يتعلم المعنى، فلا توجد جملة واحدة مفهومة، والسبب الأول أن النافذة ثمانية حروف فقط، فعندما يكتب الشطر الثاني يكون قد نسي الشطر الأول تماماً، ولا يستطيع أن يلتزم بقافية القصيدة لأنه لا يرى البيت السابق.
- لا يمكن أن نحل المشكلة بتكبير النافذة في نفس التصميم، والسبب أن كل موضع في النافذة له أوزانه الخاصة في
w1، فإذا جعلنا النافذة 64 حرفاً فسوف يصبحw1ثمانية أضعاف حجمه، والنموذج يجب أن يتعلم أن «ال» في الموضع الثالث هي نفسها «ال» في الموضع الخامس من الصفر لكل موضع على حدة، وهذا هدر كبير للأوزان والبيانات.
والحل هو أن يقرر النموذج بنفسه أي الحروف السابقة تهمه الآن، وأن يستخدم نفس الأوزان لكل موضع، وهذه هي فكرة الانتباه Attention التي سوف نبنيها في الجزء القادم.
أخطاء شائعة Common Mistakes
- قياس النموذج على نص التدريب: الخطأ على التدريب ينخفض دائماً، حتى عندما يبدأ النموذج بحفظ النص، لذلك احكم على النموذج بخطأ التحقق فقط، وقارن الاثنين لتعرف هل بدأ الحفظ الأعمى.
- نسيان التنعيم Smoothing في نموذج العد: أي زوج من الحروف لم يظهر في التدريب يعطي احتمالاً صفراً، وأول ظهور له في بيانات التحقق يجعل الخطأ مالانهاية.
- خلط النص عشوائياً قبل التقسيم: الأبيات المتجاورة متشابهة، فإذا كانت في التدريب والتحقق معاً تحصل على رقم أفضل من الحقيقة، وهذا شكل من أشكال تسرب البيانات Data Leakage.
- ترك التشكيل في نص صغير: يضاعف طول النص ويزيد الرموز، والنموذج الصغير يدفع ثمن ذلك في جودة الكلمات، واحذفه إلا إذا كان هدفك تعليم النموذج التشكيل نفسه.
- الحكم على النموذج من عينة واحدة: النص المولد عشوائي، وعينة واحدة قد تكون جيدة أو سيئة بالصدفة، والرقم الذي تعتمد عليه هو خطأ التحقق.
- البدء بأوزان كبيرة: إذا بدأت
w2بقيم كبيرة فسوف يبدأ النموذج واثقاً من إجابات خاطئة، ويكون خطؤه في الخطوة الأولى أكبر بكثير من 3.66، ويضيع جزءاً من التدريب في التخلص من هذه الثقة.
تدريب عملي
- غير طول النافذة
contextفي الدالةMlpمن 8 إلى 3 ثم إلى 16، وقارن خطأ التحقق في الحالات الثلاث، ولاحظ كيف يتغير عدد المعاملات. - عدل الشرط في الدالة
PoemText.Cleanحتى يقبل علامات التشكيل (أي المجال حتىU+0652)، ثم شغلpart2مرة أخرى، وقارن حجم المفردات والخطأ والنصوص المولدة. وتذكر أن الأرقام لا تقارن مباشرة، لأن عدد الرموز اختلف. - غير قيمة التنعيم في
BigramCountsمن 1 إلى 0.01 ثم إلى 10، ولاحظ أثرها على خطأ التدريب وخطأ التحقق.
الخلاصة
- نموذج اللغة يجيب على سؤال واحد: ما احتمال كل حرف أن يكون التالي؟ ونقيس جودته بمتوسط سالب لوغاريتم احتمال الحرف الصحيح على نص لم يره.
- بيانات التدريب قصائد المتنبي من ويكي مصدر، ننزلها بالأمر
download dataولا نضعها في المستودع بسبب ترخيص CC BY-SA 4.0، والملفSOURCES.txtيحفظ رابط كل قصيدة. - حذف التشكيل ينقص النص 30% ويجعل المفردات 39 رمزاً فقط، وكل حرف عربي في C# هو
charواحد. - النموذج الذي لا يعرف شيئاً خطؤه 3.6636، ونموذج Bigram بالعد 2.6261، ونفس النموذج كشبكة 2.6322، وشبكة MLP على ثمانية حروف 2.2123.
- درجة الحرارة تتحكم في جرأة الاختيار: المنخفضة تكرر الكلمات الشائعة، والمرتفعة تكتب حروفاً عشوائية.
- النموذج تعلم شكل الكلمة وشكل البيت ولم يتعلم المعنى، لأن نافذته قصيرة، وتكبيرها في نفس التصميم مكلف وغير فعال.
وفي الجزء القادم بإذن الله سوف نستبدل الطبقة المخفية بالانتباه Attention وكتل Transformer، ونجعل النموذج يرى 64 حرفاً، ونرى كيف يتغير شكل الأبيات التي يكتبها.
 دليلابن نموذج لغة بلغة C# من الصفر (1): محرك التعلم Autogradنبني بلغة C# ودون أي مكتبة المحرك الذي تتعلم به كل الشبكات العصبية، ونتأكد بالأرقام أن كل عملية فيه صحيحة.
 دليلابن نموذج لغة بلغة C# من الصفر (3): GPT صغير بالانتباه Attentionنضيف الانتباه Attention وكتلة Transformer إلى نموذجنا بلغة C# فيصبح GPT صغيراً، ونرى كيف يتغير الشعر الذي يكتبه أثناء التدريب.
 دليلابن نموذج لغة بلغة C# من الصفر (4): تشغيل أوزان GPT-2نحمل أوزان GPT-2 الحقيقية في النموذج الذي كتبناه بلغة C#، ونثبت أن نتائجه تطابق Hugging Face رقماً برقم.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل كود الجزء الثاني على .NET 10 (SDK 10.0.400) دون أي حزمة NuGet، وتنزيل قصائد المتنبي من ويكي مصدر بتاريخ 6 أكتوبر 2026.