


إذا قرأت مقالات مرحلة لغة C حتى هنا، فقد بنيت مكتبة ضريبة لنقطة البيع في شركة ناشئة تبيع القهوة والتمور، ثم خدمة طلبات كاملة بقاعدة بيانات وخيوط. والآن لنفرض أن الشركة وظفت مطوراً قضى عشر سنوات في كتابة C لأنظمة مدمجة، وطلبت منه أن يراجع كل ما كتبه الفريق قبل أن تعتمد عليه نقطة البيع في كل الفروع. وأول ما سيقوله لك بعد المراجعة أن أخطاءك ليست أخطاء من لا يعرف البرمجة، وإنما أخطاء من يعرف لغة أخرى جيداً: أنت تقارن النصوص كما في Java، وتعد الحروف كما في Python، وتفترض أن الفحص الذي كتبته سيبقى في البرنامج كما كتبته، وتتوقع أن الخطأ سيوقف البرنامج ويخبرك. وC لا تفعل أياً من هذا.
وفي هذا المقال جمعنا أربعة عشر خطأً من هذا النوع، وكل خطأ في ملف صغير في lab/m/ بنسختين: النسخة الخاطئة، والنسخة الصحيحة بالخيار -DFIX. وشغلنا كل نسخة خاطئة بالمترجم GCC 16.2 ثم مررناها على الأدوات التي تكشف هذا النوع من الأخطاء، وسجلنا ما رأته كل أداة وما فاتها، لأن السؤال العملي ليس «ما الأخطاء الممكنة في C؟»، فهي كثيرة، وإنما «أي أداة أشغل لكي لا يصل هذا الخطأ إلى الإنتاج؟». ثم نختم بتجربة تغذية عشوائية Fuzzing على قارئ الطلبات من مقال الخدمة، وبخطة قراءة من المصادر الرسمية.
وسوف نناقش في هذا المقال ما يلي:
- طبقات الأدوات Tools: تحذيرات المترجم، والتحليل الساكن Static Analysis، والفحص وقت التشغيل Sanitizers وValgrind، والتغذية العشوائية Fuzzing، ومن كشف ماذا في المختبر.
- أربعة عشر خطأً، لكل منها التشغيل الخاطئ الحقيقي والإصلاح: النصوص، والذاكرة، والأعداد، والماكرو، والحروف العربية، والحالة المخفية في الدوال.
- تجربة Fuzzing بالأداة libFuzzer لثلاثة ملايين ونصف مدخل عشوائي.
- إعدادات البناء التي ننصح بها لكل مرحلة، وخطة قراءة من المصادر الرسمية.
لماذا تهم هذه الأخطاء؟ أرقام من مشروع curl Memory Safety
قد يبدو بعض ما سيأتي أخطاءً صغيرة لا تحدث لمبرمج منتبه، ولكن الأرقام من أكثر مشاريع C مراجعة في العالم تقول غير ذلك. ففي مارس 2021 حلل Daniel Stenberg، مؤسس مشروع curl، كل الثغرات الأمنية في تاريخ المشروع، ونشر النتيجة في مقاله نصف ثغرات curl أخطاء C: من 98 ثغرة كانت 51 ثغرة، أي 52%، بسبب أخطاء خاصة بلغة C، مثل تجاوز المخزن والاستخدام بعد التحرير والقراءة خارج الحدود، وفي السنوات الثلاث التي سبقت المقال كانت النسبة أعلى، 18 من 26 ثغرة. وهذا مشروع يكتبه مطورون محترفون منذ 1998، ويمر كوده على مراجعات واختبارات وأدوات فحص مستمرة. وأشهر مثال على ما يمكن أن يفعله خطأ واحد من هذا النوع ثغرة Heartbleed في OpenSSL عام 2014: المكتبة صدقت طولاً جاء في رسالة من العميل ونسخت من الذاكرة بقدره، فكان المهاجم يقرأ حتى 64 KB من ذاكرة السيرفر في كل طلب، وفيها مفاتيح وكلمات مرور. وقد شرحنا في مقال أمان الذاكرة Memory Safety لماذا صار هذا النوع من الأخطاء قضية تتكلم عنها الحكومات. والدرس الذي يهمنا هنا أن الانتباه وحده لا يكفي، وأن المشاريع الجادة بلغة C تعتمد على طبقات من الأدوات، وهذا ما سنقيسه.
طبقات الأدوات Tools: من يكشف ماذا؟
الأدوات التي تكشف أخطاء C أربع طبقات، وكل طبقة تعمل في وقت مختلف وترى نوعاً مختلفاً:
- تحذيرات المترجم Compiler Warnings: الخيارات
-Wall -Wextraفي GCC وClang، وهي أرخص طبقة لأنها تعمل مع كل بناء، وتكشف ما يمكن معرفته من النص وحده، مثل مقارنة عدد بلا إشارة بصفر. - التحليل الساكن Static Analysis: المحلل
-fanalyzerفي GCC، وclang-tidy وCppcheck اللتان رأيناهما في المقال الأول. وهي تتبع مسارات التنفيذ الممكنة دون تشغيل البرنامج، فتجد مثلاً أن مؤشراً قد يكونNULLفي أحد الفروع، أو أن ذاكرة استخدمت بعد تحريرها. - الفحص وقت التشغيل Sanitizers وValgrind: AddressSanitizer للذاكرة، وUndefinedBehaviorSanitizer للسلوك غير المعرف، وThreadSanitizer للخيوط، وMemorySanitizer للقيم التي لم تعط قيمة. وهي ترى ما يحدث فعلاً، ولكن فقط في المسارات التي شغلتها الاختبارات. وValgrind تفعل جزءاً كبيراً من ذلك دون إعادة البناء، بثمن بطء كبير.
- التغذية العشوائية Fuzzing: أداة تولد ملايين المدخلات وتشغل الكود بها تحت Sanitizers، فتصل إلى مسارات لم يكتب لها أحد اختباراً.
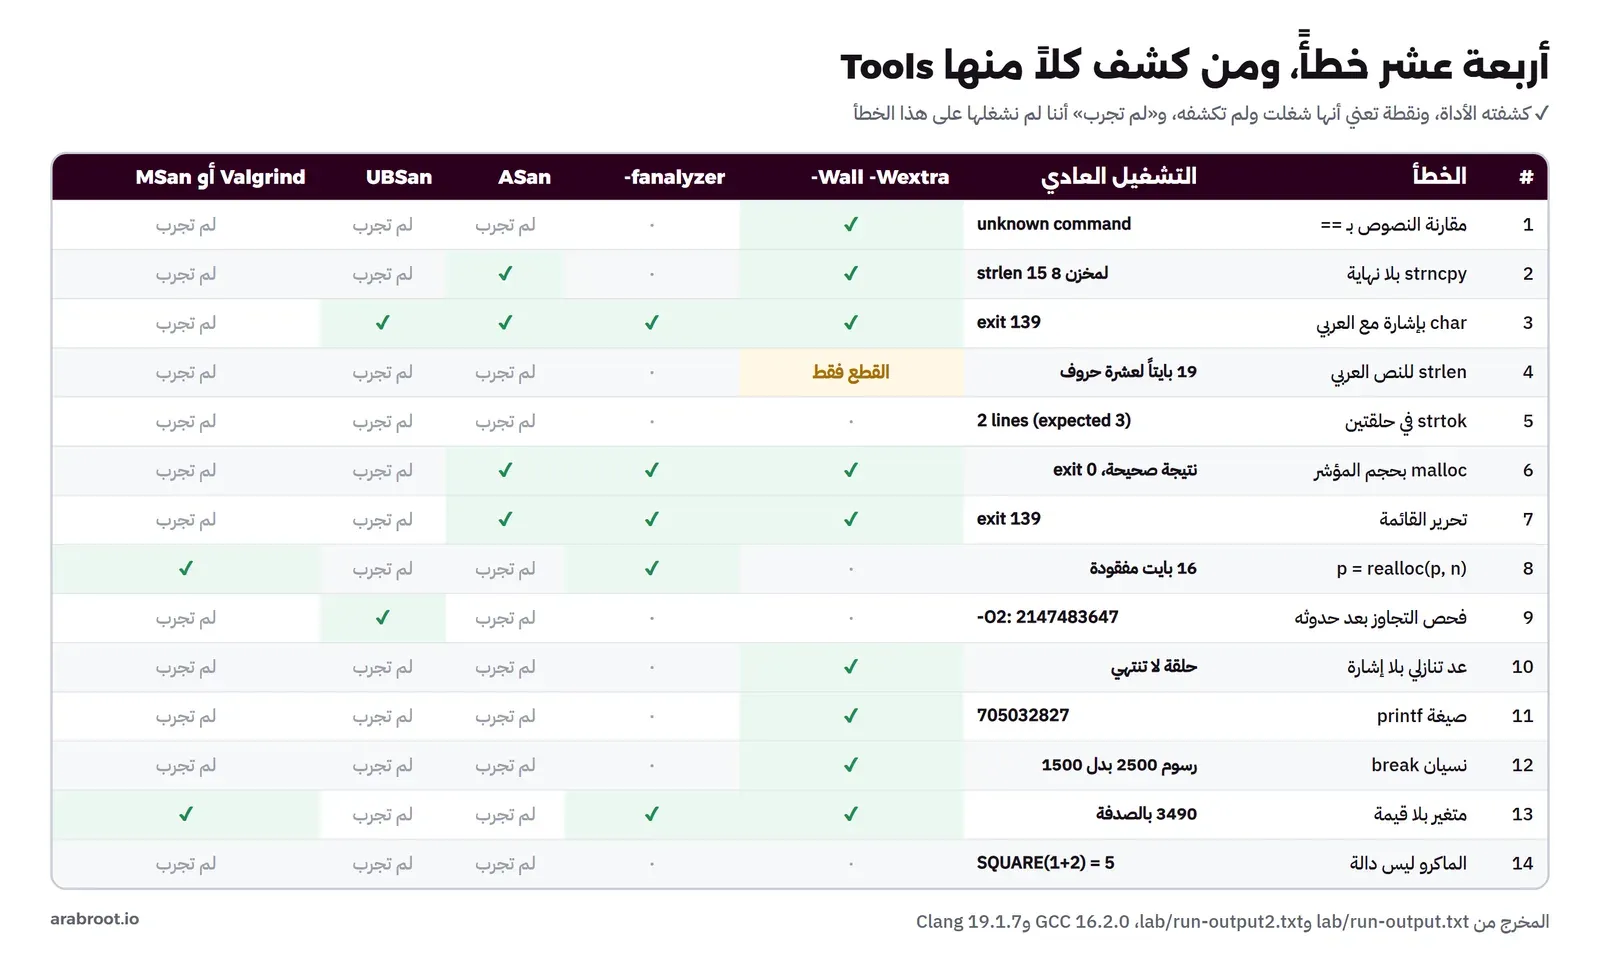
والصورة التالية تجمع نتيجة المختبر: لكل خطأ من الأربعة عشر، ماذا حدث في التشغيل العادي، وأي أداة كشفته. ولاحظ قبل أن تقرأ التفاصيل شيئين: لا توجد أداة كشفت كل الأخطاء، وخمسة أخطاء على الأقل لم تكشفها إلا أداة واحدة. وقد شغلنا تحذيرات -Wall -Wextra والمحلل -fanalyzer على الملفات الأربعة عشر كلها، والأدوات وقت التشغيل على الأخطاء التي تخصها، والمخرج كاملاً في lab/run-output.txt وrun-output2.txt وrun-output3.txt.
وقد يتساءل البعض: إذا كانت كل هذه الأدوات موجودة، فلماذا ما زالت أخطاء C تصل إلى الإنتاج في مشاريع مثل curl وOpenSSL؟ والإجابة أن كل أداة وقت التشغيل لا ترى إلا المسارات التي شغلتها، وأغلب الثغرات تعيش في مسارات لا يصل إليها الاختبار العادي: رسالة بطول غريب، أو ترميز نادر، أو خطأ في الشبكة في لحظة معينة. وثغرة Heartbleed نفسها كانت في مسار يعمل كل يوم، ولكن بطول يكذب فيه المرسل، وهو مدخل لا يكتبه أحد في اختبار. ولهذا جاءت التغذية العشوائية بعد أن صارت Sanitizers رخيصة، فالأولى تولد المسارات الغريبة، والثانية تكشف ما يحدث فيها، وكل منهما وحدها أضعف بكثير. وهذا أيضاً سبب أن الحل الذي تدفع نحوه الحكومات والشركات الكبيرة اليوم ليس أدوات أفضل لـ C، وإنما لغات تمنع هذه الفئة من الأخطاء من البداية، كما شرحنا في مقال أمان الذاكرة.
كيف تعمل هذه الأدوات من الداخل؟ Shadow Memory and Instrumentation
معرفة طريقة عمل كل أداة تشرح لك لماذا تكشف خطأً وتفوت آخر، ولماذا لا تجمع بعضها في بناء واحد. فـ AddressSanitizer تضيف المترجم حول كل قراءة وكتابة فحصاً صغيراً في ذاكرة ظل Shadow Memory، كل بايت فيها يصف ثمانية بايتات من الذاكرة الحقيقية، وتضع حول كل متغير وكل قطعة محجوزة مناطق محرمة Redzones، وتؤخر إعادة استخدام القطع المحررة في حجر صحي Quarantine لكي يظهر الاستخدام بعد التحرير. ولهذا تكشف القراءة بعد نهاية القطعة بايتاً واحداً، ولا تكشف التجاوز بين حقلين داخل نفس الهيكل، لأنه لا توجد منطقة محرمة بينهما، وهو ما رأيناه في مقال الأنواع والذاكرة. وثمنها بحسب توثيقها بطء بمقدار الضعف تقريباً. أما UndefinedBehaviorSanitizer فتضيف فحصاً حول العمليات التي قد تكون غير معرفة فقط، مثل الجمع بإشارة والإزاحة والفهرسة في مصفوفة معروفة الحجم، فهي أرخص بكثير، ويمكن جمعها مع ASan في نفس البناء كما فعلنا. وMemorySanitizer تتبع لكل بت في الذاكرة هل أعطي قيمة أم لا، وثمنها بطء ثلاثة أضعاف كما في توثيقها، وتحتاج أن تبنى كل المكتبات التي يستخدمها البرنامج بها لكي لا تعطي إنذارات خاطئة، ولهذا هي أقل استخداماً. وThreadSanitizer تسجل كل وصول للذاكرة مع الأقفال التي حوله، وثمنها بطء بين خمسة وخمسة عشر ضعفاً وذاكرة بين خمسة وعشرة أضعاف بحسب توثيقها، ولا تجتمع مع ASan في بناء واحد لأن كلاً منهما تحتاج ذاكرة الظل بطريقتها.
أما Valgrind فمختلفة تماماً: لا تحتاج إعادة بناء، وإنما تشغل البرنامج الجاهز على معالج افتراضي تترجم فيه كل تعليمة وتضيف إليها الفحص وقت التشغيل. ولهذا تعمل على أي ملف تنفيذي، حتى المكتبات التي لا تملك كودها، وهي الأداة التي وجدت تسرب اتصالات قاعدة البيانات في مقال الخدمة. وثمنها كبير، فـ دليل البداية يقول إن البرنامج يصبح أبطأ عشرين إلى ثلاثين مرة، وفي مقال الأنواع والذاكرة رأينا برنامجاً يأخذ ثانية ونصفاً تقريباً يصبح 77 ثانية تحت Valgrind. فالقاعدة العملية: Sanitizers في كل تشغيل للاختبارات لأنها رخيصة نسبياً، وValgrind في تشغيل ليلي على سيناريو أطول، أو عندما تحتاج فحص مكتبة لا تستطيع إعادة بنائها.
أخطاء النصوص Strings
1. مقارنة النصوص بالرمز == String Comparison
في Java تعلمت أن == للنصوص خطأ، ثم نسيت ذلك في Python وJavaScript حيث تعمل. وفي C الخطأ أوضح: النص مصفوفة، واسم المصفوفة عنوان، فـ cmd == "pay" تقارن عنوانين لا محتوى:
    const char *cmd = argc > 1 ? argv[1] : "pay";
    if (cmd == "pay") puts("paying");            // compares two addresses
$ /tmp/b/m01 pay
unknown command
exit 0المستخدم كتب pay بالضبط، والبرنامج قال «أمر غير معروف»، لأن النص الذي جاء من سطر الأوامر في عنوان، والنص الثابت "pay" في عنوان آخر. وبدون خيارات لم يقل المترجم شيئاً، ومع -Wall ظهر التحذير الذي يكفي لكشفه: comparison with string literal results in unspecified behavior [-Waddress]. والإصلاح strcmp(cmd, "pay") == 0، والنسخة المصلحة طبعت paying. ولاحظ الشكل == 0: الدالة strcmp ترجع صفراً عند التساوي، فكتابة if (strcmp(a, b)) تعني «إذا كانا مختلفين»، وهذا خطأ آخر يقع فيه كثيرون.
2. الدالة strncpy لا تضع نهاية النص Null Terminator
من سمع أن strcpy خطرة ينتقل إلى strncpy لأن فيها حداً، وهذا انتقال من خطأ إلى خطأ. فرمز المنتج SKU-12345 تسعة حروف، والمخزن ثمانية بايتات:
    char next[8] = "XXXXXXX";
    char sku[8];
    const char *input = "SKU-12345";
    strncpy(sku, input, sizeof sku);            // copies 8 bytes, no terminator
$ /tmp/b/m02
sku=[SKU-1234XXXXXXX] (strlen 15) next=XXXXXXX
exit 0الدالة نسخت ثمانية بايتات بالضبط ولم تضع الصفر في النهاية، لأن صفحة strncpy(3) تقول إنها لا تضعه إذا كان النص بطول الحد أو أطول. فلما طبعنا الرمز أكمل printf القراءة بعد نهاية المخزن حتى وجد صفراً، فطبع الرمز ومعه محتوى المتغير المجاور، وstrlen قالت 15 لمخزن حجمه 8. وفي برنامج حقيقي قد تكون البايتات التالية كلمة مرور أو رمزاً سرياً. والمترجم حذر هنا مع -Wall -Wextra: 'strncpy' output truncated copying 8 bytes from a string of length 9 [-Wstringop-truncation]، وASan أوقفت البرنامج بخطأ stack-buffer-overflow عند القراءة. والإصلاح snprintf(sku, sizeof sku, "%s", input) التي تقطع وتضع النهاية دائماً، فطبعت النسخة المصلحة SKU-123 بطول 7، ومع ذلك حذر المترجم بأن النص قطع [-Wformat-truncation=]، وهو تحذير مفيد: القطع الصامت لرمز منتج خطأ في المنطق حتى لو لم يكن خطأ ذاكرة، فإما أن تكبر المخزن أو ترفض الرمز الطويل.
3. الحرف char بإشارة والنص العربي Signed char
هذا الخطأ لن تراه في الأمثلة الإنجليزية في الكتب، وستراه في أول يوم تعالج فيه أسماء المنتجات العربية. البرنامج يعد تكرار كل بايت في اسم المنتج في جدول من 256 خانة:
static int counts[256];
    const char *name = "قهوة";
    for (const char *p = name; *p; p++) {
        counts[*p]++;                       // *p is negative for bytes 0x80..0xFF
    }
$ /tmp/b/m10
exit 139
Segmentation fault (core dumped)
m10_signedchar.c:10:15: runtime error: index -39 out of bounds for type 'int [256]'
==203==ERROR: AddressSanitizer: global-buffer-overflow on address 0x0000004048c4 at pc 0x00000040133d bp 0x7ffe1a69b3b0 sp 0x7ffe1a69b3a8
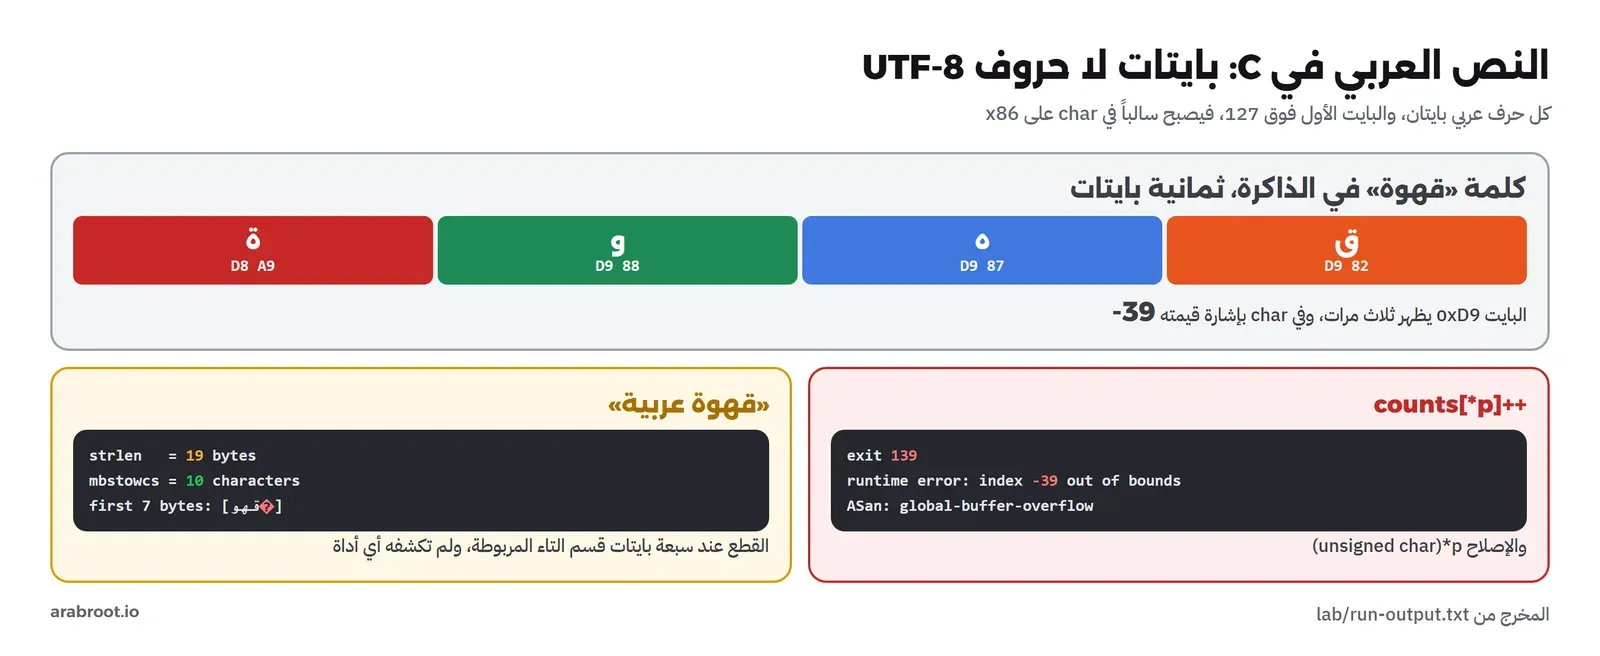
#0 0x00000040133c in main /lab/m/m10_signedchar.c:10الحروف العربية في UTF-8 بايتان، وكلاهما أكبر من 127، فالقاف مثلاً تبدأ بالبايت 0xD9. ولأن char بإشارة على x86 كما رأينا في مقال الأنواع، صار 0xD9 العدد 39-، فكتب البرنامج قبل بداية الجدول، وانهار برمز 139. وUBSan قالت ذلك بالرقم: index -39 out of bounds. والمترجم حذر مع -Wall: array subscript has type 'char' [-Wchar-subscripts]. والإصلاح أن تحول البايت إلى unsigned char قبل استخدامه فهرساً أو تمريره إلى دوال مثل isalpha وtoupper، فطبعت النسخة المصلحة byte 0xD9 seen 3 times، وهي القاف والهاء والواو، أما التاء المربوطة فتبدأ بالبايت 0xD8.
4. الدالة strlen تعد البايتات لا الحروف UTF-8
القادم من Python حيث len("قهوة عربية") تعطي 10 سوف يحسب طول الاسم بالدالة strlen ويعرضه في واجهة نقطة البيع أو يقطعه ليتسع في سطر الفاتورة:
$ /tmp/b/m11
strlen = 19 bytes
first 7 bytes: [قهو�]
$ /tmp/b/m11f
strlen = 19 bytes
mbstowcs = 10 characters
first 7 bytes: [قهو�]
الاسم عشرة حروف بالمسافة، ولكنه 19 بايتاً، تسعة حروف عربية في بايتين لكل منها ومسافة في بايت. وعندما قطعنا الاسم عند سبعة بايتات لكي يتسع في مخزن من ثمانية، انقطعت التاء المربوطة في منتصفها بعد أن أخذت القاف والهاء والواو ستة بايتات، فظهر في الطرفية رمز الاستبدال �. والمترجم مع -Wall حذر من القطع نفسه: '%s' directive output truncated writing 19 bytes into a region of size 8، ولكنه لا يعرف شيئاً عن الحروف، فلا أداة تقول لك إن القطع قسم حرفاً أو إن الطول عشرة لا تسعة عشر، لأن هذا ليس خطأ في نظر اللغة، فكل بايت في مكانه. والنسخة المصلحة تعد الحروف بالدالة mbstowcs بعد ضبط اللغة على C.UTF-8 فأعطت 10، ولكن لاحظ أن القطع ما زال خاطئاً في النسخة المصلحة نفسها، لأن إصلاحه يحتاج قطعاً على حدود الحروف لا البايتات. والقاعدة: في C النص بايتات، وكل ما يخص الحروف، من الطول إلى القطع إلى المقارنة دون حالة الأحرف، يحتاج مكتبة تفهم Unicode مثل ICU، أو كوداً تكتبه وتختبره بنصوص عربية حقيقية.
5. الدالة strtok والحالة المخفية Hidden State
ملف الطلبات من نقطة البيع يفصل الطلبات بفاصلة منقوطة، وسطور الطلب الواحد بفاصلة. والحل الذي يكتبه كل مبتدئ حلقتان بالدالة strtok:
    char orders[] = "1:990,2:2500;3:1575";
    for (char *o = strtok(orders, ";"); o; o = strtok(NULL, ";"))
        for (char *l = strtok(o, ","); l; l = strtok(NULL, ",")) { printf("line %s\n", l); lines++; }
$ /tmp/b/m13
line 1:990
line 2:2500
2 lines (expected 3)ضاع الطلب الثاني كله دون أي رسالة. والسبب أن strtok تحفظ مكانها في النص في متغير داخلي مخفي، كما تشرح صفحة strtok(3)، فلما استخدمتها الحلقة الداخلية على الطلب الأول نسيت الحلقة الخارجية أين كانت، وstrtok(NULL, ";") أكملت من حيث توقفت الداخلية فلم تجد شيئاً. ولم تكشفه أي أداة، لأنه خطأ في المنطق لا في الذاكرة. والإصلاح strtok_r التي تأخذ مكانها في متغير تمرره أنت، فطبعت النسخة المصلحة السطور الثلاثة. ونفس الحالة المخفية تجعل strtok غير آمنة مع الخيوط، ومثلها دوال قديمة أخرى ترجع مؤشراً إلى مخزن داخلي ثابت مثل strerror وlocaltime، ولكل منها نسخة _r تأخذ مخزنك أنت. والقاعدة: إذا كانت الدالة تتذكر شيئاً بين استدعاءين، فابحث عن نسختها التي لا تتذكر.
أخطاء الذاكرة Memory
6. حجم خاطئ في malloc: حجم المؤشر بدلاً من حجم البيانات sizeof
typedef struct { long id; long price; long qty; } Line;
    Line *lines = malloc(n * sizeof(Line *));   // 4 * 8 = 32 bytes for 4 * 24 bytes of data
m03_mallocsize.c:15:37: warning: array subscript 3 is outside array bounds of 'Line[1]' [-Warray-bounds=]
$ /tmp/b/m03
last price 990
exit 0
==61==ERROR: AddressSanitizer: heap-buffer-overflow on address 0x7c23bc7e0060 at pc 0x00000040123e bp 0x7ffe5b5b31e0 sp 0x7ffe5b5b31d8
WRITE of size 8 at 0x7c23bc7e0060 thread T0
#0 0x00000040123d in main /lab/m/m03_mallocsize.c:14
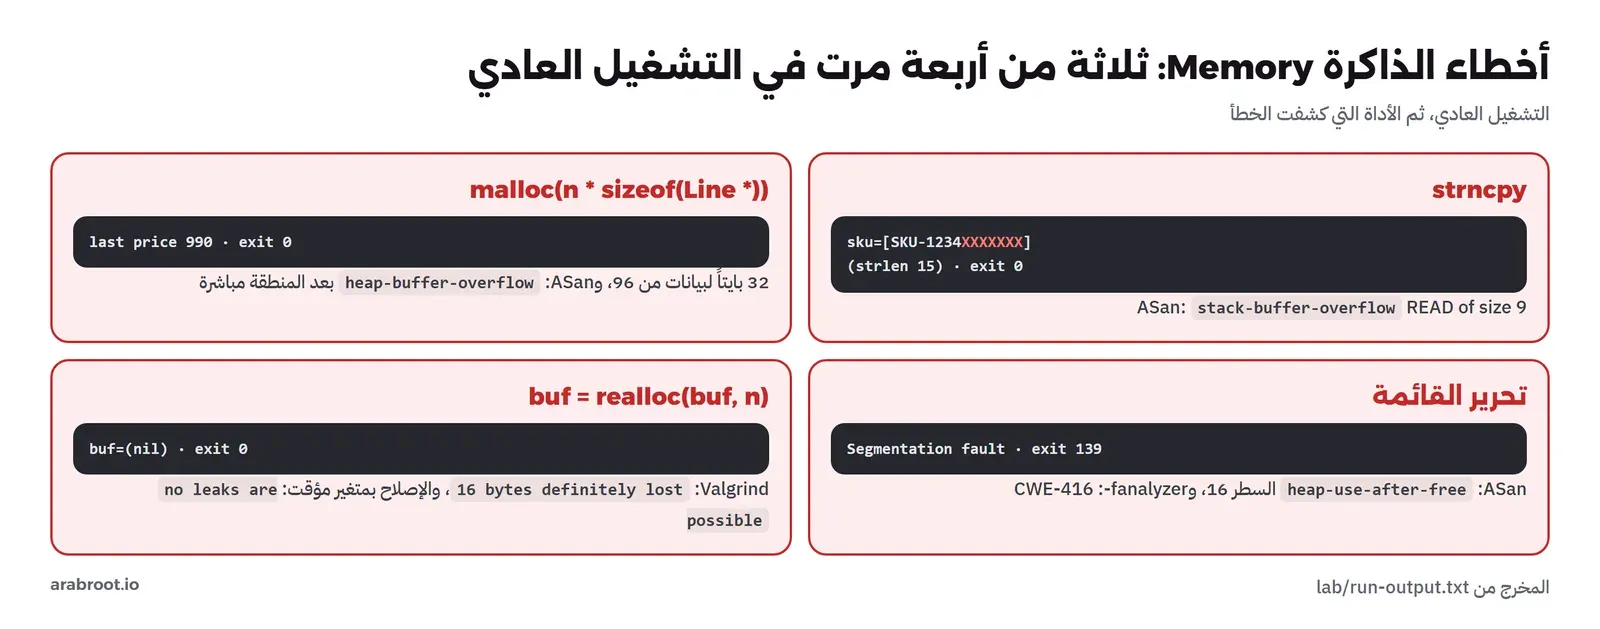
0x7c23bc7e0060 is located 0 bytes after 32-byte region [0x7c23bc7e0040,0x7c23bc7e0060)نجمة واحدة زائدة في sizeof(Line *) جعلت الحجز 32 بايتاً لبيانات حجمها 96، والبرنامج كتب فوق ذاكرة ليست له، ومع ذلك طبع النتيجة الصحيحة وخرج برمز 0، لأن ما كتب فوقه لم يستخدمه أحد بعد. وهذا أخطر ما في هذا النوع: يعمل في الاختبار، ويفسد بيانات الحجز التالي في الإنتاج. والمترجم انتبه هذه المرة مع -Wall لأن العدد ثابت والحلقة صغيرة، والمحلل -fanalyzer قال heap-based buffer overflow [CWE-122]، وASan أعطت التفاصيل كاملة: كتابة بحجم 8 بايت مباشرة بعد منطقة حجمها 32 بايتاً. والإصلاح الذي يعتمده كثير من مطوري C أسلوب لا يمكن أن يخطئ في النوع: malloc(n * sizeof *lines)، فالحجم يتبع نوع المتغير نفسه، وإذا تغير النوع يوماً تغير الحجم معه.
7. تحرير قائمة مترابطة: القراءة بعد free Use After Free
for (Node *n = head; n; n = n->next) free(n); // n->next is read from freed memory$ /tmp/b/m12
Segmentation fault (core dumped)
exit 139
==235==ERROR: AddressSanitizer: heap-use-after-free on address 0x7bdaa84e0058 at pc 0x00000040129a bp 0x7ffc14d74580 sp 0x7ffc14d74578
READ of size 8 at 0x7bdaa84e0058 thread T0
#0 0x000000401299 in main /lab/m/m12_listfree.c:16
m12_listfree.c:11:15: warning: dereference of possibly-NULL 'n' [CWE-690] [-Wanalyzer-possible-null-dereference]
m12_listfree.c:16:31: warning: use after 'free' of 'n' [CWE-416] [-Wanalyzer-use-after-free]الحلقة تبدو طبيعية جداً، ولكن خطوتها n = n->next تعمل بعد free(n)، أي أنها تقرأ المؤشر التالي من عقدة محررة. وفي مقال إدارة الذاكرة رأينا أن قراءة ذاكرة محررة قد تعطي قيمة خاطئة بصمت، وهنا كانت النتيجة انهياراً برمز 139 في البناء المحسن، لأن glibc تكتب بياناتها الإدارية في أول ستة عشر بايتاً من القطعة المحررة، والحقل next يقع فيها بعد الرقم والحشو، فقرأت الحلقة عنواناً لا معنى له. وكشفته ثلاث أدوات: ASan وقت التشغيل بالسطر 16، والمحلل الساكن -fanalyzer قبل التشغيل برقم CWE-416، وحتى -Wall وحده في GCC 16 بالتحذير pointer 'n' used after 'free' [-Wuse-after-free=]. ولاحظ أن المحلل وجد خطأً ثانياً لم نقصده: في السطر 11 لا نتحقق من أن malloc لم ترجع NULL، وهو محق. والإصلاح أن تحفظ التالي قبل التحرير: for (Node *n = head, *next; n; n = next) { next = n->next; free(n); }.
8. السطر p = realloc(p, n): تسرب Memory Leak عند الفشل
static char *grow(char *buf, size_t n) {
    buf = realloc(buf, n);              // on failure buf becomes NULL and the old block leaks
    return buf;
}
buf=(nil)
==268== 16 bytes in 1 blocks are definitely lost in loss record 1 of 1
==268== by 0x401194: main (m14_realloc.c:18)
==268== definitely lost: 16 bytes in 1 blocks
m14_realloc.c:19:5: warning: use of possibly-NULL 'buf' where non-null expected [CWE-690] [-Wanalyzer-possible-null-argument]طلبنا حجماً مستحيلاً لكي تفشل realloc، فرجعت NULL وتركت الكتلة القديمة كما هي، كما تقول صفحة realloc. ولأننا كتبنا النتيجة فوق المؤشر الوحيد إلى الكتلة، صارت 16 بايتاً لا يصل إليها أحد، وValgrind سمتها definitely lost. وفي الإنتاج يحدث هذا عندما يأتي الحجم من مدخل خاطئ، أو في Container يقترب من حد ذاكرته. والإصلاح الذي رأيناه في مقال الأنواع والذاكرة: متغير مؤقت، ثم قرار واضح عند الفشل، فخرجت النسخة المصلحة تحت Valgrind بالسطر All heap blocks were freed -- no leaks are possible.
أخطاء الأعداد Integers
9. فحص التجاوز بعد حدوثه: المترجم حذف الفحص Signed Overflow
هذا أهم خطأ في المقال، لأنه يصيب المبرمج الحريص بالذات. الدالة تضيف كمية إلى المخزون، والمبرمج يعرف أن الجمع قد يتجاوز الحد، فكتب فحصاً يبدو منطقياً تماماً: إذا صار المجموع أصغر من المخزون الأصلي فقد التف العدد:
static int add_stock(int stock, int delta, int *out) {
    if (stock + delta < stock) return -1;   // overflow is undefined, so the compiler may delete this
    *out = stock + delta;
    return 0;
}
    if (add_stock(INT_MAX, delta, &r)) puts("overflow detected");
    else printf("new stock %d\n", r);
$ /tmp/b/m04o0
new stock -2147483648
exit 0
$ /tmp/b/m04o2
new stock 2147483647
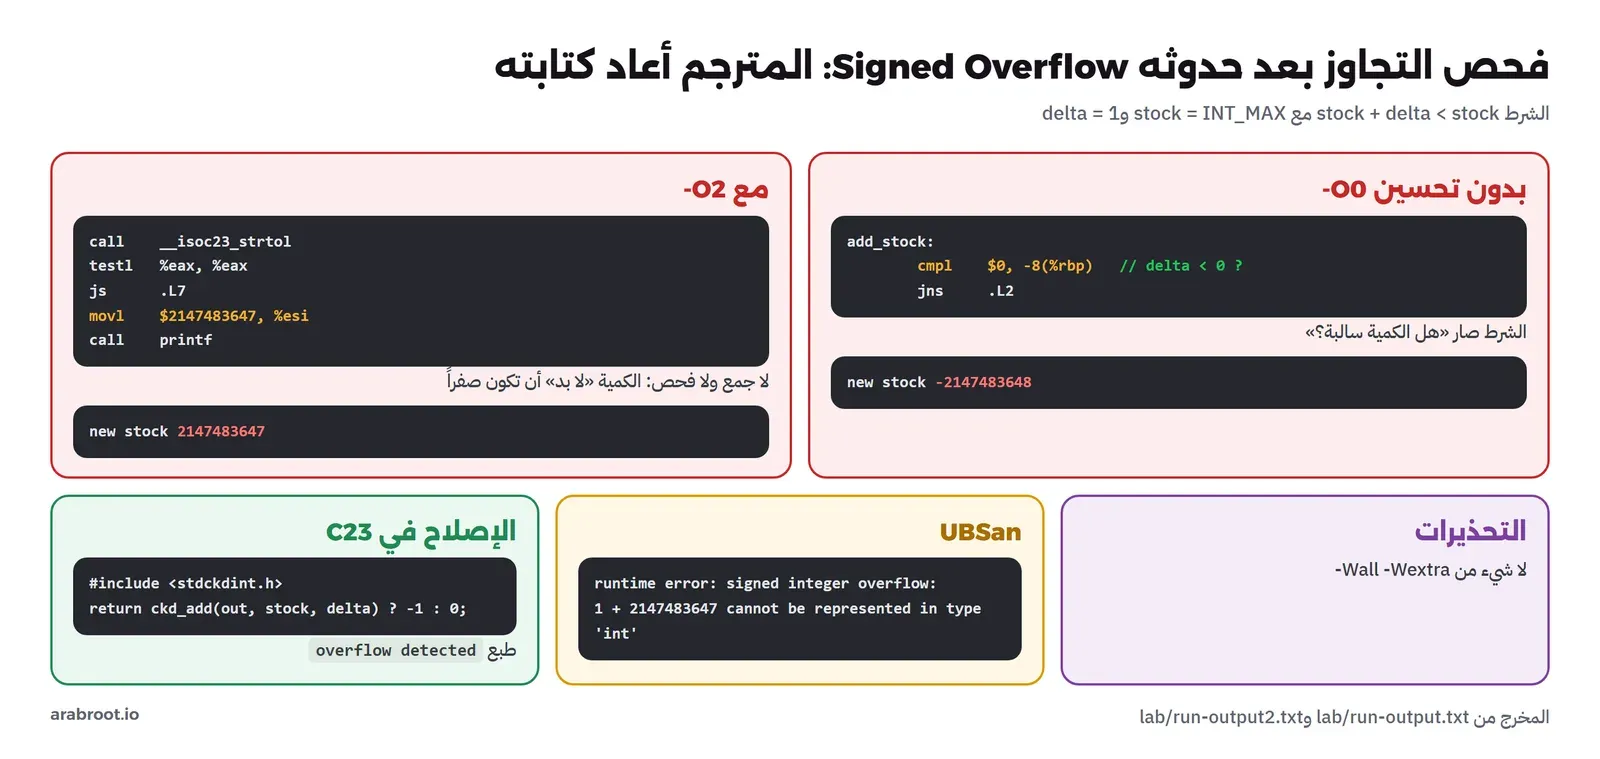
exit 0أضفنا 1 إلى أكبر عدد ممكن. والفحص لم يكتشف التجاوز في البناءين، والأغرب أن البناءين أعطيا نتيجتين مختلفتين: بدون تحسين التف العدد إلى أصغر عدد سالب، ومع -O2 طبع البرنامج الحد الأقصى نفسه، كأن الجمع لم يحدث. ولكي نفهم نظرنا في ما أنتجه المترجم. بدون تحسين، هذه مقارنة الدالة:
add_stock:
	cmpl	$0, -8(%rbp)
	jns	.L2
المترجم لم يحسب stock + delta ثم يقارن، وإنما قارن delta بالصفر مباشرة. فهو حول الشرط stock + delta < stock إلى delta < 0، وهذا التحويل صحيح رياضياً في الأعداد التي لا تلتف، والمعيار يقول إن التفاف الأعداد بإشارة سلوك غير معرف، أي أن المترجم يحق له أن يفترض أنه لا يحدث. فصار الفحص «هل الكمية سالبة؟»، وهو فحص لا علاقة له بالتجاوز. ومع -O2 ذهب المترجم أبعد، وهذا جزء من main بعد التحسين:
	call	__isoc23_strtol
	testl	%eax, %eax
	js	.L7
	movl	$2147483647, %esi
	movl	$.LC0, %edi
	xorl	%eax, %eax
	call	printf
بعد قراءة الكمية بالدالة strtol، يفحص المترجم هل هي سالبة، وإذا لم تكن يطبع الرقم الثابت 2147483647 مباشرة. والمنطق من وجهة نظره: المخزون هو INT_MAX، والكمية ليست سالبة، والجمع لا يمكن أن يتجاوز الحد لأن ذلك غير معرف، فالكمية لا بد أن تكون صفراً، والنتيجة لا بد أن تكون INT_MAX. فالمترجم لم يحذف الفحص فقط، وإنما استخدم افتراض «لا تجاوز» ليحذف الجمع كله. ولم يحذر أي خيار تحذير من هذا، وكشفه UndefinedBehaviorSanitizer فقط:
m04_overflowcheck.c:9:15: runtime error: signed integer overflow: 1 + 2147483647 cannot be represented in type 'int'
overflow detected
والإصلاح ألا تفحص بعد العملية أبداً، وإنما أن تستخدم عملية تخبرك بالتجاوز قبل حدوثه. وفي C23 صار لذلك ترويسة قياسية stdckdint.h فيها ckd_add وckd_sub وckd_mul، وهي مبنية على الدوال المدمجة التي يوفرها GCC منذ زمن، كما في توثيق دوال فحص التجاوز في GCC:
#include <stdckdint.h>
    return ckd_add(out, stock, delta) ? -1 : 0;   // C23 <stdckdint.h>: checked arithmetic
والنسخة المصلحة طبعت overflow detected في كل مستوى تحسين. وتذكر هذا المثال كلما قرأت أن السلوك غير المعرف «يعطي قيمة غريبة»، فهو قد يعطي قيمة صحيحة المظهر، أو يحذف الكود الذي كتبته لتحمي نفسك.
10. العد التنازلي بعدد بلا إشارة Unsigned Loop
for (size_t i = n - 1; i >= 0; i--) { // size_t is never negative: 0 - 1 wraps aroundm05_unsignedloop.c:9:30: warning: comparison of unsigned expression in '>= 0' is always true [-Wtype-limits]
$ /tmp/b/m05
i=2
i=1
i=0
i=18446744073709551615
i=18446744073709551614
... still loopingالحلقة طبعت 2 ثم 1 ثم 0، ثم بدل أن تتوقف طرحت 1 من الصفر فصار العدد بلا إشارة أكبر عدد ممكن، والشرط i >= 0 صحيح دائماً لعدد بلا إشارة، فلن تتوقف أبداً، وأوقفناها نحن بعداد بعد خمس دورات. وفي الكود الحقيقي تقرأ الحلقة prices[18446744073709551615] في الدورة الرابعة وتنهار. وعلى عكس الأعداد بإشارة، التفاف الأعداد بلا إشارة سلوك معرف في المعيار، ولهذا لا تنفع فيه UBSan، ولكن -Wextra يكشفه وقت الترجمة بالتحذير -Wtype-limits. والإصلاح الذي يستخدمه مطورو C هو الشكل for (size_t i = n; i-- > 0;)، الذي يفحص قبل أن يطرح، وطبعت النسخة المصلحة العناصر الثلاثة بترتيب عكسي.
11. صيغة printf الخاطئة Format String
    int64_t total = 5000000123LL;
    size_t items = 3;
    printf("total %d halalas, items %d\n", total, items);
$ /tmp/b/m09
total 705032827 halalas, items 3خمسة مليارات هللة طبعت 705 ملايين، لأن %d تقرأ أربعة بايتات من قيمة حجمها ثمانية، فأخذت النصف الأسفل. وبدون خيارات لم يقل المترجم شيئاً، ومع -Wall حذر مرتين، مرة لكل معامل: format '%d' expects argument of type 'int', but argument 2 has type 'int64_t'، لأن GCC يعرف صيغ printf ويقارنها بأنواع المعاملات. ولكن التحذير لا يظهر إذا كانت الصيغة متغيراً لا نصاً ثابتاً، ولهذا السبب نفسه لا تمرر أبداً نصاً من مستخدم كصيغة، فـ printf(user_input) ثغرة معروفة تسمح بقراءة الذاكرة والكتابة فيها. والإصلاح الصيغ الصحيحة: %zu لـ size_t، وPRId64 من inttypes.h لـ int64_t، لأن %ld تصلح على Linux وتخطئ على Windows حيث long أربعة بايتات. والنسخة المصلحة طبعت total 5000000123 halalas, items 3.
أخطاء في اللغة نفسها Language Traps
12. نسيان break في switch: الانتقال إلى الحالة التالية Fall Through
    switch (zone) {
    case 1: fee = 1500;
    case 2: fee = 2500; break;
    default: fee = 4000;
    }
$ /tmp/b/m06
zone 1 fee: 2500
m06_fallthrough.c:7:17: warning: this statement may fall through [-Wimplicit-fallthrough=]رسوم الشحن للمنطقة الأولى 15 ريالاً، والبرنامج أخذ 25، لأن الحالة الأولى أكملت إلى الثانية بعد أن نسي المبرمج break. والخيار -Wextra يحذر من ذلك بالتحذير -Wimplicit-fallthrough. وإذا كان الانتقال مقصوداً فاكتب ذلك صراحة بالخاصية [[fallthrough]]; من C23، فيسكت التحذير ويعرف من يقرأ الكود بعدك أنك قصدته.
13. متغير بلا قيمة أولى Uninitialized Variable
static int total_of(const int *prices, int n) {
    int total;                  // whatever was on the stack
    for (int i = 0; i < n; i++) total += prices[i];
    return total;
}
$ /tmp/b/m07o0
total 3490
$ /tmp/b/m07o2
total 3490
m07_uninit.c:10:39: warning: 'total' is used uninitialized [-Wuninitialized]
==154== Conditional jump or move depends on uninitialised value(s)
==154== at 0x4011A5: main (m07_uninit.c:17)النتيجة صحيحة في البناءين، 3490، والسبب صدفة: المكان في ال Stack كان صفراً في هذا التشغيل. وهذا ما يجعل هذا الخطأ مزعجاً، فهو يعمل حتى يتغير شيء بعيد، كدالة استدعيت قبله أو مستوى تحسين أو مترجم. والمترجم حذر مع -Wall، والمحلل -fanalyzer برقم CWE-457، وValgrind أشارت إلى السطر 17 حيث استخدمت القيمة في شرط. ثم جربنا MemorySanitizer، الأداة المتخصصة في هذا النوع، وهي في Clang فقط، فواجهتنا مشكلتان حقيقيتان: الأولى أن الرابط فشل بالرسالة cannot find .../libclang_rt.msan.a، لأن مكتبة الأداة في Debian في حزمة منفصلة اسمها libclang-rt-19-dev، وبعد تثبيتها عملت وطبعت WARNING: MemorySanitizer: use-of-uninitialized-value. والثانية أنها لم تطبع اسم الملف ورقم السطر، وإنما invalid path to external symbolizer!، لأنها تبحث عن الأداة llvm-symbolizer باسمها العادي، وDebian يثبتها باسم فيه الإصدار، والحل متغير البيئة MSAN_SYMBOLIZER_PATH الذي يشير إلى مكانها. والإصلاح الحقيقي للخطأ بسيط: أعط كل متغير قيمة عند تعريفه، int total = 0;.
14. الماكرو ليس دالة Macros
#define SQUARE(x) x * x
#define MAX(a, b) ((a) > (b) ? (a) : (b))
    printf("SQUARE(1 + 2) = %d\n", SQUARE(1 + 2));
    int m = MAX(next_id++, 3);
$ /tmp/b/m08
SQUARE(1 + 2) = 5
MAX(next_id++, 3) = 6, next_id is now 7
$ /tmp/b/m08f
SQUARE(1 + 2) = 9
MAX(next_id++, 3) = 5, next_id is now 6مربع 3 صار 5، لأن المعالج المسبق ينسخ النص كما هو، فصار 1 + 2 * 1 + 2، والضرب قبل الجمع. والماكرو الثاني مكتوب بالأقواس الصحيحة، ومع ذلك أخطأ: next_id++ ظهرت مرتين في النص بعد الاستبدال، فزاد الرقم مرتين، ورجع الماكرو 6 بدلاً من 5، وأحرق الرقم 6 من الأرقام التسلسلية. ولم تكشف أي أداة الخطأين، لأن الكود بعد الاستبدال صحيح تماماً في نظر المترجم. والإصلاح في النسخة المصلحة دوال static inline، وهي بنفس سرعة الماكرو بعد التحسين، ولها أنواع، وتحسب كل معامل مرة واحدة. والقاعدة: الماكرو للثوابت التي لا تستطيع أن تكون constexpr، وللتجميع الشرطي #ifdef، وليس لما يمكن أن تكتبه دالة.
التغذية العشوائية Fuzzing: ثلاثة ملايين ونصف مدخل على قارئ الطلبات
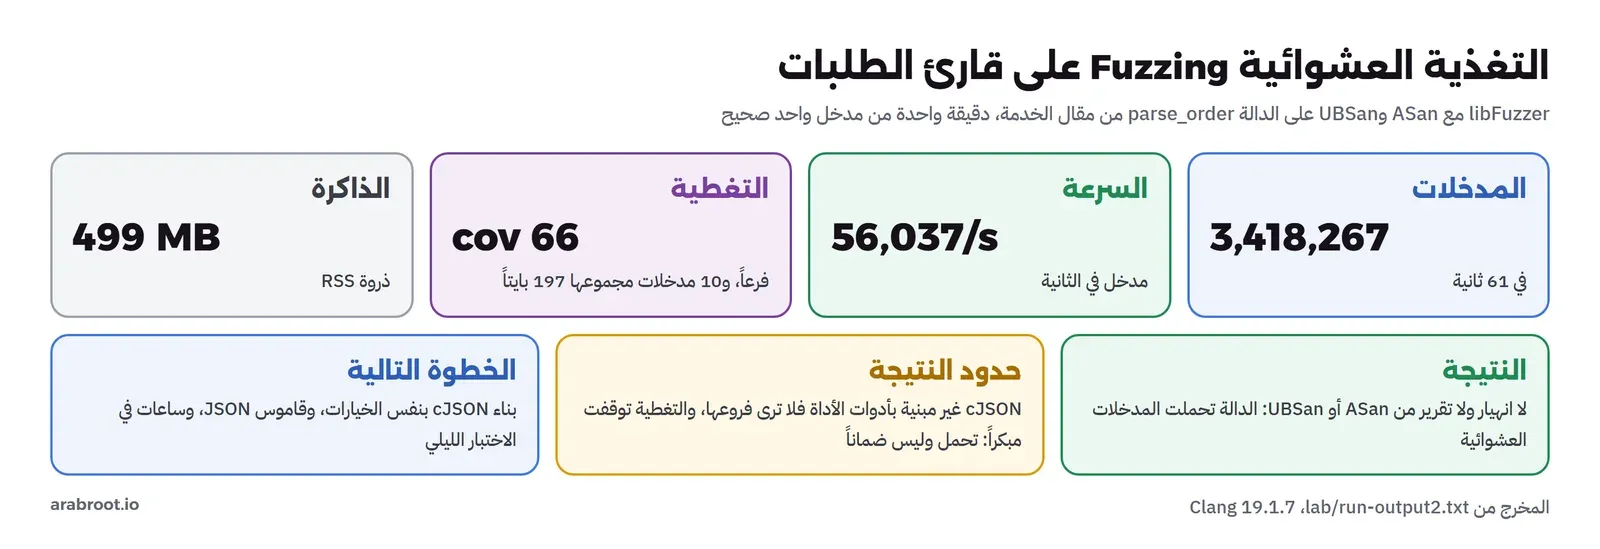
الأخطاء السابقة صنعناها بأيدينا، فعرفنا أين نبحث. ولكن كيف تجد أخطاءً لا تعرف بوجودها في كود حقيقي؟ هنا تأتي التغذية العشوائية: أداة تولد مدخلات، وتراقب أي فرع في الكود يصل إليه كل مدخل، وتحتفظ بالمدخلات التي تصل إلى فروع جديدة وتعدلها، وكل ذلك تحت ASan وUBSan، فأي تجاوز أو سلوك غير معرف يوقف التشغيل ويحفظ المدخل الذي سببه. وهذه الطريقة هي التي وجدت آلاف الأخطاء في مشاريع C المفتوحة عبر مشروع OSS-Fuzz. وجربنا libFuzzer، المدمجة في Clang، على الدالة parse_order من مقال الخدمة، وهي الدالة التي تستقبل جسم الطلب كما يرسله أي شخص على الإنترنت، فهي أول ما يجب أن يتحمل المدخلات الغريبة. ويكفي لذلك ملف صغير فيه دالة باسم محدد تستدعيها الأداة بكل مدخل:
int LLVMFuzzerTestOneInput(const uint8_t *data, size_t size) {
    OrderRequest o;
    const char *err;
    parse_order((const char *)data, size, &o, &err);
    return 0;
}
clang -g -O1 -fsanitize=fuzzer,address,undefined fuzz_parse.c src/orders.c src/money.c -o fuzz -lpq -lcjson
./fuzz -max_total_time=60 -print_final_stats=1 corpus/#524288 pulse cov: 66 ft: 74 corp: 10/197b lim: 4096 exec/s: 58254 rss: 294Mb
#2097152 pulse cov: 66 ft: 74 corp: 10/197b lim: 4096 exec/s: 55188 rss: 499Mb
#3418267 DONE cov: 66 ft: 74 corp: 10/197b lim: 4096 exec/s: 56037 rss: 499Mb
Done 3418267 runs in 61 second(s)
stat::number_of_executed_units: 3418267
stat::average_exec_per_sec: 56037
stat::peak_rss_mb: 499في دقيقة واحدة جربت الأداة 3418267 مدخلاً، حوالي 56 ألفاً في الثانية، دون أي انهيار أو تقرير من ASan أو UBSan. والرقم cov: 66 عدد الفروع التي وصلت إليها في كودنا، وقد توقف عن الزيادة مبكراً، وcorp: 10/197b يعني أنها احتفظت بعشرة مدخلات مجموعها 197 بايتاً تغطي هذه الفروع. وبدأنا من مدخل واحد صحيح هو {"items":[{"product_id":1,"qty":3}]}. وهل تعني هذه النتيجة أن الدالة بلا أخطاء؟ لا، والتفصيل أن الفروع توقفت عند 66 لأن مكتبة cJSON نفسها لم تبن بأدوات الأداة، فالأداة لا ترى فروعها، ولا تعرف كيف تولد JSON صحيحاً أعمق. والنتيجة الصحيحة أن الدالة تحملت ثلاثة ملايين ونصف مدخل عشوائي دون خطأ ذاكرة، وهذا مختلف عن «لا أخطاء فيها». والخطوة التالية في مشروع حقيقي أن تبني cJSON من المصدر مع نفس الخيارات، وأن تعطي الأداة قاموساً بكلمات JSON، وأن تتركها تعمل ساعات في خط الاختبارات الليلي لا دقيقة.
كيف تبدأ في مشروع قائم؟ Adopting the Tools
إذا شغلت -Wall -Wextra لأول مرة على مشروع C عمره سنوات، فقد تظهر لك مئات التحذيرات، والرد الطبيعي أن تطفئها وتنسى الأمر. والطريقة التي تعمل في الواقع تدريجية: ابدأ بجعل التحذيرات أخطاءً في الملفات الجديدة فقط، أو في المجلد الذي تعمل فيه، ثم اختر نوعاً واحداً من التحذيرات في كل مرة وأصلحه في كل المشروع، وابدأ بالأنواع التي تعني أخطاء حقيقية مثل -Wformat و-Wuninitialized و-Wuse-after-free، قبل الأنواع الأسلوبية مثل المتغيرات غير المستخدمة. وفي Sanitizers ابدأ ببناء الاختبارات الموجودة بـ ASan وUBSan كما هي، فكل تقرير يظهر هو خطأ حقيقي في مسار تختبره فعلاً، وإذا جاء التقرير من مكتبة خارجية لا تملكها، فلكل أداة طريقة لكتمان تقرير محدد Suppressions بملف تكتب فيه اسم الدالة، بدلاً من إطفاء الأداة كلها. والقاعدة التي ننصح بها أن يكون الهدف ألا يزيد العدد، لا أن يصل إلى صفر في أسبوع: خط الاختبارات الآلية يفشل إذا ظهر تحذير جديد أو تقرير جديد، والقديم يصلح تدريجياً.
إعدادات البناء Build Profiles: أي أداة في أي وقت؟
بعد كل ما سبق، هذا ما ننصح به لأي مشروع C، وهو ما استخدمناه في خدمة الطلبات:
| متى | الخيارات | ماذا تكشف |
|---|---|---|
| كل بناء على جهاز المطور | -std=c23 -Wall -Wextra -Wpedantic -Wconversion -g | الأخطاء 1 و2 و3 و6 و7 و10 و11 و12 و13 من هذا المقال وقت الترجمة |
| خط الاختبارات الآلية | نفس الخيارات مع -Werror، وبناء ثان بـ -fsanitize=address,undefined | كل أخطاء الذاكرة والتجاوز في المسارات التي تختبرها |
| كود فيه خيوط | بناء ثالث بـ -fsanitize=thread | سباق البيانات وترتيب الأقفال المعكوس |
| تحليل ساكن قبل الدمج | -fanalyzer وclang-tidy وCppcheck | مسارات NULL والاستخدام بعد التحرير وتجاوز الحدود دون تشغيل، ومنها الخطآن 6 و8 |
| كل ليلة | Valgrind على سيناريو طويل، وFuzzing لساعات على كل دالة تقرأ مدخلات خارجية | التسرب والمسارات التي لم يكتب لها اختبار |
| الإنتاج | -O2 -D_FORTIFY_SOURCE=3 -fstack-protector-strong | جزء من تجاوزات المخزن يوقف البرنامج بدلاً من أن يكمل |
ولاحظ أن الخطأين 5 و14 لم تكشفهما أي أداة، وأن الأدوات لم تر من الخطأ 4 إلا القطع، فهي أخطاء منطق في النصوص والماكرو، وعلاجها مراجعة الكود والاختبارات بنصوص عربية حقيقية، والقواعد التي تمنعها من البداية: لا ماكرو حيث تصلح دالة، ولا دوال بحالة مخفية، ولا قطع للنصوص على البايتات.
خطة القراءة Reading Plan: المصادر الرسمية
لا تملك C كتاباً رسمياً واحداً مثل كتاب Rust أو جولة Go، لأن اللغة معيار لا مشروع. ولكن هناك مصادر هي الأصل، وما سواها شرح لها، وهذا ترتيب نقترحه لمن انتهى من هذه المرحلة:
- توثيق المترجم الذي تستخدمه: توثيق GCC، وبالذات صفحة خيارات التحذير وصفحة خيارات الفحص. اقرأ وصف كل تحذير في
-Wallو-Wextraمرة واحدة، وستعرف أنواع الأخطاء التي يعرفها المترجم. - توثيق أدوات Clang: AddressSanitizer وUndefinedBehaviorSanitizer وThreadSanitizer وMemorySanitizer، ففيها ما تكشفه كل أداة وما لا تكشفه، وهو ما رأيناه عندما فاتت ASan التجاوز داخل الهيكل.
- صفحات الدليل man من مشروع man-pages على man7.org: لكل دالة من مكتبة C قسم
RETURN VALUEوقسمERRORS، وهما ما تحتاجه لمعالجة الأخطاء بشكل صحيح. ومعها دليل glibc لما يخص المكتبة نفسها. - المعيار نفسه: آخر مسودة لـ C23 متاحة مجاناً من لجنة WG14. لا تقرأه من أوله، وإنما ارجع إليه عندما تسأل «هل هذا معرف؟»، وابحث فيه عن الكلمة undefined.
- قواعد البرمجة الآمنة: معيار SEI CERT C من جامعة Carnegie Mellon، وهو قائمة قواعد لكل منها مثال خاطئ ومثال صحيح، والفحوص
cert-في clang-tidy مبنية عليه. - كتاب حديث مجاني: Modern C من Jens Gustedt، أحد أعضاء لجنة المعيار، ونسخته الإلكترونية متاحة مجاناً من موقعه، ويشرح C كما تكتب اليوم لا كما كتبت في الثمانينيات.
- كود حقيقي منضبط: اقرأ أسلوب نواة Linux في دليل أسلوب الكود، ثم اقرأ ملفاً من curl أو PostgreSQL، ولاحظ كيف يعالجان الأخطاء والذاكرة في كل سطر.
وللمرجع السريع أثناء الكتابة يستخدم كثيرون موقع cppreference، وهو مرجع يكتبه المجتمع وليس رسمياً، ولكنه دقيق ويذكر لكل دالة المعيار الذي أضافها.
قائمة تحقق Checklist لمراجعة كود C
- كل مقارنة نصوص بـ
strcmpمع== 0، ولاstrncpyولاstrcpyمع نص لا تعرف طوله. - كل فهرس من بايت نص يمر عبر
unsigned char، وكل ما يخص الحروف العربية يختبر بنصوص عربية حقيقية. - كل
mallocبالشكلn * sizeof *pويفحصNULL، وكلreallocفي متغير مؤقت. - لا فحص تجاوز بعد العملية، و
ckd_addوأخواتها لكل حساب قد يكبر. - لا عد تنازلي بشرط
>= 0على عدد بلا إشارة. - كل متغير له قيمة عند تعريفه، وكل
caseينتهي بـbreakأو[[fallthrough]]. - لا ماكرو حيث تصلح دالة
static inline، ولا دوال بحالة مخفية مثلstrtokفي الكود الجديد. - صيغ
printfثابتة وصحيحة:%zuوPRId64. - البناء بالإعدادات في جدول إعدادات البناء، وFuzzing لكل دالة تقرأ مدخلات من خارج البرنامج.
تدريب عملي Practice
- اكتب دالة
truncate_utf8تقطع نصاً عند عدد من البايتات دون أن تقسم حرفاً، واختبرها بالاسمقهوة عربيةوحد سبعة بايتات. - ابن cJSON من المصدر مع
-fsanitize=fuzzer-no-link,address، وأعد تجربة التغذية العشوائية، وقارن رقمcovبما رأيناه. - شغل
m04_overflowcheck.cبـ Clang بدلاً من GCC بمستويات التحسين المختلفة، ولاحظ هل يتصرف المترجم الآخر بنفس الطريقة.
الخلاصة
وصلنا لنهاية الموضوع ونهاية مرحلة لغة C، وأهم ما فيه:
- أخطاء القادمين من لغات أخرى ليست أخطاء مبتدئين، وإنما افتراضات من لغة أخرى: مقارنة النصوص، وطول النص، والفحص الذي يبقى في البرنامج، والخطأ الذي يوقفه.
- في curl كان 51 من 98 ثغرة أخطاء خاصة بـ C، فالانتباه وحده لا يكفي، والمشاريع الجادة تعتمد على طبقات من الأدوات.
- لا توجد أداة كشفت الأخطاء الأربعة عشر كلها، واثنان منها لم تكشفهما أي أداة، الماكرو و
strtok، وفي ثالث، طول النص العربي، رأت الأدوات القطع فقط ولم تر الحرف المقسوم. - فحص التجاوز بعد حدوثه حوله المترجم إلى فحص لإشارة الكمية بدون تحسين، وحذف الجمع كله مع
-O2، وكشفه UBSan وحدها، والإصلاحckd_addمن C23. - ثلاثة أخطاء ذاكرة من أربعة خرجت بنجاح أو بنتيجة صحيحة في التشغيل العادي، وكشفتها ASan وValgrind و
-fanalyzer. - الحرف العربي بايتان فوق 127، فيصبح عدداً سالباً في
char، وstrlenتعد 19 لعشرة حروف. - كل أداة لها نموذج لما تراقبه وثمن: ASan ضعف الوقت ولا ترى ما بين حقول الهيكل، وMSan ثلاثة أضعاف وتحتاج بناء كل المكتبات بها، وTSan حتى خمسة عشر ضعفاً، وValgrind لا تحتاج إعادة بناء وثمنها عشرون إلى ثلاثون ضعفاً.
- في مشروع قائم لا تحاول الوصول إلى صفر تحذيرات في أسبوع، وإنما امنع الجديد وأصلح القديم نوعاً بعد نوع.
- التغذية العشوائية جربت 3418267 مدخلاً على قارئ الطلبات في دقيقة دون خطأ، وهذه نتيجة تحمل لا ضمان.
- المصادر الرسمية: توثيق GCC وClang وصفحات man ومسودة المعيار، ومعها معيار CERT C وكتاب Modern C.
وإذا وصلت إلى هنا فقد رأيت لماذا تبقى C في نواة النظام وقواعد البيانات، ولماذا تدفع الحكومات نحو لغات آمنة الذاكرة. وفي مرحلة لغة Rust من نفس المسار ترى كيف تمنع لغة أخرى أغلب أخطاء هذا المقال وقت الترجمة:
 دليللغة C لمن يبرمج بلغة أخرى: المترجم GCC والأدواتنبني مكتبة صغيرة تحسب ضريبة الفاتورة بالهللات بأحدث GCC، ونمر على ما يختلف في C عما تعرفه، ومراحل الترجمة، والتحذيرات، وCMake، وأدوات التنسيق والفحص والاختبار والتصحيح.
 دليلالمؤشرات Pointers والذاكرة والأخطاء في لغة Cنقرأ ملف طلبات نقطة البيع بلغة C ونقف عند كل ما تسمح به اللغة دون أن تخبرك: تحويلات الأنواع، والحشو، وتجاوز المخزن، ومن يحرر الذاكرة، وكيف تصل الأخطاء بقيمة الرجوع وerrno.
 دليلالتزامن في C: الخيوط pthreads والأقفال Locksنقيس بلغة C مئة طلب شبكة وألفي ختم SHA-256 بالتسلسل وبالخيوط وبحلقة أحداث وOpenMP، ثم نصنع سباق بيانات وجموداً حقيقيين ونكشفهما بـ ThreadSanitizer ونصلحهما.
 دليلRust للمطورين: الأدوات Cargo والأساسيات في يوم واحدثبتنا Rust 1.99.1 من الصفر وبنينا مكتبة تحسب قيمة الطلب والضريبة بالهللات، ومررنا عليها بكل أداة ستكتبها يومياً مع المخرج الحقيقي، وما يفاجئ القادم من Python وJava وGo.
 دليلأمان الذاكرة Memory Safety: لماذا تدفع الحكومات نحو Rust؟ماذا طلبت الحكومات فعلاً بشأن C وC++، ولماذا تسبب أخطاء الذاكرة أغلب الثغرات الخطيرة، ومتى يكون Rust هو الاختيار الصحيح.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ الأخطاء الأربعة عشر داخل Container مبني على gcc:16.2.0-trixie مع GCC 16.2.0 وClang 19.1.7 وglibc 2.41 وValgrind 3.24.0، والتغذية العشوائية بـ libFuzzer من Clang 19.1.7 مع الحزمة libclang-rt-19-dev، على Docker Engine 29.8.0.


