


في المقالات الأربعة السابقة من سلسلة Rust بنينا للمتجر الذي نتابعه مكتبة لحساب الطلب، ثم مستورداً لأسعار المورد، ثم برامج متزامنة، ثم خدمة طلبات كاملة مع PostgreSQL. وطوال هذا الطريق كان هناك نوع من الأخطاء يتكرر، ليس لأن Rust صعبة، وإنما لأن كل واحد منا يكتب Rust في أسابيعه الأولى بيد لغته السابقة: من جاء من Python يقص النصوص بالفهرس ويحسب المال بالأرقام العشرية، ومن جاء من Java يبني كل شيء من كائنات يشير بعضها إلى بعض، ومن جاء من C يكتب حلقات بالفهرس ويحول الأنواع بلا تفكير، ومن جاء من JavaScript يكتب async وينسى أن الخيط قد يتوقف. وبعض هذه الأخطاء يرفضه المترجم برسالة واضحة، وبعضها ينبهك إليه بتحذير يسهل تجاهله، وبعضها يترجم ويعمل ويعطيك نتيجة خاطئة، أو يوقف البرنامج في الإنتاج.
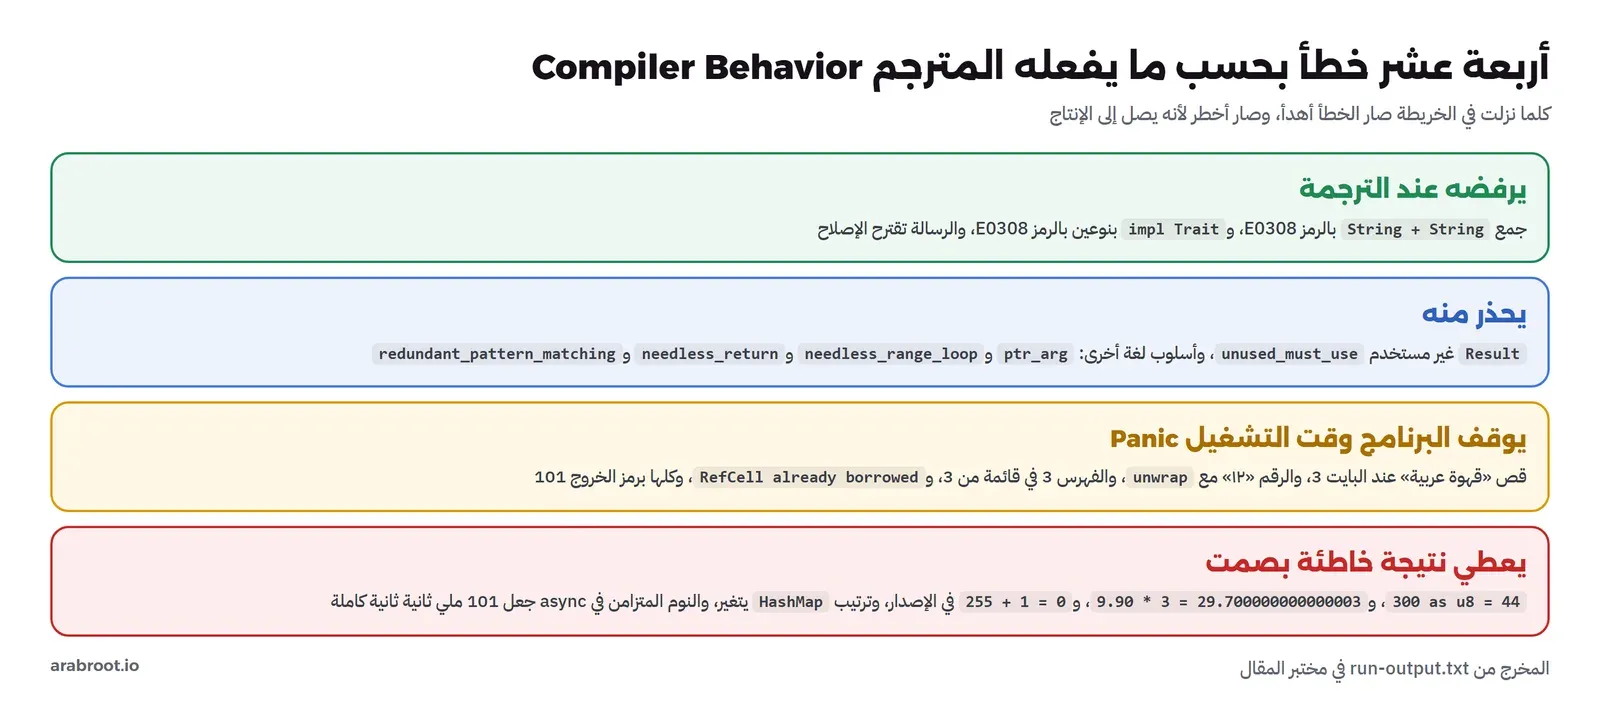
وفي هذا المقال، وهو الأخير في السلسلة، جمعنا أربعة عشر خطأ من هذا النوع، وكل خطأ له برنامج صغير حقيقي في المختبر شغلناه بالمترجم Rust 1.99.1، والمخرج الحقيقي للخطأ، ثم الطريقة التي يكتبها مبرمج Rust متمرس Idiomatic Rust ولماذا. وبعدها خطة قراءة من المصادر الرسمية فقط، مرتبة بحسب ما تحتاجه في كل مرحلة، لمن يريد أن يكمل بعد هذه السلسلة.
وسوف نناقش في هذا المقال ما يلي:
- أخطاء النصوص والأرقام: قص النص العربي بالفهرس، والأرقام العربية الهندية من النماذج، والحلقات بالفهرس، والمال بالأرقام العشرية، والتحويل
as. - أخطاء الأخطاء: تجاهل
Result، وunwrapعلى مدخلات خارجية. - أخطاء التصميم: كائنات Java في Rust بالتركيب
Rc<RefCell>، وimpl Traitبنوعين، وجمع النصوص، والاعتماد على ترتيبHashMap. - أخطاء التزامن والأداء: النوم في كود async، و
cloneفي كل مكان، والتجاوز في وضع الإصدار. - ما يقوله Clippy عن كود مكتوب بأسلوب لغة أخرى.
- جدول ملخص، وخطة قراءة رسمية بالروابط.
لماذا يبدو كود Rust غريباً في الأسابيع الأولى؟ ثلاث عادات Habits
قبل الأخطاء نفسها، من المفيد أن ترى أنها ترجع كلها تقريباً إلى ثلاث عادات تحملها من لغتك السابقة، وأن كل عادة منها كانت صحيحة هناك. العادة الأولى أن «المتغير يشير إلى كائن»، فتكتب b = a ولا تفكر من يملك البيانات، لأن جامع القمامة في Java وPython وGo يفكر عنك. وفي Rust كل قيمة لها مالك واحد، والسؤال «من يملك هذا؟» هو أول سؤال في كل تصميم، ومنه تأتي أخطاء clone في كل مكان، وRc<RefCell> في كل هيكل، والصراع مع رسائل الاستعارة. والعادة الثانية أن «الخطأ يقفز»، أي أن الاستثناء يخرج من الدالة وحده ويلتقطه شيء في الأعلى، فلا تفكر في الخطأ في كل سطر. وفي Rust الخطأ قيمة ترجع، وأنت تقرر عند كل سطر: ترجعها بالعلامة ?، أو تعالجها، أو تتجاهلها عمداً بكلمة تراها في المراجعة، ومنها تأتي أخطاء unwrap وResult المتجاهل. والعادة الثالثة أن «الأنواع تتحول وحدها»، فالرقم يصبح عشرياً، والنص فهرس حروف، والقاموس يحفظ الترتيب. وفي Rust لا شيء يتحول دون أن تكتبه، والنص بايتات، والقاموس بلا ترتيب، ومنها تأتي أخطاء as والقص والأرقام العشرية وترتيب HashMap.
والملاحظة المهمة أن المترجم يمسك أغلب أخطاء العادة الأولى، لأن الملكية هي ما بني عليه، ويمسك جزءاً من الثانية بالتحذير must_use، ولا يمسك تقريباً شيئاً من الثالثة، لأن التحويل بالكلمة as والقص بالفهرس والحساب بالأرقام العشرية كلها كود صحيح من وجهة نظر اللغة. ولهذا سوف ترى في المختبر أن أخطاء العادة الثالثة هي التي تعمل بصمت، وأن الأداة التي تمسكها هي Clippy بقواعد إضافية، كما سوف نرى في آخر المقال.
المختبر Lab: برنامج خاطئ وإصلاحه لكل خطأ
المجلد lab/wrong/ فيه برنامج لكل خطأ، وlab/fixed/ فيه نفس البرنامج بالأسلوب الصحيح، والسكربت lab/run.sh يترجم كل برنامج بالأمر rustc --edition 2024 -O ويشغله، ثم يشغل Clippy على مكتبة صغيرة في lab/clip/، ومشروعاً صغيراً بالمكتبة Tokio في lab/asyncblock/. والمخرج الكامل في lab/run-output.txt. ولاحظ أننا نترجم بالخيار -O، أي بالتحسين كما في وضع الإصدار، لأن بعض الأخطاء تتصرف بشكل مختلف فيه كما رأينا في المقال الأول.
docker run --rm -v "$PWD/lab":/lab -v slr-rs-target:/target -e CARGO_TARGET_DIR=/target slr-rs-dev:1 sh /lab/run.shأخطاء النصوص والأرقام Strings and Numbers
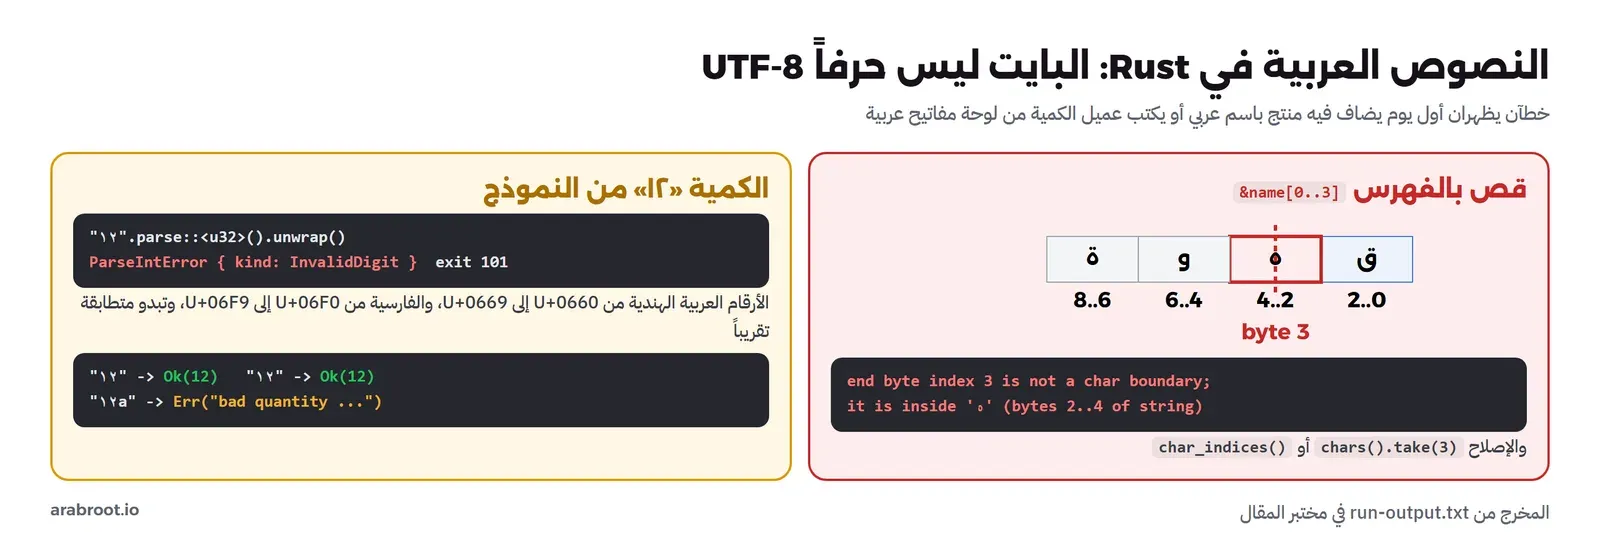
الخطأ 1: قص النص العربي بالفهرس String Slicing
في Python تكتب name[:3] فتحصل على أول ثلاثة حروف، فيكتب القادم الجديد نفس الفكرة في Rust:
let name = "قهوة عربية";
let short = &name[0..3]; // "the first 3 characters", as in Python name[:3]
thread 'main' (106) panicked at /lab/wrong/arabic_slice.rs:3:22:
end byte index 3 is not a char boundary; it is inside 'ه' (bytes 2..4 of string)
exit 101الفهرس في Rust يعد البايتات لا الحروف، كما رأينا في مقال الأنواع: الحرف العربي بايتان في UTF-8، فالبايت الثالث يقع في منتصف حرف الهاء، والنتيجة ليست نصاً صالحاً، فتوقف البرنامج. والرسالة نفسها مفيدة جداً، فهي تخبرك بالحرف الذي قطعته وبحدوده الحقيقية. وأخطر ما في هذا الخطأ أنه لا يظهر في الاختبارات إذا كانت كل أسماء المنتجات في بيانات الاختبار إنجليزية، ثم يظهر أول يوم يضاف فيه منتج باسم عربي. والطريقة الصحيحة أن تعمل بالحروف:
let short: String = name.chars().take(3).collect();
// or keep a &str without copying: find the byte offset of the 4th character
let end = name.char_indices().nth(3).map(|(i, _)| i).unwrap_or(name.len());
println!("{} (bytes 0..{end})", &name[..end]);
قهو
قهو (bytes 0..6)الطريقة الأولى تنسخ الحروف إلى نص جديد، والثانية تجد موضع الحرف الرابع بالبايت ثم تقص عنده، فتحصل على مرجع إلى النص الأصلي دون نسخ. ولاحظ أن «الحرف» نفسه ليس دائماً ما يراه القارئ: الحروف المركبة وبعض الرموز التعبيرية تتكون من أكثر من char، وإذا احتجت حدود ما يراه المستخدم فعلاً فأنت تحتاج مكتبة تقسم النص إلى عناقيد Grapheme Clusters، وهو ما يشرحه توثيق النوع str في قسمه عن UTF-8.
ماذا يحدث إذا كانت بيانات الاختبار إنجليزية؟ Test Data
قلنا إن هذا الخطأ لا يظهر في الاختبارات ببيانات إنجليزية، فلنتأكد. البرنامج lab/whatif/slice_by_data.rs فيه نفس الدالة الخاطئة، ويأخذ الأسماء من المعاملات، وشغلناه بثلاث مجموعات من البيانات:
--- English test data
coffee -> cof
dates -> dat
copper pot -> cop
exit 0
--- Arabic product names
thread 'main' (35) panicked at /lab/whatif/slice_by_data.rs:3:10:
end byte index 3 is not a char boundary; it is inside 'ه' (bytes 2..4 of string)
exit 101
--- mixed: Latin brand first
ABCقهوة -> ABC
AB قهوة -> AB
exit 0
بالأسماء الإنجليزية نجح كل شيء، وهذا ما سوف تراه في أي اختبار كتبه مطور يكتب بيانات الاختبار بالإنجليزية بحكم العادة. وبالأسماء العربية توقف البرنامج من أول اسم. والمجموعة الثالثة هي الأخطر: أسماء تبدأ باسم علامة تجارية لاتيني، مثل كثير من المنتجات في المتاجر، فنجح القص لأن أول ثلاثة بايتات حروف لاتينية، فيمر الكود في اختبار فيه اسم مختلط، ثم يتوقف مع أول منتج اسمه عربي بالكامل. ولهذا لا يكفي أن تضيف «اسماً عربياً واحداً» إلى بيانات الاختبار، وإنما تحتاج أسماء عربية بالكامل، وأسماء مختلطة، وأسماء قصيرة أقل من الطول الذي تقص عنده، وهذا هو الفرق بين اختبار يمر واختبار يحمي.
الخطأ 2: الأرقام العربية الهندية من النماذج Arabic-Indic Digits
let qty_from_form = "١٢"; // what an Arabic keyboard sends for 12
let qty: u32 = qty_from_form.parse().unwrap();
thread 'main' (47) panicked at /lab/wrong/arabic_digits.rs:3:42:
called `Result::unwrap()` on an `Err` value: ParseIntError { kind: InvalidDigit }
exit 101هنا خطآن في سطر واحد. الأول خاص بنا: لوحة المفاتيح العربية في كثير من الأجهزة ترسل الأرقام «١٢» لا «12»، والدالة parse في Rust، مثل أغلب اللغات، لا تقبل إلا الأرقام اللاتينية. والثاني عام: unwrap على مدخل من مستخدم، فتوقف البرنامج كله برمز 101 بسبب حقل في نموذج. والإصلاح دالة واحدة تحول الأرقام العربية الهندية والفارسية إلى لاتينية ثم ترجع Result برسالة واضحة:
fn parse_qty(s: &str) -> Result<u32, String> {
    let ascii: String = s
        .trim()
        .chars()
        .map(|c| match c {
            '\u{0660}'..='\u{0669}' => char::from(b'0' + (c as u32 - 0x0660) as u8), // Arabic-Indic
            '\u{06F0}'..='\u{06F9}' => char::from(b'0' + (c as u32 - 0x06F0) as u8), // Persian
            _ => c,
        })
        .collect();
    ascii.parse().map_err(|e| format!("bad quantity {s:?}: {e}"))
}
"١٢" -> Ok(12)
"12" -> Ok(12)
"۱۲" -> Ok(12)
"١٢a" -> Err("bad quantity \"١٢a\": invalid digit found in string")
"" -> Err("bad quantity \"\": cannot parse integer from empty string")ولاحظ أن الشكلين «١٢» و«۱۲» يبدوان متطابقين تقريباً، ولكنهما من نطاقين مختلفين في Unicode، الأول العربي الهندي والثاني الفارسي، وبعض لوحات المفاتيح ترسل الثاني. والمطابقة match على نطاقات الحروف '\u{0660}'..='\u{0669}' طريقة Rust النظيفة لكتابة هذا التحويل.
الخطأ 3: الحلقات بالفهرس Index Loops
let prices = vec![990, 4500, 12000];
let mut total = 0;
for i in 0..=prices.len() { // the C / Java habit: i <= len
    total += prices[i];
}
thread 'main' (388) panicked at /lab/wrong/index_loop.rs:5:24:
index out of bounds: the len is 3 but the index is 3
exit 101الخطأ القديم نفسه، <= بدلاً من <، وفي C كان سيقرأ ما بعد القائمة بصمت. وRust أوقفت البرنامج بفحص الحدود، وهذا أفضل، ولكنه ما زال توقفاً في الإنتاج. والأسلوب الصحيح ألا تكتب الفهرس أصلاً:
let total: i64 = prices.iter().sum();
for (i, p) in prices.iter().enumerate() {
    println!("line {i}: {p}");
}
والمكرر لا يمكن أن يخرج عن الحدود، فلا يحتاج المترجم فحص الحدود في كل دورة، فيكون غالباً أسرع من الحلقة بالفهرس لا أبطأ. وإذا احتجت الفهرس فعلاً فالدالة enumerate تعطيك إياه مع العنصر.
وما الذي يقابل الحالات التي كنت تحتاج فيها الفهرس فعلاً في C أو Java؟ في أغلبها يوجد مكرر مخصص في المكتبة القياسية. فإذا أردت كل عنصر مع الذي يليه، مثل مقارنة سعر اليوم بسعر الأمس، فالدالة windows(2) تعطيك أزواجاً متتالية دون أي فهرس. وإذا أردت تقسيم قائمة الطلبات إلى دفعات من مئة لإرسالها إلى قاعدة البيانات، فالدالة chunks(100) تفعل ذلك، والدفعة الأخيرة أقصر تلقائياً. وإذا أردت المرور على قائمتين معاً، مثل الأسعار والكميات، فالدالة zip تقف عند نهاية الأقصر منهما بدلاً من أن تخرج عن حدودها. وإذا كان الفهرس يأتي من الخارج، مثل رقم سطر في ملف المورد، فالدالة get(i) ترجع Option بدلاً من التوقف. والخلاصة أن الحلقة بالفهرس في Rust علامة على أن مكرراً مناسباً لم يخطر لك بعد، وClippy يقترحه في أغلب الحالات.
الخطأ 4: المال بالأرقام العشرية Floating Point Money
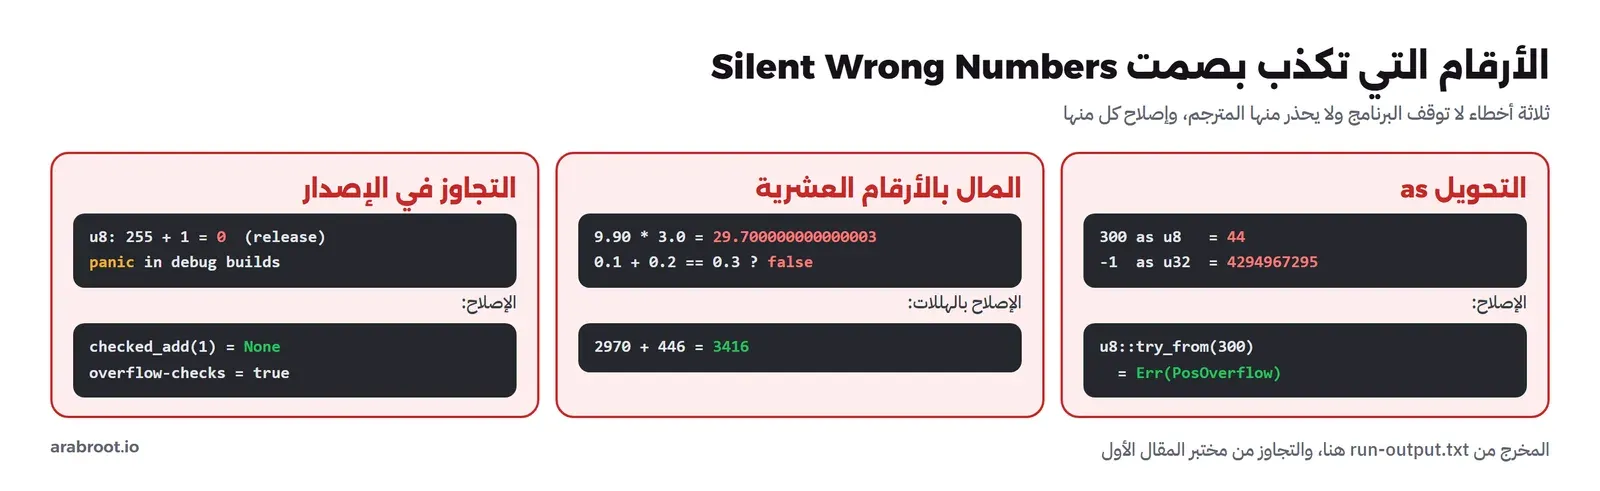
let price = 9.90_f64;
let subtotal = price * 3.0;
let vat = subtotal * 0.15;
subtotal 29.700000000000003, vat 4.455, total 34.155
rounded total 34.16
0.1 + 0.2 == 0.3 ? falseثلاث قهوات بسعر 9.90 أعطت 29.700000000000003، لأن 9.90 لا يمكن تمثيلها بدقة في النظام الثنائي، كما شرحنا في مقال الأرقام العشرية Floating Point من الداخل. والتقريب عند الطباعة أعطى 34.16 هذه المرة، ولكنه صدفة لا ضمان، فالضريبة 4.455 بالضبط على الحد بين التقريبين، وأي خطأ صغير في الاتجاه الآخر يعطي 34.15. وهذا ليس خاصاً بـ Rust، ولكن Rust لا تملك نوعاً عشرياً للمال في المكتبة القياسية مثل decimal في Python وBigDecimal في Java، فيكثر من يستخدم f64. والحل الذي استخدمناه في كل السلسلة: الهللات في i64:
subtotal 2970, vat 446, total 3416 halalasالخطأ 5: التحويل بالكلمة as يقطع بصمت Numeric Casts
let box_qty = qty as u8;      // qty is 300 at runtime
let refund_u = refund as u32; // refund is -1 at runtime
qty 300 as u8 = 44
refund -1 as u32 = 4294967295رأينا في المقالات السابقة أن Rust لا تحول بين الأرقام تلقائياً، فيتعلم القادم الجديد أن يكتب as لإسكات المترجم. ولكن as بين الأرقام لا يفحص شيئاً، كما في مرجع اللغة: الرقم 300 في u8 يقطع إلى 44، أي 300 ناقص 256، والمبلغ المسترد -1 في u32 يصبح أكثر من أربعة مليارات. ولا يوجد أي توقف ولا تحذير، حتى في وضع التطوير. والطريقة الصحيحة TryFrom عندما قد لا تتسع القيمة، وFrom عندما تتسع دائماً:
u8::try_from(300) = Err(TryFromIntError(PosOverflow))
u32::try_from(-1) = Err(TryFromIntError(NegOverflow))
i64::from(qty) = 300
والقاعدة التي نعمل بها: as بين الأرقام فقط عندما تقصد القطع، مع تعليق يقول ذلك، وtry_from في كل مكان آخر، وهو ما فعلناه في الخدمة عند كتابة المجموع في عمود int.
الخطأ 6: الاعتماد على أن التجاوز يوقف البرنامج Integer Overflow
هذا الخطأ قسناه في المقال الأول: مخزون من النوع u8 قيمته 255 زدناه واحداً، فتوقف البرنامج في وضع التطوير برسالة attempt to add with overflow، والتف إلى صفر بصمت في وضع الإصدار وطبع «stock after restock: 0». فالاختبارات التي تعمل بوضع التطوير تكشفه، والإنتاج الذي يعمل بوضع الإصدار يخفيه. والإصلاح checked_add في الحسابات المهمة، أو overflow-checks = true في [profile.release].
أخطاء التعامل مع الأخطاء Error Handling
الخطأ 7: تجاهل Result عند الكتابة must_use
fs::write("/nonexistent/dir/receipt.txt", "order 17"); // the error is silently dropped
println!("receipt saved");
warning: unused `Result` that must be used
--> /lab/wrong/unused_result.rs:4:5
|
4 | fs::write("/nonexistent/dir/receipt.txt", "order 17"); // the error is silently dropped
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: this `Result` may be an `Err` variant, which should be handled
help: use `let _ = ...` to ignore the resulting value
receipt saved
exit 0الكتابة فشلت لأن المجلد غير موجود، والبرنامج طبع «receipt saved» وخرج برمز 0. والمترجم حذر، ولكنه تحذير فقط، والبرنامج ترجم. وهذا يحدث في الواقع أكثر مما تظن: دالة لا ترجع قيمة تهمك، مثل الكتابة إلى ملف أو إرسال رسالة، فلا يخطر لك أن ترجع شيئاً منها. ولاحظ أن الاقتراح الذي يعطيه المترجم let _ = ... لا يصلح الخطأ، وإنما يقول «أعرف وأتجاهل عمداً»، وهو صحيح فقط عندما يكون التجاهل قراراً. والإصلاح أن ترجع الخطأ بالعلامة ?:
Error: Os { code: 2, kind: NotFound, message: "No such file or directory" }
exit 1
والقاعدة في الفريق: CI يعامل التحذيرات كأخطاء بالخيار -D warnings كما ذكرنا في المقال الأول، فلا يصل هذا الكود إلى الدمج أصلاً.
الخطأ 8: unwrap على كل شيء Panic in Production
رأيته في الخطأ الثاني مع الأرقام العربية، ورأيناه بالتفصيل في مقال الأنواع والأخطاء مع سعر مكتوب بفاصلة من ملف المورد: unwrap أوقف البرنامج برمز 101، وexpect أضاف رسالة، والعلامة ? رجعت بالخطأ إلى من يستطيع التعامل معه. والقاعدة المختصرة: unwrap مقبول في الاختبارات، وفي الأمثلة، وعلى شيء مستحيل الفشل فعلاً مع expect يشرح لماذا، ومرفوض على كل ما يأتي من الخارج. وفي Clippy قاعدة clippy::unwrap_used يمكنك تفعيلها لكود الإنتاج فتمنعه.
وكيف تبحث عن unwrap في مشروع قائم؟ الأمر grep -rn "unwrap()" src/ يعطيك القائمة، وستجد غالباً أن أغلبها في ثلاثة أماكن: قراءة الإعدادات عند البدء، وهي مقبولة مع expect لأن الخدمة لا تعمل دونها كما فعلنا مع DATABASE_URL في مقال الخدمة، والاختبارات، وهي مقبولة كما هي، وتحويل مدخلات المستخدم وملفات الموردين، وهي التي يجب أن تتحول إلى Result. وتمييز هذه الأماكن الثلاثة أسرع من أي قاعدة عامة تمنع unwrap في كل مكان.
أخطاء التصميم Design: كتابة لغة أخرى بكلمات Rust
الخطأ 9: كائنات Java بالتركيب Rc<RefCell>
من جاء من Java يفكر في كائنات يشير بعضها إلى بعض ويعدلها من أي مكان، وعندما يرفض المترجم ذلك يكتشف أن Rc<RefCell<T>> يسكته. فيصبح كل شيء في البرنامج مغلفاً بهذا التركيب:
let cart = Rc::new(RefCell::new(Cart { items: vec![990, 4500], total: 0 }));
let view = cart.clone();
let r = view.borrow();                     // a read borrow kept alive...
for p in r.items.iter() {
    cart.borrow_mut().total += p;          // ...while asking for a write borrow
}
thread 'main' (447) panicked at /lab/wrong/refcell.rs:11:14:
RefCell already borrowed
exit 101البرنامج ترجم دون أي اعتراض، ثم توقف وقت التشغيل. والسبب ما ذكرناه في مقال الأنواع: RefCell لا يلغي قاعدة الاستعارة، وإنما ينقل فحصها إلى وقت التشغيل، والكود هنا يقرأ السلة ويكتب فيها في نفس الوقت، وهو بالضبط ما كان المترجم سيرفضه لو لم نستخدم RefCell. فخسرنا الفحص وقت الترجمة، ودفعنا ثمن العداد والفحص وقت التشغيل، وحصلنا على توقف في الإنتاج بدلاً من خطأ ترجمة. والأسلوب الصحيح أن تسأل أولاً: من يملك السلة؟ وفي أغلب الحالات الجواب مالك واحد، والدالة التي تعدلها تأخذ &mut self:
impl Cart {
    fn recalc(&mut self) {
        self.total = self.items.iter().sum();
    }
}

let mut cart = Cart { items: vec![990, 4500], total: 0 }; // one owner, no Rc, no RefCell
cart.recalc();5490وRc<RefCell> له مكان حقيقي، في بنى مثل الرسوم البيانية أو واجهات المستخدم التي يملك فيها أكثر من طرف نفس البيانات فعلاً، ولكنه الاستثناء لا القاعدة. وإذا وجدت نفسك تكتبه في كل هيكل فهذه علامة على أن تصميم الملكية يحتاج مراجعة، وغالباً على أن البيانات يجب أن تكون في مكان واحد، مثل قائمة أو خريطة، وأن تشير إليها الأطراف الأخرى برقمها لا بمؤشر.
الخطأ 10: impl Trait بنوعين مختلفين Trait Objects
fn discount_for(code: &str) -> impl Discount {
    if code == "RAMADAN10" { Percent(10) } else { None_ }
}
error[E0308]: `if` and `else` have incompatible types
--> /lab/wrong/impl_trait.rs:8:51
|
8 | if code == "RAMADAN10" { Percent(10) } else { None_ }
| ----------- ^^^^^ expected `Percent`, found `None_`
| |
| expected because of this
help: you could change the return type to be a boxed trait object
|
7 + fn discount_for(code: &str) -> Box<dyn Discount> {
help: if you change the return type to expect trait objects, box the returned expressions
|
8 | if code == "RAMADAN10" { Box::new(Percent(10)) } else { Box::new(None_) }في Java ترجع الدالة الواجهة Discount، وأي كلاس ينفذها يصلح. وفي Rust الكتابة impl Discount لا تعني «أي نوع ينفذ السمة»، وإنما «نوع واحد محدد ينفذها، يعرفه المترجم ولا أكتبه»، لأن المترجم يحتاج أن يعرف حجم القيمة الراجعة ليضعها في ال Stack. والفرعان هنا يرجعان نوعين مختلفين بحجمين مختلفين. والمترجم اقترح الحل بالتفصيل: كائن سمة Box<dyn Discount>، أي مؤشر إلى ال Heap مع جدول دوال، وهذا هو ما تفعله Java مع كل واجهة، كما يشرح فصل كائنات السمات في الكتاب. وبعد الإصلاح أعطى خصم رمضان 10% على 3416 هللة القيمة 3075، والرمز غير المعروف 3416 كما هو. والبديل الأكثر شيوعاً في كود Rust عندما تكون الحالات معروفة ومحدودة هو تعداد enum Discount { None, Percent(i64) } مع دالة apply عليه، دون Box ولا جدول دوال.
الخطأ 11: جمع نصين String + String
error[E0308]: mismatched types
 --> /lab/wrong/string_add.rs:4:24
  |
4 |     let name = first + second;
  |                        ^^^^^^ expected `&str`, found `String`
  |
help: consider borrowing here
  |
4 |     let name = first + &second;
في كل لغة تقريباً تجمع نصين بالعلامة +، وفي Rust يرفض المترجم جمع String مع String. والسبب يرجع إلى الملكية: العامل + على النصوص يأخذ النص الأول بالملكية ويضيف إليه نسخة من الثاني المستعار، فيعيد استخدام ذاكرة الأول دون حجز جديد إذا كانت سعته تكفي. ولهذا الطرف الأيمن يجب أن يكون &str، والطرف الأيسر لا يعود صالحاً بعد الجمع. وهذا سلوك فعال ولكنه يفاجئ، ولهذا يفضل أغلب كود Rust الماكرو format! الذي لا يأخذ ملكية أي شيء:
let name = format!("{first}{second}"); // both still usable
let moved = first + &second;           // or: first is moved, second is borrowed
قهوة عربية | قهوة عربية | عربيةالخطأ 12: الاعتماد على ترتيب HashMap Iteration Order
هذا الخطأ لا يرفضه المترجم ولا يوقف البرنامج، وإنما يكسر اختباراتك يوماً بعد يوم. أضفنا خمسة منتجات إلى خريطة HashMap بنفس الترتيب، وشغلنا نفس البرنامج ثلاث مرات:
3:10 2:30 5:0 1:50 4:5
3:10 5:0 2:30 4:5 1:50
2:30 5:0 1:50 4:5 3:10
ثلاثة ترتيبات مختلفة لنفس البيانات ونفس البرنامج. والسبب أن HashMap في Rust تستخدم دالة هاش ببذرة عشوائية لكل عملية، للحماية من هجمات حجب الخدمة التي يرسل فيها المهاجم مفاتيح تتصادم كلها في نفس الخانة، فيصبح كل بحث بطيئاً. وفي Python منذ 3.7 القاموس يحفظ ترتيب الإضافة، وفي Go الترتيب عشوائي عمداً أيضاً. فمن جاء من Python يكتب اختباراً يقارن مخرجاً نصياً يمر على خريطة، فينجح مرة ويفشل مرة. والإصلاح بحسب ما تحتاجه: BTreeMap إذا أردت الترتيب بالمفتاح، وهو ما أعطى 1:50 2:30 3:10 4:5 5:0 في كل تشغيل، أو ترتيب النتيجة قبل عرضها، أو مكتبة مثل indexmap إذا أردت ترتيب الإضافة. وقد استخدمنا BTreeMap في الخدمة لسبب أهم: ترتيب الأقفال.
وفي الاختبارات تحديداً، إذا كانت الدالة ترجع HashMap لسبب وجيه، فلا تقارن نصاً مطبوعاً منها، وإنما قارن الخريطة نفسها بخريطة متوقعة بالماكرو assert_eq!، فالمساواة بين خريطتين لا تعتمد على الترتيب، أو اجمع المفاتيح في قائمة ورتبها قبل المقارنة. وبهذا يبقى الكود سريعاً بالخريطة، ويبقى الاختبار ثابتاً في كل تشغيل وعلى كل جهاز، بدلاً من اختبار ينجح على جهاز المطور ويفشل مرة كل بضعة أيام في CI فيتعلم الفريق تجاهله.
أخطاء التزامن والأداء Async and Performance
الخطأ 13: النوم أو الانتظار المتزامن داخل async Blocking
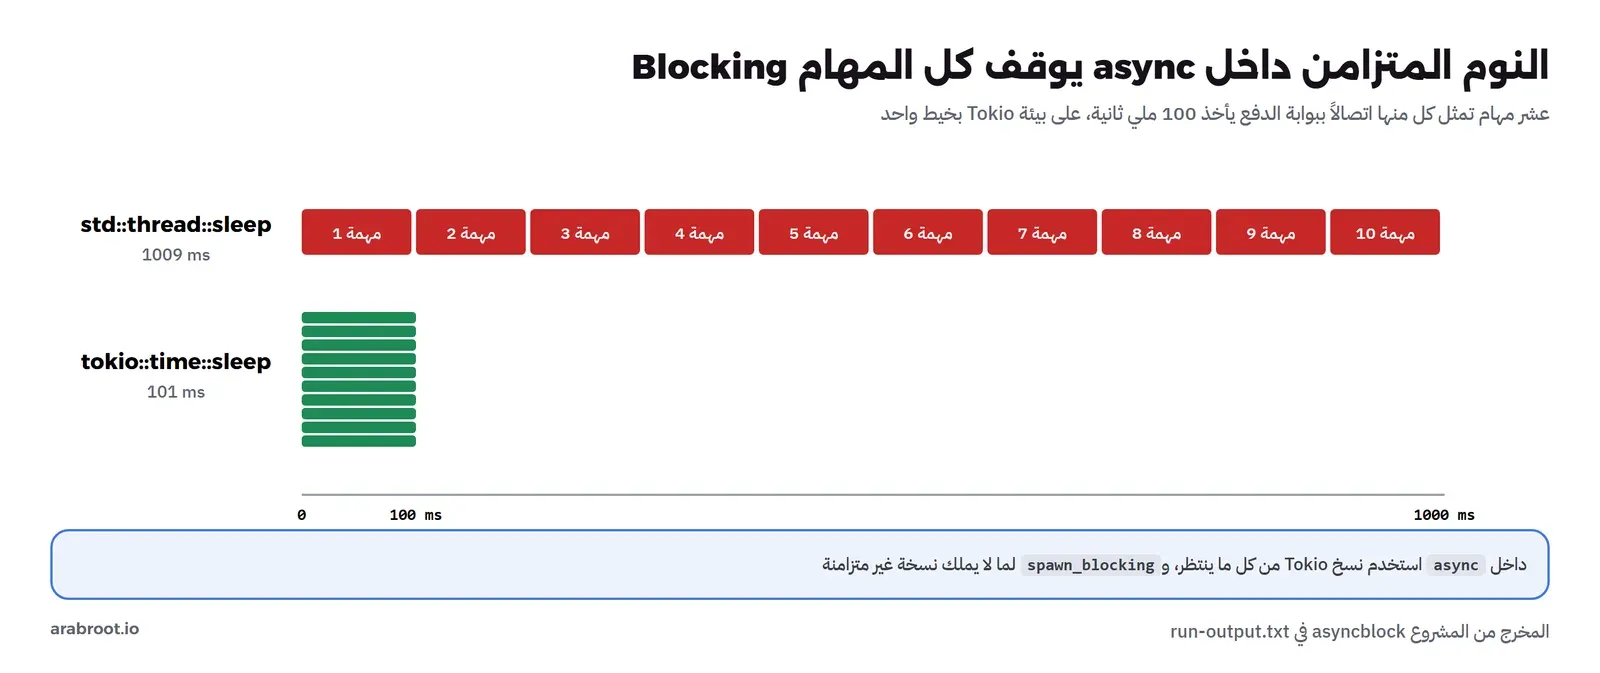
async fn pay_blocking() {
    std::thread::sleep(Duration::from_millis(100)); // blocks the only runtime thread
}

async fn pay_async() {
    tokio::time::sleep(Duration::from_millis(100)).await; // yields while waiting
}
10 tasks with std::thread::sleep: 1.009329276s
10 tasks with tokio::time::sleep: 101.241356msعشر مهام، كل منها تمثل اتصالاً ببوابة الدفع يأخذ 100 ملي ثانية، على بيئة Tokio بخيط واحد. بالنوم من المكتبة القياسية أخذت المهام العشر ثانية كاملة، أي واحدة بعد الأخرى، لأن std::thread::sleep يوقف الخيط نفسه، والخيط الوحيد هو الذي يشغل كل المهام. وبالنوم من Tokio أخذت 101 ملي ثانية، لأن المهمة تترك الخيط وتعود عندما ينتهي الوقت. وهذا هو نفس ما قسناه في مقال التزامن مع الحساب الثقيل، ولكن هنا بشكل أخفى، لأن thread::sleep لا يبدو ثقيلاً. وفي الكود الحقيقي لا يكتب أحد sleep، وإنما يستدعي مكتبة متزامنة: عميل HTTP متزامن، أو قراءة ملف بالمكتبة القياسية، أو مكتبة قاعدة بيانات متزامنة، وكلها توقف الخيط بنفس الطريقة. والقاعدة: داخل async استخدم نسخ Tokio من كل شيء ينتظر، أو spawn_blocking لما لا يملك نسخة غير متزامنة، كما في فصل async في كتاب Rust.
الخطأ 14: clone في كل مكان لإسكات المترجم Cloning
هذا الخطأ قسناه بعداد الحجوزات في مقال الأنواع والأخطاء: دالة تأخذ String وتمرر لها s.clone() لعشرة آلاف اسم منتج كلفت عشرة آلاف حجز و118890 بايتاً، والدالة التي تأخذ &str لم تكلف شيئاً، ونسخ تقرير من 400 MB أخذ 915 ملي ثانية مقابل 200 نانو ثانية للنقل. والمشكلة ليست clone نفسه، وإنما أن يصبح الرد التلقائي على كل خطأ E0382. والأسلوب الصحيح أن تقرأ الرسالة: إذا كانت الدالة تقرأ فقط فاجعلها تستعير، وإذا كانت تحتفظ بالقيمة فانقل الملكية إليها، واستخدم clone عندما تحتاج نسختين مستقلتين فعلاً.
ما يقوله Clippy عن كود بأسلوب لغة أخرى Lints
كثير من الأخطاء السابقة لا يحتاج أن تتذكره، لأن Clippy يعرفه. كتبنا في lab/clip/src/lib.rs أربع دوال صحيحة تماماً، ولكن بأسلوب Java وC، وشغلنا cargo clippy:
pub fn total(prices: &Vec<i64>) -> i64 {
    let mut sum = 0;
    for i in 0..prices.len() {
        sum += prices[i];
    }
    sum
}

pub fn label(name: &String) -> String {
    let upper = name.clone();
    return format!("[{}]", upper);
}

pub fn has_stock(stock: Option<u32>) -> bool {
    match stock {
        Some(_) => true,
        None => false,
    }
}
warning: writing `&Vec` instead of `&[_]` involves a new object where a slice will do
3 | pub fn total(prices: &Vec<i64>) -> i64 {
= note: `#[warn(clippy::ptr_arg)]` on by default
warning: the loop variable `i` is only used to index `prices`
5 | for i in 0..prices.len() {
= note: `#[warn(clippy::needless_range_loop)]` on by default
warning: unneeded `return` statement
13 | return format!("[{}]", upper);
= note: `#[warn(clippy::needless_return)]` on by default
warning: writing `&String` instead of `&str` involves a new object where a slice will do
11 | pub fn label(name: &String) -> String {
warning: redundant pattern matching
17 | / match stock {
= note: `#[warn(clippy::redundant_pattern_matching)]` on by default
help: consider using `is_some()`
warning: `clip` (lib) generated 5 warnings (run `cargo clippy --fix --lib -p clip -- ` to apply 2 suggestions)خمسة تحذيرات على أربع دوال، وكل منها درس في أسلوب Rust:
ptr_argمرتين:&Vec<T>و&Stringفي المعاملات تقيد المستدعي بلا فائدة، والنوعان الأوسع&[T]و&strيقبلان كل ما يقبله الأضيق وأكثر، مثل مصفوفة ثابتة أو نص مكتوب في الكود. وهذه قاعدة الجدول في مقال الأنواع.needless_range_loop: الحلقة بالفهرس، وهي الخطأ الثالث نفسه قبل أن يصبح خطأ.needless_return: الدالة ترجع آخر تعبير فيها، وreturnللخروج المبكر فقط، كما رأينا في جولة اللغة في المقال الأول.redundant_pattern_matching:matchبأربعة أسطر لما تقوله الدالةis_some()بكلمة. والأنواعOptionوResultفيها عشرات الدوال من هذا النوع، مثلmapوand_thenوunwrap_orوok_or، وتعلمها يختصر كثيراً من الكود.
ولاحظ السطر الأخير: cargo clippy --fix يطبق اثنين من الاقتراحات بنفسه، والباقي يحتاج قراراً منك. وقائمة كل القواعد مع أمثلتها في موقع Clippy، وتصفحها مرة واحدة يعلمك من أسلوب Rust أكثر من أي مقال.
قواعد Clippy الإضافية Restriction Lints: امسك الأخطاء الصامتة
القواعد الافتراضية في Clippy مصممة لألا تزعج، ولهذا لم تقل شيئاً عن أخطر أخطاء هذا المقال: القص بالفهرس، وas، والأرقام العشرية، وunwrap، وترتيب HashMap. ولكن Clippy يملك مجموعات أخرى معطلة افتراضياً، أهمها المجموعة الصارمة Pedantic ومجموعة القيود Restriction التي فيها قواعد تمنع أشياء صحيحة لغوياً ولكنها خطرة في سياق معين. ولكي نرى أثرها جمعنا الأخطاء الصامتة في مكتبة واحدة في lab/strict/src/lib.rs، وشغلنا Clippy مرتين: مرة بالإعدادات الافتراضية، ومرة مع جدول [lints.clippy] في ملف المشروع، وهو الطريقة الرسمية لتفعيل القواعد للمشروع كله، كما في قسم lints في كتاب Cargo:
[lints.clippy]
string_slice = "warn"
cast_possible_truncation = "warn"
cast_sign_loss = "warn"
float_arithmetic = "warn"
unwrap_used = "warn"
indexing_slicing = "warn"
iter_over_hash_type = "warn"
### default clippy, no [lints] table
### with [lints.clippy] table
warning: indexing into a string may panic if the index is within a UTF-8 character
warning: casting `i32` to `u8` may truncate the value
warning: casting `i32` to `u8` may lose the sign of the value
warning: casting `i64` to `u32` may truncate the value
--> src/lib.rs:13:5
warning: casting `i64` to `u32` may lose the sign of the value
--> src/lib.rs:13:5
warning: floating-point arithmetic detected
--> src/lib.rs:17:5
warning: used `unwrap()` on a `Result` value
--> src/lib.rs:21:5
warning: indexing may panic
--> src/lib.rs:25:5
warning: iteration over unordered hash-based type
--> src/lib.rs:30:5
warning: `strict` (lib) generated 9 warningsبالإعدادات الافتراضية لم يظهر أي تحذير على كود فيه سبعة أخطاء من هذا المقال، ومع الجدول ظهرت تسعة تحذيرات تغطيها كلها: القص الذي قد يقع داخل حرف، والتحويلان اللذان قد يقطعان أو يفقدان الإشارة، والحساب العشري، وunwrap، والفهرس الذي قد يخرج عن الحدود، والمرور على HashMap. ولماذا لا تكون هذه القواعد مفعلة دائماً؟ لأن بعضها صارم أكثر مما يناسب كل مشروع: float_arithmetic تمنع كل حساب عشري، وهذا صحيح في كود المال وخاطئ في كود يحسب إحصاءات، وindexing_slicing تمنع كل فهرس حتى الذي تعرف أنه صحيح. ولهذا الطريقة العملية أن تفعلها في الحزم التي تحتاجها، مثل حزمة الحسابات المالية في الخدمة، وأن تعطلها في السطر بالسطر #[allow(...)] مع سبب عندما يكون الاستثناء مقصوداً. وفي مساحة عمل Workspace تكتب الجدول مرة واحدة في الجذر تحت [workspace.lints.clippy]، وتورثه كل حزمة بسطر lints.workspace = true.
الخطأ المعاكس: تحسين مبكر بالأعمار ونقل الكود إلى unsafe Premature Optimization
كل الأخطاء السابقة من مبرمج يكتب Rust بسهولة لغته السابقة. وهناك نوع معاكس يظهر عند من قرأ عن أداء Rust وأراد أن يأخذه كله من اليوم الأول، وله ثلاثة أشكال. الأول هياكل مليئة بالمراجع والأعمار struct Order<'a> { name: &'a str } لتجنب نسخ نص من عشرين بايتاً، فيصبح كل نوع يلمس هذا الهيكل محتاجاً إلى عمر، وكل تعديل في التصميم يغير توقيعات عشر دوال. وقد رأينا في مقال الأنواع أن نسخ عشرة آلاف نص قصير كلف عشرة آلاف حجز صغير، وهو رقم لا يظهر في خدمة تذهب كل طلباتها إلى قاعدة البيانات كما قسنا في مقال الخدمة. والثاني استخدام unsafe لتجاوز فحص الحدود أو قواعد الاستعارة «لأنه أسرع»، وهو يلغي الضمان الذي جئت إلى Rust من أجله، ويرجع إليك أخطاء الذاكرة التي شرحنا ثمنها في مقال أمان الذاكرة، والمكسب غالباً لا يقاس، لأن المترجم يحذف فحص الحدود بنفسه في أغلب الحلقات المكتوبة بالمكررات. والثالث الأنواع العامة في كل مكان fn f<T: AsRef<str> + Into<String>> لدالة تستدعى من مكان واحد، فيطول وقت البناء ويصعب قراءة الكود دون أي فائدة. والقاعدة التي تعمل بها الفرق المتمرسة: اكتب الكود الواضح أولاً، بالملكية وString والقليل من clone، وقس، ثم حسن المكان الذي أظهره القياس فقط.
كيف ينتقل فريق كامل إلى Rust؟ Team Adoption
إذا كان المتجر سيكتب خدماته الجديدة بـ Rust، فالأخطاء في هذا المقال لن يقع فيها مطور واحد، وإنما الفريق كله في نفس الأسابيع. وما رأيناه في السلسلة يقترح ترتيباً عملياً. أولاً، الأدوات قبل الكود: ملف rust-toolchain.toml بإصدار محدد، وجدول [lints] في مساحة العمل بالقواعد التي اخترتها، وخط CI يشغل cargo fmt --check وcargo clippy -- -D warnings وcargo test، فيصبح الأسلوب قاعدة تفرضها الأداة لا رأياً في المراجعة. ثانياً، بيانات الاختبار من الواقع: أسماء منتجات عربية، وأرقام عربية هندية في المدخلات، وأسعار بالهللات تقع على حد التقريب مثل 2970، لأن نصف أخطاء هذا المقال لا يظهر ببيانات إنجليزية مرتبة. ثالثاً، المراجعة بأسئلة ثابتة: من يملك هذه القيمة؟ لماذا clone هنا؟ ماذا يحدث إذا فشل هذا السطر؟ هل يمكن أن يتوقف هذا الخيط؟ وهي الأسئلة التي يجيب عنها كل مقال في السلسلة. ورابعاً، أن يبدأ الفريق بخدمة صغيرة محددة الحدود، مثل خدمة الطلبات التي بنيناها، لا بإعادة كتابة النظام كله، وقد ناقشنا ثمن تعدد اللغات في نفس المشروع في مقال البرمجة بعدة لغات Polyglot.
كود قديم من الإنترنت: أساليب تغيرت Old Idioms
هناك مصدر أخير للأخطاء لا علاقة له بلغتك السابقة، وإنما بعمر الأمثلة التي تقرؤها. فـ Rust تتغير كل ستة أسابيع، والإجابات القديمة في المنتديات والمقالات تبقى في نتائج البحث، وأدوات الذكاء الاصطناعي تعيد إنتاجها أحياناً. والقائمة التالية تجمع ما ستقابله غالباً، وكلها تعمل أو تعطيك رسالة واضحة، ولكنها ليست الأسلوب الحالي:
- الماكرو
try!(expr): هذا ما كانت تكتبه قبل العلامة?، وأصبحتtryكلمة محجوزة في الإصدار الكبير 2018، فلا يكتب في كود جديد. وإذا رأيت سلسلة منmatchكل منها يرجع الخطأ يدوياً، فغالباً هي من نفس الزمن، والعلامة?تختصرها. - السطر
extern crate serde;في أول الملف: لم يعد ضرورياً منذ الإصدار الكبير 2018، وكتابة الاعتمادية فيCargo.tomlتكفي. - كائنات السمات دون الكلمة
dyn، مثلBox<Discount>: صارت خطأ ترجمة في الإصدار الكبير 2021، والصحيحBox<dyn Discount>كما في الخطأ العاشر. - المكتبتان
lazy_staticوonce_cellلقيمة عامة تحسب مرة واحدة: المكتبة القياسية فيها اليومOnceLockوLazyLock، فلا تحتاج اعتمادية لهذا. - مسارات Axum بالصيغة
/orders/:id: الصيغة في Axum 0.8 هي/orders/{id}، كما رأينا في مقال الخدمة، والمثال القديم يترجم ثم يتوقف عند تسجيل المسار. - عميل HTTP متزامن داخل دالة
async، مثلreqwest::blockingداخل معالج Axum: هذا هو الخطأ الثالث عشر بصورة أخرى، وفي reqwest نفسه عميل غير متزامن.
والقاعدة البسيطة لأي مثال تقرؤه: انظر إلى تاريخه وإلى الإصدار الكبير في Cargo.toml الخاص به، وإذا كان المشروع على إصدار 2015 أو 2018 فتوقع أن بعض أسلوبه تغير. والأداة cargo fix --edition تنقل مشروعاً قديماً إلى الإصدار التالي بنفسها وتغير أغلب هذه الأشياء، كما يشرح دليل الإصدارات الكبيرة. وحتى مع مثال حديث، فإن الاختبار الحقيقي هو ما فعلناه في هذا المقال: أن تشغله وترى مخرجه بنفسك قبل أن تنسخه إلى مشروعك.
جدول ملخص Summary Table: الخطأ والإصلاح
| الخطأ | ما حدث في المختبر | الأسلوب الصحيح |
|---|---|---|
| قص النص بالفهرس | توقف: not a char boundary | chars() وchar_indices() |
أرقام عربية هندية مع unwrap | توقف: InvalidDigit | تحويل الأرقام ثم Result |
| الحلقة بالفهرس | توقف: index out of bounds | iter() وenumerate() |
المال بـ f64 | 29.700000000000003 | الهللات في i64 |
التحويل as | 300 صار 44، و-1 صار 4294967295 | try_from وfrom |
| التجاوز في الإصدار | 255 + 1 = 0 بصمت | checked_add أو overflow-checks |
تجاهل Result | «receipt saved» والكتابة فشلت | العلامة ? و-D warnings |
unwrap على مدخلات خارجية | رمز 101 | Result و? |
Rc<RefCell> في كل مكان | توقف: RefCell already borrowed | مالك واحد و&mut self |
impl Trait بنوعين | E0308 عند الترجمة | Box<dyn Trait> أو enum |
String + String | E0308 عند الترجمة | format! أو a + &b |
ترتيب HashMap | ثلاثة ترتيبات في ثلاثة تشغيلات | BTreeMap أو الترتيب قبل العرض |
| النوم المتزامن في async | 1009 ملي ثانية بدلاً من 101 | tokio::time::sleep وspawn_blocking |
clone لإسكات المترجم | 10000 حجز مقابل صفر | الاستعارة في المعاملات |
| القواعد الافتراضية وحدها | صفر تحذيرات على سبعة أخطاء صامتة | جدول [lints.clippy]: تسعة تحذيرات |
خطة القراءة Reading Plan من المصادر الرسمية
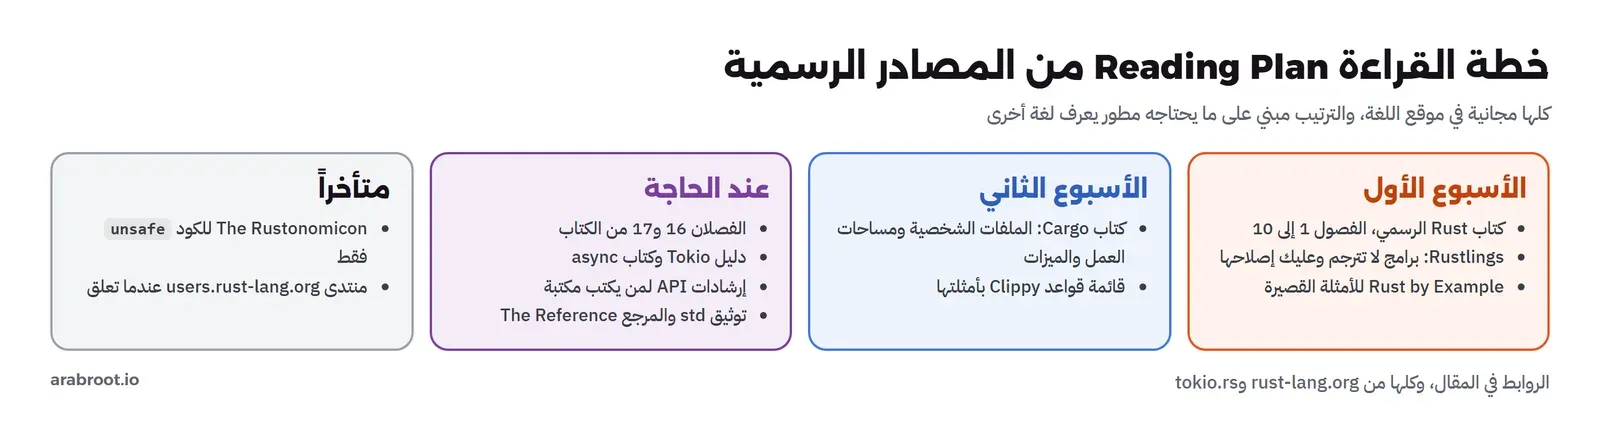
أغلب ما تحتاجه لتكمل موجود مجاناً في موقع اللغة الرسمي، وصفحة Learn Rust تجمعه. ولكن ترتيب القراءة مهم، لأن بعض هذه المصادر للمبتدئ وبعضها لمن يكتب كوداً غير آمن. والخطة التالية مبنية على ما رأيناه في السلسلة، لمطور يعرف لغة أخرى ويريد أن يكتب Rust في عمله:
- الأسبوع الأول، الأساس: كتاب Rust الرسمي The Rust Programming Language، الفصول من 1 إلى 10 على الأقل، وخاصة الفصل 4 عن الملكية والفصل 9 عن الأخطاء والفصل 10 عن الأنواع العامة والسمات والأعمار. واقرأه وأنت تكتب الأمثلة، لا قراءة فقط، ولا تتجاوز الفصل 4 قبل أن تستطيع أن تشرح لزميل لماذا رفض المترجم البرنامج
e0502_push.rsفي مقال الأنواع، فكل ما بعده مبني عليه. والفصل 8 عن المجموعات فيه شرح النصوص وUTF-8 الذي يغطي الخطأين الأول والثاني هنا. - بالتوازي، التمرين: Rustlings، وهي تمارين صغيرة من فريق Rust نفسه، كل تمرين برنامج لا يترجم وعليك إصلاحه، أي نفس ما فعلناه في هذا المقال ولكن بمئة تمرين. وRust by Example لمن يفضل الأمثلة القصيرة على الشرح الطويل.
- الأسبوع الثاني، الأدوات والمشروع: كتاب Cargo للملفات الشخصية للبناء ومساحات العمل والميزات وجدول
[lints]، وقائمة قواعد Clippy لتتعلم الأسلوب من أمثلتها. وطريقة عملية لقراءة القائمة: صفها بالمجموعة Style ثم Complexity ثم Perf، واقرأ في كل قاعدة قسمي «لماذا هذا سيئ» و«المثال»، فهي مكتوبة لتعليم الأسلوب لا لسرد القواعد فقط. وفي نفس الأسبوع اقرأ كوداً حقيقياً: مكتبة صغيرة مشهورة تستخدمها، وافتح كودها من رابط المصدر في docs.rs، ولاحظ كيف تكتب الأخطاء والاختبارات والتوثيق. - عند الحاجة إلى التزامن: الفصل 16 من الكتاب عن الخيوط، والفصل 17 عن async، ثم دليل Tokio إذا كنت ستكتب سيرفرات، وكتاب async لفهم ما تحت المستقبلات.
- عندما تكتب مكتبة يستخدمها غيرك: إرشادات تصميم الواجهات API Guidelines من فريق المكتبات، فهي تشرح لماذا تسمى الدوال كما تسمى، ومتى تنفذ أي سمة.
- كمرجع دائم: توثيق المكتبة القياسية، وفيه البحث الأسرع عن أي نوع ودالة، ومرجع اللغة The Reference عندما تحتاج القاعدة الدقيقة، مثل سلوك
asالذي ربطناه أعلاه. - متأخراً، وفقط إذا احتجته: The Rustonomicon للكود
unsafe، وهو الكتاب الذي اقتبسنا منه شرحSendوSync. ولا تبدأ به، فأغلب المطورين لا يكتبونunsafeأبداً. - وعندما تعلق: منتدى المستخدمين الرسمي، ومن عاداته أن ترفق الكود ورسالة المترجم كاملة، وهي العادة التي حاولنا أن نتبعها في هذه السلسلة.
قائمة تحقق Checklist لمراجعة كود Rust من مطور جديد
- لا يوجد قص لنصوص قد تحتوي عربية بفهارس ثابتة، والمدخلات الرقمية تقبل الأرقام العربية الهندية.
- لا توجد حلقات
for i in 0..lenإلا لسبب، وcargo clippy -- -D warningsيمر. - لا يوجد
f64في أي حساب مالي. - كل
asبين أرقام عليه تعليق يقول لماذا القطع مقصود، والباقيtry_from. - لا يوجد
unwrapعلى مدخل خارجي، ولاlet _ =علىResultدون تعليق. Rc<RefCell>أوArc<Mutex>في هيكل له تبرير مكتوب في المراجعة.- لا توجد اختبارات تعتمد على ترتيب
HashMap. - لا يوجد استدعاء متزامن يوقف الخيط داخل
async. - كل
clone()في كود يعمل مع كل طلب له سبب.
تدريب عملي
- شغل
cargo clippy -- -W clippy::pedanticعلى مشروع كتبته بنفسك، واقرأ كل تحذير جديد وقرر هل توافقه. - اكتب دالة
truncate_ar(name: &str, max: usize) -> &strتقص اسم منتج عربي إلى عدد من الحروف دون نسخ، واختبرها بأسماء عربية وإنجليزية ورموز تعبيرية. - حل تمارين Rustlings الخاصة بالملكية والأخطاء، وقارن الرسائل بما رأيته في هذه السلسلة.
حذف المختبر Cleanup
docker rmi slr-rs-dev:1 rust:1.99.1-slim-trixie
docker volume rm slr-rs-cargo slr-rs-target slr-rs-work
الخلاصة
وصلنا لنهاية الموضوع ونهاية سلسلة Rust، وأهم ما في هذا المقال:
- أغلب أخطاء الأسابيع الأولى في Rust ليست من Rust، وإنما من عادات لغة سابقة: الفهرس في النصوص والحلقات، والأرقام العشرية للمال، والكائنات المترابطة، والانتظار المتزامن.
- بعض هذه الأخطاء يرفضه المترجم برسالة تقترح الإصلاح، مثل جمع
StringمعStringوimpl Traitبنوعين، وبعضها تحذير يجب ألا يمر في CI، مثلResultغير مستخدم. - والأخطر هي التي تترجم وتعمل: قص النص العربي والأرقام العربية الهندية و
RefCellتوقف البرنامج وقت التشغيل، وasوالأرقام العشرية والتجاوز في الإصدار وترتيبHashMapوالنوم في async تعطي نتيجة خاطئة أو بطيئة بصمت. - Clippy يعرف كثيراً من هذه الأخطاء، وتشغيله بالخيار
-D warningsفي CI يعلم الفريق الأسلوب دون نقاش. - المصادر الرسمية تكفي: الكتاب وRustlings أولاً، ثم Cargo وClippy، ثم Tokio وasync عند الحاجة، والـ Rustonomicon أخيراً.
وبهذا تكتمل سلسلة Rust في مسار «لغات البرمجة عملياً»: الأدوات، والأنواع والملكية والأخطاء، والتزامن، والخدمة الحقيقية، والأسلوب. وبما أن الخدمة نفسها تبنى في كل لغات المسار، فإن أفضل خطوة بعد هذا المقال أن تقرأ نفس الخدمة بلغة تعرفها وتقارن.
 دليلRust للمطورين: الأدوات Cargo والأساسيات في يوم واحدثبتنا Rust 1.99.1 من الصفر وبنينا مكتبة تحسب قيمة الطلب والضريبة بالهللات، ومررنا عليها بكل أداة ستكتبها يومياً مع المخرج الحقيقي، وما يفاجئ القادم من Python وJava وGo.
 دليلالأنواع والملكية Ownership والأخطاء Result في Rustقسنا أحجام الأنواع وعدد الحجوزات والذاكرة عند النقل والاستنساخ، وقرأنا ست رسائل حقيقية من مدقق الاستعارة، ثم رأينا كيف تفشل Rust بالأخطاء والتوقف ورموز الخروج.
 دليلالتزامن Concurrency في Rust: الخيوط أم Tokio بالقياسقسنا مئة استدعاء بطيء وهاشاً ثقيلاً بالخيوط وTokio وRayon، ثم رأينا ما يرفضه المترجم من أخطاء التزامن وما يمر منه: مخزون بيع مرتين وجمود يظهر مرة من ثلاث.
 دليلأمان الذاكرة Memory Safety: لماذا تدفع الحكومات نحو Rust؟ماذا طلبت الحكومات فعلاً بشأن C وC++، ولماذا تسبب أخطاء الذاكرة أغلب الثغرات الخطيرة، ومتى يكون Rust هو الاختيار الصحيح.
 دليلكيف تختار لغة البرمجة Programming Language لمشروعك؟نختار لغة خدمة حقيقية بأسئلة الفريق والتوظيف والمكتبات والرخصة، ثم نكتبها بأربع لغات ونقيس البناء والحجم والذاكرة والطلبات في الثانية بأنفسنا.
 دليلالبرمجة بعدة لغات Polyglot: متى تفيد ومتى تعقد مشروعك؟نستدعي نفس الدالة من Python بخمس طرق، عبر FFI إلى C وGo وعبر HTTP وgRPC، ونقيس كلفة كل حد بين لغتين وتعقيد البناء وما يحدث عندما يتعطل الطرف الآخر.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل كل البرامج الخاطئة وإصلاحاتها بالمترجم Rust 1.99.1 (الإصدار الكبير 2024) وClippy 0.1.99 وTokio 1.54.1، داخل Container من
rust:1.99.1-slim-trixieعلى نواة Linux 5.15 (WSL2)، على Docker Engine 29.8.0.