


كل ليلة بتوقيت السعودية يعمل في خدمة الطلبات عندنا عمل مجدول يقوم بشيئين: يسأل واجهة شركة الشحن عن حالة مئة شحنة لم تصل بعد، وكل سؤال يأخذ حوالي 50 مللي ثانية، ثم يحسب بصمة SHA-256 لكل فاتورة من فواتير اليوم ويكررها ألفي مرة لتصعب محاولة تزويرها، والفواتير ألفان. والنسخة الأولى من هذا العمل كتبها زميلنا القادم من Python كما يكتبها هناك، حلقة تمر على الشحنات واحدة بعد الأخرى، ثم حلقة على الفواتير، فأخذ الجزء الأول خمس ثوان والثاني ثانيتين ونصف. وفي نفس الأسبوع حدث شيء أسوأ: في تخفيض على الهيل بعشر قطع فقط، باع المتجر عشرين قطعة، لأن عشرين عميلاً ضغطوا «اشتر» في نفس الثانية، والكود الذي يفحص المخزون ثم ينقصه كان يعمل في عشرين Goroutine في نفس الوقت.
وهذا المقال الثالث في مرحلة لغة Go للمطورين، وفيه ندخل إلى أهم ما يميز اللغة، وهو أن التزامن Concurrency جزء من اللغة نفسها بكلمة واحدة go ونوع واحد chan. وقد شرحنا الأساس العام في مقال الخيوط Threads والأقفال وasync للمبرمجين، ورأينا كيف تعمل JavaScript بخيط واحد وحلقة أحداث في مقال حلقة الأحداث Event Loop، فلن نكرر ما هو الخيط وما هو القفل، وإنما نركز على ما تفعله Go بشكل مختلف، ونقيسه بنفس المهمتين اللتين يقيسهما كل مقال تزامن في هذا المسار: مئة طلب HTTP إلى نقطة بطيئة، وبصمة SHA-256 لألفي نص بألفي دورة، بالتسلسل ثم بالتزامن.
وسوف نناقش في هذا المقال ما يلي:
- نموذج التزامن في Go وأصله في ورقة CSP، والفرق بين التزامن Concurrency والتوازي Parallelism.
- الـ Goroutine من الداخل: لماذا هي رخيصة، وكيف يوزعها المجدول Scheduler على خيوط النظام، وماذا يعني
GOMAXPROCSداخل Container. - القنوات Channels و
selectوcontext، ومتى تستخدم الحزمةsyncبدلها. - التجربة العملية: مهمة الشبكة ومهمة المعالج بالتسلسل والتزامن، بحد للمعالج وبدونه، والأرقام كما خرجت.
- حالة سباق حقيقية باعت عشرين قطعة من عشر، وكاشف السباقات، وإصلاحان.
- الجمود Deadlock بقناة وبقفلين، وتسرب الـ Goroutines وملف
goroutineleakالجديد في Go 1.27. - الأخطاء الشائعة، وجدول قرار للأداة المناسبة.
نموذج التزامن Concurrency Model في Go: من أين جاء؟
في 1978 نشر Tony Hoare ورقة بعنوان Communicating Sequential Processes، واختصارها CSP، وفكرتها أن البرنامج المتزامن مجموعة عمليات متسلسلة، كل واحدة منها بسيطة، وتتواصل فيما بينها بإرسال الرسائل، بدل أن تتشارك نفس الذاكرة وتحميها بالأقفال. وهذه الفكرة هي أصل نموذج Go، وقد عمل Rob Pike على لغات مبنية عليها قبل Go بسنوات، ولذلك تجد في قسم التزامن في Effective Go الجملة التي صارت شعار اللغة: «لا تتواصل بمشاركة الذاكرة، وإنما شارك الذاكرة بالتواصل» Do not communicate by sharing memory; instead, share memory by communicating، ويشرحها مثال كامل في مقال Share Memory By Communicating. ولكن انتبه إلى أن Go لم تمنع الطريقة الأخرى، فالأقفال والعمليات الذرية موجودة في الحزمة sync، والمكتبة القياسية نفسها تستخدمها كثيراً، والفكرة أن تختار الأداة التي تجعل الكود أوضح، كما سوف نرى في جدول القرار.
والتمييز الثاني الذي يجب أن يكون واضحاً قبل أي قياس هو الفرق بين التزامن والتوازي، ويشرحه Rob Pike في محاضرته Concurrency is not Parallelism: التزامن طريقة لتنظيم البرنامج كمهام مستقلة تتقدم في نفس الفترة، والتوازي أن تعمل عدة مهام في نفس اللحظة فعلاً على أنوية مختلفة. فمئة طلب HTTP تنتظر الشبكة تحتاج تزامناً، ولا تحتاج إلا نواة واحدة، لأن الانتظار لا يستهلك معالجاً، أما ألفا بصمة SHA-256 فتحتاج توازياً، ولا تستفيد من أي عدد من الـ Goroutines أكثر من عدد الأنوية. وهذا الفرق هو ما سوف تقوله أرقام التجربة بوضوح.
الـ Goroutine: ما هي، ولماذا هي رخيصة؟
الـ Goroutine دالة تعمل بشكل مستقل عن الدالة التي أنشأتها، وتنشئها بكتابة go قبل الاستدعاء، مثل go sendEmail(order). وهي ليست خيطاً من خيوط نظام التشغيل، وإنما وحدة يديرها الـ Runtime الخاص بـ Go، والفرق في الثمن كبير: خيط النظام في Linux يحجز مكدساً بحجم ثابت كبير، وإنشاؤه والتبديل بينه وبين غيره يمر عبر النواة، أما الـ Goroutine فتبدأ بمكدس صغير جداً يكبر عند الحاجة، والتبديل بينها يحدث داخل البرنامج نفسه دون النواة. ولكي نرى الثمن بالأرقام كتبنا البرنامج cost الذي ينشئ ألفاً ثم عشرة آلاف ثم مئة ألف Goroutine، كل واحدة تنتظر على قناة، ويقيس الذاكرة:
// How much does a parked goroutine cost?
package main

import (
	"fmt"
	"runtime"
	"sync"
	"time"
)

func main() {
	for _, n := range []int{1_000, 10_000, 100_000} {
		var before, after runtime.MemStats
		runtime.GC()
		runtime.ReadMemStats(&before)
		block := make(chan struct{})
		var wg sync.WaitGroup
		start := time.Now()
		for i := 0; i < n; i++ {
			wg.Go(func() { <-block })
		}
		spawn := time.Since(start)
		runtime.ReadMemStats(&after)
		fmt.Printf("%7d goroutines: spawn %10v, stacks %7d KiB (%.1f KiB each), Sys +%d MiB\n",
			n, spawn.Round(time.Microsecond), (after.StackInuse-before.StackInuse)>>10,
			float64(after.StackInuse-before.StackInuse)/1024/float64(n), (after.Sys-before.Sys)>>20)
		close(block)
		wg.Wait()
	}
}
والمخرج سوف يكون كما يلي:
   1000 goroutines: spawn      883µs, stacks    1984 KiB (2.0 KiB each), Sys +0 MiB
  10000 goroutines: spawn   14.931ms, stacks   19616 KiB (2.0 KiB each), Sys +28 MiB
 100000 goroutines: spawn  631.797ms, stacks  198304 KiB (2.0 KiB each), Sys +230 MiB
في المخرج أعلاه لاحظ التالي:
- كل Goroutine متوقفة أخذت 2.0 كيلوبايت من المكدسات بالضبط، في الأحجام الثلاثة، فمئة ألف Goroutine تحتاج حوالي 194 ميجابايت من المكدسات، وهذا رقم يتحمله أي سيرفر. ولو كانت خيوط نظام بمكدسات حجمها الافتراضي بالميجابايتات لاحتاجت عشرات الجيجابايتات من الذاكرة الافتراضية.
- إنشاء ألف Goroutine أخذ أقل من مللي ثانية، وعشرة آلاف حوالي 15 مللي ثانية، أي حوالي 1.5 ميكروثانية لكل واحدة. ومئة ألف أخذت 632 مللي ثانية، أي أن الثمن لكل واحدة ارتفع أربع مرات، والسبب أن البرنامج صار يطلب من النظام ذاكرة جديدة، كما يظهر في
Sys +230 MiB، وكل صفحة جديدة لها ثمن عند أول لمس. - الرقم
Sysأكبر من المكدسات، لأنه يشمل هياكل الـ Runtime لكل Goroutine وما حجزه البرنامج احتياطاً.
وهذا لا يعني أن الـ Goroutine مجانية، فكل واحدة تبقى في الذاكرة حتى تنتهي، ومئة ألف Goroutine متسربة هي مئتا ميجابايت لا يحررها جامع القمامة أبداً، كما سوف نرى في قسم التسرب.
المجدول Scheduler: كيف تعمل آلاف الـ Goroutines على خيوط قليلة؟
يوزع الـ Runtime الـ Goroutines على خيوط النظام بنموذج يسمى M:N، والأسماء في كود المجدول نفسه في الملف runtime/proc.go ثلاثة حروف: G وهي الـ Goroutine، وM وهي خيط نظام التشغيل Machine، وP وهو المعالج المنطقي Processor، وهو مورد يجب أن يملكه الخيط ليشغل كود Go. ولكل P طابور محلي من الـ Goroutines الجاهزة، والخيط الذي يملك P يأخذ منه واحدة ويشغلها، والصورة التالية تبين ذلك:
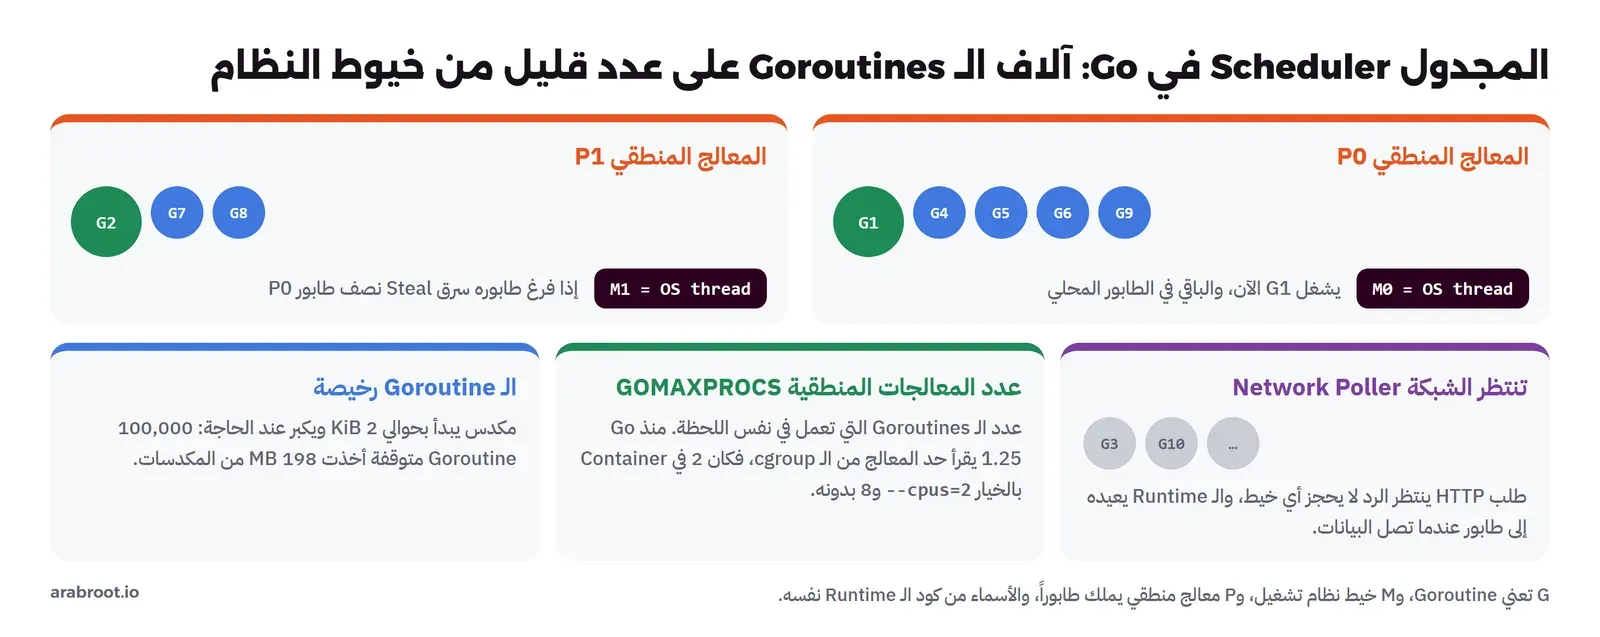
والأشياء المهمة في هذا النموذج:
- عندما تنتظر Goroutine الشبكة، مثل طلب HTTP، لا تحجز الخيط، وإنما يسجلها الـ Runtime عند مراقب الشبكة Network Poller، وهو يستخدم
epollفي Linux، ويعطي الخيط Goroutine أخرى، ثم يعيدها إلى الطابور عندما تصل البيانات. ولذلك تكتب في Go كوداً متسلسلاً عادياً يقرأ من الشبكة، دونasyncولاawaitولا Callbacks، وتحصل على نفس الفائدة التي تحصل عليها JavaScript من حلقة الأحداث. - عندما تستدعي Goroutine دالة نظام تحجز الخيط فعلاً، مثل قراءة ملف من القرص، يترك الخيط المعالج المنطقي P لخيط آخر حتى لا تتوقف بقية الـ Goroutines، وهذا سبب أن عدد خيوط النظام في برنامج Go قد يكون أكبر من
GOMAXPROCS. - عندما يفرغ طابور P يسرق Steal نصف طابور معالج آخر، فيتوزع العمل وحده.
- منذ Go 1.14 يستطيع المجدول أن يوقف Goroutine في منتصف حلقة طويلة لا تستدعي أي دالة، وهذا اسمه الإيقاف غير المتعاون Asynchronous Preemption، وقبله كانت حلقة حسابية واحدة تستطيع أن تحجز معالجاً منطقياً لنفسها.
GOMAXPROCS داخل Container
عدد المعالجات المنطقية P هو قيمة GOMAXPROCS، وكانت قبل Go 1.25 تساوي عدد الأنوية التي يراها البرنامج في الجهاز كله، حتى لو كان الـ Container محدوداً بمعالجين. وتشرح تدوينة GOMAXPROCS الواعية بالـ Container ما كان يحدث: البرنامج على جهاز بـ 64 نواة ينشئ 64 معالجاً منطقياً، ويستهلك حصة المعالجين في جزء من الفترة، فتوقفه النواة Throttling حتى نهاية الفترة، وهي عادة 100 مللي ثانية، وهذا يظهر كقفزات غريبة في زمن الاستجابة p99. ومنذ Go 1.25 يقرأ الـ Runtime حد المعالج من الـ cgroup، ويضبط GOMAXPROCS على الأقل بينه وبين عدد الأنوية، ويحدثه إذا تغير الحد. وسوف ترى في التجربة السطر GOMAXPROCS=2 NumCPU=8 داخل Container بالخيار --cpus=2، وهذا السلوك الجديد يعمل دون أي سطر منك. وقبل هذا الإصدار كانت الفرق تستخدم مكتبة automaxprocs من Uber لنفس الغرض، فإذا وجدتها في مشروع قديم يعمل على Go 1.25 أو أحدث فتستطيع أن تحذفها.
القنوات Channels: الإرسال والاستقبال والانتظار
القناة أنبوب له نوع، ترسل فيه Goroutine قيمة بالعلامة ch <- v، وتستقبلها أخرى بـ v := <-ch. والقناة التي تنشئها بـ make(chan int) بلا سعة اسمها غير مخزنة Unbuffered، والإرسال فيها ينتظر حتى يستقبل أحد، أي أن الإرسال والاستقبال يلتقيان في نفس اللحظة، وهذا يجعلها أداة تزامن وليست مجرد طابور. أما القناة المخزنة Buffered بـ make(chan int, 10) فتقبل عشر قيم دون أن ينتظر المرسل، ثم ينتظر عندما تمتلئ. وهناك قواعد قليلة يجب أن تحفظها، لأن كل خطأ فيها ينتهي بتجمد أو بتوقف البرنامج:
- الإغلاق بـ
close(ch)يقوم به المرسل وليس المستقبل، ويعني «لن يأتي شيء آخر». والاستقبال من قناة مغلقة يرجع القيمة الصفرية فوراً، والصيغةv, ok := <-chتخبرك بذلك، والحلقةfor v := range chتنتهي وحدها عند الإغلاق. - الإرسال إلى قناة مغلقة يوقف البرنامج بـ panic، والإغلاق مرتين كذلك.
- الإرسال أو الاستقبال على قناة
nilينتظر إلى الأبد، وهذا مفيد داخلselectلتعطيل حالة، وخطير في أي مكان آخر. - القناة المخزنة بسعة N تعمل كإشارة Semaphore تحدد عدد العمليات المتزامنة، وهذا ما سوف نستخدمه في التجربة لنحدد الطلبات إلى سيرفر الشحن بعشرة.
الأمر select مع context للإلغاء Cancellation
الأمر select ينتظر على عدة قنوات في نفس الوقت، وينفذ أول حالة تصبح جاهزة، وأشهر استخدام له أن تنتظر النتيجة أو انتهاء المهلة أيهما أسبق. والحزمة context هي الطريقة القياسية في Go لنقل المهلة والإلغاء عبر كل الدوال التي يمر بها الطلب، ويشرحها مقال Go Concurrency Patterns: Context: كل معالج HTTP يستلم r.Context()، وهو يلغى وحده إذا أغلق العميل الاتصال، فتمرره إلى استعلام قاعدة البيانات وإلى طلب HTTP الخارجي، فيتوقف الجميع عندما لا يعود أحد ينتظر النتيجة. والقاعدة أن كل دالة قد تنتظر شيئاً تأخذ ctx context.Context كأول معامل، وسوف نرى في قسم التسرب ماذا يحدث عندما تتجاهل Goroutine هذا السياق.
متى تستخدم الحزمة sync بدل القنوات؟
القنوات مناسبة عندما تنقل ملكية بيانات من Goroutine إلى أخرى، أو تنسق مراحل عمل مثل خط معالجة Pipeline، كما في مقال Pipelines and Cancellation. أما عندما تحمي متغيراً مشتركاً بسيطاً، مثل عداد أو خريطة ذاكرة مؤقتة، فالقفل sync.Mutex أوضح وأسرع، وهذه هي الأدوات التي سوف تستخدمها:
sync.Mutexوsync.RWMutex: قفل عادي، وقفل يسمح لعدة قراء أو كاتب واحد.sync.WaitGroup: انتظار مجموعة من الـ Goroutines حتى تنتهي، ومنذ Go 1.25 فيه الدالة WaitGroup.Go التي تنشئ الـ Goroutine وتزيد العداد وتنقصه في سطر واحد، فلا تنسىAddأوDone، وهي التي استخدمناها في كل التجارب.sync/atomic: عمليات ذرية على الأرقام، مثل العدادatomic.Int64في السيرفر البطيء أدناه.sync.Once: تنفيذ تهيئة مرة واحدة مهما كان عدد المستدعين.- errgroup من
golang.org/x/sync: مثل WaitGroup، ولكنه يرجع أول خطأ ويلغي السياق للباقين، ويستطيع أن يحدد العدد المتزامن بـSetLimit، وهو الأداة الأنسب لنداء عدة خدمات خارجية من معالج واحد.
التجربة العملية Lab: نفس المهمتين بالتسلسل والتزامن
الآن نعود إلى العمل الليلي في قصتنا، ونقيس الجزأين بنفس الطريقة التي تقاس بها كل لغة في هذا المسار، حتى تقارن الأرقام بينها.
السيرفر البطيء Slow Server وبرنامج القياس Benchmark
أولاً سيرفر يمثل واجهة شركة الشحن: كل طلب ينتظر 50 مللي ثانية ثم يرد، ويحفظ أعلى عدد من الطلبات خدمها في نفس الوقت، لنتأكد من أن التزامن حدث فعلاً عنده وليس في خيالنا:
// slow answers every request after 50 ms, like a slow upstream API,
// and remembers the highest number of requests it served at the same time.
package main

import (
	"fmt"
	"log"
	"net/http"
	"sync/atomic"
	"time"
)

func main() {
	var inflight, peak atomic.Int64
	http.HandleFunc("GET /slow", func(w http.ResponseWriter, r *http.Request) {
		n := inflight.Add(1)
		for {
			p := peak.Load()
			if n <= p || peak.CompareAndSwap(p, n) {
				break
			}
		}
		time.Sleep(50 * time.Millisecond)
		inflight.Add(-1)
		fmt.Fprintln(w, "ok")
	})
	http.HandleFunc("GET /peak", func(w http.ResponseWriter, r *http.Request) {
		fmt.Fprintln(w, peak.Swap(0))
	})
	log.Fatal(http.ListenAndServe(":8080", nil))
}
وشغلناه في Container منفصل على شبكة Docker خاصة، حتى لا يتنافس مع برنامج القياس على نفس المعالج:
docker network create slj-go-net
docker run -d --name slj-go-slow --network slj-go-net -v "$PWD:/lab" -w /lab golang:1.27.3-trixie go run ./slow
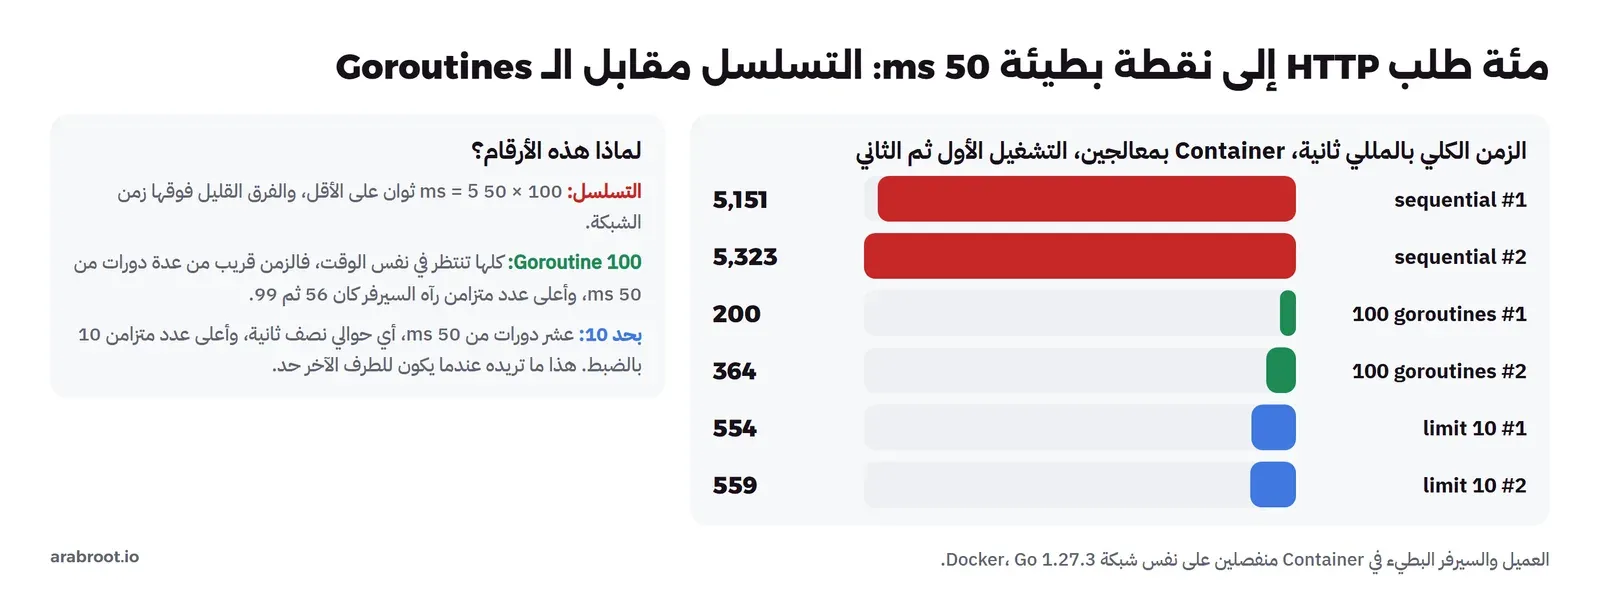
وقبل أي قياس يجب أن تتأكد من أن الطلب الواحد يأخذ فعلاً 50 مللي ثانية، والسبب مشكلة معروفة: بعض السيرفرات البسيطة، مثل http.server في Python، تكتب الترويسات ثم الجسم في عمليتي كتابة منفصلتين، فتتقاطع خوارزمية Nagle مع التأكيد المؤجل Delayed ACK في TCP وتضيف حوالي 40 مللي ثانية لكل طلب على الاتصال المفتوح، فتقيس 90 مللي ثانية وأنت تظن أنها 50. والسيرفر في net/http يكتب الرد مرة واحدة ويفعل TCP_NODELAY افتراضياً، وتأكدنا من ذلك من القياس نفسه: مئة طلب متسلسل أخذت 5,151 مللي ثانية، أي 51.5 مللي ثانية للطلب الواحد.
ثم برنامج القياس، وفيه أربع دوال مهمة. الأولى ترسل المئة طلب بالتزامن، مع حد اختياري للعدد المتزامن بقناة مخزنة:
func ioConcurrent(c *http.Client, url string, limit int) {
	var wg sync.WaitGroup
	sem := make(chan struct{}, limit)
	for i := 0; i < 100; i++ {
		wg.Go(func() {
			sem <- struct{}{}
			defer func() { <-sem }()
			if err := call(c, url); err != nil {
				panic(err)
			}
		})
	}
	wg.Wait()
}
والثانية تحسب البصمة بألفي دورة، كل دورة تأخذ ناتج السابقة:
func hashOne(s string) [32]byte {
	h := sha256.Sum256([]byte(s))
	for r := 1; r < 2000; r++ {
		h = sha256.Sum256(h[:])
	}
	return h
}
والثالثة توزع الألفي نص على عدد محدد من الـ Goroutines، كل واحدة تأخذ جزءاً متصلاً وتكتب نتائجه في مكانها من الشريحة:
func cpuConcurrent(in []string, workers int) byte {
	results := make([]byte, len(in))
	var wg sync.WaitGroup
	chunk := (len(in) + workers - 1) / workers
	for w := 0; w < workers; w++ {
		lo, hi := w*chunk, min((w+1)*chunk, len(in))
		wg.Go(func() {
			for i := lo; i < hi; i++ {
				h := hashOne(in[i])
				results[i] = h[0]
			}
		})
	}
	wg.Wait()
	var x byte
	for _, b := range results {
		x ^= b
	}
	return x
}
في الكود أعلاه لاحظ التالي:
- الحلقة لا تحتاج
w := wأوlo := lo، لأن متغيرات الحلقة جديدة في كل دورة منذ Go 1.22. - كل Goroutine تكتب في عناصر مختلفة من
results، فلا يوجد سباق ولا حاجة لقفل، وهذا أسرع بكثير من أن ترسل كل نتيجة في قناة. - القيمة
checkفي المخرج هي XOR لأول بايت من كل بصمة، وهي نفسهاd2في كل التشغيلات، وهذا تأكيد على أن الطرق المتزامنة حسبت نفس النتيجة، لأن القياس السريع الذي يحسب شيئاً خاطئاً لا قيمة له.
ثم شغلنا البرنامج في Container محدود بمعالجين مرتين، ثم مرة بلا حد:
docker run --rm --cpus=2 --network slj-go-net -v "$PWD:/lab" -w /lab golang:1.27.3-trixie go run ./bench http://slj-go-slow:8080
docker run --rm --network slj-go-net -v "$PWD:/lab" -w /lab golang:1.27.3-trixie go run ./bench http://slj-go-slow:8080
والمخرج كاملاً للتشغيلات الثلاثة:
### bench cpus=2 run 1
go1.27.3  GOMAXPROCS=2  NumCPU=8
I/O sequential (100 x 50 ms)       5150.7 ms  peak in flight 1
I/O 100 goroutines                  200.2 ms  peak in flight 56
I/O 100 goroutines, limit 10        554.3 ms  peak in flight 10
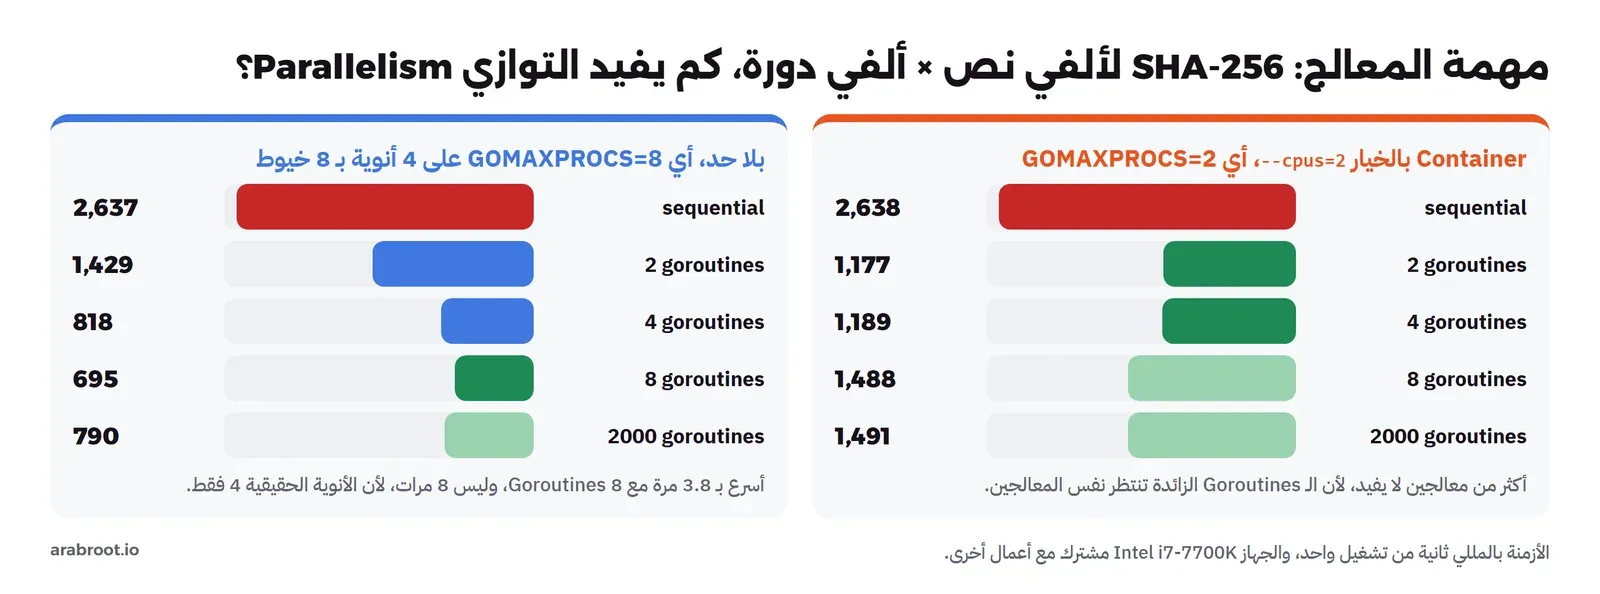
CPU sequential (2000 x 2000)       2638.1 ms  check d2
CPU 2 goroutines                   1177.1 ms  check d2
CPU 4 goroutines                   1188.5 ms  check d2
CPU 8 goroutines                   1487.9 ms  check d2
CPU 2000 goroutines                1490.7 ms  check d2

### bench cpus=2 run 2
go1.27.3  GOMAXPROCS=2  NumCPU=8
I/O sequential (100 x 50 ms)       5322.9 ms  peak in flight 1
I/O 100 goroutines                  364.3 ms  peak in flight 99
I/O 100 goroutines, limit 10        559.2 ms  peak in flight 10
CPU sequential (2000 x 2000)       2745.9 ms  check d2
CPU 2 goroutines                   1364.9 ms  check d2
CPU 4 goroutines                   1352.5 ms  check d2
CPU 8 goroutines                   1165.5 ms  check d2
CPU 2000 goroutines                1217.6 ms  check d2

### bench no cpu limit
go1.27.3  GOMAXPROCS=8  NumCPU=8
I/O sequential (100 x 50 ms)       5300.8 ms  peak in flight 1
I/O 100 goroutines                  162.4 ms  peak in flight 57
I/O 100 goroutines, limit 10        524.9 ms  peak in flight 10
CPU sequential (2000 x 2000)       2637.1 ms  check d2
CPU 2 goroutines                   1429.3 ms  check d2
CPU 4 goroutines                    818.2 ms  check d2
CPU 8 goroutines                    694.6 ms  check d2
CPU 2000 goroutines                 790.2 ms  check d2
مهمة الشبكة I/O: من خمس ثوان إلى 200 مللي ثانية
ولنقرأ أسطر مهمة الشبكة:
- التسلسل أخذ 5,151 ثم 5,323 مللي ثانية، و
peak in flight 1، أي أن السيرفر لم ير أكثر من طلب واحد في أي لحظة، وهذا هو الحد الأدنى الذي تفرضه الفيزياء: مئة مرة 50 مللي ثانية. - مئة Goroutine بلا حد أخذت 200 ثم 364 مللي ثانية، وهذا أكثر من 50 مللي ثانية التي تتوقعها لو بدأت كل الطلبات معاً. والسطر
peak in flight 56يشرح السبب: في التشغيل الأول لم يصل إلى السيرفر في أي لحظة أكثر من 56 طلباً، لأن العميل يفتح اتصال TCP جديداً لكل طلب لا يجد اتصالاً فارغاً، وفتح الاتصالات يأخذ وقتاً، فوصلت الطلبات على دفعات. وفي التشغيل الثاني وصل العدد إلى 99 ولكن الزمن كان أطول، لأن الجهاز كان أكثر انشغالاً في تلك اللحظة. والدرس أن الرقم الذي تقيسه في تجربة الشبكة يتضمن ثمن الاتصالات، وليس ثمن اللغة وحده. - بحد عشرة أخذ 554 و559 مللي ثانية، وهي أثبت الأرقام، لأنها تقريباً عشر دفعات من 50 مللي ثانية، والسيرفر رأى عشرة بالضبط. وهذا هو الشكل الذي تريده مع شركة الشحن الحقيقية، فأغلب الواجهات الخارجية لها حد للطلبات المتزامنة أو في الثانية، وإرسال مئة طلب دفعة واحدة قد ينتهي بالرد 429 أو بحظر حسابك.
ولاحظ أن الكود الذي يرسل الطلب في call متسلسل تماماً، يكتب الطلب ثم يقرأ الرد، ولا يوجد فيه await، والتزامن كله في سطرين: wg.Go والقناة. وهذا هو الفرق العملي عن Python وJavaScript، حيث يجب أن تكون كل دالة في الطريق غير متزامنة async حتى تستفيد من الانتظار، وهي المشكلة التي يسميها الناس «تلوين الدوال» Function Coloring.
مهمة المعالج CPU: التوازي Parallelism حتى عدد الأنوية
وفي مهمة المعالج القصة مختلفة تماماً:
- التسلسل أخذ حوالي 2.64 ثانية في الحالات الثلاث، وهذا منطقي، لأن Goroutine واحدة تستخدم نواة واحدة مهما كان عدد الأنوية المتاحة.
- في الـ Container المحدود بمعالجين نزل الزمن إلى 1,177 مللي ثانية مع Goroutine اثنتين، أي أسرع 2.2 مرة، والرقم أكبر قليلاً من الضعف المتوقع بسبب تذبذب الجهاز بين القياسين. ثم لم يتحسن مع أربع، وصار أسوأ مع ثمان وألفين في التشغيل الأول، لأن الـ Goroutines الزائدة تنتظر نفس المعالجين وتضيف تبديلاً بينها. وفي التشغيل الثاني انعكس ترتيب هذه الأرقام الصغيرة، وهذا يعني أن الفرق بينها ضمن التذبذب، والخلاصة الثابتة أن ما بعد اثنتين لا يفيد.
- بلا حد صار
GOMAXPROCS=8، ونزل الزمن إلى 818 مع أربع و695 مع ثمان، أي أسرع 3.8 مرة. ولماذا ليس 8 مرات؟ لأن المعالج Intel i7-7700K فيه أربع أنوية حقيقية فقط، وكل نواة تشغل خيطين بتقنية Hyper-Threading يتقاسمان نفس وحدات الحساب، فالخيط الثاني في كل نواة يعطي فائدة صغيرة في حساب كثيف مثل SHA-256. - ألفا Goroutine، واحدة لكل نص، أبطأ قليلاً من ثمان، لأن المجدول يدير ألفي مهمة بلا فائدة، ولكن الفرق صغير جداً، وهذا يبين أن إنشاء Goroutine لكل عنصر ليس كارثة في Go كما يكون إنشاء خيط لكل عنصر في Java التقليدية. ومع ذلك فالشكل الصحيح لمهمة المعالج هو عدد من الـ Workers يساوي
runtime.GOMAXPROCS(0).
وقد يتساءل البعض: لماذا لا يوجد هنا ما يشبه قفل GIL في Python؟ والإجابة أن Go لا تحتاجه، فالـ Runtime مصمم من البداية ليشغل كود المستخدم على عدة خيوط في نفس الوقت، وحماية البيانات المشتركة مسؤوليتك أنت بالقنوات أو الأقفال، ولذلك جاءت السرعة 3.8 مرة دون أي عمليات منفصلة Processes كما تحتاج Python تقليدياً، ودون worker_threads كما تحتاج Node.js، وقد قارنا هذه النماذج في مقال الخيوط.
ماذا يحدث إذا شغلت نفس البرنامج دون حد للمعالج CPU Limit؟
السطر الأول في كل تشغيل هو الجواب: GOMAXPROCS=2 NumCPU=8 مع --cpus=2، وGOMAXPROCS=8 NumCPU=8 بدونه. فالبرنامج يرى ثماني أنوية في الحالتين، ولكن الـ Runtime قرأ الحد من الـ cgroup في الحالة الأولى فأنشأ معالجين منطقيين فقط، كما وعدت ملاحظات إصدار Go 1.25. ولو شغلت نفس الكود بإصدار أقدم من 1.25، أو ضبطت GOMAXPROCS=8 بنفسك داخل الـ Container المحدود، فسوف تعمل ثمانية خيوط على حصة معالجين، وتستهلك الحصة في أول ربع من كل فترة، ثم توقفها النواة بقية الفترة، وفي مهمة المعالج قد لا ترى فرقاً كبيراً في الزمن الكلي، ولكن في سيرفر HTTP تظهر هذه التوقفات كطلبات تأخذ 100 مللي ثانية إضافية بلا سبب واضح. لذلك لا تضبط GOMAXPROCS يدوياً في الـ Container إلا إذا كنت تعرف لماذا.
حالة السباق Race Condition: عشرون مشترياً على عشر قطع
الآن الحادثة الثانية في قصتنا، التخفيض الذي باع عشرين قطعة من عشر. والبرنامج race يعيدها بأبسط شكل: مخزن فيه عشر قطع، وعشرون Goroutine تحاول كل منها أن تشتري واحدة، والدالة تفحص المخزون ثم تنقصه، وبين الفحص والتنقيص انتظار مللي ثانية يمثل أي عمل حقيقي، مثل التحقق من الدفع:
type Store struct {
	mu    sync.Mutex
	stock int
}

func (s *Store) BuyUnsafe() bool {
	if s.stock > 0 {
		time.Sleep(time.Millisecond) // the gap between "check" and "act"
		s.stock--
		return true
	}
	return false
}

func (s *Store) BuyMutex() bool {
	s.mu.Lock()
	defer s.mu.Unlock()
	if s.stock > 0 {
		time.Sleep(time.Millisecond)
		s.stock--
		return true
	}
	return false
}
والمخرج بثلاثة تشغيلات بدون كاشف السباقات:
mode=unsafe sold=20 stock left=-10
mode=unsafe sold=20 stock left=-10
mode=unsafe sold=20 stock left=-10
عشرون عملية بيع ومخزون سالب بعشر قطع، في كل مرة. والسبب أن العشرين Goroutine فحصت المخزون كلها تقريباً قبل أن تنقصه أي واحدة منها، فرأت كلها أن هناك قطعاً متوفرة، وهذا النمط اسمه «افحص ثم نفذ» Check-Then-Act، وهو أشهر شكل لحالة السباق. ولاحظ أن الانتظار لمللي ثانية جعل الخطأ يظهر في كل تشغيل، أما في الكود الحقيقي فالفجوة أقصر، فيظهر الخطأ مرة في الألف، وهذا أسوأ، لأنه يمر من الاختبارات ويظهر في يوم التخفيض.
وGo تأتي مع كاشف سباقات Race Detector مبني على أداة ThreadSanitizer، وتشغله بالخيار -race، ويشرحه دليل Data Race Detector:
go run -race ./race unsafeوأول جزء من المخرج:
==================
WARNING: DATA RACE
Write at 0x00c0000180d8 by goroutine 13:
  main.(*Store).BuyUnsafe()
      /lab/race/main.go:21 +0x108
  main.main.func2()
      /lab/race/main.go:66 +0x125

Previous read at 0x00c0000180d8 by goroutine 24:
  main.(*Store).BuyUnsafe()
      /lab/race/main.go:19 +0xc9
  main.main.func2()
      /lab/race/main.go:66 +0x125

Goroutine 13 (running) created at:
  sync.(*WaitGroup).Go()
      /usr/local/go/src/sync/waitgroup.go:238 +0x72

Goroutine 24 (running) created at:
  sync.(*WaitGroup).Go()
      /usr/local/go/src/sync/waitgroup.go:238 +0x72
==================
==================
WARNING: DATA RACE
Read at 0x00c0000180d8 by goroutine 21:
  main.(*Store).BuyUnsafe()
      /lab/race/main.go:21 +0xf0
  main.main.func2()
      /lab/race/main.go:66 +0x125

Previous write at 0x00c0000180d8 by goroutine 26:
  main.(*Store).BuyUnsafe()
      /lab/race/main.go:21 +0x108
  main.main.func2()
      /lab/race/main.go:66 +0x125

Goroutine 21 (running) created at:
  sync.(*WaitGroup).Go()
      /usr/local/go/src/sync/waitgroup.go:238 +0x72

exit=141
ونهايته عندما شغلناه مرة ثانية دون أن نقص المخرج:
exit=1
3
mode=unsafe sold=20 stock left=-5
Found 3 data race(s)
exit status 66
في المخرج أعلاه لاحظ التالي:
- كل تقرير فيه عمليتان على نفس العنوان في الذاكرة
0x00c0000180d8، وهو الحقلstock: كتابة من Goroutine 13 في السطر 21 وهوs.stock--، وقراءة سابقة من Goroutine 24 في السطر 19 وهوif s.stock > 0، أي الفحص والتنفيذ بالضبط. - كل Goroutine معها المكان الذي أنشئت فيه، وهنا
sync.(*WaitGroup).Go()، وفي كود حقيقي سوف ترى سطرك أنت. - في النهاية
Found 3 data race(s)ورمز الخروج 66، وهو رمز مخصص يجعل خط CI يفشل. وفي هذا التشغيل بقي المخزون-5وليس-10، لأن الكاشف يبطئ البرنامج فيغير التوقيت، وهذا يذكرك بأن نتيجة السباق نفسها غير ثابتة. - الكاشف يجد السباقات التي تحدث فعلاً أثناء التشغيل فقط، فهو لا يحلل الكود، لذلك شغل به الاختبارات التي تمر على الطرق المتزامنة، وليس الاختبارات الفردية فقط، وهو يضاعف الذاكرة والزمن عدة مرات، فلا تشغل به الإنتاج في العادة.
وحالات السباق ليست مشكلة نظرية في Go بسبب سهولة إنشاء الـ Goroutines، ففي ورقة A Study of Real-World Data Races in Golang المنشورة في مؤتمر PLDI عام 2022، شغل مهندسو Uber هذا الكاشف على 46 مليون سطر من كود Go في 2,100 خدمة، فوجدوا أكثر من ألفي حالة سباق، وأصلحوا أكثر من ألف منها خلال ستة أشهر بأيدي 210 مطورين. ومن ملاحظاتهم أن سهولة التزامن في اللغة نفسها، مع بعض أنماطها مثل التقاط المتغيرات في الدوال المجهولة، تجعل السباق شائعاً، وأن تشغيل الكاشف في CI بشكل منتظم هو ما جعل العدد ينخفض.
والإصلاح الأول قفل يجعل الفحص والتنقيص خطوة واحدة لا يدخلها اثنان معاً، وهو الدالة BuyMutex في نفس الملف. والثاني بأسلوب CSP: Goroutine واحدة تملك المخزون، والباقي يرسلون لها طلباً في قناة وينتظرون الجواب، فلا يلمس المخزون إلا مالكه:
	var reqs chan chan bool
	if mode == "channel" {
		// one goroutine owns the stock; the others ask it through a channel
		reqs = make(chan chan bool)
		go func() {
			for reply := range reqs {
				if s.stock > 0 {
					s.stock--
					reply <- true
				} else {
					reply <- false
				}
			}
		}()
	}
والمخرج مع الكاشف في الحالتين:
mode=mutex sold=10 stock left=0
exit=0
mode=channel sold=10 stock left=0
exit=0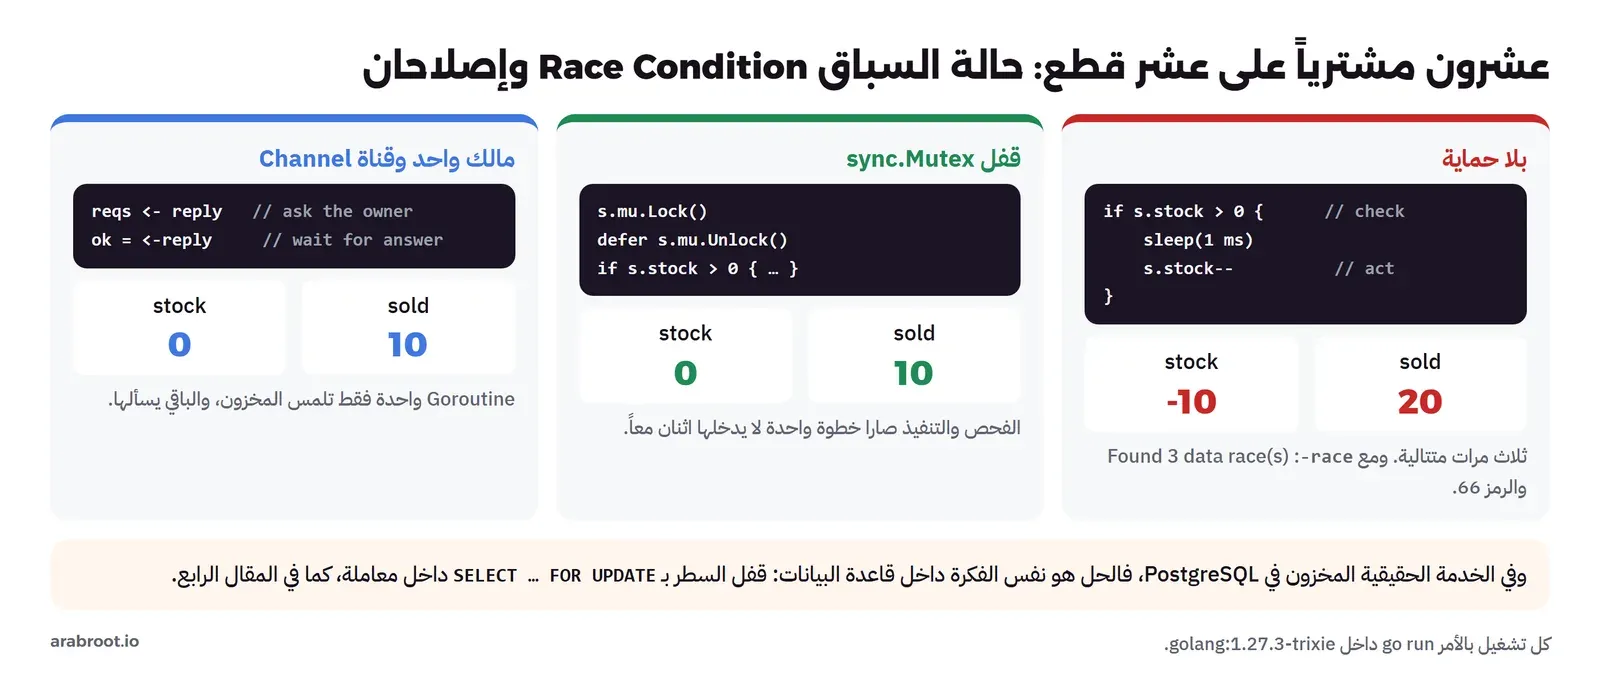
عشر عمليات بيع، والمخزون صفر، والكاشف لم يجد شيئاً. ولكن تذكر أن هذا المخزون في ذاكرة برنامج واحد، والمخزون الحقيقي في خدمة الطلبات في PostgreSQL، وقد تعمل الخدمة بنسختين خلف موزع طلبات، فلا ينفع أي قفل في ذاكرة Go، والحل هو نفس الفكرة داخل قاعدة البيانات: قفل السطر بـ SELECT … FOR UPDATE داخل المعاملة، وهو ما سوف نبنيه ونختبره بعشرين طلباً متزامناً في المقال الرابع، وقد شرحنا أقفال قاعدة البيانات نفسها في مقال الأقفال Locks والجمود Deadlock في قواعد البيانات.
الجمود Deadlock: نصنعه ثم نصلحه
الجمود أن تنتظر Goroutine شيئاً لن يحدث أبداً، وأبسط شكل له في Go قناة غير مخزنة ترسل فيها ولا يستقبل أحد:
	case "channel":
		done := make(chan bool)
		done <- true // nobody is receiving yet
		fmt.Println(<-done)
والمخرج سوف يكون كما يلي:
fatal error: all goroutines are asleep - deadlock!

goroutine 1 [chan send]:
main.main()
	/lab/deadlock/main.go:48 +0x31b
exit status 2
exit=1
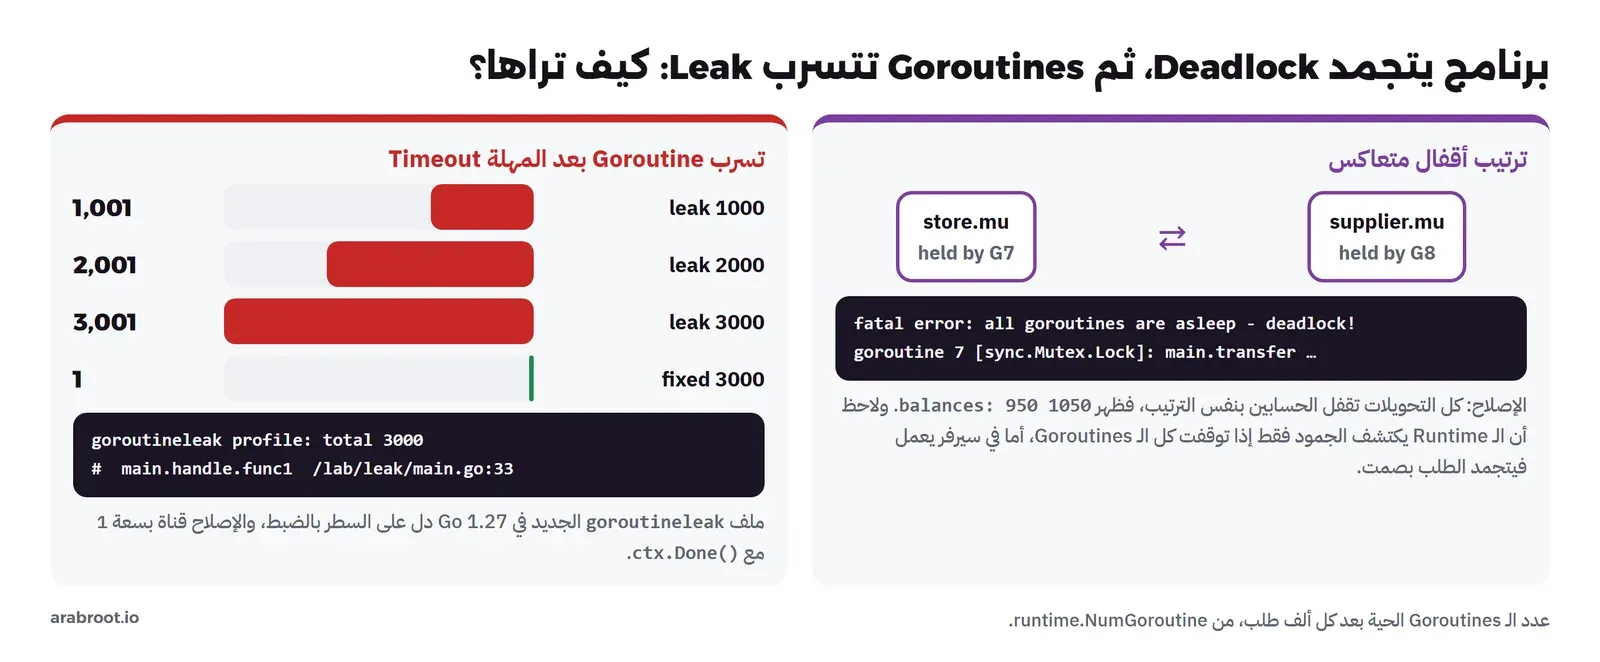
الـ Runtime لاحظ أن كل الـ Goroutines، وهنا واحدة فقط، تنتظر ولا يوجد من يوقظها، فأوقف البرنامج بالرسالة المشهورة all goroutines are asleep - deadlock!، وحدد الحالة [chan send] والسطر 48. والشكل الثاني أخطر، وهو الجمود بين قفلين، والمثال الكلاسيكي تحويل مالي: المتجر يحول للمورد، والمورد يرد مبلغاً للمتجر في نفس اللحظة، وكل تحويل يقفل حساب المرسل ثم حساب المستلم:
func transfer(from, to *Account, amount int) {
	from.mu.Lock()
	defer from.mu.Unlock()
	time.Sleep(10 * time.Millisecond)
	to.mu.Lock()
	defer to.mu.Unlock()
	from.balance -= amount
	to.balance += amount
}
والمخرج عند تشغيل التحويلين معاً:
fatal error: all goroutines are asleep - deadlock!

goroutine 1 [sync.WaitGroup.Wait]:
sync.runtime_SemacquireWaitGroup(0x5617c8?, 0xc0?)
	/usr/local/go/src/runtime/sema.go:114 +0x2e
sync.(*WaitGroup).Wait(0x32f2a0daa090)
	/usr/local/go/src/sync/waitgroup.go:206 +0x85
main.main()
	/lab/deadlock/main.go:60 +0x23d

goroutine 7 [sync.Mutex.Lock]:
internal/sync.runtime_SemacquireMutex(0x0?, 0x0?, 0x0?)
	/usr/local/go/src/runtime/sema.go:95 +0x25
internal/sync.(*Mutex).lockSlow(0x32f2a0dac080)
	/usr/local/go/src/internal/sync/mutex.go:149 +0x15a
internal/sync.(*Mutex).Lock(...)
	/usr/local/go/src/internal/sync/mutex.go:70
sync.(*Mutex).Lock(...)
	/usr/local/go/src/sync/mutex.go:46
main.transfer(0x32f2a0dac060, 0x32f2a0dac080, 0x64)
	/lab/deadlock/main.go:23 +0x9c
main.main.func1()
	/lab/deadlock/main.go:58 +0x24
sync.(*WaitGroup).Go.func1()
	/usr/local/go/src/sync/waitgroup.go:258 +0x4a
created by sync.(*WaitGroup).Go in goroutine 1
	/usr/local/go/src/sync/waitgroup.go:238 +0x7d

goroutine 8 [sync.Mutex.Lock]:
internal/sync.runtime_SemacquireMutex(0x0?, 0x0?, 0x0?)
exit=141
فالـ Goroutine 7 تملك قفل المتجر وتنتظر قفل المورد في السطر 23، والـ Goroutine 8 تملك قفل المورد وتنتظر قفل المتجر، وmain تنتظر الاثنتين في WaitGroup.Wait، فاكتشف الـ Runtime الجمود وطبع حالة كل Goroutine ومكانها. ولكن انتبه هنا إلى نقطة مهمة جداً: هذا الاكتشاف يعمل لأن كل الـ Goroutines في البرنامج متوقفة. أما في سيرفر HTTP فهناك دائماً Goroutine تستمع للاتصالات الجديدة، فلن يكتشف الـ Runtime شيئاً، وإنما يتجمد الطلبان إلى الأبد بصمت، ثم كل طلب بعدهما يحتاج نفس الحسابين، حتى تمتلئ الذاكرة أو يعيد أحد تشغيل الخدمة. والإصلاح المعروف أن تقفل الموارد دائماً بنفس الترتيب، والدالة transferOrdered تقفل الحساب الذي يأتي اسمه أولاً أبجدياً، مهما كان اتجاه التحويل:
balances: 950 1050
exit=0
وهذا نفس ما تفعله خدمة الطلبات مع أسطر المنتجات في PostgreSQL، فهي ترتب أرقام المنتجات قبل أن تقفلها، حتى لا يتجمد طلبان في كل منهما نفس المنتجين بترتيب مختلف.
تسرب الـ Goroutines Goroutine Leak وملف goroutineleak في Go 1.27
التسرب في Go يأتي غالباً من Goroutine تنتظر على قناة لن يقرأ منها أحد، ومثاله الكلاسيكي معالج طلب يطلب سعراً من خدمة بطيئة في Goroutine، وينتظر الجواب 20 مللي ثانية فقط، ثم يرد على العميل بانتهاء المهلة:
func slowPrice(ctx context.Context, out chan<- int) {
	select {
	case <-time.After(50 * time.Millisecond):
	case <-ctx.Done():
		return
	}
	out <- 990
}

func handle(mode string) {
	ctx, cancel := context.WithTimeout(context.Background(), 20*time.Millisecond)
	defer cancel()
	var out chan int
	if mode == "leak" {
		out = make(chan int)
		go func() {
			time.Sleep(50 * time.Millisecond)
			out <- 990 // nobody reads after the timeout: blocked forever
		}()
	} else {
		out = make(chan int, 1)
		go slowPrice(ctx, out)
	}
	select {
	case <-out:
	case <-ctx.Done():
	}
}
وفي النسخة الخاطئة ترسل الـ Goroutine الجواب بعد 50 مللي ثانية إلى قناة غير مخزنة، ولكن المعالج خرج بعد 20، فلا يوجد من يستقبل، فتنتظر الـ Goroutine إلى الأبد. وشغلنا ثلاث دفعات من ألف طلب، ثم طلبنا في النهاية ملف التسرب الجديد:
mode=leak after 1000 requests: goroutines=1001 stacks=4992 KiB
mode=leak after 2000 requests: goroutines=2001 stacks=7360 KiB
mode=leak after 3000 requests: goroutines=3001 stacks=8928 KiB
goroutineleak profile: total 3000
3000 @ 0x47f80a 0x41485c 0x414457 0x4e41d9 0x485721
#	0x4e41d8	main.handle.func1+0x38	/lab/leak/main.go:33

...
1
7
mode=fixed after 1000 requests: goroutines=1 stacks=3936 KiB
mode=fixed after 2000 requests: goroutines=1 stacks=4736 KiB
mode=fixed after 3000 requests: goroutines=1 stacks=4672 KiB
goroutineleak profile: total 0
في المخرج أعلاه لاحظ التالي:
- عدد الـ Goroutines يزيد ألفاً مع كل ألف طلب في النسخة الخاطئة: 1,001 ثم 2,001 ثم 3,001، وذاكرة المكدسات تزيد معه، ولن ينزل هذا العدد أبداً، لأن جامع القمامة لا يحرر Goroutine ما زالت حية في نظره.
- السطر
goroutineleak profile: total 3000ثمmain.handle.func1و/lab/leak/main.go:33: الملف الجديد عرف أن الثلاثة آلاف متسربة، ودل على السطر الذي تنتظر فيه بالضبط، وهوout <- 990. - في النسخة المصححة بقيت Goroutine واحدة، وهي
mainنفسها، والملفtotal 0.
وهذا الملف كان تجربة في Go 1.26 وصار متاحاً للجميع في Go 1.27، وتشرح ملاحظات الإصدار فكرته الذكية: الـ Goroutine المتوقفة على قناة أو قفل لا يمكن أن تستيقظ إذا كانت هذه القناة أو هذا القفل لا تصل إليه أي Goroutine أخرى قادرة على العمل، وجامع القمامة يعرف بالضبط ما يصل إليه كل شيء، فيستخدم نفس التتبع ليكتشف التسرب. وتذكر الملاحظات حده أيضاً، فإذا كانت القناة في متغير عام فلن يكتشفها، لأنها في نظره قد تستعمل يوماً ما. وفي الخدمة تحصل عليه من النقطة /debug/pprof/goroutineleak عندما تضيف الحزمة net/http/pprof على منفذ داخلي.
والإصلاح في الدالة slowPrice شيئان، وكل واحد منهما يكفي وحده ولكن الاثنين معاً أفضل: قناة بسعة 1، فيستطيع المرسل أن يضع الجواب ويخرج حتى لو لم يقرأه أحد، ثم يجمع جامع القمامة القناة، والاستماع إلى ctx.Done()، فتتوقف الـ Goroutine عن العمل أصلاً عندما يلغى الطلب، بدل أن تكمل عملاً لن يستخدمه أحد.
كيف يقارن هذا باللغات الأخرى؟ مقارنة Go مع Java أو Python أو Node.js
إذا جئت من لغة أخرى فالسؤال الطبيعي: هل نموذج Go أفضل، أم مختلف فقط؟ والإجابة الصادقة أن الفكرة نفسها، أي مهام خفيفة كثيرة فوق خيوط قليلة، صارت اليوم في أغلب اللغات، والفرق في التفاصيل التي تؤثر على كودك كل يوم:
- Java: الخيوط الافتراضية Virtual Threads التي صارت جزءاً من اللغة في Java 21 هي أقرب شيء إلى الـ Goroutines، فهي خيوط خفيفة يديرها الـ JVM فوق خيوط النظام، والكود يبقى متسلسلاً بلا
async. ولكنها جاءت بعد عشرين سنة من المكتبات المبنية على الخيوط التقليدية ومجمعات الخيوط Thread Pools، فتجد في نفس المشروع الطريقتين، بينما في Go لا توجد إلا طريقة واحدة منذ اليوم الأول، وكل مكتبة مكتوبة على افتراضها. - Python: نموذج
asyncioيعطيك تزامن الشبكة، ولكن بشرط أن تكون كل دالة في الطريقasync، وأن تكون المكتبة نفسها غير متزامنة، والقفل GIL يمنع الخيوط من تشغيل كود Python على عدة أنوية في نفس الوقت في البناء الافتراضي، فمهمة SHA-256 تحتاج عمليات منفصلة. والبناء الحر من القفل Free-threaded موجود منذ Python 3.13، ولكنه ما زال اختيارياً. - Node.js: حلقة أحداث بخيط واحد، ممتازة في انتظار الشبكة كما رأينا في مقال حلقة الأحداث، وأي حساب ثقيل فيها يوقف كل الطلبات، والحل
worker_threadsبذاكرة منفصلة وتواصل بالرسائل، وهذا قريب من CSP ولكن بثمن نسخ البيانات بين العمال.
والمكان الذي تتفوق فيه Go فعلاً ليس السرعة في هذه التجربة، وإنما أن الكود المتزامن والكود العادي يكتبان بنفس الطريقة، فالدالة call التي تنتظر الشبكة تستطيع أن تستدعيها من Goroutine أو من main دون أي تغيير، وأن الـ Runtime نفسه يستخدم كل الأنوية دون أن تختار بين خيوط وعمليات. والثمن المقابل أن اللغة لا تمنعك من مشاركة الذاكرة بلا حماية، كما تفعل Rust بنظام الملكية، فحالة السباق التي رأيناها مقبولة تماماً عند المترجم، والكاشف هو حمايتك الوحيدة، وقد قارنا بين هذه اللغات بنفس الخدمة في مقال كيف تختار لغة البرمجة لمشروعك.
اختبار الكود المتزامن testing/synctest
أصعب ما في الكود المتزامن اختباره، فالاختبار الذي يعتمد على time.Sleep لينتظر Goroutine إما بطيء وإما متقلب Flaky، ينجح على جهازك ويفشل في CI مرة كل عشرين تشغيلاً. ومنذ Go 1.25 صارت الحزمة testing/synctest جزءاً من المكتبة القياسية لحل هذه المشكلة: تشغل الاختبار داخل «فقاعة» لها ساعة وهمية، والوقت داخلها لا يتقدم إلا عندما تكون كل الـ Goroutines في الفقاعة متوقفة تنتظر، فاختبار مهلة 20 مللي ثانية مثل برنامج التسرب أعلاه يعمل فوراً وبنتيجة ثابتة في كل مرة، والدالة synctest.Wait تنتظر حتى تتوقف كل الـ Goroutines قبل أن تفحص النتيجة. وإذا كان في خدمتك كود يعتمد على المهل وإعادة المحاولة فهذه الحزمة توفر عليك ساعات من مطاردة اختبارات متقلبة، والقاعدة العامة في اختبار الكود المتزامن أن تشغل كل الاختبارات بالخيار -race، وأن تستخدم -count=100 على الاختبار المشكوك فيه لتعرف هل نجاحه ثابت أم صدفة.
مشكلات Problems واجهتنا أثناء التجربة
- في التشغيل الأول لبرنامج التسرب أضفنا استيراد
runtime/pprof، ولكن تعديل الكود الذي يستخدمه لم يطبق، فرفض المترجم البناء بالرسالة"runtime/pprof" imported and not used، وهي القاعدة التي رأيناها في المقال الأول تحمينا من نصف تعديل. أصلحنا الكود وأعدنا التشغيل. - عندما قصصنا مخرج كاشف السباقات بالأمر
headلنعرض أوله، طبع السكربت رمز الخروج 141 بدل 66، لأنheadأغلق الأنبوب فوصلت للبرنامج إشارة SIGPIPE. لذلك أعدنا التشغيل وحفظنا المخرج في ملف ثم قرأنا آخره، فظهر الرمز الصحيح والسطرFound 3 data race(s). وإذا كنت تفحص رمز الخروج في CI فلا تمرر المخرج في أنبوب قبل أن تأخذ الرمز. - عدد الطلبات المتزامنة في مهمة الشبكة تغير بين التشغيلين، 56 ثم 99، والزمن تغير معه، وحتى نفهم السبب أضفنا عداد
peakفي السيرفر نفسه، ولولاه لظننا أن الـ Goroutines لم تعمل بالتوازي في المرة الأولى. والدرس أن تقيس التزامن عند الطرف الآخر، وليس من جهة العميل فقط.
أخطاء شائعة Common Mistakes
- إنشاء Goroutine دون أن تعرف كيف ومتى تنتهي: كل
goتكتبها تحتاج جواباً عن هذا السؤال، وإلا فهي تسرب ينتظر فرصته. - Goroutine تنتظر قناة غير مخزنة بعد أن خرج المستقبل بسبب المهلة: استخدم قناة بسعة 1 أو
selectمعctx.Done(). - إطلاق مئة طلب إلى خدمة خارجية دفعة واحدة: حدد العدد بقناة مخزنة أو
errgroup.SetLimit. - عدد Goroutines أكبر من عدد الأنوية لعمل حسابي بحت، على أمل أن يسرع: لن يسرع، وقد يبطئ قليلاً.
- عدم تشغيل
go test -raceفي CI: السباقات تظهر في الإنتاج يوم التخفيض. - حماية مخزون حقيقي في قاعدة بيانات بقفل في ذاكرة البرنامج: لا يحمي شيئاً عندما تعمل نسختان من الخدمة.
- قفل موردين بترتيب يختلف بين دالتين: جمود ينتظر الضغط Load المناسب.
- إغلاق القناة من جهة المستقبل، أو إغلاقها مرتين: panic يوقف البرنامج.
- تجاهل
contextفي الدوال التي تنتظر الشبكة أو قاعدة البيانات: العميل أغلق الاتصال والخدمة ما زالت تعمل لأجله. - ضبط
GOMAXPROCSيدوياً داخل Container على Go 1.25 أو أحدث: تلغي الضبط التلقائي الذي يمنع توقف النواة لبرنامجك.
جدول قرار Decision Table: أي أداة تزامن تستخدم؟
| الحالة | الأداة | من التجربة |
|---|---|---|
| انتظار عدة طلبات شبكة | Goroutine لكل طلب مع WaitGroup.Go أو errgroup | من 5,151 إلى 200 مللي ثانية |
| طرف خارجي له حد | قناة مخزنة كإشارة أو errgroup.SetLimit | حد 10: 554 مللي ثانية و10 بالضبط عند السيرفر |
| حساب ثقيل على المعالج | عدد Workers يساوي GOMAXPROCS | 3.8 مرة على 4 أنوية، ولا فائدة بعد معالجين في Container بمعالجين |
| متغير مشترك بسيط | sync.Mutex أو atomic | البيع صار 10 والمخزون 0 |
| مورد يملكه طرف واحد | Goroutine مالكة وقناة طلبات | نفس النتيجة بلا أقفال |
| عدة أقفال معاً | ترتيب ثابت للقفل | انتهى الجمود والأرصدة 950 و1050 |
| عمل يجب أن يتوقف عند الإلغاء | context مع select | صفر Goroutines متسربة بدل 3,000 |
| مخزون في قاعدة بيانات | قفل السطر في المعاملة | في المقال الرابع |
تدريب عملي
- استبدل
WaitGroupوالقناة فيioConcurrentبالحزمةerrgroupمعSetLimit(10)، واجعل السيرفر البطيء يرجع الخطأ 500 للطلب رقم 50، ولاحظ كيف يلغى الباقي. - أضف
http.Transport{MaxConnsPerHost: 20}للعميل، وأعد مهمة الشبكة بلا حد، وانظر كيف يتغيرpeak in flightوالزمن. - شغل
benchمعGOMAXPROCS=8صراحة داخل Container بالخيار--cpus=2، وقارن أزمنة مهمة المعالج بما في الجدول. - في برنامج التسرب اجعل القناة متغيراً عاماً بدل متغير محلي، وشغل النسخة الخاطئة، واقرأ ما يقوله ملف
goroutineleakهذه المرة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التزامن في Go مأخوذ من فكرة CSP، والـ Goroutine رخيصة: 2 كيلوبايت لكل واحدة متوقفة في تجربتنا، والمجدول يوزعها على خيوط قليلة، وما ينتظر الشبكة لا يحجز أي خيط.
- مئة طلب إلى نقطة 50 مللي ثانية أخذت 5.15 ثانية بالتسلسل، و200 مللي ثانية بالـ Goroutines، و554 بحد عشرة، والكود بقي متسلسلاً بلا
async. - مهمة SHA-256 نزلت من 2.64 ثانية إلى 0.69 على أربع أنوية، وتوقف التحسن عند معالجين في الـ Container المحدود، لأن
GOMAXPROCSيقرأ حد الـ cgroup منذ Go 1.25. - «افحص ثم نفذ» بلا حماية باع عشرين قطعة من عشر في كل تشغيل، وكشفه
-raceبالسطر، والقفل أو المالك الواحد أصلحاه، والمخزون الحقيقي يحمى في قاعدة البيانات. - الـ Runtime يكتشف الجمود فقط إذا توقف كل شيء، والحل ترتيب ثابت للأقفال، والتسرب صار له ملف
goroutineleakفي Go 1.27 دل على السطر 33 من ثلاثة آلاف Goroutine متسربة.
وفي المقال التالي من مرحلة لغة Go للمطورين نجمع كل ما سبق في خدمة الطلبات الحقيقية، مع PostgreSQL والمعاملات والاختبارات واختبار العشرين طلباً المتزامن:
 دليلGo لمن يعرف البرمجة: الأدوات Toolchain وأول مشروعتثبيت Go 1.27 والفرق في صيغتها عما تعرفه، ثم أدواتها في أمر واحد وشكل المشروع، مع تجربة كاملة تبني حاسبة طلب باختباراتها وفحصها وملف تنفيذي واحد.
 دليلالأنواع والواجهات Interfaces والذاكرة والأخطاء في Goلماذا لا ينقص المخزون رغم أن الدالة تعمل، ولماذا لا يساوي الخطأ nil وهو يطبع nil، وكيف تقيس ما يحجزه كودك من الذاكرة وتختار شكل الخطأ في خدمة حقيقية بلغة Go.
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب بالإصدار Go 1.27.3 داخل الـ Image الرسمية golang:1.27.3-trixie على Windows 11 بمعالج Intel i7-7700K.


