


لنفرض أن خدمة الطلبات في المتجر الذي تعمل فيه تحتاج عند تأكيد كل سلة أن تسأل خدمة الشحن عن سعر التوصيل لكل منتج، وكل سؤال يأخذ حوالي 50 ملي ثانية، والسلة الكبيرة فيها 100 منتج. والكود الحالي يسأل عن المنتجات واحداً بعد الآخر، فينتظر العميل أكثر من خمس ثوان قبل أن يرى زر الدفع. وفي نفس الأسبوع يطلب منك قسم المالية تسريع مهمة ليلية تحسب بصمة SHA-256 متكررة لألفي إيصال حتى يكشف أي تعديل عليها، والمهمة تأخذ ثواني كثيرة على معالج واحد بينما السيرفر فيه ثمانية. ثم يصلك أسوأ الثلاثة: في يوم تخفيضات باع المتجر قطعاً من منتج أكثر مما في المخزون، والكود الذي ينقص المخزون سطر واحد stock-- لم يتغير منذ سنوات.
والمشكلات الثلاث كلها عن التزامن Concurrency، ولكن كل واحدة من نوع مختلف: الأولى انتظار I/O-Bound لا يحتاج المعالج، والثانية حساب CPU-Bound يحتاج كل نواة متاحة، والثالثة سباق بين خيوط على نفس البيانات. وهذا المقال من مرحلة لغة Java للمطورين، وسوف نأخذ فيه نفس المهمتين اللتين نقيسهما في كل لغات هذا المسار: 100 طلب HTTP إلى سيرفر محلي يتأخر 50 ملي ثانية، وSHA-256 لـ 2,000 نص كل واحد 2,000 مرة، ونشغل كل مهمة تسلسلياً ثم بكل أدوات Java: مجمع الخيوط Thread Pool، وخيط نظام لكل مهمة، والخيوط الافتراضية Virtual Threads، والتدفقات المتوازية Parallel Streams، والطلبات غير المتزامنة. ثم نصنع سباقاً حقيقياً على المخزون وجموداً Deadlock بين خيطين، ونصلحهما. والمفاهيم العامة للخيوط والأقفال وasync/await بين اللغات شرحناها في الخيوط والأقفال وasync، وسوف نركز هنا على ما تفعله Java.
وسوف نناقش في هذا المقال ما يلي:
- نموذج التزامن في Java: خيوط النظام، ومجمعات الخيوط، ولماذا جاءت الخيوط الافتراضية في Java 21.
- مهمة الانتظار I/O-Bound بخمس طرق والأرقام، وكيف تعمل الخيوط الافتراضية من الداخل.
- ماذا يحدث إذا شغلت 10,000 مهمة بخيوط النظام ثم بالخيوط الافتراضية.
- مهمة الحساب CPU-Bound على معالجين ثم على ثمانية، ولماذا لا تفيد الخيوط الافتراضية هنا.
- المشكلتان اللتان ظهرتا في التجربة: سيرفر يضاعف زمن كل طلب، وقياس أعطى 2 ملي ثانية لعمل يحتاج ثانيتين.
- حالة السباق على المخزون وإصلاحها، والجمود وكيف يكشفه
jstack. - التزامن المهيكل Structured Concurrency في JDK 25، والأخطاء الشائعة، وجدول قرار.
نموذج التزامن Concurrency Model في Java: من الخيوط إلى الخيوط الافتراضية
منذ النسخة الأولى في 1996 كانت Java من أوائل اللغات الشائعة التي جعلت الخيوط Threads جزءاً من اللغة نفسها، فالكلاس Thread والكلمة synchronized موجودتان منذ البداية، ونموذج الذاكرة Java Memory Model الذي يحدد ما يراه كل خيط من تعديلات الآخرين مكتوب في الفصل 17 من مواصفة اللغة. وكل Thread في Java كان لسنوات طويلة غلافاً مباشراً لخيط في نظام التشغيل، أي أن له مكدساً Stack يحجزه النظام بحجم يصل إلى ميجابايت، وجدولته يقوم بها النظام، والتبديل بينه وبين غيره يمر عبر النواة Kernel. وهذا يعمل جيداً عندما يكون عدد الخيوط بالمئات، ولكنه يصبح مشكلة في سيرفر يستقبل آلاف الطلبات في نفس الوقت وكل طلب ينتظر قاعدة بيانات أو خدمة أخرى، لأن كل طلب يحجز خيطاً كاملاً لا يفعل شيئاً سوى الانتظار.
ولهذا ظهرت في Java 5 عام 2004 حزمة java.util.concurrent بمجمعات الخيوط Executors، فبدلاً من أن تنشئ خيطاً لكل مهمة تعطي المهام لمجمع فيه عدد ثابت من الخيوط يعيد استخدامها. ثم ظهرت البرمجة غير المتزامنة Asynchronous بـ CompletableFuture في Java 8 ثم بمكتبات تفاعلية Reactive مثل Reactor، وهي تحل مشكلة الانتظار ولكن بكود صعب القراءة والتصحيح، لأن الـ Stack Trace لا يعود يمثل تسلسل منطقك. وفي Java 21 جاء الحل الذي انتظره الجميع: الخيوط الافتراضية Virtual Threads بالمقترح JEP 444، وهي خيوط تديرها الـ JVM لا نظام التشغيل، وتكتب بها كوداً تسلسلياً عادياً ينتظر ويعود، ومع ذلك تستطيع تشغيل مئات الآلاف منها. وفي JDK 24 أزال JEP 491 أكبر قيد عليها، وهو أن الخيط الافتراضي داخل كتلة synchronized كان يبقى ملتصقاً Pinned بخيط النظام أثناء الانتظار، فصارت تعمل مع الكود القديم الذي يستخدم synchronized دون أن تفقد فائدتها.
والسؤال الذي يهمك في كل مهمة هو: أين يذهب الوقت؟ فإذا كان في الانتظار فكل ما تحتاجه هو أن تنتظر أشياء كثيرة في نفس الوقت، وعدد الأنوية لا يهم كثيراً. وإذا كان في الحساب فلا شيء يسرعك أكثر من عدد الأنوية الموجودة، وكل خيط زائد عليها مجرد تبديل. وهذا بالضبط ما سوف تبينه الأرقام.
تجهيز المختبر Lab: سيرفر بطيء ومهمتان
نحتاج سيرفراً يتأخر 50 ملي ثانية في كل رد حتى تكون مهمة الانتظار قابلة للقياس والتكرار، فكتبناه بمكتبة Python القياسية في ملف slow.py، وشغلناه في Container اسمه slk-j-slow على نفس شبكة Docker التي يعمل عليها برنامج Java:
# Slow endpoint for the concurrency labs: every GET waits 50 ms, then answers a small JSON body.
# python3 slow.py [port]   (ThreadingHTTPServer: one thread per request, so 100 parallel calls all wait together)
import json, sys, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    disable_nagle_algorithm = True   # headers and body go out as two writes; without this, keep-alive calls wait ~40 ms more
    def do_GET(self):
        time.sleep(0.050)
        body = json.dumps({"path": self.path, "ok": True}).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)
    def log_message(self, *a):
        pass

ThreadingHTTPServer.request_queue_size = 256
ThreadingHTTPServer.daemon_threads = True
ThreadingHTTPServer(("0.0.0.0", int(sys.argv[1]) if len(sys.argv) > 1 else 8080), H).serve_forever()
ولاحظ السطر disable_nagle_algorithm = True، فهو لم يكن في النسخة الأولى، وغيابه ضاعف زمن كل طلب كما سوف ترى في فقرة المشكلات. وبرنامج القياس Bench.java يحتوي على المهمتين، والدالتان الأساسيتان فيه كما يلي:
static final HttpClient HTTP = HttpClient.newBuilder().version(HttpClient.Version.HTTP_1_1).build();
static final String BASE = System.getenv().getOrDefault("SLOW_URL", "http://slk-j-slow:8080/");

static int call(int i) {
    try {
        var req = HttpRequest.newBuilder(URI.create(BASE + i)).GET().build();
        return HTTP.send(req, HttpResponse.BodyHandlers.ofString()).statusCode();
    } catch (Exception e) {
        throw new RuntimeException(e);
    }
}

static String hash(int i) {
    try {
        var md = MessageDigest.getInstance("SHA-256");
        byte[] h = ("order-" + i).getBytes(StandardCharsets.UTF_8);
        for (int r = 0; r < 2000; r++) h = md.digest(h);
        return HexFormat.of().formatHex(h);
    } catch (Exception e) {
        throw new RuntimeException(e);
    }
}
في الكود أعلاه لاحظ التالي:
- استخدمنا HttpClient الموجود في الـ JDK منذ Java 11، وكائن واحد منه يشترك فيه كل الطلبات، لأنه يحمل مجمع الاتصالات Connection Pool، وإنشاء كائن لكل طلب يعني اتصالاً جديداً في كل مرة.
- حددنا
HTTP_1_1لأن العميل يحاول افتراضياً الترقية إلى HTTP/2 عبر ترويسة Upgrade، والسيرفر البسيط لا يدعمها. - الدالة
sendتحجز الخيط حتى يصل الرد Blocking، وهذا مقصود، لأننا نريد أن نرى كيف تتعامل كل طريقة مع خيط ينتظر. - كل بصمة تأخذ ناتج المرة السابقة وتحسب عليه SHA-256 من جديد ألفي مرة، فلا يمكن توزيع المرات داخل النص الواحد، ولكن يمكن توزيع النصوص الألفين على الأنوية.
وكل طريقة متزامنة تمر بالدالة التالية، التي تعطي المهام لمجمع وتنتظر نتائجها كلها:
static void runAll(String label, ExecutorService ex, int n, java.util.function.IntFunction<Object> task) throws Exception {
    long t0 = System.nanoTime();
    try (ex) {
        var fs = new ArrayList<Future<Object>>();
        for (int i = 0; i < n; i++) { int k = i; fs.add(ex.submit(() -> task.apply(k))); }
        for (var f : fs) f.get();
    }
    System.out.printf("%-34s %6d ms%n", label, ms(t0));
}
والصيغة try (ex) تغلق المجمع عند الخروج، وExecutorService صارت AutoCloseable منذ Java 19، وإغلاقها ينتظر انتهاء كل المهام، فلا يبقى خيط يعمل بعد القياس. وشغلنا كل شيء داخل Container بحد معالجين --cpus 2، وهو نفس الحد الذي سوف نقيس به الخدمة الحقيقية في هذه المرحلة.
مهمة الانتظار I/O-Bound: خمس طرق لنفس الطلبات
الجزء الخاص بمهمة الانتظار يسخن الـ JVM والاتصال بخمسة طلبات أولاً، لأن أول طلب يدفع ثمن تحميل الـ Classes وترجمة JIT وإنشاء الاتصال، ثم يشغل الطرق الخمس:
for (int i = 0; i < 5; i++) call(i);                     // warm-up: JIT, DNS, connection pool
long t0 = System.nanoTime();
for (int i = 0; i < 100; i++) call(i);
System.out.printf("%-34s %6d ms%n", "sequential", ms(t0));
runAll("fixed pool, 10 platform threads", Executors.newFixedThreadPool(10), 100, Bench::call);
runAll("platform thread per task", Executors.newThreadPerTaskExecutor(Thread.ofPlatform().factory()), 100, Bench::call);
runAll("virtual thread per task", Executors.newVirtualThreadPerTaskExecutor(), 100, Bench::call);
t0 = System.nanoTime();
var futures = IntStream.range(0, 100)
    .mapToObj(i -> HTTP.sendAsync(HttpRequest.newBuilder(URI.create(BASE + i)).build(), HttpResponse.BodyHandlers.ofString()))
    .toList();
CompletableFuture.allOf(futures.toArray(CompletableFuture[]::new)).join();
System.out.printf("%-34s %6d ms%n", "HttpClient.sendAsync", ms(t0));
والمخرج من تشغيلين متتاليين كما يلي:
## run 1
availableProcessors = 2
sequential                           5465 ms
fixed pool, 10 platform threads       623 ms
platform thread per task              425 ms
virtual thread per task               314 ms
HttpClient.sendAsync                  236 ms
## run 2
availableProcessors = 2
sequential                           5555 ms
fixed pool, 10 platform threads       570 ms
platform thread per task              478 ms
virtual thread per task               222 ms
HttpClient.sendAsync                  146 ms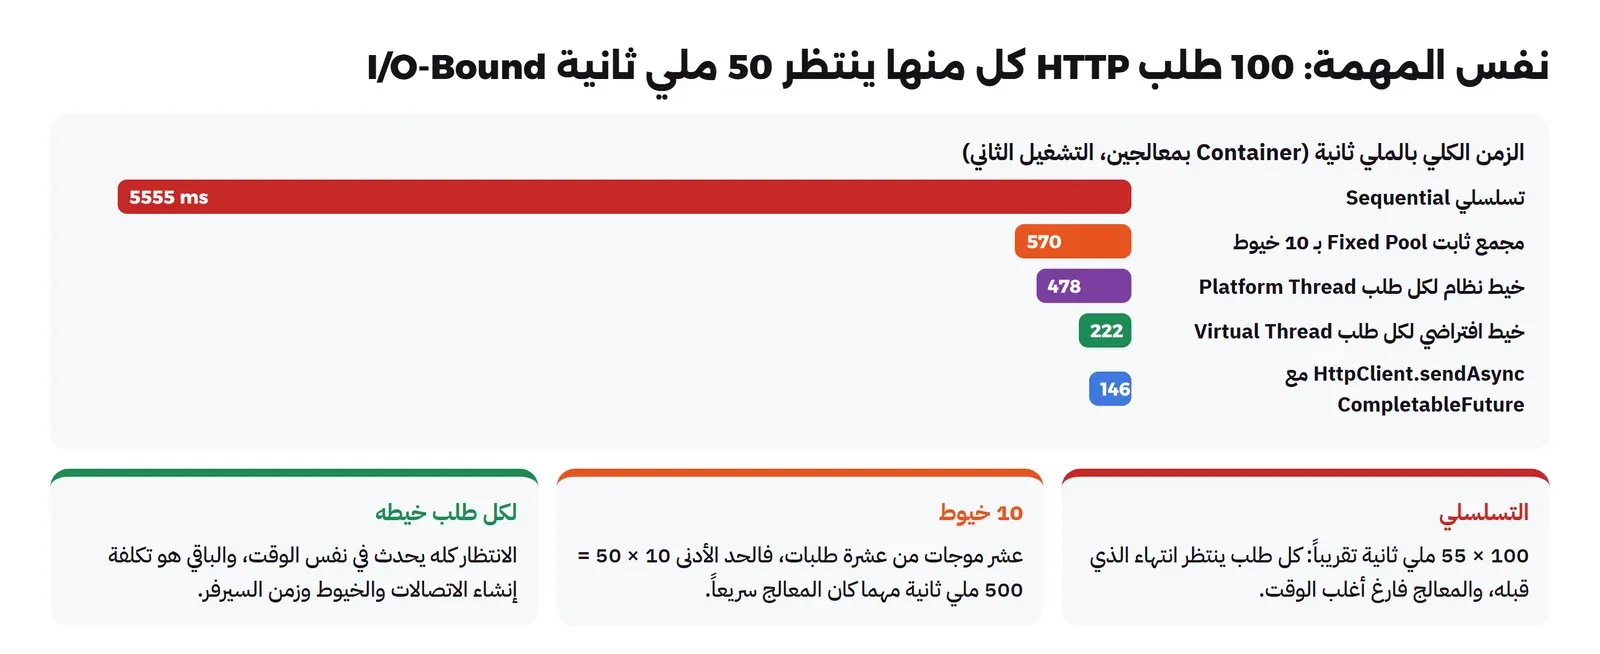
في المخرج أعلاه لاحظ التالي:
- السطر الأول يؤكد أن الـ JVM رأت معالجين فقط، فهي تقرأ حد الـ Container.
- التسلسلي أخذ حوالي 5.5 ثانية، أي 55 ملي ثانية لكل طلب: 50 ينتظرها السيرفر والباقي للشبكة وHTTP. والمعالج طوال هذا الوقت تقريباً فارغ.
- مجمع العشرة خيوط أخذ حوالي 600 ملي ثانية، وهذا منطقي لأن المئة طلب تمر في عشر موجات من عشرة، والحد الأدنى النظري 10 × 50 = 500 ملي ثانية. وهذا هو الحال في أغلب الخدمات القديمة: مجمع بحجم ثابت يحدد سقف التوازي دون أن ينتبه أحد.
- خيط نظام لكل طلب وخيط افتراضي لكل طلب أطلقا المئة طلب معاً، فاقترب الزمن من زمن طلب واحد مع تكلفة إنشاء الخيوط والاتصالات، وكانت الخيوط الافتراضية أسرع في التشغيلين لأن إنشاءها أرخص.
sendAsyncكان الأسرع لأنه لا ينشئ خيطاً لكل طلب أصلاً، وإنما يعطي الطلبات لطبقة الشبكة غير المتزامنة داخلHttpClientويعيدCompletableFutureلكل واحد.
وقد يتساءل البعض: إذا كان sendAsync الأسرع فلماذا الخيوط الافتراضية؟ والإجابة أن الفرق بينهما هنا عشرات الملي ثواني على مئة طلب، بينما الفرق في الكود كبير: مع الخيوط الافتراضية تكتب الدالة call كما هي، بـ try/catch عادي، وتستدعي داخلها قاعدة البيانات ثم خدمة أخرى ثم تكتب في ملف، وكل خطوة تنتظر بشكل طبيعي، والـ Stack Trace عند الخطأ يبين التسلسل كما كتبته. أما مع CompletableFuture فكل خطوة تصبح thenCompose وكل خطأ exceptionally، ومكتبات قواعد البيانات العادية مثل JDBC لا تدعم هذا الأسلوب أصلاً. ولهذا فإن القاعدة الحديثة في Java: اكتب كوداً متزامناً عادياً Blocking وشغله في خيوط افتراضية، واترك الأسلوب غير المتزامن للحالات التي تحتاجه فعلاً.
كيف تعمل الخيوط الافتراضية Virtual Threads من الداخل؟
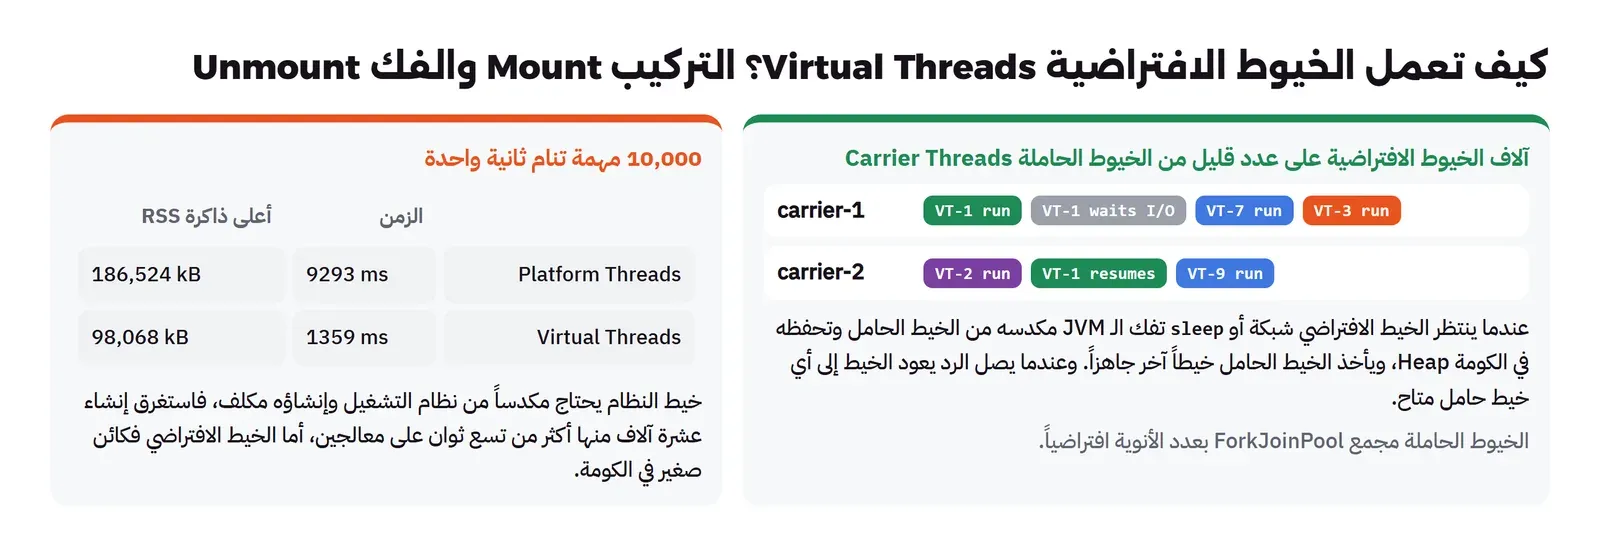
الخيط الافتراضي كائن عادي في الكومة Heap، والـ JVM تشغله على مجمع صغير من خيوط النظام تسمى الخيوط الحاملة Carrier Threads، وهو ForkJoinPool بعدد الأنوية افتراضياً. وعندما يصل الخيط الافتراضي إلى عملية تنتظر، مثل قراءة من الشبكة أو Thread.sleep أو انتظار قفل، تقوم الـ JVM بفك Unmount مكدسه من الخيط الحامل ونسخه إلى الكومة، وتعطي الخيط الحامل خيطاً افتراضياً آخر جاهزاً للعمل. وعندما يصل الرد تضع الخيط الأول في قائمة الجاهزين، ويركبه Mount أول خيط حامل يفرغ، ويكمل من نفس السطر. وكل هذا يحدث داخل مكتبات الـ JDK نفسها، فـ HttpClient.send وSocket وThread.sleep كلها تعرف أنها تعمل في خيط افتراضي، ولذلك لم نغير سطراً واحداً في call بين خيوط النظام والخيوط الافتراضية.
ولهذه الآلية حدود يجب أن تعرفها. أولها أن الخيط الافتراضي لا يجعل الكود أسرع، وإنما يجعل الانتظار أرخص، فمهمة حساب في خيط افتراضي تحجز الخيط الحامل حتى تنتهي. وثانيها أن بعض العمليات ما زالت تلصق الخيط الافتراضي بالخيط الحامل، مثل الاستدعاءات إلى كود أصلي Native عبر JNI، وبعض عمليات الملفات في أنظمة التشغيل، فإذا امتلأت الخيوط الحاملة كلها بخيوط ملتصقة توقف الجميع. وثالثها أن الخيوط الافتراضية لا تحتاج مجمعاً، فلا تضعها في newFixedThreadPool، وإنما أنشئ واحداً لكل مهمة، وإذا أردت تحديد عدد الطلبات المتزامنة إلى قاعدة بيانات فاستخدم Semaphore أو مجمع الاتصالات نفسه، لا عدد الخيوط. ويشرح دليل Oracle للخيوط الافتراضية هذه الحالات بالتفصيل.
ماذا يحدث إذا شغلت 10,000 مهمة؟ Platform Threads مقابل Virtual Threads
المئة طلب لا تكفي لترى الفرق الحقيقي، فشغلنا 10,000 مهمة كل واحدة تنام ثانية واحدة، مرة بخيط نظام لكل مهمة ومرة بخيط افتراضي، وطبع البرنامج الزمن وأعلى ذاكرة استخدمتها العملية من /proc/self/status:
availableProcessors = 2
10000 platform threads sleeping 1 s: 9293 ms, peak RSS 186524 kB
availableProcessors = 2
10000 virtual threads sleeping 1 s: 1359 ms, peak RSS 98068 kB
والمهام كلها تنام ثانية واحدة، فالزمن المثالي ثانية وقليل. والخيوط الافتراضية اقتربت منه بـ 1.36 ثانية وذاكرة 98 ميجابايت، أما خيوط النظام فأخذت أكثر من 9 ثوان، والسبب أن إنشاء عشرة آلاف خيط في نظام التشغيل على معالجين يأخذ وقتاً أطول من النوم نفسه، فالخيوط الأولى تنتهي قبل أن تنشأ الأخيرة، ومع ذلك وصلت الذاكرة إلى 187 ميجابايت. وفي خدمة حقيقية تستقبل طلبات لا تنتهي، هذا هو الفرق بين سيرفر يقبل عشرة آلاف اتصال ينتظر قاعدة البيانات، وسيرفر يرفضها أو يتوقف لنفاد الذاكرة.
ماذا عن synchronized؟ الالتصاق Pinning وما غيره JEP 491
عندما صدرت الخيوط الافتراضية في Java 21 كان فيها قيد مهم: إذا انتظر الخيط الافتراضي وهو داخل كتلة synchronized، فإن الـ JVM لا تستطيع فكه عن الخيط الحامل، لأن تطبيق الأقفال في الـ JVM كان مربوطاً بخيط النظام نفسه. فيبقى الخيط الحامل محجوزاً طوال الانتظار، وهذا ما يسمى الالتصاق Pinning. وفي مكتبة قديمة تستخدم synchronized حول استدعاء شبكة، مثل بعض مشغلات قواعد البيانات القديمة، كان هذا يعني أن عدداً قليلاً من الطلبات المنتظرة يكفي لحجز كل الخيوط الحاملة، فتتوقف الخدمة كلها رغم أن المعالج فارغ. وكانت النصيحة في Java 21 أن تستبدل synchronized بـ ReentrantLock في كل مكان يحدث فيه انتظار.
وفي JDK 24 أعاد JEP 491 كتابة تطبيق الأقفال بحيث يستطيع الخيط الافتراضي أن ينفك وهو يمسك قفلاً. ولنتأكد من ذلك على JDK 25 كتبنا Pinning.java: 1,000 خيط افتراضي، كل واحد ينام 50 ملي ثانية وهو يمسك قفلاً خاصاً به، وحددنا عدد الخيوط الحاملة باثنين فقط بالخاصية jdk.virtualThreadScheduler.parallelism، ثم شغلناه مع القفل ودونه:
ex.submit(() -> {
    Object lock = new Object();
    if (sync) {
        synchronized (lock) { Thread.sleep(50); }
    } else {
        Thread.sleep(50);
    }
    return null;
});
nolock 1000 virtual threads x 50 ms sleep on 2 carriers: 276 ms
synchronized 1000 virtual threads x 50 ms sleep on 2 carriers: 378 ms
nolock 1000 virtual threads x 50 ms sleep on 2 carriers: 210 ms
synchronized 1000 virtual threads x 50 ms sleep on 2 carriers: 289 msولو كان الخيط يلتصق بالخيط الحامل أثناء النوم داخل synchronized، لكان كل خيط حامل يخدم خيطاً واحداً كل 50 ملي ثانية، أي أن 1,000 خيط على خيطين حاملين تحتاج 1,000 × 50 ÷ 2 = 25 ثانية. والنتيجة الفعلية بين 289 و378 ملي ثانية، أي قريبة من الحالة دون قفل، والفرق الصغير تكلفة القفل نفسه. وهذا يعني أنك على JDK 24 وما بعدها لا تحتاج أن تستبدل كل synchronized في الكود القديم قبل الانتقال إلى الخيوط الافتراضية، وأن النصائح المكتوبة لـ Java 21 عن هذا القيد لم تعد تنطبق، ولهذا فإن رقم إصدار الـ JDK الذي تعمل عليه الخدمة يهم كثيراً عند قراءة أي مقال عن الخيوط الافتراضية.
كيف ترى 10,000 خيط افتراضي؟ تفريغ الخيوط Thread Dump بصيغة JSON
الأداة jstack التي سوف نستخدمها لكشف الجمود تطبع خيوط النظام، ولكنها لا تطبع الخيوط الافتراضية، لأن عددها قد يصل إلى الملايين. ولذلك أضيف إلى jcmd أمر خاص يكتب التفريغ في ملف، بنص عادي أو بصيغة JSON التي تقرؤها الأدوات. والبرنامج Waiters.java يشغل 10,000 خيط افتراضي، كل واحد باسم رقم الطلب، وينام 30 ثانية، وبعد ثلاث ثوان طلبنا التفريغ:
jcmd <pid> Thread.dump_to_file -format=json /tmp/t.jsonCreated /tmp/t.json
real 0m4.705s
bytes: 9036747
threads in dump: 10011
virtual named order-: 10000
"container": "<root>",
"threadCount": "8"
"container": "ForkJoinPool-1\/jdk.internal.vm.SharedThreadContainer@303a6a5f",
"threadCount": "3"
"container": "java.util.concurrent.ThreadPerTaskExecutor@6684ad17",
"threadCount": "10000"
"name": "order-1",
"state": "TIMED_WAITING",
"stack": [
"java.base\/java.lang.VirtualThread.parkNanos(VirtualThread.java:787)",
"java.base\/java.lang.VirtualThread.sleepNanos(VirtualThread.java:983)",
"java.base\/java.lang.Thread.sleepNanos(Thread.java:507)",
"java.base\/java.lang.Thread.sleep(Thread.java:540)",
"Waiters.lambda$main$0(Waiters.java:12)",في المخرج أعلاه لاحظ التالي:
- الملف 9 ميجابايت وفيه 10,011 خيطاً: عشرة آلاف خيط افتراضي بأسمائها، و11 خيط نظام للـ JVM نفسها والخيوط الحاملة.
- الخيوط مجمعة في حاويات Containers حسب من أنشأها، والحاوية
ThreadPerTaskExecutorفيها 10,000 خيط، بينماForkJoinPool-1وهو مجمع الخيوط الحاملة فيه 3 خيوط فقط. وهذا التجميع مفيد في الإنتاج لتعرف أي جزء من الكود أنشأ الخيوط التي تتراكم. - كل خيط افتراضي له حالته ومكدسه كاملاً، والسطر
Waiters.java:12يبين أين ينتظر، تماماً كما في خيوط النظام. - التفريغ نفسه أخذ 4.7 ثانية، فهو ليس عملية مجانية على خدمة فيها مئات الآلاف من الخيوط.
وفي المحاولة الأولى كانت الخيوط تنام 5 ثوان فقط، وطلبنا التفريغ بعد ثانيتين ونصف، فاستمر التفريغ حتى انتهت الخيوط وخرج البرنامج، وتوقفت الـ JVM برسالة SIGSEGV وكتبت ملف hs_err_pid28.log في مجلد العمل، وكان الملف الناتج ناقصاً فيه 338 خيطاً فقط من عشرة آلاف. ولم نحقق في السبب الداخلي، ولكن الدرس العملي واضح: خذ التفريغ من برنامج مستقر وليس من برنامج على وشك الخروج، وتحقق من عدد الخيوط في الملف قبل أن تعتمد عليه، واحذف ملفات hs_err وcore التي قد تبقى في مجلد العمل لأنها قد تحتوي على محتوى الذاكرة.
مهمة الحساب CPU-Bound: المعالج هو السقف
الجزء الثاني من Bench.java يحسب البصمات الألفين بخمس طرق:
for (int i = 0; i < 200; i++) hash(i);                   // warm-up
long t0 = System.nanoTime();
String last = null;
for (int i = 0; i < 2000; i++) last = hash(i);
System.out.printf("%-34s %6d ms  (last %s...)%n", "sequential", ms(t0), last.substring(0, 12));
t0 = System.nanoTime();
long n = IntStream.range(0, 2000).parallel().mapToObj(Bench::hash).toList().size();
System.out.printf("%-34s %6d ms  (%d hashes)%n", "parallel stream (ForkJoinPool)", ms(t0), n);
runAll("fixed pool, " + cores + " threads", Executors.newFixedThreadPool(cores), 2000, Bench::hash);
runAll("fixed pool, 64 threads", Executors.newFixedThreadPool(64), 2000, Bench::hash);
runAll("virtual thread per task", Executors.newVirtualThreadPerTaskExecutor(), 2000, Bench::hash);
وشغلناه في Container بمعالجين، ثم في Container دون حد على جهاز بثماني أنوية:
### cpu (--cpus 2)
## run 1
availableProcessors = 2
sequential                           3555 ms  (last aa0004c25c34...)
parallel stream (ForkJoinPool)       2086 ms  (2000 hashes)
fixed pool, 2 threads                1966 ms
fixed pool, 64 threads               2234 ms
virtual thread per task              2252 ms
## run 2
availableProcessors = 2
sequential                           3704 ms  (last aa0004c25c34...)
parallel stream (ForkJoinPool)       2007 ms  (2000 hashes)
fixed pool, 2 threads                2091 ms
fixed pool, 64 threads               1722 ms
virtual thread per task              2189 ms
### cpu (no CPU limit, 8-core host)
## run 1
availableProcessors = 8
sequential                           3608 ms  (last aa0004c25c34...)
parallel stream (ForkJoinPool)        733 ms  (2000 hashes)
fixed pool, 8 threads                 692 ms
fixed pool, 64 threads                766 ms
virtual thread per task               699 ms
## run 2
availableProcessors = 8
sequential                           3420 ms  (last aa0004c25c34...)
parallel stream (ForkJoinPool)        643 ms  (2000 hashes)
fixed pool, 8 threads                 887 ms
fixed pool, 64 threads                682 ms
virtual thread per task               745 ms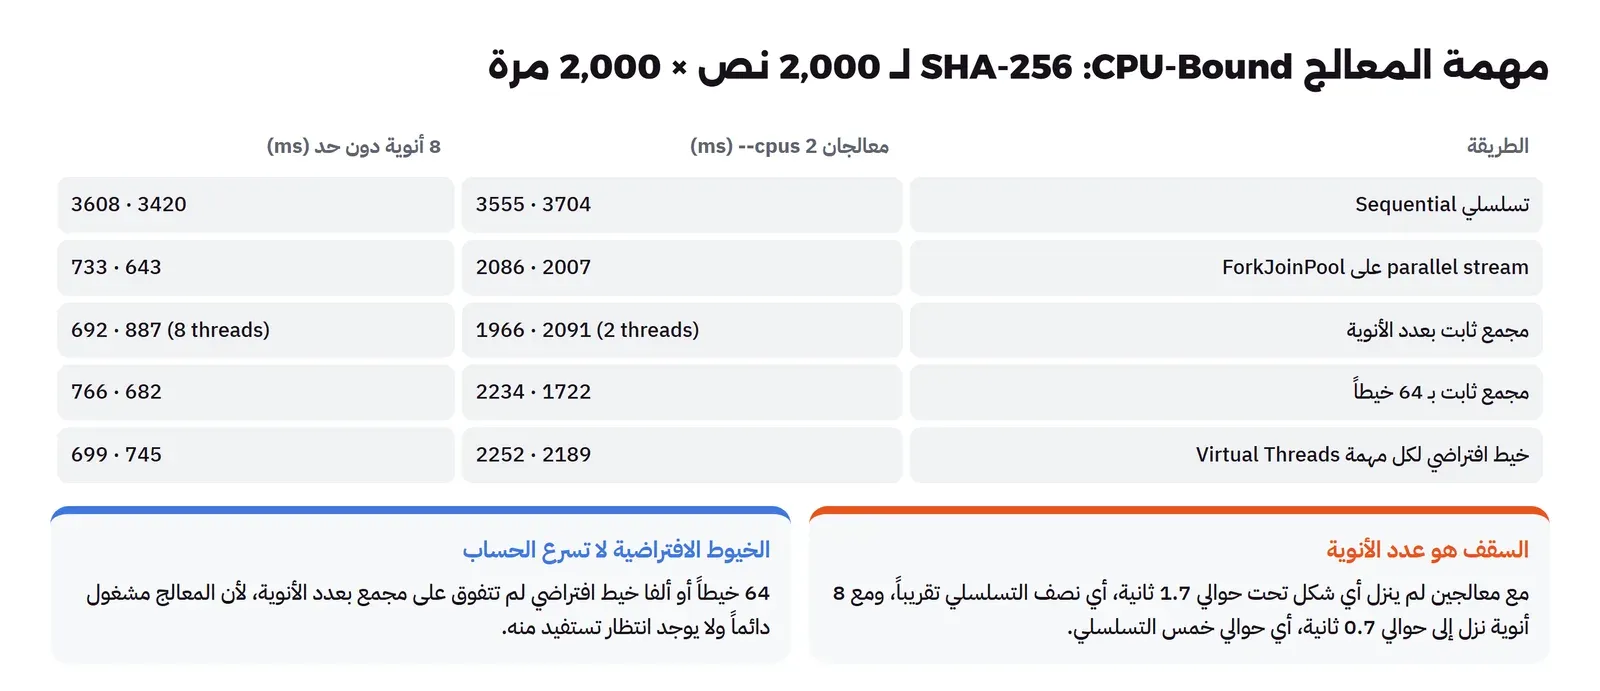
في المخرج أعلاه لاحظ التالي:
- البصمة الأخيرة
aa0004c25c34نفسها في كل تشغيل، فالعمل نفسه لم يتغير بين الطرق، وهذا أول ما يجب أن تتحقق منه قبل مقارنة الأزمنة. - التسلسلي حوالي 3.5 ثانية في الحالتين، لأنه يستخدم نواة واحدة سواء كان في الجهاز اثنتان أو ثمان.
- مع معالجين لم ينزل أي شكل متواز تحت 1.7 ثانية تقريباً، أي حوالي نصف التسلسلي، وهذا هو السقف الذي يفرضه
--cpus 2. ومع ثماني أنوية نزل إلى ما بين 0.64 و0.89 ثانية، أي حوالي خمس التسلسلي وليس ثمنه، ومن أسباب ذلك أن الجهاز كان عليه برامج أخرى تعمل في نفس الوقت، وأن توزيع العمل وجمع النتائج له تكلفة. - 64 خيطاً لم تكن أسرع من خيوط بعدد الأنوية، وألفا خيط افتراضي لم تكن أسرع أيضاً. فالخيط الزائد في مهمة حساب لا يجد معالجاً فارغاً، وكل ما يضيفه هو التبديل بين الخيوط.
- الفرق بين التشغيلين لنفس الطريقة، مثل 692 و887 ملي ثانية، أكبر أحياناً من الفرق بين الطرق، وهذا سبب أن نقيس دائماً أكثر من مرة.
والدرس لمهمة المالية الليلية: التوازي يسرعها بقدر الأنوية المتاحة، والتدفق المتوازي parallel() هو أقصر طريقة لذلك في Java لأنه يستخدم مجمعاً مشتركاً بعدد الأنوية. ولكن انتبه لأن هذا المجمع المشترك ForkJoinPool.commonPool مشترك فعلاً بين كل الكود في نفس الـ JVM، فإذا شغلت تدفقاً متوازياً ثقيلاً داخل خدمة ويب فأنت تأخذ الأنوية من كل شيء آخر. وفي الخدمات استخدم مجمعاً خاصاً بحجم محدد للمهام الحسابية، واترك الخيوط الافتراضية لما ينتظر.
مشكلتان ظهرتا في التجربة: أخطاء القياس Benchmark Pitfalls
100 طلب في 11 ثانية بدل 5: خوارزمية Nagle مع Delayed ACK
في التشغيل الأول كانت أرقام الانتظار كما يلي:
## run 1
availableProcessors = 2
sequential                          11489 ms
fixed pool, 10 platform threads      2211 ms
platform thread per task             3676 ms
virtual thread per task               522 ms
HttpClient.sendAsync                  328 ms
## run 2
availableProcessors = 2
sequential                          10400 ms
fixed pool, 10 platform threads      1168 ms
platform thread per task             1331 ms
virtual thread per task               436 ms
HttpClient.sendAsync                  314 ms
والتسلسلي أخذ أكثر من 10 ثوان، أي أكثر من 100 ملي ثانية لكل طلب، بينما السيرفر ينتظر 50 فقط. وحتى نعرف هل المشكلة في Java أم في السيرفر كتبنا عميلاً صغيراً بـ Python في probe.py يرسل 20 طلباً على اتصال واحد مفتوح Keep-Alive، ثم 20 طلباً كل واحد على اتصال جديد:
## probe.py against the first slow.py (slow-original.py), 20 calls each, from a container on slk-net
keep-alive ms/call 102.3
new connection ms/call 59.8
فالمشكلة ليست في Java، وإنما في الاتصال المفتوح. والسبب معروف منذ الثمانينيات: السيرفر البسيط في Python يكتب الترويسات Headers في كتابة، ثم جسم الرد Body في كتابة ثانية. والكتابة الأولى تخرج فوراً، أما الثانية فتحجزها خوارزمية Nagle من RFC 896 لأن هناك بيانات أرسلت ولم يصل تأكيد استلامها ACK بعد. والطرف الآخر لا يرسل ACK فوراً، لأنه يطبق التأكيد المؤجل Delayed ACK من RFC 1122 وينتظر ليرسله مع بيانات أخرى، فيقف الطرفان ينتظر كل منهما الآخر حتى ينتهي مؤقت التأكيد المؤجل، وهو حوالي 40 ملي ثانية في Linux. وعلى الاتصال الجديد لم يظهر التأخير بنفس الشكل لأن بداية الاتصال تمر بتبادل مختلف.
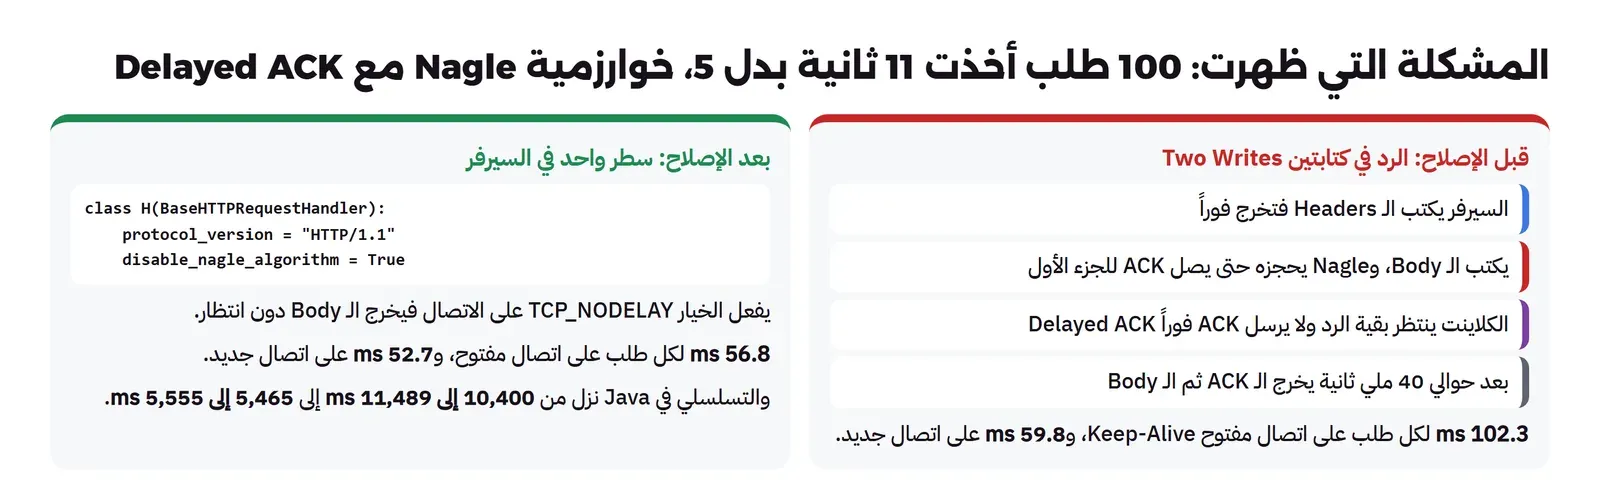
والإصلاح سطر واحد في السيرفر: الخاصية disable_nagle_algorithm في socketserver تفعل الخيار TCP_NODELAY على كل اتصال، فتخرج الكتابة الثانية دون انتظار:
## probe.py after disable_nagle_algorithm = True (slow.py)
keep-alive ms/call 56.8
new connection ms/call 52.7
ونزل التسلسلي في Java من أكثر من 10 ثوان إلى حوالي 5.5 كما رأيت في النتائج. ولاحظ أن الأرقام الخاطئة كانت متسقة ومقنعة، فلو لم نحسب الزمن المتوقع قبل القياس، 100 × 50 ملي ثانية، لكتبنا أن Java تأخذ 110 ملي ثانية للطلب الواحد. والقاعدة التي خرجنا بها: احسب قبل كل قياس الرقم الذي تتوقعه، وإذا ابتعد القياس عنه فابحث عن السبب قبل أن تفسر النتيجة. وهذه المشكلة نفسها تظهر في الإنتاج عندما يكتب كود الرد على دفعات صغيرة، والحل إما TCP_NODELAY أو تجميع الرد في كتابة واحدة.
قياس أعطى 2 ملي ثانية لعمل يحتاج ثانيتين: count() في Streams
في النسخة الأولى من Bench.java كان سطر التدفق المتوازي ينتهي بـ count() بدل toList().size()، وكانت النتيجة:
sequential                           3530 ms  (last aa0004c25c34...)
parallel stream (ForkJoinPool)          2 ms  (2000 hashes)
fixed pool, 2 threads                1912 ms
أي أن التدفق المتوازي أسرع من التسلسلي بـ 1,700 مرة على معالجين، وهذا مستحيل. والسبب مكتوب في توثيق Stream.count: يجوز للتطبيق ألا ينفذ التدفق أصلاً إذا استطاع حساب العدد من المصدر مباشرة، وفي هذه الحالة لا تنفذ أي عملية وسيطة. والمصدر هنا IntStream.range(0, 2000) يعرف حجمه، وmapToObj لا تغير العدد، فأعطت الـ JDK العدد 2000 دون أن تحسب بصمة واحدة. والدرس أعم من count: لا تضع في map أو peek عملاً له أثر جانبي Side Effect تعتمد عليه، وتأكد في كل قياس أن العمل تم فعلاً، كما فعلنا بطباعة البصمة الأخيرة في السطر التسلسلي.
الرؤية بين الخيوط Visibility: خيط لم ير التعديل أبداً
قبل أن نصل إلى السباق، هناك مشكلة أبسط منه وأغرب، ويقع فيها كثير ممن يأتون من JavaScript حيث يوجد خيط واحد، أو من Python حيث يخفي القفل GIL كثيراً من هذه التفاصيل. لنفرض أن خدمة الإيصالات فيها خيط يعمل في حلقة حتى يطلب منه خيط آخر التوقف عند إغلاق الخدمة، والطلب متغير boolean عادي. والبرنامج Visibility.java يمثل ذلك: خيط يدور في حلقة حتى يصبح المتغير true، والخيط الرئيسي يغيره بعد نصف ثانية، ثم ينتظر ثلاث ثوان:
static boolean stopPlain;
static volatile boolean stopVolatile;
// ...
if (useVolatile) { while (!stopVolatile) spins++; }
else { while (!stopPlain) spins++; }
## plain
main set the flag
worker still running after 3 s: it never saw the write
## plain
main set the flag
worker still running after 3 s: it never saw the write
## volatile
main set the flag
worker saw the flag after 317725861 spins
worker finished
## volatile
main set the flag
worker saw the flag after 261262577 spins
worker finishedومع المتغير العادي لم ير الخيط التعديل أبداً في المرتين، وبقي يدور حتى أنهينا البرنامج بـ System.exit. والسبب أن نموذج الذاكرة في Java لا يضمن أن يرى خيط ما كتبه خيط آخر إلا إذا كان بينهما ما تسميه المواصفة علاقة «يحدث قبل» Happens-Before، مثل الدخول إلى نفس القفل أو قراءة متغير volatile. ودون هذه العلاقة يحق للمترجم JIT أن يفترض أن المتغير لا يتغير داخل الحلقة لأن الحلقة نفسها لا تغيره، فيقرؤه مرة واحدة قبلها ويحولها إلى حلقة لا تنتهي، ولهذا انتظرنا نصف ثانية قبل التعديل حتى تسخن الحلقة وتترجم. ومع volatile يجب أن تقرأ كل دورة القيمة من الذاكرة، فرأى الخيط التعديل بعد مئات الملايين من الدورات في نصف الثانية.
وهذا الخطأ من أصعب الأخطاء في التشخيص، لأنه لا يظهر في وضع التصحيح Debug ولا في الاختبارات القصيرة التي لا تسخن فيها الحلقة، ويظهر في الإنتاج كخدمة لا تتوقف عند الإغلاق، أو كخيط لا يرى إعداداً تغير. والقاعدة: كل متغير يكتبه خيط ويقرؤه آخر يجب أن يكون volatile، أو Atomic، أو محمياً بقفل، أو في مجموعة آمنة للخيوط مثل ConcurrentHashMap. ولاحظ أن volatile تحل الرؤية فقط، ولا تجعل stock-- عملية واحدة، وهذا بالضبط ما سوف تراه الآن.
حالة السباق Race Condition على المخزون
نعود إلى المشكلة الثالثة: المتجر باع أكثر مما في المخزون. والبرنامج Race.java يمثلها: منتج مخزونه 100,000 قطعة، و1,000 خيط افتراضي كل واحد يبيع 100 قطعة، فالمخزون يجب أن ينتهي صفراً:
try (var ex = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int t = 0; t < 1000; t++) {
        ex.submit(() -> {
            for (int i = 0; i < 100; i++) {
                switch (mode) {
                    case "broken" -> stock--;                       // read, subtract, write: three steps
                    case "synchronized" -> { synchronized (LOCK) { stock--; } }
                    case "atomic" -> atomicStock.decrementAndGet();   // one CAS instruction
                }
            }
        });
    }
}
وشغلنا النسخة المكسورة ثلاث مرات ثم الإصلاحين، ومعالجين فقط:
broken        stock left = 4031 (expected 0), 129 ms
broken        stock left = 3600 (expected 0), 141 ms
broken        stock left = 4057 (expected 0), 112 ms
synchronized  stock left = 0 (expected 0), 119 ms
atomic        stock left = 0 (expected 0), 129 ms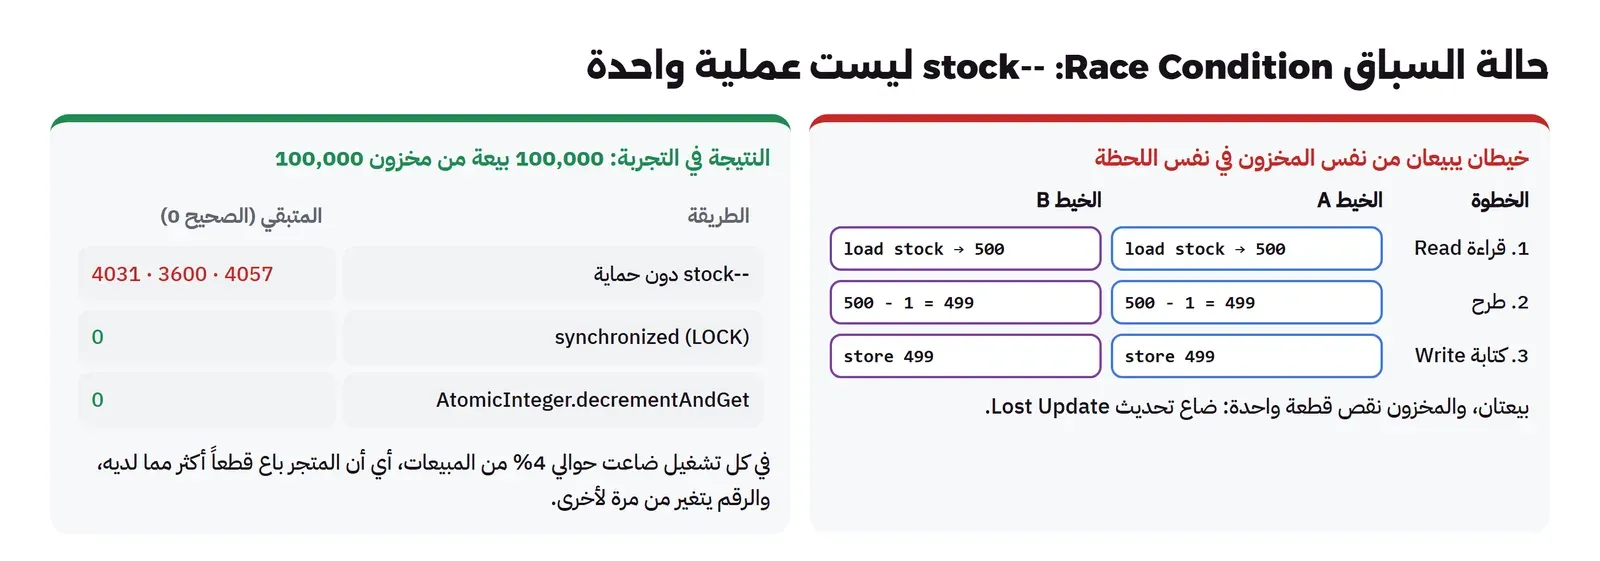
والسطر stock-- يبدو عملية واحدة، ولكنه ثلاث خطوات: قراءة القيمة من الذاكرة، وطرح واحد، وكتابة الناتج. فإذا قرأ خيطان نفس القيمة 500 قبل أن يكتب أحدهما، فإن كليهما يكتب 499، وتضيع بيعة. وفي التجربة ضاعت حوالي 4,000 بيعة من 100,000 في كل مرة، أي أن المتجر سلم حوالي 4,000 قطعة لا يملكها، والرقم مختلف في كل تشغيل، وهذا ما يجعل هذا الخطأ صعباً: لا يظهر في اختبار بخيط واحد، ويظهر في يوم التخفيضات فقط. ولاحظ أن هذا حدث مع معالجين فقط وخيوط افتراضية، فالخيوط الافتراضية لا تحمي من السباق، فهي خيوط حقيقية تعمل بالتوازي على الخيوط الحاملة.
والإصلاحان صحيحان، ولكل منهما مكانه. synchronized تجعل الكتلة لا يدخلها إلا خيط واحد في كل لحظة، وتضمن أن ما كتبه الخيط قبل الخروج يراه الخيط التالي، وهي مناسبة عندما تحتاج تعديل أكثر من متغير معاً، مثل إنقاص المخزون وإضافة سطر في سجل المبيعات. أما AtomicInteger فتنفذ القراءة والطرح والكتابة كتعليمة واحدة من المعالج تسمى المقارنة والتبديل Compare-And-Swap، دون قفل، وهي الأنسب لعداد واحد. وإذا كان العداد يحدث من خيوط كثيرة جداً ويقرأ نادراً، مثل عداد الطلبات في المراقبة، فـ LongAdder أسرع لأنه يوزع العد على عدة خلايا.
وقد يتساءل البعض: هل هذا يحل مشكلة المتجر الحقيقية؟ والإجابة لا، لأن المخزون الحقيقي ليس متغيراً في ذاكرة خدمة واحدة، وإنما صف في قاعدة البيانات تقرؤه عدة نسخ من الخدمة. والقفل في Java لا يرى النسخة الأخرى، ولذلك يجب أن يكون القفل في قاعدة البيانات نفسها، بقفل الصف داخل معاملة Transaction، وهذا ما سوف نبنيه ونختبره بعشرين طلباً متزامناً في مقال الخدمة الحقيقية من هذه المرحلة.
الجمود Deadlock: نصنعه ثم نكشفه بـ jstack
عندما تضيف أقفالاً لتمنع السباق تظهر مشكلة من الجهة الأخرى: خيطان كل منهما يمسك قفلاً وينتظر قفل الآخر. والبرنامج Deadlock.java فيه تحويل رصيد بين محفظتين، وكل تحويل يقفل محفظة المرسل ثم المستلم:
static void transferBroken(Wallet from, Wallet to, int amount) throws InterruptedException {
    synchronized (from) {
        Thread.sleep(50);                 // some work while holding the first lock
        synchronized (to) {
            from.balance -= amount;
            to.balance += amount;
        }
    }
}
وشغلنا تحويلين في نفس الوقت، من المحفظة 1 إلى 2 ومن 2 إلى 1، فتوقف البرنامج دون أي رسالة ودون أن يستهلك المعالج. وبعد ثلاث ثوان طلبنا من الأداة jstack أن تطبع حالة الخيوط، وهذا جزء مما طبعته:
Found one Java-level deadlock:
=============================
"transfer-a-to-b":
  waiting to lock monitor 0x00007fb7100020a0 (object 0x00000000e1f185d8, a Deadlock$Wallet),
  which is held by "transfer-b-to-a"

"transfer-b-to-a":
  waiting to lock monitor 0x00007fb704000f30 (object 0x00000000e1f185c0, a Deadlock$Wallet),
  which is held by "transfer-a-to-b"

Java stack information for the threads listed above:
===================================================
"transfer-a-to-b":
	at Deadlock.transferBroken(Deadlock.java:14)
	- waiting to lock <0x00000000e1f185d8> (a Deadlock$Wallet)
	- locked <0x00000000e1f185c0> (a Deadlock$Wallet)
	at Deadlock.run(Deadlock.java:50)

Found 1 deadlock.
still waiting after 3 s: deadlock (pid 28)
exit code 1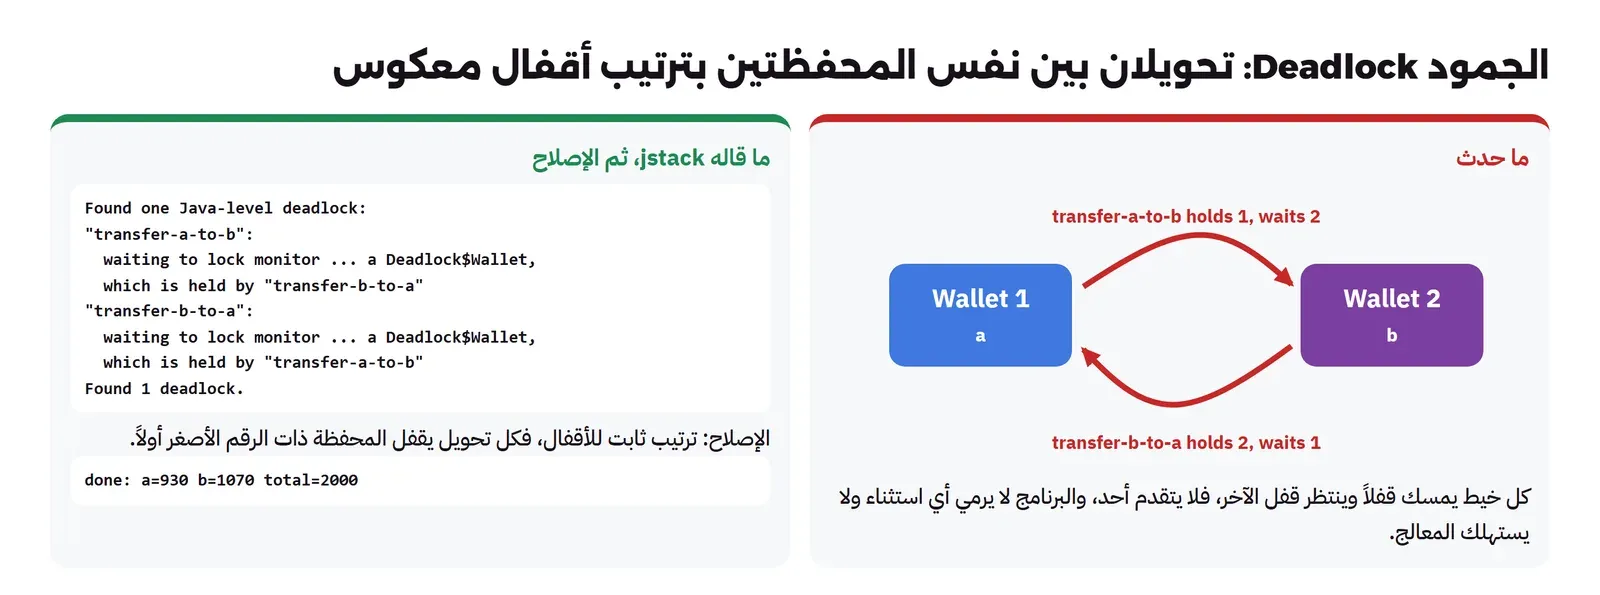
synchronized بنفسها، وjstack يطبعه بأسماء الخيوط والأسطر.في المخرج أعلاه لاحظ التالي:
- الـ JVM تكتشف الدائرة بنفسها وتطبع
Found one Java-level deadlock، فلا تحتاج أن تحلل مئات الخيوط يدوياً. - أسماء الخيوط ظهرت كما سميناها
transfer-a-to-b، وهذا سبب أن تسمي خيوطك ومجمعاتك دائماً، فاسم مثلThread-7لا يخبرك بشيء في الإنتاج. - لكل خيط سطران مهمان:
lockedلما يمسكه، وwaiting to lockلما ينتظره، ورقم السطر 14 هو الـsynchronizedالداخلية.
والإصلاح ترتيب ثابت للأقفال: كل تحويل يقفل المحفظة ذات الرقم الأصغر أولاً، مهما كان اتجاه التحويل، فلا يمكن أن تتكون دائرة:
Wallet first = from.id < to.id ? from : to;      // always lock the smaller id first
Wallet second = from.id < to.id ? to : from;
done: a=930 b=1070 total=2000والمجموع 2000 كما بدأ، فلم يضع شيء. ونفس القاعدة تنطبق على أقفال الصفوف في قاعدة البيانات: إذا قفلت معاملتان صفوف المنتجات بترتيب مختلف فقد يحدث جمود، ولهذا سوف نقفل الصفوف مرتبة برقم المنتج في الخدمة الحقيقية. وإذا احتجت انتظاراً محدوداً بدل الانتظار للأبد فاستخدم ReentrantLock.tryLock مع مهلة.
التزامن المهيكل Structured Concurrency: معاينة Preview في JDK 25
عندما تطلق عدة مهام في خيوط افتراضية لخدمة طلب واحد، مثل جلب بيانات المنتج والمخزون معاً، تظهر أسئلة لا يجيب عنها ExecutorService: إذا فشلت مهمة، من يلغي الأخرى؟ وإذا ألغي الطلب الأصلي، هل تبقى المهام تعمل؟ والتزامن المهيكل يجيب بأن المهام الفرعية تعيش داخل كتلة واحدة ولا تخرج منها، كما يعيش المتغير داخل الدالة. وفي JDK 25 ما زالت هذه الواجهة معاينة Preview للمرة الخامسة في JEP 505، أي أنها تحتاج --enable-preview وقد تتغير. وعندما شغلنا الملف دون الخيار رفضه المترجم برسالة StructuredTaskScope is a preview API and is disabled by default، ومع الخيار كان الكود والنتيجة كما يلي:
try (var scope = StructuredTaskScope.open()) {
    var product = scope.fork(() -> get("product/1"));
    var stock = scope.fork(() -> stockOf(fail));
    scope.join();
    System.out.println("product " + product.get() + ", stock " + stock.get());
} catch (StructuredTaskScope.FailedException e) {
    System.out.println("scope failed: " + e.getCause());
}
product {"path": "/product/1", "ok": true}, stock 7
elapsed 871 ms
scope failed: java.lang.IllegalStateException: inventory service is down
elapsed 113 ms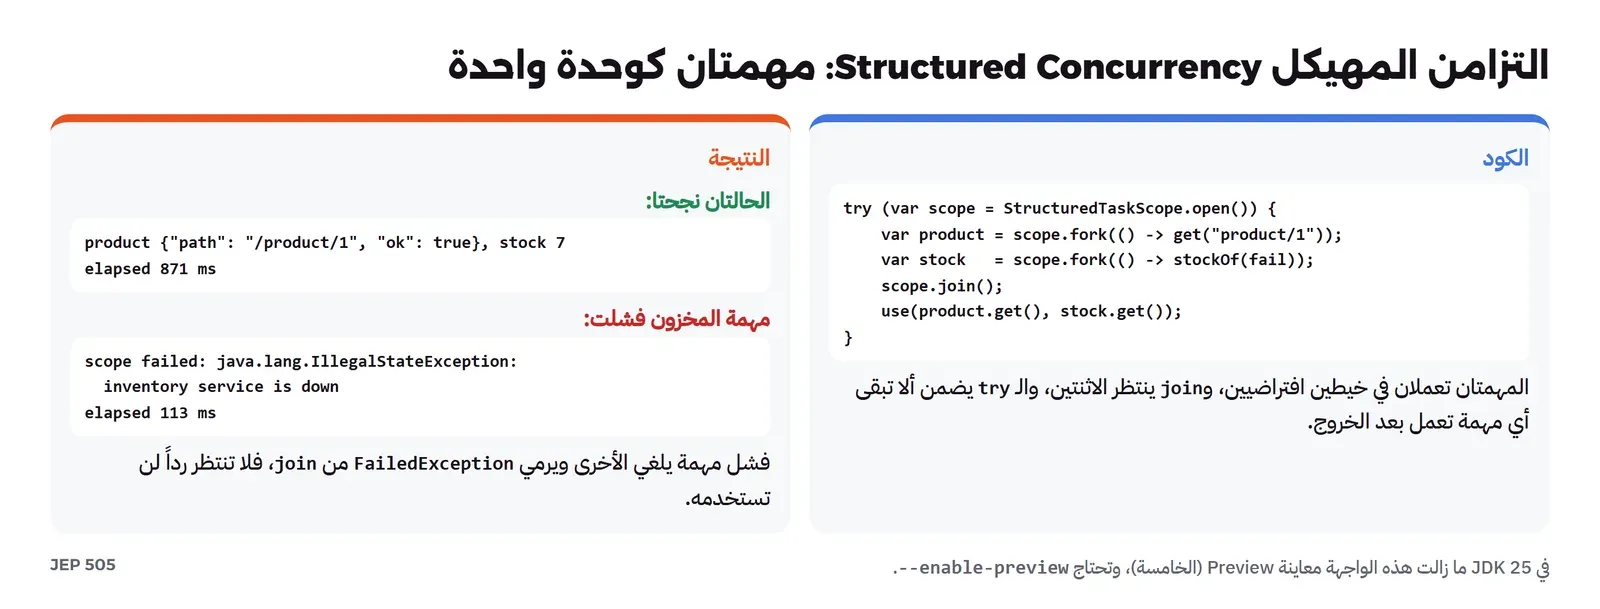
join الاستثناء مع سببه الأصلي.والتشغيل الأول نجح، وزمنه 871 ملي ثانية لأنه أول طلب في الـ JVM ويدفع ثمن التحميل. وفي الثاني فشلت مهمة المخزون فوراً، فألغيت مهمة المنتج ورمى join استثناء FailedException يحمل السبب الأصلي، وانتهى كل شيء في 113 ملي ثانية. ولاحظ أن الكتلة try تضمن أنه لا توجد مهمة تعمل بعد الخروج منها، وهذا ما لا يضمنه CompletableFuture. ولأنها معاينة فلا ننصح باستخدامها في كود الإنتاج بعد، ولكن اعرفها لأنها الشكل الذي يتجه إليه التزامن في Java، ومعها القيم المحددة النطاق Scoped Values التي صارت نهائية في JEP 506 بديلاً عن ThreadLocal مع الخيوط الافتراضية.
كيف يبدو هذا في خدمة حقيقية؟ Spring Boot ومجمع الاتصالات Connection Pool
في خدمة الطلبات لن تكتب Executors بنفسك في الغالب، لأن إطار الويب هو الذي يستقبل الطلب ويعطيه خيطاً. وفي Spring Boot يكفي سطر واحد في الإعداد حتى يعمل كل طلب في خيط افتراضي بدل مجمع خيوط Tomcat الذي حجمه الافتراضي 200 خيط، وهو spring.threads.virtual.enabled=true كما يشرح توثيق Spring Boot، والإطار يستخدمه أيضاً للمهام غير المتزامنة والمجدولة. والكود في الـ Controllers لا يتغير، فهو يستدعي قاعدة البيانات ويعيد النتيجة كما كان.
ولكن الخيوط الافتراضية تنقل عنق الزجاجة Bottleneck من مكان إلى آخر ولا تلغيه. فإذا كانت الخدمة تستقبل 5,000 طلب متزامن وكل طلب يحتاج اتصالاً بقاعدة البيانات، فإن 5,000 خيط افتراضي سوف تنتظر مجمع الاتصالات HikariCP الذي حجمه الافتراضي 10 اتصالات، وقاعدة PostgreSQL نفسها لها حد في عدد الاتصالات. وهذا في الحقيقة السلوك الصحيح، فالمجمع يحمي قاعدة البيانات، والانتظار عليه رخيص مع الخيوط الافتراضية، ولكن يجب أن تضع مهلة انتظار Timeout على الحصول على الاتصال حتى لا تتراكم الطلبات بلا حد، وأن تراقب طول طابور الانتظار. وكذلك الحال مع أي خدمة خارجية تستدعيها، مثل خدمة الشحن في قصتنا: إذا أطلقت 100 طلب لكل سلة وجاءت 50 سلة في نفس الثانية فأنت ترسل 5,000 طلب إلى خدمة قد لا تتحمل ذلك، فحدد التوازي بـ Semaphore أو بإعداد العميل، وليس بعدد الخيوط. وسوف تطبق الخدمة الحقيقية في هذه المرحلة هذه الإعدادات وتقيس نتيجتها.
جدول قرار Decision Table: أي أداة لأي مهمة؟
| المهمة | الأداة في Java 25 | لماذا | ما تتجنبه |
|---|---|---|---|
| طلبات تنتظر شبكة أو قاعدة بيانات | newVirtualThreadPerTaskExecutor وكود Blocking عادي | الانتظار رخيص والكود مقروء | مجمع ثابت صغير يحدد التوازي دون قصد |
| عدد كبير من طلبات HTTP في مكان واحد | HttpClient.sendAsync أو الخيوط الافتراضية | الأسرع في التجربة، دون خيط لكل طلب | إنشاء HttpClient لكل طلب |
| حساب ثقيل في مهمة دفعات | parallel() أو مجمع بعدد الأنوية | السقف هو الأنوية | خيوط أكثر من الأنوية، أو خيوط افتراضية |
| حساب ثقيل داخل خدمة ويب | مجمع خاص محدود الحجم | لا يأخذ الأنوية من الطلبات | commonPool المشترك |
| عداد مشترك | AtomicInteger أو LongAdder | دون قفل | count++ على متغير عادي |
| تعديل عدة متغيرات معاً | synchronized أو ReentrantLock بترتيب ثابت | تغيير كامل أو لا شيء | أقفال بترتيب مختلف |
| مخزون في قاعدة بيانات | قفل الصف في معاملة | يرى كل نسخ الخدمة | قفل في الذاكرة |
| مهام فرعية لطلب واحد | StructuredTaskScope (معاينة) | إلغاء وفشل منظم | مهام تبقى بعد انتهاء الطلب |
أخطاء شائعة Common Mistakes
- وضع الخيوط الافتراضية في مجمع ثابت: فائدتها أنها رخيصة وواحدة لكل مهمة، وتحديد عددها يعيد مشكلة المجمع الصغير.
- استخدام الخيوط الافتراضية للحساب: لم تكن أسرع في التجربة، وتحجز الخيوط الحاملة عن المهام التي تنتظر.
- الاعتماد على
ThreadLocalكـ Cache مع الخيوط الافتراضية: كل خيط افتراضي جديد يبدأ فارغاً، فلا يعاد استخدام شيء، ومع مئات الآلاف تكبر الذاكرة. count++أوstock--من عدة خيوط: ضاع 4% من المبيعات في التجربة، واستخدمAtomicIntegerأو قفلاً.- أقفال بترتيب مختلف: سبب الجمود الأشهر، ورتبها دائماً بمعرف ثابت.
- إنشاء
HttpClientأو مجمع اتصالات لكل طلب: يلغي إعادة استخدام الاتصالات ويضاعف الزمن. - قياس دون حساب الرقم المتوقع: كدنا أن نصدق 110 ملي ثانية للطلب، و2 ملي ثانية لحساب ألفي بصمة.
- عمل له أثر جانبي داخل
mapأوpeek: قد لا ينفذ أصلاً إذا كانcount()يستطيع حساب النتيجة دونه. - خيوط ومجمعات دون أسماء:
jstackفي الإنتاج يصبح قائمة منpool-3-thread-12لا تخبرك بشيء. - تجاهل
InterruptedException: إذا أمسكتها أعد ضبط الحالة بـThread.currentThread().interrupt()كما فيDeadlock.java، وإلا ضاع طلب الإلغاء.
تدريب عملي
- غير عدد الطلبات في
Bench.javaإلى 1,000، وقارن مجمع العشرة خيوط بالخيوط الافتراضية، ثم أضفSemaphoreبعشرين تصريحاً حولcallولاحظ كيف يتغير الزمن. - غير
Race.javaليستخدمLongAdder، ثم زد عدد الخيوط إلى 10,000، وقارن الزمن معAtomicInteger. - في
Deadlock.javaاستبدلsynchronizedبـReentrantLock.tryLock(100, MILLISECONDS)، واجعل التحويل يعيد المحاولة عند الفشل، ولاحظ ماذا يطبعjstackالآن. - شغل
slow-original.pyبدلslow.pyوأعد قياس الانتظار، ثم غيرBench.javaليفتح اتصالاً جديداً لكل طلب بإضافة الترويسةConnection: close، وقارن.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- 100 طلب تنتظر 50 ملي ثانية أخذت حوالي 5.5 ثانية تسلسلياً، وحوالي 0.6 ثانية بمجمع عشرة خيوط، و0.22 إلى 0.31 بالخيوط الافتراضية، و0.15 إلى 0.24 بـ
sendAsync. - الخيوط الافتراضية تجعل الانتظار رخيصاً دون تغيير الكود، و10,000 مهمة نائمة انتهت في 1.36 ثانية و98 ميجابايت مقابل 9.3 ثانية و187 ميجابايت بخيوط النظام.
- الحساب لا يتسرع بأكثر من عدد الأنوية: من حوالي 3.5 ثانية إلى حوالي 2 على معالجين وحوالي 0.7 على ثماني أنوية، والخيوط الزائدة والافتراضية لم تضف شيئاً.
- سيرفر يكتب الرد على دفعتين ضاعف زمن كل طلب بسبب Nagle وDelayed ACK، و
count()تخطى العمل كله، فاحسب الرقم المتوقع قبل كل قياس. - متغير عادي يكتبه خيط ويقرؤه آخر قد لا يرى التعديل أبداً، وفي التجربة بقيت الحلقة تدور حتى أنهينا البرنامج، و
volatileأصلحتها، وعلى JDK 25 لم يعدsynchronizedيلصق الخيط الافتراضي بالخيط الحامل. stock--من ألف خيط أضاع حوالي 4% من المبيعات، وsynchronizedوAtomicIntegerأصلحاه، أما المخزون الحقيقي فقفله في قاعدة البيانات.- الجمود يكشفه
jstackبأسماء الخيوط والأسطر، ويمنعه ترتيب ثابت للأقفال، والتزامن المهيكل في JDK 25 ما زال معاينة.
وفي المقال التالي من مرحلة لغة Java للمطورين نبني خدمة الطلبات كاملة بـ Spring Boot وPostgreSQL، ونختبر فيها نفس سباق المخزون بعشرين طلباً متزامناً على قاعدة بيانات حقيقية. وتجد هنا المقالات المرتبطة:
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلحلقة الأحداث Event Loop: لماذا تتأخر النقرة في صفحتك؟كيف ترتب JavaScript المهام والوعود والرسم على خيط واحد، ولماذا تنتظر النقرة خلف مهمة طويلة، وكيف تقسم العمل لتبقى الصفحة سريعة.
 دليلإدارة الذاكرة: يدوياً أم Garbage Collector أم Ownership؟نقيس بأيدينا في C وGo وPython وRust من يحرر الذاكرة ومتى، وكم يكلف ذلك من الذاكرة والوقت، وما الأخطاء التي تبقى ممكنة في كل طريقة.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلهل Java مجانية؟ أي JDK تستخدم في شركتكمتى تحتاج اشتراكاً في Oracle JDK ومتى لا تحتاجه، وكيف تعرف نسخ Java التي تعمل عندك وتنقلها إلى نسخة مجانية بأمان.
 دليلكيف تختار لغة البرمجة Programming Language لمشروعك؟نختار لغة خدمة حقيقية بأسئلة الفريق والتوظيف والمكتبات والرخصة، ثم نكتبها بأربع لغات ونقيس البناء والحجم والذاكرة والطلبات في الثانية بأنفسنا.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على JDK 25.0.5 (Temurin) داخل Docker بمعالجين ثم دون حد على جهاز بثماني أنوية، مع سيرفر Python 3.13 بطيء على نفس الشبكة.


