


وصلت خدمة الطلبات في متجر القهوة والتمور إلى أول متطلب يحتاج التزامن Concurrency: عندما يفتح العميل صفحة السلة، تحتاج الخدمة أن تسأل خدمة الأسعار عن سعر كل منتج، وخدمة الشحن عن تكلفة التوصيل، وخدمة المخزون عن الكمية المتاحة، وكل واحدة منها ترد في 50 جزءاً من الألف من الثانية تقريباً. والسلة الكبيرة فيها عشرات المنتجات، فإذا انتظرت الخدمة كل رد قبل أن ترسل الطلب التالي فسوف ينتظر العميل عدة ثوان. وفي نفس الأسبوع جاء طلب ثان من فريق المالية: تقرير ليلي يحسب بصمة SHA-256 لكل فاتورة عدة مرات للتحقق من سلامة الأرشيف، ويستغرق اليوم دقائق. والمطور القادم من Python يعرف asyncio ومشكلة القفل العام GIL، وزميله القادم من Android يقول «استخدم Coroutines فقط»، والقادم من Java يقول «الخيوط الافتراضية Virtual Threads في JDK 21 حلت كل هذا». وكل واحد منهم محق في جزء، والمطلوب أن نعرف بالأرقام ما يحدث فعلاً.
وهذا المقال هو الثالث في مرحلة Kotlin، وهو مبني على نفس المهمتين التي نقيسها في كل لغات المسار حتى تقارن بينها: مئة طلب HTTP إلى خدمة محلية بطيئة يأخذ كل طلب فيها 50 جزءاً من الألف من الثانية، وحساب SHA-256 لألفي نص كل واحد ألفي مرة متتالية. ولن نشرح مفاهيم الخيط Thread والعملية Process والقفل Lock من الصفر، فقد شرحناها في مقال الخيوط والأقفال وasync، وما يهمنا هنا هو طريقة Kotlin: الروتينات المساعدة Coroutines، والموزعات Dispatchers، والتزامن المنظم Structured Concurrency، ومكانها بجانب الخيوط الافتراضية في JDK 25.
وسوف نناقش في هذا المقال ما يلي:
- ما هي الروتينات المساعدة، وكيف يحولها المترجم إلى آلة حالات State Machine، ولماذا لا تحتاج خيطاً لكل انتظار.
- الموزعات Dispatchers:
DefaultوIOوlimitedParallelism، والخيوط الافتراضية كموزع. - مختبر المهمة الأولى: مئة طلب HTTP متتالية ومتزامنة بخمس طرق، مع قراءة الأرقام سطراً بسطر.
- تجربة «ماذا يحدث إذا» وضعت كوداً حاجزاً Blocking على الموزع الخطأ.
- مختبر المهمة الثانية: SHA-256 على 8 معالجات ثم على معالجين.
- التزامن المنظم Structured Concurrency والإلغاء Cancellation.
- حالة سباق Race Condition حقيقية، وثلاث طرق لإصلاحها بأسعار مختلفة.
- جمودان Deadlock حقيقيان:
Mutexلا يقبل إعادة الدخول، وrunBlockingداخل موزع بخيط واحد، وكيف تراهما بأداة التصحيح. - جدول قرار وأخطاء شائعة وقائمة تحقق.
ما هي الروتينات المساعدة Coroutines؟ دالة تتوقف دون أن تحجز خيطاً
الروتين المساعد Coroutine هو حساب يمكن أن يتوقف في منتصفه ثم يكمل من نفس المكان لاحقاً، ربما على خيط آخر. والفكرة قديمة من الستينات، ولكن Kotlin جعلتها جزءاً من اللغة نفسها منذ الإصدار 1.3 في 2018، وتشرح وثيقة التصميم KEEP: Coroutines الطريقة: اللغة تضيف كلمة واحدة فقط هي suspend، وكل الباقي، أي launch وasync وdelay والموزعات، مكتبة عادية اسمها kotlinx.coroutines، واستخدمنا منها الإصدار 1.11.0.
والتشبيه الأقرب لما يحدث هو موظف خدمة العملاء في مطعم: الطريقة الحاجزة Blocking هي أن يأخذ الموظف طلب العميل الأول ويقف أمام المطبخ حتى يجهز الطعام، ثم يعود للعميل الثاني، فإذا أردت خدمة مئة عميل في نفس الوقت تحتاج مئة موظف، وكل واحد منهم واقف معظم الوقت لا يفعل شيئاً. والطريقة المعلقة Suspending هي أن يكتب الموظف الطلب ويعطيه للمطبخ، ثم ينتقل للعميل التالي، وعندما يجهز الطعام يرن الجرس فيعود أي موظف متاح ليكمل. فالموظفون هم الخيوط، والطلبات هي الروتينات، والجرس هو استئناف الروتين Resume.
وعلى مستوى الكود، تكتب الدالة المعلقة كأنها دالة عادية متسلسلة، دون callbacks ودون .then():
// استدعاء معلق Suspending: الروتين يتوقف، والخيط يعود ليخدم غيره حتى يصل الرد
suspend fun fetchSuspending(i: Int): Int =
    client.sendAsync(req(i), HttpResponse.BodyHandlers.ofString()).await().statusCode()
والدالة sendAsync من HttpClient في JDK ترجع CompletableFuture، والدالة await() من المكتبة تعلق الروتين حتى يكتمل هذا الـ Future دون أن تحجز الخيط. والمترجم يحول كل دالة suspend إلى آلة حالات State Machine: كل نقطة توقف تصبح حالة مرقمة، والمتغيرات المحلية تحفظ في كائن صغير اسمه الاستمرار Continuation يضاف كمعامل مخفي إلى الدالة. فعندما يتوقف الروتين يبقى منه في الذاكرة هذا الكائن فقط، وليس مكدس Stack خيط كامل. ولهذا تستطيع أن تشغل مئة ألف روتين على بضعة خيوط، بينما مئة ألف خيط نظام تشغيل تحتاج جيجابايتات من المكدسات.
وقد يتساءل البعض: إذا كانت JDK 21 قد أضافت الخيوط الافتراضية Virtual Threads في JEP 444، وهي تحقق نفس الهدف دون كلمة suspend، فلماذا الروتينات أصلاً؟ والإجابة أن الحلين يحلان نفس المشكلة من مكانين مختلفين: الخيط الافتراضي يجعل الكود الحاجز القديم رخيصاً، فالـ JVM هي التي تفصل الخيط الافتراضي عن خيط النظام عند الانتظار، أما الروتينات فتجعل التوقف صريحاً في نوع الدالة، وتضيف فوقه التزامن المنظم والإلغاء وتعمل على Android وعلى منصات Kotlin الأخرى التي لا يوجد فيها JDK 21. وفي الخدمات على JDK 25 تستطيع أن تجمع الاثنين، كما سوف نجرب بعد قليل، والقرار في جدول القرار في آخر المقال.
وللقادم من Python ملاحظة مهمة قبل أن ننتقل: الروتينات في Kotlin تشبه async وawait في asyncio في الصيغة، ولكنها تختلف عنها في أهم نقطة. فحلقة الأحداث في asyncio تعمل على خيط واحد، ولا يمكن أن يعمل روتينان في نفس اللحظة، ولذلك نادراً ما تحتاج قفلاً بين نقطتي await، ومع ذلك فالعمل الحسابي يوقف الحلقة كلها ويحتاج عمليات منفصلة بسبب القفل العام GIL. أما في Kotlin فالموزع Default فيه خيط لكل نواة، والروتينات تعمل فعلاً في نفس اللحظة على عدة أنوية، فالعمل الحسابي يتوزع دون عمليات منفصلة، والثمن أن كل مشكلات الذاكرة المشتركة في Java موجودة كما هي، كما سوف ترى في تجربة السباق. والقادم من JavaScript يعرف الشيء نفسه من حلقة الأحداث في Node.js، وقد شرحناها في مقال حلقة الأحداث Event Loop. والقادم من Go سوف يجد الروتينات قريبة من Goroutines في التكلفة والعدد، مع فرق أن التوقف في Kotlin صريح بكلمة suspend، وفي Go كل استدعاء يمكن أن يكون نقطة توقف دون أن يظهر ذلك في الكود.
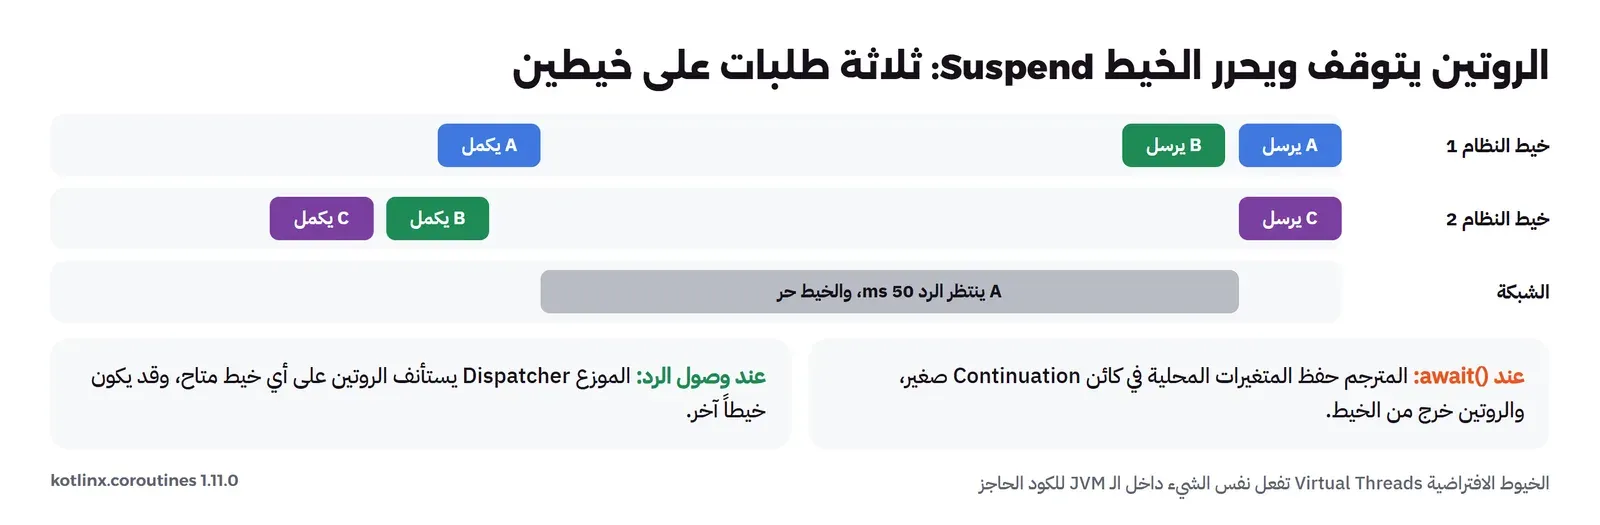
الموزعات Dispatchers: أين يعمل الروتين؟
والروتين لا يعمل في الهواء، وإنما على خيوط يحددها الموزع Dispatcher، وتشرح صفحة Coroutine context and dispatchers الأنواع. والموزعات التي تهمك في الخدمات ثلاثة:
- Dispatchers.Default: للعمل الحسابي، وعدد خيوطه بعدد أنوية المعالج وأقله اثنان، كما تقول وثائقه. وعلى جهازنا بـ 8 معالجات فيه 8 خيوط. وهذا هو الموزع الافتراضي لـ
launchوasyncإذا لم تحدد غيره. - Dispatchers.IO: للكود الحاجز الذي ينتظر قرصاً أو شبكة أو قاعدة بيانات عبر JDBC. وتقول وثائقه إن عدد الخيوط التي تعمل في نفس الوقت محدود بـ 64 أو بعدد الأنوية أيهما أكبر، ويمكن تغييره بخاصية النظام
kotlinx.coroutines.io.parallelism. وهو يشترك معDefaultفي نفس مجموعة الخيوط، فالانتقال بينهما لا يعني دائماً تبديل خيط. - limitedParallelism(n): نسخة من موزع بحد مختلف، فـ
Dispatchers.IO.limitedParallelism(100)يعطيك 100 خيط مستقلة عن حد الـ 64، وDispatchers.Default.limitedParallelism(1)يعطيك خيطاً واحداً في كل لحظة، وهذا مفيد لحصر الحالة كما سوف نرى في قسم السباق.
وأي ExecutorService من Java يمكن أن يصبح موزعاً بالدالة asCoroutineDispatcher()، ومنها Executors.newVirtualThreadPerTaskExecutor() التي تنشئ خيطاً افتراضياً لكل مهمة، فتحصل على روتينات تعمل على خيوط افتراضية. وهذا الجسر هو ما سوف نقيسه كطريقة خامسة.
المهمة الأولى I/O-Bound: مئة طلب HTTP بخمس طرق
والخدمة البطيئة التي نستدعيها مكتوبة بـ Python في ملف واحد lab/slow.py، وتعمل في Container اسمه slk-slow على شبكة Docker خاصة، فكل طلب ينتظر 50 جزءاً من الألف من الثانية ثم يرد بـ JSON صغير:
class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    disable_nagle_algorithm = True  # headers and body go out as two writes; without this, keep-alive calls wait ~40 ms for a delayed ACK
    def do_GET(self):
        time.sleep(0.050)
        body = json.dumps({"path": self.path, "ok": True}).encode()
        self.send_response(200)
        ...
ThreadingHTTPServer.request_queue_size = 256
ولاحظ السطر disable_nagle_algorithm = True، فهو درس ظهر أثناء تجهيز مختبرات المسار: السيرفر يكتب الرؤوس Headers والجسم Body في عمليتي كتابة منفصلتين، ومع الاتصال المستمر Keep-Alive كانت خوارزمية Nagle في نظام التشغيل تنتظر إشعار الاستلام المؤجل Delayed ACK من الطرف الآخر قبل إرسال الجزء الثاني، فكان كل طلب يأخذ حوالي 100 جزء من الألف من الثانية بدل 50. وإطفاء الخوارزمية بالخيار TCP_NODELAY أعاد الطلب إلى 51 جزءاً تقريباً. فإذا رأيت يوماً زمن استجابة يزيد 40 جزءاً من الألف بالضبط بين خدمتين، فابحث عن هذا قبل أي شيء آخر.
والطرق الخمس التي قسناها في الملف lab/src/main/kotlin/lab/Io.kt هي التالية:
fun ioSequential(): Int = (1..CALLS).count { fetchBlocking(it) == 200 }

suspend fun ioAsyncAwait(): Int = coroutineScope {
    (1..CALLS).map { async { fetchSuspending(it) } }.awaitAll().count { it == 200 }
}

// الطريقة الشائعة: نفس الكود الحاجز داخل Dispatchers.IO، وهو محدود بـ 64 خيطاً افتراضياً
suspend fun ioBlockingOnIo(): Int = coroutineScope {
    (1..CALLS).map { async(Dispatchers.IO) { fetchBlocking(it) } }.awaitAll().count { it == 200 }
}

suspend fun ioBlockingOnIoWide(): Int = coroutineScope {
    val wide = Dispatchers.IO.limitedParallelism(CALLS)
    (1..CALLS).map { async(wide) { fetchBlocking(it) } }.awaitAll().count { it == 200 }
}

// الخيوط الافتراضية Virtual Threads من JDK 21 كـ Dispatcher للروتينات
suspend fun ioBlockingOnVirtualThreads(): Int =
    Executors.newVirtualThreadPerTaskExecutor().asCoroutineDispatcher().use { vt ->
        coroutineScope { (1..CALLS).map { async(vt) { fetchBlocking(it) } }.awaitAll().count { it == 200 } }
    }
في الكود أعلاه لاحظ التالي:
async { }تبدأ روتيناً يرجع قيمة في المستقبل من النوعDeferred، وawaitAll()تنتظرها كلها. وهذا يقابلasyncio.gatherفي Python وPromise.allفي JavaScript.coroutineScope { }تنشئ نطاقاً لا ينتهي حتى تنتهي كل الروتينات بداخله، وإذا فشل أحدها ألغيت البقية. وهذا هو التزامن المنظم الذي سوف نعود إليه.fetchBlockingتستدعيclient.sendالحاجزة، فالخيط ينتظر الرد فعلاً، ولذلك نضعها علىDispatchers.IOأو على خيوط افتراضية، ولا نضعها علىDefault.- الدالة
use { }تغلق الموزع المبني على الخيوط الافتراضية بعد الانتهاء، وهي مثلtry-with-resourcesفي Java.
وشغلنا البرنامج في Container على نفس شبكة الخدمة البطيئة، بعد خمسة طلبات إحماء، وكررنا القياس مرتين في نفس العملية:
cpus=8  java=25.0.5  kotlin=2.4.21
-- io round 1 (100 calls x 50 ms) --
sequential, blocking send                       5475 ms   result=100
coroutines, sendAsync().await()                 2478 ms   result=100
blocking send on Dispatchers.IO                  528 ms   result=100
blocking send on IO.limitedParallelism(100)      605 ms   result=100
blocking send on virtual threads                 753 ms   result=100
-- io round 2 (100 calls x 50 ms) --
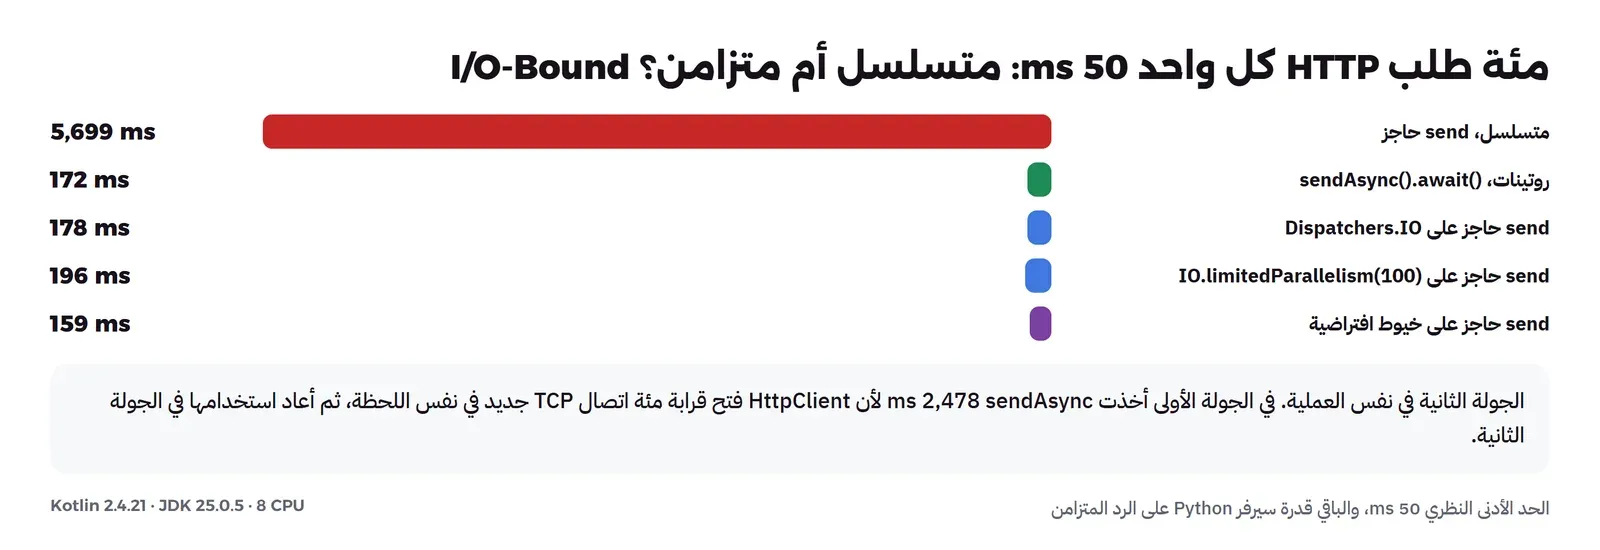
sequential, blocking send                       5699 ms   result=100
coroutines, sendAsync().await()                  172 ms   result=100
blocking send on Dispatchers.IO                  178 ms   result=100
blocking send on IO.limitedParallelism(100)      196 ms   result=100
blocking send on virtual threads                 159 ms   result=100
والمخرج يحتاج قراءة متأنية، لأن الجولة الأولى تختلف كثيراً عن الثانية:
- الطريقة المتسلسلة أخذت 5,475 و5,699 جزءاً من الألف، أي 55 إلى 57 لكل طلب: 50 انتظار السيرفر، والباقي الشبكة وتحليل الرد. وهذا هو الحد الأدنى المنطقي لمئة طلب بالتتابع، ولا يتغير بين الجولتين.
- في الجولة الأولى كانت الروتينات مع
sendAsyncأبطأ الطرق المتزامنة (2,478)، وفي الثانية صارت 172. والسبب ليس الروتينات، وإنما أنHttpClientيحتفظ بمجموعة اتصالات Connection Pool: في الجولة الأولى كان عليه أن يفتح قرابة مئة اتصال TCP جديد في نفس اللحظة، والسيرفر المكتوب بـ Python يقبلها واحداً واحداً، وفي الجولة الثانية كانت الاتصالات مفتوحة من قبل. والطرق التي جاءت بعدها في الجولة الأولى استفادت من الاتصالات التي فتحتها هي. - في الجولة الثانية كانت الطرق الأربع المتزامنة متقاربة جداً، بين 159 و196 جزءاً من الألف، أي أسرع من المتسلسلة بثلاثين مرة تقريباً. والحد الأدنى النظري 50، والباقي هو قدرة السيرفر نفسه على خدمة مئة طلب في نفس اللحظة بخيوط Python.
- والنتيجة
result=100في كل سطر تعني أن الطلبات المئة رجعت كلها بـ 200، فلا توجد طريقة أسرع لأنها أسقطت طلبات.
والدرس الأول من هذا المختبر أن الفرق بين الحلول المتزامنة صغير عندما يكون عدد الطلبات أقل من حدود الموزع، والفرق الكبير هو بين المتسلسل وأي حل متزامن. والدرس الثاني أن أول قياس يكذب: لو اكتفينا بالجولة الأولى لحكمنا بأن الروتينات مع sendAsync أبطأ بأربع مرات من الخيوط، وهذا غير صحيح.
ثم كررنا نفس التجربة بـ 300 طلب، أي أكثر من حد الـ 64 خيطاً في Dispatchers.IO، وكانت الجولة الثانية كما يلي:
-- io round 2 (300 calls x 50 ms) --
sequential, blocking send                      17643 ms   result=300
coroutines, sendAsync().await()                  520 ms   result=300
blocking send on Dispatchers.IO                  527 ms   result=300
blocking send on IO.limitedParallelism(100)      534 ms   result=300
blocking send on virtual threads                 397 ms   result=300
وكنا نتوقع أن يظهر حد الـ 64 هنا، فثلاثمئة طلب على 64 خيطاً تحتاج خمس دفعات على الأقل، أي 250 جزءاً من الألف. ولكن كل الطرق أخذت بين 397 و534، لأن السيرفر البطيء نفسه صار هو عنق الزجاجة Bottleneck: خيوط Python مع القفل GIL لا تستطيع أن ترد على 300 طلب في نفس اللحظة. وهذه مشكلة حقيقية في قياس التزامن: إذا كان الطرف الآخر أبطأ من الحد الذي تقيسه، فأنت تقيس الطرف الآخر. ولكي نرى حد الموزع وحده، احتجنا تجربة دون شبكة.
ماذا يحدث إذا وضعت كوداً حاجزاً على الموزع الخطأ؟
استبدلنا الطلب بانتظار محلي في نفس العملية، فكل مهمة تنتظر 50 جزءاً من الألف بطريقتين: Thread.sleep(50) التي تحجز الخيط مثل أي كود حاجز (JDBC أو قراءة ملف)، وdelay(50) المعلقة من مكتبة الروتينات، ثم شغلنا 300 مهمة على كل موزع:
suspend fun sleepOnIo(): Int = coroutineScope {
    (1..TASKS).map { async(Dispatchers.IO) { Thread.sleep(50); 1 } }.awaitAll().sum()
}

suspend fun sleepOnDefault(): Int = coroutineScope {
    (1..TASKS).map { async(Dispatchers.Default) { Thread.sleep(50); 1 } }.awaitAll().sum()
}

suspend fun delayOnDefault(): Int = coroutineScope {
    (1..TASKS).map { async(Dispatchers.Default) { kotlinx.coroutines.delay(50); 1 } }.awaitAll().sum()
}
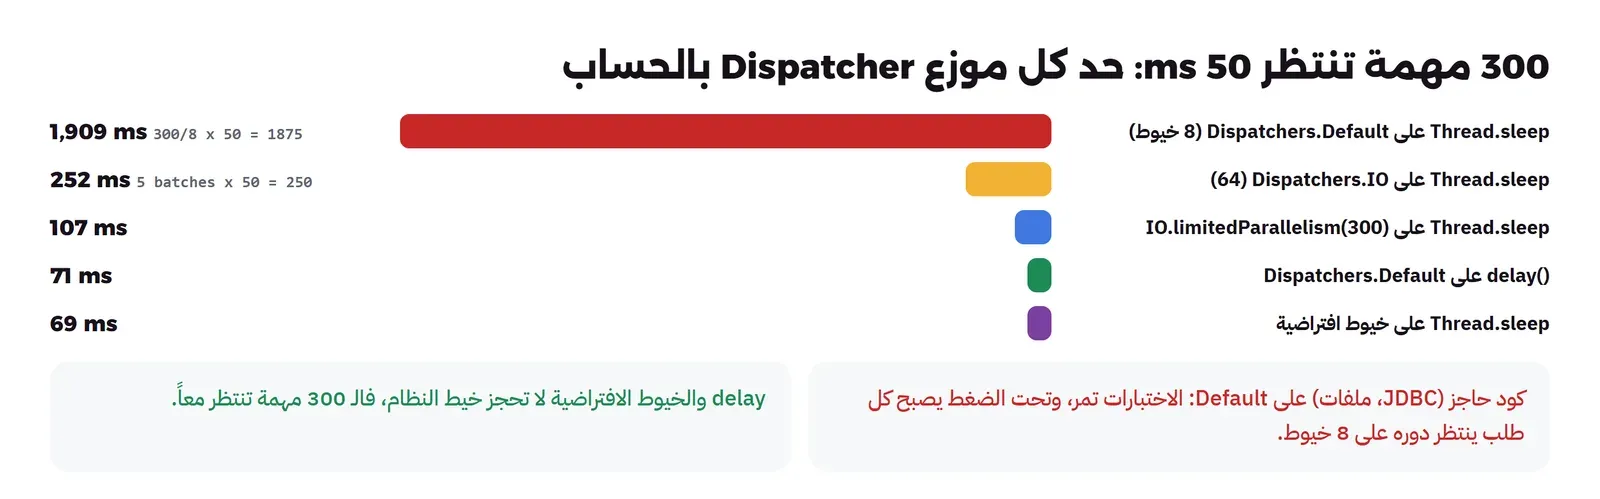
-- sleep round 2 (300 tasks x 50 ms) --
Thread.sleep on Dispatchers.IO (64) 252 ms result=300
Thread.sleep on IO.limitedParallelism(300) 107 ms result=300
Thread.sleep on Dispatchers.Default 1909 ms result=300
delay() on Dispatchers.Default 71 ms result=300
Thread.sleep on virtual threads 69 ms result=300وهنا ظهرت حدود الموزعات بأرقام تكاد تطابق الحساب:
Dispatchers.IOأخذ 252 جزءاً من الألف، و300 مهمة على 64 خيطاً تعني 5 دفعات (64 × 4 = 256، والدفعة الخامسة 44 مهمة)، و5 × 50 = 250. فالحد موجود فعلاً، ويضيف زمناً كلما زاد العدد.Dispatchers.Defaultأخذ 1,909 جزءاً من الألف، أي أبطأ بسبع مرات ونصف. والحساب: 8 خيوط فقط، و300 ÷ 8 = 38 دفعة تقريباً، و38 × 50 = 1,900. وهذا هو الخطأ الذي يقع فيه كل من يستدعي JDBC أوFile.readText()داخلlaunchعادية دونwithContext(Dispatchers.IO): الكود يعمل، والاختبارات تمر، وتحت الضغط يصبح كل طلب ينتظر دوره على ثمانية خيوط، وأسوأ من ذلك أن الخيوط الثمانية نفسها هي التي تحتاجها كل الروتينات الأخرى في الخدمة.delay()على نفس الموزعDefaultأخذ 71 فقط، لأنه لا يحجز الخيط أصلاً، فالـ 300 روتين توقفت كلها على نفس الخيوط الثمانية واستؤنفت معاً.- الخيوط الافتراضية أخذت 69، أي مثل
delay، رغم أن الكود يستدعيThread.sleepالحاجزة، لأن الـ JVM هي التي تعلق الخيط الافتراضي هنا وتحرر خيط النظام. وlimitedParallelism(300)أخذ 107 لأنه أنشأ خيوط نظام حقيقية لكل مهمة تقريباً.
والقاعدة العملية من هذه التجربة: كل كود حاجز يجب أن يعيش على موزع مصمم له، إما Dispatchers.IO، أو نسخة أوسع منه إذا كان عدد العمليات المتزامنة أكبر من 64، أو موزع مبني على الخيوط الافتراضية. والطريقة الأفضل حين تتوفر مكتبة معلقة أصلية، مثل عميل Ktor أو مكتبة قاعدة بيانات غير حاجزة، أن تستخدمها فلا تحتاج أي خيط إضافي. وتذكر أن حد الـ 64 في IO ليس عيباً، وإنما حماية: فهو يمنعك من فتح ألف اتصال بقاعدة بيانات لا تتحمل إلا عشرين، وفي الخدمة الحقيقية سوف نضع حداً أضيق منه هو حجم مجموعة الاتصالات Connection Pool.
المهمة الثانية CPU-Bound: ألفا نص وألفا جولة SHA-256
والمهمة الثانية حسابية خالصة لا تنتظر شيئاً، فكل نص يمر عبر SHA-256 ألفي مرة متتالية، والنتيجة أول 16 حرفاً من الهاش الأخير:
// نفس المهمة في كل لغات المسار: SHA-256 لكل نص 2,000 مرة متتالية
fun hashChain(s: String): String {
    val md = MessageDigest.getInstance("SHA-256")
    var bytes = s.toByteArray()
    repeat(ROUNDS) { bytes = md.digest(bytes) }
    return bytes.joinToString("") { "%02x".format(it) }.take(16)
}

fun cpuSequential(): String = inputs().map(::hashChain).last()

suspend fun cpuDefault(): String = coroutineScope {
    inputs().map { async(Dispatchers.Default) { hashChain(it) } }.awaitAll().last()
}
ولاحظ أن كل روتين ينشئ كائن MessageDigest خاصاً به، لأن هذا الكائن غير آمن للخيوط Not Thread-Safe، ومشاركته بين الروتينات كانت ستعطي هاشات خاطئة دون أي استثناء. والنتائج على 8 معالجات:
-- cpu round 2 (2000 strings x 2000 SHA-256 rounds) --
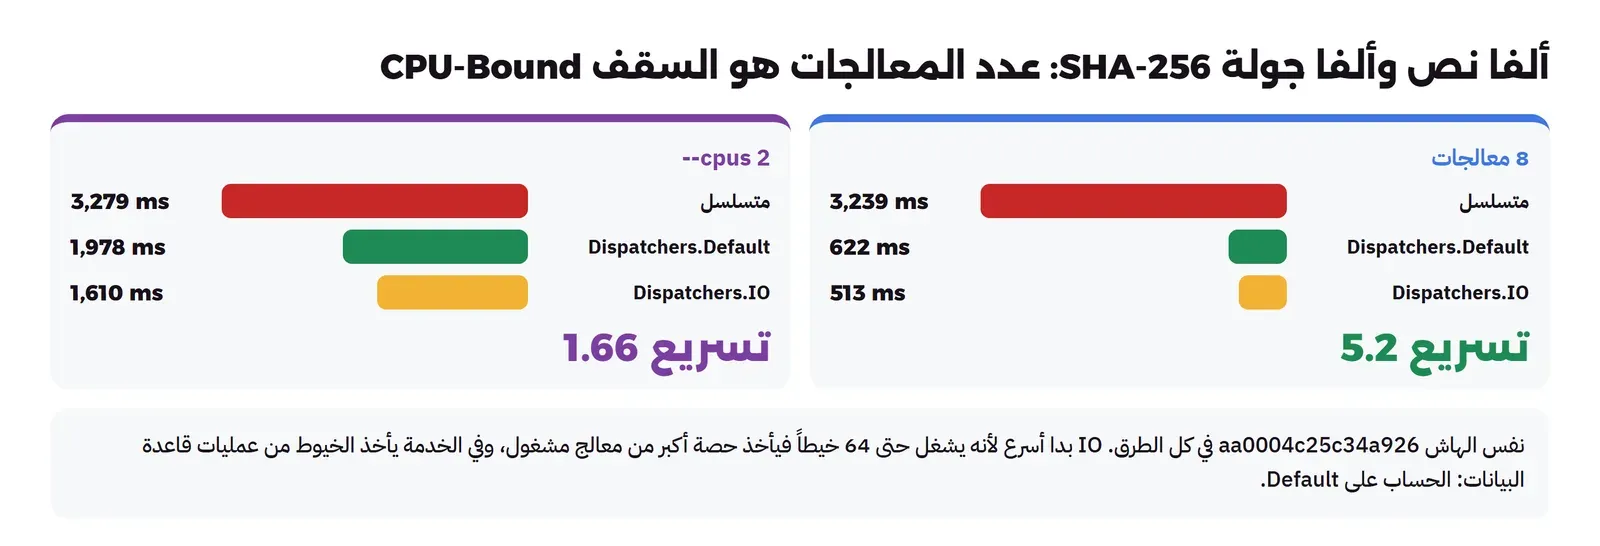
sequential                                      3239 ms   result=aa0004c25c34a926
async on Dispatchers.Default                     622 ms   result=aa0004c25c34a926
async on Dispatchers.IO                          513 ms   result=aa0004c25c34a926
ثم نفس البرنامج في Container محدود بمعالجين بالخيار --cpus 2:
cpus=2  java=25.0.5  kotlin=2.4.21
-- cpu round 2 (2000 strings x 2000 SHA-256 rounds) --
sequential                                      3279 ms   result=aa0004c25c34a926
async on Dispatchers.Default                    1978 ms   result=aa0004c25c34a926
async on Dispatchers.IO                         1610 ms   result=aa0004c25c34a926
في المخرجين أعلاه لاحظ التالي:
- الهاش النهائي
aa0004c25c34a926متطابق في كل الطرق وفي كل الجولات، وهذا أول ما تتحقق منه في أي قياس تزامن: أن السرعة لم تأت على حساب الصحة. - على 8 معالجات كان
Defaultأسرع من المتسلسل بخمس مرات وقليل (3,239 ÷ 622)، وليس بثماني مرات، لأن الجهاز كان يشغل تجارب أخرى، ولأن جمع النتائج وإنشاء ألفي روتين له تكلفة. - السطر الأول
cpus=2يقول إن الـ JVM قرأت حد الـ Container ورأت معالجين فقط، فصارDefaultبخيطين. والتسريع نزل إلى 1.6 مرة تقريباً، وهذا هو السقف المنطقي: لا يوجد تزامن يعطيك أكثر من عدد المعالجات في عمل حسابي. Dispatchers.IOكان أسرع قليلاً منDefaultفي الحالتين، وهذا يحتاج تفسيراً صادقاً:IOيستطيع أن يشغل 64 خيطاً، فهو يأخذ حصة أكبر من وقت المعالج على حساب بقية العمليات على الجهاز، وعلى جهاز مشغول بتجارب أخرى تظهر هذه الحصة على أنها سرعة. وفي خدمة حقيقية هذا سلوك سيء، فالعمل الحسابي علىIOيملأ الخيوط التي تحتاجها عمليات قاعدة البيانات، فتتأخر الطلبات العادية خلف التقرير الليلي. والقاعدة: الحساب علىDefault، والانتظار علىIO، ولا تختار الموزع من نتيجة قياس واحد.- الجولة الأولى (في ملف المخرج) كانت أبطأ في كل الطرق، 4,465 للمتسلسل مثلاً، لأن الـ JIT لم يترجم
MessageDigestبعد، وهذا نفس أثر الإحماء Warm-up الذي رأيناه في المقال الثاني.
التزامن المنظم Structured Concurrency والإلغاء Cancellation
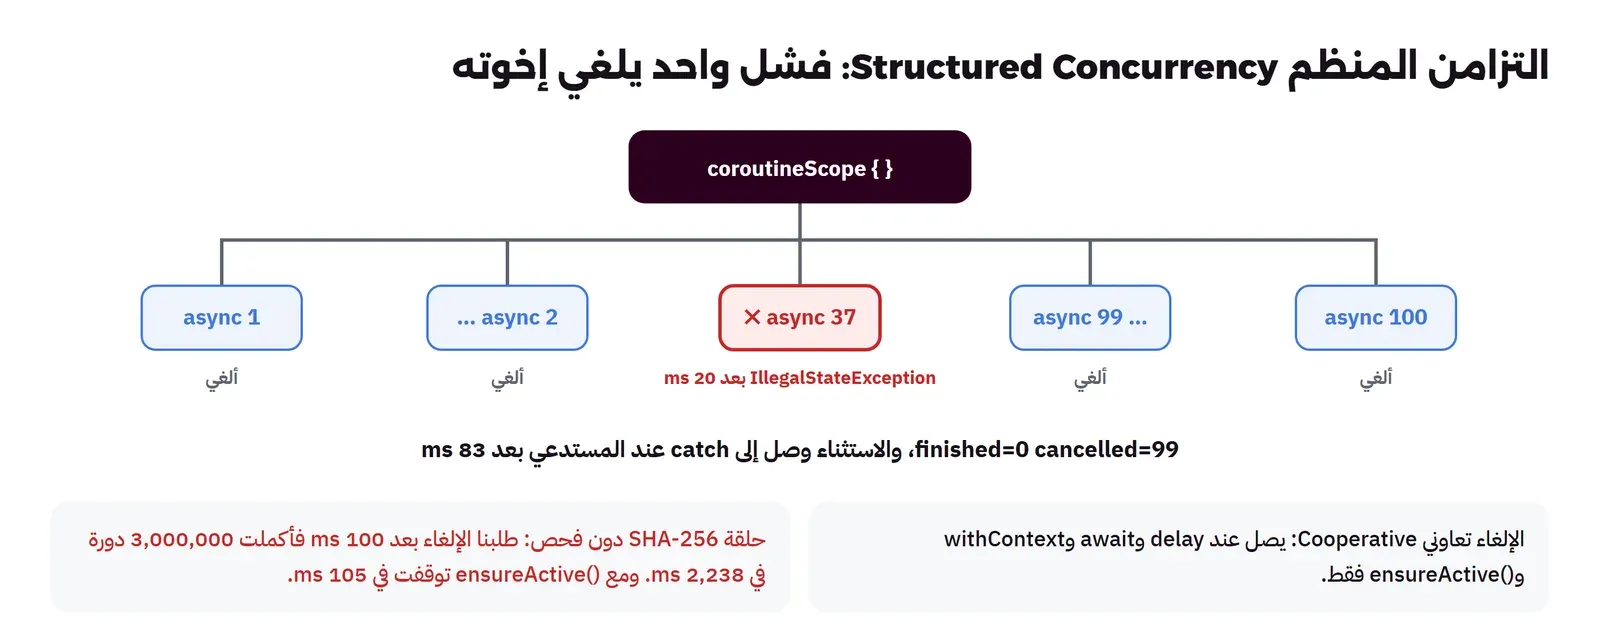
والفكرة التي تميز الروتينات في Kotlin عن مجرد خيوط رخيصة هي التزامن المنظم Structured Concurrency: كل روتين يولد داخل نطاق Scope، والنطاق لا ينتهي حتى ينتهي كل أولاده، وإذا فشل أحد الأولاد أو ألغي النطاق ألغي الجميع. وتشرح صفحة Coroutines basics هذه القاعدة. وفي الكود أعلاه، الدالة coroutineScope { } هي هذا النطاق، فإذا فشل الطلب رقم 37 من المئة برمي استثناء، تلغى الطلبات الـ 99 الأخرى فوراً، ويخرج الاستثناء من coroutineScope إلى المستدعي، ولا يبقى أي روتين يعمل في الخلفية بعد أن رجعت الدالة. وقارن هذا بـ ExecutorService.submit في Java القديمة، حيث تستطيع أن ترجع من الدالة وتترك مهام تعمل دون أن يعرف أحد، أو بـ asyncio.create_task في Python دون حفظ المرجع.
ولكي لا نكتفي بالوصف، كتبنا تجربة صغيرة: مئة روتين داخل coroutineScope، كل واحد ينتظر 50 جزءاً من الألف ويزيد عداد المنتهين، إلا الروتين رقم 37 الذي يفشل بعد 20 جزءاً من الألف برسالة «price service failed»، وكل روتين يزيد عداداً آخر إذا وصله الإلغاء:
coroutineScope {
    (1..100).map { i ->
        async {
            try {
                if (i == 37) { delay(20); error("price service failed for item $i") }
                delay(50); finished.incrementAndGet(); i
            } catch (e: CancellationException) { cancelled.incrementAndGet(); throw e }
        }
    }.awaitAll().size.toString()
}
caught: price service failed for item 37 | finished=1 cancelled=98 after 329 ms
caught: price service failed for item 37 | finished=0 cancelled=99 after 83 msفي الجولة الثانية، بعد الإحماء، لم ينته أي روتين من الـ 99، وكلها وصلها الإلغاء، والاستثناء الأصلي برسالته وصل إلى catch عند المستدعي بعد 83 جزءاً من الألف، أي قبل أن يكمل أي طلب آخر انتظاره. وفي الجولة الأولى أكمل روتين واحد قبل أن يصل الإلغاء، لأن تحميل الكلاسات أخر الروتين 37 نفسه. وهذا بالضبط السلوك الذي تريده في صفحة السلة: إذا فشلت خدمة الأسعار لمنتج واحد فلا فائدة من انتظار الباقي، ولا يجب أن تبقى طلبات معلقة تستهلك الاتصالات بعد أن رد السيرفر على العميل بالخطأ. ولاحظ السطر throw e بعد زيادة العداد، فإمساك CancellationException دون إعادة رميه يجعل الروتين يكمل كأن شيئاً لم يحدث، وهذا من أشهر الأخطاء.
والإلغاء في الروتينات تعاوني Cooperative، كما تشرح صفحة Cancellation and timeouts: الروتين لا يقتل من الخارج، وإنما عند أول نقطة توقف مثل delay أو await أو withContext يجد أنه ألغي فيرمي CancellationException. وهذا له نتيجتان مهمتان: الحلقة الحسابية الطويلة دون أي نقطة توقف لا تلغى حتى تنتهي، إلا إذا أضفت فيها ensureActive() أو yield()، والكود الحاجز مثل Thread.sleep أو JDBC لا يتأثر بالإلغاء حتى ينتهي. والأداة الأهم هنا هي withTimeout وwithTimeoutOrNull، فهي تلغي ما بداخلها إذا تجاوز المدة، وسوف نستخدمها في كشف الجمود بعد قليل. وكل طلب إلى خدمة خارجية في خدمتنا يجب أن يكون داخل withTimeout، فالخدمة التي تنتظر للأبد ليست خدمة.
وجربنا الحالة الثانية بأرقام: روتين على Default يحسب SHA-256 ثلاثة ملايين مرة، ونلغيه بعد 100 جزء من الألف، مرة دون أي فحص ومرة مع ensureActive() في كل دورة:
val job = launch(Dispatchers.Default) {
    val md = MessageDigest.getInstance("SHA-256")
    var b = ByteArray(32)
    repeat(3_000_000) { if (check) ensureActive(); b = md.digest(b); rounds++ }
}
delay(100)
job.cancel()
job.join()
check=false rounds=3000000 stopped after 2238 ms
check=true rounds=67184 stopped after 105 msفدون الفحص طلبنا الإلغاء بعد 100 جزء من الألف، والروتين لم يسمع، وأكمل ثلاثة ملايين دورة في 2.2 ثانية، وjoin() انتظره حتى النهاية. ومع ensureActive() توقف بعد 67,184 دورة في 105 أجزاء من الألف. والفحص نفسه رخيص جداً، فهو قراءة حقل واحد، فضعه في كل حلقة حسابية طويلة داخل روتين، وإلا فإن withTimeout حول هذه الحلقة لا يعني شيئاً.
الخيوط الافتراضية Virtual Threads أم الروتينات؟
ورأيت في المختبر أن الخيوط الافتراضية كانت الأسرع أو من الأسرع في كل تجربة انتظار، دون أي suspend، فهل نحتاج الروتينات في خدمة جديدة على JDK 25؟ والإجابة تعتمد على ما تريده من الأداة، والفرق الحقيقي ليس في السرعة. فالخيط الافتراضي يحل مشكلة واحدة بشكل ممتاز: كود حاجز مكتوب بالطريقة القديمة، مثل JDBC ومكتبات Java التي لا تعرف الروتينات، يصبح رخيصاً، والـ JVM تفصل الخيط الافتراضي عن خيط النظام عند كل انتظار. وكانت هناك مشكلة معروفة اسمها التثبيت Pinning، حيث يبقى الخيط الافتراضي ملتصقاً بخيط النظام إذا انتظر داخل كتلة synchronized، فيضيع كل الفضل، وقد حلتها JDK 24 في JEP 491، فصارت أغلب حالات synchronized لا تثبت الخيط في JDK 25 الذي نستخدمه.
أما الروتينات فتعطيك ما لا يعطيه الخيط الافتراضي: نوع الدالة نفسه يقول إنها قد تتوقف، فتعرف من التوقيع أين يمكن أن يحدث الانتظار والإلغاء، والتزامن المنظم والإلغاء والمهلة جزء من المكتبة كما رأيت قبل قليل، وتعمل على Android وعلى منصات Kotlin الأخرى، وأطر Kotlin على السيرفر مثل Ktor مبنية عليها من الأساس. والطريقة العملية التي سوف نتبعها في خدمة الطلبات هي الجمع بين الاثنين: الكود الجديد بالروتينات، والكود الحاجز الذي لا نملكه على Dispatchers.IO بحد مناسب، أو على موزع مبني على الخيوط الافتراضية إذا كان عدد العمليات المتزامنة كبيراً. ولا تتوقع من الخيوط الافتراضية أن تجعل الحساب أسرع، فهي لا تضيف معالجات، وقد رأيت أن العمل الحسابي محكوم بعدد الأنوية في كل الحالات.
| السؤال | الخيوط الافتراضية | الروتينات |
|---|---|---|
| الكود الحاجز القديم (JDBC، مكتبات Java) | يعمل كما هو ويصبح رخيصاً | يحتاج withContext(Dispatchers.IO) |
| الإلغاء والمهلة | المقاطعة interrupt فقط، ولا تصل إلى كل الكود | تعاوني ومنظم، withTimeout وcancel |
| فشل مهمة يلغي أخواتها | يحتاج StructuredTaskScope، وما زال معاينة Preview في JDK 25 | افتراضي في coroutineScope |
| المنصات | JDK 21 وما بعدها فقط | JVM وAndroid وKotlin Multiplatform |
| ما الذي يظهر في التوقيع | لا شيء، كل دالة قد تنتظر | suspend يحدد نقاط التوقف |
حالة السباق Race Condition: المخزون الذي نقص أقل مما يجب
والروتينات على Dispatchers.Default تعمل على عدة خيوط حقيقية في نفس الوقت، فكل مشكلات الذاكرة المشتركة في الخيوط موجودة فيها كما هي، وتشرح صفحة Shared mutable state and concurrency ذلك. ولنرى المشكلة بأرقام من عالمنا: مخزون فيه مليون وحدة، وألف روتين، كل واحد ينقص المخزون ألف مرة، فالنتيجة الصحيحة صفر:
class Stock(var units: Int)

// 1,000 روتين، كل واحد ينقص المخزون 1,000 مرة بدون حماية
suspend fun raceUnsafe(): Int {
    val stock = Stock(WORKERS * EACH)
    withContext(Dispatchers.Default) { repeat(WORKERS) { launch { repeat(EACH) { stock.units-- } } } }
    return stock.units
}
-- race round 1: expect 0 --
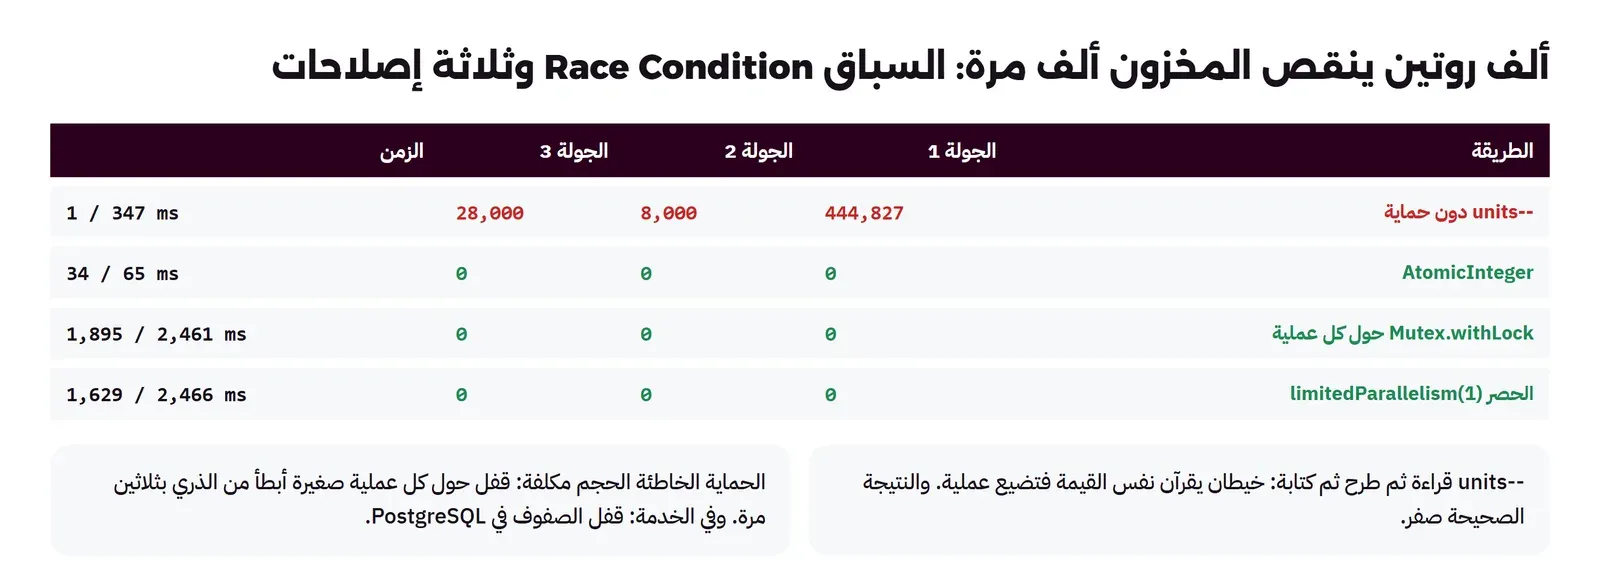
unsafe units-- 347 ms result=444827
AtomicInteger 65 ms result=0
Mutex.withLock 1895 ms result=0
confined to limitedParallelism(1) 2466 ms result=0
-- race round 2: expect 0 --
unsafe units-- 218 ms result=8000
...
-- race round 3: expect 0 --
unsafe units-- 1 ms result=28000في المخرج أعلاه لاحظ التالي:
- النسخة غير المحمية أعطت 444,827 في الجولة الأولى، أي أن قرابة 445 ألف عملية نقص ضاعت، ثم 8,000 ثم 28,000. والنتيجة مختلفة في كل مرة، وهذه علامة حالة السباق:
units--ليست عملية واحدة، وإنما قراءة ثم طرح ثم كتابة، وخيطان يقرآن نفس القيمة ويكتبان نفس النتيجة فتضيع واحدة. وفي متجر حقيقي هذا يعني أن النظام يظن أن عنده بضاعة ليست موجودة، فيبيعها مرتين. - الجولة الثالثة أخذت جزءاً واحداً من الألف وما زالت خاطئة. والتفسير الأرجح أن الـ JIT ترجم الحلقة الداخلية إلى شيء أذكى بكثير، فهو يستطيع أن يعد
repeat(EACH) { stock.units-- }في خيط واحد يمكن أن تصبح قراءة واحدة وطرح ألف وكتابة واحدة، وهذا مسموح له في نموذج الذاكرة Java Memory Model لأن الحقل ليسvolatile. فالخطأ ليس في التوقيت فقط، وإنما المترجم نفسه يفترض أن لا أحد غيرك يرى المتغير. - والطرق الثلاث المحمية أعطت صفراً في كل الجولات، ولكن بأسعار مختلفة جداً، وهذا هو القسم التالي.
ثلاثة إصلاحات بثلاثة أسعار: Atomic، Mutex، Confinement
suspend fun raceAtomic(): Int {
    val stock = AtomicInteger(WORKERS * EACH)
    withContext(Dispatchers.Default) { repeat(WORKERS) { launch { repeat(EACH) { stock.decrementAndGet() } } } }
    return stock.get()
}

suspend fun raceMutex(): Int {
    val stock = Stock(WORKERS * EACH)
    val m = Mutex()
    withContext(Dispatchers.Default) { repeat(WORKERS) { launch { repeat(EACH) { m.withLock { stock.units-- } } } } }
    return stock.units
}

// حصر الحالة في خيط واحد Confinement: كل التعديلات تمر على Dispatcher بخيط واحد
suspend fun raceConfined(): Int {
    val stock = Stock(WORKERS * EACH)
    val one = Dispatchers.Default.limitedParallelism(1)
    withContext(Dispatchers.Default) {
        repeat(WORKERS) { launch { repeat(EACH) { withContext(one) { stock.units-- } } } }
    }
    return stock.units
}- العدد الذري AtomicInteger: من Java مباشرة، و
decrementAndGetتعليمة واحدة في المعالج (Compare-And-Swap)، فأخذ بين 34 و65 جزءاً من الألف لمليون عملية. وهو الحل الصحيح لعداد واحد، ولا يصلح عندما تحتاج تعديل قيمتين معاً بشكل متسق، مثل المخزون وعدد الطلبات. - القفل Mutex: من مكتبة الروتينات وليس من Java، والفرق أن
Mutex.lockدالة معلقة، فالروتين الذي ينتظر القفل يتوقف ويحرر خيطه، بينماsynchronizedأوReentrantLockتحجز الخيط. وأخذ بين 1.9 و2.5 ثانية، أي أبطأ بثلاثين مرة من الذري، لأن كل عملية نقص صارت قفلاً وفتحاً وربما تعليق روتين واستئنافه. وتشرح وثائق Mutex شيئاً مهماً جداً سوف نصطدم به في القسم التالي: هذا القفل غير قابل لإعادة الدخول Non-Reentrant. - الحصر Confinement: لا يوجد قفل أصلاً، وإنما كل تعديل على المخزون ينتقل إلى موزع بخيط واحد، فلا يمكن أن يعدله اثنان في نفس الوقت. وأخذ بين 1.6 و2.5 ثانية لأن كل عملية صارت انتقالاً بين موزعين. وهذا الأسلوب ممتاز عندما تجمع عدة تعديلات في انتقال واحد، وسيء لعملية صغيرة واحدة كما هنا.
والرقم الذي يجب أن تتذكره من هذا القسم ليس أن الذري أسرع، فهذا متوقع، وإنما أن الحماية الخاطئة الحجم تكلف كثيراً: قفل حول كل عملية صغيرة جعل الكود أبطأ بثلاثين مرة. وفي خدمة الطلبات الحقيقية لن نحمي المخزون في الذاكرة أصلاً، لأن الخدمة سوف تعمل بأكثر من نسخة، وإنما في قاعدة البيانات بقفل الصفوف SELECT ... FOR UPDATE داخل معاملة واحدة، كما سوف نرى في المقال التالي، مع اختبار يرسل عشرين طلباً متزامناً على مخزون من عشر وحدات.
الجمود Deadlock: قفل لا يقبل إعادة الدخول
والجمود الأول الذي صنعناه حقيقي جداً، ويحدث لكل من جاء من Java وتعود على synchronized. سلة فيها قفل، والدالة add تحجز القفل وتضيف المبلغ، وإذا تجاوز الإجمالي 100 ريال تستدعي applyDiscount، وهي دالة عامة تحجز نفس القفل أيضاً لأنها قد تستدعى من الخارج:
class Cart {
    val lock = Mutex()
    var total = 0

    suspend fun add(h: Int) = lock.withLock {
        total += h
        if (total > 10_000) applyDiscount()
    }

    suspend fun applyDiscount() = lock.withLock { total -= 500 }
}

suspend fun deadlock() = coroutineScope {
    val cart = Cart()
    val r = withTimeoutOrNull(2_000) {
        cart.add(6_000)
        cart.add(6_000)
        "done"
    }
    if (r == null) println("timeout after 2000 ms, total=${cart.total}, lock.isLocked=${cart.lock.isLocked}")
    ...
}
timeout after 2000 ms, total=12000, lock.isLocked=false
fixed: total=11500, lock.isLocked=falseوالقراءة: الإضافة الأولى (60 ريالاً) نجحت، والثانية رفعت الإجمالي إلى 12,000 هللة، ثم استدعت applyDiscount التي طلبت نفس القفل، والقفل محجوز من نفس الروتين، وMutex في Kotlin لا يعرف «صاحبه» ولا يسمح بإعادة الدخول، فانتظر الروتين نفسه إلى الأبد. ولولا withTimeoutOrNull لبقي البرنامج معلقاً دون أي رسالة، ودون أي خيط محجوز يظهر في jstack، لأن الروتين متوقف وليس خيطاً ينتظر. وبعد ألفي جزء من الألف ألغت المهلة الروتين، ففك withLock القفل في طريق الخروج، ولذلك lock.isLocked=false. ولاحظ الإجمالي 12,000: الخصم لم يطبق، أي أن الجمود لم يوقف البرنامج فقط، وإنما ترك البيانات في حالة نصف منفذة. والإصلاح في السطر الثاني من المخرج: دالة داخلية خاصة تفترض أن القفل محجوز ولا تطلبه، والدالة العامة وحدها تحجز القفل:
class CartFixed {
    val lock = Mutex()
    var total = 0

    suspend fun add(h: Int) = lock.withLock {
        total += h
        if (total > 10_000) applyDiscountLocked()
    }

    private fun applyDiscountLocked() { total -= 500 } // تفترض أن القفل محجوز مسبقاً
}
وهذا النمط، أي دالة عامة تحجز القفل ودوال خاصة بلاحقة Locked لا تحجزه، هو الطريقة الصحيحة مع أي قفل غير قابل لإعادة الدخول. والسؤال المنطقي: لماذا لم يجعلوه قابلاً لإعادة الدخول؟ والسبب أن الروتين ليس له هوية ثابتة مثل الخيط، فقد يستأنف على خيط آخر، والقفل الذي يعرف صاحبه بالخيط لا يعمل مع الروتينات أصلاً.
الجمود الثاني: runBlocking داخل موزع بخيط واحد
والجمود الثاني يأتي من الدالة runBlocking، وهي الجسر بين العالم الحاجز والروتينات: تحجز الخيط الحالي حتى ينتهي الروتين بداخلها. وتقول وثائقها بوضوح إنها لا تستخدم من داخل روتين. وكتبنا الخطأ عمداً: روتين على موزع بخيط واحد يستدعي runBlocking، وبداخله عمل يحتاج نفس الموزع:
fun blockingDeadlockDump() = runBlocking {
    DebugProbes.install()
    val one = Dispatchers.Default.limitedParallelism(1)
    launch(one) {
        runBlocking { withContext(one) { println("never printed") } }
    }
    delay(1_500)
    println("--- coroutines dump after 1500 ms ---")
    DebugProbes.dumpCoroutines()
    ...
}
والخيط الوحيد للموزع one محجوز داخل runBlocking ينتظر withContext(one)، وwithContext(one) ينتظر أن يتحرر الخيط الوحيد. ولكي نرى ذلك استخدمنا مكتبة kotlinx-coroutines-debug، فالدالة DebugProbes.dumpCoroutines() تطبع كل الروتينات الحية وحالتها ومكانها، وهي للروتينات مثل jstack للخيوط:
--- coroutines dump after 1500 ms ---
Coroutines dump 2026/10/31 08:36:23

Coroutine StandaloneCoroutine{Active}@3527942a, state: RUNNING
	at java.base/jdk.internal.misc.Unsafe.park(Native Method)
	at java.base/java.util.concurrent.locks.LockSupport.parkNanos(LockSupport.java:271)
	at kotlinx.coroutines.BlockingCoroutine.joinBlocking(Builders.kt:57)
	at kotlinx.coroutines.BuildersKt__BuildersKt.runBlockingImpl(Builders.kt:30)
	...
	at lab.RaceKt$blockingDeadlockDump$1$1.invokeSuspend(Race.kt:94)

Coroutine BlockingCoroutine{Active}@942a29c, state: SUSPENDED
	at lab.RaceKt$blockingDeadlockDump$1$1$1.invokeSuspend(Race.kt:94)
في المخرج أعلاه لاحظ التالي:
- الروتين الأول حالته
RUNNING، ولكن مسار الاستدعاء يقول إنه داخلLockSupport.parkNanosمنrunBlocking، أي أنه «يعمل» من وجهة نظر المكتبة لأنه يحجز خيطاً، وهو في الحقيقة نائم. وهذه هي العلامة التي تبحث عنها: روتينRUNNINGداخلjoinBlocking. - الروتين الثاني
SUSPENDEDفي نفس السطر 94، وهوwithContext(one)الذي ينتظر خيطاً لن يتحرر. - قبل التفريغ طبعت الـ JVM ثمانية أسطر تحذير، لأن
DebugProbesيحمل وكيل Java Agent ديناميكياً عبر ByteBuddy ويستدعي مكتبة أصلية عبر JNA، وJDK 25 يحذر من الاثنين وسوف يمنعهما افتراضياً في إصدار قادم. فأداة التصحيح هذه للتطوير والاختبار، وفي الإنتاج تحتاج الخيار-XX:+EnableDynamicAgentLoadingأو تحميل الوكيل عند البدء.
والبرنامج لم يخرج من نفسه، فأنهيناه بـ Runtime.halt(3)، ولذلك كان رمز الخروج 3. والقاعدة: runBlocking في main وفي الاختبارات فقط، وداخل أي كود معلق استخدم withContext أو coroutineScope. وفي خدمة ويب يحدث هذا الجمود بشكل أخبث: معالج طلب في Ktor يستدعي مكتبة قديمة تستخدم runBlocking داخلياً، فيعمل كل شيء حتى يصل عدد الطلبات المتزامنة إلى عدد خيوط السيرفر، ثم تتوقف الخدمة كلها.
جدول قرار Decision Table: أي أداة تزامن تستخدم؟
| العمل | الأداة | السبب من المختبر |
|---|---|---|
طلبات شبكة بمكتبة معلقة (Ktor Client، sendAsync().await()) | async داخل coroutineScope على أي موزع | لا تحجز خيطاً، 172 جزءاً من الألف لمئة طلب |
| كود حاجز (JDBC، ملفات، مكتبة قديمة) | withContext(Dispatchers.IO) | على Default أخذ 1,909 بدل 252 |
| كود حاجز بأكثر من 64 عملية متزامنة | IO.limitedParallelism(n) أو موزع خيوط افتراضية | حد الـ 64 ظهر كـ 5 دفعات، والخيوط الافتراضية 69 |
| عمل حسابي | Dispatchers.Default | التسريع بعدد المعالجات، 5.2 على 8 و1.6 على 2 |
| عداد مشترك | AtomicInteger أو AtomicLong | صفر في 34 إلى 65 جزءاً من الألف |
| عدة قيم يجب أن تتغير معاً | Mutex.withLock حول المجموعة، لا حول كل عملية | قفل لكل عملية أبطأ بثلاثين مرة |
| حالة يملكها مكون واحد | حصر في limitedParallelism(1) أو Actor | لا أقفال، والتكلفة في الانتقال |
| حالة مشتركة بين نسخ الخدمة | قاعدة البيانات (FOR UPDATE) | الذاكرة لا تراها النسخة الأخرى |
| استدعاء خدمة خارجية | withTimeout دائماً | الإلغاء هو الذي أنقذنا من الجمود الأول |
أخطاء شائعة Common Mistakes
- كود حاجز على
Dispatchers.Default: الأكثر شيوعاً والأخطر، لأن الاختبارات تمر ويظهر تحت الضغط فقط. - عمل حسابي ثقيل على
Dispatchers.IO: يبدو أسرع في قياس واحد، ويأخذ الخيوط من عمليات قاعدة البيانات. runBlockingداخل كود معلق: جمود عندما يمتلئ الموزع، كما رأينا في التفريغ.- استدعاء دالة عامة من داخل
withLockتطلب نفسMutex: القفل لا يقبل إعادة الدخول. GlobalScope.launch: روتين بلا نطاق لا يلغيه أحد ولا يصل خطؤه إلى أحد، وهو عكس التزامن المنظم.- إمساك
CancellationExceptionبـcatch (e: Exception)أوrunCatchingدون إعادة رميه: يعطل الإلغاء، وسوف نجربه في مقال الأخطاء الشائعة. - حلقة حسابية طويلة دون
ensureActive(): لا تلغى حتى تنتهي. - مشاركة كائن غير آمن للخيوط مثل
MessageDigestأوSimpleDateFormatبين الروتينات. - الحكم من الجولة الأولى: فتح الاتصالات والإحماء جعلا
sendAsyncتبدو أبطأ بأربع مرات وهي ليست كذلك. - قياس التزامن مقابل خدمة أبطأ من الحد الذي تقيسه: مع 300 طلب قسنا سيرفر Python وليس الموزع.
قائمة تحقق Checklist قبل أن تضع الروتينات في الإنتاج
- هل كل استدعاء حاجز داخل
withContext(Dispatchers.IO)أو على موزع مخصص؟ - هل حد التزامن على قاعدة البيانات هو حجم مجموعة الاتصالات، وليس 64 ولا غير محدود؟
- هل كل استدعاء لخدمة خارجية داخل
withTimeout؟ - هل لا يوجد
GlobalScopeولاrunBlockingخارجmainوالاختبارات؟ - هل كل حالة مشتركة محمية بذري أو
Mutexأو حصر، والحالة بين النسخ في قاعدة البيانات؟ - هل
catchفي الكود المعلق يعيد رميCancellationException؟ - هل يوجد اختبار تزامن يكشف السباق، مثل عشرين طلباً على مخزون من عشرة؟
- هل تعرف كيف تأخذ تفريغ الروتينات
DebugProbesفي بيئة الاختبار؟
تدريب عملي
- غير
ioAsyncAwaitلتضع كل طلب داخلwithTimeout(30)، وشغلها، واقرأ الاستثناء الذي يخرج منcoroutineScope، ولاحظ هل بقي أي طلب يعمل. - شغل مهمة SHA-256 بالخاصية
-Dkotlinx.coroutines.scheduler.max.pool.size=2على 8 معالجات، وقارن بالتشغيل بـ--cpus 2. - اجعل
Stock.unitsحقلاً@Volatileوأعد تجربة السباق، ولاحظ أن النتيجة ما زالت خاطئة، واشرح لماذا. - أضف إلى
Cartدالةremoveتستدعيaddبقيمة سالبة، وتأكد أن نسختك لا تحتوي أي استدعاء لـwithLockداخلwithLock.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الروتين المساعد دالة
suspendيحولها المترجم إلى آلة حالات، فيتوقف عند الانتظار ويحرر الخيط، والموزع يحدد أي خيوط تشغله. - مئة طلب HTTP: المتسلسل 5.7 ثانية، وكل الطرق المتزامنة بين 159 و196 جزءاً من الألف بعد فتح الاتصالات، والجولة الأولى كانت مضللة.
- 300 مهمة حاجزة: 1,909 على
Defaultبثمانية خيوط، و252 علىIOبحد 64، و69 على الخيوط الافتراضية، و71 بـdelay، والأرقام تطابق الحساب. - SHA-256: تسريع 5.2 مرة على 8 معالجات و1.6 على معالجين، والعمل الحسابي مكانه
Default. - حالة السباق أعطت 444,827 بدل صفر، والإصلاح بـ
AtomicIntegerأسرع بثلاثين مرة منMutexحول كل عملية. - التزامن المنظم ألغى 99 طلباً عندما فشل واحد، ووصل الاستثناء إلى المستدعي في 83 جزءاً من الألف، والحلقة الحسابية لم تتوقف إلا مع
ensureActive(). Mutexلا يقبل إعادة الدخول، وrunBlockingداخل موزع بخيط واحد يجمد، وDebugProbesوwithTimeoutهما أداتا الكشف.
وفي المقال التالي من مرحلة لغة Kotlin للمطورين سوف نبني خدمة الطلبات الحقيقية بـ Ktor وPostgreSQL، ونضع الكود الحاجز في مكانه الصحيح، ونختبر عشرين طلباً متزامناً على مخزون من عشر وحدات. وهذه المقالات المنشورة تكمل هذا المقال:
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلحلقة الأحداث Event Loop: لماذا تتأخر النقرة في صفحتك؟كيف ترتب JavaScript المهام والوعود والرسم على خيط واحد، ولماذا تنتظر النقرة خلف مهمة طويلة، وكيف تقسم العمل لتبقى الصفحة سريعة.
 دليلإدارة الذاكرة: يدوياً أم Garbage Collector أم Ownership؟نقيس بأيدينا في C وGo وPython وRust من يحرر الذاكرة ومتى، وكم يكلف ذلك من الذاكرة والوقت، وما الأخطاء التي تبقى ممكنة في كل طريقة.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلكيف تختار لغة البرمجة Programming Language لمشروعك؟نختار لغة خدمة حقيقية بأسئلة الفريق والتوظيف والمكتبات والرخصة، ثم نكتبها بأربع لغات ونقيس البناء والحجم والذاكرة والطلبات في الثانية بأنفسنا.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجارب التزامن على Kotlin 2.4.21 وkotlinx.coroutines 1.11.0 وOpenJDK 25.0.5 داخل Docker بثمانية معالجات ثم بمعالجين، مقابل خدمة بطيئة محلية بـ Python 3.13.