


خدمة الأسعار التي بنيناها في المقالين السابقين لمتجر القهوة والتمور كبرت، وصار عليها عملان جديدان: الأول تحديث الكتالوج كل ساعة، حيث تسأل الخدمة واجهة المورد عن سعر كل منتج من مئة منتج، وكل طلب يأخذ حوالي 50 ميلي ثانية، فيأخذ التحديث كله أكثر من خمس ثوان والفريق يريده أسرع. والثاني توقيع ملفات الفواتير التي تصدر لنظام المحاسبة، حيث تحسب الخدمة سلسلة هاش SHA-256 لكل فاتورة، وألفا فاتورة تأخذ أكثر من عشر ثوان من المعالج. واقترح أحد المطورين القادمين من Java الحل المعتاد: «نستعمل Threads»، فرد عليه آخر قرأ في مكان ما أن Python فيها قفل اسمه GIL يمنع الخيوط من العمل معاً، واقترح ثالث asyncio لأنه «الطريقة الحديثة». وفي نفس الأسبوع حدثت مشكلة ثالثة أخطر: في عرض ساعة على التمر السكري باعت الخدمة عشرين كيساً بينما المخزون عشرة فقط، لأن طلبين قرآ المخزون في نفس اللحظة.
وهذا المقال الثالث في مرحلة لغة Python للمطورين، وقد شرحنا مفاهيم الخيوط والأقفال وasync في مقال Threads وasync/await، وحلقة الأحداث في JavaScript في مقال حلقة الأحداث Event Loop، أما هنا فنقيس نموذج التزامن في Python 3.15.2 نفسه بنفس المهمتين اللتين نقيس بهما كل لغات المسار: مئة طلب HTTP إلى سيرفر محلي بطيء يرد بعد 50 ميلي ثانية، وSHA-256 لألفي نص كل واحد ألفي مرة. وسوف نناقش في هذا المقال ما يلي:
- ما هو قفل المفسر العام GIL، ولماذا وجد، وما الذي تغير مع البناء الخالي من القفل Free-threaded.
- المهمة المقيدة بالانتظار I/O-bound: متتابعة، ثم بالخيوط Threads، ثم بـ
asyncioمع مكتبتين مختلفتين، ومشكلة حقيقية ظهرت في إحداهما. - المهمة المقيدة بالمعالج CPU-bound: الخيوط مع GIL، والعمليات Processes، والخيوط على البناء الخالي من القفل، وكيف تقيس التوازي على جهاز مشغول.
- حالة تسابق Race Condition حقيقية تبيع عشرين قطعة من مخزون عشرة، وعداد يفقد أكثر من نصف قيمه، وإصلاحهما.
- جمود Deadlock بين قفلين وإصلاحه بترتيب الأقفال.
- ثمن آلاف الخيوط مقابل آلاف المهام، والتزامن المنظم بـ
TaskGroupوالمهلة. - ماذا يحدث إذا وضعت عملاً حسابياً داخل دالة
async، وجدول قرار لاختيار النموذج المناسب.
نماذج التزامن Concurrency Models في Python: ثلاثة طرق وقفل واحد
قبل أن نقيس شيئاً لا بد أن نفرق بين كلمتين يخلط بينهما كثير من الناس: التزامن Concurrency هو أن يتقدم أكثر من عمل في نفس الفترة الزمنية، ولو بالتناوب على معالج واحد، كما يرد موظف الاستقبال على عدة مكالمات بوضع كل واحدة على الانتظار، أما التوازي Parallelism فهو أن يعمل أكثر من عمل في نفس اللحظة على أكثر من معالج، كأن يكون عندك عدة موظفين. والمهمة التي تنتظر الشبكة تحتاج تزامناً فقط، لأن المعالج لا يفعل شيئاً أثناء الانتظار، أما المهمة الحسابية فتحتاج توازياً، لأن المعالج هو العائق. وتقدم Python ثلاثة طرق رئيسية لذلك في مكتبتها القياسية:
- الخيوط Threads عبر الوحدة threading أو
ThreadPoolExecutor: خيوط حقيقية من نظام التشغيل، تشترك في نفس الذاكرة، ويجدولها النظام. - الـ asyncio: خيط واحد فيه حلقة أحداث Event Loop، تتناوب فيه دوال
asyncعند كلawait، وهو قريب جداً من نموذج Node.js. - العمليات Processes عبر multiprocessing أو
ProcessPoolExecutor: عدة نسخ من المفسر، لكل واحدة ذاكرتها، وتتبادل البيانات بالنسخ.
والطريقة الموحدة لاستعمال الخيوط والعمليات هي الوحدة concurrent.futures، فالكود نفسه يعمل مع ThreadPoolExecutor وProcessPoolExecutor بتغيير اسم الكلاس فقط، وهذا ما سوف نستعمله في المختبر.
قفل المفسر العام GIL: لماذا وجد؟
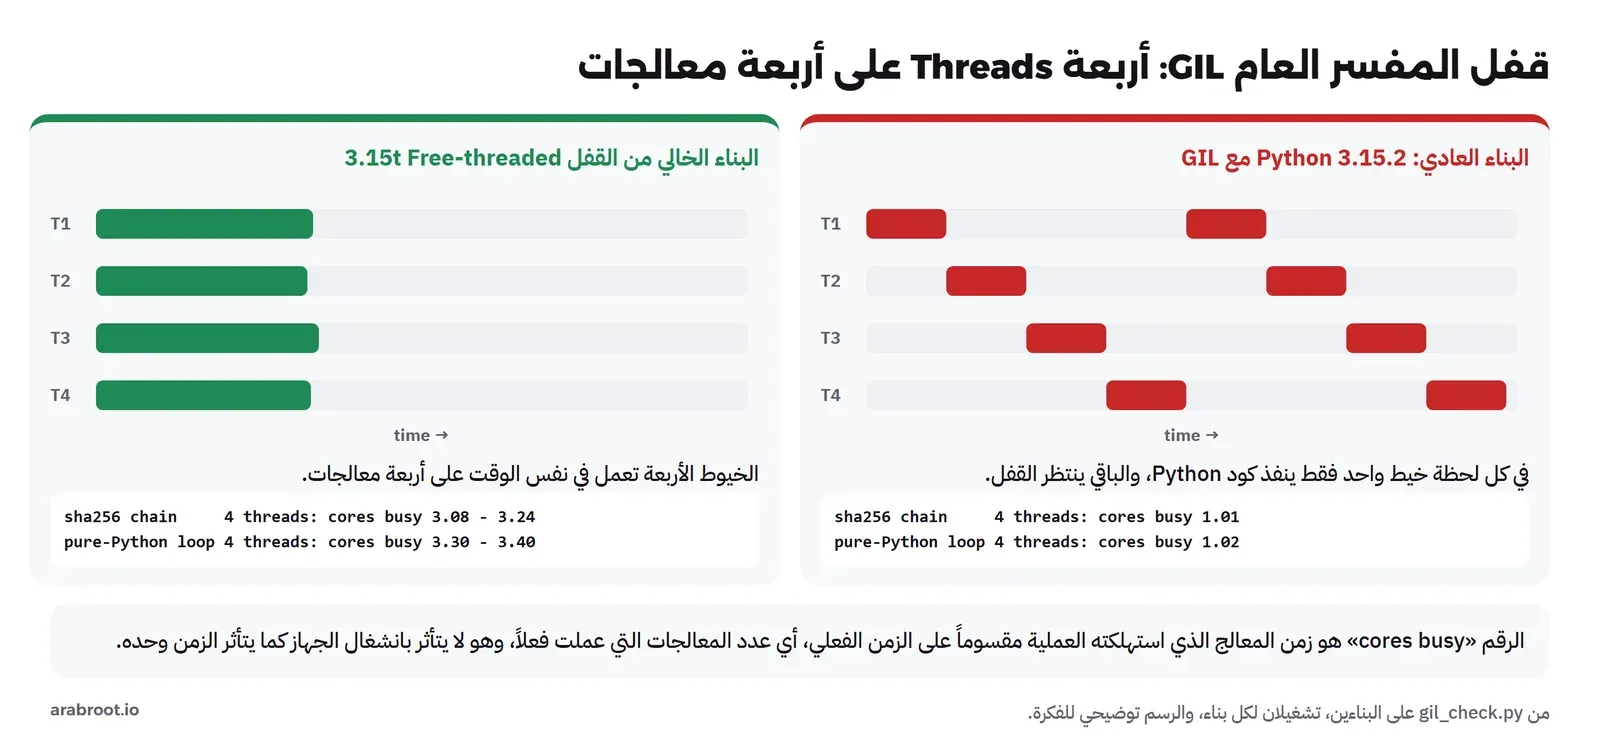
رأينا في المقال السابق أن CPython يدير الذاكرة بعداد مراجع في كل كائن، وهذا العداد يتغير مع كل إسناد وكل استدعاء دالة تقريباً، فإذا عدل خيطان نفس العداد في نفس اللحظة دون حماية فقد يضيع تعديل منهما، فيحرر كائن ما زال مستعملاً أو يبقى كائن لا يستعمله أحد. والحل الذي اختاره CPython منذ بداياته هو قفل واحد كبير اسمه قفل المفسر العام Global Interpreter Lock واختصاراً GIL: لا ينفذ كود Python إلا الخيط الذي يحمل هذا القفل، والخيط يتركه عندما ينتظر عملية إدخال وإخراج I/O مثل قراءة من الشبكة أو القرص، أو بعد فترة قصيرة من التنفيذ ليعطي غيره فرصة. وهذا القرار جعل المفسر بسيطاً وسريعاً للخيط الواحد، وجعل كتابة الإضافات بلغة C سهلة، ولكنه جعل الخيوط عديمة الفائدة للأعمال الحسابية في كود Python، وهذا ما سوف نقيسه بالأرقام.
وفي 2023 قبل الفريق PEP 703 الذي يجعل الـ GIL اختيارياً، فصار هناك بناء منفصل من CPython اسمه البناء الخالي من القفل Free-threaded، يغير طريقة عد المراجع لكي تعمل بأمان من عدة خيوط، وانتقل هذا البناء من تجريبي إلى مدعوم رسمياً بحسب PEP 779. ولكنه ما زال بناءً منفصلاً، فالـ Image الرسمية في Docker تأتي بالبناء العادي، والبناء الخالي من القفل له ملف تنفيذي باسم python3.15t، وثمنه بحسب دليل البناء الخالي من القفل بطء في الخيط الواحد يتراوح بين حوالي 1% و8% بحسب النظام، وأن بعض الإضافات المكتوبة بـ C قد تعيد تفعيل القفل تلقائياً عند استيرادها إذا لم تعلن أنها تدعم هذا البناء.
متى يبدل الـ GIL الخيوط؟ فترة التبديل Switch Interval
وقد يتساءل البعض: إذا كان خيط واحد فقط يحمل القفل، فكيف يحصل الخيط الآخر على فرصته في عمل حسابي طويل لا ينتظر أي شبكة؟ والإجابة أن الخيط الذي ينتظر القفل لا ينتظر إلى الأبد، وإنما يطلب من الخيط الحامل أن يتركه بعد فترة اسمها فترة التبديل Switch Interval، وقيمتها الافتراضية كما طبعها المختبر بالدالة sys.getswitchinterval() هي 0.005 ثانية، أي خمس ميلي ثوان. فإذا مرت هذه الفترة يترك الخيط الحامل القفل عند أول نقطة آمنة بين تعليمات الـ Bytecode، ويأخذه خيط آخر. وهذا يعني شيئين عمليين: الأول أن الخيوط في عمل حسابي تتناوب كل بضع ميلي ثوان فلا يتجمد أحدها، والثاني أن الخيط الذي ينتظر الشبكة ثم يعود رده قد ينتظر حتى خمس ميلي ثوان أخرى ليحصل على القفل إذا كان هناك خيط حسابي مشغول، وهذا هو سبب التأخير الصغير الذي سوف نراه في تجربة حلقة الأحداث. ويمكن تغيير هذه القيمة بـ sys.setswitchinterval، ولكن لا تقم بذلك إلا بعد قياس، لأن تقليلها يزيد عدد التبديلات وثمنها، وزيادتها تؤخر الخيوط التي تنتظر.
كيف يعمل asyncio من الداخل؟ Coroutines وحلقة الأحداث
الدالة المعرفة بـ async def لا تنفذ عندما تستدعيها، وإنما ترجع كائناً اسمه Coroutine، وهو دالة يمكن أن تتوقف في منتصفها ثم تكمل من نفس النقطة، والتوقف يحدث فقط عند كلمة await. وحلقة الأحداث Event Loop هي الكود الذي يدير هذه الدوال: يحتفظ بقائمة المهام Tasks الجاهزة للعمل، فيشغل واحدة حتى تصل إلى await على شيء لم يجهز بعد، كرد من الشبكة، فيسجل الحلقة كمهتمة بهذا الاتصال عند نظام التشغيل، ثم ينتقل إلى المهمة التالية. وعندما لا تبقى مهمة جاهزة تسأل الحلقة نظام التشغيل عبر epoll على Linux: أي الاتصالات وصلتها بيانات؟ فتوقظ المهام المرتبطة بها. ولهذا السبب يستطيع خيط واحد أن يدير عشرات الآلاف من الاتصالات المفتوحة، لأن الاتصال الذي ينتظر لا يكلف خيطاً، وإنما سجلاً في قائمة.
وهذا النموذج نفسه هو الذي شرحناه في حلقة الأحداث في JavaScript، مع فرقين مهمين: الأول أن Node.js كله مبني على الحلقة، فكل مكتبة فيه غير متزامنة من البداية، أما في Python فالحلقة وحدة اختيارية، ونصف المكتبات المشهورة متزامنة، فإذا استدعيت مكتبة متزامنة مثل requests داخل دالة async فسوف تحجز الحلقة كلها. والثاني أن Python تجبرك أن تكتب async وawait في كل الطريق من أعلى الاستدعاء إلى أسفله، وهذا ما يسميه الناس «تلوين الدوال» Function Coloring، فالدالة العادية لا تستطيع أن تنتظر دالة async مباشرة، ولذلك يصعب إدخال asyncio في مشروع كبير مكتوب بالطريقة المتزامنة، بينما تدخل الخيوط فيه دون تغيير الدوال.
تجهيز المختبر Lab: سيرفر بطيء وبناءان من Python
نحتاج أولاً سيرفراً يرد بعد 50 ميلي ثانية بالضبط، ولا يصبح هو نفسه العائق عندما يصله مئة طلب معاً. ولذلك كتبناه بـ asyncio من المكتبة القياسية، يقرأ رأس الطلب، ينتظر 50 ميلي ثانية بـ asyncio.sleep، ثم يكتب الرد كاملاً في عملية كتابة واحدة، ويدعم إبقاء الاتصال مفتوحاً Keep-Alive:
import asyncio, os

DELAY = float(os.environ.get("DELAY_MS", "50")) / 1000
BODY = b'{"price_halalas": 990}'


async def handle(reader: asyncio.StreamReader, writer: asyncio.StreamWriter) -> None:
    try:
        while True:
            head = await reader.readuntil(b"\r\n\r\n")
            await asyncio.sleep(DELAY)
            close = b"connection: close" in head.lower()
            writer.write(b"HTTP/1.1 200 OK\r\nContent-Type: application/json\r\n"
                         b"Content-Length: " + str(len(BODY)).encode() + b"\r\n"
                         + (b"Connection: close\r\n" if close else b"") + b"\r\n" + BODY)
            await writer.drain()
            if close:
                break
    except (asyncio.IncompleteReadError, ConnectionResetError):
        pass
    finally:
        writer.close()


async def main() -> None:
    server = await asyncio.start_server(handle, "0.0.0.0", 8080, backlog=1024)
    print(f"slow server on :8080, delay {DELAY * 1000:.0f} ms", flush=True)
    async with server:
        await server.serve_forever()

asyncio.run(main())
والسبب في كتابة الرد مرة واحدة أن إرسال الرأس في كتابة والجسم في كتابة ثانية على اتصال مفتوح يجعل خوارزمية Nagle في TCP تنتظر تأكيد الاستلام المتأخر Delayed ACK من الطرف الآخر، فيضيف ذلك حوالي 40 ميلي ثانية لكل طلب، وتظن أن السيرفر بطيء بينما المشكلة في طريقة الكتابة. وإذا استعملت http.server من المكتبة القياسية لتجربة مشابهة فاضبط disable_nagle_algorithm = True في كلاس المعالج، وتأكد دائماً من زمن طلب واحد قبل أن تقيس أي شيء آخر. وأما الـ Image الخاصة بالعميل فهي الـ Image الرسمية مع المكتبتين httpx وaiohttp، ومعها البناء الخالي من القفل الذي ثبتناه بـ uv كما في توثيق إصدارات Python في uv:
FROM python:3.15.2-slim-trixie
RUN pip install --root-user-action=ignore --no-cache-dir uv==0.13.6 httpx==0.28.1 aiohttp==3.14.5 \
 && uv python install 3.15t \
 && ln -s "$(uv python find 3.15t)" /usr/local/bin/python3.15t \
 && python3.15t -m ensurepip >/dev/null 2>&1; python3.15t -VV
WORKDIR /lab
ثم شغلنا السيرفر والعميل على شبكة Docker واحدة، والعميل محدود بأربعة معالجات وواحد جيجابايت من الذاكرة:
docker build -t slp-py-conc:1 lab
docker network create slp-py-net
docker run -d --name slp-py-slow --network slp-py-net --network-alias slow \
  -v "$PWD/lab:/lab:ro" python:3.15.2-slim-trixie python /lab/slow_server.py
docker run --rm --network slp-py-net --cpus 4 --memory 1g -v "$PWD/lab:/lab" slp-py-conc:1 sh /lab/run-all.sh
docker run --rm slp-py-conc:1 sh -c 'python3.15t -VV; python3.15t -c "import sys; print(sys._is_gil_enabled())"'
والمخرج من الأمر الأخير يؤكد أن البناء الثاني خال من القفل فعلاً:
Python 3.15.2 free-threading build (main, Oct 26 2026, 14:06:54) [Clang 23.1.3 ]
False
لاحظ أن هذا البناء مترجم بـ Clang ويأتي من مشروع python-build-standalone الذي ينزل منه uv، بينما البناء العادي في الـ Image الرسمية مترجم بـ GCC، فالمقارنة بينهما في الخيط الواحد ليست مقارنة البناءين فقط وإنما المترجمين أيضاً، ولذلك لن نبني على فرق الخيط الواحد أي حكم.
المهمة المقيدة بالانتظار I/O-bound: مئة طلب HTTP
الملف io_bound.py ينفذ نفس العمل بعدة طرق: مئة طلب إلى السيرفر البطيء، ويطبع الزمن ومجموع البايتات للتأكد أن كل الطرق قرأت نفس الردود. وأهم أجزائه كما يلي:
def fetch(i: int) -> int:
    with urllib.request.urlopen(f"{URL}?i={i}") as r:
        return len(r.read())


def sequential() -> int:
    return sum(fetch(i) for i in range(N))


def threads(workers: int) -> int:
    with ThreadPoolExecutor(max_workers=workers) as pool:
        return sum(pool.map(fetch, range(N)))


async def with_aiohttp(limit: int | None) -> int:
    sem = asyncio.Semaphore(limit or N)
    async with aiohttp.ClientSession(connector=aiohttp.TCPConnector(limit=limit or N)) as session:
        async def one(i: int) -> int:
            async with sem:
                async with session.get(URL, params={"i": i}) as r:
                    return len(await r.read())
        async with asyncio.TaskGroup() as tg:
            tasks = [tg.create_task(one(i)) for i in range(N)]
    return sum(t.result() for t in tasks)
والدالة with_asyncio تفعل نفس الشيء بالمكتبة httpx بدل aiohttp، وكلتاهما تحدد عدد الطلبات المتزامنة بـ asyncio.Semaphore. شغلنا الملف مرتين، والمخرج كما يلي:
### io (run 1)
3.15.2 GIL
sequential (urllib)                   6.06 s   bytes=2200
threads, 10 workers (urllib)          0.69 s   bytes=2200
threads, 100 workers (urllib)         0.33 s   bytes=2200
asyncio + aiohttp, 10 at a time       0.58 s   bytes=2200
asyncio + aiohttp, 100 at a time      0.33 s   bytes=2200
asyncio + httpx, 10 at a time         1.85 s   bytes=2200
asyncio + httpx, 100 at a time        1.57 s   bytes=2200
### io (run 2)
3.15.2 GIL
sequential (urllib)                   5.42 s   bytes=2200
threads, 10 workers (urllib)          0.66 s   bytes=2200
threads, 100 workers (urllib)         0.33 s   bytes=2200
asyncio + aiohttp, 10 at a time       0.58 s   bytes=2200
asyncio + aiohttp, 100 at a time      0.31 s   bytes=2200
asyncio + httpx, 10 at a time         1.59 s   bytes=2200
asyncio + httpx, 100 at a time        2.33 s   bytes=2200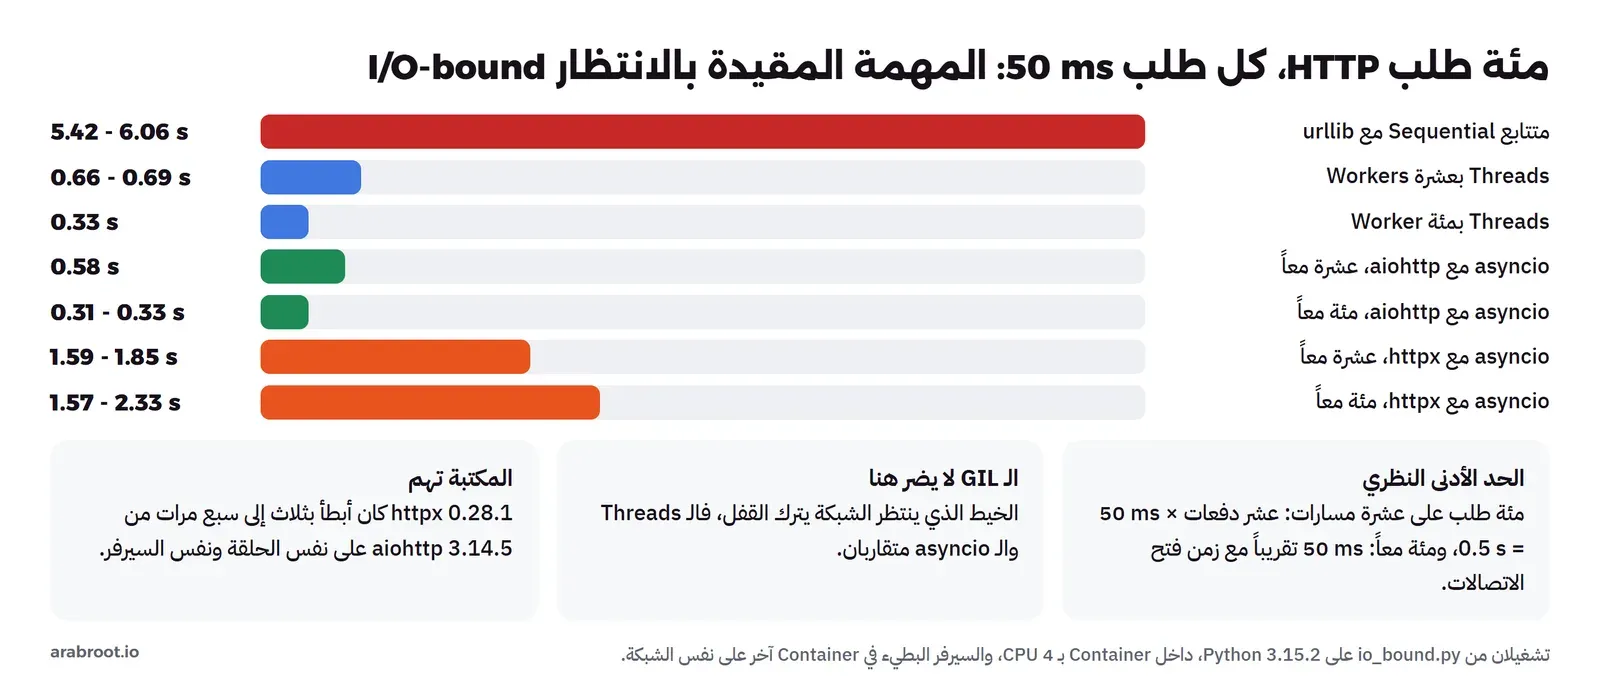
في المخرج أعلاه لاحظ التالي:
- الطريقة المتتابعة أخذت بين 5.4 و6.1 ثانية، أي حوالي 55 إلى 60 ميلي ثانية للطلب: الخمسون التي ينتظرها السيرفر والباقي فتح الاتصال والبحث عن اسم
slowفي DNS الداخلي لـ Docker، لأنurlopenيفتح اتصالاً جديداً في كل مرة. - الخيوط العشرة أنزلت الزمن إلى 0.66 ثانية، وهذا قريب من الحد الأدنى النظري: مئة طلب على عشرة مسارات تعني عشر دفعات، وكل دفعة 50 ميلي ثانية، أي نصف ثانية تقريباً. ومع مئة خيط نزل الزمن إلى 0.33 ثانية، والفرق عن الخمسين ميلي ثانية النظرية هو ثمن إنشاء مئة خيط ومئة اتصال في نفس اللحظة.
- الـ GIL لم يمنع الخيوط هنا من التسريع عشر مرات وأكثر، والسبب أن كل خيط يترك القفل وهو ينتظر الشبكة، فالقفل لا يحمي إلا الأجزاء القصيرة التي يعمل فيها كود Python فعلاً بين الطلب والرد. ولذلك القاعدة التي يكررها الناس «الخيوط لا تفيد في Python» خاطئة في المهام المقيدة بالانتظار، وهي أغلب ما تفعله خدمات الويب.
asyncioمع aiohttp أعطى نفس أرقام الخيوط تقريباً: 0.58 ثانية بعشرة طلبات متزامنة و0.31 إلى 0.33 بمئة، ولكن في خيط واحد فقط، وبدون ثمن إنشاء مئة خيط من نظام التشغيل، وهذا الفرق يظهر عندما يصبح العدد آلافاً وليس مئة.- كل الطرق قرأت 2200 بايت، أي مئة رد كل واحد 22 بايت، فلا توجد طريقة ضيعت طلباً.
ثمن الانتظار Memory Cost: آلاف الخيوط أم آلاف المهام؟
رأينا أن الخيوط وasyncio متقاربان في مئة طلب، فمتى يظهر الفرق؟ الملف costs.py ينشئ عدداً من الخيوط أو المهام التي تنتظر حدثاً فقط ولا تعمل شيئاً، ويقيس الزيادة في الذاكرة الفعلية RSS وزمن الإنشاء:
1000 sleeping threads: +  10.5 MB RSS, started in 4.54 s
5000 sleeping threads: +  71.6 MB RSS, started in 8.14 s
1000 sleeping asyncio tasks: +   1.1 MB RSS, started in 0.03 s
100000 sleeping asyncio tasks: +  83.8 MB RSS, started in 3.44 s
ألف خيط أضافت 10.5 ميجابايت فقط، وهذا أقل مما يتوقعه كثيرون، لأن نظام التشغيل يحجز لكل خيط مكدساً Stack بحجم 8 ميجابايت كما طبعه الأمر ulimit -s بالقيمة 8192 كيلوبايت، ولكنه حجز افتراضي لا يتحول إلى ذاكرة حقيقية إلا عند استعماله. ولكن إنشاء الألف خيط أخذ 4.54 ثانية على هذا الجهاز المشغول، وخمسة آلاف أخذت 72 ميجابايت و8.14 ثانية. أما المهام فألف منها أضافت 1.1 ميجابايت وأنشئت في 0.03 ثانية، ومئة ألف مهمة أخذت 84 ميجابايت، أي تقريباً نفس ذاكرة خمسة آلاف خيط لعشرين ضعفاً من الاتصالات المنتظرة. وهذا هو المكان الحقيقي لـ asyncio: ليس أنه أسرع في مئة طلب، وإنما أنه يحتمل عشرات الآلاف من الاتصالات المفتوحة معاً، كما في خدمة WebSocket أو بوابة API، بثمن صغير لكل اتصال.
مشكلة واجهناها: httpx أبطأ بثلاث مرات أو أكثر
في البداية كتبنا نسخة asyncio بالمكتبة httpx وحدها، لأنها شائعة جداً وتعطي نفس الواجهة للكود المتزامن وغير المتزامن، فجاءت النتيجة 1.7 ثانية لمئة طلب متزامن، أي أبطأ من الخيوط بخمس مرات، وهذا لا يتفق مع أي شيء نعرفه عن asyncio. فقمنا بتقسيم المشكلة: كتبنا عميلاً بسيطاً بـ asyncio.open_connection من المكتبة القياسية يرسل الطلب ويقرأ الرد، وقارناه بـ httpx على نفس السيرفر وبعشرين طلباً متزامناً، مرة باسم السيرفر ومرة بعنوان IP مباشرة لنستبعد DNS:
raw streams 20 concurrent slow 154 ms
raw streams 20 concurrent 192.168.176.2 72 ms
httpx 20 concurrent slow 683 ms
httpx 20 concurrent 192.168.176.2 959 ms
العميل البسيط أنهى العشرين طلباً في 72 ميلي ثانية مع عنوان IP، أي أن الحلقة والسيرفر يعملان بالتزامن كما يجب، بينما أخذت httpx بين 683 و959 ميلي ثانية مع الاسم ومع العنوان، فالمشكلة ليست في DNS ولا في السيرفر ولا في asyncio. ثم جربنا aiohttp بنفس الطريقة:
aiohttp 3.14.5 httpx 0.28.1 httpcore 1.0.9
aiohttp 20 concurrent 196 ms
aiohttp 100 concurrent 345 ms
httpx 20 concurrent 945 ms
ولذلك أضفنا aiohttp إلى المختبر وأبقينا httpx في الجدول كما هي، لأن الدرس هنا أهم من الرقم: في هذه التجربة كانت مكتبة العميل هي العائق وليس اللغة ولا نموذج التزامن، ولم نتتبع السبب داخل httpx وhttpcore إلى نهايته، فقد يكون في هذه التركيبة من الإصدارات بالذات. والقاعدة التي تخرج بها: قبل أن تقرر أن asyncio أو الخيوط أو اللغة كلها بطيئة، قس طلباً واحداً، ثم عشرين طلباً بعميل بسيط، ثم بمكتبتك، فالفرق بين الخطوتين يقول لك أين المشكلة.
المهمة المقيدة بالمعالج CPU-bound: SHA-256 في سلسلة
المهمة الثانية حسابية بالكامل: ألفا نص، وكل نص نحسب له SHA-256، ثم الهاش للهاش، وهكذا ألفي مرة، أي أربعة ملايين عملية هاش. والملف cpu_bound.py يقسم النصوص على أربعة Workers ويقارن الطرق:
STRINGS = [f"order-{i}-تمر-سكري" for i in range(2000)]
ROUNDS = 2000
WORKERS = int(os.environ.get("WORKERS", "4"))


def chain(s: str) -> str:
    h = s.encode()
    for _ in range(ROUNDS):
        h = hashlib.sha256(h).digest()
    return h.hex()


def run(label, fn, own_cpu=True):
    c, t = time.process_time(), time.perf_counter()
    out = fn()
    dt = time.perf_counter() - t
    busy = f"cores busy {(time.process_time() - c) / dt:4.2f}" if own_cpu else "cores busy (in child processes)"
    print(f"{label:22s} {dt:7.2f} s   {busy}   first={out[0][:12]}", flush=True)
    return dt


def chunks(n):
    return [STRINGS[i::n] for i in range(n)]


def chain_many(part):
    return [chain(s) for s in part]
ولاحظ الدالة run: إلى جانب الزمن الفعلي تحسب زمن المعالج الذي استهلكته العملية بـ time.process_time() وتقسمه على الزمن الفعلي، فإذا عمل خيط واحد طوال الوقت كان الناتج قريباً من 1، وإذا عملت أربعة خيوط معاً كان قريباً من 4. وسبب هذا العمود مشكلة حقيقية سوف نشرحها بعد المخرج. شغلنا الملف مرتين على كل بناء، والمخرج كما يلي:
### run 1, GIL build
3.15.2 GIL cpus: 8 workers: 4
sequential               12.73 s   cores busy 1.00   first=2a6f39adad9c
threads x4                6.54 s   cores busy 1.02   first=2a6f39adad9c
                       speed-up x1.95
processes x4              4.14 s   cores busy (in child processes)   first=2a6f39adad9c
                       speed-up x3.07
### run 1, free-threaded build
3.15.2 free-threaded cpus: 8 workers: 4
sequential               10.03 s   cores busy 1.00   first=2a6f39adad9c
threads x4                3.07 s   cores busy 3.21   first=2a6f39adad9c
                       speed-up x3.27
processes x4              3.26 s   cores busy (in child processes)   first=2a6f39adad9c
                       speed-up x3.07
### run 2, GIL build
3.15.2 GIL cpus: 8 workers: 4
sequential                9.17 s   cores busy 1.00   first=2a6f39adad9c
threads x4                7.19 s   cores busy 1.02   first=2a6f39adad9c
                       speed-up x1.28
processes x4              4.05 s   cores busy (in child processes)   first=2a6f39adad9c
                       speed-up x2.26
### run 2, free-threaded build
3.15.2 free-threaded cpus: 8 workers: 4
sequential                9.83 s   cores busy 1.00   first=2a6f39adad9c
threads x4                3.47 s   cores busy 3.61   first=2a6f39adad9c
                       speed-up x2.83
processes x4              3.35 s   cores busy (in child processes)   first=2a6f39adad9c
                       speed-up x2.93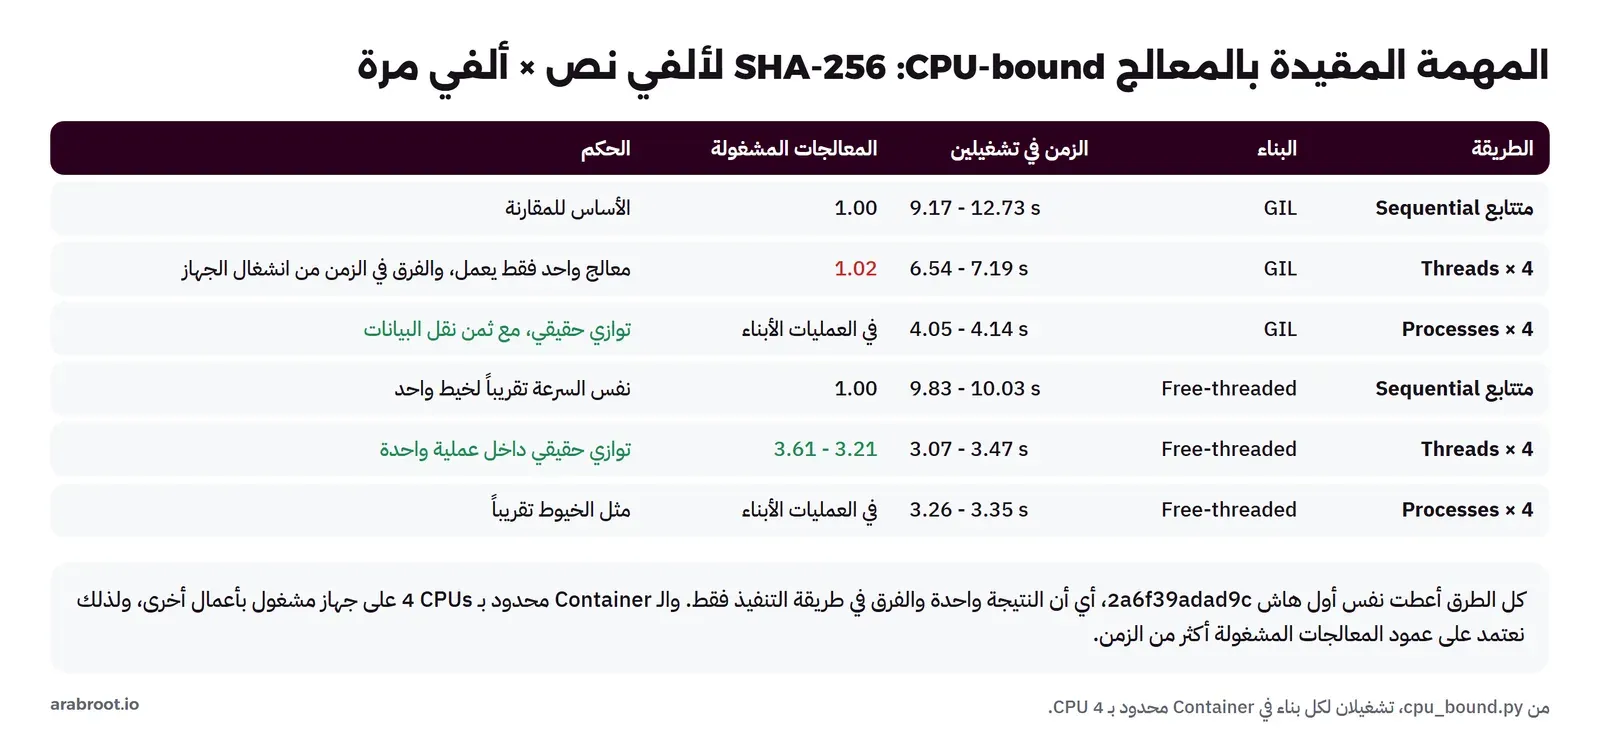
مشكلة القياس Benchmark Noise: الجهاز المشغول يكذب في الزمن
عندما رأينا السطر threads x4 6.54 s مع speed-up x1.95 في البناء العادي توقفنا، فالخيوط مع الـ GIL لا يجب أن تسرع عملاً حسابياً، والوحدة hashlib يقول توثيقها صراحة إنها تترك الـ GIL فقط عندما يكون حجم البيانات أكثر من 2047 بايت، والهاش في سلسلتنا 32 بايت فقط. ثم جاء التشغيل الثاني بتسريع 1.28 فقط، والزمن المتتابع نفسه تغير من 12.73 إلى 9.17 ثانية لنفس الكود. والسبب أن الجهاز الذي يعمل عليه Docker كان مشغولاً بأعمال أخرى في نفس الوقت، فالمعالج الذي حصل عليه الخيط الواحد في مرحلة كان أبطأ أو أكثر ازدحاماً منه في مرحلة أخرى. ولذلك كتبنا اختباراً أصغر يقيس زمن المعالج مع الزمن الفعلي، على عمل هاش وعلى حلقة Python عادية:
3.15.2 GIL
sha256 chain      1 job:  1.20 s, cores busy 1.00 | 4 jobs on 4 threads:  3.44 s, cores busy 1.01
pure-Python loop  1 job:  0.97 s, cores busy 1.00 | 4 jobs on 4 threads:  2.92 s, cores busy 1.02
3.15.2 free-threaded
sha256 chain      1 job:  1.30 s, cores busy 1.00 | 4 jobs on 4 threads:  1.52 s, cores busy 3.08
pure-Python loop  1 job:  0.96 s, cores busy 1.00 | 4 jobs on 4 threads:  1.11 s, cores busy 3.30
3.15.2 GIL
sha256 chain      1 job:  0.85 s, cores busy 1.00 | 4 jobs on 4 threads:  3.61 s, cores busy 1.01
pure-Python loop  1 job:  1.33 s, cores busy 1.00 | 4 jobs on 4 threads:  2.61 s, cores busy 1.02
3.15.2 free-threaded
sha256 chain      1 job:  1.26 s, cores busy 1.00 | 4 jobs on 4 threads:  1.66 s, cores busy 3.24
pure-Python loop  1 job:  1.06 s, cores busy 1.00 | 4 jobs on 4 threads:  1.19 s, cores busy 3.40
وهنا الصورة واضحة ولا يغيرها انشغال الجهاز: في البناء العادي لم يتجاوز عدد المعالجات المشغولة 1.02 مع أربعة خيوط في الحالتين، أي أن الخيوط تناوبت على معالج واحد كما يقول تعريف الـ GIL، وأربع مهام أخذت تقريباً أربعة أضعاف المهمة الواحدة. أما البناء الخالي من القفل فشغل بين 3.08 و3.40 معالجات، وأربع مهام أخذت تقريباً نفس زمن مهمة واحدة. والدرس العام في القياس أهم من Python نفسها: على جهاز مشترك أو سيرفر سحابي فيه جيران، الزمن الفعلي وحده قد يعطيك تسريعاً غير موجود، فقس معه زمن المعالج، وكرر التشغيل، ولا تثق برقم واحد.
ماذا تقول النتائج Results عن كل طريقة؟
- العمليات Processes مع البناء العادي أعطت توازياً حقيقياً بين 2.26 و3.07 ضعفاً على أربعة معالجات، والسبب أن كل عملية لها مفسرها وقفلها الخاص. وثمنها أن البيانات تنسخ بين العمليات بالتسلسل Pickle، وأن كل عملية تحمل نسخة من المفسر والمكتبات في الذاكرة، وأن إنشاء العمليات نفسه يأخذ وقتاً، وكل هذا داخل الرقم الذي قسناه. ولذلك تناسب العمليات المهام الكبيرة التي يكون فيها الحساب أكبر بكثير من البيانات المنقولة، كما في سلسلة الهاش هنا حيث ينتقل نص قصير ويرجع هاش قصير بعد ألفي عملية.
- الخيوط على البناء الخالي من القفل أعطت 2.83 إلى 3.27 ضعفاً، أي مثل العمليات أو أفضل قليلاً، ولكن داخل عملية واحدة وبذاكرة مشتركة دون نسخ، وهذا ما يجعل هذا البناء مهماً لأعمال مثل معالجة الصور والبيانات داخل خدمة واحدة.
- كل الطرق أعطت نفس أول هاش
2a6f39adad9c، وهذا فحص بسيط تضعه في كل قياس لتتأكد أن الطريقة الأسرع لم تسرع لأنها تقوم بعمل أقل. - لم نصل إلى أربعة أضعاف في أي طريقة، لأن الـ Container محدود بأربعة معالجات على جهاز فيه أعمال أخرى، ولأن التقسيم نفسه وجمع النتائج لهما ثمن.
وقد يتساءل البعض: إذا كان البناء الخالي من القفل يحل المشكلة، لماذا لا يكون هو الافتراضي؟ والإجابة في ثلاث نقاط من التوثيق الرسمي: بطء في الخيط الواحد يصل إلى حوالي 8% على Linux، وأن كل إضافة مكتوبة بـ C في مشروعك يجب أن تعلن دعمها لهذا البناء وإلا أعاد المفسر تفعيل القفل، وأن الكود الذي كان يعمل صحيحاً «بالصدفة» بسبب الـ GIL قد يظهر فيه تسابق جديد، وهذا ما سوف نراه حالاً. ومشروع py-free-threading يتابع حالة دعم المكتبات المشهورة لهذا البناء.
كيف تبدأ العمليات؟ طرق البدء Start Methods
عندما تنشئ ProcessPoolExecutor فهناك سؤال لا يراه أغلب المطورين: كيف تنشأ العملية الجديدة؟ في Linux توجد ثلاث طرق في الوحدة multiprocessing: الطريقة fork تنسخ العملية الحالية كما هي بكل ذاكرتها، والطريقة spawn تشغل مفسراً جديداً من البداية يستورد ملفك من جديد، والطريقة forkserver تشغل عملية خادمة صغيرة نظيفة في البداية، ثم تنسخ منها كل عملية جديدة. وقد كانت fork هي الافتراضية على Linux لسنوات، ولكن نسخ عملية فيها خيوط تعمل خطر، لأن الخيط الذي كان يمسك قفلاً لا ينتقل إلى العملية الجديدة بينما القفل نفسه ينتقل مقفلاً، فتتجمد العملية الابن عند أول محاولة لأخذه. ولذلك غيرت Python 3.14 الطريقة الافتراضية على أنظمة POSIX إلى forkserver كما في توثيق multiprocessing. والملف start_methods.py يقيس زمن إنشاء أربع عمليات واستعمالها وإغلاقها بكل طريقة، والمخرج من تشغيلين كما يلي:
default start method: forkserver
fork       pool of 4 started+used+closed in  0.33 s, child sees BIG: True
forkserver pool of 4 started+used+closed in  1.39 s, child sees BIG: True
spawn      pool of 4 started+used+closed in  0.88 s, child sees BIG: True
default start method: forkserver
fork       pool of 4 started+used+closed in  0.15 s, child sees BIG: True
forkserver pool of 4 started+used+closed in  0.65 s, child sees BIG: True
spawn      pool of 4 started+used+closed in  0.54 s, child sees BIG: True
في المخرج أعلاه لاحظ التالي:
- الطريقة الافتراضية في 3.15.2 هي
forkserverكما طبعها السطر الأول، فإذا نقلت كوداً قديماً يعتمد على أن العملية الابن ترى متغيرات أنشأها الأب وقت التشغيل فقد يتوقف عن العمل بعد الترقية، والحل أن تطلبforkصراحة بـget_context("fork")إذا كنت متأكداً أنه لا توجد خيوط، أو الأفضل أن تمرر البيانات كمعاملات. forkكانت الأسرع في التشغيلين، لأنها لا تشغل مفسراً جديداً ولا تستورد شيئاً، وforkserverكانت الأبطأ هنا لأن التجربة تدفع ثمن تشغيل الخادم نفسه أول مرة، وهذا ثمن يدفع مرة واحدة في عمر الخدمة.- القيمة
Trueفي العمود الأخير لها معنيان مختلفان: فيforkورثت العملية الابن القائمةBIGمن ذاكرة الأب مباشرة، أما فيspawnوforkserverفقد أعادت العملية الابن تنفيذ السطرBIG = list(range(2_000_000))عندما استوردت الملف من جديد، أي أن كل عملية بنت نسختها بنفسها ودفعت ثمنها. ولهذا السبب يجب أن يكون كود إنشاء العمليات داخلif __name__ == "__main__":، وإلا أعادت كل عملية ابن إنشاء عمليات جديدة عند استيراد الملف.
حالة التسابق Race Condition: عشرون كيساً من مخزون عشرة
الآن نعود إلى أخطر مشكلة في القصة: الخدمة باعت عشرين كيساً من مخزون عشرة. والملف race.py يعيد ما حدث بأبسط شكل: عشرون خيطاً تبدأ في نفس اللحظة بفضل threading.Barrier، وكل خيط يقرأ المخزون، فإذا وجده أكثر من صفر ينتظر ميلي ثانية واحدة ثم ينقصه:
def attempt(lock: threading.Lock | None, results: list, stock: dict, barrier: threading.Barrier) -> None:
    barrier.wait()                        # start all threads at the same moment
    if lock:
        lock.acquire()
    try:
        left = stock["dates"]
        if left >= 1:
            time.sleep(0.001)             # the gap a real service has: a DB call, a log line
            stock["dates"] = left - 1
            results.append("ok")
        else:
            results.append("409")
    finally:
        if lock:
            lock.release()
والميلي ثانية هنا ليست حيلة لإظهار الخطأ، وإنما تمثل ما يحدث في كل خدمة حقيقية بين القراءة والكتابة: استعلام إلى قاعدة البيانات، أو سطر في السجل، أو استدعاء خدمة الدفع. والمخرج على البناءين كما يلي:
### race GIL build
3.15.2 GIL
no lock    sold=20  rejected= 0  stock left=9
no lock    sold=20  rejected= 0  stock left=9
no lock    sold=20  rejected= 0  stock left=9
with lock  sold=10  rejected=10  stock left=0
counter: expected 800000, got 800000
counter: expected 800000, got 800000
counter: expected 800000, got 800000
### race free-threaded build
3.15.2 free-threaded
no lock    sold=20  rejected= 0  stock left=9
no lock    sold=20  rejected= 0  stock left=9
no lock    sold=20  rejected= 0  stock left=9
with lock  sold=10  rejected=10  stock left=0
counter: expected 800000, got 284666
counter: expected 800000, got 412556
counter: expected 800000, got 321183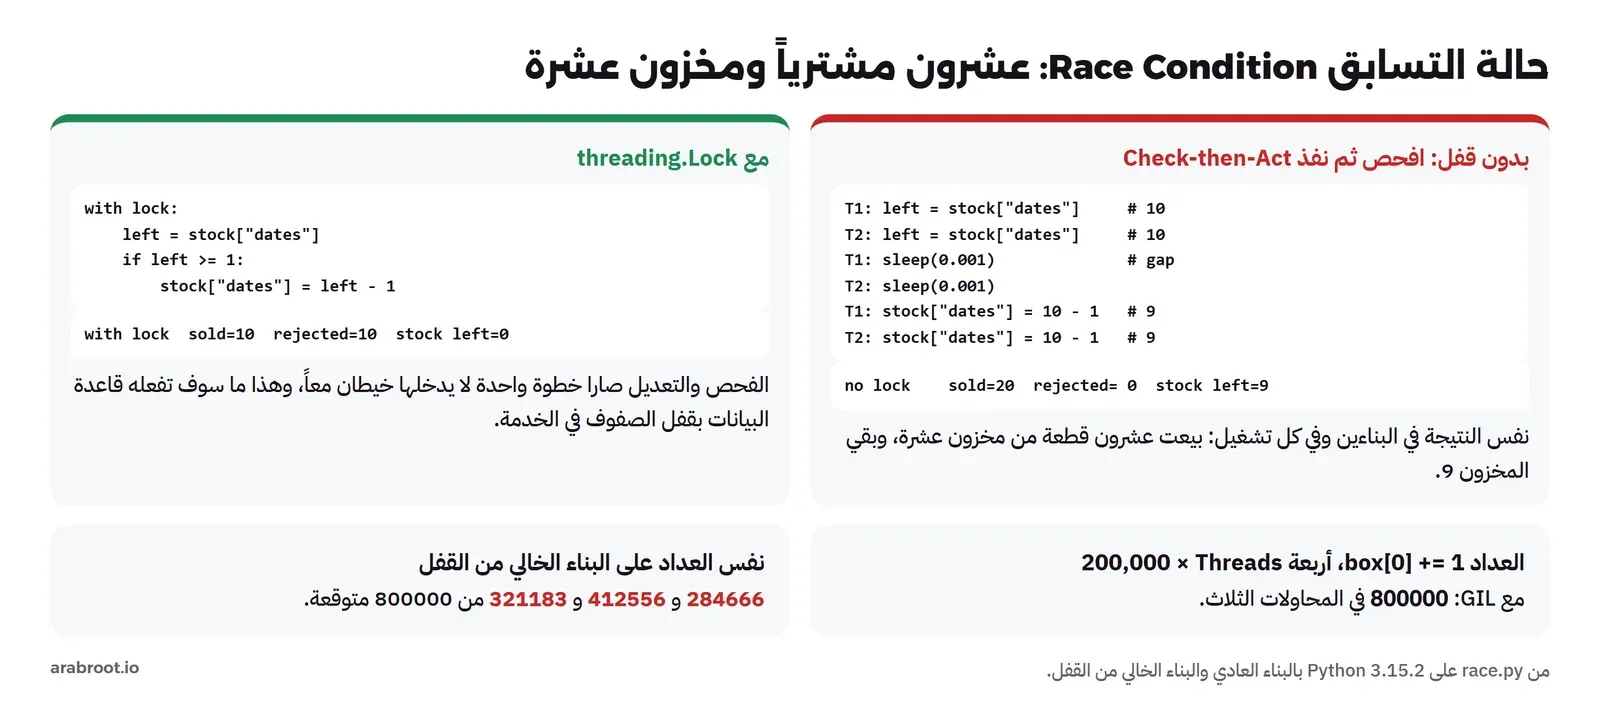
في المخرج أعلاه لاحظ التالي:
- بدون قفل باعت الخيوط عشرين قطعة في كل محاولة وعلى البناءين، وبقي المخزون 9 وليس صفراً أو سالباً، والسبب أن كل خيط قرأ 10 قبل أن يكتب أي خيط، ثم كتب كل واحد 10 ناقص 1. وهذا يسمى «افحص ثم نفذ» Check-then-Act، والـ GIL لا يحمي منه إطلاقاً، لأنه يحمي تعليمة واحدة من تعليمات المفسر وليس منطق دالتك.
- مع
threading.Lockصارت القراءة والفحص والكتابة منطقة حرجة Critical Section لا يدخلها إلا خيط واحد، فبيعت عشر قطع ورفضت عشر، وبقي المخزون صفراً. وفي الخدمة الحقيقية لن يكون القفل في ذاكرة Python، لأن الخدمة تعمل بعدة عمليات وربما عدة سيرفرات، وإنما في قاعدة البيانات بـSELECT ... FOR UPDATE، وهذا بالضبط ما سوف نختبره في المقال التالي بعشرين طلباً متوازياً على منتج مخزونه عشرة. - العداد
box[0] += 1أعطى 800000 كاملة مع الـ GIL في المحاولات الثلاث، وعلى البناء الخالي من القفل فقد أكثر من نصف القيم. والسبب أن+=ثلاث خطوات: اقرأ، أضف، اكتب، والمفسر في البناء العادي لا يبدل الخيوط في وسط هذه الخطوات في الواقع العملي لهذا الكود، فبدا كأنه آمن. وهذا هو الكود الذي يعمل «بالصدفة»، فلا يوجد في اللغة أي وعد بأن+=عملية ذرية Atomic، وأول ما يتغير المفسر يظهر الخطأ، ولذلك احم كل حالة مشتركة بقفل حتى لو بدت آمنة اليوم.
الجمود Deadlock: قفلان بترتيبين مختلفين
وبعد أن يضيف الفريق أقفالاً في كل مكان تظهر المشكلة المعاكسة: الجمود. والملف deadlock.py فيه عمليتان، الدفع Checkout يأخذ قفل المخزون ثم قفل الطلبات، والاسترجاع Refund يأخذ قفل الطلبات ثم قفل المخزون، وهو ترتيب طبيعي جداً لمن كتب كل دالة في يوم مختلف:
stock_lock = threading.Lock()
order_lock = threading.Lock()

def reserve_then_record(name: str, first: threading.Lock, second: threading.Lock, ordered: bool) -> None:
    a, b = (first, second)
    if ordered:                           # the fix: always take the locks in one global order
        a, b = sorted((first, second), key=id)
    with a:
        time.sleep(0.05)
        if b.acquire(timeout=2):
            b.release()
            print(f"  {name}: done")
        else:
            print(f"  {name}: waited 2 s for the second lock, giving up (deadlock)")
والمخرج سوف يكون كما يلي:
opposite order
  checkout: waited 2 s for the second lock, giving up (deadlock)
  refund  : done
  took 2.05 s
ordered locks
  checkout: done
  refund  : done
  took 0.10 s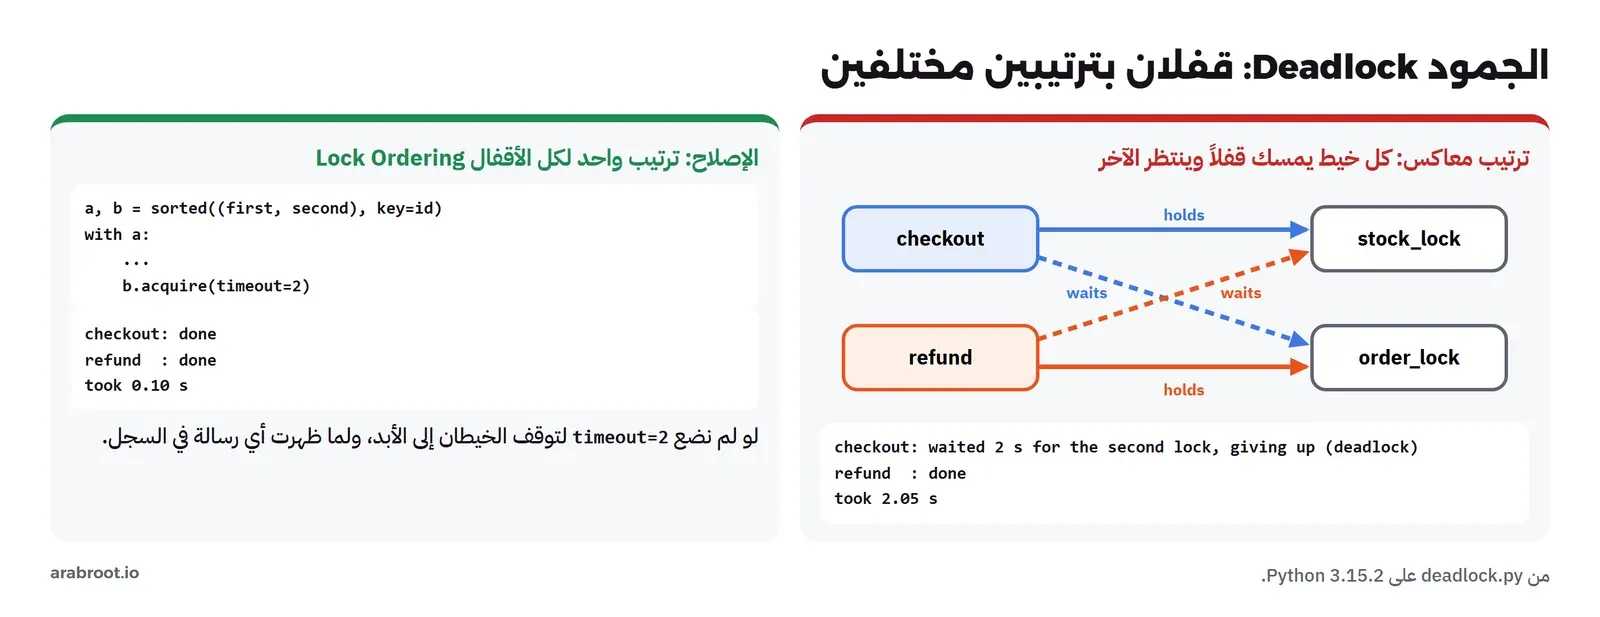
أمسك كل خيط قفله الأول، ثم انتظر القفل الثاني الذي يمسكه الآخر، فلم يتقدم أحد. ولولا timeout=2 لبقي الخيطان متوقفين إلى الأبد، ولما ظهرت أي رسالة خطأ ولا استهلاك معالج، وإنما طلبات معلقة تتراكم حتى يعيد أحدهم تشغيل الخدمة، وهذا ما يجعل الجمود من أصعب المشاكل تشخيصاً في الإنتاج. وبعد أن استسلم checkout وترك قفله أكمل refund عمله، فأخذت التجربة 2.05 ثانية. والإصلاح أن تأخذ الأقفال دائماً بترتيب واحد في كل الكود، وفي المثال رتبناها بـ id، فأخذ الخيطان القفلين بنفس الترتيب وانتهيا في 0.10 ثانية. وفي الخدمة الحقيقية التي تقفل صفوفاً في قاعدة البيانات يكون الحل نفسه: اقفل صفوف المنتجات مرتبة بالمعرف ORDER BY id، وإلا اكتشفت قاعدة البيانات الجمود وألغت أحد الطلبين.
ماذا لو What If: عمل حسابي داخل دالة async؟
رأينا أن asyncio سريع في الانتظار، ولكنه يعمل في خيط واحد، فماذا يحدث إذا وضع أحدهم حساباً ثقيلاً داخل دالة async، كتوقيع فاتورة داخل معالج طلب HTTP؟ الملف blocked_loop.py يشغل مهمة نبض Heartbeat تستيقظ كل 10 ميلي ثانية وتسجل الفجوة الفعلية بين كل نبضتين، ثم ينفذ 300 ألف عملية هاش مرة مباشرة ومرة عبر asyncio.to_thread:
async def heartbeat(gaps: list) -> None:
    last = time.perf_counter()
    for _ in range(40):
        await asyncio.sleep(0.01)
        now = time.perf_counter()
        gaps.append((now - last) * 1000)
        last = now

async def main(offload: bool) -> None:
    gaps: list[float] = []
    hb = asyncio.create_task(heartbeat(gaps))
    await asyncio.sleep(0.05)
    if offload:
        await asyncio.to_thread(hash_chain, 300_000)
    else:
        hash_chain(300_000)                    # blocks the event loop
    await hb
    print(f"{'asyncio.to_thread' if offload else 'called directly':18s} heartbeat every 10 ms: worst gap {max(gaps):6.0f} ms")
والمخرج سوف يكون كما يلي:
called directly    heartbeat every 10 ms: worst gap   1046 ms
asyncio.to_thread  heartbeat every 10 ms: worst gap     25 ms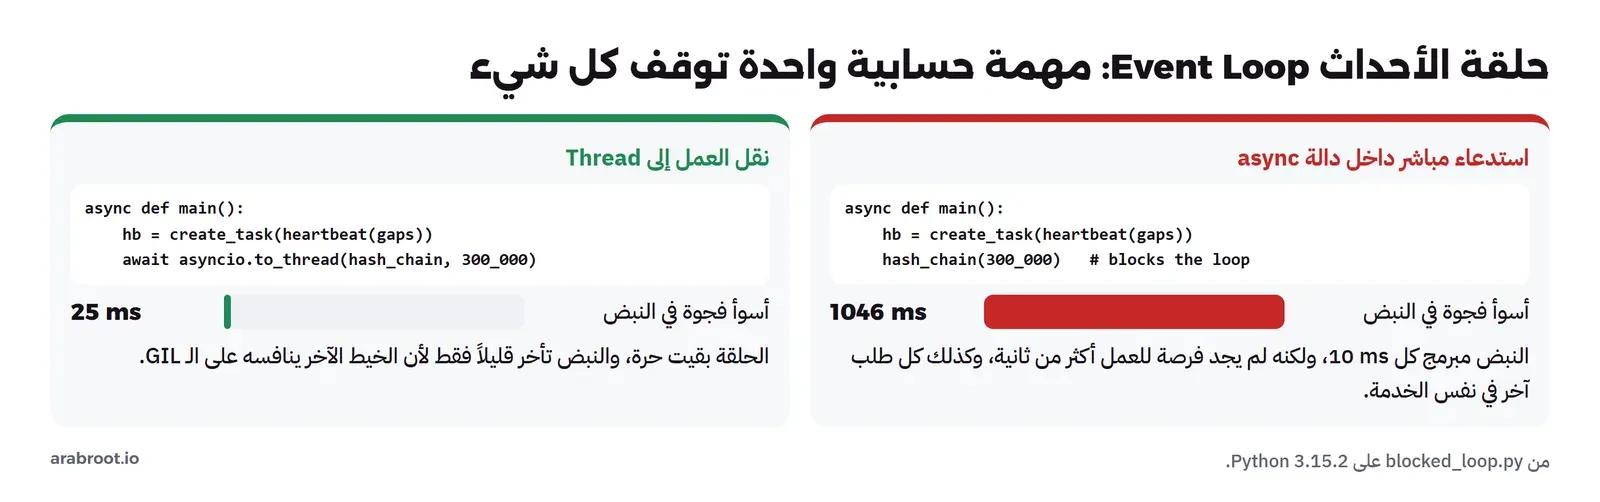
النبض المبرمج كل 10 ميلي ثانية انتظر أكثر من ثانية كاملة، لأن الحلقة لا تستطيع أن تنتقل إلى مهمة أخرى إلا عند await، والدالة hash_chain لا يوجد فيها أي await. وفي خدمة حقيقية تعني هذه الثانية أن كل الطلبات الأخرى في نفس العملية توقفت، بما فيها فحص الصحة Health Check، فقد يظن الـ Load Balancer أن الخدمة ماتت ويخرجها من الخدمة. ومع asyncio.to_thread انتقل الحساب إلى خيط آخر، فبقيت الحلقة حرة، وأسوأ فجوة كانت 25 ميلي ثانية، والتأخير القليل لأن الخيط الآخر ينافس الحلقة على الـ GIL. ولاحظ أن to_thread يحرر الحلقة ولكنه لا يجعل الحساب متوازياً مع الـ GIL، فإذا كان الحساب كبيراً ومتكرراً فمكانه ProcessPoolExecutor عبر loop.run_in_executor، أو عملية Worker منفصلة. ويذكر دليل التطوير مع asyncio وضع التصحيح Debug Mode الذي يطبع تحذيراً لأي استدعاء يحجز الحلقة أكثر من 100 ميلي ثانية، وهو مفيد جداً في بيئة التطوير.
التزامن المنظم Structured Concurrency: TaskGroup والمهلة Timeout
في تحديث الكتالوج نرسل مئة طلب إلى المورد معاً، فماذا يحدث إذا فشل طلب واحد؟ في الكود القديم المكتوب بـ asyncio.gather كانت بقية المهام تستمر في الخلفية حتى بعد أن يصلك الخطأ، وقد تبقى مهام معلقة لا يملكها أحد. ولذلك أضافت Python 3.11 الكلاس asyncio.TaskGroup الذي استعملناه في المختبر، وفكرته أن المهام التي تنشأ داخل الكتلة لا تعيش بعدها: إذا فشلت مهمة ألغيت أخواتها، ولا تخرج الكتلة إلا بعد أن تنتهي كل المهام أو تلغى، والأخطاء تجمع في ExceptionGroup كما رأينا في المقال السابق. ومعه asyncio.timeout الذي يضع مهلة على أي جزء من الكود، والتفاصيل في توثيق المهام في asyncio. والجزء الأخير من costs.py يبين الاثنين:
async def fetch(i):
    await asyncio.sleep(0.05 * i)
    if i == 2:
        raise ConnectionError(f"supplier timeout on product {i}")
    print(f"  product {i} done")

async def main():
    try:
        async with asyncio.TaskGroup() as tg:
            for i in range(1, 6):
                tg.create_task(fetch(i))
    except* ConnectionError as eg:
        print("  TaskGroup cancelled the rest:", [str(e) for e in eg.exceptions])
    try:
        async with asyncio.timeout(0.1):
            await asyncio.sleep(1)
    except TimeoutError:
        print("  asyncio.timeout(0.1) stopped a 1 s wait")
والمخرج سوف يكون كما يلي:
  product 1 done
  TaskGroup cancelled the rest: ['supplier timeout on product 2']
  asyncio.timeout(0.1) stopped a 1 s wait
انتهت المهمة الأولى بعد 50 ميلي ثانية، ثم فشلت الثانية بعد 100، فألغى الـ TaskGroup المهام الثلاث الباقية قبل أن تنتهي، ولذلك لم تطبع المنتجات 3 و4 و5 أي سطر، ووصل الخطأ الوحيد في المجموعة إلى except*. وهذا السلوك هو ما تريده في أغلب الحالات، فلا فائدة من إكمال تحديث نصف كتالوج فشل، أما إذا أردت أن تكمل المهام رغم فشل بعضها فالتقط الخطأ داخل كل مهمة وأرجعه كقيمة. والمهلة أوقفت انتظاراً مدته ثانية بعد 0.1 ثانية برمي TimeoutError، والقاعدة أن كل طلب يخرج إلى الشبكة يجب أن تكون له مهلة، لأن طلباً واحداً معلقاً بلا مهلة يحجز Semaphore أو اتصالاً إلى الأبد.
من المختبر إلى الخدمة Service: عمليات وحلقة أحداث معاً
كل ما قسناه حتى الآن كان في سكربتات منفصلة، فكيف يجتمع في خدمة ويب حقيقية مثل خدمة الطلبات التي سوف نبنيها في المقال التالي؟ الشكل الشائع اليوم لخدمة Python هو طبقتان: في الأعلى عدة عمليات Workers يديرها سيرفر مثل Uvicorn أو Gunicorn، وفي كل عملية حلقة أحداث واحدة تخدم مئات الطلبات المتزامنة بـ asyncio. والسبب في هذا الشكل هو بالضبط ما رأيناه في المختبر: الحلقة الواحدة ممتازة في الانتظار لأن الطلب الذي ينتظر قاعدة البيانات لا يكلف إلا مهمة صغيرة، ولكنها لا تستعمل إلا معالجاً واحداً بسبب الـ GIL، ولذلك نضاعف العمليات لنستعمل كل المعالجات. والقاعدة الشائعة أن تبدأ بعدد عمليات يساوي عدد المعالجات المتاحة للـ Container، ثم تقيس، فإذا كانت الخدمة تقضي أغلب وقتها في الانتظار فقد تكفيها عمليات أقل.
وهذا الشكل يغير طريقة تفكيرك في الحالة المشتركة: كل عملية لها ذاكرتها، فالقفل في ذاكرة Python يحمي البيانات داخل عملية واحدة فقط، والذاكرة المؤقتة Cache في قاموس عام تتكرر في كل عملية، والمخزون الذي يحميه threading.Lock في عملية سوف يقرؤه طلب آخر في عملية ثانية بدون أي قفل. ولذلك كل حالة يجب أن تكون صحيحة بين الطلبات، كالمخزون والطلبات والأرصدة، مكانها قاعدة البيانات بمعاملاتها Transactions وأقفال صفوفها، وهذا ما سوف نختبره بعشرين طلباً متوازياً. وأما العمل الحسابي الثقيل مثل توقيع الفواتير فلا تضعه في معالج الطلب أصلاً، وإنما في طابور مهام Job Queue تعالجه عمليات منفصلة، فلا يؤخر الطلبات الأخرى ولا يحتاج أن يعرف عنه المستخدم إلا أنه انتهى.
جدول القرار Decision Table: أي نموذج تختار؟
| نوع العمل | النموذج المناسب | ما رأيناه في المختبر |
|---|---|---|
| طلبات شبكة أو قاعدة بيانات، عشرات إلى مئات | ThreadPoolExecutor | مئة طلب من 5.4 ثانية إلى 0.33 ثانية، والكود عادي بدون async |
| آلاف الاتصالات المتزامنة، أو خدمة ويب حديثة | asyncio مع مكتبة تقيسها | نفس سرعة الخيوط في خيط واحد، وaiohttp أسرع من httpx بثلاث مرات أو أكثر هنا |
| حساب ثقيل في كود Python، وبيانات قليلة | ProcessPoolExecutor | بين 2.26 و3.07 ضعفاً على أربعة معالجات |
| حساب ثقيل مع بيانات كبيرة مشتركة | البناء الخالي من القفل بعد فحص مكتباتك | بين 2.83 و3.27 ضعفاً بالخيوط، وأكثر من ثلاثة معالجات مشغولة |
حساب داخل خدمة asyncio | asyncio.to_thread أو عملية منفصلة | فجوة النبض من 1046 إلى 25 ميلي ثانية |
| حالة مشتركة بين الخيوط | Lock وترتيب ثابت للأقفال | بدون قفل بيع 20 من 10، وقفلان بترتيب معاكس جمدا ثانيتين |
أخطاء شائعة Common Mistakes
- رفض الخيوط في كل الحالات بسبب الـ GIL، بينما هي الحل الأبسط للمهام التي تنتظر الشبكة أو القرص.
- استعمال الخيوط للحساب الثقيل في البناء العادي وتوقع تسريع، ثم قياس الزمن وحده على جهاز مشغول فيظهر تسريع وهمي.
- كتابة دالة
asyncتستدعي مكتبة متزامنة مثلrequestsأوtime.sleep، فتحجز الحلقة كما حجزها الحساب في التجربة. - الاعتماد على أن
+=على متغير مشترك آمن لأن الاختبار نجح مع الـ GIL. - حماية المخزون بقفل في ذاكرة Python بينما الخدمة تعمل بعدة عمليات أو عدة سيرفرات، والقفل الصحيح هنا في قاعدة البيانات.
- أخذ عدة أقفال بترتيب يختلف من دالة لأخرى، أو انتظار قفل بدون
timeoutفيتحول الجمود إلى خدمة معلقة بلا رسالة. - استعمال
asyncio.gatherعلى آلاف الطلبات بدون حد، فيفتح آلاف الاتصالات معاً ويضغط على الخدمة الأخرى، والحلSemaphoreكما في المختبر.
قائمة تحقق Checklist قبل أن تضيف التزامن
- هل قست زمن طلب واحد أولاً، وتأكدت أنه قريب من المتوقع قبل أن تقيس مئة؟
- هل حددت نوع العمل: انتظار أم حساب؟ وهل اخترت النموذج من الجدول أعلاه؟
- هل قست زمن المعالج مع الزمن الفعلي، وكررت التشغيل أكثر من مرة؟
- هل يوجد حد لعدد العمليات المتزامنة في كل مكان يخرج إلى الشبكة؟
- هل كل حالة مشتركة محمية بقفل، أو الأفضل أنها غير مشتركة أصلاً؟
- هل الأقفال تؤخذ بترتيب واحد، ولكل انتظار حد زمني؟
- هل يعمل وضع التصحيح في
asyncioفي بيئة التطوير ليكشف الاستدعاءات التي تحجز الحلقة؟ - إذا فكرت في البناء الخالي من القفل: هل كل مكتباتك المكتوبة بـ C تدعمه؟
تدريب عملي
- غير
DELAY_MSفي السيرفر إلى 200، وتوقع قبل التشغيل زمن كل طريقة فيio_bound.py، ثم قارن توقعك بالنتيجة. - شغل
cpu_bound.pyبالمتغيرWORKERS=8مع--cpus 4، ولاحظ هل يزيد التسريع أم لا، ولماذا. - شغل
race.pyعلى البناء الخالي من القفل مع المتغيرPYTHON_GIL=1، وقارن نتيجة العداد بالتشغيل بدونه. - أزل
timeout=2منdeadlock.pyوشغله، ثم استعملpy-spy dumpأوfaulthandlerلترى أين يقف كل خيط.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- في الانتظار لا يضر الـ GIL: مئة طلب نزلت من حوالي 5.5 ثانية إلى 0.33 ثانية بالخيوط وبـ
asyncioعلى حد سواء. - مكتبة العميل قد تكون العائق الحقيقي: httpx أخذت بين 1.57 و2.33 ثانية لنفس العمل الذي أنهته aiohttp في 0.31 ثانية في هذه التجربة.
- في الحساب لا تتجاوز الخيوط مع الـ GIL معالجاً واحداً، والعمليات أو البناء الخالي من القفل أعطت تقريباً ثلاثة أضعاف على أربعة معالجات.
- الزمن الفعلي على جهاز مشغول قد يظهر تسريعاً غير موجود، وقياس زمن المعالج معه يكشف الحقيقة.
- «افحص ثم نفذ» بدون قفل باع عشرين من عشرة على البناءين، والعداد البسيط آمن مع الـ GIL بالصدفة فقط، وفقد أكثر من نصف قيمه بدونه.
- قفلان بترتيبين متعاكسين جمدا خيطين حتى انتهت المهلة، وترتيب واحد للأقفال أصلح ذلك.
- مئة ألف مهمة
asyncioمنتظرة أخذت 84 ميجابايت، أي تقريباً ذاكرة خمسة آلاف خيط، وهذا هو المكان الحقيقي لـasyncio: آلاف الاتصالات المفتوحة وليس مئة طلب. - الطريقة الافتراضية لإنشاء العمليات على Linux صارت
forkserverمنذ 3.14، فالعملية الابن تستورد ملفك من جديد ولا ترث متغيرات وقت التشغيل. - سطر حسابي واحد داخل
asyncأوقف الحلقة أكثر من ثانية، وasyncio.to_threadأعادها إلى 25 ميلي ثانية.
وفي المقال التالي من مرحلة لغة Python للمطورين سوف نبني خدمة الطلبات كاملة بـ FastAPI وPostgreSQL، ونختبر فيها نفس مشكلة المخزون بعشرين طلباً متوازياً على قاعدة بيانات حقيقية:
 دليلPython للمطورين: التركيب Syntax والأدوات في يوم واحددليل لمن يبرمج بلغة أخرى ويريد أن يبدأ بـ Python 3.15 من أول يوم: التثبيت، وما يختلف في التركيب، والأدوات uv وruff وmypy وpytest على مشروع حقيقي بمخرجه الفعلي.
 دليلPython من الداخل: الأنواع Types والذاكرة والاستثناءاتما هو المتغير فعلاً في Python، ومن يحرر الذاكرة، وكيف تعبر اللغة عن الخطأ، بقياسات حقيقية على Python 3.15 من حجم مليون سجل إلى Container قتلته النواة دون رسالة.
 دليلThreads وasync/await: كود لا يتجمد ولا يضيع بياناتهكيف تكتب كوداً يعمل في أكثر من خيط Thread دون أن تضيع بياناته أو يتجمد، ولماذا تظهر هذه الأخطاء على السيرفر ولا تظهر على جهازك.
 دليلحلقة الأحداث Event Loop: لماذا تتأخر النقرة في صفحتك؟كيف ترتب JavaScript المهام والوعود والرسم على خيط واحد، ولماذا تنتظر النقرة خلف مهمة طويلة، وكيف تقسم العمل لتبقى الصفحة سريعة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على Python 3.15.2 بالبناء العادي والبناء الخالي من القفل 3.15t، مع aiohttp 3.14.5 وhttpx 0.28.1، داخل Container محدود بـ 4 CPU و1 GB.