

تكتب اليوم سؤالاً لأداة الذكاء الاصطناعي فتعطيك دالة تعمل من المحاولة الأولى، وهذا جميل حتى يأتي اليوم الذي تعطيك فيه دالة تعمل على بيانات التجربة ثم تخطئ في الإنتاج مع اسم عربي فيه تنوين، أو مع طلبين يصلان في نفس اللحظة، أو مع عميل في الرياض يطلب في الواحدة والنصف بعد منتصف الليل، وعندها تحتاج أن تقرأ الكود وتعرف بنفسك أين الخطأ ولماذا. وهذه المهارة تضعف إذا لم تستخدمها، تماماً مثل العضلة، لذلك جمعنا في هذا المقال تمارين Kata في البرمجة تحلها بيدك وعقلك فقط.
وهذا المقال جزء من سلسلة تمارين Kata التي شرحنا فيها الفكرة وطريقة التدريب، والتمارين هنا لا ترتبط بلغة واحدة، فكل حل مكتوب في لغتين على الأقل من C# وJava وPython وJavaScript، وكل حل شغلناه فعلاً والمخرج المنشور هو المخرج الحقيقي.
وسوف نناقش في هذا المقال ما يلي:
- كيف تستخدم هذه التمارين دون أن تفسدها على نفسك.
- المستوى الأول: ستة تمارين في الأساسيات، من FizzBuzz بشرط إضافي إلى فخاخ الأرقام.
- المستوى الثاني: ستة تمارين في النصوص العربية والبحث الثنائي والمناطق الزمنية والاختبارات والتعقيد.
- المستوى الثالث: خمسة تمارين في التصميم والتزامن وإعادة الهيكلة والذاكرة.
- جدول متابعة تنسخه وتسجل فيه تقدمك.
كيف تستخدم هذه التمارين؟
القاعدة الأولى أن تغلق أداة الذكاء الاصطناعي وإكمال الكود التلقائي Autocomplete في المحرر قبل أن تبدأ، والسبب أن الهدف ليس الوصول إلى الحل وإنما الطريق إليه، فالحل موجود أسفل كل تمرين أصلاً. ثم اضبط مؤقتاً على «الوقت المقترح» واكتب جوابك على الورق أو في ملف قبل أن تفتح أي شيء، وإذا انتهى الوقت ولم تصل فافتح «التلميح Hint» وأعط نفسك نصف الوقت مرة أخرى، وبعد ذلك فقط افتح «الحل Answer» وقارنه بما كتبت، ولاحظ أين اختلفت ولماذا.
وقد يتساءل البعض: لماذا أكتب الجواب قبل التشغيل إذا كان الحاسب يعطيني النتيجة في ثانية؟ والإجابة أن التوقع ثم المقارنة هو ما يبني الحدس، فعندما تتوقع أن السطر يطبع 42 ثم يطبع 41 فأنت تتعلم شيئاً لن تنساه، أما إذا شغلته مباشرة فسوف تقرأ الرقم وتمضي. والصورة التالية تبين التمارين على ثلاث درجات:
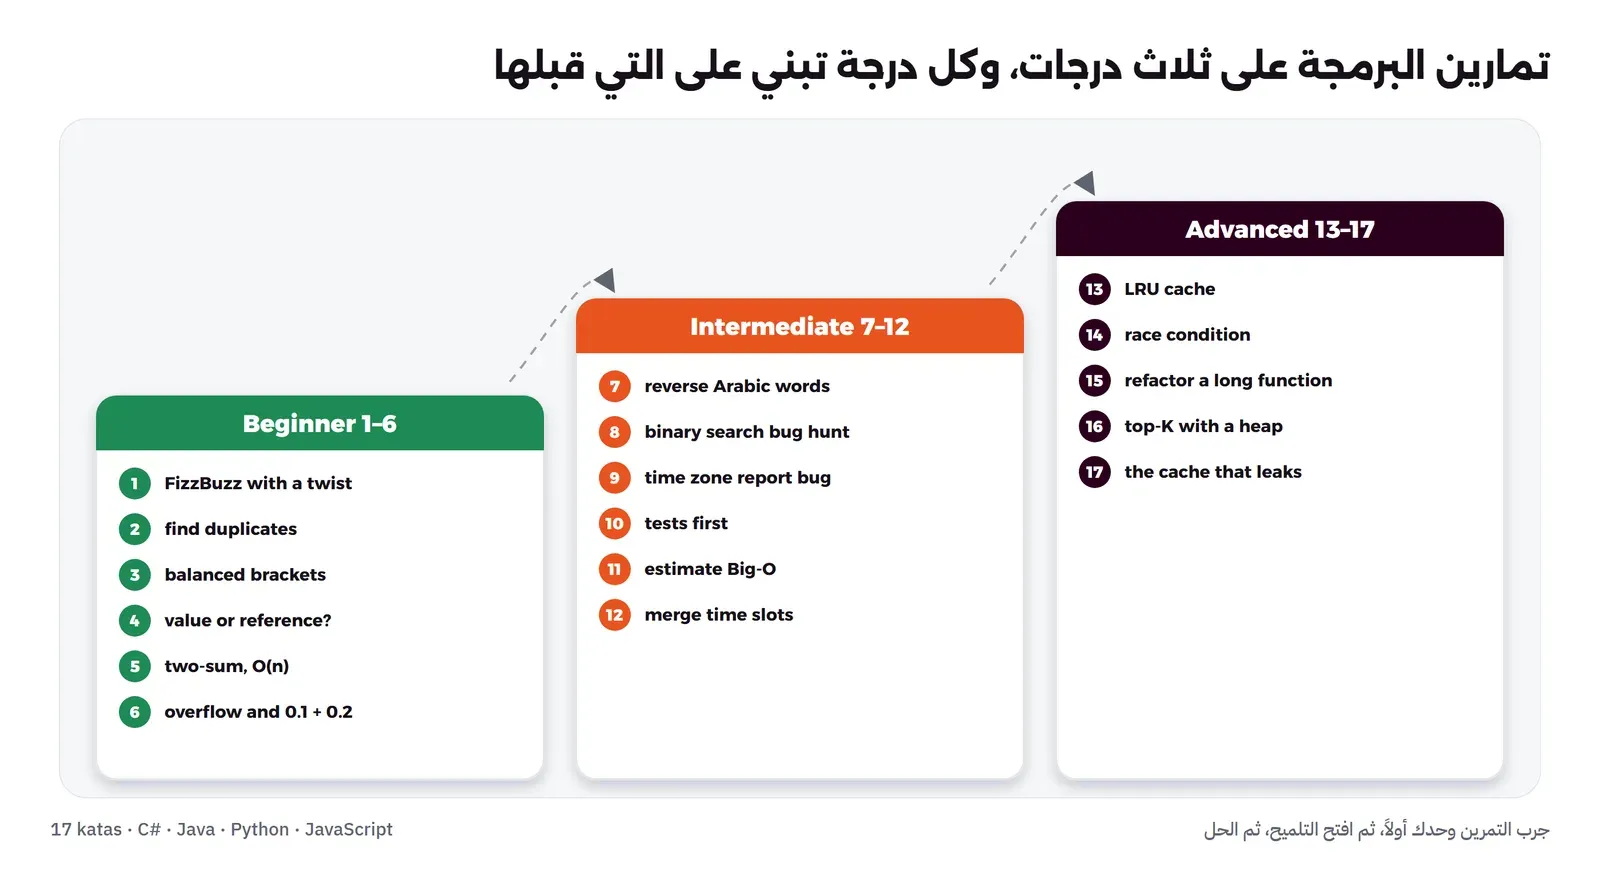
ولتشغيل الحلول بنفسك تحتاج Python 3.13 وNode.js 22 و.NET SDK 10، وكل ملف C# في هذا المقال يعمل كتطبيق من ملف واحد File-based App بالأمر dotnet run file.cs، وملفات Java تعمل دون ترجمة منفصلة بميزة تشغيل ملف المصدر مباشرة داخل Docker Image الرسمية eclipse-temurin:25-jdk إذا لم تكن Java مثبتة عندك:
docker run --rm -v "$PWD:/w" -w /w eclipse-temurin:25-jdk java Brackets.javaالمستوى الأول: مبتدئ Beginner
تمارين هذا المستوى قصيرة، ولكن في كل واحد منها فخ صغير يقع فيه أغلب من يكتب الحل بسرعة، فلا تستعجل.
1. FizzBuzz بشرط إضافي
اطبع الأرقام من 1 إلى 35 في سطر واحد، واكتب بدلاً من الرقم Fizz إذا كان يقبل القسمة على 3، وBuzz إذا كان يقبل القسمة على 5، وFizzBuzz إذا قبل القسمة على الاثنين. والشرط الإضافي أن الرقم الذي يحتوي الخانة 3 مثل 13 و31 يعامل أيضاً كأنه يقبل القسمة على 3. وبعد أن تنتهي يطلب منك مدير المنتج قاعدة جديدة: الرقم الذي يقبل القسمة على 7 يضاف له Bazz، فكم سطراً تحتاج أن تغير في كودك؟
الوقت المقترح: 10 دقائق.
تلميح Hint
بدلاً من سلسلة if وelse if لكل حالة، اجعل القواعد قائمة من أزواج (شرط، كلمة)، ثم اجمع كلمات كل القواعد التي تنطبق على الرقم بالترتيب، وإذا لم تنطبق أي قاعدة فاطبع الرقم نفسه.
الحل Answer
الحل البسيط هو أربعة فروع if تبدأ بحالة FizzBuzz، وهو يعمل، ولكن كل قاعدة جديدة تضاعف عدد الحالات المركبة (FizzBazz وBuzzBazz وFizzBuzzBazz)، لذلك نجعل القواعد بيانات Data وليست فروعاً في الكود:
# fizz.py: rules are data, so a new rule is one line, not a new if
RULES = [
    (lambda n: n % 3 == 0 or "3" in str(n), "Fizz"),   # the twist: a 3 anywhere in the number
    (lambda n: n % 5 == 0, "Buzz"),
]

def say(n, rules=RULES):
    words = "".join(word for test, word in rules if test(n))
    return words or str(n)

print(" ".join(say(n) for n in range(1, 36)))
print(" ".join(say(n, RULES + [(lambda n: n % 7 == 0, "Bazz")]) for n in range(1, 36)))
والمخرج سوف يكون كما يلي:
1 2 Fizz 4 Buzz Fizz 7 8 Fizz Buzz 11 Fizz Fizz 14 FizzBuzz 16 17 Fizz 19 Buzz Fizz 22 Fizz Fizz Buzz 26 Fizz 28 29 FizzBuzz Fizz Fizz Fizz Fizz FizzBuzz
1 2 Fizz 4 Buzz Fizz Bazz 8 Fizz Buzz 11 Fizz Fizz Bazz FizzBuzz 16 17 Fizz 19 Buzz FizzBazz 22 Fizz Fizz Buzz 26 Fizz Bazz 29 FizzBuzz Fizz Fizz Fizz Fizz FizzBuzzBazz
ونفس الفكرة في JavaScript:
// fizz.js: the same rules in JavaScript
const RULES = [
  [n => n % 3 === 0 || String(n).includes("3"), "Fizz"],
  [n => n % 5 === 0, "Buzz"],
];
const say = (n, rules = RULES) => rules.filter(([test]) => test(n)).map(([, w]) => w).join("") || String(n);

console.log(Array.from({ length: 35 }, (_, i) => say(i + 1)).join(" "));
console.log(Array.from({ length: 35 }, (_, i) => say(i + 1, [...RULES, [n => n % 7 === 0, "Bazz"]])).join(" "));
1 2 Fizz 4 Buzz Fizz 7 8 Fizz Buzz 11 Fizz Fizz 14 FizzBuzz 16 17 Fizz 19 Buzz Fizz 22 Fizz Fizz Buzz 26 Fizz 28 29 FizzBuzz Fizz Fizz Fizz Fizz FizzBuzz
1 2 Fizz 4 Buzz Fizz Bazz 8 Fizz Buzz 11 Fizz Fizz Bazz FizzBuzz 16 17 Fizz 19 Buzz FizzBazz 22 Fizz Fizz Buzz 26 Fizz Bazz 29 FizzBuzz Fizz Fizz Fizz Fizz FizzBuzzBazzفي الحل أعلاه لاحظ التالي:
- الرقم 13 و23 و31 إلى 34 أصبحت
Fizzبسبب الشرط الإضافي، و35 أصبحتFizzBuzzلأنها تحتوي 3 وتقبل القسمة على 5، فإذا كان جوابكBuzzلهذا الرقم فقد نسيت أن الشرطين يجتمعان. - إضافة القاعدة الجديدة كانت سطراً واحداً دون تعديل الدالة، والرقم 21 أصبح
FizzBazzوحده دون أن نكتب له حالة خاصة. - ترتيب القواعد في القائمة هو ترتيب الكلمات في الناتج، وهذا قرار واضح في مكان واحد بدلاً من أن يكون مخفياً في ترتيب الفروع.
2. العناوين المكررة في قائمة البريد
لديك قائمة عناوين بريد قبل إرسال نشرة، وتريد أن تعرف أي العناوين تكررت وكم مرة، بترتيب أول ظهور لكل عنوان. والمدخل:
["[email protected]", "[email protected]", " [email protected]", "[email protected]", "[email protected]", "[email protected]"]اكتب الحل في O(n)، ثم انظر إلى هذا الحل الذي كتبه زميلك وقل لماذا هو خاطئ ولماذا هو بطيء:
emails.filter((e, i) => emails.indexOf(e) !== i)الوقت المقترح: 10 دقائق.
تلميح Hint
قبل المقارنة عليك أن توحد شكل العنوان، والمسافة في البداية والحروف الكبيرة هي ما يفصل بين «نفس العنوان» و«عنوان آخر». ثم استخدم جدول هاش Hash Table يحفظ العدد لكل عنوان.
الحل Answer
الحل في C# بقاموس Dictionary وقائمة تحفظ ترتيب أول ظهور:
// dups.cs: duplicates in one pass with a Dictionary, in first-seen order
var emails = new[] { "[email protected]", "[email protected]", " [email protected]", "[email protected]", "[email protected]", "[email protected]" };

var counts = new Dictionary<string, int>();
var order = new List<string>();
foreach (var raw in emails)
{
    var key = raw.Trim().ToLowerInvariant();          // normalize before comparing
    if (counts.TryGetValue(key, out var c)) counts[key] = c + 1;
    else { counts[key] = 1; order.Add(key); }
}
foreach (var key in order.Where(k => counts[k] > 1))
    Console.WriteLine($"{key} x{counts[key]}");
dotnet run dups.cs[email protected] x3
[email protected] x2وفي JavaScript يكفي Map لأنه يحفظ ترتيب الإضافة كما يذكر توثيق Map:
// dups.js: the same idea with a Map, which keeps insertion order
const emails = ["[email protected]", "[email protected]", " [email protected]", "[email protected]", "[email protected]", "[email protected]"];

const counts = new Map();
for (const raw of emails) {
  const key = raw.trim().toLowerCase();
  counts.set(key, (counts.get(key) ?? 0) + 1);
}
for (const [key, n] of counts) if (n > 1) console.log(`${key} x${n}`);

// the simple version that looks right: indexOf inside filter is O(n²) and misses " [email protected]"
console.log(emails.filter((e, i) => emails.indexOf(e) !== i));
[email protected] x3
[email protected] x2
[ '[email protected]' ]في الحل أعلاه لاحظ التالي:
- حل الزميل وجد
[email protected]مرة واحدة فقط وفاته[email protected]تماماً، والسبب أنه يقارن النص كما هو، فالعنوان" [email protected]"بمسافة وحرف كبير يعتبر عنواناً مختلفاً. - وحل الزميل بطيء لأن
indexOfيمر على القائمة من أولها لكل عنصر، أي O(n²)، وهذا لا يظهر مع ست عناوين ويظهر مع مئة ألف. - جدول الهاش يجعل البحث والإضافة O(1) في المتوسط، فالحل كله O(n).
3. الأقواس المتوازنة
اكتب دالة تقرر هل الأقواس في نص متوازنة، أي أن كل قوس يفتح يغلق بنفس نوعه وبالترتيب الصحيح، وجربها على هذه المدخلات:
([]{}) ([)] (( }) f(a[1], {b: 2}) (empty string)الوقت المقترح: 15 دقيقة.
تلميح Hint
آخر قوس فتحته هو أول قوس يجب أن يغلق، وهذا هو تعريف المكدس Stack: آخر ما يدخل أول ما يخرج. وانتبه لحالتين: قوس يغلق والمكدس فارغ، ونص ينتهي والمكدس ما زال فيه أقواس.
الحل Answer
# brackets.py: a stack of the brackets still open
PAIRS = {")": "(", "]": "[", "}": "{"}

def balanced(text):
    stack = []
    for ch in text:
        if ch in "([{":
            stack.append(ch)
        elif ch in PAIRS:
            if not stack or stack.pop() != PAIRS[ch]:
                return False
    return not stack            # something still open means unbalanced

for t in ["([]{})", "([)]", "((", "})", "f(a[1], {b: 2})", ""]:
    print(f"{t!r:20} {balanced(t)}")
'([]{})' True
'([)]' False
'((' False
'})' False
'f(a[1], {b: 2})' True
'' Trueوالحل في Java باستخدام ArrayDeque كمكدس، لأن الكلاس Stack قديم ومتزامن دون حاجة، وتوثيق Deque يوصي باستخدامه بدلاً منه:
// Brackets.java: Deque as a stack (java.util.Stack is legacy)
import java.util.ArrayDeque;
import java.util.Deque;
import java.util.Map;

public class Brackets {
    static final Map<Character, Character> PAIRS = Map.of(')', '(', ']', '[', '}', '{');

    static boolean balanced(String text) {
        Deque<Character> stack = new ArrayDeque<>();
        for (char ch : text.toCharArray()) {
            if (ch == '(' || ch == '[' || ch == '{') stack.push(ch);
            else if (PAIRS.containsKey(ch)) {
                if (stack.isEmpty() || !stack.pop().equals(PAIRS.get(ch))) return false;
            }
        }
        return stack.isEmpty();
    }

    public static void main(String[] args) {
        for (String t : new String[] {"([]{})", "([)]", "((", "})", "f(a[1], {b: 2})", ""})
            System.out.printf("%-20s %b%n", "\"" + t + "\"", balanced(t));
    }
}
"([]{})" true
"([)]" false
"((" false
"})" false
"f(a[1], {b: 2})" true
"" trueفي الحل أعلاه لاحظ التالي:
- النص
([)]فيه عدد متساو من كل نوع، ولذلك يفشل الحل الذي يعد الأقواس فقط، أما المكدس فيرى أن)جاء وأعلى المكدس[. - السطر
return not stackهو ما يرفض((، وكثير من الحلول تنساه فتقبل نصاً لم يغلق أقواسه. - في Java قارنا بالدالة
equalsوليس بالعلامة!=، والسبب أنpop()يعيد كائنCharacterوليس قيمة، والمقارنة بين كائنين بالعلامة تقارن المراجع وليس القيم، وهي تعمل هنا صدفة لأن Java تخزن الحروف الصغيرة مسبقاً، وهذا فخ سوف تراه في التمرين الرابع.
للتفصيل: المكدس Stack في مقال هياكل البيانات.
4. ماذا يطبع هذا الكود؟ القيمة والمرجع
اقرأ الكودين التاليين واكتب المخرج سطراً سطراً قبل أن تشغل أي شيء، الأول في C#:
// print.cs: what does this code print?
var s1 = new PointS { X = 1 };
var s2 = s1;
s2.X = 99;

var c1 = new PointC { X = 1 };
var c2 = c1;
c2.X = 99;

Console.WriteLine($"{s1.X} {c1.X}");

Reset(c1);
Console.WriteLine(c1.X);

static void Reset(PointC p)
{
    p.X = 0;
    p = new PointC { X = 7 };
}

struct PointS { public int X; }
class PointC { public int X; }
والثاني في Python:
# print.py: what does this code print?
a = [1, 2]
b = a
b.append(3)
c = a[:]
c.append(4)
print(a, b, c)

def add(item, bucket=[]):
    bucket.append(item)
    return bucket

print(add(1), add(2))

s = "abc"
t = s
t += "d"
print(s, t)
الوقت المقترح: 10 دقائق.
تلميح Hint
اسأل عند كل سطر b = a: هل نسخ هذا السطر القيمة نفسها، أم نسخ عنوان الكائن فأصبح المتغيران يشيران إلى نفس الشيء؟ وفي Python اسأل أيضاً: متى تنشأ القيمة الافتراضية للمعامل bucket؟
الحل Answer
مخرج C#:
1 99
0
ومخرج Python:
[1, 2, 3] [1, 2, 3] [1, 2, 3, 4]
[1, 2] [1, 2]
abc abcd
في الكود أعلاه لاحظ التالي:
PointSهو struct أي نوع قيمة Value Type، فالسطرs2 = s1نسخ الرقم، وتغييرs2لم يلمسs1، أماPointCفهو class أي نوع مرجع Reference Type، فالمتغيران يشيران إلى نفس الكائن في ال Heap.- الدالة
Resetغيرتp.Xفتغير الكائن الأصلي إلى 0، ثم جعلتpيشير إلى كائن جديد، وهذا لم يغيرc1لأن المرجع نفسه مرر بالقيمة، لذلك المخرج 0 وليس 7. - في Python
b = aلا ينسخ القائمة، وa[:]ينسخها، لذلك ظهر الرقم 4 فيcوحدها. - السطر الثاني
[1, 2] [1, 2]هو أشهر فخ في Python، فالقيمة الافتراضية[]تنشأ مرة واحدة عند تعريف الدالة وليس عند كل استدعاء كما يذكر الدليل الرسمي، فالاستدعاءان أضافا إلى نفس القائمة، والحلbucket=Noneثم إنشاء القائمة داخل الدالة. - النص في Python غير قابل للتغيير Immutable، فالعملية
t += "d"أنشأت نصاً جديداً ولم تغيرs.
للتفصيل: نوع القيمة ونوع المرجع في مقال الذاكرة.
5. مجموع رقمين Two-Sum
أعطيت مصفوفة أرقام ورقماً هدفاً target، أعد موقعي رقمين مجموعهما يساوي الهدف، أو لا شيء إذا لم يوجدا. مثلاً [2, 7, 11, 15] مع الهدف 9 تعطي (0, 1). اكتب حلاً بحلقتين متداخلتين، ثم حلاً في O(n)، وتوقع كم مرة سوف يكون الثاني أسرع مع خمسة آلاف رقم.
الوقت المقترح: 15 دقيقة.
تلميح Hint
عندما تقف عند الرقم x فأنت تبحث عن target - x، فإذا كنت تحفظ كل رقم مررت عليه مع موقعه في جدول هاش فالسؤال «هل رأيته من قبل؟» يصبح O(1).
الحل Answer
# twosum.py: indexes of two numbers that add up to target
import time

def two_sum_slow(nums, target):            # O(n²): every pair
    for i in range(len(nums)):
        for j in range(i + 1, len(nums)):
            if nums[i] + nums[j] == target:
                return i, j
    return None

def two_sum(nums, target):                 # O(n): remember what we saw
    seen = {}                              # value -> index
    for i, x in enumerate(nums):
        if target - x in seen:
            return seen[target - x], i
        seen[x] = i
    return None

print(two_sum([2, 7, 11, 15], 9), two_sum([3, 3], 6), two_sum([1, 2], 7))

n = 5_000
nums = list(range(1, n + 1))               # the only pair is the last two numbers
for f in (two_sum_slow, two_sum):
    t = time.perf_counter()
    r = f(nums, 2 * n - 1)
    print(f"{f.__name__:13} n={n:,} -> {r}  {(time.perf_counter() - t) * 1000:.1f} ms")
(0, 1) (0, 1) None
two_sum_slow n=5,000 -> (4998, 4999) 2221.5 ms
two_sum n=5,000 -> (4998, 4999) 3.3 msوالحل في Java بنفس الفكرة باستخدام HashMap:
// TwoSum.java: the same O(n) idea with a HashMap
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;

public class TwoSum {
    static int[] twoSum(int[] nums, int target) {
        Map<Integer, Integer> seen = new HashMap<>();   // value -> index
        for (int i = 0; i < nums.length; i++) {
            Integer j = seen.get(target - nums[i]);
            if (j != null) return new int[] {j, i};
            seen.put(nums[i], i);
        }
        return null;
    }

    public static void main(String[] args) {
        System.out.println(Arrays.toString(twoSum(new int[] {2, 7, 11, 15}, 9)));
        System.out.println(Arrays.toString(twoSum(new int[] {3, 3}, 6)));
        System.out.println(Arrays.toString(twoSum(new int[] {1, 2}, 7)));
    }
}
[0, 1]
[0, 1]
nullفي الحل أعلاه لاحظ التالي:
- الحل البسيط فحص نحو 12.5 مليون زوج لأن الزوج الوحيد في آخر المصفوفة، والحل بجدول الهاش مر على الأرقام مرة واحدة، والفرق في هذه التجربة على جهاز واحد مئات المرات، وهي أرقام توضيحية تتغير من جهاز لآخر، أما شكل النمو فلا يتغير.
- نتحقق من
target - xقبل إضافةxإلى الجدول، وهذا ما يجعل[3, 3]مع الهدف 6 يعمل، فلو أضفنا أولاً لوجد الرقم نفسه. - ثمن السرعة ذاكرة إضافية O(n) للجدول، وهي مقايضة الوقت بالذاكرة التي تتكرر في أغلب التمارين القادمة.
للتفصيل: اختيار الهيكل الصحيح في مقال Big-O.
6. فخاخ الأرقام: الفيضان Overflow والكسور العشرية
توقع مخرج كل سطر في الملفات الثلاثة التالية، واكتب توقعك بجانب كل سطر:
// traps.cs: predict each line before you run it
int max = int.MaxValue;
Console.WriteLine(max + 1);
Console.WriteLine(0.1 + 0.2 == 0.3);
Console.WriteLine(0.1m + 0.2m == 0.3m);
Console.WriteLine((int)3.99);
Console.WriteLine(7 / 2);
try { Console.WriteLine(checked(max + 1)); }
catch (OverflowException e) { Console.WriteLine(e.GetType().Name); }
// traps.js: predict each line before you run it
console.log(0.1 + 0.2);
console.log(2 ** 53 + 1 === 2 ** 53);
console.log(9007199254740993);
console.log(2n ** 53n + 1n);
console.log(7 / 2, Math.trunc(-3.5), Math.round(-2.5));
console.log((0.1 * 3).toFixed(20));# traps.py: predict each line before you run it
from decimal import Decimal
print(2 ** 63)
print(0.1 + 0.2 == 0.3, abs((0.1 + 0.2) - 0.3) < 1e-9)
print(Decimal("0.1") + Decimal("0.2"), Decimal(0.1))
print(7 / 2, 7 // 2, -7 // 2, int(-3.5))
print(round(2.5), round(3.5), round(2.675, 2))الوقت المقترح: 15 دقيقة.
تلميح Hint
الرقم الصحيح int في C# له 32 بت ويلتف عند تجاوزه دون أي خطأ إلا في سياق checked، وكل الأرقام في JavaScript من نوع double بدقة 53 بت، والرقم 0.1 لا يمكن كتابته بالضبط في النظام الثنائي، وPython تقرب الأنصاف إلى الرقم الزوجي.
الحل Answer
مخرج C# ثم JavaScript ثم Python:
-2147483648
False
True
3
3
OverflowException
0.30000000000000004
true
9007199254740992
9007199254740993n
3.5 -3 -2
0.300000000000000044419223372036854775808
False True
0.3 0.1000000000000000055511151231257827021181583404541015625
3.5 3 -4 -3
2 4 2.67في المخرج أعلاه لاحظ التالي:
int.MaxValue + 1أصبح أصغر رقم سالب بصمت، وهذا هو الالتفاف في المتمم الثنائي Two's Complement، أما داخلcheckedفرمت C# الاستثناءOverflowExceptionكما يذكر توثيق checked، لذلك استخدمه في الحسابات المالية والعدادات.0.1 + 0.2 == 0.3خطأ في اللغات الثلاث، والنوعdecimalفي C# وDecimal("0.1")في Python يعطيان الجواب الصحيح لأنهما عشريان، ولاحظ أنDecimal(0.1)من رقم عشري يكشف القيمة الحقيقية المخزنة لأن الخطأ حدث قبل أن يصل إليه.- في JavaScript لا يستطيع النوع Number تمثيل 2⁵³ + 1، فطبع الرقم المكتوب في الكود ناقصاً واحداً، والحل BigInt كما يذكر توثيق MAX_SAFE_INTEGER، وهذا يهم كل من يستقبل معرفات من نوع 64 بت في JSON.
Math.round(-2.5)يعطي -2، وround(2.5)في Python يعطي 2 لأنها تقرب الأنصاف إلى الزوجي كما في توثيق round، وround(2.675, 2)يعطي 2.67 لأن الرقم المخزن أصغر قليلاً من 2.675.- في Python لا يوجد فيضان للأرقام الصحيحة، فالرقم 2⁶³ طبع كاملاً، و
-7 // 2تعطي -4 لأن القسمة الصحيحة تقرب إلى الأسفل بينماint(-3.5)يقطع نحو الصفر.
للتفصيل: الفيضان Overflow والأرقام العشرية Floating Point في مقال الأنظمة العددية.
المستوى الثاني: متوسط Intermediate
في هذا المستوى يصبح الخطأ أقل وضوحاً، فالكود يعمل على المثال الأول ويخطئ على حالة لا تخطر على البال إلا إذا تدربت على البحث عنها.
7. عكس الكلمات العربية دون كسرها
لديك الجملة التالية، وفيها مسافتان بين الكلمة الأولى والثانية، وتنوين، ورمز تعبيري Emoji بلون بشرة:
مرحباً بكم في عرب رووت 👋🏽المطلوب أولاً: اعكس ترتيب الكلمات فقط. وثانياً: لاختبار عرض المرآة في واجهة، اعكس حروف الكلمة مرحباً👋🏽 بحيث يبقى كل حرف يراه القارئ سليماً. ثم أجب: ما طول هذه الكلمة في JavaScript وفي Python، ولماذا يختلفان؟
الوقت المقترح: 20 دقيقة.
تلميح Hint
التنوين علامة مستقلة في Unicode تأتي بعد الحرف، والرمز التعبيري بلون البشرة رمزان، وكل رمز منهما خارج النطاق الأساسي يأخذ وحدتين في UTF-16. ابحث عن الوحدة التي يسميها Unicode «Grapheme Cluster».
الحل Answer
// words.js: reverse the order of words, and mirror letters without breaking them
const text = "مرحباً  بكم في عرب رووت 👋🏽";

// 1) word order: split on any run of whitespace, not on a single " "
console.log(text.trim().split(/\s+/u).reverse().join(" "));

// 2) the simple letter reverse breaks marks and emoji
const word = "مرحباً👋🏽";
console.log([...word].reverse().join(""));
console.log(word.length, [...word].length);

// 3) reverse by grapheme (what the reader sees as one character)
const seg = new Intl.Segmenter("ar", { granularity: "grapheme" });
const graphemes = [...seg.segment(word)].map(s => s.segment);
console.log(graphemes.length, graphemes.reverse().join(""));
👋🏽 رووت عرب في بكم مرحباً
🏽👋ًابحرم
10 8
6 👋🏽اًبحرموفي Python تحتاج المكتبة regex لأن الوحدة re القياسية لا تدعم النمط \X:
# words.py: the same in Python; grapheme splitting needs the third-party regex module (\X)
import regex

text = "مرحباً  بكم في عرب رووت 👋🏽"
print(" ".join(reversed(text.split())))     # split() with no argument splits on any whitespace run

word = "مرحباً👋🏽"
print(word[::-1], len(word))
g = regex.findall(r"\X", word)
print(len(g), "".join(reversed(g)))
print([hex(ord(c)) for c in word[-4:]])
👋🏽 رووت عرب في بكم مرحباً
🏽👋ًابحرم 8
6 👋🏽اًبحرم
['0x627', '0x64b', '0x1f44b', '0x1f3fd']والصورة التالية تبين لماذا تعطي الطرق المختلفة أطوالاً مختلفة لنفس الحرفين الأخيرين:
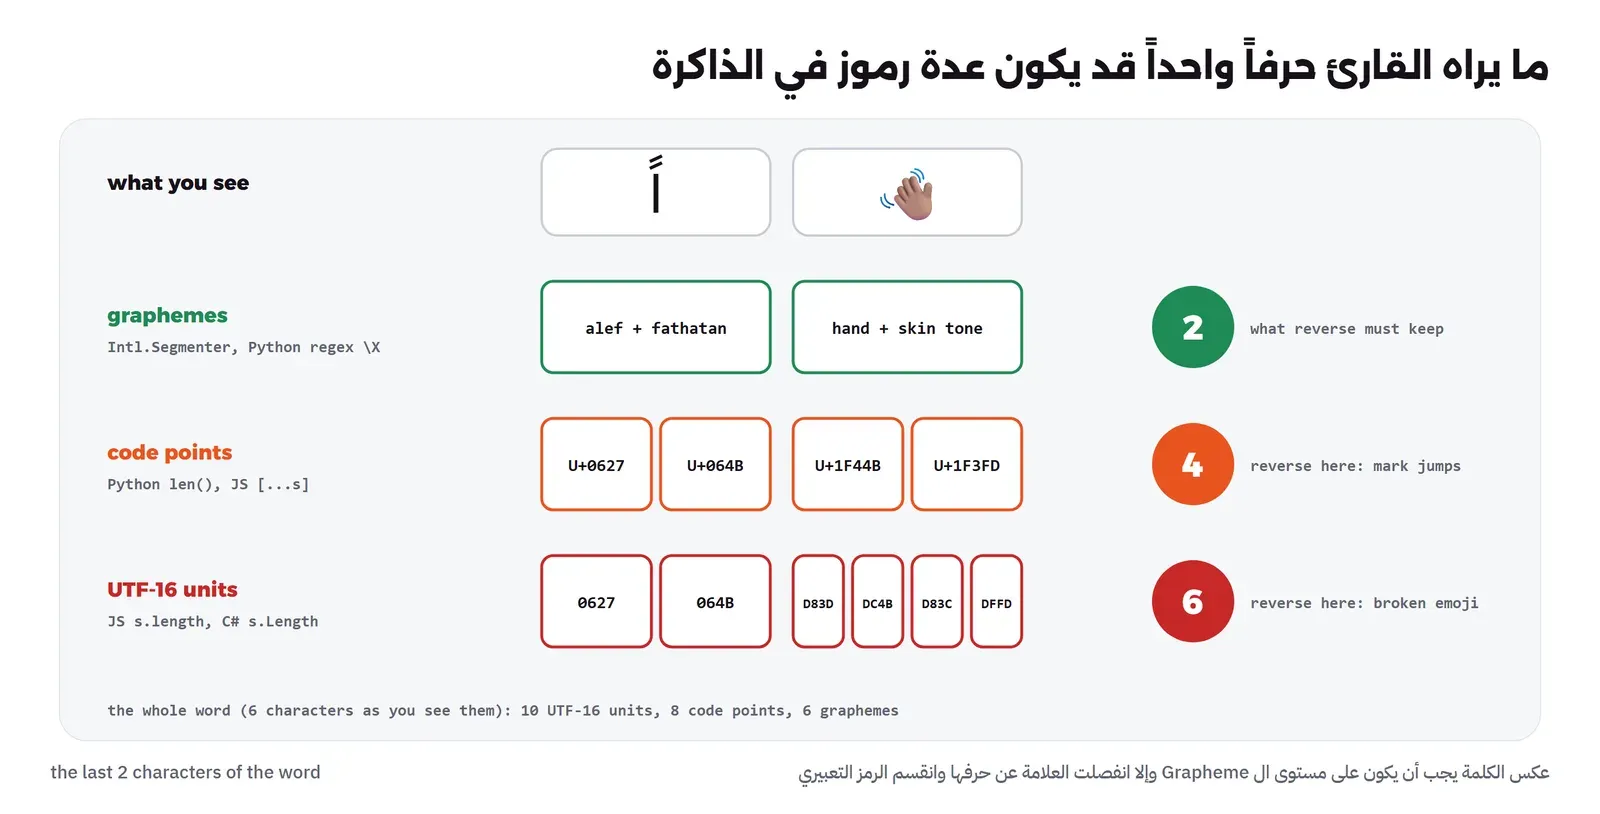
في الحل أعلاه لاحظ التالي:
- القسمة على مسافة واحدة
split(" ")كانت ستعطي كلمة فارغة بين المسافتين، لذلك قسمنا على أي عدد من المسافات\s+، وفي Python تفعلsplit()دون معامل نفس الشيء. - العكس البسيط بالحروف
[...word].reverse()أوword[::-1]وضع التنوين قبل الألف فالتصق بالرمز التعبيري، وفصل لون البشرة عن اليد، والسبب أنه يعكس نقاط Unicode وليس ما يراه القارئ. - طول الكلمة 10 في JavaScript لأن
lengthيعد وحدات UTF-16، و8 في Python لأنها تعد نقاط Unicode، و6 بالتقسيم إلى Graphemes كما يعرفها معيار Unicode UAX #29 ويطبقها Intl.Segmenter، وهذا يهم أيضاً عندما تحدد طول اسم المستخدم أو تقطع نصاً لعرضه.
للتفصيل: مجموعة الحروف والترميز ASCII وUnicode وUTF-8 في مقال الترميز.
8. اصطد الخطأ في البحث الثنائي Binary Search
كتب زميلك دالة البحث الثنائي التالية، وقال إنها تعمل لأنها وجدت 10 و30 و40 و50. ابحث عن الخطأين فيها، ثم اكتب طريقة تثبت أن الإصلاح صحيح في كل الحالات وليس في المثال فقط:
# bsearch.py: find the bugs, then prove the fix against a brute-force answer
def find_buggy(a, x, max_steps=100):
    lo, hi = 0, len(a)
    steps = 0
    while lo < hi:
        steps += 1
        if steps > max_steps:
            return "STUCK"                    # guard added only for this kata
        mid = (lo + hi) // 2
        if a[mid] == x:
            return mid
        if a[mid] < x:
            lo = mid
        else:
            hi = mid - 1
    return -1
الوقت المقترح: 20 دقيقة.
تلميح Hint
قرر أولاً هل hi داخل المجال أم خارجه، فالسطر الأول يقول إنه خارجه لأنه len(a). ثم جرب بيدك المصفوفة [10, 20] مع البحث عن 10، والمصفوفة الكاملة مع البحث عن 20.
الحل Answer
الخطأ الأول lo = mid: عندما يكون lo وhi متجاورين فإن mid يساوي lo ولا يتحرك شيء، فتدور الحلقة إلى الأبد. والخطأ الثاني hi = mid - 1: المجال نصف مفتوح [lo, hi) أي أن hi مستبعد أصلاً، فطرح واحد يستبعد عنصراً لم نفحصه بعد. وهذا هو الملف كاملاً مع الإصلاح والفحص الشامل:
# bsearch.py: find the bugs, then prove the fix against a brute-force answer
def find_buggy(a, x, max_steps=100):
    lo, hi = 0, len(a)
    steps = 0
    while lo < hi:
        steps += 1
        if steps > max_steps:
            return "STUCK"                    # guard added only for this kata
        mid = (lo + hi) // 2
        if a[mid] == x:
            return mid
        if a[mid] < x:
            lo = mid
        else:
            hi = mid - 1
    return -1

def find(a, x):
    lo, hi = 0, len(a)                         # half-open range [lo, hi)
    while lo < hi:
        mid = (lo + hi) // 2
        if a[mid] == x:
            return mid
        if a[mid] < x:
            lo = mid + 1                       # mid is checked, skip it
        else:
            hi = mid                           # hi is excluded already
    return -1

a = [10, 20, 30, 40, 50]
print([find_buggy(a, x) for x in (10, 20, 30, 40, 50, 35, 60)], find_buggy([10, 20], 10))
print([find(a, x) for x in (10, 20, 30, 40, 50, 35, 60)])

# exhaustive check: every array size 0..9, every target 0..20
def expected(a, x):
    return a.index(x) if x in a else -1

bad = sum(1 for n in range(10) for x in range(21)
          if find(list(range(1, 2 * n, 2)), x) != expected(list(range(1, 2 * n, 2)), x))
bad_old = sum(1 for n in range(10) for x in range(21)
          if find_buggy(list(range(1, 2 * n, 2)), x) != expected(list(range(1, 2 * n, 2)), x))
print("wrong answers: buggy", bad_old, "fixed", bad, "of", 10 * 21)
[0, 'STUCK', 2, 3, 4, -1, 'STUCK'] -1
[0, 1, 2, 3, 4, -1, -1]
wrong answers: buggy 132 fixed 0 of 210والأسلوب الآخر الصحيح هو المجال المغلق [lo, hi] في Java، ولاحظ أن كل الحدود تتغير معاً:
// BSearch.java: closed range [lo, hi], the other correct style
public class BSearch {
    static int find(int[] a, int x) {
        int lo = 0, hi = a.length - 1;
        while (lo <= hi) {
            int mid = (lo + hi) >>> 1;          // no overflow on huge arrays
            if (a[mid] == x) return mid;
            if (a[mid] < x) lo = mid + 1; else hi = mid - 1;
        }
        return -1;
    }

    public static void main(String[] args) {
        int[] a = {10, 20, 30, 40, 50};
        StringBuilder sb = new StringBuilder();
        for (int x : new int[] {10, 20, 30, 40, 50, 35, 60}) sb.append(find(a, x)).append(' ');
        System.out.println(sb.toString().trim());
        System.out.println(java.util.Arrays.binarySearch(a, 35));   // -(insertion point) - 1
    }
}
0 1 2 3 4 -1 -1
-4في الحل أعلاه لاحظ التالي:
- الحماية
max_stepsأضفناها لهذا التمرين فقط حتى تطبع الدالةSTUCKبدلاً من أن يتوقف البرنامج، فالبحث عن 20 و60 دار إلى الأبد، والبحث عن 10 في[10, 20]أعاد -1 مع أن الرقم موجود. - الإثبات لم يكن بأمثلة نختارها نحن، وإنما بمقارنة الدالة بالجواب البديهي
a.index(x)على كل المصفوفات حتى تسعة عناصر وكل الأهداف من 0 إلى 20، فأخطأت الدالة القديمة في 132 حالة من 210، والجديدة في صفر، وهذه الفكرة هي أساس الاختبار بالخصائص Property-Based Testing. Arrays.binarySearchفي Java يعيد -4 للرقم 35 وليس -1، لأنه يعيد -(موقع الإدخال) -1 كما في التوثيق، فلا تقارن نتيجته بالرقم -1.
للتفصيل: البحث الثنائي Binary Search في مقال Big-O، وفيه قصة خطأ (low + high) / 2 في مكتبة Java.
9. تقرير المبيعات اليومي يضع الطلبات في اليوم الخطأ
يحفظ تطبيق متجر في الرياض وقت الطلب بتوقيت UTC، وهذا صحيح، ثم يجمع تقرير المبيعات اليومي الطلبات حسب اليوم بالسطر o.date(). اشتكى عميل أن طلبه في الساعة 01:30 فجر يوم 7 أكتوبر ظهر في تقرير يوم 6. والطلبات بتوقيت UTC كما تعيدها قاعدة البيانات:
2026-10-06 20:59 UTC
2026-10-06 21:00 UTC
2026-10-06 22:30 UTC
2026-10-07 09:15 UTC
كم طلباً في كل يوم بتوقيت الرياض؟ ثم الجزء الثاني: تذكير يومي في الساعة 09:00 بتوقيت برلين، يحسبه الكود بإضافة 24 ساعة إلى الوقت بتوقيت UTC، بدءاً من السبت 24 أكتوبر 2026. في أي ساعة سوف يصل التذكير يومي الأحد والاثنين؟
الوقت المقترح: 20 دقيقة.
تلميح Hint
الرياض UTC+3 طوال السنة، فاليوم المحلي يبدأ في الساعة 21:00 من اليوم السابق بتوقيت UTC. وأوروبا تنهي التوقيت الصيفي في آخر أحد من أكتوبر، فابحث عن تاريخه في 2026.
الحل Answer
في Python نحول إلى المنطقة الزمنية قبل أخذ التاريخ، وعلى Windows تحتاج الحزمة tzdata لأن النظام لا يوفر قاعدة المناطق التي تقرأ منها الوحدة zoneinfo:
# tz.py: orders are stored in UTC (correct); the report groups them by day (the bug)
from datetime import datetime, timedelta, timezone
from zoneinfo import ZoneInfo
from collections import Counter

RIYADH = ZoneInfo("Asia/Riyadh")
orders = [  # created_at in UTC, as the database returns it
    datetime(2026, 10, 6, 20, 59, tzinfo=timezone.utc),
    datetime(2026, 10, 6, 21, 0, tzinfo=timezone.utc),
    datetime(2026, 10, 6, 22, 30, tzinfo=timezone.utc),
    datetime(2026, 10, 7, 9, 15, tzinfo=timezone.utc),
]

print("buggy:", dict(Counter(o.date().isoformat() for o in orders)))
print("fixed:", dict(Counter(o.astimezone(RIYADH).date().isoformat() for o in orders)))
print(orders[2].astimezone(RIYADH).isoformat())

# part 2: "remind me every day at 09:00 Berlin time", computed by adding 24 hours in UTC
BERLIN = ZoneInfo("Europe/Berlin")
first = datetime(2026, 10, 24, 9, 0, tzinfo=BERLIN)
utc = first.astimezone(timezone.utc)
for i in range(3):
    buggy = (utc + timedelta(days=i)).astimezone(BERLIN)
    fixed = (first + timedelta(days=i))                 # wall-clock arithmetic in the zone
    print(f"day {i}: buggy {buggy:%a %H:%M %Z}   fixed {fixed:%a %H:%M %Z}")
buggy: {'2026-10-06': 3, '2026-10-07': 1}
fixed: {'2026-10-06': 1, '2026-10-07': 3}
2026-10-07T01:30:00+03:00
day 0: buggy Sat 09:00 CEST fixed Sat 09:00 CEST
day 1: buggy Sun 08:00 CET fixed Sun 09:00 CET
day 2: buggy Mon 08:00 CET fixed Mon 09:00 CETوفي JavaScript نستخدم Intl.DateTimeFormat مع المنطقة، والإعداد en-CA يعطي التاريخ بالشكل YYYY-MM-DD:
// tz.js: the report day in the customer's zone with Intl
const orders = ["2026-10-06T20:59:00Z", "2026-10-06T21:00:00Z", "2026-10-06T22:30:00Z", "2026-10-07T09:15:00Z"];
const day = new Intl.DateTimeFormat("en-CA", { timeZone: "Asia/Riyadh", year: "numeric", month: "2-digit", day: "2-digit" });

const buggy = {}, fixed = {};
for (const o of orders) {
  const d = new Date(o);
  const utcDay = d.toISOString().slice(0, 10);
  buggy[utcDay] = (buggy[utcDay] ?? 0) + 1;
  const local = day.format(d);                      // en-CA gives YYYY-MM-DD
  fixed[local] = (fixed[local] ?? 0) + 1;
}
console.log("buggy:", buggy);
console.log("fixed:", fixed);
buggy: { '2026-10-06': 3, '2026-10-07': 1 }
fixed: { '2026-10-06': 1, '2026-10-07': 3 }في الحل أعلاه لاحظ التالي:
- الطلب في 20:59 UTC هو 23:59 في الرياض يوم 6، والطلب بعده بدقيقة هو منتصف الليل يوم 7، لذلك الجواب الصحيح طلب واحد يوم 6 وثلاثة يوم 7، والتقرير الخاطئ عكس الرقمين تقريباً.
- التخزين بتوقيت UTC لم يكن الخطأ، وإنما أخذ التاريخ دون تحويل، فالقاعدة أن تحفظ UTC وتحول عند الأطراف، وحدود اليوم في التقرير طرف من الأطراف.
- في الجزء الثاني انتهى التوقيت الصيفي في أوروبا يوم الأحد 25 أكتوبر 2026 حسب التوجيه الأوروبي 2000/84/EC الذي يحدده بآخر أحد من أكتوبر، فإضافة 24 ساعة بتوقيت UTC أوصلت التذكير في 08:00، أما الإضافة على الوقت المحلي في المنطقة نفسها فأبقته في 09:00.
للتفصيل: احفظ UTC وحول عند الأطراف والتوقيت الصيفي في مقال التاريخ والوقت.
10. اكتب الاختبارات أولاً Test-First
المطلوب دالة parse_duration تحول نصاً مثل 1h30m إلى عدد الثواني. والمواصفات: الوحدات h وm وs بهذا الترتيب فقط، وكل وحدة مرة واحدة على الأكثر، والأرقام صحيحة موجبة، والمسافات حول النص مسموحة، وكل شيء آخر يرمي خطأ. اكتب الاختبارات Tests قبل أن تكتب سطراً واحداً من الدالة، وشغلها وتأكد أنها تفشل، ثم اكتب أقل كود يجعلها تنجح.
الوقت المقترح: 25 دقيقة.
تلميح Hint
اكتب قائمة المدخلات المرفوضة قبل المقبولة، فهي التي تكشف الخطأ: النص الفارغ، والوحدة دون رقم، والرقم دون وحدة، والترتيب المعكوس، والوحدة المكررة، والكسر، والسالب، والمسافة في الوسط، والوحدة غير المعروفة.
الحل Answer
الاختبارات أولاً بالوحدة unittest المدمجة في Python، واستخدمنا subTest حتى يظهر كل مدخل مرفوض كحالة مستقلة:
# test_duration.py: written BEFORE duration.py has any code
import unittest
from duration import parse_duration

class ParseDuration(unittest.TestCase):
    def test_single_units(self):
        self.assertEqual(parse_duration("90s"), 90)
        self.assertEqual(parse_duration("2m"), 120)
        self.assertEqual(parse_duration("2h"), 7200)

    def test_combined_in_order(self):
        self.assertEqual(parse_duration("1h30m"), 5400)
        self.assertEqual(parse_duration("1h0m5s"), 3605)

    def test_spaces_around_are_ignored(self):
        self.assertEqual(parse_duration(" 15m "), 900)

    def test_rejects_bad_input(self):
        for bad in ["", "h", "10", "1m1h", "1h1h", "1.5h", "-5m", "5 m", "5d"]:
            with self.subTest(bad=bad):
                with self.assertRaises(ValueError):
                    parse_duration(bad)

if __name__ == "__main__":
    unittest.main()
ثم ملف الدالة فيه سطر واحد يرمي NotImplementedError، والتشغيل يفشل كما يجب، وهذا أول المخرج وآخره:
python -m unittest test_durationEEEEEEEEEEEE
----------------------------------------------------------------------
Ran 4 tests in 0.012s
FAILED (errors=12)والعدد 12 هو ثلاثة اختبارات وتسعة مدخلات مرفوضة، كل واحد منها حالة مستقلة. بعد ذلك نكتب الدالة:
# duration.py: written after the tests, only enough code to make them pass
import re

PATTERN = re.compile(r"(?:(\d+)h)?(?:(\d+)m)?(?:(\d+)s)?")

def parse_duration(text):
    m = PATTERN.fullmatch(text.strip())
    if not m or not any(m.groups()):
        raise ValueError(f"bad duration: {text!r}")
    h, mnt, s = (int(g) if g else 0 for g in m.groups())
    return h * 3600 + mnt * 60 + s
python -m unittest -v test_durationtest_combined_in_order (test_duration.ParseDuration.test_combined_in_order) ... ok
test_rejects_bad_input (test_duration.ParseDuration.test_rejects_bad_input) ... ok
test_single_units (test_duration.ParseDuration.test_single_units) ... ok
test_spaces_around_are_ignored (test_duration.ParseDuration.test_spaces_around_are_ignored) ... ok
----------------------------------------------------------------------
Ran 4 tests in 0.001s
OKونفس المواصفات في JavaScript بالوحدة المدمجة node:test دون أي مكتبة خارجية:
// duration.test.mjs: the same spec with node:test (built into Node.js)
import { test } from "node:test";
import assert from "node:assert/strict";

const parseDuration = (text) => {
  const m = /^(?:(\d+)h)?(?:(\d+)m)?(?:(\d+)s)?$/.exec(text.trim());
  if (!m || !m.slice(1).some(Boolean)) throw new RangeError(`bad duration: ${text}`);
  const [h = 0, mn = 0, s = 0] = m.slice(1).map(g => Number(g ?? 0));
  return h * 3600 + mn * 60 + s;
};

test("units and combinations", () => {
  assert.equal(parseDuration("90s"), 90);
  assert.equal(parseDuration("1h30m"), 5400);
  assert.equal(parseDuration(" 15m "), 900);
});
test("rejects bad input", () => {
  for (const bad of ["", "h", "10", "1m1h", "1.5h", "-5m", "5 m", "5d"])
    assert.throws(() => parseDuration(bad), RangeError, bad);
});
node --test duration.test.mjs1..2
# tests 2
# suites 0
# pass 2
# fail 0
# cancelled 0
# skipped 0
# todo 0
# duration_ms 557.1408في الحل أعلاه لاحظ التالي:
- رؤية الاختبار يفشل أولاً تثبت أنه يختبر شيئاً، فالاختبار الذي ينجح قبل كتابة الكود قد يكون لا يستدعي الدالة أصلاً.
- كل الأقسام في التعبير النمطي Regex اختيارية، فالنص الفارغ يطابقه، لذلك أضفنا الشرط
any(m.groups())، وهذا السطر لم نكن لنتذكره لولا وجود""في قائمة المرفوضات. fullmatchوليسmatch، لأنmatchيقبل1h1hبمطابقة أول جزء وتجاهل الباقي.
11. قدر التعقيد Big-O من الكود
اكتب ترتيب Big-O لكل دالة من الدوال الست التالية قبل أن تقرأ الجزء الذي يعد الخطوات، ثم توقع: عندما تتضاعف n كم مرة يتضاعف العمل؟ والدالة C تمثل حلقة فيها seen.includes(i)، فكتبنا الحلقة الداخلية صراحة حتى نعدها:
// ops.js: count the steps of each snippet when n doubles (counting, not timing, so the numbers are exact)
let ops = 0;
const A = (n) => { for (let i = 0; i < n; i++) for (let j = i + 1; j < n; j++) ops++; };
const B = (n) => { for (let i = 1; i < n; i *= 2) ops++; };
const C = (n) => { const seen = []; for (let i = 0; i < n; i++) { for (const s of seen) { ops++; if (s === -1) break; } seen.push(i); } };
const D = (n) => { const a = Array.from({ length: n }, (_, i) => (i * 7919) % n); a.sort((x, y) => { ops++; return x - y; }); };
const E = (n) => { for (let i = 0; i < n; i++) for (let j = 0; j < 3; j++) ops++; };
const F = (n) => { const fib = (k) => { ops++; return k < 2 ? k : fib(k - 1) + fib(k - 2); }; fib(n); };
الوقت المقترح: 15 دقيقة.
تلميح Hint
عد كم مرة يدور كل سطر بدلالة n. الحلقة التي تضاعف عدادها i *= 2 تدور log n مرة، والحلقة الداخلية بعدد ثابت لا تغير الترتيب، والترتيب الجاهز Built-in Sort يكلف n log n مقارنة تقريباً.
الحل Answer
بدلاً من قياس الزمن، وهو يتأثر بالجهاز، نعد الخطوات نفسها ونقارن العدد عندما تتضاعف n، وهذا هو الملف كاملاً:
// ops.js: count the steps of each snippet when n doubles (counting, not timing, so the numbers are exact)
let ops = 0;
const A = (n) => { for (let i = 0; i < n; i++) for (let j = i + 1; j < n; j++) ops++; };
const B = (n) => { for (let i = 1; i < n; i *= 2) ops++; };
const C = (n) => { const seen = []; for (let i = 0; i < n; i++) { for (const s of seen) { ops++; if (s === -1) break; } seen.push(i); } };
const D = (n) => { const a = Array.from({ length: n }, (_, i) => (i * 7919) % n); a.sort((x, y) => { ops++; return x - y; }); };
const E = (n) => { for (let i = 0; i < n; i++) for (let j = 0; j < 3; j++) ops++; };
const F = (n) => { const fib = (k) => { ops++; return k < 2 ? k : fib(k - 1) + fib(k - 2); }; fib(n); };

const run = (name, f, sizes) => {
  const row = sizes.map(n => { ops = 0; f(n); return ops; });
  const ratio = (row.at(-1) / row.at(-2)).toFixed(2);
  console.log(`${name}  ${sizes.map((n, i) => `n=${n}: ${row[i].toLocaleString("en")}`).join("  ")}  last ratio ${ratio}`);
};
run("A", A, [1000, 2000, 4000]);
run("B", B, [1000, 2000, 4000]);
run("C", C, [1000, 2000, 4000]);
run("D", D, [1000, 2000, 4000]);
run("E", E, [1000, 2000, 4000]);
run("F", F, [20, 21, 22]);
A n=1000: 499,500 n=2000: 1,999,000 n=4000: 7,998,000 last ratio 4.00
B n=1000: 10 n=2000: 11 n=4000: 12 last ratio 1.09
C n=1000: 499,500 n=2000: 1,999,000 n=4000: 7,998,000 last ratio 4.00
D n=1000: 8,525 n=2000: 18,586 n=4000: 38,343 last ratio 2.06
E n=1000: 3,000 n=2000: 6,000 n=4000: 12,000 last ratio 2.00
F n=20: 21,891 n=21: 35,421 n=22: 57,313 last ratio 1.62والإجابات:
| الدالة | الترتيب | عند مضاعفة n | والسبب |
|---|---|---|---|
| A | O(n²) | ×4 | عدد الأزواج n(n−1)/2، والقسمة على 2 ثابت لا يغير الترتيب |
| B | O(log n) | +1 | العداد يتضاعف فيصل إلى n بعد log₂ n خطوة |
| C | O(n²) | ×4 | includes داخل الحلقة حلقة مخفية |
| D | O(n log n) | أكثر قليلاً من ×2 | عدد المقارنات في الترتيب الجاهز |
| E | O(n) | ×2 | الحلقة الداخلية ثلاث مرات دائماً |
| F | أسية O(2ⁿ) كحد أعلى | ×1.62 عند كل زيادة واحدة في n | كل استدعاء يولد استدعاءين |
في المخرج أعلاه لاحظ التالي:
- A وC أعطتا نفس العدد بالضبط مع أن C تبدو حلقة واحدة، وهذا أهم درس في التمرين: الدالة الجاهزة داخل الحلقة لها تكلفة يجب أن تعرفها.
- في F زدنا n بواحد فقط وليس بالمضاعفة، والنسبة 1.62 هي النسبة الذهبية تقريباً، لذلك التعقيد الدقيق O(φⁿ)، وهو أقل من 2ⁿ ولكنه أسي، وإضافة عشرة إلى n تضرب العمل في أكثر من مئة.
للتفصيل: ترميز Big-O والاستدعاء الذاتي والحفظ Memoization.
12. دمج المواعيد المتداخلة Merge Intervals
لديك أوقات حجز غرفة اجتماعات بالدقائق من منتصف الليل، وتريد عرض الفترات المشغولة دون تكرار، والفترتان المتلاصقتان مثل 11:40 إلى 12:00 ثم 12:00 إلى 12:10 تعتبران فترة واحدة. والمدخل:
(800, 810) (540, 600) (570, 660) (720, 730) (700, 720) (590, 600)الوقت المقترح: 15 دقيقة.
تلميح Hint
رتب الفترات حسب البداية، فعندها لا تحتاج أن تقارن الفترة إلا بآخر فترة دمجتها. وانتبه للفترة التي تقع كاملة داخل فترة سابقة.
الحل Answer
# merge.py: busy slots of a meeting room in minutes from midnight, merged
def merge(slots):
    out = []
    for start, end in sorted(slots):                  # sort by start: O(n log n)
        if out and start <= out[-1][1]:               # overlaps or touches the last one
            out[-1][1] = max(out[-1][1], end)         # max: the new slot may be inside the old one
        else:
            out.append([start, end])
    return out

slots = [(800, 810), (540, 600), (570, 660), (720, 730), (700, 720), (590, 600)]
print(merge(slots))
fmt = lambda m: f"{m // 60:02}:{m % 60:02}"
print([f"{fmt(s)}-{fmt(e)}" for s, e in merge(slots)])
[[540, 660], [700, 730], [800, 810]]
['09:00-11:00', '11:40-12:10', '13:20-13:30']// merge.cs: the same merge in C#
var slots = new List<(int Start, int End)> { (800, 810), (540, 600), (570, 660), (720, 730), (700, 720), (590, 600) };
var merged = new List<(int Start, int End)>();
foreach (var s in slots.OrderBy(s => s.Start))
{
if (merged.Count > 0 && s.Start <= merged[^1].End)
merged[^1] = (merged[^1].Start, Math.Max(merged[^1].End, s.End));
else
merged.Add(s);
}
Console.WriteLine(string.Join(" ", merged.Select(m => $"[{m.Start},{m.End}]")));[540,660] [700,730] [800,810]في الحل أعلاه لاحظ التالي:
- الفترة (590, 600) تقع داخل (540, 660) بعد الدمج، ولو كتبت
out[-1][1] = endبدلاً منmaxلقصرت الفترة المشغولة إلى 10:00 وظهرت الغرفة فارغة وهي محجوزة. - الشرط
start <= endبالمساواة هو ما دمج (700, 720) مع (720, 730)، والمواصفات هي التي تحدد هل المتلاصقتان واحدة، فاقرأها قبل أن تختار بين<و<=. - التكلفة O(n log n) بسبب الترتيب، والمرور بعده O(n).
للتفصيل: الترتيب الجاهز Built-in Sort في اللغات.
المستوى الثالث: متقدم Advanced
تمارين هذا المستوى أقرب إلى ما يحدث في مراجعة الكود Code Review في فريق حقيقي، فالمطلوب فيها قرار تصميم أو قراءة سلوك لا يظهر في التشغيل الأول.
13. صمم ذاكرة مؤقتة LRU Cache
صمم ذاكرة مؤقتة Cache بسعة محددة، والعمليتان get وput كل منهما في O(1)، وعندما تمتلئ تحذف العنصر الذي لم يستخدم منذ أطول وقت Least Recently Used. ثم توقع مخرج هذا التسلسل بسعة 2:
put(a, 1) put(b, 2) get(a) put(c, 3) get(b) get(a) get(c)الوقت المقترح: 30 دقيقة.
تلميح Hint
تحتاج هيكلين معاً: جدول هاش يجد العنصر بالمفتاح في O(1)، وقائمة مترابطة مزدوجة Doubly Linked List تنقل العنصر إلى نهايتها وتحذف من أولها في O(1). وأغلب اللغات توفر الهيكلين في كلاس واحد.
الحل Answer
في Python الكلاس OrderedDict هو جدول هاش مع قائمة مزدوجة، وفيه move_to_end وpopitem(last=False):
# lru.py: get and put in O(1); OrderedDict is a hash table plus a doubly linked list
from collections import OrderedDict

class LRUCache:
    def __init__(self, capacity):
        self.capacity = capacity
        self.data = OrderedDict()

    def get(self, key):
        if key not in self.data:
            return None
        self.data.move_to_end(key)                 # just used: move to the "newest" end
        return self.data[key]

    def put(self, key, value):
        self.data[key] = value
        self.data.move_to_end(key)
        if len(self.data) > self.capacity:
            self.data.popitem(last=False)          # drop the oldest

c = LRUCache(2)
c.put("a", 1); c.put("b", 2)
print(c.get("a"))          # a becomes the newest
c.put("c", 3)              # evicts b, not a
print(c.get("b"), c.get("a"), c.get("c"), list(c.data))
1
None 1 3 ['a', 'c']وفي Java يكفي LinkedHashMap بترتيب الوصول Access Order مع removeEldestEntry:
// Lru.java: LinkedHashMap in access order already is an LRU
import java.util.LinkedHashMap;
import java.util.Map;

public class Lru {
    static class LRUCache<K, V> extends LinkedHashMap<K, V> {
        private final int capacity;
        LRUCache(int capacity) { super(16, 0.75f, true); this.capacity = capacity; }   // true = access order
        @Override protected boolean removeEldestEntry(Map.Entry<K, V> eldest) { return size() > capacity; }
    }

    public static void main(String[] args) {
        LRUCache<String, Integer> c = new LRUCache<>(2);
        c.put("a", 1); c.put("b", 2);
        System.out.println(c.get("a"));
        c.put("c", 3);
        System.out.println(c.get("b") + " " + c.get("a") + " " + c.get("c") + " " + c.keySet());
    }
}
1
null 1 3 [a, c]وفي JavaScript يحفظ Map ترتيب الإضافة، فالحذف ثم الإضافة ينقل المفتاح إلى النهاية، وسوف نستخدم هذا الملف في التمرين 17:
// lru.js: a Map keeps insertion order, so delete + set moves a key to the newest end
class LRUCache {
  constructor(capacity) { this.capacity = capacity; this.map = new Map(); }
  get(key) {
    if (!this.map.has(key)) return undefined;
    const v = this.map.get(key);
    this.map.delete(key); this.map.set(key, v);
    return v;
  }
  set(key, value) {
    this.map.delete(key); this.map.set(key, value);
    if (this.map.size > this.capacity) this.map.delete(this.map.keys().next().value);   // oldest
  }
}
module.exports = { LRUCache };
if (require.main === module) {
  const c = new LRUCache(2);
  c.set("a", 1); c.set("b", 2);
  console.log(c.get("a"));
  c.set("c", 3);
  console.log(c.get("b"), c.get("a"), c.get("c"), [...c.map.keys()]);
}
1
undefined 1 3 [ 'a', 'c' ]في الحل أعلاه لاحظ التالي:
- السطر
get(a)جعلaالأحدث، فلما أضفناcحذفbوليسa، ومن توقع حذفaفقد بنى ذاكرة FIFO وليس LRU. - الحل البسيط بقائمة عادية يبحث عن المفتاح لينقله، وهذا O(n) في كل
get، وهو ما يمنعه شرط O(1). - في Java المعامل الثالث
trueفي المنشئ Constructor هو ما يحول الترتيب من ترتيب الإضافة إلى ترتيب الوصول، ونسيانه يعطي FIFO بصمت.
للتفصيل: القائمة المترابطة Linked List وجدول الهاش في مقال هياكل البيانات.
14. حالة السباق Race Condition
في C# يزيد هذا الكود عداداً مليون مرة من عدة خيوط Threads في نفس الوقت. ما قيمة count في النهاية؟ وهل تتكرر نفس القيمة عند كل تشغيل؟
// race.cs: one million increments from many threads
int count = 0, safe = 0, locked = 0;
object gate = new();

Parallel.For(0, 1_000_000, _ =>
{
    count++;                                  // read, add, write: three steps, not one
    Interlocked.Increment(ref safe);          // one atomic step
    lock (gate) { locked++; }                 // one thread at a time
});
Console.WriteLine($"count++ {count:N0}   Interlocked {safe:N0}   lock {locked:N0}   cores {Environment.ProcessorCount}");
والجزء الثاني في JavaScript، وهي تعمل على خيط واحد: رصيد الحساب 100، ووصل طلبا سحب بمبلغ 80 في نفس اللحظة. كم يصبح الرصيد؟
// race.js: one thread, and still a race: check, then await, then write
let balance = 100;
const sleep = (ms) => new Promise(r => setTimeout(r, ms));

async function withdraw(amount) {
  if (balance >= amount) {          // check
    await sleep(10);                // e.g. a call to the payment service or the database
    balance -= amount;              // act on a value that may be stale now
    return "ok";
  }
  return "rejected";
}

// fix: make check and act one step that nothing can interleave with
الوقت المقترح: 25 دقيقة.
تلميح Hint
العملية count++ ثلاث خطوات: قراءة ثم جمع ثم كتابة. وفي JavaScript لا يتداخل كودان في نفس اللحظة، ولكن كل await هو نقطة يتوقف فيها الكود ويعمل غيره، فماذا يحدث للتحقق الذي سبقه؟
الحل Answer
شغلنا ملف C# ثلاث مرات على جهاز بثماني نوى:
dotnet run race.cscount++ 998,722 Interlocked 1,000,000 lock 1,000,000 cores 8
count++ 1,000,000 Interlocked 1,000,000 lock 1,000,000 cores 8
count++ 999,704 Interlocked 1,000,000 lock 1,000,000 cores 8والصورة التالية تبين كيف تضيع الزيادة:
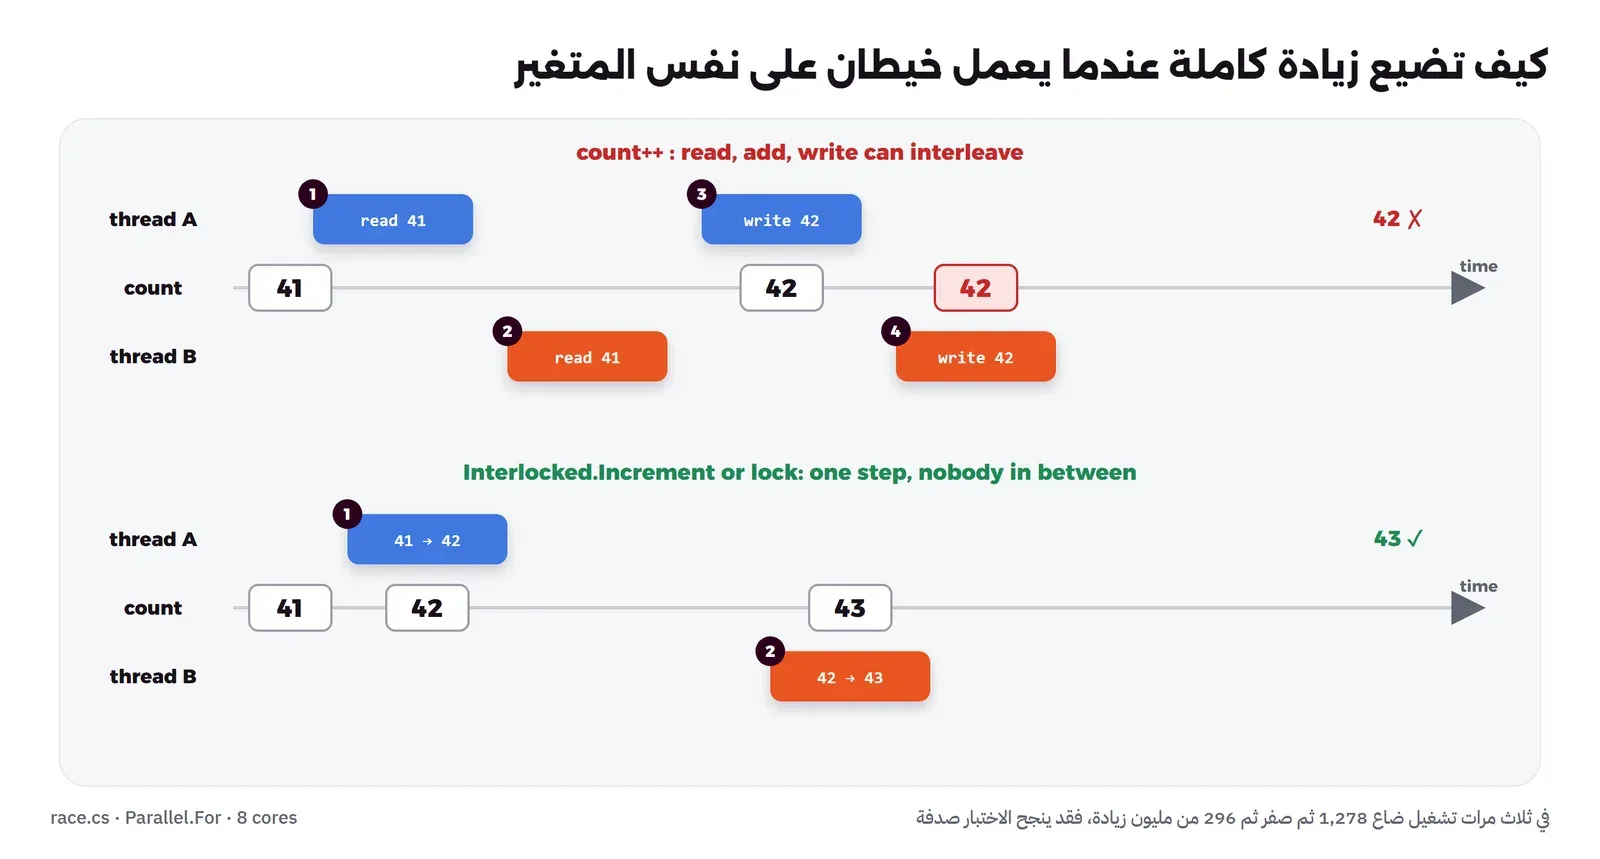
وهذا ملف JavaScript كاملاً مع الإصلاح:
// race.js: one thread, and still a race: check, then await, then write
let balance = 100;
const sleep = (ms) => new Promise(r => setTimeout(r, ms));

async function withdraw(amount) {
  if (balance >= amount) {          // check
    await sleep(10);                // e.g. a call to the payment service or the database
    balance -= amount;              // act on a value that may be stale now
    return "ok";
  }
  return "rejected";
}

// fix: make check and act one step that nothing can interleave with
let queue = Promise.resolve();
function withdrawSafe(amount) {
  const run = queue.then(() => withdraw(amount));
  queue = run.catch(() => {});
  return run;
}

(async () => {
  console.log(await Promise.all([withdraw(80), withdraw(80)]), "balance", balance);
  balance = 100;
  console.log(await Promise.all([withdrawSafe(80), withdrawSafe(80)]), "balance", balance);
})();
[ 'ok', 'ok' ] balance -60
[ 'ok', 'rejected' ] balance 20في الحل أعلاه لاحظ التالي:
- المخرج الثاني في C# كان مليوناً كاملاً بالصدفة، وهذا أخطر ما في حالة السباق، فالاختبار ينجح مرة ويفشل مرة، ومن يشغله مرة واحدة يظن أن الكود سليم. والحل Interlocked.Increment للعداد البسيط أو
lockلما هو أكبر منه. - في JavaScript نجح السحبان وأصبح الرصيد -60، مع أنه لا يوجد إلا خيط واحد، والسبب أن التحقق والتنفيذ Check-then-Act بينهما
await، وهذا نفس نمط ثغرة TOCTOU. - الطابور في
withdrawSafeيكفي داخل عملية واحدة فقط، فإذا كان التطبيق يعمل على أكثر من سيرفر فالحل أن يكون التحقق والخصم جملة واحدة في قاعدة البيانات، مثلUPDATE accounts SET balance = balance - 80 WHERE id = 1 AND balance >= 80ثم فحص عدد الصفوف التي تغيرت.
للتفصيل: الخيوط المتعددة Multithreading وحلقة الأحداث Event Loop في مقال المعالج والتزامن، وثغرات TOCTOU في مقال البرمجة الآمنة.
15. أعد هيكلة دالة طويلة Refactoring دون أن تغير سلوكها
ورثت هذه الدالة، والمطلوب أن تضيف دولة جديدة بضريبة مختلفة الأسبوع القادم، فقررت أن تعيد هيكلتها أولاً. قسمها إلى دوال صغيرة لكل منها مهمة واحدة، والأهم: كيف تثبت أن السلوك لم يتغير وليس لها أي اختبار؟
# order_old.py: the long function you inherited
def process_order(order):
    if not order.get("items"):
        return "ERROR: empty order"
    total = 0
    for it in order["items"]:
        if it["qty"] <= 0:
            return "ERROR: bad qty for " + it["sku"]
        total = total + it["price"] * it["qty"]
    if order.get("coupon") == "WELCOME10":
        total = total - total * 10 / 100
    elif order.get("coupon") == "FLAT50":
        if total >= 200:
            total = total - 50
    if order["country"] == "SA":
        total = total + total * 15 / 100
    elif order["country"] == "AE":
        total = total + total * 5 / 100
    if total < 300:
        if order["country"] == "SA":
            total = total + 25
        else:
            total = total + 60
    return "TOTAL: " + str(round(total, 2))
الوقت المقترح: 35 دقيقة.
تلميح Hint
قبل أن تغير أي سطر، احفظ مخرج الدالة القديمة على مئات الطلبات المتنوعة، ثم قارن مخرج الدالة الجديدة بها، وهذا يسمى اختبار التوصيف Characterization Test أو Golden Master. وانتبه لترتيب الخطوات: الخصم ثم الضريبة ثم الشحن.
الحل Answer
الدالة بعد إعادة الهيكلة، وأصبحت الضرائب والشحن بيانات في جداول صغيرة، فالدولة الجديدة سطر في VAT:
# order_new.py: same behaviour, one job per function, rules as data
VAT = {"SA": 0.15, "AE": 0.05}
SHIPPING = {"SA": 25}
DEFAULT_SHIPPING, FREE_SHIPPING_FROM = 60, 300

def validate(items):
    if not items:
        return "empty order"
    for it in items:
        if it["qty"] <= 0:
            return "bad qty for " + it["sku"]
    return None

def subtotal(items):
    return sum(it["price"] * it["qty"] for it in items)

def apply_coupon(total, coupon):
    if coupon == "WELCOME10":
        return total - total * 10 / 100
    if coupon == "FLAT50" and total >= 200:
        return total - 50
    return total

def add_vat(total, country):
    return total + total * VAT.get(country, 0)

def add_shipping(total, country):
    if total >= FREE_SHIPPING_FROM:
        return total
    return total + SHIPPING.get(country, DEFAULT_SHIPPING)

def process_order(order):
    error = validate(order.get("items"))
    if error:
        return "ERROR: " + error
    total = subtotal(order["items"])
    total = apply_coupon(total, order.get("coupon"))
    total = add_vat(total, order["country"])
    total = add_shipping(total, order["country"])
    return "TOTAL: " + str(round(total, 2))
واختبار التوصيف يولد 2402 طلباً بكل تركيبات الدول والقسائم، مع بذرة ثابتة Seed حتى يتكرر نفس الاختبار:
# golden.py: characterization test, the old and new functions must agree on many orders
import itertools, random
import order_old, order_new

random.seed(7)
cases = [{"items": []}, {"items": [{"sku": "x", "price": 10, "qty": 0}], "country": "SA"}]
for country, coupon in itertools.product(["SA", "AE", "EG"], [None, "WELCOME10", "FLAT50", "BAD"]):
    for _ in range(200):
        items = [{"sku": f"s{i}", "price": random.choice([5, 19.99, 49.5, 120, 250]), "qty": random.randint(1, 4)}
                 for i in range(random.randint(1, 3))]
        cases.append({"items": items, "country": country, "coupon": coupon})

diff = [c for c in cases if order_old.process_order(c) != order_new.process_order(c)]
print(len(cases), "orders,", len(diff), "different")
print(order_new.process_order(cases[5]), "|", order_old.process_order(cases[5]))
2402 orders, 0 different
TOTAL: 59.5 | TOTAL: 59.5ثم كسرنا الكود عمداً لنتأكد أن الاختبار يرى الخطأ، فبدلنا سطري الخصم والضريبة في نسخة مؤقتة، وكانت النتيجة:
2402 orders, 253 differentفي الحل أعلاه لاحظ التالي:
- تبديل الخطوتين غير النتيجة في قسيمة
FLAT50فقط، لأن الضريبة قد ترفع المجموع فوق 200 فيطبق الخصم، أما الخصم بالنسبةWELCOME10فلا يتأثر بالترتيب، وهذا خطأ لا تراه العين في المراجعة ورآه الاختبار في 253 طلباً. - الحالة
{"items": []}دون دولة بقيت تعمل لأن التحقق يأتي قبل قراءةorder["country"]، وهو سلوك قديم يجب أن يبقى حتى لو بدا غريباً. - اختبار التوصيف يثبت أن السلوك لم يتغير ولا يثبت أنه صحيح، فبعد أن تنتهي حوله إلى اختبارات وحدة لكل دالة صغيرة.
للتفصيل: اختبار الانحدار Regression Test في مقال أنواع الاختبارات.
16. أكثر المسارات طلباً Top-K مع ترتيب ثابت
من سجل الوصول Access Log التالي استخرج أكثر ثلاثة مسارات طلباً، والمسارات المتساوية في العدد ترتب أبجدياً حتى يعطي التقرير نفس الجواب في كل مرة. ثم فكر: إذا كان السجل فيه مليون مسار مختلف وتريد أعلى عشرة فقط، هل ترتب المليون كله؟
GET /api/orders 200
GET /login 200
GET /api/orders 200
POST /login 401
GET /health 200
GET /api/users 200
GET /health 200
POST /login 401
GET /api/orders 500
GET /api/users 200
GET /health 200
GET /login 200
GET /api/users 200
الوقت المقترح: 25 دقيقة.
تلميح Hint
الكومة الصغرى Min-Heap بحجم k تحفظ أفضل k عنصر حتى الآن، وأسوأها في أعلاها، فكل عنصر جديد أفضل منه يدخل ويخرج الأسوأ، والتكلفة O(n log k) بدلاً من O(n log n). وانتبه أن «الأسوأ» يجب أن يشمل قاعدة التساوي.
الحل Answer
# topk.py: the 3 most requested paths; equal counts are ordered by path so the answer never changes
import heapq
from collections import Counter

counts = Counter(line.split()[1] for line in open("access.log"))
print(counts.most_common(3))                                   # ties keep first-seen order
print(heapq.nsmallest(3, counts.items(), key=lambda kv: (-kv[1], kv[0])))   # O(n log k)
[('/login', 4), ('/api/orders', 3), ('/health', 3)]
[('/login', 4), ('/api/orders', 3), ('/api/users', 3)]والحل في Java بكومة يدوية من PriorityQueue:
// TopK.java: a min-heap of size k keeps only the best k while reading
import java.nio.file.*;
import java.util.*;

public class TopK {
    public static void main(String[] args) throws Exception {
        Map<String, Integer> counts = new HashMap<>();
        for (String line : Files.readAllLines(Path.of(args[0])))
            counts.merge(line.split(" ")[1], 1, Integer::sum);

        int k = 3;
        // the "worst" of the kept k sits on top: smaller count first, then the larger path
        Comparator<Map.Entry<String, Integer>> worstFirst =
            Map.Entry.<String, Integer>comparingByValue().thenComparing(Map.Entry.comparingByKey(Comparator.reverseOrder()));
        PriorityQueue<Map.Entry<String, Integer>> heap = new PriorityQueue<>(worstFirst);
        for (var e : counts.entrySet()) {
            heap.offer(e);
            if (heap.size() > k) heap.poll();          // drop the worst, the heap never grows past k
        }
        List<Map.Entry<String, Integer>> top = new ArrayList<>(heap);
        top.sort(worstFirst.reversed());
        System.out.println(top);
    }
}
java TopK.java access.log[/login=4, /api/orders=3, /api/users=3]في الحل أعلاه لاحظ التالي:
- ثلاثة مسارات لها 3 طلبات، و
most_commonاختار/healthلأنه ظهر قبل/api/usersفي السجل، وهذا موثق في توثيق Counter، فالجواب يتغير إذا تغير ترتيب السجل، ولذلك أضفنا المسار نفسه إلى مفتاح الترتيب. - في Java الكومة ترتب «الأسوأ أولاً»: العدد الأقل، ثم عند التساوي المسار الأكبر أبجدياً، لأنه الأولى بالخروج، وهذا عكس ما تتوقعه في المرة الأولى، فإذا أخطأت في الاتجاه سوف يخرج الأفضل ويبقى الأسوأ.
- مع مليون مسار وk = 10 تبقى الكومة بحجم عشرة عناصر في الذاكرة، والدالة heapq.nsmallest تفعل نفس الشيء من الداخل.
17. الذاكرة المؤقتة التي تسرب الذاكرة Memory Leak
هذه الدالة في سيرفر Node.js تحفظ ملف المستخدم في Map حتى لا تطلبه من قاعدة البيانات مرة أخرى، وبعد أسبوع من التشغيل يعيد نظام التشغيل تشغيل العملية لأنها تجاوزت حد الذاكرة. أين المشكلة، مع أن JavaScript فيها جامع قمامة Garbage Collector؟ وكيف تصلحها دون أن تفقد فائدة الذاكرة المؤقتة؟
// leak.js: a "cache" that only grows, then the same cache with a limit
//   node --expose-gc leak.js map      node --expose-gc leak.js lru
const { LRUCache } = require("./lru.js");
const cache = process.argv[2] === "lru" ? new LRUCache(10_000) : new Map();

function getProfile(userId) {
  let v = cache.get(userId);
  if (v === undefined) {
    v = { id: userId, profile: "x".repeat(1024) };   // as if loaded from the database
    cache.set(userId, v);
  }
  return v;
}
الوقت المقترح: 20 دقيقة.
تلميح Hint
جامع القمامة يحذف ما لا يشير إليه أحد، فهل يوجد عنصر في هذه ال Map لا يشير إليه أحد؟ والتمرين 13 فيه نصف الحل.
الحل Answer
شغلنا نفس الدالة مرة مع Map ومرة مع ذاكرة LRU من التمرين 13 بسعة عشرة آلاف، مع تشغيل جامع القمامة قبل كل قياس حتى لا نقيس ما ينتظر الحذف:
// leak.js: a "cache" that only grows, then the same cache with a limit
//   node --expose-gc leak.js map      node --expose-gc leak.js lru
const { LRUCache } = require("./lru.js");
const cache = process.argv[2] === "lru" ? new LRUCache(10_000) : new Map();

function getProfile(userId) {
  let v = cache.get(userId);
  if (v === undefined) {
    v = { id: userId, profile: "x".repeat(1024) };   // as if loaded from the database
    cache.set(userId, v);
  }
  return v;
}

for (let round = 1; round <= 3; round++) {
  for (let i = 0; i < 100_000; i++) getProfile(`user-${(round - 1) * 100_000 + i}`);   // new users keep arriving
  global.gc();
  const mb = (process.memoryUsage().heapUsed / 1048576).toFixed(1);
  const size = cache.size ?? cache.map.size;
  console.log(`${process.argv[2]} after ${round * 100}k requests: heapUsed ${mb} MB, entries ${size.toLocaleString("en")}`);
}
node --expose-gc leak.js map
node --expose-gc leak.js lrumap after 100k requests: heapUsed 37.5 MB, entries 100,000
map after 200k requests: heapUsed 71.7 MB, entries 200,000
map after 300k requests: heapUsed 109.2 MB, entries 300,000
lru after 100k requests: heapUsed 7.4 MB, entries 10,000
lru after 200k requests: heapUsed 7.6 MB, entries 10,000
lru after 300k requests: heapUsed 7.6 MB, entries 10,000في الحل أعلاه لاحظ التالي:
- كل مئة ألف مستخدم جديد أضافت نحو 35 MB لا تخرج أبداً، والسبب أن ال Map نفسها متغير عام يعيش طوال عمر العملية، وهي تشير إلى كل الكائنات، فلا يستطيع جامع القمامة حذف أي منها، فهو لا يعرف أنك لن تحتاجها.
- مع LRU بقي عدد العناصر عشرة آلاف وبقيت الذاكرة نحو 7.6 MB بعد 300 ألف طلب، والثمن أن المستخدم القديم الذي يعود سوف يقرأ من قاعدة البيانات مرة أخرى، وهذا مقبول.
- كل ذاكرة مؤقتة تحتاج حداً أعلى للحجم أو مدة صلاحية TTL، وإلا فهي تسرب ذاكرة بطيء، والأرقام هنا توضيحية على جهاز واحد.
جدول المتابعة
انسخ هذا الجدول إلى ملف عندك، وسجل في العمود الأخير التاريخ والوقت الذي أخذه كل تمرين، ثم أعد التمارين التي احتجت فيها الحل بعد شهر، ويجب أن تنتهي منها في وقت أقل دون تلميح:
| # | المستوى | التمرين | الوقت المقترح | تم / الوقت الفعلي |
|---|---|---|---|---|
| 1 | مبتدئ | FizzBuzz بشرط إضافي | 10 دقائق | ☐ |
| 2 | مبتدئ | العناوين المكررة | 10 دقائق | ☐ |
| 3 | مبتدئ | الأقواس المتوازنة | 15 دقيقة | ☐ |
| 4 | مبتدئ | القيمة والمرجع | 10 دقائق | ☐ |
| 5 | مبتدئ | Two-Sum | 15 دقيقة | ☐ |
| 6 | مبتدئ | فخاخ الأرقام | 15 دقيقة | ☐ |
| 7 | متوسط | عكس الكلمات العربية | 20 دقيقة | ☐ |
| 8 | متوسط | خطأ البحث الثنائي | 20 دقيقة | ☐ |
| 9 | متوسط | تقرير المبيعات والمناطق الزمنية | 20 دقيقة | ☐ |
| 10 | متوسط | الاختبارات أولاً | 25 دقيقة | ☐ |
| 11 | متوسط | تقدير Big-O | 15 دقيقة | ☐ |
| 12 | متوسط | دمج المواعيد | 15 دقيقة | ☐ |
| 13 | متقدم | LRU Cache | 30 دقيقة | ☐ |
| 14 | متقدم | حالة السباق | 25 دقيقة | ☐ |
| 15 | متقدم | إعادة هيكلة دالة طويلة | 35 دقيقة | ☐ |
| 16 | متقدم | Top-K بترتيب ثابت | 25 دقيقة | ☐ |
| 17 | متقدم | الذاكرة المؤقتة التي تسرب | 20 دقيقة | ☐ |
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- اكتب توقعك قبل أن تشغل الكود، فالفرق بين ما توقعته وما حدث هو ما يتعلمه عقلك.
- أغلب الأخطاء في هذه التمارين لم تكن في الفكرة وإنما في الحدود: المجال نصف المفتوح، والتنوين الذي ينفصل عن حرفه، ومنتصف الليل بتوقيت آخر، والتساوي في الترتيب.
- الدالة الجاهزة داخل الحلقة لها تكلفة، و
includesفي حلقة هو O(n²) متنكر. - حالة السباق قد تنجح في الاختبار صدفة، فلا تعتمد على تشغيل واحد، واجعل التحقق والتنفيذ خطوة واحدة.
- قبل إعادة الهيكلة ثبت السلوك الحالي باختبار توصيف، وكل ذاكرة مؤقتة تحتاج حداً أعلى.
وبقية تمارين السلسلة في مرحلة Kata في صفحة الخارطة، والمقالات التي شرحنا فيها أساس هذه التمارين:
 دليللماذا تتمرن دون ذكاء اصطناعي؟ تمارين Kata لك ولفريقكما الذي تقوله الأبحاث عن تسليم التفكير للأدوات، وكيف يحفظ روتين صغير من التمارين تحلها بيدك مهارتك وحدك ومع فريقك.
 دليلهياكل البيانات Data Structures للمبتدئينلماذا تكون نفس العملية سريعة في هيكل بيانات وبطيئة في آخر، وأين تقابل كل هيكل في السيرفرات وقواعد البيانات.
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلالذاكرة للمبرمجين: كيف تعمل ال Stack وال Heapلماذا تتغير قائمة لم تطلب تغييرها، وكيف تتسرب الذاكرة في لغة فيها جامع قمامة Garbage Collector، بأمثلة حقيقية من عدة لغات.
 دليلالأنظمة العددية للمبرمجين: من Binary إلى Floating Pointلماذا يظهر القرص 465 بدل 500، ويصبح العداد سالباً فجأة، ولا يساوي 0.1 + 0.2 القيمة 0.3؟ الإجابة في طريقة تخزين الأرقام.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل كل الحلول على Windows 11 باستخدام Python 3.13.3 وNode.js 22.14.0 و.NET SDK 10.0.400، وJava من Eclipse Temurin 25.0.4.1 داخل Docker.


