

في تطبيق الفيديو القصير يسحب المستخدم الشاشة إلى الأعلى فيبدأ الفيديو التالي فوراً، دون دائرة تحميل ودون صفحة اختيار، ويقرر في أقل من ثانيتين هل يكمله أم يسحب مرة أخرى، وفي هاتين الثانيتين يكمن كل ما يميز هذا النوع من التطبيقات: أن يكون الفيديو التالي جاهزاً على الهاتف قبل أن يطلبه المستخدم، وأن يكون اختياره مناسباً لهذا الشخص بالذات، وأن يتعلم النظام من هذا السحب نفسه ليكون الاختيار التالي أفضل. وهذا يختلف عن منصة الفيديو عند الطلب التي شرحناها في كيف تبني منصة فيديو عند الطلب مثل Netflix، فهناك يختار المشاهد فيلماً ويشاهده ساعتين، وهنا يختار النظام عشرات المقاطع في الدقيقة، وكل ثانية مشاهدة إشارة يتعلم منها.
وسوف نأخذ TikTok مثالاً لأنها شرحت بنفسها كيف تختار خلاصة For You في منشور رسمي سنة 2020، ونشرت ByteDance ورقة بحثية عن نظام توصية يتعلم في الوقت الحقيقي، ولن نتحدث عن أي تفصيل داخلي لم تنشره الشركة. ومفاهيم الفيديو والبث المتكيف لها مقالات مستقلة في قسم الفيديو والبث المباشر، فلن نكررها:
 دليلمفاهيم الفيديو: الحاوية والترميز Codec ومعدل البتما الذي يحدد حجم ملف الفيديو وجودته، ولماذا يعمل ملف في متصفح ولا يعمل في آخر، مع تجربة حقيقية تقيس الفرق بين الترميزات.
 دليلكيف يعمل بث الفيديو المباشر وعند الطلب؟كيف يصل الفيديو إلى كل مشاهد بجودة تناسب سرعة اتصاله، ولماذا يتأخر البث المباشر عشرين ثانية أحياناً وأقل من ثانية أحياناً أخرى.
وسوف نناقش في هذا المقال ما يلي:
- الصورة الكاملة: مسار للرفع والتوصيل، ومسار يتعلم من كل مشاهدة.
- المعمارية الكاملة: المكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو، وماذا يحدث عندما يتعطل كل جزء.
- الرفع والتحرير على الهاتف، والمعالجة السريعة بمهام متوازية.
- الخلاصة التي لا تنتهي والتحميل المسبق Prefetch، ومتى يصبح هدراً.
- نظام التوصية: المرشحون والترتيب وإعادة الترتيب، وإشارات التفاعل، والبداية الباردة Cold Start، كما تصفها TikTok نفسها.
- مراجعة المحتوى آلياً وبشرياً، والتخزين والتوصيل عندما يرفع الناس ملايين المقاطع.
- تجربة عملية: معالجة مقطع عمودي، وواجهة خلاصة تعيد الفيديوهات التالية مع روابط التحميل المسبق، وترتيب بسيط من إشارات مشاهدة اصطناعية، ومحاكاة لكلفة التحميل المسبق.
الصورة الكاملة: مساران يدوران حول الهاتف
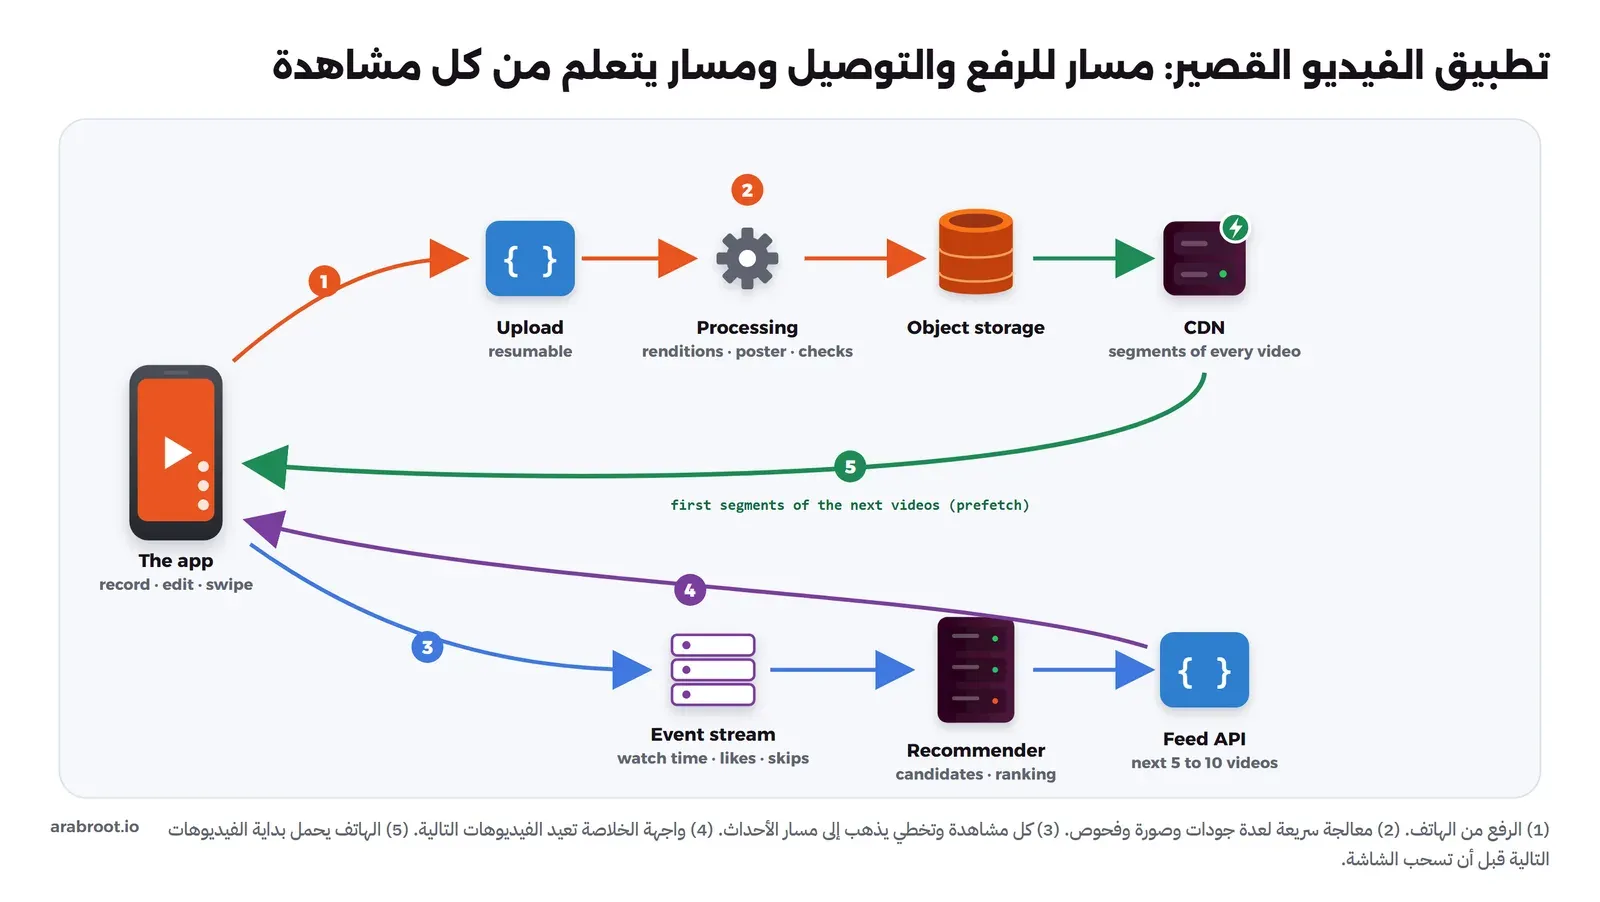
في التطبيق مساران: الأول يأخذ المقطع من هاتف صانعه، ويعالجه ويخزنه ويوزعه عبر ال CDN، والثاني يأخذ من هاتف كل مشاهد أحداثاً صغيرة، مثل كم ثانية شاهد وهل أعاد المقطع وهل سحبه بسرعة، ويحولها إلى توصيات، ثم تعيد واجهة الخلاصة Feed API للهاتف قائمة الفيديوهات التالية، فيبدأ الهاتف تحميل بدايتها فوراً، والصورة التالية تبين المسارين:
المعمارية الكاملة: كيف تتصل الأجزاء ببعضها؟
الصورة السابقة تبين المسارين حول الهاتف، أما عند البناء فتحتاج أن تعرف أي خدمة تستقبل كل طلب، وأين تحفظ كل معلومة، وأي عمل ينتظره المستخدم وأي عمل يذهب إلى طابور أو سجل أحداث ويكمل وحده، لأن هذا ما يقرر هل تبدأ الخلاصة في أجزاء من الثانية أم يرى المستخدم دائرة التحميل. والصورة التالية تبين المعمارية في خمسة أعمدة: الكلاينت Clients، ثم الحافة Edge، ثم الخدمات Services، ثم البيانات Data، ثم ال Workers:
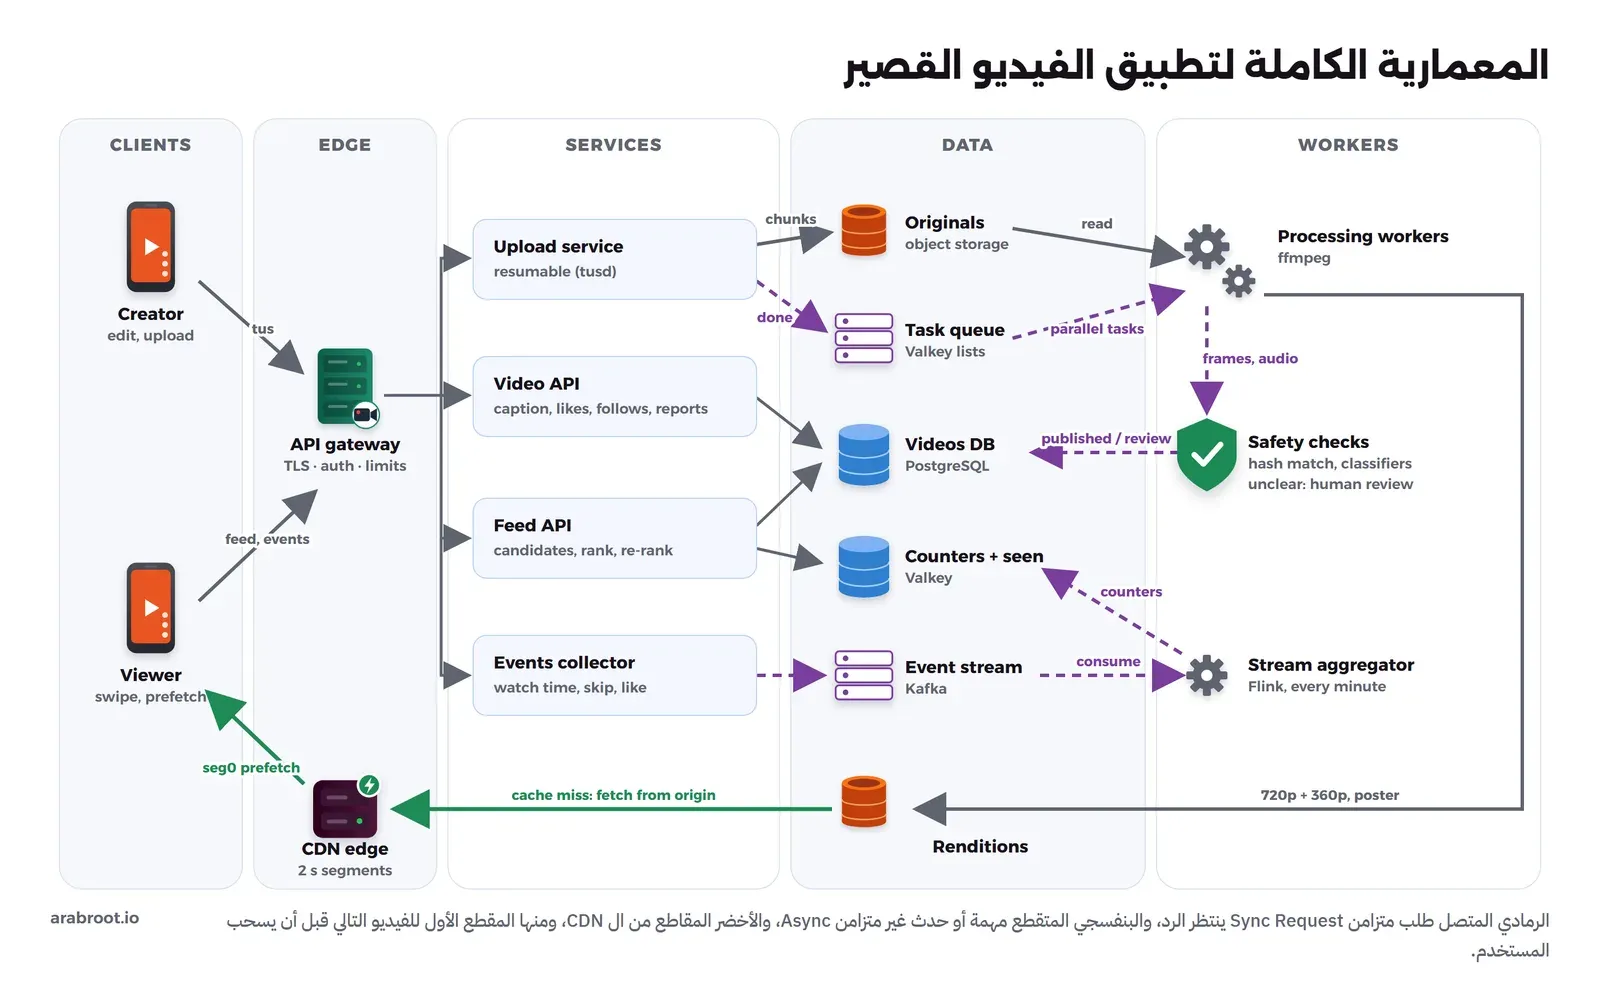
وفي الصورة أعلاه لاحظ ثلاث قواعد: أن واجهة الخلاصة Feed API لا تحسب شيئاً ثقيلاً أثناء الطلب، فهي تقرأ عدادات جاهزة من Valkey وترتب بها، والسبب أنها أكثر واجهة يطلبها التطبيق، وكل مللي ثانية فيها يشعر بها المستخدم مع كل سحبة. وأن أحداث المشاهدة لا تكتب في قاعدة البيانات مباشرة، وإنما تذهب إلى سجل أحداث، ثم يجمعها Worker كل دقيقة ويكتب العدادات، وفي التجربة كانت الواجهة تحدث العدادات بنفسها لأن الأحداث قليلة. وأن المقطع لا يصبح منشوراً إلا عندما تكتب فحوص السلامة حالته في قاعدة الفيديوهات، فلا يصل إلى مرحلة المرشحين قبل ذلك.
المكونات ومسؤولية كل منها
| المكون | مسؤوليته | أداة مفتوحة المصدر مقترحة | لماذا هي |
|---|---|---|---|
| تطبيق الهاتف | التصوير والتحرير والضغط، والتشغيل مع التحميل المسبق، وإرسال أحداث المشاهدة دفعات | AndroidX Media3 (Apache-2.0) على Android، والمشغل المدمج في iOS | يشغل HLS ويسمح بتحميل بداية المقطع التالي في الخلفية |
| بوابة ال API Gateway | TLS، والتحقق من التوكن، وحدود الطلبات لكل مستخدم | Traefik (MIT) | إعداد بسيط، وحدود الطلبات جاهزة دون كود |
| الهوية Identity | تسجيل الدخول وإصدار التوكن | Keycloak (Apache-2.0) | OpenID Connect جاهز، فلا تكتب تسجيل الدخول بنفسك |
| خدمة الرفع | رفع قابل للاستئناف من شبكة الهاتف، ثم إشعار بأن الرفع اكتمل | tusd (MIT) | الخادم المرجعي لبروتوكول tus، ويكتب إلى تخزين متوافق مع S3 |
| تخزين الكائنات | الملفات الأصلية، والمقاطع الجاهزة والصور | Garage (AGPL-3.0) | متوافق مع S3 ويعمل على أجهزة عادية |
| طابور المهام | المهام المتوازية بعد كل رفع، والضرورية منها أولاً | Valkey (BSD-3-Clause) | قائمة لكل أولوية تكفي، وهو نفسه الذي يحمل العدادات |
| Workers المعالجة | الجودتان والصورة وشريط المعاينة، ثم بصمة الصوت وال Embeddings | FFmpeg | نفس الأوامر التي في process.sh |
| فحوص السلامة | مطابقة البصمات مع محتوى ضار معروف، والمصنفات، وطابور المراجعة البشرية | خوارزميات PDQ وTMK+PDQF في مستودع ThreatExchange من Meta (BSD)، ومصنفاتك | بصمات مفتوحة للصور والفيديو، أما PhotoDNA فخدمة من Microsoft وليست مفتوحة |
| قاعدة الفيديوهات | الفيديوهات وحالتها، والمتابعة، وحالات المراجعة | PostgreSQL (PostgreSQL License) | معاملات وقيود، وتكفي لملايين الصفوف كما في PostgreSQL لكل شيء |
| العدادات وما شوهد | إشارات كل مقطع، واهتمامات كل مستخدم، وما عرض عليه | Valkey | قراءة في أجزاء من المللي ثانية، وهي نفس المفاتيح التي في التجربة |
| سجل الأحداث Event Stream | كل أحداث المشاهدة بالترتيب، تحفظ أياماً ويقرؤها أكثر من مستهلك | Apache Kafka (Apache-2.0) | إذا تعطل المجمع لا تضيع الأحداث، ويمكن إعادة حساب العدادات منها |
| مجمع الأحداث | جمع الأحداث كل دقيقة إلى عدادات لكل مقطع ولكل مستخدم | Apache Flink (Apache-2.0) | مبني لحساب النوافذ الزمنية على تدفق أحداث لا يتوقف |
| البحث عن المتشابه، لاحقاً | مرشحون قريبون في ال Embeddings مما أكمله المستخدم | pgvector (PostgreSQL License) أو Qdrant (Apache-2.0) | الأول داخل PostgreSQL الذي لديك، والثاني قاعدة متجهات مستقلة عندما يكبر العدد |
| ال CDN | المقاطع والصور قريبة من المشاهد | nginx (BSD-2-Clause) كنقطة Cache، ثم CDN تجارية | المقاطع ملفات ثابتة لا تتغير بعد المعالجة |
نموذج البيانات
في التجربة العملية كانت كل البيانات في Valkey: لكل مقطع Hash اسمه video:<id> فيه الصانع والتصنيف والطول والعدادات impressions وwatch_s وcomplete وrewatch وlike وshare وskip، ولكل تصنيف Sorted Set اسمه topic:<topic>، ولكل مستخدم user:<id>:topics وuser:<id>:seen، والمقاطع الجديدة في fresh. وفي الإنتاج تبقى هذه المفاتيح كما هي لأنها ما تقرؤه واجهة الخلاصة، ويضاف إليها مصدر الحقيقة في PostgreSQL، وسجل الأحداث في Kafka:
-- PostgreSQL: the source of truth for videos, follows and moderation (users live in Keycloak)
CREATE TABLE videos (
  id           text PRIMARY KEY,                 -- v183, new0 ... as in the lab
  creator_id   text NOT NULL,                    -- c23
  topic        text NOT NULL,                    -- cooking, football, tech ...
  length_s     int  NOT NULL,
  upload_key   text NOT NULL UNIQUE,             -- the tus upload id: one upload, one video
  status       text NOT NULL CHECK (status IN ('uploading', 'processing', 'review', 'published', 'removed')),
  hls_path     text,                             -- /media/<id>/master.m3u8
  created_at   timestamptz NOT NULL DEFAULT now(),
  published_at timestamptz
);
CREATE TABLE follows (
  follower_id text NOT NULL,
  creator_id  text NOT NULL,
  created_at  timestamptz NOT NULL DEFAULT now(),
  PRIMARY KEY (follower_id, creator_id)
);
CREATE TABLE moderation_cases (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  video_id   text NOT NULL REFERENCES videos (id),
  source     text NOT NULL CHECK (source IN ('hash', 'classifier', 'report')),
  score      real,                             -- classifier score between the two thresholds
  state      text NOT NULL DEFAULT 'open' CHECK (state IN ('open', 'approved', 'removed', 'appealed')),
  decided_by text,
  decided_at timestamptz
);
-- Kafka topic watch_events: the lab's POST /event body plus a time,
--   {"user": "u0001", "video": "v183", "watched_s": 12.5, "like": false, "share": false, "ts": 1791509936}
-- Valkey, the lab's keys, written by the aggregator every minute and read by the Feed API:
--   video:<id> (hash of counters), topic:<topic> (sorted set), user:<id>:topics (sorted set),
--   user:<id>:seen (set, with an expiry), fresh (set of new videos)
في الإعداد أعلاه لاحظ التالي:
- الحالة
reviewتعني أن المقطع ينتظر مراجعة بشرية، ولا يدخلtopic:<topic>ولاfreshحتى يصبحpublished، وهكذا لا تستطيع واجهة الخلاصة أن توصي به حتى لو أرادت. - المفتاح
user:<id>:seenفي التجربة يكبر بلا نهاية، وفي الإنتاج يجب أن تكون له مدة صلاحية، والسبب في تقدير السعة التالي. - الأحداث في Kafka هي الأصل، والعدادات في Valkey نتيجة محسوبة منها، فإذا فقدت Valkey أعدت حسابها من الأحداث.
الواجهات الرئيسية
| الطريقة والمسار | ما تفعله | ملاحظات |
|---|---|---|
POST /uploads ثم PATCH /uploads/{id} | إنشاء الرفع بطول الملف، ثم إرسال الأجزاء بترويسة Upload-Offset | بروتوكول tus: بعد الانقطاع يسأل التطبيق عن آخر موضع بطلب HEAD ويكمل منه |
POST /videos | تربط الرفع بالوصف والتصنيف، وتنشئ سجل الفيديو بحالة processing، وتضع مهام المعالجة | معرف الرفع فريد، فتكرار الطلب يعيد نفس الفيديو |
GET /videos/{id} | حالة المقطع لصانعه: قيد المعالجة أو المراجعة أو منشور | لصاحب المقطع فقط |
GET /feed?user=u0001&n=5 | الصفحة التالية من الخلاصة، مع روابط المقطع الأول لثاني وثالث مقطع | نفس رد feed.py، والمستخدم في الإنتاج يؤخذ من التوكن وليس من الرابط |
POST /events | دفعة من أحداث المشاهدة بنفس شكل POST /event في التجربة، تكتب إلى Kafka ويرد 202 | لكل حدث معرف يرسله التطبيق، فيتجاهل المجمع الحدث المكرر عند إعادة الإرسال |
PUT /videos/{id}/like | الإعجاب | بطريقة PUT وDELETE بدل التبديل، فتكرار الطلب لا يعكس النتيجة |
POST /reports | بلاغ على مقطع يفتح حالة في moderation_cases | البلاغات الكثيرة على مقطع منتشر ترفع أولويته |
GET /media/{id}/master.m3u8 و/media/{id}/360p/seg0.m4s | ملف التشغيل والمقطع الأول من ال CDN | المسارات التي تعيدها الخلاصة في التجربة، والمقاطع بصلاحية طويلة لأنها لا تتغير |
تقدير السعة
لنفرض تطبيقاً وصل إلى 100,000 مستخدم نشط في اليوم، وكل رقم هنا افتراض نكتبه صراحة، إلا ما أخذناه من التجربة، والتجربة نفسها ببيانات اصطناعية، فغير الأرقام بأرقام مستخدميك:
- افتراض: كل مستخدم يقضي 30 دقيقة في اليوم، وساعة الذروة ثلاثة أضعاف متوسط الساعة.
- من توزيع المشاهدة الاصطناعي في محاكاة التحميل المسبق: 45% يسحبون بعد 1.15 ثانية في المتوسط، و35% بعد 8 ثوان، و20% يكملون 15 ثانية، أي 6.3 ثانية لكل مقطع في المتوسط.
- من التجربة: جودة 360p قرابة 85 كيلوبايت لكل ثانية من المقطع، والجودتان والصورتان معاً قرابة 4.8 ميجابايت لكل مقطع، والمعالجة 11.8 ثانية لكل مقطع.
- افتراض: 1% من المستخدمين يرفعون مقطعاً واحداً في اليوم، والملف الأصلي بعد ضغط الهاتف 15 ميجابايت.
impressions per day   100,000 x 1,800 s / 6.3 s          = ~28.6 million
events                28.6 M / 86,400 s                   = ~330/s average, x3 = ~1,000/s at peak
feed requests         28.6 M / 5 per page / 86,400 s      = ~66/s average, ~200/s at peak
viewers at the peak   100,000 x 30 min / 1,440 min x 3    = ~6,250 at the same time
egress at the peak    6,250 x 85 KB/s x 8                 = ~4.3 Gbit/s at 360p (720p: ~235 KB/s, almost 3 times more)
egress per day        28.6 M x 6.3 s x 85 KB/s            = ~15 TB per day at 360p
uploads               100,000 x 1%                        = 1,000 clips per day
storage per day       1,000 x (4.8 MB ready + 15 MB original) = ~20 GB per day = ~7.2 TB per year
processing            1,000 x 11.8 s                      = ~3.3 worker-hours per day
seen sets in Valkey   28.6 M new members per day x ~50 bytes = ~1.4 GB more every day without an expiry
ولاحظ ثلاثة أشياء في هذه الأرقام: أن المعالجة صغيرة جداً، فثلاث ساعات عمل في اليوم يكفيها Worker واحد، والمهم فيها زمن المقطع الواحد وليس العدد، لأن الصانع ينتظر النشر. وأن النقل الخارج هو البند الأكبر مرة أخرى، 15 تيرابايت في اليوم بالجودة المنخفضة فقط، لذلك يبدأ التشغيل ب 360p ويرفع الجودة لمن يستمر. وأن قائمة ما شوهد لكل مستخدم تزيد الذاكرة قرابة 1.4 جيجابايت كل يوم، والرقم 50 بايت لكل عنصر تقدير تقريبي، فإذا لم تجعل لها مدة صلاحية امتلأت ذاكرة Valkey خلال أسابيع.
مراحل النمو
| الجزء | MVP: سيرفر أو اثنان | النمو: آلاف المستخدمين في نفس الوقت | الحجم الكبير: ملايين المستخدمين |
|---|---|---|---|
| الخلاصة والترتيب | عدادات في Valkey وترتيب بسيط كما في التجربة، والواجهة تحدث العدادات بنفسها | أحداث في Kafka ومجمع كل دقيقة، ونموذج ترتيب يتدرب كل يوم مع اختبارات A/B | مرشحون من ال Embeddings في قاعدة متجهات، وتدريب مستمر كما في ورقة Monolith |
| المعالجة | Worker واحد بجودتين | عدد ال Workers يزيد مع طول الطابور، والمهام الضرورية في طابور له أولوية | إعادة ترميز المقاطع المنتشرة بجودة أعلى وترميز أحدث، وترميز في العتاد |
| التخزين والتوصيل | Garage وnginx كنقطة Cache | CDN تجارية، وقواعد دورة الحياة للمقاطع القديمة | تخزين في عدة مناطق، وإرسال المقاطع المنتشرة مسبقاً إلى نقاط ال CDN |
| المراجعة | مطابقة البصمات وزر البلاغ ومراجعة يدوية | مصنفات بعتبتين، وطابور مراجعة بأولويات | فرق مراجعة بحسب اللغة والمنطقة، ومسار للاعتراض |
| قاعدة البيانات | PostgreSQL واحد ونسخة احتياطية | نسخ قراءة للمتابعة والملفات الشخصية | تقسيم بيانات المستخدمين والمتابعة على أكثر من قاعدة |
ولا تقم ببناء ما في العمود الأخير من اليوم الأول، فلا تبن تدريباً مستمراً ولا قاعدة متجهات قبل أن يكون لديك ملايين الأحداث، بل لا تحتاج Kafka وFlink في البداية أصلاً، فواجهة تحدث العدادات بنفسها كما في التجربة تكفي حتى تصبح الأحداث مئات في الثانية، والسبب أن كل قطعة إضافية تحتاج من يشغلها ويراقبها، وقد شرحنا متى يستحق التعلم الآلي ثمنه في كيف تبني نظام توصية من الصفر.
ماذا لو تعطل جزء؟
| ماذا لو تعطل...؟ | الأثر | كيف تخففه |
|---|---|---|
| واجهة الخلاصة | التطبيق يفتح على شاشة فارغة، وهذا أسوأ ما يمكن أن يراه المستخدم | صفحة منتشرة محسوبة مسبقاً لكل منطقة في Cache، والتطبيق يحتفظ بآخر صفحة وصلته |
| Valkey للعدادات | الترتيب بلا إشارات، والمستخدم لا يعرف ما شاهده | نسخة احتياطية مع تحويل تلقائي، والرجوع إلى الصفحة المنتشرة، ثم إعادة حساب العدادات من Kafka |
| سجل الأحداث أو المجمع | العدادات تتأخر، فتصبح التوصيات قديمة لكن التطبيق يعمل | راقب تأخر المستهلك Consumer Lag، والأحداث محفوظة في Kafka حتى يعود المجمع |
| Workers المعالجة | المقاطع الجديدة تنتظر قبل النشر | المهام الضرورية في طابور له أولوية، وال Embeddings وبصمة الصوت تنتظر، وعدد ال Workers يزيد مع طول الطابور |
| فحوص السلامة | إذا نشرت دونها وصل المحتوى الضار إلى الخلاصات | لا تنشر مقطعاً لم يفحص، فيبقى في حالة processing ويرى صانعه أنه قيد المراجعة |
| ال CDN | كل سحبة تنتظر أو تفشل | CDN ثانية يعرفها التطبيق، والمقطع الأول للصفحة الأولى محفوظ من الجلسة السابقة |
الرفع والتحرير على الهاتف
أرخص معالجة هي التي تحدث على هاتف صانع المقطع قبل الرفع: القص والفلاتر والنص والموسيقى، ثم ضغط المقطع إلى دقة ومعدل بت معقولين، فالهاتف الحديث فيه شريحة ترميز في العتاد تفعل ذلك بسرعة ودون أن تكلفك شيئاً، ورفع 15 ثانية بدقة 1080p ومعدل معقول أسرع بكثير من رفع الملف الخام من الكاميرا. ثم يكون الرفع قابلاً للاستئناف، لأن المستخدم يرفع من شبكة هاتف تنقطع، بنفس الطرق التي شرحناها في قسم الرفع في مقال منصة الفيديو، مثل بروتوكول tus أو الرفع المجزأ إلى S3 مباشرة. ويمكن أن يبدأ الرفع في الخلفية أثناء ما يكتب المستخدم الوصف، فيبدو النشر فورياً.
المعالجة السريعة: لا تنتظر كل شيء قبل النشر
في منصة الفيديو عند الطلب لا يضر أن ينتظر الفيلم دقائق قبل أن يظهر، أما هنا فصانع المقطع يريد أن يرى مقطعه منشوراً خلال ثوان، لذلك تقسم المعالجة إلى مهام متوازية، وينشر المقطع بعد المهام الضرورية فقط، والصورة التالية تبين ذلك:
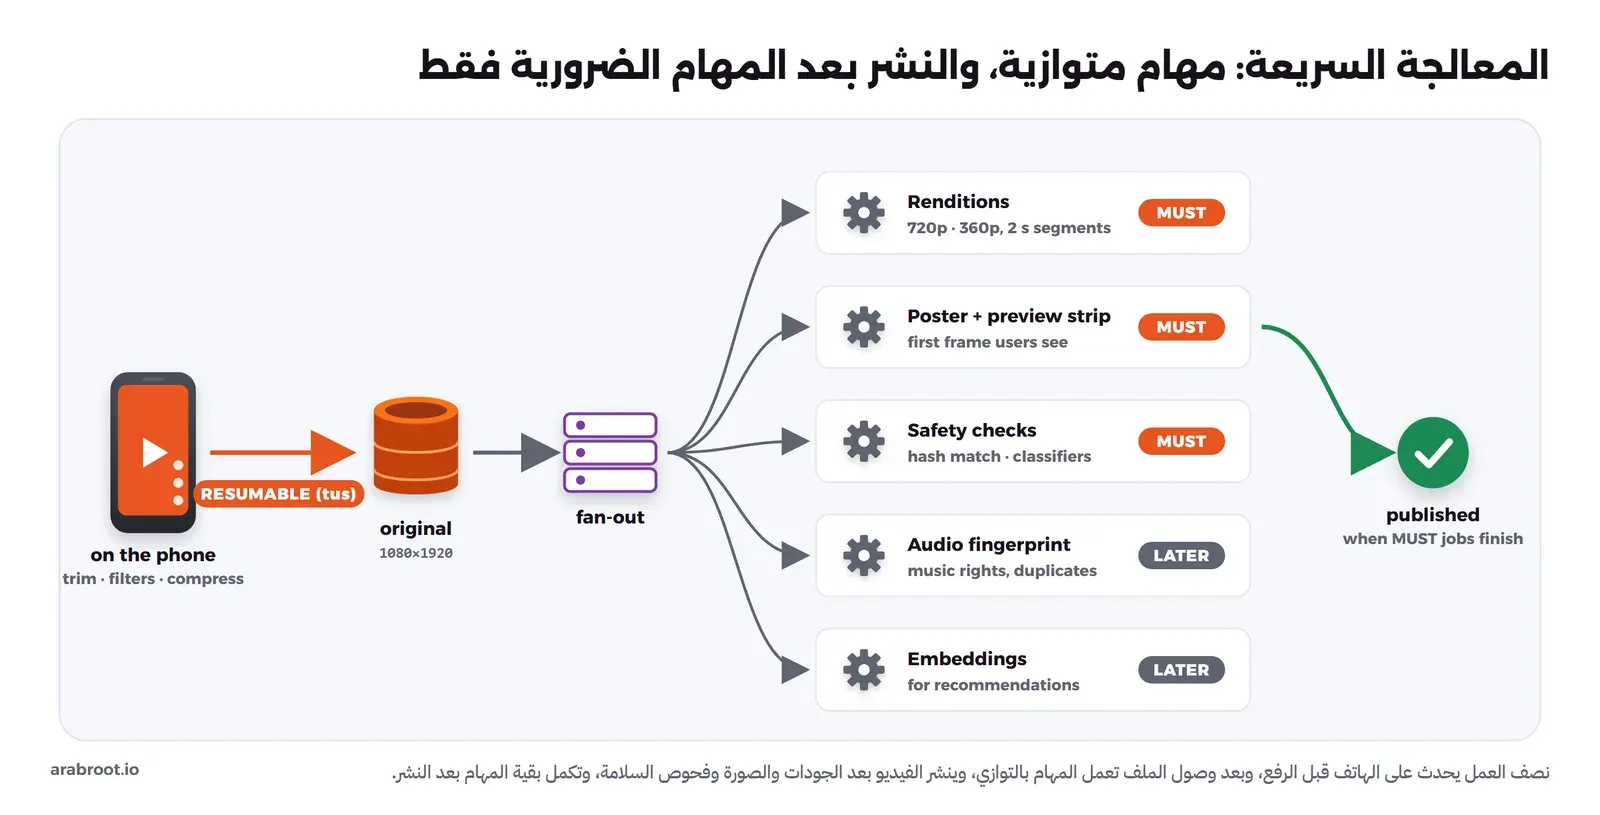
- الجودات Renditions: المقطع القصير يحتاج سلماً أقصر من الفيلم، مثل 720p و360p، بمقاطع ثانيتين حتى يبدأ التشغيل بعد تحميل جزء صغير، وسوف ترى في التجربة أن أول مقطع بدقة 360p حجمه 144 كيلوبايت فقط.
- الصورة Poster وشريط المعاينة: الصورة هي أول ما يراه المستخدم قبل أن يبدأ الفيديو، فتعرض فوراً بينما يحمل المقطع الأول.
- فحوص السلامة: يجب أن تنتهي قبل أن يصل المقطع إلى خلاصة أي شخص، كما سنرى في قسم المراجعة.
- بصمة الصوت Audio Fingerprint وال Embeddings: الأولى لمعرفة الموسيقى المستخدمة وحقوقها والمقاطع المكررة، والثانية متجهات أرقام تصف محتوى المقطع لنظام التوصية، وكلاهما يمكن أن يتأخر دقيقة بعد النشر.
الخلاصة التي لا تنتهي والتحميل المسبق Prefetch
الخلاصة صفحات صغيرة، فواجهة الخلاصة Feed API في المعمارية أعلاه تعيد للهاتف 5 إلى 10 مقاطع في كل مرة، ثم يطلب الهاتف الصفحة التالية قبل أن يصل إلى آخر مقطع، وهكذا لا تنتهي. والمهم فيها أن المقطع التالي يجب أن يبدأ فور السحب، والحل البسيط أن يبدأ الهاتف تحميل المقطع عندما يظهر على الشاشة، فينتظر المستخدم زمن الاتصال وزمن تحميل المقطع الأول في كل سحبة. والحل الأنسب أن يحمل الهاتف أثناء تشغيل المقطع الحالي بداية المقطع التالي، أي ملف التشغيل والمقطع الأول فقط، والصورة التالية تبين الفكرة مع نتيجة المحاكاة من التجربة:
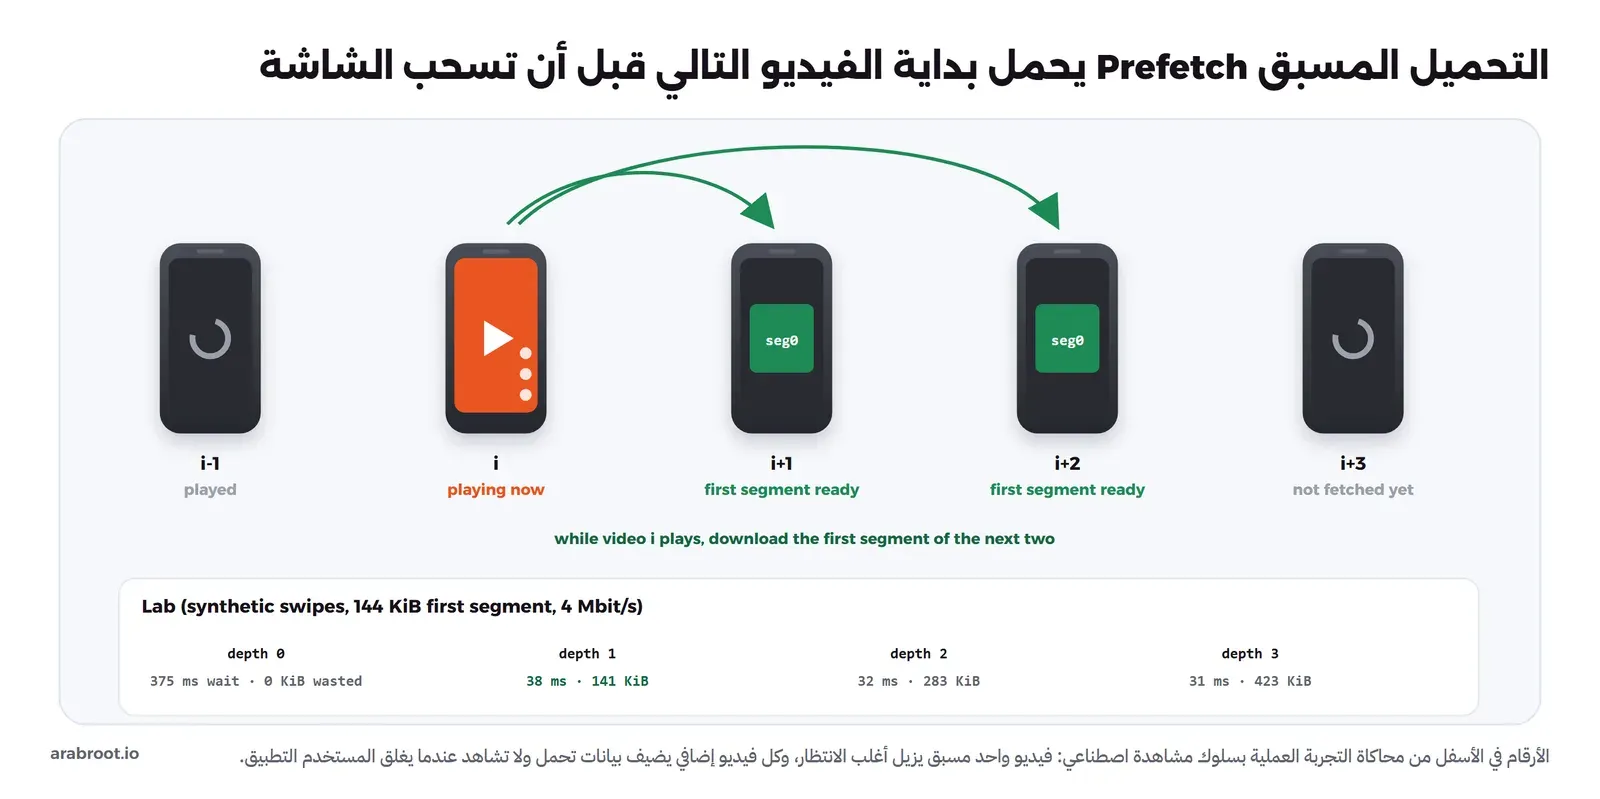
وقد يتساءل البعض: لماذا لا نحمل الفيديوهات الخمسة كاملة ونرتاح؟ والإجابة أن كل بايت يحمل ولا يشاهد هو تكلفة عليك في فاتورة النقل، وعلى المستخدم في باقة بياناته وبطاريته، والمستخدم يسحب أغلب المقاطع قبل أن تنتهي ويغلق التطبيق في أي لحظة. لذلك فالقاعدة العملية: حمل بداية المقطع التالي أو اثنين فقط، وبالجودة المنخفضة، ثم ارفع الجودة إذا استمر المستخدم في المشاهدة، وقلل التحميل المسبق أو أوقفه إذا كان الهاتف على شبكة بطيئة أو في وضع توفير البيانات، وهذا ما تقيسه المحاكاة في التجربة العملية.
نظام التوصية: كيف يختار المقطع التالي؟
ما الذي نشرته TikTok؟
في 18 يونيو 2020 نشرت TikTok منشوراً بعنوان How TikTok recommends videos #ForYou يشرح خلاصة For You، وأهم ما فيه:
- الترتيب يعتمد على تفاعلات المستخدم، مثل المقاطع التي أعجبته أو شاركها والحسابات التي يتابعها وتعليقاته وما ينشره، وعلى معلومات المقطع، مثل الوصف والأصوات والوسوم Hashtags، وعلى إعدادات الجهاز والحساب مثل اللغة والدولة ونوع الجهاز، والأخيرة بوزن أقل لأن المستخدم لا يعبر بها عن اهتمامه.
- الإشارة القوية تأخذ وزناً أكبر، ومثالها في المنشور أن يكمل المستخدم مقطعاً طويلاً من بدايته إلى نهايته، والإشارة الضعيفة تأخذ وزناً أقل، مثل أن يكون المشاهد وصانع المقطع في نفس الدولة.
- عدد متابعي الحساب، وكون الحساب نشر مقاطع ناجحة من قبل، ليسا عاملين مباشرين في الترتيب.
- الخلاصة عادة لا تعرض مقطعين متتاليين بنفس الصوت أو من نفس الصانع، ولا تعرض المكرر ولا ما شاهده المستخدم من قبل ولا ما يعتبر Spam، وتدخل أحياناً مقاطع خارج اهتمامات المستخدم عمداً للتنوع.
- المستخدم الجديد يختار تصنيفات تهمه، فإذا لم يختر يبدأ بمقاطع منتشرة، ثم تتعلم الخلاصة من أول إعجابات وتعليقات وإعادات مشاهدة.
- المقاطع التي رفعت للتو أو التي تحت المراجعة قد لا تكون مؤهلة للتوصية.
ثلاث مراحل: المرشحون ثم الترتيب ثم إعادة الترتيب
لا يستطيع أي نظام أن يحسب نموذجاً معقداً لكل مقطع في المكتبة لكل مستخدم في كل طلب، لذلك تعمل أنظمة التوصية على مراحل، كل مرحلة على عدد أقل من التي قبلها وبحساب أغلى، والصورة التالية تبين هذا الشكل الشائع:
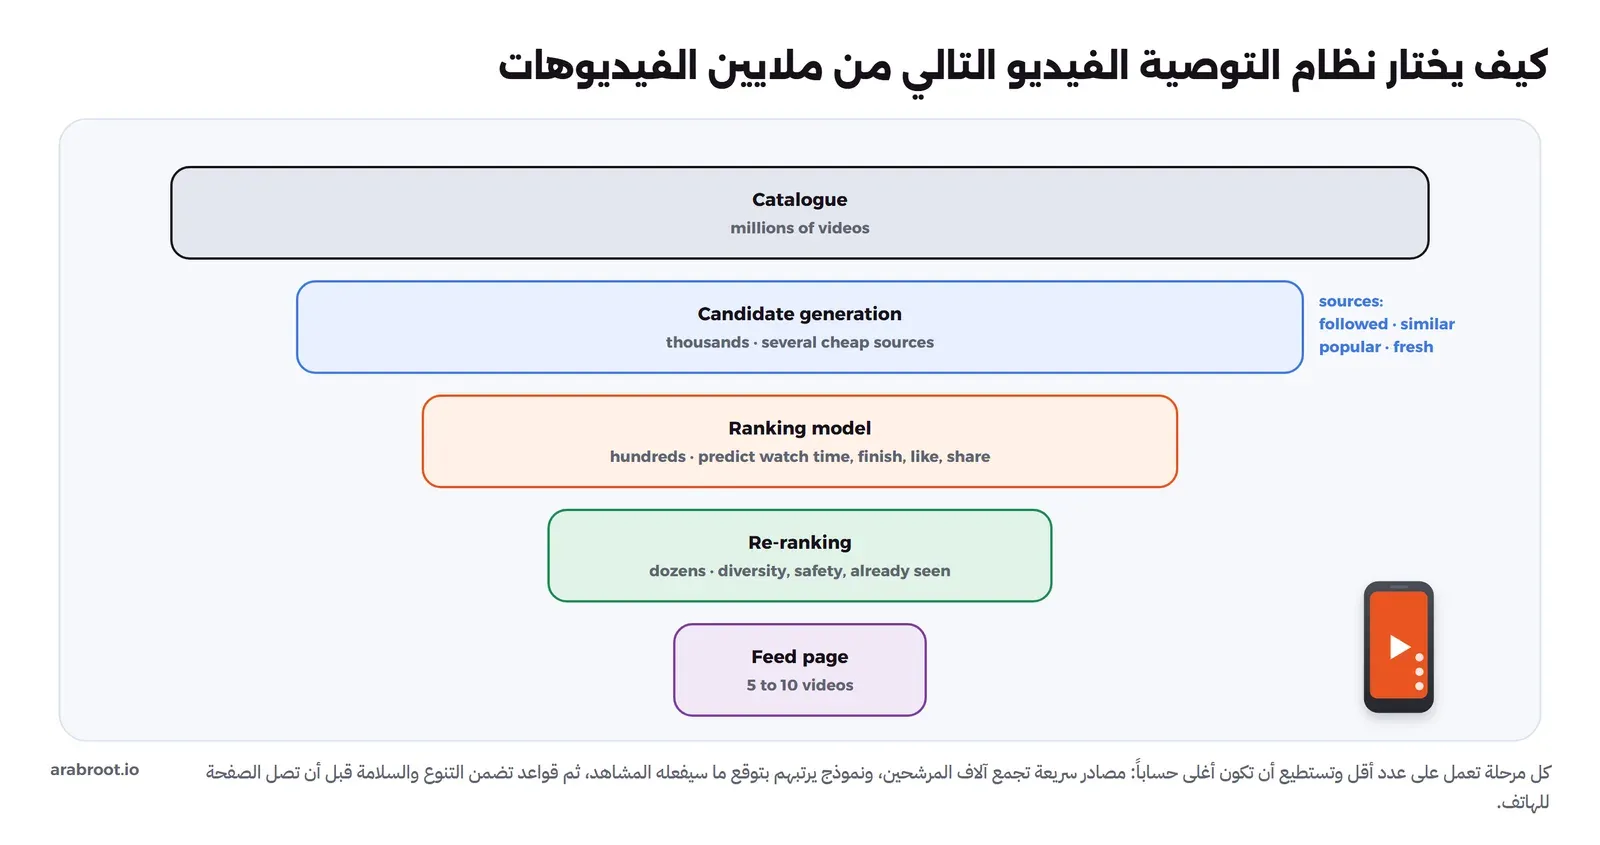
- توليد المرشحين Candidate Generation: عدة مصادر سريعة تجمع آلاف المقاطع، مثل مقاطع الحسابات التي يتابعها، والمقاطع القريبة في ال Embeddings مما أكمله مؤخراً، والمنتشرة في منطقته، ونسبة من المقاطع الجديدة التي تحتاج اختباراً.
- الترتيب Ranking: نموذج تعلم آلي يتوقع لكل مرشح احتمال أن يكمله المستخدم وأن يعجب به ويشاركه، ثم يجمعها في رقم واحد بأوزان تقررها المنصة، وقد شرحنا أساسيات النماذج والتقييم في التعلم الآلي للمبتدئين.
- إعادة الترتيب Re-ranking: قواعد بعد النموذج، مثل ألا يأتي مقطعان من نفس الصانع متتاليين، وحذف ما شوهد، وإدخال مقاطع للتنوع، واستبعاد ما لم ينته فحصه.
وما يميز الفيديو القصير أن الإشارات تصل بسرعة كبيرة، فكل مستخدم يعطي عشرات الإشارات في الدقيقة، وكلما تعلم النموذج منها أسرع كانت الخلاصة أفضل. وفي سبتمبر 2022 نشر مهندسون في ByteDance ورقة Monolith: Real Time Recommendation System With Collisionless Embedding Table، تشرح أن أطر التعلم العامة تفصل التدريب عن الخدمة فلا يتفاعل النموذج مع ردود المستخدمين في الوقت الحقيقي، وتقدم نظاماً للتدريب المستمر Online Training بجدول Embeddings لا تتصادم فيه المعرفات، مع حذف ال Embeddings القديمة وتجاهل النادرة لتوفير الذاكرة، وتذكر أن النظام يعمل في منتج BytePlus Recommend، ونشرت ByteDance كوده في مستودع bytedance/monolith وهو مؤرشف الآن. ولا تحتاج شيئاً من هذا في بدايتك، والسبب أن نظام التدريب المستمر يستحق ثمنه عندما يكون لديك ملايين المستخدمين يغيرون اهتماماتهم كل ساعة، أما في البداية فترتيب بسيط من الإشارات يتحدث كل دقيقة يكفي، كما في التجربة.
إشارات التفاعل: ماذا تقيس؟
الإشارات في الفيديو القصير كثيرة، وأغلبها لا يكتبه المستخدم وإنما يفعله، ومن أهمها:
- نسبة المشاهدة Watch Ratio: كم ثانية شوهدت من طول المقطع، وهي أهم إشارة لأنها تأتي من كل مشاهدة.
- الإكمال Completion وإعادة المشاهدة Rewatch: إكمال مقطع طويل إشارة قوية كما ذكرت TikTok، وإعادته أقوى.
- التخطي السريع Skip: سحب المقطع في أقل من ثانيتين إشارة سلبية.
- الإعجاب والتعليق والمشاركة والحفظ والمتابعة: أقل عدداً من المشاهدة، لكن كل منها أقوى، والمشاركة أقواها لأنها تقول إن المستخدم يضع اسمه على المقطع.
- «غير مهتم» والبلاغ: إشارات سلبية صريحة يجب أن تؤثر فوراً.
ولاحظ أن نسبة المشاهدة تحتاج تصحيحاً بحسب طول المقطع، فإكمال مقطع مدته 9 ثوان أسهل من إكمال مقطع مدته دقيقة، وأن المقاطع ذات المشاهدات القليلة تعطي نسباً متطرفة، فمقطع شاهده شخصان وأكملاه نسبة إكماله 100%، لذلك نسحب الأرقام القليلة نحو المتوسط، كما سترى في كود التجربة.
البداية الباردة Cold Start
البداية الباردة هي مشكلة الشيء الذي لا توجد عنه إشارات بعد، وهي هنا مشكلتان: مقطع جديد لم يشاهده أحد، ومستخدم جديد لا تعرف عنه شيئاً، والصورة التالية تبين الحل الشائع لكل منهما:
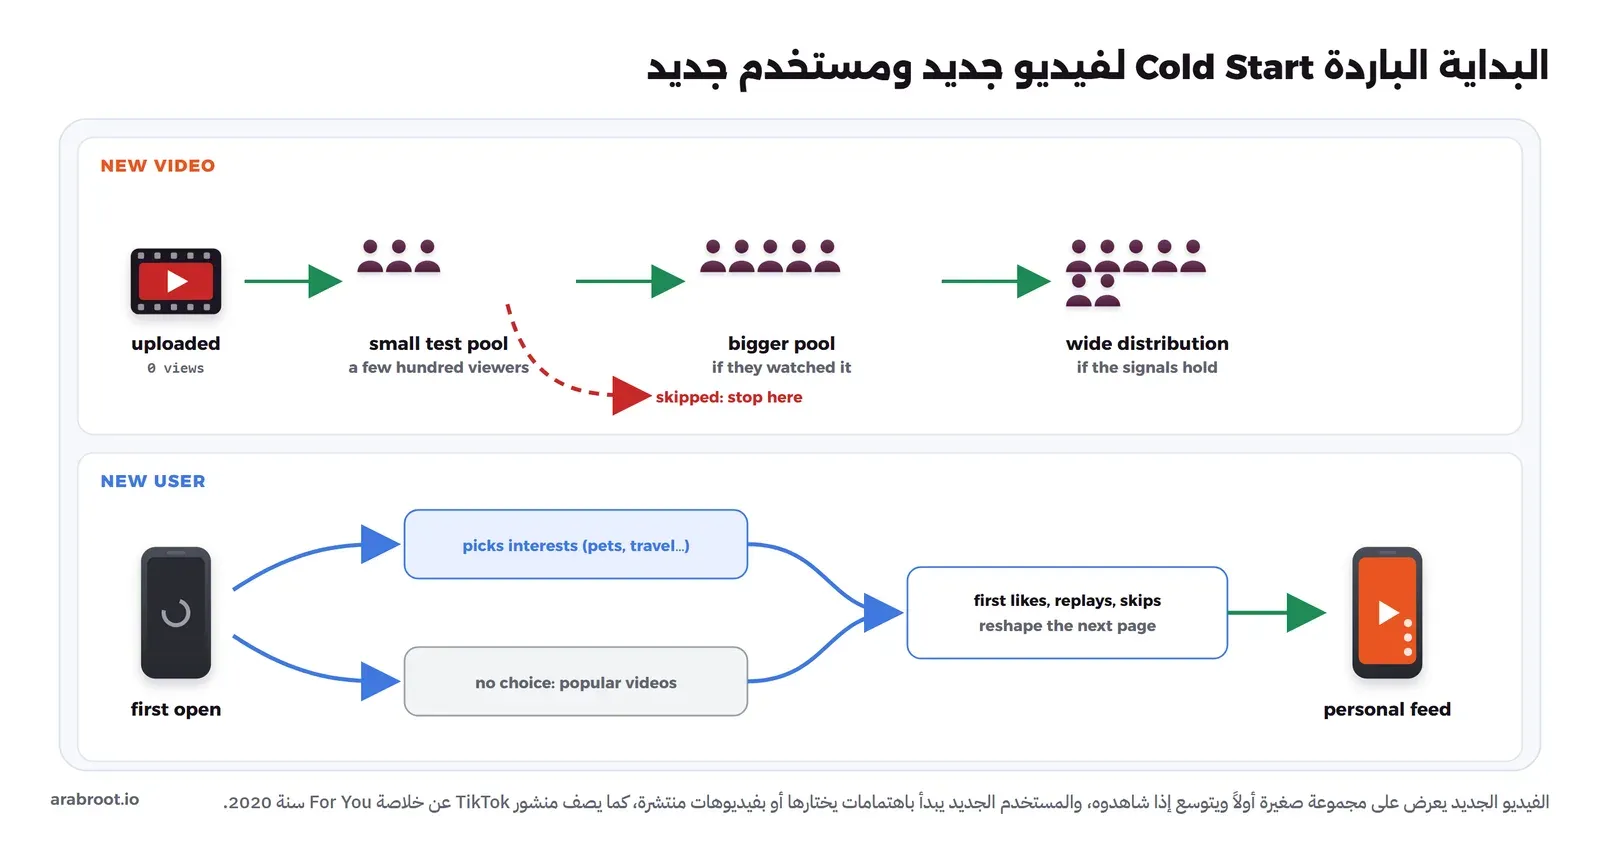
فالمقطع الجديد يحصل على مكان صغير ثابت في الخلاصة، مثل موضع من كل خمسة مواضع يخصص لمقاطع لم تختبر بعد، فإذا جاءت إشاراته الأولى جيدة ارتفع ترتيبه ووصل إلى مجموعة أكبر، وإذا سحبه الناس توقف. والمستخدم الجديد يبدأ من التصنيفات التي اختارها أو من المنتشر كما تصف TikTok، ثم تتعلم الخلاصة من أول جلسة.
مراجعة المحتوى: آلياً لكل رفع، وبشرياً لما لا يتضح
عندما يرفع الناس ملايين المقاطع يومياً لا يستطيع أي فريق أن يشاهدها كلها، ولا تستطيع أي آلة أن تفهمها كلها، لذلك تعمل المراجعة على طبقتين، والصورة التالية تبين ذلك:
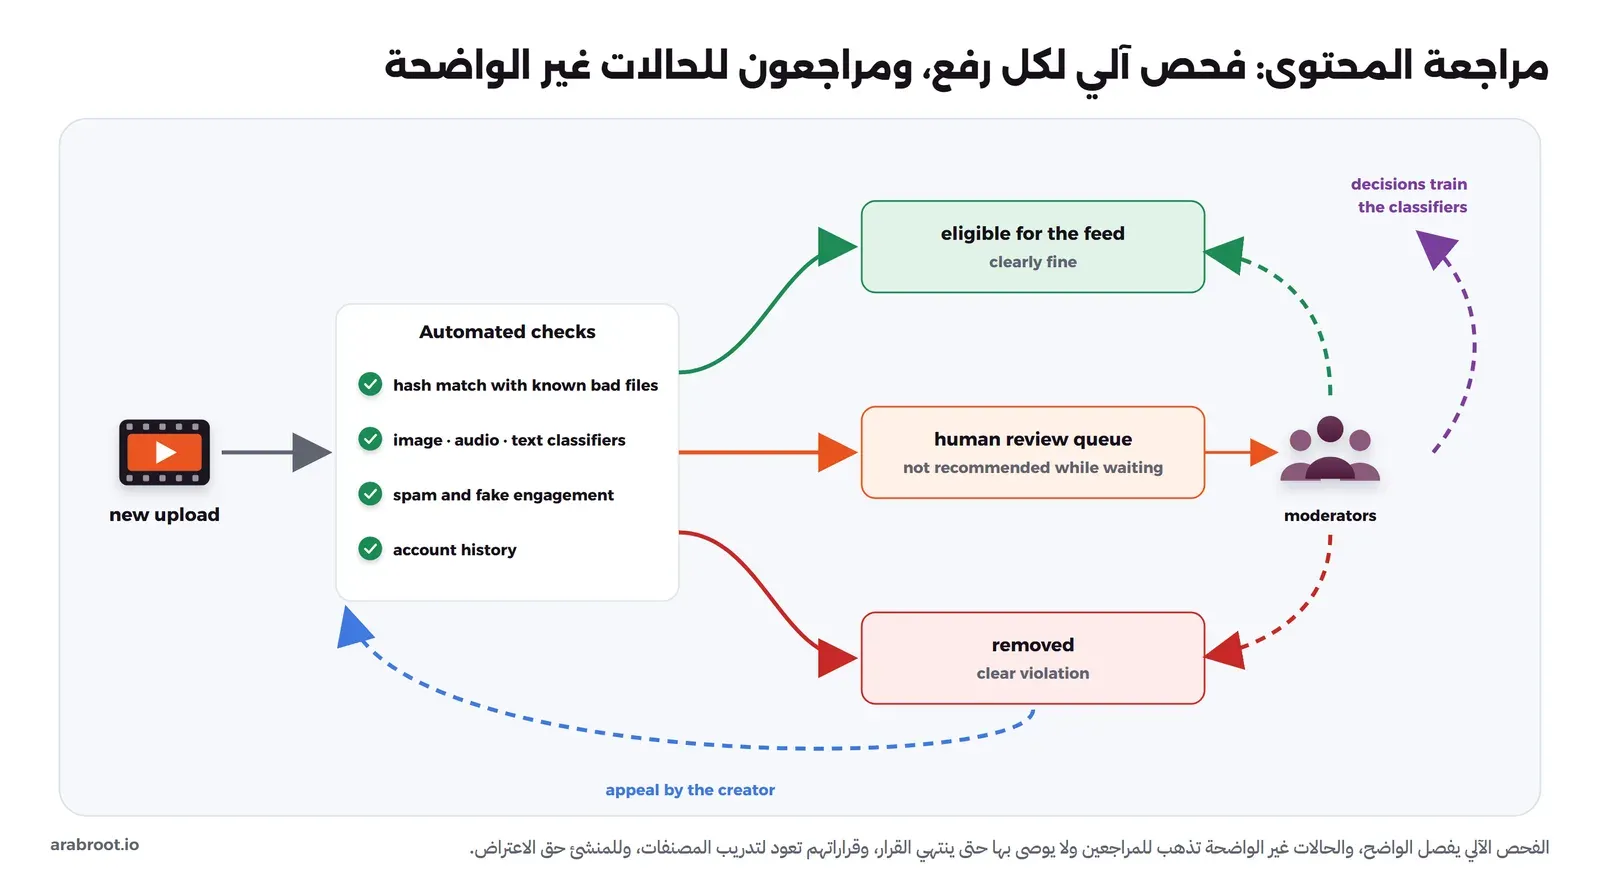
- مطابقة البصمات Hash Matching: مقارنة بصمة المقطع ببصمات محتوى ضار معروف مسبقاً، وأشهر أمثلتها تقنية PhotoDNA من Microsoft المستخدمة ضد صور استغلال الأطفال، وهي تمسك ما عرف من قبل فقط.
- المصنفات Classifiers: نماذج تقدر احتمال أن يكون المقطع عنيفاً أو مخالفاً، على عينات من الإطارات والصوت المحول إلى نص والوصف، وكل مصنف له نسبة خطأ، لذلك تحدد عتبتين: فوق الأولى يحذف، وبين الاثنتين يذهب للمراجعة.
- المراجعة البشرية: طابور بأولويات، فالمقطع الذي يصل إلى جمهور أكبر أو عليه بلاغات أكثر يراجع أولاً، والمقطع تحت المراجعة لا يوصى به، وهو ما ذكرته TikTok في منشورها.
- الاعتراض Appeal: الصانع يستطيع الاعتراض، وقرارات المراجعين تعود لتدريب المصنفات.
ولاحظ أن المراجعة جزء من تصميم الخلاصة نفسها وليست خدمة جانبية، فالمقطع لا يدخل مرحلة توليد المرشحين إلا بعد أن تنتهي فحوصه الضرورية، وهذا ما جعلنا نضعها في المهام الضرورية قبل النشر، وجعل الحالة review في نموذج البيانات تمنع التوصية به.
التخزين والتوصيل بحجم كبير
المقطع القصير صغير، لكن عددها كبير، وأغلبها يشاهد قليلاً جداً، وقليل منها ينتشر بقوة، وهذا الشكل يحدد قرارات التخزين والتوصيل:
- لا تصنع كل الجودات لكل مقطع فوراً، فاصنع جودتين عند النشر، وأضف جودة أعلى وترميزاً أحدث للمقاطع التي تبدأ في الانتشار فقط، لأن التوفير في النقل يستحق ثمن المعالجة الإضافية عندما يشاهد المقطع كثيراً، كما شرحنا في Per-Title Encoding.
- المقاطع القديمة التي لا يشاهدها أحد تنتقل إلى فئة تخزين أرخص بقواعد دورة الحياة Lifecycle، وقد شرحناها في أنواع التخزين.
- المقاطع المنتشرة تبقى في ال CDN، وأي مقطع يبدأ في الانتشار يمكن أن يرسل مسبقاً إلى نقاط ال CDN قبل أن يطلبه الناس.
- التحميل المسبق يضيف إلى فاتورة النقل كل بايت لا يشاهد، فاحسبه كما في التجربة، ونقل البيانات الخارج هو البند الأكبر كما شرحنا في التكاليف الخفية في السحابة.
MVP بأدوات مفتوحة المصدر
النسخة الأولى من تطبيق فيديو قصير لا تحتاج نظام توصية معقداً، وإنما هذه القطع: تطبيق هاتف بمشغل يدعم HLS ويحمل مسبقاً، ورفع بال tus أو S3 إلى تخزين كائنات مثل Garage، وطابور وعمال ffmpeg كما في تجربة منصة الفيديو، وقاعدة بيانات للمقاطع والمستخدمين، وValkey للعدادات السريعة والخلاصة، وجدول أحداث مشاهدة تجمع منه الإشارات كل دقيقة، ثم ترتيب بسيط كالذي في التجربة. وعندما تصبح لديك أحداث تكفي للتدريب، فأضف نموذج ترتيب يتدرب كل يوم، ثم Embeddings للمرشحين المتشابهين، ولا تبدأ بالخطوة الأخيرة، وهذا هو عمود MVP في جدول مراحل النمو.
تجربة عملية: معالجة مقطع وخلاصة بترتيب بسيط
الآن سوف نبني ثلاث قطع صغيرة: سكربت يعالج مقطعاً عمودياً كما يحدث بعد الرفع ويقيس الزمن والأحجام، وواجهة خلاصة تعيد الفيديوهات التالية لكل مستخدم مع روابط التحميل المسبق وترتبها بإشارات مخزنة في Valkey، ومحاكاة لكلفة التحميل المسبق. وكل البيانات في هذه التجربة اصطناعية Synthetic: مقاطع ومستخدمون ومشاهدات ولدها سكربت بأرقام عشوائية، فهي لفهم الفكرة وليست دليلاً على أي نظام حقيقي.
ملفات التجربة
FROM python:3.13.16-alpine3.24
RUN apk add --no-cache ffmpeg
RUN pip install --no-cache-dir redis==8.1.0
WORKDIR /app
COPY seed.py feed.py prefetch.py process.sh ./
name: lab-short
services:
valkey:
image: valkey/valkey:9.1.2-alpine
api:
build: .
image: lab-short-app:1
command: ["python", "feed.py"]
environment: { VALKEY_HOST: valkey }
ports: ["127.0.0.1:38960:8000"]معالجة مقطع عمودي
السكربت process.sh يولد مقطعاً بدقة 1080 في 1920 مدته 15 ثانية بدل المقطع المرفوع، ثم يصنع الصورة وشريط المعاينة، ثم جودتين HLS بمقاطع ثانيتين، ويطبع الزمن والأحجام:
# Fast processing of one uploaded short clip (vertical 1080x1920, 15 s):
# a poster, a 3-frame preview strip and two renditions as HLS with 2-second segments.
set -e
SRC=/work/clip.mp4; OUT=/work/out; rm -rf $OUT; mkdir -p $OUT
ffmpeg -hide_banner -loglevel error -y -f lavfi -i testsrc2=size=1080x1920:rate=30:duration=15 \
  -f lavfi -i sine=frequency=500:duration=15 -c:v libx264 -preset fast -crf 20 -pix_fmt yuv420p -c:a aac -shortest $SRC
now() { python -c "import time; print(time.time())"; }
start=$(now)
ffmpeg -hide_banner -loglevel error -y -ss 1 -i $SRC -frames:v 1 -vf scale=360:-2 $OUT/poster.jpg
ffmpeg -hide_banner -loglevel error -y -i $SRC -vf "fps=1/5,scale=180:-2,tile=3x1" -frames:v 1 $OUT/strip.jpg
t_images=$(now)
ffmpeg -hide_banner -loglevel error -y -i $SRC -filter_complex "[0:v]split=2[a][b];[a]scale=720:1280[v1];[b]scale=360:640[v2]" \
  -map "[v1]" -map 0:a -map "[v2]" -map 0:a \
  -c:v libx264 -preset veryfast -g 60 -keyint_min 60 -sc_threshold 0 -c:a aac -b:a 96k \
  -b:v:0 1800k -maxrate:v:0 2000k -bufsize:v:0 3600k -b:v:1 600k -maxrate:v:1 700k -bufsize:v:1 1200k \
  -f hls -hls_time 2 -hls_playlist_type vod -hls_segment_type fmp4 \
  -var_stream_map "v:0,a:0,name:720p v:1,a:1,name:360p" -master_pl_name master.m3u8 \
  -hls_segment_filename "$OUT/%v/seg%d.m4s" "$OUT/%v/index.m3u8"
end=$(now)
python -c "print(f'poster and strip: {$t_images - $start:.1f} s   two renditions: {$end - $t_images:.1f} s')"
ls -l $OUT/poster.jpg $OUT/strip.jpg | awk '{print $5, $9}'
for r in 720p 360p; do
  echo "$r: $(ls $OUT/$r/*.m4s | wc -l) segments, first $(stat -c %s $OUT/$r/seg0.m4s) bytes, total $(cat $OUT/$r/*.m4s | wc -c) bytes"
done
docker compose build
mkdir -p work
docker run --rm --name lab-short-process -v "$PWD/work:/work" lab-short-app:1 sh process.shوالمخرج سوف يكون كما يلي:
poster and strip: 1.8 s   two renditions: 10.0 s
15231 /work/out/poster.jpg
19124 /work/out/strip.jpg
720p: 8 segments, first 436902 bytes, total 3527239 bytes
360p: 8 segments, first 147573 bytes, total 1275323 bytes
لاحظ أن الصورة جاهزة بعد أقل من ثانيتين، وهي كافية لعرض المقطع في الخلاصة مع دائرة تحميل، بينما احتاجت الجودتان 10 ثوان لمقطع مدته 15 ثانية، وهذا هو سبب نشر المقطع بعد المهام الضرورية فقط. ولاحظ أن أول مقطع بدقة 360p حجمه 147,573 بايت، أي 144 كيلوبايت، وهو كل ما يحتاجه الهاتف ليبدأ التشغيل، وهو الرقم الذي نستخدمه في المحاكاة.
واجهة الخلاصة والترتيب
أولاً seed.py، وهو يولد 300 مقطع من 40 صانعاً في 8 تصنيفات، و3,000 مستخدم لكل منهم تصنيفان يحبهما ولا تعرفهما الخلاصة، ثم 120,000 مشاهدة اصطناعية، ويكتب العدادات في Valkey كما يفعل مسار الأحداث بعد تجميعها، ثم يضيف ثلاثة مقاطع جديدة لم يشاهدها أحد:
# SYNTHETIC data only: 300 videos, 40 creators, 8 topics, 3000 users with hidden tastes.
# It writes per-video counters (impressions, watch time, completions, rewatches, likes, shares, skips)
# and per-user topic affinities to Valkey, as an event pipeline would after aggregating real events.
import os, random
import redis

random.seed(7)
db = redis.Redis(host=os.environ["VALKEY_HOST"], decode_responses=True)
db.flushdb()
TOPICS = ["cooking", "football", "tech", "comedy", "travel", "cars", "quran", "gaming"]
videos = []
for v in range(300):
    videos.append({"id": f"v{v:03d}", "creator": f"c{v % 40:02d}", "topic": random.choice(TOPICS),
                   "length": random.choice([9, 15, 21, 30, 45, 60]),
                   "quality": random.betavariate(2, 3)})          # hidden: how good the video really is
users = [{"id": f"u{u:04d}", "likes": random.sample(TOPICS, 2)} for u in range(3000)]

pipe = db.pipeline()
for v in videos:
    pipe.hset(f"video:{v['id']}", mapping={"creator": v["creator"], "topic": v["topic"], "length": v["length"],
                                            "impressions": 0, "watch_s": 0, "complete": 0, "rewatch": 0,
                                            "like": 0, "share": 0, "skip": 0})
    pipe.zadd(f"topic:{v['topic']}", {v["id"]: 0})
pipe.execute()

for _ in range(120_000):                                       # 120k synthetic impressions
    u, v = random.choice(users), random.choice(videos)
    fit = 1.0 if v["topic"] in u["likes"] else 0.25
    p = v["quality"] * fit                                     # chance the viewer stays
    watched = v["length"] * min(1.0, random.random() ** (1 / (0.2 + 2 * p)))
    k = f"video:{v['id']}"
    pipe.hincrby(k, "impressions", 1)
    pipe.hincrbyfloat(k, "watch_s", round(watched, 1))
    if watched < 2: pipe.hincrby(k, "skip", 1)
    if watched >= v["length"] * 0.98:
        pipe.hincrby(k, "complete", 1)
        if random.random() < p * 0.4: pipe.hincrby(k, "rewatch", 1)
    if random.random() < p * 0.15: pipe.hincrby(k, "like", 1)
    if random.random() < p * 0.03: pipe.hincrby(k, "share", 1)
    # the user's taste: watching more than the usual 40% of a video counts for its topic, a skip counts against it
    pipe.zincrby(f"user:{u['id']}:topics", round(watched / v["length"] - 0.4, 3), v["topic"])
pipe.execute()
# three new videos that nobody has seen yet: the cold start case
for i, t in enumerate(["cooking", "tech", "travel"]):
    vid = f"new{i}"
    db.hset(f"video:{vid}", mapping={"creator": f"c9{i}", "topic": t, "length": 15, "impressions": 0, "watch_s": 0,
                                    "complete": 0, "rewatch": 0, "like": 0, "share": 0, "skip": 0})
    db.zadd(f"topic:{t}", {vid: 0}); db.sadd("fresh", vid)
print("seeded", db.dbsize(), "keys (synthetic)")
hit = sum(set(db.zrevrange(f"user:{u['id']}:topics", 0, 1)) == set(u["likes"]) for u in users)
print(f"hidden taste found in the top 2 topics for {hit / len(users):.0%} of users")
for u in users[1:3]: print(u["id"], "hidden taste:", u["likes"])
ثم واجهة الخلاصة feed.py:
# Feed API (toy ranking on SYNTHETIC signals).
#   GET  /feed?user=u0001&n=5   next videos for this user, with prefetch hints
#   POST /event                 {"user","video","watched_s","like","share"}: a watch event updates the counters now
import json, os
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from urllib.parse import urlparse, parse_qs
import redis

db = redis.Redis(host=os.environ["VALKEY_HOST"], decode_responses=True)
PRIOR_N = 20                    # smoothing: a video with few views is pulled toward the average
WEIGHTS = {"watch": 1.0, "complete": 0.8, "rewatch": 1.5, "like": 2.0, "share": 4.0, "skip": -1.0}

def stats(vid):
    h = db.hgetall(f"video:{vid}")
    n, length = int(h["impressions"]), float(h["length"])
    rate = lambda k, avg: (float(h[k]) + PRIOR_N * avg) / (n + PRIOR_N)
    s = {"watch": (float(h["watch_s"]) / length + PRIOR_N * 0.4) / (n + PRIOR_N),
         "complete": rate("complete", 0.2), "rewatch": rate("rewatch", 0.02),
         "like": rate("like", 0.03), "share": rate("share", 0.005), "skip": rate("skip", 0.2)}
    return h, n, sum(WEIGHTS[k] * s[k] for k in WEIGHTS)

def feed(user, size):
    taste = {t: s for t, s in db.zrevrange(f"user:{user}:topics", 0, -1, withscores=True) if s > 0}
    total = sum(taste.values()) or 1
    seen = db.smembers(f"user:{user}:seen")
    # 1) candidates: the user's two strongest topics, plus everything when we know nothing about him
    topics = list(taste)[:2] or [t.split(":")[1] for t in db.keys("topic:*")]
    pool = {v for t in topics for v in db.zrange(f"topic:{t}", 0, -1)} - seen
    pool |= set(db.srandmember("fresh", 3)) - seen          # new videos always get a chance
    # 2) score: video quality from signals x how much the user likes the topic
    scored = []
    for vid in pool:
        h, n, base = stats(vid)
        affinity = taste.get(h["topic"], 0) / total
        scored.append({"id": vid, "creator": h["creator"], "topic": h["topic"], "views": n,
                       "score": round(base * (0.5 + affinity), 3), "why": "ranked"})
    scored.sort(key=lambda x: -x["score"])
    # 3) exploration: slot 3 of every page goes to a video with fewer than 50 views
    fresh = [x for x in scored if x["views"] < 50]
    # 4) re-rank: never the same creator twice in a row
    page, last = [], None
    for x in scored:
        if len(page) == size: break
        if len(page) == 2 and fresh:
            f = fresh.pop(0); f["why"] = "explore"; page.append(f); last = f["creator"]
            if f is x: continue
        if x["creator"] == last or x in page: continue
        page.append(x); last = x["creator"]
    db.sadd(f"user:{user}:seen", *[x["id"] for x in page])
    for x in page:
        x["hls"] = f"/media/{x['id']}/master.m3u8"
        x["first_segment"] = f"/media/{x['id']}/360p/seg0.m4s"
    return {"user": user, "items": page,
            "prefetch": [x["first_segment"] for x in page[1:3]]}   # start downloading the next two now

def event(e):
    k = f"video:{e['video']}"
    length = float(db.hget(k, "length"))
    w = float(e["watched_s"])
    p = db.pipeline()
    p.hincrby(k, "impressions", 1); p.hincrbyfloat(k, "watch_s", w)
    if w < 2: p.hincrby(k, "skip", 1)
    if w >= length * 0.98: p.hincrby(k, "complete", 1)
    if w > length: p.hincrby(k, "rewatch", 1)
    if e.get("like"): p.hincrby(k, "like", 1)
    if e.get("share"): p.hincrby(k, "share", 1)
    p.zincrby(f"user:{e['user']}:topics", round(min(w / length, 1.0) - 0.4, 3), db.hget(k, "topic"))
    p.execute()

class H(BaseHTTPRequestHandler):
    def send(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code); self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data))); self.end_headers(); self.wfile.write(data)
    def do_GET(self):
        q = parse_qs(urlparse(self.path).query)
        self.send(200, feed(q["user"][0], int(q.get("n", ["5"])[0])))
    def do_POST(self):
        event(json.loads(self.rfile.read(int(self.headers["Content-Length"]))))
        self.send(202, {"ok": True})
    def log_message(self, *a): pass

ThreadingHTTPServer(("0.0.0.0", 8000), H).serve_forever()
في الكود أعلاه لاحظ التالي:
- الدالة
statsتسحب كل نسبة نحو متوسط افتراضي كأن كل مقطع شوهد 20 مرة إضافية بالمتوسط، فلا يتصدر مقطع شاهده شخصان وأكملاه. - الأوزان في
WEIGHTSتعطي المشاركة أكبر وزن والتخطي وزناً سالباً، وهي أرقام اخترناها للتجربة، وفي الإنتاج يتعلمها نموذج ويختبرها اختبار A/B. - المرشحون من أقوى تصنيفين عند المستخدم، والمقاطع الجديدة تضاف دائماً، وهذه هي مرحلة توليد المرشحين في أبسط صورها.
- الموضع الثالث من كل صفحة لمقطع له أقل من 50 مشاهدة، وهذا هو حل البداية الباردة للمقطع الجديد.
- لا يأتي مقطعان متتاليان من نفس الصانع، وكل ما يعرض يضاف إلى قائمة ما شوهد فلا يتكرر، كما تصف TikTok.
- الرد يحمل روابط المقطع الأول لثاني وثالث مقطع في الصفحة، فيبدأ الهاتف تحميلهما أثناء تشغيل الأول.
وأخيراً show.py الذي يطبع صفحة الخلاصة سطراً لكل مقطع:
# prints a feed page as one line per video
import json, sys, urllib.request
user = sys.argv[1]
page = json.load(urllib.request.urlopen(f"http://127.0.0.1:38960/feed?user={user}&n=5"))
for x in page["items"]:
    print(f"{x['id']:6} {x['topic']:9} {x['creator']}  views={x['views']:<4} score={x['score']:.3f}  {x['why']}")
print("prefetch:", " ".join(page["prefetch"]))
نشغل الواجهة، ونولد البيانات، ونقارن ما تعلمته الخلاصة عن مستخدمين بما يحبانه فعلاً، ثم نطلب صفحتين للأول وصفحة للثاني:
docker compose up -d
docker compose exec api python seed.py
for u in u0001 u0002; do echo "$u learned: $(docker exec lab-short-valkey-1 valkey-cli ZREVRANGE user:$u:topics 0 2 WITHSCORES \
  | paste - - | awk '{printf "%s %.2f  ", $1, $2}')"; done
python show.py u0001; python show.py u0001; python show.py u0002
seeded 3312 keys (synthetic)
hidden taste found in the top 2 topics for 33% of users
u0001 hidden taste: ['cooking', 'cars']
u0002 hidden taste: ['quran', 'cars']
u0001 learned: cooking 0.36 cars 0.35 travel -0.04
u0002 learned: cars 0.98 quran 0.43 gaming 0.27
v183 cooking c23 views=400 score=0.591 ranked
v016 cars c16 views=424 score=0.530 ranked
new0 cooking c90 views=0 score=0.473 explore
v275 cooking c35 views=396 score=0.503 ranked
v161 cooking c01 views=389 score=0.422 ranked
prefetch: /media/v016/360p/seg0.m4s /media/new0/360p/seg0.m4s
v032 cooking c32 views=414 score=0.415 ranked
v030 cars c30 views=402 score=0.399 ranked
new1 tech c91 views=0 score=0.235 explore
v010 cars c10 views=382 score=0.380 ranked
v231 cooking c31 views=389 score=0.370 ranked
prefetch: /media/v030/360p/seg0.m4s /media/new1/360p/seg0.m4s
v016 cars c16 views=428 score=0.539 ranked
v030 cars c30 views=402 score=0.406 ranked
new1 tech c91 views=0 score=0.268 explore
v010 cars c10 views=382 score=0.386 ranked
v140 quran c20 views=382 score=0.344 ranked
prefetch: /media/v030/360p/seg0.m4s /media/new1/360p/seg0.m4sفي المخرج أعلاه لاحظ التالي:
- الخلاصة عرفت التصنيفين الحقيقيين للمستخدمين u0001 وu0002 من مشاهداتهما فقط، لكنها عرفتهما بدقة عند 33% فقط من كل المستخدمين، والسبب أن كل مستخدم له قرابة 40 مشاهدة عشوائية موزعة على 8 تصنيفات، أي 5 مشاهدات لكل تصنيف، وهذا قليل جداً، وهو درس البداية الباردة للمستخدم بالأرقام: الاهتمامات التي يختارها المستخدم في البداية تختصر عشرات المشاهدات.
- الصفحة الثانية لم تكرر شيئاً من الأولى، والموضع الثالث في كل صفحة لمقطع جديد بعلامة
exploreرغم أن ترتيبه أقل، وأحدها في تصنيف لا يحبه المستخدم أصلاً، وهذا هو التنوع المقصود. - لا يوجد مقطعان متتاليان من نفس الصانع، ورابطا التحميل المسبق هما المقطع الأول لثاني وثالث مقطع في الصفحة.
مقطع جديد يكسب جمهوره
السكربت cold.py يرسل أحداث 60 مشاهداً اصطناعياً حصلوا على المقطعين الجديدين new1 وnew2 في موضع الاستكشاف، فالأول أكمله أغلبهم وأعجب به بعضهم، والثاني سحبوه بعد ثانية:
# Cold start: 60 synthetic viewers get new1 and new2 through the exploration slot.
# new1 is mostly watched to the end (a few like and share it); new2 is skipped after one second.
import json, random, urllib.request
random.seed(5)
def post(e):
    req = urllib.request.Request("http://127.0.0.1:38960/event", json.dumps(e).encode(),
                                 {"Content-Type": "application/json"})
    urllib.request.urlopen(req).read()
for i in range(60):
    user = f"u{1000 + i:04d}"
    post({"user": user, "video": "new1", "watched_s": random.choice([15, 15, 15, 15, 22, 9, 6, 4]),
          "like": random.random() < .15, "share": random.random() < .04})
    post({"user": user, "video": "new2", "watched_s": 1.0})
print("posted 120 synthetic events")
python cold.py
for v in new1 new2; do echo "$v: $(docker exec lab-short-valkey-1 valkey-cli HMGET video:$v impressions complete rewatch like share skip | tr '\n' ' ')"; done
docker exec lab-short-valkey-1 valkey-cli ZREVRANGE user:u0079:topics 0 1
python show.py u0079posted 120 synthetic events
new1: 60 39 10 11 3 0
new2: 60 0 0 0 0 60
tech
quran
new1 tech c91 views=60 score=1.949 ranked
v245 tech c05 views=435 score=0.605 ranked
new0 cooking c90 views=0 score=0.264 explore
v209 tech c09 views=380 score=0.575 ranked
v291 tech c11 views=419 score=0.561 ranked
prefetch: /media/v245/360p/seg0.m4s /media/new0/360p/seg0.m4sالمقطع new1 أكمله 39 من 60 وأعاده 10 وأعجب به 11، فصار أول الخلاصة لمستخدم يحب التصنيف tech بترتيب عادي وليس استكشافاً، أما new2 فسحبه الستون كلهم بسرعة فلم يظهر. ولاحظ الخطر في هذا الرقم: 60 مشاهدة عينة صغيرة، وإشاراتها هنا أقوى بكثير من متوسط المكتبة لأننا كتبناها بأيدينا، لذلك ترفع المنصات المقطع الجديد إلى مجموعة أكبر على مراحل ثم تعيد القياس، بدل أن تعطيه الصدارة لكل المستخدمين بعد أول دفعة.
كم يكلف التحميل المسبق؟
المحاكاة prefetch.py تأخذ حجم أول مقطع من خطوة المعالجة، وتفترض اتصال هاتف بسرعة 4 ميجابت في الثانية وزمن ذهاب وعودة 80 مللي ثانية، وسلوك مشاهدة اصطناعياً: 45% يسحبون خلال ثانيتين، و35% يشاهدون جزءاً، و20% يكملون، وبعد كل مقطع احتمال 8% أن يغلق المستخدم التطبيق:
# Prefetch trade-off on SYNTHETIC swipes: how long the viewer waits after a swipe, and how many bytes
# are downloaded but never watched, for a prefetch depth of 0 to 3 videos.
# Segment size comes from the real encode in process.sh (360p, first 2-second segment).
import random, sys
random.seed(3)
SEG = int(sys.argv[1])               # bytes of the first 360p segment
MBPS, RTT = 4.0, 0.08                # a mid mobile connection: 4 Mbit/s, 80 ms round trip
fetch = lambda b: RTT + b * 8 / (MBPS * 1e6)
# synthetic viewing: 45% swipe within 2 s, 35% watch part of it, 20% watch to the end (15 s clips)
def watch_time():
    r = random.random()
    return random.uniform(0.3, 2) if r < .45 else random.uniform(2, 14) if r < .8 else 15.0
print(f"first segment {SEG / 1024:.0f} KiB, fetch on demand {fetch(SEG) * 1000:.0f} ms")
LEAVE = 0.08                         # after each video, 8% chance the user closes the app
print("depth  wait after swipe (avg / p95)   prefetched but never played, per session")
for depth in range(4):
    random.seed(11)
    waits, wasted, sessions = [], 0, 2000
    for _ in range(sessions):
        cached, i = set(), 0
        while True:
            w = watch_time()
            waits.append(0.0 if i in cached else fetch(SEG))
            cached.discard(i)
            # while video i plays, fetch the first segment of the next `depth` videos if there is time
            budget = w
            for j in range(i + 1, i + 1 + depth):
                if j not in cached and budget >= fetch(SEG):
                    cached.add(j); budget -= fetch(SEG)
            if random.random() < LEAVE:
                wasted += len(cached) * SEG          # downloaded, never played
                break
            i += 1
    w = sorted(waits)
    print(f"  {depth}    {sum(w) / len(w) * 1000:6.0f} ms / {w[int(.95 * len(w))] * 1000:4.0f} ms"
          f"            {wasted / sessions / 1024:6.0f} KiB")
docker compose exec api python prefetch.py 147573first segment 144 KiB, fetch on demand 375 ms
depth wait after swipe (avg / p95) prefetched but never played, per session
0 375 ms / 375 ms 0 KiB
1 38 ms / 375 ms 141 KiB
2 32 ms / 375 ms 283 KiB
3 31 ms / 375 ms 423 KiBبلا تحميل مسبق ينتظر المستخدم 375 مللي ثانية بعد كل سحبة، وهذا انتظار يلاحظه، ومقطع واحد مسبق خفض المتوسط إلى 38 مللي ثانية مقابل 141 كيلوبايت لا تشاهد في كل جلسة، ثم كل مقطع إضافي يزيد الهدر بنفس المقدار ولا يحسن الانتظار إلا مللي ثانية واحدة. والنسبة 95% بقيت 375 لأن أول مقطع في كل جلسة لا يمكن تحميله مسبقاً بهذه الطريقة، ولهذا تعيد بعض التطبيقات أول مقطع مع رد الخلاصة نفسه أو تبقيه محفوظاً من الجلسة السابقة. وغير الأرقام في السكربت بحسب مستخدميك، فعلى شبكة أبطأ يصبح المقطع الثاني المسبق أكثر قيمة.
حذف المختبر
docker compose down -v
docker image rm lab-short-app:1
rm -rf work
أخطاء شائعة
- ترتيب الخلاصة بعدد الإعجابات أو المتابعين فقط، فيأخذ المشهورون كل شيء ولا يجد المقطع الجيد من صانع جديد أي مشاهد، وTikTok تقول صراحة إن عدد المتابعين ليس عاملاً مباشراً.
- نسب المشاهدة دون تصحيح للمقاطع قليلة المشاهدات أو لطول المقطع.
- تحميل مسبق لعدة مقاطع كاملة بأعلى جودة، فتدفع على بيانات لا تشاهد ويستنزف المستخدم باقته.
- نشر المقطع قبل انتهاء فحوص السلامة، أو التوصية بمقطع تحت المراجعة.
- خلاصة تعرض نفس الصانع أو نفس النوع مرات متتالية، فيمل المستخدم حتى لو كانت كل المقاطع مناسبة له.
- بناء نظام تدريب مستمر قبل أن يكون لديك ما يكفي من المستخدمين والأحداث.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- تطبيق الفيديو القصير مساران حول الهاتف: مسار للرفع والمعالجة والتوصيل، ومسار يأخذ كل ثانية مشاهدة ويعيدها توصيات.
- عالج على الهاتف قبل الرفع، وارفع بطريقة قابلة للاستئناف، وانشر بعد الجودات والصورة وفحوص السلامة فقط، وفي التجربة جهزت الصورة في أقل من ثانيتين والجودتان في 10 ثوان.
- حمل بداية المقطع التالي مسبقاً بالجودة المنخفضة، فمقطع واحد مسبق أزال أغلب الانتظار في المحاكاة، وكل مقطع إضافي أضاف هدراً تقريباً دون فائدة.
- التوصية مراحل: مرشحون من مصادر سريعة، ثم ترتيب يتوقع ما سيفعله المشاهد، ثم قواعد للتنوع والسلامة وما شوهد، والإشارة الأقوى هي ما يفعله المستخدم لا ما يكتبه.
- البداية الباردة تحل بموضع ثابت للمقاطع الجديدة وتوسيع جمهورها على مراحل، وباهتمامات يختارها المستخدم الجديد بدل عشرات المشاهدات.
- المراجعة آلية لكل رفع وبشرية لما لا يتضح، والمقطع تحت المراجعة لا يوصى به.
وبهذا نكون قد بنينا الأنواع الثلاثة من تطبيقات الفيديو في هذا القسم، وفي الأدلة القادمة بإذن الله نشرح تثبيت المنصات الجاهزة منها خطوة بخطوة:
 دليلكيف تبني منصة فيديو عند الطلب مثل Netflixكيف يتحول فيديو مرفوع إلى بث يناسب كل شاشة وسرعة اتصال، وما الذي تحتاجه منصتك من التحويل إلى التوصيل والتكلفة.
 دليلكيف تبني تطبيق بث مباشر مثل Jaco وTwitchكيف يصل بث المذيع إلى آلاف المشاهدين بتأخير ثانية أو ثانيتين، ومعه دردشة وهدايا لا تتوقف عند الذروة.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلالتكاليف الخفية في السحابة وكيف تخفضهاالبنود التي لا تظهر في حساب يوم التصميم ثم تملأ فاتورة السحابة بعد أشهر، وكيف تحسب كل بند وتخفضه.
سجل التحديثات
- أكتوبر 2026: إضافة قسم المعمارية الكاملة: المخطط والمكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو.
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع FFmpeg 8.1.2 وValkey 9.1.2 وPython 3.13.16 مع redis-py 8.1.0، ببيانات مشاهدة اصطناعية.


