

في مقال أنظمة التوصية للمبتدئين شرحنا الأفكار: الأكثر شعبية كخط أساس، وتشابه العناصر Item-item، وتحليل المصفوفة ALS، والتقسيم بالزمن، ومقاييس precision@k وNDCG. والآن لنفرض أن مديرك طلب منك قائمة «قد يعجبك أيضاً» في التطبيق خلال أسبوعين، فمن أين تبدأ؟ هل تكتب نموذجاً عميقاً؟ وكيف تعرف أن ما بنيته أفضل من قائمة الأكثر مبيعاً؟ وكيف ترد على الطلب في بضع ملي ثوان والنموذج يحتاج ثانية ليتدرب؟
في هذا المقال سوف نبني نظام توصية كاملاً على سيرفرك من الصفر، على بيانات أفلام حقيقية، بالأدوات الأبسط التي تكفي لأغلب الشركات في بدايتها، وكل رقم فيه من تشغيل حقيقي. وسوف نناقش ما يلي:
- البيانات ورخصتها، وتجهيز بيئة Python ثابتة الإصدارات في Docker.
- تقسيم البيانات بالزمن، ثم ثلاث طرق على نفس الاختبار: الأكثر شعبية، وتشابه العناصر بجيب التمام Cosine، وALS من مكتبة implicit، بمقاييس precision@10 وrecall@10 وNDCG@10.
- ضبط ALS بالطريقة الصحيحة على بيانات تحقق Validation منفصلة.
- نكسر التجربة عمداً: التقسيم العشوائي وتسرب البيانات Data Leakage بالأرقام.
- الخدمة: تدريب ليلي يكتب المرشحين في Redis، وواجهة FastAPI تقرأ منها، مع حل البداية الباردة Cold Start وتحديث لحظي بعد كل إعجاب، وقياس زمن الاستجابة.
- المعمارية الكاملة في الإنتاج: الأدوات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو وما يحدث عندما يتعطل كل جزء.
- كيف يكبر هذا النظام إلى الاسترجاع Retrieval ثم الترتيب Ranking، ومتى تستخدم Gorse بدل أن تبني.
 دليلأنظمة التوصية Recommender Systems للمبتدئينكيف تعرف المتاجر ومنصات الفيديو ما قد يعجبك، وما الفرق بين طرق التوصية، وكيف تقيس جودتها قبل أن تصل للمستخدم.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلكيف تبني تطبيق فيديو قصير مثل TikTokكيف يجهز تطبيق الفيديو القصير المقطع التالي قبل أن تسحب الشاشة، وكيف يختار ما يناسبك من إشارات المشاهدة.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
المعمارية الكاملة: ماذا سنبني وكيف تتصل الأجزاء؟
الفكرة الأساسية في أغلب أنظمة التوصية الصغيرة والمتوسطة أن الحساب الثقيل لا يحدث أثناء الطلب، وإنما في مهمة دورية، والطلب يقرأ نتيجة جاهزة ويضيف إليها آخر ما فعله المستخدم، والصورة التالية تبين ما سنبنيه:
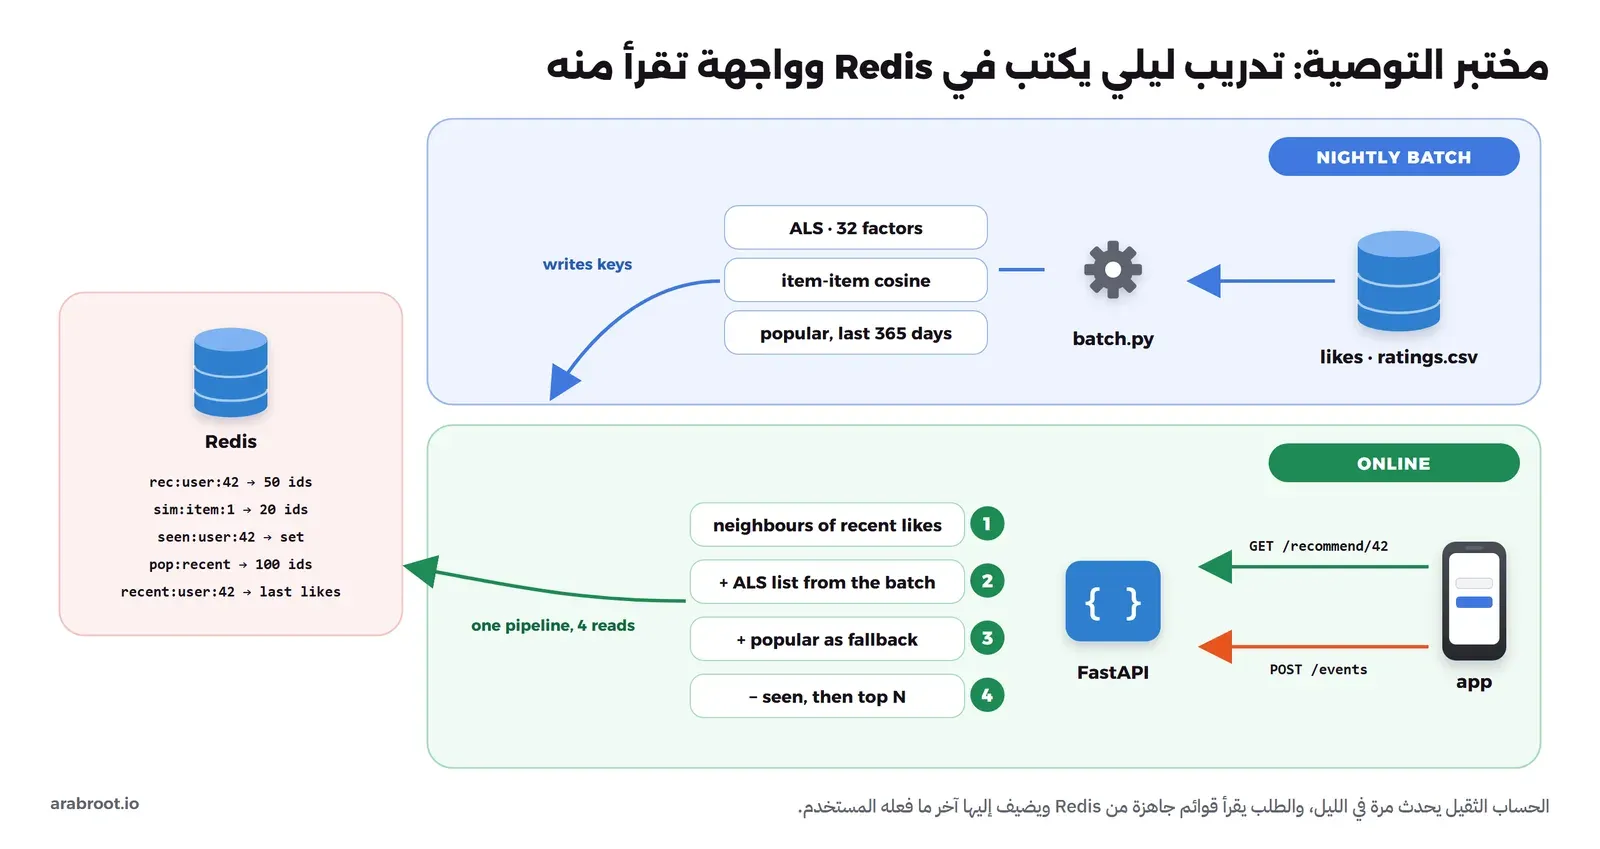
- مهمة ليلية batch.py تقرأ كل الإعجابات، وتدرب ALS، وتحسب لكل فيلم أقرب 20 فيلماً، وتحسب الأكثر شعبية، ثم تكتب كل ذلك في Redis.
- واجهة FastAPI ترد على GET /recommend/{user} بقراءة هذه القوائم، وتخلطها مع جيران آخر ما أعجب المستخدم، وتحذف ما شاهده.
- التطبيق يرسل كل إعجاب إلى POST /events، فيظهر أثره في القائمة التالية مباشرة دون انتظار الليل.
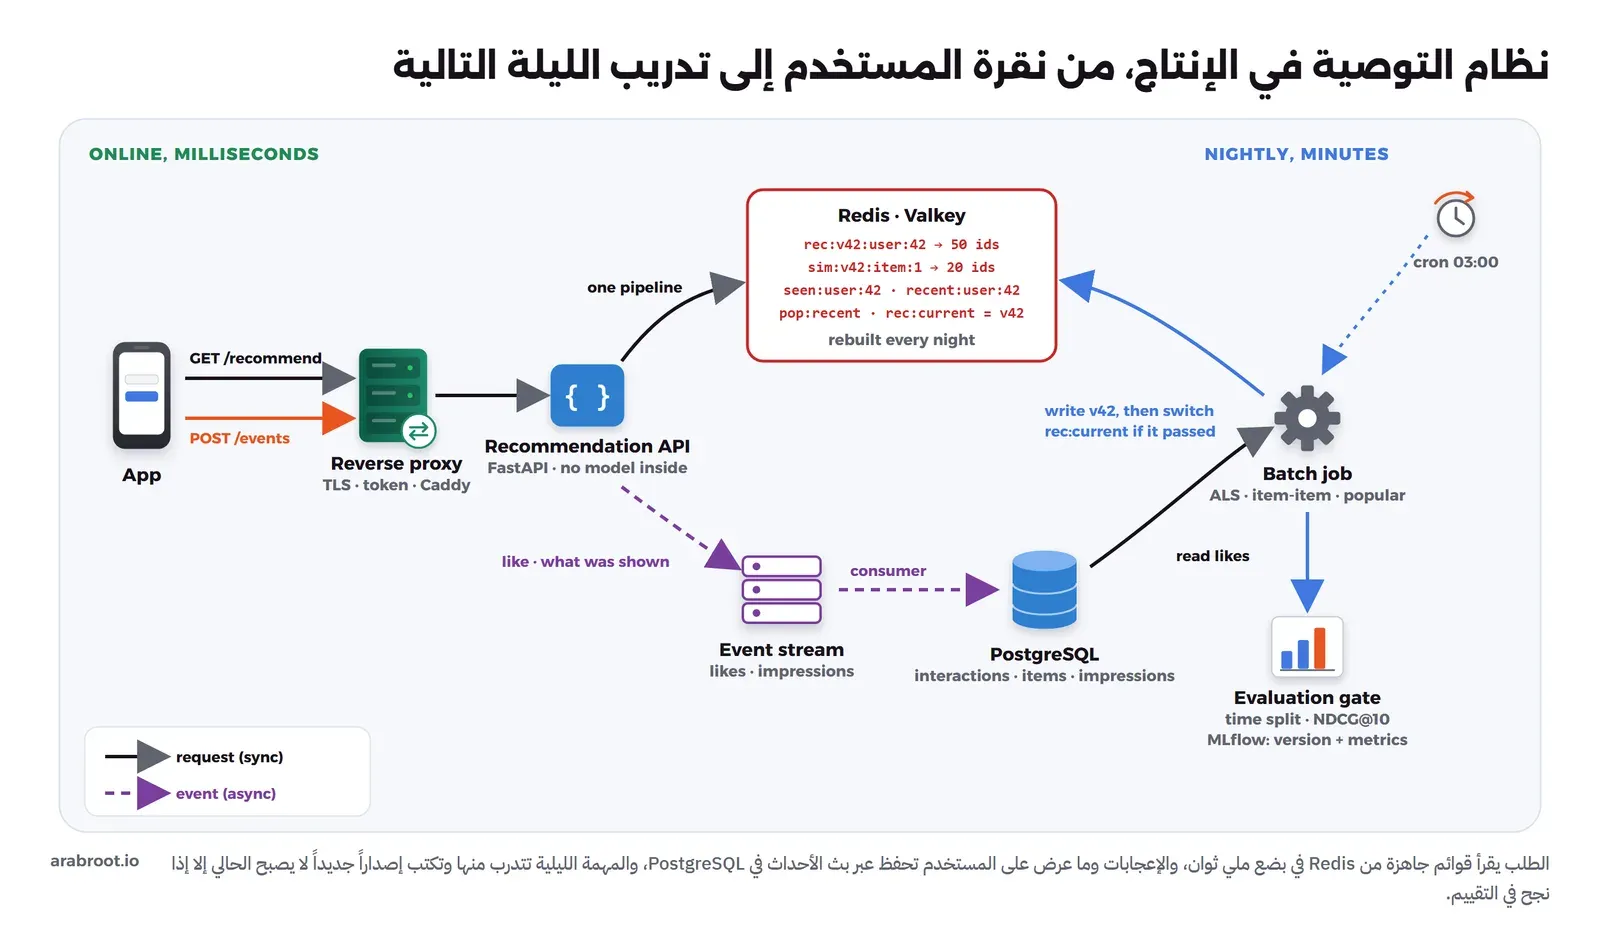
وهذا ما سوف نبنيه في المختبر على جهاز واحد، أما في الإنتاج فيضاف حوله ما يجعله يعمل كل يوم دون أن تراقبه: طريق دائم للأحداث حتى تدخل في تدريب الليلة التالية، وتسجيل ما عرض على المستخدم، وتقييم يمنع النموذج السيئ من الوصول إلى المستخدمين، وإصدارات للمفاتيح حتى لا يرى المستخدم نصف قائمة قديمة ونصفها جديد. والصورة التالية تبين النظام كاملاً، والخط المتصل فيها طلب ينتظر رداً Sync، والخط المتقطع حدث يرسل ولا ينتظر Async:
المكونات والأدوات المقترحة
| المكون | مسؤوليته | أداة مفتوحة المصدر مقترحة | لماذا هي |
|---|---|---|---|
| Reverse Proxy | TLS والتحقق من توكن التطبيق وحد الطلبات | Caddy (Apache-2.0) | شهادات تلقائية وإعداد قصير، والواجهة نفسها لا تعرف شيئاً عن TLS |
| واجهة التوصية | قراءة القوائم وخلطها وحذف ما شوهد وتسجيل ما عرض | FastAPI (MIT) مع uvicorn، كما في المختبر | غير متزامنة، فتنتظر Redis دون أن تحجز خيطاً لكل طلب، ولا تحمل أي نموذج |
| مخزن المرشحين | قوائم كل مستخدم وجيران كل عنصر والأكثر شعبية وآخر الإعجابات | Redis 8 (RSALv2 أو SSPLv1 أو AGPLv3) أو Valkey (BSD-3-Clause) بنفس الكود | كل طلب قراءة لمفاتيح معروفة من الذاكرة، وإذا ضاع يعاد بناؤه من المهمة الليلية |
| بث الأحداث | نقل الإعجابات وما عرض من الواجهة إلى المخزن الدائم | Valkey Streams في البداية، ثم Apache Kafka (Apache-2.0) | الواجهة لا تنتظر قاعدة البيانات، والحدث لا يضيع إذا تأخر المستهلك |
| المخزن الدائم | الإعجابات والعناصر وما عرض، وهي مصدر الحقيقة للتدريب | PostgreSQL (PostgreSQL License) | جداولك الأخرى فيه أصلاً، والتدريب يقرأ منه باستعلام واحد كما ناقشنا في قسم التخزين أدناه |
| المهمة الليلية | التدريب وحساب الجيران والأكثر شعبية وكتابة إصدار جديد | implicit (MIT) مع pandas وSciPy، تشغلها cron أو Apache Airflow (Apache-2.0) | cron يكفي لمهمة واحدة، وAirflow عندما تصبح المهام سلسلة تعتمد كل خطوة فيها على التي قبلها |
| التقييم وسجل النماذج | حفظ أرقام كل تدريب وإصداره، ومنع النشر إذا ساءت الأرقام | MLflow (Apache-2.0) | تعرف أي نموذج يخدم الآن، وبأي أرقام، وترجع إلى الإصدار السابق بسطر واحد |
| البحث بالتشابه ANN لاحقاً | أقرب العناصر من بين ملايين بدل حساب الدرجات لكل عنصر | pgvector (PostgreSQL License) أو Qdrant (Apache-2.0) | pgvector داخل نفس قاعدة البيانات، وQdrant عندما يكبر عدد المتجهات |
| المراقبة | زمن الاستجابة p99 ونسبة الطلبات التي ذهبت إلى قائمة الاحتياط وعمر آخر تدريب | Prometheus (Apache-2.0) مع Grafana (AGPL-3.0) | تنبيه إذا لم يكتمل تدريب الليلة، قبل أن يلاحظ أحد أن القوائم لم تتغير منذ أسبوع |
نموذج البيانات
المفاتيح في Redis هي نفس مفاتيح المختبر مع بادئة الإصدار التي اقترحناها في قسم التدريب الليلي أدناه، والجداول في PostgreSQL هي الأعمدة نفسها التي يقرؤها المختبر من ملف ratings.csv:
-- lab: movie:title
CREATE TABLE items (
    item_id bigint PRIMARY KEY, title text NOT NULL, created_at timestamptz NOT NULL, active boolean NOT NULL DEFAULT true
);

-- the source of truth for training (lab: ratings.csv with userId, movieId, rating, timestamp; rating >= 4 = like)
CREATE TABLE interactions (
    event_id  uuid PRIMARY KEY,                 -- sent by the app, so a retried POST /events is stored once
    user_id   text   NOT NULL,
    item_id   bigint NOT NULL REFERENCES items(item_id),
    event     text   NOT NULL CHECK (event IN ('like', 'view', 'purchase')),
    ts        timestamptz NOT NULL
);
CREATE INDEX ON interactions (ts);              -- the nightly job and the time split read by time

-- what was shown, and from which source: the negative examples a ranking model needs later
CREATE TABLE impressions (
    request_id    uuid, position smallint, user_id text, item_id bigint,
    source        text,                         -- 'als-batch', 'item-item (new user)', 'popular (cold start)'
    model_version text,                         -- lab: rec:meta model and trained_at
    shown_at      timestamptz NOT NULL,
    PRIMARY KEY (request_id, position)
);

-- Redis (rebuilt every night; v42 = the version written by tonight's job):
--   rec:v42:user:<user>   JSON list of 50 item ids from ALS          (lab: rec:user:<user>)
--   sim:v42:item:<item>   JSON list of 20 nearest items               (lab: sim:item:<item>)
--   pop:recent              100 most liked items in the last 365 days
--   rec:current             = v42, switched only after the job and its evaluation pass
--   seen:user:<user>      set, updated by the batch and by POST /events
--   recent:user:<user>    list of the last 20 likes, written by POST /events
الواجهات الرئيسية
| الطريقة | المسار | ماذا يفعل |
|---|---|---|
| GET | /recommend/{user}?n=10 | القائمة مع الحقل source كما في المختبر، وفي الإنتاج يؤخذ المستخدم من التوكن وليس من المسار، حتى لا يطلب أحد قائمة غيره |
| POST | /events | إعجاب أو مشاهدة أو شراء، ويحمل event_id ينشئه التطبيق، فإذا أعاد التطبيق الطلب بعد انقطاع لا يحسب الإعجاب مرتين |
| GET | /similar/{item}?n=10 | «قد يعجبك أيضاً» في صفحة العنصر من sim:item، ولا تحتاج مستخدماً مسجلاً |
| GET | /health/model | الإصدار الحالي ووقت التدريب وعدد المستخدمين والعناصر، كما في المفتاح rec:meta، وتنبه المراقبة إذا كان أقدم من يومين |
تقدير السعة على ظهر ورقة
الأرقام التالية افتراضات لمتجر أو تطبيق محتوى متوسط، وطريقة الحساب هي المهمة، كما شرحنا في مدخل إلى تصميم الأنظمة:
- مليون مستخدم مسجل، منهم 200 ألف نشطون في اليوم، وكل منهم يفتح 10 شاشات فيها توصيات ويرسل 30 حدثاً.
- ساعة الذروة أعلى من المتوسط بخمس مرات، والكتالوج 100 ألف عنصر، وكل مستخدم يحتاج قرابة كيلوبايت واحد في Redis لقائمته وما شاهده، وهذا تقدير.
- سرعة الكتابة في Redis كما قسناها في المختبر: 7519 مفتاحاً في 5 ثوان.
recommendation requests = 200,000 x 10 / 86,400       ~ 23/s average, ~ 116/s at peak
events                  = 200,000 x 30 / 86,400       ~ 69/s average, ~ 350/s at peak

impressions             = 200,000 x 10 x 10 items     = 20,000,000 rows/day
impressions storage     = 20,000,000 x ~60 B          ~ 1.2 GB/day  ~ 438 GB/year

Redis memory            = 1,000,000 users x ~1 KB     ~ 1 GB
                          + 100,000 items x ~300 B    ~ 30 MB

nightly keys            = 1,000,000 x 2 + 100,000     = 2,100,000 keys
write time at lab speed = 2,100,000 / (7,519 / 5 s)   ~ 1,400 s  ~ 23 minutes
وفي الحساب أعلاه لاحظ التالي:
- 116 طلباً في الثانية رقم صغير، فسيرفر واحد يقرأ من Redis يكفيه، كما رأيت في قياس زمن الاستجابة في المختبر، لذلك فالجزء الذي يحتاج تفكيراً ليس الواجهة وإنما المهمة الليلية والتخزين.
- سجل ما عرض هو أكبر ما تخزنه، أكثر من الإعجابات بثلاث مرات تقريباً، فاحفظه مقسماً بالشهر واحذف القديم، أو احفظ عينة منه إذا لم تكن تحتاجه كله للتدريب.
- كتابة 2.1 مليون مفتاح بنفس سرعة المختبر تأخذ 23 دقيقة، والسبب أن المختبر يكتب في pipeline واحد من خيط واحد، فاكتب على دفعات بعدة عمليات، أو اكتب فقط للمستخدمين الذين نشطوا في آخر 90 يوماً، وهم غالباً أقل بكثير من مليون.
مراحل النمو
| الجزء | البداية MVP (سيرفر أو اثنان) | النمو (آلاف المستخدمين في نفس الوقت) | الحجم الكبير (ملايين) |
|---|---|---|---|
| التدريب | cron على نفس السيرفر، الأكثر شعبية وتشابه العناصر وALS كما في المختبر | سيرفر مستقل للتدريب، وتقييم بالزمن قبل النشر، وMLflow | عدة مصادر مرشحين ونموذج ترتيب، وتدريب أكثر من مرة في اليوم، كما في قسم «كيف يكبر هذا النظام» أدناه |
| التخزين | PostgreSQL وRedis على نفس السيرفر | Redis مستقل بمفاتيح بإصدارات، وجدول ما عرض مقسم بالشهر | بحث ANN في pgvector أو Qdrant، ومخزن خصائص Feature Store للخصائص السريعة |
| الأحداث | الواجهة تكتب في Redis وفي PostgreSQL مباشرة | Valkey Streams بين الواجهة والقاعدة | Kafka، والخصائص اللحظية تحسب من البث نفسه |
| القرار | مقارنة بالأرقام على الاختبار بالزمن | اختبار A/B لكل تغيير في الخلط أو النموذج | عدة تجارب A/B في نفس الوقت، ومراقبة التنوع والتغطية مع الدقة |
ولا تقم في اليوم الأول ببناء نموذج ترتيب أو مخزن خصائص أو تدريب مستمر، والسبب أن الأكثر شعبية وتشابه العناصر وALS المضبوط على بيانات التحقق تعطيك أغلب القيمة كما رأيت في الأرقام، وكل خطوة بعدها تحتاج بيانات وفريقاً ومراقبة، فأضفها فقط عندما يثبت اختبار A/B أن الخطوة الحالية وصلت إلى حدها.
ماذا لو تعطل جزء؟
| ماذا لو تعطل…؟ | الأثر | الحل |
|---|---|---|
| Redis | الواجهة لا تجد القوائم | الواجهة تحفظ في ذاكرتها نسخة من pop:recent وترد بها، ثم تعيد تشغيل المهمة الليلية فتعيد بناء كل شيء، فلا تضيع بيانات لأن المصدر في PostgreSQL |
| المهمة الليلية | لا يوجد إصدار جديد | المفتاح rec:current يبقى على إصدار الأمس فيعمل كل شيء، والمراقبة تنبه من عمر آخر تدريب |
| نموذج سيئ | توصيات أسوأ لكل المستخدمين | بوابة التقييم ترفض الإصدار الذي ساءت أرقامه، وإذا مر فالرجوع بتغيير rec:current إلى الإصدار السابق |
| بث الأحداث | الإعجابات لا تصل إلى PostgreSQL | القوائم تعمل لأنها من Redis، وآخر الإعجابات في recent:user تغير القائمة فوراً، والأحداث تنتظر في البث أو يعيدها التطبيق بنفس event_id |
| PostgreSQL | لا تدريب ولا حفظ دائم للأحداث | الخدمة نفسها لا تتأثر لأنها تقرأ من Redis، والمهمة الليلية تنتظر حتى تعود القاعدة |
| الواجهة كلها | لا توجد توصيات | التطبيق يعرض قائمة الأكثر شعبية من ملف ثابت أو من ال Cache عنده، والسبب أن الشاشة الفارغة أسوأ من قائمة عامة |
تجربة عملية: نظام توصية على بيانات MovieLens
البيانات ورخصتها
نستخدم مجموعة MovieLens الصغيرة ml-latest-small من مجموعة GroupLens البحثية في جامعة Minnesota، وتقول صفحة وصفها إنها تحتوي 100836 تقييماً من 610 مستخدمين على 9742 فيلماً، بين مارس 1996 وسبتمبر 2018، ولا تحتوي أي معلومات شخصية عن المستخدمين سوى رقم. والرخصة مكتوبة في نفس الصفحة، وأهم شروطها أن الاستخدام للأغراض البحثية، وأن الاستخدام التجاري أو الذي يدر دخلاً يحتاج إذناً من GroupLens أولاً، وأن تذكر المصدر في أي منشور، وأن أي إعادة توزيع تكون بنفس الشروط. لذلك لا نضع البيانات في أي مستودع، وإنما ننزلها من موقع GroupLens مباشرة داخل Volume خاص بالتجربة، ولا تستخدمها في منتج تجاري، وإنما استخدم بيانات منتجك الحقيقية بنفس الكود. والمرجع المطلوب ذكره هو ورقة F. Maxwell Harper وJoseph A. Konstan سنة 2015 بعنوان The MovieLens Datasets: History and Context في مجلة ACM Transactions on Interactive Intelligent Systems.
ولاحظ أن MovieLens بيانات تقييم صريح من نصف نجمة إلى خمس نجوم، ونحن نحولها إلى إشارة ضمنية: التقييم 4 أو أكثر يعني «أعجبه»، وما دون ذلك نتجاهله، وهذا يقربها من بيانات أغلب المنتجات التي لا يقيم فيها أحد، وإنما يشتري أو يشاهد.
تجهيز البيئة
نضع كل الملفات في مجلد واحد، وأولها ملف Dockerfile بإصدارات ثابتة لكل مكتبة، حتى تحصل على نفس الأرقام التي في المقال:
FROM python:3.13.16-slim
ENV OPENBLAS_NUM_THREADS=1 PYTHONUNBUFFERED=1
RUN pip install --no-cache-dir implicit==0.7.3 numpy==2.5.3 scipy==1.18.1 pandas==3.0.6 \
    fastapi==0.143.0 uvicorn==0.54.0 redis==8.1.0 httpx==0.28.1
# implicit is built with OpenMP and needs libgomp, which the slim image does not have
RUN apt-get update && apt-get install -y --no-install-recommends libgomp1 && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
في الإعداد أعلاه لاحظ التالي:
- implicit 0.7.3 هي مكتبة ALS التي سنستخدمها، وFastAPI وuvicorn للواجهة، وredis للاتصال بـ Redis، وhttpx لقياس زمن الاستجابة.
- OPENBLAS_NUM_THREADS=1 لأن implicit توزع العمل على الأنوية بنفسها، وإذا كان OpenBLAS يستخدم أكثر من خيط Thread تطبع تحذيراً RuntimeWarning يقول إن ذلك قد يسبب مشكلات أداء شديدة.
- السطر الثاني بعد pip يثبت libgomp1، وبدونه سوف ترى هذا الخطأ عند أول استيراد لـ implicit، لأن نسخة slim من Docker Image الرسمية لا تحتوي مكتبة OpenMP التي بنيت بها implicit:
  File "/usr/local/lib/python3.13/site-packages/implicit/cpu/als.py", line 14, in <module>
    from . import _als
ImportError: libgomp.so.1: cannot open shared object file: No such file or directory
ثم نبني ال Image وننشئ الشبكة وال Volume، ونعرف اختصاراً للأمر الذي نشغل به كل برنامج في Container مؤقت:
docker build -t lab-rec-py:1 .
docker network create lab-rec-net
docker volume create lab-rec-data
alias rec='docker run --rm --name lab-rec-run --network lab-rec-net -v "$PWD:/lab" -v lab-rec-data:/data lab-rec-py:1'
والبرنامج التالي download.py ينزل البيانات إلى ال Volume مرة واحدة ويطبع ملخصها:
# Downloads MovieLens ml-latest-small from GroupLens into the data volume (never into the repo)
import io, os, urllib.request, zipfile
import pandas as pd

URL = "https://files.grouplens.org/datasets/movielens/ml-latest-small.zip"
if not os.path.exists("/data/ml-latest-small/ratings.csv"):
    zipfile.ZipFile(io.BytesIO(urllib.request.urlopen(URL).read())).extractall("/data")
r = pd.read_csv("/data/ml-latest-small/ratings.csv")
print("ratings:", len(r), "users:", r.userId.nunique(), "movies:", r.movieId.nunique())
print("from", pd.to_datetime(r.timestamp.min(), unit="s").date(), "to", pd.to_datetime(r.timestamp.max(), unit="s").date())
print(r.rating.value_counts().sort_index().to_string())
rec python download.pyوالمخرج سوف يكون كما يلي:
ratings: 100836 users: 610 movies: 9724
from 1996-03-29 to 2018-09-24
rating
0.5     1370
1.0     2811
1.5     1791
2.0     7551
2.5     5550
3.0    20047
3.5    13136
4.0    26818
4.5     8551
5.0    13211
لاحظ أن عدد الأفلام التي لها تقييم 9724 وليس 9742 كما في صفحة الوصف، والسبب أن الرقم الثاني عدد الأفلام في ملف movies.csv، وبعضها لا يوجد له أي تقييم. ولاحظ أيضاً أن التقييمات 4 و4.5 و5 مجموعها 48580، وهي التي سنعتبرها إعجاباً.
الكود المشترك recs.py
هذا الملف فيه كل شيء نحتاجه في الخطوات التالية: تحميل الإعجابات، وثلاث طرق للتقسيم، وبناء مصفوفة المستخدمين والأفلام، والطرق الثلاث، ودالة التقييم:
# Shared code: data loading, the three recommenders and the metrics
import numpy as np, pandas as pd, scipy.sparse as sp
from implicit.als import AlternatingLeastSquares

def load(min_rating=4.0):
    r = pd.read_csv("/data/ml-latest-small/ratings.csv")
    r = r[r.rating >= min_rating]                     # implicit feedback: a rating of 4 or more counts as "liked"
    return r[["userId", "movieId", "timestamp"]].reset_index(drop=True)

def global_split(df, test_share=0.2):
    cut = df.timestamp.quantile(1 - test_share)       # one moment for everyone: after it is the future
    return df[df.timestamp <= cut], df[df.timestamp > cut]

def time_split(df, test_share=0.2):
    # per user: the oldest 80% of his likes are the past (train), the newest 20% are the future (test)
    pos = df.groupby("userId").timestamp.rank(method="first", pct=True)
    return df[pos <= 1 - test_share], df[pos > 1 - test_share]

def random_split(df, test_share=0.2, seed=42):
    # the same 20% per user, but picked at random: the test set is mixed in time with the training set
    test = df.groupby("userId").sample(frac=test_share, random_state=seed)
    return df.drop(test.index), test

class Data:
    """Index users and items of the training set and build the user x item matrix."""
    def __init__(self, train):
        self.users = np.sort(train.userId.unique()); self.items = np.sort(train.movieId.unique())
        self.u = {u: i for i, u in enumerate(self.users)}; self.i = {m: j for j, m in enumerate(self.items)}
        rows = train.userId.map(self.u).to_numpy(); cols = train.movieId.map(self.i).to_numpy()
        self.X = sp.csr_matrix((np.ones(len(train), dtype=np.float32), (rows, cols)), shape=(len(self.users), len(self.items)))

class Popular:
    def __init__(self, d, train, days=None):
        t = train if days is None else train[train.timestamp > train.timestamp.max() - days * 86400]
        counts = t.movieId.value_counts()
        self.d, self.order = d, np.array([d.i[m] for m in counts.index])
    def recommend(self, uidx, n=10):
        seen = set(self.d.X[uidx].indices) if uidx is not None else set()
        return [j for j in self.order if j not in seen][:n]

class ItemKNN:
    """Item-item cosine similarity, without building the full item x item matrix."""
    def __init__(self, d):
        self.d = d
        norms = np.sqrt(np.asarray(d.X.sum(axis=0)).ravel()); norms[norms == 0] = 1
        self.Xn = d.X @ sp.diags(1 / norms)              # each item column has length 1
    def scores(self, item_idx):                          # sum of cosine similarity to the given items
        v = np.zeros(self.d.X.shape[1], dtype=np.float32); v[item_idx] = 1
        return self.Xn.T @ (self.Xn @ v)
    def similar(self, j, n=10):
        s = self.scores([j]); s[j] = -1
        return list(np.argsort(-s)[:n])
    def recommend(self, uidx, n=10, items=None):
        items = list(self.d.X[uidx].indices) if items is None else items
        s = self.scores(items); s[items] = -np.inf
        return list(np.argsort(-s)[:n])

class ALS:
    def __init__(self, d, factors=64, reg=0.05, alpha=10.0, iters=20, seed=1):
        self.d = d
        self.m = AlternatingLeastSquares(factors=factors, regularization=reg, alpha=alpha, iterations=iters, random_state=seed)
        self.m.fit(d.X, show_progress=False)
    def recommend(self, uidx, n=10):
        ids, _ = self.m.recommend(uidx, self.d.X[uidx], N=n, filter_already_liked_items=True)
        return list(ids)

def evaluate(model, d, test, k=10):
    truth = test[test.userId.isin(d.u)].groupby("userId").movieId.apply(set)
    p = r = n = 0.0; shown = set()
    for user, rel in truth.items():
        recs = [d.items[j] for j in model.recommend(d.u[user], k)]
        shown.update(recs)
        hits = [1 if m in rel else 0 for m in recs]
        p += sum(hits) / k
        r += sum(hits) / len(rel)
        dcg = sum(h / np.log2(i + 2) for i, h in enumerate(hits))
        idcg = sum(1 / np.log2(i + 2) for i in range(min(len(rel), k)))
        n += dcg / idcg
    c = len(truth)
    return {"users": c, "precision@10": p / c, "recall@10": r / c, "ndcg@10": n / c, "coverage": len(shown) / len(d.items)}
في الكود أعلاه لاحظ التالي:
- الكلاس Data يبني مصفوفة متفرقة Sparse Matrix من نوع CSR، صف لكل مستخدم وعمود لكل فيلم، فيها 1 حيث أعجبه الفيلم، وذلك لأن أكثر من 98% من خاناتها فارغة، والمصفوفة الكاملة تهدر الذاكرة.
- ItemKNN يحسب تشابه جيب التمام دون أن يبني مصفوفة الأفلام في الأفلام كاملة: يقسم كل عمود على طوله مرة واحدة، ثم يحسب درجات المستخدم بضربين لمصفوفة متفرقة في متجه، وهذا يكفي لآلاف الأفلام. وفي الكتالوج الكبير تحسب قائمة الجيران لكل عنصر مسبقاً، كما سنفعل في المهمة الليلية.
- ALS يستخدم AlternatingLeastSquares من implicit، والمعامل alpha هو وزن الثقة Confidence الذي شرحناه في مقال المفاهيم، وregularization يمنع الأرقام من الكبر حتى لا يحفظ النموذج البيانات.
- evaluate تحسب لكل مستخدم في الاختبار قائمة من 10، وتقارنها بما أعجبه فعلاً في فترة الاختبار، ثم تأخذ المتوسط على كل المستخدمين، وتحسب التغطية Coverage كنسبة الأفلام التي ظهرت في قائمة أي مستخدم.
التقسيم بالزمن: نقطة واحدة للجميع أم لكل مستخدم؟
الحل البسيط للتقسيم بالزمن أن تختار لحظة واحدة، كل ما قبلها تدريب وكل ما بعدها اختبار، وهذا ما تفعله global_split. ولكن عند تشغيلها على MovieLens ظهرت مشكلة، فمن 118 مستخدماً لهم إعجابات بعد نقطة القطع، 26 فقط لهم إعجابات قبلها، والسبب أن أغلب مستخدمي MovieLens يقيمون أفلامهم في فترة قصيرة ثم يختفون، فيصبح الاختبار على 26 مستخدماً، وهذا عدد صغير لا تثق بأرقامه. لذلك تقسم time_split بالزمن لكل مستخدم: أقدم 80% من إعجاباته تدريب، وأحدث 20% اختبار، فيبقى الاختبار على كل المستخدمين ولا يرى النموذج مستقبل أي مستخدم. وفي منتجك الحقيقي الذي يعود إليه الناس كل يوم، استخدم نقطة قطع واحدة، فهي الأقرب لما يحدث فعلاً في الإنتاج، حيث تدرب الليلة وتقيس على الغد.
المقارنة: الأكثر شعبية وتشابه العناصر وALS
البرنامج التالي evaluate.py يقسم البيانات بالزمن ثم يقيس الطرق الثلاث، ويضيف نسخة من الأكثر شعبية في آخر 90 يوماً فقط:
# Step 1-4: time split, then popularity, item-item and ALS compared on the same test set
import time, pandas as pd
from recs import *

df = load()
g_train, g_test = global_split(df)
print("global cut: test users who also appear in train:", g_test.userId[g_test.userId.isin(g_train.userId)].nunique(), "of", g_test.userId.nunique())
train, test = time_split(df)
print("liked (rating >= 4):", len(df), "| train:", len(train), "| test:", len(test), "| users:", df.userId.nunique())
d = Data(train)
print("test likes on movies that never appear in train:", (~test.movieId.isin(d.i)).sum())

rows = {}
for name, make in [("popular (all time)", lambda: Popular(d, train)),
                   ("popular (last 90 days)", lambda: Popular(d, train, days=90)),
                   ("item-item cosine", lambda: ItemKNN(d)),
                   ("ALS (implicit)", lambda: ALS(d))]:
    t = time.perf_counter(); m = make(); fit = time.perf_counter() - t
    rows[name] = evaluate(m, d, test) | {"fit_s": fit}
print(pd.DataFrame(rows).T.round(4).to_string())
rec python evaluate.pyوالمخرج سوف يكون كما يلي:
global cut: test users who also appear in train: 26 of 118
liked (rating >= 4): 48580 | train: 38614 | test: 9966 | users: 609
test likes on movies that never appear in train: 1143
                        users  precision@10  recall@10  ndcg@10  coverage   fit_s
popular (all time)      608.0        0.0503     0.0522   0.0680    0.0102  0.0124
popular (last 90 days)  608.0        0.0431     0.0363   0.0498    0.0070  0.0026
item-item cosine        608.0        0.0725     0.0786   0.0915    0.0943  0.0126
ALS (implicit)          608.0        0.0600     0.0687   0.0815    0.1405  0.8067
في المخرج أعلاه لاحظ التالي:
- تشابه العناصر هو الأفضل في كل المقاييس الثلاثة: NDCG@10 يساوي 0.0915 مقابل 0.0680 للأكثر شعبية، أي بزيادة 35% تقريباً، وتدرب في 13 ملي ثانية.
- ALS بالإعدادات التي اخترناها دون ضبط، 64 عاملاً وalpha يساوي 10، جاء أقل من تشابه العناصر، وهذا يحدث كثيراً، فالنموذج الأعقد ليس أفضل تلقائياً، وسوف نضبطه في الخطوة التالية.
- الأكثر شعبية في آخر 90 يوماً أسوأ من الأكثر شعبية على كل الفترة، والسبب خاص بهذه البيانات: آخر 90 يوماً هي صيف 2018، ولكن فترة اختبار كل مستخدم هي فترة نشاطه هو، وقد تكون سنة 2005، فما كان رائجاً في 2018 لا يعني له شيئاً. أما في منتجك فالرائج حديثاً هو غالباً الأفضل، لأن كل المستخدمين يعيشون في نفس الوقت.
- التغطية Coverage تقول الكثير: الأكثر شعبية عرض 1% من الأفلام فقط على كل المستخدمين، وتشابه العناصر 9%، وALS 14%، أي أن ALS يكتشف أفلاماً أكثر تنوعاً حتى وهو أقل دقة.
- 1143 إعجاباً في الاختبار كانت على أفلام لم تظهر في التدريب أبداً، ولا تستطيع أي طريقة Collaborative Filtering أن توصي بها، وهذه هي البداية الباردة للعناصر بالأرقام.
- الأرقام نفسها تبدو صغيرة، فنحو 7 أفلام من كل 100 توصية أعجبت المستخدم لاحقاً، ولكن تذكر أن الاختبار يعرف فقط ما قيمه المستخدم، فالفيلم الذي أوصينا به ولم يشاهده ليس بالضرورة خطأ، لذلك قارن الأرقام ببعضها على نفس الاختبار، ولا تقارنها بأرقام بيانات أخرى.
ضبط ALS على بيانات التحقق Validation
وقد يتساءل البعض: لماذا لا نجرب إعدادات كثيرة لـ ALS ونأخذ الأفضل على الاختبار؟ والإجابة أن هذا تسرب آخر، فإذا اخترت الإعداد بأرقام الاختبار فأنت تدرب على الاختبار بطريقة غير مباشرة، ويصبح الرقم الذي تنشره أعلى مما ستحصل عليه في الإنتاج. والطريقة الصحيحة أن تقسم بيانات التدريب نفسها بالزمن مرة ثانية، فتختار الإعداد على الجزء الأحدث منها، ثم تقيس الإعداد المختار مرة واحدة على الاختبار:
# Choose the ALS settings on a validation set cut from the training data, never on the test set
import itertools
from recs import *

df = load()
train, test = time_split(df)
fit_part, valid = time_split(train)                 # the newest 20% of each user's past is the validation set
dv = Data(fit_part)
best = None
for f, a, reg in itertools.product([32, 64, 128], [1, 10, 40], [0.05, 0.5]):
    e = evaluate(ALS(dv, factors=f, alpha=a, reg=reg), dv, valid)
    print(f"factors={f:<4} alpha={a:<3} reg={reg:<5} valid ndcg@10={e['ndcg@10']:.4f}")
    if best is None or e["ndcg@10"] > best[0]:
        best = (e["ndcg@10"], f, a, reg)
_, f, a, reg = best
d = Data(train)
e = evaluate(ALS(d, factors=f, alpha=a, reg=reg), d, test)
print(f"best on validation: factors={f} alpha={a} reg={reg}")
print("test with these settings:", {k: round(float(v), 4) for k, v in e.items()})
rec python tune.pyوالمخرج سوف يكون كما يلي:
factors=32   alpha=1   reg=0.05  valid ndcg@10=0.1104
factors=32   alpha=1   reg=0.5   valid ndcg@10=0.1109
factors=32   alpha=10  reg=0.05  valid ndcg@10=0.1056
factors=32   alpha=10  reg=0.5   valid ndcg@10=0.1049
factors=32   alpha=40  reg=0.05  valid ndcg@10=0.0887
factors=32   alpha=40  reg=0.5   valid ndcg@10=0.0880
factors=64   alpha=1   reg=0.05  valid ndcg@10=0.1010
factors=64   alpha=1   reg=0.5   valid ndcg@10=0.1006
factors=64   alpha=10  reg=0.05  valid ndcg@10=0.0966
factors=64   alpha=10  reg=0.5   valid ndcg@10=0.0971
factors=64   alpha=40  reg=0.05  valid ndcg@10=0.0860
factors=64   alpha=40  reg=0.5   valid ndcg@10=0.0869
factors=128  alpha=1   reg=0.05  valid ndcg@10=0.0834
factors=128  alpha=1   reg=0.5   valid ndcg@10=0.0816
factors=128  alpha=10  reg=0.05  valid ndcg@10=0.0790
factors=128  alpha=10  reg=0.5   valid ndcg@10=0.0767
factors=128  alpha=40  reg=0.05  valid ndcg@10=0.0813
factors=128  alpha=40  reg=0.5   valid ndcg@10=0.0805
best on validation: factors=32 alpha=1 reg=0.5
test with these settings: {'users': 608.0, 'precision@10': 0.0798, 'recall@10': 0.0829, 'ndcg@10': 0.1028, 'coverage': 0.0798}
في المخرج أعلاه لاحظ التالي:
- الإعداد الأفضل على بيانات التحقق 32 عاملاً وalpha يساوي 1، ومعه أصبح ALS الأفضل على الاختبار في كل المقاييس: NDCG@10 يساوي 0.1028 مقابل 0.0915 لتشابه العناصر و0.0680 للأكثر شعبية.
- عدد العوامل الأكبر كان أسوأ في كل الحالات، والسبب أن البيانات صغيرة، 609 مستخدمين فقط، فالعوامل الكثيرة تحفظ البيانات بدل أن تتعلم منها.
- ورقة ALS الأصلية تذكر أن alpha يساوي 40 أعطاها نتائج جيدة على بيانات مشاهدة التلفزيون، وعندنا كان alpha يساوي 40 الأسوأ، فلا تنقل إعدادات أي ورقة أو مقال إلى بياناتك دون أن تضبطها عليها.
- التغطية نزلت من 14% إلى 8% مع الإعداد الجديد، فالدقة الأعلى جاءت مع تنوع أقل، وهذا من القرارات التي لا تحسمها الأرقام وحدها، وإنما اختبار A/B ورأي فريق المنتج.
نكسرها: التقسيم العشوائي وتسرب البيانات
الآن نشغل نفس النماذج بنفس الإعدادات، والفرق الوحيد أن 20% من إعجابات كل مستخدم تختار للاختبار عشوائياً بدل أن تكون الأحدث، وهذا ما يفعله أي شخص يستخدم دالة train_test_split بإعداداتها الافتراضية:
# Break it: the same models on a random split, where the training set contains the future
import pandas as pd
from recs import *

df = load()
results = {}
for split in ["time", "random"]:
    train, test = (time_split(df) if split == "time" else random_split(df))
    d = Data(train)
    for name, m in [("popular", Popular(d, train)), ("item-item", ItemKNN(d)), ("ALS", ALS(d))]:
        e = evaluate(m, d, test)
        results[(split, name)] = {k: e[k] for k in ["users", "precision@10", "recall@10", "ndcg@10"]}
print(pd.DataFrame(results).T.round(4).to_string())
rec python leak.pyوالمخرج سوف يكون كما يلي:
                  users  precision@10  recall@10  ndcg@10
time   popular    608.0        0.0503     0.0522   0.0680
       item-item  608.0        0.0725     0.0786   0.0915
       ALS        608.0        0.0600     0.0687   0.0815
random popular    608.0        0.1015     0.0956   0.1385
       item-item  608.0        0.1530     0.1617   0.2112
       ALS        608.0        0.1395     0.1625   0.2012
والصورة التالية تبين ما حدث:
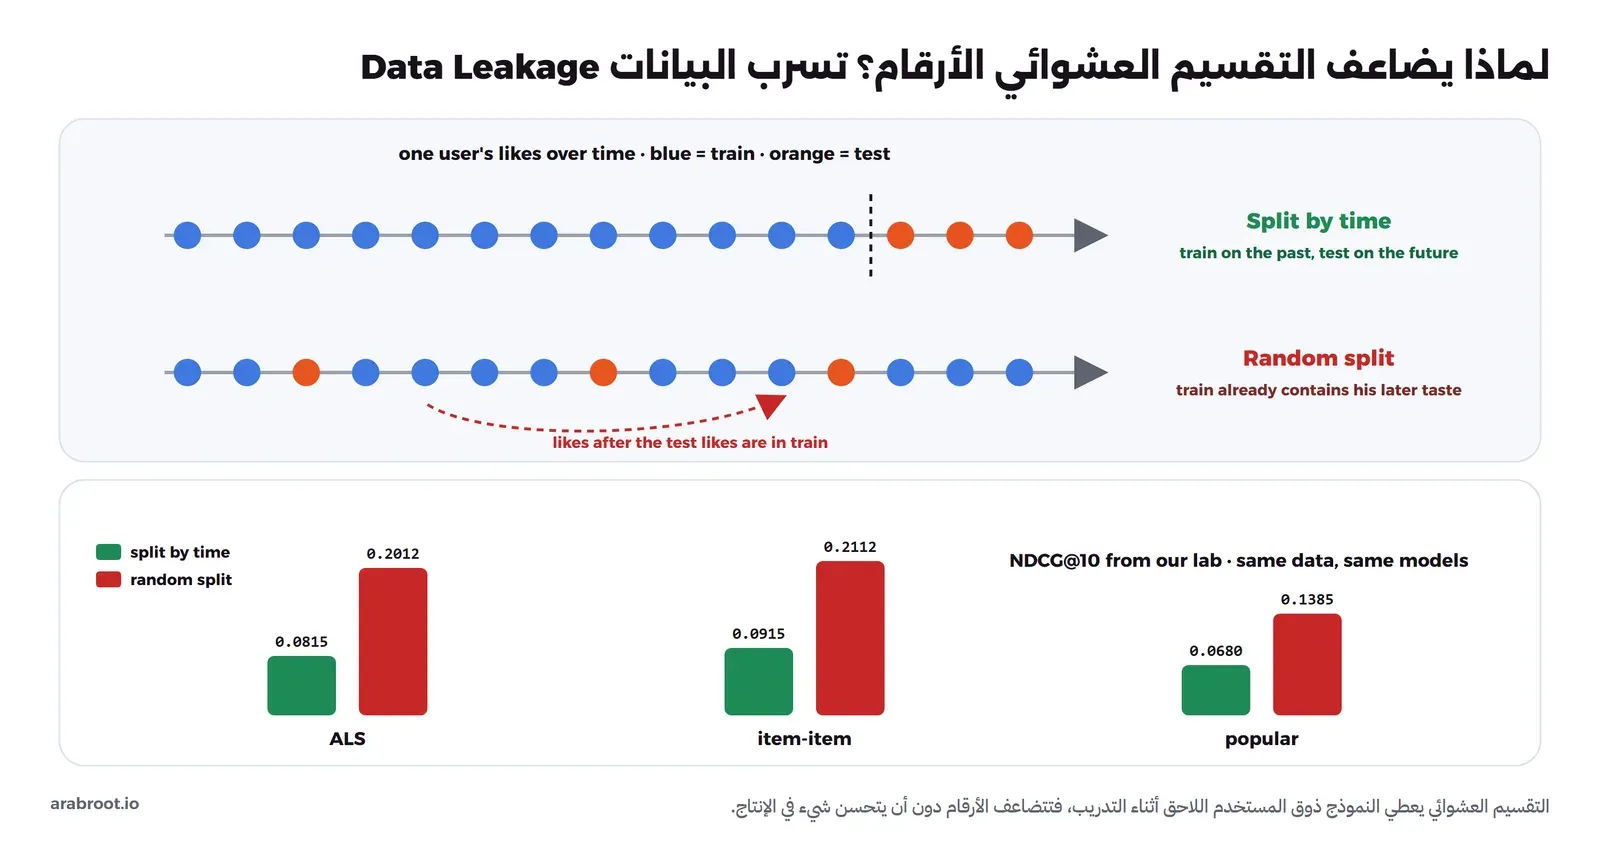
كل الأرقام تضاعفت تقريباً، فـ NDCG@10 لتشابه العناصر قفز من 0.0915 إلى 0.2112، ولم يتغير في النموذج سطر واحد. والسبب أن التقسيم العشوائي يضع في التدريب إعجابات حدثت بعد الإعجابات التي نختبرها، فإذا شاهد المستخدم ثلاثية سينمائية في أسبوع واحد، واختير الجزء الثاني للاختبار، فالنموذج رأى الجزء الأول والثالث في التدريب، وتوقع الجزء الثاني سهل جداً. وحتى الأكثر شعبية تضاعف، لأن شعبية الأفلام محسوبة الآن من فترة تشمل فترة الاختبار نفسها. ولو نشرت هذه الأرقام في تقرير فسوف يتوقع الجميع نتيجة لن تراها في الإنتاج أبداً، لأن النموذج في الإنتاج لا يرى المستقبل، وهذا هو تسرب البيانات Data Leakage الذي شرحناه في التعلم الآلي للمبتدئين.
التدريب الليلي والكتابة في Redis
بعد أن عرفنا الإعداد الأفضل، ندرب في الإنتاج على كل البيانات المتاحة حتى الليلة، ونكتب لكل مستخدم أفضل 50 فيلماً من ALS، ولكل فيلم أقرب 20 فيلماً، وقائمة الأكثر شعبية في آخر سنة، وما شاهده كل مستخدم. نشغل Redis أولاً:
docker run -d --name lab-rec-redis --network lab-rec-net redis:8.8.3-alpineثم المهمة الليلية batch.py:
# Nightly batch: train on everything we have, then write candidates to Redis for the API to read
import json, time, numpy as np, pandas as pd, redis
from recs import *

t0 = time.perf_counter()
df = load(); d = Data(df)
als = ALS(d, factors=32, alpha=1, reg=0.5); knn = ItemKNN(d); pop = Popular(d, df, days=365)
t1 = time.perf_counter()

r = redis.Redis(host="lab-rec-redis", decode_responses=True)
p = r.pipeline(transaction=False)
movies = pd.read_csv("/data/ml-latest-small/movies.csv").set_index("movieId").title
p.hset("movie:title", mapping={int(m): movies[m] for m in d.items})
for uidx, user in enumerate(d.users):
    p.set(f"rec:user:{user}", json.dumps([int(d.items[j]) for j in als.recommend(uidx, 50)]))
    p.delete(f"seen:user:{user}"); p.sadd(f"seen:user:{user}", *map(int, d.items[d.X[uidx].indices]))
for j, m in enumerate(d.items):
    p.set(f"sim:item:{m}", json.dumps([int(d.items[k]) for k in knn.similar(j, 20)]))
p.set("pop:recent", json.dumps([int(d.items[j]) for j in pop.order[:100]]))
p.hset("rec:meta", mapping={"model": "als-32f", "trained_at": time.strftime("%Y-%m-%dT%H:%M:%S"), "users": len(d.users), "items": len(d.items)})
p.execute()
t2 = time.perf_counter()
print(f"trained on {len(df)} likes from {len(d.users)} users and {len(d.items)} movies in {t1 - t0:.1f}s")
print(f"wrote {r.dbsize()} keys to Redis in {t2 - t1:.1f}s, memory used: {r.info('memory')['used_memory_human']}")
rec python batch.pyوالمخرج سوف يكون كما يلي:
trained on 48580 likes from 609 users and 6298 movies in 0.5s
wrote 7519 keys to Redis in 5.0s, memory used: 3.53M
في الإعداد أعلاه لاحظ التالي:
- التدريب كله، ALS وتشابه العناصر والشعبية، أخذ نصف ثانية، والكتابة أخذت خمس ثوان، أي أن الكتابة هي الجزء الأبطأ، لذلك نستخدم pipeline يرسل الأوامر دفعة واحدة بدل انتظار رد كل أمر.
- عدد المفاتيح 7519: لكل مستخدم من 609 مفتاحان rec:user وseen:user، ولكل فيلم من 6298 مفتاح sim:item، ثم pop:recent وrec:meta وmovie:title، وكل ذلك في 3.53 ميجابايت من الذاكرة.
- الأكثر شعبية هنا لآخر 365 يوماً من البيانات، وهي قائمة الاحتياط للمستخدم الجديد.
- في الإنتاج يشغل هذا الأمر جدول مهام، مثل سطر cron الساعة 3 فجراً، أو مهمة في pg_cron إذا كانت الإعجابات في PostgreSQL.
الواجهة API مع FastAPI
الواجهة لا تحمل أي نموذج، وإنما تقرأ القوائم الجاهزة من Redis بطلب واحد عبر pipeline، ثم تخلطها:
# The serving API: reads precomputed candidates from Redis, filters what the user has seen, adds fresh signals
import json, time
import redis.asyncio as redis
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI()
r = redis.Redis(host="lab-rec-redis", decode_responses=True)

class Event(BaseModel):
    user: str
    movie: int

@app.post("/events")
async def event(e: Event):                       # a "like" arrives in real time
    p = r.pipeline(transaction=False)
    p.lpush(f"recent:user:{e.user}", e.movie); p.ltrim(f"recent:user:{e.user}", 0, 19)
    p.sadd(f"seen:user:{e.user}", e.movie)
    await p.execute()
    return {"ok": True}

@app.get("/recommend/{user}")
async def recommend(user: str, n: int = 10):
    t = time.perf_counter()
    p = r.pipeline(transaction=False)
    p.get(f"rec:user:{user}"); p.smembers(f"seen:user:{user}"); p.lrange(f"recent:user:{user}", 0, 2); p.get("pop:recent")
    batch, seen, recent, popular = await p.execute()
    seen = {int(x) for x in seen}
    fresh = []
    if recent:                                  # real time: neighbours of what the user liked minutes ago
        sims = await r.mget([f"sim:item:{m}" for m in recent])
        fresh = [m for s in sims if s for m in json.loads(s)]
    if batch:
        source, base = "als-batch", json.loads(batch)
    elif fresh:
        source, base = "item-item (new user)", []
    else:
        source, base = "popular (cold start)", json.loads(popular)
    out = []
    for m in fresh[: n // 2] + base + fresh[n // 2:] + json.loads(popular):   # mix, then dedupe and drop seen
        if m not in seen and m not in out:
            out.append(m)
        if len(out) == n:
            break
    titles = await r.hmget("movie:title", out)
    return {"user": user, "source": source + (" + recent likes" if fresh and batch else ""),
            "items": [{"id": m, "title": tt} for m, tt in zip(out, titles)],
            "server_ms": round((time.perf_counter() - t) * 1000, 2)}
docker run -d --name lab-rec-api --network lab-rec-net -p 127.0.0.1:18080:8000 \
-v "$PWD:/lab" lab-rec-py:1 uvicorn api:app --host 0.0.0.0 --port 8000
curl -s "127.0.0.1:18080/recommend/42?n=5"والمخرج سوف يكون كما يلي:
{"user":"42","source":"als-batch","items":[{"id":2858,"title":"American Beauty (1999)"},{"id":1732,"title":"Big Lebowski, The (1998)"},{"id":480,"title":"Jurassic Park (1993)"},{"id":368,"title":"Maverick (1994)"},{"id":2916,"title":"Total Recall (1990)"}],"server_ms":13.37}في الكود أعلاه لاحظ التالي:
- المنفذ 18080 مربوط بالعنوان 127.0.0.1 فقط، فلا يصل إليه أحد من خارج جهازك، وفي الإنتاج تضع الواجهة خلف Reverse Proxy وتطلب توكن من التطبيق.
- المستخدم 42 موجود في التدريب الليلي، فجاءت قائمته من ALS، والمصدر مكتوب في الحقل source، وهذا مفيد جداً عند التحقيق في سبب ظهور توصية غريبة.
- زمن أول طلب 13 ملي ثانية لأنه أول اتصال بـ Redis، وسوف نقيس الزمن الحقيقي بعد قليل.
- حذف ما شاهده المستخدم يحدث في الواجهة وليس في المهمة الليلية فقط، لأن المستخدم قد يشاهد شيئاً بعد التدريب.
مستخدم جديد بلا تاريخ
المستخدم u-new لم يكن موجوداً عند التدريب، فلا يوجد له مفتاح rec:user، والواجهة ترجع إلى قائمة الأكثر شعبية:
curl -s "127.0.0.1:18080/recommend/u-new?n=5"{"user":"u-new","source":"popular (cold start)","items":[{"id":318,"title":"Shawshank Redemption, The (1994)"},{"id":2571,"title":"Matrix, The (1999)"},{"id":356,"title":"Forrest Gump (1994)"},{"id":79132,"title":"Inception (2010)"},{"id":58559,"title":"Dark Knight, The (2008)"}],"server_ms":1.74}ثم يعجبه فيلم واحد، Finding Nemo ورقمه 6377، فتتغير قائمته في الطلب التالي إلى أفلام تشبهه من جدول تشابه العناصر:
curl -s -X POST 127.0.0.1:18080/events -H 'Content-Type: application/json' -d '{"user":"u-new","movie":6377}'
curl -s "127.0.0.1:18080/recommend/u-new?n=5"
{"ok":true}
{"user":"u-new","source":"item-item (new user)","items":[{"id":4886,"title":"Monsters, Inc. (2001)"},{"id":4306,"title":"Shrek (2001)"},{"id":8961,"title":"Incredibles, The (2004)"},{"id":4995,"title":"Beautiful Mind, A (2001)"},{"id":4963,"title":"Ocean's Eleven (2001)"}],"server_ms":1.86}ثلاثة أفلام رسوم متحركة من نفس الفترة في المقدمة بعد إعجاب واحد فقط، وهذا هو المسار الذي شرحناه في البداية الباردة: الأكثر شعبية لمن لا نعرف عنه شيئاً، ثم تشابه العناصر من أول إعجاب، ثم ALS عندما يدخل المستخدم في التدريب الليلي التالي.
الإعجاب يغير القائمة فوراً
والآن المستخدم 42 الذي له قائمة من ALS يعجبه Toy Story ورقمه 1:
curl -s -X POST 127.0.0.1:18080/events -H 'Content-Type: application/json' -d '{"user":"42","movie":1}'
curl -s "127.0.0.1:18080/recommend/42?n=5"
{"ok":true}
{"user":"42","source":"als-batch + recent likes","items":[{"id":3114,"title":"Toy Story 2 (1999)"},{"id":2858,"title":"American Beauty (1999)"},{"id":1732,"title":"Big Lebowski, The (1998)"},{"id":480,"title":"Jurassic Park (1993)"},{"id":368,"title":"Maverick (1994)"}],"server_ms":6.43}ظهر Toy Story 2 في المقدمة مباشرة، وبقيت بعده قائمة ALS الليلية. والواجهة تضع جيران آخر الإعجابات في النصف الأول من القائمة ثم قائمة ALS، وهذه النسبة قرار منتج وليس قراراً تقنياً، فإذا أعطيت الجديد وزناً كبيراً تقلبت القائمة مع كل نقرة، وإذا أعطيته وزناً صغيراً شعر المستخدم أن التطبيق لا يسمعه.
قياس زمن الاستجابة محلياً
البرنامج التالي يرسل 2000 طلب، واحداً بعد الآخر، لمستخدمين عشوائيين من Container آخر على نفس الشبكة، ويحسب النسب المئوية Percentiles:
# Local latency test: 2000 sequential requests from another container on the same Docker network
import random, statistics, time, httpx
random.seed(7)
users = [str(random.randint(1, 610)) for _ in range(2000)]
with httpx.Client(base_url="http://lab-rec-api:8000") as c:
    c.get("/recommend/1")                                       # warm up
    times = []
    for u in users:
        t = time.perf_counter(); c.get(f"/recommend/{u}").raise_for_status(); times.append((time.perf_counter() - t) * 1000)
q = statistics.quantiles(times, n=100)
print(f"requests: {len(times)}  p50: {q[49]:.2f} ms  p95: {q[94]:.2f} ms  p99: {q[98]:.2f} ms  max: {max(times):.2f} ms")
rec python bench.pyrequests: 2000 p50: 6.11 ms p95: 15.82 ms p99: 21.42 ms max: 39.54 msهذه أرقام محلية على جهاز التطوير، Docker Desktop بثمانية أنوية مشتركة مع برامج أخرى، وطلب واحد في كل لحظة، وعامل uvicorn واحد، فلا تعتبرها رقماً للإنتاج، وإنما دليلاً على أن تصميم «احسب في الليل واقرأ في الطلب» يرد في بضع ملي ثوان، لأن كل طلب هو قراءة واحدة من الذاكرة وبعض العمليات على قوائم صغيرة. وعند تكرار القياس على نفس الجهاز تغير p50 بين 4 و6 ملي ثوان بحسب حمل الجهاز. والمهم هنا أن تقيس النسبة p99 وليس المتوسط، لأن المستخدم يشعر بأبطأ الطلبات.
حذف المختبر
unalias rec
docker rm -f lab-rec-api lab-rec-redis
docker volume rm lab-rec-data
docker network rm lab-rec-net
docker rmi lab-rec-py:1
التدريب الليلي أم التحديث اللحظي؟
التصميم الذي بنيناه يجمع الاثنين، وهو الجزءان ONLINE وNIGHTLY في مخطط المعمارية أعلاه، والسؤال الحقيقي هو أي جزء يحتاج أن يكون لحظياً:
- التدريب الليلي Batch: يحسب ما يتغير ببطء، مثل عوامل ALS وجداول التشابه والشعبية. وهو بسيط، وسهل الاختبار، ويمكن إعادته إذا فشل، ولكن المستخدم الذي سجل اليوم لا يدخل فيه حتى الغد، والذوق الذي تغير صباحاً لا يظهر حتى الليل.
- التحديث اللحظي Real-time: يأخذ آخر الإعجابات ويغير القائمة في الطلب التالي، كما فعلنا بجيران آخر الإعجابات. وهو لا يعيد تدريب أي نموذج، وإنما يعيد ترتيب نتائج جاهزة، وهذا يكفي لأغلب المنتجات.
- التدريب المستمر Online Training: النموذج نفسه يتحدث مع كل حدث، كما شرحنا في نظام ByteDance في مقال الفيديو القصير، وهو مكلف ومعقد، ولا يستحق ثمنه إلا عندما يكون لديك ملايين المستخدمين يغيرون اهتماماتهم كل ساعة.
ولاحظ مشكلتين في المهمة الليلية كما كتبناها: الأولى أنها تكتب المفاتيح واحداً بعد الآخر والواجهة تعمل، فيرى بعض المستخدمين لثوان قائمة قديمة وبعضهم قائمة جديدة، وهذا مقبول هنا. فإذا لم يكن مقبولاً عندك فاكتب كل تدريب تحت بادئة برقم إصدار، مثل rec:v42:user:1، ثم غير مفتاحاً واحداً يشير إلى الإصدار الحالي بعد انتهاء الكتابة. والثانية أن الإعجابات التي تصل عبر /events تبقى في Redis فقط، وفي الإنتاج يجب أن تكتب أيضاً في جدول الإعجابات الدائم، عادة عبر طابور Queue أو بث أحداث Event Streaming كما شرحنا في الطابور أم بث الأحداث، حتى تدخل في تدريب الليلة القادمة.
أين تخزن المرشحين؟ Redis أم PostgreSQL
استخدمنا Redis لأن كل طلب قراءة لمفاتيح معروفة من الذاكرة، وهذا أسرع وأبسط ما يكون، ويمكنك استخدام Valkey بنفس الكود، كما فعلنا في تجربة الفيديو القصير. ولكن إذا كان لديك PostgreSQL أصلاً، وعدد المستخدمين بعشرات الآلاف، فجدول واحد فيه رقم المستخدم ومصفوفة أرقام العناصر ووقت التدريب يكفيك تماماً، وقراءة صف واحد بالمفتاح الأساسي Primary Key سريعة جداً. وميزة PostgreSQL أنها تحفظ البيانات بعد إعادة التشغيل، وأنك تستطيع أن تربط التوصيات بجداول المخزون والأسعار في استعلام واحد، وقد ناقشنا متى تكفيك قاعدة واحدة لكل شيء في PostgreSQL لكل شيء. وفي الحالتين، تذكر أن Redis هنا مخزن مؤقت يعاد بناؤه كل ليلة من المصدر، فإذا ضاع لا تضيع بيانات، وإنما تعيد تشغيل المهمة.
كيف يكبر هذا النظام؟
ما بنيناه هو مرحلة الاسترجاع Retrieval بثلاثة مصادر وخلط ثابت، والصورة التالية تبين كيف يكبر عندما يكبر المنتج:
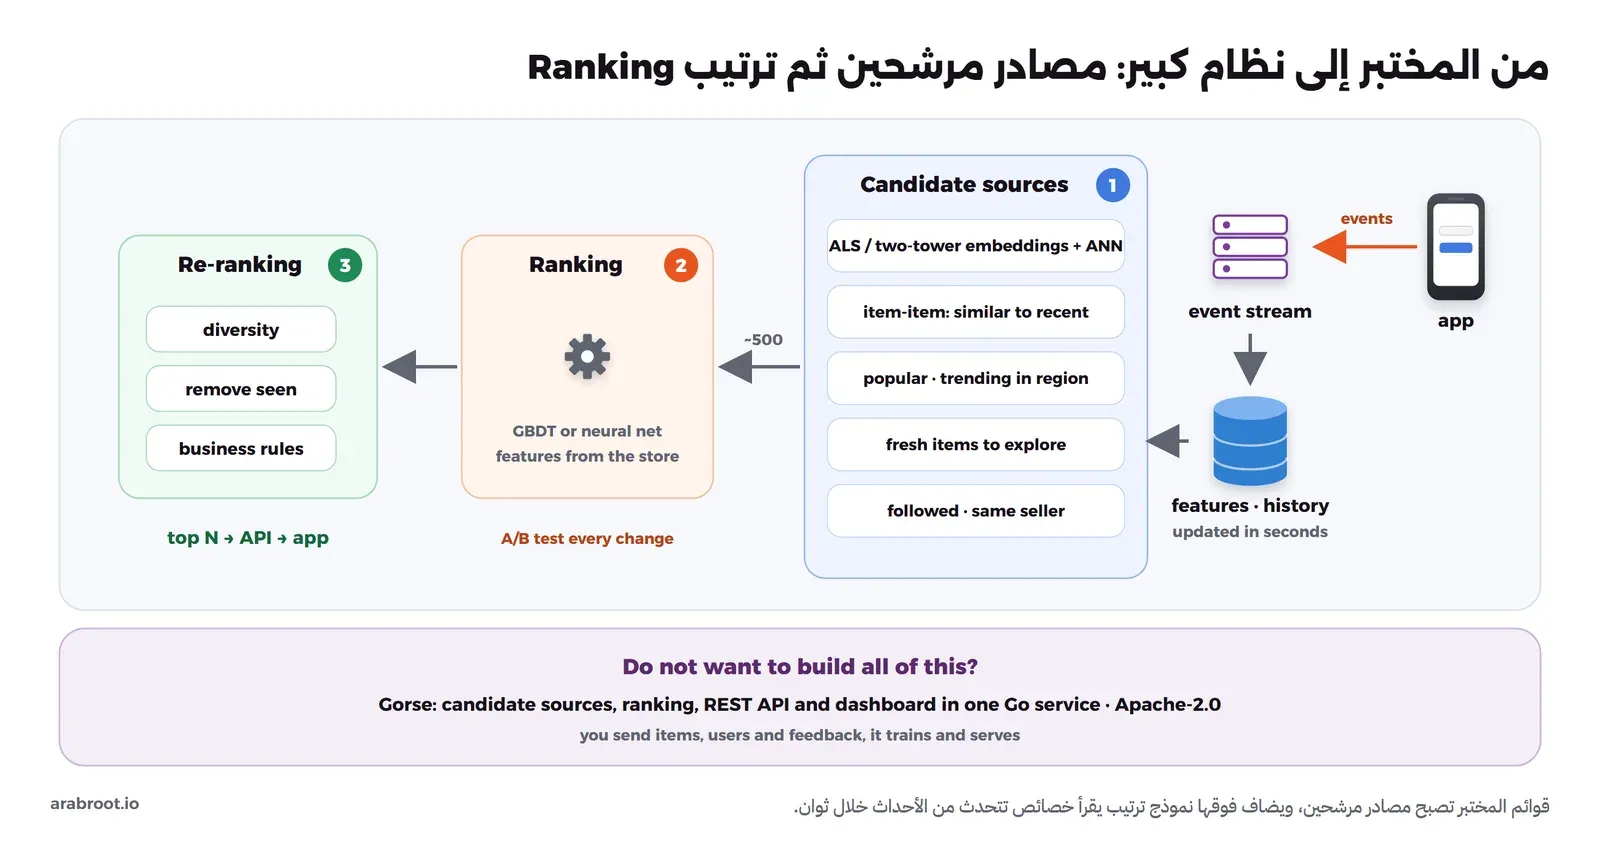
- مصادر مرشحين أكثر: كل قائمة في المختبر تصبح مصدراً واحداً من عدة مصادر، ويضاف إليها الجديد الذي يحتاج اختباراً، والرائج في المنطقة، وما يخص منتجك مثل نفس البائع أو الحسابات التي يتابعها. وعندما يكبر الكتالوج إلى ملايين، تخزن عوامل ALS أو Embeddings نموذج آخر في قاعدة بيانات شعاعية Vector Database وتبحث فيها بـ ANN بدل حساب الدرجات لكل عنصر، كما شرحنا في مقال RAG.
- نموذج ترتيب Ranking: بدل الخلط الثابت، نموذج Gradient Boosting يأخذ المرشحين من كل المصادر مع خصائص المستخدم والعنصر والسياق، ويتوقع احتمال النقر أو الشراء، ويتدرب على سجل ما عرض وما ضغط عليه. وهنا يصبح تسجيل ما عرض Impressions ضرورياً، لأنه الأمثلة السلبية للنموذج.
- مخزن خصائص Feature Store: الخصائص التي تتغير بسرعة، مثل آخر خمسة عناصر شاهدها المستخدم، تتحدث من بث الأحداث خلال ثوان، والخصائص البطيئة تحسب في الليل.
- اختبار A/B لكل تغيير: كما شرحنا في مقال المفاهيم، الأرقام بدون اتصال تختار المرشح، والمستخدمون الحقيقيون يقررون.
ولا تبن هذا كله دفعة واحدة، فكل خطوة منها تحتاج بيانات وفريقاً ومراقبة، ونصيحتنا أن تضيف الخطوة التالية فقط عندما يثبت اختبار A/B أن الخطوة الحالية وصلت إلى حدها.
متى تستخدم Gorse بدل أن تبني؟
Gorse نظام توصية مفتوح المصدر بلغة Go برخصة Apache-2.0، تعطيه العناصر والمستخدمين والتفاعلات عبر REST API، فيدرب النماذج ويجمع مصادر متعددة مثل الأحدث وتشابه المستخدمين وتشابه العناصر وال Collaborative Filtering، ويرد على طلب التوصية، وفيه لوحة تحكم لمراقبة الخطوات وتعديلها، كما تشرح صفحة توثيقه. وهو مناسب لك في الحالات التالية:
- لا يوجد في فريقك من يملك وقتاً لكتابة وصيانة مهمة التدريب والواجهة والتقييم، وتريد شيئاً يعمل هذا الشهر.
- منتجك يشبه الحالة العامة: عناصر ومستخدمون وتفاعلات بأنواع قليلة، مثل الإعجاب والقراءة والشراء.
- تريد أن تبقى البيانات على سيرفرك بدل خدمة توصية سحابية، لأسباب الخصوصية التي شرحناها في مقال المفاهيم.
وابن بنفسك كما في هذا المقال عندما تكون التوصية جزءاً أساسياً من قيمة منتجك وتحتاج تحكماً كاملاً في الخلط وقواعد العمل، أو عندما تكون لديك أصلاً منصة بيانات تريد أن تعيش التوصية داخلها. وفي الحالتين، طريقة التقييم بالزمن واختبار A/B واحدة.
أخطاء شائعة
- التقسيم العشوائي: رأيت في التجربة أنه ضاعف كل الأرقام دون أي تحسن حقيقي.
- اختيار الإعدادات على الاختبار: استخدم بيانات تحقق منفصلة، ولا تنظر إلى الاختبار إلا مرة واحدة في النهاية.
- نقل إعدادات الأوراق كما هي: alpha يساوي 40 كان الأفضل في الورقة الأصلية والأسوأ عندنا.
- تحميل النموذج في الواجهة وحساب الدرجات مع كل طلب: احسب في الليل واقرأ في الطلب، إلا إذا احتجت فعلاً غير ذلك.
- نسيان حذف ما شاهده المستخدم بعد التدريب: لا يوجد ما يزعج المستخدم أكثر من توصية بشيء اشتراه للتو.
- عدم تسجيل مصدر كل توصية: الحقل source في الرد يوفر عليك ساعات عند أول شكوى.
- استخدام بيانات بحثية في منتج تجاري: رخصة MovieLens لا تسمح بذلك دون إذن، فدرب على بياناتك.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- بنينا نظام توصية كاملاً على 48580 إعجاباً حقيقياً: الأكثر شعبية كخط أساس بـ NDCG@10 يساوي 0.0680، وتشابه العناصر 0.0915، وALS بعد ضبطه على بيانات التحقق 0.1028.
- النموذج الأعقد لم يكن الأفضل قبل ضبطه، والضبط يكون على بيانات تحقق منفصلة وليس على الاختبار.
- التقسيم العشوائي ضاعف كل الأرقام دون أن يتغير النموذج، فقسم بالزمن دائماً.
- التصميم «احسب في الليل واقرأ في الطلب» مع Redis رد في بضع ملي ثوان محلياً، والأكثر شعبية يخدم المستخدم الجديد، وجيران آخر إعجاب تجعل القائمة تتغير فوراً.
- عندما يكبر المنتج تصبح هذه القوائم مصادر مرشحين، ويضاف فوقها نموذج ترتيب، وإذا لم ترد البناء فـ Gorse يعطيك هذا الشكل جاهزاً على سيرفرك.
دليلأنظمة التوصية Recommender Systems للمبتدئينكيف تعرف المتاجر ومنصات الفيديو ما قد يعجبك، وما الفرق بين طرق التوصية، وكيف تقيس جودتها قبل أن تصل للمستخدم.دليلكيف تبني تطبيق فيديو قصير مثل TikTokكيف يجهز تطبيق الفيديو القصير المقطع التالي قبل أن تسحب الشاشة، وكيف يختار ما يناسبك من إشارات المشاهدة. دليلكيف تبني منصة فيديو عند الطلب مثل Netflixكيف يتحول فيديو مرفوع إلى بث يناسب كل شاشة وسرعة اتصال، وما الذي تحتاجه منصتك من التحويل إلى التوصيل والتكلفة.
 دليلالطابور Queue أم بث الأحداث Event Streaming؟ما يحدث للرسالة بعد قراءتها هو الفرق بين طابور مثل RabbitMQ وسجل أحداث مثل Kafka، ومنه تعرف أيهما يناسب مشروعك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجربة على Docker Engine 29.8.0 (Docker Desktop، ثمانية أنوية) مع python:3.13.16-slim وimplicit 0.7.3 وNumPy 2.5.3 وSciPy 1.18.1 وpandas 3.0.6 وFastAPI 0.143.0 وuvicorn 0.54.0 وredis-py 8.1.0 وhttpx 0.28.1، وRedis 8.8.3 (redis:8.8.3-alpine)، وبيانات MovieLens ml-latest-small.
- أكتوبر 2026: إضافة قسم المعمارية الكاملة: المخطط والمكونات ونموذج البيانات والواجهات وتقدير السعة ومراحل النمو.


