

عندما تفتح متجراً إلكترونياً فتجد تحت المنتج قائمة «اشترى العملاء أيضاً»، أو تنهي فيلماً فتقترح عليك المنصة الفيلم التالي، أو تفتح تطبيق توصيل الطعام فيعرض عليك مطاعم تشبه ما طلبته الأسبوع الماضي، فأنت أمام نظام توصية Recommender System. ووظيفة هذا النظام في جملة واحدة: أن يختار من آلاف أو ملايين العناصر عدداً صغيراً يعرضه لهذا الشخص في هذه اللحظة، بحيث يرجح أن يضغط عليه أو يشاهده أو يشتريه. وقد يتساءل البعض: لماذا لا نعرض الأكثر مبيعاً للجميع وننتهي؟ والإجابة أن هذا فعلاً هو أول حل يجب أن تبنيه، ولكنه يعطي نفس القائمة لطالب يبحث عن كتب برمجة ولأم تبحث عن ألعاب أطفال، وكل نظام توصية بعده هو محاولة للتفريق بين هذين الشخصين.
وسوف نناقش في هذا المقال ما يلي:
- أين تظهر التوصيات، والفرق بين التقييم الصريح Explicit Feedback والإشارات الضمنية Implicit Feedback.
- طرق التوصية من الأبسط: الأكثر شعبية Popularity، ثم التوصية بالمحتوى Content-based، ثم Collaborative Filtering بنوعيه وتحليل المصفوفة Matrix Factorization بمثال صغير نحسبه بالكود، ثم الأنظمة الهجينة Hybrid.
- الشكل الحديث للأنظمة الكبيرة: الاسترجاع Retrieval بال Embeddings ثم الترتيب Ranking بالخصائص، ونماذج التسلسل Sequence Models باختصار.
- المشكلات التي تواجه كل نظام: البداية الباردة Cold Start، وحلقة التغذية الراجعة Feedback Loop، وانحياز الشعبية Popularity Bias، والفقاعة Filter Bubble، والتنوع Diversity.
- التقييم: precision@k وrecall@k وMAP وNDCG والتغطية Coverage بحساب حقيقي، ولماذا لا يظهر تحسن الأرقام دائماً عند المستخدمين.
- البيانات والخصوصية، ثم الأدوات المفتوحة ورخصها.
وهذا المقال يشرح المفاهيم، أما بناء نظام كامل على بيانات حقيقية مع واجهة API وقياس وتسرب بيانات مقصود فهو في المقال التالي كيف تبني نظام توصية من الصفر.
 دليلكيف تبني نظام توصية من الصفر بلغة Pythonنبني نظام توصية على بيانات أفلام حقيقية، ونقارن ثلاث طرق بالأرقام، ثم نقدمه عبر واجهة API سريعة تقرأ من Redis.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليلكيف تبني تطبيق فيديو قصير مثل TikTokكيف يجهز تطبيق الفيديو القصير المقطع التالي قبل أن تسحب الشاشة، وكيف يختار ما يناسبك من إشارات المشاهدة.
أين تظهر التوصيات، ومن أين تأتي إشاراتها؟
التوصية موجودة في كل منتج فيه عناصر كثيرة وشاشة صغيرة: المتجر يعرض «اشترى العملاء أيضاً»، ومنصة الفيديو تعرض «التالي» وصفحة «لك»، وموقع الأخبار يعرض «أخبار مشابهة»، وتطبيق الموسيقى يصنع لك قائمة يومية، وتطبيق توصيل الطعام يرتب المطاعم في الصفحة الأولى. والفكرة واحدة في كل هذه الحالات، وما يختلف هو نوع الإشارات التي يتعلم منها النظام، والصورة التالية تبين ذلك:
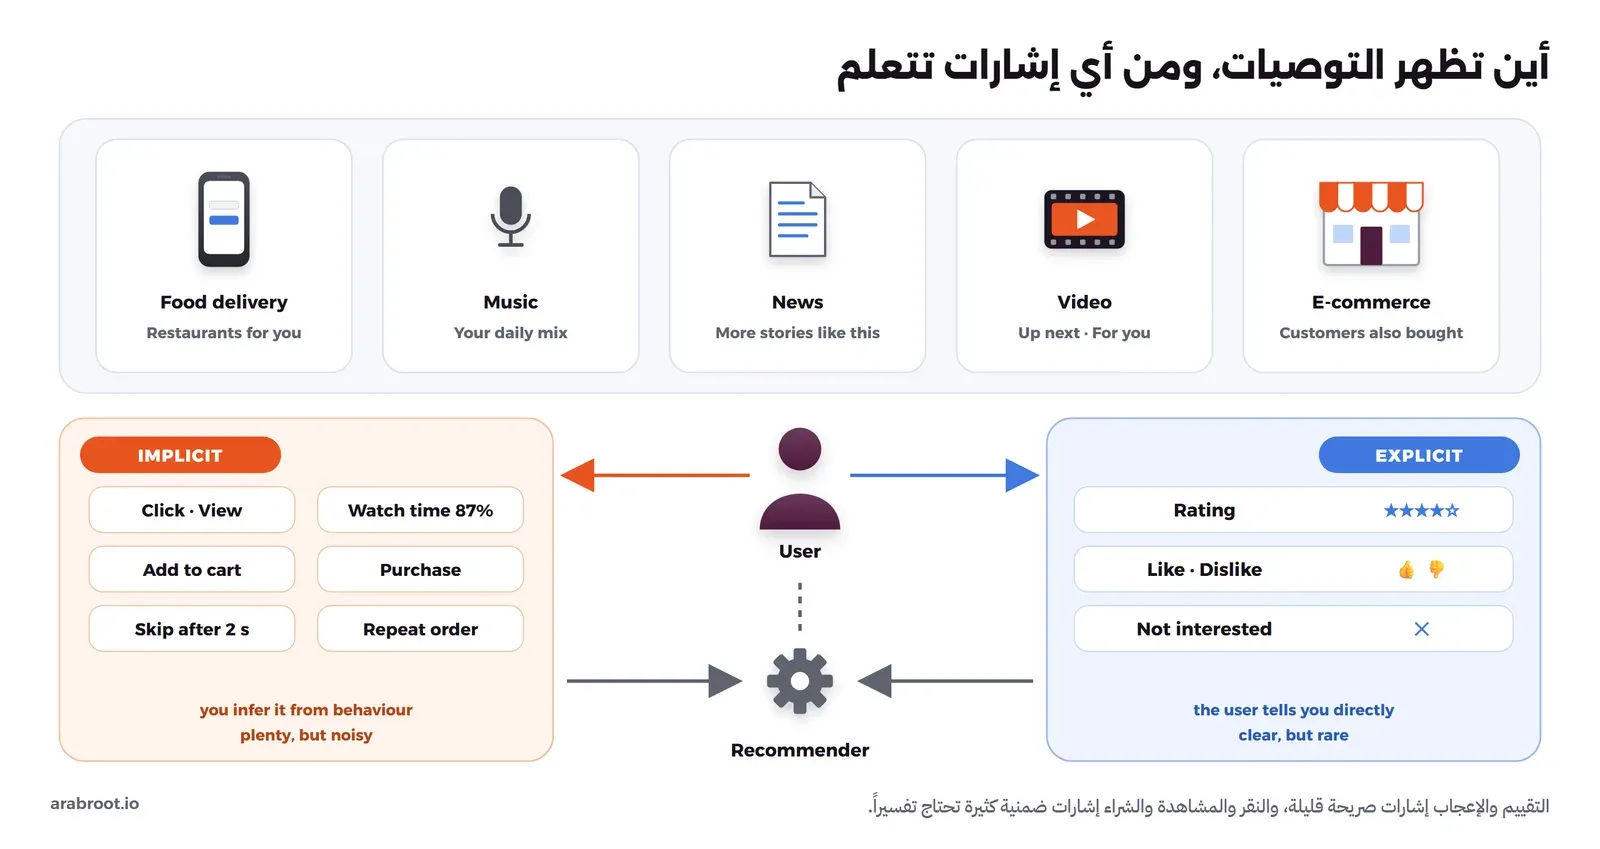
- التقييم الصريح Explicit Feedback: المستخدم يقول رأيه مباشرة، مثل خمس نجوم أو زر الإعجاب أو «غير مهتم». وهو واضح، ولكنه قليل جداً، لأن أغلب الناس لا يقيمون ما يشترونه أو يشاهدونه.
- الإشارات الضمنية Implicit Feedback: ما يفعله المستخدم دون أن يقصد إخبارك، مثل النقر والمشاهدة ونسبة الإكمال والإضافة للسلة والشراء وتكرار الطلب والتخطي بعد ثانيتين. وهي كثيرة جداً، ولكنها غامضة، فالنقرة قد تكون فضولاً، والمشاهدة الكاملة قد تكون لأن الهاتف بقي مفتوحاً على الطاولة.
ولاحظ أن غياب الإشارة الضمنية لا يعني الرفض، فإذا لم يشتر المستخدم منتجاً فقد يكون لم يره أصلاً، وهذا فرق مهم بين النوعين سوف يعود معنا في تحليل المصفوفة، لأن الخانات الفارغة فيها ليست «لا يعجبني» وإنما «لا أعرف». ولهذا تتعامل أغلب الأنظمة الحديثة مع الإشارات الضمنية كأساس، وتستخدم التقييم الصريح حيث يوجد كإشارة أقوى.
طرق التوصية من الأبسط إلى الأعقد
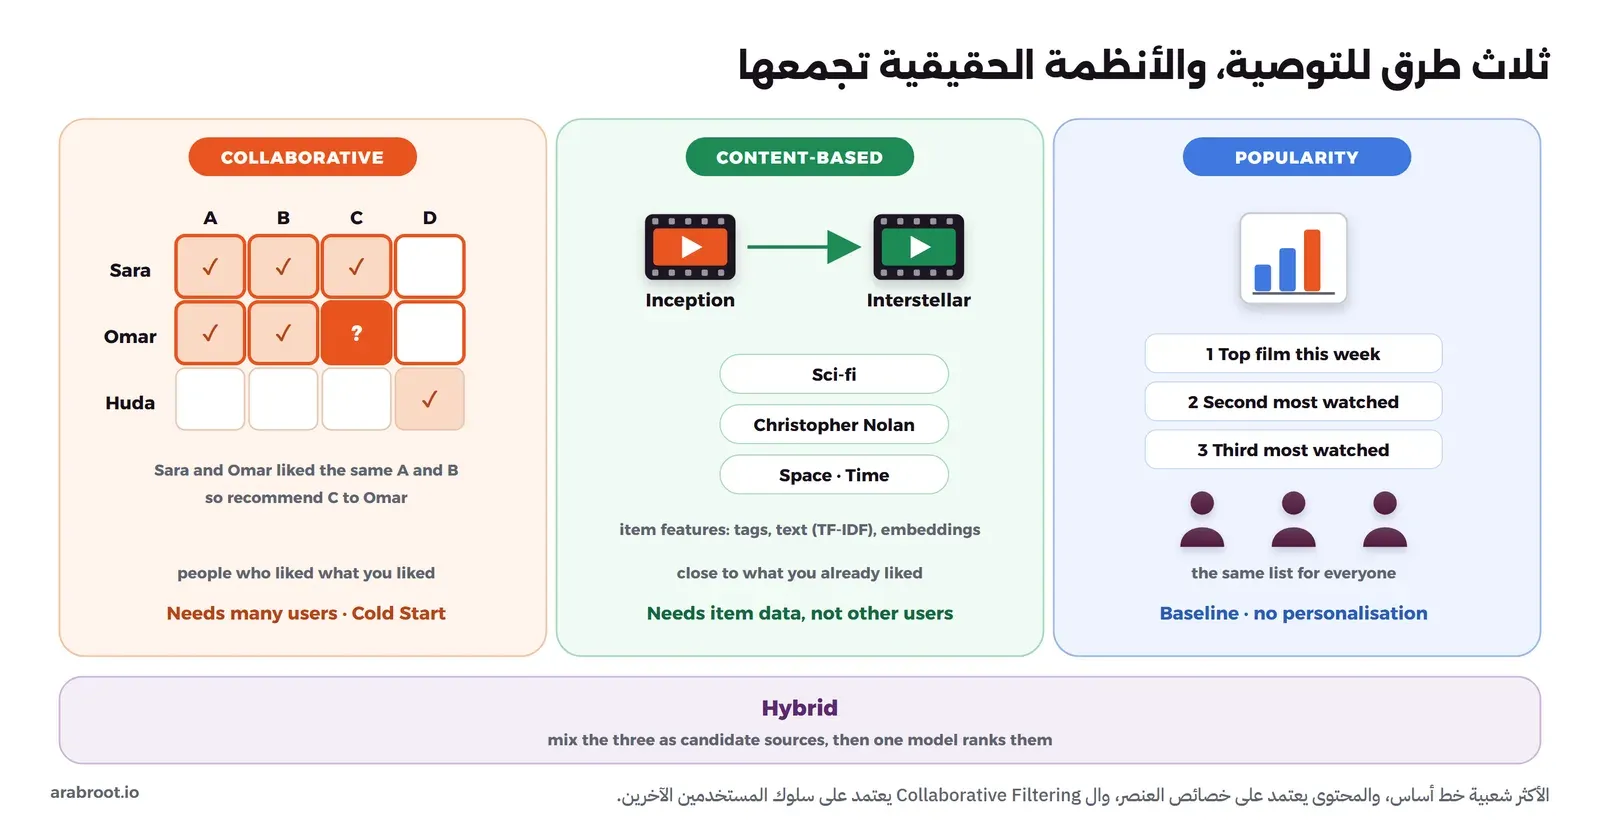
هناك ثلاث عائلات رئيسية، وكل نظام حقيقي يجمع بينها في النهاية، والصورة التالية تبين الفكرة في كل منها:
الأكثر شعبية Popularity: خط الأساس الذي يجب أن تهزمه
الحل البسيط أن ترتب العناصر بعدد المشترين أو المشاهدين وتعرض الأعلى للجميع، مع حذف ما شاهده المستخدم من قبل. ونسخة أفضل قليلاً هي الرائج Trending: الأكثر تفاعلاً في آخر 7 أيام أو آخر 90 يوماً، أو الأكثر في مدينة المستخدم أو لغته، وذلك لأن الشعبية القديمة تبقي نفس العناصر في الأعلى سنوات. وهذه الطريقة لا تخصص شيئاً لأحد، ولكنها ليست ضعيفة كما تبدو، ففي مقارنة المقال التالي على بيانات أفلام حقيقية جاء الأكثر شعبية قريباً من الطرق الأعقد، لذلك ابدأ به دائماً كخط أساس Baseline كما شرحنا في التعلم الآلي للمبتدئين، ولا تقبل أي نموذج لا يهزمه بفارق واضح.
التوصية بالمحتوى Content-based
هنا يقترح النظام عناصر تشبه في خصائصها ما أعجب المستخدم، فإذا شاهد Inception فاقترح Interstellar لأنهما من نفس النوع ونفس المخرج. وتمثيل العنصر يكون بإحدى طريقتين:
- TF-IDF على النص والوسوم Tags: كل عنصر يصبح متجهاً Vector من الكلمات المهمة فيه، والتشابه بين عنصرين هو التشابه بين متجهيهما، وهي نفس الفكرة التي شرحناها في ترتيب نتائج البحث. وتستطيع أن تحصل على هذا جاهزاً من محرك البحث نفسه، فاستعلام more_like_this في OpenSearch وElasticsearch يأخذ مستنداً أو نصاً، ويختار الكلمات التي تميزه، ثم يبحث عن المستندات التي تحتويها، وهذا يكفي لقائمة «مقالات مشابهة» في موقع أخبار دون أي نموذج.
- ال Embeddings: نموذج لغة أو نموذج صور يحول وصف العنصر أو صورته إلى متجه أرقام يمثل المعنى، فيقترب «مسلسل جريمة تركي» من «دراما بوليسية» رغم اختلاف الكلمات، وقد شرحنا ال Embedding في كيف تعمل نماذج اللغة وتخزينها والبحث فيها في مقال RAG.
ونقطة القوة في هذه الطريقة أنها لا تحتاج مستخدمين آخرين، فتعمل مع منتج جديد في أول يوم له. ونقطة الضعف أنها تبقى قريبة مما يعرفه المستخدم، فمن قرأ عن كرة القدم يرى كرة قدم إلى الأبد، ولا تعرف أن من يحب هذا الكتاب يحب غالباً كتاباً من مجال مختلف تماماً.
ال Collaborative Filtering: الناس الذين يشبهونك
وهنا لا ينظر النظام إلى محتوى العنصر إطلاقاً، وإنما إلى سلوك المستخدمين، والفكرة أن من اتفقوا معك في الماضي سيتفقون معك غالباً في المستقبل. ويبدأ كل شيء من مصفوفة التفاعل Interaction Matrix: صف لكل مستخدم، وعمود لكل عنصر، وفي الخانة 1 إذا أعجبه أو اشتراه، وفارغة إذا لم يحدث شيء. وهناك طريقتان كلاسيكيتان:
- على أساس المستخدم User-based: ابحث عن المستخدمين الأقرب لهذا المستخدم في الصفوف، واقترح ما أعجبهم ولم يره. ومشكلتها أن عدد المستخدمين كبير ويتغير كل دقيقة، فحساب الجيران لكل زيارة مكلف.
- على أساس العنصر Item-based أو Item-to-Item: احسب التشابه بين الأعمدة، أي بين العناصر، فعنصران يشتريهما نفس الناس متشابهان، ثم اقترح للمستخدم العناصر الأقرب لما أعجبه. والتشابه بين العناصر أثبت من التشابه بين المستخدمين، فيمكن حسابه مسبقاً مرة في اليوم.
ولاحظ في القصة أن مشكلة الأكثر مبيعاً تظهر حتى داخل ال Collaborative Filtering نفسه، والسبب أن العناصر الشائعة تتكرر مع كل شيء، لذلك فالتشابه يجب أن يقسم على شعبية العنصر، وهذا ما يفعله تشابه جيب التمام Cosine Similarity عندما يقسم على طول كل عمود، كما سترى في المثال التالي.
تحليل المصفوفة Matrix Factorization بمثال صغير
مصفوفة التفاعل الحقيقية ضخمة وأغلبها فارغ، ففي بيانات الأفلام التي نستخدمها في المقال التالي 609 مستخدمين و6298 فيلماً، وعدد الخانات المملوءة أقل من 2% منها. وفكرة تحليل المصفوفة أن نمثل كل مستخدم بعدد صغير من الأرقام، وكل عنصر بنفس العدد من الأرقام، بحيث يقترب حاصل ضربهما من الخانات المعروفة، فإذا نجحنا في ذلك فحاصل الضرب في الخانات الفارغة هو التوقع. وهذه الأرقام تسمى العوامل الكامنة Latent Factors، ولا يحددها أحد بيده، وإنما يكتشفها التدريب، فقد يصبح أحدها مقياساً لـ«خيال علمي» وآخر لـ«دراما رومانسية» دون أن يسميه أحد.
ولنأخذ مثالاً من أربعة مستخدمين وخمسة أفلام: سارة أعجبتها Matrix وInception وInterstellar، وعمر أعجبه Matrix وInception فقط، وهدى أعجبها Titanic وThe Notebook، وخالد أعجبه Inception وTitanic وThe Notebook. والسؤال: ماذا نقترح لعمر؟ البرنامج التالي يحسب ذلك بطريقتين، تشابه العناصر Item-item، ثم ALS، واختصاره Alternating Least Squares، وفكرته أن تثبت عوامل الأفلام وتحسب أفضل عوامل للمستخدمين، ثم تثبت عوامل المستخدمين وتحسب أفضل عوامل للأفلام، وتكرر ذلك حتى يقل الخطأ. ويحسب البرنامج في آخره مقاييس التقييم التي سنشرحها لاحقاً:
# The tiny example of the concepts article: 4 users x 5 items, item-item cosine, ALS by hand, and the metrics
import numpy as np
np.set_printoptions(precision=2, suppress=True)
items = ["Matrix", "Inception", "Interstellar", "Titanic", "Notebook"]
R = np.array([[1, 1, 1, 0, 0],      # Sara
              [1, 1, 0, 0, 0],      # Omar
              [0, 0, 0, 1, 1],      # Huda
              [0, 1, 0, 1, 1]],     # Khaled
             dtype=float)
n = np.linalg.norm(R, axis=0)
S = (R.T @ R) / np.outer(n, n)
print("item-item cosine:\n", S)
print("Omar, item-item scores:", R[1] @ S)

k, lam = 2, 0.1
rng = np.random.default_rng(0)
U, V = rng.normal(0, 0.1, (4, k)), rng.normal(0, 0.1, (5, k))
for it in range(10):                 # alternate: fix V and solve U, then fix U and solve V
    U = R @ V @ np.linalg.inv(V.T @ V + lam * np.eye(k))
    V = R.T @ U @ np.linalg.inv(U.T @ U + lam * np.eye(k))
    if it in (0, 9):
        print(f"iteration {it + 1}: squared error {((R - U @ V.T) ** 2).sum():.3f}")
print("user factors U:\n", U); print("item factors V:\n", V)
print("predicted U x V^T:\n", U @ V.T)

recs, rel = ["Interstellar", "Titanic", "Notebook", "Matrix", "Inception"], {"Interstellar", "Matrix"}
for kk in (3, 5):
    hits = [1 if x in rel else 0 for x in recs[:kk]]
    dcg = sum(h / np.log2(i + 2) for i, h in enumerate(hits)); idcg = sum(1 / np.log2(i + 2) for i in range(min(len(rel), kk)))
    print(f"@{kk}: hits={hits} precision={sum(hits)/kk:.3f} recall={sum(hits)/len(rel):.3f} ndcg={dcg/idcg:.3f}")
احفظه باسم tiny.py وشغله في Container مؤقت لا يحتاج أكثر من NumPy:
docker run --rm --name lab-rec-tiny -v "$PWD:/lab" -w /lab python:3.13.16-slim \
  sh -c "pip install -q --root-user-action=ignore numpy==2.5.3 && python tiny.py"
والمخرج سوف يكون كما يلي:
item-item cosine:
 [[1.   0.82 0.71 0.   0.  ]
 [0.82 1.   0.58 0.41 0.41]
 [0.71 0.58 1.   0.   0.  ]
 [0.   0.41 0.   1.   1.  ]
 [0.   0.41 0.   1.   1.  ]]
Omar, item-item scores: [1.82 1.82 1.28 0.41 0.41]
iteration 1: squared error 4.168
iteration 10: squared error 0.704
user factors U:
 [[-0.25 -1.13]
 [-0.26 -0.88]
 [-0.95  0.23]
 [-1.21 -0.2 ]]
item factors V:
 [[-0.01 -0.89]
 [-0.48 -0.87]
 [ 0.01 -0.51]
 [-0.88  0.22]
 [-0.88  0.22]]
predicted U x V^T:
 [[ 1.01  1.11  0.57 -0.03 -0.03]
 [ 0.79  0.89  0.44  0.03  0.03]
 [-0.19  0.26 -0.12  0.89  0.89]
 [ 0.19  0.76  0.09  1.02  1.02]]
@3: hits=[1, 0, 0] precision=0.333 recall=0.500 ndcg=0.613
@5: hits=[1, 0, 0, 1, 0] precision=0.400 recall=1.000 ndcg=0.877
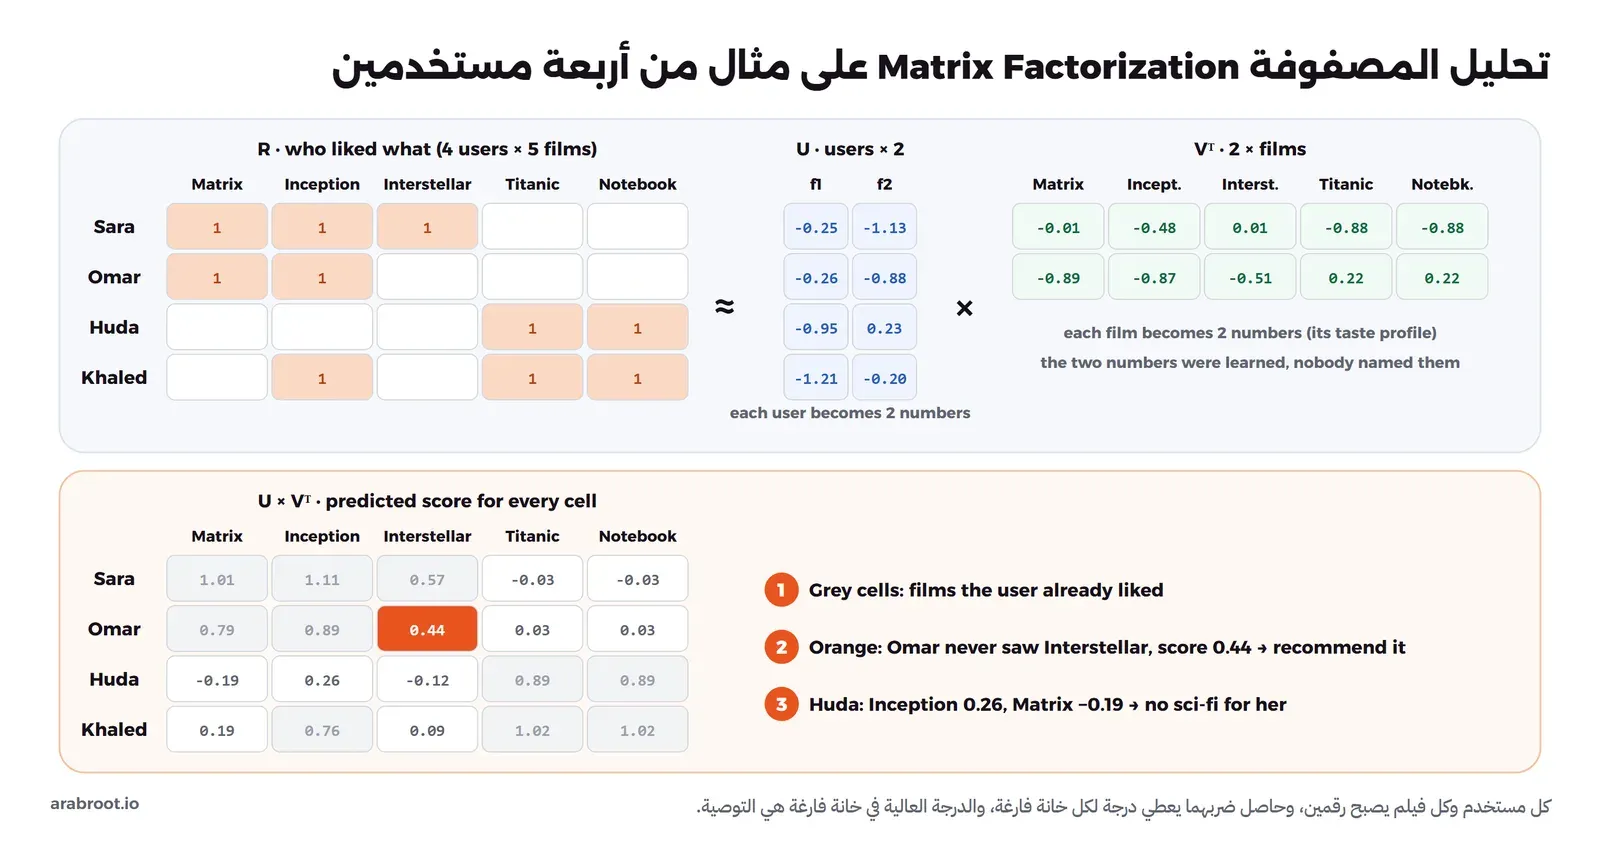
والصورة التالية تضع نفس الأرقام في شكل المصفوفات:
في المخرج أعلاه لاحظ التالي:
- مصفوفة تشابه العناصر تقول إن Matrix وInception متشابهان بدرجة 0.82، لأن نفس الناس أعجبهم الاثنان، وإن Titanic وThe Notebook متطابقان تقريباً بدرجة 1، وإن Inception له صلة ضعيفة بهما 0.41 بسبب خالد وحده.
- درجات عمر من تشابه العناصر هي مجموع تشابه كل فيلم مع ما أعجبه، وبعد حذف ما شاهده يبقى Interstellar بدرجة 1.28 في المقدمة بفارق كبير عن Titanic بدرجة 0.41، فالتوصية Interstellar.
- ALS نزل بالخطأ من 4.168 في أول دورة إلى 0.704 بعد عشر دورات، ولم يصل إلى صفر لأن رقمين لكل شخص لا يكفيان لحفظ كل خانة، وهذا مقصود، لأن النموذج الذي يحفظ كل خانة لا يتوقع شيئاً جديداً.
- في التوقع، خانة عمر مع Interstellar أخذت 0.44، وهي أعلى خانة فارغة في صفه، فيتفق ALS مع تشابه العناصر. وهدى أخذت 0.26 مع Inception و-0.19 مع Matrix، أي أن النموذج فهم وحده أن ذوقها بعيد عن الخيال العلمي.
- العمود الثاني في V سالب وكبير لأفلام الخيال العلمي الثلاثة، والعمود الأول سالب وكبير لفيلمي الدراما، وهذان هما «الذوقان» اللذان اكتشفهما التدريب دون أن نخبره بنوع أي فيلم.
ولاحظ أن هذا الشكل البسيط من ALS يعامل الخانات الفارغة كأصفار بنفس وزن الخانات المملوءة، وهذا لا يناسب الإشارات الضمنية لأن الفراغ فيها يعني «لا أعرف». لذلك اقترح Hu وKoren وVolinsky في ورقة Collaborative Filtering for Implicit Feedback Datasets سنة 2008 أن تعطى كل خانة ثقة Confidence تزيد مع عدد التفاعلات، فالخانة التي اشترى فيها المستخدم المنتج عشر مرات أوثق من خانة فيها نقرة واحدة، والخانات الفارغة تبقى بثقة منخفضة، وهذا هو ALS الذي تنفذه مكتبة implicit والذي سنستخدمه في المقال التالي، ويضبطه المعامل alpha.
وهناك طريقة ثانية مشهورة للإشارات الضمنية هي BPR، واختصارها Bayesian Personalized Ranking، من ورقة Rendle وزملائه سنة 2009، وفكرتها أن النموذج لا يحاول توقع رقم كل خانة، وإنما يتعلم الترتيب مباشرة: لكل مستخدم، العنصر الذي تفاعل معه يجب أن يأخذ درجة أعلى من عنصر عشوائي لم يتفاعل معه. وهذا أقرب لما نريده فعلاً، لأننا لا نعرض للمستخدم أرقاماً، وإنما قائمة مرتبة.
الأنظمة الهجينة Hybrid
كل طريقة من الطرق السابقة تسد نقصاً في الأخرى: المحتوى يعمل مع العنصر الجديد الذي لم يتفاعل معه أحد، وال Collaborative Filtering يكتشف علاقات لا تظهر في الوصف، والشعبية تعطي شيئاً معقولاً لمستخدم لا تعرف عنه شيئاً. لذلك تجمع الأنظمة الحقيقية بينها، إما بنموذج واحد يأخذ خصائص المستخدم والعنصر إلى جانب التفاعلات، كما تفعل مكتبة LightFM، وإما بجمع قوائم من عدة مصادر ثم ترتيبها بنموذج واحد، وهذا هو الشكل الذي نشرحه الآن.
الشكل الحديث: الاسترجاع Retrieval ثم الترتيب Ranking
لا يستطيع أي نظام أن يشغل نموذجاً معقداً على كل عنصر في الكتالوج لكل مستخدم في كل طلب، فإذا كان لديك عشرة ملايين منتج وتريد الرد في أقل من 100 ملي ثانية فالحساب لن يكفي. لذلك تعمل الأنظمة الكبيرة على مرحلتين، والصورة التالية تبين ذلك:
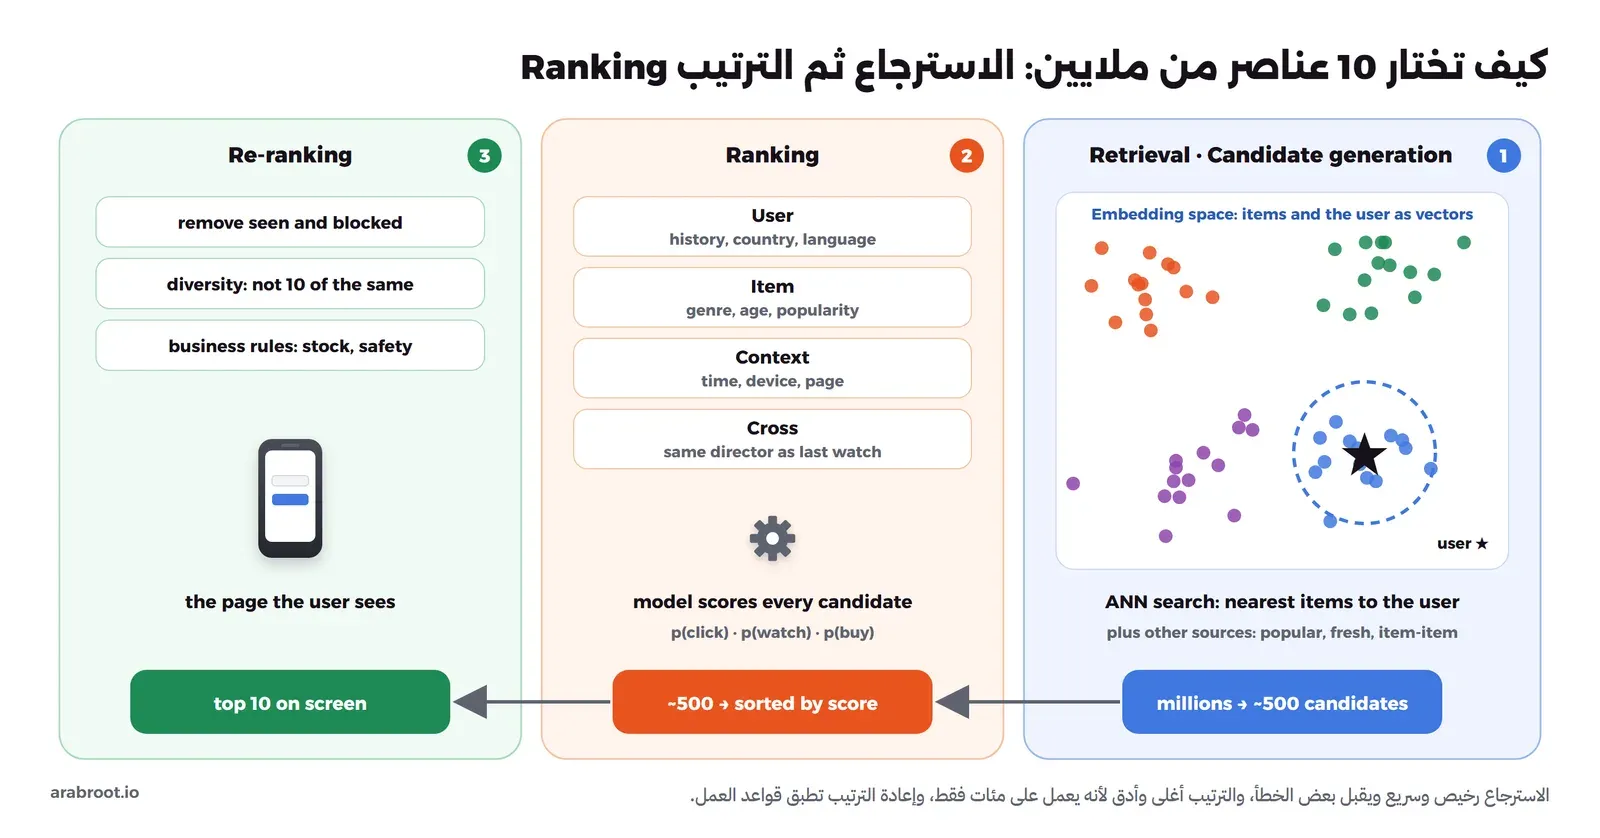
- الاسترجاع Retrieval، ويسمى أيضاً توليد المرشحين Candidate Generation: عدة مصادر سريعة تجمع بضع مئات من العناصر المحتملة. أهمها اليوم أن تمثل المستخدم والعنصر كمتجهين في نفس الفضاء، ثم تبحث عن أقرب العناصر لمتجه المستخدم بالبحث التقريبي عن الجيران ANN، واختصاره Approximate Nearest Neighbors، وهو نفس فهرس HNSW الذي شرحناه في مقال RAG. ويضاف إليه مصادر أخرى مثل العناصر المشابهة لآخر ما تفاعل معه، والرائج في منطقته، والجديد الذي يحتاج اختباراً.
- الترتيب Ranking: نموذج تعلم آلي أدق وأغلى يعطي كل مرشح درجة، مثل احتمال النقر أو الشراء أو المشاهدة الكاملة، ويقرأ خصائص Features كثيرة: تاريخ المستخدم وبلده ولغته، وعمر العنصر وشعبيته وسعره، والسياق مثل الوقت ونوع الجهاز، وخصائص مشتركة مثل «هل هذا الفيلم من مخرج آخر فيلم شاهده؟». وغالباً يكون النموذج من نوع Gradient Boosting أو شبكة عصبية، كما شرحناهما في التعلم الآلي للمبتدئين.
- إعادة الترتيب Re-ranking: قواعد بعد النموذج، مثل حذف ما شاهده، وألا تأتي عشرة عناصر من نفس النوع، واستبعاد ما نفد من المخزون أو ما لم تنته مراجعته.
وهذا الشكل وصفته YouTube بوضوح في ورقة Deep Neural Networks for YouTube Recommendations التي قدمها Paul Covington وJay Adams وEmre Sargin في مؤتمر RecSys سنة 2016: شبكة لتوليد المرشحين تختار من ملايين الفيديوهات بضع مئات، ثم شبكة للترتيب تعطيها درجات، وعند الخدمة يتحول توليد المرشحين إلى بحث عن أقرب الجيران لأن المطلوب الرد خلال عشرات الملي ثواني. وفي الورقة ملاحظتان مفيدتان لأي فريق: الأولى أن الترتيب بنسبة النقر Click-through Rate يرفع الفيديوهات المضللة التي لا يكملها المستخدم Clickbait، لذلك رتبوا بوقت المشاهدة المتوقع. والثانية أنهم أضافوا عمر مثال التدريب كخاصية Example Age حتى لا يفضل النموذج الفيديوهات القديمة التي جمعت مشاهدات أكثر في فترة التدريب.
وقد شرحنا تطبيق هذا الشكل على خلاصة الفيديو القصير، مع إشارات المشاهدة ونظام ByteDance للتدريب المستمر، في مقال تطبيق الفيديو القصير، فلن نكرره هنا.
نماذج التسلسل Sequence Models والجلسة Session
الطرق السابقة تعامل تاريخ المستخدم كمجموعة بلا ترتيب، ولكن الترتيب مهم: من أضاف هاتفاً إلى السلة الآن يحتاج غطاء وشاحناً، وليس هاتفاً آخر. ونماذج التسلسل تأخذ آخر العناصر بترتيبها وتتوقع العنصر التالي، وبدأت بشبكات RNN مثل GRU4Rec للجلسات القصيرة دون حساب مسجل، ثم انتقلت إلى الانتباه Attention ونماذج Transformer، وهي نفس الفكرة التي تعمل بها نماذج اللغة التي تتوقع الكلمة التالية. وفي البداية يكفيك تقريب بسيط: اخلط في القائمة عناصر مشابهة لآخر شيء فعله المستخدم، كما سنفعل في المقال التالي.
المشكلات التي تواجه كل نظام توصية
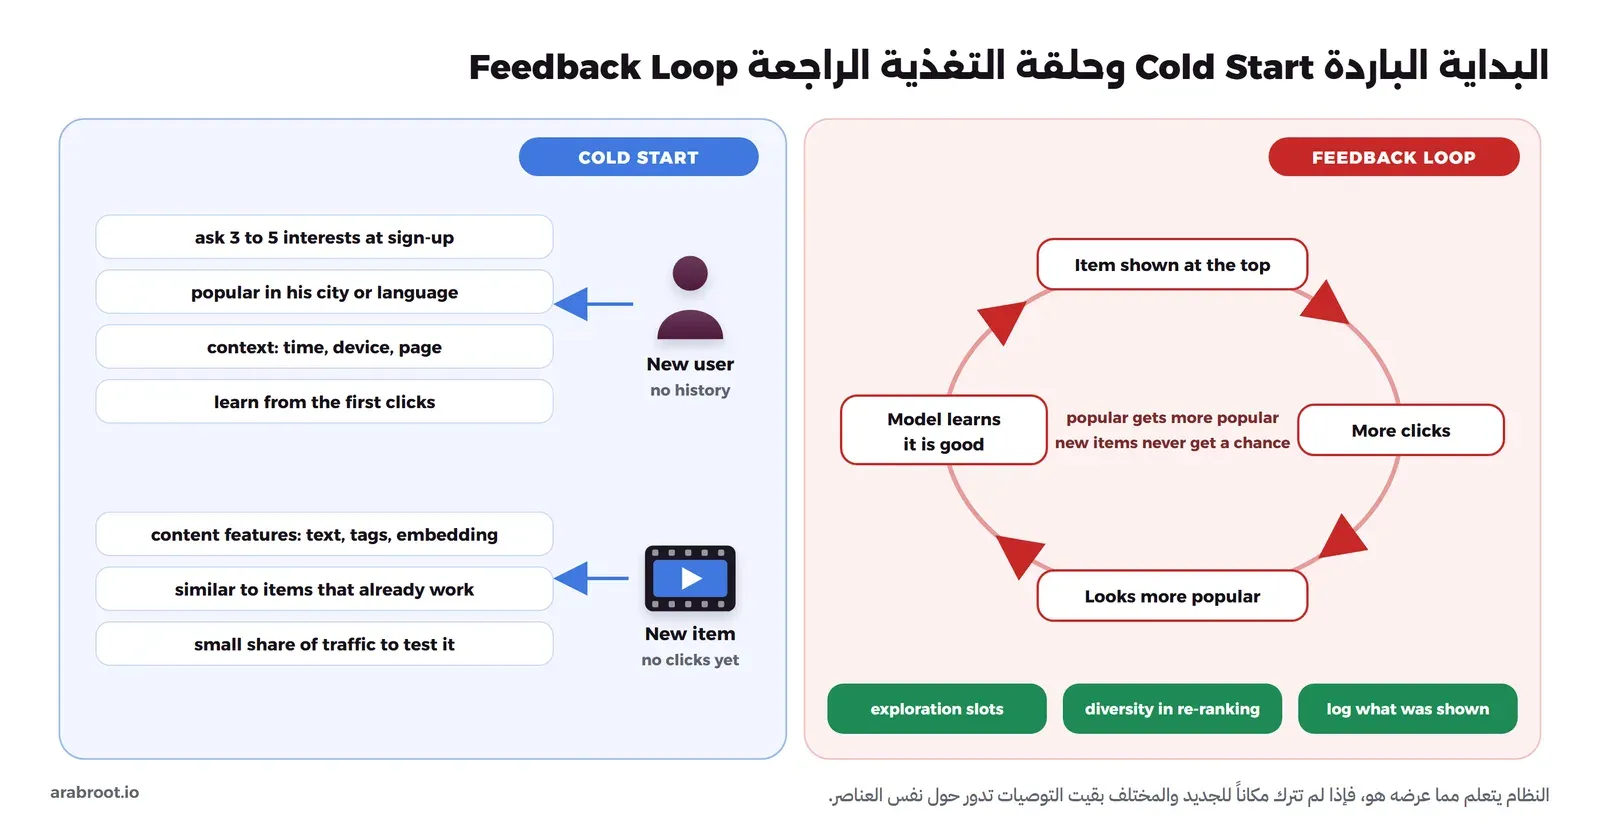
الصورة التالية تجمع أشهر مشكلتين، البداية الباردة وحلقة التغذية الراجعة:
البداية الباردة Cold Start
ال Collaborative Filtering لا يعرف شيئاً عن مستخدم أو عنصر بلا تفاعلات، وهذه هي البداية الباردة، وهي في الحقيقة ثلاث حالات:
- مستخدم جديد: ابدأ بالأكثر شعبية في مدينته أو لغته، واسأله عن ثلاثة أو خمسة اهتمامات عند التسجيل، واستخدم السياق مثل الصفحة التي جاء منها، ثم تعلم من أول نقراته، فبعد نقرتين أو ثلاث يكفي تشابه العناصر لتقديم شيء شخصي.
- عنصر جديد: لا أحد تفاعل معه، فاعتمد على خصائص محتواه وال Embedding الخاص بوصفه، وخصص له نسبة صغيرة من الزيارات حتى تجمع عنه إشارات، كما تفعل خلاصة الفيديو القصير التي شرحناها في ذلك المقال.
- نظام جديد: لا توجد بيانات أصلاً، وهنا لا ينفعك أي نموذج، فابدأ بالشعبية والمحتوى وسجل كل تفاعل من أول يوم، لأن جدول التفاعلات هو المادة الخام لكل ما بعده.
حلقة التغذية الراجعة وانحياز الشعبية
النظام يتعلم من النقرات، والنقرات تأتي على ما عرضه النظام نفسه، فالعنصر الذي ظهر في الأعلى يأخذ نقرات أكثر، فيبدو في البيانات أكثر شعبية، فيتعلم النموذج أنه جيد، فيعرضه أكثر. وهذه هي حلقة التغذية الراجعة Feedback Loop، ونتيجتها انحياز الشعبية Popularity Bias: قلة من العناصر تأخذ أغلب العرض، والعناصر الجديدة أو المتخصصة لا تحصل على فرصة لتثبت نفسها. وعلى مستوى المستخدم نفسه تظهر الفقاعة Filter Bubble، فمن ضغط على نوع واحد من الأخبار يرى منه فقط، ويختفي عنه كل ما عداه.
والحلول المعروفة ثلاثة: أن تخصص أماكن قليلة ثابتة للاستكشاف Exploration تعرض فيها عناصر لم تختبر بعد، وأن تفرض التنوع Diversity في إعادة الترتيب فلا تأتي القائمة كلها من نوع واحد، وأن تسجل ما عرضته Impressions وليس فقط ما ضغط عليه المستخدم، حتى تعرف أن العنصر لم يأخذ نقرات لأنه لم يعرض، وليس لأنه سيئ. وهناك مقياسان يساعدانك على مراقبة ذلك: الجدة Novelty، أي هل تعرض عناصر لا يعرفها المستخدم مسبقاً، والتغطية Coverage، أي كم نسبة من الكتالوج ظهرت في توصيات أي مستخدم، وسنحسبها في التقييم.
كيف تعرف أن التوصية جيدة؟
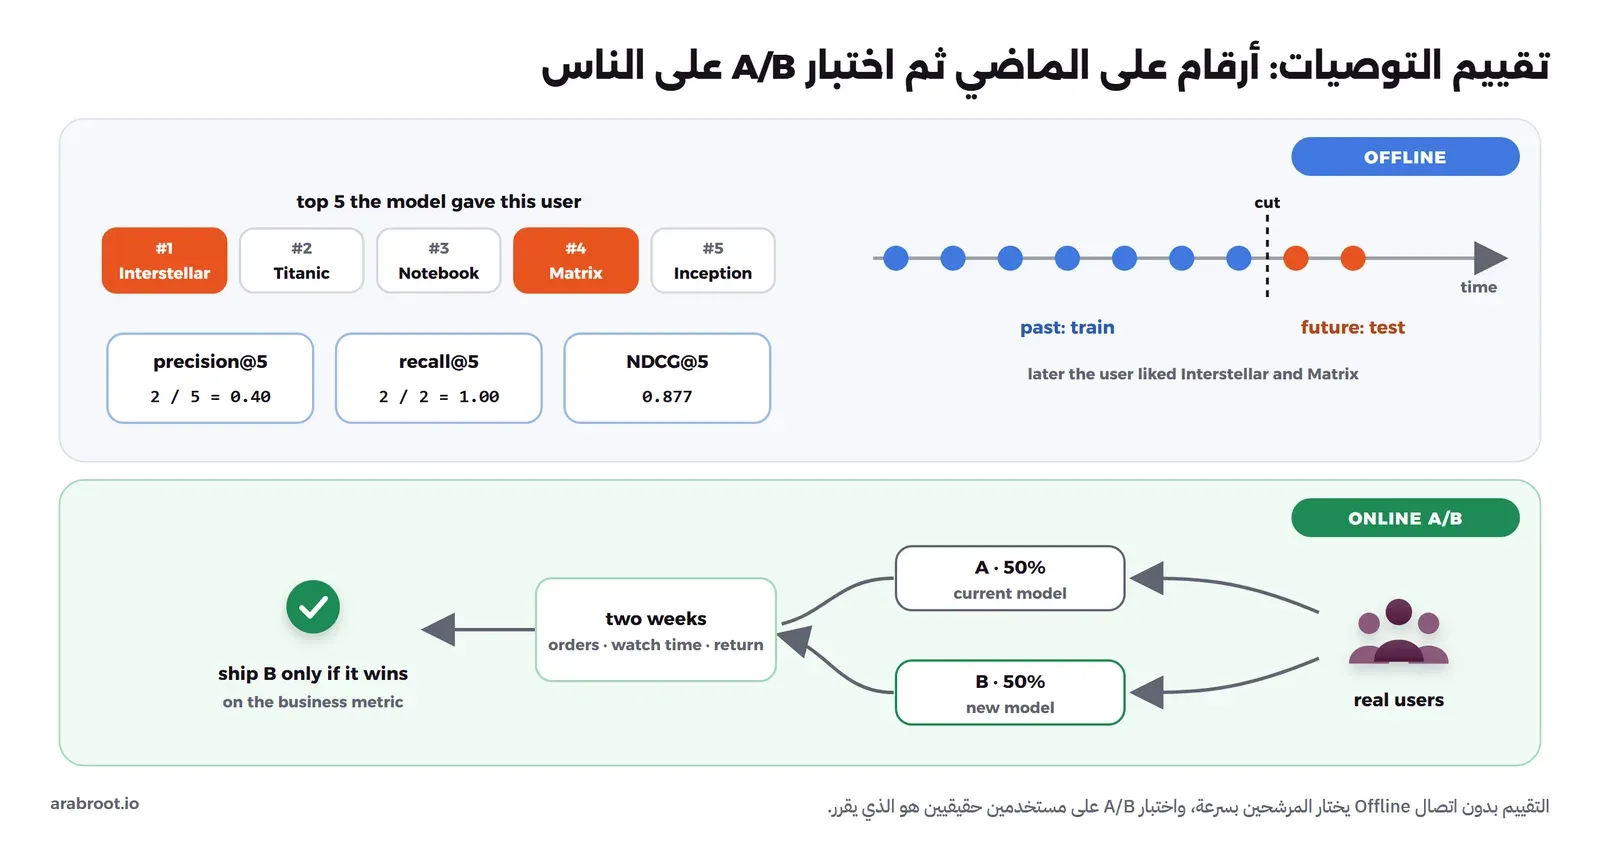
التقييم يحدث على مرحلتين، بالأرقام على بيانات الماضي ثم على مستخدمين حقيقيين، والصورة التالية تبين المرحلتين:
مقاييس التقييم بدون اتصال Offline Metrics
الطريقة الصحيحة أن تخفي آخر ما فعله كل مستخدم، وتدرب النموذج على ما قبله، ثم تسأله عن قائمته وتقارنها بما حدث فعلاً. ولنفرض أن المستخدم أعجبه لاحقاً فيلمان هما Interstellar وMatrix، وأن النموذج أعطاه هذه القائمة بالترتيب: Interstellar ثم Titanic ثم The Notebook ثم Matrix ثم Inception. وهذا هو الجزء الأخير من tiny.py أعلاه، والمقاييس كما يلي:
- الدقة Precision@k: كم من أول k عنصراً أصاب. في أول 5 أصاب 2، فالنتيجة 2 / 5 = 0.40، وفي أول 3 أصاب واحداً فالنتيجة 0.333.
- الاستدعاء Recall@k: كم مما أعجبه فعلاً ظهر في أول k. أعجبه 2 وظهر الاثنان في أول 5، فالنتيجة 2 / 2 = 1.00، وفي أول 3 ظهر واحد فقط فالنتيجة 0.500.
- متوسط الدقة MAP، واختصاره Mean Average Precision: لكل إصابة نحسب الدقة عند موضعها ثم نأخذ المتوسط، فالإصابة الأولى في الموضع 1 دقتها 1 / 1، والثانية في الموضع 4 دقتها 2 / 4 = 0.5، فمتوسط الدقة لهذا المستخدم (1 + 0.5) / 2 = 0.75، و MAP هو متوسط هذا الرقم على كل المستخدمين. وميزته أنه يكافئ الإصابة المبكرة.
- NDCG، واختصاره Normalized Discounted Cumulative Gain: كل إصابة تأخذ وزناً يقل كلما نزل موضعها، والوزن 1 / log2(الموضع + 1). الإصابة في الموضع 1 وزنها 1، وفي الموضع 4 وزنها 1 / log2(5) = 0.431، فالمجموع 1.431. وأفضل ترتيب ممكن أن تأتي الإصابتان في الموضعين 1 و2، ومجموعه 1 + 1 / log2(3) = 1.631. والقسمة 1.431 / 1.631 = 0.877، وهو نفس رقم البرنامج. وهذا المقياس هو الأكثر استخداماً لأنه يقيس ما يهم المستخدم فعلاً: هل الأشياء الجيدة في أعلى الشاشة.
- التغطية Coverage: نسبة عناصر الكتالوج التي ظهرت في قائمة أي مستخدم. وفي مقارنة المقال التالي غطى الأكثر شعبية 1% فقط من الأفلام، وغطى ALS 14%، والرقمان يقولان الكثير عن انحياز الشعبية.
وأهم قاعدة في هذه المرحلة أن تقسم البيانات بالزمن، فالتدريب على الماضي والاختبار على المستقبل، ولا تقم بتقسيم عشوائي، والسبب أن التقسيم العشوائي يضع في التدريب إعجابات حدثت بعد الإعجابات التي تختبرها، فيعرف النموذج ذوق المستخدم اللاحق، وهذا تسرب بيانات Data Leakage كما شرحناه في التعلم الآلي للمبتدئين. وفي تجربة المقال التالي ضاعف التقسيم العشوائي كل الأرقام تقريباً دون أن يتغير أي شيء في النموذج.
لماذا لا يظهر التحسن عند المستخدمين؟ اختبار A/B
الأرقام على الماضي تقيس قدرة النموذج على توقع ما فعله الناس عندما كان النظام القديم يعرض عليهم ما يعرض، ولا تقيس ما سيفعلونه عندما يتغير ما يرونه. لذلك يحدث كثيراً أن يتحسن NDCG ولا يتغير شيء في المبيعات، أو أن يكون النموذج الأدق مكلفاً جداً في التشغيل. وقد كتبت YouTube في نفس الورقة السابقة أنها تستخدم المقاييس بدون اتصال لتوجيه التطوير، ولكن القرار النهائي يكون لاختبار A/B على مستخدمين حقيقيين، لأن نتائجه لا تتفق دائماً مع النتائج بدون اتصال. وقصة Netflix Prize مثال آخر معروف، فقد دفعت Netflix مليون دولار للخليط الذي حسن دقة التوقع، ثم لم تضعه كاملاً في الإنتاج لأن زيادة الدقة لم تبرر الجهد الهندسي، كما شرحنا في مقال منصة الفيديو نقلاً عن مدونة Netflix التقنية.
واختبار A/B يعني أن تقسم المستخدمين عشوائياً إلى مجموعتين، كل مستخدم يبقى في مجموعته طوال الاختبار، فترى المجموعة A النموذج الحالي والمجموعة B النموذج الجديد، ثم تقارن مقياس العمل الحقيقي، مثل الطلبات أو وقت المشاهدة أو العودة بعد أسبوع، لمدة كافية مثل أسبوعين. وقد شرحنا كيف تقسم المستخدمين بنسب ثابتة في مقال Feature Flags والإطلاق التدريجي، وكيف تختار مقياس العمل في مقاييس المنتج Product Metrics. ولاحظ أن مقياس العمل يجب أن يكون أبعد من النقرة، فالنموذج الذي يرفع النقرات بعناوين مضللة يخسر الثقة، كما وجدت YouTube مع الترتيب بنسبة النقر.
البيانات والخصوصية
نظام التوصية يعيش على سجل ما فعله كل شخص، وهذا من أكثر البيانات الشخصية حساسية في منتجك، فقائمة المشتريات أو المشاهدات تقول عن صاحبها أكثر مما يقوله ملفه الشخصي. وفي المملكة يحكم ذلك نظام حماية البيانات الشخصية وتعديلاته، وفيه مواد تمس التوصية مباشرة:
- المادة الحادية عشرة: محتوى البيانات يكون مقصوراً على الحد الأدنى اللازم للغرض، فلا تقم بجمع كل حركة في التطبيق لأنك قد تحتاجها يوماً، وإنما الإشارات التي يستخدمها النموذج فعلاً.
- المادة الثامنة عشرة: إتلاف البيانات بعد انتهاء الغرض من جمعها، أو إزالة ما يعرف بصاحبها، لذلك حدد مدة لسجل التفاعلات، ونماذج التوصية عادة لا تحتاج تاريخاً أقدم من سنة أو سنتين.
- المادة الخامسة والعشرون والمادة السادسة والعشرون: إرسال المواد الدعائية على وسائل الاتصال الشخصية مثل البريد يحتاج موافقة المتلقي وطريقة واضحة للتوقف، ومعالجة البيانات لأغراض تسويقية تكون إذا جمعت من صاحبها مباشرة ووافق، فبريد «منتجات قد تعجبك» ليس مثل قائمة داخل التطبيق.
وقد شرحنا القواعد الهندسية لجمع الأحداث بأقل قدر من البيانات الشخصية في قسم الخصوصية في مقاييس المنتج، وهي نفسها هنا: معرف داخلي بدل البريد والاسم، ولا تقم بإرسال سجل التفاعلات إلى خدمة توصية خارجية دون مراجعة مسؤول الالتزام في شركتك، والسبب أن هذا نقل لبيانات شخصية إلى طرف آخر وربما إلى خارج المملكة. وهذه من أقوى حجج تشغيل نظام التوصية على سيرفرك.
الأدوات المفتوحة ورخصها
الجدول التالي يلخص أشهر الأدوات المفتوحة، والرخص وتواريخ الإصدارات من مستودعاتها في أكتوبر 2026:
| الأداة | ما هي | الرخصة | آخر إصدار |
|---|---|---|---|
| Gorse | نظام توصية كامل بلغة Go: API ولوحة تحكم وتدريب وخدمة | Apache-2.0 | v0.5.11، يوليو 2026 |
| implicit | مكتبة Python لـ ALS وBPR وتشابه العناصر على الإشارات الضمنية | MIT | v0.7.3، مايو 2026 |
| LightFM | مكتبة Python لنموذج هجين يأخذ خصائص المستخدم والعنصر | Apache-2.0 | 1.17، مارس 2023 |
| Recommenders | أمثلة وأدوات تقييم وتقسيم بيانات بدأتها Microsoft | MIT | 1.2.1، ديسمبر 2024 |
| RecBole | مكتبة أبحاث على PyTorch فيها عشرات الخوارزميات | MIT | v1.2.1، فبراير 2025 |
| NVIDIA Merlin | أدوات تدريب وخدمة على بطاقات NVIDIA للبيانات الضخمة | Apache-2.0 | v24.06.00، يونيو 2024 |
- Gorse: تصفه صفحته بأنه نظام توصية مفتوح المصدر تعطيه العناصر والمستخدمين والتفاعلات فيدرب النماذج تلقائياً ويرد على طلبات التوصية عبر REST API، ويجمع مصادر متعددة مثل الأحدث وتشابه المستخدمين وتشابه العناصر وال Collaborative Filtering، ويدعم المحتوى المتعدد عبر ال Embeddings. ويخزن البيانات في MySQL أو MongoDB أو PostgreSQL، والنتائج المؤقتة في Redis أو نفس قاعدة البيانات، ويعمل بعقدة رئيسية Master للتدريب وعقد Worker للتوصيات المسبقة وعقد Server للـ API. وهو الخيار الأقرب إذا أردت نظاماً جاهزاً على سيرفرك بدل أن تبنيه.
- implicit: أسرع طريق لتدريب ALS وBPR في Python، ويستخدم كل أنوية المعالج، وفيه دعم لبطاقات NVIDIA، وهو ما نستخدمه في المقال التالي.
- LightFM: مفيد عندما تملك خصائص للعناصر أو المستخدمين وتريد نموذجاً واحداً يتعامل مع البداية الباردة، كما في ورقته، ولكن لاحظ أن آخر إصدار له في مارس 2023 ولا يوجد نشاط يذكر بعده، فلا تبن عليه نظاماً جديداً طويل العمر دون أن تقبل ذلك.
- Recommenders: ليس محركاً تشغله، وإنما مجموعة دفاتر Notebooks وأدوات لتقسيم البيانات وحساب المقاييس، ونقل إلى مؤسسة Linux Foundation AI & Data، وهو مرجع ممتاز لتتعلم وتقارن الخوارزميات على بياناتك.
- RecBole: يذكر مستودعه 94 خوارزمية في أربعة أنواع، منها نماذج التسلسل، و44 مجموعة بيانات بصيغة موحدة، وهو مناسب للمقارنة البحثية أكثر من الإنتاج.
- NVIDIA Merlin: مصمم للبيانات بحجم التيرابايت على بطاقات NVIDIA، وآخر إصدار له في يونيو 2024، وتوقفت التغييرات في كوده عملياً بعد ذلك، فلا ننصح ببدء مشروع جديد عليه.
- قواعد البيانات الشعاعية Vector Databases: لمرحلة الاسترجاع بال Embeddings، وقد قارنا Qdrant وpgvector وغيرهما في مقال RAG، وشرحنا متى يكفيك pgvector داخل قاعدة بياناتك في PostgreSQL لكل شيء.
- OpenSearch أو Elasticsearch: إذا كان لديك محرك بحث أصلاً، فاستعلام more_like_this يعطيك «مشابه لهذا» بالمحتوى دون أي تدريب، وقد شرحنا البحث العربي فيهما في البحث في النصوص العربية.
أخطاء شائعة
- البدء بنموذج عميق قبل خط الأساس: إذا لم تقارن بالأكثر شعبية فلن تعرف هل نموذجك يضيف شيئاً.
- تقسيم البيانات عشوائياً: الأرقام تتضاعف ثم تنهار في الإنتاج، فقسم بالزمن دائماً.
- معاملة غياب التفاعل كرفض: المستخدم لم يشتر المنتج لأنه لم يره غالباً، وليس لأنه لا يريده.
- تسجيل النقرات دون تسجيل ما عرض: لن تعرف معدل النقر الحقيقي، ولن تستطيع كسر حلقة التغذية الراجعة.
- الحكم بالأرقام على الماضي وحدها: القرار لاختبار A/B على مقياس عمل حقيقي، وليس على NDCG.
- إهمال قواعد العمل: نموذج ممتاز يوصي بمنتج نفد من المخزون أو بمقطع لم تنته مراجعته يضر أكثر مما ينفع.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- نظام التوصية يختار من عناصر كثيرة قائمة صغيرة لشخص محدد، ويتعلم من التقييم الصريح القليل ومن الإشارات الضمنية الكثيرة، وغياب الإشارة يعني «لا أعرف» وليس «لا يعجبني».
- ابدأ بالأكثر شعبية كخط أساس، ثم التوصية بالمحتوى للعناصر الجديدة، ثم ال Collaborative Filtering بتشابه العناصر أو تحليل المصفوفة ALS وBPR عندما تتراكم التفاعلات، ثم اجمعها.
- الأنظمة الكبيرة تسترجع مئات المرشحين بال Embeddings وANN، ثم ترتبها بنموذج يقرأ خصائص كثيرة، ثم تطبق قواعد التنوع والعمل.
- البداية الباردة وحلقة التغذية الراجعة مشكلتان في كل نظام، وحلهما في التصميم: أماكن للاستكشاف، وتنوع، وتسجيل ما عرض.
- قس بالزمن precision@k وrecall@k وNDCG والتغطية، ثم اترك القرار لاختبار A/B.
- سجل التفاعلات بيانات شخصية حساسة، فاجمع الحد الأدنى وحدد مدة الاحتفاظ وفكر قبل إرسالها لخدمة خارجية.
وفي المقال التالي سوف نبني كل هذا عملياً على بيانات أفلام حقيقية: ثلاث طرق ومقارنتها، وواجهة API تقرأ من Redis، وتسرب بيانات مقصود نرى أثره بالأرقام.
دليلكيف تبني نظام توصية من الصفر بلغة Pythonنبني نظام توصية على بيانات أفلام حقيقية، ونقارن ثلاث طرق بالأرقام، ثم نقدمه عبر واجهة API سريعة تقرأ من Redis.دليلكيف تبني تطبيق فيديو قصير مثل TikTokكيف يجهز تطبيق الفيديو القصير المقطع التالي قبل أن تسحب الشاشة، وكيف يختار ما يناسبك من إشارات المشاهدة. دليلكيف تبني منصة فيديو عند الطلب مثل Netflixكيف يتحول فيديو مرفوع إلى بث يناسب كل شاشة وسرعة اتصال، وما الذي تحتاجه منصتك من التحويل إلى التوصيل والتكلفة.
 دليلمقاييس المنتج Product Metrics وكيف تعرف أن الميزة نجحتكيف تختار مقياساً رئيسياً North Star لمنتجك، وتبني قمع التحويل Funnel وجدول العودة Retention من أحداث تطبيقك بأدوات تستضيفها على سيرفرك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل المثال الصغير على Docker Engine 29.8.0 مع python:3.13.16-slim وNumPy 2.5.3، والتحقق من رخص الأدوات وإصداراتها من مستودعاتها.


