في مقال ابن مفسراً صغيراً بيدك بنينا لغة صيغ صغيرة اسمها calc لنظام فواتير، يكتب فيها فريق المبيعات قواعد الخصم والضريبة دون أن ينتظر نشر إصدار جديد. وبعد أسابيع من استخدامها صار الفريق يحفظ الصيغ في ملفات .calc داخل مستودع Git، ويعدلها المبرمجون في VS Code مثل أي كود آخر، وهنا ظهرت شكوى متكررة: عندما يخطئ المبرمج في ملف TypeScript يظهر تحت الخطأ خط أحمر قبل أن يحفظ الملف، وعندما يكتب اسم متغير خطأ في ملف .calc لا يظهر أي شيء، ولا يكتشف الخطأ إلا عندما تفشل الفواتير في الليل وتصل رسالة الخطأ من السيرفر.
والسؤال الذي يطرح نفسه هنا: كيف عرف المحرر أصلاً أن "45" نص وأن الحقل يحتاج رقماً؟ فالمحرر VS Code لا يحتوي مترجم TypeScript ولا يعرف قواعد Python، ومع ذلك يلون الكود ويقترح أسماء الدوال وينقلك إلى تعريف الدالة في ملف آخر. والإجابة أن هذا الفهم لا يسكن في المحرر، وإنما في برنامج منفصل اسمه خادم اللغة Language Server يتكلم مع المحرر ببروتوكول مشترك اسمه Language Server Protocol، واختصاراً LSP، ومعه أداة ثانية اسمها Tree-sitter تحلل الكود بسرعة تكفي لإعادة التحليل مع كل حرف تكتبه. وفي هذا المقال سوف نفتح هذا الصندوق: نلتقط الرسائل الحقيقية بين محرر وخادم، ونقيس Tree-sitter على ملف حقيقي، ثم نبني خادماً للغة calc يضع الخط الأحمر في VS Code بنفسه.
وسوف نناقش في هذا المقال ما يلي:
- المشكلة التي جاء LSP ليحلها، ولماذا كان كل محرر يعيد بناء نفس الميزات لكل لغة.
- شكل الرسائل في البروتوكول: الطلب Request والإشعار Notification والرد Response، وسطر
Content-Lengthالذي يسبق كل رسالة. - جلسة حقيقية ملتقطة من خادم TypeScript 7 الجديد ومن Pyright، رسالة رسالة، من المصافحة إلى الإغلاق.
- الدفع Push والسحب Pull في التشخيص Diagnostics، والمزامنة الكاملة والجزئية للنص.
- Tree-sitter والتحليل التزايدي Incremental Parsing، مع قياس على ملف من 6,357 سطراً، واستعادة الأخطاء Error Recovery.
- بناء خادم لغة للغة
calcبلغة Python دون مكتبات، وتشغيله في VS Code مع تشخيص وتلميح وانتقال إلى التعريف وإصلاح سريع. - ثلاث مشكلات حقيقية ظهرت في المختبر: خادم توقف بسبب الحروف العربية، وأداة شهيرة لم تعد تعمل مع TypeScript 7، وتشخيص قديم وصل بعد الإصلاح.
قبل LSP: مشكلة M×N بين المحررات Editors واللغات
لنفرض أنك صاحب لغة برمجة جديدة وتريد أن يحصل مستخدموها على ما يحصل عليه مستخدمو Java في IntelliJ: إكمال تلقائي Completion، وخط أحمر تحت الأخطاء، وانتقال إلى التعريف Go to Definition، وإعادة تسمية Rename في كل الملفات. قبل 2016 كان عليك أن تكتب هذه الميزات مرة لكل محرر، فإضافة لـ VS Code بلغة TypeScript وبواجهته البرمجية API، وإضافة لـ Vim بلغة Vimscript، وإضافة لـ Emacs بلغة Lisp، وإضافة لـ Eclipse بلغة Java، وكل واحدة منها تعيد نفس المنطق: تحليل الكود، وبناء جدول الرموز Symbol Table، ومعرفة نوع كل متغير. وفي الجهة الأخرى كان كل محرر يريد أن يدعم عشرات اللغات، فيضرب عدد المحررات M في عدد اللغات N، وهذا ما يسمى مشكلة M×N.
والحل الذي أعلنته Microsoft مع Red Hat وCodenvy في يونيو 2016، كما في إعلان VS Code عن البروتوكول المشترك، هو أن يخرج «ذكاء اللغة» من المحرر إلى عملية Process مستقلة، وأن يتفق الجميع على بروتوكول واحد للكلام معها. فالمحرر يتعلم البروتوكول مرة واحدة ويصبح عميلاً Client، وصاحب اللغة يكتب خادماً Server واحداً، وأي خادم يعمل مع أي محرر، فيصبح العدد M+N بدل M×N. وفي نفس الإعلان ذكرت Red Hat أنها تعمل على خادم لغة Java يعمل مع أي أداة تدعم البروتوكول، وهذا ما حدث فعلاً، فاليوم تجد في قائمة الخوادم الرسمية مئات الخوادم للغات من C++ إلى SQL. فحتى ملفات Terraform بلغة HCL التي ذكرناها في مقال Terraform أم OpenTofu؟ لها خادم رسمي هو terraform-ls تصونه HashiCorp ويعمل مع أي محرر يدعم البروتوكول، واستعلامات SQL التي شرحناها في مقال تعلم SQL لها خوادم تكمل أسماء الجداول والأعمدة من قاعدة البيانات نفسها.
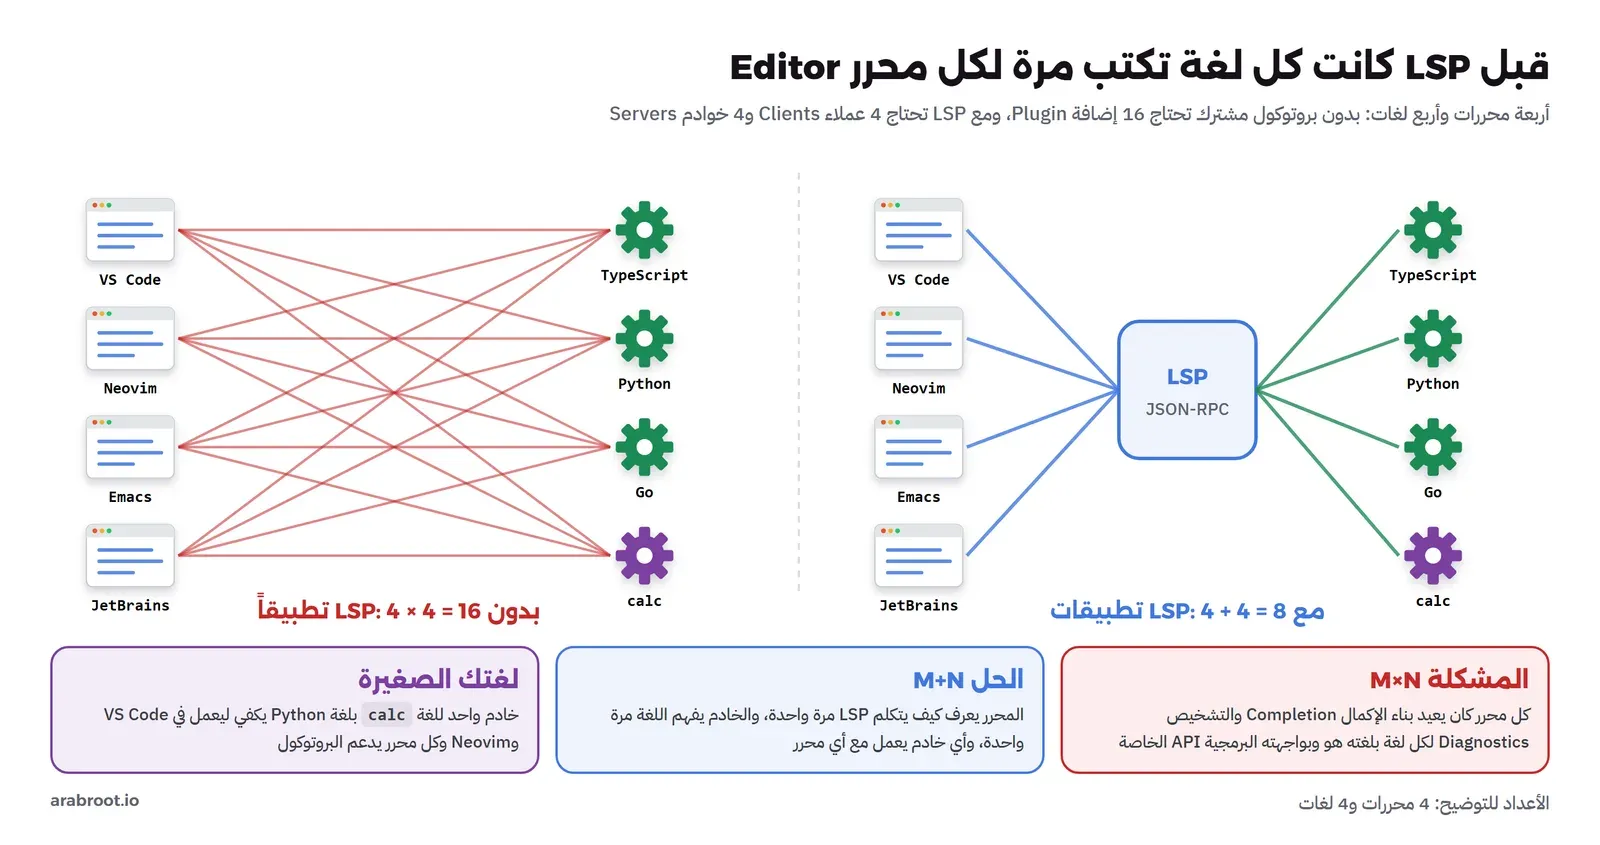
وقد يتساءل البعض: لماذا لا يتفقون على شكل شجرة AST مشتركة بدل بروتوكول؟ والإجابة في صفحة شرح البروتوكول نفسها: البروتوكول لا يتكلم بلغة الأشجار والأنواع، وإنما بلغة يفهمها أي محرر، أي رابط الملف URI وموقع المؤشر Position (سطر وعمود)، ونطاق Range بين موقعين. وتوحيد «السطر 10 العمود 9» بين كل اللغات سهل، أما توحيد شجرة تصلح لـ Haskell وSQL وPython معاً فمستحيل عملياً. وهذا القرار البسيط هو سر انتشار البروتوكول، وسوف نرى أنه أيضاً مصدر أكثر الأخطاء شيوعاً عند كتابة خادم، لأن «العمود» يحتاج تعريفاً دقيقاً.
ما هو بروتوكول خادم اللغة Language Server Protocol؟
البروتوكول في جوهره رسائل JSON صغيرة تمر بين عمليتين، والمحرر عادة هو الذي يشغل الخادم كعملية فرعية Child Process ويتكلم معه عبر المدخل والمخرج القياسيين stdin وstdout، ويمكن أن يكون الاتصال عبر Socket أو Named Pipe أيضاً. والرسائل تتبع مواصفة JSON-RPC 2.0، وهي مواصفة قصيرة جداً تعرف ثلاثة أنواع من الرسائل، وكل ما تبقى في مواصفة LSP 3.17 هو أسماء الطلبات وشكل معاملاتها.
الرسائل Messages: طلب Request وإشعار Notification ورد Response
- الطلب Request: رسالة فيها
idوmethodوparams، ومن يرسلها ينتظر رداً بنفس الرقم. مثلtextDocument/definition: «أين عرف الاسم الذي تحت المؤشر؟». - الرد Response: رسالة فيها نفس
idومعهresultأوerror، ولا تحمل اسم الطريقة، لذلك يجب على المرسل أن يتذكر ماذا طلب بكل رقم. - الإشعار Notification: رسالة فيها
methodبدونid، ولا ينتظر أحد رداً عليها. مثلtextDocument/didChange: «المستخدم كتب حرفاً».
ولاحظ أن الطلبات تسير في الاتجاهين، فالخادم أيضاً يطلب من المحرر أشياء، مثل إعدادات المستخدم بالطلب workspace/configuration، أو تسجيل قدرة جديدة بالطلب client/registerCapability. وسوف نرى ذلك في الجلسة الحقيقية، وإذا نسي العميل أن يرد على طلبات الخادم فقد يتوقف الخادم ينتظر رداً لن يأتي.
التأطير Framing: سطر Content-Length قبل كل رسالة
المدخل القياسي stdin مجرد تيار من البايتات لا يعرف أين تنتهي رسالة وتبدأ أخرى، لذلك يسبق كل رسالة رأس Header فيه طول الرسالة، ثم سطر فارغ، ثم الرسالة نفسها:
Content-Length: 126\r\n
\r\n
{"jsonrpc":"2.0","id":2,"method":"textDocument/diagnostic","params":{"textDocument":{"uri":"file:///lab/shop-ts/invoice.ts"}}}
والنقطة التي يجب أن تتذكرها من الآن: الرقم 126 هو عدد البايتات Bytes بترميز UTF-8، وليس عدد الحروف. وفي النص الإنجليزي الرقمان متساويان، فلن تلاحظ الفرق في أي اختبار، حتى يفتح شخص ملفاً فيه تعليق عربي، وهذا بالضبط ما أوقف الخادم الذي بنيناه في نسخته الأولى كما سيأتي.
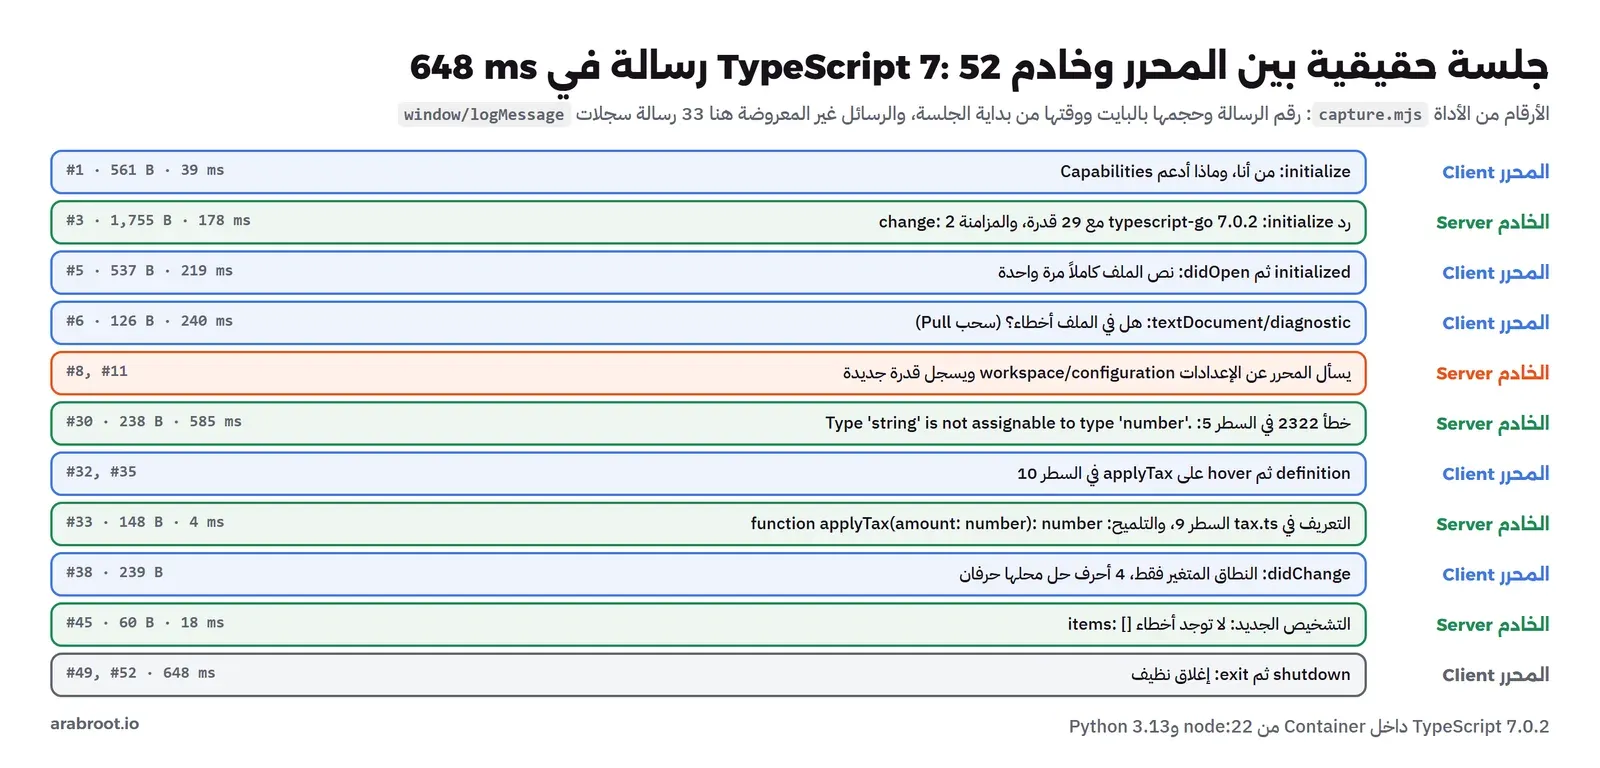
نلتقط جلسة حقيقية Session مع خادم TypeScript 7
أفضل طريقة لفهم البروتوكول أن تلعب دور المحرر بنفسك. والملف capture.mjs في مختبر المقال عميل LSP صغير بلغة JavaScript دون أي مكتبة، يشغل الخادم، ويرسل نفس الرسائل التي يرسلها VS Code عندما تفتح ملفاً وتمرر المؤشر على دالة وتصلح خطأ، ويطبع كل رسالة في الاتجاهين بحجمها ووقتها. وقلب العميل هو دالة الإرسال ودالة القراءة:
// ---------- framing: "Content-Length: N\r\n\r\n" + N bytes of UTF-8 JSON ----------
function send(msg) {
    const body = Buffer.from(JSON.stringify({ jsonrpc: '2.0', ...msg }), 'utf8');
    server.stdin.write(`Content-Length: ${body.length}\r\n\r\n`);
    server.stdin.write(body);
    show('-->', body.length, msg);
}
let buf = Buffer.alloc(0);
server.stdout.on('data', (chunk) => {
    buf = Buffer.concat([buf, chunk]);
    for (;;) {
        const end = buf.indexOf('\r\n\r\n');
        if (end < 0) return;
        const len = Number(/Content-Length: (\d+)/i.exec(buf.subarray(0, end).toString())[1]);
        if (buf.length < end + 4 + len) return;
        const body = buf.subarray(end + 4, end + 4 + len);
        buf = buf.subarray(end + 4 + len);
        receive(JSON.parse(body.toString('utf8')), len);
    }
});
في الكود أعلاه لاحظ التالي:
- الطول يحسب من
Bufferأي من البايتات، لا منbody.lengthلنص JavaScript الذي يعد وحدات UTF-16. - القراءة تجمع ما يصل في مخزن
buf، لأن نظام التشغيل قد يسلمك نصف رسالة في دفعة ونصفها الآخر في دفعة تالية، أو ثلاث رسائل في دفعة واحدة، والحلقة لا تخرج رسالة إلا إذا اكتملت بايتاتها.
والملف الذي سوف نفتحه هو invoice.ts، وفيه خطأ متعمد: سعر مكتوب كنص "45" في مصفوفة من نوع Line[] حيث السعر رقم، وهو نفس نوع الأخطاء الذي شرحناه في مقال TypeScript للمطورين:
import { applyTax, Line } from "./tax";

const lines: Line[] = [
  { sku: "A-100", price: 120, qty: 2 },
  { sku: "B-200", price: "45", qty: 1 },
];

export function invoiceTotal(items: Line[]): number {
  const subtotal = items.reduce((sum, l) => sum + l.price * l.qty, 0);
  return applyTax(subtotal);
}

console.log(invoiceTotal(lines).toFixed(2));
والخادم هو خادم TypeScript 7 نفسه. فقد أعلن فريق TypeScript في مارس 2025 في مقال A 10x Faster TypeScript أنه يعيد كتابة المترجم بلغة Go، وأنه سوف ينتقل معه إلى بروتوكول LSP بدل البروتوكول الخاص القديم tsserver، والكود في مستودع typescript-go. وفي الإصدار 7.0.2 الذي استخدمناه صار الخادم جزءاً من الأمر tsc نفسه. والتشغيل داخل Container واحد فيه Node 22 وPython 3.13 والخوادم كلها (الـ Dockerfile في مجلد المختبر):
docker build -t scc3-lsp:1 lab/
docker run --rm -v "$PWD/lab":/lab -w /lab scc3-lsp:1 node capture.mjs ts
والمخرج سوف يكون كما يلي (حذفنا منه 33 سطراً من رسائل السجل window/logMessage التي يرسلها الخادم ليشرح ما يفعله):
   39 ms #1   -->    561 B  request  initialize (id 1)
  178 ms #3   <--   1755 B  response initialize (id 1)

server: typescript-go 7.0.2
capabilities: _vs_onAutoInsertProvider, _vs_referencesProvider, callHierarchyProvider, codeActionProvider, codeLensProvider, completionProvider, definitionProvider, diagnosticProvider, documentFormattingProvider, documentHighlightProvider, documentOnTypeFormattingProvider, documentRangeFormattingProvider, documentSymbolProvider, experimental, foldingRangeProvider, hoverProvider, implementationProvider, inlayHintProvider, linkedEditingRangeProvider, positionEncoding, referencesProvider, renameProvider, selectionRangeProvider, semanticTokensProvider, signatureHelpProvider, textDocumentSync, typeDefinitionProvider, workspace, workspaceSymbolProvider
textDocumentSync: {"openClose":true,"change":2,"save":true}  positionEncoding: utf-16

diagnostics model: pull (textDocument/diagnostic)

  202 ms #4   -->     52 B  notify   initialized
  219 ms #5   -->    537 B  notify   textDocument/didOpen
  240 ms #6   -->    126 B  request  textDocument/diagnostic (id 2)
  288 ms #8   <--    175 B  request  workspace/configuration (id ts1)
  313 ms #9   -->     59 B  response  (id ts1)
  383 ms #11  <--    249 B  request  client/registerCapability (id ts2)
  389 ms #12  -->     42 B  response  (id ts2)
  575 ms #26  <--    130 B  notify   textDocument/publishDiagnostics
  585 ms #30  <--    238 B  response textDocument/diagnostic (id 2)

diagnostics after didOpen: 1
  5:19 error 2322: Type 'string' is not assignable to type 'number'.
  591 ms #32  -->    162 B  request  textDocument/definition (id 3)
  595 ms #33  <--    148 B  response textDocument/definition (id 3)

definition of the name at 10:10 -> tax.ts 9:17
  600 ms #35  -->    157 B  request  textDocument/hover (id 4)
  603 ms #36  <--    202 B  response textDocument/hover (id 4)
hover: "(alias) function applyTax(amount: number): number"

  611 ms #38  -->    239 B  notify   textDocument/didChange
  615 ms #39  -->    126 B  request  textDocument/diagnostic (id 5)
  633 ms #45  <--     60 B  response textDocument/diagnostic (id 5)

diagnostics after didChange (incremental): 0
  642 ms #49  -->     58 B  request  shutdown (id 6)
  645 ms #51  <--    104 B  response shutdown (id 6)
  648 ms #52  -->     47 B  notify   exit

52 messages in 648 ms
كل سطر هنا رسالة حقيقية، والعمود الأول هو الوقت من بداية الجلسة، ثم رقم الرسالة، ثم الاتجاه (--> من المحرر إلى الخادم و<-- العكس)، ثم الحجم بالبايت، ثم النوع والطريقة. وسوف نمشي عليها مرحلة مرحلة.
المصافحة Handshake: initialize والقدرات Capabilities
أول رسالة دائماً الطلب initialize، يرسل فيه المحرر رقم عمليته ومجلد المشروع وقائمة «ما أستطيع التعامل معه» وتسمى قدرات العميل Client Capabilities، مثل أنه يفهم التشخيص بالدفع وبالسحب، وأنه يعد الأعمدة بوحدات UTF-16. ويرد الخادم بقدراته Server Capabilities، والرد هنا 1,755 بايت فيه 29 قدرة، من الإكمال Completion إلى التلميحات داخل السطر Inlay Hints إلى إعادة التسمية Rename. وهذه المصافحة هي التي تجعل البروتوكول يتطور دون أن يتعطل القديم، فالخادم الذي لا يعلن renameProvider لن يرسل له المحرر طلبات إعادة التسمية أبداً، ولن يظهر الأمر في القائمة، وخادم calc الذي سوف نبنيه يعلن ست قدرات فقط ويعمل بشكل كامل.
ومن القدرات المهمة في الرد قيمة textDocumentSync، وفيها "change": 2 أي أن الخادم يريد التعديلات الجزئية Incremental فقط، لا الملف كاملاً مع كل حرف، وpositionEncoding: utf-16 أي أن كل رقم عمود في هذه الجلسة يعد وحدات UTF-16. وبعد الرد يرسل المحرر الإشعار initialized ليقول «استلمت، ابدأ»، ولا يرسل أي طلب آخر قبله.
فتح الملف didOpen والتشخيص Diagnostics
الإشعار textDocument/didOpen يحمل نص الملف كاملاً، 537 بايت، ومعه رقم إصدار version: 1. ومن هذه اللحظة لا يقرأ الخادم الملف من القرص، فالحقيقة صارت في ذاكرة المحرر، والخادم يحتفظ بنسخة يحدثها مع كل تعديل، وهذا ما يسمح بأن يظهر الخط الأحمر قبل أن تحفظ الملف. وكل النص التالي في الجلسة مبني على هذه النسخة، لذلك إذا اختلفت نسخة الخادم عن نسخة المحرر بحرف واحد فكل المواقع بعده تصبح خطأ.
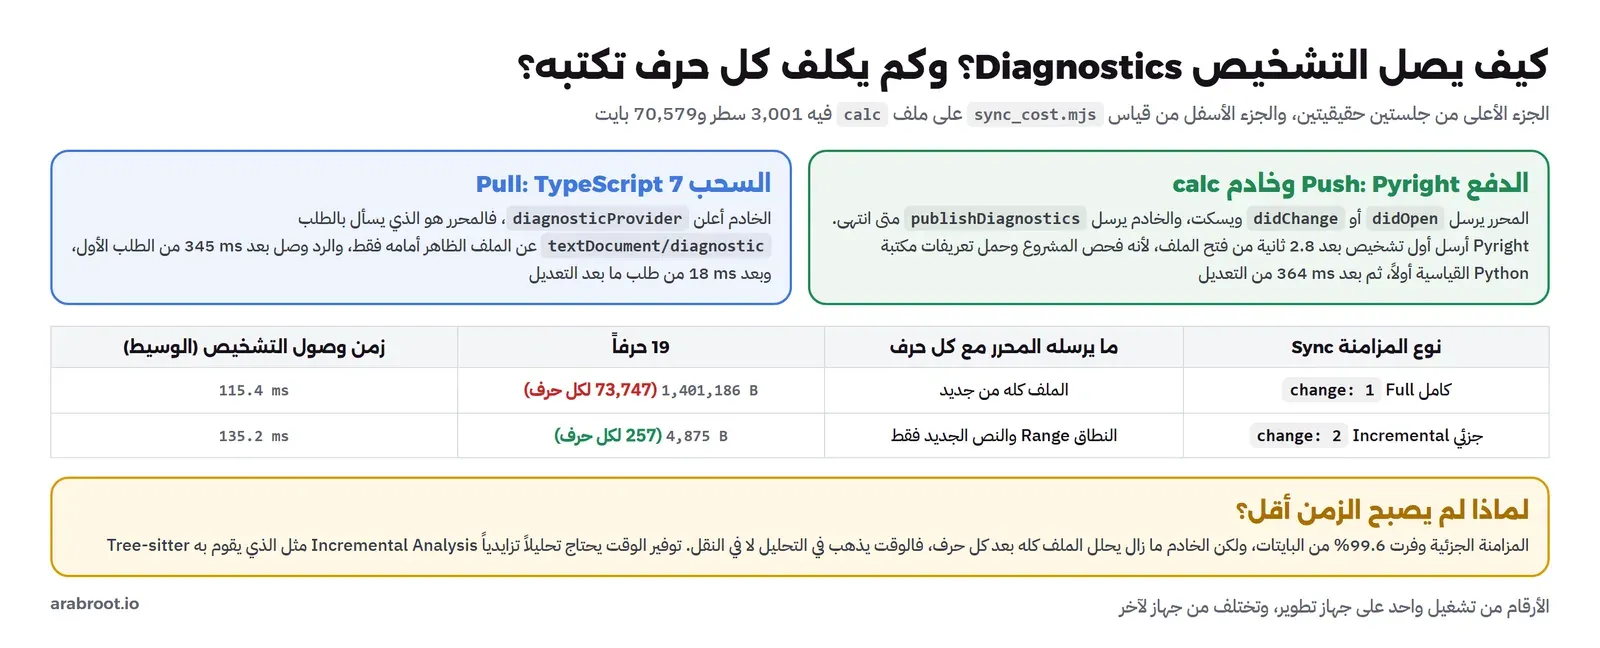
بعد ذلك طلب العميل التشخيص بالطلب textDocument/diagnostic، وهذا هو نموذج السحب Pull الذي أضيف في الإصدار 3.17 من البروتوكول، لأن خادم TypeScript 7 أعلن القدرة diagnosticProvider. وقبل أن يرد، أرسل الخادم طلبين للمحرر: يسأل عن إعدادات typescript وjavascript وeditor، ويسجل قدرة جديدة ليعرف متى تتغير الإعدادات. وبعد 345 ms من الطلب جاء الرد، والرسالة 30 كاملة كما يلي:
{"jsonrpc": "2.0", "id": 2, "result": {"kind": "full", "items": [{"range": {"start": {"line": 4, "character": 18}, "end": {"line": 4, "character": 23}}, "severity": 1, "code": 2322, "source": "ts", "message": "Type 'string' is not assignable to type 'number'."}]}}في الرد أعلاه لاحظ التالي:
- السطر
4والعمود18يبدآن من الصفر، أي أن الخطأ في السطر الخامس العمود 19 كما يعرضه المحرر، والنطاق من 18 إلى 23 هو الكلمةpriceبالضبط، وهي الكلمة التي سوف يرسم المحرر تحتها الخط الأحمر. severity: 1يعني خطأ Error، و2 تحذير Warning، و3 معلومة، و4 تلميح Hint، والمحرر يختار اللون من هذا الرقم.code: 2322هو رقم الخطأ في TypeScript، وهو نفس الرقم الذي يطبعهtscفي الطرفية، لأن المترجم والخادم نفس البرنامج.- الخادم أرسل في الرسالة 26 إشعار
publishDiagnosticsأيضاً، ولكن لملفtsconfig.jsonوقائمته فارغة، فهو يدفع تشخيص ملفات الإعداد ويترك تشخيص ملفات الكود للسحب.
الانتقال إلى التعريف Go to Definition والتلميح Hover
عندما تضغط F12 على applyTax في السطر العاشر يرسل VS Code الطلب textDocument/definition ومعه رابط الملف والموقع، وهذا ما أرسله العميل في الرسالة 32 بالموقع {"line": 9, "character": 9}. والرد في الرسالة 33 بعد 4 ms فقط:
{"jsonrpc": "2.0", "id": 3, "result": [{"uri": "file:///lab/shop-ts/tax.ts", "range": {"start": {"line": 8, "character": 16}, "end": {"line": 8, "character": 24}}}]}أي أن الدالة معرفة في ملف آخر هو tax.ts في السطر التاسع، والخادم عرف ذلك لأنه حلل جملة import وفتح الملف الثاني من القرص بنفسه، فالملفات التي لم يفتحها المحرر يقرأها الخادم من القرص، والملفات المفتوحة يأخذها من رسائل المحرر. وطلب التلميح textDocument/hover على نفس الموقع أعاد توقيع الدالة (alias) function applyTax(amount: number): number، وهو النص الذي يظهر في المربع الصغير عندما تقف بالفأرة على اسم.
ولاحظ سرعة الرد: 4 ms للتعريف، لأن الخادم بنى البرنامج Program مرة واحدة عند فتح الملف (رسالة السجل قالت إن تحميل المشروع أخذ نحو 140 ms)، وكل طلب بعد ذلك بحث في بنية جاهزة في الذاكرة. وهذا هو الفرق بين خادم اللغة وبين تشغيل tsc مع كل طلب: الخادم عملية تعيش طوال الجلسة وتحتفظ بكل ما فهمته.
التعديل didChange: المزامنة الجزئية Incremental Sync
الآن يصلح المستخدم الخطأ ويحذف علامتي الاقتباس، فيرسل المحرر الإشعار textDocument/didChange برقم إصدار جديد، وبما أن الخادم طلب المزامنة الجزئية فالرسالة لا تحمل الملف، وإنما النطاق الذي تغير والنص الجديد فقط:
{"method": "textDocument/didChange", "params": {"textDocument": {"uri": "file:///lab/shop-ts/invoice.ts", "version": 2}, "contentChanges": [{"range": {"start": {"line": 4, "character": 25}, "end": {"line": 4, "character": 29}}, "text": "45"}]}}والمعنى: «في السطر الخامس، من العمود 26 إلى العمود 29، ضع 45 مكان ما كان هناك»، أي أن الأحرف الأربعة "45" صارت حرفين. وبعد ذلك سحب العميل التشخيص من جديد، فجاء الرد بعد 18 ms بقائمة فارغة "items": []، أي أن الملف صار سليماً، والمحرر يزيل الخط الأحمر. وفي النهاية الطلب shutdown الذي يطلب من الخادم أن يستعد للإغلاق ويرد، ثم الإشعار exit الذي يخرج بعده الخادم، والفصل بينهما يسمح للخادم أن يحفظ ما يحتاجه قبل أن يموت.
نفس العميل Client مع Pyright: ماذا تغير؟
الآن نجرب فكرة M+N عملياً: نفس العميل، ونفس الرسائل، ولكن مع لغة أخرى وخادم كتبه فريق آخر. والخادم هو Pyright، وهو مدقق أنواع Type Checker للغة Python وخادم لغة في نفس الوقت، والملف invoice.py فيه نفس الخطأ: سعر نصي في كلاس بياناته من نوع float:
docker run --rm -v "$PWD/lab":/lab -w /lab scc3-lsp:1 node capture.mjs py 30 ms #1 --> 561 B request initialize (id 1)
751 ms #5 <-- 1046 B response initialize (id 1)
server: ?
capabilities: callHierarchyProvider, codeActionProvider, completionProvider, declarationProvider, definitionProvider, documentHighlightProvider, documentSymbolProvider, executeCommandProvider, hoverProvider, referencesProvider, renameProvider, signatureHelpProvider, textDocumentSync, typeDefinitionProvider, workspace, workspaceSymbolProvider
textDocumentSync: 2 positionEncoding: (utf-16 default)
diagnostics model: push (publishDiagnostics)
755 ms #6 --> 52 B notify initialized
757 ms #7 --> 437 B notify textDocument/didOpen
760 ms #8 <-- 134 B request workspace/configuration (id 0)
771 ms #9 --> 40 B response (id 0)
773 ms #10 <-- 135 B request workspace/configuration (id 1)
787 ms #11 --> 40 B response (id 1)
3553 ms #19 <-- 579 B notify textDocument/publishDiagnostics
diagnostics after didOpen: 1
3:47 error reportArgumentType: Argument of type "Literal['45']" cannot be assigned to parameter "price" of type "float" in function "__init__"
3557 ms #20 --> 163 B request textDocument/definition (id 2)
3565 ms #21 <-- 149 B response textDocument/definition (id 2)
definition of the name at 8:12 -> tax.py 13:5
3568 ms #22 --> 158 B request textDocument/hover (id 3)
3576 ms #23 <-- 202 B response textDocument/hover (id 3)
hover: "(function) def apply_tax(amount: float) -> float"
3583 ms #24 --> 239 B notify textDocument/didChange
3947 ms #25 <-- 139 B notify textDocument/publishDiagnostics
diagnostics after didChange (incremental): 0
3949 ms #26 --> 58 B request shutdown (id 4)
3951 ms #27 <-- 38 B response shutdown (id 4)
3954 ms #28 --> 47 B notify exit
28 messages in 3954 msفي المخرج أعلاه لاحظ التالي:
- العميل لم يتغير فيه سطر واحد، ومع ذلك حصل على تشخيص وتعريف وتلميح من لغة مختلفة تماماً، وهذه هي الفائدة كلها في جملة واحدة.
- Pyright لم يرسل
serverInfoفي رده فظهر الاسم?، ولم يعلنpositionEncodingفبقي الافتراضي UTF-16، وأعلنtextDocumentSync: 2كرقم مباشر بدل كائن، والمواصفة تسمح بالشكلين، لذلك يجب أن يتعامل العميل مع الاثنين. - القدرات 16 فقط، ولا يوجد بينها
diagnosticProvider، لذلك عمل العميل بنموذج الدفع Push: أرسلdidOpenوانتظر حتى أرسل الخادمpublishDiagnosticsمن نفسه. - أول تشخيص وصل بعد 2.8 ثانية من فتح الملف، ورسائل السجل تشرح السبب: الخادم بدأ «خدمة» للمشروع، وبحث عن ملفات Python فيه («Found 2 source files» عند الثانية 3.5)، وحمل تعريفات مكتبة Python القياسية. أما بعد التعديل فالتشخيص الجديد وصل خلال 364 ms، لأن كل ذلك صار في الذاكرة.
- الرسالة 19 تحمل
"version": 1، أي أن الخادم يقول صراحة إن هذا التشخيص يخص الإصدار الأول من الملف، وسوف نرى بعد قليل لماذا هذا الحقل مهم جداً.
الدفع Push أم السحب Pull للتشخيص Diagnostics؟
في نموذج الدفع يقرر الخادم متى يرسل التشخيص ولأي ملف، وهذا بسيط ولكن فيه مشكلتان. الأولى أن الخادم قد يحلل ملفات لا يراها المستخدم ويرسل تشخيصها، فيضيع وقتاً في مشروع من آلاف الملفات. والثانية أن المحرر لا يعرف أي تشخيص يخص أي نسخة من الملف إذا لم يرسل الخادم رقم الإصدار، فقد يصل تشخيص قديم بعد أن أصلح المستخدم الخطأ. وفي نموذج السحب يسأل المحرر عن الملف الظاهر أمامه في الوقت الذي يريده، والرد مرتبط بالطلب برقمه، فلا يوجد أي التباس. والصورة التالية تجمع النموذجين مع قياس سوف نشرحه في قسم «ماذا يحدث إذا…».
مشكلة حقيقية Real Problem: typescript-language-server مع TypeScript 7
قبل TypeScript 7 لم يكن خادم TypeScript يتكلم LSP، وإنما بروتوكوله الخاص tsserver، لذلك ظهرت أداة typescript-language-server التي تقف في الوسط: تتكلم LSP مع المحرر من جهة، وتشغل tsserver.js من حزمة typescript وتترجم الرسائل من جهة أخرى، وهي الأداة التي يعتمد عليها كثير من مستخدمي Neovim وHelix للغة TypeScript منذ سنوات. وكانت خطتنا الأولى أن نلتقط الجلسة منها، فثبتنا أحدث إصدار 6.0.2 مع أحدث TypeScript 7.0.2، وكان الرد على أول طلب كما يلي:
{"jsonrpc": "2.0", "id": 1, "error": {"code": -32603, "message": "Request initialize failed with message: Could not find a valid TypeScript installation. Please ensure that the \"typescript\" dependency is installed in the workspace or that a valid `tsserver.path` is specified. Exiting."}}والسبب أن حزمة TypeScript 7 لم تعد تحتوي الملف tsserver.js أصلاً، ففي مجلد lib ستجد tsc.js وgetExePath.js فقط، والمترجم الحقيقي ملف تنفيذي مكتوب بلغة Go في حزمة فرعية حسب نظام التشغيل، والخادم صار الأمر tsc --lsp --stdio نفسه. وبالتالي فالأداة الوسيطة تعمل مع TypeScript 6 وما قبله فقط، وجربنا ذلك بتثبيت [email protected] في مجلد المشروع:
   26 ms #1   -->    570 B  request  initialize (id 1)
  939 ms #3   <--   1593 B  response initialize (id 1)
  ...
  984 ms #6   <--     98 B  notify   $/typescriptVersion
10538 ms #9   <--    131 B  notify   textDocument/publishDiagnostics

diagnostics after didOpen: 0
10957 ms #11  <--    564 B  notify   textDocument/publishDiagnostics
  ...
11048 ms #15  -->    243 B  notify   textDocument/didChange
11062 ms #16  <--    564 B  notify   textDocument/publishDiagnostics

diagnostics after didChange (incremental): 1
  5:19 Type 'string' is not assignable to type 'number'.
وهنا ظهرت مشكلة ثانية أخطر، لأنها تعطي جواباً خاطئاً دون أي رسالة خطأ: العميل قال إن الملف بعد فتحه سليم (صفر أخطاء)، وبعد الإصلاح فيه خطأ، والعكس هو الصحيح. والسبب في الرسائل نفسها، فهذه الأداة ترسل التشخيص على دفعات: الرسالة 9 قائمة فارغة لأنها تبدأ بالأخطاء النحوية Syntax Errors ولا يوجد منها شيء، ثم الرسالة 11 بعد نحو 420 ms فيها خطأ الأنواع Semantic Error. والعميل الذي كتبناه أخذ أول دفعة بعد didOpen على أنها الجواب النهائي، ثم أخذ الدفعة المتأخرة من النسخة الأولى على أنها جواب ما بعد التعديل، ولم يستطع أن يميز لأن الأداة لا ترسل الحقل version في publishDiagnostics كما فعل Pyright.
والدرس هنا للطرفين: إذا كنت تكتب عميلاً فلا تفترض أن إشعار تشخيص واحداً هو الجواب النهائي، وإنما عامل كل إشعار على أنه «الحالة الحالية لهذا الملف» تستبدل ما قبلها، وهذا ما يفعله VS Code. وإذا كنت تكتب خادماً فأرسل رقم الإصدار مع التشخيص، أو استخدم نموذج السحب الذي يربط الرد بالطلب. ولاحظ أيضاً أن أول تشخيص هنا وصل بعد نحو 9.5 ثانية من فتح الملف في هذا التشغيل، مقابل 345 ms من خادم TypeScript 7 على نفس الملفين، وهذا يتفق مع هدف إعادة الكتابة بلغة Go المعلن في مقال الفريق.
لماذا لا يكفي LSP وحده؟ التلوين Highlighting والتحليل التزايدي Incremental Parsing
خادم اللغة عملية منفصلة، وكل طلب يمر عبر JSON وأنبوب وعملية أخرى، وقد يحتاج الخادم ثانيتين أو أكثر في البداية كما رأينا مع Pyright. وهذا مقبول للتشخيص والتعريف، ولكنه غير مقبول للتلوين Syntax Highlighting الذي يجب أن يتغير في نفس اللحظة التي تكتب فيها الحرف، ولا للطي Folding وتحديد الكتل. لذلك تحتاج المحررات طبقة ثانية سريعة جداً تعمل داخل المحرر نفسه وتفهم شكل الكود فقط دون أنواعه.
وفي VS Code هذه الطبقة هي قواعد TextMate، وهي مجموعات من التعبيرات النمطية Regex تلون الكود سطراً سطراً، وفوقها التلوين الدلالي Semantic Highlighting الذي يأتي من الخادم بعد لحظات. والتعبيرات النمطية سريعة، ولكنها كما شرحنا في مقال التعبيرات النمطية Regex لا تفهم البنى المتداخلة، فلا تعرف أن هذا القوس يغلق ذلك القوس بعد مئة سطر. أما المحررات الأحدث مثل Neovim وHelix وZed فتستخدم أداة Tree-sitter، وهي بحسب موقعها مولد محللات Parser Generator ومكتبة تحليل تزايدي، تبني شجرة للملف كله وتحدثها بكفاءة كلما تغير النص، وتهدف إلى أن تكون سريعة بما يكفي للتحليل مع كل ضغطة زر، ومتينة بما يكفي لتعطي نتيجة مفيدة رغم وجود أخطاء نحوية، ومكتوبة بلغة C دون أي اعتمادات لتدخل في أي برنامج.
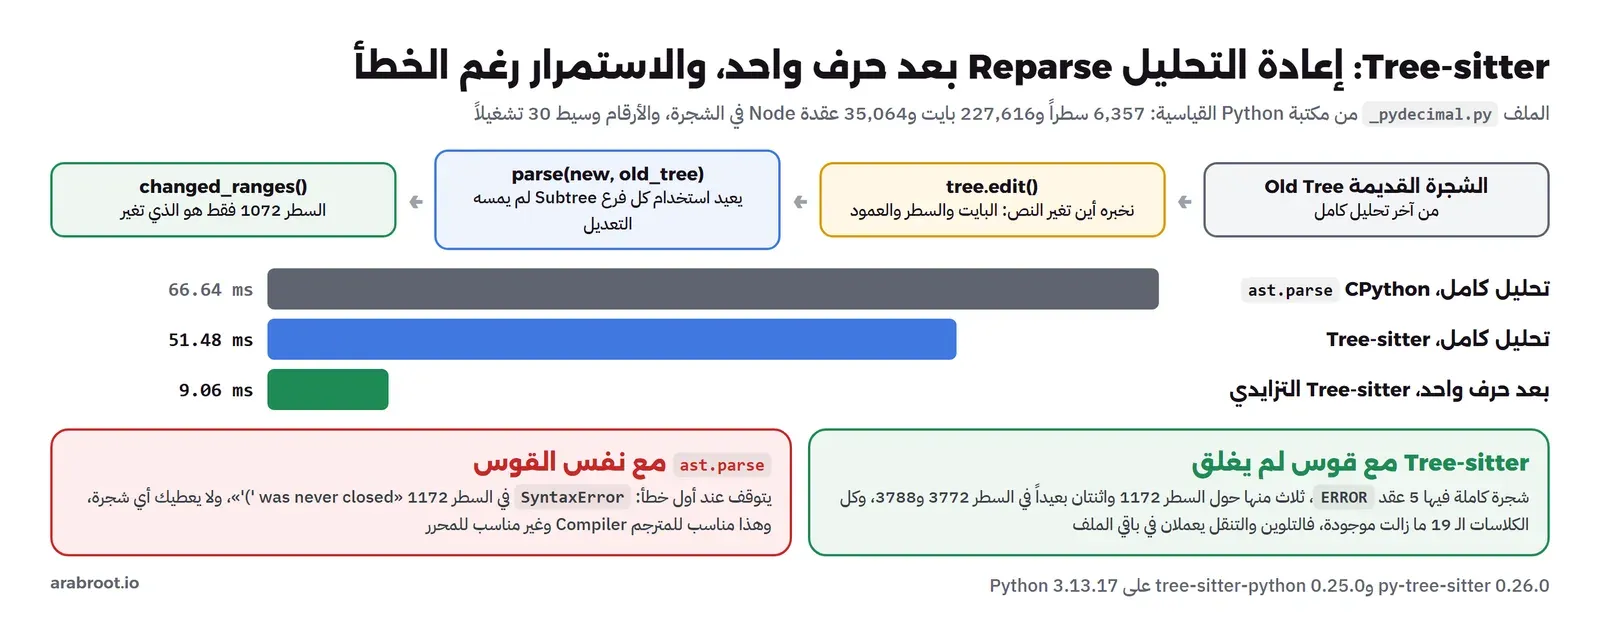
وحتى نختبر هذا الكلام بالأرقام، كتبنا الملف ts_measure.py الذي يستخدم ربط Python لمكتبة Tree-sitter مع قواعد لغة Python، ويختبرها على الملف _pydecimal.py من مكتبة Python القياسية، وهو من أكبر ملفاتها: يحلل الملف كاملاً، ثم يضيف حرفاً واحداً في وسطه ويعيد التحليل تزايدياً، ثم يحذف قوساً ليرى ماذا يحدث مع كود نصف مكتوب، ويقارن كل ذلك بالمحلل الذي تستخدمه Python نفسها ast.parse. والجزء الأساسي هو كيف نخبر Tree-sitter بالتعديل:
def edited(tree, src, start, old_len, new_text):
    """apply one text edit to the bytes and tell the old tree about it"""
    new_src = src[:start] + new_text + src[start + old_len:]
    tree.edit(start_byte=start, old_end_byte=start + old_len, new_end_byte=start + len(new_text),
              start_point=point(src, start), old_end_point=point(src, start + old_len),
              new_end_point=point(new_src, start + len(new_text)))
    return new_src

times = []
for _ in range(30):
    old_tree = parser.parse(src)
    new = edited(old_tree, src, start, 0, b"x")      # context -> xcontext
    t = time.perf_counter()
    new_tree = parser.parse(new, old_tree)            # the old tree lets tree-sitter reuse unchanged subtrees
    times.append((time.perf_counter() - t) * 1000)
inc = statistics.median(times)
docker run --rm -v "$PWD/lab":/lab -w /lab scc3-lsp:1 python3 ts_measure.py /usr/local/lib/python3.13/_pydecimal.pyوالمخرج سوف يكون كما يلي:
file: /usr/local/lib/python3.13/_pydecimal.py  227,616 bytes  6,357 lines
nodes in the tree: 35,064  has_error=False
full parse, tree-sitter :   51.48 ms
full parse, ast.parse   :   66.64 ms   (CPython's own parser, for comparison)

edit 1: insert one character at line 1072
incremental reparse     :    9.06 ms   (6x faster than a full parse)
changed ranges          : [(1072, 1072)]

edit 2: remove one ')' at line 1172
has_error=True  error nodes: 5
  ERROR at line 1160, column 44: b'\n        """Return self - other"""\n     '
  ERROR at line 1172, column 58: b'context\n\n    def __rsub__(self, other, c'
  ERROR at line 1174, column 5: b'def __rsub__'
  ERROR at line 3772, column 75: b'\n\ndef _dec_from_triple(sign, coefficient'
  ERROR at line 3788, column 16: b''
top-level classes still found: 19 (same file without the error: 19)
ast.parse on the same text: SyntaxError at line 1172: '(' was never closed
كيف يعيد Tree-sitter التحليل Reparse بعد حرف واحد؟
الشجرة هنا فيها 35,064 عقدة Node لملف من 227 ألف بايت، والتحليل الكامل أخذ 51 ms، وهو أسرع قليلاً من محلل CPython الذي يبني شجرة AST. ولكن الرقم المهم هو الثاني: بعد إضافة حرف واحد في السطر 1072 أخذت إعادة التحليل 9 ms، أي أسرع بست مرات تقريباً. والفكرة أن الدالة tree.edit() لا تحلل شيئاً، وإنما تخبر الشجرة القديمة أن البايتات من موقع كذا إلى كذا تغيرت، فتعلم Tree-sitter العقد التي تغطي هذا النطاق بأنها «متغيرة»، وتزيح مواقع كل العقد التي بعدها. ثم عندما نمرر الشجرة القديمة إلى parse(new, old_tree) يمشي المحلل على النص الجديد، وكلما وصل إلى فرع Subtree لم يتغير ولم يتأثر بما حوله أخذه كما هو دون أن يحلل حروفه، فيعيد بناء الطريق من العقدة المتغيرة إلى الجذر فقط.
والدالة changed_ranges() تعطي المحرر شيئاً لا يقل أهمية عن السرعة: قائمة الأجزاء التي تغير شكلها في الشجرة، وهنا السطر 1072 وحده، فيعيد المحرر تلوين سطر واحد بدل 6,357 سطراً. ولاحظ أن 9 ms في هذا القياس تشمل عبور الحدود بين Python ومكتبة C في كل استدعاء، وأن الرقم يختلف حسب موقع التعديل، ففي قياسات أخرى على نفس الملف أخذ التعديل في السطر 66 نحو 5 ms وفي السطر 3156 نحو 9 ms، لأن التعديل داخل كلاس ضخم مثل Decimal الذي يمتد على آلاف الأسطر يجبر المحلل على إعادة بناء طريق أطول من العقد.
استعادة الأخطاء Error Recovery: كود نصف مكتوب
الكود في المحرر نصف مكتوب في أغلب الأوقات، فأنت تفتح القوس ثم تكتب ما بداخله، وبين اللحظتين الملف غير صحيح نحوياً. والتجربة الثانية تحذف قوس الإغلاق من السطر 1172، وast.parse فعل ما يجب أن يفعله المترجم: توقف عند أول خطأ برسالة '(' was never closed، ولم يعط أي شجرة، فلو اعتمد المحرر عليه لاختفى التلوين والتنقل من الملف كله حتى تغلق القوس. أما Tree-sitter فأعطى شجرة كاملة فيها خمس عقد ERROR، ثلاث منها حول الخطأ في الأسطر 1160 إلى 1174، وما زالت الكلاسات الـ 19 في الملف موجودة في الشجرة، فالتلوين في باقي الملف لا يتأثر.
ولكن لاحظ العقدتين الأخيرتين في السطر 3772 و3788، أي على بعد أكثر من ألفي سطر من القوس المحذوف. فالاستعادة تخمين: المحلل يجرب أن يتجاهل رمزاً أو يفترض رمزاً ناقصاً حتى يعود إلى حالة يفهمها، والتخمين الذي اختاره هنا جعل جزءاً من نهاية الكلاس يفهم بشكل مختلف. وهذا هو نفس السلوك الذي تراه أحياناً عندما ينسى أحد علامة اقتباس فيتغير لون نصف الملف، وهو ثمن مقبول مقابل ألا يتوقف كل شيء. وهذه الفكرة نفسها، أن يكمل المحلل بعد الخطأ، هي ما سوف نطبقه بشكل أبسط في خادم calc.
متى تستخدم Tree-sitter ومتى تحتاج خادم لغة Language Server؟
الطبقتان تكملان بعضهما ولا تتنافسان. فـ Tree-sitter يعرف شكل الكود: هذه دالة، وهذا نص، وهذه الكتلة تبدأ هنا وتنتهي هناك، ويعرف ذلك في ملي ثوان قليلة بعد كل تعديل ودون أي إعداد للمشروع. ولكنه لا يعرف أن "45" لا يناسب حقلاً من نوع number، ولا أين عرفت applyTax إذا كانت في ملف آخر مستورد، لأن هذا يحتاج فهم معنى الكود Semantics: الأنواع، والاستيراد، ونطاق المتغيرات Scope، وإعدادات المشروع في tsconfig.json. وهذا عمل خادم اللغة، الذي غالباً ما يكون المترجم نفسه أو جزءاً منه. لذلك المحرر الحديث يلون بالأولى فوراً، ثم يضيف فوقها ما يأتي من الثانية بعد لحظات.
نبني خادم لغة Language Server للغة calc
الآن نعود إلى شكوى فريق الفواتير. لدينا محلل لغة calc جاهز من مقال المفسر في الملف calc.py، ونحتاج برنامجاً يتكلم LSP ويستخدم هذا المحلل ليجيب المحرر. والملف calc_lsp.py يفعل ذلك في 234 سطراً من Python دون أي مكتبة خارجية، ويقدم خمس ميزات: التشخيص، والتلميح، والانتقال إلى التعريف، والإكمال، والإصلاح السريع. وملف الاختبار هو invoice.calc وفيه خطآن متعمدان، اسم متغير مكتوب خطأ discont، وقوس لم يغلق:
# قاعدة فاتورة الجملة: price و qty و discount تأتي من سطر الفاتورة
let tax = 0.15
let subtotal = price * qty - discont
let total = subtotal * (1 + tax
round(total, 2)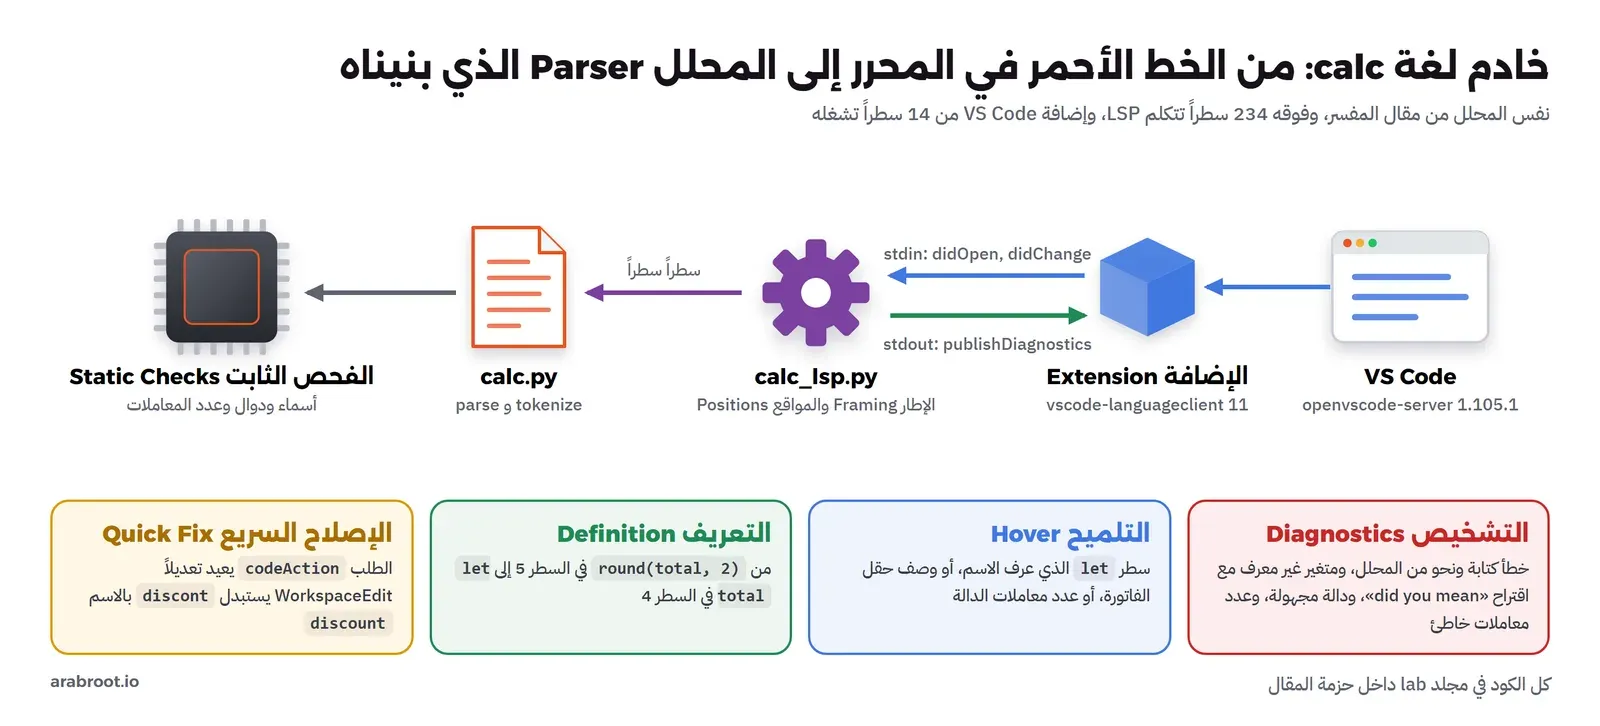
الإطار Framing بالبايت Bytes لا بالحرف: المشكلة التي أوقفت الخادم
كتبنا النسخة الأولى من دالتي القراءة والكتابة بالطريقة التي تخطر في البال أولاً، فالمدخل في Python نص، والدالة read تأخذ طولاً، والدالة len تعطي طول النص (احتفظنا بها في الملف framing_v1.py):
def read_message():
    length = None
    while True:
        line = sys.stdin.readline()
        if line == "":
            return None
        if line in ("\r\n", "\n"):
            break
        name, _, value = line.partition(":")
        if name.lower() == "content-length":
            length = int(value)
    return json.loads(sys.stdin.read(length))


def write_message(msg):
    body = json.dumps({"jsonrpc": "2.0", **msg}, ensure_ascii=False)
    sys.stdout.write(f"Content-Length: {len(body)}\r\n\r\n{body}")
    sys.stdout.flush()
وعند تشغيل العميل عليه كان المخرج كما يلي:
   15 ms #1   -->    567 B  request  initialize (id 1)
[calc_lsp] started, sync=incremental
  224 ms #2   <--    295 B  response initialize (id 1)
  ...
  227 ms #3   -->     52 B  notify   initialized
  230 ms #4   -->    370 B  notify   textDocument/didOpen
client error: timeout
المصافحة نجحت، والخادم استلم initialized، ثم توقف كل شيء بعد didOpen حتى انتهت مهلة العميل بعد 30 ثانية. والسبب في السطر الأول من ملف الفاتورة، أي التعليق العربي. فرسالة didOpen طولها 370 بايت كما كتب العميل في الرأس، ولكنها 334 حرفاً فقط، لأن كل حرف عربي من الحروف الـ 36 في التعليق يأخذ بايتين في UTF-8. والدالة sys.stdin.read(370) في مدخل نصي تقرأ 370 حرفاً لا بايتاً، فبقيت تنتظر 36 حرفاً إضافية لن تصل أبداً، لأن المحرر أرسل كل ما عنده وينتظر الرد. ولم تظهر المشكلة في initialize لأن تلك الرسالة كلها حروف إنجليزية، والبايت فيها يساوي الحرف.
والإصلاح أن نتعامل مع البايتات في الاتجاهين، فنقرأ من sys.stdin.buffer ونكتب إلى sys.stdout.buffer، ونحسب الطول بعد التحويل إلى UTF-8:
def read_message():
    stdin = sys.stdin.buffer                      # bytes, not text: the length is in bytes
    length = None
    while True:
        line = stdin.readline()
        if line == b"":
            return None
        if line in (b"\r\n", b"\n"):
            break
        name, _, value = line.decode("ascii").partition(":")
        if name.lower() == "content-length":
            length = int(value)
    return json.loads(stdin.read(length).decode("utf-8"))


def write_message(msg):
    body = json.dumps({"jsonrpc": "2.0", **msg}, ensure_ascii=False).encode("utf-8")
    sys.stdout.buffer.write(b"Content-Length: %d\r\n\r\n" % len(body) + body)
    sys.stdout.buffer.flush()
ولاحظ أن دالة الكتابة كان فيها نفس الخطأ في الاتجاه الآخر، فالتلميح على حقل مثل price يعيد وصفاً عربياً، والرأس كان سيقول عدد الحروف، فيقرأ المحرر رسالة ناقصة ويفشل في تحليل JSON. وهذا الخطأ لا يظهر في أي اختبار بنص إنجليزي، لذلك اجعل في اختباراتك دائماً ملفاً فيه نص عربي، وقد شرحنا الفرق بين الحرف والبايت بالتفصيل في مقال ترميز النصوص Text Encoding.
التشخيص Diagnostics سطراً سطراً مع استعادة الأخطاء Error Recovery
المحلل في calc.py يرفع استثناء CalcError عند أول خطأ ويتوقف، تماماً مثل ast.parse، وهذا مناسب لتنفيذ الصيغة ولكنه سيئ للمحرر، لأن المستخدم الذي في ملفه خطآن سوف يرى الأول فقط، ثم يصلحه فيظهر الثاني. ولأن كل سطر في calc جملة مستقلة، يحلل الخادم كل سطر وحده، فخطأ في سطر لا يمنع فحص الأسطر التي بعده. وبعد التحليل النحوي يمشي على شجرة كل سطر صحيح ويفحص أشياء لم يكن المفسر يفحصها إلا عند التشغيل: هل الاسم معرف بجملة let قبله أو هو من حقول الفاتورة price وqty وdiscount؟ وهل الدالة موجودة في قائمة الدوال المسموحة؟ وهل عدد معاملاتها صحيح؟
for n, source in enumerate(lines, start=1):
    if not source.strip() or source.lstrip().startswith("#"):
        continue
    try:
        statements = parse(source)
    except CalcError as e:
        report(n, e.col, e.message, code=e.kind)
        # error recovery: "let total = ..." still defines total, so the next lines do not report it again
        try:
            toks = tokenize(source)
            if toks[0].kind == "LET" and toks[1].kind == "NAME":
                defined[toks[1].text] = (n, toks[1].col)
        except CalcError:
            pass
        continue
    for st in statements:
        for node in walk(st):
            if isinstance(node, Var) and node.name not in defined and node.name not in FIELDS:
                known = list(defined) + list(FIELDS)
                near = difflib.get_close_matches(node.name, known, n=1)
                hint = f", did you mean '{near[0]}'?" if near else ""
                report(n, node.col, f"'{node.name}' is not defined{hint}", length=len(node.name), code="NameError",
                       fix=near[0] if near else None)
والجزء المكتوب تحت تعليق «error recovery» لم يكن في النسخة الأولى، وهذا مخرجها على ملف الفاتورة (الملف before-recovery.out):
diagnostics after didOpen: 3
  3:30 error NameError: 'discont' is not defined, did you mean 'discount'?
  4:32 error SyntaxError: expected ')', found end of input
  5:7 error NameError: 'total' is not defined, did you mean 'subtotal'?
الخطأ الثالث غير صحيح، فالمتغير total معرف في السطر الرابع، ولكن السطر الرابع فشل تحليله فلم يسجل الخادم الاسم، فاشتكى السطر الخامس من اسم غير معرف، واقترح subtotal أيضاً. وهذا ما يسمى الأخطاء المتتالية Cascading Errors، وهي سبب أن بعض المترجمات تعطيك خمسين خطأ بسبب فاصلة منقوطة واحدة. والإصلاح استعادة بسيطة: إذا فشل تحليل سطر يبدأ بالكلمة let ثم اسم، فنسجل الاسم كمعرف رغم الفشل، لأن نية المستخدم واضحة. وبعدها صار المخرج خطأين فقط، وهما الخطآن الحقيقيان. والاقتراح «did you mean» يأتي من الدالة difflib.get_close_matches في مكتبة Python القياسية، وهي تقارن الاسم المجهول بكل الأسماء المعروفة وتعيد الأقرب.
التلميح Hover والتعريف Definition والإكمال Completion
بعد أن صار عند الخادم جدول بالأسماء المعرفة ومكان تعريف كل اسم، صارت الميزات الأخرى بضعة أسطر. فطلب التعريف يأخذ الكلمة تحت المؤشر، ويبحث عنها في الجدول، ويعيد موقع جملة let التي عرفتها. والتلميح يعيد نص تلك الجملة نفسها، أو وصف حقل الفاتورة، أو عدد معاملات الدالة. والإكمال يعيد كل الدوال والحقول والأسماء المعرفة مع نوع كل واحد منها، والمحرر يرتبها ويفلترها حسب ما كتبه المستخدم. وعند تشغيل نفس العميل على الخادم الجديد:
docker run --rm -v "$PWD/lab":/lab -w /lab scc3-lsp:1 node capture.mjs calc 15 ms #1 --> 567 B request initialize (id 1)
[calc_lsp] started, sync=incremental
237 ms #2 <-- 323 B response initialize (id 1)
server: calc-lsp 0.1
capabilities: codeActionProvider, completionProvider, definitionProvider, hoverProvider, positionEncoding, textDocumentSync
textDocumentSync: {"openClose":true,"change":2} positionEncoding: utf-16
diagnostics model: push (publishDiagnostics)
241 ms #3 --> 52 B notify initialized
244 ms #4 --> 370 B notify textDocument/didOpen
248 ms #5 <-- 570 B notify textDocument/publishDiagnostics
diagnostics after didOpen: 2
3:30 error NameError: 'discont' is not defined, did you mean 'discount'?
4:32 error SyntaxError: expected ')', found end of input
251 ms #6 --> 166 B request textDocument/definition (id 2)
254 ms #7 <-- 169 B response textDocument/definition (id 2)
definition of the name at 5:7 -> invoice.calc 4:5
257 ms #8 --> 161 B request textDocument/hover (id 3)
259 ms #9 <-- 129 B response textDocument/hover (id 3)
hover: "let total = subtotal * (1 + tax (line 4)"
261 ms #10 --> 249 B notify textDocument/didChange
263 ms #11 <-- 329 B notify textDocument/publishDiagnostics
diagnostics after didChange (incremental): 1
4:32 expected ')', found end of input
265 ms #12 --> 58 B request shutdown (id 4)
267 ms #13 <-- 43 B response shutdown (id 4)
272 ms #14 --> 47 B notify exit
14 messages in 273 msفي المخرج أعلاه لاحظ التالي:
- رسالة
didOpenهي نفسها 370 بايت التي أوقفت النسخة الأولى، والتشخيص وصل بعدها بأربعة ملي ثانية، لأن الخادم يحلل خمسة أسطر فقط. - التعريف من
totalفي السطر الخامس انتقل إلى السطر الرابع العمود 5، رغم أن السطر الرابع نفسه فيه خطأ، وهذه فائدة الاستعادة التي أضفناها. - بعد أن صحح العميل
discontإلىdiscountبرسالة جزئية، بقي خطأ واحد هو القوس، وهذا صحيح، والقائمة في التشخيص هي دائماً كل الأخطاء الحالية في الملف لا الأخطاء الجديدة فقط. - القدرات المعلنة ست، ومنها
codeActionProviderالتي سوف نشرحها في القسم التالي. - الجلسة كلها 14 رسالة في 273 ms، والخادم لم يرسل أي رسالة سجل، وكل ما يطبعه للتشخيص يذهب إلى stderr لا إلى stdout، لأن أي حرف زائد في stdout يفسد الإطار ويفهمه المحرر على أنه بداية رسالة.
الإصلاح السريع Quick Fix عبر codeAction
بما أن الخادم يعرف الاسم المقترح، فلماذا لا يصلحه بنفسه؟ في البروتوكول يتم ذلك بالطلب textDocument/codeAction، فالمحرر يرسل التشخيصات الموجودة تحت المؤشر، والخادم يعيد قائمة إجراءات، وكل إجراء فيه تعديل WorkspaceEdit جاهز: في هذا الملف، في هذا النطاق، ضع هذا النص. ولكي يعرف الخادم الاسم المقترح دون أن يحلل الملف من جديد، يضعه في الحقل data داخل التشخيص نفسه عند إرساله، والمحرر يعيده كما هو:
elif method == "textDocument/codeAction":
    # a quick fix for each diagnostic the editor sends back that carries a suggested name
    uri = params["textDocument"]["uri"]
    return [{"title": f"Change to '{d['data']['replace']}'", "kind": "quickfix", "diagnostics": [d],
             "isPreferred": True,
             "edit": {"changes": {uri: [{"range": d["range"], "newText": d["data"]["replace"]}]}}}
            for d in params["context"]["diagnostics"] if d.get("data", {}).get("replace")]
ولاحظ أن الخادم لا يغير الملف بنفسه أبداً، فهو يعيد وصف التعديل فقط، والمحرر هو الذي ينفذه، فيدخل في سجل التراجع Undo مثل أي تعديل كتبه المستخدم بيده.
ربط الخادم بالمحرر VS Code: إضافة Extension من 14 سطراً
بقي أن يعرف VS Code أن ملفات .calc لها خادم. وهذا عمل إضافة صغيرة فيها ملفان: package.json يعرف اللغة calc وامتداد ملفاتها، وextension.js يشغل الخادم ويسلمه إلى مكتبة vscode-languageclient الرسمية التي تقوم بكل ما قام به capture.mjs يدوياً، كما يشرح دليل خوادم اللغة في توثيق VS Code:
// The whole VS Code side of the calc language: start the server and let vscode-languageclient speak LSP to it.
const { LanguageClient, TransportKind } = require('vscode-languageclient/node');
const path = require('path');

let client;
function activate(context) {
  const server = path.join(process.env.CALC_LSP_DIR || context.extensionPath, 'calc_lsp.py');
  client = new LanguageClient('calc', 'calc language server',
    { command: 'python3', args: [server], transport: TransportKind.stdio },
    { documentSelector: [{ language: 'calc' }] });
  return client.start();
}
function deactivate() { return client && client.stop(); }
module.exports = { activate, deactivate };
ولتصوير النتيجة شغلنا openvscode-server 1.105.1، وهو VS Code كامل يعمل في المتصفح، داخل Container فيه Python 3.13 والإضافة، وفتحنا ملف الفاتورة:
docker build -t scc3-vscode:1 lab/calc-vscode/
docker run -d --name scc3-vscode -p 127.0.0.1:19500:3000 -e CALC_LSP_DIR=/srv/calc \
  -v "$PWD/lab":/srv/calc:ro -v "$PWD/lab/shop-calc":/home/workspace/shop scc3-vscode:1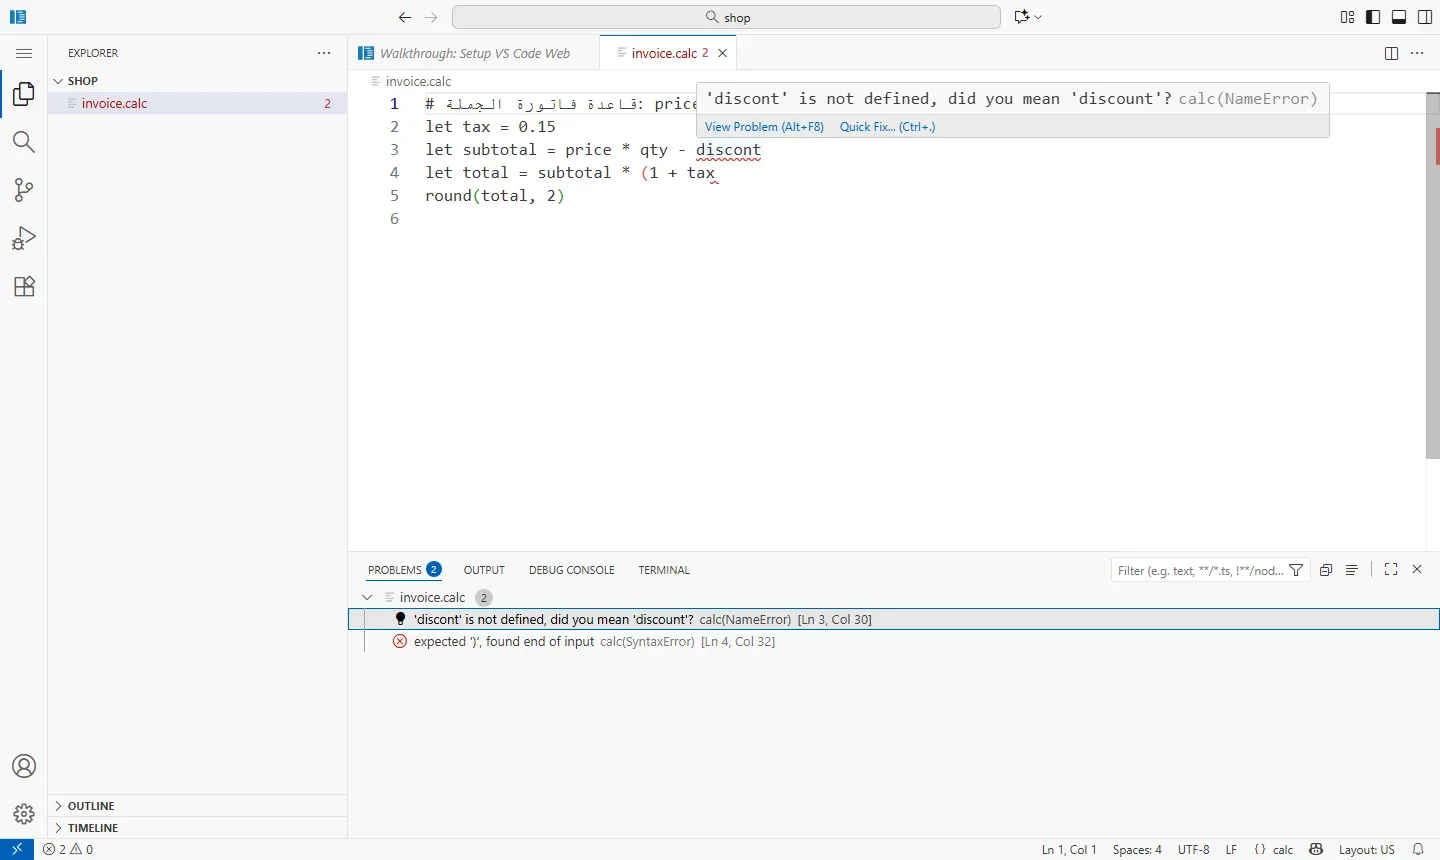
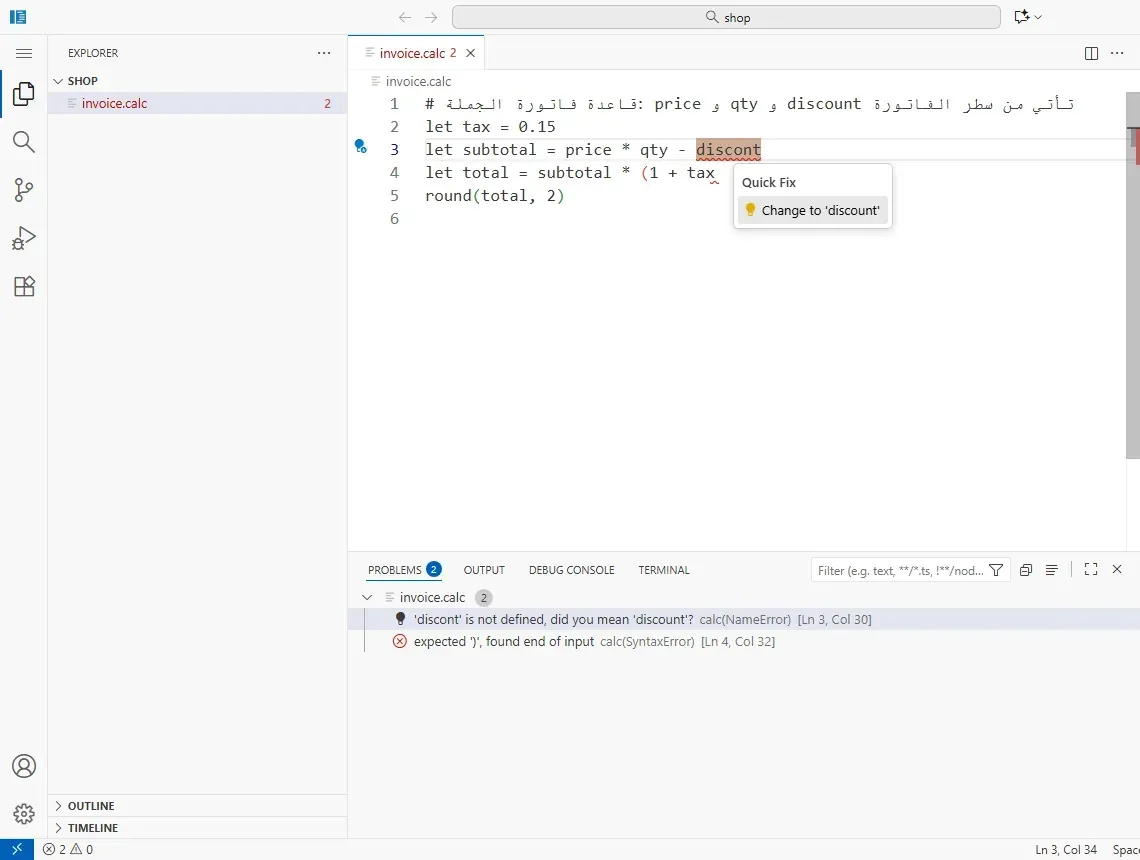
ولاحظ في الصورة الأولى شريط الحالة في الأسفل، حيث تجد اسم اللغة calc بدل Plain Text، وهذا يعني أن الإضافة تعرفت على الملف وشغلت الخادم. وفي أول محاولة لم يظهر أي خط أحمر، والسبب نافذة «Do you trust the authors of the files in this folder?»، فقبل أن تثق بالمجلد يعمل VS Code في الوضع المقيد Restricted Mode ولا يشغل الإضافات التي لم تعلن أنها آمنة في المجلدات غير الموثوقة، وخادم اللغة برنامج يعمل على جهازك، لذلك هذا السلوك صحيح، وقد شرحنا الثقة بالمجلدات في مقال بيئة البرمجة للمبتدئين ومعه توثيق Workspace Trust.
المواقع Positions بوحدات UTF-16: فخ الرموز التعبيرية Emoji
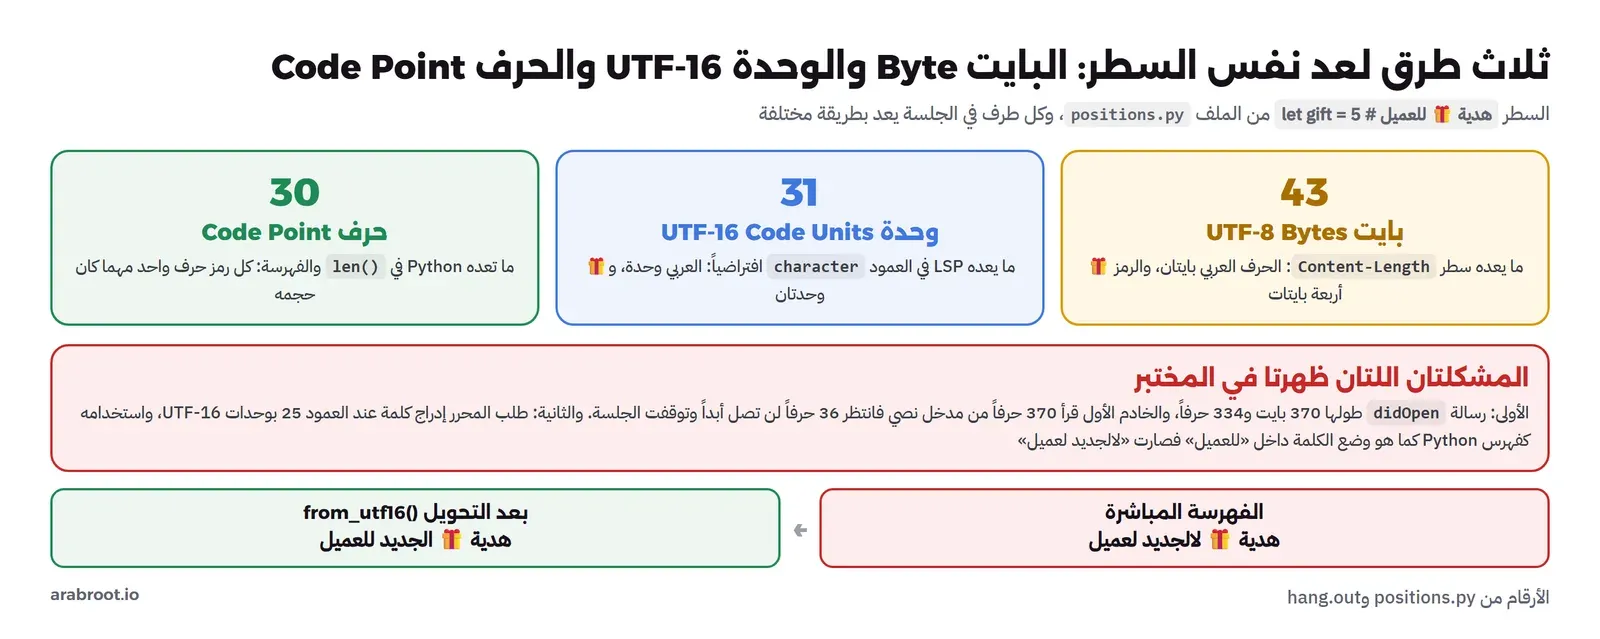
رأينا أن البايت والحرف مختلفان في الإطار، وفي المواقع مشكلة ثالثة. فالمواصفة تقول إن العمود character يعد وحدات UTF-16 Code Units افتراضياً، وهذا موروث من أن VS Code وJavaScript يخزنان النصوص بهذا الترميز. وفي الإصدار 3.17 أضيفت القدرة positionEncoding التي تسمح للطرفين بالاتفاق على UTF-8 أو UTF-32، ولكن المواصفة تشترط أن يدعم كل خادم UTF-16 لأنها الافتراضية، وكل الخوادم الثلاثة في هذا المقال أعلنتها أو سكتت عنها. أما Python فتعد الحروف Code Points، والحرف العربي في الحالتين وحدة واحدة، لذلك لن تلاحظ أي فرق مع النص العربي، والفرق يظهر مع الحروف خارج المستوى الأساسي، مثل الرموز التعبيرية التي تأخذ وحدتين في UTF-16 وحرفاً واحداً في Python. والملف positions.py يجرب ذلك على تعليق فيه هدية 🎁:
line = "let gift = 5   # هدية 🎁 للعميل"
print("characters (Python len):", len(line), "  UTF-16 units:", len(line.encode("utf-16-le")) // 2,
      "  UTF-8 bytes:", len(line.encode("utf-8")))
end = to_utf16(line, line.index("للعميل"))
print("column of 'للعميل' : Python", line.index("للعميل"), " LSP (UTF-16)", end)

# the editor says: insert "الجديد " at UTF-16 column `end` (just before للعميل)
change = {"range": {"start": {"line": 0, "character": end}, "end": {"line": 0, "character": end}}, "text": "الجديد "}
naive = line[:end] + change["text"] + line[end:]           # using the LSP number as a Python index
print("naive  :", naive)
print("correct:", apply_change(line, change))
characters (Python len): 30 UTF-16 units: 31 UTF-8 bytes: 43
column of 'للعميل' : Python 24 LSP (UTF-16) 25
naive : let gift = 5 # هدية 🎁 لالجديد لعميل
correct: let gift = 5 # هدية 🎁 الجديد للعميلنفس السطر طوله 43 بايت في الإطار، و31 وحدة في LSP، و30 حرفاً في Python. والمحرر طلب إدراج كلمة عند العمود 25 بوحدات UTF-16، أي قبل «للعميل» مباشرة، والخادم الذي يستخدم الرقم 25 كفهرس Python كما هو وضع الكلمة بعد اللام الأولى، فصار النص «لالجديد لعميل». والأخطر من الشكل أن نسخة الخادم من الملف صارت مختلفة عن نسخة المحرر، وكل تعديل جزئي بعد ذلك يطبق في مكان خطأ، وكل تشخيص يرسم تحت الكلمة الخطأ، حتى يغلق المستخدم الملف ويفتحه. والدالتان to_utf16 وfrom_utf16 في الخادم تحولان بين الطريقتين في كل موقع يدخل أو يخرج.
ماذا يحدث إذا طلب الخادم الملف كاملاً مع كل حرف؟ المزامنة الكاملة Full Sync
المزامنة الجزئية تحتاج كوداً أكثر في الخادم، ومعها كل مشكلات المواقع التي رأيناها، والمزامنة الكاملة تريحك من كل ذلك: المحرر يرسل الملف كله مع كل تعديل، والخادم يستبدل نسخته. فما الذي تخسره؟ الملف sync_cost.mjs يجيب بالأرقام: يولد ملف calc من 3,000 سطر، ويفتحه، ثم يكتب سطراً جديداً في وسطه حرفاً حرفاً كما يكتب إنسان، ويقيس البايتات المرسلة والوقت حتى يصل التشخيص بعد كل حرف. والخادم يقرأ نوع المزامنة من متغير البيئة CALC_SYNC:
for m in 1 2; do docker run --rm -e CALC_SYNC=$m -v "$PWD/lab":/lab -w /lab scc3-lsp:1 node sync_cost.mjs; donelast diagnostics: 0 problems
sync mode: full (1) file: 3001 lines, 70579 bytes
didOpen sent: 73902 bytes
19 keystrokes sent: 1401186 bytes (73747 bytes per keystroke)
keystroke -> diagnostics: median 115.4 ms, max 133.6 ms
last diagnostics: 0 problems
sync mode: incremental (2) file: 3001 lines, 70579 bytes
didOpen sent: 73902 bytes
19 keystrokes sent: 4875 bytes (257 bytes per keystroke)
keystroke -> diagnostics: median 135.2 ms, max 218.8 msفي المخرج أعلاه لاحظ التالي:
- الملف 70,579 بايت، ولكن
didOpenكان 73,902 بايت، والفرق هو تحويل كل سطر جديد إلى\nداخل JSON والرأس وحقول الرسالة. - مع المزامنة الكاملة أرسل المحرر 1.4 ميجابايت لكتابة 19 حرفاً، أي الملف كله تقريباً مع كل حرف، ومع الجزئية 4,875 بايت فقط، أي توفير 99.6% من البايتات.
- ولكن الوقت لم يتحسن، بل كان الوسيط مع الجزئية 135 ms مقابل 115 ms مع الكاملة، والفرق بينهما في حدود التذبذب بين التشغيلات. والسبب أن نقل 73 كيلوبايت عبر أنبوب داخل نفس الجهاز يأخذ جزءاً صغيراً من الملي ثانية، أما الذي يأخذ أكثر من مئة ملي ثانية فهو أن الخادم يحلل الأسطر الـ 3,001 كلها بعد كل حرف، ويبني جدول الأسماء من جديد.
وبالتالي فالمزامنة الجزئية وحدها لا تجعل الخادم أسرع، وإنما تقلل البايتات، وهذا مهم عندما يكون الخادم على جهاز آخر كما في بيئات التطوير البعيدة Remote Development، أو عندما يكون الملف بالميجابايتات. أما السرعة فتحتاج أن يكون التحليل نفسه تزايدياً: أن يعيد الخادم تحليل الأسطر التي تغيرت فقط، ويحتفظ بنتائج الباقي، وهذا بالضبط ما رأيناه في Tree-sitter. وفي خادم calc يمكن تحقيق ذلك بسهولة نسبية لأن كل سطر جملة مستقلة، فنحفظ نتيجة كل سطر ونعيد تحليل السطر المتغير فقط، مع إعادة فحص الأسماء التي تعتمد على ما عرف قبله. والحل الآخر الذي تستخدمه المحررات هو التأخير Debounce: ألا يحلل الخادم إلا إذا توقف المستخدم عن الكتابة 200 ms مثلاً، فلا يضيع وقتاً في تحليل «let bo» و«let bon» و«let bonu».
أخطاء شائعة Common Mistakes عند بناء خادم لغة Language Server
- حساب
Content-Lengthبعدد الحروف أو القراءة من مدخل نصي: يعمل مع الإنجليزي ويتوقف مع أول تعليق عربي، كما حدث مع النسخة الأولى. - الكتابة إلى stdout بدالة
printللتصحيح: أي حرف خارج الإطار يفسد الجلسة، والسجل مكانه stderr أو الإشعارwindow/logMessage. - استخدام رقم العمود من المحرر كفهرس في نص Python أو Go أو Rust مباشرة: العمود بوحدات UTF-16، ورمز تعبيري واحد يزيح كل ما بعده.
- إيقاف التحليل عند أول خطأ: المستخدم يرى خطأ واحداً في كل مرة، والأخطاء المتتالية تملأ اللوحة بأخطاء غير حقيقية.
- عدم الرد على طلبات الخادم إلى العميل مثل
workspace/configurationإذا كنت تكتب عميلاً: بعض الخوادم تنتظر الرد قبل أن تكمل. - افتراض أن إشعار التشخيص الأول هو النهائي، أو أنه يخص آخر نسخة من الملف: الإشعارات قد تأتي على دفعات ومتأخرة، والحقل
versionهو الذي يحسم. - تحليل الملف كله مع كل حرف دون تأخير ودون تخزين النتائج: المزامنة الجزئية لن تنقذك كما رأينا في القياس.
- ترك استثناء واحد يسقط الخادم: الخادم في
calc_lsp.pyيلتقط أي استثناء في معالج الطلب ويرد بخطأ JSON-RPC رقمه-32603، ويكمل خدمة الطلبات التالية. - الاعتماد على أداة وسيطة دون تثبيت إصدار اللغة:
typescript-language-server6.0.2 رفض TypeScript 7 تماماً، فثبت الإصدار الذي اختبرته فيpackage.json.
جدول قرار Decision Table: ماذا تبني للغتك؟
| ما تحتاجه | الأنسب | والسبب |
|---|---|---|
| تلوين ملفات لغتك في VS Code فقط | قواعد TextMate في الإضافة | بضعة تعبيرات نمطية تكفي، ولا تحتاج أي عملية منفصلة |
| تلوين وطي وتنقل في أكثر من محرر، أو بحث في كود كثير | قواعد Tree-sitter | شجرة كاملة تتحدث في ملي ثوان وتتحمل الكود نصف المكتوب |
| أخطاء بالأسماء والأنواع، وتعريف، وإكمال يفهم المعنى | خادم لغة LSP | يحتاج فهم المعنى والمشروع، ويعمل مع كل محرر يدعم البروتوكول |
لغة صغيرة داخلية مثل calc يستخدمها فريق واحد | خادم صغير فوق المحلل الموجود | 234 سطراً أعطت التشخيص والتلميح والتعريف والإصلاح السريع |
| محرر داخل المتصفح في لوحة إدارة | محرر Monaco مع نفس الخادم | Monaco هو محرر الكود الذي يعمل داخل VS Code، ويمكن ربطه بخادم LSP عبر WebSocket |
قائمة تحقق Checklist قبل نشر خادم لغة Language Server
- الإطار بالبايت في القراءة والكتابة، واختبار بملف فيه تعليق عربي ورمز تعبيري.
- تحويل كل موقع بين UTF-16 والفهرسة الداخلية، أو الاتفاق على
positionEncodingآخر إذا أعلنه العميل. - القدرات المعلنة في
initializeتطابق ما ينفذه الخادم فعلاً، ولا شيء أكثر. - التشخيص يعيد كل أخطاء الملف، مع استعادة تمنع الأخطاء المتتالية، ومع رقم الإصدار إذا كان بالدفع.
- السجلات إلى stderr فقط، ومعالج يلتقط الاستثناءات ويرد بخطأ بدل أن يسقط.
- تأخير Debounce أو تحليل تزايدي إذا كانت الملفات كبيرة.
- اختبار الخادم بعميل بسيط مثل
capture.mjsقبل VS Code، لأن رؤية الرسائل الخام توفر ساعات من التخمين. - إصدار اللغة والخادم مثبت في المشروع، ومجرب مع المحرر الذي يستخدمه فريقك.
تدريب عملي Practice
- اجعل خادم
calcيحفظ نتيجة تحليل كل سطر، ويعيد تحليل الأسطر المتغيرة فقط، ثم شغلsync_cost.mjsمن جديد وقارن الزمن. - أضف القدرة
renameProviderحتى تعيد تسمية متغير معرف بجملةletفي كل أسطر الملف. - أضف في العميل
capture.mjsفحصاً للحقلversionفي إشعارات التشخيص، وشغله علىtypescript-language-serverمع TypeScript 6 لترى أي الدفعات قديمة.
حذف المختبر Cleanup
كل التجارب استخدمت Container يحذف نفسه بالخيار --rm، ما عدا محرر openvscode-server الذي يعمل في الخلفية، فأوقفه واحذف الـ Images إذا لم تعد تحتاجها:
docker rm -f scc3-vscode
docker rmi scc3-vscode:1 scc3-lsp:1 gitpod/openvscode-server:1.105.1 node:22-slim
rm -rf lab/__pycache__ lab/*.jsonl
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المحرر لا يفهم اللغات بنفسه، وإنما يتكلم مع خادم لغة في عملية منفصلة ببروتوكول LSP، وهذا حول مشكلة M×N بين المحررات واللغات إلى M+N.
- الرسائل JSON-RPC: طلبات بأرقام وردود عليها وإشعارات بلا رد، في الاتجاهين، ويسبق كل رسالة رأس
Content-Lengthبالبايت. - الجلسة الحقيقية مع TypeScript 7 كانت 52 رسالة في 648 ms: مصافحة بالقدرات، ثم
didOpenبالنص كاملاً، ثم تشخيص بالسحب، ثم تعريف في 4 ms، ثم تعديل جزئي. - نفس العميل عمل مع Pyright دون تغيير سطر، بنموذج الدفع، وأول تشخيص بعد 2.8 ثانية ثم 364 ms، والحقل
versionيربط التشخيص بنسخة الملف. - TypeScript 7 صار خادم LSP بنفسه بالأمر
tsc --lsp --stdio، والأداة الوسيطةtypescript-language-serverلا تعمل معه. - Tree-sitter حلل ملفاً من 6,357 سطراً في 51 ms، وأعاد التحليل بعد حرف في 9 ms، وأعطى شجرة رغم قوس ناقص حيث توقف
ast.parse. - خادم
calcفي 234 سطراً أعطى تشخيصاً وتلميحاً وتعريفاً وإكمالاً وإصلاحاً سريعاً في VS Code، بعد إصلاح الإطار بالبايت، واستعادة الأخطاء المتتالية، وتحويل المواقع إلى UTF-16. - المزامنة الجزئية وفرت 99.6% من البايتات ولم توفر وقتاً، لأن الوقت في التحليل، والسرعة تأتي من التحليل التزايدي أو التأخير.
وفي المرحلة نفسها سوف نتناول بإذن الله كيف تصمم لغة مجال DSL كاملة لمشروعك، ومتى لا تحتاج لغة أصلاً.
 دليلابن مفسراً صغيراً Interpreter بيدك: من النص إلى ASTنبني بلغة Python لغة صيغ صغيرة لحقل في نظام فواتير، من المحلل اللغوي إلى شجرة AST والتنفيذ ورسائل الخطأ، ونرى لماذا لا تصلح eval لهذا العمل.
 دليلTypeScript للمطورين: أي الأخطاء تكشفها الأنواع Types؟زرعنا تسعة أخطاء في كود سلة مشتريات وفحصناها بالمترجم tsc بثلاثة إعدادات، لنرى ما يكشفه الوضع الصارم وما يمر رغم كل الأنواع ولماذا تحتاج التحقق وقت التشغيل.
 دليلبيئة البرمجة للمبتدئين: المحرر VS Code والطرفية Terminalنجهز المحرر والطرفية وPython وNode على جهاز نظيف، ونفهم كل رسالة خطأ تظهر في الأيام الأولى مثل command not found وPATH وpython3 قبل أن نكتب أول برنامج.
 دليلالتعبيرات النمطية Regex للمبتدئين، مع النص العربيكيف تقرأ وتكتب تعبيراً نمطياً جزءاً بجزء، ولماذا يختلف سلوكه مع النص العربي بين اللغات، وكيف يوقف نمط واحد سيرفرك.
 دليلترميز النصوص Text Encoding: من ASCII إلى UTF-8نتابع نصاً عربياً بايتاً بايتاً من الكتابة إلى قاعدة البيانات، ونرى لماذا يتحول إلى «Ø§Ù„» وكيف تمنع ذلك وتقارن النصوص وتقطعها بشكل صحيح.
 دليلTerraform أم OpenTofu؟ قصة تغيير الترخيص وما يعنيه لكلماذا غير Terraform رخصته في 2023 فولد منه OpenTofu، وأين يختلف المشروعان اليوم، وكيف تختار بينهما.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل كل الأمثلة داخل Container مبني على
python:3.13.17-slimمع Node.js 22.23.4 وTypeScript 7.0.2 وPyright 1.1.414 وtypescript-language-server 6.0.2 وpy-tree-sitter 0.26.0، وتصوير VS Code من openvscode-server 1.105.1، على Docker Engine 29.8.0.