


لنفرض أنك في فريق شركة ناشئة تبيع خدمة توصيل عبر تطبيق، وقد جمعتم سجلات الخدمات الثماني في Grafana Loki كما شرحنا في دليل Loki، والأمور تسير جيداً منذ أشهر. ثم أضاف المطورون إلى كل سطر معرف التتبع trace_id ومعرف المستخدم user_id، لأن فريق الدعم يريد أن يكتب رقم العميل فيرى كل ما حدث له. وبعد أسبوعين بدأت الشكاوى: البحث عن trace_id واحد يأخذ عشر ثوان، وسؤال «كم عميلاً تأثر بخطأ الدفع اليوم؟» يرجع خطأ لا يفهمه أحد، والسيرفر الذي يشغل Loki يحتاج ذاكرة أكثر كل شهر. وفي اجتماع الفريق قال أحدهم: «قرأت أن VictoriaLogs يحل هذا بذاكرة أقل بكثير»، فطلب منه المدير أرقاماً من بياناتنا نحن، وليس من صفحة الشركة.
وقد قارنا في مقارنة أدوات السجلات المركزية خمس أدوات على 500 ألف حدث، وكان VictoriaLogs الأخف في المختبر، ولكننا تركناه هناك «خياراً يستحق التجربة» لأننا لم نكتب له دليلاً. وهذا المقال هو ذلك الدليل: نثبت VictoriaLogs ونفهم كيف يحفظ السجل، ثم نضع فيه وفي Loki البيانات نفسها بعشرة أضعاف الحجم السابق، أي خمسة ملايين حدث فيها الحقول كثيرة القيم التي أتعبت الفريق، ونقيس الإدخال والقرص والذاكرة وسرعة الأسئلة، ثم نبني تنبيهاً من السجلات. والمواضيع في هذه المرحلة:
- السجلات Logging للمطورين ومديري السيرفرات.
- سجلات تساعدك فعلاً.
- مسار السجل Log Pipeline.
- أدوات الجمع المركزي: Grafana Loki وGraylog وSeq وVictoriaLogs (الموضوع الحالي).
- مقارنة أدوات السجلات المركزية بالأرقام.
- سجل التدقيق Audit Trail.
وسوف نناقش في هذا المقال ما يلي:
- لماذا ظهر VictoriaLogs، وما مشكلة الحقول كثيرة القيم High Cardinality التي يحاول حلها.
- كيف يحفظ السجل من الداخل: التدفقات Streams والأقسام اليومية والأعمدة وفلاتر Bloom، ومقارنة ذلك بLoki.
- مختبر بخمسة ملايين حدث (1.42 GB) في VictoriaLogs ثم في Loki، مع الإجابات الصحيحة المحسوبة من الملف.
- القرص والذاكرة وخمسة أسئلة بلغتي LogsQL وLogQL، ومشكلتان واجهتانا في Loki وحلهما.
- ماذا يحدث إذا وضعت user_id في التدفق في الأداتين.
- التنبيه من السجلات مع vmalert، ومشكلة إدخال نجح بالرمز 200 ولم يصل منه شيء.
- الاحتفاظ بالمدة وبحجم القرص، وتجربة لم يحذف فيها شيء، ثم نقاط القوة ونقاط الضعف ومتى تنتقل.
لماذا ظهر VictoriaLogs؟ مشكلة الحقول كثيرة القيم High Cardinality
الحقل كثير القيم High Cardinality هو حقل يأخذ عدداً كبيراً جداً من القيم المختلفة، مثل معرف التتبع الذي يختلف في كل طلب، ومعرف المستخدم الذي قد يكون له مئات الآلاف من القيم، وعنوان IP للكلاينت. وفي المقابل الحقل قليل القيم مثل اسم الخدمة ومستوى السجل، فقيمه معدودة ولا تتغير. وهذه الحقول كثيرة القيم هي بالضبط ما يحتاجه فريق الدعم والمطورون، لأن السؤال الحقيقي في يوم العمل ليس «كم خطأ في خدمة الدفع؟» وإنما «ماذا حدث للعميل u143952 الساعة التاسعة؟» و«أعطني كل سطور الطلب 75e508f3».
وكل أداة سجلات تتعامل مع هذه الحقول بطريقة مختلفة، كما شرحنا في المقارنة. فالأدوات التي تبني فهرساً معكوساً لكل كلمة مثل OpenSearch تجد الإبرة فوراً ولكنها تدفع الثمن قرصاً وذاكرة، وLoki اختار العكس: يفهرس التسميات Labels فقط، وكل تركيبة قيم من التسميات تصبح سلسلة Stream لها ملفاتها، فإذا جعلت user_id تسمية صار عندك سلسلة لكل مستخدم، ولذلك يضع Loki حداً لعدد السلاسل ويرفض ما بعده، وقد رأينا ذلك في دليل Loki عندما أصبح معرف الطلب تسمية. والحل الذي يقترحه Loki هو أن تضع هذه الحقول في البيانات الوصفية المنظمة Structured Metadata، أي بجانب السطر دون فهرس، وهذا يحمي الإدخال، ولكن البحث بها يبقى قراءة لكل السطور في الفترة، وهذا ما سوف نقيسه.
وجاء VictoriaLogs من الشركة نفسها التي تطور VictoriaMetrics، وهي قاعدة سلاسل زمنية معروفة متوافقة مع Prometheus، وفكرته أن يأخذ من Loki بساطة التشغيل والتسميات القليلة، ويضيف إليها فهرسة لكل الحقول بطريقة رخيصة. فبحسب توثيقه الرسمي يقبل الحقول كثيرة القيم مثل trace_id وuser_id وip، ويذكر أنه يستخدم ذاكرة أقل حتى 30 مرة وقرصاً أقل حتى 15 مرة من Elasticsearch وLoki. وهذه أرقام الشركة نفسها، ولذلك لن نكررها في المقال على أنها حقيقة، وإنما نقيس على بياناتنا ونرى أين تقع أرقامنا منها. وترخيصه Apache-2.0 كما في مستودعه، وله نسخة Enterprise مدفوعة ونسخة Cluster مفتوحة بالترخيص نفسه.
كيف يحفظ VictoriaLogs السجل؟ التدفقات Streams مع الأعمدة Columns
حتى تفهم أرقام المختبر يجب أن تعرف أين يذهب الحدث بعد أن يصل، والصورة التالية تبين الحدث نفسه كما يحفظه كل من المخزنين:
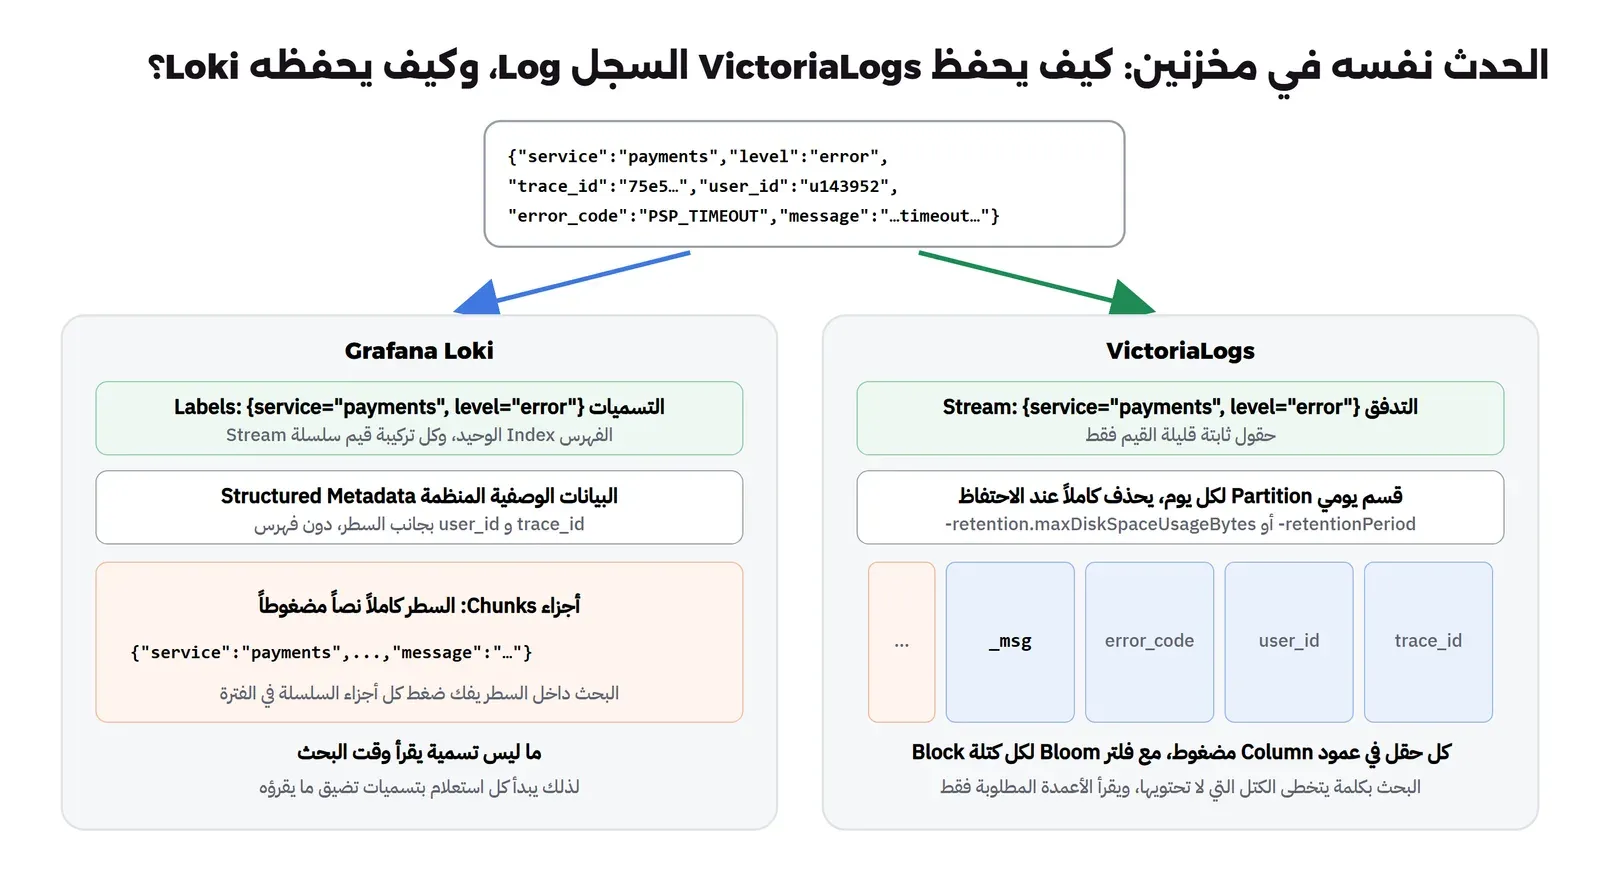
وفيما يلي الأجزاء الأربعة التي تراها في الجانب الأيمن من الصورة:
- التدفق Stream: يعرفه توثيق المفاهيم بأنه السجلات التي تأتي من نسخة واحدة من تطبيق، وتحدده أنت بالحقول التي ترسلها في
_stream_fields، مثل الخدمة والمستوى أو اسم السيرفر. وهو يقابل التسميات في Loki، والسجلات من التدفق نفسه تحفظ متجاورة فتنضغط بشكل أفضل، والبحث المقيد بتدفق يقرأ أقل. - القسم اليومي Partition: كل يوم في مجلد خاص به، وعندما تنتهي مدة الاحتفاظ يحذف المجلد كاملاً، فالحذف رخيص جداً ولا يحتاج عملية تنظيف ثقيلة.
- الأعمدة Columns: يذكر قسم الأسئلة الشائعة أن قيم الحقل الواحد تحفظ معاً في كتل بيانات مستقلة، فالسؤال عن user_id يقرأ عمود user_id فقط ولا يقرأ الرسالة ولا بقية الحقول، وبعض الأنواع تحفظ بترميز خاص، مثل عنوان IP في 4 بايت بدل نص.
- فلاتر Bloom: لكل كتلة فلتر صغير يجيب عن سؤال «هل يمكن أن تكون هذه الكلمة في هذه الكتلة؟»، فإذا كانت الإجابة لا تخطى الكتلة كلها دون أن يفك ضغطها، ولذلك يجد الإبرة trace_id دون أن يقرأ خمسة ملايين سطر.
وقد يتساءل البعض: إذا كان VictoriaLogs يفهرس كل الحقول، فلماذا لا يكون قرصه بحجم OpenSearch؟ والإجابة أن فلتر Bloom ليس فهرساً معكوساً، فهو لا يحفظ أين توجد الكلمة بالضبط، وإنما يحفظ بتات قليلة تقول «ربما هنا» أو «ليست هنا بالتأكيد»، وحجمه صغير جداً مقارنة بالفهرس المعكوس الذي يحفظ قائمة المواضع لكل كلمة. وثمن ذلك أن الكتل التي يقول عنها «ربما» يجب أن تقرأ وتفحص، وهذا يعمل جيداً عندما تكون الكلمة نادرة مثل trace_id، وأقل جودة عندما تكون الكلمة في كل مكان.
ماذا تضع في حقول التدفق Stream Fields؟
هذا هو القرار الوحيد المهم الذي تتخذه عند الإعداد، ويحذر التوثيق بوضوح: لا تجعل حقلاً كثير القيم جزءاً من التدفق أبداً، ويسمي بالاسم ip وuser_id وtrace_id، لأن ذلك يبطئ الإدخال والبحث ويزيد الذاكرة والمعالج والقرص. والقاعدة العملية:
- في التدفق: ما يصف مصدر السجل ولا يتغير بين سطر وآخر من المصدر نفسه، مثل الخدمة والبيئة والسيرفر والمستوى أحياناً.
- حقول عادية: كل شيء آخر، trace_id وuser_id وrequest_id وعنوان IP والمدة ورمز الحالة، وهي مفهرسة ومتاحة للبحث والتجميع على أي حال.
ولاحظ الفرق عن Loki هنا: في Loki الخطأ في هذا القرار يوقف الإدخال، وفي VictoriaLogs يستمر الإدخال ولكنك تدفع الثمن بصمت، وسوف نرى الحالتين بالأرقام في قسم «ماذا يحدث إذا».
المختبر Lab: خمسة ملايين حدث في VictoriaLogs ثم في Loki
سوف نشغل الأداتين على سيرفر واحد بثمانية معالجات وذاكرة 32 GB، كل أداة وحدها، وبالأداة نفسها لإرسال السجلات وهي Vector 0.60.0 التي استخدمناها في مسار السجل. والإصدارات هي VictoriaLogs v1.53.0 وLoki 3.7.9 بالإعداد نفسه الذي استخدمناه في المقارنة، وvmalert v1.155.0 للتنبيه، وكل ال Containers أسماؤها تبدأ بـ dv2m-.
البيانات Dataset مع الإجابات الصحيحة
كتبنا سكربت Python بالمكتبة القياسية فقط يولد خمسة ملايين حدث JSON موزعة بالتساوي على 24 ساعة، لثماني خدمات، بنسبة 2% أخطاء و6% تحذيرات، وفي كل حدث trace_id عشوائي من 32 خانة، وuser_id من 200 ألف مستخدم، وعنوان IP:
# Generates the dataset for this lab: 5,000,000 JSON log events spread over the 24 hours before END (fixed seed),
# with high-cardinality fields (trace_id on every event, 200,000 users, client IPs).
# usage: python gen.py <out.jsonl> <END as 2026-11-03T18:00:00Z>
import json, random, sys
from datetime import datetime, timedelta

random.seed(2611)
N = 5_000_000
OUT, END = sys.argv[1], datetime.fromisoformat(sys.argv[2].replace("Z", "+00:00"))
START = END - timedelta(hours=24)
STEP = 24 * 3600 * 1000 / N                      # ms between events (17.28 ms)
SERVICES = ["orders-api", "payments", "catalog", "auth", "search", "notifications", "shipping", "reports"]
ROUTES = {"orders-api": "/orders", "payments": "/charge", "catalog": "/products", "auth": "/login",
          "search": "/search", "notifications": "/send", "shipping": "/quote", "reports": "/export"}
ERRORS = [("PSP_TIMEOUT", "payment provider timeout after 2000 ms"), ("DB_POOL_EXHAUSTED", "database pool exhausted, waited 5000 ms"),
          ("UPSTREAM_502", "upstream returned 502 bad gateway"), ("VALIDATION_FAILED", "request validation failed: missing field customer_id")]
with open(OUT, "w", newline="\n", encoding="utf-8") as f:
    for i in range(N):
        ts = START + timedelta(milliseconds=i * STEP)
        svc = random.choice(SERVICES)
        r = random.random()
        level = "error" if r < 0.02 else "warn" if r < 0.08 else "info"
        ev = {"ts": ts.isoformat(timespec="milliseconds").replace("+00:00", "Z"), "level": level, "service": svc,
              "trace_id": "%032x" % random.getrandbits(128), "user_id": f"u{random.randint(1, 200_000)}",
              "client_ip": f"10.{random.randint(0, 255)}.{random.randint(0, 255)}.{random.randint(1, 254)}",
              "http_route": ROUTES[svc], "duration_ms": round(random.lognormvariate(4, 0.8), 1)}
        if level == "error":
            code, msg = random.choice(ERRORS)
            ev.update(http_status=502 if code != "VALIDATION_FAILED" else 400, error_code=code, message=msg)
        elif level == "warn":
            ev.update(http_status=200, message=f"slow request: {ev['duration_ms']} ms on {ROUTES[svc]}")
        else:
            ev.update(http_status=200, message=f"request completed in {ev['duration_ms']} ms")
        f.write(json.dumps(ev) + "\n")
وحجم الملف الناتج 1,421,688,278 بايت، أي قرابة 1.42 GB، وهذا أول سطرين منه:
{"ts": "2026-11-02T18:00:00.000Z", "level": "info", "service": "shipping", "trace_id": "971a49f1ba871cd4a291eccde0a7de7d", "user_id": "u3974", "client_ip": "10.185.2.140", "http_route": "/quote", "duration_ms": 55.4, "http_status": 200, "message": "request completed in 55.4 ms"}
{"ts": "2026-11-02T18:00:00.017Z", "level": "info", "service": "search", "trace_id": "f551727ff915acc1eac05ecded1d3a1a", "user_id": "u42785", "client_ip": "10.246.40.106", "http_route": "/search", "duration_ms": 74.0, "http_status": 200, "message": "request completed in 74.0 ms"}
وقبل أن نسأل أي أداة حسبنا الإجابات الصحيحة من الملف نفسه بسكربت ثان، حتى لا نقارن السرعة على إجابات خاطئة:
errors per service {'auth': 12558, 'catalog': 12461, 'notifications': 12876, 'orders-api': 12609, 'payments': 12330, 'reports': 12363, 'search': 12490, 'shipping': 12360} total 100047
timeout lines 24952
needle ('75e508f33e546bf4c37ee966a17d543b', '2026-11-03T09:04:46.709Z', 'notifications', 'u143952')
distinct users with errors 78932 top 3 [('u105397', 6), ('u71141', 5), ('u17002', 5)]
والإبرة Needle هي الحدث رقم 3,141,592 في الملف، اخترناه من المنتصف حتى لا يكون في أول البيانات أو آخرها.
تشغيل VictoriaLogs مع الإدخال عبر Vector
VictoriaLogs ملف تنفيذي واحد، وال Image حجمها 45 MB فقط، ويكفيه أمر واحد:
docker network create dv2m-net
docker run -d --name dv2m-vlogs --network dv2m-net -p 127.0.0.1:19428:9428 -v dv2m-vlogs-data:/vlogs \
  victoriametrics/victoria-logs:v1.53.0 -storageDataPath=/vlogs -retentionPeriod=30d
في الأمر أعلاه لاحظ التالي:
- المنفذ الافتراضي 9428، ومنه الإدخال والبحث والواجهة ومقاييس Prometheus على
/metrics، ولا يوجد فيه تسجيل دخول، لذلك ربطناه على 127.0.0.1، وفي الإنتاج ضعه خلف Reverse Proxy بمصادقة. -retentionPeriod=30d: القيمة الافتراضية سبعة أيام، والأهم أن VictoriaLogs يرفض السجلات التي وقتها أقدم من مدة الاحتفاظ، فإذا استوردت سجلات عمرها شهر بالإعداد الافتراضي فلن يدخل منها شيء.- لا يوجد ملف إعداد، فكل شيء أعلام Flags في سطر الأمر، وهذا من أكبر الفروق عن Loki الذي يحتاج ملف YAML فيه المخطط Schema والتخزين والحدود.
ويقبل VictoriaLogs السجلات بعدة صيغ، منها واجهة Elasticsearch bulk وواجهة Loki وOpenTelemetry وJSON lines وSyslog، كما في صفحة الإدخال، لذلك تستطيع أن ترسل إليه من Vector أو Fluent Bit أو Promtail أو Alloy دون أن تغير التطبيقات. واستخدمنا من Vector مخرج Elasticsearch:
# Vector reads the dataset and sends it to VictoriaLogs through its Elasticsearch bulk API.
# _stream_fields: only low-cardinality fields (service, level); trace_id, user_id and client_ip stay ordinary fields.
data_dir: /var/lib/vector
sources:
  dataset:
    type: file
    include: ["/data/dataset.jsonl"]
    read_from: beginning
    max_line_bytes: 1048576
transforms:
  prep:
    type: remap
    inputs: ["dataset"]
    source: |
      . = parse_json!(.message)
      .timestamp = parse_timestamp!(.ts, "%+")
      del(.ts)
sinks:
  vlogs:
    type: elasticsearch
    inputs: ["prep"]
    endpoints: ["http://dv2m-vlogs:9428/insert/elasticsearch/"]
    api_version: v8
    compression: gzip
    healthcheck: { enabled: false }
    query:
      _msg_field: message
      _time_field: timestamp
      _stream_fields: service,level
والجزء المهم في الملف هو query في آخره: هذه معاملات تضاف إلى رابط الإدخال وتخبر VictoriaLogs أي حقل هو الرسالة _msg وأي حقل هو الوقت _time وأي الحقول تكون التدفق. وإذا نسيت _msg_field فلن يجد VictoriaLogs رسالة في الحدث، ويضع القيمة الافتراضية مكانها، فيبقى البحث بالحقول يعمل ويتوقف البحث بالكلمات في الرسالة.
تشغيل Loki على البيانات نفسها
استخدمنا ملف إعداد Loki نفسه الذي في المقارنة: الوضع Monolithic، والتخزين على القرص المحلي، والمخطط TSDB v13، مع إضافة سطر واحد هو reject_old_samples: false لأننا نستورد يوماً كاملاً دفعة واحدة. وفي Vector أرسلنا تسميتين فقط هما الخدمة والمستوى، ووضعنا trace_id وuser_id في البيانات الوصفية المنظمة، وهذا هو الإعداد الصحيح الذي يوصي به Loki، حتى نقارنه في أفضل حالاته:
sinks:
  loki:
    type: loki
    inputs: ["prep"]
    endpoint: http://dv2m-loki:3100
    tenant_id: shop
    encoding: { codec: text }
    labels:
      service: "{{ service }}"
      level: "{{ level }}"
    structured_metadata:
      trace_id: "{{ trace_id }}"
      user_id: "{{ user_id }}"
ثم كتبنا سكربتاً واحداً run.py يشغل الأداة ويرسل الملف ويقيس كل شيء بالطريقة نفسها: يقرأ عدد السطور التي قبلتها الأداة من مقاييسها كل خمس ثوان، ويأخذ عينة من docker stats كل خمس ثوان، ثم يقيس القرص، ثم يسأل الأسئلة الخمسة ثلاث مرات لكل سؤال ويحسب الوقت من جهاز الاختبار حتى وصول الرد.
مشكلة واجهتنا: القياس الذي أبطأ Loki
في المحاولة الأولى كان السكربت يعرف متى انتهى الإدخال بسؤال الأداة نفسها كل خمس ثوان: «كم سطراً عندك؟». وفي VictoriaLogs يأخذ هذا السؤال أجزاء من الثانية، أما في Loki فهو استعلام count_over_time على 26 ساعة، يقرأ كل السطور التي وصلت حتى الآن، فكلما زادت البيانات ثقل السؤال، حتى وصل معالج Loki إلى 533% وذاكرته إلى 1.55 GiB، وأخذ الإدخال أكثر من عشر دقائق. والأسوأ أن العدد توقف عند قرابة 4,999,600 وأخذ ينقص قليلاً مع كل سؤال:
  625.2s searchable=4999633
  642.9s searchable=4999632
  662.1s searchable=4999629
  680.1s searchable=4999626
والسبب أن الاستعلام وهو يعمل كان يقرأ البيانات من ذاكرة ال Ingester ومن الأجزاء المكتوبة على القرص معاً ويحذف المكرر بينهما، وتحت هذا الضغط لم يكن العدد ثابتاً. فأوقفنا التجربة وحذفنا البيانات، وغيرنا السكربت ليقرأ العدد من مقياس الأداة نفسها، loki_distributor_lines_received_total في Loki وvl_rows_ingested_total في VictoriaLogs، وهذا رقم يقرأ من الذاكرة ولا يكلف شيئاً، ثم يسأل سؤال العد الحقيقي مرة واحدة في النهاية، فكانت النتيجة 5,000,000 بالضبط في الأداتين. والدرس هنا أكبر من المختبر: لوحة Grafana فيها استعلام سجلات ثقيل يتحدث كل خمس ثوان على مدى يوم كامل قد تكون هي سبب بطء Loki عندك، فراقب استعلامات اللوحات كما تراقب الإدخال.
النتائج Results: زمن الإدخال مع القرص والذاكرة
بعد إعادة القياس بالطريقة الصحيحة كانت النتيجة كما يلي:
| القياس | VictoriaLogs v1.53.0 | Loki 3.7.9 |
|---|---|---|
| زمن الإدخال حتى قبول 5,000,000 سطر | 372 ثانية | 370 ثانية |
| العد النهائي | 5,000,000 | 5,000,000 (بعد POST /flush) |
| القرص بعد الإدخال | 165 MB | 846 MB: أجزاء 394 MB وسجل كتابة WAL بحجم 452 MB |
| أعلى ذاكرة أثناء الإدخال | 374 MiB | 1.53 GiB |
| الذاكرة بعد الأسئلة | 165 MiB | 1.22 GiB |
| زمن البدء بعد إعادة التشغيل | 0.22 ثانية لفتح التخزين | 25 ثانية حتى /ready |
والصورة التالية تضع أرقام القرص والذاكرة جنباً إلى جنب:
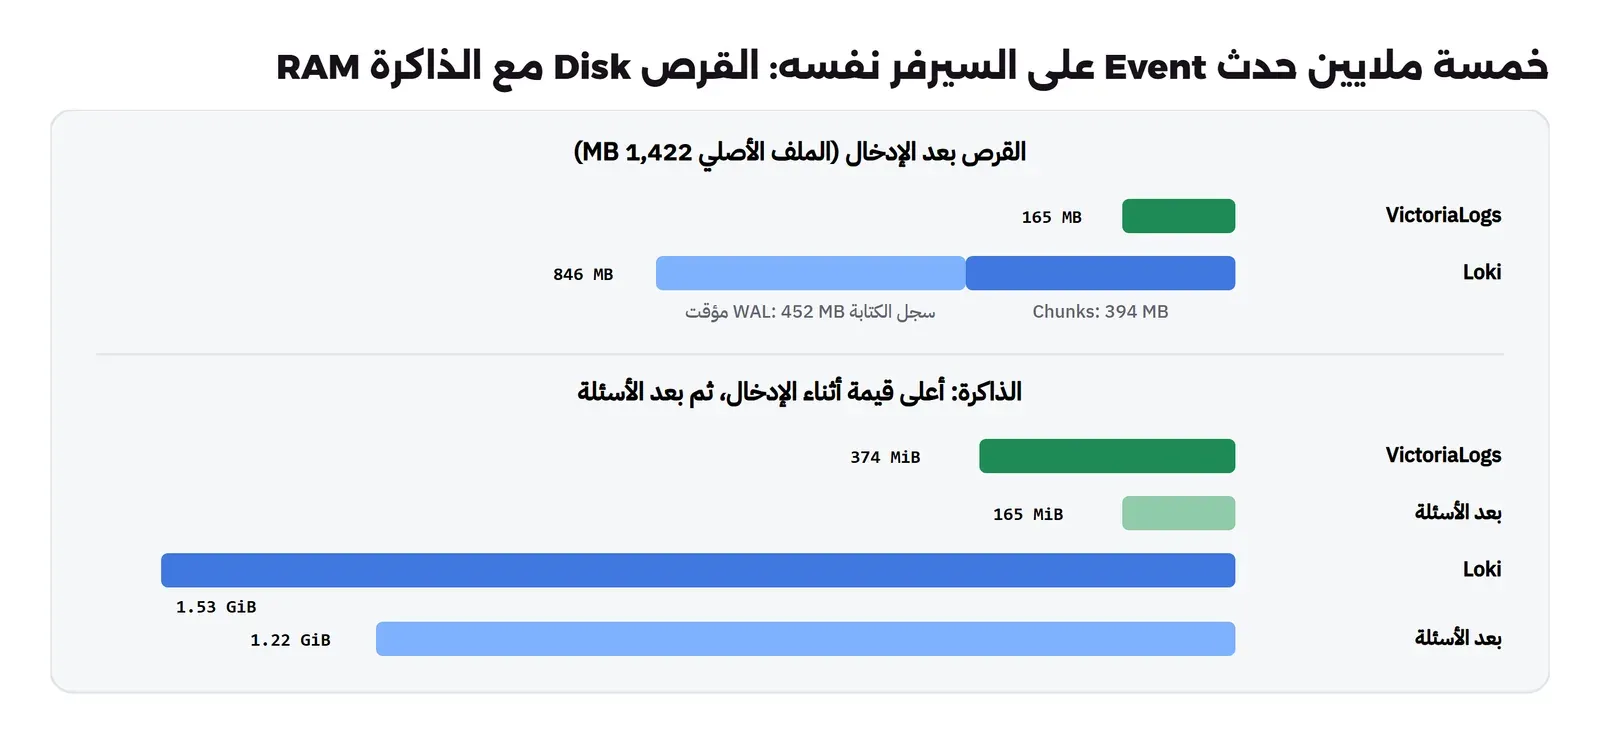
في النتائج أعلاه لاحظ التالي:
- زمن الإدخال متساو تقريباً، والسبب ليس الأداتين: في الحالتين كان Vector يقرأ ملفاً واحداً ويحلل JSON في كل سطر، وهو الحد الأبطأ في هذا الخط، فالأداتان كانتا تنتظران Vector. وفي المحاولة الأولى لVictoriaLogs، والجهاز أقل انشغالاً، انتهى الإدخال في 271 ثانية. فلا تحكم على أداة بزمن الإدخال حتى تتأكد أن المرسل ليس هو الحد، وهذا ما نسيه كثير من المقارنات المنشورة.
- القرص: ضغط VictoriaLogs الملف من 1.42 GB إلى 165 MB، أي قرابة 8.6 مرة، وكتب Loki أجزاء بحجم 394 MB، أي أكبر بمرتين ونصف. وسجل الكتابة WAL في Loki مؤقت، فهو نسخة من البيانات التي لم تكتب بعد في أجزاء نهائية، ويحميها إذا توقف Loki فجأة، ويقل حجمه مع الوقت، ولكن يجب أن تحسب له مساحة على القرص في وقت الذروة.
- الذاكرة: هذا هو الفرق الأكبر، فبعد انتهاء الإدخال والأسئلة بقي VictoriaLogs على 165 MiB وبقي Loki على 1.22 GiB، والسبب أن Loki يحتفظ بالأجزاء المفتوحة في ذاكرة ال Ingester حتى تمتلئ أو تمر مدتها، وكلما زاد عدد السلاسل والسطور الحديثة زاد ما يحفظه. وبعد إعادة تشغيله وقراءة سجل الكتابة رجع إلى 745 MiB.
- الأرقام مقابل ادعاء الشركة: رأينا قرابة أربعة أضعاف في الذاكرة ومرتين ونصف في الأجزاء على القرص، وهذا أقل بكثير من «30 مرة» و«15 مرة» في صفحة VictoriaLogs، فتلك أرقام أفضل الحالات أو مقارنة مع Elasticsearch، وأرقامنا تقول إن الفرق حقيقي وكبير ولكنه ليس بهذا الحجم مع Loki في إعداده الصحيح.
خمسة أسئلة Queries بلغتين: LogsQL مقابل LogQL
سألنا الأداتين الأسئلة نفسها، وهذه هي كما كتبناها بلغة كل أداة:
| السؤال | LogsQL في VictoriaLogs | LogQL في Loki |
|---|---|---|
| حدث واحد بمعرف التتبع | trace_id:75e508f33e546bf4c37ee966a17d543b | {service=~".+"} | trace_id="75e508f3…" |
| الأخطاء لكل خدمة | level:error | stats by (service) count() n | sum by (service) (count_over_time({level="error"}[26h])) |
| كلمة timeout في الرسالة | timeout | stats count() n | sum(count_over_time({service=~".+"} |= "timeout" [26h])) |
| أكثر 3 مستخدمين أخطاء | level:error | stats by (user_id) count() n | sort by (n desc) | limit 3 | topk(3, sum by (user_id) (count_over_time({level="error"}[26h]))) |
| عدد المستخدمين المختلفين الذين أصابهم خطأ | level:error | stats count_uniq(user_id) u | count(sum by (user_id) (count_over_time({level="error"}[26h]))) |
والنتائج بوسيط ثلاث مرات لكل سؤال:
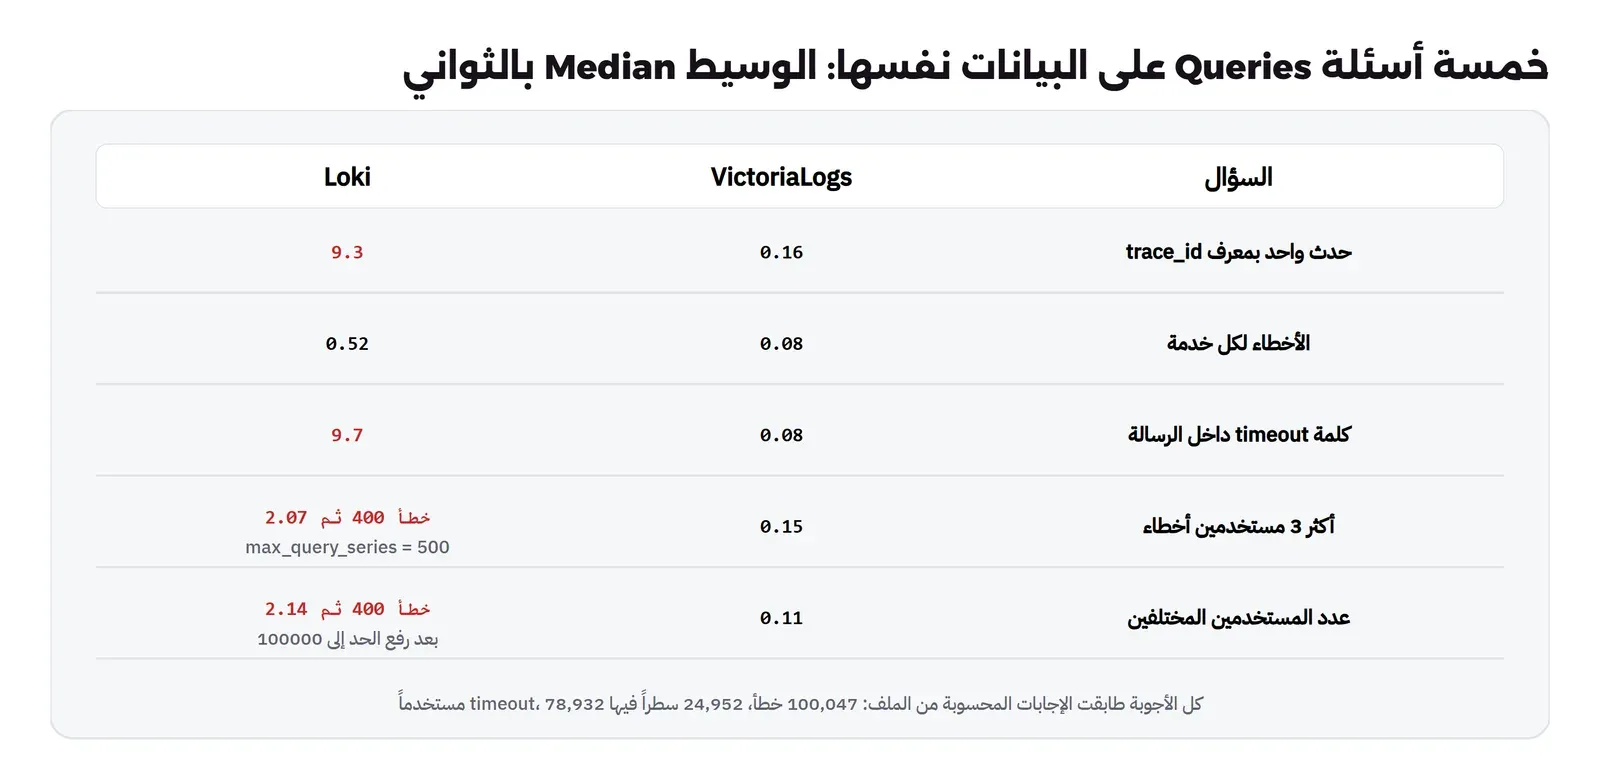
في النتائج أعلاه لاحظ التالي:
- كل الإجابات صحيحة: 12,330 خطأ لخدمة الدفع و24,952 سطراً فيها timeout و78,932 مستخدماً في الأداتين، وهي نفس الأرقام المحسوبة من الملف.
- الإبرة والكلمة: أخذتا في Loki قرابة عشر ثوان، والسبب أن الاستعلام يحدد كل السلاسل
{service=~".+"}لأننا لا نعرف خدمة الطلب، فيفك ضغط كل الأجزاء في 26 ساعة ويفحص كل سطر، وقد ذكرت إحصائيات Loki أنه عالج 5.37 مليون سطر و2 GB لسؤال الكلمة. أما VictoriaLogs فتخطى أغلب الكتل بفلاتر Bloom وأجاب في أقل من خمس الثانية. وهذا هو السؤال الذي يسأله فريق الدعم كل يوم. - التجميع بالتسميات: الأخطاء لكل خدمة أخذت نصف ثانية في Loki، لأنها تعتمد على التسميات فقط، وهذه هي الحالة التي صمم لها Loki. ولو كانت المدة أسبوعاً بدل يوم لزاد الفرق، فقس على المدة التي يسألها فريقك فعلاً.
مشكلة واجهتنا: Loki يرفض سؤال المستخدمين max_query_series
السؤالان الأخيران رجعا من Loki بهذا الخطأ:
HTTP 400: maximum number of series (500) reached for a single query; consider reducing query cardinality by adding more specific stream selectors, reducing the time range, or aggregating results with functions like sum(), count() or topk()والسبب أن sum by (user_id) ينتج سلسلة نتيجة لكل مستخدم، أي 78,932 سلسلة، والحد الافتراضي في Loki للسلاسل في استعلام واحد هو 500، وهذا الحد يحمي ذاكرة ال Querier. ولاحظ أن رسالة الخطأ تقترح topk()، مع أن استعلامنا الأول فيه topk(3, …) أصلاً، والسبب أن الحد يطبق على الاستعلام الداخلي قبل topk. والحل أن ترفع الحد في limits_config بالمفتاح max_query_series، أو بالعلم كما فعلنا:
docker run -d --name dv2m-loki ... grafana/loki:3.7.9 -config.file=/etc/loki/loki.yaml -querier.max-query-series=100000top 3 users by errors [2.074, 1.97, 2.136] [{"metric": {"user_id": "u105397"}, "value": [1793732400, "6"]}, {"metric": {"user_id": "u197749"}, "value": [1793732400, "5"]}, ...]
distinct users with errors [2.136, 2.343, 1.936] [{"metric": {}, "value": [1793732400, "78932"]}]فأجاب في ثانيتين بالأرقام الصحيحة. ولكن تذكر أن الحد موجود لسبب، فرفعه يعني أن أي شخص يكتب استعلاماً بتجميع على حقل كثير القيم قد يستهلك ذاكرة كبيرة، فارفعه بقدر ما تحتاج وليس إلى رقم ضخم.
لماذا اختلف ثاني وثالث مستخدم؟ الترتيب Sort مع التعادل Ties
إذا نظرت إلى إجابات «أكثر 3 مستخدمين» فسوف تجد أن الأول u105397 بستة أخطاء في كل مكان، أما الثاني والثالث فكانا في الملف u71141 وu17002، وفي Loki u197749 وu71195، وفي VictoriaLogs في تشغيلين مختلفين u71141 وu67581 ثم u99971 وu95959. وكلها صحيحة، لأن هناك عشرات المستخدمين بخمسة أخطاء، وأي ترتيب بينهم صحيح ما دام الترتيب بالعدد فقط. والصورة التالية من واجهة VictoriaLogs تبين ذلك بأول خمسة:
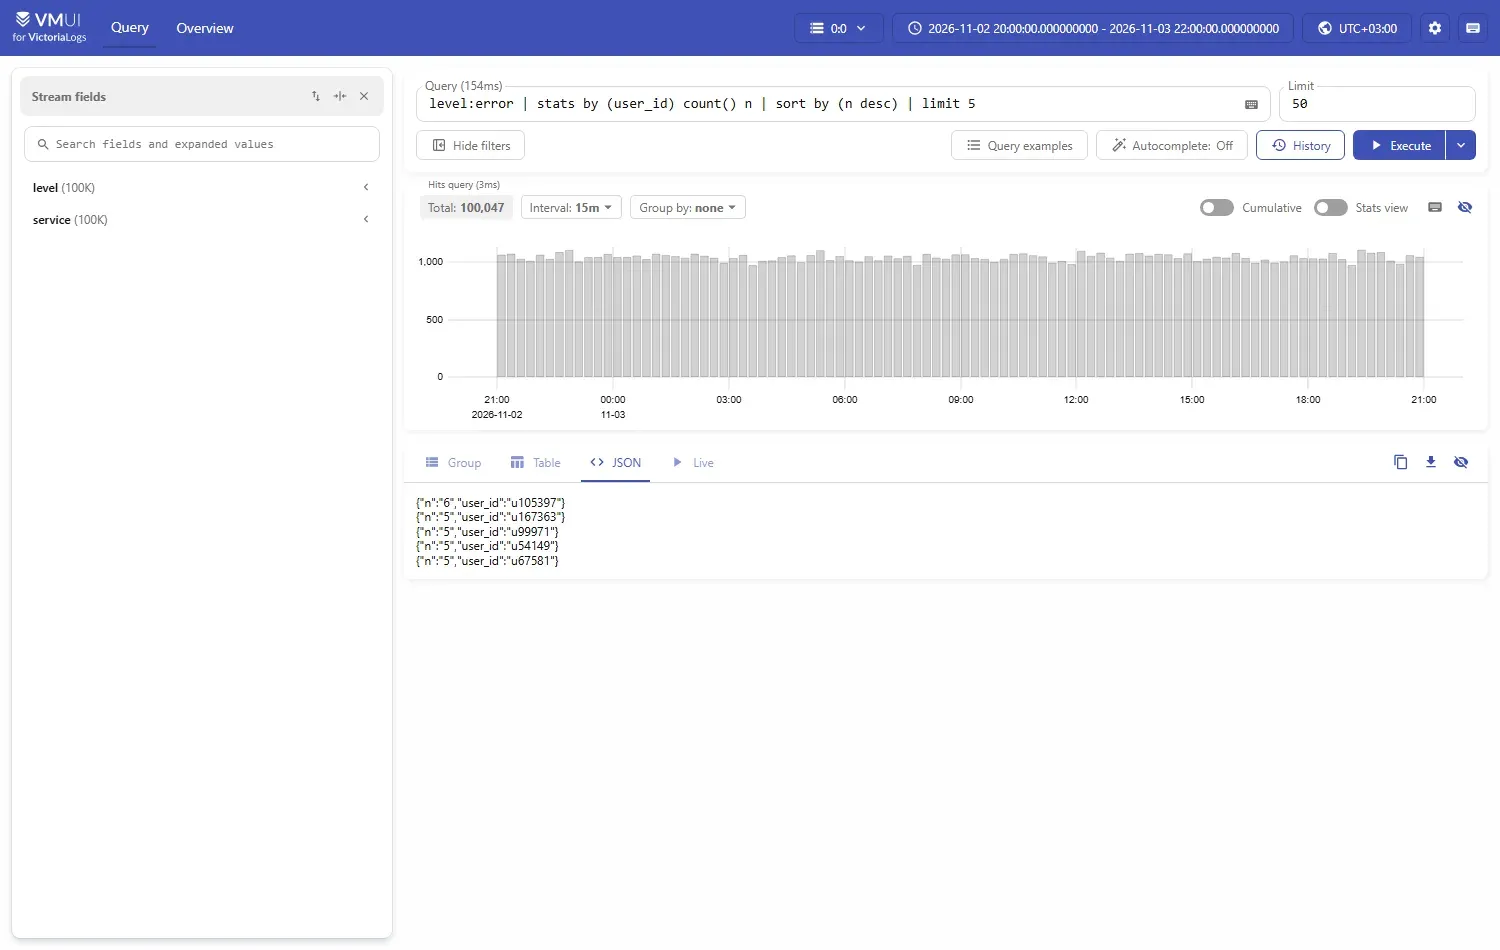
وهذه ليست مشكلة في الأداة، ولكنها مشكلة في تقرير يرسل للإدارة كل أسبوع ويتغير ترتيبه دون أن تتغير البيانات. فإذا أردت نتيجة ثابتة فأضف معياراً ثانياً للترتيب، مثل sort by (n desc, user_id) في LogsQL.
لغة LogsQL للمبتدئين: الفلاتر Filters مع الأنابيب Pipes
إذا كنت تعرف LogQL من Loki فسوف تجد LogsQL مختلفة في الشكل وأبسط في الفكرة، فبحسب توثيق اللغة يتكون الاستعلام من جزأين: فلاتر تختار السجلات، ثم أنابيب Pipes تبدأ بالرمز | وتعالج ما اختير. وفيما يلي ما تحتاجه في أول أسبوع:
- كلمة وحدها:
timeoutتبحث عن الكلمة في الرسالة_msg، وهي تطابق الكلمات كاملة وليس أجزاء الكلمات، فـtimeلا تجدtimeout. - حقل بقيمة:
service:paymentsوuser_id:u143952، ويمكن جمعها بمسافة وهي تعني «و»، أو بـor، أو نفيها بـ-أو!. - الوقت:
_time:5mلآخر خمس دقائق، أو تحديد البداية والنهاية في معاملات الطلب كما فعلنا في السكربت. - التدفق:
{service="payments"}بالصيغة نفسها التي تعرفها من Loki، وهي أسرع فلتر لأنها تستبعد تدفقات كاملة. - الأنابيب:
statsللعد والتجميع، وsortوlimit، وfieldsلاختيار الحقول، وfilterلتصفية نتيجةstats، وهو ما سوف نحتاجه في قاعدة التنبيه.
وفي VictoriaLogs واجهة مدمجة اسمها vmui على الرابط /select/vmui/، تكتب فيها الاستعلام وترى رسماً لعدد السجلات عبر الوقت والنتائج، دون أن تثبت Grafana. والصورة التالية لأخطاء مزود الدفع في يوم المختبر:
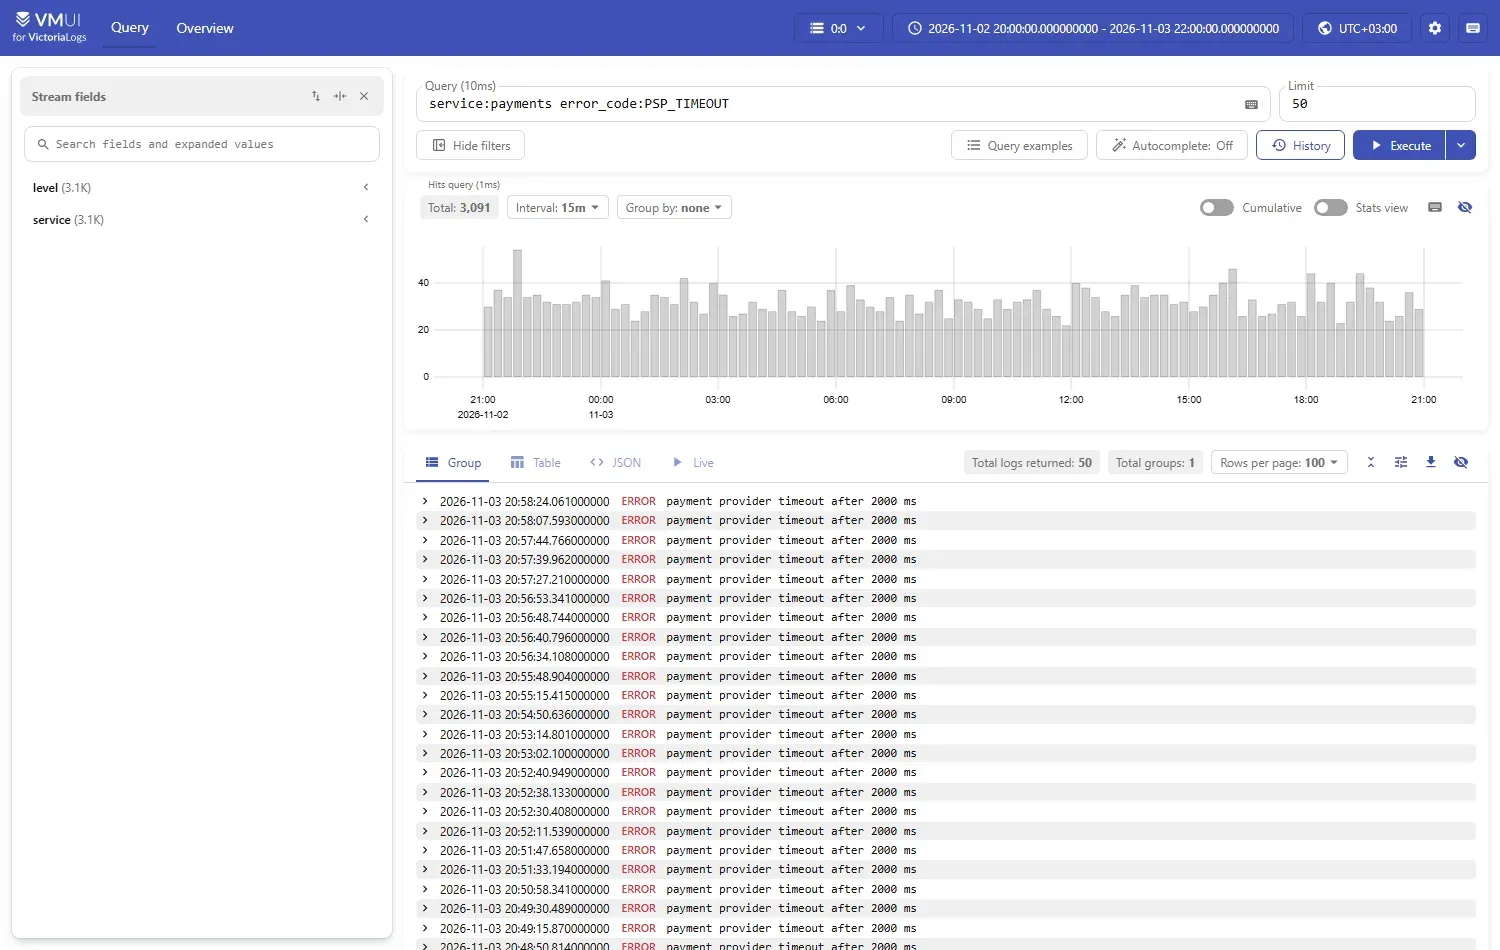
أما إذا كان فريقك يستخدم Grafana للمقاييس، فهناك مصدر بيانات VictoriaLogs لGrafana تضيفه كإضافة Plugin، فتعرض السجلات في Explore وفي اللوحات بجانب المقاييس، ولم نحتجه في هذا المختبر لأن vmui كفى.
ماذا يحدث إذا وضعت user_id في التدفق Stream؟
قلنا إن الخطأ في اختيار حقول التدفق يوقف Loki ويكلف VictoriaLogs بصمت، فجربنا ذلك على أول 500 ألف حدث من البيانات نفسها، ثلاث مرات: VictoriaLogs بالتدفق الصحيح service,level، ثم VictoriaLogs مع user_id في التدفق، ثم Loki مع user_id تسمية. والنتيجة:
vl-low: accepted 500000 in 58.4s, peak memory 218 MiB
  user_id:u143952 | stats count() n: 0.021s -> {"n":"2"}
  metrics: ['vl_streams_created_total 24', 'vl_data_size_bytes{type="indexdb"} 1342', 'vl_data_size_bytes{type="storage"} 17919346']
  disk: 17.6M	/d
vl-high: accepted 500000 in 44.7s, peak memory 502 MiB
  user_id:u143952 | stats count() n: 0.237s -> {"n":"2"}
  metrics: ['vl_streams_created_total 439644', 'vl_data_size_bytes{type="indexdb"} 44706890', 'vl_data_size_bytes{type="storage"} 84934268']
  disk: 123.9M	/d
وفي Loki توقف الإدخال بعد ثوان، وظهر في سجله:
level=warn msg=gRPC err="rpc error: code = Code(429) desc = maximum active stream limit exceeded when trying to create stream {level=\"info\", service=\"notifications\", service_name=\"notifications\", user_id=\"u98778\"}, reduce the number of active streams (reduce labels or reduce label values), or contact your Loki administrator to see if the limit can be increased, user: 'shop'"
loki_ingester_memory_streams{tenant="shop"} 5000
loki_distributor_lines_received_total{...} 87650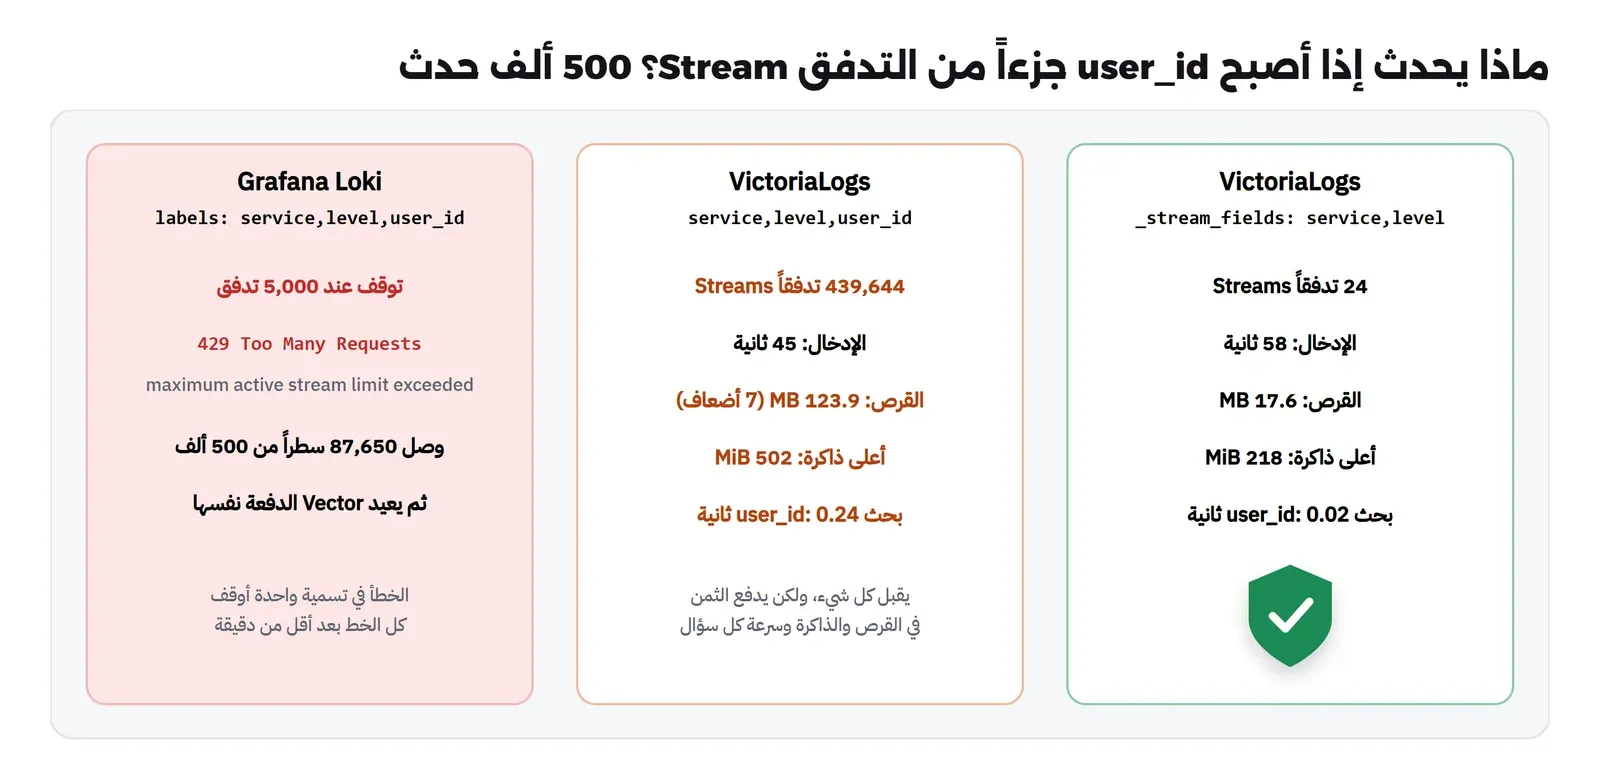
في النتائج أعلاه لاحظ التالي:
- VictoriaLogs قبل كل شيء: 439,644 تدفقاً لنصف مليون حدث، أي تدفق لكل سطر تقريباً، وهذا يعني أن فكرة «السجلات المتجاورة تنضغط أفضل» انتهت، فكبر القرص سبع مرات، وظهر فهرس التدفقات
indexdbبحجم 44.7 MB بعد أن كان 1.3 KB، وتضاعفت الذاكرة، وأصبح كل سؤال أبطأ عشر مرات تقريباً حتى سؤال user_id نفسه. - Loki توقف عند 5000 سلسلة بالضبط: وهو الحد الافتراضي للسلاسل النشطة لكل مستأجر Tenant، ثم رد بالرمز 429 لكل دفعة فيها سلسلة جديدة، وVector يعيد الدفعة نفسها دون توقف، فتوقف كل الخط وليس السطور الخاطئة فقط. وبعد عشر دقائق كان قد وصل 87,650 سطراً من 500 ألف.
- أيهما أفضل؟ لا يوجد أفضل هنا، فتوقف Loki مزعج ولكنه واضح ويظهر في التنبيهات في أول ساعة، أما VictoriaLogs فيعمل وقرصه يكبر ولن تعرف حتى تراجع الأرقام. لذلك إذا اخترت VictoriaLogs فراقب المقياس
vl_streams_created_total، وإذا وجدته يرتفع كل دقيقة فهناك حقل كثير القيم دخل التدفق.
وقد شرحنا في دليل Loki كيف تقرأ خطأ حد السلاسل وتعالجه بالتفصيل، فلا نعيده هنا.
التنبيه من السجلات Alerting مع vmalert
السجلات لا تفيد في الليل إلا إذا أخرجت تنبيهاً، وفي قصتنا يريد الفريق أن يعرف إذا بدأ مزود الدفع يرد بانتهاء المهلة أكثر من المعتاد، قبل أن يتصل العملاء. وفي Loki يتم هذا بال Ruler كما شرحنا في دليله، أما VictoriaLogs فلا يقيم القواعد بنفسه، وإنما يستخدم vmalert، وهو برنامج القواعد نفسه الذي يستخدمه VictoriaMetrics، ويفهم LogsQL عندما يكون نوع المجموعة vlogs، كما يشرح دليل التنبيه من VictoriaLogs. والصورة التالية تبين المسار الذي بنيناه:
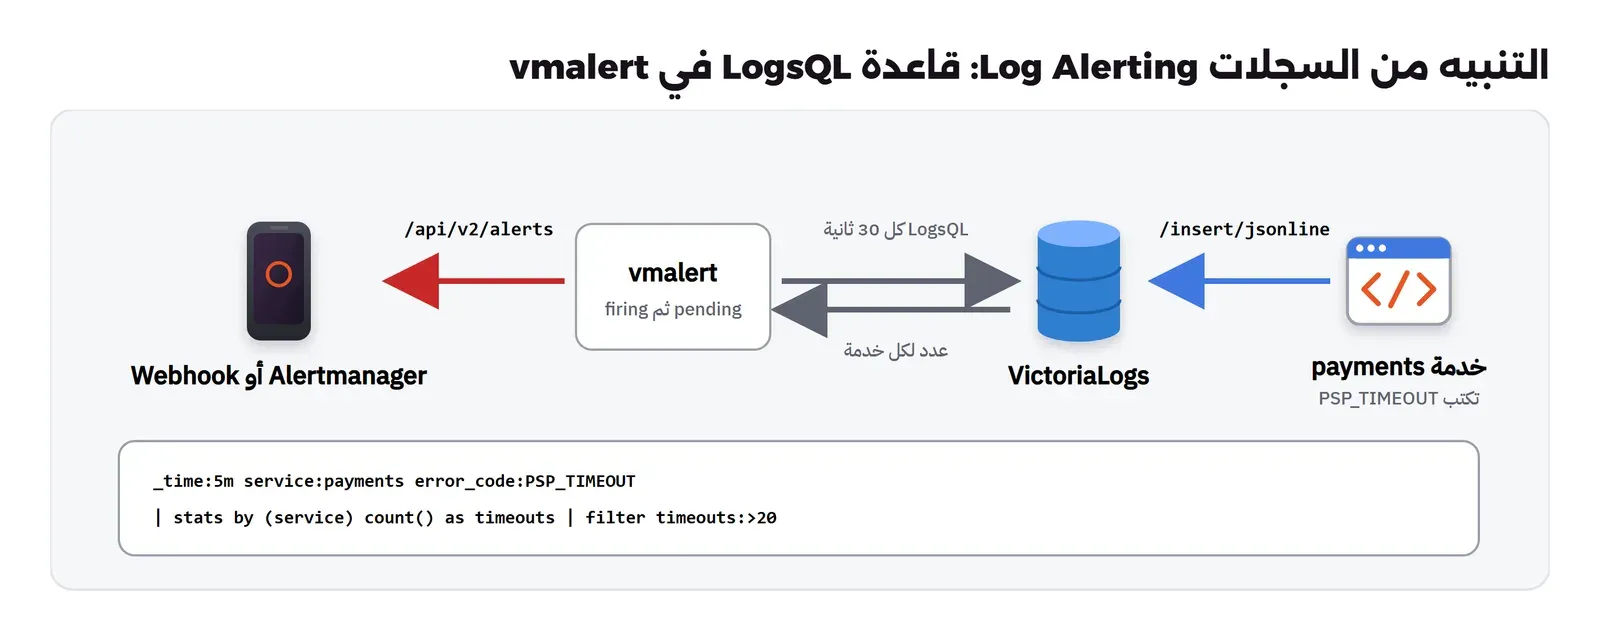
وهذا ملف القاعدة:
# vmalert rules written in LogsQL: alert when payments logs more than 20 PSP_TIMEOUT errors in 5 minutes.
groups:
  - name: payments-logs
    type: vlogs
    interval: 30s
    rules:
      - alert: PaymentProviderTimeouts
        expr: '_time:5m service:payments error_code:PSP_TIMEOUT | stats by (service) count() as timeouts | filter timeouts:>20'
        annotations:
          summary: "{{ $labels.service }}: {{ $value }} PSP timeouts in the last 5 minutes"
في القاعدة أعلاه لاحظ التالي:
type: vlogs: يخبر vmalert أن التعبير LogsQL وليس PromQL.- التعبير يجب أن يحتوي
statsحتى ينتج رقماً، وكل مجموعة فيby (service)تصبح تنبيهاً مستقلاً بتسميةservice. _time:5m: يضيف vmalert افتراضياً فلتر وقت بطول فترة المجموعة، أي 30 ثانية هنا، ولكننا نريد عد آخر خمس دقائق ونقيم القاعدة كل 30 ثانية، فكتبنا الفلتر بأنفسنا كما يسمح الدليل.filter timeouts:>20: هو الحد، فالتنبيه يطلق عندما توجد نتيجة بعد الفلتر.
ثم شغلنا vmalert ووجهنا تنبيهاته إلى مستقبل Webhook صغير بلغة Python يطبع كل ما يصله، بدل Alertmanager، حتى نرى الرسالة كما هي:
docker run -d --name dv2m-vmalert --network dv2m-net -p 127.0.0.1:18880:8880 -v "$PWD/alerts.yml:/etc/alerts.yml:ro" \
  victoriametrics/vmalert:v1.155.0 -rule=/etc/alerts.yml -datasource.url=http://dv2m-vlogs:9428 \
  -notifier.url=http://dv2m-hook:8080 -rule.defaultRuleType=vlogs -evaluationInterval=30s
والبيانات في المختبر قديمة، أي أن آخر حدث فيها قبل ساعة من التشغيل، فلن يطلق التنبيه عليها، لذلك كتبنا سكربتاً صغيراً يرسل أحداث خطأ حية بوقت اللحظة الحالية إلى واجهة JSON lines.
مشكلة واجهتنا: الإدخال ينجح بالرمز 200 ولا يصل شيء Silent Ingest
أرسلنا 15 حدثاً ثم 15 أخرى، وكل طلب رجع بالرمز 200، ولكن التنبيه لم يطلق، وسؤال VictoriaLogs عن آخر عشر دقائق رجع صفراً:
19:00:29 sent 15 status 200
19:01:10 sent 15 status 200
{"n":"0"}
فقرأنا مقاييس VictoriaLogs نفسها:
curl -s http://127.0.0.1:19428/metrics | grep -E "vl_rows_ingested_total|vl_rows_dropped"vl_rows_dropped_total{reason="too_big_timestamp"} 0
vl_rows_dropped_total{reason="too_small_timestamp"} 0
vl_rows_ingested_total{type="elasticsearch_bulk"} 5000000
vl_rows_ingested_total{type="jsonline"} 0لا يوجد سطر مرفوض ولا سطر مقبول من JSON lines، أي أن VictoriaLogs لم ير في الطلب أي سطر. والسبب في مكتبة Python نفسها: urllib.request عندما ترسل جسماً دون أن تحدد نوع المحتوى تضع Content-Type: application/x-www-form-urlencoded، فقرأ VictoriaLogs الجسم كنموذج Form وليس كسطور JSON، ولم يجد فيه سجلات، فرد بنجاح لأن الطلب نفسه صحيح. والحل سطر واحد:
req = urllib.request.Request("http://127.0.0.1:19428/insert/jsonline?_stream_fields=service,level", data=lines.encode(), method="POST",
                             headers={"Content-Type": "application/stream+json"})   # without it urllib sends a form body
وبعد الإصلاح ارتفع العداد إلى 25 مع أول إرسال. والدرس العام: الرمز 200 من مخزن السجلات لا يعني أن السجلات وصلت، فراقب عداد السطور المقبولة لكل نوع إدخال، ونبه إذا توقف عن الزيادة، فهذا أهم تنبيه على السجلات نفسها.
لماذا عد vmalert 24 حدثاً ثم 25؟ التأخير evalDelay
بعد الإصلاح أرسلنا 25 حدثاً وقتها بين 19:07:06 و19:07:30، فوصل التنبيه بعد أقل من دقيقة:
19:08:17 /api/v2/alerts [{"startsAt":"2026-11-03T19:07:30Z", ... "labels": {"alertgroup":"payments-logs","alertname":"PaymentProviderTimeouts","service":"payments","stats_result":"timeouts"},"annotations": {"summary":"payments: 24 PSP timeouts in the last 5 minutes"}}]ولاحظ أن الرسالة الأولى تقول 24 وليس 25، ثم كانت الرسائل التالية كلها 25. والسبب في العلم -rule.evalDelay، وقيمته الافتراضية 30 ثانية، فvmalert يقيم القاعدة على وقت متأخر 30 ثانية عن الآن، لأن VictoriaMetrics قد يؤخر ظهور البيانات قليلاً، فكان وقت التقييم الأول 19:07:30، والحدث الأخير وقته 19:07:30.03، أي بعد نهاية النافذة بجزء من الثانية. ويذكر الدليل أن VictoriaLogs لا يؤخر ظهور السجلات عمداً، فتستطيع أن تقلل هذا العلم إلى ثوان قليلة إذا أردت تنبيهاً أسرع. وبعد خمس دقائق من آخر حدث خرجت الأحداث من النافذة، فأرسل vmalert نهاية التنبيه بوقت endsAt يساوي 19:12:30.
الاحتفاظ Retention بالمدة أو بحجم القرص
في VictoriaLogs طريقتان للاحتفاظ، ولا يمكن الجمع بين الحد بالبايت والحد بالنسبة المئوية معاً:
- بالمدة:
-retentionPeriod، والافتراضي سبعة أيام، وكل قسم يومي أقدم منها يحذف كاملاً. - بحجم القرص:
-retention.maxDiskSpaceUsageBytesأو-retention.maxDiskUsagePercent، فإذا تجاوز المجلد الحد حذف أقدم الأقسام اليومية.
والطريقة الثانية تبدو مثالية لسيرفر بقرص صغير، فجربناها: أعدنا تشغيل VictoriaLogs على بيانات المختبر بحد 150 MiB، والبيانات في قسمين:
41.8M	/d/partitions/20261102
123.0M	/d/partitions/20261103
أي 164.8 MB، وهي أكبر من الحد، فتوقعنا أن يحذف قسم 2 نوفمبر. وبعد أكثر من سبع دقائق لم يحذف شيء، وبقي العد 5,000,025 من أول حدث في 2026-11-02 18:00. والسبب مكتوب في التوثيق: VictoriaLogs يحتفظ دائماً بآخر يومين على الأقل حتى تبقى السجلات الحديثة متاحة للبحث، حتى لو تجاوز ذلك الحد. ويحذر التوثيق أيضاً من أن الاستخدام قد يتجاوز الحد بين فحص وآخر، وأن القرص إذا امتلأ بالكامل انتقل VictoriaLogs إلى وضع القراءة فقط ولم يستطع أن يحذف. والقاعدة العملية من ذلك: حد القرص شبكة أمان وليس خطة سعة، فاحسب حجم يومين من سجلاتك على الأقل، واترك 20% من القرص فارغاً، واستخدم المدة كحد أساسي.
وبالأرقام من مختبرنا: 5 ملايين حدث في اليوم تحتاج قرابة 165 MB، فثلاثون يوماً قرابة 5 GB، وهذا رقم صغير لأي سيرفر، أما في Loki فالأجزاء وحدها قرابة 400 MB في اليوم، أي 12 GB لثلاثين يوماً، دون سجل الكتابة.
التوسع Scaling مع النسخ الاحتياطي Backup
كل ما رأيته في المختبر هو النسخة الواحدة Single Node، وهي تكفي أغلب الشركات الصغيرة والمتوسطة لفترة طويلة، فبأرقامنا يحتاج سيرفر يستقبل خمسة ملايين حدث في اليوم قرابة 5 GB لشهر كامل وأقل من نصف جيجابايت من الذاكرة. ولكن عندما يكبر الحجم إلى مئات الملايين في اليوم، أو تريد ألا يتوقف البحث إذا توقف سيرفر واحد، فهناك نسخة Cluster بالترخيص نفسه، تفصل الإدخال عن التخزين عن البحث في مكونات مستقلة تشغل منها ما تحتاج، بالفكرة نفسها التي يتبعها VictoriaMetrics للمقاييس. وقبل أن تنتقل إليها اسأل نفسك سؤالاً بسيطاً: هل المشكلة في سعة سيرفر واحد فعلاً، أم في استعلامات ثقيلة أو حقول تدفق خاطئة؟ فقد رأيت في هذا المقال أن خطأ واحداً في حقول التدفق ضاعف الذاكرة وضاعف القرص سبع مرات، وإصلاحه أرخص بكثير من Cluster.
أما النسخ الاحتياطي فهو أبسط مما في Loki، لأن البيانات أقسام يومية في مجلدات، والقسم الذي انتهى يومه لا يتغير بعد ذلك إلا بالدمج في الخلفية. لذلك الطريقة العملية أن تأخذ لقطة Snapshot للمجلد من نظام الملفات أو من مزود السحابة، أو أن تنسخ أقسام الأيام المكتملة إلى مكان آخر كل ليلة، وتختبر الاستعادة بتشغيل نسخة ثانية على النسخة المنسوخة والبحث فيها، كما شرحنا في قاعدة النسخ الاحتياطي 3-2-1. وقد يتساءل البعض: هل أحتاج نسخاً احتياطياً للسجلات أصلاً؟ والإجابة تعتمد على ما تحفظه فيها: سجلات التشغيل العادية يكفيها غالباً أن تبقى مدة الاحتفاظ، أما السجلات التي تحتاجها لتحقيق أمني أو لمتطلبات تنظيمية فمكانها سجل التدقيق بنسخ لا تعدل، وليس مخزن السجلات العام.
وتذكر أخيراً أن VictoriaLogs يعرض مقاييسه على /metrics بصيغة Prometheus، فأضفه إلى Prometheus الذي بنيناه في سلسلة المراقبة، وضع تنبيهاً على ثلاثة أرقام على الأقل: توقف عداد السطور المقبولة، وارتفاع عدد التدفقات الجديدة، والمساحة الحرة في القرص. وبهذه الثلاثة تعرف أن السجلات تصل، وأن أحداً لم يضع حقلاً كثير القيم في التدفق، وأن القرص لن يمتلئ فينتقل المخزن إلى وضع القراءة فقط.
الانتقال من Loki إلى VictoriaLogs: ماذا يتغير؟
إذا قرر فريق قصتنا الانتقال، فهذه هي الأشياء التي تتغير، مرتبة من الأسهل إلى الأصعب:
- الإرسال: VictoriaLogs يقبل واجهة Loki للإدخال، فتستطيع أن توجه Promtail أو Alloy أو Vector إليه بتغيير الرابط، والتسميات تصبح حقول التدفق. والأفضل أن ترسل إلى الأداتين معاً أسبوعاً أو أسبوعين، وتقارن.
- الاستعلامات: لغة مختلفة، فكل لوحة واستعلام محفوظ يجب أن يكتب من جديد بLogsQL، وهذا هو العمل الأكبر في الفرق التي بنت لوحات كثيرة.
- التنبيهات: من قواعد Loki Ruler إلى vmalert، وصيغة الملف قريبة من Prometheus، والتعبيرات تتغير.
- البيانات القديمة: لا توجد أداة رسمية تنقل أجزاء Loki إلى VictoriaLogs، فالطريق العملي أن تترك Loki للقراءة حتى تنتهي مدة احتفاظه، وتبدأ VictoriaLogs بالسجلات الجديدة.
VictoriaLogs أم Loki؟ نقاط القوة مع نقاط الضعف
VictoriaLogs
نقاط القوة:
- أقل ذاكرة وقرصاً في مختبرنا: 165 MiB مقابل 1.22 GiB، و165 MB مقابل 394 MB من الأجزاء.
- البحث بالحقول كثيرة القيم والكلمات داخل الرسالة سريع، أقل من خمس الثانية مقابل عشر ثوان، وهذا ما يحتاجه فريق الدعم.
- تشغيل بسيط: ملف تنفيذي واحد وأعلام في سطر الأمر، والبدء في أقل من ثانية، وواجهة بحث مدمجة.
- يقبل صيغ إدخال كثيرة منها واجهة Loki وElasticsearch وOpenTelemetry، وترخيص Apache-2.0.
نقاط الضعف:
- الخطأ في حقول التدفق لا يوقف شيئاً ويكلف بصمت، فرأينا سبعة أضعاف القرص دون أي خطأ.
- لغة جديدة على الفريق، ونظام أصغر من Grafana: إضافة Grafana منفصلة، وأمثلة ولوحات جاهزة أقل.
- لا يوجد فيه تسجيل دخول أو مصادقة، فأي شخص يصل إلى المنفذ يقرأ ويكتب، وتحتاج Reverse Proxy بمصادقة أمامه.
- مشروع أحدث، والمستودع المستقل له أنشئ في 2025، فتابع ملاحظات الإصدارات قبل كل ترقية.
Grafana Loki
نقاط القوة:
- جزء من مجموعة Grafana، فالسجلات بجانب المقاييس والتتبع في واجهة واحدة، ومجتمع كبير وأمثلة كثيرة.
- التجميع بالتسميات سريع ورخيص، وتعدد المستأجرين والتنبيه بال Ruler مدمجان.
- مصمم للتوسع بفصل مكوناته والتخزين على Object Storage رخيص.
- الحدود الصارمة تكشف الخطأ في التسميات مبكراً بدل أن تكلفك بصمت.
نقاط الضعف:
- البحث بما ليس تسمية يقرأ كل السطور في الفترة، فأخذ عشر ثوان على يوم واحد في مختبرنا.
- ذاكرة أكبر بأربع مرات تقريباً، وسجل كتابة على القرص بحجم الأجزاء نفسها تقريباً.
- حدود افتراضية تحتاج ضبطاً، مثل
max_query_seriesالذي رفض سؤال المستخدمين المختلفين. - ترخيص AGPLv3، وهو لا يمسك إذا شغلته لسجلات جهتك، ولكن يهمك إذا قدمته خدمة لغيرك.
والقاعدة العملية: إذا كانت أسئلة فريقك بالتسميات في الغالب، مثل «أخطاء خدمة الدفع في آخر ساعة»، وGrafana هو مركز كل شيء عندكم، فابق مع Loki واضبط حدوده. وإذا كان فريق الدعم والمطورون يبحثون كل يوم بمعرف الطلب والعميل وكلمات من الرسالة، أو كانت الذاكرة على سيرفر السجلات هي مشكلتك، فVictoriaLogs يستحق الانتقال، وأرقام هذا المختبر تقول إن الفرق ليس صغيراً.
أخطاء شائعة Common Mistakes
- حقل كثير القيم في
_stream_fields: لا يظهر أي خطأ، ويكبر القرص والذاكرة، فراقبvl_streams_created_total. - نسيان
_msg_field: تدخل السجلات ولا يجد البحث بالكلمات شيئاً في الرسالة. - استيراد سجلات أقدم من مدة الاحتفاظ: الافتراضي سبعة أيام، وما هو أقدم يرفض.
- إرسال JSON lines دون نوع المحتوى الصحيح: رد بالرمز 200 ولم يدخل شيء، فتحقق من العداد وليس من رمز الرد.
- الاعتماد على حد القرص وحده: يحتفظ بآخر يومين دائماً، وقد يتجاوز الحد بين الفحوص.
- مقارنة الأدوات بزمن الإدخال والمرسل هو الحد: كان Vector هو الأبطأ في مختبرنا، فتساوت الأداتان.
- استعلام ثقيل في لوحة يتحدث كل خمس ثوان: أبطأ Loki في محاولتنا الأولى وأعطى أعداداً متغيرة.
- ترك المنفذ 9428 مفتوحاً: لا يوجد تسجيل دخول، ومن يصل إليه يقرأ ويكتب كل السجلات.
قائمة تحقق Checklist قبل الإنتاج
| البند | كيف تتحقق منه |
|---|---|
| حقول التدفق قليلة القيم فقط | vl_streams_created_total ثابت بعد أول ساعة |
| الرسالة والوقت معرفان | _msg_field و_time_field في كل مرسل، وبحث بكلمة يجد نتائج |
| مدة الاحتفاظ تناسب القرص | حجم يوم من du مضروب في المدة، مع 20% فارغة |
| الإدخال مراقب | تنبيه إذا توقف vl_rows_ingested_total عن الزيادة لكل نوع إدخال |
| المنفذ غير مكشوف | خلف Reverse Proxy بمصادقة، وفحص من الخارج يفشل |
| التنبيهات تعمل | قاعدة vmalert وحدث حي يطلقها ويصل إلى قناة الفريق |
| نسخة احتياطية للبيانات المهمة | لقطة Snapshot للمجلد أو نسخ الأقسام اليومية المكتملة |
| الإصدار مثبت | رقم الإصدار في أمر التشغيل، ومراجعة ملاحظات الإصدار قبل الترقية |
تدريب عملي Practice
- أرسل البيانات نفسها إلى VictoriaLogs عبر واجهة Loki للإدخال
/insert/loki/api/v1/pushبمخرج Loki في Vector بدل Elasticsearch، وقارن حجم القرص وعدد التدفقات. - اكتب قاعدة vmalert ثانية تنبه إذا أصاب خطأ واحد أكثر من 100 مستخدم مختلف في عشر دقائق، باستخدام
count_uniq(user_id).
حذف المختبر Cleanup
docker rm -f dv2m-vlogs dv2m-loki dv2m-vector dv2m-vmalert dv2m-hook
docker volume rm dv2m-vlogs-data dv2m-loki-data
docker network rm dv2m-net
docker rmi victoriametrics/victoria-logs:v1.53.0 victoriametrics/vmalert:v1.155.0 grafana/loki:3.7.9
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- VictoriaLogs يحفظ كل حقل في عمود مضغوط مع فلاتر Bloom، فيبحث بالحقول كثيرة القيم دون فهرس معكوس كبير، وقرارك الوحيد المهم هو حقول التدفق.
- على خمسة ملايين حدث (1.42 GB) احتاج VictoriaLogs 165 MB من القرص و165 MiB من الذاكرة، واحتاج Loki 394 MB من الأجزاء و452 MB سجل كتابة و1.22 GiB من الذاكرة.
- البحث بمعرف التتبع أو بكلمة أخذ أقل من خمس الثانية في VictoriaLogs وقرابة عشر ثوان في Loki، والتجميع بالتسميات كان سريعاً في الاثنين.
- user_id في التدفق أوقف Loki عند 5000 سلسلة، وكلف VictoriaLogs سبعة أضعاف القرص بصمت.
- التنبيه من السجلات يتم بvmalert وقواعد LogsQL، وراقب عداد السطور المقبولة، فقد رد VictoriaLogs بالرمز 200 ولم يدخل شيء بسبب نوع المحتوى.
وفي المقال القادم من هذه المرحلة بإذن الله ننتقل إلى سجل التدقيق Audit Trail، أي السجلات التي لا تحذف ولا تعدل، وتجيب عن سؤال من فعل ماذا ومتى.
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلأي أداة لسجلاتك المركزية؟ مقارنة بالأرقام على البيانات نفسهاأدخلنا 500 ألف حدث في Loki وGraylog وSeq وOpenSearch، وقارنا التخزين والذاكرة والبحث بالعربية والتكلفة ومن يناسبه كل منها.
 دليلمسار السجل Log Pipeline من التطبيق إلى البحث والتنبيهكيف ينتقل السجل من التطبيق إلى المخزن عبر الناقل Shipper، وكيف تخفي البيانات الشخصية وتوجه الأخطاء وتحمي السجلات إذا توقفت الوجهة.
 دليلAudit Trail: كيف تبني سجل تدقيق لا يقبل العبثكيف تصمم سجلاً يجيب عن سؤال من غير هذه الصلاحية ومتى، وتحميه من الحذف والتعديل بعد كتابته.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات VictoriaLogs v1.53.0 وvmalert v1.155.0 وGrafana Loki 3.7.9 وVector 0.60.0 على Docker Engine 29.8.0، بخمسة ملايين حدث.


