في صباح يوم عمل عادي على كود متجر إلكتروني صغير، تفتح المحرر فتجد أمامك ثلاث مهام: دالة صغيرة لم يكتمل جسمها في ملف الإحصاءات، ودالة قديمة لحساب تكلفة الشحن يخاف الجميع من لمسها وتريد إعادة كتابتها بشكل أوضح، واختبار في سلة المشتريات بدأ يفشل بعد تعديل زميلك أمس ولا تعرف السبب. والمحرر نفسه يعرض عليك ثلاث أدوات من الذكاء الاصطناعي: نص رمادي يظهر عند المؤشر وينتظر أن تضغط Tab، ونافذة محادثة على الجانب، وزر يقول «دع الوكيل يتولى المهمة». والسؤال الذي يواجهه أغلب المطورين اليوم ليس هل يستخدمون هذه الأدوات، وإنما أي أداة يختارون لأي مهمة، لأن كل أداة منها ترسل للنموذج شيئاً مختلفاً، وتأخذ منه شيئاً مختلفاً، وتكلفك وقتاً ومالاً مختلفين.
وفي هذا المقال سوف نأخذ هذه المهام الثلاث نفسها ونعطيها للأدوات الثلاث، ولكن بدل أن نعتمد على أداة تجارية لا نرى ما بداخلها، سوف نبني كل طريقة بأنفسنا في بضعة أسطر من JavaScript فوق نموذج برمجة مفتوح يعمل على جهازك مع Ollama، حتى ترى بالضبط ماذا يرسل المحرر في كل طريقة، وماذا يعود منه، وأين ينجح النموذج وأين يفشل، ونحكم على كل نتيجة بالاختبارات لا بالانطباع.
وسوف نناقش في هذا المقال ما يلي:
- الفرق الحقيقي بين الإكمال التلقائي والمحادثة والوكيل: النموذج قد يكون واحداً، والذي يتغير هو ما حوله.
- الإكمال التلقائي Inline Completion وطريقة الملء من المنتصف Fill-in-the-Middle التي تجعل النموذج يكتب ما بين سطرين.
- المحادثة Chat: لماذا يعتمد جوابها على ما تلصقه أنت، وكيف تخطئ في إعادة كتابة كود قديم دون أن تشعر.
- الوكيل Agent: الحلقة والأدوات والحدود، ولماذا يستهلك أضعاف ما تستهلكه المحادثة.
- مختبر واحد يشغل الطرق الثلاث على مشروع صغير بالنموذج نفسه، ونتائج كل طريقة.
- الزمن والتكلفة، وما تقوله دراسة محكمة عن السرعة الحقيقية، وكيف تختار الأداة المناسبة للمهمة.
النموذج واحد والذي يتغير هو ما حوله
قبل أن نقارن الأدوات يجب أن نتفق على شيء مهم، وهو أن الإكمال التلقائي والمحادثة والوكيل ليست ثلاثة أنواع من النماذج، وإنما ثلاث طرق لاستدعاء نموذج لغة كبير Large Language Model، وقد يكون النموذج نفسه في الطرق الثلاث كما سنفعل في المختبر. فالنموذج في كل الحالات يفعل الشيء نفسه الذي شرحناه في مقال كيف تعمل نماذج اللغة الكبيرة: يأخذ نصاً ويتوقع التوكن Token التالي ثم الذي بعده، والذي يختلف هو ثلاثة أشياء يقررها البرنامج المحيط به: ما النص الذي يرسل إليه، ومن ينفذ ما يقترحه، وكم مرة يستدعى قبل أن تحصل على النتيجة. والشكل التالي يبين هذه الفروق الثلاثة:
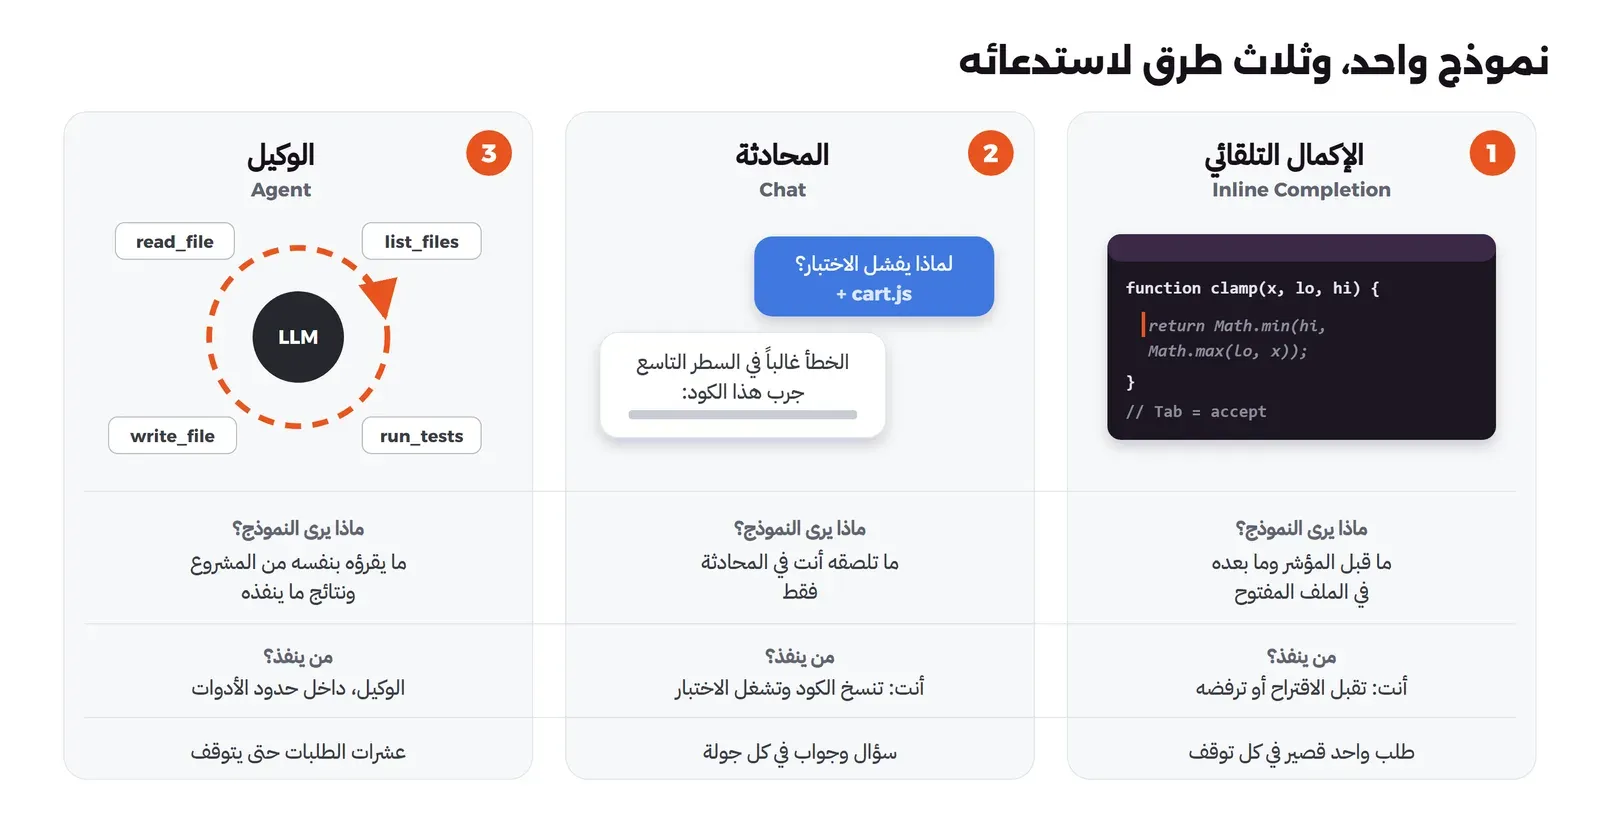
- الإكمال التلقائي Inline Completion: عندما تتوقف عن الكتابة لحظة، يرسل المحرر ما قبل المؤشر وما بعده في الملف المفتوح، ويعود النموذج ببضعة أسطر تظهر رمادية في مكان المؤشر، وأنت تقبلها بضغطة أو تتجاهلها. الطلب صغير، ويتكرر عشرات المرات في الساعة، والنموذج لا يرى إلا ما حول المؤشر.
- المحادثة Chat: تكتب سؤالاً وتلصق معه ما تراه مناسباً من الكود أو رسالة الخطأ، فيعود النموذج بشرح وكود، ثم تنسخ أنت الكود إلى الملف وتشغل الاختبارات وتعود له إذا فشل شيء. النموذج هنا يرى ما تلصقه فقط، وأنت من ينفذ كل خطوة.
- الوكيل Agent: تعطيه هدفاً، وتعطيه أدوات يستطيع أن يطلب تشغيلها مثل قراءة ملف وكتابة ملف وتشغيل الاختبارات، فيعمل في حلقة: يطلب أداة، والبرنامج المحيط به ينفذها ويعيد له النتيجة، ثم يطلب التالية، حتى يقرر أنه انتهى. وهذا هو التعريف الذي تستخدمه Anthropic في مقالها Building effective agents، حيث تصف الوكلاء بأنهم أنظمة يوجه فيها النموذج خطواته واستخدامه للأدوات بنفسه، وأنها في الغالب نموذج يستخدم أدوات بناءً على نتائج البيئة في حلقة.
ولاحظ أن الفرق بين الطرق الثلاث ليس في الذكاء، وإنما في المسؤولية: في الإكمال التلقائي أنت تكتب والنموذج يقترح سطراً، وفي المحادثة النموذج يقترح حلاً وأنت تنفذه وتتحقق منه، وفي الوكيل النموذج ينفذ وأنت تراجع ما فعله في النهاية. وكلما انتقلت من الطريقة الأولى إلى الثالثة زاد ما يفعله النموذج دون أن تراه، وزاد عدد الطلبات وزادت التكلفة، وهذا ما سوف نقيسه في المختبر.
المختبر: مشروع صغير ونموذج يعمل على جهازك
لكي تكون المقارنة عادلة نحتاج مشروعاً واحداً تعطى مهامه للطرق الثلاث، ونموذجاً واحداً يعمل في الطرق الثلاث، واختبارات تقرر النجاح بدل أن نقرره نحن بالنظر. والمشروع الذي سوف نستخدمه هو جزء صغير من كود متجر، فيه أربعة ملفات واختباراتها بأداة الاختبار المدمجة في Node.js node:test دون أي حزمة إضافية:
repo/
  package.json
  src/stats.js       دوال تقرير المبيعات، وفيها ثلاث دوال جسمها فارغ (// TODO)
  src/cart.js        حساب إجمالي السلة مع القسيمة وضريبة القيمة المضافة 15%
  src/coupons.js     القسائم ونسبة الخصم لكل منها
  src/shipping.js    قواعد شحن قديمة مكتوبة بطريقة صعبة القراءة
  test/stats.test.js  test/cart.test.js  test/shipping.test.js
والمبالغ في المشروع أعداد صحيحة بالهللة، أي أن 100 هللة تساوي ريالاً واحداً، وذلك لأن حساب المال بالأعداد العشرية يعطي أخطاء تقريب صغيرة تتراكم، كما شرحنا في مقال الأرقام العشرية Floating Point من الداخل. وهذا ملف الإحصاءات كما هو، والدوال الثلاث التي فيها // TODO هي مهمة الإكمال التلقائي:
// Helpers for the shop's daily sales report. Amounts are integers in halalas (100 halalas = 1 SAR).

export function average(nums) {
  if (nums.length === 0) return 0;
  return nums.reduce((a, b) => a + b, 0) / nums.length;
}

// Keep x between lo and hi (inclusive).
export function clamp(x, lo, hi) {
  // TODO
}

// The middle value of the numbers (the mean of the two middle values for an even count); 0 for an empty list.
// Must not change the caller's array.
export function median(nums) {
  // TODO
}

// 123450 halalas -> "SAR 1,234.50"; negative amounts -> "-SAR 2.50".
export function formatSAR(halalas) {
  // TODO
}

export function percentChange(before, after) {
  if (before === 0) return null;
  return ((after - before) / before) * 100;
}
واختباراتها تحدد السلوك المطلوب بدقة، ولاحظ أن بعضها يختبر حالات يسهل نسيانها، مثل أن ترتيب الأرقام يجب أن يكون رقمياً لا نصياً، وألا تغير الدالة المصفوفة التي أرسلها المستدعي، وأن المبلغ السالب يكتب بإشارة قبل كلمة SAR:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { clamp, median, formatSAR } from '../src/stats.js';

test('clamp: inside, below, above', () => {
  assert.equal(clamp(5, 0, 10), 5);
  assert.equal(clamp(-3, 0, 10), 0);
  assert.equal(clamp(42, 0, 10), 10);
});

test('median: odd and even counts, empty list', () => {
  assert.equal(median([3, 1, 2]), 2);
  assert.equal(median([4, 1, 3, 2]), 2.5);
  assert.equal(median([]), 0);
});

test('median: numbers, not text order', () => {
  assert.equal(median([10, 9, 2]), 9);
});

test('median: leaves the input array as it was', () => {
  const sales = [30, 10, 20];
  median(sales);
  assert.deepEqual(sales, [30, 10, 20]);
});

test('formatSAR: thousands and halalas', () => {
  assert.equal(formatSAR(123450), 'SAR 1,234.50');
  assert.equal(formatSAR(5), 'SAR 0.05');
  assert.equal(formatSAR(100000000), 'SAR 1,000,000.00');
});

test('formatSAR: negative amounts', () => {
  assert.equal(formatSAR(-250), '-SAR 2.50');
});
أما النموذج فهو Qwen2.5-Coder، وهي عائلة نماذج برمجة مفتوحة الأوزان من فريق Qwen، وصدرت بستة أحجام من 0.5 إلى 32 مليار معامل Parameter كما يذكر التقرير التقني للعائلة، وسوف نستخدم في الطرق الثلاث حجم 1.5 مليار معامل، لأنه يعمل على حاسوب عادي دون كرت شاشة GPU، ونستخدم حجم 3 مليارات في بعض تجارب المحادثة والوكيل فقط عندما لم ينجح الحجم الأصغر. ونشغلها مع Ollama في Container واحد، ونكلمها من JavaScript عبر واجهة HTTP التي يوفرها Ollama على المنفذ 11434. والمخرج التالي يبين الإصدار والنموذجين بالضبط، والعمود الأخير بصمة Digest كل نموذج، فإذا أعدت التجربة ووجدت بصمة مختلفة فهذا يعني أن النموذج تحدث تحت الاسم نفسه وقد تختلف نتائجك:
ollama 0.40.13, node v22.14.0
qwen2.5-coder:1.5b      1.5B Q4_K_M  0.99 GB  d7372fd82851
qwen2.5-coder:3b        3.1B Q4_K_M  1.93 GB  f72c60cabf62
وكل التجارب تعمل بدرجة حرارة Temperature صفر وبذرة Seed ثابتة، أي أن النموذج يختار في كل خطوة التوكن الأعلى احتمالاً، وبالتالي يعطي الجواب نفسه إذا أعدت التشغيل على النموذج نفسه، وهذا ما يجعل النتائج قابلة للمقارنة. وكل محاولة تعمل على نسخة جديدة من المشروع، حتى لا تؤثر تعديلات نموذج على تجربة النموذج التالي. ولتشغيل المختبر كاملاً تحتاج Node.js 22 وDocker فقط، ثم تشغل الأمر التالي من مجلد المختبر:
#!/bin/bash
# The whole lab: an Ollama server with qwen2.5-coder 1.5b (and 3b where 1.5b could not do the task), then the three modes on the same small repo.
# Needs Node.js 22 (no packages) and Docker. From this folder:  bash run.sh
set -e
if ! curl -sf http://localhost:11434/api/version > /dev/null; then
  docker run -d --name lab-ollama -p 127.0.0.1:11434:11434 -v lab-ollama:/root/.ollama ollama/ollama:0.40.13
  sleep 5
fi
for m in 1.5b 3b; do docker exec "$(docker ps -qf publish=11434)" ollama pull qwen2.5-coder:$m > /dev/null; done
node versions.mjs              # out-00: Ollama version and the exact models
node 01-fim.mjs                # out-01: inline completion (fill in the middle)
node 01b-fim-lead.mjs          # out-01b: the same, after typing the first line yourself
node 02-chat.mjs               # out-02: chat with pasted code
node 02b-chat-3b.mjs           # out-02b: the two cart questions again with the 3b model
node 03-agent.mjs              # out-03: an agent loop with four tools
node 04-tokens.mjs # out-04: input tokens of one request in each modeالإكمال التلقائي Autocomplete: النموذج يكتب ما بين سطرين
أول أداة برمجة بالذكاء الاصطناعي انتشرت بين المطورين كانت من هذا النوع، ففي عام 2021 نشر فريق OpenAI ورقة Codex، وهو نموذج GPT تم تدريبه على كود منشور في GitHub، وذكرت الورقة أن نسخة إنتاجية منه هي التي تشغل GitHub Copilot، وكانت فكرته أن يكمل لك السطر أو الدالة وأنت تكتب. ولكن هناك مشكلة رئيسية في الإكمال بالطريقة العادية، وهي أن نموذج اللغة يقرأ النص من أوله ويتوقع ما بعده، أي أنه يرى ما قبل المؤشر فقط، بينما أنت في المحرر تكتب في الغالب داخل ملف موجود، والمؤشر في وسطه، وما بعد المؤشر مهم جداً: اسم المتغير الذي ستعيده الدالة، والقوس الذي يغلقها، والدالة التالية التي لا يجب أن يكررها النموذج.
الملء من المنتصف Fill-in-the-Middle
والحل الذي تستخدمه نماذج البرمجة اليوم اسمه الملء من المنتصف Fill-in-the-Middle، واختصاراً FIM، وقد وصفته ورقة من OpenAI عام 2022 بعنوان Efficient Training of Language Models to Fill in the Middle. والفكرة بسيطة جداً: أثناء التدريب نأخذ ملفاً، ونقطع منه جزءاً من الوسط، وننقل هذا الجزء إلى آخر النص، ونضع بين الأجزاء علامات خاصة تخبر النموذج أين البداية وأين النهاية وأين الوسط المفقود، ثم يتدرب النموذج على هذا النص كما يتدرب على أي نص آخر، من أوله إلى آخره. وبهذا الشكل يتعلم أن ما يأتي بعد العلامة الأخيرة هو الجزء الذي يربط البداية بالنهاية. وأهم ما أثبتته الورقة أن تدريب النموذج على نسبة كبيرة من البيانات بهذا الشكل لا يضعف قدرته العادية على الكتابة من اليسار إلى اليمين، ولذلك أوصت بأن تدرب نماذج اللغة على FIM بشكل افتراضي. والشكل التالي يبين الفكرة في مرحلتي التدريب والاستخدام:
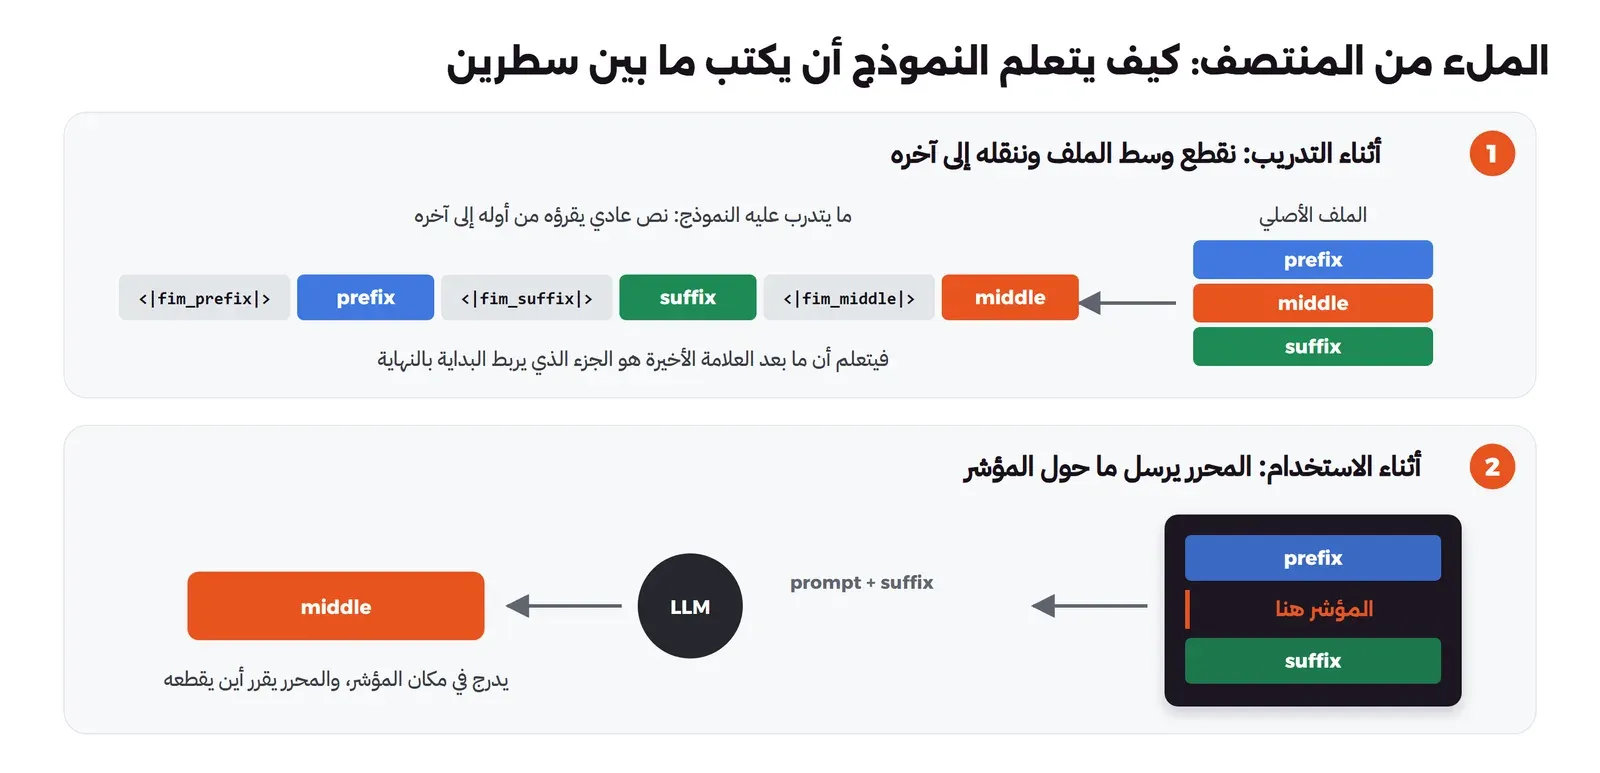
وكل عائلة نماذج تستخدم أسماء مختلفة لهذه العلامات، وفي Qwen تكون <|fim_prefix|> و<|fim_suffix|> و<|fim_middle|> كما يبين مستودع المشروع، ولكنك لا تحتاج أن تكتبها بنفسك مع Ollama، لأن واجهة /api/generate تقبل حقلاً اسمه suffix بجانب prompt، وتبني النص بالعلامات الصحيحة للنموذج الذي تستخدمه. وهذا ما تفعله إضافة المحرر عندما تتوقف عن الكتابة: تأخذ ما قبل المؤشر وتضعه في prompt، وما بعده في suffix، وترسل الطلب.
الإكمال التلقائي في 75 سطراً
البرنامج التالي يفعل ما تفعله إضافة المحرر بالضبط: يضع المؤشر على سطر // TODO داخل كل دالة، ويرسل ما قبله وما بعده للنموذج، ثم يدرج الجواب في مكان المؤشر ويشغل اختبارات تلك الدالة فقط. ويكرر ذلك للدوال الثلاث:
// Mode 1, inline completion: the editor sends the code before the cursor (prefix) and after it (suffix),
// the model writes only the missing middle (fill-in-the-middle, FIM). One request, no conversation, no tools.
import { writeFileSync, mkdirSync } from 'node:fs';
import { resolve } from 'node:path';
import { ollama, warm, freshRepo, runTests, writer, read, secs, LAB } from './lib.mjs';

const MODELS = (process.env.MODELS || 'qwen2.5-coder:1.5b').split(',');
const TASKS = ['clamp', 'median', 'formatSAR'];
const LIMIT = 100;   // tokens: stop the model here if it does not stop by itself
const out = writer('out-01-fim.txt');
const src = read(resolve(LAB, 'repo/src/stats.js'));
mkdirSync(resolve(LAB, 'answers'), { recursive: true });

// the cursor sits on the "// TODO" line inside the function: everything above it is the prefix, everything below the suffix
function split(fn) {
    const head = src.indexOf(`export function ${fn}(`);
    const todo = src.indexOf('  // TODO\n', head);
    return { prefix: src.slice(0, todo), suffix: src.slice(todo + '  // TODO\n'.length) };
}

// what an editor does before showing the suggestion: keep the indented body lines and stop at the first line
// that starts at column 0, because the closing "}" is already in the suffix
const cut = (text) => { const lines = text.split('\n'); const end = lines.findIndex(l => /^\S/.test(l)); return (end < 0 ? lines : lines.slice(0, end)).join('\n').replace(/\n*$/, '\n'); };

function check(model, fn, prefix, middle, suffix, tag) {
    const dir = freshRepo(`fim-${model.replace(/\W/g, '_')}-${fn}-${tag}`);
    // the editor inserts the answer at the cursor; the code after the cursor stays in the file either way
    writeFileSync(resolve(dir, 'src/stats.js'), prefix + middle + suffix);
    const t = runTests(dir, ['test/stats.test.js'], `^${fn}`);
    return { t, verdict: t.syntax ? 'syntax error' : t.pass + t.fail === 0 ? 'file broken' : `${t.pass} pass ${t.fail} fail` };
}

async function fill(model, fn, withSuffix) {
    const { prefix, suffix } = split(fn);
    const r = await ollama('/api/generate', { model, prompt: prefix, ...(withSuffix ? { suffix } : {}), options: { temperature: 0, seed: 42, num_predict: LIMIT } });
    const tag = withSuffix ? '' : '-nosuffix';
    writeFileSync(resolve(LAB, 'answers', `fim-${fn}${tag}.txt`), r.response);   // the raw answer, as the model wrote it
    return { r, prefix, suffix, raw: check(model, fn, prefix, r.response, suffix, 'raw' + tag), trimmed: check(model, fn, prefix, cut(r.response), suffix, 'cut' + tag) };
}

out('### 1. The model fills the three function bodies (prefix + suffix)');
out('model                fn         as returned    after the cut  tokens  time');
const shown = {};
for (const model of MODELS) {
    await warm(model);
    for (const fn of TASKS) {
        const f = await fill(model, fn, true);
        out(`${model.padEnd(20)} ${fn.padEnd(10)} ${f.raw.verdict.padEnd(14)} ${f.trimmed.verdict.padEnd(14)} ${String(f.r.eval_count).padStart(5)}  ${secs(f.r.total_duration / 1e6)}`);
        shown[`${model}/${fn}`] = { body: cut(f.r.response), rawLines: f.r.response.split('\n').length, failed: f.trimmed.t.lines.filter(l => l.startsWith('not ok')) };
    }
}

for (const [n, fn] of [[2, 'median'], [3, 'formatSAR']]) {
    out('');
    out(`### ${n}. What the model wrote for ${fn}() (after the cut)`);
    for (const model of MODELS) {
        const s = shown[`${model}/${fn}`];
        out(`--- ${model}: ${s.failed.length ? s.failed.join(' | ') : `all ${fn} tests pass`}`);
        out(s.body.replace(/\n+$/, ''));
    }
}

out('');
out('### 4. What the model returned for clamp() before the cut');
const c = await fill(MODELS[0], 'clamp', true);
out(c.r.response.split('\n').slice(0, 16).join('\n').replace(/\n+$/, ''));
out(`... ${c.r.response.split('\n').length} lines in total, ${c.r.eval_count} tokens (the limit was ${LIMIT})`);

out('');
out('### 5. The same request for median() without the suffix (the code after the cursor is not sent)');
for (const model of MODELS) {
    const f = await fill(model, 'median', false);
    out(`--- ${model}: as returned ${f.raw.verdict}, after the cut ${f.trimmed.verdict}, ${f.r.eval_count} tokens`);
    out(f.r.response.split('\n').slice(0, 12).join('\n').replace(/\n+$/, ''));
}
في الكود أعلاه لاحظ التالي:
- الدالة
splitتقسم الملف عند المؤشر، والطلب فيfillطلب واحد فيهpromptوsuffix، ولا توجد محادثة ولا أدوات. - الحد
num_predict: 120يوقف النموذج بعد 120 توكن إذا لم يتوقف بنفسه، وهذا مهم كما سوف ترى. - الدالة
cutتفعل ما تفعله إضافات المحرر قبل أن تعرض الاقتراح: تأخذ الأسطر التي تبدأ بمسافة، أي أسطر جسم الدالة، وتقطع عند أول سطر يبدأ من العمود الأول، لأن القوس الذي يغلق الدالة موجود أصلاً بعد المؤشر. ونختبر كل جواب مرتين: كما عاد من النموذج، وبعد هذا القطع. - الدالة
runTestsفيlib.mjsتشغلnode --testمع--test-name-patternحتى لا تؤثر الدوال الأخرى التي ما زالت فارغة على النتيجة.
النتيجة: دالة واحدة من ثلاث
عند تشغيل البرنامج على النموذج بحجم 1.5 مليار معامل كانت النتيجة كما يلي، والعمود الأول بعد اسم الدالة هو نتيجة الاختبار إذا أدرجنا الجواب كما عاد، والثاني بعد القطع الذي يفعله المحرر:
### 1. The model fills the three function bodies (prefix + suffix)
model                fn         as returned    after the cut  tokens  time
qwen2.5-coder:1.5b   clamp      syntax error   1 pass 0 fail    100  50.3 s
qwen2.5-coder:1.5b   median     syntax error   1 pass 2 fail    100  31.4 s
qwen2.5-coder:1.5b   formatSAR  syntax error   0 pass 2 fail    100  20.4 s
في النتائج أعلاه لاحظ التالي:
- الأجوبة الثلاثة كما عادت من النموذج تكسر الملف كله بخطأ في الصياغة Syntax Error، وكلها وصلت إلى حد 100 توكن، أي أن النموذج لم يتوقف بنفسه في أي مرة.
- بعد القطع نجحت
clamp، وفشلتmedianوformatSAR، ولكن ليس لأن النموذج كتب كوداً خاطئاً، وإنما لأنه لم يكتب كوداً أصلاً كما سوف نرى. - الأزمنة من 20 إلى 50 ثانية لطلب واحد على هذا الجهاز المشغول، وهذا غير مقبول في الإكمال التلقائي الذي يجب أن يظهر خلال جزء من الثانية وأنت تكتب، ولذلك تعمل أدوات الإكمال التجارية على سيرفرات بكروت شاشة، أو بنماذج صغيرة جداً على جهازك إذا كان فيه كرت شاشة مناسب، وقد شرحنا حساب ذلك في مقال تشغيل نماذج اللغة على جهازك.
والمخرج التالي يبين ما عاد به النموذج لدالة clamp قبل القطع:
  return Math.max(lo, Math.min(hi, x));
}

// The sum of the numbers (the total of the list); 0 for an empty list.
export function sum(nums) {
  if (nums.length === 0) return 0;
  return nums.reduce((a, b) => a + b, 0);
}

// The average of the numbers (the mean of the list); 0 for an empty list.
export function mean(nums) {
  if (
... 12 lines in total, 100 tokens (the limit was 100)
السطر الأول هو الجواب الصحيح بالضبط، ثم القوس الذي يغلق الدالة، وهذا القوس موجود أصلاً بعد المؤشر، ثم استمر النموذج يكتب دوالاً جديدة لم يطلبها أحد: sum ثم mean، وتوقف في منتصف سطر لأنه وصل إلى الحد. ولو أدرج المحرر هذا الجواب كما هو لأصبح في الملف قوسان يغلقان الدالة وكود ناقص، ولذلك لا تعرض أدوات الإكمال جواب النموذج كما هو، وإنما تقطعه قبل أن تعرضه عليك، فالبرنامج المحيط بالنموذج هو الذي يقرر أين ينتهي الاقتراح، وجودة هذا القطع جزء من جودة الأداة لا تقل أهمية عن جودة النموذج.
النموذج يكمل ما يراه في الملف
أما median فهذا ما عاد به النموذج كاملاً:
  // TODO
}

// The sum of the numbers (0 for an empty list).
export function sum(nums) {
  // TODO
}

// 123450 halalas -> "1,234.50 SAR"; negative amounts -> "-2.50 SAR".
export function formatSAR(halalas) {
  // TODO
}

export function percentChange(before, after) {
  if (before === 0) return null;
  return
كتب النموذج // TODO مكان الجسم، ثم أغلق الدالة، ثم اخترع دوالاً أخرى جسمها كلها // TODO، بل وكرر formatSAR بتعليق مختلف عن الأصلي. وهذا السلوك منطقي إذا فهمت كيف يعمل الإكمال: النموذج لا يعرف أنك تريد تنفيذ الدالة، وإنما يتوقع النص الأكثر احتمالاً بين ما قبل المؤشر وما بعده، والملف الذي أمامه فيه ثلاث دوال جسمها // TODO، فأكثر ما يشبه هذا الملف هو دالة أخرى جسمها // TODO. وفي المشاريع الحقيقية ستجد الشيء نفسه بشكل أخف: الإكمال يقلد أسلوب الملف الذي تكتب فيه، فإذا كان الملف مليئاً بالكود المنسوخ أو بالأخطاء المتكررة فسوف يقترح عليك المزيد منها.
ماذا يحدث إذا لم ترسل ما بعد المؤشر Suffix؟
جربنا الطلب نفسه لدالة median دون حقل suffix، أي كما يعمل الإكمال القديم الذي يرى ما قبل المؤشر فقط:
--- qwen2.5-coder:1.5b: as returned syntax error, after the cut 1 pass 2 fail, 100 tokens
```javascript
// Helpers for the shop's daily sales report. Amounts are integers in halalas (100 halalas = 1 SAR).

export function average(nums) {
  if (nums.length === 0) return 0;
  return nums.reduce((a, b) => a + b, 0) / nums.length;
}

// Keep x between lo and hi (inclusive).
export function clamp(x, lo, hi) {
  return Math.max(lo,
دون ما بعد المؤشر لم يعد الطلب طلب ملء من المنتصف، وإنما صار نصاً عادياً ينتهي بسطر export function median(nums) {، فتعامل النموذج معه كبداية سؤال، وبدأ يكتب الملف كله من أوله داخل كتلة Markdown كما يفعل في المحادثة. وهذا يبين أن suffix ليس تحسيناً بسيطاً، وإنما هو ما يجعل النموذج يفهم أنه داخل ملف يجب أن يكمل فجوة فيه.
اكتب السطر الأول بنفسك
والطريقة التي يستخدم بها أغلب المطورين الإكمال التلقائي ليست أن يقفوا على دالة فارغة وينتظروا، وإنما أن يكتبوا بداية الفكرة ثم يتركوا الأداة تكمل، فجربنا ذلك: كتبنا السطر الأول من جسم كل دالة، ووضعنا المؤشر بعده، وأرسلنا الطلب نفسه:
// Mode 1 again, the way developers really use it: type the first line of the body yourself, then let the model go on.
// Same request as 01-fim.mjs (prefix + suffix, one call), only the prefix now ends with the line you typed.
import { writeFileSync } from 'node:fs';
import { resolve } from 'node:path';
import { ollama, warm, freshRepo, runTests, writer, read, secs, LAB } from './lib.mjs';

const MODEL = process.env.MODEL || 'qwen2.5-coder:1.5b';
const LIMIT = 100;
const out = writer('out-01b-fim-lead.txt');
const src = read(resolve(LAB, 'repo/src/stats.js'));
// the first line continues the line being typed, so the cut looks from the second line on
const cut = (text) => { const lines = text.split('\n'); const end = lines.findIndex((l, i) => i > 0 && /^\S/.test(l)); return (end < 0 ? lines : lines.slice(0, end)).join('\n').replace(/\n*$/, '\n'); };

// what the developer types before pausing (the cursor is at the end of this line)
const LEAD = {
    median: '  if (nums.length === 0) return 0;\n  const sorted = ',
    formatSAR: '  const sign = halalas < 0 ? \'-\' : \'\';\n',
};

await warm(MODEL);
out(`### 1. ${MODEL}: the first line is typed by the developer, the model writes the rest`);
for (const [fn, lead] of Object.entries(LEAD)) {
    const head = src.indexOf(`export function ${fn}(`), todo = src.indexOf('  // TODO\n', head);
    const prefix = src.slice(0, todo) + lead, suffix = src.slice(todo + '  // TODO\n'.length);
    const r = await ollama('/api/generate', { model: MODEL, prompt: prefix, suffix, options: { temperature: 0, seed: 42, num_predict: LIMIT } });
    const body = cut(r.response);
    const dir = freshRepo(`fim-lead-${fn}`);
    writeFileSync(resolve(dir, 'src/stats.js'), prefix + body + suffix);
    const t = runTests(dir, ['test/stats.test.js'], `^${fn}`);
    out(`--- ${fn}: ${t.syntax || `${t.pass} pass ${t.fail} fail`} (${r.eval_count} tokens, ${secs(r.total_duration / 1e6)})`);
    for (const l of t.lines.filter(l => l.startsWith('not ok'))) out('  ' + l);
    out((lead + body).replace(/\n+$/, ''));
}
والنتيجة كما يلي:
### 1. qwen2.5-coder:1.5b: the first line is typed by the developer, the model writes the rest
--- median: 3 pass 0 fail (100 tokens, 17.5 s)
  if (nums.length === 0) return 0;
  const sorted = nums.slice().sort((a, b) => a - b);
  const mid = Math.floor(sorted.length / 2);
  if (sorted.length % 2 === 0) {
    return (sorted[mid - 1] + sorted[mid]) / 2;
  } else {
    return sorted[mid];
  }
--- formatSAR: 0 pass 2 fail (100 tokens, 13.5 s)
  not ok 1 - formatSAR: thousands and halalas
  not ok 2 - formatSAR: negative amounts
  const sign = halalas < 0 ? '-' : '';
  const halalasStr = Math.abs(halalas).toFixed(2);
  return `${sign}SAR ${halalasStr}`;
مع سطر واحد كتبناه نجحت median في الاختبارات الثلاثة، بما فيها الحالتان اللتان يسهل نسيانهما: الترتيب الرقمي (a, b) => a - b بدل الترتيب النصي الافتراضي في JavaScript الذي يضع 10 قبل 9، ونسخ المصفوفة بـ slice() قبل ترتيبها حتى لا تتغير مصفوفة المستدعي. أما formatSAR فكتب النموذج كوداً يبدو معقولاً ولكنه خاطئ في شيئين: لم يقسم الهللات على 100 فصار المبلغ 123450.00 بدل 1,234.50، ولم يضع فاصل الآلاف، ولو كنت تقرأ الاقتراح بسرعة وأنت تكتب لقبلته غالباً لأنه يبدو كالمطلوب.
والخلاصة من هذه التجارب أن الإكمال التلقائي ممتاز في الأسطر التي تعرف أنت ما يجب أن تكون عليه، فهو يوفر عليك الكتابة لا التفكير، ويصبح خطيراً في الدوال التي فيها قاعدة عمل لم تكتبها بعد، لأنه سيكتب أقرب شيء يشبه ما حوله، وأنت من يقرر في ثانية واحدة هل تضغط Tab. ولذلك فالقاعدة العملية: اقبل الاقتراح الذي تستطيع التحقق منه بنظرة، أما ما يحتاج تفكيراً فاكتبه أنت أو اكتب اختباره أولاً.
المحادثة Chat: النموذج يرى ما تلصقه أنت فقط
المهمة الثانية في صباحنا مختلفة تماماً، فلا توجد فجوة صغيرة يملؤها النموذج، وإنما دالة شحن قديمة كاملة تريد أن تعيد كتابتها بشكل أوضح دون أن يتغير سلوكها، ثم اختبار في السلة يفشل ولا تعرف لماذا. وهذا النوع من المهام لا يصلح له الإكمال التلقائي، لأنه يحتاج أن تشرح للنموذج ما تريد بكلمات، وأن يعود لك بشرح وكود كامل، وهذا ما صممت له المحادثة Chat. والفرق المهم الذي يغفل عنه كثير من المطورين أن النموذج في المحادثة لا يرى المشروع، وإنما يرى رسالتك فقط، فإذا لصقت الملف الخطأ أو نسيت ملفاً مهماً فسوف يجيبك بثقة عن كود لم يره، وقد شرحنا لماذا يحدث هذا في مقال متى يكون الذكاء الاصطناعي واثقاً ومخطئاً.
وهذه دالة الشحن القديمة، ولاحظ أن فيها سلوكاً غريباً قليلاً لكنه سلوك حقيقي يعتمد عليه النظام، مثل أن مقارنة اسم المدينة حساسة لحالة الأحرف، فـ Riyadh بحرف كبير تحسب كمدينة أخرى، وأن الشرط على الوزن فوق 30 كيلو يأتي بعد حساب السعر:
// Old shipping rules, written years ago. Weights in kg, prices in SAR.
export function shippingCost(weightKg, city, express) {
  var cost = 0;
  if (city == 'riyadh' || city == 'jeddah' || city == 'dammam') {
    if (weightKg <= 1) { cost = 15 } else { cost = 15 + Math.ceil(weightKg - 1) * 5 }
  } else {
    if (weightKg <= 1) { cost = 25 } else { cost = 25 + Math.ceil(weightKg - 1) * 7 }
  }
  if (express) { cost = cost * 2 }
  if (weightKg > 30) { return null }
  return cost
}
واختبارات الشحن تثبت السلوك الحالي كما هو، وهي تنجح كلها على الكود القديم، وبالتالي أي إعادة كتابة صحيحة يجب أن تبقيها ناجحة:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { shippingCost } from '../src/shipping.js';

test('shipping: main cities, up to 1 kg', () => {
  assert.equal(shippingCost(1, 'riyadh', false), 15);
  assert.equal(shippingCost(0.4, 'dammam', false), 15);
});

test('shipping: every started kilo counts', () => {
  assert.equal(shippingCost(1.2, 'jeddah', false), 20);
  assert.equal(shippingCost(3, 'riyadh', false), 25);
});

test('shipping: other cities', () => {
  assert.equal(shippingCost(1, 'abha', false), 25);
  assert.equal(shippingCost(2.5, 'tabuk', false), 39);
});

test('shipping: express doubles the price', () => {
  assert.equal(shippingCost(2, 'riyadh', true), 40);
});

test('shipping: over 30 kg is not shipped', () => {
  assert.equal(shippingCost(31, 'riyadh', false), null);
  assert.equal(shippingCost(30, 'riyadh', false), 160);
});

test('shipping: city names are matched exactly as stored (lower case)', () => {
  assert.equal(shippingCost(1, 'Riyadh', false), 25);
});
أما السلة فهذا كودها، وهي تستدعي applyCoupon من ملف آخر:
import { applyCoupon } from './coupons.js';

export const VAT_RATE = 0.15;

// items: [{ price, qty }] with price in halalas. Returns the total after the coupon, with VAT, in halalas.
export function cartTotal(items, couponCode) {
  const subtotal = items.reduce((sum, it) => sum + it.price * it.qty, 0);
  const afterCoupon = applyCoupon(subtotal, couponCode);
  return afterCoupon + Math.round(afterCoupon * VAT_RATE);
}
وهذا هو الملف الآخر، والخطأ فيه وليس في السلة، فالقسمة على 10 بدل 100 تجعل خصم 10% يأخذ المبلغ كله، وخصم 25% يأخذ أكثر من ضعفه:
// Coupon codes and how many percent each one takes off.
const COUPONS = { WELCOME10: 10, RAMADAN25: 25 };

export function applyCoupon(amount, code) {
  const percent = COUPONS[code] ?? 0;
  return amount - Math.round((amount * percent) / 10);
}
وهذا يشبه ما يحدث في المشاريع الحقيقية: الاختبار الذي يفشل في ملف، والسبب في ملف آخر يستورده، والمطور الذي يسأل المحادثة يلصق في الغالب الملف الذي يراه أمامه في رسالة الخطأ.
المحادثة كما يستخدمها المطور
البرنامج التالي يقلد ما يفعله المطور: يكتب سؤالاً ويلصق فيه الكود، ثم يأخذ أول كتلة كود من الجواب ويضعها في الملف كما ينسخها المطور بيده، ثم يشغل الاختبارات. ويجرب ثلاث رسائل: إعادة كتابة دالة الشحن، ثم سؤال عن خطأ السلة مع لصق cart.js فقط ورسالة الخطأ، ثم السؤال نفسه مع لصق الملفين معاً:
// Mode 2, chat: the developer pastes code into a conversation, reads the answer and copies the code back by hand.
// The model sees only what was pasted; it cannot open other files or run the tests.
import { writeFileSync, mkdirSync } from 'node:fs';
import { resolve } from 'node:path';
import { ollama, warm, freshRepo, runTests, writer, read, secs, codeBlocks, LAB, OPTS } from './lib.mjs';

const MODELS = (process.env.MODELS || 'qwen2.5-coder:1.5b').split(',');
const out = writer('out-02-chat.txt');
const repo = (p) => read(resolve(LAB, 'repo', p));
const raw = resolve(LAB, 'answers'); mkdirSync(raw, { recursive: true });   // every chat answer as the model wrote it

async function ask(model, tag, content) {
    const r = await ollama('/api/chat', { model, messages: [{ role: 'user', content }], options: { ...OPTS, num_predict: 500 } });
    writeFileSync(resolve(raw, `${tag}-${model.replace(/\W/g, '_')}.md`), r.message.content);
    return r;
}
const stat = (r) => `${r.eval_count} tokens out, ${secs(r.total_duration / 1e6)}`;
const verdict = (t) => t.syntax ? t.syntax : `${t.pass} pass ${t.fail} fail`;

// the failing test output exactly as the developer sees it in the terminal
const fresh = freshRepo('chat-baseline');
const failing = runTests(fresh, ['test/cart.test.js']);
const failText = failing.raw.split('\n').filter(l => /^not ok|expected|actual|^  (- |\+ )|AssertionError/.test(l.trim()) || /^not ok/.test(l)).slice(0, 12).join('\n');

out('### 1. Refactor shipping.js "without changing its behaviour", then run the old tests');
const REFACTOR = 'Refactor this JavaScript function for readability. Keep its behaviour exactly the same. Reply with the full file in one code block.\n\n```js\n' + repo('src/shipping.js') + '```';
for (const model of MODELS) {
    await warm(model);
    const r = await ask(model, 'refactor', REFACTOR);
    const code = codeBlocks(r.message.content)[0];
    const dir = freshRepo(`chat-refactor-${model.replace(/\W/g, '_')}`);
    if (code) writeFileSync(resolve(dir, 'src/shipping.js'), code);
    const t = runTests(dir, ['test/shipping.test.js']);
    out(`--- ${model}: ${code ? verdict(t) : 'no code block'} (${stat(r)})`);
    for (const l of t.lines.filter(l => l.startsWith('not ok'))) out('  ' + l);
}

out('');
out('### 2. The bug, pasting only cart.js and the failing test output');
const ONLY_CART = 'My test fails:\n\n```\n' + failText + '\n```\n\nHere is cart.js:\n\n```js\n' + repo('src/cart.js') + '```\n\nFind the bug and reply with the full corrected cart.js in one code block.';
for (const model of MODELS) {
    const r = await ask(model, 'cart-only', ONLY_CART);
    const code = codeBlocks(r.message.content)[0];
    const dir = freshRepo(`chat-cart-${model.replace(/\W/g, '_')}`);
    if (code) writeFileSync(resolve(dir, 'src/cart.js'), code);
    const t = runTests(dir, ['test/cart.test.js']);
    out(`--- ${model}: ${code ? verdict(t) : 'no code block'} (${stat(r)})`);
    for (const l of t.lines.filter(l => l.startsWith('not ok'))) out('  ' + l);
    out('  the model said: ' + r.message.content.split('\n').find(l => l.trim() && !l.startsWith('```'))?.trim().slice(0, 300));
}

out('');
out('### 3. The same question, pasting cart.js and coupons.js together');
const BOTH = ONLY_CART.replace('Here is cart.js:', 'Here is cart.js and the file it imports, coupons.js:')
    .replace('Find the bug and reply with the full corrected cart.js in one code block.',
        '```js\n' + repo('src/coupons.js') + '```\n\nFind the bug and reply with every file you change, each in its own code block whose first line is a comment with the file name, like // coupons.js');
for (const model of MODELS) {
    const r = await ask(model, 'cart-both', BOTH);
    const dir = freshRepo(`chat-both-${model.replace(/\W/g, '_')}`);
    const applied = [];
    for (const code of codeBlocks(r.message.content)) {
        // a human would paste each block into the file it belongs to: by its name comment, or by what it defines
        const name = code.match(/^\s*\/\/\s*(?:src\/)?(cart|coupons)\.js/)?.[1] || (/function applyCoupon/.test(code) ? 'coupons' : /function cartTotal/.test(code) ? 'cart' : null);
        if (name) { writeFileSync(resolve(dir, `src/${name}.js`), code); applied.push(`${name}.js`); }
    }
    const t = runTests(dir, ['test/cart.test.js']);
    out(`--- ${model}: changed ${applied.join(', ') || 'nothing'}: ${verdict(t)} (${stat(r)})`);
    for (const l of t.lines.filter(l => l.startsWith('not ok'))) out('  ' + l);
}
لاحظ أن كل رسالة في هذا البرنامج طلب واحد مستقل، فالنموذج لا يتذكر الرسالة السابقة، وكل ما يعرفه عن المشروع هو النص الموجود في content، وهذا هو حال المحادثة في أي أداة: ما يسمى ذاكرة المحادثة هو أن الأداة ترسل الرسائل السابقة كلها مع كل رسالة جديدة، ولذلك تطول المحادثة فتزداد تكلفة كل رسالة، كما شرحنا في مقال تكلفة التوكنات.
إعادة الكتابة Refactoring: كود أجمل وسلوك مختلف
طلبنا من النموذج أن يعيد كتابة دالة الشحن لتكون أوضح، وأن يبقي سلوكها كما هو تماماً، ثم أخذنا الكود من جوابه وشغلنا عليه الاختبارات القديمة نفسها، وكانت النتيجة كما يلي:
### 1. Refactor shipping.js "without changing its behaviour", then run the old tests
--- qwen2.5-coder:1.5b: 1 pass 5 fail (197 tokens out, 117.2 s)
  not ok 1 - shipping: main cities, up to 1 kg
  not ok 2 - shipping: every started kilo counts
  not ok 4 - shipping: express doubles the price
  not ok 5 - shipping: over 30 kg is not shipped
  not ok 6 - shipping: city names are matched exactly as stored (lower case)
خمسة اختبارات من ستة فشلت، والكود الذي عاد به النموذج يبدو عند قراءته السريعة أفضل من الأصلي بكثير، فيه أسماء واضحة وتعليقات على كل خطوة وجدول للأسعار بدل الشروط المتداخلة:
// Refactored shippingCost function for improved readability
export function shippingCost(weightKg, city, express) {
  // Define the base cost for different cities
  const baseCost = {
    Riyadh: 15,
    Jeddah: 15,
    Damam: 15,
    Other: 25
  };

  // Determine the base cost based on the city
  const baseCostForCity = baseCost[city] || baseCost.Other;

  // Calculate the additional cost based on the weight
  const additionalCost = Math.ceil(weightKg - 1) * (express ? 2 : 7);

  // Calculate the total cost
  const totalCost = baseCostForCity + additionalCost;

  // Check if the weight exceeds the maximum allowed weight
  if (weightKg > 30) {
    return null;
  }

  return totalCost;
}
وعند تشغيل الاختبارات سوف تجد أن هذا الكود الجميل يغير السلوك في أربعة أماكن على الأقل، ولاحظ التالي:
- أسماء المدن في الجدول تبدأ بحرف كبير
Riyadhبينما يخزنها النظام بأحرف صغيرة، فأصبحت كل المدن الرئيسية تحسب كمدينة أخرى بسعر 25 بدل 15، وهذا وحده أفشل أغلب الاختبارات. - كتب النموذج
Damamبدلdammam، أي أن خطأً إملائياً صغيراً في مفتاح جدول يغير سعر الشحن لمدينة كاملة، ولن يلاحظه أحد في المراجعة السريعة. - الطلب المستعجل Express لم يعد يضاعف السعر، وإنما صار يغير سعر الكيلو الإضافي إلى 2 ريال، وهذا تغيير في قاعدة عمل لا في شكل الكود.
- سعر الكيلو الإضافي صار 7 لكل المدن، والمدن الرئيسية كان سعرها 5.
وهذه أخطر نتيجة في المختبر كله، لأن الكود الخاطئ هنا لا يبدو خاطئاً، بل يبدو تحسيناً، ولو لم تكن لدينا اختبارات تثبت السلوك القديم لكان من السهل أن يقبله المطور ويقبله من يراجعه. والقاعدة التي تخرج بها: لا تطلب من المحادثة إعادة كتابة كود قديم إلا بعد أن تكتب اختبارات تثبت سلوكه الحالي، بما فيه السلوك الغريب، ثم شغلها على الكود الجديد قبل أن تقرأه، وقد شرحنا كيف تكتب هذه الاختبارات وكيف تحكم عليها في مقال الاختبارات التي يكتبها الذكاء الاصطناعي.
الخطأ في ملف لم تلصقه
الرسالة الثانية هي ما يكتبه أغلب المطورين عندما يفشل اختبار: رسالة الخطأ كما ظهرت في الطرفية Terminal، والملف الذي يظهر اسمه فيها، وطلب إصلاح الخطأ. ورسالة الخطأ التي لصقناها في السؤال كانت كما يلي:
not ok 2 - cart: WELCOME10 takes 10% off before VAT
  name: 'AssertionError'
  expected: 20700
  actual: 0
not ok 3 - cart: RAMADAN25 on two items
  name: 'AssertionError'
  expected: 8625
  actual: -17250
ولاحظ أن الرقم -17250 هو الإجمالي بعد الضريبة، وأن الاختبار يتوقع 8625، وكل من يعرف الكود يفهم من الإشارة السالبة أن الخصم أكبر من المبلغ، ولكن النموذج لم ير ملف القسائم الذي يحسب الخصم، وكانت النتيجة كما يلي:
### 2. The bug, pasting only cart.js and the failing test output
--- qwen2.5-coder:1.5b: 2 pass 2 fail (318 tokens out, 163.8 s)
  not ok 2 - cart: WELCOME10 takes 10% off before VAT
  not ok 3 - cart: RAMADAN25 on two items
وهذا هو جواب النموذج كاملاً:
The bug in the `cartTotal` function is that it does not handle the case where the `applyCoupon` function returns a negative value. When the coupon code is invalid or the coupon does not apply, `applyCoupon` should return `null` or a value that is not negative. In this case, the `applyCoupon` function is returning `-17250`, which is negative.

To fix this bug, we need to add a check to ensure that the `applyCoupon` function returns a non-negative value before adding it to the subtotal. Here's the corrected `cartTotal` function:

```js
import { applyCoupon } from './coupons.js';

export const VAT_RATE = 0.15;

// items: [{ price, qty }] with price in halalas. Returns the total after the coupon, with VAT, in halalas.
export function cartTotal(items, couponCode) {
  const subtotal = items.reduce((sum, it) => sum + it.price * it.qty, 0);
  const afterCoupon = applyCoupon(subtotal, couponCode);
  if (afterCoupon >= 0) {
    return afterCoupon + Math.round(afterCoupon * VAT_RATE);
  } else {
    throw new Error('Invalid coupon code or coupon does not apply');
  }
}
```

With this fix, the `cartTotal` function will now correctly handle cases where the coupon code is invalid or the coupon does not apply, and it will throw an error if the `applyCoupon` function returns a negative value.
النموذج اخترع قصة لا وجود لها، فقال إن applyCoupon تعيد -17250 بينما هذا هو الإجمالي بعد الضريبة، ثم أضاف شرطاً يرمي خطأ Error عندما يكون المبلغ سالباً، أي أنه عالج العرض لا السبب، فالقسيمة ما زالت تأخذ عشرة أضعاف نسبتها، والفرق الوحيد أن السلة صارت ترمي خطأً بدل أن تعيد رقماً سالباً. وهذا ما يحدث عندما يجيب النموذج عن كود لم يره: لا يقول «أحتاج أن أرى coupons.js»، وإنما يكتب أقرب جواب معقول للنص الذي أمامه.
وقد يتساءل البعض: إذا لصقنا الملفين معاً، هل يصلح النموذج الخطأ؟ جربنا ذلك بالنموذج نفسه، وكانت النتيجة أسوأ:
### 3. The same question, pasting cart.js and coupons.js together
--- qwen2.5-coder:1.5b: changed cart.js: 0 pass 4 fail (245 tokens out, 361.4 s)
  not ok 1 - cart: no coupon adds 15% VAT
  not ok 2 - cart: WELCOME10 takes 10% off before VAT
  not ok 3 - cart: RAMADAN25 on two items
  not ok 4 - cart: unknown coupon changes nothing
رأى النموذج ملف القسائم هذه المرة، ولكنه لم يفهم أن القسمة على 10 هي المشكلة، وكتب مرة أخرى شرطاً على المبلغ السالب، ثم أعاد دالة cartTotal وحدها دون سطر import ودون تعريف VAT_RATE، فلما وضعناها في الملف كما ينسخها المطور فشلت الاختبارات الأربعة كلها. وهذا يبين حد النموذج الصغير، فلكي نعرف هل يفيد السياق الإضافي فعلاً أعدنا السؤالين بحجم 3 مليارات معامل:
--- changed cart.js: 2 pass 2 fail (243 tokens out, 321.0 s)
  not ok 2 - cart: WELCOME10 takes 10% off before VAT
  not ok 3 - cart: RAMADAN25 on two items
The issue in the `cartTotal` function is that the `applyCoupon` function is not returning the expected value. Let's assume that `applyCoupon` is supposed to return the discounted price after applying the coupon, but it's not doing so correctly. We need to ensure that `applyCoupon` is returning the correct value.
Here's the corrected `cartTotal` function:
[code]
If `applyCoupon` is not returning the expected value, you should check the implementation of `applyCoupon` in the `coupons.js` file. Make sure that it correctly applies the coupon to the subtotal and returns the discounted price.
--- changed cart.js: 1 pass 3 fail (215 tokens out, 121.0 s)
  not ok 2 - cart: WELCOME10 takes 10% off before VAT
  not ok 3 - cart: RAMADAN25 on two items
  not ok 4 - cart: unknown coupon changes nothing
The bug in the `cartTotal` function is in the calculation of the VAT. The VAT is calculated as 15% of the total after the coupon, but the VAT is being added to the total after the coupon, which is incorrect. The VAT should be added to the subtotal after the coupon, not to the total after the coupon.
Here is the corrected `cartTotal` function:
[code]
With this change, the test should pass.
النموذج الأكبر كان أصدق في الحالة الأولى، فعندما لم ير ملف القسائم لم يخترع قصة، وإنما قال صراحة إن المشكلة غالباً في أن applyCoupon لا تعيد القيمة المتوقعة، ونصح بفحصها في coupons.js، وهذا جواب مفيد للمطور حتى لو كان الكود الذي أرفقه لم يغير شيئاً. أما عندما لصقنا الملفين معاً فقد ترك القسيمة، وقرر أن الخطأ في حساب الضريبة، وحذف التقريب Math.round، فصارت السلة تعيد أجزاء من الهللة، وفشل اختبار ثالث كان ناجحاً قبل الإصلاح:
// cart.js
import { applyCoupon } from './coupons.js';

export const VAT_RATE = 0.15;

// items: [{ price, qty }] with price in halalas. Returns the total after the coupon, with VAT, in halalas.
export function cartTotal(items, couponCode) {
  const subtotal = items.reduce((sum, it) => sum + it.price * it.qty, 0);
  const afterCoupon = applyCoupon(subtotal, couponCode);
  const vat = afterCoupon * VAT_RATE;
  return afterCoupon + vat;
}
والدرس من هذه المحاولات الخمس ليس أن المحادثة لا تنفع، فالنماذج الكبيرة في الأدوات التجارية أقدر على فهم خطأ كهذا عندما ترى الملفين، وإنما أن جواب المحادثة محكوم بشيئين: ما لصقته أنت، وقدرة النموذج على فهمه، وأنت لا ترى أياً منهما في الجواب، لأن النموذج يكتب بالثقة نفسها في كل الحالات. وفي المحاولات الخمس قدم النموذج كوده على أنه الحل، ولم تنجح الاختبارات كاملة في أي منها، ولذلك فالخطوة التي لا تتركها أبداً مع المحادثة هي أن تشغل الاختبارات بنفسك على الكود الذي نسخته قبل أن تقبله.
الوكيل Agent: النموذج يقرأ وينفذ في حلقة Loop
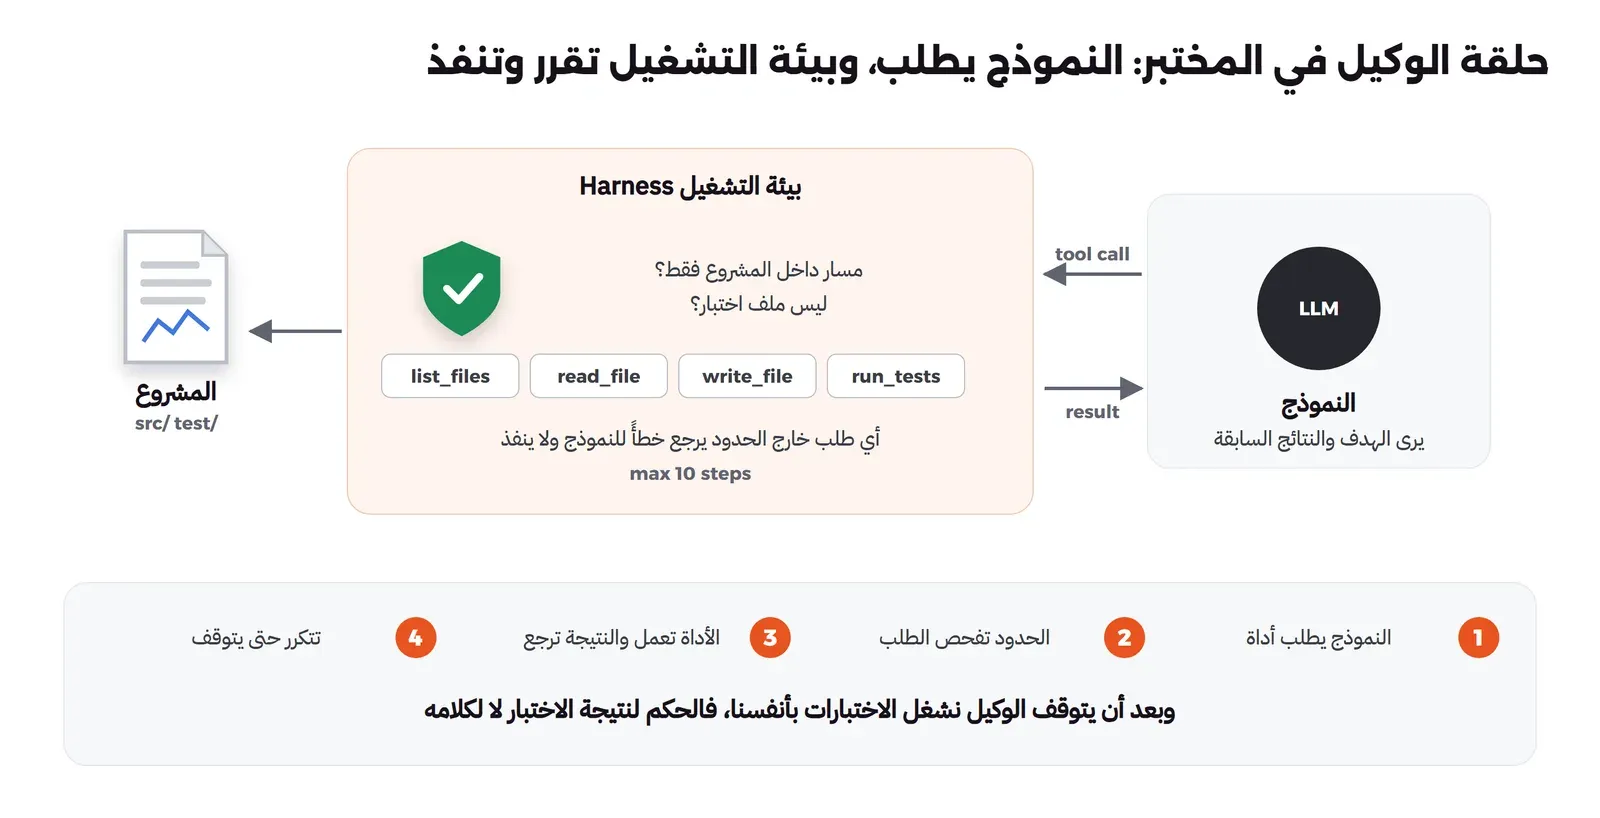
في المحادثة رأينا أن المطور يقوم بثلاثة أعمال لا يقوم بها النموذج: يختار الملفات التي يلصقها، وينقل الكود إلى المشروع، ويشغل الاختبارات ويرجع بالنتيجة. والوكيل Agent هو أن تعطي هذه الأعمال الثلاثة للنموذج نفسه، فبدل أن تلصق الملفات تعطيه أداة يقرأ بها أي ملف، وبدل أن تنسخ الكود تعطيه أداة يكتب بها، وبدل أن تشغل الاختبارات تعطيه أداة تشغلها وتعيد له النتيجة، ثم تضع كل ذلك في حلقة تدور حتى يقرر النموذج أنه انتهى أو تصل الحلقة إلى حد أقصى من الخطوات.
وقد يتساءل البعض: كيف يشغل النموذج أداة وهو لا يفعل إلا توقع النص؟ والإجابة أن النموذج لا يشغل شيئاً، وإنما يكتب طلباً منظماً فيه اسم الأداة ومعطياتها، والبرنامج المحيط به هو الذي يقرأ هذا الطلب ويقرر هل ينفذه، ثم ينفذه ويرسل النتيجة في الرسالة التالية. وهذا البرنامج المحيط بالنموذج يسمى بيئة التشغيل Harness، وهو الذي يحدد ما يستطيع الوكيل فعله وما لا يستطيع، ولذلك فالأمان في الوكيل يأتي من الحدود التي تكتبها في الـ Harness، لا من التعليمات التي تكتبها للنموذج. وفي Ollama تعطي النموذج قائمة الأدوات في حقل tools كما يبين دليل استدعاء الأدوات، فيعود الجواب بحقل tool_calls بدل النص عندما يريد النموذج استخدام أداة. والشكل التالي يبين الحلقة التي سوف نبنيها:
وكيل كامل في 120 سطراً
البرنامج التالي وكيل كامل بأربع أدوات، وهو أبسط بكثير من الأدوات التجارية، ولكنه يعمل بالطريقة نفسها: هدف، وأدوات، وحلقة، وحد أقصى للخطوات. والحدود فيه ثلاثة: لا قراءة ولا كتابة خارج مجلد المشروع، ولا تعديل لأي ملف تحت test/، وأداة الاختبارات تشغل أمراً واحداً ثابتاً لا يستطيع النموذج تغييره:
// Mode 3, agent: the model gets a goal and tools, and a loop runs its tool calls until it stops.
// The harness below decides what the tools may do: read and write inside the repo only, never edit tests,
// and run one fixed test command. The final check is ours, not the agent's word.
import { readdirSync, statSync, writeFileSync, mkdirSync } from 'node:fs';
import { resolve, relative, sep } from 'node:path';
import { ollama, warm, freshRepo, runTests, writer, read, secs, LAB, OPTS } from './lib.mjs';

const MODELS = (process.env.MODELS || 'qwen2.5-coder:1.5b,qwen2.5-coder:3b').split(',');
const MAX_STEPS = 10;
const TEST_FILES = ['test/cart.test.js', 'test/shipping.test.js'];
const out = writer('out-03-agent.txt');
const raw = resolve(LAB, 'data', 'agent'); mkdirSync(raw, { recursive: true });

const TOOLS = [
    { name: 'list_files', description: 'List every file in the repository.', parameters: { type: 'object', properties: {} } },
    { name: 'read_file', description: 'Read a file of the repository.', parameters: { type: 'object', properties: { path: { type: 'string', description: 'path relative to the repository root, e.g. src/cart.js' } }, required: ['path'] } },
    { name: 'write_file', description: 'Replace the whole content of a file in the repository.', parameters: { type: 'object', properties: { path: { type: 'string' }, content: { type: 'string', description: 'the complete new file content' } }, required: ['path', 'content'] } },
    { name: 'run_tests', description: 'Run the test suite and return the results.', parameters: { type: 'object', properties: {} } },
].map(f => ({ type: 'function', function: f }));

const GOAL = 'The tests of this repository fail. Find the cause and fix the source code so that run_tests passes. '
    + 'Do not edit files under test/. Use the tools; when the tests pass, reply with one sentence describing the fix.';

function makeTools(dir, log) {
    const inside = (p) => { const full = resolve(dir, String(p || '')); const rel = relative(dir, full); return rel && !rel.startsWith('..') && !rel.includes(':') ? { full, rel: rel.split(sep).join('/') } : null; };
    const walk = (d) => readdirSync(d).flatMap(f => { const p = resolve(d, f); return statSync(p).isDirectory() ? walk(p) : [relative(dir, p).split(sep).join('/')]; });
    return {
        list_files: () => walk(dir).join('\n'),
        read_file: ({ path }) => { const p = inside(path); if (!p) return 'error: path outside the repository'; try { return read(p.full); } catch { return `error: no such file ${path}`; } },
        write_file: ({ path, content }) => {
            const p = inside(path); if (!p) { log.push('BLOCKED write outside repo: ' + path); return 'error: path outside the repository'; }
            if (p.rel.startsWith('test/')) { log.push('BLOCKED write to ' + p.rel); return 'error: editing tests is not allowed'; }
            writeFileSync(p.full, String(content ?? '')); log.push('wrote ' + p.rel); return `ok, wrote ${p.rel}`;
        },
        run_tests: () => { const t = runTests(dir, TEST_FILES); return [`pass ${t.pass} fail ${t.fail}`, ...t.raw.split('\n').filter(l => /^not ok|expected|actual|Error/.test(l.trim())).slice(0, 20)].join('\n'); },
    };
}

// Some small models write the tool call as plain JSON text instead of the format the server turns into tool_calls,
// and put real line breaks inside the file content, which is not valid JSON. The lenient harness finds every
// {...} object in the text, escapes line breaks that sit inside strings, and runs it if it names a known tool.
function textCalls(content, tools) {
    const calls = [];
    let depth = 0, inStr = false, esc = false, start = -1, fixed = '';
    for (const ch of content) {
        if (depth > 0) fixed += inStr && ch === '\n' ? '\\n' : inStr && ch === '\t' ? '\\t' : ch;
        if (inStr) { if (esc) esc = false; else if (ch === '\\') esc = true; else if (ch === '"') inStr = false; continue; }
        if (ch === '"' && depth > 0) inStr = true;
        else if (ch === '{') { if (depth++ === 0) { start = 1; fixed = '{'; } }
        else if (ch === '}' && depth > 0 && --depth === 0 && start > 0) {
            try { const j = JSON.parse(fixed); if (tools[j.name]) calls.push({ function: { name: j.name, arguments: j.arguments || {} } }); } catch { /* not a call */ }
            start = -1;
        }
    }
    return calls;
}

async function agent(model, lenient = false) {
    const tag = `${model.replace(/\W/g, '_')}${lenient ? '-lenient' : ''}`;
    const dir = freshRepo(`agent-${tag}`);
    const log = [], steps = [];
    const tools = makeTools(dir, log);
    const messages = [{ role: 'system', content: 'You are a coding agent working in a JavaScript repository. You can only act through the tools.' }, { role: 'user', content: GOAL }];
    let tin = 0, tout = 0, ms = 0, final = null;
    for (let i = 1; i <= MAX_STEPS; i++) {
        const r = await ollama('/api/chat', { model, messages, tools: TOOLS, options: { ...OPTS, num_predict: 400 } });
        tin += r.prompt_eval_count || 0; tout += r.eval_count || 0; ms += r.total_duration / 1e6;
        const msg = r.message; messages.push(msg);
        let calls = msg.tool_calls || [], asText = false;
        if (!calls.length && lenient) { calls = textCalls(msg.content, tools); asText = calls.length > 0; }
        if (!calls.length) {
            // no tool call: either the agent is done, or it wrote the call as plain text that a strict harness cannot run
            final = msg.content.trim(); steps.push(`${i}. (answer) ${final.replace(/\s+/g, ' ').slice(0, 160)}`); break;
        }
        for (const c of calls) {
            const name = c.function.name, args = c.function.arguments || {};
            const result = tools[name] ? tools[name](args) : `error: unknown tool ${name}`;
            const shown = name === 'write_file' ? `${args.path} (${String(args.content ?? '').split('\n').length} lines)` : args.path || '';
            steps.push(`${i}. ${name}(${shown})${asText ? ' [written as text]' : ''} -> ${String(result).split('\n')[0].slice(0, 90)}`);
            messages.push({ role: 'tool', content: String(result), tool_name: name });
        }
    }
    writeFileSync(resolve(raw, `${tag}.json`), JSON.stringify(messages, null, 1));
    const check = runTests(dir, TEST_FILES);
    const changed = ['src/cart.js', 'src/coupons.js', 'src/shipping.js'].filter(f => read(resolve(dir, f)) !== read(resolve(LAB, 'repo', f)));
    return { steps, log, final, check, changed, tin, tout, ms, dir };
}

const results = {};
const fixed = () => Object.values(results).some(r => r.check.fail === 0 && r.check.pass > 0);
function report(label, a) {
    out(`--- ${label}`);
    for (const s of a.steps) out('  ' + s);
    for (const l of a.log.filter(l => l.startsWith('BLOCKED'))) out('  harness: ' + l);
    out(`  our own test run after the agent stopped: pass ${a.check.pass} fail ${a.check.fail}; files changed: ${a.changed.join(', ') || 'none'}`);
    out(`  tokens in ${a.tin}, tokens out ${a.tout}, model time ${secs(a.ms)}`);
}

out(`### 1. One goal, four tools, at most ${MAX_STEPS} steps; only real tool_calls are run`);
for (const model of MODELS) {
    if (fixed()) break;   // the bigger model runs only if the smaller one could not fix the bug
    await warm(model);
    const a = await agent(model); results[model] = a; report(model, a);
}

out('');
out('### 2. The same, with a harness that also accepts a tool call written as JSON text');
for (const model of MODELS) {
    if (fixed()) break;
    // only for a model whose answer was a tool call written as text
    if (!results[model] || !/^\s*(```(json)?\s*)?\{\s*"name"/.test(results[model].final || '')) continue;
    const a = await agent(model, true); results[`${model} lenient`] = a; report(`${model}, lenient harness`, a);
}

out('');
out('### 3. What the agents changed in the source');
for (const [label, a] of Object.entries(results)) {
    for (const f of a.changed) { out(`--- ${label}: ${f}`); out(read(resolve(a.dir, f)).replace(/\n+$/, '')); }
}
في الكود أعلاه لاحظ التالي:
- الهدف في
GOALلا يذكر أي ملف، فالوكيل يجب أن يكتشف بنفسه أين المشكلة، وهذا هو الفرق الأساسي عن المحادثة التي لصقنا فيها الملفات بأيدينا. - الدالة
insideترفض أي مسار يخرج من مجلد المشروع، وwrite_fileترفض الكتابة تحتtest/، وكل رفض يسجل فيlogويعود للنموذج كرسالة خطأ ليعرف أن طلبه لم ينفذ. - عندما يعود النموذج بنص دون
tool_callsتتوقف الحلقة، وهذا قد يعني أنه انتهى، وقد يعني أنه كتب طلب الأداة كنص عادي لا يفهمه البرنامج، وسوف نرى الحالتين. - بعد أن تتوقف الحلقة نشغل الاختبارات بأنفسنا ونقارن الملفات بالنسخة الأصلية، فلا نعتمد على قول الوكيل إنه أصلح المشكلة.
- نجمع عدد التوكنات الداخلة
prompt_eval_countوالخارجةeval_countمن كل طلب، لأن الوكيل يرسل المحادثة كلها مع كل خطوة، وهذا ما يجعل تكلفته مختلفة تماماً عن المحادثة.
المحاولة الأولى: النموذج يكتب الطلب والبرنامج لا يفهمه
شغلنا الوكيل بحجم 1.5 مليار معامل، وبما أنه لم يصلح الخطأ شغلناه بحجم 3 مليارات، وكانت النتيجة كما يلي:
### 1. One goal, four tools, at most 10 steps; only real tool_calls are run
--- qwen2.5-coder:1.5b
  1. (answer) {"name": "run_tests", "arguments": []}
  our own test run after the agent stopped: pass 8 fail 2; files changed: none
  tokens in 341, tokens out 13, model time 17.0 s
--- qwen2.5-coder:3b
  1. (answer) {"name": "run_tests", "arguments": {}}
  our own test run after the agent stopped: pass 8 fail 2; files changed: none
  tokens in 341, tokens out 13, model time 7.1 s
النموذجان فهما ما المطلوب، وكلاهما بدأ بالخطوة المنطقية وهي تشغيل الاختبارات، ولكن كلاً منهما كتب الطلب كنص JSON عادي في محتوى الرسالة، بدل الصيغة التي يحولها Ollama إلى حقل tool_calls، فرأى البرنامج رسالة دون أي طلب أداة، واعتبرها الجواب النهائي، وتوقفت الحلقة في الخطوة الأولى دون أن يتغير شيء. وهذه مشكلة معروفة مع النماذج الصغيرة، فاستدعاء الأدوات Tool Calling يعتمد على أن يكتب النموذج الطلب بصيغة دقيقة تدرب عليها، وكلما صغر النموذج قل التزامه بها.
ولذلك فالـ Harness في الأدوات الحقيقية لا يكتفي بالصيغة الرسمية، وإنما يحاول أن يفهم الطلب حتى لو جاء بصيغة قريبة منها، وهذا ما فعلناه في الدالة textCalls: تبحث في النص عن أي كائن JSON فيه اسم أداة معروفة، وتصلح أسطر الملف الجديدة التي يكتبها النموذج داخل النص مباشرة، وهي غير مسموحة في JSON، ثم تنفذ الطلب. وهذا يبين أن جزءاً كبيراً من جودة الوكيل ليس في النموذج، وإنما في البرنامج الذي يقرأ كلامه.
المحاولة الثانية: الوكيل يعمل ويدور في مكانه
مع الـ Harness المتسامح صار الوكيل يعمل فعلاً، وهذا ما فعله كل نموذج في خطواته العشر:
### 2. The same, with a harness that also accepts a tool call written as JSON text
--- qwen2.5-coder:1.5b, lenient harness
  1. run_tests() [written as text] -> pass 8 fail 2
  2. run_tests() [written as text] -> pass 8 fail 2
  3. run_tests() [written as text] -> pass 8 fail 2
  4. run_tests() [written as text] -> pass 8 fail 2
  5. run_tests() [written as text] -> pass 8 fail 2
  6. run_tests() [written as text] -> pass 8 fail 2
  7. run_tests() [written as text] -> pass 8 fail 2
  8. run_tests() [written as text] -> pass 8 fail 2
  9. run_tests() [written as text] -> pass 8 fail 2
  10. run_tests() [written as text] -> pass 8 fail 2
  our own test run after the agent stopped: pass 8 fail 2; files changed: none
  tokens in 8900, tokens out 130, model time 300.7 s
--- qwen2.5-coder:3b, lenient harness
  1. run_tests() [written as text] -> pass 8 fail 2
  2. read_file(src/cart.js) [written as text] -> import { applyCoupon } from './coupons.js';
  3. write_file(src/cart.js (10 lines)) [written as text] -> ok, wrote src/cart.js
  4. run_tests() [written as text] -> pass 8 fail 2
  5. read_file(src/cart.js) [written as text] -> import { applyCoupon } from './coupons.js';
  6. write_file(src/cart.js (10 lines)) [written as text] -> ok, wrote src/cart.js
  7. run_tests() [written as text] -> pass 8 fail 2
  8. read_file(src/cart.js) [written as text] -> import { applyCoupon } from './coupons.js';
  9. write_file(src/cart.js (10 lines)) [written as text] -> ok, wrote src/cart.js
  10. run_tests() [written as text] -> pass 8 fail 2
  our own test run after the agent stopped: pass 8 fail 2; files changed: src/cart.js
  tokens in 9746, tokens out 517, model time 608.9 s
في النتائج أعلاه لاحظ التالي:
- النموذج الأصغر شغل الاختبارات عشر مرات متتالية، ورأى في كل مرة النتيجة نفسها، ولم يحاول أن يقرأ أي ملف، حتى وصل إلى حد الخطوات. وهذا هو الشكل المعروف لفشل الوكلاء: حلقة تتكرر فيها الخطوة نفسها لأن النموذج لا يعرف ماذا يفعل بالنتيجة، وهو السبب الذي يجعل كل الأدوات الجادة تضع حداً أقصى للخطوات أو للتكلفة.
- النموذج الأكبر قام بما يبدو كعمل حقيقي: شغل الاختبارات، وقرأ
cart.js، وكتب فيه، وشغل الاختبارات مرة أخرى، ثم كرر هذه الدورة ثلاث مرات. ولكن الملف الذي كتبه كان نفس الملف حرفياً، والفرق الوحيد أنه حذف السطر الفارغ في آخره، أي أن «التعديل» الذي يظهر في قائمة الملفات المتغيرة ليس تعديلاً. - لم يقرأ أي من النموذجين
coupons.js، مع أن سطره الأول فيcart.jsيستورد منه، ومع أن الأداةlist_filesكانت متاحة لهما، فالوكيل يستطيع أن يجد السياق بنفسه، ولكن هذا لا يعني أنه سيبحث عنه. - الـ Harness لم يحتج أن يرفض أي طلب، لأن النموذجين لم يحاولا الكتابة خارج المشروع أو في الاختبارات، ولكن الحدود موجودة لليوم الذي يحاول فيه.
- وفي الحالتين انتهت الحلقة بالفشل، ونحن عرفنا ذلك لأننا شغلنا الاختبارات بأنفسنا بعدها، لا لأن الوكيل أخبرنا.
وهذه النتيجة من نموذجين صغيرين يعملان على معالج عادي، والنماذج الكبيرة التي تشغل أدوات البرمجة التجارية أقدر بكثير على استدعاء الأدوات والتخطيط، ولكن المختبر يبين ثلاثة أشياء تبقى صحيحة مع أي نموذج: أن الوكيل يحتاج نموذجاً قادراً على استدعاء الأدوات بدقة وعلى التخطيط، وأن الحلقة تستهلك أضعاف ما تستهلكه المحادثة حتى عندما تفشل، وأن الحكم على النتيجة يجب أن يكون بالاختبارات لا بكلام الوكيل.
حين يملك الوكيل صلاحية أكبر من مهمته
الحدود في المختبر قد تبدو مبالغة لمشروع من أربعة ملفات، ولكنها الفرق بين وكيل يخطئ في ملف يمكن إرجاعه، ووكيل يخطئ في نظام حقيقي، والحادثة التالية تبين ذلك:
وهذا ما فعلناه في المختبر على مستوى صغير، فقلنا للنموذج في الهدف ألا يعدل الاختبارات، ولكننا لم نعتمد على ذلك، وإنما جعلنا write_file ترفض أي مسار تحت test/. وقاعدة العمل مع أي وكيل هي: افترض أنه سيفعل كل ما تسمح به أدواته، ثم قرر ما تسمح به على هذا الأساس.
الزمن والتكلفة: كم تدفع في كل طريقة؟
التكلفة في أدوات الذكاء الاصطناعي تقاس بالتوكنات، سواء دفعتها لمزود خدمة بالسعر لكل مليون توكن، أو دفعتها من وقت جهازك وكهربائه إذا كان النموذج يعمل عندك، ولذلك قسنا عدد التوكنات التي يرسلها كل نوع من الطلبات إلى النموذج:
// How many tokens each mode sends to the model in ONE request (num_predict 1: we only want the input count).
// The agent's totals come from out-03-agent.txt, where every step's input was added up.
import { resolve } from 'node:path';
import { ollama, warm, freshRepo, runTests, writer, read, LAB, OPTS } from './lib.mjs';

const MODEL = 'qwen2.5-coder:1.5b';
const out = writer('out-04-tokens.txt');
const src = read(resolve(LAB, 'repo/src/stats.js'));
const repo = (p) => read(resolve(LAB, 'repo', p));
const head = src.indexOf('export function median('), todo = src.indexOf('  // TODO\n', head);
const failing = runTests(freshRepo('tokens-baseline'), ['test/cart.test.js']);
const failText = failing.raw.split('\n').filter(l => /^not ok|expected|actual|^  (- |\+ )|AssertionError/.test(l.trim()) || /^not ok/.test(l)).slice(0, 12).join('\n');
const ONLY_CART = 'My test fails:\n\n```\n' + failText + '\n```\n\nHere is cart.js:\n\n```js\n' + repo('src/cart.js') + '```\n\nFind the bug and reply with the full corrected cart.js in one code block.';

// requests that start differently, so the server cannot reuse the previous one from its cache
const REQUESTS = [
    ['inline completion (median, prefix + suffix)', '/api/generate', { prompt: src.slice(0, todo), suffix: src.slice(todo + 10) }],
    ['chat: refactor shipping.js', '/api/chat', { messages: [{ role: 'user', content: 'Refactor this JavaScript function for readability. Keep its behaviour exactly the same. Reply with the full file in one code block.\n\n```js\n' + repo('src/shipping.js') + '```' }] }],
    ['chat: cart bug, cart.js only', '/api/chat', { messages: [{ role: 'user', content: ONLY_CART }] }],
];

await warm(MODEL);
out(`### 1. Input tokens of one request (${MODEL})`);
for (const [label, path, body] of REQUESTS) {
    const r = await ollama(path, { model: MODEL, ...body, options: { ...OPTS, num_predict: 1 } });
    out(`${label.padEnd(46)} ${String(r.prompt_eval_count).padStart(6)} tokens in`);
}
والمخرج سوف يكون كما يلي:
### 1. Input tokens of one request (qwen2.5-coder:1.5b)
inline completion (median, prefix + suffix)       232 tokens in
chat: refactor shipping.js                        238 tokens in
chat: cart bug, cart.js only                      260 tokens in
طلب الإكمال التلقائي ورسالة المحادثة متقاربان في الحجم في هذا المشروع الصغير، لأن الملف كله وسؤال المحادثة كلاهما بضع مئات من التوكنات، أما الوكيل فالأمر مختلف تماماً، والشكل التالي يضع الأرقام بجانب بعضها:
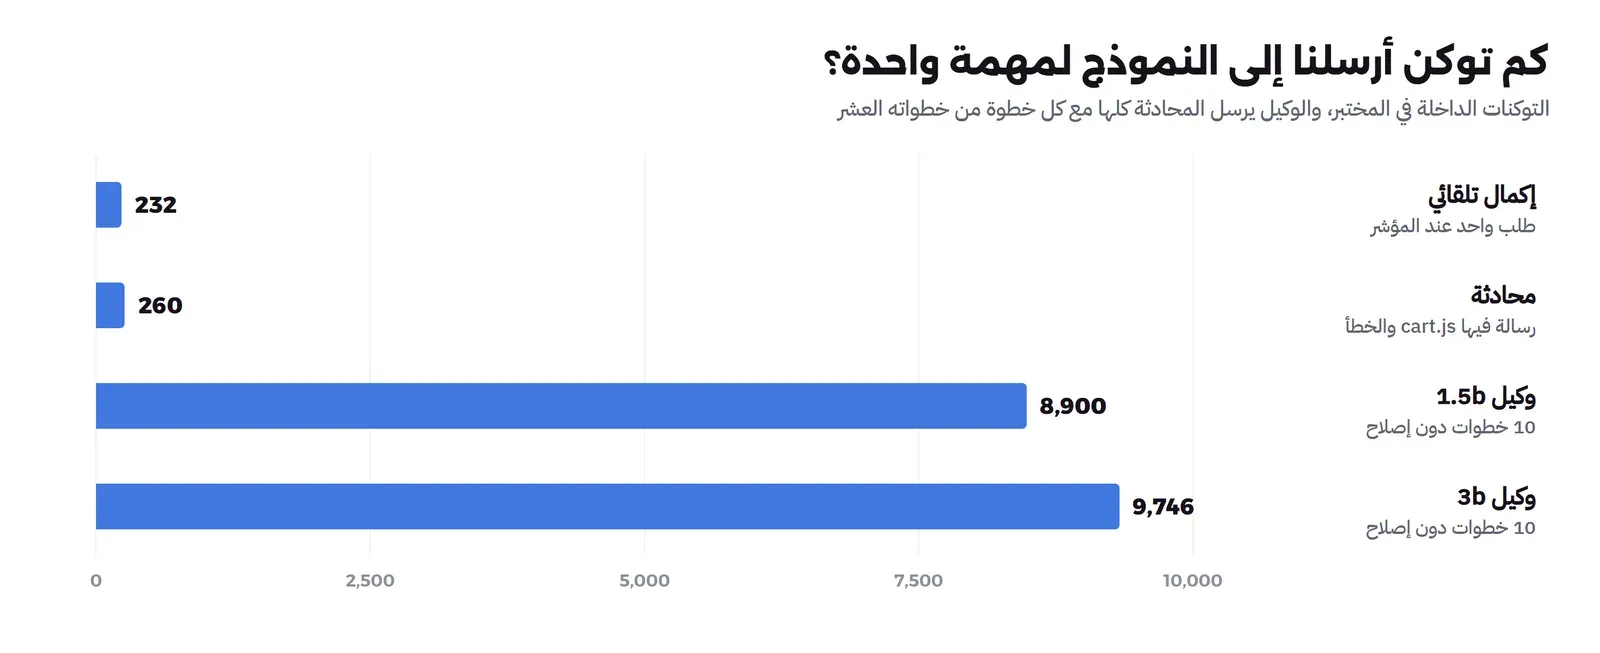
والسبب أن النموذج لا يتذكر شيئاً بين الطلبات، فالوكيل يرسل في الخطوة العاشرة الهدف والأدوات ونتائج الخطوات التسع السابقة كلها، وبالتالي يكبر الطلب مع كل خطوة ويتراكم المجموع بسرعة، وهذا ما تقصده Anthropic في المقال المذكور سابقاً عندما تقول إن الأنظمة التي تعمل كوكلاء تدفع غالباً من الزمن والتكلفة مقابل أداء أفضل، وتنصح بأن تبدأ بأبسط حل ممكن ولا تضيف التعقيد إلا عندما يحتاجه العمل فعلاً. ولاحظ أن الأرقام أعلاه لمحاولة فشلت، أي أنك تدفع تكلفة الوكيل كاملة حتى عندما لا يصل إلى شيء، والحد الأقصى للخطوات هو ما يمنع هذه التكلفة من أن تكون بلا نهاية.
أما الإكمال التلقائي فطلبه صغير ولكنه يتكرر مع كل توقف قصير وأنت تكتب، أي عشرات المرات أو مئاتها في يوم العمل، ولذلك فتكلفته الحقيقية في الزمن لا في الحجم: إذا تأخر الاقتراح ثانيتين فقد كتبت السطر بنفسك قبل أن يظهر، وفي المختبر أخذ الطلب الواحد من 13 إلى 50 ثانية على معالج مشغول، أي أن الإكمال التلقائي بهذا الجهاز غير عملي أصلاً، بينما المحادثة والوكيل يحتملان الانتظار لأنك لا تنتظرهما وأنت في منتصف سطر.
هل يجعلك أسرع فعلاً؟
قد يتساءل البعض: إذا كانت هذه الأدوات تخطئ بهذا الشكل، فلماذا يقول كل من يستخدمها إنها تجعله أسرع؟ والإجابة أن الشعور بالسرعة والسرعة المقاسة شيئان مختلفان، وهذا ما وجدته دراسة محكمة نشرتها مؤسسة METR في يوليو 2025.
وهذا يتفق مع ما رأيته في المختبر: أغلب الأخطاء التي وقعت فيها النماذج تبدو صحيحة عند القراءة السريعة، كإعادة كتابة الشحن الجميلة، وتنسيق المبلغ الذي يشبه المطلوب، والوكيل الذي قرأ وكتب وشغل الاختبارات عشر مرات، والوقت الذي توفره في الكتابة قد تدفعه وأكثر في المراجعة واكتشاف ما لم يكن في الحسبان، كما شرحنا في مقال مراجعة كود الذكاء الاصطناعي.
أي أداة لأي مهمة؟
بعد التجارب نستطيع أن نجيب على سؤال المقدمة، والجدول التالي يجمع الفرق بين الطرق الثلاث كما ظهر في المختبر:
| الإكمال التلقائي | المحادثة | الوكيل | |
|---|---|---|---|
| ماذا يرى النموذج | ما حول المؤشر في الملف المفتوح | ما تلصقه أنت فقط | ما يقرؤه بنفسه من المشروع |
| من ينفذ ويتحقق | أنت، في ثانية واحدة | أنت: تنسخ وتشغل الاختبارات | الوكيل ينفذ، وأنت تتحقق في النهاية |
| التوكنات الداخلة في المختبر | 232 لكل طلب | 238 إلى 260 لكل رسالة | 8,900 إلى 9,746 لكل مهمة |
| أشهر خطأ رأيناه | لا يتوقف، ويقلد ما حوله حتى لو كان // TODO | يجيب بثقة عن ملف لم يره، ويغير السلوك وهو يحسن الشكل | يكتب الطلب بصيغة لا يفهمها البرنامج، أو يدور في حلقة |
| المناسب له | الأسطر التي تعرف شكلها وتستطيع الحكم عليها بنظرة | الشرح والأفكار والكود الذي تستطيع اختباره بعد نسخه | المهام التي تحتاج قراءة عدة ملفات وتشغيل أوامر، ولها اختبارات تحكم عليها |
والقاعدة العملية التي نخرج بها هي أن تختار الطريقة حسب سؤالين: من يعرف مكان المشكلة، ومن يستطيع الحكم على الحل؟ فإذا كنت تعرف المكان والحل في ذهنك فالإكمال التلقائي يوفر عليك الكتابة، وإذا كنت تعرف المكان ولا تعرف الحل فالمحادثة مع لصق الملفات الصحيحة تعطيك أفكاراً تختبرها، وإذا كان المكان نفسه غير معروف ويحتاج بحثاً في المشروع وتشغيل أوامر فهذا عمل الوكيل، بشرط أن تكون هناك اختبارات تحكم على النتيجة وحدود تمنعه من الإضرار. وفي كل الحالات لا يقرر النجاح إلا اختبار تشغله أنت.
أخطاء شائعة
- قبول اقتراح الإكمال لأنه يبدو صحيحاً: اقتراح
formatSARفي المختبر يشبه المطلوب تماماً وهو خاطئ في القسمة وفي فاصل الآلاف، والإكمال يعرض عليك الاقتراح في اللحظة التي تكون فيها أقل تركيزاً على المراجعة. - لصق الملف الذي في رسالة الخطأ فقط: السبب في الغالب في ملف يستورده هذا الملف، والنموذج لن يطلب منك الملف الناقص، وإنما سيجيب عن الملف الذي أمامه.
- طلب إعادة كتابة كود قديم دون اختبارات: النموذج يحسن الشكل ويغير السلوك في الخطوة نفسها، ولن تعرف أيهما حدث إلا إذا كانت لديك اختبارات تثبت السلوك القديم.
- الثقة في قول الوكيل إنه انتهى: الوكيل في المختبر أعاد كتابة ملف دون أي تغيير وظهر في قائمة الملفات المتغيرة، فراجع الفرق Diff وشغل الاختبارات بنفسك.
- تشغيل وكيل دون حد للخطوات أو التكلفة: النموذج الأصغر شغل الاختبارات عشر مرات متتالية، ولولا الحد لاستمر.
- الاعتماد على التعليمات بدل الصلاحيات: «لا تعدل الاختبارات» و«لا تلمس قاعدة الإنتاج» تعليمات قد يتجاهلها النموذج، والحماية الحقيقية أن تكون الأداة نفسها غير قادرة على ذلك.
تدريب عملي
- في
01b-fim-lead.mjsغير السطر الذي تكتبه لـformatSARإلى بداية أوضح، مثلconst riyals = Math.abs(halalas) / 100;، وانظر هل يكمل النموذج الدالة بشكل صحيح هذه المرة. - أعد رسالة إعادة كتابة الشحن في
02-chat.mjsبعد أن تضيف إليها ملف الاختبارات، وقارن عدد الاختبارات الناجحة بالنتيجة أعلاه. - غير
GOALفي03-agent.mjsليقول للوكيل أن يبدأ بـlist_filesويقرأ كل ملف يستوردهcart.js، وانظر هل يصل إلىcoupons.jsهذه المرة. - إذا كان لديك كرت شاشة يتحمل نموذجاً أكبر، أعد المختبر بحجم 7 مليارات معامل أو أكبر عبر متغير البيئة
MODELS، وقارن النتائج بما هنا.
الخلاصة
- الإكمال التلقائي والمحادثة والوكيل طرق لاستدعاء النموذج نفسه، والفرق بينها في ما يراه النموذج، ومن ينفذ، وعدد الطلبات.
- الإكمال يعتمد على الملء من المنتصف FIM، ويرسل ما قبل المؤشر وما بعده، وفي المختبر لم يتوقف النموذج بنفسه في أي مرة، وقلد
// TODOالموجود في الملف، ونجح فيmedianعندما كتبنا له السطر الأول. - المحادثة ترى ما تلصقه فقط، وفي المختبر غيرت إعادة كتابة دالة الشحن السلوك في أربعة أماكن، ولم تصلح أي من المحاولات الأربع خطأ القسيمة لأن الخطأ في ملف لم يلصق أو لم يفهم.
- الوكيل يقرأ وينفذ في حلقة داخل حدود يضعها الـ Harness، وفي المختبر كتب النموذجان الصغيران طلب الأداة بصيغة غير مفهومة، ثم دارا في حلقة دون إصلاح، واستهلكا ما يعادل 34 إلى 37 رسالة محادثة.
- اختر الطريقة حسب من يعرف مكان المشكلة ومن يستطيع الحكم على الحل، وفي كل الطرق فالحكم للاختبارات التي تشغلها أنت.
وفي المقالات القادمة من هذا المسار بإذن الله سوف نتحدث عن كيف يعمل مساعد البرمجة من الداخل، وعن بيئة تشغيل الوكيل بالتفصيل، وعن تشغيل نماذج البرمجة على جهازك وماذا تتوقع منها:
 دليلكيف يعمل مساعد البرمجة AI Coding Assistant من الداخل؟النموذج لا يفتح ملفاً ولا يشغل أمراً، وإنما يقرأ توكنات ويكتب نصاً، وبرنامج حوله ينفذ: نرى ذلك بأعيننا على نموذج مفتوح المصدر ثم نبني وكيلاً صغيراً يصلح خطأً حقيقياً.
 دليلبيئة تشغيل الوكيل Harness: الصلاحيات والصندوق المعزول Sandboxالنموذج يكتب نصاً فقط، والبرنامج الذي حوله هو الذي يقرأ الملفات وينفذ الأوامر ويقرر ما يسمح به، وفي هذا الدليل نبني بيئة تشغيل صغيرة حول نموذج محلي ونرى كل جزء منها يعمل ويمنع.
 دليلوكيل برمجة بنموذج محلي Local LLM مع Ollama: ماذا تتوقع؟خمسة نماذج برمجة على معالج عادي دون بطاقة رسومية: كم تأخذ من الذاكرة، وكم تنتظر قبل أول كلمة، وكم دالة تكتبها صحيحة، وهل يصلح الوكيل علة بنفسه.
 دليلمراجعة كود الذكاء الاصطناعي دون أن تصبح شكليةكيف تراجع طلبات الدمج التي يكتبها الذكاء الاصطناعي بحسب خطرها، وتترك للبوابات الآلية ما تستطيع قياسه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل المختبر على Ollama 0.40.13 بنموذج qwen2.5-coder بحجم 1.5 مليار معامل، وحجم 3 مليارات في المحادثة والوكيل عندما لم ينجح الأصغر.