في OpenTelemetry للمطورين وصل فريق المتجر إلى Traces كاملة: خدمة الدفع بلغة Node.js، وخدمة الأسعار بلغة Python، وعامل الإيميل خلف طابور Redis، كلها في Trace واحد. ثم جاءت أول عطلة نهاية أسبوع، فحدث أحد الزملاء سيرفر المراقبة وأعاد تشغيل Jaeger، وفي صباح الأحد كتب عميل للدعم عن طلب فشل مساء الجمعة، ففتح الفريق Jaeger فوجده فارغاً تماماً. والسبب بسيط: Jaeger كان يعمل بالإعداد الافتراضي الذي يحفظ في الذاكرة، وهو الإعداد الذي استخدمناه في كل التجارب حتى الآن. وفي الأسبوع نفسه ظهر سؤالان آخران: طلبات فحص الصحة من موزع الطلبات Load Balancer تملأ Jaeger بآلاف ال Traces التي لا يريدها أحد، والمدير يريد شاشة تقول له زمن الاستجابة ونسبة الأخطاء لكل خدمة دون أن يفتح Traces واحداً واحداً.
وقد شرحنا في التتبع الموزع Distributed Tracing المفاهيم الأساسية، واستخدمنا واجهة Jaeger للبحث عن Span بطيء وSpan فاشل، فلن نعيد ذلك هنا. وهذا المقال عن Jaeger نفسه كأداة تشغلها في الإنتاج: كيف بني الإصدار الثاني، وأين يخزن، وكم يأخذ من القرص والذاكرة، وكيف تتحكم في العينة من مكان واحد، وكيف تحول ال Traces إلى لوحة أداء الخدمات.
وسوف نناقش في هذا المقال ما يلي:
- Jaeger v2 من الداخل: لماذا أصبح مبنياً على OpenTelemetry Collector، وماذا تغير عن الإصدار الأول.
- خيارات التخزين، ومختبر بتخزين Badger على القرص، ومشكلة صلاحيات واجهتنا في أول تشغيل.
- كم أخذ 24 ألف Trace من القرص والذاكرة، ولماذا قال المقياس إن الملف 2 GB وهو في الحقيقة 4 KB.
- إعادة التشغيل والاحتفاظ TTL: ماذا بقي وماذا حذف، بأوقات حقيقية.
- العينة البعيدة Remote Sampling من ملف واحد، وثلاث مشكلات واجهتنا فيها، أهمها أن القرار يتخذ قبل أن يعرف ال Span اسمه.
- لوحة أداء الخدمات SPM من ال Spans مع Prometheus، وخريطة الخدمات، والواجهة البرمجية API v3.
Jaeger v2: أداة تتبع مبنية على OpenTelemetry Collector
بدأ Jaeger في شركة Uber كما ذكرنا في المقال السابق، وكان الإصدار الأول مجموعة برامج منفصلة: Agent على كل سيرفر يستقبل ال Spans، وCollector يكتبها في التخزين، وQuery يعرض الواجهة، وIngester يقرأ من Kafka، وبرنامج all-in-one يجمعها للتجارب. ولكل برنامج أعلامه ومتغيراته، وكانت مكتبات Jaeger الخاصة هي التي تنتج ال Spans. ثم أصبح OpenTelemetry هو الطريقة المعيارية لإنتاج التتبع، وأصبح OpenTelemetry Collector هو البرنامج الذي يعرفه الجميع للاستقبال والمعالجة، فلم يعد منطقياً أن يحافظ Jaeger على نسخة خاصة من كل هذا. ولذلك يقول توثيق الإصدار 2.22 إن الإصدار الثاني معمارية جديدة تستخدم إطار OpenTelemetry Collector أساساً، وتضيف إليه ما يخص Jaeger. والصورة التالية تبين ما يعنيه ذلك:
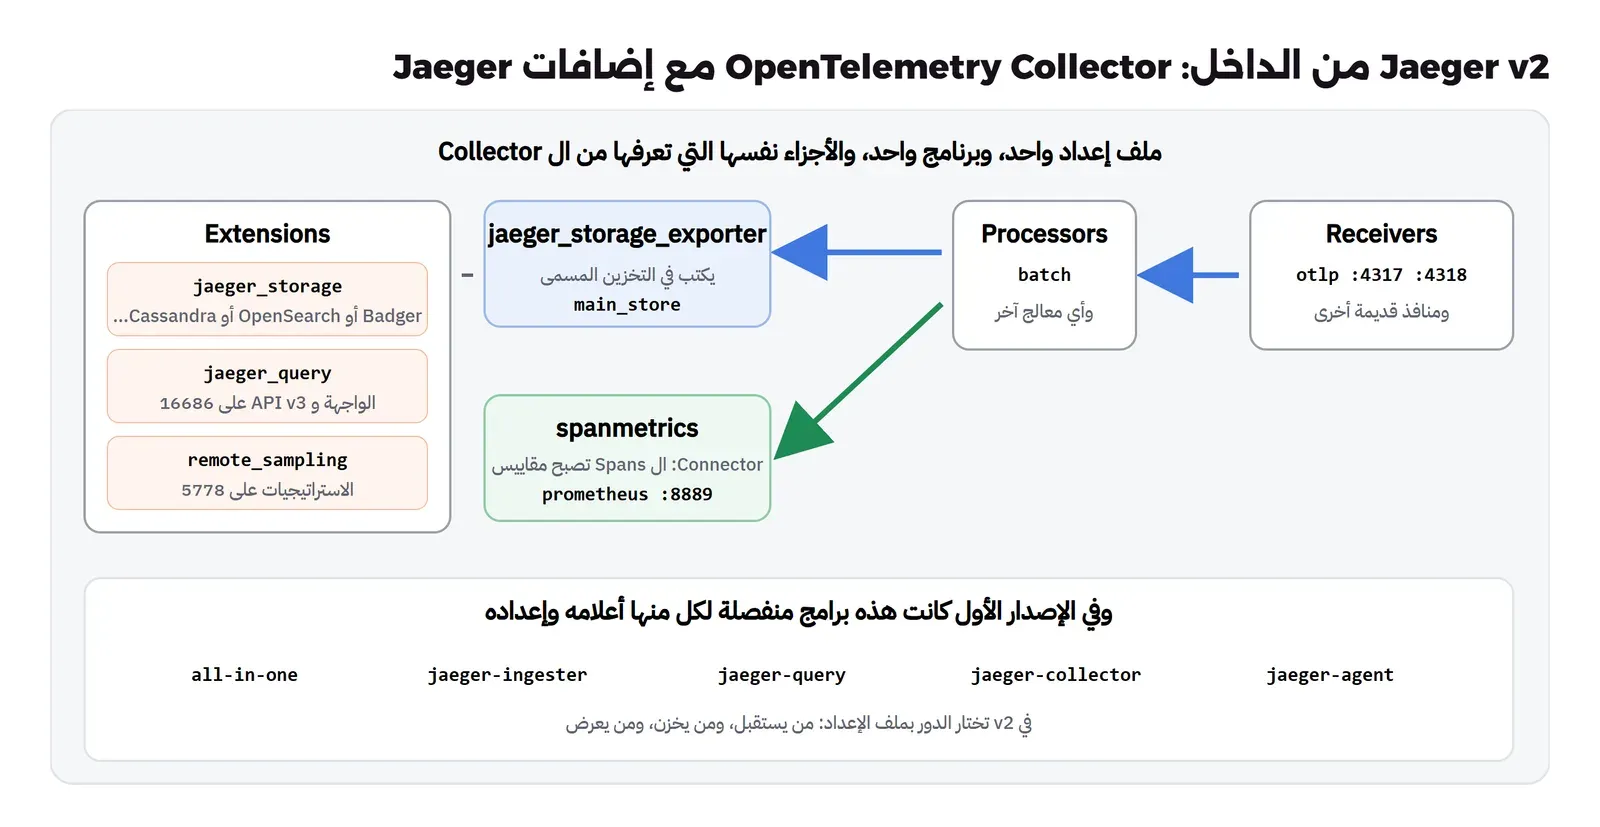
وفيما يلي ما يعنيه ذلك لك عملياً:
- ملف YAML واحد: فيه المستقبلات والمعالجات والمصدرات وال Pipelines بالصيغة نفسها التي كتبناها لل Collector في المقال السابق، ومعها إضافات Extensions خاصة بJaeger:
jaeger_storageللتخزين، وjaeger_queryللواجهة والبحث، وremote_samplingللعينة. - الدور يحدده الإعداد: نفس البرنامج يعمل كل شيء في سيرفر واحد، أو يستقبل فقط ويكتب في التخزين، أو يعرض الواجهة فقط، بحسب ما تضعه في الملف، بدل خمسة برامج مختلفة.
- يستقبل OTLP مباشرة: فتستطيع أن ترسل من ال SDK إلى Jaeger دون Collector في المنتصف، كما سوف نفعل في هذا المختبر، أو تضع Collector أمامه كما فعلنا في المقال السابق إذا أردت المعالجات والحماية.
- معالجات ال Collector متاحة: مثل معالج الحذف ومعالج العينة في النهاية، لأنها أجزاء من الإطار نفسه، فلا تحتاج برنامجاً آخر لها في الأنظمة الصغيرة.
أين يخزن Jaeger ال Traces؟ اختيار التخزين Storage
التخزين هو القرار الأهم في تشغيل Jaeger، لأنه يحدد ماذا يبقى بعد إعادة التشغيل، وكم تدفع للقرص، وهل تستطيع أن تشغل أكثر من نسخة. ويذكر التوثيق الخيارات التالية، ووجدنا في مستودع الإصدار 2.22 ملفات إعداد جاهزة لكل منها:
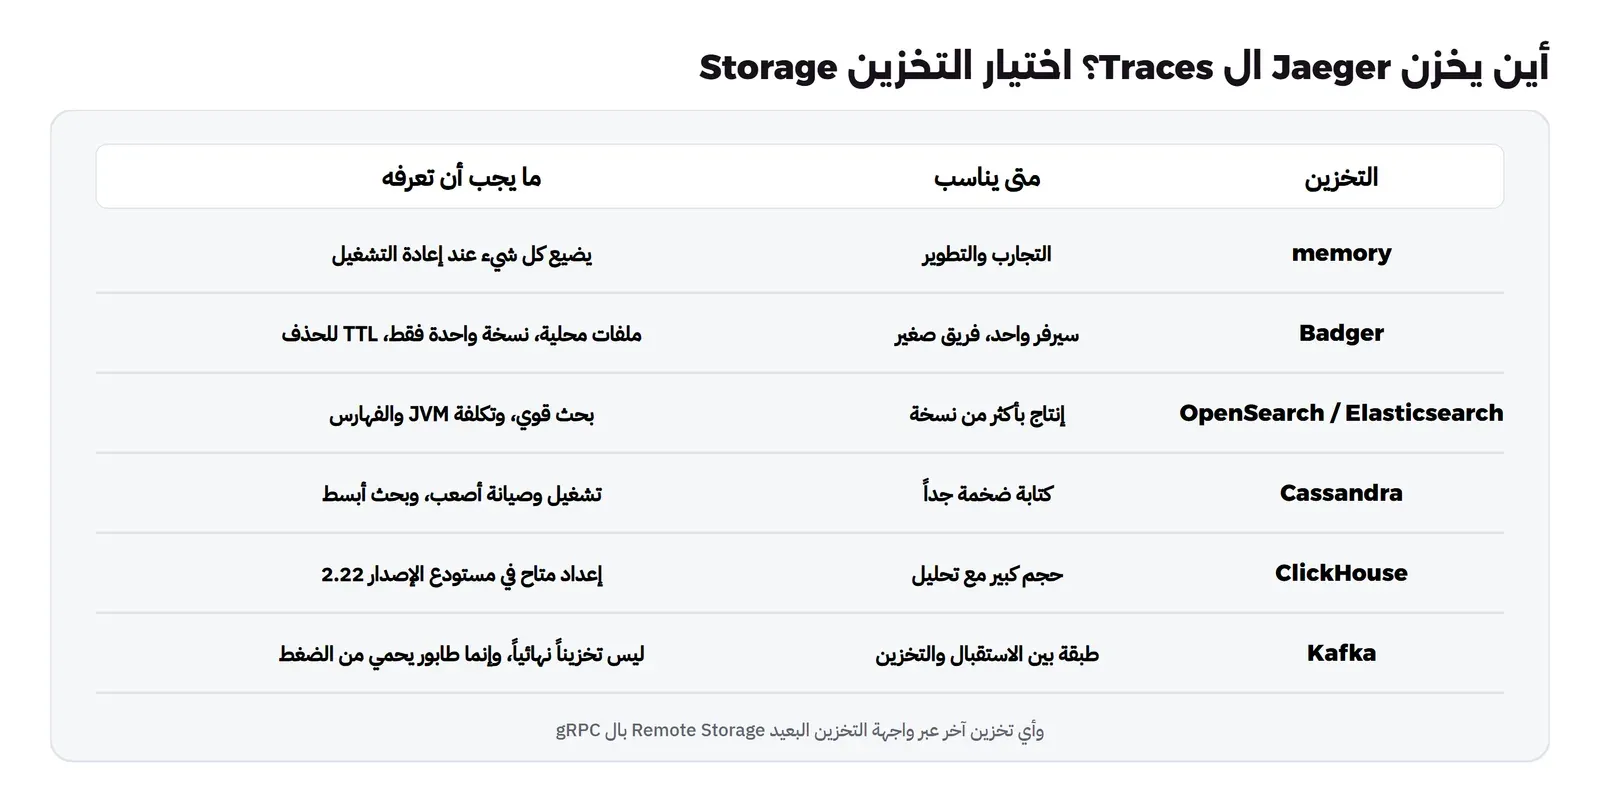
وفي قصتنا فريق صغير بسيرفر مراقبة واحد، فالاختيار الطبيعي هو Badger، وهو قاعدة مفتاح وقيمة مكتوبة بلغة Go تعمل داخل عملية Jaeger نفسها وتحفظ في ملفات محلية، فلا تحتاج قاعدة بيانات منفصلة. ويذكر التوثيق قيدين يجب أن تعرفهما من البداية: أنه مناسب لنسخة واحدة فقط ولا يتوسع أفقياً، وأن ملفاته لا يمكن أن تتشارك بين برنامج يكتب وبرنامج يعرض، لذلك يستخدم مع التشغيل الكامل في برنامج واحد. فإذا احتجت أكثر من نسخة لأن Jaeger أصبح مهماً لا يجوز أن يتوقف، فالخيار هو OpenSearch أو Elasticsearch، وقد شرحنا تشغيل OpenSearch وتكلفته في مقالات السجلات.
وقد يتساءل البعض: متى يصبح Badger صغيراً على فريقي؟ والإجابة في ثلاثة أسئلة: هل يجب أن يبقى البحث في ال Traces متاحاً عندما يتوقف سيرفر المراقبة للصيانة؟ هل تحتاج أن تحتفظ بأسابيع من التتبع لحركة كبيرة لا يتسع لها قرص سيرفر واحد؟ هل تريد أن تفصل الاستقبال عن البحث حتى لا يبطئ مستخدم يبحث في شهر كامل عملية الكتابة؟ فإذا كانت الإجابة لا عن الثلاثة، وهي كذلك في أغلب الفرق الصغيرة والمتوسطة، فBadger على قرص SSD جيد يكفي، وتكلفته صفر غير القرص. وإذا كانت نعم عن أحدها فالانتقال إلى OpenSearch يعني عقداً إضافية وذاكرة JVM وفهارس يومية تحتاج سياسة دورة حياة، فاحسب ذلك قبل أن تبدأ به من اليوم الأول لأن «الإنتاج يحتاج Elasticsearch». وفي الحالتين يبقى ما تكتبه الخدمات كما هو، لأنها ترسل OTLP، والتغيير في ملف إعداد Jaeger وحده.
المختبر Lab: Jaeger بتخزين Badger مع Prometheus
استخدمنا المتجر نفسه من المقال السابق، مع تغييرين: الخدمات ترسل مباشرة إلى Jaeger دون Collector، وخدمة الدفع فيها مسار لفحص الصحة /health كما يطلبه أي موزع طلبات. وأضفنا Prometheus 3.15.1 من أجل لوحة الأداء. والإصدارات هي Jaeger 2.22.0، وOpenTelemetry JS 0.300.0 على Node.js 22.23.4، وOpenTelemetry Python 1.45.2، وRedis 8.10.3، وكل ال Containers أسماؤها تبدأ بـ dv2m-.
وهذا ملف إعداد Jaeger كاملاً، ونشرحه جزءاً جزءاً في الأقسام التالية:
# Jaeger 2.22.0 as a single binary: OTLP in, Badger on disk, remote sampling from a file, SPM metrics via spanmetrics + Prometheus.
service:
  extensions: [jaeger_storage, jaeger_query, remote_sampling, healthcheckv2]
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [jaeger_storage_exporter, spanmetrics]
    metrics/spanmetrics:
      receivers: [spanmetrics]
      exporters: [prometheus]
  telemetry:
    resource:
      service.name: jaeger
    metrics:
      level: detailed
      readers:
        - pull:
            exporter:
              prometheus:
                host: 0.0.0.0
                port: 8888
    logs:
      level: info

extensions:
  healthcheckv2:
    use_v2: true
    http:
  jaeger_query:
    storage:
      traces: main_store
      metrics: prom_store
  jaeger_storage:
    backends:
      main_store:
        badger:
          directories:
            keys: /badger/keys
            values: /badger/values
          ephemeral: false
          ttl:
            spans: ${env:SPAN_TTL:-48h}
    metric_backends:
      prom_store:
        prometheus:
          endpoint: http://dv2m-prom:9090
          normalize_calls: true
          normalize_duration: true
  remote_sampling:
    file:
      path: /etc/jaeger/sampling/strategies.json
      reload_interval: 10s        # 0 (the default) means the file is read once at start
    http:
      endpoint: 0.0.0.0:5778

connectors:
  spanmetrics:
    metrics_flush_interval: 15s

receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch:

exporters:
  jaeger_storage_exporter:
    trace_storage: main_store
  prometheus:
    endpoint: 0.0.0.0:8889
في الإعداد أعلاه لاحظ التالي:
- التخزين له اسم نختاره نحن
main_store، وكل جزء يشير إليه بالاسم: المصدر يكتب فيه، والواجهة تقرأ منه. وهذا يسمح بأكثر من تخزين في الملف نفسه، مثل تخزين أرشيف Archive بمدة احتفاظ أطول للTraces التي تحفظها يدوياً من الواجهة. ttl.spansهي مدة الاحتفاظ، وجعلناها من متغير بيئة بقيمة افتراضية 48 ساعة حتى نغيرها في التجربة دون أن نعدل الملف.- Jaeger يرسل تتبعه الخاص ومقاييسه الداخلية على المنفذ 8888، وسوف نقرأ منها عدد ال Spans وحجم Badger، ولاحظ أنه ظهر في قائمة الخدمات باسم
jaegerلأنه يتتبع طلبات واجهته أيضاً.
مشكلة واجهتنا: Badger لا يستطيع إنشاء مجلده Permission Denied
في أول تشغيل بالأمر docker compose -p dv2m-jaeger up -d --build توقف Jaeger بعد ثانية:
Error: failed to start extensions: cannot find factory for trace storage main_store: failed to initialize storage 'main_store':
  failed to initialize storage 'main_store': Error Creating Dir: "/badger/keys" err: mkdir /badger/keys: permission denied
والسبب أن Image Jaeger تعمل بمستخدم غير root، فسألنا Docker عنه:
docker image inspect jaegertracing/jaeger:2.22.0 --format '{{.Config.User}}'10001أما ال Volume الجديد فينشئه Docker مملوكاً لل root، فلم يستطع المستخدم 10001 أن ينشئ فيه مجلداً. وهذا تصرف صحيح من Image Jaeger، لأن البرنامج الذي يستقبل بيانات من الشبكة لا يجب أن يعمل بصلاحيات root، فالحل ليس أن تشغله كroot وإنما أن تعطيه ال Volume. فأضفنا Container صغيراً يعمل مرة واحدة قبله ويغير المالك:
  badger-init:                       # the Jaeger image runs as a non-root user: give it the volume first
    image: alpine:3.24
    container_name: dv2m-badger-init
    command: ["chown", "-R", "10001:10001", "/badger"]
    volumes: ["dv2m-badger:/badger"]
  jaeger:
    image: jaegertracing/jaeger:2.22.0
    ...
    depends_on:
      badger-init: { condition: service_completed_successfully }
وبعدها ظهر في السجل أن Badger فتح ملفاته، وأن الإضافات بدأت. وإذا شغلت Jaeger على سيرفر مباشرة بدل Docker فالمشكلة نفسها تظهر عندما يكون مجلد البيانات مملوكاً لمستخدم آخر، والتوثيق يشير إلى دليل لحلها في صفحة Badger.
كم يأخذ Badger من القرص Disk مع الذاكرة RAM؟
أرسلنا عشرين ألف طلب دفع بثمانية طلبات متوازية، ثم أربعة آلاف بعدها، وكل طلب ينتج عشرة Spans من ثلاث خدمات:
requests=20000 parallel=8 errors=0 seconds=193.7 p50=70.3 p95=134.6 p99=182.7
requests=4000 parallel=2 errors=0 seconds=91.0 p50=38.6 p95=80.5 p99=114.2
وانتظرنا حتى أنهى العامل كل المهام في الطابور، وهذا أخذ قرابة عشرين دقيقة لأن العامل يعالج مهمة كل 50 ملي ثانية، ثم قسنا مجلد Badger:
docker run --rm -v dv2m-jaeger_dv2m-badger:/b alpine:3.24 sh -c 'du -s -k /b/keys /b/values; ls -la /b/values'172084 /b/keys
20 /b/values
-rw-r--r-- 1 10001 10001 20 Nov 3 21:16 000002.vlog
-rw-r--r-- 1 10001 10001 2147483646 Nov 3 21:16 000003.vlogثم قرأنا مقاييس Jaeger نفسها:
jaeger_storage_badger_size_bytes_lsm{name="main_store",role="tracestore"} 1.69178999e+08
jaeger_storage_badger_size_bytes_vlog{name="main_store",role="tracestore"} 2.147483666e+09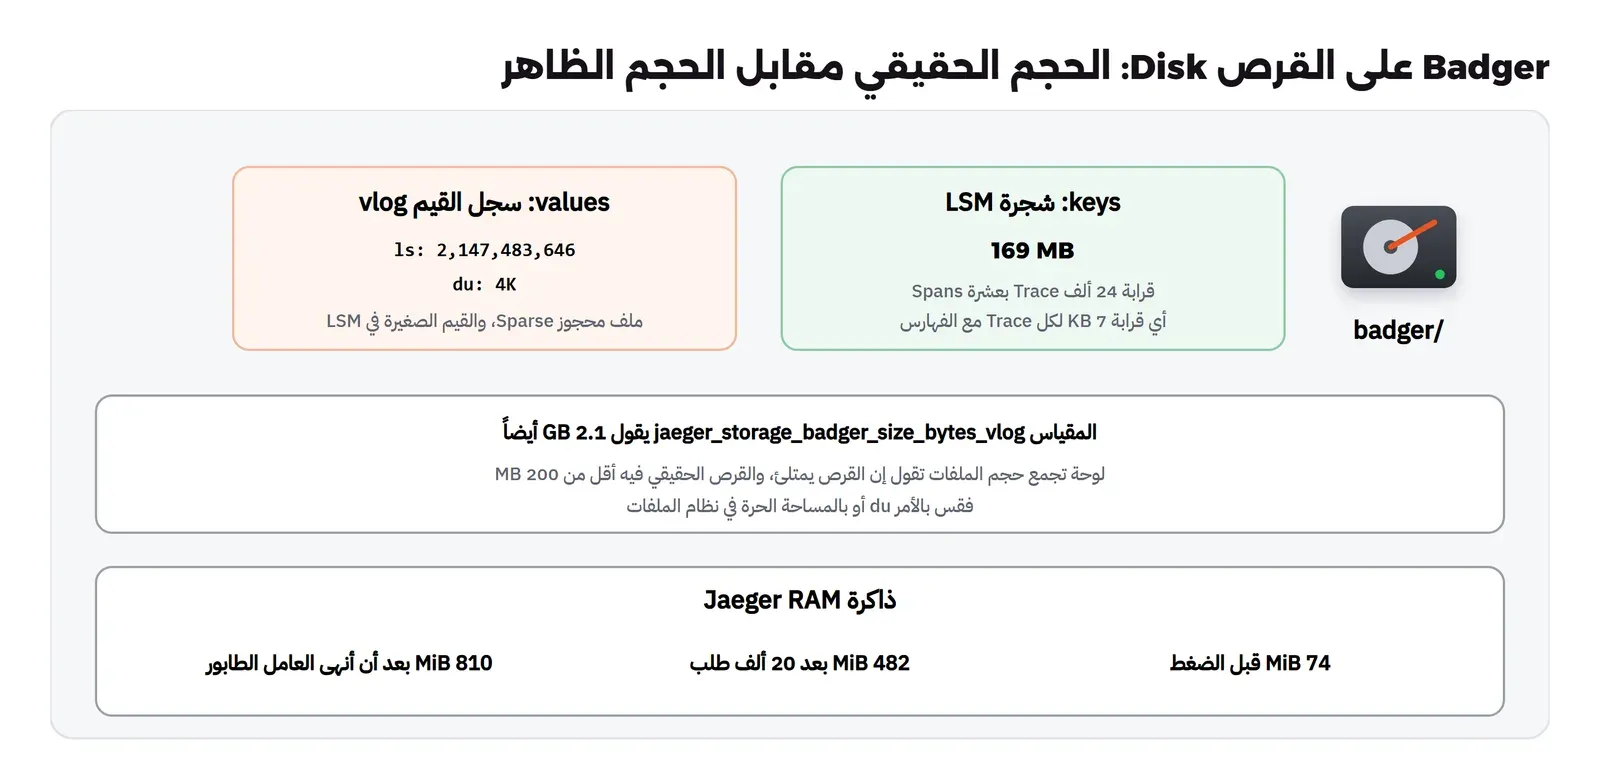
في النتائج أعلاه لاحظ التالي:
- الحجم الحقيقي: شجرة LSM في مجلد keys أخذت 169 MB لقرابة 24 ألف Trace، أي قرابة 7 KB لكل Trace من عشرة Spans، وهذا يشمل الفهارس التي يكتبها Jaeger ليبحث بالخدمة والعملية والمدة والخصائص، فقد سجل عداد الكتابة في Badger أكثر من 600 ألف عملية كتابة لـ 42 ألف Span بعد آخر إعادة تشغيل، أي قرابة 14 مفتاحاً لكل Span. وبهذا الرقم تستطيع أن تحسب: مليون Trace في اليوم تحتاج قرابة 7 GB في اليوم، وبمدة احتفاظ يومين قرابة 14 GB.
- الحجم الظاهر: ملف القيم
000003.vlogيظهر بحجم 2 GiB بالأمرlsوبالمقياسsize_bytes_vlog، ولكنه يأخذ 4 KB فقط على القرص، لأن Badger يحجز الملف مسبقاً كملف متفرق Sparse، ويضع القيم الصغيرة مثل Spans مباشرة في شجرة LSM. فإذا بنيت لوحة على هذا المقياس أو على مجموع أحجام الملفات فسوف تقول لك إن القرص يمتلئ وهو ليس كذلك، فقس بالأمرduأو بالمساحة الحرة في نظام الملفات كما في مقاييس السيرفرات. - الذاكرة: بدأ Jaeger بـ 74 MiB، ووصل إلى 482 MiB بعد عشرين ألف طلب، ثم 810 MiB بعد أن وصلت كل Spans العامل، والسبب أن Badger يحتفظ بجداول في الذاكرة Memtables وذاكرة مؤقتة للكتل، وكلما زاد ما يكتب زاد ما يحفظه. فلا تحكم على ذاكرة Jaeger وهو فارغ، واترك له هامشاً على سيرفر المراقبة.
كيف يبحث Jaeger؟ الفهارس Indexes داخل Badger
رأينا أن كل Span كلف قرابة 14 كتابة في Badger، فما هذه الكتابات؟ قرأنا ملف كاتب ال Spans في تخزين Badger فوجدنا أنه يكتب لكل Span مفتاحاً يحمل ال Span نفسه، ثم فهارس ثانوية بمفاتيح فقط دون قيمة:
	entriesToStore = append(
		entriesToStore,
		trace,
		w.createBadgerEntry(createIndexKey(serviceNameIndexKey, []byte(span.Process.ServiceName), startTime, span.TraceID), nil, expireTime),
		w.createBadgerEntry(createIndexKey(operationNameIndexKey, []byte(span.Process.ServiceName+span.OperationName), startTime, span.TraceID), nil, expireTime),
	)
	...
	for _, kv := range span.Tags {
		// Convert everything to string since queries are done that way also
		// KEY: it<serviceName><tagsKey><traceId> VALUE: <tagsValue>
		entriesToStore = append(entriesToStore, w.createBadgerEntry(createIndexKey(tagIndexKey, []byte(span.Process.ServiceName+kv.Key+kv.AsString()), startTime, span.TraceID), nil, expireTime))
	}

	for _, kv := range span.Process.Tags {
		entriesToStore = append(entriesToStore, w.createBadgerEntry(createIndexKey(tagIndexKey, []byte(span.Process.ServiceName+kv.Key+kv.AsString()), startTime, span.TraceID), nil, expireTime))
	}
في الكود أعلاه لاحظ التالي:
- لكل Span فهرس بالخدمة، وفهرس بالخدمة مع اسم العملية، وفهرس بالمدة، وهذه هي الحقول التي تبحث بها في الواجهة: الخدمة، والعملية، وأقل مدة وأكثر مدة.
- ثم فهرس لكل خاصية في ال Span، ولكل خاصية في المورد Resource، ولكل حقل في كل حدث Event. والمفتاح يبدأ بالخدمة ثم اسم الخاصية وقيمتها ثم الوقت ومعرف ال Trace، فالبحث عن
error=trueفي خدمة الدفع هو قراءة مجال من المفاتيح المرتبة، وليس قراءة كل ال Spans. - كل هذه المفاتيح تحمل وقت الانتهاء نفسه
expireTime، وهذا ما رأيناه في تجربة TTL: الفهرس وال Span يختفيان معاً.
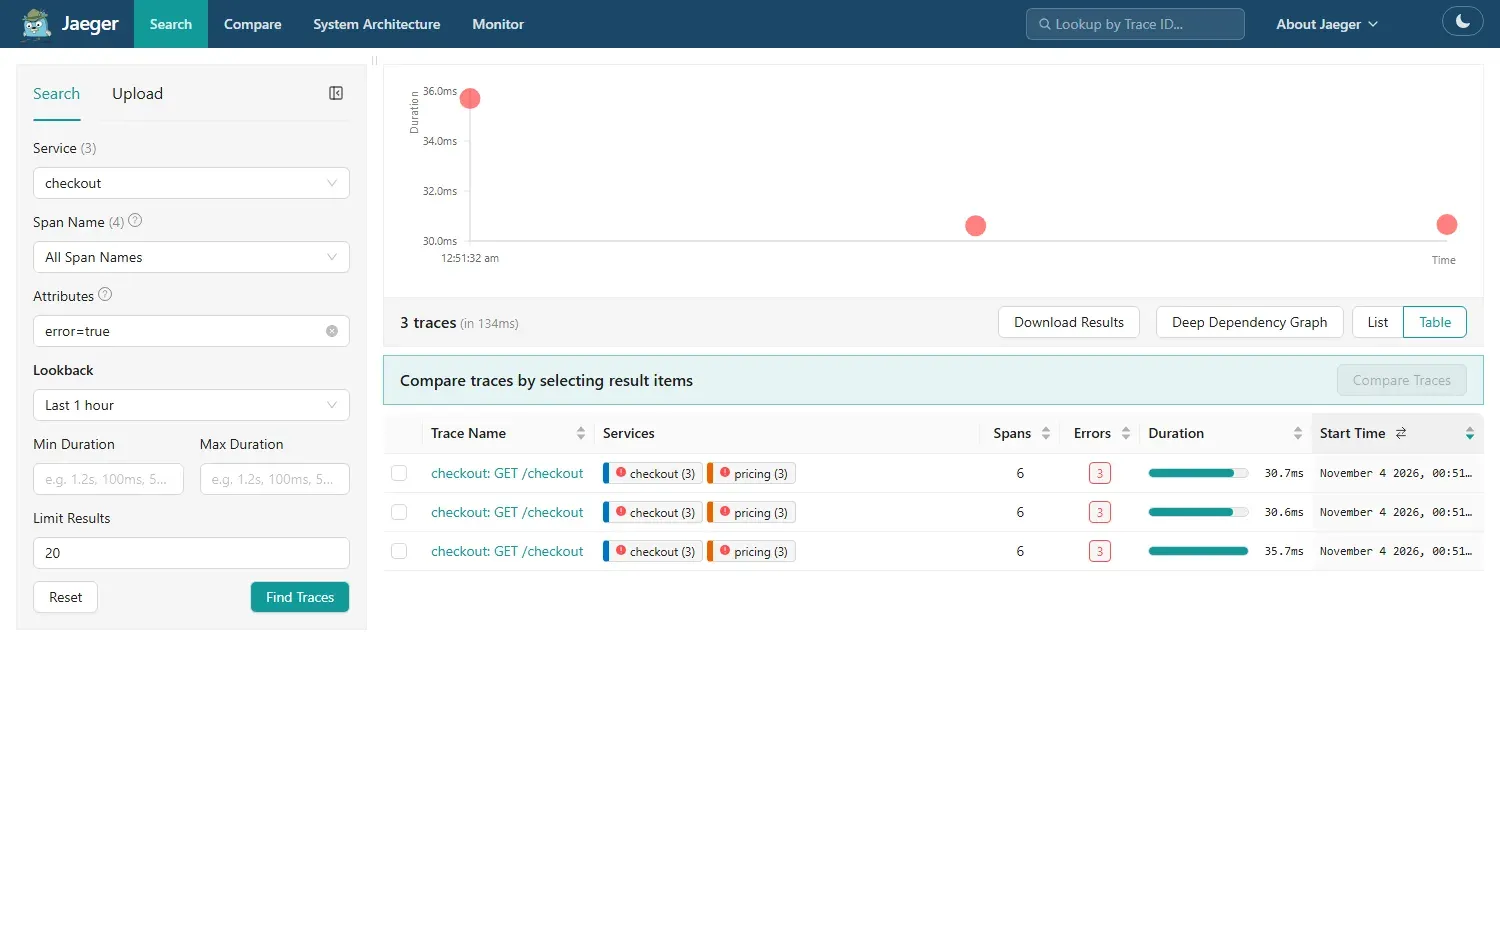
وهذا يفسر رقمين من المختبر: الأول سرعة البحث بالخصائص، فقد بحثنا في الواجهة عن ال Traces التي فيها error=true في خدمة الدفع خلال ساعة فيها قرابة 24 ألف Trace، فرجعت الثلاثة الفاشلة بالضبط في 134 ملي ثانية:
والرقم الثاني هو حجم القرص، فكل خاصية تكتبها في ال Span أو في المورد تكلف مفتاحاً إضافياً لكل Span. وتذكر من المقال السابق أن ال SDK في Node أضاف إلى المورد تلقائياً خصائص مثل process.command_args وprocess.executable.path وhost.arch، وهذه كلها تفهرس مع كل Span رغم أن أحداً لن يبحث بها. فإذا كان حجم التخزين يهمك فاحذف من المورد ما لا تحتاجه، إما في ال SDK بإيقاف كاشفات الموارد Resource Detectors التي لا تريدها، أو في Collector أمام Jaeger بمعالج يحذف هذه الخصائص قبل أن تصل. وكذلك لا تضع في الخصائص قيماً طويلة مثل جسم الطلب، فهي تفهرس كاملة.
ماذا يحدث عند إعادة التشغيل Restart ثم انتهاء الاحتفاظ TTL؟
هذه هي المشكلة التي بدأت بها القصة، فأخذنا معرف Trace من البيانات، وأعدنا إنشاء Container Jaeger، وطلبناه مرة ثانية. وفي الوقت نفسه غيرنا مدة الاحتفاظ إلى خمس دقائق حتى نرى الحذف:
T=$(python traces.py checkout 30 1 | head -1 | cut -d' ' -f1)
curl -s -o /dev/null -w "before restart: %{http_code}\n" "http://127.0.0.1:16686/api/v3/traces/$T"
SPAN_TTL=5m SAMPLER_MODE=remote docker compose -p dv2m-jaeger up -d jaeger
trace 38fb544174b7f8193b5d72eed9d7b72c
before restart: 200
21:29:29
Container dv2m-jaeger Started
21:29:38
after restart spans: 7
badger 2026/11/03 21:29:36 INFO: All 44 tables opened in 8msرجع Jaeger خلال تسع ثوان، وفتح Badger 44 جدولاً في 8 ملي ثانية، وال Trace موجود بعد إعادة التشغيل. ولاحظ أنه رجع بسبعة Spans وليس عشرة، لأن العامل لم يكن قد وصل إلى مهمة هذا الطلب بعد بسبب الطابور المتراكم، وهذا تذكير بأن ال Trace في Jaeger ليس شيئاً يكتمل مرة واحدة، فال Spans تصل في أوقات مختلفة وتظهر عندما تصل.
ثم أرسلنا ثلاثين طلباً بمدة الاحتفاظ الجديدة، وبحثنا عنها في أوقات مختلفة:
2026-11-03T21:29:58Z   requests=30 parallel=1 errors=0
21:31:42  pricing traces in window: 30
21:33:05  pricing traces in window: 30
21:36:13  HTTP 404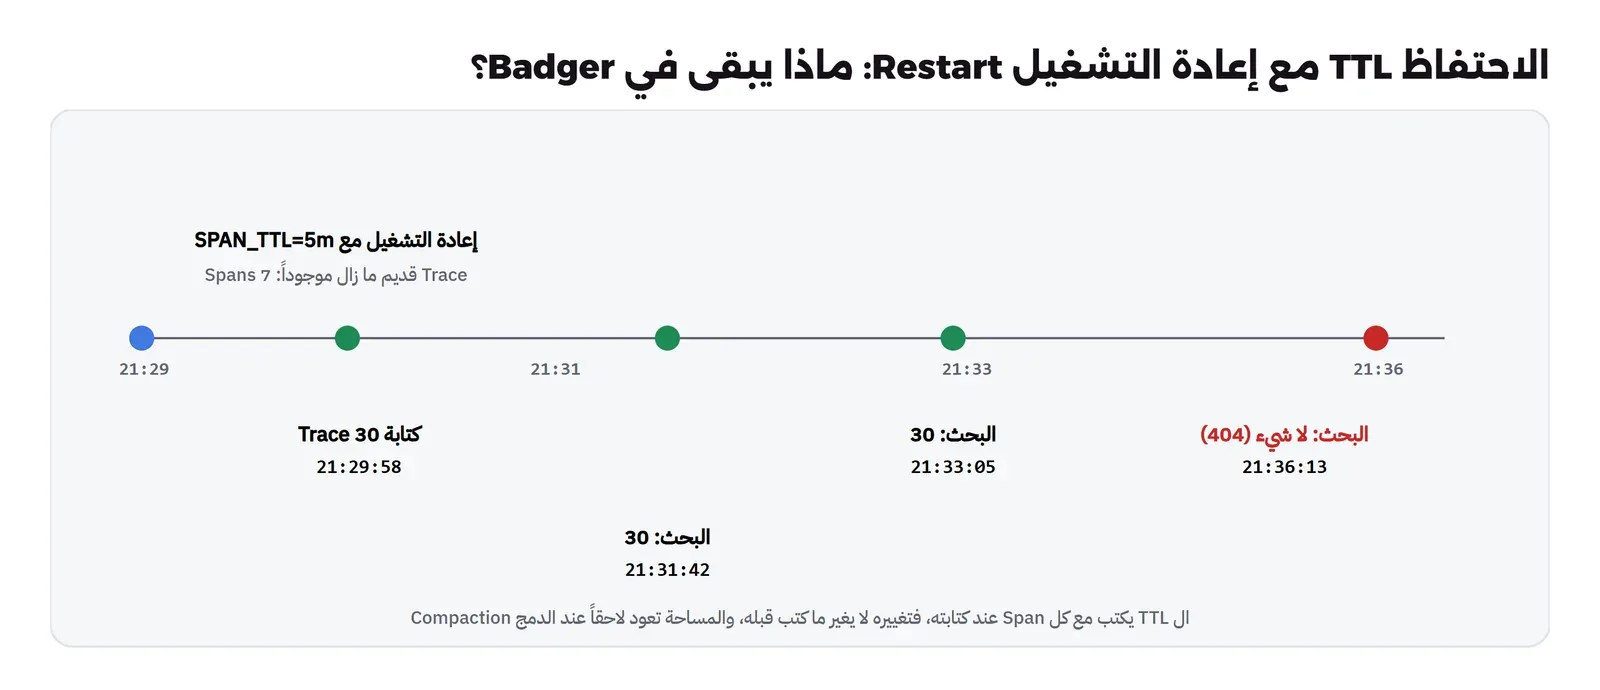
وفي النتائج أعلاه نقطتان مهمتان للإنتاج: الأولى أن مدة الاحتفاظ تكتب مع كل Span لحظة كتابته، فإذا غيرتها من 48 ساعة إلى 7 أيام فلن تطول حياة ما كتب قبل التغيير، والعكس صحيح. والثانية أن الحذف من البحث فوري عند انتهاء المدة، أما المساحة على القرص فتعود عندما يدمج Badger ملفاته في الخلفية، فلا تتوقع أن ينزل استخدام القرص في الدقيقة نفسها. وفي قصتنا كان الحل لمشكلة عطلة نهاية الأسبوع هو Badger بمدة احتفاظ سبعة أيام، والحساب بالرقم الذي قسناه: كل 100 ألف Trace في اليوم تحتاج قرابة 700 MB لكل يوم احتفاظ، أي قرابة 5 GB لأسبوع، فاضرب في حجم حركتك الحقيقي قبل أن تختار المدة.
العينة البعيدة Remote Sampling من مكان واحد
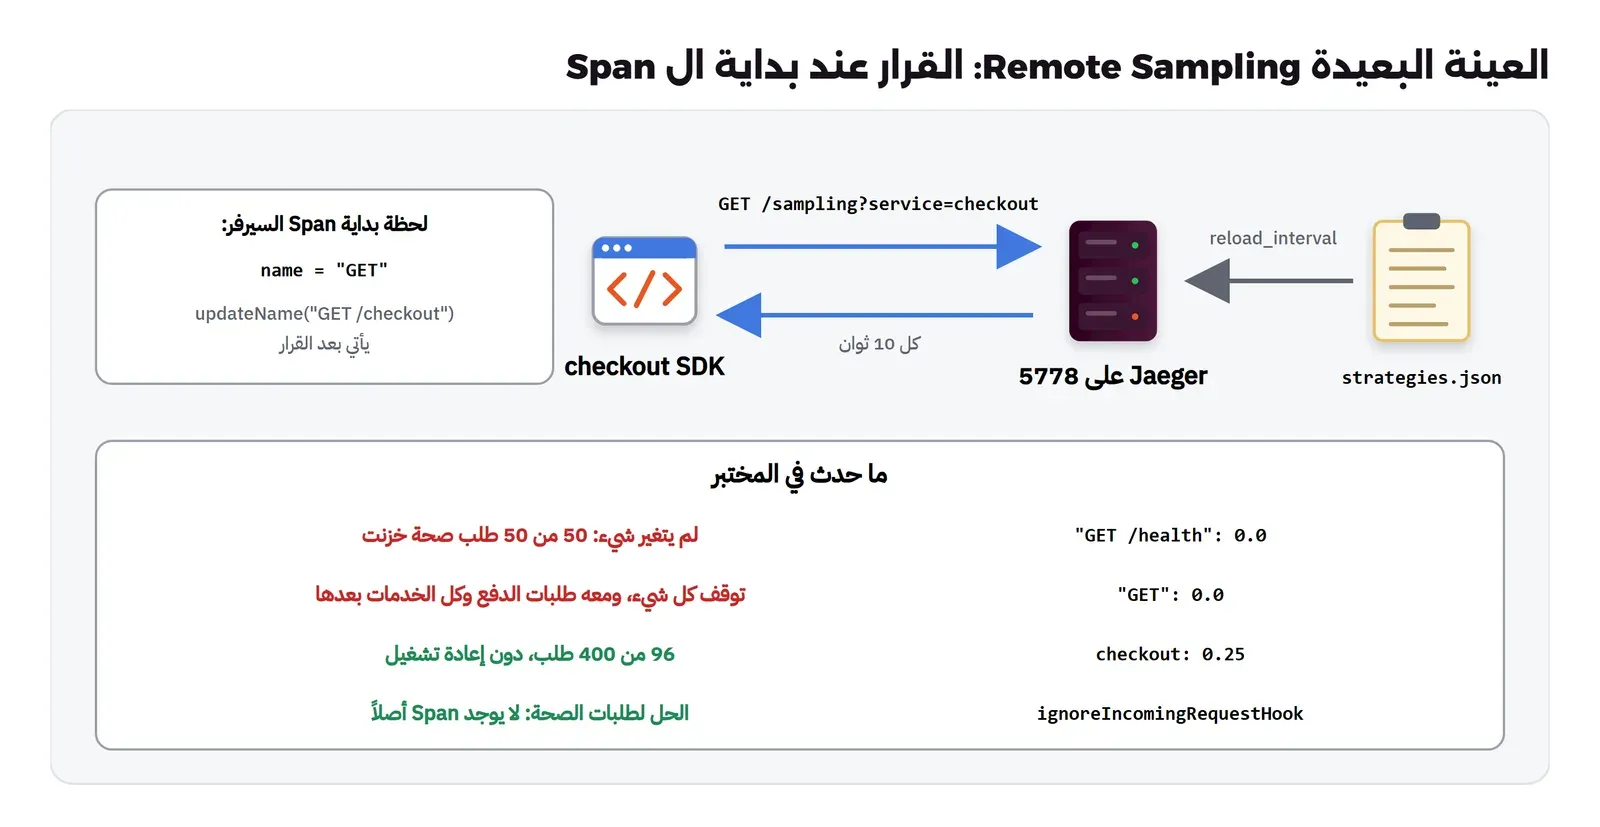
في المقال السابق ضبطنا العينة بمتغير بيئة في كل خدمة، وهذا يعني أنك إذا أردت أن تغير النسبة أثناء حادثة فعليك أن تعيد نشر الخدمة. أما العينة البعيدة فهي كما يشرح توثيق العينة عينة في البداية، ولكن ال SDK يسأل Jaeger عن الاستراتيجية كل فترة، فتغير النسبة في ملف واحد وتصل إلى كل الخدمات. ويستطيع Jaeger أن يحسب الاستراتيجية من ملف، أو أن يحسبها تلقائياً من حجم الحركة بالعينة التكيفية Adaptive Sampling. وكتبنا في الملف نسبة 100% لخدمة الدفع، وصفراً لطلبات الصحة:
{
  "service_strategies": [
    {
      "service": "checkout",
      "type": "probabilistic",
      "param": 1.0,
      "operation_strategies": [
        { "operation": "GET /health", "type": "probabilistic", "param": 0.0 }
      ]
    }
  ],
  "default_strategy": { "type": "probabilistic", "param": 1.0 }
}
وسألنا Jaeger عما سوف يقوله لل SDK:
curl -s "http://127.0.0.1:15778/sampling?service=checkout"{"strategyType":"PROBABILISTIC","probabilisticSampling":{"samplingRate":1},"operationSampling":{"defaultSamplingProbability":1,
"defaultLowerBoundTracesPerSecond":0,"perOperationStrategies":[{"operation":"GET /health","probabilisticSampling":{"samplingRate":0}}],
"defaultUpperBoundTracesPerSecond":0}}ثم غيرنا إعداد ال SDK في خدمة الدفع ليستخدم العينة البعيدة بحزمة @opentelemetry/sampler-jaeger-remote، داخل عينة تتبع قرار الأب حتى تبقى الخدمات بعدها متسقة كما شرحنا في المقال السابق:
const sampler = process.env.SAMPLER_MODE === 'remote'
  ? new ParentBasedSampler({ root: new JaegerRemoteSampler({
      endpoint: process.env.JAEGER_SAMPLING_URL,       // http://dv2m-jaeger:5778/sampling
      serviceName: 'checkout',
      poolingInterval: 10000,                          // ms between polls (the option name is spelled this way)
      initialSampler: new AlwaysOnSampler(),           // until the first answer arrives
    }) })
  : undefined;
ولاحظ initialSampler: هو ما يستخدمه ال SDK قبل أن يصله أول رد من Jaeger، فإذا كان Jaeger متوقفاً عند بدء الخدمة بقيت الخدمة على هذه العينة، فاختر له قيمة آمنة، لا تسجيل كل شيء في خدمة بآلاف الطلبات في الثانية، ولا لا شيء في خدمة تريد أن تراها.
مشكلة واجهتنا: عينة العملية لا تعمل لأن اسم ال Span يأتي متأخراً
أرسلنا خمسين طلب صحة وعشرين طلب دفع، وعددنا ال Traces في Jaeger بحسب اسم Span الجذر:
     20 /checkout 10
     50 /health 1
كل طلبات الصحة سجلت رغم أن الاستراتيجية تقول صفراً. والسبب في ترتيب الأحداث: العينة تقرر عند إنشاء ال Span، كما شرحنا في المقال السابق، ومكتبة HTTP في Node تنشئ Span السيرفر باسم GET فقط لأنها لا تعرف المسار وقتها، ثم يغير كودنا الاسم إلى GET /health بالدالة updateName بعد ذلك. فالعينة البعيدة رأت عملية اسمها GET، ولا توجد استراتيجية لها، فطبقت النسبة الافتراضية 100%. وحتى نتأكد من هذا التفسير غيرنا الاستراتيجية إلى العملية GET بنسبة صفر، فكانت النتيجة:
no traces (API v3 answers 404)لم يسجل أي شيء، لا الصحة ولا الدفع، ولا خدمة الأسعار ولا العامل بعدهما، لأن كل Span سيرفر في Node يبدأ باسم GET، والخدمات بعده تتبع قرار الأب. وهذا يعني أن استراتيجيات العمليات في العينة البعيدة تعمل فقط مع Spans يعرف اسمها النهائي لحظة إنشائها، مثل Spans يدوية تنشئها أنت باسمها، أو إطارات تعرف المسار قبل إنشاء ال Span. أما لطلبات الصحة فالحل الصحيح ألا تنشئ لها Span أصلاً، بخيار في مكتبة HTTP نفسها:
  instrumentations: [new HttpInstrumentation({
    ignoreIncomingRequestHook: (req) => req.url === '/health',   // no span at all for the load balancer probe
  })],
20 /checkout 10عشرون Trace للدفع، وصفر للصحة، وهذا أرخص من أي عينة لأن ال Span لا ينشأ أصلاً.
مشكلة واجهتنا: الملف تغير ولم يتغير شيء reload_interval
أثناء التجربة السابقة عدلنا ملف الاستراتيجيات وانتظرنا، فبقي Jaeger يرد بالاستراتيجية القديمة ثلاث دقائق، مع أن التوثيق يقول إن الملف يعاد تحميله تلقائياً إذا تغير محتواه. وكان في الطريق مشكلتان: الأولى أننا ربطنا الملف نفسه في ال Container، وبعض المحررات تكتب الملف الجديد ثم تستبدل القديم به، فيبقى الربط يشير إلى الملف القديم، لذلك ربطنا المجلد بدل الملف. والثانية أهم: قرأنا كود الإصدار 2.22.0 في ملف إعداد إضافة العينة فوجدنا الحقل reload_interval ورسالة خطأ تقول إن القيمة صفر تعني تعطيل إعادة التحميل التلقائي، والقيمة الافتراضية صفر. فأضفنا reload_interval: 10s، ولاحظنا أن docker compose up لم يعد إنشاء Jaeger لأن تغيير محتوى ملف مربوط لا يغير تعريف ال Container، فأعدنا تشغيله بنفسنا. وبعدها:
21:16:34   (file changed)
21:16:43   "operation":"GET"
تسع ثوان من تعديل الملف حتى رد Jaeger بالاستراتيجية الجديدة، وال SDK يسأل كل عشر ثوان، فخلال عشرين ثانية تقريباً يصل التغيير إلى كل الخدمات دون إعادة نشر. وجربنا ذلك بنسبة 25% لخدمة الدفع:
{"strategyType":"PROBABILISTIC","probabilisticSampling":{"samplingRate":0.25}}
requests=400 parallel=4 errors=0 seconds=5.2 p50=49.2 p95=77.8 p99=97.7
     96 /checkout
96 Trace من 400 طلب، أي 24%، دون أن نلمس خدمة واحدة.
أما العينة التكيفية Adaptive Sampling فتحسب النسبة لكل خدمة وعملية بنفسها حتى يصل عدد ال Traces إلى رقم تحدده في الثانية، وتحتاج تخزيناً لحساباتها، ويذكر التوثيق أن Badger من التخزينات المدعومة لذلك. وهي مفيدة عندما تكون الحركة متغيرة جداً بين ساعات اليوم، ولكن انتبه إلى أنها تعتمد على أسماء العمليات أيضاً، فمشكلة GET نفسها تجعلها ترى كل طلبات Node عملية واحدة.
لوحة أداء الخدمات SPM: من ال Spans إلى مقاييس
المدير في قصتنا يريد ثلاثة أرقام لكل خدمة: عدد الطلبات، ونسبة الأخطاء، وزمن الاستجابة، وهي طريقة RED التي شرحناها في الإشارات الذهبية. وفي تلك المقالة كتبنا المقاييس في كود الخدمة نفسها، أما هنا فنحسبها من ال Spans التي تصل إلى Jaeger أصلاً، دون سطر كود جديد. وهذا ما يسميه توثيق Jaeger مراقبة أداء الخدمات Service Performance Monitoring، واختصاراً SPM، ويعمل بثلاث قطع رأيتها في ملف الإعداد:
- الموصل spanmetrics: Connector في ال Collector، أي جزء يكون مصدراً في Pipeline ومستقبلاً في Pipeline أخرى، فيأخذ كل Span ويحدث عدادات ومدرجات Histograms بحسب الخدمة واسم ال Span ونوعه وحالته.
- Prometheus: يسحب هذه المقاييس من المنفذ 8889 ويحفظها.
- مخزن المقاييس في jaeger_query: يجعل تبويب Monitor في الواجهة يسأل Prometheus ويرسم النتيجة.
وبعد دقائق من الحركة سألنا Prometheus عن معدل الطلبات لكل Span:
curl -s 'http://127.0.0.1:19090/api/v1/query' --data-urlencode 'query=sum by (service_name, span_name, span_kind) (rate(traces_span_metrics_calls_total[1m]))'{'service_name': 'email-worker', 'span_kind': 'SPAN_KIND_CONSUMER', 'span_name': 'emails process'} 18.333740749794444
{'service_name': 'email-worker', 'span_kind': 'SPAN_KIND_INTERNAL', 'span_name': 'smtp-send'} 18.333740749794444
{'service_name': 'checkout', 'span_kind': 'SPAN_KIND_SERVER', 'span_name': 'GET /checkout'} 0
{'service_name': 'pricing', 'span_kind': 'SPAN_KIND_SERVER', 'span_name': 'GET /price'} 0
{'service_name': 'jaeger', 'span_kind': 'SPAN_KIND_SERVER', 'span_name': '/api/v3/traces'} 0
...والعامل كان يعالج قرابة 18 مهمة في الثانية في تلك اللحظة، وهو الرقم الذي يفسر لماذا تراكم الطابور: عشرون ألف طلب في ثلاث دقائق، وعامل يعالج 18 في الثانية، أي أن السعة أقل من الحاجة بخمس مرات تقريباً. وهذا سؤال لم نكن لنعرف إجابته من ال Traces وحدها. ولاحظ أن اسم Span السيرفر في Node هنا GET /checkout لأن الموصل يرى ال Span بعد انتهائه، أي بعد updateName، بعكس العينة التي تراه عند بدايته. وهذه هي الشاشة التي يريدها المدير:
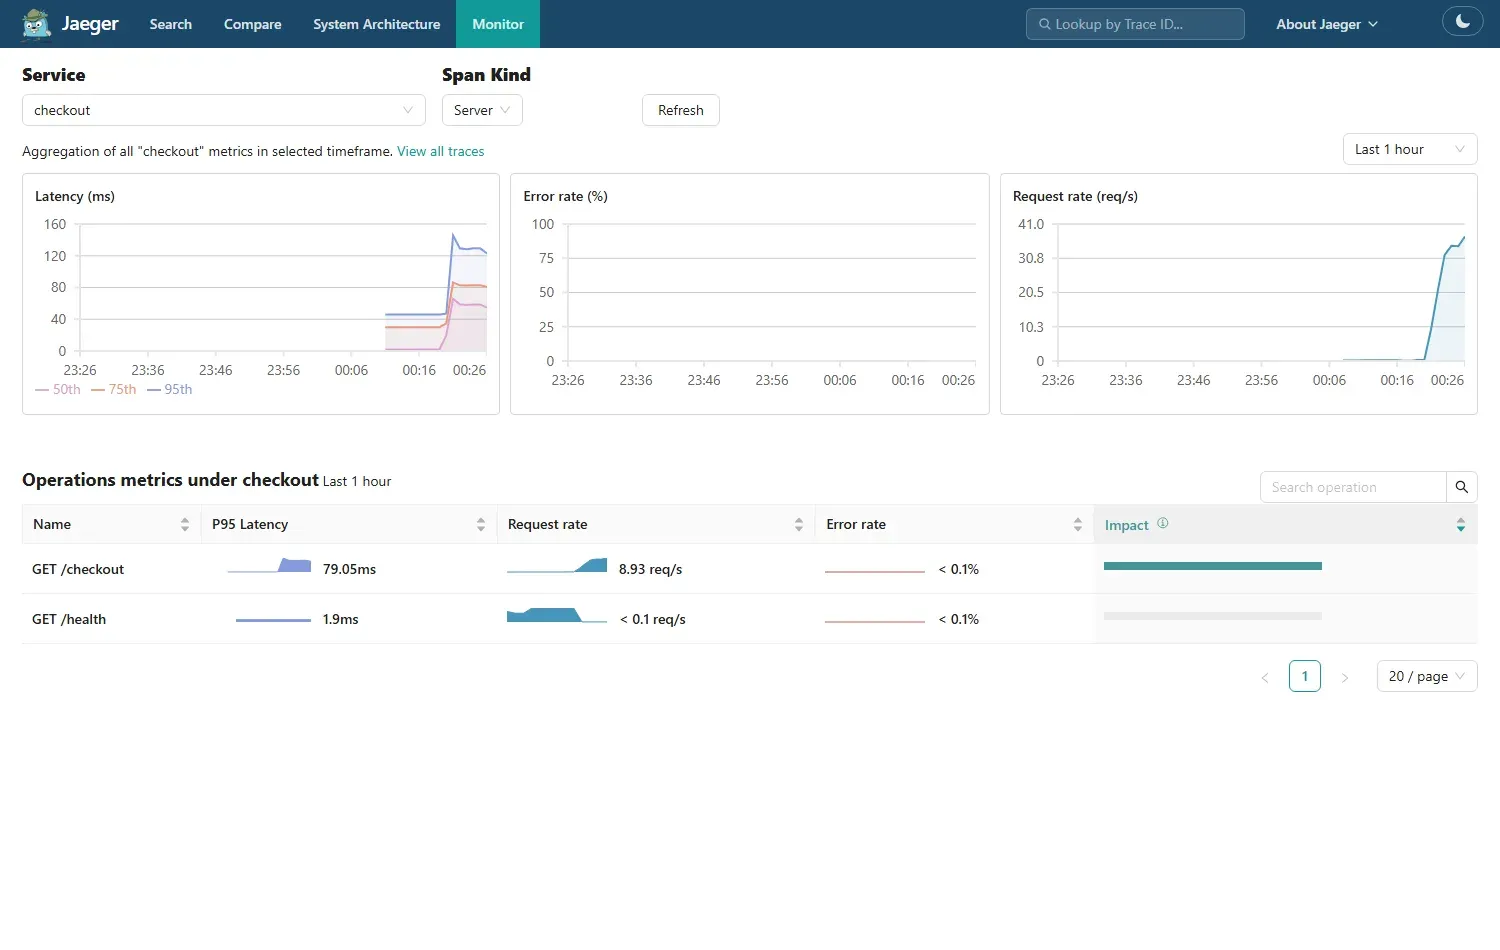
وقد يتساءل البعض: إذا كانت العينة 10%، فهل تكون أرقام هذه اللوحة 10% من الحقيقة؟ والإجابة نعم، لأن الموصل يحسب من ال Spans التي وصلت فقط، فإذا كنت تستخدم العينة في ال SDK فاللوحة تحتاج أن تضرب في النسبة، أو أن تحسب المقاييس قبل العينة، كأن يكون الموصل في Collector يستقبل كل ال Spans ثم يأخذ عينة في النهاية. ولهذا السبب بالذات لا تعتمد على SPM وحده للتنبيه، وابق على مقاييس الخدمة الحقيقية في Prometheus كما في السلسلة السابقة.
نسبة الأخطاء Error Rate: من حالة ال Span لا من رمز HTTP
أرسلنا عشرة طلبات بمبلغ سالب، فترد خدمة الأسعار بالرمز 400 وترد خدمة الدفع بالرمز 502، ومعها 300 طلب عادي، ثم سألنا Prometheus عن عدد الطلبات بحسب حالة ال Span في آخر دقيقتين:
curl -s 'http://127.0.0.1:19090/api/v1/query' --data-urlencode 'query=sum by (service_name, span_name, status_code) (increase(traces_span_metrics_calls_total{span_kind="SPAN_KIND_SERVER", service_name!="jaeger"}[2m]))'{'service_name': 'checkout', 'span_name': 'GET /checkout', 'status_code': 'STATUS_CODE_UNSET'} 342.9
{'service_name': 'pricing', 'span_name': 'GET /price', 'status_code': 'STATUS_CODE_UNSET'} 354.3
{'service_name': 'checkout', 'span_name': 'GET /checkout', 'status_code': 'STATUS_CODE_ERROR'} 11.4في المخرج أعلاه لاحظ التالي:
- خدمة الدفع ظهرت فيها الأخطاء، لأن Span السيرفر فيها حالته Error مع الرمز 502، والرقم 11.4 وليس 10 لأن الدالة
increaseتقدر الزيادة على حدود النافذة، فلا تتوقع منها أعداداً صحيحة. - خدمة الأسعار لا تظهر فيها أخطاء أبداً، مع أنها ردت بالرمز 400 عشر مرات، لأن الاتفاقيات الدلالية تترك حالة Span السيرفر دون تعيين في رموز 4xx كما شرحنا في المقال الأول، والموصل يحسب الأخطاء من الحالة فقط.
وهذا قد يكون ما تريده تماماً، فالطلب غير الصالح ليس خطأ في الخدمة، وقد لا يكون، فإذا كانت خدمتك ترد بالرمز 429 عندما تمتلئ، أو بالرمز 404 لأن بيانات اختفت بسبب خطأ، فلن تراها هذه اللوحة. والحل في الكود وليس في Jaeger: عين حالة Error بنفسك على ال Span في الحالات التي تعدها خطأ، أو احسب نسبة الأخطاء من مقياس رمز الحالة في Prometheus كما في الإشارات الذهبية، واترك SPM لما يقوله التتبع.
زمن الاستجابة p95 من مدرج Histogram بحدود خشنة
بعد أن عملت اللوحة أردنا أن نحسب زمن الاستجابة للمئين 95 بأنفسنا من Prometheus، كما نفعل في التنبيهات، فأرسلنا 1500 طلب وسألنا:
curl -s 'http://127.0.0.1:19090/api/v1/query' --data-urlencode 'query=histogram_quantile(0.95, sum by (le, service_name, span_name) (rate(traces_span_metrics_duration_milliseconds_bucket{span_kind="SPAN_KIND_SERVER"}[1m])))'checkout GET /checkout 49.9
pricing GET /price 48.0الرقمان متقاربان بشكل مريب، مع أن طلب الدفع يحتوي طلب الأسعار وأكثر منه. فسألنا Prometheus عن حدود المدرج التي ينتجها الموصل:
['+Inf', '10.0', '100.0', '1000.0', '10000.0', '1400.0', '15000.0', '2.0', '200.0', '2000.0', '4.0', '400.0', '50.0', '5000.0', '6.0', '8.0', '800.0']والسبب واضح بعد ترتيبها: الحدود الافتراضية 2 و4 و6 و8 و10 ثم 50 ثم 100 ملي ثانية، فكل طلب يأخذ بين 10 و50 ملي ثانية يقع في الخانة نفسها، والدالة histogram_quantile تفترض أن الطلبات موزعة بالتساوي داخل الخانة، فتعطي رقماً قريباً من حدها الأعلى لأي خدمة تقع معظم طلباتها هناك. أي أن الرقم ليس خاطئاً تماماً، ولكنه لا يستطيع أن يفرق بين 20 و45 ملي ثانية، وهذا هو المجال الذي تعيش فيه أغلب الخدمات السريعة. والحل أن تحدد الحدود بنفسك في إعداد الموصل بما يناسب خدماتك، مثل:
connectors:
  spanmetrics:
    metrics_flush_interval: 15s
    histogram:
      explicit:
        buckets: [5ms, 10ms, 20ms, 30ms, 50ms, 75ms, 100ms, 150ms, 250ms, 500ms, 1s, 2s, 5s]
وتذكر أن كل حد إضافي يضيف سلسلة في Prometheus لكل خدمة وعملية، فاختر الحدود حول أهدافك، مثل حد عند 100 ملي ثانية إذا كان هدفك أن يكون p95 أقل منها، كما شرحنا في الإشارات الذهبية.
خريطة الخدمات System Architecture مع الواجهة البرمجية API
في الواجهة تبويب System Architecture يرسم من يستدعي من، وهذا ما ظهر في مختبرنا:
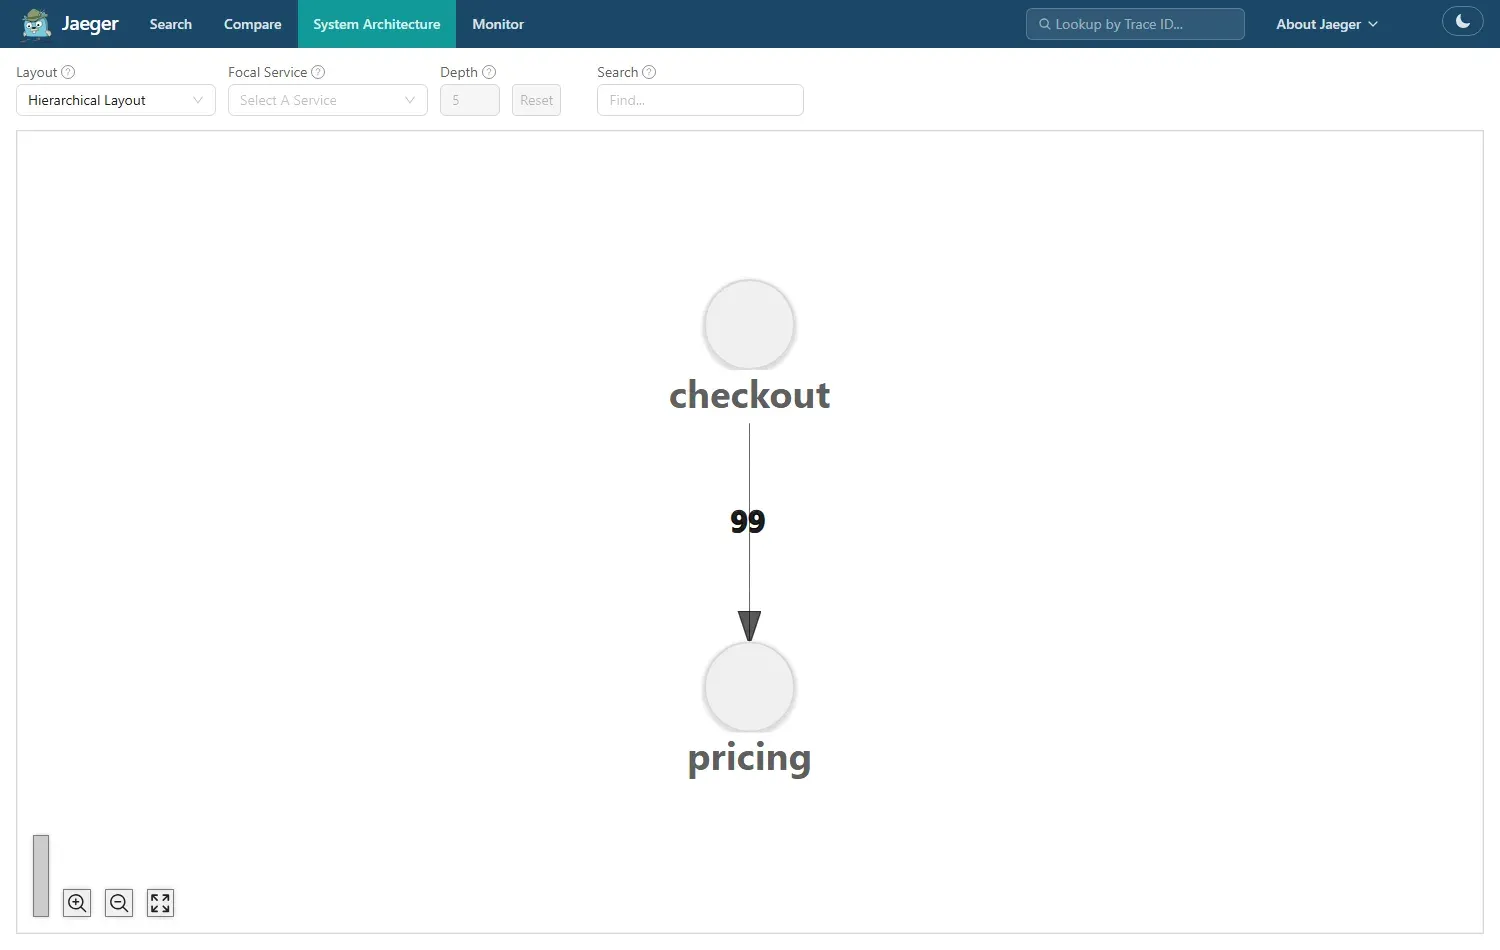
ولاحظ أمرين غريبين: الرقم 99 وليس آلاف الطلبات، ولا يوجد سهم إلى العامل مع أن ال Traces تبين أنه ابن لخدمة الدفع. فقرأنا الكود الذي يحسب الخريطة في تخزين Badger، فوجدناه يبحث عن ال Traces في الفترة ثم يمر عليها ويعد كل علاقة أب بابن بين خدمتين مختلفتين، والبحث نفسه له حد افتراضي لعدد ال Traces، فالرقم هو عدد الاستدعاءات في آخر مجموعة صغيرة من ال Traces وليس المجموع. وأما العامل فكان متأخراً عشرين دقيقة عن الطلبات بسبب الطابور، فلم تكن Spans العامل قد وصلت لآخر ال Traces التي قرأها. والدرس: خريطة Badger مفيدة لترى شكل النظام، وليست مصدراً لأعداد الطلبات، ولأعداد دقيقة تستخدم المقاييس من القسم السابق، وفي التخزينات الكبيرة مثل OpenSearch تحسب الخريطة بمهمة منفصلة كل فترة.
أما إذا أردت أن تقرأ Jaeger من سكربت كما فعلنا في كل هذا المختبر، فاستخدم الواجهة البرمجية الثالثة API v3، وهي بحسب صفحة الواجهات مستقرة وتعيد البيانات بصيغة OTLP JSON. وقد اكتشفنا الفرق بالطريقة الصعبة، فالسكربت الأول طلب قائمة الخدمات من الواجهة القديمة:
curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:16686/api/services
curl -s http://127.0.0.1:16686/api/v3/services
404
{"services":["email-worker","pricing","checkout"]}والصفحة نفسها تصف /api/* بأنها واجهة داخلية غير رسمية تستخدمها الواجهة الرسومية، فقد تتغير أو تختفي في أي إصدار، كما رأينا مع /api/services، بينما ما زالت /api/dependencies تعمل في الإصدار نفسه. فإذا كان عندك سكربتات أو لوحات قديمة تقرأ Jaeger، فانقلها إلى /api/v3 قبل الترقية، وانتبه إلى أن API v3 ترد بالرمز 404 عندما لا يوجد Trace مطابق للبحث، وليس بقائمة فارغة.
Jaeger مباشرة أم خلف Collector؟
في هذا المختبر أرسلت الخدمات إلى Jaeger مباشرة، لأن Jaeger يستقبل OTLP بنفسه، وهذا أبسط تشغيل ممكن: Container واحد بدل اثنين. ولكن تذكر ما رأيناه في المقال السابق عندما توقف ال Collector 51 ثانية: ال SDK لا يحفظ إلا ثوان قليلة في الذاكرة، فضاعت كل Spans خدمة Node وأغلب Spans خدمة Python. وJaeger هنا هو نفسه نقطة الاستقبال، فكل إعادة تشغيل له، مثل التي قسناها بتسع ثوان، وكل ترقية، تضيع فيها ال Spans التي تنتج في تلك الثواني. وفي فريق صغير قد يكون هذا مقبولاً، فبضع ثوان من التتبع عند كل ترقية ليست خسارة كبيرة.
أما عندما يصبح التتبع مهماً، أو تكبر الحركة، فالترتيب الذي نراه في أغلب الفرق: Collector قريب من الخدمات بدور الوكيل Agent يستقبل ويحفظ في طابور خاص به، ويحذف البيانات الشخصية والخصائص التي لا تحتاجها، ثم يرسل إلى Jaeger. وبهذا تستطيع أن تعيد تشغيل Jaeger أو تنقله أو تغير تخزينه دون أن تلمس الخدمات ودون أن تضيع شيئاً، لأن ال Collector يعيد الإرسال عندما يعود. وهذا أيضاً المكان الصحيح للعينة في النهاية التي شرحناها في المقال الأول، إذا أردت أن تحتفظ بكل الأخطاء وبنسبة من الباقي. والقاعدة العملية: ابدأ مباشرة، وأضف ال Collector في اليوم الذي تسأل فيه «هل ضاع شيء أثناء الترقية؟».
الانتقال من الإصدار الأول Migration: ماذا يتغير عندك؟
إذا كان عندك Jaeger قديم بالإصدار الأول، فالانتقال ليس تحديث رقم ال Image فقط، وهذه هي الأشياء التي تتغير، مرتبة بحسب ما يكسر أولاً:
- الإعداد: الأعلام ومتغيرات البيئة مثل
SPAN_STORAGE_TYPEلم تعد طريقة الإعداد الأساسية، وإنما ملف YAML كالذي رأيته، فاكتب الملف من جديد بدل أن تنقل الأعلام واحداً واحداً، ويشير توثيق الإصدار 2.22 إلى دليل انتقال منفصل لهذا. - ال Agent: لم يعد هناك برنامج Agent خاص بJaeger، والبديل هو OpenTelemetry Collector بدور الوكيل كما في القسم السابق، أو إرسال ال SDK مباشرة.
- المكتبات القديمة: الخدمات التي ما زالت تستخدم مكتبات Jaeger القديمة وترسل بصيغة Thrift إلى المنافذ 6831 و14268 تحتاج أن تفعل المستقبل
jaegerفي ملف الإعداد، فهو غير مفعل في ملفنا، وتذكر صفحة الواجهات أن هذه الصيغ باقية للتوافق فقط، والطريق الصحيح نقل الخدمات إلى OpenTelemetry. - السكربتات واللوحات: كل ما يقرأ
/api/*ينقل إلى/api/v3كما رأينا. - التخزين: إذا كانت بياناتك في OpenSearch أو Cassandra فاقرأ في دليل الانتقال ما يخص التوافق مع البيانات الموجودة، وجرب الإصدار الثاني على نسخة منها قبل الإنتاج، وخذ نسخة احتياطية قبل أي ترقية كما في أي قاعدة بيانات.
والترتيب الآمن: شغل الإصدار الثاني بجانب الأول على تخزين جديد، ووجه إليه خدمة واحدة، ثم الباقي، واترك الأول للقراءة حتى تنتهي مدة احتفاظ بياناته، وهي الطريقة نفسها التي اقترحناها لنقل السجلات بين المخازن.
Jaeger أم Tempo أم SigNoz؟ نقاط القوة مع نقاط الضعف
قارنا في المقال السابق بين Jaeger وGrafana Tempo باختصار، وشرحنا SigNoz في دليل مستقل، وبعد هذا المختبر نستطيع أن نقول عن Jaeger بالتحديد:
نقاط القوة:
- برنامج واحد بملف إعداد واحد يعرفه كل من يعرف OpenTelemetry Collector، ويبدأ في ثوان، ويحفظ في Badger دون قاعدة بيانات منفصلة.
- واجهة جاهزة للبحث والمقارنة وخريطة الخدمات، ولوحة RED من ال Spans دون كود إضافي.
- عينة بعيدة من ملف واحد تصل إلى كل الخدمات في عشرين ثانية، وعينة تكيفية لمن يحتاجها.
- ترخيص Apache-2.0، ومشروع متخرج Graduated في CNCF.
نقاط الضعف:
- تتبع فقط: لا سجلات ولا مقاييس بنفسه، فتحتاج Prometheus للوحة الأداء، وأداة أخرى للسجلات.
- Badger لنسخة واحدة، والتوسع يعني OpenSearch أو Cassandra وتكلفتهما.
- الحجم الظاهر لملفات Badger وحدود الخريطة قد تضللك إذا لم تعرفها.
- بعض التوثيق لا يطابق الكود، كما رأينا في إعادة تحميل ملف العينة.
والقاعدة العملية: إذا كان فريقك يستخدم Grafana للمقاييس والسجلات فTempo يكمل المجموعة نفسها، وإذا أردت كل شيء في أداة واحدة بواجهة واحدة فSigNoz، وإذا أردت أداة تتبع مستقلة تعرف بالضبط ما فيها وتبدأ بها في دقائق على سيرفر واحد، فJaeger مع Badger هو الأبسط، وتكلفتها في مختبرنا قرابة 7 KB من القرص لكل Trace من عشرة Spans، وأقل من 1 GB من الذاكرة تحت الضغط. وإذا كنت تقارن هذا بخدمة سحابية فقد جمعنا الأرقام في تكلفة المراقبة.
أخطاء شائعة Common Mistakes
- Jaeger بتخزين الذاكرة في الإنتاج: إعادة تشغيل واحدة تمسح كل شيء، كما حدث في القصة.
- تشغيل Jaeger كroot لحل مشكلة الصلاحيات: أعط المستخدم 10001 مجلد البيانات بدل ذلك.
- مراقبة حجم Badger بحجم الملفات: ملف القيم 2 GiB في الظاهر و4 KB في الحقيقة.
- تغيير ال TTL وتوقع أن يتغير عمر البيانات القديمة: المدة تكتب مع كل Span لحظة كتابته.
- ملف عينة بلا
reload_interval: القيمة الافتراضية صفر، فلا يعاد تحميل الملف مهما تغير. - استراتيجيات عمليات لSpans تسمى لاحقاً: العينة ترى
GETفقط، فإما أن تتجاهل المسار كله أو تستخدم اسماً معروفاً عند الإنشاء. - الاعتماد على أعداد خريطة الخدمات: محسوبة من مجموعة صغيرة من ال Traces الأخيرة.
- سكربتات على
/api/*: واجهة داخلية تختفي بين الإصدارات، فاستخدم/api/v3. - لوحة SPM مع عينة في ال SDK: الأرقام جزء من الحقيقة بنسبة العينة.
قائمة تحقق Checklist لتشغيل Jaeger
| البند | كيف تتحقق منه |
|---|---|
| التخزين دائم | إعادة تشغيل Jaeger ثم طلب Trace قديم بمعرفه يرجع 200 |
| مدة الاحتفاظ محسوبة | حجم LSM لكل Trace في المقياس مضروب في عدد ال Traces في اليوم وفي ال TTL |
| القرص مراقب بالحجم الحقيقي | تنبيه على المساحة الحرة في نظام الملفات، وليس على size_bytes_vlog |
| طلبات الصحة لا تنتج Spans | لا توجد عملية /health في قائمة العمليات |
| العينة تتغير من مكان واحد | تعديل الملف يغير رد /sampling خلال reload_interval |
| لوحة الأداء تعمل | تبويب Monitor يعرض RED لكل خدمة، وPrometheus يسحب المنفذ 8889 |
| السكربتات على الواجهة المستقرة | لا يوجد طلب إلى /api/ دون v3 |
| Jaeger نفسه مراقب | فحص من الخارج للمنفذ 16686 وتنبيه على otelcol_receiver_refused_spans |
تدريب عملي Practice
- غير
remote_samplingمنfileإلىadaptiveمعsampling_store: main_store، وأرسل حركة بمعدلين مختلفين، وراقب كيف تتغير النسبة في رد/sampling. - أضف تخزين أرشيف بBadger في مجلد ثان بمدة 30 يوماً، واربطه في
jaeger_queryبالمفتاحtraces_archive، ثم احفظ Trace من الواجهة وتأكد أنه يبقى بعد انتهاء مدة التخزين الرئيسي.
حذف المختبر Cleanup
docker compose -p dv2m-jaeger down -v --rmi local
docker rmi jaegertracing/jaeger:2.22.0 redis:8.10.3-alpine
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Jaeger v2 برنامج واحد مبني على OpenTelemetry Collector، بإضافات للتخزين والواجهة والعينة، وملف إعداد واحد يحدد دوره.
- Badger يحفظ على القرص لسيرفر واحد: 24 ألف Trace أخذت 169 MB حقيقية، وملف القيم ظهر 2 GiB وهو 4 KB، والذاكرة وصلت إلى 810 MiB تحت الضغط.
- ال Trace بقي بعد إعادة التشغيل، وال Traces المكتوبة بمدة خمس دقائق اختفت من البحث بعدها، والمدة تكتب مع كل Span.
- العينة البعيدة غيرت النسبة إلى 25% دون إعادة نشر، ولكن احتاجت
reload_interval، ولم تعمل استراتيجيات العمليات لأن اسم Span السيرفر في Node يأتي بعد القرار. - لوحة SPM أعطت RED لكل خدمة من ال Spans، وكشفت أن العامل يعالج 18 مهمة في الثانية فقط، أما خريطة الخدمات فأرقامها من عينة صغيرة.
- الموصل يحسب الأخطاء من حالة ال Span فقط، فلم يحسب ردود 400 في خدمة الأسعار، وحدود المدرج الافتراضية جعلت p95 لخدمتين مختلفتين قرابة 50 ملي ثانية، فحدد الحدود حول أهدافك قبل أن تبني عليها تنبيهات.
وفي المقال القادم بإذن الله ننتقل إلى المنصات التي تجمع التتبع مع السجلات والمقاييس في مكان واحد، ونقارنها بالأرقام.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلOpenTelemetry للمطورين: تتبع الطلبات Traces عبر خدمتيننكتب تتبع OpenTelemetry بأيدينا في خدمة Node.js وخدمة Python وطابور Redis، ونرى ماذا يضيع إذا توقف ال Collector وكم يكلف التتبع من زمن الطلب.
 دليلSigNoz: بديل Datadog مفتوح المصدر Open Source على سيرفرككيف تشغل SigNoz وترسل إليه التتبع والسجلات والمقاييس عبر OpenTelemetry، وما الذي يقدمه فعلاً مقابل Datadog وبكم من الذاكرة.
 دليلكم تكلف منصات المراقبة Observability؟ مقارنة بالأرقامحسبنا بسكربت مفتوح فاتورة المراقبة لشركة بعشرين سيرفراً على Datadog والمنصات المنافسة، وقارناها بتشغيل SigNoz على سيرفرك.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Jaeger 2.22.0 مع Badger وspanmetrics وPrometheus 3.15.1، وOpenTelemetry JS 0.300.0 مع @opentelemetry/sampler-jaeger-remote 0.300.0، وOpenTelemetry Python 1.45.2، وRedis 8.10.3.