


لنفرض أنك في شركة ناشئة تبيع منتجاتها عبر متجر إلكتروني، والفريق يستعد لموسم التخفيضات، والمدير يسألك سؤالاً واحداً: كم نواة وكم ذاكرة نحتاج في السيرفر الجديد؟ فتفتح صفحة متطلبات كل برنامج فتجد أن PostgreSQL يعمل على أي جهاز تقريباً، وأن Redis لا يذكر رقماً ثابتاً، وأن تطبيق Node.js الذي كتبه الفريق لا توجد له صفحة متطلبات أصلاً، ثم تسأل زميلاً فيقول «خذ 16 نواة و64 جيجابايت حتى ترتاح»، وتسأل آخر فيقول «4 أنوية تكفي». وكلاهما يخمن، والتخمين هنا مكلف في الاتجاهين، فالسيرفر الأكبر من الحاجة يدفع ثمنه كل شهر دون فائدة، والأصغر منها يظهر عيبه في أسوأ وقت، أي في يوم التخفيضات نفسه.
وفي المقالين السابقين من هذه المرحلة رأينا ما يجعل الجهاز سيرفراً، وأي شكل يناسب أي مكان، أما هذا المقال فعن الرقمين اللذين تكتبهما في طلب الشراء أو في إعداد الجهاز الافتراضي: عدد الأنوية وحجم الذاكرة. والطريقة التي سوف نتبعها هي القياس وليس التخمين، فسوف نشغل أربع خدمات حقيقية في Containers، ونضغطها بأدوات حقيقية، ونقرأ ما تستهلكه كل خدمة، ثم نحول الأرقام إلى قاعدة تطبقها على خدماتك، ونتحقق منها بتشغيل الخدمات في الحجم الذي حسبناه، وسوف نناقش في هذا المقال ما يلي:
- لماذا يخطئ التقدير بالحدس، وما الذي يجب أن تقيسه بدلاً منه.
- النواة Core والخيط Thread والتردد Clock، وماذا يعني vCPU، ولماذا يهم أن تعرف هل برنامجك يستخدم أكثر من نواة.
- NUMA في السيرفرات ذات المعالجين، ومتى يهمك.
- من أين تأتي ذاكرة كل خدمة، وما الذي يعرضه
docker statsبالضبط. - تجربة عملية كاملة: PostgreSQL وRedis وNode.js وNginx تحت ضغط wrk وpgbench، ثم ماذا يحدث إذا قللت المعالج أو الذاكرة.
- قاعدة التقدير من القياس، والإفراط في الحجز Overcommit، والأخطاء الشائعة وقائمة تحقق.
لماذا يخطئ التقدير بالحدس؟
الطرق التي يستخدمها أغلب الناس لتقدير الحجم ثلاث، وكلها تبدو منطقية من الوهلة الأولى، ولكنها تفشل لأسباب مختلفة:
- نسخ الحد الأدنى من صفحة المتطلبات: صفحة المتطلبات تقول لك ما يحتاجه البرنامج ليعمل، وليس ما يحتاجه ليخدم ألفي طلب في الثانية ببياناتك أنت، فهي تجيب عن سؤال آخر.
- أخذ أكبر جهاز في الميزانية: يحل المشكلة اليوم ويخفي سؤالاً مهماً، وهو هل يستخدم برنامجك هذه الأنوية أصلاً، وسوف نرى في التجربة أن تطبيق Node.js بقي عند نواة واحدة تقريباً وفي الجهاز ثمانية معالجات منطقية، أي أن الجهاز الكبير لم يكن ليساعده.
- مضاعفة ما لدينا الآن: تفترض أن العلاقة بين عدد المستخدمين والموارد خطية، وهذا صحيح في جزء من المنحنى فقط، فعند نقطة معينة يصبح الاختناق في القرص أو في الأقفال داخل قاعدة البيانات، وعندها لا تفيد مضاعفة المعالج، كما سوف نرى في تجربة pgbench.
والطريقة الصحيحة أن تقيس تطبيقك تحت ضغط يشبه الحقيقة، وتعرف أي خدمة تستهلك ماذا، وأي مورد ينفد أولاً، ثم تحول ذلك إلى وحدة تستطيع أن تضربها في الرقم المتوقع، مثل عدد الأنوية لكل ألف طلب في الثانية. وقد شرحنا أنواع اختبارات الضغط وكيف تقرأ نتائجها، ومنها نقطة الانعطاف Knee والنسب المئوية لزمن الرد، في اختبار الضغط للمبتدئين، أما هنا فنستخدم تلك الأدوات لسؤال واحد: كم نواة وكم ذاكرة؟ وقبل أن نقيس، نحتاج أن نتفق على معنى «النواة» نفسها.
النواة Core والخيط Thread: ماذا تعني الأرقام التي تراها؟
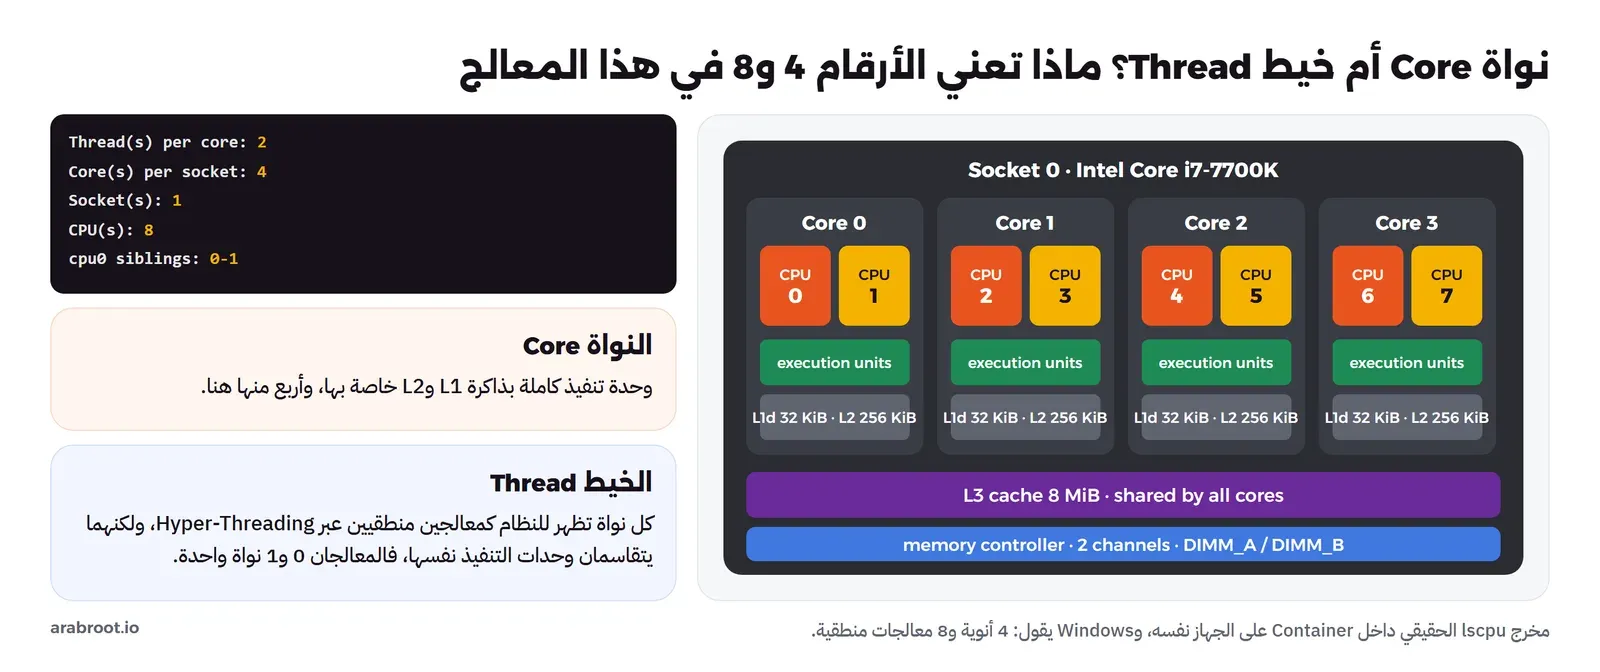
عندما يقول لك نظام التشغيل إن في الجهاز 8 معالجات، فقد تكون 8 أنوية حقيقية، وقد تكون 4 أنوية في كل منها خيطان. والأمر lscpu يبين ذلك، والأوامر التالية تشغله داخل Container على جهاز بمعالج Intel Core i7-7700K، مع عدد المعالجات الذي يراه البرنامج، وحجم الذاكرة، وإعداد الإفراط في الحجز الذي سوف نعود إليه:
docker run --rm --name inff-cpu debian:trixie-slim sh -c "nproc; lscpu | grep -E '^(Architecture|CPU\(s\)|On-line|Model name|Thread|Core|Socket|NUMA|L1d|L2|L3)'; grep MemTotal /proc/meminfo; cat /proc/sys/vm/overcommit_memory /proc/sys/vm/overcommit_ratio"والمخرج سوف يكون كما يلي:
8
Architecture:                         x86_64
CPU(s):                               8
On-line CPU(s) list:                  0-7
Model name:                           Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
Thread(s) per core:                   2
Core(s) per socket:                   4
Socket(s):                            1
L1d cache:                            128 KiB (4 instances)
L2 cache:                             1 MiB (4 instances)
L3 cache:                             8 MiB (1 instance)
MemTotal:       32804872 kB
1
50
في المخرج أعلاه لاحظ التالي:
- CPU(s) 8 = Socket(s) 1 × Core(s) per socket 4 × Thread(s) per core 2: أي معالج واحد فيه 4 أنوية حقيقية، وكل نواة تظهر للنظام كمعالجين منطقيين بتقنية Hyper-Threading، وهذا ما يقوله Windows أيضاً على الجهاز نفسه في
Win32_Processor: أربع أنوية NumberOfCores وثمانية معالجات منطقية NumberOfLogicalProcessors. - L1d وL2 بأربع نسخ، وL3 بنسخة واحدة: لكل نواة ذاكرتها المؤقتة الصغيرة الخاصة بها، والذاكرة المؤقتة الكبيرة مشتركة بين الأنوية كلها، وقد شرحنا هرم الذاكرة المؤقتة في كيف يعمل المعالج CPU من الداخل.
- MemTotal: قرابة 31 جيجابايت، وهي الذاكرة التي أعطاها Docker Desktop للآلة الافتراضية التي يعمل عليها، وليست ذاكرة الجهاز كله.
- لا يوجد سطر NUMA: لأن الجهاز بمعالج واحد، وسوف نعود إلى هذا في القسم التالي.
ولكي نعرف أي معالجين منطقيين يتقاسمان نواة واحدة، نقرأ ملف thread_siblings_list لكل معالج، فكان المعالجان 0 و1 على النواة 0، و2 و3 على النواة 1، وهكذا حتى 6 و7 على النواة 3. والخيطان في النواة الواحدة يتقاسمان وحدات التنفيذ نفسها، لذلك فالمعالج المنطقي الثاني في النواة لا يعطيك نواة ثانية كاملة، وإنما يستغل الوقت الذي تنتظر فيه النواة الذاكرة أو القرص، والفائدة الفعلية تعتمد على البرنامج. والصورة التالية ترسم هذا المعالج كما وصفه lscpu:
ماذا يعني vCPU في الخادم الافتراضي؟
عندما تشتري خادماً افتراضياً VPS أو تنشئ جهازاً افتراضياً في Proxmox VE وتكتب 4 vCPU، فأنت تحصل غالباً على أربعة معالجات منطقية، أي أربعة خيوط قد تكون على نواتين حقيقيتين فقط، وقد تتقاسمها مع أجهزة افتراضية أخرى على السيرفر نفسه. وقد شرحنا الفرق بين المعالج المشترك Shared والمخصص Dedicated، ووقت السرقة Steal Time الذي يظهر عندما يأخذ جيرانك وقت المعالج، في كيف تختار خادماً افتراضياً VPS، لذلك لن نكرره، والمهم هنا أن الرقم الذي سوف تحسبه في نهاية هذا المقال هو عدد معالجات منطقية تحتاجها خدماتك، وسوف نتحقق منه بحصر الخدمات في أربعة معالجات منطقية على نواتين، أي بالشكل نفسه الذي تحصل عليه في جهاز افتراضي بأربعة vCPU.
التردد Clock: متى تكون الأنوية القليلة السريعة أفضل؟
هناك فرق مهم بين برنامج يستطيع أن يقسم عمله على أنوية كثيرة، وبرنامج ينفذ عمله في خيط واحد. فقاعدة بيانات PostgreSQL تشغل عملية مستقلة لكل اتصال، فإذا جاءها ستة عشر اتصالاً معاً استطاعت أن تستخدم عدة أنوية في الوقت نفسه، أما Node.js فينفذ كود JavaScript في حلقة أحداث Event Loop داخل خيط واحد، فإذا كان كل ما لديك نسخة واحدة من التطبيق فإنها لن تتجاوز نواة واحدة تقريباً مهما كبر الجهاز، والذي يسرعها هنا هو تردد النواة Clock وحجم الذاكرة المؤقتة وليس عدد الأنوية. ولذلك يقدم Node.js نفسه وحدة cluster لتشغيل عدة نسخ من التطبيق تتوزع عليها الطلبات، والأبسط في عالم Containers أن تشغل عدة نسخ خلف Reverse Proxy، وهذا ما سوف نقيسه في التجربة. والقاعدة: قبل أن تشتري أنوية أكثر، اعرف هل برنامجك يستخدمها.
NUMA: عندما يكون في السيرفر معالجان
في السيرفرات ذات المعالجين، مثل التي رأيناها في المقالين السابقين، لكل معالج متحكم ذاكرة خاص به ومنافذ ذاكرة متصلة به مباشرة، فدليل Lenovo SR630 V3 مثلاً يذكر 8 قنوات و16 منفذ ذاكرة لكل معالج. ويسمى هذا التصميم الوصول غير المتماثل للذاكرة Non-Uniform Memory Access، واختصاراً NUMA، وفكرته كما يشرحها توثيق Proxmox VE أن الذاكرة بدلاً من أن تكون مجمعاً واحداً تصل إليه كل الأنوية بالسرعة نفسها، توزع على بنوك محلية قريبة من كل مقبس، وهذا يزيل اختناق ناقل الذاكرة المشترك، ولكنه يعني أن قراءة المعالج الأول من ذاكرة المعالج الثاني أبطأ من قراءته من ذاكرته، لأنها تمر عبر الوصلة بين المعالجين. ويشرح توثيق NUMA في نواة Linux كيف تعرض النواة كل مجموعة من الأنوية مع ذاكرتها القريبة كعقدة Node، وكيف تحاول أن تعطي كل عملية ذاكرة من عقدتها.
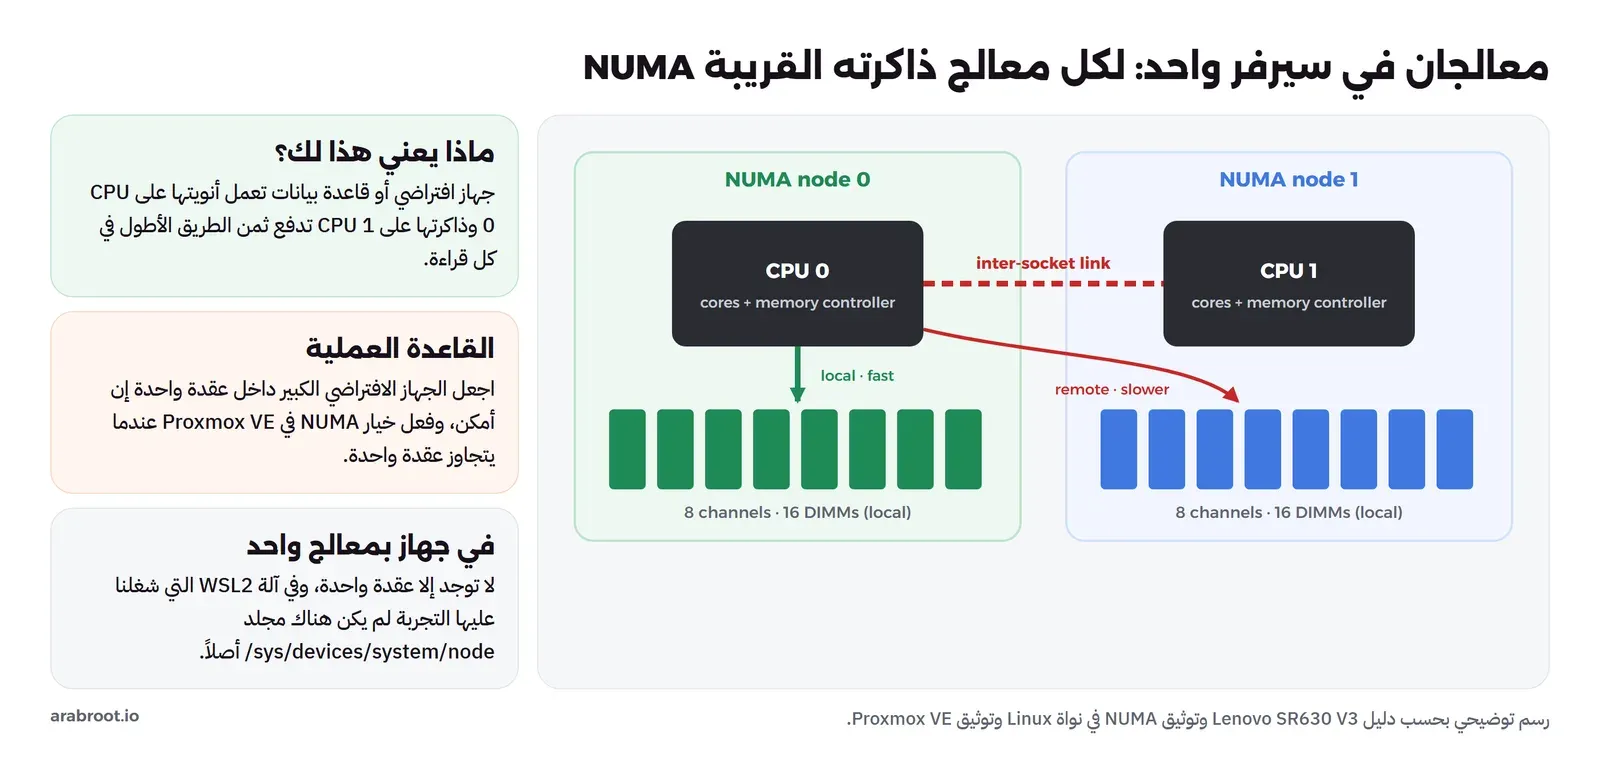
ومتى يهمك هذا؟ عندما يكون لديك جهاز افتراضي أو قاعدة بيانات كبيرة تتجاوز أنويتها أو ذاكرتها ما في عقدة واحدة. فإذا كان السيرفر بمعالجين في كل منهما 32 نواة و256 جيجابايت، وأنشأت جهازاً افتراضياً بـ 48 vCPU و384 جيجابايت، فسوف يمتد على العقدتين لا محالة، وعندها يقول توثيق Proxmox VE إنك إذا كان نظامك بمعمارية NUMA فينصح بتفعيل خيار NUMA في الجهاز الافتراضي، حتى يعرف النظام داخله أين تقع ذاكرته وأنويته ويوزع العمل بشكل صحيح. والقاعدة العملية أن تجعل الأجهزة الافتراضية أصغر من عقدة واحدة كلما أمكن، وأن تفعل NUMA في الكبيرة منها. أما الجهاز الذي أجرينا عليه التجربة فبمعالج واحد، أي عقدة واحدة، ولم يكن في آلة WSL2 مجلد /sys/devices/system/node أصلاً، فلا مكان لهذه المسألة فيه، وهذا حال أغلب أجهزة الهوم لاب والسيرفرات الصغيرة بمعالج واحد.
من أين تأتي ذاكرة كل خدمة؟
قبل أن نقرأ أرقام الذاكرة يجب أن نعرف ماذا نقرأ، فالذاكرة التي تستخدمها خدمة واحدة تتكون من أجزاء مختلفة:
- ذاكرة العملية نفسها: الكود والمكتبات وبيانات البرنامج، مثل كائنات JavaScript في Node.js، وهي تنمو مع عدد الطلبات المتزامنة وتعود جزئياً بعد أن يعمل جامع النفايات Garbage Collector.
- الذاكرة التي تحجزها الخدمة عمداً: مثل
shared_buffersفي PostgreSQL، وهي ذاكرة مشتركة يحفظ فيها صفحات الجداول، ويقول توثيق PostgreSQL إن البداية المعقولة لها في سيرفر قاعدة بيانات مخصص بذاكرة 1 جيجابايت أو أكثر هي 25% من الذاكرة، وإنه من غير المرجح أن يكون أكثر من 40% أفضل، لأن PostgreSQL يعتمد أيضاً على ذاكرة الملفات في نظام التشغيل. ومثلها البيانات في Redis، فكل مفتاح تخزنه يبقى في الذاكرة. - ذاكرة الملفات المؤقتة Page Cache: ما يحفظه Linux من ملفات القرص في الذاكرة الفارغة لتسريع القراءة، وهي ليست ذاكرة مستهلكة بمعنى النفاد، كما شرحنا في تحليل أداء سيرفر Linux في 60 ثانية، ولكن قاعدة البيانات تحتاجها لتبقى سريعة.
ولاحظ أن docker stats لا يعرض الأجزاء الثلاثة كما هي، فبحسب توثيق docker stats تطرح أداة Docker في Linux ذاكرة الملفات المؤقتة من الاستخدام الكلي، وتعرف الذاكرة المؤقتة على أنظمة cgroup v1، وهو ما يعمل عليه جهازنا، بقيمة total_inactive_file. أي أن الرقم الذي سوف تراه هو أقرب إلى ما تحتاجه الخدمة فعلاً، وهذا ما نريده للتقدير، ثم نضيف ذاكرة الملفات للبيانات فوقه في الحساب النهائي.
تجربة عملية: نقيس أربع خدمات حقيقية تحت الضغط
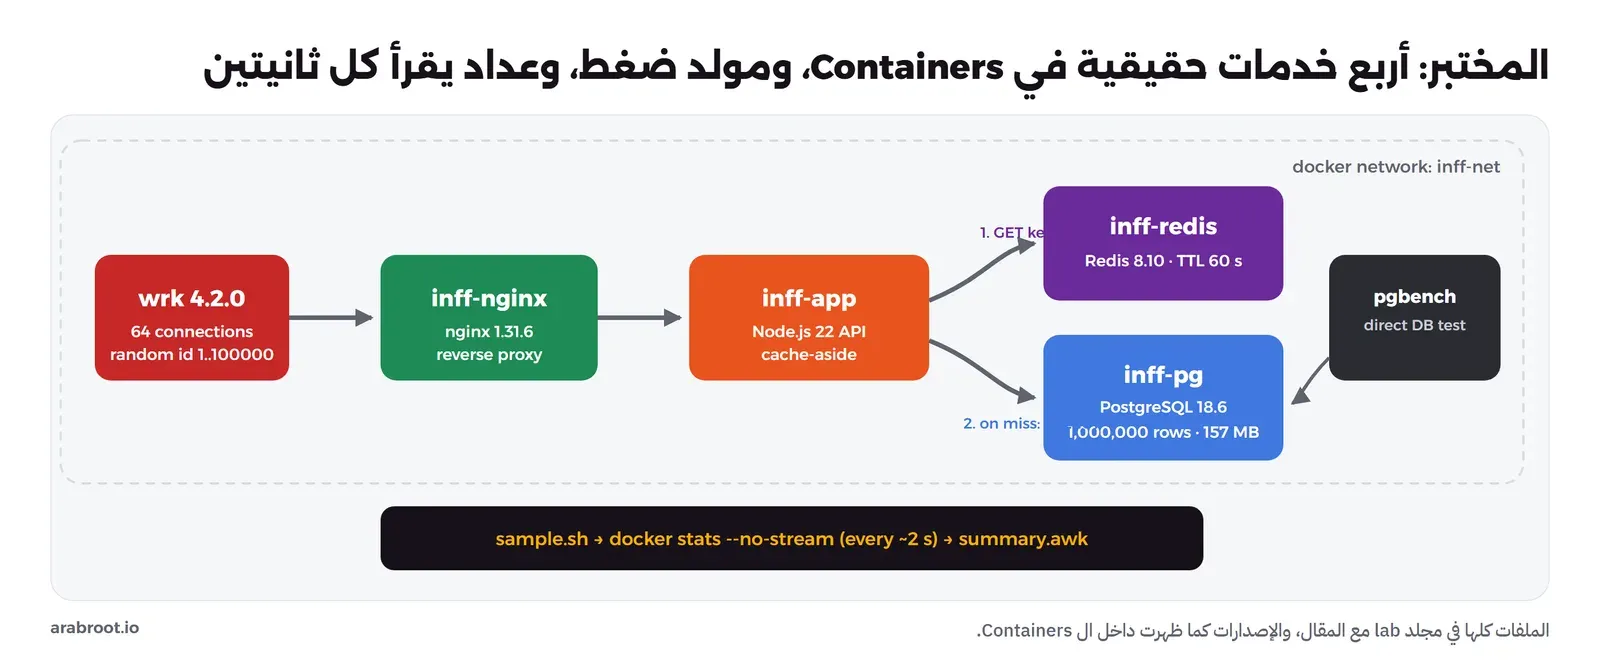
نبني الآن نسخة صغيرة من خلفية المتجر: Nginx في الأمام كـ Reverse Proxy، وتطبيق Node.js يقرأ رصيد حساب من PostgreSQL، ويحفظ النتيجة في Redis لمدة 60 ثانية بنمط Cache-Aside، أي أنه يسأل Redis أولاً، فإذا لم يجد المفتاح قرأ من قاعدة البيانات ثم حفظه. والبيانات من أداة pgbench نفسها، ونضغط الخدمة بأداة wrk، ونقرأ استهلاك كل Container بـ docker stats كل ثانيتين تقريباً. والصورة التالية ترسم المختبر:
ملفات المختبر
كل الملفات في مجلد lab مع المقال، والملف الأول compose.yaml يعرف الخدمات الأربع، وكلها بأسماء تبدأ بـ inff- حتى تحذفها بسهولة بعد التجربة:
name: inff-sizing
services:
  pg:
    image: postgres:18-alpine
    container_name: inff-pg
    environment: { POSTGRES_PASSWORD: lab, POSTGRES_DB: shop }
    command: ["postgres", "-c", "shared_buffers=256MB", "-c", "max_connections=100"]
  redis:
    image: redis:8-alpine
    container_name: inff-redis
  app:
    build: ./app
    image: inff-api:1
    container_name: inff-app
    depends_on: [pg, redis]
  nginx:
    image: nginx:1.31.6-alpine
    container_name: inff-nginx
    volumes: ["./nginx/default.conf:/etc/nginx/conf.d/default.conf:ro"]
    depends_on: [app]
networks:
  default:
    name: inff-net
والتطبيق في app/server.js، وهو كامل كما يلي:
// A small API in front of PostgreSQL and Redis (cache-aside), used to measure CPU and memory per service.
const http = require('node:http');
const { Pool } = require('pg');
const { createClient } = require('redis');

const pool = new Pool({ host: 'inff-pg', user: 'postgres', password: 'lab', database: 'shop', max: 10 });
const cache = createClient({ url: 'redis://inff-redis:6379' });

async function account(id) {
  const key = `acct:${id}`;
  const hit = await cache.get(key);
  if (hit) return { id, balance: Number(hit), from: 'cache' };
  const { rows } = await pool.query('SELECT abalance FROM pgbench_accounts WHERE aid = $1', [id]);
  if (!rows.length) return null;
  await cache.set(key, String(rows[0].abalance), { EX: 60 });
  return { id, balance: rows[0].abalance, from: 'db' };
}

const server = http.createServer(async (req, res) => {
  const m = req.url.match(/^\/api\/accounts\/(\d+)$/);
  if (!m) { res.writeHead(404).end(); return; }
  try {
    const a = await account(Number(m[1]));
    res.writeHead(a ? 200 : 404, { 'content-type': 'application/json' }).end(JSON.stringify(a));
  } catch (e) {
    res.writeHead(500).end(e.message);
  }
});

cache.connect().then(() => server.listen(3000, () => console.log('api on :3000')));
وملف app/Dockerfile يبنيه على node:22-alpine مع المكتبتين pg بالإصدار 8.23.1 وredis بالإصدار 5.8.2 المثبتين في package.json، وإعداد Nginx في nginx/default.conf يمرر /api/ إلى التطبيق باتصالات دائمة:
upstream api { server inff-app:3000; keepalive 32; }
server {
  listen 80;
  location /api/ {
    proxy_pass http://api;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
  }
  location / { return 200 "ok\n"; }
}
وأداة wrk نبنيها من Alpine في ملف wrk.Dockerfile بسطرين، FROM alpine:3.24 ثم RUN apk add --no-cache wrk، ونعطيها ملف Lua صغيراً اسمه random.lua يطلب في كل مرة حساباً عشوائياً من أول مئة ألف حساب، حتى لا يكون كل طلب نسخة من الطلب الذي قبله:
-- every request asks for a random account among the first 100,000 (pgbench scale 10 has 1,000,000)
request = function()
  return wrk.format("GET", "/api/accounts/" .. math.random(1, 100000))
end
التشغيل والقياس الأول وهي خاملة
docker build -q -t inff-wrk:1 -f wrk.Dockerfile .
docker compose up -d --build
docker stats --no-stream --format 'table {{.Name}}\t{{.CPUPerc}}\t{{.MemUsage}}\t{{.MemPerc}}\t{{.PIDs}}' inff-pg inff-redis inff-app inff-nginx
والمخرج سوف يكون كما يلي:
NAME         CPU %     MEM USAGE / LIMIT     MEM %     PIDS
inff-pg      0.02%     61.18MiB / 31.29GiB   0.19%     9
inff-redis   0.21%     11.71MiB / 31.29GiB   0.04%     6
inff-app     0.00%     45.88MiB / 31.29GiB   0.14%     11
inff-nginx   0.00%     8.406MiB / 31.29GiB   0.03%     9
الخدمات الأربع خاملة تستهلك قرابة 127 ميبيبايت معاً، والعمود LIMIT يعرض 31.29 جيجابايت لأننا لم نضع حداً لأي Container بعد، فكل منها يستطيع أن يأخذ ذاكرة الآلة كلها، وهذا ما سوف نغيره لاحقاً. ثم نملأ قاعدة البيانات بجداول pgbench بمعامل حجم 10، أي مليون حساب:
docker exec inff-pg pgbench -U postgres -i -s 10 shop
docker exec inff-pg psql -U postgres -d shop -t -c "select pg_size_pretty(pg_database_size('shop'));"
1000000 of 1000000 tuples (100%) of pgbench_accounts done (elapsed 1.54 s, remaining 0.00 s)
vacuuming...
creating primary keys...
done in 2.19 s (drop tables 0.00 s, create tables 0.01 s, client-side generate 1.61 s, vacuum 0.17 s, primary keys 0.39 s).
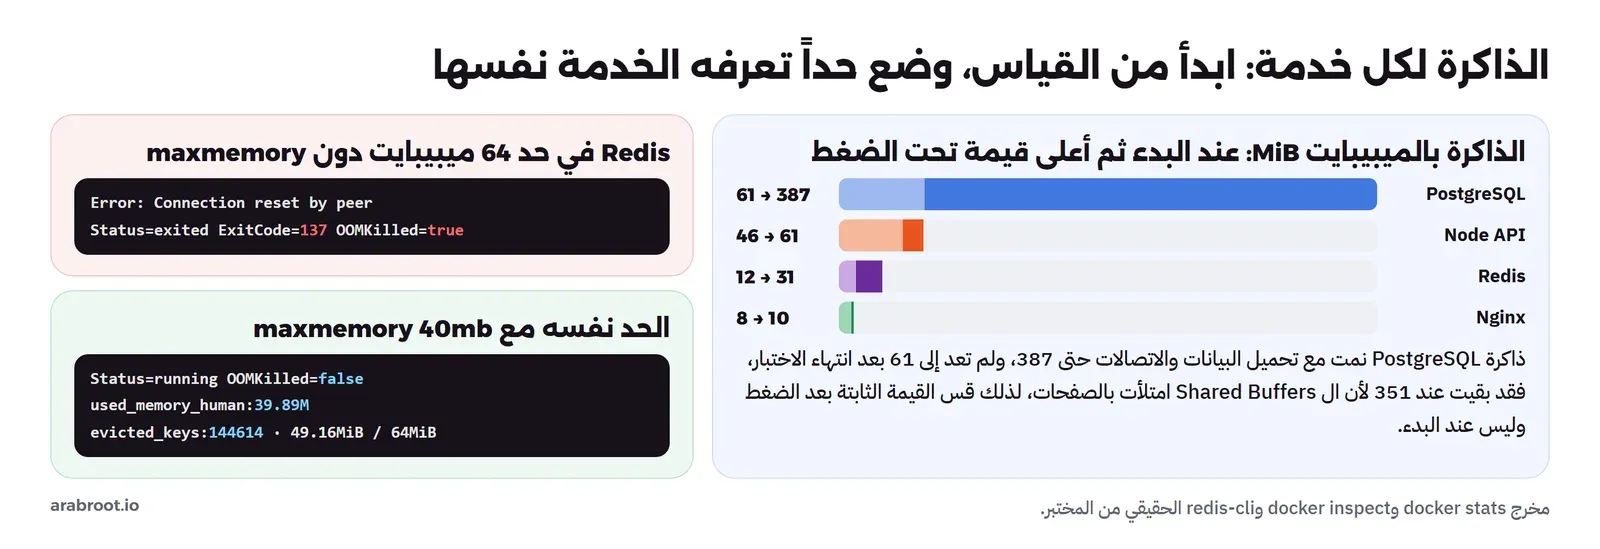
157 MBحجم قاعدة البيانات 157 ميجابايت، وارتفعت ذاكرة inff-pg بعد التحميل من 61.18 إلى 189.5 ميبيبايت، لأن الصفحات التي كتبها pgbench دخلت إلى ال Shared Buffers.
العداد: docker stats في حلقة
القراءة الواحدة من docker stats لحظة واحدة، ونحن نريد المتوسط والقمة طوال الاختبار، لذلك نكتب سكربتاً صغيراً اسمه sample.sh يكرر القراءة حتى ينتهي الوقت ويكتب كل سطر مع الوقت:
#!/bin/sh
# usage: sh sample.sh <seconds> <container>... > stats.csv   (one line per container per sample: time,name,cpu%,memory)
secs=$1; shift
end=$(( $(date +%s) + secs ))
while [ "$(date +%s)" -lt "$end" ]; do
  t=$(date +%s)
  docker stats --no-stream --format '{{.Name}},{{.CPUPerc}},{{.MemUsage}}' "$@" | sed "s/^/$t,/"
done
وملف summary.awk يحسب لكل Container عدد العينات ومتوسط المعالج وقمته وقمة الذاكرة بالميبيبايت:
# usage: awk -F, -f summary.awk stats.csv   -> per container: samples, average and peak CPU %, peak memory in MiB
function mib(s,   v) { v = s + 0
  if (s ~ /GiB/) return v * 1024; if (s ~ /KiB/) return v / 1024; if (s ~ /B$/ && s !~ /iB/) return v / 1048576; return v }
{ cpu = $3; sub(/%/, "", cpu); cpu += 0; split($4, m, " / "); mem = mib(m[1])
  n[$2]++; sum[$2] += cpu; if (cpu > peak[$2]) peak[$2] = cpu; if (mem > mpk[$2]) mpk[$2] = mem }
END { printf "%-11s %7s %9s %9s %10s\n", "container", "samples", "avg_cpu%", "peak_cpu%", "peak_MiB"
  for (c in n) printf "%-11s %7d %9.1f %9.1f %10.1f\n", c, n[c], sum[c] / n[c], peak[c], mpk[c] }
ولاحظ أن نسبة المعالج في docker stats محسوبة على أساس أن 100% نواة واحدة، أي معالج منطقي واحد، فـ 250% تعني قرابة معالجين ونصف.
التجربة الأولى: نسخة واحدة من التطبيق
نشغل العداد في الخلفية لمدة 62 ثانية، ثم wrk لمدة 60 ثانية بأربعة خيوط و64 اتصالاً متزامناً:
sh sample.sh 62 inff-pg inff-redis inff-app inff-nginx > run1.csv &
docker run --rm --name inff-load --network inff-net -v "$PWD/random.lua:/random.lua:ro" \
  inff-wrk:1 wrk -t4 -c64 -d60s --latency -s /random.lua http://inff-nginx/
awk -F, -f summary.awk run1.csv | sort
والمخرج سوف يكون كما يلي:
Running 1m test @ http://inff-nginx/
  4 threads and 64 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency    18.15ms   11.34ms 353.33ms   84.45%
    Req/Sec     0.92k   223.27     1.90k    69.99%
  Latency Distribution
     50%   17.00ms
     75%   20.85ms
     90%   27.34ms
     99%   50.41ms
  219532 requests in 1.00m, 43.89MB read
Requests/sec:   3654.97
Transfer/sec:    748.33KB
container   samples  avg_cpu% peak_cpu%   peak_MiB
inff-app         30      99.9     159.5       56.1
inff-nginx       30      69.3     116.0       10.3
inff-pg          30      66.4      77.2      224.3
inff-redis       30       5.6       9.9       15.4
في المخرج أعلاه لاحظ التالي:
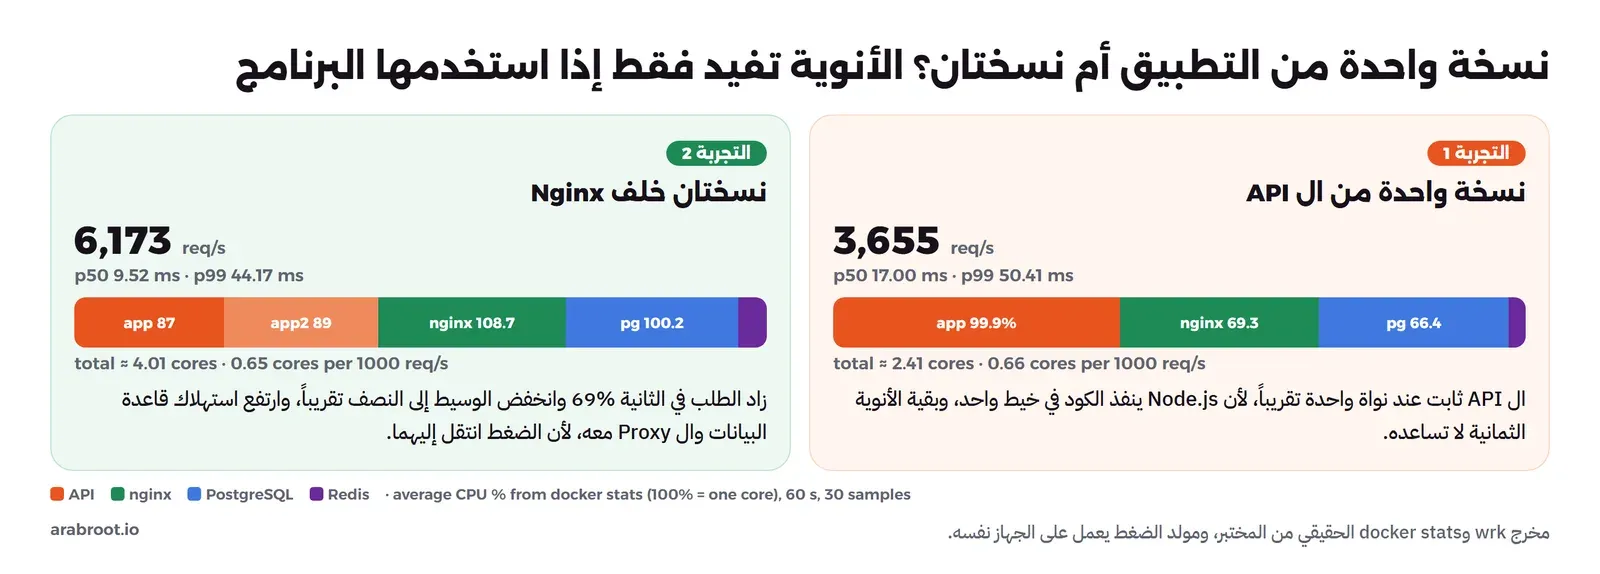
- Requests/sec 3654.97: هذا ما استطاعت الخدمات أن تقدمه مع 64 اتصالاً، والوسيط p50 هو 17 ملي ثانية، و99% من الطلبات انتهت في أقل من 50.41 ملي ثانية.
- inff-app بمتوسط 99.9%: التطبيق ثابت عند نواة واحدة تقريباً طوال الدقيقة، وهو أول من وصل إلى حده، والقمة 159.5% كانت في أول عينة فقط، لأن عملية Node.js فيها خيوط مساعدة غير الخيط الذي ينفذ الكود، ولكن الكود نفسه يبقى في خيط واحد. أي أن الاختناق هنا هو التطبيق وليس الجهاز، ففي الجهاز ثمانية معالجات منطقية، ومجموع ما استخدمته الخدمات الأربع قرابة 2.41 فقط.
- inff-pg بمتوسط 66.4%: قاعدة البيانات مرتاحة، لأن جزءاً من الطلبات يجد الرصيد في Redis ولا يصل إليها.
- الذاكرة: القمة 224.3 ميبيبايت لقاعدة البيانات، و56.1 للتطبيق، و15.4 لـ Redis، و10.3 لـ Nginx، أي قرابة 306 ميبيبايت للخدمات كلها، وهذا أقل بكثير مما يتوقعه أغلب الناس لخدمة تقدم أكثر من ثلاثة آلاف طلب في الثانية.
ونحسب من ملف العينات مجموع المعالج لكل عينة ثم متوسطه، حتى نعرف كم نواة استخدمت الخدمات معاً:
awk -F, '{c=$3; sub(/%/,"",c); s[$1]+=c} END {for (t in s) {tot+=s[t]; n++}; printf "average total CPU %.1f%% = %.2f cores\n", tot/n, tot/n/100}' run1.csvaverage total CPU 241.2% = 2.41 coresمشكلة ظهرت: المتوسط أكبر من القمة
في أول تشغيل للملخص خرج سطر التطبيق بمتوسط 99.9% وقمة 99.8%، أي أن القمة أصغر من المتوسط، وهذا مستحيل. والسبب أن awk يقارن القيم كنصوص إذا جاءت من تقسيم سطر ولم تستخدم في عملية حسابية، فكانت المقارنة "159.53" > "99.8" مقارنة أحرف، والحرف 1 أصغر من 9، فرفضت القيمة الأكبر. والحل هو السطر cpu += 0 في الملف أعلاه، فهو يجبر awk على اعتبار القيمة رقماً، وبعده ظهرت القمة الصحيحة 159.5. والدرس أن تراجع كل رقم يخرج من أداة كتبتها بنفسك قبل أن تبني عليه قراراً، فقد كان هذا الخطأ سوف يجعلنا نظن أن التطبيق لم يتجاوز نواة واحدة أبداً.
التجربة الثانية: نسختان من التطبيق
إذا كان التطبيق هو الاختناق لأنه في خيط واحد، فالحل ليس جهازاً أكبر وإنما نسخة ثانية منه. نشغل inff-app2 من ال Image نفسه، ونشغل Nginx بإعداد فيه السيرفران في ال upstream، ونفرغ Redis حتى نبدأ من الحالة نفسها:
sed 's/upstream api { server inff-app:3000; keepalive 32; }/upstream api { server inff-app:3000; server inff-app2:3000; keepalive 32; }/' \
  nginx/default.conf > nginx/two-apps.conf
docker run -d --name inff-app2 --network inff-net inff-api:1
docker stop inff-nginx
docker run -d --name inff-nginx2 --network inff-net --network-alias inff-nginx \
  -v "$PWD/nginx/two-apps.conf:/etc/nginx/conf.d/default.conf:ro" nginx:1.31.6-alpine
docker exec inff-redis redis-cli flushall
sh sample.sh 62 inff-pg inff-redis inff-app inff-app2 inff-nginx2 > run2.csv &
docker run --rm --name inff-load --network inff-net -v "$PWD/random.lua:/random.lua:ro" \
  inff-wrk:1 wrk -t4 -c64 -d60s --latency -s /random.lua http://inff-nginx/
Latency Distribution
50% 9.52ms
75% 13.80ms
90% 19.55ms
99% 44.17ms
370739 requests in 1.00m, 74.38MB read
Socket errors: connect 0, read 0, write 0, timeout 1
Requests/sec: 6173.13
Transfer/sec: 1.24MB
container samples avg_cpu% peak_cpu% peak_MiB
inff-app 30 87.0 99.9 60.2
inff-app2 30 89.1 141.1 57.0
inff-nginx2 30 108.7 151.7 9.7
inff-pg 30 100.2 131.4 241.7
inff-redis 30 16.5 21.3 20.4
average total CPU 401.4% = 4.01 coresفي المخرج أعلاه لاحظ التالي:
- ارتفع عدد الطلبات في الثانية من 3,655 إلى 6,173، أي بنسبة 69%، وانخفض الوسيط من 17 إلى 9.52 ملي ثانية، والجهاز نفسه لم يتغير، والذي تغير أن الخدمات أصبحت تستخدم معالجات كانت فارغة.
- لم تعد أي نسخة من التطبيق عند 100% طوال الوقت، وانتقل الضغط إلى Nginx الذي تجاوز نواة واحدة، وإلى قاعدة البيانات التي وصلت إلى نواة كاملة في المتوسط، وهذا ما يحدث دائماً: عندما تزيل اختناقاً يظهر الذي بعده.
- مجموع المعالج أصبح 4.01 نواة لـ 6,173 طلباً في الثانية، أي 0.65 نواة لكل ألف طلب، وفي التجربة الأولى كان 2.41 نواة لـ 3,655 طلباً، أي 0.66 نواة لكل ألف طلب. الرقمان متطابقان تقريباً، وهذا هو الرقم الذي سوف نبني عليه القاعدة، لأنه لا يعتمد على عدد النسخ وإنما على ما يكلفه الطلب الواحد.
- الذاكرة لم تتغير كثيراً: نسخة ثانية من التطبيق أضافت قرابة 57 ميبيبايت فقط.
ويجدر الإشارة هنا إلى حد في هذه التجربة، فمولد الضغط wrk يعمل على الجهاز نفسه ويأخذ من معالجاته، كما يحذر منه مقال اختبار الضغط في قسم مولد الضغط على جهاز آخر، لذلك فالأرقام المطلقة هنا للمقارنة بين التجارب، وفي تجربة التحقق في آخر المختبر سوف نفصل wrk على معالجات مختلفة عن الخدمات.
قاعدة البيانات وحدها: سريعة في القراءة، وبطيئة في الكتابة والمعالج فارغ
نضغط الآن قاعدة البيانات مباشرة بأداة pgbench من Container منفصل، حتى لا يحسب استهلاك pgbench نفسه على قاعدة البيانات. والاختبار الافتراضي في pgbench يشبه معاملة بنكية TPC-B، فيه تحديث لثلاثة جداول وإدخال في جدول رابع في كل معاملة:
sh sample.sh 62 inff-pg > run3.csv &
docker run --rm --name inff-bench --network inff-net -e PGPASSWORD=lab postgres:18-alpine \
  pgbench -h inff-pg -U postgres -c 16 -j 4 -T 60 -P 20 shop
progress: 20.0 s, 452.4 tps, lat 35.148 ms stddev 40.208, 0 failed
progress: 40.0 s, 449.5 tps, lat 35.552 ms stddev 45.950, 0 failed
progress: 60.0 s, 463.1 tps, lat 34.610 ms stddev 40.916, 0 failed
transaction type: <builtin: TPC-B (sort of)>
scaling factor: 10
number of clients: 16
number of threads: 4
number of transactions actually processed: 27316
latency average = 35.128 ms
tps = 455.245050 (without initial connection time)
container samples avg_cpu% peak_cpu% peak_MiB
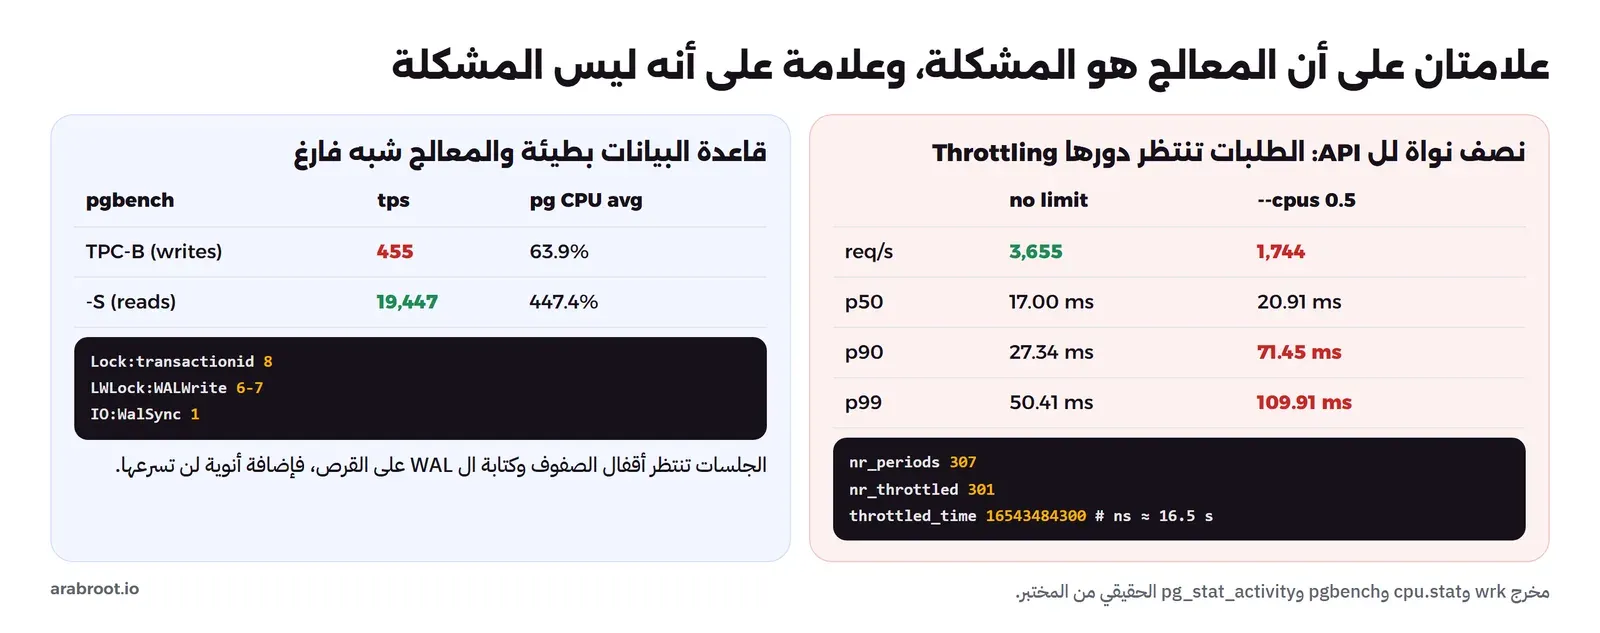
inff-pg 31 63.9 102.8 388.3455 معاملة في الثانية بزمن 35 ملي ثانية للمعاملة، وقاعدة البيانات تستخدم 63.9% من نواة واحدة في المتوسط، وفي الجهاز ثمانية معالجات منطقية. فإذا كانت قاعدة البيانات بطيئة والمعالج فارغ، فأين يذهب الوقت؟ نسأل PostgreSQL نفسه أثناء اختبار ثان، من جدول pg_stat_activity الذي يعرض لكل جلسة ما تنتظره الآن، كما في توثيق الإحصاءات:
docker exec inff-pg psql -U postgres -At -c "select coalesce(wait_event_type,'CPU') || ':' || coalesce(wait_event,'running') as w, count(*)
  from pg_stat_activity where datname='shop' and backend_type='client backend' and pid<>pg_backend_pid() group by 1 order by 2 desc;"
Lock:transactionid|8
LWLock:WALWrite|6
IO:WalSync|1
Lock:tuple|1نصف الجلسات تنتظر قفلاً على صف تعدله جلسة أخرى Lock:transactionid، لأن pgbench بمعامل حجم 10 فيه عشرة فروع فقط في جدول pgbench_branches، وكل معاملة تحدث فرعاً منها، والستة عشر عميلاً يتزاحمون على عشرة صفوف. والنصف الآخر ينتظر كتابة سجل المعاملات WAL إلى القرص ومزامنته WALWrite وWalSync. أي أن الاختناق في الأقفال والقرص، وإضافة أنوية لن تسرع هذه المعاملات أبداً. وللمقارنة شغلنا الاختبار نفسه بخيار -S، أي قراءة فقط:
latency average = 0.792 ms
tps = 19446.736082 (without initial connection time)
container   samples  avg_cpu% peak_cpu%   peak_MiB
inff-pg          31     447.4     521.4      386.5
هنا 19,447 معاملة في الثانية، وقاعدة البيانات تستخدم قرابة 4.5 معالج منطقي في المتوسط، لأن القراءة لا تنتظر أقفالاً ولا قرصاً، فكل اتصال يعمل في عمليته على معالج. والدرس للتقدير مهم: قبل أن تقرر أن قاعدة البيانات تحتاج أنوية أكثر، انظر إلى ما تنتظره، فإذا كانت تنتظر القرص فالحل قرص أسرع، وإذا كانت تنتظر الأقفال فالحل في تصميم المعاملات. ولاحظ أيضاً أن ذاكرة PostgreSQL وصلت إلى 386.5 ميبيبايت مع ستة عشر اتصالاً، فكل اتصال عملية لها ذاكرتها، وهذا ما يجعل عدد الاتصالات جزءاً من حساب الذاكرة.
ماذا لو أعطينا التطبيق نصف نواة فقط؟
نرجع إلى نسخة واحدة من التطبيق مع Nginx الأول، ونضع حداً للمعالج بنصف نواة، وهو ما يحدث عندما تقدر الحجم أقل من الحاجة، ثم نقرأ إحصاءات الحد من cgroup قبل الاختبار وبعده:
docker rm -f inff-nginx2 inff-app2 && docker start inff-nginx
docker update --cpus 0.5 inff-app
docker exec inff-redis redis-cli flushall
docker run --rm --name inff-load --network inff-net -v "$PWD/random.lua:/random.lua:ro" \
  inff-wrk:1 wrk -t4 -c64 -d30s --latency -s /random.lua http://inff-nginx/
docker exec inff-app cat /sys/fs/cgroup/cpu/cpu.stat /sys/fs/cgroup/cpu/cpu.cfs_quota_us /sys/fs/cgroup/cpu/cpu.cfs_period_us
Latency Distribution
50% 20.91ms
75% 65.39ms
90% 71.45ms
99% 109.91ms
52417 requests in 30.06s, 10.48MB read
Requests/sec: 1743.64
nr_periods 307
nr_throttled 301
throttled_time 16543484300
50000
100000في المخرج أعلاه لاحظ التالي:
- الحد
--cpus 0.5، وهو من حدود الموارد في Docker، كتبه Docker في cgroup كحصة 50000 ميكروثانية في كل فترة طولها 100000 ميكروثانية، أي أن التطبيق يعمل 50 ملي ثانية من كل 100، كما يشرح توثيق CFS Bandwidth Control في نواة Linux. - في 301 فترة من 307 استنفد التطبيق حصته وأوقفته النواة حتى الفترة التالية
nr_throttled، ومجموع وقت الإيقاف 16.5 ثانية تقريباً في اختبار مدته 30 ثانية. - انخفضت الطلبات في الثانية إلى أقل من النصف، 1,744 بدلاً من 3,655، والأخطر أن p90 ارتفع من 27.34 إلى 71.45 ملي ثانية، وp99 من 50.41 إلى 109.91، لأن الطلب الذي يصل والتطبيق موقف ينتظر حتى الفترة التالية. وهذا هو شكل نقص المعالج من جهة المستخدم: الوسيط يتغير قليلاً، والذيل يطول كثيراً.
ماذا لو وضعنا Redis في حد ذاكرة دون maxmemory؟
نقص الذاكرة أخطر من نقص المعالج، لأن المعالج الناقص يبطئ الخدمة، أما الذاكرة الناقصة فتوقفها. نشغل نسخة من Redis بحد ذاكرة 64 ميبيبايت، ثم نكتب فيها مئة ألف مفتاح عشوائي بقيمة 2000 بايت لكل منها، أي قرابة 200 ميجابايت من البيانات:
docker run -d --name inff-redis-small --network inff-net --memory 64m --memory-swap 64m redis:8-alpine
docker run --rm --name inff-rb --network inff-net redis:8-alpine \
  redis-benchmark -h inff-redis-small -t set -n 200000 -r 100000 -d 2000 -q
docker inspect inff-redis-small --format 'Status={{.State.Status}} ExitCode={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}}'
docker logs inff-redis-small | tail -1
SET: rps=37552.0 (overall: 21220.9) avg_msec=0.850 (overall: 1.488)Error: Connection reset by peer
Status=exited ExitCode=137 OOMKilled=true
1:M 16 Nov 2026 02:06:10.796 # WARNING: Redis does not require authentication and is not protected by network restrictions. Redis will accept connections from any IP address on any network interface.Redis لا يعرف شيئاً عن حد ال Container، فاستمر في قبول المفاتيح حتى وصل إلى 64 ميبيبايت، فقتلته النواة OOMKilled=true برمز الخروج 137، وانقطع الاتصال في وجه العميل، وآخر سطر في سجل Redis هو تحذير البدء نفسه، ولا يوجد فيه أي شيء عن السبب، لأنه قتل ولم يخرج بنفسه. وفي الإنتاج يعني هذا أن كل ال Cache ضاع، وأن كل الطلبات ذهبت إلى قاعدة البيانات في اللحظة نفسها. والحل أن تخبر Redis بالحد نفسه، بخيار maxmemory أقل من حد ال Container، مع سياسة إخراج مفاتيح مثل allkeys-lru كما في توثيق الإخراج في Redis:
docker rm inff-redis-small
docker run -d --name inff-redis-small --network inff-net --memory 64m --memory-swap 64m redis:8-alpine \
  redis-server --maxmemory 40mb --maxmemory-policy allkeys-lru
docker run --rm --name inff-rb --network inff-net redis:8-alpine \
  redis-benchmark -h inff-redis-small -t set -n 200000 -r 100000 -d 2000 -q
docker exec inff-redis-small redis-cli info memory | grep -E "^(used_memory_human|maxmemory_human|maxmemory_policy)"
docker exec inff-redis-small redis-cli info stats | grep evicted_keys
docker inspect inff-redis-small --format 'Status={{.State.Status}} OOMKilled={{.State.OOMKilled}}'
docker stats --no-stream --format '{{.Name}} {{.MemUsage}}' inff-redis-small
SET: 33333.33 requests per second, p50=0.711 msec
used_memory_human:39.89M
maxmemory_human:40.00M
maxmemory_policy:allkeys-lru
evicted_keys:144614
Status=running OOMKilled=false
inff-redis-small 49.16MiB / 64MiBالحد نفسه والبيانات نفسها، ولكن Redis الآن يخرج المفاتيح الأقدم استخداماً عندما يصل إلى 40 ميجابايت، فأخرج 144,614 مفتاحاً وبقي يعمل، وال Container كله عند 49.16 من 64 ميبيبايت، لأن العملية نفسها تحتاج ذاكرة فوق البيانات، ولهذا تركنا بين الحدين هامشاً. وهذا ينطبق على كل خدمة لها ذاكرة تحجزها بنفسها: shared_buffers في PostgreSQL، وحجم ال Heap في Java، وmaxmemory في Redis، فالخدمة يجب أن تعرف حدها، وحد ال Container أو الجهاز الافتراضي يجب أن يكون فوقه بهامش.
التحقق: هل يكفي الحجم الذي حسبناه؟
سوف نحسب في القسم التالي أن خدمة تصل إلى 2000 طلب في الثانية تحتاج قرابة 2.2 معالج منطقي إذا أردنا ألا يتجاوز الاستخدام 60%، فلنختبر ذلك قبل أن نثق به. والطريقة الأولى التي تخطر على البال أن نقسم 2.2 نواة على الخدمات بحدود ثابتة، ومعها حدود ذاكرة لكل خدمة فوق ما قسناه، ونعيد نسختي التطبيق خلف Nginx:
docker update --cpus 0.7 --memory 512m --memory-swap 512m inff-pg
docker update --cpus 0.5 --memory 128m --memory-swap 128m inff-app
docker run -d --name inff-app2 --network inff-net --cpus 0.5 --memory 128m --memory-swap 128m inff-api:1
docker run -d --name inff-nginx2 --network inff-net --network-alias inff-nginx --cpus 0.4 --memory 64m --memory-swap 64m \
  -v "$PWD/nginx/two-apps.conf:/etc/nginx/conf.d/default.conf:ro" nginx:1.31.6-alpine
docker update --cpus 0.1 --memory 64m --memory-swap 64m inff-redis
docker exec inff-redis redis-cli config set maxmemory 48mb
docker exec inff-redis redis-cli flushall
sh sample.sh 62 inff-pg inff-redis inff-app inff-app2 inff-nginx2 > run5.csv &
docker run --rm --name inff-load --network inff-net -v "$PWD/random.lua:/random.lua:ro" \n  inff-wrk:1 wrk -t4 -c64 -d60s --latency -s /random.lua http://inff-nginx/
for c in inff-pg inff-redis inff-app inff-app2 inff-nginx2; do
  printf "%s " $c; docker exec $c sh -c 'tr "
" " " < /sys/fs/cgroup/cpu/cpu.stat'; echo
done
Latency Distribution
50% 33.42ms
90% 91.90ms
99% 203.34ms
Requests/sec: 1671.85
inff-pg nr_periods 740 nr_throttled 36 throttled_time 5597675000
inff-redis nr_periods 794 nr_throttled 186 throttled_time 9195370100
inff-app nr_periods 931 nr_throttled 402 throttled_time 19608822400
inff-app2 nr_periods 646 nr_throttled 206 throttled_time 9089198300
inff-nginx2 nr_periods 619 nr_throttled 370 throttled_time 57606834500لم نصل حتى إلى 2000 طلب، و p99 تجاوز 200 ملي ثانية، والسبب ظاهر في إحصاءات cgroup: Nginx أوقف في 370 فترة من 619، وRedis بعشر نواة أوقف في 186 فترة، أي أن تقسيم المعالج بحدود ثابتة لكل خدمة جعل خدمتين تختنقان بينما بقيت حصص الخدمات الأخرى غير مستخدمة. وهذا ما يحدث عندما تقسم سيرفراً واحداً إلى أجهزة افتراضية صغيرة كثيرة بدلاً من أن تترك الخدمات تتقاسم المعالجات. والطريقة الأصح تمثل جهازاً افتراضياً بأربعة vCPU: نحصر الخدمات الخمس كلها في المعالجات المنطقية من 0 إلى 3، أي النواتين 0 و1 بخيوطهما، ونترك لها أن تتقاسمها، ونشغل wrk على المعالجات من 4 إلى 7 حتى لا يزاحمها، ونبقي حدود الذاكرة كما هي:
for c in inff-pg inff-redis inff-app inff-app2 inff-nginx2; do docker update --cpus 4 --cpuset-cpus 0-3 $c; done
docker exec inff-redis redis-cli flushall
sh sample.sh 62 inff-pg inff-redis inff-app inff-app2 inff-nginx2 > run6.csv &
docker run --rm --name inff-load --cpuset-cpus 4-7 --network inff-net -v "$PWD/random.lua:/random.lua:ro" \
  inff-wrk:1 wrk -t4 -c64 -d60s --latency -s /random.lua http://inff-nginx/
awk -F, -f summary.awk run6.csv | sort
awk -F, '{c=$3; sub(/%/,"",c); s[$1]+=c} END {for (t in s) {tot+=s[t]; n++}; printf "average total CPU %.1f%% = %.2f cores
", tot/n, tot/n/100}' run6.csv
for c in inff-pg inff-redis inff-app inff-app2 inff-nginx2; do docker inspect $c --format "{{.Name}} OOMKilled={{.State.OOMKilled}}"; done
Latency Distribution
50% 13.81ms
75% 19.93ms
90% 28.83ms
99% 60.75ms
255332 requests in 1.00m, 51.29MB read
Requests/sec: 4248.77
container samples avg_cpu% peak_cpu% peak_MiB
inff-app 30 68.3 81.9 63.0
inff-app2 30 70.7 85.2 29.1
inff-nginx2 30 79.3 92.6 9.5
inff-pg 30 77.2 99.1 245.8
inff-redis 30 13.2 19.2 30.1
average total CPU 308.8% = 3.09 cores
/inff-pg OOMKilled=false
/inff-redis OOMKilled=false
/inff-app OOMKilled=false
/inff-app2 OOMKilled=false
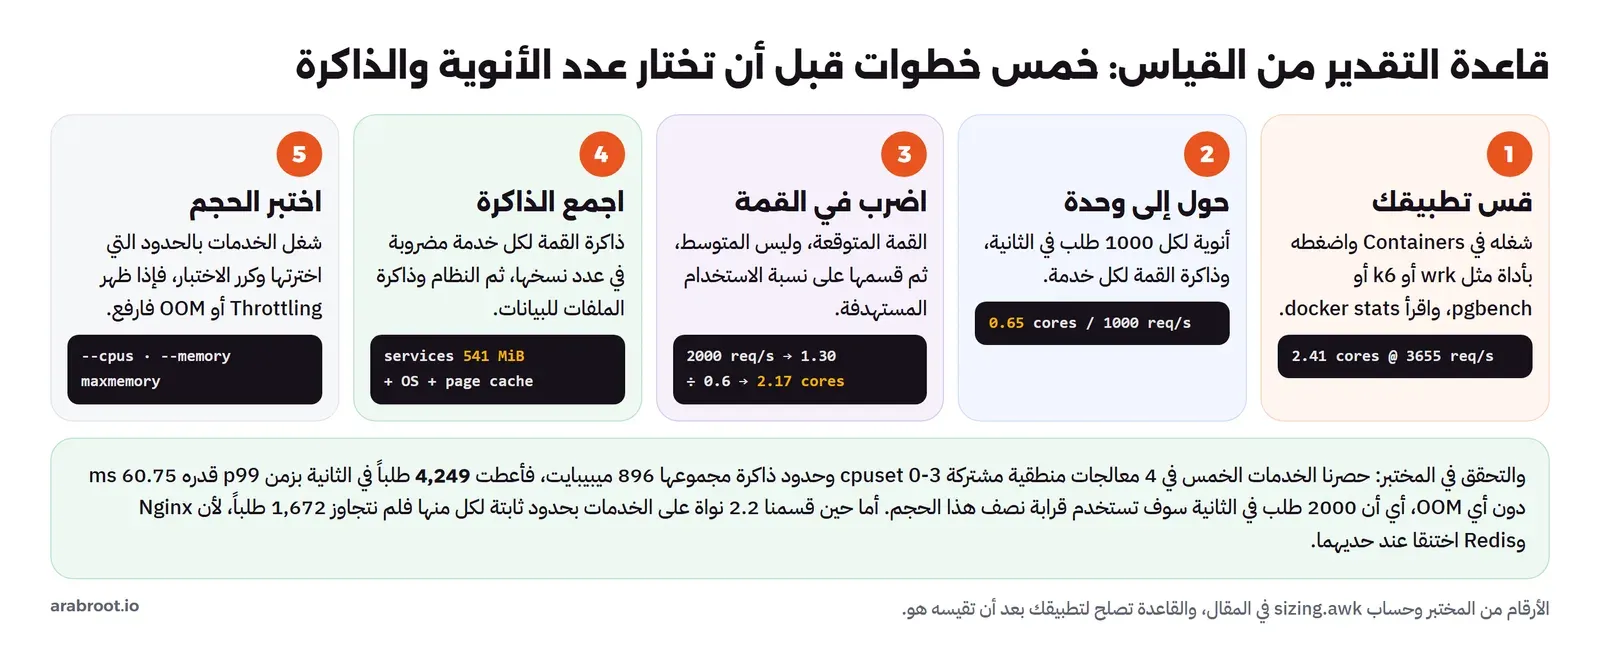
/inff-nginx2 OOMKilled=falseعلى أربعة معالجات منطقية مشتركة قدمت الخدمات 4,249 طلباً في الثانية بزمن p99 قدره 60.75 ملي ثانية، دون أن تقتل أي خدمة بسبب الذاكرة، وحدود الذاكرة مجموعها 896 ميبيبايت. أي أن 2000 طلب في الثانية سوف تستخدم أقل من نصف هذا الحجم، وهذا يؤكد القاعدة بهامش جيد. ولاحظ أن المعالج لكل ألف طلب هنا 0.73 بدلاً من 0.65، لأن الخيطين في النواة الواحدة يتقاسمان وحدات التنفيذ، فالمعالج المنطقي أبطأ من النواة الكاملة، وهذا سبب آخر لتترك هامشاً.
وهنا مشكلة ثانية واجهتنا أثناء التحقق: في المحاولة الأولى لهذه الخطوة استخدمنا docker update --cpus 0 لإزالة حدود المعالج، فخرجت النتيجة 1,870 طلباً فقط، ثم تبين من docker inspect أن الحد ما زال كما هو، فقيمة NanoCpus لقاعدة البيانات بقيت 700000000، أي 0.7 نواة. لذلك وضعنا حداً أعلى من عدد المعالجات المتاحة --cpus 4 بدلاً من محاولة إزالته، وتحققنا منه قبل الاختبار بالأمر التالي، فلا تقم بتعديل حدود Container دون أن تقرأها بعد التعديل:
docker inspect inff-pg --format '{{.Name}} cpuset={{.HostConfig.CpusetCpus}} nano={{.HostConfig.NanoCpus}} quota={{.HostConfig.CpuQuota}}'/inff-pg cpuset=0-3 nano=4000000000 quota=0حذف المختبر
docker rm -f inff-app2 inff-nginx2 inff-redis-small
docker compose down -v
docker rmi inff-api:1 inff-wrk:1
والأمر down -v يحذف ال Volume الذي أنشأه PostgreSQL لبياناته أيضاً، فلا يبقى من التجربة شيء على القرص.
من الأرقام إلى قاعدة: كيف تحسب الحجم؟
الآن نحول ما قسناه إلى حساب تكرره على أي خدمة. الأرقام التي نحتاجها اثنان من المختبر: المعالج لكل ألف طلب في الثانية، وهو 0.65 نواة، وقمة الذاكرة لكل خدمة. ثم رقمان من العمل: القمة المتوقعة للطلبات في الثانية، وليس المتوسط، لأن يوم التخفيضات هو الذي يحدد الحجم، ونسبة الاستخدام التي لا نريد أن نتجاوزها في القمة، وقد اخترنا 60% حتى يبقى هامش لما لم نقسه، مثل النسخ الاحتياطي الليلي، وتحديث النظام، وطلبات أثقل من الطلب الذي اختبرناه. والملف memory.txt فيه قمة كل خدمة وعدد نسخها:
postgres 387 1
api      61  2
nginx    11  1
redis    21  1
والملف sizing.awk يجمعها ويحسب المعالج:
# usage: awk -v peak_rps=2000 -v cores_per_1000=0.65 -v target=0.6 -f sizing.awk memory.txt
# memory.txt: one line per service: name peak_MiB instances
{ mem += $2 * $3; printf "%-10s %6.0f MiB x %d\n", $1, $2, $3 }
END {
  cpu = peak_rps / 1000 * cores_per_1000
  printf "\nCPU at peak      : %.2f cores\n", cpu
  printf "CPU at %d%% target: %.2f cores\n", target * 100, cpu / target
  printf "services memory  : %.0f MiB\n", mem
}
awk -v peak_rps=2000 -v cores_per_1000=0.65 -v target=0.6 -f sizing.awk memory.txtpostgres 387 MiB x 1
api 61 MiB x 2
nginx 11 MiB x 1
redis 21 MiB x 1
CPU at peak : 1.30 cores
CPU at 60% target: 2.17 cores
services memory : 541 MiBوالخطوات بعد هذا المخرج كما يلي:
- المعالج: 2.17 نواة عند هدف 60%، فنقرب إلى 4 vCPU، لأن الأجهزة الافتراضية تأتي بأعداد زوجية غالباً، ولأن التحقق أعلاه بين أن المعالج المنطقي أبطأ من النواة الكاملة، ولأننا نحتاج نسختين من التطبيق على الأقل حتى نستخدم أكثر من نواة.
- ذاكرة الخدمات: 541 ميبيبايت في القمة، وهي تشمل shared_buffers التي اخترناها 256 ميجابايت.
- ذاكرة الملفات للبيانات: قاعدة البيانات 157 ميجابايت، ونريد أن تبقى كلها في الذاكرة، أي في ال Shared Buffers أو في ذاكرة الملفات.
- نظام التشغيل والأدوات: النظام نفسه، وSSH، والمراقبة، ووكيل النسخ الاحتياطي، وكلها تحتاج ذاكرتها.
- هامش النمو: البيانات تكبر كل شهر، وعدد الاتصالات يكبر مع النسخ.
والنتيجة أن 2 جيجابايت تكفي تقنياً اليوم، و4 جيجابايت هي الحجم المريح الذي يترك مكاناً لنمو البيانات وللنظام، ومع 4 جيجابايت تصبح shared_buffers بنسبة 25% التي يقترحها توثيق PostgreSQL قرابة 1 جيجابايت، أي أكبر من قاعدة البيانات كلها اليوم. فالحجم المقترح للمتجر في موسم التخفيضات 4 vCPU و4 جيجابايت ذاكرة، مع نسختين من التطبيق، وهو أقل بكثير من 16 نواة و64 جيجابايت التي اقترحها الزميل في البداية، وأكثر من التخمين الآخر لأنه يحسب حساب القمة. والصورة التالية تلخص الخطوات:
وقد يتساءل البعض: هل أستطيع أن أستخدم الرقم 0.65 نواة لكل ألف طلب لتطبيقي؟ والإجابة لا، فهذا الرقم لهذا التطبيق بهذا الطلب، وقد يكون تطبيقك أثقل بعشرة أضعاف إذا كان كل طلب يبني صفحة كاملة من عشرين استعلاماً، أو أخف إذا كان يقرأ من ال Cache فقط. الذي تنقله إلى تطبيقك هو الطريقة: قس، وحول إلى وحدة، واضرب في القمة، واجمع الذاكرة، ثم تحقق بالحجم نفسه.
الإفراط في الحجز Overcommit: الذاكرة والمعالج
عندما تجمع أحجام الأجهزة الافتراضية أو ال Containers على سيرفر واحد فسوف تجد غالباً أن المجموع أكبر مما في السيرفر، وهذا يسمى الإفراط في الحجز Overcommit، وهو مقبول في المعالج بحدود، وخطر في الذاكرة. ففي المعالج يعني أن 16 vCPU موزعة على أجهزة افتراضية في سيرفر فيه 8 معالجات منطقية تتقاسمها بالوقت، وهذا يعمل جيداً ما دامت لا تحتاجها كلها في اللحظة نفسها، وعندما تحتاجها تظهر علامة واضحة هي وقت السرقة Steal Time داخل الأجهزة الافتراضية، كما في قسم السيرفر البطيء مع استهلاك منخفض.
أما الذاكرة فلا تتقاسم بالوقت، فالصفحة التي يستخدمها برنامج لا يستطيع غيره أن يستخدمها في الوقت نفسه. ونواة Linux نفسها تسمح للبرامج بحجز ذاكرة أكثر مما هو موجود، لأن أغلب البرامج تحجز أكثر مما تكتب فيه فعلاً، ويحدد ذلك الإعداد vm.overcommit_memory الذي رأيناه في مخرج lscpu أعلاه، وقيمته في آلة WSL2 هي 1. ويشرح توثيق Overcommit في نواة Linux أن القيمة 0 هي الافتراضية وتعني الحجز بتقدير يرفض الطلبات الواضحة المبالغة، و1 تعني القبول دائماً، و2 تعني الحساب الصارم. وفي كل الحالات عندما تكتب البرامج فعلاً في ذاكرة أكثر من الموجودة يتدخل قاتل العمليات OOM Killer كما رأينا مع Redis، وقد شرحنا كيف تقرأ سجله في تحليل أداء سيرفر Linux.
وفي Proxmox VE يقدم الجهاز الافتراضي ميزة البالون Ballooning، ويشرح توثيقه أنك إذا جعلت الحد الأدنى للذاكرة أقل من الذاكرة الكلية فإن Proxmox VE يضمن الحد الأدنى دائماً، ويعطي الجهاز الافتراضي ما فوقه بحسب استخدام الذاكرة في السيرفر، وإذا جعلتهما متساويين فإنه يحجز الذاكرة كاملة، وينصح بإبقاء جهاز البالون مفعلاً لأنه يعطيك معلومات عن الذاكرة التي يستخدمها الجهاز الافتراضي فعلاً. والقاعدة العملية: أفرط في حجز المعالج بقدر ما تسمح المراقبة، ولا تفرط في حجز الذاكرة للأجهزة الافتراضية التي تحمل قواعد بيانات، واجعل حدها الأدنى مساوياً لحجمها، وقد شرحنا إعداد المعالج والذاكرة عند إنشاء الجهاز الافتراضي في تبويبي CPU وMemory من مقال إنشاء أول جهاز افتراضي، والفرق بين الجهاز الافتراضي و LXC الذي يتقاسم النواة في LXC في Proxmox.
قس على السيرفر الحقيقي، وليس في المختبر فقط
المختبر يعطيك التكلفة لكل طلب، ولكن الإنتاج يعطيك شكل الطلبات الحقيقي: أي الصفحات تطلب أكثر، وكم مرة يجد التطبيق البيانات في ال Cache، ومتى تأتي القمة. لذلك فالخطوة التالية بعد أن تشغل السيرفر أن تجمع المقاييس طوال الوقت، وأن تقرر الحجم من النسبة المئوية 95 أو 99 لاستخدام المعالج والذاكرة على مدى أسبوع أو شهر، وليس من المتوسط، لأن المتوسط يخفي القمة التي تهمك. وقد شرحنا جمع هذه المقاييس ورسمها في مقاييس السيرفرات مع Prometheus وGrafana، وفي الأنوية الحديثة يوجد مقياس آخر مفيد اسمه ضغط الموارد Pressure Stall Information يقيس الوقت الذي تنتظر فيه المهام المعالج أو الذاكرة أو القرص، كما في توثيق PSI، ولكنه لم يكن مفعلاً في نواة آلة WSL2 التي أجرينا عليها التجربة، فلم يكن في المسار /proc/pressure شيء.
وهناك علامات تخبرك أن الحجم أصبح صغيراً قبل أن يشتكي المستخدمون: المعالج فوق 70 أو 80% في القمة بشكل متكرر، أو ارتفاع p99 بينما الوسيط ثابت كما رأينا مع حد نصف النواة، أو ظهور Throttling في cgroup، أو OOM في سجل النواة، أو ذاكرة الملفات التي تتقلص باستمرار حتى تقرأ قاعدة البيانات من القرص ما كانت تقرؤه من الذاكرة. وعلامات أن الحجم أكبر من الحاجة واضحة أيضاً: معالج تحت 20% في القمة لأسابيع، وذاكرة الملفات أكبر من البيانات كلها بأضعاف.
وماذا عن سعر الذاكرة؟
الذاكرة هي المورد الذي ينفد أولاً في أغلب السيرفرات التي تشغل أجهزة افتراضية، وهي أيضاً القطعة التي يتغير سعرها بشدة من سنة إلى أخرى، لذلك فالتقدير الصحيح يوفر عليك أكثر من مجرد إيجار شهري. فإذا كنت تشتري سيرفراً، فاحسب الحاجة كما فعلنا، ثم اختر عدد الوحدات بحيث تبقى منافذ فارغة للتوسعة، وراجع قبل الشراء لماذا ترتفع أسعار الذاكرة وتنهار، ومتى يكون الشراء أنسب، في المقال التالي من هذه المرحلة أسعار الذاكرة RAM: لماذا ترتفع وتنهار، وهل تشتري الآن؟. وإذا كنت تستأجر خادماً افتراضياً، فقد شرحنا في كيف تختار خادماً افتراضياً لماذا تبدأ بحساب الذاكرة أولاً.
جدول سريع: ماذا قسنا لكل خدمة، وماذا تراقب؟
| الخدمة | الذاكرة التي قسناها | المعالج | ما يحدد حاجتها | انتبه إلى |
|---|---|---|---|---|
| Nginx | 8 إلى 11 ميبيبايت | وصل إلى أكثر من نواة مع 6 آلاف طلب في الثانية | عدد الطلبات والاتصالات | لا تخنقه بحد صغير، فهو أمام كل شيء |
| Node.js API | 46 إلى 63 ميبيبايت لكل نسخة | نواة واحدة تقريباً لكل نسخة | تكلفة الطلب الواحد، وعدد النسخ | شغل نسخاً بعدد الأنوية التي تريدها |
| Redis | 12 إلى 31 ميبيبايت هنا، وتزيد مع البيانات | أقل من خمس نواة | حجم البيانات المخزنة | maxmemory أقل من حد الذاكرة دائماً |
| PostgreSQL | 61 عند البدء، و387 في القمة مع 16 اتصالاً | 4.5 معالج في القراءة، وأقل من نواة في الكتابة المتزاحمة | shared_buffers وعدد الاتصالات وحجم البيانات | انتظار الأقفال والقرص قبل المعالج |
أخطاء شائعة
- التقدير من المتوسط: المتوسط اليومي يخفي القمة، والقمة هي التي تحدد الحجم.
- أنوية أكثر لبرنامج في خيط واحد: رأينا التطبيق عند نواة واحدة وفي الجهاز ثمانية معالجات، فالحل كان نسخة ثانية وليس جهازاً أكبر.
- أنوية أكثر لقاعدة بيانات تنتظر: قاعدة البيانات التي تنتظر الأقفال أو القرص لن تسرع بالمعالج، فانظر إلى أحداث الانتظار أولاً.
- حد ذاكرة لا تعرفه الخدمة: Redis قتل بسبب حد ال Container، والحل أن تعرف الخدمة حدها بنفسها مع هامش تحته.
- تقسيم المعالج بحدود ثابتة صغيرة: 2.2 نواة مقسمة بحدود ثابتة أعطت 1,672 طلباً، والمعالجات نفسها مشتركة أعطت أكثر من ضعفها.
- اعتبار vCPU نواة كاملة: المعالج المنطقي يتقاسم النواة مع خيط آخر، فاترك هامشاً.
- مولد الضغط على الجهاز نفسه دون فصل: wrk يأخذ من المعالج نفسه، فافصله على أنوية أخرى أو جهاز آخر عندما تريد أرقاماً مطلقة.
- الثقة بأداة دون مراجعة مخرجها: المتوسط الذي كان أكبر من القمة في أول ملخص، والحد الذي لم يزل بعد
--cpus 0، خطآن كانا سوف يغيران القرار لو لم نراجع الأرقام. - الإفراط في حجز ذاكرة أجهزة قواعد البيانات: الذاكرة لا تتقاسم بالوقت مثل المعالج، والنتيجة OOM في أسوأ لحظة.
قائمة التحقق قبل أن تكتب الأرقام في طلب الشراء
- هل قست تطبيقك نفسه تحت ضغط يشبه الحقيقة، بطلبات متنوعة وليس طلباً واحداً متكرراً؟
- هل تعرف أي خدمة تصل إلى حدها أولاً، وهل هي محدودة بالمعالج أم بالقرص أم بالأقفال؟
- هل حولت النتيجة إلى وحدة، مثل نواة لكل ألف طلب، وضربتها في القمة المتوقعة وليس المتوسط؟
- هل تستخدم برامجك الأنوية التي سوف تشتريها، أم تحتاج نسخاً أكثر؟
- هل جمعت ذاكرة القمة لكل خدمة بعدد نسخها، وأضفت النظام وذاكرة الملفات للبيانات وهامش النمو؟
- هل تعرف كل خدمة حد ذاكرتها، مثل shared_buffers وmaxmemory، تحت حد الجهاز أو ال Container؟
- هل تحققت بتشغيل الخدمات بالحجم نفسه الذي حسبته، وقرأت Throttling وOOM بعد الاختبار؟
- هل في الخطة مراقبة تقيس النسبة المئوية 95 للمعالج والذاكرة بعد التشغيل؟
تدريب عملي
- غير ملف
random.luaليطلب الحسابات من مليون حساب بدلاً من مئة ألف، وأعد التجربة الثانية، ثم قارن نسبة استخدام قاعدة البيانات، وفكر لماذا تغيرت، وما علاقة ذلك بنسبة الطلبات التي يجدها التطبيق في Redis. - شغل ثلاث نسخ من التطبيق بدلاً من اثنتين، وراقب أي خدمة تصل إلى حدها الآن، ثم احسب المعالج لكل ألف طلب وقارنه بـ 0.65.
- غير
shared_buffersإلى 64MB وأعد اختبار pgbench بخيار-S، ثم قارن الذاكرة والمعاملات في الثانية.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التقدير بالحدس يخطئ في الاتجاهين، والطريقة الصحيحة أن تقيس تطبيقك وتحول القياس إلى وحدة تضربها في القمة.
- عدد المعالجات الذي تراه قد يكون خيوطاً على أنوية أقل، والبرنامج الذي يعمل في خيط واحد مثل نسخة Node.js لا يستفيد من الأنوية الإضافية إلا إذا شغلت منه نسخاً أكثر.
- NUMA يهمك في السيرفر بمعالجين عندما يتجاوز جهاز افتراضي عقدة واحدة، فاجعل الأجهزة أصغر من العقدة أو فعل خيار NUMA.
- في المختبر كلف الطلب الواحد قرابة 0.65 نواة لكل ألف طلب في الثانية، وكانت الخدمات الأربع تحتاج قرابة 541 ميبيبايت في القمة، فخرج الحجم المقترح لـ 2000 طلب في الثانية 4 vCPU و4 جيجابايت، وتحققنا منه فأعطى 4,249 طلباً دون OOM.
- نقص المعالج يطيل الذيل p99 قبل الوسيط، ونقص الذاكرة يقتل الخدمة، والخدمة يجب أن تعرف حد ذاكرتها بنفسها.
- قاعدة البيانات البطيئة والمعالج الفارغ يعنيان انتظار الأقفال أو القرص، وهنا لا يفيد المعالج الأكبر.
 دليلكيف تختار خادماً افتراضياً VPSكم تحتاج من المعالج والذاكرة والقرص، وما الذي يميز مزوداً عن آخر غير السعر، حتى تختار VPS يناسب احتياجك.
 دليلأسعار الذاكرة RAM: لماذا ترتفع وتنهار، وهل تشتري الآن؟لماذا تتكرر دورات ارتفاع أسعار الذاكرة وانهيارها منذ 2010 بأرقام من مصادرها، وكيف تقرر هل تشتري الآن أم تنتظر.
 دليلإنشاء أول جهاز افتراضي في Proxmox VE بعنوان IP ثابتكيف تنشئ أول جهاز افتراضي VM على سيرفر Proxmox VE، وتثبت عليه Ubuntu Server بعنوان IP ثابت جاهزاً للنسخ الاحتياطي.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلاختبار الضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلأنواع السيرفرات: Tower وRack وBlade ومتى تختار كلاً منهامقارنة بين أشكال السيرفرات من البرجي إلى ال Blade بأرقام الكثافة والضجيج والكهرباء من أوراق الشركات، حتى تختار الشكل الذي يناسب المكان الذي سيعيش فيه جهازك.
 دليلالسيرفر والكمبيوتر العادي: ECC والتكرار Redundancyلماذا يكلف السيرفر أضعاف جهاز مكتبي بالمعالج نفسه، وماذا تشتري فعلاً بهذا الفرق من ذاكرة ECC ومزودي طاقة وBMC وضمان، ومتى يكفيك الكمبيوتر العادي.
سجل التحديثات
- 2026-11-16: كتابة المقال وتجربته على Docker Engine 29.8.0 في Docker Desktop مع WSL2 وcgroup v1، بـ PostgreSQL 18.6 وpgbench 18.6، وRedis 8.10.3، وNode.js 22.23.4 مع pg 8.23.1 وredis 5.8.2، وNginx 1.31.6، وwrk 4.2.0 على Alpine 3.24، وlscpu من util-linux 2.41.5 على Debian trixie.


